最新記事
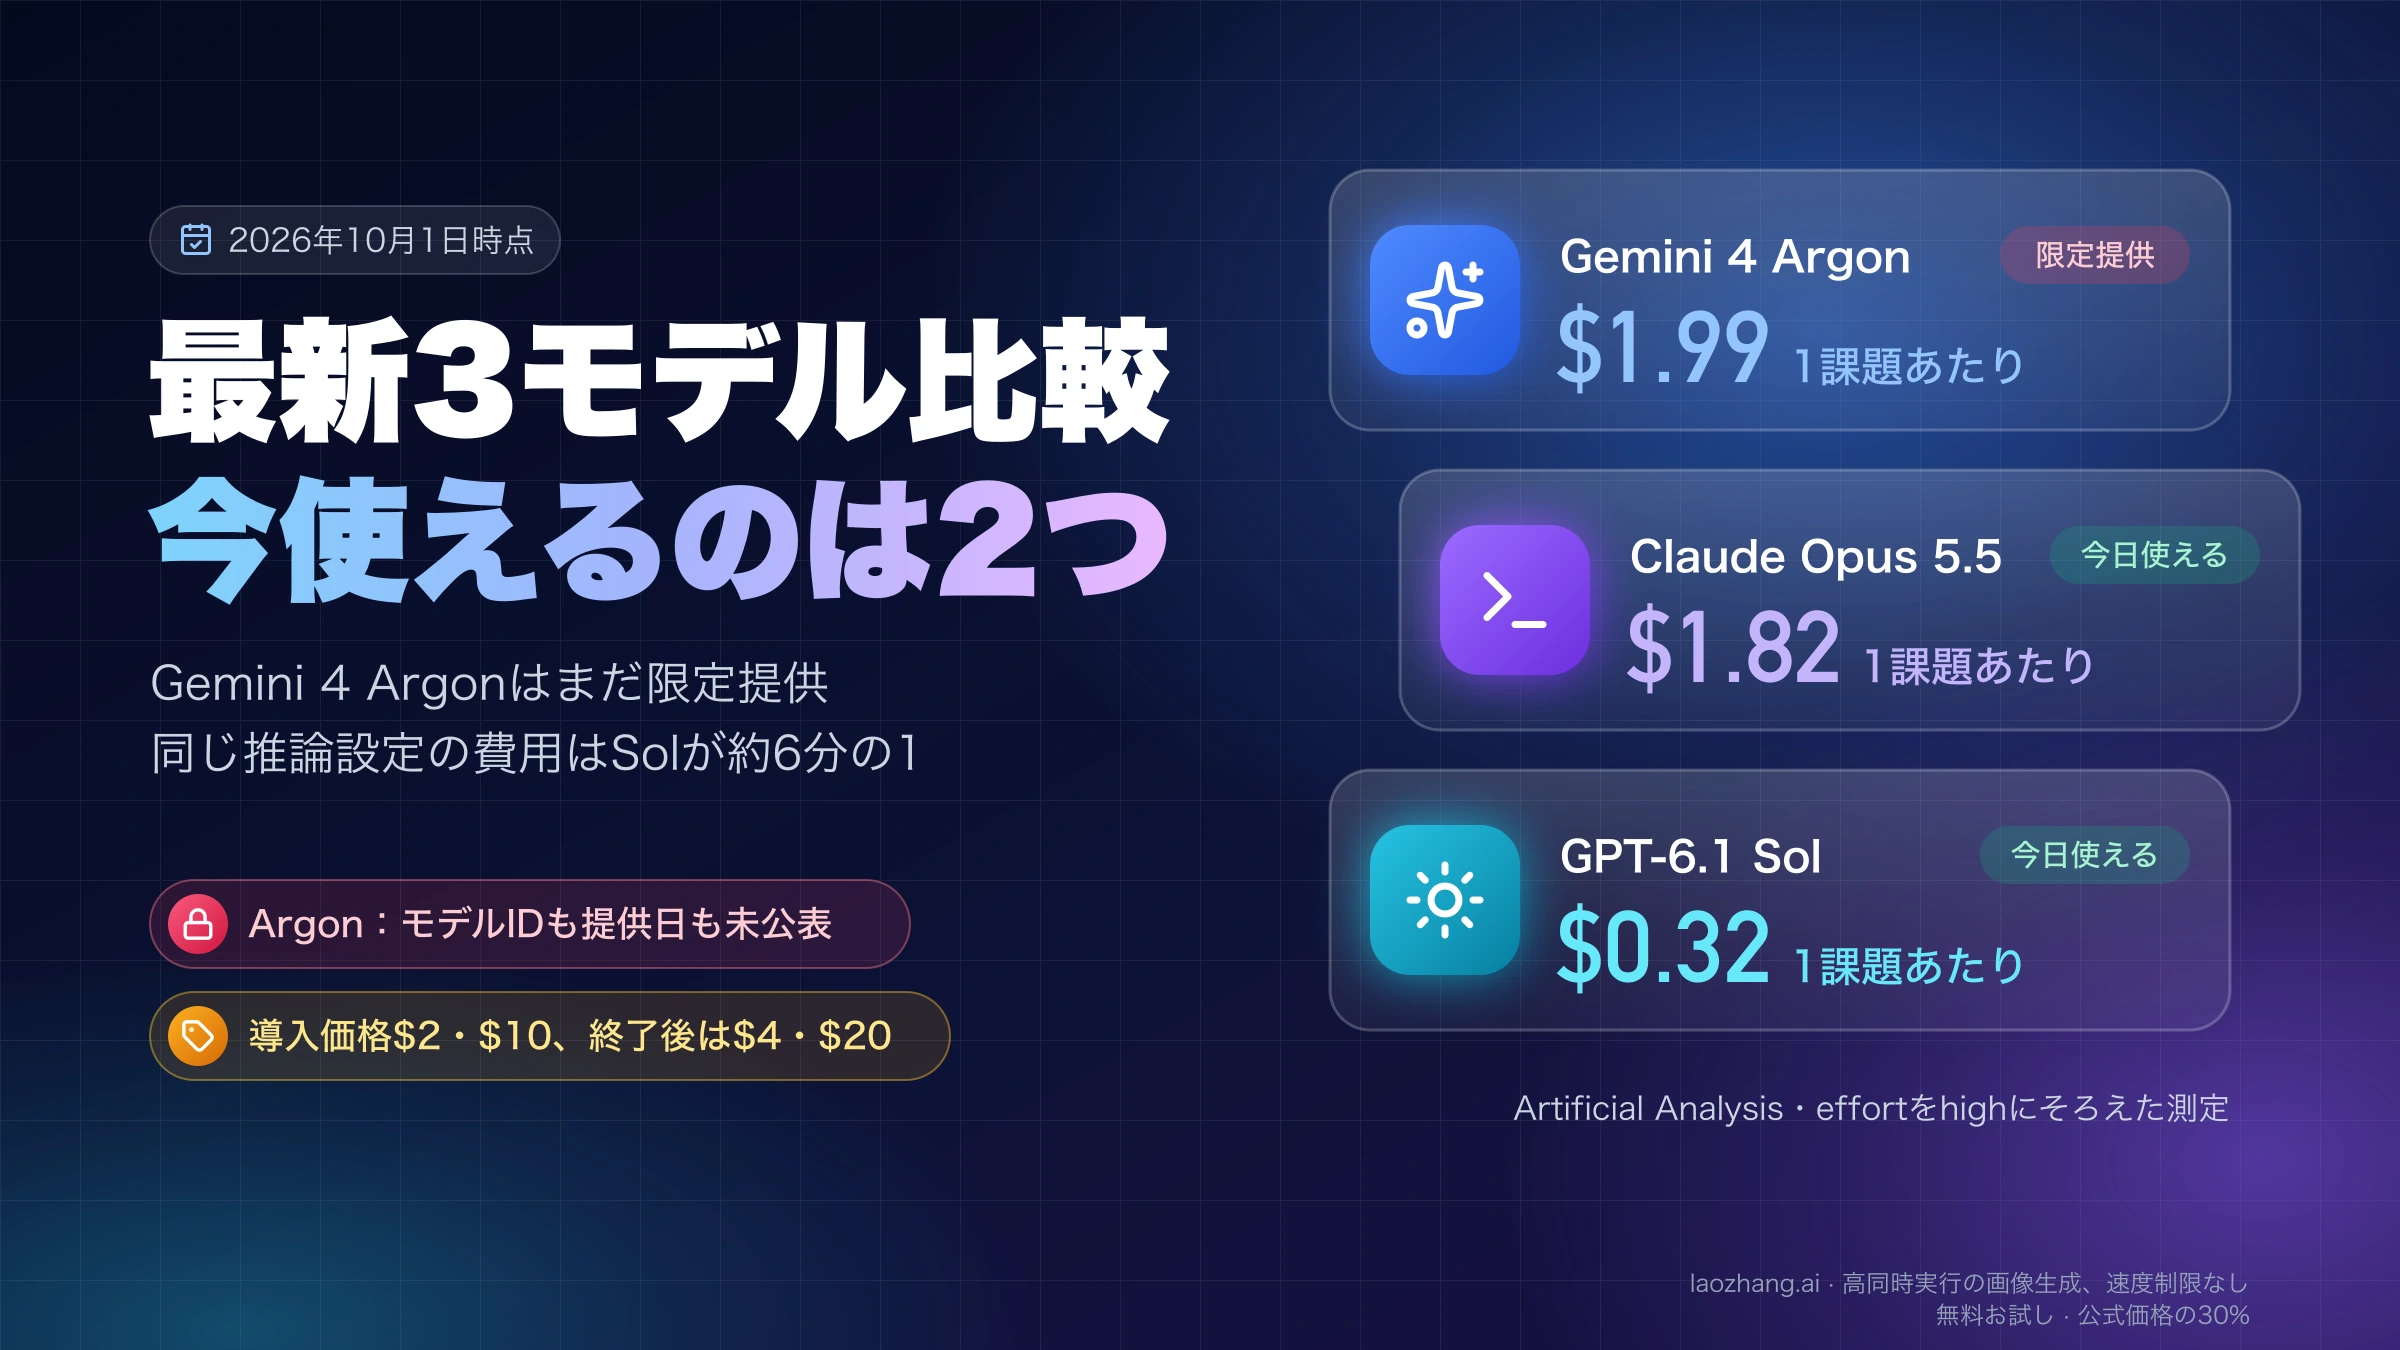
Gemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:Argonは12月に単価2倍
Gemini 4 Argonは10月13日に一般提供。単価は11月30日まで$2・$10、12月から$4・$20で、1課題の費用はhigh同士でGPT-6.1 Solの約6倍です。
36 分
Gemini 4 Argonは10月13日に一般提供。単価は11月30日まで$2・$10、12月から$4・$20で、1課題の費用はhigh同士でGPT-6.1 Solの約6倍です。
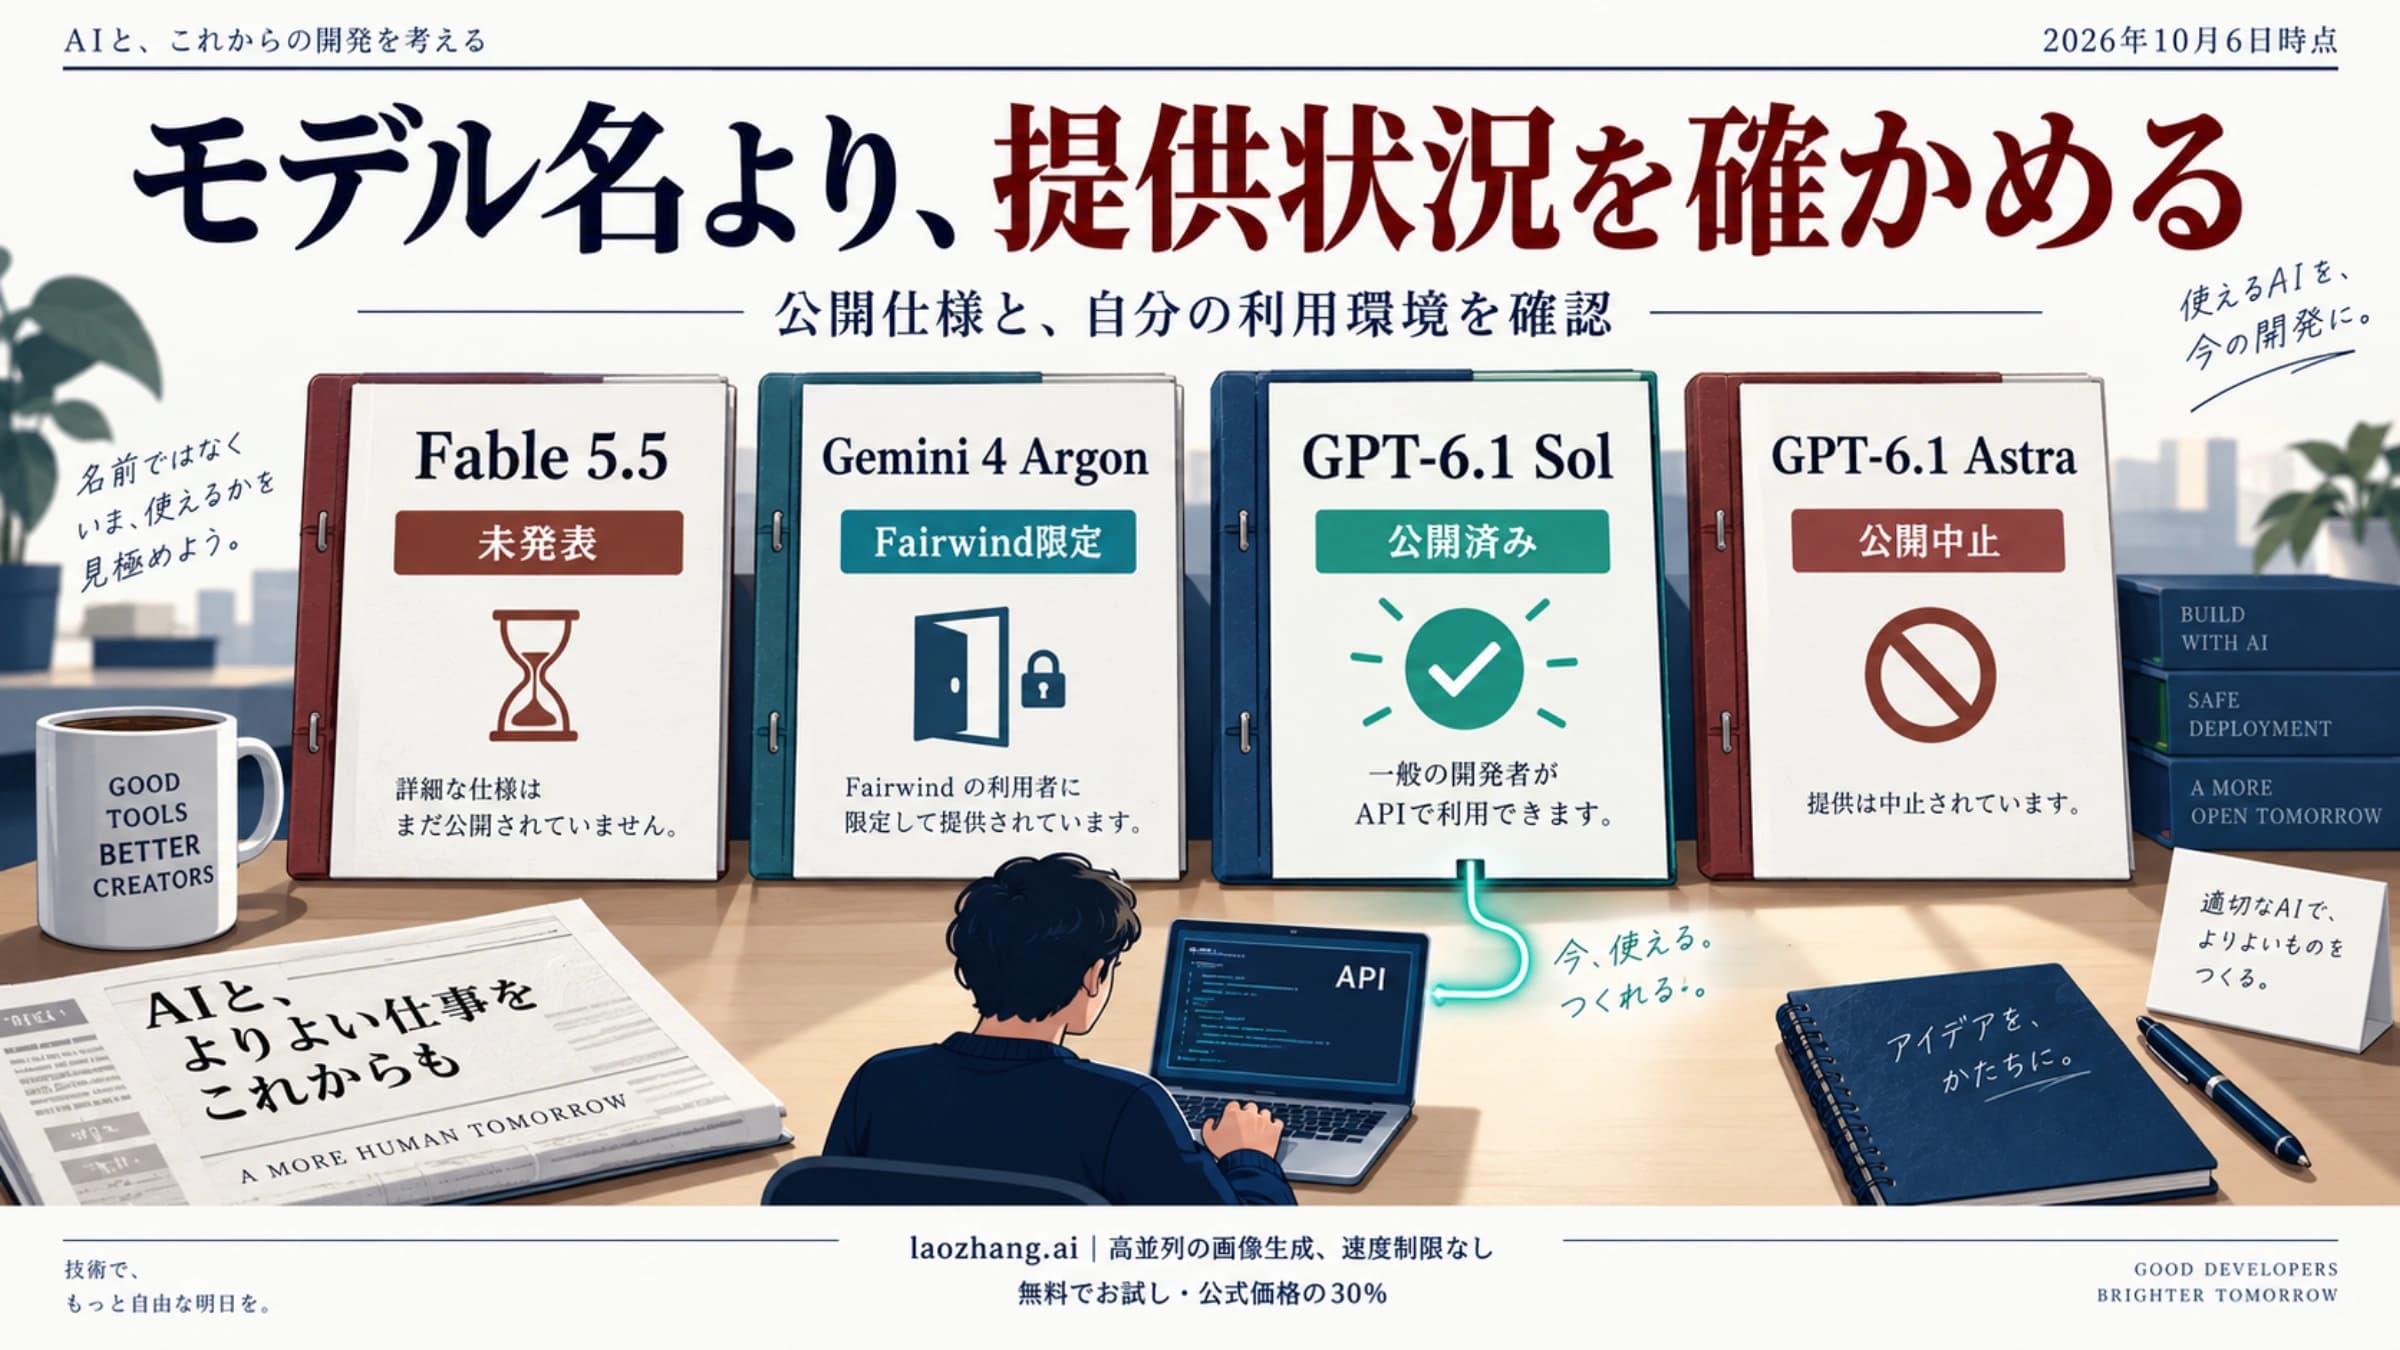
10月14日時点で使えるのはGPT-6.1 SolとGemini 4 Argon(10月13日に一般提供)。Fable 5.5は未発表、GPT-6.1 Astraは公開中止です。
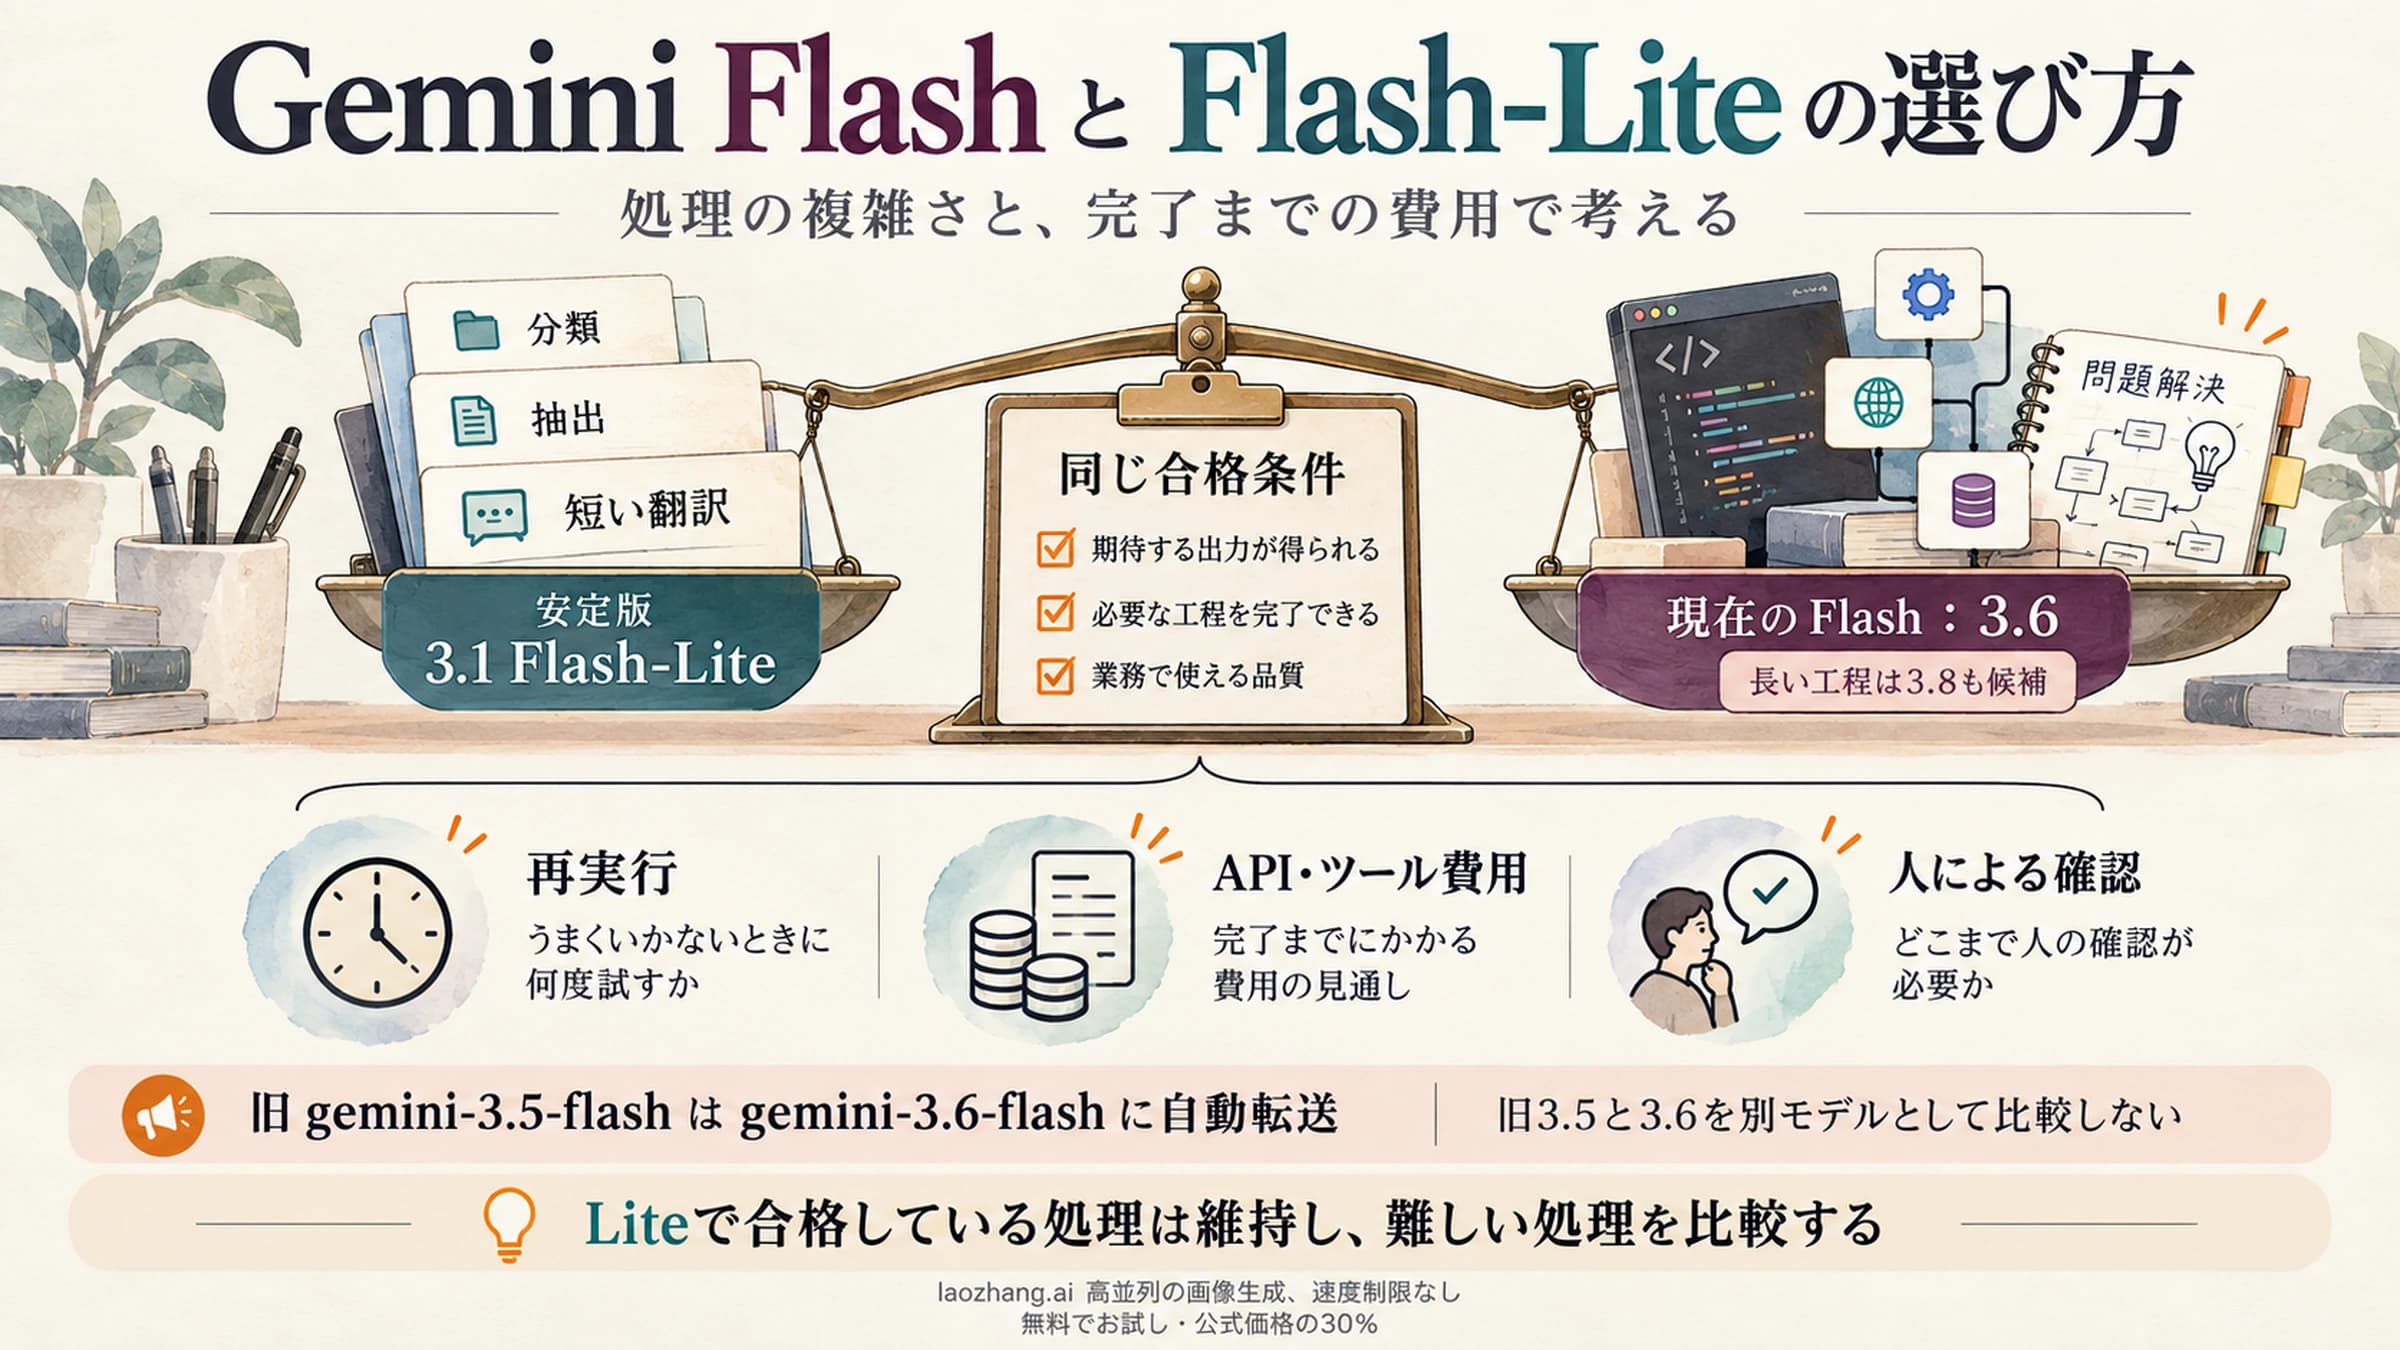
軽い分類・抽出は安定版Gemini 3.1 Flash-Liteを候補にし、複雑なコード修正やツール連携は現在のFlashで比較します。旧gemini-3.5-flashは3.6へ自動転送されるため、移行では指定IDと応答のmodelVersionを分けて確認します。
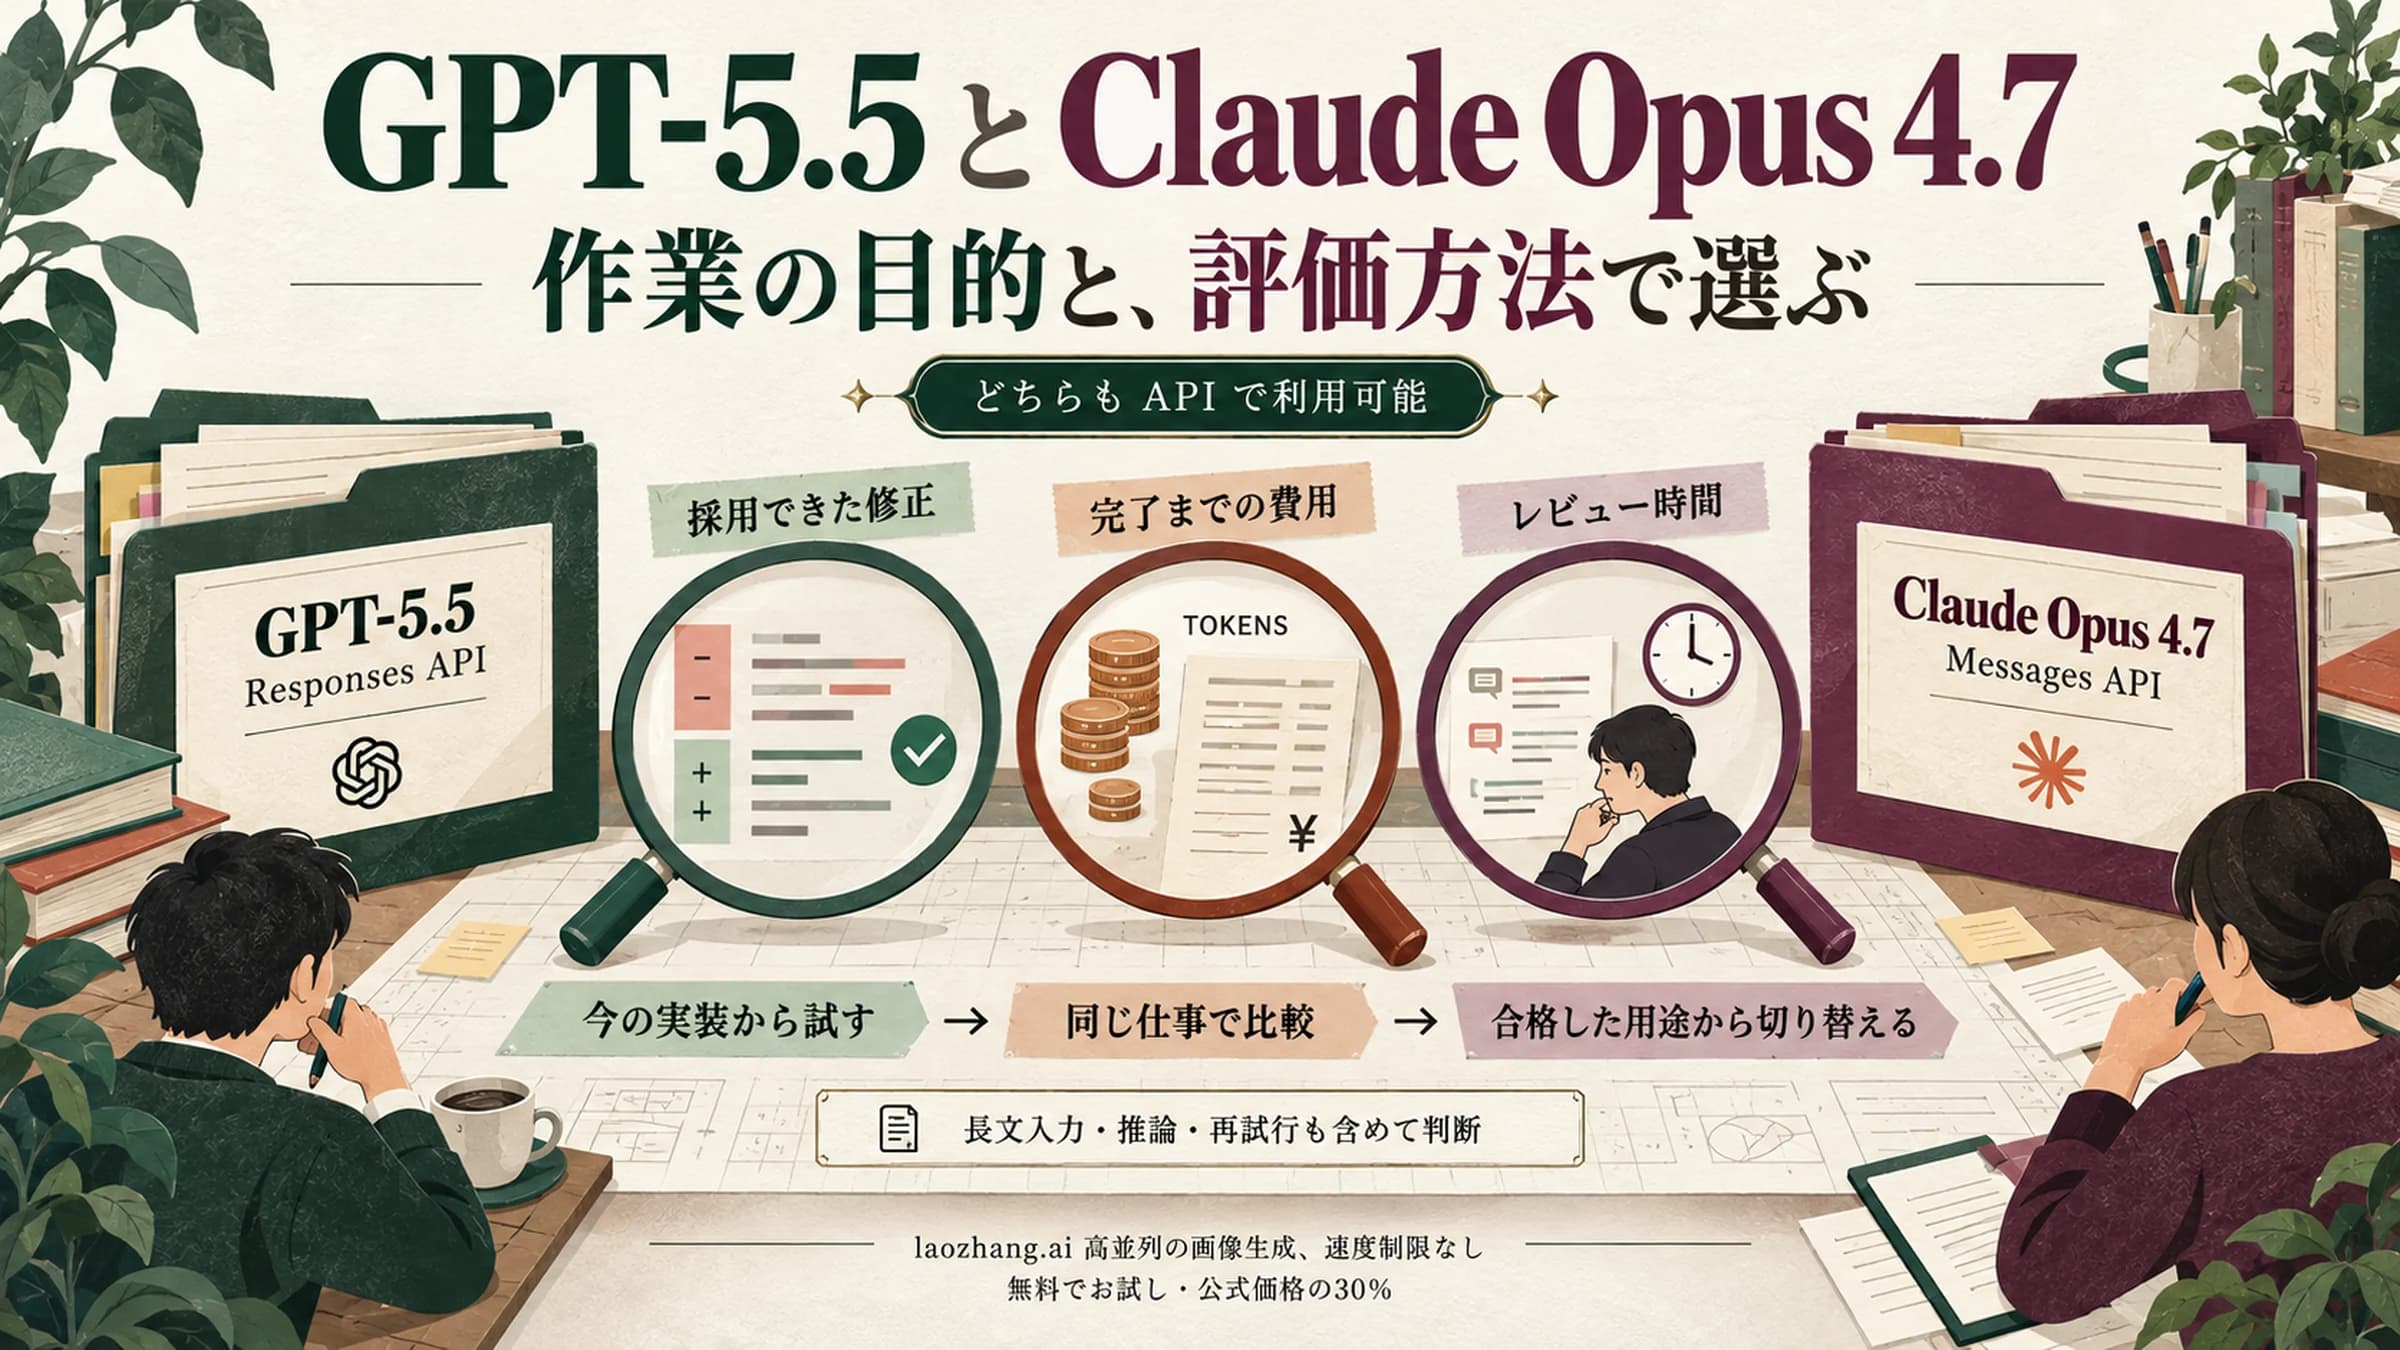
GPT-5.5もClaude Opus 4.7もAPIで利用できます。既存の接続先から評価を始め、長文入力と推論を含む費用、採用できたコード修正、レビュー時間を比べると、切り替える価値を判断しやすくなります。
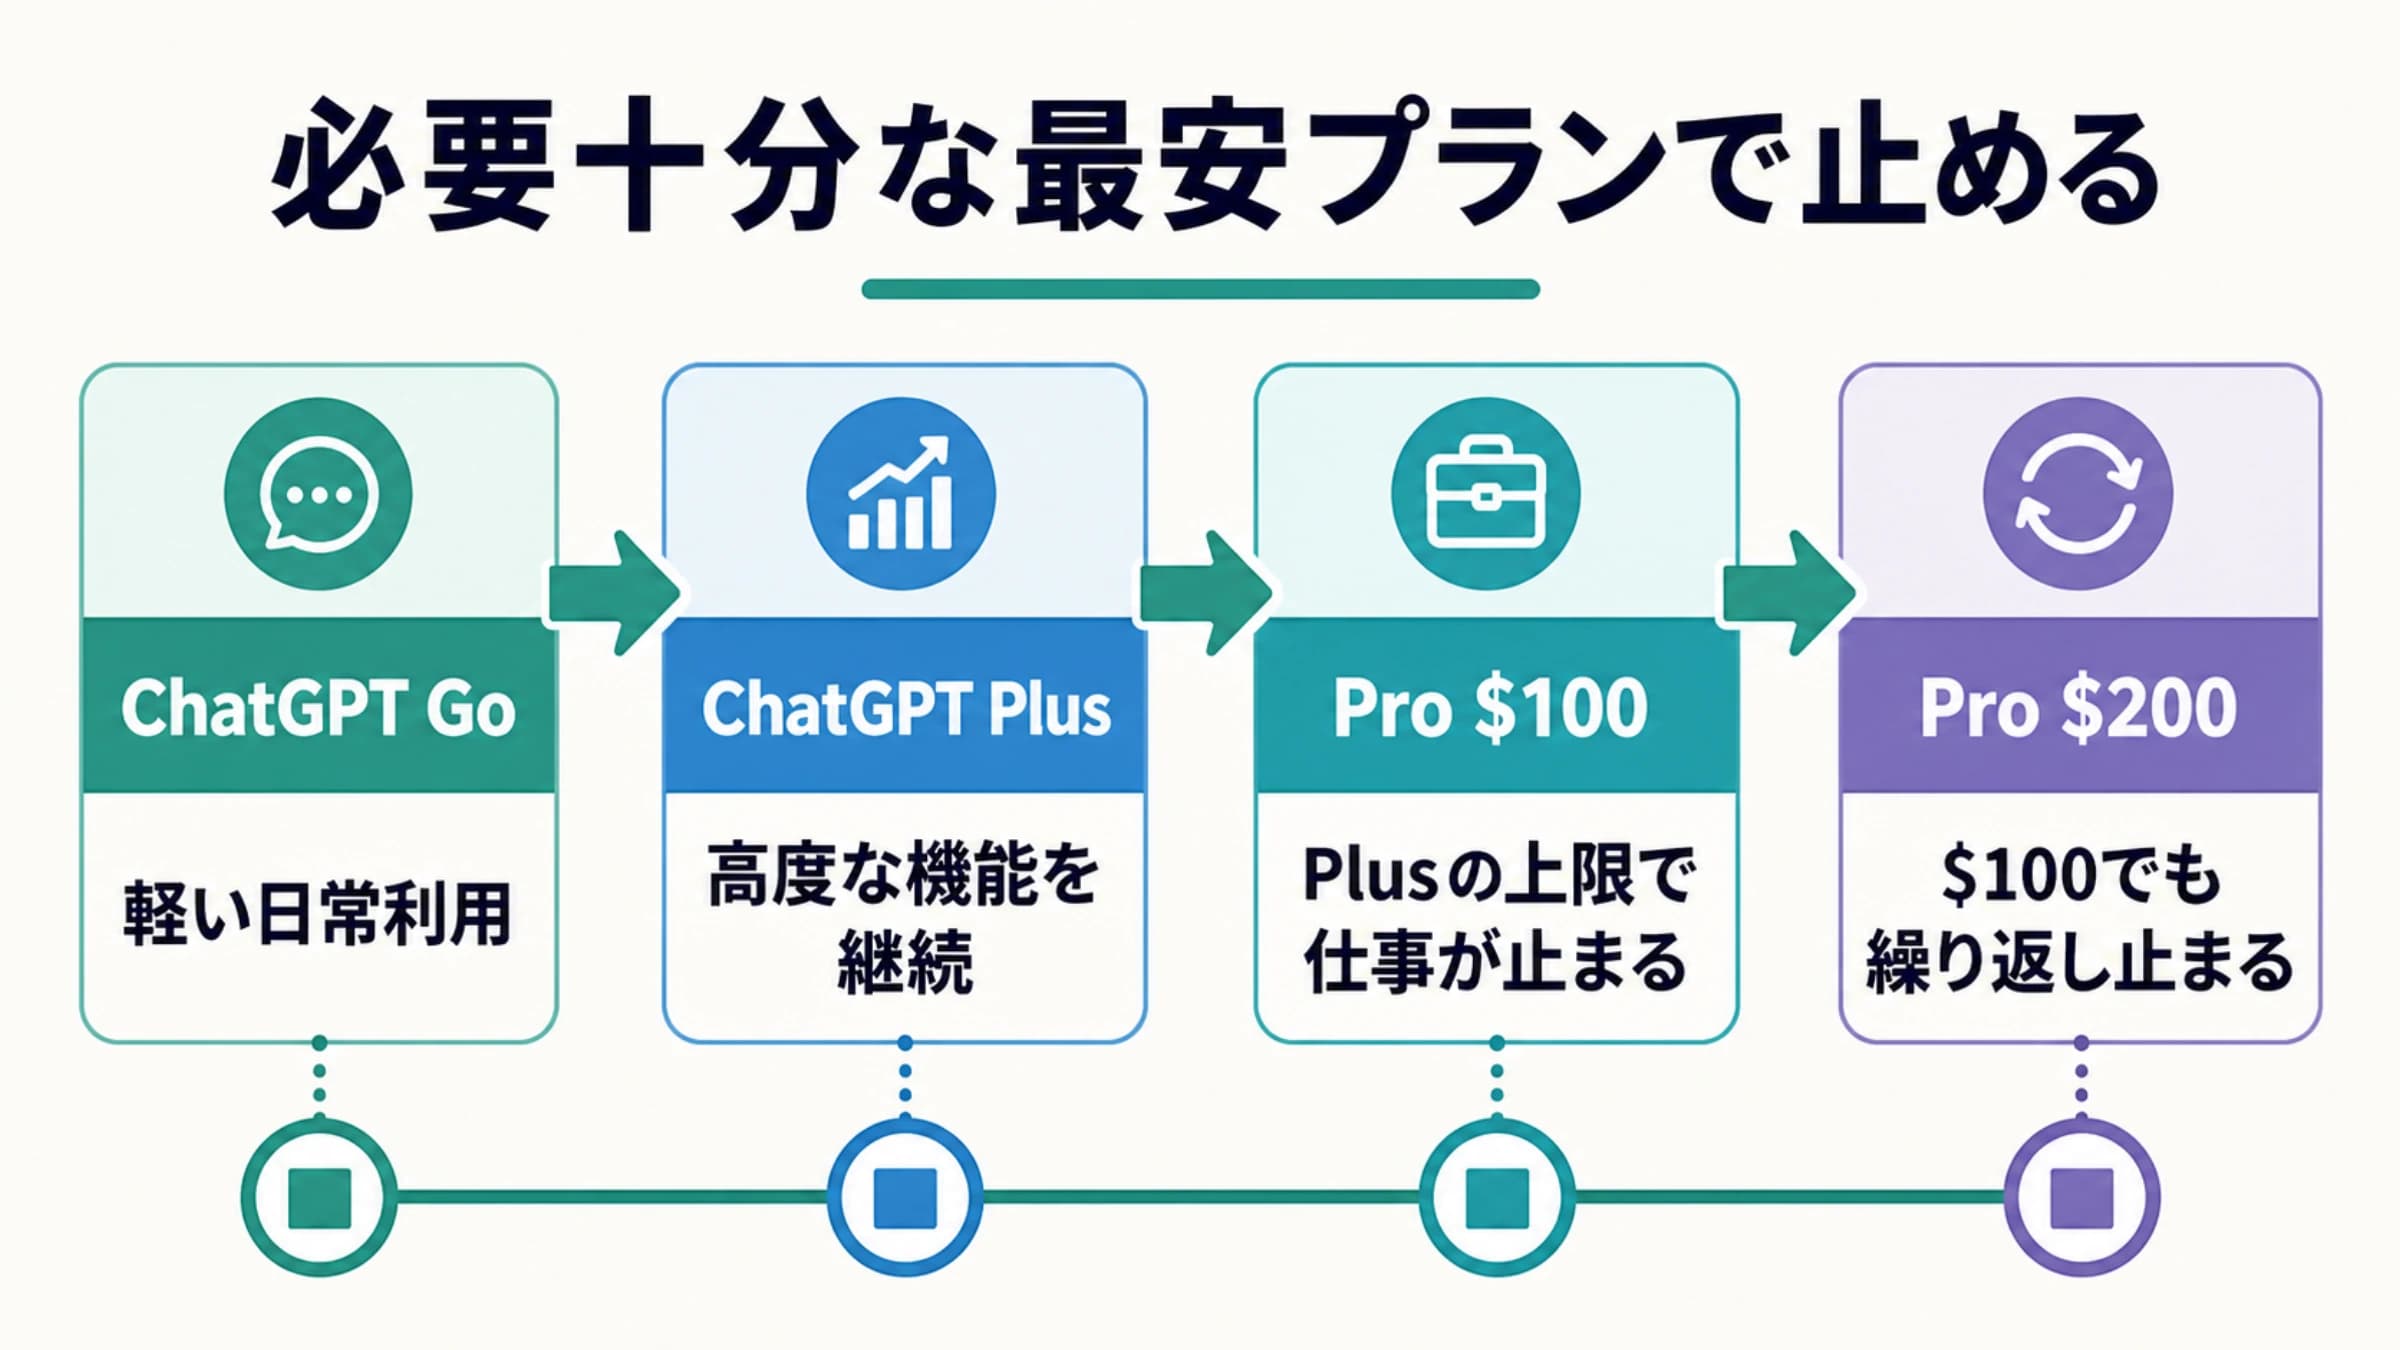
2026年10月時点の月額はGo $8、Plus $20、Pro $100〜$500。日常チャットは無制限なので、Thinking、GPT-6 Pro、Codexの上限で選びます。
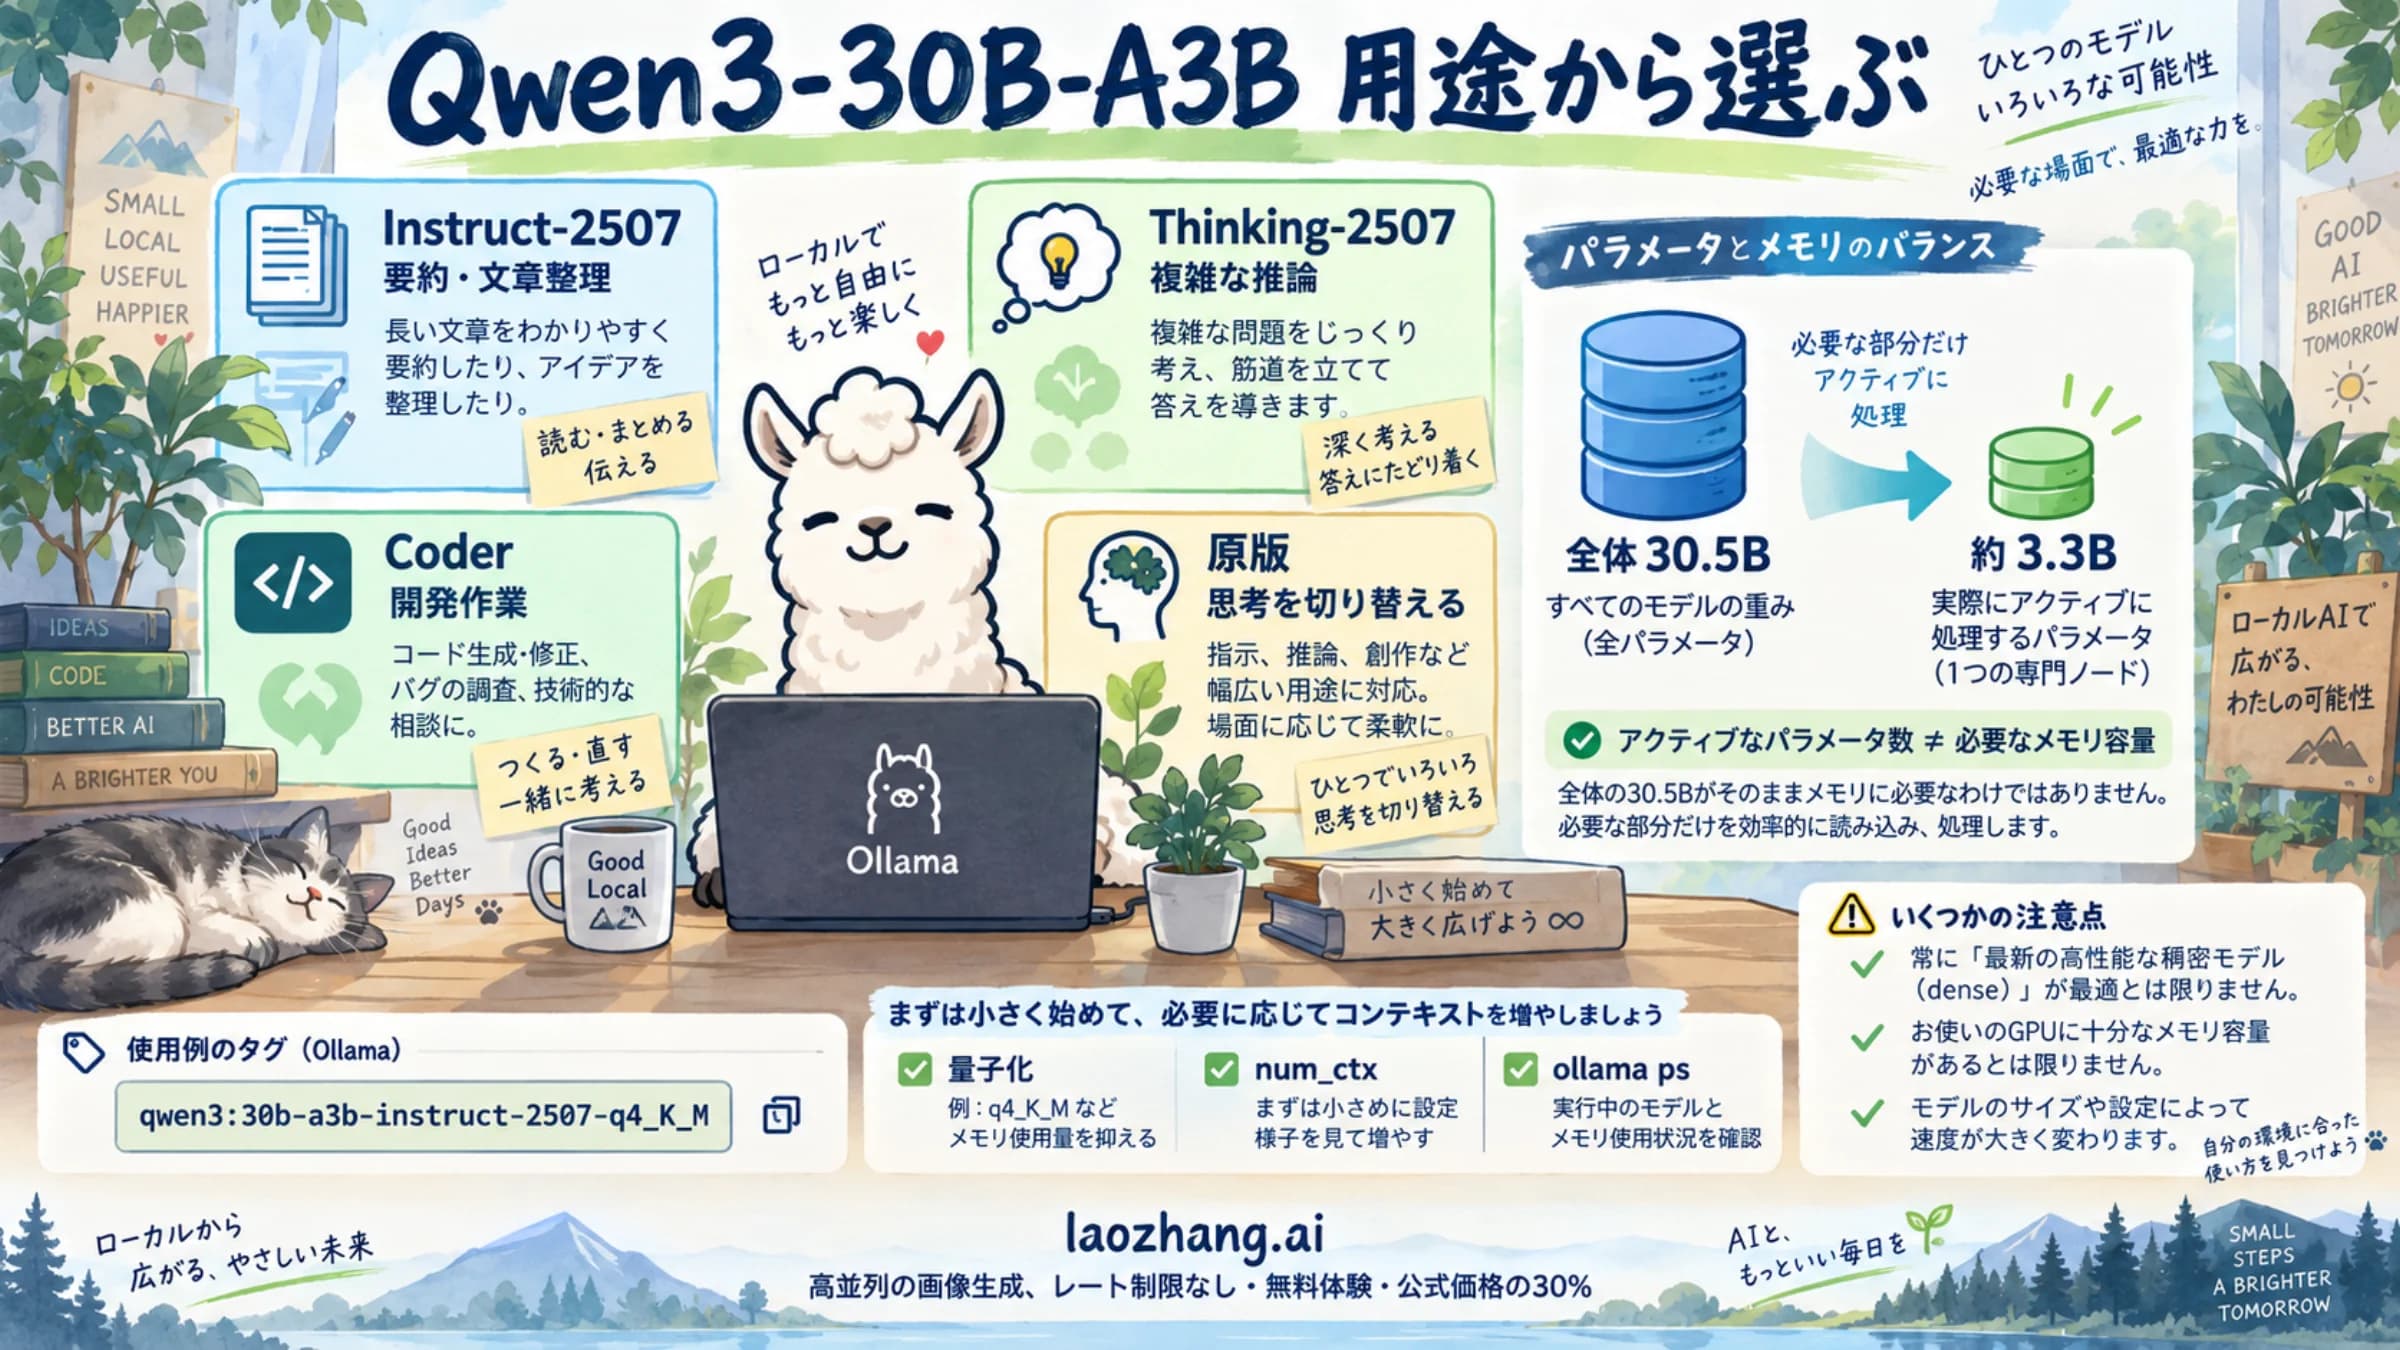
Qwen3-30B-A3Bは用途と思考モードで選びます。短い要約ならInstruct-2507、推論を深めるならThinking-2507、開発ならCoderが候補です。原版は思考の切り替えが必要な場合に使えます。Ollamaのモデル名と実際の設定を確認してから、メモリに合わせて使い始めましょう。
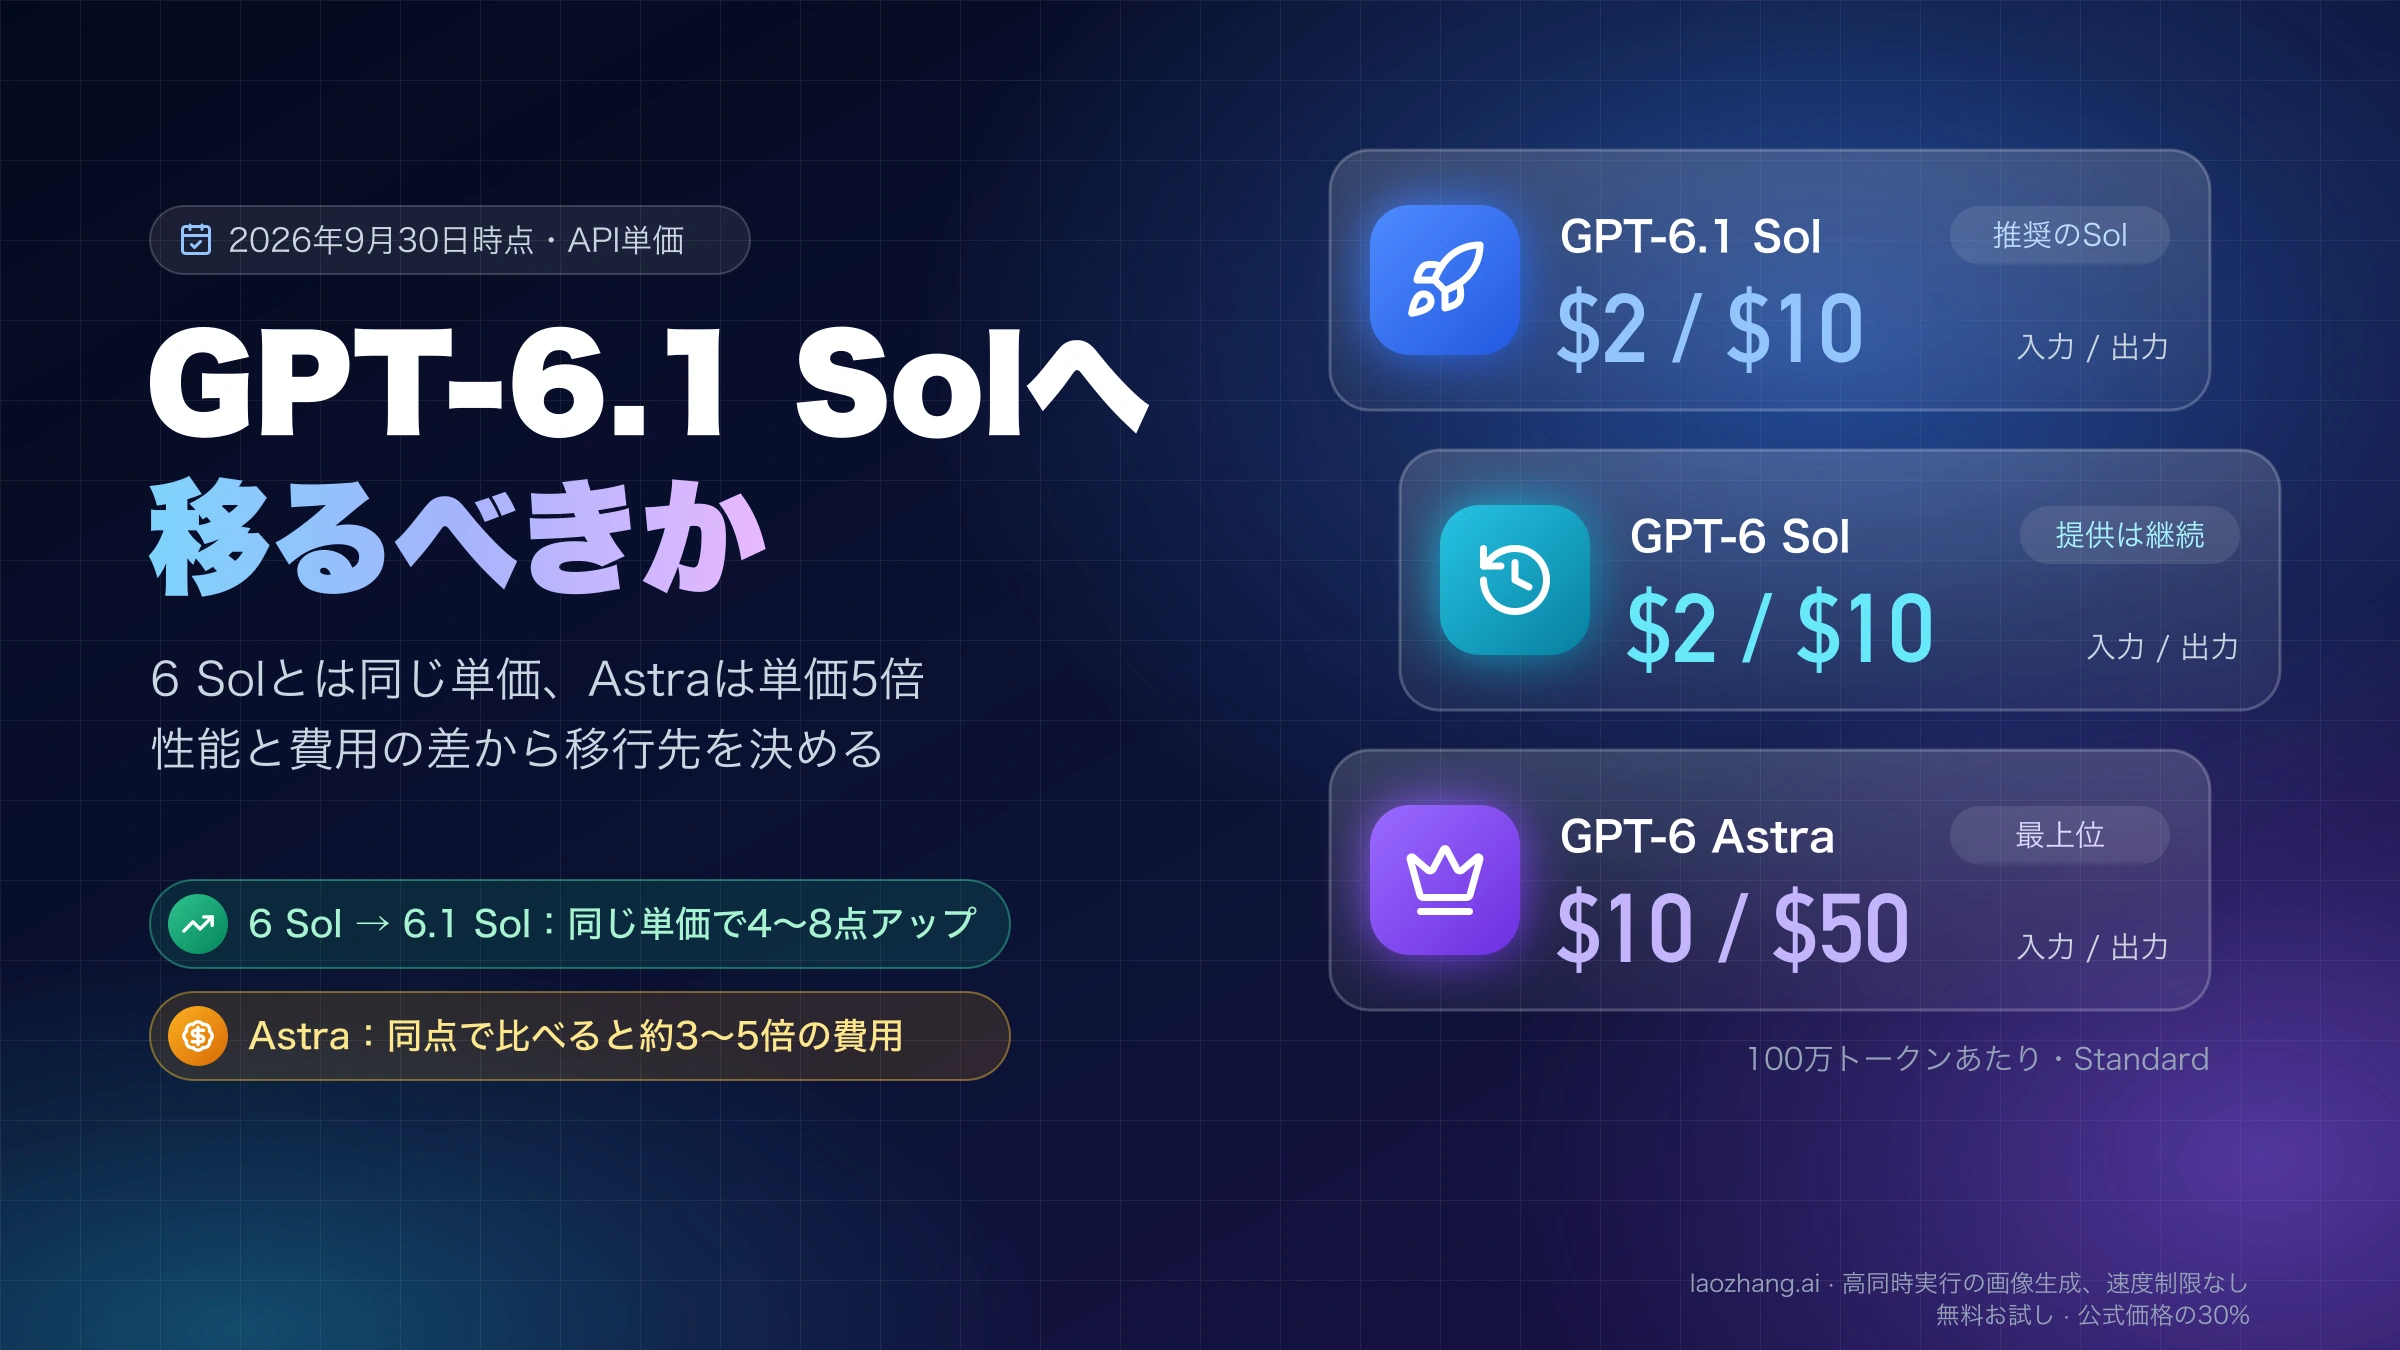
GPT-6 Solからは同じ単価で性能が上がる6.1 Solへ移るのが基本で、none設定だけ要注意です。Astraは同点で比べると3〜5倍高く、最上位の精度が要る仕事に絞ります。
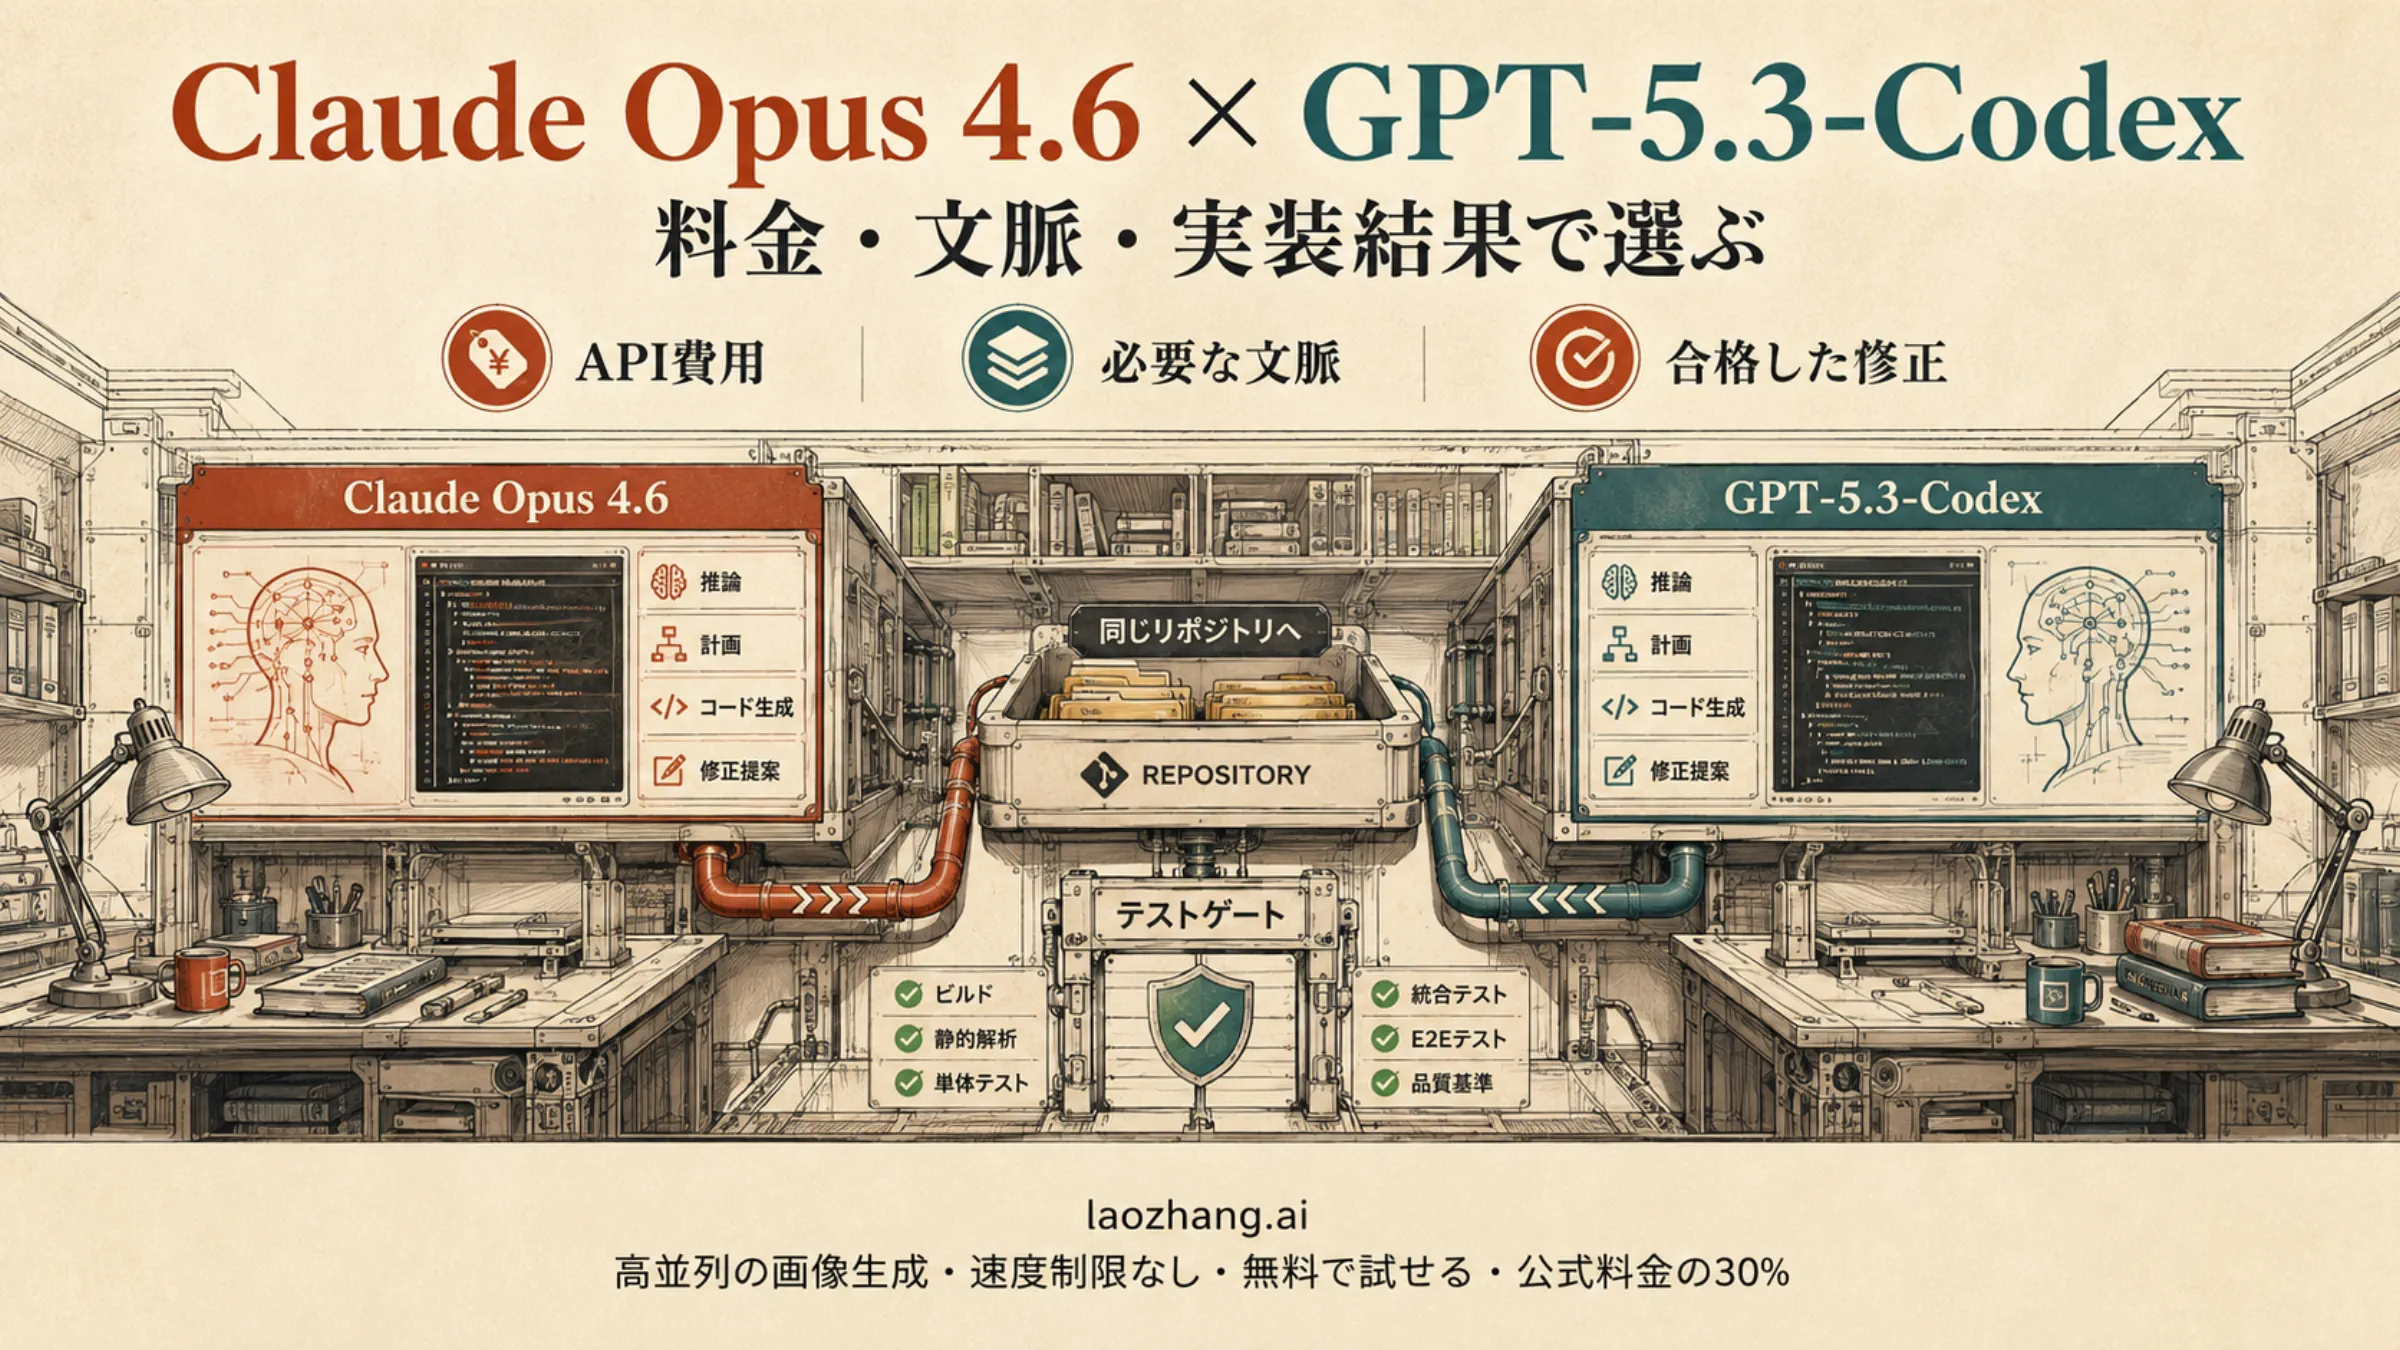
Claude Opus 4.6とGPT-5.3-CodexのAPI単価、キャッシュ料金、コンテキスト上限を比較。同じトークン数での費用計算と、既存リポジトリで実装・テスト・手直しまで比べる手順をまとめます。
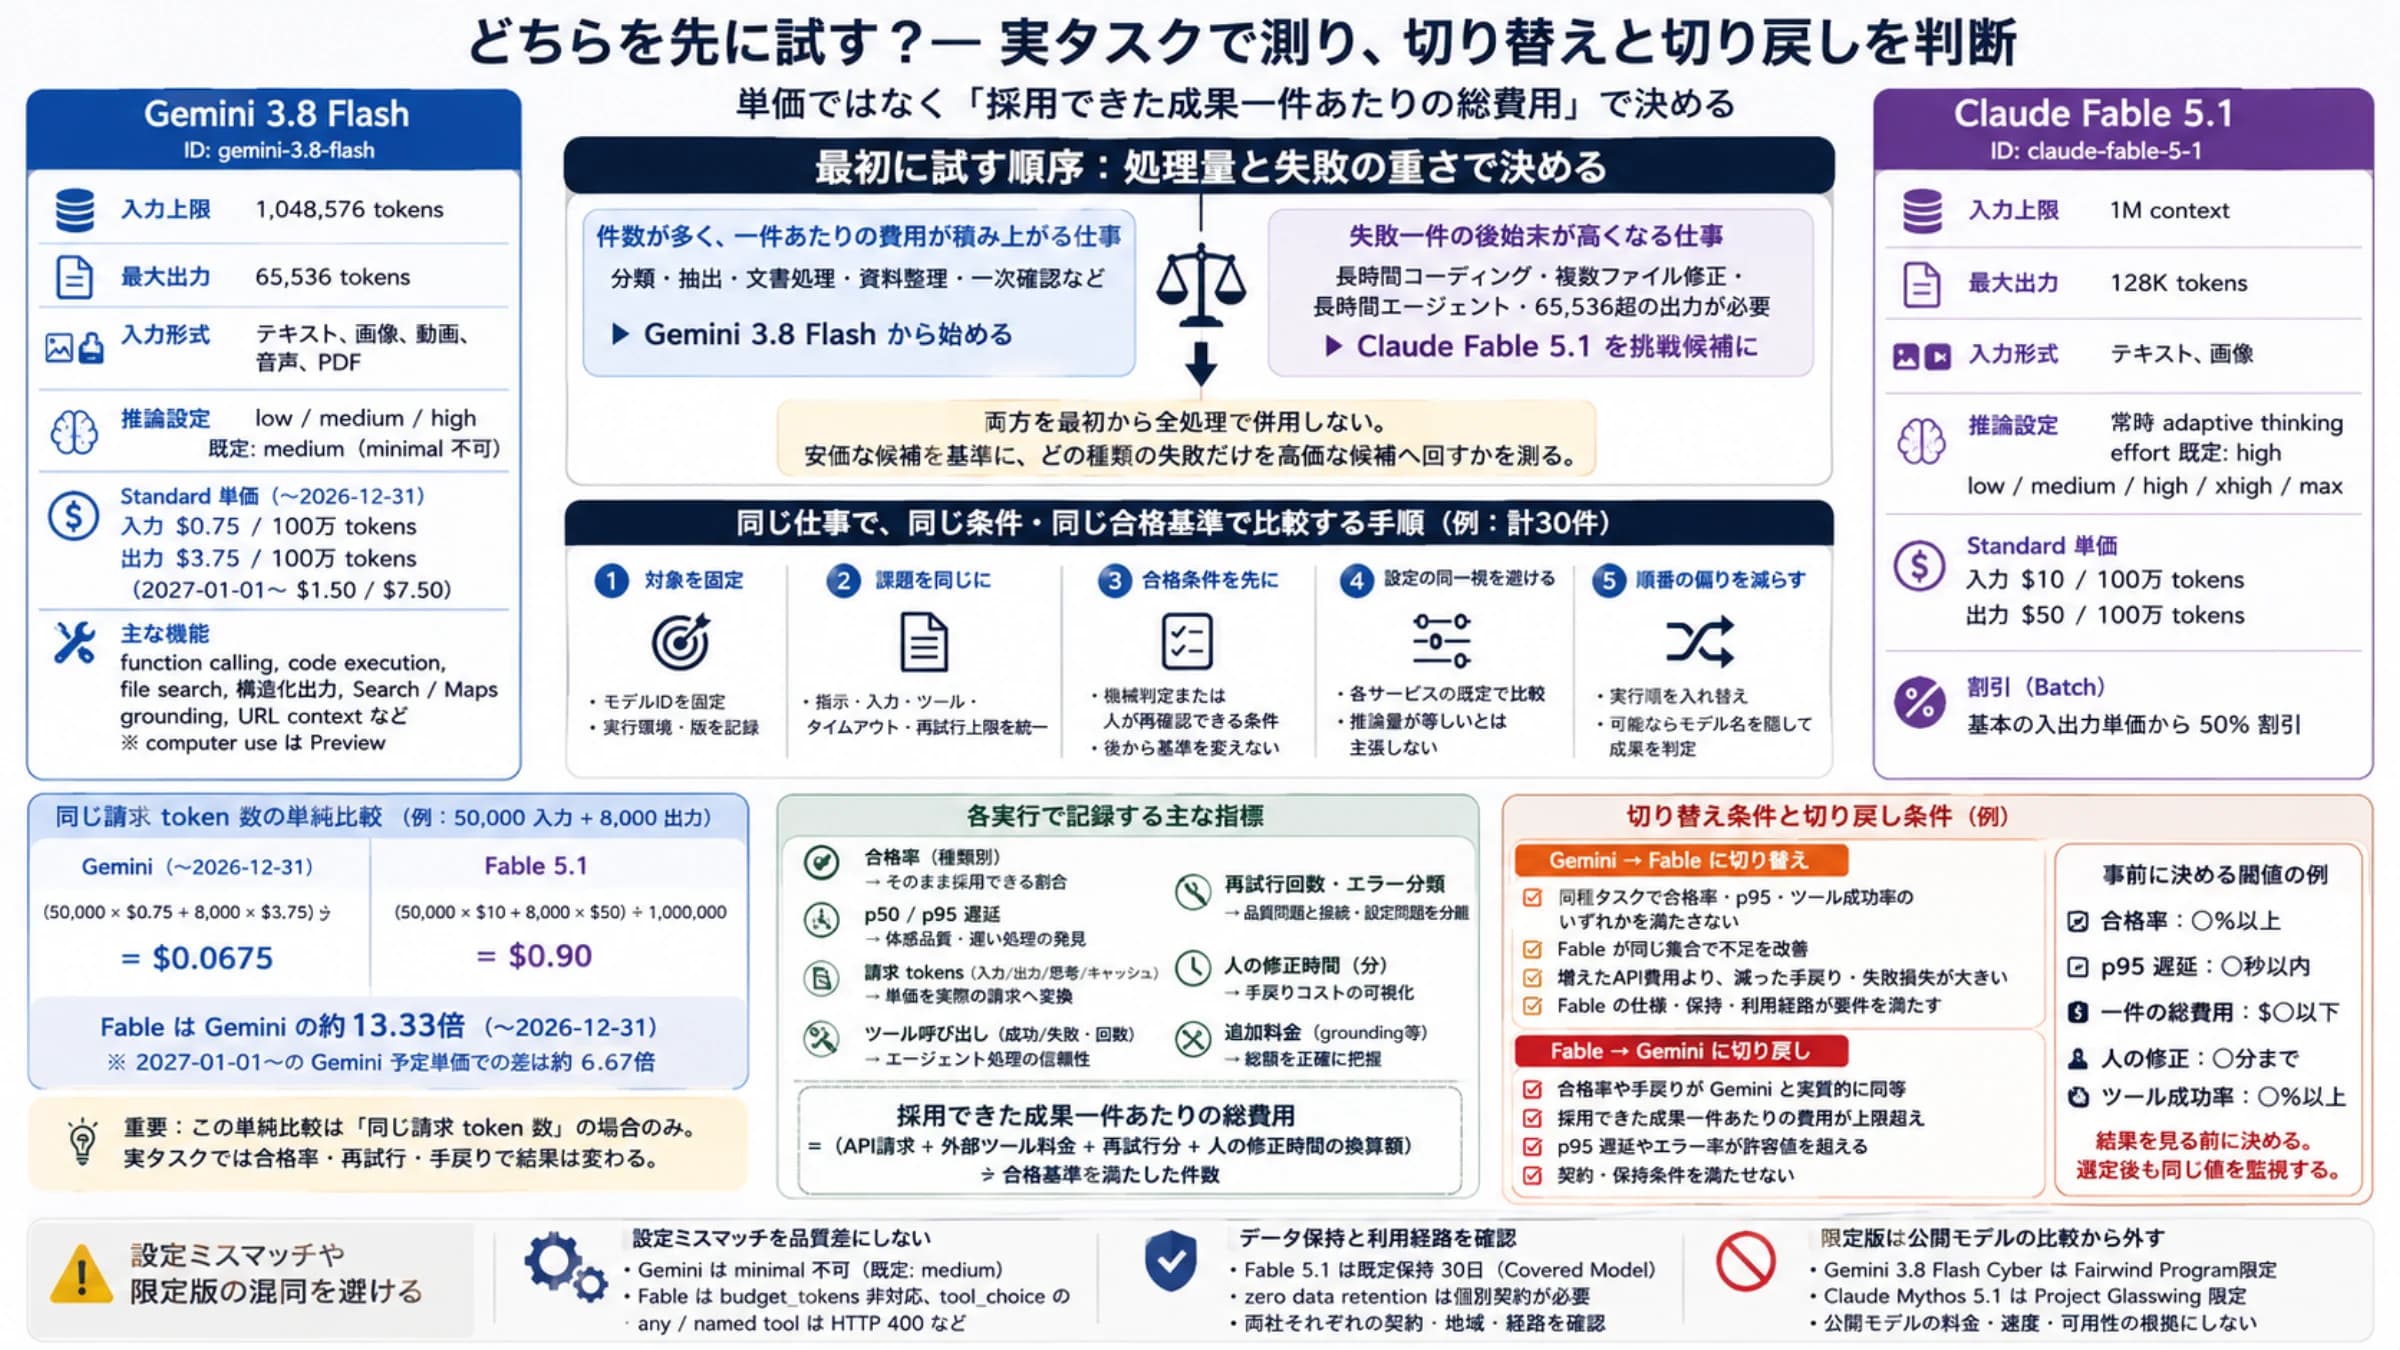
大量処理や費用を優先するならGeminiを先に、高価な失敗を減らせるか確かめたいならFableを挑戦候補にします。単価表ではなく、採用できた成果一件あたりの費用で判断します。
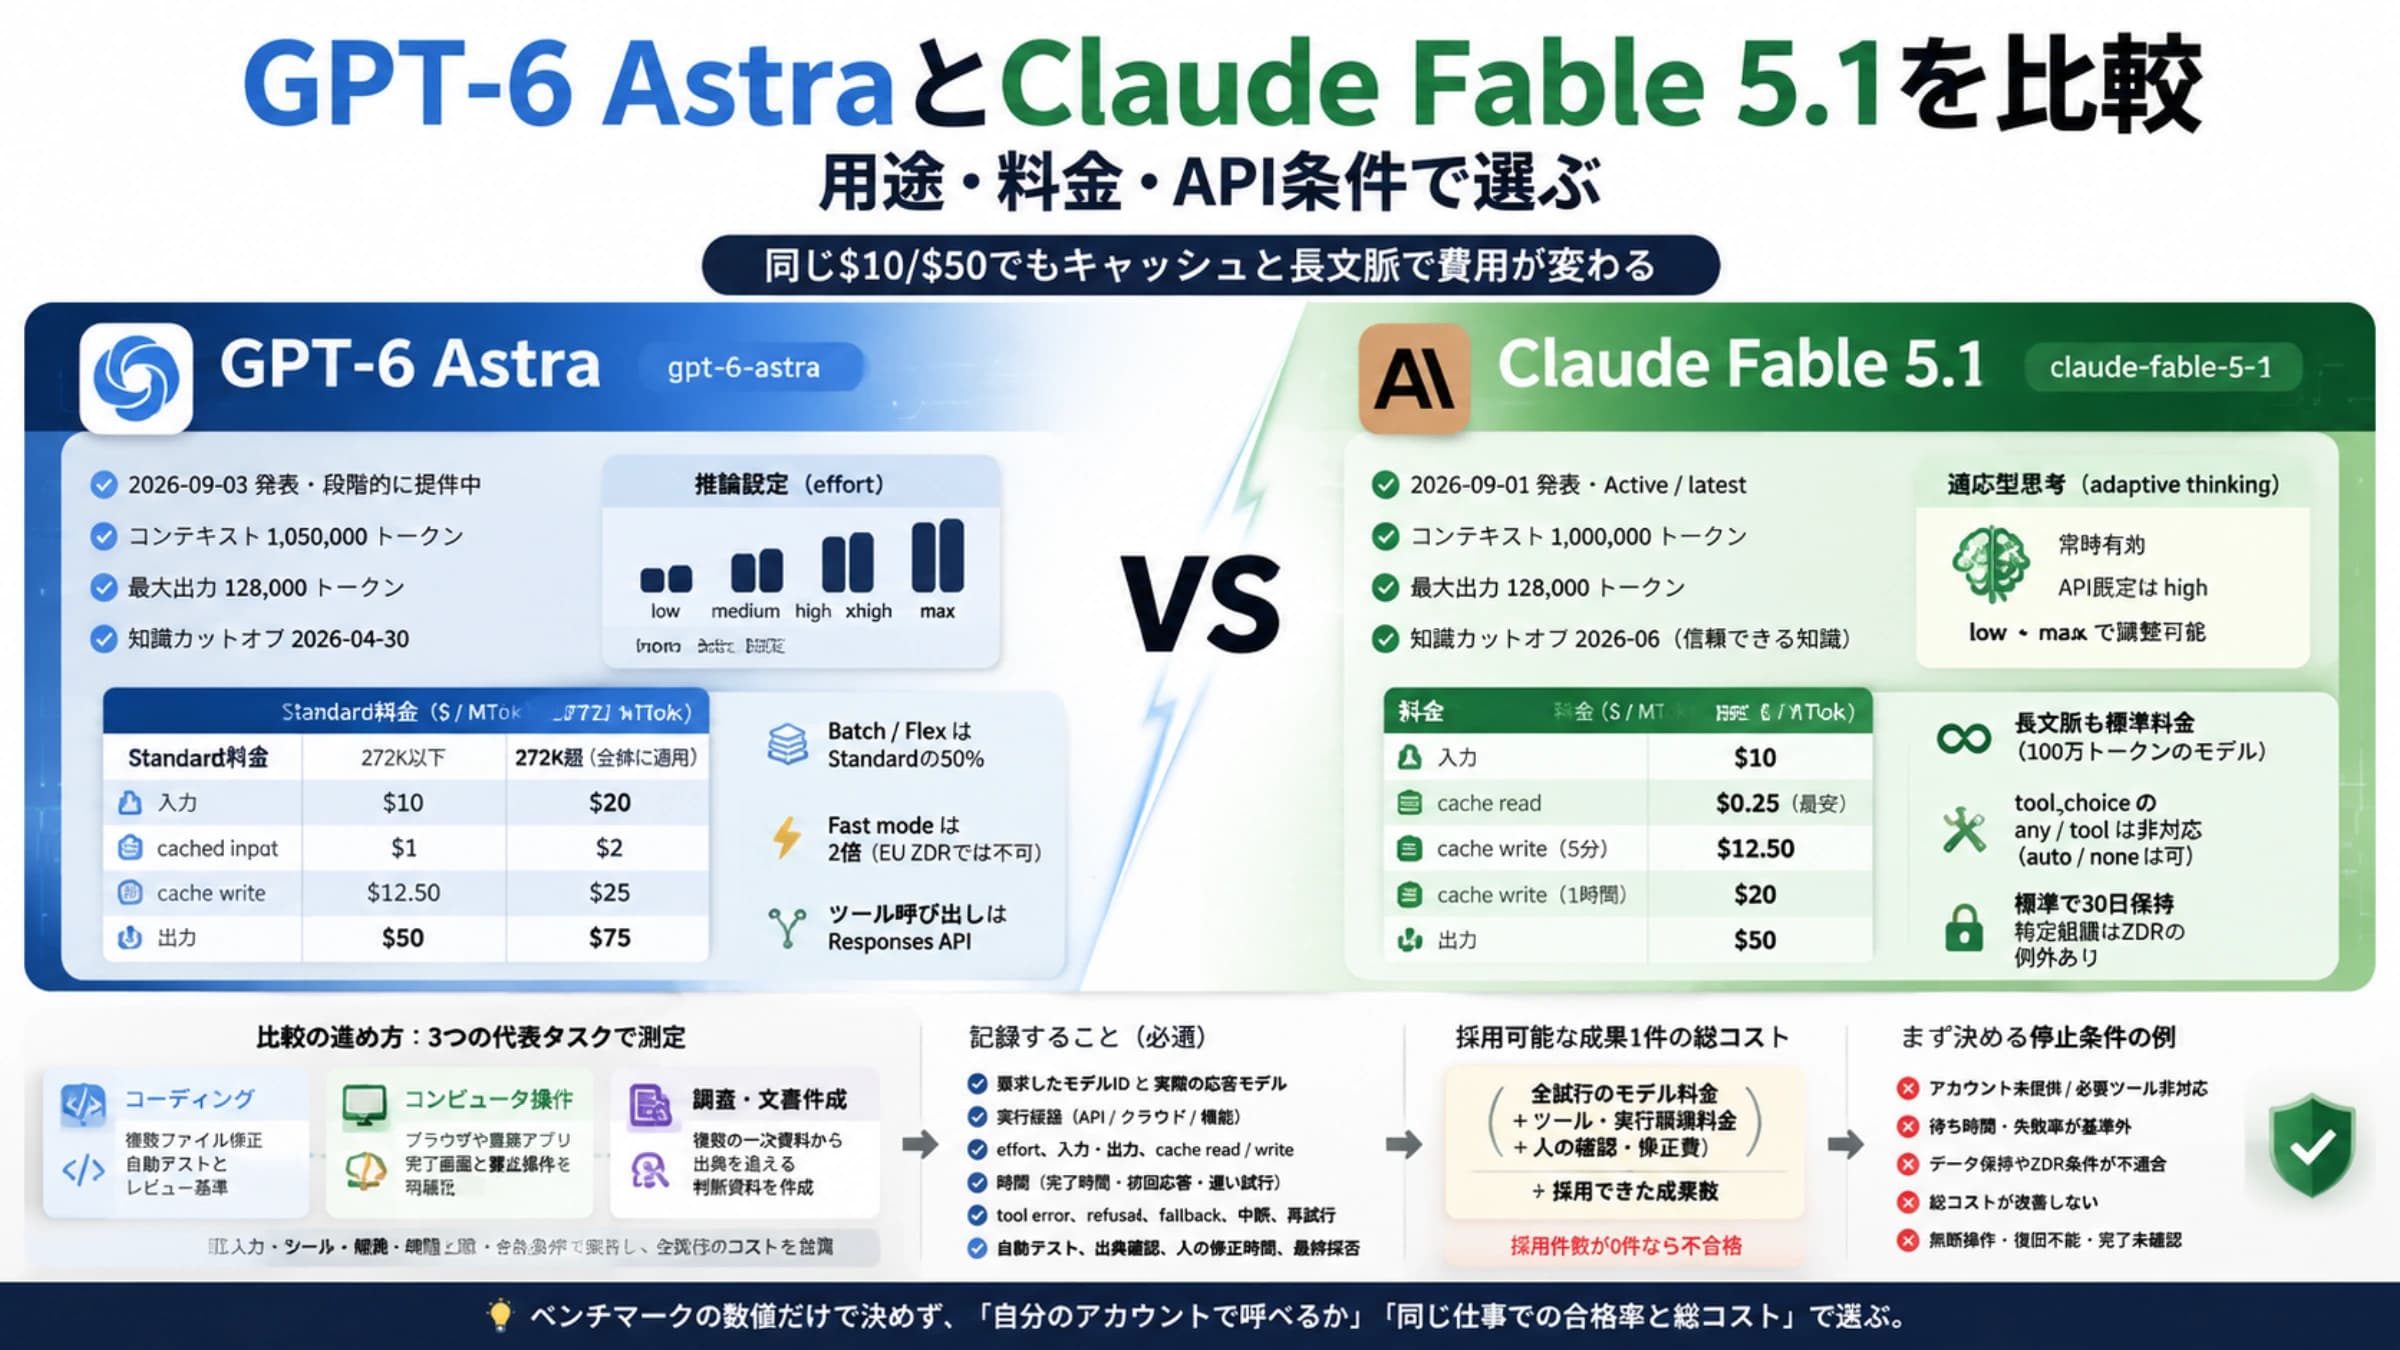
AstraとFable 5.1は基本のAPI単価が同じです。選択を分けるのは、272K超の入力、キャッシュ再利用、データ保持、ツール実装、そして自社タスクの合格率です。
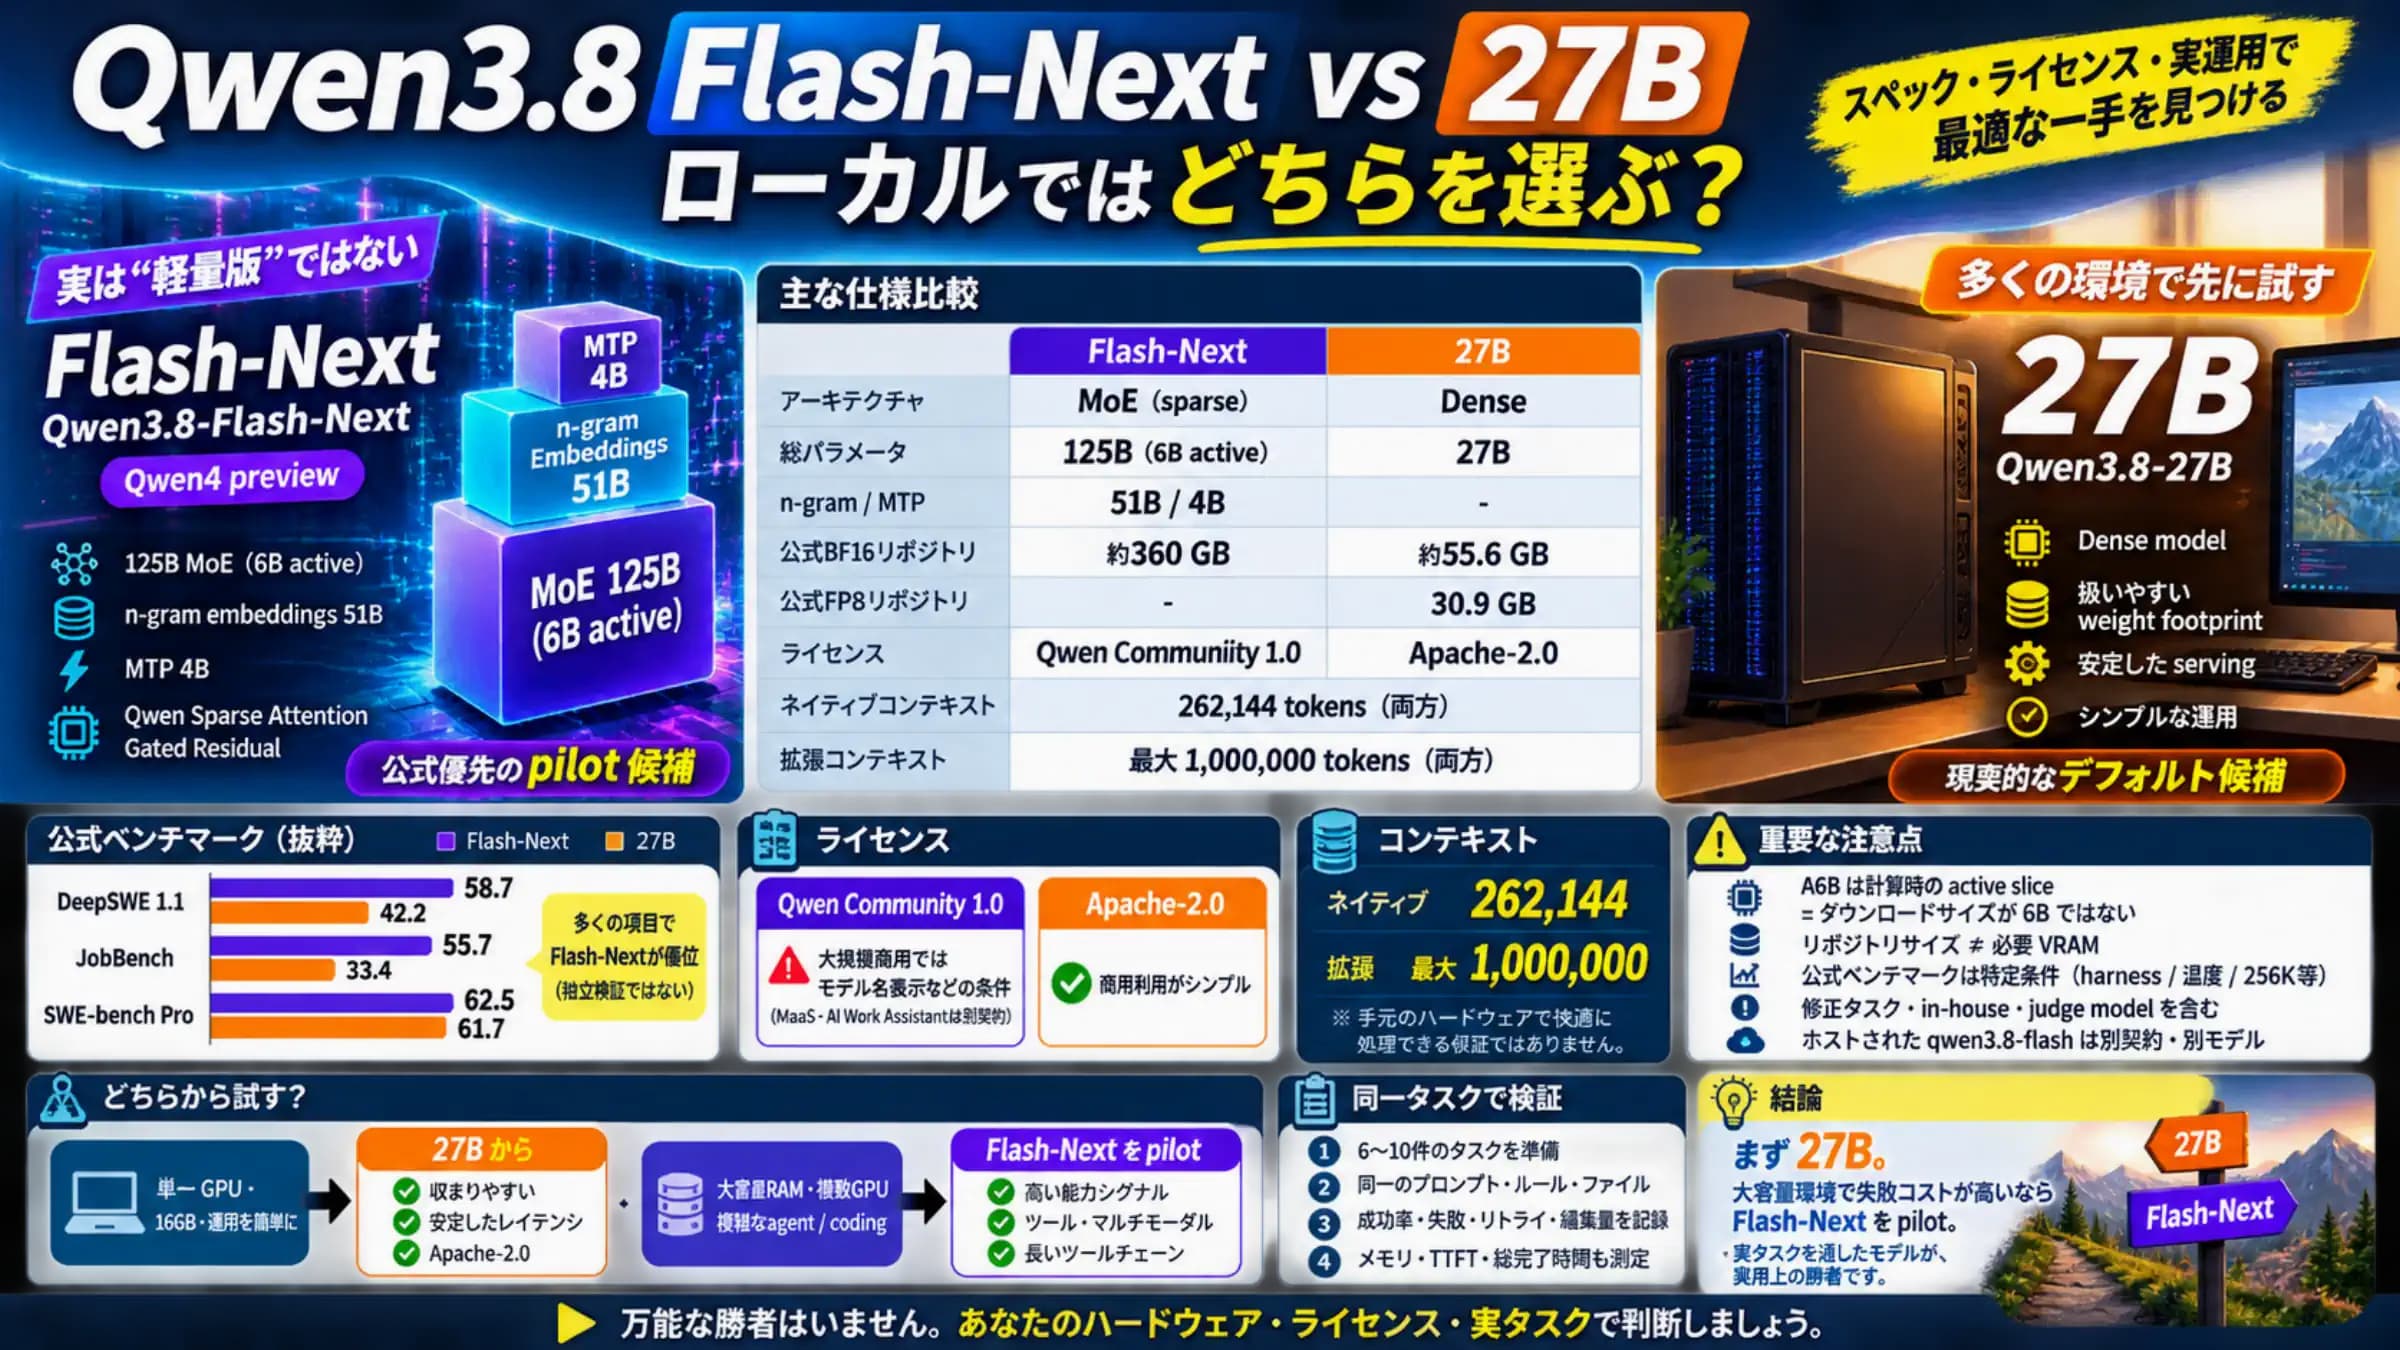
1台のマシンで使うなら、まず必要メモリを確認しやすい27Bから検討します。大容量メモリを確保でき、複雑なコーディングやエージェント業務の失敗を減らしたい場合にFlash-Nextを試します。
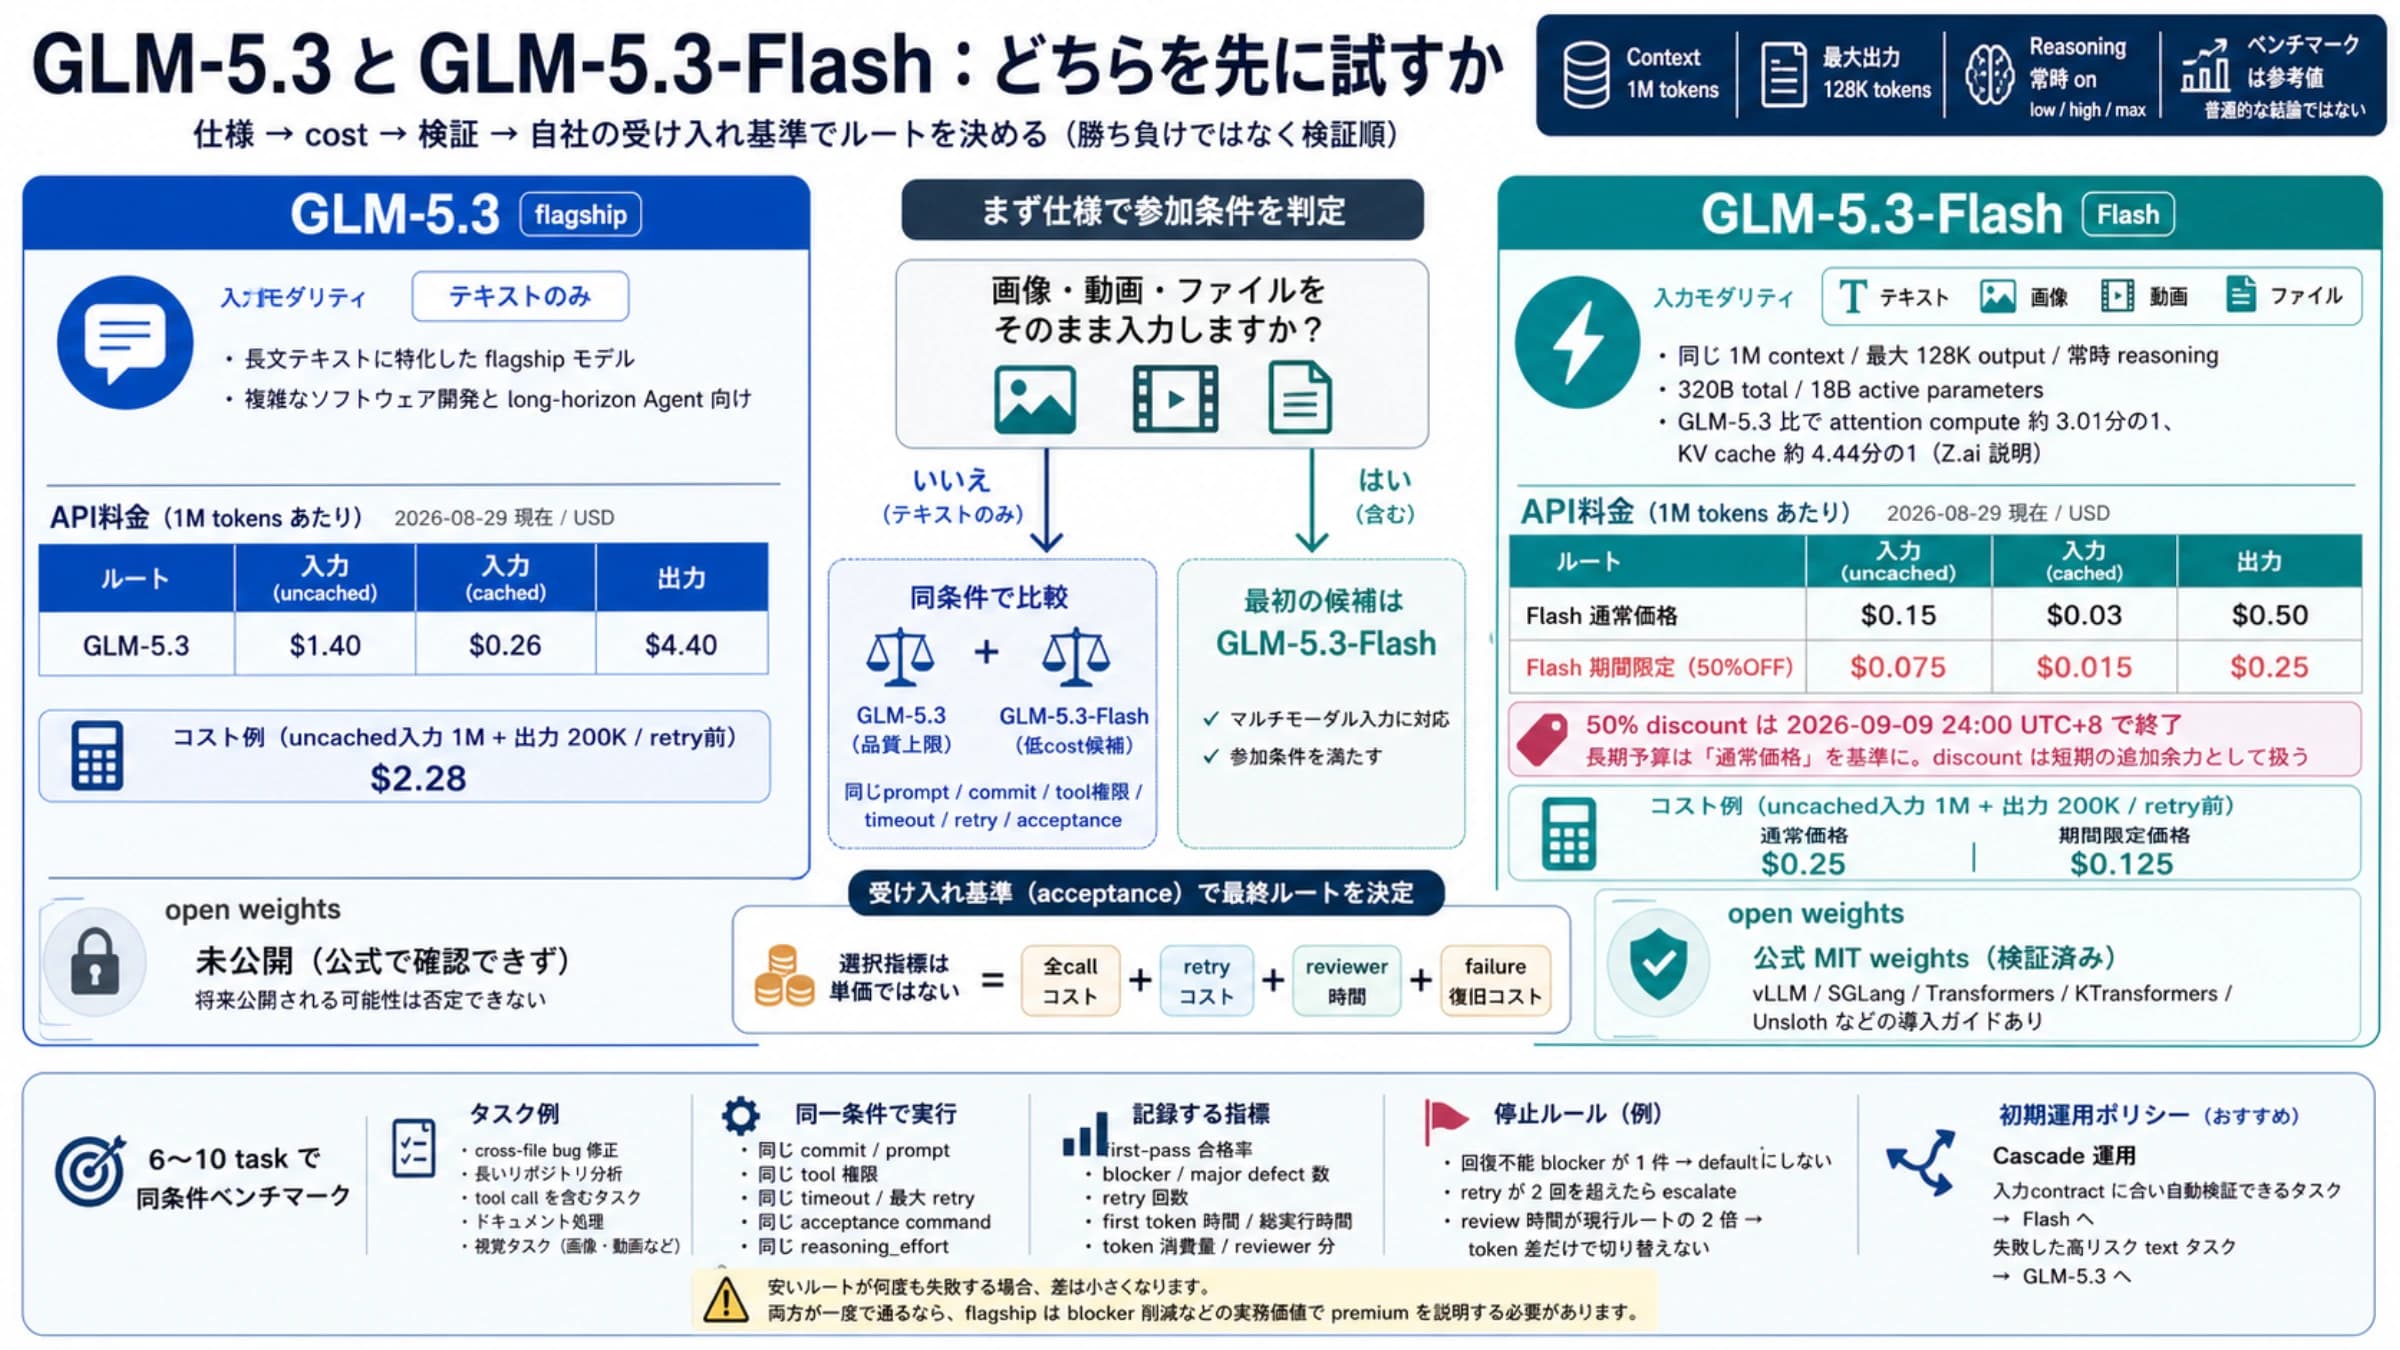
画像を含む仕事や費用を抑えたい処理では、まずGLM-5.3-Flashを試します。失敗の影響が大きいテキスト中心の開発業務では、GLM-5.3も同じ条件で試し、手戻りを含む費用で選びます。
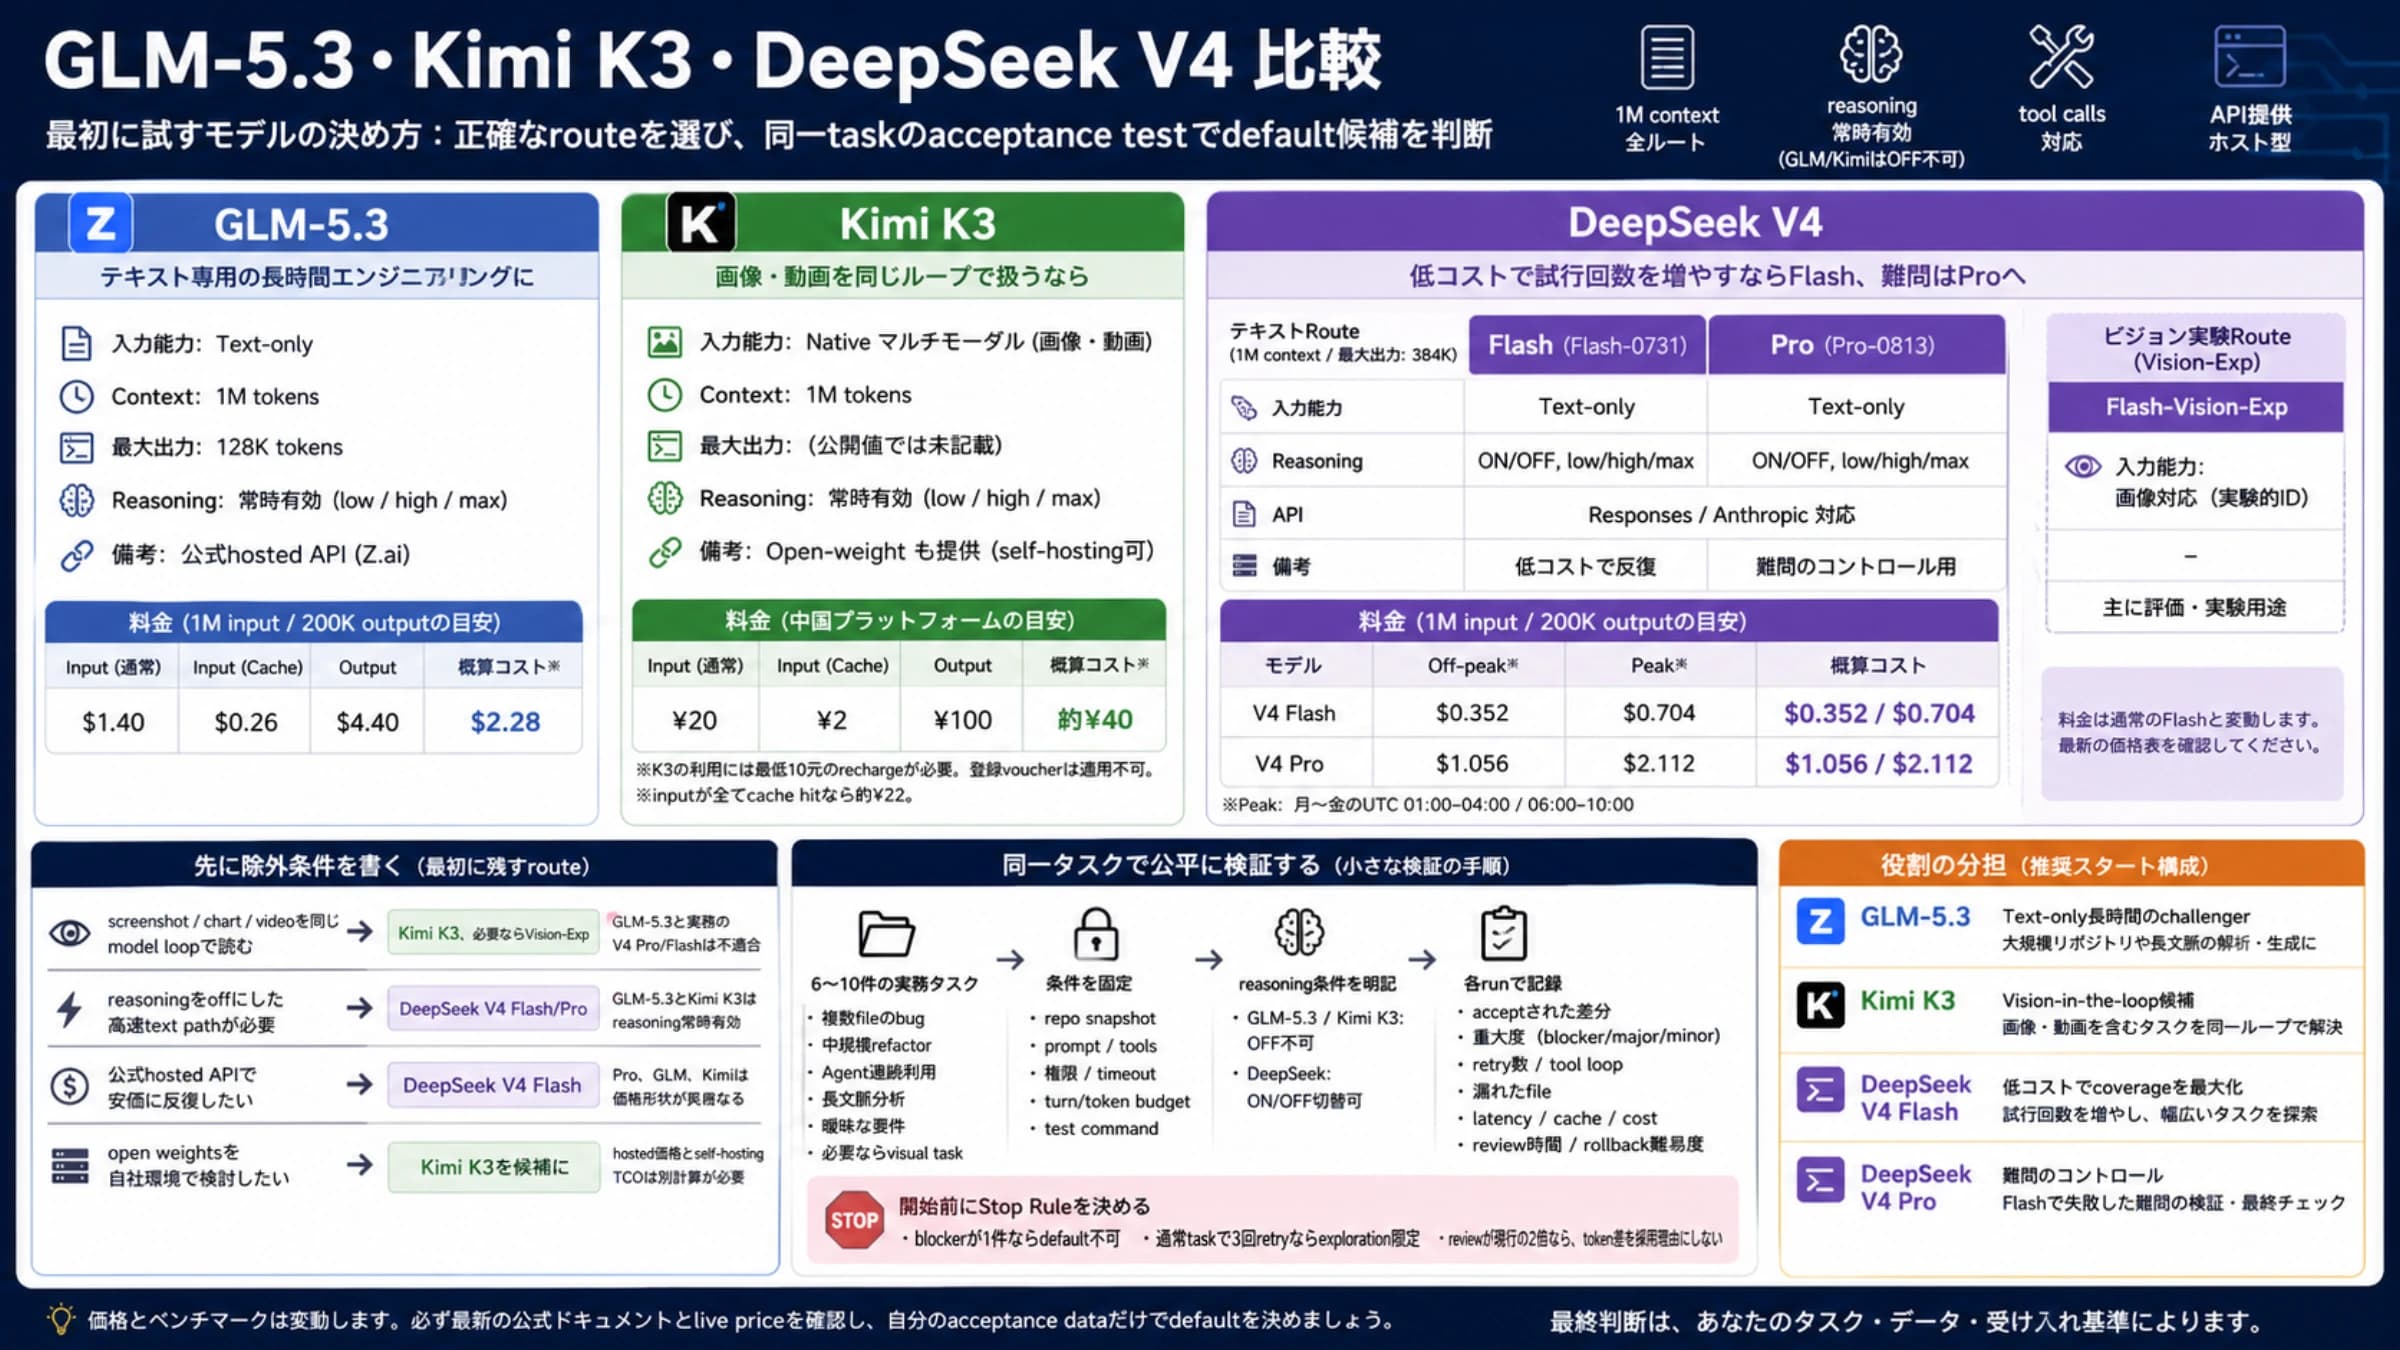
テキスト中心の長時間エンジニアリングはGLM-5.3、画像を同じループで扱うならKimi K3、低コストで試行回数を増やすならDeepSeek V4 Flashを先に検証し、難しいケースだけProと比べます。
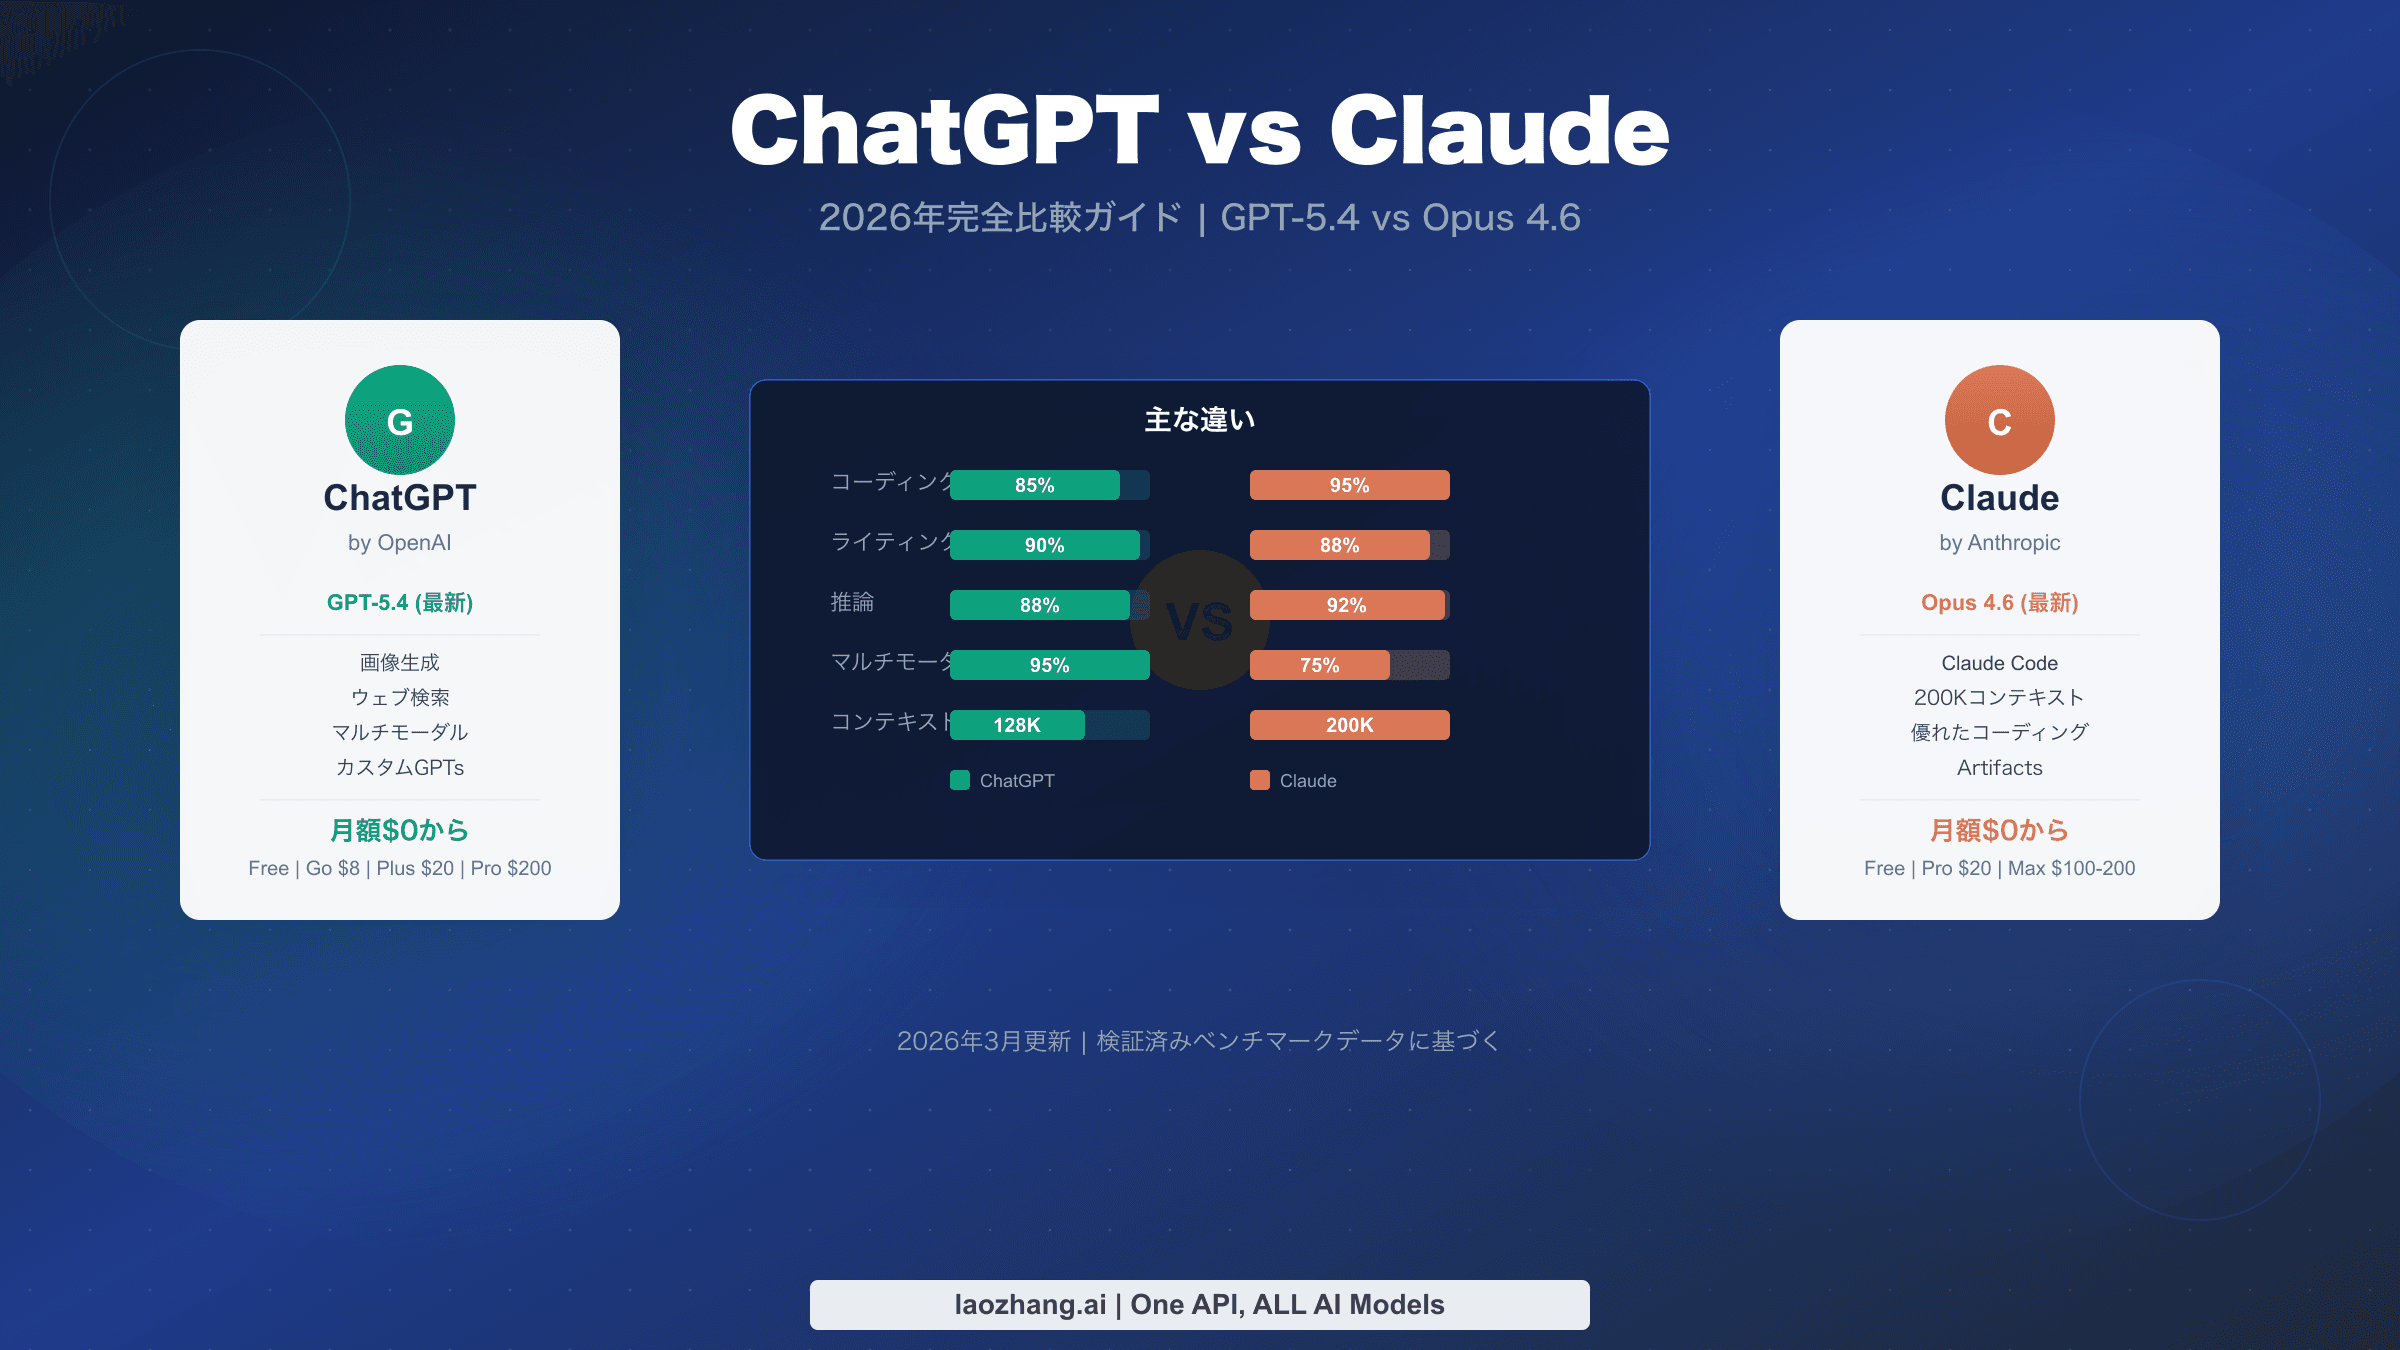
2026年3月時点で、ChatGPT(GPT-5.4)とClaude(Opus 4.6)は、それぞれ異なる強みを持つ2大AIアシスタントです。ChatGPTはマルチモーダルタスク、画像生成、ウェブ検索に優れ、Claudeはコーディング精度、長文分析、開発者ツールでリードしています。両方とも無料プランと月額$20の有料プランを提供。本ガイドでは、検証済みベンチマークデータに基づき、コーディング、文章作成、リサーチ、料金、APIの各分野で比較します。
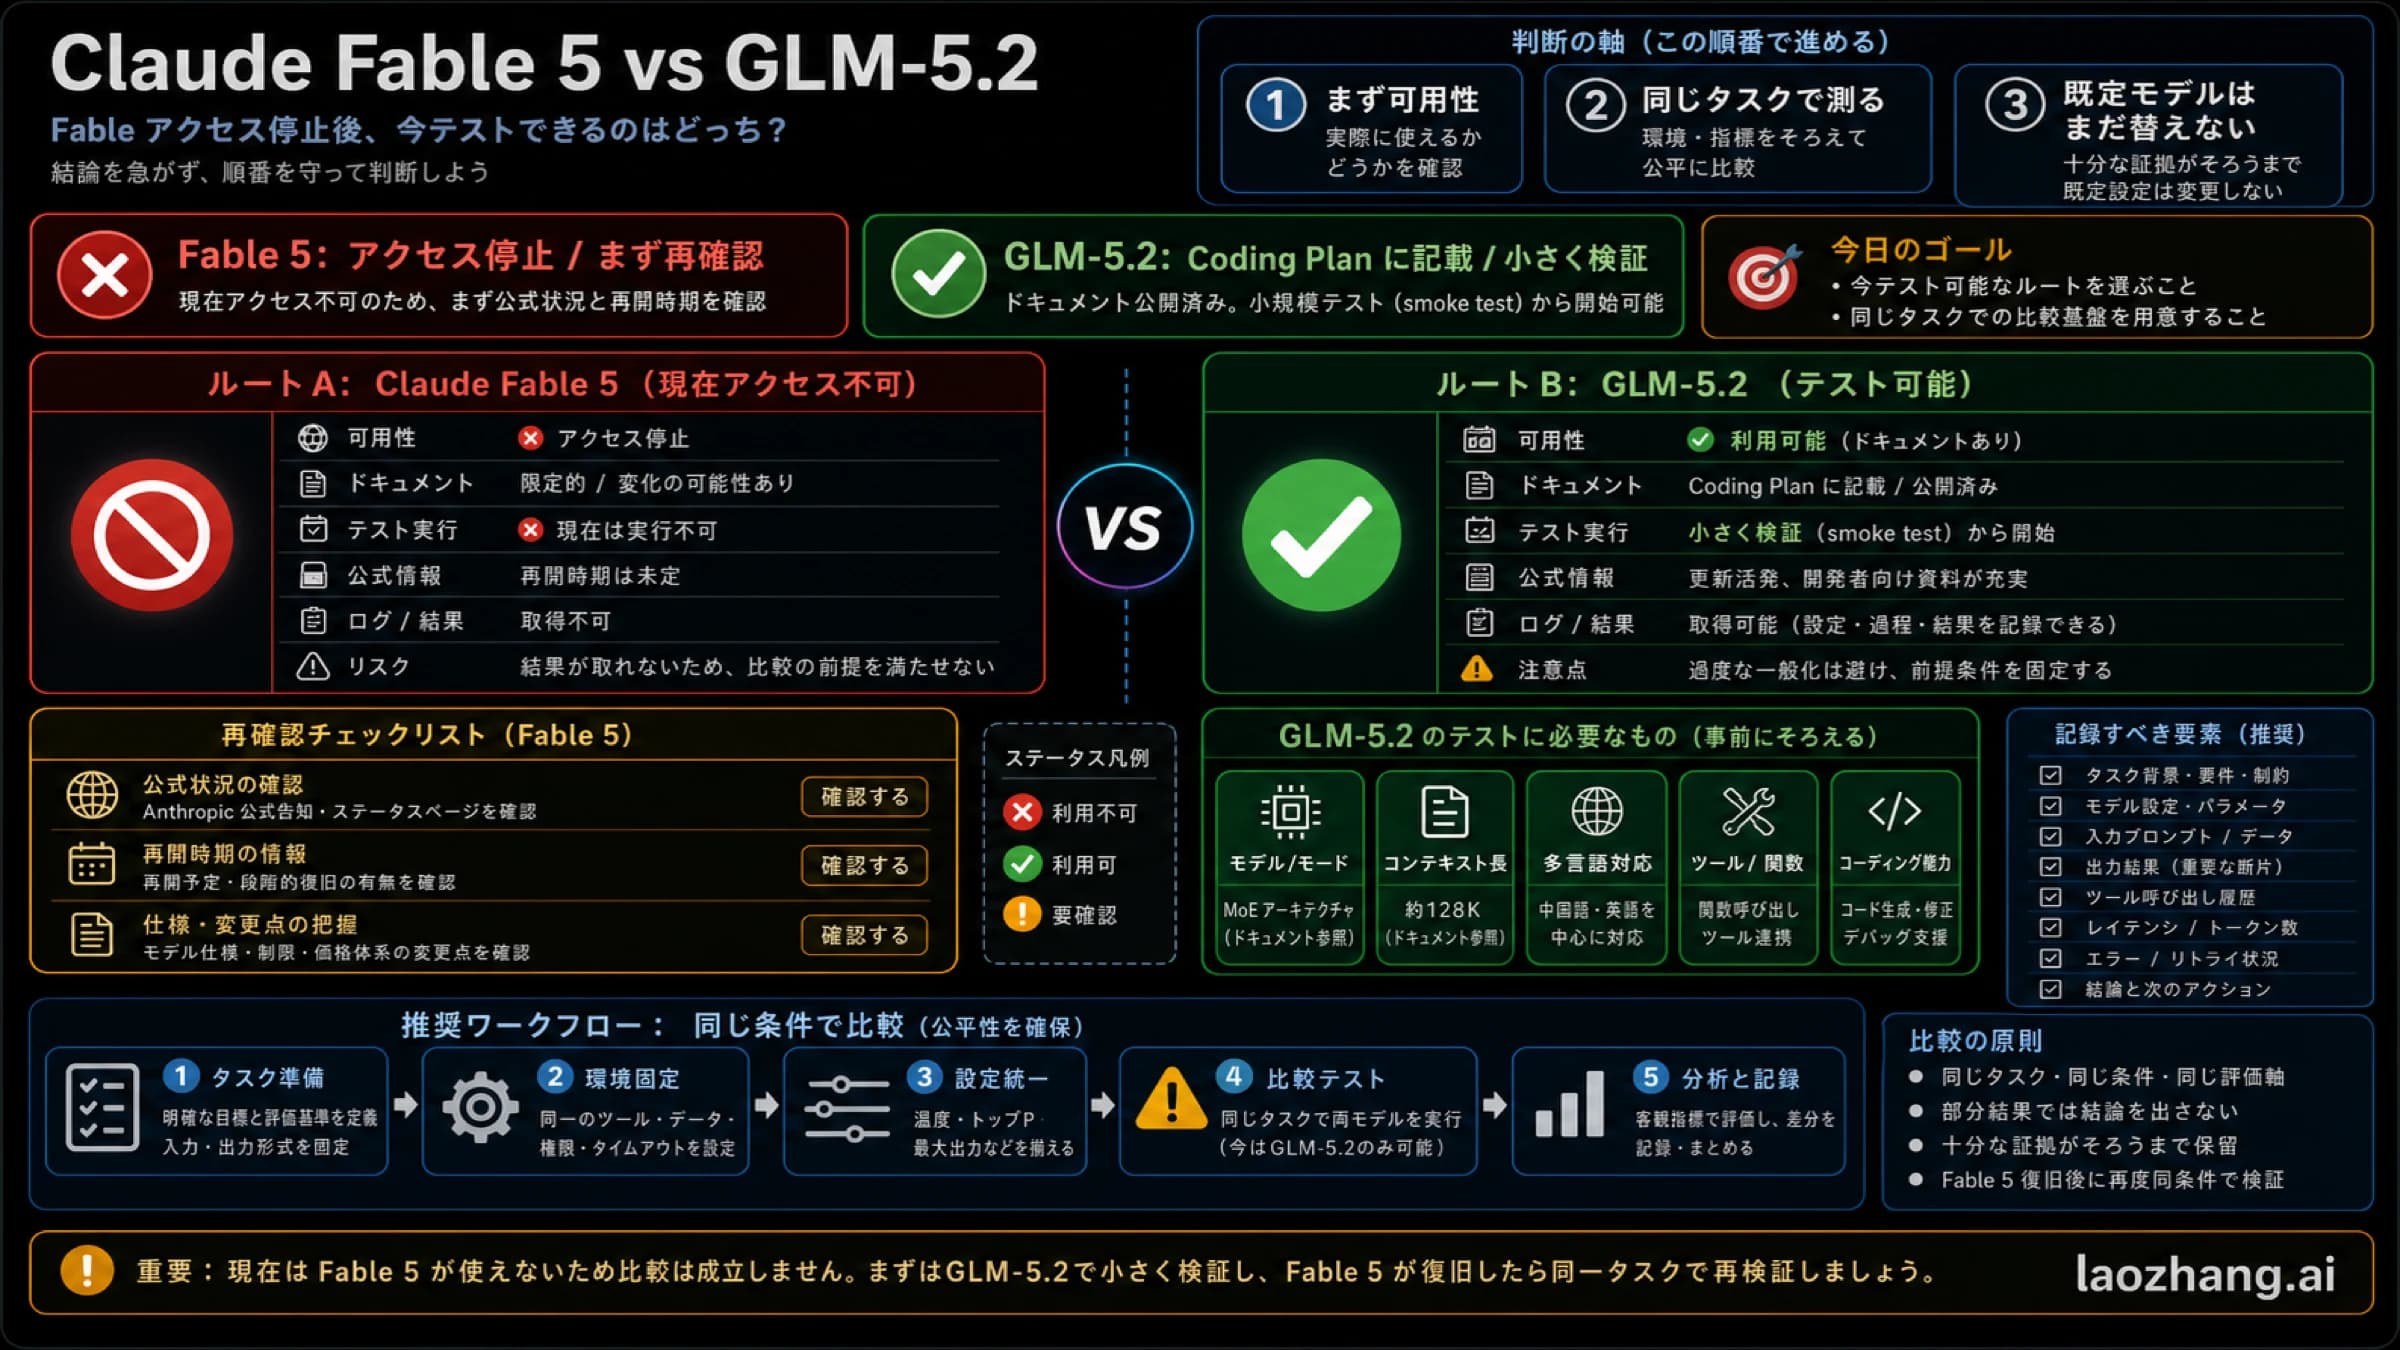
2026年6月14日時点では、Fable 5 は再確認待ちの枝、GLM-5.2 は Z.AI Coding Plan で小さく検証できる枝です。同じタスクの証拠なしに既定モデルを替えないでください。
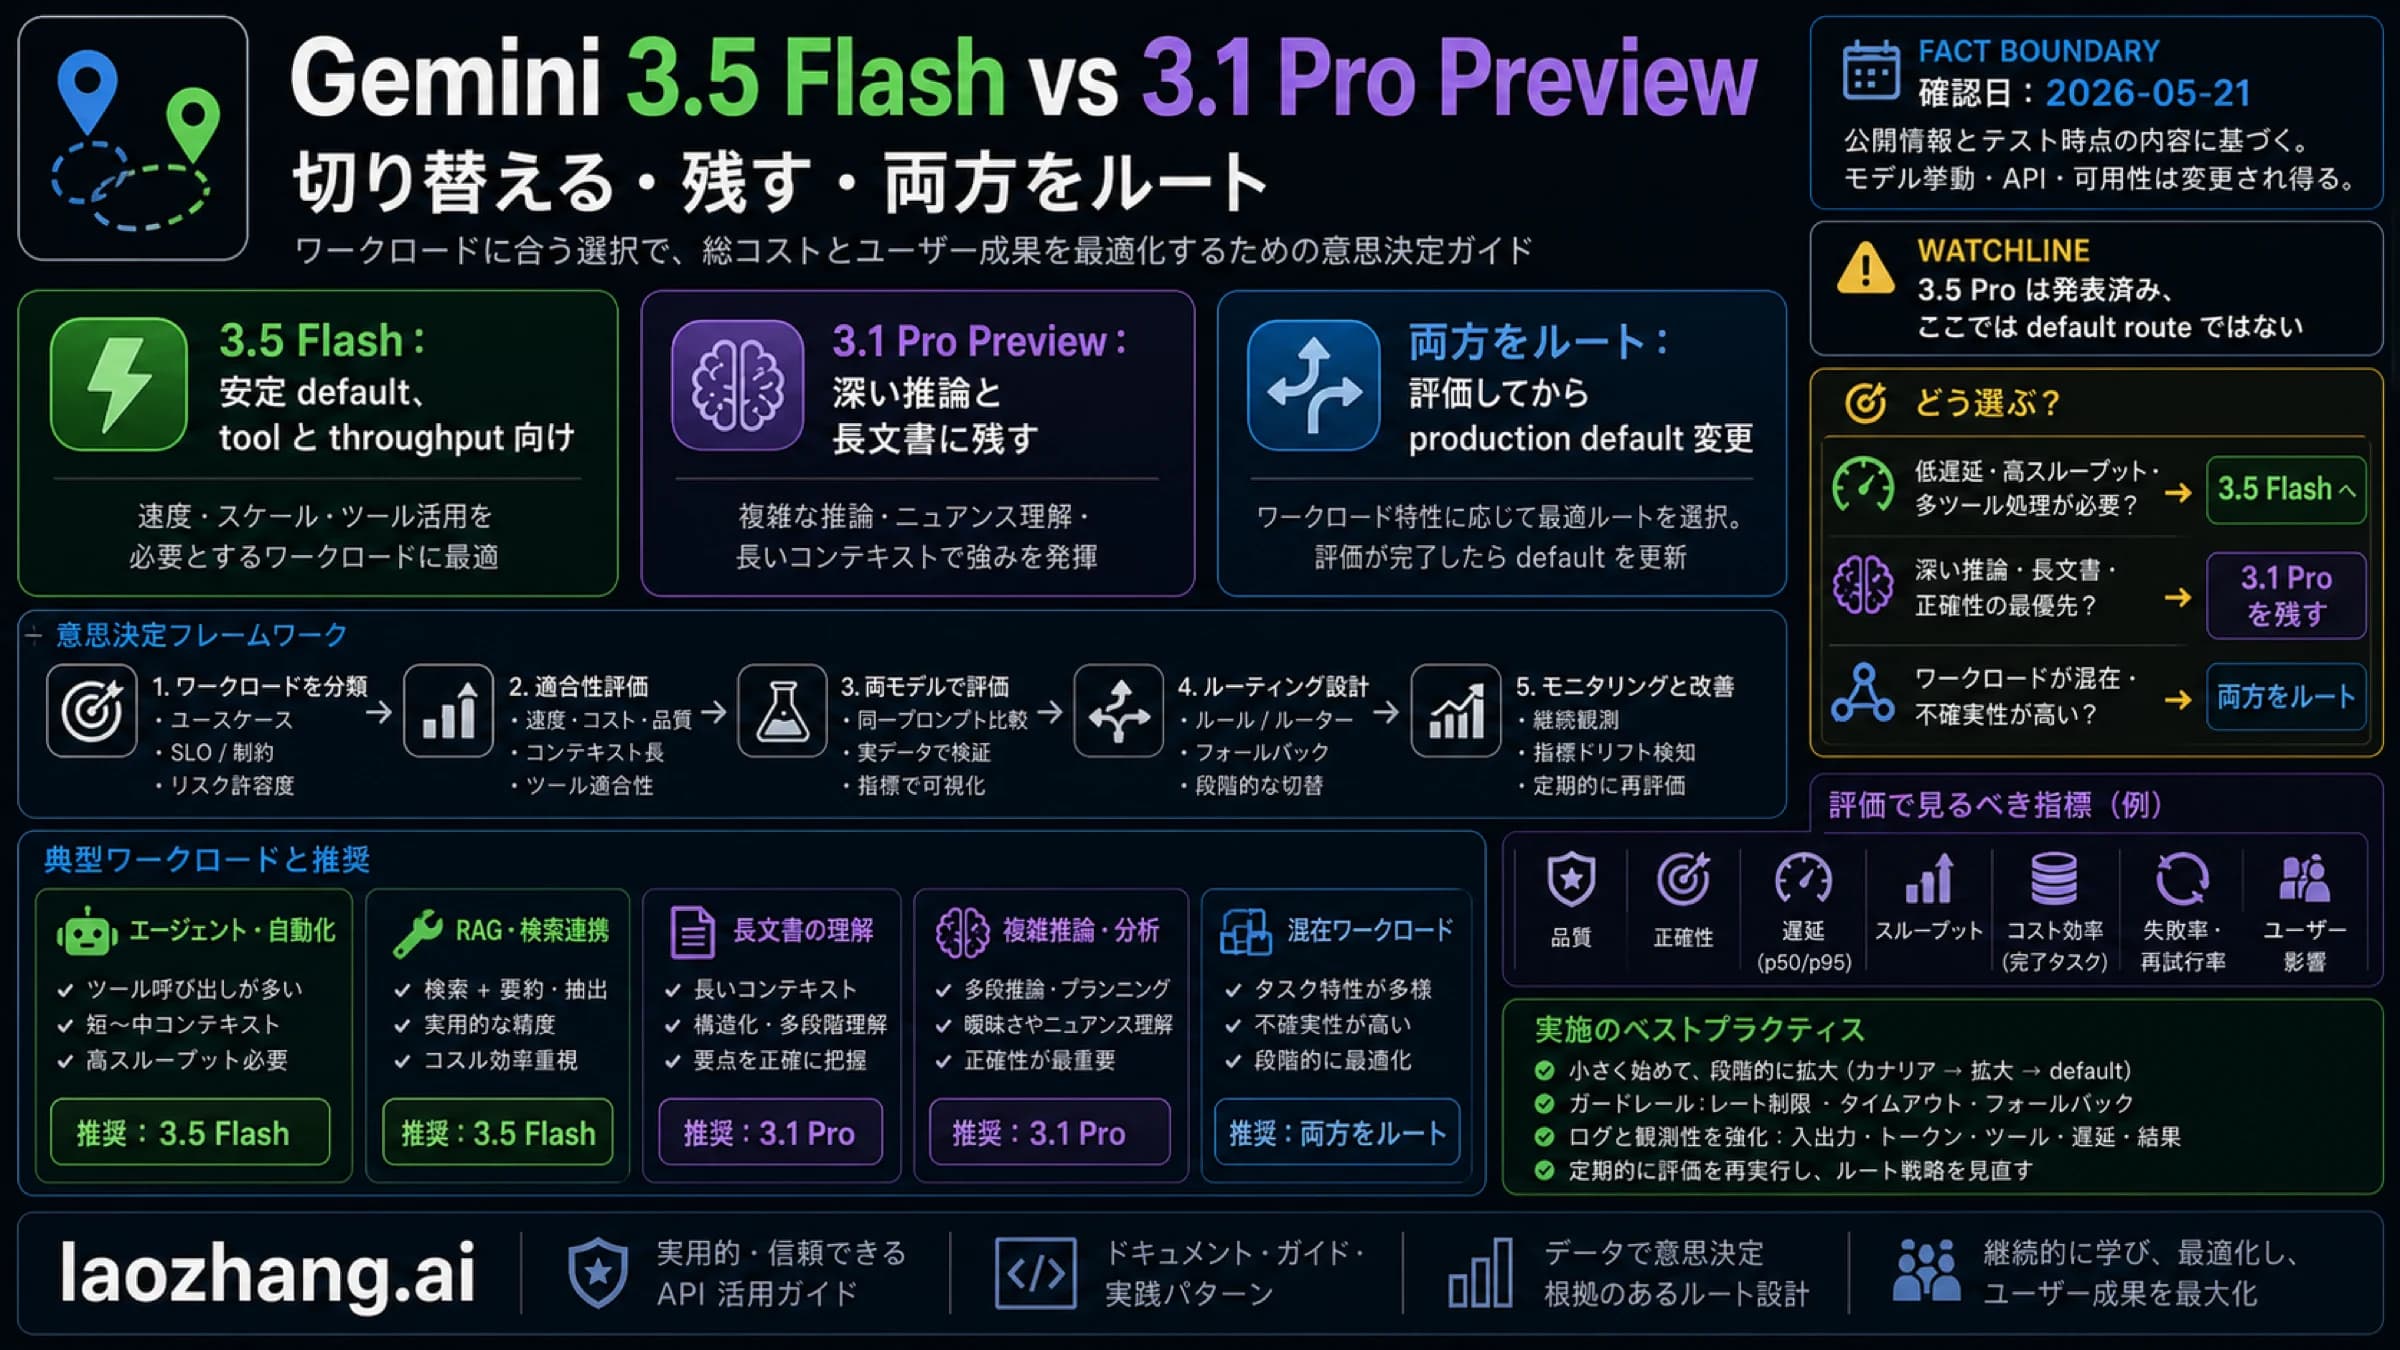
Gemini 3.5 Flash は高速なコーディング、ツール呼び出し、API ループの第一候補ですが、Gemini 3.1 Pro Preview は深い推論、長文読解、customtools にまだ役割があります。
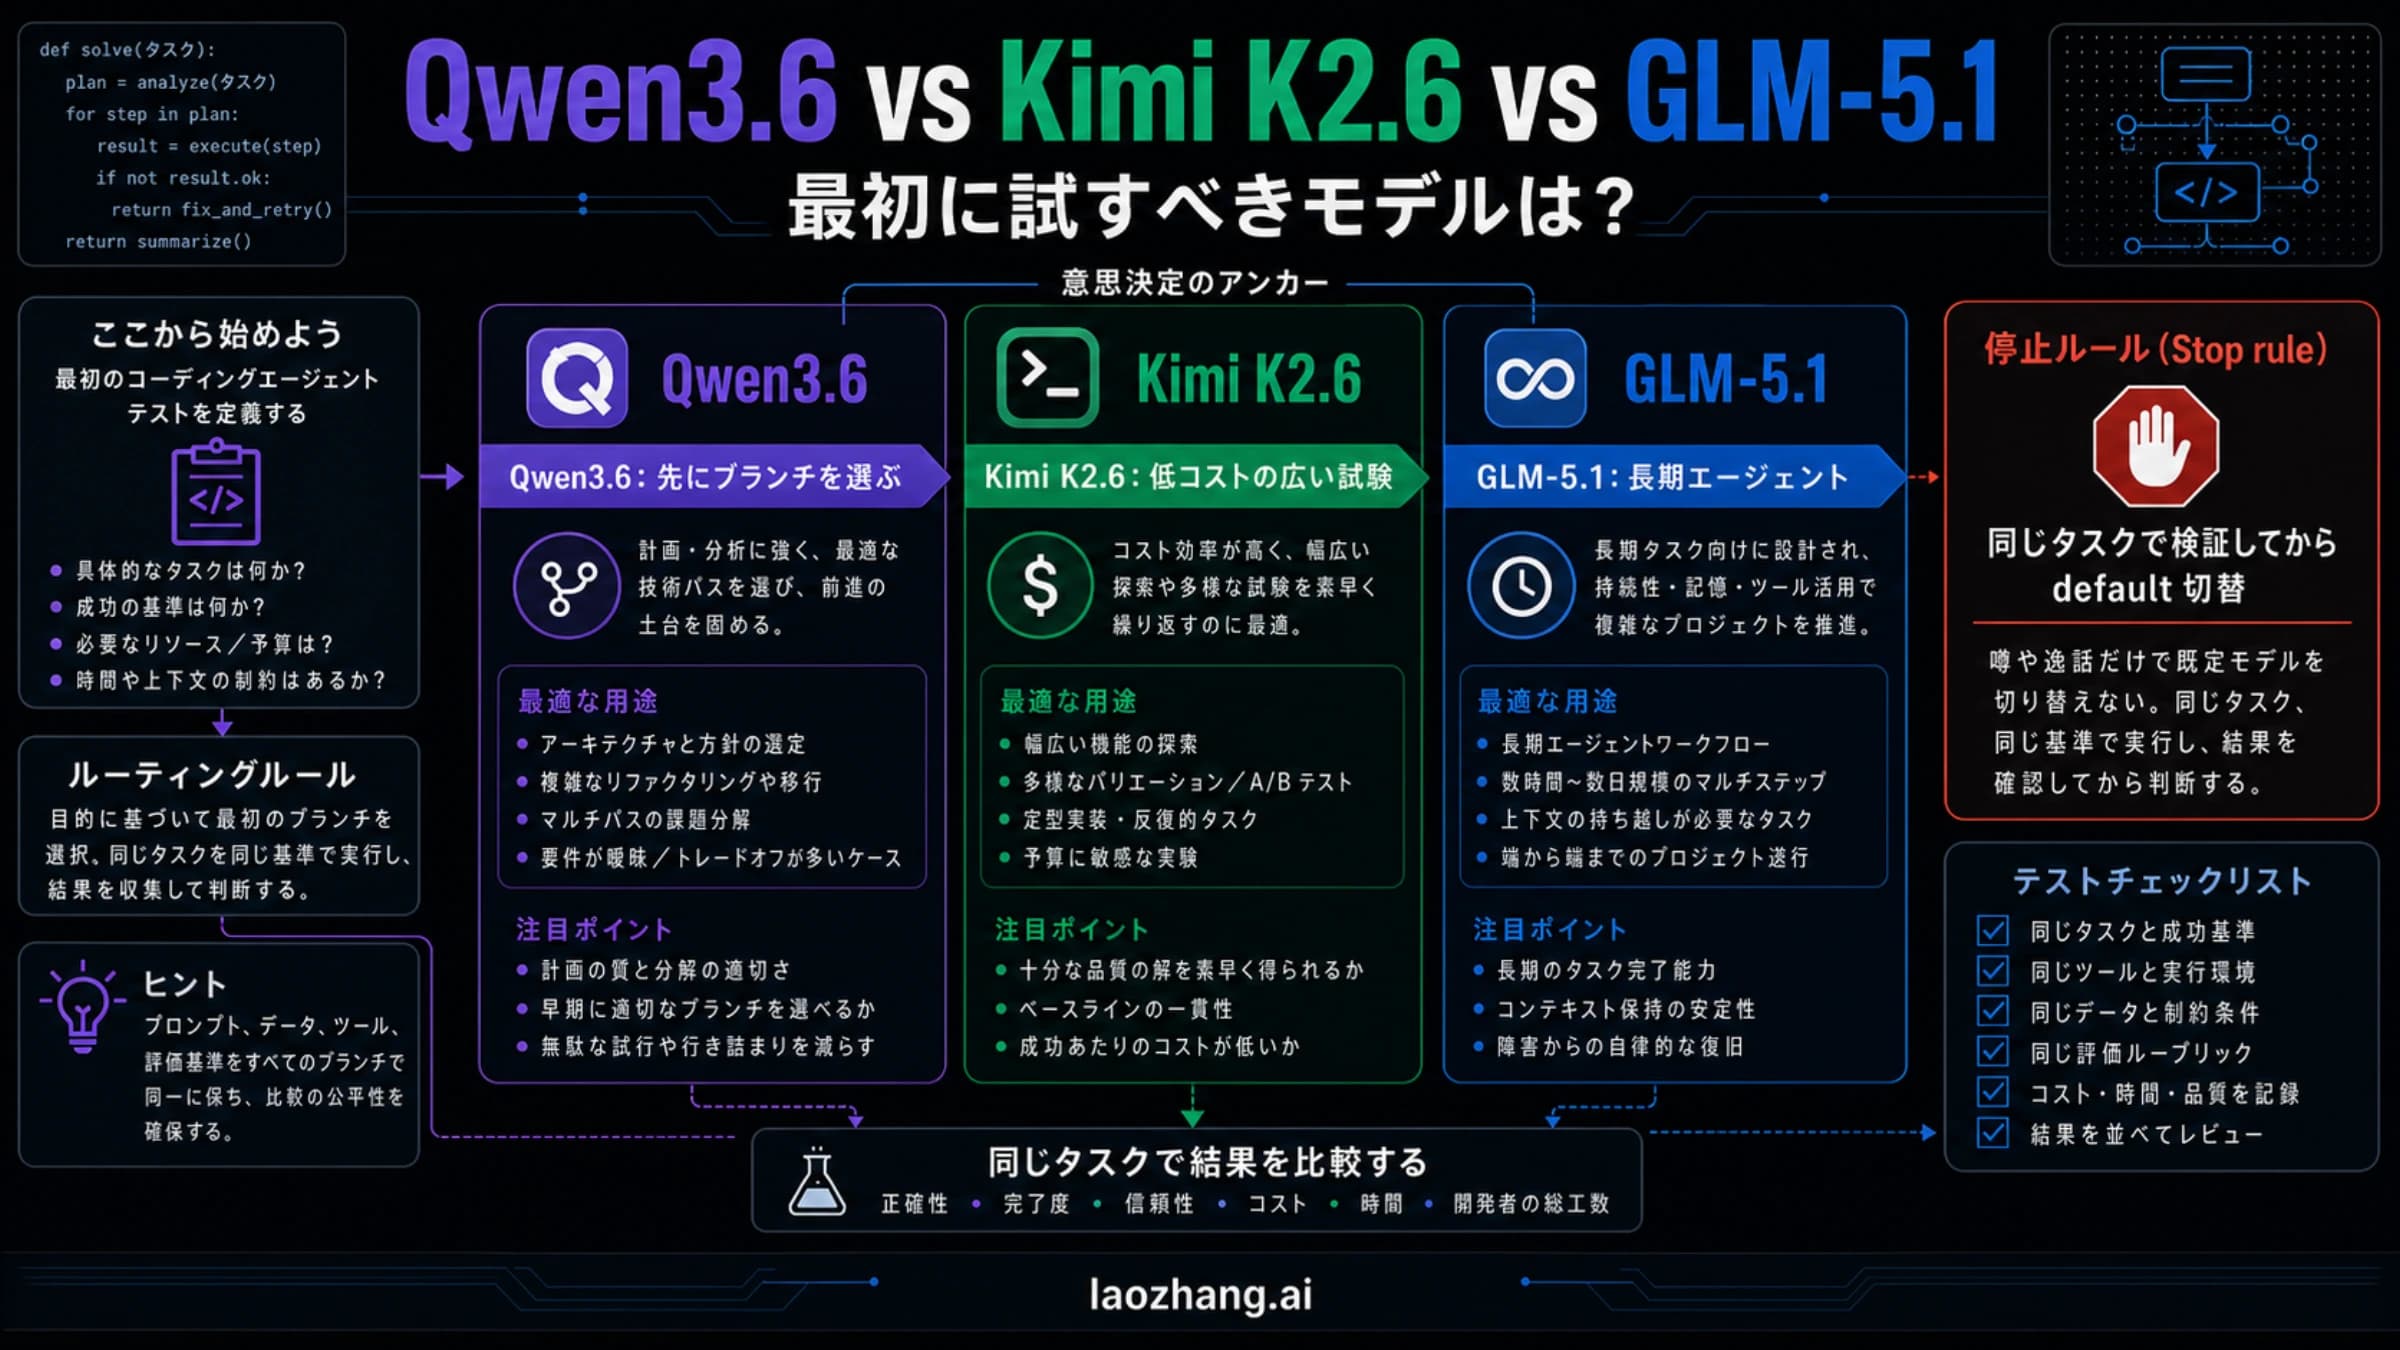
長時間の自律coding agentならGLM-5.1、安い大量pilotならKimi K2.6。Qwen3.6は35B-A3Bかhosted branchを先に選びます。
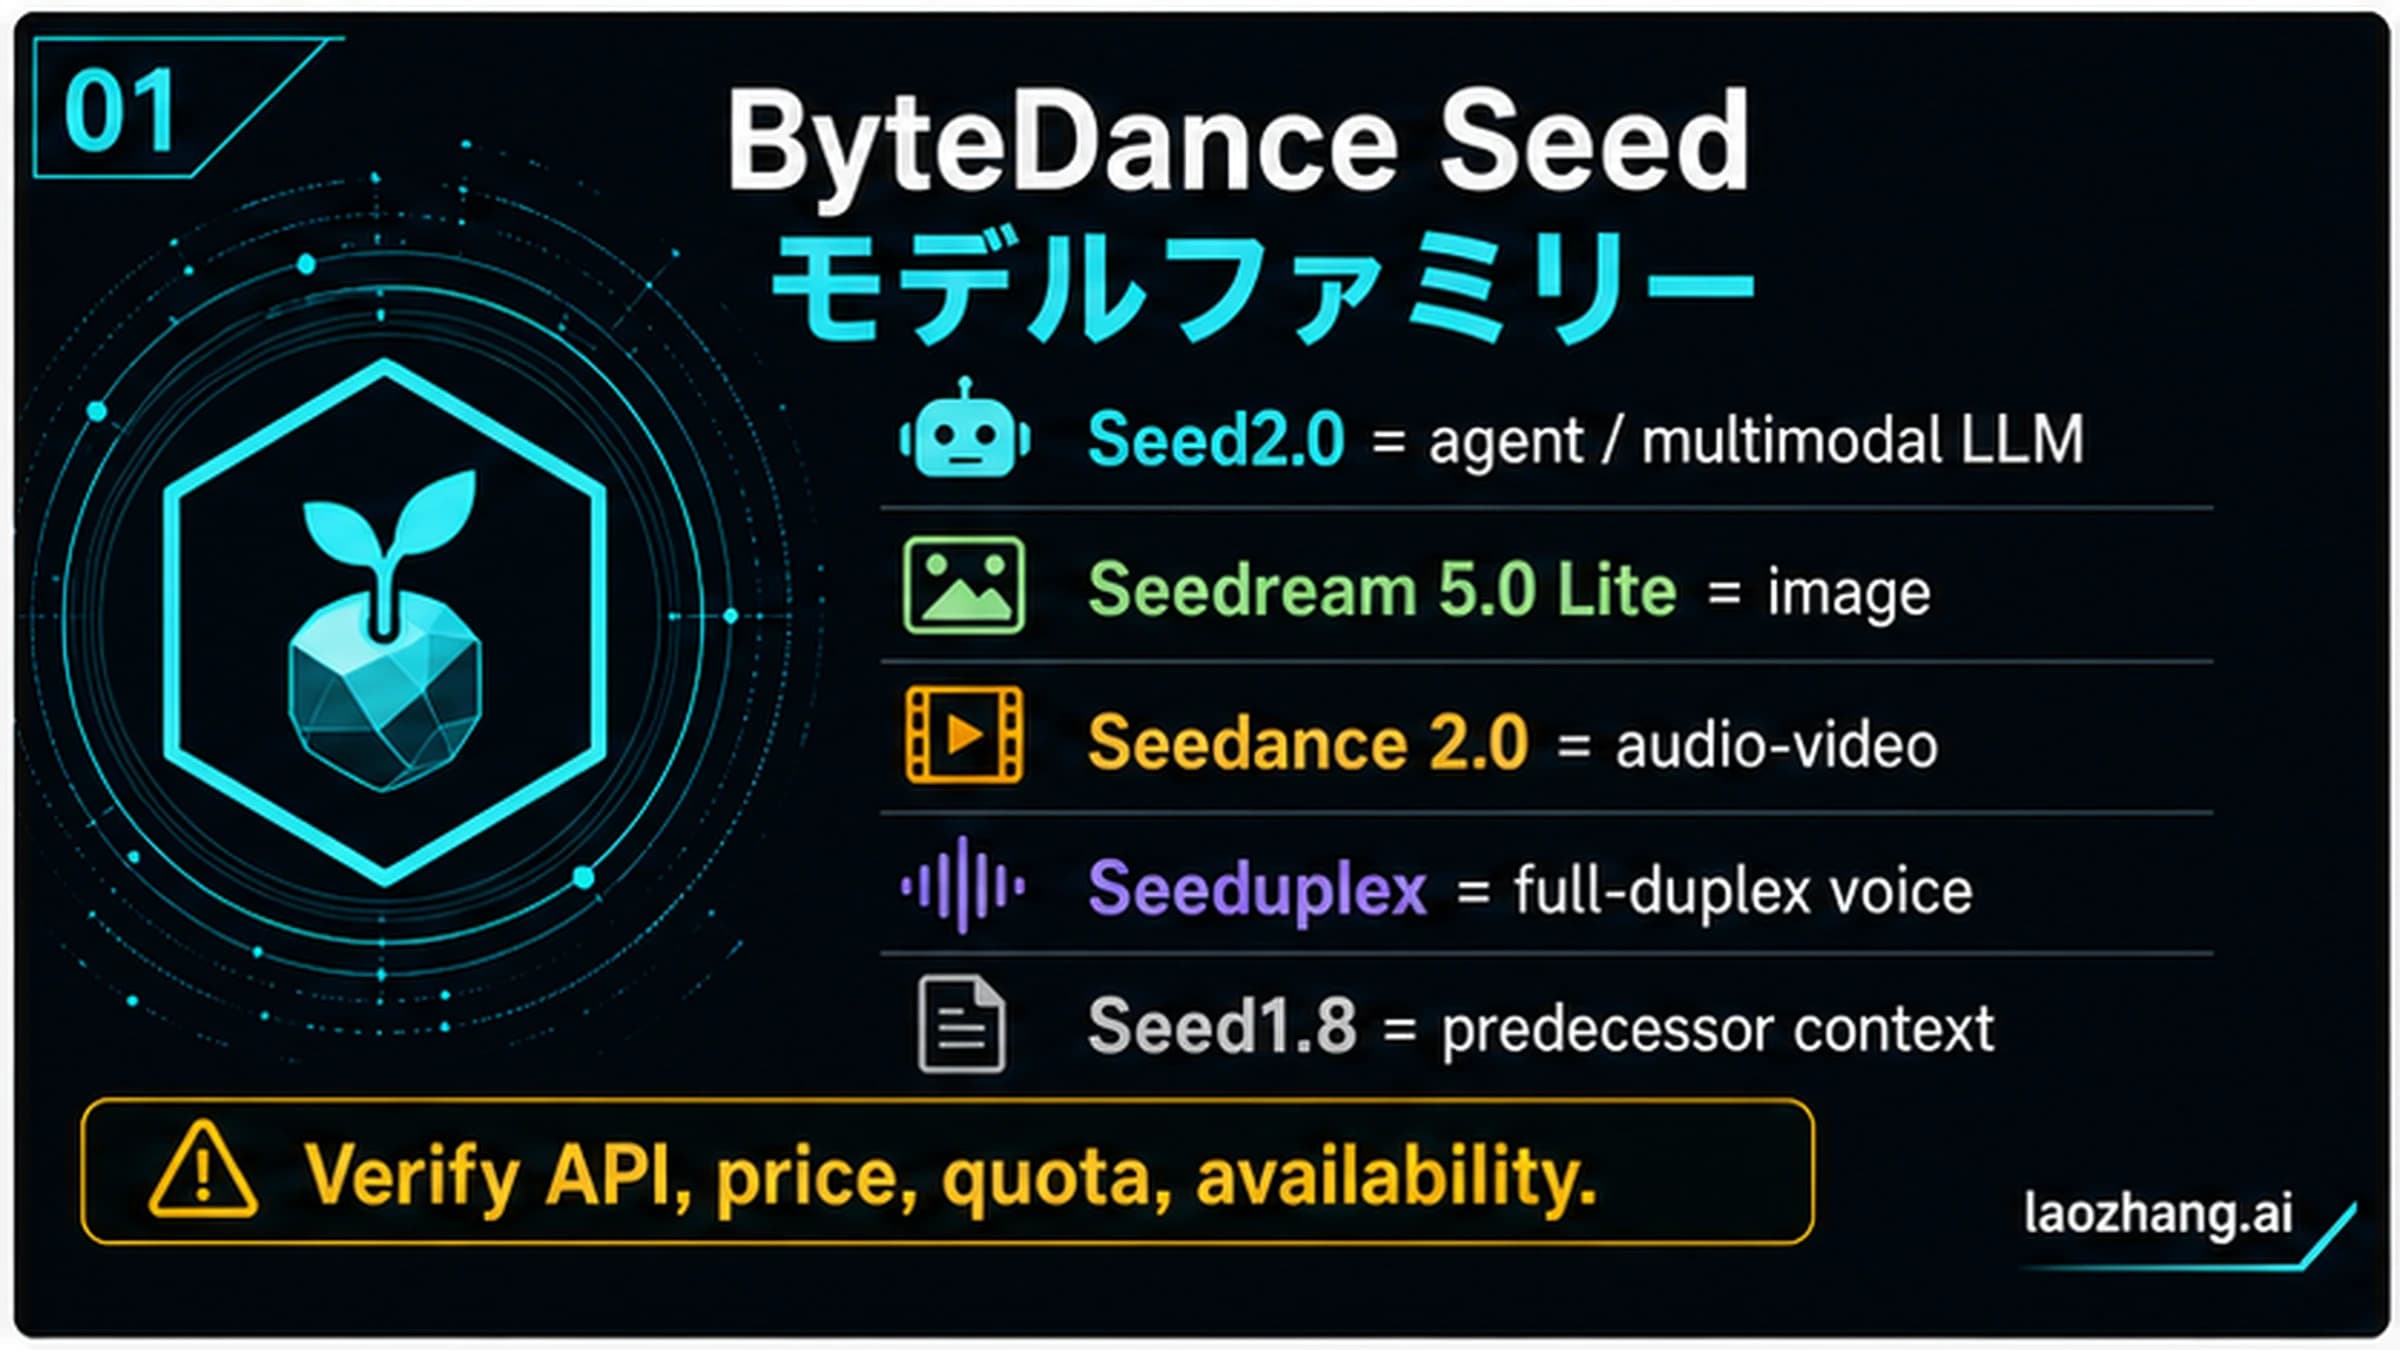
Agent とマルチモーダル理解は Seed2.0、画像は Seedream、音声付き動画は Seedance、リアルタイム音声は Seeduplex、Seed1.8 は前世代の文脈です。
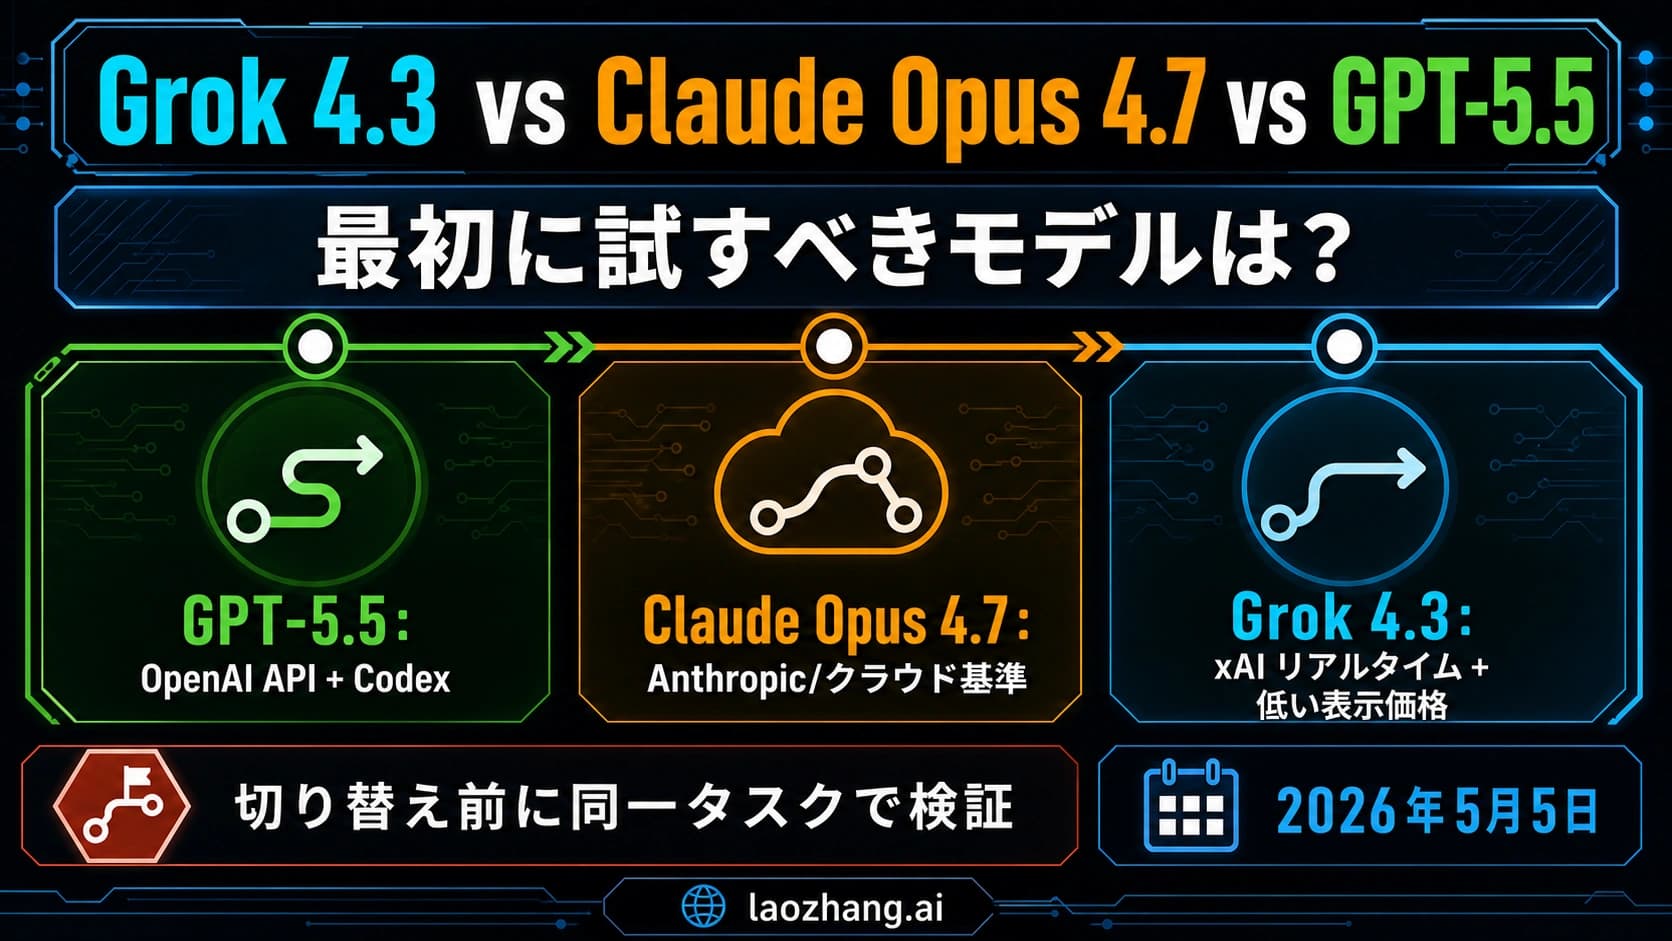
OpenAIネイティブならGPT-5.5、Anthropic/クラウドの高リスク制御ならClaude Opus 4.7、xAIリアルタイムや低い表示価格ならGrok 4.3から検証します。
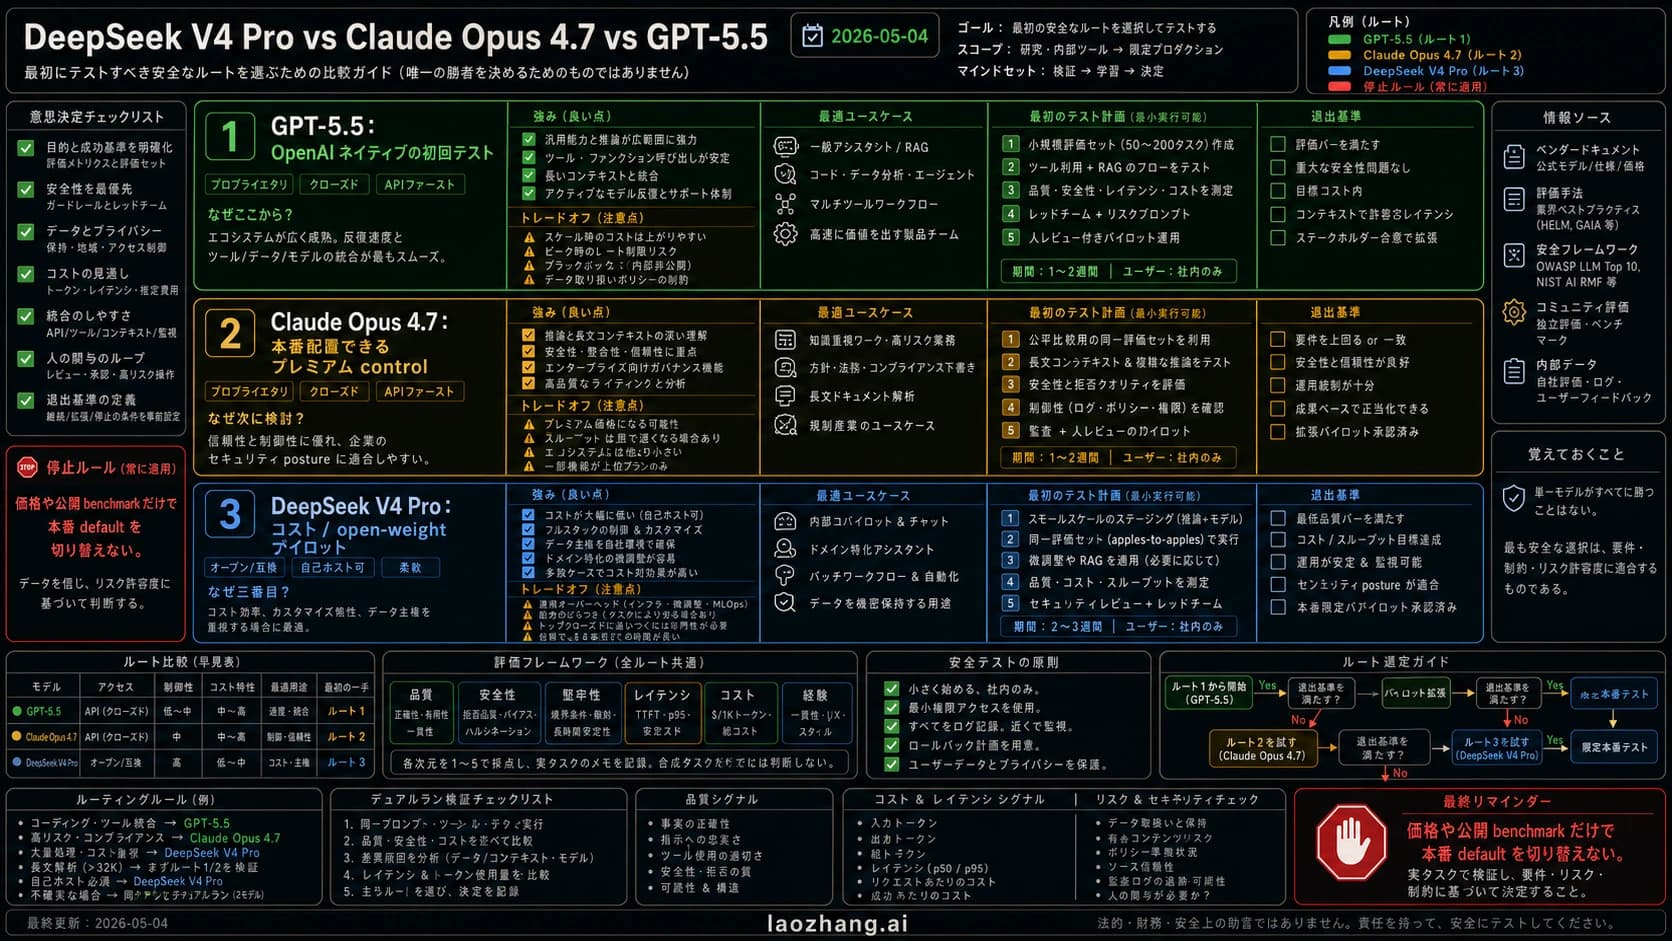
OpenAIネイティブの作業はGPT-5.5を先に試し、高リスクのAPI/agentはClaude Opus 4.7をcontrolに残し、DeepSeek V4 Proはコストまたはopen-weight目的の同一タスク試験に回す。
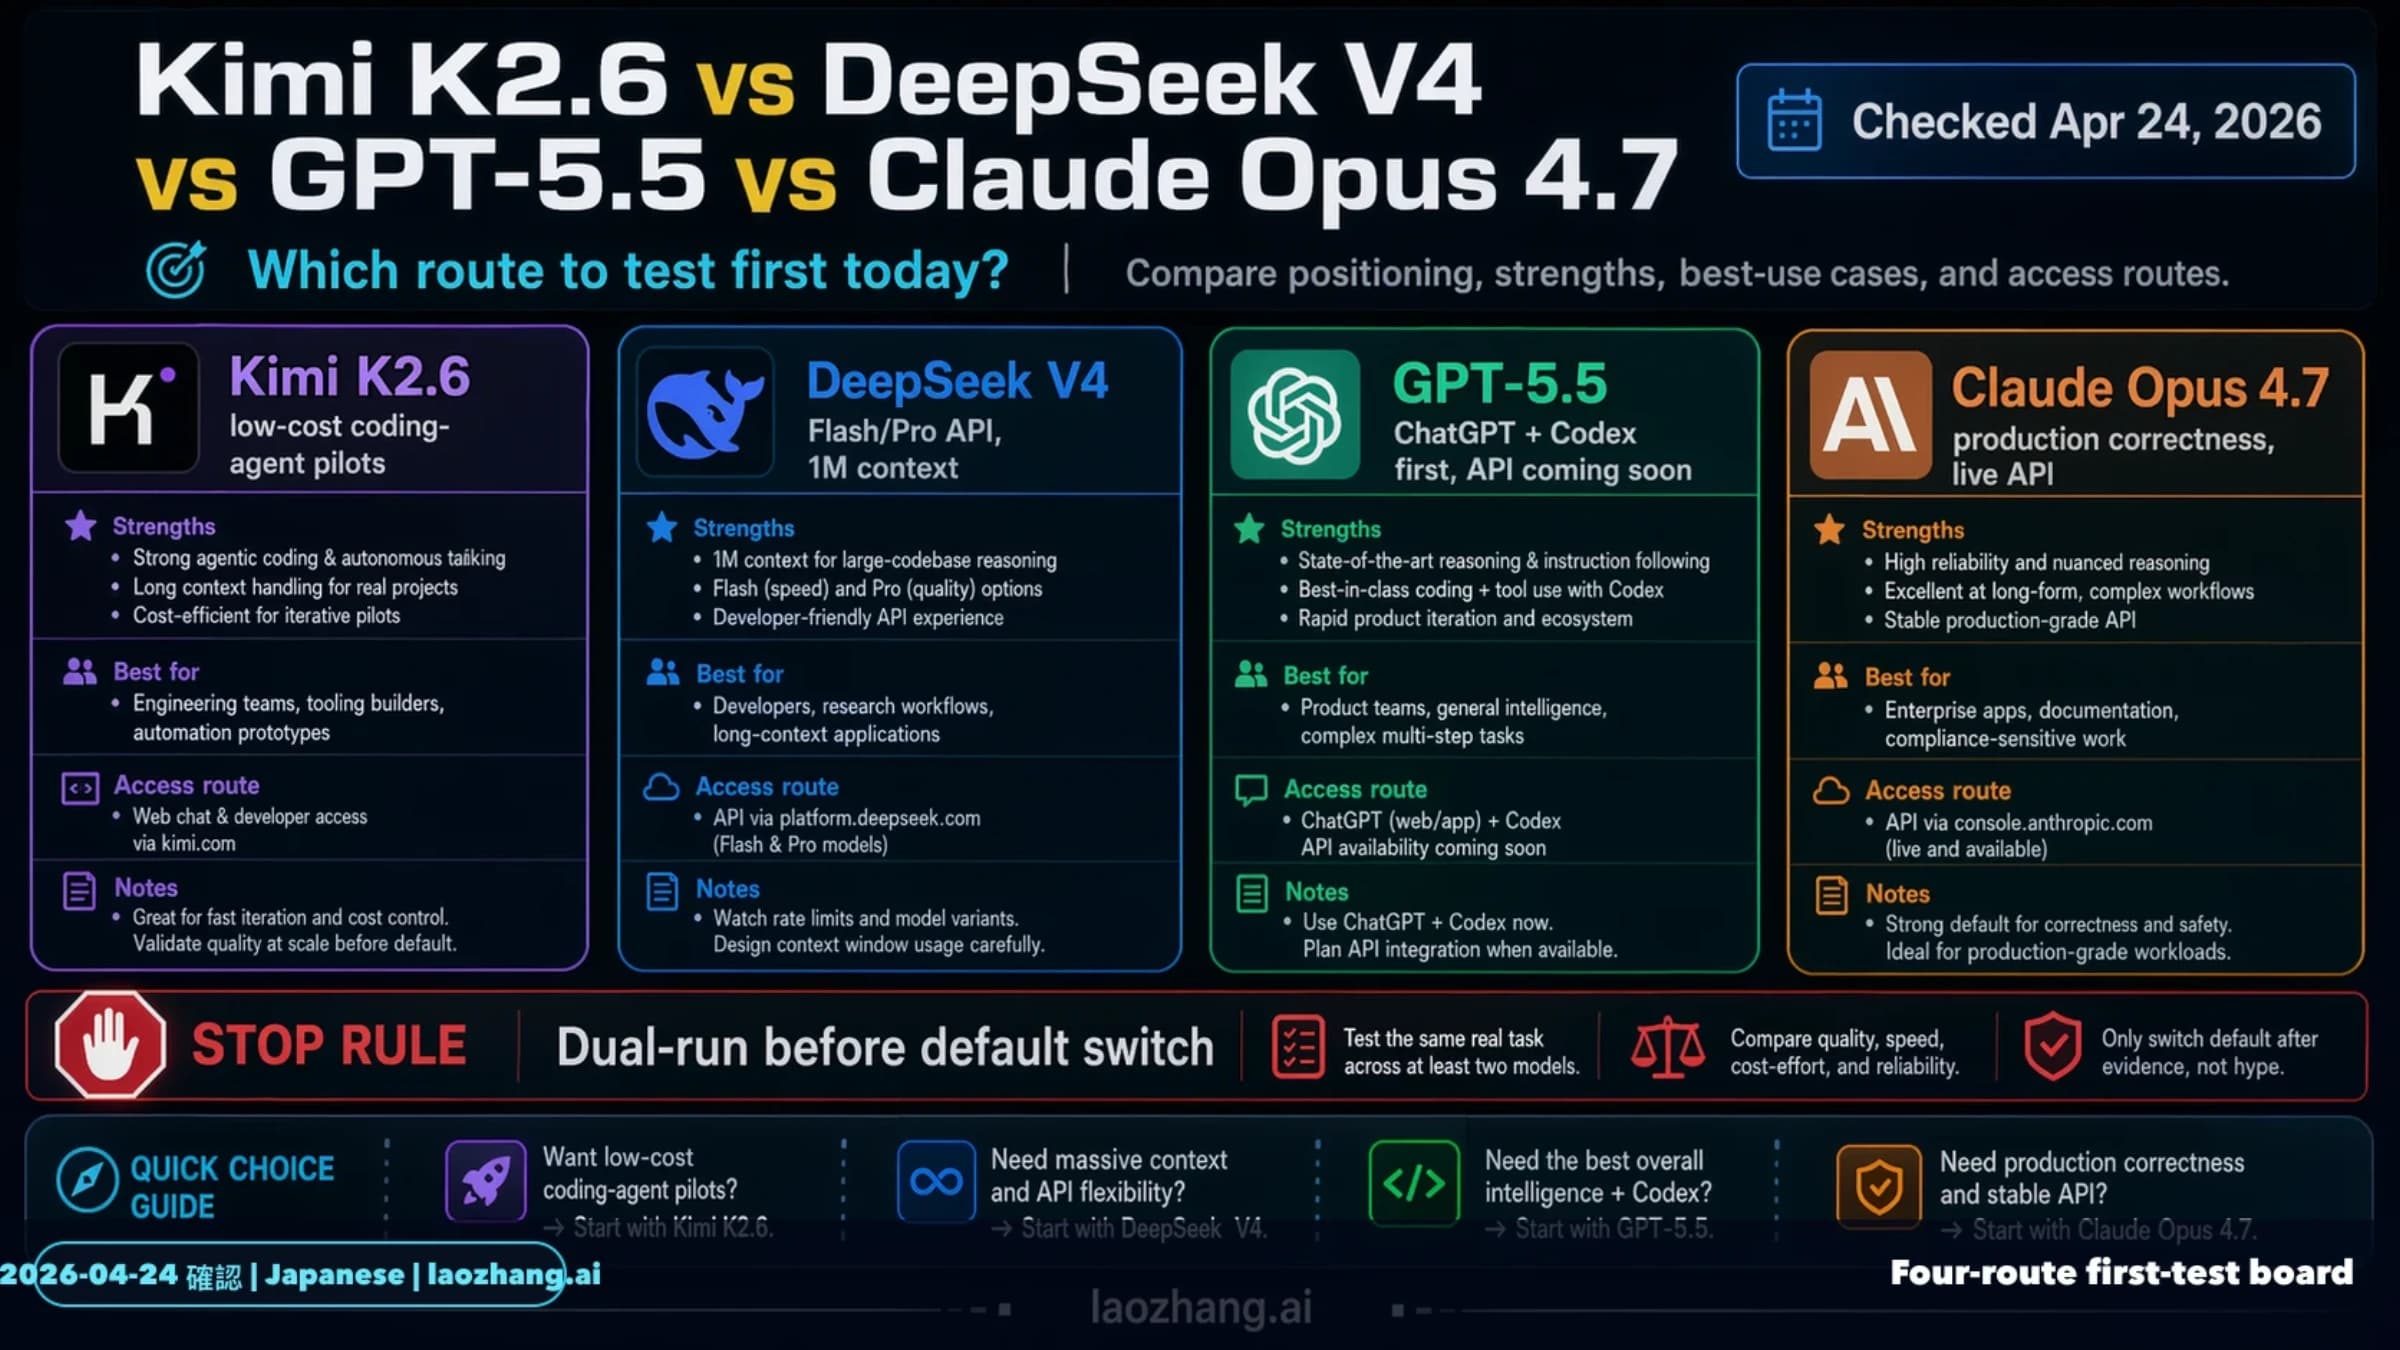
安い試行はKimi、現在のDeepSeek APIはV4、OpenAI作業面はGPT-5.5、高リスク本番はOpus 4.7を最初に見るべきです。
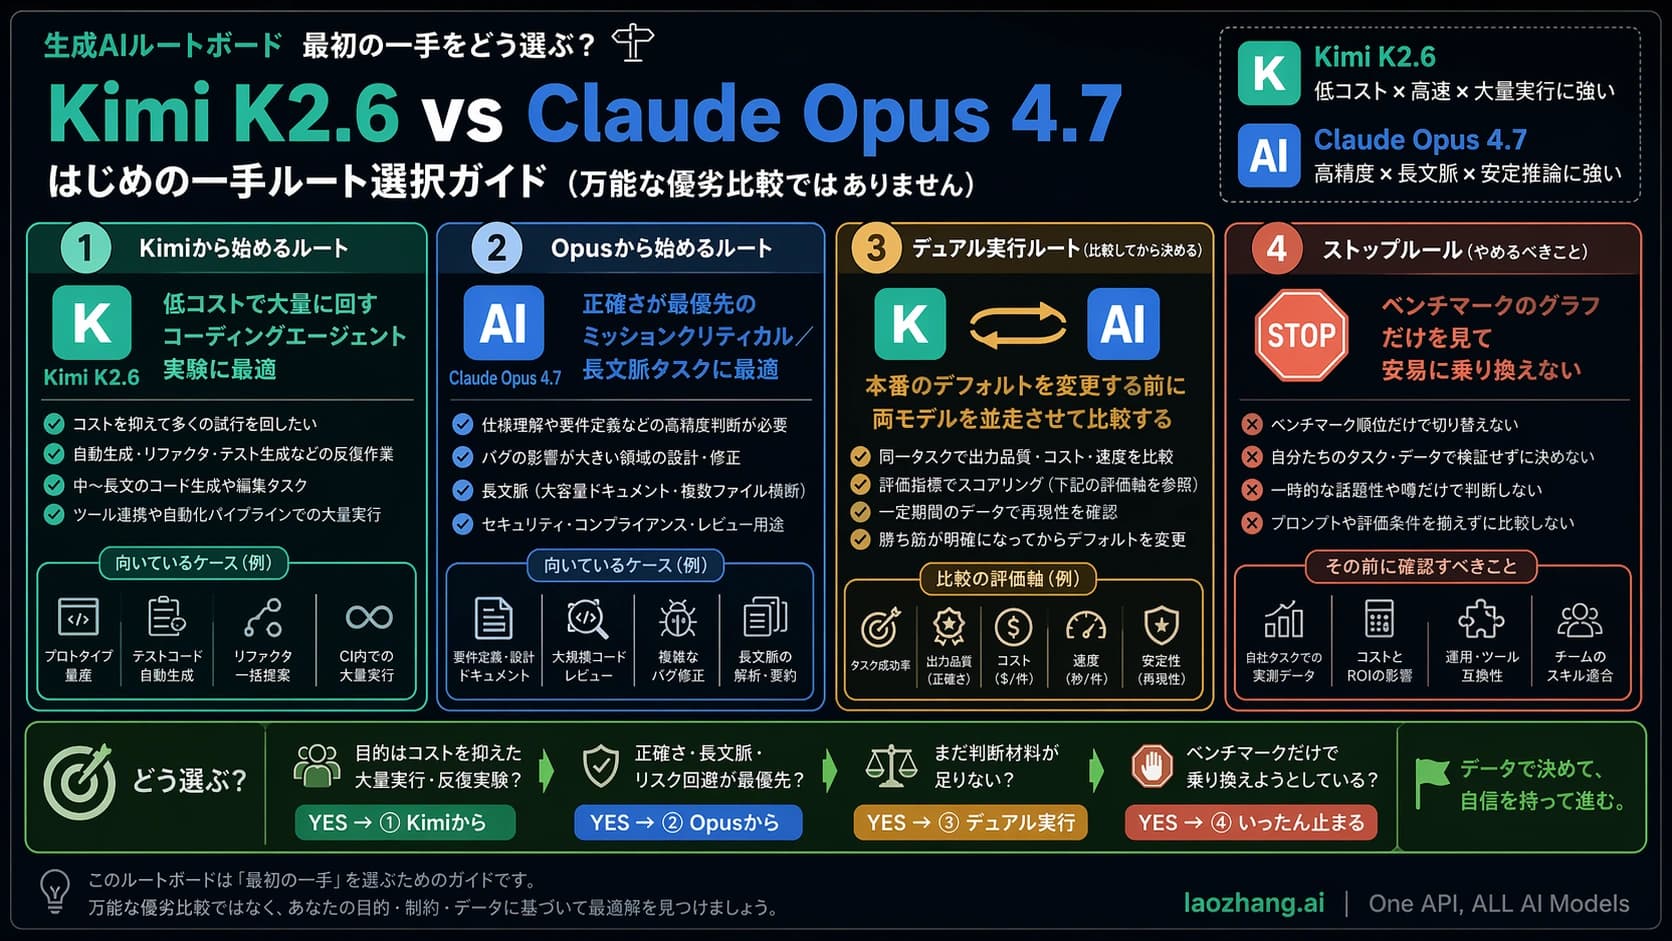
低コストで試行回数を増やしたいなら Kimi、正確性と長文脈が重要なら Opus、default 変更前は dual-run です。
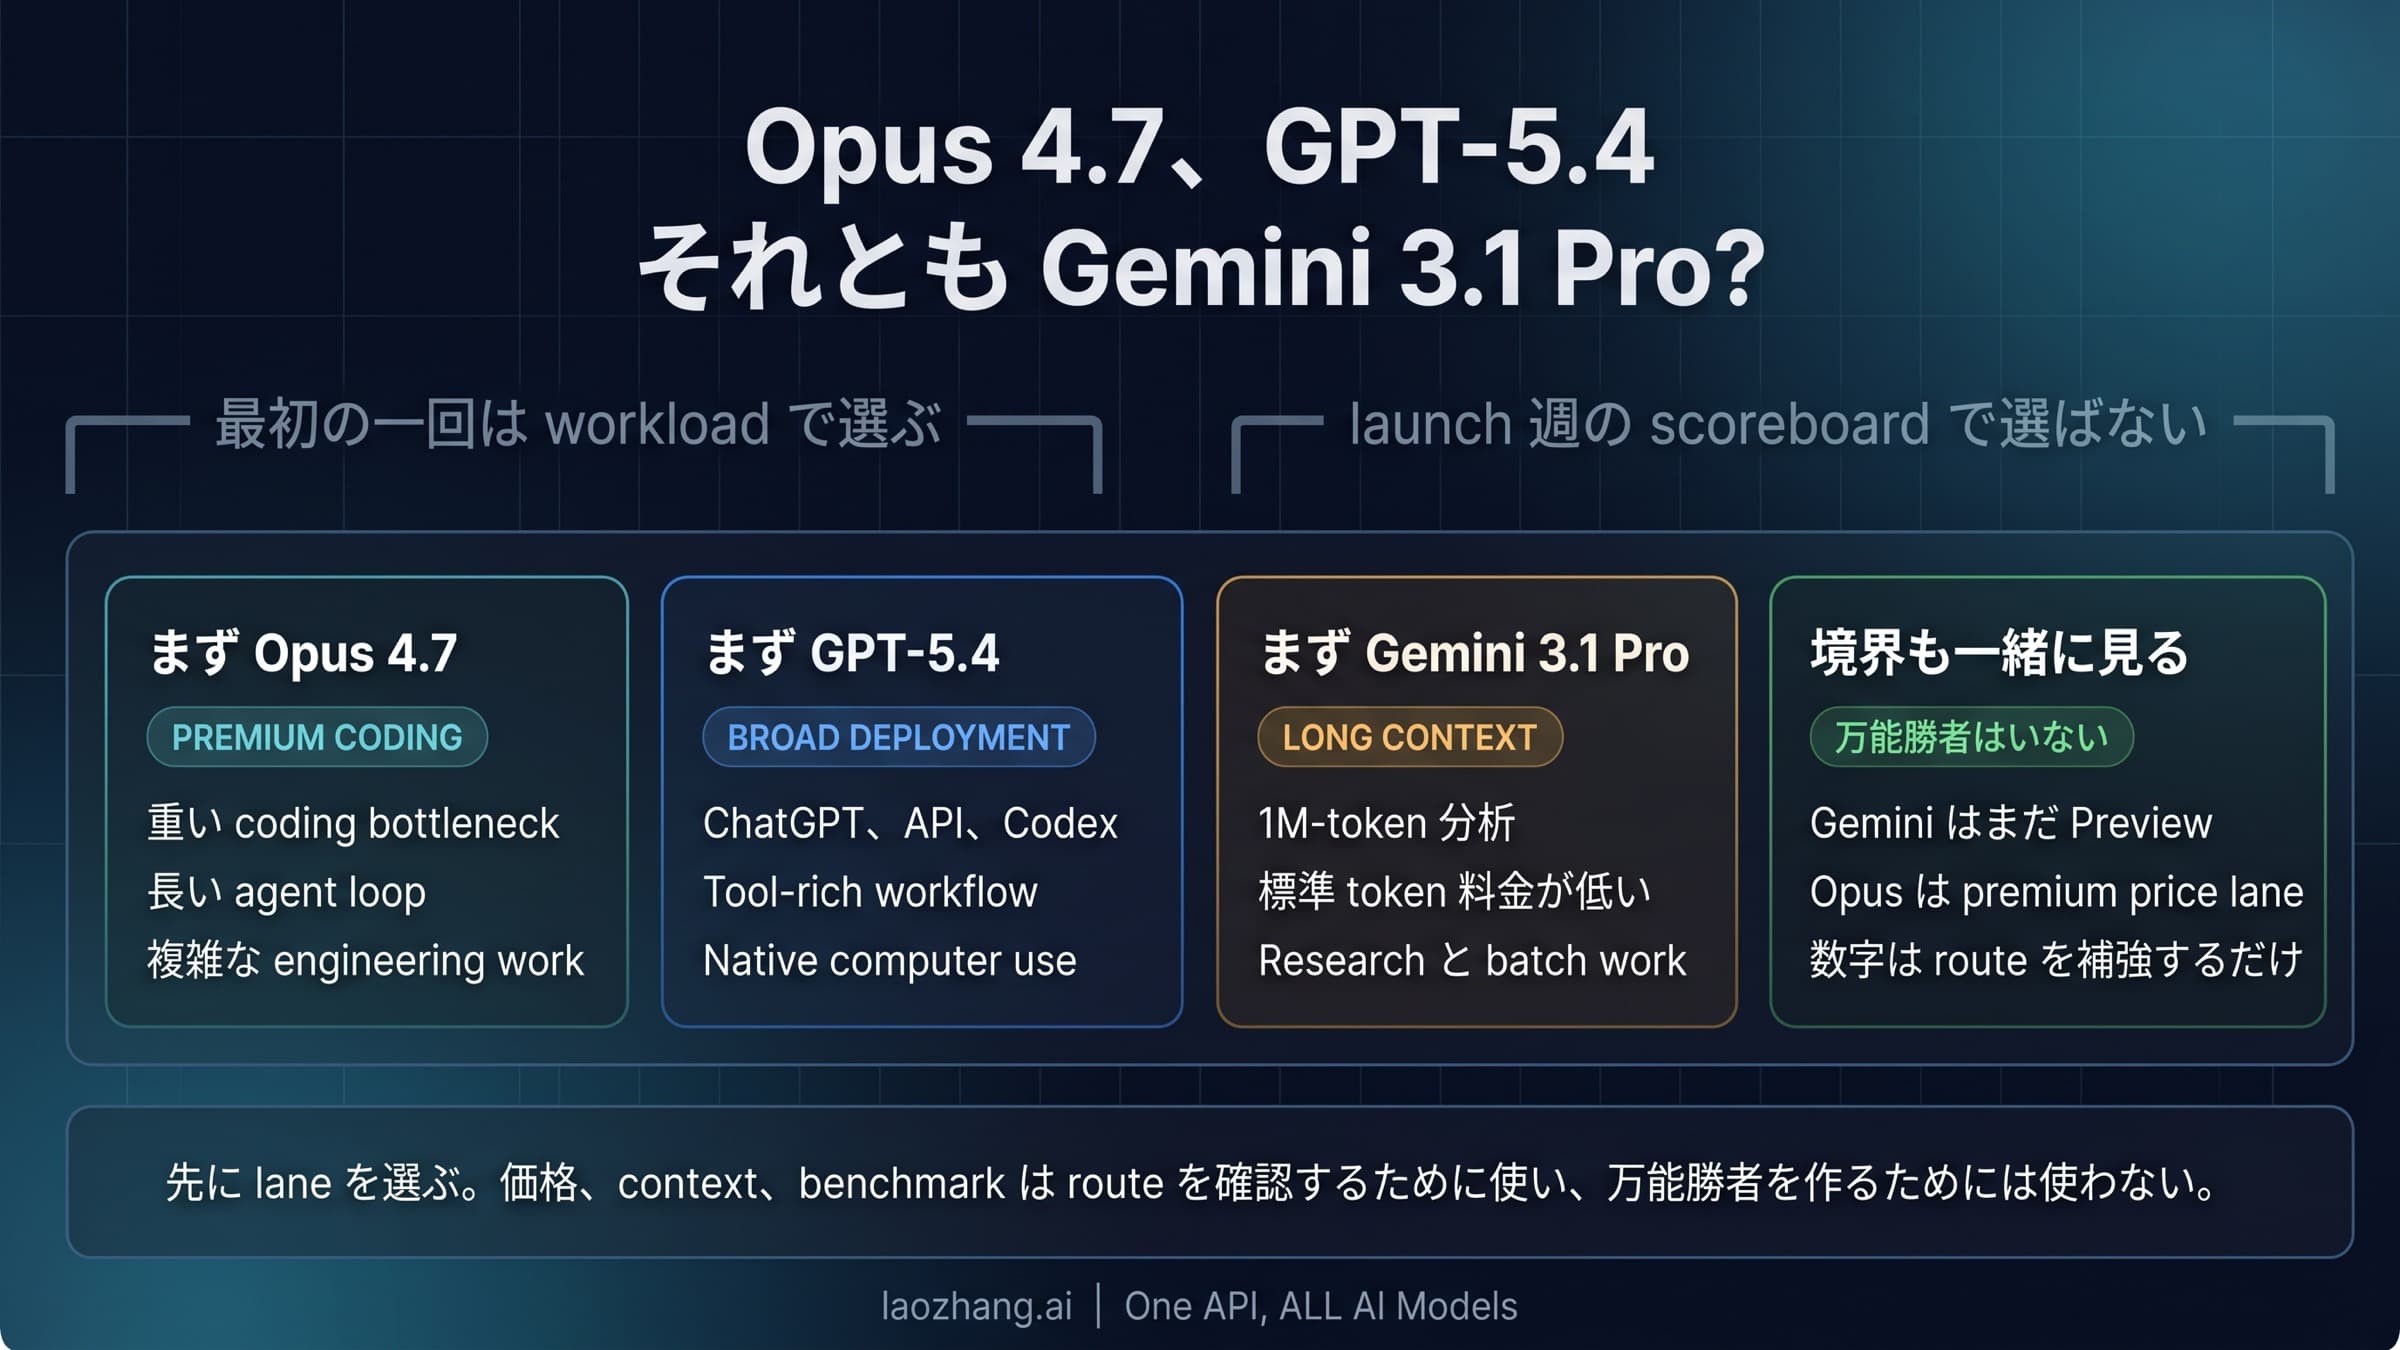
最初の一回をどこから始めるかで迷うなら、重い coding は Opus 4.7、広い実運用 surface は GPT-5.4、長文脈と token コストは Gemini 3.1 Pro という切り分けが最も実務的です。
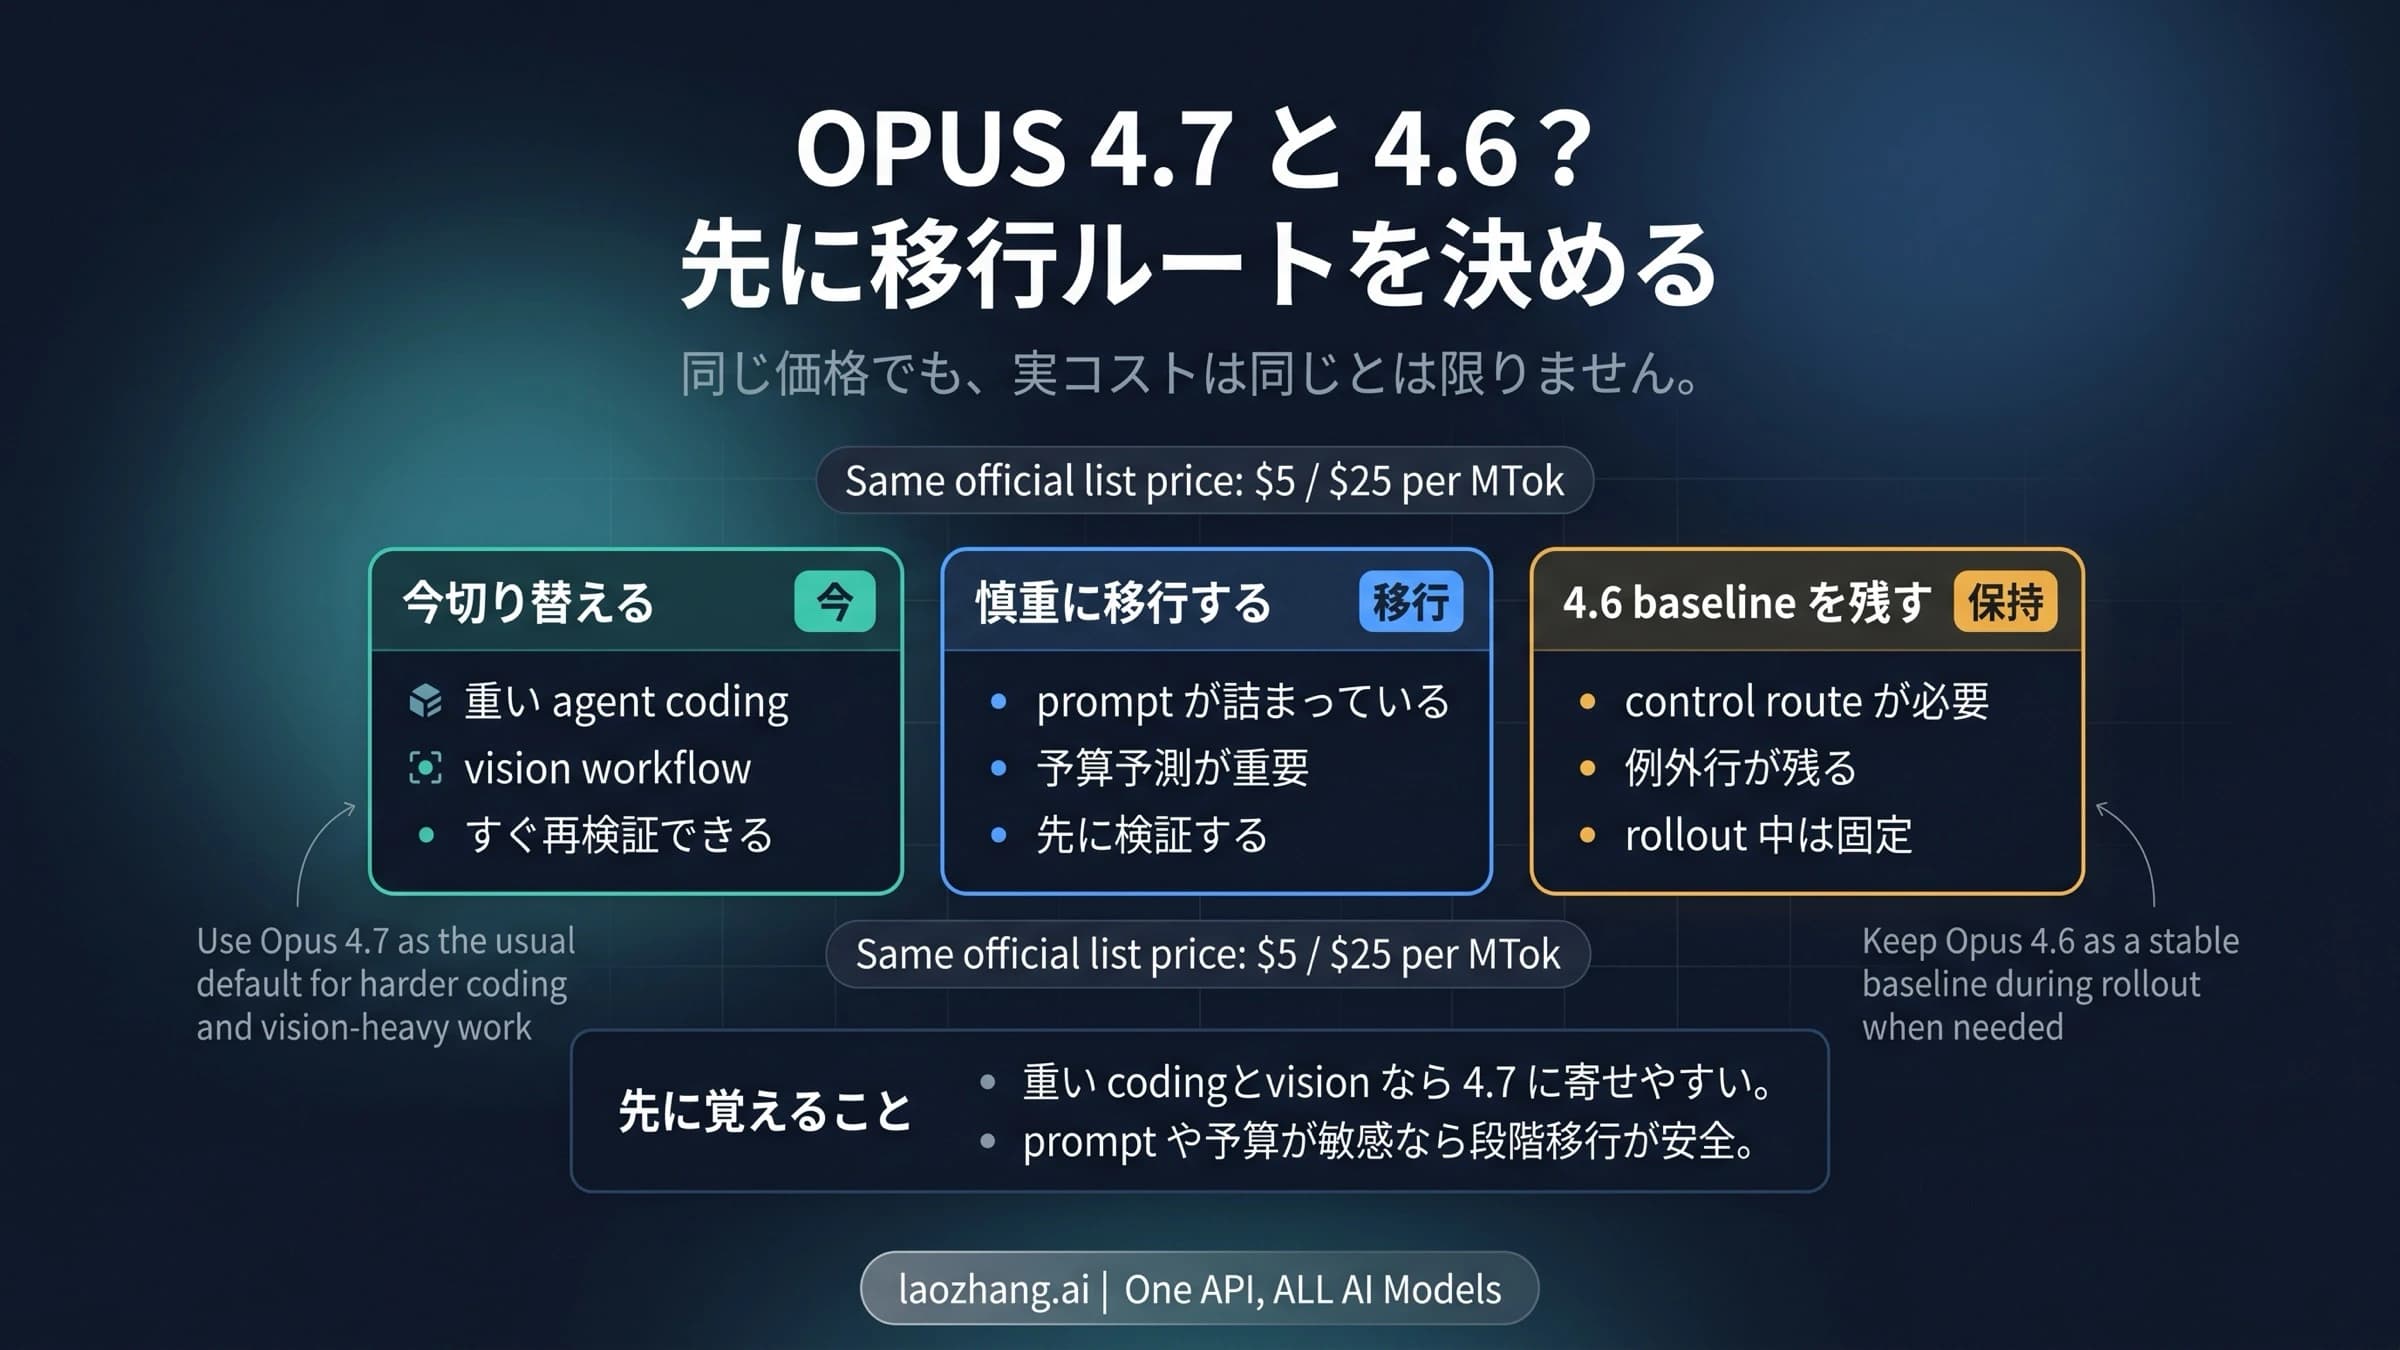
これはリリース要約ではなく、アップグレード判断のためのガイドです。Claude Opus 4.7 を新しい default にすべき場面、移行を段階化すべき場面、そして Claude Opus 4.6 を control route として残すべき場面を分けて考えます。