GPT-6 AstraとClaude Fable 5.1を比較:料金とトークン実測で選ぶ
定価は同じでも、2026年10月26日の実測でFable 5.1の費用はAstraの1.49〜1.61倍でした。前置きの再利用と272K超の入力ではFableが安くなります。
目次
2026年10月28日時点の総合点では、GPT-6 Astra(gpt-6-astra)がClaude Fable 5.1(claude-fable-5-1)を上回っています。第三者機関Artificial AnalysisのIntelligence Indexは2026年10月27〜28日に9評価で構成するv5.0へ改定され、すべての推論設定でAstraが5〜8点上、最大の推論設定で57対49です(旧版v4.3.2では53対53の同点でした)。定価は100万トークン当たり入力$10・出力$50で同じですが、Fableは同じ文章をより多いトークンで数えるため、請求額は同じになりません。
2026年10月26日に同じ8問を両モデルに解かせたテストでは、どちらも全問合格し、定価で換算した費用はFableがAstraの1.49倍と1.61倍でした。そのため、毎回内容が変わる短いタスクや、272Kトークン以下の一度きりの長い入力なら、GPT-6 Astraから試すのが妥当です。同じ大きな前置きをキャッシュから毎ターン読むエージェントや、272Kトークンを超える入力では、キャッシュ読み出しが4分の1で長文脈の割増もないClaude Fable 5.1が安くなりやすく、日本語のトークン差が1.23倍と小さいことはFableに有利に働きます。
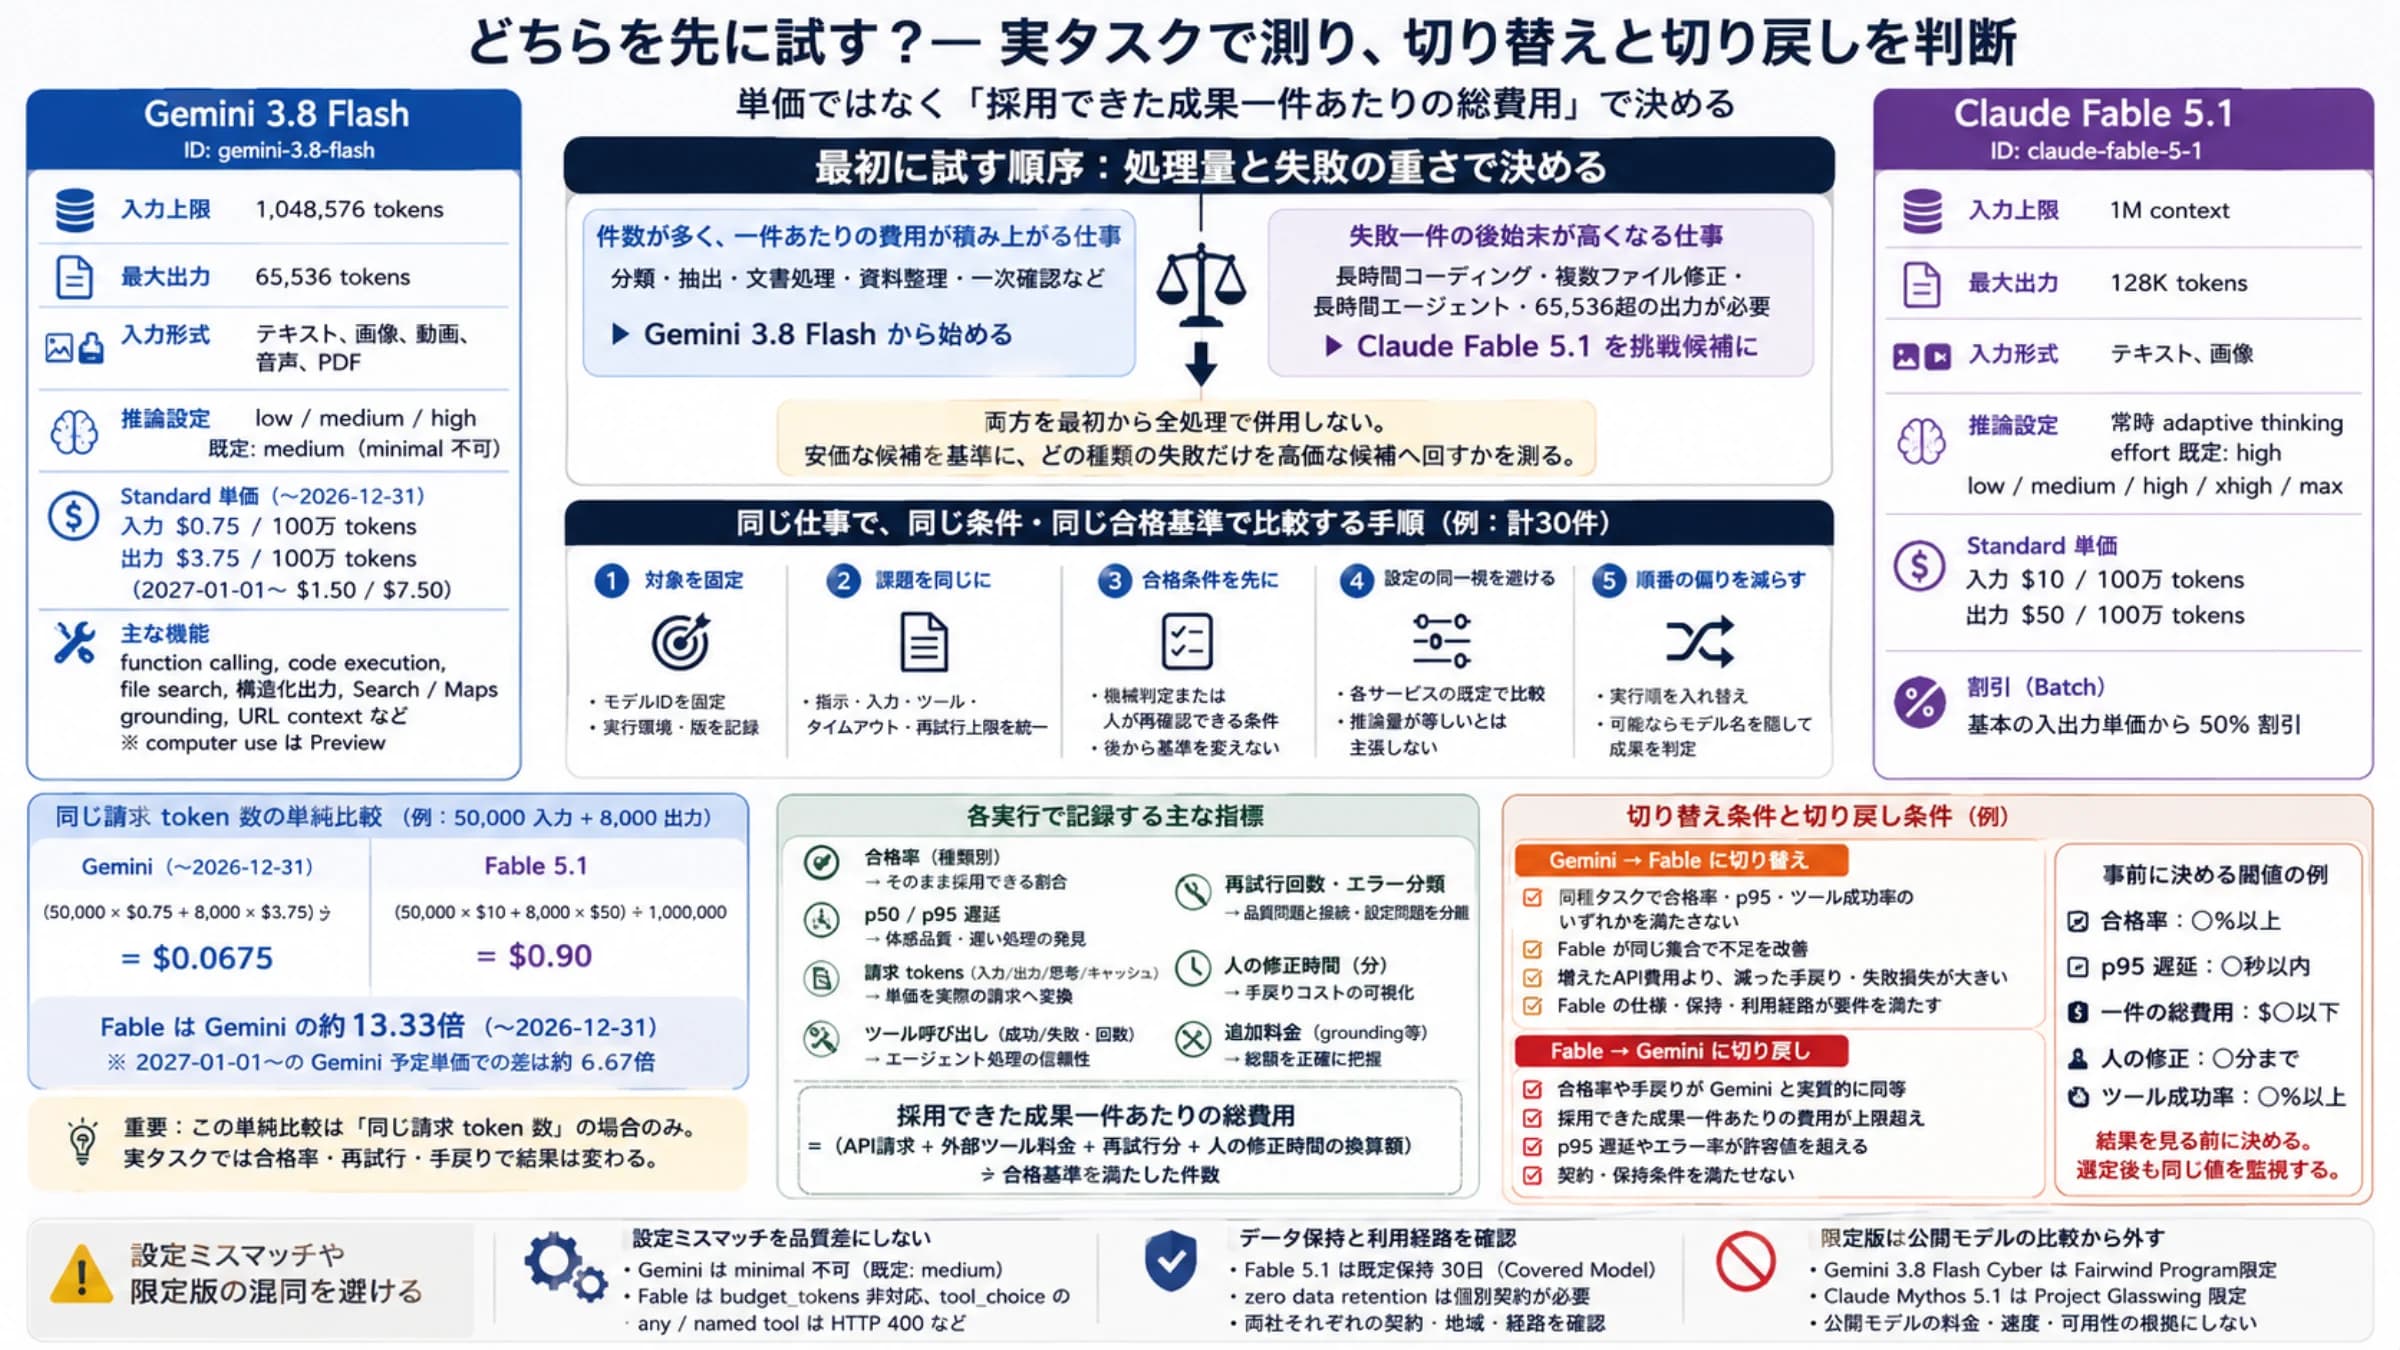
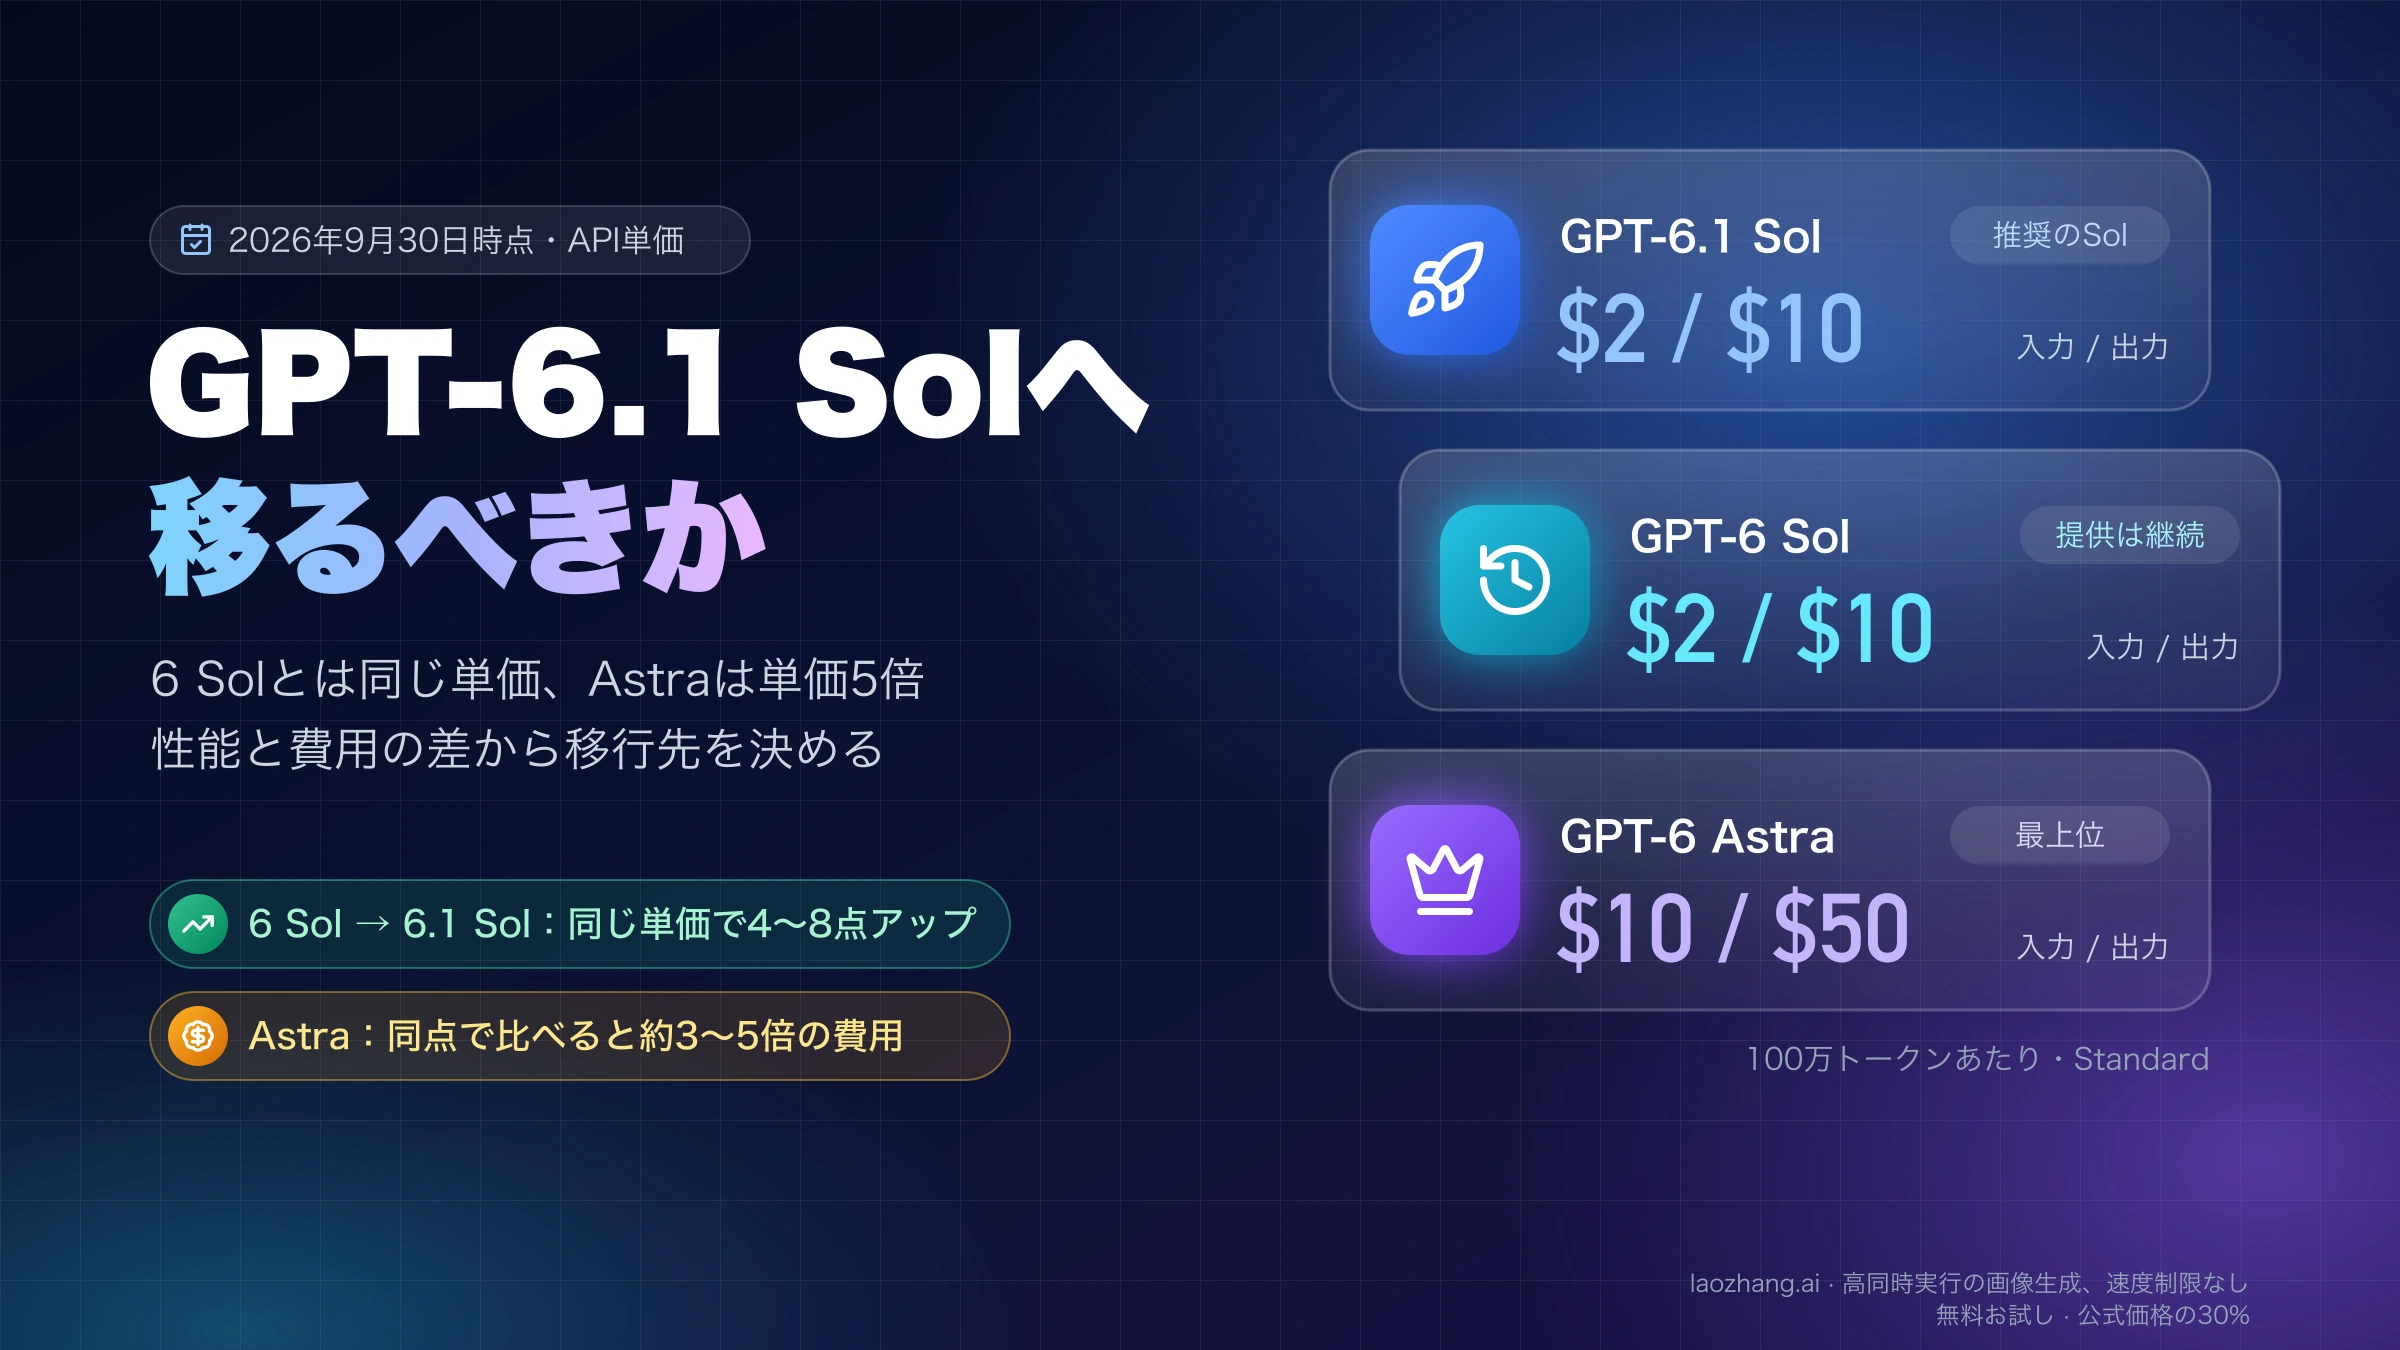
ただし、二つとも最上位の高価なモデルです。Anthropicは現在、多くの用途でまずClaude Opus 5.5を使うよう勧め、OpenAIはGPT-6.1 Solを「Astraに近い性能を低いコストで」提供するモデルと位置づけています。同じ8問をGPT-6.1 Solで解いた費用はAstraの約5分の1でした。安いモデルで不合格が出る仕事だけを、AstraとFableで比べてください。
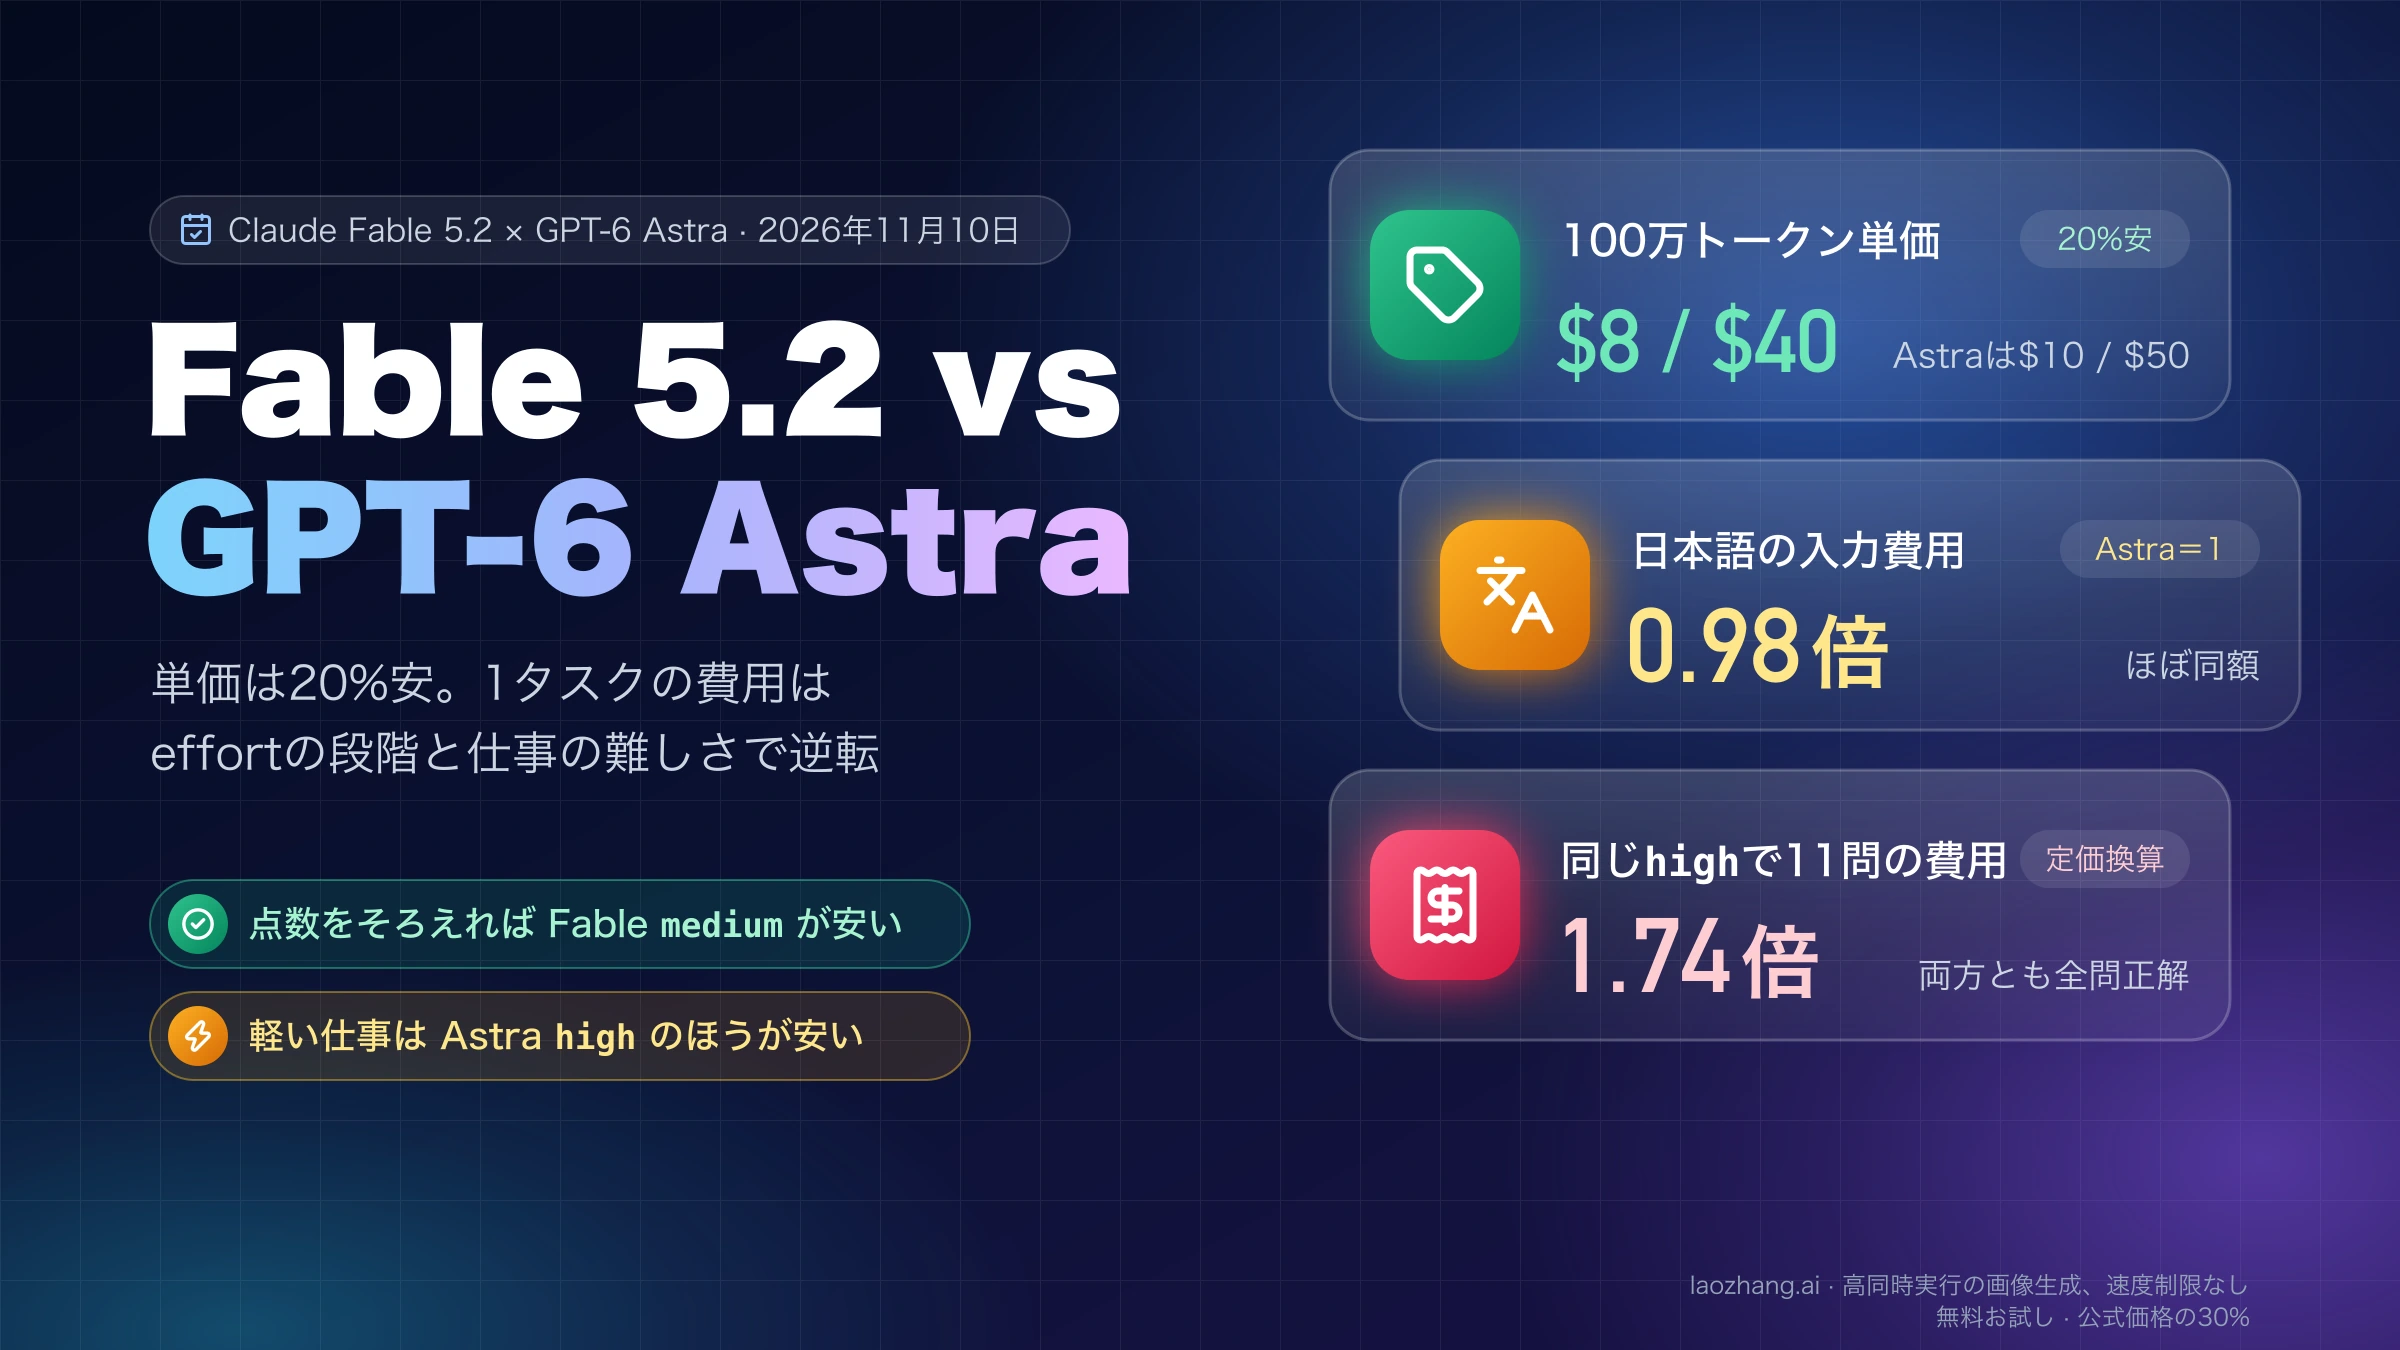
2026年11月9日にAnthropicはClaude Fable 5.2を公開しました。料金は100万トークンあたり入力$8・出力$40で、Fable 5.1も引き続き利用できます。このページはFable 5.1の比較のままです。新しいモデルについてはGPT-6 AstraとClaude Fable 5.2比較:effort対応と1タスクの費用をご覧ください。
仕様表は「候補から外す条件」を見つけるために使う
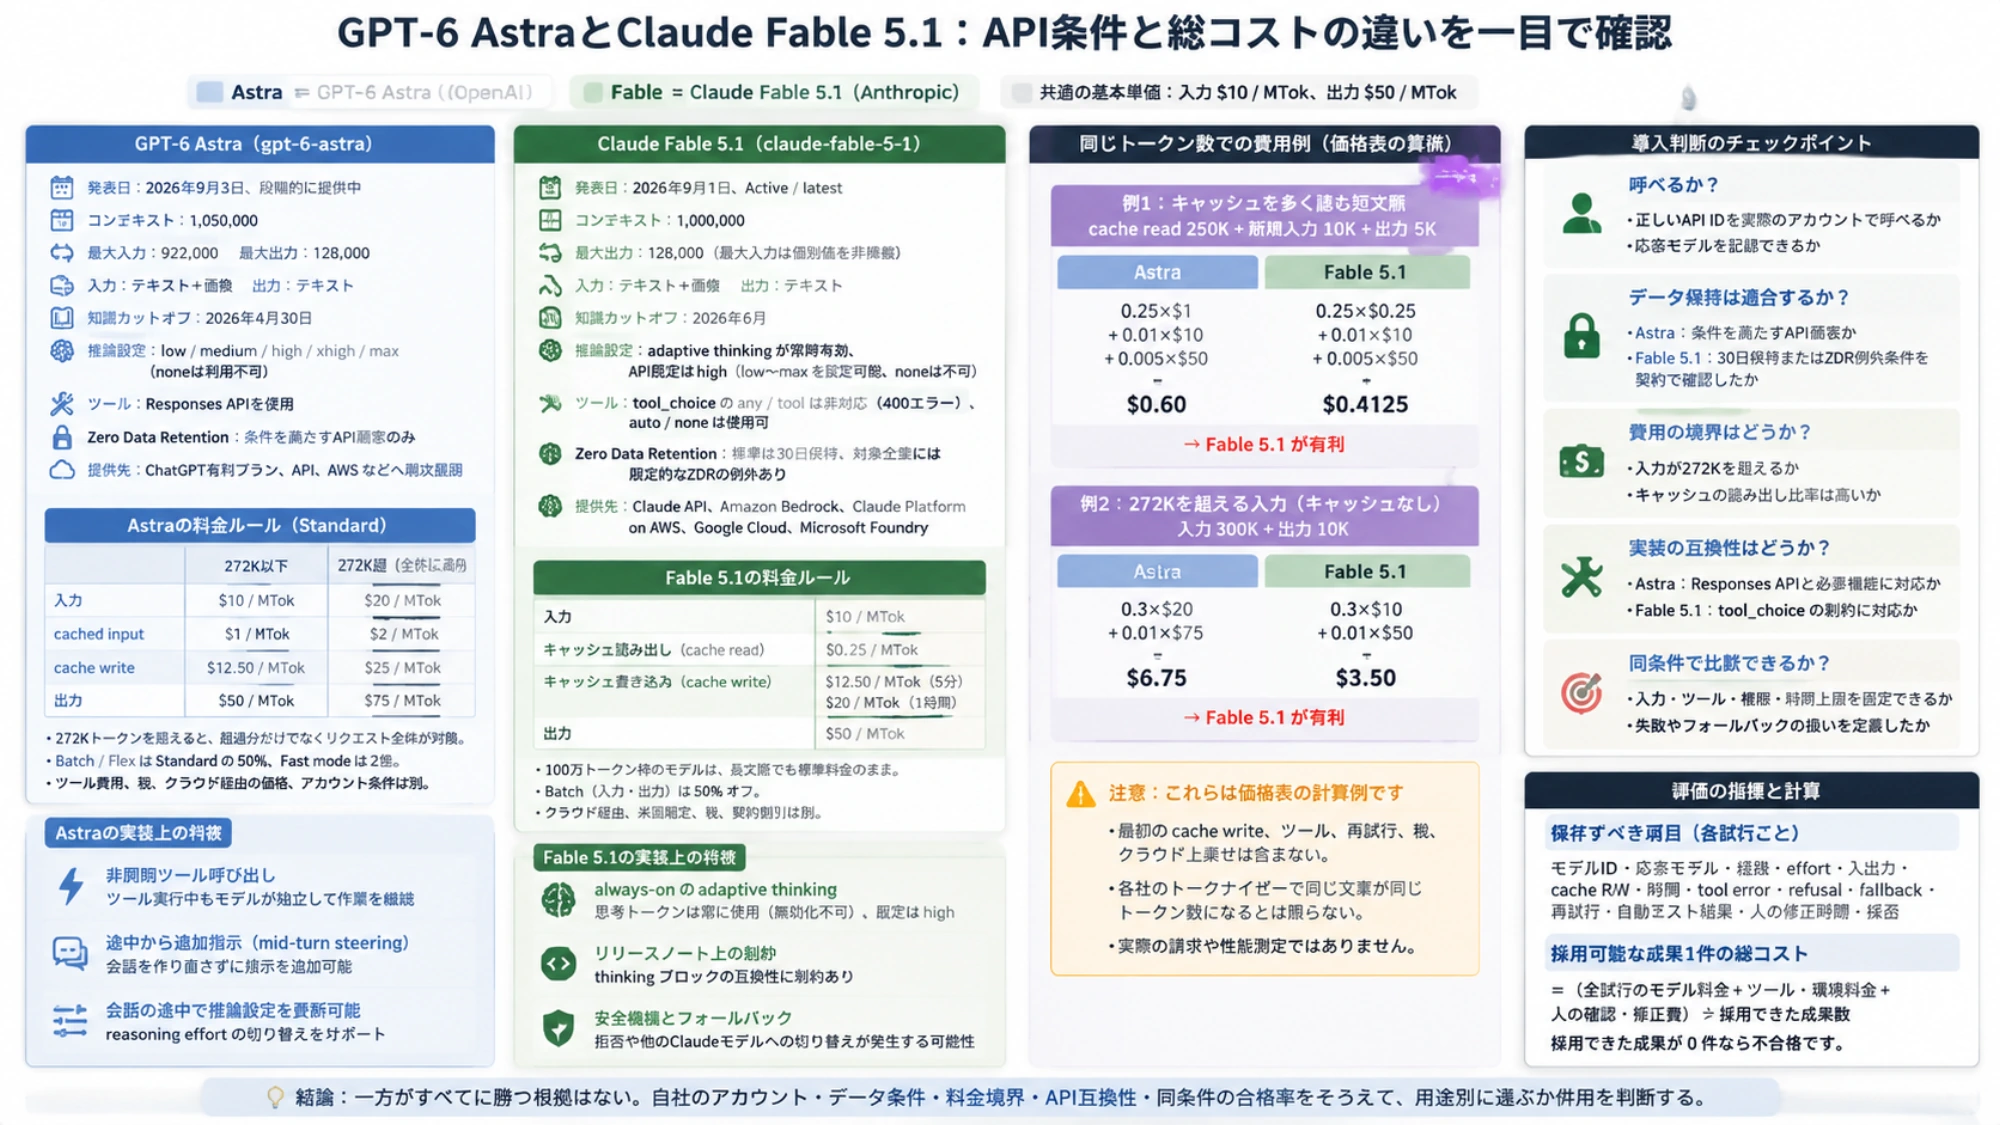
仕様の差は、性能を比べる前に候補を落とす材料になります。OpenAIはGPT-6 Astraのモデルページで、コンテキストウィンドウ1,050,000トークン、最大入力922,000トークン、最大出力128,000トークン、知識カットオフ2026年4月30日としています。AnthropicはClaude Fable 5.1のモデルページで、コンテキストウィンドウ100万トークン、最大出力128Kトークン、知識カットオフ2026年6月としています。どちらもテキストと画像を入力し、テキストを出力します。
| 確認項目 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| API公開 | 2026年9月3日 | 2026年9月1日 |
| API ID | gpt-6-astra | claude-fable-5-1 |
| コンテキスト | 1,050,000 | 1,000,000 |
| 最大入力 | 922,000 | 個別値の記載なし |
| 最大出力 | 128,000 | 128,000 |
| 推論設定 | low〜max、noneは400エラー | 適応的思考(adaptive thinking)が常時有効、low〜max |
| 推論設定の既定値 | 公式ドキュメントに記載なし | API既定はhigh |
| ツール呼び出し | Responses APIが必要 | Messages APIで利用可、強制指定は不可 |
| 提供終了予定 | 記載なし | 2027年9月1日より前には終了しない |
コンテキストの公称値ではAstraが5万トークン大きく見えますが、同じ文章をFableは多いトークンで数えるため、実際に入る文章量の差はこれより開きます(日本語での目安は後述の6言語の節にあります)。Claudeでは入力、出力、思考トークンが同じ枠を使うので、実際の資料を各社のトークン計数機能で測り、出力とツール実行の余白を残してから判断します。
GPT-6 AstraはOpenAIのAPIの変更履歴で2026年9月3日に公開されています。ChatGPT側では、OpenAIのChatGPTのモデル案内と料金ページによると、PlusとBusiness標準プランはWork・Codexで5時間当たり約5〜45メッセージ、Proは5時間の上限なしで、EnterpriseとEduはワークスペースの管理者が有効にするまで使えません。ワークスペースで有効にしてもAPIの利用権は付かず、APIはキーの組織とプロジェクトに従います。Chat画面でどのプランがAstraを使えるかは公式の案内に記載がなく、第三者の報告ではPro・Business・Enterpriseとされています。APIで最初の応答を得るまでの手順はGPT-6 Astra APIの始め方:利用権限の確認から最初の応答までにまとめています。
Claude側では、AnthropicのFable 5.1のプラン別ヘルプによると、Maxなどの上位プランは週の利用上限の50%までFable 5.1を追加料金なしで使え、Proは最初のメッセージから利用クレジットによる従量課金で、Freeでは使えません。Claude Codeで使うには2.1.255以降が必要です。APIではClaude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundryで提供されていますが、組織設定、地域、クラウド側のモデル名は実際の利用先で確認します。プランごとの上限の数え方はClaudeの使用制限プラン別一覧:5時間・週次上限と3種類のクレジットで確認できます。
同じ基本単価でも、キャッシュと長文脈で差が開く
料金表の数字が同じでも請求が分かれる理由は四つあります。同じ文章のトークン数がFableのほうが多いこと、Astraは既定でキャッシュを書き込みFableは指定したときだけ書き込むこと、Astraは272Kトークンを超えるとリクエスト全体が割増になること、そして出力と思考に使うトークン量がモデルで違うことです。単価は2026年10月26日時点のOpenAIのAPI料金表とAnthropicのClaude APIの価格表によります。
| 100万トークン当たりのStandard料金 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 入力 | $10 | $10 |
| キャッシュ読み出し | $1 | $0.25 |
| 短い保持のキャッシュ書き込み | $12.50(30分) | $12.50(5分) |
| 長い保持のキャッシュ書き込み | $25(12時間) | $20(1時間) |
| 出力 | $50 | $50 |
| 272K超の入力があるリクエスト | 入力$20、読み出し$2、書き込み$25/$50、出力$75 | 割増なし |
| Batch | 50%引き(Flexも同じ) | 50%引き |
| 高速モード | Fast 2倍、Ultrafast 6倍 | 提供なし |
カタカナで「アストラ」と呼ばれることもあるGPT-6 Astraでは、2026年10月20日に12時間のキャッシュ書き込み$25が加わり、書き込み単価が30分と12時間の2種類になりました。272Kを超えると、超えた部分だけでなくリクエスト全体に2倍の入力・キャッシュ料金と1.5倍の出力料金がかかります。Fable 5.1はClaudeのコンテキスト説明のとおり、100万トークンまで標準料金のままです。ツール料金、税、クラウド経由の価格、契約割引はこの表に含みません。
キャッシュの既定の動き方も逆です。OpenAIのプロンプトキャッシュのガイドは、対応モデルではキャッシュが既定で有効で、GPT-5.6以降の書き込みは通常入力の1.25倍と説明しています。2026年10月26日のテストでも、キャッシュ設定を何も送らなかった10,106トークンのプロンプトで、Astraは10,103トークンを自動で書き込み、通常入力より約$0.025多く課金されました。再利用しない長い入力が多いなら、prompt_cache_options.modeを"explicit"にしてブレークポイントを置かなければ、書き込みは発生しません。一方Fableは、Claudeのプロンプトキャッシュ説明のとおりcache_controlを付けたときだけ書き込み、同じテストでも指定なしでは書き込みはゼロでした。$0.25の読み出し単価は、cache_controlを設定して初めて効きます。
片方のモデルだけの月額を見積もる場合は、GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法とClaude Fable 5.1のAPI料金:単価と月額の目安を使えます。Fable 5.1とOpus 5のキャッシュ費用や移行条件まで検討する場合は、Fable 5.1の料金とタスク単価の比較で計算方法を続けて確認できます。
同じ8問の実測:全問合格、費用はFableが1.49〜1.61倍
2026年10月26日に、laozhang.aiのAPIゲートウェイを通して同じ8問を両モデルに解かせると、両方とも全問合格し、定価で換算した費用はFableがAstraの1.49倍(1回目)と1.61倍(2回目)でした。Astraは/v1/chat/completions、Fable 5.1は/v1/messagesで呼び、推論設定は送らずモデルの既定値に任せ、最大出力32,000トークン、システムプロンプト・ツール・キャッシュ設定なしで、いずれもストリーミングです。問題は文章題、区間の結合、時間文字列の解析、単語の頻度集計、6,723語の英文記事の5点要約、数式の評価、CSV行の解析、桁和の数え上げで、隠しテストで採点しました。費用はゲートウェイが返したトークン数に両社の定価を掛けて計算しています。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| ラウンド | モデル | 合格 | 入力トークン | 出力トークン | 定価換算の費用 | 合計時間 |
|---|---|---|---|---|---|---|
| 1回目(5問×1回) | GPT-6 Astra | 5/5 | 10,545 | 1,839 | $0.2227 | 50.3秒 |
| 1回目(5問×1回) | Claude Fable 5.1 | 5/5 | 15,948 | 3,431 | $0.3310 | 43.3秒 |
| 2回目(3問×2回) | GPT-6 Astra | 6/6 | 862 | 3,656 | $0.1914 | 78.6秒 |
| 2回目(3問×2回) | Claude Fable 5.1 | 6/6 | 1,254 | 5,896 | $0.3073 | 72.4秒 |
差の大半は出力トークンで、Fableは1回目で1.87倍、2回目で1.61倍を使いました。このゲートウェイ経由ではFableの思考の中身は返ってきませんが、output_tokensには思考分が含まれます。「ok」と一語返すだけの呼び出しで、Fableは出力132トークン・15.4秒、Astraは5トークン・2.8秒でした。Astraは思考に使ったトークンをreasoning_tokensとして別に返し、最初の文章題では出力412トークンのうち256トークンでした。所要時間はほぼ同じで、合計ではFableが1回目で14%、2回目で8%速く終わっています。
前日の2026年10月25日に同じ8問をGPT-6.1 Solで解いた費用は、1回目$0.0387、2回目$0.0368で、こちらも全問合格でした。Astraはその5.8倍と5.2倍です。テスト全体の費用は38回の呼び出しで$1.10でした。
この結果は性能の順位ではありません。使ったゲートウェイは一つ、実施は1日、各問1〜2回で、問題は両方が解ける大きさです。トークン数はゲートウェイが返した値で、キャッシュ読み出しと272K超の入力はこのテストに含まれていません。Responses API、推論設定の変更、OpenAIとAnthropicの直接のエンドポイントも試していないため、次の節以降の計算は定価に基づく試算です。
同じ日本語でFableは何トークン多いか:1.23倍、英語は1.45倍
同じ意味の文章を6言語で用意し、各APIが返した入力トークン数から指示文だけの分(Astra 23、Fable 34)を引くと、Fableのトークン数は日本語でAstraの1.23倍、英語で1.45倍でした。測定は2026年10月26日、上と同じゲートウェイ経由です。6言語のうち日本語の差がいちばん小さく、韓国語とスペイン語では2倍近くになります。
| 言語 | 文字数 | GPT-6 Astra | Claude Fable 5.1 | Fable / Astra |
|---|---|---|---|---|
| 日本語 | 344 | 254 | 312 | 1.23倍 |
| 英語 | 685 | 137 | 199 | 1.45倍 |
| 中国語 | 246 | 165 | 247 | 1.50倍 |
| ロシア語 | 791 | 193 | 302 | 1.56倍 |
| スペイン語 | 799 | 162 | 304 | 1.88倍 |
| 韓国語 | 363 | 208 | 396 | 1.90倍 |
英語の長い記事(6,723語)ではAstra 10,106に対しFable 15,335で1.52倍、コード寄りのプロンプトでは1.46倍でした。Anthropicのトークン計数の説明は、Fable 5.1のトークナイザーが旧世代のClaudeより約30%多く数えるとしか書いておらず、ClaudeとOpenAIの比較は公式には示されていません。中国語で検証したCrazyrouterの第三者テストも、英語の詰め物テキストでFableが1.91倍と、同じ向きの差を報告しています。
どの言語でも、各言語1段落(英語で約120〜150語相当)の測定です。自分のプロンプトの比率は、OpenAIの入力トークン計数APIとAnthropicのトークン計数APIに同じ文章を渡せば求められます。この比率を当てはめると、Fableの100万トークンの枠に入る日本語は、Astraの数え方で約81万トークン分、英語なら約69万トークン分と推定できます(1,000,000 ÷ 1.23、1,000,000 ÷ 1.45)。Astraの最大入力922,000トークンと272Kの境目は、Astraのトークンで数えます。
使い方別の請求額:前置きの再利用、272K超、短いタスク
同じ文章をFableが何倍のトークンで数えるかをrとすると、どちらが安いかはrと使い方で決まります。同じ大きな前置きを毎ターン読むならrが1.455未満、272Kトークン超のキャッシュなし入力ならrが1.93未満のときFableが安くなります。日本語の1.23倍はどちらも下回り、英語の1.45倍は前者でほぼ同額です。272Kトークン以下でキャッシュを使わない入力と短いタスクでは、Astraが安くなります。以下は表の定価だけを使った試算で、数量はAstraのトークンで数え、Fable側は入力も出力もr倍になると仮定しています。
同じ大きな前置きを毎ターン読む場合
キャッシュ読み出し250K、新規入力10K、出力5Kの1ターンで比べると、GPT-6 Astraは0.25 × $1 + 0.01 × $10 + 0.005 × $50 = $0.60、Claude Fable 5.1はr × (0.25 × $0.25 + 0.01 × $10 + 0.005 × $50) = r × $0.4125です。rが1.23なら約$0.51、1.45なら約$0.60、1.9なら約$0.78で、$0.60 ÷ $0.4125 ≈ 1.455が損益分岐です。ただし、2026年10月26日のテストではFableの出力がトークナイザーの差を超えて1.61〜1.87倍になりました。日本語で出力だけ1.87倍とすると1.23 × (0.25 × $0.25 + 0.01 × $10) + 0.005 × 1.87 × $50 ≈ $0.67となり、Astraのほうが安くなります。出力が短い作業ほど、Fableの読み出し単価が効きます。
最初の書き込みも差になります。250Kの前置きを書き込むターンは、Astraが30分保持で0.25 × $12.50 + 0.01 × $10 + 0.005 × $50 = $3.475、Fableが5分保持でr × $3.475、日本語なら約$4.27です。この差約$0.80を1ターン約$0.09の差で取り戻すには、(1.23 − 1) × $3.475 ÷ ($0.60 − $0.507) ≈ 8.6から、約9ターンのキャッシュ読み出しが必要です。Fableの5分保持は読み出すたびに延長されますが、ターンの間隔が5分を超えるなら1時間保持の$20で書き込むことになり、最初の差はさらに広がります。
272Kトークンを超える入力を一度だけ渡す場合
キャッシュなしの入力300K、出力10Kでは、Astraはリクエスト全体が長文脈料金になり0.30 × $20 + 0.01 × $75 = $6.75、Fable 5.1はr × (0.30 × $10 + 0.01 × $50) = r × $3.50です。日本語の1.23倍なら約$4.3、英語の1.45倍なら約$5.08で、rが1.93を超えるまでFableが安いままです。逆に入力が250Kのように272Kを下回ると、Astraは0.25 × $10 + 0.01 × $50 = $3.00、Fableはr × $3.00となり、日本語でも約$3.69とAstraが安くなります。境目はAstraのトークンで数えるので、資料のトークン数を実際に測ってから判断します。
毎回内容が変わる短いタスクの場合
キャッシュが効かない短いタスクは、上の実測そのものです。Fableは入力がr倍、出力が思考を含めて1.6〜1.9倍になり、同じ合格率で1.49〜1.61倍の費用でした。Batchは両社とも50%引きなので、この比率は変わりません。Fableを選ぶ理由になるのは、Astraが落とす問題をFableが解き、再試行を含めた合格1件当たりの費用が逆転する場合だけです。
APIの違いは、モデルの賢さより先に障害になる
AstraとFableでは、モデル名を書き換えるだけでは動かない設定がそれぞれにあります。Astraはツール呼び出しにResponses APIが必要で、GPT-6 AstraのモデルページはChat CompletionsではAstraとGPT-6.1 Solの関数呼び出しに対応しないと明記しています。推論設定はlow、medium、high、xhigh、maxで、noneを送ると400エラーになり、temperatureやtop_pの指定とlogprobsにも対応しません。API側の既定値は公式に書かれていませんが、ChatGPTとCodexの案内は、Astraを「Light」(APIのlow)から始めるよう勧めています。
GPT-6 Astraの開発者ガイドが示す非同期ツール呼び出しは、アプリ側で時間のかかる処理を実行している間に、モデルが独立した作業を進められる仕組みです。途中から追加指示を渡す機能や、会話を作り直さずにreasoning effortを変更する機能もあります。長時間のエージェントをすでにResponses APIで構築している場合、これらはAstraを先に試す実装上の理由になります。ただし、機能があることと、自社タスクの品質や待ち時間が改善することは別です。
Fable 5.1は思考を無効にできず、APIの既定はhigh effortです。Fable 5.1の新機能と変更点によると、tool_choiceのanyとtoolは400エラーになり、autoとnoneは従来どおり使えます。アシスタント応答の先頭を埋めるプリフィル、budget_tokensによる思考量の指定、temperature・top_p・top_kも400エラーです。強制的なツール選択を前提にした処理は、strictなツール定義や構造化出力へ移す必要があります。
同じページは、Fable 5.1が生成したthinkingブロックを読めるのはFable 5.1とMythos 5.1だけで、会話の途中で別のモデルへ移ると以後のターンでは思考が引き継がれないと説明しています。システムプロンプト、ツール定義、過去のメッセージを書き換えて再送すると、次のリクエストがエラーになるか、ブロックが捨てられます。この検査は2026年8月31日以降に作成されたアカウントで有効です。会話履歴を書き換える独自の再試行処理や、途中でモデルを切り替えるフォールバックを使っているなら、長時間試験の前にこの挙動を確認します。
データ保持とフォールバックは別々に検証する
データ保持の条件は、APIキーを持っているだけでは決まりません。OpenAIのAPIのデータ管理ガイドによると、Zero Data Retention(ZDR)はOpenAIの事前承認を受けて組織またはプロジェクト単位で設定するもので、/v1/responsesと/v1/chat/completionsは対象です。Astraだけを除外する記載はありませんが、OpenAIは特定の顧客について事前通知のうえモデルをZDRの対象外にできるとしています。EUのデータ保管を使う場合、AstraのFastモードは使えません。
AnthropicのAPIのデータ保持の説明では、Fable 5.1は30日間の保持が必要な対象モデルで、Anthropicが明示的に認めない限りZDRでは使えません。条件を満たさない組織からのリクエストはHTTP 400になり、ZDRの組織が特定のワークスペースだけ30日保持を有効にする方法も用意されています。機密情報を扱う場合は、「Anthropicだから不可」「例外があるから可」のどちらにも短絡せず、自社契約で許可された条件を書面で確認します。
安全機構による切り替えにも備えます。AnthropicのFableのモデル切り替えに関するヘルプによると、Claudeのアプリでは安全機構がリクエストに反応すると、別のモデルが回答に切り替わることがあり、通知に回答したモデルが表示されます。Astra側も、Responses APIのエージェント作業ではミスアライメント監視が非同期に動き、警告を出したり会話を止めて確認に回したりすることがあります。成功判定にはHTTPステータスだけでなく、停止理由、要求モデル、実際の応答モデル、中断の有無を含めます。
この確認を省くと、Astraの結果を別のOpenAI経路へ、Fable 5.1の結果をフォールバック先のClaudeへ誤って帰属する恐れがあります。比較表に書くべきなのはブランド名だけではなく、実際に評価したモデルと処理経路です。
公式ベンチマークだけでは直接対決にならない
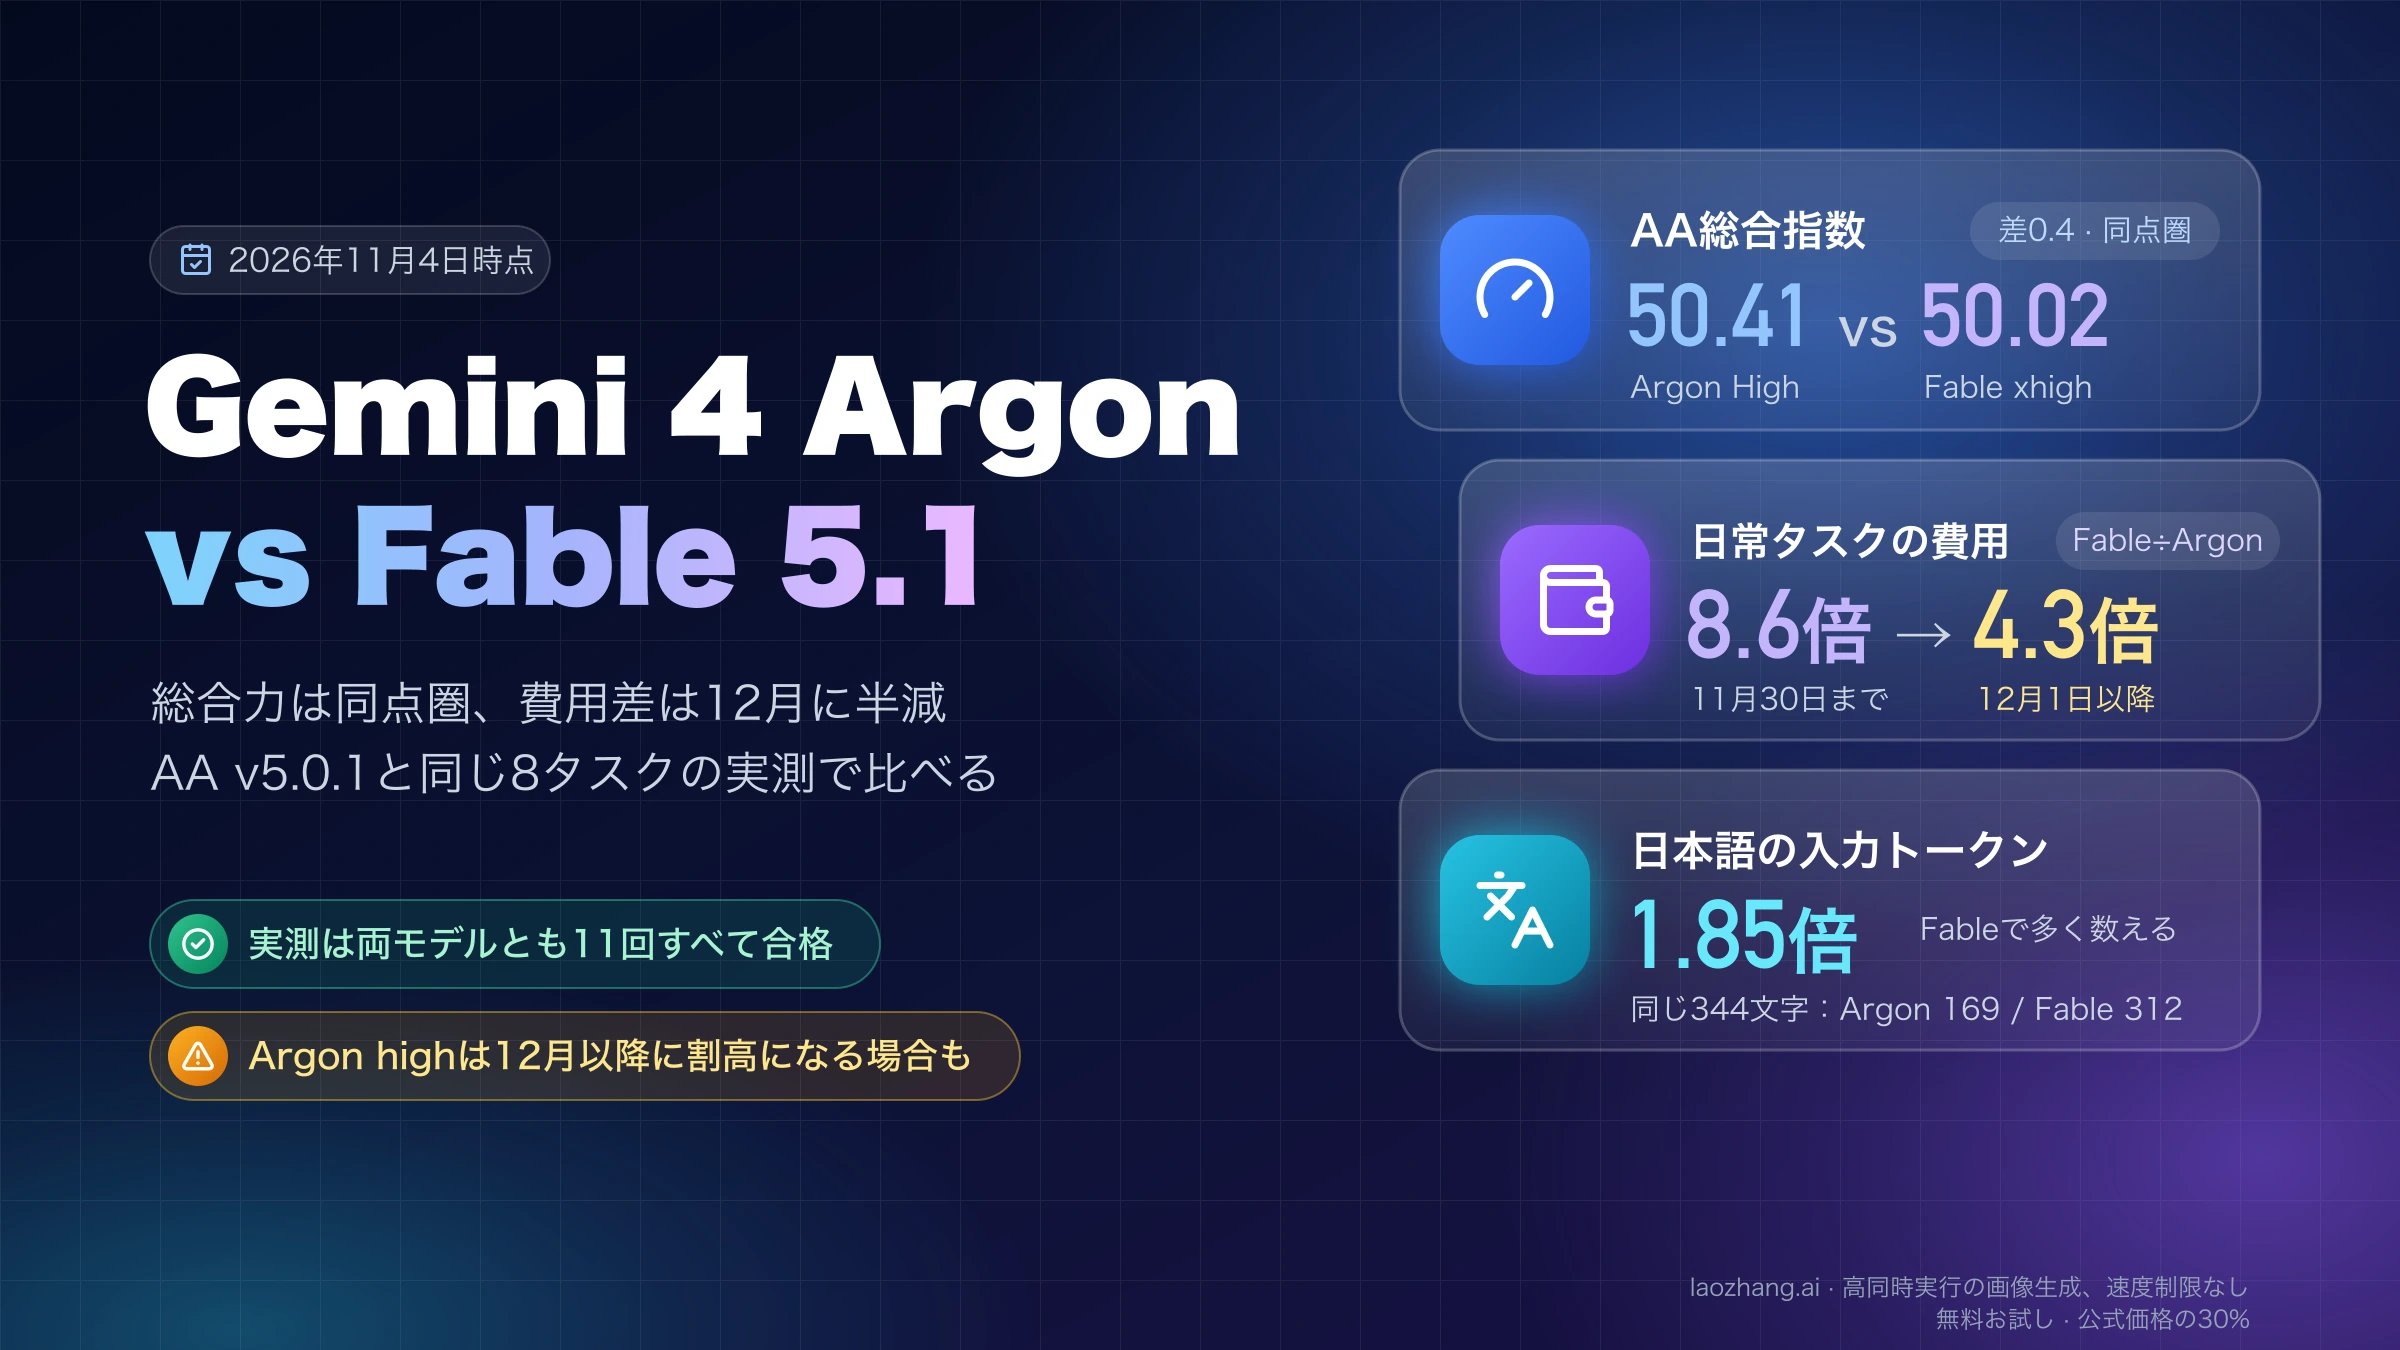
2026年10月28日時点の総合点は、すべての推論設定でAstraが上です。Artificial AnalysisのAstraとFable 5.1の比較ページでは、Intelligence Index v5.0の点数が最大の推論設定でAstra 57対Fable 49です。発売直後に広く引用された「Fable 66対Astra 61」は旧版のIndex v4.1、10月27日の改定前まで表示されていた53対53はv4.3.2の数字で、どちらも現在のv5.0とは比べられません。
| 推論設定 | Fable 5.1の点数 | Astraの点数 | Fable 5.1の1タスク費用 | Astraの1タスク費用 |
|---|---|---|---|---|
| max | 49 | 57 | $13.04 | $6.24 |
| xhigh | 50 | 55 | $10.89 | $3.66 |
| high | 47 | 55 | $7.56 | $3.24 |
| medium | 43 | 51 | $5.58 | $2.73 |
| low | 38 | 43 | $4.49 | $1.42 |
点数と費用はいずれもArtificial Analysis v5.0の表示です。Fableの最高点はmaxではなくxhighの50で、これもAstraのmedium(51点、1タスク$2.73)に届きません。同じ推論設定で比べると、Fableの1タスク当たりの費用はAstraの2.0〜3.2倍で、実測の1.49〜1.61倍より差が大きく出ています。max設定の1タスク当たりの所要時間もFable 1,178秒、Astra 711秒です。
「Astraのすごいところ」を挙げるなら、端末操作と業務の自動化です。Artificial Analysisの測定ではTerminal-Bench 4.0でAstra 59.1%対Fable 52.0%、AutomationBench-AAで68.5%対59.4%と、Astraが上回りました。OpenAIの発表表でもDeepSWE v1.1で74.1%対67.4%です。v5.0の9評価のmax設定では、ほかにFrontierCode 2.0(42.4%対31.6%)、GDP.pdf(31.0%対26.2%)、HLE-Diamond(63.8%対60.1%)、CritPt(70.5%対51.0%)、Terminal-Bench-Science(63.3%対43.3%)もAstraが上です。Fableが上回るのは、実務文書を評価するAA-Briefcase(1669対1568)と知識の正確さを測るAA-Omniscience(46対42)の二つだけです。v4.3.2でFableが上だった実務文書のGDPval-AA v2.1(1754対1573)、科学計算のSciCode(63.1%対56.5%)、長文読解のAA-LCR(85.3%対80.7%)は、v5.0で指標から外れました。OpenAIの表では、ツール付きHumanity's Last Exam(65.0%対57.2%)でFableが上です。OpenAIの表は各社最大の推論設定と自社の評価環境によるもので、Claude側の安全機構やフォールバックに関する注記も付いています。
第三者や個人の報告は、条件をそろえるとどちらにも振れます。2026年9月5日のCrazyrouterのテストでは、29の採点項目でFableが29、Astraが16を満たし、Astraは三者が並ぶ問いへの答え漏れと誤った前提への追従で失点しました。X上のある投稿者は15の用途でFableの出力を高く評価する一方、所要時間は37分12秒対23分30秒、費用は$26.61対$12.14だったと報告しています。速度では、OpenRouterの中央値でFableが毎秒57トークン、Astraが36トークンですが、Artificial Analysisのmax設定の出力速度はAstra 71トークン、Fable 66トークンと、測り方で順序が入れ替わります。同社のmax設定での最初のトークンまでの時間は、2026年10月26日の表示でFable 180.5秒、10月28日の再測定でAstra 268.7秒です。
ベンチマークの数字を自分の判断に使う前に、同じ問題・入力データ・開始状態か、ツール・ネットワーク・権限・時間上限が同じか、effortと最大出力が分かるかを確かめます。拒否やフォールバックを0点・再試行・別モデルのどれとして数えたか、価格に全試行やキャッシュ、人の修正を含めたかでも結果は変わります。条件が違う数値は、その設定での提供者や投稿者の測定として読むにとどめます。自社の代表タスクへ移せるかは、次の小規模評価で確かめます。
三つの代表タスクで、採用可能な成果を測る
自社で比べるなら、両方が簡単に解ける問題ではなく、安いモデルが落とす失敗条件の明確な仕事を三つ用意します。2026年10月26日の8問は両モデルとも全問合格し、差は費用と速度にしか出ませんでした。コーディング、コンピュータ操作、調査・文書作成のように性格の違う仕事を選ぶと、モデルを用途で分ける判断もしやすくなります。
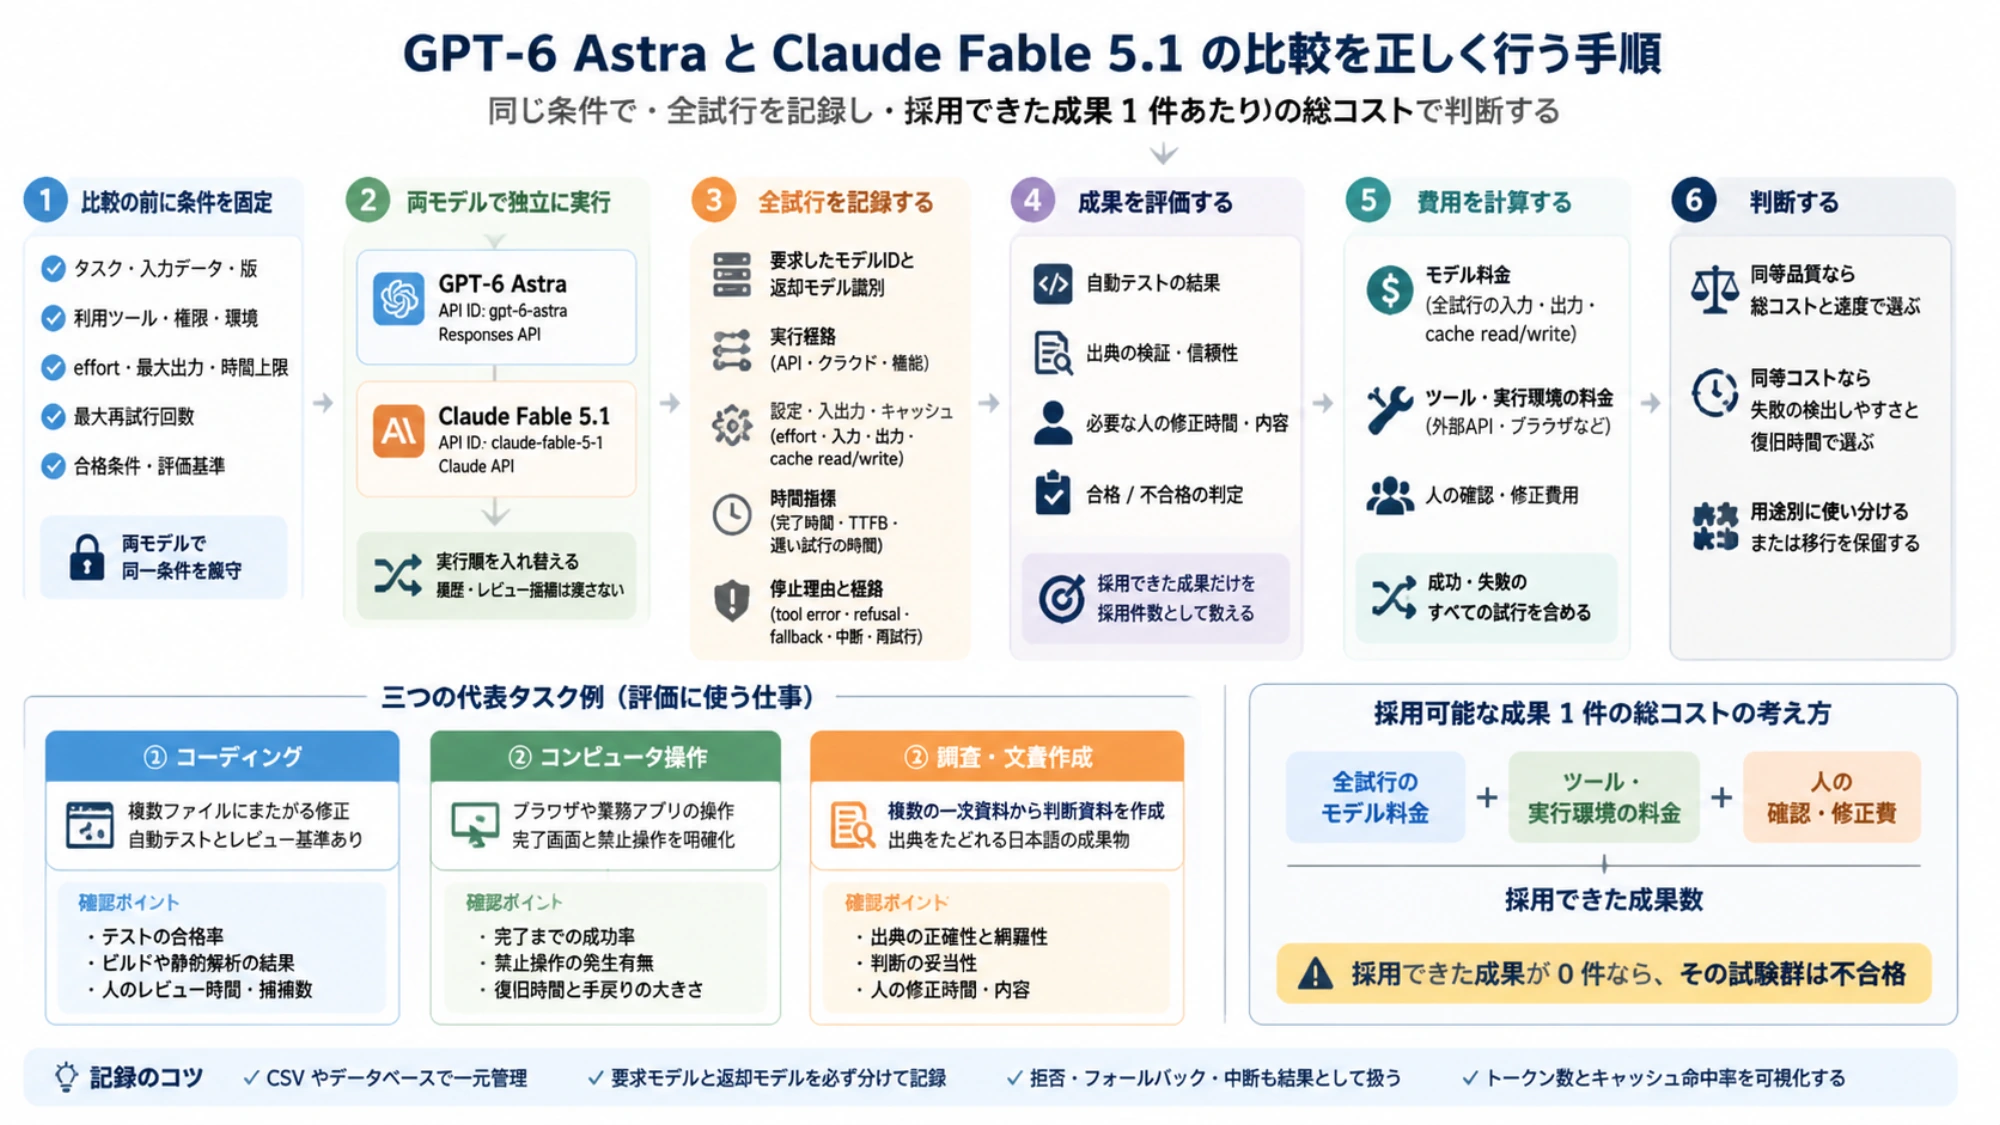
手順は次のとおりです。
- 仕事を三つ選びます。小規模でも複数ファイルにまたがり自動テストがある修正、完了画面と禁止操作を決められるブラウザ操作、複数の一次資料から出典付きの日本語の判断資料を作る仕事が目安です。
- まずGPT-6.1 SolとClaude Opus 5.5で同じ仕事を解かせ、不合格が出た仕事だけを残します。
- 入力資料の版、利用できるツール、権限、時間上限、最大再試行回数、合格条件を固定します。
- 両社のトークン計数APIで同じプロンプトを数え、自分のトークン比
rを求めます。 - 二つ目のモデルに一つ目の作業履歴やレビュー指摘を渡さず、実行順も入れ替えて各3回以上実行します。
high同士の結果に加え、必要なら費用をそろえた設定も別に測ります。 - 費用は成功した回だけでなく、失敗した試行も含めて合計します。
一回ごとに、要求したモデルIDと返却されたモデル、API・クラウド・製品機能を含む実行経路、effort、入力・出力・キャッシュ読み出し・キャッシュ書き込みのトークン数を残します。Astraではreasoning_tokensとキャッシュ書き込みの値、Fableでは思考を含むoutput_tokensを記録しておくと、請求の差を後から説明できます。完了時間、最初の応答までの時間、遅い試行の時間、ツールエラー、拒否、フォールバック、中断、再試行、自動テストの結果、人の修正時間、最終的な採否も記録します。
採用可能な成果1件の総コスト =(全試行のモデル料金 + ツール・実行環境の料金 + 人の確認・修正費)÷ 採用できた成果数
採用できた成果が0件なら、その試験群は不合格です。生成量や途中まで完了した手順を、採用件数の代わりに使いません。品質が同等なら費用と速度で選び、費用が同等なら失敗の検出しやすさと復旧時間で選びます。一方がすべての仕事で勝つ必要はなく、コーディングと長文書でモデルを分ける判断も成立します。
用途別に、最初の候補と停止条件を決める
最初に試す候補は、入力の再利用のされ方、272Kを超えるか、言語の三つでほぼ決まります。下の表は、その候補を試すのをやめる条件も先に決めておくためのものです。
| 状況 | 最初に確認する候補 | 先に決める停止条件 |
|---|---|---|
| 毎回内容が変わる短いタスク、272K以下の一度きりの入力 | GPT-6 Astra | Fableより合格率が低く、再試行込みの費用が逆転する |
| Responses APIのツールやコンピュータ操作を活かしたい | GPT-6 Astra | アカウント未提供、必要なツール非対応、待ち時間・失敗率が基準外 |
| 日本語の長い共通入力を毎ターン再利用する | Claude Fable 5.1 | cache_controlを付けられない、読み出しが約9ターンに届かない、出力が多く差が消える |
| 英語・韓国語・スペイン語の共通入力を再利用する | 両方を同じ条件で測る | トークン比が1.455倍を超え、Fableの読み出し単価の利点が消える |
| 272K超の入力を扱う | Claude Fable 5.1 | 30日保持が不適合、自分の資料のトークン比が1.93倍を超える |
| ZDRが絶対条件 | 契約で対象と確認できた側 | 対象資格、ツール、地域のいずれかがZDR外 |
| 速度が最優先 | 事前には決めない | 中央値だけでなく遅い試行が業務上限を超える |
Astraの1.05Mという数字だけで、大量資料の仕事に有利だとは言えません。272Kを超える入力ではリクエスト全体の料金が変わり、不要な資料を詰め込むほど検索精度や復旧も難しくなります。Fable 5.1のキャッシュ価格も、cache_controlを付けて共通の入力を繰り返し読み、キャッシュが実際に命中して初めて効きます。
逆に、入力が数万トークンで毎回内容が変わるなら、選択を決めるのは合格率、再試行、出力トークン、ツールの安定性、人の修正時間です。高速モードやクラウド経由の価格を比べる場合は、Standard料金の表へ混ぜず、別の実行経路として測定します。
2026年10月26日時点の実務判断
GPT-6 Astraを先に試す合理性があるのは、実際のアカウントでgpt-6-astraを呼べ、Responses APIの機能が仕事に合い、入力の多くが272K以下で毎回変わり、データ条件も確認できた場合です。Claude Fable 5.1を先に試す合理性があるのは、日本語の長い前置きをcache_controlで繰り返し読む、または272Kを超える資料を扱い、30日保持または明示的な例外条件を受け入れられ、thinkingブロックとツール選択の制約を実装できる場合です。
2026年9月4日の時点から変わったことは四つあります。総合指数が旧版v4.1の「Fable優位」から、2026年10月28日のv5.0ではすべての推論設定で「Astra優位」に変わったこと、Astraに12時間のキャッシュ書き込みが加わったこと、Anthropicが多くの用途でまずOpus 5.5を勧めるようになったこと、OpenAIがAstraに近い性能のGPT-6.1 Solを$2/$10で出したことです。そのため、二つを比べる前に安いモデルで足りるかを確かめる順番が、9月より重要になっています。
コーディング用にAstraを検討している場合も、Anthropicが多くの用途でまずOpus 5.5を使うよう勧めている以上、自分のテストには安いClaudeの候補としてOpus 5.5を入れておくのが妥当です。FableにOpus 5.5より多く払う価値があるかは、Claude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?で判断できます。AstraにGPT-6.1 Solより多く払う価値があるかはGPT-6.1 Sol・6 Sol・Astra比較:移行の判断、安いClaudeとAstraの比較はSonnet 5.5とGPT-6 Astra比較:費用と使い分けで扱っています。まだ公開されていない次のモデルも候補に入れたい場合は、Fable 5.5・Gemini 4・GPT-6.1の提供状況比較:Fable 5.2は公開済みで現状を確かめてください。
Claude CodeとCodexの操作性やサブスクリプションを比べたい場合は、モデルAPIとは請求と利用枠が異なるため、Claude Code と Codex の料金比較:月額、利用上限、API 実コストを参照してください。ここでの結論は、正確なAPI ID、利用可能なアカウント、データ条件、同じ仕事の合格結果をそろえて初めて有効になります。
参考資料18
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
参考資料18
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
- 1.GPT-6 Astraのモデルページdevelopers.openai.com/api/docs/models/gpt-6-astra
- 2.Claude Fable 5.1のモデルページplatform.claude.com/docs/en/models/fable-5-1/overview
- 3.APIの変更履歴developers.openai.com/api/docs/changelog
- 4.ChatGPTのモデル案内learn.chatgpt.com/docs/models
- 5.Fable 5.1のプラン別ヘルプsupport.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 6.API料金表developers.openai.com/api/docs/pricing
- 7.Claude APIの価格表platform.claude.com/docs/en/about-claude/pricing
- 8.Claudeのコンテキスト説明platform.claude.com/docs/en/build-with-claude/context-windows
- 9.プロンプトキャッシュのガイドdevelopers.openai.com/api/docs/guides/prompt-caching
- 10.Claudeのプロンプトキャッシュ説明platform.claude.com/docs/en/build-with-claude/prompt-caching
- 11.トークン計数の説明platform.claude.com/docs/en/build-with-claude/token-counting
- 12.入力トークン計数APIdevelopers.openai.com/api/docs/guides/token-counting
- 13.GPT-6 Astraの開発者ガイドdevelopers.openai.com/api/docs/guides/latest-model
- 14.Fable 5.1の新機能と変更点platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- 15.APIのデータ管理ガイドdevelopers.openai.com/api/docs/guides/your-data
- 16.APIのデータ保持の説明platform.claude.com/docs/en/manage-claude/api-and-data-retention
- 17.Fableのモデル切り替えに関するヘルプsupport.claude.com/en/articles/15363606-why-claude-switched-models-in-your-conversation-with-fable-5-or-fable-5-1
- 18.Artificial AnalysisのAstraとFable 5.1の比較ページartificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-1