Gemini 4 Carbon vs Argon:性能と料金、初回応答は約2倍遅い
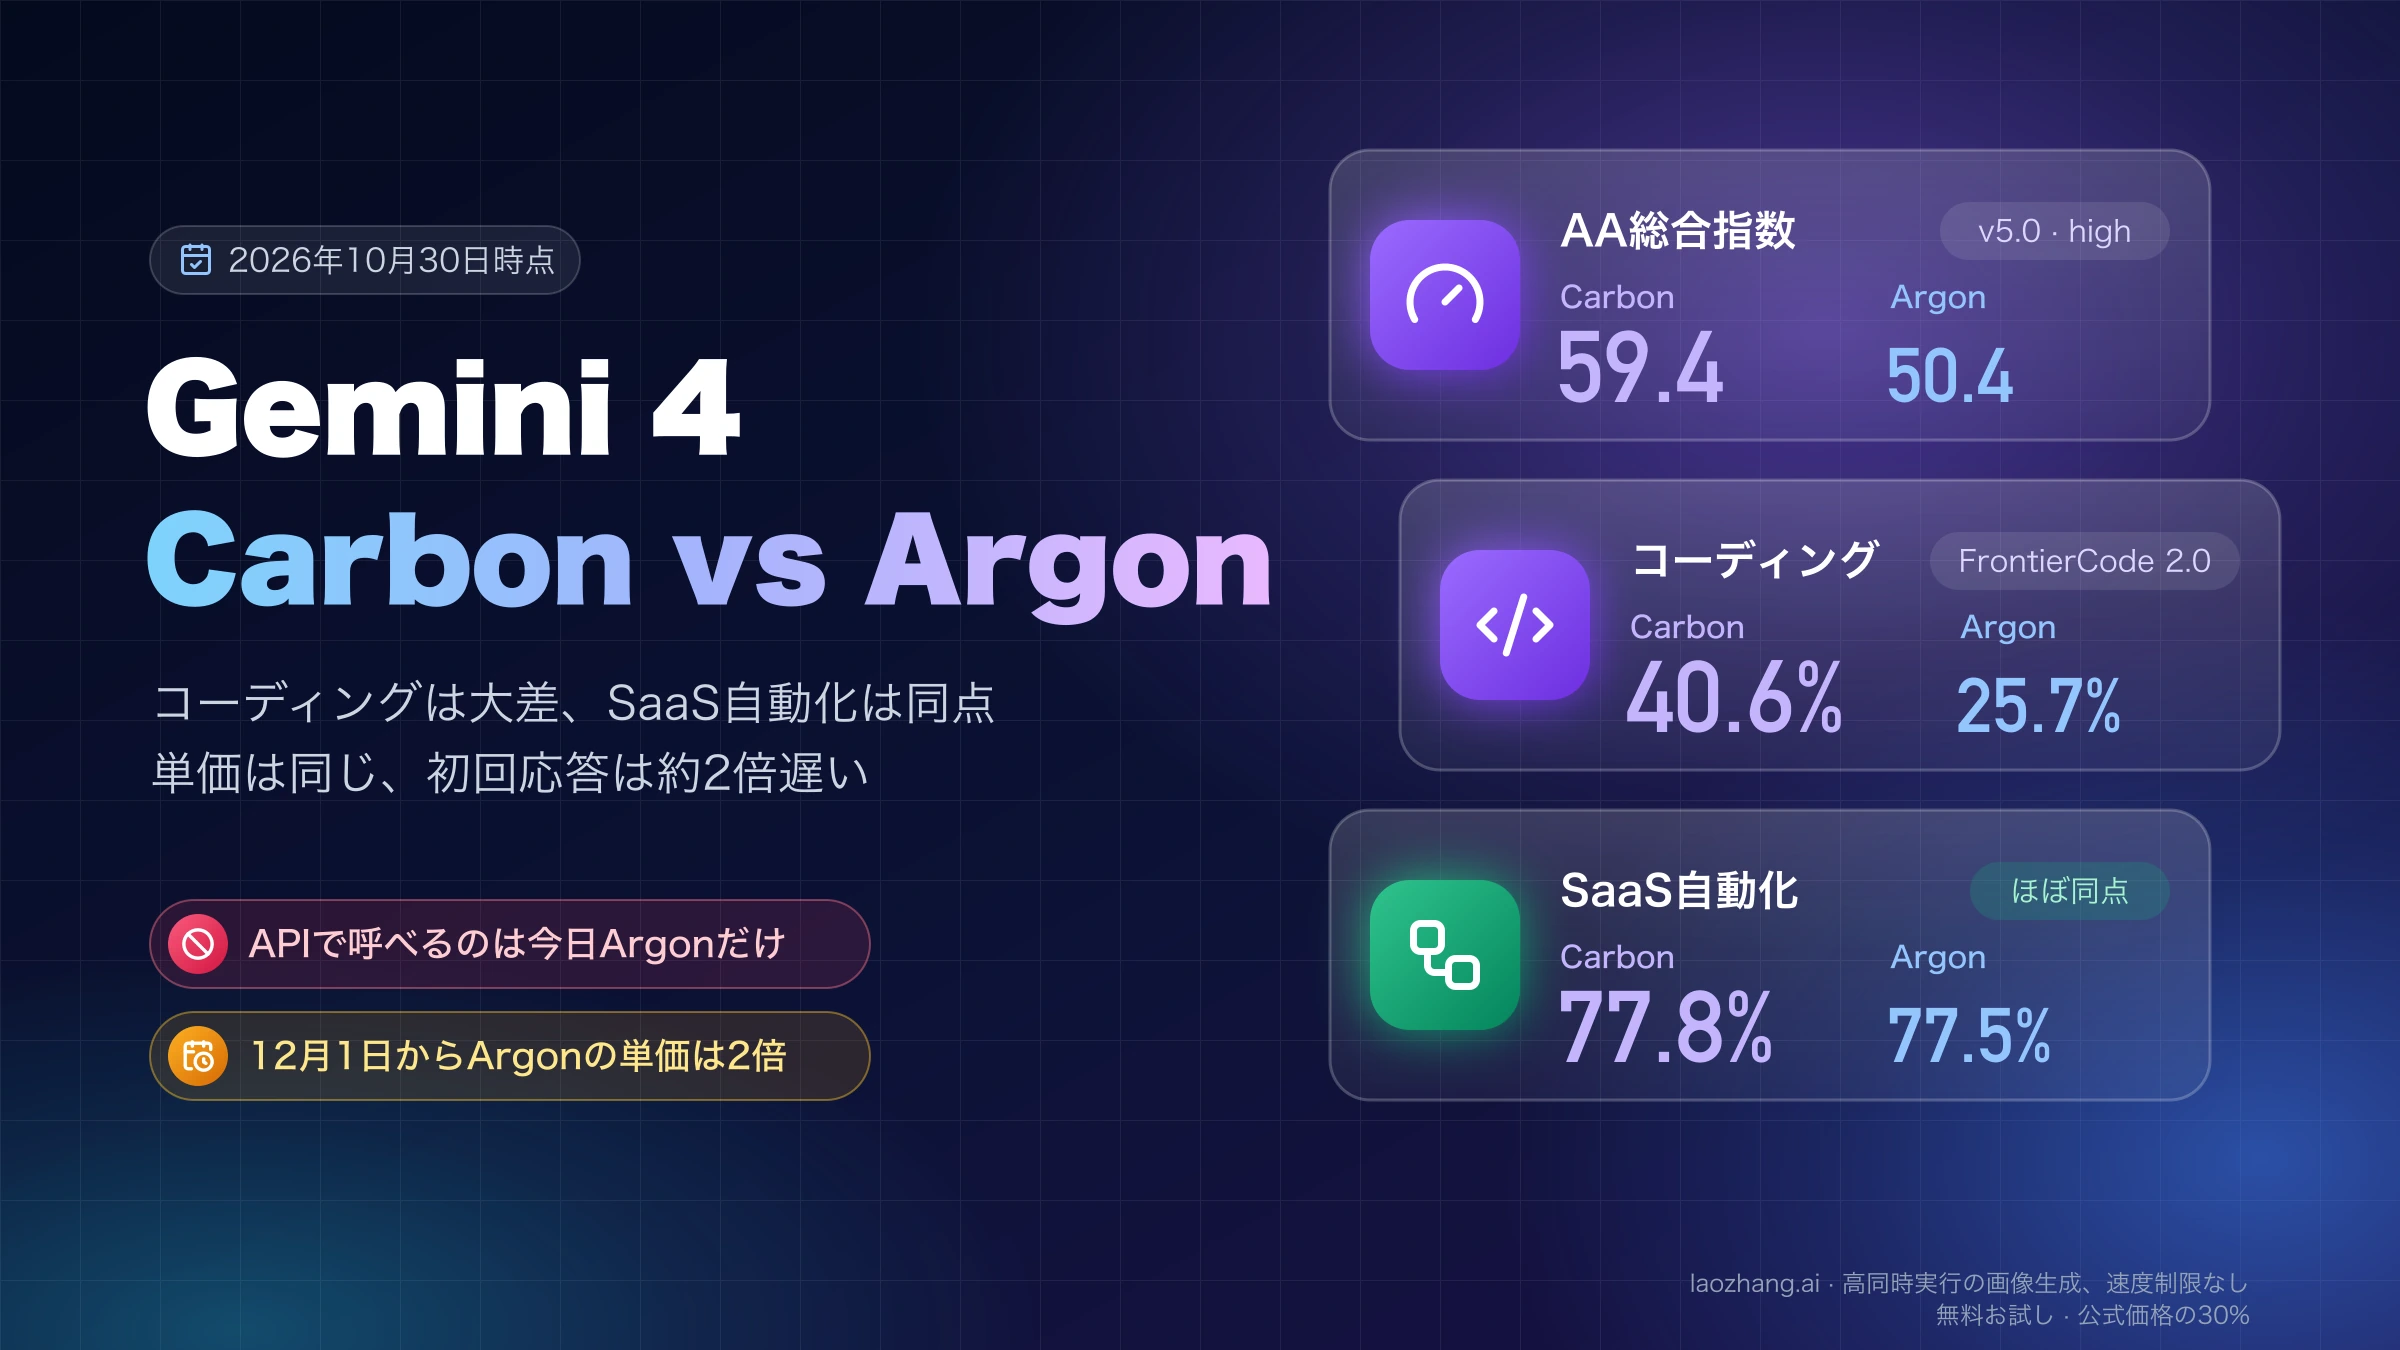
CarbonはコーディングでArgonを大きく上回り、SaaS自動化はほぼ同点です。単価は同じでも最初の応答は約2倍遅く、2026年10月30日時点で呼べるのはArgonだけです。
目次
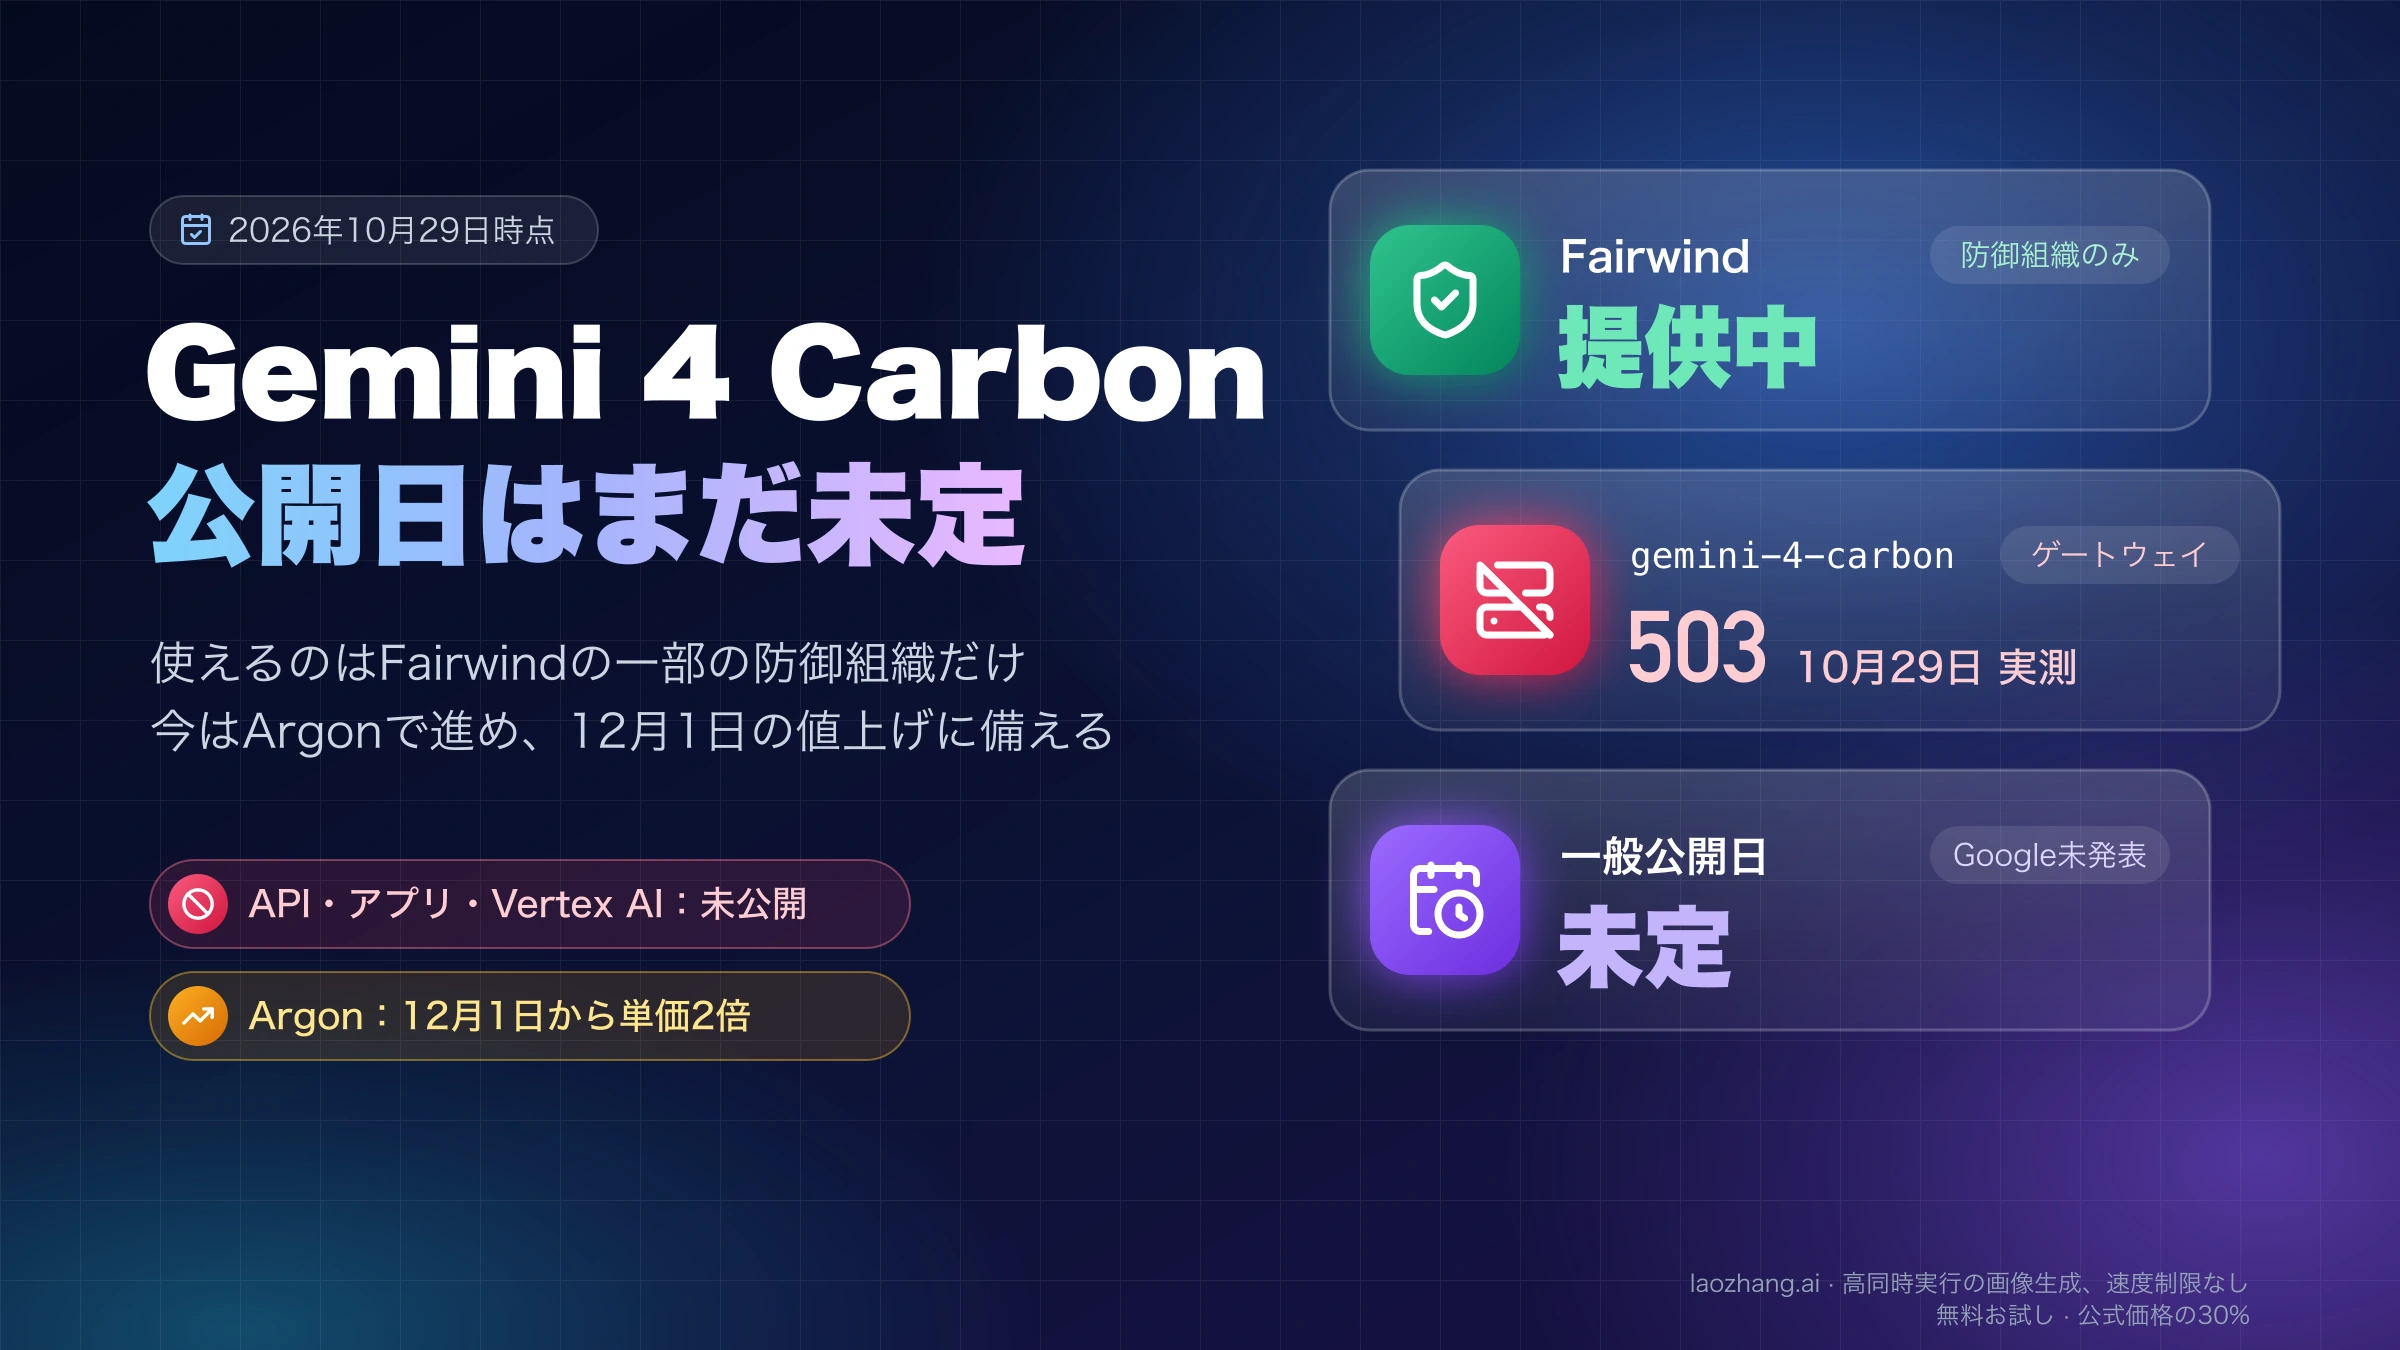
2026年10月30日時点で、APIから呼べるのはGemini 4 Argon(gemini-4-argon)だけです。Googleは10月28日にGemini 4 Carbonを発表しましたが、提供はまず一部のサイバー防御担当者に限られ、一般の開発者向けのモデルIDも公開日も示していません。今日やることは、Argonで出荷を続けながら、コードの中のモデル名を設定値1か所にまとめ、12月1日にArgonの単価が上がる分を予算に入れておくことです。
切り替えを準備する価値が大きいのは、コーディングエージェントと推論・研究の仕事です。第三者機関Artificial Analysis(AA)の総合指数v5.0ではCarbonが59.4、Argonが50.4で、オープンソースのリポジトリでの開発を測るFrontierCode 2.0は40.6%対25.7%と最も差が開きました。一方、SaaSをまたぐ業務自動化を測るAutomationBench-AAは77.8%対77.5%でほぼ同点なので、この種の仕事ではCarbonを待つ理由がほとんどありません。
「料金は同じ」「Carbonは遅い」は、どちらも半分だけ正しい言い方です。100万トークンあたりの単価は同じ料金期間なら同じですが、Argonの導入価格が11月30日で終わる一方、Carbonの導入価格の終了日は公表されていません。速度も、最初のトークンが届くまではCarbonが約2倍かかるものの、生成速度はほぼ同じで、コーディングエージェントのタスク全体ではCarbonのほうが早く終わっています。
Carbonは今呼べるか:10月30日のAPIテストではArgonだけ
Gemini 4 Carbonは2026年10月30日時点で一般の開発者には公開されておらず、誰がいつ使えるようになるか、公開を待つべきかはGemini 4 Carbonとは:防御者限定でAPI未公開、一般公開はいつ?で詳しく説明しています。GoogleのGemini 4 Carbon発表記事によると、提供は一部のサイバー防御担当者から始まり、Fairwindプログラムを通じて信頼できるパートナーに広げたあと、開発者・企業・一般向けの製品に出す順番です。Fairwindの参加条件はGemini 3.8 Flash Cyberの申請条件:Fairwind参加前に確認することを参照してください。
実際に呼べるかどうかは、2026年10月30日9時12分(日本時間、00:12 UTC)にlaozhang.aiのAPI(api.laozhang.ai、従量課金キー)で試しました。GET /v1/modelsは192モデルを返し、そのうちGemini 4系はgemini-4-argonだけでした。Chat Completions形式でgemini-4-carbonとgemini-4-carbon-previewを、Gemini形式でgemini-4-carbon:generateContentを呼ぶと、3つとも約1.1秒でHTTP 503「no available channels」が返り、料金は発生していません。10月29日に2回試したときも同じ結果でした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
このテストでわかるのは、このゲートウェイでは今日Carbonにリクエストを届けられない、というところまでです。Googleのキーで公式のGemini APIを直接呼ぶテストはしていません。ただし同じ日のGoogleのGemini APIモデル一覧、Gemini API料金ページ、変更履歴のいずれにも、CarbonのモデルIDは載っていません。
GoogleはCarbonを「Argonを土台にした」モデルと説明していますが、Argonの提供終了や置き換えは発表していません。Argonは100万トークンのコンテキストが公開されている一方、Carbonのコンテキスト長、入力の種類、Batch・Flexの料金はまだ公表されていないので、仕様がArgonと同じかどうかは公開時に確かめる必要があります。
どの仕事で上か:コーディングと研究で大差、SaaS自動化は同点
Carbonの伸びは仕事の種類によって大きく違います。AAの指数v5.0を構成する9つの評価を仕事ごとに並べると、エージェントによるコード開発と難しい推論・科学の課題では10ポイント前後の差がある一方、SaaSの業務自動化ではほとんど差がありません。数値はAAのCarbonとArgonの比較ページに掲載された2026年10月30日時点のものです。
| 仕事の種類 | AAの評価(何を測るか) | Carbon | Argon | 差 |
|---|---|---|---|---|
| 総合 | Intelligence Index v5.0(下の9評価の総合点) | 59.4 | 50.4 | +9.0 |
| コーディング | FrontierCode 2.0(OSSリポジトリでのエージェント開発) | 40.6% | 25.7% | +14.9 |
| コーディング | Terminal-Bench 4.0(ターミナルでの作業課題) | 65.2% | 57.1% | +8.1 |
| 推論・研究 | HLE-Diamond(専門家レベルの難問) | 69.1% | 56.7% | +12.4 |
| 推論・研究 | Terminal-Bench-Science(ターミナルでの科学課題) | 64.8% | 52.9% | +11.9 |
| 推論・研究 | CritPt v2 Hard(物理学の研究課題) | 63.0% | 52.5% | +10.5 |
| 文書・知的作業 | AA-Briefcase(エージェントの知的業務、Eloレーティング) | 1610 | 1483 | +127 |
| 文書・知的作業 | GDP.pdf(業務文書の作成、全項目合格率) | 28.4% | 21.8% | +6.6 |
| 事実知識 | AA-Omniscience v1.1(知識の正確さ、誤答は減点) | 53.5 | 46.1 | +7.4 |
| SaaS自動化 | AutomationBench-AA(複数のSaaSをまたぐ業務フロー) | 77.8% | 77.5% | +0.3 |
AAが両モデルを測ったのは推論設定highだけで、lowやmediumの比較はありません。測定は公開前のアクセスで行われたもので、公開APIが出たあとに数字が変わる可能性があります。また、10月27日より前に引用されていた旧指数v4.3.2の点数とは採点方法が違うため、混ぜて比べることはできません。
Googleも発表記事で自社測定の比較表を出しています。Googleによると、脆弱性の発見を測るSEC-bench Proは88.2%対83.4%、悪用を測るExploitGymは54.8%対42.0%、修正を測るCWE-benchは71.0%対68.0%で、間接的なプロンプトインジェクション攻撃の成功率を測るGray Swanの評価では0.7%から0.0%に下がりました。長いコンテキストのGraphWalksは96.2%対84.2%、コンピューター操作のOSWorld-2.1は81.5%対74.7%で、差が最も小さいのはVals Index v2.2の70.4%対69.2%です。サイバー系の評価は最も高い思考設定で、安全対策を外して実行したとGoogleは説明しており、AAとは別のベンダー自身の測定です。
自分の仕事ならどちらか:6つの用途別の判断
コーディングエージェントは、Carbonへの切り替えを最も準備しておく価値がある用途です。AAがAntigravity CLIで測ったコーディングエージェント指数はCarbonが59.4、Argonが53.2で、Claude CodeとOpus 5.5(max)の61.7にあと一歩の位置です(AAのコーディングエージェント比較)。Opus 5.5とどちらを選ぶかはGemini 4 CarbonとOpus 5.5比較:Opusが上の仕事と費用の逆転条件で扱っています。いまArgonで動かしているエージェントは、過去に失敗したタスクを評価用に集めておくと、公開初日にすぐ差を確かめられます。
推論・研究の仕事も、HLE-Diamondで12.4ポイント、科学課題で11.9ポイントの差があり、準備する価値があります。この種の仕事はもともと1件に時間がかかるため、最初の応答が遅いことは問題になりにくいはずです。文書中心の知的作業では、AA-Briefcaseが127ポイント、GDP.pdfが6.6ポイント上がり、AAの分野別指数でも金融(55.9→62.6)、法務(54.6→62.0)、エンジニアリング(57.3→64.7)、経済(54.0→61.0)はそれぞれ7ポイント前後伸びました。ただし戦略・運用は57.2から60.9と伸びが最も小さく、医療はCarbonの値が出ていません。
SaaSの業務自動化は、AutomationBench-AAで両者がほぼ同点なので、Argonのままで構いません。逆にArgonでも性能が余っていると感じるなら、Gemini 4 Argonと3.8 Flashの違い:実測コストと使い分けで軽いモデルとの比較を確かめるほうが先です。事実確認のQ&Aは、正答率が上がった一方で誤答の割合も上がっているため、切り替える前に自分の質問セットで試す必要があります。誤答が増えた理由は下のハルシネーションの節で説明します。応答速度が大事な対話機能は、最初のトークンまでの待ち時間がArgonの約2倍になるので、今の段階ではArgonのままにするのが無難です。
Carbonは高いのか:単価は同じ、差が開くのは12月1日から
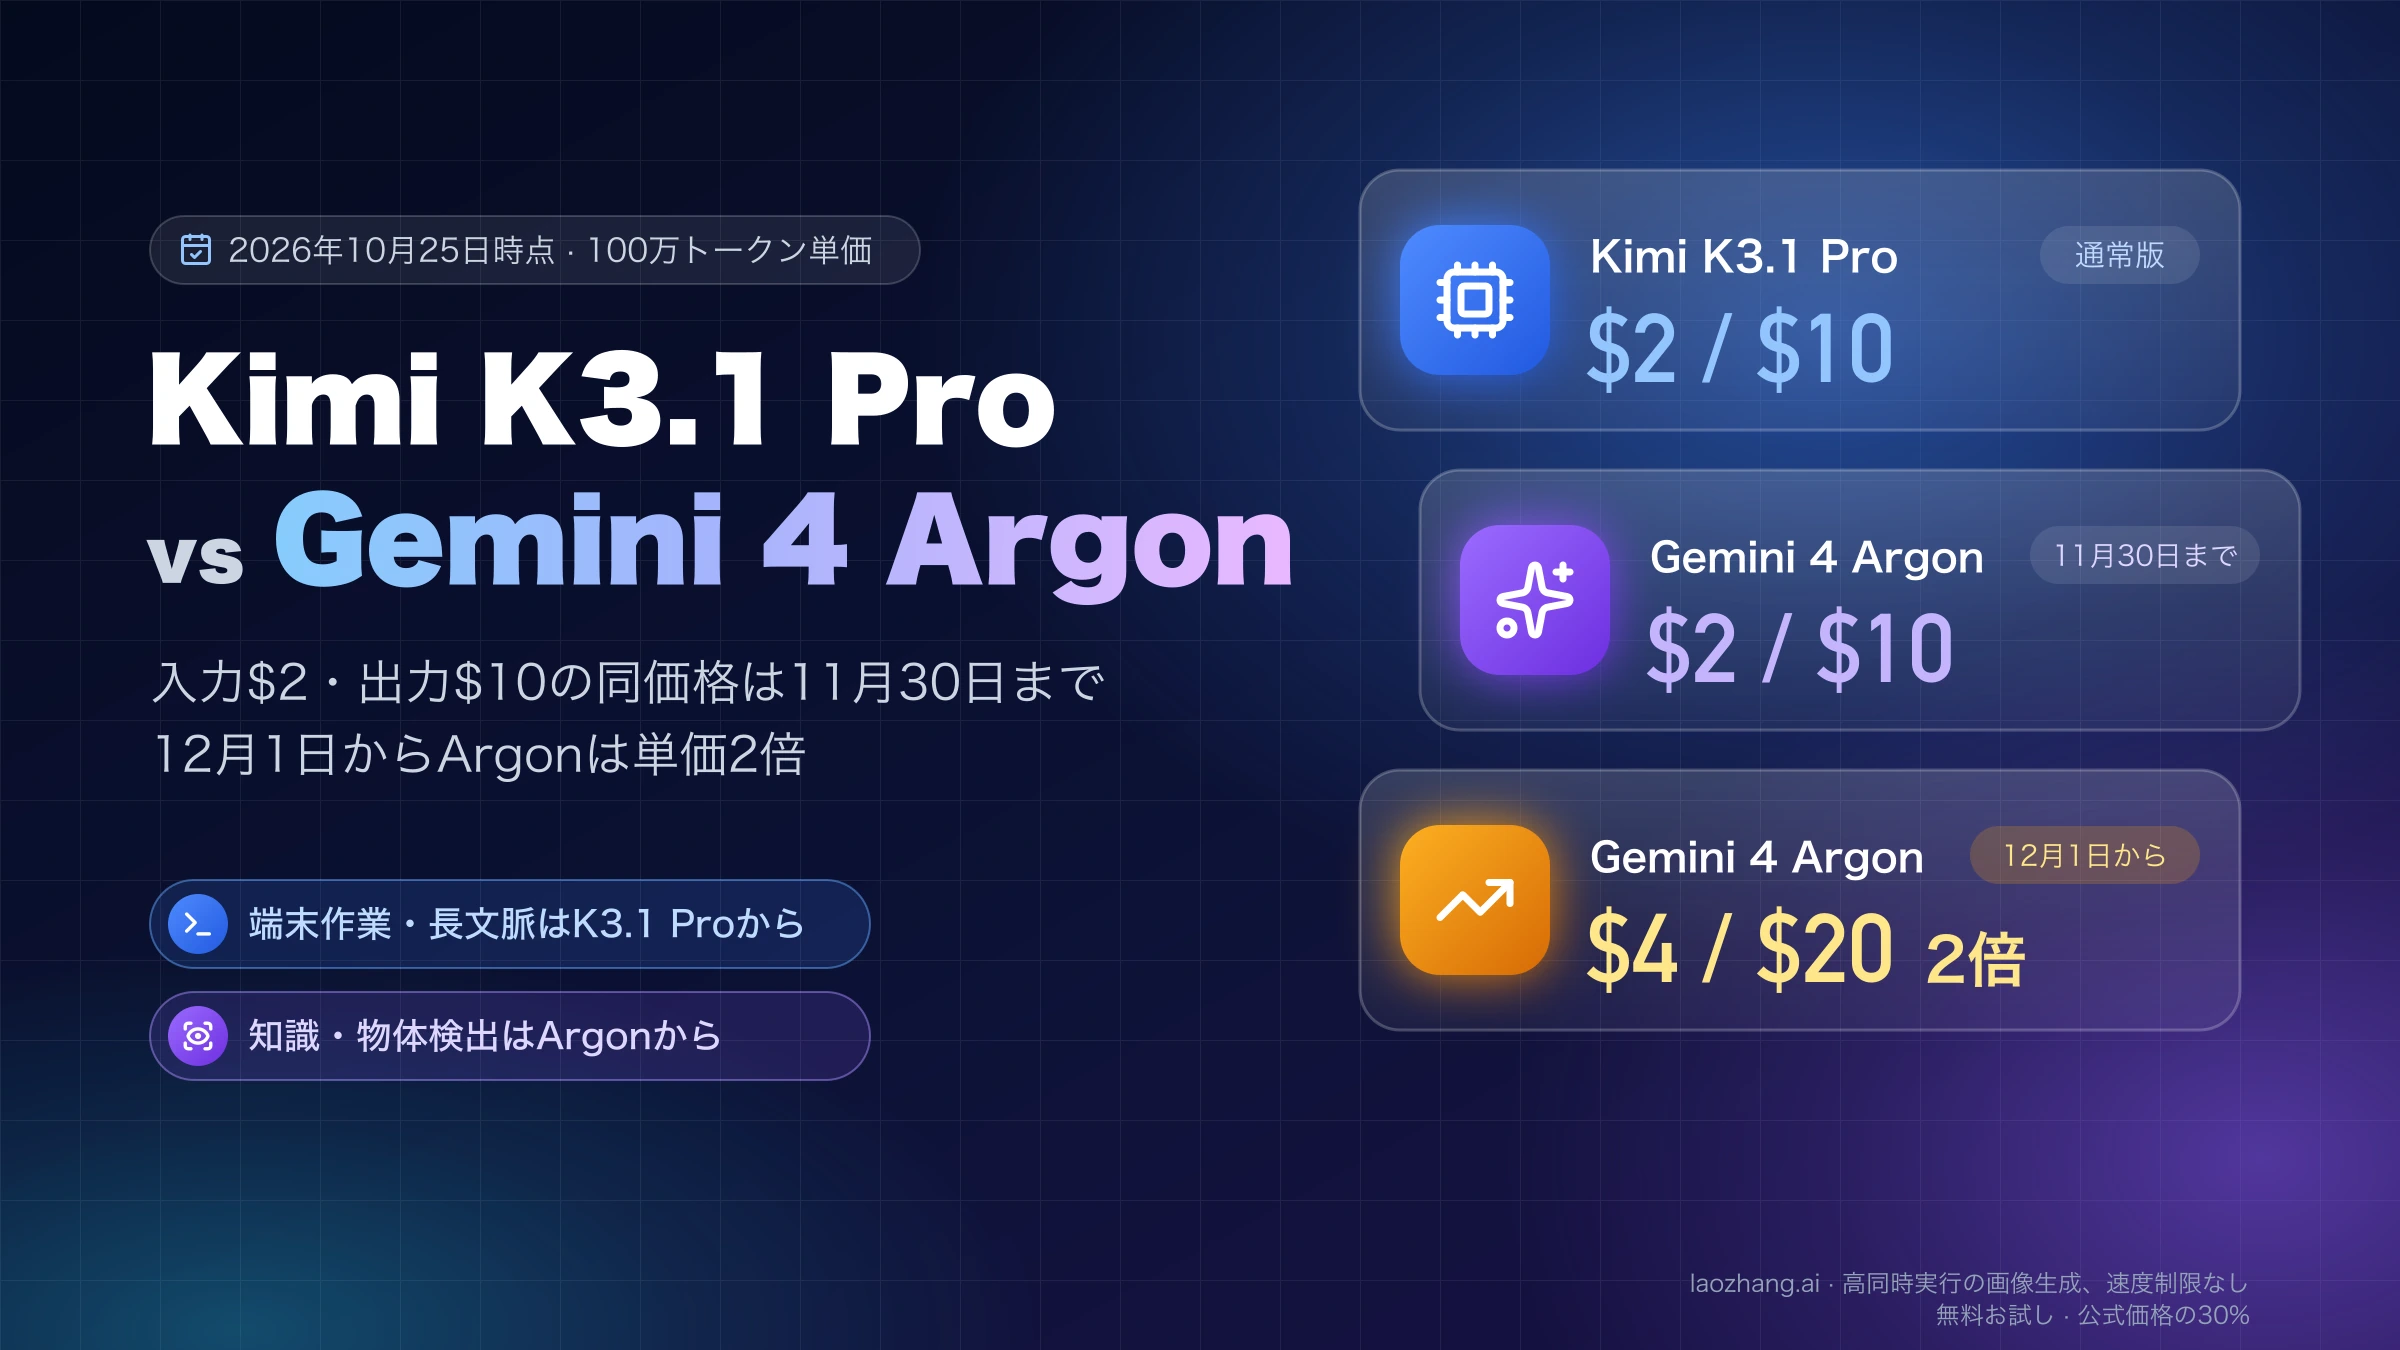
100万トークンあたりの単価は、同じ料金期間ならCarbonとArgonで同じです。どちらも導入価格は入力$2・出力$10(キャッシュ入力$0.10)、標準価格は入力$4・出力$20(キャッシュ入力$0.20)です。違うのは導入価格の終わり方で、Argonは2026年11月30日まで導入価格、12月1日から標準価格になるとGemini API料金ページに書かれていますが、Carbonの導入価格がいつ終わるかはGoogleもAAも示していません。
そこで、AAが公表しているタスク1件あたりのコストの内訳からトークン数を逆算し、料金期間ごとに計算し直しました。下の表の「指数タスク」はAAの総合指数のタスク1件、「コーディングエージェント」はAntigravity CLIで測ったコーディングエージェント指数のタスク1件です。
| 料金期間 | 指数タスク Argon | 指数タスク Carbon | コーディングエージェント Argon | コーディングエージェント Carbon |
|---|---|---|---|---|
| 2026年11月30日まで(現在) | $3.84 | 呼べない | $5.87 | 呼べない |
| 両方が導入価格 | $3.84 | $3.88 | $5.87 | $3.87 |
| 両方が標準価格 | $7.68 | $7.76 | $11.73 | $7.74 |
| 12月1日以降、Carbonが導入価格のまま公開された場合 | $7.68 | $3.88 | $11.73 | $3.87 |
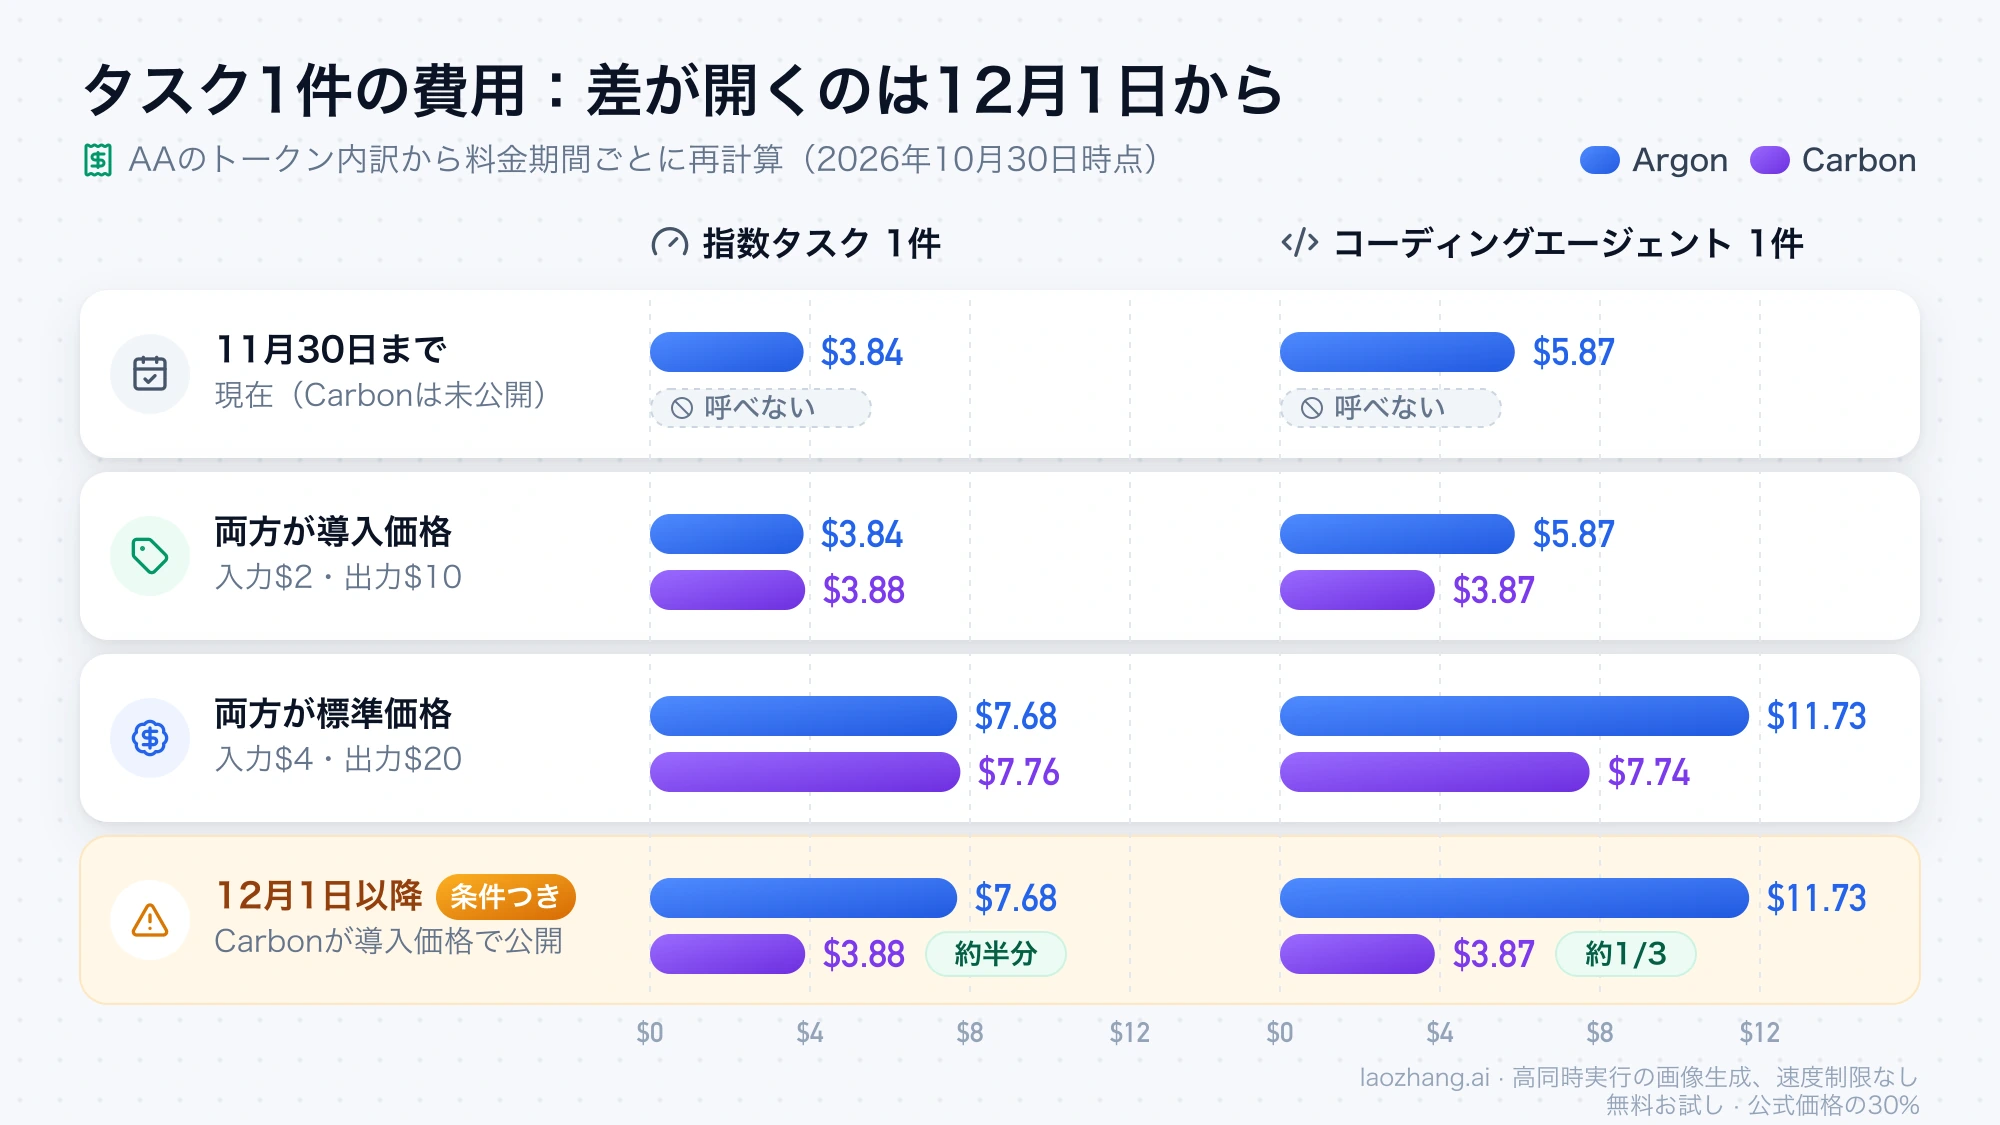
計算の入力は次のとおりです。指数タスク1件でArgonは出力116,368トークン、キャッシュ読み込み1,036万トークン、通常単価の入力82万トークンを使い、標準価格では「116,368×$20+1,036万×$0.20+82万×$4」を100万で割って$7.68になります。Carbonは出力122,768トークン、キャッシュ読み込み10,195,728トークン、通常単価の入力815,261トークン(約81.5万)で、同じ式で$7.76です。いずれもAAの表示額と一致し、導入価格はちょうどその半額です。指数1ポイントあたりにすると、標準価格でArgonが$0.152、Carbonが$0.131です。
同じ単価なら、汎用のタスクではCarbonが1%ほど高く、コーディングエージェントのタスクではCarbonのほうが約34%安くなります。AAのデータでは、Carbonはキャッシュヒット率が95.2%(Argonは87.0%)と高く、入力トークンも1,244万対1,376万と少なめで、出力は両方とも約10.9万トークンです。安さの理由はトークン単価ではなく、キャッシュの効き方と入力量の差だと考えられます。
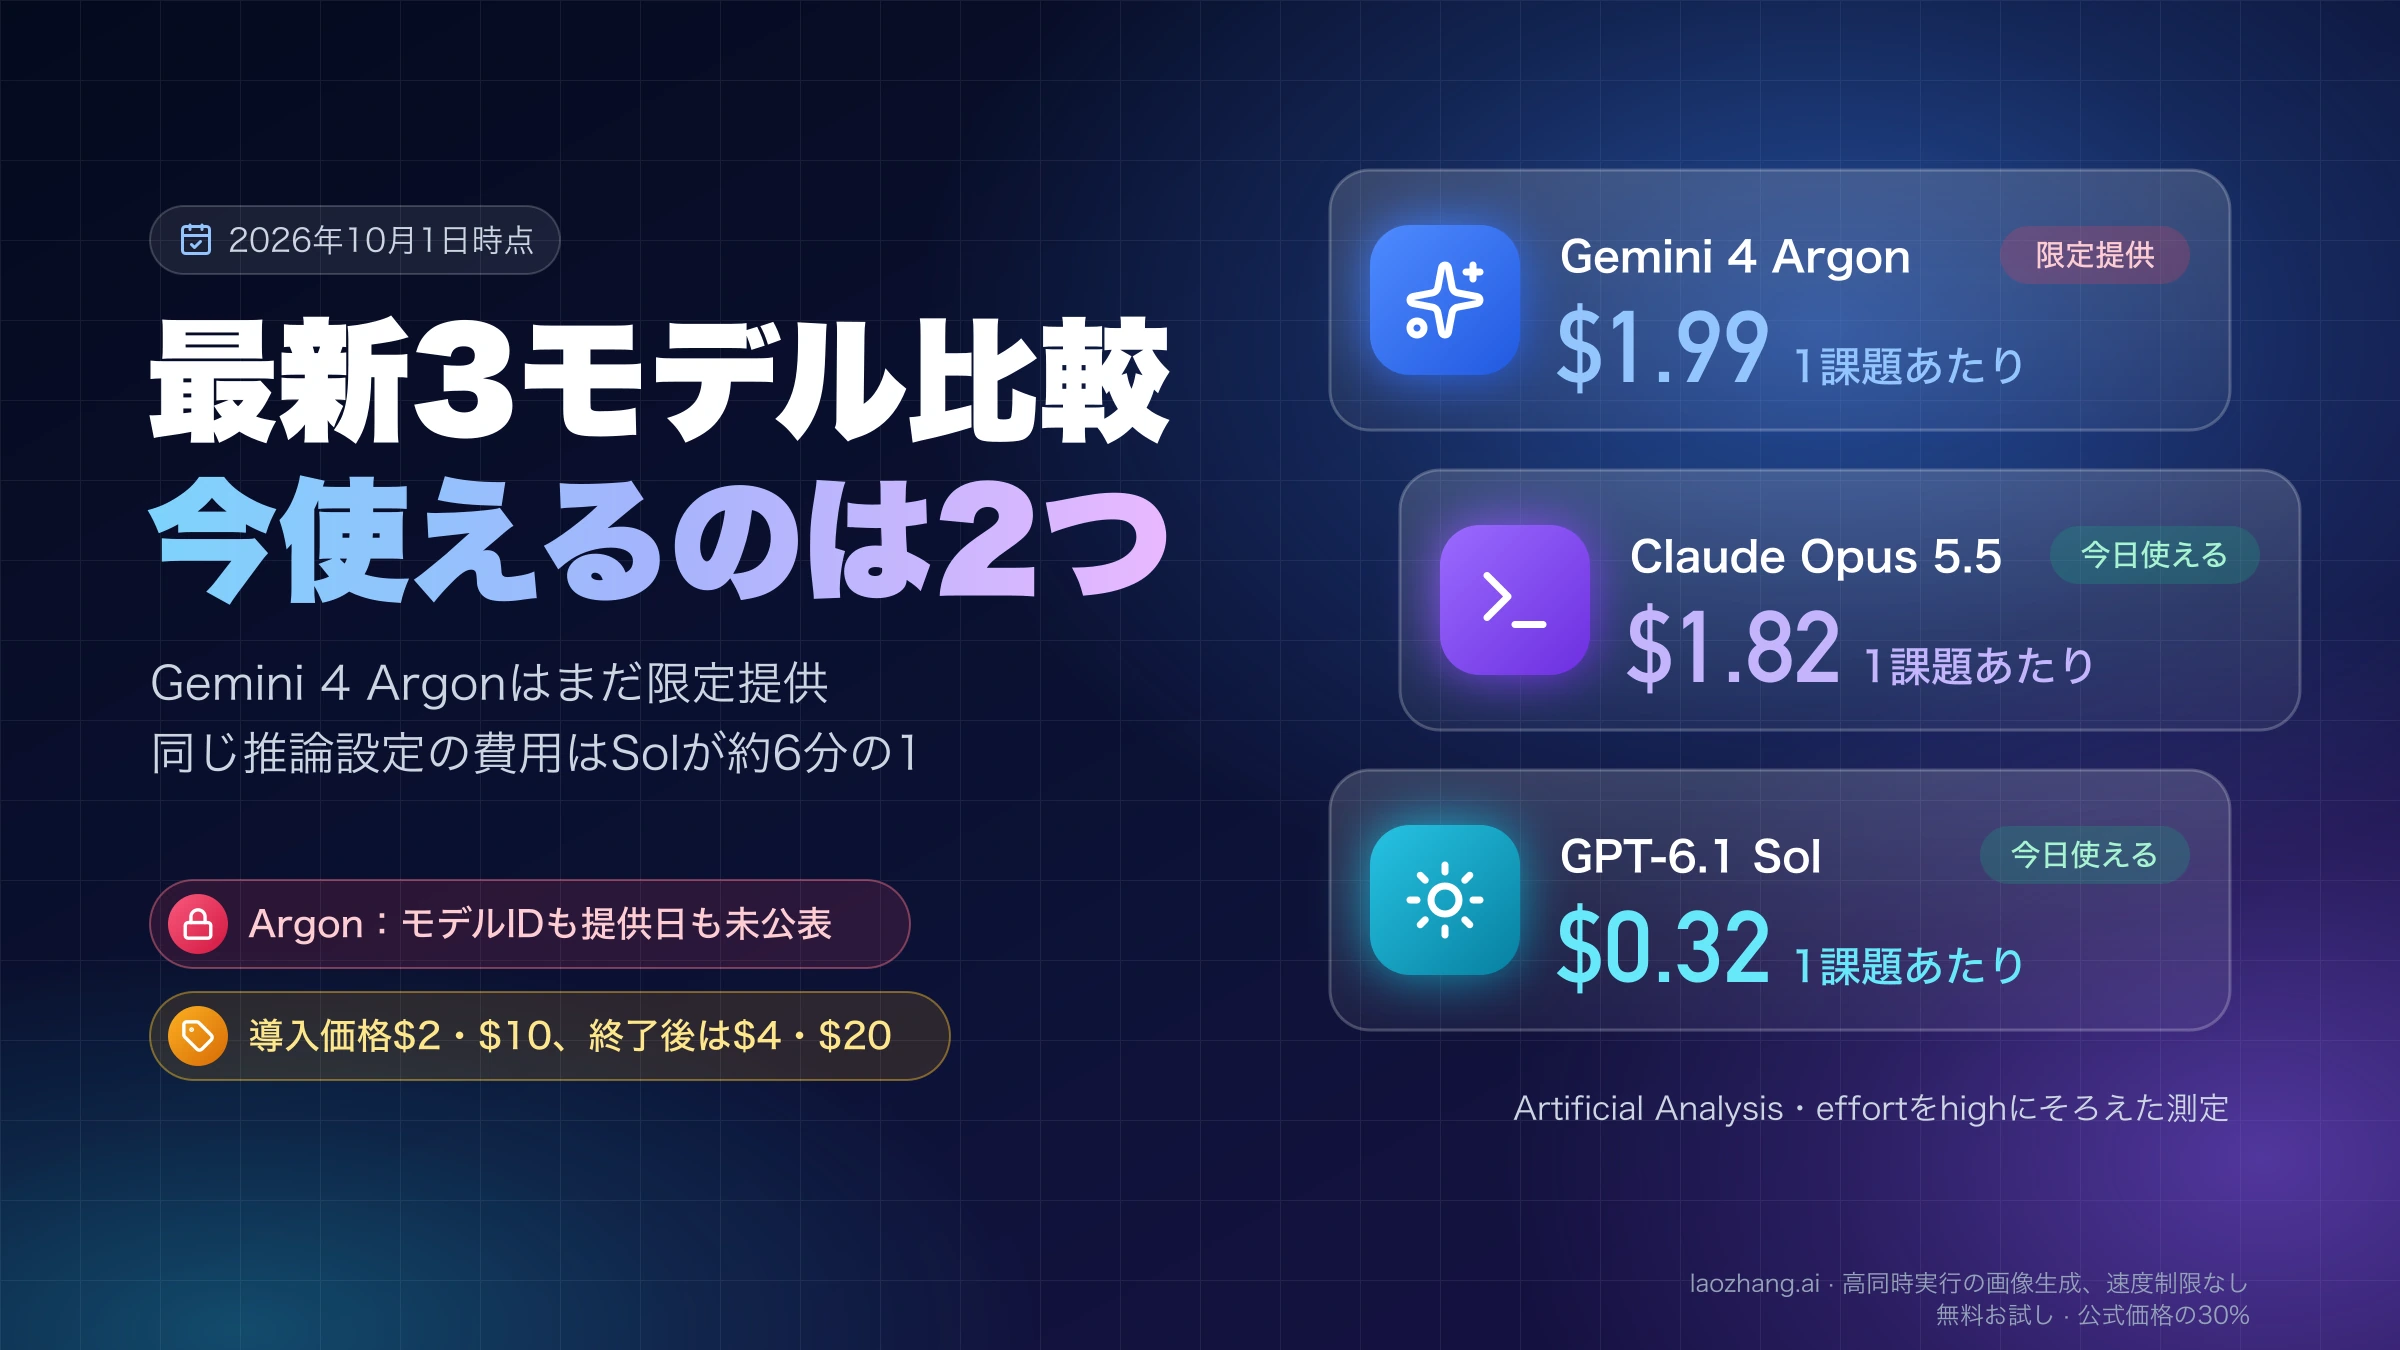
表の最後の行は条件つきです。もしCarbonが12月1日以降に導入価格のまま公開されれば、標準価格になったArgonと比べて指数タスクで約半分、コーディングエージェントのタスクで約3分の1の費用になります。導入価格の終了日が公開時に示されたら、この行は計算し直す必要があります。Argonを含む今日使えるフラッグシップ3モデルの費用差はGemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:Argonは12月に単価2倍にまとめています。
Carbonは遅いのか:初回応答は約2倍、生成速度はほぼ同じ
Carbonが遅いのは、最初のトークンが届くまでの時間です。AAの2026年10月30日時点の測定では、最初のトークンまでがCarbon 97.94秒、Argon 47.20秒で約2.1倍、思考を含めて500トークンを出力し終えるまでが103.82秒対53.23秒で約2倍でした。一方、出力が始まってからの生成速度は毎秒85トークン対83トークンでほぼ同じです。
AAの「タスクあたりの時間」は、最初のトークンまでの時間やオーバーヘッドを含まない生成時間だけの値で、Carbon 1452.93秒、Argon 1364.94秒です。1件あたりの出力が12.3万トークン対11.6万トークンとCarbonのほうが少し多いぶん長くなっていますが、実際に待つ時間とは別物です。速度の値は日によって動き、10月29日にはCarbonの生成速度が毎秒99.8トークンと表示されていました。公開APIが出れば、また変わる可能性があります。
エージェントのタスク全体で見ると、結果は逆になります。AAのコーディングエージェント指数(Antigravity CLI、2026年10月29日時点のデータ)では、タスク1件の所要時間はCarbonが29.8分、Argonが34.7分で、ステップ数はCarbonの178回に対してArgonは166回でした。呼び出しごとの待ち時間は長くても、必要な作業を早く終えているということです。
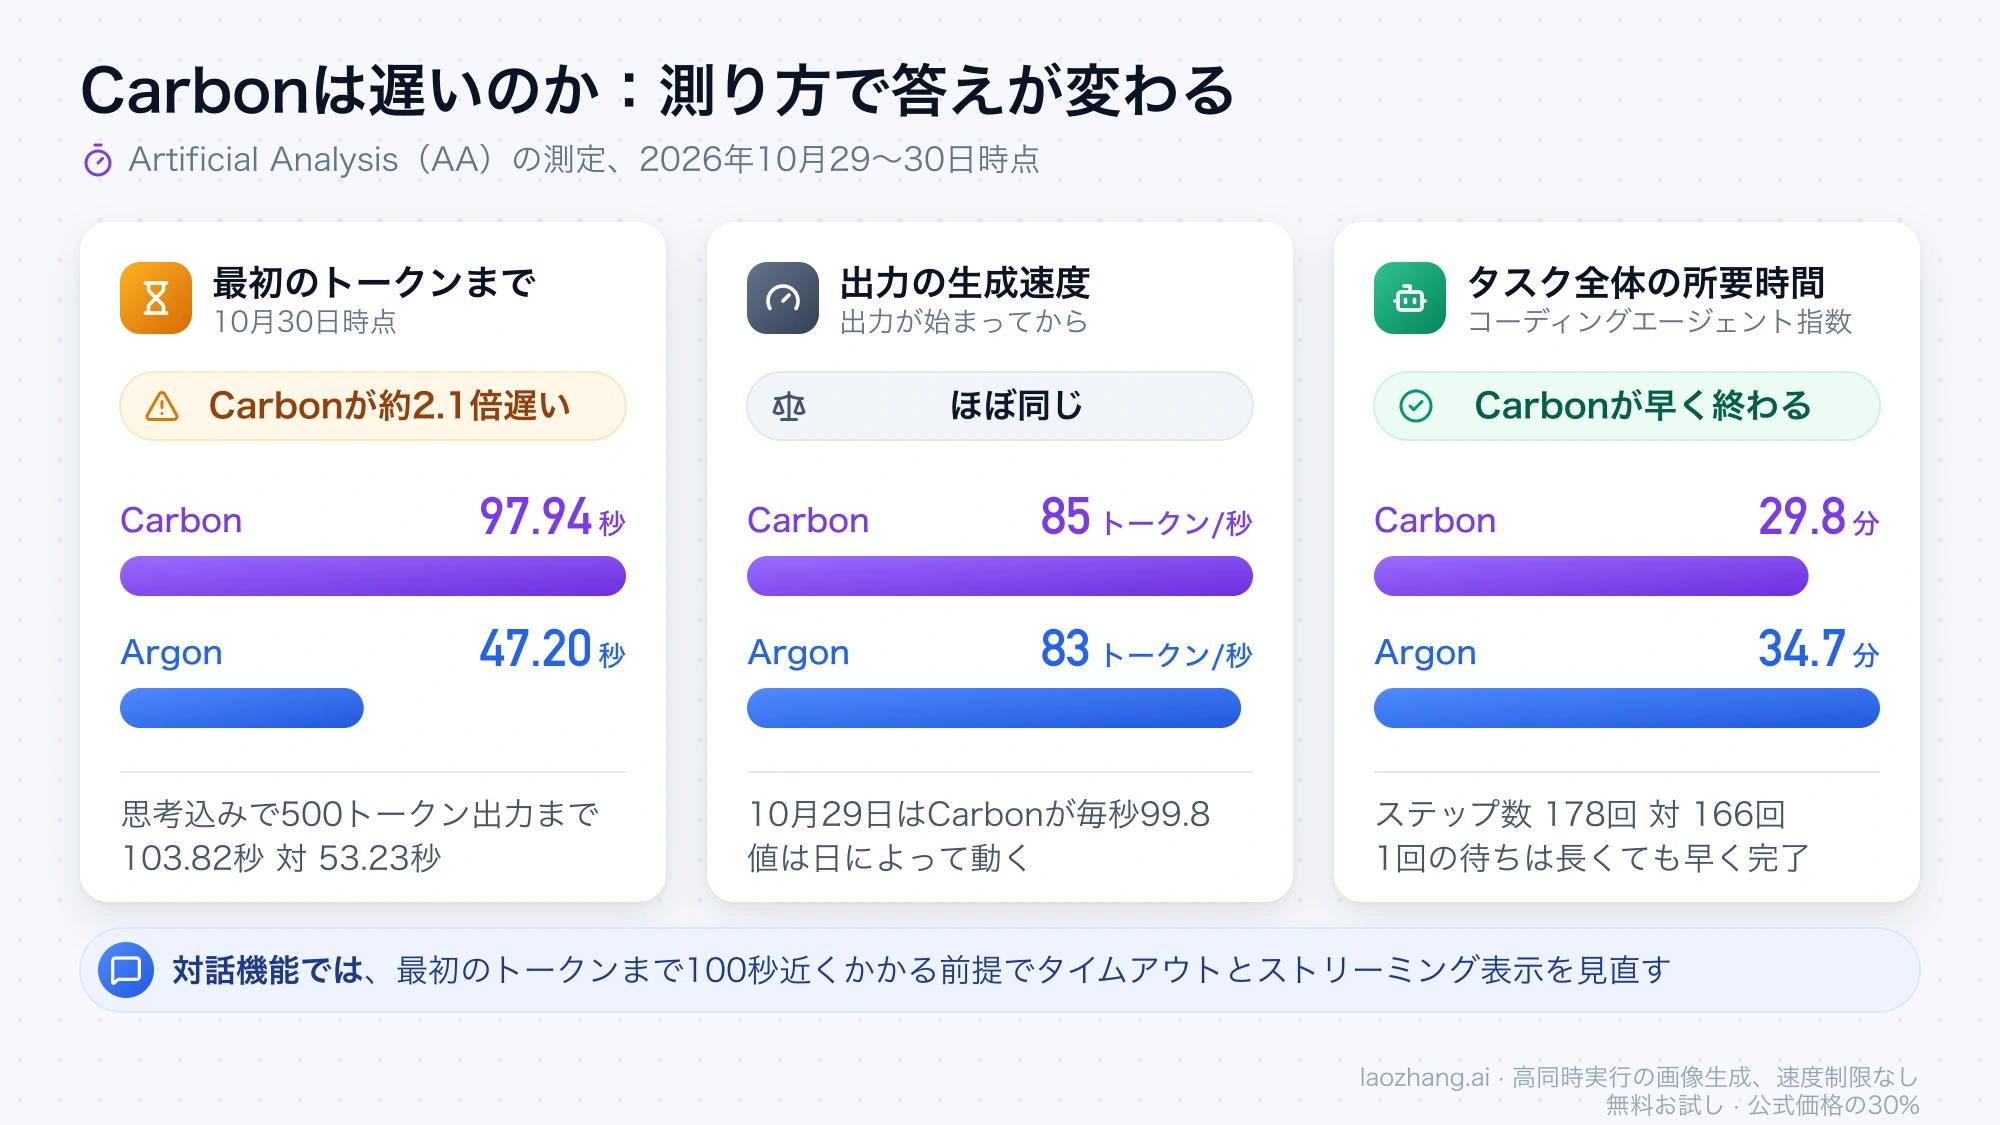
「Carbonは2〜4倍遅い」という話は、2026年10月28日のletslearngenaiの記事が伝えた、公開前のArenaでのブラインドテストの報告がもとになっています。記事自身が、標準化した遅延の測定ではなく早期アクセスとブラインドテストに基づくと断っており、AAの測定が支えるのは「最初の応答まで約2倍」までです。対話機能に組み込む場合は、クライアントのタイムアウトとストリーミング表示を、最初のトークンまで100秒近くかかる前提で見直してください。
ハルシネーションは増えたか:AAの11.4%とGoogleの半減
AAの測定では、Carbonのハルシネーション率は上がりました。ただしGoogleの「根拠のない主張は約半分になった」という説明とは測っているものが違うので、どちらも成り立ちます。
AA-Omniscience v1.1は知識を問う質問で、正解に加点、誤答に減点し、答えを控えた場合は減点しない評価です。AAのGemini 4 Carbonの分析記事によると、正答率は48.3%から58.3%に上がり、答えられない問題で控えずに誤答した割合(ハルシネーション率)は4.3%から11.4%に上がりました。Carbonは答える回数が増えたぶん、正解も誤答も増えたということです。それでもこの値はAAが測ったモデルの中でArgonに次いで2番目に低く、Opus 5.5(max)やGPT-6 Astra(max)は約50%です。
Googleが言っているのは、エージェントの成果物の中にある根拠のない主張です。発表記事によると、Googleの社内テストでCarbonは根拠のない主張をArgonの約半分に減らし、証拠が足りないときは推測で埋めずに注意書きを成果物に書き込むか、残りの必要事項を示して作業を止めるとしています。ただしこれは社内テストの結果で、方法は公開されていません。
事実確認のQ&Aに使うなら、切り替える前に、自分のサービスで実際に来る質問と正解のセットを用意し、正答・誤答・回答控えの3つに分けて数えてください。「わからない」と返すほうが安全なサービスでは、Argonの答えを控える傾向のほうが合っている可能性があります。
Carbon公開前にやること:モデル名、12月の予算、初日の測定
Carbonがいつ公開されても1行の変更で試せるように、今のうちにArgon側で次の準備をしておきます。
- コード内に散らばった
gemini-4-argonを、環境変数などの設定値1か所から読み込むように変えます。 - 12月1日からArgonの単価が入力$4・出力$20、キャッシュ入力$0.20になることを予算に入れます。同じトークン量なら費用はちょうど2倍で、急がない処理はArgonのBatchやFlex(半額)に回せます。
- 自分の仕事の代表的なタスク、過去に失敗したタスク、事実確認の質問セットを評価用にまとめておきます。
- Carbon公開初日に、モデルID、導入価格の終了日、最初のトークンまでの時間、1タスクあたりの費用とキャッシュヒット率、誤答と回答控えの割合を測り、Argonと比べます。
Gemini 4 CarbonとArgonのよくある質問
Terminal-Bench 4.0のCarbonの数字が65.2%と63.6%で違うのはなぜですか?
測った環境が違うためです。65.2%(Argon 57.1%)はGoogleの比較表とAAのモデル評価の値で、63.6%(Argon 56.1%)はAAがAntigravity CLIというエージェント環境の中で測ったコーディングエージェント指数の内訳の値です。2026年10月30日時点のAAの公表値で、比べるときは同じ測定どうしで比べてください。
CarbonのBatchやFlexの料金はいくらですか?
2026年10月30日時点で、Googleが公表しているのはCarbonの通常の導入価格と標準価格だけで、Batch、Flex、Priorityの料金は出ていません。ArgonはGemini API料金ページでBatchとFlexが通常の半額とされているので、Carbonに同じ割引があるかは公開時に料金ページで確認してください。
Argonの長い出力が途中で切れるときはどうすればいいですか?
Argonの同期リクエストの出力上限は65,536トークンで、それを超えると回答が途中で終わります。finish_reasonの見分け方と続きを生成させる方法はGemini 4 Argon APIのfinish_reason:途中で切れる回答の続け方で説明しています。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月30日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月30日。
- 1.Gemini 4 Carbon発表記事blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 2.Gemini APIモデル一覧ai.google.dev/gemini-api/docs/models
- 3.Gemini API料金ページai.google.dev/gemini-api/docs/pricing
- 4.AAのCarbonとArgonの比較ページartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-4-carbon
- 5.AAのコーディングエージェント比較artificialanalysis.ai/agents/coding-agents
- 6.Gemini 4 Carbonの分析記事artificialanalysis.ai/articles/gemini-4-carbon-new-number-1