Kimi K3.1 Pro vs GPT-6.1 Sol比較:同じ単価、タスク単価は約3倍
公式単価は同じでも、AAの1タスク費用はK3.1 Proが$2.11、Sol maxが$0.72です。指数は55対52でK3.1 Proが上、272K超の長文では約半額です。
目次
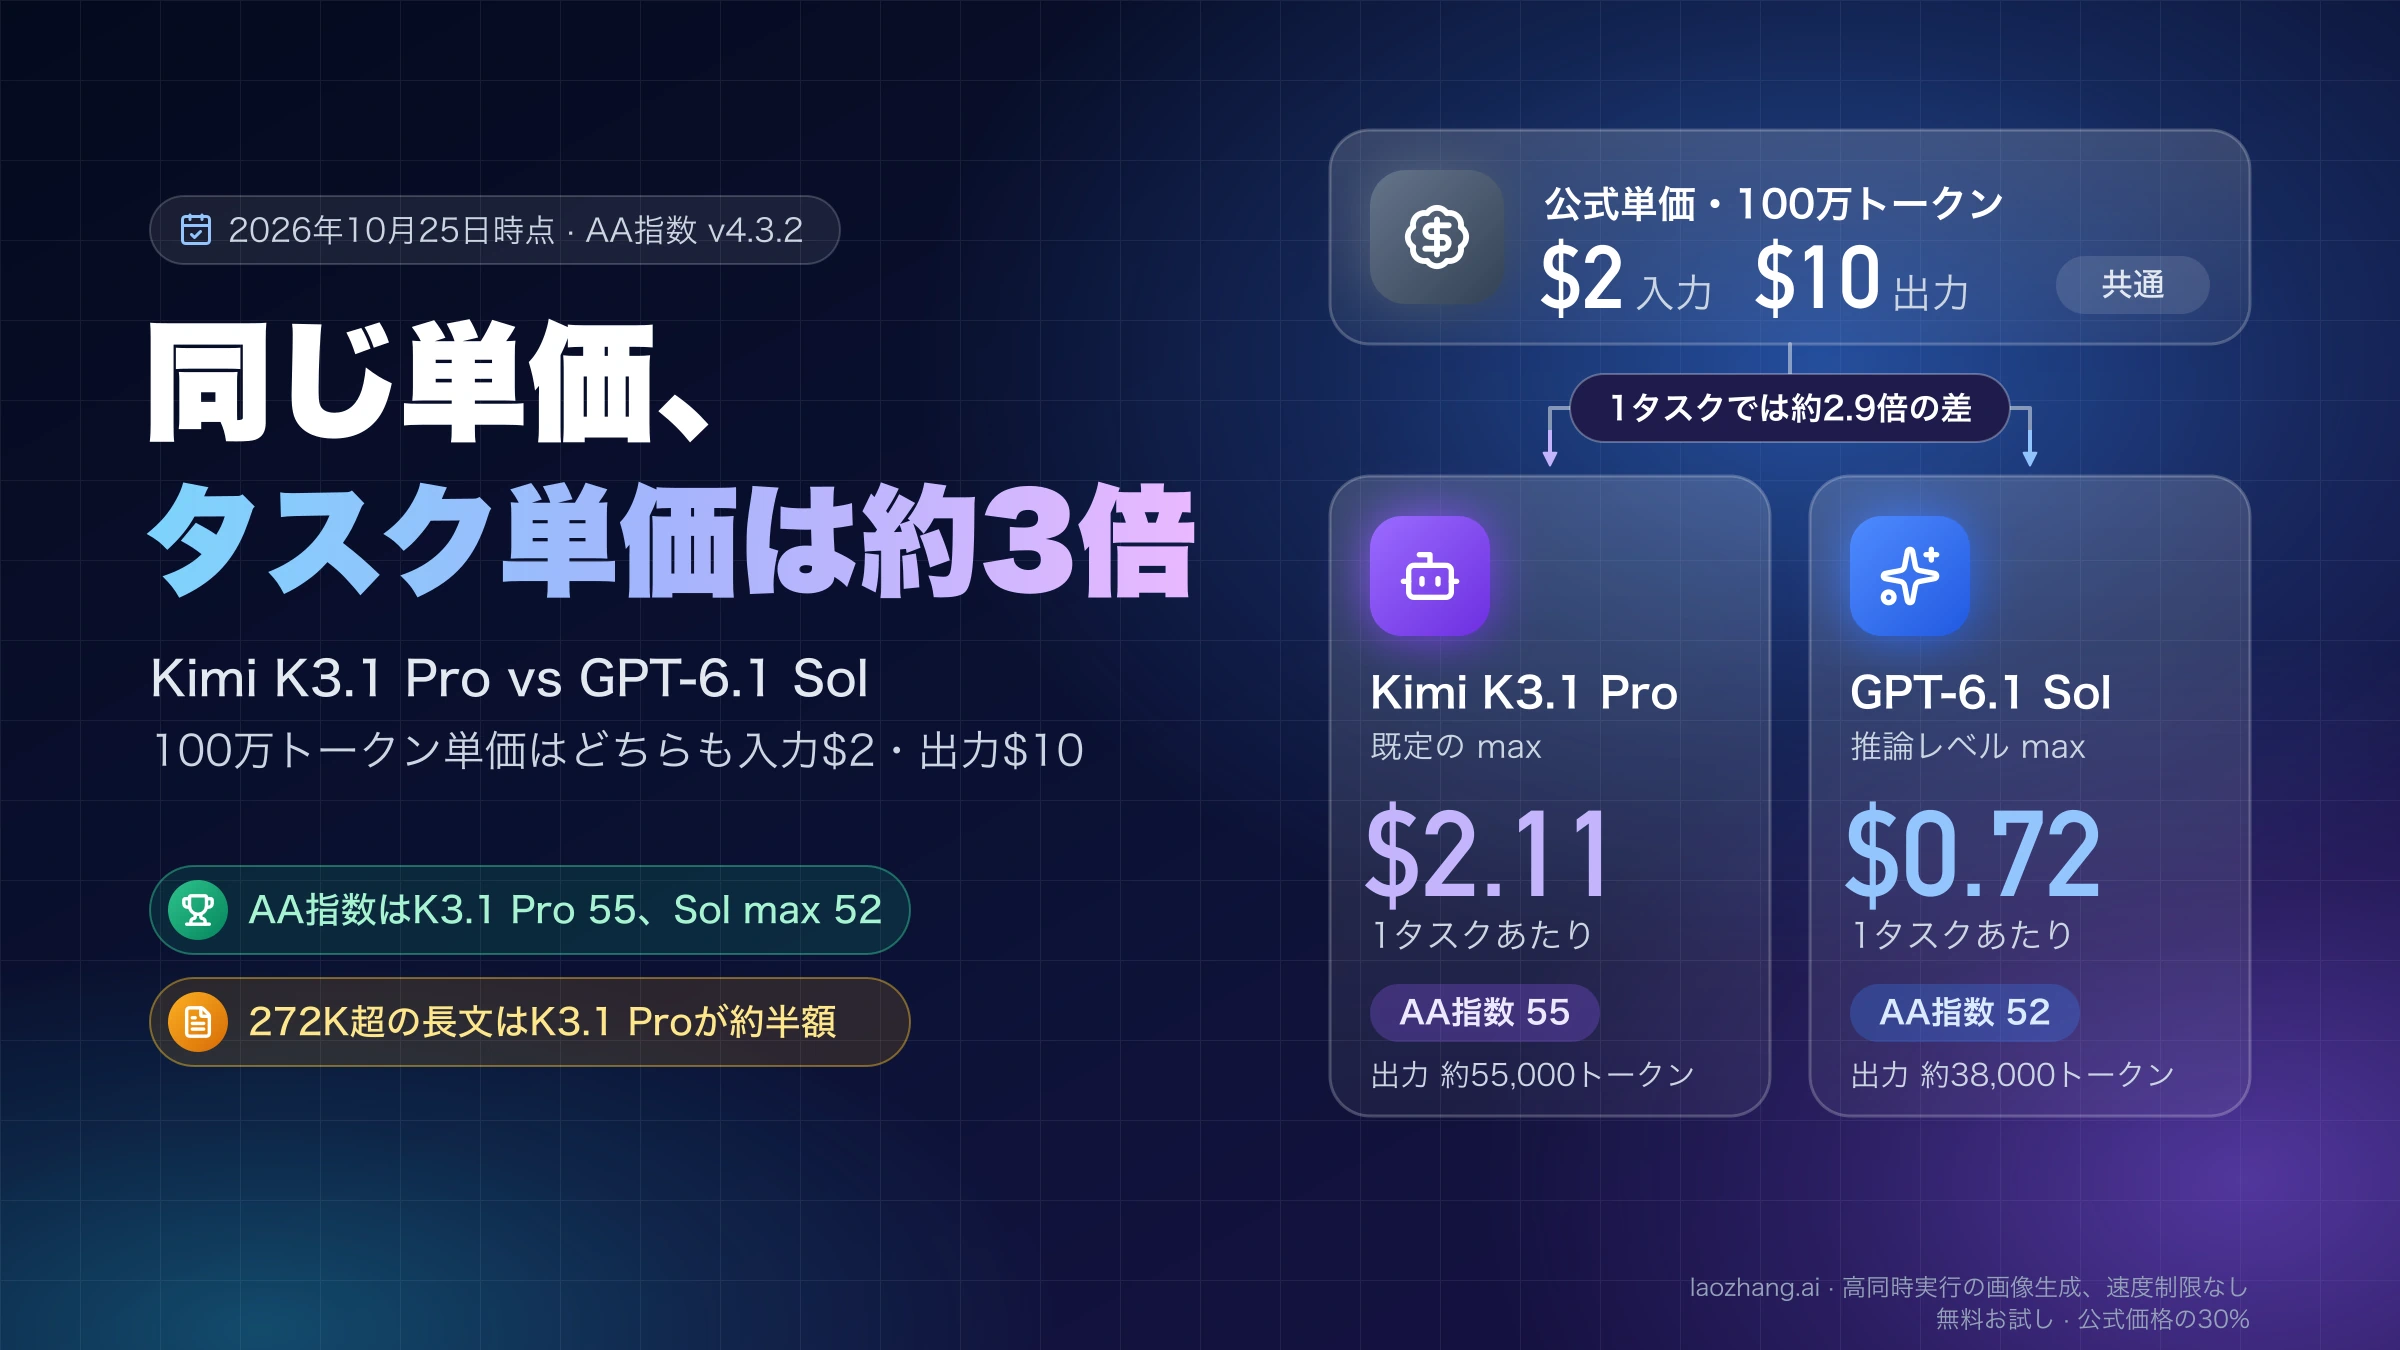
GPT-6.1 Solを使っているなら、普段のモデルはSolのままにして、Kimi K3.1 Pro(kimi-k3.1-pro)はエージェント作業と272Kトークンを超える長いプロンプトで試す、という分け方が現実的です。100万トークンあたりの公式単価はどちらも入力$2・出力$10ですが、Artificial Analysis(AA)の総合指数で1タスクにかかる費用は、K3.1 Proが$2.11、Solの最上位設定maxが$0.72で約2.9倍です。そのかわり指数はK3.1 Proが55、Sol maxが52で、Solのどの推論レベルも55には届きません。
K3.1 Proへの乗り換えが得になりやすいのは、端末操作や業務自動化のようなエージェント系の仕事で3点の差が手戻りを減らす場合と、入力が272Kを超えてSolの料金がリクエスト全体で上がる場合です。反対に、キャッシュを効かせた短いターンの繰り返し、Batchで回す一括処理、$1だけチャージした直後の低いレート制限のもとでは、Solのほうが安いか、K3.1 Proがそもそも回りません。試すときはモデルIDを替えるだけでなく、推論レベル(reasoning_effort)の既定がK3.1 Proはmax、Solはmediumと違うこと、Codexなら~/.codex/config.tomlのmodel_providerをKimiに向ける必要があることを押さえてください。
数字は2026年10月25日時点のものです。この日に実際に行ったのは、laozhang.aiのAPIキー1つから両モデルをChat Completionsで呼び出して同じ8問を解かせる小規模なテスト、OpenRouterの公開APIでの提供元の読み取り、公式単価を使ったコストの再計算の3つです。小規模テストでは返ってきた回答がすべて合格し、差が出たのは費用と待ち時間でした。8問・1〜2回ずつ・1日だけの結果なので、品質の比較はAAの計測値を基準にし、それぞれの条件は各節に書きます。MoonshotやOpenAIへの直接接続、Sol のmax、K3.1 Proのlow、CodexからKimiへの接続は試していません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
単価が同じでも安くない理由:1タスク$2.11対$0.72
単価が同じなのに「全然安くない」と感じるのは、K3.1 Proが1タスクで出力するトークンが多いからです。AAの計測では、K3.1 Proは指数の1タスクあたり約55,000トークンを出力し(うち推論が約35,000)、Sol maxの約38,000、Sol highの約13,000を大きく上回ります。推論トークンも出力として課金されるので、同じ出力単価$10でも、請求額は出力の量に比例して開きます。
| 設定 | AA指数 | 1タスクの費用 | 1タスクの出力トークン | 1タスクの時間 |
|---|---|---|---|---|
| K3.1 Pro(既定のmax) | 55 | $2.11 | 約55,000 | 618秒 |
| Sol low | 42 | $0.13 | 約4,000 | 83秒 |
| Sol medium(既定) | 48 | $0.21 | 約8,000 | 168秒 |
| Sol high | 50 | $0.32 | 約13,000 | 257秒 |
| Sol xhigh | 51 | $0.39 | 約18,000 | 342秒 |
| Sol max | 52 | $0.72 | 約38,000 | 680秒 |
値は2026年10月25日時点のArtificial AnalysisのKimi K3.1 ProとGPT-6.1 Solの比較ページ(Intelligence Index v4.3.2)によるものです。「1タスクの費用」は、AAが各評価で使われた入出力トークンに公式単価を掛けて加重平均した値で、あなたの請求額そのものではありません。指数全体を回すのに要した出力トークンは、K3.1 Proが1億4,800万、Sol maxが6,700万で、2倍を超えています。
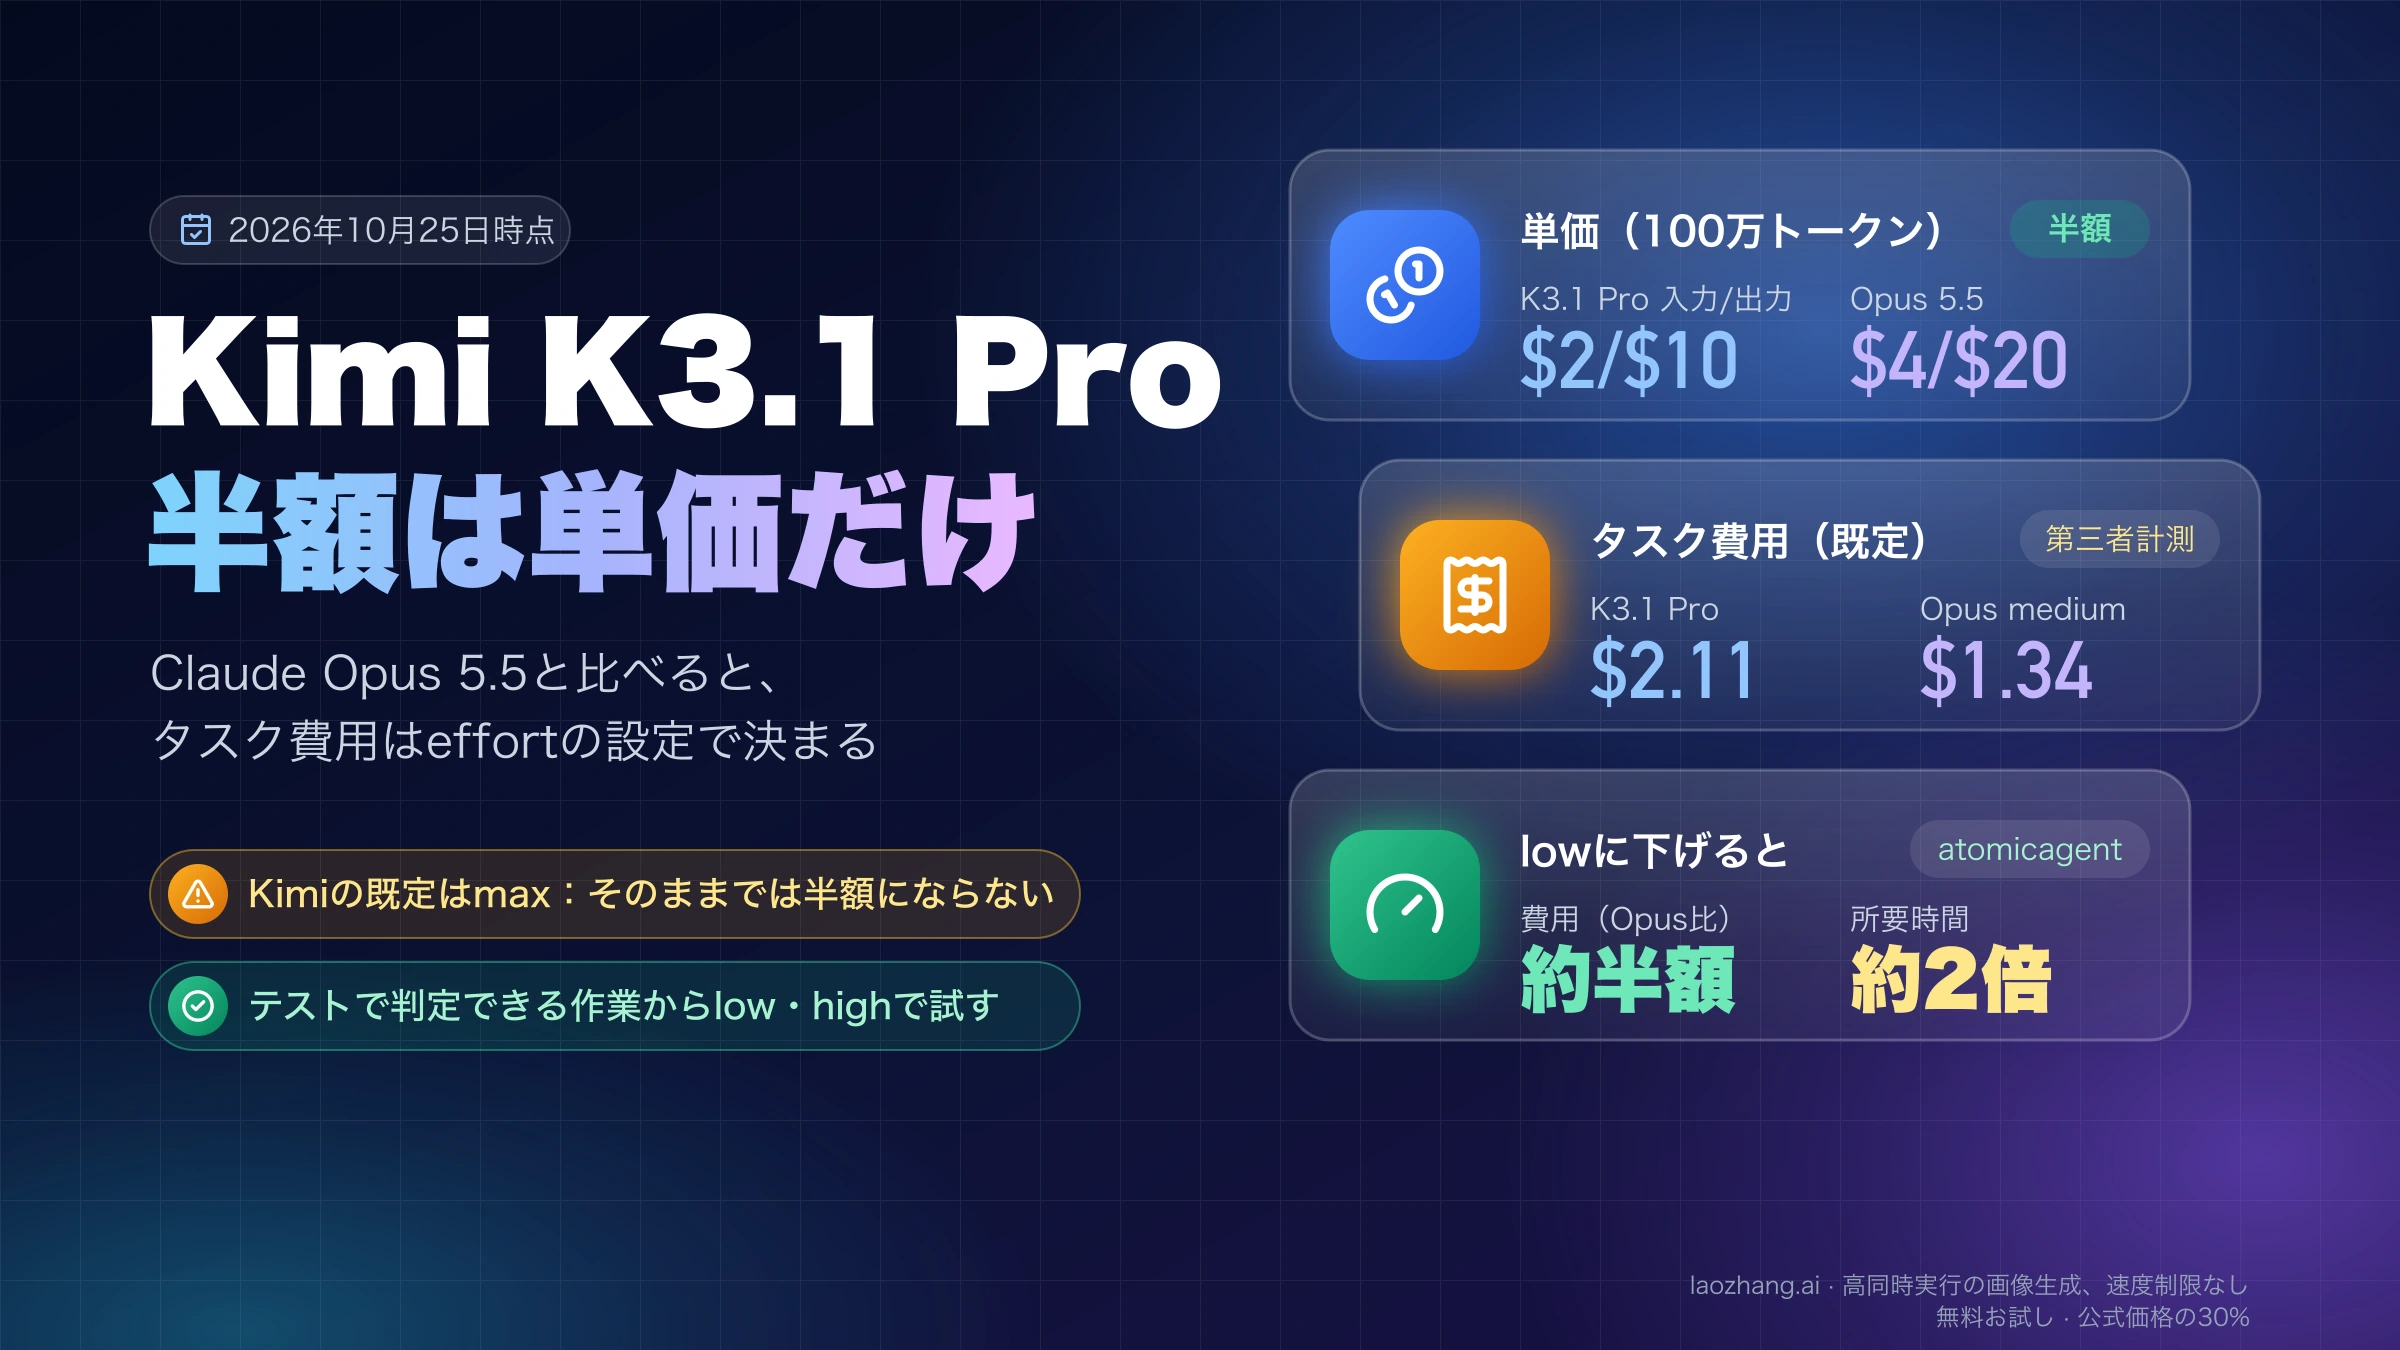
ここで注意したいのは、「既定どうし」が「同じ推論レベルどうし」ではないことです。K3.1 Proの既定は最も深いmaxで、AAもこの設定しか測っていません。一方、Solの既定はmedium(48点、$0.21)なので、何も設定せずに乗り換えると1タスクの費用は約10倍になります。K3.1 Proをhighやlowにした場合の点数と費用はAAが公表していません。highについては下の同じプロンプトでのテストで、maxより出力トークンも費用も少なく済むことを確かめましたが、点数への影響とlowの費用は自分の仕事で測るしかありません。
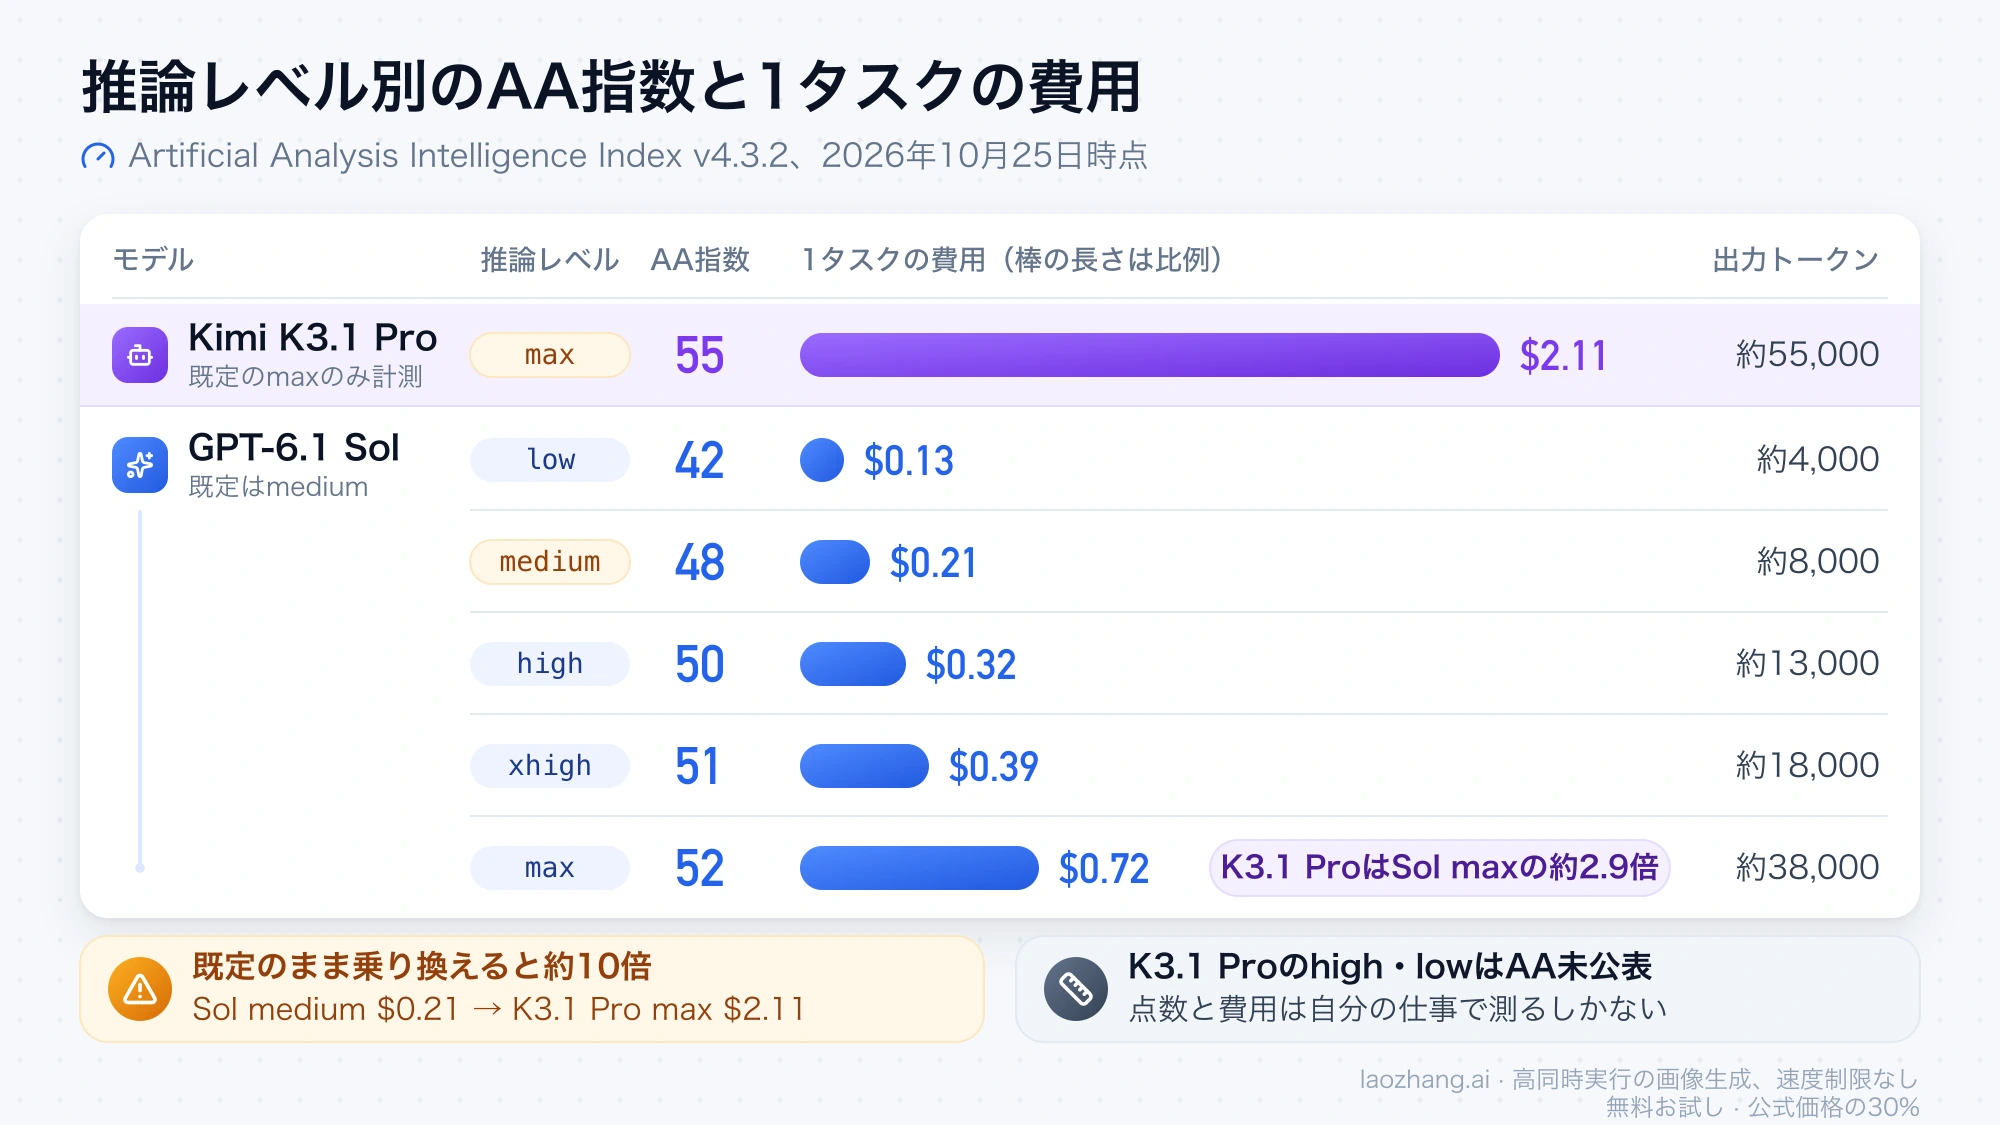
公表されている範囲で言えば、K3.1 ProはSol maxに対して指数3点の上乗せに約2.9倍、Sol highに対して5点の上乗せに約6.6倍の費用を払う計算です($2.11÷$0.72、$2.11÷$0.32)。この差に見合うかどうかは、Solで失敗していた仕事がK3.1 Proで通るかどうかで決まります。Solをほかのフラッグシップと1タスクの費用で比べたい場合は、Gemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:Argonは12月に単価2倍が参考になります。
速度の数字は見方によって逆転します。AAの計測では、K3.1 Proは2.97秒で推論の出力が始まり、最初の回答トークンまで30.19秒、出力速度は毎秒73トークンです。Sol maxは推論を回答として流さないため、最初のトークンまで162.10秒かかり、出力速度は毎秒57トークンです。ただし1タスクを終えるまでの時間はK3.1 Proが618秒、Sol maxが680秒とほぼ同じで、Solをhigh以下に下げれば257秒以内に収まります。次の小規模テストでは、K3.1 Proの既定設定は難しめの問題で最初の回答トークンまで7分近くかかり、待ち時間の差はAAの数字より大きく出ました。
同じプロンプトで8問:全問合格、1回目の費用はSol既定の1.37〜2.94倍
2026年10月25日に、laozhang.aiのAPIキー1つから両モデルをChat Completionsで呼び出し、同じ8問を4つの設定で解かせました。設定はSolの既定(medium)とhigh、K3.1 Proのhighと既定(max)です。問題は文章題1問、隠しテスト付きのコーディング5問、6,723語の記事を形式指定どおりに要約する1問、桁の和の条件を満たす数を数える1問で、合否の基準は回答を読む前に決めてあります。返ってきた回答はすべて合格したので、この結果が示すのは同じ正解にかかる費用と時間の差で、どちらが賢いかではありません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 設定(1回目の5問) | 合格 | 出力トークン | 費用(定価で計算) | Sol既定との比 | 5問の所要時間 |
|---|---|---|---|---|---|
| Sol 既定(medium) | 5/5 | 1,759 | $0.0387 | 1.00倍 | 39秒 |
| Sol high | 5/5 | 3,209 | $0.0532 | 1.37倍 | 51秒 |
| K3.1 Pro high | 5/5 | 5,312 | $0.0748 | 1.93倍 | 160秒 |
| K3.1 Pro 既定(max) | 5/5 | 9,194 | $0.1136 | 2.94倍 | 251秒 |
費用は各レスポンスのusageに公式の定価を掛けて計算しました。K3.1 Proをhighにすると、maxに比べて出力トークンが約42%、費用が約34%減っています。AAにはhighのデータがないので、K3.1 Proを試すならhighから始めるという判断の材料になりますが、5問・1回ずつの結果である点は割り引いてください。
2回目は難しめの3問を各2回ずつ解かせ、費用はSol既定$0.0368、Sol high $0.0604、K3.1 Pro high $0.1121でした。K3.1 Proの既定設定では、式を評価するパーサーを書く問題で、ストリーミングなしの2回の呼び出しがどちらも約300秒でサーバー側から切断され、応答が返りませんでした。stream: trueで再実行すると2回とも完了して合格しましたが、所要時間は421秒と465秒、最初の回答トークンが届くまで410秒と450秒、出力は15,342トークンと16,624トークン、費用は$0.154と$0.166です。同じ問題をSolの既定設定は約14秒、出力約1,000トークン、約$0.01で解いています。K3.1 Proをmaxで使うならストリーミングと10分程度のタイムアウトを前提にするか、highに下げるのが現実的です。
このテストの範囲ははっきり限られています。問題は8問と少なく、各1〜2回、経路はlaozhang.aiのゲートウェイ1つ、実施は1日だけで、MoonshotやOpenAIへの直接接続、Responses API、Solのmax、K3.1 Proのlowは試していません。約300秒での切断はこの経路のストリーミングなしの呼び出しで起きたもので、Moonshotに直接つないだ場合も同じかはわかりません。切断された2回が課金されたかどうかも不明です。定価で計算した支出は全体で$0.93でした。
「GPT-6.1 Solの少し上」は本当か:エージェント作業はK3.1 Pro、知識はSol
AAの総合指数でK3.1 Pro(55)がSol max(52)を上回っているのは事実ですが、差がついているのはエージェント系の評価です。端末操作、SaaSの業務自動化、実務タスクではK3.1 Proが明確に上で、知識の正確さと物理の推論ではSolが上回ります。AAの順位は2026年10月25日時点でK3.1 Proが215モデル中4位、Sol maxが13位です。
| AAの評価 | 測るもの | K3.1 Pro | Sol max |
|---|---|---|---|
| Terminal-Bench 4.0 | エージェントによるコーディングと端末操作 | 67% | 56% |
| AutomationBench-AA | SaaSの業務フロー自動化 | 73% | 65% |
| GDPval-AA v2.1 | 実務タスク(Elo) | 1846 | 1596 |
| AA-Briefcase v1.1 | エージェントによる知的作業(Elo) | 1678 | 1555 |
| SciCode | 科学計算のコーディング | 61% | 54% |
| AA-LCR v1.1 | 長文脈の読解と推論 | 86% | 83% |
| Humanity's Last Exam | 推論と知識 | 52% | 53% |
| GDP.pdf | 専門文書の読解 | 31% | 31% |
| CritPt | 物理の推論 | 25% | 32% |
| AA-Omniscience | 知識の正確さ(誤答の少なさを含む) | 30 | 42 |
Solが目に見えて勝っているのは、AA-Omniscience(42対30)とCritPt(32%対25%)の2つです。事実を問う質問で誤答を避けたい用途、たとえば社内ナレッジの問い合わせ対応や調べものの下書きでは、指数の合計点よりこちらの差のほうが効きます。Humanity's Last ExamとGDP.pdfはほぼ同じです。
SNSでは「K3.1 ProがGPT-6 Sol(52)に勝った」という言い方も見かけますが、AAの52点はmax設定のGPT-6.1 Solの点数で、GPT-6 Solは別の旧モデルです。また、Moonshot AIが発表時に出した比較表の相手はGPT-6 AstraとOpus 5.5で、GPT-6.1 Solは入っていません。発表資料にあるTerminal-Bench 4.0の65.7%はMoonshot自身の環境での数字なので、AAが測ったSolの56%と並べて比べることはできません。両モデルを同じ方法で測った第三者の数字は、2026年10月25日時点ではAAのものだけです。K3.1 ProをOpus 5.5と比べたい場合は、同じくタスク単価で計算したKimi K3.1 ProとOpus 5.5比較:半額は単価だけ、effort別に計算を参照してください。
負荷の形で変わる請求額:272K超はK3.1 Pro、キャッシュ多用はSol
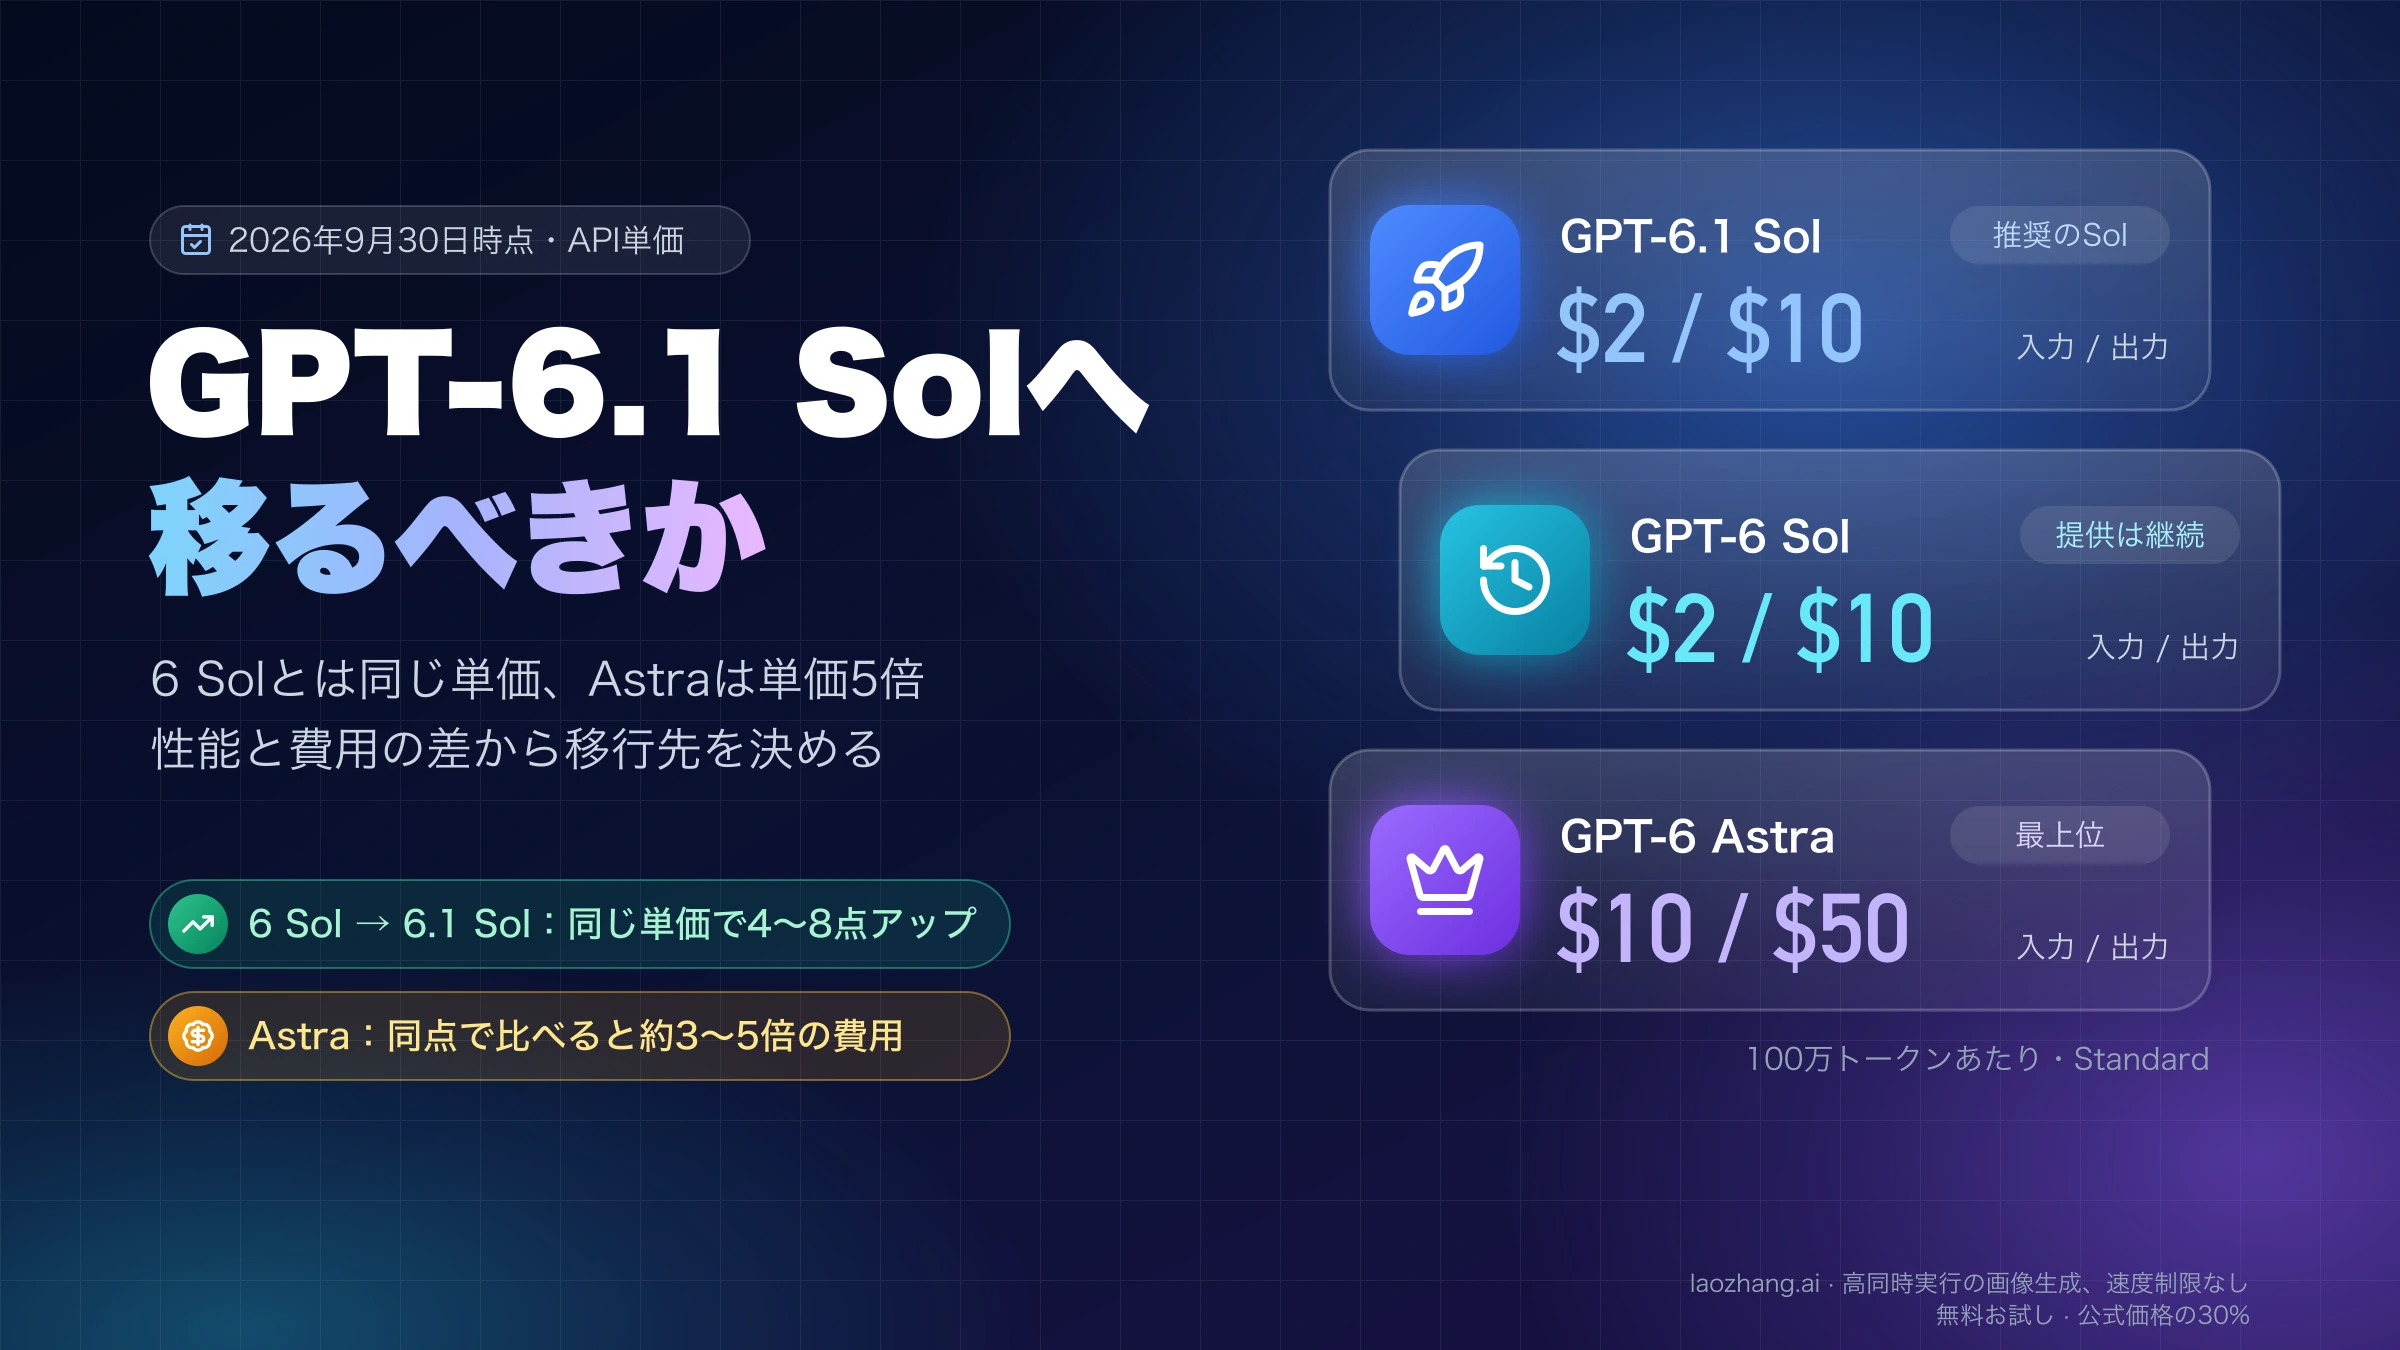
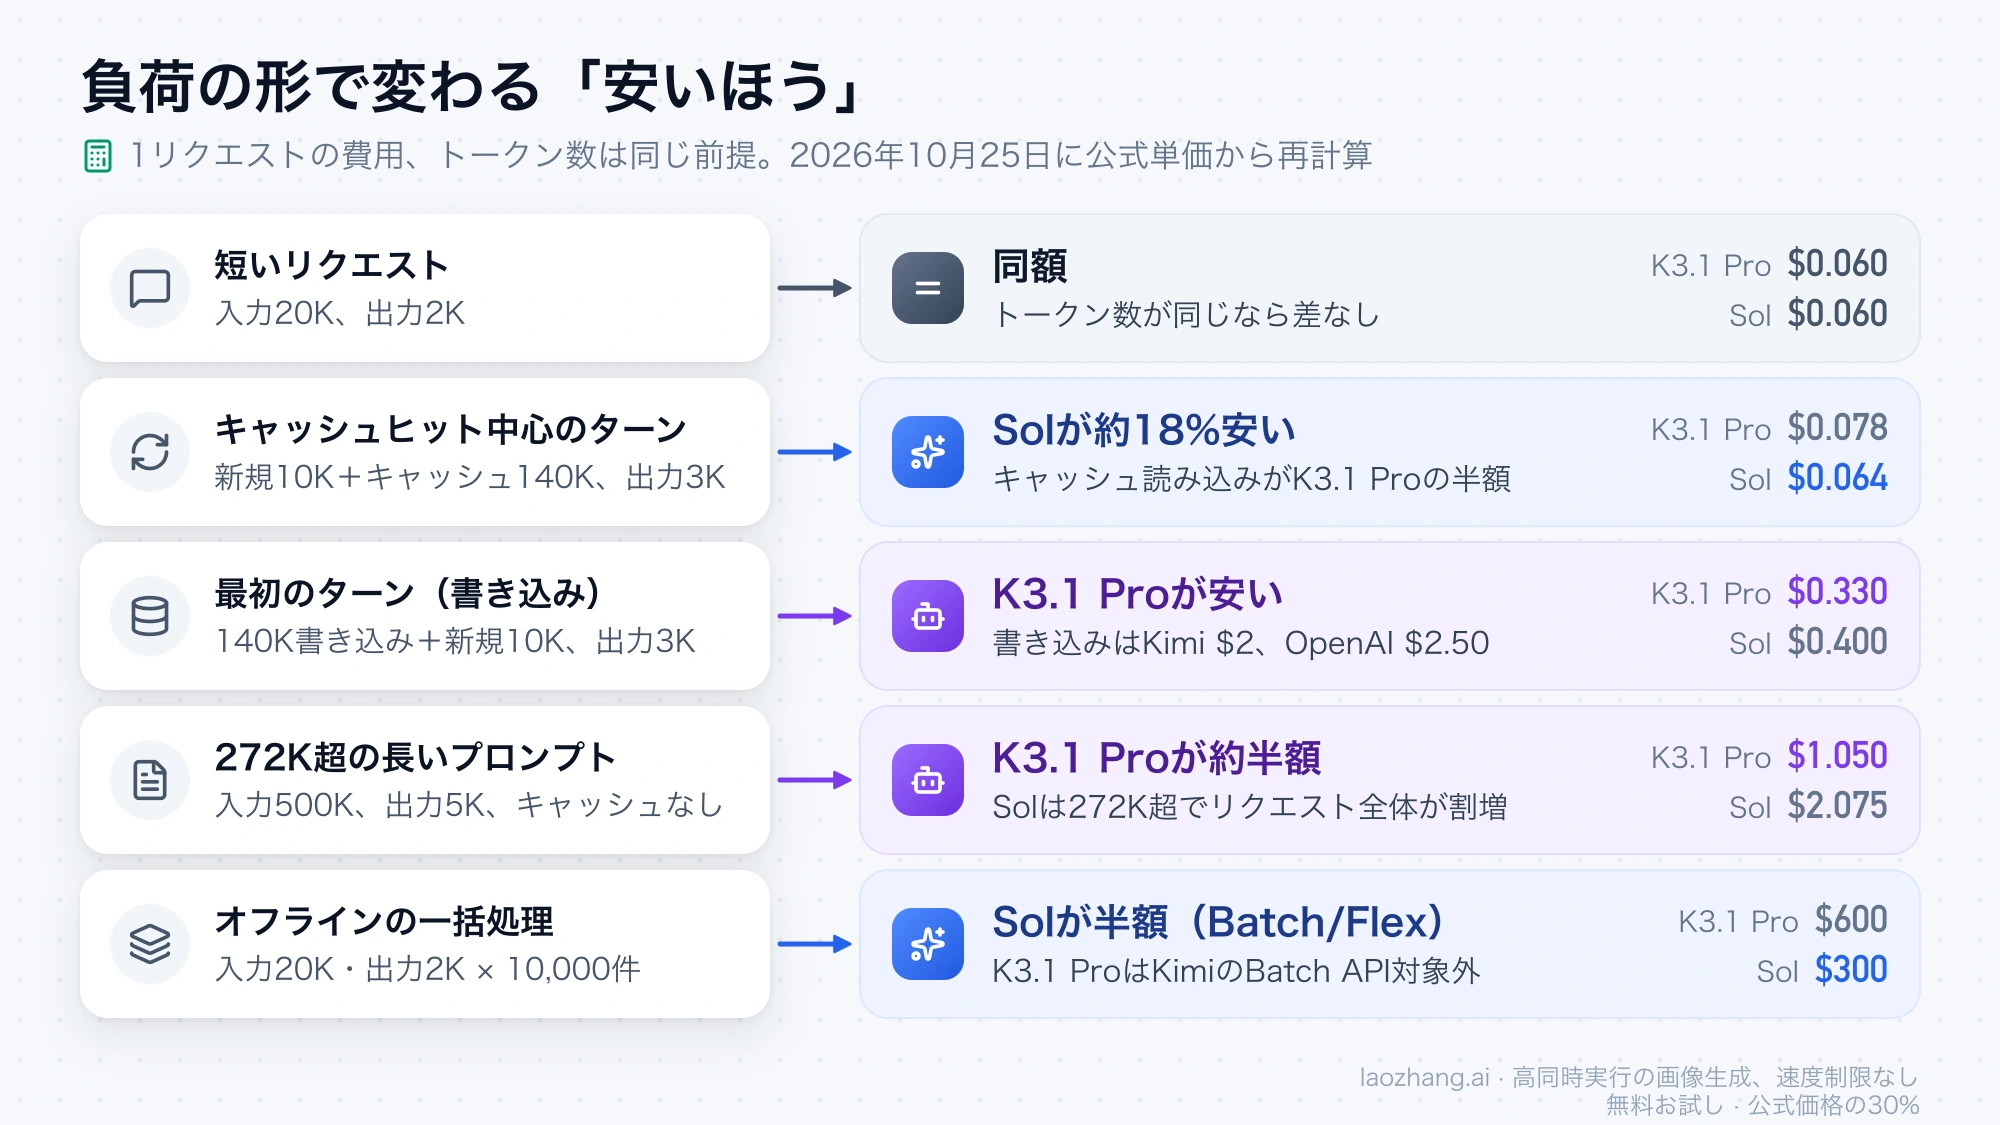
トークン数を同じにして公式単価だけで計算すると、どちらが安いかはキャッシュと入力の長さで決まります。キャッシュ読み込みはSolが$0.10でK3.1 Proの$0.20の半額なので、長いプレフィックスを使い回すエージェントのターンではSolが安くなります。一方、入力が272Kトークンを超えるとSolはリクエスト全体の単価が上がるため、長いプロンプトではK3.1 Proが約半額です。下の表は、2026年10月25日に両社の公式単価から再計算したものです。
| ケース(1リクエスト) | K3.1 Pro | GPT-6.1 Sol | Sol÷K3.1 |
|---|---|---|---|
| 短いリクエスト:入力20K、出力2K | $0.060 | $0.060 | 1.00倍 |
| エージェントの1ターン:新規入力10K+キャッシュヒット140K、出力3K | $0.078 | $0.064 | 0.82倍 |
| 最初のターン:140Kのプレフィックスを書き込み、新規入力10K、出力3K | $0.330 | $0.400 | 1.21倍 |
| 長いプロンプト:入力500K(キャッシュなし)、出力5K | $1.050 | $2.075 | 1.98倍 |
| 長いプロンプト+キャッシュ:新規入力50K+キャッシュヒット450K、出力5K | $0.240 | $0.365 | 1.52倍 |
| 一括処理:入力20K・出力2Kを10,000件 | $600 | $600(Batch/Flexなら$300) | 1.00倍(0.50倍) |
計算は「トークン数÷100万×単価」の合計です。たとえば入力500Kのケースは、K3.1 Proが0.5×$2+0.005×$10=$1.050、Solは272K超の料金(入力$4、出力$15)が全体に掛かるので0.5×$4+0.005×$15=$2.075になります。出力トークンには推論トークンも含みます。単価の出典はKimi APIの料金ページとOpenAI APIの料金ページで、Solの272K超の扱いや処理区分ごとの単価はGPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点で詳しく扱っています。
キャッシュの書き込みでは差が逆になります。Kimiのコンテキストキャッシュは既定の5分保持なら書き込み単価が入力と同じ$2で、1時間保持にすると2倍の$4です。OpenAIのプロンプトキャッシュは既定の30分保持で入力の1.25倍($2.50)、12時間保持で2.5倍($5)です。最初のターンだけK3.1 Proが安いのはこのためで、保持時間もKimiは5分か1時間、Solは30分か12時間と長さが違います。
ターンを重ねたときの合計は次のとおりです。1ターン目で140Kのプレフィックスを書き込み、2〜50ターン目は毎回140Kのキャッシュヒットと10Kの新規入力という前提で、出力トークン数だけを変えています。
| 50ターンのセッション | K3.1 Pro | GPT-6.1 Sol |
|---|---|---|
| 両方とも1ターン3Kトークンを出力 | $4.15 | $3.54 |
| SolがAAのmaxと同じ比率で少なく出力(約2,073トークン) | $4.15 | $3.07 |
| SolがAAのhighと同じ比率で少なく出力(約709トークン) | $4.15 | $2.39 |
2行目と3行目は、AAで測られた1タスクの出力量の比(Sol max 38kとSol high 13k、K3.1 Pro 55k)をそのまま当てはめた例で、あなたの仕事での実測ではありません。また、Kimiの5分キャッシュは前のヒットから5分以上間が空くと切れるので、ターンの間に人の確認が挟まる使い方では、1時間保持を選ぶか書き込み直しの費用を見込む必要があります。
これを負荷の形ごとにまとめると、次のようになります。キャッシュを効かせたエージェントループは、トークン数が同じでもSolが約18%安く、出力が少ない分さらに差が開きます。272Kを超える長いプロンプトはK3.1 Proが約半額で、1,048,576トークンまで単価が変わりません。オフラインの一括処理は、SolがBatchかFlexで50%引きになるのに対し、KimiのBatch APIは対象がkimi-k2.7-codeとkimi-k2.6だけでK3.1 Proは使えないため、Solが半額です。応答の速さが大事なチャットでは、Solのlow〜medium(1タスク83〜168秒)が向いています。K3.1 Proは推論をオフにできないためです。
乗り換えで変える設定:推論レベルの既定はmaxとmedium
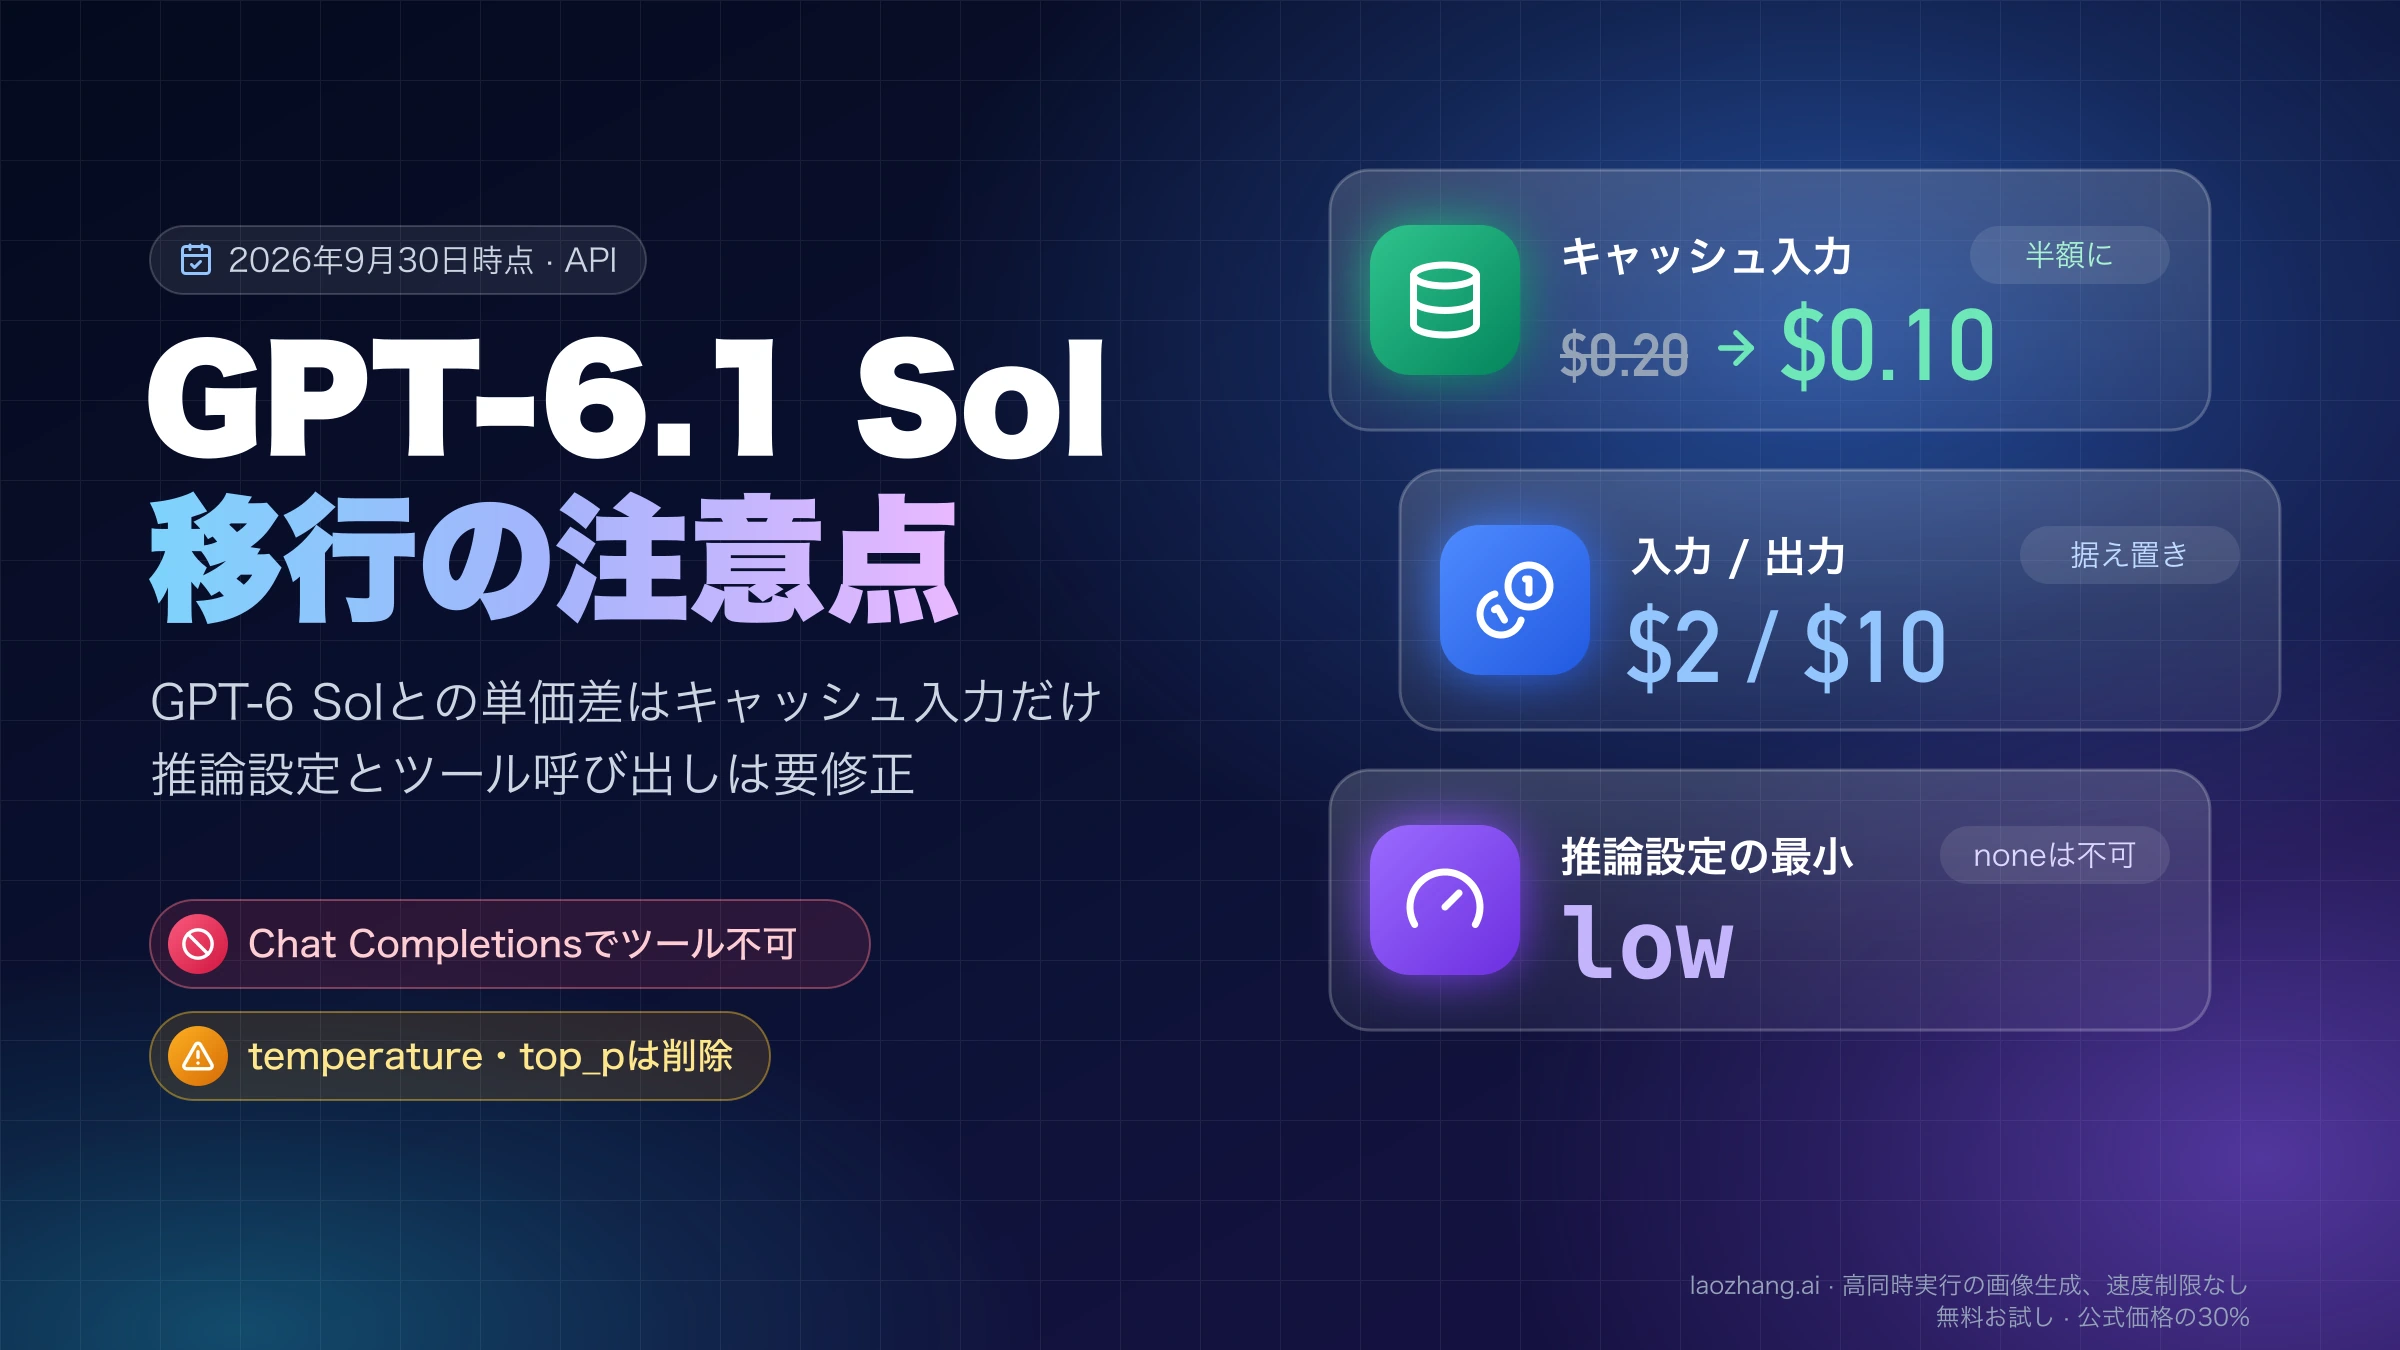
Solからの乗り換えで一番つまずきやすいのは推論レベルです。K3.1 Proはトップレベルのreasoning_effortでlow・high・maxの3つだけを受け付け、既定はmaxで、推論そのものはオフにできません。Solのreasoning.effortはlowからmaxまで5段階で既定はmediumなので、Solの設定値をそのまま流用せず、K3.1 Pro側の値を明示して渡すようにします。
| 項目 | Kimi K3.1 Pro | GPT-6.1 Sol |
|---|---|---|
| モデルID | kimi-k3.1-pro | gpt-6.1-sol |
| 推論レベル | reasoning_effort:low/high/max、既定max、オフ不可 | reasoning.effort:low/medium/high/xhigh/max、既定medium、noneとminimalは非対応 |
| API | Chat Completions(https://api.moonshot.ai/v1)、Responses API、Anthropic Messages互換 | Responses API。Chat Completionsはツール呼び出しなしでのみ利用可 |
| サンプリング設定 | OpenRouterのエンドポイントではtemperature・top_p・seedが公開されていない | 2026年10月5日のテストで、Chat Completionsはtemperature: 0.2を拒否(既定値1のみ) |
| コンテキスト/最大出力 | 1,048,576/943,718トークン(OpenRouter表示) | 1,050,000/128,000トークン |
| 長いプロンプトの料金 | 1,048,576トークンまで単一料金 | 272K超でリクエスト全体が入力・キャッシュ2倍、出力1.5倍 |
| キャッシュの保持時間 | 自動、既定5分。prompt_cache_optionsで1時間 | 自動、既定30分。prompt_cache_options.ttlで12時間。最小1,024トークン |
| Batch処理 | K3.1 Proは非対応 | Batch/Flexで50%引き |
| 高速版 | 別モデルIDkimi-k3.1-pro-highspeed | 処理区分のFast(2倍)、Ultrafast(6倍) |
| 利用開始直後のレート制限 | 最低$1のチャージでTier0:同時実行1、RPM 3、TPM 50万、1日150万トークン | Build:5,000 RPM、100万TPM(Freeでは利用不可) |
出典はKimi K3.1 Proのクイックスタート、Kimiの推論レベルのガイド、Kimiのレート制限のページ、OpenAIのGPT-6.1 Solモデルページで、最大出力943,718トークンは2026年10月25日にOpenRouterの公開APIから読み取った値です。サンプリング設定の行のSol側は、ゲートウェイ経由で行った以前のテストの結果です。
コードで見落としやすいのが会話履歴の扱いです。K3.1 Proはストリーミングで推論(reasoning_content)と回答(content)を分けて返し、複数ターンの会話やツール呼び出しでは、APIが返したassistantメッセージをreasoning_contentとtool_callsも含めてそのまま次のリクエストに入れるよう求めています。contentだけを履歴に残す実装は、K3.1 Proでは公式の使い方から外れます。ツール呼び出しはK3.1 ProならChat Completionsでもできますが、SolはResponses APIでしかできないので、Solから移る場合はResponses APIのコードをそのまま使えるかどうかを先に確認すると手戻りが減ります。
CodexでK3.1 Proを使うconfig.toml
Kimiの公式ガイド「Use Kimi K3.1 Pro in Codex」によると、Kimi Open PlatformはCodexが使うResponses APIにそのまま対応しているので、変換用のプロキシなしでK3.1 Proを指定できます。APIキーは環境変数KIMI_API_KEYに入れ、~/.codex/config.tomlに次の設定を追加します(すでにmodelやmodel_providerがある場合は値を置き換えます)。
model = "kimi-k3.1-pro"
model_provider = "kimi"
model_context_window = 1048576

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.moonshot.ai/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"
この設定はKimiのドキュメントに載っているもので、Codexからの接続は実行していません。ガイドによれば、Codex Desktopではモデル名が「Custom」と表示されることがあり、Model metadata for kimi-k3.1-pro not foundという警告も想定内です。platform.kimi.aiで作ったキーはhttps://api.moonshot.ai/v1でしか使えず、組み合わせが違うと401になります。429はTierごとのレートや同時実行数の上限によるもので、Codexのエージェントは1回の作業でリクエストを何度も繰り返すため、Tier0のままでは止まりやすいと考えておくべきです。
プロバイダー設定全般や認証エラーの切り分けはCodex カスタムプロバイダー設定:APIキーとBase URLの選び方にまとめています。ChatGPTのプランでCodexのSolを使っている場合は、Kimiに切り替えると、プランの利用枠ではなくKimi APIの従量課金で支払うことになります。プラン利用とAPIキー利用の違いはCodex APIキーとChatGPTサブスクの違い:クレジット換算はAPIと同額を参照してください。
Kimi K3.1 Proの料金と始め方:最低$1のチャージで解禁
Kimi K3.1 ProのAPI料金は、2026年10月25日時点の国際版プラットフォームで100万トークンあたり入力$2.00、出力$10.00、キャッシュ入力$0.20、キャッシュ書き込みは5分保持$2.00・1時間保持$4.00で、税は別です。入力が1,048,576トークンまで長くなっても割増はありません。料金は従量制のみで、KimiのメンバーシップやKimi Codeとは別建てなので、APIで使うにはプラットフォームでのチャージが必要です。
始め方は、platform.kimi.aiでAPIキーを作り、最低$1をチャージするとK3.1 Proが使えるようになります。レート制限はチャージ額の累計で決まり、累計$1のTier0は上の表のとおり厳しく、1日150万トークンをAAの1タスクの出力量(約55,000トークン)で割ると、出力だけで1日約27タスクが上限です。累計$10のTier1になると同時実行15、RPM 100、TPM 200万、1日の上限なしに上がります。累計$5で$5分のバウチャーがもらえますが、バウチャーは累計チャージ額に数えられず、K3.1 Proの支払いに使えるかどうかは国際版の規約に書かれていません。
支払い方法について、Kimiのアカウントに関するFAQは、個人ユーザーのオンラインチャージはWeChat PayとAlipayのQRコード決済に対応すると書いています。利用規約にはクレジットカードやデビットカードによる支払いへの言及もありますが、カードでのチャージが日本から通るかは公開情報からは確かめられません。
提供元の数にも差があります。2026年10月25日にOpenRouterの公開API(/api/v1/models/{id}/endpoints)を読み取ったところ、K3.1 Proのエンドポイントは2つで、どちらもMoonshot AI自身の標準版とHighspeed版でした。GPT-6.1 Solは8つで、OpenAIの標準・Flex・Fast・Ultrafastに加え、Azure、Azure EU、Azure US、Amazon Bedrock(us-east-1、入力$2.20・出力$11)が並んでいます。OpenAI APIの対応国一覧には日本が含まれており、SolはChatGPTとCodexでもPlus・Pro・Business・Enterprise・Eduの各プランから使えます。なお、laozhang.aiのモデル一覧にはgpt-6.1-solがあり、2026年10月25日にはkimi-k3.1-proとkimi-k3.1-pro-highspeedもKimiの定価(100万トークンあたり、kimi-k3.1-proは入力$2・出力$10でキャッシュ書き込み5分$2・1時間$4、高速版は入力$4・出力$20で書き込み$4・$8、キャッシュ読み取りはどちらも$0.20)で追加されました。呼び出しはChat Completionsで、1つのキーで両モデルを試せます。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
切り替える前に自分のタスクでK3.1 ProとSolを比べる手順
AAの数字は他人の評価セットでの平均なので、乗り換えるかどうかは自分の仕事で小さく比べてから決めるのが確実です。次の順に進めると、判断に必要な数字がそろいます。
- 自分の仕事から代表的なタスクを20〜30件選び、以前に人の手直しが必要だったものも混ぜます。合否を自動で判定できるテストや採点基準を先に決めておくと、比較が印象に流されません。
- Kimiのプラットフォームで累計$10までチャージし、Tier1にしてから流します。Tier0のままでは1件ずつしか流せず、AAの1タスク618秒で計算すると30件で約5時間かかります。
- Solは今使っている推論レベルと一段上のレベルの2つで、K3.1 Proは既定の
maxとhighの2つで同じタスクを流します。K3.1 ProのhighはAAが測っておらず、上の小規模テストでもmaxとの費用差が大きかったので、必ず含めます。maxは1回の応答に7分以上かかることがあるため、stream: trueにしてクライアントのタイムアウトを10分程度まで延ばしておきます。 - 各レスポンスの使用量(usage)から、入力・キャッシュ読み込み・出力のトークン数をタスクごとに記録します。2026年10月25日のlaozhang.ai経由のテストでは、K3.1 Proのusageには推論トークンの内訳がなく、
completion_tokensに推論分が含まれていました。同じ短いプロンプトでも入力トークンがSolより80ほど多く数えられたので、短いリクエストが多い処理ではこの差も費用に入れておきます。Moonshotへの直接接続では確かめていないので、自分の経路でも一度確認してください。 - 合計の費用を合格したタスクの件数で割り、「合格1件あたりの費用」と完了までの時間で比べます。失敗の多い安い設定が、やり直しを含めると高くつくことがここで見えます。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
272Kを超える入力が多い処理や、キャッシュの書き込みが頻繁な処理は、件数が少ないと平均がぶれるので、上のコスト表の規則で月間のトークン量から別に見積もっておくと安全です。
Kimi K3.1 ProとGPT-6.1 Solのよくある質問
Kimi K3.1 Proはオープンウェイトですか?
2026年10月25日時点では、まだ重みは公開されていません。Moonshot AIはクイックスタートで完全なモデルの重みを11月4日までに公開するとしており、AAの一覧では現時点で非公開(プロプライエタリ)扱いです。重みが公開されれば、Moonshot AI以外の事業者がホストする可能性があり、提供元の数や価格の選択肢は変わるかもしれません。
Highspeed版に切り替えれば速くなりますか?
kimi-k3.1-pro-highspeedは設定のスイッチではなく、別のモデルIDです。Moonshot AIはK3.1 Proの2〜3倍の速度としており、単価は2026年10月25日時点で入力$4.00・出力$20.00と標準版の2倍、キャッシュ入力は同じ$0.20です。AAの速度の数字は標準版のものなので、Highspeed版の実際の待ち時間は自分で測る必要があります。
Kimi K3とK3.1 Proは何が違い、料金は下がりましたか?
Moonshot AIによると、K3.1 ProはKimi K3に大幅に多い計算量で追加学習を施したモデルで、K3.1シリーズの最初のモデルです。2026年10月25日時点の国際版の単価は、kimi-k3が入力$3.00・出力$15.00、kimi-k3.1-proが入力$2.00・出力$10.00で、100万トークンあたりではK3.1 Proのほうが安くなっています。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
- 1.Artificial AnalysisのKimi K3.1 ProとGPT-6.1 Solの比較ページartificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-gpt-6-1-sol
- 2.Kimi APIの料金ページplatform.kimi.ai/docs/pricing/chat
- 3.OpenAI APIの料金ページdevelopers.openai.com/api/docs/pricing
- 4.コンテキストキャッシュplatform.kimi.ai/docs/guide/context-caching
- 5.プロンプトキャッシュdevelopers.openai.com/api/docs/guides/prompt-caching
- 6.Batch APIplatform.kimi.ai/docs/pricing/batch
- 7.Kimi K3.1 Proのクイックスタートplatform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 8.Kimiの推論レベルのガイドplatform.kimi.ai/docs/guide/use-reasoning-effort
- 9.Kimiのレート制限のページplatform.kimi.ai/docs/pricing/limits
- 10.OpenAIのGPT-6.1 Solモデルページdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 11.Use Kimi K3.1 Pro in Codexplatform.kimi.ai/docs/guide/codex-kimi