DeepSeek V4.1 FlashとGLM-5.3-Flash比較:料金は時間帯で逆転
オフピークならDeepSeek V4.1 Flashが安くて速く、単価が2倍になる平日の日本時間10〜13時と15〜19時はGLM-5.3-Flashが逆転しやすくなります。
目次
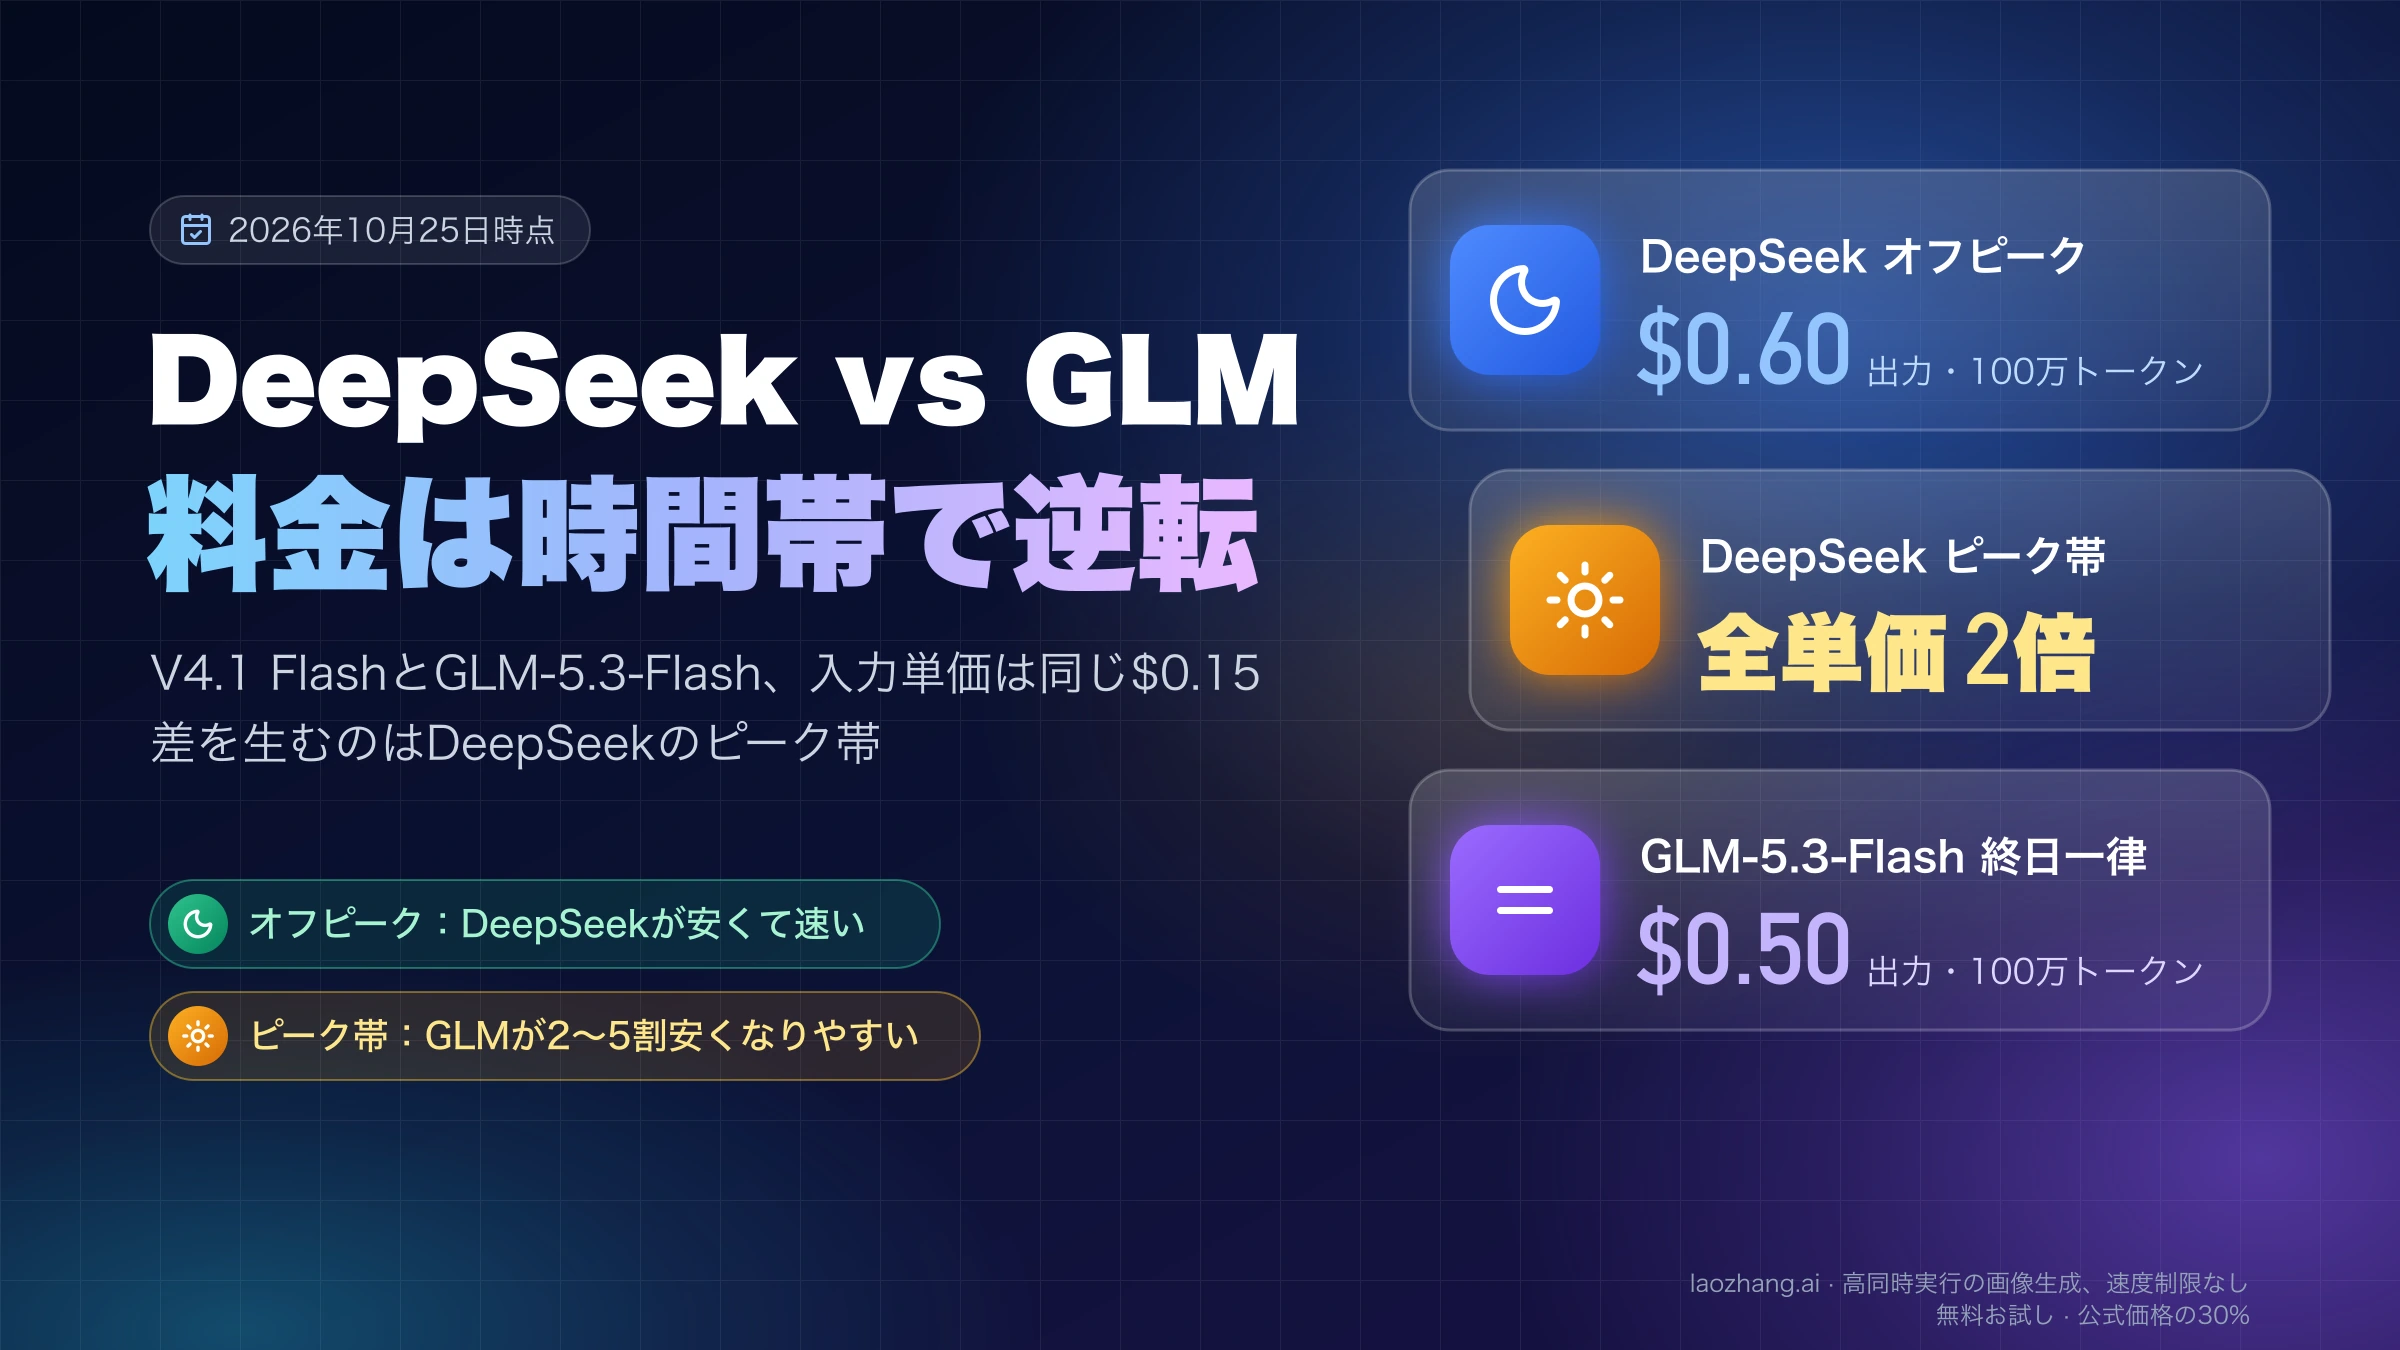
2026年10月25日時点で、DeepSeek V4.1 Flash(APIのモデル名はdeepseek-flash)とGLM-5.3-Flash(glm-5.3-flash)は、入力単価が100万トークンあたり$0.15、コンテキスト1M、MITライセンスで重みも公開と、表の上ではほとんど同じ条件です。どちらが安いかを分けるのは呼び出す時刻で、DeepSeekは平日の日本時間10〜13時と15〜19時に全単価が2倍になり、日本の業務時間の多くがこのピーク帯に重なります。それ以外の時間帯ならDeepSeekのほうが安く、Artificial Analysisが同じ方法で測った総合指数(45対42)と出力速度(毎秒195対69トークン)でも上回ります。
迷ったらdeepseek-flashを既定にして、ピーク帯に集中する処理だけ、時間をずらすかglm-5.3-flashに回して費用を比べてください。両モデルに同じ量を書かせる想定なら、ピーク帯はGLMのほうが2〜5割安くなります。ただしGLM-5.3-Flashは思考をオフにできないので、短い呼び出しを大量に送る用途では不利になりやすく、128Kトークンを超える出力はDeepSeek(上限384K)、動画やファイルの入力はGLMしか受け付けません。
トークン数の計測、公開単価からのコスト計算、OpenRouterのモデル一覧とHugging Faceの重みサイズの読み取りは、2026年10月25日に実行した結果です。同じプロンプトで2つのモデルを走らせて品質・速度・実際の請求額を比べるテストは含まれておらず、品質と速度はArtificial Analysisの計測、仕様と単価はDeepSeekとZ.aiの公式ドキュメントに基づきます。
2つの名前の中身:deepseek-flashは10月17日から1017版
DeepSeek APIのモデル名deepseek-flashは、2026年10月17日からDeepSeek-V4.1-Flash-1017を指しています。末尾の「1017」はバージョン番号ではなく、10月17日に入れ替わったチェックポイントの日付です。DeepSeekのAPI更新履歴によると、9月10日に公開したV4.1-Flashよりベンチマークが上がり、タスクの完了が速く、出力が短くなったとされ、API名と料金は変わっていません。旧名のdeepseek-v4-flashも受け付けられますが、元のモデルはすでに引退しており、中身は1017版、料金もFlashの単価です。8〜9月時点のV4 Flash(0731)や9月版のV4.1 Flashの単価・評価は、今のdeepseek-flashには当てはまりません。
GLM-5.3-Flashは2026年8月に公開されたZ.aiのモデルで、同じ系列に高速版のGLM-5.3-FlashX(glm-5.3-flashx)があります。どちらも名前はFlashですが、小型モデルではありません。DeepSeekは総パラメータ552BのMoEで、1トークンあたり入力時8B・出力時16Bが働き、GLMは総パラメータ320B、活性パラメータ18Bです(Z.aiのGLM-5.3-Flashガイド)。
OpenRouterなどのルーター経由で使う場合は、IDの取り違えに注意が要ります。2026年10月25日にOpenRouterの公開APIでモデル一覧を読んだ時点では、deepseek/deepseek-v4.1-flash-1017を29社(34エンドポイント)、z-ai/glm-5.3-flashを34社(38エンドポイント)が提供していました。1017以前のdeepseek/deepseek-v4.1-flashも別IDとして残っているので、必ず-1017付きを指定してください。量子化(fp4、fp8など)と最大出力は提供元ごとに違い、FlashXのz-ai/glm-5.3-flashxを出しているのはZ.AIの1社だけでした。
どちらが安いか:オフピークはDeepSeek、ピーク帯はGLMが逆転しやすい
同じ処理量なら、DeepSeekのオフピーク時間帯はほぼすべての想定でDeepSeekが安く、ピーク帯は出力量と思考の長さ次第でGLM-5.3-Flashが逆転します。2026年10月25日時点の100万トークンあたりの公式単価は、DeepSeekのオフピークがキャッシュヒット$0.003、キャッシュミスの入力$0.15、出力$0.60で、ピーク帯はすべて2倍です(DeepSeekの料金ページ)。GLM-5.3-Flashは時間帯に関係なく、キャッシュ入力$0.03、入力$0.15、出力$0.50です(Z.aiの料金ページ)。
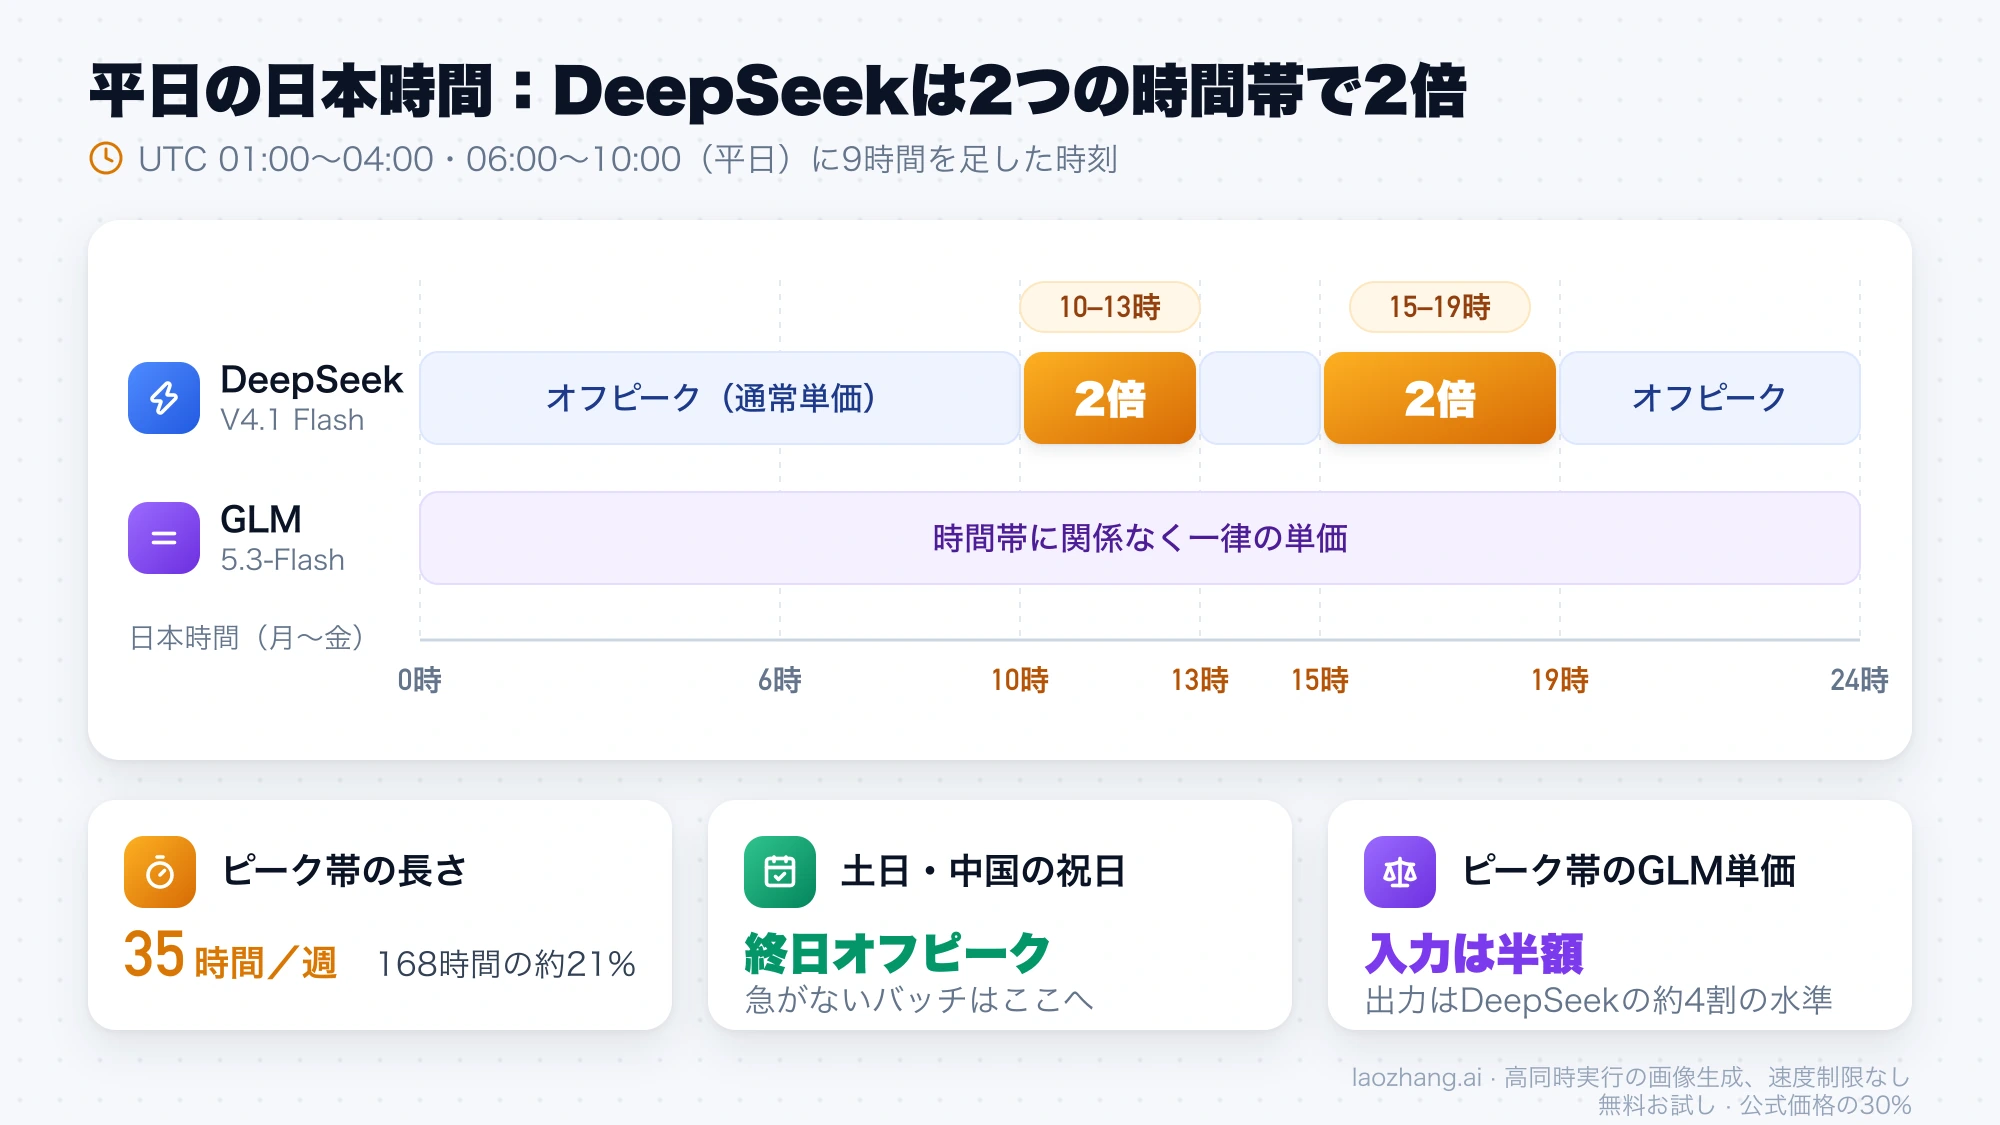
DeepSeekのピーク帯は、UTCで平日の01:00〜04:00と06:00〜10:00(中国の祝日を除く)と定められています。9時間足して日本時間に直すと平日の10:00〜13:00と15:00〜19:00で、週168時間のうち35時間(約21%)にあたり、土日と中国の祝日は終日オフピークです。時間帯ごとの費用の出し方はDeepSeek APIの料金:日本時間のピークと費用計算で確認できます。
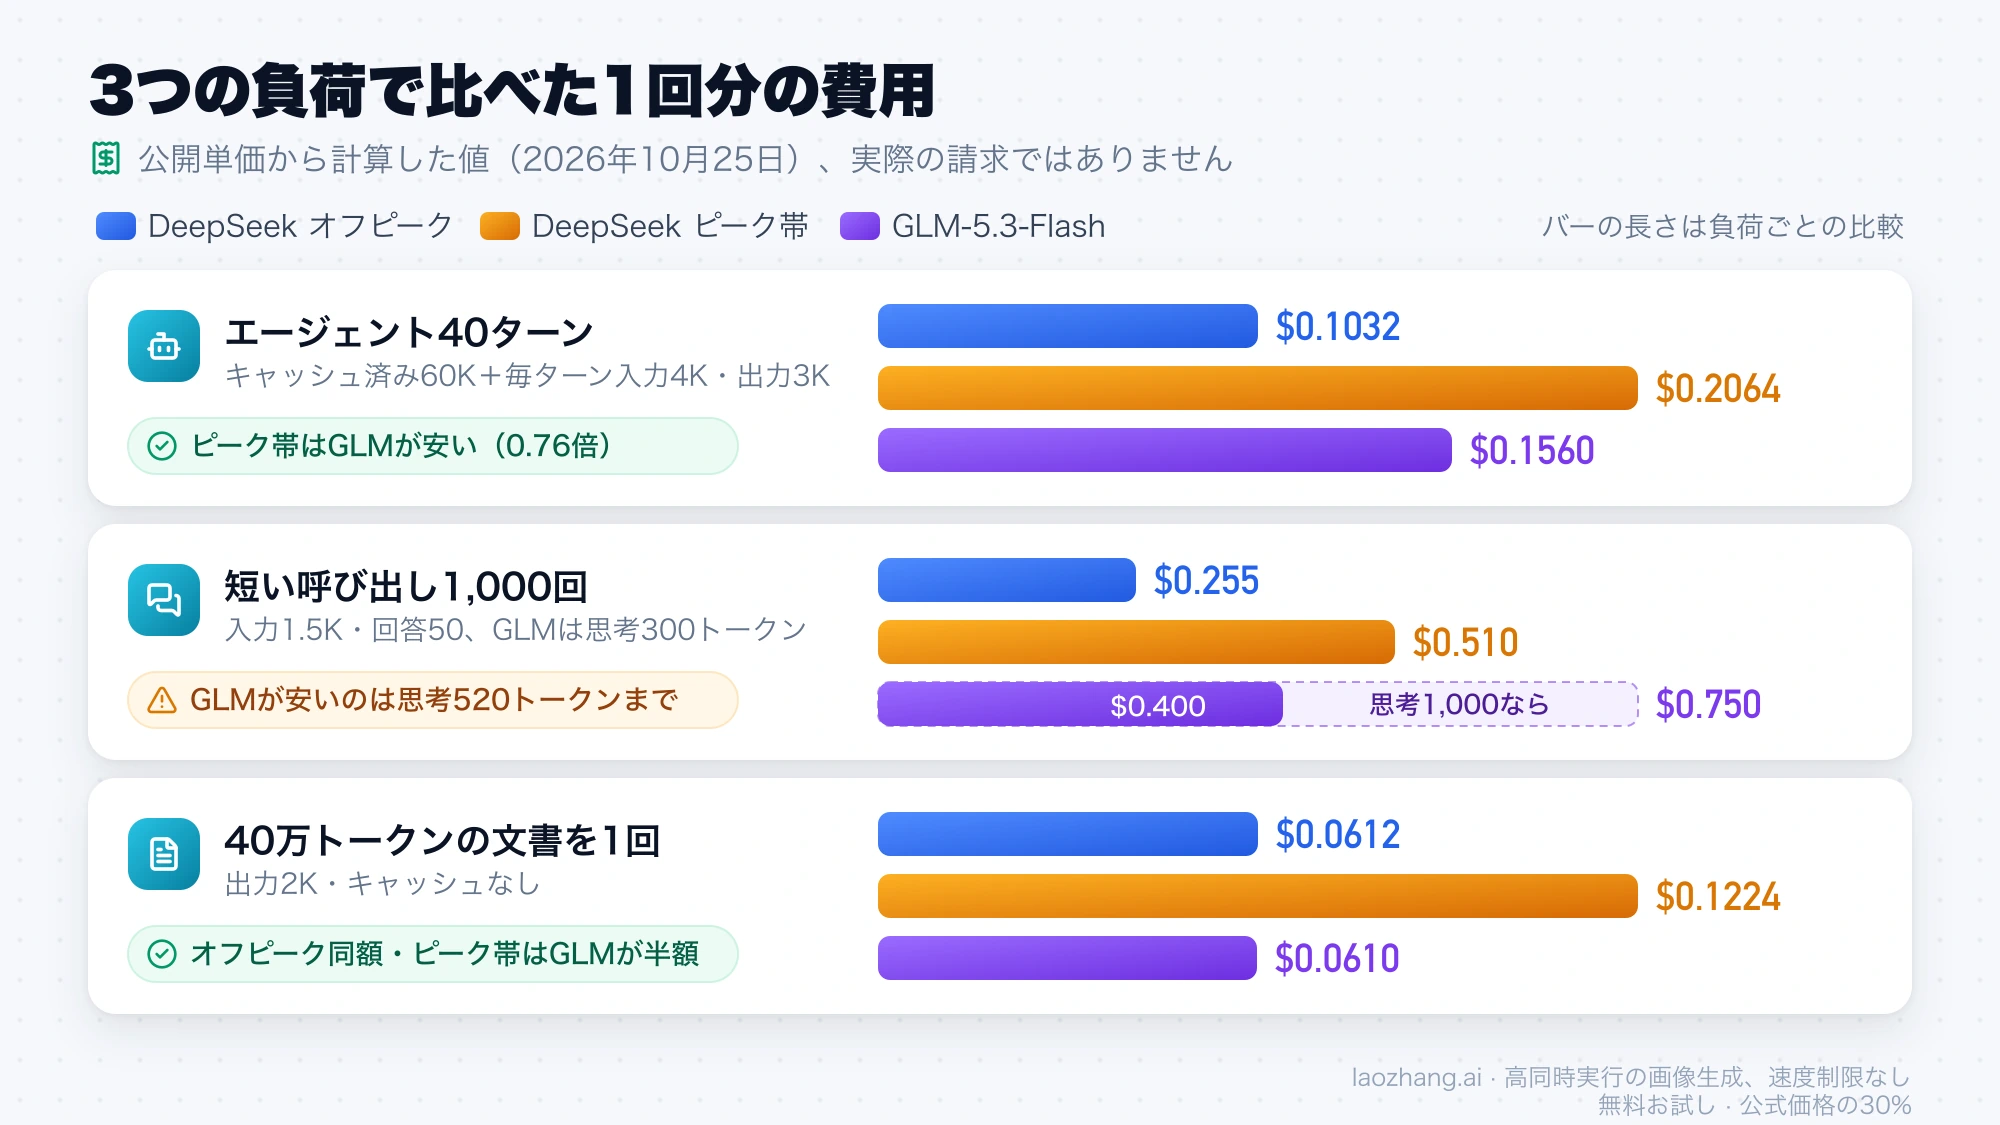
この単価で、よくある負荷の形ごとに1回分の費用を計算したのが次の表です。
| 負荷の形 | DeepSeek オフピーク | DeepSeek ピーク | GLM-5.3-Flash | GLM÷DeepSeek(オフピーク/ピーク) |
|---|---|---|---|---|
| Artificial Analysisの評価タスク1件 | $0.13 | $0.26 | $0.28 | 2.15倍/1.08倍 |
| エージェント40ターン(キャッシュ済み60K+毎ターン新規入力4K・出力3K) | $0.1032 | $0.2064 | $0.1560 | 1.51倍/0.76倍 |
| 短い呼び出し1,000回(入力1.5K、回答50トークン)、GLMの思考300トークン | $0.255 | $0.510 | $0.400 | 1.57倍/0.78倍 |
| 同じ1,000回、GLMの思考1,000トークン | $0.255 | $0.510 | $0.750 | 2.94倍/1.47倍 |
| 40万トークンの文書を1回読ませ、出力2K(キャッシュなし) | $0.0612 | $0.1224 | $0.0610 | 1.00倍/0.50倍 |
| エージェント40ターンで、GLMの出力だけ2倍 | $0.1032 | $0.2064 | $0.2160 | 2.09倍/1.05倍 |
2026年10月25日に公開単価から計算した値で、実際の請求ではありません。トークン数は説明用の想定で、出力には思考トークンを含みます。短い呼び出しの行はDeepSeekの思考をオフにし、思考を切れないGLMには思考分を上乗せしています。計算は「トークン数÷100万×単価」の合計で、たとえばエージェントの行のDeepSeekオフピークは、キャッシュ240万×$0.003+新規入力16万×$0.15+出力12万×$0.60=$0.1032です。最初の行は、Artificial AnalysisがDeepSeekのピーク単価で出したタスク単価$0.26を、オフピークの半額に直したものです。
表の分かれ目は思考の長さと出力量です。短い呼び出しでは、GLMが1回あたり10トークンを超えて考えるとDeepSeekの思考なし・オフピークより高くなり、520トークンを超えるとピーク帯のDeepSeekよりも高くなります。エージェント用途でも、GLMの出力がDeepSeekの2倍になれば、ピーク帯の逆転はほぼ消えます。どちらの会社もキャッシュの保持時間を公開しておらず、GLMのキャッシュ保存料は「期間限定で無料」なので、この2点は変わりうる前提です。
単価表だけで請求額が決まらない3つの理由:時刻、キャッシュ、強制思考
単価表を横に並べると、入力は同額で出力はGLMが$0.10安く見えますが、実際の請求額は呼び出す時刻、キャッシュの比率、思考を切れるかどうかの3点で大きく動きます。どれも単価表の1行には出てこない条件なので、自分の使い方に当てはめてから比べる必要があります。
1つ目の時刻は、DeepSeekだけにある条件です。ピーク帯ではDeepSeekの単価が2倍になるため、キャッシュミスの入力はGLMが半額、出力はGLMが約4割の水準になります。オフピークでは入力が同額、出力はGLMが約2割安いだけなので、同じ処理でも呼ぶ時刻によって安いほうが入れ替わります。
2つ目のキャッシュは、差がいちばん大きい項目です。キャッシュヒットの単価はGLMがDeepSeekのオフピークの10倍、ピークの5倍で、長いシステムプロンプトやリポジトリの文脈を毎ターン送り直すコーディングエージェントほど、この差が効きます。上の表のエージェントの行では、キャッシュ分だけでDeepSeekのオフピークが$0.0072、GLMが$0.072で、GLMがオフピークで1.5倍になる理由の大半はここです。
3つ目は思考です。DeepSeekは既定で思考がオン(effortはhigh)ですが、{"thinking":{"type":"disabled"}}でオフにできます(DeepSeekの思考モードのガイド)。GLM-5.3-Flashはthinking.typeにenabledしか指定できず、Z.aiの思考モードの説明でも思考は強制で無効化できないとしています。分類、抽出、短い翻訳のように考えなくてよい呼び出しでも、GLMでは思考トークンの出力代と待ち時間が必ず乗ります。
出力トークンはどちらが多いか:総合評価ではDeepSeek、文章評価ではGLM
どちらが多く書くかは、タスクによって逆になります。Artificial Analysisの総合評価では、1タスクあたりの出力がDeepSeek(最大effort)8.9万トークン、GLM 6.9万トークン(うち思考は5.9万と4.7万)で、DeepSeekのほうが多く書いています。一方、X上で@Whats_AIが2026年10月20日ごろに報告した文章評価ToneBenchでは、台本1本あたりの思考がDeepSeek 1.7万トークン、GLM 3.7万トークンとGLMが約2倍で、順位は134設定中23位と24位でほぼ並んでいました。
出力量はモデルごとに決まった性格というより仕事の種類で変わるので、他人の測定をそのまま自分の請求額の予測に使うのは危険です。コスト表の最終行のとおり、出力量の差だけでピーク帯の損得は入れ替わるため、自分の代表的なタスクでレスポンスのusageから出力トークン数を数えてから判断してください。
入力側については、同じ文章のトークン数はほぼ同じで、単価はそのまま比べて構いません。2026年10月25日に、Hugging Faceにある両モデルの公式tokenizer.jsonで同じテキストを数えたところ、日本語の記事(約1万800文字)はDeepSeek 6,231トークン、GLM 6,381トークンでGLMが2.4%多いだけでした。TypeScriptのソースはGLMが4.7%少なく、英語・中国語・ロシア語・スペイン語もすべて±5%以内に収まり、例外は韓国語(GLMが約13%多い)だけです。チャットテンプレートや画像のトークンを含まない数え方なので、思考の長さの差に比べればごく小さな要因です。
品質はどちらが上か:Artificial Analysisの総合指数は45対42
同じ方法で両モデルを測った独立評価では、DeepSeek V4.1 Flash 1017がわずかに上です。Artificial Analysisの比較ページでは、2026年10月25日時点で総合指数(Intelligence Index)がDeepSeek(最大effort)45、GLM-5.3-Flash 42でした。項目別では、AutomationBench-AAが67%対60%、GDPval-AAが1746対1642、CritPtが24%対15%とDeepSeekが離す一方、Terminal-Bench 4.0は34%対33%、長文脈のAA-LCRは83%対80%とほぼ互角で、知識の正確さを見るAA-Omniscienceは5対7でGLMが上でした。
各社の自己申告の数字は、比べ方が揃っていません。両社ともDeepSWE v1.1の点数を公表していますが、DeepSeekはMini-SWE-V2という実行環境を明記し、Z.aiのガイドには実行環境の記載がないため、並べて勝ち負けを決められる数字ではありません。Z.aiのガイドにある「Artificial Analysisの指数で57」は旧版の指数と発売時の割引価格での数字で、今の42と同じ物差しではありません。ほかで見かける指数39やDeepSWE 74.2は、9月版のV4.1 Flashの数字です。
点差がこの程度なら、自分の仕事でどちらが合うかは別に確かめる価値があります。Redditのr/opencodeのスレッド(2026年9月ごろ、コメント80件超)では「遅延はDeepSeekのほうが明らかに小さいが、デザインの腕はGLMのほうが上かもしれない」という声があり、最も支持された回答も「自分の用途では」GLMを選んでいました。1017版が出る前の、個人の感想です。
どちらが速いか:DeepSeekは毎秒195トークン、GLMは69
速度ははっきりDeepSeekが上です。Artificial Analysisの計測では、出力速度がDeepSeek毎秒195トークン、GLM-5.3-Flash毎秒69トークン、最初のトークンまでが1.14秒対3.29秒、評価タスク1件の所要時間は357.60秒対831.77秒でした。いずれも同社が選んだ提供元での計測で、すべてのルートで同じとは限りません。GLM側で速度を上げる手段は高速版のFlashXで、Z.aiは毎秒200トークンとしていますが、単価は入力$0.37、キャッシュ入力$0.075、出力$1.25とFlashの2倍以上になり、GLM Coding Planではまだ使えません。
仕事の形で選ぶ:DeepSeekに回す処理、GLMに回す処理
既定の1つを選ぶならDeepSeek V4.1 Flashです。オフピークの費用、速度、総合指数の3点で上回り、思考のオン・オフも呼び出しごとに選べます。そのうえで、下の条件に当てはまる処理だけGLM-5.3-Flashを候補にすると、両方の利点を取れます。
OpenCodeやClaude Codeのように長い文脈をキャッシュしながら何十ターンも回すコーディングエージェントは、オフピークならDeepSeekが明確に安く、キャッシュヒットの単価差がそのまま効きます。日本の平日日中に作業が集中するチームでは多くのセッションがピーク帯に入り、出力量が同程度ならGLMが約2割安くなりますが、GLMのほうが長く書くタスクではその差が消えます。どちらに寄せるかは、自分のリポジトリで数セッション分のusageを比べてから決めるのが確実です。
分類、抽出、定型の書き換えのように短い呼び出しを大量に送る処理は、DeepSeekで思考をオフにして回すのが基本です。GLMはごく短い思考でもオフピークのDeepSeekを上回る費用になり、待ち時間も伸びます。急がないバッチは、ピーク帯を避けて夜間や土日にDeepSeekでまとめて流すと、単価が半分で済みます。
長い文書を1回だけ読ませる処理は、オフピークならほぼ同額、ピーク帯ならGLMが半額です。ただし出力が128Kトークンを超える要約や変換はGLMの上限に当たるのでDeepSeekしか使えず、逆に動画やファイルを直接入力したい場合は、テキストと画像だけを受け付けるDeepSeekではなくGLMを選ぶことになります。
切り替えでコードの何が変わるか:思考、effort、最大出力
モデル名の書き換えだけで済まないのは、主に思考まわりの設定と最大出力です。DeepSeekで思考をオフにしていた呼び出しは、GLMに移すと思考が必ず入ります。DeepSeekで128Kトークンを超える出力を許していた処理は、GLMでは上限で止まります。ほかの差は次の表のとおりです。
| 項目 | DeepSeek V4.1 Flash | GLM-5.3-Flash |
|---|---|---|
| モデルID | deepseek-flash(旧名deepseek-v4-flashも可) | glm-5.3-flash、高速版はglm-5.3-flashx |
| ベースURL | https://api.deepseek.com(OpenAI形式)、https://api.deepseek.com/anthropic(Anthropic形式) | https://api.z.ai/api/paas/v4/(Chat Completion API) |
| 思考のオン・オフ | 既定でオン、{"thinking":{"type":"disabled"}}でオフ | enabledのみで、オフにできない |
| 思考の強さ | reasoning_effortはlow、high、maxで、既定はhigh | 推奨設定はreasoning_effort: max |
| サンプリング | 思考モードではtemperatureなどが無視される(エラーにはならない)、top_pの有効範囲は0.95〜1.0 | 推奨はtemperature: 1、top_p: 0.95 |
| 前のターンの思考 | ツールを使う会話ではreasoning_contentを毎回返す。返さないと400エラー | clear_thinking: false(推奨)のときはreasoning_contentを無加工のまま返す |
| 最大出力 | 384Kトークン | 128Kトークン |
| 入力の種類 | テキスト、画像 | テキスト、画像、動画、ファイル |
| キャッシュ | ヒット分を割安な単価で課金 | 自動で、usage.prompt_tokens_details.cached_tokensで確認。保存料は期間限定で無料 |
| そのほか | FIM補完は思考なしのときだけ、同時接続の上限は2,500 | ストリーミングではstreamとtool_streamをともにオンにするのが推奨 |
出典はDeepSeekの料金ページと思考モードのガイド、Z.aiのGLM-5.3-FlashガイドとZ.aiの思考モードの説明です。どちらの会社も思考の長さをトークン数で指定する方式ではなく、effortの段階で調整します。
DeepSeekとGLMを自分のタスクで公平に比べる6つの手順
他人の測定は自分の請求額の予測に使えないので、本番に入れる前に、次の順で小さな比較を1回回してください。
- 実際の仕事から代表的なタスクを10〜20件選び、合格・不合格の基準を先に書いておきます。
- 両モデルを公式APIで、同じプロンプト、同じツール定義、同じ最大出力で呼びます。ルーター経由なら
-1017付きのIDを指定し、量子化が違うので提供元も固定します。 - 思考の条件を揃えます。DeepSeekは
reasoning_effort: maxと思考なしの2通り、GLMはZ.aiの推奨設定で走らせます。 - 毎回のレスポンスの
usageから、キャッシュヒット、キャッシュミスの入力、出力(思考を含む)のトークン数と所要時間を記録します。 - 記録したトークン数に、DeepSeekはオフピークとピークの両方の単価、GLMは一律の単価を掛け、合格したタスク1件あたりの費用で比べます。
- 自分のチームが実際に呼ぶ時間帯の比率で、DeepSeekの2つの費用を加重平均します。
DeepSeek V4.1 FlashとGLM-5.3-Flashのよくある質問
GLM-5.3-Flashはローカルで動きますか?必要なメモリは?
公式の重みのままでは、一般的なPC1台では動きません。2026年10月25日にHugging Faceで公式チェックポイントのファイルサイズを合計すると、GLM-5.3-Flashが305.8GiB(FP8)、DeepSeek V4.1 Flash 1017が475.3GiB(FP8、エキスパート部分はFP4)で、ここにKVキャッシュや実行時の作業領域が加わります。構成例と手順はGLM-5.3-Flash導入ガイド:Ox Alphaの正体、API料金、ローカル実行にあります。
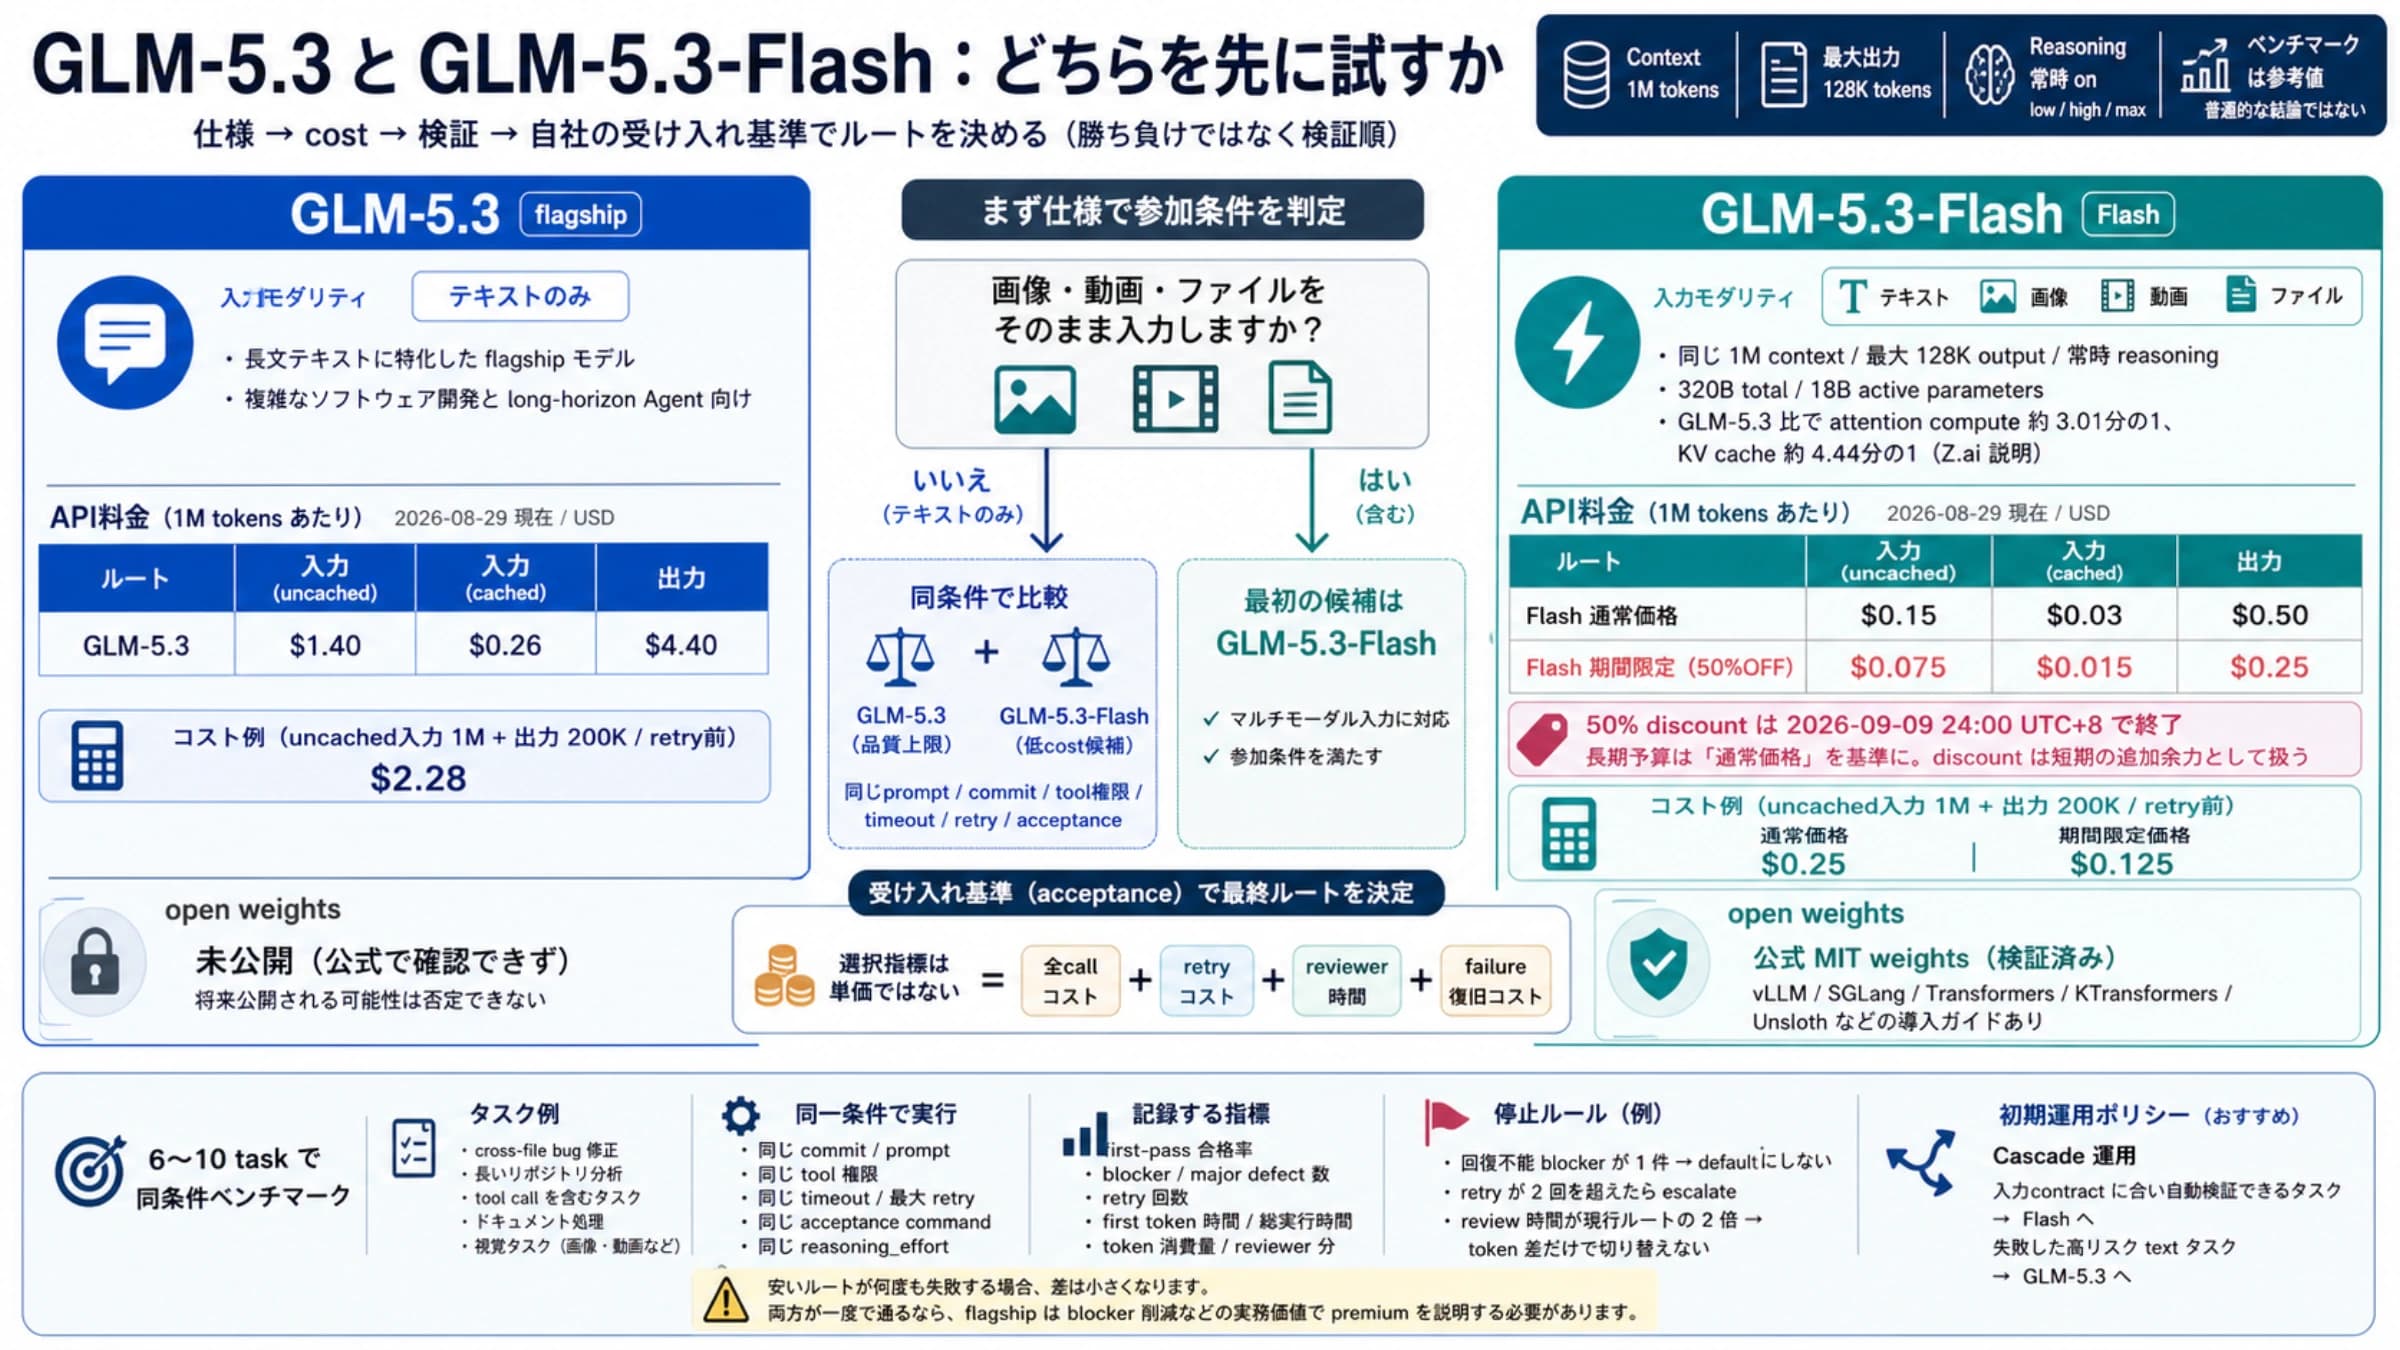
GLM-5.3とGLM-5.3-Flashはどちらを先に試せばいいですか?
画像を含む仕事や費用を抑えたい処理はGLM-5.3-Flashから、失敗の影響が大きいテキスト中心の開発はGLM-5.3も同じ条件で試すのが目安です。詳しい比較はGLM-5.3とGLM-5.3-Flash:実務ではどちらを先に試すかにあります。
GLM Coding PlanでGLM-5.3-Flashは使えますか?
使えます。2026年10月25日時点のZ.aiのガイドでは、GLM-5.3-FlashはGLM Coding Planで使え、利用枠はGLM-5.3の3倍とされています。プランはポイント制で、土日終日を含むオフピーク時間帯の呼び出しは通常の50%のポイントで済みます。高速版のFlashXはまだプランの対象外です。
Claude CodeでDeepSeek V4.1 Flashを使うには?
DeepSeekはAnthropic形式のエンドポイントhttps://api.deepseek.com/anthropicを用意しているので、Claude Codeの接続先をここに向け、モデルにdeepseek-flashを指定します。設定手順と最初のエラーへの対処はClaude CodeでOpenRouterとDeepSeekを使う:経路、設定、初回エラー対応で確認できます。DeepSeekの料金ページによると、Claude Code経由で呼ばれるサーバー側のSearchとFetchは現在無料ですが、日本時間2026年11月1日1時(北京時間0時)から成功1,000回あたり$0.75の課金が始まります。
参考資料7
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
参考資料7
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
- 1.API更新履歴api-docs.deepseek.com/updates
- 2.Z.aiのGLM-5.3-Flashガイドdocs.z.ai/guides/vlm/glm-5.3-flash
- 3.DeepSeekの料金ページapi-docs.deepseek.com/quick_start/pricing
- 4.Z.aiの料金ページdocs.z.ai/guides/overview/pricing
- 5.DeepSeekの思考モードのガイドapi-docs.deepseek.com/guides/thinking_mode
- 6.思考モードの説明docs.z.ai/guides/capabilities/thinking-mode
- 7.Artificial Analysisの比較ページartificialanalysis.ai/models/comparisons/deepseek-v4-1-flash-1017-vs-glm-5-3-flash