Kimi K3.1 ProとOpus 5.5比較:半額は単価だけ、effort別に計算
Kimi K3.1 Proのトークン単価はClaude Opus 5.5の半分ですが、既定のmaxではタスク費用がOpusと同程度以上です。安くするにはeffortを下げます。
目次
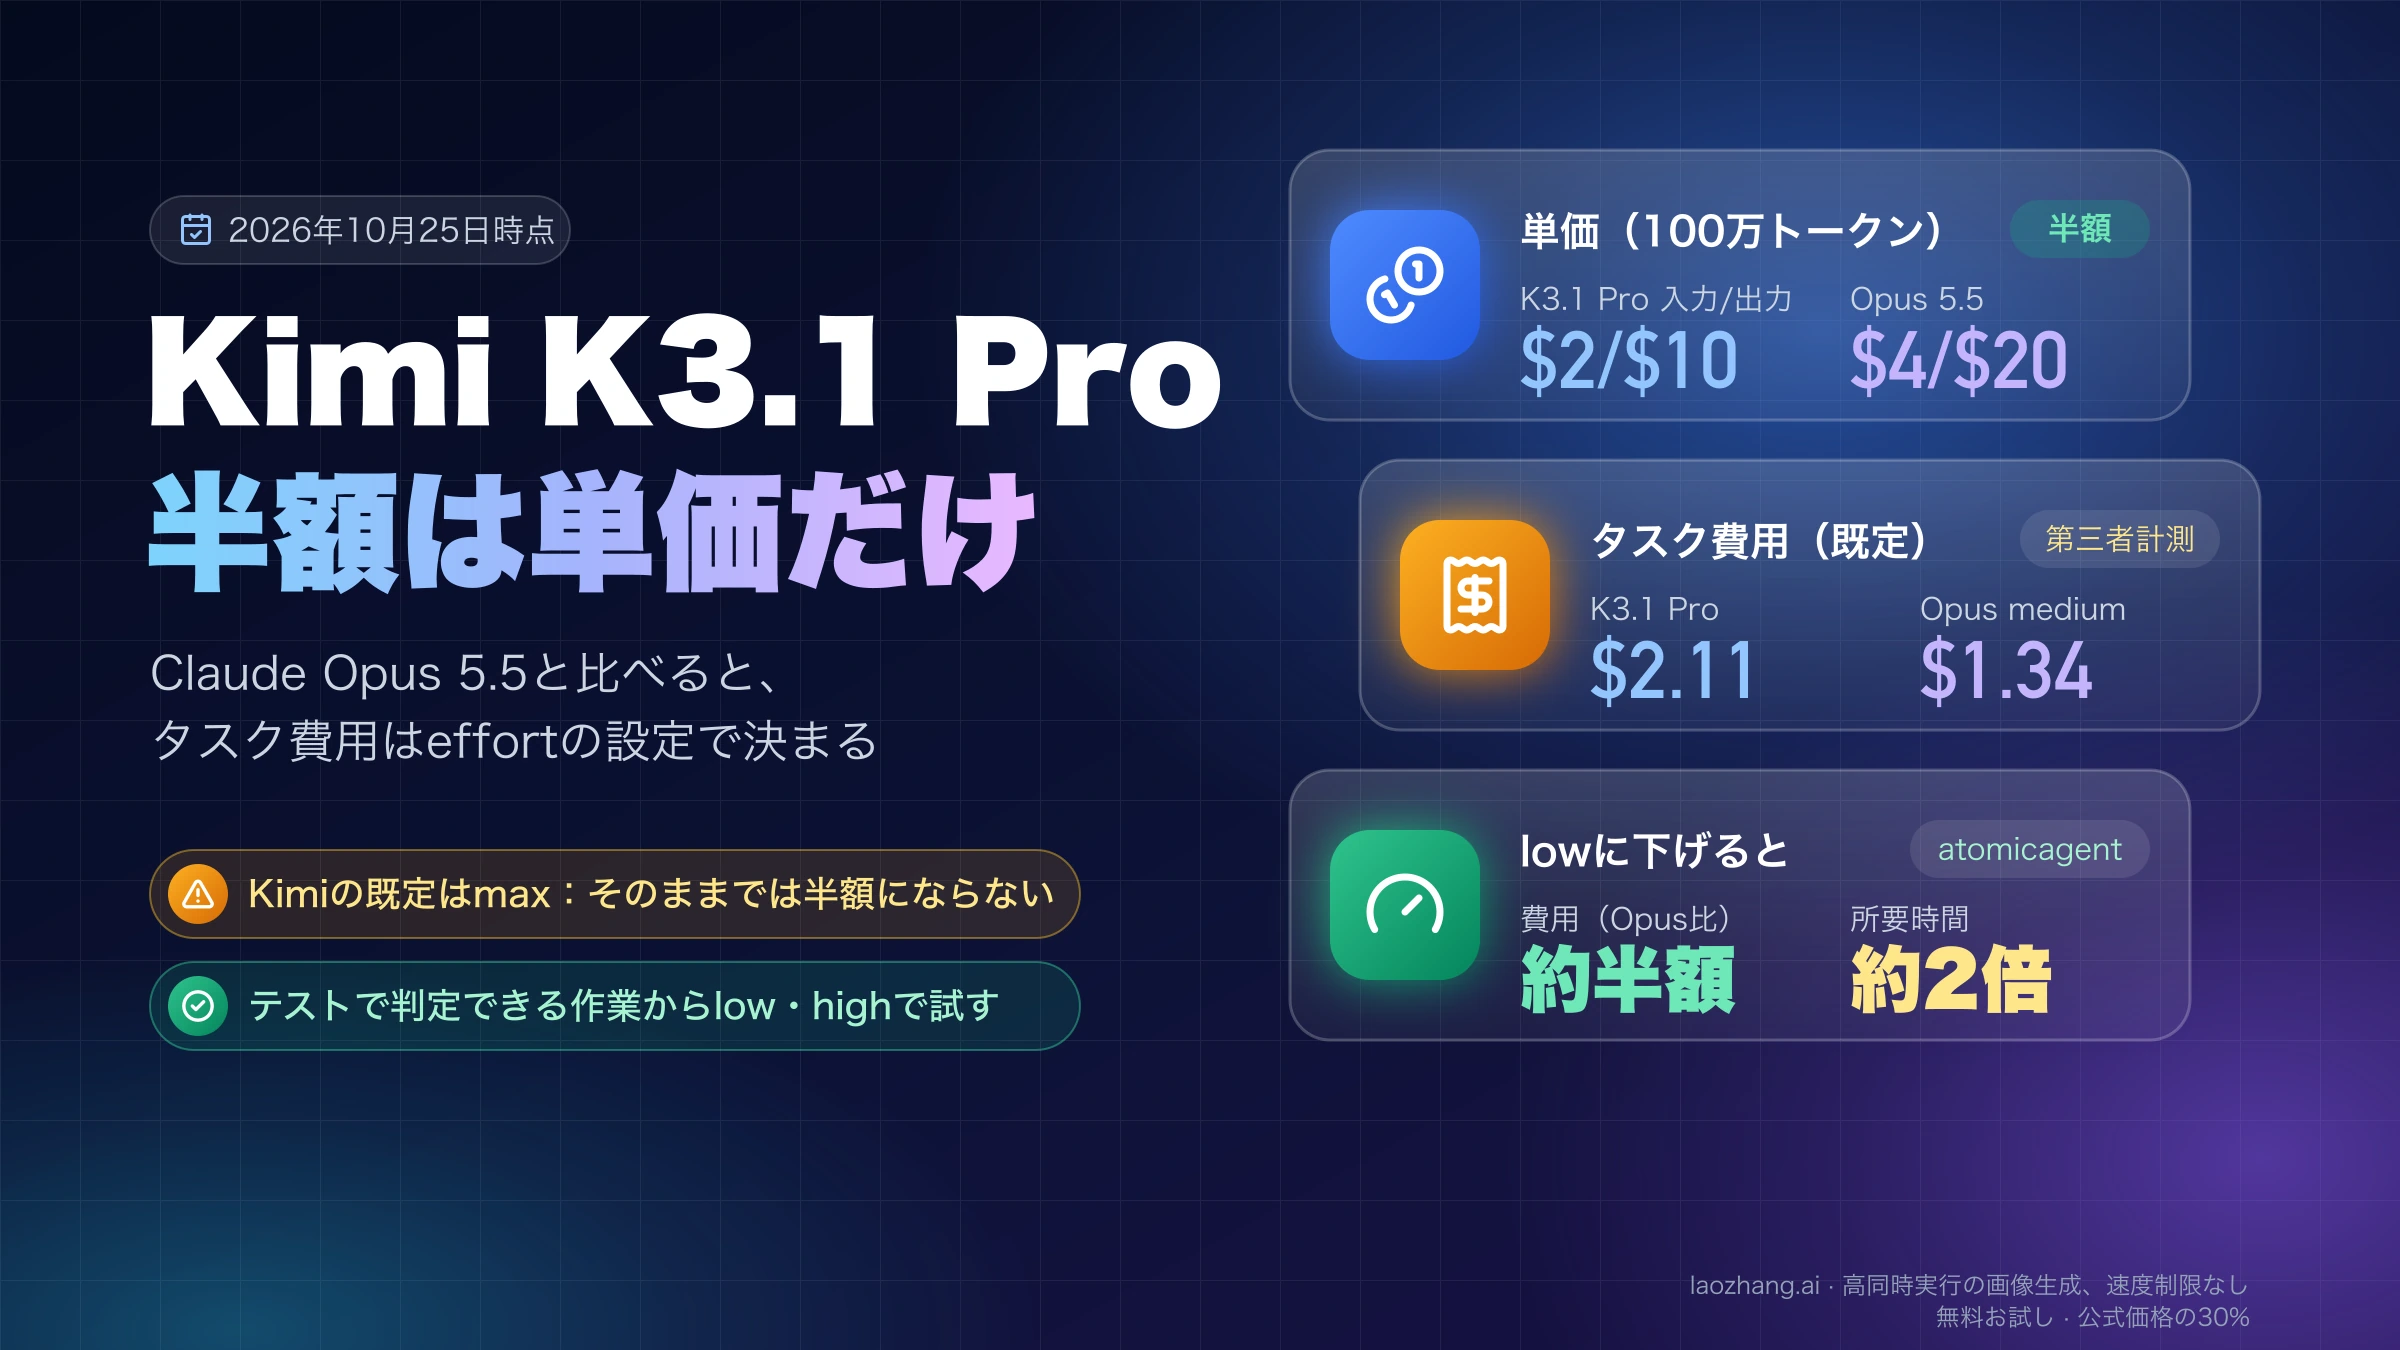
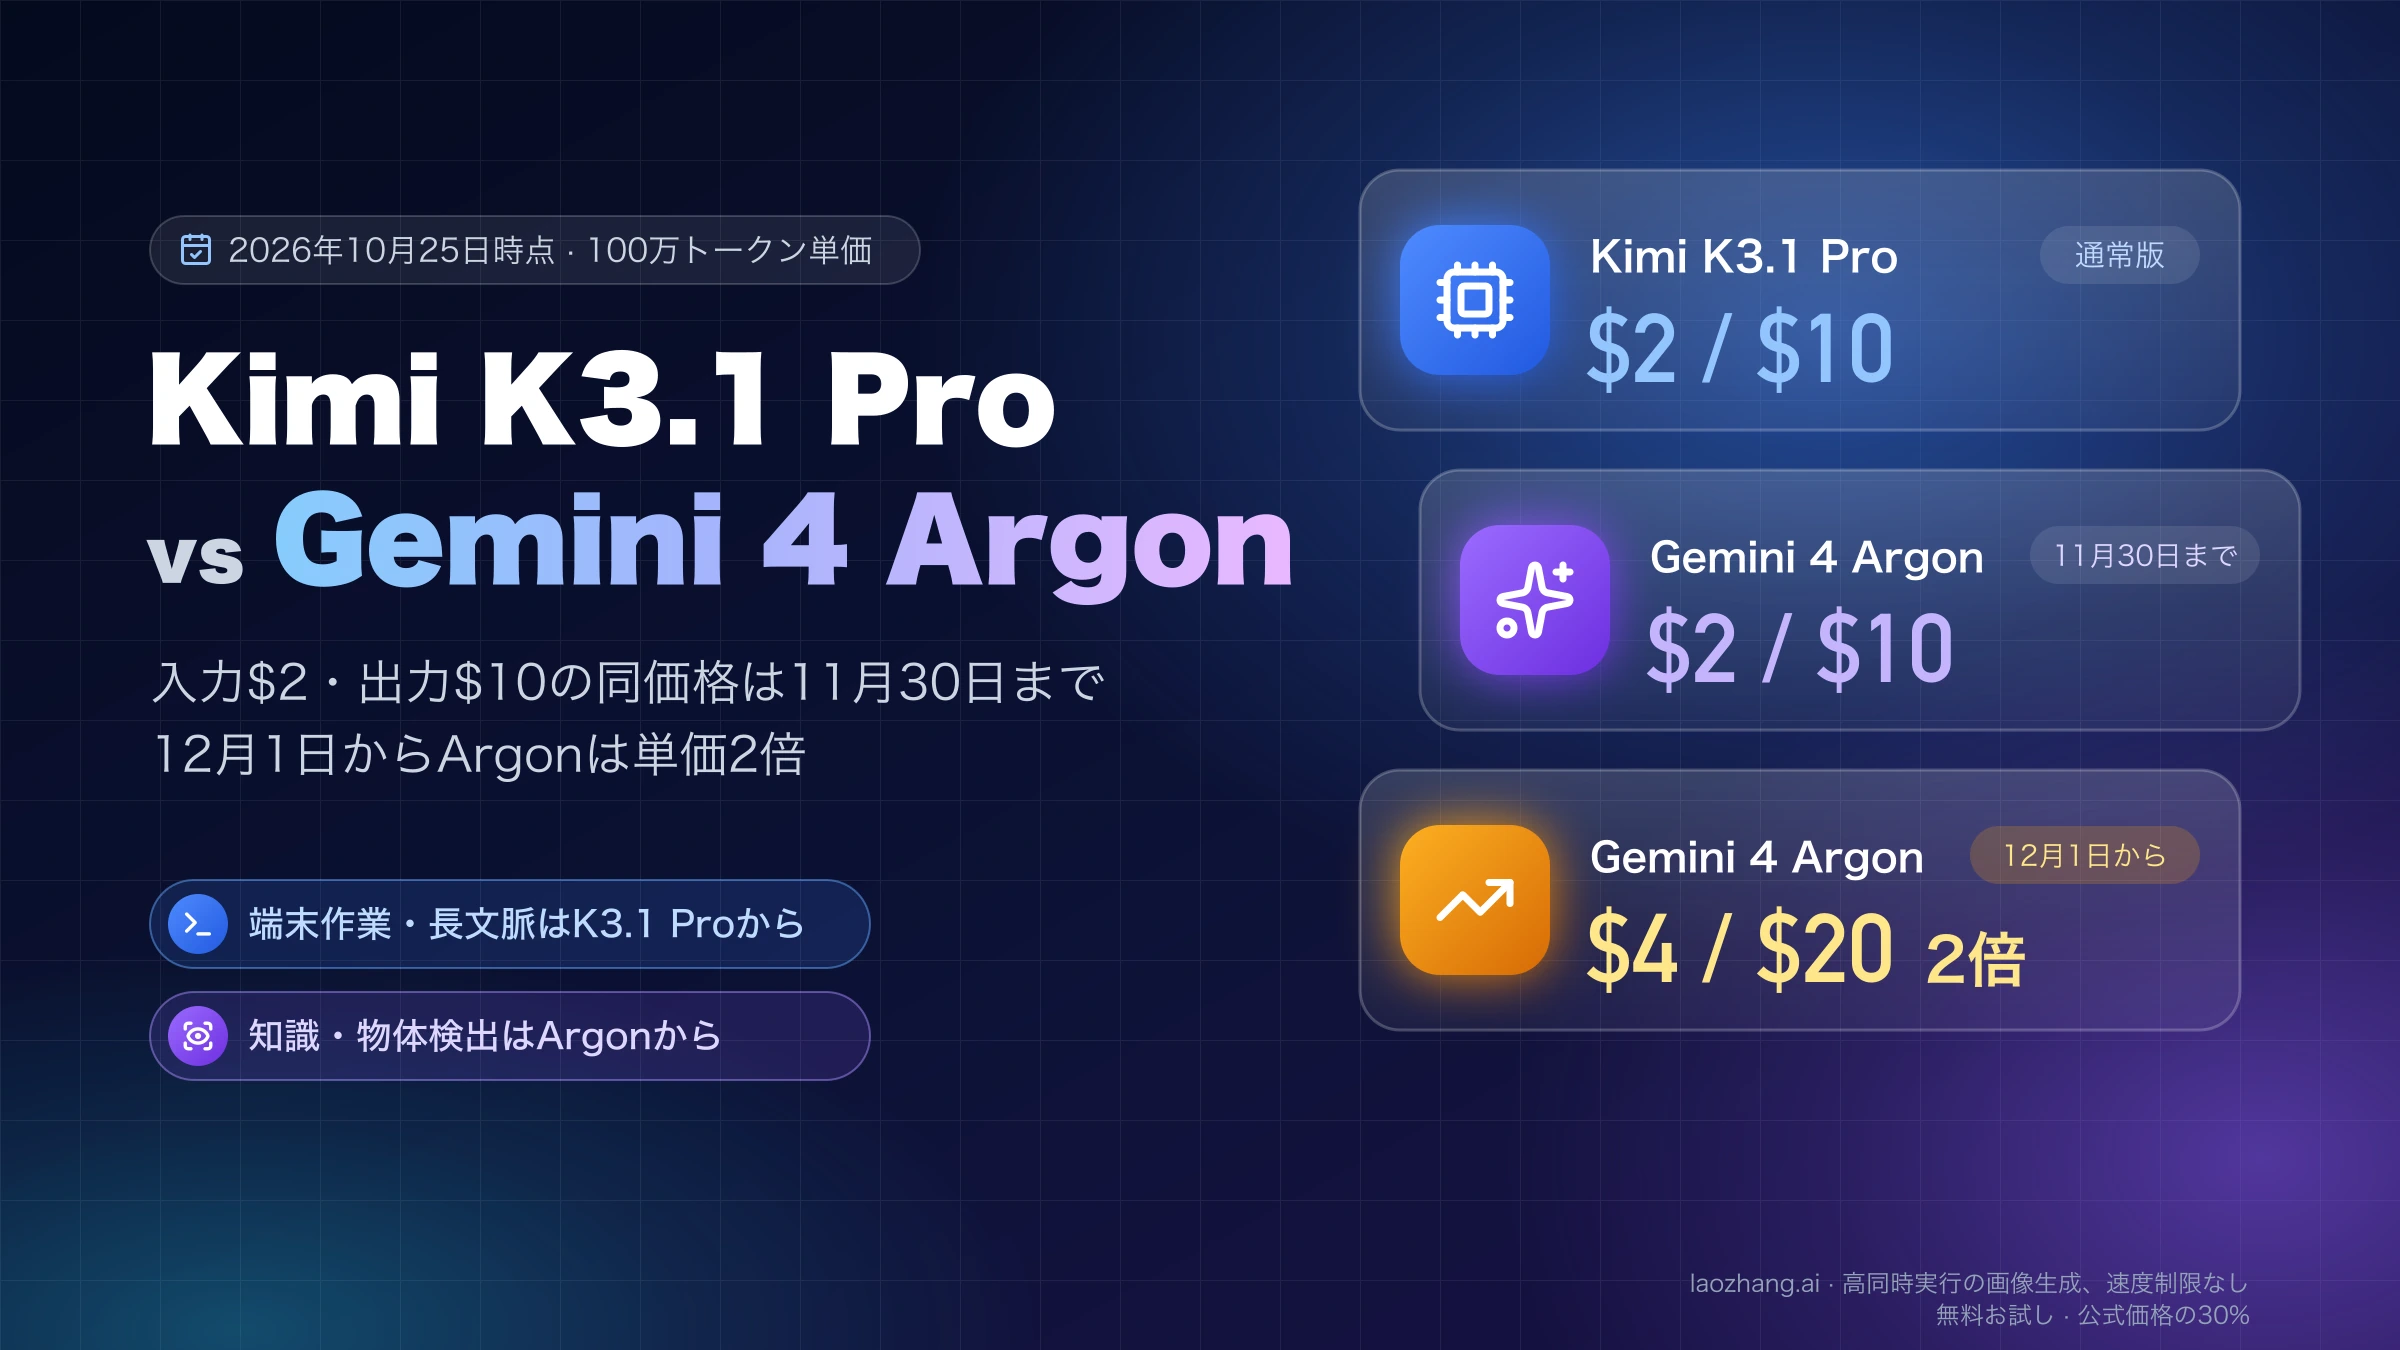
Kimi K3.1 Pro(kimi-k3.1-pro)のAPI単価は100万トークンあたり入力$2・出力$10で、Claude Opus 5.5(claude-opus-5-5)の$4・$20のちょうど半分です。ただし「半額」はトークン単価の話で、作業1件あたりの費用は思考にどれだけトークンを使うかで決まります。Kimi APIのreasoning_effortの既定は最も重いmaxで、第三者機関Artificial Analysisの計測では、K3.1 Proのタスクあたり費用が$2.11だったのに対し、Opus 5.5はAPI既定のmediumで$1.34、highでも$1.82でした。設定を変えずに置き換えても、請求額は半分になりません。
乗り換えを考えるなら、全部を一度に移すのではなく、テストで合否を自動判定でき、待ち時間が問題にならない作業から、K3.1 Proのlowかhighで試すのが現実的です。atomicagentの検証では、lowのK3.1 Proは小さなコーディング課題でOpus 5.5の約半分の費用で全テストを通しましたが、所要時間は約2倍でした。応答の速さが要る対話的な作業、科学・知識系の難問、AWSやGoogle Cloud経由の契約が前提の業務は、Opus 5.5に残すほうが安全です。
内容は2026年10月25日時点の公開情報に基づきます。手元で実際に行ったのは、定価とArtificial Analysisの計測値を使ったコストの再計算と、OpenRouterなどの公開モデル一覧の読み取りだけで、同じ課題を両モデルに解かせる直接比較は実施していません。品質と速度の数字はMoonshot AI(Kimi)、Anthropic、Artificial Analysis、atomicagentの公表値です。K3.1 Proの重みは11月4日までに公開される予定で、それまでAPIの提供元はMoonshotだけです。
「半額」はトークン単価だけ:キャッシュ読み取りは同額
半額になっているのは、通常の入力と出力の単価だけです。キャッシュに当たった入力はどちらも100万トークンあたり$0.20で差がなく、5分キャッシュの書き込みは$2対$5で2.5倍、1時間キャッシュの書き込みは$4対$8で2倍の差です。下の表はKimi APIの料金説明とAnthropicの料金ページにある米ドル建ての定価(税別、2026年10月25日時点)です。
| 100万トークンあたり | Kimi K3.1 Pro | K3.1 Pro Highspeed | Claude Opus 5.5 |
|---|---|---|---|
| 入力 | $2.00 | $4.00 | $4.00 |
| 出力 | $10.00 | $20.00 | $20.00 |
| キャッシュヒット入力 | $0.20 | $0.20 | $0.20 |
| キャッシュ書き込み(5分) | $2.00 | $4.00 | $5.00 |
| キャッシュ書き込み(1時間) | $4.00 | $8.00 | $8.00 |
Moonshotが「K3.1 Proの2〜3倍の速度」とするK3.1 Pro Highspeed(kimi-k3.1-pro-highspeed)は、入力・出力・1時間書き込みの単価がOpus 5.5と同じです。速さを求めてHighspeedを選ぶと、単価の差はなくなります。どちらのモデルも100万トークンの文脈全体で単価は変わらず、長い入力への割増はありません。Kimiは思考トークンを出力として課金するかを明記していませんが、OpenRouterとArtificial Analysisは出力として扱っています。
Opus 5.5側には単価を変える選択肢がいくつかあります。Message BatchesはStandardの半額($2・$10)で、K3.1 Proと同じ単価になります。逆に、高速モードは$8・$40、Amazon Bedrock、Google Vertex AI、Microsoft Azureのリージョン指定エンドポイントはOpenRouter上で1.1倍の$4.40・$22です。Opus 5.5の料金体系そのものはClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順で詳しく扱っています。
同じトークン数なら差は1.05〜2.00倍
単価の差が実際の請求でどう効くかを、2026年10月25日時点の上の定価で再計算すると次のとおりです。トークン数は使い方を想定した例で、出力には思考トークンを含み、キャッシュは最初の1回だけを5分書き込みとしています。
| 想定する使い方 | K3.1 Pro | Opus 5.5 | Opus÷K3.1 |
|---|---|---|---|
| 1回きりの呼び出し(入力8K、出力2K) | $0.036 | $0.072 | 2.00倍 |
| エージェントの40ターン(キャッシュ済み60K、毎ターン新規入力4K・出力3K) | $2.108 | $3.808 | 1.81倍 |
| 400Kトークンの文書に5分以内で10問 | $1.676 | $3.032 | 1.81倍 |
| キャッシュ読み取り1Mトークン+出力1K | $0.210 | $0.220 | 1.05倍 |
計算は「トークン数÷100万×単価」を項目ごとに足しただけです。たとえば1回きりの呼び出しは、K3.1 Proが0.008×$2+0.002×$10=$0.036、Opus 5.5が0.008×$4+0.002×$20=$0.072です。キャッシュ読み取りが大半を占める使い方ほど、両者の差は同額の$0.20に引き寄せられて縮みます。長い文書でも最初の書き込みが費用の多くを占めるうちは約1.8倍の差が残りますが、出力が少なくキャッシュ読み取りだけが積み上がる処理では、乗り換えても費用はほとんど下がりません。
タスク単位の費用:既定同士ならほぼ互角、半額はlowのとき
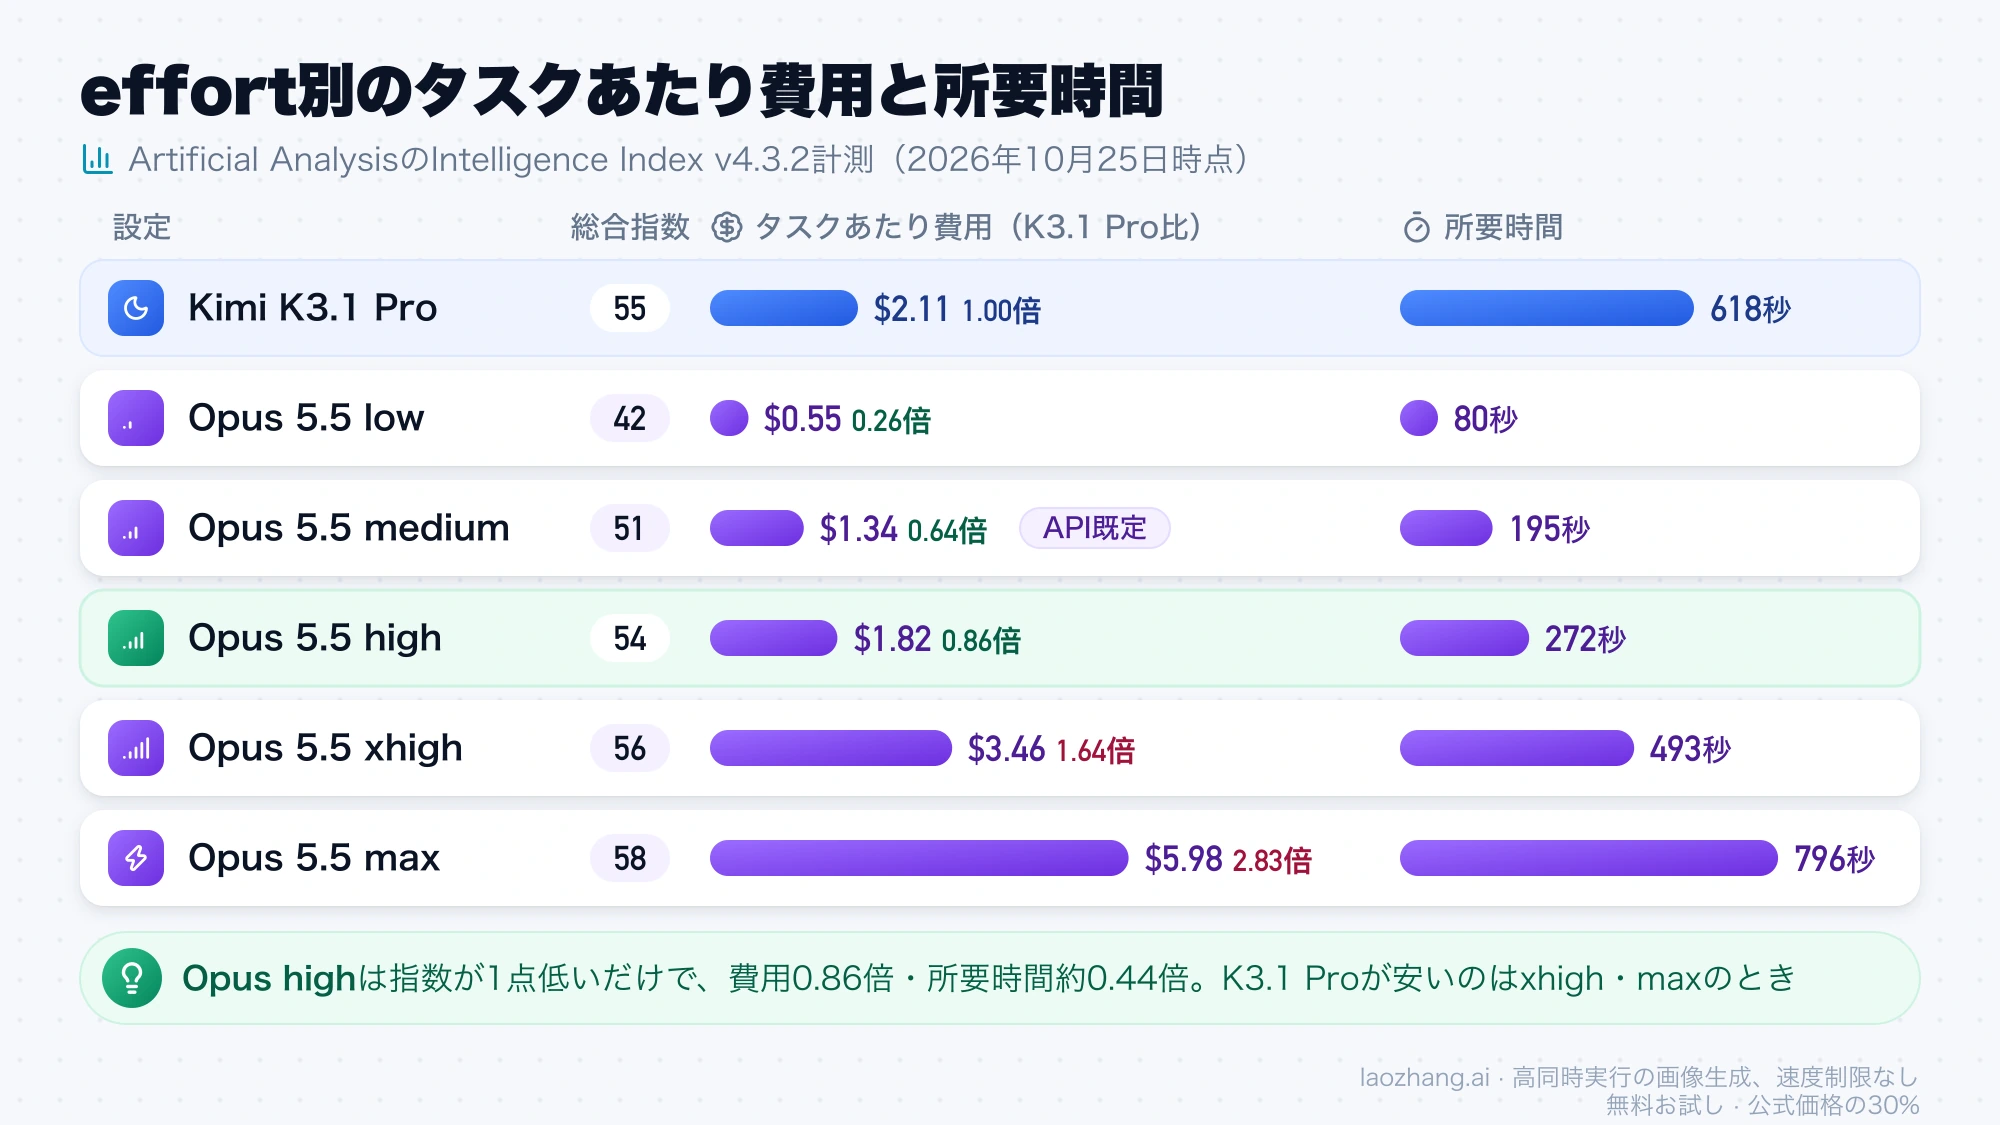
同じ作業でも、モデルと推論の段階によって出力するトークン数がまったく違うため、タスクあたりの費用は単価の比とは一致しません。Artificial Analysisが2026年10月25日時点で公開している計測(Intelligence Index v4.3.2、10種類の評価)では、K3.1 Proは1タスクあたり約55,000トークンを出力し、Opus 5.5のmedium(約26,000)の2倍以上でした。同機関はK3.1 Proを「平均より遅く、非常に冗長」と評しており、指数全体の実行に使ったトークンは1億5,000万で、中央値の8,700万を大きく上回ります。
| 設定 | 総合指数 | タスクあたり費用 | K3.1 Pro比 | 所要時間 | 出力トークン |
|---|---|---|---|---|---|
| K3.1 Pro(段階の表示なし) | 55 | $2.11 | 1.00倍 | 618秒 | 55k |
| Opus 5.5 low | 42 | $0.55 | 0.26倍 | 80秒 | 10k |
| Opus 5.5 medium(API既定) | 51 | $1.34 | 0.64倍 | 195秒 | 26k |
| Opus 5.5 high | 54 | $1.82 | 0.86倍 | 272秒 | 36k |
| Opus 5.5 xhigh | 56 | $3.46 | 1.64倍 | 493秒 | 66k |
| Opus 5.5 max | 58 | $5.98 | 2.83倍 | 796秒 | 119k |
出典はArtificial AnalysisのKimi K3.1 ProとClaude Opus 5.5の比較ページで、K3.1 Pro比は各行の費用をK3.1 Proの$2.11で割った値です。K3.1 Proの55点はOpusのhigh(54点)とxhigh(56点)の間にあります。highと比べると、Opusは指数が1点低いだけで費用は0.86倍、所要時間は約0.44倍です。K3.1 Proがはっきり安くなるのはOpusをxhighやmaxで動かした場合で、指数全体の実行費用もK3.1 Proの$3,117に対し、Opus maxは$8,708でした。
発表で目立つ「Opusの約3分の1のコスト」は、MoonshotがTerminal-Bench 4.0について示した散布図から来ていると考えられます。tbench.aiのデータに基づくこの図では、maxのK3.1 Proが約65.7%・1タスク約$5.2、Opus 5.5が約65%・約$14.3です。tbench.aiに載っているOpusはmaxでの実行なので、比べている相手はOpusの最大設定と考えられます。同じ図でK3.1 Proをhighに下げると約53%・約$4.2になり、費用は2割ほどしか下がらない一方で点数は13ポイントほど落ちます。値は図から読み取ったおおよその数字です。
出力の長さだけで再計算すると
2026年10月25日に、Artificial Analysisの出力トークン数を使い、入力を新規の20Kトークンに固定して定価で再計算しました。K3.1 Proは0.02×$2+0.055×$10=$0.59です。Opus 5.5はlowで$0.28(0.47倍)、mediumで$0.60(1.02倍)、highで$0.80(1.36倍)、xhighで$1.40(2.37倍)、maxで$2.46(4.17倍)になり、API既定のmedium同士ではほぼ同額です。
この計算では上の実測よりOpusが割高に出ます。入力を固定しているためで、実測額から出力分を差し引くと、入力側の費用はK3.1 Proが約$1.56($2.11−$0.55)、Opus mediumが約$0.82($1.34−$0.52)です。K3.1 Proは呼び出しの回数が多く、入力も多く読んでいると読めます。
atomicagentの検証:lowで約半額、ただし約2倍遅い
atomicagentは2026年10月23日、5つのバグと2つの未実装機能を仕込んだ小さなPythonパッケージを、同じエージェントで両モデルに3回ずつ修正させました。Opus 5.5はOpenRouter経由でAnthropicに固定し、K3.1 ProはKimi APIで既定のmaxとlowの2通りです。どの設定も隠しテストをすべて通しました。タスクあたりの費用はK3.1 Proのlowが$0.16〜0.21、既定のmaxが$0.35〜0.46、Opus 5.5が$0.37で、所要時間はlowが約2.2分、maxが約4.9分、Opusが69秒でした。
差を生んだのは作業の進め方です。maxのK3.1 Proは1回の実行あたり平均28回モデルを呼び出し、思考トークンは約12,000で、Opusの7回・約700を大きく上回りました。入力の約96%はキャッシュから読まれていましたが、呼び出しが積み重なって費用が膨らみます。atomicagentのまとめは「トークン単価の安さがタスクの安さになるのは、推論を下げたときだけ」です。K3.1 Proの費用に幅があるのは、6回の実行でKimiの残高が$2.02減ったのに対し、トークン数からの計算は$1.52だったためです。課題は1つだけで、発表当日の計測でもあり、長期のエージェント作業やHighspeedについては何も示していません(atomicagentのKimi K3.1 Pro検証記事)。
比べる前にeffortをそろえる:Kimiの既定はmax、Opusはmedium
両モデルとも思考をオフにはできず、どれだけ考えさせるかを推論の段階(effort)で調整します。何も指定しなければ、K3.1 Proはreasoning_effortの3段階(low、high、max)のうち最も重いmaxで動き、Opus 5.5はeffortの5段階(low、medium、high、xhigh、max)のうち中間のmediumで動きます。既定のまま比べると、Kimiの最上位とOpusの中間を比べることになります。同じ「max」でも、Kimiでは3段階の上限、Opusではxhighのさらに上の段階で、意味が違います。
K3.1 Proで最初に試す段階は、作業の性質で分けます。仕様がはっきりしていてテストで合否が決まる作業はlowから始め、テストが通らなくなったらhighへ上げます。atomicagentの課題ではlowでも全テストを通過しました。ターミナル操作を伴う長い作業は、Moonshotの図でhighに下げると点数が大きく落ちているため、maxのまま、Opusのhighかxhighと比べるのが妥当です。
Opus 5.5は、API既定のmediumを基準にしてhighを並べて比べます。Opus 5はhighが既定だったため、effortを省略したリクエストはOpus 5.5では1段階軽く動きます(Anthropicのeffortの説明)。Anthropicはxhighを30分を超える長いエージェント作業やコーディング向けとしており、high以上では思考と本文を合わせた出力の上限になるmax_tokensを大きく取るよう勧めています。Opus 5.5は会話の途中でメッセージごとのoutput_configによってeffortを変えられ、プロンプトキャッシュも保たれます(ベータ機能)。
どのベンチを信じる?0.7ポイント差・67対60・64.8%の出どころ
Terminal-Bench 4.0の数字は少なくとも3つの出どころがあり、どれも条件が違います。「Opusに0.7ポイント差」はMoonshotの発表図、「K3.1 Proが上」はArtificial Analysisの独自計測で、公開ランキングのtbench.aiにはK3.1 Proがまだ載っていません。ハーネス(モデルを動かすエージェントの仕組み)とeffortが変われば、勝者も入れ替わります。
| 出どころ | K3.1 Pro | Opus 5.5 | 条件 |
|---|---|---|---|
| Moonshotの発表図 | 65.7% | 66.4% | 全モデル最大effortと注記。ただしOpusの66.4%はAnthropicが自社発表で示したxhighの値 |
| tbench.aiのTerminal-Bench 4.0ランキング | 掲載なし | 64.8% ±3.1% | Opusはmax、Claude Codeで実行 |
| Artificial Analysis | 67% | 60%(highは57%) | 同機関独自の実行環境、Opusはmax |
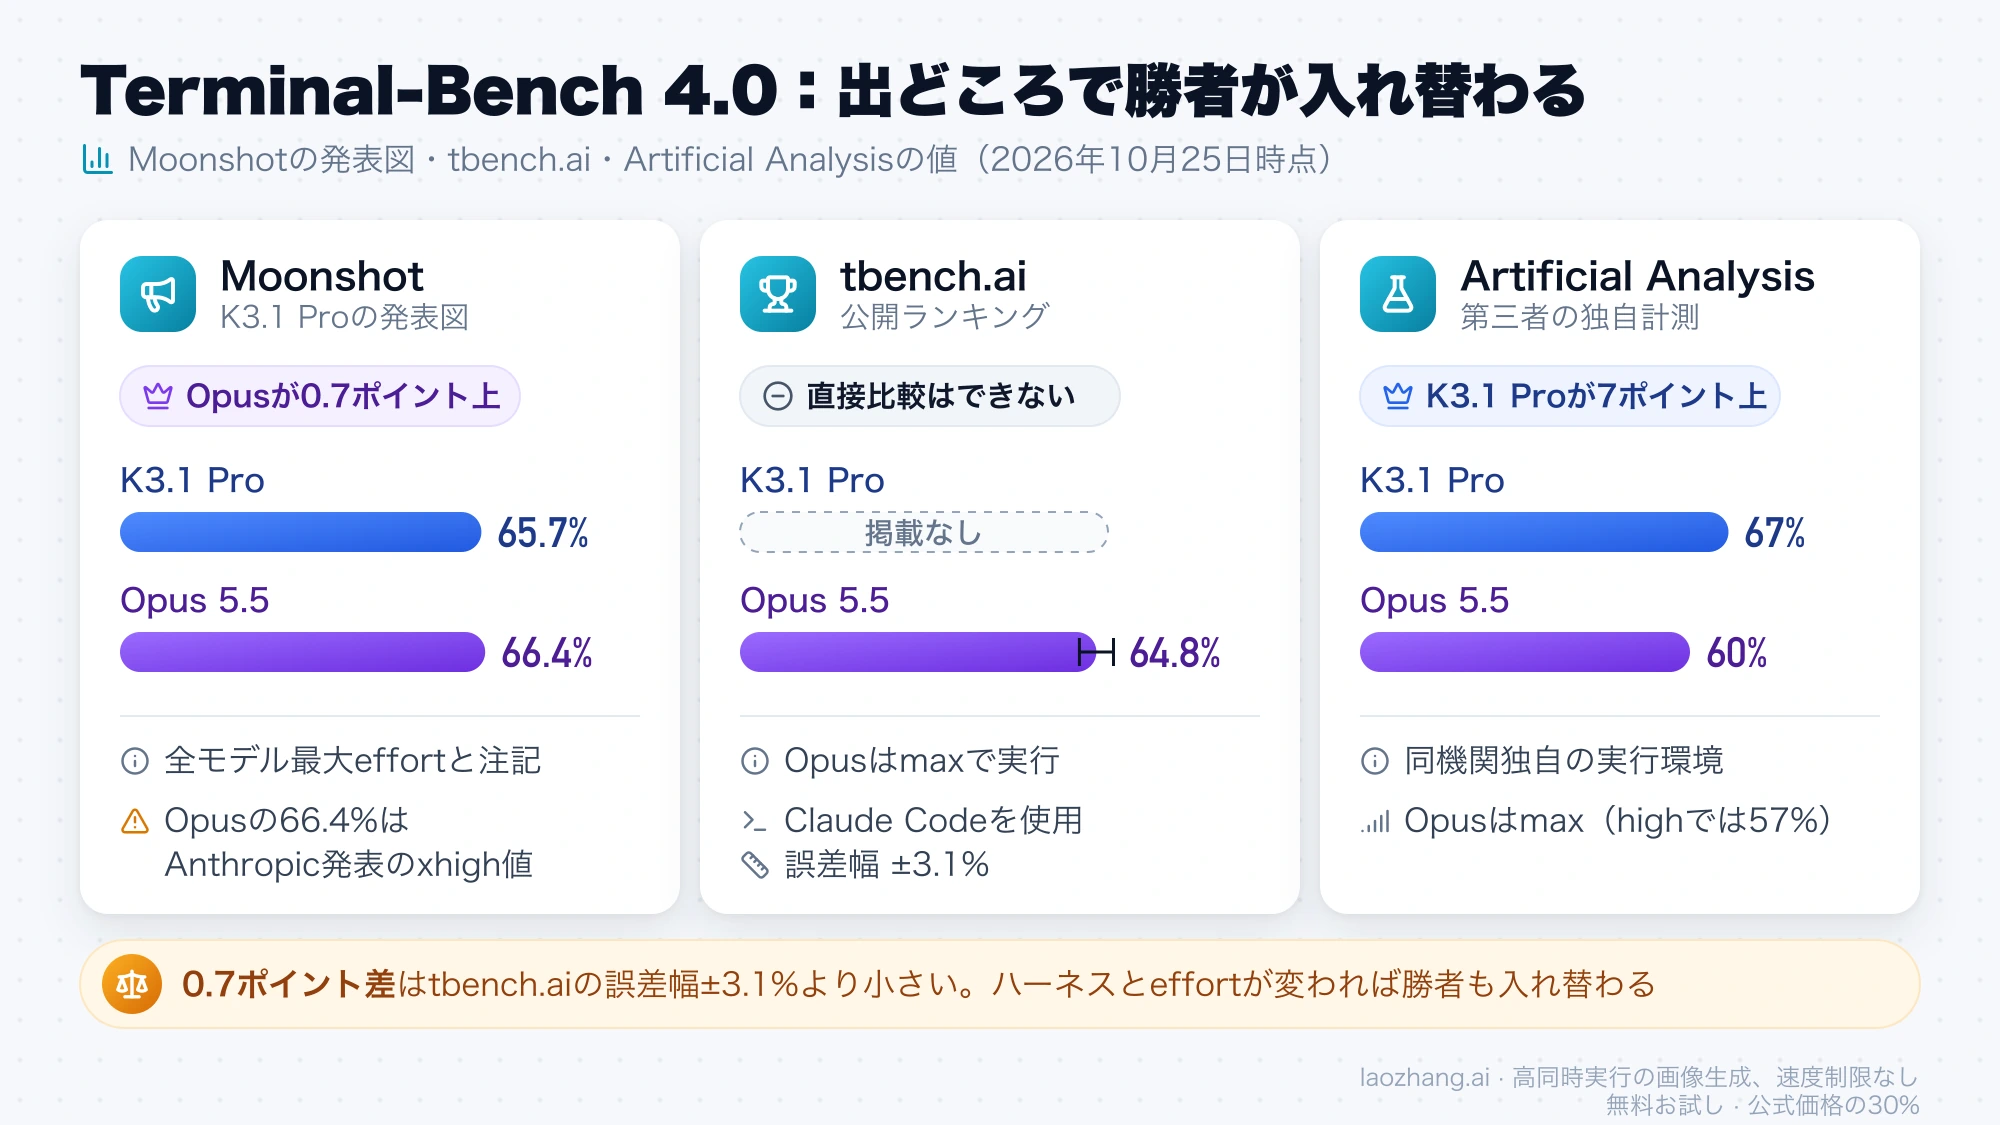
0.7ポイントという差は、tbench.aiがOpusの結果に付けている誤差幅(±3.1%)より小さく、この1項目だけでは優劣を言えません。Moonshotの14項目の図(以下、数字はK3.1 Pro対Opus 5.5の順)では、K3.1 Proが9項目、Opusが5項目で上回っていますが、K3.1 Proが勝つ項目の多くは2〜5ポイントの小差です。SWE Marathonは51.7対46.3、Kimi Code Bench 3.0の長期タスク(Moonshot社内の評価)は61.2対58.5、GDP.pdfは34.6対30.6でした。逆にOpusが勝つ項目では、Terminal-Bench Scienceの38.1対63.3のように大差のものがあり、BenchCAD(92.7対96.2)とOSWorld(79.6対81.8)もOpusが上です。Opusの列にはAnthropicの自社発表の値やArtificial Analysisの値が混ざっており、条件は統一されていません。
Artificial Analysisの項目別(K3.1 Pro対Opus 5.5 maxの順)では、K3.1 Proが上回ったのはTerminal-Bench 4.0、AutomationBench(73%対70%)、GDP.pdf(31%対26%)などで、Opusが上だったのはHLE(52%対61%)、SciCode(61%対67%)、CritPt(25%対32%)、知識の正確さを測るAA-Omniscience(30対46)、AA-Briefcase(1678対1801)です。総合指数はK3.1 Proが55、Opus 5.5はmaxで58です。知識や科学を問う評価でOpusが上回るのはArtificial Analysisの結果で、Moonshotの図では知識系のHLE Full(ツールあり)はK3.1 Proが上(70.0対67.7)、Opusが大差をつけたのはTerminal-Bench Scienceだけです。Anthropic自身も、ベンチマークの差は実際の違いを測る目安として信頼性が下がっていると述べています。
ほかに、Redditでは自分たちのベンチでK3.1 Pro(high)が87.9、Opus 5.5が86.7だったという投稿や、K3.1 Proのほうが3.5分の1の費用だったという報告があり、発表当日の宣伝が組織的だったと疑うコメントもあります。どれも単独の事例です。
コードで差し替えると壊れる設定:サンプリング固定と思考オフ不可
モデル名とベースURLを書き換えるだけでは動かない箇所があります。とくにK3.1 Proは、temperature(1.0)、top_p(0.95)、n(1)、presence_penaltyとfrequency_penalty(0)が固定値で、Kimi K3.1 Proのクイックスタートはリクエストから省くよう求めています。Opus向けのコードで温度を指定していれば、その行を消すところから始まります。
| 項目 | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| モデルID | kimi-k3.1-pro | claude-opus-5-5(Bedrockはanthropic.claude-opus-5-5) |
| 接続先 | https://api.moonshot.ai/v1(Anthropic互換は/anthropic) | Anthropic API、Bedrock、Vertex AI、Foundry |
| 思考のオフ | 不可(常にオン) | 不可。thinking: {"type": "disabled"}は400エラー |
| 推論の段階 | reasoning_effort:low/high/max、既定max | effort:low/medium/high/xhigh/max、既定medium |
| 最大出力 | max_completion_tokens既定131,072、最大1,048,576 | 128K(Message Batchesはベータヘッダーで300K) |
| 文脈の長さ | 100万トークン | 100万トークン |
| キャッシュ | 自動、既定5分、prompt_cache_options.ttlで1時間 | 書き込みは5分と1時間の2種類 |
K3.1 Proには、ほかにもOpus向けのコードにない決まりがあります。複数ターンの会話やツール呼び出しでは、モデルが返したアシスタントメッセージを手を加えずにそのまま送り返す必要があります。画像は公開URLでは渡せず、base64かms://で始まるファイルIDを使います。json_schemaのstrict: trueで出力を縛れますが、解析するのはmessage.contentだけで、思考を含むreasoning_contentは対象外です。Kimi公式のウェブ検索ツールは更新中で、当面は本番利用を勧めないとされています。
最大出力は両方向で注意が要ります。Opus 5.5はStandardで128Kが上限なので、K3.1 Pro用に数十万トークンの出力上限を指定していると、Opusの上限を超えます。逆にOpusでmax_tokensを小さく絞っていた設定をK3.1 Proへ持ち込むと、既定maxの長い思考で上限に達しやすくなります。
提供元の数:K3.1 ProはMoonshotのみ、Opusは11か所
2026年10月25日にOpenRouterの公開API(/api/v1/modelsとモデル別のendpoints)を読むと、moonshotai/kimi-k3.1-proのエンドポイントは2つで、どちらもMoonshot AI自身でした(通常版$2・$10とHighspeed$4・$20)。最大出力は943,718トークンで、対応パラメーターにreasoning_effortやツール、構造化出力は含まれますが、temperatureとtop_pはありません。anthropic/claude-opus-5.5は、Anthropic、Amazon Bedrock、Google Vertex、Azure、Claude Platform on AWSの計11エンドポイントで、うち5つのリージョン指定は$4.40・$22でした。
この差は、データの保管場所やクラウド契約が決まっている組織では、それだけで判断材料になります。重みが公開されれば提供元は増える可能性がありますが、2026年10月25日時点でK3.1 Proを使える経路はMoonshotのAPIだけです。日本はAnthropicの対応地域に含まれており、Claude API、Claude Code、クラウド経由のClaudeはいずれも利用対象です。
API集約サービスのlaozhang.aiのモデル一覧(2026年10月25日時点の/v1/models)にはclaude-opus-5-5がAnthropic定価の$4・$20で載っており、同日午後にはkimi-k3.1-proとkimi-k3.1-pro-highspeedもKimiの定価(100万トークンあたり$2・$10と$4・$20、キャッシュ読み取り$0.20)で追加されました。同サービスのClaudeは1回の応答の出力が32,768トークンまでで、BatchesやFilesにも対応していないため、xhighやmaxで長く考えさせる用途には向きません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
K3.1 Proに移す作業、Opus 5.5に残す作業
K3.1 Proで試す価値があるのは、結果を機械的に検証でき、時間がかかっても困らない作業です。テストで合否が決まるバグ修正や機能追加をCIや夜間のバッチで回す場合なら、lowやhighに下げても失敗をテストで拾えるため、単価の安さがそのまま費用に出やすくなります。Moonshotの図で小差ながらK3.1 Proが上回っている長期のコーディングや、表や資料を扱う事務・財務系の作業も候補ですが、根拠は同社の発表値なので、自分の課題で確かめてから移します。
Opus 5.5に残すのは、待ち時間がそのまま人の作業時間になる対話的な開発です。Artificial Analysisの計測ではK3.1 Proのタスクあたり時間はOpus highの約2.3倍で、atomicagentの課題ではlowでも約2倍かかりました。専門知識の正確さや科学計算が要る仕事は、Artificial AnalysisのHLE、AA-Omniscience、SciCode、CritPtでOpusが上回っています。Moonshotの図でもTerminal-Bench Science(38.1対63.3)はOpusの大差です。画面操作を伴う作業やCADも、Moonshot自身の図でOpusが上です。BedrockやVertex AIの契約、特定リージョンでの処理が前提の業務も、重みが公開されて提供元が増えるまでは移せません。
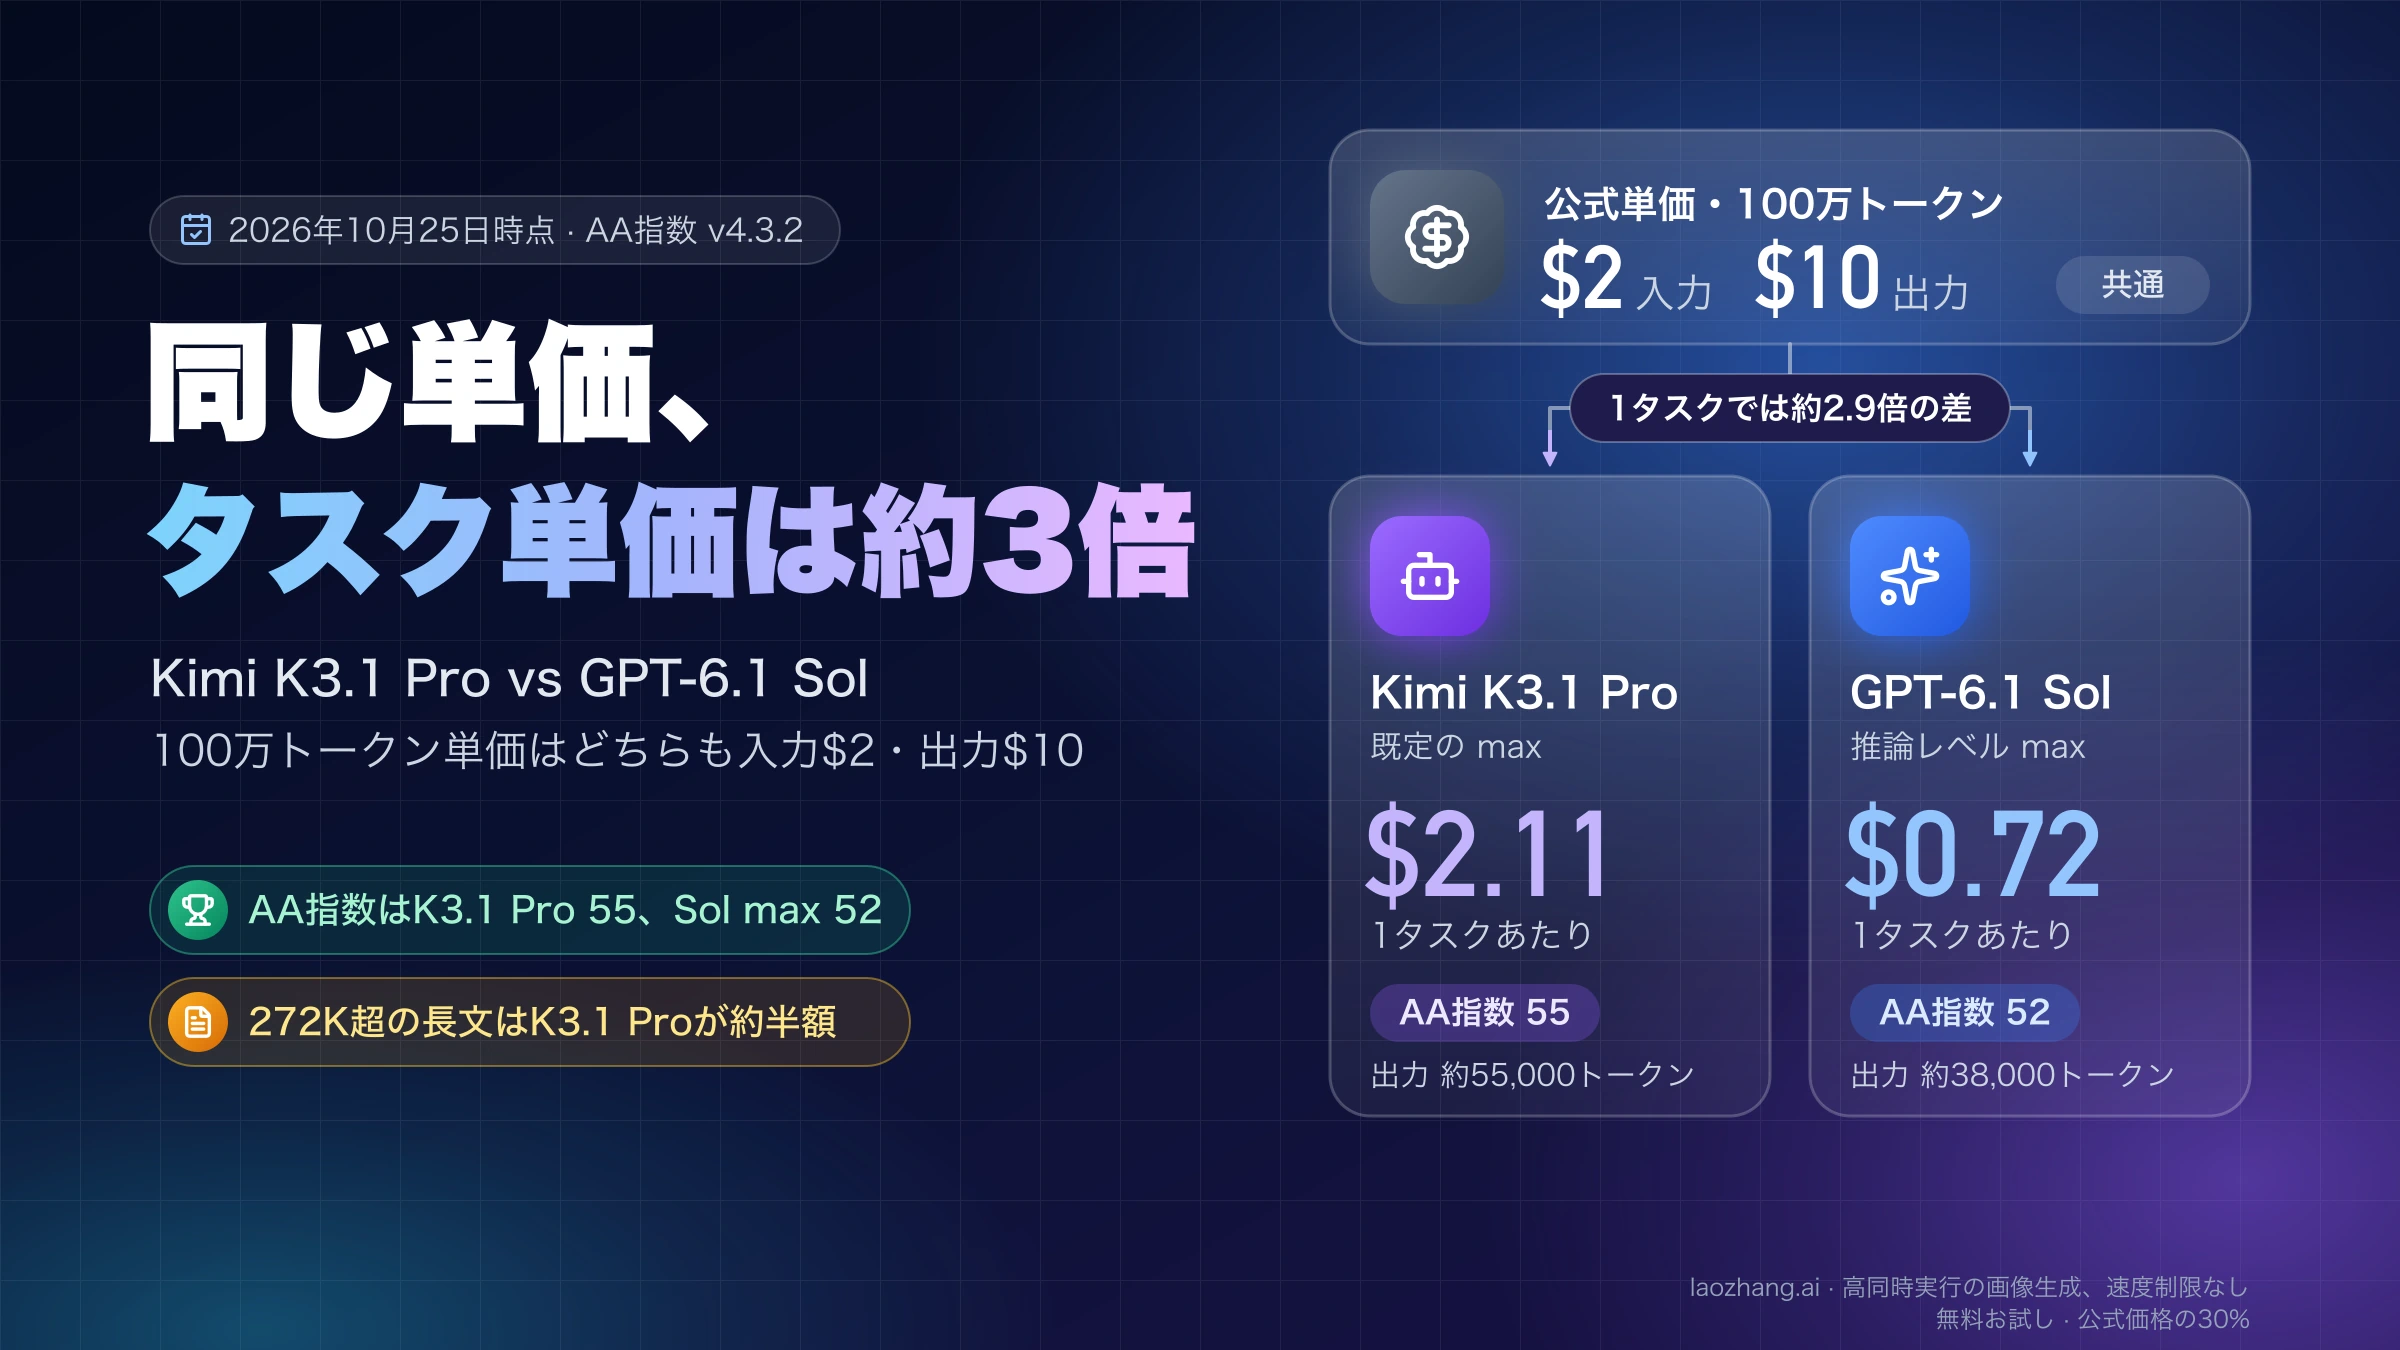
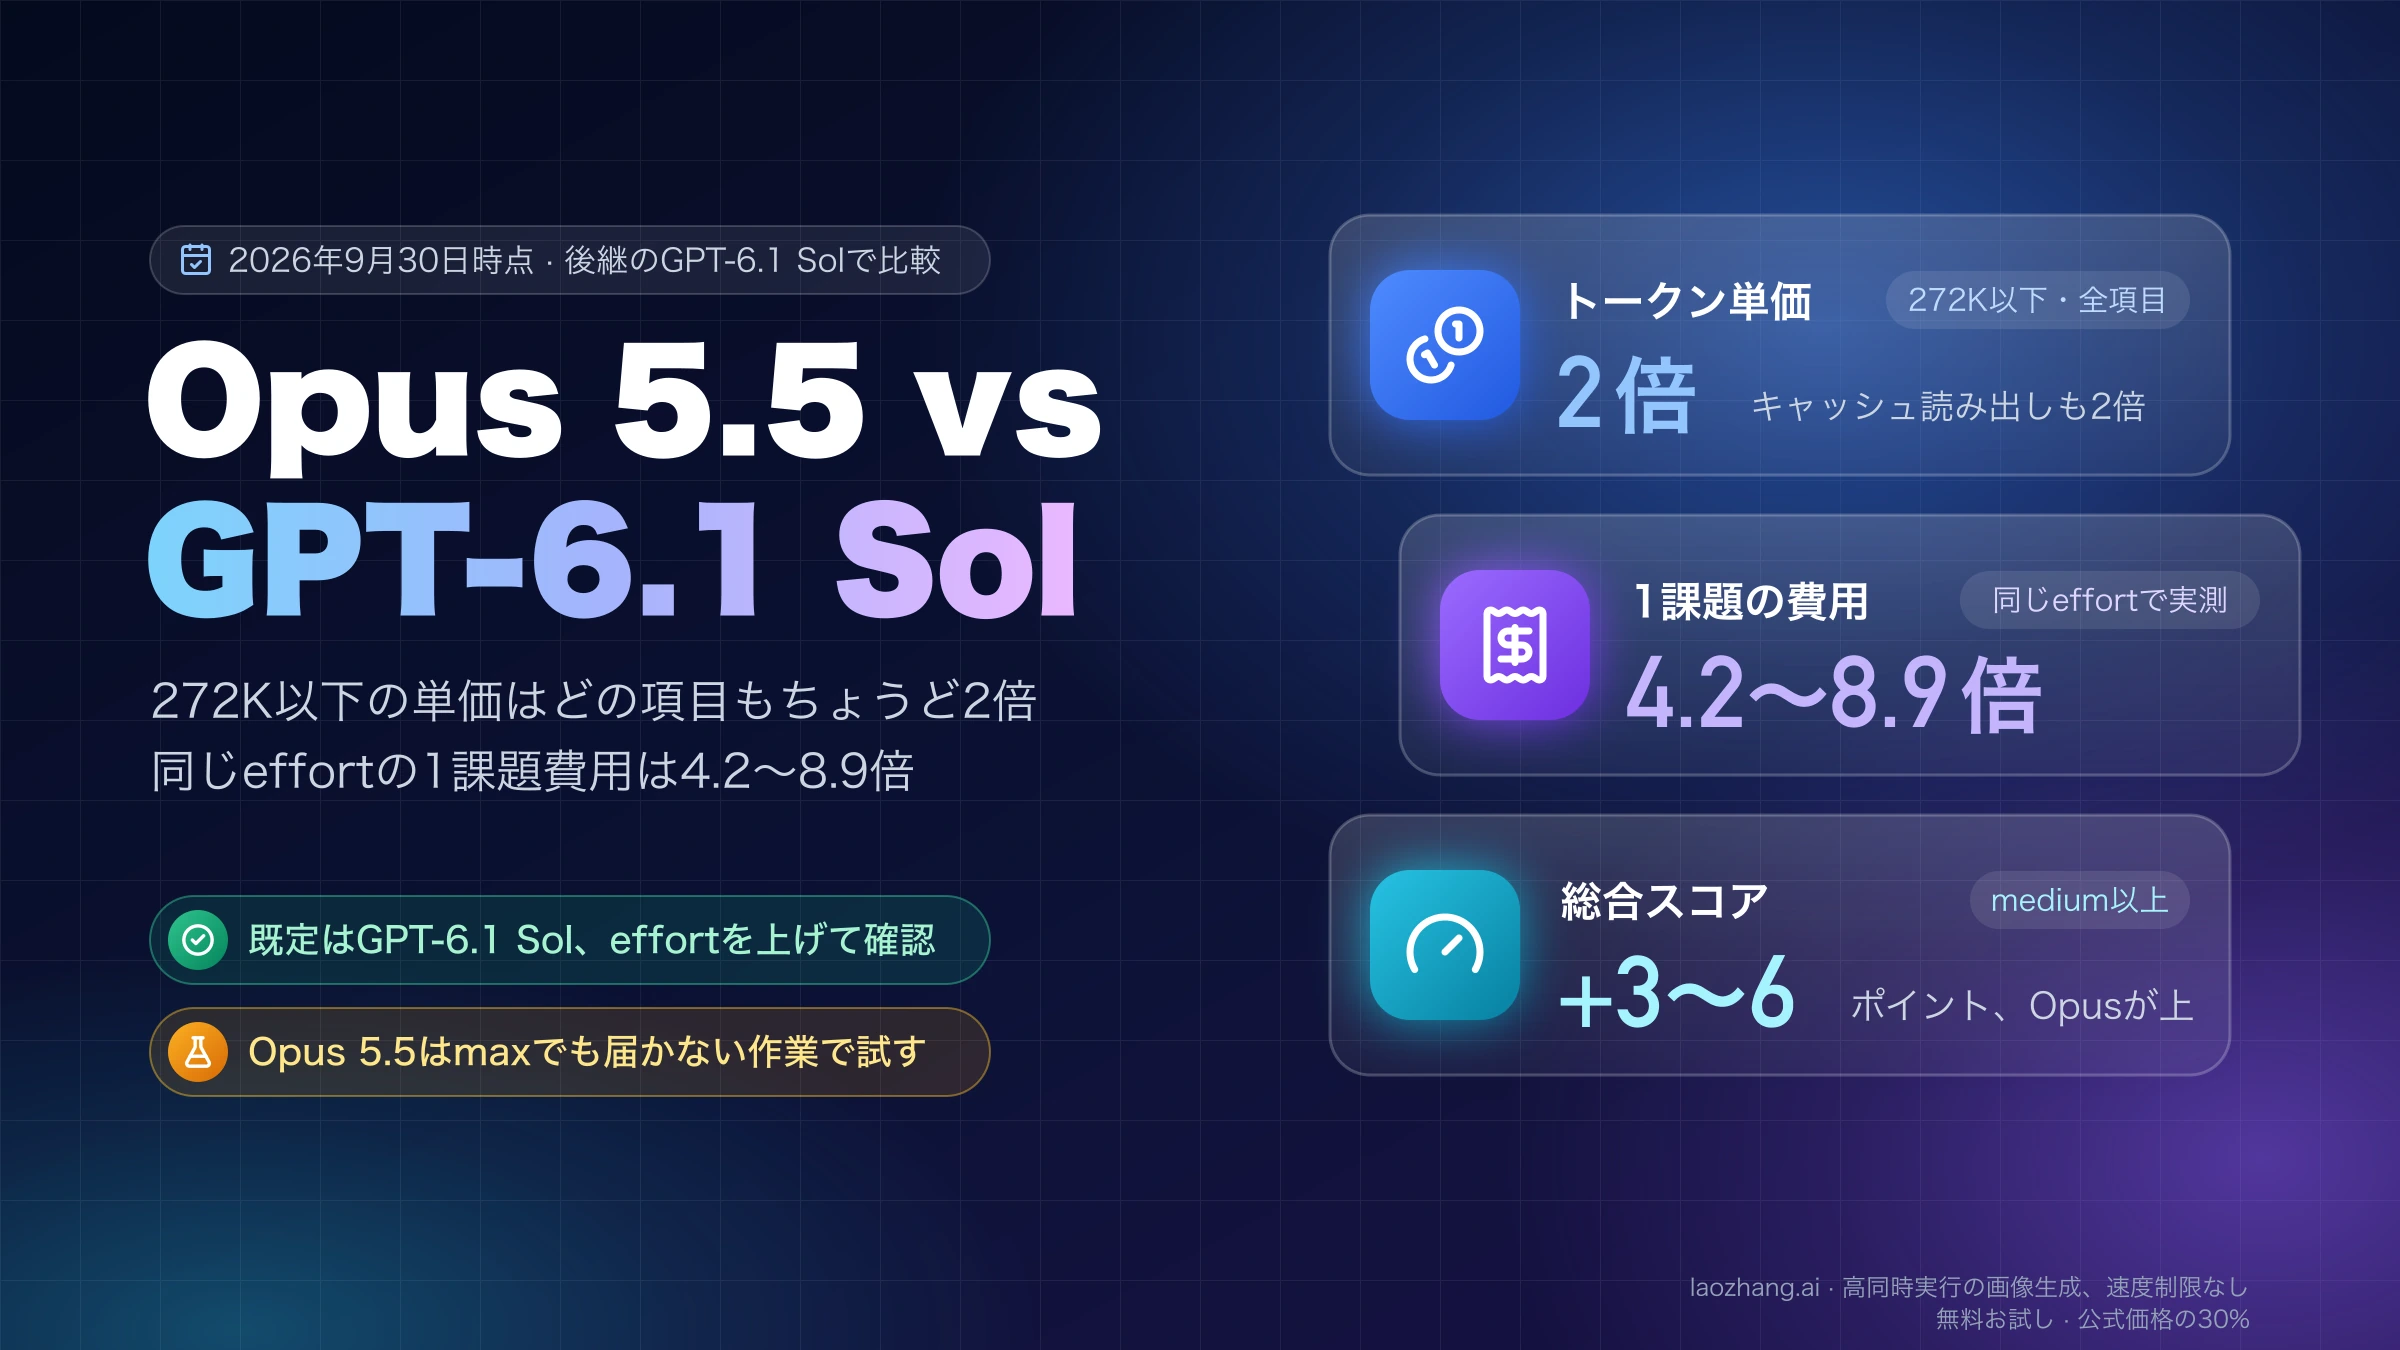
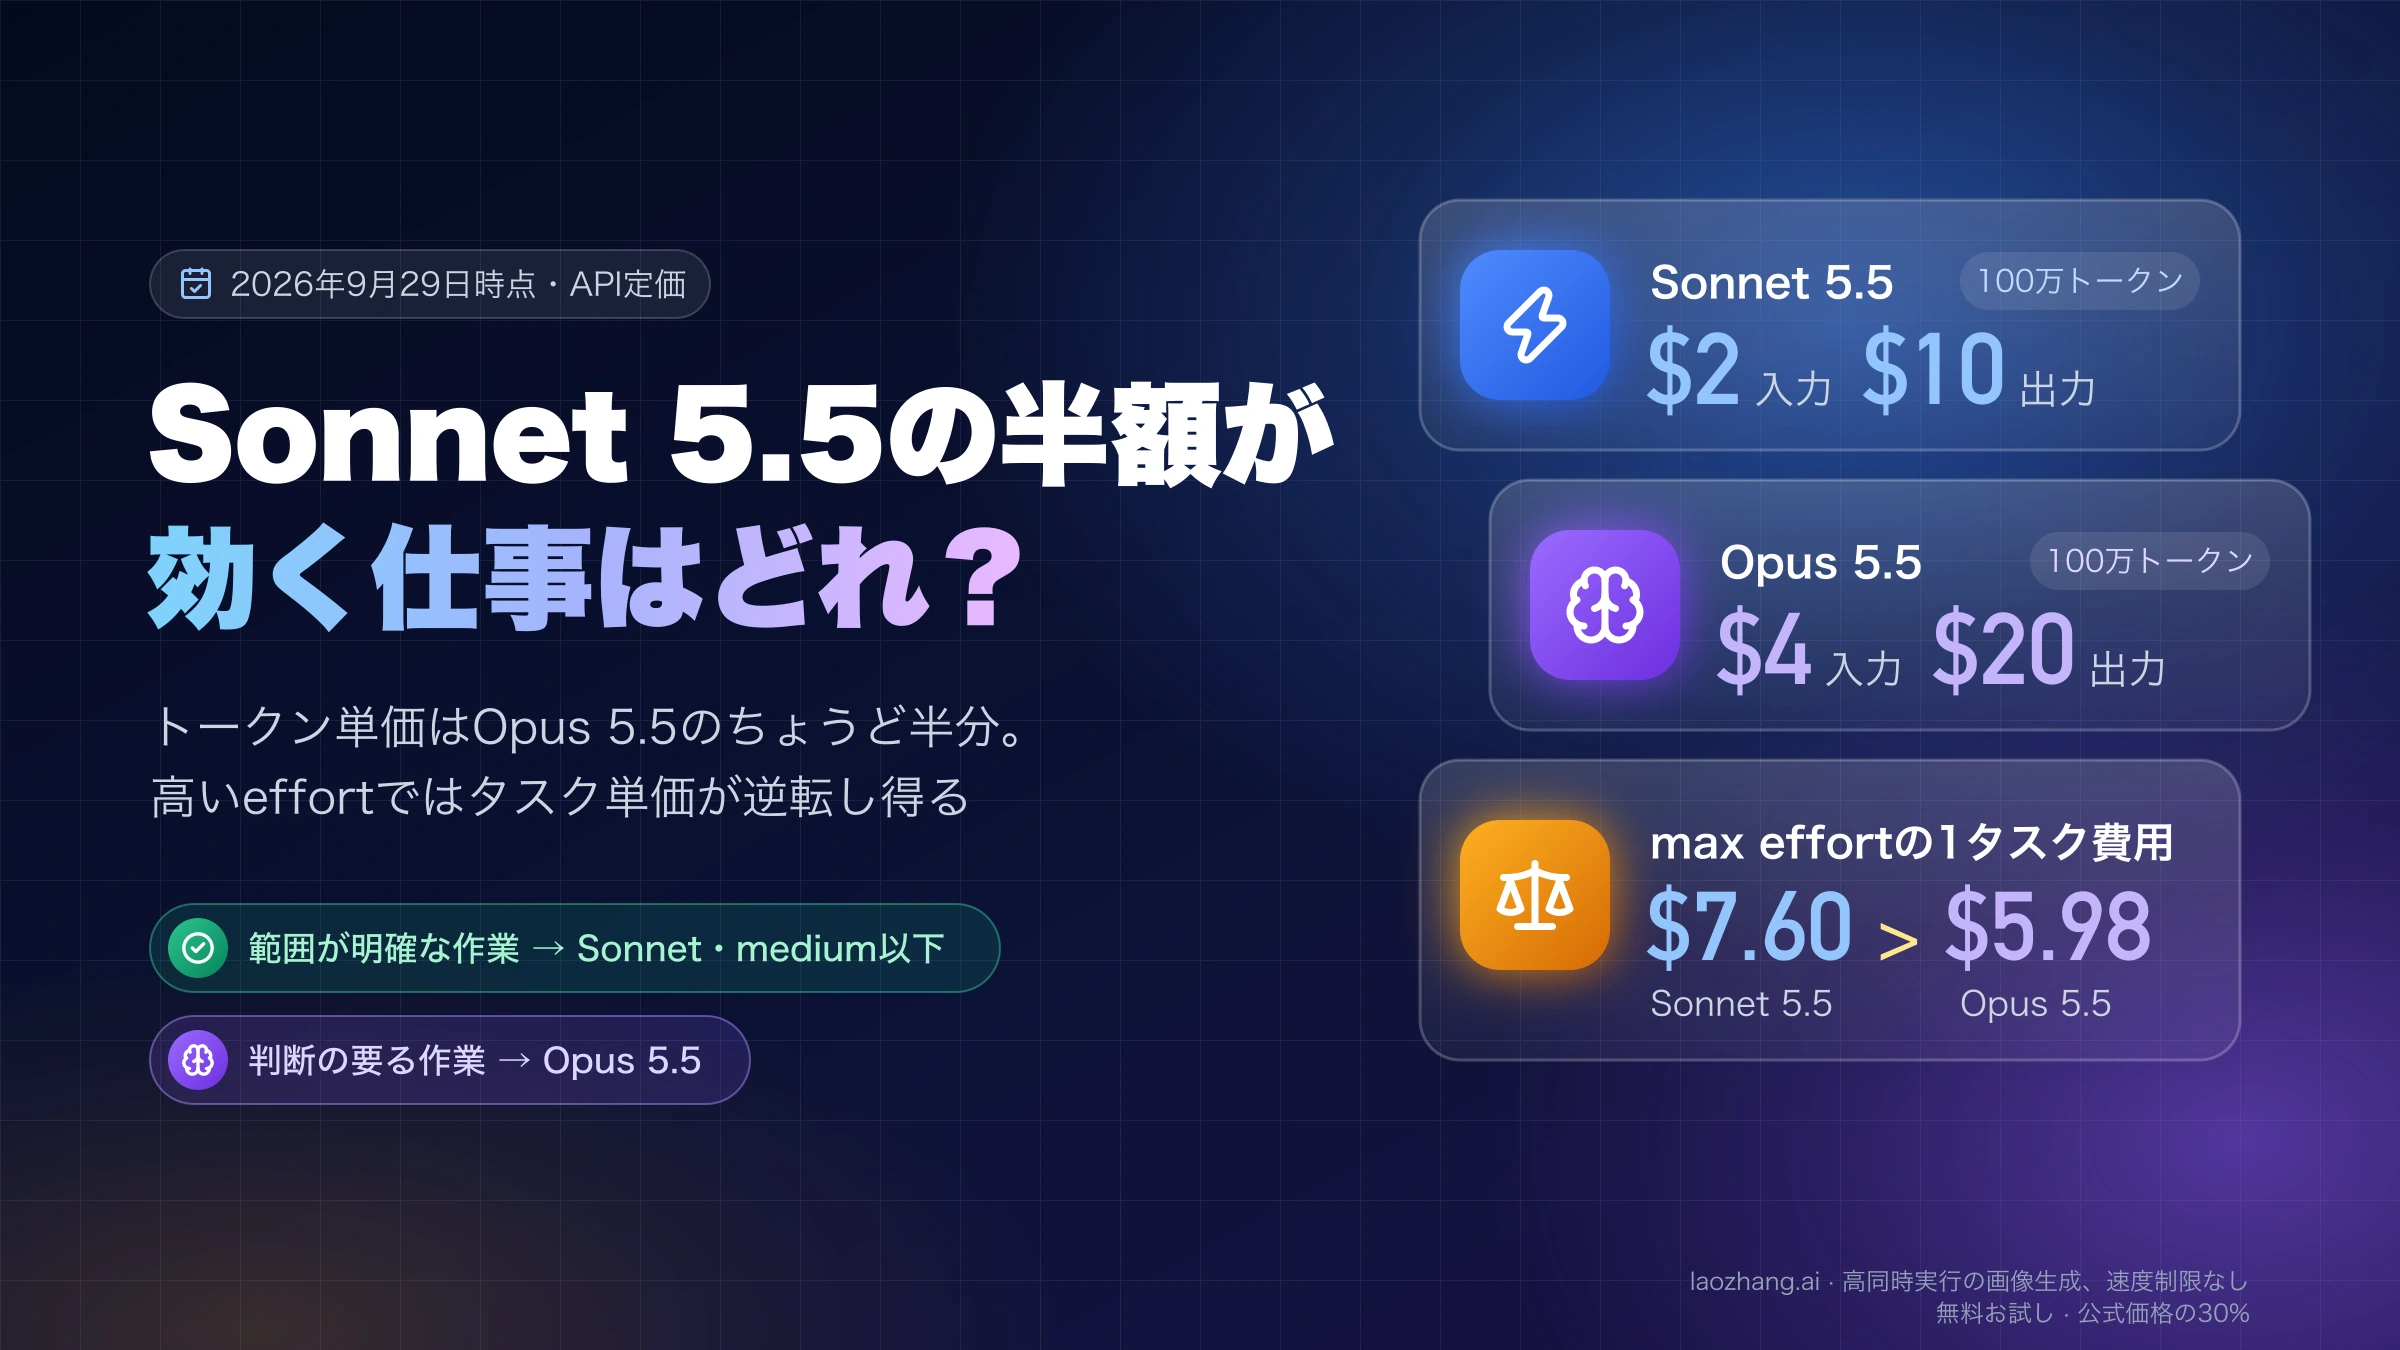
Claudeの中で単価を半分にしたいなら、Sonnet 5.5の入出力単価がK3.1 Proと同じ$2・$10で、キャッシュヒットは$0.10とK3.1 Proの半分です。タスク単位でも半額が効くかはSonnet 5.5とOpus 5.5の使い分け:半額が効く仕事で扱っています。OpenAIのGPT-6.1 Solも入出力単価は$2・$10で、K3.1 Proとのタスク単価の差はKimi K3.1 Pro vs GPT-6.1 Sol比較:同じ単価、タスク単価は約3倍で計算しています。
自分のタスクで公平に試す5つの手順
公開ベンチマークも第三者の検証も、自分のコードベースでの結果を代わりには示してくれません。移行を決める前に、同じ条件で小さく比べます。
- 最近実際に依頼した作業から、合否をテストやチェックリストで判定できるものを選びます。簡単にうまくいった依頼だけでなく、以前に人の手直しが必要だった依頼も入れます。
- effortを明示して組み合わせを決めます。K3.1 Proは
lowとmax(必要ならhigh)、Opus 5.5はmediumとhighを基本にし、どちらも既定値に任せません。 - エージェント、ツール、プロンプト、作業ディレクトリをそろえます。K3.1 Pro向けには
temperatureなどの固定パラメーターを外し、アシスタントメッセージをそのまま返す処理と、十分な出力上限を確認します。 - 1件ごとに、合否、所要時間、呼び出し回数、費用を記録します。費用はトークン数からの計算ではなく、管理画面の残高や請求の減り方で見ます。atomicagentの検証ではKimiの残高の減りが計算より約3割多くなりました。
- 「合格した作業1件あたりの費用」と所要時間で比べ、作業の種類ごとにどちらへ回すかを決めます。
Claude CodeのままK3.1 Proに切り替える設定
Claude Codeの操作に慣れていてモデルだけを替えたい場合、MoonshotはAnthropic互換のエンドポイントを案内しています(KimiのClaude Code連携ガイド)。以下はそのガイドに沿った手順で、手元では実行していません。K3.1 Proを使うには、platform.kimi.aiで$1以上をチャージしておく必要があります。
- Kimi PlatformのコンソールでAPIキーを作成します。
~/.claude/settings.jsonのenvに次の値を書き、Claude Codeを再起動します。
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.moonshot.ai/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "YOUR_MOONSHOT_API_KEY",
    "ANTHROPIC_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_FABLE_MODEL": "kimi-k3.1-pro",
    "CLAUDE_CODE_SUBAGENT_MODEL": "kimi-k3.1-pro",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "CLAUDE_CODE_EFFORT_LEVEL": "max"
  }
}- 端末で接続を確かめ、Claude Codeで
/statusを開いてBase URLがhttps://api.moonshot.ai/anthropicになっているかを見ます。
curl https://api.moonshot.ai/anthropic/v1/messages \
  --header "Authorization: Bearer YOUR_MOONSHOT_API_KEY" \
  --header "Content-Type: application/json" \
--data '{"model": "kimi-k3.1-pro", "max_tokens": 1, "messages": [{"role": "user", "content": "hi"}]}'2026年10月25日時点のガイドの設定例は、各モデル枠を旧世代のkimi-k3[1m](Haiku枠はkimi-k2.7-code)に割り当てたままで、K3.1 Proの名前は確認用のcurlにだけ出てきます。上の例は、kimi-k3[1m]の枠をすべてkimi-k3.1-proに置き換え、Haiku枠もkimi-k2.7-codeからkimi-k3.1-proに変えたものです。Haiku枠をガイドどおりkimi-k2.7-codeにする場合、このモデルは思考を切れないため、Claude Code側で思考をオンにしておく必要があるとガイドは説明しています。[1m]の付け方がK3.1 Proにも当てはまるかはガイドに書かれていません。モデル枠を一部でも設定し忘れると、その枠を使うサブエージェントやバックグラウンド処理がエラー表示なしに失敗します。settings.jsonのenvは端末でexportした同名の変数より優先され、APIキーが平文で残るので、Gitに含めないよう注意してください。
MoonshotはCLAUDE_CODE_EFFORT_LEVELをmaxにするよう勧めていますが、atomicagentの検証ではmaxのタスク費用はOpusとほぼ同じでした。費用を下げたい場合は低い値でも比べてください。Claude Codeの段階の値がKimiの3段階にどう対応するかは、ガイドには記載がありません。
Kimi K3.1 ProとOpus 5.5のよくある質問
Kimi K3.1 Proはオープンソース(オープンウェイト)ですか?
2026年10月25日時点では、まだ重みは公開されていません。MoonshotはK3.1 Proを「3T級のオープンウェイトモデル」と呼び、11月4日までに重みを公開するとしていますが、それまではAPIでしか使えず、Artificial Analysisもオープンウェイトには分類していません。パラメーター数は、Artificial Analysisとatomicagentが前世代K3と同じ総数2.8兆・アクティブ1,040億と記載しています。
日本からKimi K3.1 ProのAPIを使うには?
海外向けのplatform.kimi.aiで、米ドルの従量課金として使います。2026年10月25日時点では、$1以上をチャージするとK3.1 Proが使えるようになり、累計$5のチャージで$5分のクーポンが付きます。同時接続数や1分あたりのリクエスト数などの上限は累計チャージ額で決まり、不正利用対策の制限が一度かかると解除できないとKimiのチャージと利用制限のページに書かれています。Kimiの会員プランやKimi Codeのサブスクとは別の支払いです。
Claude MaxとKimiのサブスクで比べるとどうなりますか?
プランの枠は会社ごとに計算方法が違い、API料金とは比べられません。参考になる事例は、X上の1人のユーザーによる報告くらいです。同じ3Dシーンの課題で、$100のClaudeプランでは5時間枠の62%を使ったのに対し、KimiのVivaceプランではセッション枠の0.53%で済んだとしており、完了はClaudeが少し早かったそうです。
この比較はいつ見直すべきですか?
変わりやすい点は3つあります。11月4日までに予定される重みの公開で提供元が増えるかどうか、tbench.aiの公開ランキングにK3.1 Proが載るかどうか、そして公開直後の数日で改訂されることがあるArtificial Analysisの計測値です。どれかが変わったら、タスクあたりの費用とTerminal-Bench 4.0の比較を見直してください。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月25日。
- 1.Kimi APIの料金説明platform.kimi.ai/docs/pricing/chat
- 2.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 3.Artificial AnalysisのKimi K3.1 ProとClaude Opus 5.5の比較ページartificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-claude-opus-5-5
- 4.atomicagentのKimi K3.1 Pro検証記事atomicagent.io/blog/kimi-k3-1-pro
- 5.Anthropicのeffortの説明platform.claude.com/docs/en/build-with-claude/effort
- 6.tbench.aiのTerminal-Bench 4.0ランキングtbench.ai/leaderboard/terminal-bench/4.0
- 7.Kimi K3.1 Proのクイックスタートplatform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 8.KimiのClaude Code連携ガイドplatform.kimi.ai/docs/guide/claude-code-kimi
- 9.Kimi Platformのコンソールplatform.kimi.ai/console/api-keys
- 10.Kimiのチャージと利用制限のページplatform.kimi.ai/docs/pricing/limits