Sonnet 5.5とGemini 3.8 Flash比較:実測費用はFlashが2.4倍
単価は3.8 Flashが約62%安いのに、同じ8題をhighで解かせると合計費用はSonnet 5.5の2.4倍でした。コードはSonnet、長文要約はFlashが目安です。
目次
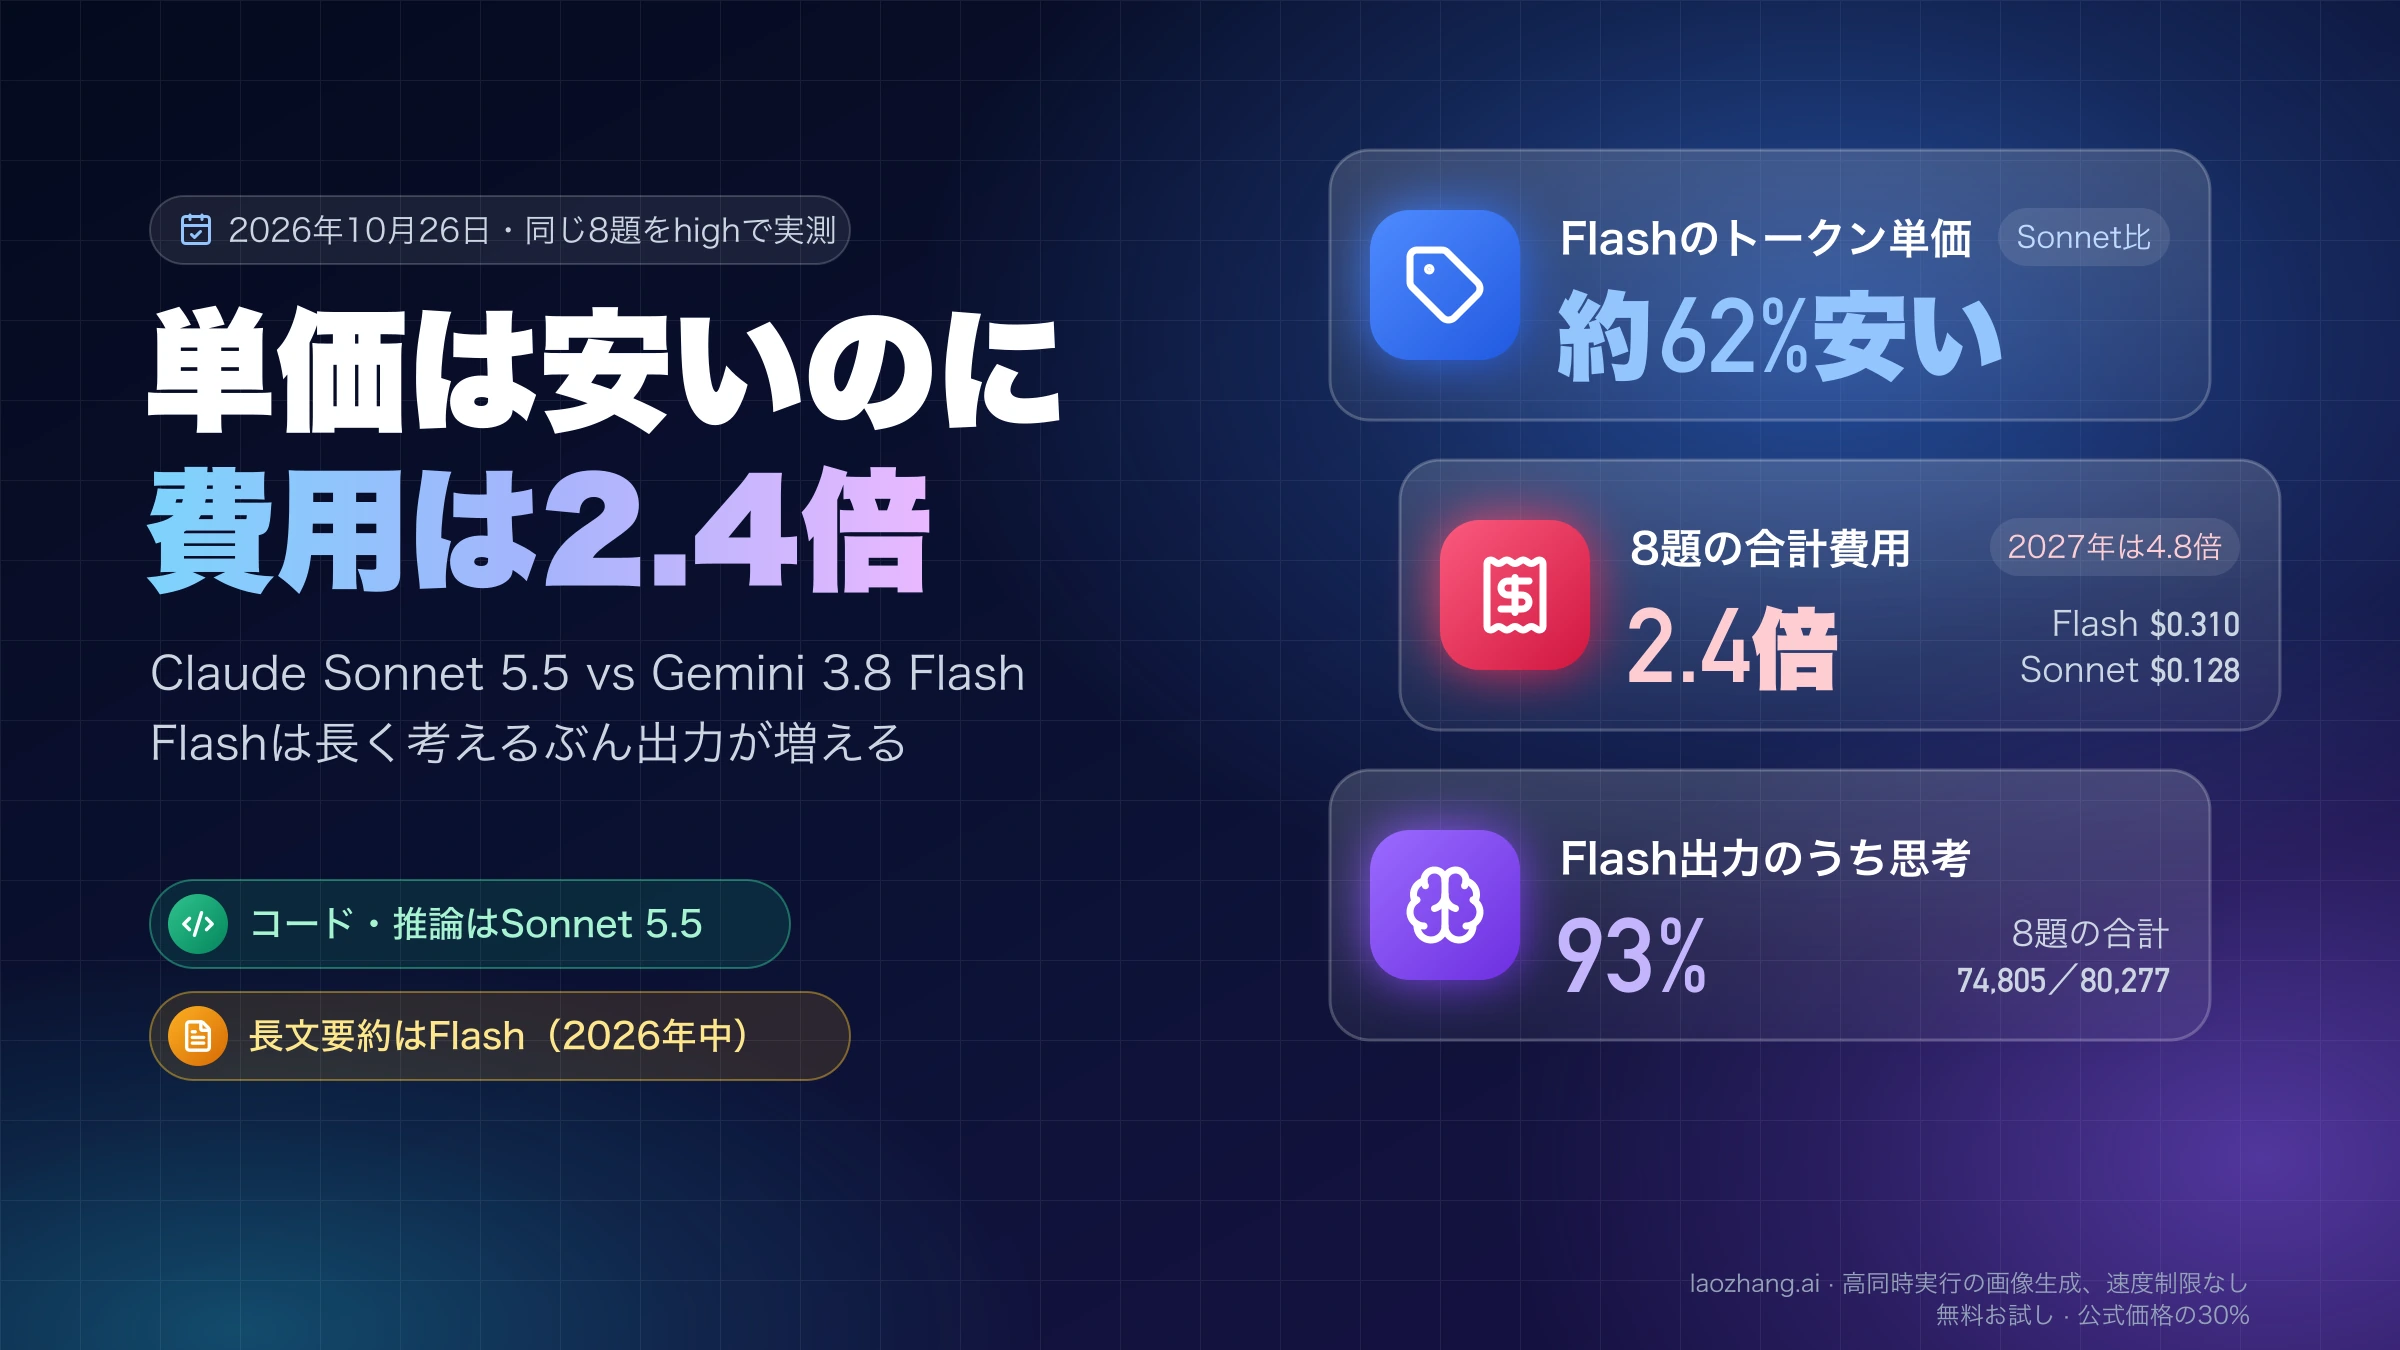
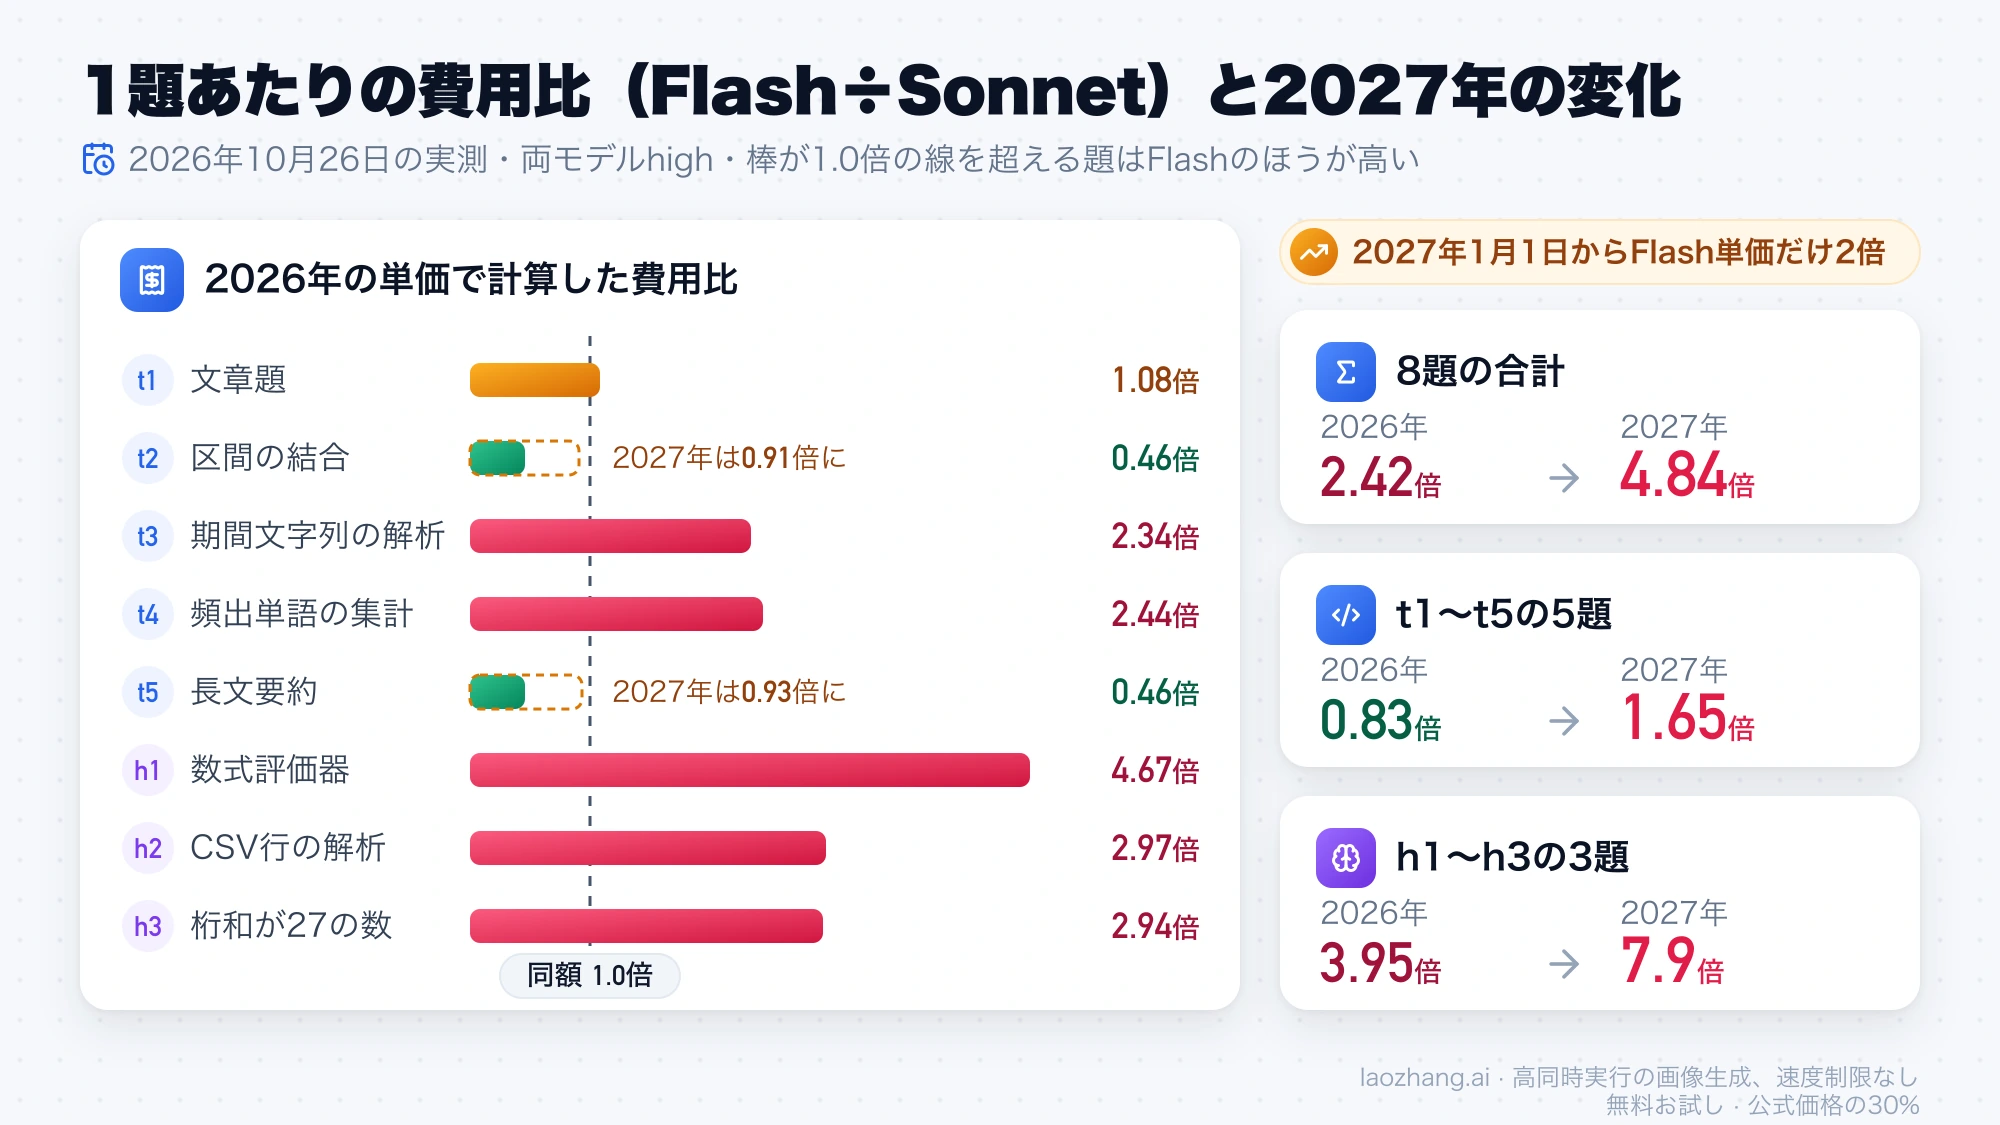
100万トークンあたりの単価だけを見ると、Gemini 3.8 FlashはClaude Sonnet 5.5より約62%安く、入力は$0.75対$2、出力は$3.75対$10です(2026年12月31日までのGemini API標準料金)。ところが2026年10月26日に同じ8題を両モデルともhighで解かせたところ、両方が全題に正解したうえで、合計費用はFlashが$0.310、Sonnetが$0.128となり、Flashのほうが2.4倍かかりました。答えが返るまでの時間も合計でFlashが702秒、Sonnetが86秒です。差を生んだのはFlashの思考トークンで、Flashの出力トークンの93%が思考に使われていました。
既定モデルを決めるなら、コードの生成や修正、テストを通す実装、手順の多い推論はclaude-sonnet-5-5にし、長い文書を読ませて短く返す要約や抽出はgemini-3.8-flashに回すのが現時点の目安です。実測でFlashが安くなったのは、Flashの思考が短く済んだ題と、長い文書を入力した題だけでした。2027年1月1日からはFlashの単価だけが2倍になり、同じ8題の合計はSonnetの4.8倍に広がって、長文要約での優位もほぼ消えます。
この測定は1つのゲートウェイを通した1日分の結果で、どちらもhighだけを試しています。SonnetのmediumやFlashの思考レベルmedium、複数ステップのエージェント作業は測っていません。能力の水準を示す数字はArtificial Analysis(AA)の比較によるもので、AAで同じ総合指数41になる設定どうしで比べても、Flashの1タスク費用はSonnetの約2.6倍です。
作業ごとの既定モデル:コードと推論はSonnet、長文要約はFlash
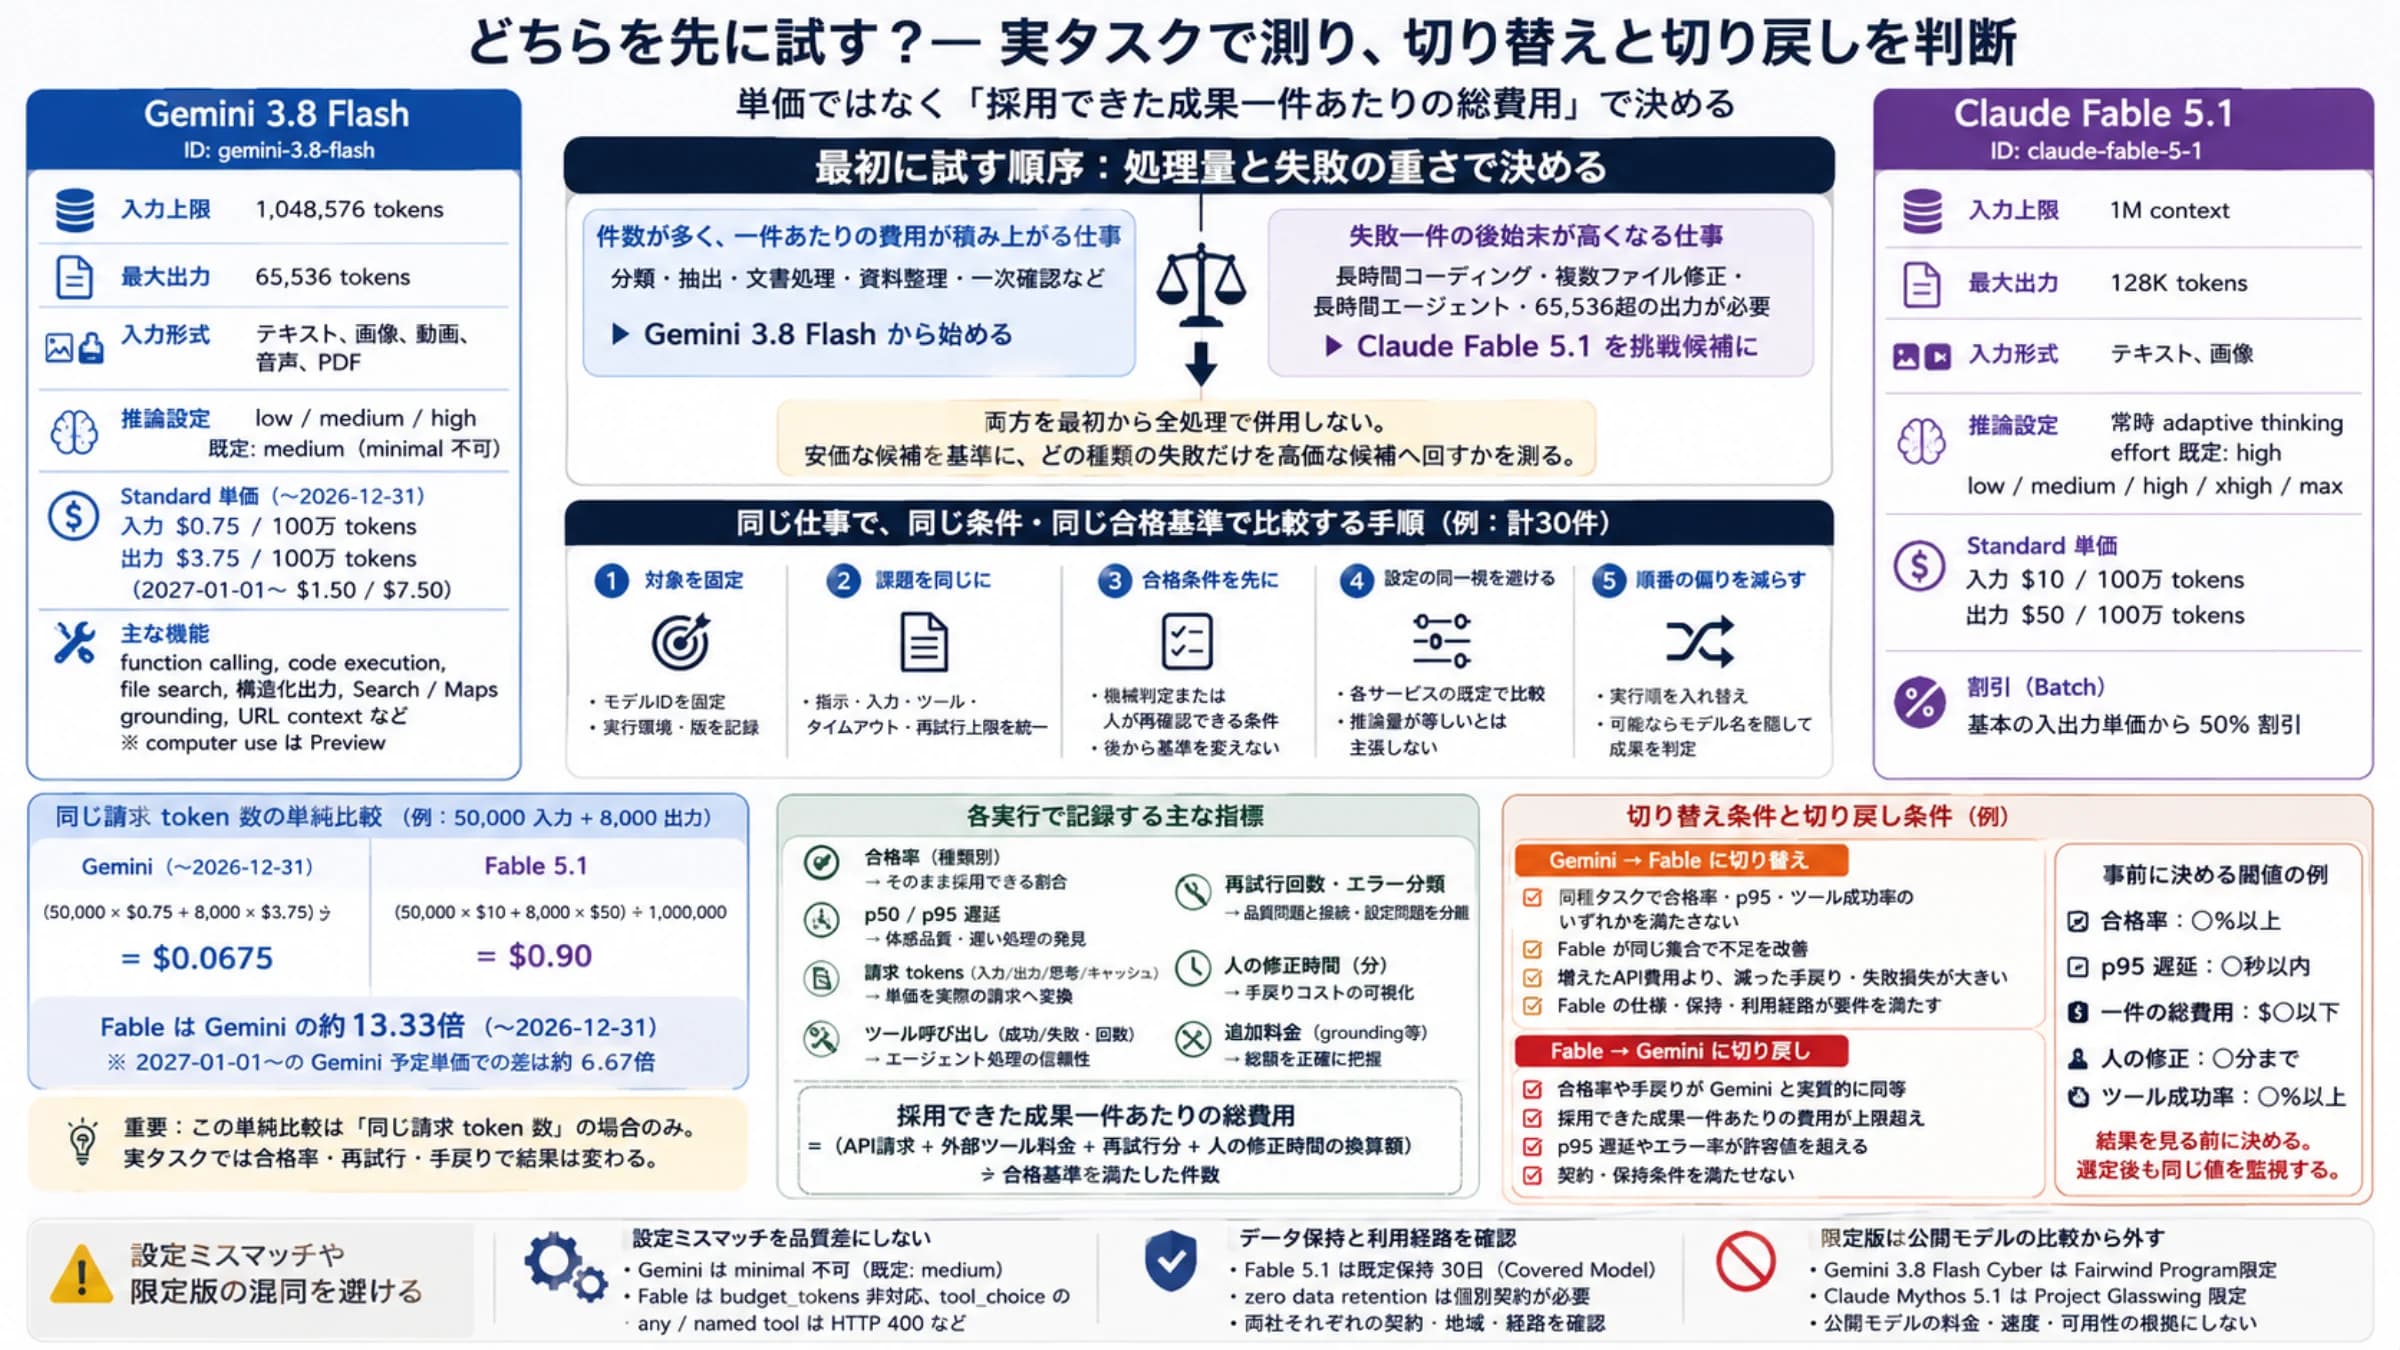
迷ったときは、その作業が「短い入力から考えて書く」ものか、「長い入力を読んで短く返す」ものかで分けると判断しやすくなります。前者ではFlashが長く考えるぶん出力トークンが増え、単価の安さが打ち消されます。後者では出力が短く、入力の単価差がそのまま効くため、2026年中はFlashが安く済みます。下の表は、2026年10月26日の実測とAAの項目別スコア(どちらもhigh同士)を作業別にまとめたものです。
| 作業 | 既定にするモデル | 根拠 |
|---|---|---|
| コードの生成・バグ修正・テストを通す実装 | Sonnet 5.5 | 実測のコード5題のうち4題でFlashの費用が2.3〜4.7倍、残る1題(区間の結合)はFlashが半額以下 |
| ターミナル操作を含むエージェント作業 | Sonnet 5.5 | AAのTerminal-Bench 4.0でSonnet 43.9%、Flash 19.7%。多段の作業は実測していない |
| 数学・アルゴリズムの推論 | Sonnet 5.5 | 桁和の題は両方正解で、Flashは費用2.9倍、時間は約10倍。AAのCritPtはSonnet 24.6%、Flash 18.3% |
| 長い文書の要約・抽出 | Gemini 3.8 Flash(2026年中) | 長文要約の題でFlash $0.0155、Sonnet $0.0334。AA-LCRはFlash 81.3%、Sonnet 78.0%。2027年からはほぼ同額 |
| 動画・音声をそのまま入力する処理 | Gemini 3.8 Flash | Sonnet 5.5は動画と音声を入力できない(PDFはClaude APIで読める) |
| 事実知識を問う質問応答 | Gemini 3.8 Flash | 知識の正確さを測るAA-OmniscienceでFlash 30、Sonnet 21。費用は実測していない |
Sonnet 5.5を既定にする場合、effortはAPIの既定値であるhighから始め、仕様がはっきりしたエージェント的なコーディングや応答の速さを優先する用途ではmediumに下げる、というのがAnthropic自身の目安です。Claude CodeでのSonnet 5.5の既定はmediumです。Flashを使う場合は、AAの数字では思考レベルをmediumにすると指数が41から40に下がるだけで1タスク費用は$1.24から$0.93に減ります。ただしmediumのFlashは実測していないので、自分の題でhighと比べてから切り替えてください。
同じ8題をhighで解かせた実測:トークン、費用、秒数
2026年10月26日の日本時間12時41分〜55分に、同じ8題を両モデルに送り、返ってきたトークン数に公式の標準単価を掛けて費用を出しました。経路はこのブログと同じチームが運営するlaozhang.aiのAPIで、同じキーから両モデルを呼んでいます。Sonnet 5.5はAnthropic Messages形式でoutput_config.effort: "high"(APIの既定値)を指定し、thinkingは指定せず適応型思考に任せました。Gemini 3.8 FlashはGeminiネイティブのgenerateContentでthinkingConfig.thinkingLevel: "high"を指定しています。最大出力はどちらも32,000トークン、システムプロンプトとツールはなしです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
ClaudeのeffortとGeminiの思考レベルは別の仕組みで、同じhighでも中身は一致しません。Flashではhighが最上位ですが、Sonnetにはhighの上にxhighとmaxがあります。両方highは、名前と位置づけが最も近い組み合わせとして選んだものです。
題は8つで、t1はペンの購入数を求める文章題、t2〜t4はPython関数の実装(区間の結合、期間文字列の解析、頻出単語の集計)、t5は6,723語の英文記事を「25語以内の5項目」に要約する題です。h1〜h3は難しめの題で、evalを使わない数式評価器、csvモジュールを使わないCSV行の解析、100万未満で各桁の和が27になる数の個数(答えは55,252)を求めます。t1〜t5は1回ずつ、h1〜h3は2回ずつ送り、コードはモデルに見せていないテスト(8〜25件)で採点しました。両モデルとも全22回答が正解で、エラーや再試行はありません。
| 題 | Sonnet出力 | Flash出力 | うちFlashの思考 | Sonnet費用/秒 | Flash費用/秒 | 費用比(Flash÷Sonnet) |
|---|---|---|---|---|---|---|
| t1 文章題 | 704 | 2,071 | 1,716 | $0.0072/7.1 | $0.0078/78.5 | 1.08倍 |
| t2 区間の結合 | 1,217 | 1,496 | 974 | $0.0124/9.3 | $0.0057/25.6 | 0.46倍 |
| t3 期間文字列の解析 | 723 | 4,781 | 4,463 | $0.0077/7.5 | $0.0181/30.5 | 2.34倍 |
| t4 頻出単語の集計 | 160 | 1,245 | 1,115 | $0.0019/3.0 | $0.0047/27.2 | 2.44倍 |
| t5 長文要約 | 277 | 1,887 | 1,733 | $0.0334/5.0 | $0.0155/14.3 | 0.46倍 |
| h1 数式評価器 | 1,816/1,849 | 15,606/31,530 | 14,876/30,721 | $0.0190/13.7 | $0.0885/156.9 | 4.67倍 |
| h2 CSV行の解析 | 880/432 | 4,546/6,538 | 4,175/6,167 | $0.0070/6.1 | $0.0209/34.2 | 2.97倍 |
| h3 桁和が27の数 | 678/647 | 5,678/4,899 | 4,831/4,034 | $0.0068/7.0 | $0.0199/71.9 | 2.94倍 |
| 合計(11回ずつ) | 9,383 | 80,277 | 74,805 | $0.128/86 | $0.310/702 | 2.42倍 |
出力はトークン数、秒はゲートウェイ経由で1回の呼び出しが返るまでの実時間です。h1〜h3の出力は1回目/2回目、費用と秒は2回の平均で、合計行は22回分すべての呼び出しを足しています。SonnetのAPIは思考と回答を合わせたoutput_tokensを1つの数字で返すため、Sonnetの出力には表示されない思考も含まれます。Flashのh1は2回目で32,000トークンの上限のうち31,530を使い、1回目の約2倍になりました。題ごとの数字は振れ幅が大きいので、判断には合計と傾向を使ってください。
次の条件は測っていません。Sonnetのmedium・low・xhigh・max、Flashのmedium・low、AnthropicとGoogleのAPIへの直接接続、Batch、キャッシュ、ツールを使う多段のエージェント作業、複数ターンの会話、英語以外の文章、画像や音声の入力です。題はどれも仕様がはっきりした小さな課題で、両モデルが全問解けたため、Flashがどこで失敗しやすいかはこの実測からは分かりません。その判断にはAAの項目別スコアを使ってください。
なぜ単価が2.67倍安いのに1題あたりは高くなるのか
1題あたりの費用は「入力トークン×入力単価+出力トークン×出力単価」で決まり、単価の差は掛け算の片側にすぎません。Flashは8題の合計で出力トークンがSonnetの8.6倍あり、その93%(80,277のうち74,805)が思考トークンでした。Gemini APIでは思考トークンも出力単価で課金されます。出力が費用の大半を占める題では、Flashの出力トークンがSonnetの2.67倍を超えた時点でFlashのほうが高くなる計算です。
実測でもこの境目どおりに分かれました。t2ではFlashの出力がSonnetの約1.2倍にとどまり、費用は0.46倍でした。h1ではFlashの出力が2回合計でSonnetの約13倍(47,136対3,665トークン)に達し、費用は4.67倍です。t1は約2.9倍で境目をわずかに超え、費用は1.08倍とほぼ同じでした。難しい題ほどFlashの思考が長くなる傾向があり、h1〜h3だけを足すとFlashの費用はSonnetの3.95倍です。
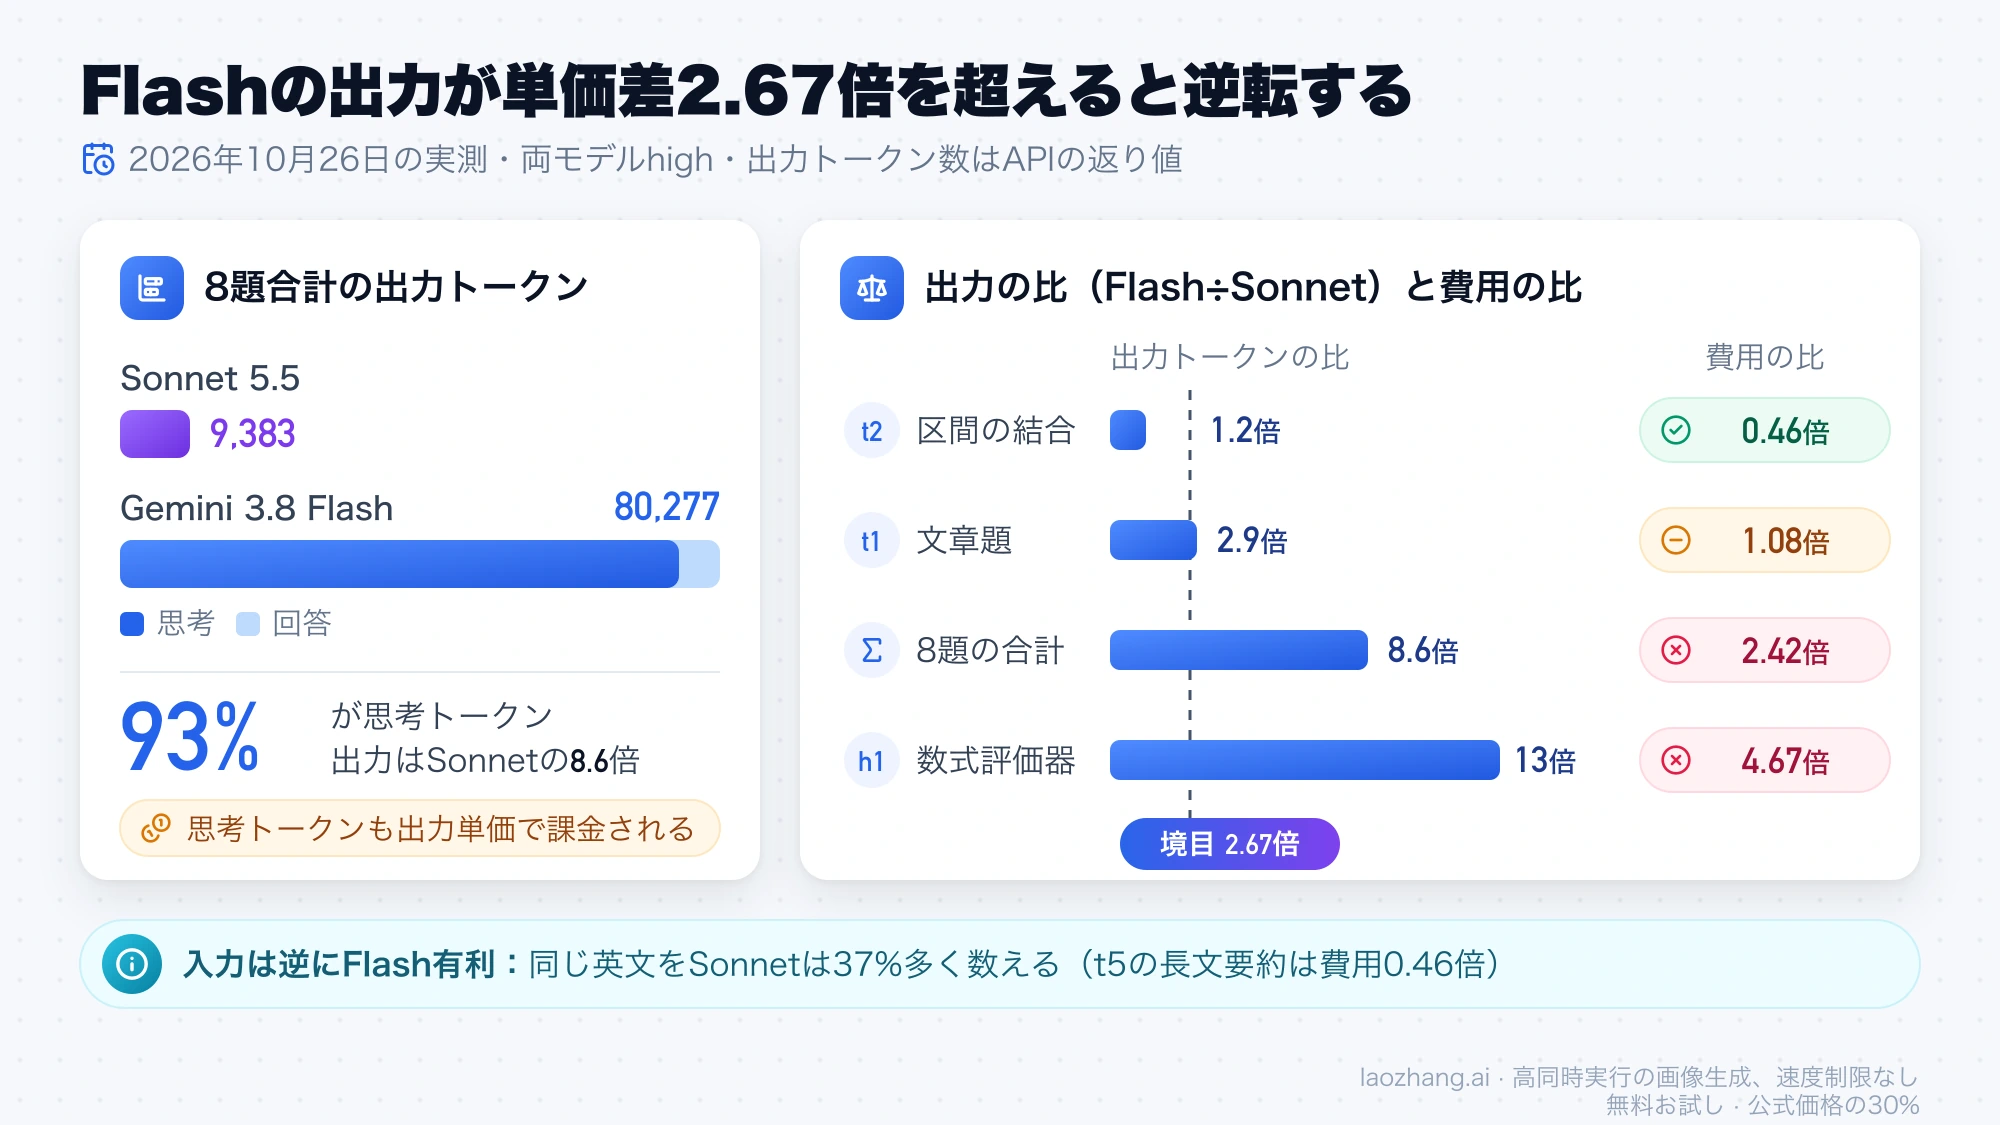
もう1つの理由はトークナイザーの違いで、こちらは逆にFlashに有利に働きます。t5で同じ6,723語の英文を渡したとき、Sonnetは入力を15,335トークン、Flashは11,198トークンと数え、Sonnet側が37%多くなりました。英文の入力に限れば、実質的な入力単価の差は2.67倍ではなく約3.65倍(2.67×1.37)です。入力が大きく出力が小さい題でFlashが安くなるのはこのためです。ただしSonnetの数字にはAnthropicのメッセージ形式のトークンも含まれ、日本語やコードの入力で同じ比率になるかは測っていません。
長い文書を扱うならFlash? 2026年中は半額、2027年からはほぼ同額
長い文書を読ませて短く要約させる用途では、2026年中はFlashが安く、読み取りの正確さでもわずかに上回ります。6,723語の英文記事を5項目に要約させたt5では、Flashの費用が$0.0155、Sonnetが$0.0334で、Flashは半分以下でした。ただし2027年1月1日の値上げ後は、同じ呼び出しでFlashの費用が約2倍になり、Sonnetの0.93倍とほぼ同額になります。
精度の面では、AAの長文推論テストAA-LCR v1.1でFlashのhighが81.3%、Sonnetのhighが78.0%でした。Flashのmediumは84.0%で、AAが比べた8つの設定の中で最も高い数字です。コンテキストの長さはSonnetが100万トークン、Flashが1,048,576トークンでほぼ同じで、Sonnet 5.5は100万トークンまで同じ単価で課金されます。長さを理由にどちらかを選ぶ必要はありません。
量で考えると差がはっきりします。t5と同じ形(1万1千〜1万5千トークン程度の文書を入れ、短い要約を返す)の呼び出しを1万回行うと、2026年の単価でFlashは約$155、Sonnetは約$334です。2027年からはFlashが約$310となり、差は1割を切ります。これはt5の1回分のトークン数を1万倍した計算で、同じ文書を繰り返し渡すならキャッシュ(Sonnet $0.10、Flash $0.075/100万トークン)で入力費用はさらに下がりますが、キャッシュは試していません。待ち時間はFlashのほうが長く、t5でもFlash 14.3秒、Sonnet 5.0秒でした。
どちらが速いか:毎秒トークン数とタスク完了時間で答えが逆になる
答えが手元に届くまでの時間で比べるなら、high同士ではSonnet 5.5のほうが速く終わります。8題の実測ではSonnetが合計86秒、Flashが702秒で、AAの1タスクあたり所要時間もSonnet 217秒、Flash 498秒です。一方、生成が始まってからの毎秒トークン数ではAAの計測でFlashのほうが速く、この数字だけを見ると「Flashのほうが速い」ことになります。
「速い」には少なくとも3つの意味があります。1つ目は毎秒の出力トークン数で、AAではFlash highが137トークン、Sonnet highが106トークンです。2つ目は最初のトークンが届くまでの時間で、AAではSonnet highが10.46秒、Flash highが27.26秒、Sonnet mediumなら1.35秒です。3つ目がタスクを終えるまでの時間で、Flashは毎秒のトークン数が多くても、思考に使うトークンがはるかに多いため、完了までは長くかかります。
OpenRouterの比較ページ(2026年10月5日更新のデータ)では、実際に流れたリクエストの中央値でSonnetが毎秒108.0トークン、Flashが52.0トークン、レイテンシーはSonnet 2.39秒、Flash 2.14秒と、AAとは逆の順位になっています。集計の対象になったリクエストと設定が異なるため、どちらかが誤っているわけではありません。利用者の待ち時間を左右するのは3つ目の完了時間なので、迷ったら自分の題で答えが返るまでの秒数を測ってください。Antigravityで3.8 Flashが極端に遅い場合は、Antigravityで3.8 Flashが遅い・止まる時の対処で原因を切り分けられます。
2027年1月1日以降:Flashの費用だけが2倍になる
2027年1月1日から、Gemini 3.8 Flashの単価は入力$1.50、出力$7.50に上がり、Claude Sonnet 5.5は$2と$10のままです。トークン数が変わらないとすると、同じ8題の合計はFlashが$0.621、Sonnetが$0.128で、差は2.4倍から4.8倍に広がります。2026年中にFlashが勝っていた題も、ほとんどが互角か逆転します。
| 対象 | Sonnet 5.5 | Flash(2026年12月31日まで) | Flash(2027年1月1日から) |
|---|---|---|---|
| 8題の合計(11回) | $0.128 | $0.310(2.42倍) | $0.621(4.84倍) |
| t1〜t5の5題 | $0.0627 | $0.0518(0.83倍) | $0.1036(1.65倍) |
| h1〜h3の3題(各2回) | $0.0655 | $0.2586(3.95倍) | $0.5172(7.9倍) |
2026年の単価ではt1〜t5の5題に限ってFlashが17%安かったものの、2027年の単価では1.65倍になります。題ごとに見ても、半額以下だったt2は0.91倍、t5は0.93倍まで差が縮みます。AAの数字に当てはめると、Flash highの1タスク費用は約$2.48になり、同じ指数41のSonnet medium($0.48)の約5.2倍です。Gemini APIの料金全体と前払いの仕組みはGemini API料金確認:3.8 Flashは2027年に2倍、無料枠超過は前払いにまとめています。
AAの性能比較:同じ指数41ならFlashのタスク費用は約2.6倍
AAのIntelligence Index(v4.3.2)では、Sonnet 5.5のmediumとGemini 3.8 Flashのhighがどちらも41点で並びます。この同点の組み合わせで比べると、AAのテストセットでの1タスクあたりの費用はSonnetが$0.48、Flashが$1.24、所要時間は121秒と498秒で、Flashは約2.6倍の費用と約4.1倍の時間がかかります。どちらもhighにした場合はSonnetが47点、Flashが41点で、1タスク費用はSonnet $0.88、Flash $1.24とSonnetが29%安くなります。
AAの比較ページの見出しは「タスク単価が最も安いのはSonnet 5.5のlow($0.35)、Flashはmediumの$0.93」という形ですが、これは異なる設定どうしの比較です。性能が同じ水準の設定で並べると、上の指数41の組になります。なおAAのテストは複数分野の長く難しい課題なので、短い単発の呼び出しでは費用の比率が変わります。実測でt1〜t5の5題に限ればFlashが安かったことも、この違いと合っています。
AAの項目(両方high) | Sonnet 5.5 | Gemini 3.8 Flash |
|---|---|---|
| Intelligence Index | 47 | 41 |
| 1タスクの費用 | $0.88 | $1.24 |
| 1タスクの所要時間 | 217秒 | 498秒 |
| Terminal-Bench 4.0 | 43.9% | 19.7% |
| GDPval-AA | 1548 | 1436 |
| AA-Briefcase | 1635 | 1202 |
| AutomationBench-AA | 59.4% | 59.9% |
| SciCode | 53.7% | 56.6% |
| Humanity's Last Exam | 45.8% | 47.8% |
| CritPt | 24.6% | 18.3% |
| AA-Omniscience | 21 | 30 |
| AA-LCR v1.1 | 78.0% | 81.3% |
差が大きいのはターミナル操作のTerminal-Bench 4.0と、実務文書系のGDPval-AA、AA-Briefcaseで、いずれもSonnetが上です。Flashが上回るのは知識のAA-Omniscience、長文推論のAA-LCR、科学計算のSciCodeとHumanity's Last Examで、差は数ポイントです。Sonnetをmediumに下げてもTerminal-Bench 4.0は29.8%でFlash highの19.7%より高く、AA-LCRは76.3%、AA-Omniscienceは20でFlashを下回ります。Anthropicが自社で公表しているSonnet 5.5のTerminal-Bench 4.0(70.6%)は測定条件が異なるため、AAの数字と同じ表には並べられません。
仕様の違い:コンテキスト、最大出力、入力形式、キャッシュ、無料枠
コンテキストの長さはどちらも約100万トークンで、ここでは差がつきません。違いが出るのは最大出力(Sonnet 128K、Flash 65,536トークン)、入力できるファイルの種類(Flashは動画と音声も受け付ける)、そしてGemini APIにある無料枠です。料金と仕様はAnthropicの料金ページとモデル概要、Gemini APIの料金ページとGemini 3.8 Flashのモデルページに基づき、2026年10月26日時点の内容です。
| 項目 | Claude Sonnet 5.5 | Gemini 3.8 Flash |
|---|---|---|
| APIモデルID | claude-sonnet-5-5 | gemini-3.8-flash |
| 公開日 | 2026年9月28日 | 2026年9月2日(一般提供) |
| 入力/出力(100万トークン) | $2/$10 | $0.75/$3.75、2027年から$1.50/$7.50 |
| キャッシュ読み取り | $0.10(2026年10月7日に$0.20から値下げ) | $0.075+保存料1時間$0.50、2027年から$0.15+$1.00 |
| バッチ | $1/$5 | $0.375/$1.875(Flexも同額)、2027年から$0.75/$3.75 |
| コンテキスト | 100万トークン | 1,048,576トークン |
| 最大出力 | 128Kトークン(Batchでベータヘッダーを付けると300K) | 65,536トークン |
| 入力形式 | テキスト、画像、PDF(Claude APIのdocumentブロック、1リクエスト600ページ・32MBまで) | テキスト、画像、動画、音声、PDF |
| 思考の調整 | effort:low〜maxの5段階、APIの既定はhigh | 思考レベル:low・medium・high、既定はmedium |
| 無料で試す方法 | 新規ユーザーに少額の無料クレジット | 無料枠あり(入力内容は製品改善に使われる) |
Sonnet 5.5では思考を完全に切ることができず、thinkingにdisabledを指定すると400エラーになります。high以下のeffortで{"type": "between_tools"}を指定すると、応答前の思考を省けます。Flashの思考レベルにはlowより下のminimalがなく、指定するとエラーになります。キャッシュ値下げでSonnetの入力費用がどこまで下がるかはClaude Sonnet 5.5のキャッシュ読み取り料金は$0.10:削減率の求め方で計算しています。
Gemini APIの無料枠は入力・出力とも無料ですが、無料枠で送った内容はGoogleの製品改善に使われ、有料枠では使われません。リクエスト数の上限は公開の表がなく、超えたときの扱いはGemini API無料枠の利用上限 2026:無料モデルと超えたらどうなるかで説明しています。
APIを使わない場合:Claude.ai、Geminiアプリ、Claude Code、Antigravity
APIを使わずに試すなら、Sonnet 5.5はClaude.aiの無料プランで誰でも使え、Gemini 3.8 FlashはAntigravityで無料プランから選べます。逆にAntigravityでSonnet 5.5を使うには、試用ではないGoogle AI Pro以上の契約が必要です。サブスクリプションで使う場合は思考の段階や利用上限がプランで決まるため、API向けの費用比較はそのまま当てはまりません。
| 入口 | Claude Sonnet 5.5 | Gemini 3.8 Flash |
|---|---|---|
| Claude.ai | 無料プランを含め誰でも使える。effortの選択メニューあり | 対象外 |
| Geminiアプリ | 対象外 | プランなしは自動選択かFlash-Lite。Google AI Plus・Pro・Ultraは「Flash」を選べる |
| Claude Code | 使える。Sonnet 5.5の既定effortはmedium | 対象外 |
| Antigravity | Google AI Pro(試用を除く)、Ultra、Enterprise | 無料プランとGoogle AI Plusを含む全プラン |
Claude.aiの無料プランでSonnet 5.5のどのeffortが使えるかは、Anthropicのヘルプに記載がありません。2026年10月11日のlinux.doの投稿では、無料プランではlowしか選べなかったという1人の報告があり、同じ投稿者は、Gemini Proのサブスクリプションで3.8 Flashのhighに頼んだ動的なグラフ作成が、3〜4回手直ししても完成度6割ほどで最後は出力が返らなくなり、無料プランのSonnet 5.5では完了したと書いています。1件の体験談なので、傾向としては扱えません。Geminiアプリは自動選択をオンにすると、推論が必要な質問でFlashやProが使われることがあります。Claude CodeをProやMaxのサブスクリプションで使う場合の上限はClaude ProとMaxを比較:料金、Claude Code制限、Maxの損益分岐点を参照してください。
Haiku 5.5、Opus 5.5、Gemini 4 Argonに替えるべき場合
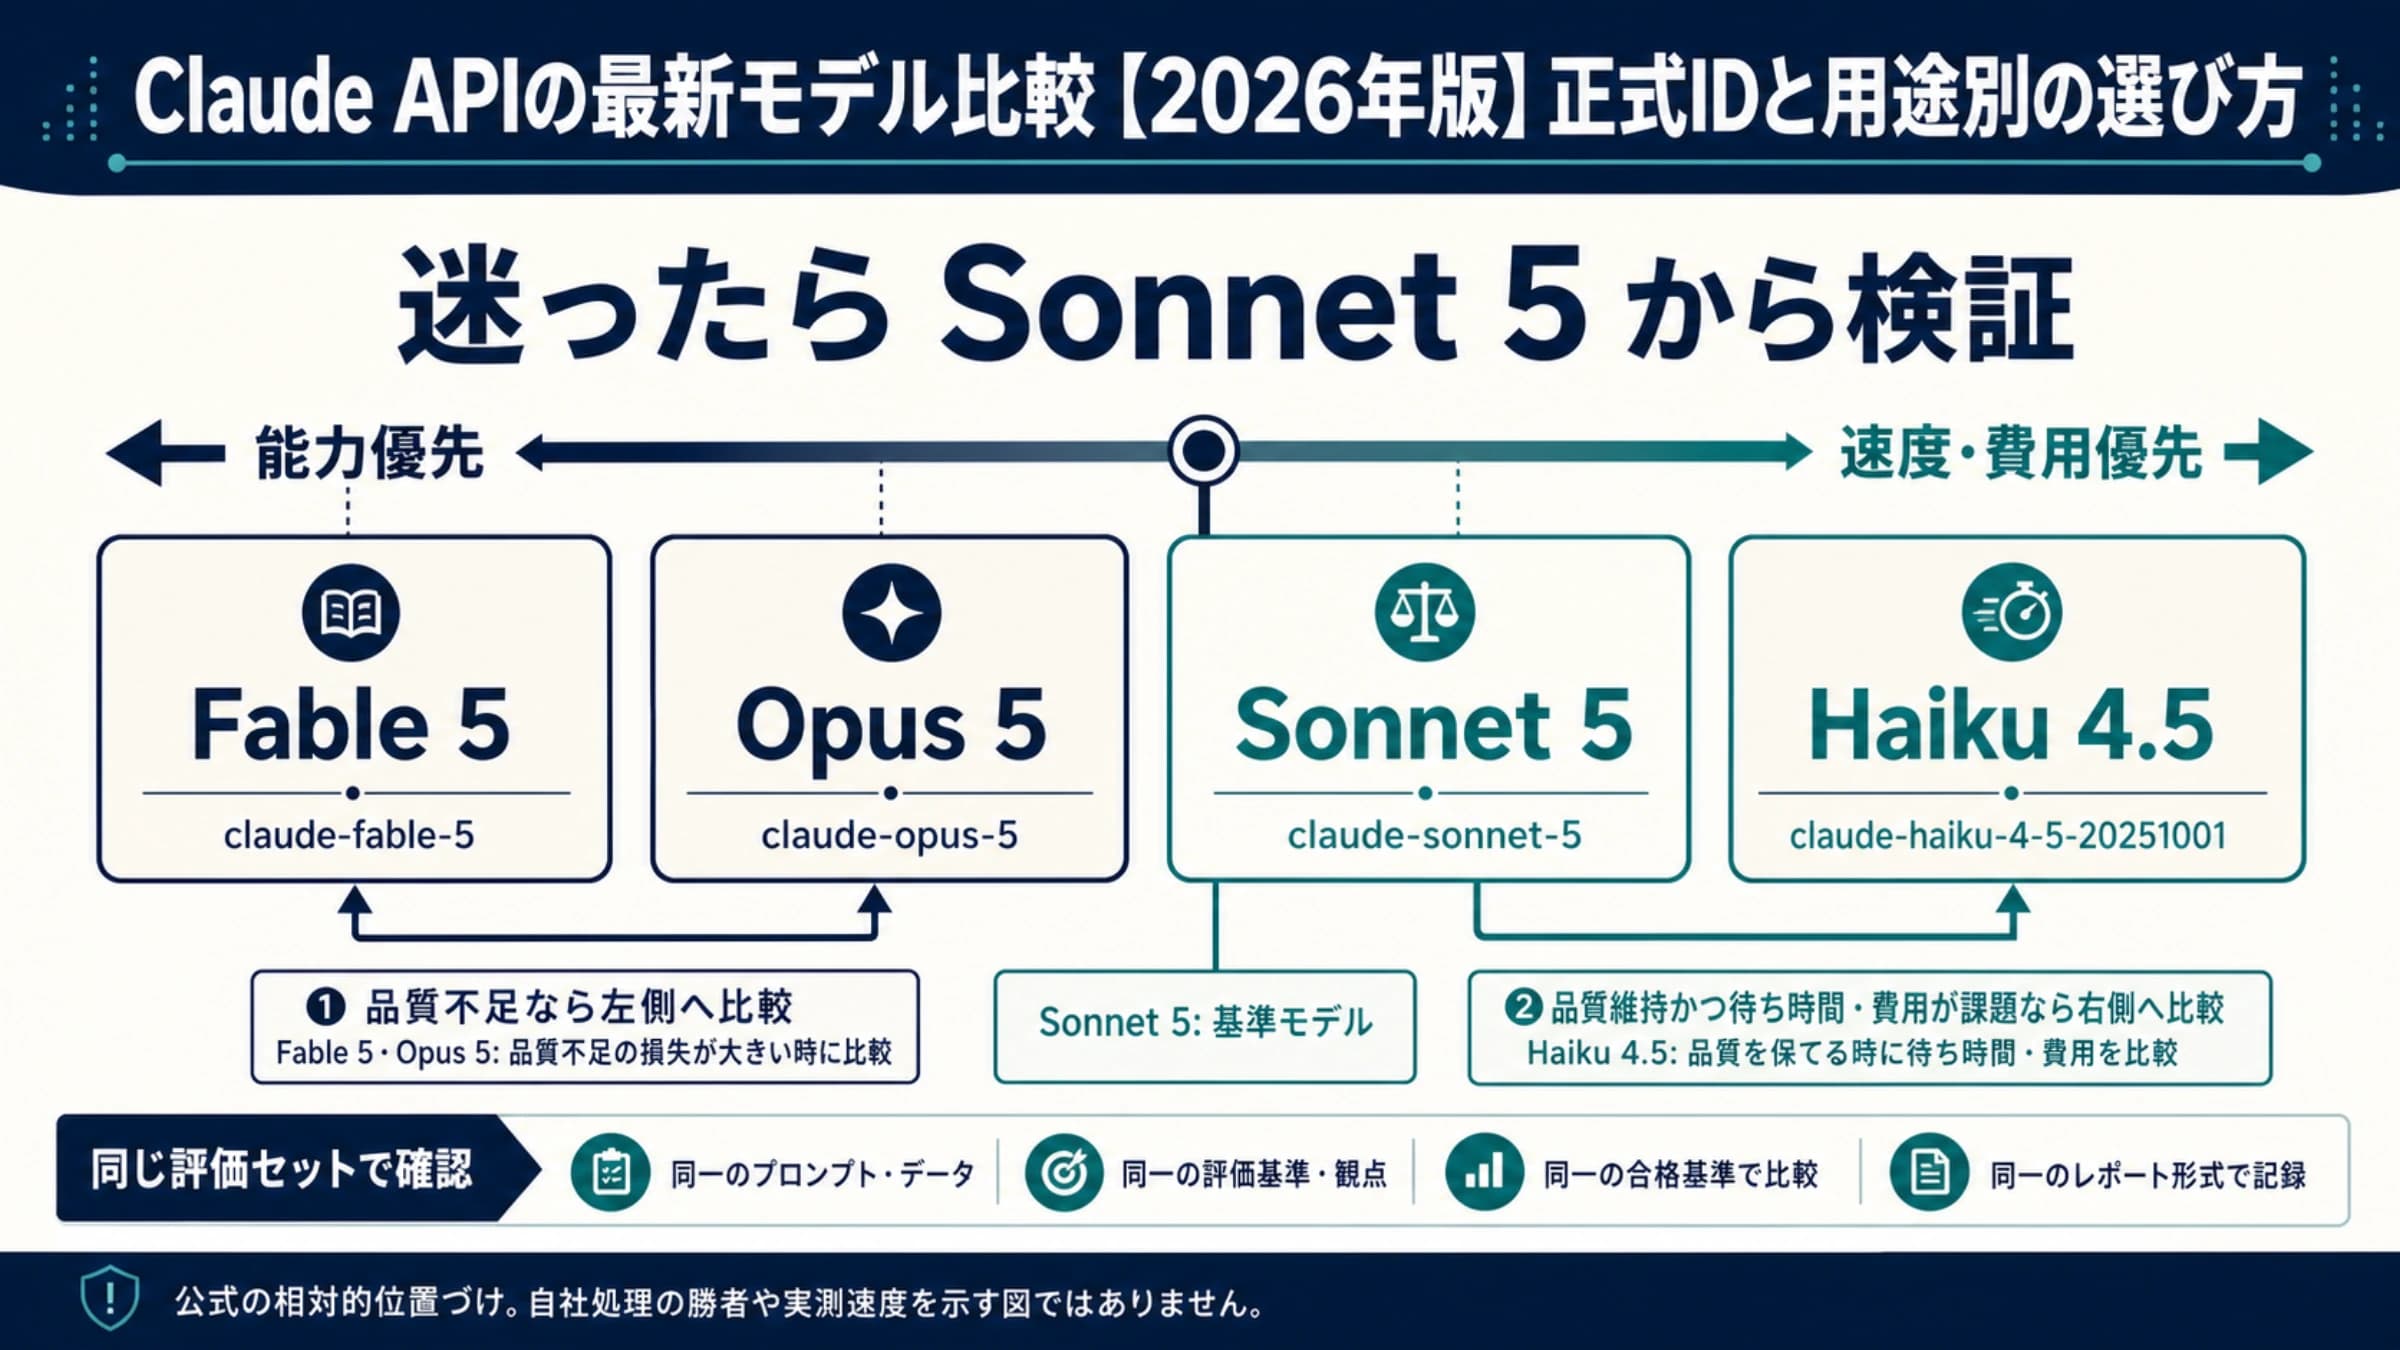
この2つのどちらでも合わないときは、費用を下げたいのか品質を上げたいのかで次の候補が決まります。Claudeの中で費用を下げるならHaiku 5.5、Sonnetで品質が足りないならOpus 5.5、Googleの中で一段上げるならGemini 4 Argonです。
Sonnet 5.5の単価でも負担が大きい大量処理は、Claude Haiku 5.5とSonnet 5.5の違い:単価差20倍をタスク費用で比較で下げてよい作業を確かめられます。effortを上げてもSonnetで品質が届かない仕事は、Sonnet 5.5とOpus 5.5の使い分け:半額が効く仕事が判断材料になります。3.8 Flash自体の評価と、Google内で上位モデルに移す条件はGemini 4 Argonと3.8 Flashの違い:実測コストと使い分け、OpenAIの同じクラスと比べるならSonnet 5.5とGPT-6 Astra比較:費用と使い分けを見てください。
Sonnet 5.5とGemini 3.8 Flashのよくある質問
Claude Sonnet 5とSonnet 5.5は同じモデルですか?
別のモデルです。API単価はどちらも入力$2、出力$10ですが、2026年10月26日時点でキャッシュ読み取りはSonnet 5.5が$0.10、Sonnet 5は$0.20のままです。「Sonnet 5 vs Gemini 3.8 Flash」と題した比較のスコアや費用は、Sonnet 5.5の数字ではありません。
3.8 Flashをmediumに下げればSonnetより安い?
AAの数字では、Flashをmediumに下げると1タスク費用は$0.93、Intelligence Indexは40で、high($1.24、41点)より25%ほど安くなります。それでも同じ41点のSonnet 5.5 medium($0.48)の約1.9倍です。短い単発の呼び出しでは結果が変わる可能性があり、2026年10月26日の実測でもmediumは試していないため、自分の題で両方を測るのが確実です。
Gemini APIの無料枠で使えば、Flashの費用はゼロになりますか?
無料枠の範囲では入力・出力とも課金されませんが、送った内容はGoogleの製品改善に使われます。社外秘のコードや顧客データを送る用途では有料枠が前提になり、その場合は上の費用比較がそのまま当てはまります。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
- 1.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 2.モデル概要platform.claude.com/docs/en/about-claude/models/overview
- 3.Gemini APIの料金ページai.google.dev/gemini-api/docs/pricing
- 4.Gemini 3.8 Flashのモデルページai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- 5.documentブロックplatform.claude.com/docs/en/build-with-claude/pdf-support