Claude Sonnet 5.5とGPT-6.1 Sol比較:同単価でもタスク費用2〜8倍
単価は同じでも1タスク費用はSonnet 5.5がGPT-6.1 Solの2.2〜7.9倍(AA、同じeffort)。短い処理はSol、272K超の長文書はSonnetが割安です。
目次
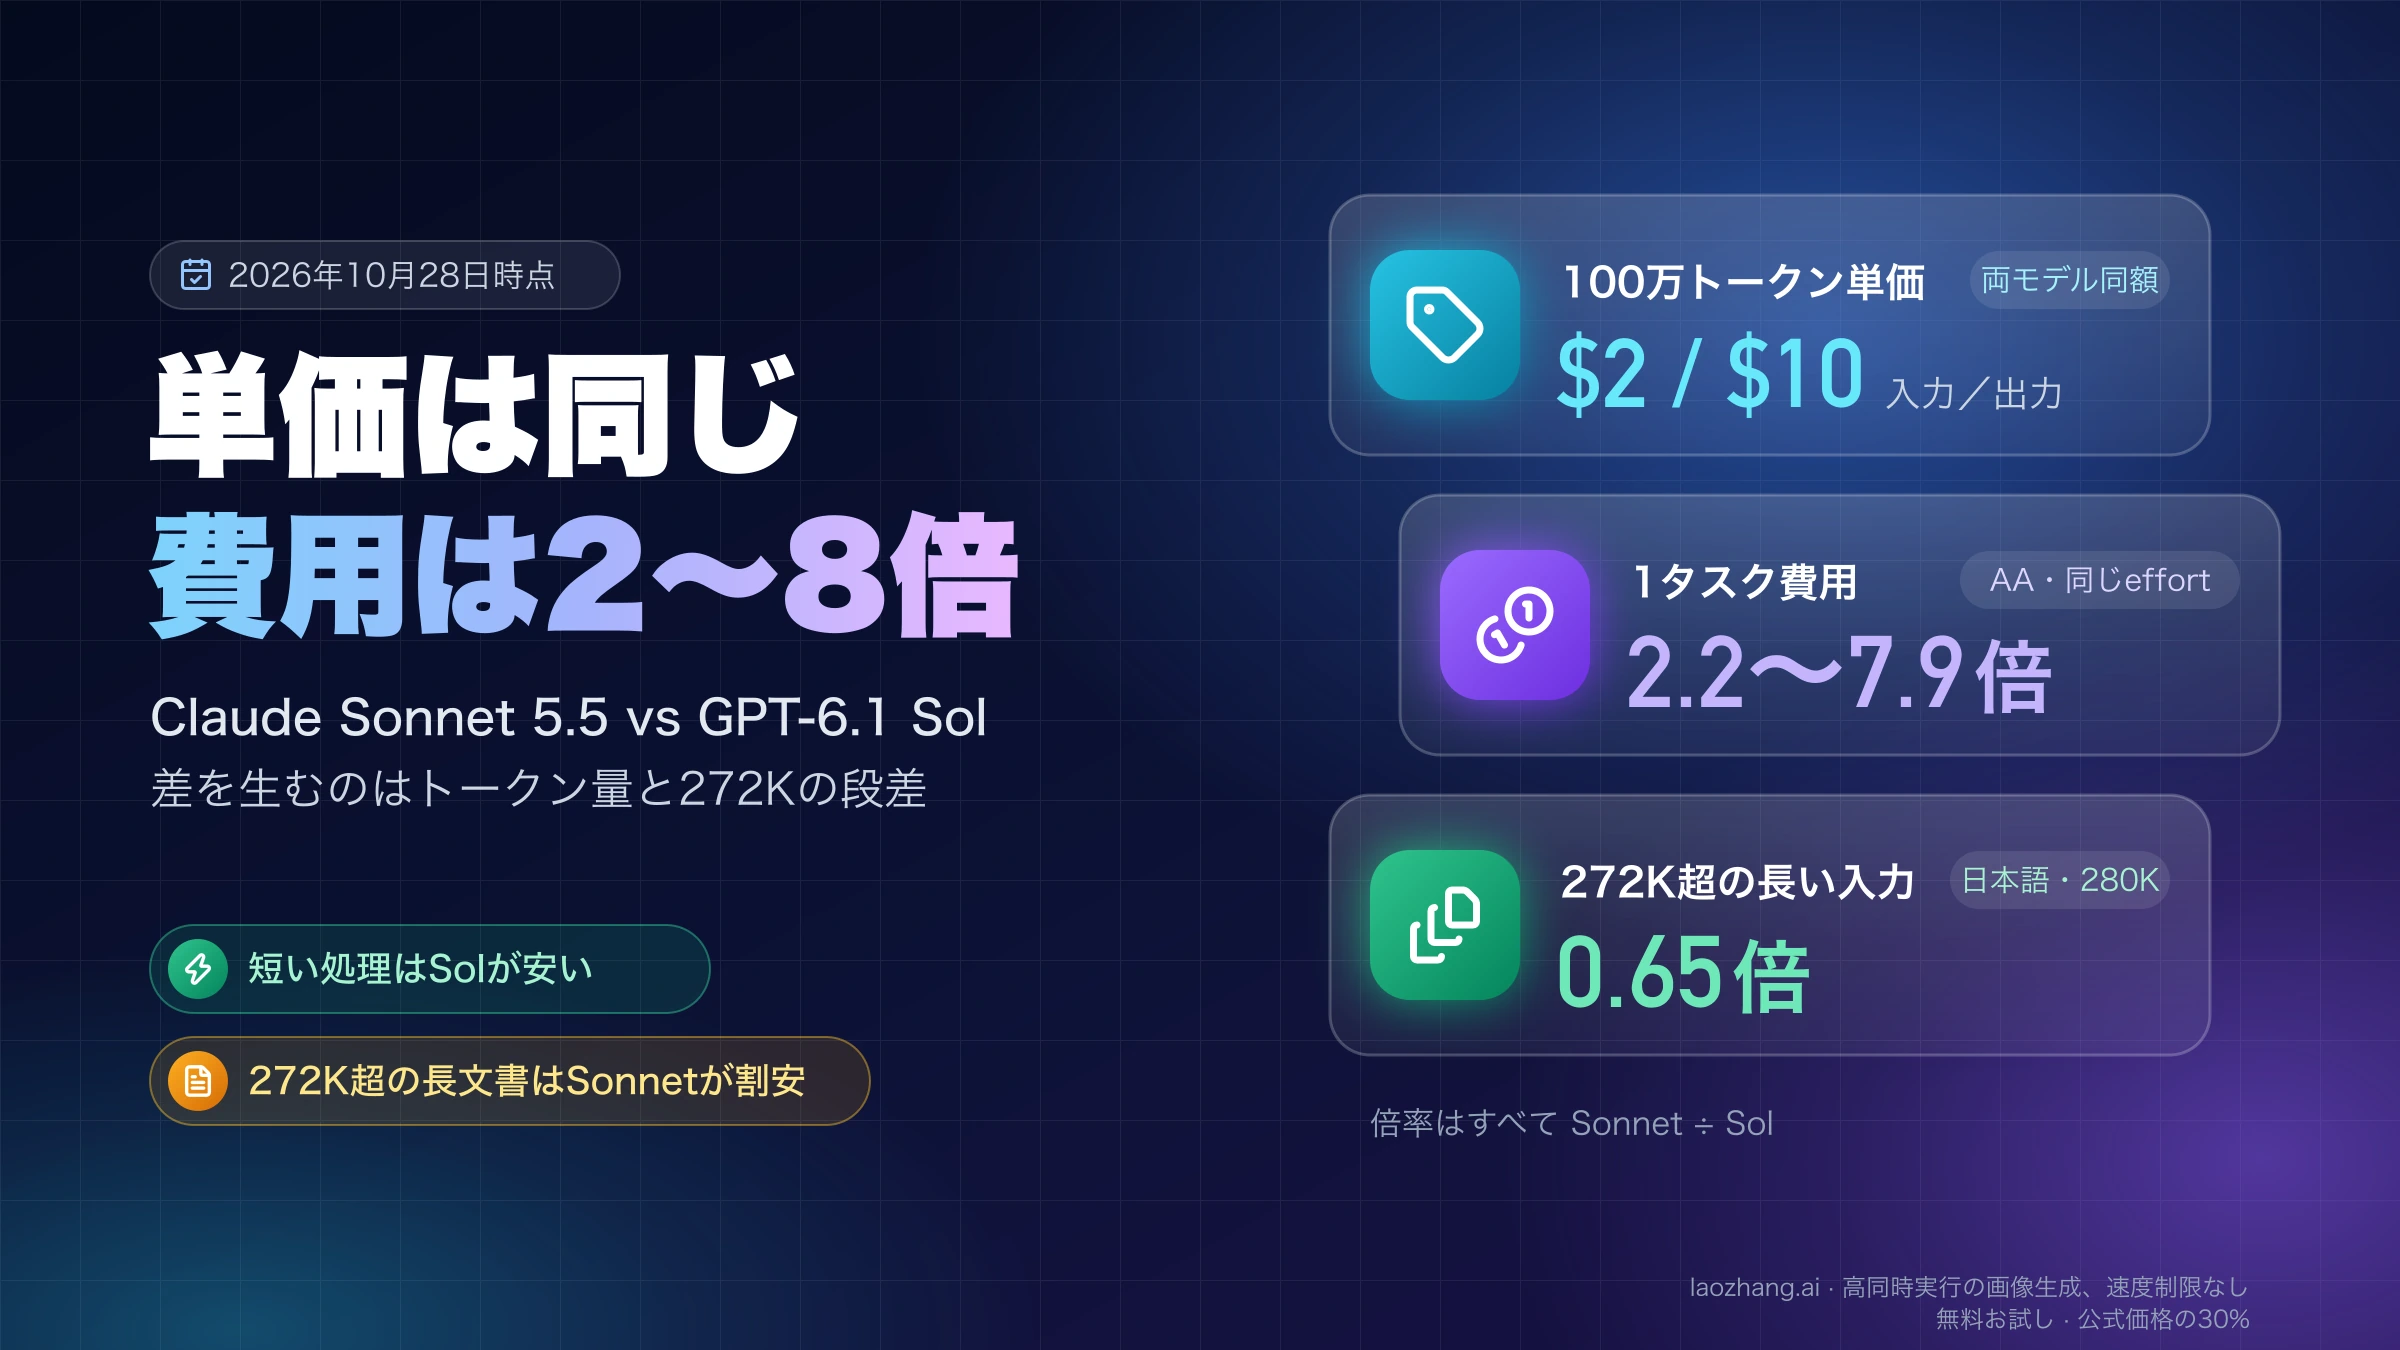
API処理でClaude Sonnet 5.5とGPT-6.1 Solのどちらを使うか迷ったら、まずgpt-6.1-solを既定のmediumで試し、272Kトークンを超える長い文書をまとめて渡す処理と、ターミナル操作を伴うコーディングエージェントで最上位の品質が要る処理だけをclaude-sonnet-5-5に回すのが基本です。第三者機関Artificial Analysis(以下AA)の総合指数v5.0では、同じeffort(推論にかける強さの設定)同士で比べるとどの段階でもSolの点数が上で、その差は最上位のmaxでほぼなくなります。1タスクの費用はSonnetがSolの2.2〜7.9倍です。
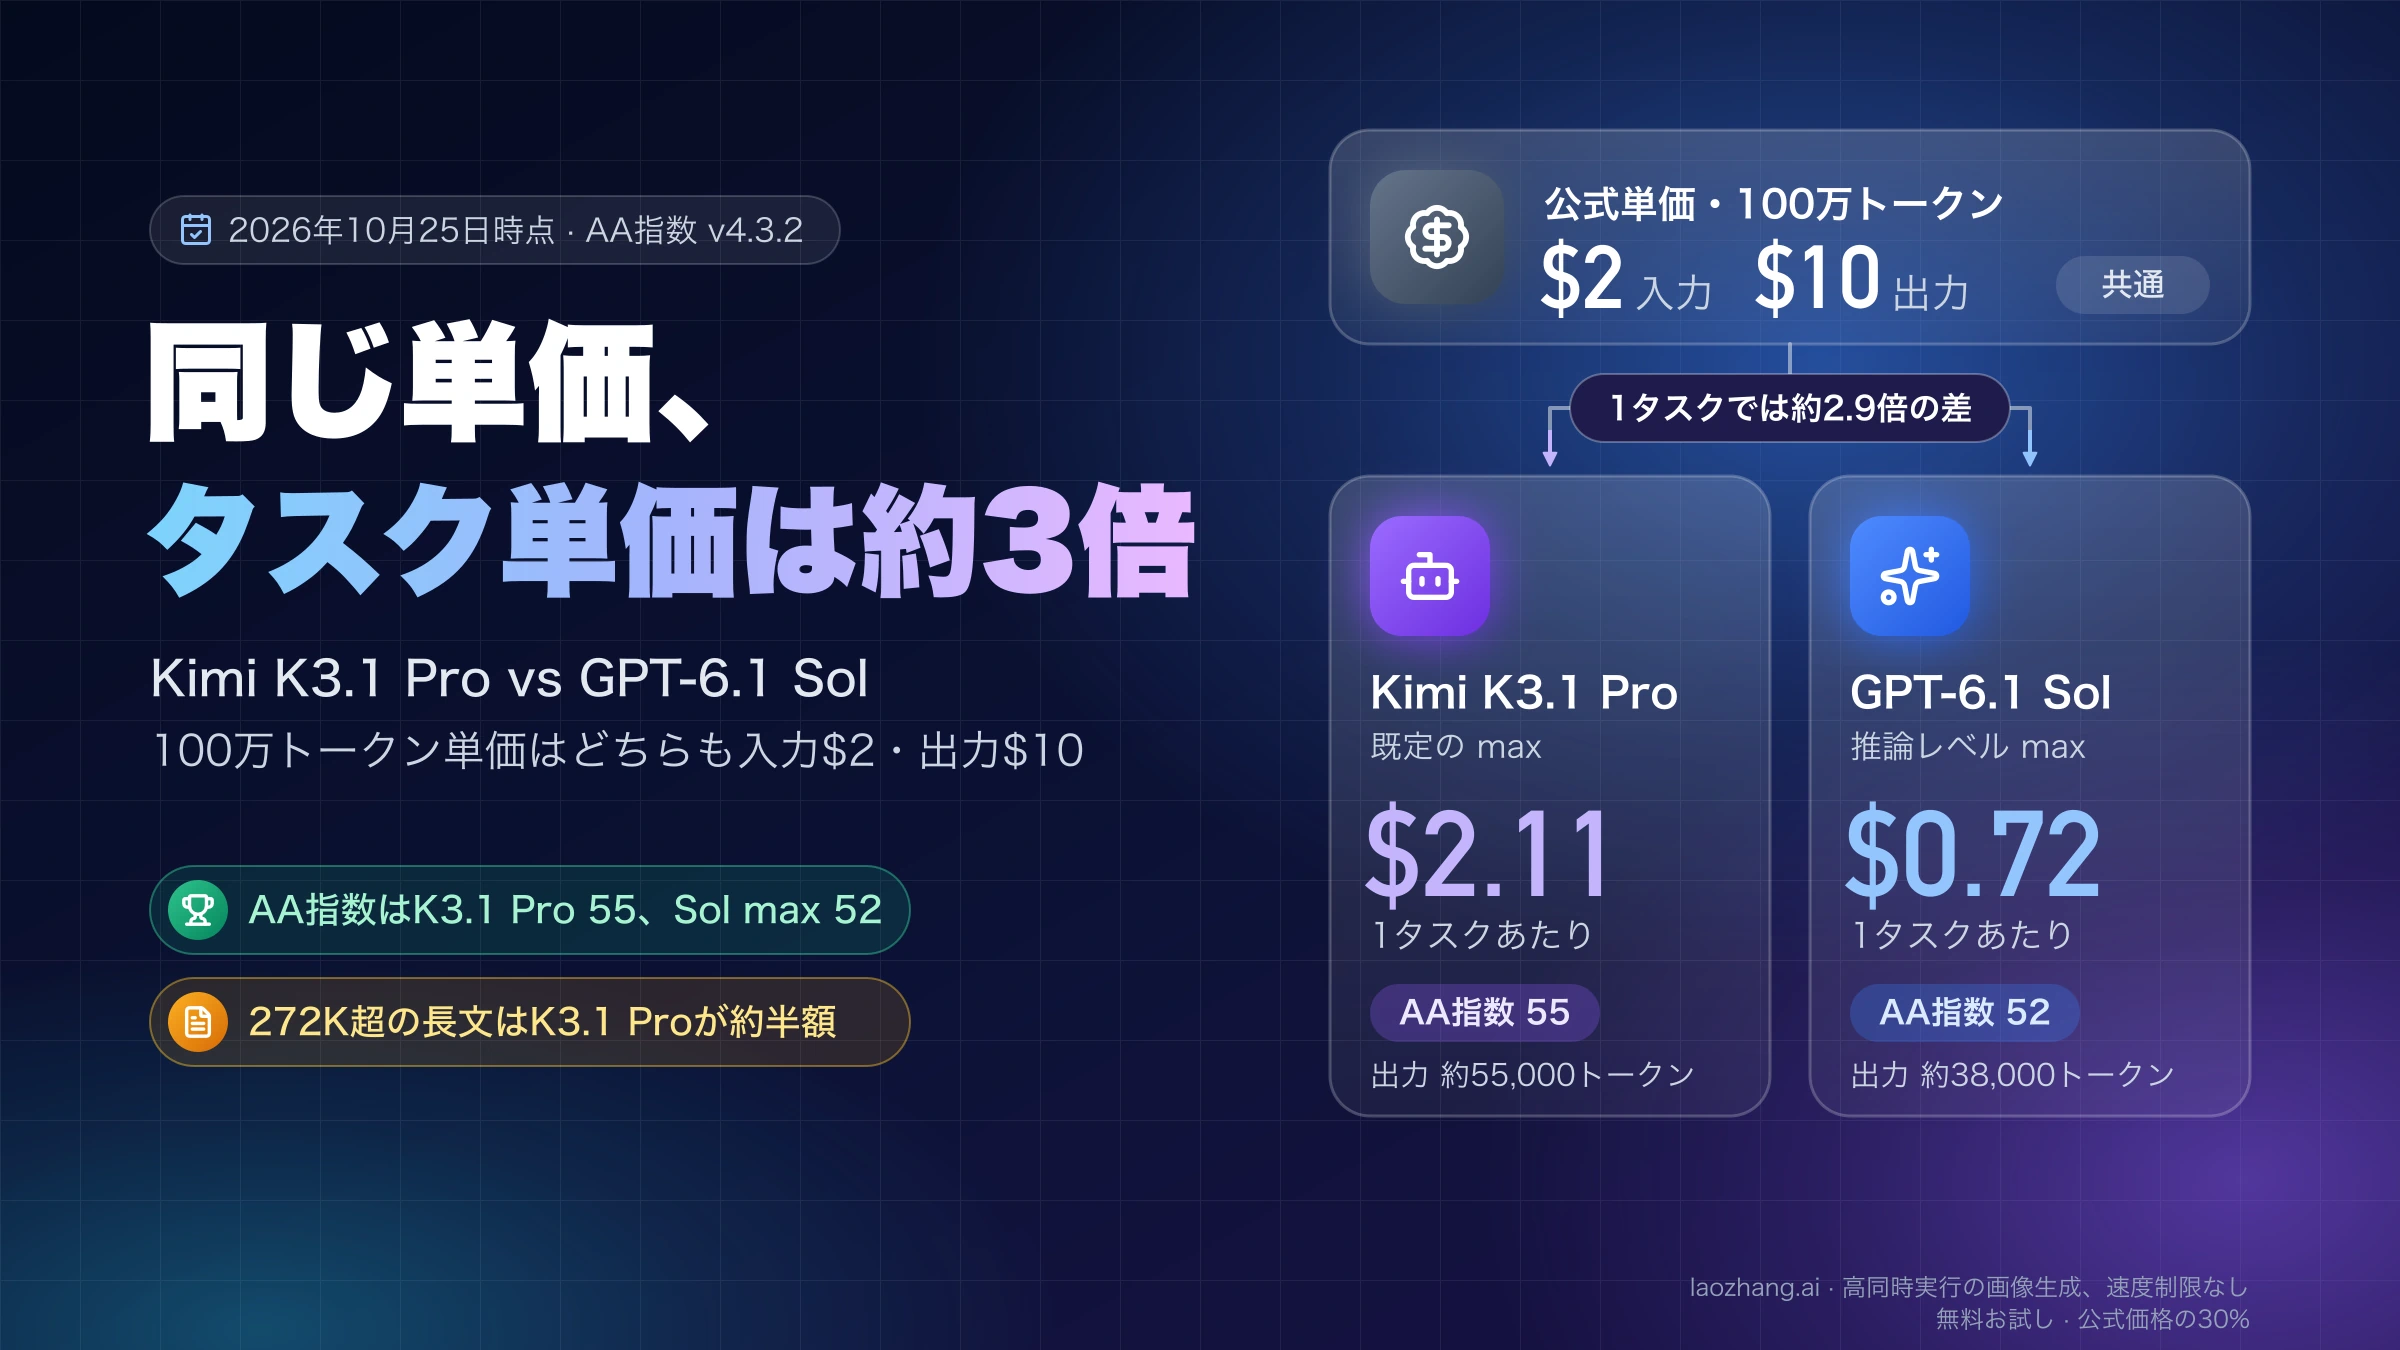
単価は2026年10月28日時点で、どちらも100万トークンあたり入力$2、出力$10、キャッシュ読み取り$0.10と同じです。それでも請求額が変わる理由は4つあります。同じ日本語の文章でもSonnetのほうがトークン数が約1.29倍多いこと、同じeffort段階でもSonnetは1タスクに使うトークンがずっと多いこと、Solは入力が272Kを超えるとリクエスト全体が値上がりすること、そしてSolは何も設定しなくてもキャッシュを書き込み、書き込み料金がかかることです。Sonnetに移すならcache_controlを必ず書き、Solに移すならツール呼び出しをResponses APIに書き換えるのが最初の作業になります。
2026年10月28日にLaoZhangのAPI経由で実際に動かしたのは、12問の単発タスク(Sonnetのhigh、Solの既定とhigh)、言語別のトークン数の計測、定価での費用の再計算です。各社APIへの直接接続、Responses API、ツール呼び出し、複数ターンのエージェント、Solのxhighとmax、Sonnetのhigh以外の段階は、このテストの範囲外です。12問はどの設定もほぼ全問正解だったため、このテストで比べられるのは同じ合格率での費用・トークン・時間で、品質の比較はAAの数字に基づいています。
Sonnet 5.5とGPT-6.1 Solの使い分け:用途別に先に試すモデルとeffort
用途で分けると、品質の要求と費用のどちらが判断を左右するかがはっきりします。下の表はAA v5.0の点数と個別評価、そして後半の費用試算をもとにした出発点で、最終的には自分のタスクで合格率を確かめてから固定します。
| 用途 | 先に試す設定 | 理由 |
|---|---|---|
| 分類・抽出・要約・短い対話 | gpt-6.1-solのmedium(既定) | 既定同士でもSolのほうが点数が高く、1タスクの費用も安い |
| 272Kトークン前後から超える文書を一度に渡す | claude-sonnet-5-5。272K以内に分けられるならSol | Solは272K超でリクエスト全体が入力$4・出力$15になり、日本語でもSonnetのほうが安くなる |
| キャッシュを使うエージェントのループ | Sol(自動でキャッシュされる) | Sonnetはcache_controlを書かないと、共通部分を毎ターン定価で読み直す |
| ターミナル操作を伴う長いコーディングエージェント | 品質優先ならSonnetのxhighかmax、費用優先ならSolのhighかxhigh | Terminal-Bench 4.0でSonnetが上回るのはxhigh以上で、その段階の1タスク費用は5〜8倍 |
| 資料を渡さずに事実を答える処理、科学系の問題 | Solのhigh以上 | AA-Omniscience、HLE-Diamond、CritPt v2ですべての段階でSolが上 |
| 待ち時間を短くしたい対話 | Sonnetのlowかmedium。品質が足りなければSolのmedium | Sonnetは出力が速く最初の応答も早いが、lowとmediumの点数はSolより低い |
| 急がない大量処理 | SolのBatch(Flexも同じ半額) | どちらもBatchは半額で、日本語ならSonnetが約1割高い |
どちらとも決めにくい処理は、先にSolで回し、テストに落ちたものだけSonnetのxhighに回す振り分けが費用を抑えやすい方法です。Solの半額の選択肢は「GPT-6.1 TerraとSolの違い:単価は半額、Codex実測で2倍速」、さらに安いOpenAIのモデルとの比較は「Claude Sonnet 5.5とGPT-6 Luna比較:単価20倍、同水準なら5〜8倍」、Anthropicの一つ上のモデルは「Opus 5.5とGPT-6 Sol・6.1 Sol比較:費用差」、サブスクやコーディングエージェントの月額は「Claude Code と Codex の料金比較:月額、利用上限、API 実コスト」で扱っています。
API料金は272Kトークン以内なら同額、違うのは長文とキャッシュ
272Kトークン以内のリクエストなら、入力・出力・キャッシュ読み取り・短いキャッシュ書き込みの単価は両モデルでまったく同じです。違いが出るのは、Solの272K超の料金、長いキャッシュの保持時間、Solだけにある高速処理の区分、そしてキャッシュが自動か手動かです(2026年10月28日時点、Anthropicの料金ページ、OpenAI APIの料金表)。
| 区分(100万トークンあたり) | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| 入力/出力 | $2/$10(1Mまで同額) | $2/$10、272K超は$4/$15 |
| キャッシュ読み取り | $0.10 | $0.10、272K超は$0.20 |
| 短いキャッシュ書き込み | $2.50(5分) | $2.50(30分、既定で自動) |
| 長いキャッシュ書き込み | $4(1時間) | $5(12時間、Responses APIのみ) |
| Batch | $1/$5、キャッシュ割引と併用可 | $1/$5、Flexも同額 |
| 高速処理 | なし(Fastモードは対象外) | Fast $4/$20、Ultrafast $12/$60 |
| 地域を限定した処理 | 米国内のみの推論は1.1倍 | データレジデンシーは10%増し |
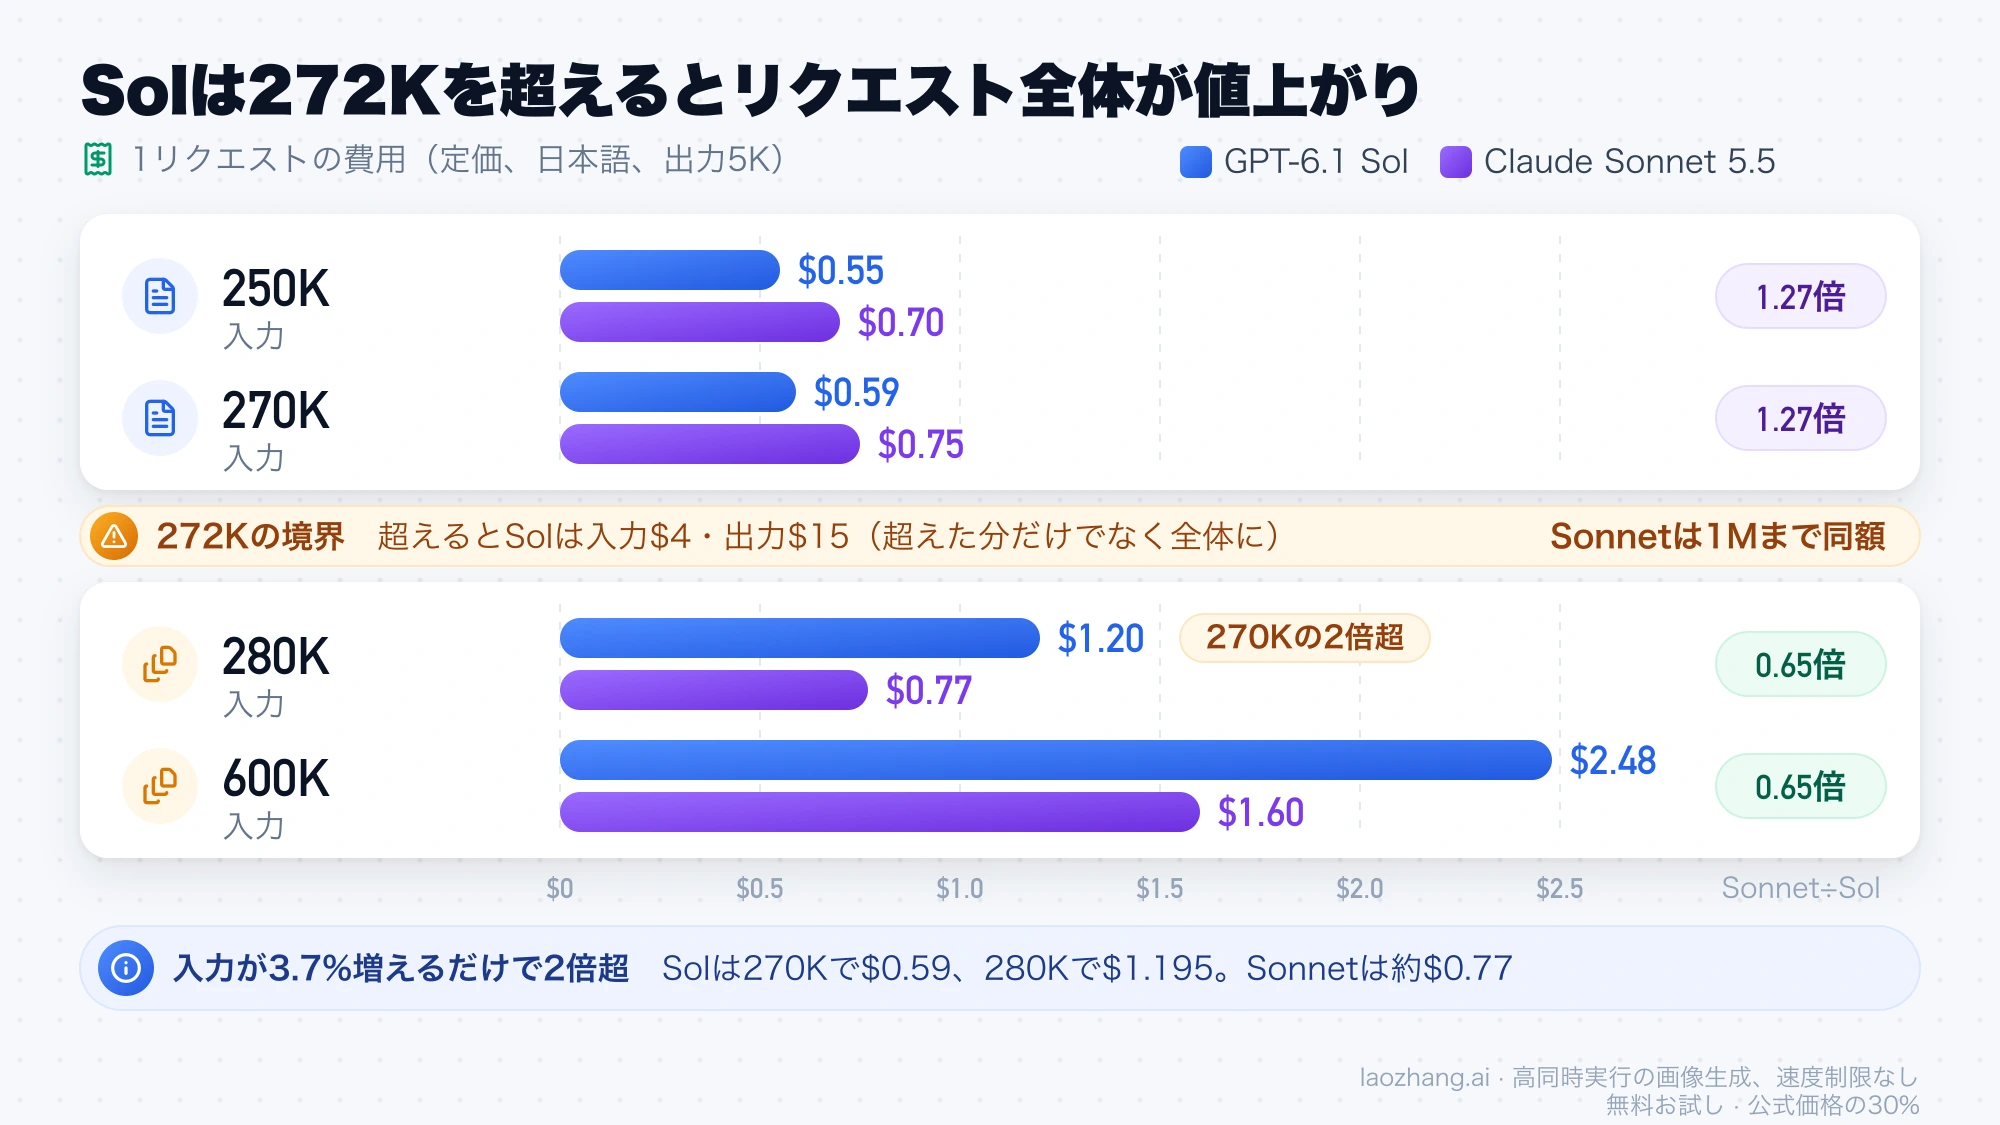
Solの272Kの段差は、超えた分だけでなくリクエスト全体にかかります。GPT-6.1 Solのモデルページには「272Kを超える入力トークンのプロンプトは、リクエスト全体に対して入力とキャッシュが2倍、出力が1.5倍の料金」とあります。一方Anthropicは、Sonnet 5.5を含むClaude 4.6以降のモデル(Haiku 5.5を除く)は1Mトークンのコンテキストすべてが通常料金だとしています。
「キャッシュ読み取りはSolのほうが半額で安い」という説明は、2026年10月7日より前の情報です。この日AnthropicがSonnet 5.5のキャッシュ読み取りを$0.20から$0.10に下げたため、現在は両モデルとも$0.10です。値下げの中身は「Claude Sonnet 5.5のキャッシュ読み取り料金は$0.10:削減率の求め方」で計算しています。
同じ単価なのに何倍も違うのはなぜか:見方ごとの倍率
Sonnet 5.5がGPT-6.1 Solより何倍高いかは、何を単位に数えるかで1倍未満から約8倍まで変わります。トークン単価は同じでも、同じ文章を数えるトークン数、1タスクを解くのに使うトークン量、長文の料金段差がそれぞれ別の倍率を生むからです。
| 見方 | Sonnet÷Sol | 条件 |
|---|---|---|
| 100万トークンあたりの単価 | 1倍 | 272K以内 |
| 同じ日本語の文章の入力費用 | 1.29倍 | 2026年10月28日の実測、英語は1.45倍 |
| 12問の単発タスクの合計費用 | 1.52倍 | Sonnetのhigh対Solの既定、2026年10月28日の実測 |
| AAの同じeffort段階の1タスク | 2.2〜7.9倍 | mediumで最小、maxで最大 |
| AAの既定同士の1タスク | 4.6倍 | Sonnetのhigh(41.1点)対Solのmedium(46.1点) |
| AAでほぼ同じ点数になる段階の1タスク | 6.9倍/7.9倍 | 約50点(Sonnetのxhigh対Solのhigh)/約54点(両方max) |
| 272Kを超える長い入力 | 0.65倍 | 日本語、280K入力と5K出力の試算 |
AAの倍率がここまで開くのは、Sonnetが1タスクを解くまでに文脈を何度も読み直すからです。AAが公開しているmaxでの1タスク費用の内訳では、Sonnetの$10.02のうち$7.17が入力側(キャッシュ読み取り$4.88、キャッシュ書き込み$2.27)で、出力は$2.85です。Solは$1.27のうち入力側が$0.59、出力が$0.68でした。指数全体をmaxで回したトークン量も、Sonnetが入力306億・出力3億3,520万、Solが入力19億2,000万・出力6,370万と、入力で約16倍の差があります。
海外の掲示板Redditには「3Dタスクでは30倍高かった」という投稿もありますが、上のどの見方でも30倍にはなりません。個々のタスクでの体験は幅が大きいので、自分の用途に近い見方で比べるのが確実です。
effort別の点数と1タスク費用:AA Intelligence Index v5.0
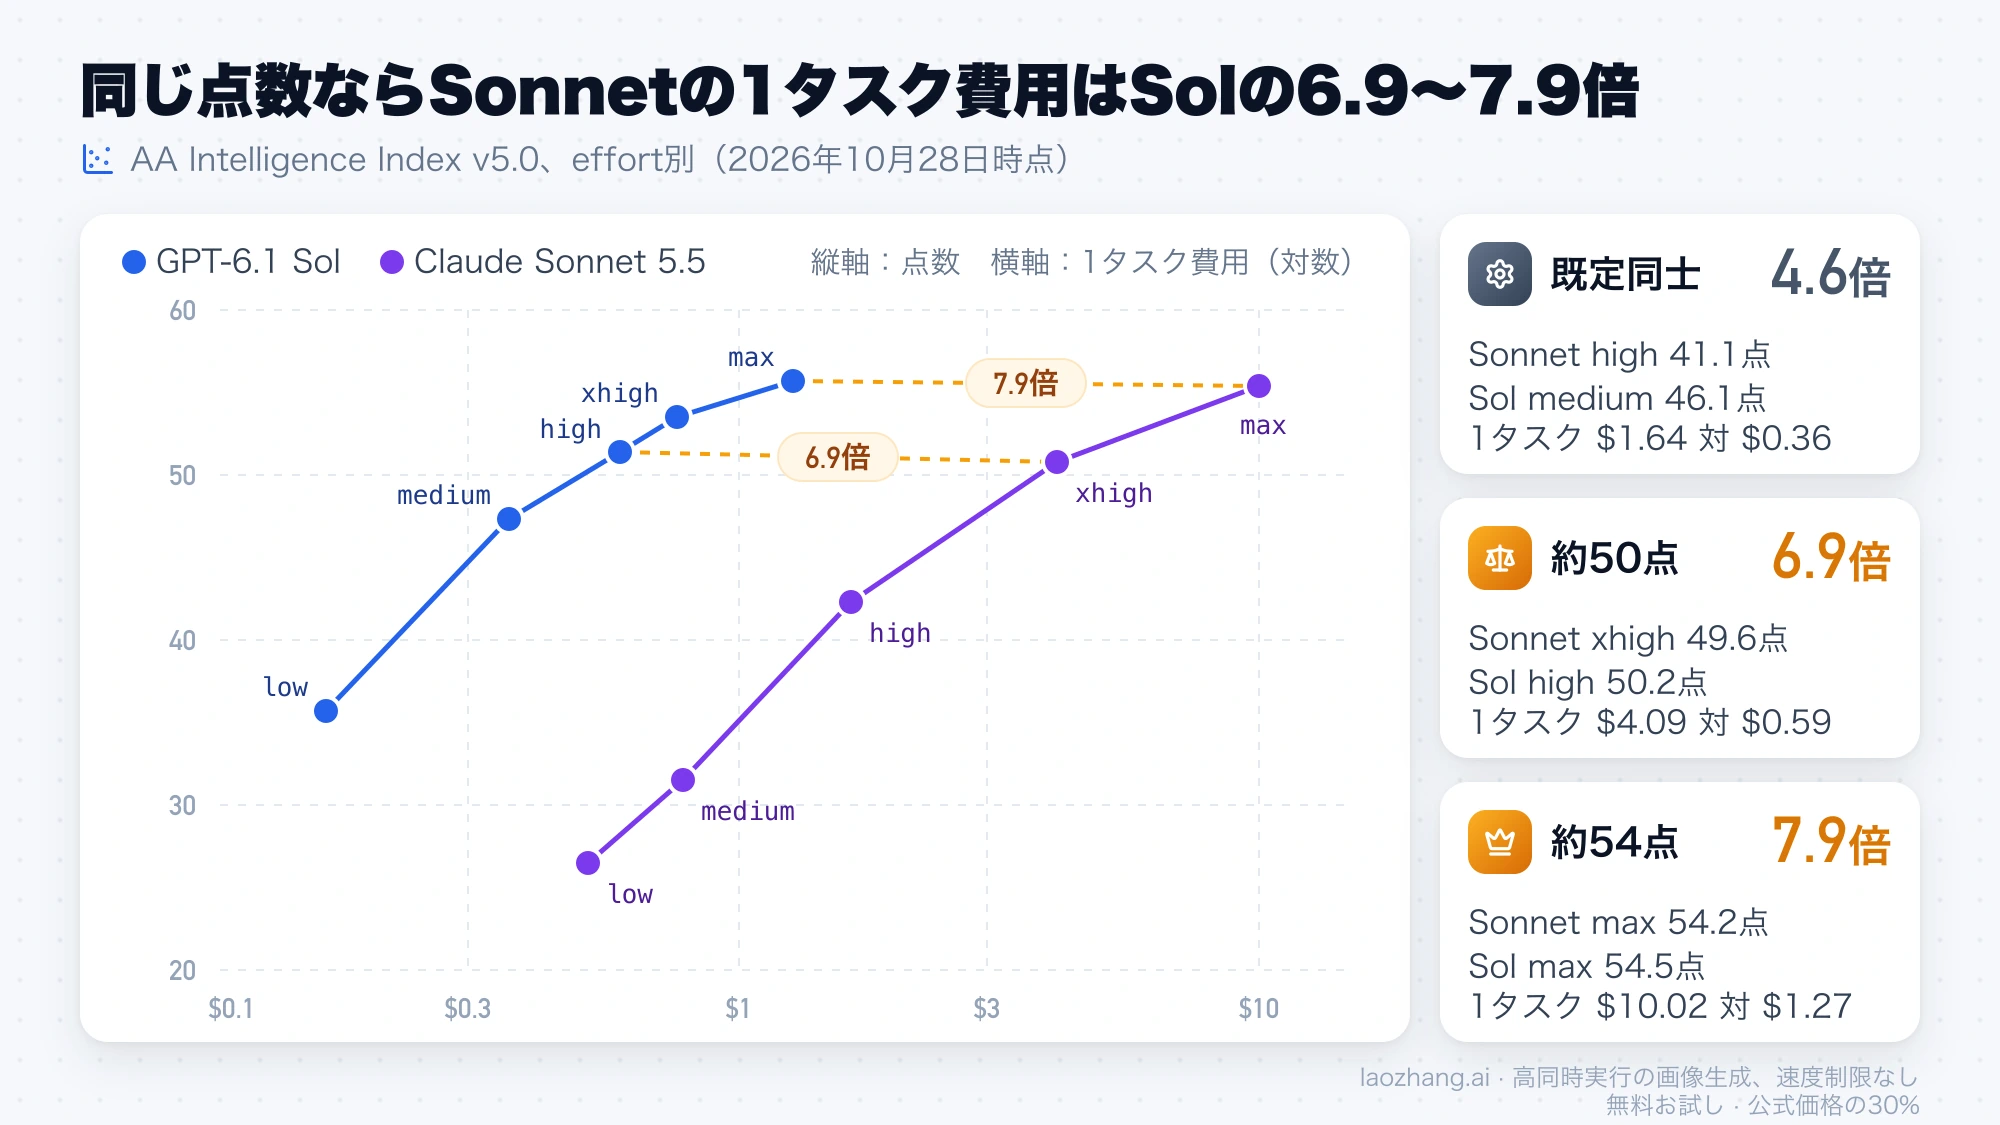
AAの総合指数v5.0(2026年10月28日時点)では、同じ名前のeffort段階で比べるとすべての段階でGPT-6.1 Solの点数が高く、1タスクの費用は安くなっています。Claude Sonnet 5.5が追いつくのは最上位のmaxだけです。数値はAAのClaude Sonnet 5.5とGPT-6.1 Solの比較ページから取り、費用はAAが指数の評価タスクにかかったトークンに定価を掛けた1タスクあたりの平均です。
| effort | Sol 点数 | Sol 1タスク費用 | Sol 1タスク時間 | Sonnet 点数 | Sonnet 1タスク費用 | Sonnet 1タスク時間 |
|---|---|---|---|---|---|---|
low | 34.5 | $0.16 | 104秒 | 25.3 | $0.51 | 121秒 |
medium | 46.1 | $0.36 | 231秒 | 30.3 | $0.78 | 178秒 |
high | 50.2 | $0.59 | 322秒 | 41.1 | $1.64 | 332秒 |
xhigh | 52.3 | $0.76 | 436秒 | 49.6 | $4.09 | 691秒 |
max | 54.5 | $1.27 | 858秒 | 54.2 | $10.02 | 1,326秒 |
「既定同士」で比べるときは、既定の段階が違う点に注意が必要です。Sonnet 5.5のAPIの既定はhigh(Claude Codeとアプリではmedium)、Solの既定はmediumです。点数を揃えたいなら、Sonnetは一段上のxhigh(49.6点)でSolのhigh(50.2点)とほぼ並び、1タスクの時間は691秒対322秒と2倍以上かかります。最上位はSonnetのmaxが54.2点、Solのmaxが54.5点で、ここまで上げるとSonnetは1タスクに$10を超えます。
ページによってAAの点数が違って見えるのは、AAが2026年10月に指数をv4.3.2からv5.0へ切り替えたためです。v5.0ではHLE-Diamond、FrontierCode 2.0、Terminal-Bench-Scienceが加わり、GDPval-AA、SciCode、AA-LCR、Humanity's Last Examが外れました。旧版ではSonnetのmaxが56点でSolのmaxの52点を上回っていましたが、v5.0では順位が入れ替わっています。両方の版の数字を混ぜて比べることはできません。
得意分野:ターミナル操作はSonnetの上位段階、知識と科学はSol
AA v5.0の個別評価では、Claude Sonnet 5.5が勝つのは主にxhighとmaxの段階で、lowとmediumではAA-Briefcaseを除くすべての評価でGPT-6.1 Solが上回ります。下の表は、よく使われるhighと最上位のmaxを並べたものです(2026年10月28日時点、AAの比較ページ)。
| 評価 | Sol high | Sonnet high | Sol max | Sonnet max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 51.5% | 43.9% | 56.1% | 63.6% |
| FrontierCode 2.0 | 36.7% | 25.7% | 40.6% | 41.7% |
| AA-Briefcase(Elo) | 1,466 | 1,634 | 1,555 | 1,812 |
| AA-Omniscience | 41.0 | 18.7 | 42.0 | 30.5 |
| HLE-Diamond | 51.9% | 33.8% | 58.8% | 53.3% |
| CritPt v2(Hard) | 67.5% | 47.5% | 68.5% | 56.0% |
ターミナル操作を伴うコーディングでは、Sonnetはxhigh(57.1%)からSolの同段階(54.0%)を上回り、maxでは差が7.5ポイントに広がります。AutomationBench-AAでもmaxではSonnetが71.8%でSolの64.9%を上回り、AA-Briefcaseはlow(1,268対1,114)とmedium(1,438対1,361)を含むすべての段階でSonnetが上です。逆に、資料を渡さずに事実を答えるAA-Omniscienceや科学系のHLE-Diamond、CritPt v2、GDP.pdfでは、Solがすべての段階で上回ります。Terminal-Bench-ScienceはxhighだけSonnetが52.4%対50.5%で上で、ほかの段階はSolが上です。
つまり、コーディングエージェントで最高の完了率が欲しい場合はSonnetの上位段階に意味がありますが、その段階の1タスク費用は前の節のとおり大きく膨らみます。知識や科学の質問にSonnetを使う理由は、この数字からは見当たりません。
2026年10月28日の12問実測:費用・トークン・時間
2026年10月28日、LaoZhangのAPI経由で、隠しテストか正解が決まっている単発タスク12問を3つの設定に1回ずつ送りました。Sonnet 5.5はAnthropic形式のMessages APIでthinking: adaptiveとeffort: highを指定し、GPT-6.1 SolはChat Completionsで既定(medium)とreasoning_effort: highの2通りです。ツールもシステムプロンプトも使っていません。テストに使ったlaozhang.aiでは両モデルとも公式と同じ単価で、SolはChat Completionsのみのためツール呼び出しはできません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 設定 | 合格 | 費用(定価) | 出力トークン(うち推論) | 合計時間 | 1回の中央値 |
|---|---|---|---|---|---|
Sonnet 5.5 high | 11/12 | $0.1761 | 10,945(内訳は非表示) | 101秒 | 7.6秒 |
| GPT-6.1 Sol 既定 | 12/12 | $0.1157 | 6,162(2,423) | 187秒 | 14.0秒 |
GPT-6.1 Sol high | 12/12 | $0.1581 | 10,398(6,311) | 442秒 | 21.2秒 |
同じ12問の費用はSonnetがSolの既定の1.52倍、Solのhighの1.11倍で、長文書を使う2問を除くとSolの既定の1.83倍でした。Sonnetが落とした1問は「5項目、各25語以内」の要約で、1項目目が26語になった書式の取りこぼしです。この回はadaptive thinkingが働いておらず、思考ブロックが返ったのは12問中8問でした。存在しない標準ライブラリ関数を2つ混ぜた質問には3設定とも「存在しない」と答え、36個のテストがあるnpm形式のバージョン範囲判定もすべて通っています。
キャッシュでは予想外の動きがありました。Solは約1万トークンの文書を含む2問で、キャッシュの設定を何もしていないのにcache_write_tokensが10,103と10,195返り、通常入力の1.25倍($2.50)で計算されています。同じ文書のプロンプトを約5.5分後にreasoning_effort: highで送り直すと、キャッシュは読まれず(0トークン)、もう一度書き込まれました。原因がeffortの違いか、経路か、上流側かはわかっていません。Sonnetはcache_controlを付けていないので、何もキャッシュしていません。
言語別のトークン数:日本語はSonnetが1.29倍
同じ文章を両モデルに入力し、指示文だけの分を差し引いて数えると、Sonnet 5.5のトークン数はどの言語でもGPT-6.1 Solより多くなりました(2026年10月28日、各言語6,000文字)。日本語の文章はSonnetが4,900トークン、Solが3,793トークンで1.29倍と、計測した言語の中でいちばん差が小さく、英語は1.45倍、中国語は1.41倍、韓国語は1.65倍、Pythonのコードは1.46倍でした。英語の記事1本(6,723語)を丸ごと入れた場合も、Sonnet 15,335トークン対Sol 10,106トークンで1.52倍です。
GPT-6 Lunaに同じ文章を送ると、すべてのサンプルでSolとまったく同じトークン数でした。OpenAIはGPT-6系のトークナイザー名を公開しておらず、tiktokenにもGPT-6系の対応表はないので、正確な数はOpenAIの入力トークン数のカウントAPIで確かめます。
中継サービス経由のSonnetはthinkingを明示する
2026年10月26日に同じLaoZhangの経路で試したときは、thinkingとeffortを省いたSonnet 5.5のリクエストでは9問すべてで思考ブロックが返らず、thinking: adaptiveとeffort: highを明示すると9問中7問で返りました。Anthropicの文書では、Sonnet 5.5でthinkingを省くとadaptiveの既定highとして扱われます。直接APIで同じことが起きるかは試していないので、中継サービスを使うときは両方を明示しておくのが安全です。
どちらが速いか:出力速度はSonnet、1タスクの時間はeffort次第
1秒あたりの出力はClaude Sonnet 5.5のほうが速く、最初の応答もxhighまではSonnetが早く返ります。ただし上位の段階ではSonnetが書く量が多いため、1タスクが終わるまでの時間はGPT-6.1 Solのほうが短くなります。AAの計測(2026年10月28日時点)では、出力速度はSonnetが109〜140トークン/秒、Solが59〜81トークン/秒です。最初の回答トークンまでの時間は、mediumでSonnet 3.0秒対Sol 3.6秒、highで11.1秒対40.8秒ですが、maxでは455.0秒対278.0秒と逆転します。
12問のテストでも、1回の呼び出しの中央値はSonnetの7.6秒に対してSolの既定が14.0秒、highが21.2秒で、短い単発タスクではSonnetが速く返りました。Solのhighでは514トークンしか出力しない呼び出しに150.6秒かかった回もあり、経路や混み具合による振れも大きいです。Solが遅いと感じるときの原因と設定は「GPT-6.1 Solが遅いのは解消した?10月26日の実測と速くする設定」で扱っています。
使い方別の費用試算:272K超の長文書ではSonnetが安い
定価で計算すると、短いリクエストやキャッシュを正しく使うループではClaude Sonnet 5.5がGPT-6.1 Solの1.1〜1.3倍、272Kを超える長い入力では逆にSonnetが約3分の2の費用になります。いちばん高くつくのは、Sonnetでcache_controlを書き忘れたエージェントのループです。
| ケース(トークン数はSol基準) | GPT-6.1 Sol | Claude Sonnet 5.5(日本語) | Sonnet÷Sol |
|---|---|---|---|
| 短い対話:2K入力+500出力 | $0.0090 | $0.0102 | 1.13倍 |
| 文書:250K入力+5K出力 | $0.55 | $0.70 | 1.27倍 |
| 文書:270K入力+5K出力 | $0.59 | $0.75 | 1.27倍 |
| 文書:280K入力+5K出力 | $1.20 | $0.77 | 0.65倍 |
| 文書:600K入力+5K出力 | $2.48 | $1.60 | 0.65倍 |
| 50ターンのループ:100Kの共通部分をキャッシュ、毎ターン2K入力+1K出力 | $1.44 | $1.71 | 1.19倍 |
同じループでSonnetにcache_controlなし | $1.44 | $13.68 | 9.50倍 |
| Batch:1万件×(3K入力+1K出力) | $80.00 | $88.76 | 1.11倍 |
前提は2026年10月28日時点の定価です。トークン数はSolで数えた値とし、Sonnetの入力には日本語の実測比1.29倍を掛け、出力トークンは両モデル同数と仮定しています。キャッシュのループは、Solが初回に30分のキャッシュを自動で書き込み、Sonnetはcache_controlで5分のキャッシュを書き込み、どちらも保持時間内に次のターンが来る想定です。実際にはSonnetのほうが出力が多くなりやすいので(前の節のAAの数字)、ここでの倍率は下限に近い見積もりです。英語の文章なら比率は1.45倍になり、280K入力で0.72倍、キャッシュ付きのループで1.29倍、書き忘れで10.6倍です。
272Kの段差は、280K入力の行で確かめられます。Solは0.28×$4+0.005×$15=$1.195、Sonnetは0.28×1.29×$2+0.005×$10≒$0.77です。Solは270Kなら$0.59なので、入力が3.7%増えただけで費用は2倍を超えます。日本語では6,000文字がSolで3,793トークンだったので、272Kトークンは約43万文字にあたります。Sonnetのトークン比が2倍未満である限り、272Kを超えた入力はSonnetのほうが安くなります。
乗り換えで壊れる設定:Responses API、none、cache_control
モデル名を書き換えるだけでは、どちらの方向にも動かない設定があります。いちばん影響が大きいのは、GPT-6.1 Solのツール呼び出しがResponses APIでしか使えないことと、Claude Sonnet 5.5のキャッシュがcache_controlを書かない限り働かないことです(Anthropicのモデル概要、GPT-6.1 Solのモデルページ、OpenAIのプロンプトキャッシュの解説)。
| 項目 | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| モデルIDと公開日 | claude-sonnet-5-5、2026年9月28日 | gpt-6.1-sol、2026年9月29日 |
| effortの段階と既定 | low〜max、APIの既定はhigh(Claude Codeとアプリはmedium) | low〜max、既定はmedium |
| 推論を最小にする設定 | thinking: {type: "disabled"}は拒否され、最低はbetween_tools | noneとminimalは非対応で、最低はlow |
| ツール呼び出し | Messages APIで使えるが、強制tool_choice(any・tool)は400エラー | Responses APIが必須で、Chat Completionsでは使えない |
| キャッシュ | cache_controlを指定したときだけ。5分か1時間、最小512トークン | 既定で自動、30分。12時間はResponses APIのみ、最小1,024トークン |
| 入出力の上限 | コンテキスト1M、最大出力128K(Batchはベータヘッダーで300K) | コンテキスト1,050,000、最大入力922,000、最大出力128,000 |
| 高速処理 | Fastモードなし | Fast(2倍)とUltrafast(6倍) |
| 知識のカットオフ | 2026年6月 | 2026年4月30日 |
SolからSonnetに移すときは、none相当の軽い処理をlowかbetween_toolsで置き換え、繰り返し送る共通部分にcache_controlを付けます。SonnetからSolに移すときは、ツールを使う処理をResponses APIに移し、Solの「コンテキスト1M」は最大入力が922,000トークンで、272Kから料金が変わる点を前提にします。旧版のSonnet 5やGPT-6 Solから移る場合の変更点は、「Claude Sonnet 5.5移行ガイド:effort別の費用差と5つの破壊的変更」と「GPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点」にまとめています。
乗り換え前の試し方:合格タスクあたりの費用を測る
比べるべき数字は単価でも点数でもなく、自分のタスクを1件合格させるのにかかる費用と時間です。12問のテストに当てはめると、Sonnetのhighは$0.1761÷11問=約$0.016、Solの既定は$0.1157÷12問=約$0.0096で、この組み合わせではSolが合格1件あたり約6割の費用でした。同じ計算を自分のタスクで行う手順は次のとおりです。
- 普段の処理から20〜50件を選び、テストコード、正解、文字数の上限など、合否を機械的に判定できる形にします。
- 両モデルの設定を明示します。Sonnetは
thinking: adaptiveとeffort、Solはreasoning.effortを書き、中継サービス経由ではとくに省略しません。 - 既定同士だけでなく、点数の近い組み合わせ(Solの
mediumとhigh、Sonnetのhighとxhigh)も走らせます。 - 各呼び出しの
usageから、入力・出力・推論トークン、キャッシュの書き込み(Solのcache_write_tokens)と読み取りを記録し、定価で費用を計算します。 - 合計費用を合格数で割って合格1件あたりの費用を出し、所要時間の合計と中央値も並べます。
- 片方で落ちたタスクだけをもう一方か一段上のeffortに回す振り分けで同じ計算をし、一本化した場合と比べます。
272K前後の長い文書を扱うなら、送る前にSol側の入力トークン数をOpenAIのカウントAPIで確かめ、境界を超えるかどうかで振り分け先を決めます。Sonnetに日本語のプロンプトを大量に送る場合は、Solで数えたトークンの約1.29倍で予算を見積もっておくと、請求額とのずれが小さくなります。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
- 1.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 2.OpenAI APIの料金表developers.openai.com/api/docs/pricing
- 3.GPT-6.1 Solのモデルページdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 4.AAのClaude Sonnet 5.5とGPT-6.1 Solの比較ページartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-sol
- 5.Anthropicのモデル概要platform.claude.com/docs/en/about-claude/models/overview
- 6.OpenAIのプロンプトキャッシュの解説developers.openai.com/api/docs/guides/prompt-caching