Gemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:high同士はOpusが安い
Gemini 4 Argonの単価は11月30日までOpus 5.5の半額ですが、high同士では実測でも第三者評価でもOpusが安く、12月1日の値上げで差が開きます。
目次
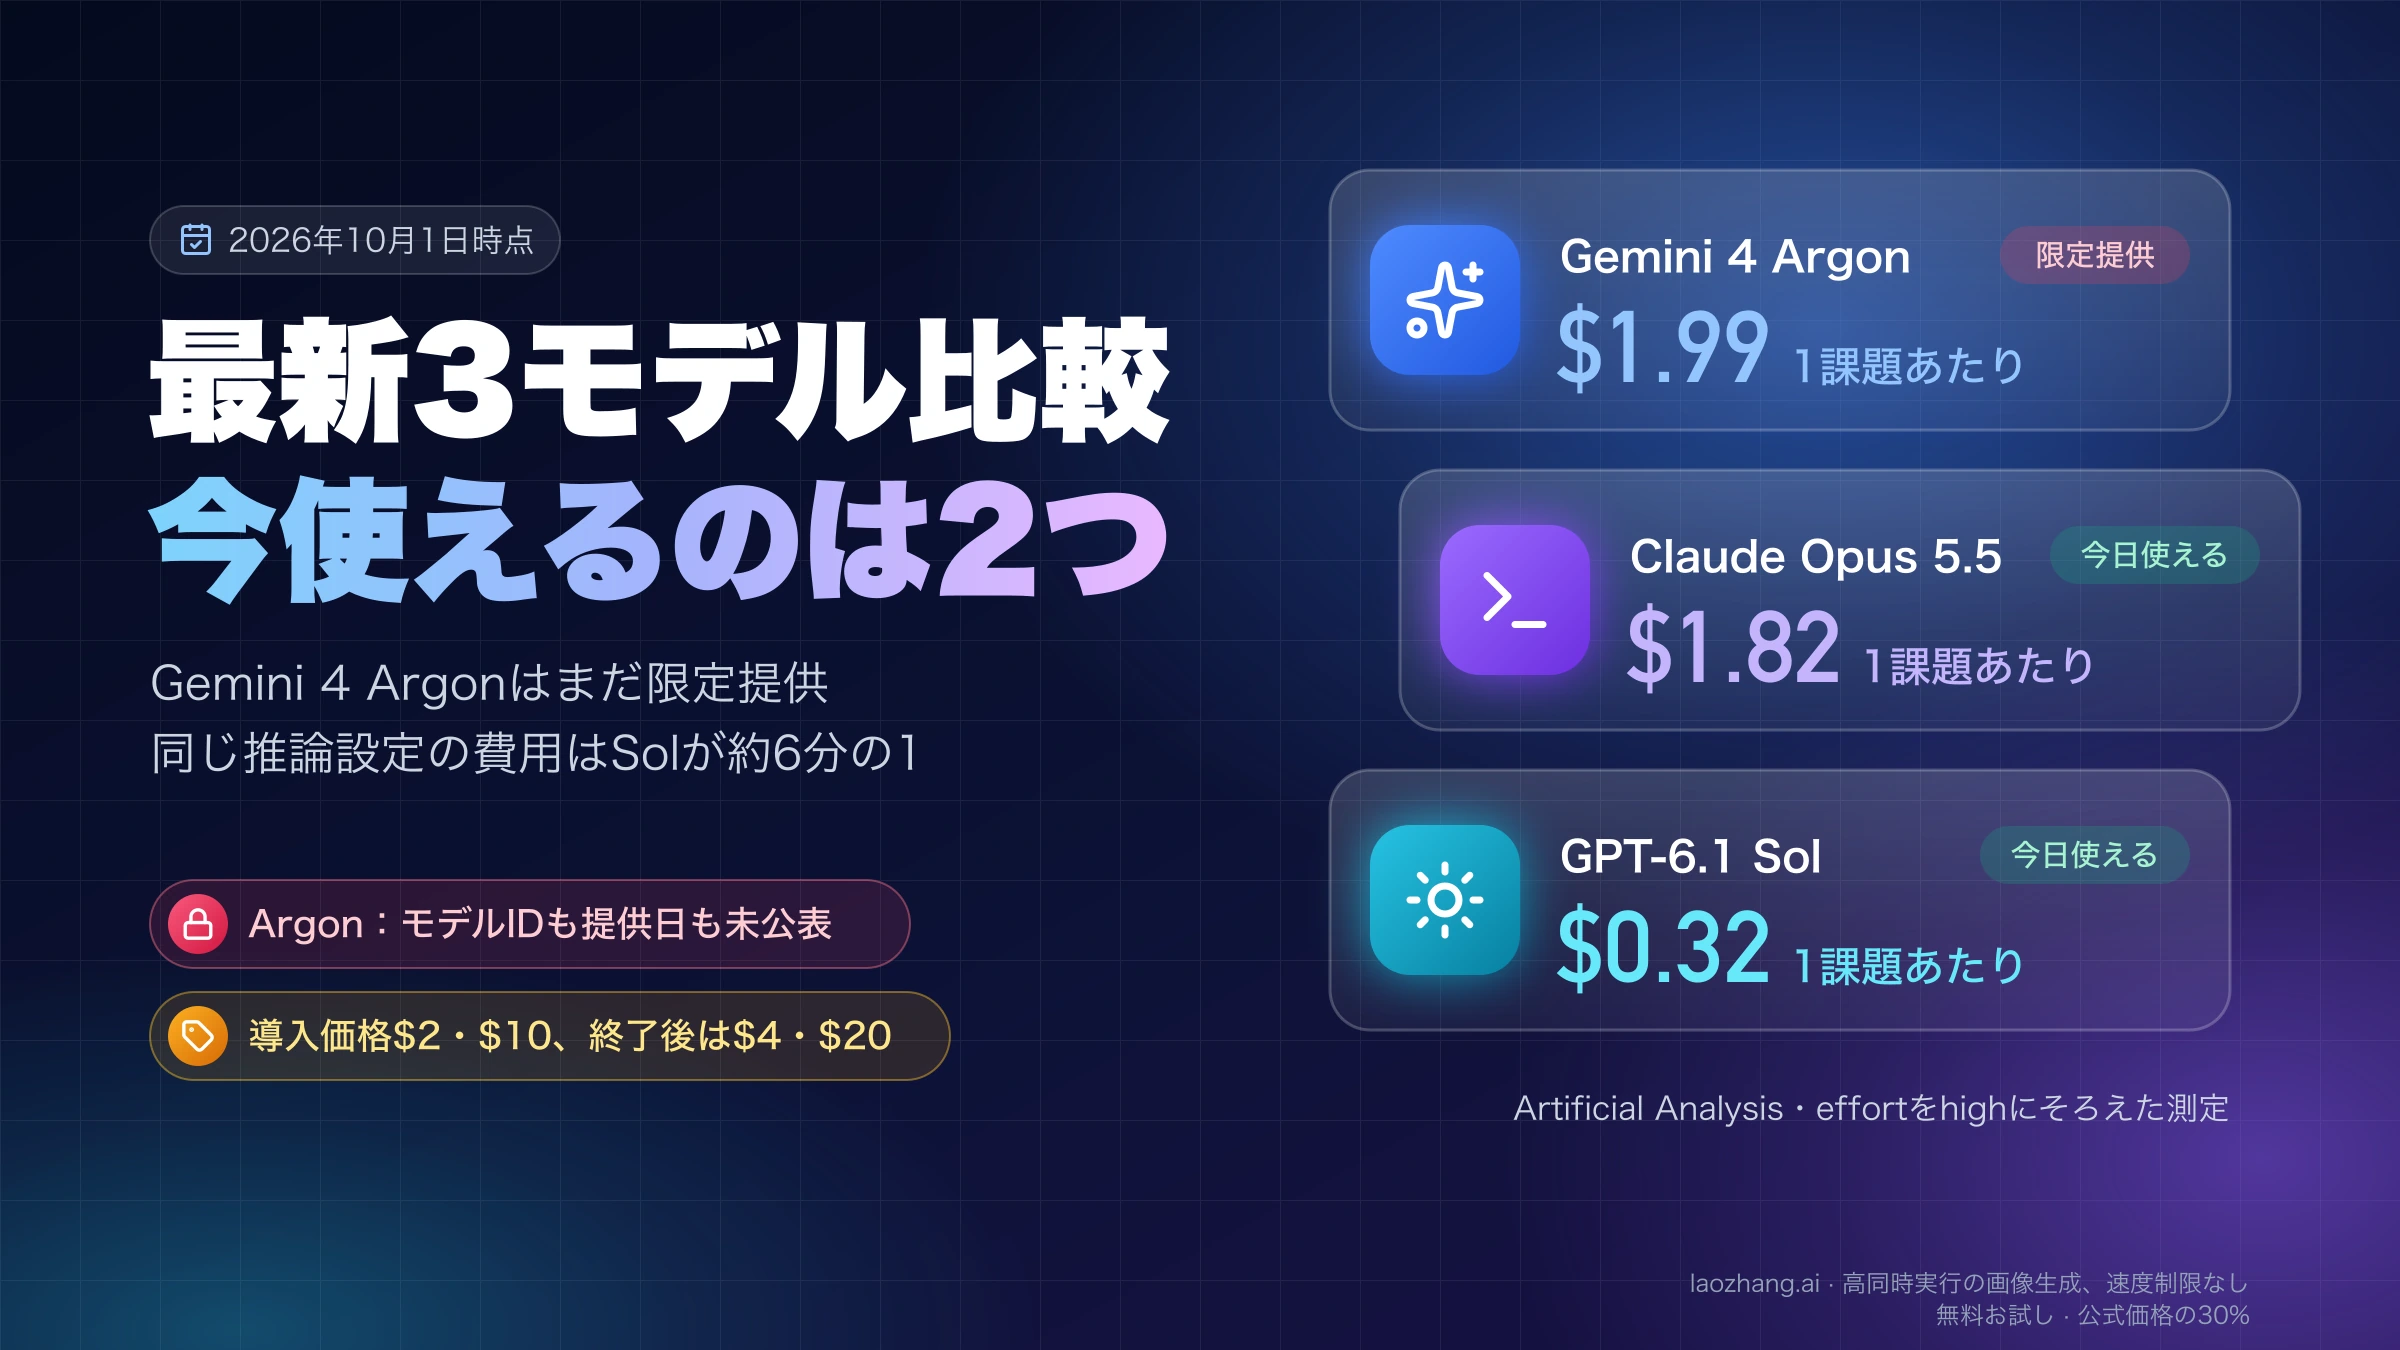
Gemini 4 ArgonとClaude Opus 5.5のどちらでAPI開発を進めるかは、推論の設定と、12月1日以降も使い続けるかどうかで答えが変わります。それぞれの既定の設定(Argonは思考レベルmedium、Opus 5.5はeffort medium)で小さなコーディング課題を解かせるなら、11月30日までの導入価格ではArgonの費用はOpusの約3分の1です。ところが両方をhighに上げた場合や、長いログを正確に集計させる仕事では、今の単価のままでもOpus 5.5のほうが安く、12月1日にArgonの単価が$4・$20へ2倍になると差はさらに開きます。「ArgonはOpusの半額」が成り立つのは、11月30日までのトークン単価に限った話です。
根拠の1つは、LaoZhangのAPIゲートウェイ経由で両モデルに同じ8課題を解かせた試験です(Argonは2026年11月4日、Opus 5.5は11月11日に実行)。既定同士では正解がArgon 10/11、Opus 11/11で、費用は$0.093対$0.290でした。high同士はどちらも11/11で、費用は$0.403対$0.308とOpusが低く、12月1日からの単価で計算し直すとOpusの費用はArgonの0.38倍です。第三者のArtificial Analysis(AA)の指数でも、high同士の1課題あたりの費用はArgonがOpus 5.5の1.44倍(導入価格に換算した場合)、12月1日以降は2.88倍で、総合スコアは50対52とOpusが上です。
ここから出てくる判断は次のとおりです。コーディングエージェントや長い入力を正確に扱う仕事は、Opus 5.5(claude-opus-5-5)をeffort mediumのまま試すところから始めます。Argon(gemini-4-argon)は、既定の設定でテストが通る軽い処理を11月30日までにまとめて流す場合や、法務エージェントや25万トークンを超える文脈のようにGoogleの比較表で差が大きい仕事で候補になります。費用を最優先するならGPT-6.1 Solが基準で、AAのhighではArgonと同じ50点を1課題$0.59で出しています。12月1日までに自分の課題をそれぞれの既定とhighで流し、正解数と出力トークン数を記録して、12月以降の単価で計算し直してから決めるのが確実です。
Gemini 4 Argonはどこで使えるか:10月13日から一般提供
GoogleのGemini 4 Argonの一般提供を伝える発表記事(2026年10月13日)によると、ArgonはAI StudioとGemini platformのAPIで開発者と企業に「本日から世界的に提供」され、Geminiアプリや法人向けのGemini for businessにも広がりました。9月30日の発表から13日間はFairwindプログラムの参加者に限った提供でした。Gemini APIのモデル一覧でも、gemini-4-argon は安定版(Stable)として掲載されています。2026年10月14日時点で、どこで誰が使えるかをまとめると次のようになります。
| Argonを使える場所 | 使える人・条件 |
|---|---|
| Gemini API(AI Studio、Android Studioから利用) | 課金を設定した有料枠の利用者。無料枠では使えない。AI Studioの画面ではAI Proに「より多い」、Ultraに「最も多い」利用枠(2026年11月6日時点) |
| Gemini platform(Google Cloud) | 開発者と企業。モデルIDは gemini-4-argon |
| Google Antigravity | Google AI Ultraの契約者と、有料のGoogle AI Proの契約者、または対象の高級端末に付いてくるAI Proトライアルの利用者(2026年10月23日時点。端末名は挙げられておらず、通常の無料トライアルは対象に挙げられていない。AI Proは順次提供)。Antigravityアプリ、CLI、IDE拡張機能で使え、Antigravity IDEでは使えない |
| Geminiアプリ、Google検索のAIモード | Google AI ProとGoogle AI Ultraの契約者 |
| Gemini for business(ウェブ、デスクトップ、モバイル) | Gemini for businessの利用者 |
| Fairwindプログラム | セキュリティ防御側の参加組織。サイバー分野のガードレールを外した版を順次提供 |
注意したいのはGoogle AI Proの扱いです。2026年11月11日時点のGemini APIの料金ページは、Argonについて「無料枠では利用できない」とだけ書いており、以前あった「Google AI Proプランでも利用できない」という一文はなくなっています。AI Studioのプラン説明(2026年11月6日時点)では、AI ProにArgonを使える「より多い」利用枠、Ultraに「最も多い」利用枠が付き、無料のアカウントではArgonを使えません。ただし、どのサブスクリプションでもAPIの呼び出し自体は対象外で、自分のコードからArgonを呼ぶには課金を設定した有料のAPI(従量課金)が必要です。一方、Geminiアプリと検索のAIモードについては、発表記事がAI ProとUltraの契約者を対象に挙げています。Google Antigravityについては、Google Antigravityのモデル一覧ページが2026年10月23日時点で、Ultraに加えて有料のAI Proと、Googleが「対象の高級端末」と呼ぶ端末に付いてくるAI ProトライアルもArgonの対象にしています(端末名は挙げられていません)。通常の無料トライアルは対象に挙げられていません。なお、この記載に変わる前の10月中旬には、スマホの購入特典やキャンペーンで付いたAI Proでは使えなかったというユーザー報告がありました。つまりAI Proの契約者は、Geminiアプリ、AI Studio、AntigravityではArgonを使えても、プランの料金でAPIの呼び出しまでまかなうことはできません。Google AI Plusと無料のGeminiアプリは、発表記事の対象に含まれていません。
Argonのレート制限は、発表記事・モデルページ・料金ページのいずれにも数字が載っていません。日本はGemini APIの提供地域に含まれています。
3つのモデルを並べると、次のとおりです。
| Gemini 4 Argon | Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|---|
| 公開日 | 2026年9月30日発表、10月13日一般提供 | 2026年9月22日公開 | 2026年9月29日公開 |
| 主な提供先 | Gemini APIの有料枠、AI Studio、Antigravity(有料のPro・Ultra)、Geminiアプリと検索のAIモード(Pro・Ultra)、Gemini for business | Claudeアプリ(Pro・Max・Ultra・Team・Enterprise。Freeは対象外)、Claude Code、Claude API、AWS・Google Cloud・Azure | OpenAI API、ChatGPTのWorkとCodex(Plus・Pro・Business・Enterprise・Edu) |
| モデルID | gemini-4-argon | claude-opus-5-5 | gpt-6.1-sol |
| コンテキスト長 | 1,048,576(入力と出力の合計) | 1M | 1,050,000 |
| 出力上限 | 65,536(通常の同期呼び出し。ストリーミングなしは32,768)、long decodeで最大1,048,576 | 128K | 128,000 |
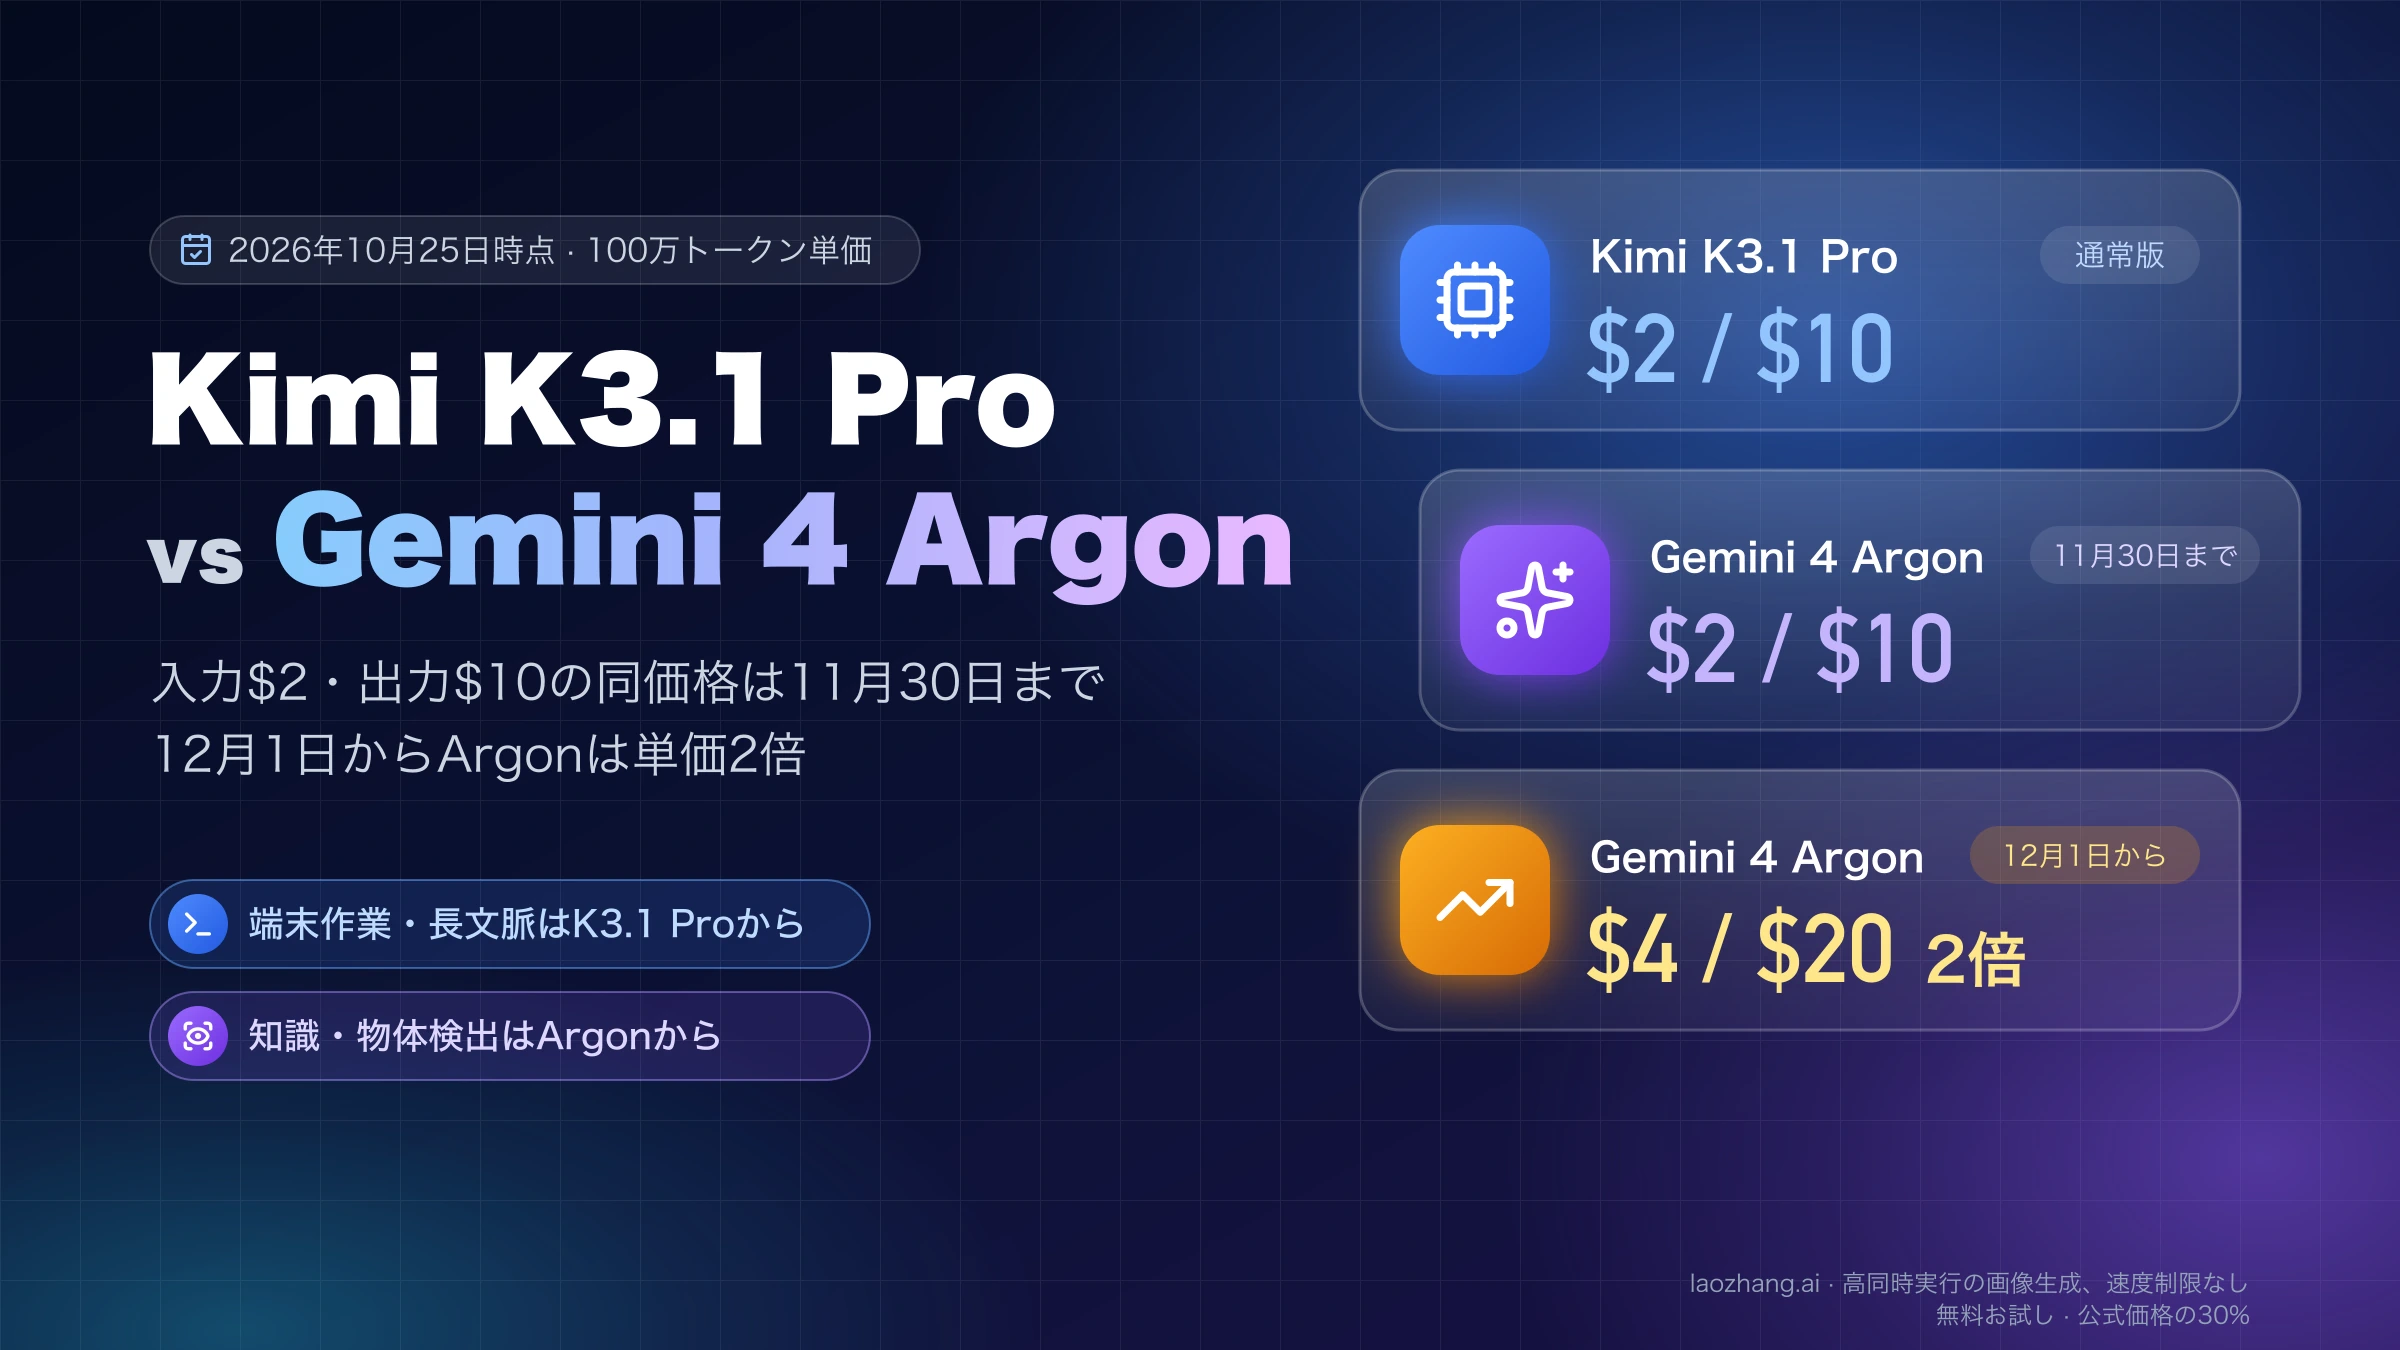
| 入力・出力の単価(100万トークン) | 11月30日まで$2・$10、12月1日から$4・$20 | $4・$20 | $2・$10(入力272K超の依頼は$4・$15) |
単価は、Argonが2026年11月11日時点、Opus 5.5が11月10日時点、GPT-6.1 Solが10月14日時点の各社の料金ページの値です。それ以外の行は、Argonが10月13日更新のGemini 4 ArgonのGemini APIモデルページ、Opus 5.5がAnthropicの9月25日時点、GPT-6.1 SolがOpenAIの9月30日時点の公開情報です。GPT-6.1 Sol(検索で「GPT 6.1」と書かれているモデル)はChatGPTの通常のチャット画面では選べず、FreeとGoのプランも対象外です。ツール呼び出しにはResponses APIが必要になります。細かい移行条件はGPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点にまとめてあります。
Claudeアプリでは、無料プランでOpus 5.5を使えません。対象はPro(月$20)、Max($100)、Ultra($200)、Team、Enterpriseで、MaxとUltraは2026年10月30日にMax 5x・Max 20xから名前が変わったプランです(2026年11月6日時点)。Argonを無料で試せる条件はGemini 4 Argonは無料で使える?どこで使えるかと0円になる条件、Opus 5.5の入口と使っているモデルの確かめ方はClaude Opus 5.5の使い方:無料で使う方法と外部サービスの無料枠にまとめてあります。
Fairwindは、Googleがセキュリティの防御側に限って先行提供してきた枠組みです。一般提供が始まったいまは、サイバー分野のガードレールを外した版を使うための経路という位置づけで、Googleは参加組織を「数百」規模で追加していくとしています。どういう組織が対象になるかはGemini 3.8 Flash Cyberの申請条件:Fairwind参加前に確認することで確認できますが、これはGemini 3.8 Flash Cyber向けに書かれた内容で、Argonの申請手順としてそのまま当てはまるものではありません。
トークン単価:Solと同額なのは11月30日までの導入価格だけ
2026年11月11日時点のGemini APIの料金ページでは、Argonの単価が「2026年11月30日まで」と「12月1日から」の2段で書かれています。12月1日からは、入力・出力・キャッシュ済み入力のすべてが2倍になります。
| Gemini 4 Argon(100万トークンあたり) | 11月30日まで | 12月1日から |
|---|---|---|
| 標準:入力 | $2.00 | $4.00 |
| 標準:出力(思考トークンを含む) | $10.00 | $20.00 |
| 標準:キャッシュ済み入力 | $0.10 | $0.20 |
| Batch・Flex:入力・出力(キャッシュ済み入力) | $1.00・$5.00($0.05) | $2.00・$10.00($0.10) |
| Priority:入力・出力(キャッシュ済み入力) | $3.60・$18.00($0.18) | $7.20・$36.00($0.36) |
Argonのキャッシュは暗黙的キャッシュ(implicit caching)だけで、明示的にキャッシュを作る方式には対応していません。キャッシュの書き込み料金や保存料金はなく、長い入力に対する別の料金区分もありません。Google検索とGoogleマップによるグラウンディングは、Gemini 3以降のモデル合計で月5,000リクエストまで無料、その後は1,000リクエストあたり$14です。
3つの定価を100万トークン単位の式にすると、次のようになります。Uは新規の入力、Rはキャッシュからの読み出し、Oは推論分を含む出力です。
| モデルと条件 | 費用の式(ドル) |
|---|---|
| Gemini 4 Argon(11月30日まで) | 2U + 0.10R + 10O |
| Gemini 4 Argon(12月1日から) | 4U + 0.20R + 20O |
| GPT-6.1 Sol(入力272K以下) | 2U + 0.10R + 10O |
| GPT-6.1 Sol(入力272K超) | 4U + 0.20R + 15O |
| Claude Opus 5.5 | 4U + 0.20R + 20O |
キャッシュへの書き込みには、GPT-6.1 Solで100万トークンあたり$2.50、Opus 5.5の5分キャッシュで$5の料金がかかります。Argonの暗黙的キャッシュには書き込み料金がありません。
新規入力10万トークン、出力2万トークンの依頼で計算すると、11月30日までのArgonは0.1×2+0.02×10で$0.40、GPT-6.1 Solも$0.40、Opus 5.5は0.1×4+0.02×20で$0.80です。12月1日からのArgonは同じ計算で$0.80になり、Opus 5.5と並びます。つまりトークン数が同じなら、導入価格のArgonはSolと同額でOpusの半額、12月1日以降のArgonはOpusと同額です。急がない処理をまとめて流すBatchでも同じ関係で、12月以降のArgonのBatchは$2・$10とOpus 5.5のBatchと同額、GPT-6.1 SolのBatchは$1・$5です。
「ArgonはOpusの半額」と言えるのは、このトークン単価の比較に限った話で、期限は11月30日です。12月1日からは入力・出力とも単価が同じになり、残る違いはArgonにキャッシュの書き込み料金がない点くらいです。しかも同じ文章でも、モデルによって数えられるトークン数が違います。同じ日本語の段落を送ったとき、Opus 5.5の入力トークン数はArgonの1.85倍でした(LaoZhang経由で各APIが返した値。Argonは2026年11月4日、Opusは11月11日に計測)。英語の段落では1.45倍、6,723語の英文記事では1.38倍で、数字やIDが中心のログファイルでは0.99倍とほぼ同じです。12月以降は単価が並んでも、日本語のプロンプトではOpus側の入力の費用が2倍近くになると見込んでおきます。
12月以降も使い続けるなら、見積もりは最初から$4・$20で組んでおくほうが安全です。導入価格の終了日は2026年11月11日時点の料金ページでも変わっていませんが、Googleが後から変えることもありえます。Opus 5.5とGPT-6.1 Solの単価をキャッシュやバッチまで含めて突き合わせたい場合は、Opus 5.5とGPT-6 Sol・6.1 Sol比較:費用差に計算例があります。
Google以外では、API提供サービスのlaozhang.aiが2026年11月11日時点で gemini-4-argon を入力$2・出力$10・キャッシュ読み出し$0.10、claude-opus-5-5 を入力$4・出力$20・キャッシュ読み出し$0.20(いずれも100万トークンあたり)で掲載しています。12月1日以降のArgonの価格は記載がありません。後半の実測は、このゲートウェイを経路にしたものです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
1課題あたりの費用は単価どおりにならない:ArgonはSolの8〜17倍
同じ課題を解かせても、モデルによって消費するトークン数が大きく違います。そのため、請求額を決めるのは単価よりも「1課題を終えるまでに何トークン使うか」です。Artificial Analysisは9種類の評価をまとめた総合指数(Intelligence Index v5.0.1)で、スコアと1課題あたりの費用を公開しています。Artificial Analysisは2026年10月27日から28日にかけて指数をv4.3.2からv5.0に切り替えたため、それより前に引用された数値とは値が異なります。ArgonはHighの設定だけが掲載されているので、ほかの2つもhighにそろえて並べます。
| effortをhighにそろえた比較 | 総合スコア | 1課題あたりの費用(11月30日まで) | 1課題あたりの費用(12月1日から) |
|---|---|---|---|
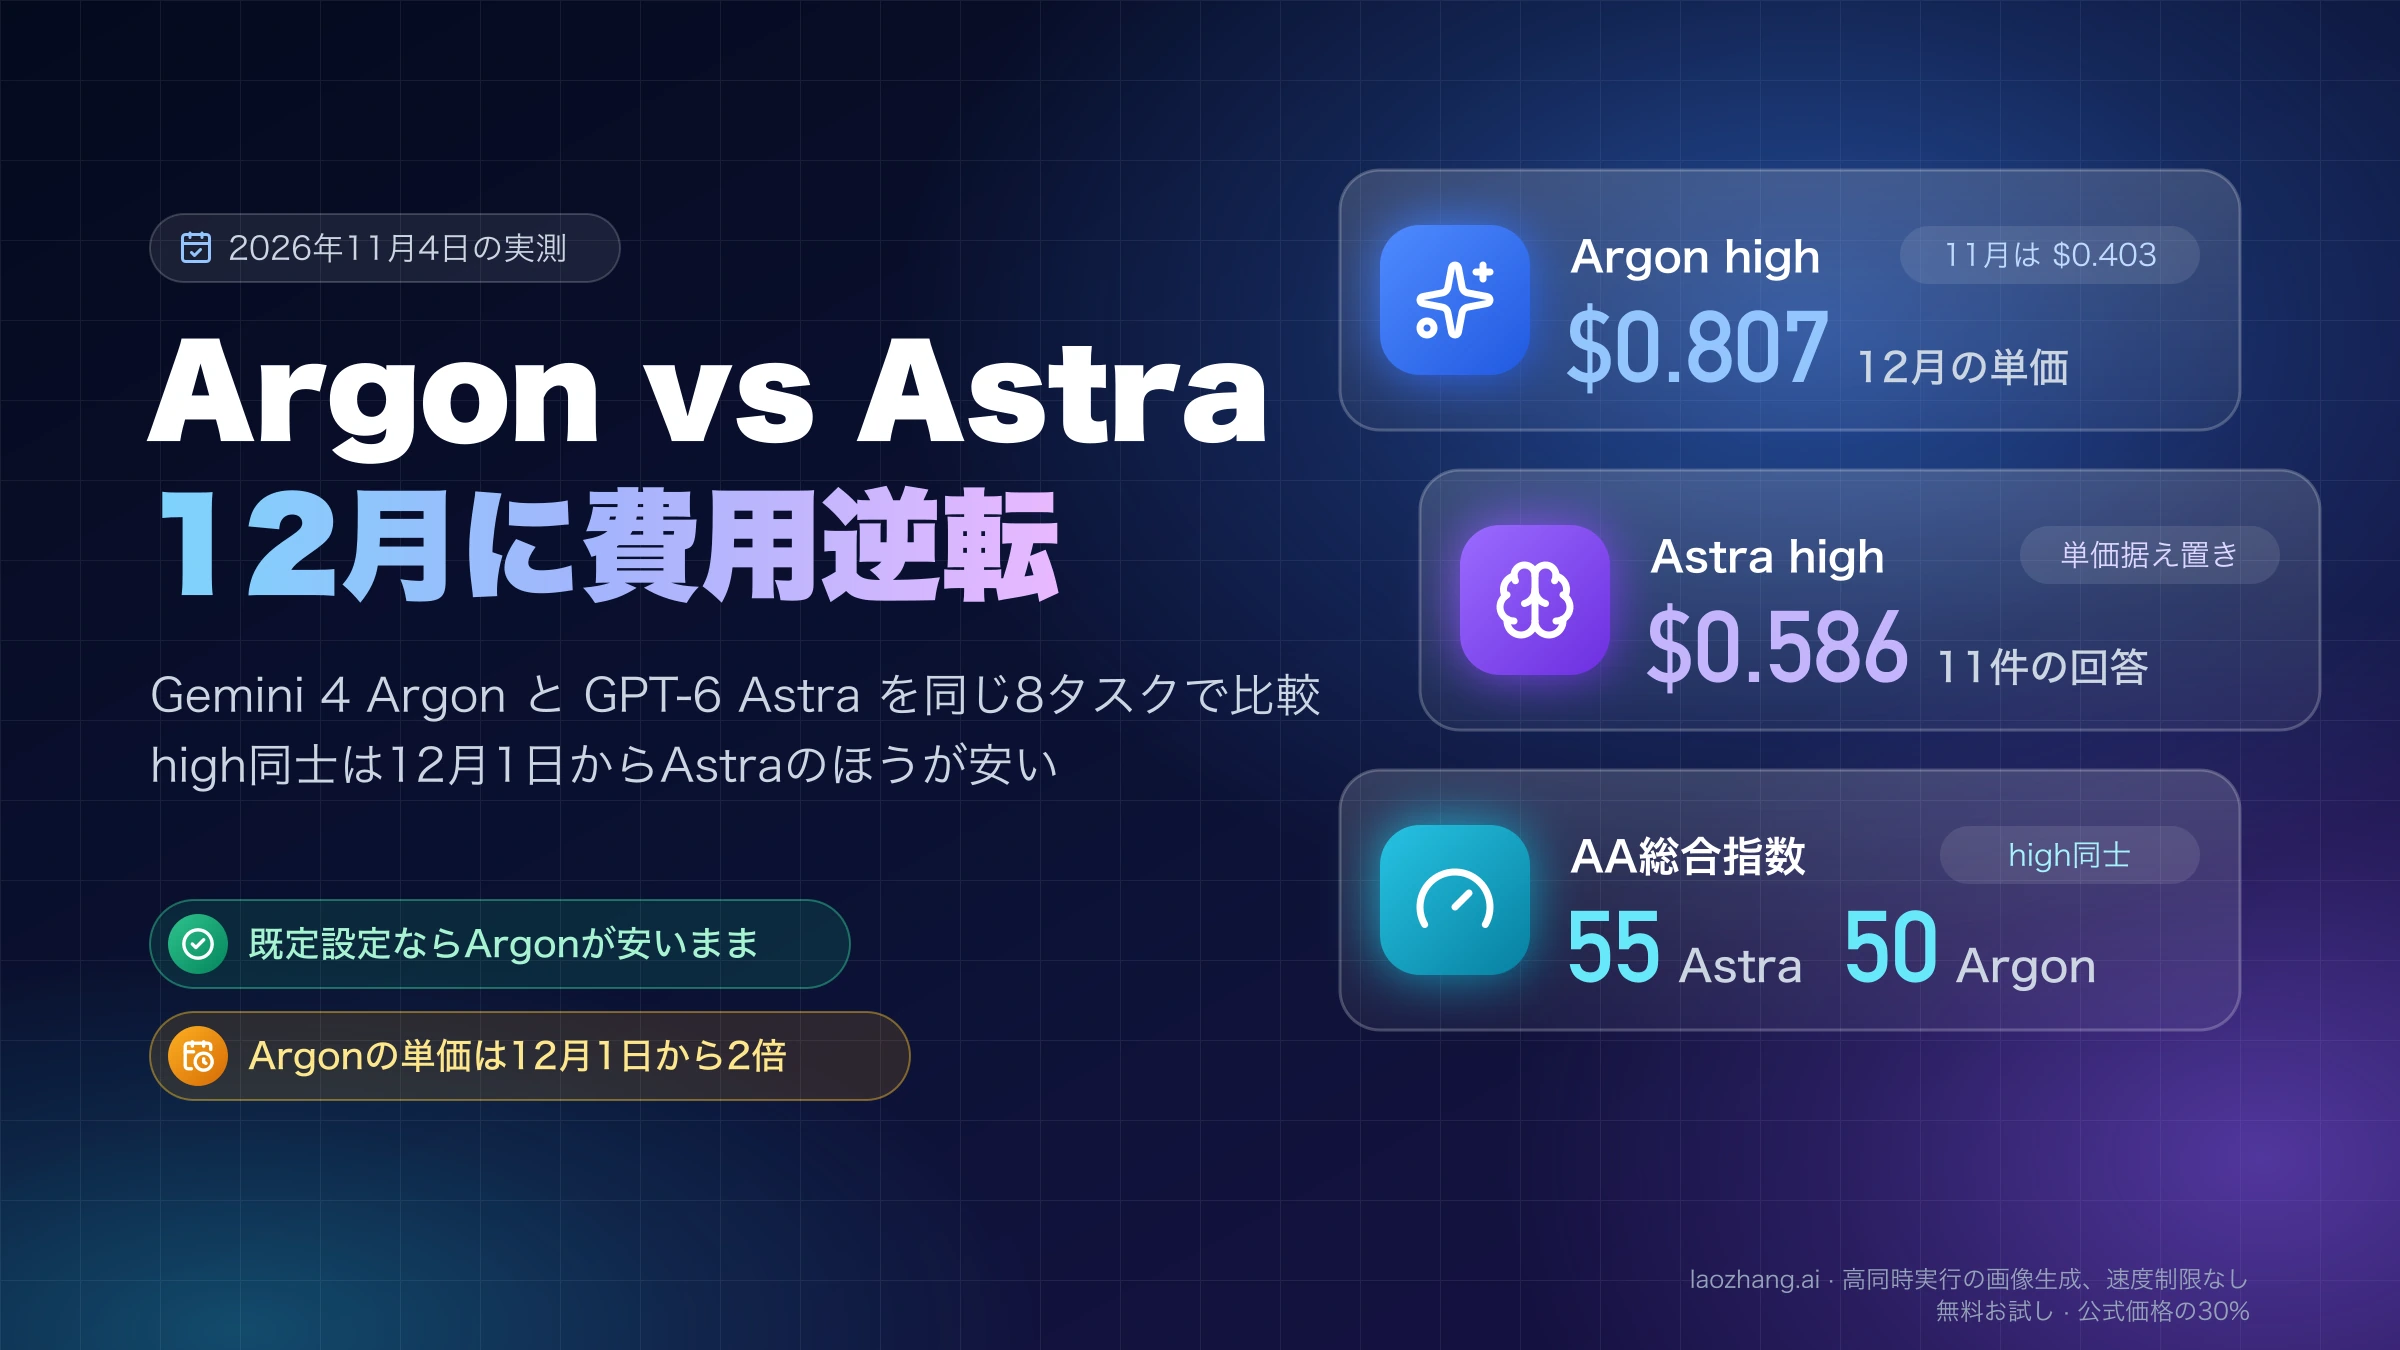
| Gemini 4 Argon | 50 | 約$4.98(AAの値を導入価格に換算) | $9.95(AAの公表値) |
| Claude Opus 5.5 | 52 | $3.46 | $3.46(単価の変更なし) |
| GPT-6.1 Sol | 50 | $0.59 | $0.59(単価の変更なし) |
値はArgonが2026年11月11日時点、Opus 5.5が11月10日時点、GPT-6.1 Solが11月4日時点のものです。AAはArgonの費用を12月以降と同じ$4・$20で計算しているため、$9.95がそのまま12月からの目安になります。導入価格の期間はすべての種類のトークンで単価がちょうど半分なので、$9.95÷2で約$4.98です(AAの数字ではなく換算値)。このAAのArgonの費用は、2026年11月4日時点では$7.68でした。11月11日までに$9.95へ上がり、1課題の所要時間も22.7分から28.6分に延びていますが、9つの評価のスコアはまったく同じで、AAは変更の理由を示していません。
ArgonはSolと同じ50で、Opus 5.5より2ポイント低くなっています。1つの総合指数での2ポイント差は大きくありませんが、点数はOpusのほうがやや高く、費用は導入価格のいまでもOpusのほうが低い結果です。
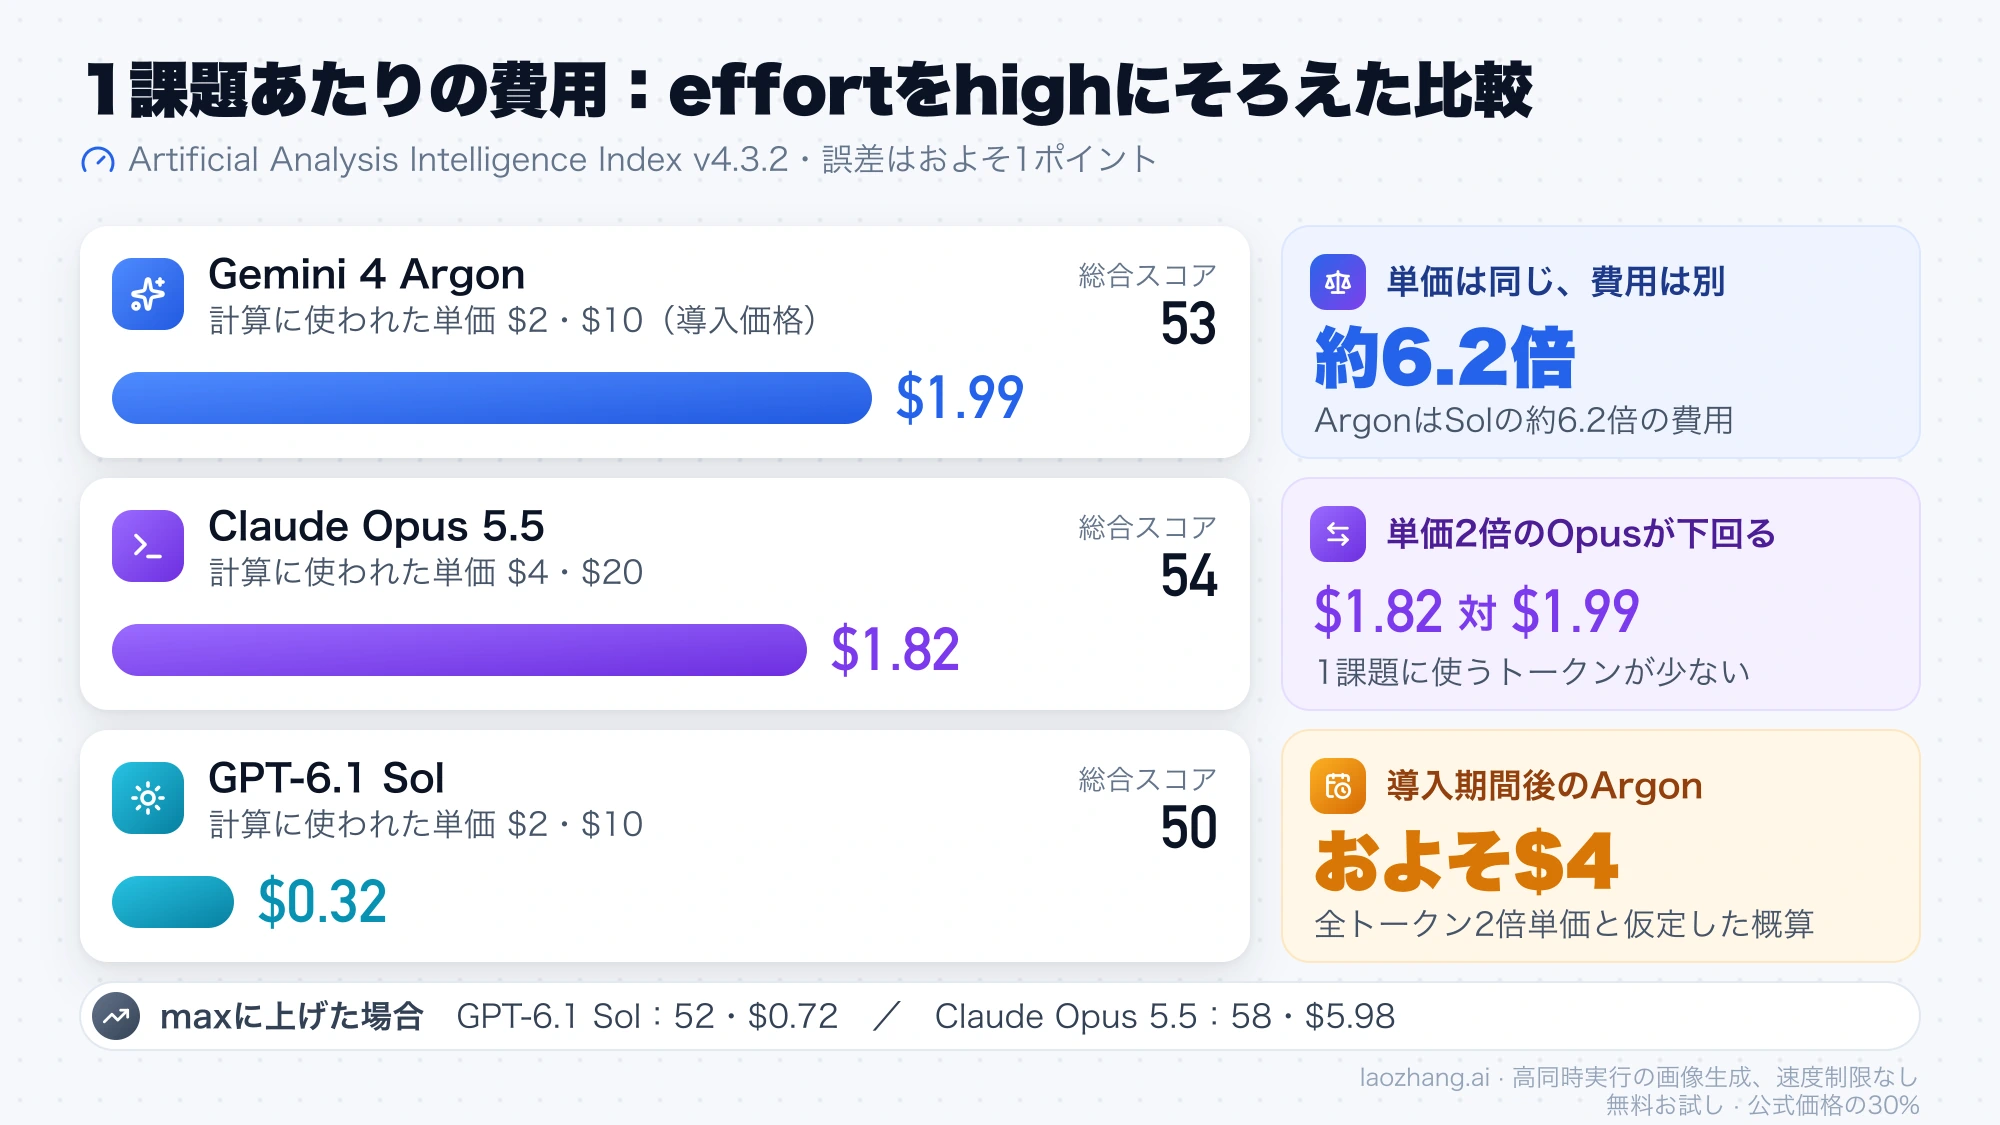
このグラフは旧版の数字(Artificial Analysisの以前の指数v4.3.2の値)です。最新の値(v5.0.1、2026年11月11日時点)は上の表のとおりです。
費用のほうは差がはっきり出ています。
- ArgonはSolの約8.4倍($4.98÷$0.59)、12月以降は約16.9倍($9.95÷$0.59)です。単価は11月30日まで同じなので、今の差は消費したトークン数の差です。AAによると、Argonは1課題で平均約11万6,000トークンを出力し、そのうち約6万8,300トークンが思考です。
- ArgonはOpus 5.5の1.44倍($4.98÷$3.46)、12月以降は2.88倍($9.95÷$3.46)です。Opusの単価は導入価格のArgonの2倍ですが、1課題に使うトークンが少ないぶん、合計では逆転しています。
- GPT-6.1 Solをmaxまで上げた場合は55・$1.27です。Argonのhighより5ポイント高く、費用は導入価格のArgonの約26%($1.27÷$4.98)、12月以降のArgonの約13%($1.27÷$9.95)です。
Opus 5.5をxhighに上げると57・$6.05です。導入価格のArgonのhigh(約$4.98)よりは高いものの、12月以降のArgon($9.95)より39%安く、点数は7ポイント高くなります。maxでは59・$10.04で、12月以降のArgonのhighとほぼ同じ費用で9ポイント上です。AAの比較ページはArgonの「High」とOpus 5.5の「Max, Default Fallback」(AAの設定の表記で、製品名ではありません)を並べているので、そこに出る「Opus 59対Argon 50」はeffortがそろっていない比較です。これらの試算はAAの課題でのトークン消費を前提にしたもので、自分の課題での請求額を示すものではありません。
正解した成果1件あたりで比べると、判断の線がはっきりします。1件あたりの費用は「1回の費用÷合格率」なので、high同士でArgonがOpus 5.5より安くなるのは、自分の課題でのArgonの合格率がOpusの1.44倍(12月以降は2.88倍)を超える場合だけです。Opusの合格率が70%あればArgonは100%でも届かず、12月以降はOpusの合格率が35%でも同じことが起きます。逆にGPT-6.1 Solのhighは、合格率がArgonの11.9%(12月以降は5.9%)を上回っている限り、Argonより安く済みます。
Valsの「1テストあたりの費用」は前提が違う
Vals AIのVals Indexは金融・コーディング・法務・税務の課題をまとめた指数で、v2.2(10月30日更新の順位表、2026年11月4日時点)ではArgonが32モデル中4位の69.24%、1テストあたり$13.37です。Claude Opus 5.5は70.18%で$28.12、Claude Sonnet 5.5は70.85%、Gemini 4 Carbonは70.45%でした。点数はOpusが約1ポイント上ですが、費用だけを見るとArgonはOpusの半分以下に見えます。
Artificial Analysisと費用の向きが逆になる理由は、測定の前提にあります。10月1日時点の掲載では、ValsはArgonを導入価格ではなく$4・$20で計算し、effortはhighで実行していました。$4・$20は12月1日以降の単価と同じです。一方、Kingy AIによるフロンティアモデルのまとめが引くVals側の注記によれば、Opus 5.5はMaxで実行されています。highのArgonとmaxのOpusを比べているので、Opusの費用が高く出るのは当然です。
Valsは、長いエージェント作業でArgonの費用が跳ね上がることも示しています。10月1日時点の掲載では、CUA-benchが1テスト$193.78、コード移行(Code Migration)が$57.82で、CUA-benchのスコアは4.83%と8モデル中7位でした。パソコン操作を任せるような長い作業では、導入価格のあいだでも請求額の見通しを立てにくいということです。GPT-6.1 SolのVals Index v2.2は63.94%で、Argonより約5ポイント低くなっています。
Argon vs Opus 5.5を同じ8課題で実測:正解数と費用
小さなコーディング課題では、既定同士・high同士のどちらでも正解数にほとんど差がなく、差が出たのは費用と時間でした。既定同士ではArgonが安く、high同士ではOpus 5.5が安くなります。2026年11月にLaoZhangのAPIゲートウェイ(api.laozhang.ai)を通して同じプロンプトを両モデルに送り、APIが返したトークン数から定価で費用を計算した結果です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
課題は8つです。文章題、区間を結合する関数(隠しテスト8件)、時間表記を解析する関数(18件)、頻出語を数える関数(10件)、6,723語の英文記事をちょうど5項目に要約する課題、evalを使わない式の評価器(25件)、csvモジュールを使わないCSV行の解析(16件)、各桁の和の条件を満たす数を数える問題(正解55,252)で、最後の3つは2回ずつ解かせたので1設定あたり11件を採点しました。Argonは2026年11月4日にGeminiのネイティブAPI(generateContent、ストリーミングなし)で呼び、既定は思考レベルを指定しない設定(Googleの既定はmedium)、highはthinkingLevelをhighにしています。Opus 5.5は11月11日にAnthropic Messages API(ストリーミングあり、adaptive thinking)で呼び、既定はeffort medium(APIの既定値)、highはeffortをhighにしています。
| 設定 | 正解 | 入力トークン | 出力トークン | 費用(11月30日まで) | 費用(12月1日から) | 所要時間 |
|---|---|---|---|---|---|---|
Argon 既定(medium) | 10/11 | 12,712 | 6,782 | $0.093 | $0.187 | 163秒 |
| Argon high | 11/11 | 12,712 | 39,514 | $0.403 | $0.807 | 463秒 |
Opus 5.5 既定(effort medium) | 11/11 | 17,202 | 11,056 | $0.290 | $0.290 | 126秒 |
| Opus 5.5 high | 11/11 | 17,202 | 11,968 | $0.308 | $0.308 | 147秒 |
既定同士では、Opus 5.5の費用はArgonの3.11倍で、12月1日からの単価でも1.55倍です。出力トークンはOpusが1.63倍でしたが、所要時間はArgonの0.77倍と短く済みました。high同士では関係が逆になります。Argonのhighは思考だけで33,105トークンを使い、出力はOpusのhighの3.3倍、時間は3.1倍かかったため、費用は今の単価でもOpusがArgonの0.76倍、12月1日からは0.38倍です。同じプロンプトでもOpusの入力トークン数はArgonの約1.35倍でしたが、費用の差を決めたのは出力のほうでした。
不正解は1件だけです。Argonの既定は、式の評価器の1回目で" 1 + 2 "のように空白が余分な入力にValueErrorを出しました。同じ日にArgonの既定をもう一度走らせた試験では11/11で、2回を合わせると22件中21件が正解です。Opus 5.5のhighは区間結合の課題で関数とテストを2つのファイルに分けて返しましたが、ファイルを分けて実行すると隠しテスト8件と自作の6件がすべて通りました。
速さでは、この試験の所要時間は既定同士で126秒対163秒、high同士で147秒対463秒とOpus 5.5のほうが短く済みました。ただしArgonはストリーミングなし、Opusはストリーミングありで呼んでいるので、時間の比較には呼び方の差が残ります。AAの指数でも、1課題の所要時間はArgonのhighが28.6分、Opus 5.5のhighが9.5分です。
146KBのログ集計:Opusは既定で正解、Argonはhighが必要
長い入力を正確に数える課題では、はっきり差が出ました。1,500行(そのうちERROR行が326行)の架空のアプリケーションログ146KBを渡し、5種類のエラーコードごとの件数、E503が出たユーザーの数、リトライ回数が最大のリクエストを答えさせる課題で、正解はスクリプトで作ってgrepでも確かめてあります。Opus 5.5は既定・highで2回ずつ、計4回すべて全問正解で、1回55.7〜59.0秒、入力78,537トークン・出力7,699〜8,255トークン、費用は1回$0.47〜0.48でした(12月以降も同じ)。
Argonの既定は2回とも不正解でした。思考トークンを使わずに7秒で答え、5つのエラー件数はどれも実際より20〜37%少なく(E503は94件を59件)、E503のユーザー数も78人を46人と答えています。費用は1回$0.16、12月からは$0.32です。Argonのhighをストリーミングなしで呼ぶと、1回は考えている途中で32,768トークンの出力上限に達し、回答がないまま$0.49が課金されました。ストリーミングで呼んだ2回は全問正解でしたが、271秒と402秒かかり、費用は$0.53〜0.55、12月からの単価では$1.06〜1.09です。このほかArgonのhighの2回は、手元のプロキシが約300秒で接続を切ったため結果がなく、集計から外しています(課金なし)。
この試験の範囲ははっきりしています。経路はゲートウェイ1つ、各条件の回数は1〜4回で、Argonは11月4日、Opusは11月11日と測定日が1週間ずれています。課題の多くは仕様がはっきりした小さなもので、両モデルとも解けるため差がつきにくく、両社の「effort」も同じものではありません(ArgonはthinkingLevel、Opusはeffort)。モデルの品質の順位を示すものではないので、総合的な比較はAAやGoogleの表と合わせて読みます。
ArgonはOpus 5.5より上なのか:総合では50対52で僅差
Googleが9月30日のGemini 4 Argonの発表記事に載せた比較表は、ArgonをGPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5と並べたもので、GPT-6.1 Solの列はありません。表は19行あり、長い文脈を扱うGraphWalksが2行に分かれているため、これを1つと数えると18項目になります。Argonが単独1位なのは、18項目と数えれば12項目、19行と数えれば13行で、「18項目中12」と「19項目中13」は同じ表の数え方の違いです。CWE-bench v1はGPT-6 Astraと同点の1位です。
Opus 5.5と直接比べられるのは、Opusにスコアがある18行です。そのうち14行でArgonが上、4行でOpusが上になっています。
| Googleの比較表(%) | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Terminal-bench 4.0 | 57.4 | 66.4 |
| FrontierSWE v2 | 55.0 | 62.3 |
| PostTrainBench | 45.3 | 49.3 |
| Terminal-Bench Science 0.1 | 57.6 | 63.3 |
| DeepSWE v1.1 | 77.9 | 74.2 |
| Vibe Code Bench | 91.9 | 90.3 |
| Vals Finance Agent v2 | 65.4 | 58.6 |
| Harvey Legal Agent | 19.6 | 3.8 |
| LABBench 2 | 88.8 | 73.1 |
| GraphWalks 256k〜1M | 84.2 | 66.8 |
| LVBench | 91.7 | 83.7 |
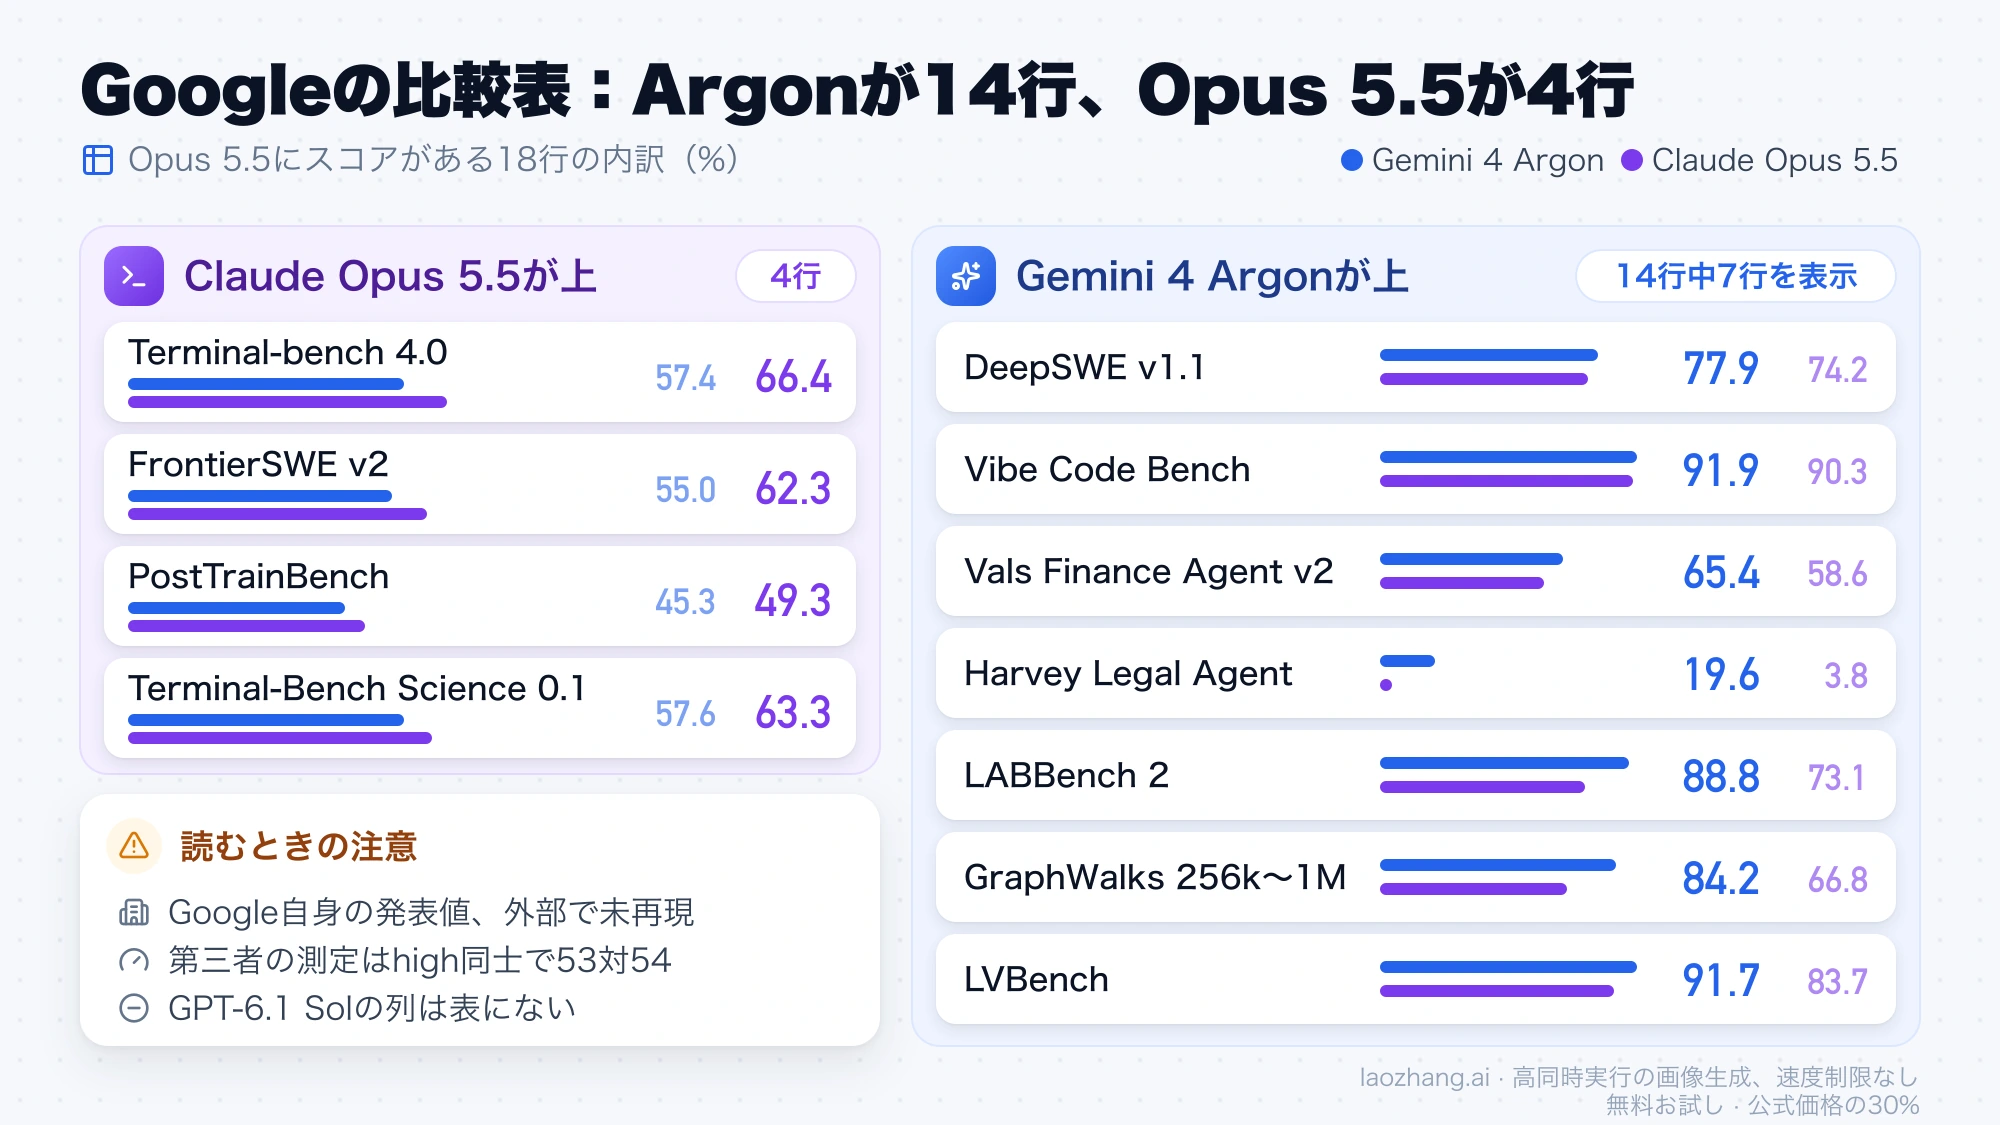
Opusが上回る4行は、ターミナルを操作するエージェント型のコーディング、機械学習モデルの追加学習、科学分野のターミナル作業に集まっています。Argonの差が大きいのは、法務エージェント、LABBench 2、25万トークンを超える長い文脈、動画を扱うLVBenchです。コーディングでもDeepSWEやVibe Code BenchではArgonが上なので、「コーディングはOpus」と一括りにはできず、ターミナル上で長く自走させる使い方かどうかが分かれ目になります。
この表を読むときの注意は2つあります。1つは、これがGoogle自身の発表値で、外部で再現された結果ではないことです。Kingy AIは評価方法の資料を読んだうえで、ArgonのDeepSWEには別の実行環境(mini-swe)が使われていること、Terminal-Bench Scienceでは検証の制限時間が6倍であること、LVBenchでは動画から読み込むフレーム数がモデルごとに違うことを指摘しています。これはKingy AIによる読み取りで、Googleが発表記事の本文で説明している内容ではありません。10月13日の一般提供の発表記事では、ERQAの87%やLabBenchの52.2%といった数値が加わりましたが、他社モデルとの比較は載っていません。
もう1つは、第三者の測定では差がずっと小さいことです。Artificial Analysisのv5.0.1ではhigh同士で50対52とOpus 5.5が2ポイント上、Vals Index v2.2でも69.24%対70.18%とOpusが約1ポイント上です。どちらの指数でもOpusがわずかに上回っていますが、差は2ポイント以内にとどまります。「分野によって得意が分かれ、総合では2ポイント以内で競り合う」と読むのが、今ある数字にいちばん合っています。
AAの9つの評価をhigh同士で見ても、得意は分かれます。ArgonはAutomationBench-AAで77.5%対63.2%、Terminal-Bench-Scienceで52.9%対49.0%と上回り、Opus 5.5はFrontierCode 2.0で35.9%対25.7%、CritPt v2で59.5%対52.5%と上回っています(Argonは2026年11月11日、Opusは11月10日時点)。Gemini 4にはArgonのほかにCarbonもあり、こちらとの比較はGemini 4 CarbonとOpus 5.5比較:Opusが上の仕事と費用の逆転条件で扱っています。
法務や金融の文書処理、業務の自動化といったナレッジワークに使う場合も、根拠によって向きが変わります。Googleの表(2026年9月30日の発表値)では、Harvey Legal Agentが19.6対3.8、Vals Finance Agent v2が65.4対58.6、AutomationBenchが51.3対42.5、25万〜100万トークンのGraphWalksが84.2対66.8と、どれもArgonが大きく上回ります。AAの独立した評価でも、AutomationBench-AAではArgonのhighが77.5%と、Opus 5.5のhigh(63.2%)にもmax(69.5%)にも勝っています。ところがAAのナレッジワーク系の評価であるAA-Briefcaseは1484対1801、GDP.pdfは21.8%対26.2%とOpusが上です。ただしこの2つはAAの比較ページがArgonのhighとOpusのmaxを並べた値で、設定はそろっていません。業務フローの自動化や25万トークンを超える文書の処理ならArgonを先に試す価値があり、それ以外の文書作業はOpus 5.5を基準に置くのが、今ある数字に沿った選び方です。長い文書から件数や金額を正確に拾う仕事では、上のログ集計の実測のとおり、Argonはhighとストリーミングが前提になります。
GPT-6.1 SolはGoogleの表に載っていないので、位置づけは第三者の測定から読むしかありません。Artificial Analysisのv5.0.1では、highで50とArgonに並び、Opus 5.5のhighより2ポイント低いだけで、費用は導入価格に換算したArgonの約12%(12月以降は約6%)、Opusの17%です。maxに上げると55・$1.27で、ArgonやOpusのhighを上回ります。57〜59点まで取りにいくならOpus 5.5のxhighかmaxが必要ですが、それに近い点数をはるかに安く出すモデルという位置です。OpenAIの3モデルの中でどれを選ぶかはGPT-6.1 Sol・6 Sol・Astra比較:移行の判断で扱っています。
コーディングならArgonかOpus 5.5か:根拠ごとに答えが違う
コーディングに使うなら、ターミナルで長く自走させるエージェント型の作業はOpus 5.5が有利で、短く仕様の決まった関数を書かせる作業はどちらでも解け、費用は設定しだいで変わります。ただしこれは3種類の根拠を合わせた答えで、根拠ごとに向きが少しずつ違うので、分けて見ておきます。
Google自身の発表値(2026年9月30日)では、Opus 5.5がTerminal-bench 4.0(66.4%対57.4%)、FrontierSWE v2(62.3%対55.0%)、Terminal-Bench Science、PostTrainBenchで上回り、ArgonがDeepSWE v1.1(77.9%対74.2%)とVibe Code Bench(91.9%対90.3%)で上回ります。ターミナル操作を伴う長い作業はOpus、コード生成の一部の課題はArgonという分かれ方です。
AAの独立した測定では、Terminal-Bench 4.0の差はほぼ消えます。Argonのhighが57.1%、Opus 5.5のhighが56.6%、maxが59.6%で、Googleの表で9ポイントあった差が1ポイント以内です。一方、FrontierCode 2.0ではArgonのhighの25.7%に対して、Opusはhighで35.9%、maxで46.4%と大きく上回ります(2026年11月10〜11日時点、Intelligence Index v5.0.1)。
LaoZhang経由の実測(2026年11月4日・11日)では、小さなコーディング課題はどちらの設定でもほぼ全問正解で、Argonの既定が空白の扱いで1件だけ落としました。長い入力を正確に処理する課題では、Opusは既定で足りたのに対し、Argonはhighとストリーミングの両方が必要でした。
3つを合わせると、コーディングエージェントに組み込むなら、Opus 5.5をeffort mediumで動かす構成を基準にし、Argonは既定の設定でテストが通る種類の作業に限って費用を比べるのが、どの根拠とも食い違わない選び方です。12月1日以降も、既定同士ならこの実測ではArgonのほうが安く(Opusの約3分の2)、highを使う仕事ならOpusのほうが安くなります。
「出力1M」は長い回答が返るという意味ではない
一般提供に合わせて、Googleは上限の書き方を変えました。Gemini 4 Argonのモデルページでは、コンテキストウィンドウが「入力と出力を合わせた上限」として1,048,576トークン、最大出力が「通常の同期呼び出しで65,536、long decodeを使うと最大1,048,576」とされています。発表記事の表現も「入力と出力で共通の1Mトークン上限」です。9月30日の発表にあった「出力上限を64Kから1Mへ広げた」という書き方とは意味が違います。
ここから読み取れることは3つあります。
- 普通にAPIを呼んだときの出力は最大65,536トークンで、Opus 5.5(128K)やGPT-6.1 Sol(128,000)の約半分です。しかもGoogleのAPIドキュメント(2026年11月4日時点)では、ストリーミングを使わない呼び出しの出力上限は32,768トークンで、65,536まで使うにはストリーミングが必要です。1回の応答で長い成果物を書かせる設計なら、ここが最初の制約になります。
- 入力と出力は同じ1,048,576トークンの枠を分け合います。90万トークンの入力を送れば、出力に残るのは148,576トークンです。
- 1Mに近い出力は、long decodeという別のモードでの上限です。VentureBeatは、これが途切れのない1回の応答とどう対応するのかをGoogleが説明していないと指摘しています。long decodeを前提に設計するなら、指定方法と課金の扱いをGemini APIのドキュメントで先に確かめてください。
出力の上限には思考トークンも含まれます。上のログ集計の実測では、Argonのhighをストリーミングなしで呼んだ1回が、32,768トークンのほぼすべてを思考に使ったところで止まり、回答が返らないまま$0.49が課金されました。Argonをhighにして長い入力を考えさせる呼び出しは、最初からストリーミングで組んでおくのが安全です。Valsが9月の評価時に記載していた「最大出力262k」は、一般提供前の評価環境での値です。
出力は、思考トークンを含めてどのモデルでも最も単価が高い部分です。通常の呼び出しの上限65,536トークンを出し切ると、11月30日までは約$0.66、12月1日からは約$1.31です(0.065536×10、0.065536×20)。long decodeで50万トークンを出力すれば、それぞれ$5と$10になります(0.5×10、0.5×20)。上限が大きいことは、1回の依頼で使える金額の上限が大きいことでもあります。
今週の選び方と、12月1日までに確かめること
Argonの導入価格は11月30日までなので、判断は今の単価と12月以降の単価の両方で考えます。そのうえで、仕事の種類ごとに出発点を決めておくと迷いません。
費用が先に効く仕事は、GPT-6.1 Solから始めます。AAのhighで50・$0.59、maxでも55・$1.27で、点数が足りなければeffortを上げる余地があります。Solの単価には2026年10月14日時点で変更の告知がなく、大量に回すバッチ処理や、失敗しても再実行で済む作業が当てはまります。
コーディングエージェントや、長い入力を正確に扱う仕事はOpus 5.5に回します。上の実測ではeffort mediumのままログ集計を全問正解し、AAのhigh同士でも1課題の費用は今の時点でArgonの約7割、12月以降は約3分の1です。プラン側の枠で使う場合はClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順も確認してください。Anthropicは11月9日にClaude Fable 5.2(100万トークンあたり$8・$40)を公開しましたが、ほとんどの仕事はOpus 5.5から始めるよう勧めており、2つの違いはClaude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍で比べています。
Argonが候補になるのは、法務文書のエージェント処理や業務フローの自動化といったナレッジワーク、25万トークンを超える文脈、動画の理解のようにGoogleの表で差が大きい分野と、既定の設定でテストが通る軽い処理を11月30日までにまとめて流す場合です。Googleの表は発表値なので、単価が半分のうちに自分の課題で確かめます。highで長く考えさせるならストリーミングで呼び、出力の上限も設計に入れておきます。
Google AI ProかUltraを契約している人は、Geminiアプリと検索のAIモードでArgonの答え方を試せます。ただしアプリでの利用はAPIの費用とは別物で、1課題あたりの費用はAPIで流さないと分かりません。サイバー分野のガードレールを外した版が必要なセキュリティの防御業務では、Fairwindプログラムが経路になります。
11月30日までに、次の順で確かめておくと、12月1日の切り替えで慌てずに済みます。
- 自分の仕事を代表する課題をいくつか選び、Argonの思考レベル(thinking level)とOpus 5.5のeffortを、それぞれの既定とhighの2通りで流す。GPT-6.1 Solも並べる。成功した件数、入力・キャッシュ・出力のトークン数、所要時間を記録する。
- 記録したトークン数を12月1日以降の式(4U + 0.20R + 20O)に入れて、1課題あたりの費用を出す。Opus 5.5も同じ式なので、12月以降の両者の費用差はトークン消費の差だけで決まる。日本語のプロンプトはOpusで多めに数えられるので、入力も実測値で入れる。
- Argonの出力が上限で切れていないかを見る。ストリーミングなしなら32,768トークン、ストリーミングでも65,536トークンが上限で、highで回答が空のまま返ってきたら上限に達していないか確かめる。長い出力が必要なら、long decodeの仕様と費用を確かめる。
- キャッシュがどれだけ効いているかを見る。Argonは暗黙的キャッシュだけなので、同じ前置きを繰り返す依頼で、キャッシュ済み入力として計上されたトークン数を使用量で確認する。
- 急がない処理をBatchかFlexに回せるかを決める。12月以降のArgonのBatchは$2・$10で、Opus 5.5のBatchと同額になる。
- レート制限は公開ページに数字がないので、本番の流量を流す前に、自分のプロジェクトで実際の上限を確かめる。
1と2が最も重要です。上の実測では設定をhighに変えただけで安いモデルが入れ替わり、AAの数字では同じ単価のArgonとSolで1課題の費用が約8.4倍開いています。自分の課題でその倍率がいくつになるかは、流してみないと分かりません。導入価格のうちに評価を済ませ、12月以降の単価で採算が合うかどうかまで見てから本番に入れると、価格が切り替わったときに慌てずに済みます。
Gemini 4 Argonのよくある質問
Gemini 4 Argonは今すぐ使えますか?
はい、2026年10月13日(米国時間)に一般提供が始まりました。モデルID gemini-4-argon で、有料のGemini API(AI Studioを含む)から呼び出せます。Google AI ProとUltraの契約者はGeminiアプリと検索のAIモードで使えます。Google Antigravityでは、Ultraの契約者に加えて、2026年10月23日時点で有料のAI Proの契約者と、対象の高級端末に付いてくるAI Proトライアルの利用者も使えます(端末名は非公表で、通常の無料トライアルは挙げられていません。Antigravity IDEは対象外)。Gemini APIの無料枠では使えず、レート制限の数字は公表されていません。
Gemini 4 Argonの料金はGPT-6.1 Solと同じですか?
2026年11月30日までの導入価格のあいだは同じです。Argonの導入価格は100万トークンあたり入力$2・出力$10で、入力272K以下のGPT-6.1 Solと同額です。12月1日からは$4・$20になり、Claude Opus 5.5と並びます。ただし単価が同じでも、1課題あたりの費用は同じになりません。Artificial Analysisのhighの値(2026年11月11日時点、Intelligence Index v5.0.1)では、導入価格に換算したArgonが約$4.98、GPT-6.1 Solが$0.59です。
12月1日以降、Gemini 4 Argonの料金はいくらになりますか?
100万トークンあたり入力$4、出力$20、キャッシュ済み入力$0.20で、どれも導入価格の2倍です。Batch・Flexは$2・$10、Priorityは$7.20・$36になります(2026年11月11日時点のGemini API料金ページ)。これでトークン単価はClaude Opus 5.5と同じになり、「ArgonはOpusの半額」は12月1日以降は当てはまりません。Artificial Analysisが$4・$20で計算したArgonのhighの1課題あたり費用は$9.95で、Opus 5.5のhigh($3.46)の約2.9倍です。
Google AI ProでGemini 4 Argonは使えますか?
Geminiアプリと検索のAIモードでは使えます。AI Studioでも、2026年11月6日時点のプラン説明ではAI ProにArgonを使える「より多い」利用枠が付きます(Ultraは「最も多い」枠、無料のアカウントは対象外)。2026年10月23日時点では、有料のAI Pro、または対象の高級端末に付いてくるAI ProトライアルならGoogle Antigravityでも使えます。ただしAPIの呼び出しはどのプランにも含まれず、自分のコードからArgonを呼ぶには課金を設定した有料のGemini APIが必要です。2026年11月11日時点のGemini APIの料金ページはArgonを「無料枠では利用できない」とだけしており、以前あったAI Proについての一文はなくなっています。Antigravityで使えるのはAntigravityアプリ、CLI、IDE拡張機能で、Antigravity IDEは対象外です。AI Proへの提供は順次進んでいます。トライアルで対象になるのは対象の高級端末に付いてくるものとされ(端末名は挙げられていません)、通常の無料トライアルは対象に挙げられていません。
Gemini 4 ArgonはClaude Opus 5.5より性能が高いですか?
分野によって分かれ、総合では2ポイント以内で競り合っています。Googleの比較表では、両方にスコアがある18行のうち14行でArgonが上、Terminal-bench 4.0など4行でOpus 5.5が上ですが、これはGoogle自身の発表値です。第三者の測定では、Artificial Analysisの総合スコア(v5.0.1、2026年11月11日時点)がeffortをhighにそろえて50対52、Vals Index v2.2(2026年11月4日時点)が69.24%対70.18%で、どちらもOpus 5.5がわずかに上です。
Argonの出力100万トークンとは、長い回答が返るという意味ですか?
いいえ。約100万トークン(1,048,576)は入力と出力を合わせた上限で、通常のAPI呼び出しで返る出力は最大65,536トークンです。ストリーミングを使わない呼び出しでは32,768トークンまでで、思考トークンもここに含まれます。1Mに近い出力はlong decodeという別のモードでの上限で、それが途切れのない1回の応答として返るのかどうかは、Googleが説明していません。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月11日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月11日。
- 1.Gemini 4 Argonの一般提供を伝える発表記事blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon
- 2.Gemini APIのモデル一覧ai.google.dev/gemini-api/docs/models
- 3.Gemini APIの料金ページaistudio.google.com/docs/pricing
- 4.Google Antigravityのモデル一覧ページantigravity.google/docs/models
- 5.Gemini 4 ArgonのGemini APIモデルページai.google.dev/gemini-api/docs/models/gemini-4-argon
- 6.Artificial Analysisartificialanalysis.ai/models/gemini-4-argon
- 7.Vals AIのVals Indexvals.ai/benchmarks/vals_index
- 8.Kingy AIによるフロンティアモデルのまとめkingy.ai/blog/frontier-ai-models-gemini-4-argon-gpt-6-astra-sol-claude
- 9.Gemini 4 Argonの発表記事blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon