GPT-6.1 TerraとSolの違い:単価は半額、Codex実測で2倍速
GPT-6.1 Terraは単価がSolの半額で、10月27日のCodex実測では同じ作業を約半分の時間で終えました。難しいコーディングと同点比較ではSolが有利です。
目次
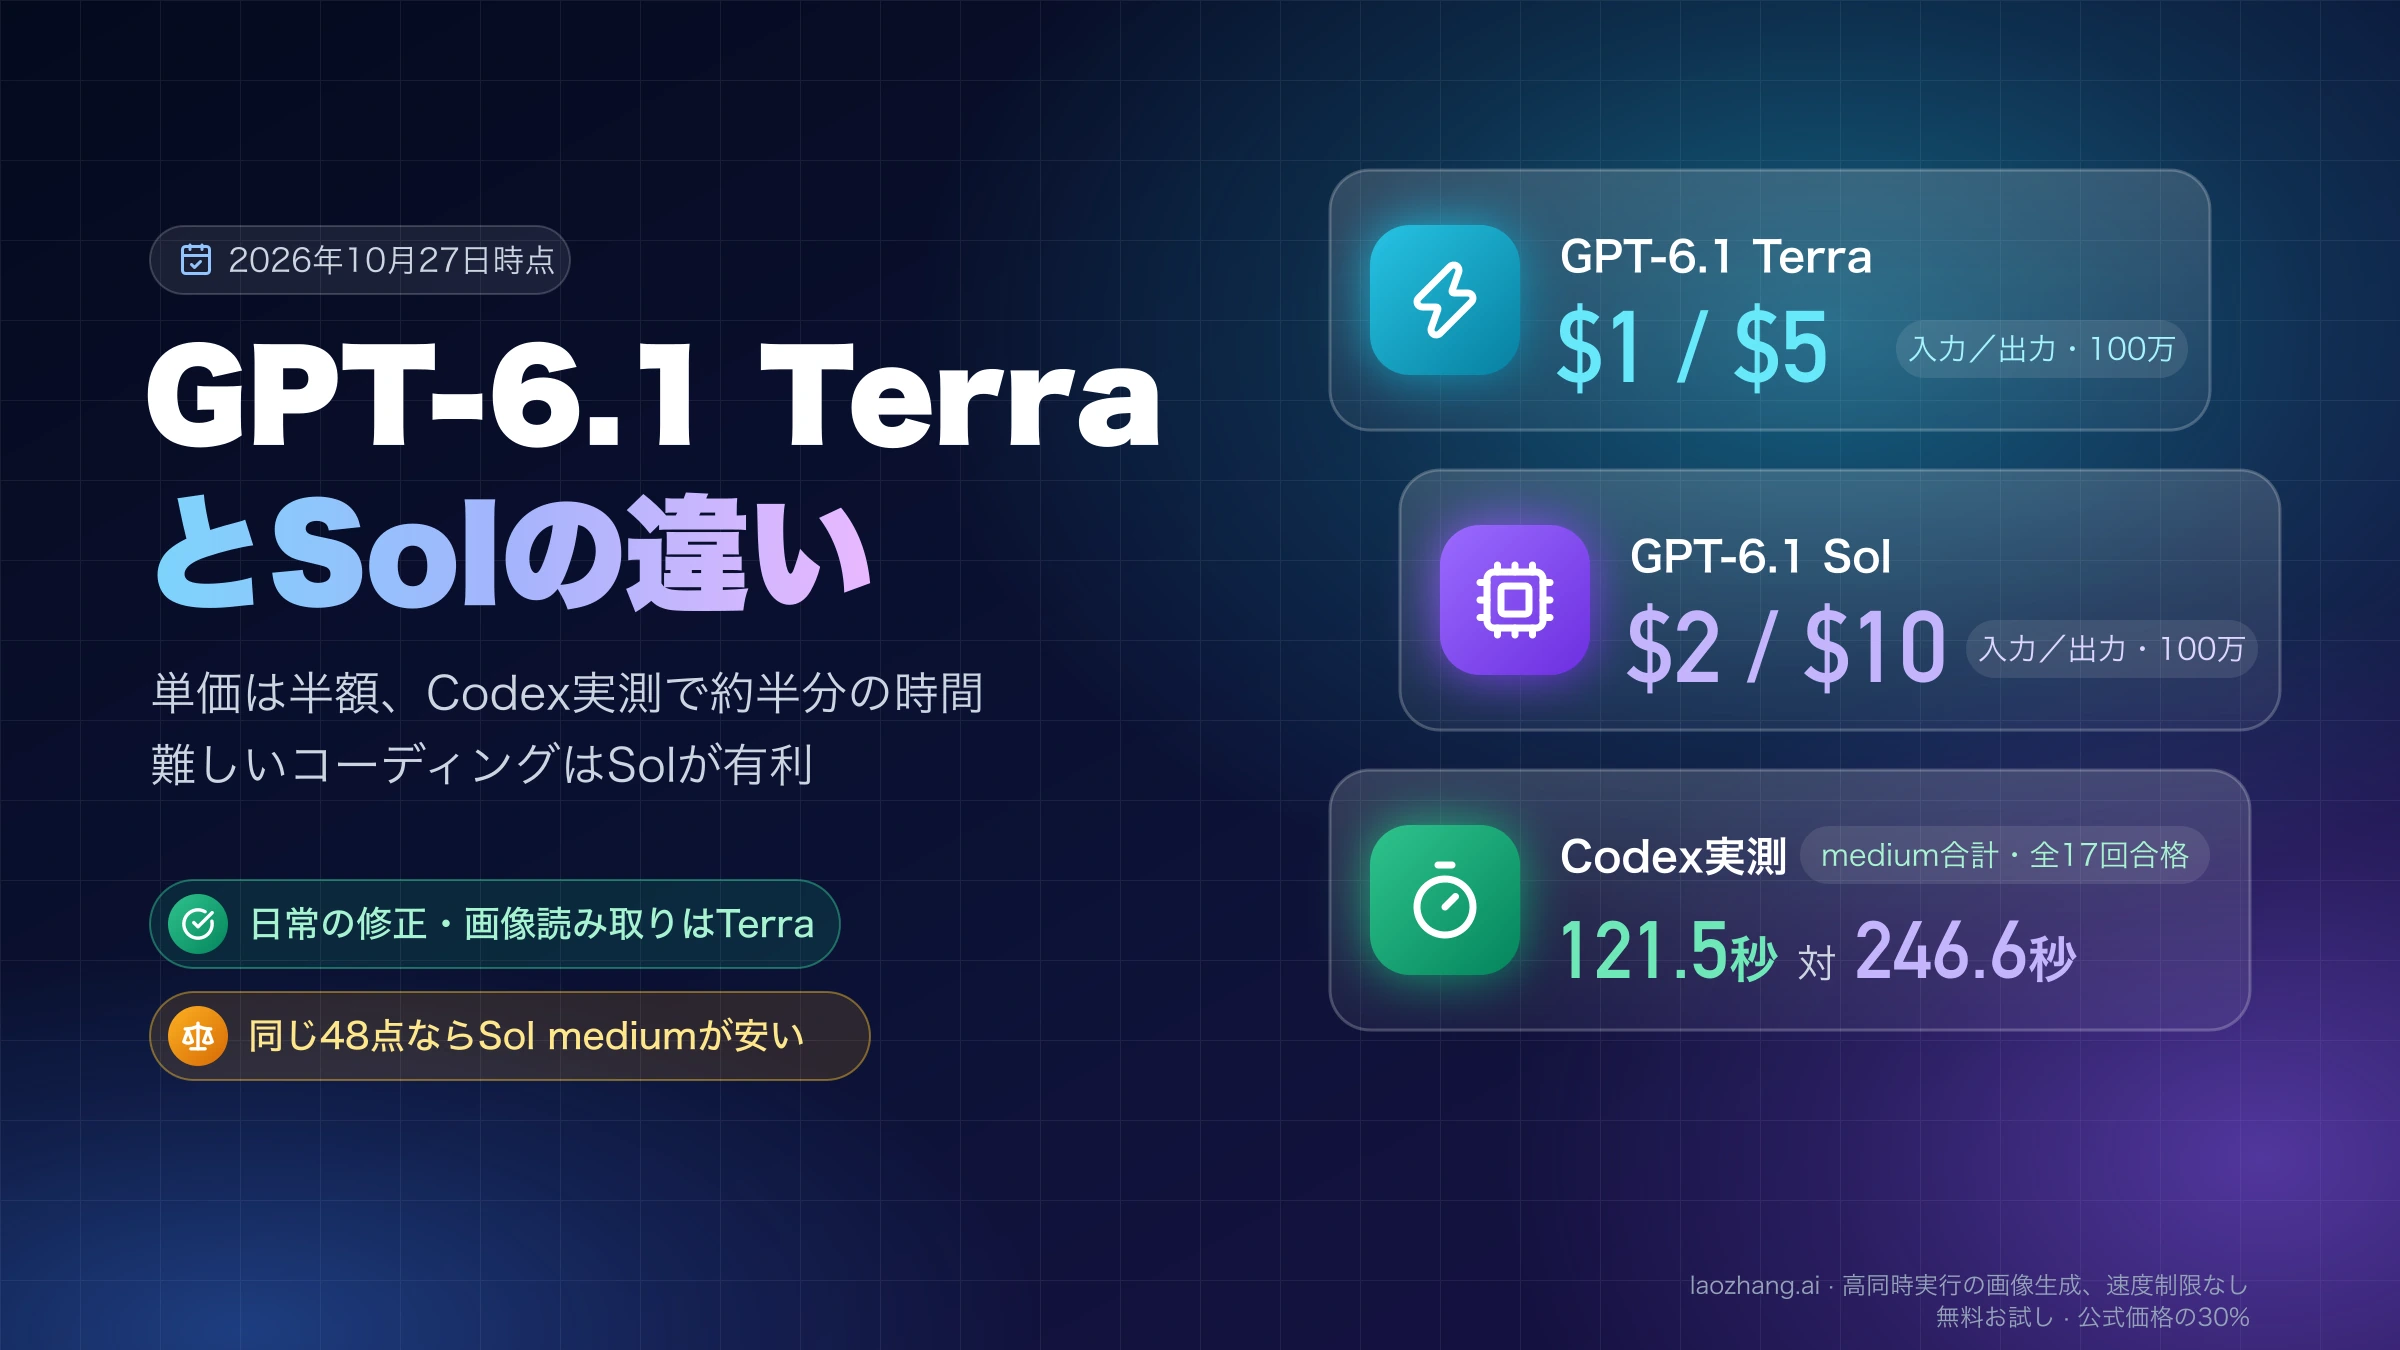
OpenAIは2026年10月26日にGPT-6.1 Terraを公開しました。APIのトークン単価は入力$1・出力$5で、GPT-6.1 Sol(入力$2・出力$10)のちょうど半分です。日常的なコード修正、画像や画面からの読み取り、フォーム入力のような作業なら、まずgpt-6.1-terraをmediumで試し、難しい多段階のコーディングはgpt-6.1-solに残すのが現実的な分け方です。Codexではcodex -m gpt-6.1-terraで切り替えられます。
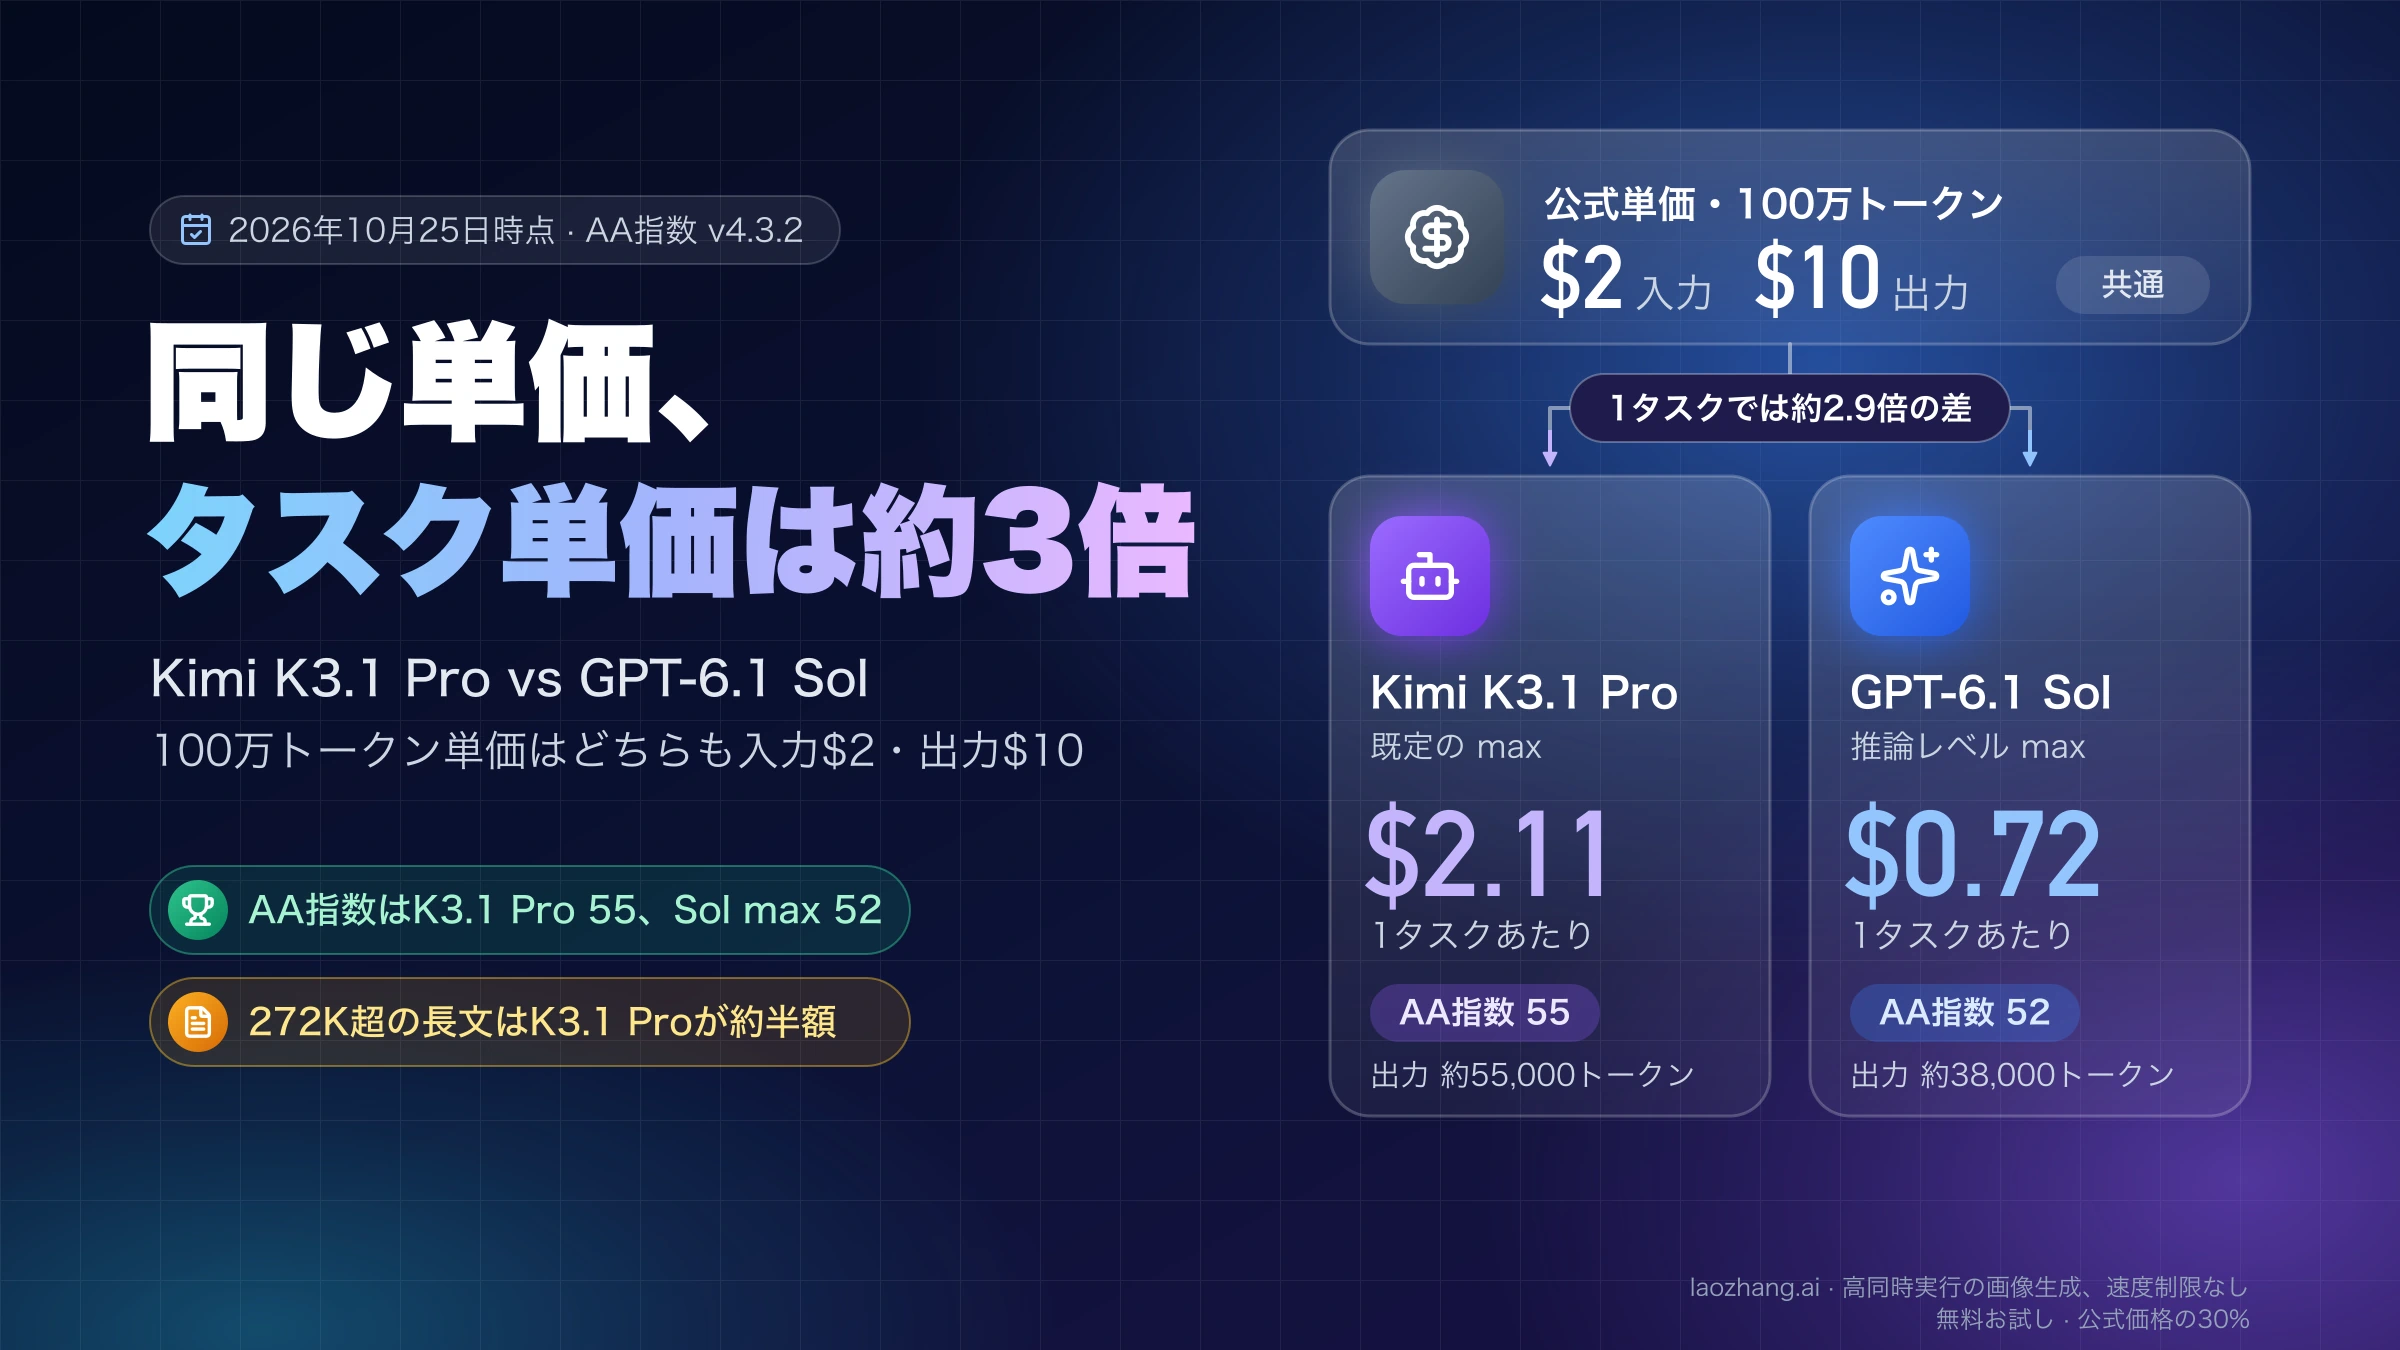
2026年10月27日にCodex CLIで3種類の作業を両モデルに実行したところ、全17回が合格し、medium同士ではTerraがSolの約半分の時間と約4割のクレジットで終えました。ただし「半額だから必ずタスク単価も安い」とは限りません。Artificial Analysisの総合指数で同じ48点になる組み合わせでは、Terraのmaxが1タスク$0.40、Solのmediumが$0.21です。Terraを最高設定まで上げないと品質が出ない仕事なら、Solのmediumのほうが安く速く済みます。
切り替えを決める前に知っておきたい制約もあります。どちらもChatGPTの通常のチャットでは使えず、使えるのはChatGPTのWork、Codex、APIです。TerraにはUltrafastがなく、Solには推論レベルnoneがありません。TerraはUAEの推論データ所在地にも対応していません。
GPT-6.1 TerraとSolの違い:作業別にどちらから試すか
作業の種類で最初に試すモデルを決め、推論レベル(reasoning effort)は低めから上げていくのが基本です。画像の読み取りや画面操作、仕様がはっきりしたコード修正はTerraで足りることが多く、時間もクレジットも半分前後で済みます。一方、難しい多段階のコーディングではmedium同士で差が大きく、Terraを最高設定まで上げるとSolのmediumより高くつくため、最初からSolを使うほうが合理的です。
| 作業 | 最初に試す設定 | Solに替える・Solを残す目安 |
|---|---|---|
| 日常的なコード修正、仕様どおりの小さめの実装 | Terra medium(急ぐならlow) | Terraをhighにしてもテストが通らない |
| 請求書・グラフ・スクリーンショットの読み取り、フォーム入力、画面操作 | Terra medium | 読み取りの誤りが残る、判断を伴う手順が長い |
| 難しい多段階のコーディング、大きな改修 | Sol medium | Terraを試すならhigh以上で比べ、maxが要るならSolに戻す |
| Codexの利用上限が気になる常用 | Terra | 失敗のやり直しで結局回数が増える |
| APIで低遅延の応答が要る処理 | Terra low(noneも選べる) | Solはlowが最低で、noneがない |
| とにかく最速の応答が要る | Sol Ultrafast | TerraはUltrafast非対応 |
表の振り分けは、下で説明するOpenAIの料金・仕様、Artificial Analysisの指数、2026年10月27日のCodex実測を組み合わせた目安です。自分の作業での最終判断は、最後の節の方法で「採用できた結果1件あたりのコスト」を測って決めます。
GPT-6.1 Terraとは:GPT-5.6 Terraとの関係と仕様の違い
GPT-6.1 Terraは、OpenAIが「画像を使った推論、正確なコンピューター操作、明快で自然な文章」向けの速く効率的なモデルとして出したもので、旧世代のGPT-5.6 Terraの後継です(OpenAIのGPT-6.1 Terra発表記事)。GPT-5.6 Terraも2026年10月27日時点でAPI料金表に残っており、単価は入力$2・出力$12とGPT-6.1 Terraより高いので、「Terra」とだけ書かれた情報はどちらの世代の話かを確かめてください。
GPT-6.1 Solとの仕様の違いは、推論レベルの下限と知識のカットオフに集中しています。コンテキスト長、最大出力、使えるツールは同じです。
| 項目 | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| モデルID | gpt-6.1-terra | gpt-6.1-sol |
| 公開日 | 2026年10月26日 | 2026年9月29日 |
| 推論レベル | none、low、medium(既定)、high、xhigh、max | low、medium、high、xhigh、max |
| 知識のカットオフ | 2026年6月1日 | 2026年4月30日 |
| コンテキスト/最大出力 | 105万トークン/12.8万トークン | 105万トークン/12.8万トークン |
| 入力と出力 | テキスト・画像を入力、テキストを出力 | テキスト・画像を入力、テキストを出力 |
| ツール | 関数呼び出し、Web検索、ファイル検索、コンピューター操作 | 同じ |
| Ultrafast | 非対応 | 対応 |
出典はGPT-6.1 TerraのAPIモデルページとOpenAI APIのモデル一覧です。どちらもツール呼び出しにはResponses APIが必要です。いまnoneで動かしている処理はSolに移すとlow以上になり、応答時間とトークンが増えます。Solのnone非対応など、GPT-6 Solから6.1 Solに移るときに変わる設定は「GPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点」にまとめています。
料金の違い:API単価はどの区分でもTerraがSolの半額
2026年10月27日時点のOpenAI API料金表では、GPT-6.1 Terraの単価は入力・キャッシュ入力・キャッシュ書き込み・出力のすべてで、GPT-6.1 Solのちょうど半分です。長文、Batch、Fastでも比率は変わりません。違いが出るのはUltrafastだけで、料金表にSolの行はあってもTerraの行はありません。
| 区分(100万トークンあたり) | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| Standard 入力/キャッシュ入力/出力(入力272K以下) | $1.00/$0.05/$5.00 | $2.00/$0.10/$10.00 |
| Standard キャッシュ書き込み 30分/12時間 | $1.25/$2.50 | $2.50/$5.00 |
| 長文 入力/キャッシュ入力/出力(入力272K超) | $2.00/$0.10/$7.50 | $4.00/$0.20/$15.00 |
| 長文 キャッシュ書き込み 30分/12時間 | $2.50/$5.00 | $5.00/$10.00 |
| Batch・Flex 入力/出力(272K以下) | $0.50/$2.50 | $1.00/$5.00 |
| Fast 入力/出力(272K以下) | $2.00/$10.00 | $4.00/$20.00 |
| Ultrafast 入力/キャッシュ入力/出力(272K以下) | 非対応 | $12.00/$0.60/$60.00 |
入力が272Kトークンを超えると、そのリクエスト全体に長文の単価がかかります。地域処理のエンドポイントを使う場合は両モデルとも10%上乗せです。同じトークン数ならTerraの請求額はSolの半分になりますが、実際のタスクではモデルごとに使うトークン数が違うので、次の節で見るとおり作業1件あたりの差は2倍ちょうどにはなりません。キャッシュ書き込みや長文を含めた請求額の見積もり方は「GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法」の手順がそのまま使えます。
タスク単位でも安い?同じ点数ならSolのmediumがTerraのmaxより安い
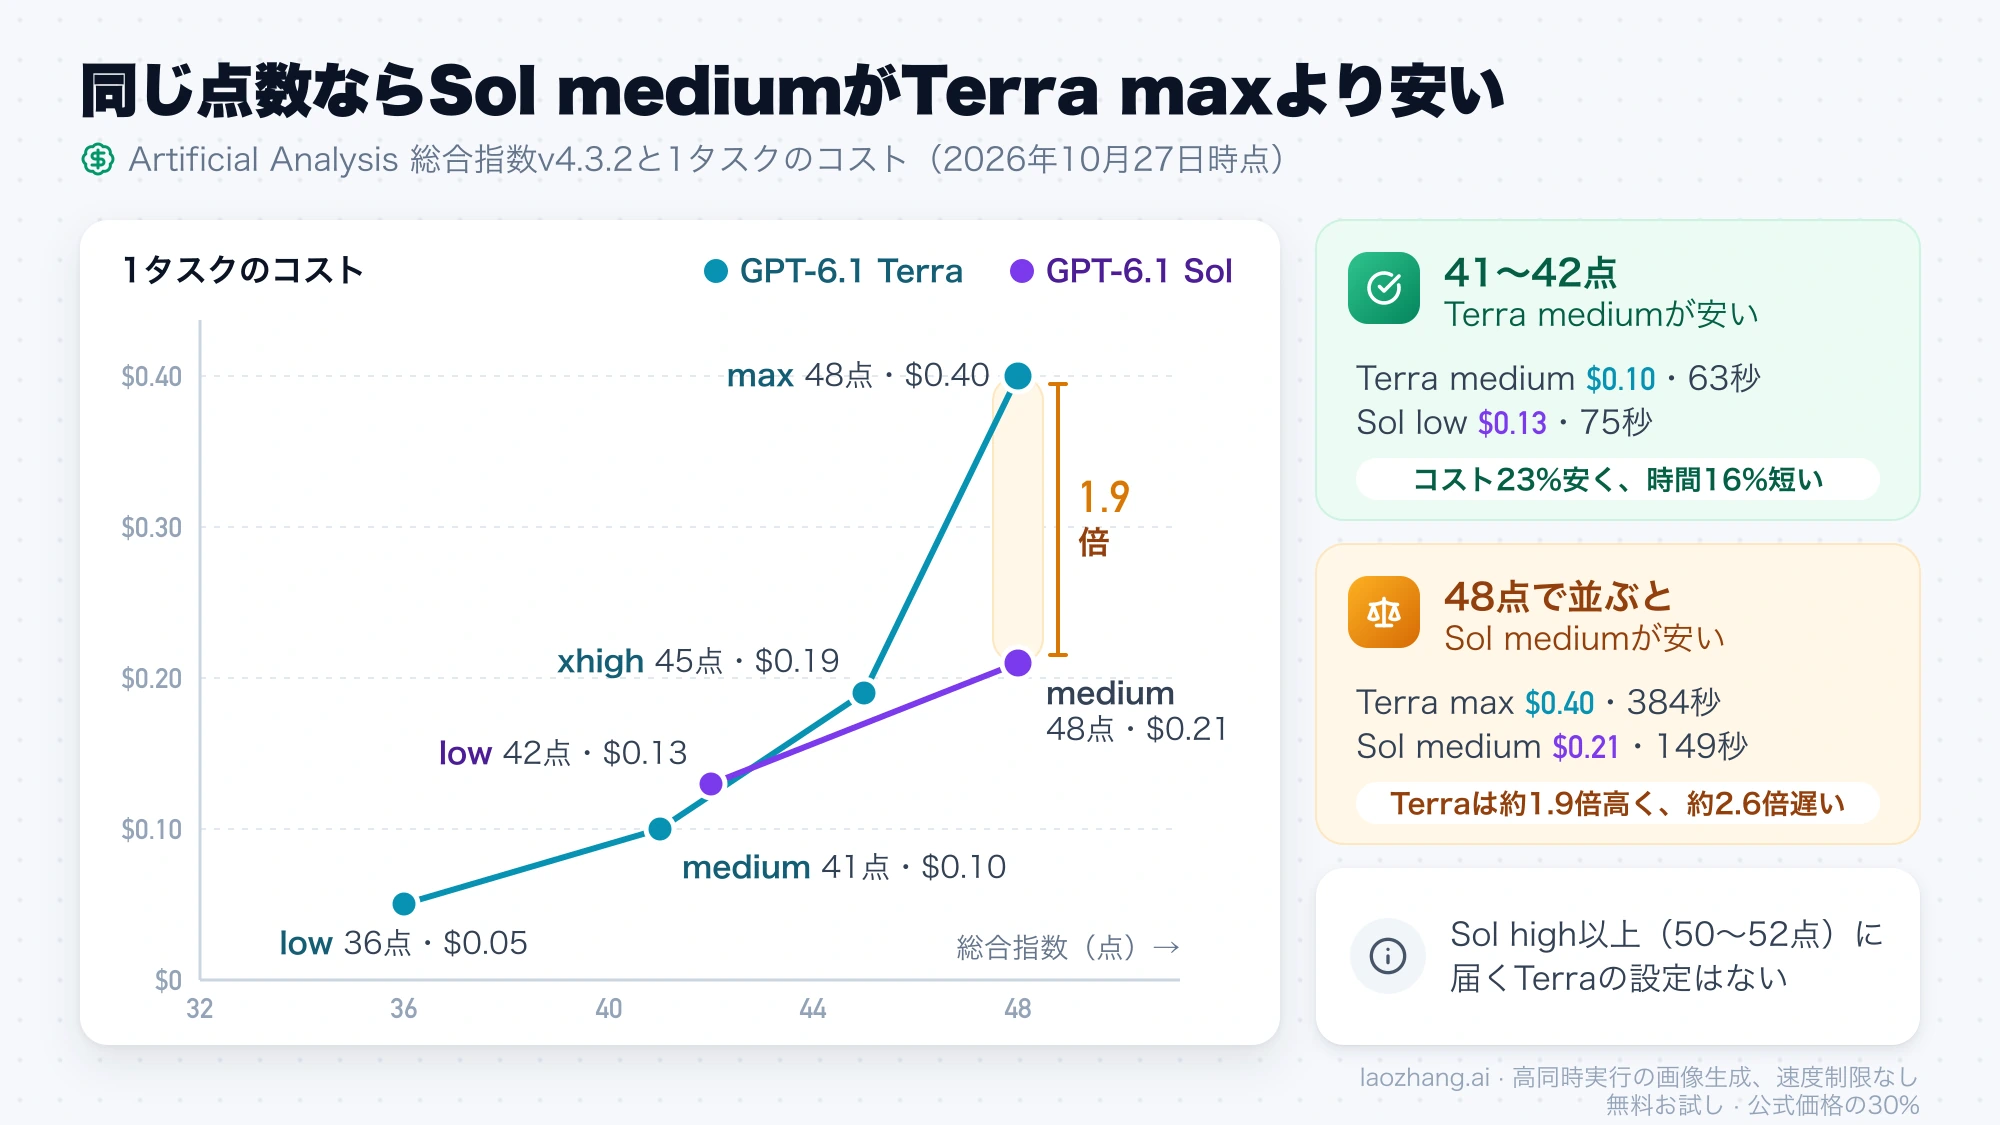
トークン単価が半分でも、1件の作業に使うトークンと時間が増えれば逆転します。第三者機関Artificial Analysisの総合指数(Intelligence Index v4.3.2)を推論レベルごとに見ると、Terraが安いのはlowからhigh程度までで、点数を揃えて上の設定同士を比べるとSolが逆に安くなります。
| Terraの設定 | Terra(点数・1タスクのコスト・時間) | 比べるSolの設定 | Sol(点数・1タスクのコスト・時間) |
|---|---|---|---|
| low | 36点・$0.05・29秒 | 相当する設定なし | Sol lowでも42点 |
| medium | 41点・$0.10・63秒 | low | 42点・$0.13・75秒 |
| xhigh | 45点・$0.19・159秒 | low | 42点・$0.13・75秒 |
| max | 48点・$0.40・384秒 | medium | 48点・$0.21・149秒 |
数値はArtificial AnalysisのGPT-6.1 TerraとGPT-6.1 Solの比較ページの2026年10月27日時点の値です。Terra mediumはSol lowより1点低いだけで、コストは23%安く($0.13−$0.10=$0.03、÷$0.13)、時間も16%短くなります(75秒−63秒=12秒、÷75秒)。Terra lowの36点・$0.05はSolのどの設定よりも安く、ここはTerraにしかない選択肢です。
逆に、同じ48点で並ぶTerra maxとSol mediumでは、Terraが$0.40÷$0.21で約1.9倍高く、384秒÷149秒で約2.6倍遅くなります。Terra xhighもSol lowより3点高い代わりに、コストは約1.5倍、時間は約2.1倍です。Solのhigh(50点)、xhigh(51点)、max(52点)に届くTerraの設定はありません。つまり「Terraをhigh以上に上げてようやく足りる仕事」は、Solのmediumと比べてから決めるべきです。
noneも最安とは限りません。Artificial Analysisの値ではTerraのnone(推論なし)は33点・$0.11・52秒で、lowの36点・$0.05・29秒より点が低く、コストも時間もかかっています。総合指数は10種類の評価をまとめた点数なので、特定の作業では順位が変わることがあります。
Codexで実測(2026年10月27日):全17回合格、Terraは約半分の時間
2026年10月27日、ChatGPTのサブスクリプションでサインインしたCodex CLI 0.164.0-alpha.11.1(macOS、1アカウント、Standard速度)で、3種類の作業を両モデルに実行しました。毎回作業フォルダを新しくコピーし、codex exec -m gpt-6.1-terra -c model_reasoning_effort=medium --jsonのようにモデルと推論レベルを指定して起動し、起動から終了までの時間と、終了時に出るトークン使用量を記録しています。クレジットは使用量にCodexのクレジット単価を掛けた値です。
作業は次の3つです。請求計算は、バグのあるPythonの請求計算を7つのルールを書いた仕様書どおりに直すもので、非公開の36テストで採点します(直さないままだと13/36)。請求書とグラフは、紛らわしい品番が並び1行だけ金額をわざと誤記した12行の請求書と、数値ラベルのない12本の棒グラフの2枚の画像から、数値を書き出して誤記を指摘させるものです。semver範囲判定は、npmのプレリリース規則を含む長い仕様からsatisfies()を実装するもので、これも非公開の36テストで採点します。
| 作業 | モデル・推論レベル | 時間 | クレジット | 結果 |
|---|---|---|---|---|
| 請求計算の修正 | Terra low | 29.2秒 | 0.42 | 36/36 |
| 請求計算の修正 | Terra medium | 31.9秒 | 0.44 | 36/36 |
| 請求計算の修正 | Terra high | 34.0秒 | 0.52 | 36/36 |
| 請求計算の修正 | Sol medium | 51.5秒 | 1.32 | 36/36 |
| 請求計算の修正 | Sol high | 62.0秒 | 1.35 | 36/36 |
| 請求書とグラフの読み取り | Terra none | 28.8秒 | 0.87 | 数値40/40、グラフ12/12、誤記を指摘 |
| 請求書とグラフの読み取り | Terra medium | 36.4秒 | 0.81 | 数値40/40、グラフ12/12、誤記を指摘 |
| 請求書とグラフの読み取り | Terra high | 38.1秒 | 0.86 | 数値40/40、グラフ12/12、誤記を指摘 |
| 請求書とグラフの読み取り | Sol medium | 78.8秒 | 1.69 | 数値40/40、グラフ12/12、誤記を指摘 |
| 請求書とグラフの読み取り | Sol high | 55.4秒 | 1.47 | 数値40/40、グラフ12/12、誤記を指摘 |
| semver範囲判定 | Terra low | 27.5秒 | 0.58 | 36/36 |
| semver範囲判定 | Terra medium(2回) | 28.1秒、25.1秒 | 0.60、0.45 | 36/36 |
| semver範囲判定 | Terra high | 36.9秒 | 1.10 | 36/36 |
| semver範囲判定 | Sol low | 44.2秒 | 1.33 | 36/36 |
| semver範囲判定 | Sol medium(2回) | 59.1秒、57.2秒 | 1.47、1.08 | 36/36 |
medium同士の4組を合計すると、Terraは121.5秒・2.30クレジット、Solは246.6秒・5.56クレジットで、Solは時間が約2.0倍、クレジットが約2.4倍かかりました。それぞれの使用量をAPIの定価に換算すると$0.0917対$0.2222です。単価の差で説明できるのは2倍までで、残りはSolのほうが出力トークンが多かったこと(請求計算のmediumで1,821対1,245)と、画像の作業でSolのmediumが6回コマンドを実行したのに対してTerraのmediumは2回だったことによります。
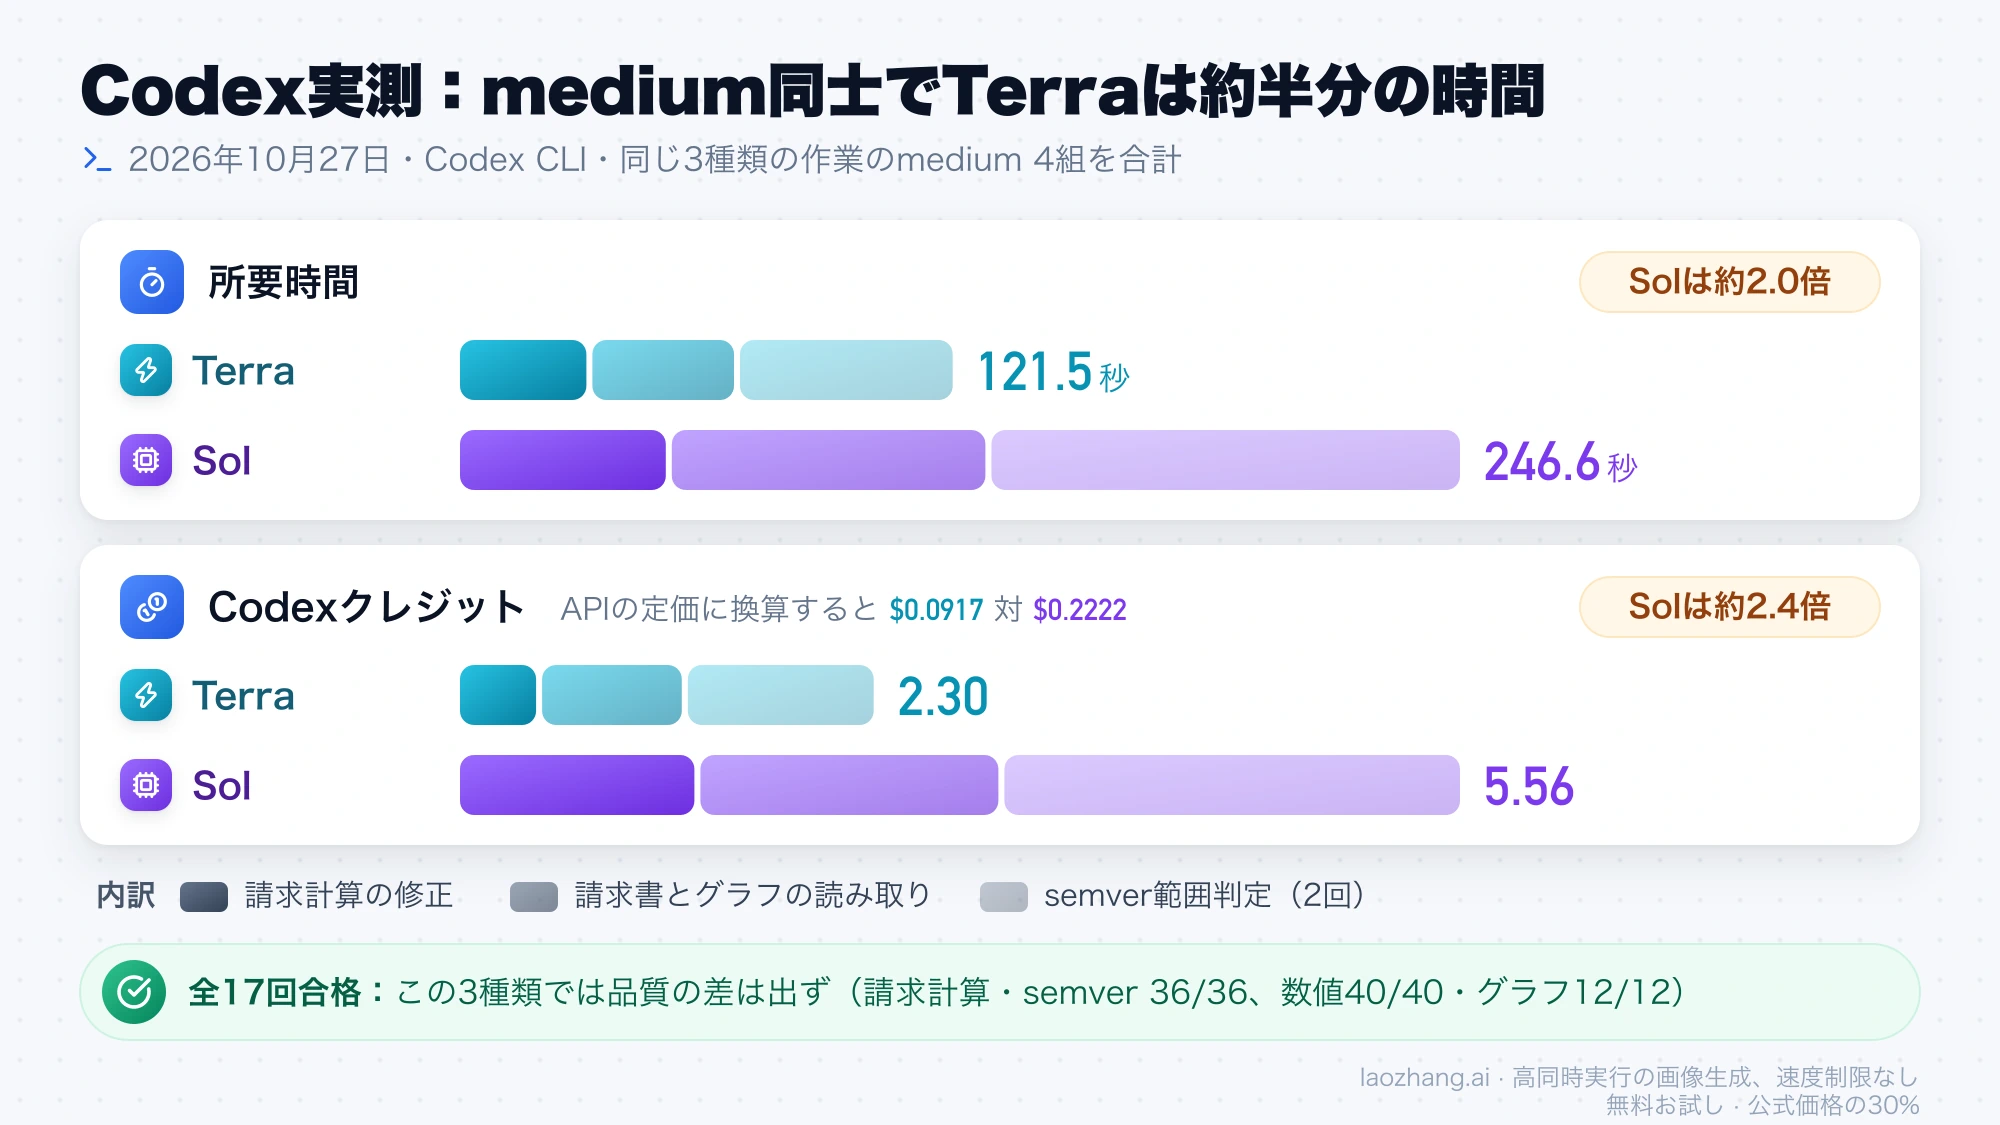
結果の読み方には限りがあります。どの作業も両モデルが全回合格したので、この3種類では品質の差は出ていません。各設定はほぼ1回ずつ(semverのmediumだけ2回)、1台・1アカウントでの計測で、APIではなくCodexのエージェントとしての時間です。FastとUltrafastは測っていません。画像の作業では両モデルとも品番2つ(LM-1l07とDW-1I1l)を同じように読み違えましたが、等幅フォントでl・I・1がほぼ同じ形になるため採点から除いています。
「3倍速い」は本当?タスク完了時間と出力速度を分けて見る
「3倍以上速い」は、OpenAIがAgents' Last Examというコンピューター操作の評価で、GPT-6 AstraとGPT-6.1 Solに比べてタスクを終えるまでの速さについて述べたものです。トークンを出す速さとは別の話で、Artificial Analysisの計測ではTerraの出力速度はどの推論レベルでも毎秒91トークン、Solは毎秒54〜73トークンなので、出力速度だけなら1.2〜1.7倍程度の差です。
タスク全体の時間は、出力速度に加えて考える量と手順の数で決まります。2026年10月27日のCodex実測では、同じ作業・同じ推論レベルでSolはTerraの1.5〜2.3倍の時間がかかりました(請求計算のmediumで51.5秒対31.9秒、画像の作業のmediumで78.8秒対36.4秒)。OpenAIのCodex担当者が2026年10月26日にXに投稿した、Fastモードでのフォーム入力の1回の例では、Terra 53.5秒対Sol 3分21.7秒と約3.8倍の差でした。小さめの作業では約2倍、手順の多いコンピューター操作ではそれ以上の差になる、と考えるのが実態に近いです。
Solが遅いと感じる原因がモデル選びではなく設定にある場合もあります。Sol側の速度の実測と設定の見直しは「GPT-6.1 Solが遅いのは解消した?10月26日の実測と速くする設定」で扱っています。
Terraはコーディングで劣る?簡単な修正は互角、難しい課題はSol
小さめの修正や仕様どおりの実装ではTerraとSolに差は出ませんでしたが、難しい課題を集めたベンチマークではmedium同士で大きな差があります。2026年10月27日のCodex実測では、請求計算の修正もsemver範囲判定も両モデルが全回36/36でした。どちらもテストを書いて直す手順を自分で回すため、この程度の難しさでは差がつきません。
差が見えるのは、コマンドラインでの問題解決を測るTerminal-Bench 4.0です。Artificial Analysisの計測では、mediumでTerra 32.3%対Sol 48.0%、lowで15.2%対30.8%と大きく開き、maxでようやく55.6%対56.1%とほぼ並びます。OpenAIの発表記事ではTerraのmaxは50.3%(同社の計測)で、OpenAI自身が「最も複雑なコーディング作業では、GPT-6.1 SolとGPT-6 Astraのほうが引き続き良い選択」と書いています。Redditのr/codexにある発表スレッド(2026年10月27日時点でコメント370件以上)でも、「特定の作業ではTerraが強いが、難しいコーディングはSol」という声が出ています。
難しいコーディングでTerraを使うなら推論レベルをhigh以上にする必要があり、そうするとタスク単価の節で見たとおりSolのmediumとの価格差が消えていきます。最初からSolのmediumで始め、Solでも足りない仕事だけGPT-6 Astraとの比較に進むのが順当です。Astraに上げる価値がある場面は「GPT-6.1 Sol・6 Sol・Astra比較:移行の判断」で整理しています。
画像の読み取り・フォーム入力・画面操作はGPT-6.1 Terraで足りる?
請求書やグラフの読み取り程度ならTerraで足ります。2026年10月27日のCodex実測では、Terraはnone・medium・highのどの設定でも請求書の数値40件とグラフの値12本をすべて正しく読み、わざと誤記した1行も見つけました。Solも同じ結果で、時間はTerraの約1.5〜2.2倍でした。どちらのモデルも、答える前にPythonで画像を切り抜いて拡大してから読んでいます。
OpenAIはTerraを、画像や画面の解釈、元の書類からのフォーム入力に向くモデルとして案内しています(ChatGPTとCodexのモデル案内)。発表記事では、画像を使った推論の評価MMMU-Proで、Astraや6.1 Solに近い点数をはるかに低いコストで出したとしています。発表記事の本文にはSolの具体的な点数がなく、2026年10月26日のXでの第三者によるグラフの読み取りではMMMU-Proが約85.5対約86.3、デスクトップ操作のOSWorld 2.1が約78対約79と、ほぼ互角です。いずれもOpenAIの社内評価のグラフを読んだ概算です。
注意点は2つあります。実測の画像はきれいに作った合成画像で、品番のl・I・1のように形の似た文字は両モデルとも読み違えました。品番や口座番号のように1文字の誤りが問題になる作業では、TerraでもSolでも照合の工程を残してください。もう1つは知識の正確さで、Artificial Analysisの知識問題と誤答を測る評価AA-OmniscienceではSolが38〜42点、Terraは推論レベルによって4〜30点と差があります。OpenAIの社内評価では、誤りを誘う質問でのTerraの誤答率はlowで16.7%、maxで4.3%と、maxならSolに近いとされています。資料や検索結果を渡さずにモデルの知識だけで答えさせる用途では、Terraの推論レベルを上げるか、Solを使うほうが安全です。
どこで使える?ChatGPT・Codex・API・GitHub Copilotの対応
GPT-6.1 TerraもSolも、ChatGPTの通常のチャットでは選べません。使えるのはChatGPTのWork(Webとデスクトップアプリ)とCodex、OpenAI APIで、FreeとGoはどちらのモデルの対象にも挙がっていません。
| 入口 | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| ChatGPTの通常のチャット | 使えない | 使えない |
| ChatGPT WorkとCodex | Plus、Pro、Business、Enterprise、Edu | 提供あり(Enterprise・Eduは管理者が有効にするまでオフ) |
| Codex CLI | 0.159.0以降が必要 | 対応 |
| CodexのUltrafast | 非対応 | Pro $500と対象のEnterprise・Edu |
| OpenAI API | gpt-6.1-terra | gpt-6.1-sol |
| UAEの推論データ所在地 | 非対応 | 料金ページに記載なし |
表は2026年10月27日時点のChatGPTとCodexの料金ページによります。OpenAIの発表記事は対象プランを「Plus、Pro、Enterprise、Edu」と書いてBusinessを挙げていませんが、より具体的なCodexの料金ページにはBusinessが含まれています。Enterpriseではワークスペースの提供状況と管理者の設定にも左右されます。
GitHub Copilotでも、2026年10月26日からGPT-6.1 TerraがCopilot Pro、Pro+、Max、Business、Enterpriseに順次提供されています(GitHubの変更履歴)。OpenAI互換のAPIゲートウェイ経由で使う場合は、Terraが追加されているかをモデル一覧で確かめてください。たとえばLaoZhang API(laozhang.ai)のGET /v1/modelsは、2026年10月27日時点でgpt-6.1-solを返しますがgpt-6.1-terraは返しません(LaoZhang APIのモデル情報)。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Plus・Businessの利用上限:5時間でTerra 35〜285回、Sol 15〜160回
Codexの利用上限が気になるなら、Terraに替えると同じ枠で回せる回数がおよそ2倍になります。ChatGPTとCodexの料金ページの目安では、PlusとStandardのBusinessで5時間あたりのローカルメッセージがGPT-6.1 Terraで35〜285回、GPT-6.1 Solで15〜160回です。OpenAIはこれを固定の上限ではなく作業の大きさで変わる目安としており、週単位の上限がかかることや、クラウドのタスクはより多く消費することもあります。Proには現在5時間の上限がありません。
プランの枠を使い切った後や柔軟な料金のワークスペースで使うCodexクレジットは、100万トークンあたり入力・キャッシュ入力・出力の順にTerraが25・1.25・125、Solが50・2.5・250で、ここもちょうど半分です。キャッシュ書き込みの別料金はありません。旧GPT-5.6 Terraは50・5・300なので、旧Terraから移るだけでも単価は下がります。
API料金(ドル)、Codexクレジット、プランの回数の目安は別々の物差しで、1つの数字には換算できません。OpenAIも、クレジット単価だけでプランに含まれる利用量が決まるわけではないとしています。実際の消費は使用量のダッシュボードで確かめてください。
CodexでGPT-6.1 Terraに切り替える手順
GPT-6.1 TerraにはCodex CLI 0.159.0以降が必要です。手順は次のとおりです(ChatGPTとCodexのモデル案内)。
codex --versionでバージョンを確かめ、0.159.0より古ければ更新します。- 起動時にモデルを指定します。
codex -m gpt-6.1-terraで起動し、推論レベルも固定するなら-c model_reasoning_effort="medium"を付けます。 - すでに開いているセッションでは
/modelを入力し、モデルと推論レベルを選び直します。 - スクリプトから動かす場合は
codex exec -m gpt-6.1-terra "作業の指示"のように、非対話の実行でも同じ指定が使えます。
デスクトップアプリとWeb版のWorkでは、Powerの操作からAdvancedを開き、モデル一覧でGPT-6.1 Terraを選びます。選べるモデルはプラン、ワークスペース、提供の進み具合によって違います。APIではmodelをgpt-6.1-terraにし、reasoning.effortを指定します。SolからTerraへは推論レベルをそのまま持ち込めますが、Terraでnoneを使っていた処理をSolに戻すときはlow以上に変える必要があります。
乗り換え前に確かめる:合格1件あたりのコストを測る方法
最後は自分の作業で、採用できた結果1件あたりのコストを比べて決めます。総合指数や上の実測は出発点で、作業の中身が変われば差の出方も変わるからです。次の順で比べます。
- 代表的な作業を5〜10件選びます。うまくいった簡単な依頼だけでなく、以前に人が直した難しい依頼も入れます。
- 合否の基準を先に決めます。テストが通る、正解データと一致する、など機械的に判定できる形が理想です。
- Terra medium、Terra high、今使っているSolの設定の3つを、同じ指示・同じ作業フォルダの新しいコピーで実行します。
codex exec --jsonなら、終了時のイベントにトークン使用量が出ます。 - 各回のコストを「非キャッシュ入力×入力単価+キャッシュ入力×キャッシュ単価+出力×出力単価」で計算します。
- 「合計コスト÷合格件数」を両モデルで比べます。Terraがmaxでやっと合格する作業は、Solのmediumとも比べます。
4の計算は、2026年10月27日の請求計算・mediumの実測で確かめられます。Terraは入力58,622トークン(うちキャッシュ49,792)、出力1,245トークンだったので、8,830×25÷100万=0.221、49,792×1.25÷100万=0.062、1,245×125÷100万=0.156で、合計0.44クレジットです。Solは入力78,624(うちキャッシュ64,512)、出力1,821で、14,112×50÷100万=0.706、64,512×2.5÷100万=0.161、1,821×250÷100万=0.455の合計1.32クレジットになります。APIで比べるときは、同じ式にドルの単価を入れます。
5の比較には目安があります。実測のmedium同士の合計ではTerraのクレジットがSolの約41%(2.30÷5.56)でした。同じ件数を流して1件あたりの消費がこの比率に近ければ、Terraの合格件数がSolの合格件数の41%を超えている限り、合格1件あたりはTerraが安くなります。ただし不合格を人が直す手間はこの式に入っていません。失敗1件の手直しが高くつく仕事では、「失敗件数×1件の手直し費用」を両方の合計に足してから比べてください。
GPT Luna・Sol・Terraの違い:Codexでの4モデルの位置づけ
GPT-6.1 TerraとSolのほかにGPT-6 LunaとGPT-6 Astraも並ぶCodexでは、安い順にLuna、Terra、Sol、Astraです。OpenAIのChatGPTとCodexのモデル案内は、Lunaを「良い結果の形がわかっている、決まった大量の作業」、Terraを文章・画像の理解・画面操作、Solを費用を抑えたいコードや資料の長い作業、Astraを最も要求の厳しい作業に勧めています。
2026年10月27日時点のChatGPTとCodexの料金ページでは、GPT-6 LunaのCodexクレジットが100万トークンあたり入力2.5・キャッシュ入力0.25・出力12.5とTerraの10分の1で、PlusとBusinessの5時間あたりの目安は350〜3,000回です。反対にGPT-6 Astraは250・25・1,250とSolの5倍で、目安は5〜45回にとどまります。
Artificial Analysisは2026年10月26日のXの投稿で、Terraのmaxは総合指数で6.1 Solより4点低く、GPT-6 Lunaより10点高いと伝えています。合否がはっきりした定型作業ならLunaで足りるかを先に試し、判断や画像の読み取りが要る作業からTerra、難しいコーディングからSol、という順に上げていくと無駄が出にくくなります。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月27日。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月27日。
- 1.OpenAIのGPT-6.1 Terra発表記事openai.com/index/introducing-gpt-6-1-terra
- 2.GPT-6.1 TerraのAPIモデルページdevelopers.openai.com/api/docs/models/gpt-6.1-terra
- 3.OpenAI APIのモデル一覧developers.openai.com/api/docs/models
- 4.OpenAI API料金表developers.openai.com/api/docs/pricing
- 5.Artificial AnalysisのGPT-6.1 TerraとGPT-6.1 Solの比較ページartificialanalysis.ai/models/releases/comparisons/gpt-6-1-terra-vs-gpt-6-1-sol
- 6.ChatGPTとCodexのモデル案内learn.chatgpt.com/docs/models
- 7.ChatGPTとCodexの料金ページlearn.chatgpt.com/docs/pricing
- 8.GitHubの変更履歴github.blog/changelog/2026-10-26-gpt-6-1-terra-in-github-copilot