GLM-5.3・Kimi K3・DeepSeek V4比較:最初に試すモデルの決め方
テキスト中心の長時間エンジニアリングはGLM-5.3、画像を同じループで扱うならKimi K3、低コストで試行回数を増やすならDeepSeek V4 Flashを先に検証し、難しいケースだけProと比べます。
目次
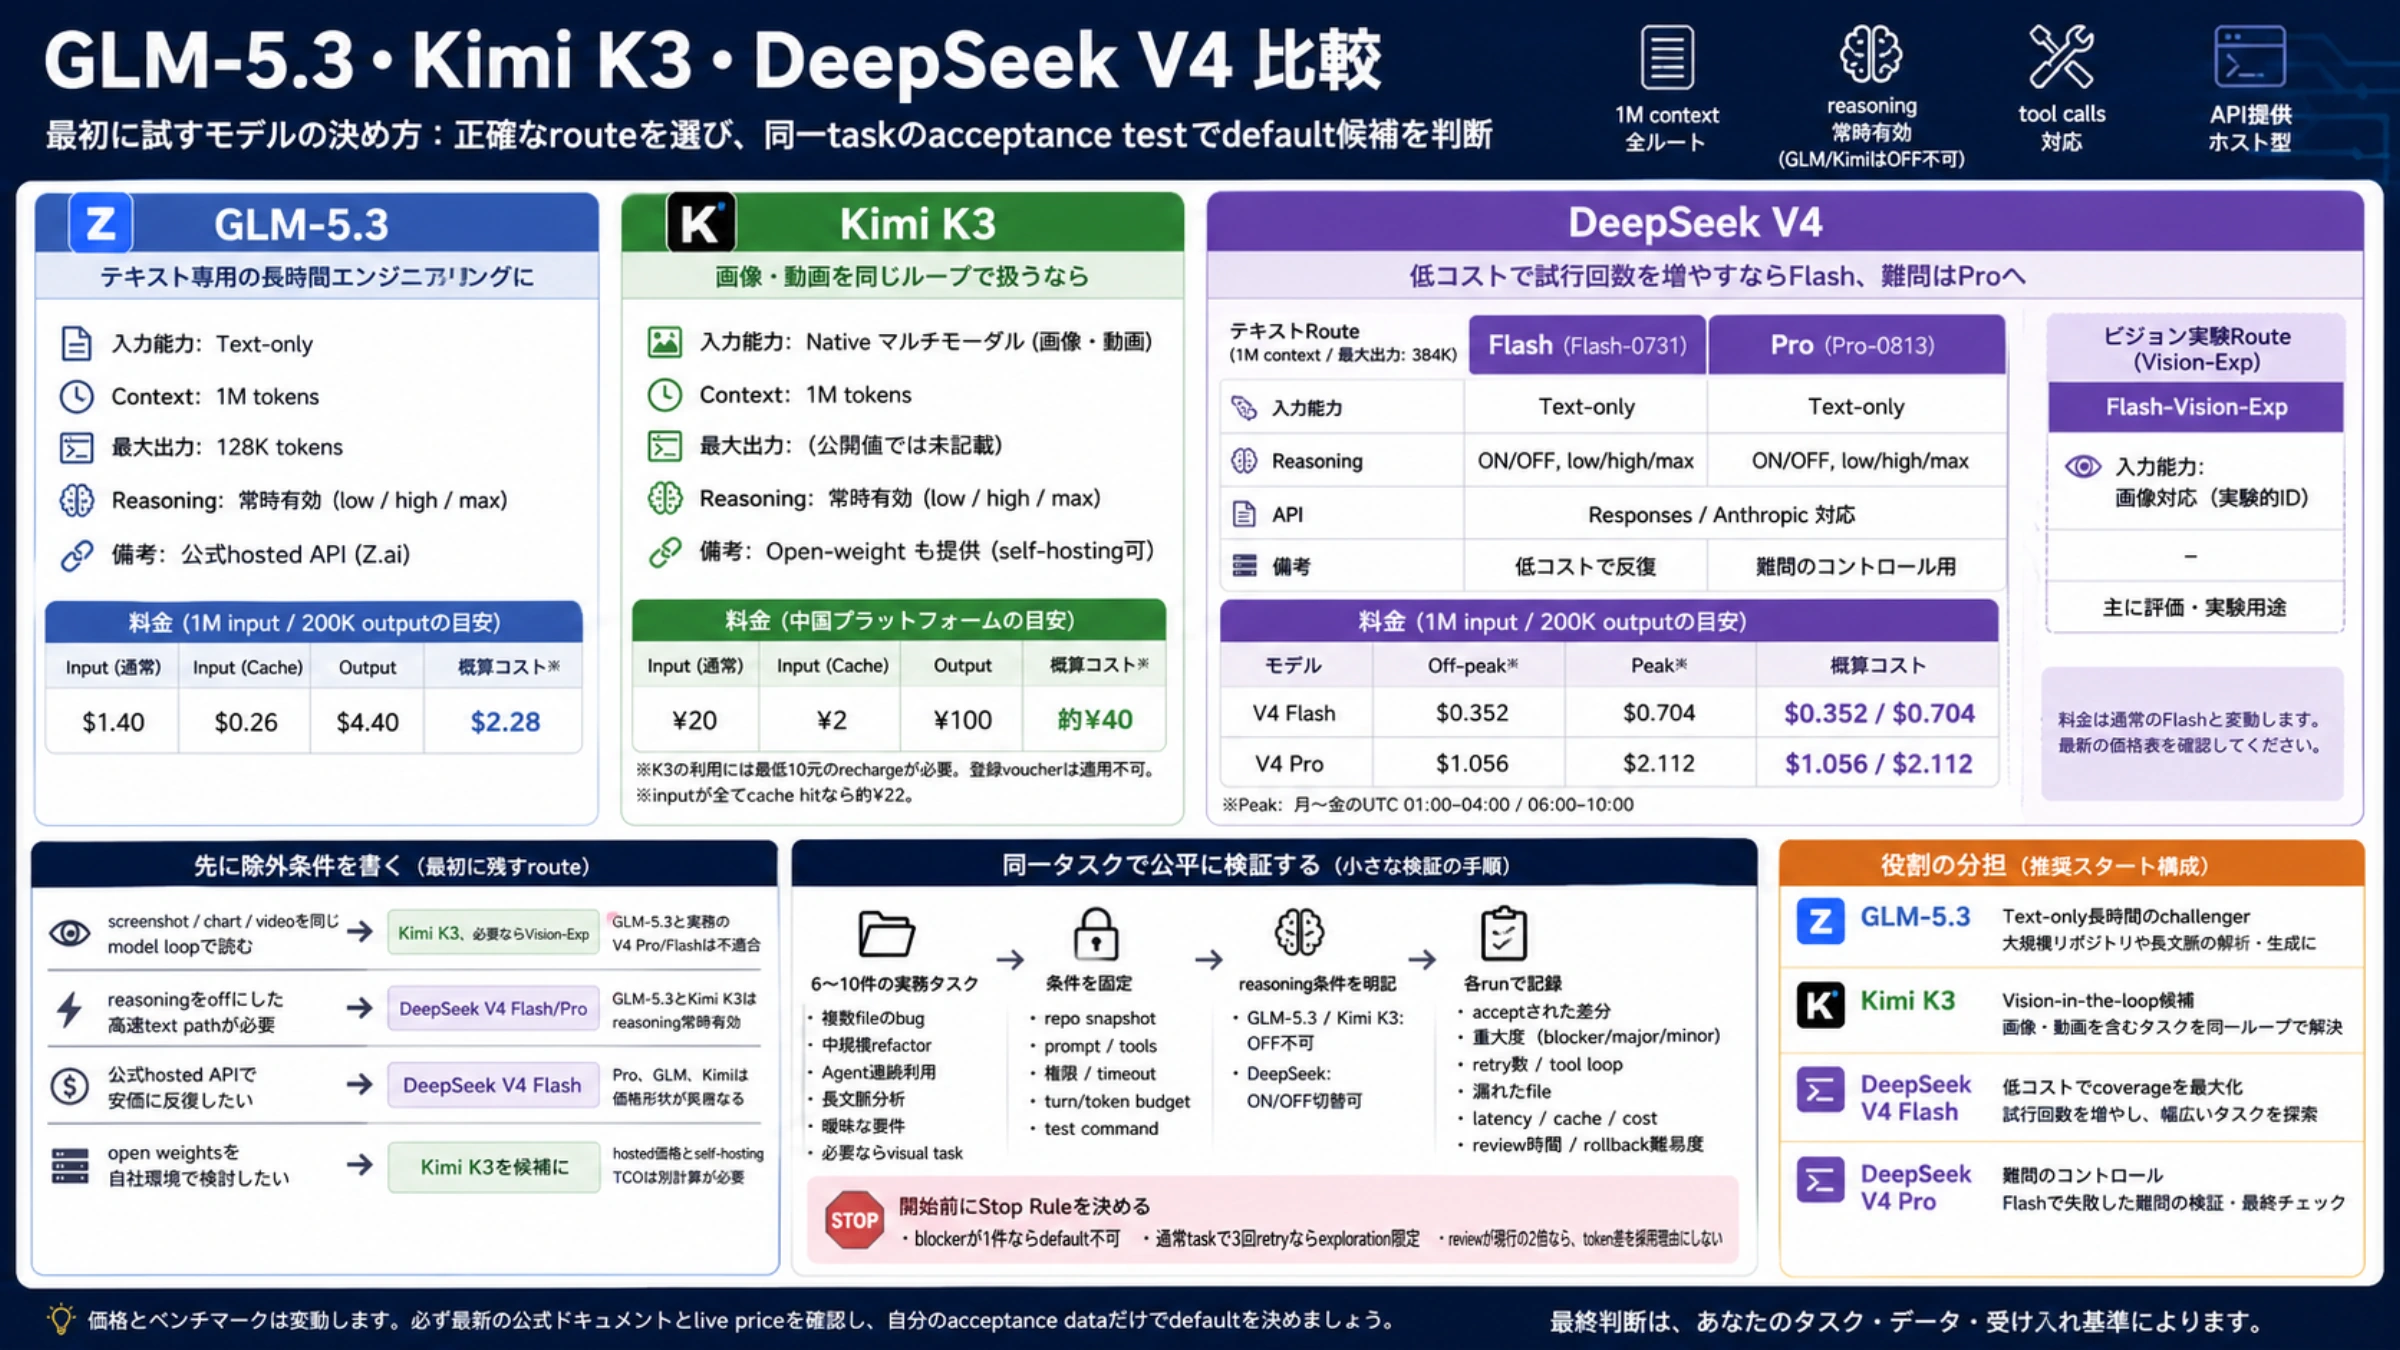
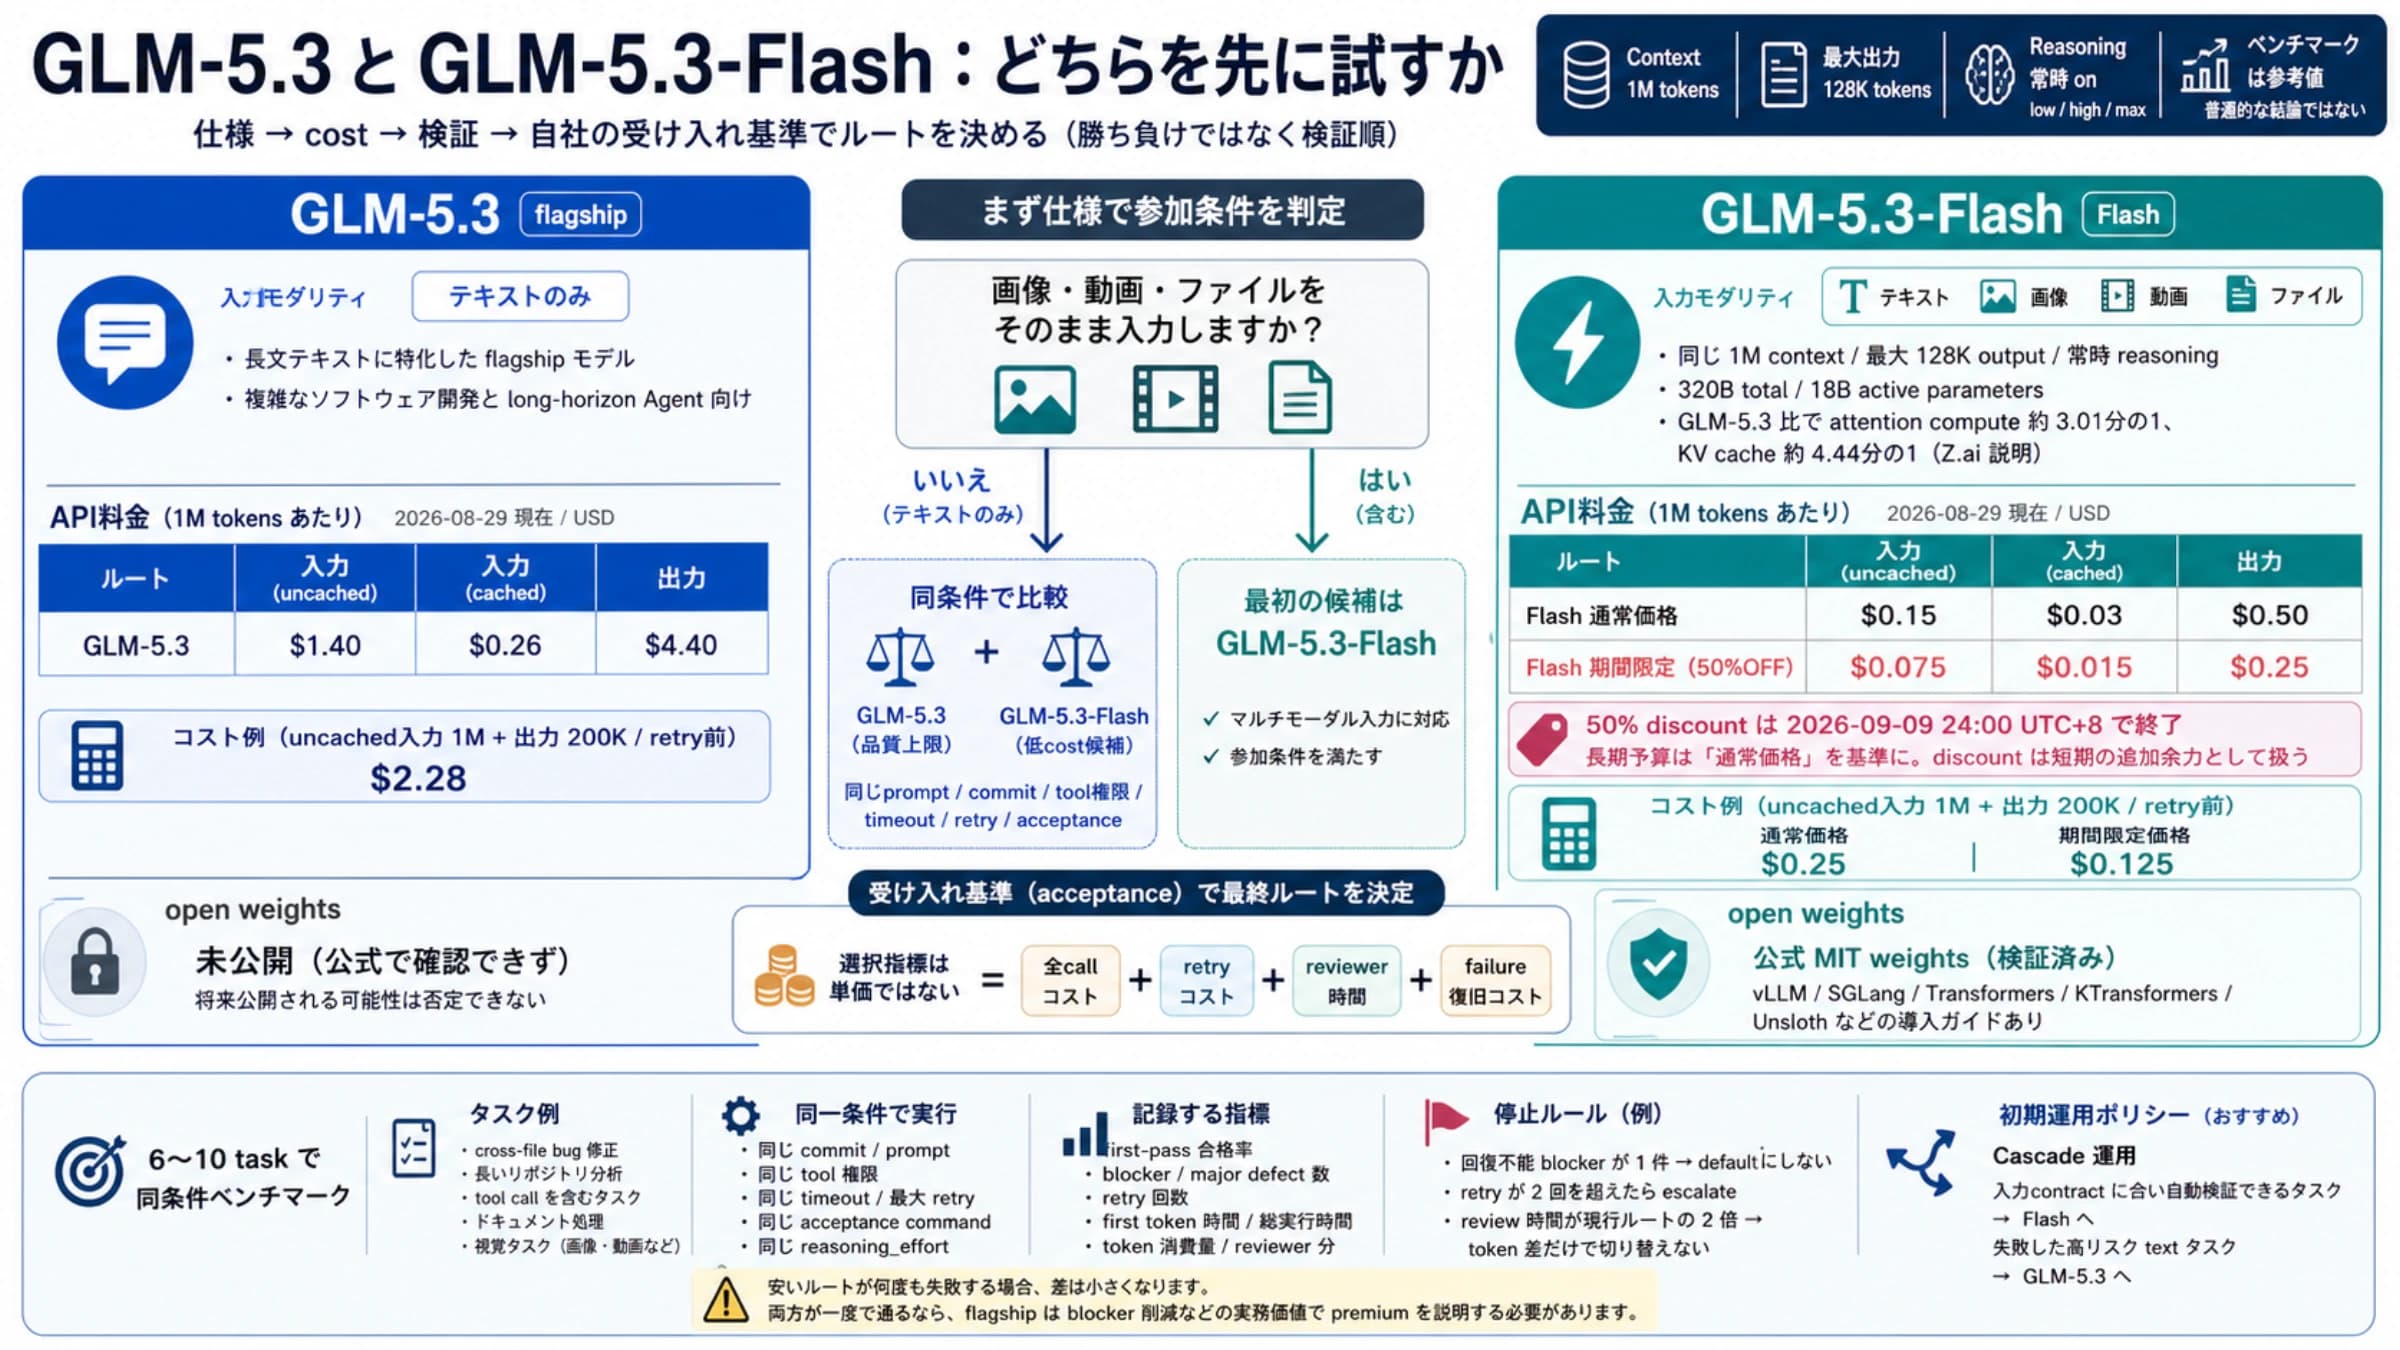
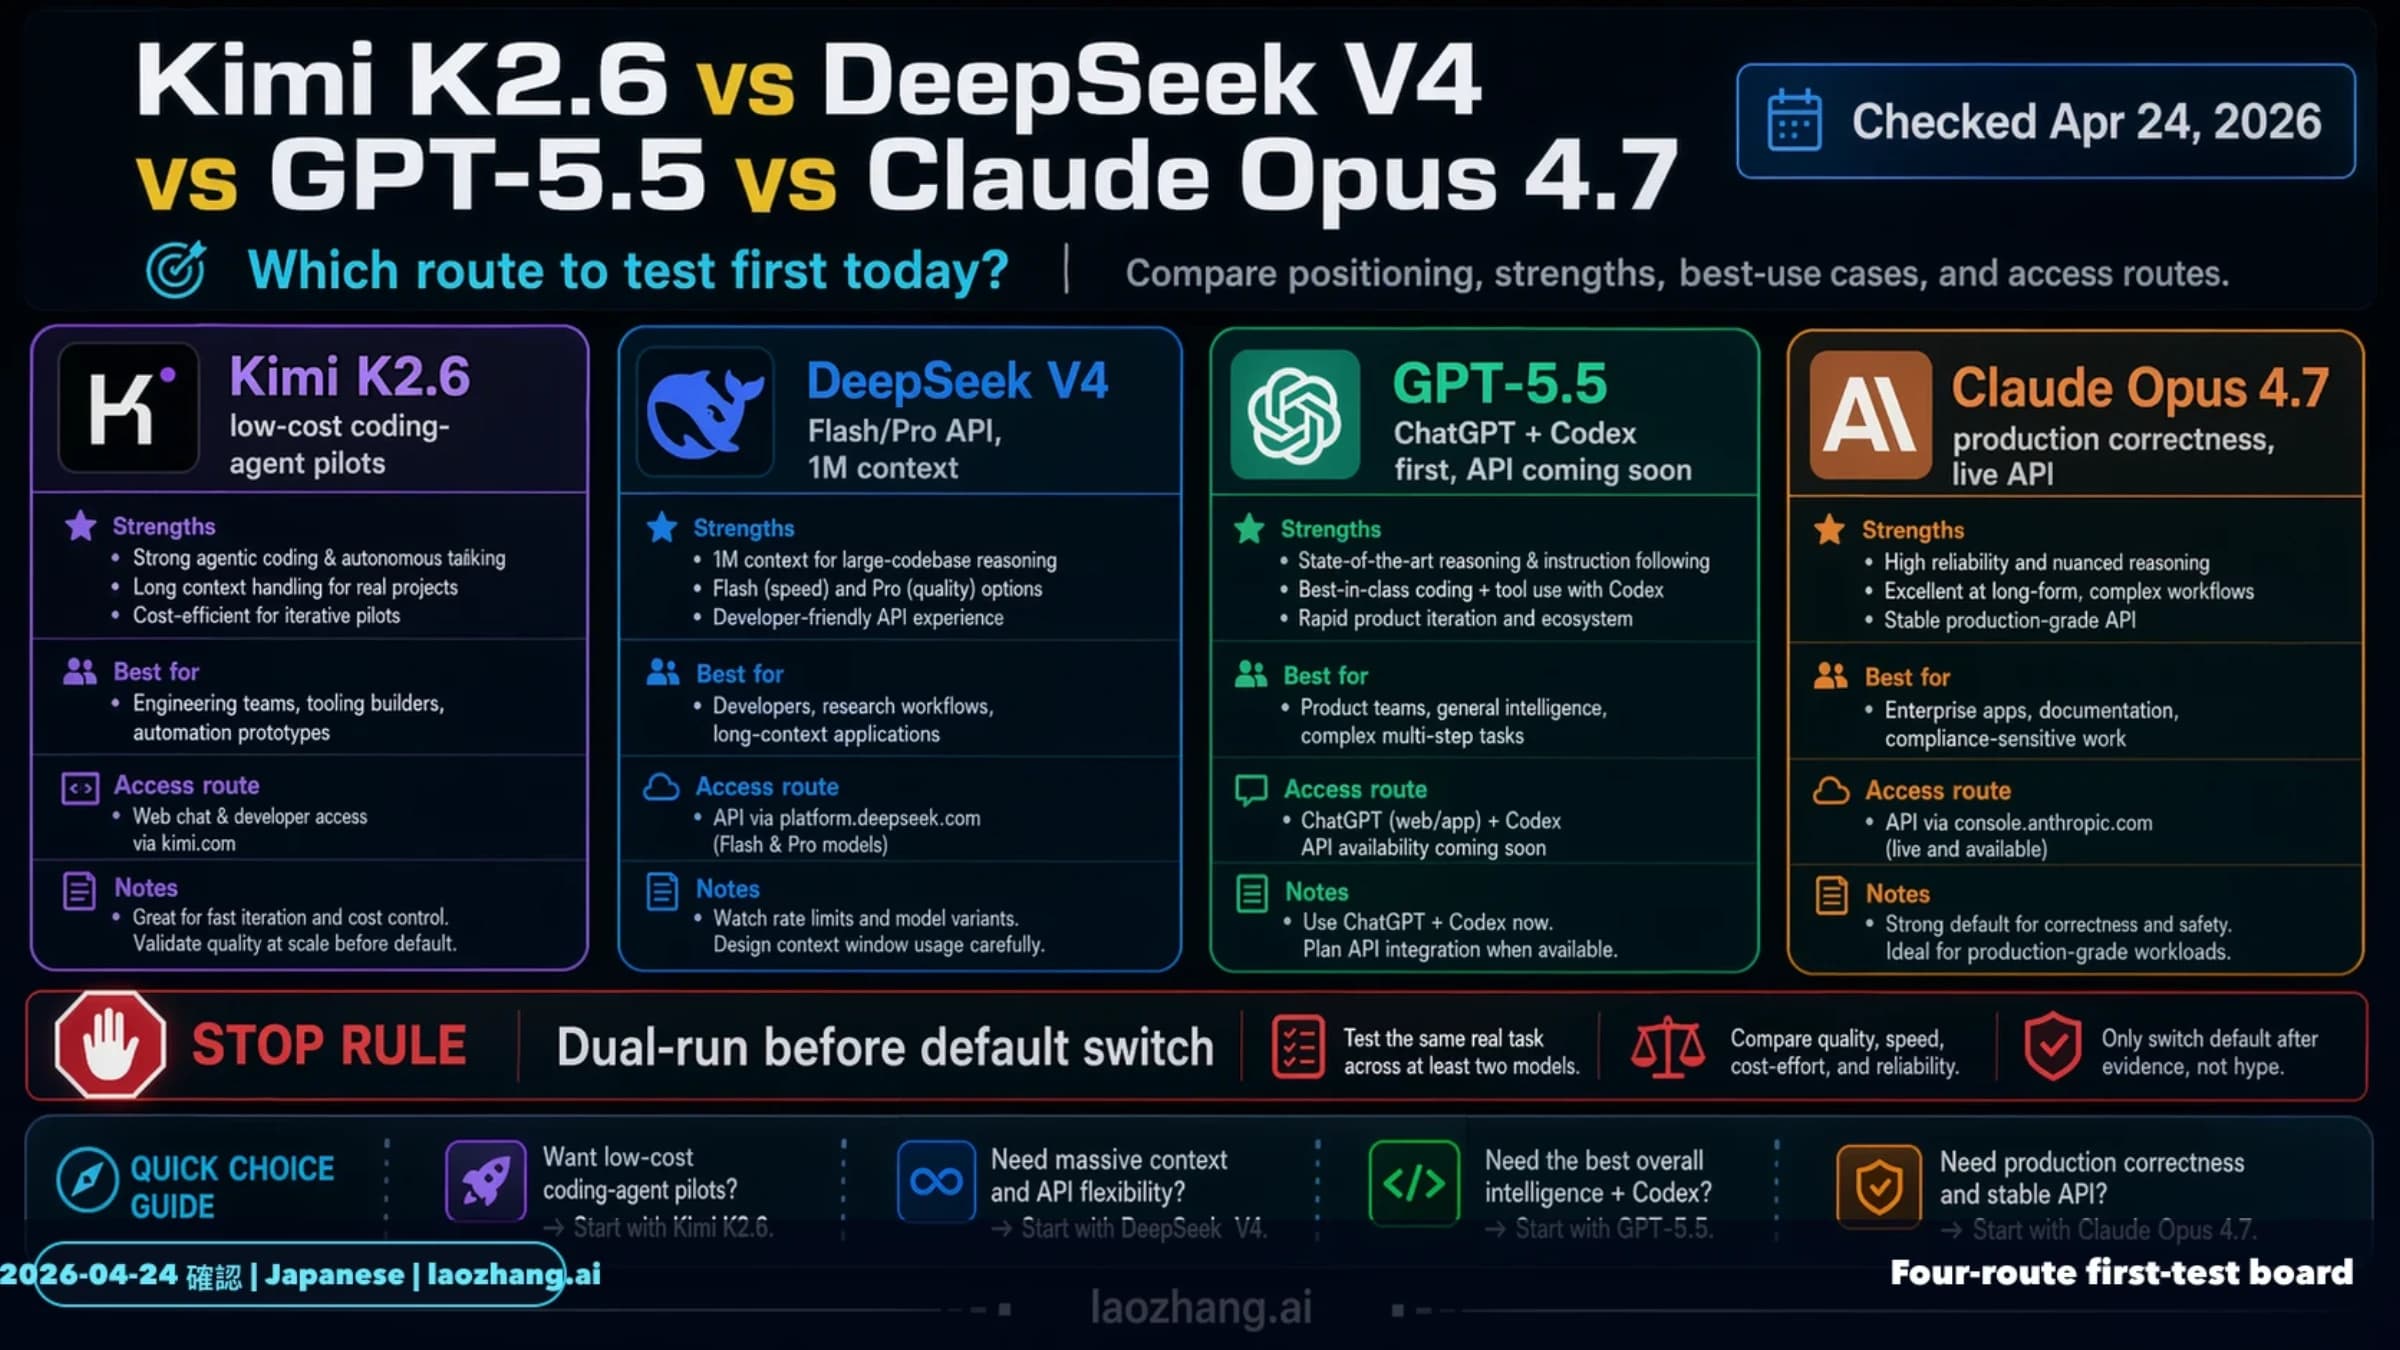
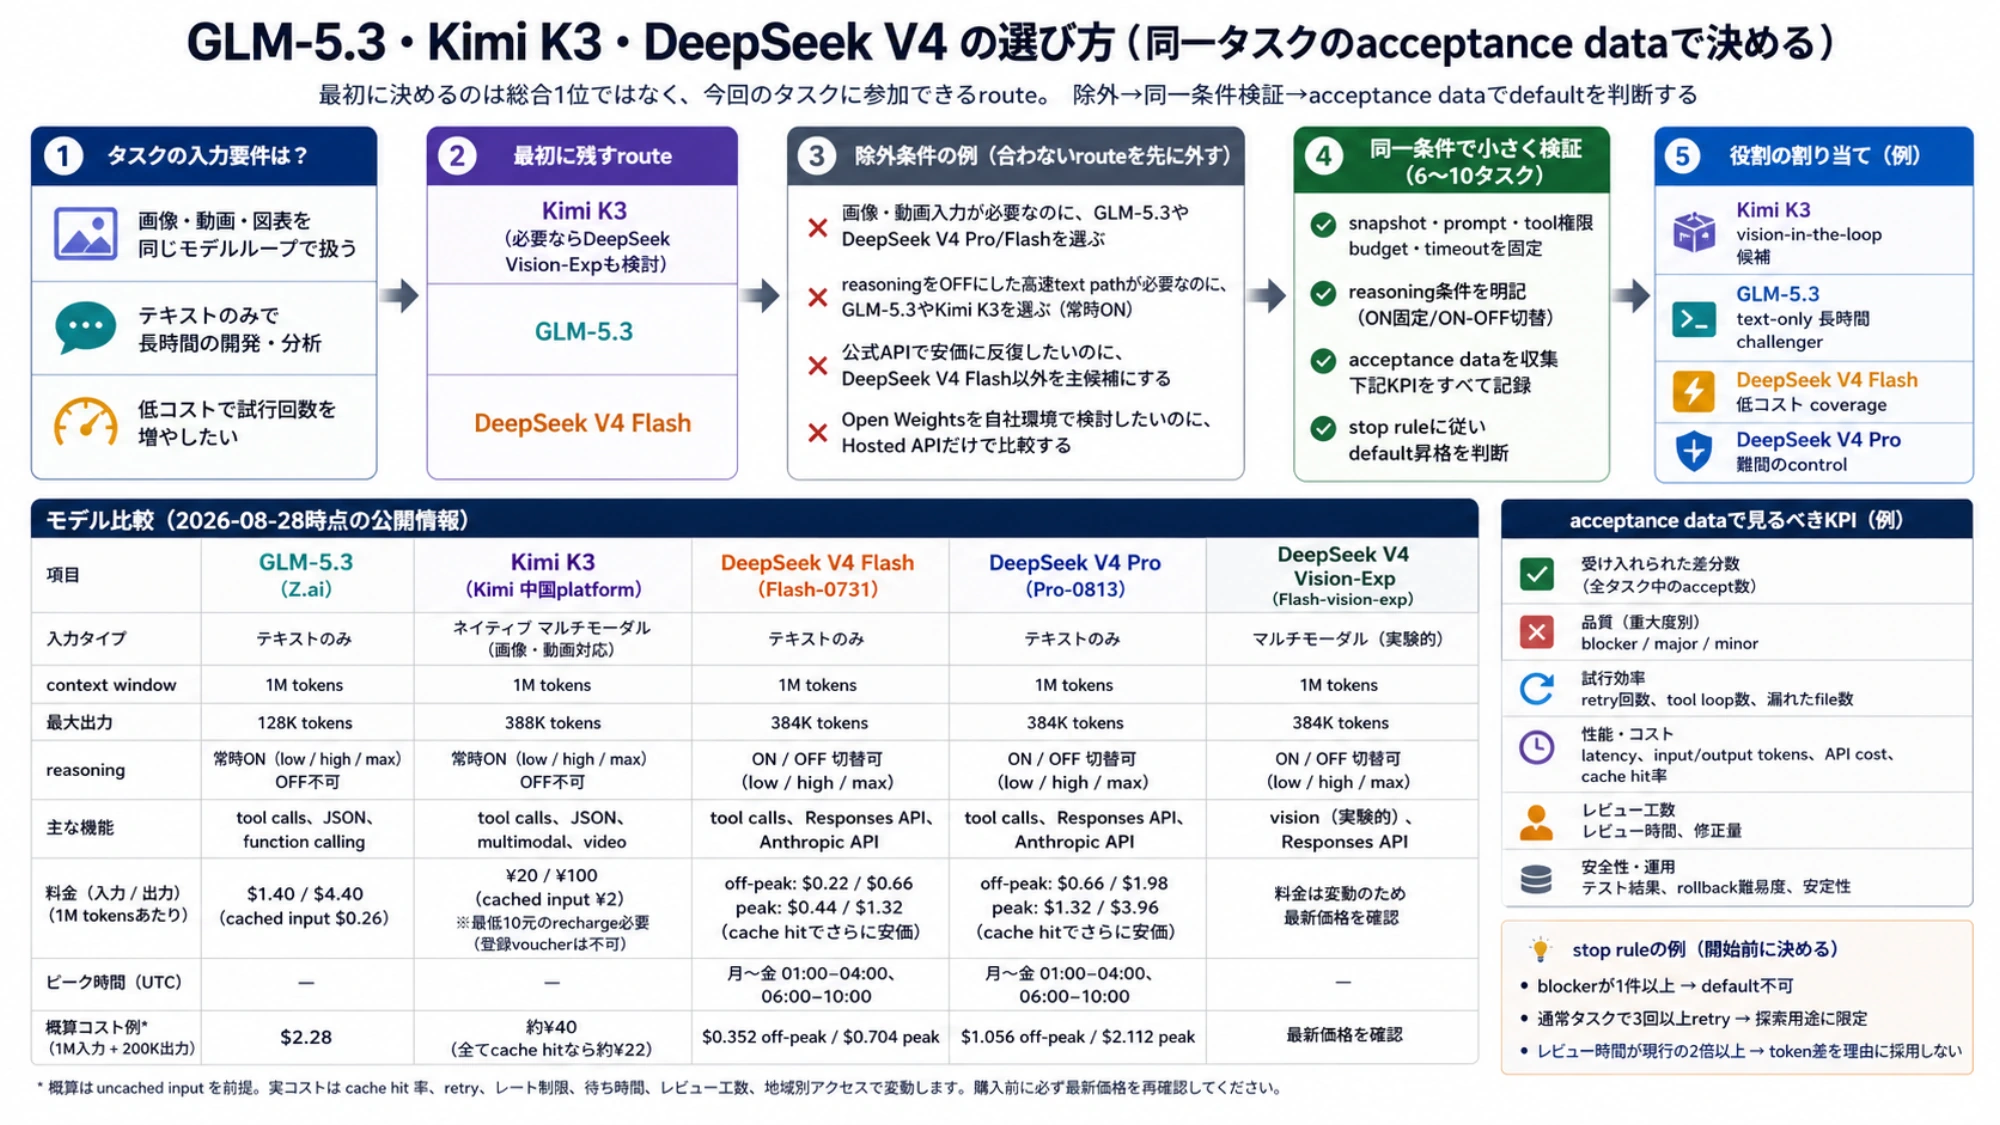
最初に決めるべきなのは総合1位ではなく、今回のタスクに参加できるrouteです。画像や動画をそのまま入力するなら、Kimi K3が自然な最初の候補です。テキストだけで大規模リポジトリを長時間扱うならGLM-5.3を入れます。試行回数とAPI費用が優先ならDeepSeek V4 Flashから始め、難しい失敗例をV4 Proへ送ります。
この順序は性能順位ではありません。公開仕様で不適合な候補を外し、残ったrouteを同じ条件で測るための入口です。
比較前にモデル名を正規化する
glm-5.3はZ.ai公式仕様でtext-only、1M context、最大128K outputとされています。reasoningは常時有効で、low、high、maxを選びます。無効化はできません。
kimi-k3も1M contextでreasoning常時有効ですが、画像と動画を扱えます。Kimi K3 APIガイドでは、複数turnやtool callの次回requestに完全なassistant messageを戻す必要があります。最終contentだけを保存する既存wrapperでは、モデル性能より先にcontract不一致が起きます。
DeepSeek V4は1モデルではありません。現行モデル表にある主要なtext routeはdeepseek-v4-flash(Flash-0731)とdeepseek-v4-pro(Pro-0813)です。どちらも1M context、最大384K output、thinkingのon/off、low/high/max、tool calls、Responses API、Anthropic APIをサポートします。
画像対応は別の実験的ID、deepseek-v4-flash-vision-expです。「DeepSeek V4はvision対応」と一括りにすると、Proに存在しない入力能力を比較表へ移してしまいます。
先に除外条件を書く
| 必須条件 | 最初に残すroute | 先に外す理由 |
|---|---|---|
| screenshot、chart、videoを同じmodel loopで読む | Kimi K3、必要ならDeepSeek Vision-Exp | GLM-5.3と通常のV4 Pro/Flashはこの入力contractではない |
| reasoningをoffにした高速text pathが必要 | DeepSeek V4 Flash/Pro | GLM-5.3とKimi K3はreasoning常時有効 |
| 公式hosted APIで安価に反復したい | DeepSeek V4 Flash | Pro、GLM、Kimiは同じtoken量でも価格形状が違う |
| open weightsを自社環境で検討したい | Kimi K3を候補にする | hosted API価格とself-hosting TCOは別計算が必要 |
除外後も候補が複数残るなら、そこで初めて品質テストをします。parameter数やvendor benchmarkだけで除外しないことが重要です。
API料金は時計とcacheで変わる
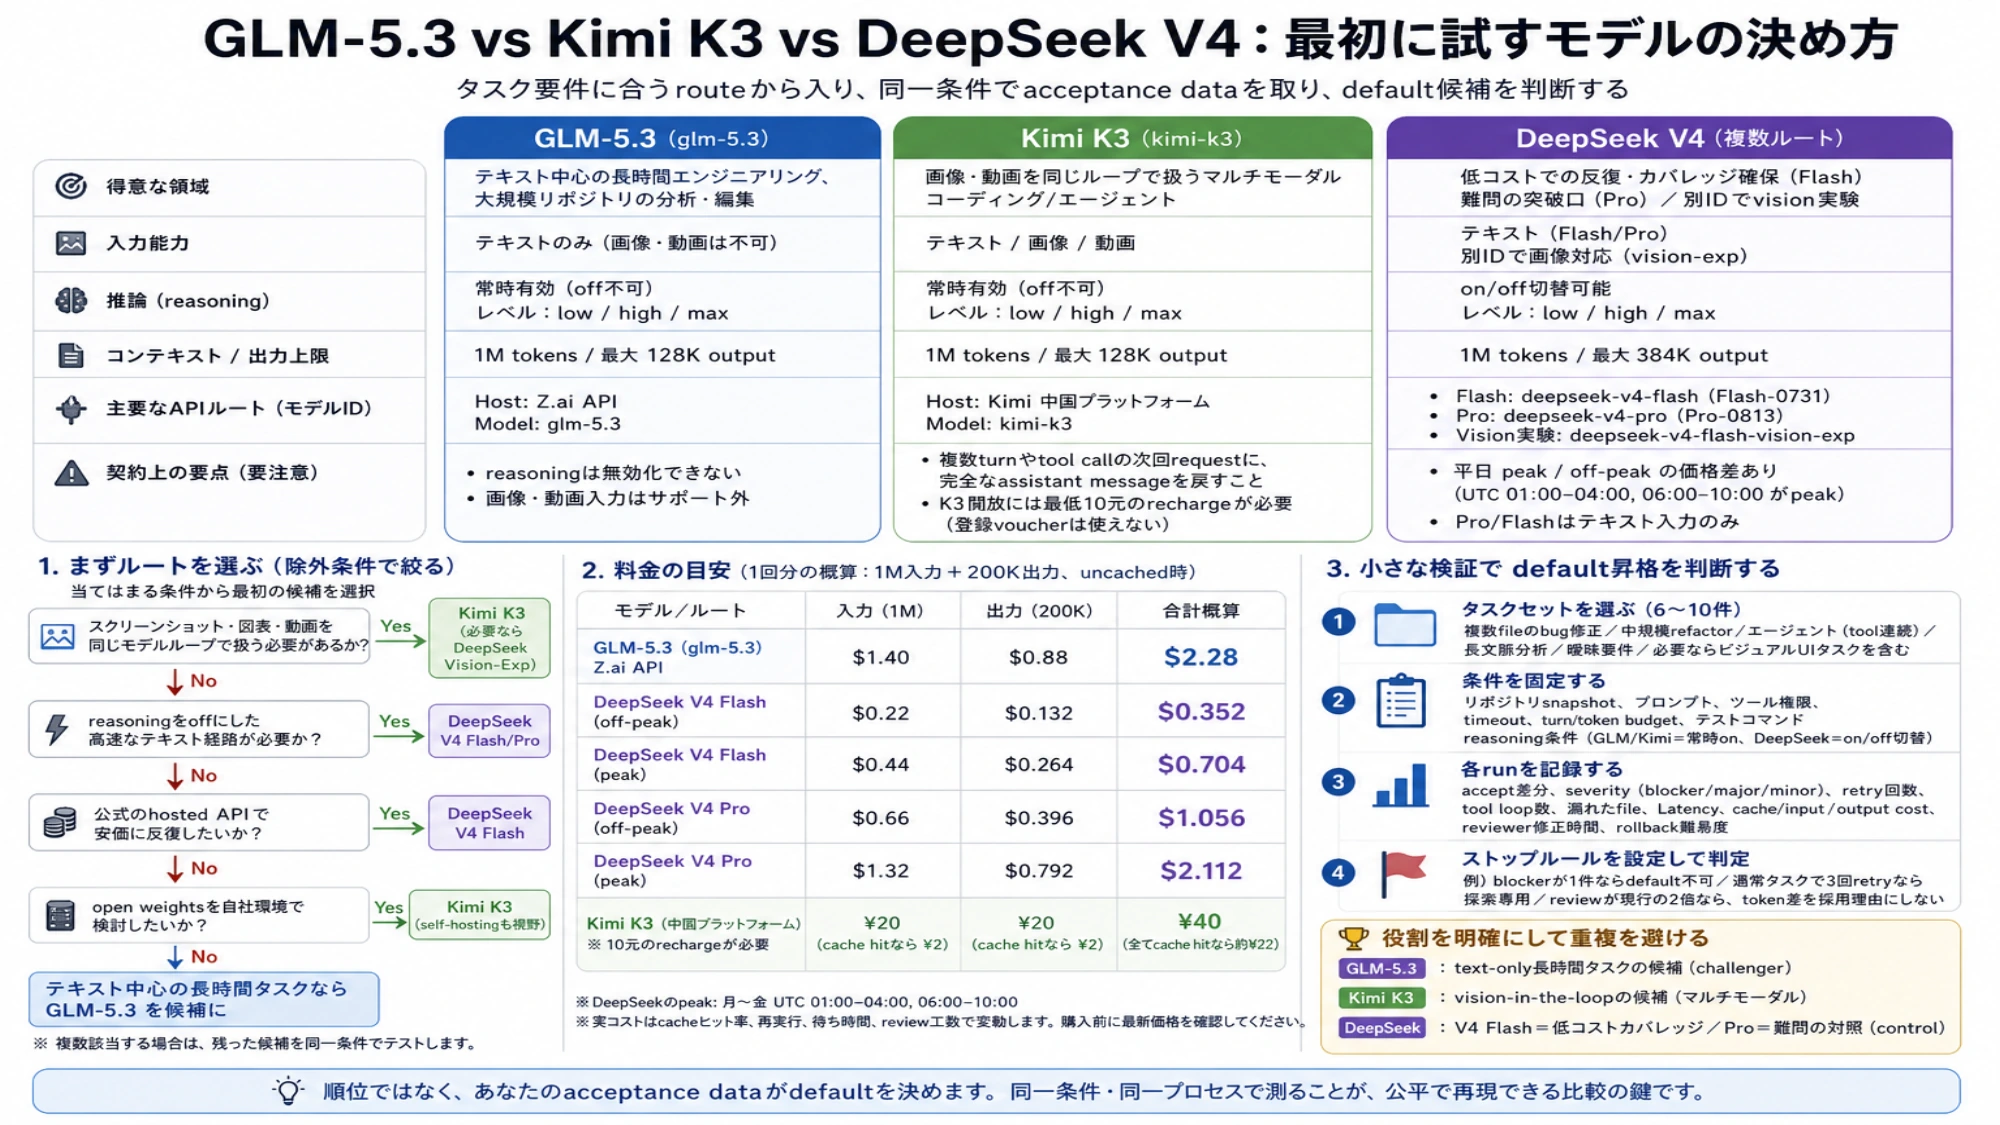
2026年8月28日時点で、Z.ai価格表はGLM-5.3を1M tokensあたりinput $1.40、cached input $0.26、output $4.40としています。
Kimi中国platformはK3をcached input ¥2、通常input ¥20、output ¥100 / MTokと表示しています。K3を開放するには最低10元のrechargeが必要で、登録voucherは使えません。これは中国platformの条件であり、他providerの価格や利用可能性ではありません。
DeepSeekは平日のpeak/off-peak制です。V4 Flashの通常input/outputはoff-peak $0.22/$0.66、peak $0.44/$1.32。V4 Proはoff-peak $0.66/$1.98、peak $1.32/$3.96です。peakは月曜から金曜のUTC 01:00–04:00と06:00–10:00です。cache hitはさらに安くなります。
たとえば1M uncached inputと200K outputの1回分なら、retry前の概算は次の通りです。
- GLM-5.3: $2.28
- DeepSeek V4 Flash: $0.352 off-peak / $0.704 peak
- DeepSeek V4 Pro: $1.056 off-peak / $2.112 peak
- Kimi K3中国platform: ¥40(inputが全てcache hitなら約¥22)
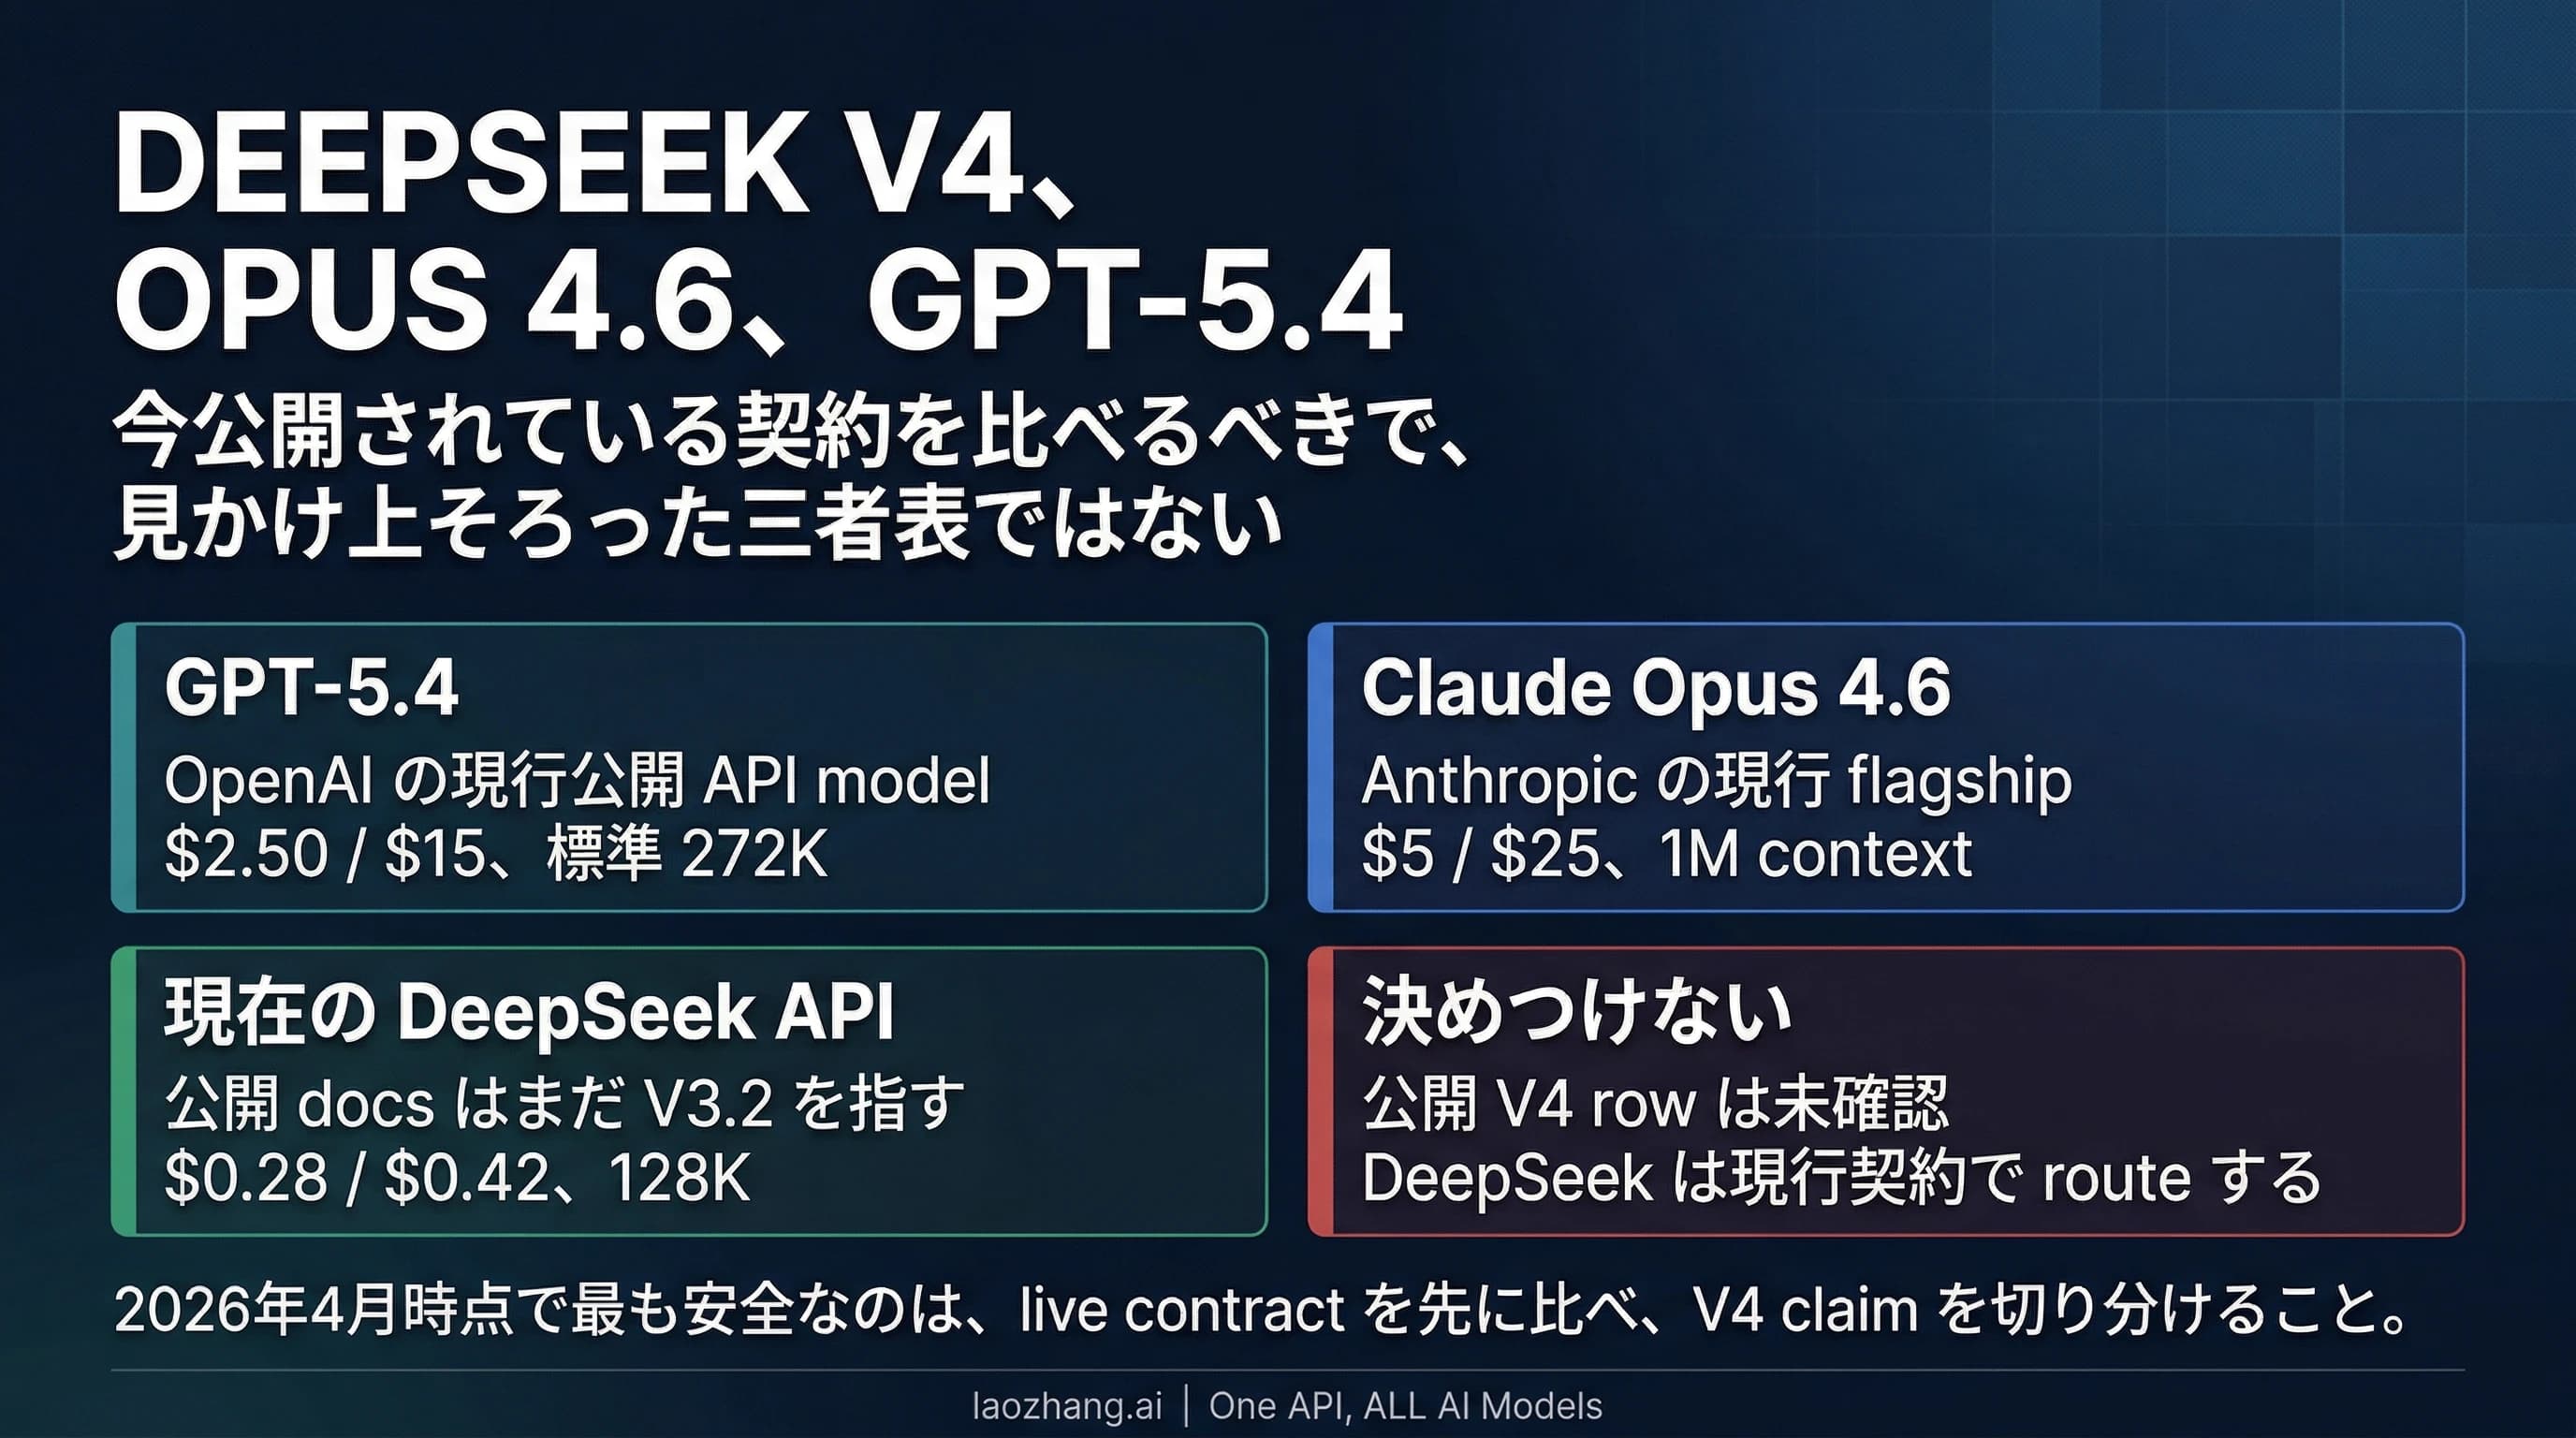
ここで比較できるのはtoken contractだけです。失敗による再実行、rate limit、待ち時間、review、地域別accessを足すと、accepted taskあたりの順序は変わります。購入前には必ずlive priceを再確認します。
benchmarkから読み取るべきは順位よりvariance
vendorのlaunch scoreは、harness、tool、effort、budget、datasetが揃っていません。数字が同じ表に載っていても、同一条件とは限りません。
Aikidoの脆弱性発見benchmarkは、32件の新しい脆弱性、prompt、tool、評価policyを固定し、各modelを3回実行しました。この限定されたworkloadでは、DeepSeek V4 Pro-0813が3回を統合したrecallで最高、Kimi K3がテストしたopen-weightモデル中のpooled precisionで最高、GLM-5.3はrecallとconsistencyを両立しました。
これはgeneral codingの勝者を決めません。むしろ同じmodelでもrunごとに探索先が変わり、recallを増やす反復がfalse leadと後処理を増やすことを示します。frontend、document、visionでは別のacceptanceが必要です。
小さな検証でdefault昇格を判断する
実務から6〜10件を選びます。複数fileのbug、中規模refactor、toolを連続利用するAgent、長文脈分析、曖昧なrequirement、必要ならvisual frontend taskを含めます。repository snapshot、prompt、tool権限、timeout、turn/token budget、test commandを固定します。
reasoning条件も明記します。GLM-5.3とKimi K3はoffにできず、DeepSeekは切替可能です。Kimi maxとDeepSeek non-thinkingを比べるなら、それが実際に採用するproduction configurationである必要があります。
各runで、acceptされた差分、blocker/major/minor、retry数、tool loop、漏れたfile、latency、cache/input/output cost、reviewerの修正時間、rollback難易度を残します。開始前に「blockerが1件ならdefault不可」「通常taskで3回retryならexploration限定」「reviewが現行の2倍ならtoken差を採用理由にしない」といったstop ruleを決めます。
最終的には、GLM-5.3をtext-only long-horizon challenger、Kimi K3をvision-in-the-loop候補、DeepSeek V4 Flashを低コストcoverage、Proを難問controlとして扱うと、試験の役割が重複しません。DeepSeek family内のmodel IDや移行だけが目的なら、より狭いDeepSeek V4 APIガイドを使えます。cross-providerのdefaultは、自分のacceptance dataだけで決めます。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年8月28日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年8月28日。