Claude Opus 5.5とGPT-6.1 Terra比較:「9分の1」の条件と使い分け
GPT-6.1 Terraが課題当たり約9分の1になるのはmax同士の比較です。点数が並ぶOpus highとTerra maxでは3.6倍、同じ7問の実測では4.5倍でした。
目次
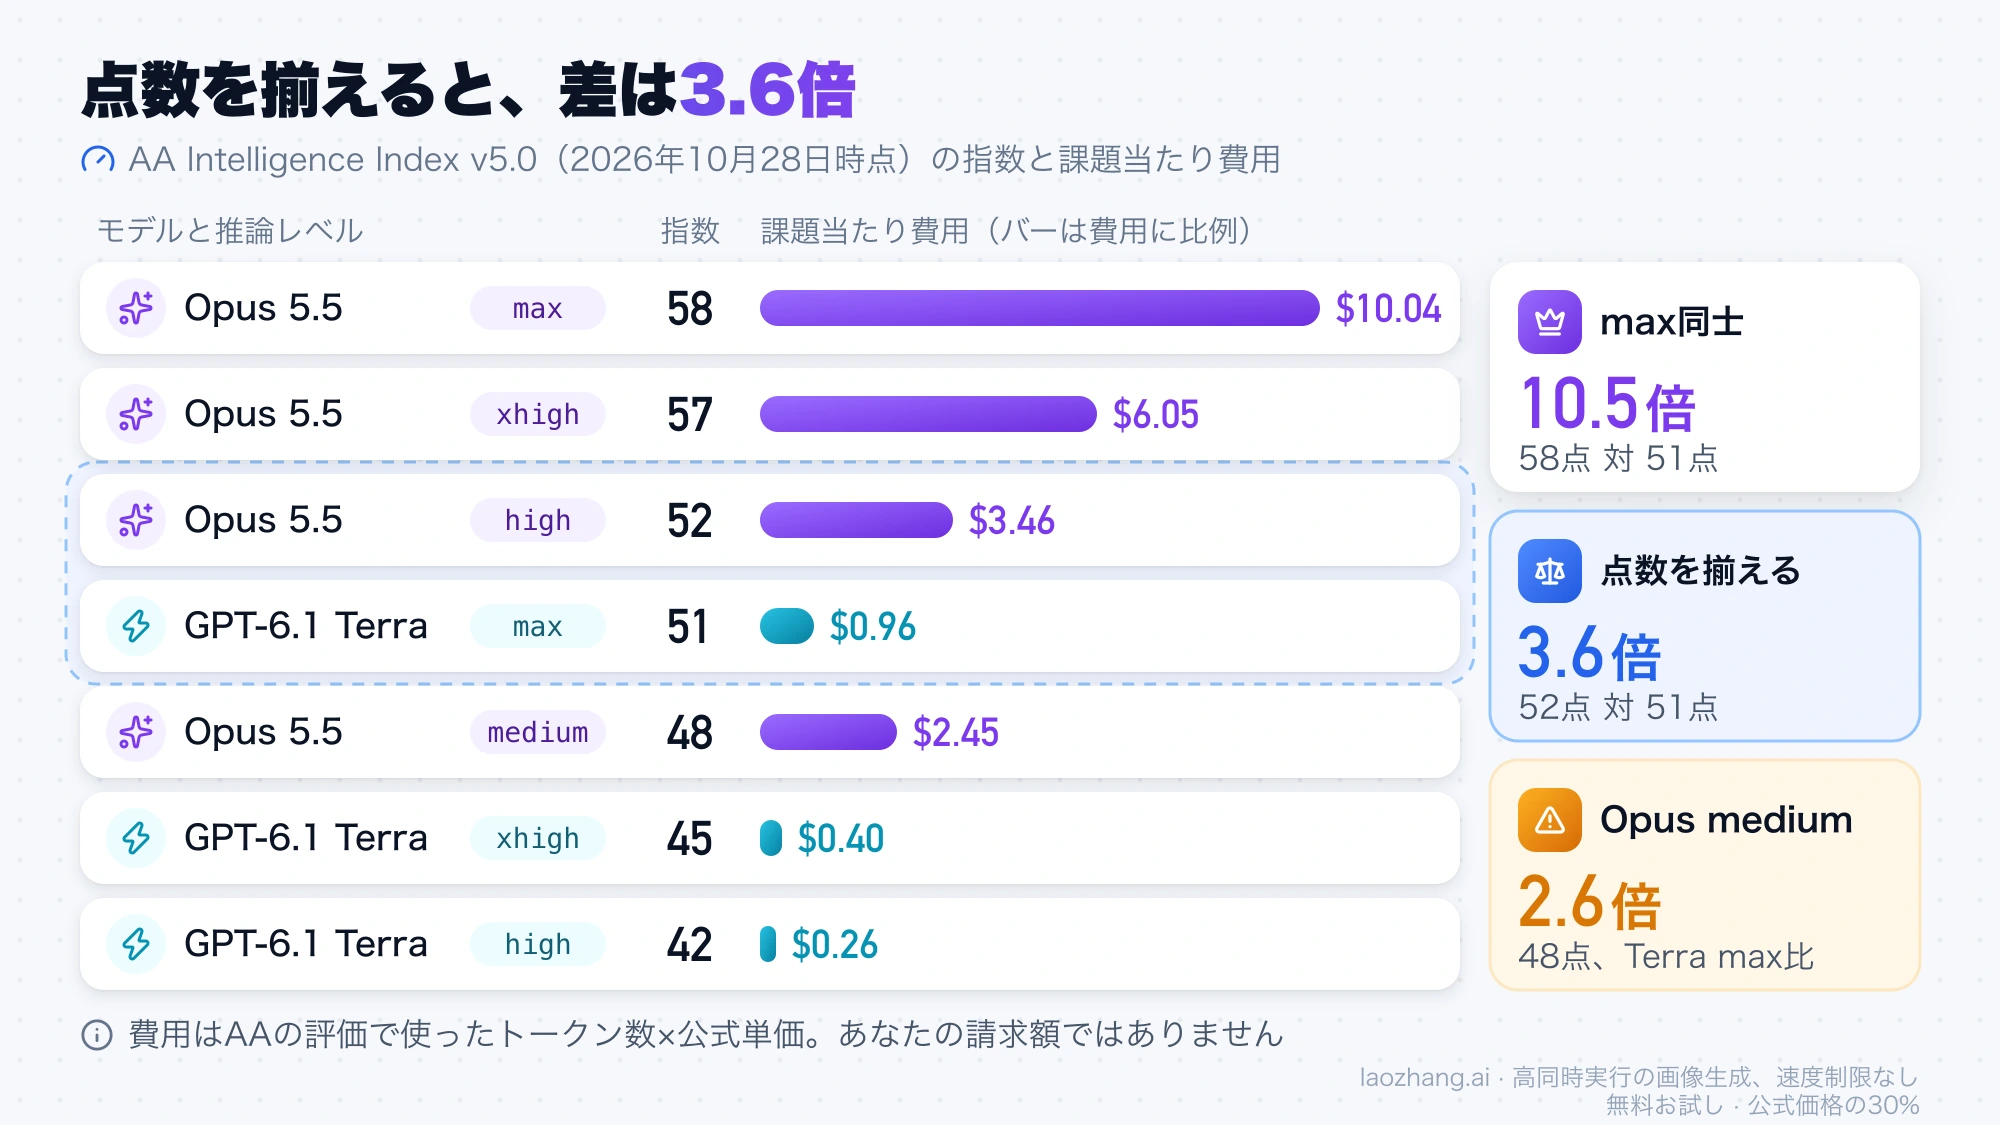
OpenAIは2026年10月26日にGPT-6.1 Terra(APIのモデルIDはgpt-6.1-terra)を公開し、推論レベル(reasoning effort)をmaxにした比較では、Claude Opus 5.5より課題当たりの費用が約9分の1になると発表しました。これは両モデルを同じmaxで動かした数字で、点数は揃っていません。第三者機関Artificial Analysis(AA)のIntelligence Index v5.0(2026年10月28日時点)では、max同士はOpus 5.5が58点、GPT-6.1 Terraが51点です。点数がほぼ並ぶOpus 5.5のhigh(52点)とTerraのmax(51点)で比べると、Opusの課題当たり費用は3.6倍まで縮みます。
乗り換えは仕事ごとに決めるのが現実的です。仕様とテストがはっきりした単発のコーディングや大量の定型処理は、gpt-6.1-terraのhighかmaxへ移して試す価値があります。2026年10月28日に同じ7問を両モデルのhighで解かせた結果では、Opus 5.5の11回、GPT-6.1 Terraの15回の呼び出しがすべて合格し、公式単価で計算した費用はOpusが4.5倍でした。一方、知識問題や財務・法務などの業務文書でOpus highが上回っている仕事、52点を超える精度が要る仕事は、claude-opus-5-5のhigh以上に残します。
例外もあります。入力が272Kトークンを超えるとTerraに長文脈料金がかかり、単価差は2〜2.7倍に縮みます。Terraでツール呼び出しを使うにはResponses APIが必要で、2026年10月28日にLaoZhang経由で呼んだ時点ではmaxもResponses APIでしか通らず、Chat Completionsはxhighまででした。ChatGPTではTerraはWorkとCodexでしか選べません。また同じ日本語の文章でも、Opusは入力トークンを約1.24倍多く数えるため、入力の費用は約5.0倍になります。
GPT-6.1 Terraに移す仕事、Claude Opus 5.5に残す仕事
判断の基準は推論レベルの名前ではなく、自分の仕事に必要な精度にどちらがいくらで届くかです。AA v5.0では、Terraの最上位であるmax(51点)がOpus 5.5のhigh(52点)とほぼ同点なので、その水準で足りる仕事はTerraに移すと費用が下がります。52点より上にはOpusのxhigh(57点)とmax(58点)しかなく、この精度が要る仕事ではTerraは代わりになりません。
| 仕事の種類 | 先に試す設定 | Opus 5.5に残す条件と根拠 |
|---|---|---|
| 仕様とテストが決まった単発のコーディング(関数、パーサ、形式変換) | Terra high | 2026年10月28日の7問では両モデルとも全問合格。自分のテストでTerraだけが落ちる仕事が出たら残す |
| 大量の定型処理(抽出、分類、要約) | Terra medium〜high | 入力が多いほど費用差が開く。抜き取り検査で精度が落ちる仕事だけ残す |
| 研究寄りのコード、科学計算 | Terra max | AA v5.0のFrontierCode、CritPt、Terminal-Bench-ScienceでTerra maxがOpus highを上回る |
| 端末を操作するエージェント作業 | Terra maxとOpus highを並べて試す | Terminal-Bench 4.0は55.6%対56.6%でほぼ互角。ツール呼び出しの経路が違うので自分の環境で確かめる |
| 知識問題、財務・法務・戦略などの業務文書 | Opus high以上 | HLE-Diamond、AA-Briefcase、業種別の指数でOpus highがTerra maxを上回る |
| 最高の精度が要る難しい仕事 | Opus xhighかmax | 57〜58点に届く設定はOpusにしかない |
| 1課題を早く終わらせたい仕事 | Opus high | AAの1課題あたりの時間はOpus high 464秒、Terra max 657秒 |
OpenAI自身も発表の中で、最も複雑なコーディングにはGPT-6.1 SolかGPT-6 Astraのほうが適しているとしています。Terraでは足りないがOpusほどは払いたくない場合、中間の候補はGPT-6.1 Solです。OpenAIの中でのTerraとSolの選び方はGPT-6.1 TerraとSolの違い:単価は半額、Codex実測で2倍速、OpusとSolの費用差はOpus 5.5とGPT-6 Sol・6.1 Sol比較:費用差で比べられます。Claudeのまま費用を下げたいなら、Sonnet 5.5とOpus 5.5の使い分け:半額が効く仕事が判断材料になります。
「課題当たり約9分の1」はmax同士で比べた数字
OpenAIのGPT-6.1 Terra発表は、最高の推論レベルではTerraのトークン効率がOpus 5.5の3倍以上、1トークンあたりの価格が4分の1で、課題当たりの費用は約9分の1になると説明しています。評価を実行したのはOpenAI自身です。AAの独立した計測でも、max同士の課題当たり費用はOpus $10.04、Terra $0.96で約10.5倍となり、差の向きと大きさは発表とおおむね合っています。
ただし、この比較では両モデルの到達点が違います。AA v5.0のmax同士は58点対51点で、1課題あたりの出力トークンはOpusが約173,000(うち推論が約120,000)、Terraが約60,000です。Opusのmaxは、Terraが届かない点数を取るために約2.9倍のトークンを使っており、そこに4倍の単価が掛かって10倍前後の差になっています。「同じ仕事がTerraなら9分の1でできる」とは読めず、同じ点数で比べるとTerraのmaxに並ぶのはOpusのhighです。
「Opus 54点対Terra 48点」や「58点対48点」という数字は、AAが2026年10月27日から28日にかけて指数をv5.0へ切り替える前の旧版(v4.3.2)の値です。旧版ではTerraのmaxは48点、v5.0では51点で、評価の構成が入れ替わっているため新旧の点数は比べられません。AAの指数は業務文書、端末操作、コーディング、知識問題など9種類の評価をまとめた総合点で、コーディングだけの点数ではありません。
推論レベル別の点数と費用:同点ならOpus highが3.6倍
AAのClaude Opus 5.5とGPT-6.1 Terraのリリース比較ページは、両モデルのすべての推論レベルを同じ指数で測っています。点数の高い順に並べると、Opus 5.5のhigh(52点)とTerraのmax(51点)が隣り合い、この2つで比べるとOpusの課題当たり費用は3.6倍($3.46対$0.96)、1課題にかかる時間はOpusのほうが短くなります。
| モデルと推論レベル | 指数 | 課題当たり費用 | 1課題の時間 |
|---|---|---|---|
Opus 5.5 max | 58 | $10.04 | 1,133秒 |
Opus 5.5 xhigh | 57 | $6.05 | 779秒 |
Opus 5.5 high | 52 | $3.46 | 464秒 |
GPT-6.1 Terra max | 51 | $0.96 | 657秒 |
Opus 5.5 medium | 48 | $2.45 | 337秒 |
GPT-6.1 Terra xhigh | 45 | $0.40 | 287秒 |
GPT-6.1 Terra high | 42 | $0.26 | 182秒 |
GPT-6.1 Terra medium | 38 | $0.17 | 118秒 |
Opus 5.5 low | 35 | $0.98 | 147秒 |
GPT-6.1 Terra none(推論なし) | 30 | $0.23 | 104秒 |
GPT-6.1 Terra low | 29 | $0.07 | 48秒 |
数値はIntelligence Index v5.0、2026年10月28日時点のものです。課題当たり費用は、AAの評価で各モデルが使ったトークン数に公式単価を掛けたもので、あなたの請求額ではありません。AAは指数を更新すると点数も費用も変わるため、引用するときは版と日付を添えてください。
この表から言えるのは、Opusをmedium以下で使う理由が費用面ではほとんどないことです。Opus mediumは48点でTerra maxの51点より低いのに、費用は2.6倍かかります。Opus lowの費用($0.98)はTerra maxとほぼ同じですが、点数は16点低くなります。Terraの中で下げる場合も、Terra xhigh(45点、$0.40)はOpus medium(48点、$2.45)の約6分の1の費用で、差は3点です。逆にTerra maxを選ばない理由があるのは、52点以上が要るときと、1課題の時間を短くしたいときです。Terra maxはOpus highより1課題あたり約1.4倍長くかかります。
Opus 5.5が強い評価、GPT-6.1 Terraが強い評価
総合点がほぼ同じOpus highとTerra maxでも、評価ごとに勝ち負けははっきり分かれます。AA v5.0(2026年10月28日時点)では、Terra maxは研究寄りのコーディングと科学計算でOpus highを上回り、Opus highは知識問題と業務文書の評価で上回っています。端末操作と自動化の評価は、どちらも数ポイント差の範囲です。
| AA v5.0の評価 | Opus 5.5 high | GPT-6.1 Terra max | 参考:Opus 5.5 max |
|---|---|---|---|
| FrontierCode 2.0 | 35.9% | 42.3% | 46.4% |
| CritPt v2(Hard Subset) | 58.0% | 64.5% | 61.0% |
| Terminal-Bench-Science 0.1 | 49.0% | 57.6% | 59.0% |
| Terminal-Bench 4.0 | 56.6% | 55.6% | 59.6% |
| AutomationBench-AA | 63.2% | 60.2% | 69.5% |
| GDP.pdf | 28.8% | 28.6% | — |
| HLE-Diamond | 55.6% | 47.3% | 67.9% |
| AA-Briefcase v1.1 | 1681 | 1402 | 1800 |
CritPtではTerra maxがOpus maxさえ上回っており、Terminal-Bench-Scienceでもmax同士の差は1.4ポイントです。OpenAIも発表で、Terminal-Bench-ScienceのmaxではTerraがOpus 5.5に5ポイント未満の差まで迫り、推定費用は5分の1未満だと述べており、AAの数字と矛盾しません。反対に、HLE-DiamondではOpus highが8.3ポイント、AA-Briefcaseでは279点上です。業種別の指数でも、Opus highとTerra maxは財務・会計53対49、戦略・業務58対50、法務52対46、エンジニアリング58対54、経済57対49と、すべてOpusが上回っています。
どの評価もAAが設定ごとに1回実行した結果なので、数ポイントの差は入れ替わることがあります。読むべきなのは差の向きで、自分の仕事が研究寄りのコードに近いならTerra、知識と判断を含む文書仕事に近いならOpusを先に試す、という使い方が合っています。
同じ7問の実測:両モデル全問合格、費用はOpusが4.5倍
2026年10月28日、LaoZhang API(laozhang.ai)の1つのキーから両モデルを呼び、同じ7問を解かせました。Opus 5.5はAnthropicのMessages形式でthinkingをadaptive、output_config.effortをhighに、GPT-6.1 TerraはChat Completionsでreasoning_effortをhighにしています。どの呼び出しもストリーミング、ユーザーメッセージ1つ、システム指示とツールなしで、採点用の隠しテストは回答を見る前に用意しました。結果はOpusの11回、Terraの15回がすべて合格で、7問の中に両者の差がつく問題はありませんでした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 課題 | 合格(Opus/Terra) | 1回の費用 Opus | 1回の費用 Terra | 倍率 | 出力トークン(Opus/Terra) |
|---|---|---|---|---|---|
evalを使わない数式パーサ(隠しテスト25件) | 1/1、2/2 | $0.0389 | $0.0106 | 3.7倍 | 1,884/2,081 |
| CSVの1行パーサ(16件) | 1/1、2/2 | $0.0184 | $0.00298 | 6.2倍 | 871/564 |
| 100万未満で桁の和が27になる数の個数 | 1/1、2/2 | $0.0178 | $0.00212 | 8.4倍 | 877/413 |
| npm形式のsemver範囲判定(36件) | 2/2、2/2 | $0.0640 | $0.0169 | 3.8倍 | 3,066/3,294 |
| 約6,800語の英文から3つのメモを拾って計算(答え$76.80) | 1/1、2/2 | $0.0667 | $0.0106 | 6.3倍 | 234/80 |
| 存在しない標準ライブラリ関数を見抜く | 2/2、2/2 | $0.00558 | $0.000765 | 7.3倍 | 244/128 |
| 5項目のcron式から次の実行時刻を求める(41件) | 3/3、3/3 | $0.0698 | $0.0192 | 3.6倍 | 3,391/3,763 |
費用は各呼び出しが返したトークン数に公式単価を掛けた額の平均で、7問を1回ずつ合計するとOpus $0.2812、Terra $0.0632、約4.5倍です。長いコードを書くsemverとcronでは出力トークンがほぼ同じで、差は単価の4倍に近い3.6〜3.8倍でした。短い答えの問題ではOpusがTerraの約2倍のトークンを書き、差は6〜8倍に広がっています。1回あたりの時間は大差なく、cronはOpus 32.2秒対Terra 27.5秒、英文のメモ計算は5.1秒対4.5秒でした。
わかったのは、仕様がはっきりした単発の課題なら両モデルとも解け、Terraの費用は約4.5分の1になるということです。ツール呼び出し、複数ステップのエージェント作業、画像入力、長文脈からの検索、Opus maxとTerra maxは試しておらず、Opusが勝つ場面は上のAAの評価から読むしかありません。試行は課題ごとに1〜3回、アジアのMac1台から1つのゲートウェイ経由で1日だけです。Opusの思考はストリームに返ってきませんでしたが、出力トークン数には含まれています。
同日のGET /v1/modelsにはgpt-6.1-terraとclaude-opus-5-5の両方が載っていました。LaoZhang上の料金設定は、Terraが272K以下と超過の区分を含めてOpenAIの公式単価と同じ式、Opusが入力$4/出力$20です。費用の列はこの公式単価で計算したもので、キーを他の作業と共用していたためゲートウェイの実際の請求額ではありません。LaoZhang経由のClaudeは1回の出力が32,768トークンまでで、max_tokensを大きくしても上限で打ち切られます(LaoZhangのClaude API説明)。Anthropicの直接APIでは最大128Kトークンなので、長い出力を比べるときはこの差に注意してください。
自分の請求は何倍か:単価4倍×トークン数×推論レベル
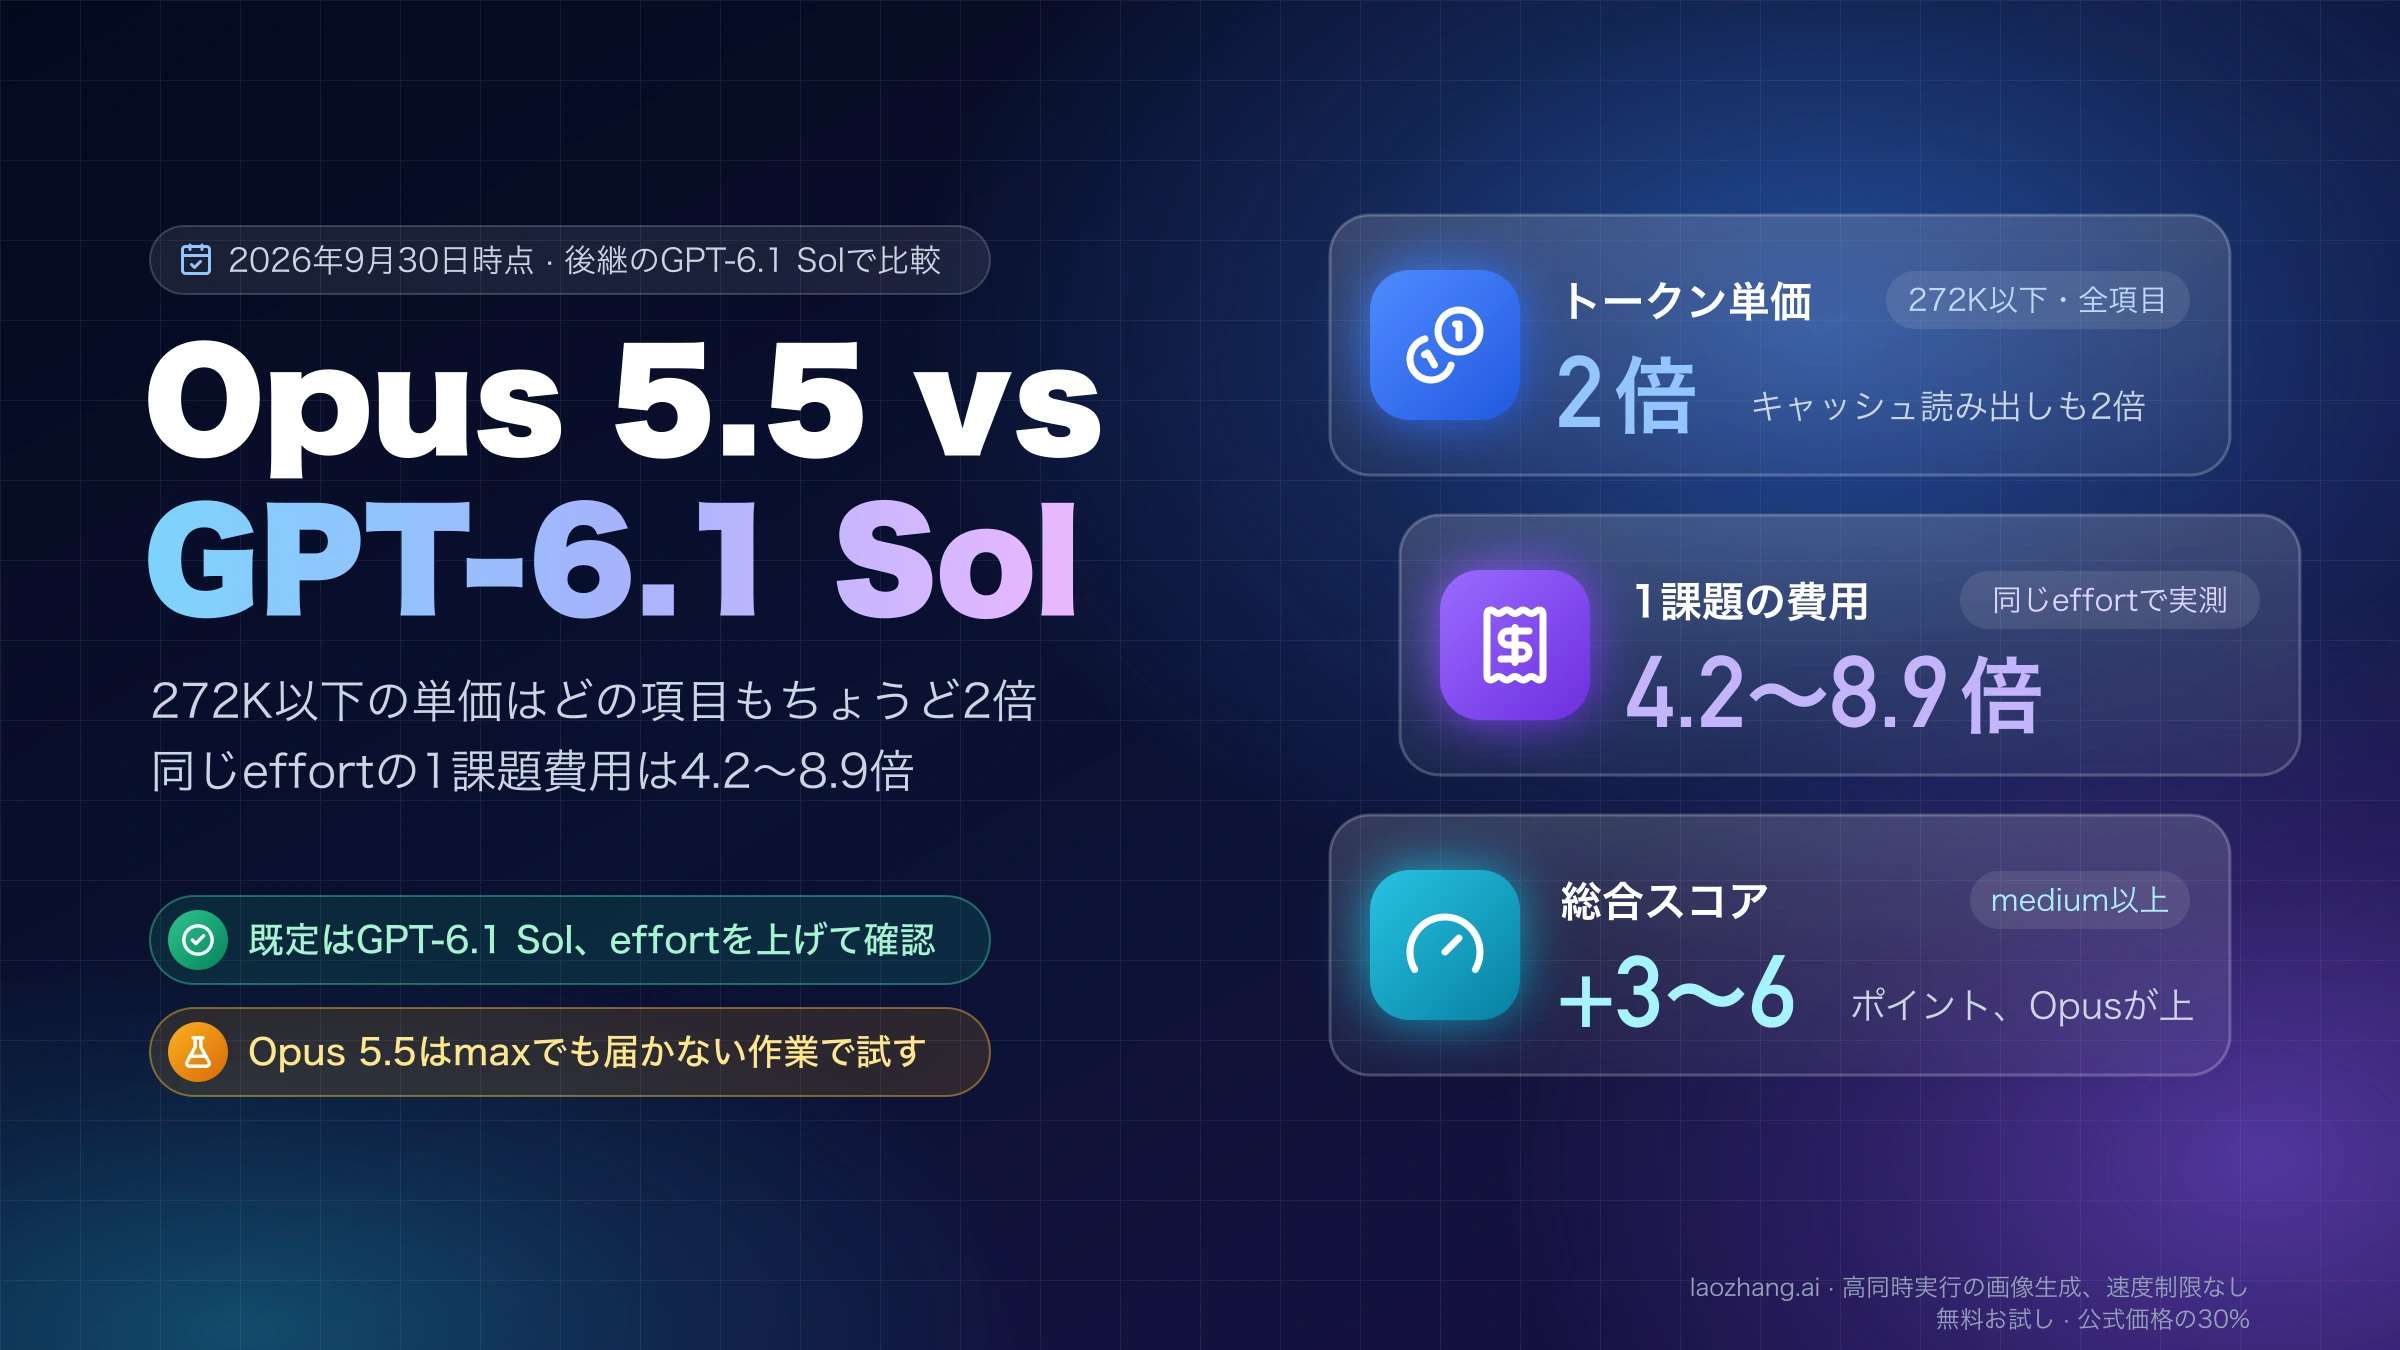
入力が272Kトークン以下なら、Opus 5.5とGPT-6.1 Terraの公式単価はどの項目もちょうど4倍の差です。100万トークンあたり、Opusは入力$4、出力$20、キャッシュ読み出し$0.20、5分キャッシュの書き込み$5(Claude APIの料金ページ)、Terraは入力$1、出力$5、キャッシュ読み出し$0.05、30分キャッシュの書き込み$1.25です(OpenAI APIの料金表)。実際の倍率は、この4倍に「同じ文章を何トークンと数えるか」と「何トークン出力するか」が掛かって決まります。
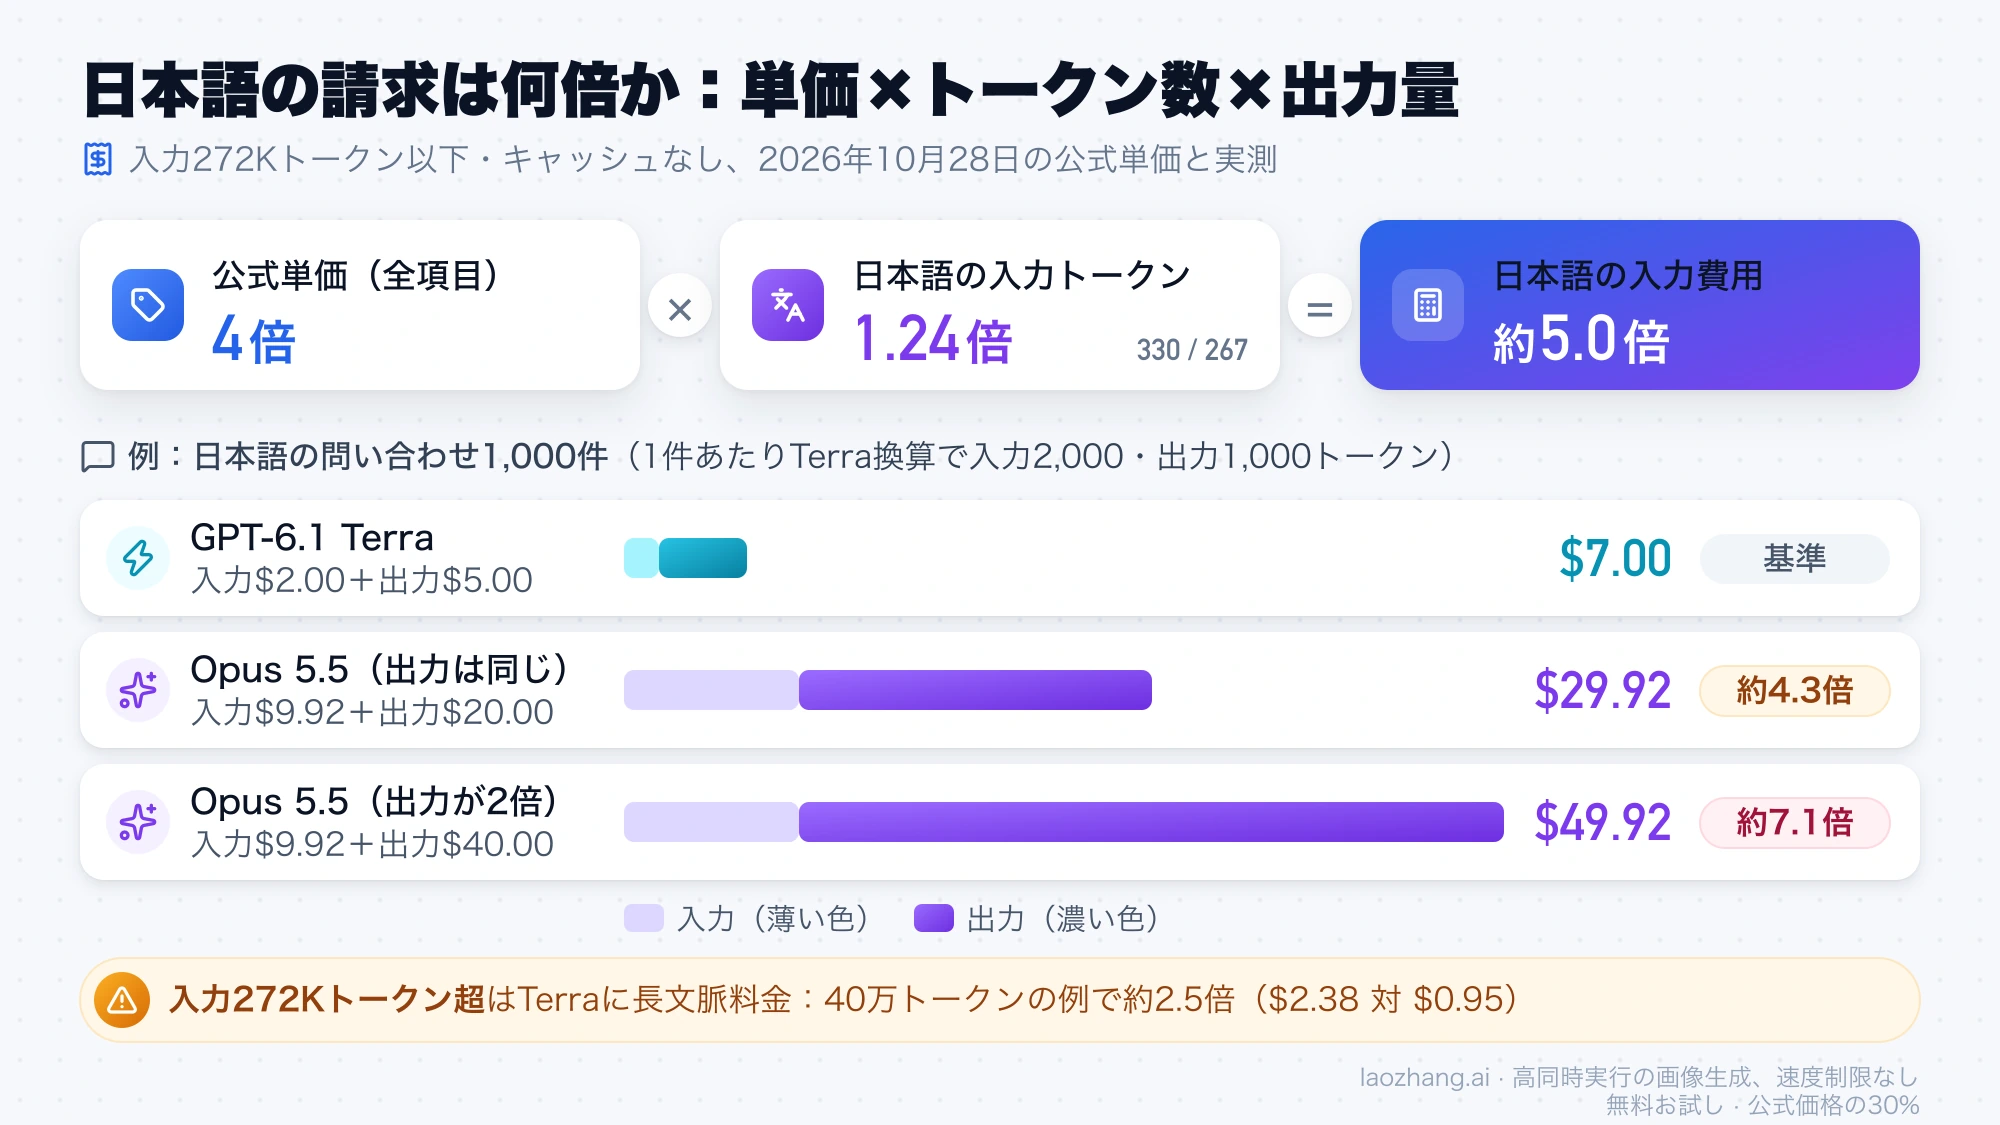
入力トークン数の差は言語で変わります。2026年10月28日に同じ内容の短い文章を各言語で1回ずつ両モデルに送り、APIが返した入力トークン数を比べた結果が下の表です。日本語は6言語の中で差がもっとも小さく、Opusが1.24倍で、単価の4倍を掛けると同じ日本語の入力は約5.0倍の費用になります。
| 言語 | Opus 5.5の入力トークン | Terraの入力トークン | トークン数の比 | 入力費用の差 |
|---|---|---|---|---|
| 日本語 | 330 | 267 | 1.24倍 | 約5.0倍 |
| 英語 | 217 | 150 | 1.45倍 | 約5.8倍 |
| 中国語 | 265 | 178 | 1.49倍 | 約6.0倍 |
| ロシア語 | 320 | 206 | 1.55倍 | 約6.2倍 |
| スペイン語 | 322 | 175 | 1.84倍 | 約7.4倍 |
| 韓国語 | 414 | 221 | 1.87倍 | 約7.5倍 |
どの言語も短い文章1つで、メッセージの書式分の数トークンを含みます。前の節の約6,800語の英文では15,495対10,198で1.52倍でした。2026年10月26日にClaude Fable 5.1とGPT-6 Astraで測った比率もほぼ同じで(GPT-6 AstraとClaude Fable 5.1を比較:料金とトークン実測で選ぶ)、AnthropicとOpenAIの現行トークナイザーの差がそのまま出ていると考えられます。
出力トークン数は言語より仕事と推論レベルで決まります。たとえば日本語の問い合わせを1,000件処理し、1件あたりTerraで数えて入力2,000トークン、出力1,000トークン、キャッシュなしとします。Opusの入力は1.24倍の2,480トークンです。
| ケース | 入力の費用 | 出力の費用 | 合計 | Terraとの差 |
|---|---|---|---|---|
| GPT-6.1 Terra | 200万×$1=$2.00 | 100万×$5=$5.00 | $7.00 | — |
| Opus 5.5(出力はTerraと同じ) | 248万×$4=$9.92 | 100万×$20=$20.00 | $29.92 | 約4.3倍 |
| Opus 5.5(出力がTerraの2倍) | 248万×$4=$9.92 | 200万×$20=$40.00 | $49.92 | 約7.1倍 |
出力が同じなら4倍台、短い答えの問題で見られたようにOpusが2倍書くと7倍前後になります。推論レベルを上げると推論トークンも出力として課金されるため、AAのmax同士のようにOpusの出力が約2.9倍になる設定では差が10倍前後まで広がります。
キャッシュの扱いにも違いがあります。OpenAIはGPT-5.6以降のモデルでプロンプトキャッシュが既定で有効になっており、prompt_cache_options.modeを"explicit"にしない限りキャッシュの書き込みにも課金されます。上の7問ではどちらの呼び出しにもキャッシュのトークンは記録されませんでした。なお、旧モデルのGPT-5.6 Terraは単価の違う別モデルなので、料金を調べるときはgpt-6.1-terraの行を見てください。
入力が272Kトークンを超えると差は2.5倍前後に縮む
GPT-6.1 Terraは、1回の入力が272Kトークンを超えるとリクエスト全体に長文脈料金がかかり、入力$2、キャッシュ読み出し$0.10、出力$7.50になります。Opus 5.5は1Mトークンまで同じ単価なので、この領域では単価差が入力とキャッシュで2倍、出力で約2.67倍に縮みます。長い契約書やコードベースを丸ごと読ませる使い方では、Opusの割高感は短い依頼より小さくなります。
計算例として、Terraで数えて40万トークンの日本語資料を1回読ませ、2万トークンを出力させます。Terraは40万×$2+2万×$7.50で$0.80+$0.15=$0.95です。Opusは入力が1.24倍の49.6万トークンになり、49.6万×$4+2万×$20で$1.984+$0.40=約$2.38、差は約2.5倍です。
一方で、Opusは同じ日本語を約1.24倍のトークンで数えるため、1Mトークンのコンテキストに入る文章量はTerraの1.05Mトークンより少なくなります。Terraで85万トークンほどの資料は、Opusでは1Mトークンを超える計算です。
使える場所:ChatGPTではWorkとCodexだけ、OpusはClaude Codeでも
ChatGPTの中では、GPT-6.1 TerraはWorkとCodexで使え、通常のチャットのモデル一覧にはありません。発表ではPlus、Pro、Enterprise、Eduが対象とされ、Codexのドキュメントにはこれに加えてBusinessも載っています。APIではgpt-6.1-terraとして提供され、推論レベルはnone、low、medium(既定)、high、xhigh、maxの6段階です。ただし2026年10月28日にLaoZhang経由で呼んだ時点では、maxが通るのはResponses APIだけで、Chat Completionsはxhighまででした。そのほかコンテキストは1.05Mトークン、最大出力は128Kトークンです。
Claude Opus 5.5は、Claudeアプリ(Pro、Max、Team、Enterprise)、Claude Code、Claude APIのほか、AWS、Google Cloud、Azureでも使えます。サブスクリプションで乗り換えを考えるなら、Claude CodeからCodexへの移行がAPIでのOpusからTerraへの切り替えに当たります。
プランの利用枠は製品ごとに別に決まっていて、Codexは5時間あたりの目安としてPlusでTerra 35〜285メッセージ(固定の上限ではない)を公開している一方、AnthropicはOpus 5.5のメッセージ数を公表していません。Claude側の枠の確認方法はClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順で扱っています。
乗り換え前に自分の依頼で同条件テストをする手順
AAの点数も上の7問も、他人が用意した課題です。自分の仕事でTerraが足りるかは、代表的な依頼を5〜10件使った小さなテストで確かめられます。上の7問は2モデル合わせて26回の呼び出しで、公式単価で計算した合計は$0.64でした。
- 移したい仕事から代表的な依頼を5〜10件選び、回答を見る前に合否の基準(通すべきテスト、正解の数値、必ず含むべき項目)を書いておきます。以前に人の手直しが必要だった依頼も混ぜます。
- 推論レベルは名前で揃えず、AAで点数が並ぶOpus
highとTerramaxを基準の組にし、安い候補としてTerrahighも加えます。TerramaxはResponses APIで呼びます。 - 同じ経路、同じ依頼文、同じメッセージ構成で、各依頼を2〜3回ずつ呼びます。パラメータの書き方は下の例を使います。
- 各呼び出しが返したusage(入力、出力、キャッシュのトークン数)と所要時間を記録し、公式単価で費用を計算します。日本語の依頼なら、Opusの入力トークンが約1.24倍になっているかもここで確かめられます。
- 依頼ごとに合否、費用、時間を並べ、Terraで不合格が出た仕事だけOpusに残します。両方合格なら費用の低いほうに移します。
呼び出し方には3つの違いがあります。1つ目はmaxの指定先です。2026年10月28日の確認では、Chat Completionsでreasoning_effortを"max"にするとHTTP 400になり、エラーは対応値をnone、low、medium、high、xhighと示しました。同じ日にResponses API(POST /v1/responses)でreasoning: {"effort": "max"}を送ると200が返り、応答にもmaxが記録されていました。AAでOpus highと並ぶTerra maxを試すなら、Responses APIを使ってください。
{
  "model": "gpt-6.1-terra",
  "reasoning": {"effort": "max"},
  "input": "(依頼文)"
}
2つ目は出力上限のパラメータ名です。同じ日の確認では、GPT-6.1 Terraを非ストリーミングのChat Completionsで呼び、max_tokensを付けるとHTTP 400で「Unsupported parameter: 'max_tokens' is not supported with this model. Use 'max_completion_tokens' instead.」が返りました。max_completion_tokensに変えると通ります。ストリーミングではmax_tokens付きでも200が返りましたが、上限として効いているかは応答からは判別できません。1つ目と2つ目はどちらもLaoZhang経由の呼び出しで起きた挙動で、OpenAIの直接APIは対象外です。
{
  "model": "gpt-6.1-terra",
  "reasoning_effort": "high",
  "max_completion_tokens": 32000,
  "messages": [{"role": "user", "content": "(依頼文)"}]
}
上はChat Completionsでhighを指定する例で、xhighまでならこの形で動きます。Terraでツール呼び出しを含む仕事を試す場合も、Chat CompletionsではなくResponses APIを使います。3つ目はOpus側で、Messages APIのthinkingとoutput_config.effortを明示して推論の条件を固定します。
{
  "model": "claude-opus-5-5",
  "max_tokens": 32000,
  "thinking": {"type": "adaptive"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "(依頼文)"}]
}参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
- 1.OpenAIのGPT-6.1 Terra発表openai.com/index/introducing-gpt-6-1-terra
- 2.Claude Opus 5.5とGPT-6.1 Terraのリリース比較ページartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-1-terra
- 3.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 4.OpenAI APIの料金表developers.openai.com/api/docs/pricing