Claude Sonnet 5.5とGPT-6 Luna比較:単価20倍、同水準なら5〜8倍
単価はSonnet 5.5がGPT-6 Lunaの20倍、点数の近い推論レベルどうしなら費用差5〜8倍。Lunaの最高38点で足りる処理はLuna、それ以上はSonnetです。
目次
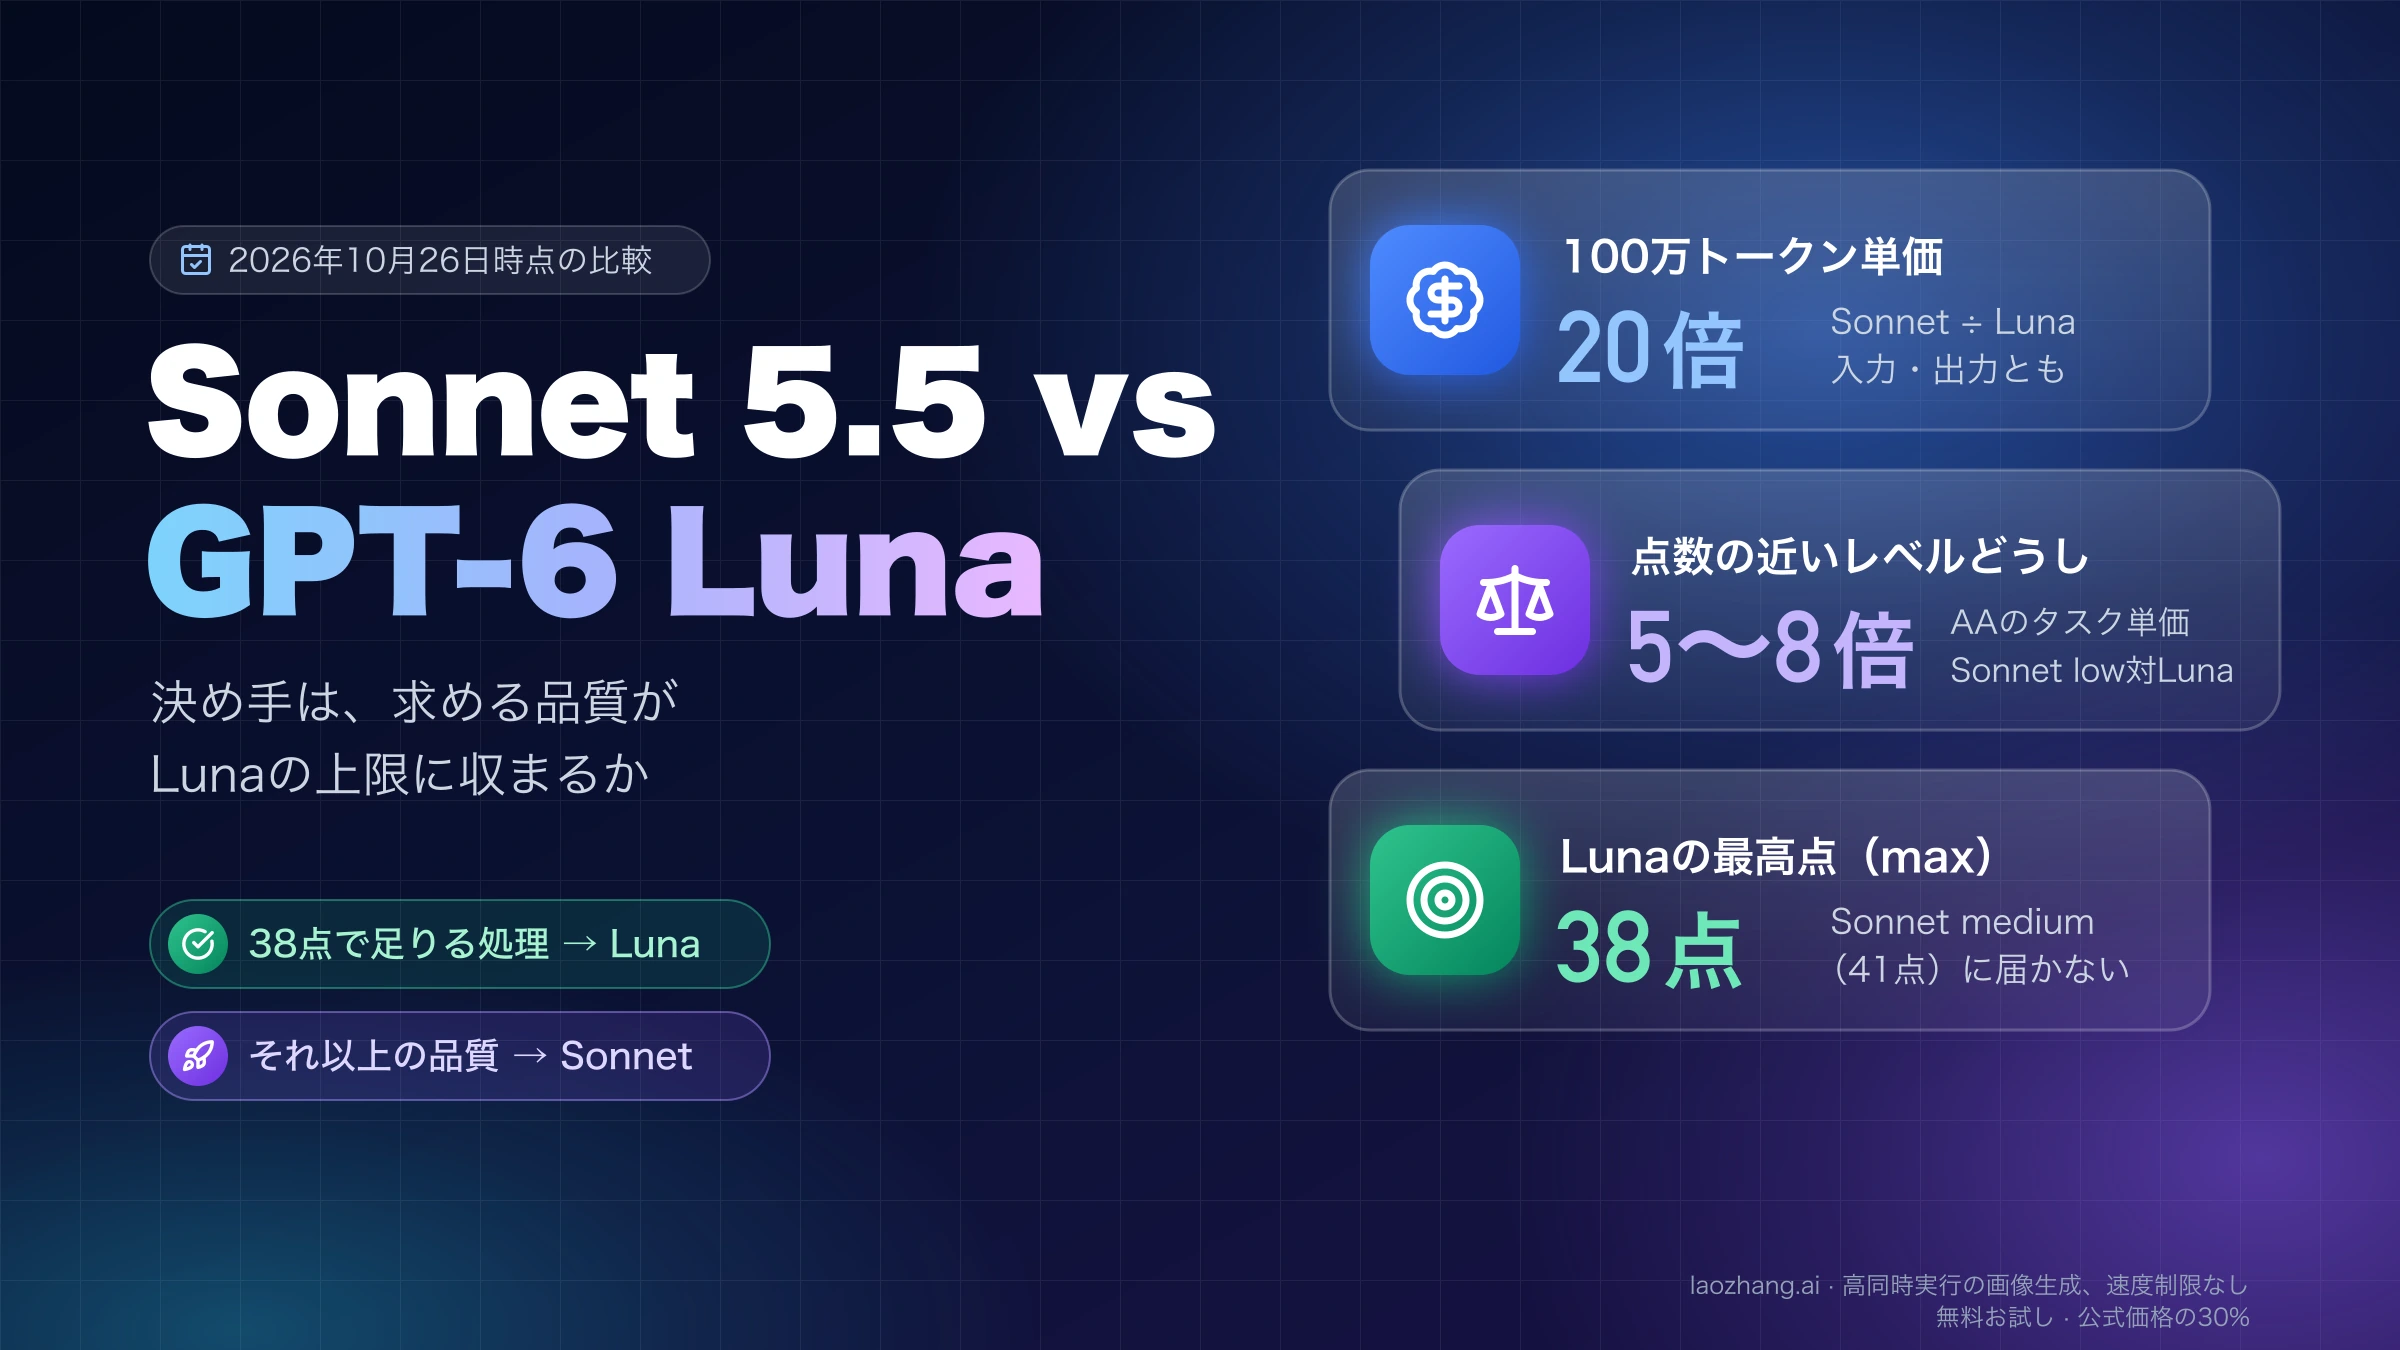
API処理でClaude Sonnet 5.5とGPT-6 Lunaのどちらを使うかは、求める品質がGPT-6 Lunaの上限に収まるかで決まります。分類・抽出・要約のような短い大量リクエスト、バッチ処理、長文ドキュメントの読み取りはgpt-6-lunaから始め、ターミナル操作を伴うエージェント型のコーディングや、資料を渡さずに事実を答えさせる処理はclaude-sonnet-5-5の推論レベルlowから始めるのが基本です。どちらとも言えない処理は先にLunaで回し、テストに落ちたものだけSonnetに振り分けます。
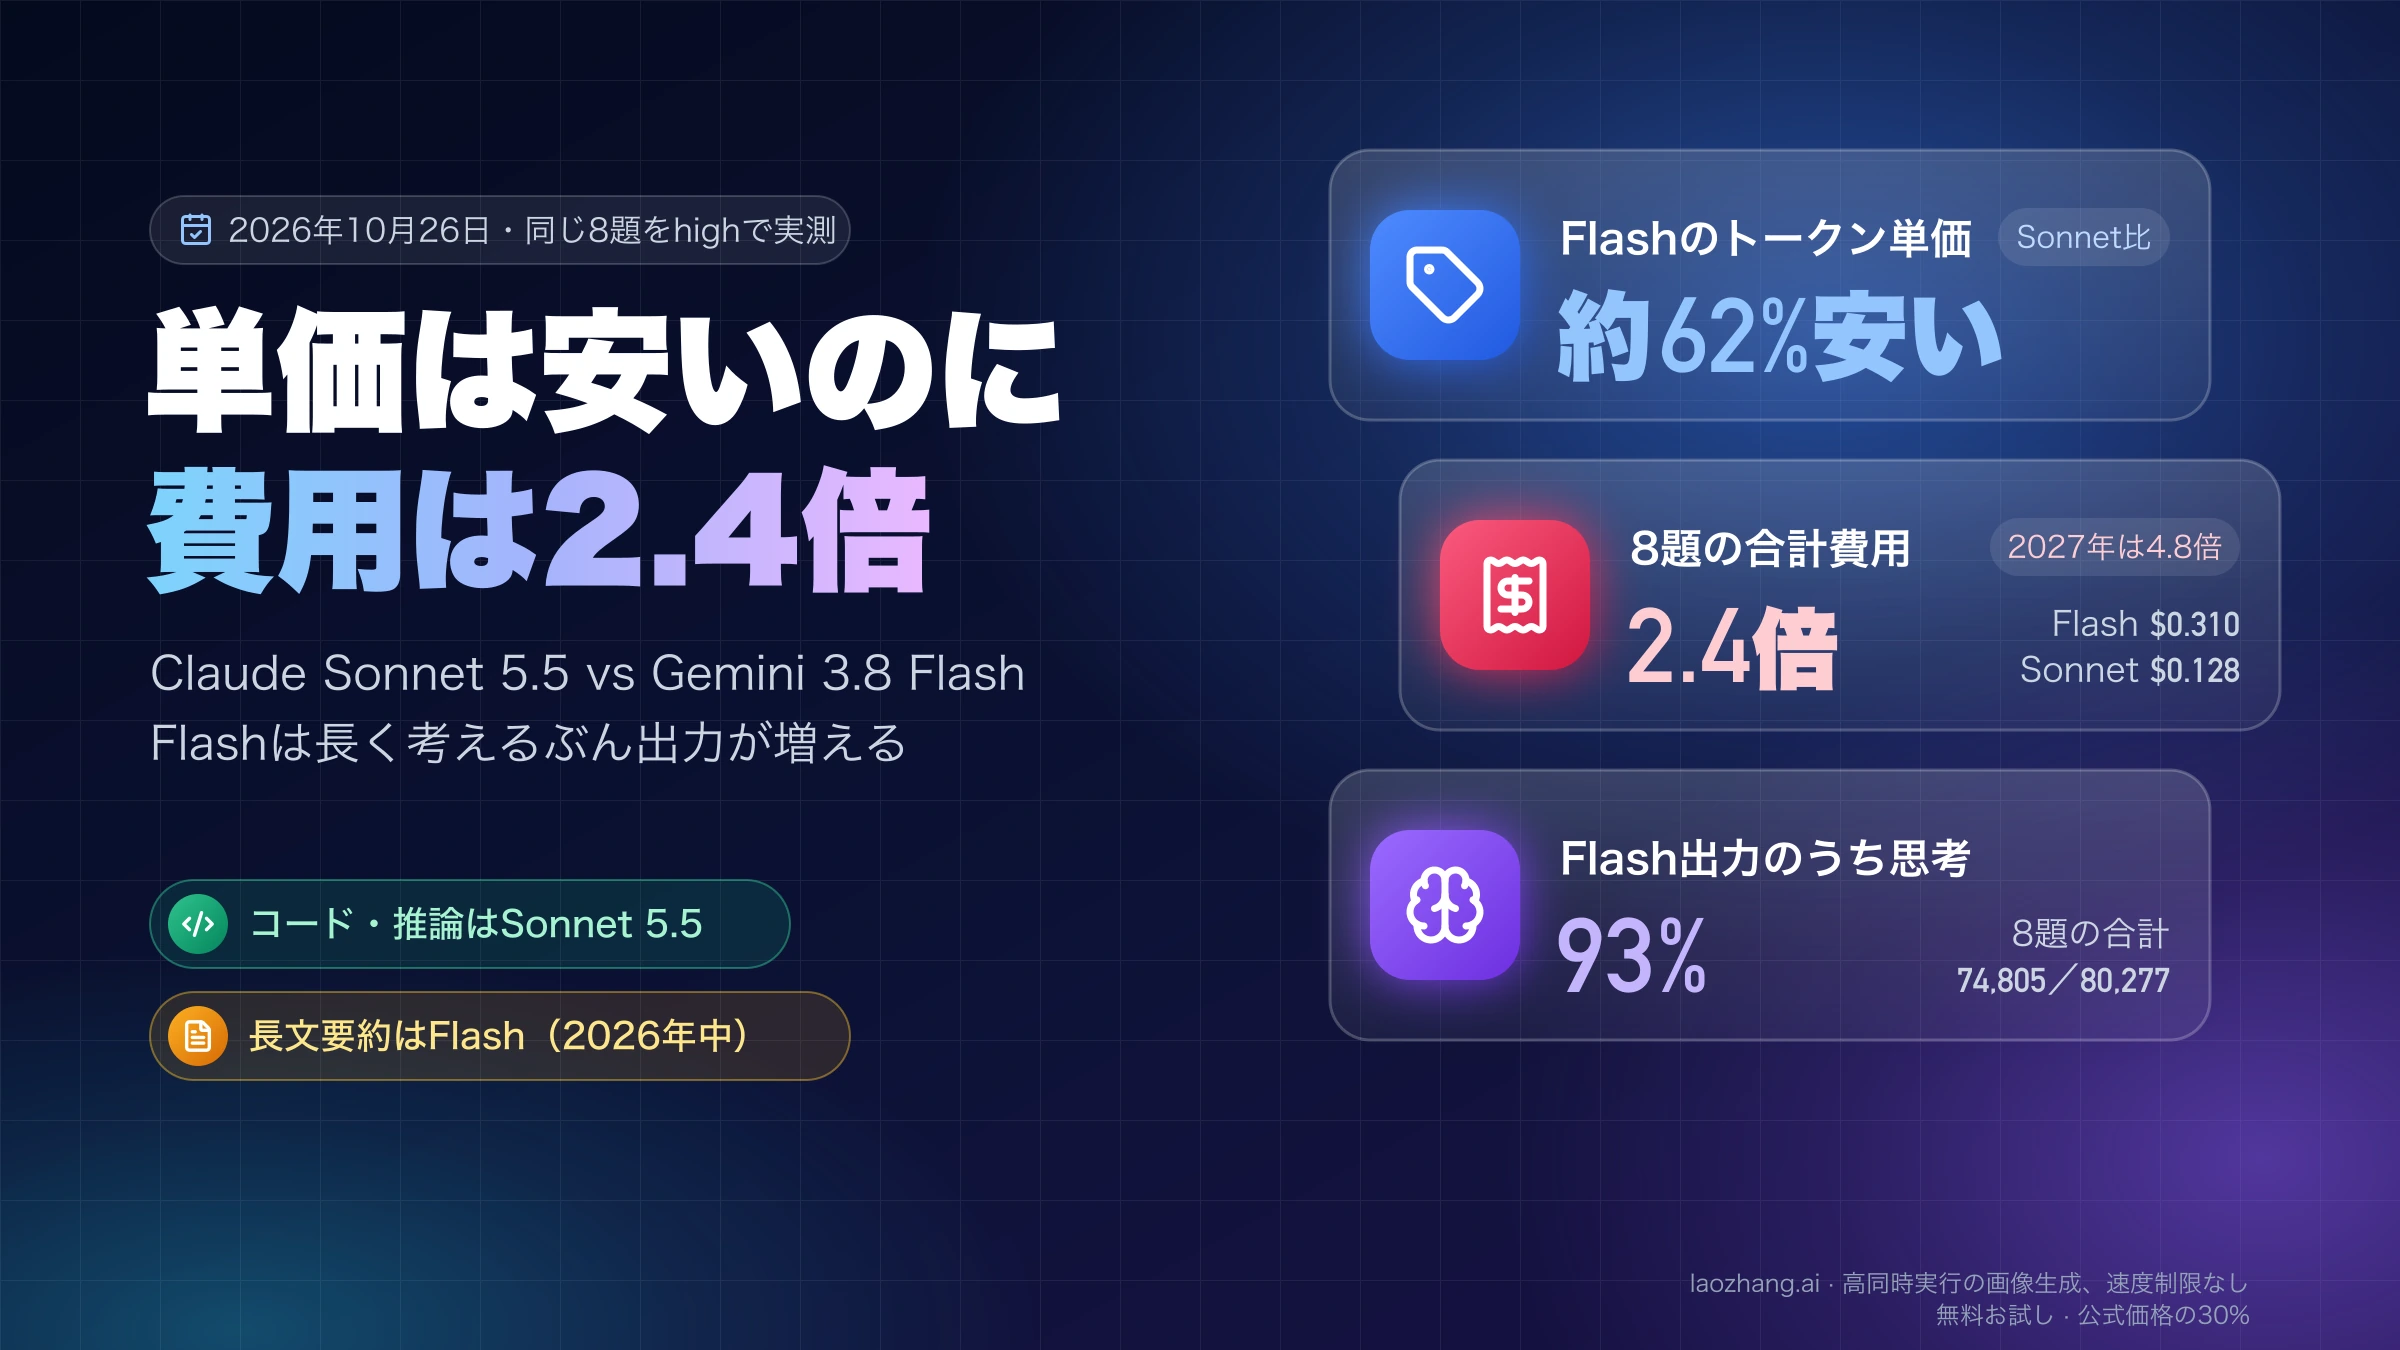
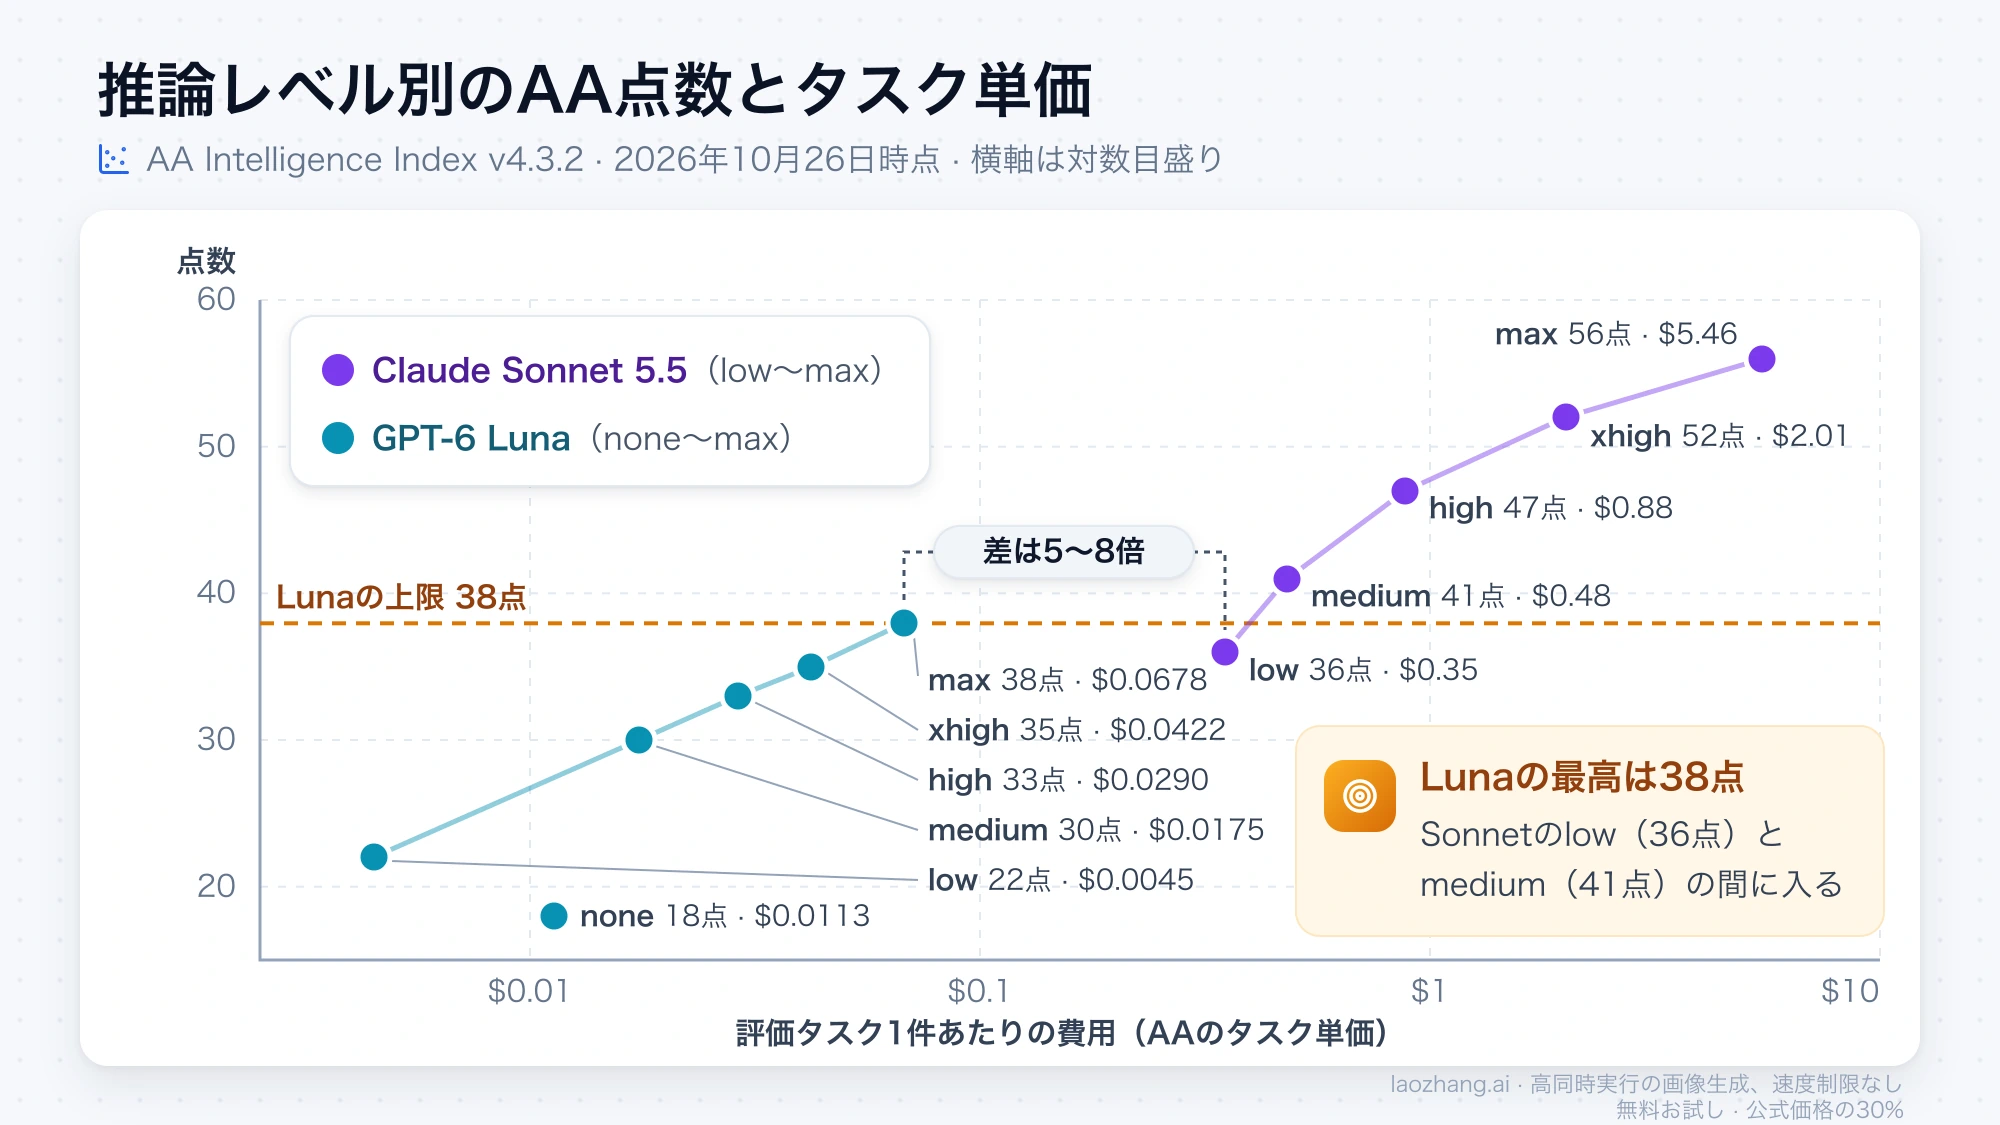
差は1つの倍率では表せません。2026年10月26日時点の公表価格では、100万トークンあたりの単価はSonnetがLunaの20倍です。ただし同じ文章でもSonnetのほうがトークン数が多く、日本語で1.29倍、英文で約1.5倍になるため、入力費用は実質26〜30倍です。第三者機関Artificial Analysis(以下AA)の評価で点数の近い推論レベルどうしを比べるとタスク費用の差は5〜8倍に縮み、それぞれの既定値どうしでは約50倍に広がります。そしてLunaは最上位のmaxでも38点で、Sonnetのmedium(41点)以上のどのレベルにも届きません。
実際に試したのは、2026年10月26日に1つのAPIゲートウェイ経由で行った9問の同一プロンプトテスト、日本語・英語・コードのトークン数の計測、公表価格による費用の再計算です。各社の直接API、ツール呼び出し、SonnetのhighとLunaのmedium以外の推論レベルは試しておらず、品質の比較はAAの評価に基づきます。
どちらを使うか:38点で足りる処理はLuna、それ以上はSonnet
Claude Sonnet 5.5とGPT-6 Lunaの使い分けは、処理ごとに「Lunaの品質で合格するか」と「合格したときにいくら安くなるか」で決まります。AAのタスク単価では、Sonnetで最も安いlowでもLunaで最も高いmaxの約5倍かかるため、Lunaで合格する処理をあえてSonnetに回す理由は、1件あたりの時間を短くしたい場合くらいです。下の表は2026年10月26日時点のAAのサブ評価と公表価格による計算から出した最初の選択で、それぞれの用途で合格率を測った結果ではありません。
| 処理の形 | 最初に試すモデル | 判断の根拠 |
|---|---|---|
| 分類・抽出・短い要約などの大量リクエスト | GPT-6 Luna(lowかmedium) | 短い入出力では単価の20倍がそのまま費用差になる |
| バッチ処理 | GPT-6 Luna | 両社ともBatchは標準の半額で、差は20倍のまま |
| 922,000トークンまでの長文ドキュメントの読解 | GPT-6 Luna(medium以上) | 長文読解の評価は同じ推論レベルならLunaが同等以上。入力272K超は割増で差が約10倍に縮む |
| キャッシュを使うエージェントループ | 品質で決める | キャッシュ読み取りの差は10倍で、50ターンの例では14.9倍 |
| ターミナル操作を伴うエージェント型コーディング | Claude Sonnet 5.5 | Terminal-Bench 4.0ではSonnetのlowでもLunaの最高を上回る |
| 資料を渡さずに事実を答えさせる質問応答 | Claude Sonnet 5.5 | 知識の信頼性の評価でLunaはどのレベルでも1以下 |
| AAで38点を超える品質が要る処理 | Claude Sonnet 5.5(medium以上) | Lunaの推論レベルを上げても届かない |
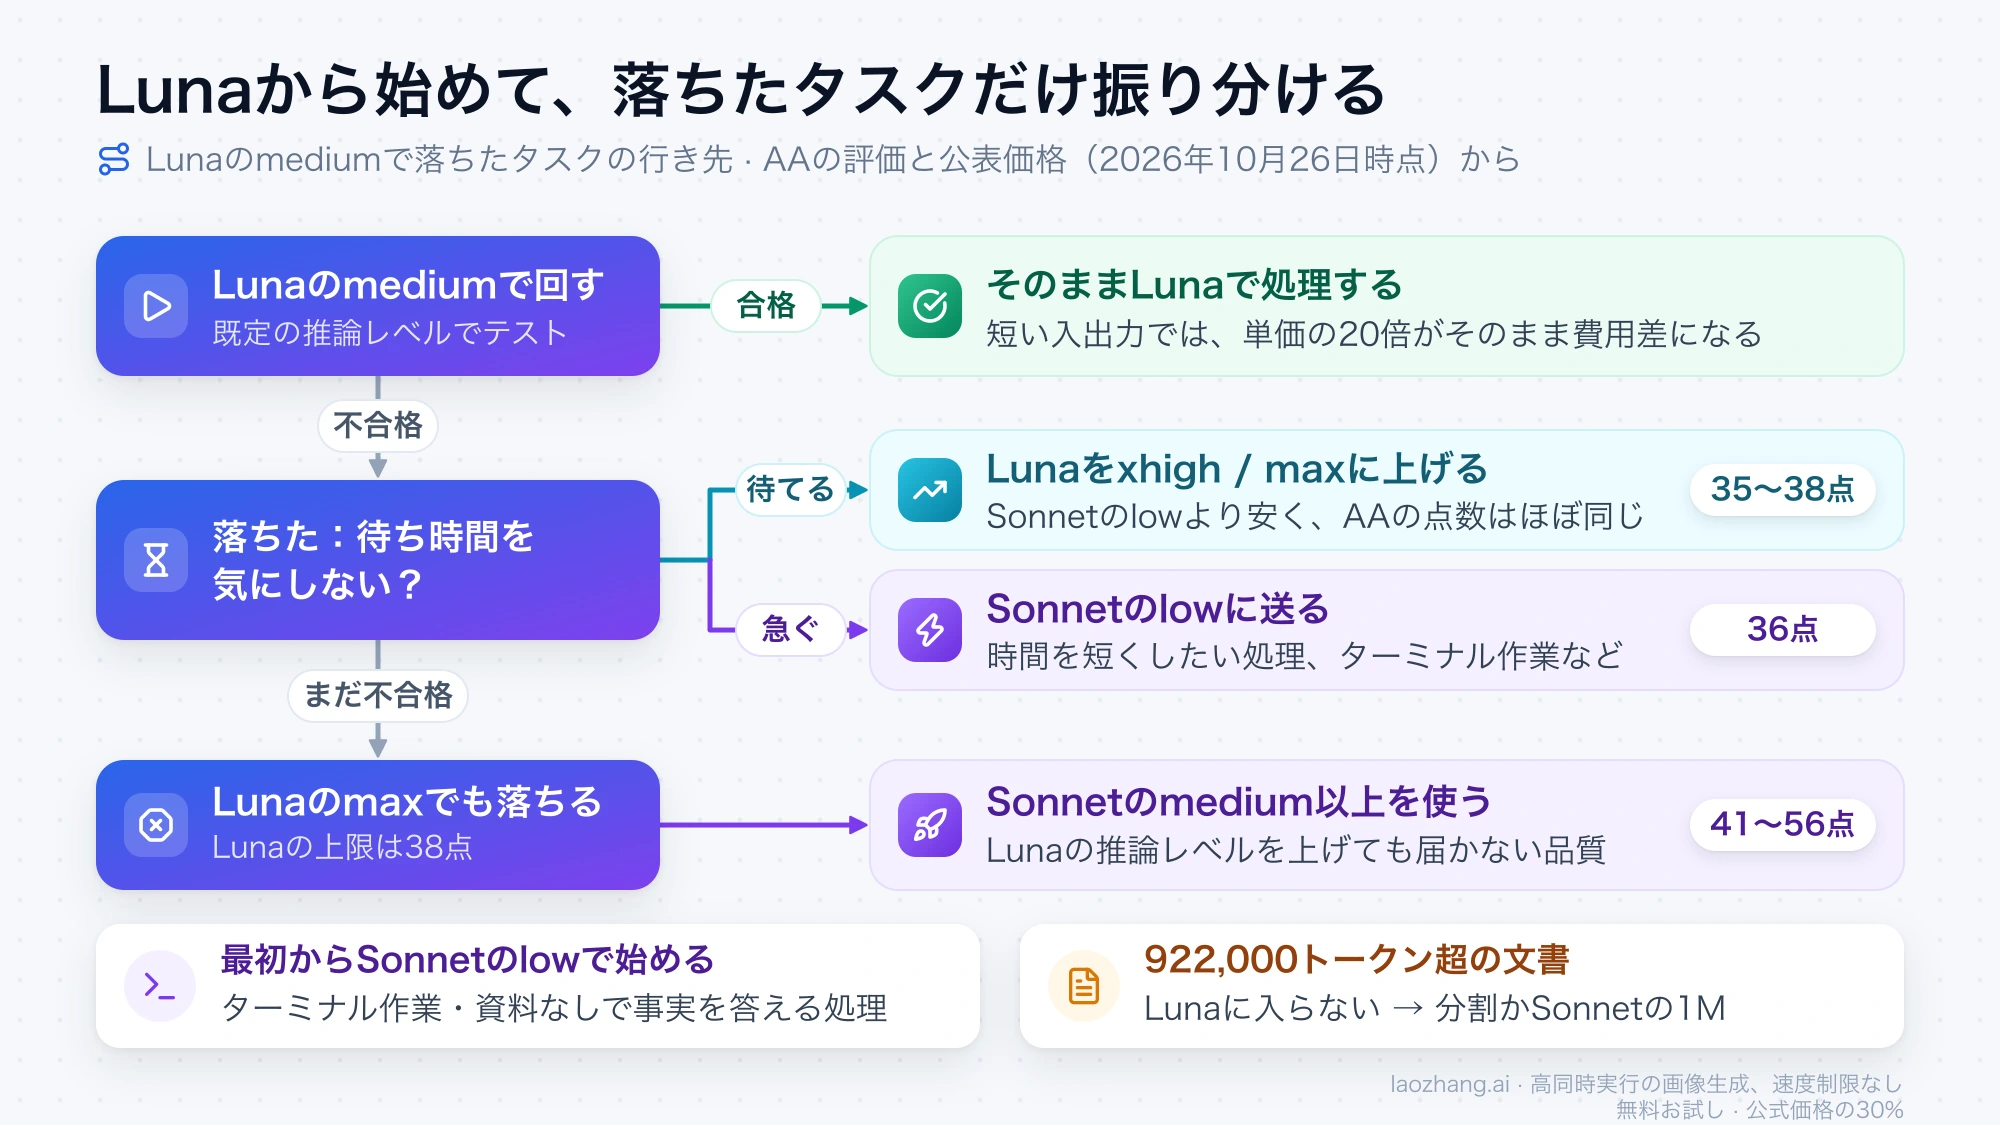
Lunaのmediumで落ちたタスクの行き先は2つあります。待ち時間を気にしないなら、Lunaをxhighかmaxに上げるほうが安く、AAの点数はSonnetのlowとほぼ同じです。1件あたりの時間を短くしたい場合や、ターミナル作業のようにSonnetが得意な種類のタスクなら、Sonnetのlowに送ります。Lunaのmaxでも落ちる品質が必要なら、Sonnetのmedium以上を使います。入力が922,000トークンを超える文書はLunaに入らないため、分割するかSonnetの1Mコンテキストを使います。
「20倍」の数え方:単価・トークン数・タスク費用で5〜50倍
Claude Sonnet 5.5のAPI単価は、入力も出力もGPT-6 Lunaのちょうど20倍です。2026年10月26日時点のAnthropicの料金ページとOpenAIのAPI料金表の標準料金を並べると次のとおりで、単位は100万トークンあたりの米ドルです。キャッシュから読み込んだ入力の料金を、Anthropicはcache hits、OpenAIはcached input(キャッシュ入力)と呼びますが、ここではどちらも「キャッシュ読み取り」と書きます。
| 項目 | Claude Sonnet 5.5 | GPT-6 Luna(入力272K以下) | 倍率 |
|---|---|---|---|
| 入力 | $2 | $0.10 | 20倍 |
| キャッシュ読み取り | $0.10 | $0.01 | 10倍 |
| キャッシュ書き込み | $2.50(5分)、$4(1時間) | $0.125(30分)、$0.25(12時間) | 20倍(5分と30分の比較) |
| 出力 | $10 | $0.50 | 20倍 |
| 入力272K超のリクエスト | 単価は変わらない | 入力$0.20、キャッシュ読み取り$0.02、出力$0.75 | 入力10倍、出力13.3倍 |
| Batch | 入力$1、出力$5 | 入力$0.05、出力$0.25 | 20倍 |
20倍から外れるのは2か所です。キャッシュ読み取りは、Sonnet 5.5が2026年10月7日に$0.20から$0.10へ値下げされたため10倍差になりました(計算方法はClaude Sonnet 5.5のキャッシュ読み取り料金は$0.10:削減率の求め方)。もう1つはLunaの入力が272Kトークンを超えたときで、GPT-6 Lunaのモデルページにあるとおり、入力とキャッシュは2倍、出力は1.5倍の単価がリクエスト全体にかかります。Sonnetは1Mトークンまで同じ単価なので、この範囲では差が縮みます。
単価の比較には、1トークンの大きさが同じという前提が隠れています。2026年10月26日に同じ文章を両モデルに送り、APIが返した入力トークン数を比べると、日本語の記事本文6,000文字はSonnet 5.5が4,900、Lunaが3,793で1.29倍、6,723語の英文記事は15,335対10,106で1.52倍、6,000文字のPythonコードは2,352対1,609で1.46倍でした。入力費用に直すと、日本語は20×1.29で約26倍、英文は約30倍です。どれも言語ごとに1本の文章で測った値で、出力トークン数はモデルがどれだけ書くかで変わるため含みません。
| 数え方 | Sonnet 5.5 ÷ GPT-6 Luna | 条件 |
|---|---|---|
| 100万トークンあたりの単価 | 20倍 | 入力・出力とも。キャッシュ読み取りは10倍、Lunaの入力272K超は10〜13倍 |
| 同じ文章の入力費用 | 約26〜30倍 | 単価の差に、測ったトークン数の差を掛けた値(日本語は約26倍、英文は約30倍) |
| 同じ9問のテスト | 25倍 | 両モデルとも9問合格。Sonnetはhigh、Lunaはmedium |
| AAのタスク単価:点数の近いレベルどうし | 5〜8倍 | Sonnet low(36点)対Luna max(38点)・xhigh(35点) |
| AAのタスク単価:既定値どうし | 約50倍 | Sonnet high(47点)対Luna medium(30点) |
タスク単価の倍率が単価の20倍と食い違うのは、推論レベルごとに出力するトークン数が違うからです。AAの評価タスク1件あたりの出力は、Sonnetのlowで14.3K、maxで197.4K、Lunaのlowで2.1K、maxで50.0Kトークンです。「既定値どうし」も同じ条件ではありません。Sonnet 5.5の推論レベルはAPIの既定がhigh(Claude Codeとアプリではmedium)、Lunaはmediumで、AAの点数は17点離れています。
推論レベル別の点数と費用:Sonnetのlowは36点、Lunaのmaxは38点
AAのIntelligence Index v4.3.2(10種類の評価をまとめた総合点)で両モデルの全推論レベルを並べると、Lunaの最高点38はSonnetのlow(36点)とmedium(41点)の間に入ります。値は2026年10月26日時点のAAのClaude Sonnet 5.5とGPT-6 Lunaの比較ページによります。
| 推論レベル | Sonnet 5.5 点数 | Sonnet 5.5 タスク単価 | Sonnet 5.5 時間 | Luna 点数 | Luna タスク単価 | Luna 時間 |
|---|---|---|---|---|---|---|
max | 56 | $5.46 | 936秒 | 38 | $0.0678 | 364秒 |
xhigh | 52 | $2.01 | 434秒 | 35 | $0.0422 | 215秒 |
high | 47 | $0.88 | 217秒 | 33 | $0.0290 | 164秒 |
medium | 41 | $0.48 | 121秒 | 30 | $0.0175 | 126秒 |
low | 36 | $0.35 | 85秒 | 22 | $0.0045 | 18秒 |
none(推論なし) | 設定なし | — | — | 18 | $0.0113 | 31秒 |
タスク単価は、AAが評価タスク1件を解かせたときの費用で、あなたの請求額ではありません。時間はタスク1件を終えるまでの時間です。AAはSonnetの各レベルを「with fallback」と表記しています。Anthropicのサーバー側のフォールバック設定を指す表記です。Sonnetのタスク単価は10月7日のキャッシュ読み取り値下げの後に下がっており、maxを1タスク$7台とする数字は値下げ前の計測です。
点数をそろえて比べられるのは、Sonnetのlow(36点)とLunaのxhigh(35点)・max(38点)の組だけです。この組ではLunaが安く、Sonnetが速いという関係になります。同じ推論レベル名どうしで比べると、タスク単価の差はmediumの27倍からmaxの81倍まで開きます(low77倍、high30倍、xhigh48倍)。レベル名が同じでも、考える量も点数も同じではありません。
得意分野の差:ターミナル作業と知識はSonnet、長文読解は互角
総合点の差がどこから来るかは、AAのサブ評価で分かります。ターミナルでのエージェント作業と知識の信頼性ではSonnetが大きく上回り、長文の読解と推論ではLunaが同じ推論レベルでSonnetと同等以上です。下の表は2026年10月26日時点の同じAAの比較ページの値で、各モデルの最も低いレベルから最も高いレベルまでの範囲です。
| AAの評価 | 測るもの | Claude Sonnet 5.5(low〜max) | GPT-6 Luna(none〜max) |
|---|---|---|---|
| Terminal-Bench 4.0 | ターミナルでのエージェント作業 | 20.7〜63.6% | 0.0〜12.6% |
| AutomationBench-AA | 業務の自動化 | 49.4〜71.8% | 9.1〜53.2% |
| AA-LCR v1.1 | 長文コンテキストでの推論 | 76.0〜82.7% | 39.7〜83.3% |
| AA-Omniscience | 知識の信頼性(マイナスは誤答が正答より多い) | 19〜32 | −22〜1 |
| SciCode | 科学計算のコード | 49.1〜61.0% | 43.1〜54.6% |
| Humanity's Last Exam | 高難度の知識と推論 | 36.2〜55.0% | 8.6〜38.5% |
Terminal-Bench 4.0の差はとくに大きく、Sonnetの最も低いlow(20.7%)でもLunaの最高(12.6%)を上回ります。シェルでコマンドを実行しながら作業を進めるエージェントを作るなら、Lunaの推論レベルを上げて追いつくことは期待できません。
長文の読解は逆で、medium以上の同じレベルどうしではLunaがわずかに上です。mediumではLuna 78.3%対Sonnet 76.3%、maxでは83.3%対82.7%でした。ただしLunaの推論なし(none)は39.7%まで落ちるため、長文を扱うときは推論を切らないことが前提です。
AA-Omniscienceは値が高いほど良く、マイナスは誤答が正答より多いことを意味します。Lunaはすべてのレベルで1以下なので、資料を渡さずに事実を答えさせる用途ではSonnetを使うか、Lunaには根拠となる文書や検索結果を一緒に渡すほうが安全です。
同じ9問を解かせた結果:両方9/9、費用は25倍
2026年10月26日、LaoZhangのゲートウェイ経由で両モデルに同じ9問を1回ずつ解かせました。文章題、区間のマージ、時間文字列の解析、数式の評価、CSV行の解析、SemVerの比較など、事前に書いた隠しテストで合否を判定できる小さなタスクに、6,723語の英文記事の要約を加えたものです。両モデルとも9問すべてに合格し、公表価格で計算した費用はSonnet 5.5が$0.1119、GPT-6 Lunaが$0.0044で、差は25.4倍でした。
| 設定 | 合格 | 入力トークン | 出力トークン | 費用(公表価格) | 合計時間 |
|---|---|---|---|---|---|
Sonnet 5.5(thinkingをadaptive、推論レベルhigh) | 9/9 | 16,957 | 7,802 | $0.1119 | 71秒 |
Sonnet 5.5(thinkingと推論レベルを指定しない) | 8/9 | 16,957 | 4,896 | $0.0829 | 50秒 |
GPT-6 Luna(既定のmedium) | 9/9 | 11,213 | 6,545(うち推論3,897) | $0.0044 | 128秒 |
SonnetはAnthropicのMessages形式(/v1/messages)、LunaはChat Completions(/v1/chat/completions)で呼び、システムプロンプトとツールは使っていません。小さなタスクでもLunaのmediumはSonnetのhighに近い量を出力し、その6割が推論トークンでした。費用差が単価の20倍を超えたのは、Sonnetのほうが入力トークンが約1.5倍多く、出力も多かったためです。LaoZhangは両モデルを公表価格と同じ単価で提供しており、1つのAPIキーで両方を呼べますが、Claude系は1回の出力が32,768トークンまでで、Message Batches APIはありません。
1問だけ落ちたのは、Sonnetにthinkingを送らなかった設定です。区間マージの問題で「接する(touching)区間」を隣り合う整数のことと解釈して(1, 2)と(3, 4)を1つにまとめましたが、隠しテストは別々のままを期待していました。曖昧な語の解釈違いで、adaptive thinkingを明示した設定では正しく処理しています。
このゲートウェイでは、thinkingを省いたリクエストは9問すべてで思考ブロックが返らず、thinking: {"type": "adaptive"}とoutput_config: {"effort": "high"}を明示すると7問で思考ブロックが返り、出力トークンは4,896から7,802に増えました。Anthropicのthinkingのドキュメントでは、Sonnet 5.5はthinkingを省くとadaptive thinkingで動くとされていますが、直接APIでは試していません。プロキシやゲートウェイを経由するときは、thinkingと推論レベルを明示して送るほうが確実です。
このテストで分かるのは、両モデルがほぼ全問を解ける小さなタスクで費用・トークン数・時間がどう違うかで、どちらが賢いかではありません。品質の差を判断するには、前の2つの節のAAの評価のほうが参考になります。
どちらが速いか:同じ品質ならSonnet、最速はLunaのlow
どちらが速いかは、推論レベルと経路で答えが変わります。AAが各社のAPIで測った出力速度(2026年10月26日時点)は、Sonnet 5.5が毎秒105〜134トークン、Lunaが92〜140トークンで、ほぼ同じ水準です。差が出るのは考える量で、1タスクを終える時間はLunaのlowが最も短い一方、点数の近い組ではSonnetのlowがLunaのxhighより2.5倍、maxより4.3倍早く終わります。
最初のトークンが返るまでの時間は、Sonnetのlowが0.98秒、mediumが1.35秒、Lunaのlowが2.45秒、mediumが2.79秒、推論なしが0.87秒です。対話で最初の文字を早く見せたいなら、Sonnetの低いレベルかLunaの推論なしが向いています。
一方、10月26日のゲートウェイ経由のテストでは、9問すべてでLunaのほうが遅く、数式評価の問題ではLunaが33.2秒、Sonnetが13.0秒でした。1日・1経路・逐次実行の結果で、経路の混み具合で変わります。OpenRouterはSonnet 5.5を毎秒106トークン、Lunaを42トークンと報告していますが、計測方法がAAとは違うため、同じ基準の数字としては比べられません。
自分の処理でいくらかかるか:5つのケースで10〜20倍
自分の処理での費用差は、両モデルのトークン数を同じとして数えると、入力の長さとキャッシュの使い方によって10〜20倍の間に収まります。トークン数の差を入れると倍率は上がり、ケースAとBでは日本語で13〜23倍、英文で15〜25倍になります。下の表は2026年10月26日時点の公表価格で計算したもので、トークン数はどちらのモデルでも同じと仮定した値です。
| ケース | Claude Sonnet 5.5 | GPT-6 Luna | 倍率 |
|---|---|---|---|
| A. 1回の対話:入力2K、出力500 | $0.0090 | $0.00045 | 20.0倍 |
| B. 300Kトークンの文書1本と出力5K | $0.65 | $0.0638 | 10.2倍 |
| B2. Bと同じで入力250K(272K以下) | $0.55 | $0.0275 | 20.0倍 |
| C. 50ターンのエージェントループ:キャッシュ100K(書き込み1回)、毎ターン新規入力2K・出力1K | $1.45 | $0.0975 | 14.9倍 |
| D. バッチ10,000件:1件あたり入力3K・出力1K、両社とも半額 | $80 | $4 | 20.0倍 |
BはLunaの入力が272Kを超えるため、リクエスト全体に割増の単価がかかります。Lunaは0.3M×$0.20+0.005M×$0.75で$0.0638、Sonnetは0.3M×$2+0.005M×$10で$0.65です。同じ文書が250Kに収まるB2では、倍率は20倍に戻ります。
Cはターンの間隔が5分以内でキャッシュが切れない前提です。Sonnetはキャッシュ書き込み(5分)0.1M×$2.50=$0.25、キャッシュ読み取り50回×0.1M×$0.10=$0.50、新規入力0.1M×$2=$0.20、出力0.05M×$10=$0.50で合計$1.45です。Lunaは書き込み(30分)0.1M×$0.125=$0.0125、読み取り5M×$0.01=$0.05、新規入力0.1M×$0.10=$0.01、出力0.05M×$0.50=$0.025で$0.0975です。キャッシュ読み取りの差が10倍しかないため、キャッシュの比率が高いループほど倍率は20倍から下がります。
実際の文章では、前の節で測ったトークン数の差を入れると倍率が上がります。日本語でSonnetの入力を1.29倍として数えると、Aは入力2,580トークンで$0.0102対$0.00045の22.6倍、BはLunaで300Kトークンの文書がSonnetでは約387Kになり、$0.824対$0.0638の12.9倍です。英文(1.52倍)なら、Aは$0.0111対$0.00045で24.6倍、Bは約456Kトークンで$0.962対$0.0638の15.1倍です。出力トークン数はモデルがどれだけ書くかで変わるので、補正していません。
切り替えで壊れる設定:関数呼び出し・thinking・tool_choice
Claude Sonnet 5.5とGPT-6 Lunaを入れ替えるとき、モデルIDの書き換えだけでは動かない箇所があります。Lunaに移る側では関数呼び出しに使うAPI、Sonnetに移る側では思考を切る設定とツールの強制呼び出しがとくに引っかかりやすい点です。仕様はGPT-6 LunaのモデルページとAnthropicのthinkingのドキュメントによります(2026年10月26日時点)。
| 項目 | Claude Sonnet 5.5 | GPT-6 Luna |
|---|---|---|
| モデルID | claude-sonnet-5-5 | gpt-6-luna |
| 推論レベルの指定と既定値 | output_config.effortでlow〜maxの5段階。APIの既定はhigh | reasoning.effort(Chat Completionsではreasoning_effort)でnone〜maxの6段階。既定はmedium |
| 推論を切る | thinking: {type: "disabled"}は400エラー。最低は{type: "between_tools"}(推論レベルhigh以下) | noneを指定 |
| 関数呼び出し | Messages APIで可能。tool_choiceのany・toolによる強制は400エラー | Chat Completionsではreasoning_effort: "none"のときだけ。それ以外はResponses API |
| 思考の中身 | 既定で空の思考ブロック(display: "omitted")。思考トークンは課金される | 推論トークン数はusageのcompletion_tokens_details.reasoning_tokensに出る |
| 入力と出力の上限 | コンテキスト1M、最大出力128K | 最大入力922,000、最大出力128,000。入力272K超は割増 |
| 使えるAPI・基盤 | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundryなど | Chat Completions、Responses、Batch。Realtimeとファインチューニングはなし |
| 知識のカットオフ | 2026年6月 | 2026年5月18日 |
SonnetからLunaへ移るとき、推論を使いながらツールを呼ぶ処理はResponses APIに書き換える必要があります。Chat Completionsのまま関数呼び出しを続けるならreasoning_effort: "none"にするしかなく、AAの点数は18点まで下がります。Responses APIではweb検索、ファイル検索、コード実行、MCPなどの組み込みツールも使えます。
LunaからSonnet 5.5へ移るときは、ツールの強制呼び出しに注意します。Sonnet 5.5ではtool_choiceのany・toolが400エラーになるため、autoにしてプロンプトでツールを使う条件を指示します。Sonnet 5など他のClaudeモデル向けにthinking: {type: "disabled"}を送っていたコードも400エラーになるので、{type: "between_tools"}に置き換えます。思考テキストは既定で返りませんが課金はされるので、出力トークンが想定より多いときは思考の分を疑ってください。Sonnet 5.5の推論レベルはSonnet 5から目盛りが調整し直されており、Anthropicは移行時に推論レベルを振り直して比べることを勧めています。
切り替える前の試し方:合格1件あたりの費用で比べる
切り替えるかどうかは、モデルの単価ではなく「合格したタスク1件あたりの費用」で決めます。数十件の小さなテストでも判断の材料になり、10月26日の9問のテストは公表価格で$0.21に収まりました。次の順に進めます。
- 実際の処理から代表的なタスクを集め、合否を機械的に判定できる期待値や隠しテストを、モデルの回答を見る前に書きます。曖昧な指示で落ちたのか能力で落ちたのかを後で見分けられるよう、判定の基準も文章で残します。
- Lunaを既定の
mediumで回し、レスポンスのusageから入力・出力(推論を含む)トークンを記録して費用を計算します。 - Sonnetは
thinking: {"type": "adaptive"}とoutput_config.effortを明示し、lowから回します。ゲートウェイ経由で指定を省くと、思考が動かないことがあります。 - 落ちたタスクだけ、Lunaは
highかxhigh、Sonnetはmediumに上げて再試行します。 - モデルと推論レベルごとに「総費用÷合格数」を出し、再試行の回数と人が直した手間も並べて比べます。
- Lunaで落ちるタスクが特定の種類に偏っていれば、その種類だけをSonnetに送る振り分けにします。
振り分けにするときは、落ちたかどうかを判定する仕組みがそのまま振り分けの条件になります。テストや検証で落ちたものを自動でSonnetに再送できる処理なら、落ちる割合が小さいかぎり全体の費用はLunaに近いまま、品質の下限をSonnetで支えられます。
Sonnet 5.5とGPT-6 Lunaのよくある質問
GPT-6 Luna ProやGPT-6.1 Lunaはありますか?
2026年10月26日時点で、OpenAIのモデル一覧とAPI料金表にあるLunaはgpt-6-lunaだけで、「GPT-6 Luna Pro」もgpt-6.1-lunaも載っていません。「Luna Pro」の名前で出回っている入力$0.10・出力$0.50・コンテキスト1,050,000トークンという値は、gpt-6-lunaと同じです。OpenAIのGPT-6系の名前と用途の違いはGPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶにまとめています。
Lunaと同じ単価のClaudeはありますか?
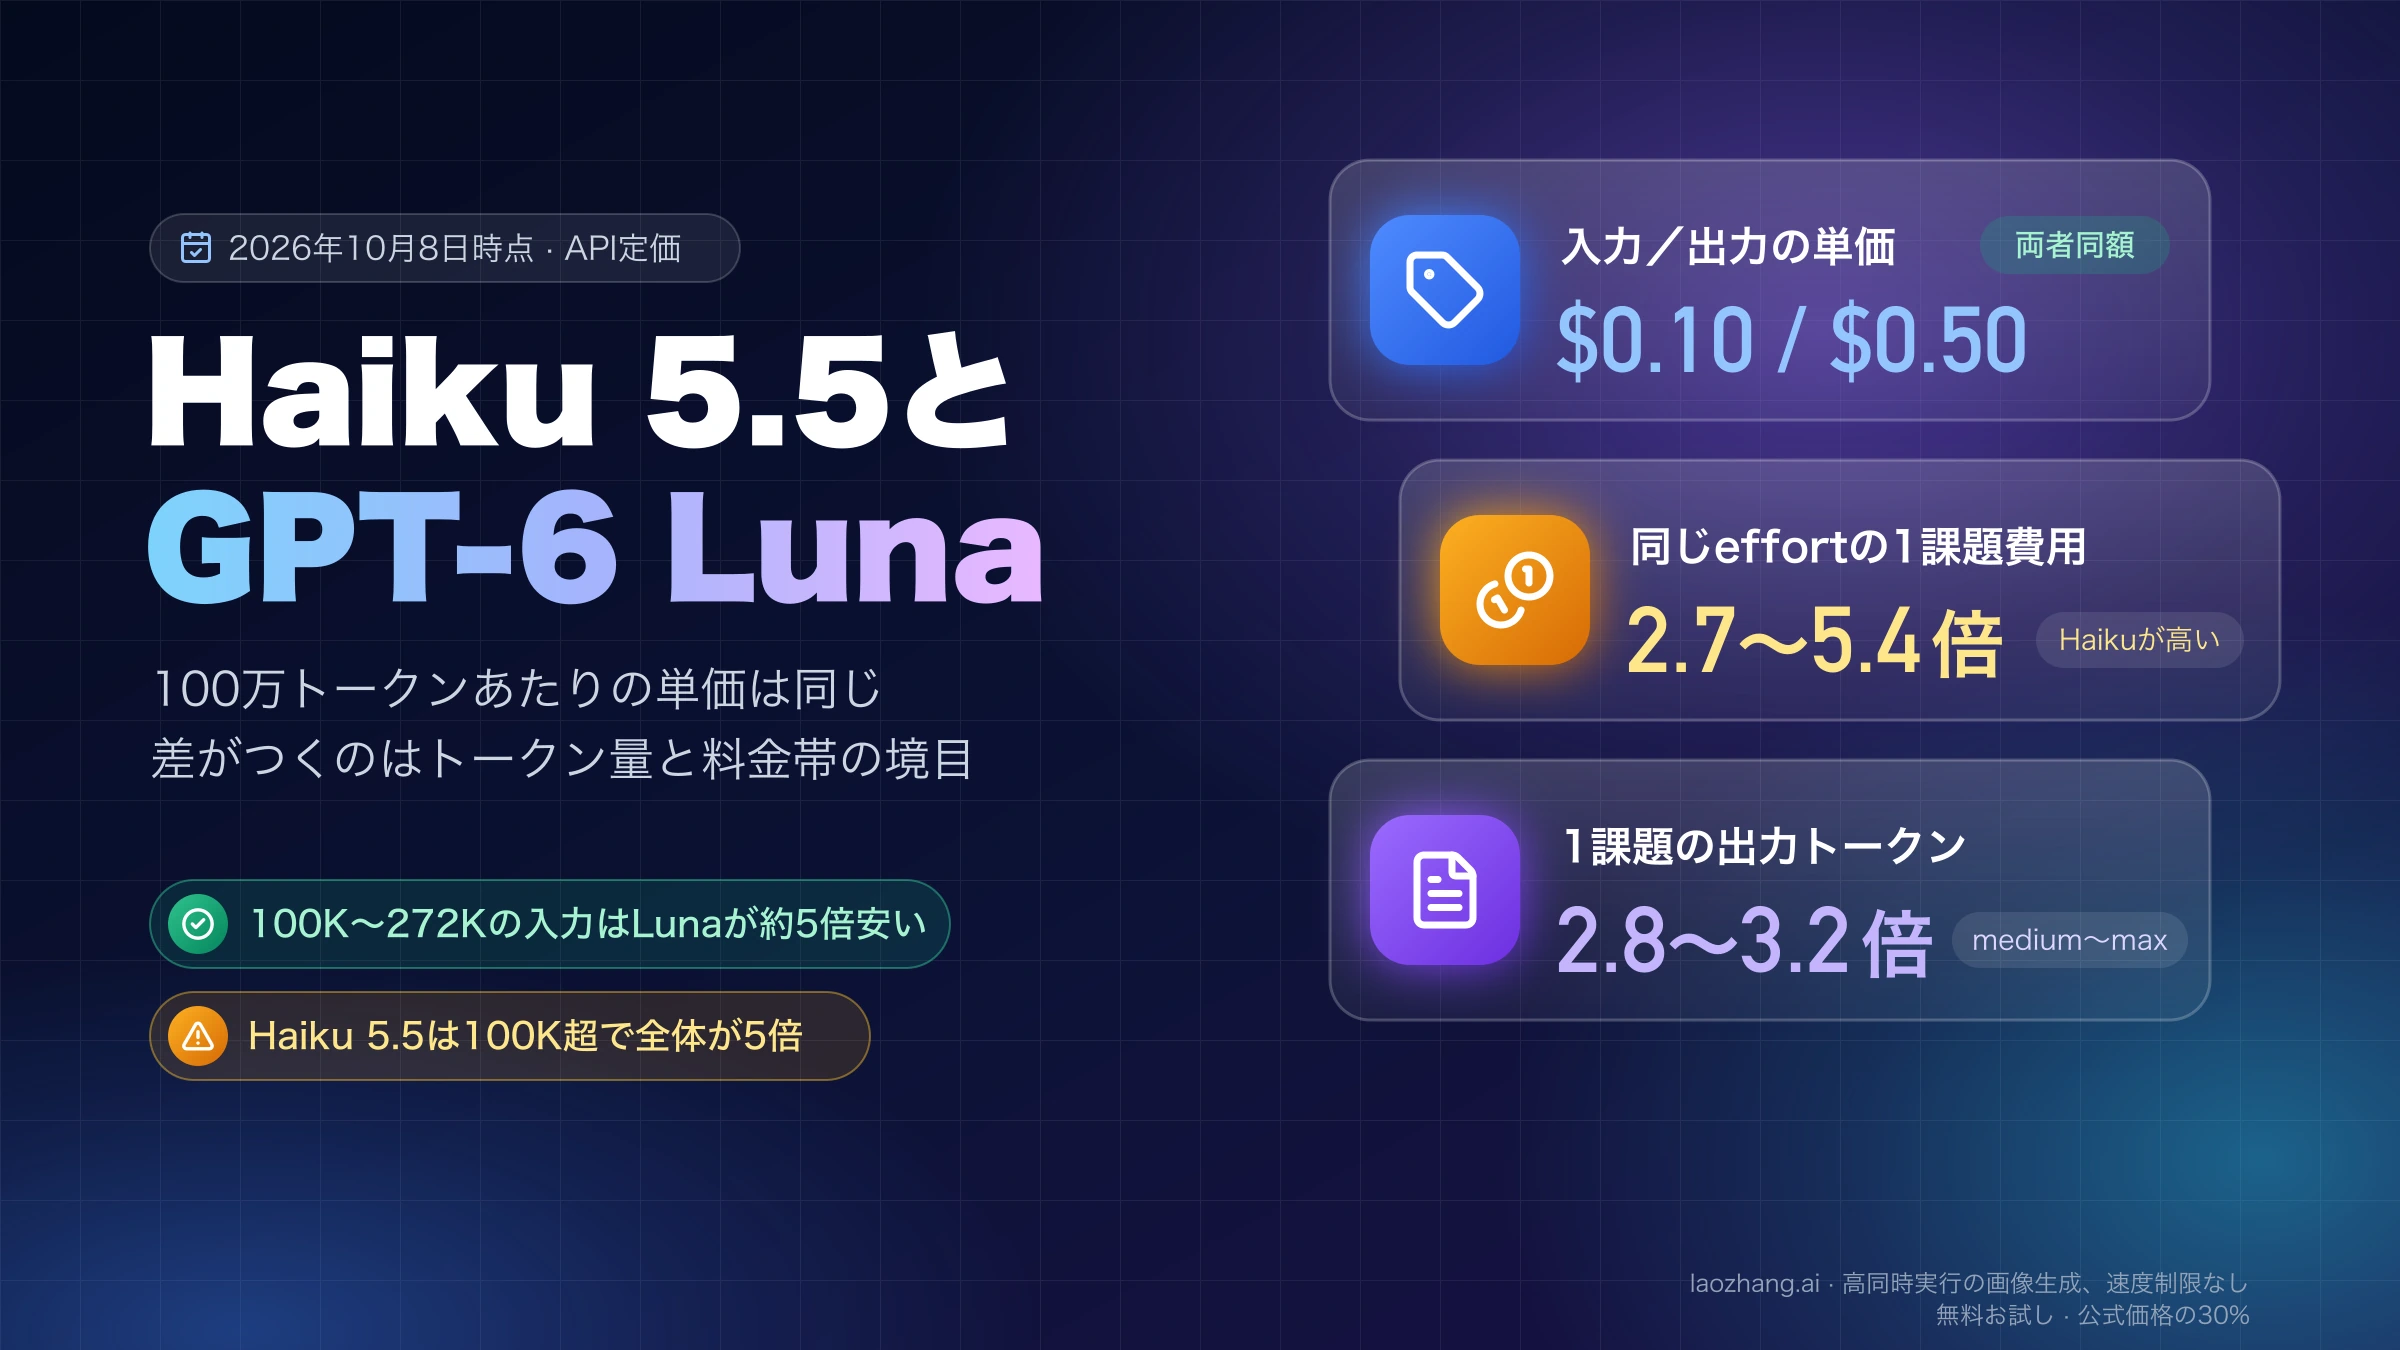
Claude Haiku 5.5は入力$0.10・出力$0.50で、プロンプトが100Kトークンまでなら単価はLunaと同じです(超えるとリクエスト全体が5倍)。費用の比較はClaude Haiku 5.5とGPT-6 Luna比較:単価は同じ、費用差は2.7〜5.4倍、Anthropicの中での同じ20倍の差はClaude Haiku 5.5とSonnet 5.5の違い:単価差20倍をタスク費用で比較を参照してください。
ChatGPTやClaudeの無料プランで使えるのも同じモデルですか?
ChatGPTの無料プランとGoプランでは、2026年10月8日からGPT-6 Lunaが使われています。Claudeの無料プランでもSonnetが使えますが、料金ページはバージョンを明記していません。アプリの利用料はAPIの単価とは別の仕組みで、詳しくはGPT-6は無料で使える?ChatGPT無料プランは10月8日からGPT-6 Lunaで説明しています。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
- 1.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 2.OpenAIのAPI料金表developers.openai.com/api/docs/pricing
- 3.GPT-6 Lunaのモデルページdevelopers.openai.com/api/docs/models/gpt-6-luna
- 4.AAのClaude Sonnet 5.5とGPT-6 Lunaの比較ページartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-luna
- 5.Anthropicのthinkingのドキュメントplatform.claude.com/docs/en/build-with-claude/thinking