Gemini 4 Argon vs Claude Fable 5.1比較:費用差は12月に半減
総合力はAA v5.0.1でほぼ互角。同じタスクの実測では日常作業でFable 5.1がArgon既定の8.6倍の費用、12月1日の値上げ後も4.3倍です。
目次
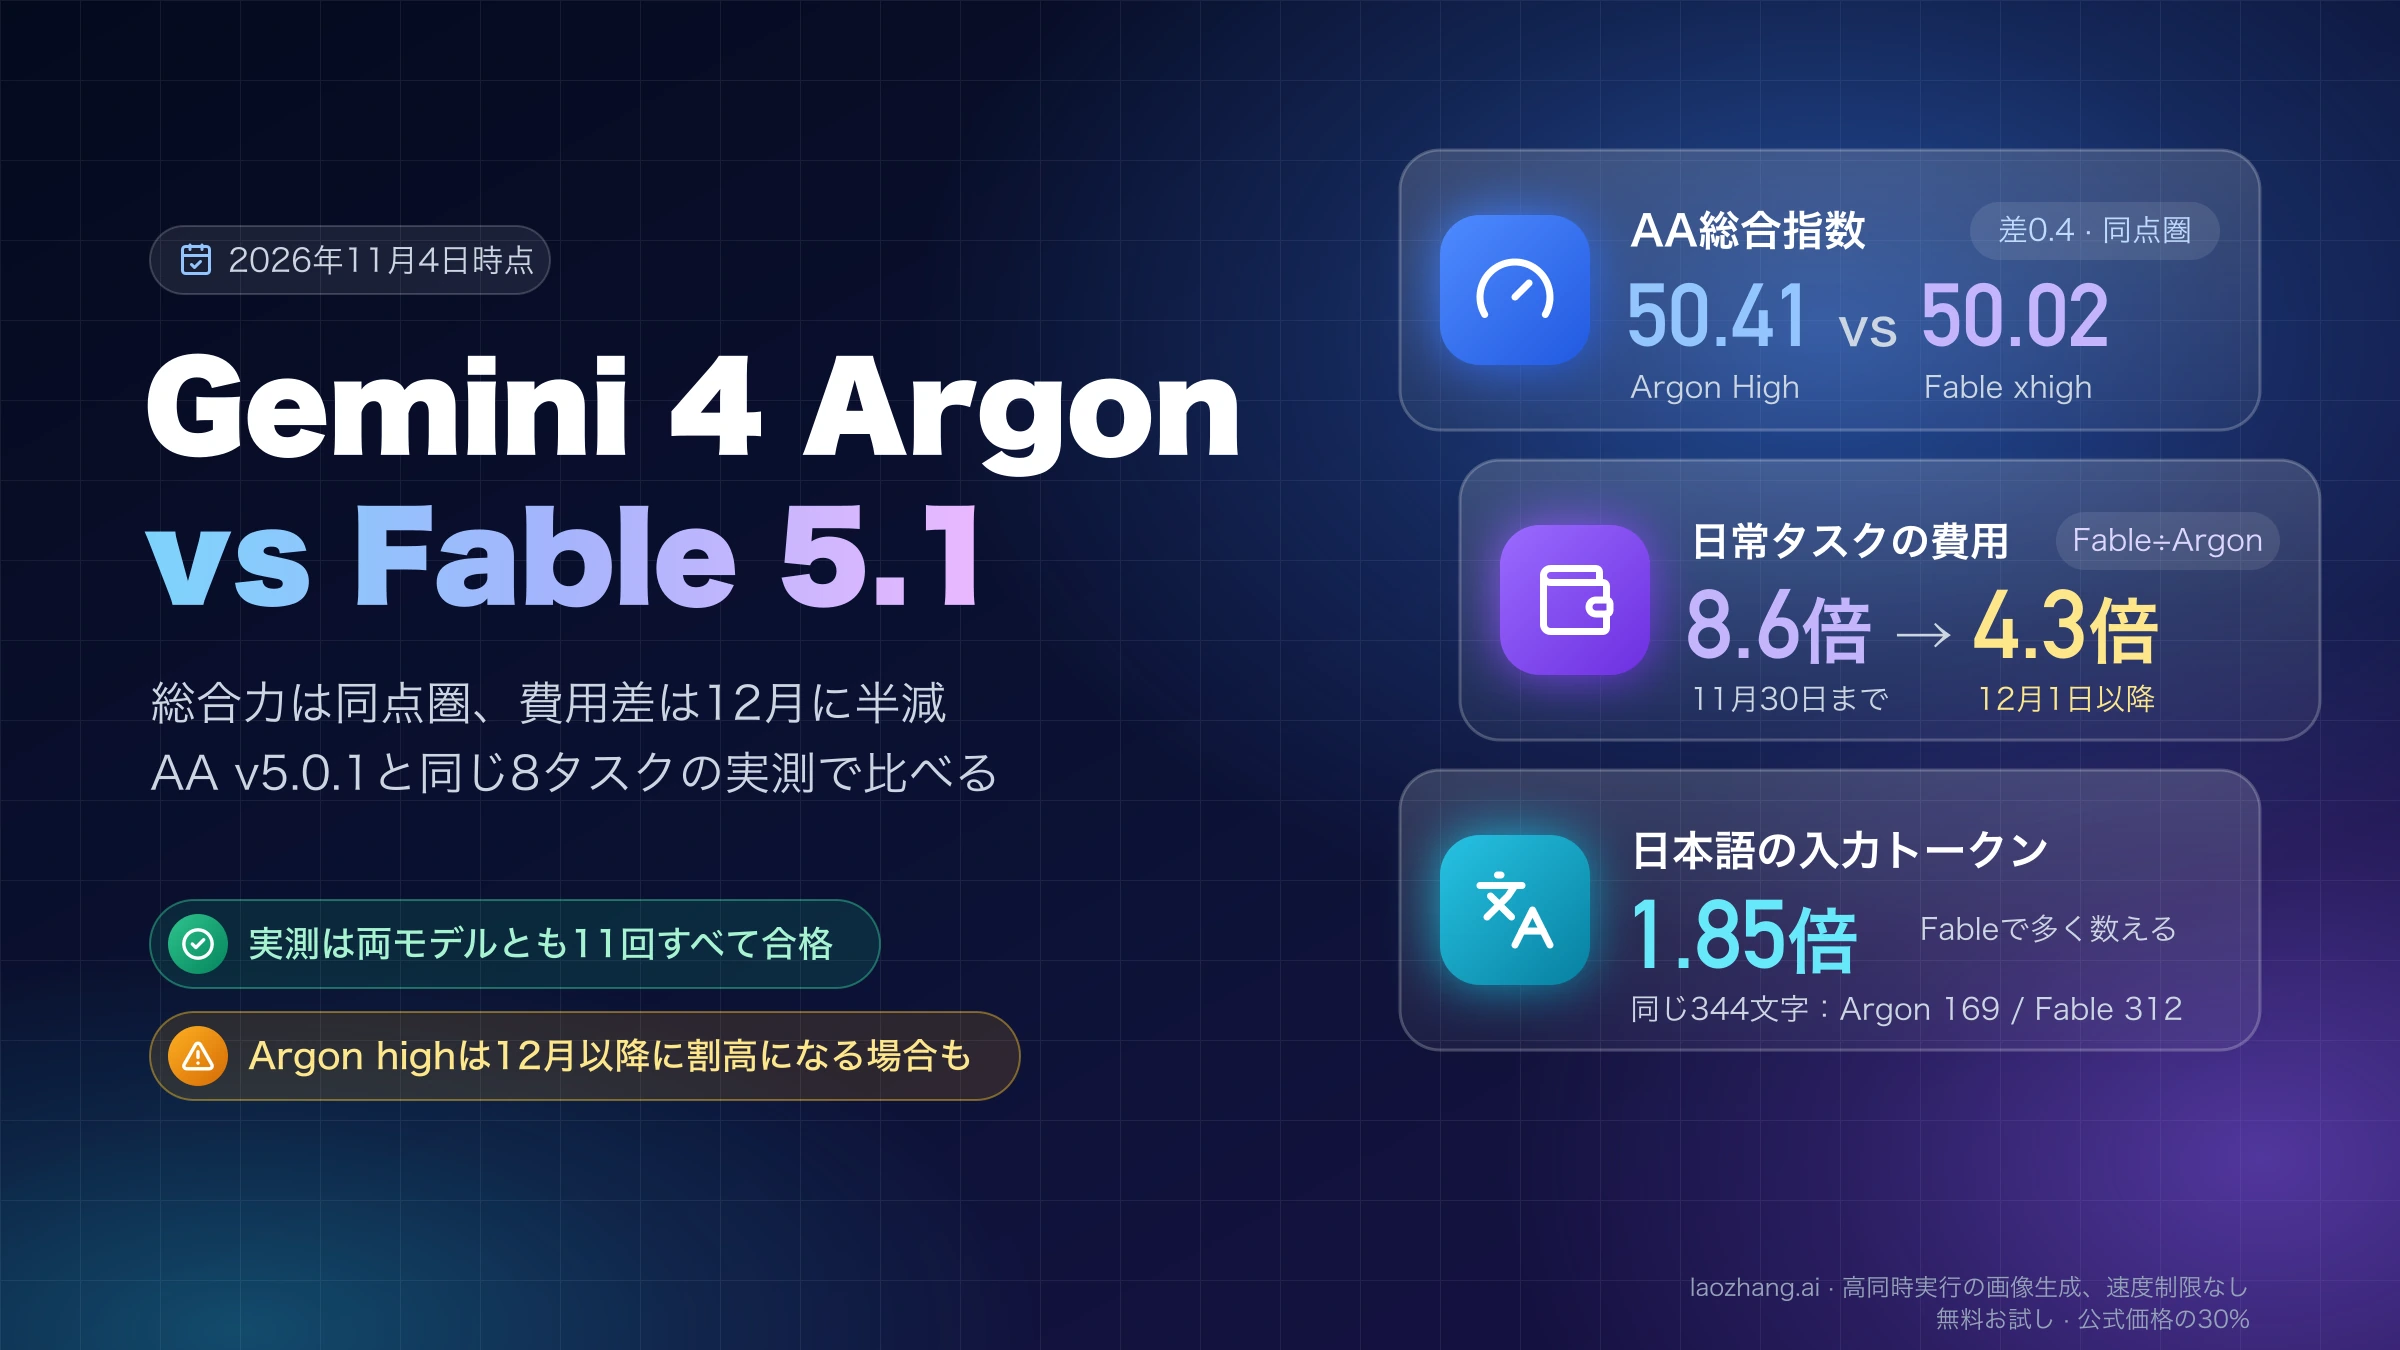
Claude Fable 5.1を使っていて、Gemini 4 Argonへ移すか迷っているなら、まずエージェントの自動化、ツール呼び出し、ターミナル作業、大量のバッチ処理をGemini 4 Argon(gemini-4-argon)の既定設定で試すのが妥当です。2026年11月4日時点で、第三者機関Artificial Analysis(AA)の総合指数v5.0.1では両モデルが50点前後で並び、同じ8タスクを両モデルに解かせた実測でも全問合格でした。一方、費用は日常的な5タスクでFable 5.1がArgon既定の8.6倍かかり、Argonの単価が2倍になる12月1日以降も4.3倍の差が残ります。
Claude Fable 5.1(claude-fable-5-1)を残す価値があるのは、表計算や資料を扱う知的作業、難度の高いコーディング、文書を読み込む推論のように、AAの評価別スコアでFableが上回る仕事です。最初のトークンが早く返ってほしい対話的な使い方や、1回で128Kトークンまで書かせたい長い出力もFable向きです。
例外は、Argonの思考レベルをhighに上げて使う場合です。思考トークンが大きく増えるため、12月1日以降は難しめのタスクでArgon highのほうがFableの既定より高くつきました。日本語のプロンプトはFableで1.85倍のトークンに数えられるので、入力の多い仕事ほどArgon側の節約が大きくなります。
Fable 5.1はArgonより上か:AA v5.0.1では同点圏
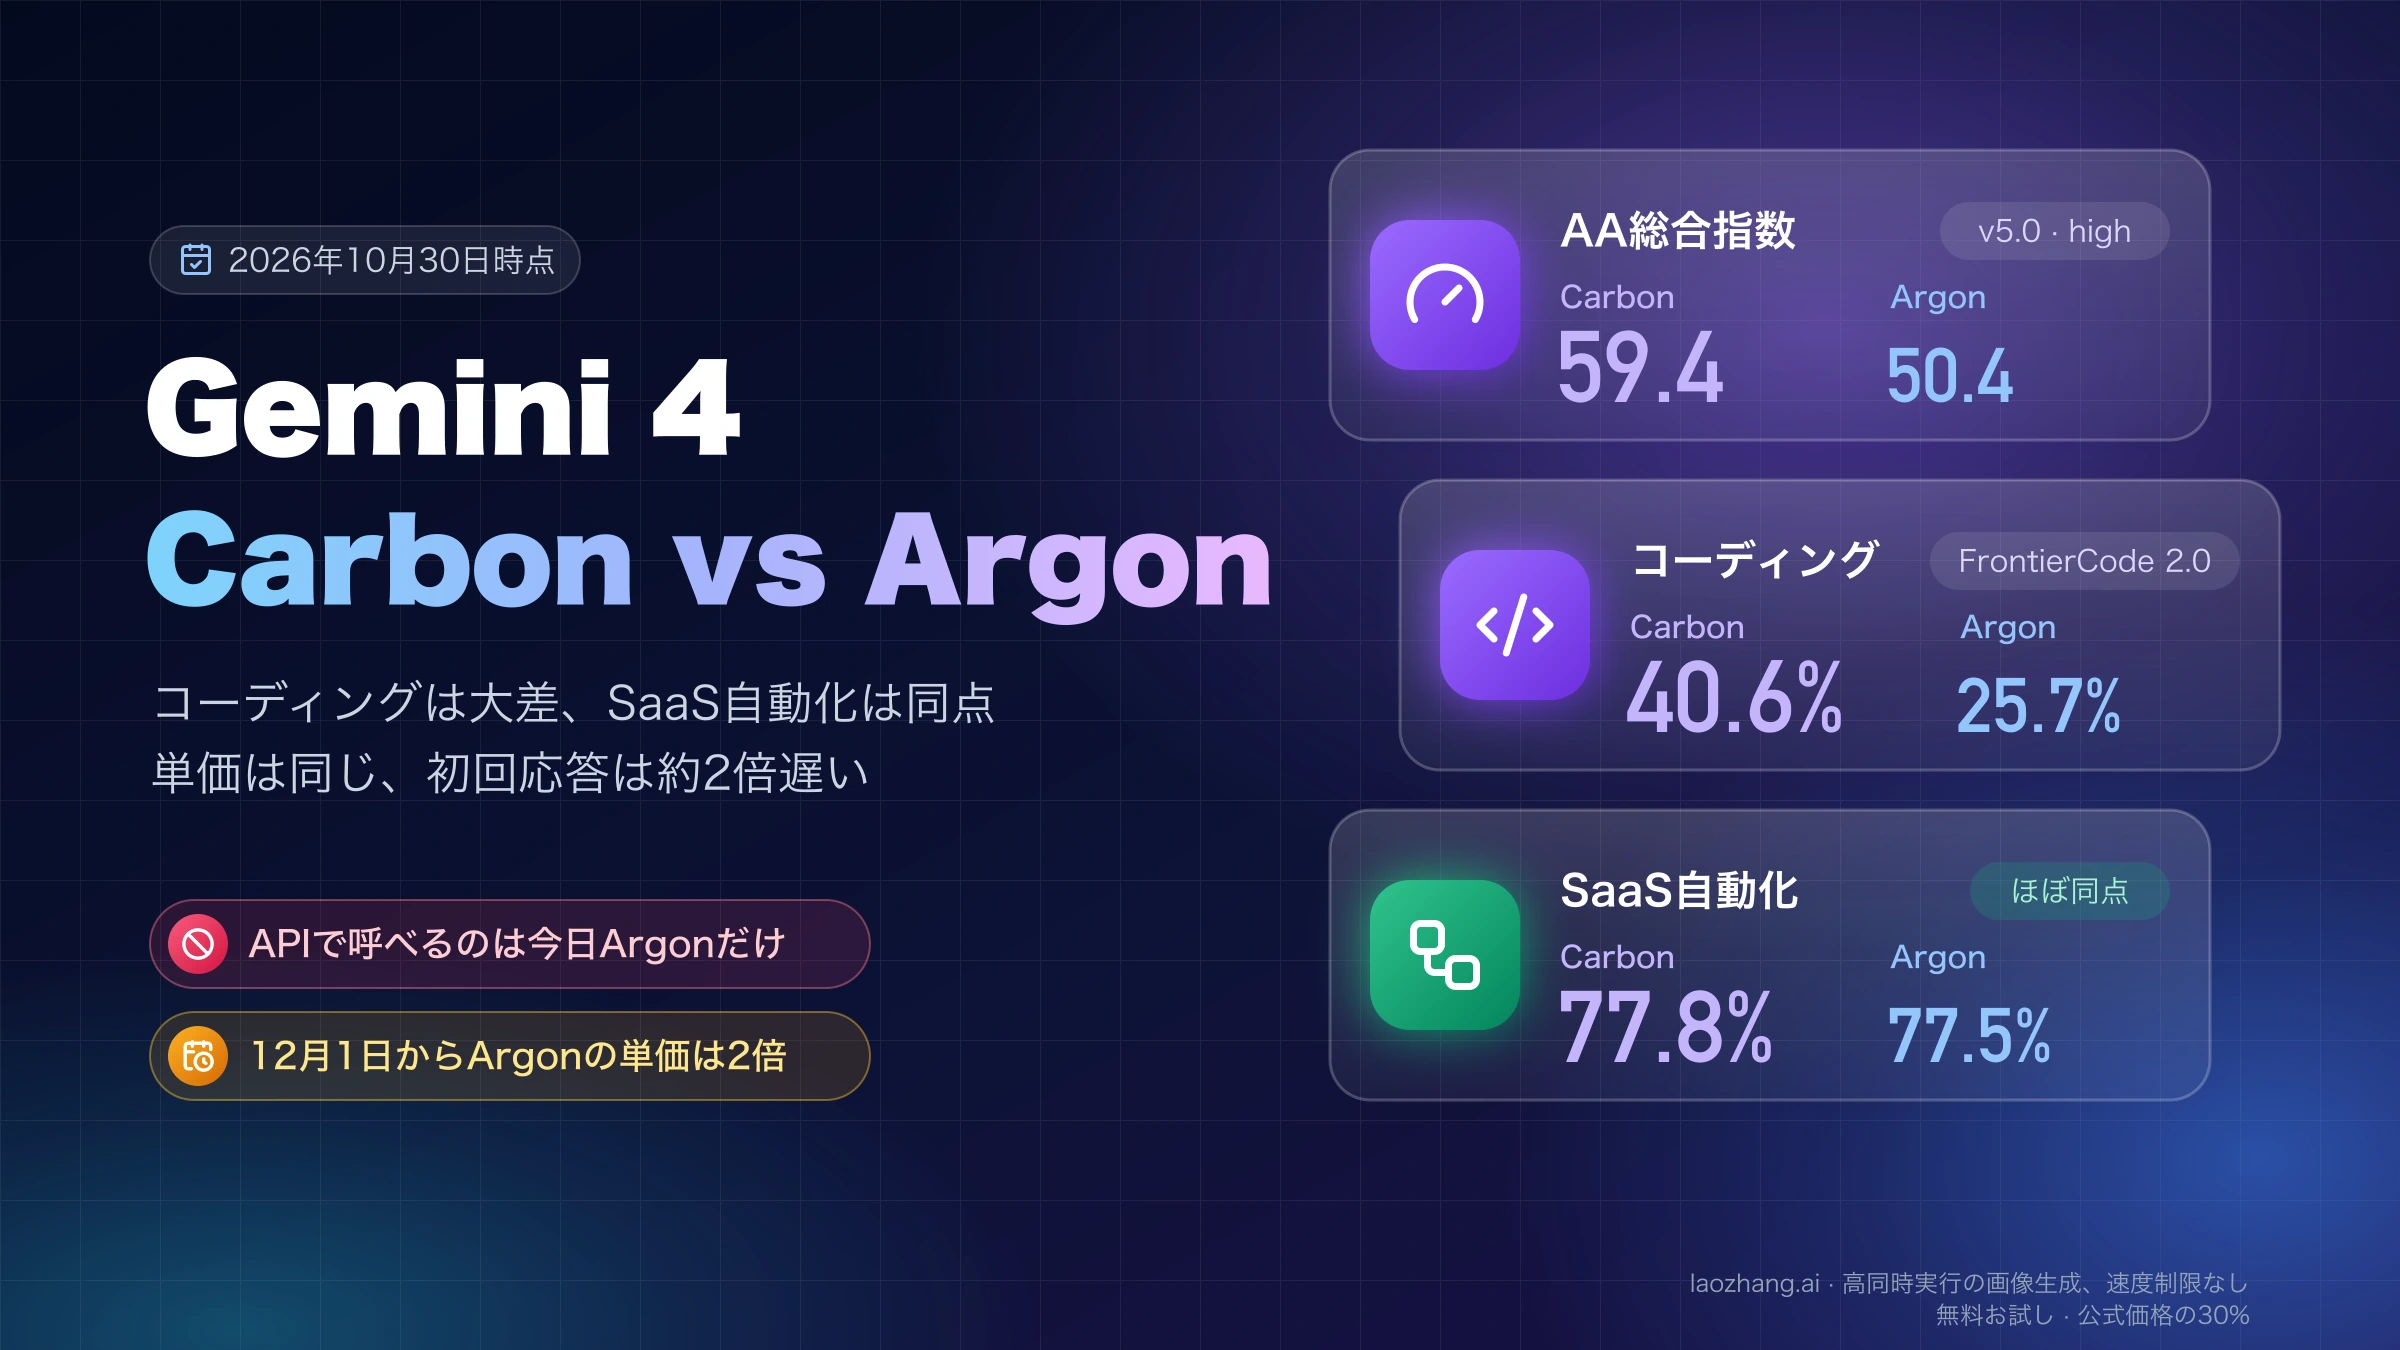
2026年11月4日時点のAA総合指数v5.0.1では、Gemini 4 Argon(High)が50.41、Claude Fable 5.1(xhigh)が50.02です。差は0.4ポイントで、1ポイント未満の差はAAの計測のぶれの範囲に入るため、どちらが上とは言えません。差がつくのは、同じ点数を出すまでの費用と待ち時間です。
比べる前に、設定名の違いを押さえておく必要があります。Argonは思考レベル(thinkingLevel)をlow・medium・highから選び、既定はmediumで、思考を完全に切ることはできません(Gemini APIの思考に関するドキュメント)。Fableは推論の強さ(effort)をlowからmaxまで5段階で選び、既定はhighです(Claude APIのeffortドキュメント)。両社の「high」は名前が同じだけで、同じ計算量を意味しません。AAが計測したArgonはHighの1設定だけで、これはAPIの既定より1段上です。そのためFableとは、費用が同じ水準のhigh、点数が同じ水準のxhighの2通りで比べるのが公平です。
| 設定 | AA指数v5.0.1 | 1タスクの出力トークン | 1タスクの所要時間 | 最初のトークンまで |
|---|---|---|---|---|
| Gemini 4 Argon High | 50.41 | 116,368 | 1,362.9秒 | 41.5秒 |
Claude Fable 5.1 max | 49.16 | 117,941 | 1,066.4秒 | 252.5秒 |
Claude Fable 5.1 xhigh | 50.02 | 97,059 | 965.7秒 | 79.5秒 |
Claude Fable 5.1 high(既定) | 47.17 | 66,031 | 719.8秒 | 18.3秒 |
Claude Fable 5.1 medium | 43.17 | 48,545 | 537.1秒 | 14.7秒 |
Claude Fable 5.1 low | 38.68 | 37,837 | 421.3秒 | 2.6秒 |
出典:AAのGemini 4 ArgonのページとAAのGemini 4 Argon対Claude Fable 5.1比較ページ、2026年11月4日時点。
費用が同じ水準のhigh同士なら、Argon Highが3.2ポイント上です。点数をそろえるならFableはxhighが必要で、最初のトークンが返るまでの時間はArgonの41.5秒に対してFable xhighは79.5秒になります。v5.0.1ではFableのmaxがxhighより点数が低く、時間は長くかかるので、maxまで上げる理由は総合点からは見つかりません。逆に、すぐに返事がほしい対話ではFableの既定highが18.3秒と速く、Argon Highの半分以下で書き始めます。
別の第三者指標も同じ結論です。Epoch AIの能力指数ECI(2026年11月3日更新)はFable 5.1が166.36、Argonが166.07で、信頼区間が大きく重なっています。AAは2026年10月に指数をv5.0系へ切り替え、11月にv5.0.1へ更新したため、9〜10月に出回った「AAで約53の同点」「0.79ポイント差」といった旧指数v4.3.2の数字は、現在の点数とは比べられません。Vals AIの総合指数は10月19日にv2.2へ更新され、Argonは69.24%で32モデル中4位ですが、Fable 5.1は現在のランキングに載っておらず、以前の65.83%はv2.1の数字です。
評価別の勝ち負け:Argonは自動化とターミナル、Fableは資料作業とコード
総合点が同じでも、評価ごとの向きははっきり分かれます。AA v5.0.1の9評価のうち、Argonは自動化(AutomationBench)とターミナル系(Terminal-Bench 4.0、Terminal-Bench-Science)の3評価で上回り、Fableはオフィス・知的作業(Briefcase)、難しいコーディング(FrontierCode)、文書を使う推論(GDP.pdf)、高難度の知識問題(HLE-Diamond)で上回ります。残りの2評価(AA-OmniscienceとCritPt v2 Hard)は、Fable maxと比べるとほぼ同点です。Fable xhighと比べた場合は、CritPt v2 HardでFableが上、AA-OmniscienceでArgonが上になります。
| AA v5.0.1の評価 | Argon High | Fable 5.1 max | Fable 5.1 xhigh |
|---|---|---|---|
| AutomationBench-AA | 77.5% | 59.4% | 57.8% |
| Terminal-Bench 4.0 | 57.1% | 52.0% | 55.1% |
| Terminal-Bench-Science | 52.9% | 43.3% | 40.5% |
| AA-Briefcase | 1484 | 1669 | 1649 |
| FrontierCode 2.0 | 25.7% | 31.6% | 35.7% |
| GDP.pdf | 21.8% | 26.2% | 26.2% |
| HLE-Diamond | 56.7% | 60.1% | 58.8% |
| AA-Omniscience | 46.1 | 46.3 | 44.3 |
| CritPt v2 Hard | 52.5% | 52.5% | 60.0% |
出典は前節と同じAAの比較ページ(2026年11月4日時点)。指数全体を1回走らせた費用は、Argon Highが$6,103、Fable maxが$13,327でした。
AutomationBenchの差は18〜20ポイントと大きく、ツールを順に呼び出して手続きを片づける仕事ではArgonを先に試す根拠になります。Fableが勝つ評価は、資料や表を読んで成果物を作る仕事と、仕様の難しいコードを書く仕事に集中しています。FrontierCodeではxhighがmaxより高く、コーディングでもmaxが最善とは限りません。
Googleが2026年9月30日の発表で示した比較表では、共通する17項目のうちArgonが15項目で上回り、FableはFrontierSWE v2(55.0対56.3)とTerminal-bench 4.0(57.4対57.9)の2項目だけで上でした(GoogleのGemini 4 Argon発表記事)。Argonの差が大きいのは自動化(AutomationBench 51.3対31.4)、法務エージェント(Harvey Legal Agent 19.6対6.7)、長文脈の参照(GraphWalks 256k〜1Mで84.2対65.0)、グラフ読解(Chartography 71.6対46.2)です。ただし、これはGoogleが両モデルを自社で測ったベンダー計測で、Argonは最も高い思考設定です。Terminal-Bench 4.0はAAの計測ではArgonが上なので、数ポイントの差は計測方法しだいで入れ替わると考えてください。
1タスクの費用:AAの指数タスクでは12月以降ほぼ同額
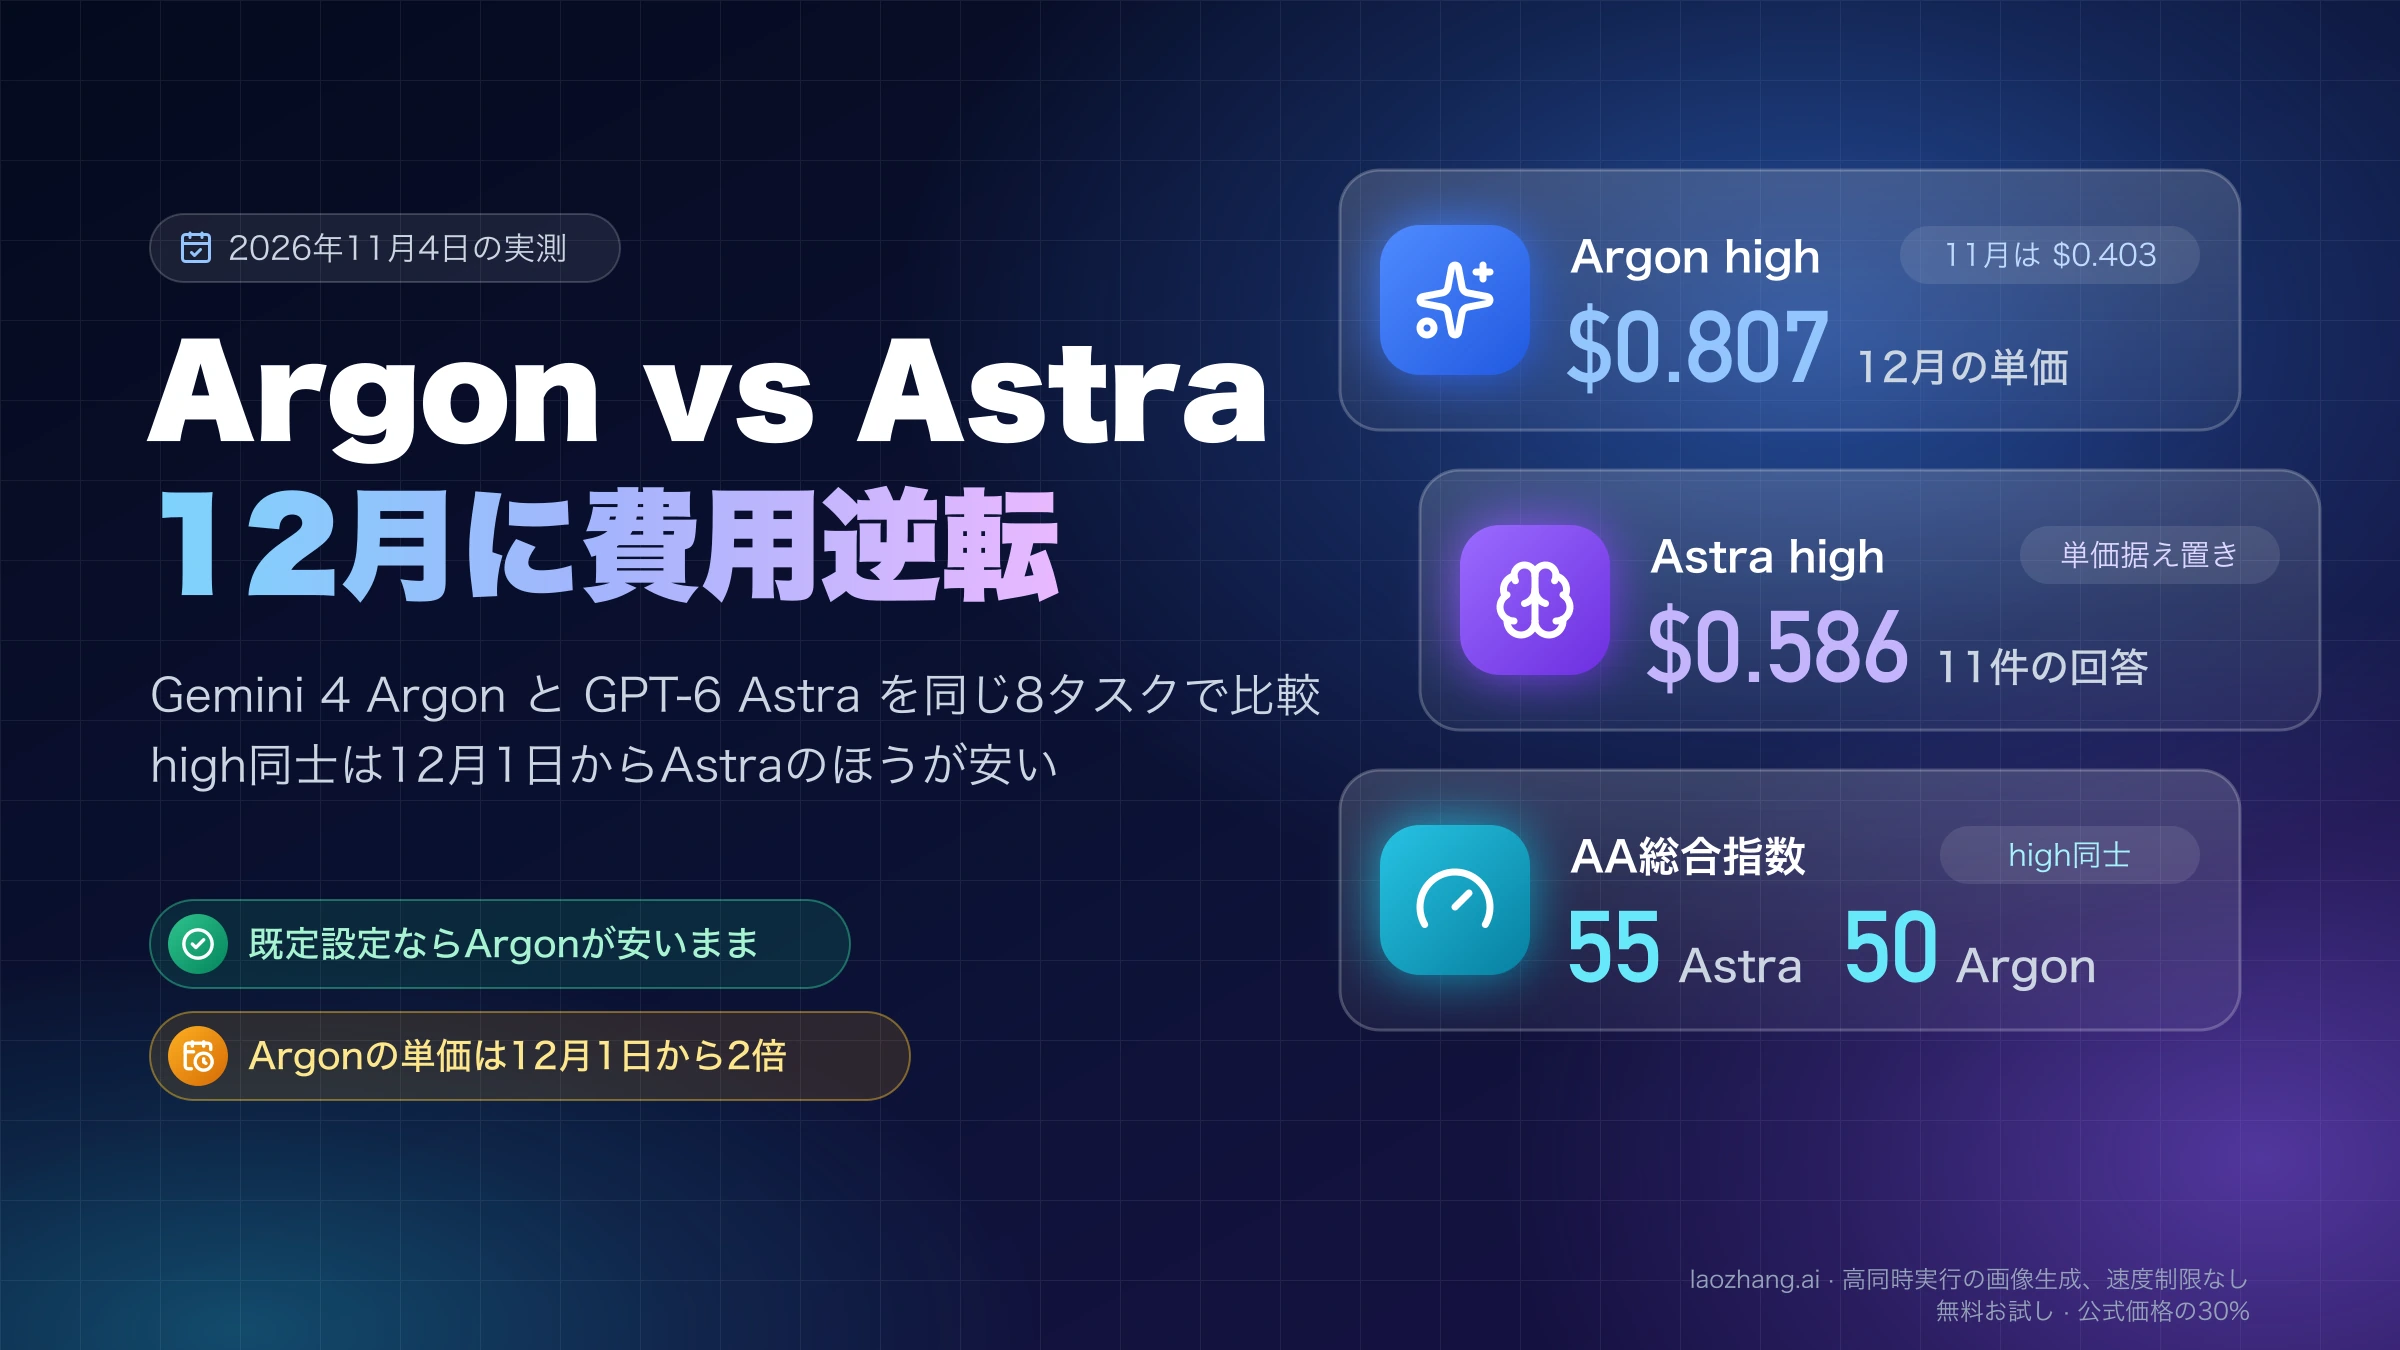
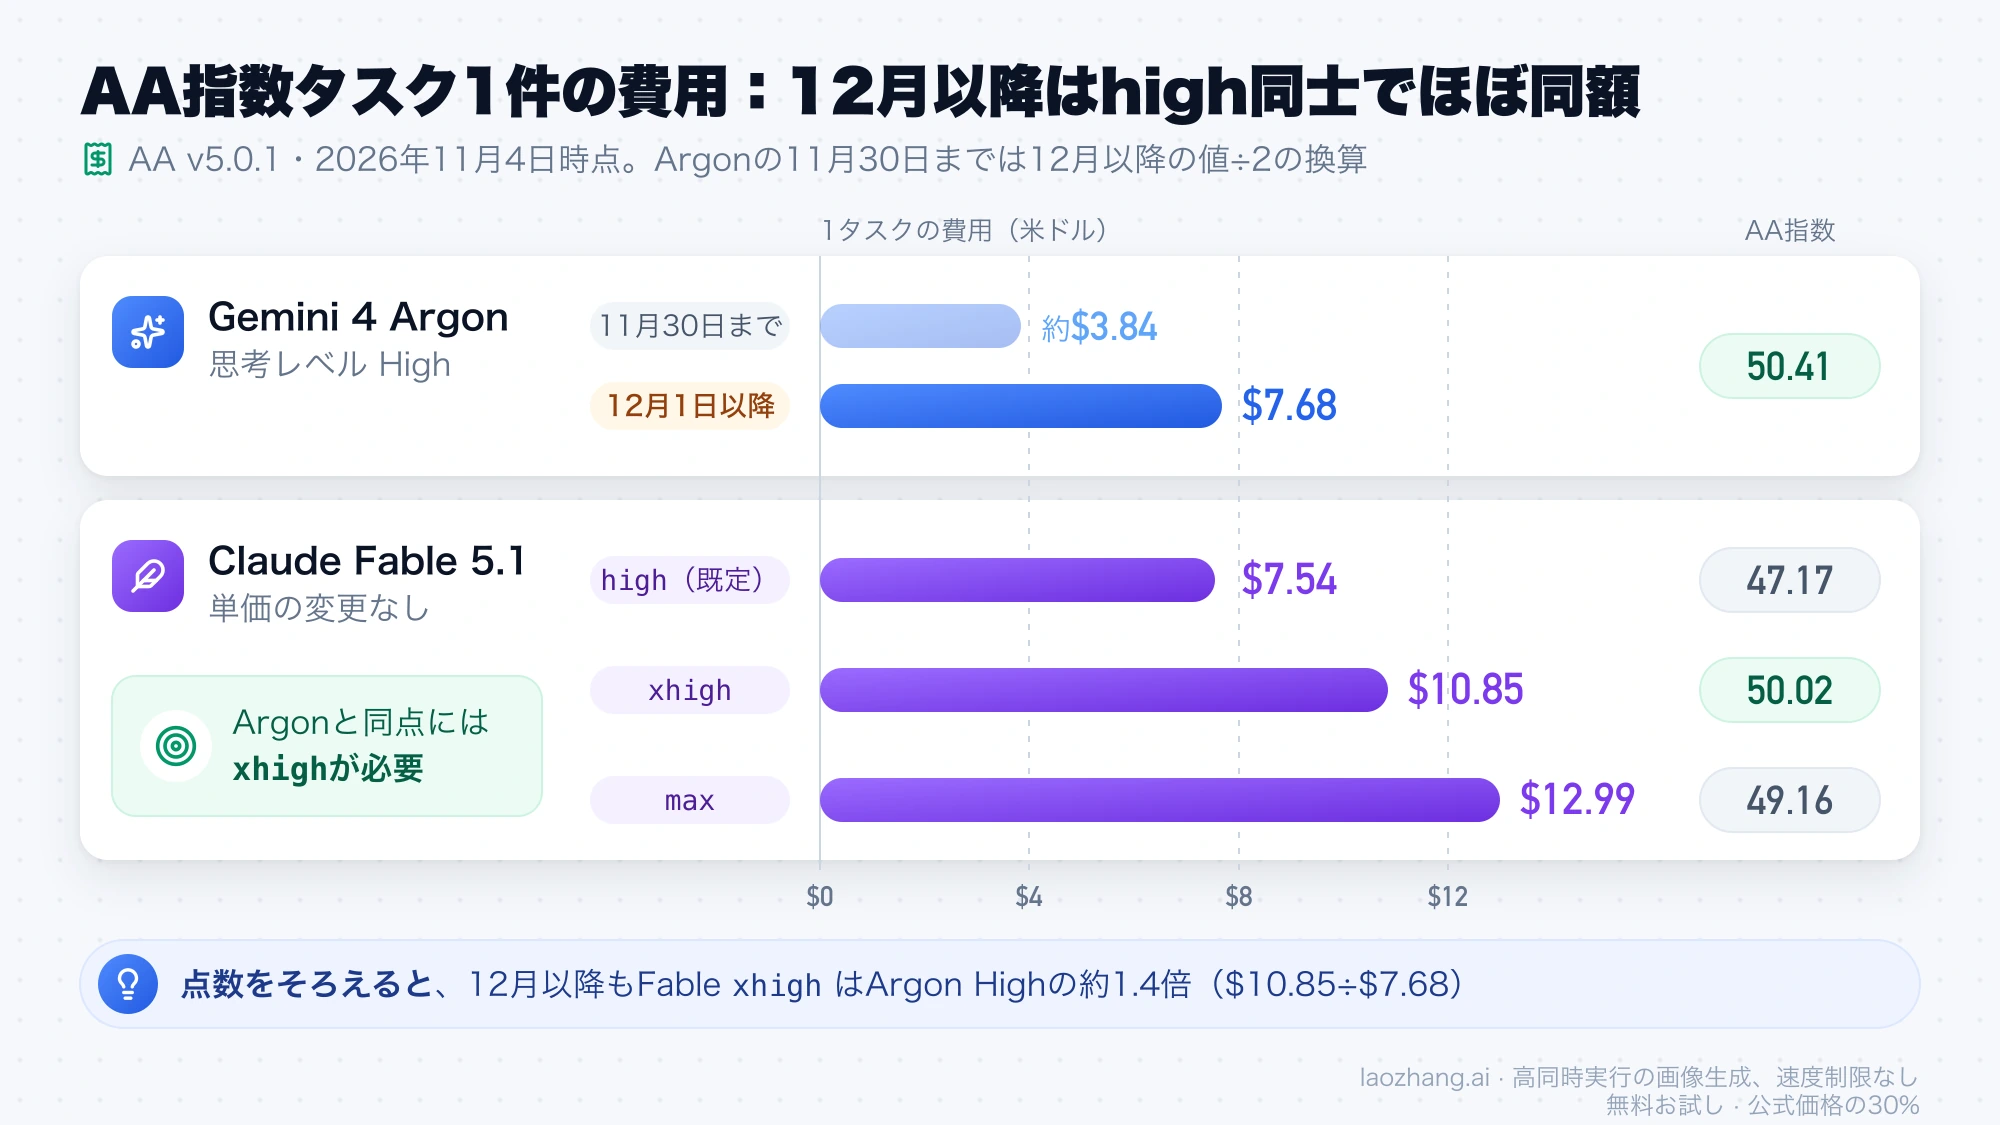
AAの指数タスク1件あたりの費用で見ると、12月1日以降の単価ではArgon Highが$7.68、Fable 5.1の既定(high)が$7.54でほぼ同じです。11月30日まではArgonの単価がすべて半分なので、Argon Highは約$3.84になり、Fable highはその約2.0倍、同じ点数のxhighは約2.8倍です。
| 設定 | AA指数v5.0.1 | 1タスク:11月30日まで | 1タスク:12月1日以降 |
|---|---|---|---|
| Gemini 4 Argon High | 50.41 | 約$3.84 | $7.68 |
Claude Fable 5.1 high(既定) | 47.17 | $7.54 | $7.54 |
Claude Fable 5.1 xhigh | 50.02 | $10.85 | $10.85 |
Claude Fable 5.1 max | 49.16 | $12.99 | $12.99 |
12月1日以降の列はAAの公表値で、AAはすでにArgonの12月以降の単価で計算しています。11月30日までのArgonの約$3.84は、Argonの単価がすべて半分であることから$7.68を2で割った換算値で、AAの公表値ではありません。点数をそろえて比べると、12月1日以降もFable xhighはArgon Highの約1.4倍($10.85÷$7.68)です。
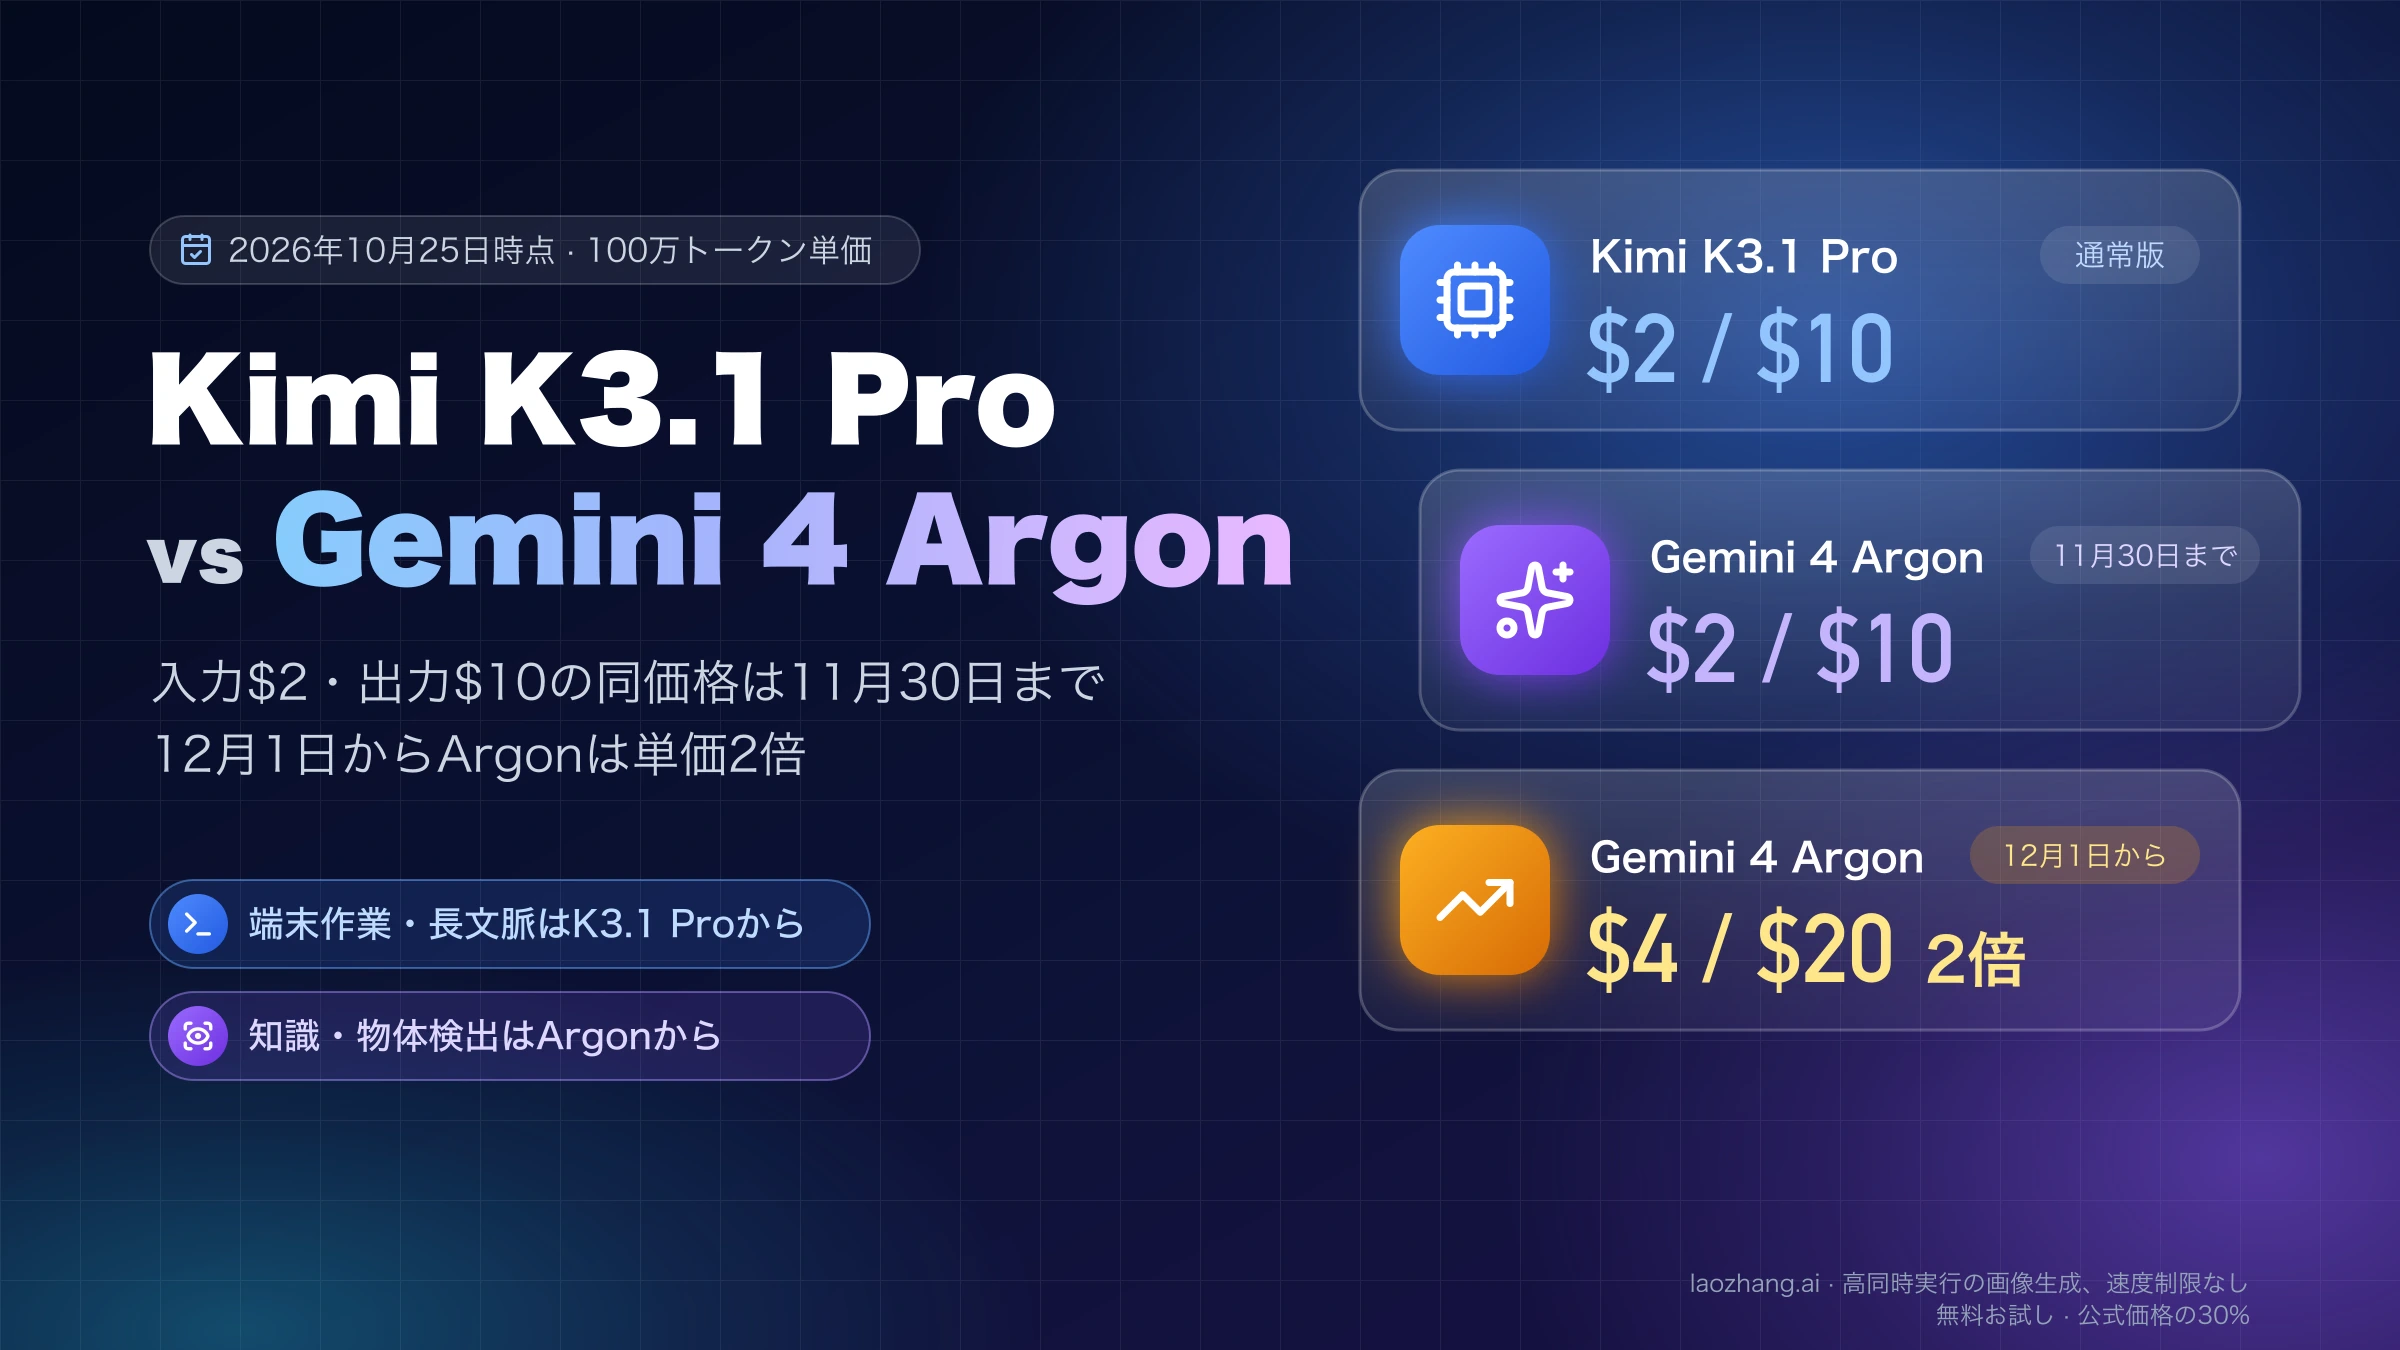
単価そのものは次のとおりです。100万トークンあたりで、Gemini 4 Argonは入力$2.00・出力$10.00・キャッシュ入力$0.10が11月30日まで、12月1日から入力$4.00・出力$20.00・キャッシュ入力$0.20になり、思考トークンは出力として課金されます(Gemini APIの料金ページ)。Claude Fable 5.1は入力$10・出力$50・キャッシュ読み出し$0.25で(Claude APIの料金ページ)、12月1日に変わるのはArgonの単価だけです。単価の差は入出力とも11月30日までが5倍、12月1日以降は2.5倍に縮まります。急がない処理なら、ArgonのBatch・Flexは入力$1・出力$5(12月1日から$2・$10)、FableのBatchは入力$5・出力$25です。Googleは導入価格の延長について何も発表していません。課金の細部はGemini API料金確認:3.8 Flashは2027年に2倍、無料枠超過は前払いとClaude Fable 5.1のAPI料金:単価と月額の目安にまとめています。
AAの指数タスクは、Argon Highが1件で11万トークン以上を出力する重い課題です。短い依頼を大量にこなす使い方では、出力の量も思考の量も違うので、次の実測の倍率のほうが実態に近くなります。
同じ8タスクの実測:全問合格、日常作業の費用はFableが8.6倍
2026年11月4日、Claude Fable 5.1が10月26日に解いたのと同じ8タスクを、同じAPIゲートウェイ(LaoZhang API)経由でGemini 4 Argonに解かせました。隠しテストによる採点では、Argonの既定設定、Argonのhigh、Fableの既定(high)の3設定とも11回すべて合格で、品質の差は出ていません。差が出たのは費用と時間です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
タスクは2回に分けています。日常的な5タスク(文章題、区間のマージ、時間表記の解析、頻出語の集計、6,723語の英文記事の要約)を各1回、難しめの3タスク(数式の評価器、CSV行のパーサー、桁和のパズル)を各2回です。Argonの既定はthinkingConfigを付けない呼び出し(Googleの既定はmedium)で、Gemini APIの形式で呼び出しました。キャッシュとツールは使っていません。Fableは10月26日の結果を使い、11月4日にそのうち1タスクを1回呼び直して、モデルIDと入力トークン数が変わっていないことを確かめています。費用は、各APIが返したトークン数に定価を掛けた値です。
| 設定 | 合格 | 日常5タスク(11月30日まで→12月1日以降) | 難しめ3タスク×2(同) | 出力トークン(うち思考) | 11回の所要時間 |
|---|---|---|---|---|---|
| Argonの既定 | 11/11 | $0.0384→$0.0768 | $0.0556→$0.1112 | 6,859(1,531) | 128秒 |
Argon high | 11/11 | $0.1364→$0.2728 | $0.2565→$0.5130 | 36,746(31,016) | 532秒 |
| Fable 5.1の既定 | 11/11 | $0.3310 | $0.3073 | 9,327(思考を含む、内訳なし) | 116秒 |
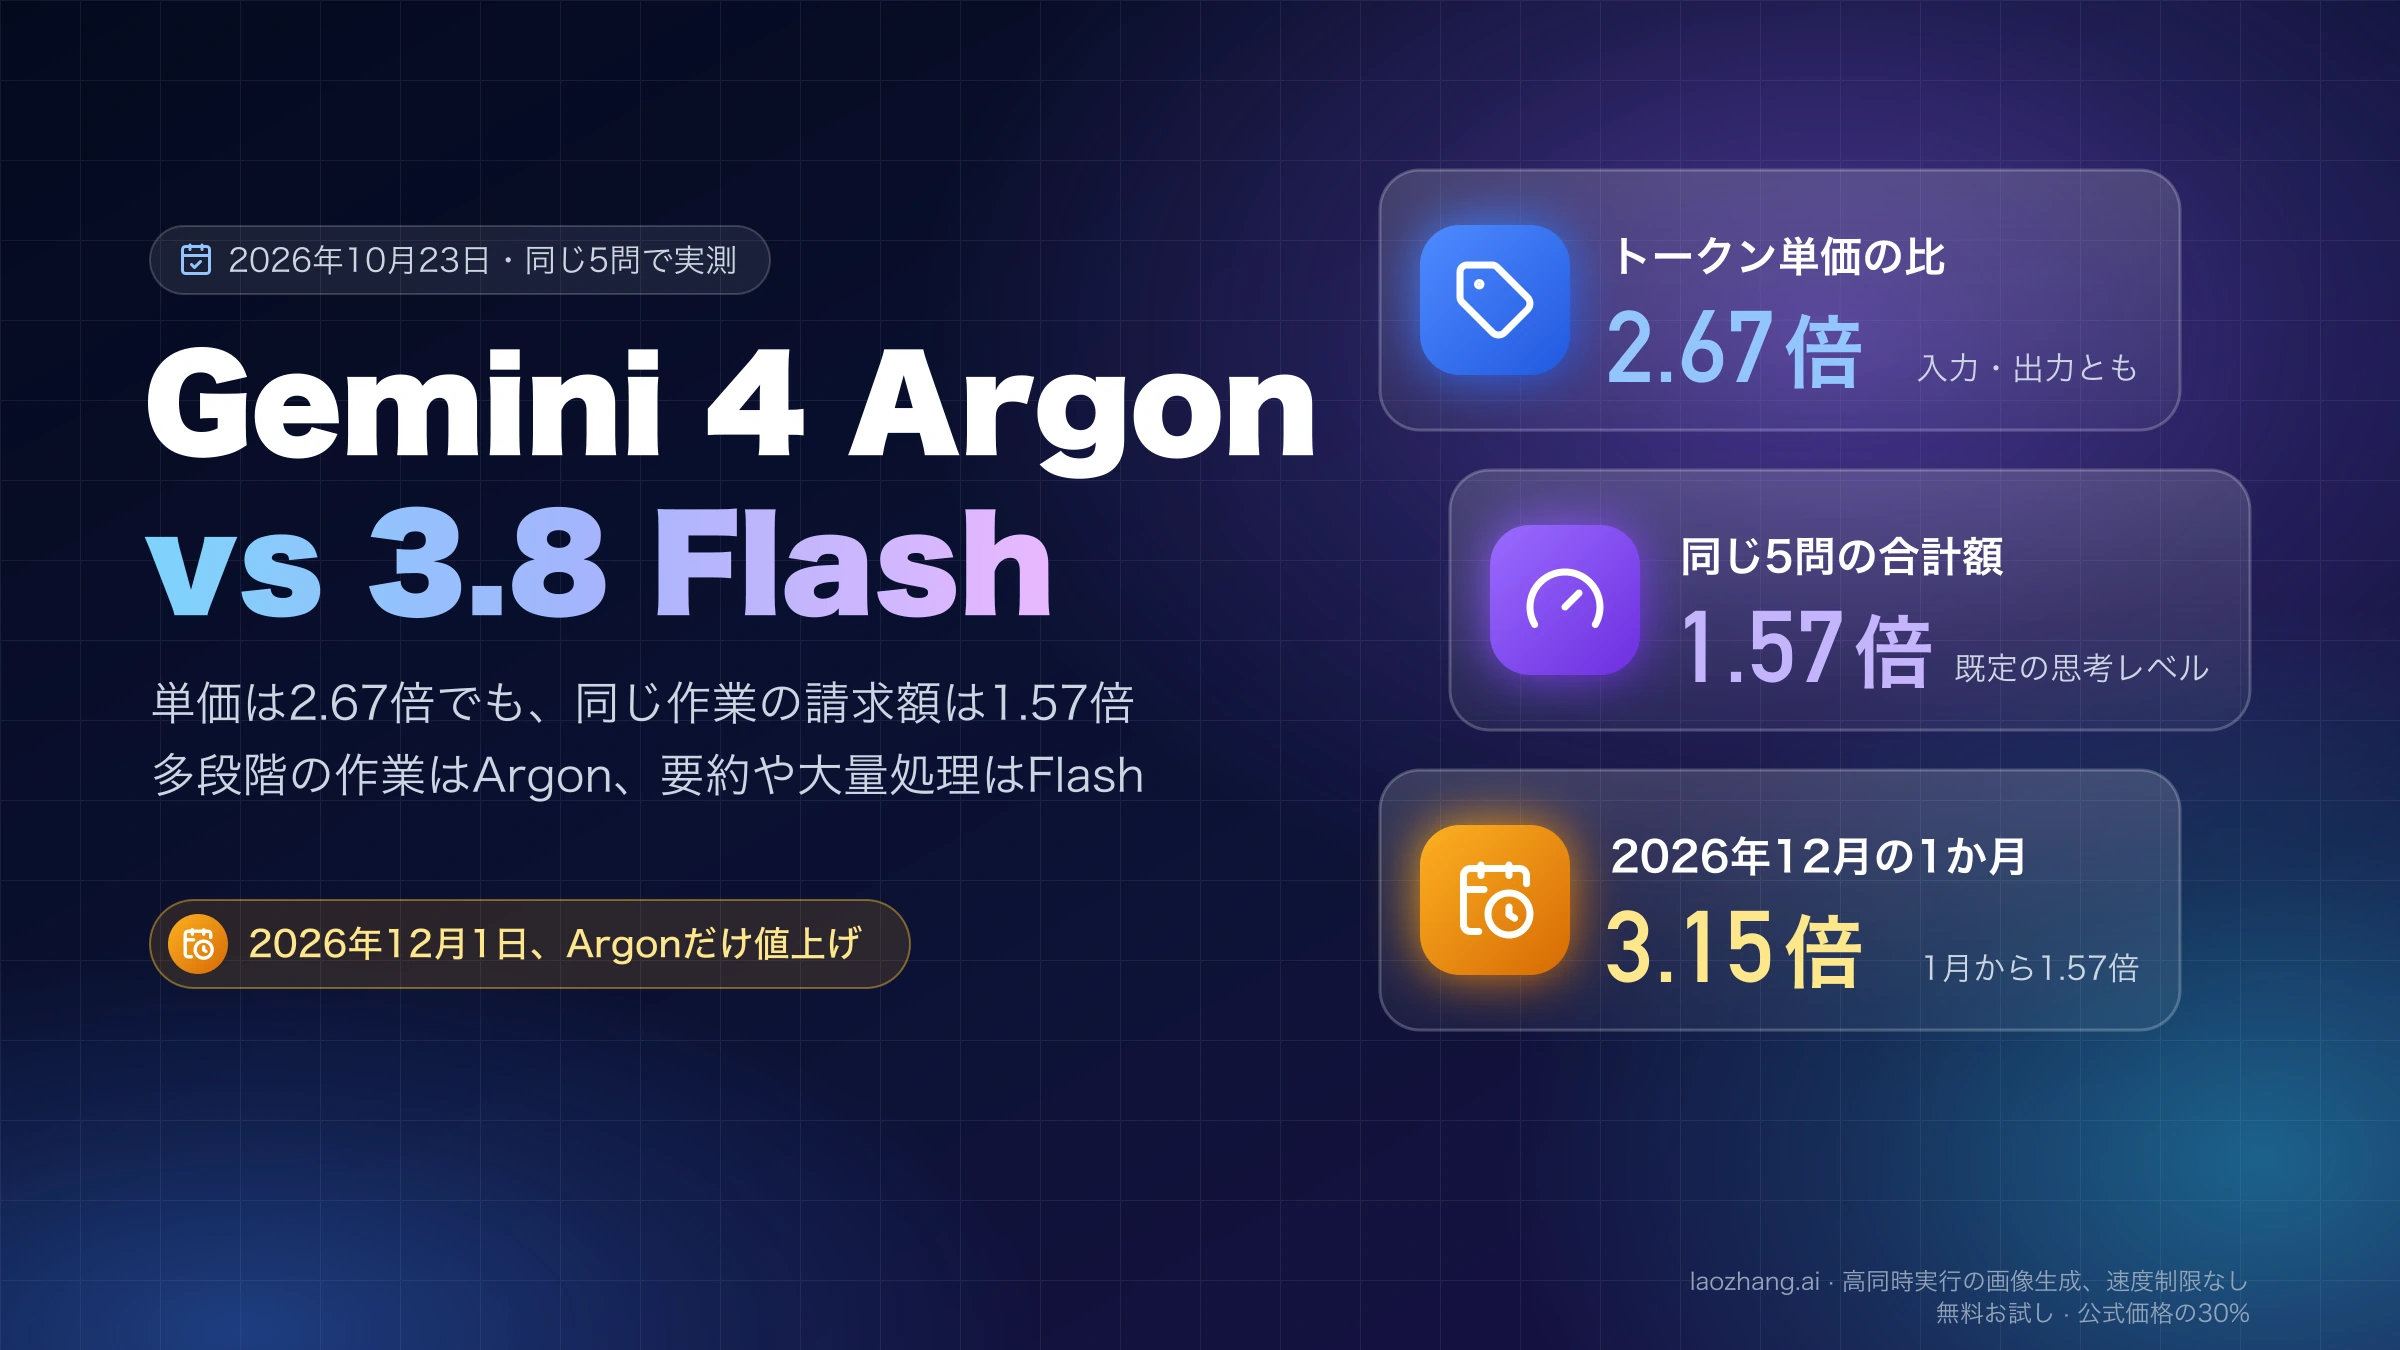
日常5タスクでは、FableはArgon既定の8.6倍の費用で、12月1日以降の単価でも4.3倍です。難しめの3タスクでは5.5倍が2.8倍になります。Argonの既定は11回中9回で思考トークンが0で、考えたのは桁和のパズルだけでした。そのため出力が短く、時間もFableとほぼ同じです。
Argonをhighにすると話が変わります。すべての呼び出しで思考し、出力トークンは既定の5倍以上に増え、所要時間はFableの約4.6倍になりました。難しめの3タスクの費用は12月1日以降の単価で$0.5130となり、Fable既定の$0.3073を上回ります。FableがArgon highの0.60倍で済む計算で、highのArgonは「安いほう」ではなくなります。日常5タスクでも、Fableとの差は11月30日までの2.4倍から12月1日以降は1.2倍まで縮みます。
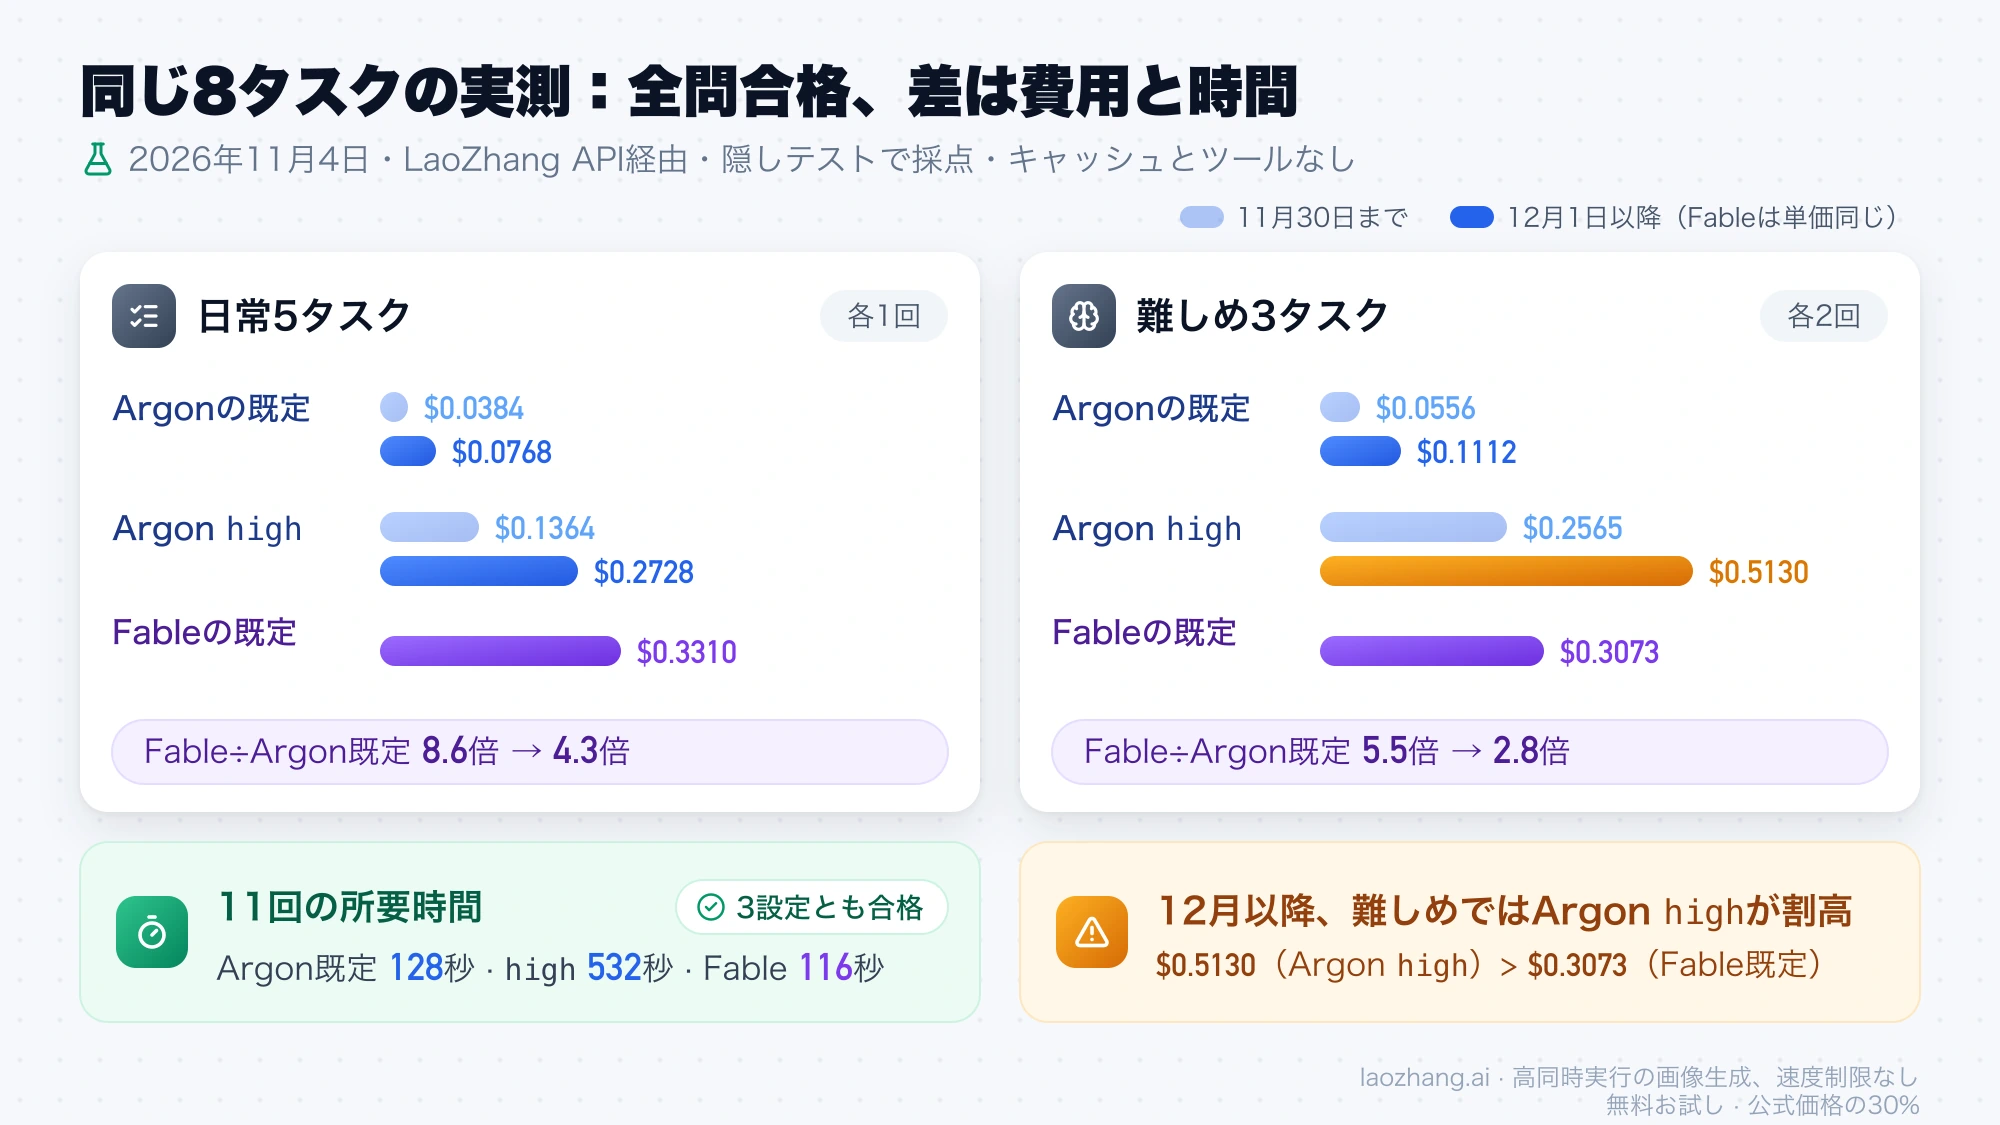
この実測から言えるのは、仕様がはっきりした小さなタスクでは両モデルとも正解し、既定どうしならArgonが大幅に安いということです。逆に、エージェントのループ、ツール呼び出し、数万トークンの長い出力、キャッシュを使う運用は試しておらず、サンプルも1タスク1〜2回です。同じFableでも10月26日と11月4日で同じタスクの出力が773トークンと674トークンに分かれたように、回ごとのばらつきもあります。品質の優劣は、前の2節のAAとGoogleの表で判断してください。なお、LaoZhang APIの料金表ではArgonが入力$2・出力$10、Fable 5.1が入力$10・出力$50で、Argonの12月1日以降の扱いは公表されていません。
日本語の入力はFableで1.85倍のトークンになる
同じ日本語の文章を入力すると、Claude Fable 5.1はGemini 4 Argonの1.85倍のトークンとして数えます。単価差と掛け合わせると、キャッシュなしの入力の請求は11月30日までで約9.2倍、12月1日以降で約4.6倍です。単価の差(5倍、12月以降2.5倍)だけで見積もると、日本語の仕事ではFableの請求を小さく見積もることになります。
2026年11月4日の計測では、344文字の日本語の文章をArgonは169トークン、Fableは312トークンと数えました(指示文だけの呼び出しとの差から文章部分を取り出した値で、Fableの数は10月26日に同じ文章で計測)。同じ内容の英語版(685文字)では1.45倍、6,723語の英文記事ではArgonの11,110トークンに対してFableが15,335トークンで1.38倍です。日本語は英語よりも差が開きます。Fable 5.1はClaude Opus 4.7で導入されたトークナイザーを使っており、Anthropicも旧世代のClaudeよりトークン数がおよそ30%多くなると説明しています(Claude APIのトークン数の数え方)。
計算式は「単価の倍率×トークン数の倍率」で、日本語の入力なら11月30日までが5×1.85≒9.2倍、12月1日以降が2.5×1.85≒4.6倍です。出力側は思考の量しだいで、前節の実測ではFableの出力トークンがArgon既定の1.4倍、Argon highの0.25倍でした。長い日本語の資料を毎回読ませる要約や検索拡張のように入力が大半を占める仕事ほど、Argonへ移したときの節約は大きくなります。
仕事別の使い分け:どの作業をArgonへ移すか
移す候補は、エージェントの自動化、ツール呼び出しを多用する処理、ターミナル作業、入力の多い大量処理です。Fableに残す候補は、資料・表計算を扱う知的作業、難しいコーディング、すぐに返事がほしい対話、1回で長い文章を書かせる仕事です。どちらの場合も、2026年11月4日時点のAA v5.0.1の評価別スコアと、ここまでの実測が根拠です。
| 仕事 | 先に試す設定 | 理由 | 判断が変わる条件 |
|---|---|---|---|
| ツールを順に呼ぶ自動化、エージェント | Argonの既定 | AutomationBenchでArgonが大差、既定は費用も小さい | 失敗したタスクだけhighを試し、合格1件の費用で比べる |
| ターミナル操作、科学計算の手順実行 | Argonの既定 | AAのTerminal-Bench系2評価でArgonが上 | Googleの表ではTerminal-Bench 4.0がほぼ同点 |
| 日本語の長い資料の要約・検索拡張 | Argonの既定 | 入力がFableで1.85倍に数えられる | 固定の長い前置きを繰り返すならFableのキャッシュも比較 |
| 資料・表計算を使うオフィス業務 | Fable high | BriefcaseとGDP.pdfでFableが上 | 出力が短く件数が多いなら費用差が効く |
| 仕様の難しいコーディング | Fable xhigh | FrontierCodeでxhighが最も高い | 小さく明確な課題なら両者とも合格した |
| すぐ返事がほしい対話 | Fable high | 最初のトークンまでの時間がArgon Highの半分以下 | Argonの既定は実測でFableとほぼ同じ時間 |
すでにFableで安定している業務を一度に置き換える必要はありません。費用の大きい処理から順に、自分のタスクでArgonの既定を試し、合格率が変わらなければ移すのが安全です。合格率が下がった仕事でArgonをhighに上げると、12月1日以降は費用の優位が消えることがあるので、その場合はFableに残すほうが安上がりになり得ます。
キャッシュ・出力上限・データ保持で答えが変わる場合
単価と実測の倍率は、キャッシュの使い方、1回に必要な出力の長さ、データ保持の要件で変わります。どれも実測では試していない条件なので、該当する場合は自分の構成で確かめてください。
キャッシュの仕組みは両社でまったく違います。Fableのキャッシュ読み出し$0.25は、リクエストにcache_controlを付けたときだけ適用され、書き込みは5分保持で$12.50、1時間保持で$20かかります。Argonは明示的なキャッシュに対応しておらず、Googleが自動で行う暗黙キャッシュだけです。対象になるのは約4,000〜6,000トークン以上のプロンプトで、Gemini APIの最新モデルガイドは4,096トークン、Google Cloudのページには6,144トークンとする箇所があります。キャッシュ読み出しの単価差は11月30日までが2.5倍、12月1日以降は1.25倍に縮むため、長い共通の前置きを毎回読み直す構成では、Fableでもキャッシュを確実に効かせれば差は小さくなります。10月30日の別の検証では、LaoZhang API経由のArgonのキャッシュヒットは断続的で一部にとどまりました。詳しくはClaudeプロンプトキャッシュの使い方:5分/1時間の損益分岐と実測値とGeminiコンテキストキャッシュの使い方:損益分岐と実測ヒット率を参照してください。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
1回の出力の上限も違います。Argonは同期リクエスト1回で65,536トークンまでで、ストリーミングなしの1往復は32,768トークンで止まります。それ以上はbackground=trueの長時間デコードか、クライアント側で続きを要求する方法で最大1,048,576トークンまで伸ばせます(Gemini 4 Argonのモデルページ)。途中で切れた回答の扱いはGemini 4 Argon APIのfinish_reason:途中で切れる回答の続け方にまとめています。Fableは1回で128Kトークンまで出力でき、high以上ではmax_tokensを大きく取るようAnthropicが勧めています。ただし、LaoZhang API経由のClaudeは1回の出力が32,768トークンまでです。
データ保持の条件も確認が必要です。Fable 5.1は30日間のデータ保持が必須とされているため(Claude Fable 5.1のモデル概要)、社内規程で保持を認めない場合は候補から外れます。
アプリとコーディングツールで使うには:Google AI ProとClaude Pro以上
アプリでGemini 4 Argonを使うにはGoogle AI ProかUltra、Claude Fable 5.1を使うにはClaudeのPro以上が必要です。どちらも無料プランでは使えず、Googleのプラン特典はAPIの利用料には充てられません。
Geminiアプリでは、2026年10月13日からGoogle AI Pro(米国で月$19.99)とUltra(月$99.99または$199.99、最も多い利用枠)でArgonが使えます。Google AI Plus(月$4.99)はFlashモデルだけでArgonは含まれず、価格は国によって異なります(Google AIプランの料金ページ)。Google AI StudioのWeb画面もProとUltraにArgonの枠があり、無料ユーザーにはありません(Google AI StudioのGoogle AIプランの説明)。コーディングでは、10月下旬時点で有料のGoogle AI ProとUltraがAntigravityでArgonを使え、アプリとは別の週間枠です。Gemini CLIはArgon向けに最適化されていないとして、Antigravityが案内されています。Googleは利用量に応じた上限を5時間ごとに回復させ、週の上限を設けていますが、Argonのプロンプト回数は公表していません。
Claudeの無料プランではFable 5.1は使えません。Proプラン(月$20、年払いなら月$17)だとFable 5.1は最初のメッセージから使用クレジットで支払う扱いです。Max(月$100)とUltra(月$200)は、週の利用上限の半分までFableを使え、それを超えると使用クレジットか別のモデルに切り替わります。この「半分」は同じ週の上限の中の上限で、追加の枠ではありません。MaxとUltraには毎月$100と$200のAPIクレジットも付きます。プラン名は2026年10月30日に、旧Max 5xがMax、旧Max 20xがUltraへ変わりました。Claude CodeでFable 5.1を使うには、バージョン2.1.255以降が必要です(ClaudeのFableモデルとプランの説明)。
乗り換える前に自分のタスクで比べる手順
切り替えの判断は、自分の実際のタスクで合否と費用を並べてからにします。AAの点数も実測も、あなたのプロンプトでの結果ではないからです。次の順に進めると、設定の違いによる取り違えを避けられます。
- 実際の業務から10〜20件のタスクを選びます。うまくいった依頼だけでなく、以前に人が修正した依頼も入れ、テストの合格や必要な根拠など、合否の基準を先に決めておきます。
- Gemini 4 Argonは
thinkingConfigを付けない既定、Claude Fable 5.1は既定(effortはhigh)で、同じ入力を流します。OpenAI互換のエンドポイント経由ではArgonがreasoning_effortを無視するため、思考レベルを変えるときはGemini APIの形式でthinkingConfig.thinkingLevelを指定します。 - 各APIが返す使用量から、入力トークンと出力トークンを記録します。Argonの思考トークンは出力として課金され、Fableの出力トークンには思考が含まれます。費用は「入力トークン÷100万×入力単価+出力トークン÷100万×出力単価」で、11月30日までと12月1日以降の2つの単価で計算します。
- 不合格になったタスクだけ、Argonの
highとFableのxhighで再試行します。最後に、合格した1件あたりの費用と待ち時間で比べます。
日本語の長い入力が多い業務では、手順3の入力トークンの比が1.85倍前後になっているかも見ておくと、月の請求の見積もりがずれにくくなります。
Opus 5.5、GPT-6 Astra、Fable 5.5、Gemini 4 Carbonはどうか
Anthropicの中で選ぶなら、多くの用途はOpus 5.5から始め、Fable 5.1は高度な推論や長時間のエージェント作業、またはOpus 5.5のeffortを上げても自社の評価に届かない場合に使う、というのがAnthropic自身のモデル選択の案内です。Fable 5.1とOpus 5.5の単価や使い分けはClaude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?、ArgonとOpus 5.5・GPT-6.1 Solの比較はGemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:Argonは12月に単価2倍、OpenAIの最上位との比較はGPT-6 AstraとClaude Fable 5.1を比較:料金とトークン実測で選ぶで扱っています。Argonほどの性能が要らない仕事なら、Gemini 4 Argonと3.8 Flashの違い:実測コストと使い分けも参考になります。
Claude Fable 5.5とGemini 4 Carbonは、どちらも2026年11月4日時点で一般には使えません。Fable 5.5はAnthropicのドキュメント、APIのリリースノート、ニュースのどこにも載っておらず、Fable 5.1が最新のままです(経緯はFable 5.5・Gemini 4・GPT-6.1の提供状況比較:使えるのはSolとArgon)。Carbonは10月28日に発表されましたが、使えるのはサイバー防御に携わる一部の組織だけで、公開のモデルIDもAPIも提供時期もなく、GoogleはArgonの提供終了も告げていません(Gemini 4 Carbonとは:防御者限定でAPI未公開、一般公開はいつ?、Gemini 4 Carbon vs Argon:性能と料金、初回応答は約2倍遅い)。発表前に出回った「Gemini 4 Pro」は正式なモデル名ではなく、いま一般に使えるGemini 4はArgonです。
参考資料16
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月4日。
参考資料16
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月4日。
- 1.Gemini APIの思考に関するドキュメントaistudio.google.com/docs/thinking
- 2.Claude APIのeffortドキュメントplatform.claude.com/docs/en/build-with-claude/effort
- 3.AAのGemini 4 Argonのページartificialanalysis.ai/models/gemini-4-argon
- 4.AAのGemini 4 Argon対Claude Fable 5.1比較ページartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-1
- 5.Fable 5.1が166.36、Argonが166.07epoch.ai/benchmarks/eci
- 6.GoogleのGemini 4 Argon発表記事blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 7.Gemini APIの料金ページaistudio.google.com/docs/pricing
- 8.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 9.Claude APIのトークン数の数え方platform.claude.com/docs/en/build-with-claude/token-counting
- 10.Gemini APIの最新モデルガイドaistudio.google.com/docs/latest-model
- 11.Gemini 4 Argonのモデルページaistudio.google.com/docs/models/gemini-4-argon
- 12.Claude Fable 5.1のモデル概要platform.claude.com/docs/en/models/fable-5-1/overview
- 13.Google AIプランの料金ページgemini.google/us/subscriptions
- 14.Google AI StudioのGoogle AIプランの説明aistudio.google.com/docs/google-ai-plans
- 15.ClaudeのFableモデルとプランの説明support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 16.モデル選択の案内platform.claude.com/docs/en/about-claude/models/overview