モデル比較
Claude Mythos Preview vs GPT-5.4: 今はGPT-5.4を使うべきか、それともMythosを追い続けるべきか
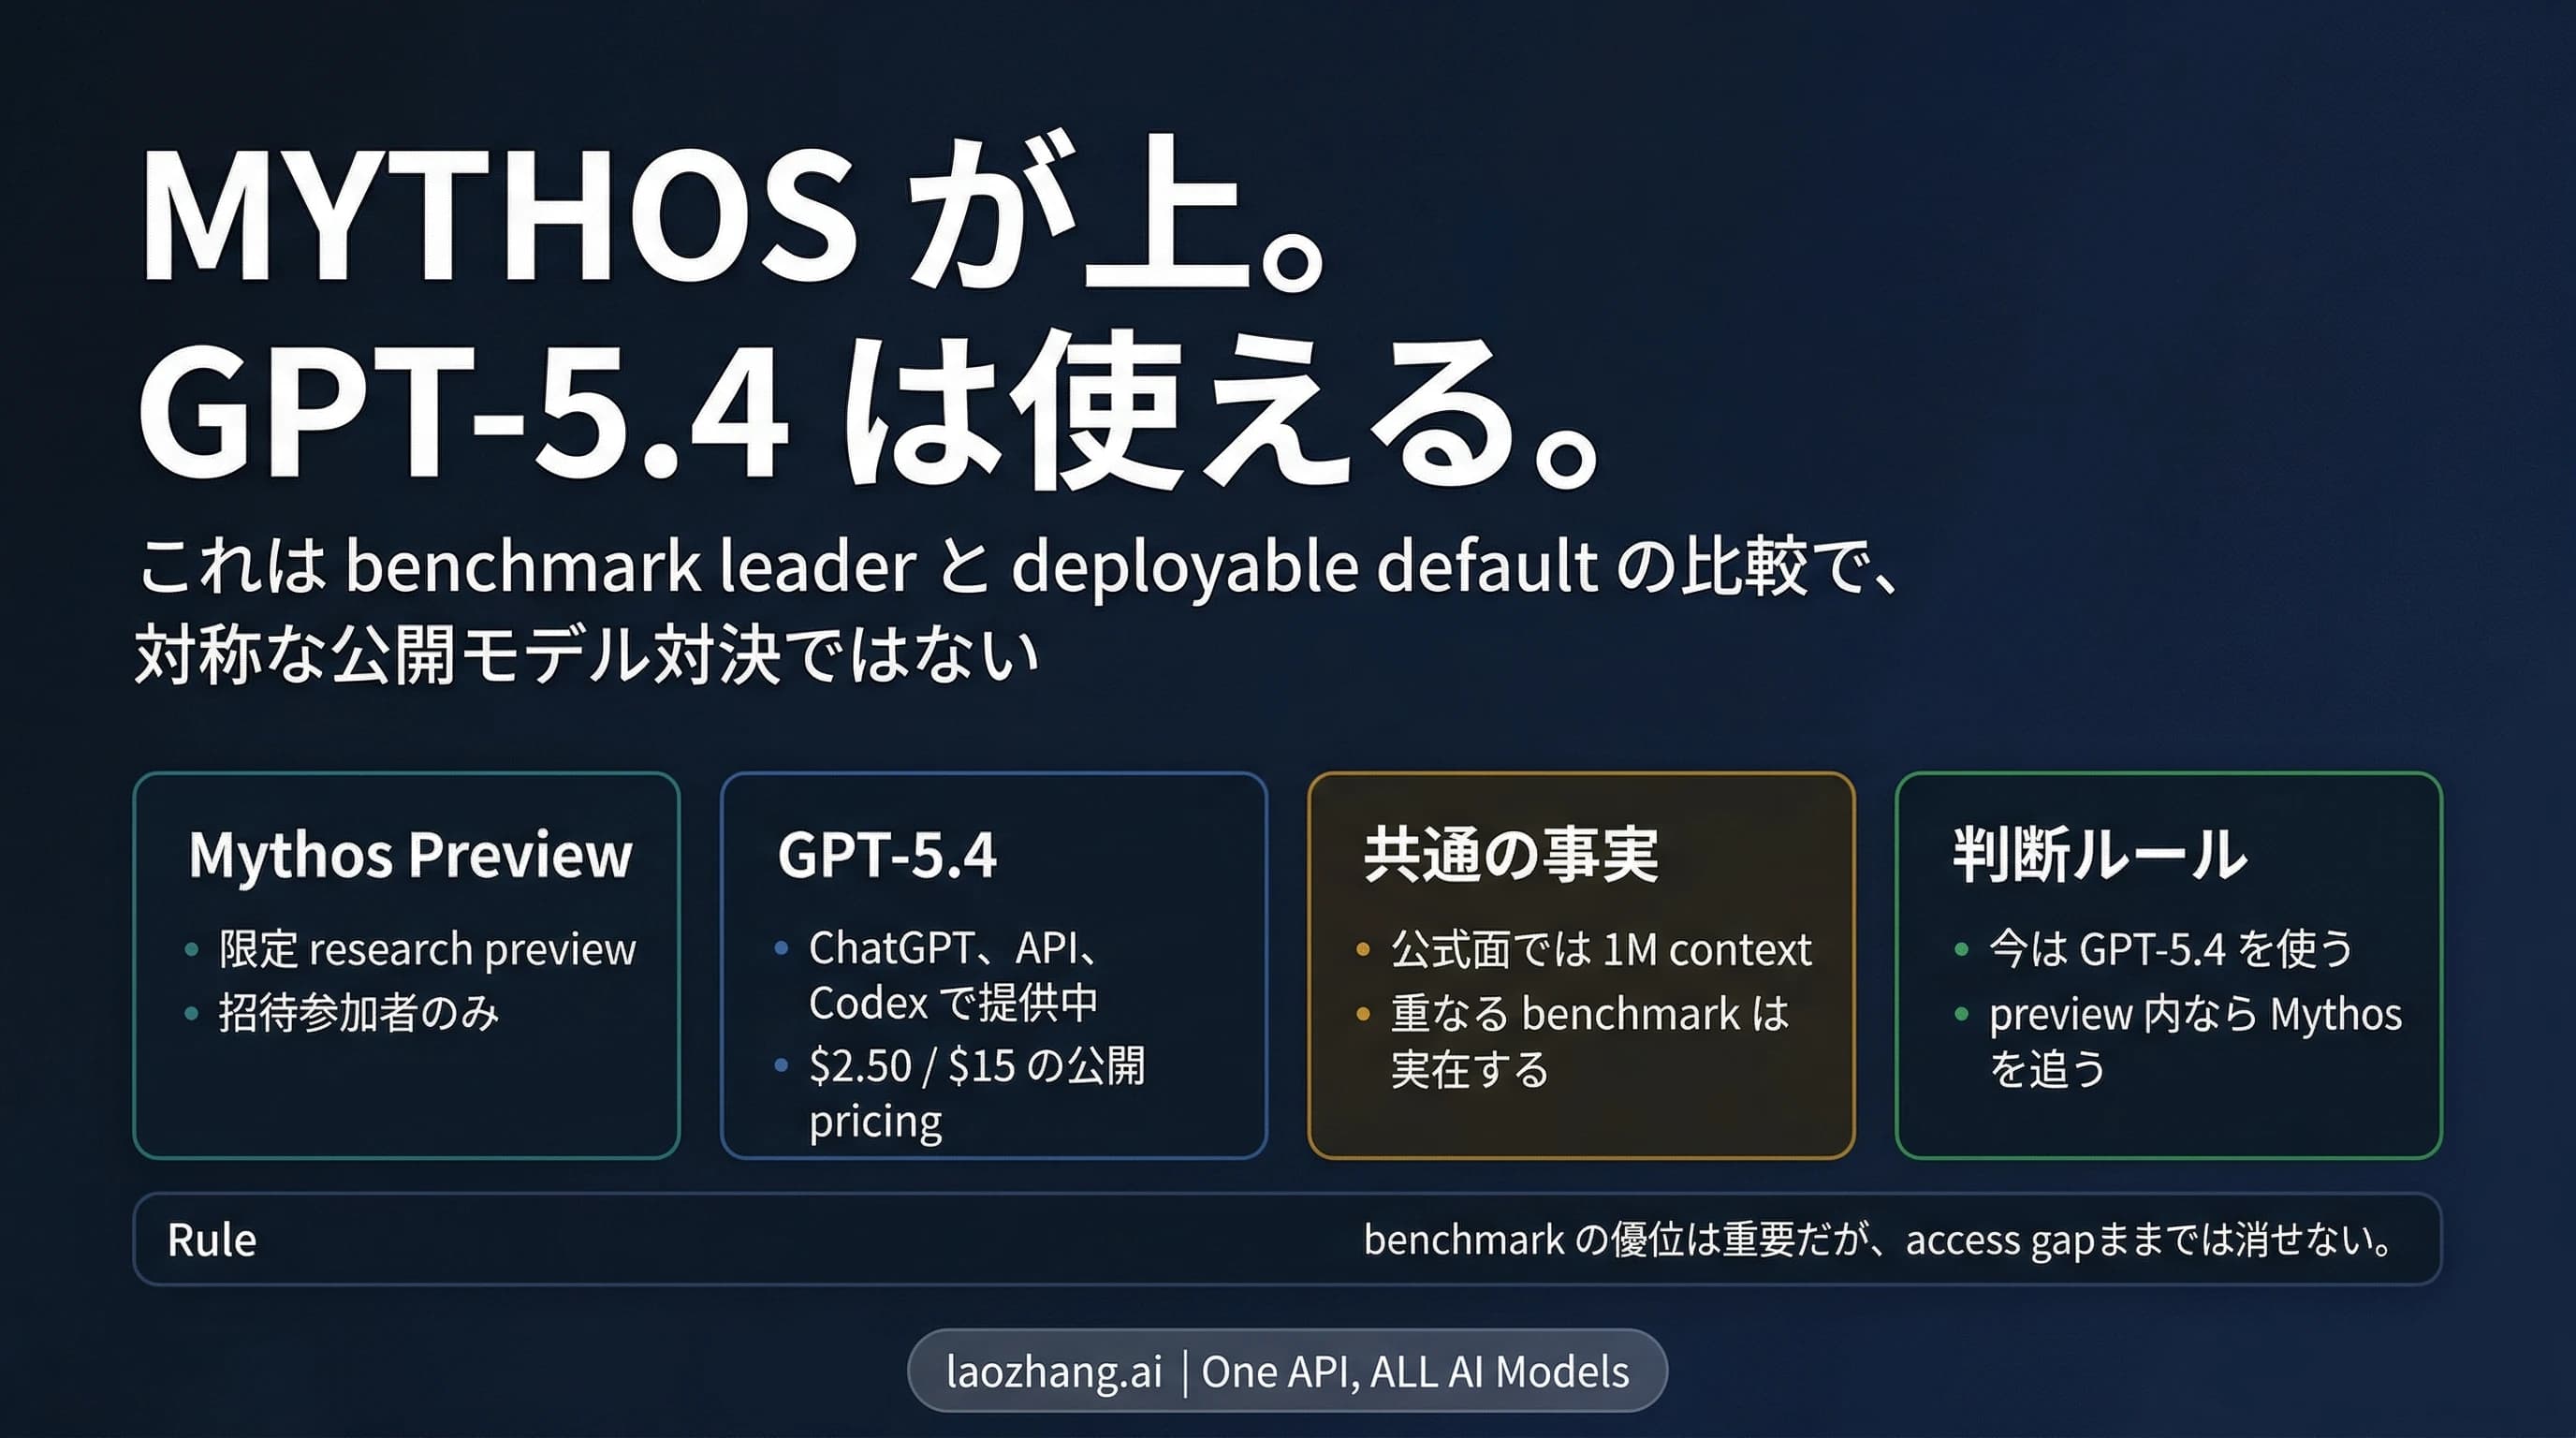
今すぐモデルが必要なら、実用上の答えはまだGPT-5.4です。Claude Mythos Previewが注目に値するのはAnthropic公式のベンチマークが強いからですが、現時点では通常の公開ルートではなく、招待制のresearch previewにとどまっています。
9 分
今すぐモデルが必要なら、実用上の答えはまだGPT-5.4です。Claude Mythos Previewが注目に値するのはAnthropic公式のベンチマークが強いからですが、現時点では通常の公開ルートではなく、招待制のresearch previewにとどまっています。
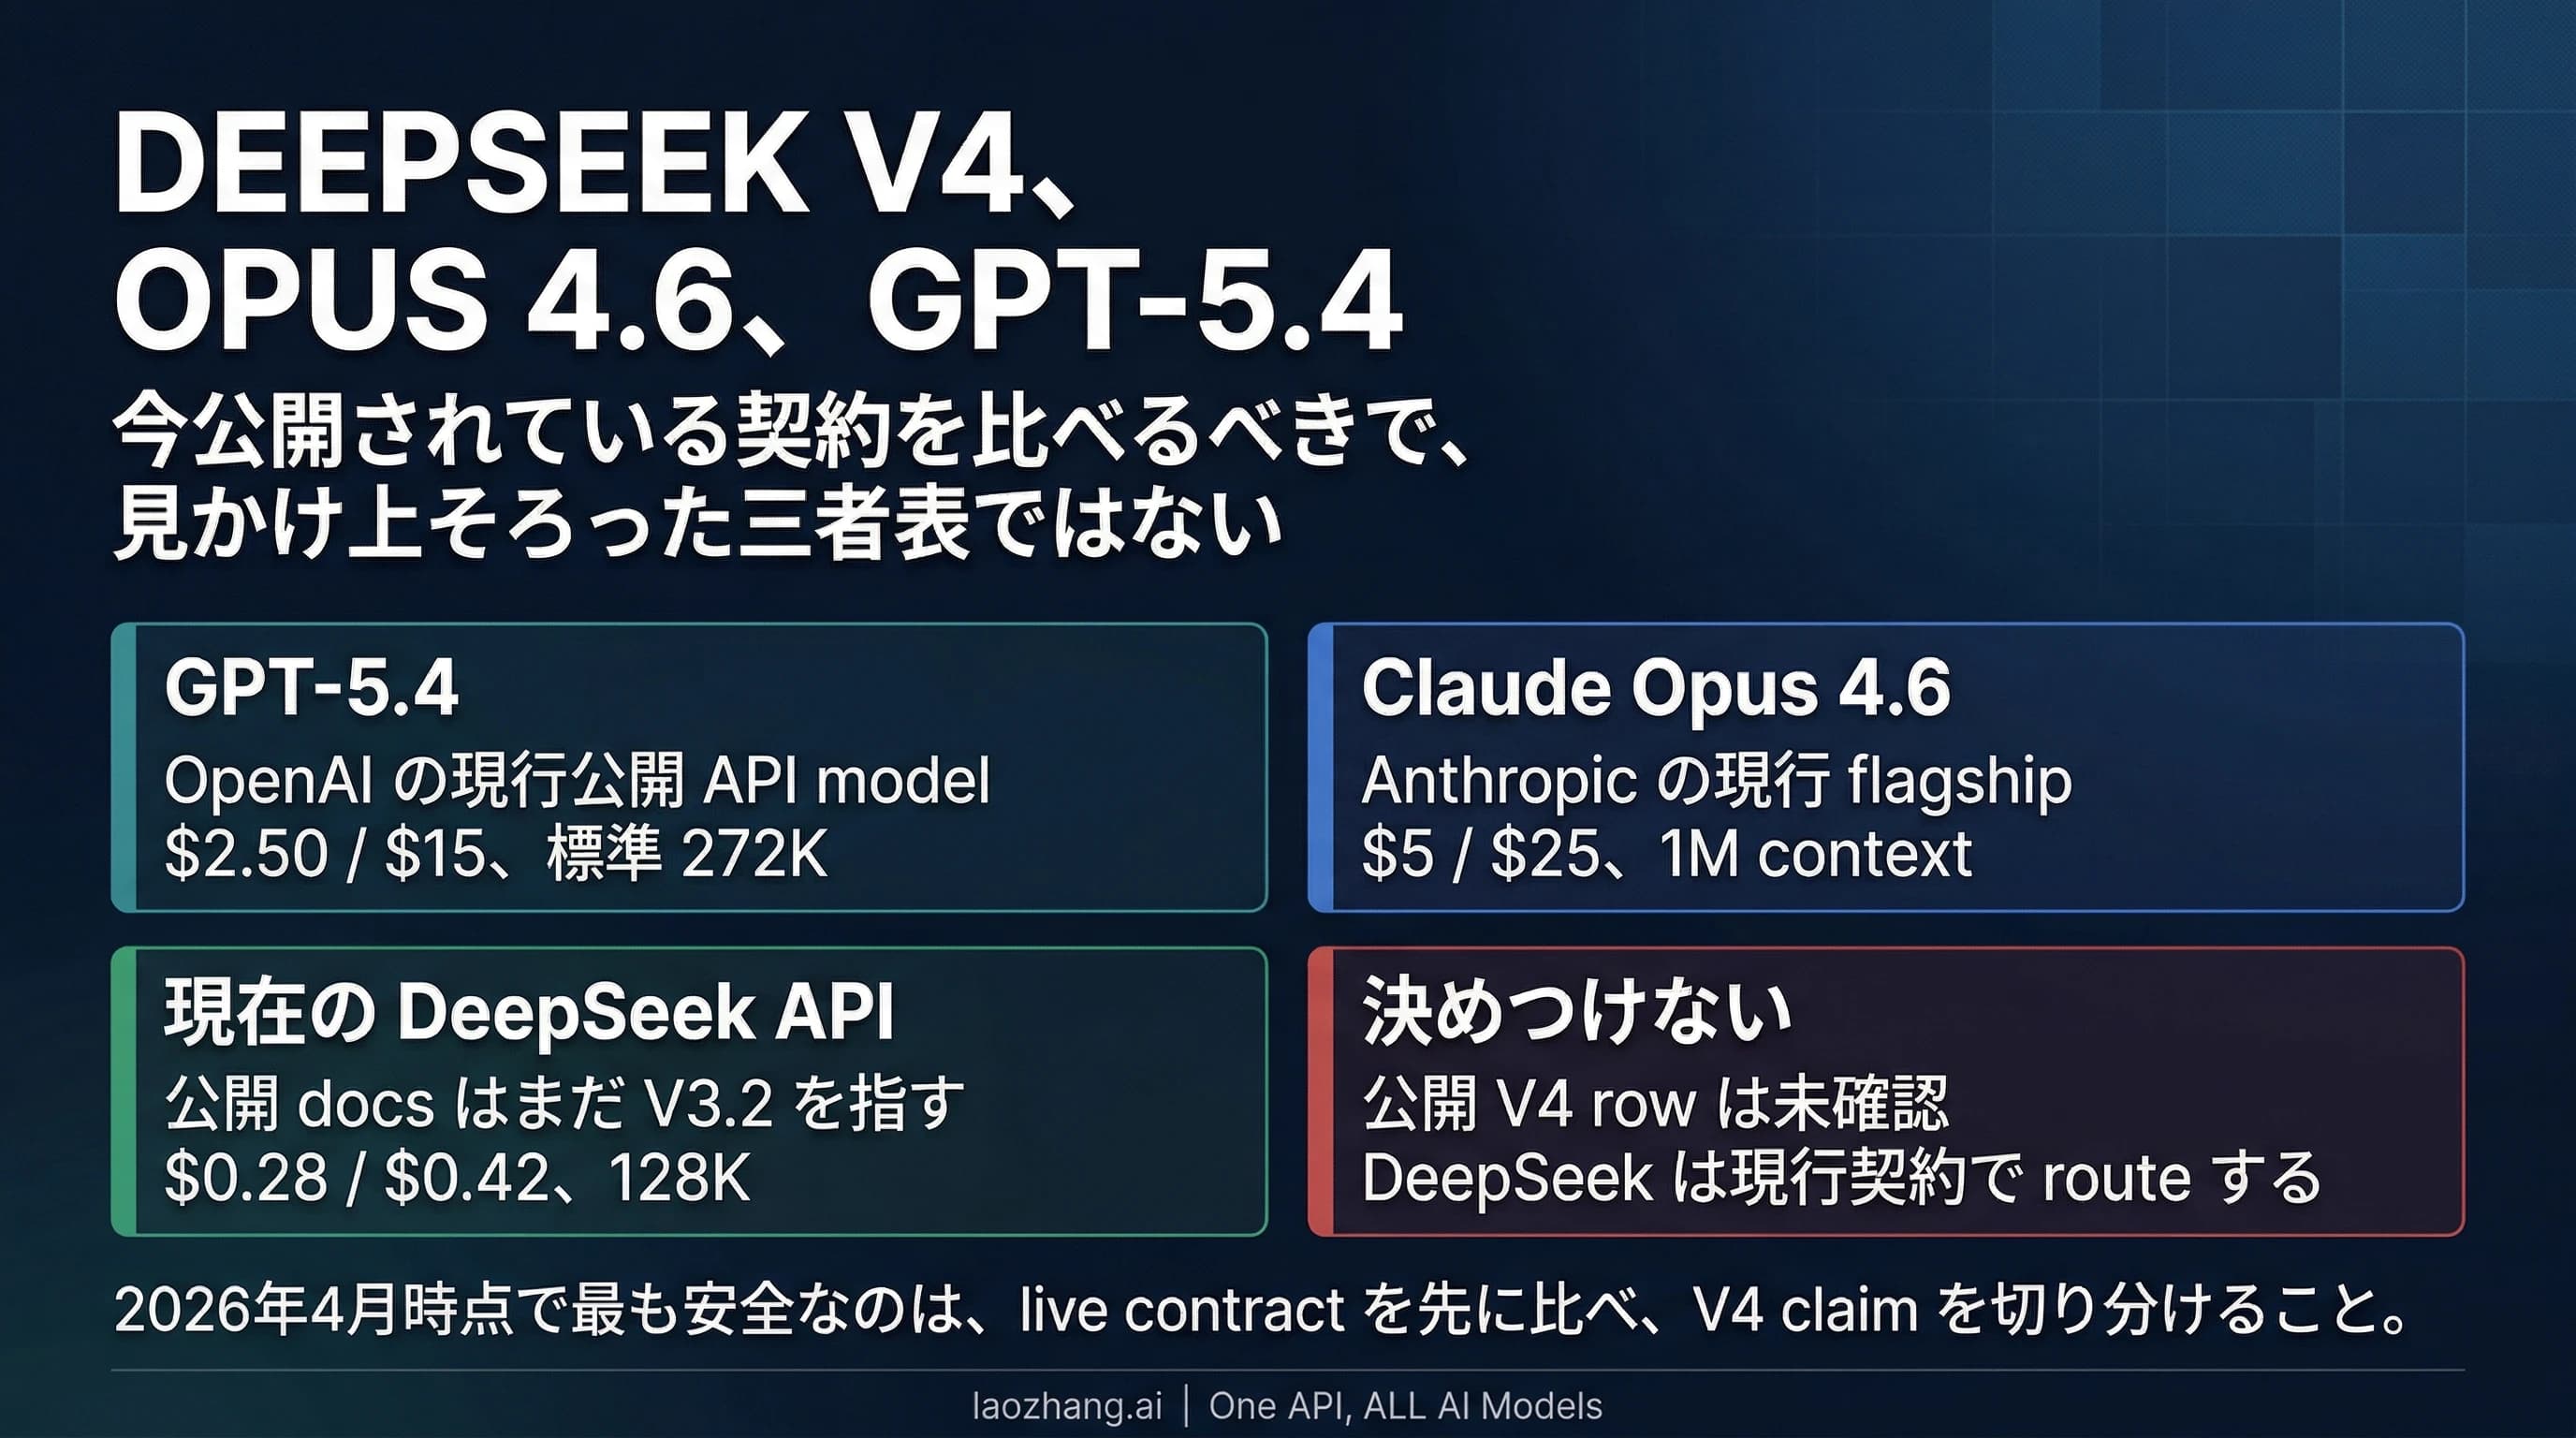
今すぐ本番判断をするなら、DeepSeek V4、Claude Opus 4.6、GPT-5.4 を最初から横並びの三者として扱うべきではありません。まずは GPT-5.4 と Claude Opus 4.6 を現在公開済みの frontier contract として比べ、そのあと DeepSeek を現行の V3.2 ベース public API の位置で評価するのが安全です。
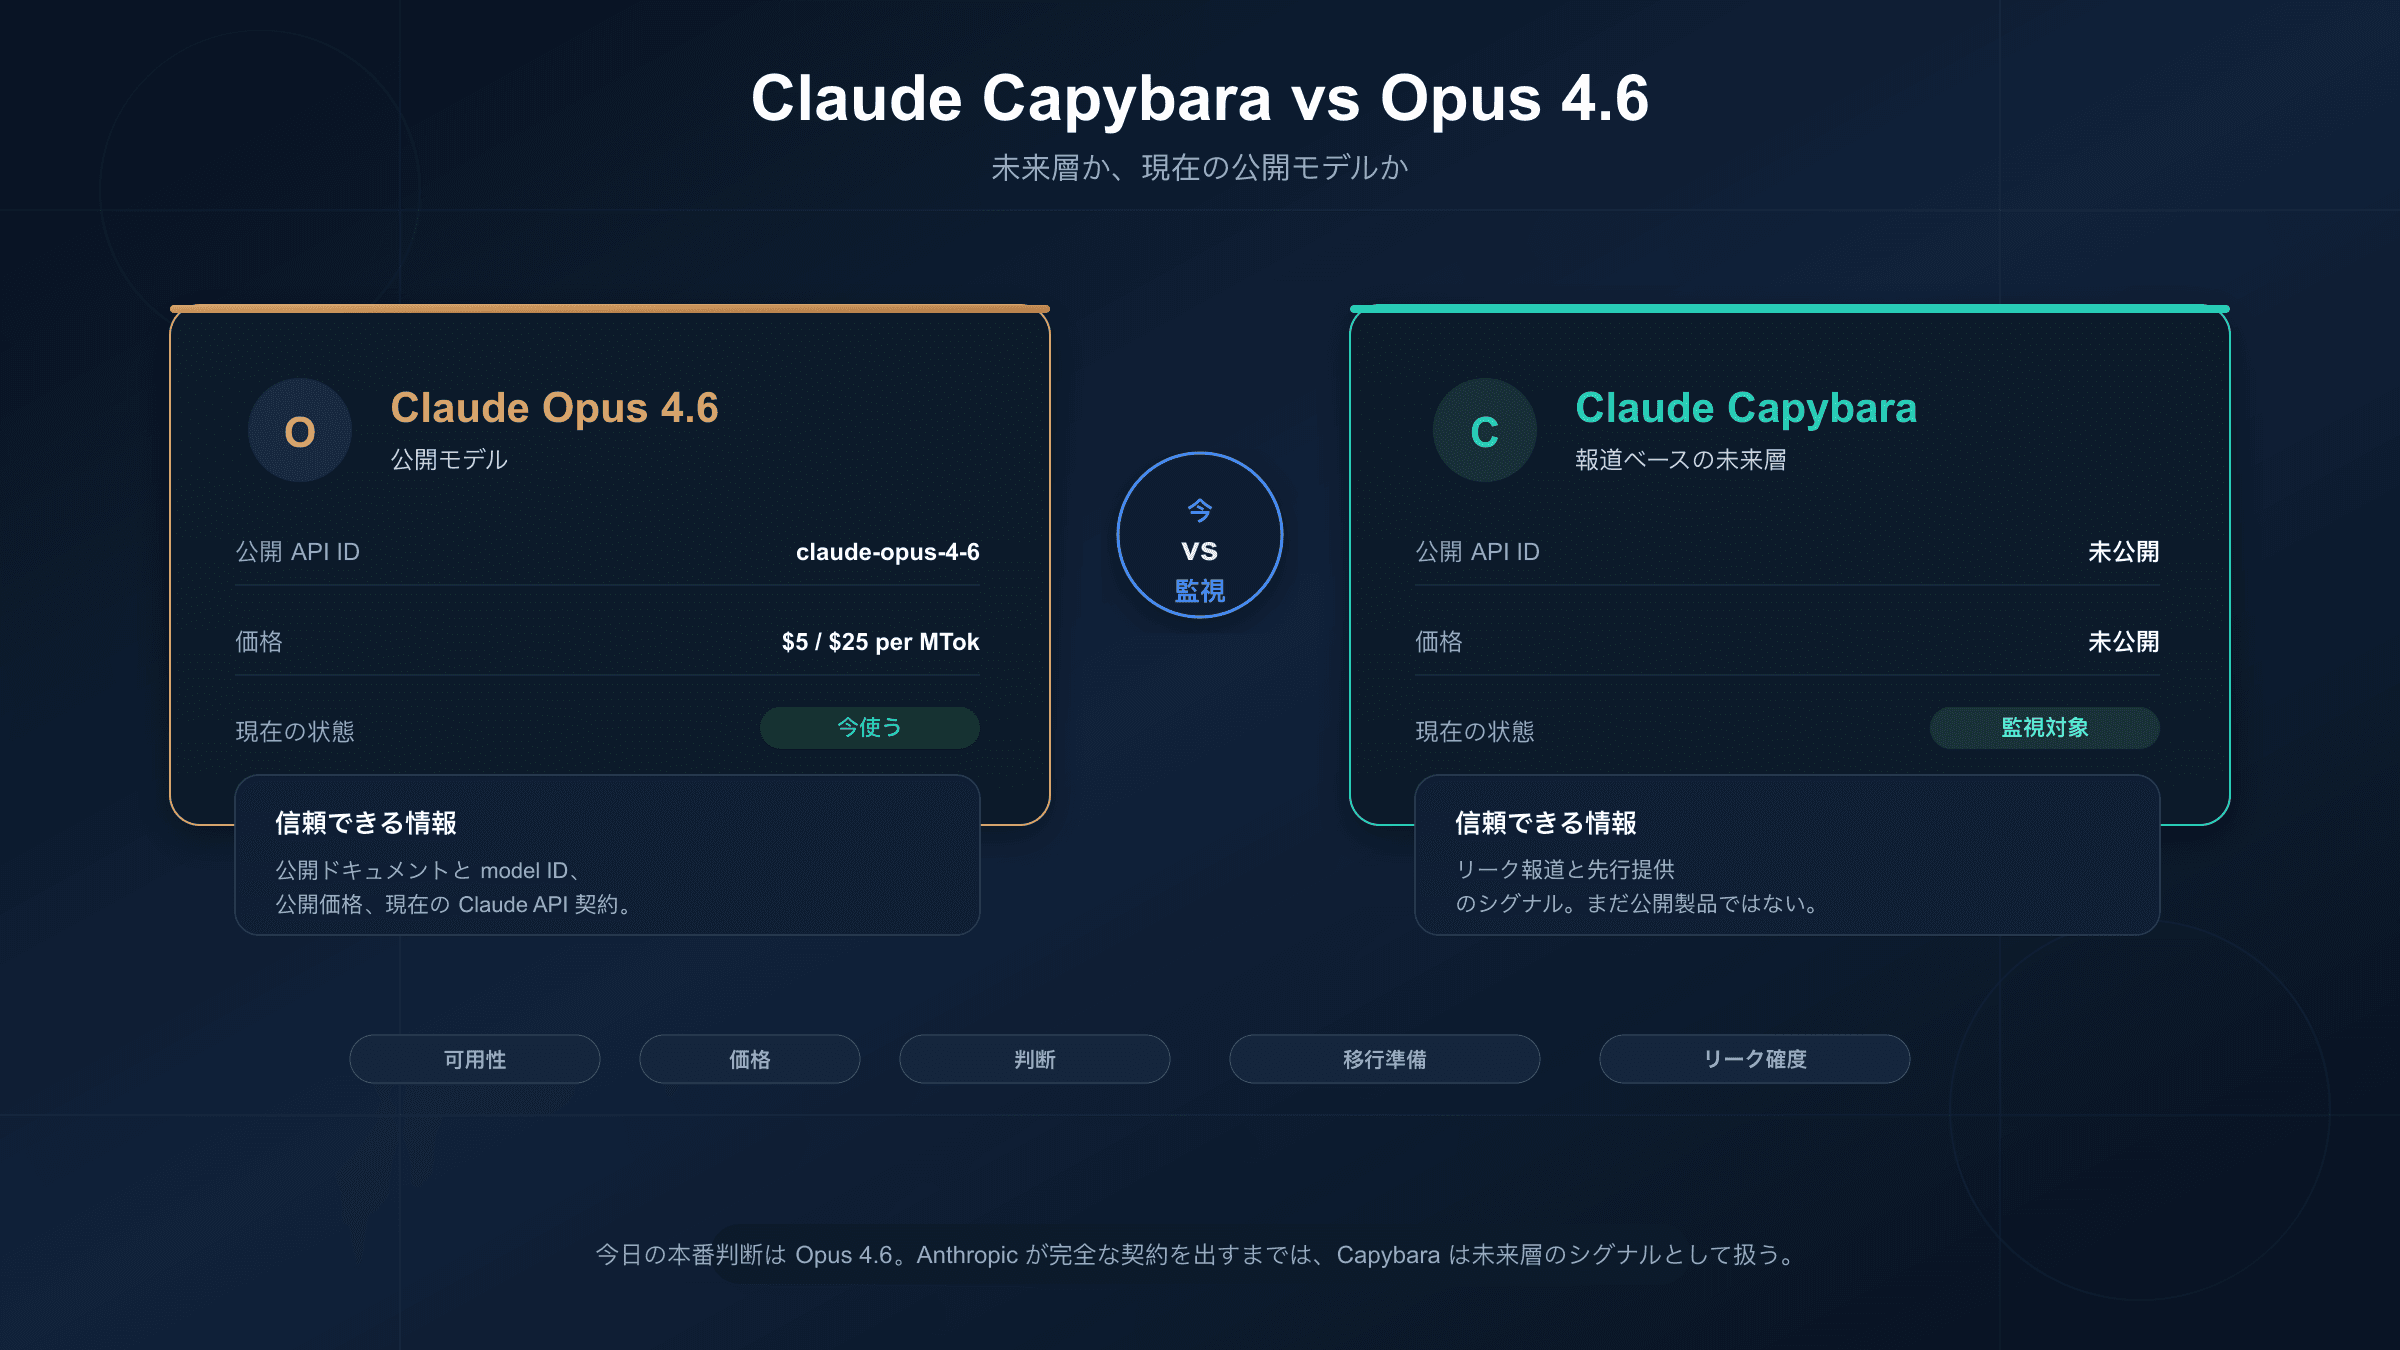
Claude Capybara は、まだ今日そのまま選べる Anthropic の公開モデルではありません。Anthropic の公開ドキュメントは、いまも Claude Opus 4.6 を最上位の公開モデルとして示しています。Capybara は、将来の上位層を示すシグナルとしては重要ですが、現時点では監視対象として扱うのが妥当です。
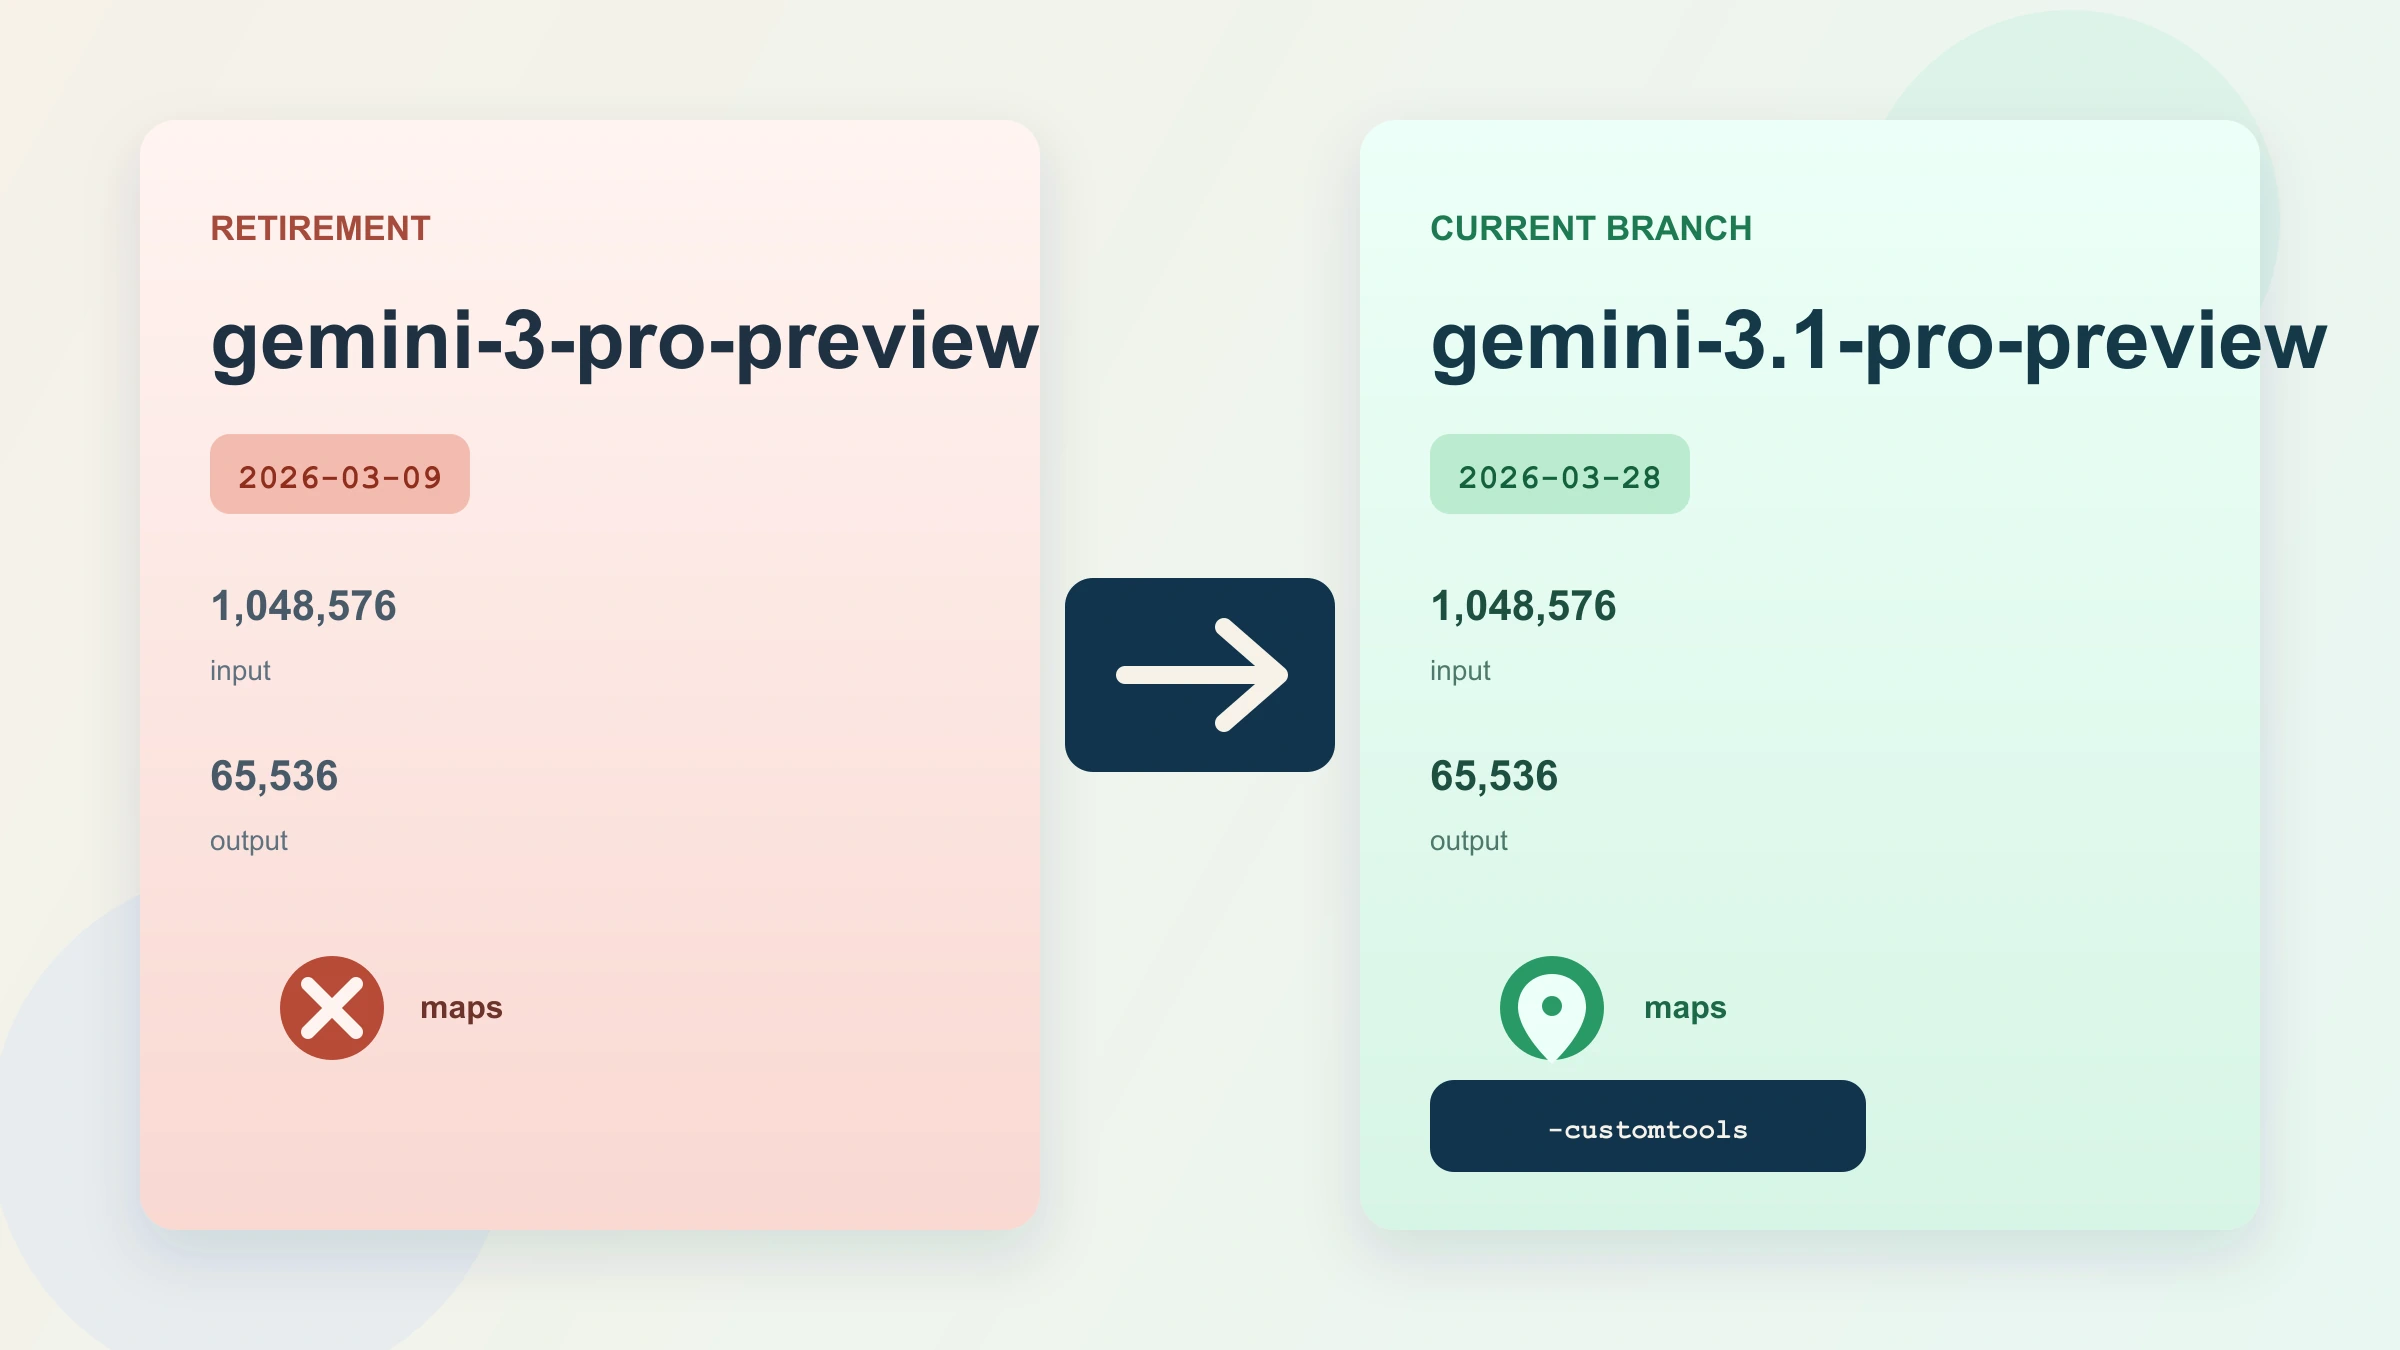
Gemini 3 Pro はすでに停止済みなので、これは普通の新旧比較ではありません。重要なのは Gemini 3.1 Pro で何が変わり、何が変わらず、移行時に何を再確認すべきかです。
2026年3月28日時点で、この3つの名前の中で現役の旗艦選択肢と言えるのは Gemini 3.1 Pro Preview だけです。Gemini 3 Pro Preview は 2026年3月9日に停止され、OpenAI も GPT-4 Turbo を古い系統として扱い、より新しい GPT-4o を勧めています。
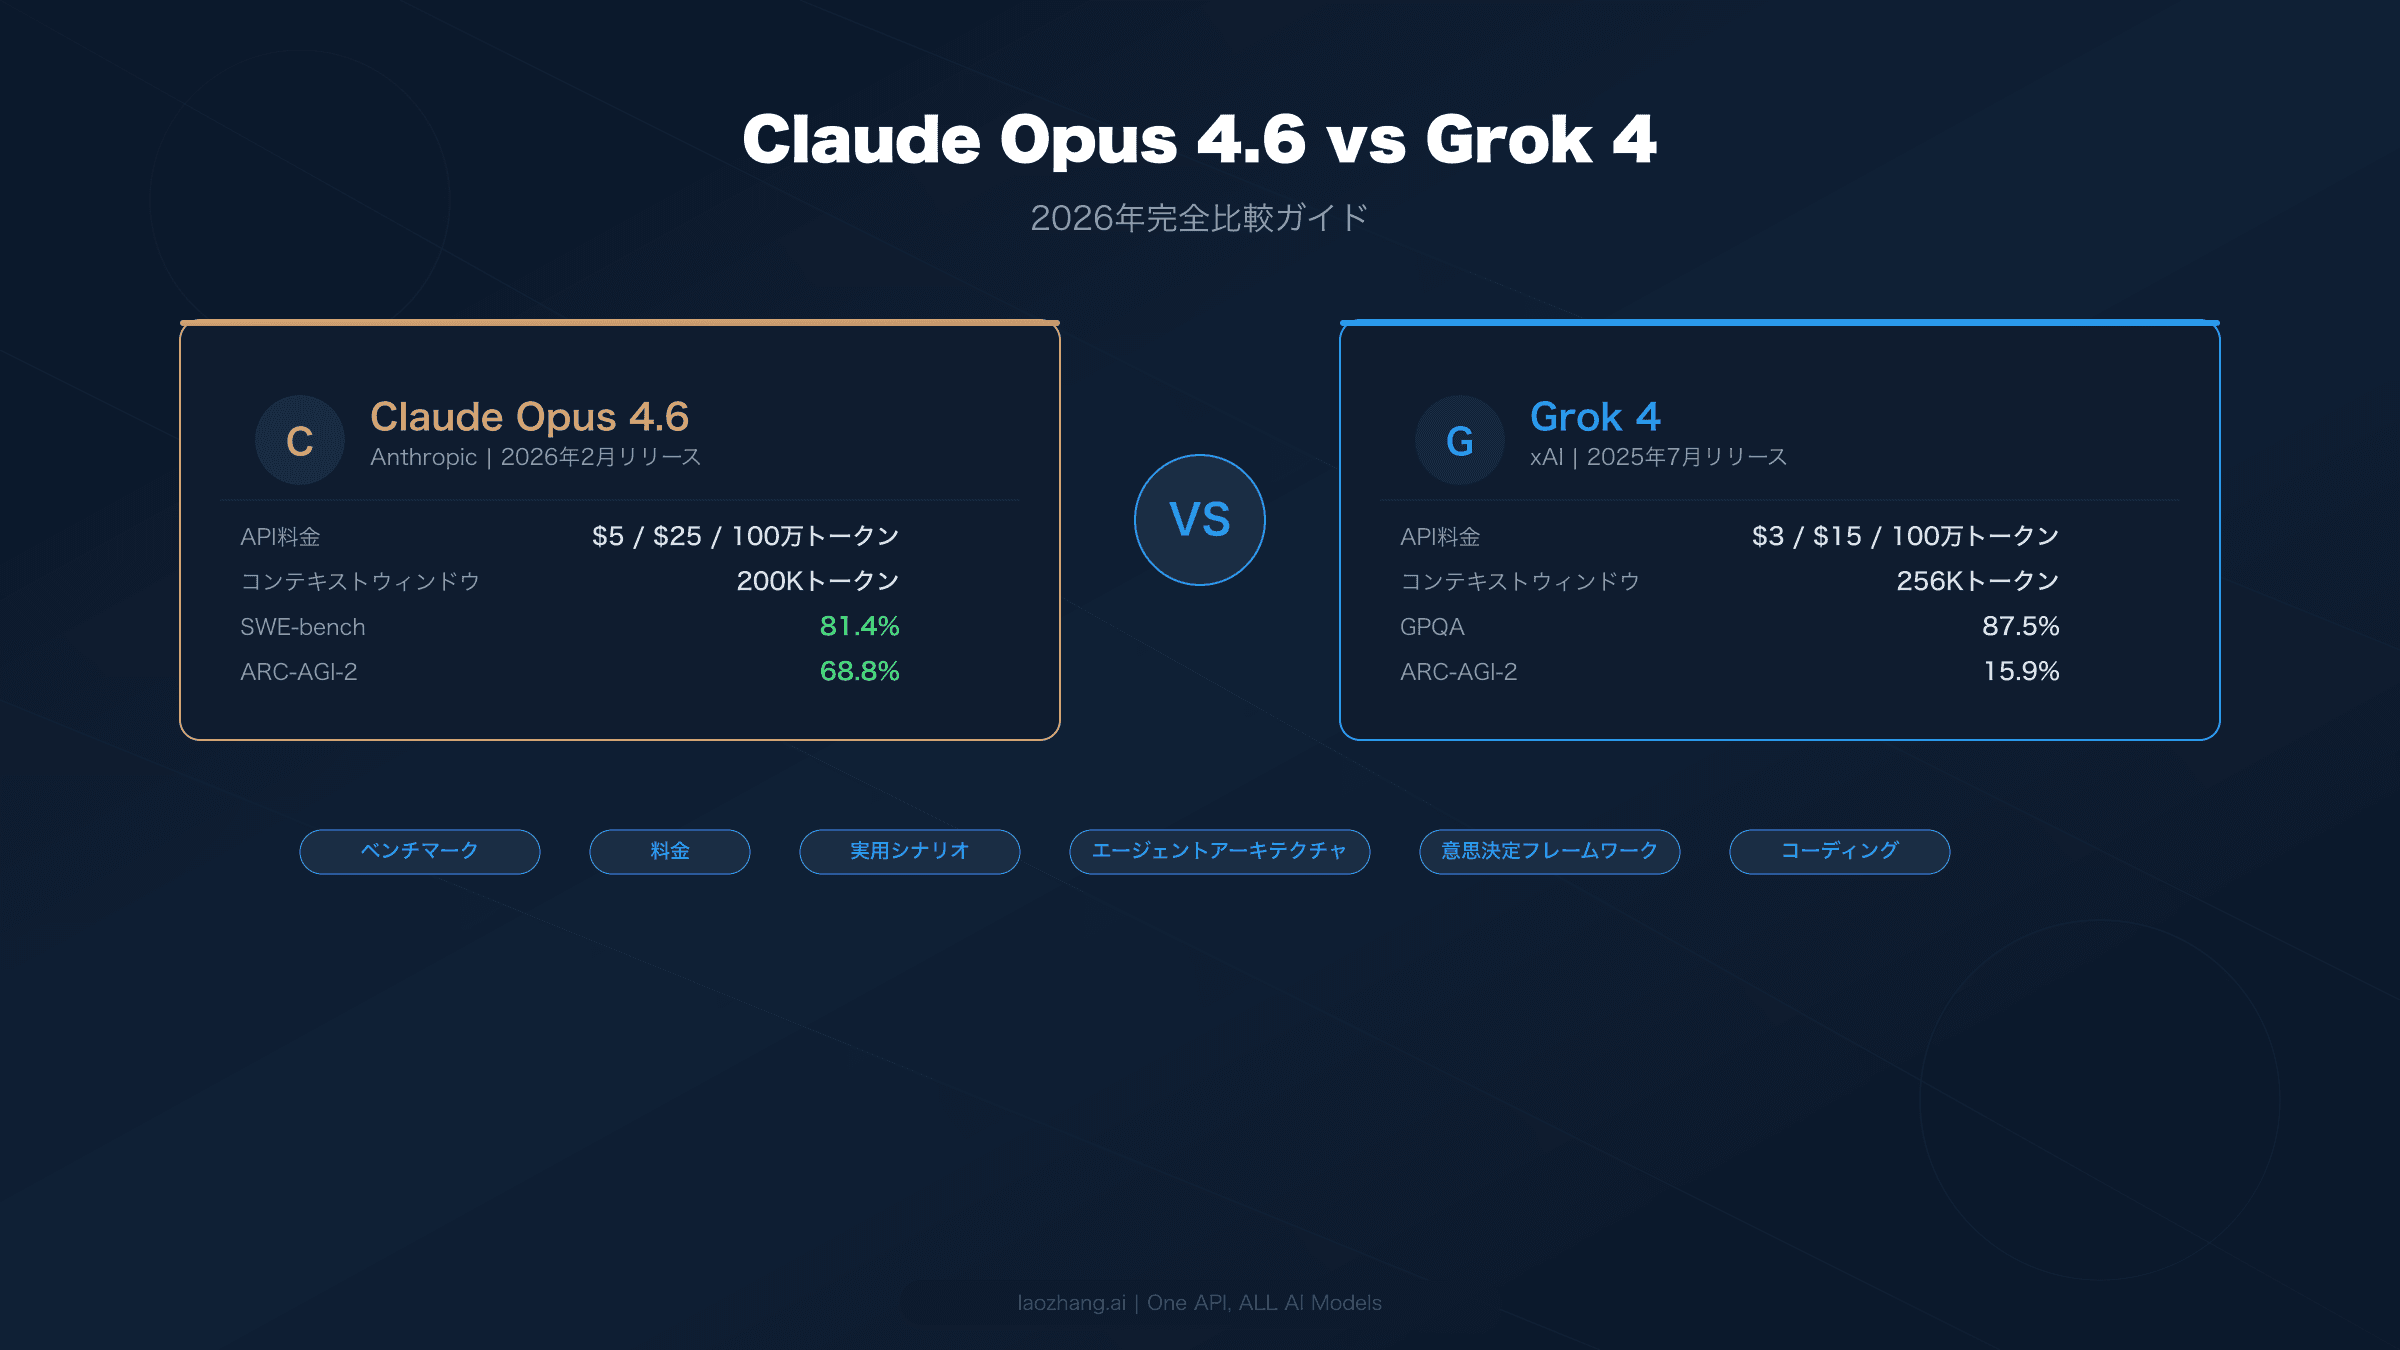
Claude Opus 4.6はコーディングベンチマーク(SWE-bench 81.4% vs 約72%)と推論タスク(ARC-AGI-2 68.8% vs 15.9%)でGrok 4を上回る一方、Grok 4は100万トークンあたり$3/$15と40%低コストです。本記事ではベンチマーク、料金、コーディング能力、エージェントアーキテクチャを網羅的に比較し、シナリオ別の意思決定フレームワークを提供します。
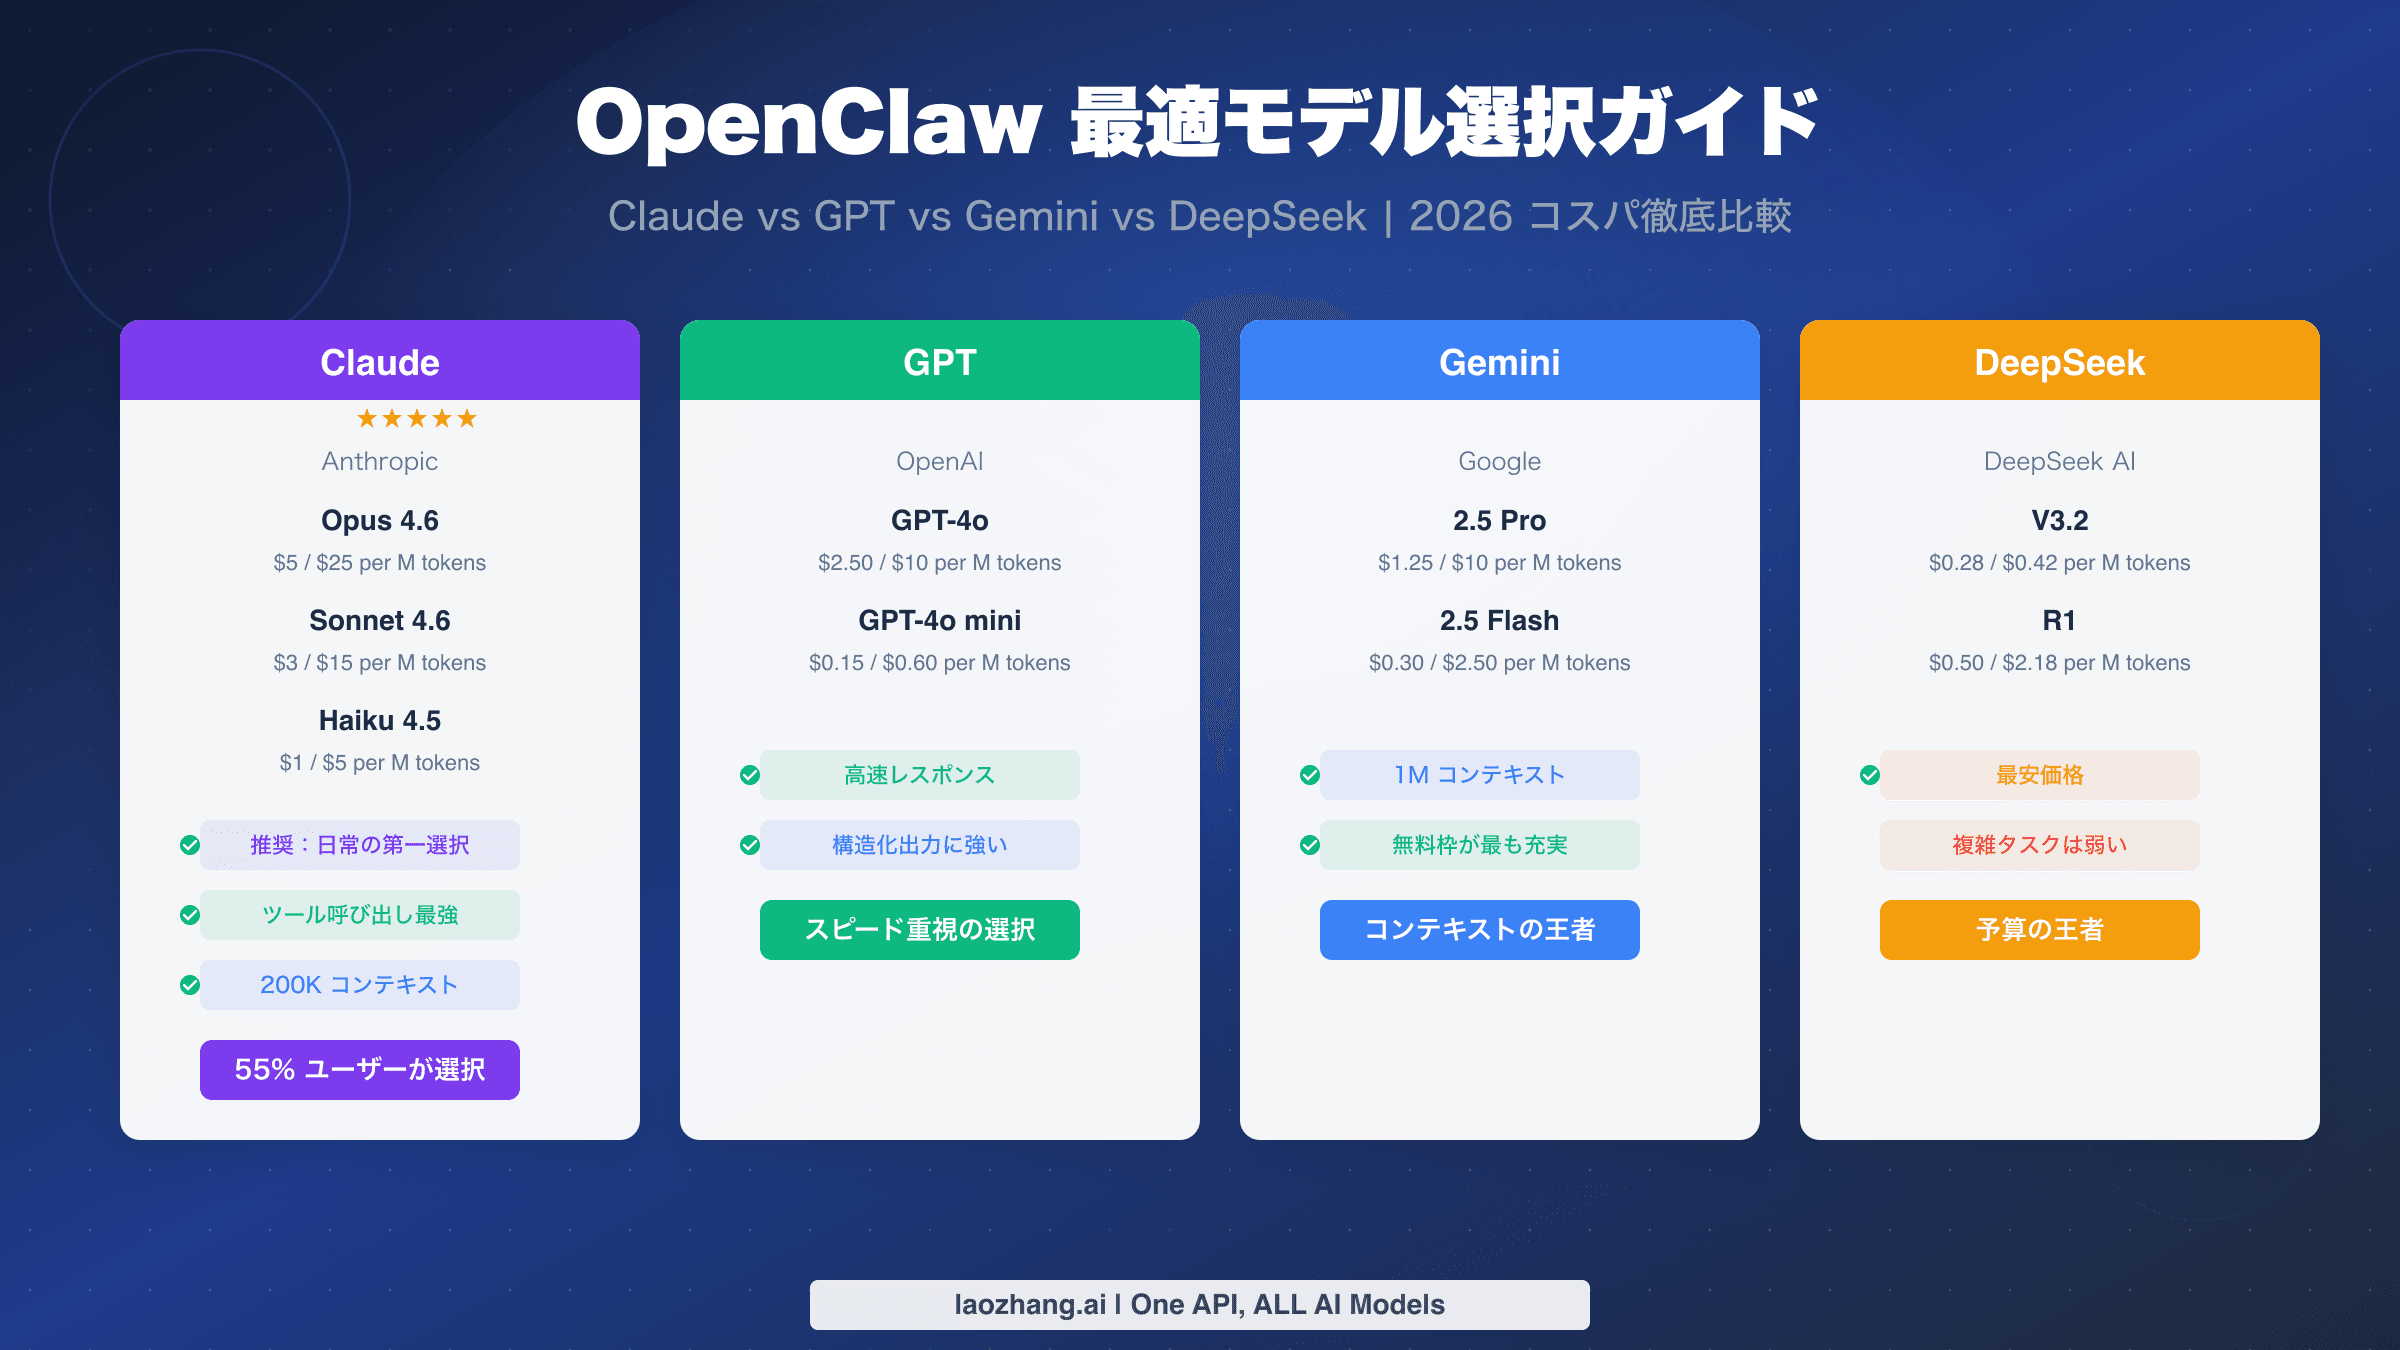
OpenClawはClaude、GPT、Gemini、DeepSeekなど10種類以上のAIモデルに対応しています。Claude Sonnet 4.6($3/$15/M tokens)は多くのユーザーにとって最適な出発点であり、DeepSeek V3.2($0.28/$0.42)は予算重視のシーンに適しています。本記事では9種類の主要モデルの価格・性能・設定方法を比較し、三層ルーティング戦略でAPI費用を65〜80%削減する方法を紹介します。
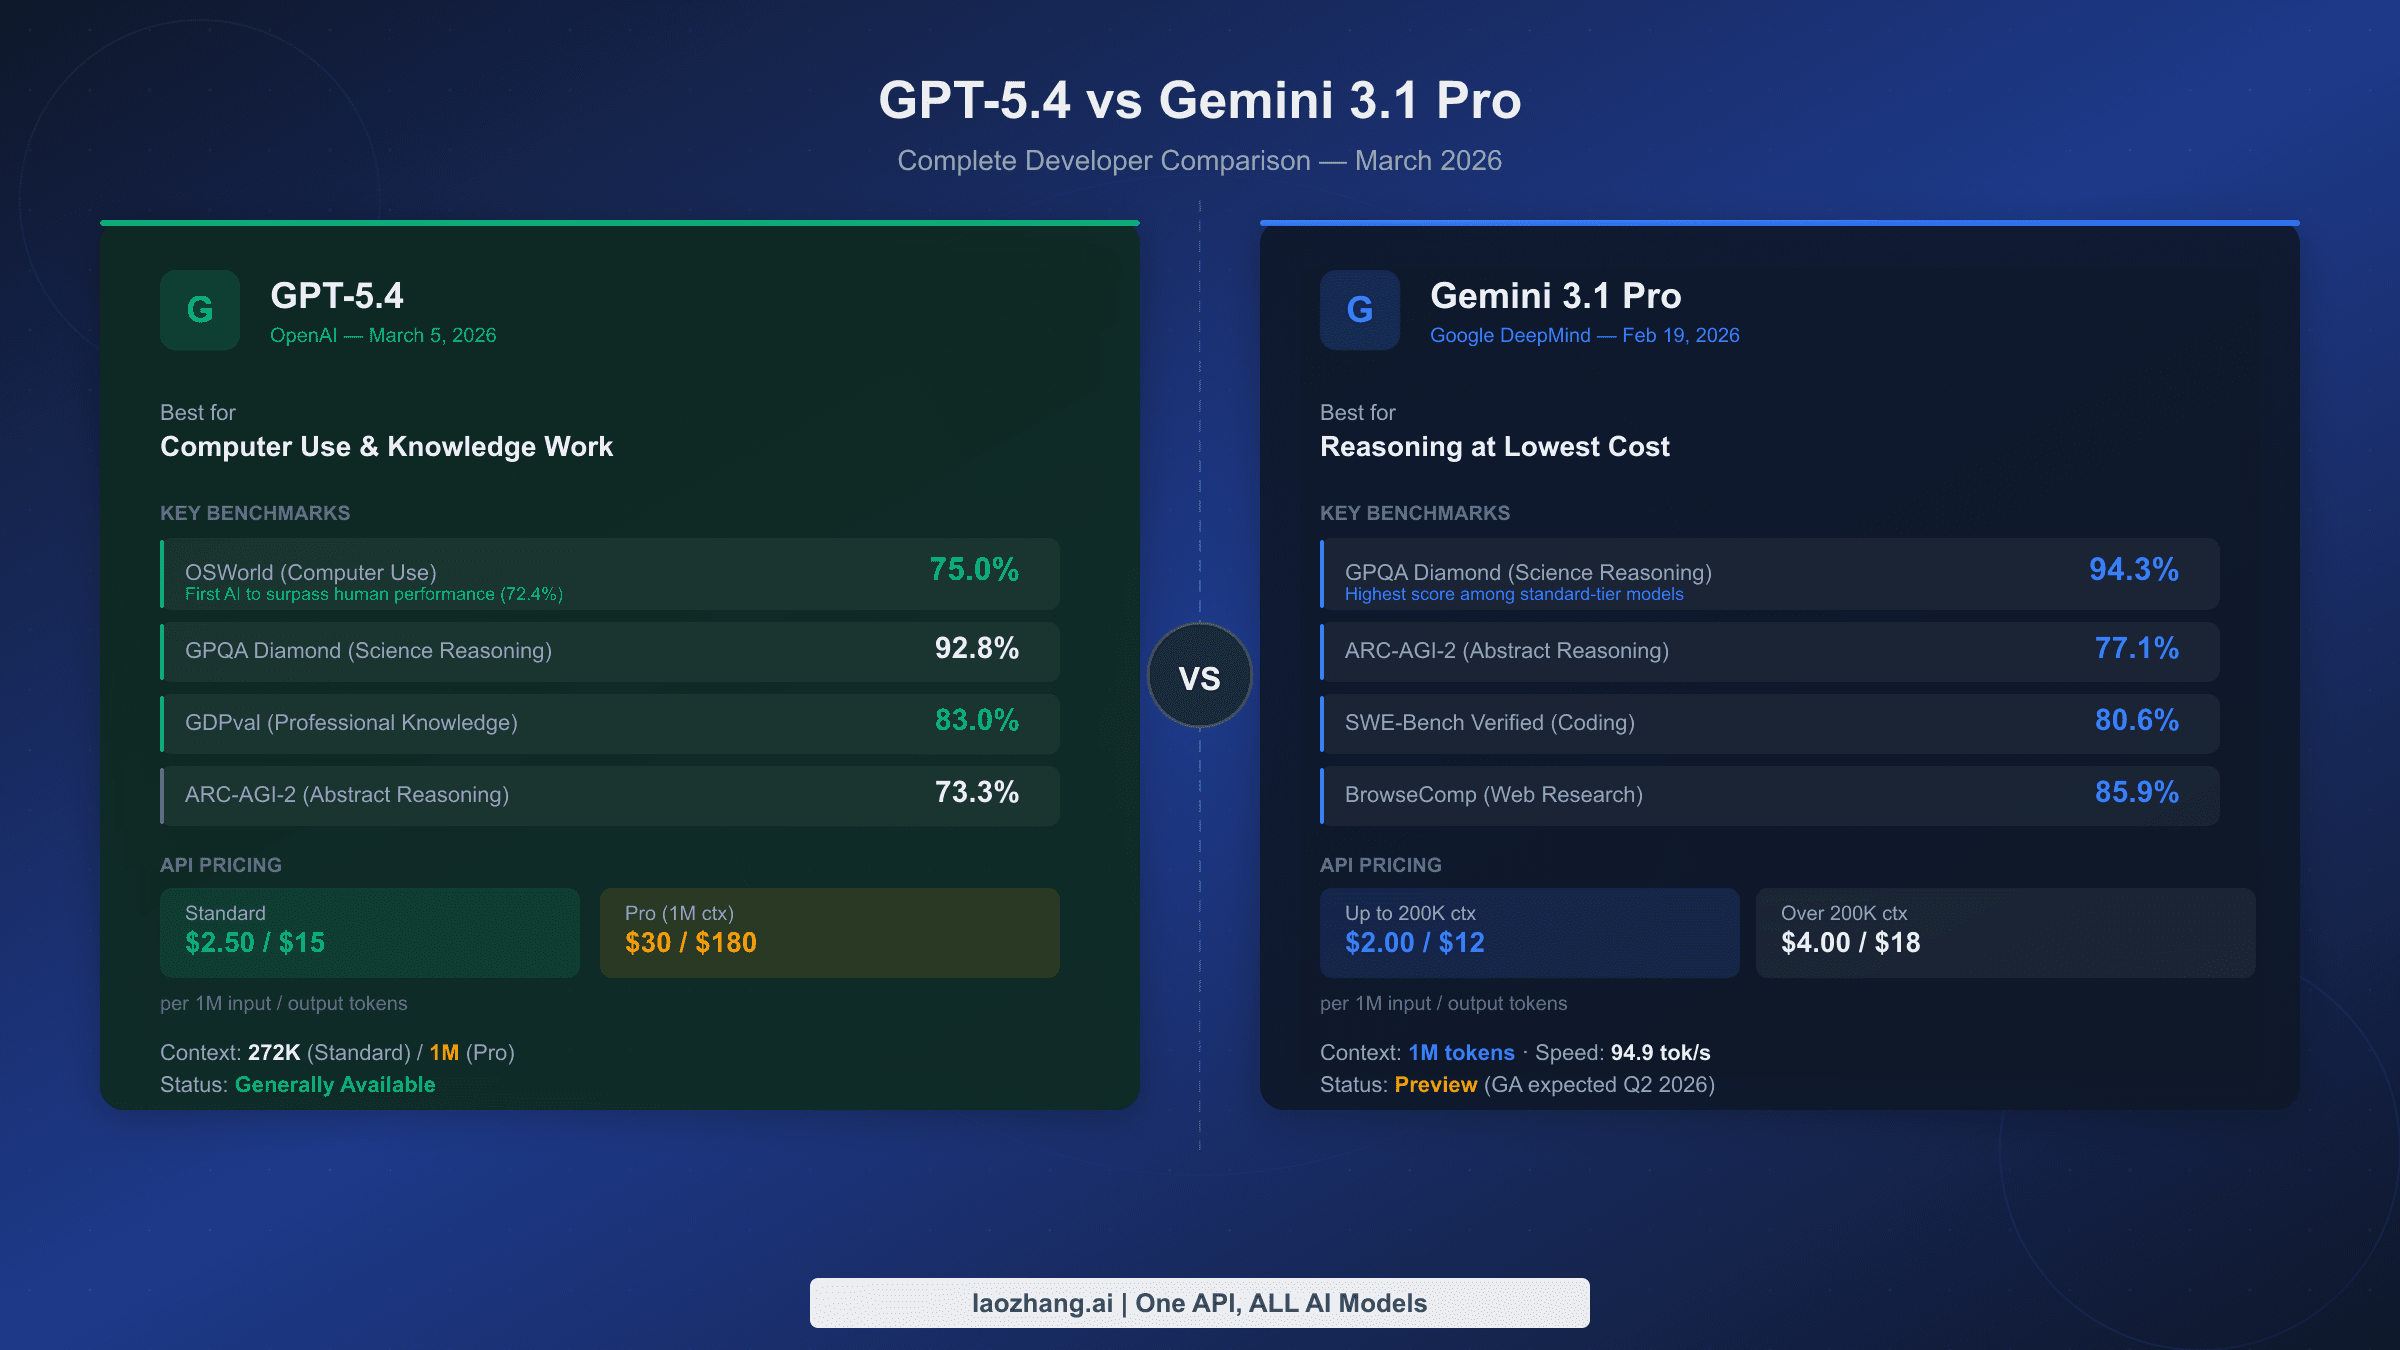
GPT-5.4 と Gemini 3.1 Pro はベンチマークをほぼ均等に分け合っています。Gemini は抽象的推論でリード(GPQA Diamond 94.3%)し、標準プランで約20%安く、Proプラン比較では最大15倍安くなります。GPT-5.4 はデスクトップPC操作で人間水準を超えた初のAI(OSWorld 75%)です。