GPT-5.5 vs Claude Opus 4.7:API料金とコーディングで選ぶ基準
GPT-5.5もClaude Opus 4.7もAPIで利用できます。既存の接続先から評価を始め、長文入力と推論を含む費用、採用できたコード修正、レビュー時間を比べると、切り替える価値を判断しやすくなります。
目次
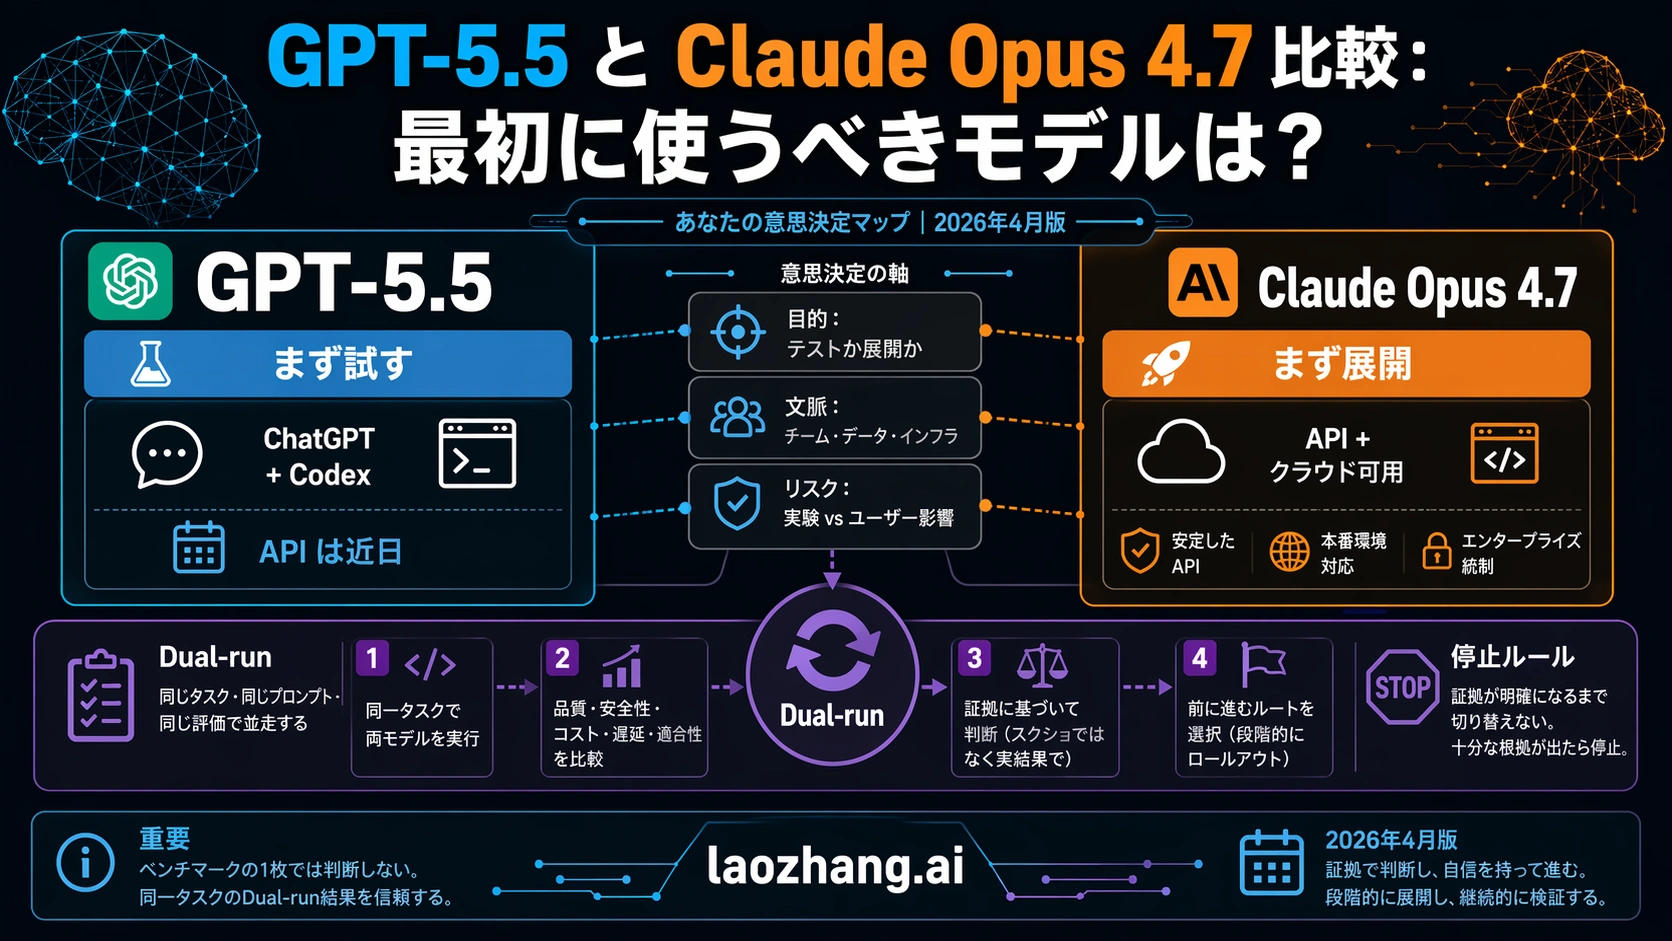
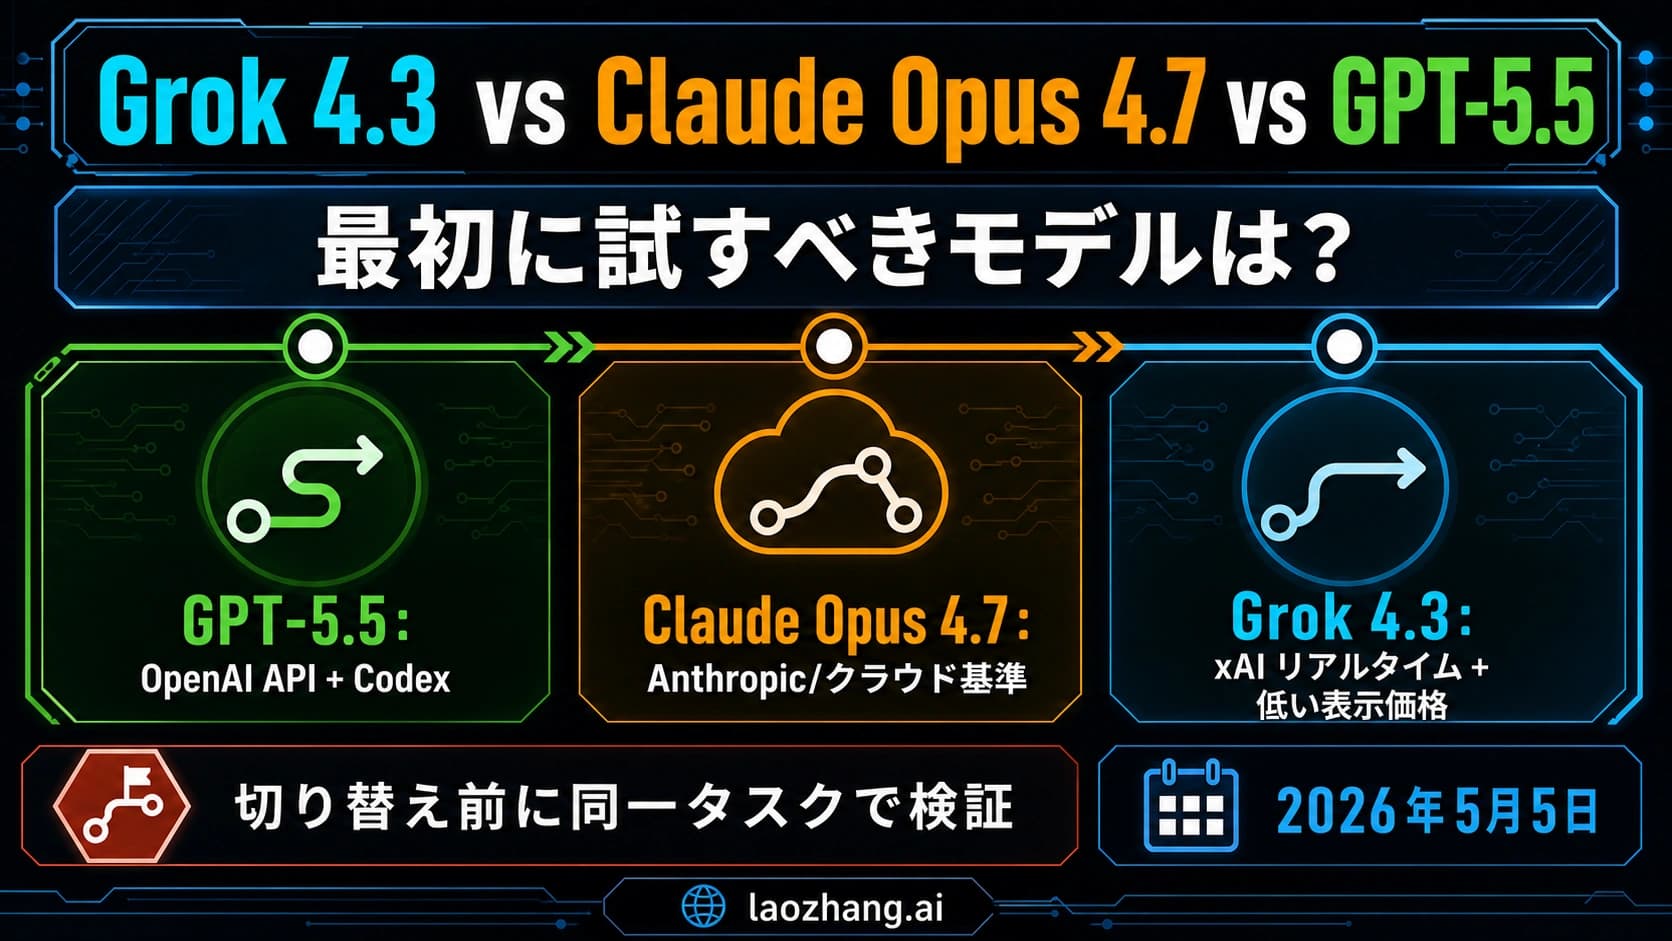
GPT-5.5とClaude Opus 4.7は、どちらもAPIで利用できます。 すでにOpenAI Responses APIでアプリを動かしているならGPT-5.5を、Claude Messages APIでコードエージェントを動かしているならOpus 4.7を、最初の評価対象にするのが実務的です。接続先を維持した比較を先に行うと、モデルの差と実装変更の影響を分けやすくなります。GPT-5.5のモデル仕様とOpus 4.7の仕様で、両方の提供が確認できます。
費用を優先する場合は、入力の長さが分岐になります。キャッシュを使わない標準APIでは、入力272,000トークン以下のGPT-5.5は入力100万トークンあたり5米ドル、出力30米ドル。Opus 4.7は入力5米ドル、出力25米ドルです。GPT-5.5は入力272,000トークンを超えると長文料金になり、Opus 4.7は100万トークンの文脈全体で標準単価が適用されます。大量の資料を毎回渡すなら、まずOpus 4.7の費用を基準に比較するとよいでしょう。品質の優劣は、同じ資料で別に確かめます。OpenAIの料金表、Anthropicの料金表
なお、2026年10月14日に予定されているGPT-5.5のChatGPT、ChatGPT Work、Codexからの提供終了は、OpenAI APIには適用されません。画面上で選ぶモデルの移行と、APIアプリの比較は分けて考えてください。この記事は2026年10月13日時点のAPI仕様・料金を基準にしています。公式の提供終了案内
どちらから試すかは、既存実装と入力の量で決める
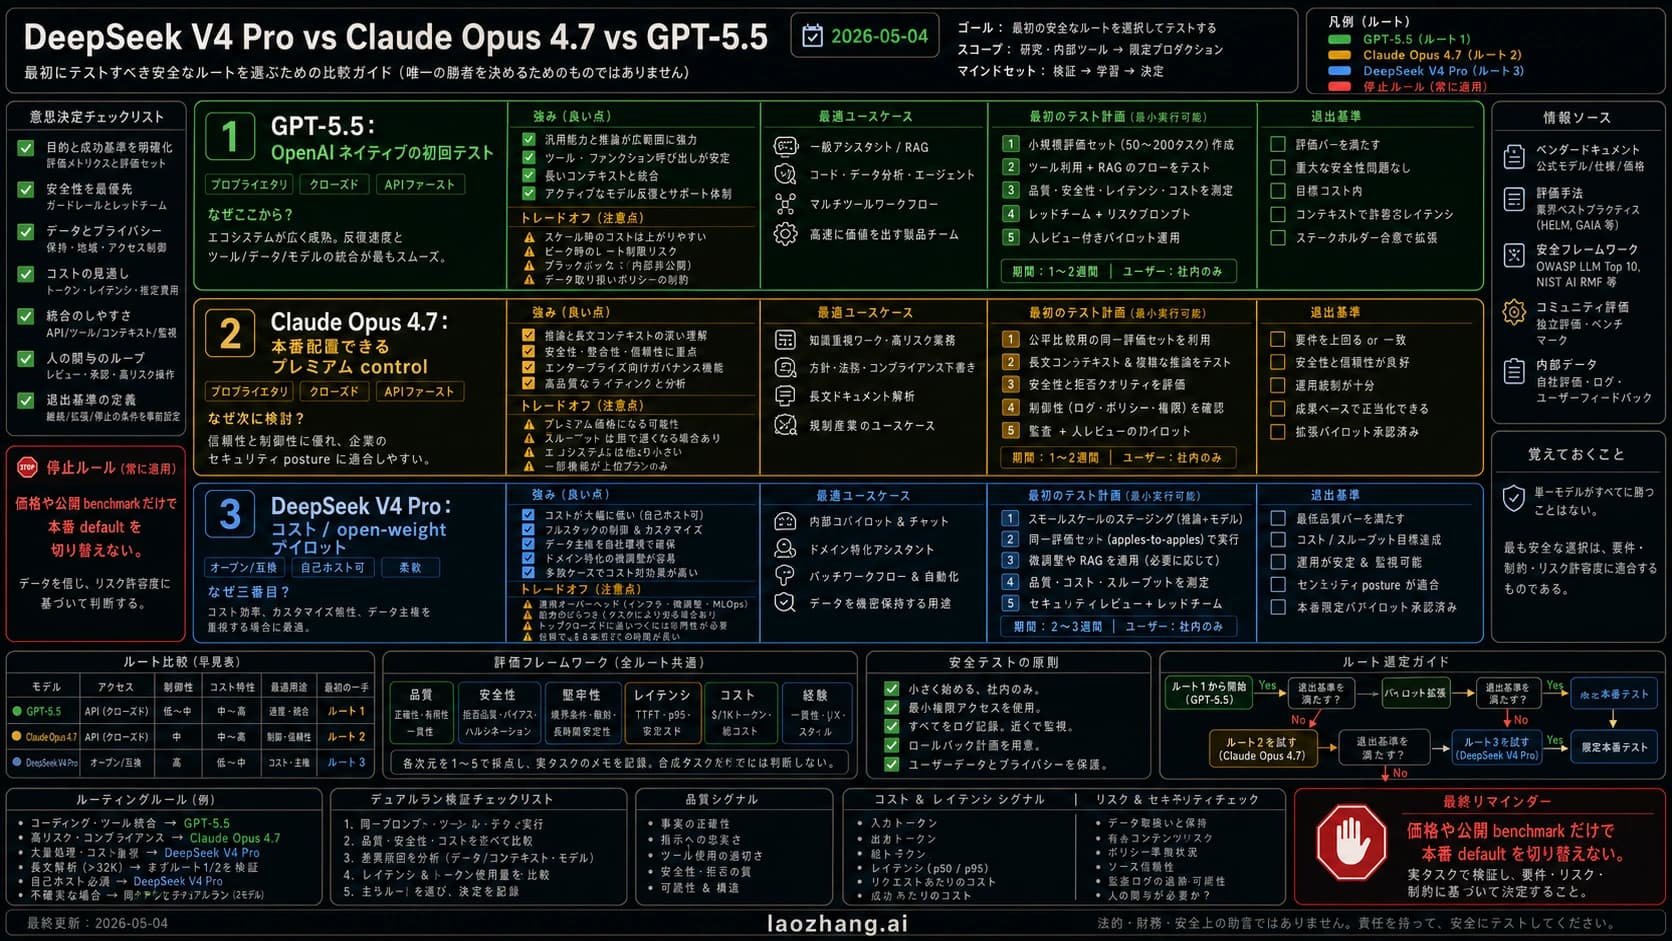
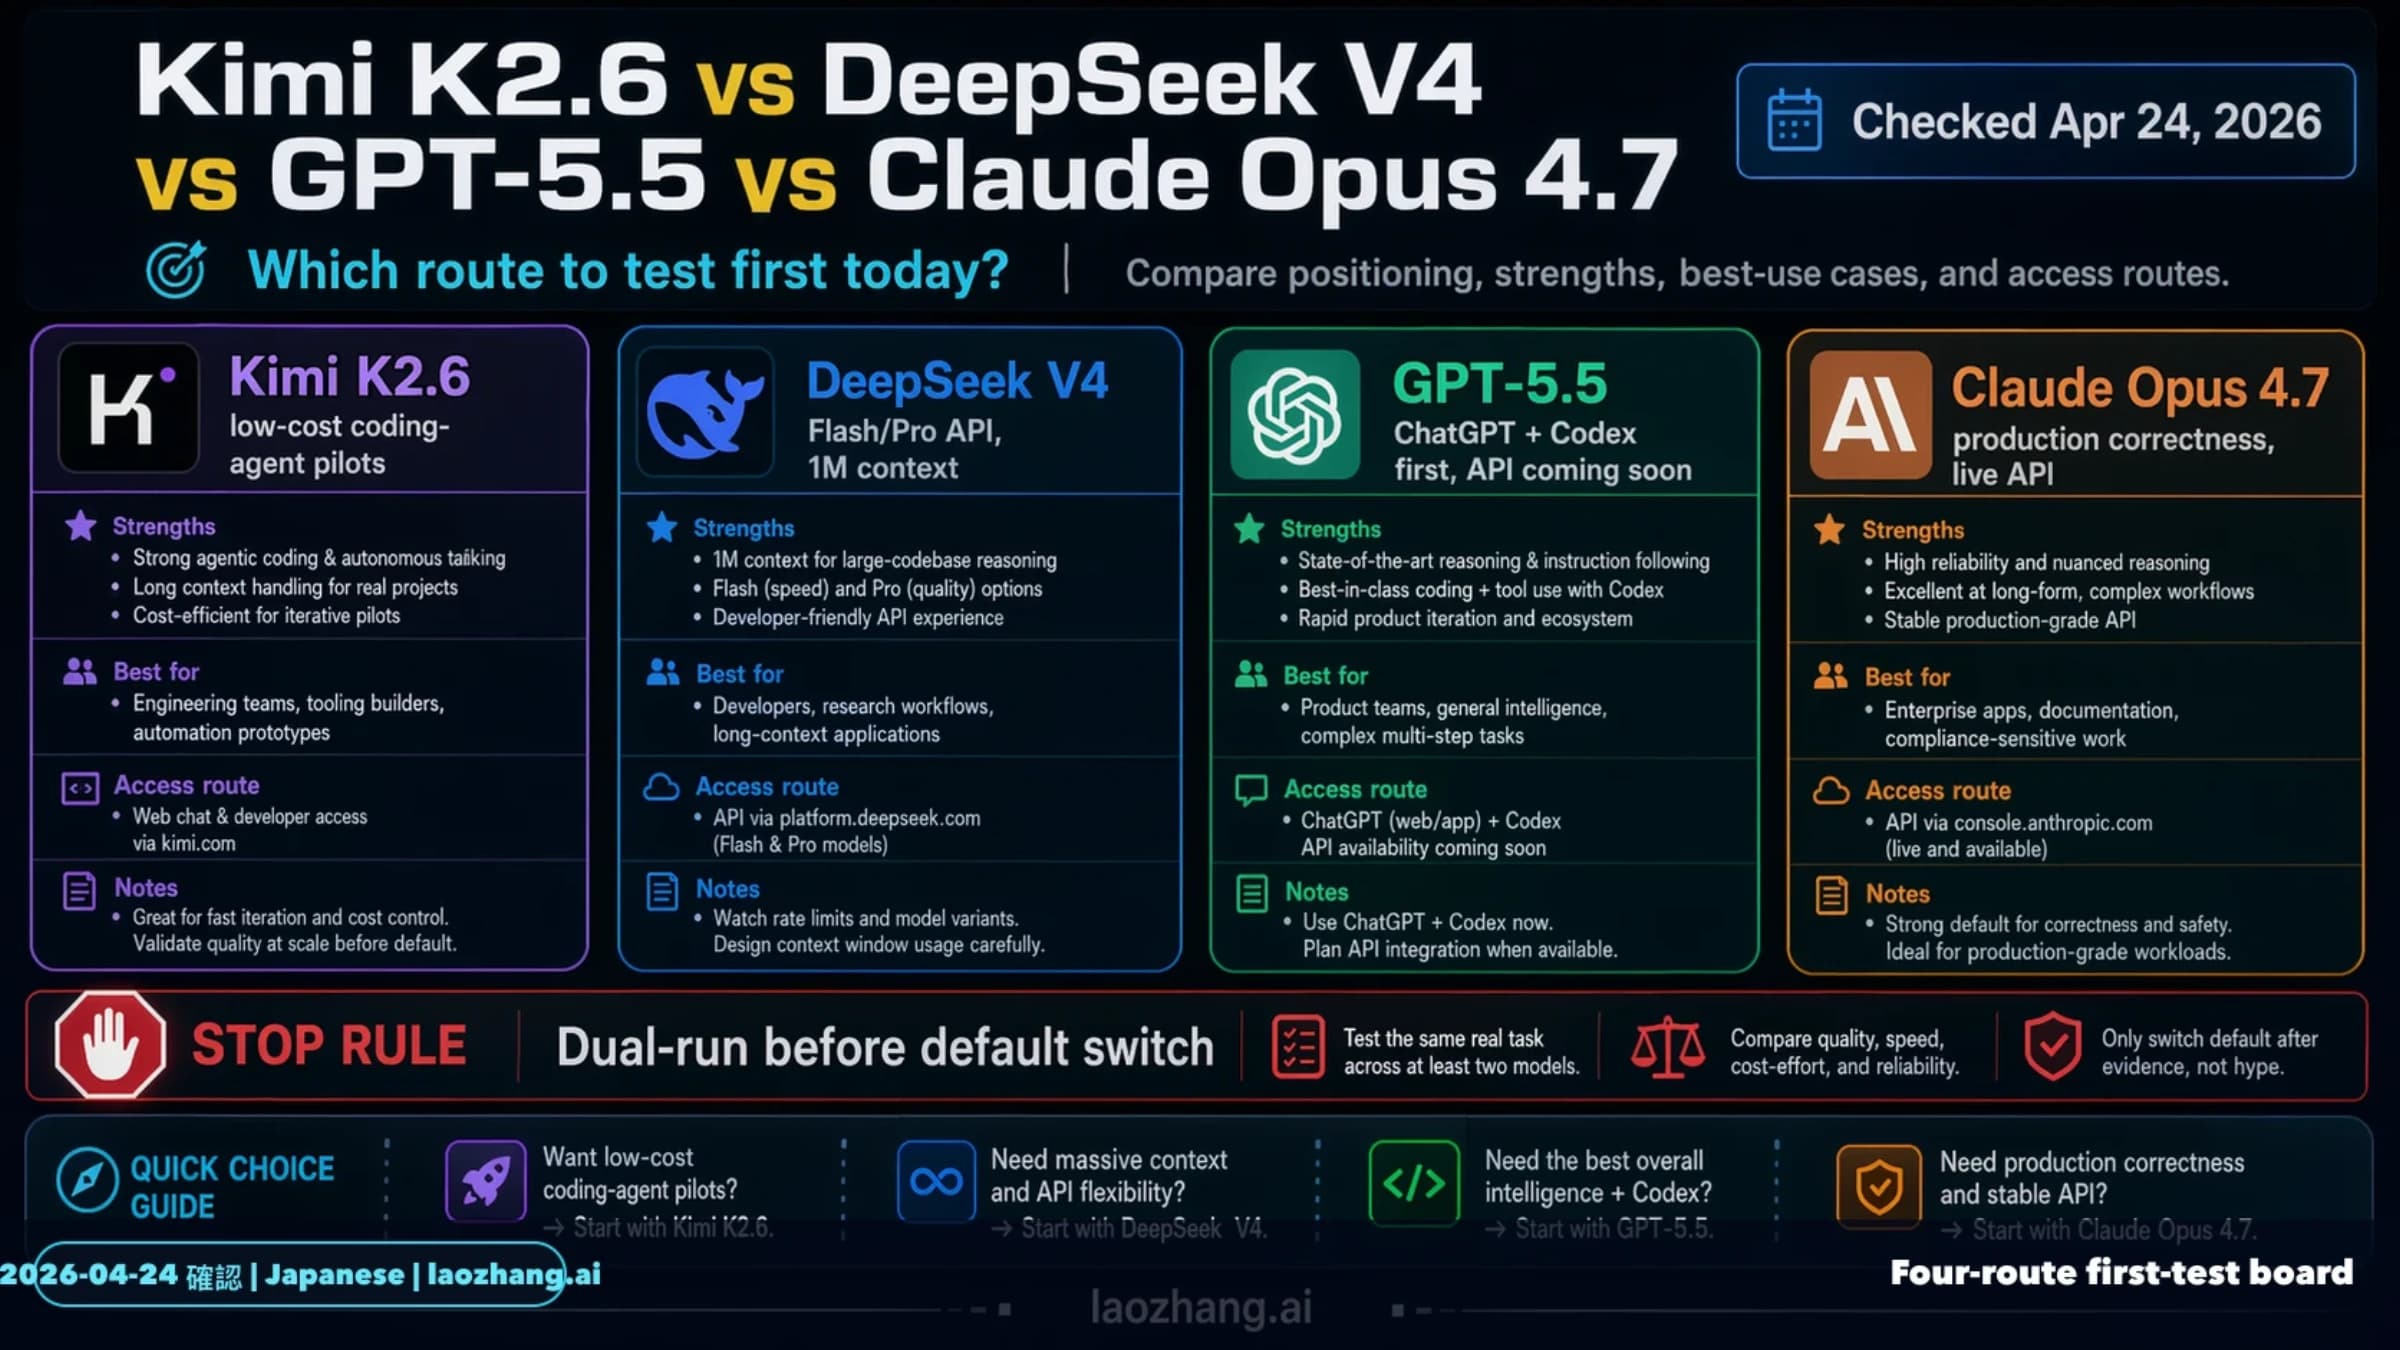
最初の候補は、次のように絞れます。これは導入順序の提案であり、同じ仕事を両モデルに実行させた測定結果ではありません。
| 現在の状況 | 最初に評価するモデル | 判断を変える結果 |
|---|---|---|
| Responses API、OpenAIのツールや会話管理をすでに使っている | GPT-5.5 | Opus 4.7が、接続変更の工数を含めても失敗やレビュー時間を減らす |
| Claude Messages APIとツール実行処理が整っている | Claude Opus 4.7 | GPT-5.5が同じタスクで、採用できる成果までの費用や所要時間を減らす |
| 272,000トークンを超える資料を繰り返し入力する | Opus 4.7を費用の比較基準にする | GPT-5.5の回答精度が手戻りを減らし、長文料金の差を回収する |
| 長い文書から、離れた箇所の情報を照合する | GPT-5.5を品質の評価候補に入れる | 根拠箇所の特定や矛盾の扱いでOpus 4.7が同等以上の成果を出す |
| ChatGPTやCodexの画面でGPT-5.5を使っている | その製品で提供される後継モデルを確認する | APIの継続可否とは別の判断。画面での利用をGPT-5.5 APIの評価と混同しない |
長文照合でGPT-5.5を候補にする根拠には、後述するArtificial AnalysisのAA-LCR結果があります。ただし、大きなコードベースの修正や日本語の契約書で同じ差が出るとは限りません。すでに安定しているモデルがある場合は、そのモデルを残し、失敗の多い仕事から比較する方が判断しやすくなります。
APIの継続、モデルID、文脈の上限を確認する
2026年10月13日時点の、提供元のAPI仕様は次のとおりです。利用できるAPIが公開されていることと、個々のアカウントに必要な権限・処理枠があることは別です。
| 項目 | GPT-5.5 | Claude Opus 4.7 |
|---|---|---|
| 提供元のAPIモデルID | gpt-5.5 | claude-opus-4-7 |
| バージョンを固定する場合 | gpt-5.5-2026-04-23 | claude-opus-4-7自体が固定スナップショット |
| 文脈の上限 | 1,050,000トークン | 1,000,000トークン |
| 通常の最大出力 | 128,000トークン | 128,000トークン |
| 入出力 | テキスト・画像を入力、テキストを出力 | テキスト・画像を入力、テキストを出力 |
| 本記事で使うインターフェース | Responses API | Messages API |
| 現在の提供状況 | API提供中。10月14日の製品提供終了の対象外 | Active(legacy)。モデル一覧では引き続き利用可能 |
仕様の出典はGPT-5.5のモデルページ、Opus 4.7のモデルページ、ClaudeのモデルIDとバージョン管理です。GPT-5.5はChat CompletionsとBatchにも対応しています。
Opus 4.7の「legacy」は、今後の更新を受けず、将来非推奨になる可能性があるという分類です。現在の提供停止を意味しません。Anthropic運営のClaude API、Claude Platform on AWS、Microsoft Foundryについては、提供終了は2027年4月16日より前には行わないと案内されています。この日は確定した終了日ではなく、Amazon BedrockとGoogle Cloudには各社の提供日程があります。モデルのライフサイクル
また、日付のないclaude-opus-4-7が自動的に新しいOpusへ置き換わるわけではありません。そのIDの重みと設定は固定されますが、配信基盤などの更新によって観察できる挙動が多少変わることはあります。再現性を確保したい場合は、モデルIDだけでなく、設定、ツール、入力資料、評価日も保存します。固定スナップショットの説明
文脈の上限には、入力だけでなく生成に必要な領域も関わります。100万トークンの資料を入れた後で、さらに最大出力を丸ごと使えると考えないでください。長い推論や回答に必要な余裕を残すことが、最後まで回答を得るための前提です。OpenAIの文脈と推論の説明
料金比較:長文入力とキャッシュで差が変わる
以下は提供元へ直接接続する標準APIの単価です。単位は100万トークンあたりの米ドル。月額プラン、他社クラウド、API仲介サービスの請求額とは分けてください。
| 課金区分 | GPT-5.5:入力272,000以下 | GPT-5.5:入力272,000超 | Claude Opus 4.7 |
|---|---|---|---|
| 通常入力 | 5 | 10 | 5 |
| キャッシュ読み出し | 0.50 | 1 | 0.50 |
| キャッシュ書き込み | 追加の書き込み料金なし | 追加の書き込み料金なし | 5分保持:6.25、1時間保持:10 |
| 出力(課金される推論を含む) | 30 | 45 | 25 |
GPT-5.5の長文料金は、超過した部分だけへの加算ではありません。モデルページでは、標準・Batch・Flexのセッション全体について入力2倍、出力1.5倍と説明しています。Opus 4.7には、入力200,000トークンを超えることで発生する長文割増はありません。GPT-5.5の料金条件、OpenAIのモード別料金、Anthropicの料金とキャッシュ
出力単価25米ドルは30米ドルより約16.7%低く、逆に30米ドルは25米ドルより20%高いという関係です。これを「Opusなら仕事全体が20%安い」と読み替えると、入力、推論、再試行の差を落としてしまいます。
同じトークン数ならいくらになるか
キャッシュなし・標準モード・地域加算なしで、1回のリクエストに次のトークン数が計上されたと仮定します。出力は画面に見える文章だけでなく、課金対象の生成トークン全体です。ツール料金、再試行、人のレビューは除外しています。
| 仮定する1回の使用量 | GPT-5.5の計算 | Opus 4.7の計算 |
|---|---|---|
| 入力50,000、出力8,000 | 0.05 × 5 + 0.008 × 30 = 0.49米ドル | 0.05 × 5 + 0.008 × 25 = 0.45米ドル |
| 入力300,000、出力8,000 | 0.3 × 10 + 0.008 × 45 = 3.36米ドル | 0.3 × 5 + 0.008 × 25 = 1.70米ドル |
これは単価差を見るための計算例です。同じ日本語やコードでも、両モデルが同じトークン数になるとは限りません。実際の比較では、各APIが返す使用量を別々に記録します。入力300,000の例ではOpus 4.7の料金差が大きいので、GPT-5.5を採用するなら、より少ない修正依頼で完成するなど、その差を埋める成果が必要になります。
繰り返し入力では、最初のキャッシュ作成も数える
GPT-5.5のキャッシュは自動で働き、追加の書き込み料金はありません。安定したprompt_cache_keyで関連リクエストの振り分けを最適化できます。保持設定はprompt_cache_retention: "24h"ですが、実際の寿命は通常約30分、最大24時間という説明であり、24時間のヒットを保証するものではありません。明示的なブレークポイントや、全リクエスト共通の最小1,024トークンというルールをGPT-5.5にそのまま適用しないでください。モデルごとのキャッシュ仕様
Opus 4.7では、5分保持の書き込みに通常入力の1.25倍、1時間保持に2倍の単価を使います。一方、ヒットした読み出しは通常入力の0.1倍です。Anthropicのキャッシュ料金
たとえば、固定資料100,000トークンと毎回異なる入力10,000トークンを2回送り、各回の出力を3,000トークンとします。2回目に固定資料全体がヒットすると仮定した標準料金は、GPT-5.5が合計0.83米ドル、Opus 4.7の5分キャッシュが合計0.925米ドルです。Opusは最初の書き込み料金が加わるため、この条件では出力単価が低くても合計額が上回ります。固定資料を何度再利用するか、実際にヒットした量はいくらかで結果が変わります。
Batch、Flex、地域指定は別の条件で比べる
非同期処理に適した仕事なら、両社のBatchは通常の入出力料金から50%割引になります。短い入力のGPT-5.5 Batchは入力2.50米ドル・出力15米ドル、Opus 4.7 Batchは入力2.50米ドル・出力12.50米ドルです。GPT-5.5のFlexにも同じ短文単価が掲載されていますが、BatchとFlexを同じ実行方式として扱うことはできません。OpenAI料金表、Anthropic Batch料金
低遅延を目的とするOpenAIのFastモードは、GPT-5.5の短い入力で入力12.50米ドル・出力75米ドルです。Opus 4.7ではFastは利用できず、speed: "fast"はエラーになります。標準単価のまま速度だけ上がる設定ではありません。地域処理にも追加料金があり、GPT-5.5のデータ所在地指定は10%加算、Claude APIのinference_geo: "us"は全トークン区分に1.1倍が適用されます。実際に利用する契約とモードをそろえて見積もります。OpenAI料金条件、AnthropicのFast・地域料金
コーディングの勝敗は、採用できた修正で判断する
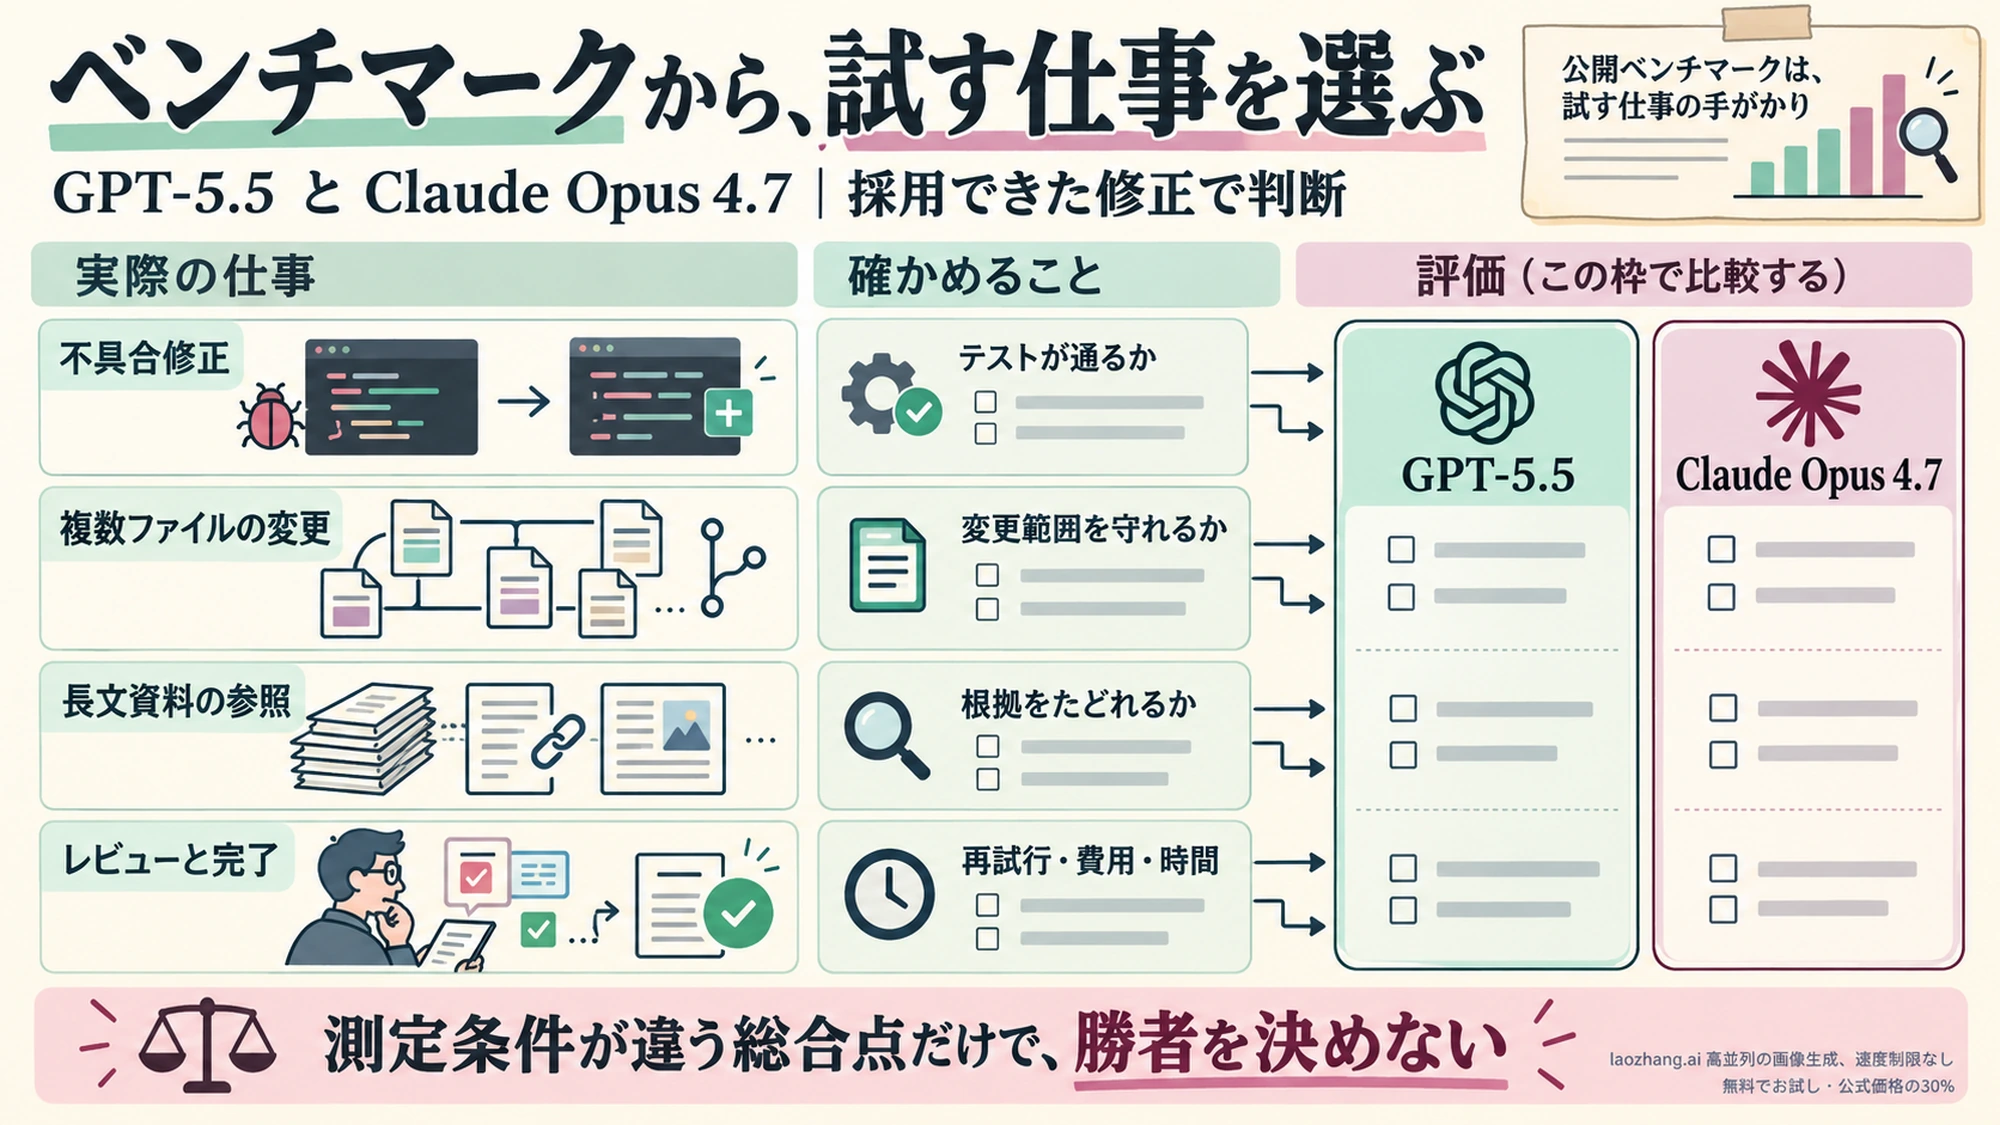
コードエージェントでは、モデル単体だけでなく、ファイル探索、ツールの説明、テスト実行、会話履歴を管理する仕組みが成果を左右します。これらを含む評価ハーネスが異なる結果から、「ターミナルはGPT、修正はClaude」と普遍的な役割分担を決めるのは早計です。
2026年4月25日のサーバーワークスの比較記事も、一部のベンチマークは両社でハーネスや採点方式が一致せず、日本語性能と実運用コストは別に評価する必要があると説明しています。MCPの出自だけで特定モデルのツール連携が優れているとも判断できません。
現在参照できる共通の測定例として、Artificial Analysisの比較を使うことはできます。2026年10月13日に確認したページの対象はGPT-5.5のHigh設定とOpus 4.7のMax設定で、同じ名前の設定をそろえた比較ではありません。
| Artificial Analysisの比較項目 | GPT-5.5 High | Opus 4.7 Max | 判断に使える範囲 |
|---|---|---|---|
| Intelligence Index v4.3.2 | 37 | 41(推定値) | Opus側の独立評価が今後実施されるという注記があり、確定した総合勝者にはできない |
| AA-LCR v1.1 | 84% | 79% | 長文照合を自社の評価対象に入れる根拠 |
| Humanity’s Last Exam | 45% | 42% | この測定条件での難問への回答結果 |
| 出力速度 | 88トークン/秒 | 51トークン/秒 | 最初の応答を受け取った後の生成速度 |
| 最初のトークンまで | 30.53秒 | 23.57秒 | 同ページの設定・測定条件における待ち時間 |
| 500トークン回答の所要時間 | 36.20秒 | 33.38秒 | 思考・初回待ち・生成速度を含めた計算値 |
出典:Artificial AnalysisのHigh対Max比較。500トークンの所要時間は60種類のプロンプトに基づく推論量などを用いた値です。出力速度が速いモデルでも、短い返答が早く完成するとは限らないことが分かります。日本語のコード説明や特定のリポジトリで同じ秒数になる保証はありません。
このページではOpus 4.7のタスクあたり費用などに空欄が残っています。空欄をゼロ扱いして費用対効果を順位付けしないでください。また、同ページの「100万トークンあたり4.35対3.85米ドル」はキャッシュ読み出し・入力・出力を7:2:1で混ぜた単価で、提供元の通常入力単価ではありません。
実プロジェクトでは、同じタスクから完成までを記録する
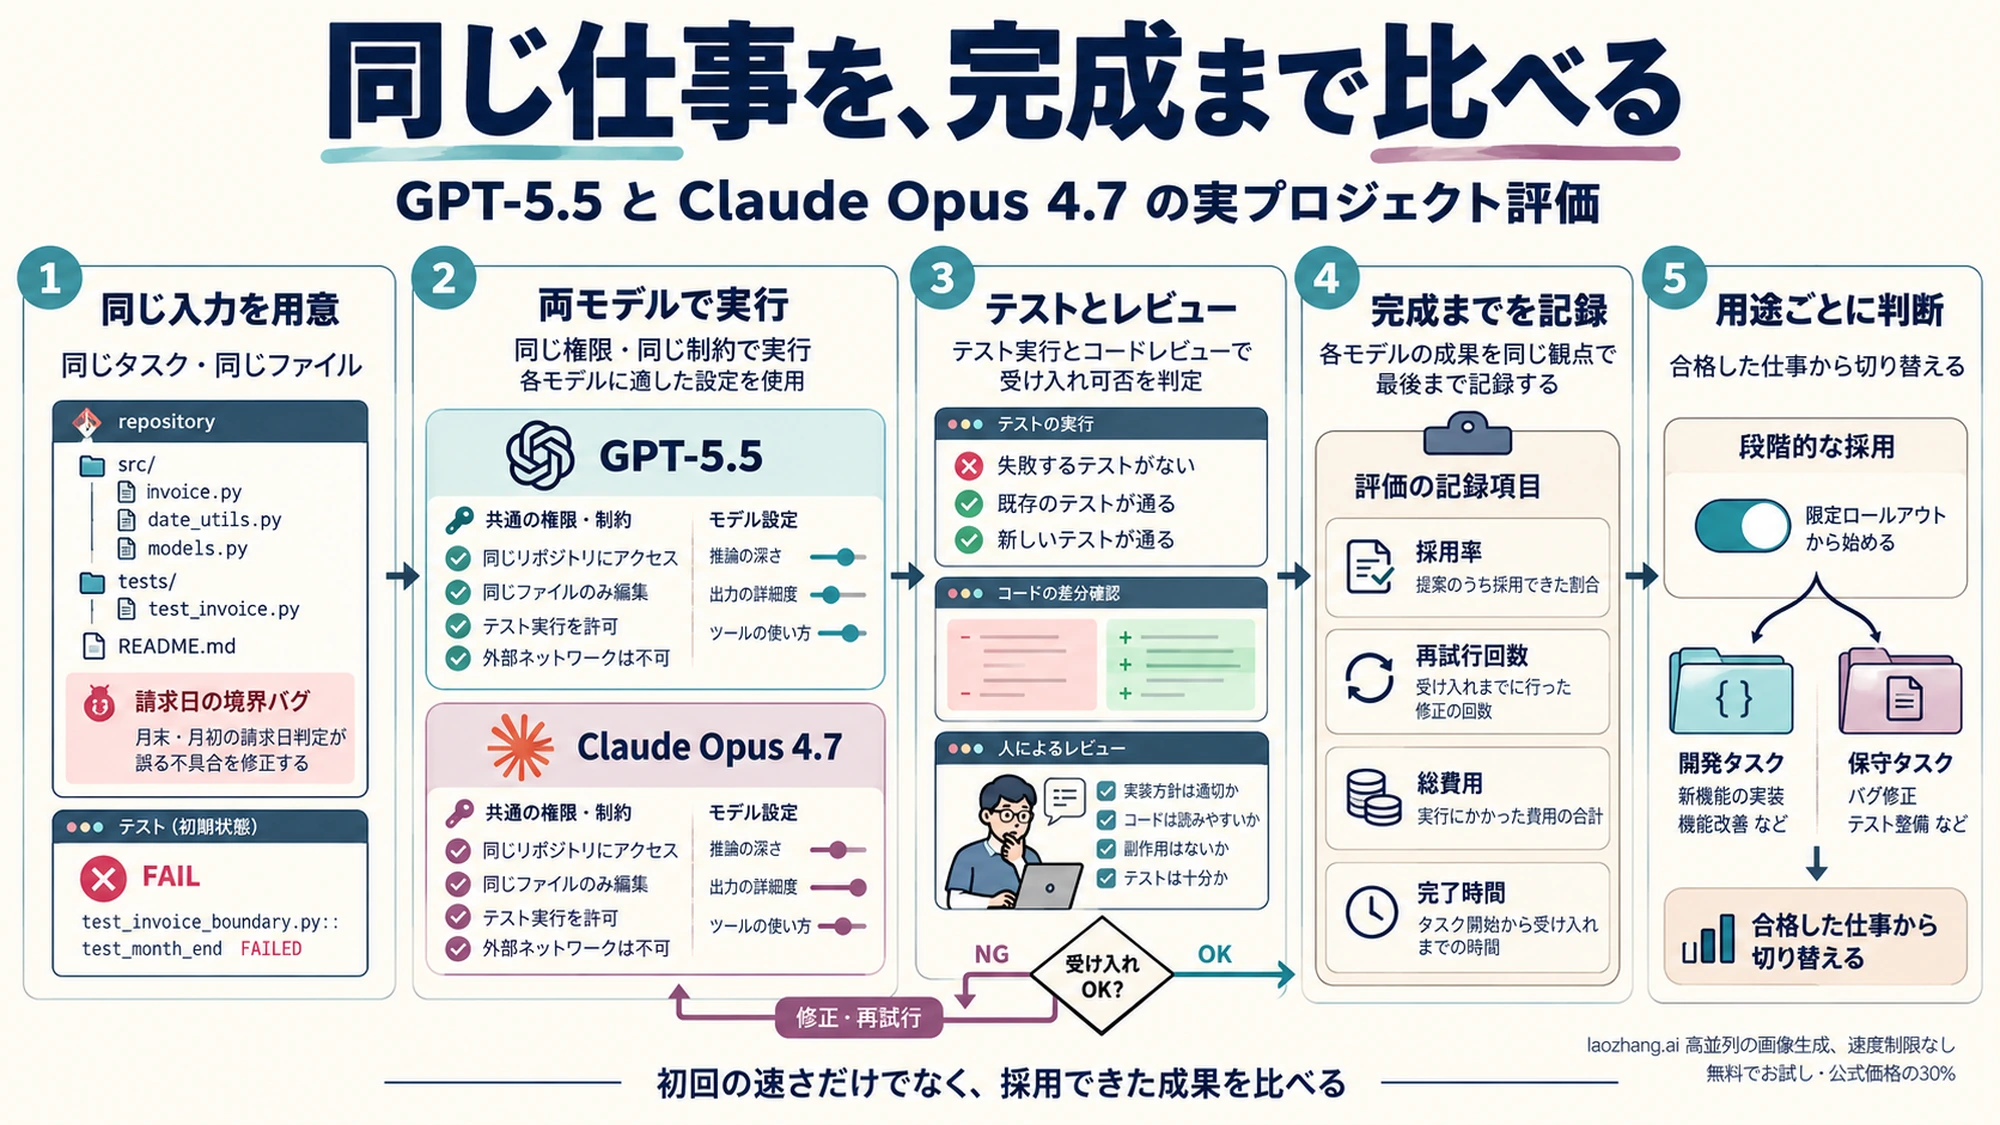
比較に使うのは、実際に手戻りが発生している修正です。たとえば「請求書の日付境界で誤る処理を直す」というタスクなら、同じリポジトリの状態、同じ失敗再現、同じアクセス可能なファイルを渡し、修正後のテストと差分を確認します。説明がもっともらしいだけで合格にしません。
記録する項目は、次のように成果と負担を結び付けます。
- 採用率:既存テストと追加した受け入れ条件を満たし、人が採用できた修正の割合。
- 手戻り:追加指示、再生成、ツールエラーからの復帰にかかった回数と時間。
- 総費用:失敗した試行も含めたAPI料金、ツール料金、レビュー時間。
- 完了時間:最初の文字が出るまでではなく、採用できる差分がそろうまでの時間。
「採用できた1件あたりのAPI費用」は、比較対象のタスク群で発生したAPI費用の合計を、採用できた件数で割ると計算できます。人件費を含める場合は、レビュー時間と社内の時間単価も別に加えます。出力単価が高いGPT-5.5でも、やり直しが減れば逆転し得ます。Opus 4.7でも、推論やツール往復が増えれば表示単価の利点が消えます。
両モデルに同じ成果と制約を与え、モデルごとに適切なAPI設定を使ってください。「両方ともhighだから計算量は同じ」とは仮定できません。品質が改善しないまま費用や完了時間だけが増える設定は採用せず、合格したタスクの種類から段階的に切り替えるのがよいでしょう。
推論設定を合わせる前に、各APIの意味を確認する
GPT-5.5のreasoning.effortはnone、low、medium、high、xhighに対応し、既定値はmediumです。まず既定値で基準を作り、難しい修正で受け入れ結果が改善するときにhighやxhighを評価します。OpenAI自身も、高い設定ほど常に良くなるとは説明していません。GPT-5.5の利用ガイド
Opus 4.7は、推論を有効にする場合にthinking: {"type": "adaptive"}を使います。推論は既定ではオフで、output_config.effortの既定値はhighです。low、medium、high、xhigh、maxに対応し、Anthropicはコーディングやエージェント用途ではxhighからの評価を推奨しています。古いtype: "enabled"とbudget_tokensの組み合わせは4.7では拒否されます。temperatureも非推奨で、既定値だけが受け入れられます。推論設定の対応表、Opus 4.7のeffort推奨
出力上限は、回答を最後まで書ける量を残す
GPT-5.5のmax_output_tokensには推論、表示される回答、非表示の書式用生成トークンが含まれます。上限に達するとstatus: "incomplete"となり、本文が出る前に推論だけで費用が発生する場合もあります。Opus 4.7のmax_tokensも推論を含む生成の上限で、到達するとstop_reason: "max_tokens"になります。どちらも、値を大きくすれば正しい完成品が保証される設定ではありません。OpenAIの生成上限、Claudeの途中停止
Opus 4.7のxhighやmaxを評価する際は、Anthropicの推奨どおり1リクエストに十分な生成余地を確保します。公式の開始目安は64,000トークンです。費用が気になるから上限だけを極端に下げると、能力比較よりも「どちらが先に回答を切られるか」の比較になってしまいます。effortと出力上限
Task Budgetsは、タスク全体の請求上限ではない
Opus 4.7のMessages APIにはTask Budgetsのベータ機能があります。task-budgets-2026-03-13ヘッダーを付け、output_config.task_budgetでタスクの目安を伝えます。最小のtotalは20,000トークンで、推論、ツール呼び出し・結果、回答を含む一連の作業を対象にします。
ただし、これはモデルへの目安であり、超過を強制的に防ぐ上限ではありません。残り予算はレスポンスのusageにも返されません。max_tokensは1リクエストの生成を制限し、Task Budgetsは複数リクエストにまたがる作業の進め方に影響します。アプリ全体の費用を止めるには、使用量の累積、追加リクエスト数、経過時間をアプリ側で管理する必要があります。Claude CodeやCoworkの機能としては提供されていません。Task Budgetsの公式仕様
提供元のAPIで短い文書レビューを始める例
以下は、同じ日本語の仕様文に含まれる矛盾を指摘させる独立したPython例です。公式SDKが利用でき、各提供元のAPIキーをサーバー側の環境変数OPENAI_API_KEYまたはANTHROPIC_API_KEYへ安全に設定済みであることが前提です。GPT-5.5はAPIのFree tierに対応していないため、一般的なクイックスタートの無料案内から、このモデルの無料枠を想定しないでください。OpenAI SDKの導入案内、Claude SDKの導入案内、GPT-5.5の利用枠
コードはAPIの使い分けを示す文書例で、本記事のために実行した結果ではありません。実行するとAPI使用量が発生します。
GPT-5.5:Responsesで完成状態と使用量を確認する
from openai import OpenAI

client = OpenAI()
request_text = """
次の仕様の矛盾を指摘し、確認が必要な点を日本語で簡潔に列挙してください。
資料にない前提は補わないでください。
仕様A:返品は購入日から30日以内に受け付ける。
仕様B:返品受付期間は商品到着日から14日以内とする。
"""

response = client.responses.create(
    model="gpt-5.5-2026-04-23",
    input=request_text,
    reasoning={"effort": "medium"},
    text={"verbosity": "low"},
    max_output_tokens=8192,
)

print("status:", response.status)
if response.usage is not None:
    print("usage:", response.usage.model_dump())

if response.status == "completed" and response.output_text:
    print(response.output_text)
elif response.status == "incomplete":
    print("未完了:", response.incomplete_details)
    if response.output_text:
        print("途中までの回答:", response.output_text)
else:
print("完成したテキストを取得できませんでした。状態を確認してください。")料金の記録では、usage.input_tokens_details.cached_tokensをキャッシュ入力として扱い、input_tokensから引いた残りを通常入力として扱います。usage.output_tokensには推論も含まれ、内訳はoutput_tokens_details.reasoning_tokensで確認できます。total_tokensをすべて出力単価で掛けたり、推論をもう一度加算したりしないでください。Responsesのusage例と推論課金
Opus 4.7:Messagesでテキストブロックと停止理由を確認する
import anthropic

client = anthropic.Anthropic()
request_text = """
次の仕様の矛盾を指摘し、確認が必要な点を日本語で簡潔に列挙してください。
資料にない前提は補わないでください。
仕様A:返品は購入日から30日以内に受け付ける。
仕様B:返品受付期間は商品到着日から14日以内とする。
"""

message = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=16384,
    thinking={"type": "adaptive"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": request_text}],
)

answer = "\n".join(
    block.text for block in message.content if block.type == "text"
)
print("stop_reason:", message.stop_reason)
print("usage:", message.usage.model_dump())

if message.stop_reason == "end_turn" and answer:
    print(answer)
elif message.stop_reason == "max_tokens":
    print("生成上限に達したため、回答を完成品として採用しないでください。")
    if answer:
        print("途中までの回答:", answer)
else:
print("停止理由と応答ブロックを確認してください。")先頭のブロックが常に本文とは限らないため、content[0].textだけを取り出さず、種類がtextのブロックを選びます。この短い文書レビューではhighを使っています。長いコード修正の推奨設定xhighをそのまま使った例ではありません。Messagesの基本形と推論ブロック
どちらの例も、APIが正常に返り、完成したテキストと使用量が得られたことは接続確認になりますが、回答の正しさは別に確認します。複数ターンやツール実行へ広げる場合は、ClaudeのMessagesが会話履歴を明示的に送る方式であること、推論を含むツール応答では返されたブロックを維持することも重要です。OpenAIのResponsesとClaudeのMessagesは別のインターフェースなので、モデル名だけの置き換えでは移植が完了しません。GPT-5.5の会話管理、Claudeの会話・ツール処理
よくある質問
GPT-5.5は10月14日以降もAPIで使えますか?
公式通知では、2026年10月14日のChatGPT、ChatGPT Work、Codexでの提供終了はOpenAI APIには適用されません。APIアプリについて、この通知だけを理由にモデルを置き換える必要はありません。通知には具体的な終了時刻やタイムゾーンは示されていません。公式通知
Claude Opus 4.7は古いモデルなので、もう使えませんか?
利用できます。2026年10月13日時点ではActive(legacy)で、日付のないclaude-opus-4-7は固定されたモデルIDです。Anthropic運営の対象プラットフォームでは、2027年4月16日より前には提供終了しないと案内されています。BedrockやGoogle Cloudは各社の日程を確認してください。Opus 4.7の現状、ライフサイクルの適用範囲
コーディングでは、Opus 4.7の方が確実に優れていますか?
自社タスクでの確実な優位は、公開ベンチマークだけでは判断できません。既存のClaudeエージェントならOpus 4.7を基準に、OpenAIの実装ならGPT-5.5を基準にし、同じコード修正の採用率とレビュー負担を比べてください。Artificial Analysisの総合比較はGPT-5.5 High対Opus 4.7 Maxで、Opus側の総合指数は推定値です。比較条件と結果
月額のClaudeプランでAPI料金もまかなえますか?
条件を満たすMaxとTeamプランには月次APIクレジットがあります。2026年10月13日時点の案内では、Max 5xは100米ドル、Max 20xは200米ドル、TeamはStandard席あたり20米ドル、Premium席あたり100米ドルを合算し、月500米ドルが上限です。Free、Pro、Enterpriseは対象外です。
対象プランで7日以上経過し、必要なプラン・Console権限を持つ人が、条件を確認して1つのConsole組織へ連携する必要があります。クレジットは請求周期末に失効し、繰り越されません。対話型のClaude Codeや他社クラウドの利用には適用されず、APIのトークン課金やプラン内の利用制限もなくなりません。実際の対象表示と残高を確認してから、費用に織り込んでください。Max・Teamの月次APIクレジット
GPT-5.5 Proも同じ料金で比較できますか?
できません。gpt-5.5-proは別モデルで、標準の短文料金は入力30米ドル・出力180米ドル、キャッシュ入力の割引もありません。ResponsesとBatchに対応しますが、通常のGPT-5.5と同じ費用や応答時間を前提にしないでください。必要な品質改善が通常モデルでは得られない場合に、別枠で評価する候補です。GPT-5.5 Pro仕様、モード別料金
参考資料20
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月13日。
参考資料20
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月13日。
- 1.GPT-5.5のモデル仕様developers.openai.com/api/docs/models/gpt-5.5
- 2.Opus 4.7の仕様platform.claude.com/docs/en/models/opus-4-7/overview
- 3.OpenAIの料金表developers.openai.com/api/docs/pricing
- 4.Anthropicの料金表platform.claude.com/docs/en/about-claude/pricing
- 5.公式の提供終了案内learn.chatgpt.com/docs/models
- 6.ClaudeのモデルIDとバージョン管理platform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 7.モデルのライフサイクルplatform.claude.com/docs/en/about-claude/model-deprecations
- 8.OpenAIの文脈と推論の説明developers.openai.com/api/docs/guides/reasoning
- 9.モデルごとのキャッシュ仕様developers.openai.com/api/docs/guides/prompt-caching
- 10.サーバーワークスの比較記事blog.serverworks.co.jp/2026/04/25/190000
- 11.Artificial AnalysisのHigh対Max比較artificialanalysis.ai/models/comparisons/gpt-5-5-high-vs-claude-opus-4-7
- 12.GPT-5.5の利用ガイドdevelopers.openai.com/api/docs/guides/latest-model
- 13.推論設定の対応表platform.claude.com/docs/en/build-with-claude/thinking-troubleshooting
- 14.Opus 4.7のeffort推奨platform.claude.com/docs/en/build-with-claude/effort
- 15.Task Budgetsの公式仕様platform.claude.com/docs/en/build-with-claude/task-budgets
- 16.OpenAI SDKの導入案内developers.openai.com/api/docs/quickstart
- 17.Claude SDKの導入案内platform.claude.com/docs/en/get-started
- 18.Messagesの基本形と推論ブロックplatform.claude.com/docs/en/claude_api_primer
- 19.Max・Teamの月次APIクレジットsupport.claude.com/en/articles/17154008-monthly-api-credits-for-max-and-team-plans
- 20.GPT-5.5 Pro仕様developers.openai.com/api/docs/models/gpt-5.5-pro