Claude Sonnet 5.5とGPT-6.1 Terra比較:実測でSonnetが2.8倍高い
同じ12問の実測で合格数は並び、費用はSonnet 5.5がGPT-6.1 Terraの2.8倍。短い仕事はTerraへ、Terraの上限を超える品質が要る仕事はSonnetへ。
目次
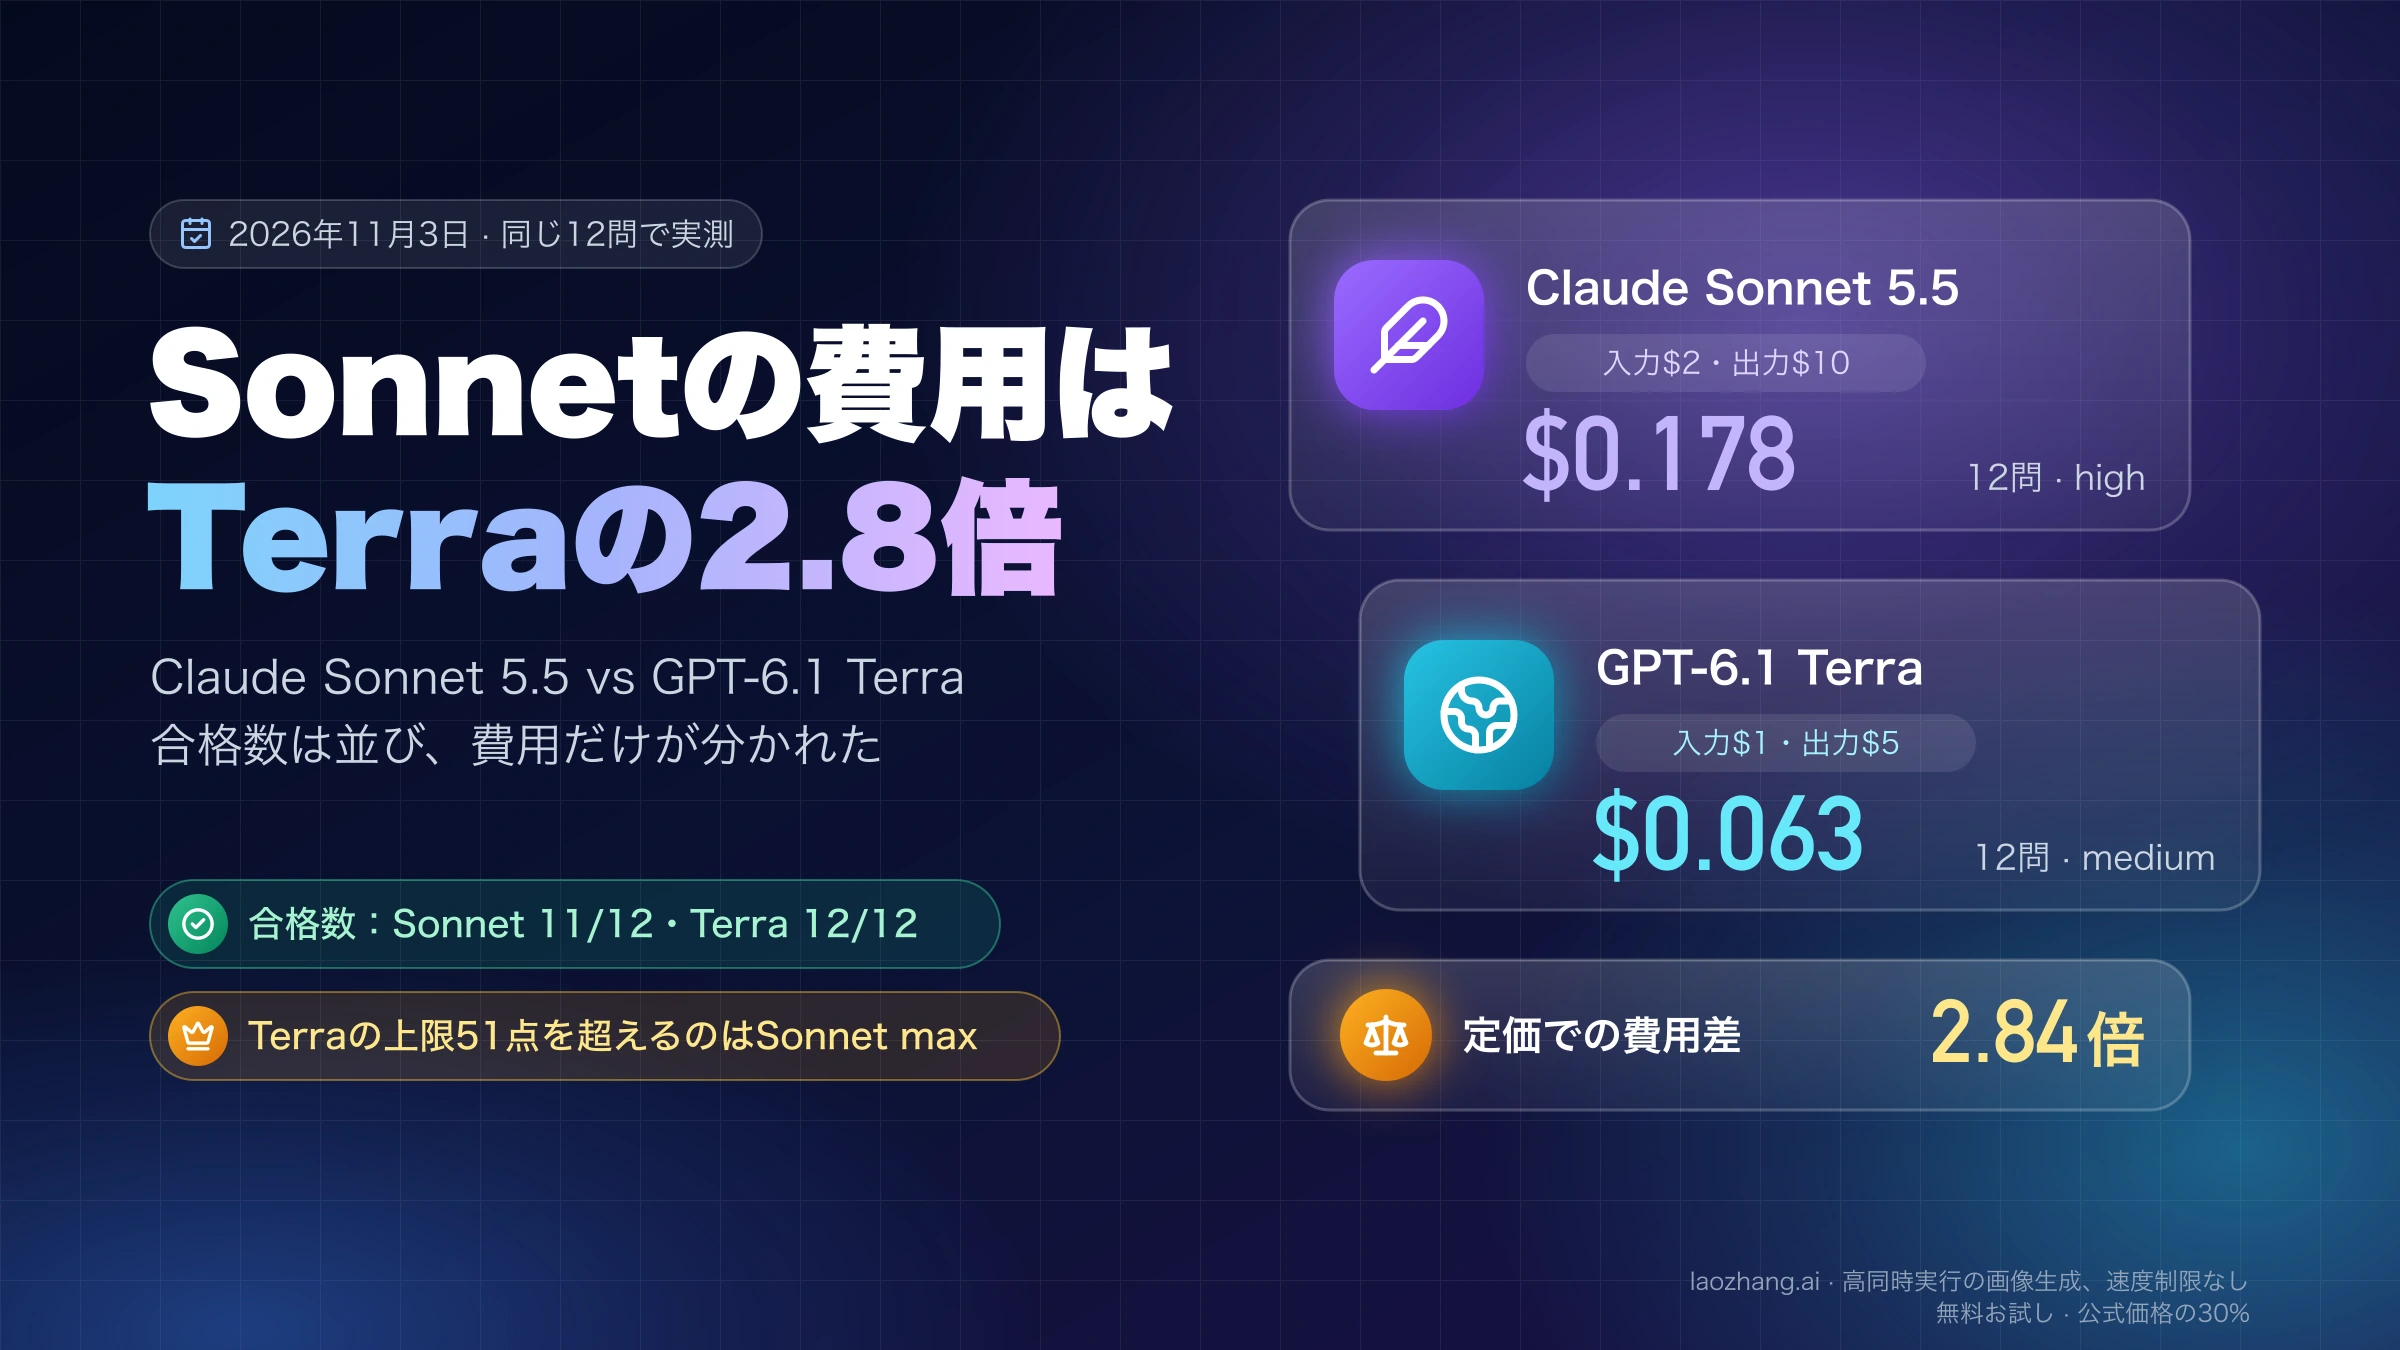
Claude Sonnet 5.5で回している仕事のうち、単発のコード修正、要約、抽出、仕様のはっきりした関数の実装は、gpt-6.1-terraを既定の推論の強さ(effort)mediumで試す価値があります。2026年11月3日に同じ12問を両モデルに解かせたところ、Sonnetのhigh(Claude APIの既定)は11問、Terraのmediumは12問に合格し、定価で計算した費用はSonnetが$0.178、Terraが$0.063で2.84倍の差でした。
Sonnetに残すのは、Terraの最上位設定maxでも届かない品質が要る仕事と、ターミナル操作や業務手順を何段も進めるエージェント型の仕事です。Artificial Analysisのインテリジェンス指数(Intelligence Index)v5.0では、Terraの最高はmaxの51点で、これを上回るのはSonnetのmax(54点、1タスク$10.02)だけです。
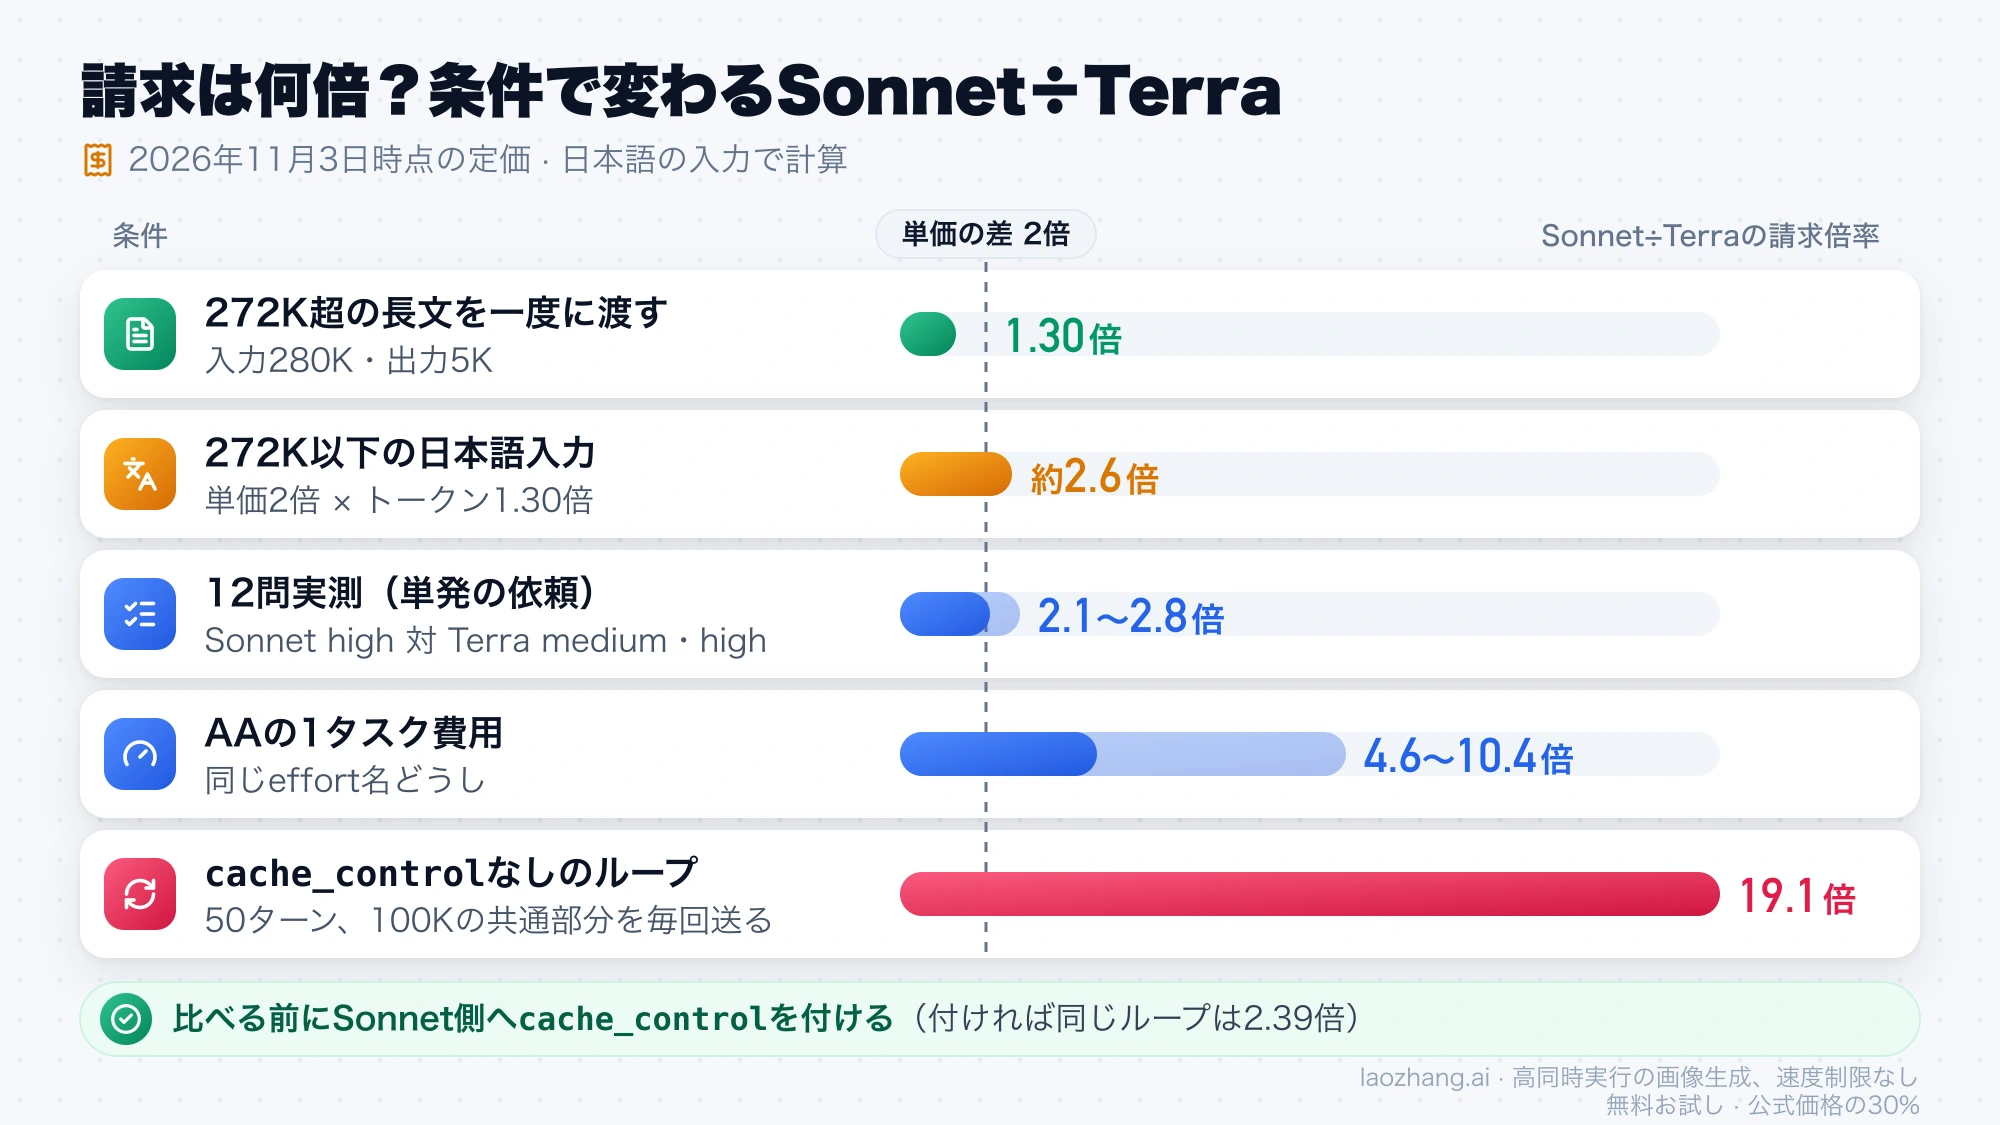
例外は2つあります。Terraは入力が272Kトークンを超えるとリクエスト全体の単価が上がるため、長い資料を一度に渡す処理では差が日本語で約1.3倍まで縮みます。逆に、Sonnetでcache_controlを付けずにエージェントのループを回していると、差は約19倍まで開きます。ここでのTerraは2026年10月26日公開のGPT-6.1 Terraで、旧モデルのGPT-5.6 Terraではありません。
Sonnet 5.5からGPT-6.1 Terraに移す仕事、Sonnetに残す仕事
使い分けの基本は、まずTerraのmediumに回し、テストや受け入れ基準に落ちた依頼だけを段階的に上の設定へ送ることです。Terraは同じ名前のeffortならhighまでSonnetと同等以上の点数で、1タスクの費用ははるかに低いからです。Sonnetを最初から選ぶのは、エージェント操作の評価でSonnetが上回る仕事と、Terraの上限を超える品質が必要な仕事に限られます。
| 仕事の種類 | 先に試す設定 | 根拠 |
|---|---|---|
| 単発のコード修正、関数の実装、テキスト処理 | Terraのmedium | 2026年11月3日の12問実測で全問合格 |
| 分類、抽出、要約を大量に回す | Terraのlowかmedium、急がなければBatch | AAのlow同士でもTerraが4点上 |
| 難しいコーディング課題 | Terraのhighからmax | FrontierCode 2.0でTerra maxがSonnet maxとほぼ同じ |
| 物理など科学系の推論 | Terraのmax | CritPt v2でTerra maxがSonnet maxを上回る |
| ターミナル操作、複数手順のエージェント、業務書類 | Sonnetのxhighかmax | 指数が近い段階同士でもSonnetが上 |
Terraのmaxで足りない品質が必須 | Sonnetのmax | Terraの上限51点を超えるのはSonnet maxだけ |
| 272Kトークンを超える資料を一度に渡す | どちらでも可、品質で選ぶ | 入力単価が同じになり、差はほぼトークン数の比だけ |
表の割り当ては、Artificial Analysis(AA)の評価ごとの向きと12問の実測を組み合わせた出発点で、それぞれの用途で勝率を測ったものではありません。OpenAI自身も、GPT-6.1 Terraの発表で最も複雑なコーディングにはGPT-6.1 SolかGPT-6 Astraを勧めています(OpenAIのGPT-6.1 Terra発表)。迷う依頼は、Terraのmedium、high、maxの順に上げ、それでも落ちるものをSonnetのxhighに回すと、費用の大きい設定を使う範囲を最小にできます。
「単価が半分」は「請求が半分」?同じ仕事でSonnetは2〜10倍
単価が半分でも、Sonnetの請求がTerraのちょうど2倍になるとは限らず、多くの場合はそれより大きく開きます。請求額は単価、トークン数、effortごとの出力量の掛け算で、Sonnetは同じ文章を日本語で約1.30倍のトークンとして数え、AAのタスクでは同じeffort名でも多くのトークンを使います。その結果、2026年11月3日の12問実測では2.1〜2.8倍、AAの1タスクあたりの費用(AAの算定)では同じeffort名で4.6〜10.4倍の差になります。
単価そのものは、2026年11月3日時点で次のとおりです(100万トークンあたり、Standard)。
| 項目 | Claude Sonnet 5.5 | GPT-6.1 Terra(入力272K以下) | GPT-6.1 Terra(入力272K超) |
|---|---|---|---|
| 入力 | $2.00 | $1.00 | $2.00 |
| 出力 | $10.00 | $5.00 | $7.50 |
| キャッシュ読み取り | $0.10 | $0.05 | $0.10 |
| キャッシュ書き込み | $2.50(5分)、$4.00(1時間) | $1.25(30分)、$2.50(12時間) | $2.50(30分)、$5.00(12時間) |
出典はClaude APIの料金ページとOpenAI APIの料金ページです。Sonnet 5.5は100万トークンのコンテキスト全体で単価が変わらず、Terraは入力が272Kトークンを超えるとリクエスト全体に上の右列が適用されます。Batchはどちらも半額で、Sonnetが入力$1・出力$5、Terraが(272K以下で)入力$0.50・出力$2.50です。コンテキストはSonnetが100万、Terraが105万トークン、最大出力はどちらも128Kトークンです。OpenAIの地域処理エンドポイントを使う場合は、2026年3月5日以降に公開されたモデルに10%が上乗せされます。
effort別の点数と1タスク費用:AA Intelligence Index v5.0
同じ名前のeffortで比べると、Terraはhighまで点数でSonnetと並ぶか上回り、1タスクの費用は4.6〜7.3分の1です。逆転するのはxhighとmaxで、ここではSonnetが5点と3点上回る代わりに費用は10倍を超えます。数値はAAのリリース比較ページ(Claude Sonnet 5.5とGPT-6.1 Terraの比較)の2026年11月3日時点の値で、1タスクあたりの費用はAAのタスクで使われたトークンを定価で計算したものです。
| effort | Sonnet 5.5(点・1タスク費用・時間) | GPT-6.1 Terra(点・1タスク費用・時間) | 費用の倍率(Sonnet÷Terra) |
|---|---|---|---|
max | 54点・$10.02・1,263秒 | 51点・$0.96・533秒 | 10.4倍 |
xhigh | 50点・$4.09・719秒 | 45点・$0.40・248秒 | 10.2倍 |
high | 41点・$1.64・344秒 | 42点・$0.26・172秒 | 6.3倍 |
medium | 30点・$0.78・190秒 | 38点・$0.17・118秒 | 4.6倍 |
low | 25点・$0.51・127秒 | 29点・$0.07・48秒 | 7.3倍 |
推論なし(none) | AAの測定なし | 30点・$0.23・104秒 | — |
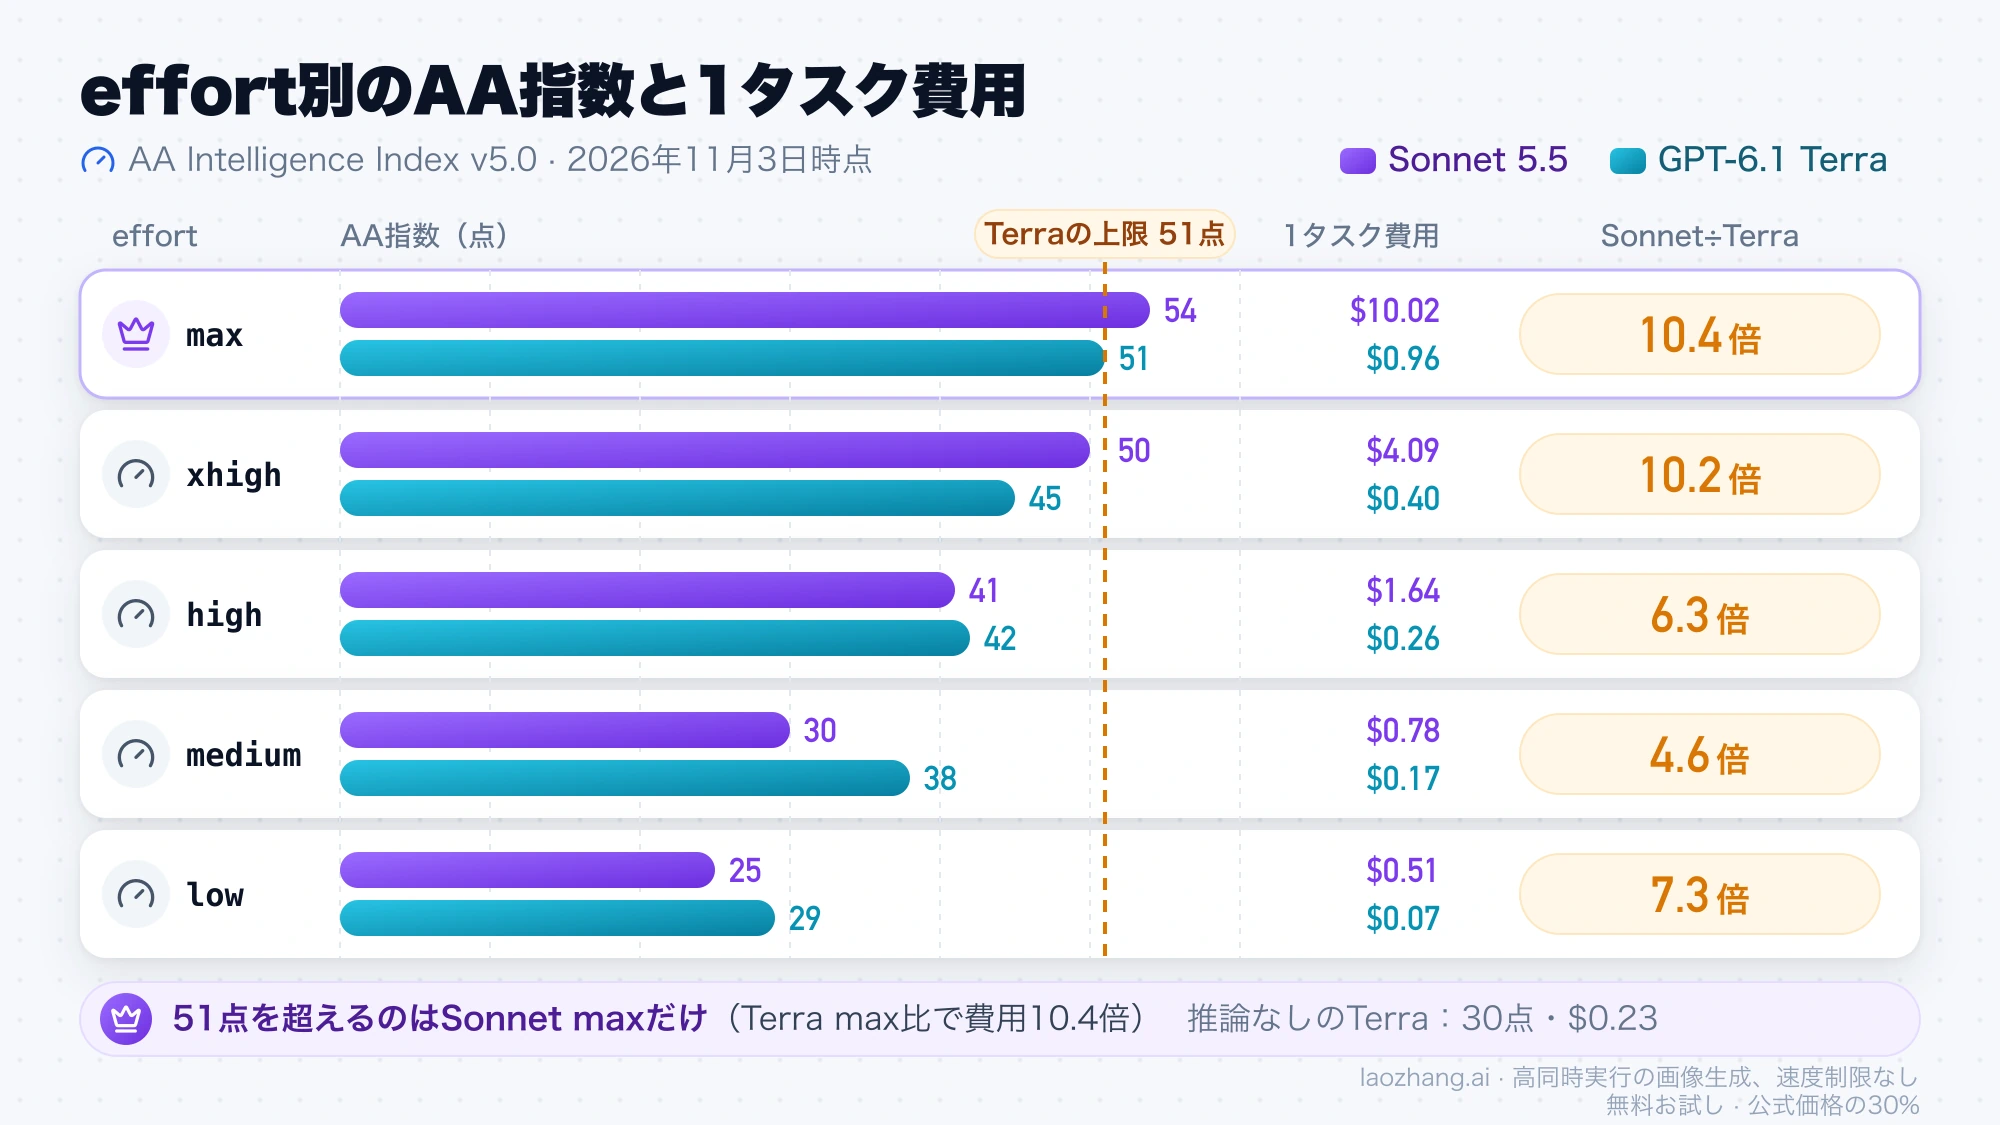
ただし、2社のeffort名は同じ尺度ではないので、名前をそろえるより「既定同士」と「点数が近い段階同士」で読むほうが判断に使えます。Claude APIでSonnetの既定はhigh、Terraの既定はmediumで、既定のまま使うとSonnetは3点高い代わりに費用が9.6倍、時間が2.9倍です。Claude CodeとClaudeのアプリではSonnetの既定がmediumなので、Terraのmediumより8点低く、費用は4.6倍になります(Claude Codeでのモデル別の既定値は「Claude Code の effort とは:既定値・おすすめ・設定が効かない原因」)。
点数が近い段階同士では、Sonnetのxhigh(50点、$4.09、719秒)とTerraのmax(51点、$0.96、533秒)が並び、Terraが1点上で費用は4.3分の1、時間は約4分の3です。Sonnetのmedium(30点)に相当するのはTerraの推論なし(30点)で、費用差は3.4倍です。Terraの上限51点を超えられるのはSonnetのmaxだけで、その1タスクはTerraのmaxの10.4倍の費用と2.4倍の時間がかかります。なお、maxは設定の名前で、どちらのモデルでも最高品質を保証するものではありません。
AAは2026年10月27日から28日にかけて指数をv4.3.2からv5.0に切り替えました。「lowとmediumで同点、xhighで52対45」という比較は10月27日に測られた旧指数v4.3.2の数字で、v5.0ではどの段階にも同点はありません。AAの値は構成ごとに1回の測定で、更新されれば変わります。
Sonnetが上の評価とTerraが上の評価:エージェント操作か、難問と科学か
指数がほぼ同じSonnetのxhigh(50点)とTerraのmax(51点)を個別の評価で比べると、Sonnetはターミナル操作や業務の自動化といったエージェント寄りの評価で上回り、Terraは難しいコーディング課題と科学系の評価で上回ります。総合点が並んでいても、得意な仕事ははっきり分かれます。
| 評価(AA v5.0) | Sonnet xhigh(指数50) | Terra max(指数51) | Sonnet max(指数54) |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.1% | 55.6% | 63.6% |
| AutomationBench-AA | 65.5% | 60.2% | 71.8% |
| AA-Briefcase v1.1 | 1744 | 1402 | 1814 |
| HLE-Diamond | 44.1% | 47.3% | 53.3% |
| FrontierCode 2.0 | 35.6% | 42.3% | 41.7% |
| CritPt v2(Hard) | 54.0% | 64.5% | 56.0% |
| Terminal-Bench-Science 0.1 | 52.4% | 57.6% | 53.3% |
Sonnetのmaxまで上げても、FrontierCode 2.0、CritPt v2、Terminal-Bench-ScienceではTerraのmaxが上です。反対にTerminal-Bench 4.0、AutomationBench、Briefcaseでは、SonnetのmaxはTerraのmaxに8〜12ポイント、Briefcaseでは400点以上の差をつけます。業種別の指数では、SonnetのxhighとTerraのmaxが金融・会計49対49、法務47対46、エンジニアリング53対54とほぼ同じで、最も差が大きいのは戦略・業務運営の54対50でした。AAの1回ずつの測定なので、数ポイントの差は自分の仕事で確かめる必要があります。
2026年11月3日の12問実測:合格数は並び、費用は2.1〜2.8倍
2026年11月3日に、LaoZhangのAPIゲートウェイ経由で同じ12問を両モデルに解かせた結果、合格数はほぼ同じで、費用だけがはっきり分かれました。Sonnet 5.5はhigh、GPT-6.1 Terraは既定のmediumとhighで、各問1回ずつ、ストリーミングなし、ツールなし、1通のメッセージだけで送っています。費用はゲートウェイの残高ではなく、返ってきたトークン数に各社の定価を掛けて計算しました。
| 設定 | 合格 | 定価での費用 | 呼び出し時間の合計 | 出力トークン(うち推論) | 入力トークン |
|---|---|---|---|---|---|
Sonnet 5.5 high | 11/12 | $0.1782 | 103秒 | 11,155 | 33,300 |
GPT-6.1 Terra medium | 12/12 | $0.0628 | 130秒 | 7,149(3,740) | 21,977 |
GPT-6.1 Terra high | 11/12 | $0.0839 | 176秒 | 11,375(7,816) | 21,977 |
12問は、隠しテスト付きのコード課題(数式の評価25件、CSVの1行の解析16件、semverの比較30件、npm形式のバージョン範囲36件など)、正解が1つに決まる計算や文章題、約6,700語の英文に埋め込んだ3つのメモから$76.80を出す問題、存在しないCPythonの関数を尋ねる問題などです。不合格の2件はどちらも「25語以内の箇条書き5つで要約」の問題で、1行が26語になった同じ書式ミスでした。1回ずつの結果なので、この1問の差でモデルの優劣は決められません。
示せたのは費用の差です。Sonnetの費用はTerraのmediumの2.84倍、highの2.12倍で、問題ごとにはmedium比で2.0〜5.8倍、high比で1.1〜4.0倍でした。同じhigh同士では出力トークンが11,155対11,375とほぼ同じで、差の大半は単価の2倍と、Sonnetが入力を1.52倍のトークンとして数えたことで説明できます。Terraは約10.1Kトークンの長いプロンプト2件で、キャッシュの設定をしていないのにcache_write_tokens(10,103と10,195)を返しました。定価では30分のキャッシュ書き込み単価で計算される分です。Sonnetはcache_controlを送っていないので、キャッシュの記録はありません。
速さはAAと逆向きでした。この経路では1回の呼び出しが、SonnetのhighはTerraのmediumより12問中11問で、Terraのhighより12問すべてで速く終わっています。AAの「1タスクあたりの時間」は数百秒かかるエージェント型のタスクの測定で、問題も測り方も違うため、どちらかが誤りというわけではありません。
このテストで分からないのは、ツール呼び出し、複数ターンのエージェント、画像入力、Responses API、各社APIへの直接接続での結果、そしてSonnetのhigh以外とTerraのxhigh・maxです。ほぼ全問が合格したので、どちらが賢いかの順位ではなく、合格率が並んだときの費用とトークン数の比較として読んでください。品質の目安にはAA v5.0の点数を使います。
自分の請求は何倍?日本語の入力はSonnetで1.30倍のトークン
自分の請求倍率は、入力トークン×入力単価+キャッシュ書き込み×書き込み単価+キャッシュ読み取り×読み取り単価+出力トークン×出力単価を両モデルで計算すれば見積もれます。そのときSonnet側の入力トークンは、Terraで数えた値の1.30倍(日本語)にします。2026年11月3日に同じ日本語6,000字を各APIに数えさせると、Sonnetが4,907トークン、Terraが3,776トークンでした。単価が2倍なので、同じ日本語の入力は272K以下でSonnetが約2.6倍の請求になります。
言語やコードが混ざる場合は比率が変わります。同じ測り方で英語は1.43倍、Pythonのコードは1.46倍、韓国語は1.62倍で、測った6言語の中では日本語の差がいちばん小さくなりました。各言語1つの文章で測った値なので、自分のプロンプトで数え直すとより正確です。
| ケース(トークン数はTerra基準) | GPT-6.1 Terra | Sonnet(同じトークン数の場合) | Sonnet(日本語、入力1.30倍) |
|---|---|---|---|
| 対話1回:入力2K、出力500 | $0.0045 | $0.0090(2.00倍) | $0.0102(2.27倍) |
| 資料1件:入力270K、出力5K | $0.2950 | $0.5900(2.00倍) | $0.7520(2.55倍) |
| エージェント50ターン:100Kの共通部分をキャッシュ、毎ターン新規2K・出力1K | $0.72 | $1.44(2.00倍) | $1.72(2.39倍) |
| Batch 10,000件:各入力3K、出力1K | $40.00 | $80.00(2.00倍) | $89.00(2.23倍) |
この表は出力トークンを両モデルで同じと置いた計算で、単価と入力トークンの差だけを反映しています。実際にはeffortによって出力量が変わり、AAのタスクではSonnetのほうが多くのトークンを使うため、AAの1タスク費用の倍率(4.6〜10.4倍)はこの表より大きくなります。自分の仕事が短い単発の依頼に近いなら12問実測の2.1〜2.8倍、長く考えさせるエージェント型ならAAの倍率に近いと考えるのが目安です。
272K超の長文とキャッシュなしのループでは倍率が変わる
Terraは入力が272Kトークンを超えると、そのリクエスト全体が入力$2、出力$7.50、キャッシュ読み取り$0.10になり、入力の単価がSonnetと同じになります。入力280K、出力5Kで計算すると、Terraは$0.5975、同じトークン数のSonnetは$0.610で差は1.02倍、日本語のトークン差を入れても1.30倍です。272KはTerraで数えた値なので、日本語ではSonnetで約354Kトークンに当たる長さが境目です。272K以内に分割できる資料なら、分割したほうがTerraの低い単価が残ります。
キャッシュの扱いも2社で違います。OpenAIはGPT-5.6以降のモデルで自動的にキャッシュし、書き込みも請求します。Anthropicは、リクエストの最上位にcache_controlを付けるか、ブロックごとにcache_controlの区切りを置いたときだけキャッシュし、付けなければ何もキャッシュしません(Claude APIのプロンプトキャッシュの説明)。Sonnet 5.5のキャッシュ読み取りは入力単価の5%の$0.10です。
この違いは、同じ長い共通部分を毎ターン送るエージェントのループで最も効きます。前節の50ターンの例で、Sonnetがcache_controlなしだと請求は同じトークン数でも$10.70(Terraの14.9倍)、日本語なら$13.76(19.1倍)です。Sonnetからの乗り換えで大幅に安くなったように見えても、その多くはキャッシュの有無による差かもしれません。公平に比べるなら、先にSonnet側へcache_controlを付けてから測り直してください。
どのTerra?GPT-6.1 TerraとGPT-5.6 Terraの見分け方
「Sonnet 5.5とTerra 5.6」という組み合わせで調べている場合、相手はGPT-6.1 Terraではなく、2026年11月3日時点でも提供が続いている旧モデルのgpt-5.6-terraです。OpenAIのGPT-5.6 Terraのモデルページでは、単価は入力$2、出力$12、知識のカットオフは2026年2月16日で、OpenAIはおおよそminiモデルの位置にあたると説明しています。入力はSonnet 5.5と同じ$2で、出力はSonnetの$10より高い$12です。この記事の数値はすべてgpt-6.1-terraのもので、GPT-6系の各モデルと2つのTerraの関係は「GPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶ」で整理しています。
ChatGPTとClaudeのプランで使う場合:TerraはWorkとCodexだけ
ChatGPTのプランでGPT-6.1 Terraを使えるのは、WorkとCodexの中だけで、通常のチャットのモデル選択には出てきません。OpenAIの発表では対象がPlus、Pro、Enterprise、Eduで、Codexのドキュメントでは加えてBusinessも挙がっています。Claude Sonnet 5.5はClaudeのアプリとClaude Codeで使え、既定のeffortはAPIと違ってmediumです。
サブスクの利用量はAPIの単価から決まるわけではないので、APIで半額だからといってプランで2倍使えるとは限りません。Anthropicは各プランでのSonnet 5.5のメッセージ数を公表しておらず、CodexでのTerraとSolの5時間あたりの目安は「GPT-6.1 TerraとSolの違い:単価は半額、Codex実測で2倍速」にまとめています。
APIで切り替えるときの注意:Responses APIと出力上限の指定
Terraへ移すときにまず変わるのは、出力上限の指定とeffortの段階です。2026年10月28日にLaoZhangのゲートウェイで確かめたところ、TerraのChat Completionsはmax_tokensを指定するとHTTP 400を返し、max_completion_tokensを使うよう求めました。同じChat Completionsではreasoning_effort: "max"も400になり(受け付けるのはnone、low、medium、high、xhigh)、Responses APIでreasoning: {"effort": "max"}を送ると200が返りました。
つまり、AAでSonnetのxhighに並ぶTerraのmaxを使うには、Responses APIへの移行が必要です。OpenAIのモデル仕様でも、Terraのツール呼び出しはResponses APIが前提です。Chat Completionsのまま使えるのは、ツールを使わないxhighまでの依頼になります。
{
  "model": "gpt-6.1-terra",
  "input": "…",
  "reasoning": { "effort": "max" }
}Sonnet側では、effortをoutput_config.effortで、拡張思考をthinkingで明示しておくと比較の条件がはっきりします。2026年11月3日の実測では次の形で送り、ゲートウェイ経由でthinkingを省いた場合には思考ブロックが返りませんでした(2026年10月26日の確認)。
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 32000,
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "high" },
  "messages": [{ "role": "user", "content": "…" }]
}LaoZhangのAPI(laozhang.ai)経由でClaudeを使う場合、1回の出力は32,768トークンまでで、Anthropicが仕様に挙げる128Kより短くなります。documentブロック、サーバー側ツール、トークン数の計測、Batches、Filesも使えません。長い文章を1回で書かせる処理を移す前に、この上限に当たらないか確かめてください。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
切り替える前に自分のプロンプトで試す手順
切り替えの判断は、合格1件あたりの費用で比べると誤りにくくなります。12問実測のように合格率が並ぶ仕事なら単純な費用の比較で足りますが、落ちる依頼が出る仕事では、やり直しの費用も含めて見る必要があります。
- 実際に使っている依頼を数十件集めます。以前に人が直す必要があった依頼も必ず入れます。
- 合否を機械で判定できる基準を決めます。コードならテスト、計算なら正解の値、要約なら語数や項目数です。
- Sonnetは今の設定(APIなら
high、Claude Codeならmedium)のまま、Terraはmediumとhighで、同じプロンプトを送ります。共通部分が長い依頼では、Sonnet側にもcache_controlを付けます。 - 返ってきた使用量から、入力、出力、キャッシュ書き込み、キャッシュ読み取りのトークン数を記録し、定価で費用を計算します。共有のキーでは残高の差から費用を割り出せません。
- 合格数で割って、合格1件あたりの費用を出します。Terraで落ちた依頼だけを
xhigh、Responses APIのmax、Sonnetのxhighの順に試します。 - 落ちた依頼は2〜3回送り直します。1回だけの不合格は、12問実測の書式ミスのように偶然の差であることがあります。
Sonnet対Sol、Opus対Terra、Terra対Solを比べたい場合
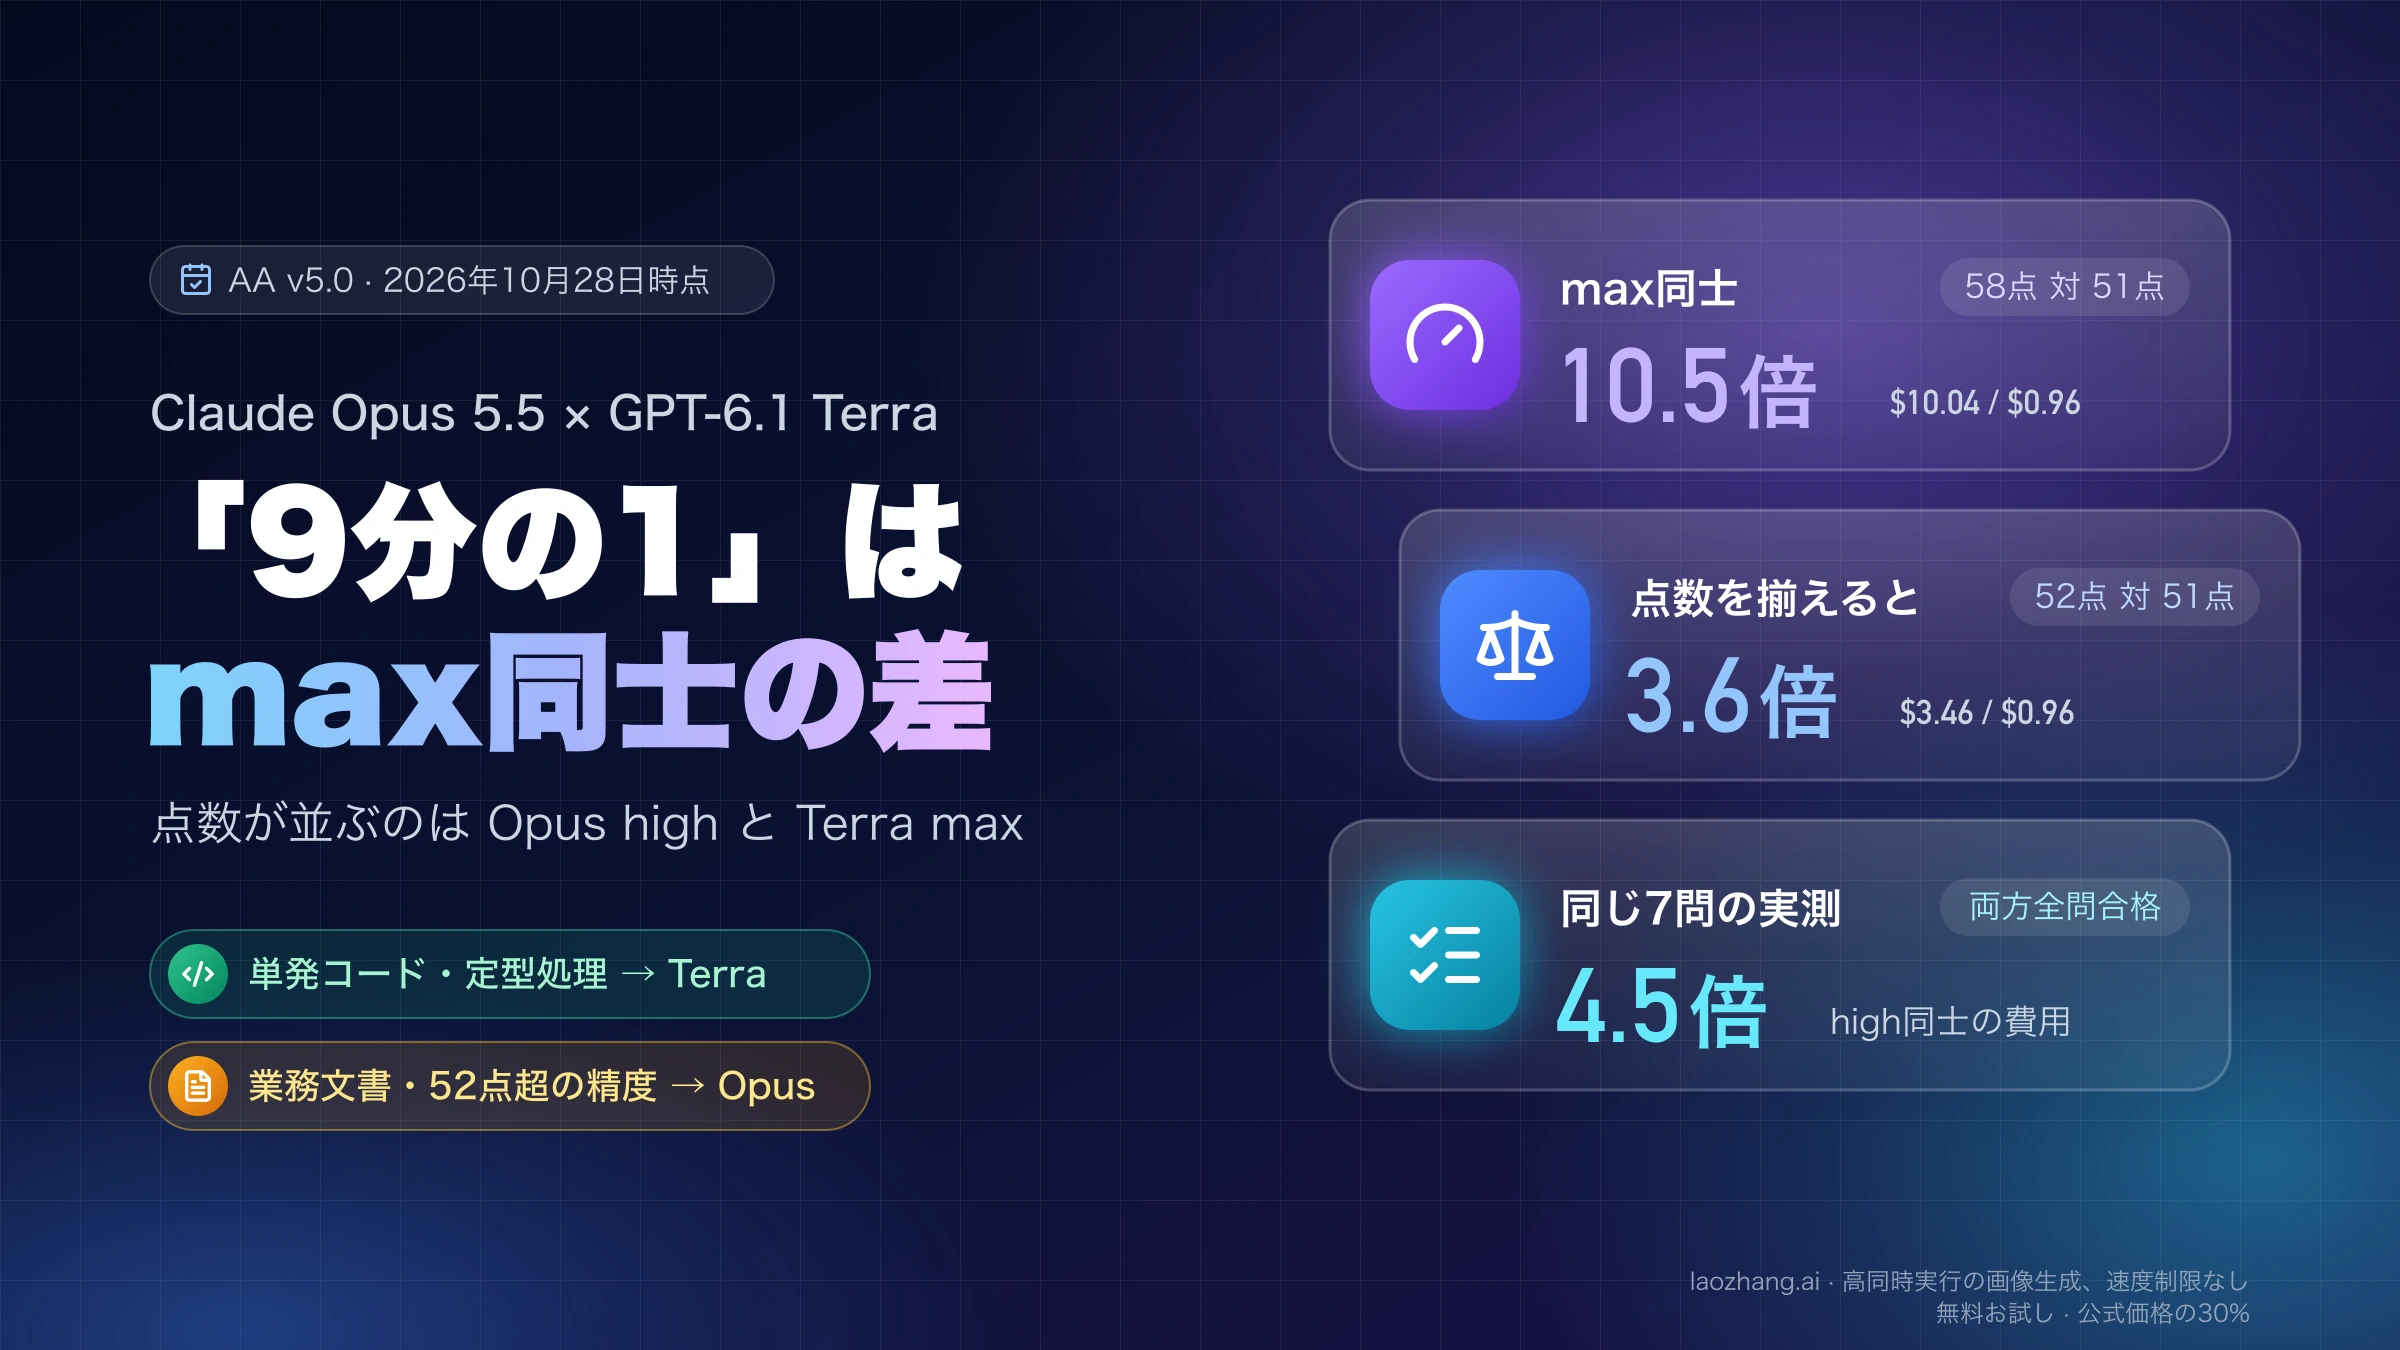
同じ単価のGPT-6.1 Solと比べるなら「Claude Sonnet 5.5とGPT-6.1 Sol比較:同単価でもタスク費用2〜8倍」が対象です。OpenAIが発表で挙げた「1タスクの費用は約9分の1」はClaude Opus 5.5のmaxとの比較で、Sonnetについての主張ではありません。その条件は「Claude Opus 5.5とGPT-6.1 Terra比較:「9分の1」の条件と使い分け」で扱っています。GPT-6.1 Solは単価がTerraの2倍で、OpenAI自身が最も複雑なコーディング向けに勧めているモデルです。TerraとSolのどちらを使うかは「GPT-6.1 TerraとSolの違い:単価は半額、Codex実測で2倍速」で比べています。OpenAIの中でさらに安い選択肢を探すなら「GPT-6.1 TerraとGPT-6 Lunaの違い:単価10倍、1タスクでは2.7〜6.3倍」が続きです。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月3日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月3日。
- 1.OpenAIのGPT-6.1 Terra発表openai.com/index/introducing-gpt-6-1-terra
- 2.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 3.OpenAI APIの料金ページdevelopers.openai.com/api/docs/pricing
- 4.Claude Sonnet 5.5とGPT-6.1 Terraの比較artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-terra
- 5.Claude APIのプロンプトキャッシュの説明platform.claude.com/docs/en/build-with-claude/prompt-caching
- 6.GPT-5.6 Terraのモデルページdevelopers.openai.com/api/docs/models/gpt-5.6-terra