DeepSeek V4.1 Flash vs Gemini 3.8 Flash比較:実測費用2.2〜4.3倍
2026年11月6日の実測で、既定のGemini 3.8 Flashの費用はDeepSeek V4.1 Flashの2.2〜4.3倍。音声・動画入力が要るならGeminiです。
目次
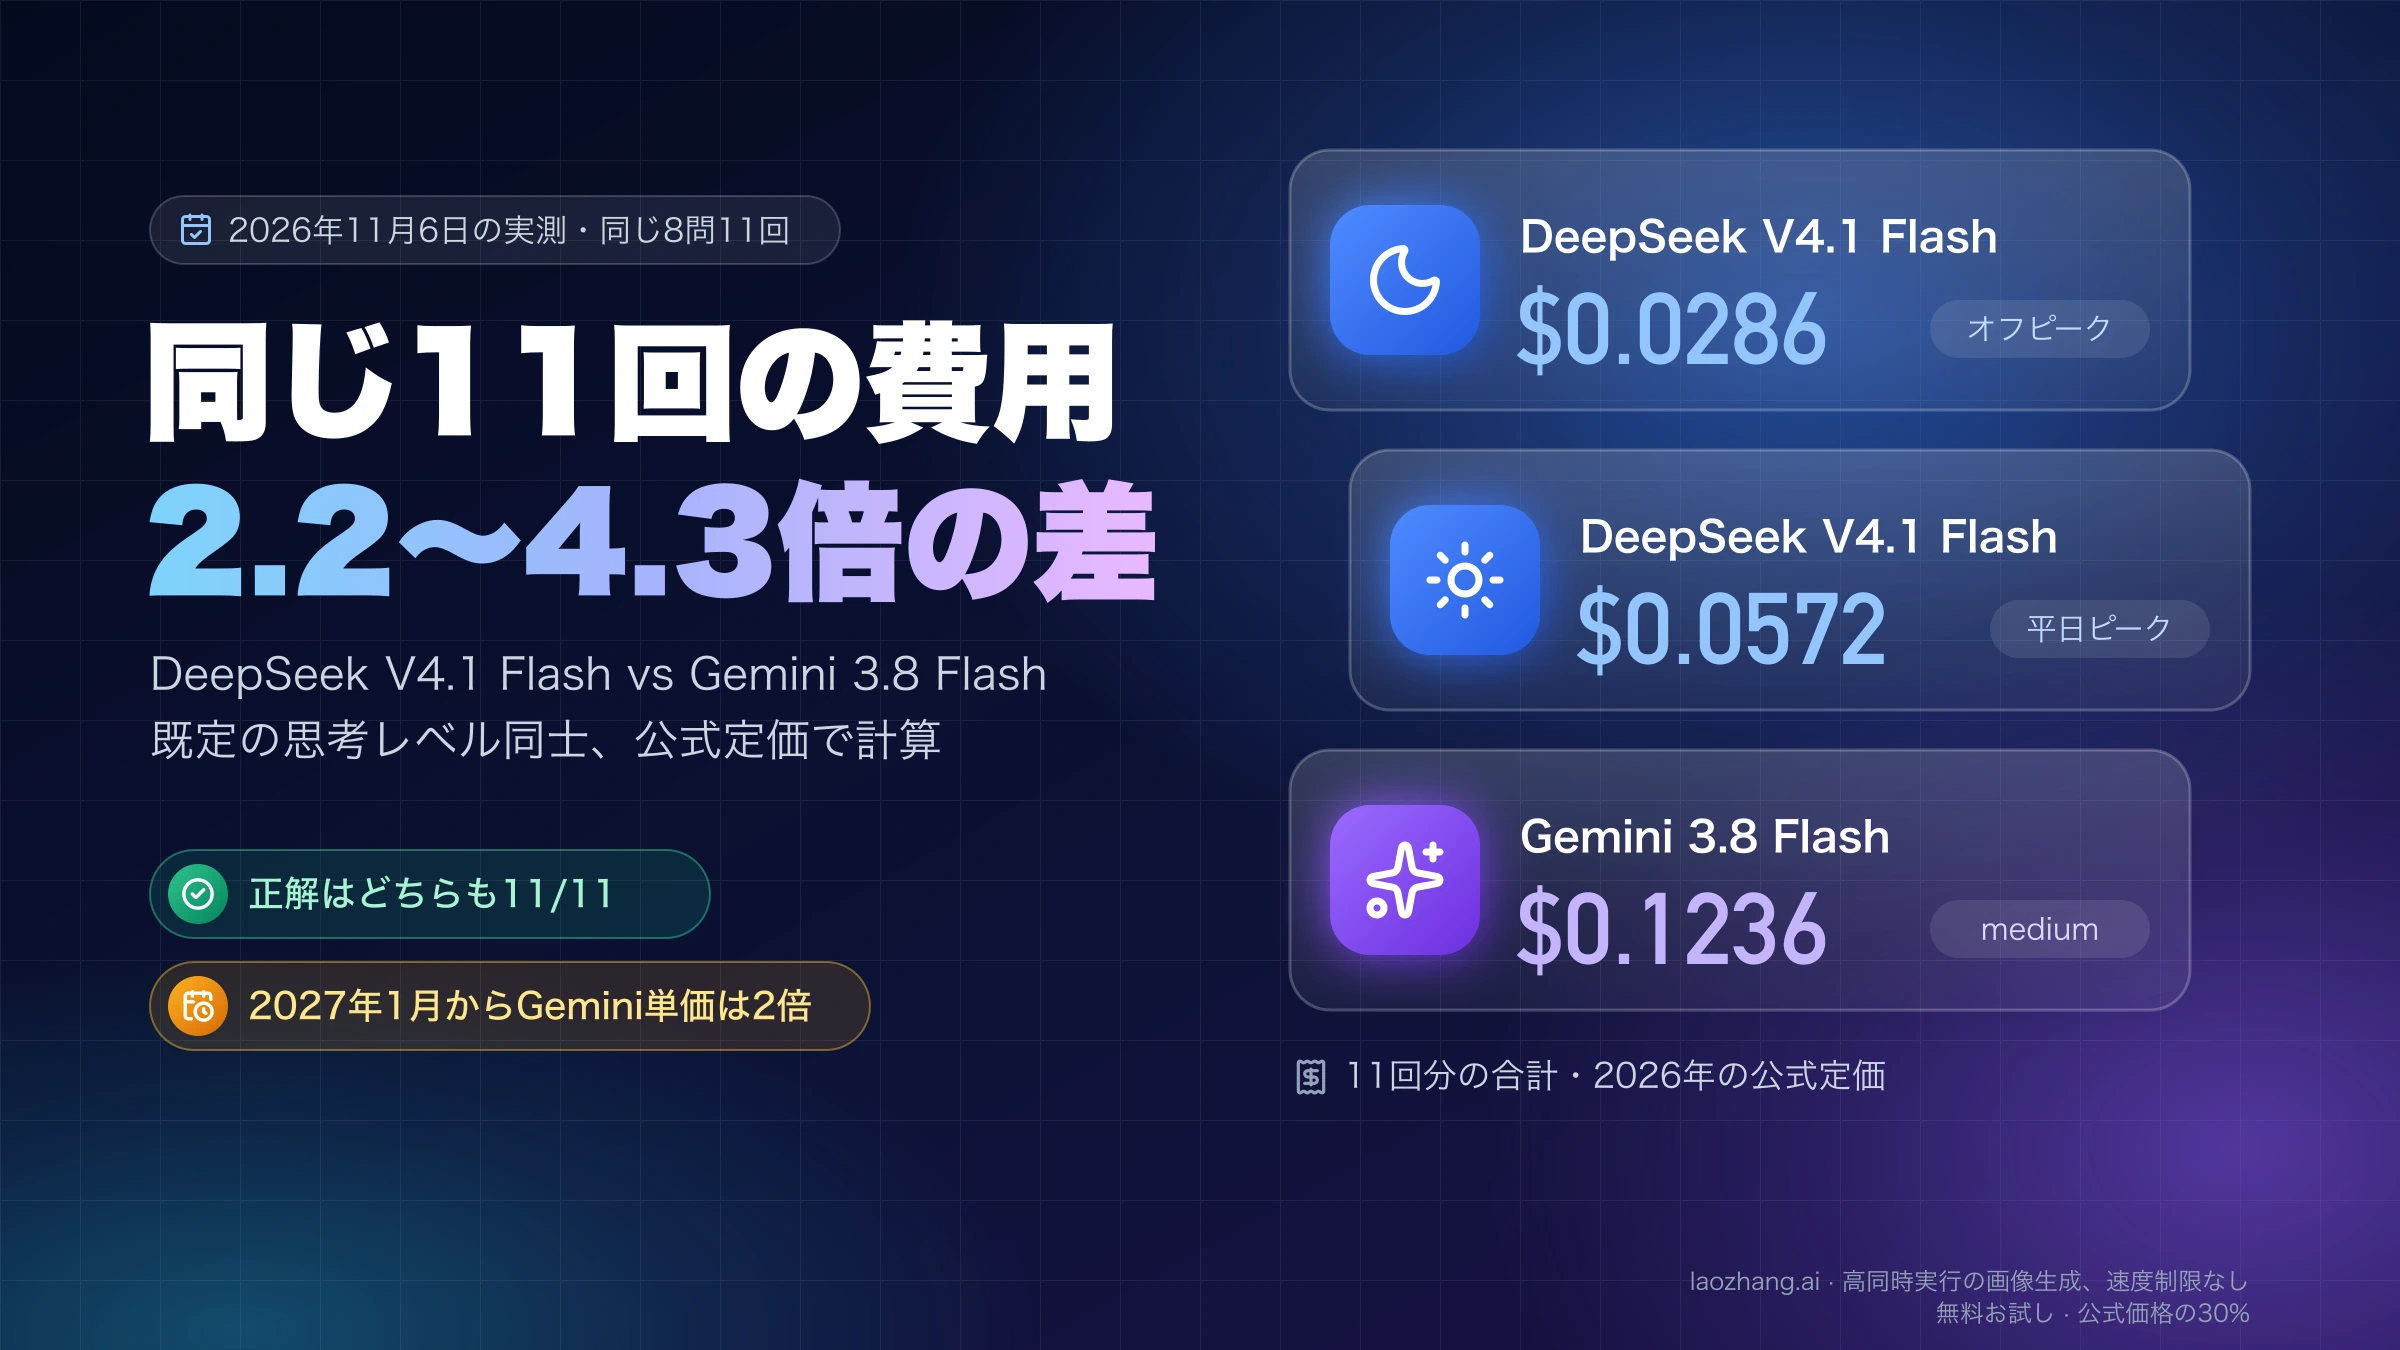
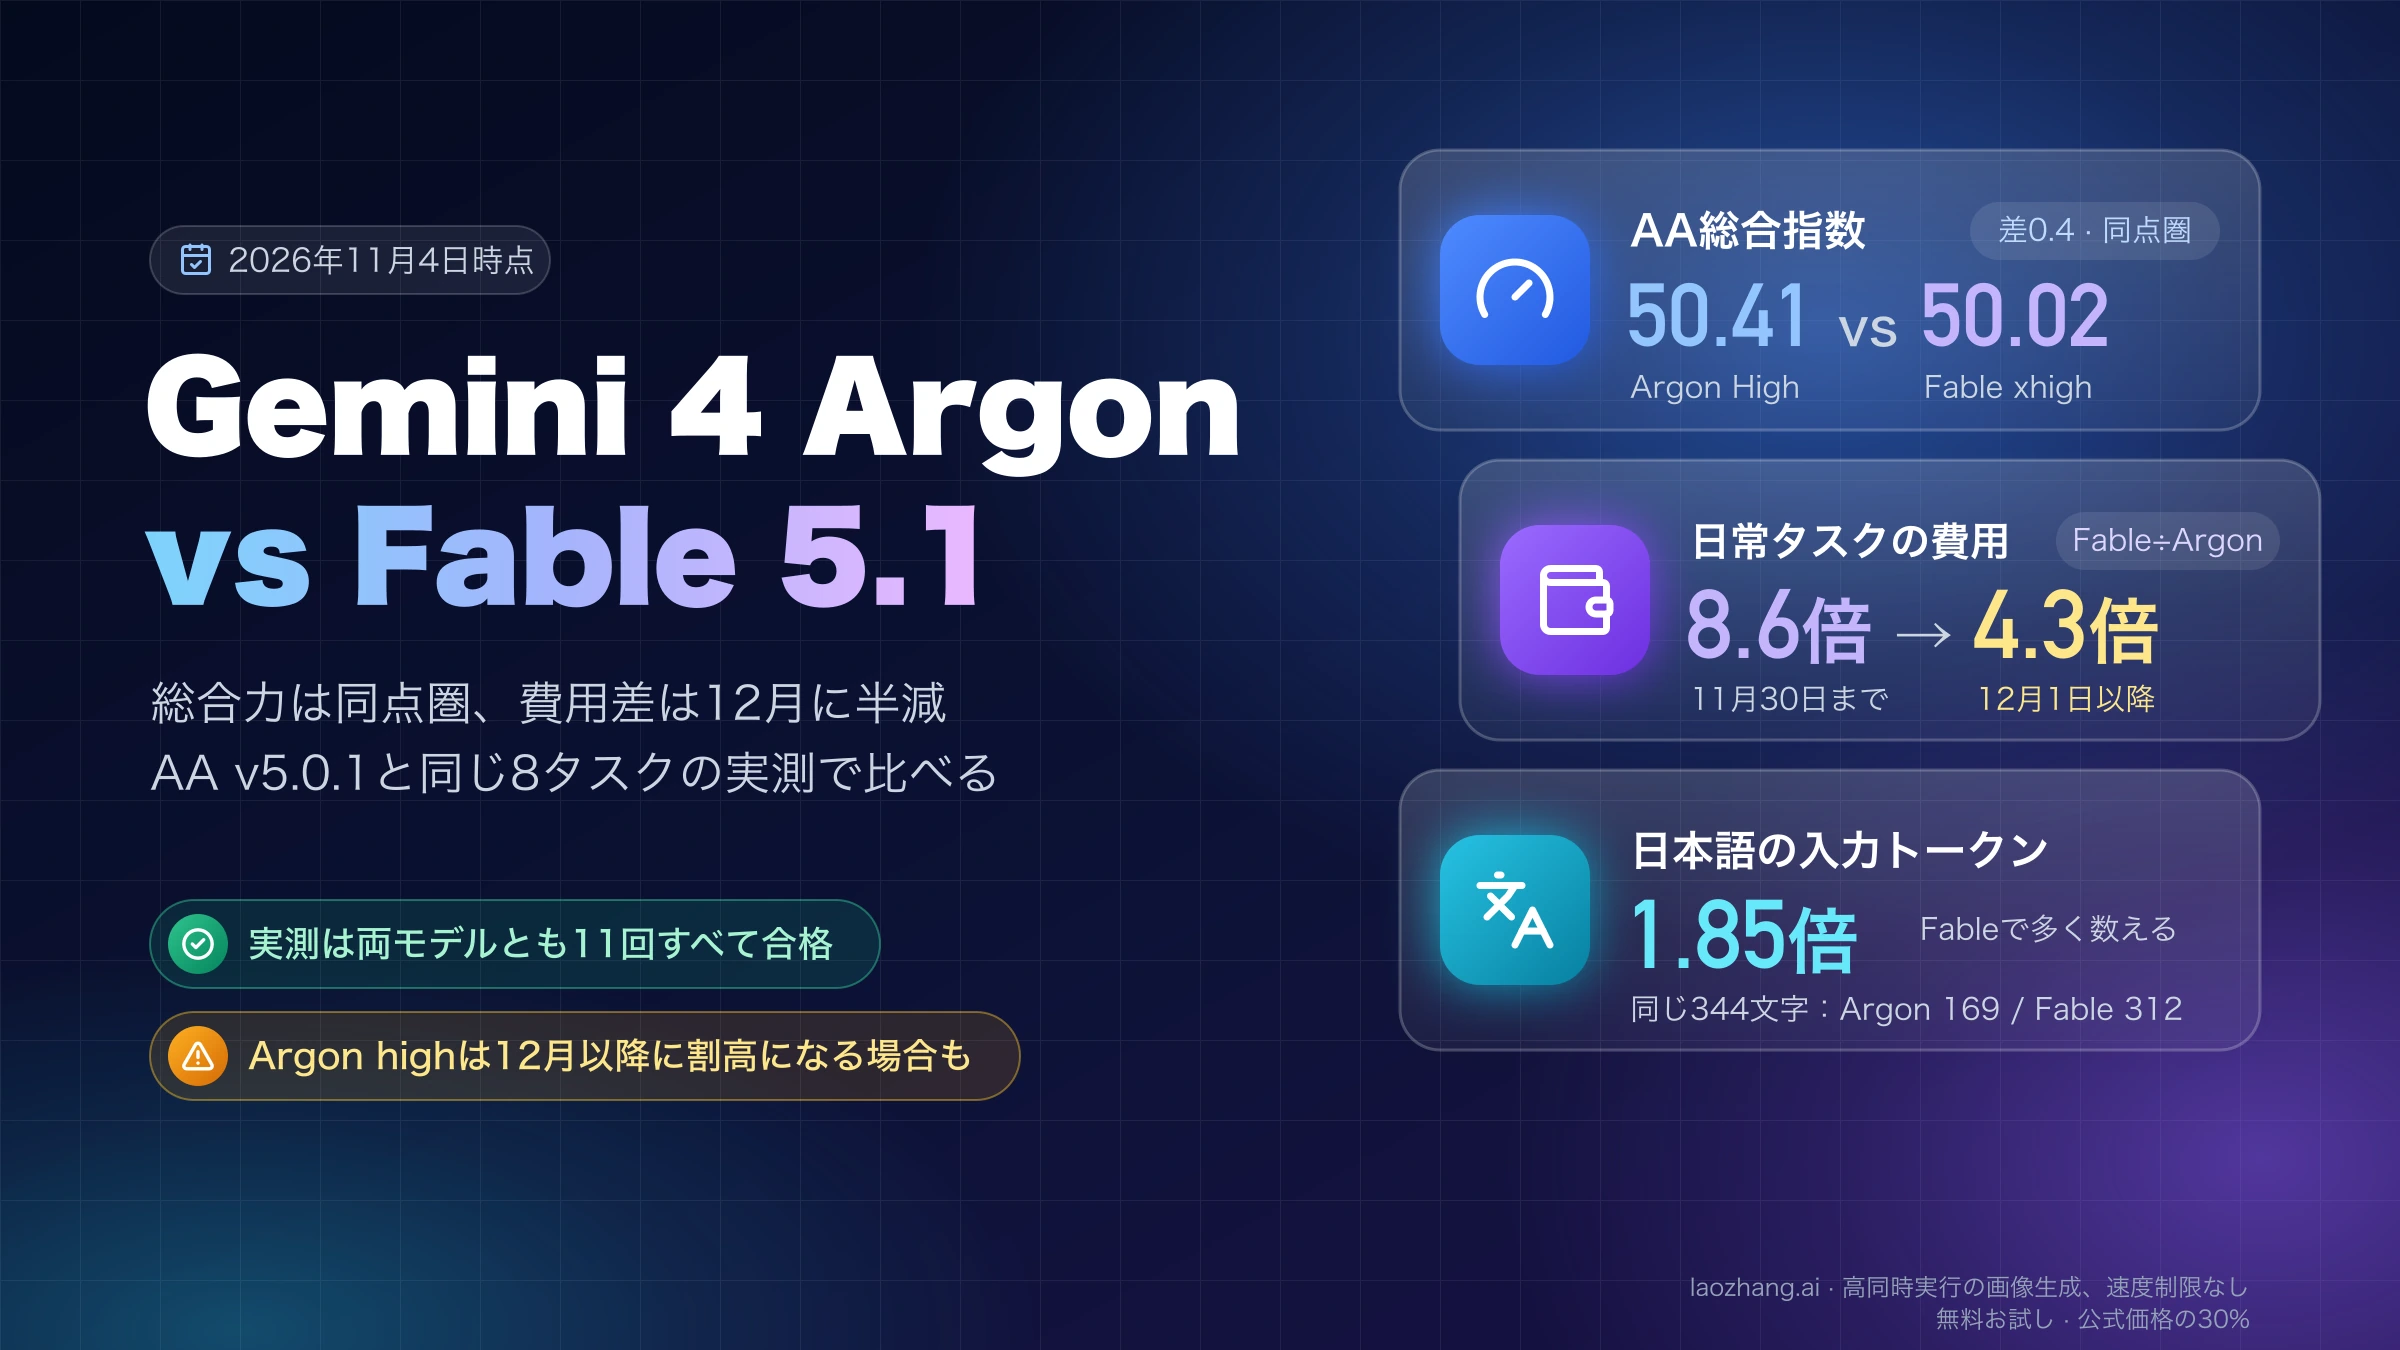
テキストだけを扱うAPI処理なら、DeepSeek V4.1 Flash(モデル名deepseek-flash、2026年10月17日更新の1017版)を既定の思考レベルhighのまま使うのが費用面で有利です。2026年11月6日にLaoZhangのゲートウェイ経由で同じ8問(計11回の呼び出し)を両モデルに送ったところ、正解はどちらも11回中11回で、公式定価で計算した費用はGemini 3.8 Flash(gemini-3.8-flash、既定のmedium)がDeepSeekのオフピーク料金の4.3倍、日本時間平日のピーク料金と比べても2.2倍でした。
Gemini 3.8 Flashを選ぶのは、音声・動画・PDFをそのまま入力したいときや、Google検索・Googleマップによるグラウンディング、コード実行のようなGoogle側の機能が必要なときです。日中にしか回せない処理なら、GeminiのBatch(半額)とDeepSeekのピーク料金で費用はほぼ並びます。ただしGoogleの単価は2027年1月1日に2倍になるので、来年も使う予算では、同じ11回の費用差がDeepSeekのオフピーク比で8.6倍に広がります。
例外は、長く考える必要がある難しいコーディングです。npm形式のバージョン範囲(semver)を実装させる問題では、出力上限32,000トークンの条件でGeminiが思考の途中で打ち切られ、上限を65,536トークンに上げると4回すべて正解しました。GeminiではmaxOutputTokensを上限近くまで上げること、DeepSeekでは大量処理を日本時間のピーク(平日10:00〜13:00と15:00〜19:00)から外すことが、最初に変える設定です。
2026年11月6日の実測:8問11回はどちらも全問正解
易しめの8問では、DeepSeek V4.1 Flash(high)もGemini 3.8 Flash(mediumとhigh)も11回すべて正解し、違いは費用と待ち時間にだけ出ました。2026年11月6日(金)12:50〜13:00 UTC、日本時間では21:50〜22:00で、DeepSeekはオフピークの時間帯です。どちらもLaoZhangのゲートウェイから同じAPIキーで呼び出し、システムプロンプトやツールは使わず、ユーザーメッセージ1件をストリーミングで送りました。
DeepSeekはOpenAI互換の/v1/chat/completionsに、公式の既定と同じreasoning_effort: "high"とthinking: {"type": "enabled"}を付けて送り、返ってきたモデル名は毎回deepseek-v4-1-flash-261017でした。GeminiはGemini形式のstreamGenerateContentでthinkingLevelをmedium(既定)とhighにした2通りで、すべてのチャンクがgemini-3.8-flashを名乗った呼び出しだけを数えています。出力上限はどちらも32,000トークンです。
問題は、文章題1問、隠しテストで採点するPython関数5問(区間の結合、時間文字列の解析、単語の頻度集計、evalを使わない数式の評価、CSV 1行の解析)、6,723語の英文記事を25語以内の5項目に要約する1問、各桁の和が27になる100万未満の整数を数える1問(正解55,252)です。難しめの数式評価・CSV解析・桁和の3問は2回ずつ送りました。
| 設定 | 正解 | 出力トークン(うち思考) | 費用(2026年の定価) | 条件を変えた費用 | 最初の回答トークンまで | 1回の所要時間 |
|---|---|---|---|---|---|---|
| DeepSeek V4.1 Flash high(既定) | 11/11 | 44,807(41,674) | $0.0286(オフピーク) | $0.0572(ピーク) | 10.9秒 | 12.3秒 |
| Gemini 3.8 Flash medium(既定) | 11/11 | 30,467(25,476) | $0.1236 | $0.2472(2027年単価) | 22.0秒 | 24.1秒 |
| Gemini 3.8 Flash high | 11/11 | 78,258(72,699) | $0.3028 | $0.6057(2027年単価) | 27.9秒 | 30.1秒 |
費用は11回分の合計で、APIが返したトークン数に公式定価を掛けたものです。入力トークンはDeepSeekが11,836、Geminiが12,486でした。時間は中央値です。
結果は1つの経路、1日、各問1〜2回の記録で、ベンチマークではありません。DeepSeekとGoogleの公式エンドポイントへの直接接続では測っておらず、ゲートウェイが待ち時間に影響している可能性があります。同じ回の中でもばらつきは大きく、DeepSeekは数式評価の問題を同じ文面で2回送ると出力が8,708トークンと19,986トークンに分かれ、Gemini highも16,326トークンと22,490トークンでした。
Gemini highの費用は再現しています。2026年10月26日に同じ8問・同じキーでGemini 3.8 Flash highを非ストリーミングで呼んだときは11/11正解、出力80,277トークン、$0.3104で、11日後の今回(78,258トークン、$0.3028)との差は3%以内でした。
1タスクの費用:単価差6.25倍がそのまま出ない理由
出力単価はGemini 3.8 Flashの$3.75に対してDeepSeek V4.1 Flashのオフピークが$0.60で6.25倍ですが、11回分の費用差は4.3倍でした。費用は単価と、思考を含めて何トークン出力したかの掛け算で決まるからです。既定のmediumのGeminiはDeepSeekの0.68倍しか出力しなかったので差が縮み、highにすると1.75倍出力したので10.6倍に開きました。両社とも思考トークンは出力として課金されます。
| 100万トークンあたり | 入力 | キャッシュ入力 | 出力(思考を含む) |
|---|---|---|---|
| DeepSeek V4.1 Flash(オフピーク) | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash(ピーク) | $0.30 | $0.006 | $1.20 |
| Gemini 3.8 Flash(2026年12月31日まで) | $0.75 | $0.075 | $3.75 |
| Gemini 3.8 Flash(2027年1月1日から) | $1.50 | $0.15 | $7.50 |
| Gemini 3.8 Flash Batch(2026年) | $0.375 | $0.0375 | $1.875 |
単価は2026年11月6日時点のDeepSeek APIの料金ページとGemini APIの料金ページによります。GeminiはFlexも入力・出力がBatchと同じ半額で、キャッシュには別に保存料(2026年は100万トークン1時間あたり$0.50)がかかります。
計算式は「(入力−キャッシュヒット)×入力単価+キャッシュヒット×キャッシュ単価+出力×出力単価」を100万で割ったものです。DeepSeekのオフピークなら、11,580×$0.15+256×$0.003+44,807×$0.60で約$0.0286、Gemini mediumなら12,486×$0.75+30,467×$3.75で約$0.1236になります。
問題ごとの差は一定ではありません。6,723語の要約は入力が1万トークンを超えるため入力単価の差(5倍)が効き、Gemini mediumの思考も2,266トークンとDeepSeekの1,379トークンより多かったので、1回$0.0176対$0.0025と約7倍でした。数式評価の問題は、DeepSeekが$0.0053と$0.0120、Gemini mediumが$0.0156と$0.0274です。
同じ長い文書を繰り返し送る処理では、キャッシュの効き方も費用に効きます。10,387トークンの文書を含むプロンプトを2回送ると、DeepSeekは2回目に10,368トークンをキャッシュヒットとして返し、費用は$0.0019から$0.0004に下がりました。Geminiも2回目に11,300トークン中8,168トークンが暗黙的キャッシュに入り、$0.0107から$0.0054になっています。どちらも設定なしで自動的に効きましたが、キャッシュ単価が入力単価の何分の1かはDeepSeekが50分の1、Geminiが10分の1です。
トークンの数え方の違いは結論を変えません。日本語の記事本文3,000文字を両モデルに入力すると、DeepSeekは1,808トークン、Geminiは1,713トークンで、日本語ではGeminiが5.3%少なく数えました。英語の6,723語の記事ではDeepSeek 10,288対Gemini 11,198で、Geminiが8.8%多くなります。差は言語によらず±11%以内でした。
LaoZhang経由で両方を1つのキーで使う場合、2026年11月6日時点の料金はdeepseek-flashが時間帯に関係なく入力$0.44・出力$1.32、gemini-3.8-flashはGoogleと同じ$0.75・$3.75です。DeepSeekはどの時間帯でも公式料金より高く、この料金で11回分を計算するとDeepSeek $0.0643、Gemini medium $0.1236で、差は1.9倍になります。
日本時間のピークと2027年1月で、既定同士の差は2.2〜8.6倍
既定同士の費用差4.3倍は、DeepSeekのオフピークと2026年中のGemini単価という組み合わせでの数字です。日本の業務時間帯に呼べば2.2倍に縮み、2027年1月1日以降は8.6倍に広がります。DeepSeekのピークはUTCの01:00〜04:00と06:00〜10:00(月〜金)で、日本時間では平日10:00〜13:00と15:00〜19:00にあたります。DeepSeekは公式に、オフピーク料金を「ピーク料金の半額」と定めており、土日と中国の祝日は終日オフピークです。
同じ11回分で倍率を並べると、Gemini medium(既定)はDeepSeekのオフピークに対して2026年が4.3倍・2027年が8.6倍、ピークに対しては2.2倍・4.3倍です。Gemini highではオフピーク比で10.6倍・21.2倍、ピーク比で5.3倍・10.6倍になります。
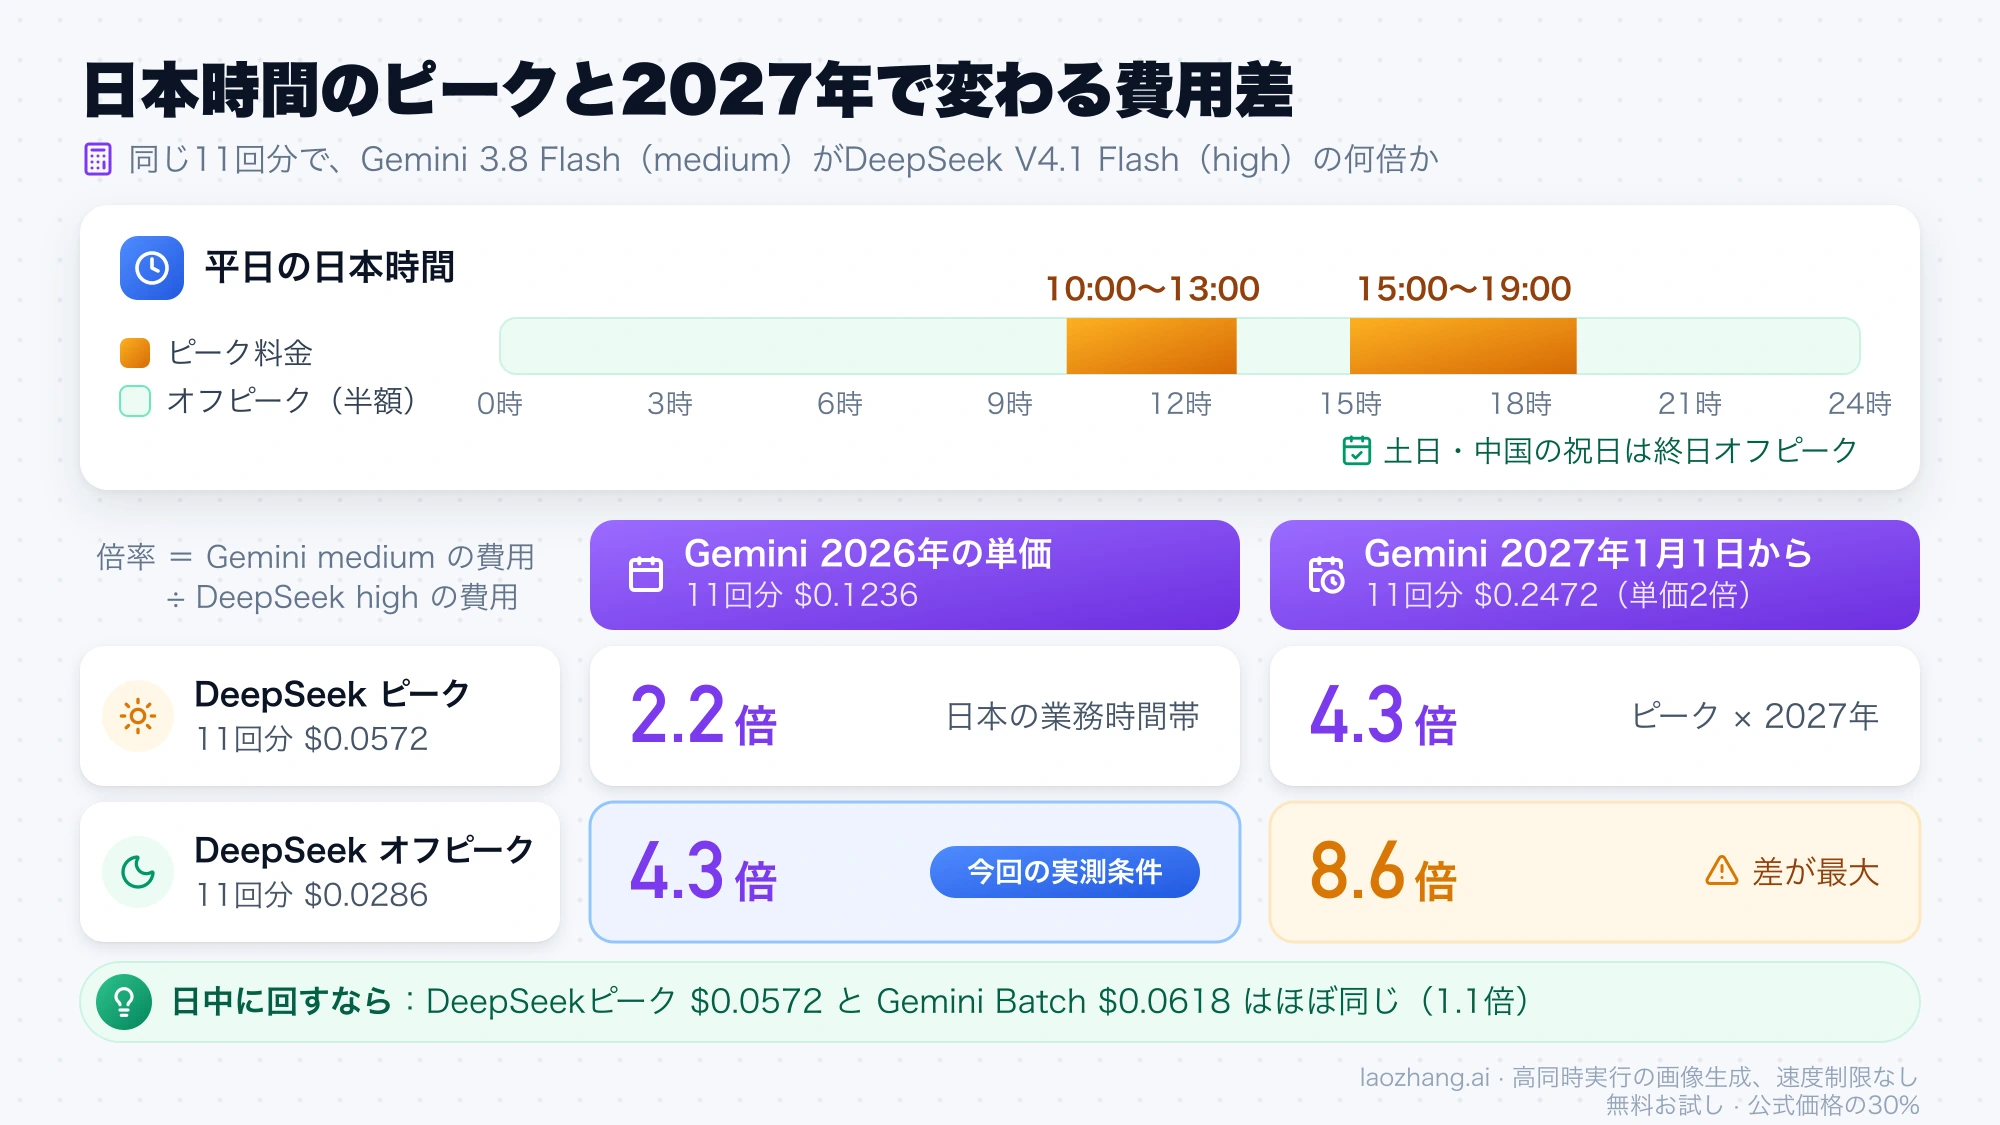
リアルタイム性が要らない処理なら、Gemini側もBatchで半額にできます。今回のGemini mediumの使用量をBatch単価に当てはめると$0.0618で、DeepSeekのオフピークの2.2倍、ピークの1.1倍です。日中にDeepSeekを呼ぶ処理とGeminiのBatchとでは費用がほぼ並ぶので、DeepSeekを選ぶ理由が費用だけなら、夜間や週末に回せるかどうかで判断が分かれます。時間帯ごとの細かい計算はDeepSeek APIの料金:日本時間のピークと費用計算、Geminiの2027年の改定と前払いの仕組みはGemini API料金確認:3.8 Flashは2027年に2倍、無料枠超過は前払いで確認できます。
難しいsemver問題:Geminiの不正解は出力上限32,000トークンが原因
差が出たのはsemverの実装問題だけで、Geminiの不正解はすべて出力上限32,000トークンに達して思考の途中で止まったものでした。上限を65,536トークンに上げた再実行では、Geminiもmedium・highとも2回ずつ正解しています。同じ日の12:55〜13:26 UTC(日本時間21:55〜22:26、DeepSeekはオフピーク)に、モデルの差が出やすい3問を各設定2回ずつ送った結果です。
semverの問題は、キャレット(^)、チルダ(~)、ハイフン範囲、OR、プレリリース版の扱いを含むnpm形式のバージョン範囲の判定関数を書かせ、36件の隠しテストで採点しました。Geminiはこの回からincludeThoughts: trueで思考の要約もストリーミングしています。課金は変わりません。
| 設定 | 出力上限 | 正解 | 出力トークン | 1回の費用 | 所要時間 |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash high | 32,000 | 2/2 | 24,531/23,154 | $0.0148/$0.0139 | 150秒/141秒 |
| Gemini 3.8 Flash medium | 32,000 | 1/2 | 31,996(打ち切り)/22,468 | $0.1203/$0.0846 | 210秒/193秒 |
| Gemini 3.8 Flash high | 32,000 | 0/2 | 31,898/31,996(どちらも打ち切り) | $0.1199/$0.1203 | 255秒/237秒 |
| Gemini 3.8 Flash medium | 65,536 | 2/2 | 30,421/30,794 | $0.1144/$0.1158 | 199秒/218秒 |
| Gemini 3.8 Flash high | 65,536 | 2/2 | 55,224/38,875 | $0.2074/$0.1461 | 308秒/300秒 |
DeepSeekの費用はオフピーク料金で、ピークなら1回$0.030と$0.028です。Geminiは2026年の単価です。
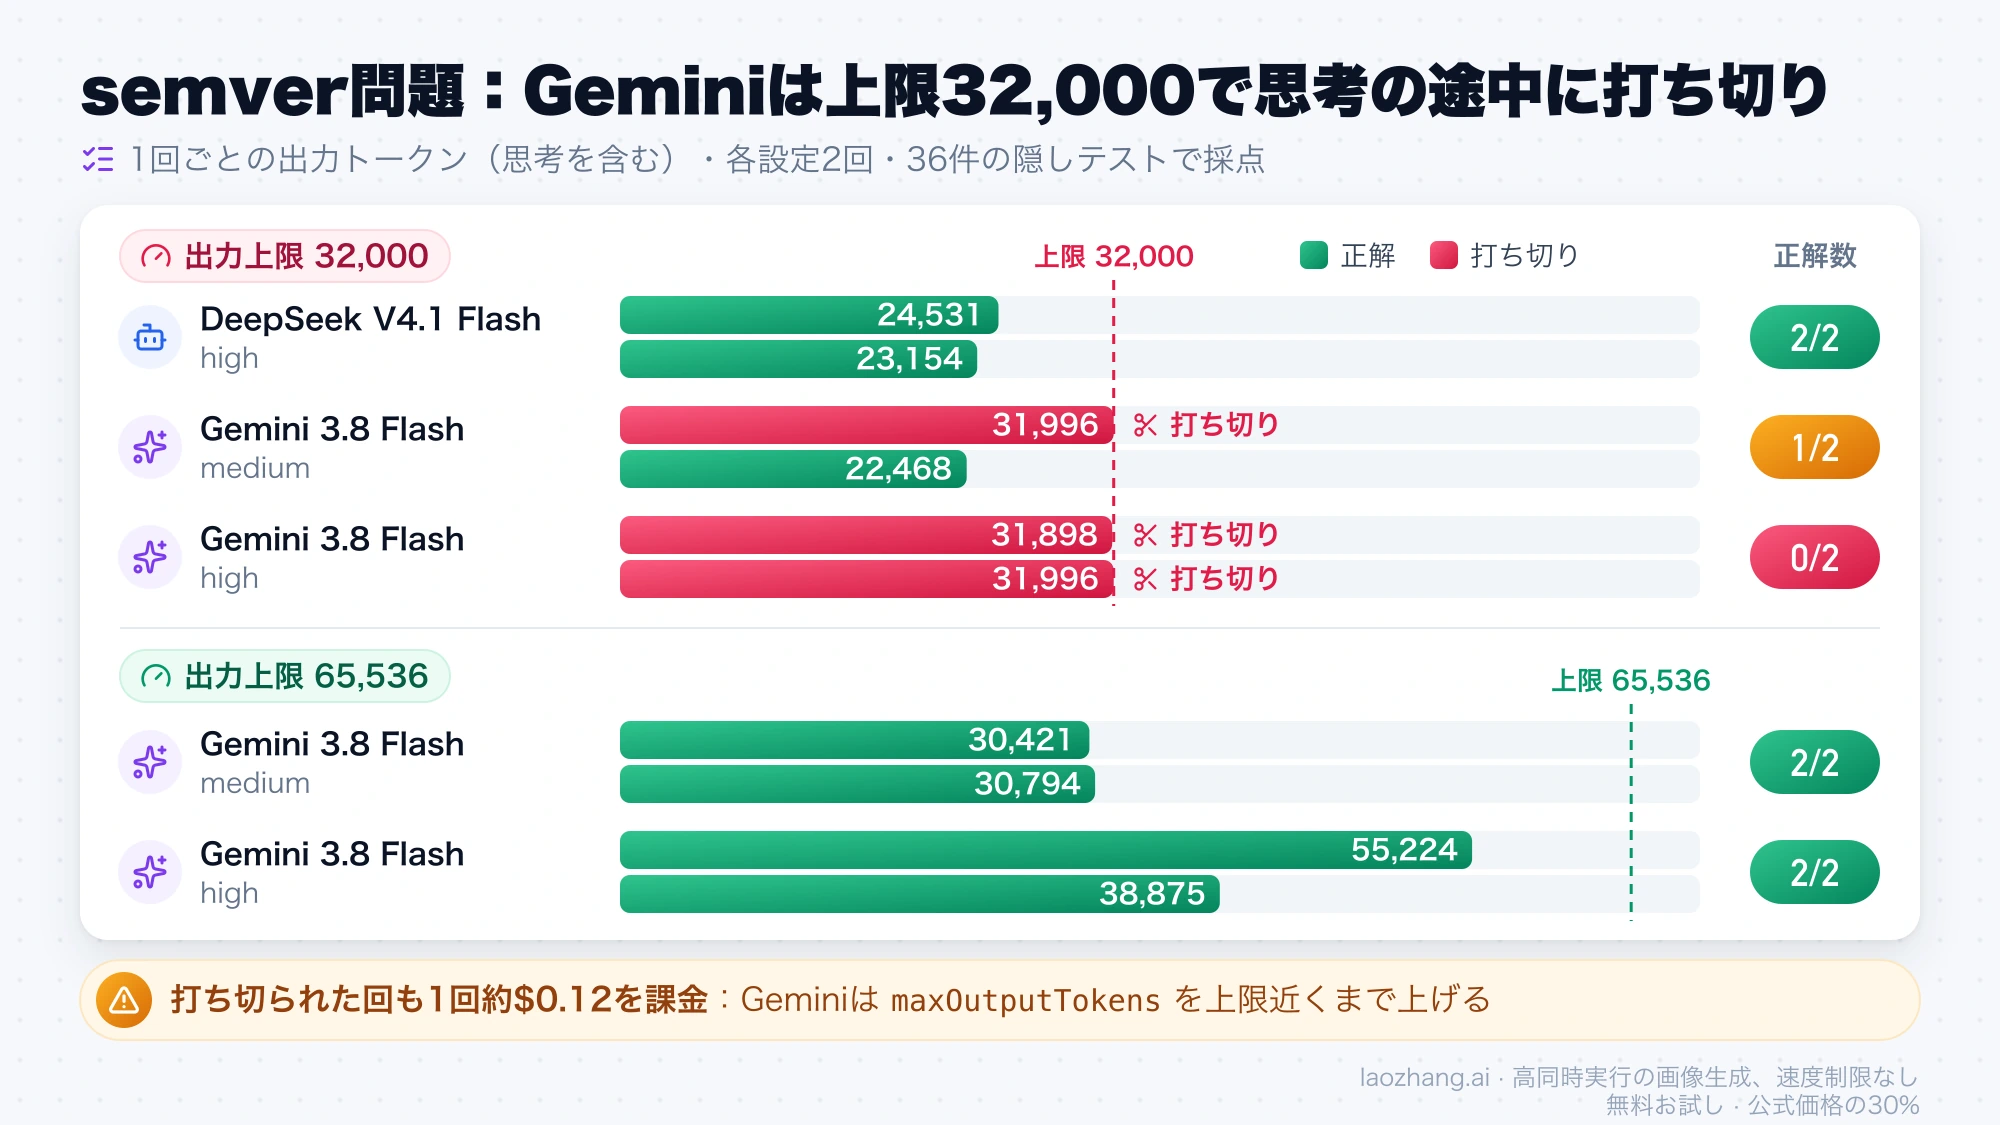
打ち切られた3回は、どれもfinishReasonがMAX_TOKENSで、思考だけで30,719〜31,898トークンを使い、コードが出ないか途中で切れていました。書いたコードが間違っていたのではなく、考えきる前に予算が尽きたということです。Gemini 3.8 Flashはこの問題を解けますが、1回の正解に約$0.115(medium)かかり、DeepSeekのオフピーク約$0.014の約8倍、ピーク比でも約4倍でした。打ち切られた呼び出しにも1回約$0.12が課金されている点にも注意が要ります。
Geminiの出力上限65,536トークンには思考トークンも含まれるため、highで55,224トークンを使った回は上限まで余裕がほとんどありませんでした。これより難しい仕事で思考が長くなると、上限を最大にしても打ち切られる可能性があります。DeepSeekの最大出力は384Kトークンです。
残る2問では差が出ませんでした。Geminiはmedium・high合わせて8回、DeepSeekは4回答え、すべて正解です。6,723語の記事に紛れた3つのメモ(予算、使用量、後から入った25%の修正)から金額を計算する問題では、どの回も正解の$76.80を出しました。Python 3.13の標準ライブラリについて、存在しない2つの関数(statistics.winsorized_meanとfunctools.memoize_method)を混ぜて尋ねた問題でも、どちらも「存在しない」と答え、架空の関数をでっち上げませんでした。各設定2回ずつ、1つの仕様での結果なので、一般的な順位とは受け取らないでください。
Gemini 3.8 Flashのほうが賢い?第三者指数では既定同士でほぼ互角
総合的な賢さは、既定の思考レベル同士ではほぼ互角です。第三者機関Artificial Analysisの総合指数v5.0.1(2026年11月6日時点)で、DeepSeek V4.1 Flash 1017はhighが29点、maxが33点、Gemini 3.8 Flashはmediumが30点、highが31点、lowが23点でした。
得意分野ははっきり分かれます。端末操作を伴うコーディングの評価Terminal-Bench 4.0ではDeepSeekがmaxで33.8%、highで28.8%と、Gemini highの19.7%を上回りました。一方、知識や科学の問題ではGeminiが強く、HLE-DiamondはGemini highの33.1%に対してDeepSeek maxが25.3%、CritPt v2は46.5%対25.0%、知識の正確さを測るAA-Omniscienceは23〜24対1〜2です。コードを書かせる処理ならDeepSeek、事実を答えさせる処理ならGeminiを優先して試す、というのが数字から言える範囲です。
同じ指数での1タスクあたり費用は、DeepSeek highが$0.46、Gemini mediumが$6.26でした。Artificial AnalysisはDeepSeekをピーク料金で計算しているので、オフピークならDeepSeekの値はおよそ半分になります。差の大きさはタスクで変わり、11回の実測では4.3倍、この指数のタスクでは約13.6倍でしたが、DeepSeekが安いという向きはどちらも同じです(Artificial AnalysisのDeepSeek V4.1 Flash 1017とGemini 3.8 Flashの比較ページ)。
比較表の数字が食い違うときは、3点を確かめると見分けられます。1つ目はDeepSeekの版です。DeepSeekは2026年10月17日の1017版で「タスクの実行時間と出力の長さを減らした」と説明しており、2026年9月10日の初版(0910版)のデータは今の挙動を表しません。たとえば10月上旬のAI/ML APIのXへの投稿にある、three.jsの3Dシーン6つを作らせた比較では、DeepSeekが16万8千トークン、Geminiが2万1千トークンを出力していましたが、これは1017版より前の測定です。2つ目は価格の出どころで、DeepSeekの公式単価は入力$0.15〜0.30、出力$0.60〜1.20です。これと違う数字は、別の事業者の価格やキャッシュ単価をDeepSeekの価格として載せていることがあります。3つ目は思考レベルで、DeepSeek maxとGemini highの組み合わせは既定同士の比較ではありません。
最初の文字までの時間:DeepSeekは思考を2.6秒で流し始める
2026年11月6日の実測で、DeepSeek V4.1 Flashは呼び出しから中央値2.6秒で最初のトークンを返しました。ただしこれは思考の本文(reasoning_content)が最初からストリーミングされるためで、回答の最初のトークンが届いたのは中央値10.9秒です。Gemini 3.8 Flashは思考の要約を求めなかった最初の8問では回答まで何も流れず、最初のトークンも回答の最初のトークンも中央値でmedium 22.0秒、high 27.9秒でした。
「DeepSeekのほうが早く始まる」という印象の多くは、思考を流すかどうかの違いです。GeminiもincludeThoughts: trueを付けた後半の3問では、最初のチャンクが中央値でmedium 4.8秒、high 4.0秒に届きました。回答の最初のトークンまでは、後半の3問でもDeepSeek 9.4秒、Gemini medium 27.0秒、high 42.1秒です。
この順序は測る環境で入れ替わります。2026年11月6日時点のArtificial Analysisの測定(同社の評価用タスクと計測環境による値)では、回答の最初のトークンまでがDeepSeek highで24.11秒、Gemini mediumで10.01秒と、LaoZhang経由の実測(DeepSeek 10.9秒、Gemini medium 22.0秒、1日・11回の中央値)とは逆の順でした。出力速度は同じ測定でDeepSeek 175トークン/秒、Gemini 116トークン/秒です。チャット画面のように最初の文字が大事な用途は、自分のプロンプトで両方を測ってから決めてください。待ち時間を問わないバッチ処理なら、比べるのは費用と正解率です。
入力の種類と出力上限:音声・動画・PDFはGemini、長い出力はDeepSeek
音声・動画・PDFをそのまま入力したいなら、選べるのはGemini 3.8 Flashです。モデルページでは入力がテキスト・画像・動画・音声・PDF、入力上限1,048,576トークン、出力上限65,536トークンとされています(Gemini 3.8 Flashのモデルページ)。DeepSeek V4.1 Flashはコンテキスト1M、最大出力384Kで、画像入力(Vision)には対応していますが、料金ページの機能一覧に音声・動画・PDFの入力はありません。画像や音声の入力は今回の実測に含まれていません。Gemini APIの利用可能地域には、2026年11月6日時点で日本が含まれています。
周辺機能もGemini側が広く、Batch、コード実行、関数呼び出し、Googleマップによるグラウンディングに対応しています。Google検索によるグラウンディングは、Gemini 3以降のモデル共通で月5,000件まで無料、その後は1,000件あたり$14です。DeepSeek側はJSON出力、ツール呼び出し、Anthropic API形式に対応し、同時接続の上限は2,500です。DeepSeekにも別課金の検索APIがあり、料金はDeepSeek検索APIの料金:1,000件$0.75、Claude Codeは11月1日からで確認できます。
既定の思考レベルと変え方:DeepSeekはhigh、Geminiはmedium
DeepSeek V4.1 Flashの思考モードは既定でオンになっており、強さはhighです。reasoning_effortにはlow・high・maxを指定でき、mediumやxhighを送るとhigh、minimalはlowとして扱われます。thinkingを{"type": "disabled"}にすると思考を止められます。思考モードではtemperatureなどのサンプリング設定がエラーにならずに無視されるので、既存コードの設定が効いていると思い込まないようにしてください(DeepSeekの思考モードのガイド)。
from openai import OpenAI

client = OpenAI(base_url="https://api.deepseek.com", api_key="YOUR_DEEPSEEK_KEY")
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "..."}],
    reasoning_effort="high",                      # low / high / max
    extra_body={"thinking": {"type": "enabled"}},  # "disabled" で思考オフ
)
Gemini 3.8 Flashの既定はmediumで、選べるのはlow・medium・highの3段階です。minimalはないため、思考を完全には止められません(Gemini APIの思考のドキュメント)。ドキュメントのパラメータ名はthinking_levelで、今回の実測で使ったgenerateContent系のリクエストでは次のようにgenerationConfigの中に書きました。
{
  "contents": [{"role": "user", "parts": [{"text": "..."}]}],
  "generationConfig": {
    "maxOutputTokens": 65536,
    "thinkingConfig": {"thinkingLevel": "medium", "includeThoughts": true}
  }
}
思考レベルを上げる前に、出力上限を確かめるほうが先です。Gemini highはmediumの2.6倍のトークンを出力し、11回分の費用は2.4倍、1回の所要時間の中央値は24.1秒から30.1秒に伸びましたが、易しい8問の正解数は同じ11/11でした。semverの問題でも、上限を65,536トークンにすればmediumで2回とも正解しています。DeepSeekのmaxとGeminiのlowは今回測っていません。Artificial Analysisの指数では、DeepSeek maxはhighより4点高く、1タスクの費用は$0.46から$0.60に上がります。
DeepSeek V4.1 FlashとGemini 3.8 Flashを乗り換える前に確認すること
乗り換えで最初に確認するのは、モデル名・エンドポイント・思考パラメータの3つです。DeepSeekのモデル名はdeepseek-flashで、旧名のdeepseek-v4-flashとdeepseek-v4-flash-vision-expも受け付けますが、どちらも1017版が応答し、Flashの料金で課金されます。エンドポイントはOpenAI形式がhttps://api.deepseek.com、Anthropic形式がhttps://api.deepseek.com/anthropicです。Geminiはgemini-3.8-flashをGeminiのAPI形式で呼び、思考のパラメータ名も返り値の形も異なるので、モデル名の置き換えだけでは動きません。
次に、出力上限を思考込みで見直します。DeepSeekの思考はreasoning_contentとして返り、GeminiはincludeThoughtsを付けたときだけ思考の要約を返します。返し方は違っても、思考トークンはどちらも出力として課金されます。GeminiのmaxOutputTokensは思考と回答の合計なので、DeepSeekで使っていた上限をそのまま移すと、難しい問題で途中で打ち切られることがあります。
最後に、自分の処理から10〜20件のプロンプトを選んで両方に送り、返ってきたトークン数に上の計算式で単価を掛けてください。同じ文面でもトークン数は2倍以上ぶれることがあるので、1回ではなく複数回の合計で比べるのが安全です。DeepSeekを選ぶなら、その処理を日本時間のピークから外せるかもあわせて決めておきます。
DeepSeek V4.1 FlashとGemini 3.8 Flashのよくある質問
DeepSeek V4.1 Flash 1017と0910は何が違いますか?
1017は2026年10月17日のスナップショットを指す表記で、バージョン番号ではありません。V4.1 Flashの初版は2026年9月10日に公開され、10月17日の更新で、呼び出し方と料金は変えずにベンチマーク結果と出力の長さが改善されたとDeepSeekは説明しています(DeepSeek APIの更新履歴)。今deepseek-flashを呼ぶと応答するのは1017版です。
DeepSeek V4.1 FlashはローカルやGGUFで動かせますか?
DeepSeek V4.1 Flashは重みが公開されたオープンなモデル(Artificial Analysisの表記でLicense: Open)なので、ローカル実行の選択肢があるのはDeepSeek側だけです。Gemini 3.8 Flashは重みが公開されていないため、ローカルでは動かせません。
Gemini 3.8 Flashの無料枠で比較を試せますか?
2026年11月6日時点で、Gemini 3.8 Flashは無料枠でも入力・出力とも無料で使えますが、無料枠で送った内容は製品の改善に使われ、Batchは無料枠では使えません。1日の上限は料金ページに数字が載っていないため、何件まで試せるかはGemini API無料枠の利用上限 2026:無料モデルと超えたらどうなるかを参照してください。
ほかのFlashや上位モデルと比べるなら?
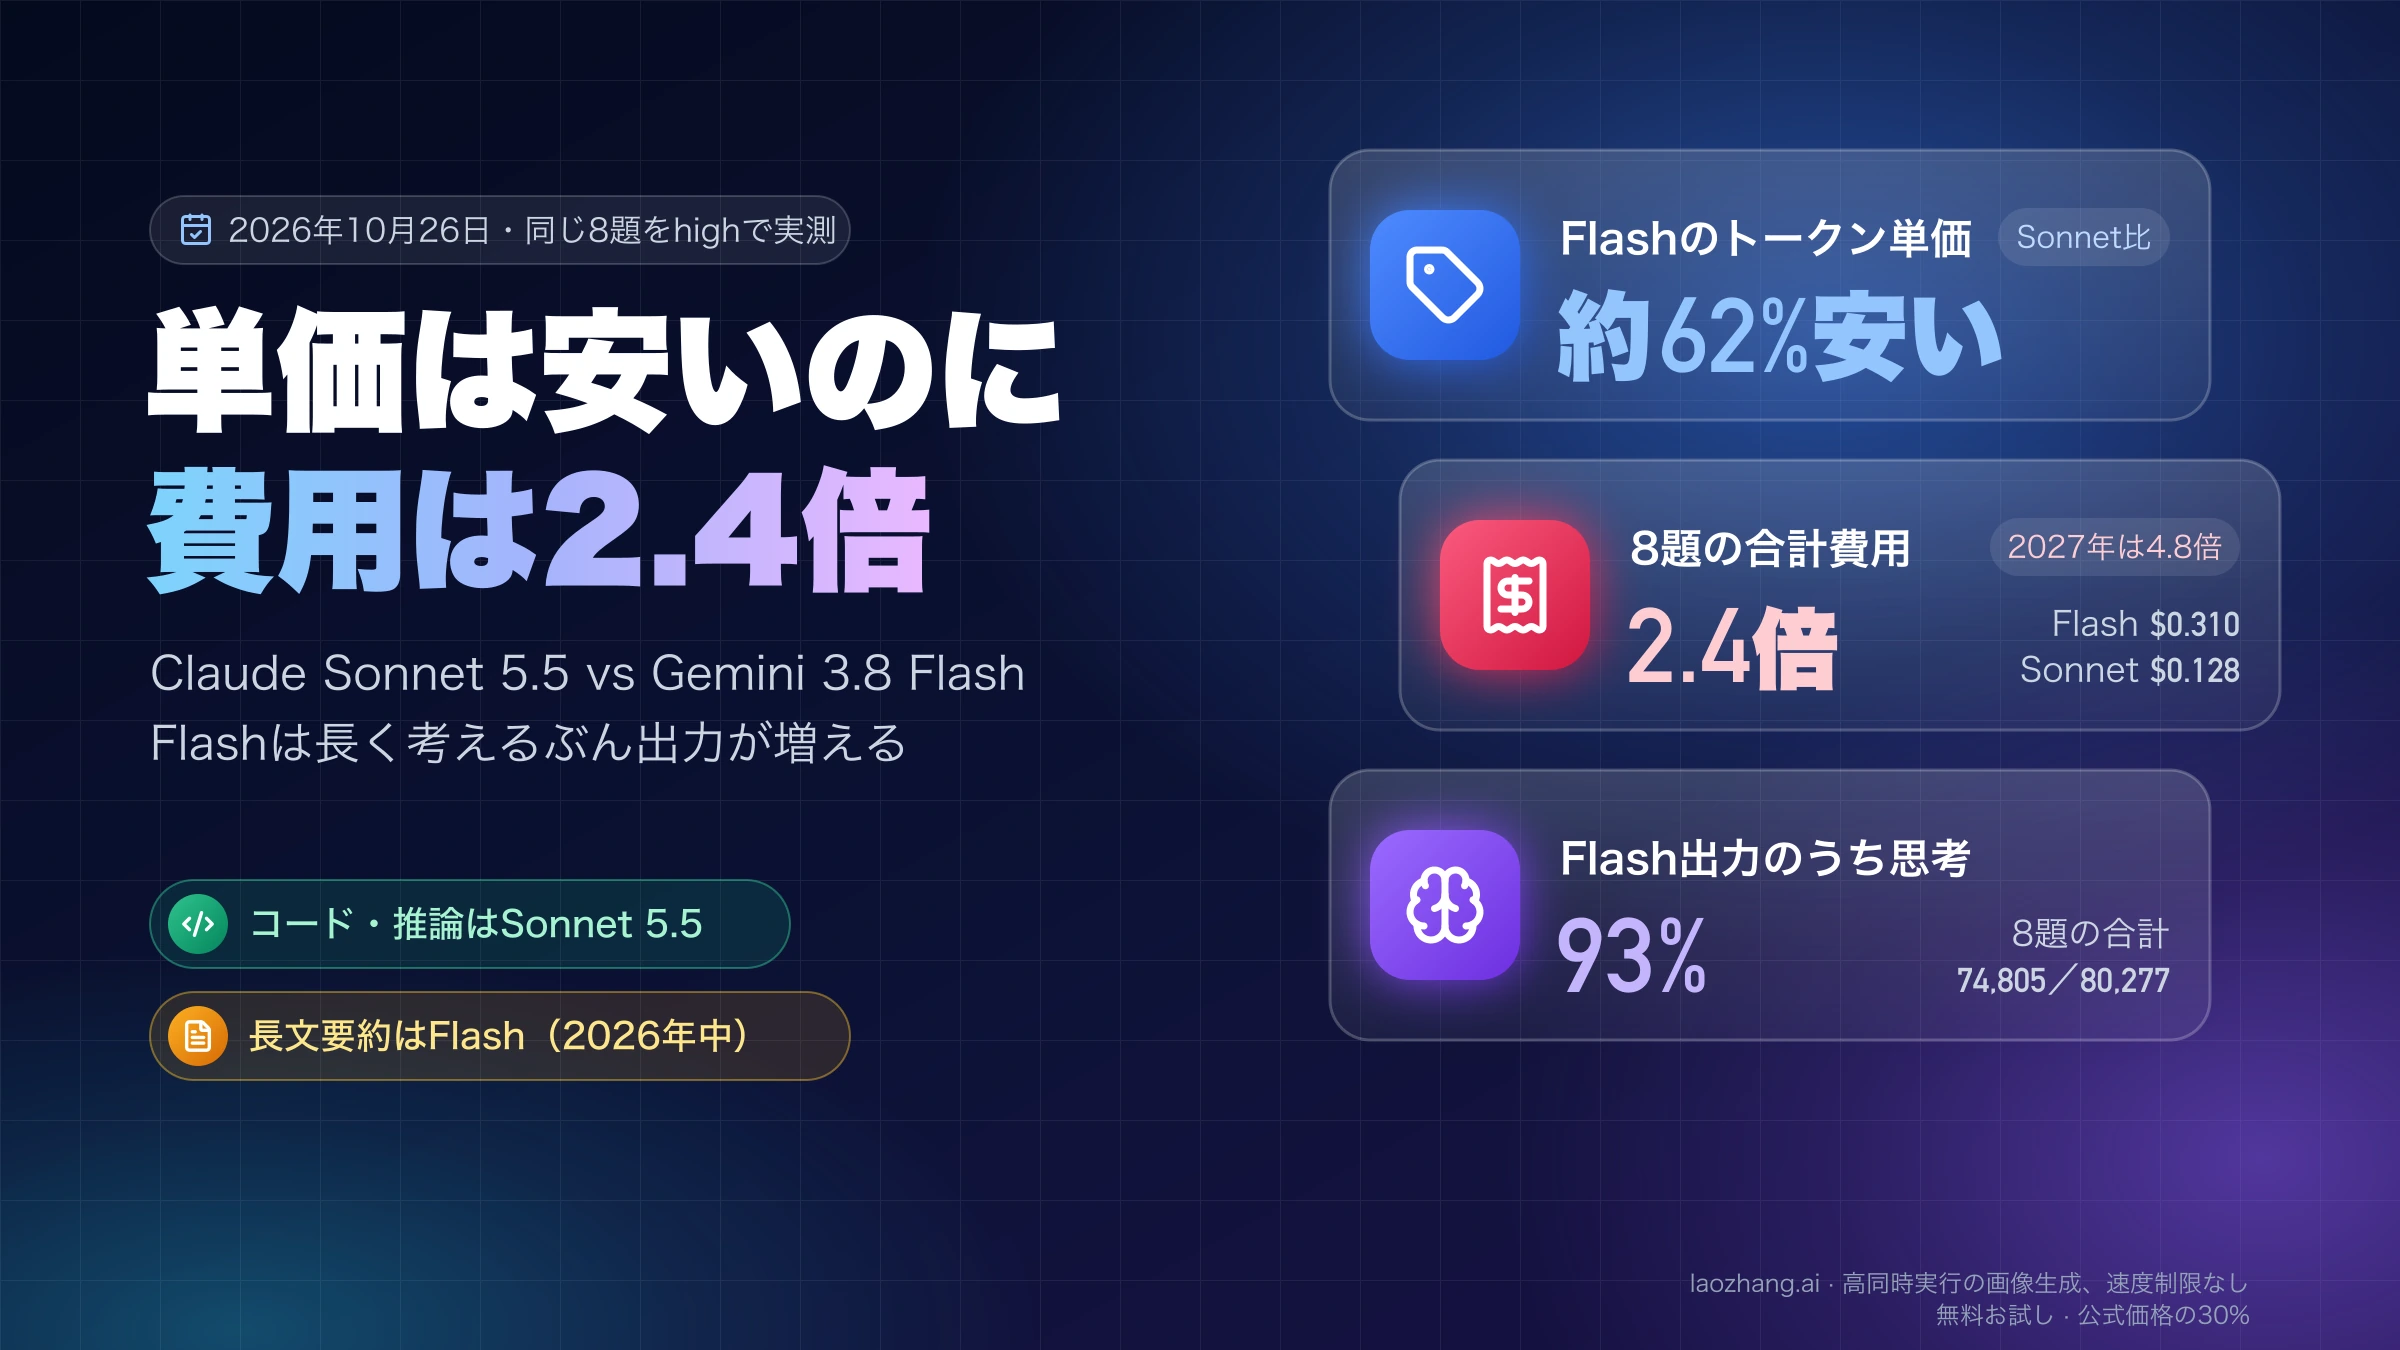
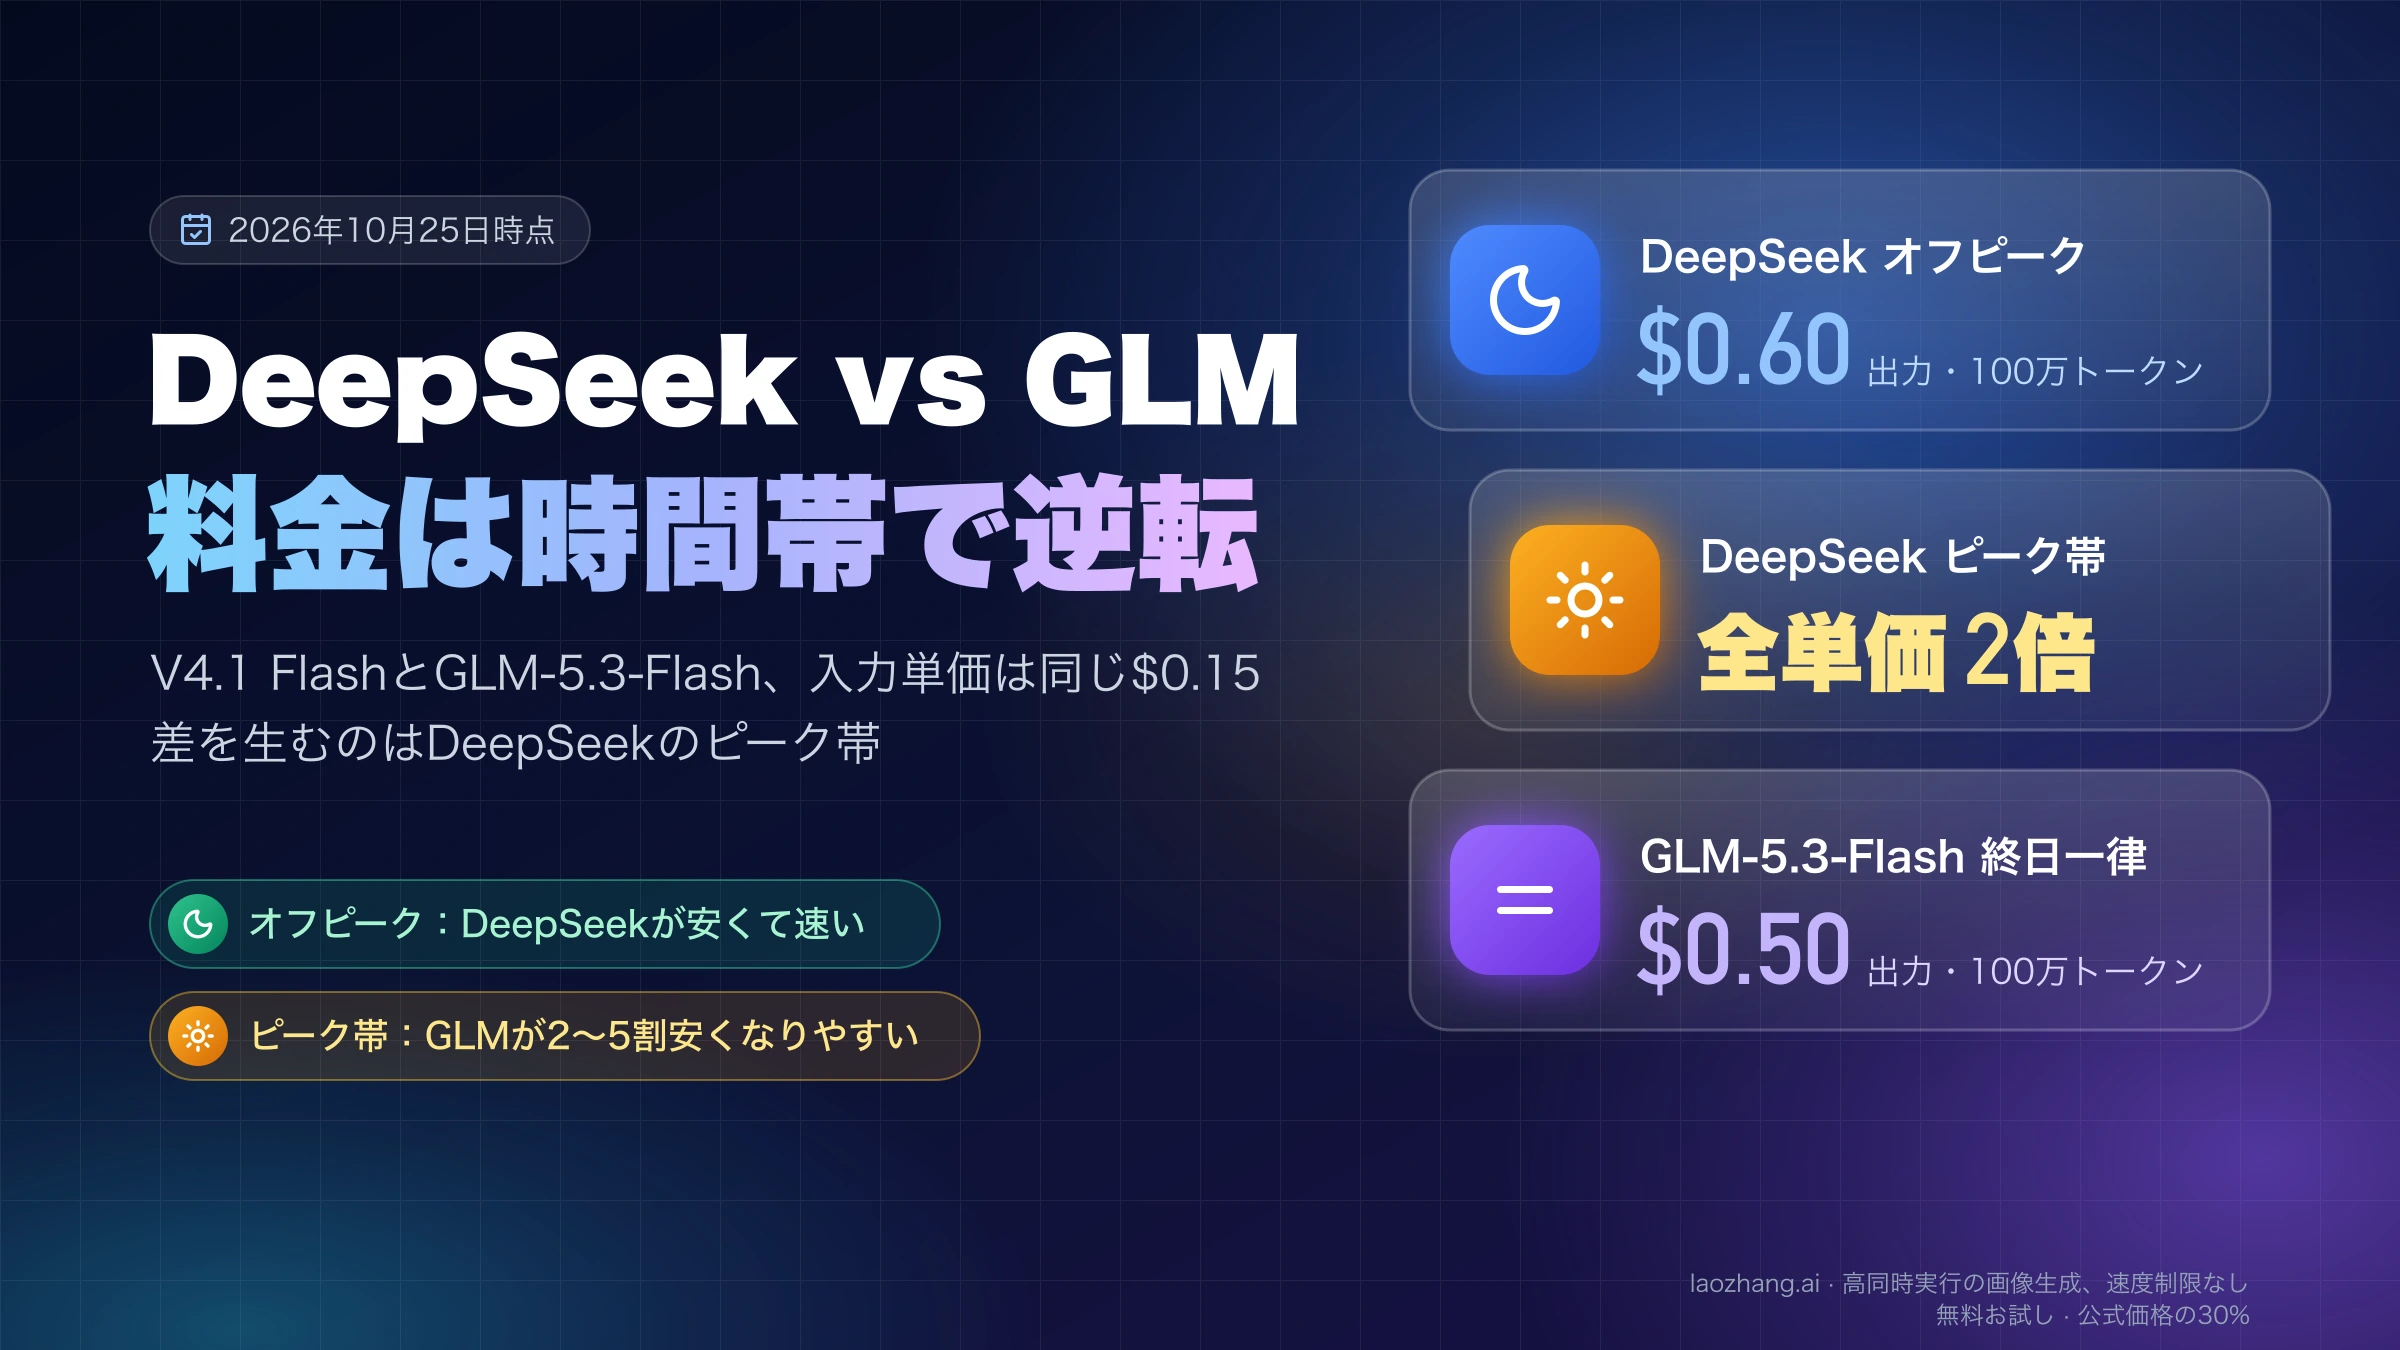
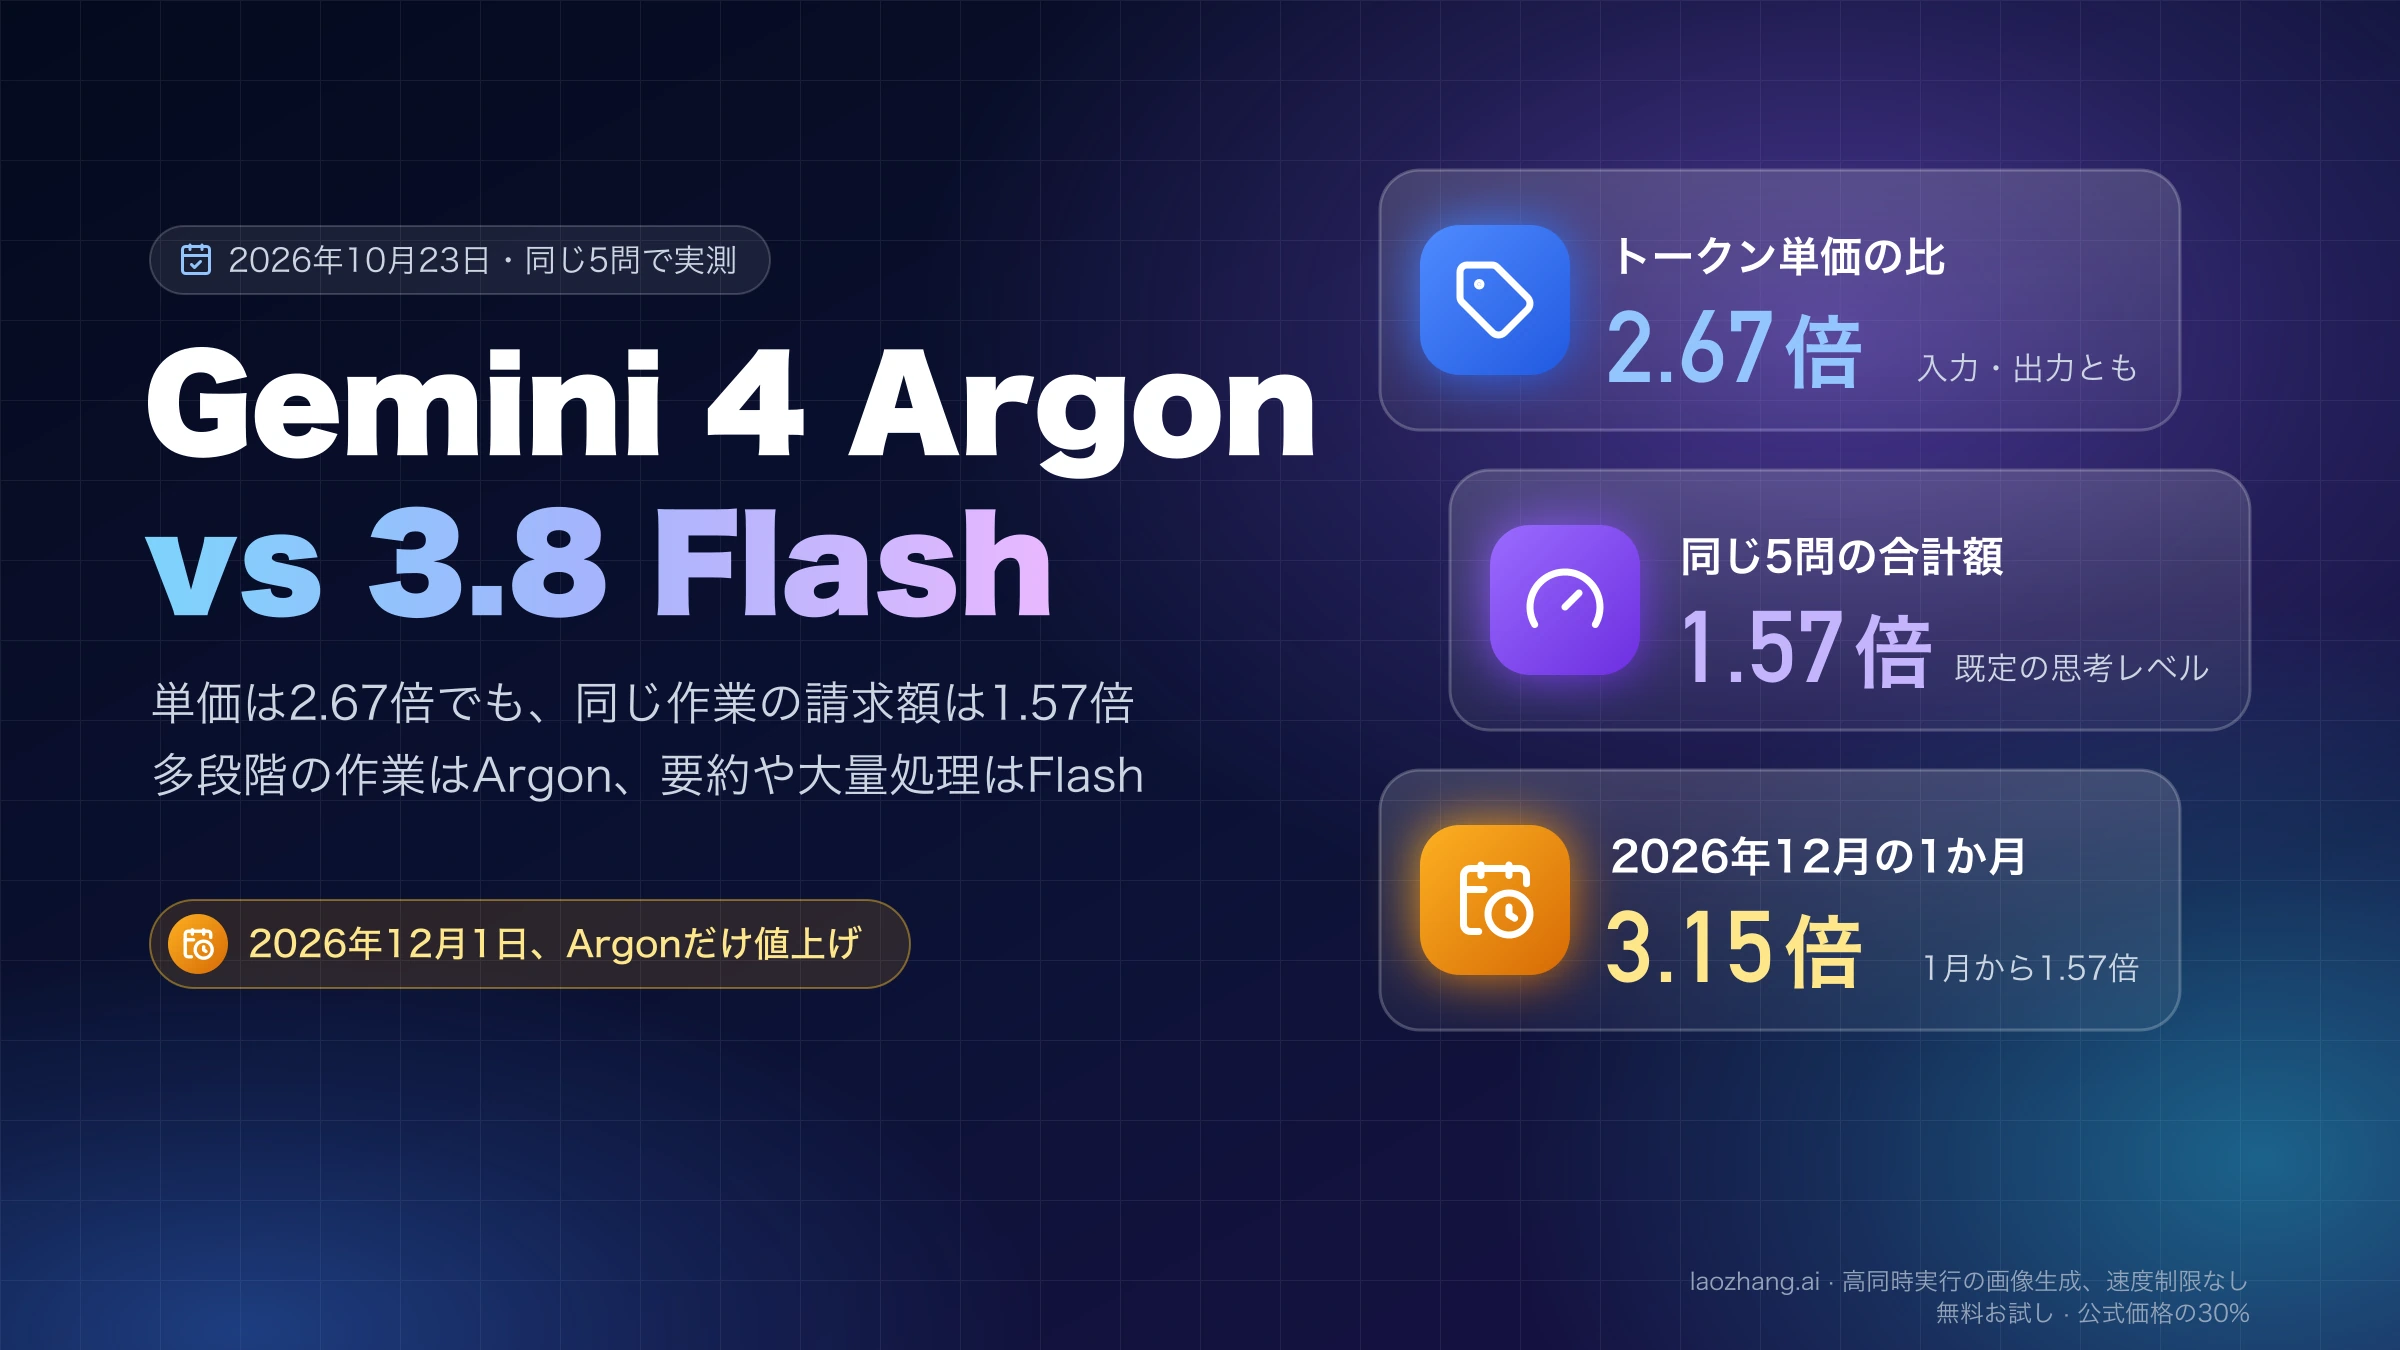
DeepSeek V4.1 Flashをもう一つの安いFlashと比べるならDeepSeek V4.1 FlashとGLM-5.3-Flash比較:料金は時間帯で逆転、Gemini 3.8 Flashを高いモデルと同じ問題で比べた結果はSonnet 5.5とGemini 3.8 Flash比較:実測費用はFlashが2.4倍、3.8 Flashから上位に上げるべき場面はGemini 4 Argonと3.8 Flashの違い:実測コストと使い分けにあります。主要5社の単価を横に並べたい場合はAI API 料金比較:主要5社の単価と最安モデルの選び方が便利です。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月6日。
参考資料8
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月6日。
- 1.DeepSeek APIの料金ページapi-docs.deepseek.com/quick_start/pricing
- 2.Gemini APIの料金ページaistudio.google.com/docs/pricing
- 3.Artificial AnalysisのDeepSeek V4.1 Flash 1017とGemini 3.8 Flashの比較ページartificialanalysis.ai/models/releases/comparisons/deepseek-v4-1-flash-1017-vs-gemini-3-8-flash
- 4.AI/ML APIのXへの投稿x.com/aimlapi/status/2098056487465578894
- 5.Gemini 3.8 Flashのモデルページaistudio.google.com/docs/models/gemini-3.8-flash
- 6.DeepSeekの思考モードのガイドapi-docs.deepseek.com/guides/thinking_mode
- 7.Gemini APIの思考のドキュメントaistudio.google.com/docs/thinking
- 8.DeepSeek APIの更新履歴api-docs.deepseek.com/updates