Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más
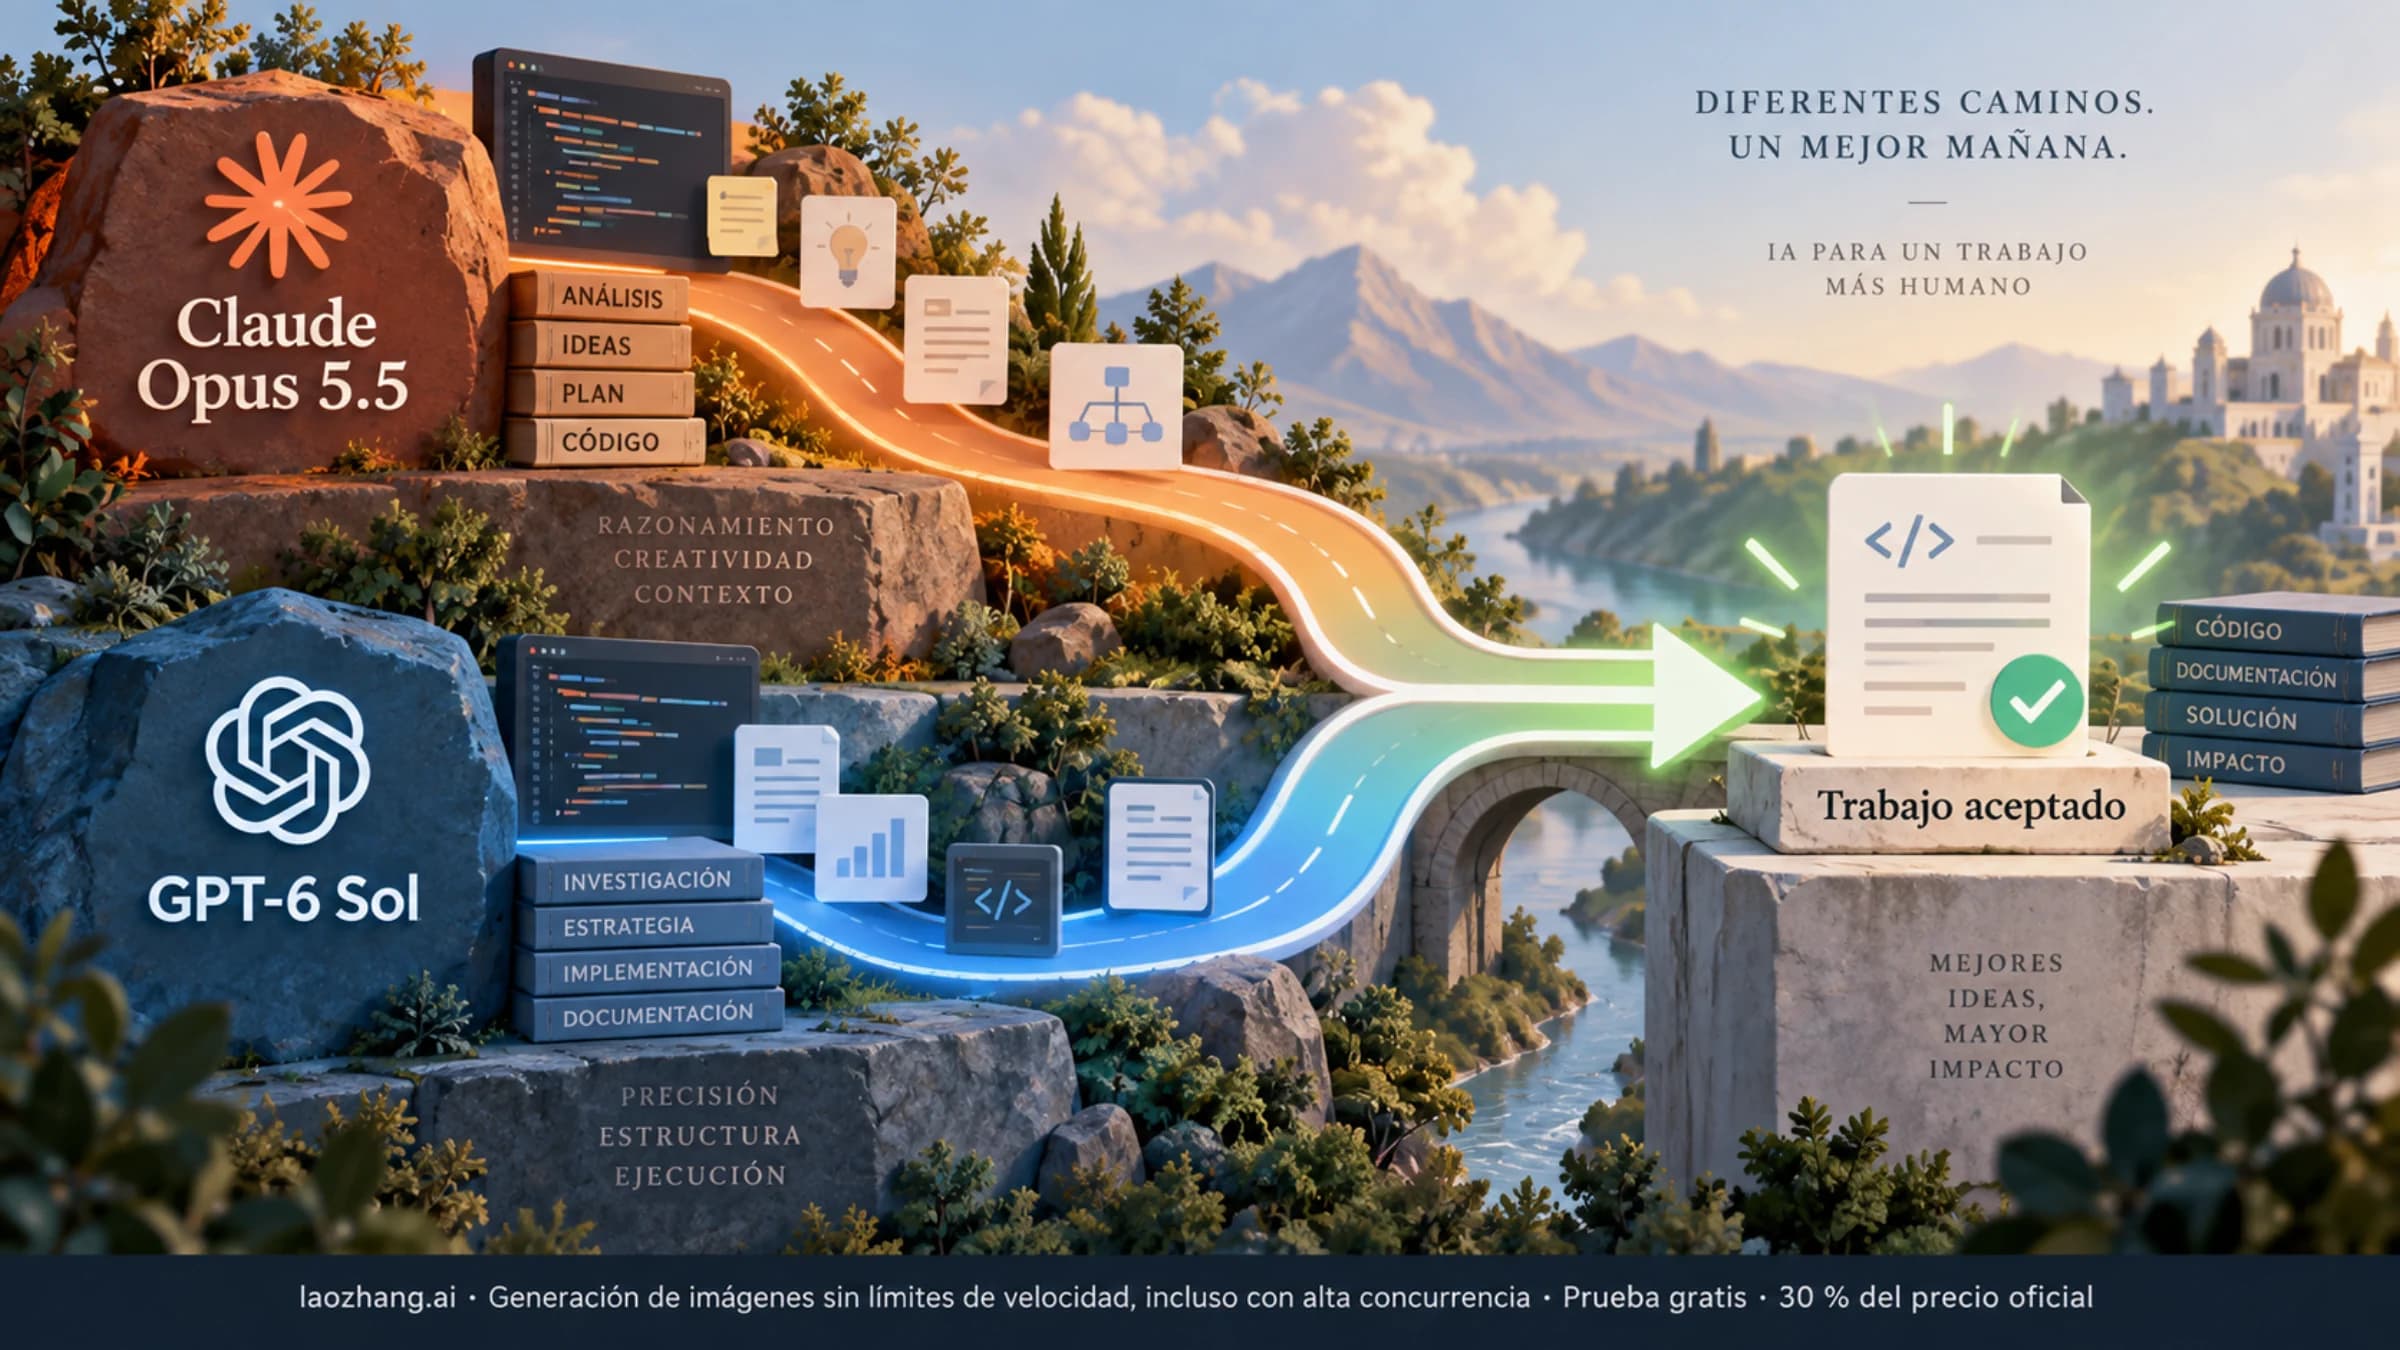
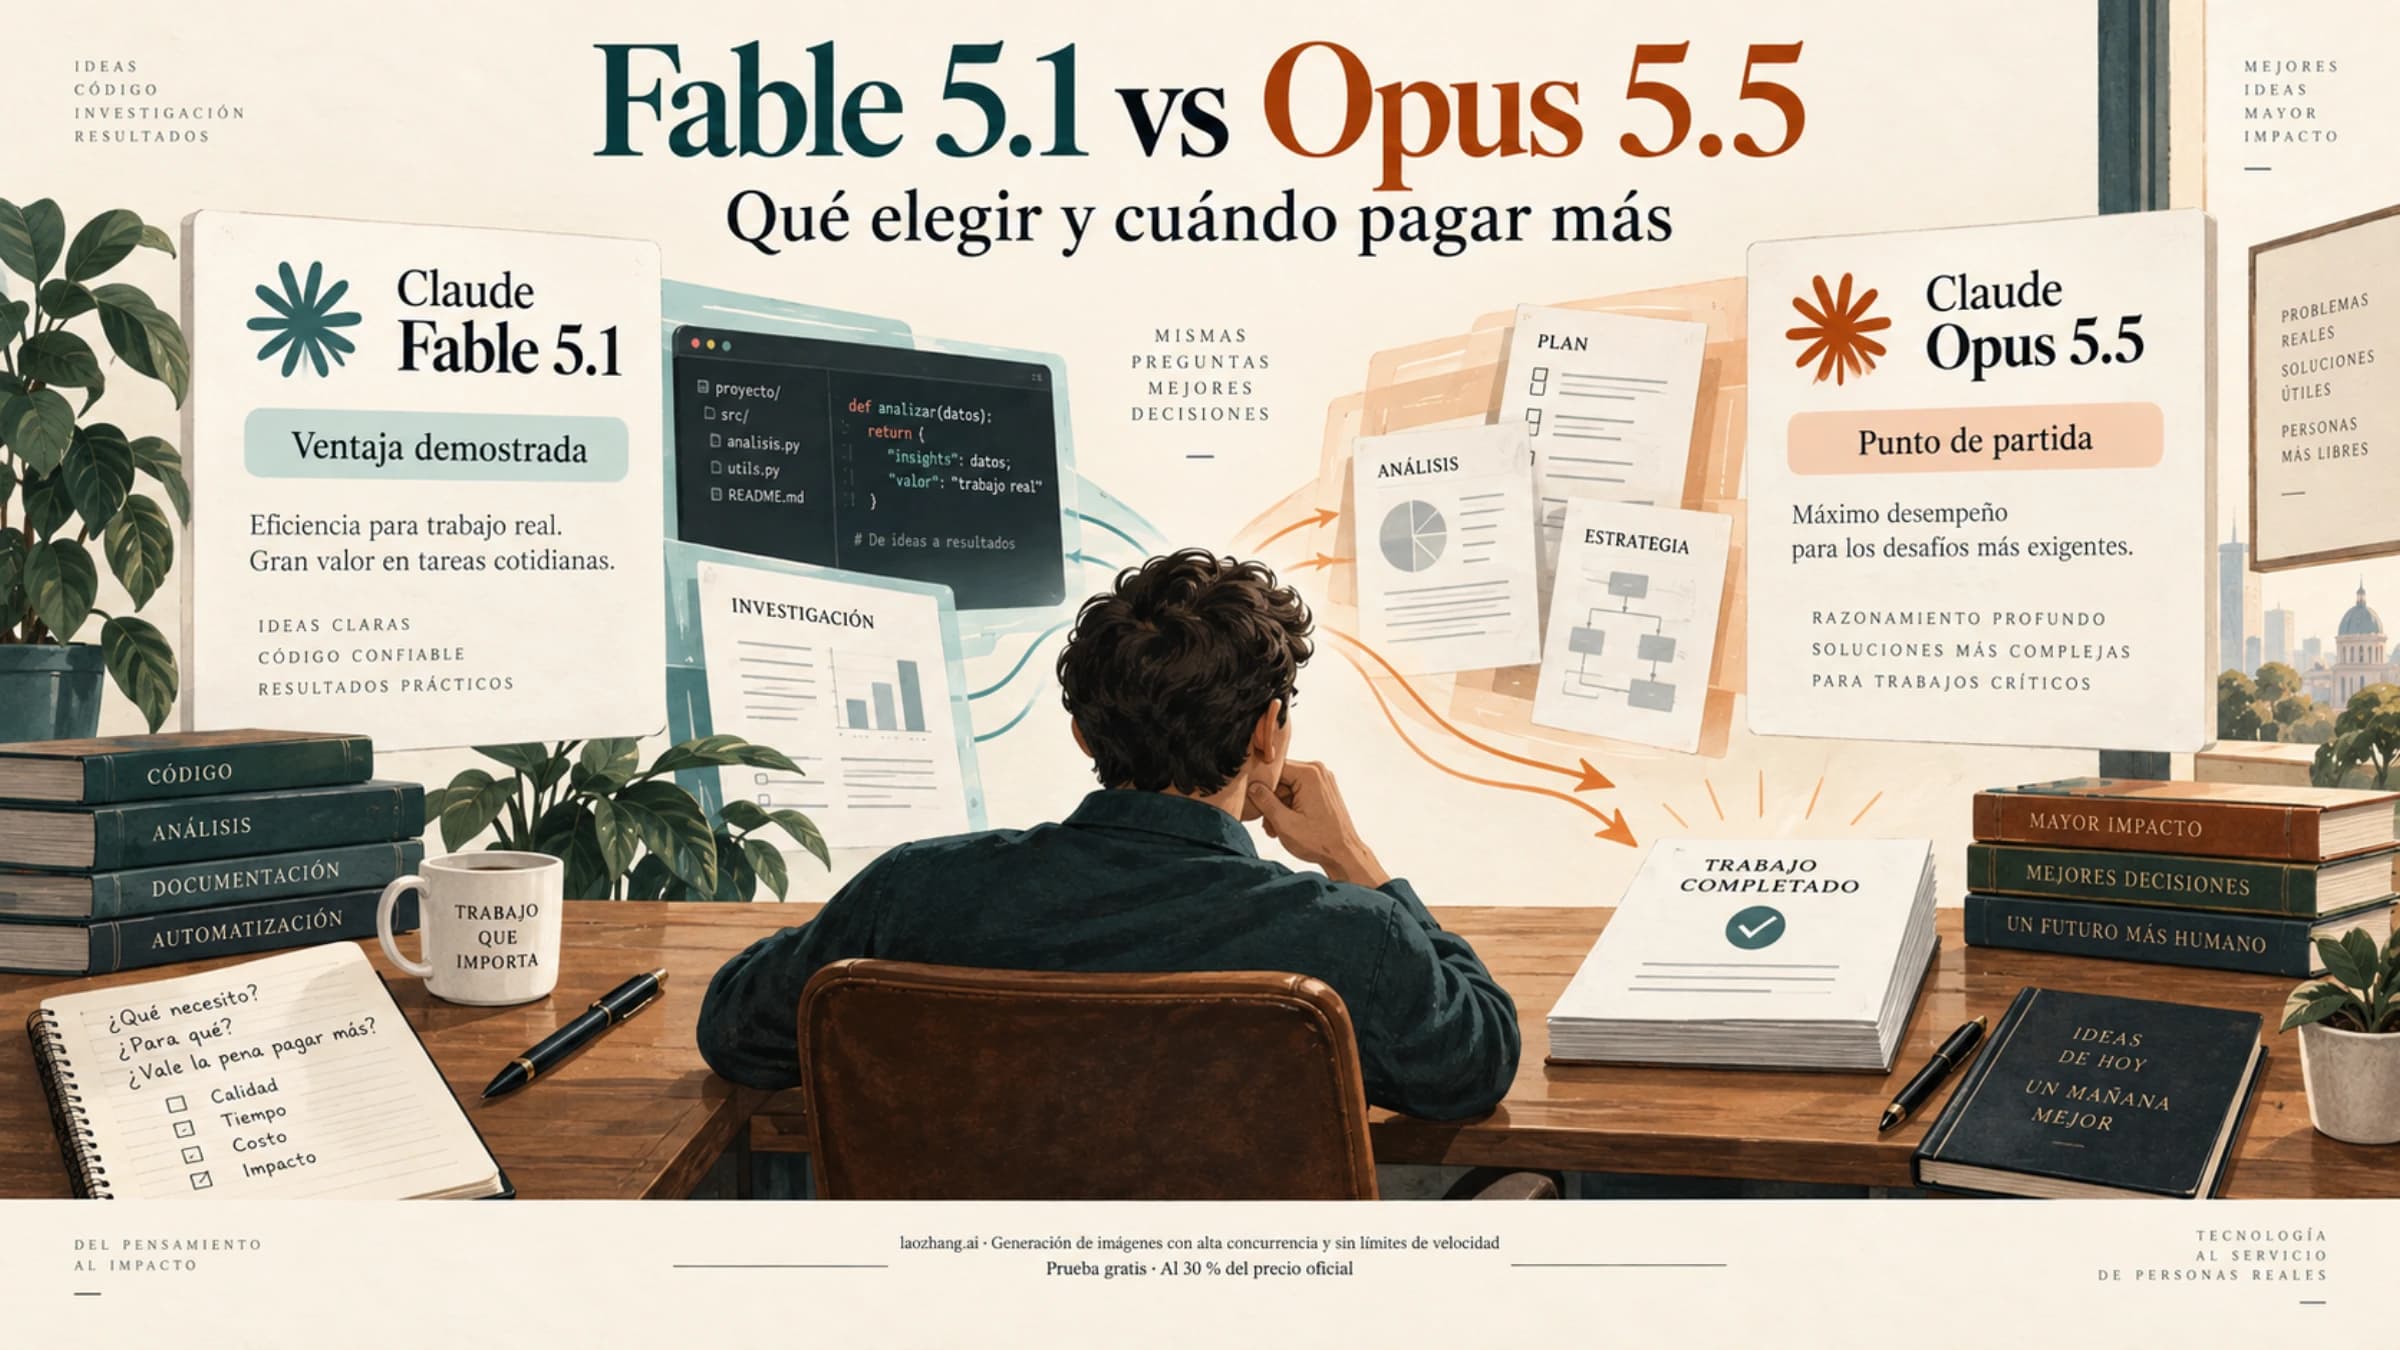
Empieza por Opus 5.5 y reserva Fable 5.1 para las tareas donde demuestre una ventaja. El ahorro cambia con la caché, los reintentos y el esfuerzo de razonamiento.

Empieza por Opus 5.5 y reserva Fable 5.1 para las tareas donde demuestre una ventaja. El ahorro cambia con la caché, los reintentos y el esfuerzo de razonamiento.

Empieza probando GPT-6 Sol si ambas API sirven para tu flujo: su tarifa estándar de entrada y salida es la mitad hasta 272K tokens de entrada. Prueba Opus 5.5 en las tareas donde una mayor tasa de aceptación pueda justificar el coste total.

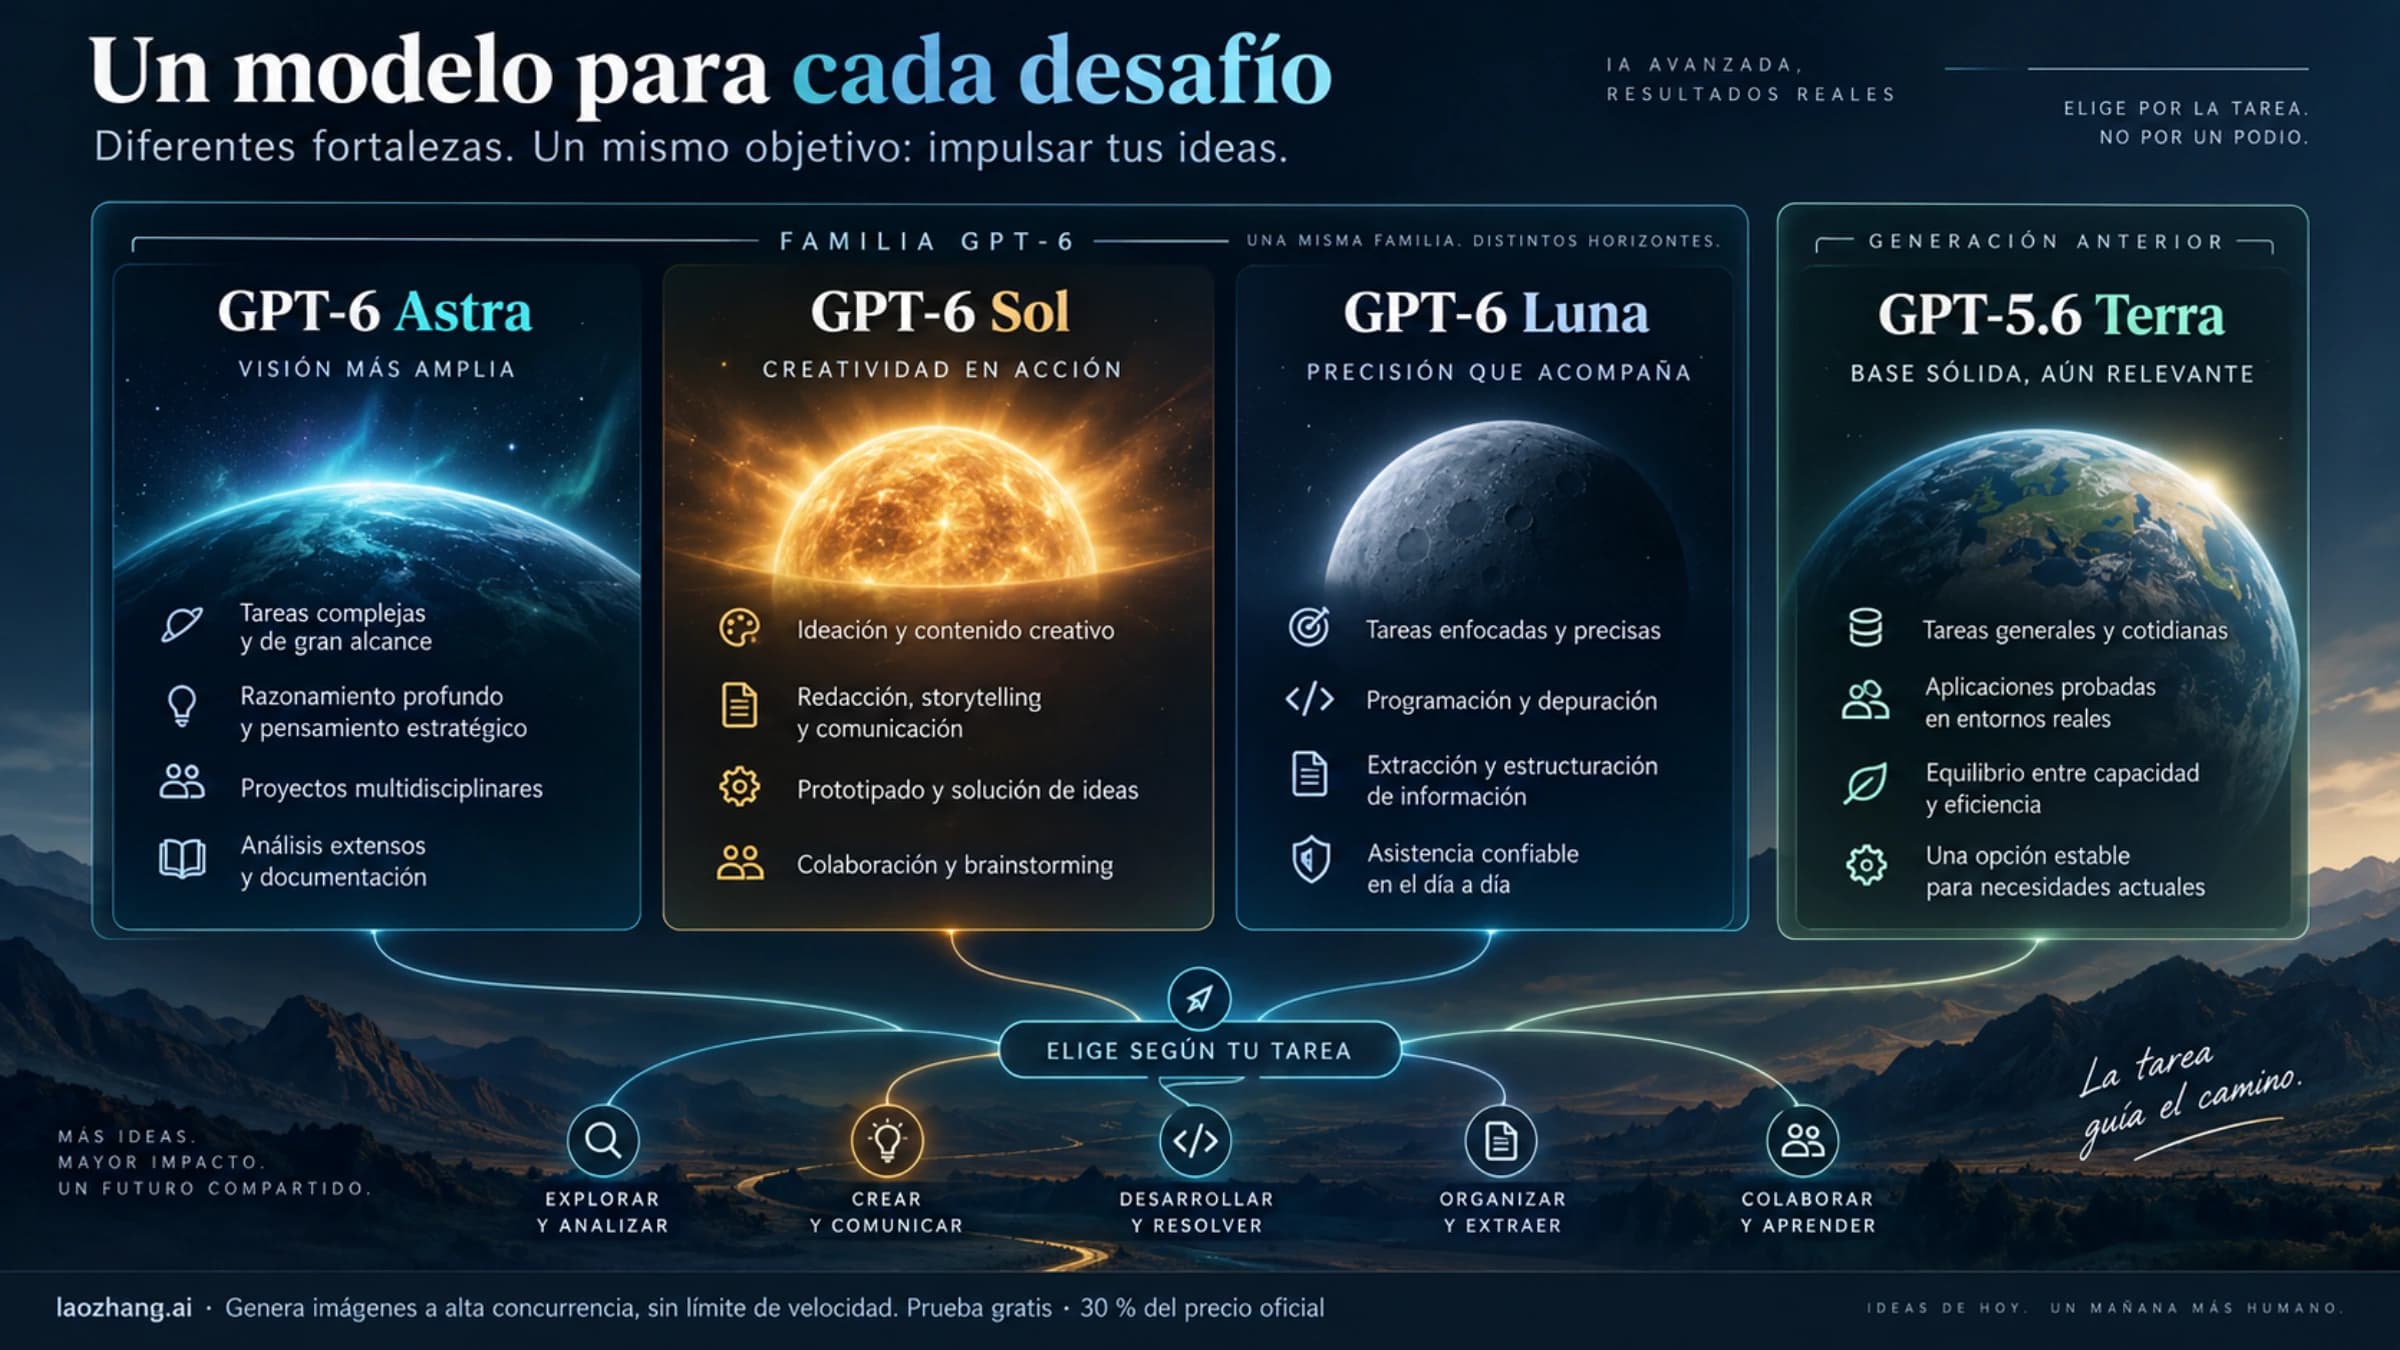
Sol, Luna y Astra son GPT-6; Terra pertenece a GPT-5.6. Mira las tarifas de API con el mismo contexto y mide cuánto cuesta obtener un resultado válido.

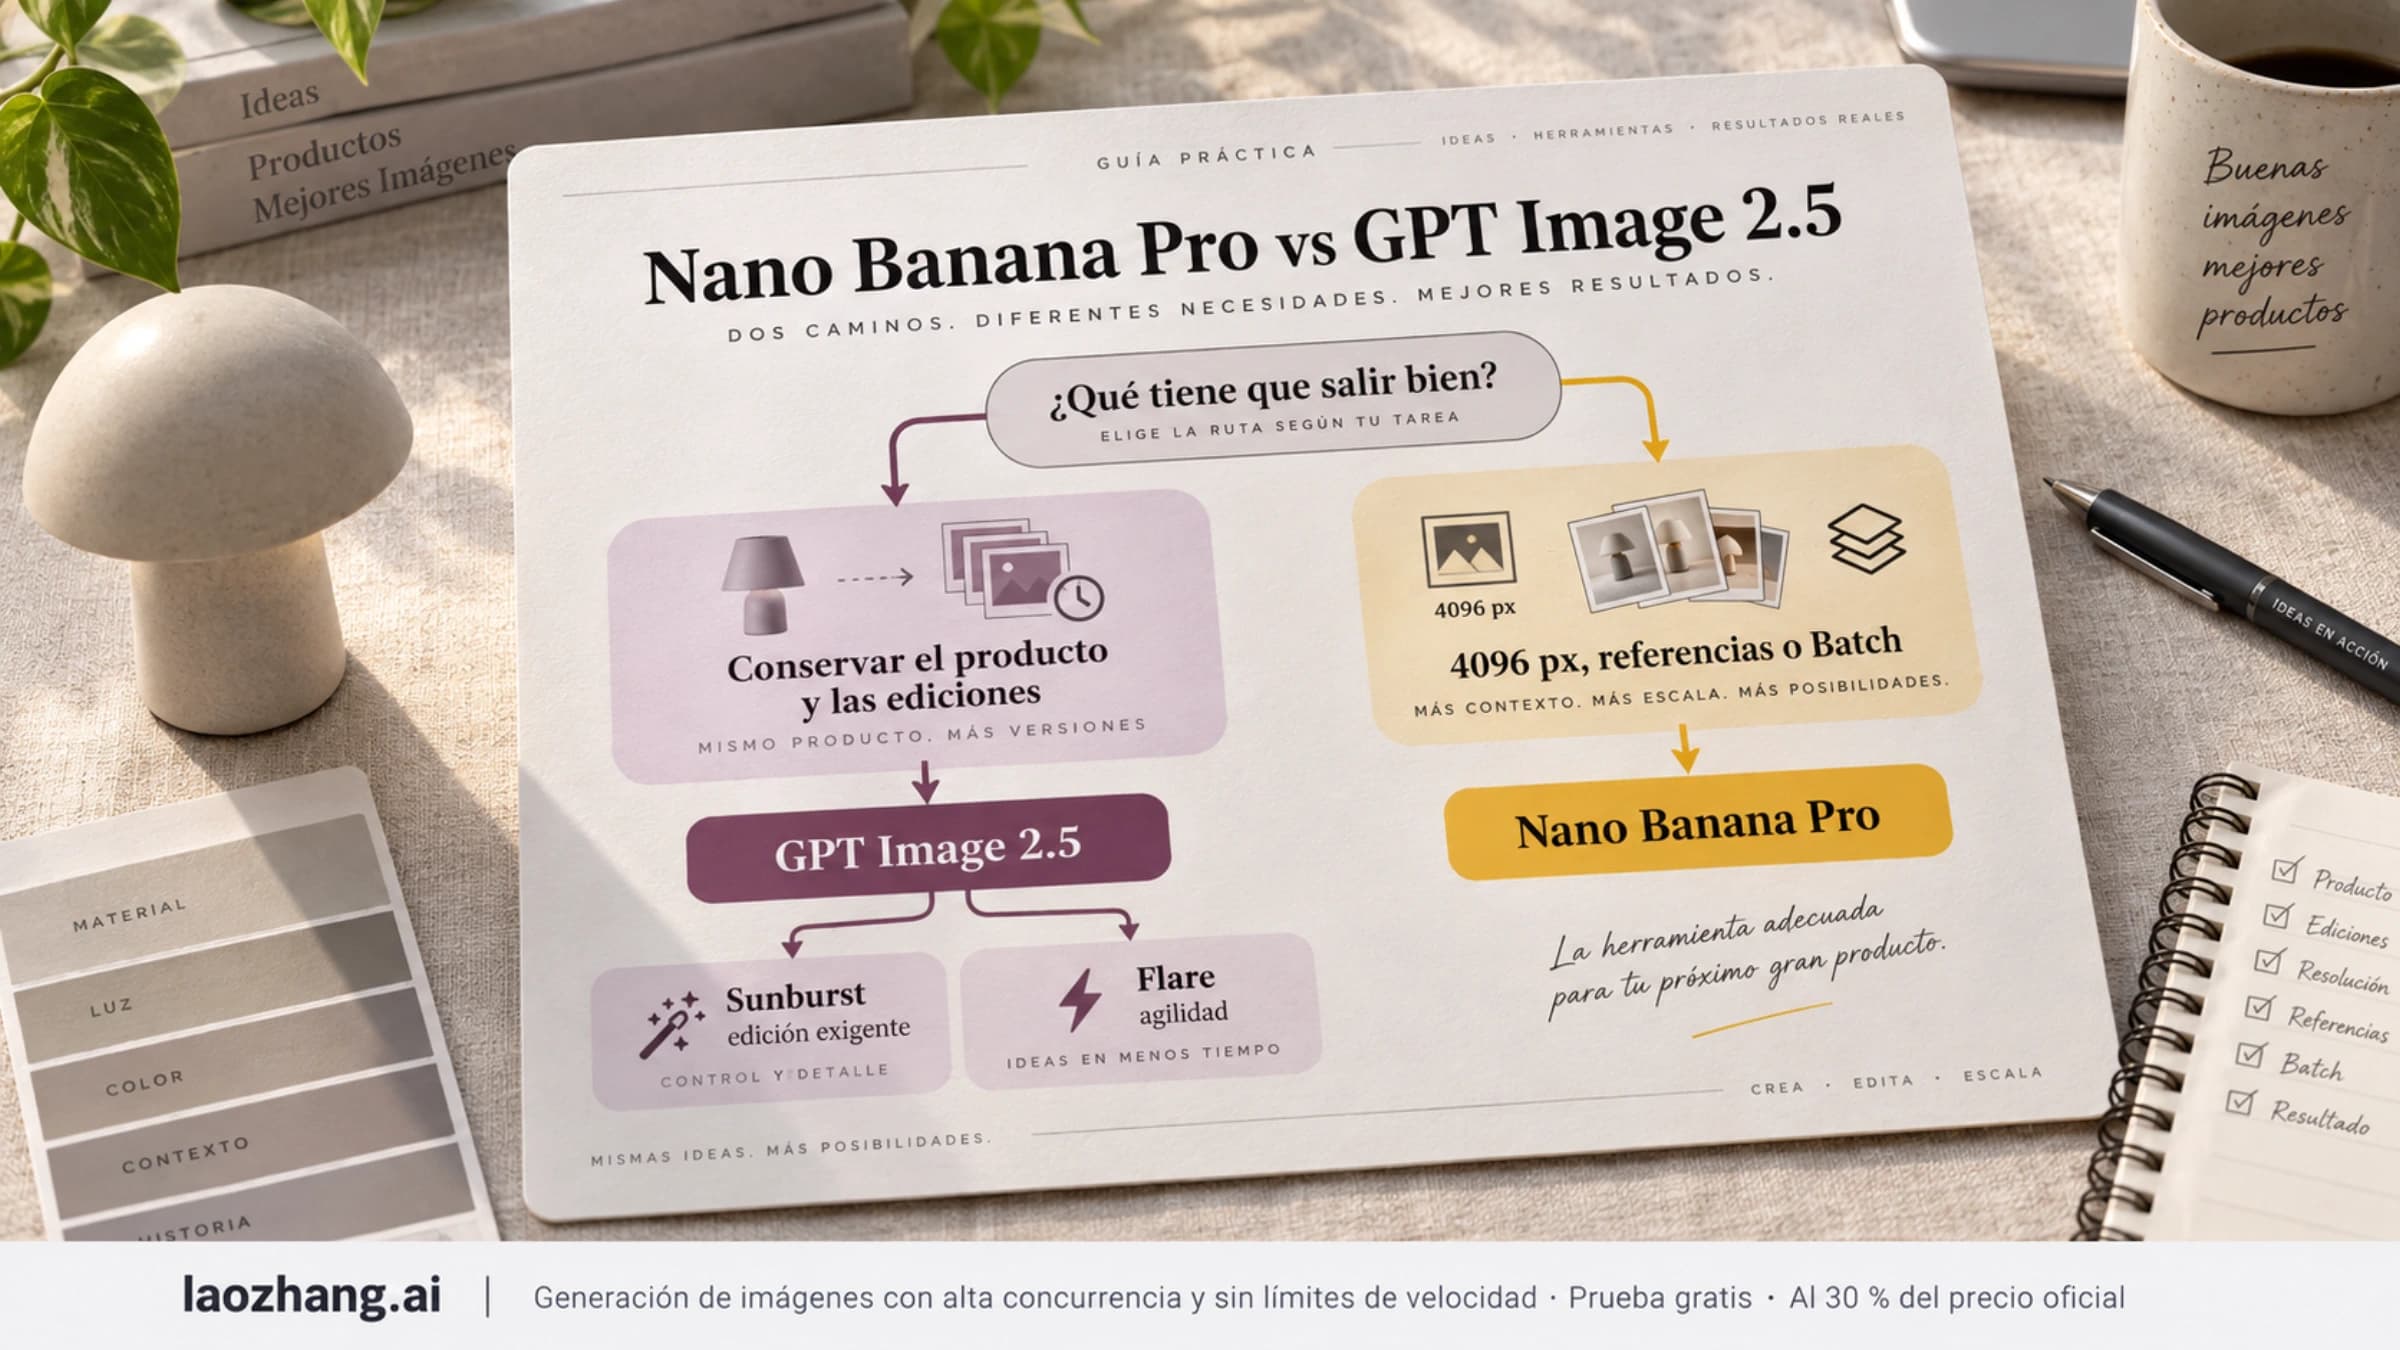
Empieza por GPT Image 2.5 si la silueta del producto o las ediciones encadenadas deben mantenerse; por Nano Banana Pro si necesitas 4096 px o más referencias.

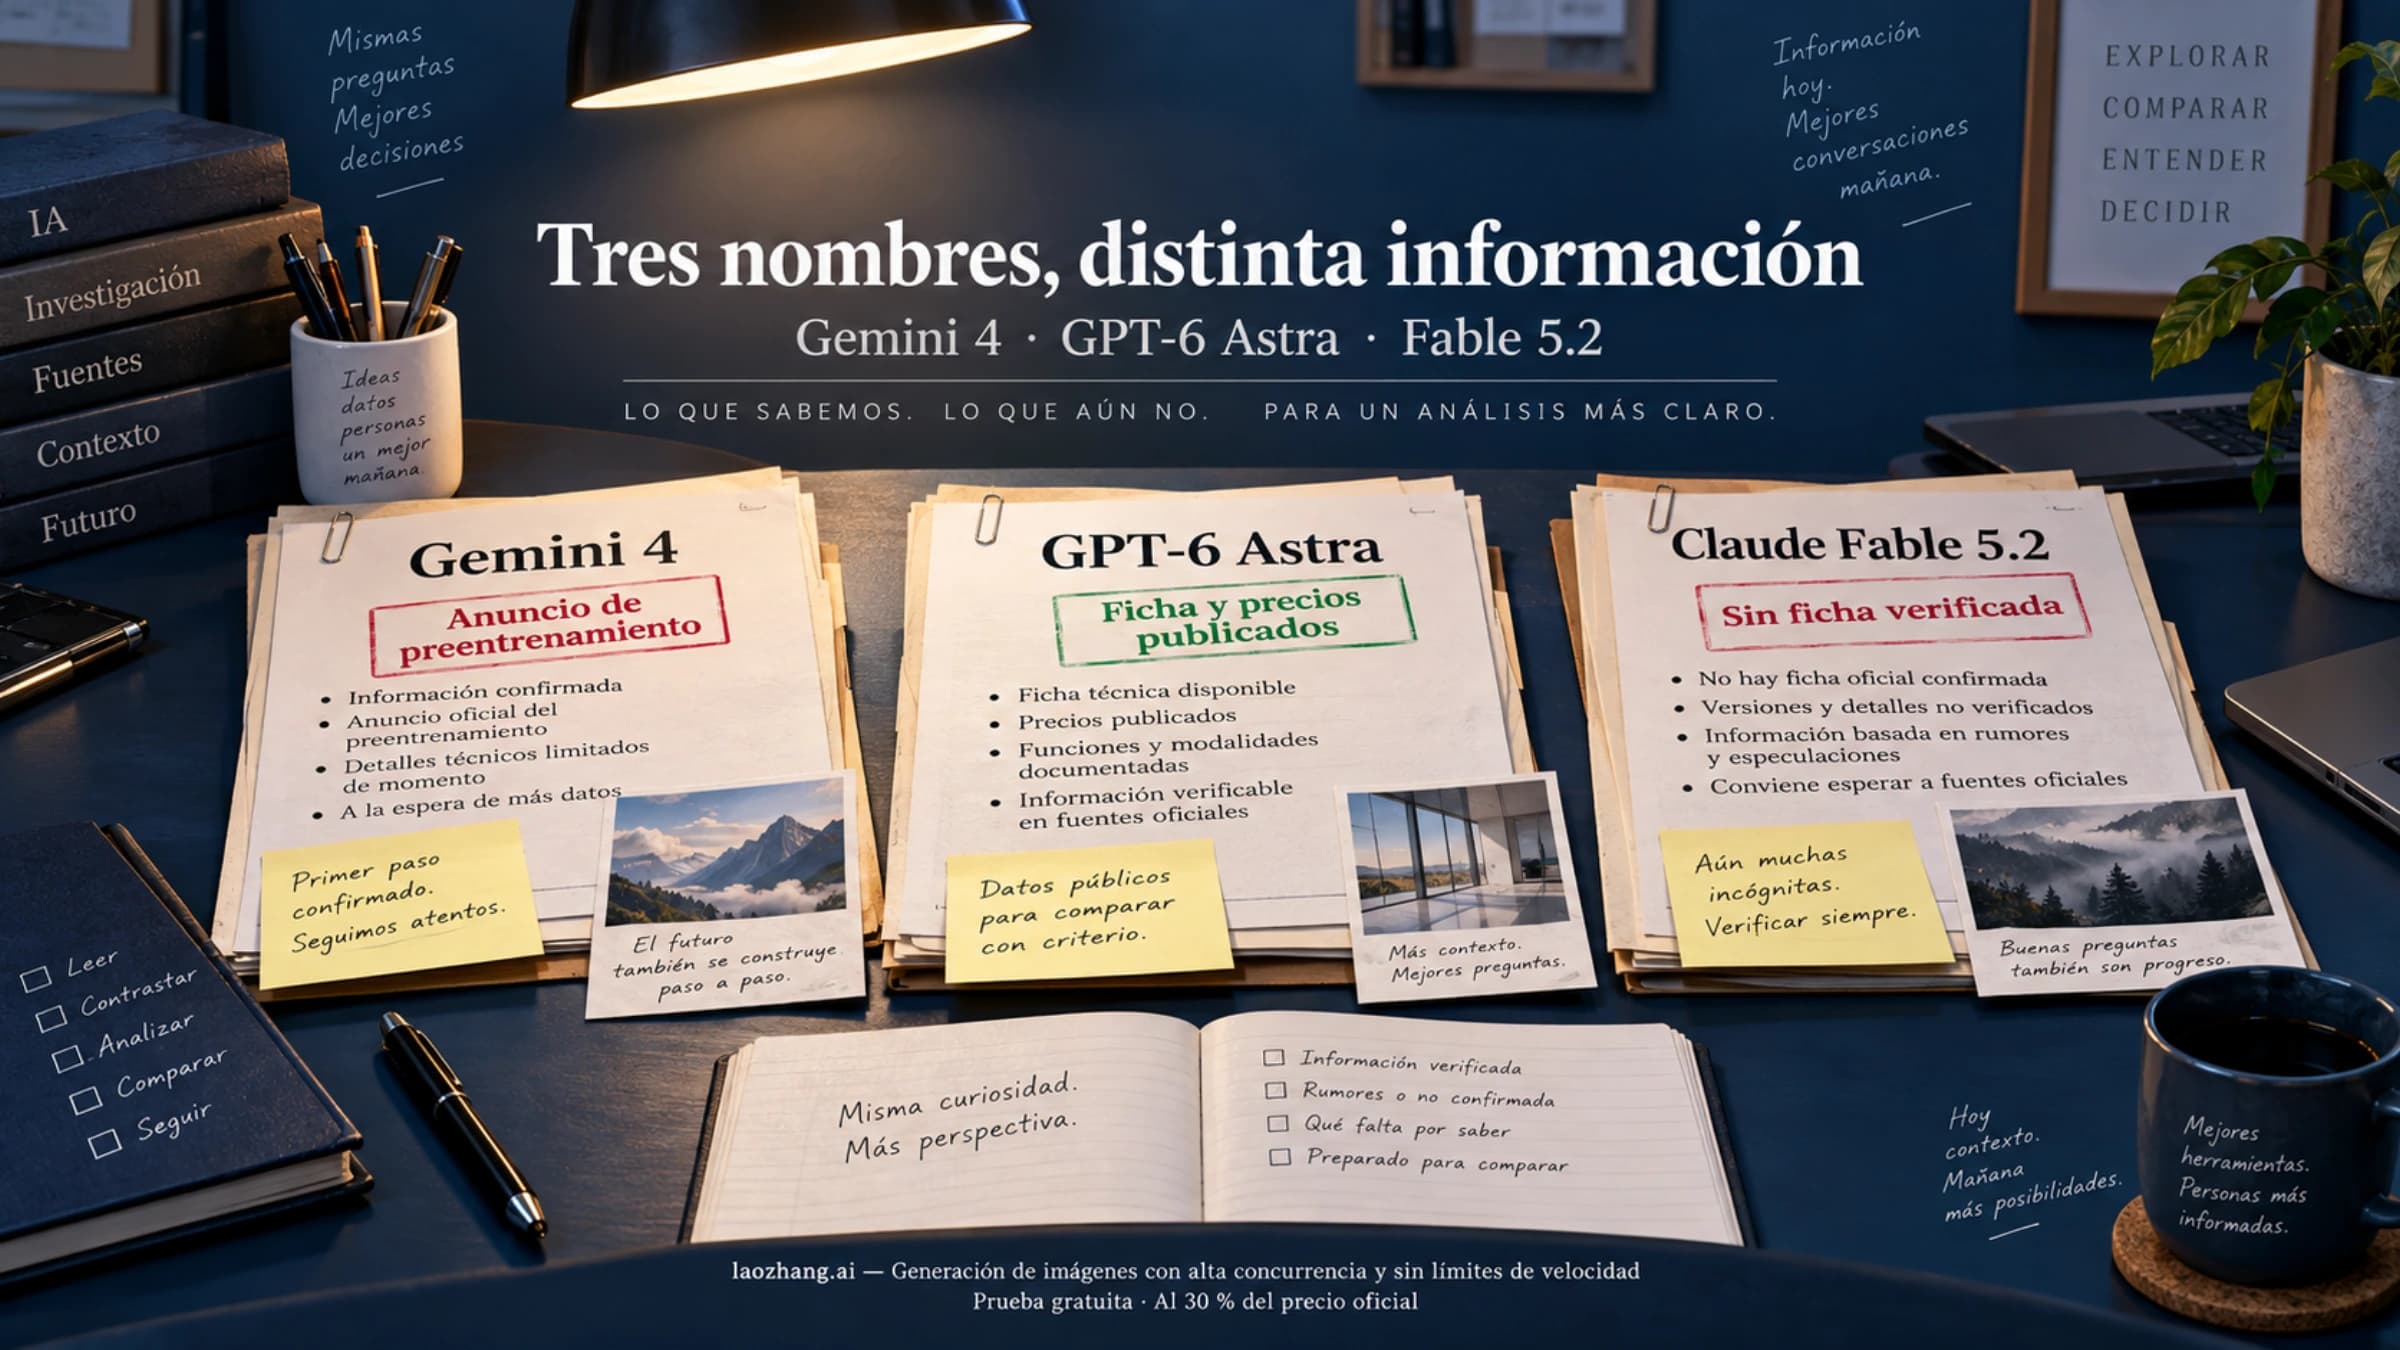
Las primeras demostraciones atribuidas a Gemini 4 y al próximo Fable apuntan a mejoras en detalle visual y código, con posibles costes de tiempo y dinero. Contrastamos los casos frente a Astra y explicamos qué decisiones permiten adelantar.

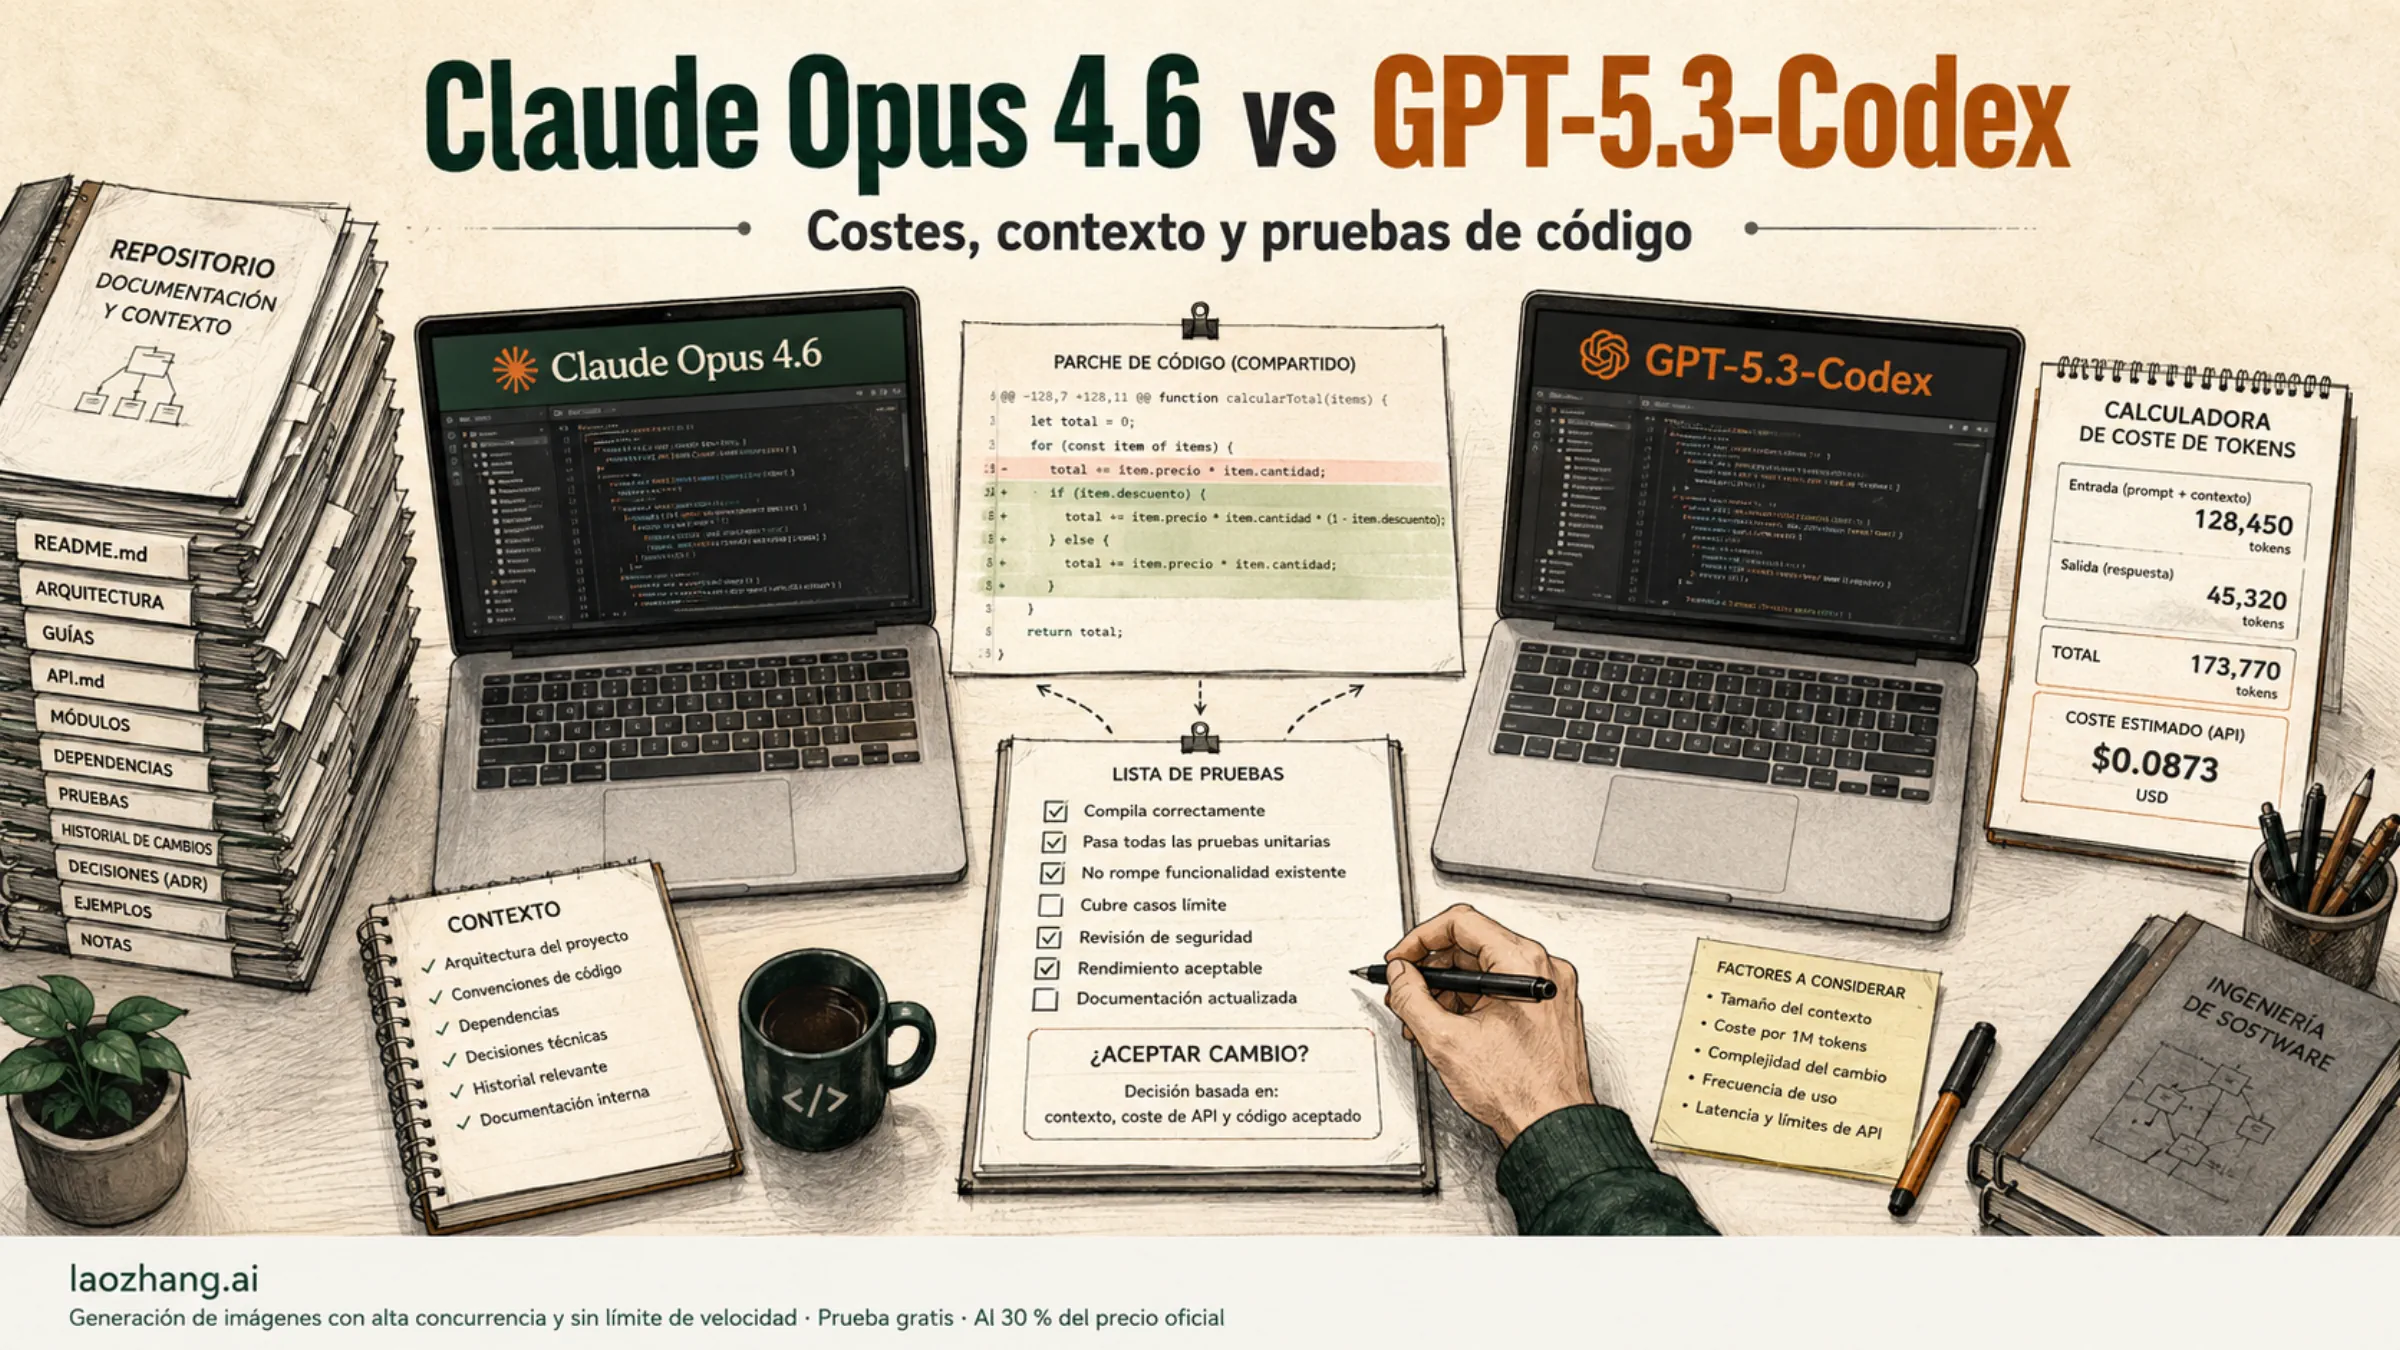
GPT-5.3-Codex cuesta menos por token; Opus 4.6 admite más contexto. Compara las tarifas API, la caché y el coste por entrega con una prueba reproducible.

Compara las entradas admitidas, el contexto y la facturación de estas tres API, con costes calculados por petición y criterios para evaluar código, documentos y herramientas.

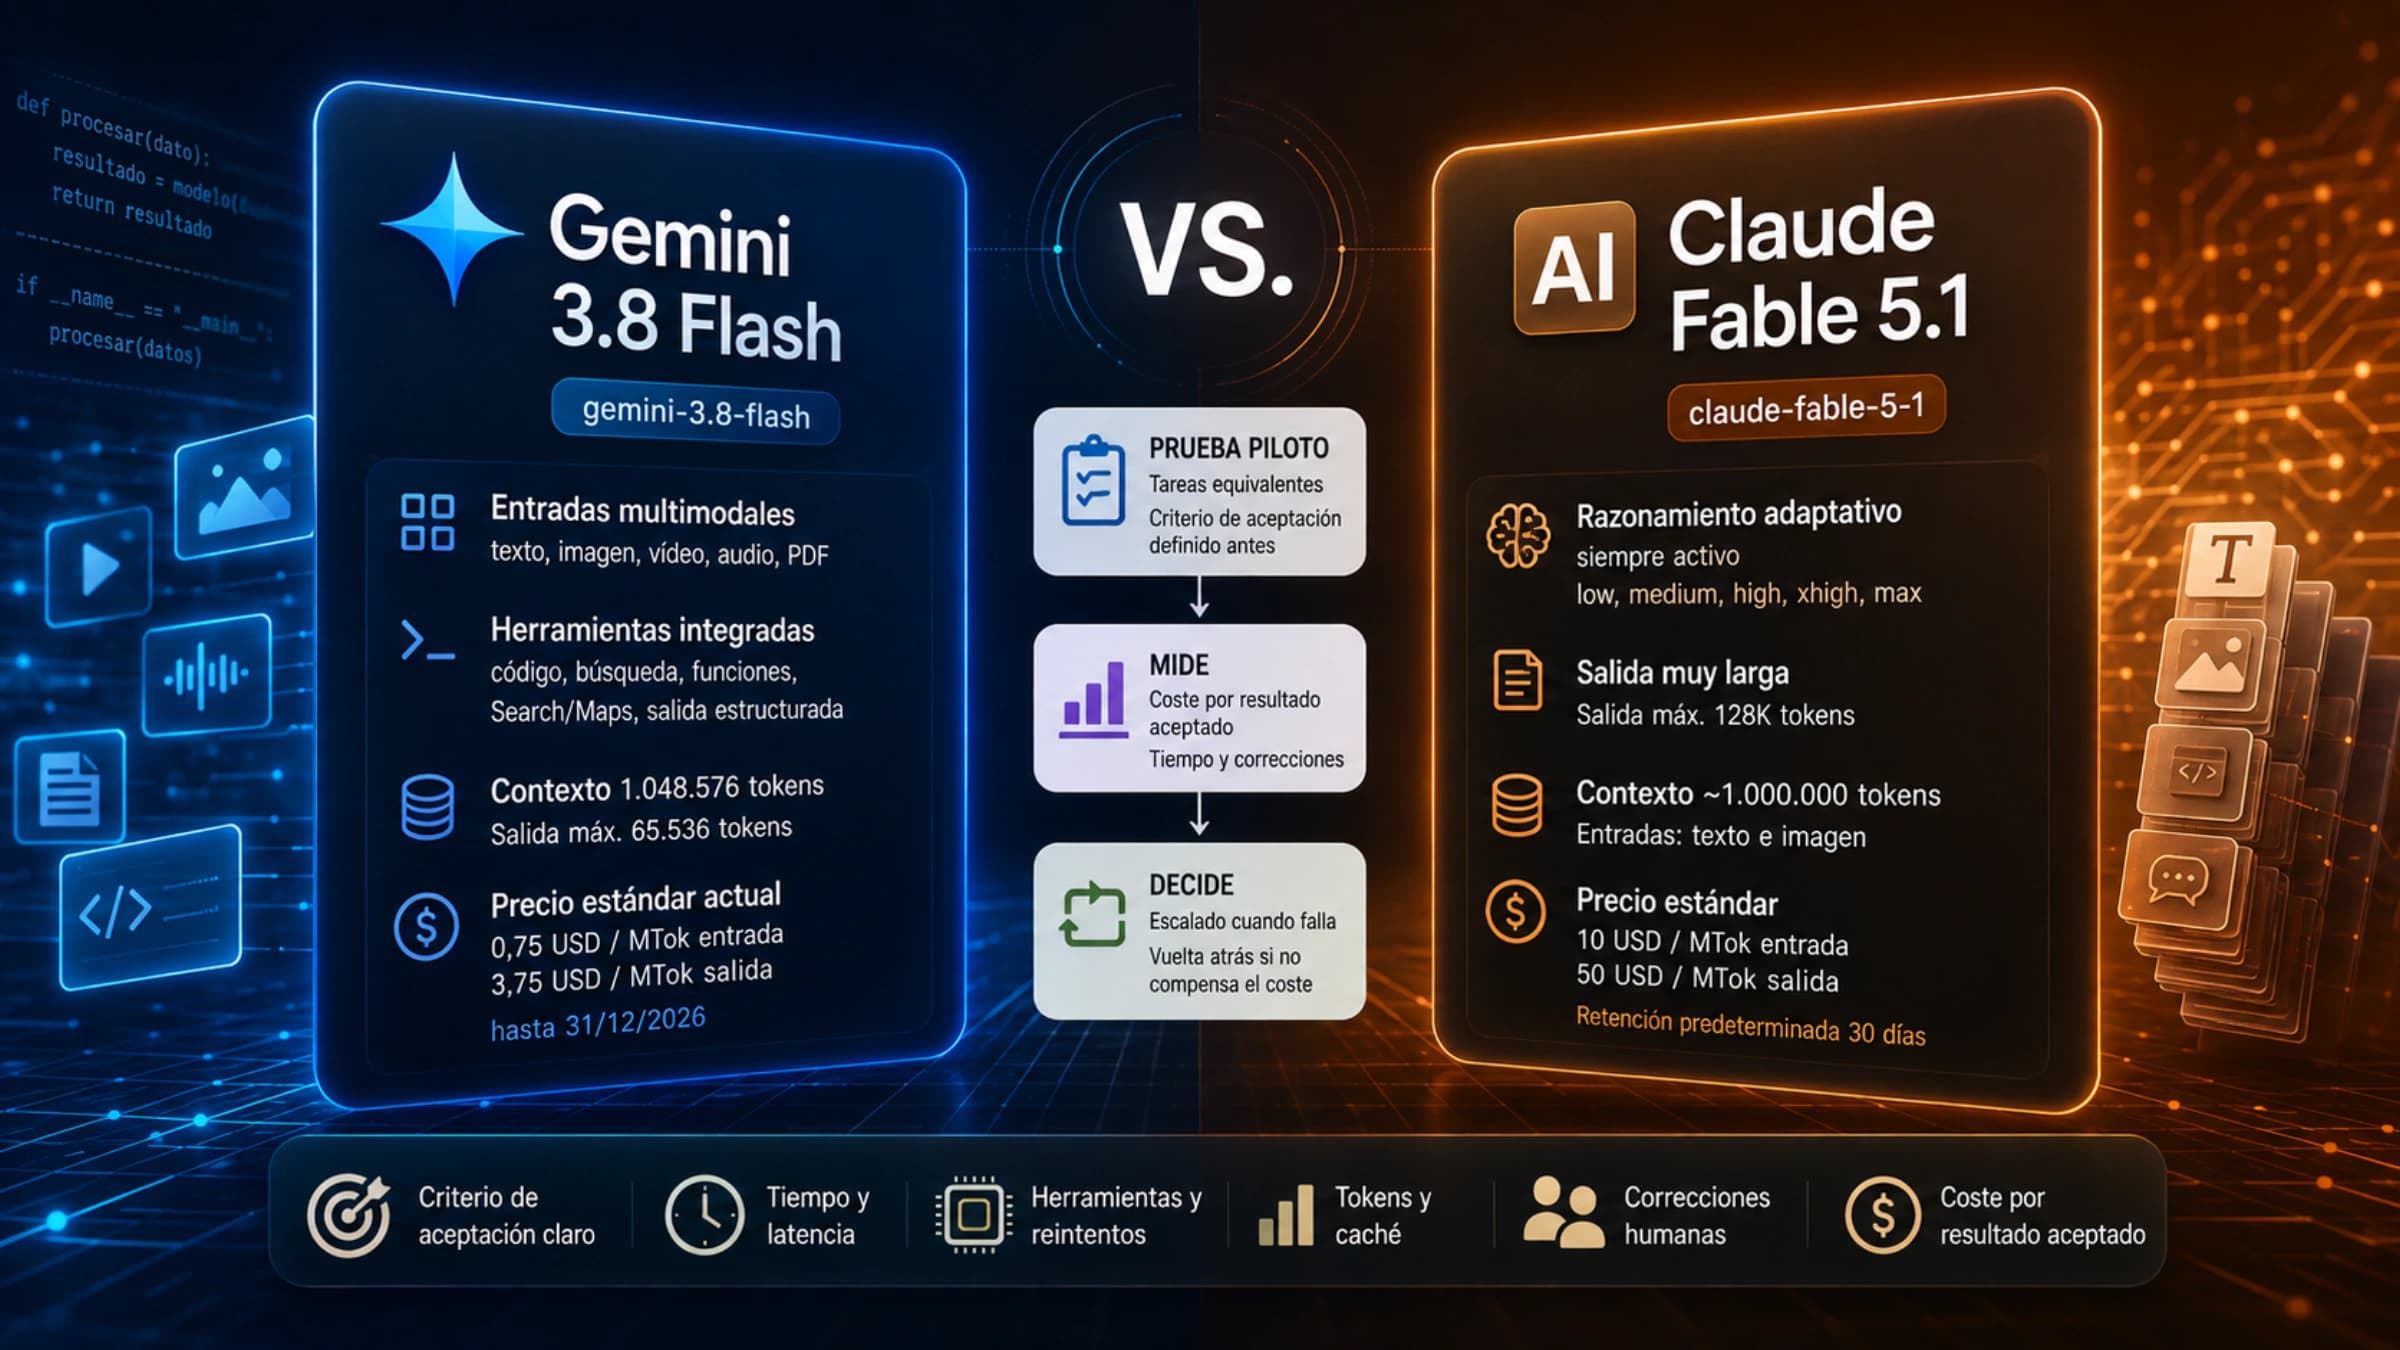
Gemini 3.8 Flash es el primer candidato más económico para muchas cargas; Fable 5.1 merece una prueba cuando el trabajo difícil, la salida larga o el ahorro de correcciones pueden justificar su coste.

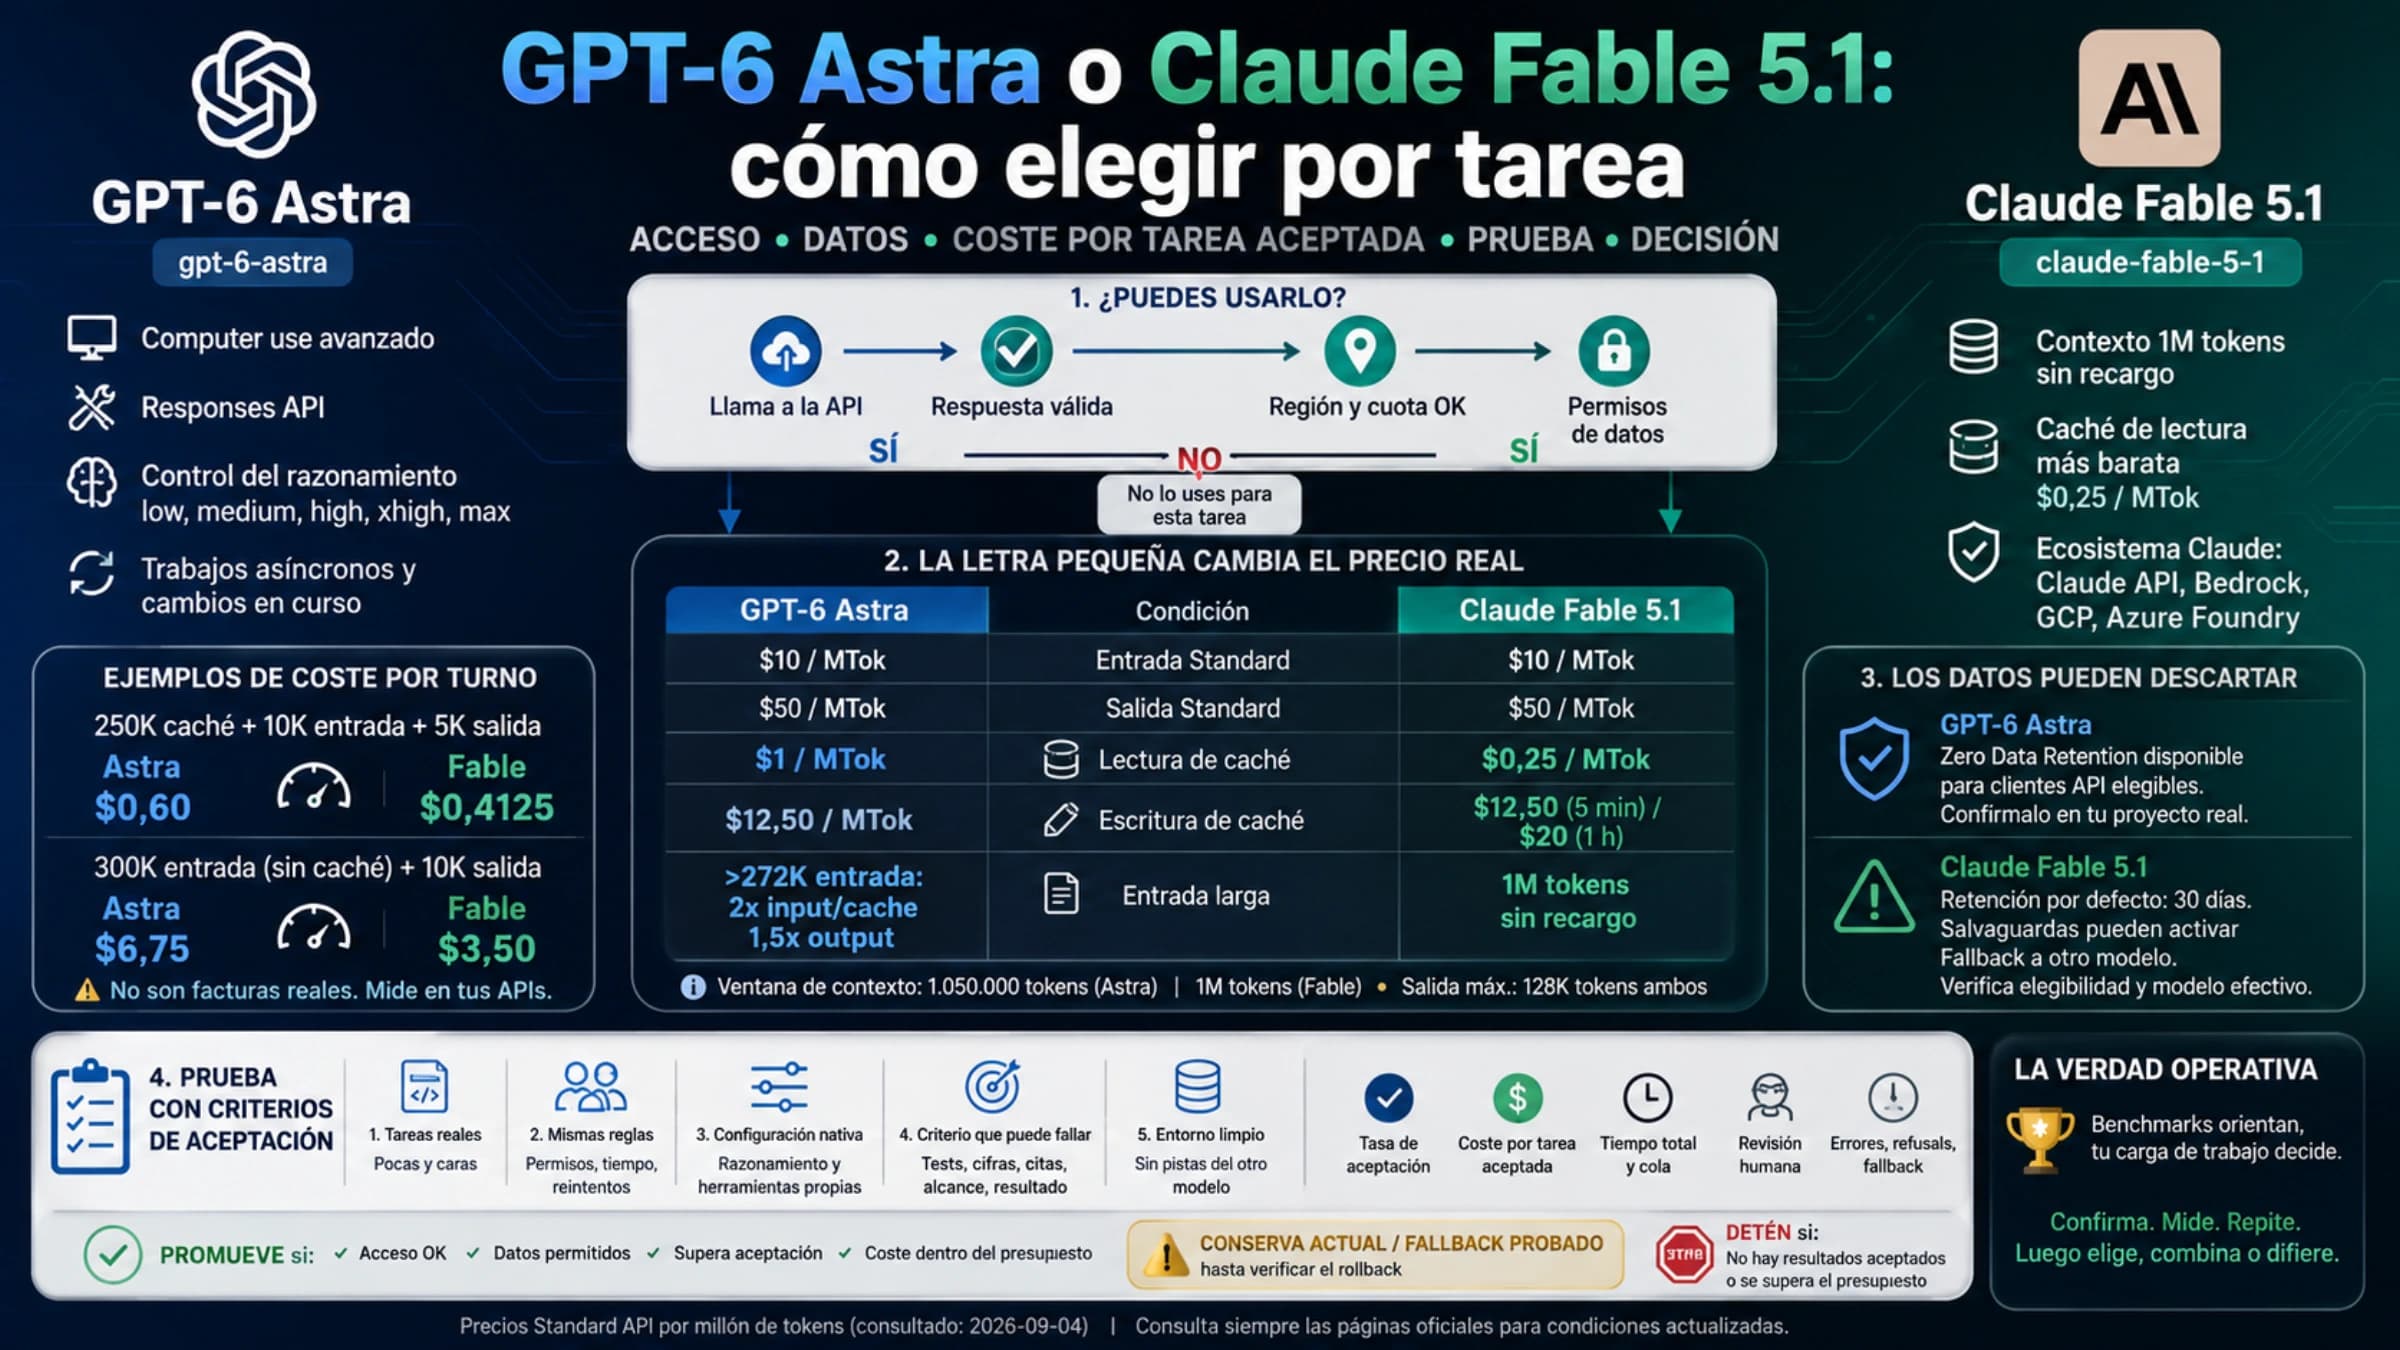
Comparten la tarifa base de entrada y salida, pero la caché, el contexto largo, el acceso y el tratamiento de datos pueden cambiar por completo la opción adecuada.

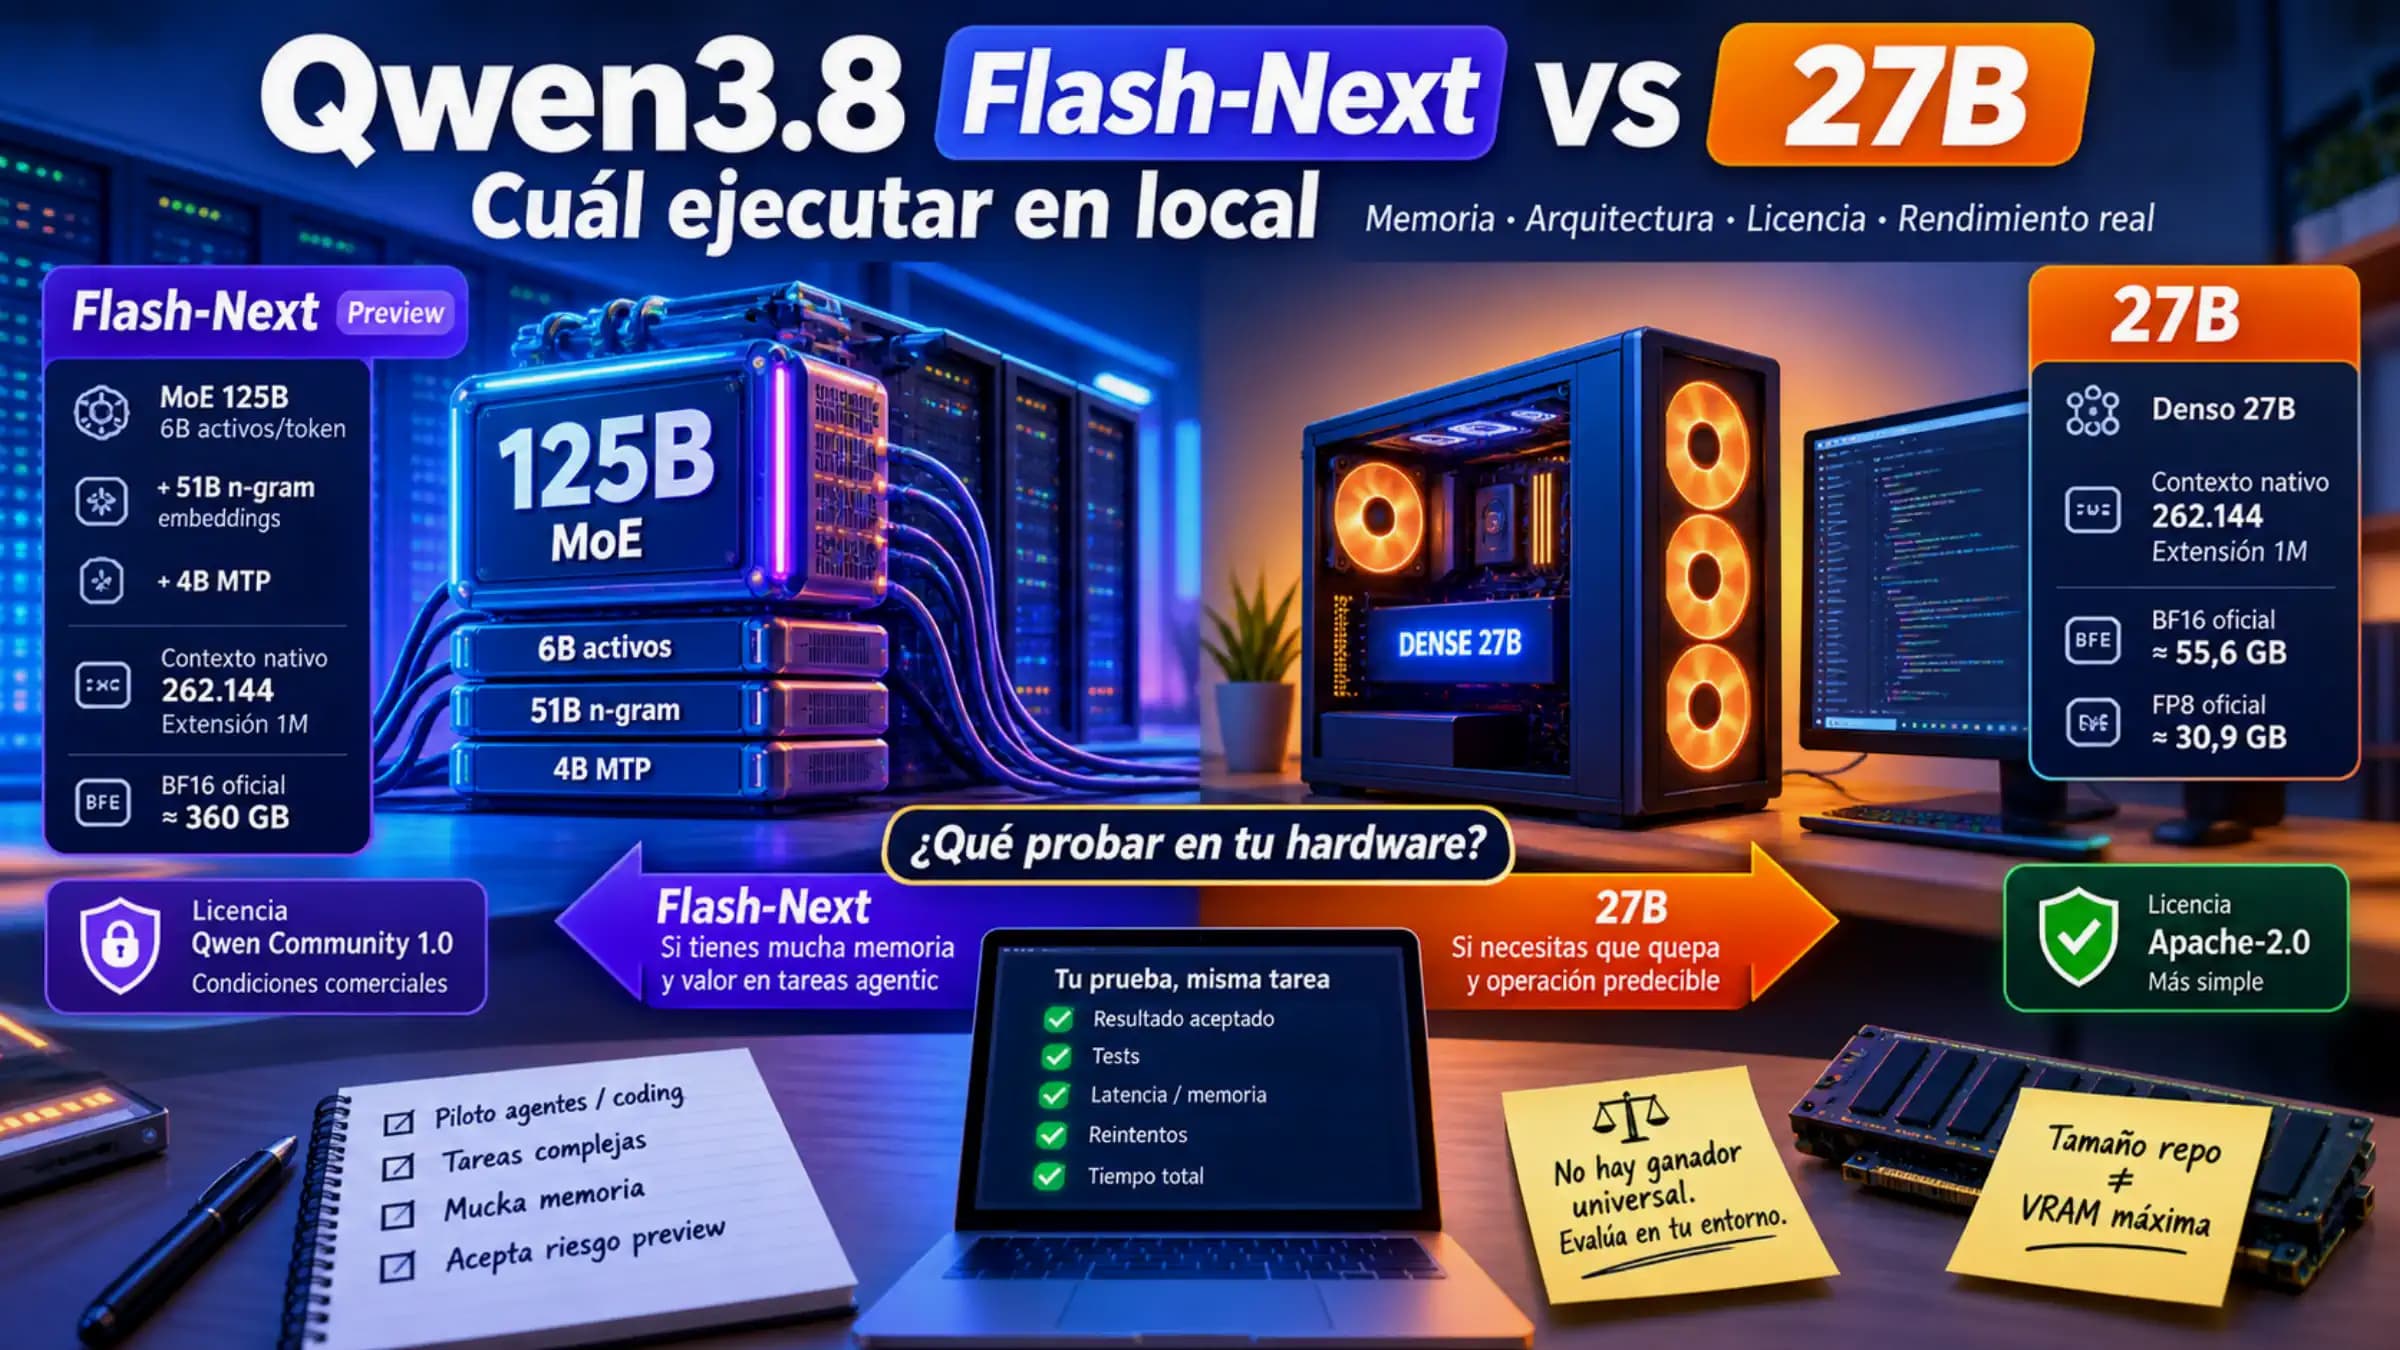
Empieza con 27B si necesitas que el modelo quepa y sea fácil de operar. Prueba Flash-Next cuando dispongas de mucha más memoria y las tareas de agentes justifiquen su consumo de memoria.

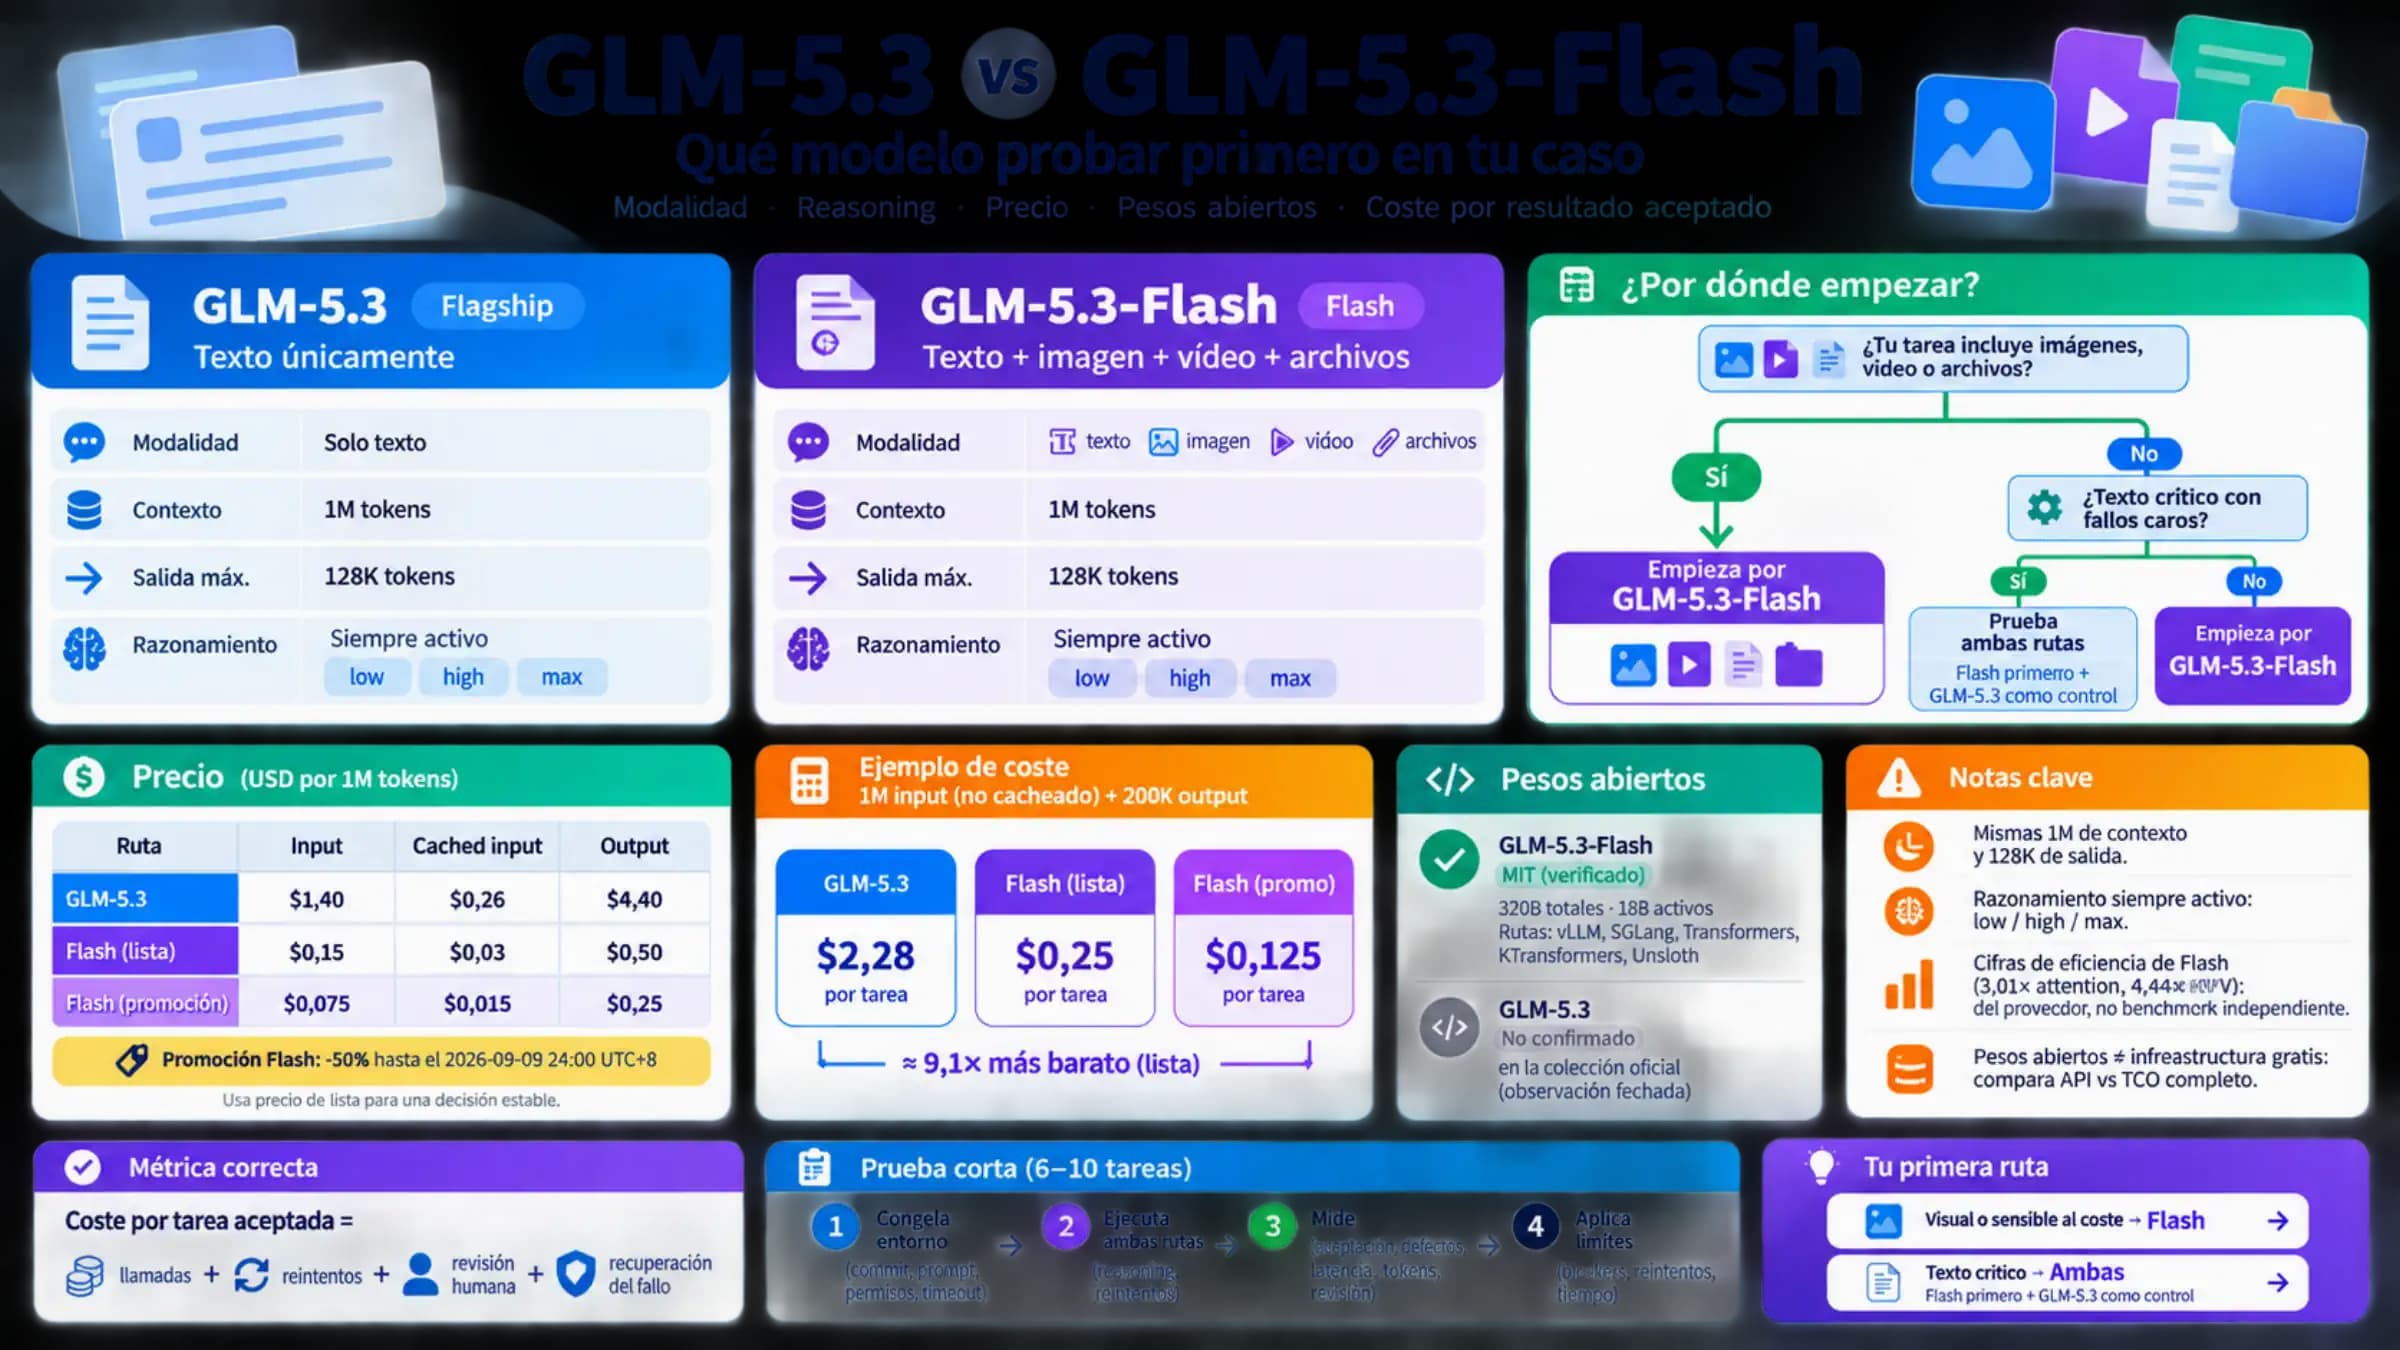
Prueba Flash primero para entradas visuales o trabajo sensible al coste. Conserva GLM-5.3 como referencia de calidad en ingeniería de texto con fallos caros.

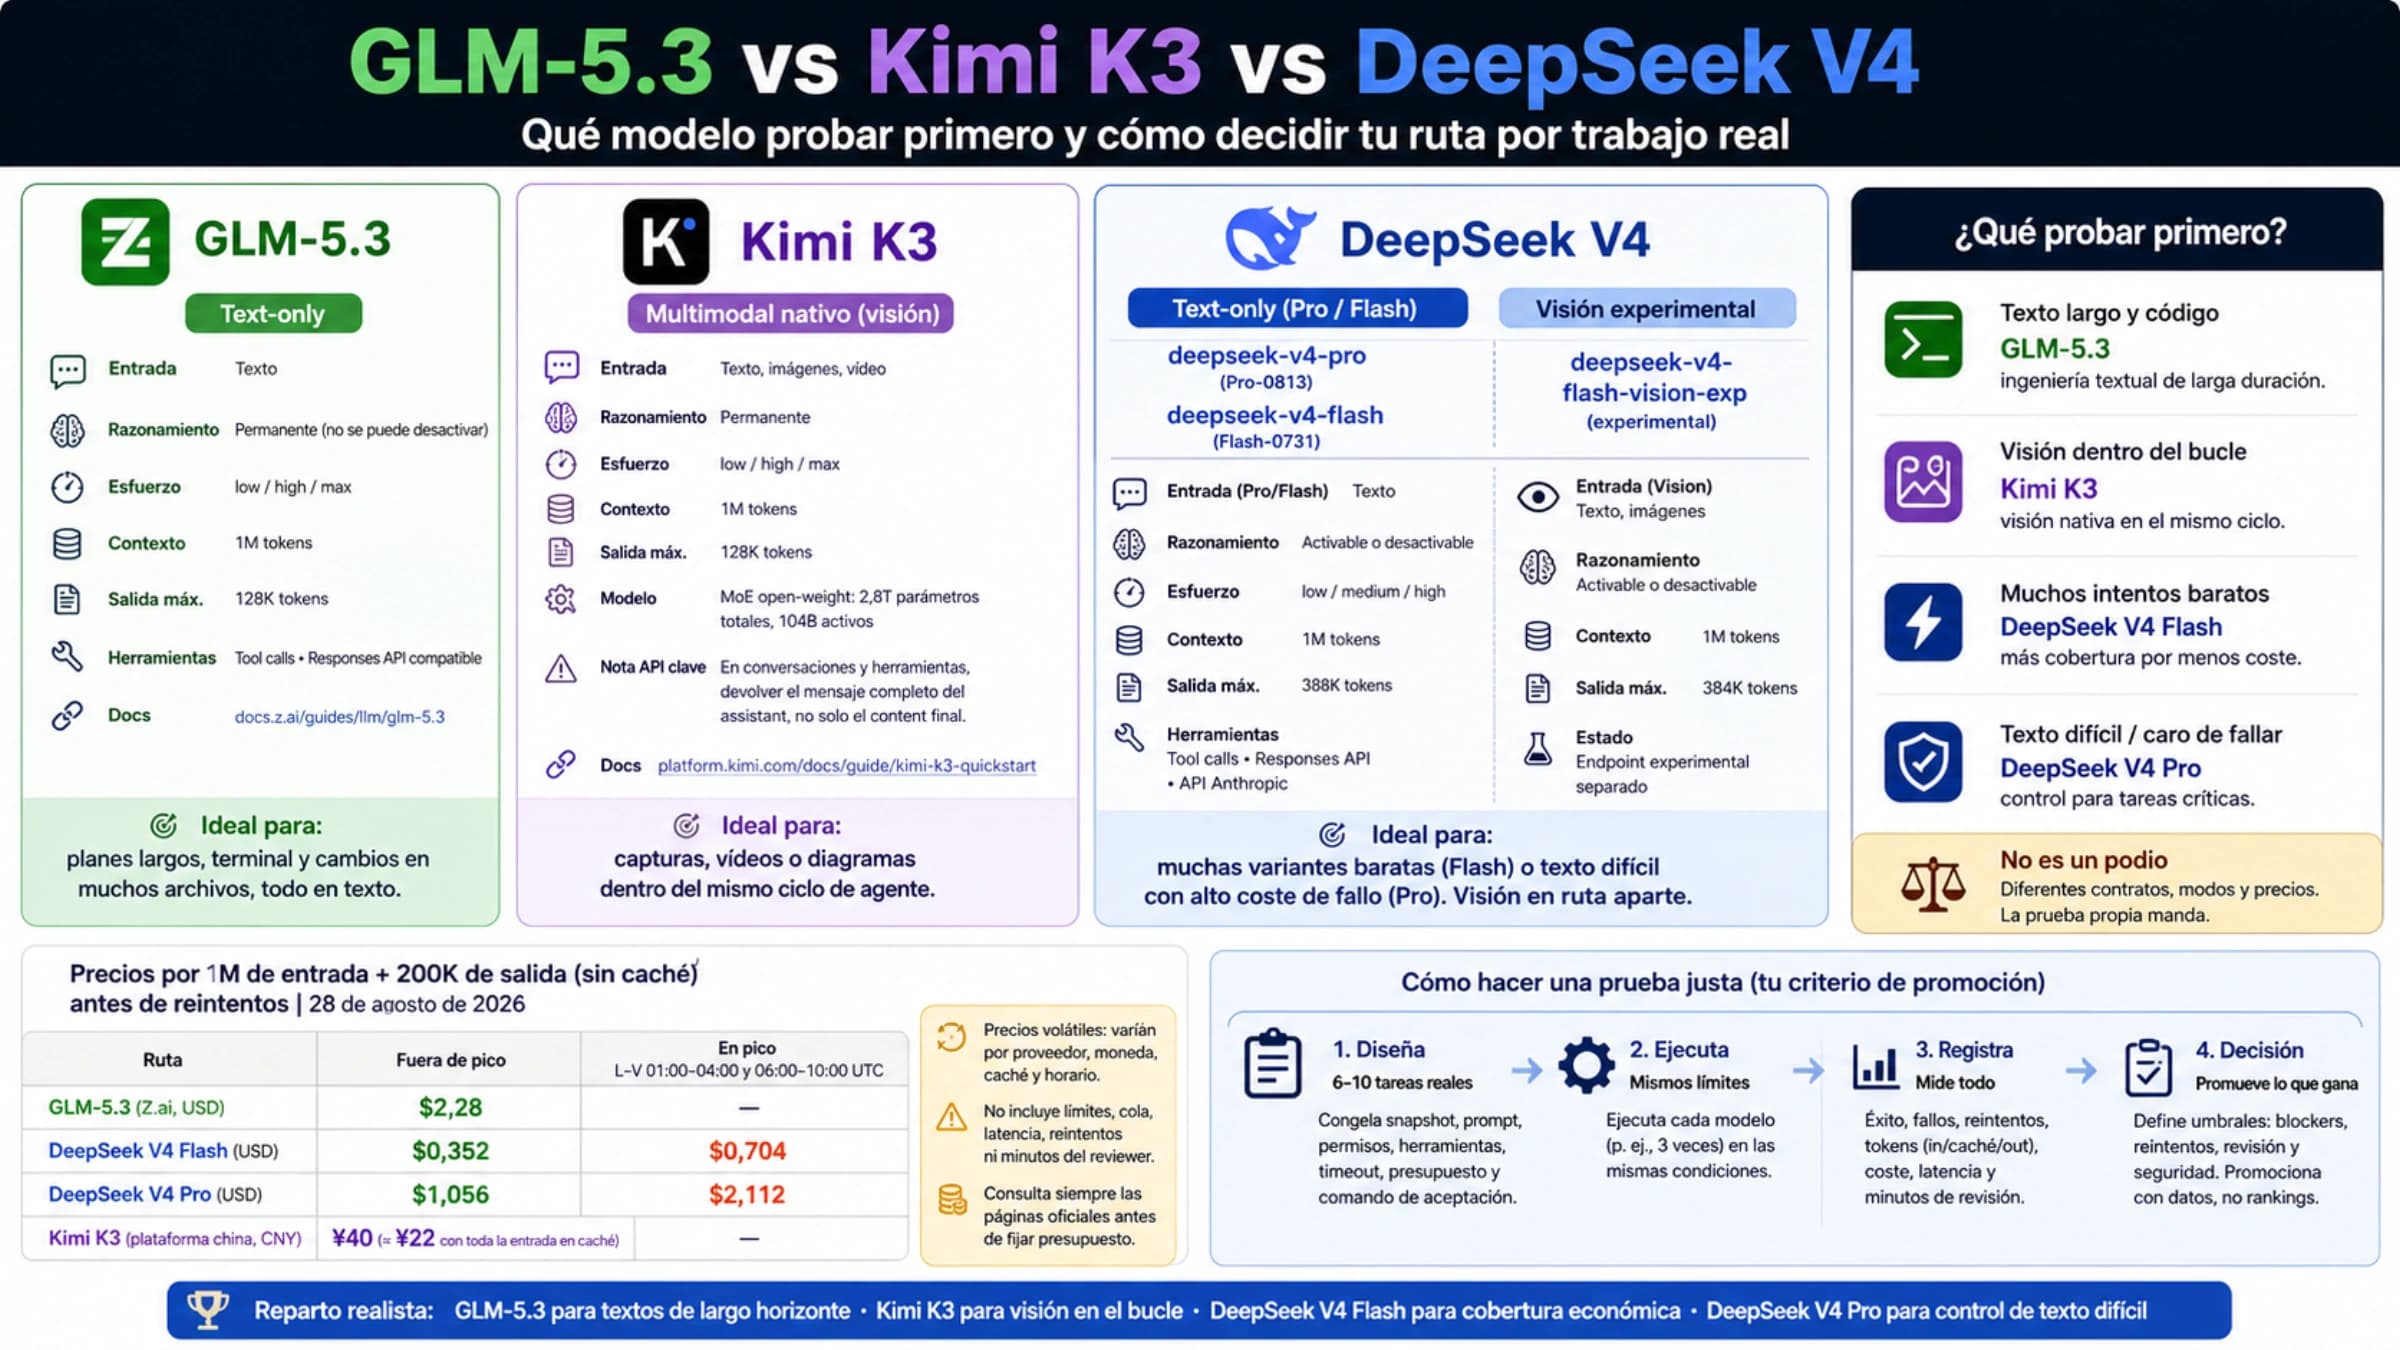
Prueba GLM-5.3 para ingeniería textual de larga duración, Kimi K3 cuando la visión deba estar dentro del bucle y DeepSeek V4 Flash para comprar más intentos baratos; usa Pro como control de tareas difíciles.

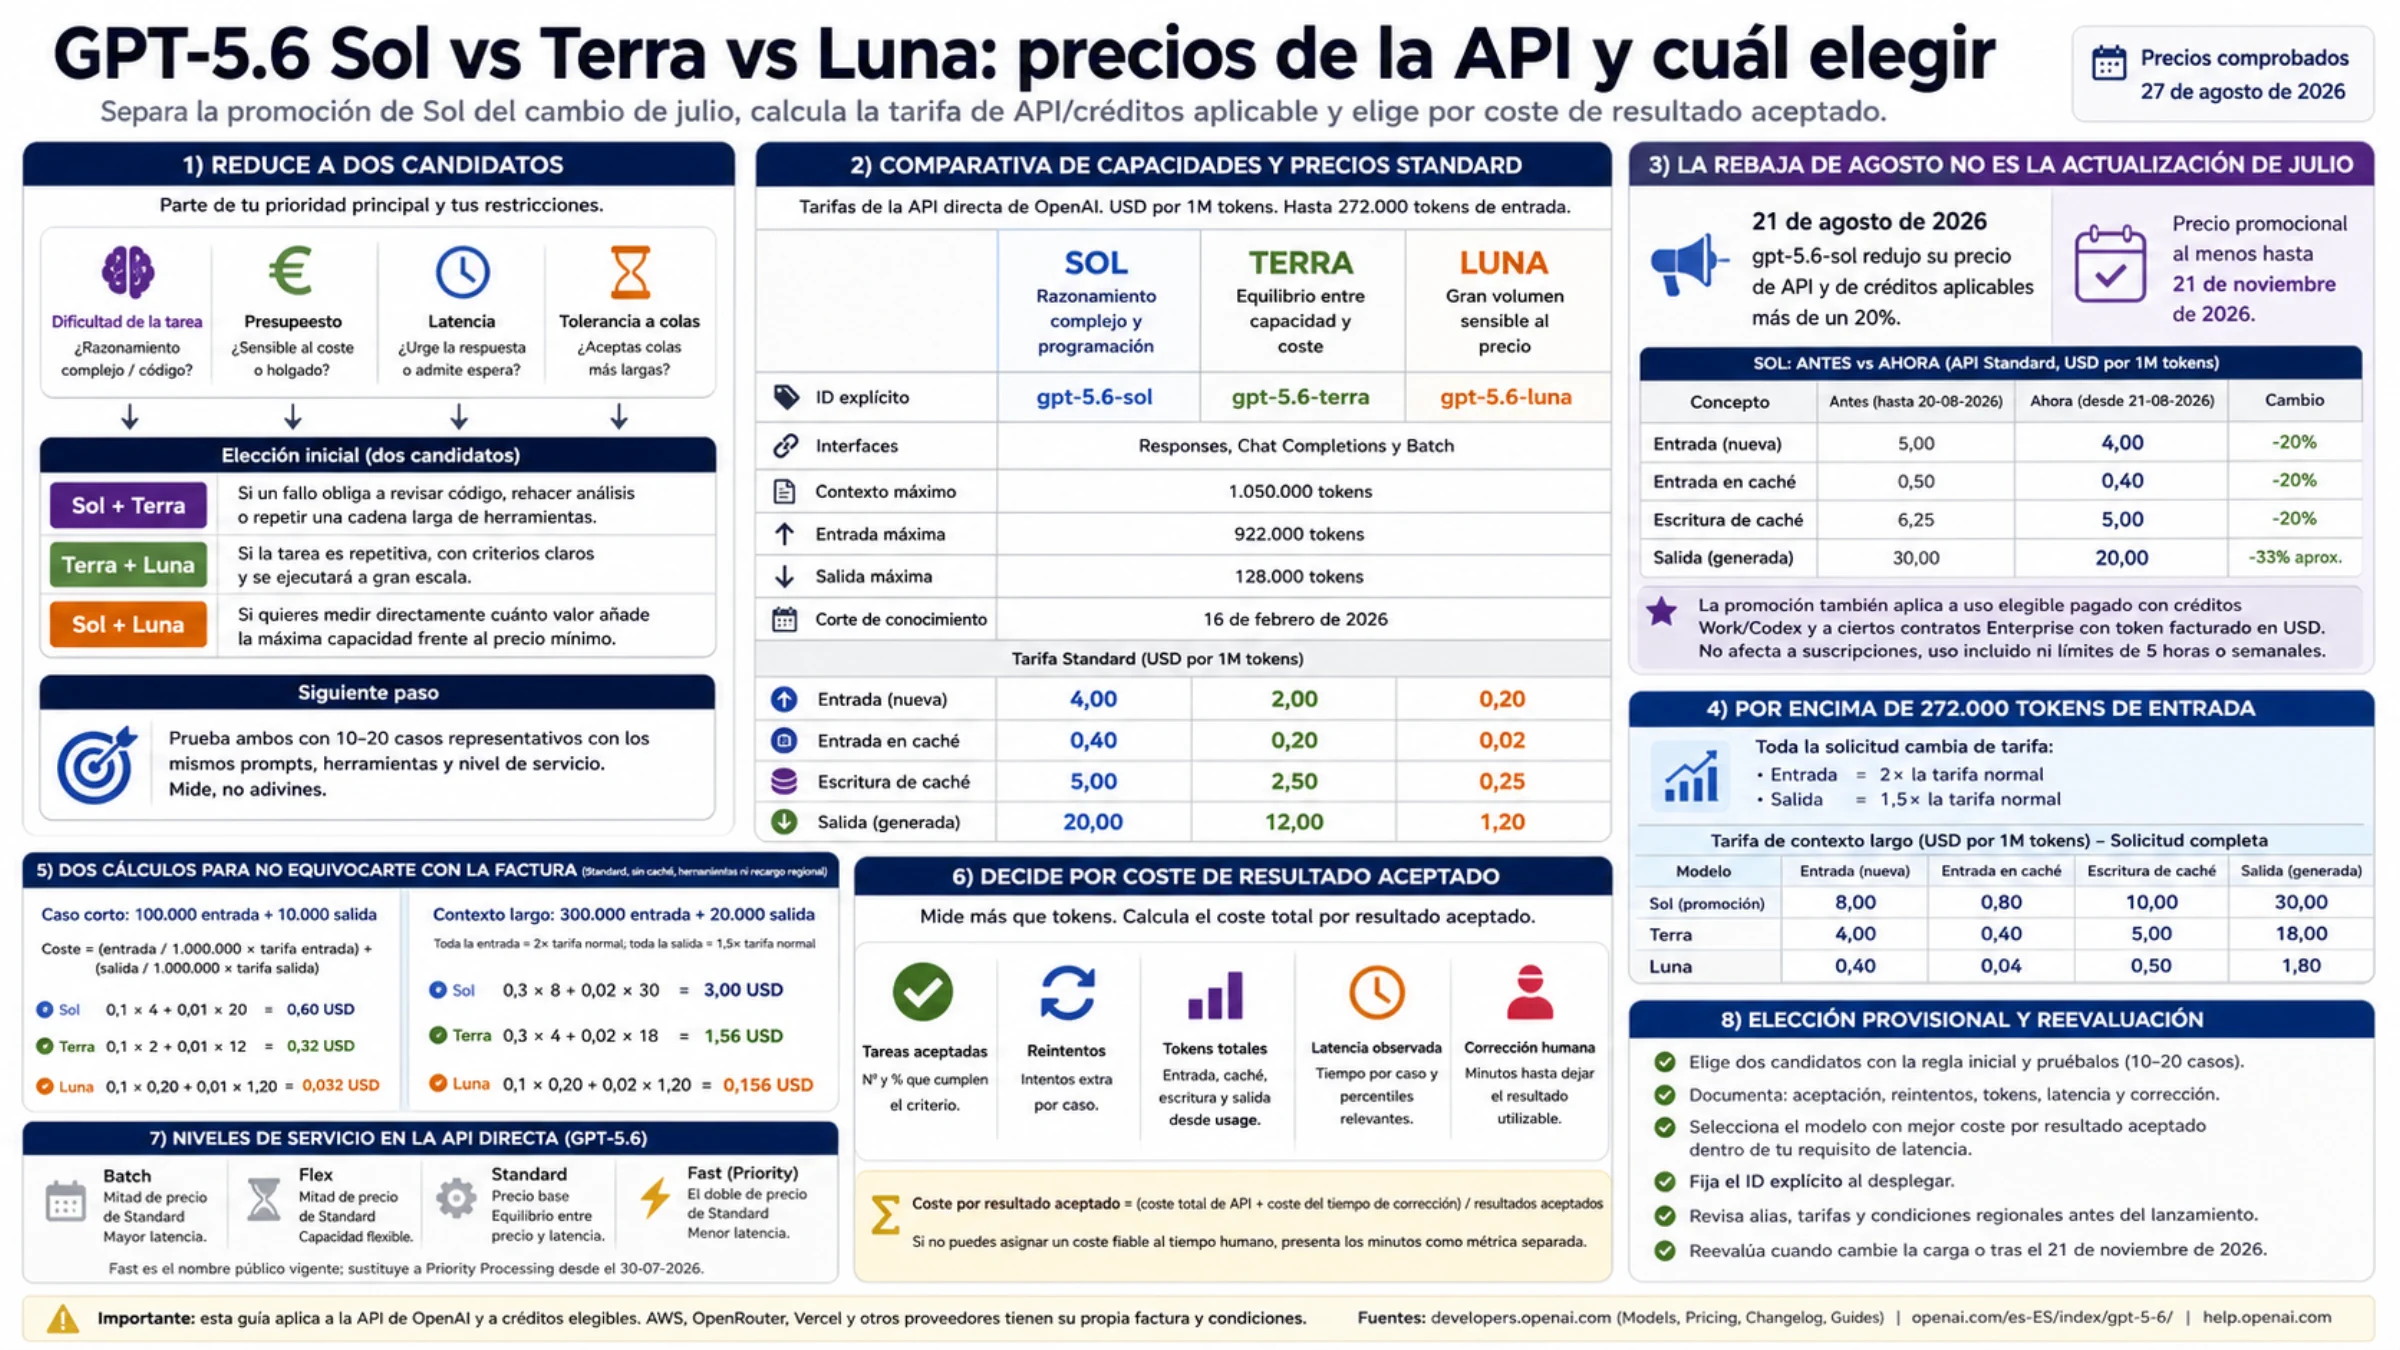
Sol tiene una tarifa promocional temporal. Separa API, créditos y límites incluidos, calcula la petición y compara los tres niveles con tus tareas.

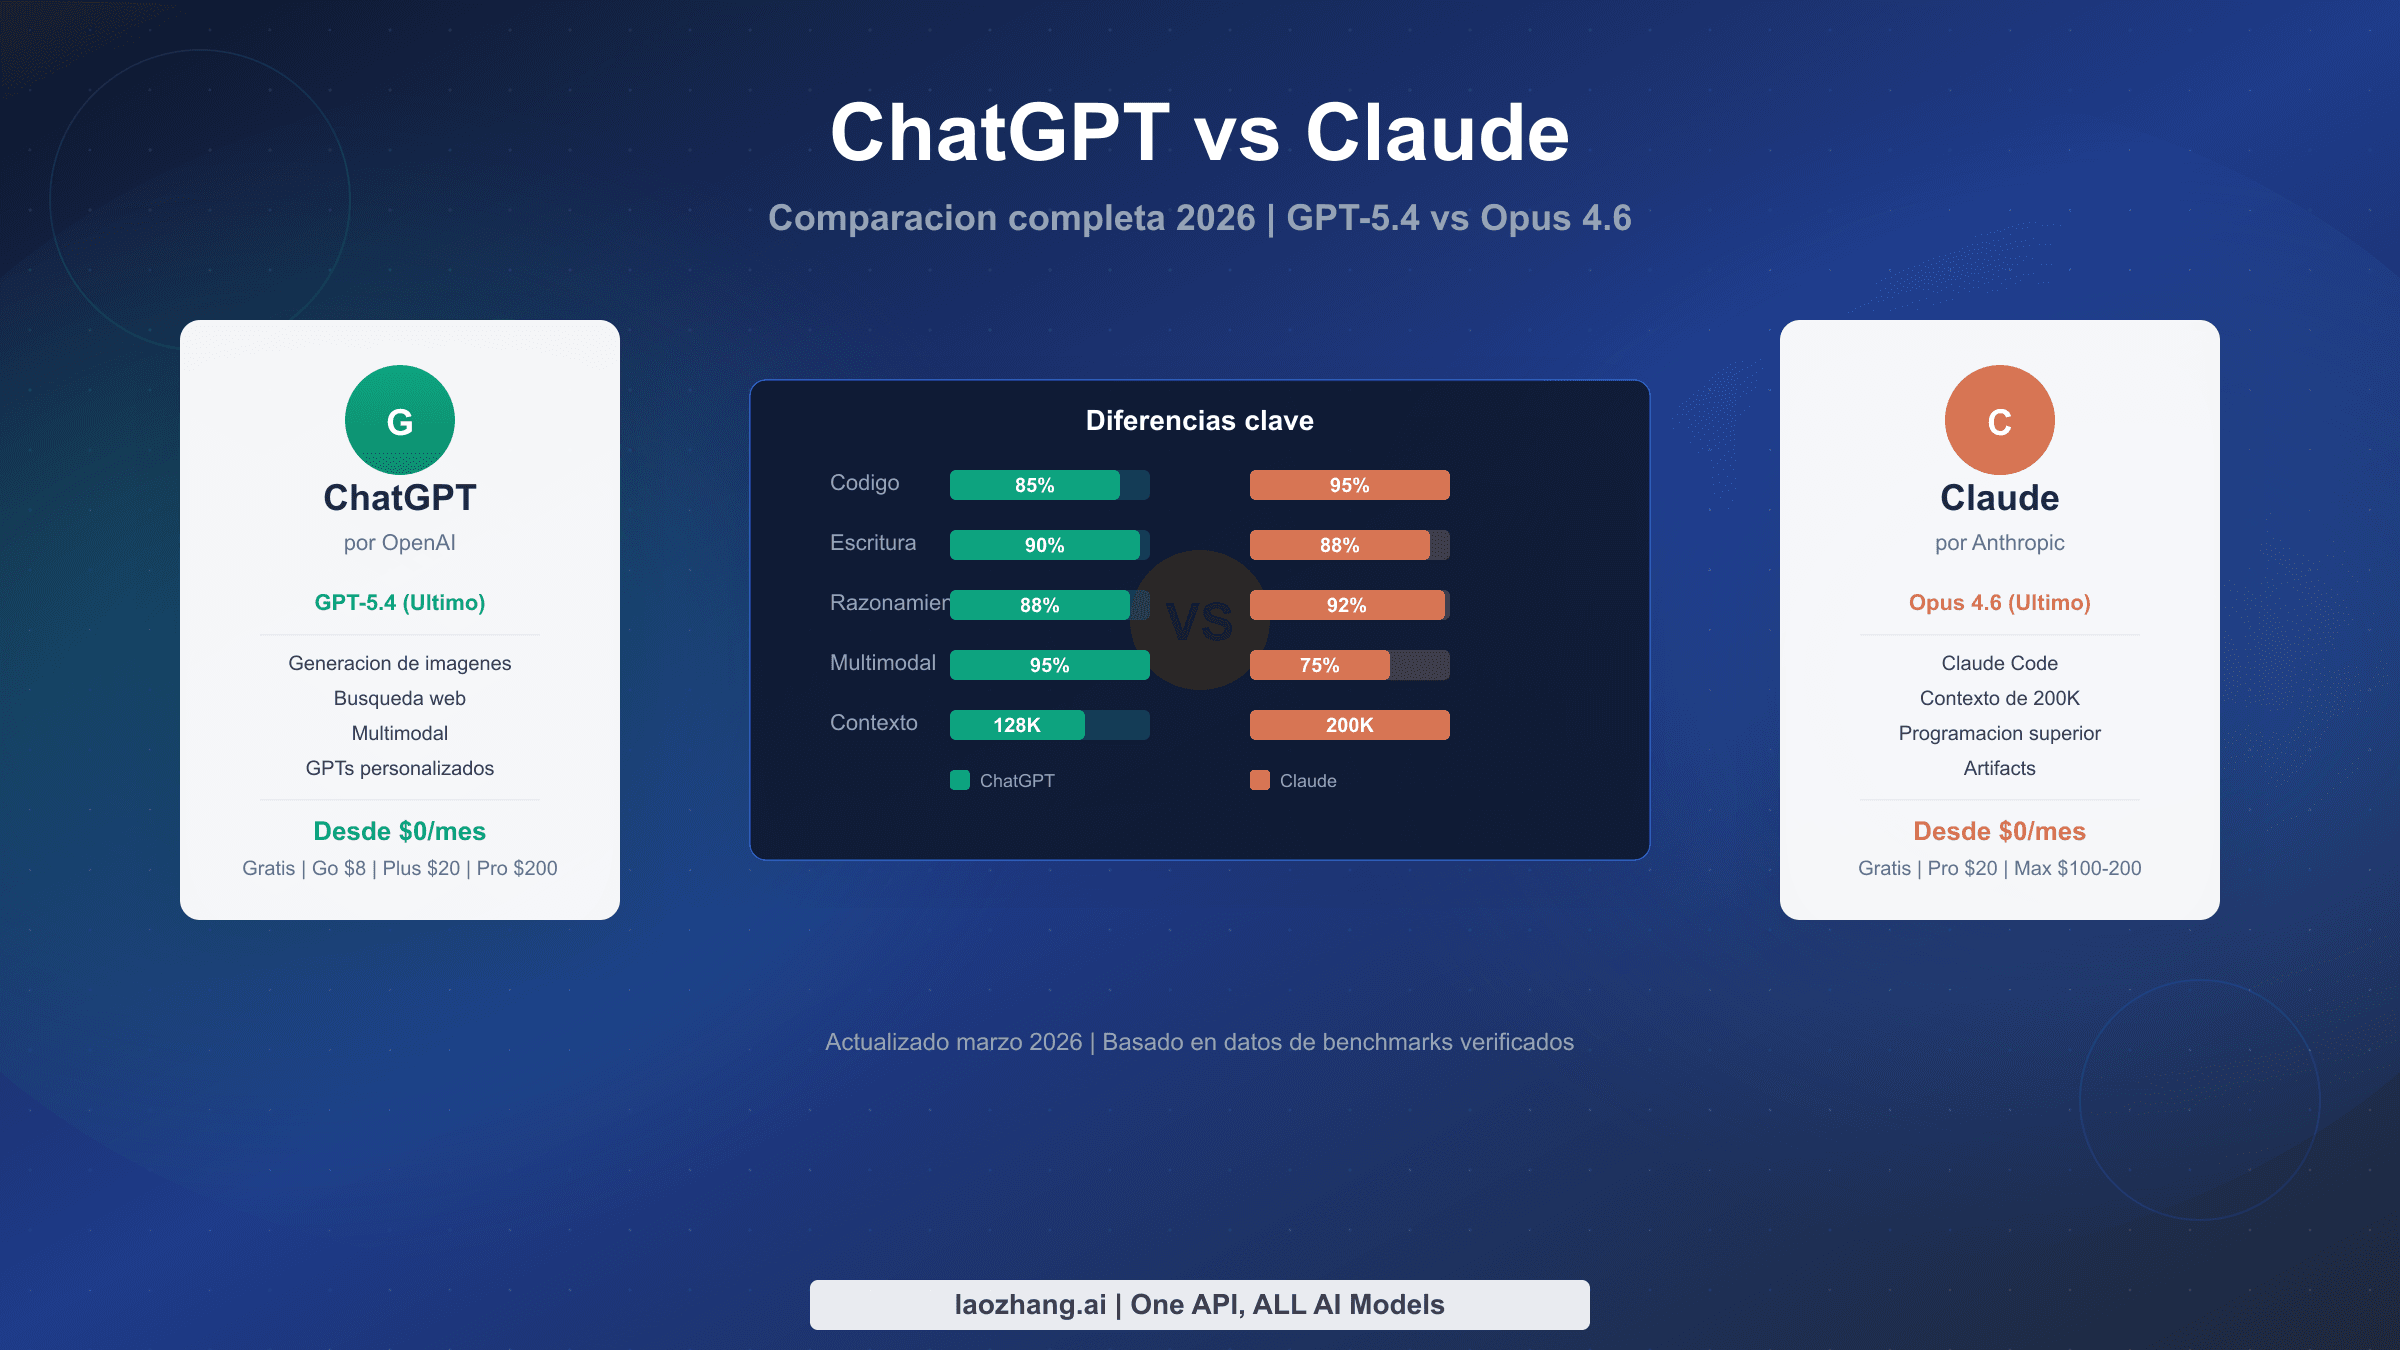
En marzo de 2026, ChatGPT (GPT-5.4) y Claude (Opus 4.6) representan los dos asistentes de IA lideres con fortalezas distintas. ChatGPT destaca en tareas multimodales, generacion de imagenes y busqueda web, mientras que Claude lidera en precision de codigo, analisis de documentos extensos y herramientas para desarrolladores. Ambos ofrecen planes gratuitos y suscripciones de $20/mes. Esta guia los compara en programacion, escritura, investigacion, precios y capacidades de API con datos de benchmarks verificados.

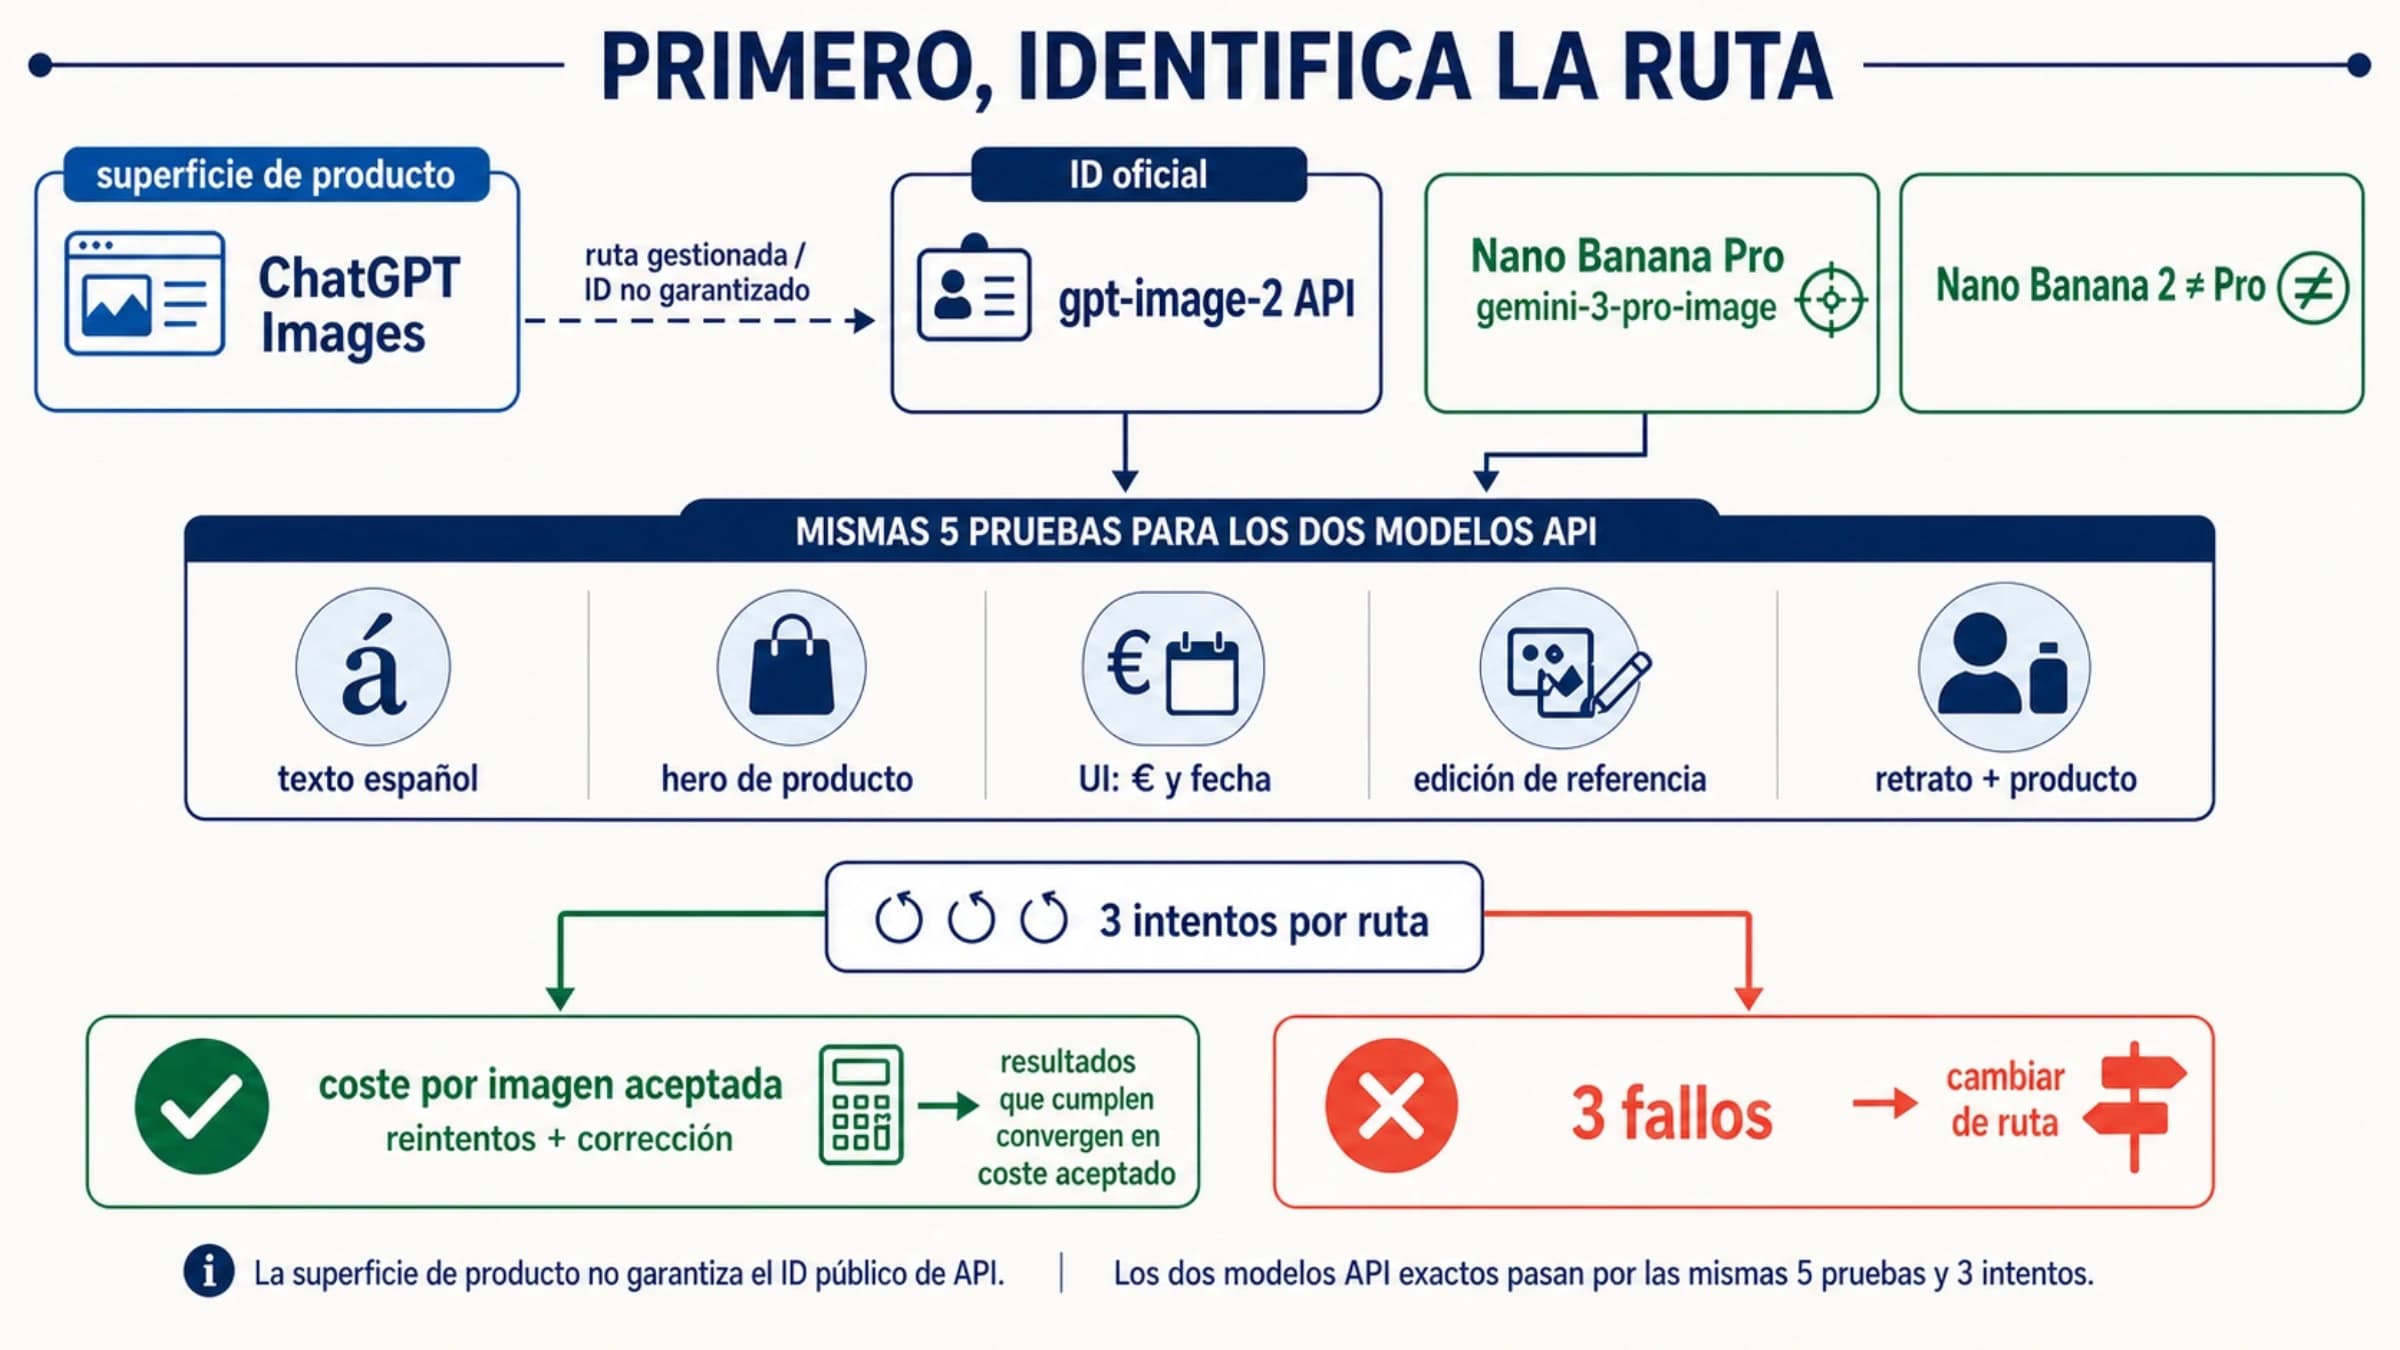
No hay un ganador de calidad para todos los trabajos. Prueba GPT Image 2 si necesitas la ruta directa de OpenAI, tamaños flexibles o edición; prueba Nano Banana Pro para diseño complejo, visualización factual, varias referencias y finales 4K. Decide después de tres intentos por tarea.

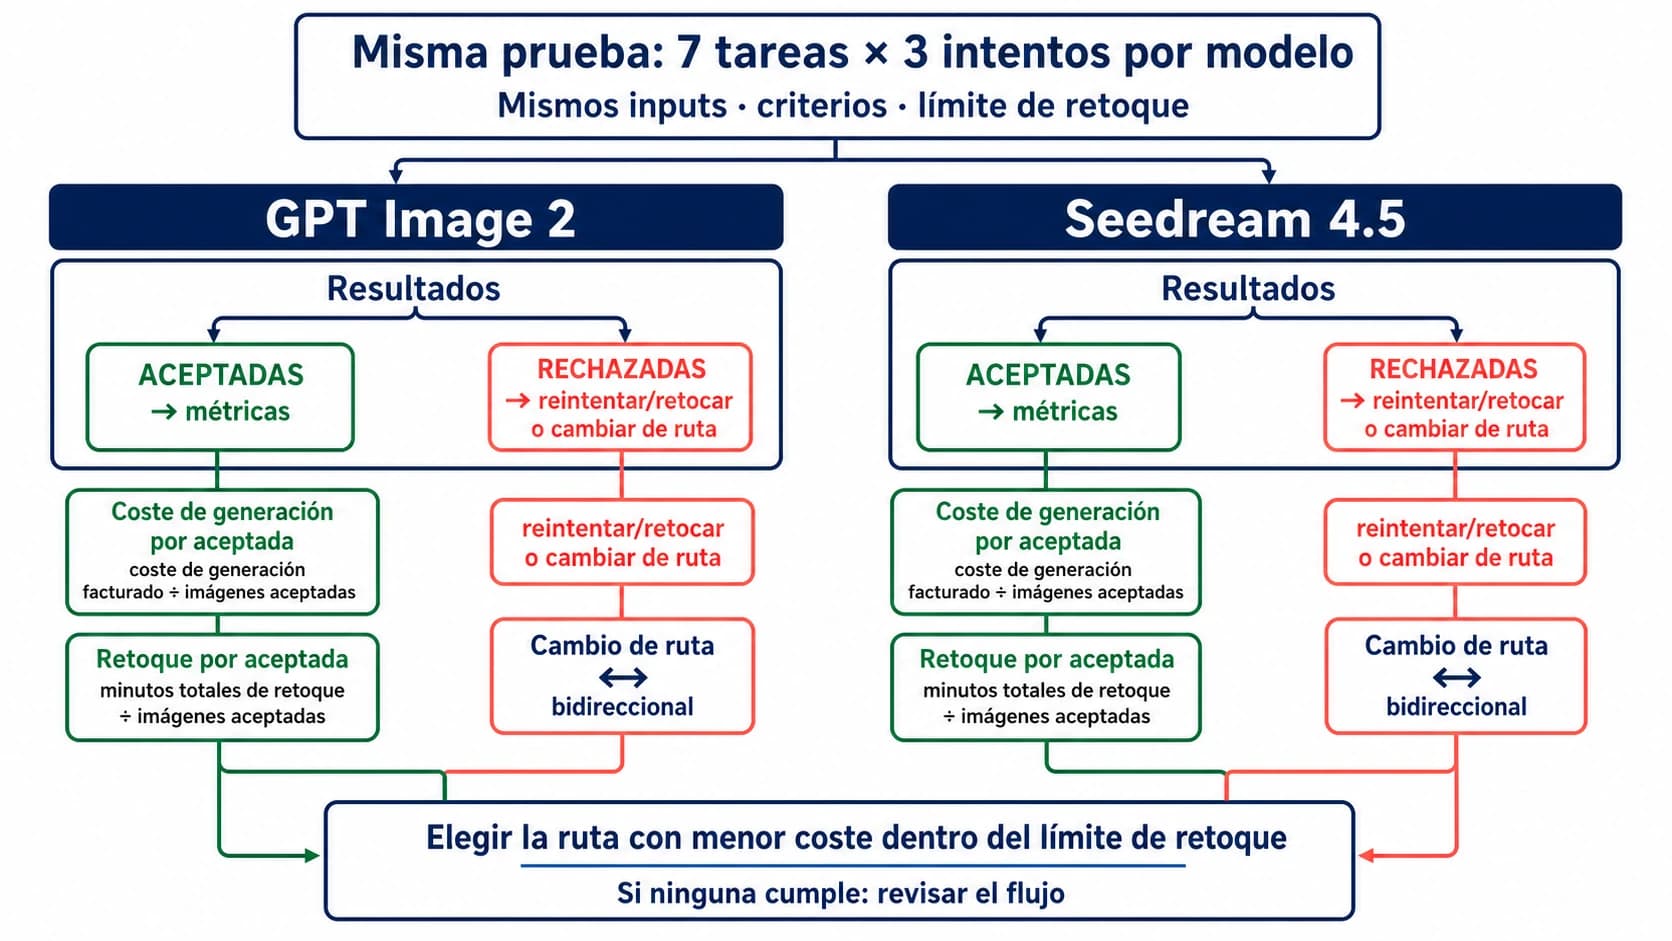
Prueba primero GPT Image 2 si necesitas control nativo de OpenAI; empieza por Seedream 4.5 si mandan las referencias múltiples. Decide después con 21 resultados por modelo.

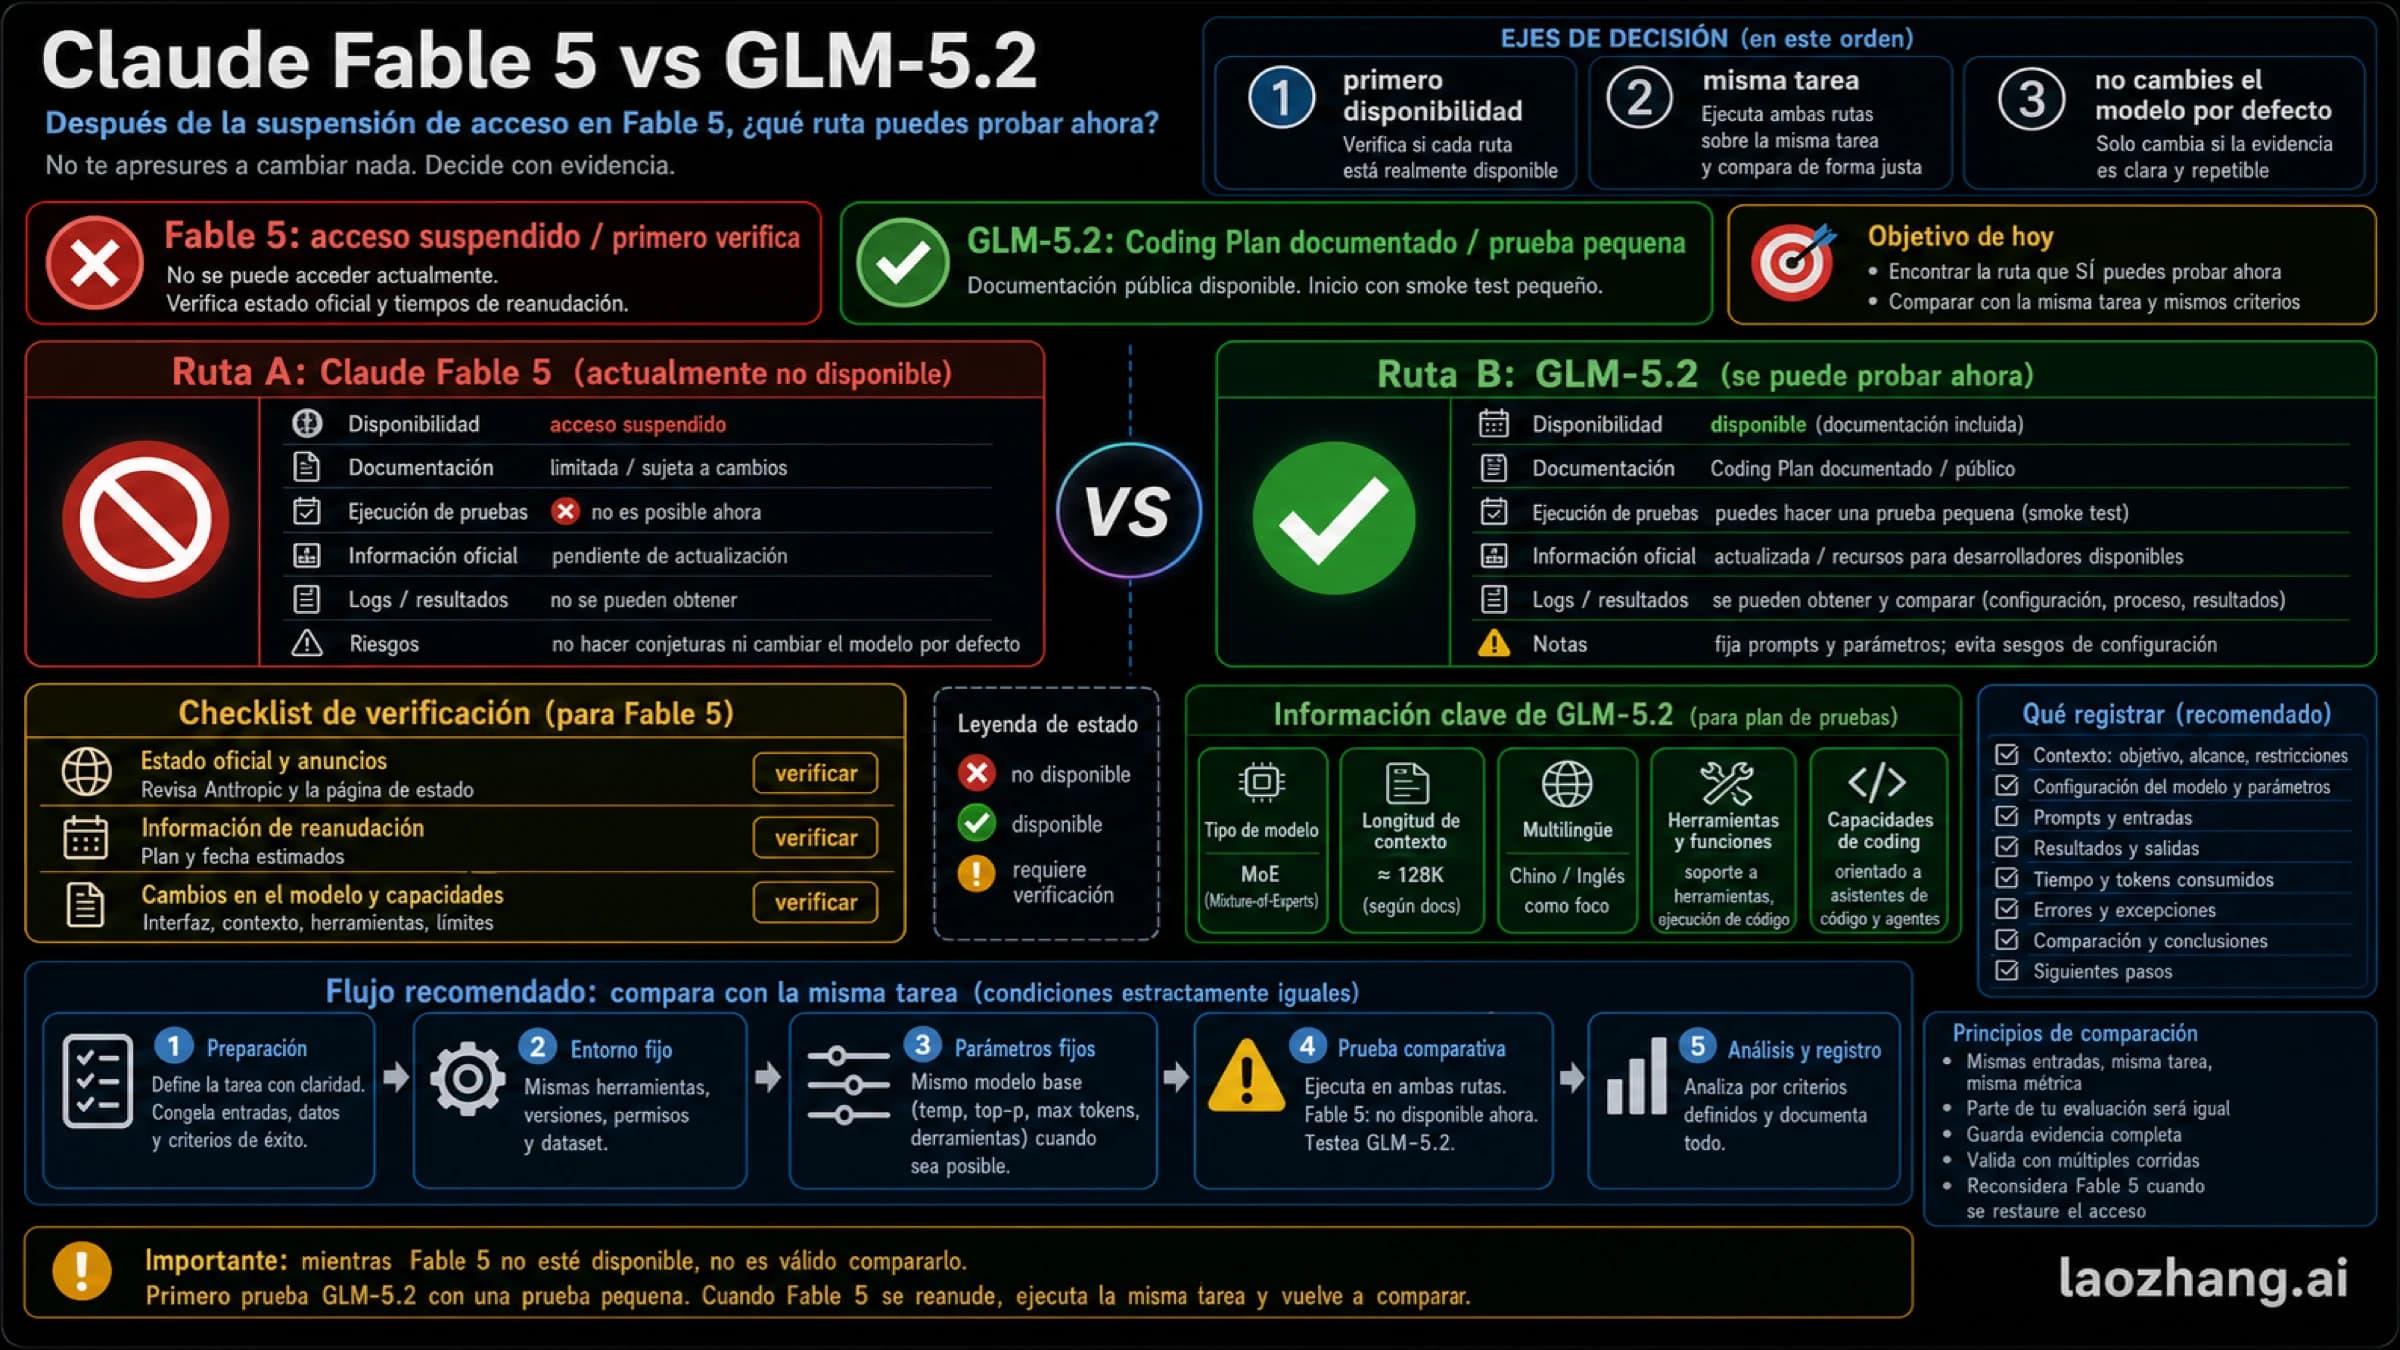
Fable 5 es una rama de espera y verificación; GLM-5.2 es una ruta documentada en Z.AI Coding Plan que se puede probar con una tarea pequena. No cambies el modelo por defecto sin evidencia de la misma tarea.

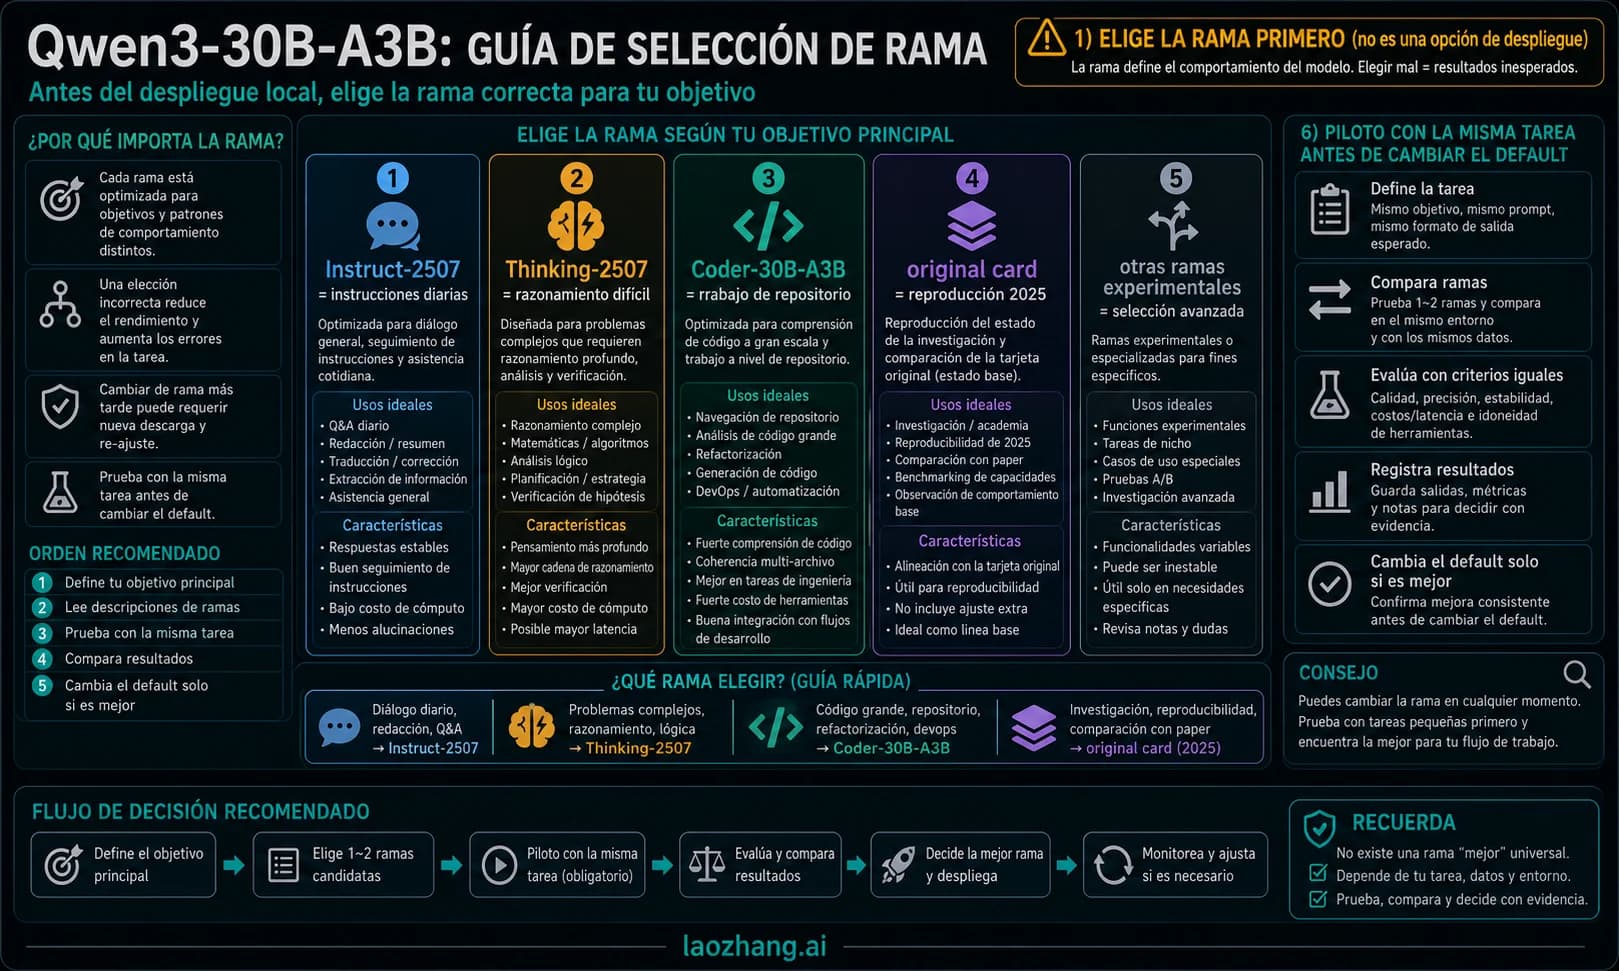
Elige primero la rama Qwen3-30B-A3B: Instruct-2507 para instrucciones diarias, Thinking-2507 para razonamiento, Coder para coding de repositorio y original card solo para reproducir abril de 2025.

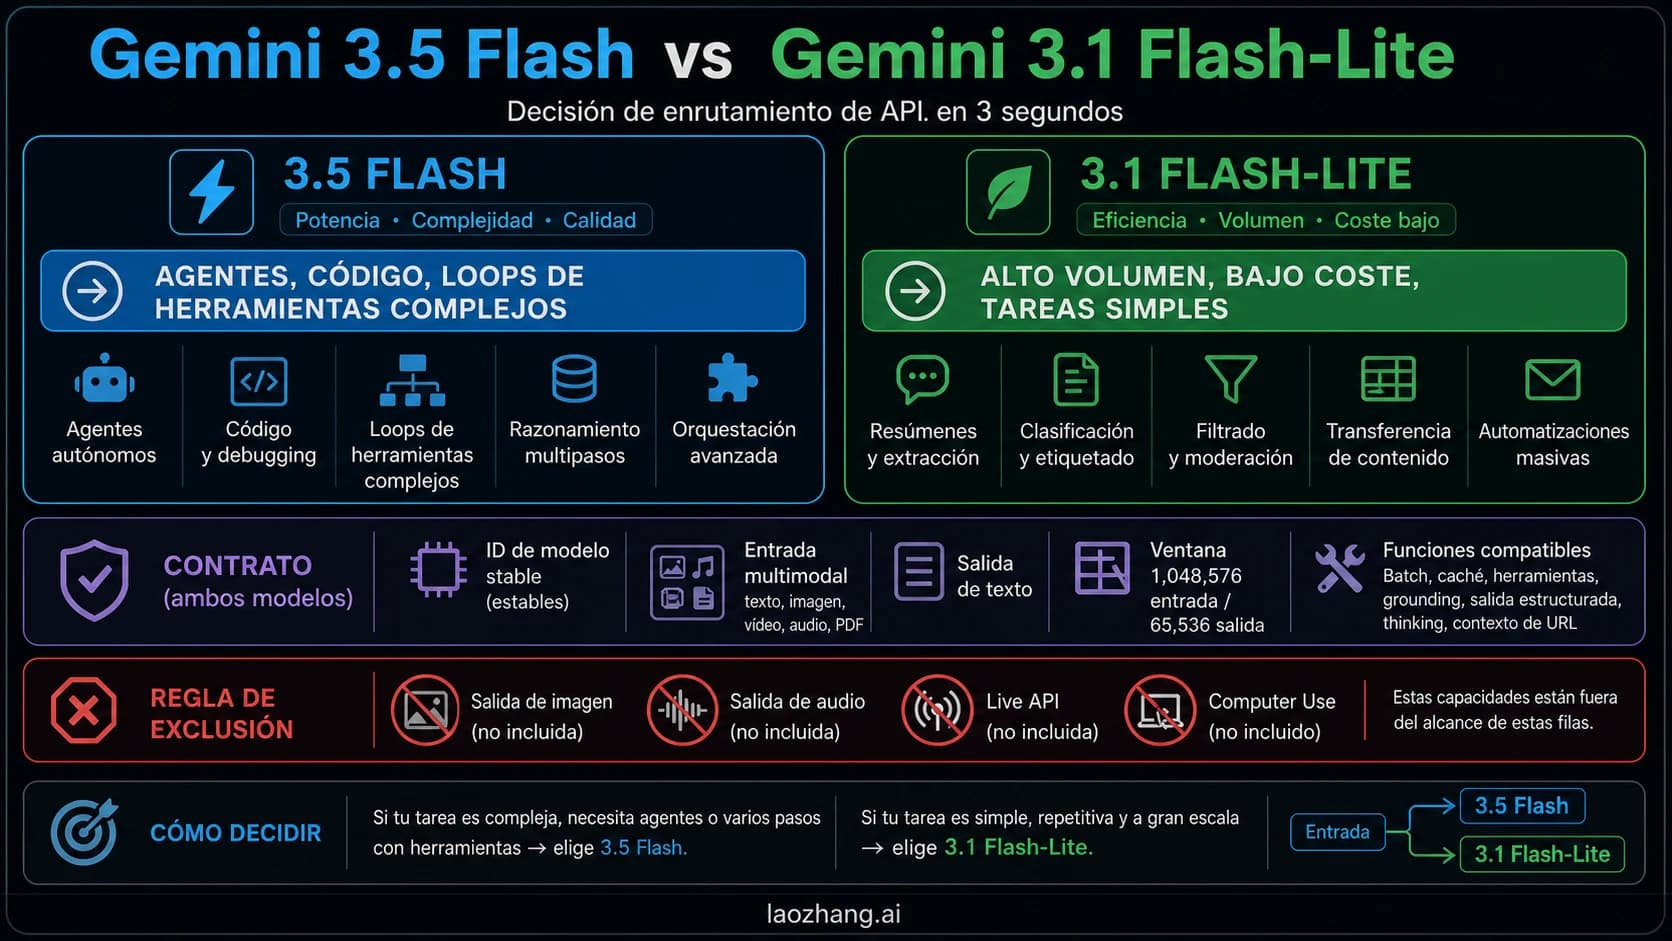
Prueba Gemini 3.5 Flash cuando la calidad en agentes, código y tool loops reduzca reintentos. Mantén Gemini 3.1 Flash-Lite para tareas simples, masivas y sensibles al coste.

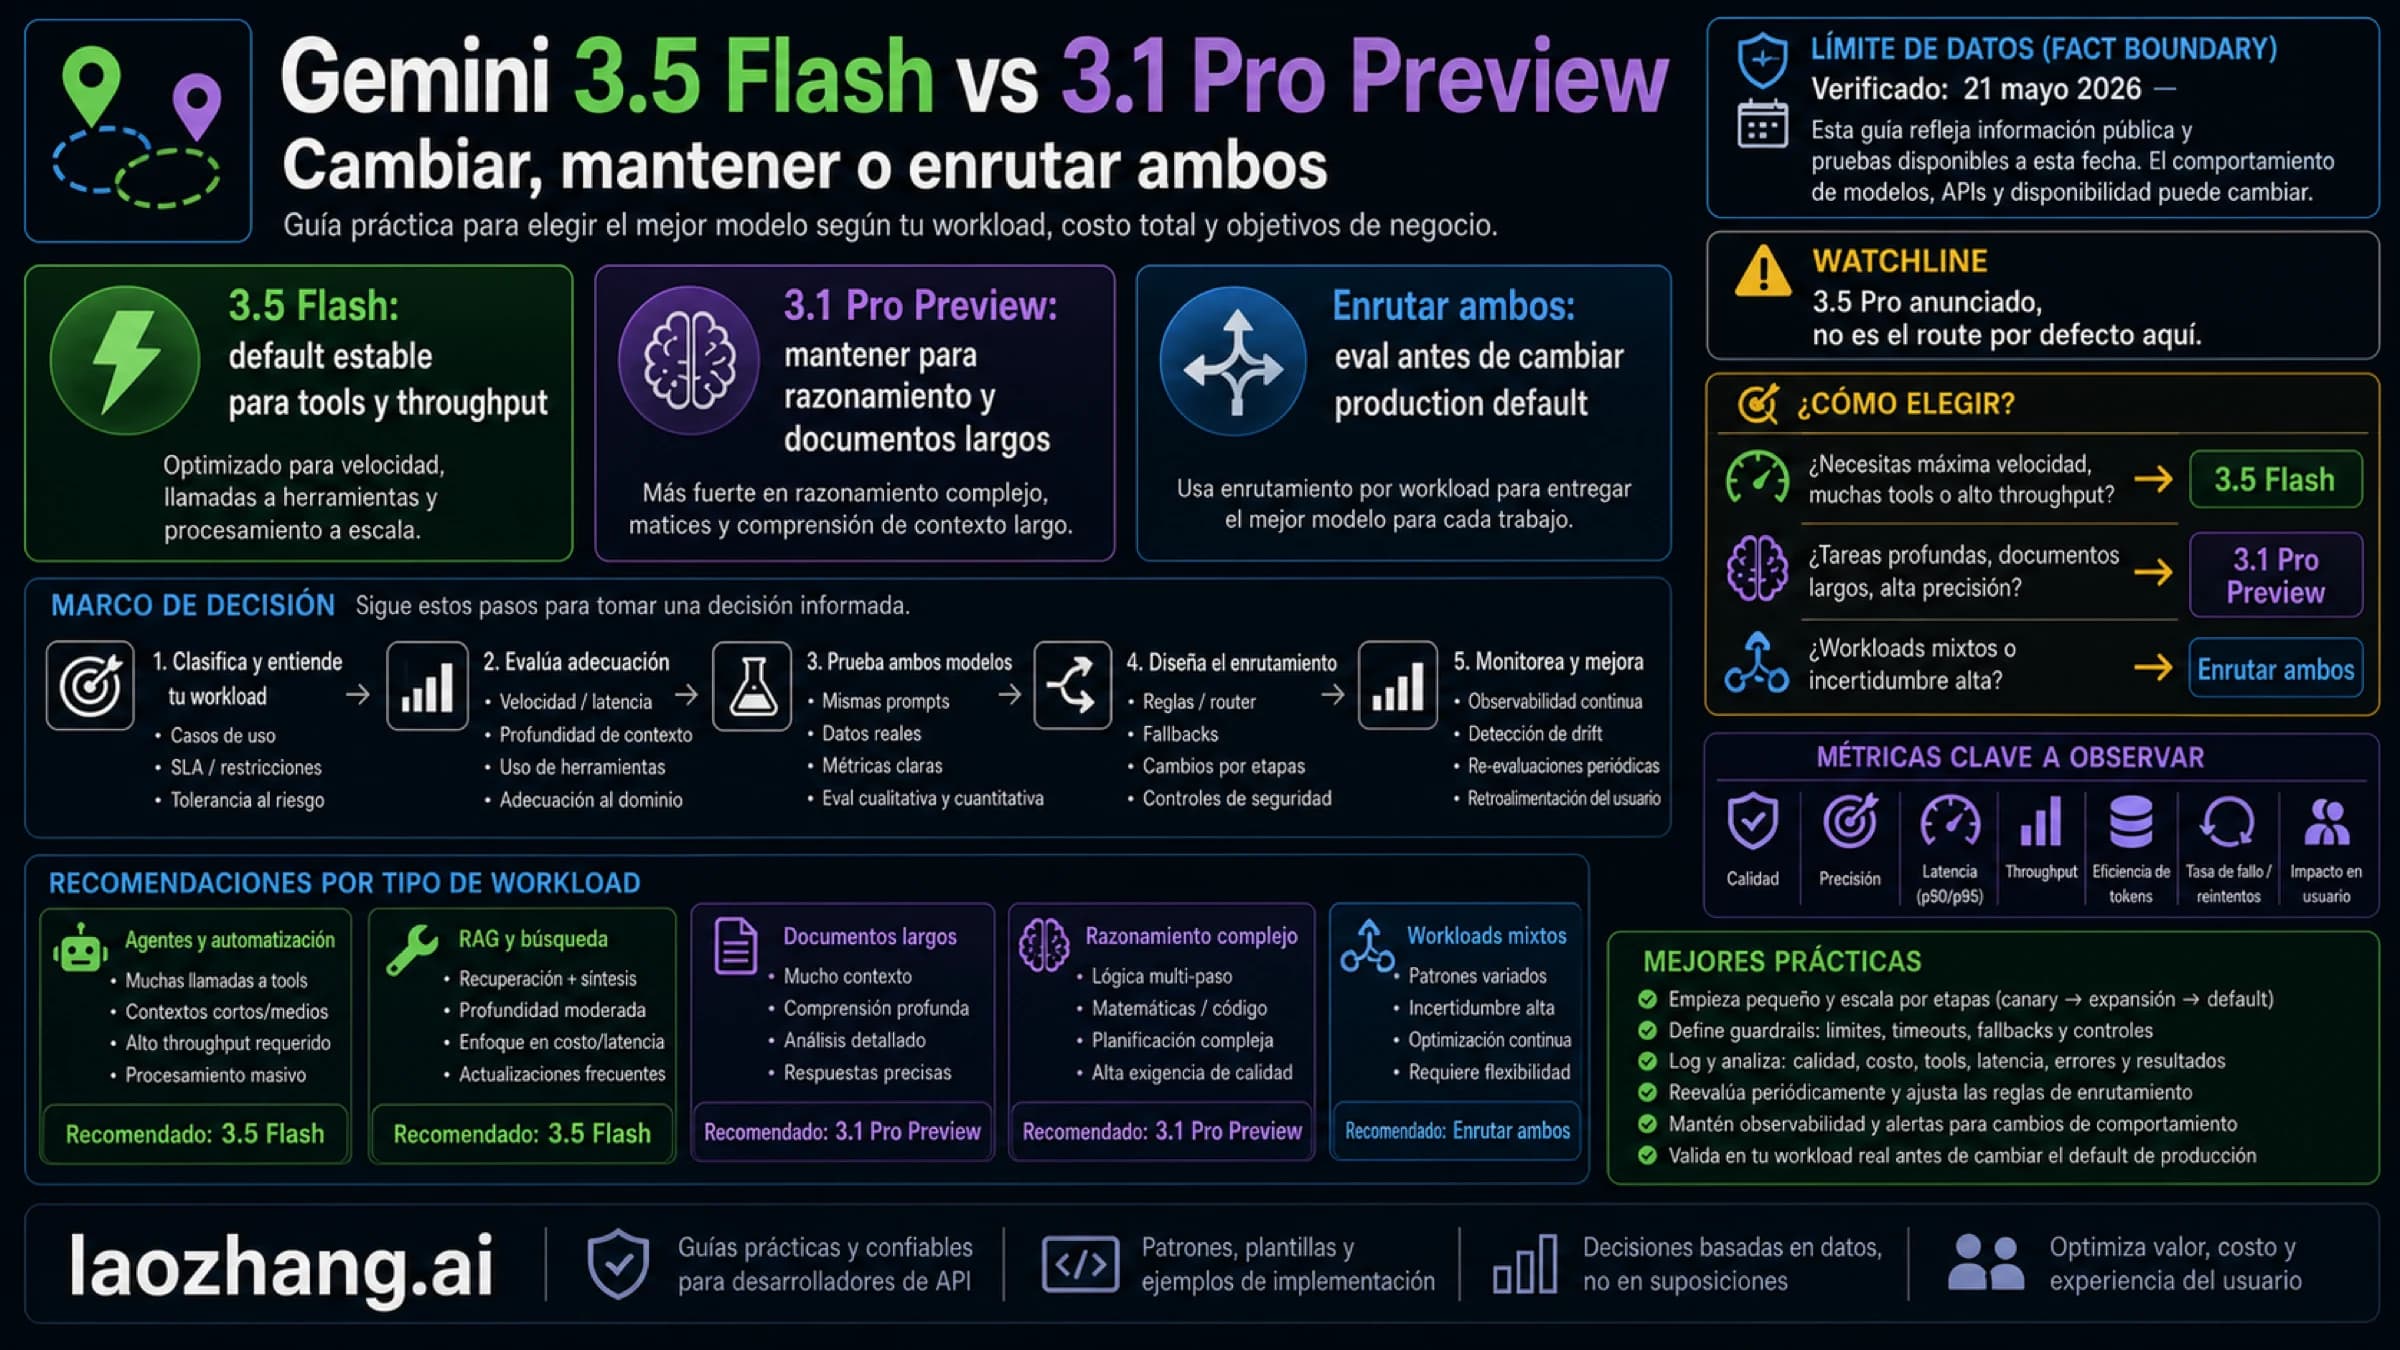
Gemini 3.5 Flash debe probarse primero en agentes rápidos, coding y tool calling, pero Gemini 3.1 Pro Preview sigue teniendo sentido para razonamiento profundo, documentos largos y customtools.

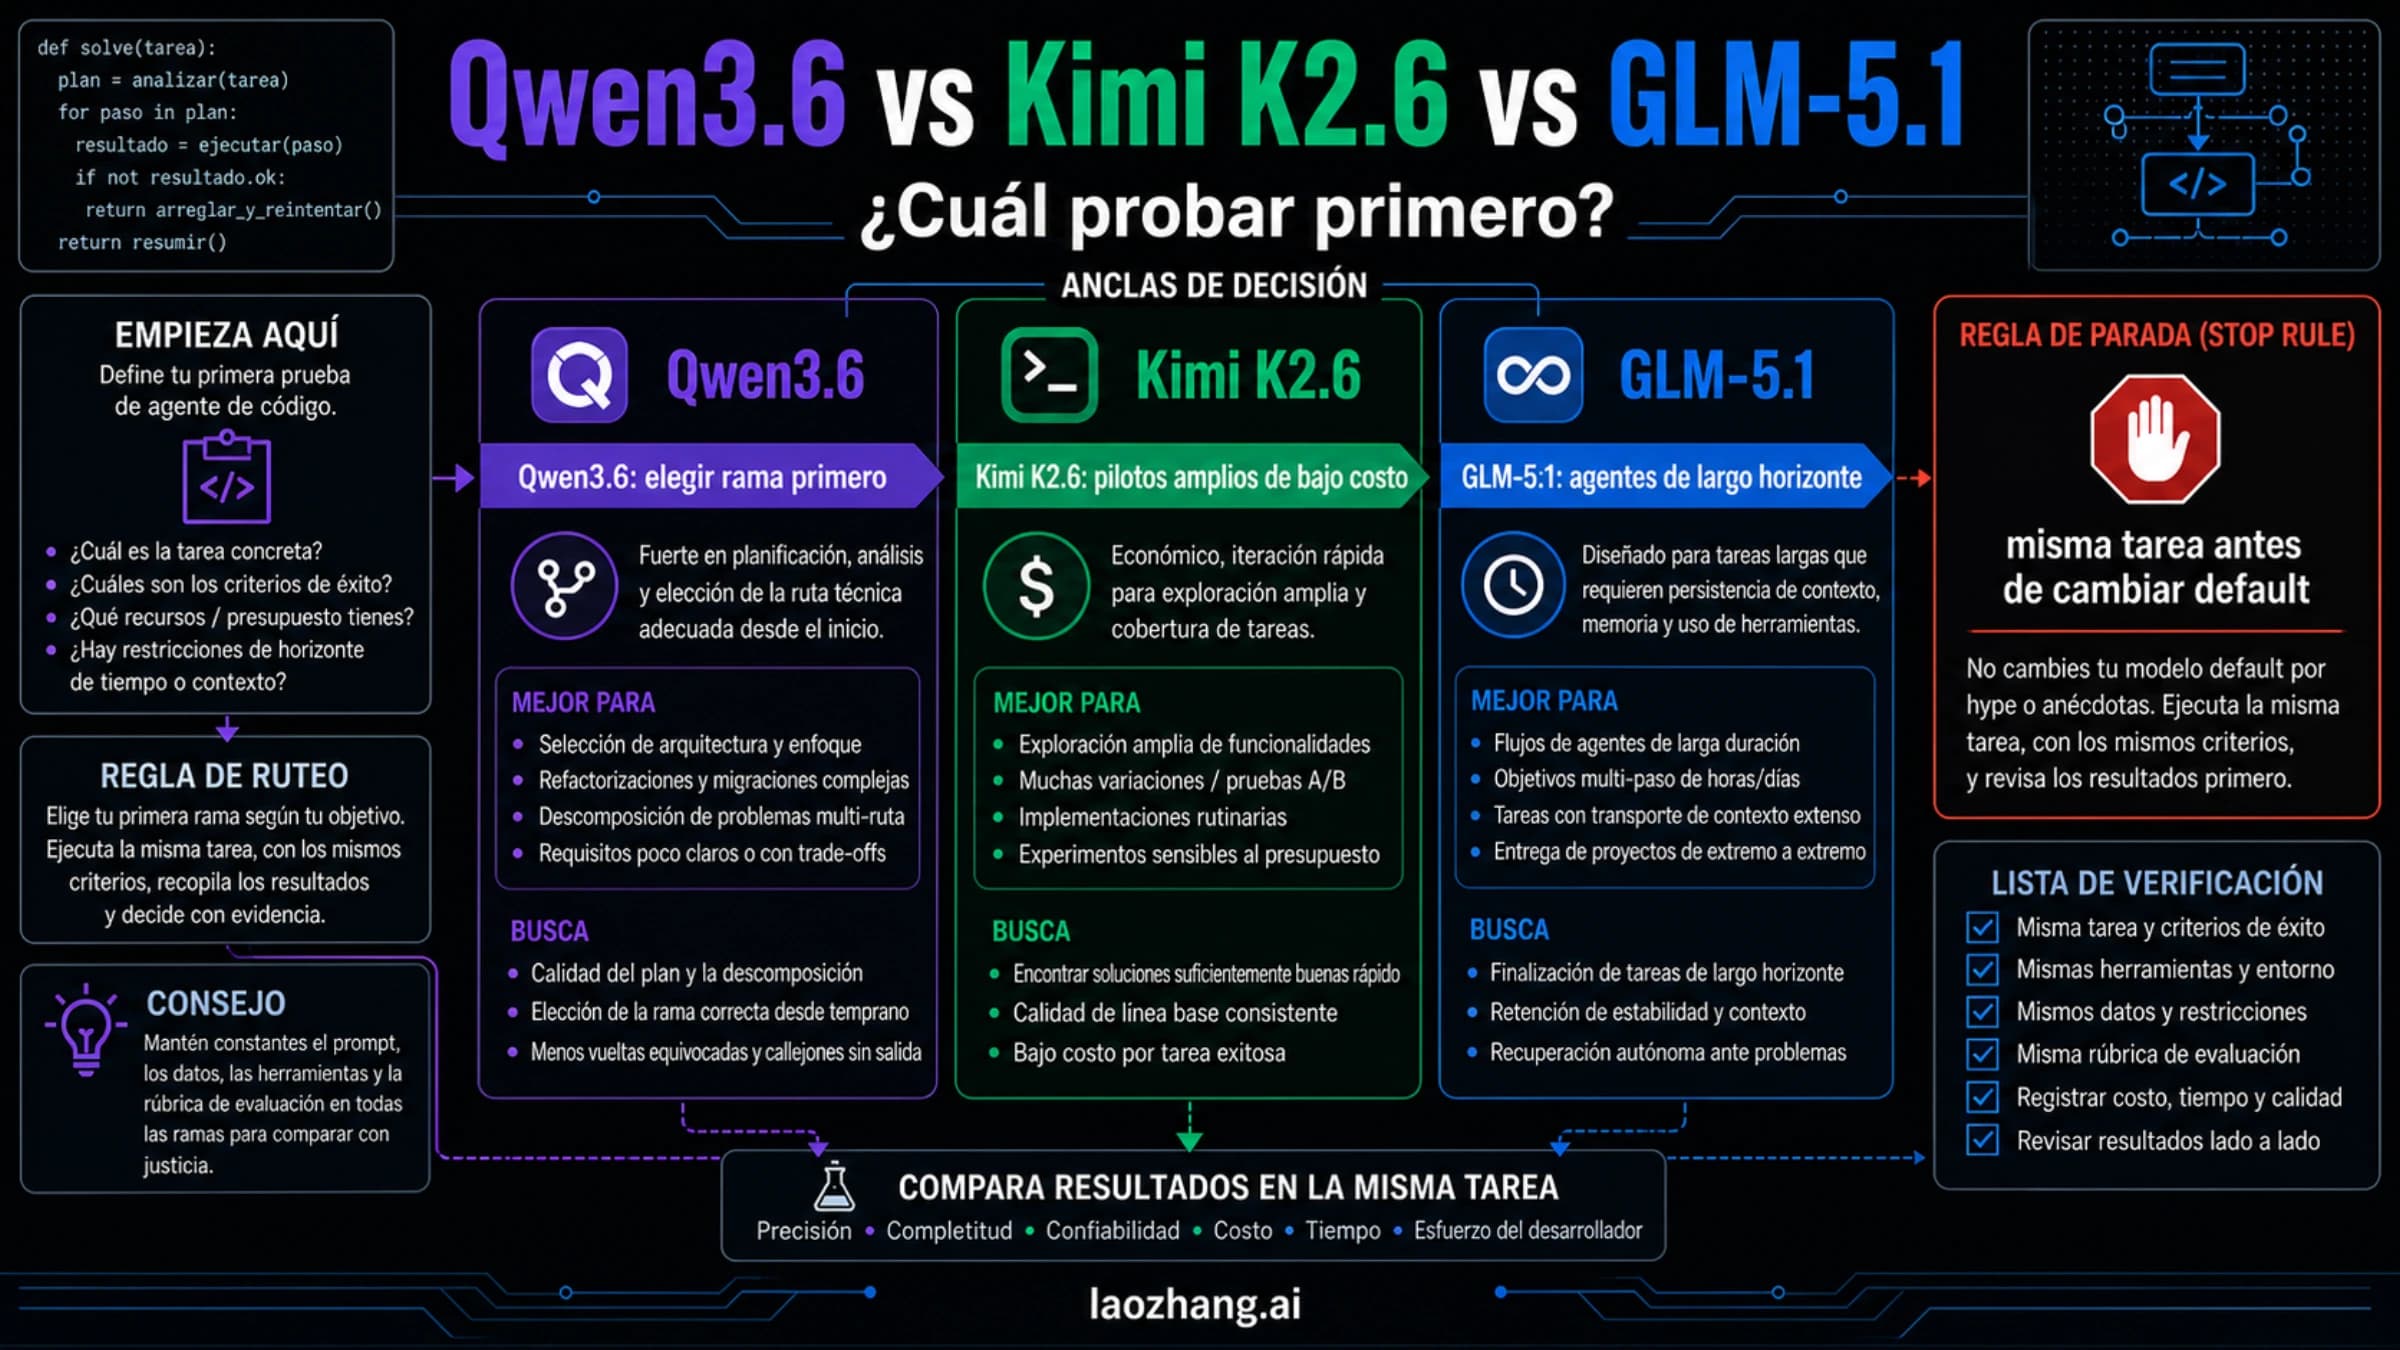
Prueba primero GLM-5.1 para agentes de largo recorrido, Kimi K2.6 para pilotos baratos y Qwen3.6 solo después de elegir 35B-A3B u otra rama alojada.

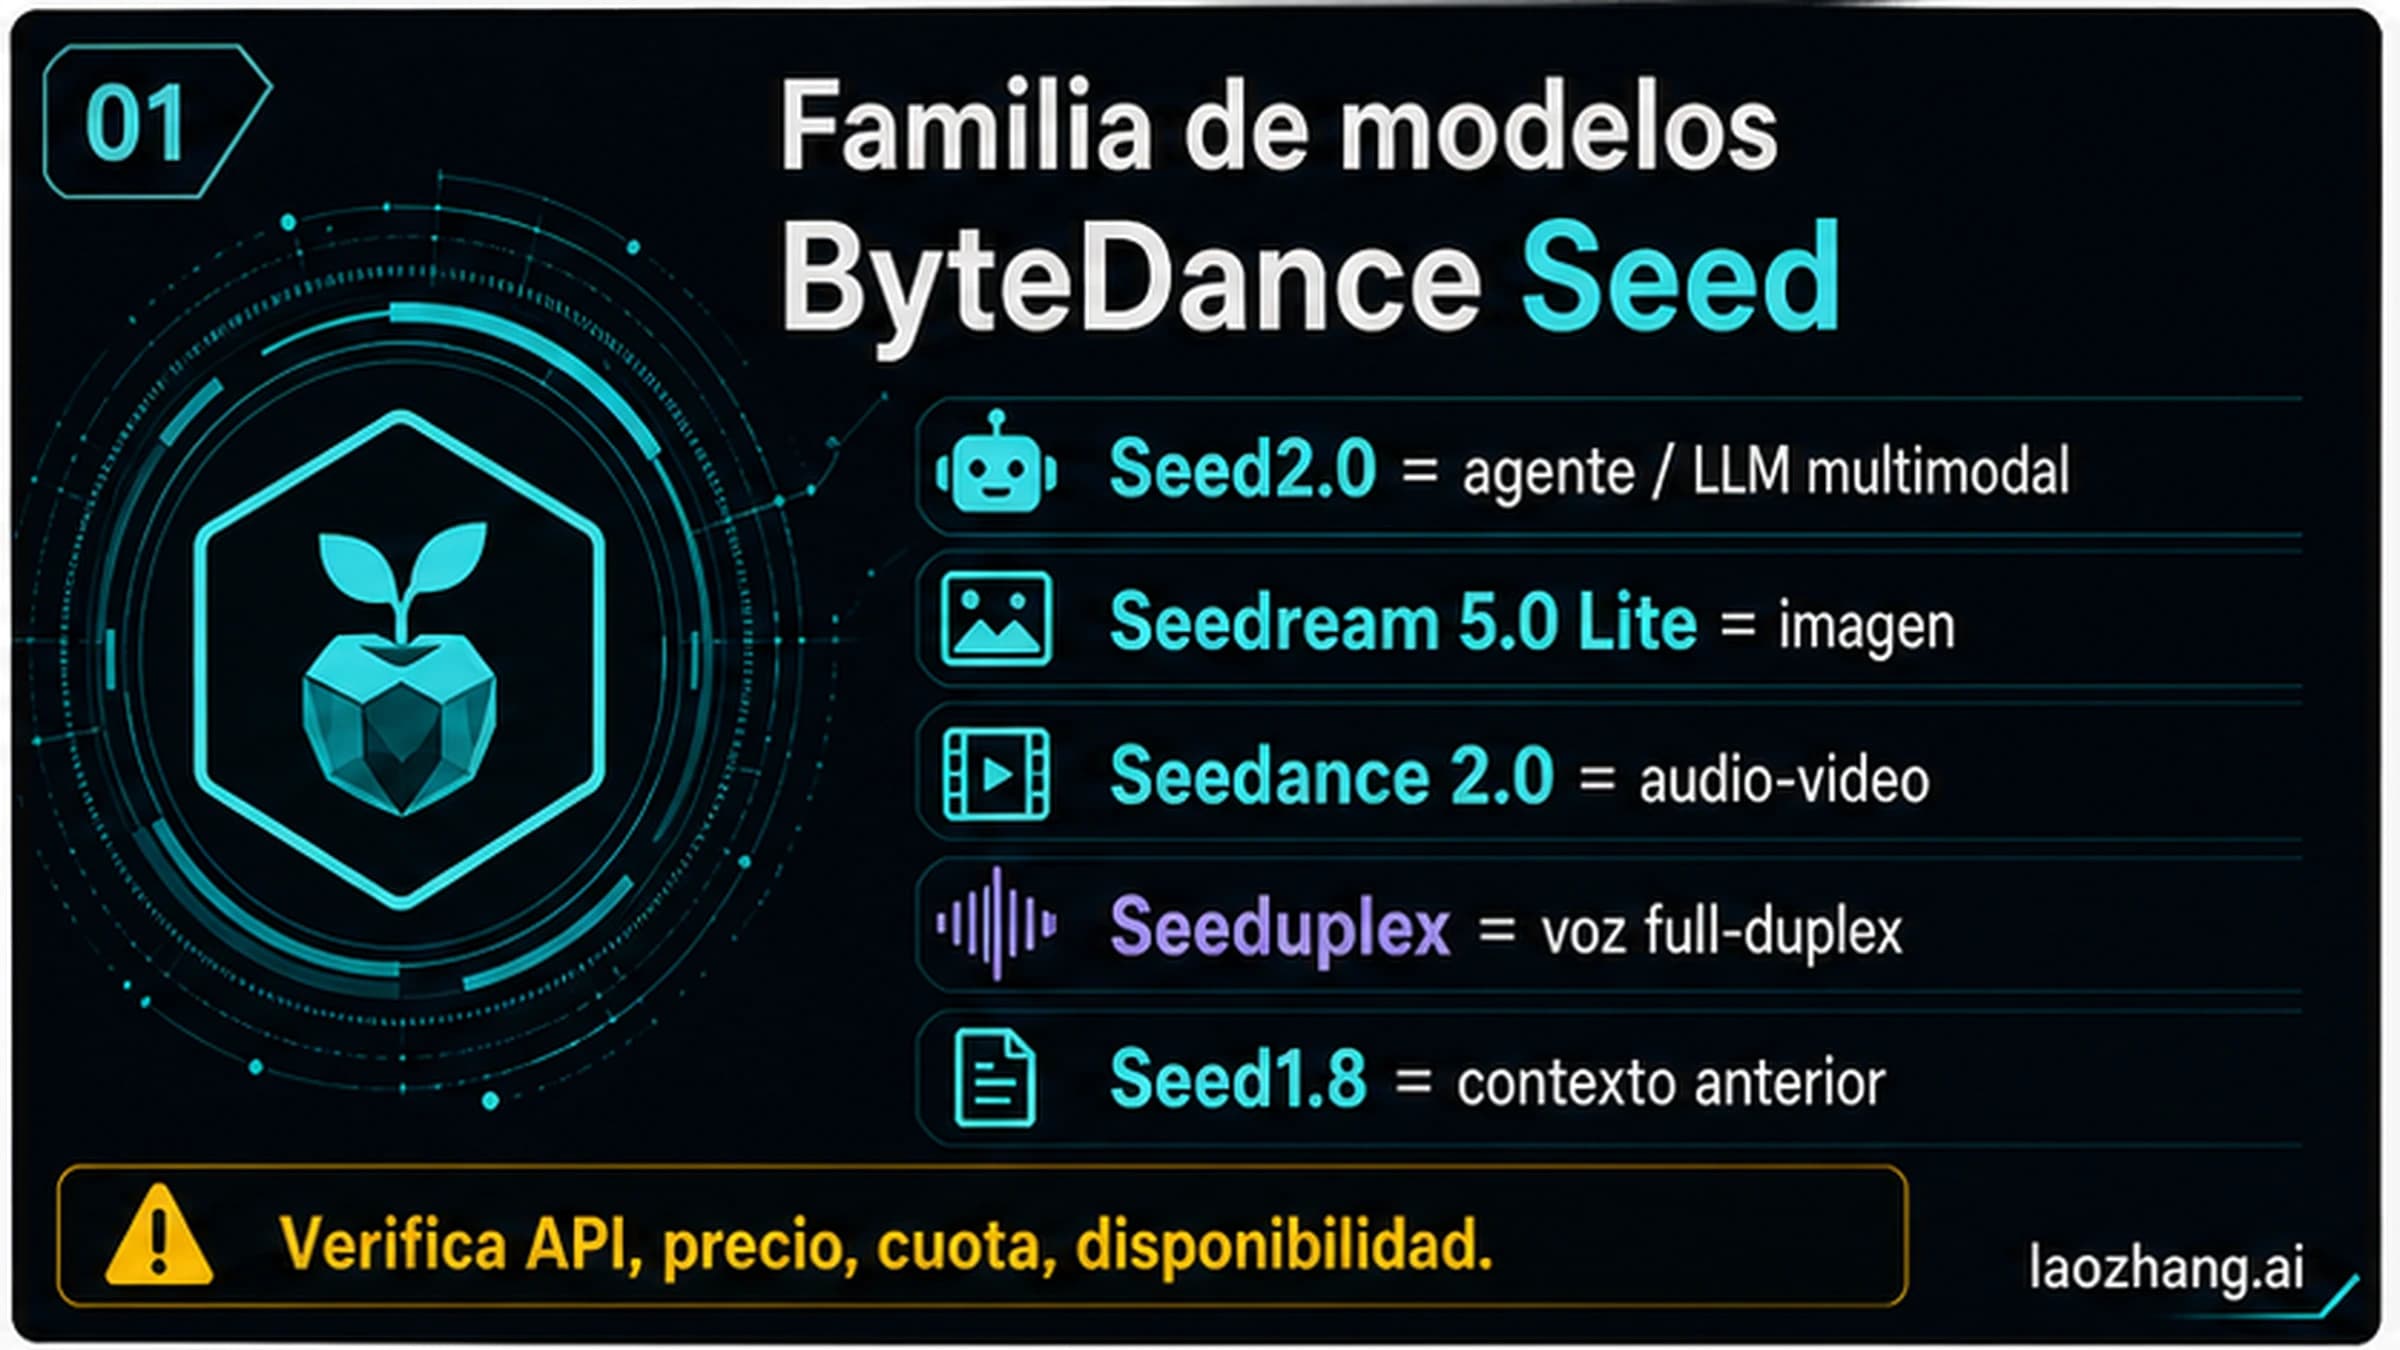
Usa Seed2.0 para trabajo agentic y multimodal, Seedream para imágenes, Seedance para audio-vídeo, Seeduplex para voz, y Seed1.8 solo como contexto previo.

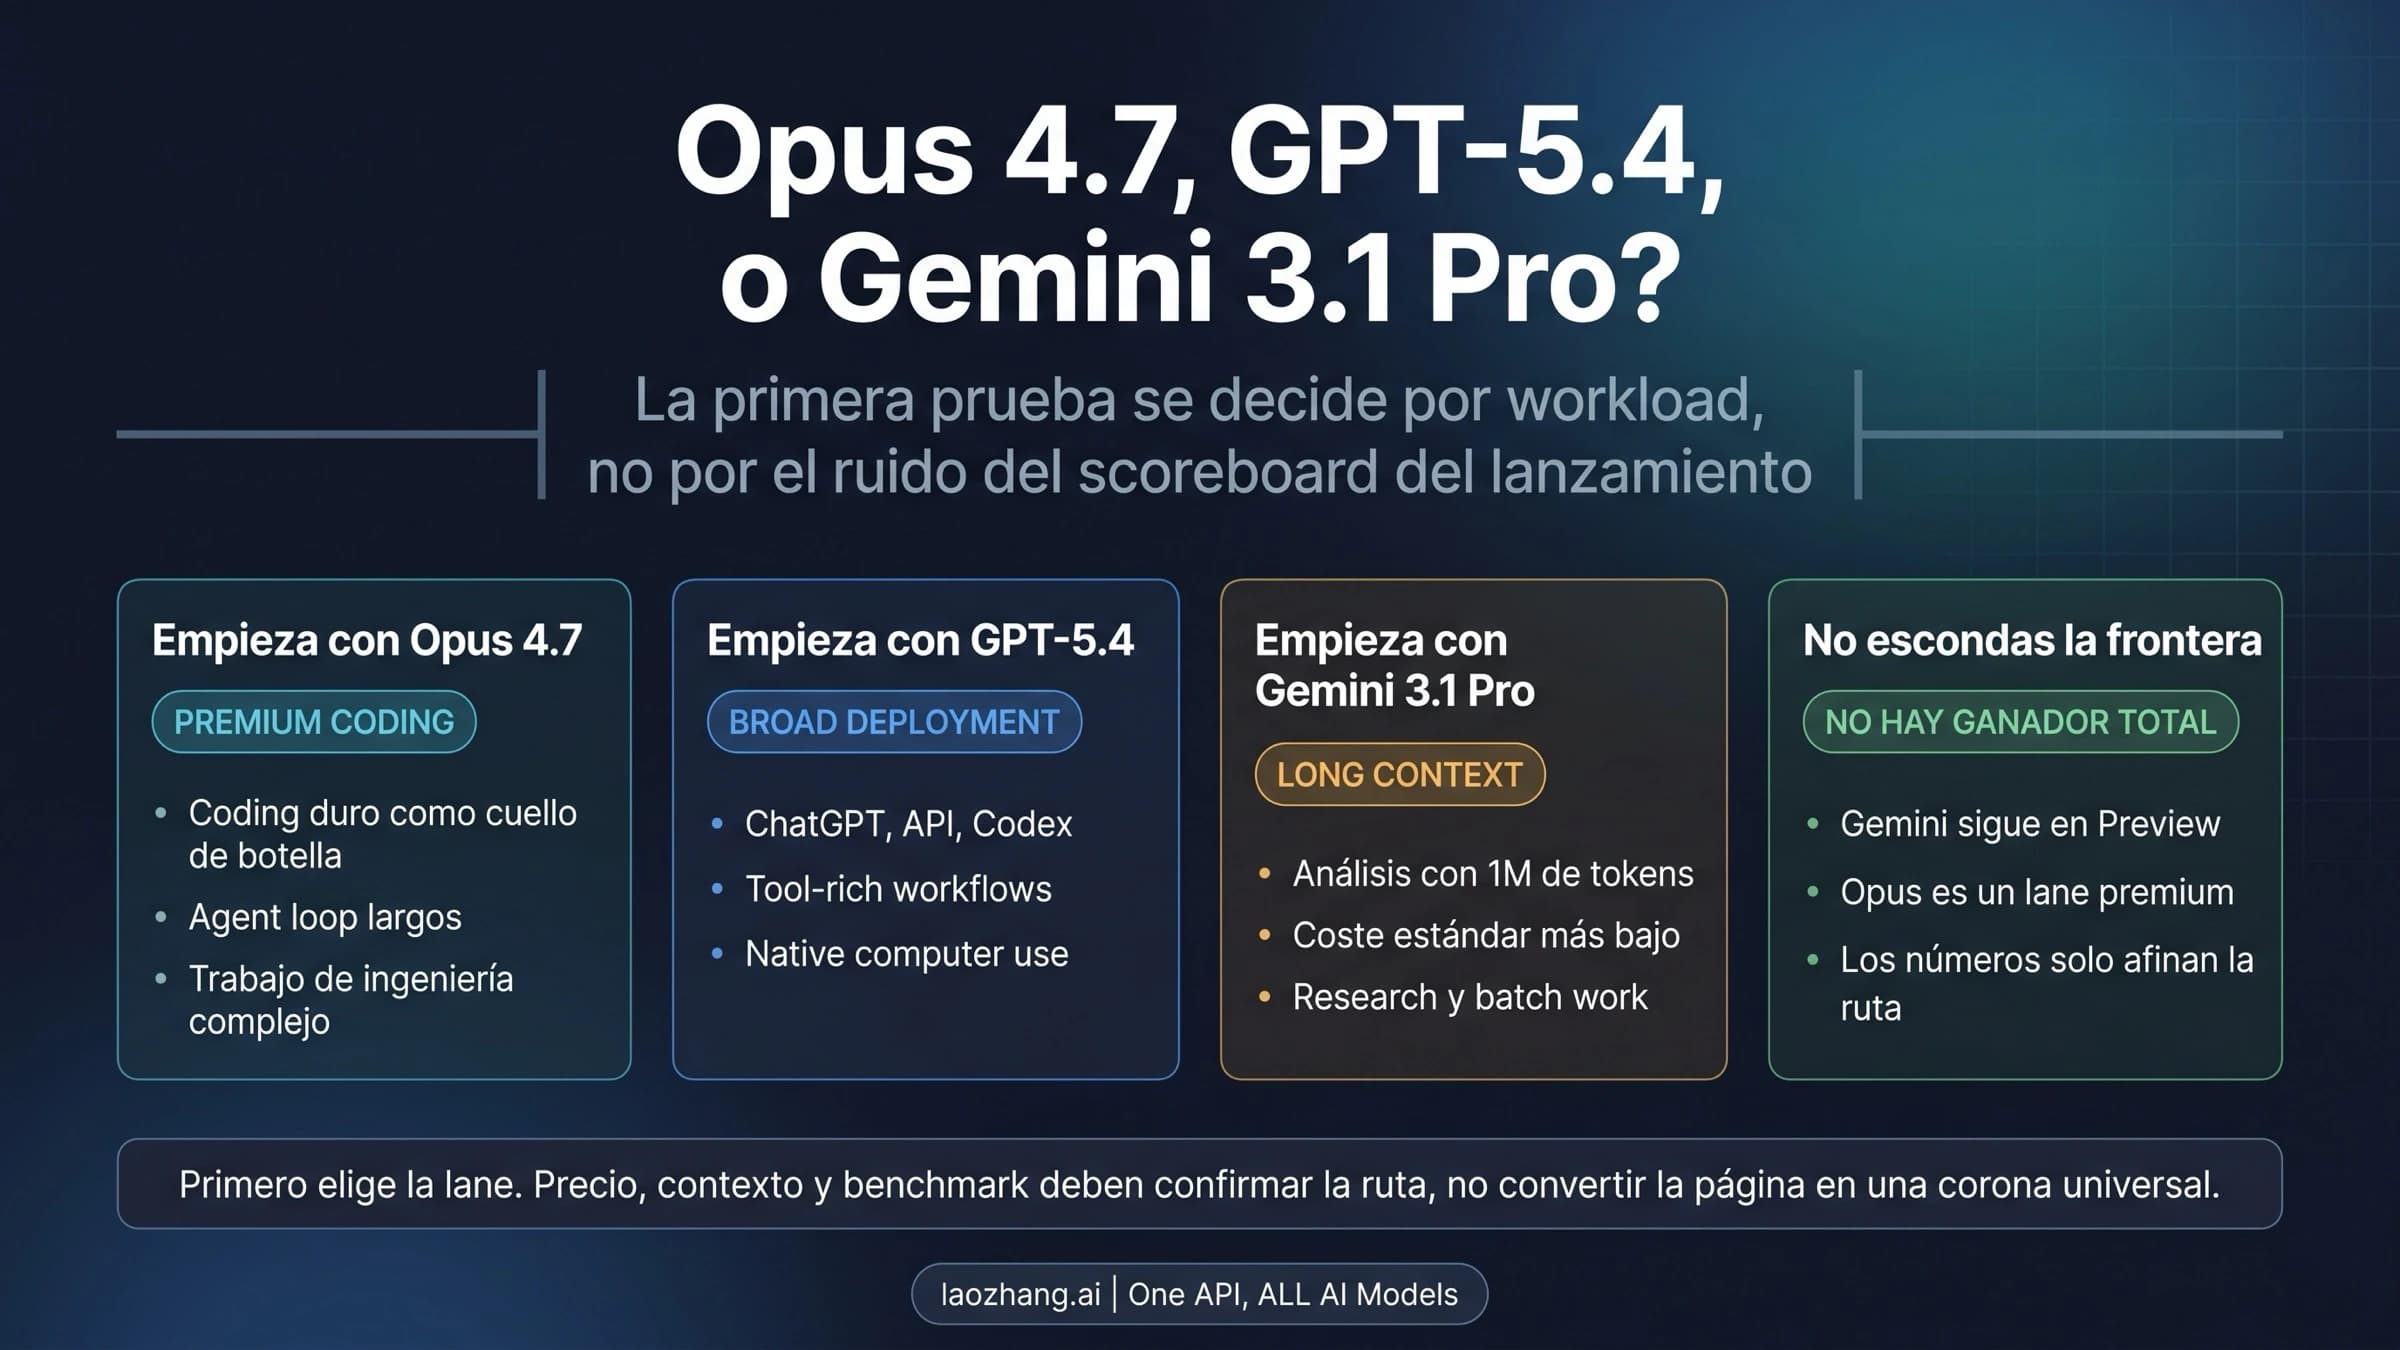
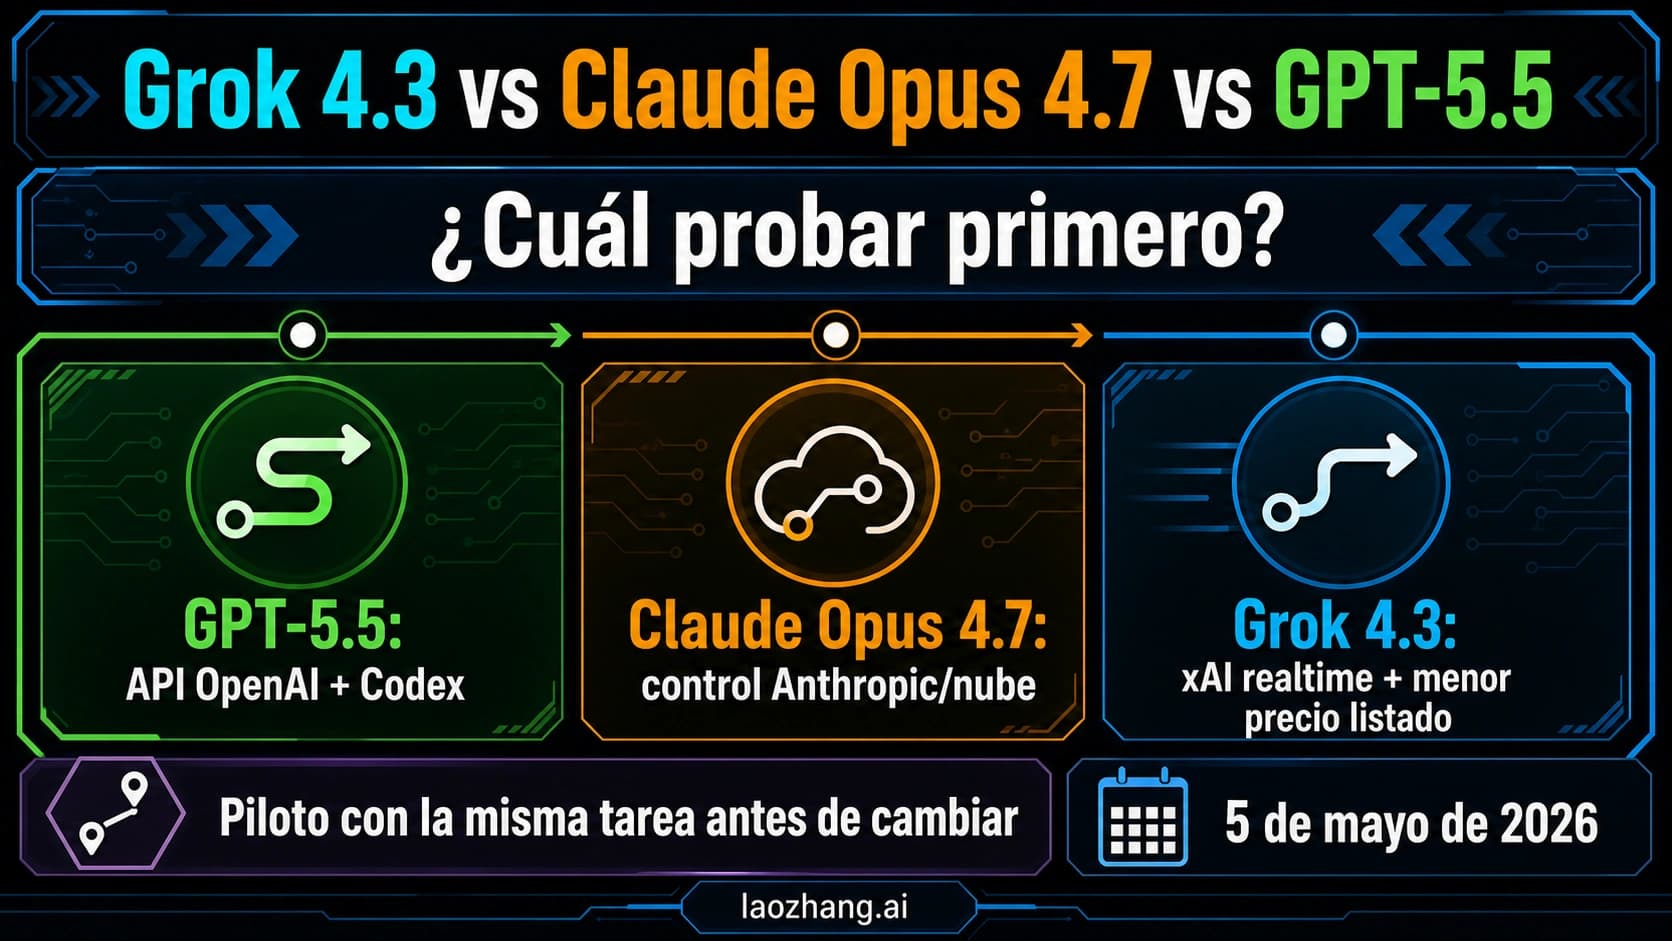
GPT-5.5 es la primera prueba para stacks OpenAI-native, Claude Opus 4.7 es el control premium y Grok 4.3 entra primero por xAI realtime, precio o long-context pilot.

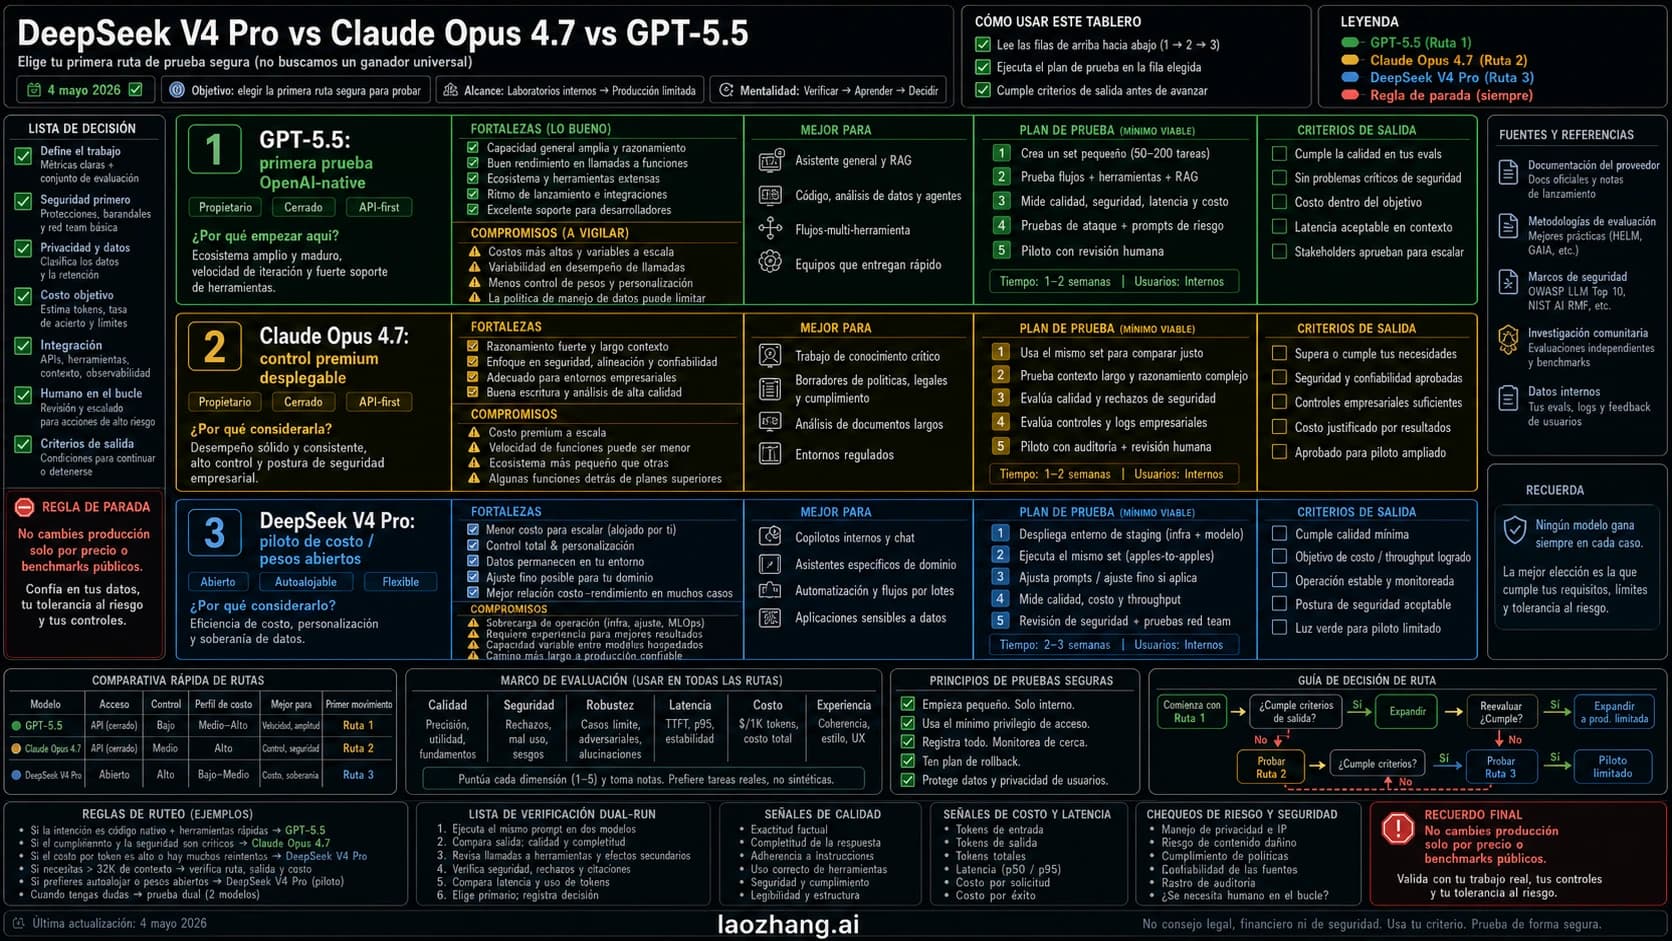
Prueba GPT-5.5 primero en flujos nativos de OpenAI, conserva Claude Opus 4.7 como control premium y usa DeepSeek V4 Pro como piloto de coste u open-weight con validación en la misma tarea.