Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar
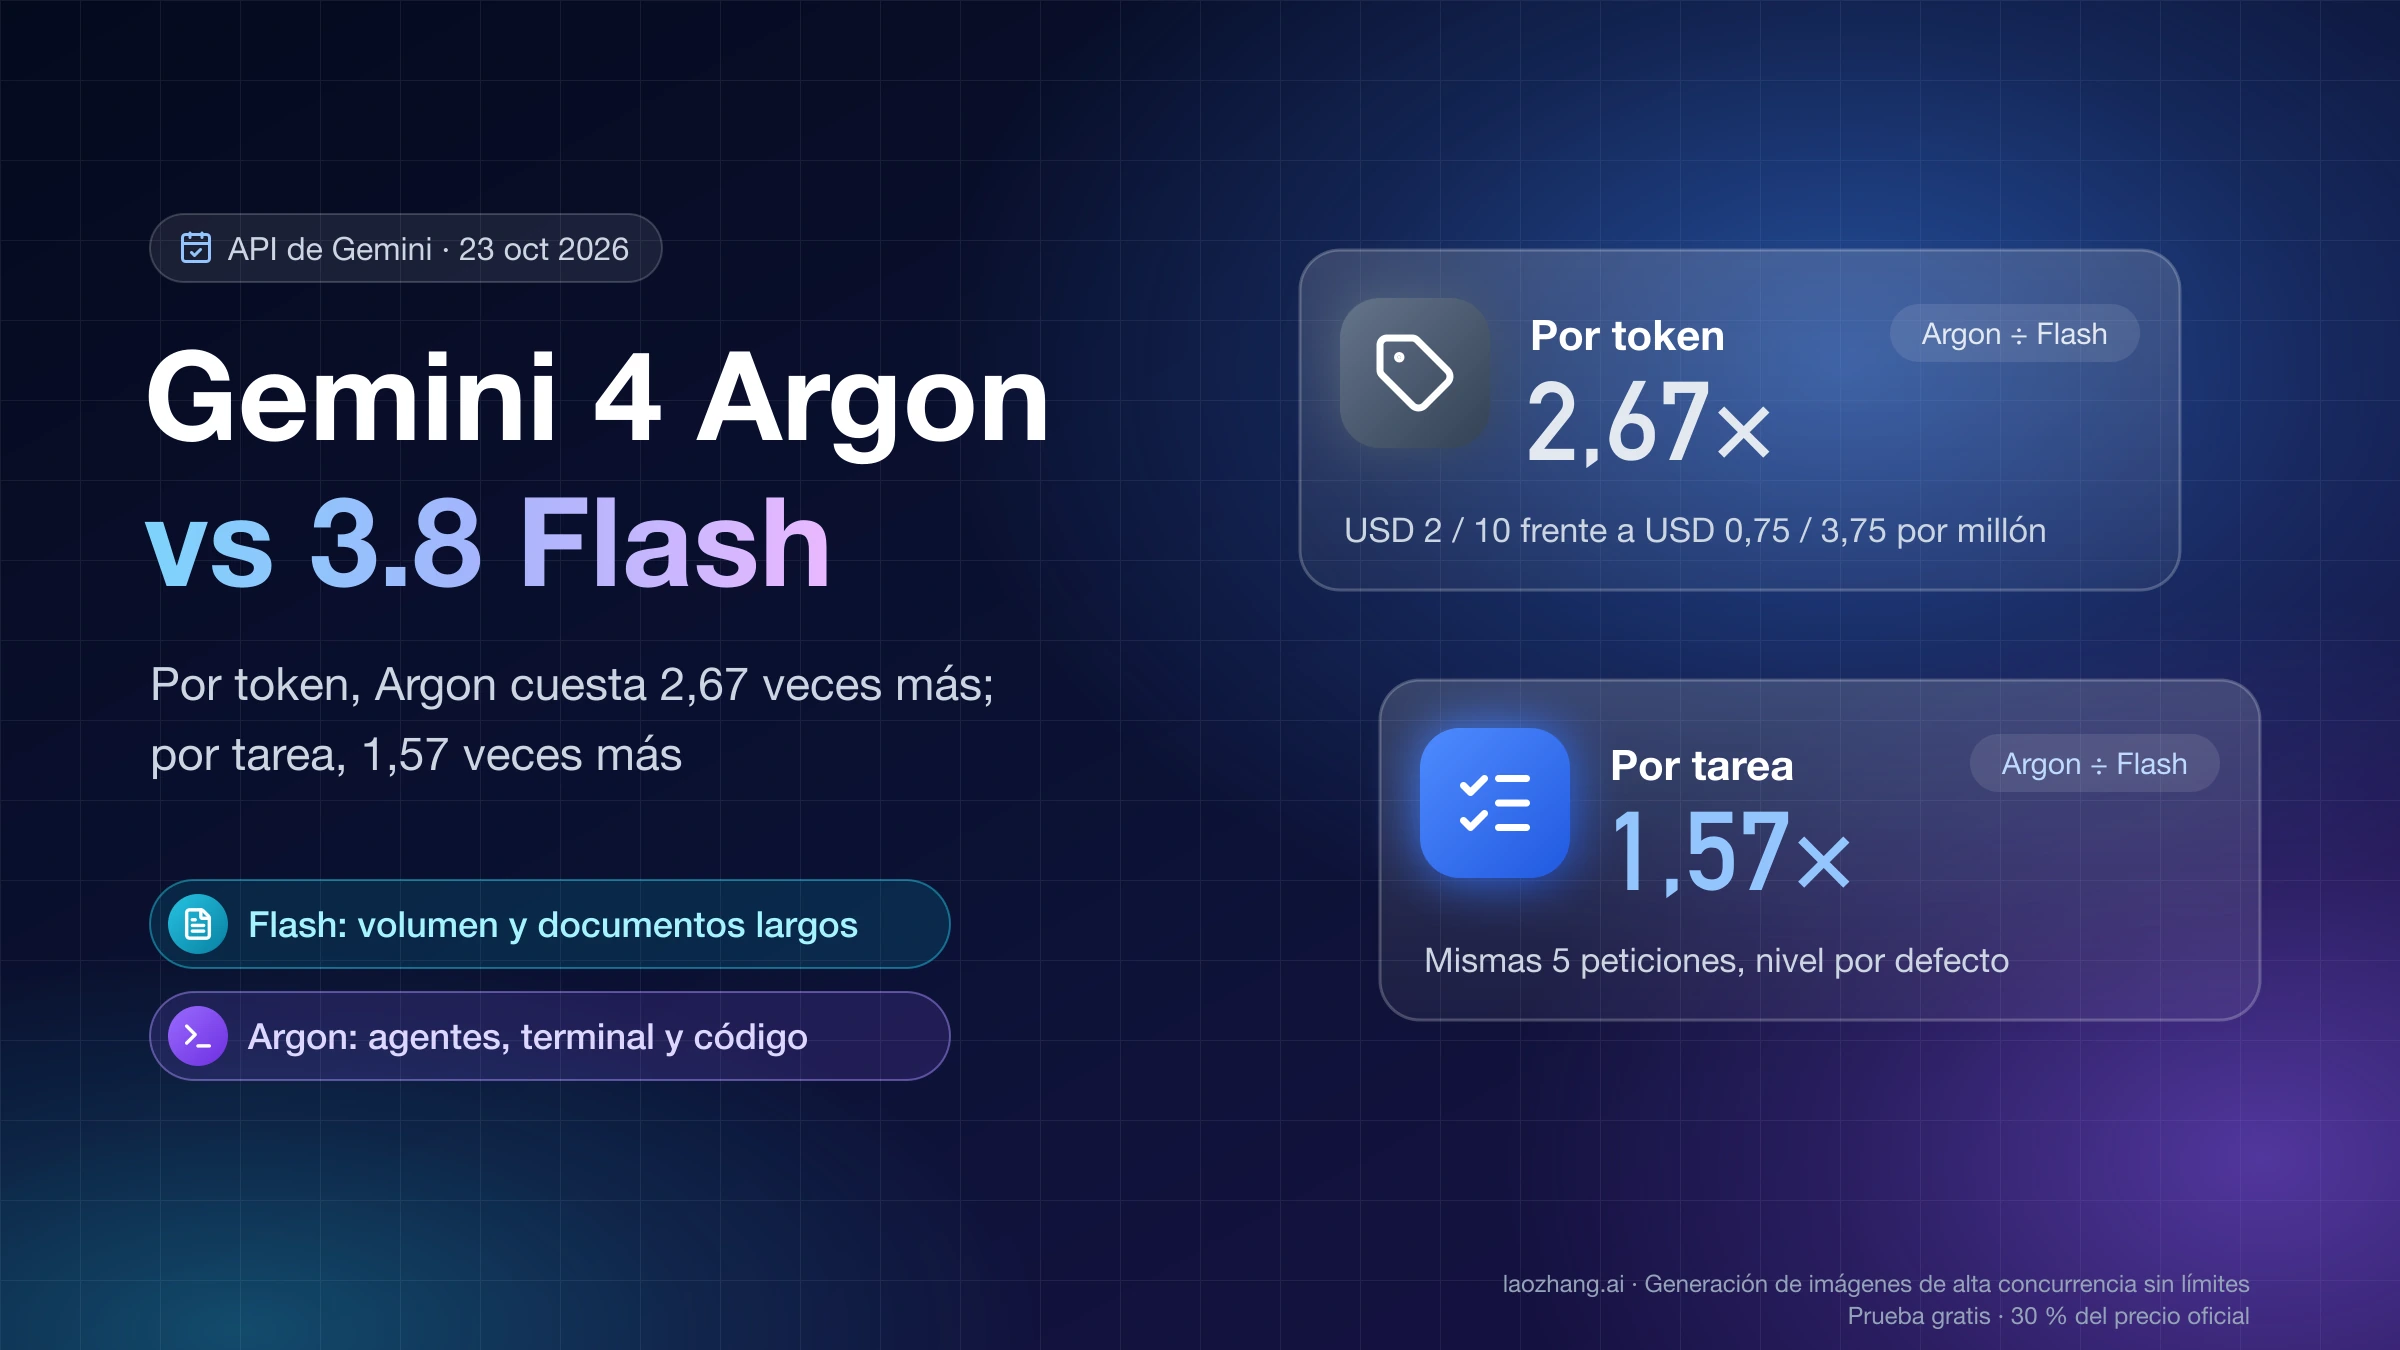
Argon cobra 2,67 veces más por token que 3.8 Flash, pero con las mismas cinco peticiones costó 1,57 veces más. Flash para volumen; Argon para agentes.
En esta página
Si ya llamas a gemini-3.8-flash, no cambies todo a gemini-4-argon. Deja en Flash los resúmenes, la lectura de documentos largos y el volumen que hoy aprovecha el nivel gratuito, y prueba Argon en las tareas de terminal, de agente y de varios pasos, que es donde la distancia es grande: en Terminal-Bench 4.0, Artificial Analysis da a Argon un 57 % frente al 20 % de Flash, mientras que en razonamiento sobre contexto largo quedan prácticamente empatados (80 % frente a 81 %). Argon está disponible de forma general desde el 13 de octubre de 2026 y no tiene nivel gratuito en la API.
El precio por millón de tokens engaña si lo tomas como precio por tarea. Hasta el 30 de noviembre de 2026, Argon cobra USD 2 de entrada y USD 10 de salida, 2,67 veces lo que cobra Flash (USD 0,75 y USD 3,75). En una prueba del 23 de octubre de 2026 con las mismas cinco peticiones, cada modelo en su nivel de razonamiento por defecto, Argon salió 1,57 veces más caro en total, porque Flash gastó entre 402 y 1.456 tokens de razonamiento por llamada y Argon no declaró ninguno. Esa proporción se mueve dos veces: del 1 al 31 de diciembre de 2026 Argon duplica su tarifa y Flash todavía no, y desde el 1 de enero de 2027 Flash también se duplica.
Al cambiar el ID del modelo pierdes el nivel gratuito y la caché explícita, y tienes que subir max_output_tokens a 32.768 como mínimo y los tiempos de espera del cliente a 15 minutos. En la app de Gemini y en Antigravity, Argon está en los planes Google AI Pro y Ultra, y en Antigravity también en Enterprise.
Dónde Argon supera a 3.8 Flash y dónde empatan: benchmarks
Argon saca mucha ventaja en terminal, agentes, programación de varios pasos y matemáticas de frontera, y casi empata en lectura de contexto largo, documentos y vídeo. En el Intelligence Index de Artificial Analysis, con los dos modelos en razonamiento high, Argon suma 53 puntos y 3.8 Flash 41, según su comparativa de Gemini 4 Argon y Gemini 3.8 Flash a 23 de octubre de 2026. Las filas siguientes combinan esa comparativa con la de BenchLM entre Gemini 3.8 Flash y Gemini 4 Argon, actualizada el 20 de octubre de 2026.
| Benchmark | Qué mide | Gemini 4 Argon | Gemini 3.8 Flash | Fuente |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Tareas en terminal | 57 % | 20 % | Artificial Analysis (high) |
| FrontierSWE v2 | Ingeniería de software difícil | 55,0 % | 19,6 % | BenchLM |
| ARC-AGI-3 | Razonamiento abstracto nuevo | 46,3 % | 10,4 % | BenchLM |
| FrontierMath v2 Tier 4 | Matemáticas de investigación | 78,0 % | 22,0 % | BenchLM |
| AutomationBench-AA | Automatización con herramientas | 78 % | 60 % | Artificial Analysis (high) |
| OSWorld 2.0 | Uso del ordenador | 69,2 % | 59,0 % | BenchLM |
| DeepSWE | Corrección de código | 77,9 % | 73,8 % | BenchLM |
| AA-LCR v1.1 | Razonamiento sobre contexto largo | 80 % | 81 % | Artificial Analysis (high) |
| LVBench | Comprensión de vídeo largo | 91,7 % | 87,1 % | BenchLM |
| GDP.pdf | Trabajo con documentos PDF | 22 % | 21 % | Artificial Analysis (high) |
| Gray Swan IPI | Éxito de la inyección de instrucciones (menos es mejor) | 0,7 % | 5,5 % | BenchLM |
La distancia crece cuanto más pasos encadena la tarea y más tiene que corregirse el modelo a sí mismo. Varios usuarios cuentan lo mismo desde el uso diario: en r/singularity, alguien relata que Argon se proclamó campeón en Pokémon con menos de la mitad de los tokens que 3.8 Flash gastó en conseguir tres medallas, y en X otro usuario escribe que Flash «necesitó una cantidad absurda de pasos y llamadas a herramientas para terminar algo». Son informes sueltos, no mediciones, pero van en la misma dirección que los recuentos de tokens de Artificial Analysis. En razonamiento sobre contexto largo Flash va incluso un punto por delante (81 % frente a 80 %), y en PDF y vídeo Argon solo saca entre uno y cinco puntos, así que ahí pagas más sin una mejora clara.
La puntuación global de BenchLM cambia entre lecturas: el 23 de octubre de 2026 rondaba 69 para Flash y entre 81 y 83 para Argon. Las filas concretas son más útiles para decidir que ese número.
Precio de Gemini 4 Argon y 3.8 Flash hasta 2027: tres periodos
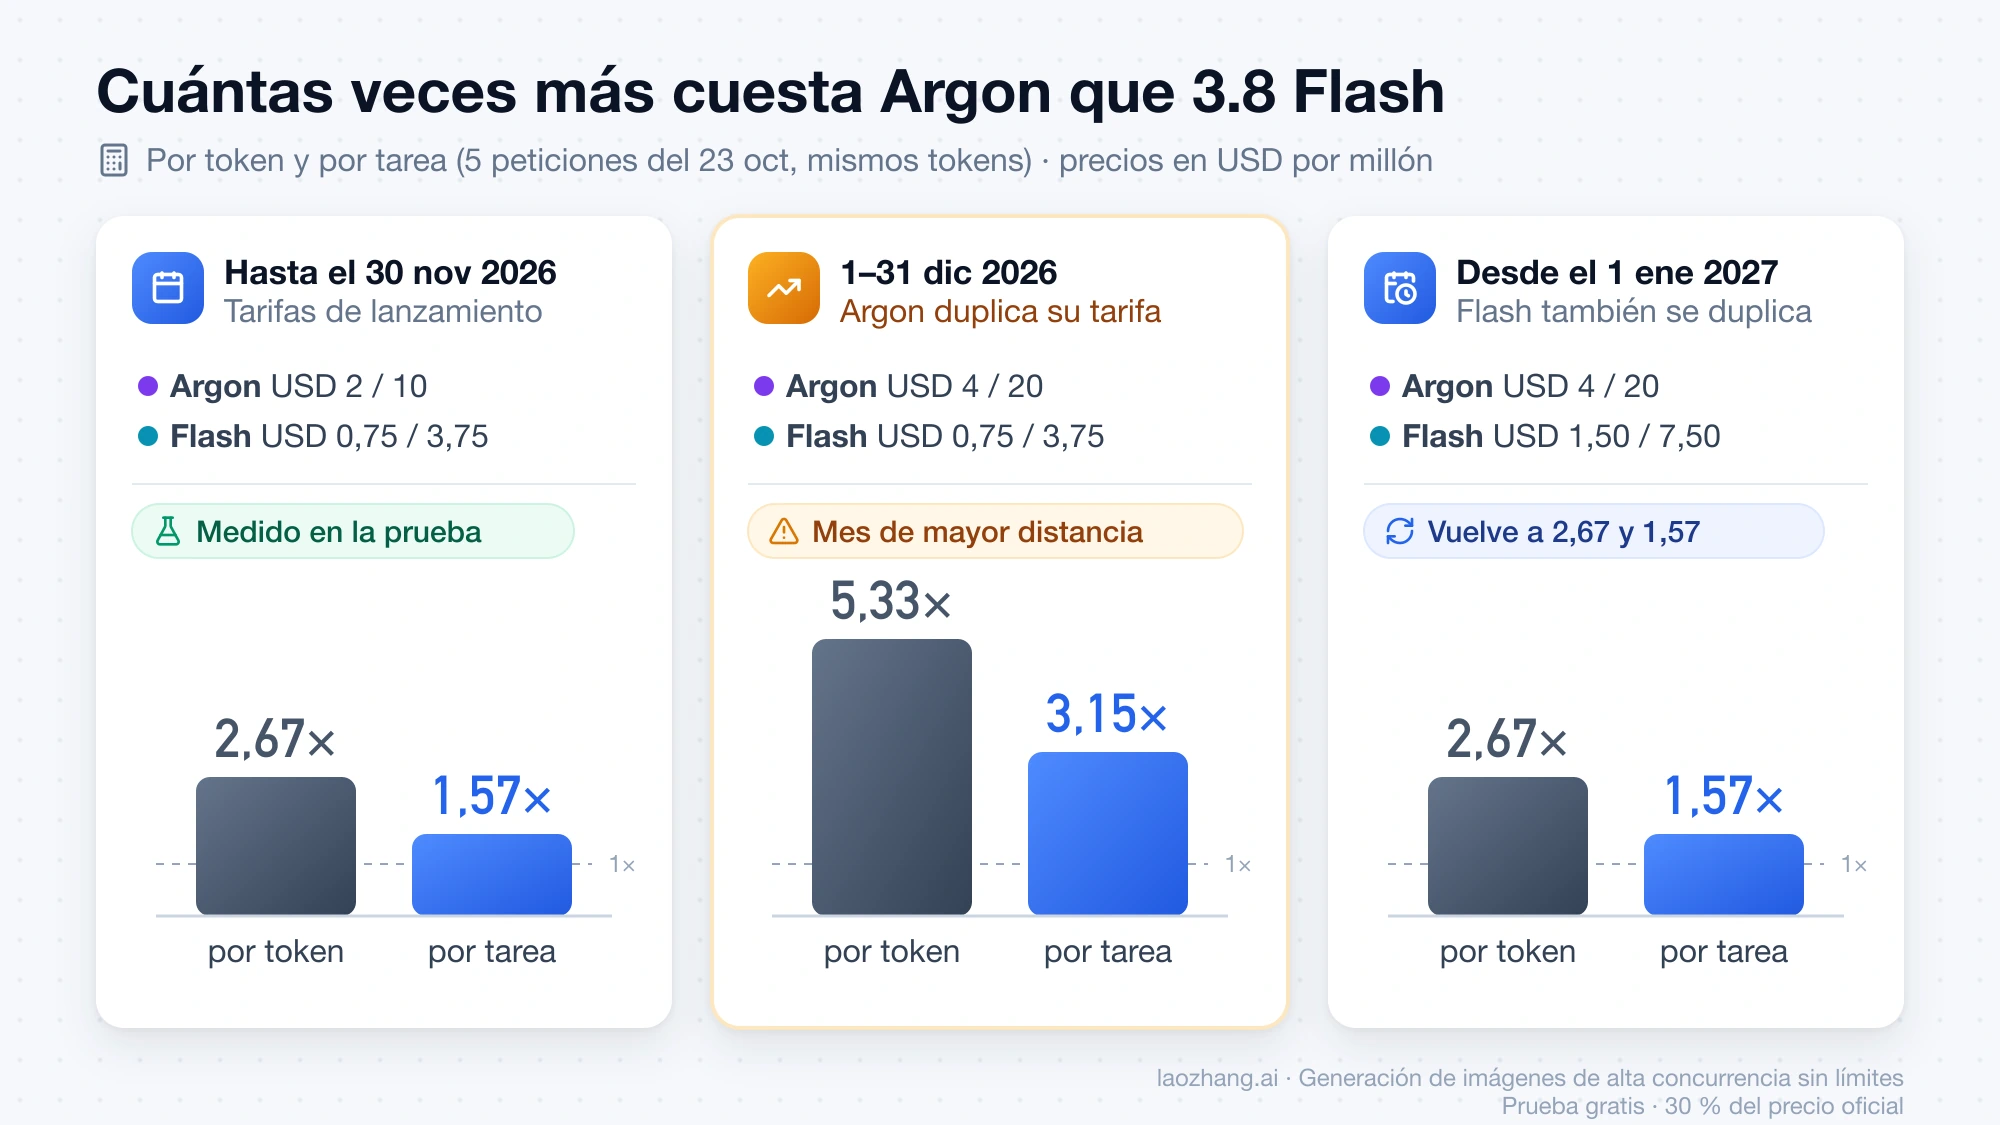
Por millón de tokens, Argon cuesta 2,67 veces lo que 3.8 Flash hasta el 30 de noviembre de 2026, 5,33 veces del 1 al 31 de diciembre de 2026 y otra vez 2,67 veces desde el 1 de enero de 2027. Las dos subidas tienen fecha en la página de precios de la API de Gemini a 23 de octubre de 2026, la de Argon el 1 de diciembre de 2026 y la de Flash el 1 de enero de 2027, y en los dos casos la tarifa se duplica. Los tokens de razonamiento se cobran como salida en los dos modelos.
| Periodo | Argon, entrada / salida | 3.8 Flash, entrada / salida | Argon ÷ Flash por token | Argon ÷ Flash por tarea difícil (cálculo con datos de AA, high) |
|---|---|---|---|---|
| Hasta el 30 de noviembre de 2026 | USD 2 / USD 10 | USD 0,75 / USD 3,75 | 2,67 | 1,6 (USD 1,99 frente a USD 1,24) |
| Del 1 al 31 de diciembre de 2026 | USD 4 / USD 20 | USD 0,75 / USD 3,75 | 5,33 | 3,2 (USD 3,98 frente a USD 1,24) |
| Desde el 1 de enero de 2027 | USD 4 / USD 20 | USD 1,50 / USD 7,50 | 2,67 | 1,6 (USD 3,98 frente a USD 2,48) |
Precios estándar por millón de tokens en la API de Gemini (claves de AI Studio), sin tramo distinto para peticiones de más de 200.000 tokens en ninguno de los dos. La última columna parte del coste por tarea del Intelligence Index de Artificial Analysis con las tarifas de lanzamiento y aplica las nuevas tarifas suponiendo que cada modelo gasta los mismos tokens; Artificial Analysis publicará sus propias cifras cuando cambien los precios.
Batch y Flex cuestan la mitad en los dos modelos (Argon USD 1/5 hasta el 30 de noviembre de 2026, Flash USD 0,375/1,875 hasta el 31 de diciembre de 2026), así que el trabajo que no corre prisa abarata ambos por igual sin cambiar la proporción. Diciembre de 2026 es el mes en que más se separan: si vas a mover un volumen grande a Argon, ese es el mes que conviene presupuestar aparte.
Prueba del 23 de octubre con las mismas peticiones: coste por llamada
El 23 de octubre de 2026 se enviaron las mismas 12 peticiones a cada modelo, con una sola ejecución por petición y sin repetir respuestas. Las cinco tareas eran un asunto de correo de una línea (t1), un problema aritmético de paquetes de bolígrafos (t2), una función Python merge_intervals con 6 pruebas de pytest (t3), el resumen de un artículo de 6.723 palabras, unos 11.100 tokens de entrada, con tres afirmaciones que comprobar (t4), y un plan de viaje en cuatro turnos que termina en una tabla con presupuesto en euros (t5). Cada tarea se lanzó en el nivel por defecto, que es medium en los dos modelos; t3 también en low y medium, y t1–t5 también en high. El coste se calculó con los tokens que devolvió cada llamada y la tarifa de Google hasta el 30 de noviembre de 2026.
Las llamadas pasaron por LaoZhang API, y no por el mismo endpoint en los dos modelos. 3.8 Flash fue por el endpoint compatible con OpenAI (/v1/chat/completions con reasoning_effort), porque esa tarde el endpoint nativo de Gemini para gemini-3.8-flash agotó el tiempo de espera en cuatro intentos. Argon fue por el endpoint nativo (generateContent con thinkingConfig.thinkingLevel), porque en el compatible con OpenAI el valor de reasoning_effort no tenía efecto visible en Argon: high daba lo mismo que el valor por defecto y no aparecían tokens de razonamiento. Las dos vías terminan en Google y las dos informan de los tokens de razonamiento, y todas las respuestas devolvieron gemini-3.8-flash o gemini-4-argon como modelo.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Tarea, nivel por defecto | Flash: entrada / razonamiento / salida | Argon: entrada / razonamiento / salida | Flash por llamada | Argon por llamada | Argon ÷ Flash |
|---|---|---|---|---|---|
| t1, asunto de correo | 23 / 402 / 67 | 53 / 0 / 129 | USD 0,0018 | USD 0,0014 | 0,79 |
| t2, problema aritmético | 61 / 778 / 456 | 92 / 0 / 347 | USD 0,0047 | USD 0,0037 | 0,78 |
| t3, función con pruebas | 61 / 522 / 503 | 91 / 0 / 577 | USD 0,0039 | USD 0,0060 | 1,53 |
| t4, resumen de 6.723 palabras | 11.191 / 1.456 / 741 | 11.102 / 0 / 1.097 | USD 0,0166 | USD 0,0332 | 1,99 |
| t5, plan de viaje en 4 turnos | 218 / 834 / 676 | 267 / 0 / 693 | USD 0,0058 | USD 0,0075 | 1,28 |
| Total de las cinco tareas | USD 0,0328 | USD 0,0516 | 1,57 |
En las dos tareas más cortas Argon salió más barato que Flash, porque Flash razonó con cientos de tokens para escribir un asunto de correo y Argon contestó directamente. En el resumen largo pasa lo contrario: la entrada es más o menos la mitad del coste de Flash y dos tercios del de Argon, y en esa parte el razonamiento extra de Flash no compensa nada, así que la proporción sube a 1,99. Con las mismas cifras de tokens, el total de las cinco tareas pasa a 3,15 veces del 1 al 31 de diciembre de 2026 (Argon USD 0,1033 frente a USD 0,0328) y vuelve a 1,57 desde el 1 de enero de 2027 (USD 0,1033 frente a USD 0,0656).
En high cambia la cuenta. Argon declaró entonces entre 445 y 2.439 tokens de razonamiento por llamada y el total de las cinco tareas subió a USD 0,1110, 3,44 veces lo que costó Flash en su ejecución high (USD 0,0322), y 6,89 veces en diciembre de 2026. Esa fila de Flash no es una medición real de su nivel alto: por el endpoint compatible con OpenAI el ajuste no movió sus recuentos (t3 dio 522 tokens de razonamiento por defecto, 516 en low, 588 en medium y 512 en high). Argon, en cambio, no declaró razonamiento en low, medium ni por defecto con estas peticiones; si en tu cuenta sí lo factura en medium, su coste por llamada será mayor que el de la tabla.
Calidad, tiempos y lo que no midió la prueba
Los dos modelos resolvieron bien las dos tareas que se pudieron corregir. El código de las 8 respuestas de t3 (cuatro niveles por modelo) pasó las 6 pruebas con pytest 9.1.1 en todos los casos, y las cuatro respuestas de t2 (Flash y Argon, por defecto y en high) eligieron 4 paquetes de 10 y 3 de 6, 58 bolígrafos por USD 41,50, que es la respuesta correcta. t1, t4 y t5 no se puntuaron. Con tareas así de fáciles la prueba enseña cuánto cuesta cada modelo, no cuál es más listo; para eso están los benchmarks de la sección anterior.
Los tiempos dependen de la vía de acceso y de esa tarde. Por defecto, Argon tardó 6,8, 10,8, 15,5, 20,1 y 59,7 segundos en t1–t5, y Flash 98,6, 9,3, 8,8, 124,9 y 15,5 segundos. El 98,6 de Flash fue al cuarto intento: entre las 20:17 y las 20:21 (hora de China) Flash devolvió errores 429 de saturación y 503 «This model is currently experiencing high demand», el mensaje de capacidad de Google, además de algunos tiempos de espera agotados, mientras que todas las llamadas a Argon funcionaron a la primera. Una tarde y una vía de acceso no bastan para decir que Flash falla más; como referencia de velocidad, Artificial Analysis mide 142 tokens por segundo en Flash frente a 82 en Argon.
Quedaron fuera el endpoint directo de Google, Vertex AI, Batch y Flex, las sesiones largas de agente, la app de Gemini y Antigravity. El gasto total, incluidas las ejecuciones descartadas, fue de unos USD 0,32 a precio de tarifa.
Por qué 2,67 veces por token no son 2,67 veces por tarea
Lo que pagas por una tarea es la entrada por su precio más la salida y el razonamiento por el precio de salida, y 3.8 Flash suele gastar más tokens de salida que Argon para llegar al mismo sitio. En la prueba del 23 de octubre de 2026, Flash usó 6.435 tokens de salida y razonamiento en las cinco tareas por defecto y Argon 2.843. En el Intelligence Index de Artificial Analysis, con los dos en high, Flash gastó unos 71.000 tokens de salida por tarea y Argon unos 62.000, de los que 43.000 y 36.000 fueron de razonamiento. Por eso Argon costó USD 1,99 por tarea frente a USD 1,24 de Flash, 1,6 veces y no 2,67. Son dos métodos distintos que no se pueden mezclar en una misma cifra, pero llevan a la misma conclusión: el razonamiento extra de Flash se come parte de su descuento por token.
El descuento de Flash se nota más cuanto más pesa la entrada. Un resumen como t4 lleva unos 11.000 tokens de entrada y solo entre 1.100 y 2.200 de salida: la entrada supone cerca de la mitad del coste en Flash (USD 0,0084 de USD 0,0166) y dos tercios en Argon (USD 0,0222 de USD 0,0332), y por eso la proporción llega a 1,99, la más alta de las cinco tareas, aunque sin alcanzar el 2,67 de la tarifa. Si tu tráfico se parece a 100.000 resúmenes de ese tamaño al mes, la cuenta con los tokens de la prueba queda así (cálculo, no medición):
| Periodo | 3.8 Flash, 100.000 resúmenes tipo t4 | Argon, 100.000 resúmenes tipo t4 |
|---|---|---|
| Hasta el 30 de noviembre de 2026 | USD 1.663 | USD 3.317 |
| Del 1 al 31 de diciembre de 2026 | USD 1.663 | USD 6.635 |
| Desde el 1 de enero de 2027 | USD 3.326 | USD 6.635 |
Con 100.000 llamadas cortas como t1 la relación se invierte: USD 177,60 en Flash frente a USD 139,60 en Argon hasta el 30 de noviembre de 2026, siempre que Argon siga sin razonar en ese tipo de peticiones. Para calcular tu caso, mide durante unos días cuántos tokens de entrada, de razonamiento y de salida devuelve cada modelo con tus peticiones reales y multiplícalos por la tarifa de cada periodo.
Qué llamadas dejar en 3.8 Flash y cuáles pasar a Argon
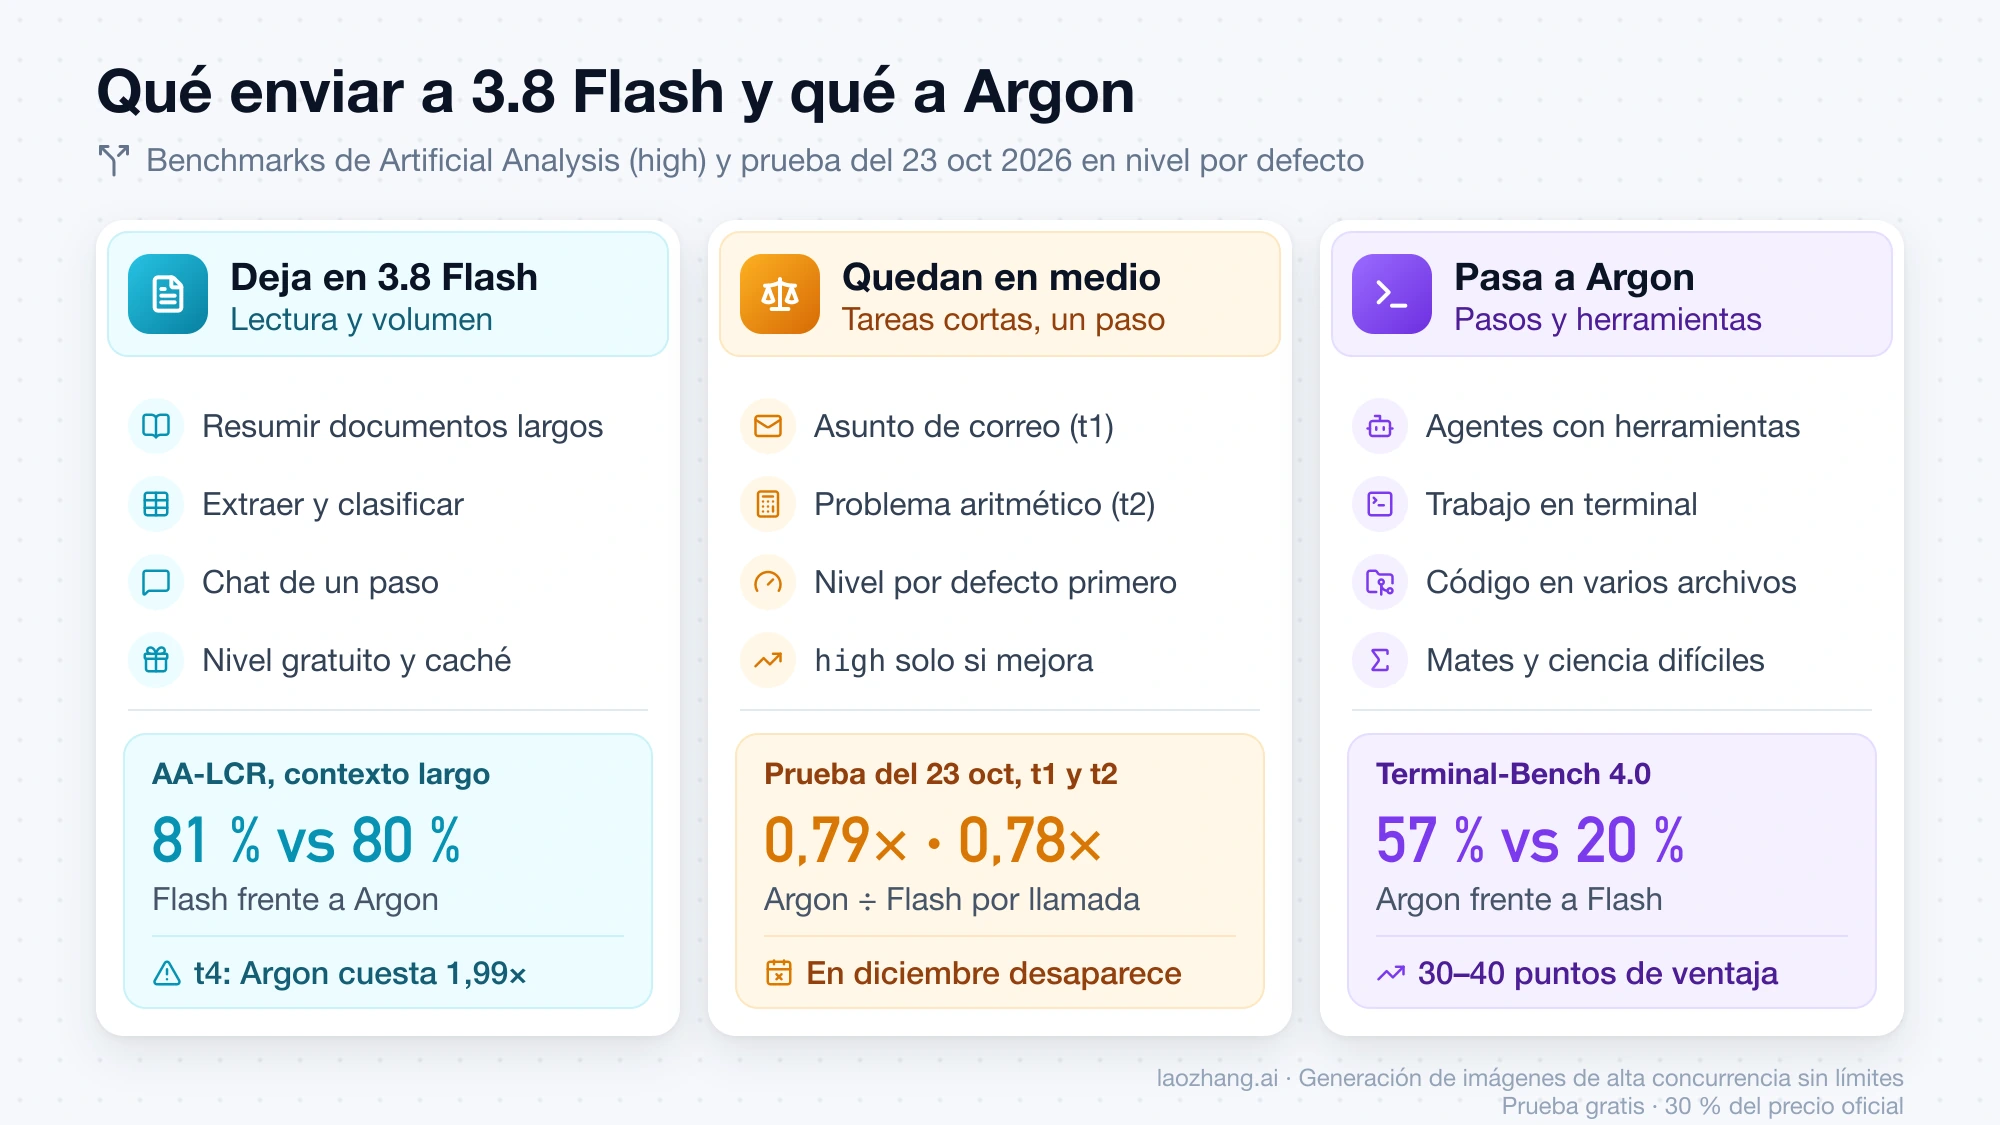
Reparte por tipo de trabajo en lugar de elegir un solo modelo. Deja en 3.8 Flash la lectura y el resumen de documentos largos, la extracción de datos y la clasificación, porque en contexto largo los dos rinden casi igual y Argon cuesta el doble en ese tipo de llamada. Deja también en Flash las respuestas de chat de un paso, aunque aquí el motivo no es el precio sino la velocidad y el volumen: Flash es más rápido generando texto y sigue siendo la única de las dos opciones con nivel gratuito y con caché explícita. Google lo presenta como el modelo de trabajo diario, y para ese volumen no hace falta más.
Pasa a Argon las tareas de agente con herramientas, el trabajo en terminal, los cambios de código que tocan varios archivos y los problemas de matemáticas o ciencia que Flash no resuelve tras un par de intentos. Ahí la diferencia en Terminal-Bench, FrontierSWE o ARC-AGI-3 es de 30 a 40 puntos y los informes de usuarios coinciden en que Argon termina en menos pasos, así que un coste por token más alto puede acabar en una factura por tarea parecida. Un autor de la publicación de Google Cloud en Medium llega a decir que, en Antigravity, el coste por tarea de Argon es comparable al de Flash; es una afirmación suya sobre su uso, no una cifra que puedas trasladar sin medir.
Si solo miras el coste, las tareas cortas de un paso quedan en medio. En la prueba del 23 de octubre de 2026 Argon fue incluso un poco más barato que Flash por llamada en t1 y t2 (0,79 y 0,78 veces), pero esa ventaja desaparece del 1 al 31 de diciembre de 2026, cuando Argon dobla su tarifa, y no cubre el nivel gratuito, así que mover el chat a Argon solo por precio no compensa. Si mueves alguna de estas tareas, empieza en el nivel por defecto: sube a high solo en las tareas donde compruebes que mejora la respuesta, porque en la prueba ese nivel encareció las cinco tareas de Argon 2,15 veces respecto a su nivel por defecto (USD 0,1110 frente a USD 0,0516).
Qué cambiar en el código al pasar de gemini-3.8-flash a gemini-4-argon
Cambiar el ID no basta. La guía de Google para migrar al último modelo enumera los ajustes, y estos son los que afectan a una integración que hoy usa Flash:
- Comprueba que el proyecto tiene facturación activa antes de cambiar el ID. Argon no está en el nivel gratuito de la API, así que una clave que hoy funciona gratis con Flash fallará con Argon; qué sigue siendo gratis lo explica la guía Gemini API free tier 2026: modelos gratis, límites y API key.
- Sube
max_output_tokensa 32.768 como mínimo, porque Argon puede gastar más parte de ese límite en razonar. En llamadas síncronas el máximo es 65.536 tokens y por encima la API devuelve un error 400; las salidas más largas, hasta 1.048.576 tokens, necesitanbackground=True. - Elimina la caché explícita (
cachedContents), que Argon no admite. Argon aplica caché implícita por defecto a las peticiones de 4.096 tokens o más, con un 95 % de descuento en los aciertos; si con Flash pagabas almacenamiento de caché (USD 0,50 por millón de tokens y hora hasta el 31 de diciembre de 2026), ese coste desaparece, pero ya no controlas qué se guarda. - Quita
temperature,top_pytop_k, que Argon ignora. - Amplía el tiempo de espera del cliente a 15 minutos o más para las peticiones difíciles, porque con un límite corto el cliente corta respuestas que Argon todavía está generando.
- Prueba tu carga en
low,mediumyhigh. Los dos modelos usanmediumpor defecto y ninguno aceptaminimal. Si llamas a Argon a través de un endpoint compatible con OpenAI, comprueba quereasoning_effortcambia de verdad los tokens de razonamiento; en la prueba del 23 de octubre de 2026 no lo hizo, y el ajuste solo funcionó conthinkingConfig.thinkingLevelen el endpoint nativo. - En conversaciones de varios turnos con la Interactions API, encadena las peticiones con
previous_interaction_id.
Para una primera prueba sin cuenta de facturación de Google, LaoZhang API ofrece los dos modelos con las mismas tarifas de lanzamiento que Google por el endpoint nativo y el compatible con OpenAI; qué hará con el precio de Argon a partir del 1 de diciembre de 2026 no está publicado. Las tarifas de Flash y su subida de 2027 están detalladas en Clave de API de Gemini gratis y precio: qué sube en 2027.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Quién puede usar Argon en la app de Gemini, Antigravity y Gemini CLI
En la app de Gemini, Argon solo está en Google AI Pro y Ultra, según el artículo de ayuda de Google sobre los modelos de Gemini a 23 de octubre de 2026; Google AI Plus no lo incluye y sin plan solo tienes Auto o Flash-Lite. En el selector aparecen como «3.8 Flash» y «4 Argon», y en la app el nivel de razonamiento por defecto es Low. Google no publica cuántos mensajes permite cada modelo: el límite es un consumo compartido que se renueva cada 5 horas hasta un tope semanal, y la ayuda dice que los modelos más avanzados y los niveles de razonamiento más altos gastan más de ese límite. En r/GeminiAI hay usuarios que cuentan haber agotado el uso de Argon tras unos 10 mensajes, que es un testimonio, no una cifra oficial.
En Antigravity, la tabla de modelos de Antigravity a 23 de octubre de 2026 da 3.8 Flash en todos los planes, Free incluido, y Argon solo en Google AI Pro de pago (o en prueba con dispositivos premium que cumplan los requisitos), Ultra y Enterprise; Argon funciona en la app, la CLI y las extensiones de Antigravity para IDE, no en el IDE de Antigravity. Varun Mohan, de Google, escribió en X el 15 de octubre de 2026 que en Pro Argon tiene una cuota semanal aparte para no gastar la de Flash, algo que la documentación todavía no recoge. El repositorio de Gemini CLI en GitHub avisa de que la herramienta no está optimizada para Argon y remite a Antigravity; un usuario de Threads midió en Gemini CLI que un turno de Argon en high le consumió 27,8 veces la cuota de un turno de Flash en high, en una sola prueba. Si Flash te va lento en Antigravity, el diagnóstico está en Gemini 3.8 Flash va lento en Antigravity: qué está esperando.
Gemini 4 Argon y 3.8 Flash: otras preguntas
¿Existe Gemini 4 Flash?
No. A 23 de octubre de 2026 no hay ningún modelo gemini-4-flash en la lista de modelos ni en las notas de versión de la API de Gemini, y Google solo dice en el anuncio de Argon que traerá «el resto de la familia Gemini 4», sin fecha. Los mensajes de Reddit sobre 3.8 Flash redirigido a un Gemini 4 Flash son rumores, y el nombre gemini-4-flash-preview que figuró en el SDK de Python de Google entre junio y agosto de 2026 se retiró sin anuncio. Si todavía llamas a gemini-3.7-flash, Google lo redirige a gemini-3.8-flash desde el 8 de octubre de 2026.
¿Gemini 4 Argon es mejor que Claude Opus 5.5 o GPT-6.1 Sol?
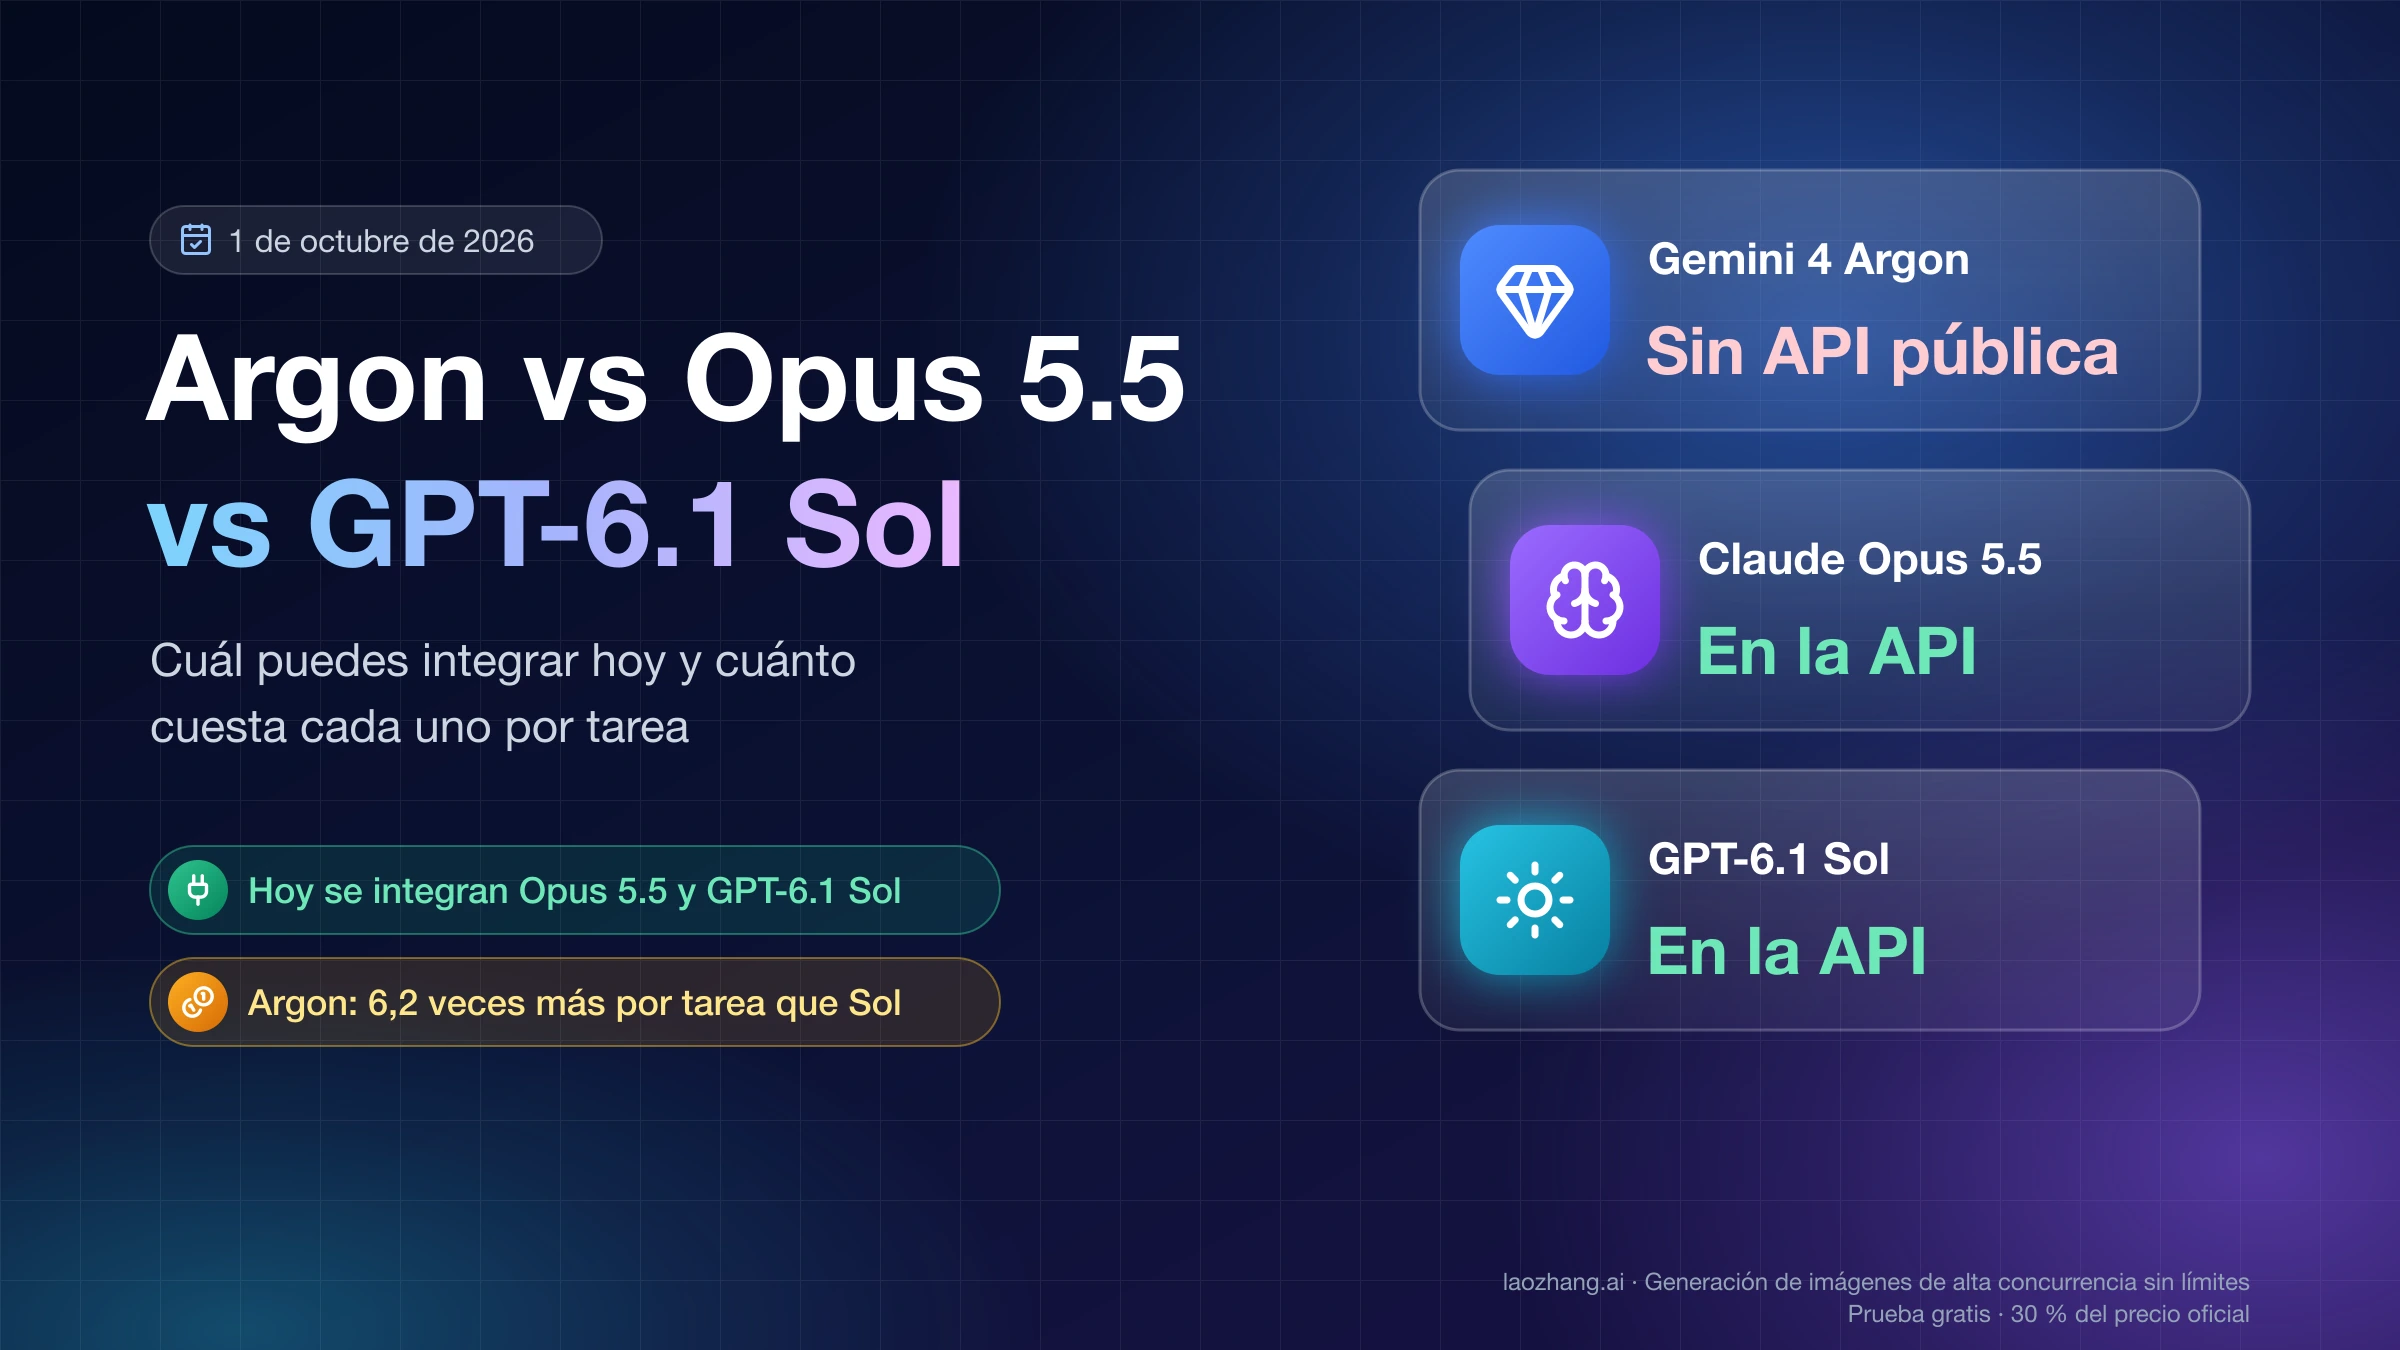
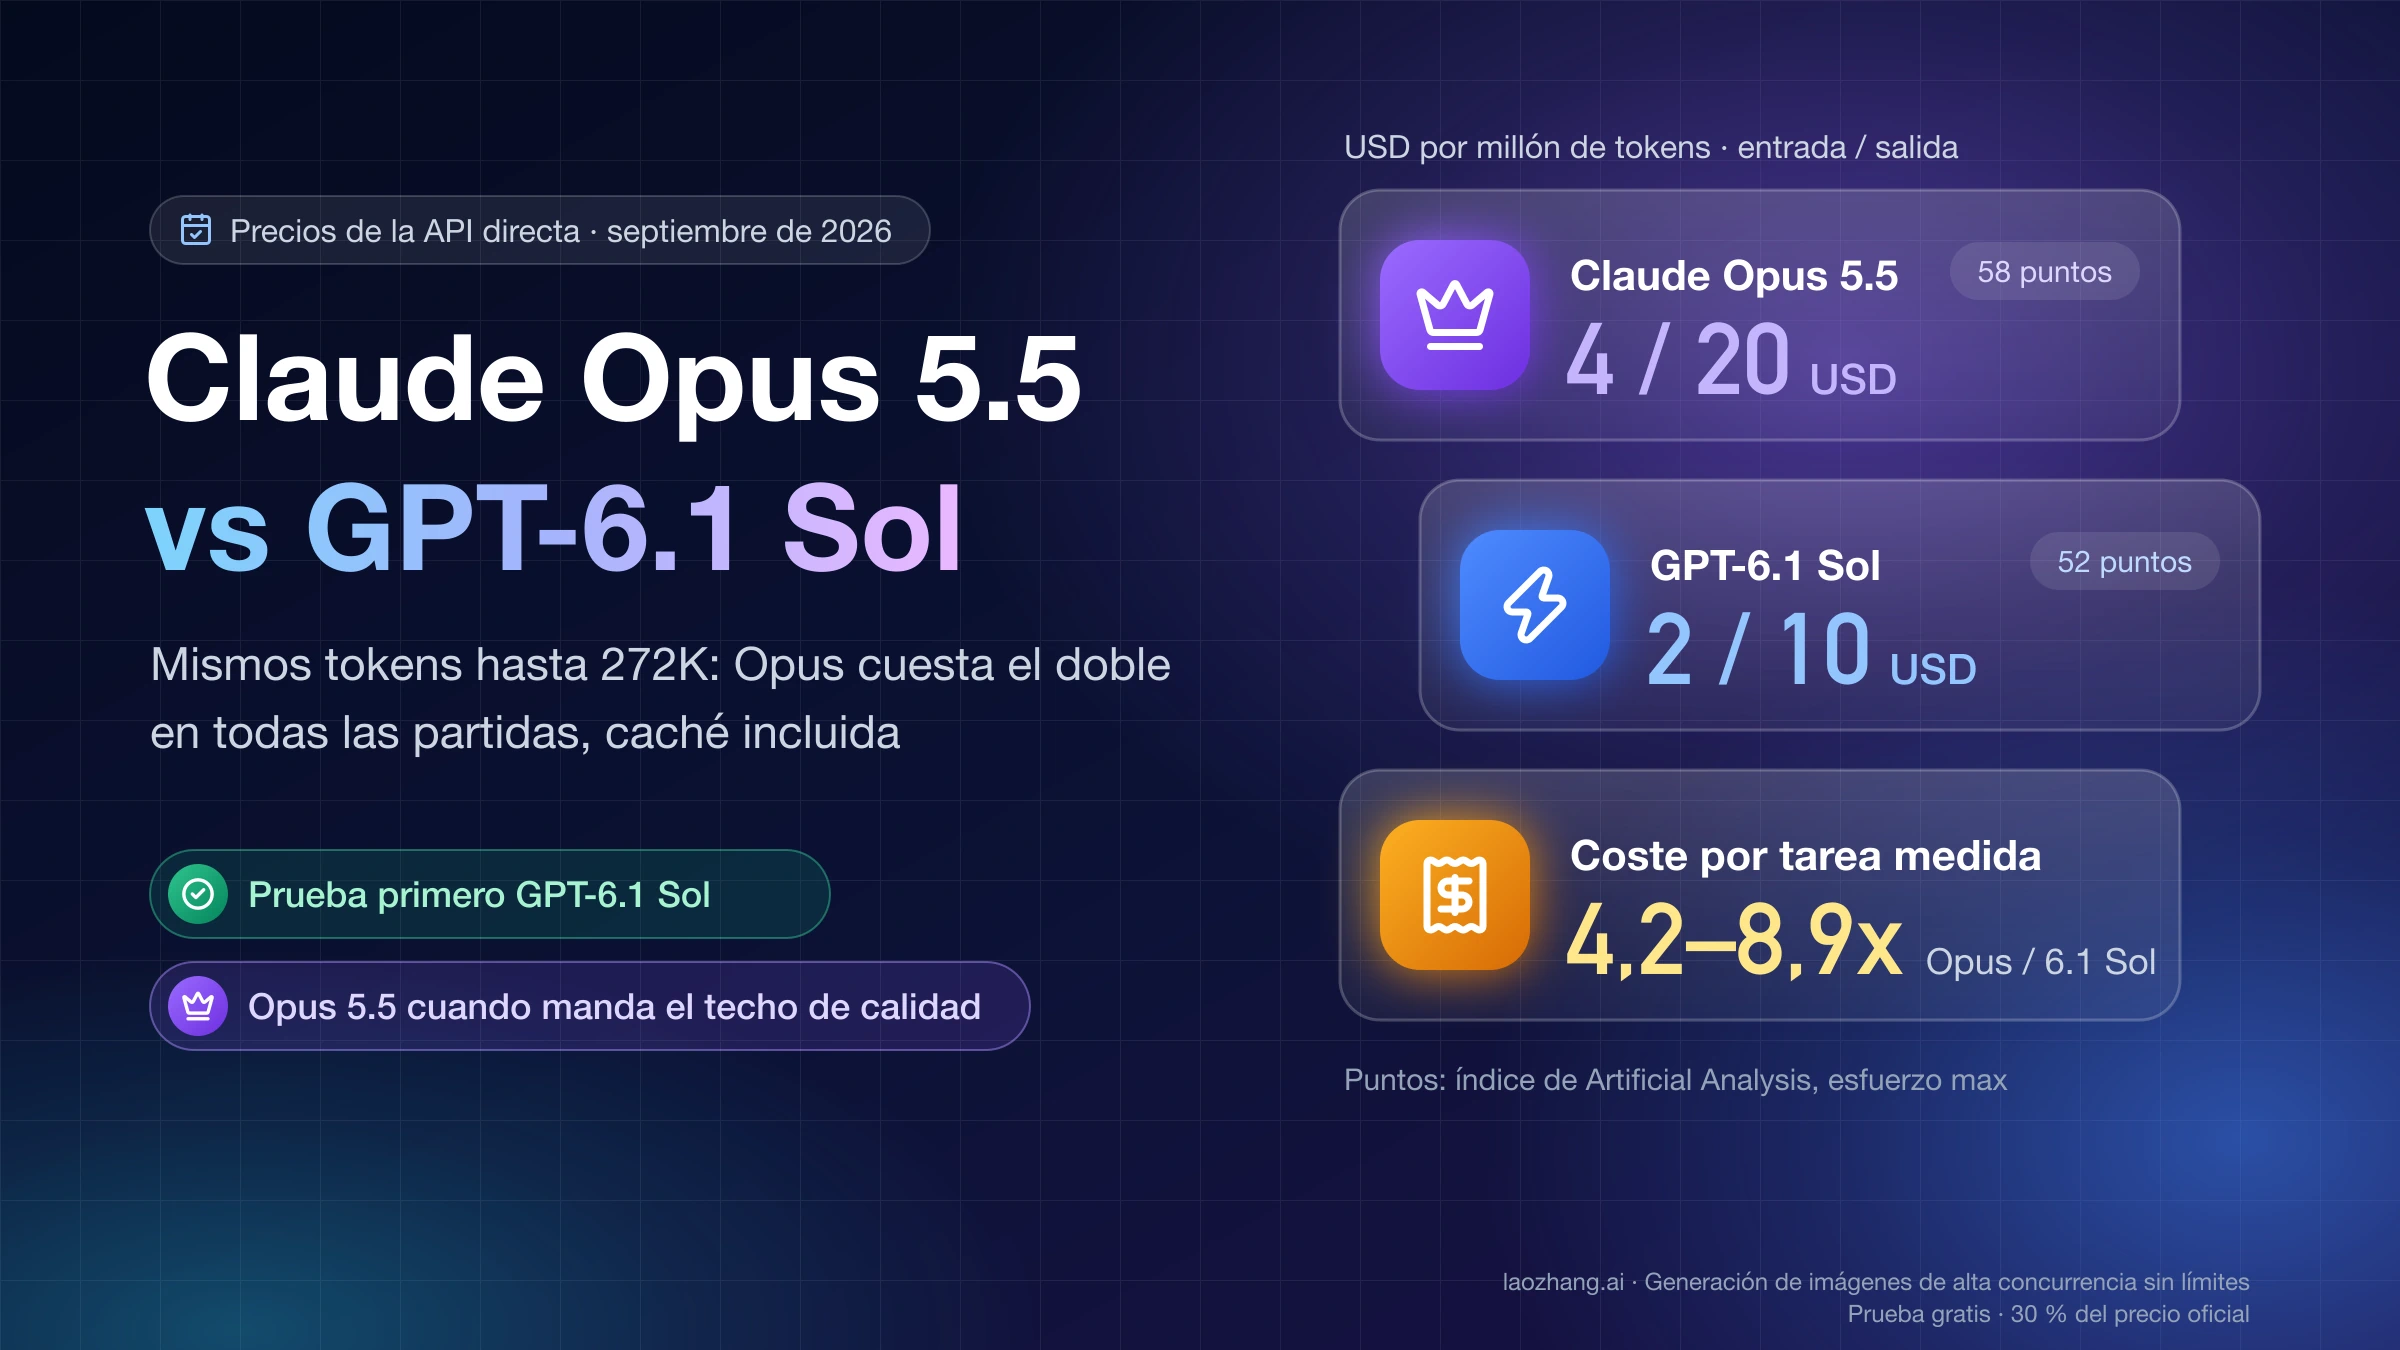
Es otra decisión, con otras tarifas y otros benchmarks, y la comparación con los modelos de otras empresas está en Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy. Qué modelos de la nueva generación ya se pueden usar lo resume Fable 5.5 vs Gemini 4 vs GPT-6.1: Argon ya salió, Fable 5.5 no.
¿Google retira Gemini 3.8 Flash con la llegada de Argon?
No hay fecha de retirada anunciada. A 23 de octubre de 2026 la página de modelos de la API marca 3.8 Flash y Argon como estables, y Flash sigue siendo el modelo con nivel gratuito, así que puedes mantener las dos integraciones en paralelo.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 23 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 23 oct 2026.
- 1.comparativa de Gemini 4 Argon y Gemini 3.8 Flashartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash
- 2.BenchLM entre Gemini 3.8 Flash y Gemini 4 Argonbenchlm.ai/compare/gemini-3-8-flash-vs-gemini-4-argon
- 3.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 4.guía de Google para migrar al último modeloai.google.dev/gemini-api/docs/latest-model
- 5.artículo de ayuda de Google sobre los modelos de Geminisupport.google.com/gemini/answer/18648722
- 6.tabla de modelos de Antigravityantigravity.google/docs/models
- 7.repositorio de Gemini CLI en GitHubgithub.com/google-gemini/gemini-cli