Claude Opus 5.5 vs GPT-6.1 Terra: coste real y cuándo cambiarse
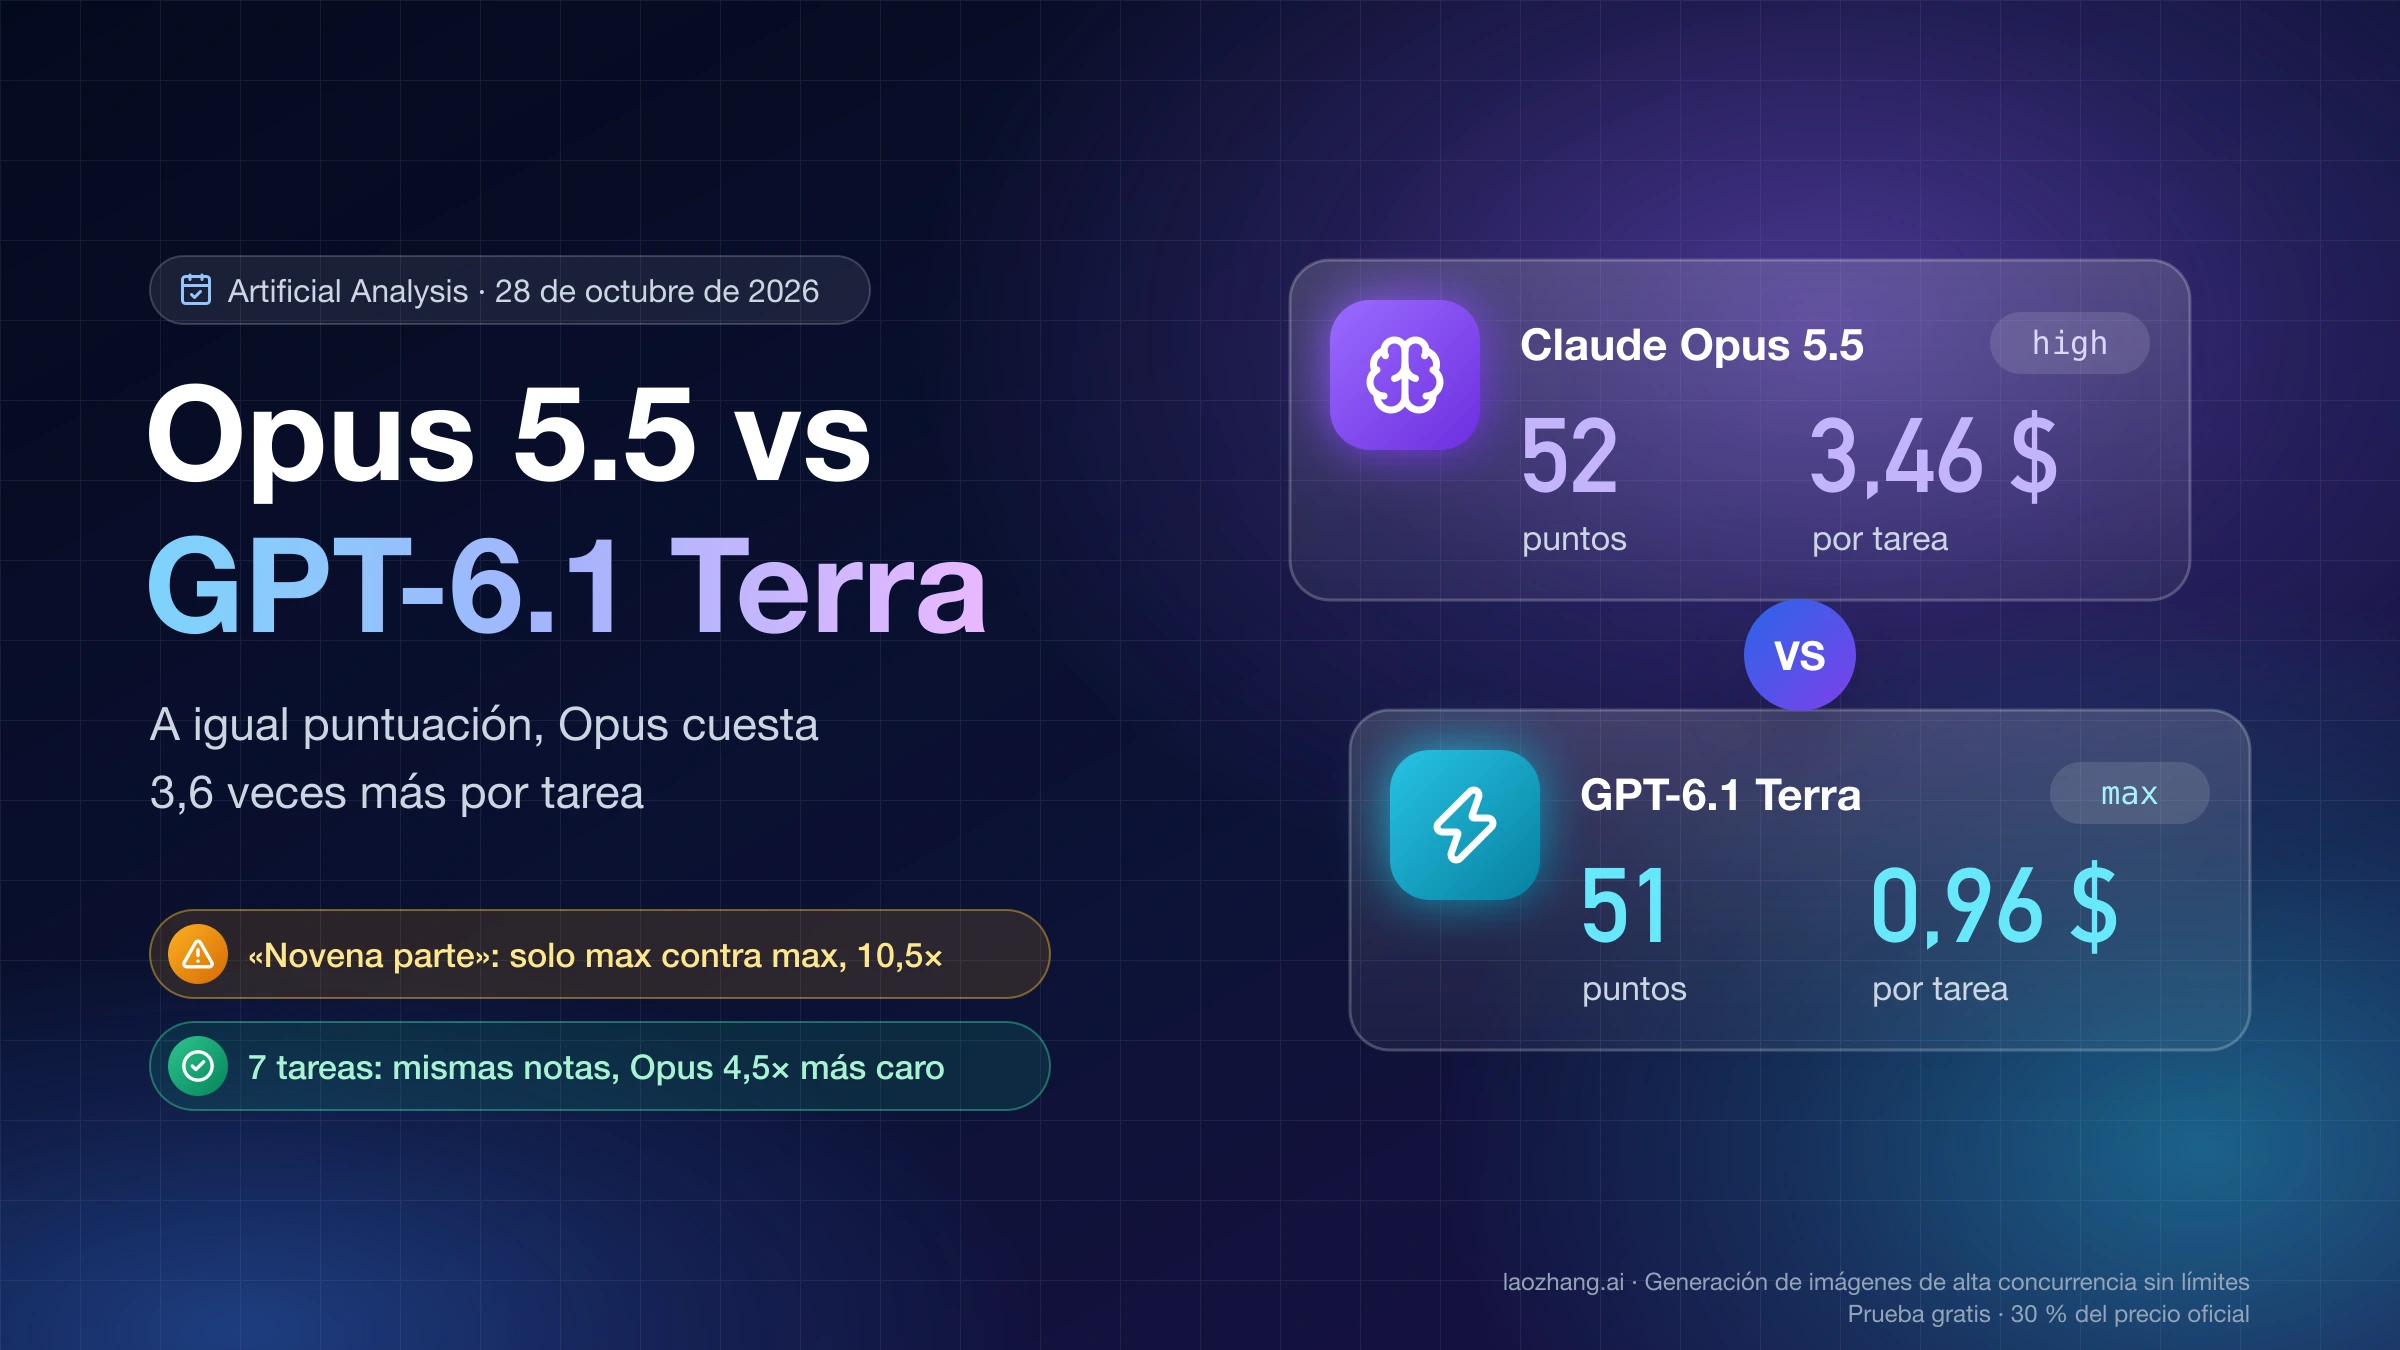
La «novena parte» de OpenAI es max contra max. A igual puntuación en Artificial Analysis, Claude Opus 5.5 cuesta 3,6 veces más por tarea que GPT-6.1 Terra.
En esta página
Si hoy pagas Claude Opus 5.5 (claude-opus-5-5) por la API o en Claude Code, GPT-6.1 Terra (gpt-6.1-terra) puede quedarse con buena parte de ese trabajo, pero no con todo. Pasa a Terra las tareas de programación bien definidas, las que tienen tests o una respuesta comprobable, y el código técnico o científico; empieza con el nivel de razonamiento (reasoning effort) en high y súbelo a max si falla, teniendo en cuenta que, en una prueba del 28 de octubre de 2026 a través de LaoZhang API, max solo funcionó por la Responses API (la API directa de OpenAI no se probó). Deja en Opus 5.5, en high o por encima, el trabajo con documentos, el análisis de finanzas, derecho o estrategia y cualquier tarea que pida más nivel del que Terra alcanza.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
La «novena parte del coste» que anunció OpenAI el 26 de octubre de 2026 solo aparece al comparar los dos modelos en max, donde Opus puntúa bastante más. A igual puntuación en Artificial Analysis (Intelligence Index v5.0, consultado el 28 de octubre de 2026), Opus en high saca 52 puntos y Terra en max 51: Opus cuesta 3,6 veces más por tarea y, aun así, termina antes. En una prueba del 28 de octubre de 2026 con siete tareas idénticas, los dos modelos aprobaron todas sus llamadas y Opus costó 4,5 veces más a precio de lista.
La cuenta cambia en tres casos. Si escribes los prompts en español, Opus cuenta 1,84 veces más tokens para el mismo texto, así que esa entrada te sale unas 7,4 veces más cara que en Terra. Con prompts de más de 272.000 tokens, Terra pasa a su tarifa de contexto largo y la diferencia se reduce. Y en ChatGPT, Terra solo está en Work y en Codex, no en el chat normal.
¿Es cierto que GPT-6.1 Terra cuesta una novena parte que Opus 5.5?
Es cierto en un caso concreto: los dos modelos con el nivel de razonamiento en max. En el anuncio de GPT-6.1 Terra en el blog de OpenAI, del 26 de octubre de 2026, la empresa explica que en max Terra aprovecha los tokens más de tres veces mejor que Claude Opus 5.5 y cobra una cuarta parte por token, de modo que cada tarea cuesta aproximadamente una novena parte. Las mediciones independientes de Artificial Analysis (AA) cuadran con esa cifra: en max, Opus cuesta 10,04 $ por tarea del índice y Terra 0,96 $, 10,5 veces menos, en buena parte porque Opus genera 173.000 tokens de salida por tarea frente a 60.000 de Terra.
El problema es que max contra max no compara dos resultados iguales. En el mismo índice, Opus en max puntúa 58 y Terra en max 51, siete puntos de diferencia, y Opus tarda 1.133 segundos por tarea frente a 657. Si necesitas el nivel de Opus max, Terra no lo ofrece a ningún precio; si te basta con lo que da Terra max, la comparación justa es con el nivel de Opus que saca la misma nota, que cuesta mucho menos que su max.
El propio anuncio pone otro límite: para las tareas de programación más complejas, OpenAI sigue recomendando GPT-6.1 Sol o GPT-6 Astra, no Terra. Terra se presenta como un modelo rápido y eficiente para razonamiento visual, uso del ordenador (computer use) y redacción clara, y las comparaciones con Opus de ese anuncio son evaluaciones de la propia OpenAI.
Opus 5.5 frente a GPT-6.1 Terra a igual puntuación, nivel por nivel
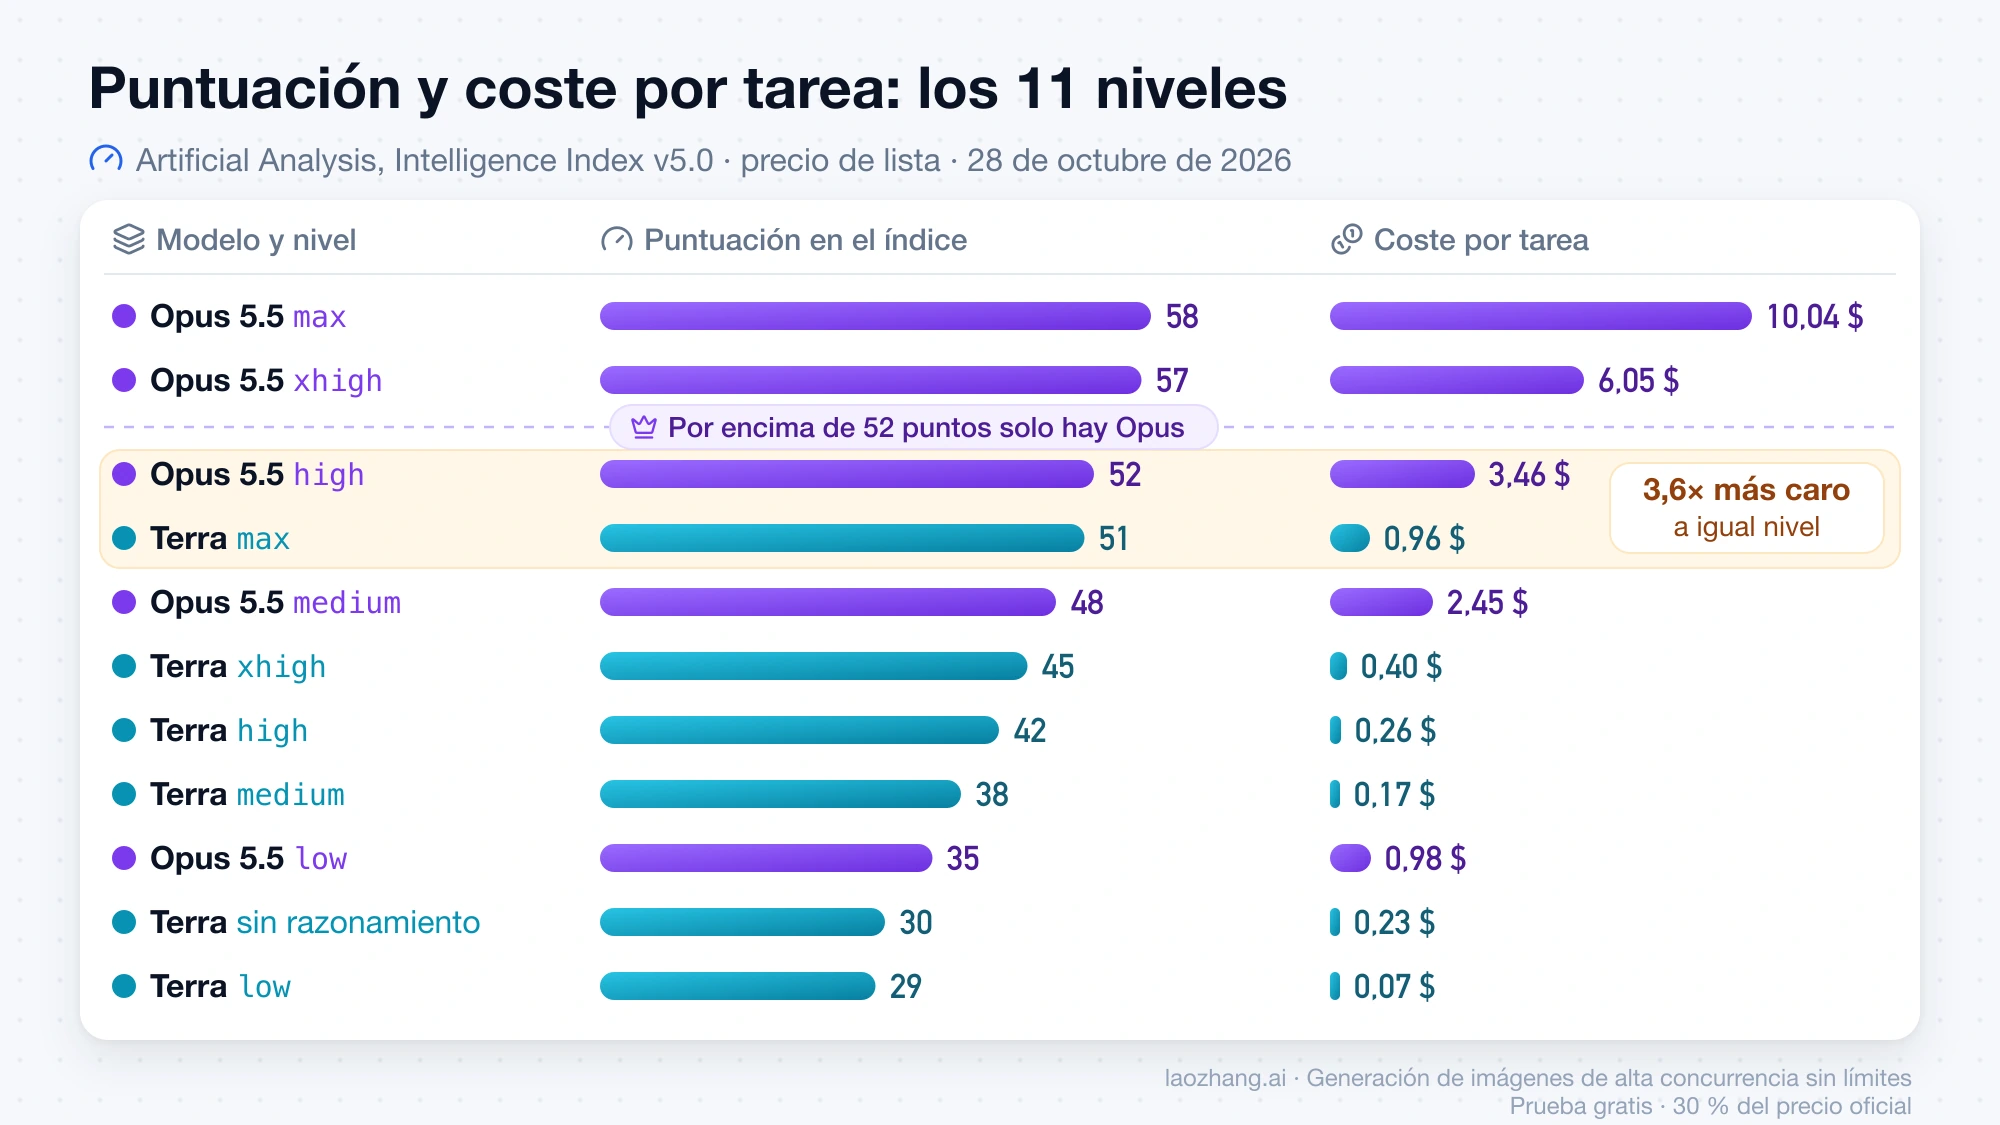
Comparar por puntuación y no por el nombre del nivel cambia la respuesta. En AA (Intelligence Index v5.0, a 28 de octubre de 2026), Opus 5.5 en high obtiene 52 puntos y GPT-6.1 Terra en max 51: Opus cuesta 3,46 $ por tarea frente a 0,96 $ y tarda 464 segundos por tarea frente a 657. Si hoy usas Opus en high, ese es el par que tiene sentido comparar, y la diferencia que verás ahí es de 3,6 veces, no de 10,5.
| Modelo y nivel de razonamiento | Intelligence Index v5.0 | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
Opus 5.5 max | 58 | 10,04 $ | 1.133 s |
Opus 5.5 xhigh | 57 | 6,05 $ | 779 s |
Opus 5.5 high | 52 | 3,46 $ | 464 s |
GPT-6.1 Terra max | 51 | 0,96 $ | 657 s |
Opus 5.5 medium | 48 | 2,45 $ | 337 s |
GPT-6.1 Terra xhigh | 45 | 0,40 $ | 287 s |
GPT-6.1 Terra high | 42 | 0,26 $ | 182 s |
GPT-6.1 Terra medium | 38 | 0,17 $ | 118 s |
Opus 5.5 low | 35 | 0,98 $ | 147 s |
| GPT-6.1 Terra sin razonamiento | 30 | 0,23 $ | 104 s |
GPT-6.1 Terra low | 29 | 0,07 $ | 48 s |
Fuente: comparativa de versiones de Claude Opus 5.5 y GPT-6.1 Terra en Artificial Analysis. El coste por tarea es la mezcla de tokens de AA a precio de lista, con una sola ejecución por configuración.
Leída por filas, la tabla deja tres conclusiones. Opus en medium (48) queda por debajo de Terra en max (51) y cuesta 2,6 veces más, aunque Terra tarda casi el doble por tarea (657 segundos frente a 337). Opus en low cuesta casi lo mismo que Terra en max (0,98 $ frente a 0,96 $) con 16 puntos menos, así que no tiene sentido como opción barata. Y por encima de 52 puntos solo existe Opus: xhigh saca 57 y max 58, con costes de 6,05 $ y 10,04 $ por tarea.
Si en otras páginas ves comparaciones de 54 frente a 48 o de 58 frente a 48, vienen del índice anterior de AA, la versión 4.3.2, que AA sustituyó por la 5.0 entre el 27 y el 28 de octubre de 2026. Con la versión antigua, Terra max sacaba 48 puntos y tardaba 384 segundos por tarea; las dos versiones usan evaluaciones distintas y sus cifras no se pueden mezclar.
Dónde gana Opus 5.5 y dónde GPT-6.1 Terra en las pruebas de AA
Con Opus en high y Terra en max, el reparto es claro: Terra gana en código difícil y en problemas científicos, y Opus en conocimiento experto y trabajo de oficina. El Intelligence Index es la media de nueve evaluaciones de temas distintos, no una nota de programación, así que la fila que más se parezca a tu trabajo pesa más que el índice global.
| Evaluación de AA (v5.0) | Opus 5.5 high | GPT-6.1 Terra max | Opus 5.5 max |
|---|---|---|---|
| FrontierCode 2.0 | 35,9 % | 42,3 % | 46,4 % |
| CritPt v2 (subconjunto difícil) | 58,0 % | 64,5 % | 61,0 % |
| Terminal-Bench-Science 0.1 | 49,0 % | 57,6 % | 59,0 % |
| Terminal-Bench 4.0 | 56,6 % | 55,6 % | 59,6 % |
| AutomationBench-AA | 63,2 % | 60,2 % | 69,5 % |
| HLE-Diamond | 55,6 % | 47,3 % | 67,9 % |
| AA-Briefcase v1.1 (puntos) | 1.681 | 1.402 | 1.800 |
En los índices por sector de AA, Opus high va por delante de Terra max en los cinco: finanzas y contabilidad (53 frente a 49), estrategia y operaciones (58 frente a 50), derecho (52 frente a 46), ingeniería (58 frente a 54) y economía (57 frente a 49). En Terminal-Bench 4.0 y GDP.pdf (28,8 % frente a 28,6 %) están prácticamente empatados. La cifra de OpenAI sobre Terminal-Bench-Science también cuadra: en max, Terra se queda a 1,4 puntos de Opus.
Prueba del 28 de octubre de 2026: mismas notas, Opus 4,5 veces más caro
El 28 de octubre de 2026 se enviaron las mismas siete tareas a los dos modelos con una sola clave de LaoZhang API (laozhang.ai): Opus 5.5 por la API de Messages de Anthropic con thinking adaptativo y output_config.effort en high, y Terra por Chat Completions con reasoning_effort en high. Cada llamada llevaba un único mensaje, sin herramientas y con streaming, y las pruebas ocultas de cada tarea se escribieron antes de ver ninguna respuesta. El coste sale de los tokens que devolvió cada API multiplicados por los precios de lista de Anthropic y OpenAI; la pasarela listaba ese día los dos modelos y cobra gpt-6.1-terra con la misma fórmula que la tarifa de OpenAI y claude-opus-5-5 a 4 $ y 20 $ por millón de tokens.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Tarea (pruebas ocultas) | Opus 5.5 aprobadas | Terra aprobadas | Opus por llamada | Terra por llamada | Diferencia |
|---|---|---|---|---|---|
Evaluador de expresiones sin eval (25) | 1/1 | 2/2 | 0,0389 $ | 0,0106 $ | 3,7× |
Parser de una línea CSV sin el módulo csv (16) | 1/1 | 2/2 | 0,0184 $ | 0,0030 $ | 6,2× |
| Contar números menores de 1.000.000 cuyos dígitos suman 27 | 1/1 | 2/2 | 0,0178 $ | 0,0021 $ | 8,4× |
| Rangos de versiones al estilo npm (36) | 2/2 | 2/2 | 0,0640 $ | 0,0169 $ | 3,8× |
| Documento de casi 7.000 palabras con tres notas escondidas | 1/1 | 2/2 | 0,0667 $ | 0,0106 $ | 6,3× |
| Detectar funciones inventadas de la biblioteca estándar de Python 3.13 | 2/2 | 2/2 | 0,0056 $ | 0,0008 $ | 7,3× |
next_run para expresiones cron de cinco campos (41) | 3/3 | 3/3 | 0,0698 $ | 0,0192 $ | 3,6× |
| Las siete tareas, una llamada media de cada una | 11/11 | 15/15 | 0,2812 $ | 0,0632 $ | 4,5× |
Ninguna tarea separó a los dos modelos: Opus aprobó 11 de 11 llamadas y Terra 15 de 15, incluidas la de versiones npm y la de funciones inventadas, que MiniMax M3.1 Flash había fallado el 26 de octubre. La diferencia de coste depende de la longitud de la respuesta. En las respuestas de código largas, los dos escribieron casi los mismos tokens (3.066 frente a 3.294 en la de versiones, 3.391 frente a 3.763 en la de cron), así que la diferencia se queda cerca del precio por token, unas cuatro veces; en las respuestas cortas, Opus escribió el doble y la diferencia sube hasta 8,4 veces. El tiempo por llamada fue parecido: 32,2 segundos frente a 27,5 en la tarea de cron y 5,1 frente a 4,5 en la del documento.
La prueba no dice dónde gana Opus. Compara Terra en high, que en AA saca 42 puntos, con Opus en high, que saca 52, y las siete tareas no fueron lo bastante difíciles para notar esa distancia. Tampoco cubrió llamadas a herramientas, agentes de varios pasos, imágenes, contextos de más de unos 15.000 tokens ni los niveles max, y los tiempos se midieron desde un solo Mac en Asia a través de la pasarela, no como benchmark de latencia. Para trabajo con terminal, documentos o agentes, las evaluaciones de AA son la referencia.
Cuánto más pagarás con Opus 5.5: precio por token × tokens × nivel
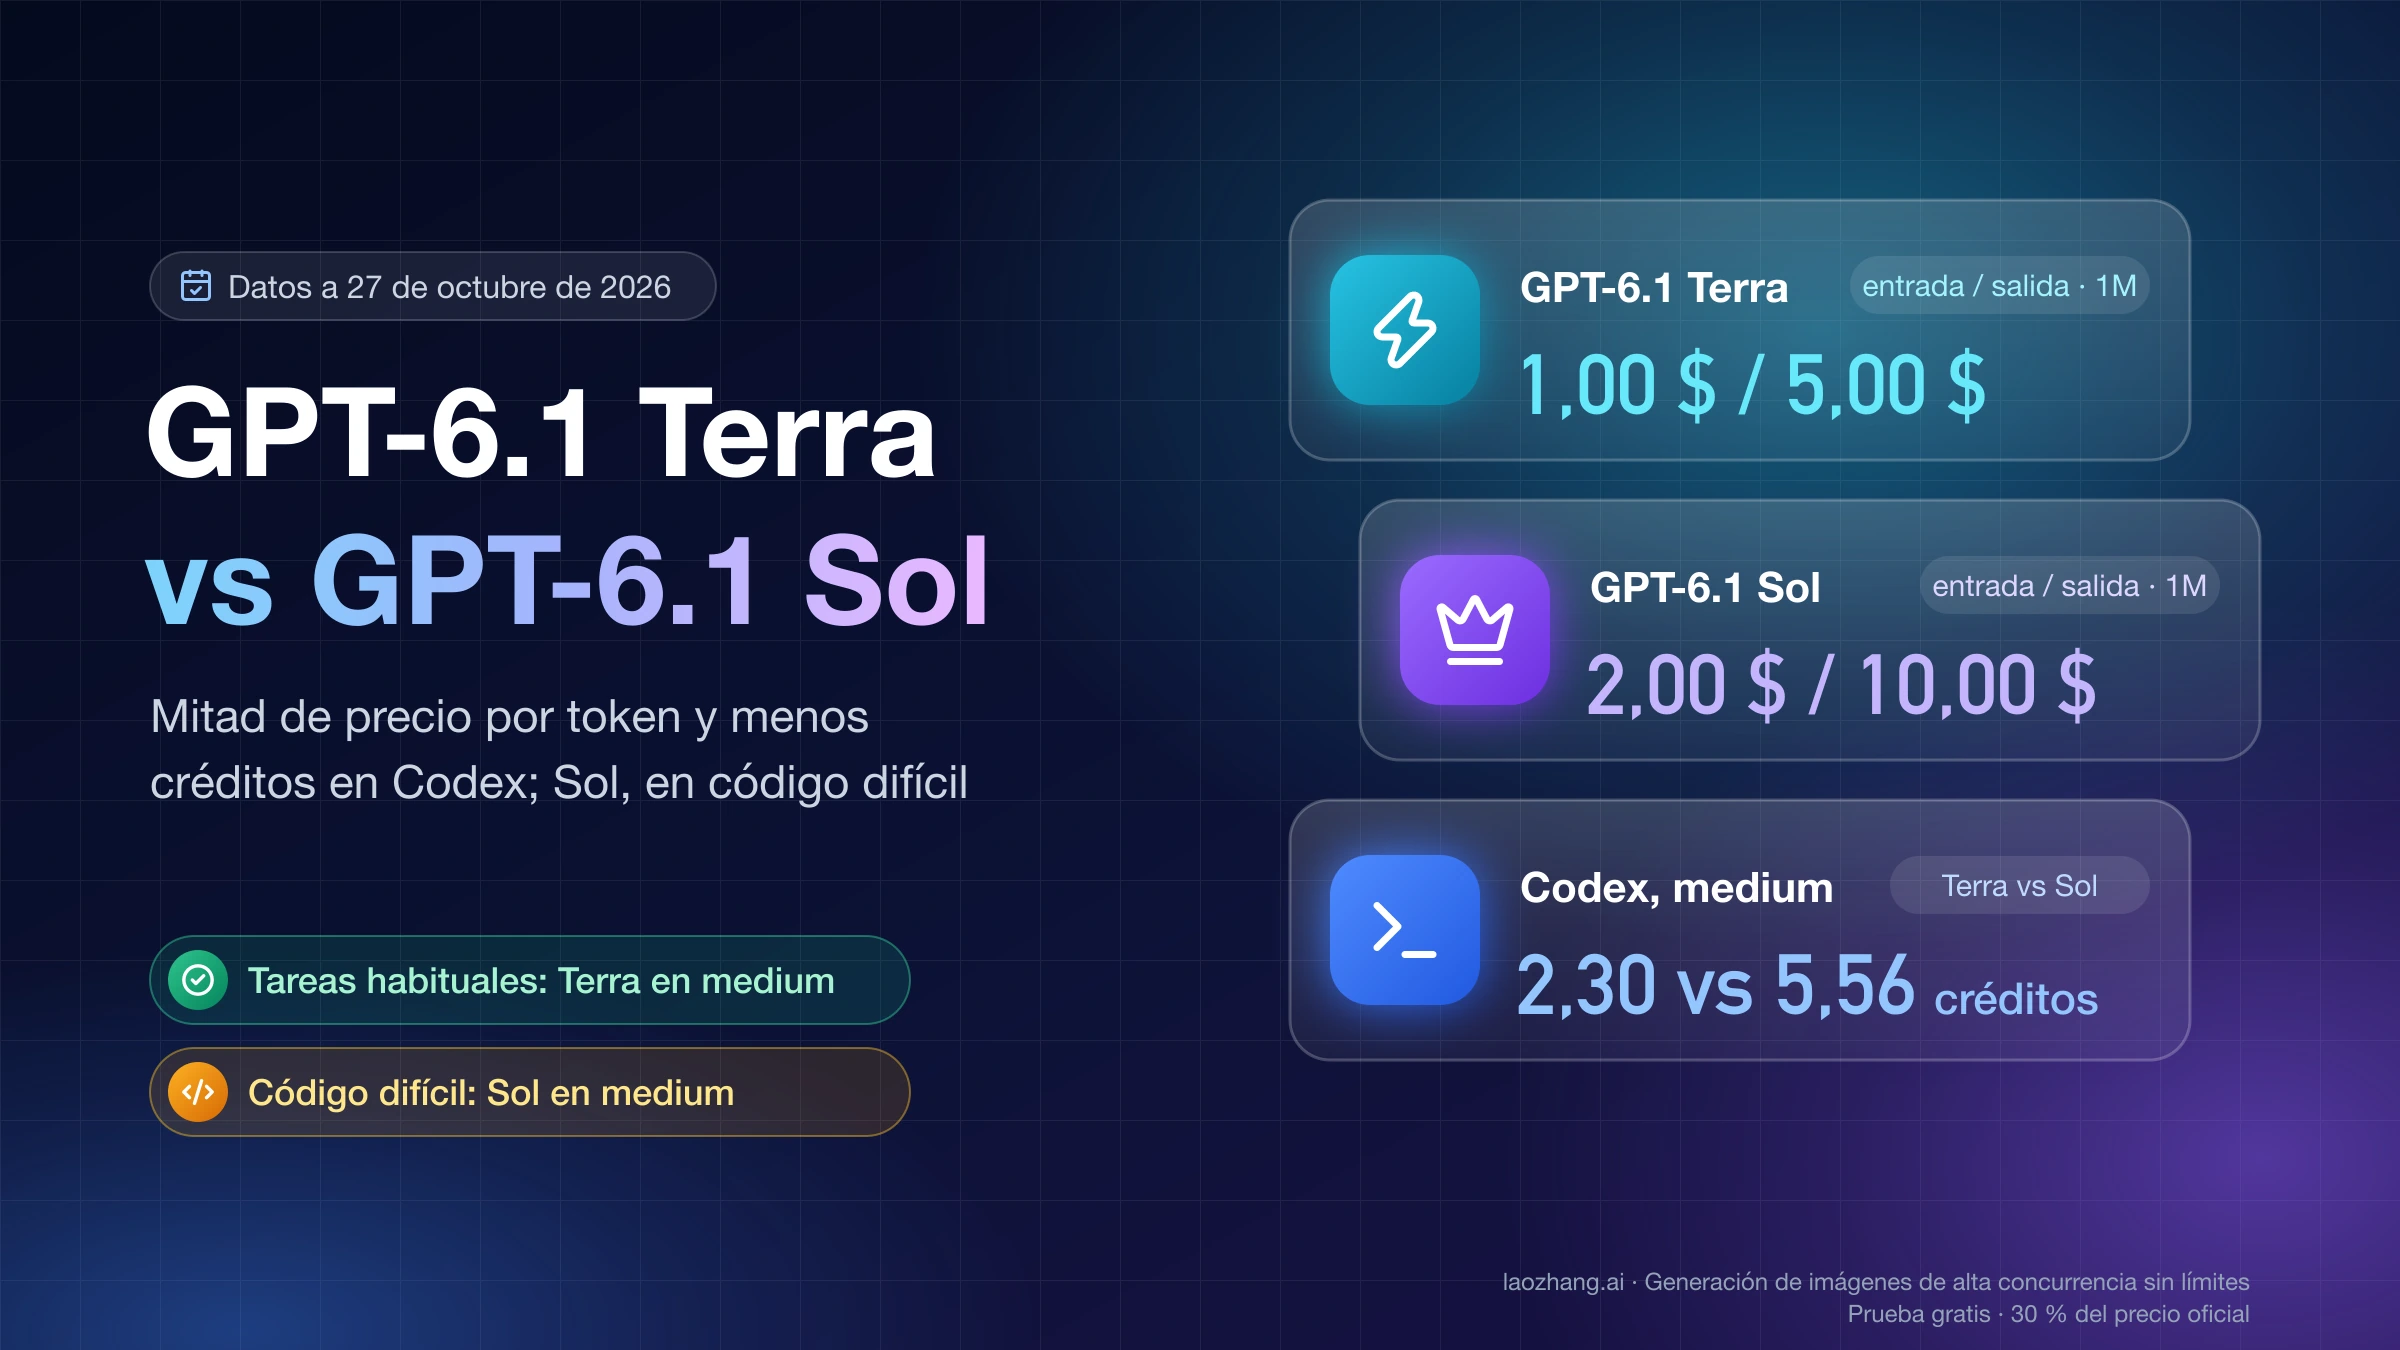
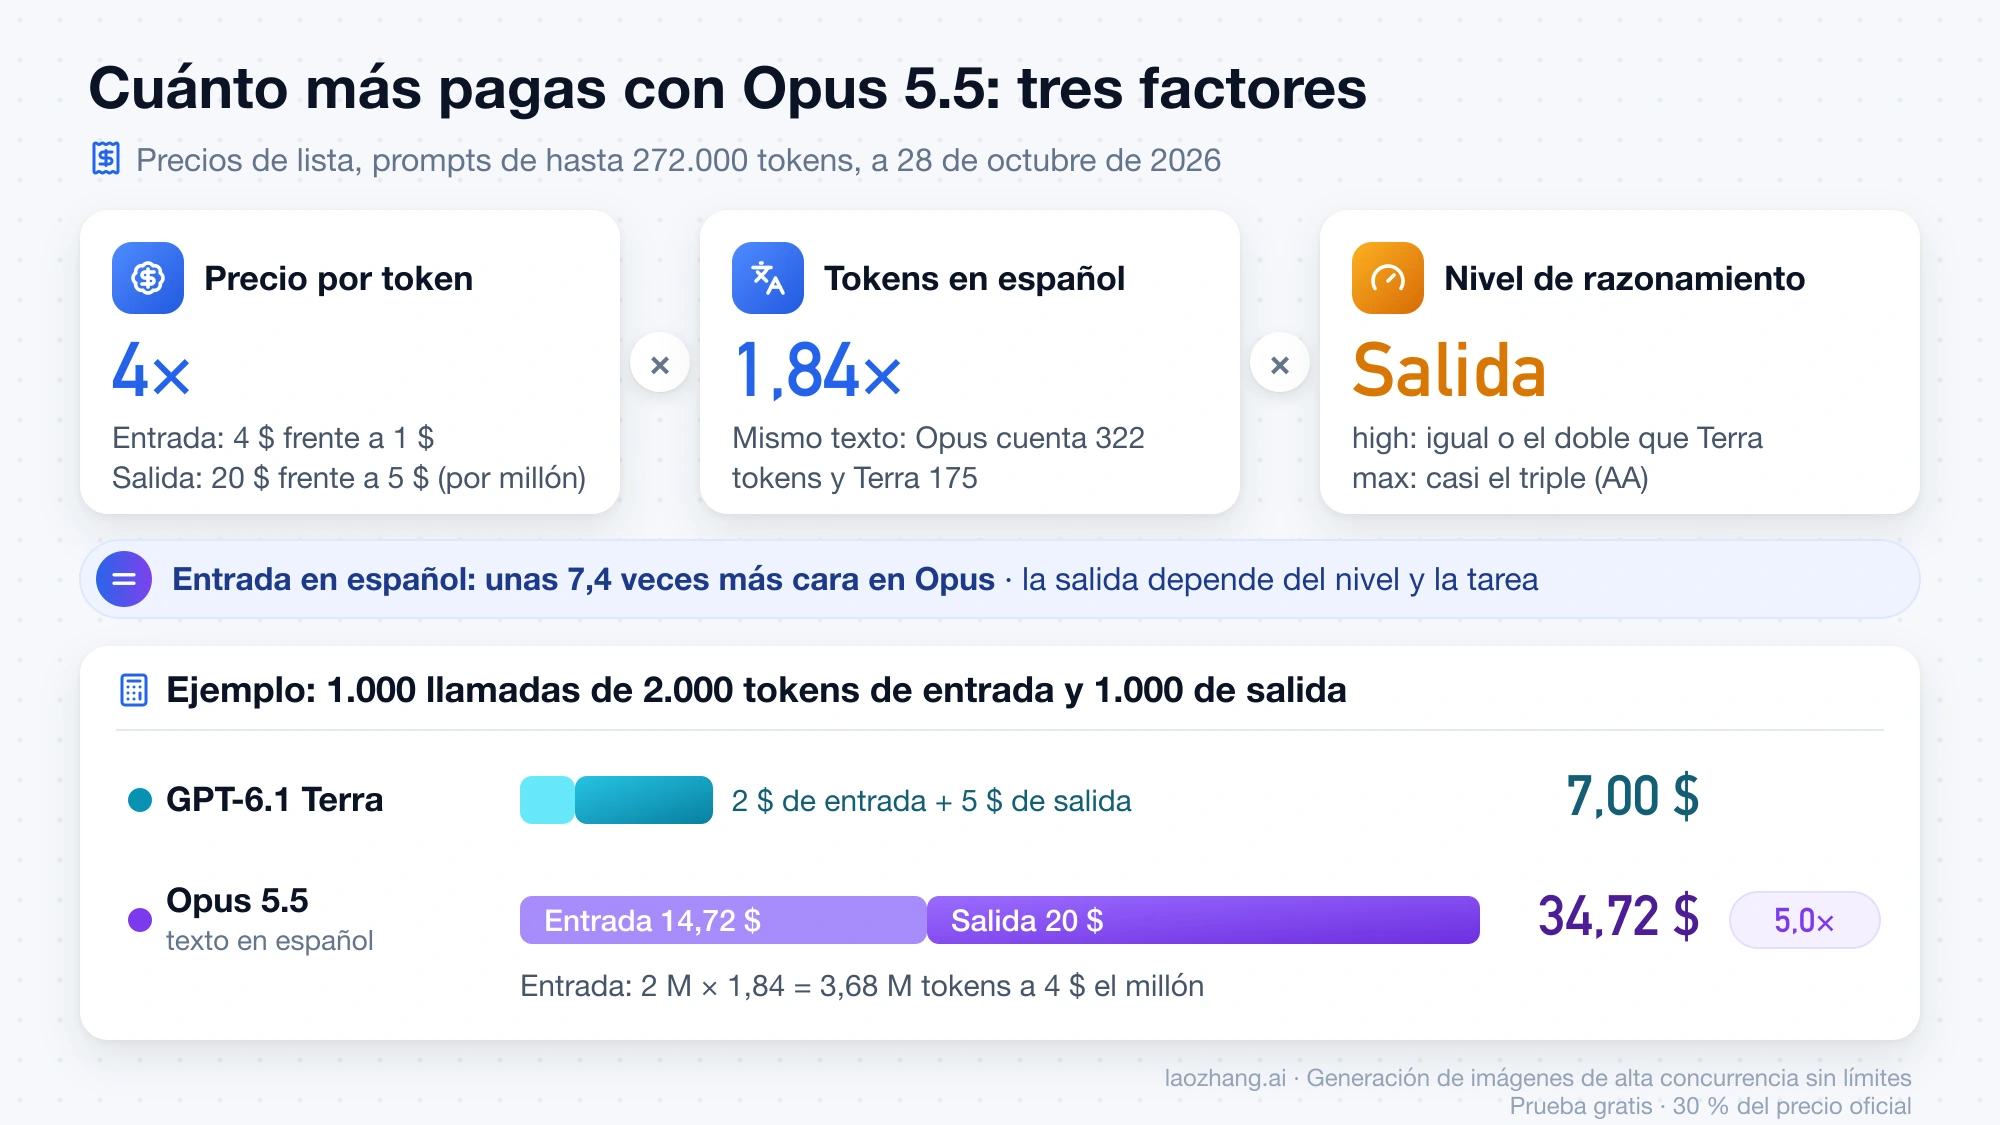
Tu multiplicador real sale de tres factores que se multiplican. El primero es fijo: con prompts de hasta 272.000 tokens, Opus 5.5 cobra exactamente cuatro veces lo que Terra en cada concepto, a 28 de octubre de 2026 (4 $ frente a 1 $ por millón de tokens de entrada, 20 $ frente a 5 $ de salida y 0,20 $ frente a 0,05 $ por lectura de caché), según la tabla de precios de la API de Claude y la página de precios de la API de OpenAI. El segundo es cuántos tokens cuenta cada modelo para el mismo texto, y el tercero cuántos tokens de salida y de razonamiento genera cada uno con el nivel que elijas.
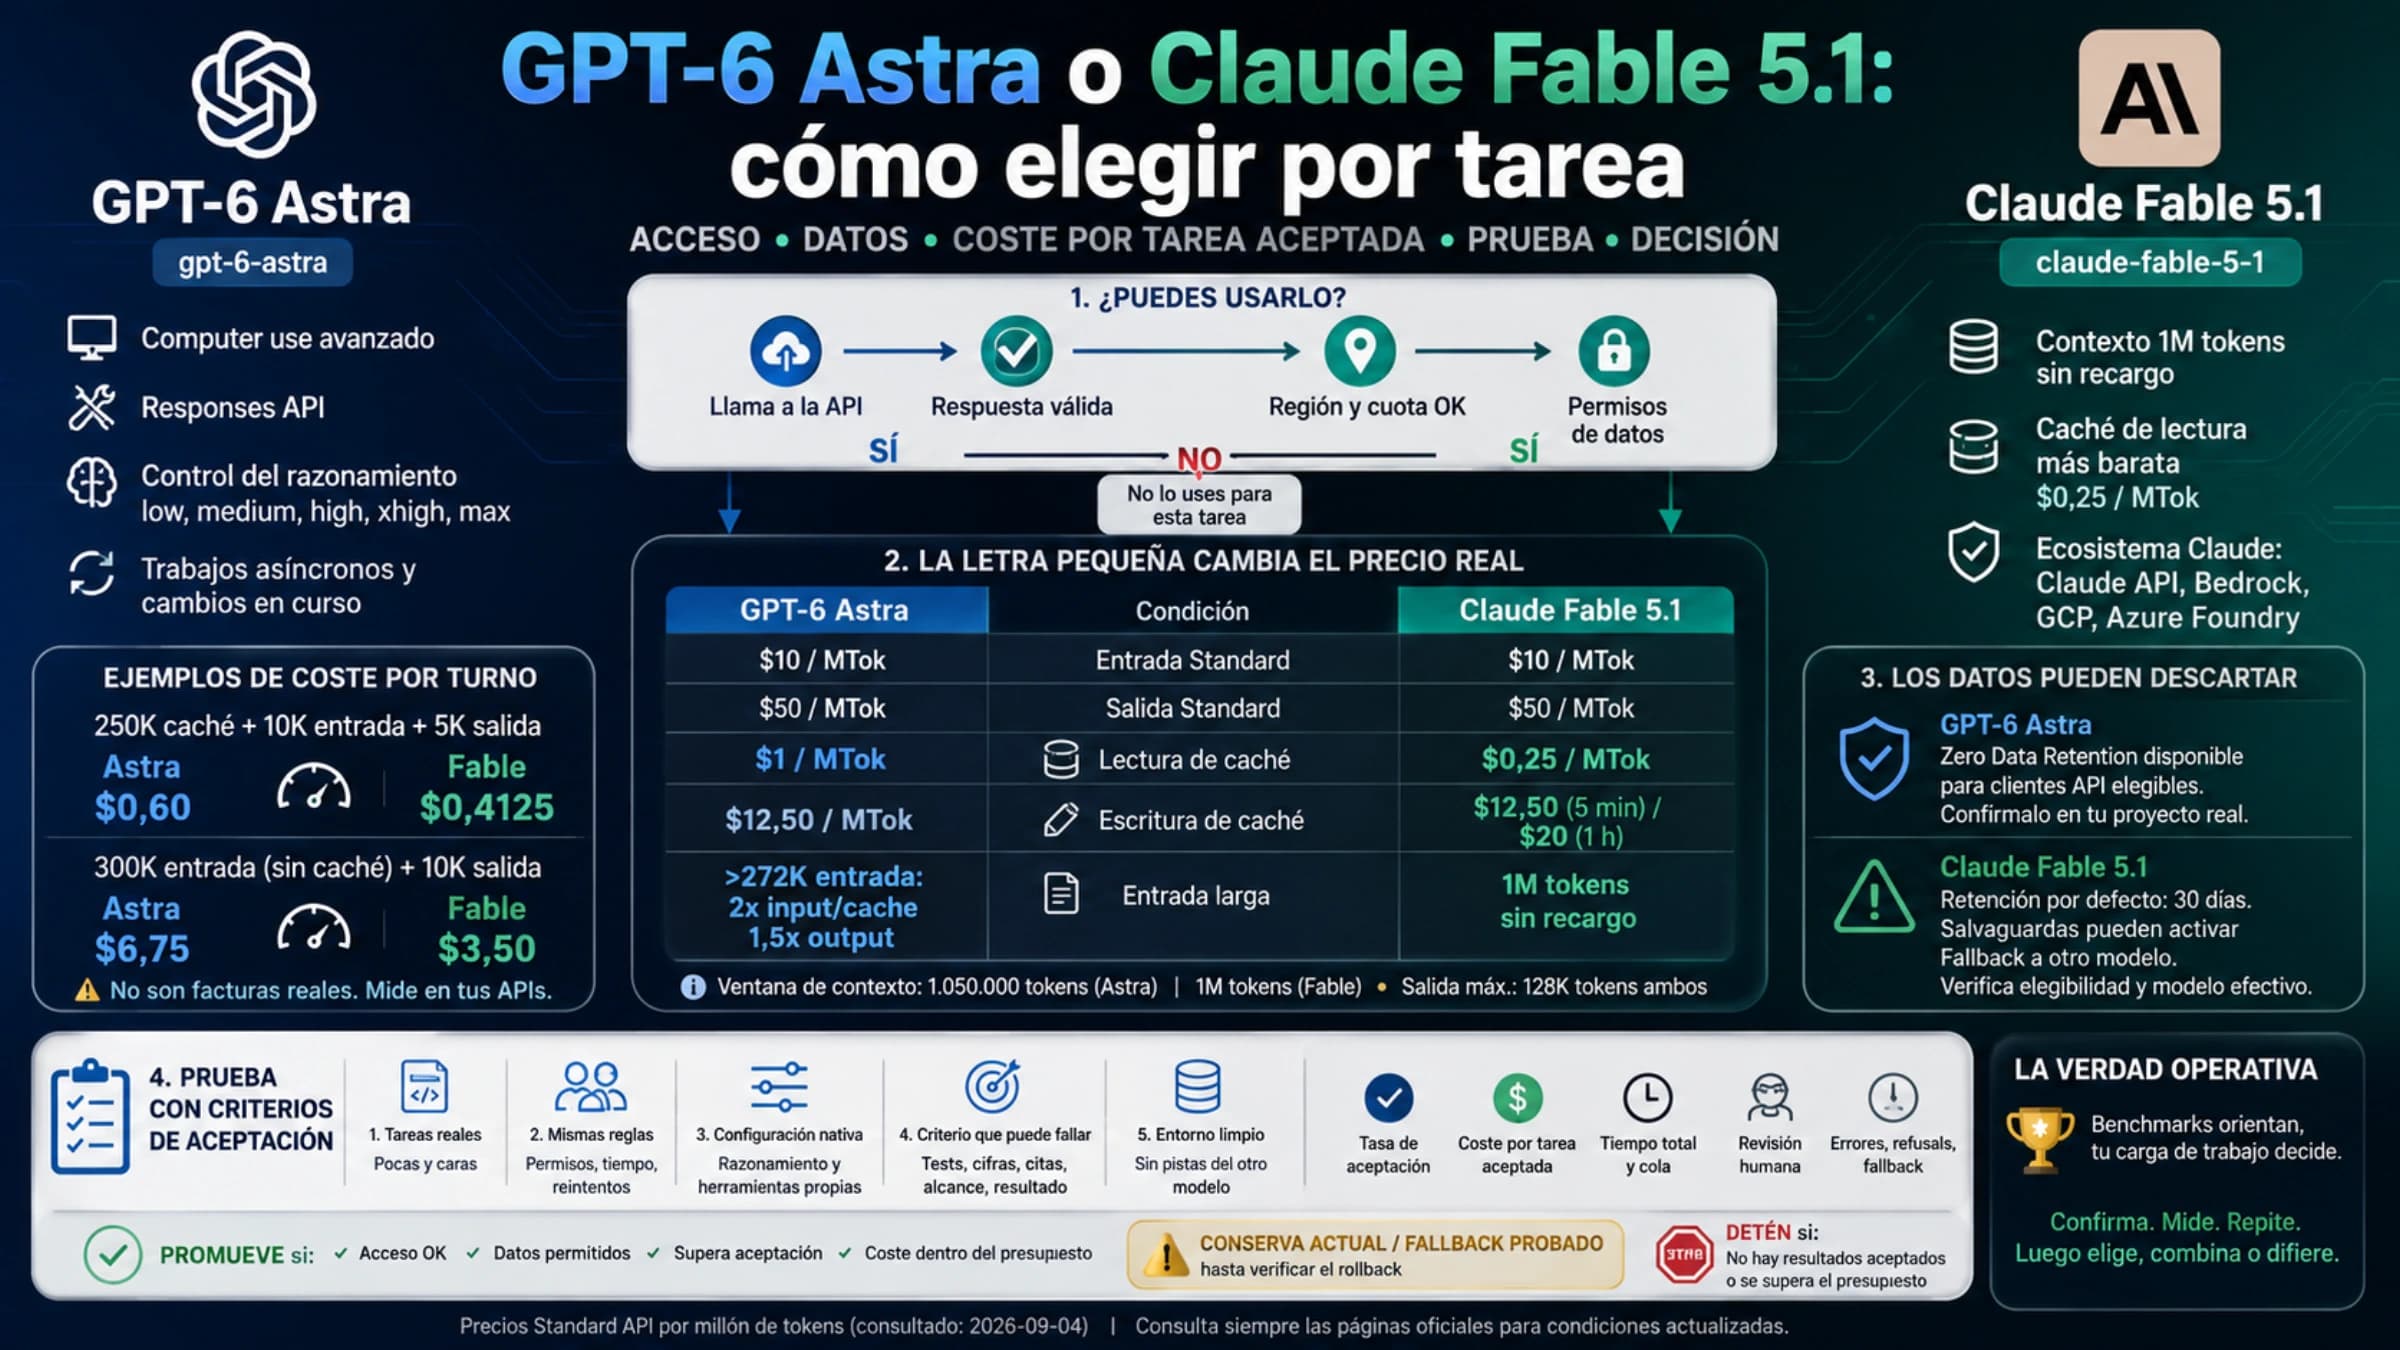
El idioma pesa más de lo que parece. El 28 de octubre de 2026 se envió el mismo pasaje de unos 800 caracteres en español a los dos modelos: Opus contó 322 tokens de entrada y Terra 175, 1,84 veces más, de modo que la misma entrada en español cuesta unas 7,4 veces más en Opus. En inglés la proporción fue de 1,45 (1,52 en el documento de casi 7.000 palabras), en ruso 1,55, en coreano 1,87, en chino 1,49 y en japonés 1,24. Una diferencia de tokenizador casi idéntica aparece en GPT-6 Astra o Claude Fable 5.1: cómo elegir por tarea y coste.
La salida depende sobre todo del nivel de razonamiento. En high, en la prueba de las siete tareas, Opus escribió lo mismo que Terra en las respuestas largas y el doble en las cortas; en max, AA midió casi el triple de tokens de salida en Opus, y por eso la diferencia por tarea se acerca a la novena parte que anuncia OpenAI. Para tu propio caso, calcula así:
Multiplicador ≈ 4 × (tokens que cuenta Opus ÷ tokens que cuenta Terra), por separado para la entrada (depende del idioma) y para la salida (depende del nivel y de la tarea).
| Caso, con los tokens contados por Terra | Terra | Opus, texto en inglés | Opus, texto en español |
|---|---|---|---|
| 1.000 llamadas de 2.000 tokens de entrada y 1.000 de salida | 7,00 $ | 31,60 $ (4,5×) | 34,72 $ (5,0×) |
| Una petición de 400.000 tokens con 20.000 de salida | 0,95 $ | 2,72 $ (2,9×) | 3,34 $ (3,5×) |
| Bucle de agente: 50.000 tokens nuevos, 950.000 leídos de caché y 30.000 de salida | 0,25 $ | 1,17 $ (4,7×) | 1,32 $ (5,3×) |
Los tres casos usan precios de lista estándar, la misma salida en los dos modelos y la entrada de Opus multiplicada por la proporción de su idioma, sin escrituras de caché. En la primera fila, Terra cobra 2 millones de tokens de entrada a 1 $ y 1 millón de salida a 5 $, 7 $ en total; Opus cuenta esa entrada en español como 3,68 millones de tokens (2 × 1,84), que a 4 $ son 14,72 $, más 20 $ de salida: 34,72 $. Si Opus escribe más salida que Terra, como pasa en max, el multiplicador sube por encima de estas cifras.
Prompts de más de 272.000 tokens: la diferencia baja a 2–2,7 veces por token
Cuando la entrada de una petición supera los 272.000 tokens, Terra cobra la petición entera con su tarifa de contexto largo: 2 $ por millón de entrada, 0,10 $ por lectura de caché y 7,50 $ por millón de salida. Opus 5.5 mantiene la misma tarifa en toda su ventana de un millón de tokens, así que, en peticiones largas, Opus pasa a costar el doble por token de entrada y 2,67 veces por token de salida. Por eso la petición de 400.000 tokens de la tabla anterior sale 3,5 veces más cara en Opus con texto en español, y no las 5 veces de las llamadas cortas. El umbral cuenta los tokens como los cuenta Terra; los dos modelos admiten hasta 128.000 tokens de salida por respuesta en su API directa.
Qué pasar a GPT-6.1 Terra y qué dejar en Claude Opus 5.5
Pasa a Terra lo que tenga un criterio de aprobado claro y lo que hoy resuelves con Opus en medium o por debajo; deja en Opus el trabajo de conocimiento y lo que exige más puntuación de la que Terra alcanza. Cuanto más texto en español mandes, más ahorras con el cambio, siempre que Terra apruebe tus tareas.
| Si hoy usas Opus 5.5 para… | Prueba | Por qué, a 28 de octubre de 2026 |
|---|---|---|
| Funciones, scripts y parsers con tests, en una sola petición | Terra en high | En la prueba de las siete tareas los dos aprobaron todo, con Terra mucho más barata |
Tareas generales con Opus en medium | Terra en max | Más puntuación en AA y menos coste por tarea, aunque cada tarea tarda casi el doble |
| Código difícil o problemas científicos | Terra en max | Supera a Opus high en FrontierCode 2.0, CritPt y Terminal-Bench-Science |
| Documentos, finanzas, derecho, estrategia o preguntas de experto | Opus en high | Por delante en HLE-Diamond, AA-Briefcase y los cinco índices por sector |
Lo más difícil, cuando Opus high ya se queda corto | Opus en xhigh o max | Terra no pasa de 51 puntos en el índice |
| Agentes con herramientas y sesiones largas de terminal | Opus, mientras pruebas Terra en la Responses API | Terminal-Bench 4.0 casi empatado y AutomationBench con Opus 3 puntos por delante; ninguna prueba propia cubrió herramientas |
Entre los dos hay opciones intermedias. GPT-6.1 Sol cobra la mitad por token que Opus y, en AA v5.0, saca 55 puntos en max con 1,27 $ por tarea, entre Terra max y Opus xhigh: lo tienes en Claude Opus 5.5 vs GPT-6 Sol y 6.1 Sol: cuál probar y qué pagas. Para elegir entre las dos de OpenAI, GPT-6.1 Terra vs Sol: diferencias y cuándo Terra sale más barata incluye una prueba en Codex CLI, con cifras del índice 4.3.2 de AA. Y si prefieres quedarte en Claude pagando menos, mira Claude Sonnet 5.5 vs Opus 5.5: cuál gasta menos por tarea.
Dónde usar cada uno: ChatGPT Work y Codex, apps de Claude y API
GPT-6.1 Terra está en la API como gpt-6.1-terra y, en ChatGPT, solo en Work y en Codex: el anuncio la ofrece en Plus, Pro, Enterprise y Edu, la documentación de Codex añade Business, y no aparece en el chat normal. Claude Opus 5.5 está en las apps de Claude con Pro, Max, Team y Enterprise, en Claude Code, en la API de Claude y en AWS, Google Cloud y Azure. En una suscripción no pagas por token, así que el multiplicador de cuatro veces no se aplica tal cual; lo que cuenta es cuánto uso te deja cada plan.
Esa cuenta es distinta en cada lado: en Codex, los planes Plus y Business estándar dan entre 35 y 285 mensajes locales de Terra por ventana de cinco horas, que OpenAI describe como orientativos y no como un límite fijo, mientras que Anthropic no publica cifras de mensajes para Opus 5.5; los límites de los planes de Claude están en Claude Opus 5.5: precio de la API y restablecimiento de límites.
Cómo probar Opus 5.5 y GPT-6.1 Terra con tus prompts antes de cambiar
Una prueba de una tarde con tus propias tareas responde mejor que cualquier índice, porque tu idioma, la longitud de tus prompts y tu criterio de aprobado son los que fijan el multiplicador. La prueba de las siete tareas del 28 de octubre de 2026 costó 0,64 $ a precio de lista por 26 llamadas, así que el gasto es pequeño comparado con lo que puede cambiar la factura.
- Elige entre cinco y diez tareas reales y escribe, antes de lanzar nada, qué cuenta como aprobado: los tests que deben pasar, la cifra correcta o los campos que no pueden faltar. Mezcla respuestas cortas y largas, porque la diferencia de coste cambia mucho entre unas y otras.
- Escribe los prompts en el idioma que usarás en producción; traducirlos al inglés para la prueba esconde la diferencia de tokens.
- Fija el nivel de razonamiento en las dos llamadas: Opus en el que usas hoy y Terra en
highy enmax, este último por la Responses API, que fue la que lo aceptó el 28 de octubre de 2026 a través de LaoZhang API. Si Terra solo aprueba enmax, compárala con Opushigh, que es su equivalente en puntuación. - Lanza cada tarea dos o tres veces por configuración y guarda el
usagede cada respuesta: tokens de entrada, de salida y de caché. - Calcula el coste con los precios de lista y divídelo entre las tareas aprobadas. La cifra que decide es el coste por tarea aprobada, no el precio por token.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Las peticiones de la prueba tenían esta forma. Para Opus 5.5, por la API de Messages:
{
  "model": "claude-opus-5-5",
  "max_tokens": 32000,
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "high" },
  "messages": [{ "role": "user", "content": "..." }]
}
Para GPT-6.1 Terra, por Chat Completions:
{
  "model": "gpt-6.1-terra",
  "reasoning_effort": "high",
  "max_completion_tokens": 32000,
  "messages": [{ "role": "user", "content": "..." }]
}
Cuatro detalles de estas llamadas, observados el 28 de octubre de 2026 a través de LaoZhang API, pueden estropear la prueba. El primero es que, por esa ruta, Chat Completions no admitió Terra en max (la API directa de OpenAI no se probó): reasoning_effort: "max" devolvió HTTP 400 y el mensaje de error solo aceptaba none, low, medium, high y xhigh, mientras que POST /v1/responses con reasoning: {"effort": "max"} sí funcionó. Como max es el nivel de Terra que iguala a Opus high en AA, por Chat Completions te quedas en xhigh, que saca 45 puntos. Además, en Terra, una llamada a Chat Completions sin streaming con max_tokens devuelve HTTP 400 con el mensaje Unsupported parameter: 'max_tokens' is not supported with this model. Use 'max_completion_tokens' instead.; con streaming el mismo parámetro pasa sin error, pero no queda claro si se aplica, así que usa siempre max_completion_tokens. Si tus tareas llaman a herramientas, Terra exige la Responses API, donde el nivel va en reasoning.effort. En Opus, fija thinking y output_config.effort en cada petición para saber qué nivel estás comparando; el razonamiento no se devolvió en el streaming, pero se cobra dentro de los tokens de salida.
Dos condiciones más afectan al coste. OpenAI activa la caché de prompts por defecto desde GPT-5.6 y cobra las escrituras (1,25 $ por millón de tokens para 30 minutos en Terra) salvo que pidas prompt_cache_options.mode: "explicit". Y si llamas a Claude a través de LaoZhang API, cada respuesta queda limitada a 32.768 tokens de salida, frente a los 128.000 de la API de Anthropic, lo que importa en generaciones largas. Las API directas de OpenAI y Anthropic no se probaron.
Preguntas frecuentes sobre Claude Opus 5.5 y GPT-6.1 Terra
¿GPT-6.1 Terra es lo mismo que GPT-5.6 Terra?
No. GPT-5.6 Terra es el modelo anterior de la misma línea, con su propio precio y sus propias puntuaciones, y Artificial Analysis tiene una comparativa aparte de esa versión con Opus 5.5. GPT-6.1 Terra se lanzó el 26 de octubre de 2026 con el ID gpt-6.1-terra y, frente a GPT-5.6 Terra, en la página de precios de la API de OpenAI la entrada baja de 2 $ a 1 $ por millón de tokens y la salida de 12 $ a 5 $ en la tarifa estándar. OpenAI lo resume como un precio un 50 % inferior, pero eso solo se cumple en la entrada; en la salida la rebaja es del 58 %. Antes de usar una cifra, comprueba que habla de 6.1.
¿Batch, Flex o Fast cambian la proporción entre Opus 5.5 y Terra?
No, si usas el mismo modo en los dos. A 28 de octubre de 2026, la API Batch cuesta la mitad en ambos (Terra también tiene Flex a mitad de precio) y el modo Fast duplica la tarifa en ambos (2 $ y 10 $ por millón en Terra, 8 $ y 40 $ en Opus), así que la diferencia por token sigue siendo de cuatro veces. Cambia si mezclas modos: Terra en Batch frente a Opus en estándar es una diferencia de ocho veces por token. Terra no tiene modo Ultrafast, y en Anthropic el modo Fast no se puede combinar con Batch.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
- 1.anuncio de GPT-6.1 Terra en el blog de OpenAIopenai.com/index/introducing-gpt-6-1-terra
- 2.comparativa de versiones de Claude Opus 5.5 y GPT-6.1 Terra en Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-1-terra
- 3.tabla de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 4.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing