Kimi K3.1 Pro vs Gemini 4 Argon: precio, benchmarks y cuál probar
Mismo precio por token hasta el 30 de noviembre; luego Argon cuesta el doble. K3.1 Pro gana en terminal y documentos; Argon, en conocimientos e imágenes.
En esta página
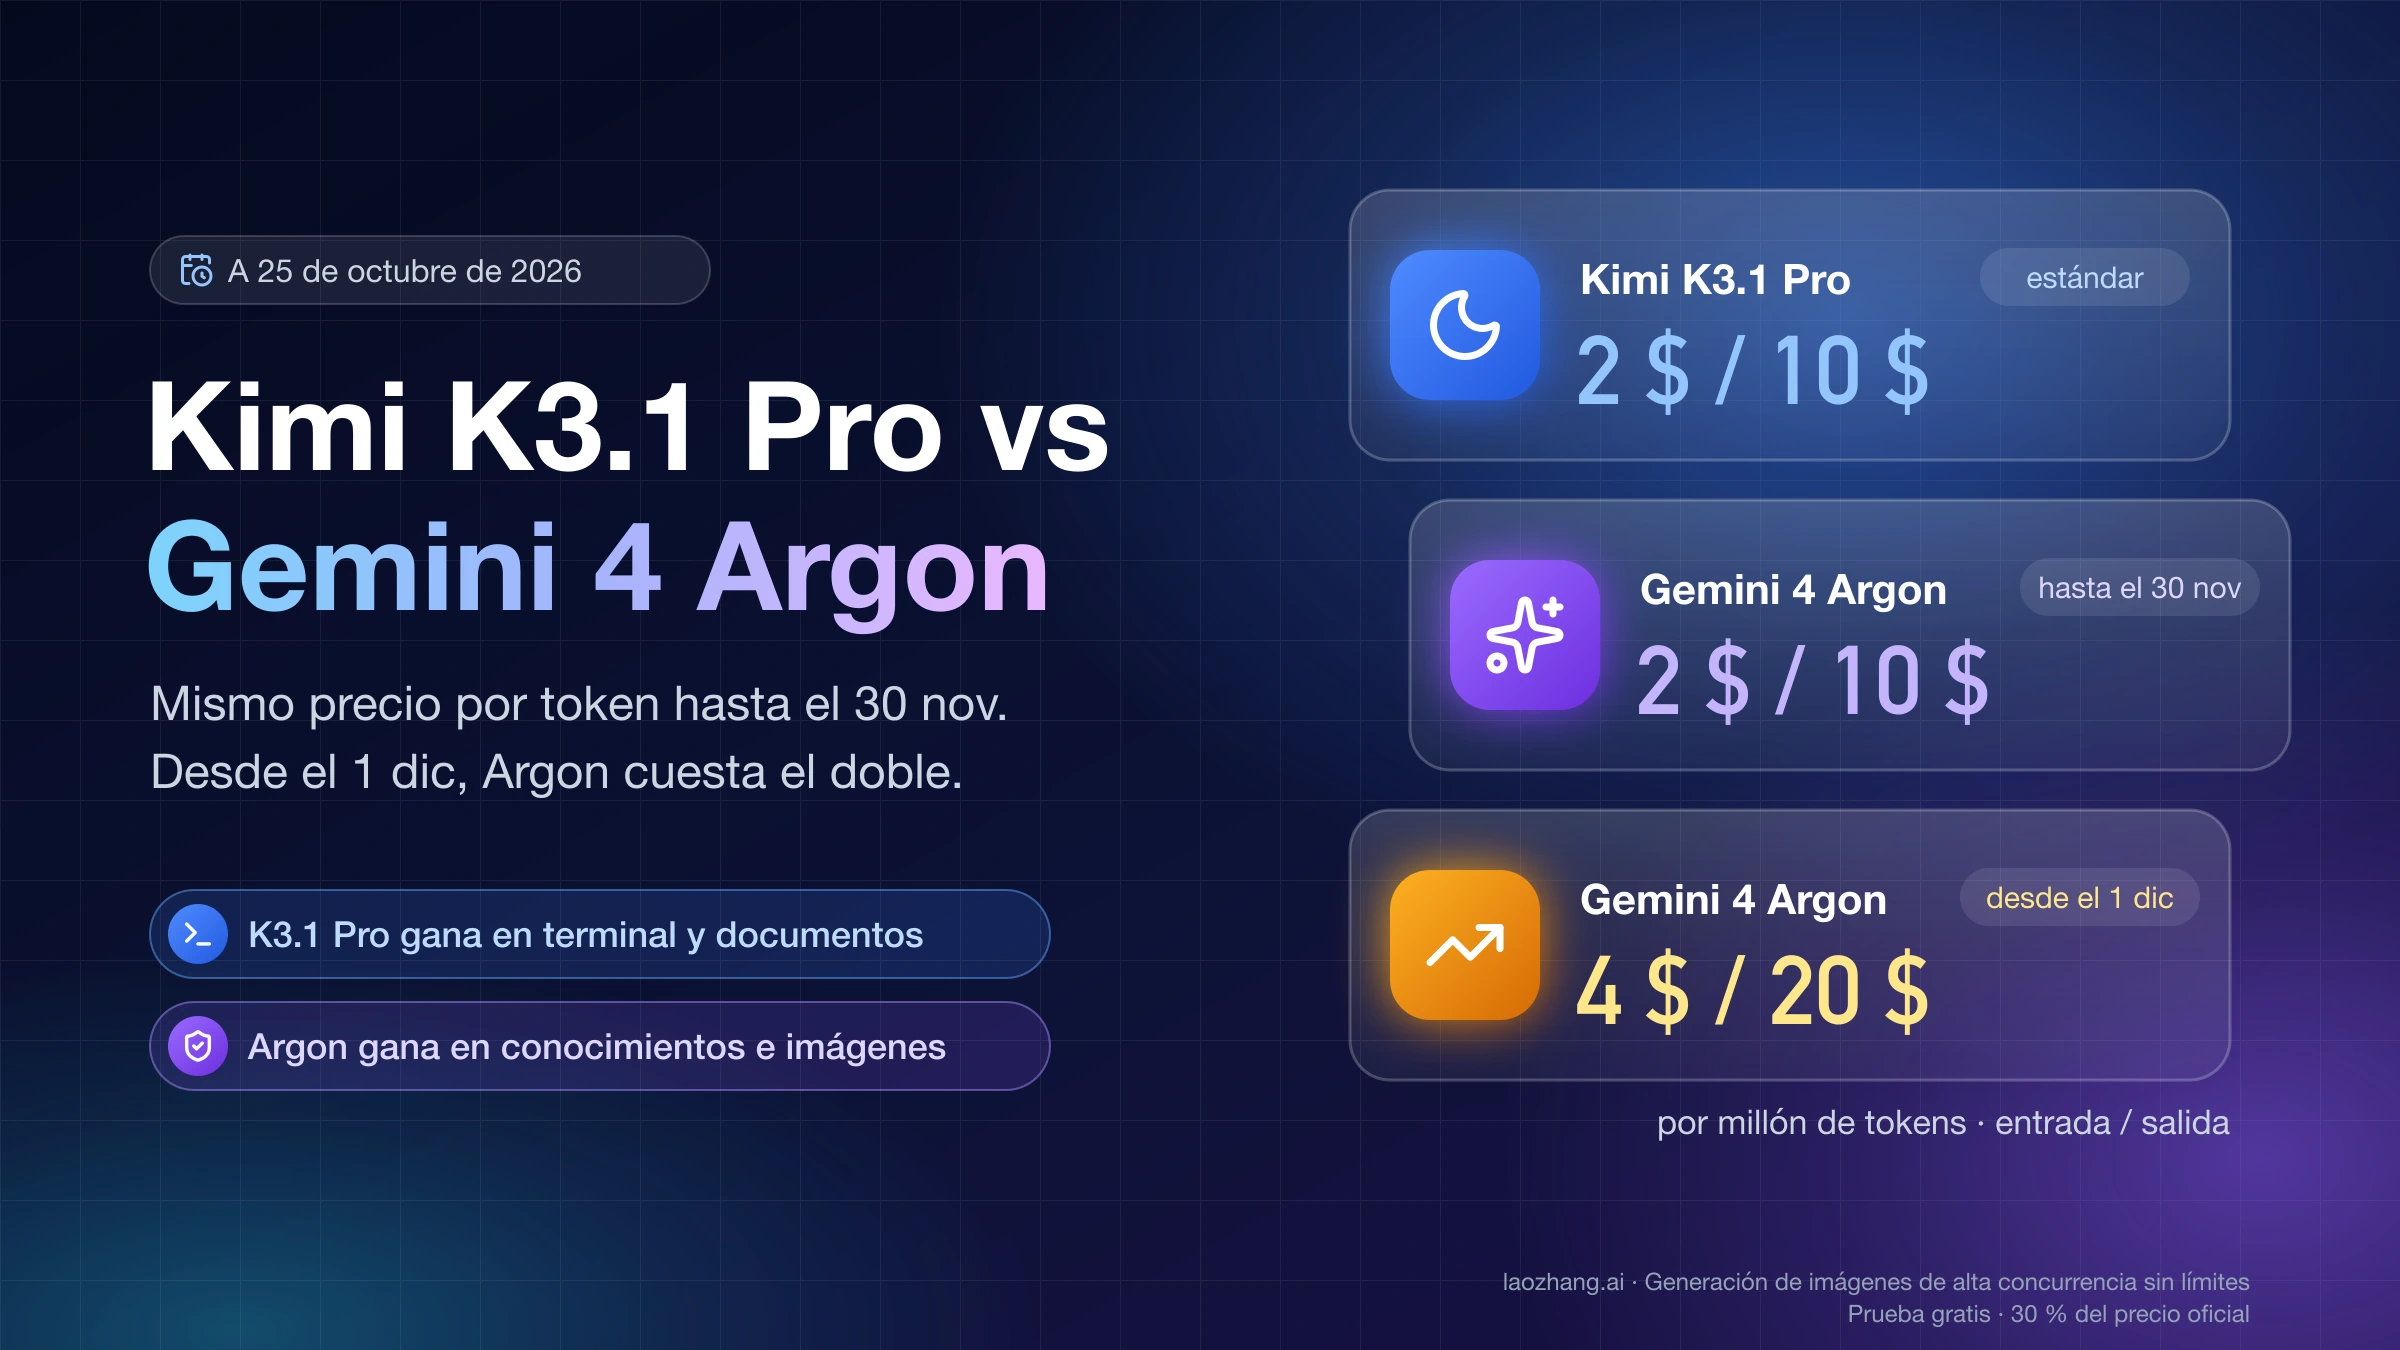
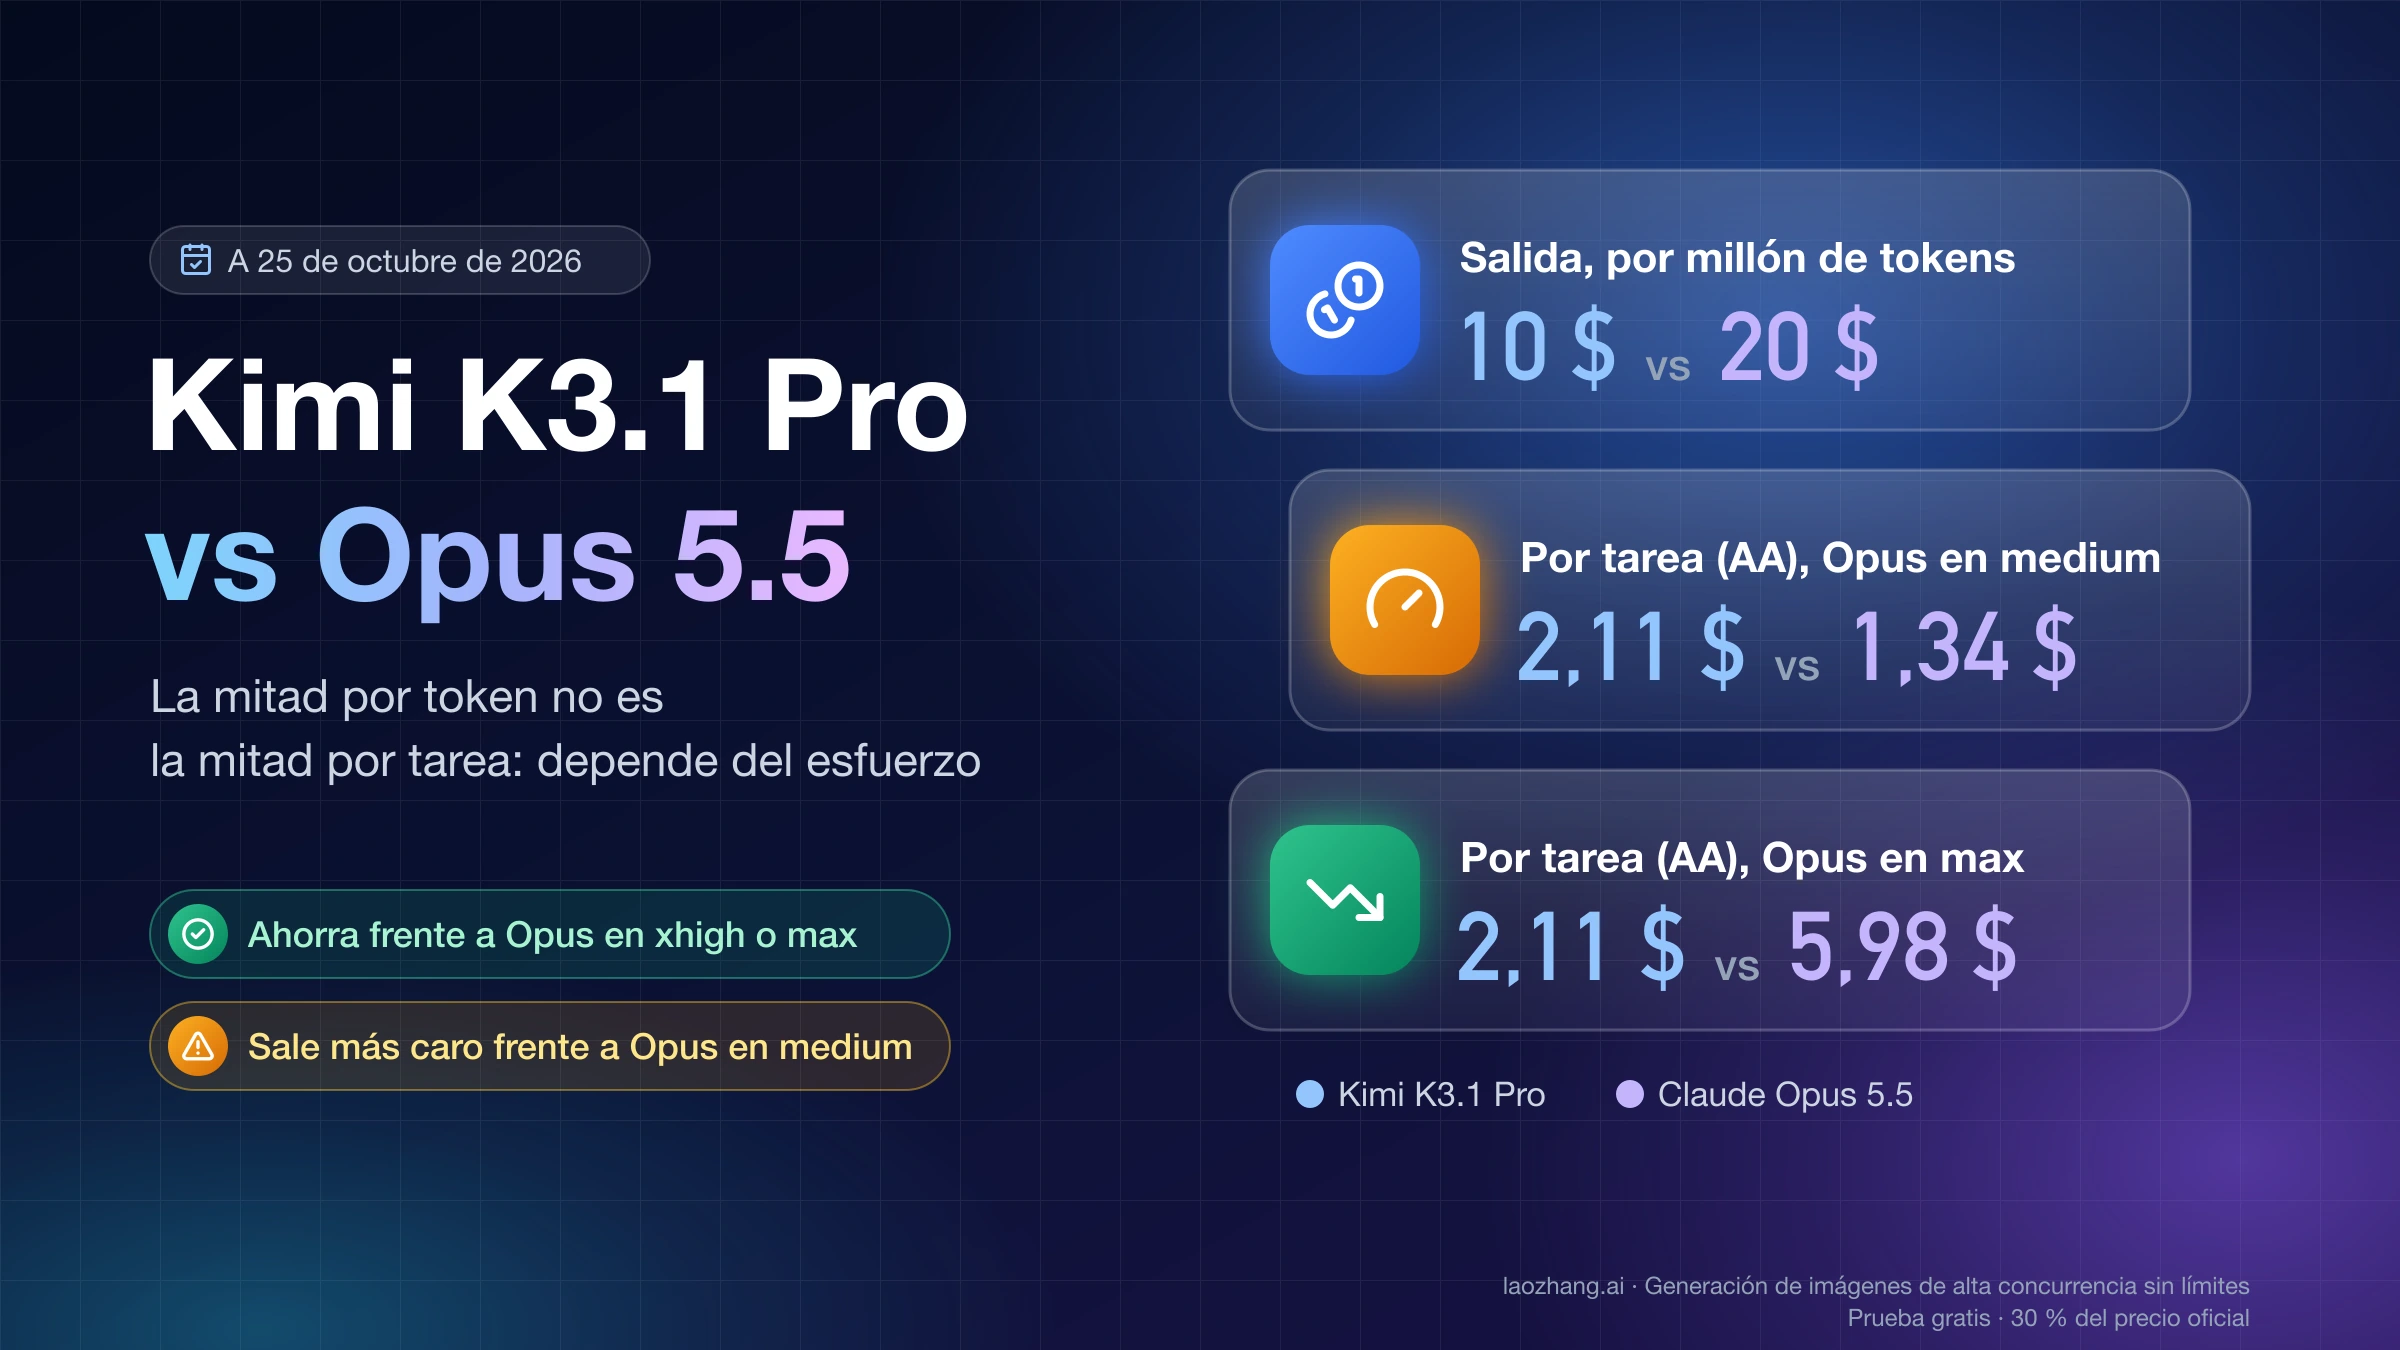
A 25 de octubre de 2026, Kimi K3.1 Pro (kimi-k3.1-pro) y Gemini 4 Argon (gemini-4-argon) cobran lo mismo en su API estándar: 2 $ por millón de tokens de entrada y 10 $ por millón de salida. Con el precio empatado, elige por el tipo de trabajo. Prueba primero Kimi K3.1 Pro si tu caso es programación con agentes en la terminal, documentos de oficina o razonamiento sobre un contexto muy largo. Prueba primero Gemini 4 Argon si te importa más que no invente datos, si automatizas procesos entre aplicaciones o si necesitas localizar objetos en imágenes.
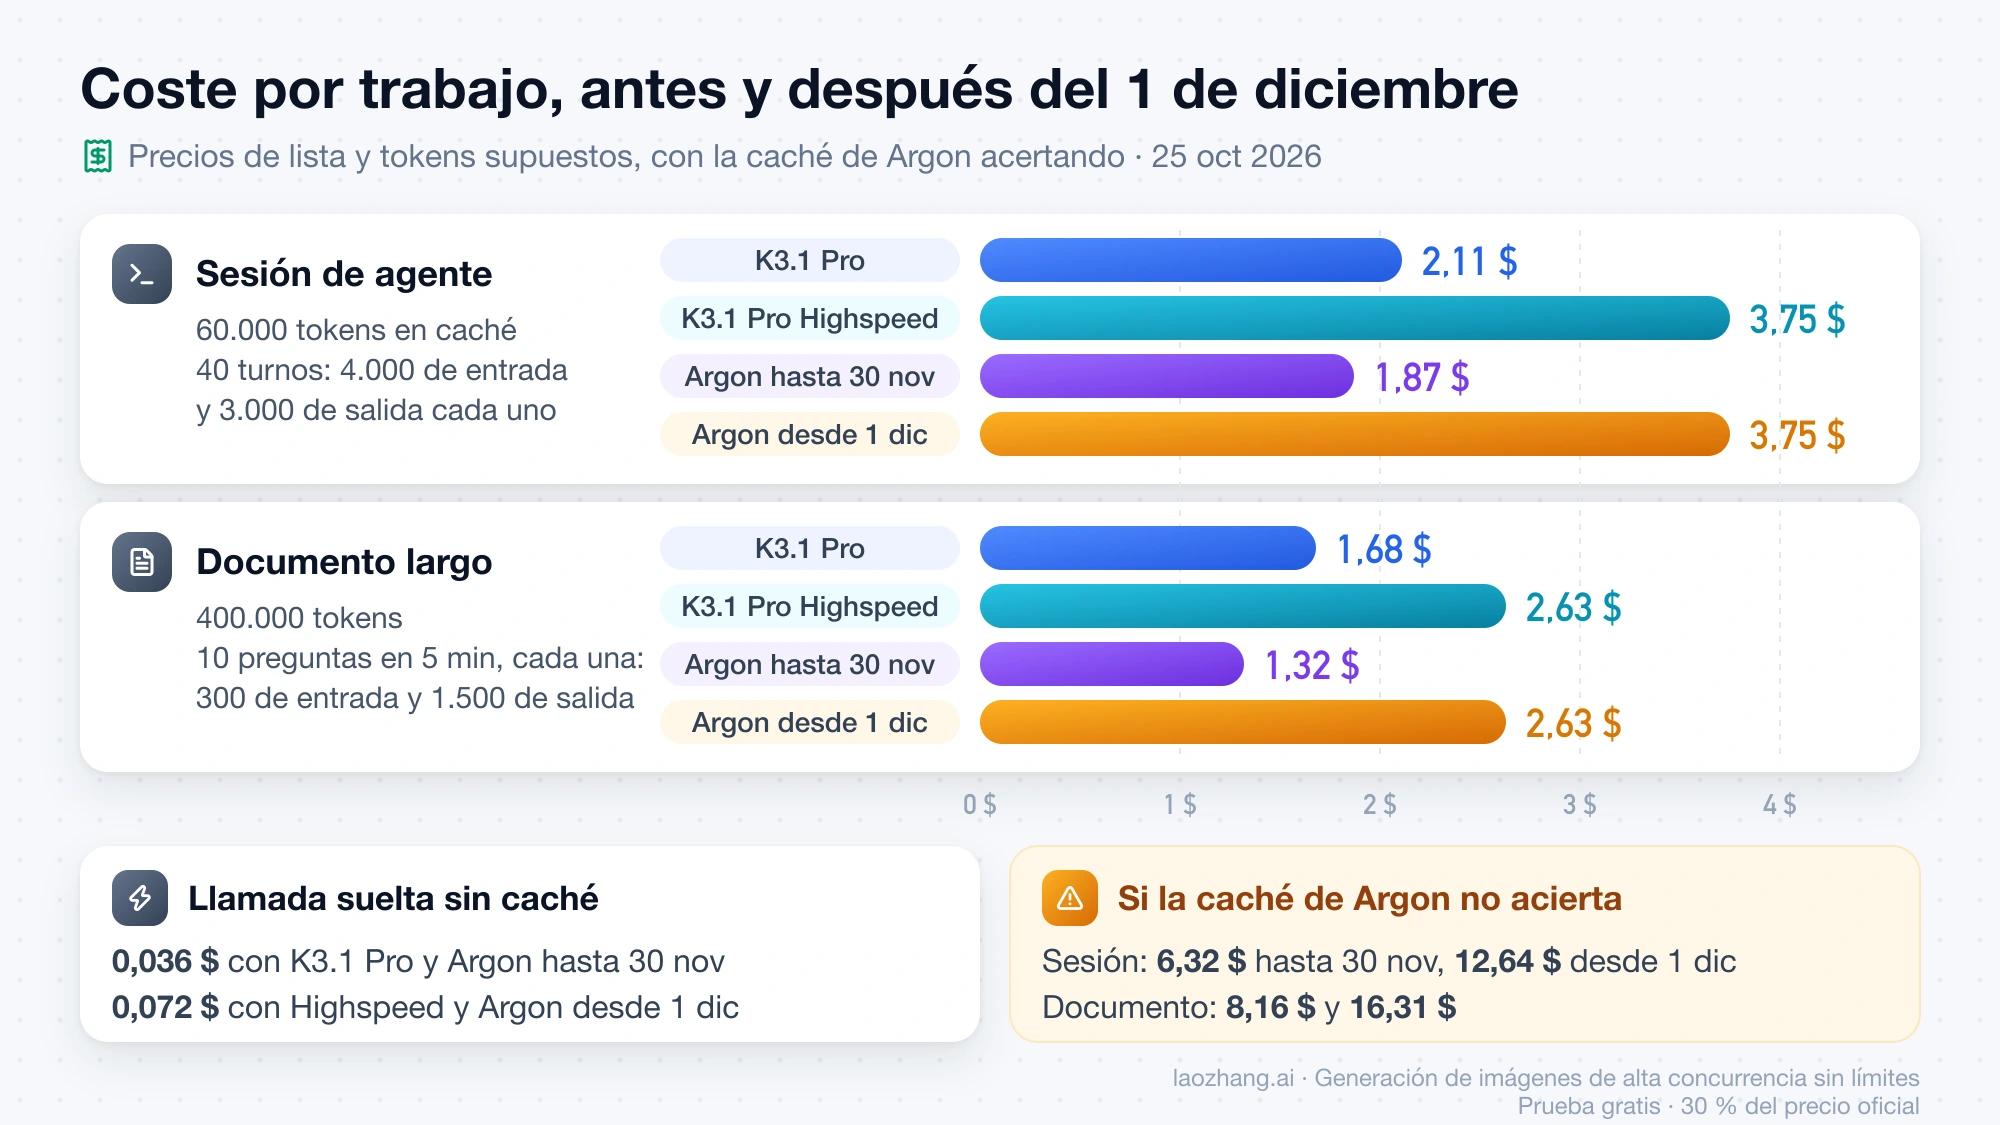
El empate dura hasta el 30 de noviembre de 2026. Desde el 1 de diciembre, Google sube Argon a 4 $ de entrada y 20 $ de salida por millón de tokens, el mismo precio que la variante rápida K3.1 Pro Highspeed. En una sesión de agente de programación con caché, con volúmenes de tokens supuestos, Argon pasa de costar 1,87 $ a 3,75 $, mientras que K3.1 Pro se queda en 2,11 $. Si tu prueba o tu puesta en producción se alarga hasta diciembre, haz las cuentas con la tarifa nueva.
Las cifras de calidad que siguen vienen de pruebas de Artificial Analysis y Ultralytics y de los propios fabricantes, cada una con su configuración, no de una prueba directa con los mismos prompts en los dos modelos. Lo que sí se ejecutó el 25 de octubre de 2026 fue una lectura del catálogo público de OpenRouter y un recálculo de costes a precio de lista, ambos explicados más abajo.
Precio de Kimi K3.1 Pro y Gemini 4 Argon: igual hasta el 30 de noviembre
Hasta el 30 de noviembre de 2026, los dos modelos cobran 2 $ por millón de tokens de entrada y 10 $ por millón de salida. Desde el 1 de diciembre, Argon duplica todas sus tarifas y queda al nivel de K3.1 Pro Highspeed. La única partida en la que Argon es más barato hoy es la lectura de caché, que cuesta la mitad que en Kimi.
| Por millón de tokens | K3.1 Pro | K3.1 Pro Highspeed | Argon hasta el 30 nov | Argon desde el 1 dic |
|---|---|---|---|---|
| Entrada | 2 $ | 4 $ | 2 $ | 4 $ |
| Salida, con razonamiento | 10 $ | 20 $ | 10 $ | 20 $ |
| Lectura de caché | 0,20 $ | 0,20 $ | 0,10 $ | 0,20 $ |
| Escritura de caché | 2 $ (5 min) o 4 $ (1 h) | 4 $ (5 min) u 8 $ (1 h) | Sin tarifa propia: el prefijo se paga como entrada la primera vez | Sin tarifa propia: el prefijo se paga como entrada la primera vez |
Los precios de Argon salen de la página de precios de la API de Gemini, actualizada el 22 de octubre de 2026, que también fija la subida del 1 de diciembre. Los de Kimi, de la tabla de precios de la plataforma de Kimi, sin impuestos y sin tramos por longitud de contexto. Google cuenta los tokens de razonamiento como salida; Kimi no lo aclara en su tabla, y los cálculos de este texto suponen que también. Según Kimi, Highspeed responde entre 2 y 3 veces más rápido que K3.1 Pro.
Argon tiene además dos modos a mitad de precio si tu carga admite esperar, Batch y Flex: 1 $ de entrada y 5 $ de salida hasta el 30 de noviembre, 2 $ y 10 $ desde el 1 de diciembre. Es decir, en diciembre el modo Batch de Argon costará lo que hoy cuesta su modo estándar. El modo Priority, a 3,60 $ y 18 $, también se duplica. En la API de Gemini, Argon no tiene nivel gratuito.
Cuánto cuesta un trabajo real: tres casos recalculados
El precio por token no dice cuánto pagas por tarea, porque la caché cambia mucho la cuenta. El 25 de octubre de 2026 se recalculó el coste de tres trabajos con los precios de lista anteriores. Los volúmenes de tokens son supuestos, no tráfico medido. En Kimi, el prefijo común se escribe una vez en la caché de 5 minutos (2 $ por millón) y después se lee a 0,20 $. En Argon, el prefijo se paga a precio de entrada en la primera llamada y después a precio de caché, siempre que la caché implícita acierte.
| Trabajo (tokens supuestos) | K3.1 Pro | K3.1 Pro Highspeed | Argon hasta el 30 nov | Argon desde el 1 dic |
|---|---|---|---|---|
| Sesión de agente de programación: prefijo de 60.000 en caché, 40 turnos con 4.000 de entrada nueva y 3.000 de salida | 2,11 $ | 3,75 $ | 1,87 $ | 3,75 $ |
| Documento de 400.000 tokens y 10 preguntas en 5 minutos, con 300 de entrada y 1.500 de salida cada una | 1,68 $ | 2,63 $ | 1,32 $ | 2,63 $ |
| Llamada suelta sin caché: 8.000 de entrada y 2.000 de salida | 0,036 $ | 0,072 $ | 0,036 $ | 0,072 $ |
Puedes rehacer cualquier fila. La sesión de agente con Argon hasta el 30 de noviembre suma 60.000 tokens a 2 $ en el primer turno (0,12 $), 39 lecturas de 60.000 a 0,10 $ (0,234 $), 160.000 tokens de entrada nueva a 2 $ (0,32 $) y 120.000 de salida a 10 $ (1,20 $), siempre por millón: 1,874 $. Con K3.1 Pro, la escritura inicial cuesta lo mismo, pero las 39 lecturas a 0,20 $ suben a 0,468 $, y el total queda en 2,108 $.
El riesgo está en la caché de Argon. Google solo ofrece caché implícita: se activa sola en prompts de 4.096 tokens o más, con un 95 % de descuento cuando acierta, pero no puedes reservarla como en Kimi. Si nunca acertara, la sesión de agente costaría 6,32 $ hasta el 30 de noviembre y 12,64 $ desde el 1 de diciembre, y el documento largo, 8,16 $ y 16,31 $. En la llamada suelta no hay caché que perder, así que el único cambio es la subida de diciembre.
Las tarifas tampoco recogen cuánto razona cada modelo. En las pruebas de Artificial Analysis, una tarea media de su índice cuesta 2,11 $ con K3.1 Pro y 1,99 $ con Argon (High), con el precio de lanzamiento de Argon; Argon genera unos 62.000 tokens de salida por tarea y K3.1 Pro unos 55.000. Si Argon consumiera los mismos tokens después del 1 de diciembre, esa tarea pasaría a costar unos 3,98 $, casi el doble que con Kimi.
Benchmarks de Kimi K3.1 Pro y Gemini 4 Argon, prueba a prueba
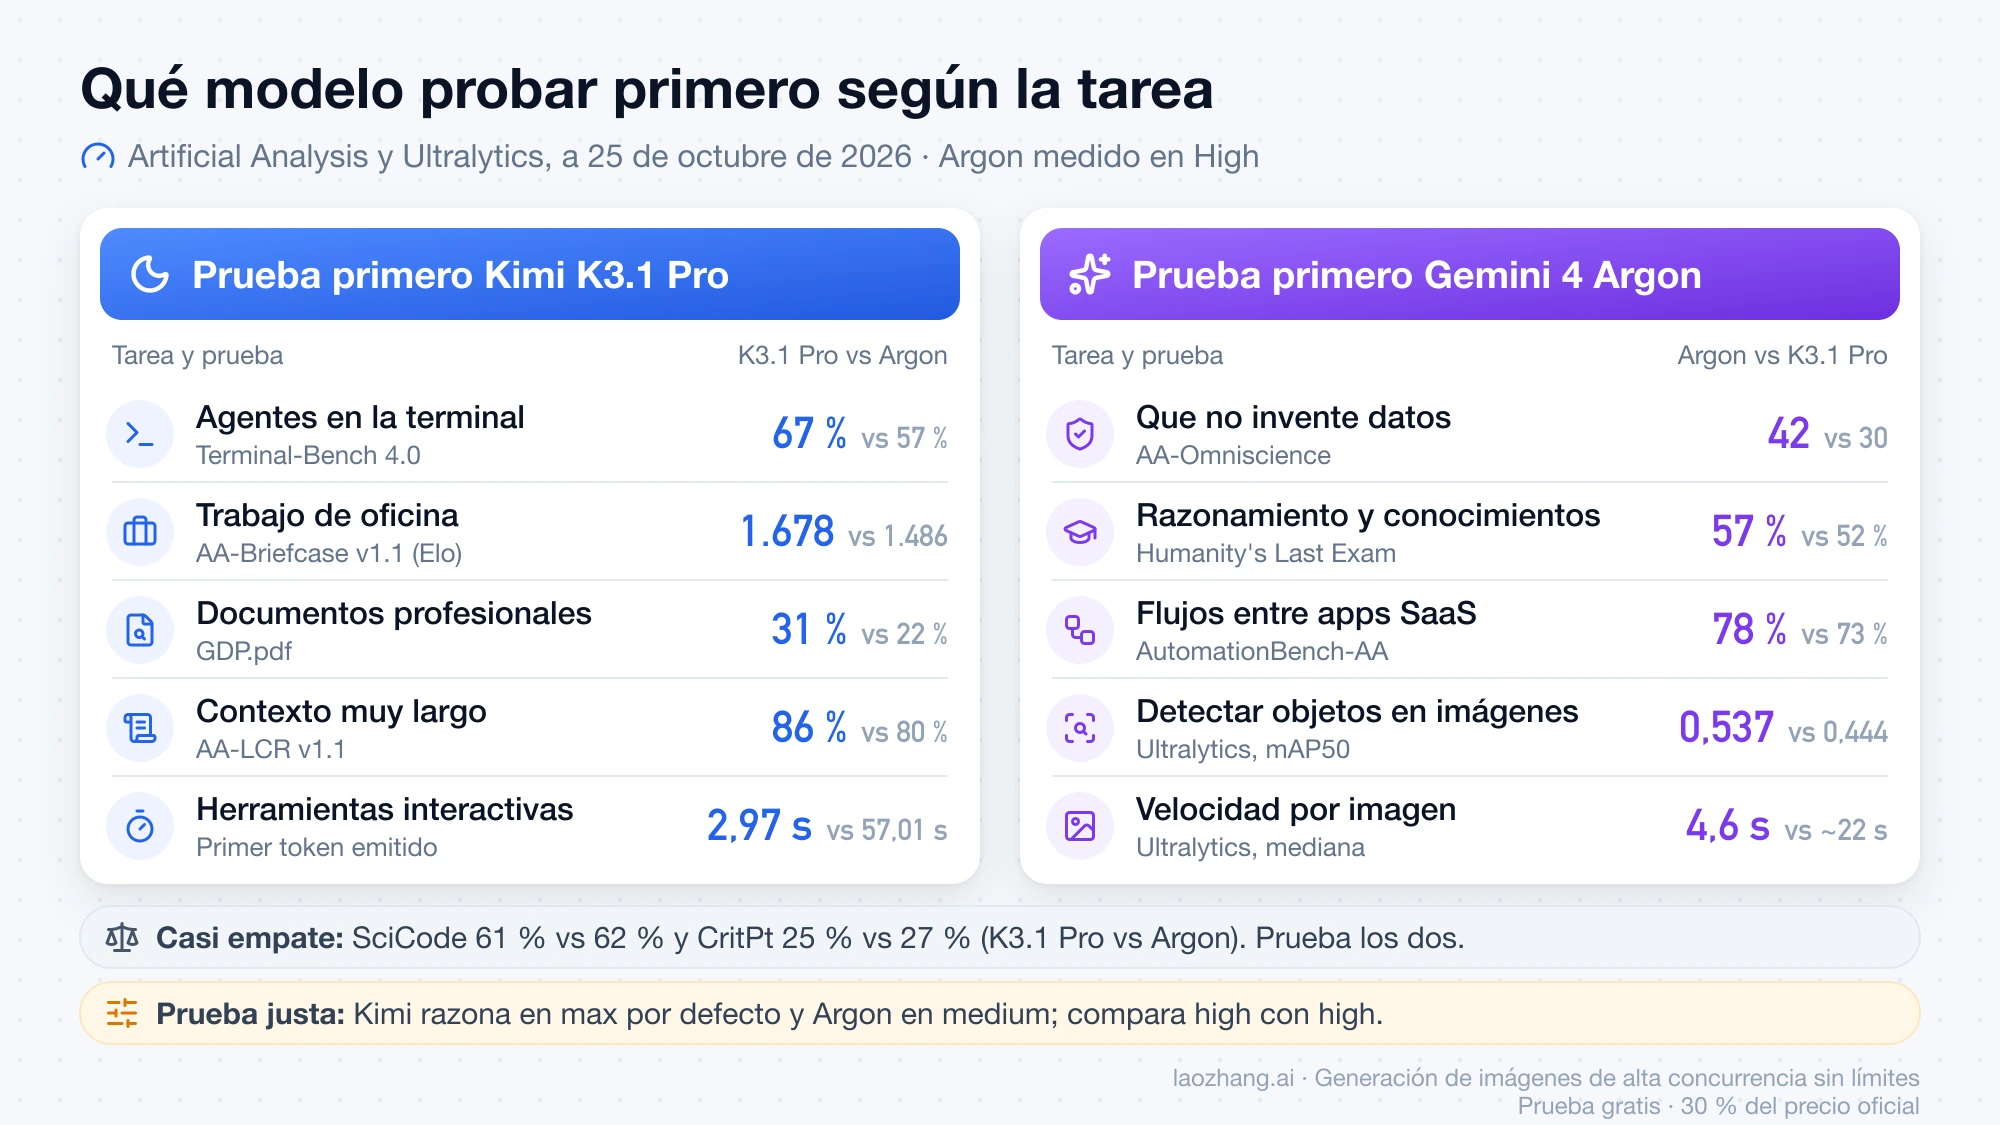
En el índice de Artificial Analysis, Kimi K3.1 Pro saca 55 puntos y Gemini 4 Argon (High) 53, una diferencia demasiado pequeña para decidir. Lo útil es el desglose: K3.1 Pro gana en programación en terminal, trabajo de oficina con documentos y razonamiento con contexto largo; Argon gana en precisión de conocimientos y automatización de procesos, y empata o gana por poco en ciencia.
| Prueba de Artificial Analysis | Qué mide | Kimi K3.1 Pro | Gemini 4 Argon (High) |
|---|---|---|---|
| Terminal-Bench 4.0 | Programación con agentes en la terminal | 67 % | 57 % |
| AA-Briefcase v1.1 | Trabajo de conocimiento con agentes (Elo) | 1.678 | 1.486 |
| GDPval-AA v2.1 | Tareas profesionales reales con agentes (Elo) | 1.846 | 1.624 |
| GDP.pdf | Razonamiento sobre documentos profesionales | 31 % | 22 % |
| AA-LCR v1.1 | Razonamiento con contexto largo | 86 % | 80 % |
| AutomationBench-AA | Flujos con agentes en aplicaciones SaaS | 73 % | 78 % |
| AA-Omniscience | Conocimientos fiables: premia aciertos y penaliza inventar | 30 | 42 |
| Humanity's Last Exam | Razonamiento y conocimientos | 52 % | 57 % |
| SciCode | Programación científica | 61 % | 62 % |
| CritPt | Razonamiento de física | 25 % | 27 % |
Datos de la comparación de Artificial Analysis entre Kimi K3.1 Pro y Gemini 4 Argon, a 25 de octubre de 2026, dos días después del lanzamiento de K3.1 Pro, así que pueden revisarse. Argon se midió con razonamiento alto (High), mientras que su valor por defecto en la API es medio; para K3.1 Pro no se indica el ajuste, y su ficha en Artificial Analysis corresponde al valor por defecto, el máximo. Por eso tu primera prueba con la configuración de fábrica no reproducirá estas cifras.
La latencia también separa a los dos. K3.1 Pro empieza a emitir tokens a los 2,97 segundos y Argon a los 57,01, porque Argon no muestra su razonamiento mientras piensa. Hasta el primer token de la respuesta, ya sin razonamiento, K3.1 Pro tarda 30,19 segundos y Argon los mismos 57,01; la respuesta completa llega en 37,00 frente a 63,33 segundos. Una vez que escribe, Argon es algo más rápido: 79 tokens por segundo frente a 73.
Kimi publica sus propias cifras. En su página en chino declara un 65,7 % en Terminal-Bench 4.0, y en una prueba de estrés diseñada para provocar errores, su tasa de afirmaciones inventadas baja del 23,35 % de Kimi K3 al 6,85 % de K3.1 Pro, según la guía de inicio rápido de Kimi K3.1 Pro. Son datos del fabricante, sin comparación con Argon.
Detección de objetos en imágenes: Argon gana en la prueba de Ultralytics
Para dibujar cajas alrededor de objetos, Gemini 4 Argon sale claramente por delante. En la prueba de anotación automática de Ultralytics con Kimi K3.1 Pro, Kimi K3 y Gemini 4 Argon, publicada el 24 de octubre de 2026, Argon obtiene un mAP50 de 0,537 y K3.1 Pro de 0,444, séptimo de 29 modelos. La prueba usa 360 imágenes, 10 de cada uno de 36 conjuntos de datos reales, y K3.1 Pro se ejecutó con razonamiento alto porque con Kimi K3 en el nivel máximo cerca del 40 % de las imágenes superaba el límite de 115 segundos.
K3.1 Pro no pierde en todo: va por delante en 6 conjuntos de datos, entre ellos tenis, fútbol, espigas de trigo y ecografía de tiroides, y en deportes saca 0,68 frente a 0,60. Aun así, Argon procesa cada imagen en una mediana de 4,6 segundos frente a unos 22, y 1.000 imágenes cuestan unos 7,60 $ frente a unos 22,50 $. Con la tarifa de diciembre, ese coste de Argon subiría a unos 15,20 $ si usara los mismos tokens, todavía por debajo de Kimi. El resultado vale solo para este tipo de tarea, no para la comprensión de imágenes en general.
Qué modelo probar primero según tu trabajo
Empieza por Kimi K3.1 Pro si tu agente trabaja en la terminal, si necesitas informes, hojas o presentaciones a partir de documentos profesionales, o si razonas sobre documentos muy largos: son las pruebas de Terminal-Bench, AA-Briefcase, GDPval-AA, GDP.pdf y AA-LCR, donde saca ventajas de 6 a 10 puntos porcentuales o de unos 190 a 220 puntos de Elo. También encaja mejor en herramientas interactivas, porque el usuario ve algo en 3 segundos y no en casi un minuto. Y si tu uso va a seguir en diciembre, a partir del 1 de diciembre cobrará la mitad que Argon por token de entrada y de salida.
Empieza por Gemini 4 Argon si una respuesta inventada te sale cara, porque saca 12 puntos más en AA-Omniscience y 5 más en Humanity's Last Exam; si automatizas flujos entre aplicaciones SaaS, donde gana en AutomationBench-AA; o si tu tarea es detectar objetos en imágenes, donde es más preciso, más rápido y más barato. En programación científica y física la diferencia es de uno o dos puntos, así que prueba los dos con tus propios problemas. Hasta el 30 de noviembre, Argon también es el más barato en trabajos que reutilizan mucho contexto, siempre que su caché implícita acierte.
Para que la primera prueba sea justa, fija el esfuerzo de razonamiento en los dos. Por defecto, Kimi razona al máximo (max) y Argon a nivel medio, así que con los valores de fábrica Kimi gastará más tiempo y tokens de los que necesitaría en high, y Argon no estará en el ajuste con el que se midieron las cifras de arriba. Compara high con high y mide el coste real por tarea en tu factura, no solo el precio por token.
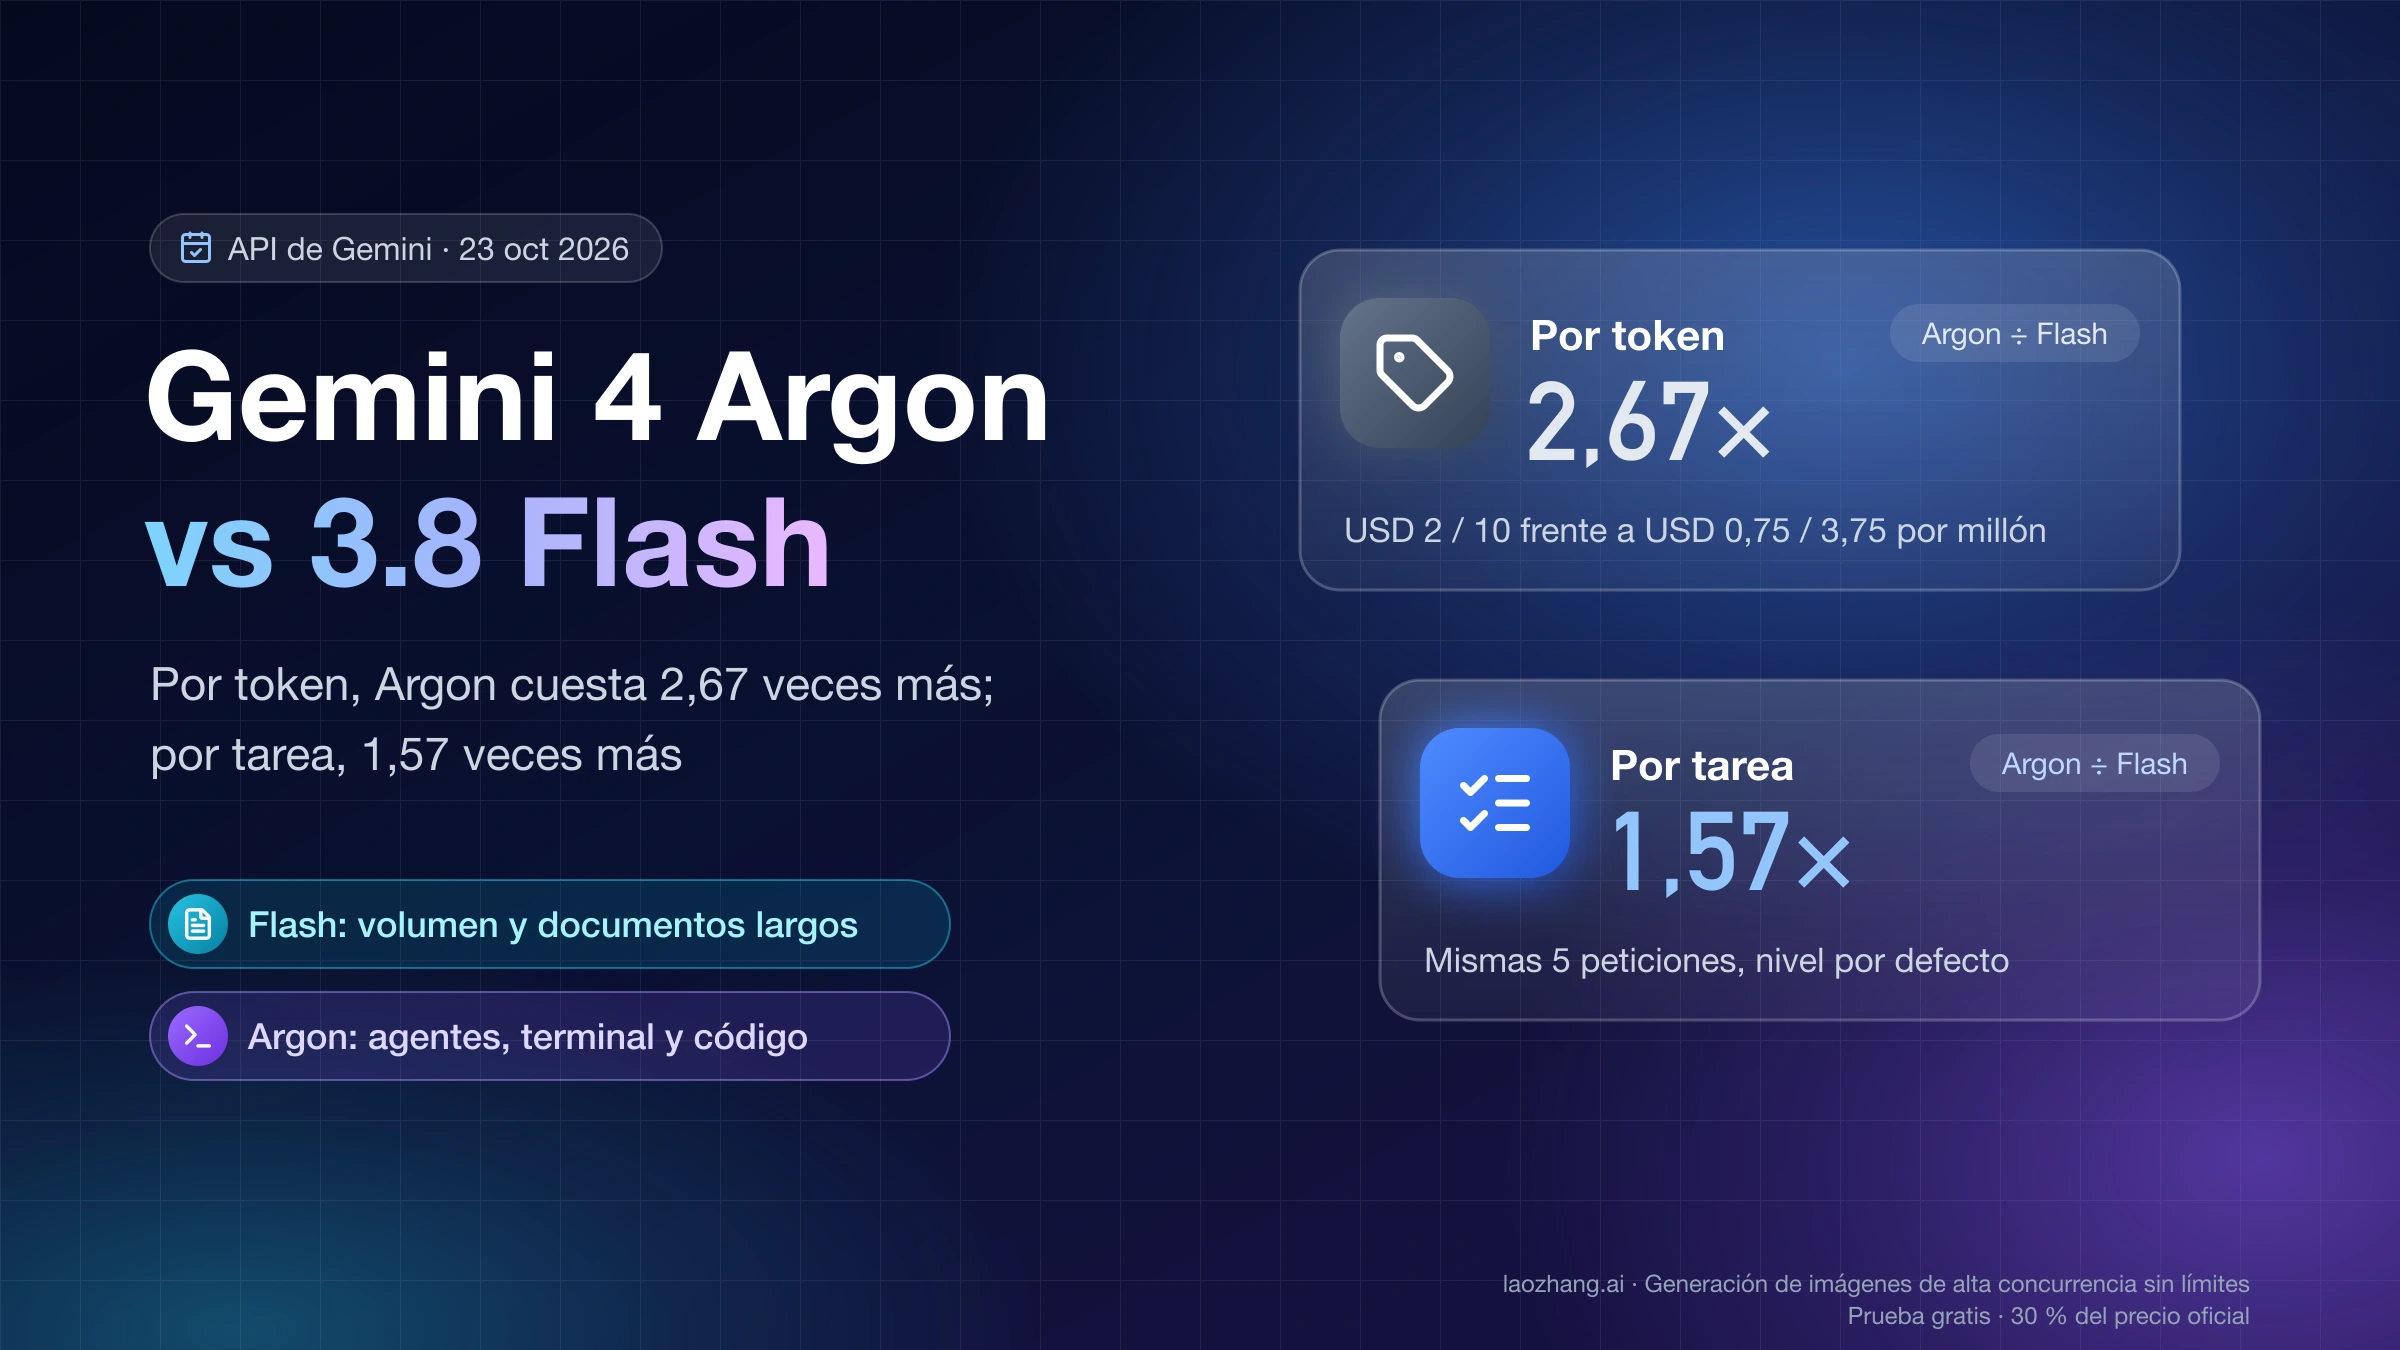
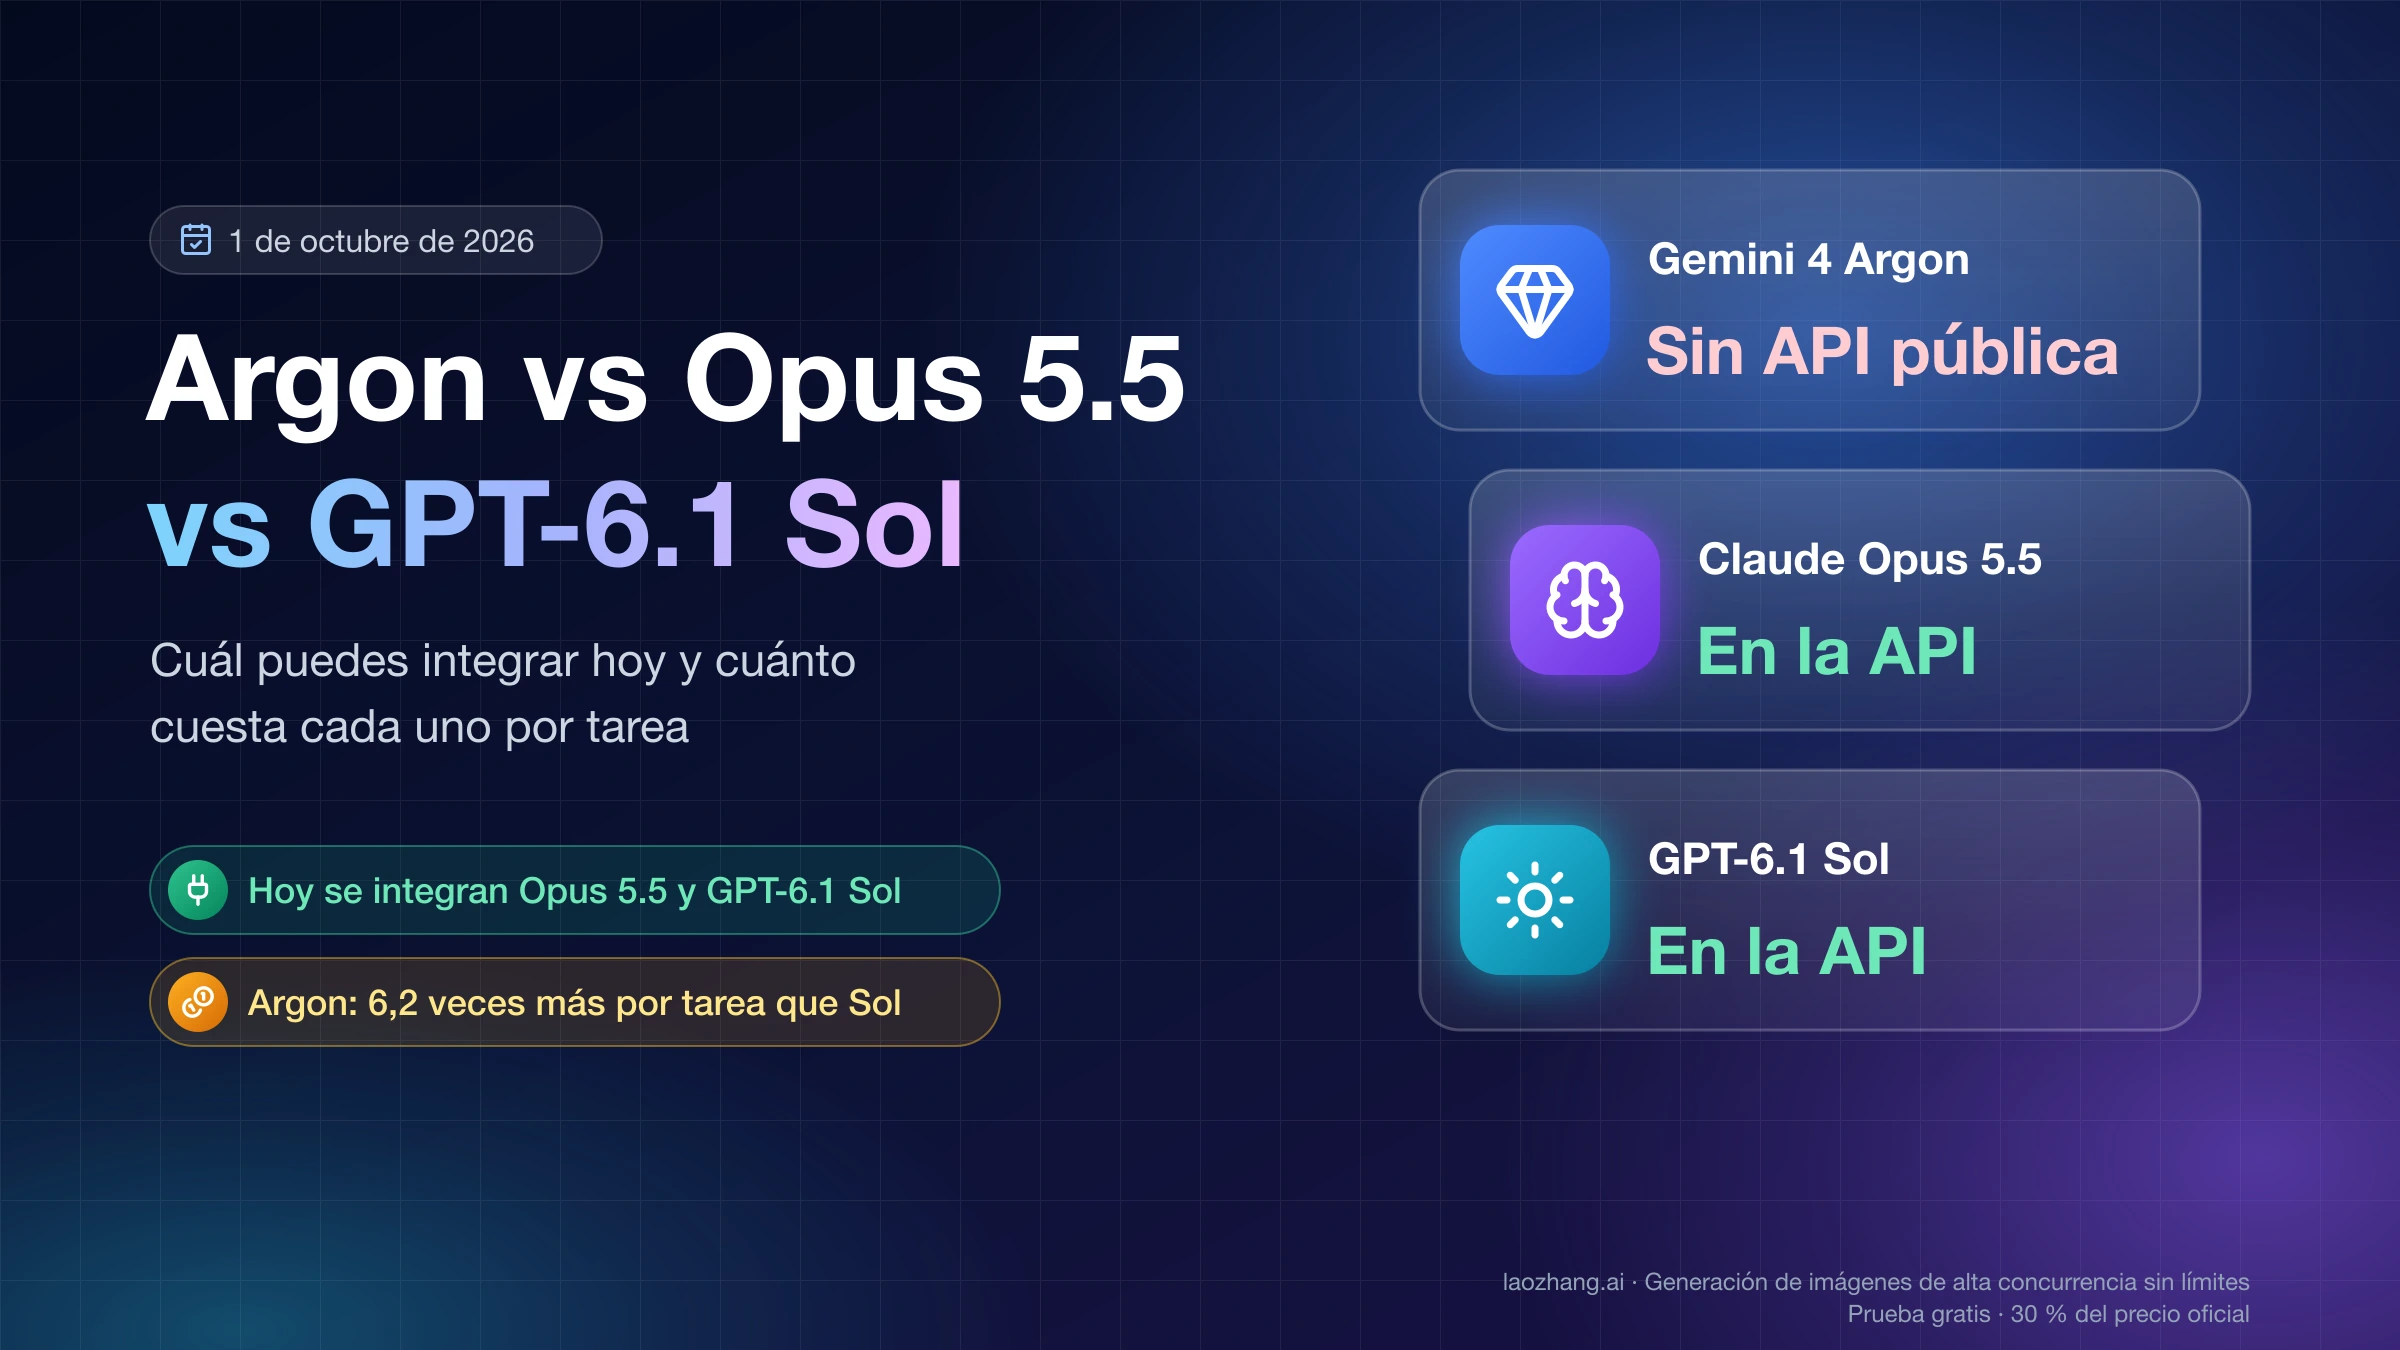
Si además dudas entre Argon y los buques insignia cerrados de Anthropic y OpenAI, la comparativa Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy compara los tres. Si prefieres quedarte en Google con un modelo más barato, Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar hace las cuentas para Flash.
Qué cambia en tu código al pasar de K3.1 Pro a Argon, o al revés
Los dos modelos aceptan un contexto de 1.048.576 tokens, pero no se comportan igual con los mismos parámetros. Las diferencias que más alteran una primera prueba son el esfuerzo de razonamiento por defecto (máximo en Kimi, medio en Argon), los parámetros de muestreo que cada uno ignora o fija, el tipo de caché y el límite de salida en una llamada normal.
| Aspecto | Kimi K3.1 Pro | Gemini 4 Argon |
|---|---|---|
| ID del modelo | kimi-k3.1-pro y kimi-k3.1-pro-highspeed | gemini-4-argon (estable desde el 13 de octubre de 2026) |
| Cliente y endpoint | SDK de OpenAI con base_url https://api.moonshot.ai/v1 | API de Gemini (AI Studio) o Vertex AI |
| Razonamiento | Siempre activo; reasoning_effort en low, high o max; por defecto max | low, medium o high; por defecto medium; no hay minimal |
| Parámetros de muestreo | temperature=1.0, top_p=0.95, n=1 y penalizaciones fijas; hay que omitirlos | temperature, top_p y top_k se ignoran |
| Caché | Automática por prefijo, 5 minutos por defecto o 1 hora con prompt_cache_options.ttl; la escritura se cobra | Solo implícita, desde 4.096 tokens, 95 % de descuento al acertar; no admite cachedContents |
| Salida máxima | max_completion_tokens: 131.072 por defecto, hasta 1.048.576 | 65.536 en llamada normal; hasta 1.048.576 solo con background=True |
| Entradas | Texto, imagen y vídeo; imágenes en base64 o ms://<file-id>, no URL públicas | Texto, imagen, vídeo, audio y PDF |
| Desbloqueo | Tras una recarga mínima de 1 $ | Solo en el nivel de pago |
Fuentes: la guía de inicio rápido de Kimi K3.1 Pro y la ficha de Gemini 4 Argon en la documentación de la API de Gemini.
Al migrar a Argon, el cambio que más fallos produce es el límite de salida. El contexto de Argon es compartido entre entrada, razonamiento y salida, y si pides más de 65.536 tokens de salida en una llamada normal la API devuelve un error 400. La salida de hasta un millón de tokens solo existe en el modo de decodificación larga en segundo plano. Google recomienda además subir max_output_tokens al menos a 32.768 y dar a tus clientes un tiempo de espera de 15 minutos o más para las peticiones difíciles.
Al migrar a Kimi, revisa dos cosas. En conversaciones de varios turnos y con herramientas tienes que devolver el mensaje completo del asistente sin modificarlo, y si tu código envía URL de imágenes tendrás que pasarlas a base64 o subirlas primero como archivo. Kimi también desaconseja su búsqueda web oficial en producción.
Acceso desde España, proveedores y pesos abiertos de K3.1 Pro
Desde España puedes usar los dos por API: España figura en la lista de regiones disponibles de la API de Gemini, y Kimi desbloquea K3.1 Pro en platform.kimi.ai tras una recarga mínima de 1 $. Hoy cada modelo tiene un único proveedor, su propio fabricante: Argon es un modelo cerrado y los pesos de K3.1 Pro todavía no se han publicado.
Kimi no publica una lista de países admitidos, así que lo práctico es comprobar si tu tarjeta pasa la recarga; el total recargado determina tu nivel y tus límites de uso. Fuera de la API, Argon también está en la app Gemini con Google AI Pro o Ultra y en Antigravity, mientras que la página de planes de la app de Kimi no indica qué modelos incluye cada plan, así que no consta si K3.1 Pro está disponible allí.
El 25 de octubre de 2026 se consultó el catálogo público de OpenRouter (https://openrouter.ai/api/v1/models y la lista de endpoints de cada modelo). K3.1 Pro aparece con dos endpoints, ambos de Moonshot AI: el estándar a 2 $ y 10 $ y el Highspeed a 4 $ y 20 $. Argon aparece con seis, todos de Google: AI Studio y Vertex global a 2 $ y 10 $, AI Studio Flex a 1 $ y 5 $, Vertex en Estados Unidos a 2,20 $ y 11 $ con salida limitada a 65.536 tokens, y Priority en AI Studio y Vertex a 3,60 $ y 18 $, además de una variante batch a 1 $ y 5 $. En ese catálogo, los endpoints de K3.1 Pro no aceptan temperature, top_p ni seed, mientras que los de Argon sí los listan, aunque Google indica que Argon ignora los dos primeros. Pasar por un intermediario no te da hoy otro servidor de respaldo para ninguno de los dos.
Eso puede cambiar para Kimi. Moonshot AI promete publicar los pesos completos de K3.1 Pro antes del 4 de noviembre de 2026, y a partir de ahí podrán aparecer otros proveedores y podrás alojarlo tú mismo. Hasta entonces, Artificial Analysis marca los dos modelos como cerrados, y Argon seguirá siéndolo.
Otra vía para Argon es laozhang.ai, que ofrece gemini-4-argon a 2 $ de entrada y 10 $ de salida por millón de tokens sin cuenta de facturación de Google; desde el 25 de octubre de 2026 también ofrece kimi-k3.1-pro (2 $ / 10 $, acierto de caché 0,2 $) y kimi-k3.1-pro-highspeed (4 $ / 20 $) por su endpoint compatible con OpenAI, y no ha publicado qué precio aplicará a Argon desde el 1 de diciembre.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Preguntas frecuentes sobre Kimi K3.1 Pro y Gemini 4 Argon
¿Las comparativas de Kimi K3 vs Gemini 4 Argon sirven para Kimi K3.1 Pro?
No del todo. Kimi K3.1 Pro, publicado el 23 de octubre de 2026, es una versión de Kimi K3 con entrenamiento adicional y tiene resultados propios, así que las puntuaciones de K3 no se pueden trasladar a K3.1 Pro. Lo mismo pasa con los 2,8 billones de parámetros totales y 104.000 millones activos: Moonshot AI los publicó para K3 y no los repite en la ficha de K3.1 Pro.
¿Gemini 4 Argon tiene menos contexto que Kimi K3.1 Pro?
No. Según la documentación de cada fabricante, los dos admiten 1.048.576 tokens de contexto, y Artificial Analysis los lista a ambos con un millón. La diferencia práctica está en la salida: Argon reparte ese contexto entre entrada, razonamiento y salida, con el límite por llamada que aparece en la tabla de diferencias de API.
¿Llegará pronto Gemini 4 Carbon?
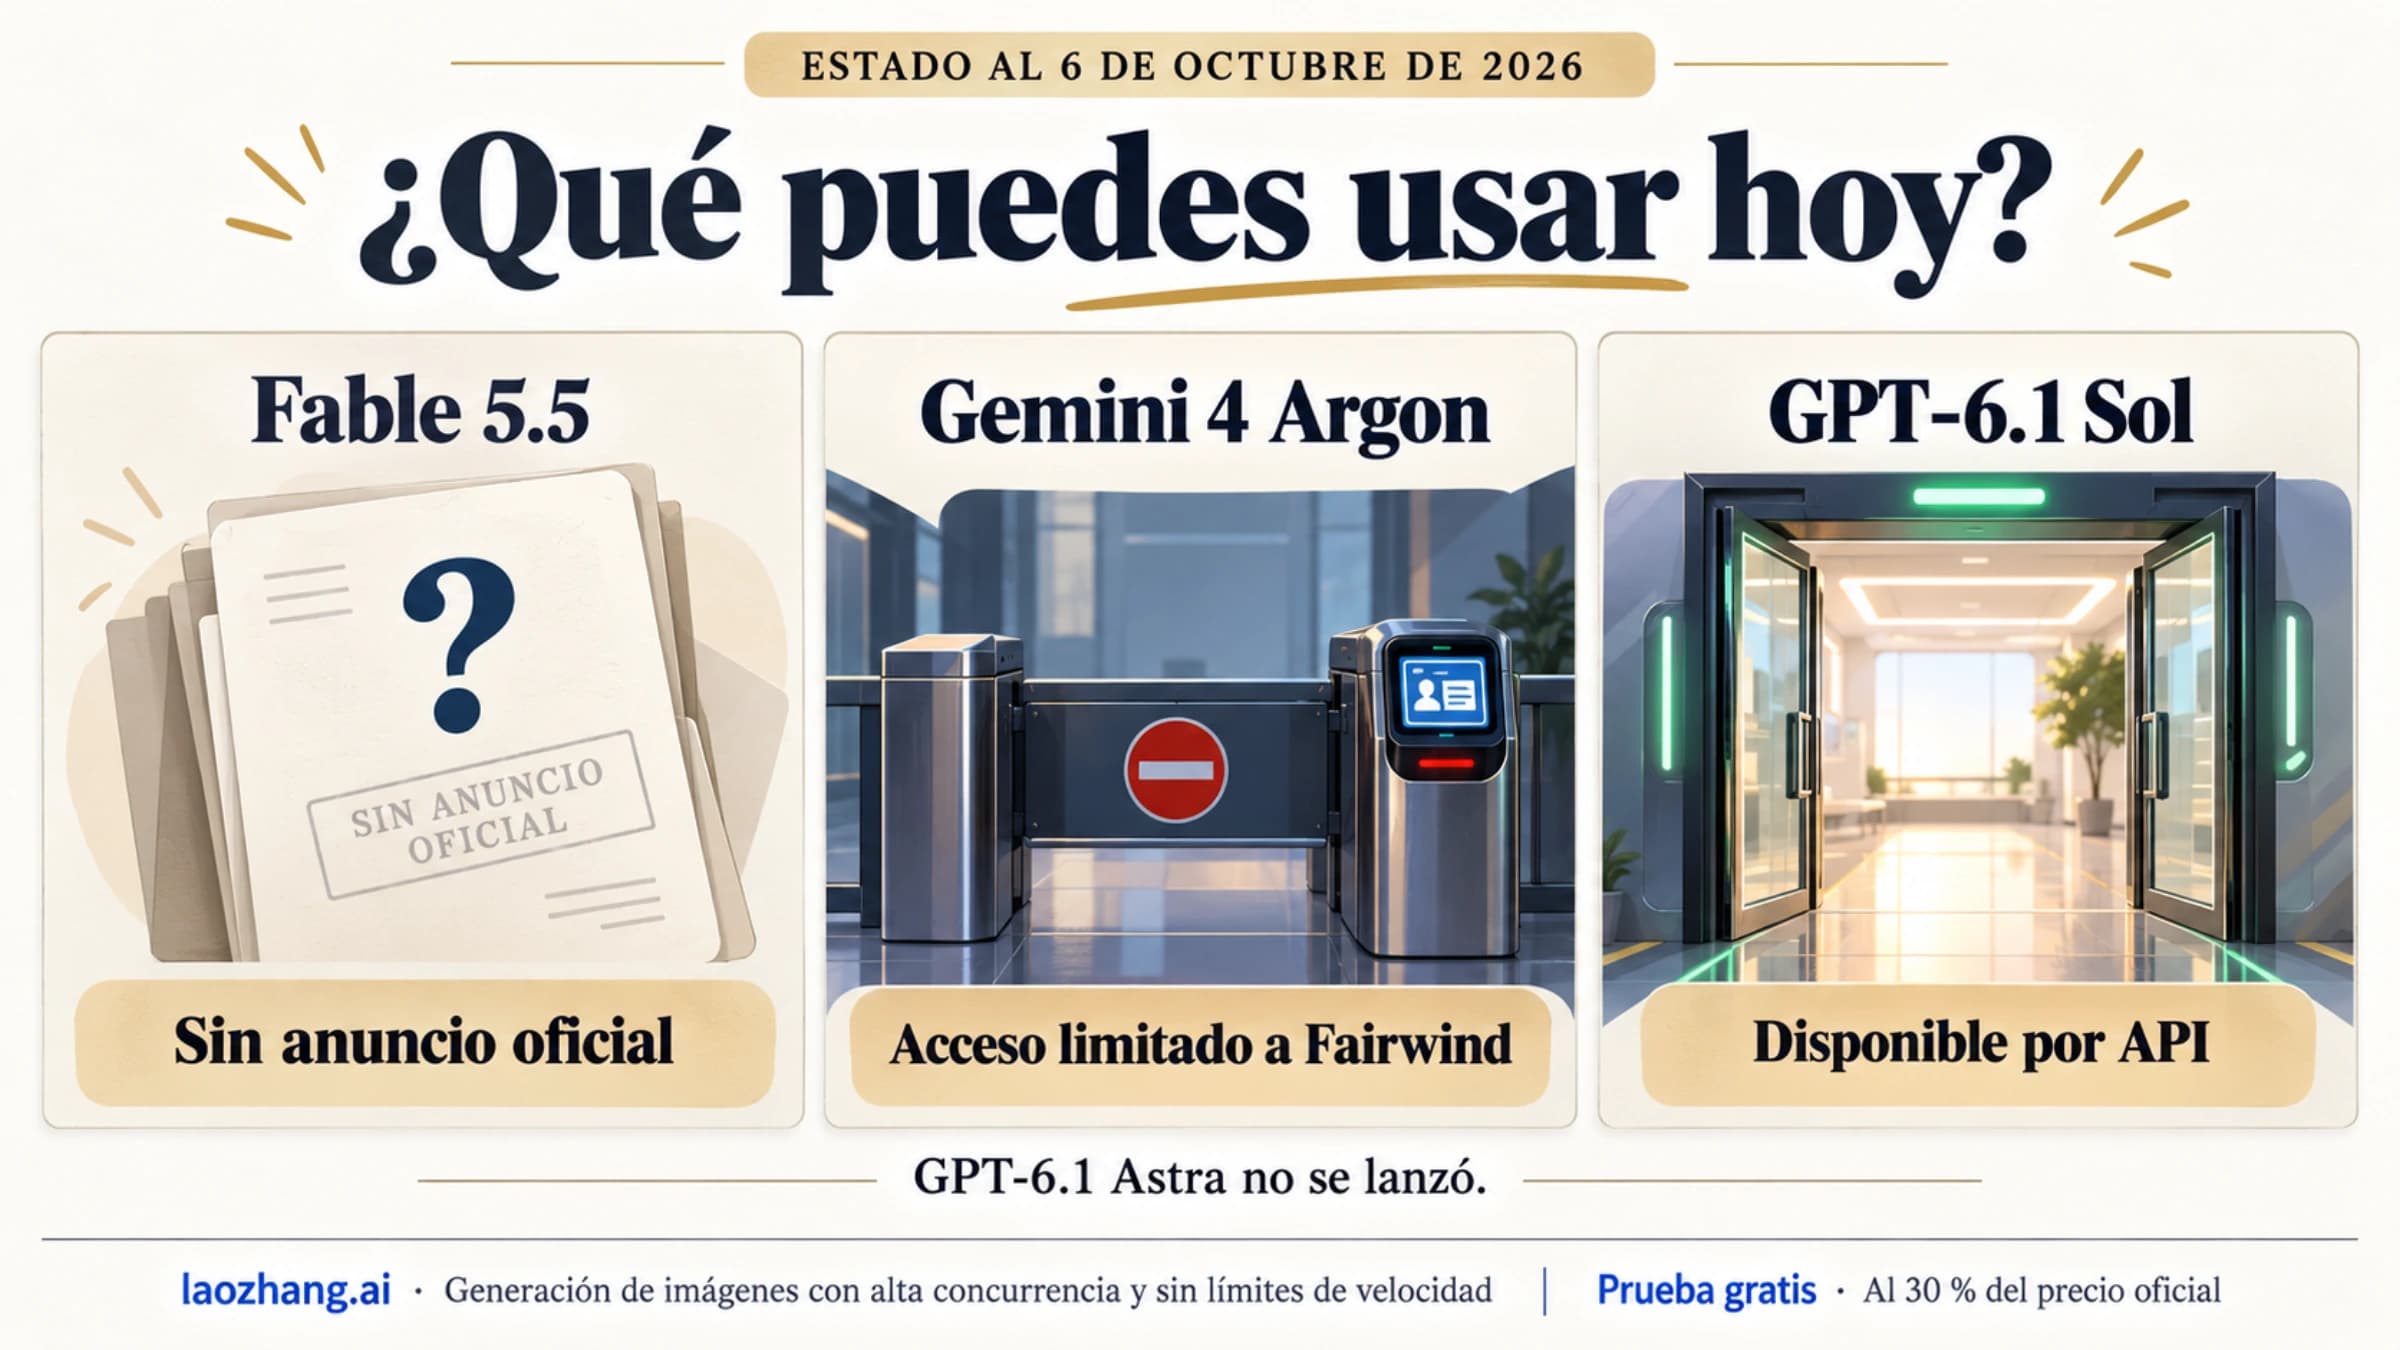
No hay nada oficial. Business Insider informó el 9 de octubre de 2026 de que empleados de Google prueban una versión interna de Gemini 4 llamada Carbon, pero Google no ha publicado identificador, fecha, precio ni resultados. Sobre qué modelos de nueva generación ya están disponibles, consulta Fable 5.5 vs Gemini 4 vs GPT-6.1: Argon ya salió, Fable 5.5 no.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
- 1.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 2.tabla de precios de la plataforma de Kimiplatform.kimi.ai/docs/pricing/chat
- 3.comparación de Artificial Analysis entre Kimi K3.1 Pro y Gemini 4 Argonartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-kimi-k3-1-pro
- 4.guía de inicio rápido de Kimi K3.1 Proplatform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 5.prueba de anotación automática de Ultralytics con Kimi K3.1 Pro, Kimi K3 y Gemini 4 Argonultralytics.com/blog/kimi-k3-1-pro-auto-annotation
- 6.ficha de Gemini 4 Argon en la documentación de la API de Geminiai.google.dev/gemini-api/docs/models/gemini-4-argon
- 7.lista de regiones disponibles de la API de Geminiai.google.dev/gemini-api/docs/available-regions