GPT-6.1 Terra vs GPT-6 Luna: diferencias y coste real por tarea
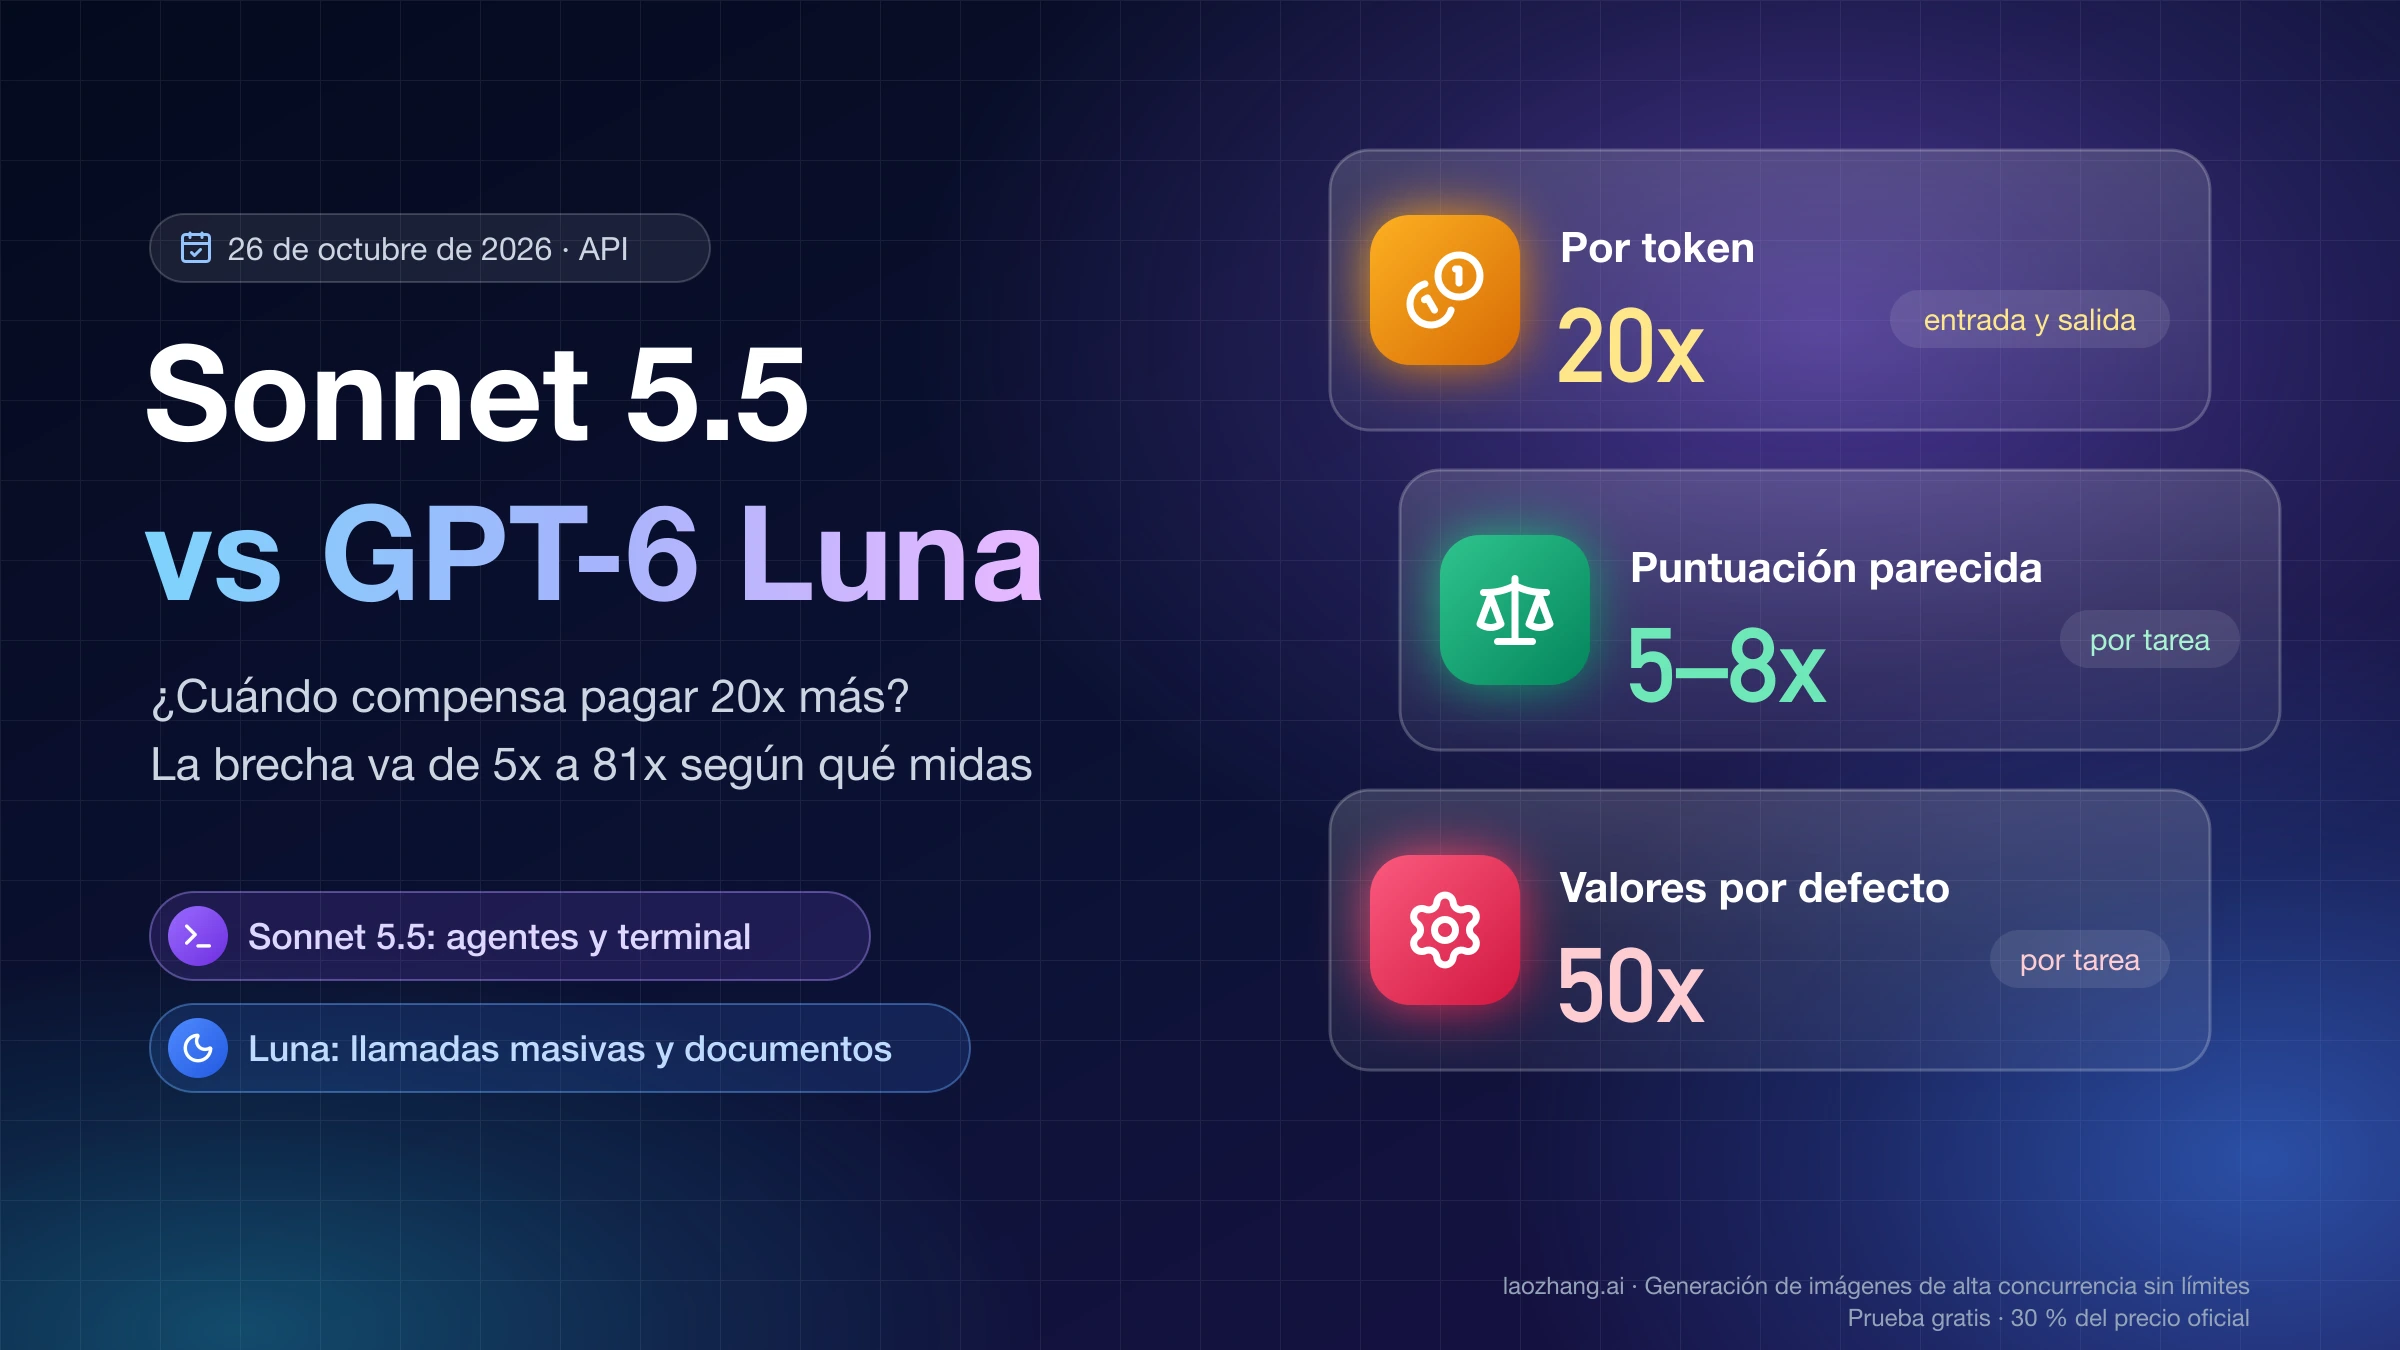
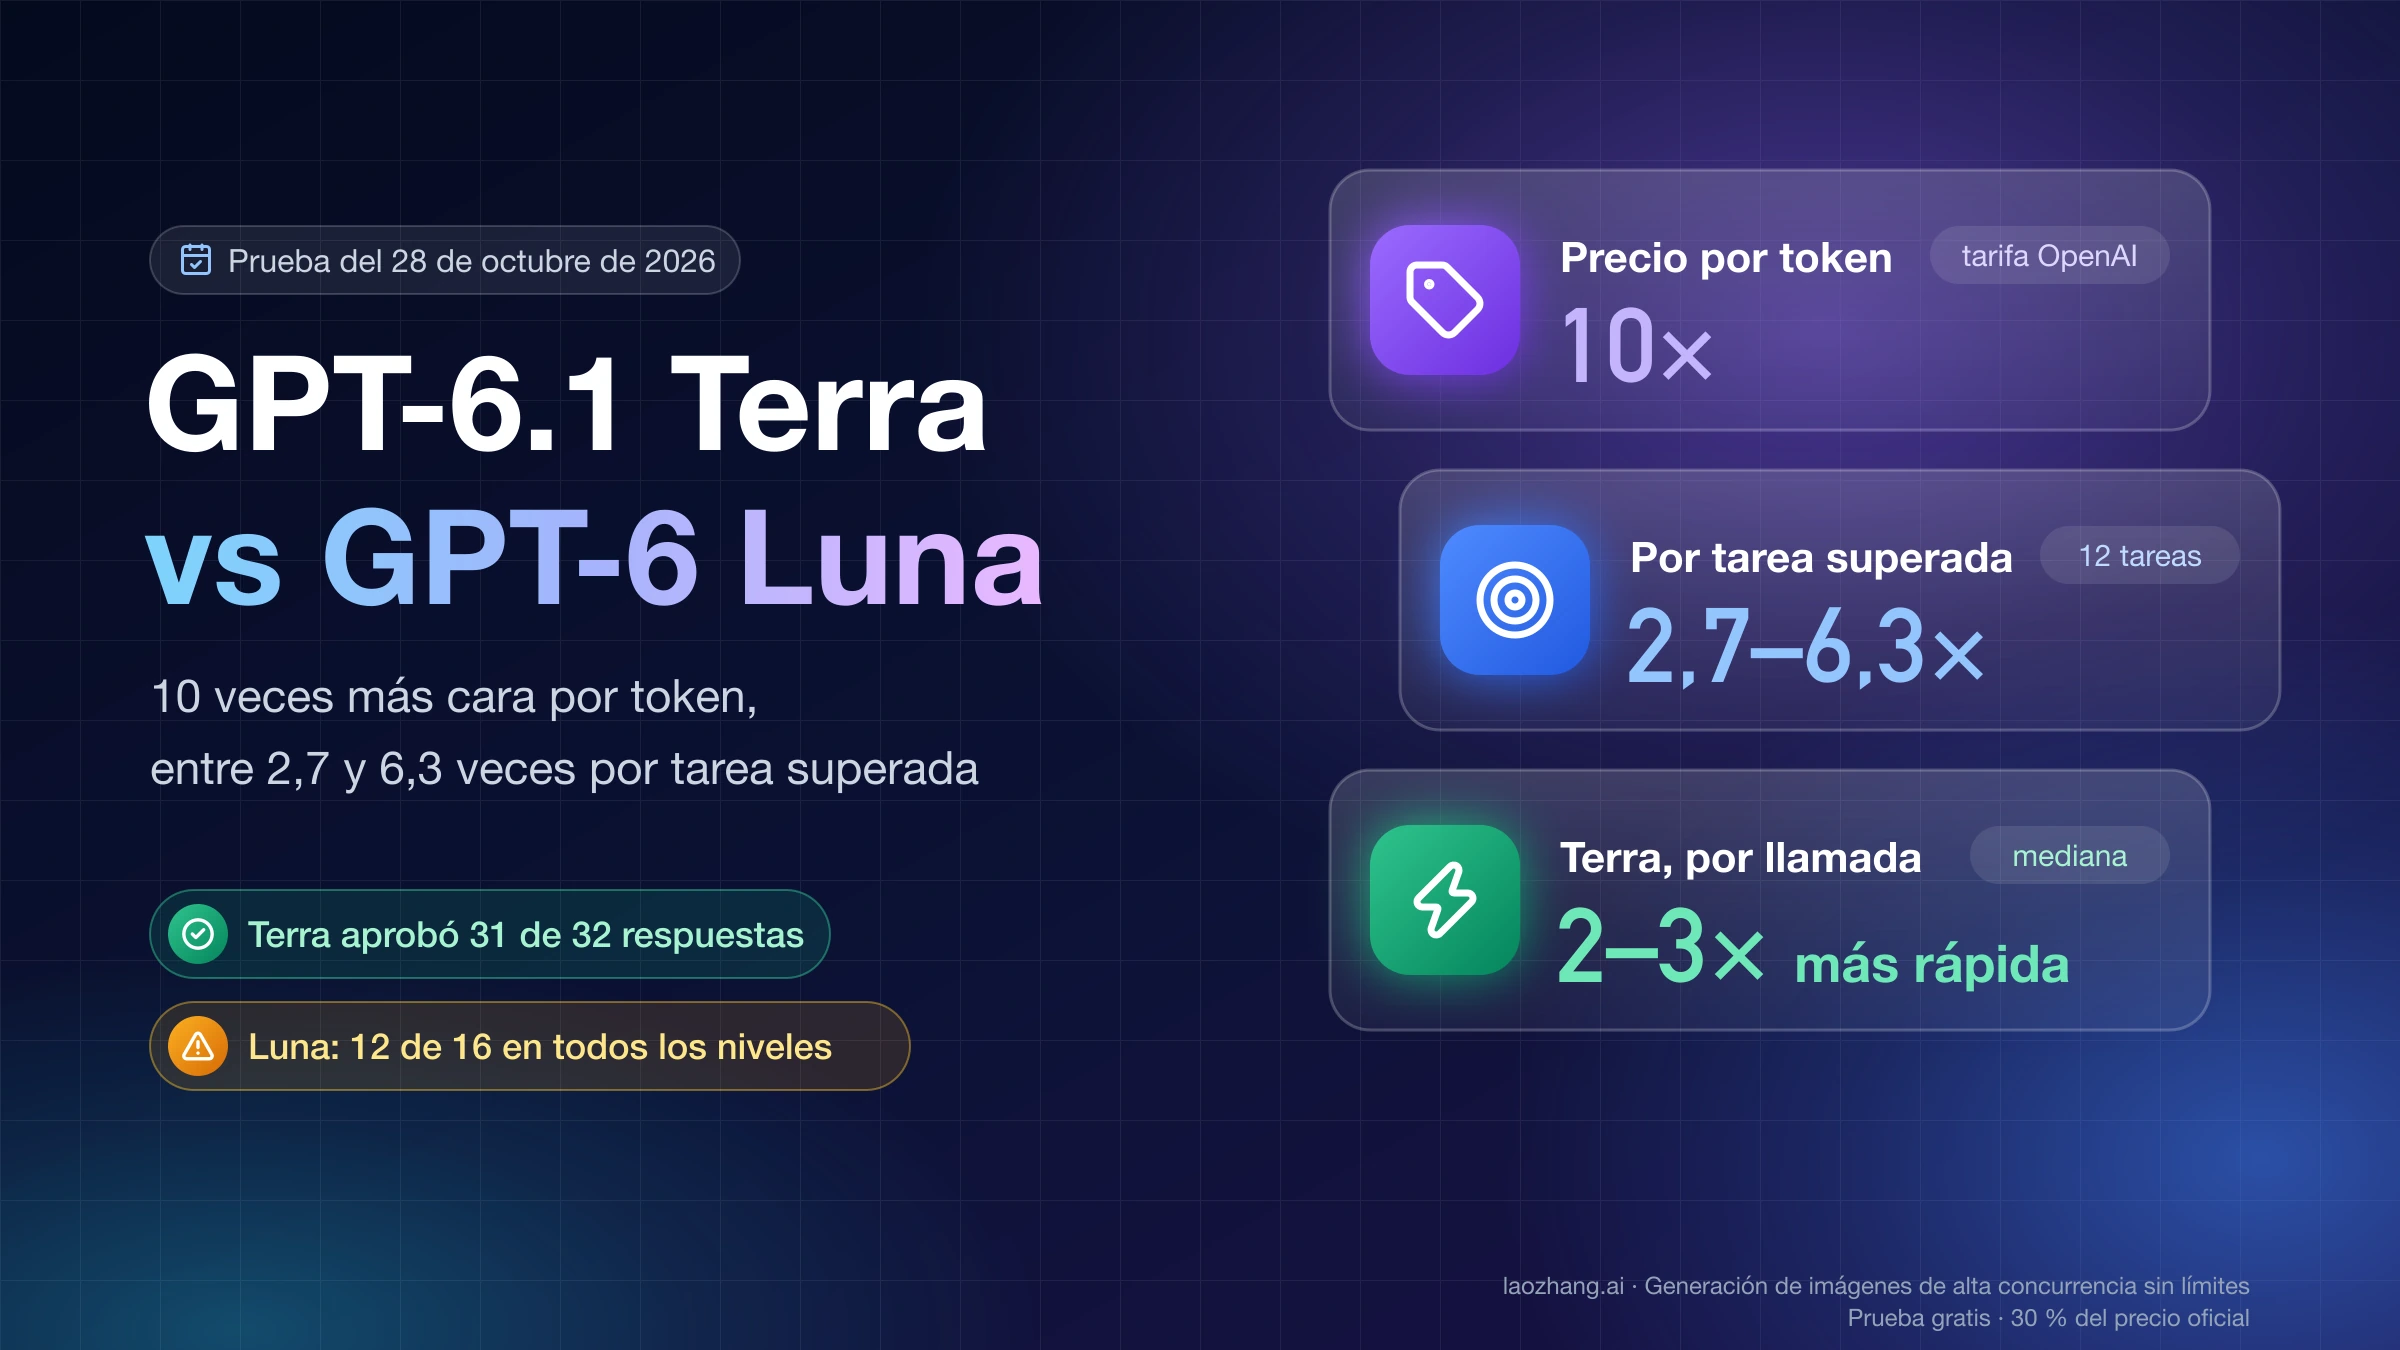
GPT-6.1 Terra cobra 10 veces más por token que GPT-6 Luna, pero en 12 tareas probadas el 28 de octubre de 2026 salió entre 2,7 y 6,3 veces más cara por acierto.
En esta página
Si tus llamadas a gpt-6-luna ya resuelven bien resúmenes, extracción de texto, cálculos y funciones de código con pruebas, no hace falta pasarlas todas a gpt-6.1-terra: Luna aprueba ese tipo de trabajo por una fracción del coste. Prueba Terra en low o medium solo donde Luna falla o tarda demasiado, como leer imágenes con caracteres que se confunden, implementar especificaciones llenas de casos límite o devolver una respuesta en pocos segundos. El «10 veces más cara» es la tarifa por token que publica OpenAI a 28 de octubre de 2026, no lo que te cuesta cada tarea terminada.
El 28 de octubre de 2026 se ejecutaron las mismas 12 tareas en los dos modelos a través de la misma pasarela de API. Terra aprobó 15 de 16 respuestas en low y 16 de 16 en medium, mientras que Luna se quedó en 12 de 16 en medium, high y xhigh. Por tarea superada, Terra salió entre 2,7 y 6,3 veces más cara, no 10, porque Luna genera muchos más tokens de razonamiento, y cada llamada de Terra fue entre 2 y 3 veces más rápida.
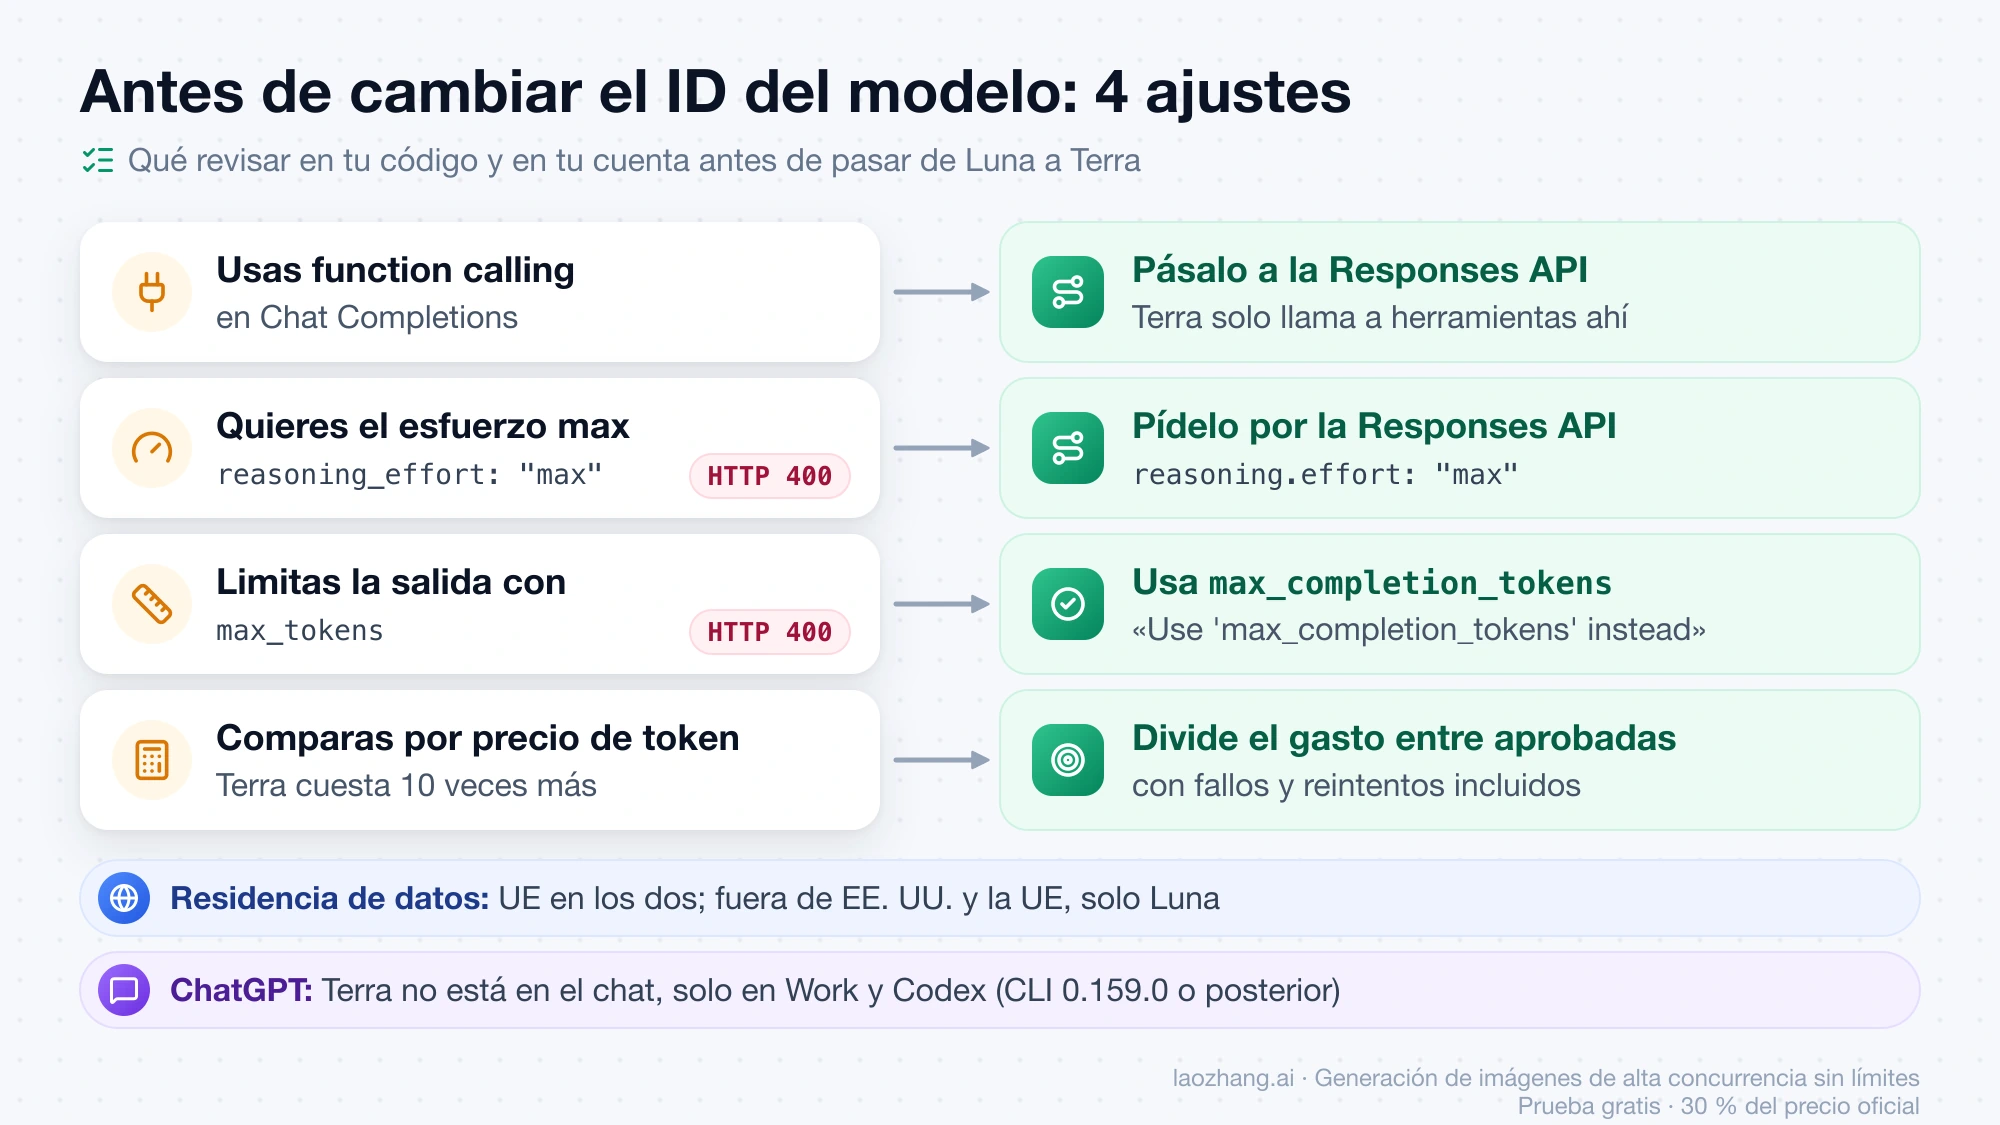
Cambiar solo el ID del modelo no basta si tu código llama a herramientas desde Chat Completions, porque Terra las exige en la Responses API, ni si quieres usar el esfuerzo max, que en la prueba dio error en Chat Completions con los dos modelos y sí funcionó en la Responses API. Ten en cuenta también que Terra no aparece en el chat normal de ChatGPT, solo en Work y Codex. La residencia de datos en la UE, en cambio, no te frena: OpenAI la ofrece en ambos.
Qué diferencia a GPT-6.1 Terra de GPT-6 Luna y qué comparten
Las dos son modelos de razonamiento de OpenAI con la misma ventana y los mismos niveles de esfuerzo; lo que cambia es el precio, el tipo de trabajo para el que se anuncian y la vía para usar herramientas. OpenAI lanzó GPT-6.1 Terra el 26 de octubre de 2026 como «un modelo rápido y eficiente para razonamiento visual, uso preciso del ordenador y redacción clara y natural», con ejemplos como cotejar fotos de producto con un catálogo, interpretar planos técnicos o actuar sobre pantallas de una aplicación. GPT-6 Luna, publicado con GPT-6 Sol el 22 de septiembre de 2026 (instantánea gpt-6-luna-2026-09-22), es según su ficha «el modelo más eficiente para tareas acotadas y de gran volumen».
Según las fichas de GPT-6.1 Terra y GPT-6 Luna en la documentación de la API de OpenAI, a 28 de octubre de 2026 ambos tienen 1.050.000 tokens de contexto y hasta 128.000 de salida, aceptan texto e imagen, devuelven texto y admiten reasoning.effort en none, low, medium (por defecto), high, xhigh y max. Los tokens de razonamiento se cobran como salida en los dos, y ninguno procesa audio ni vídeo. Las diferencias técnicas son la fecha de corte del conocimiento (18 de mayo de 2026 en Luna, 1 de junio de 2026 en Terra) y las herramientas: Terra solo llama a herramientas a través de la Responses API, y Luna acepta function calling en Chat Completions únicamente con reasoning_effort en none. Un repositorio grande o un documento largo no es, por tanto, motivo para elegir uno u otro.
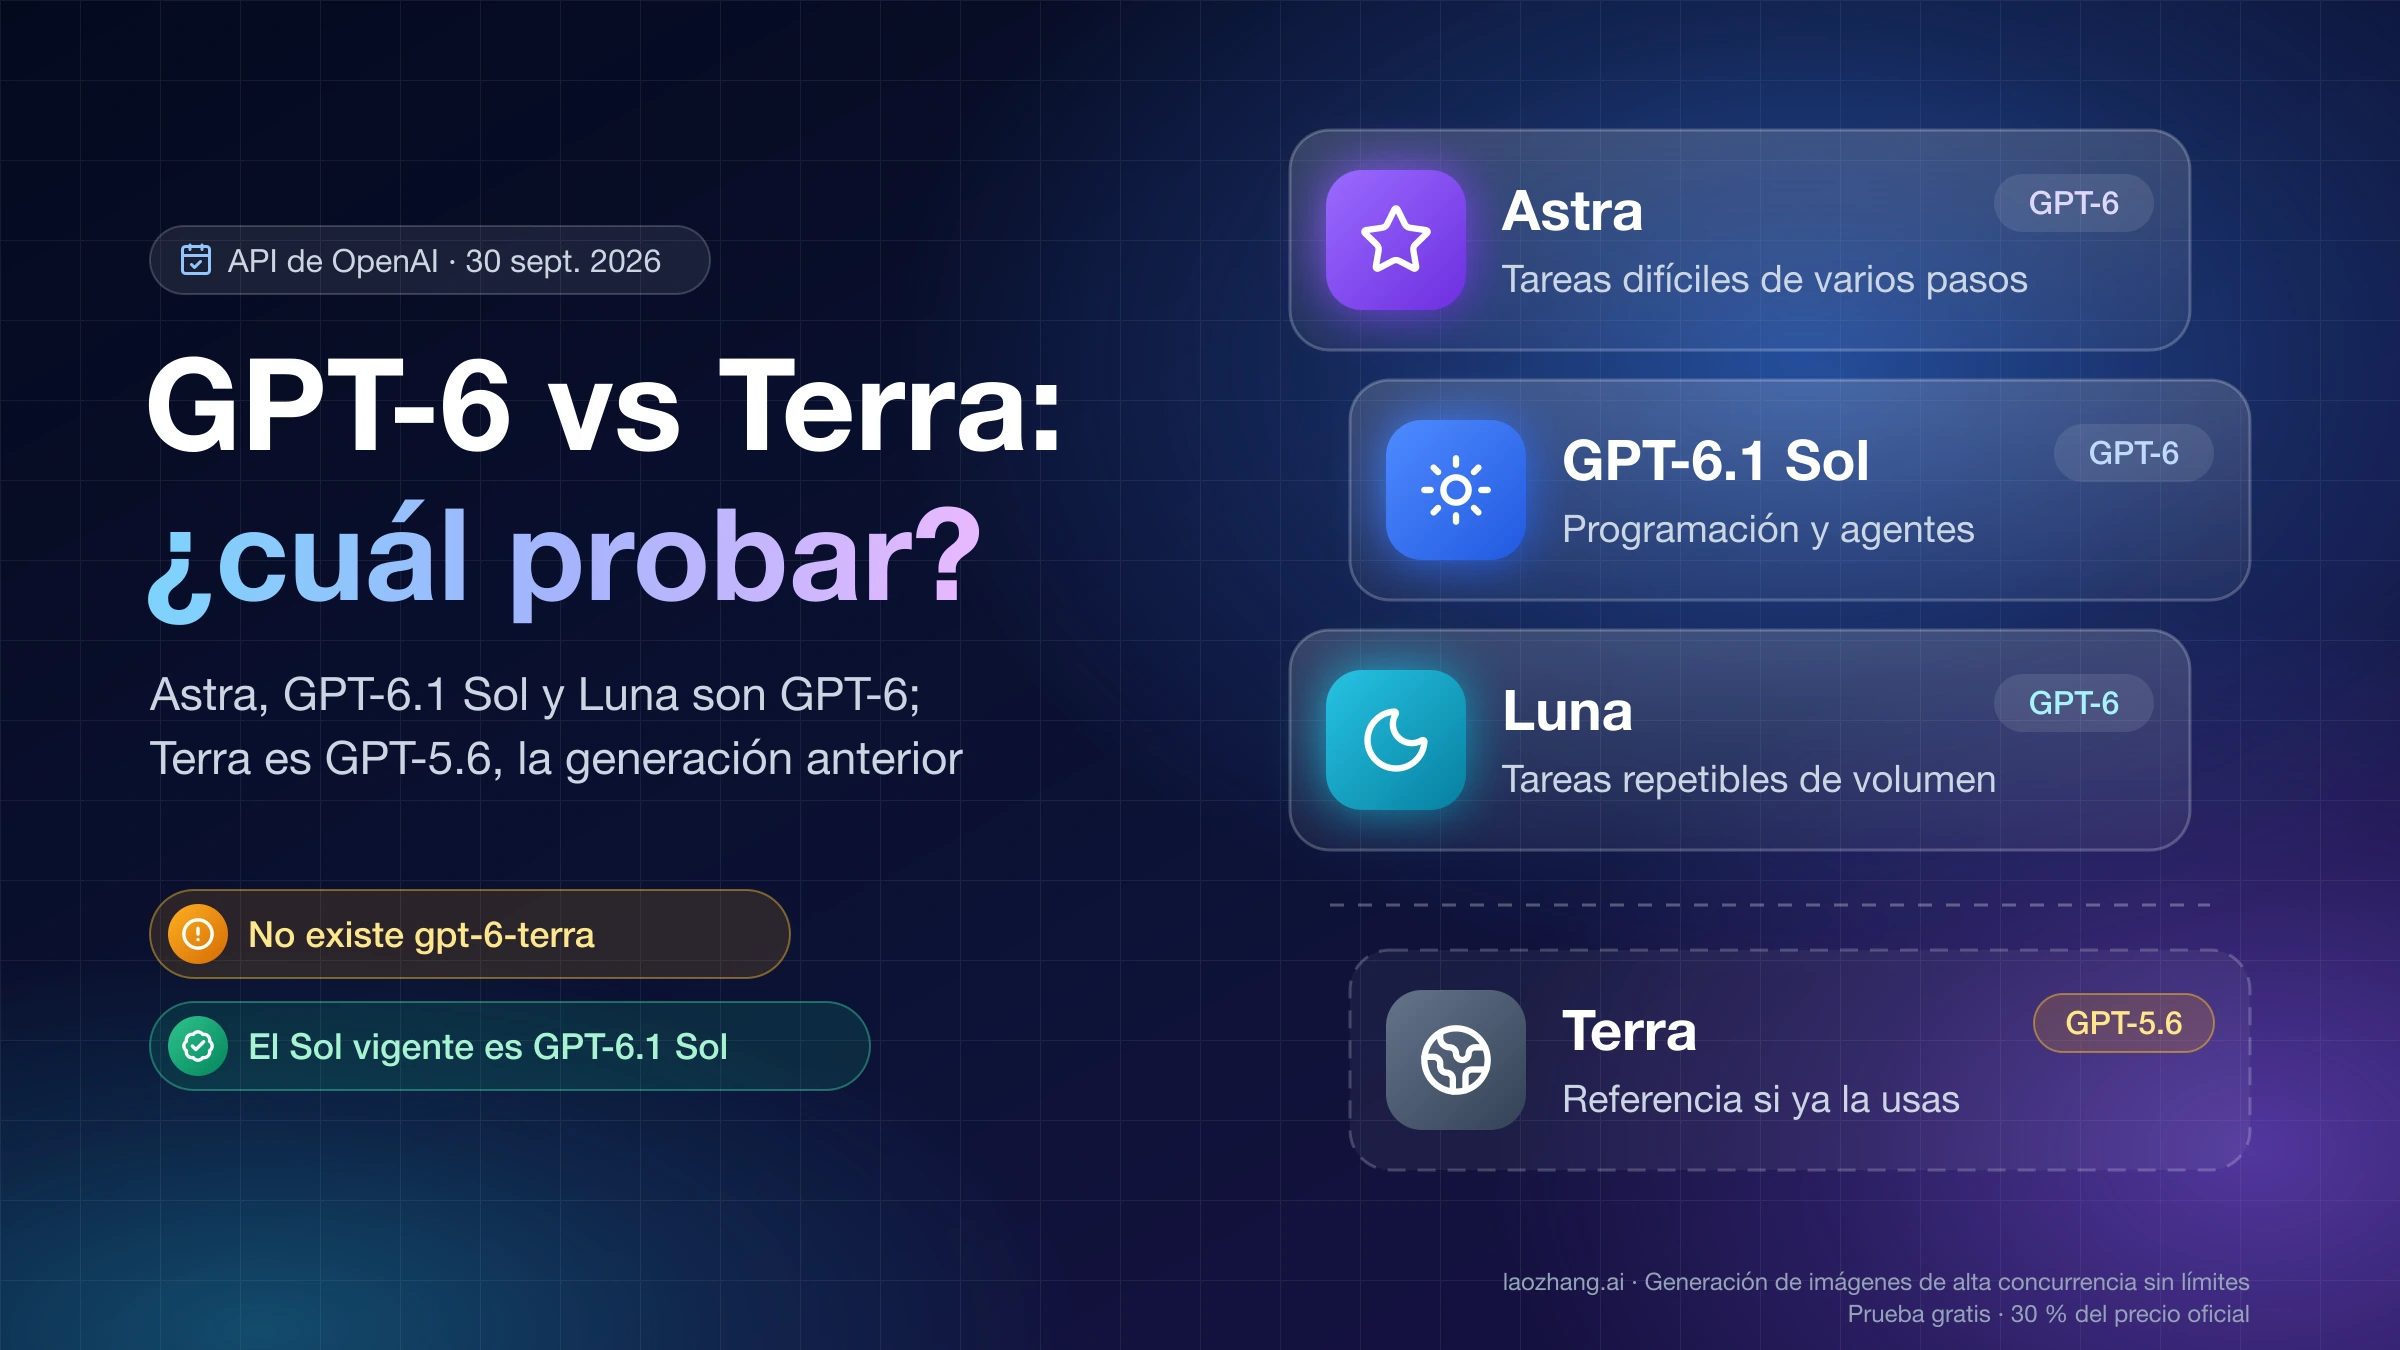
Conviene no mezclar versiones. GPT-6.1 Terra es la primera Terra de la familia GPT-6 (no existe un ID gpt-6-terra), y la GPT-5.6 Terra anterior sigue en la lista de precios a 2 $ la entrada y 12 $ la salida por millón de tokens, así que una comparación de «Terra y Luna» con esas cifras habla del modelo viejo. Tampoco existe GPT-6.1 Luna: a 28 de octubre de 2026, la tabla principal de precios de OpenAI enumera GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra y GPT-6 Luna.
Cuánto cuesta cada una: 10 veces por token, 5 veces en caché
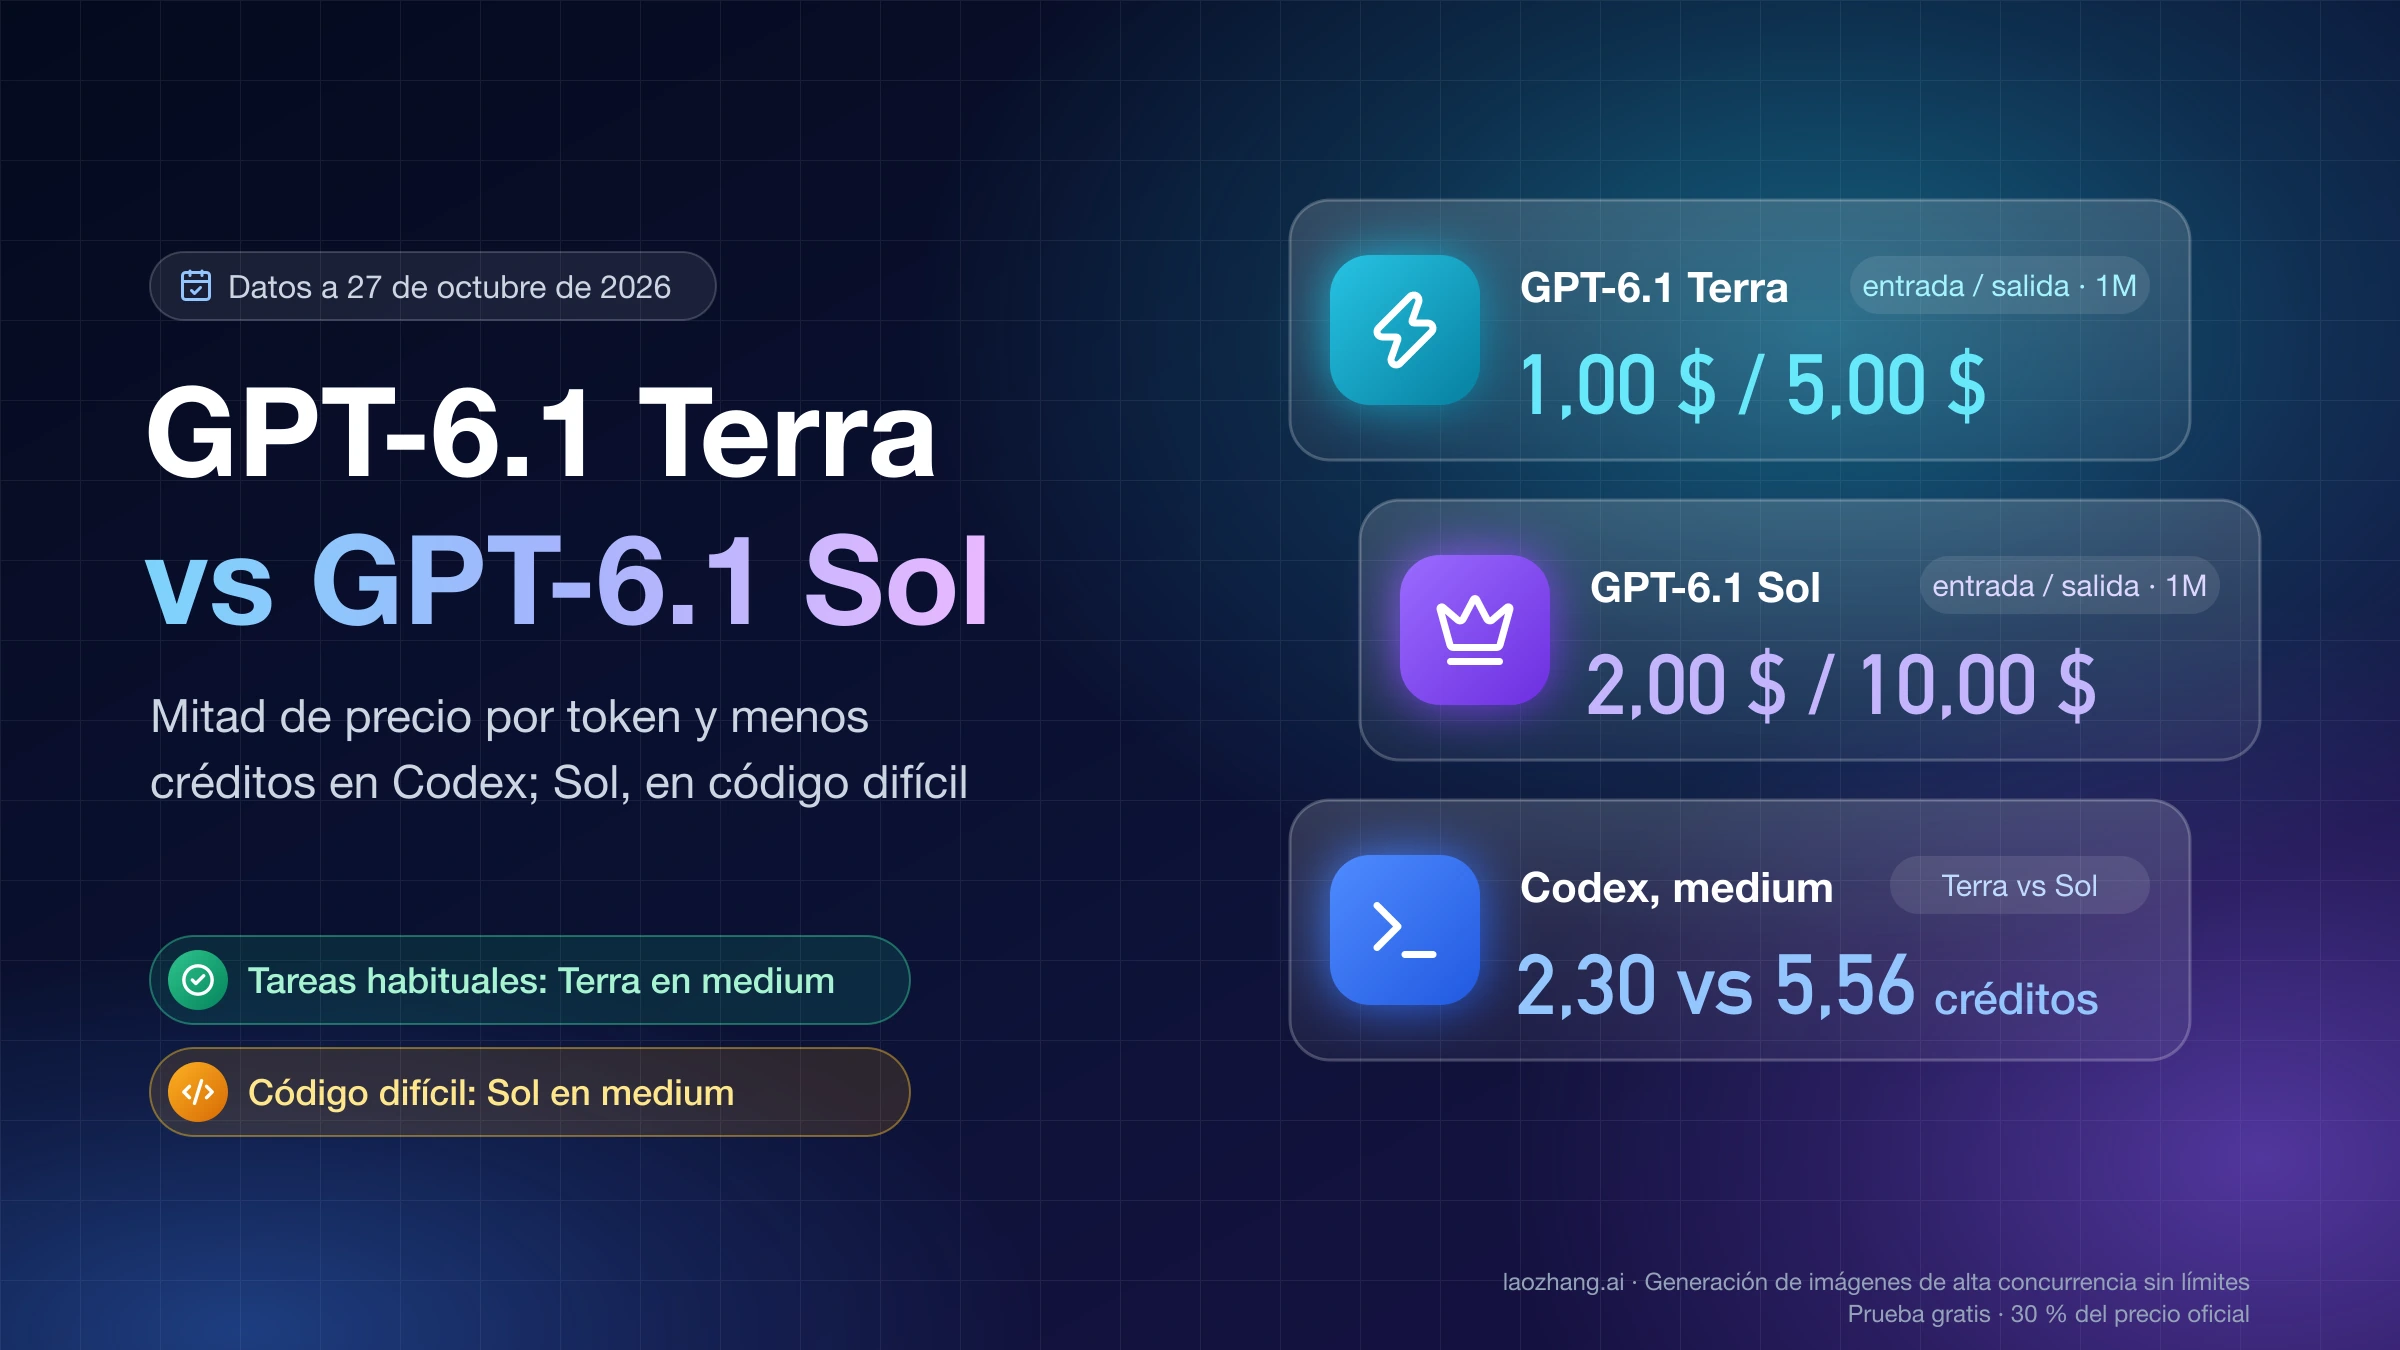
En la tarifa Standard de la API, GPT-6.1 Terra cuesta exactamente 10 veces lo que GPT-6 Luna en entrada, escrituras en caché y salida, y 5 veces en la entrada en caché, porque Terra cobra la caché al 5 % de su entrada y Luna al 10 %. Estos son los precios en dólares por millón de tokens que muestra la página de precios de la API de OpenAI a 28 de octubre de 2026:
| Por millón de tokens | GPT-6.1 Terra | GPT-6 Luna | Terra / Luna |
|---|---|---|---|
| Entrada (hasta 272.000 tokens) | 1,00 $ | 0,10 $ | 10 veces |
| Entrada en caché | 0,05 $ | 0,01 $ | 5 veces |
| Escritura en caché de 30 minutos | 1,25 $ | 0,125 $ | 10 veces |
| Escritura en caché de 12 horas | 2,50 $ | 0,25 $ | 10 veces |
| Salida | 5,00 $ | 0,50 $ | 10 veces |
| Entrada de más de 272.000 tokens | 2,00 $ | 0,20 $ | 10 veces |
| Salida con más de 272.000 tokens de entrada | 7,50 $ | 0,75 $ | 10 veces |
Las reglas comunes no cambian la proporción. Por encima de 272.000 tokens de entrada, toda la petición paga el doble en entrada y caché y 1,5 veces en salida; Batch y Flex cuestan la mitad que Standard, el modo Fast el doble y el procesamiento regional añade un 10 %. Ninguno de los dos está disponible en Ultrafast, que a esa fecha solo incluye GPT-6 Astra y GPT-6.1 Sol.
La proporción de 10 veces solo se convierte en tu factura si los dos modelos gastan los mismos tokens para la misma tarea. El coste de una llamada es la suma de los tokens de entrada por su precio más los de salida, razonamiento incluido, por el suyo. Si Luna necesita pensar el triple de tokens para llegar a la respuesta, la distancia real baja; si además falla y tienes que repetir, baja todavía más. La prueba de más abajo mide justo eso.
Artificial Analysis v5.0: Terra en low ya puntúa más que Luna en max
En el Intelligence Index v5.0 de Artificial Analysis (AA), GPT-6.1 Terra en low saca 29 puntos con un coste por tarea del índice de 0,07 $ y 48 segundos, frente a los 28 puntos, 0,15 $ y 597 segundos de GPT-6 Luna en max. Es decir, el nivel más bajo de Terra con razonamiento ya supera al nivel más alto de Luna por la mitad de coste y unas 12 veces más rápido (597 / 48). La tabla recoge la comparación de AA entre GPT-6.1 Terra y GPT-6 Luna a 28 de octubre de 2026:
| Esfuerzo | GPT-6.1 Terra | GPT-6 Luna |
|---|---|---|
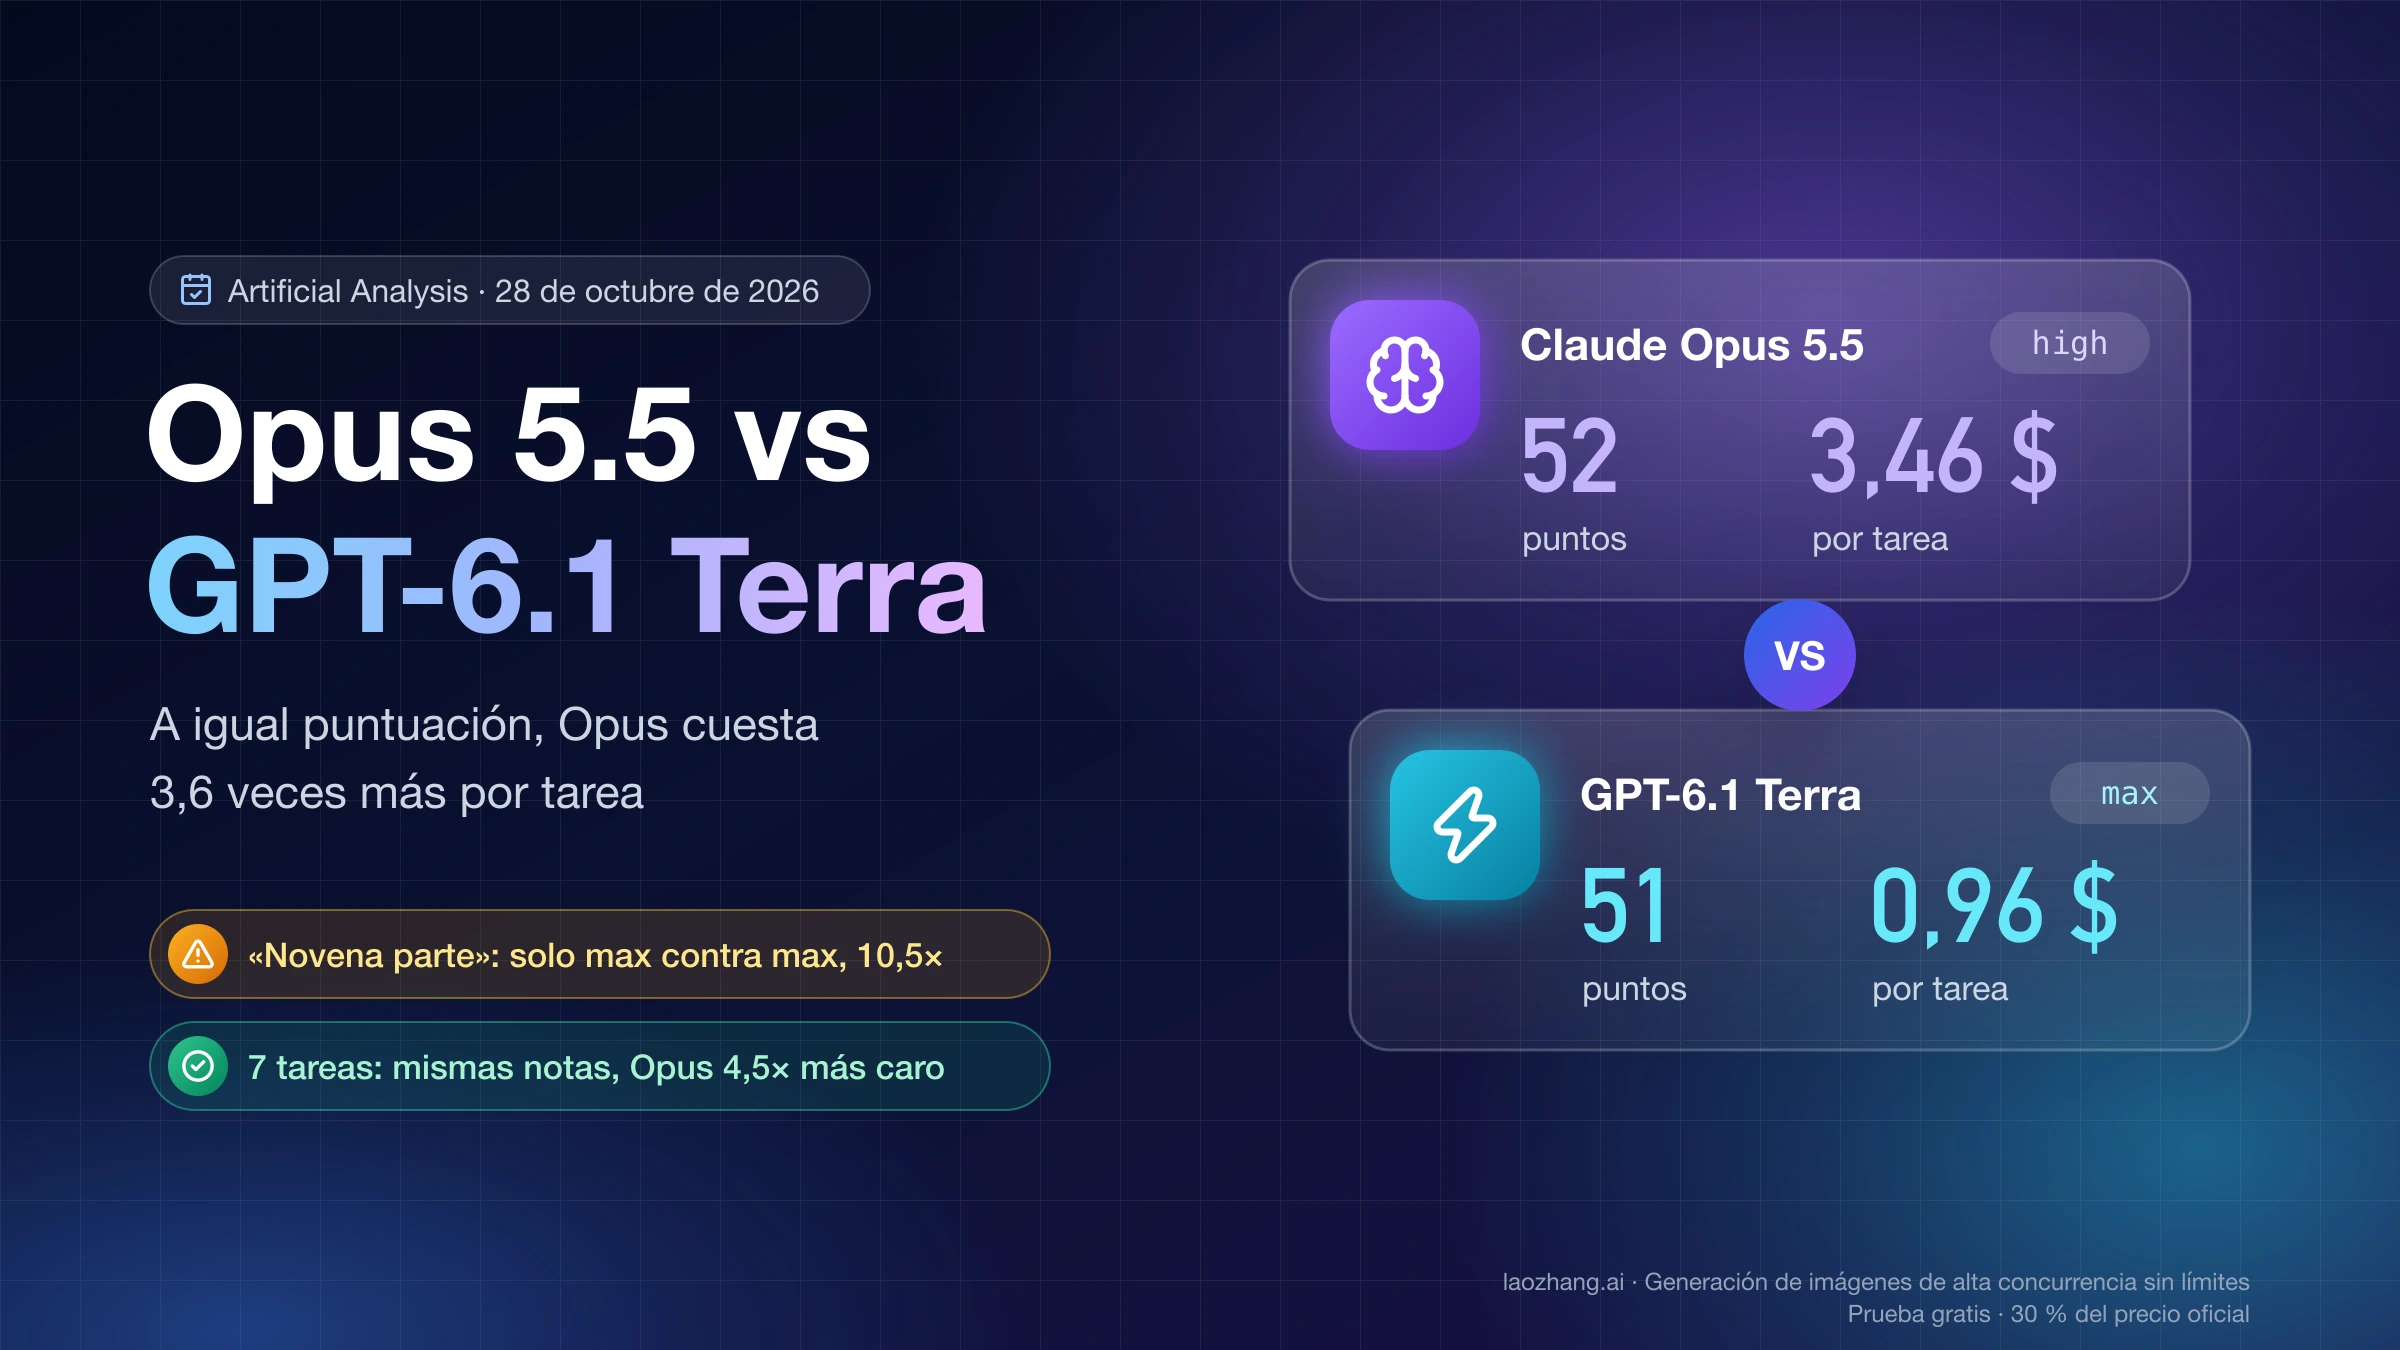
max | 51 · 0,96 $ · 657 s | 28 · 0,15 $ · 597 s |
xhigh | 45 · 0,40 $ · 287 s | 23 · 0,10 $ · 357 s |
high | 42 · 0,26 $ · 182 s | 21 · 0,07 $ · 269 s |
medium | 38 · 0,17 $ · 118 s | 18 · 0,04 $ · sin dato |
low | 29 · 0,07 $ · 48 s | 10 · 0,01 $ · 28 s |
none | 30 · 0,23 $ · 104 s | 9 · 0,07 $ · 86 s |
Puntuación · coste por tarea del índice · tiempo por tarea. El coste es lo que gasta la batería de pruebas de AA en la API de OpenAI, no lo que te costará a ti una tarea.
Luna solo es más barata en los niveles donde también puntúa menos: 18 puntos por 0,04 $ en medium y 10 por 0,01 $ en low, una zona a la que Terra no baja. Subir Luna de low a max multiplica su coste por 15 (de 0,01 $ a 0,15 $) a cambio de 18 puntos, mientras que pasar Terra de low a medium lo multiplica por 2,4 (de 0,07 $ a 0,17 $) para ganar 9. Terra sin razonamiento (none) sale peor que en low: más cara, más lenta y con una puntuación casi igual.
Entre las pruebas que forman el índice, la mayor brecha está en terminal y en fiabilidad del conocimiento. En Terminal-Bench 4.0, Terra en max resuelve el 55,6 % y Luna en max el 12,6 % (Terra en low, el 15,2 %). En AA-Omniscience v1.1, que penaliza responder mal frente a reconocer que no se sabe, Terra puntúa entre 23 y 30 con razonamiento y Luna queda en negativo en todos sus niveles, de −8 a −26. Es una señal para tareas donde un dato inventado sale caro, aunque se trata de un índice compuesto y una carga de trabajo concreta puede ordenar los modelos de otra forma. La cifra de «10 puntos de diferencia» que circuló el día del lanzamiento procede del índice anterior, v4.3.2; con v5.0 la distancia en max es de 51 frente a 28.
Prueba del 28 de octubre de 2026: las mismas 12 tareas en Terra y Luna
En 12 tareas con criterios de aprobado fijados de antemano, GPT-6.1 Terra falló una respuesta de 32 y GPT-6 Luna falló 4 de cada 16 en los tres niveles probados, sin mejorar al subir el esfuerzo. Las tareas cubren un problema de aritmética con enunciado, tres funciones de código con pruebas ocultas, un resumen en exactamente cinco viñetas de un artículo de 6.723 palabras, un evaluador de expresiones sin eval, un analizador de líneas CSV, un recuento de números cuya suma de dígitos es 27, una función satisfies() de rangos semver al estilo npm con 36 pruebas ocultas, un documento largo con notas de corrección escondidas que cambian el total, una pregunta sobre funciones inventadas de la biblioteca estándar de Python y la extracción a JSON de una factura y un gráfico en imagen.
Todas las llamadas se hicieron el 28 de octubre de 2026 a través de la misma pasarela de API, LaoZhang (laozhang.ai), un servicio compatible con la API de OpenAI que ofrece los dos modelos. Se usó Chat Completions en streaming, un único mensaje de usuario sin herramientas, max_completion_tokens en 32.000 y 16 llamadas por configuración (una o dos muestras por tarea). El coste es el uso que devolvió cada llamada multiplicado por la tarifa Standard de OpenAI de la tabla anterior, no la factura de la pasarela, y el gasto total fue de 0,197 $. En una primera pasada, 12 de las 48 llamadas de Luna se cortaron, 11 sin texto y 1 a medias, ninguna con recuento de uso; se repitieron una vez, se completaron con normalidad y no cuentan como fallos. Es una muestra pequeña de un solo día, una sola pasarela y un solo turno, útil para ver dónde tropieza cada modelo, no para fijar una tasa de error general.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Configuración | Aprobadas | Coste de las 16 llamadas | Coste por tarea superada | Mediana por llamada | Mediana hasta el primer token de respuesta | Tokens de salida (de razonamiento) |
|---|---|---|---|---|---|---|
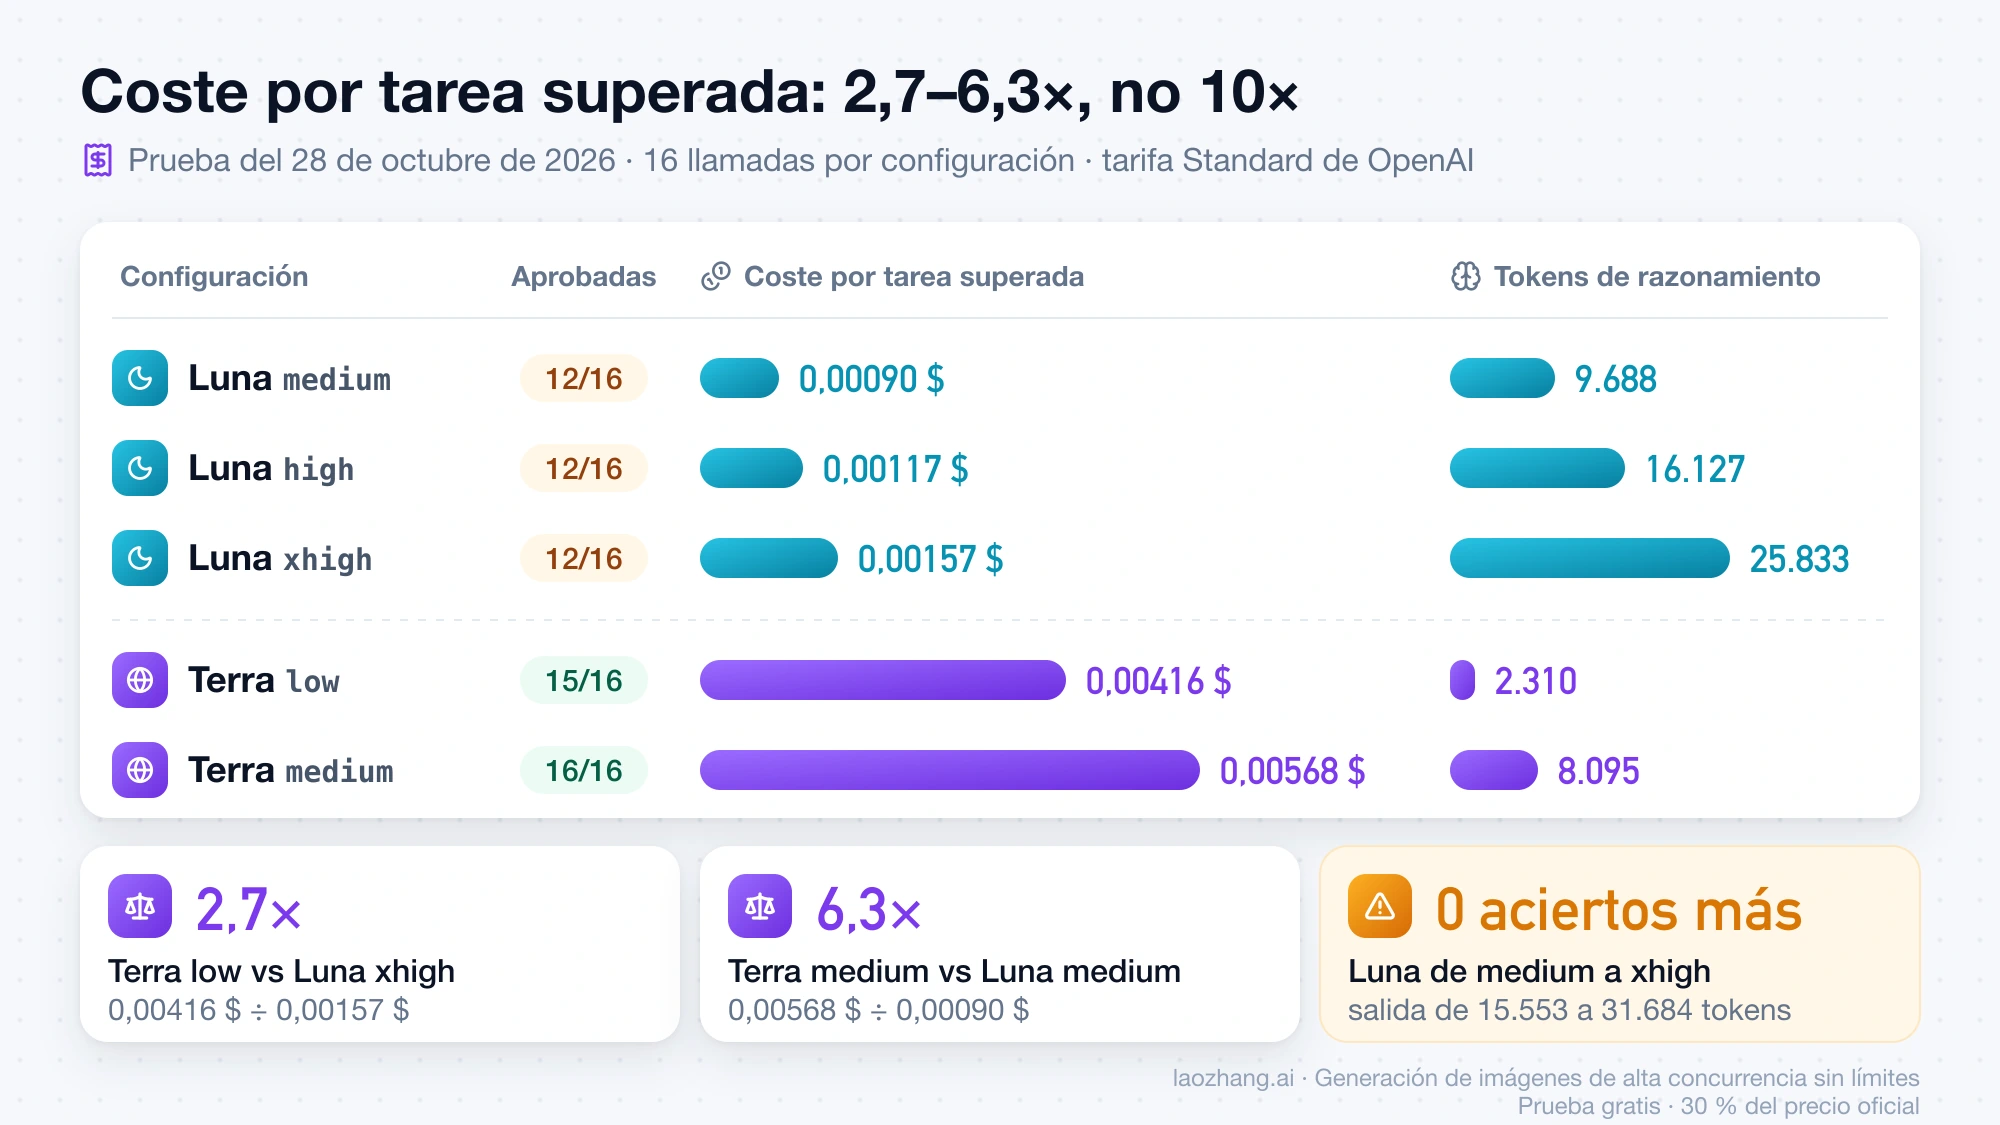
Luna medium | 12/16 | 0,0108 $ | 0,00090 $ | 11,4 s | 7,1 s | 15.553 (9.688) |
Luna high | 12/16 | 0,0140 $ | 0,00117 $ | 14,2 s | 9,8 s | 22.063 (16.127) |
Luna xhigh | 12/16 | 0,0188 $ | 0,00157 $ | 15,6 s | 11,2 s | 31.684 (25.833) |
Terra low | 15/16 | 0,0625 $ | 0,00416 $ | 4,7 s | 4,0 s | 7.227 (2.310) |
Terra medium | 16/16 | 0,0909 $ | 0,00568 $ | 5,9 s | 4,6 s | 12.916 (8.095) |
El coste por tarea superada es el gasto de las 16 llamadas dividido entre las respuestas aprobadas, fallos incluidos: 0,0625 $ / 15 = 0,00416 $ para Terra en low y 0,0188 $ / 12 = 0,00157 $ para Luna en xhigh. Con esa cuenta, Terra cuesta 2,7 veces más que Luna emparejando Terra low con Luna xhigh y 6,3 veces más emparejando los dos en medium (0,00568 / 0,00090). La razón es el razonamiento: en las mismas 16 llamadas, Luna en xhigh generó 25.833 tokens de razonamiento y Terra en low, 2.310. Subir Luna de medium a xhigh duplicó sus tokens de salida (de 15.553 a 31.684) y no sumó ni una tarea aprobada. En tiempo, la mediana de Terra quedó entre 4,7 y 5,9 segundos por llamada frente a los 11,4–15,6 de Luna, porque Luna piensa más antes de empezar a responder.
Quedaron fuera de esta prueba la API directa de OpenAI, ejecuciones completas por la Responses API, las llamadas a herramientas y el uso del ordenador (justo donde OpenAI sitúa a Terra), los agentes de varios turnos, Batch y Flex, y Codex o Work. Para esos casos, la referencia sigue siendo el índice de AA de la sección anterior.
Dónde falló GPT-6 Luna: un número de factura y una especificación semver
El fallo más claro de Luna fue de lectura, no de razonamiento. En la tarea de factura y gráfico, sus 6 respuestas leyeron bien los 40 números, situaron las 12 barras con un margen de ±2 y detectaron el total de línea erróneo que se había colocado a propósito, pero las 6 transcribieron el número de factura INV-2026-10-0O81, que lleva una letra O, como INV-2026-10-0081. Las 4 respuestas de Terra lo leyeron exacto, tardaron entre 8 y 17 segundos frente a los 24–54 de Luna y costaron entre 0,0045 $ y 0,0139 $ cada una frente a 0,0011–0,0025 $. Las imágenes eran sintéticas y un solo carácter decidió el resultado, pero es justo el tipo de error que pasa una revisión rápida y rompe una búsqueda en tu base de datos.
En la función de rangos semver, Luna aprobó 2 de 6 intentos y Terra 4 de 4. Tres fallos de Luna fueron la misma prueba oculta, un rango terminado en || como ^1.0.0 ||, que debía rechazarse como inválido y Luna aceptó; el cuarto rompió los rangos con acento circunflejo y falló 14 de las 36 pruebas. Cada intento de Luna tardó entre 36 y 70 segundos y cada uno de Terra entre 9 y 18. Fuera de esas dos tareas, Luna en high dio una vez 67.252 en el recuento de números cuya suma de dígitos es 27 (la respuesta correcta es 55.252), y tanto Luna en xhigh como Terra en low escribieron una viñeta de 26 palabras en el resumen limitado a 25. Todo lo demás, desde el problema de aritmética y las tres funciones de código hasta los analizadores, la cuenta del documento con notas de corrección y la detección de funciones inventadas, lo aprobaron todas las configuraciones.
Qué tareas dejar en GPT-6 Luna y cuándo pasar a GPT-6.1 Terra
Deja en Luna el trabajo de gran volumen que puedes comprobar automáticamente y que ya aprueba: resúmenes, extracción de datos de texto, cálculos sobre documentos largos y funciones de código con pruebas. En esa parte de la prueba, Luna en medium acertó lo mismo que Terra por 0,00090 $ por tarea superada, y ningún nivel de Luna más alto añadió aciertos. Pasa a Terra, empezando por low, cuando el error es caro y difícil de detectar (identificadores exactos en facturas, fotos o planos), cuando la tarea es una especificación con muchos casos límite, cuando necesitas la respuesta en pocos segundos o cuando el trabajo implica herramientas y manejo de pantallas, que es para lo que OpenAI anuncia Terra, aunque la prueba de arriba no incluyó herramientas.
Si Luna falla en una tarea, subir su esfuerzo no suele ser la solución más barata. En la prueba, Luna en xhigh aprobó las mismas 12 respuestas de 16 que en medium y siguió leyendo mal el número de factura, y en el índice de AA Luna en max cuesta más por tarea que Terra en low con una puntuación algo menor. Muchas integraciones salen ganando con las dos: Luna por defecto y Terra para las peticiones que no superan tu validación o para los tipos de tarea donde ya sabes que Luna tropieza, de modo que solo pagas la tarifa alta donde aporta algo.
Cómo probar Terra con tus tareas antes de cambiar el ID del modelo
La forma fiable de decidir es repetir con tus propias tareas lo que hizo la prueba: el mismo conjunto en los dos modelos, un criterio de aprobado escrito antes y el gasto dividido entre aciertos. Estos pasos evitan los errores de configuración que aparecieron al hacerlo:
- Reúne entre 10 y 20 tareas reales con un criterio de aprobado que puedas comprobar sin opinar, e incluye las que hoy Luna resuelve mal o te obligan a revisar a mano.
- Compara niveles por resultado, no por nombre: enfrenta Terra en
lowymediumcon Luna en el nivel que usas hoy y enhighoxhigh. - Usa
max_completion_tokenspara limitar la salida; en peticiones sin streaming,max_tokensdevolvió HTTP 400 con el mensaje «Use 'max_completion_tokens' instead». - Si quieres probar
max, hazlo por la Responses API conreasoning.effort: "max". El 28 de octubre de 2026, en Chat Completions sin streaming,reasoning_effort: "max"devolvió HTTP 400 en los dos modelos («Supported values are: 'none', 'low', 'medium', 'high', and 'xhigh'»), y en streaming Luna dio 400 y Terra 200, así que no cuentes con ese comportamiento. - Si tu código usa function calling, migra esas llamadas a la Responses API antes de cambiar a Terra; con Luna en Chat Completions las herramientas solo funcionan con
reasoning_effortennone. - Divide el gasto total, con fallos y reintentos, entre las tareas aprobadas, y suma las escrituras en caché si usas caché, porque Chat Completions no las desglosó en el uso devuelto.
Con la Responses API, una prueba mínima de los dos modelos con el SDK oficial de Python queda así; el objeto usage te da los tokens de entrada, salida y razonamiento para hacer la cuenta del último paso:
from openai import OpenAI

client = OpenAI()
tarea = "Extrae a JSON el número de factura y el total de esta factura: ..."

for modelo, esfuerzo in [("gpt-6-luna", "high"), ("gpt-6.1-terra", "low")]:
    r = client.responses.create(
        model=modelo,
        reasoning={"effort": esfuerzo},
        input=tarea,
    )
    print(modelo, esfuerzo, r.usage)
    print(r.output_text)
Residencia de datos en la UE: GPT-6.1 Terra también la admite
Sí, las dos admiten residencia de datos en la UE. La guía de OpenAI sobre el tratamiento de tus datos en la API indica a 28 de octubre de 2026 que GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Sol y GPT-6 Luna admiten residencia en la UE con Standard, Flex y Batch, y que el modo Fast también la admite en GPT-6.1 Terra y GPT-6 Luna. El límite está fuera de Europa: GPT-6.1 Terra solo admite residencia en EE. UU. y la UE, mientras que Luna figura en más regiones, así que un proyecto con su región de residencia de datos fuera de EE. UU. y la UE puede seguir en Luna pero no pasar a Terra. Ten en cuenta que esas otras regiones, como Japón, Corea, India o el Reino Unido, guardan los datos allí sin garantizar que la inferencia ocurra en ellas; en Codex y Work, Terra tampoco admite la residencia de inferencia en Emiratos Árabes Unidos.
GPT-6.1 Terra en ChatGPT y Codex: no está en el chat, sí en Work
GPT-6.1 Terra no aparece en el chat normal de ChatGPT con ningún plan; según la página de precios y límites de ChatGPT Work y Codex, está disponible en Work y Codex para Plus, Pro, Business, Enterprise y Edu. Luna, en cambio, está en ambos sitios: desde el despliegue que empezó el 8 de octubre de 2026, el chat de los planes Free y Go funciona con GPT-6 Luna, como se explica en GPT-6 gratis en ChatGPT: el plan Free usa Luna, no Sol ni Astra.
En Work y Codex no pagas por token, sino con mensajes y créditos. A 28 de octubre de 2026, OpenAI estima para Plus y Business estándar entre 350 y 3.000 mensajes locales cada 5 horas con Luna y entre 35 y 285 con Terra, aclarando que son estimaciones y no límites fijos; Pro no tiene límite de 5 horas, aunque puede haber límites semanales. Con créditos de ChatGPT, el millón de tokens cuesta 2,5 créditos de entrada, 0,25 en caché y 12,5 de salida con Luna, frente a 25, 1,25 y 125 con Terra, la misma proporción de 10 y 5 veces que en la API. Para usar Terra en la CLI de Codex necesitas la versión 0.159.0 o posterior y codex -m gpt-6.1-terra; a 27 de octubre de 2026, la documentación de modelos de Codex incluía Luna en la extensión para IDE pero no Terra.
¿Mejor GPT-6.1 Sol o un modelo de Claude?
Si Terra se te queda corta, el siguiente paso dentro de OpenAI es GPT-6.1 Sol, que OpenAI, en el anuncio de Terra, sigue recomendando junto con GPT-6 Astra para las tareas de programación más complejas; cuándo compensa subir se analiza en GPT-6.1 Terra vs Sol: diferencias y cuándo Terra sale más barata, y la visión de conjunto de los cuatro modelos está en GPT-6 Sol, Luna y Astra frente a Terra 6.1: precios y cuál usar. Si estás valorando Anthropic, Claude Opus 5.5 vs GPT-6.1 Terra: coste real y cuándo cambiarse enfrenta Terra con el modelo más alto de Claude, y Claude Sonnet 5.5 vs GPT-6 Luna: cuándo compensa pagar 20x más hace lo mismo con Luna.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
- 1.GPT-6.1 Terradevelopers.openai.com/api/docs/models/gpt-6.1-terra
- 2.GPT-6 Lunadevelopers.openai.com/api/docs/models/gpt-6-luna
- 3.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 4.comparación de AA entre GPT-6.1 Terra y GPT-6 Lunaartificialanalysis.ai/models/releases/comparisons/gpt-6-1-terra-vs-gpt-6-luna
- 5.guía de OpenAI sobre el tratamiento de tus datos en la APIdevelopers.openai.com/api/docs/guides/your-data
- 6.página de precios y límites de ChatGPT Work y Codexlearn.chatgpt.com/docs/pricing
- 7.documentación de modelos de Codexlearn.chatgpt.com/docs/models