Saltar al contenido principal

Comparativas de modelos · Página 2 de 2

Comparativas de modelos de IA por tareas reales, costes y límites.
35
Artículos
23 sept 2026
Última actualización
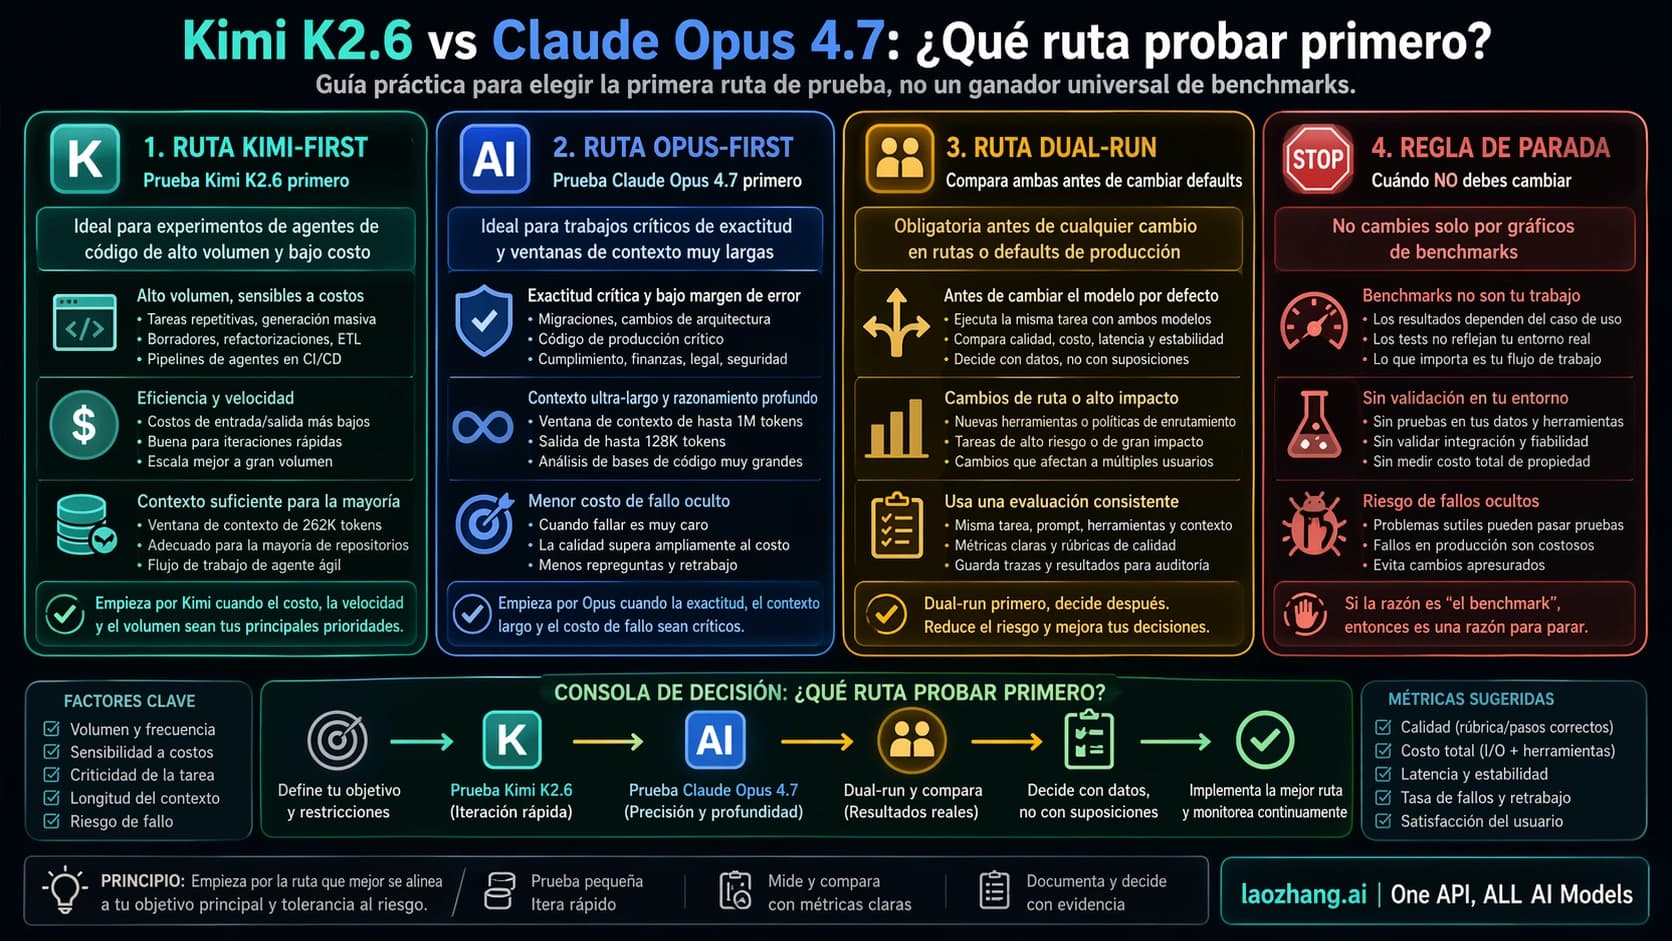
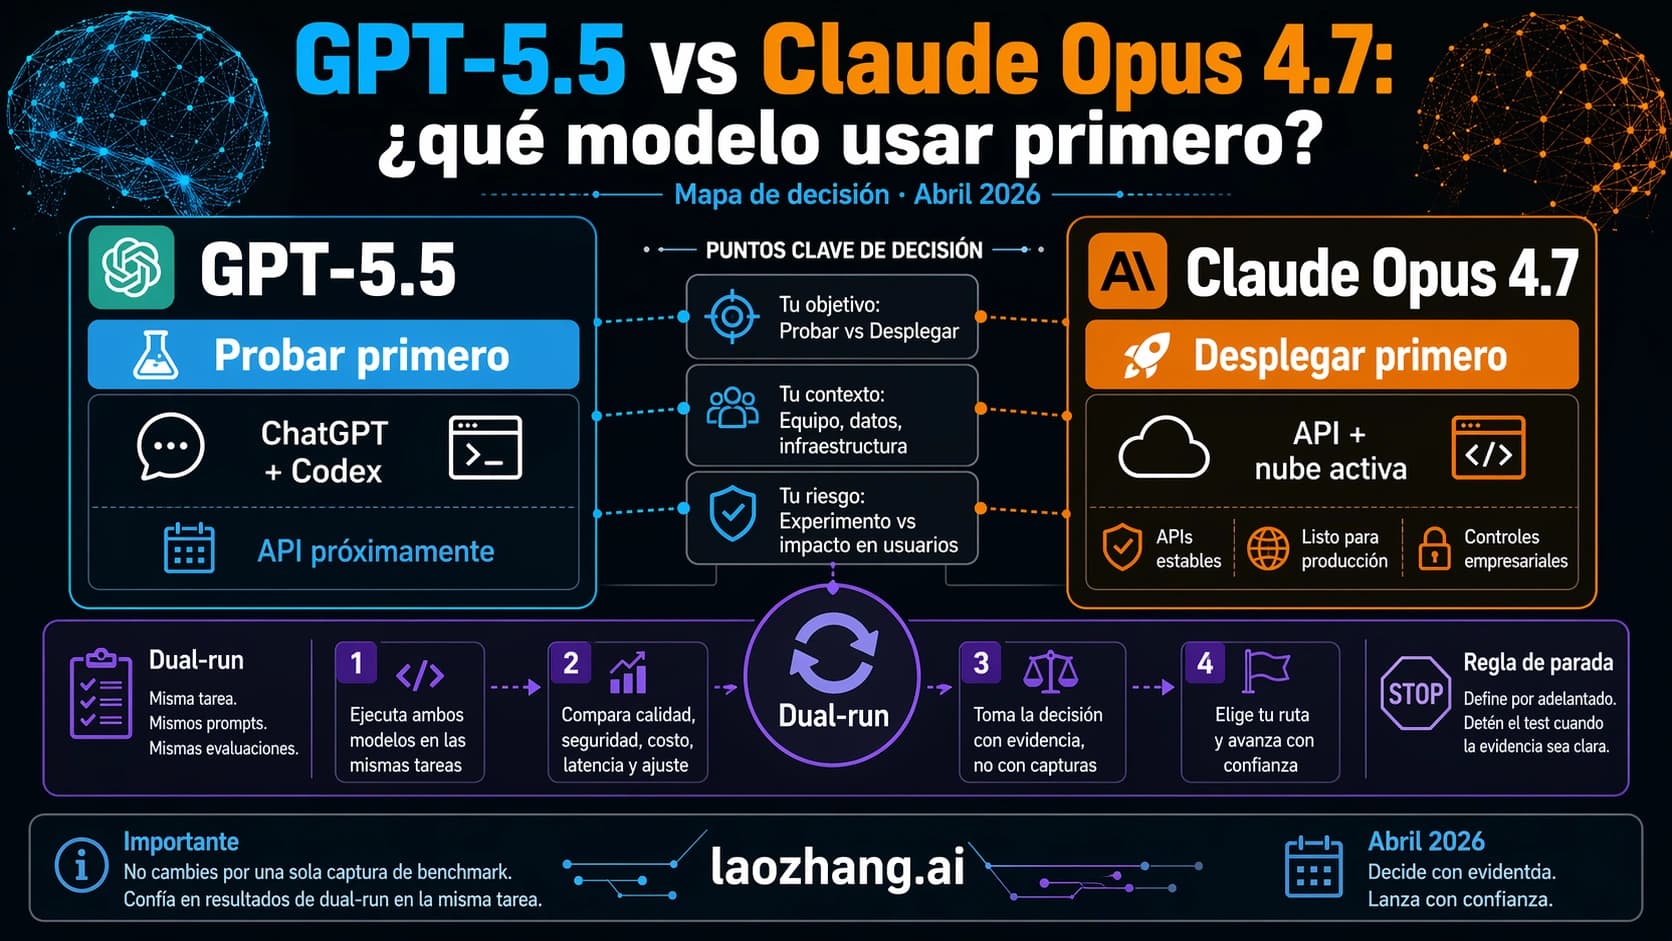
Route board comparing GPT-5.5 and Claude Opus 4.7 by testing route, deployment route, dual-run, and stop rule
Comparativas de modelos

GPT-5.5 vs Claude Opus 4.7: qué modelo probar primero

Prueba GPT-5.5 primero en ChatGPT, Codex y flujos OpenAI-native; usa Claude Opus 4.7 primero si necesitas API o cloud en producción hoy; antes de cambiar un default, ejecuta ambos en las mismas tareas.

12 min
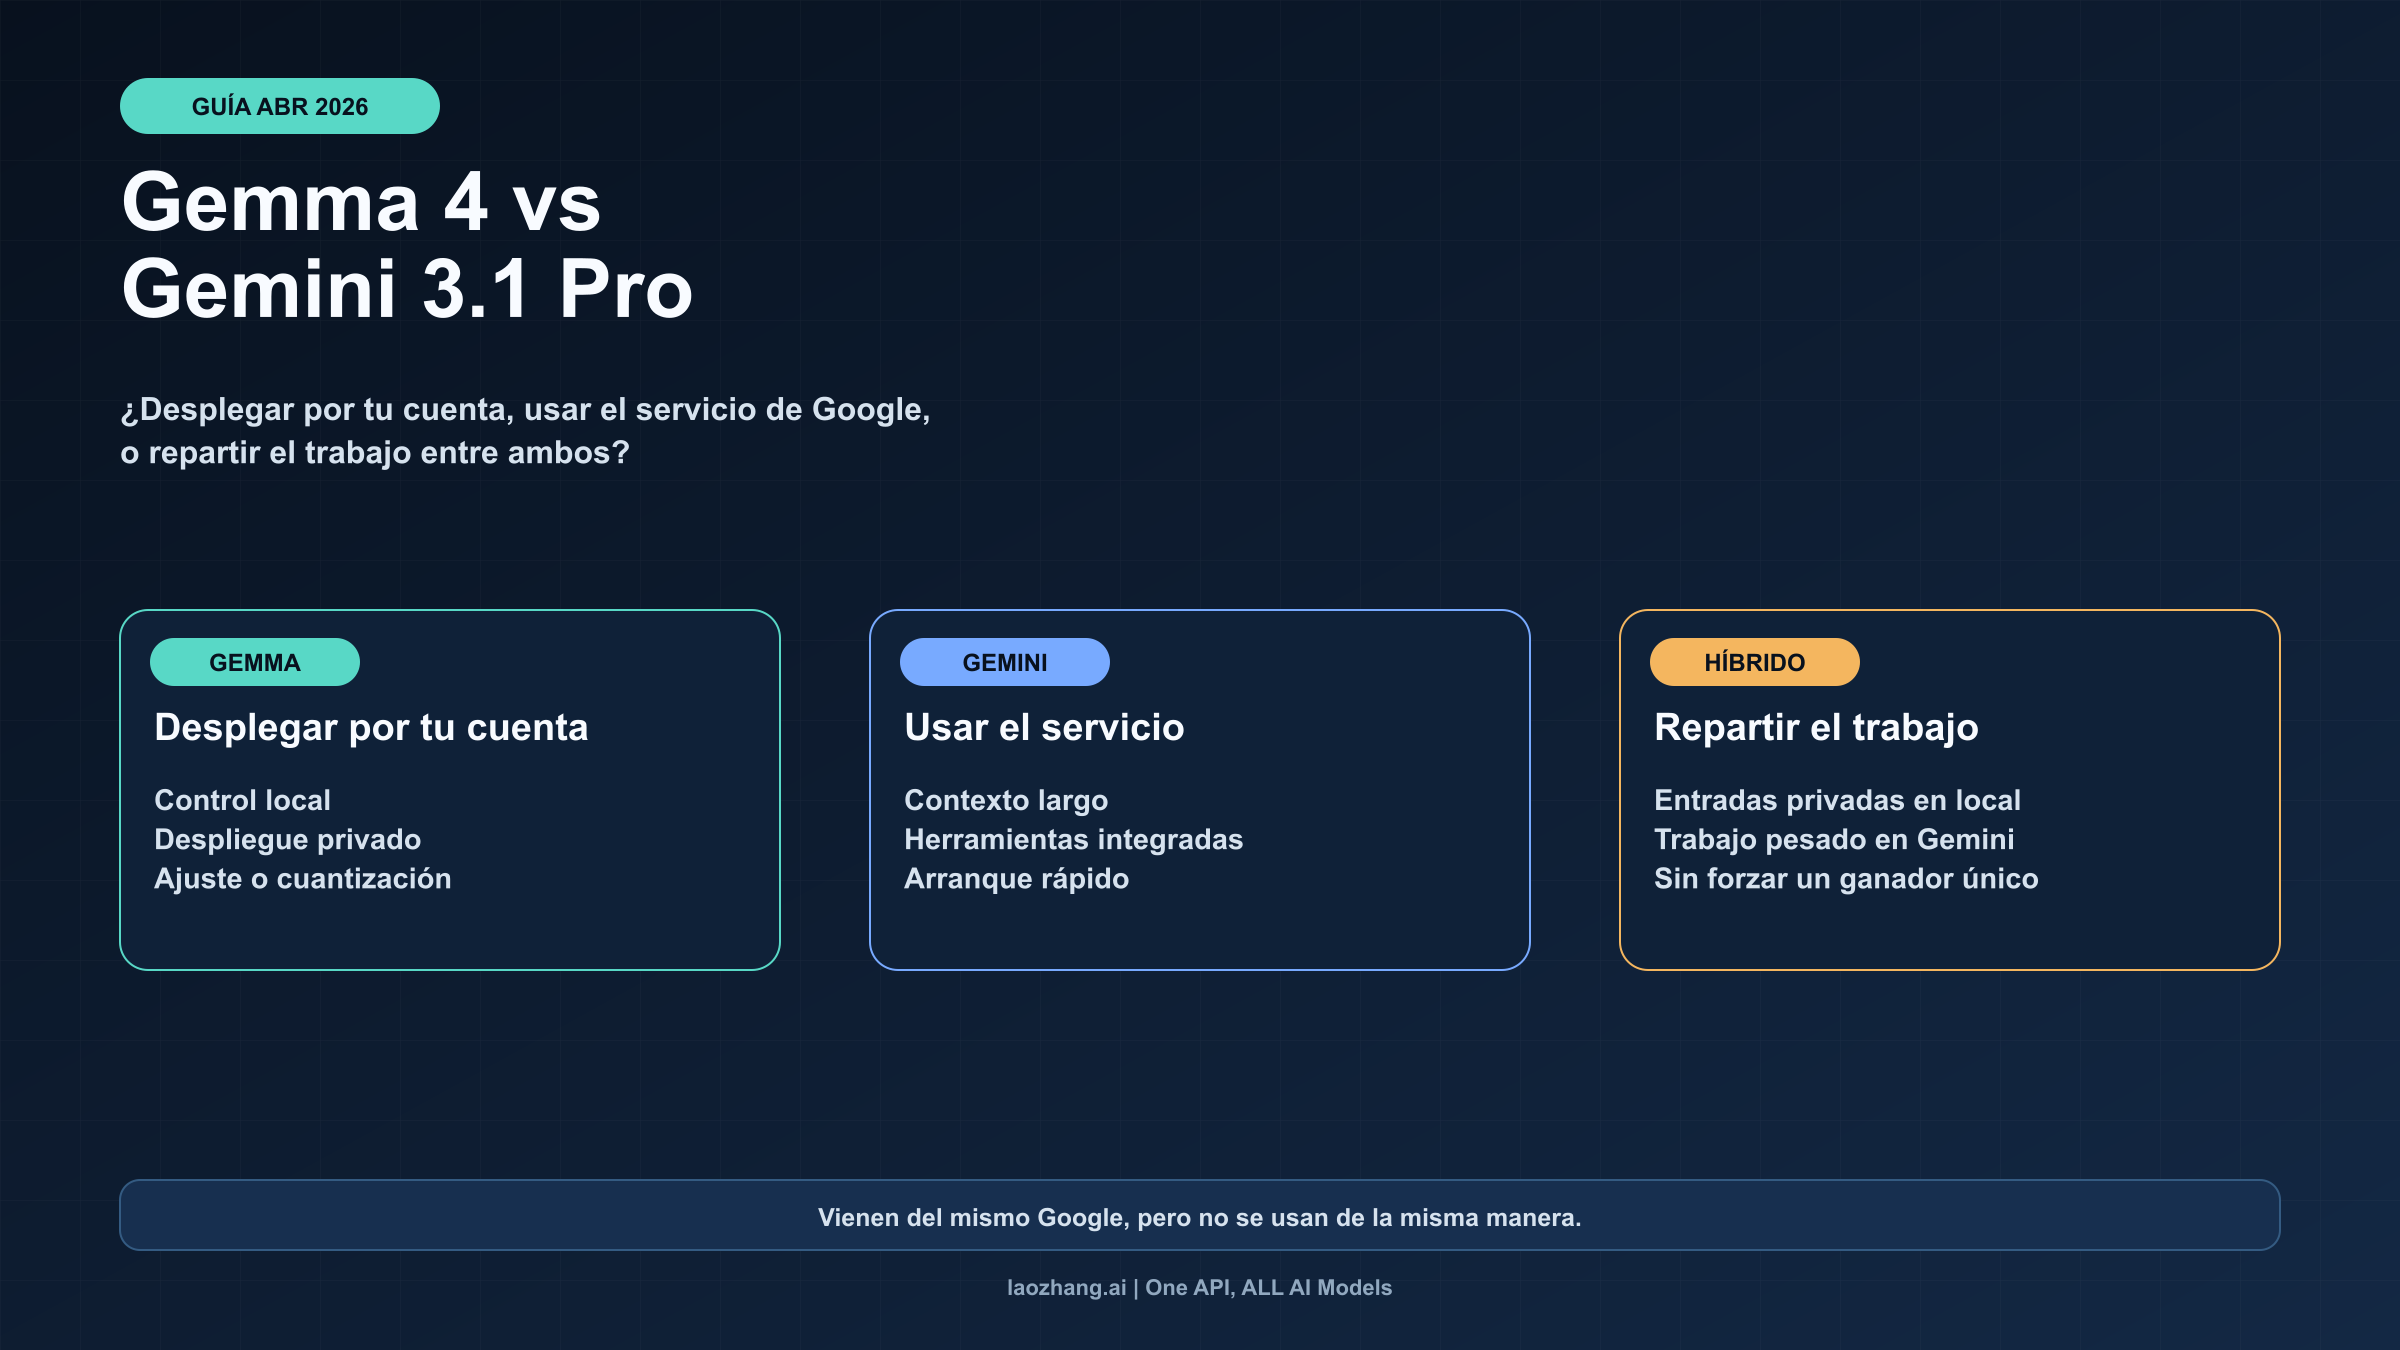
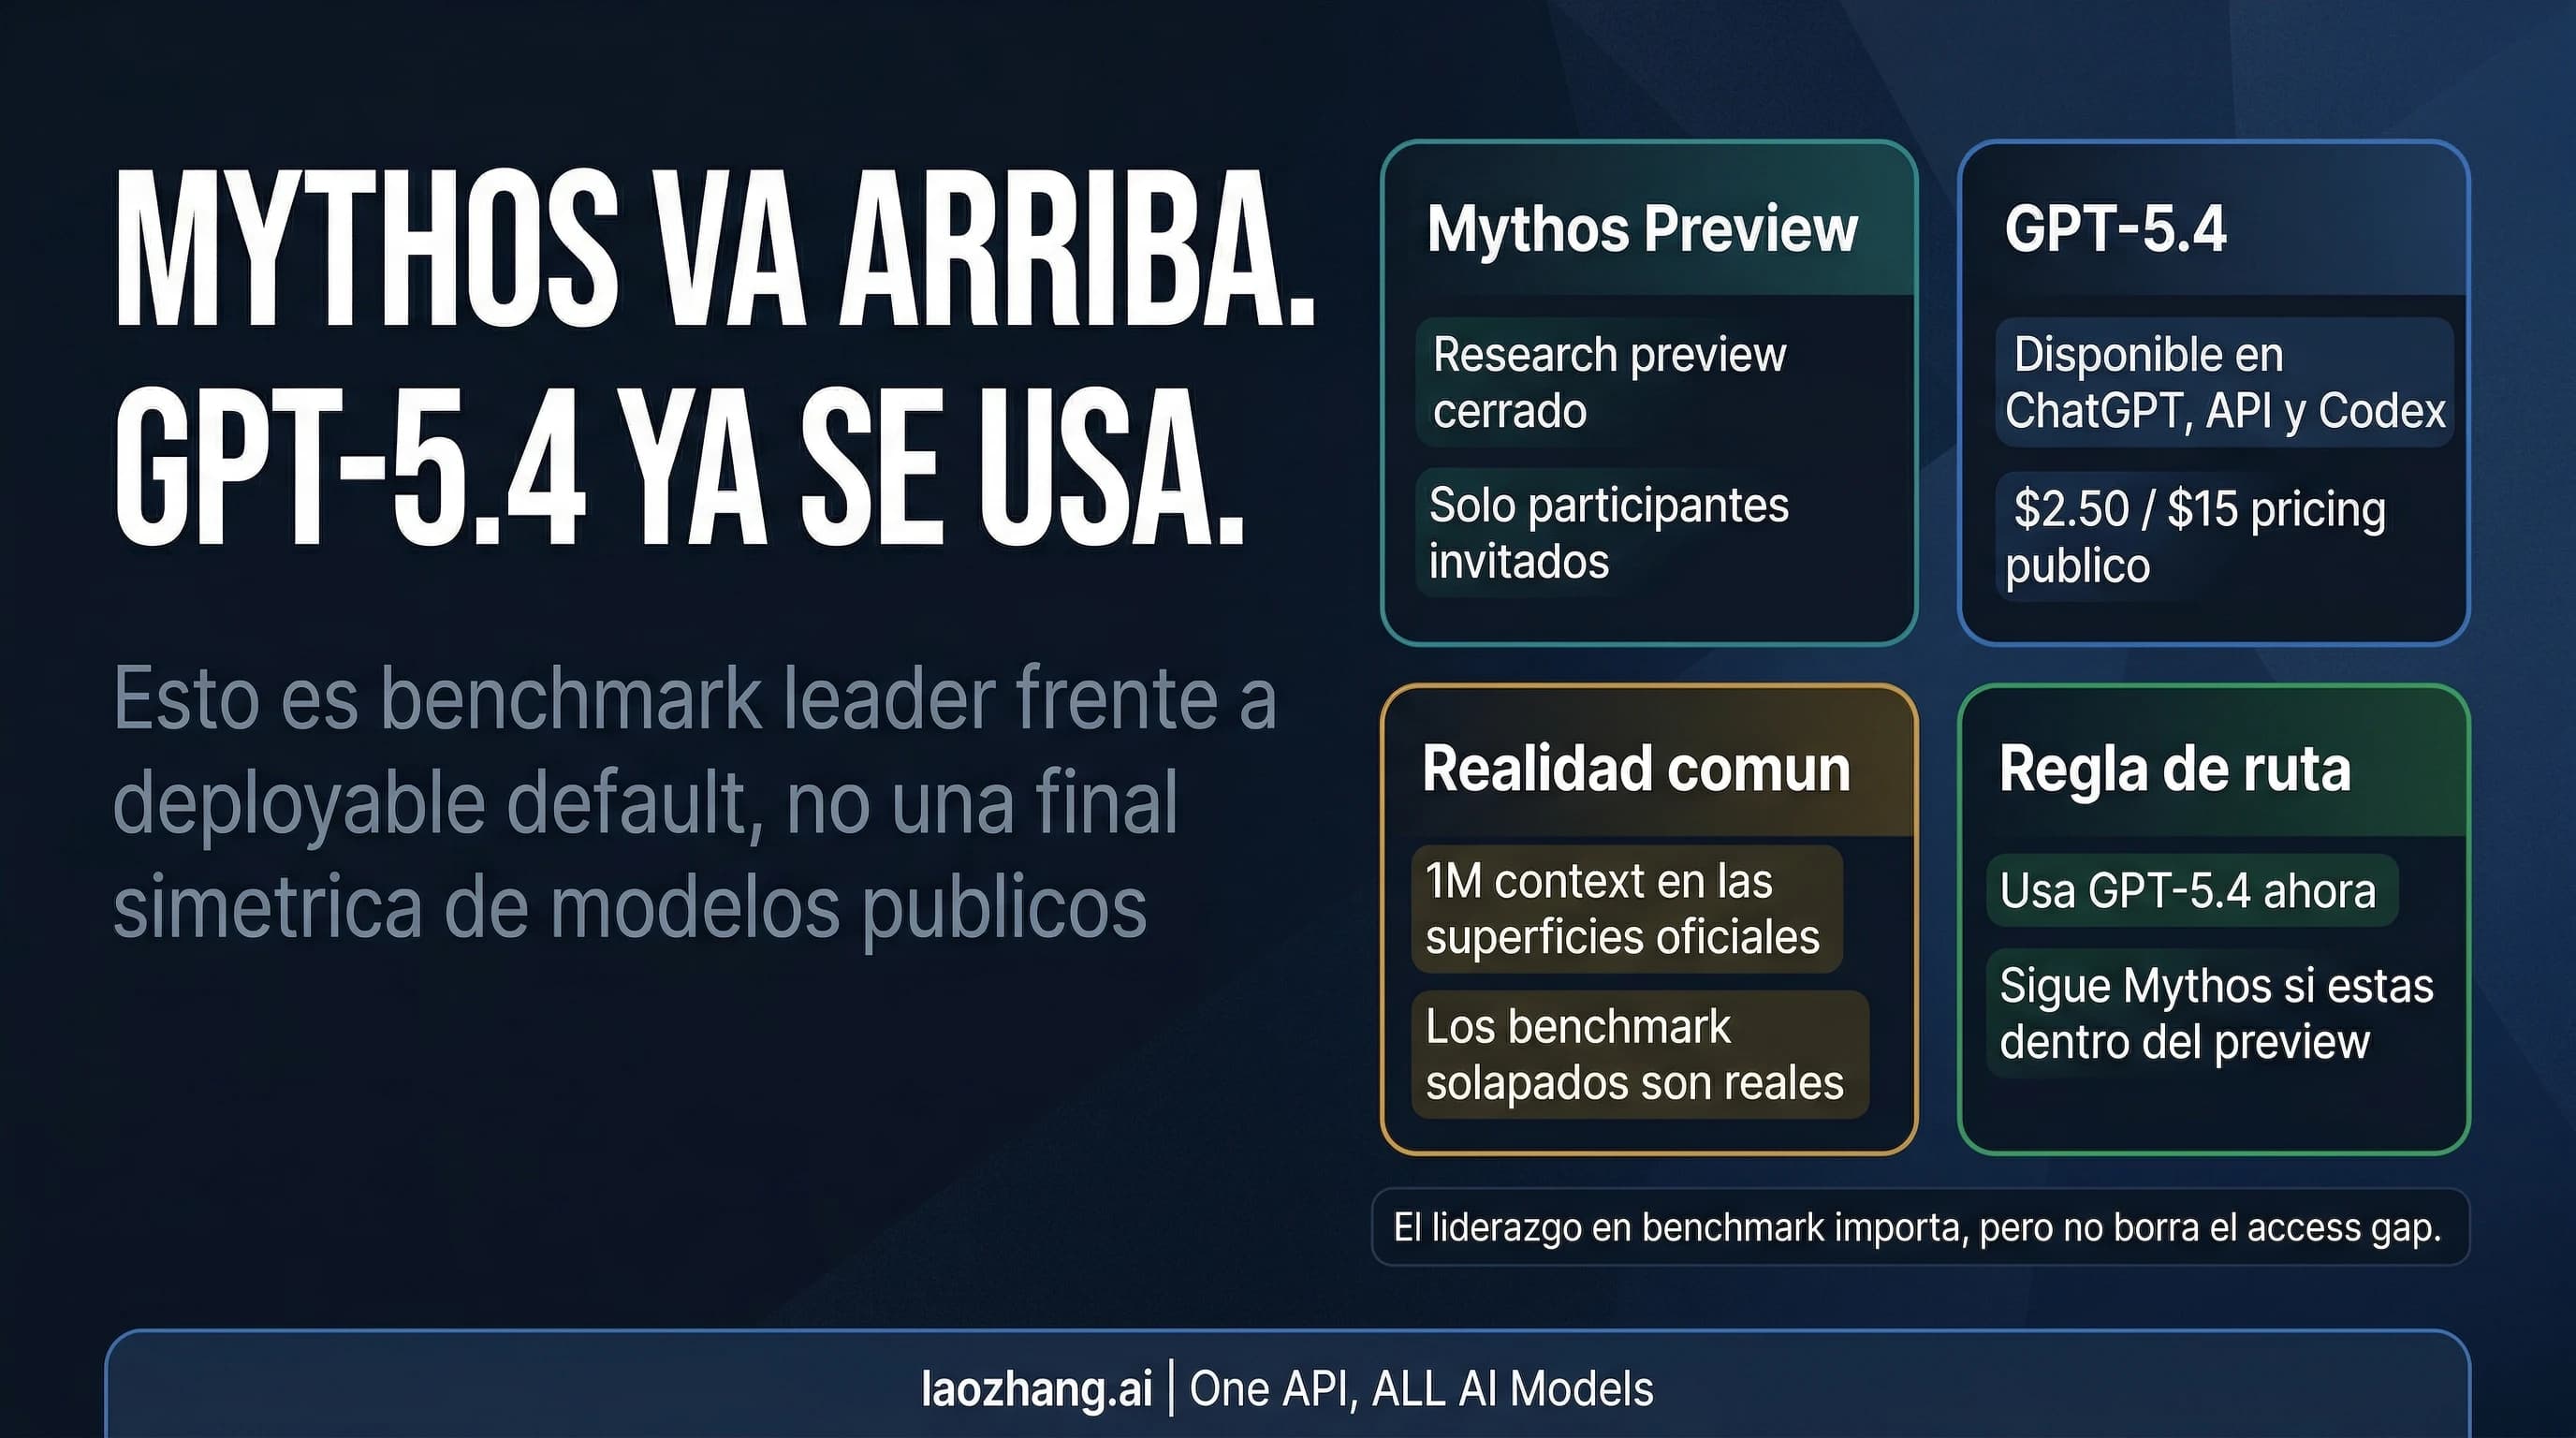
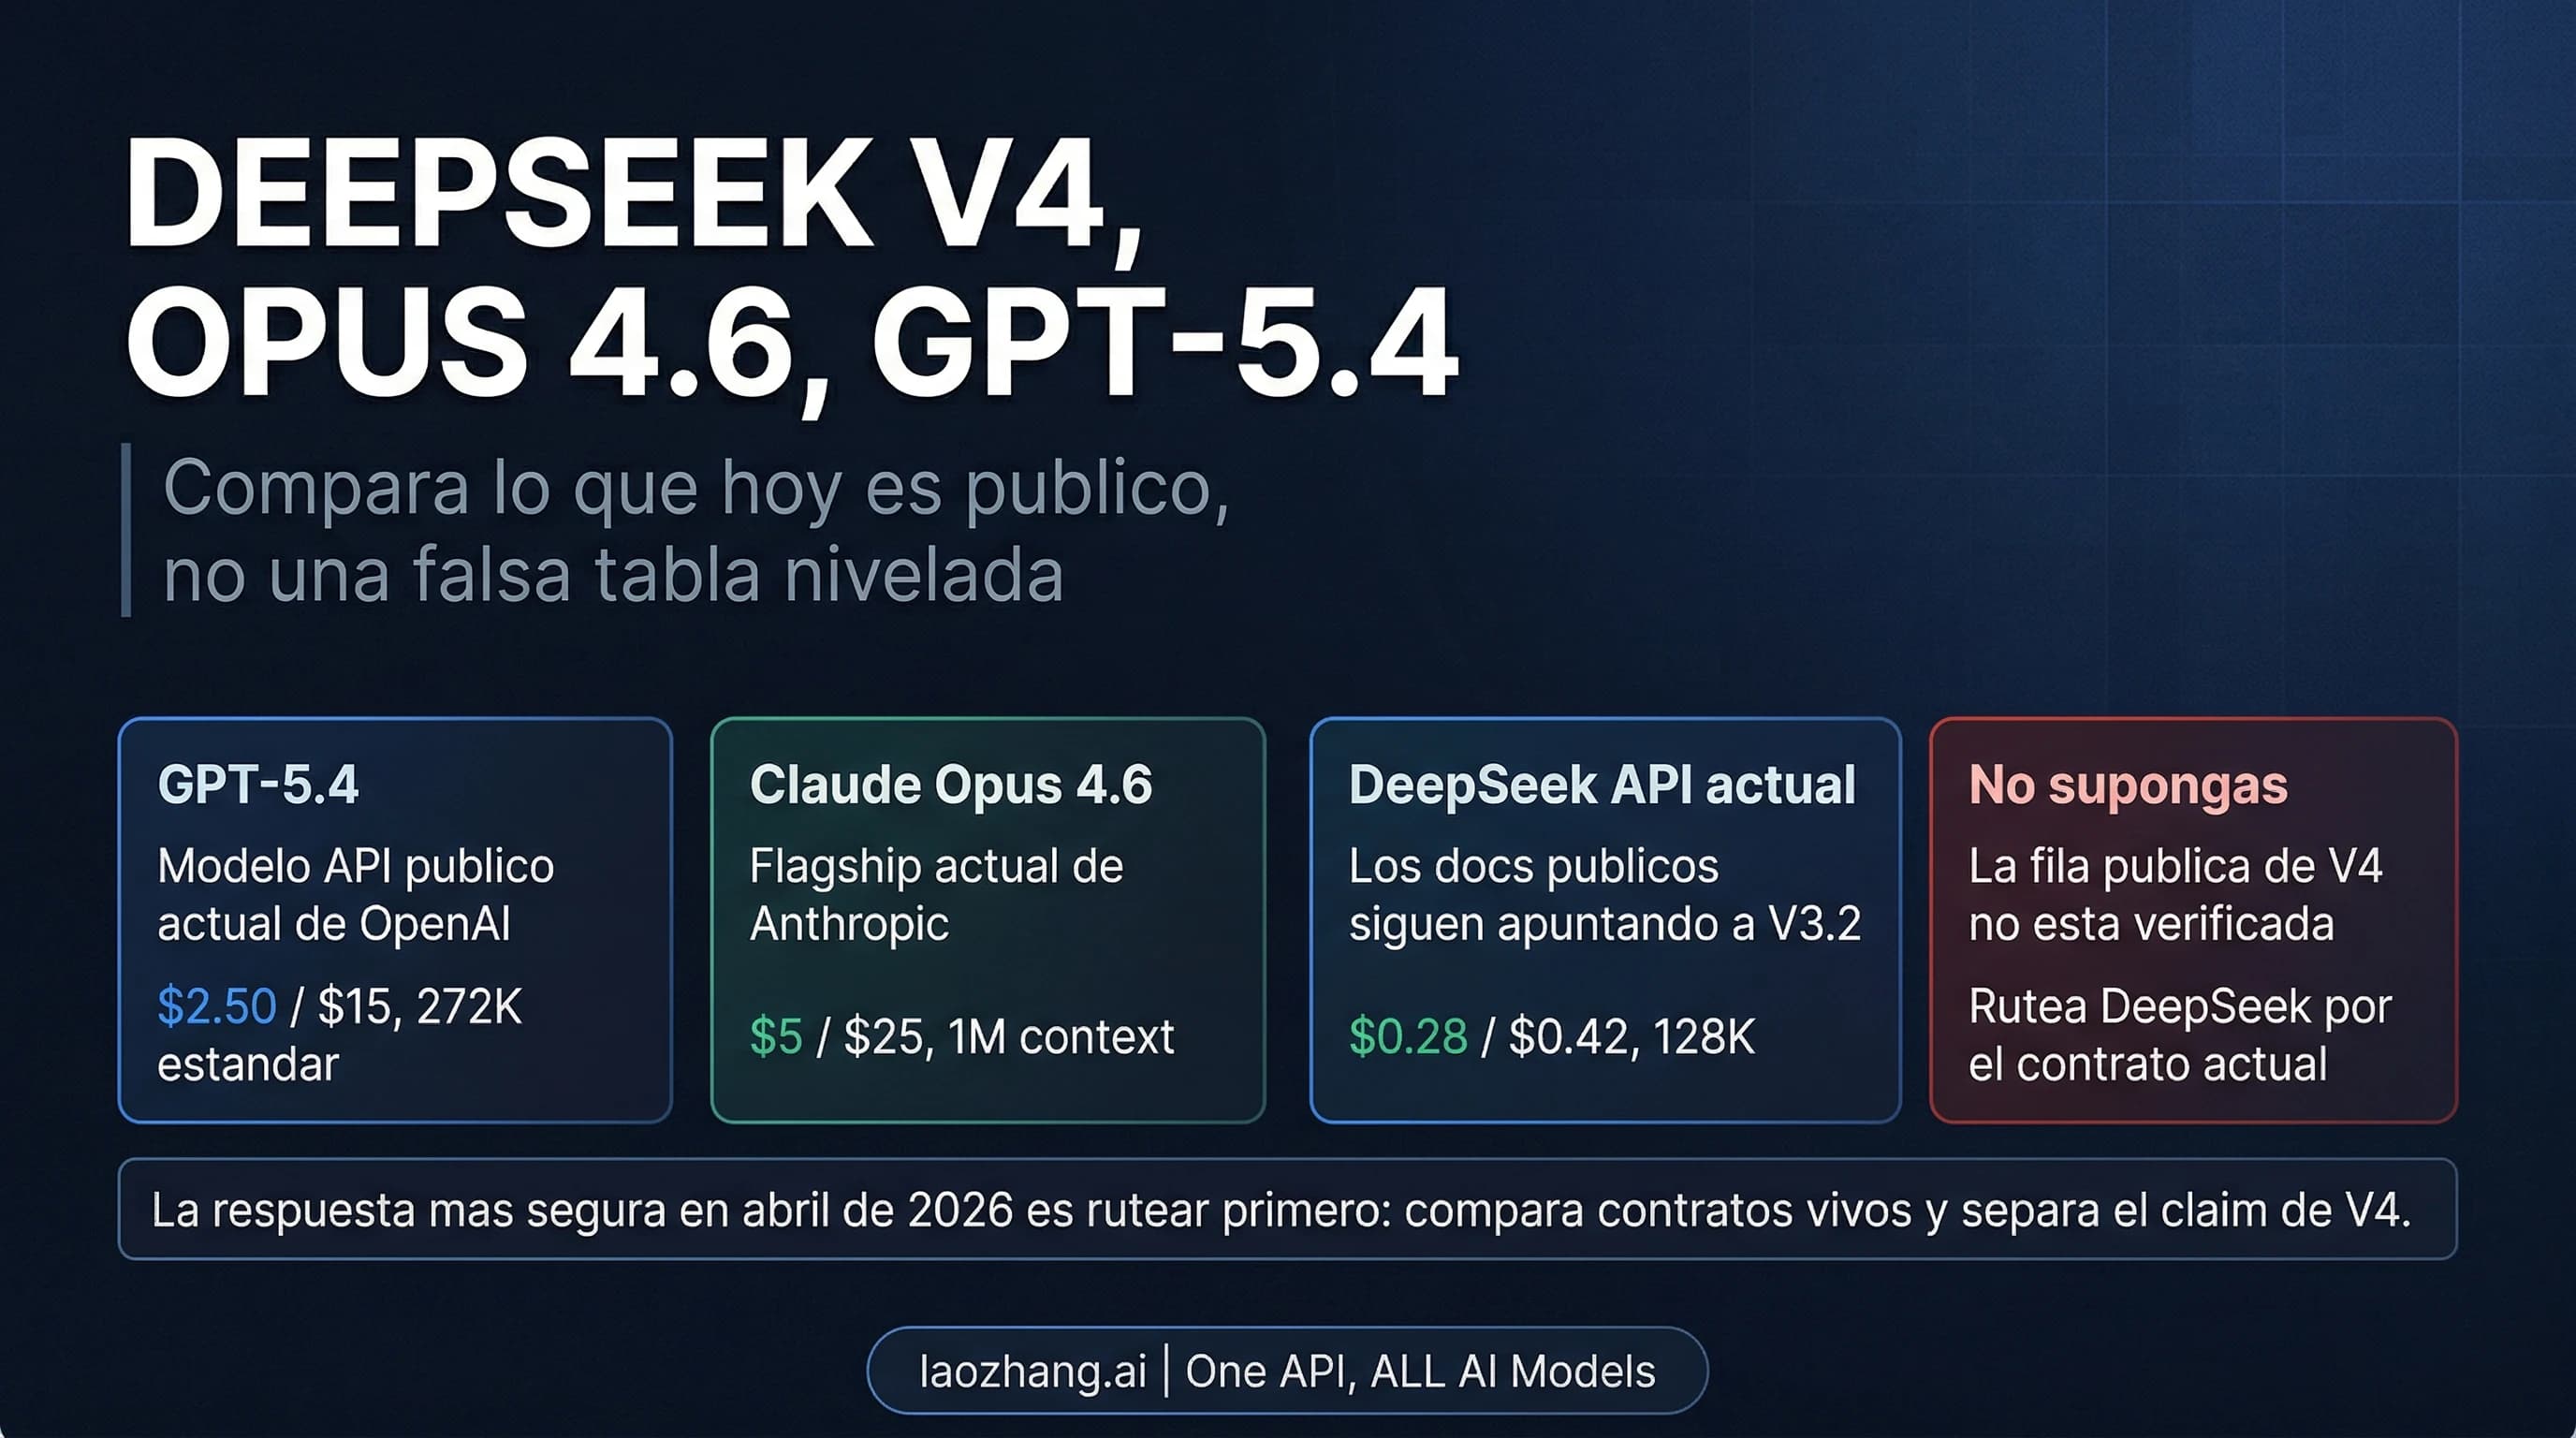
Comparacion de DeepSeek V4, Claude Opus 4.6 y GPT-5.4 centrada en lo que esta documentado publicamente en abril de 2026
Comparativas de modelos

DeepSeek V4 vs Claude Opus 4.6 vs GPT-5.4: que se puede comparar de verdad en abril de 2026

Si tienes que elegir hoy para produccion, no conviene empezar tratando a DeepSeek V4, Claude Opus 4.6 y GPT-5.4 como tres contratos publicos igual de claros. Lo mas util es comparar primero GPT-5.4 y Claude Opus 4.6 como los dos frontier contracts limpios y actuales, y despues ubicar a DeepSeek desde el API publico actual basado en V3.2.

13 min
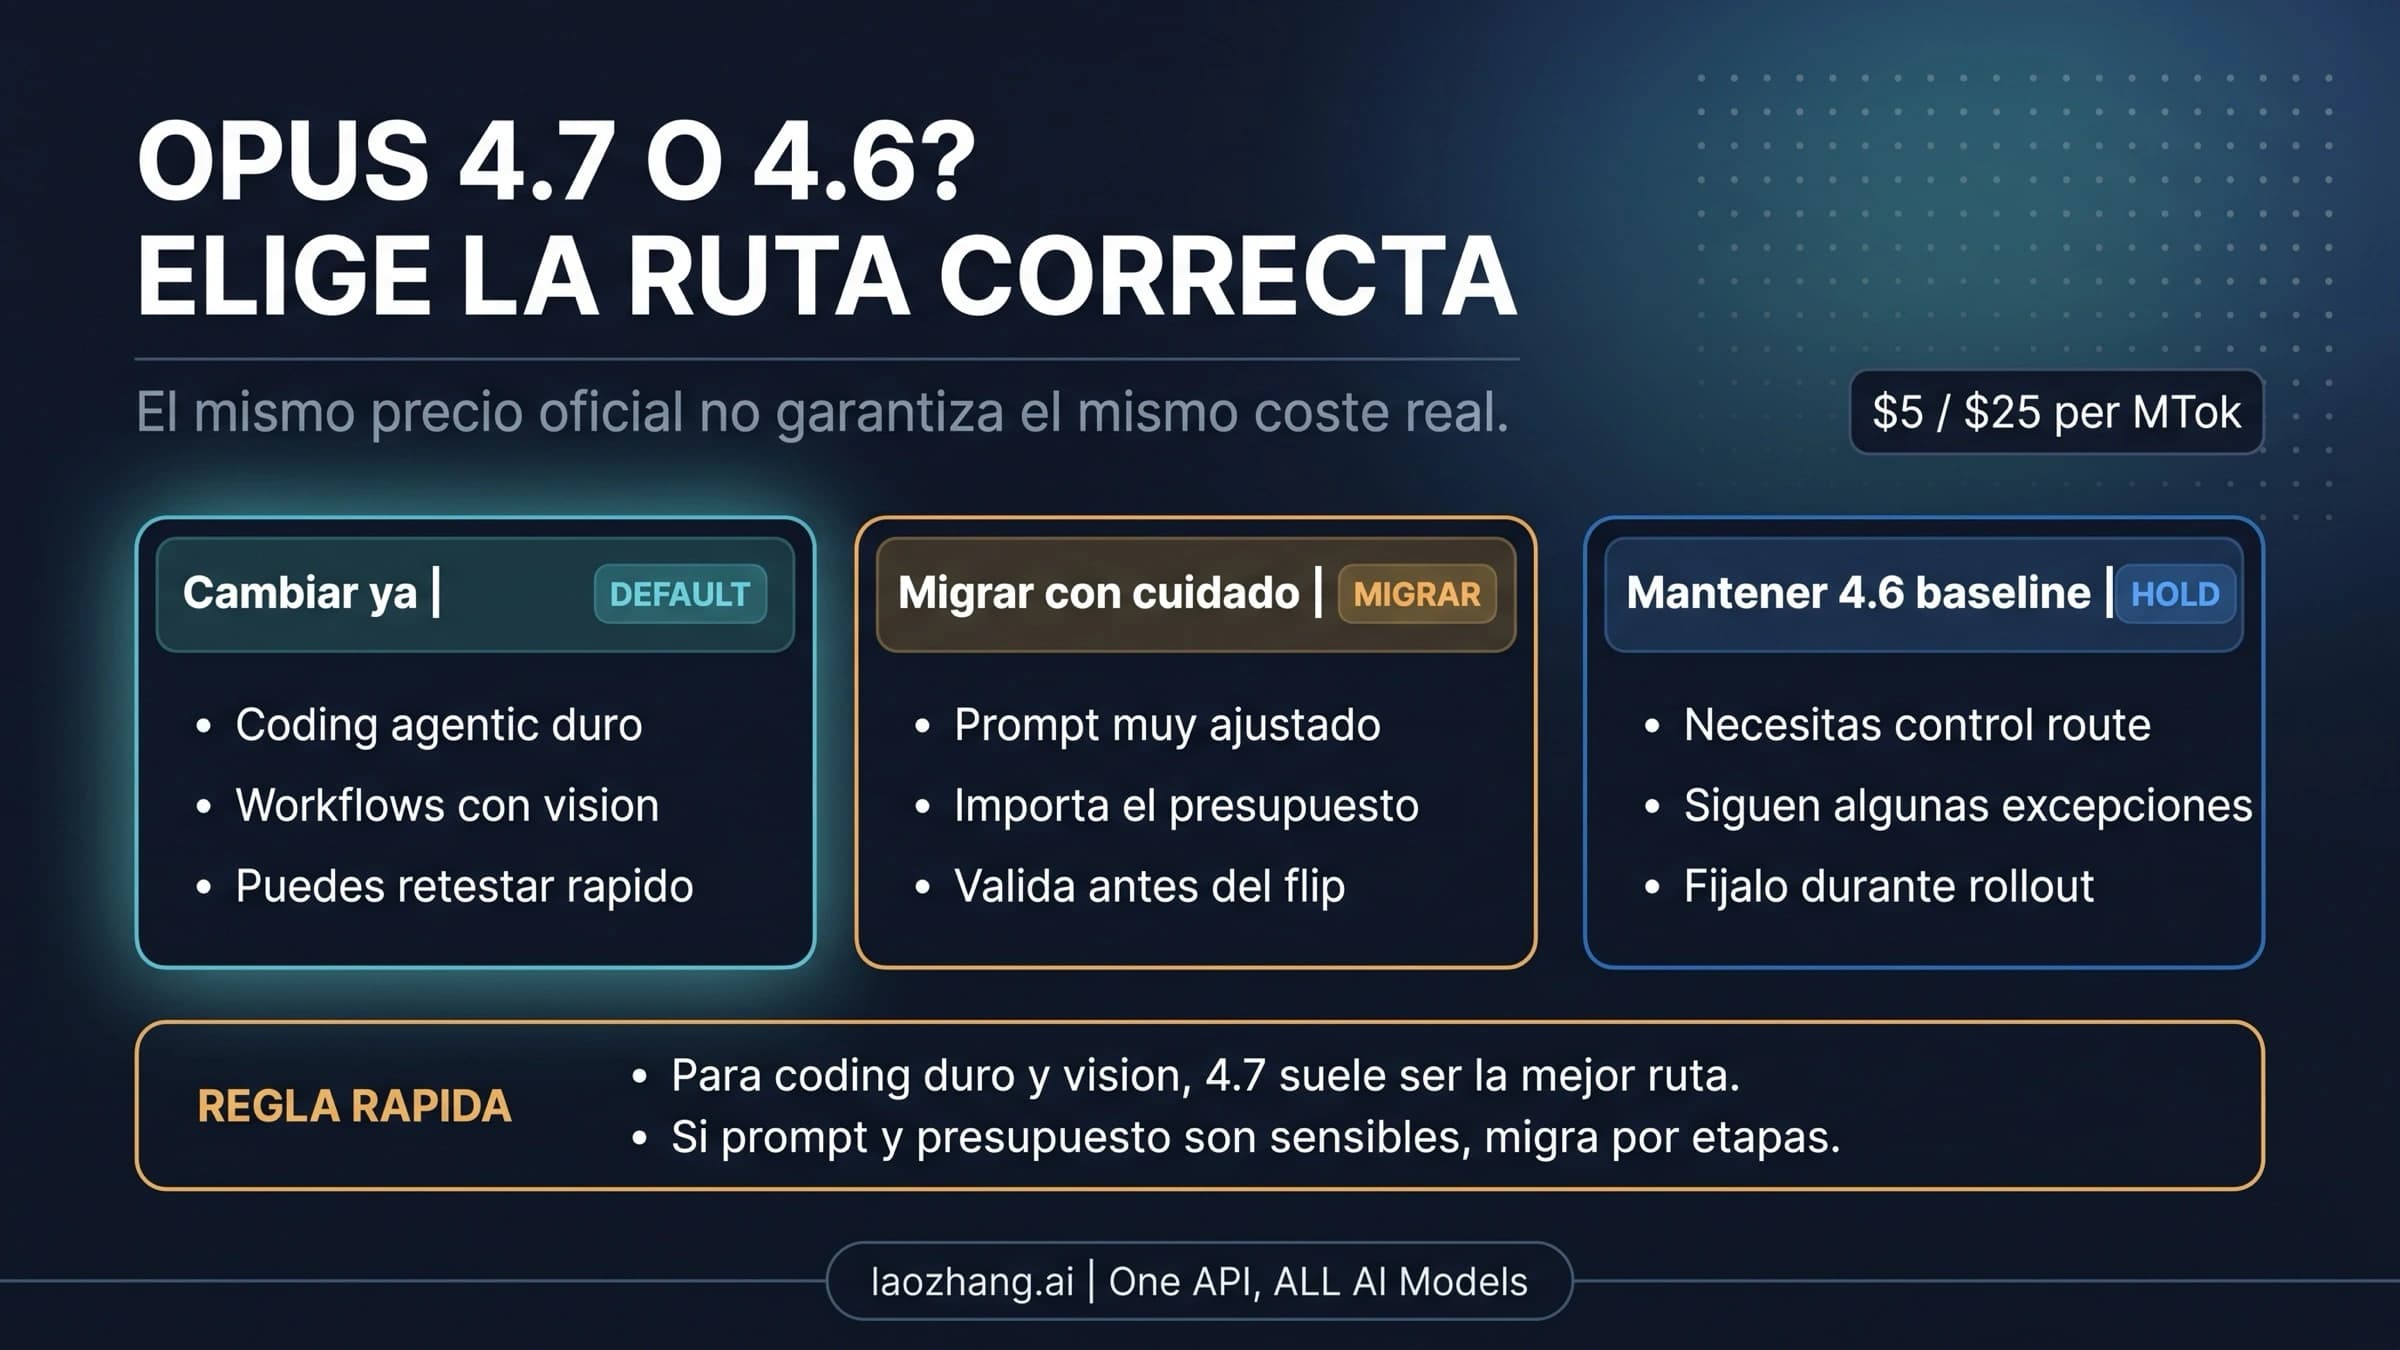
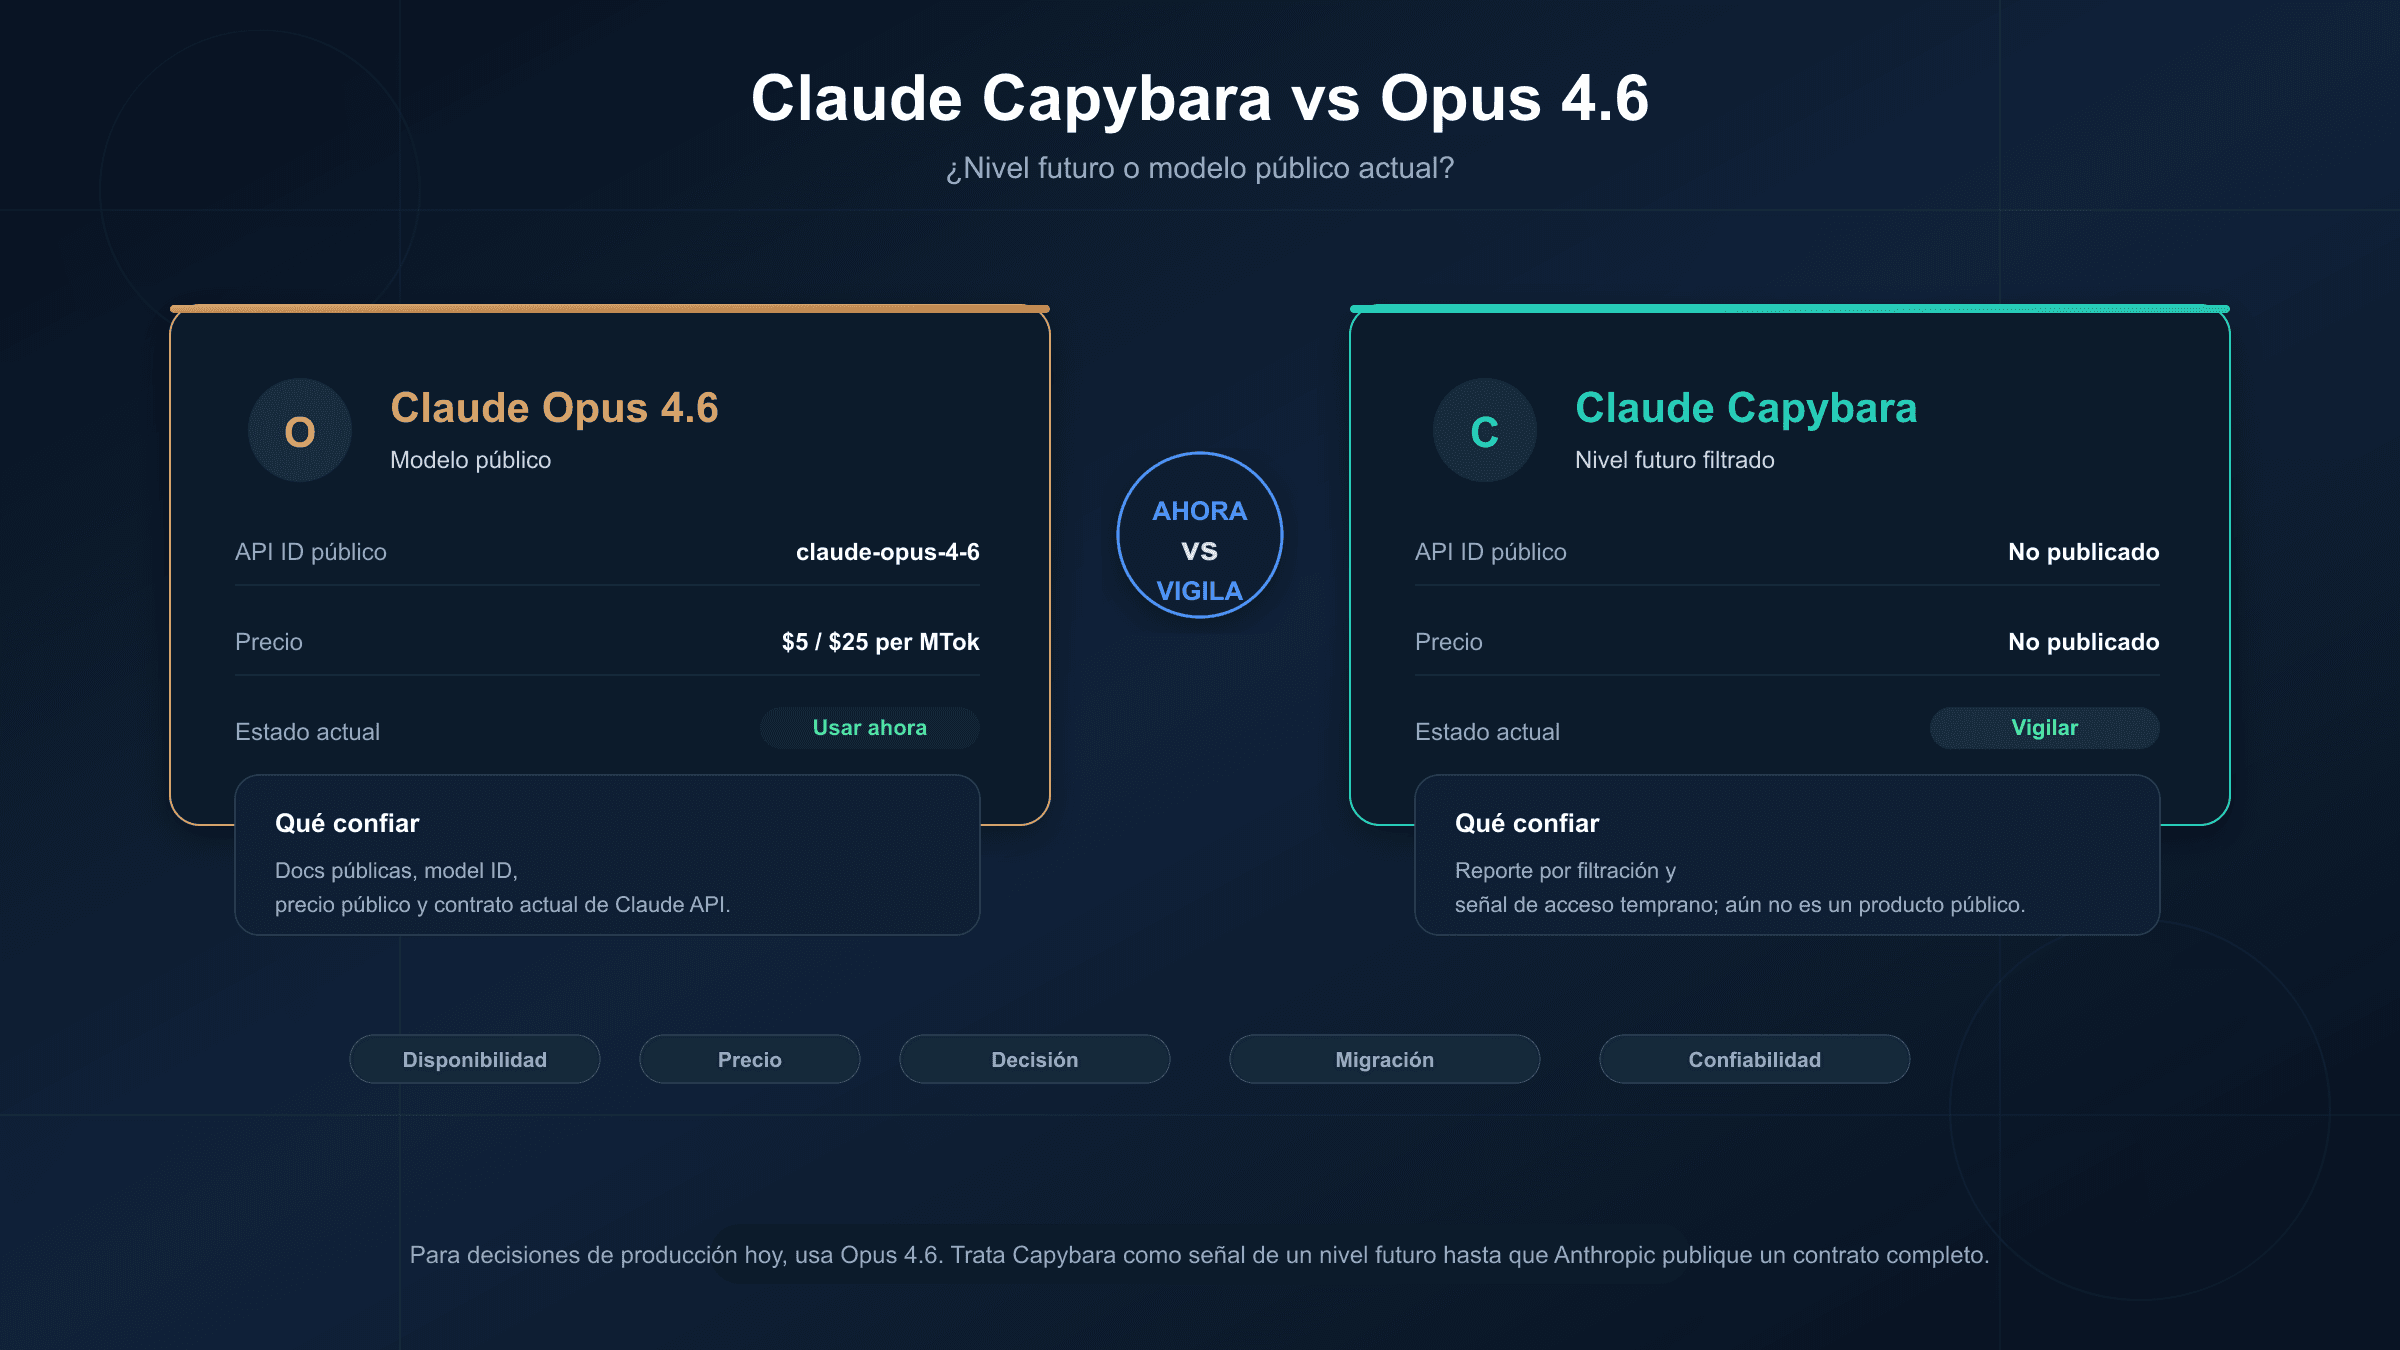
Claude Capybara y Opus 4.6: nivel en observación frente al modelo público actual
Comparativas de modelos

Claude Capybara vs Opus 4.6: ¿conviene esperar o usar Opus ahora?

Claude Capybara todavía no es un contrato de modelo público de Anthropic que puedas seleccionar hoy. La documentación pública de Anthropic sigue señalando a Claude Opus 4.6 como su modelo público de nivel superior, mientras que Capybara funciona más como una señal de un nivel futuro que como una opción de despliegue inmediata.

9 min
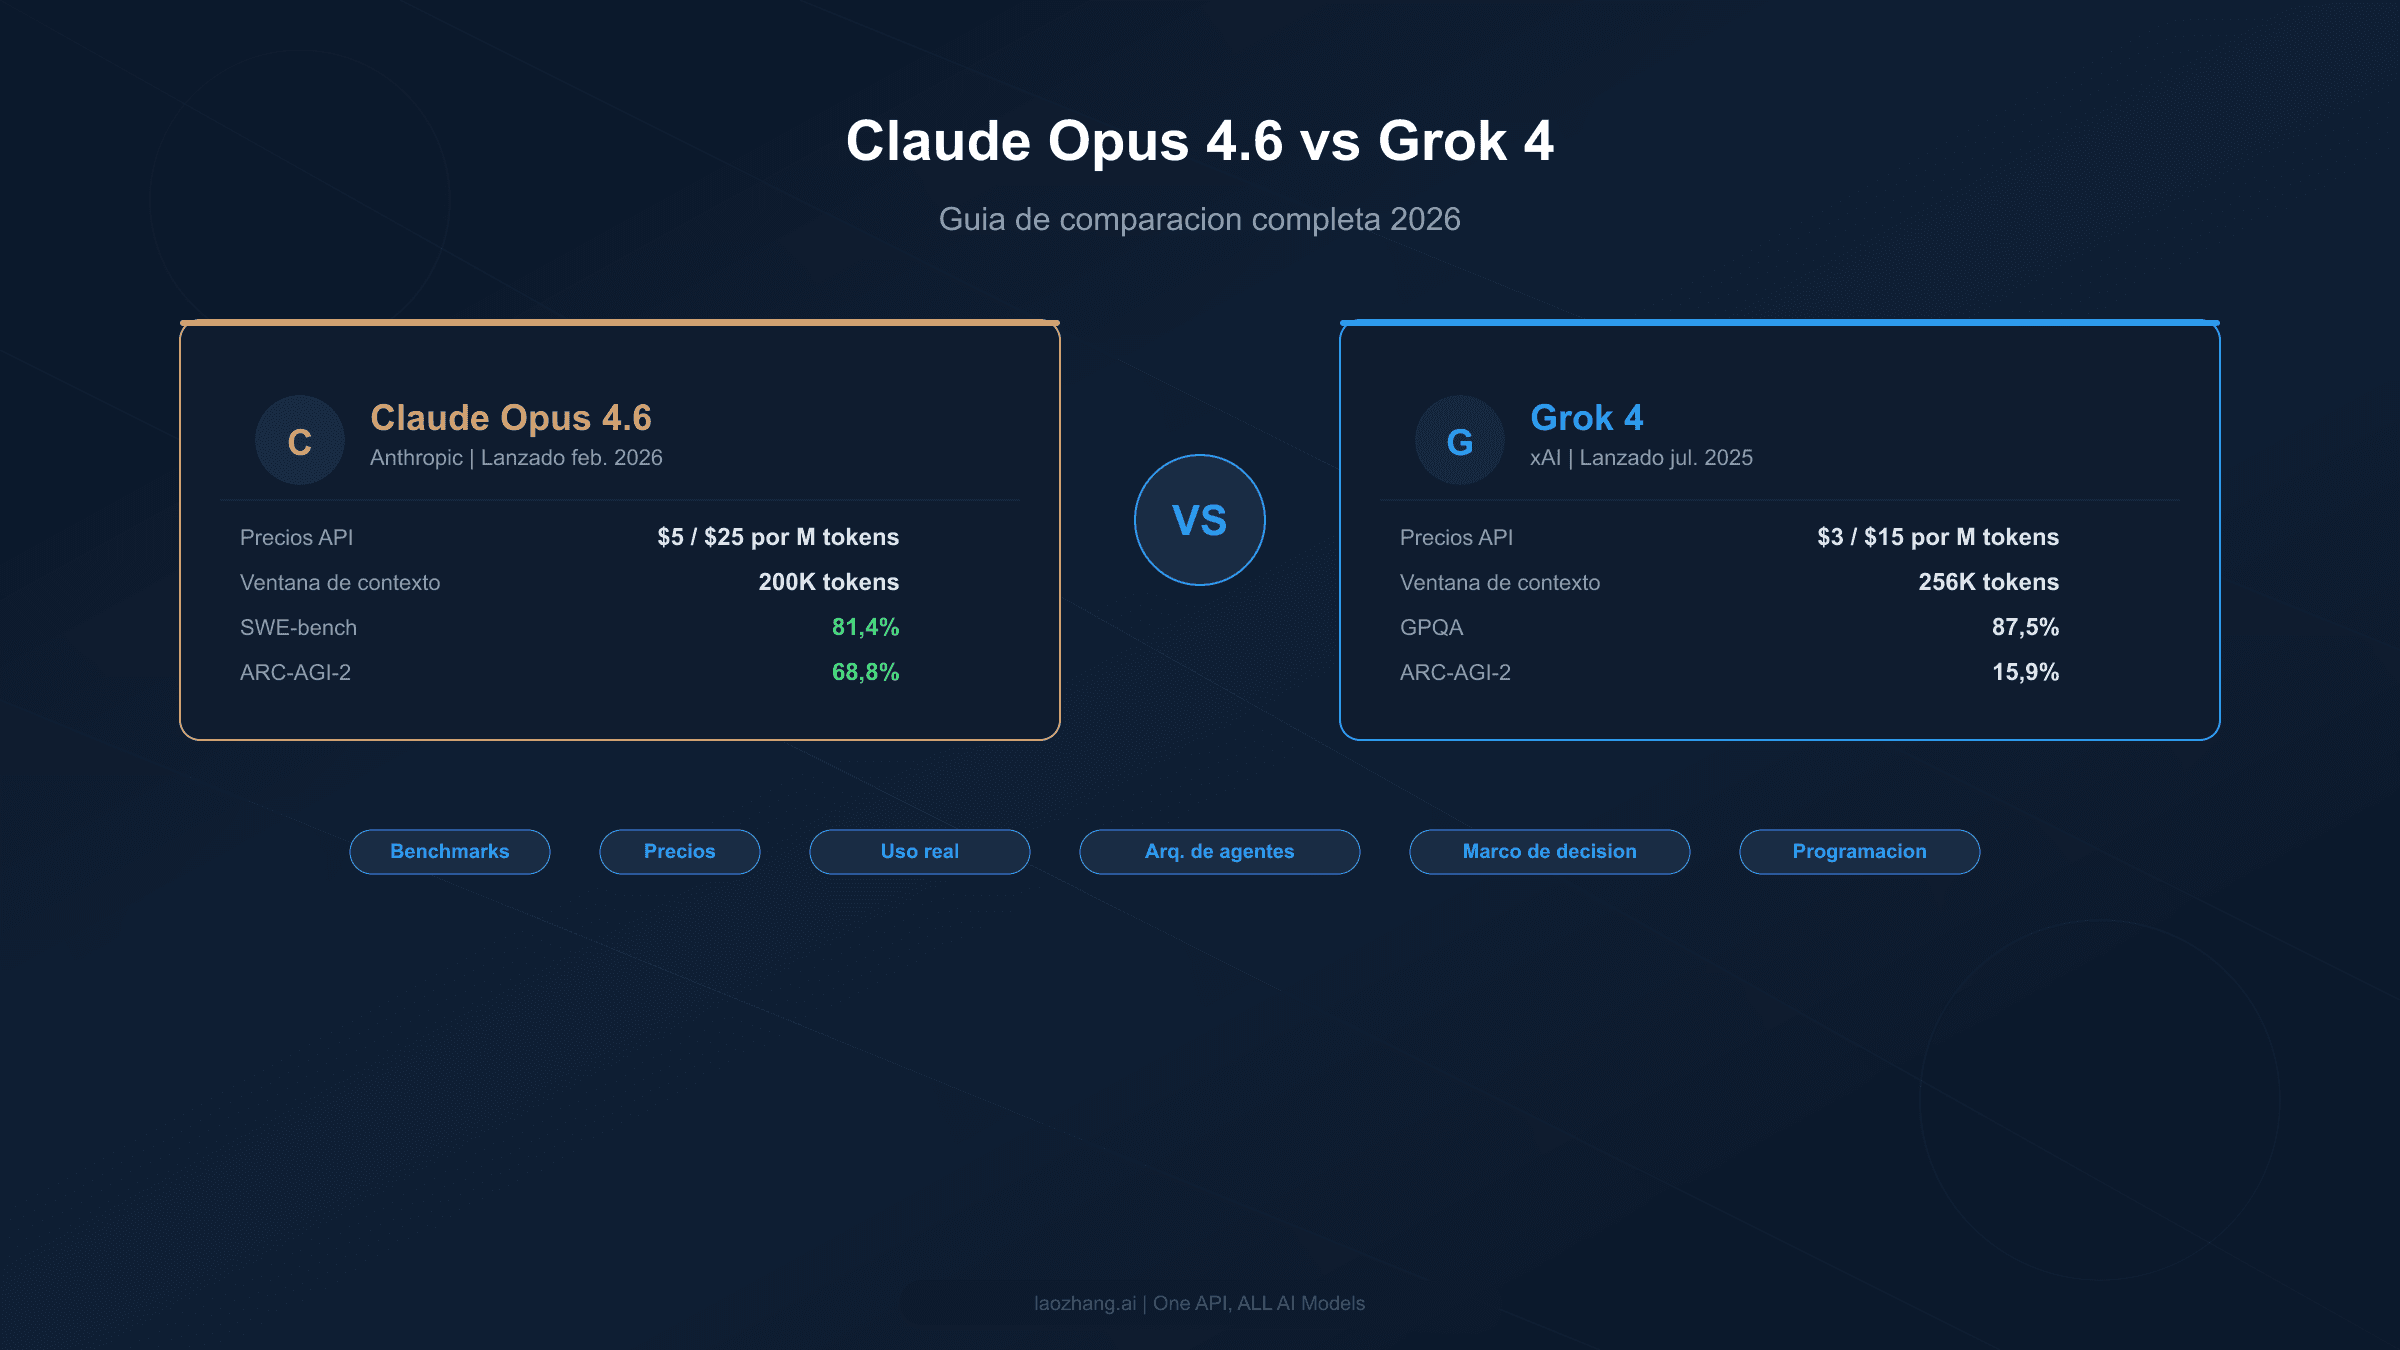
Guía completa de comparación Claude Opus 4.6 vs Grok 4 con benchmarks y precios
Comparativas de modelos

Claude Opus 4.6 vs Grok 4: Comparación completa 2026 (Benchmarks, precios y rendimiento)

Claude Opus 4.6 supera a Grok 4 en benchmarks de programación (81,4% vs ~72% en SWE-bench) y tareas de razonamiento (68,8% vs 15,9% en ARC-AGI-2), mientras que Grok 4 cuesta un 40% menos a $3/$15 por millón de tokens. Esta comparación exhaustiva cubre benchmarks, precios, capacidades de programación, arquitectura de agentes y ofrece un marco de decisión basado en escenarios para ayudarte a elegir el modelo adecuado.

26 min