Claude Sonnet 5.5 vs GPT-6.1 Terra: Sonnet cuesta 2–3 veces más
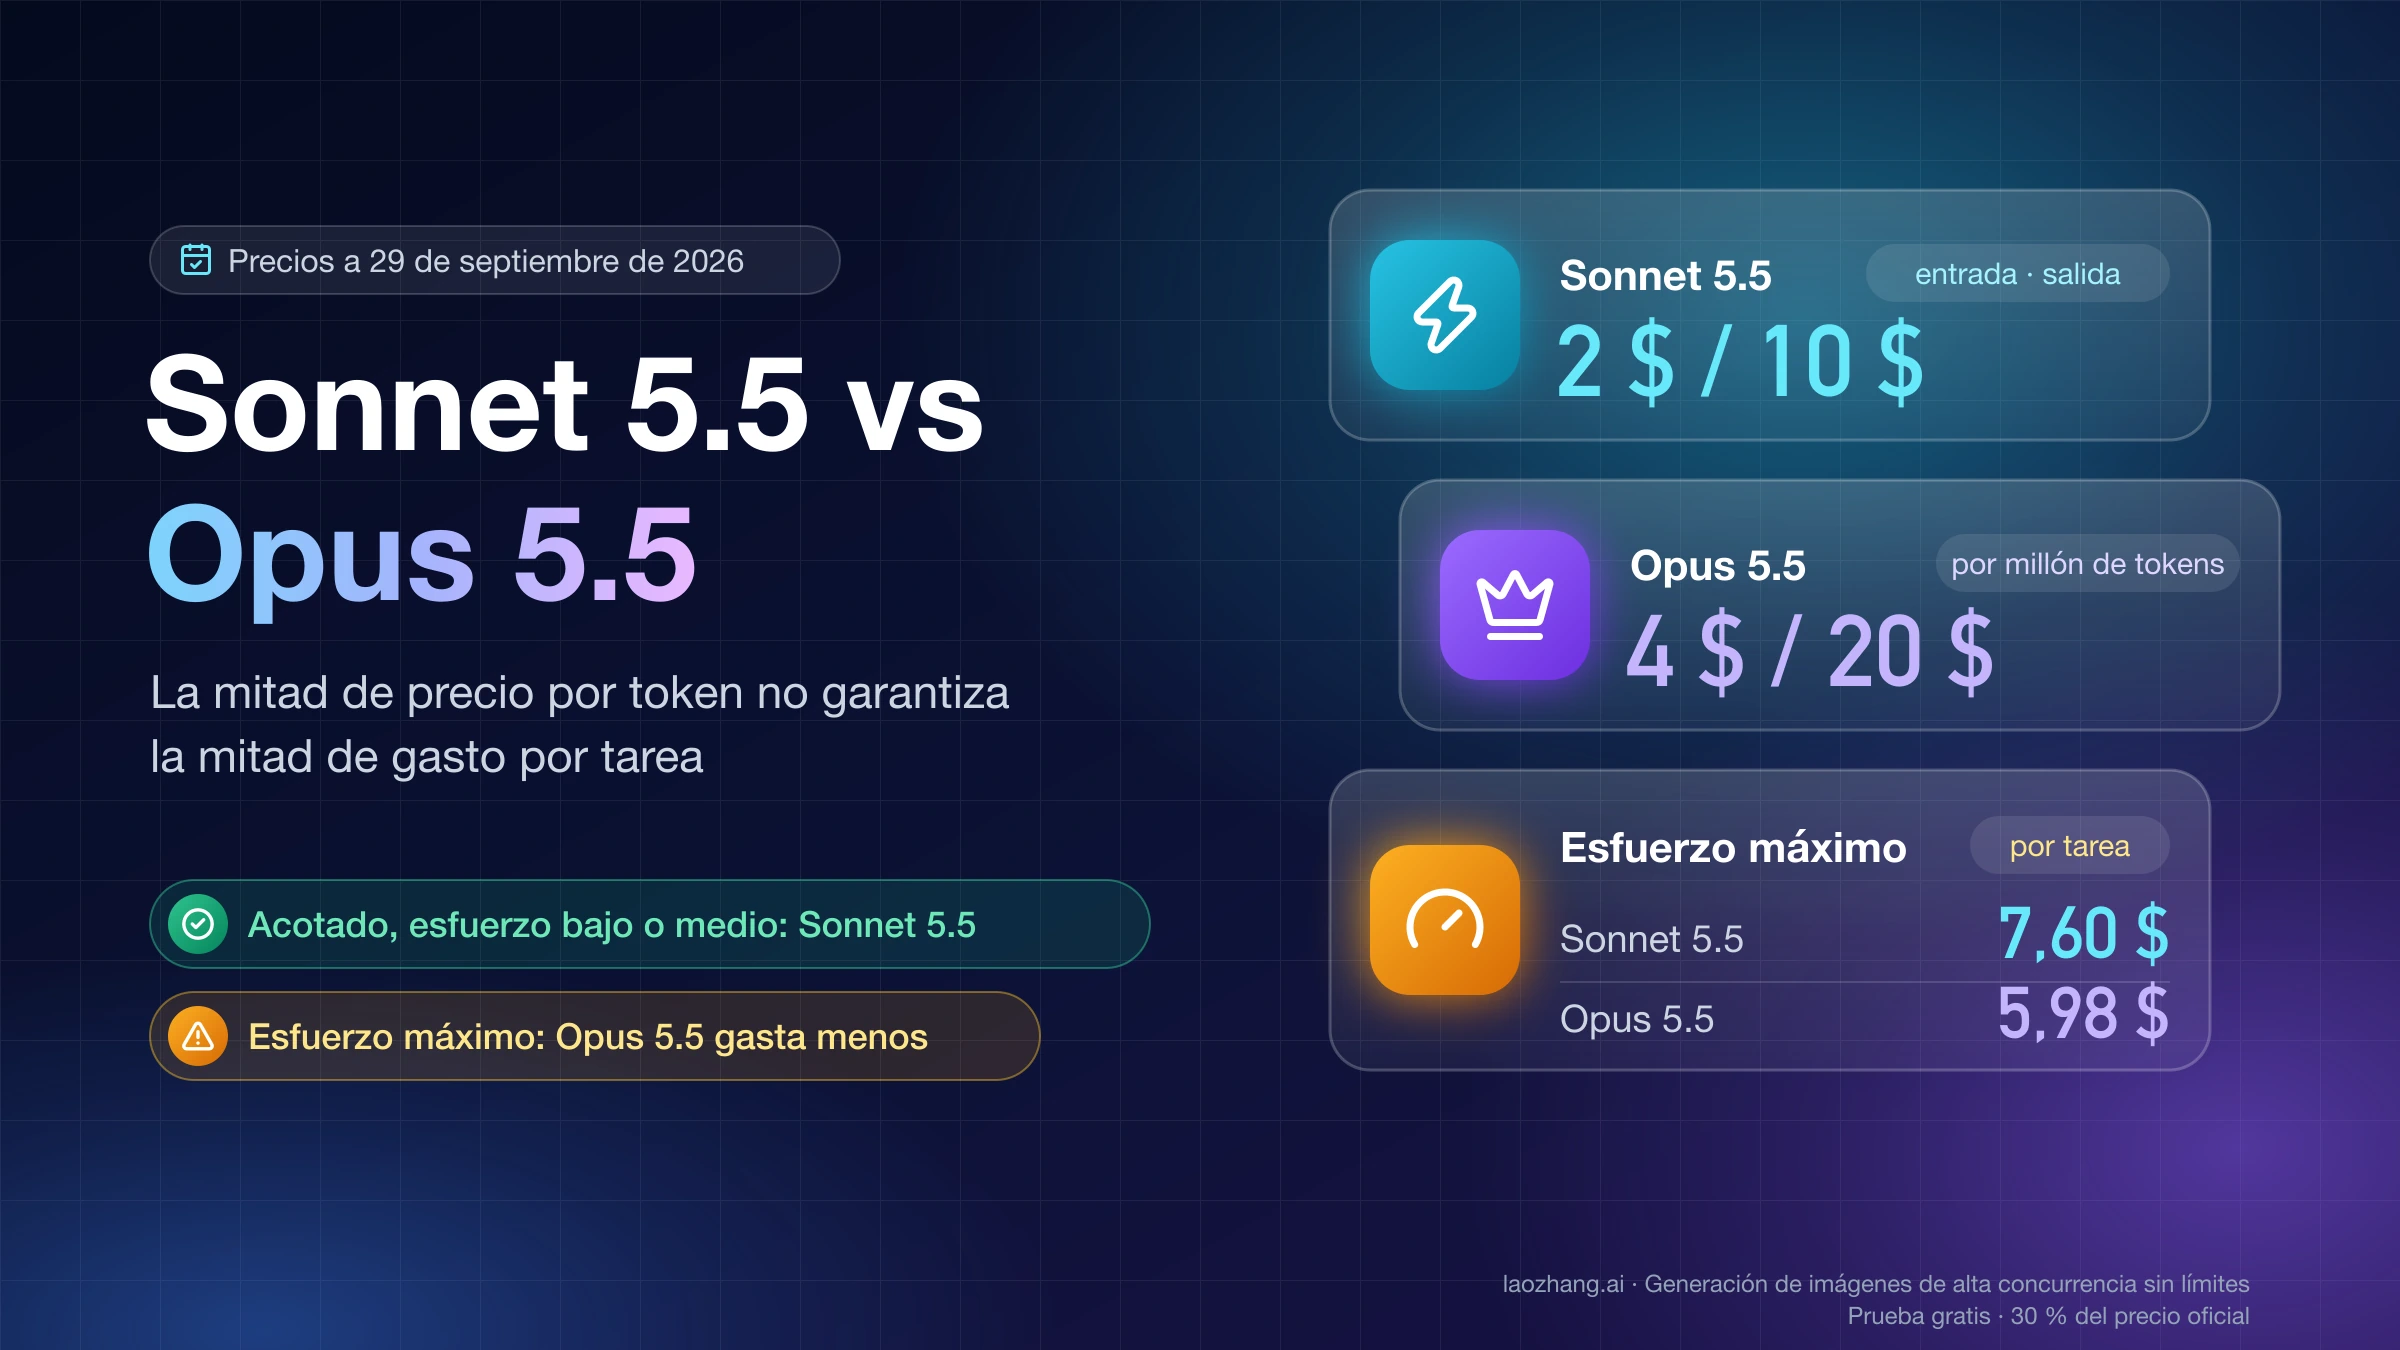
GPT-6.1 Terra cobra la mitad por token y, en 12 tareas de prueba, Sonnet 5.5 costó 2,84 veces más. Con texto en español, Sonnet cuenta 1,55 veces más tokens.
En esta página
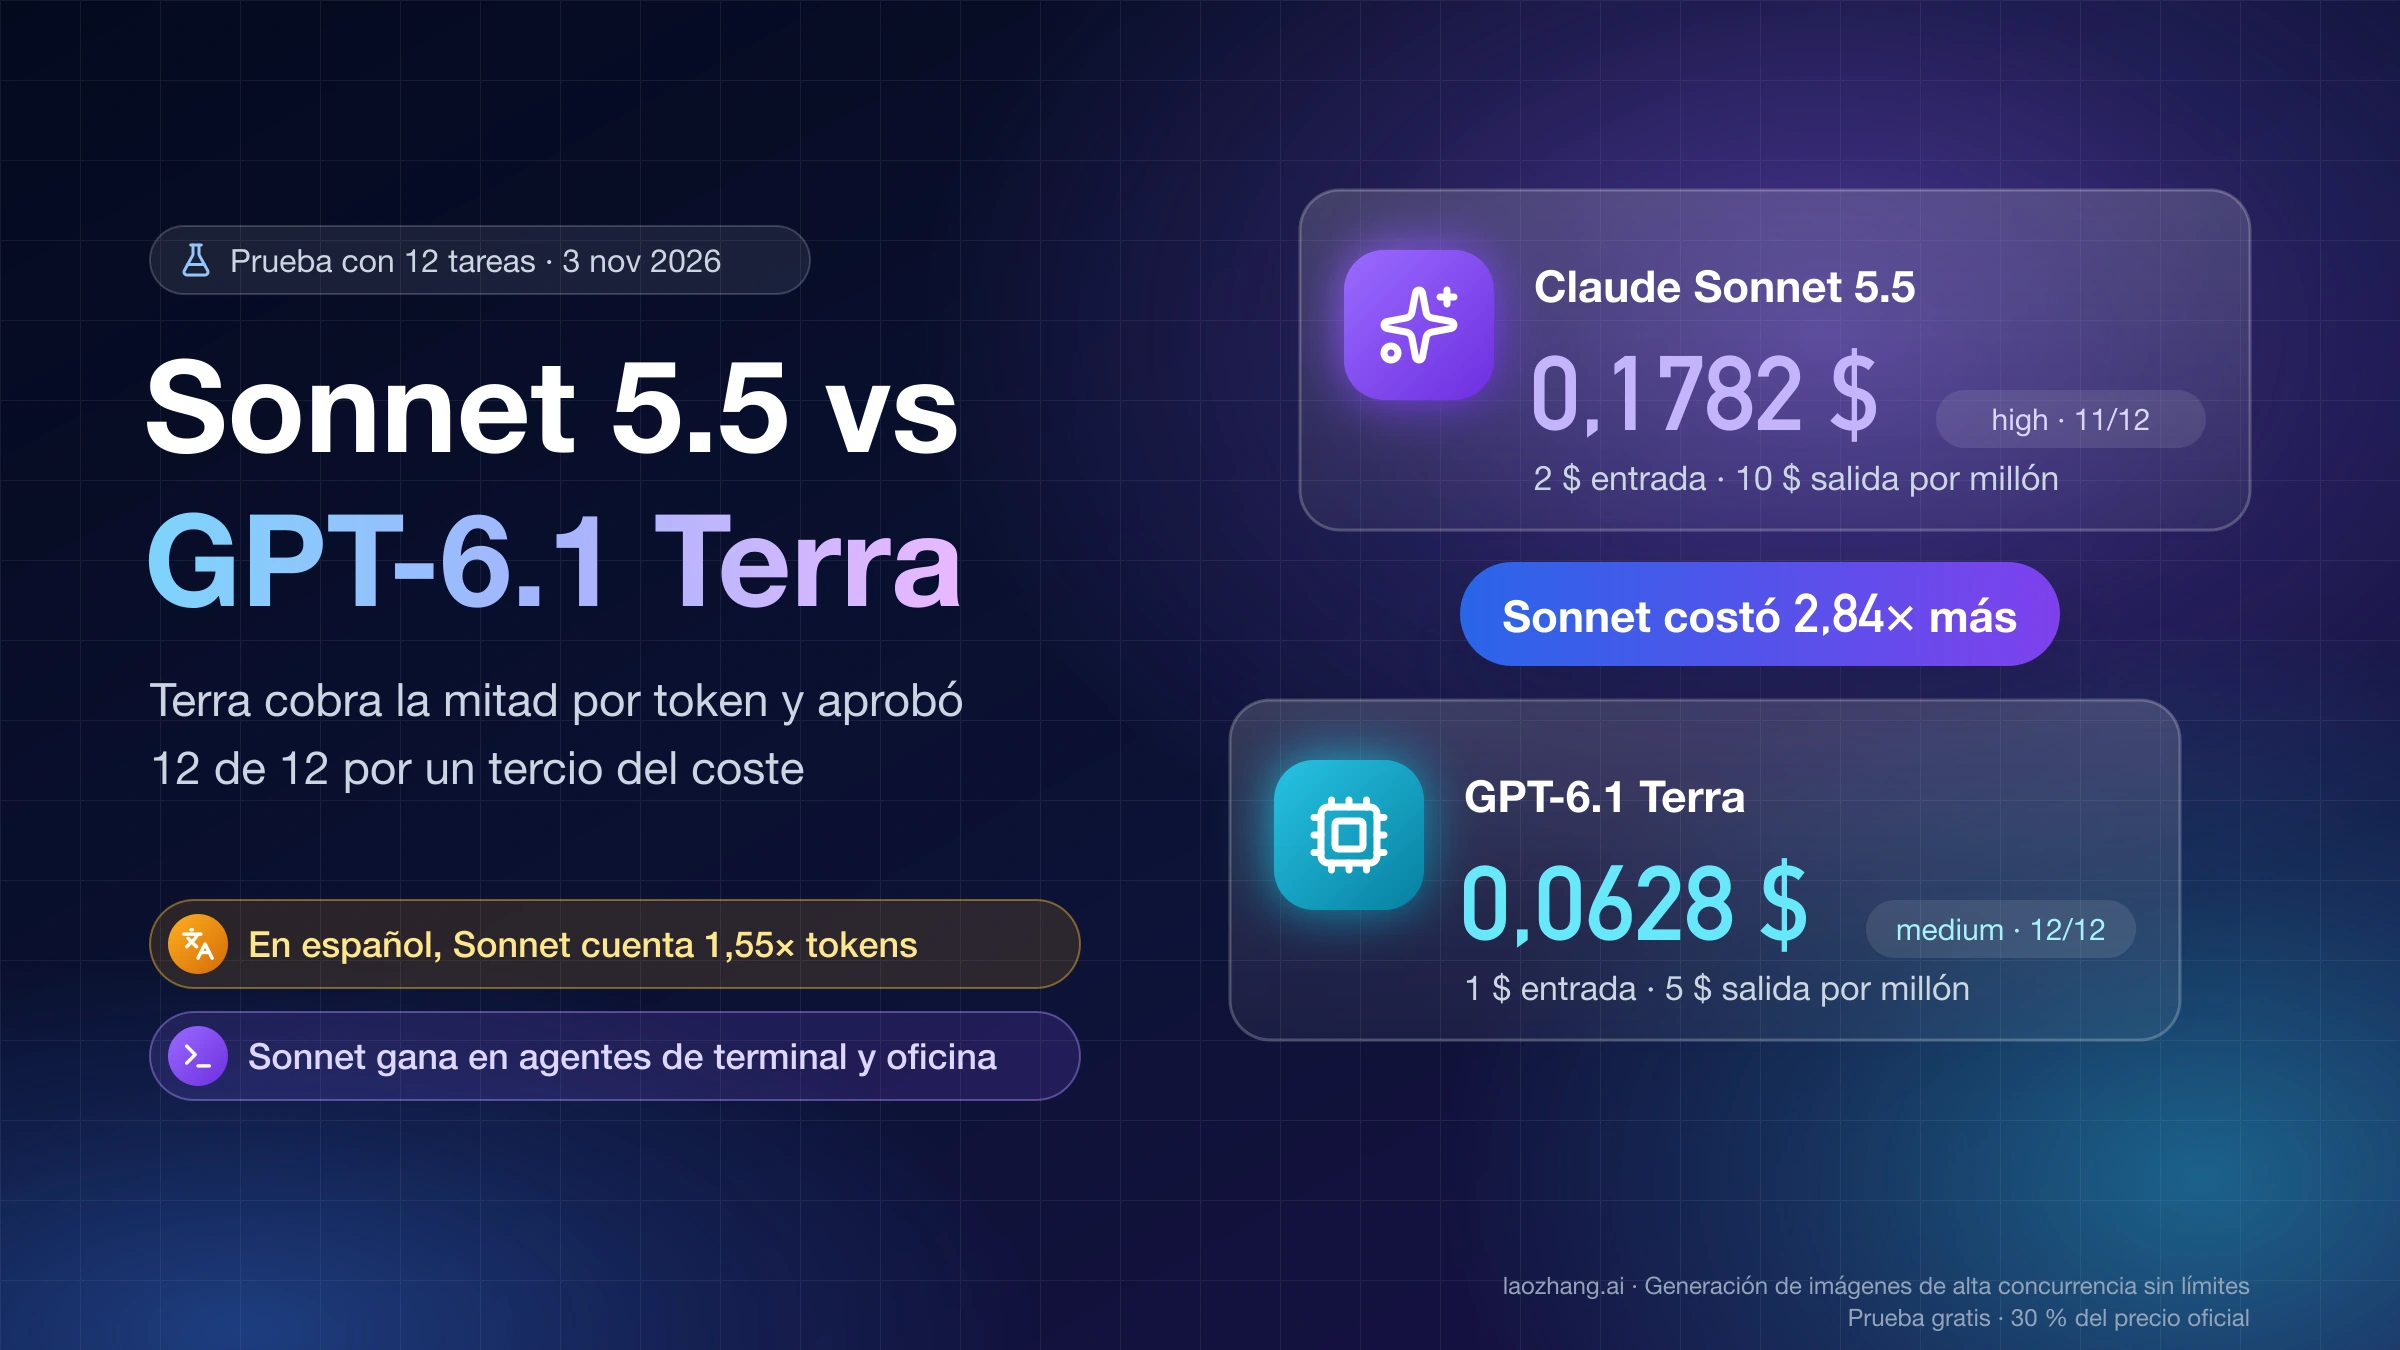
Si pagas Claude Sonnet 5.5 (claude-sonnet-5-5) por la API para tareas de una sola vuelta con un resultado comprobable, como funciones con tests, extracción de datos o resúmenes con formato fijo, puedes pasar ese trabajo a GPT-6.1 Terra (gpt-6.1-terra) en su nivel de razonamiento (effort) por defecto, medium. En una prueba del 3 de noviembre de 2026 con 12 tareas y tests ocultos, Terra en medium aprobó 12 de 12 y Sonnet en high, su valor por defecto en la API, 11 de 12, y a precio de lista Sonnet costó 0,1782 $ frente a 0,0628 $: 2,84 veces más. Quédate en Sonnet para agentes que trabajan en terminal o con documentos de oficina, donde el índice de Artificial Analysis le da ventaja a puntuación parecida, y para el trabajo que necesita más de 51 puntos en ese índice, el techo de Terra.
«La mitad de precio» no es la mitad de factura. Terra cobra 1 $ y 5 $ por millón de tokens de entrada y salida frente a los 2 $ y 10 $ de Sonnet, pero Sonnet cuenta 1,55 veces más tokens para el mismo texto en español, así que esa entrada se factura unas 3,1 veces más cara en Sonnet. La diferencia se estrecha en dos casos: con prompts de más de 272.000 tokens, donde Terra duplica su precio y la brecha queda en torno a 1,5 veces, y si comparas Terra en high en lugar de medium. Se dispara en el caso contrario: un bucle de agente en Sonnet sin cache_control puede salir más de 15 veces más caro que en Terra, que cachea sin pedírselo.
Qué mostró la prueba con los mismos 12 prompts (3 de noviembre de 2026)
Las 12 tareas no separaron a los dos modelos por calidad, pero sí por coste: Sonnet 5.5 en high costó 2,84 veces lo que Terra en medium y 2,12 veces lo que Terra en high, con casi los mismos aciertos. La prueba se hizo el 3 de noviembre de 2026 a través de la pasarela LaoZhang API (laozhang.ai), con una sola clave para los dos modelos y una muestra por tarea. Sonnet se llamó por la API de Messages con thinking: {"type": "adaptive"} y output_config.effort: "high"; Terra, por Chat Completions con reasoning_effort en medium y en high y max_completion_tokens de 32.000, sin herramientas, sin prompt de sistema y sin streaming. El coste es el usage que devolvió cada respuesta multiplicado por el precio de lista de cada fabricante.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Las tareas tienen respuesta exacta o tests que el modelo no ve: un problema aritmético, fusionar intervalos, interpretar duraciones (18 tests), contar las palabras más frecuentes (10), un evaluador de expresiones (25), leer una línea CSV (16), comparar versiones semver (30) y rangos de versiones al estilo de npm (36), contar números por la suma de sus dígitos, encontrar tres notas escondidas en un documento largo y sumarlas (76,80 $), preguntar por funciones de CPython que no existen y resumir un artículo de unas 6.700 palabras en exactamente 5 viñetas de 25 palabras como máximo.
| Configuración | Tareas aprobadas | Coste a precio de lista | Tokens de entrada | Tokens de salida (de razonamiento) | Suma de tiempos |
|---|---|---|---|---|---|
Claude Sonnet 5.5, high | 11/12 | 0,1782 $ | 33.300 | 11.155 (sin desglose) | 103 s |
GPT-6.1 Terra, medium | 12/12 | 0,0628 $ | 21.977 | 7.149 (3.740) | 130 s |
GPT-6.1 Terra, high | 11/12 | 0,0839 $ | 21.977 | 11.375 (7.816) | 176 s |
Los dos fallos son el mismo error de formato en el resumen: Sonnet y Terra en high escribieron una viñeta de 26 palabras con un límite de 25, y Sonnet ya había cometido ese mismo desliz en una ejecución del 28 de octubre de 2026. Con una sola muestra por tarea, esa diferencia no ordena a los modelos; lo que sí muestra la prueba es que, en trabajo bien especificado de una vuelta, Terra entregó lo mismo con una factura de entre la mitad y un tercio. Tarea por tarea, Sonnet salió entre 2,0 y 5,8 veces más caro que Terra en medium y entre 1,1 y 4,0 veces más que Terra en high.
Dos resultados van contra lo que cabría esperar. Sonnet fue más rápido por llamada en esta ruta: ganó a Terra en medium en 11 de las 12 tareas y a Terra en high en las 12, al revés que el tiempo por tarea que publica Artificial Analysis; son tareas y medidas distintas, y una sola ruta desde un solo equipo no explica por qué. Y Terra escribió caché sin que nadie se lo pidiera: en los dos prompts largos, de unos 10.100 tokens, su usage registró 10.103 y 10.195 tokens de escritura en caché, que se cobran a 1,25 $ por millón, mientras que Sonnet no cacheó nada porque la petición no llevaba cache_control.
La prueba no cubre agentes con varios turnos, llamada a herramientas, imágenes, la Responses API ni los endpoints directos de OpenAI y Anthropic, y solo probó Sonnet en high y Terra en medium y high. Para comparar la calidad en tareas más largas, la referencia es el índice de Artificial Analysis de más abajo.
¿La mitad de precio es la mitad de factura? Tokens, effort y caché
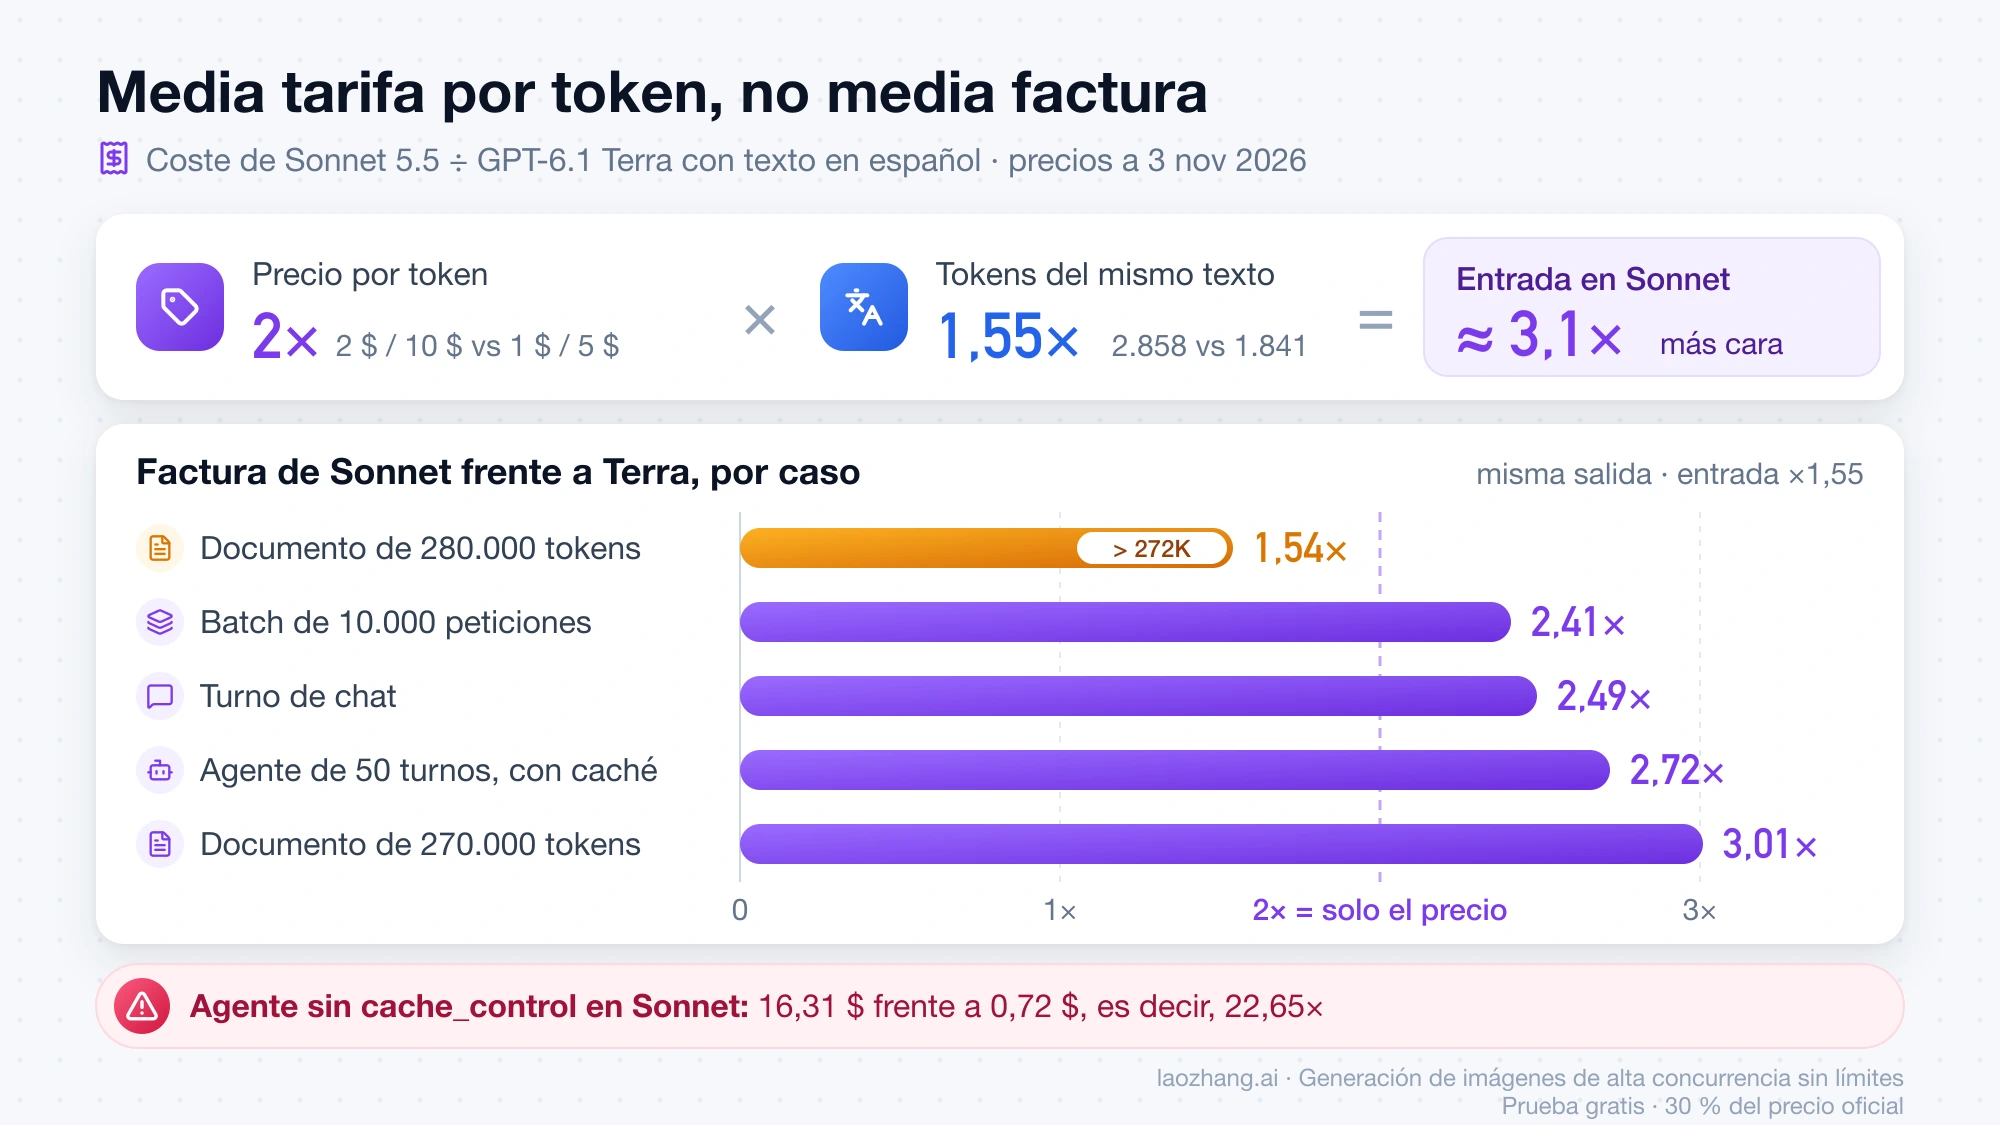
No, porque la factura es precio por token multiplicado por los tokens que cuenta cada modelo, el volumen de salida que genera el effort elegido y lo que se cachea, y solo el primer factor está a la mitad. El segundo juega en contra de Sonnet: el 3 de noviembre de 2026, contando el mismo pasaje de 6.000 caracteres con la API de cada modelo, Sonnet registró 2.858 tokens de entrada en español y Terra 1.841, es decir, 1,55 veces más. En inglés la proporción fue de 1,43, en código Python de 1,46, y en las siete muestras medidas osciló entre 1,30 y 1,62. Como el precio unitario de Sonnet es el doble, el mismo texto en español cuesta unas 3,1 veces más como entrada de Sonnet.
El effort pesa en la salida, que es la parte cara de los dos. Con el mismo nombre de nivel, high, los dos modelos escribieron casi la misma salida en la prueba (11.155 tokens Sonnet, 11.375 Terra), así que la diferencia se redujo al precio unitario más los tokens de entrada; Terra en medium escribió un 37 % menos que en high. Los valores por defecto tampoco coinciden: Sonnet usa high en la API y medium en Claude Code y en las apps de Claude, según el anuncio de Claude Sonnet 5.5, y Terra usa medium. Comparar «por defecto contra por defecto» en la API es poner a Sonnet a razonar más que a Terra.
La caché funciona al revés en cada fabricante. OpenAI cachea por defecto los prompts de Terra y cobra la escritura; Anthropic solo cachea si la petición lleva cache_control, ya sea en el nivel superior o en puntos de corte concretos, según su documentación de prompt caching. Si reutilizas un prefijo largo y nunca has configurado la caché en Sonnet, estás pagando el precio completo en cada llamada.
Cuánto cambia tu factura: fórmula y ejemplos con texto en español
Por debajo de 272.000 tokens y con caché activada en los dos, Sonnet 5.5 te costará entre 2,4 y 3 veces lo que Terra si tu texto está en español: el doble por precio unitario y el resto por los tokens adicionales. Puedes calcular tu caso con los precios por millón de tokens a 3 de noviembre de 2026, tomados de la tabla de precios de la API de OpenAI y de la página de precios de la API de Claude:
- Sonnet 5.5, a cualquier longitud hasta 1 millón de tokens: 2 $ × entrada nueva + 2,50 $ × escritura en caché de 5 minutos + 0,10 $ × lectura de caché + 10 $ × salida.
- GPT-6.1 Terra hasta 272.000 tokens de entrada: 1 $ × entrada nueva + 1,25 $ × escritura en caché de 30 minutos + 0,05 $ × lectura de caché + 5 $ × salida.
- GPT-6.1 Terra por encima de 272.000 tokens, para toda la petición: 2 $ × entrada + 2,50 $ × escritura + 0,10 $ × lectura + 7,50 $ × salida.
La salida incluye los tokens de razonamiento. Para pasar tus tokens de Terra a tokens de Sonnet, multiplica la entrada por 1,55 si el texto está en español (1,43 en inglés, 1,46 en código). Los ejemplos de abajo mantienen la misma salida en los dos modelos, cuentan la entrada en tokens de Terra y aplican esa proporción del español; en la práctica la salida cambia con el modelo y el effort.
| Caso | GPT-6.1 Terra | Sonnet 5.5, mismos tokens | Sonnet 5.5, texto en español (×1,55) |
|---|---|---|---|
| Turno de chat: 2.000 de entrada y 500 de salida | 0,0045 $ | 0,0090 $ (2,00×) | 0,0112 $ (2,49×) |
| Documento: 270.000 de entrada y 5.000 de salida | 0,295 $ | 0,590 $ (2,00×) | 0,887 $ (3,01×) |
| Agente de 50 turnos con un prefijo de 100.000 en caché, 2.000 nuevos y 1.000 de salida por turno | 0,72 $ | 1,44 $ (2,00×) | 1,96 $ (2,72×) |
| Batch: 10.000 peticiones de 3.000 de entrada y 1.000 de salida | 40 $ | 80 $ (2,00×) | 96,50 $ (2,41×) |
En el agente, el primer turno paga la escritura del prefijo (30 minutos en Terra, 5 minutos en Sonnet) y los siguientes lo leen de caché. El Batch aplica el 50 % de descuento a los dos y, en Terra, la columna de hasta 272.000 tokens. La proporción de tokens es la de un solo pasaje por idioma, así que conviene medir la tuya con tus propios textos antes de dar el número por bueno.
Prompts de más de 272.000 tokens y bucles de agente sin caché
Con prompts de más de 272.000 tokens de Terra, la ventaja de precio de Terra en la entrada desaparece y la diferencia queda en la proporción de tokens. OpenAI cobra toda la petición a 2 $ por millón de entrada y 7,50 $ de salida en cuanto la entrada supera ese umbral, mientras que Sonnet 5.5 mantiene 2 $ y 10 $ en toda su ventana de 1 millón. Un documento de 280.000 tokens con 5.000 de salida cuesta 0,5975 $ en Terra y 0,918 $ en Sonnet si está en español (1,54 veces), y uno de 600.000 tokens, 1,24 $ frente a 1,91 $. Ten en cuenta que el umbral se mide en tokens de Terra: 272.000 tokens de Terra equivalen a unos 422.000 de Sonnet con texto en español.
En la dirección contraria, un agente que reenvía el mismo contexto en cada turno es donde Sonnet puede salir más caro de lo que sugiere cualquier precio de lista. Terra cachea el prefijo sin configuración, mientras que Sonnet sin cache_control vuelve a cobrar el prefijo entero en cada turno. En el ejemplo de 50 turnos de la tabla anterior, Sonnet pasa de 1,96 $ a 16,31 $ con texto en español, 22,65 veces lo que cuesta Terra; incluso con el mismo número de tokens serían 10,70 $. Antes de comparar facturas de agentes, comprueba que tu cliente o tu framework envía cache_control a Anthropic.
Sonnet 5.5 y GPT-6.1 Terra por nivel de effort en Artificial Analysis v5.0
Con el mismo nombre de nivel, Terra está a la par o por encima de Sonnet hasta high y cuesta entre 4,6 y 7,3 veces menos por tarea; por encima, Sonnet sube más, y solo su nivel max supera el techo de Terra. Son datos del índice de inteligencia de Artificial Analysis (Intelligence Index) v5.0, en la comparativa de versiones de Claude Sonnet 5.5 y GPT-6.1 Terra a 3 de noviembre de 2026. El coste por tarea es un cálculo de AA: los tokens que gastó cada modelo en sus tareas, a precio de lista. Como el precio unitario de Sonnet es el doble, un coste 6 o 10 veces mayor significa que en esas tareas Sonnet gastó bastantes más tokens que Terra.
| Nivel de effort | Sonnet 5.5: índice · coste por tarea · tiempo | GPT-6.1 Terra: índice · coste por tarea · tiempo | Coste de Sonnet ÷ Terra |
|---|---|---|---|
none | no existe | 30 · 0,23 $ · 104 s | — |
low | 25 · 0,51 $ · 127 s | 29 · 0,07 $ · 48 s | 7,3× |
medium | 30 · 0,78 $ · 190 s | 38 · 0,17 $ · 118 s | 4,6× |
high | 41 · 1,64 $ · 344 s | 42 · 0,26 $ · 172 s | 6,3× |
xhigh | 50 · 4,09 $ · 719 s | 45 · 0,40 $ · 248 s | 10,2× |
max | 54 · 10,02 $ · 1.263 s | 51 · 0,96 $ · 533 s | 10,4× |
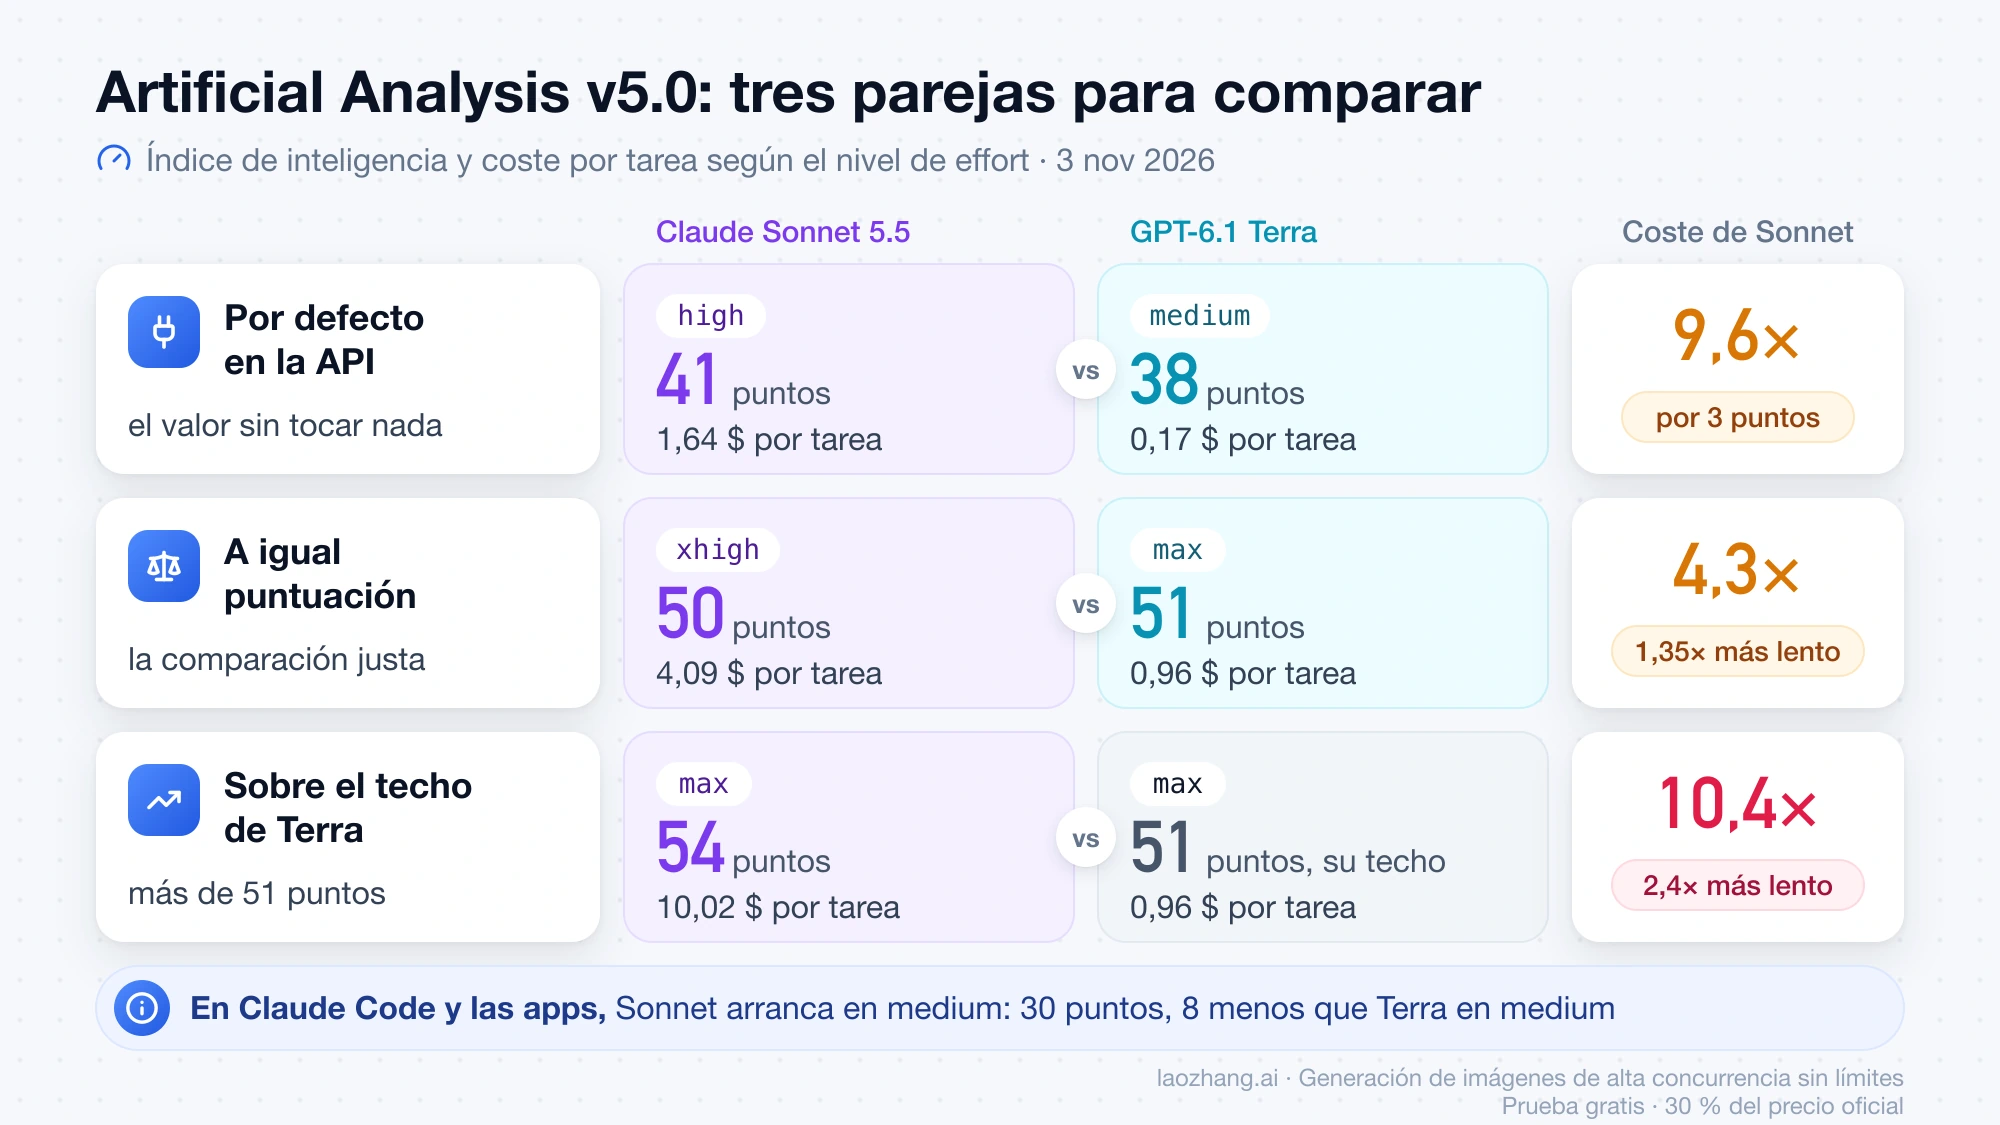
Los nombres de nivel no son equivalentes entre fabricantes, así que la tabla se lee mejor por parejas. Por defecto contra por defecto en la API, Sonnet en high saca 41 puntos frente a los 38 de Terra en medium, con un coste por tarea 9,6 veces mayor y 2,9 veces más tiempo, así que pagas esos 3 puntos muy caros. Si usas Sonnet en Claude Code o en las apps, donde arranca en medium, sus 30 puntos quedan 8 por debajo de Terra en medium y su coste es 4,6 veces mayor. A igual puntuación, Sonnet en xhigh (50 puntos, 4,09 $) se empareja con Terra en max (51 puntos, 0,96 $): 4,3 veces más caro y 1,35 veces más lento. Solo Sonnet en max, con 54 puntos, queda fuera del alcance de Terra, a 10,4 veces el coste de Terra en max y 2,4 veces su tiempo.
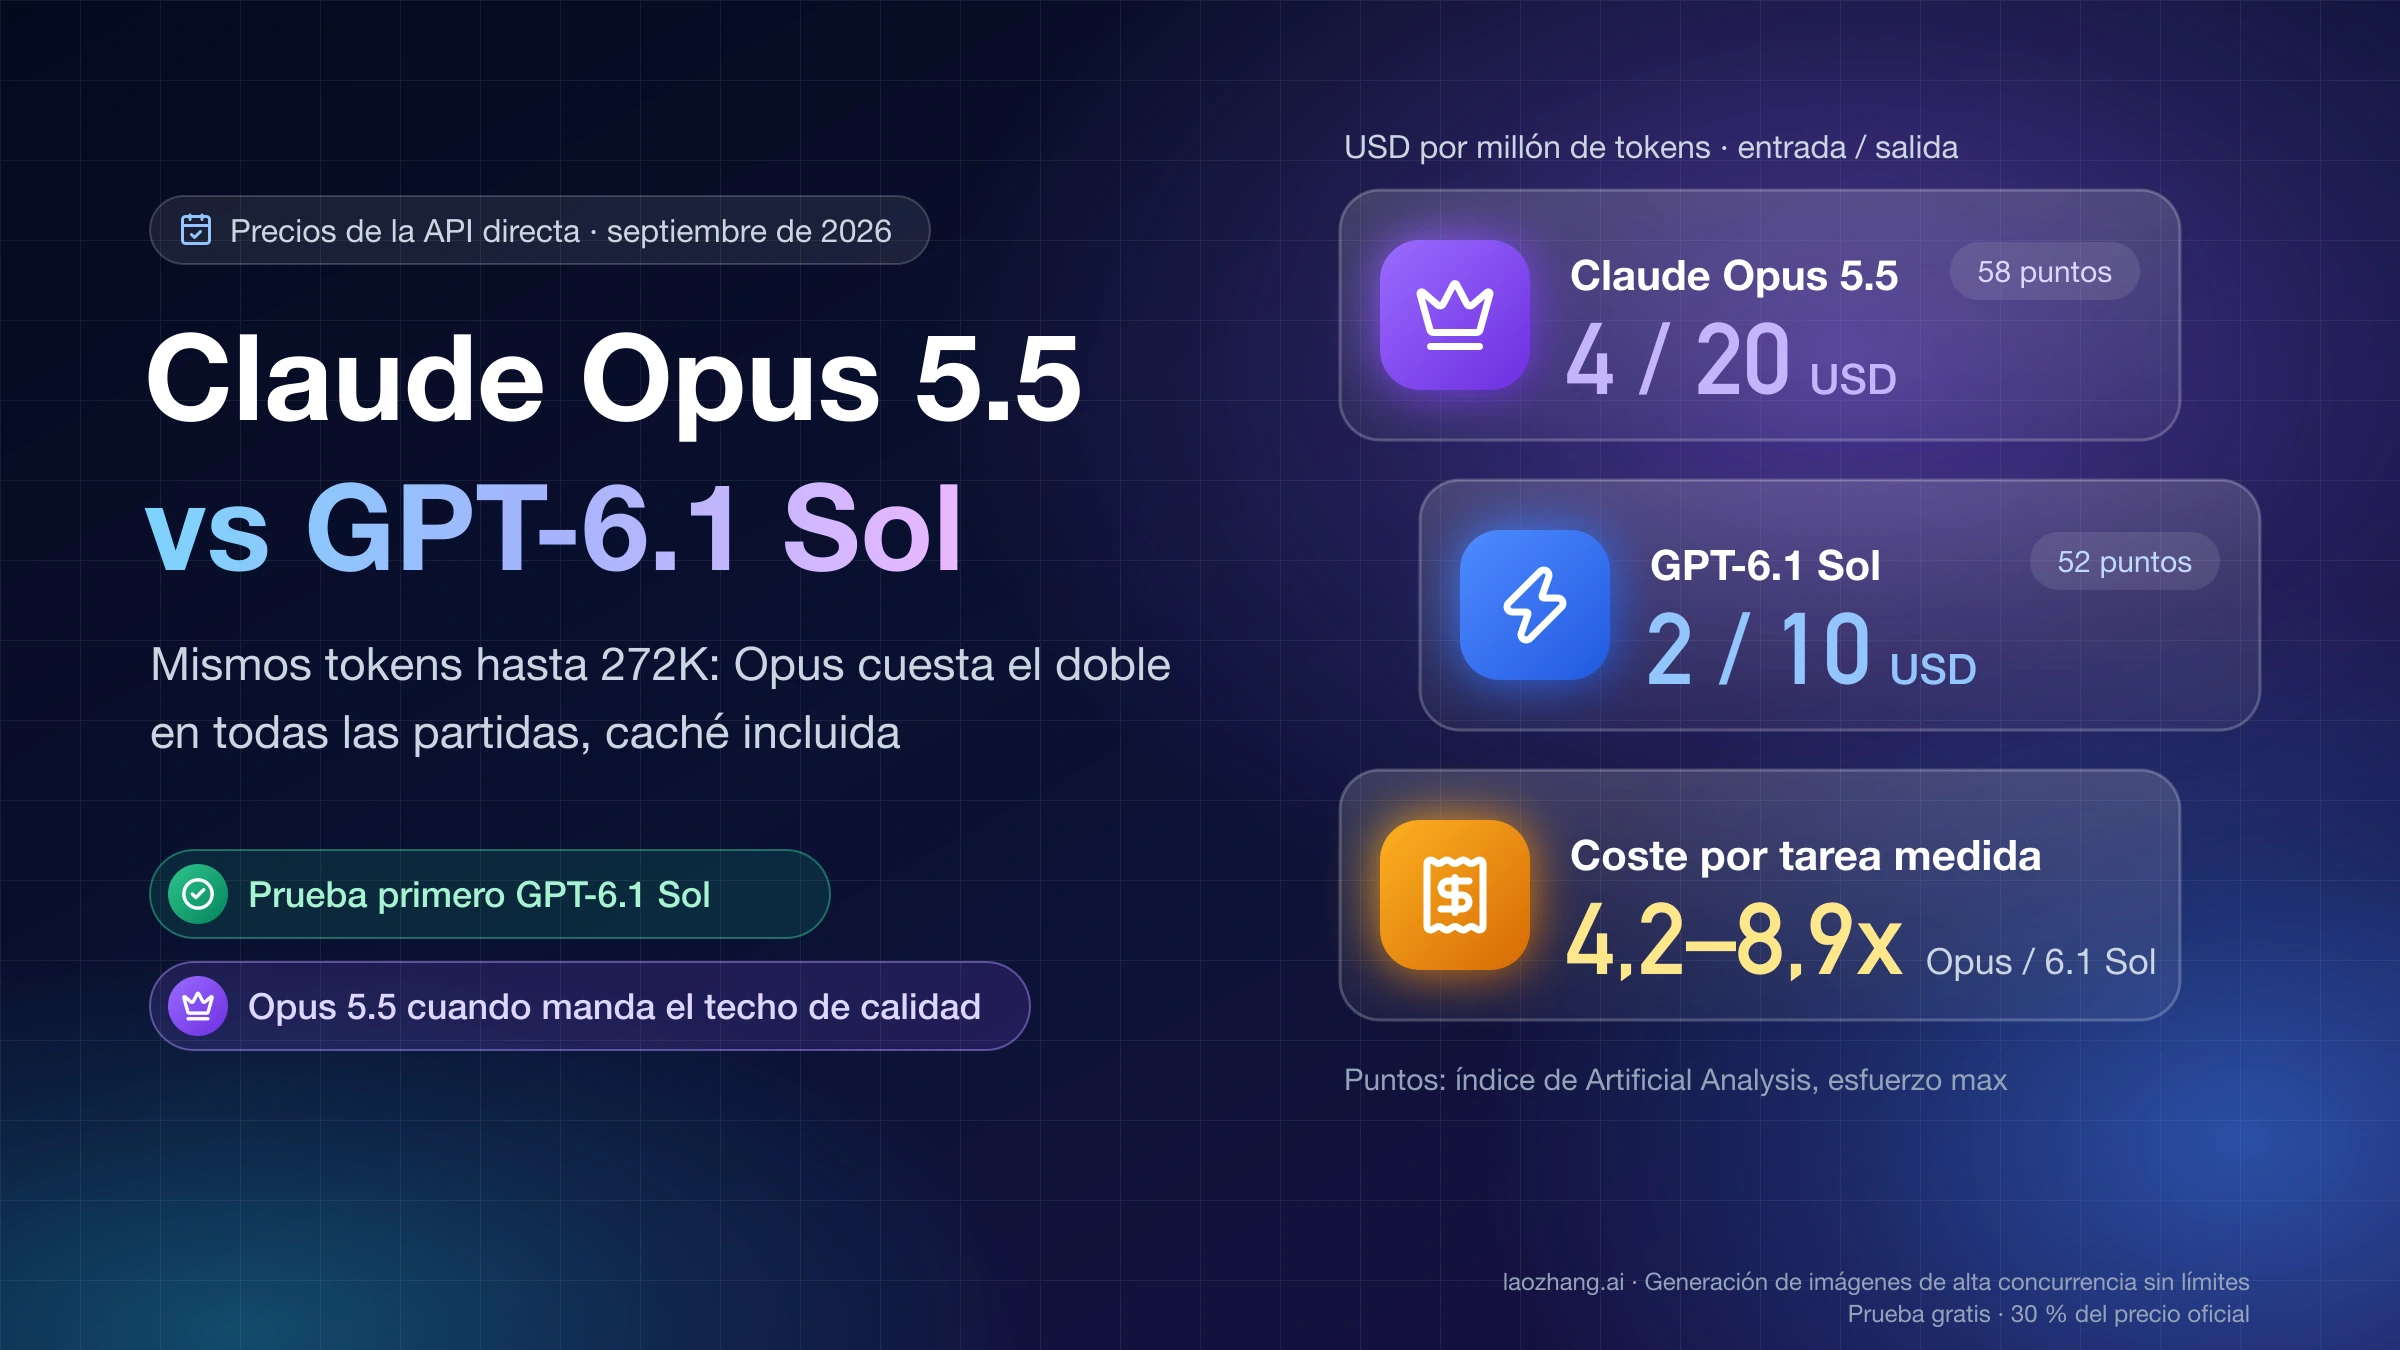
Esos 51 puntos de Terra exigen max, y en la pasarela LaoZhang ese nivel solo se aceptó por la Responses API (prueba del 28 de octubre de 2026), así que cuenta con ese cambio de endpoint si lo necesitas. AA cambió su índice de la versión 4.3.2 a la 5.0 entre el 27 y el 28 de octubre de 2026 y con él cambiaron todas las cifras: un empate en low y medium o un 52 frente a 45 en xhigh corresponden a la versión anterior. Tampoco confundas esta comparación con la de OpenAI: su anuncio calcula un coste por tarea unas nueve veces menor frente a Claude Opus 5.5, no frente a Sonnet, y de dónde sale esa cifra se explica en Claude Opus 5.5 vs GPT-6.1 Terra: coste real y cuándo cambiarse.
Dónde sigue ganando Sonnet 5.5 y dónde gana Terra
A puntuación global parecida, Sonnet 5.5 gana en las evaluaciones de agentes y trabajo de oficina, y Terra en programación difícil y razonamiento científico. La comparación justa es la del par de 50 y 51 puntos, Sonnet en xhigh frente a Terra en max, con datos de Artificial Analysis v5.0 a 3 de noviembre de 2026. Sonnet va por delante en Terminal-Bench 4.0 (57,1 % frente a 55,6 %), AutomationBench-AA (65,5 % frente a 60,2 %) y AA-Briefcase v1.1 (1.744 frente a 1.402). Terra gana en FrontierCode 2.0 (42,3 % frente a 35,6 %), CritPt v2 Hard (64,5 % frente a 54,0 %), Terminal-Bench-Science 0.1 (57,6 % frente a 52,4 %) y HLE-Diamond (47,3 % frente a 44,1 %).
La dirección importa más que los decimales, porque AA hace una sola ejecución por configuración. Si tu trabajo se parece a un agente que maneja la terminal, automatiza flujos o prepara documentos, Sonnet conserva la ventaja, aunque a un coste por tarea 4,3 veces mayor; en Terminal-Bench, AutomationBench y Briefcase, Sonnet en max amplía la distancia (63,6 %, 71,8 % y 1.814). En programación difícil la dirección es la contraria: en FrontierCode 2.0, Terra en max saca 42,3 % frente al 41,7 % de Sonnet en max. En los índices por sector del mismo par, como finanzas, legal, salud o ingeniería, la diferencia queda entre 0 y 4 puntos.
Para la programación más compleja, el propio anuncio de OpenAI sigue recomendando GPT-6.1 Sol y GPT-6 Astra antes que Terra; la diferencia dentro de la gama de OpenAI está en GPT-6.1 Terra vs Sol: diferencias y cuándo Terra sale más barata. Si buscas un modelo de OpenAI al mismo precio por token que Sonnet, la comparación es Claude Sonnet 5.5 vs GPT-6.1 Sol: mismo precio, distinta factura.
Qué Terra: GPT-6.1 Terra no es GPT-5.6 Terra
GPT-6.1 Terra (gpt-6.1-terra) salió el 26 de octubre de 2026 y es el modelo de todas las cifras de esta comparativa; GPT-5.6 Terra (gpt-5.6-terra) es el Terra anterior y sigue activo. A 3 de noviembre de 2026, la página del modelo GPT-5.6 Terra lo cobra a 2 $ de entrada y 12 $ de salida, y la página de retiradas de OpenAI no le asigna fecha de cierre. Si comparas tu factura de Sonnet con «Terra», comprueba qué ID usa tu código, porque con 5.6 Terra la entrada cuesta lo mismo que en Sonnet. Cómo encaja Terra con Sol, Luna y Astra está en GPT-6 Sol, Luna y Astra frente a Terra 6.1: precios y cuál usar, y el escalón más barato, en GPT-6.1 Terra vs GPT-6 Luna: diferencias y coste real por tarea.
Terra en ChatGPT y Codex, Sonnet en Claude Code y las apps
Fuera de la API, GPT-6.1 Terra solo está en ChatGPT Work y en Codex, no en el chat normal de ChatGPT, mientras que Sonnet 5.5 está en las apps de Claude y en Claude Code. El anuncio de GPT-6.1 Terra lo ofrece en los planes Plus, Pro, Enterprise y Edu, y la documentación de Codex añade Business. En Claude Code y en las apps, Sonnet arranca en medium, el nivel en el que AA le da 30 puntos; cómo subirlo y por qué vuelve a ese valor lo explica Claude Code effort level: qué es y por qué vuelve a medium.
La proporción de precios de la API no se traslada a las suscripciones, porque cada producto fija su propio margen de uso: a 27 de octubre de 2026, la página de precios de Codex estimaba entre 35 y 285 mensajes locales de Terra cada 5 horas en Plus, como horquilla orientativa y no como límite fijo, y Anthropic no publica una cifra equivalente para Sonnet 5.5 en sus planes. Si usas Terra en Codex mediante CC Switch y no te aparece, la solución está en GPT-6.1 Terra no aparece en Codex con CC Switch: causa y solución.
Cómo probar los dos modelos con tus prompts antes de cambiar
Antes de mover trabajo de Sonnet a Terra, repite una prueba pequeña con tus propios prompts y mide aciertos y coste con el usage real, porque la proporción de tokens y el volumen de salida dependen de tu idioma y de tus tareas. Con 10 o 20 prompts basta para ver si la cuenta de arriba se cumple en tu caso:
- Elige prompts reales cuyo resultado puedas comprobar sin leerlo a ojo: funciones con tests, extracciones con un valor exacto o formatos con reglas que se puedan contar, como el número de viñetas o su longitud.
- Fija el effort de forma explícita en las dos llamadas. En Sonnet envía
thinking: {"type": "adaptive"}youtput_config.effort, conhighsi quieres reproducir la API omediumsi quieres reproducir Claude Code; por la pasarela LaoZhang API, las peticiones a Sonnet que omitíanthinkingvolvieron sin bloques de razonamiento (26 de octubre de 2026). En Terra pruebamediumyhigh. - Llama a Terra con
max_completion_tokens, porque en Chat Completionsmax_tokensdevolvió un error 400 en la pasarela LaoZhang el 28 de octubre de 2026, y pasa a la Responses API conreasoning: {"effort": "max"}si necesitasmax, que Chat Completions rechazó ese mismo día, o la llamada a herramientas, que según OpenAI requiere esa API. - Guarda el
usagede cada respuesta, incluidos los tokens de razonamiento y los de escritura y lectura de caché, y aplica la fórmula de precios de cada modelo en lugar de comparar solo el precio por millón. - Corrige con los tests y repite las tareas que fallen antes de sacar conclusiones, porque una viñeta de más en una sola muestra no dice qué modelo es mejor.
- Si tu trabajo real incluye prompts de más de 272.000 tokens de Terra o bucles de agente, añade uno de cada a la prueba, con
cache_controlactivado en Sonnet.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Los cuerpos mínimos de las dos peticiones que se usaron el 3 de noviembre de 2026 fueron estos. Para Sonnet, por la API de Messages (/v1/messages):
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 32000,
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "high" },
  "messages": [{ "role": "user", "content": "..." }]
}
Para Terra, por Chat Completions (/v1/chat/completions):
{
  "model": "gpt-6.1-terra",
  "reasoning_effort": "medium",
  "max_completion_tokens": 32000,
  "messages": [{ "role": "user", "content": "..." }]
}
Si haces la prueba por la pasarela LaoZhang API, ten en cuenta que Claude limita allí cada respuesta a 32.768 tokens de salida, frente a los 128.000 de la API de Anthropic, y no ofrece Batches, Files, el recuento de tokens ni las herramientas de servidor, así que una prueba de documentos muy largos o de generación extensa conviene hacerla en la API directa.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 3 nov 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 3 nov 2026.
- 1.anuncio de Claude Sonnet 5.5anthropic.com/news/claude-sonnet-5-5
- 2.documentación de prompt cachingplatform.claude.com/docs/en/build-with-claude/prompt-caching
- 3.tabla de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 4.página de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 5.comparativa de versiones de Claude Sonnet 5.5 y GPT-6.1 Terraartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-terra
- 6.página del modelo GPT-5.6 Terradevelopers.openai.com/api/docs/models/gpt-5.6-terra
- 7.anuncio de GPT-6.1 Terraopenai.com/index/introducing-gpt-6-1-terra
- 8.página de precios de Codexlearn.chatgpt.com/docs/pricing