GPT-6 Astra o Claude Fable 5.1: cómo elegir por tarea y coste
Misma tarifa, distinta factura: en una prueba del 26 de octubre de 2026, Fable 5.1 contó 1,88 veces más tokens en español y costó 1,5–1,6 veces lo que Astra.
En esta página
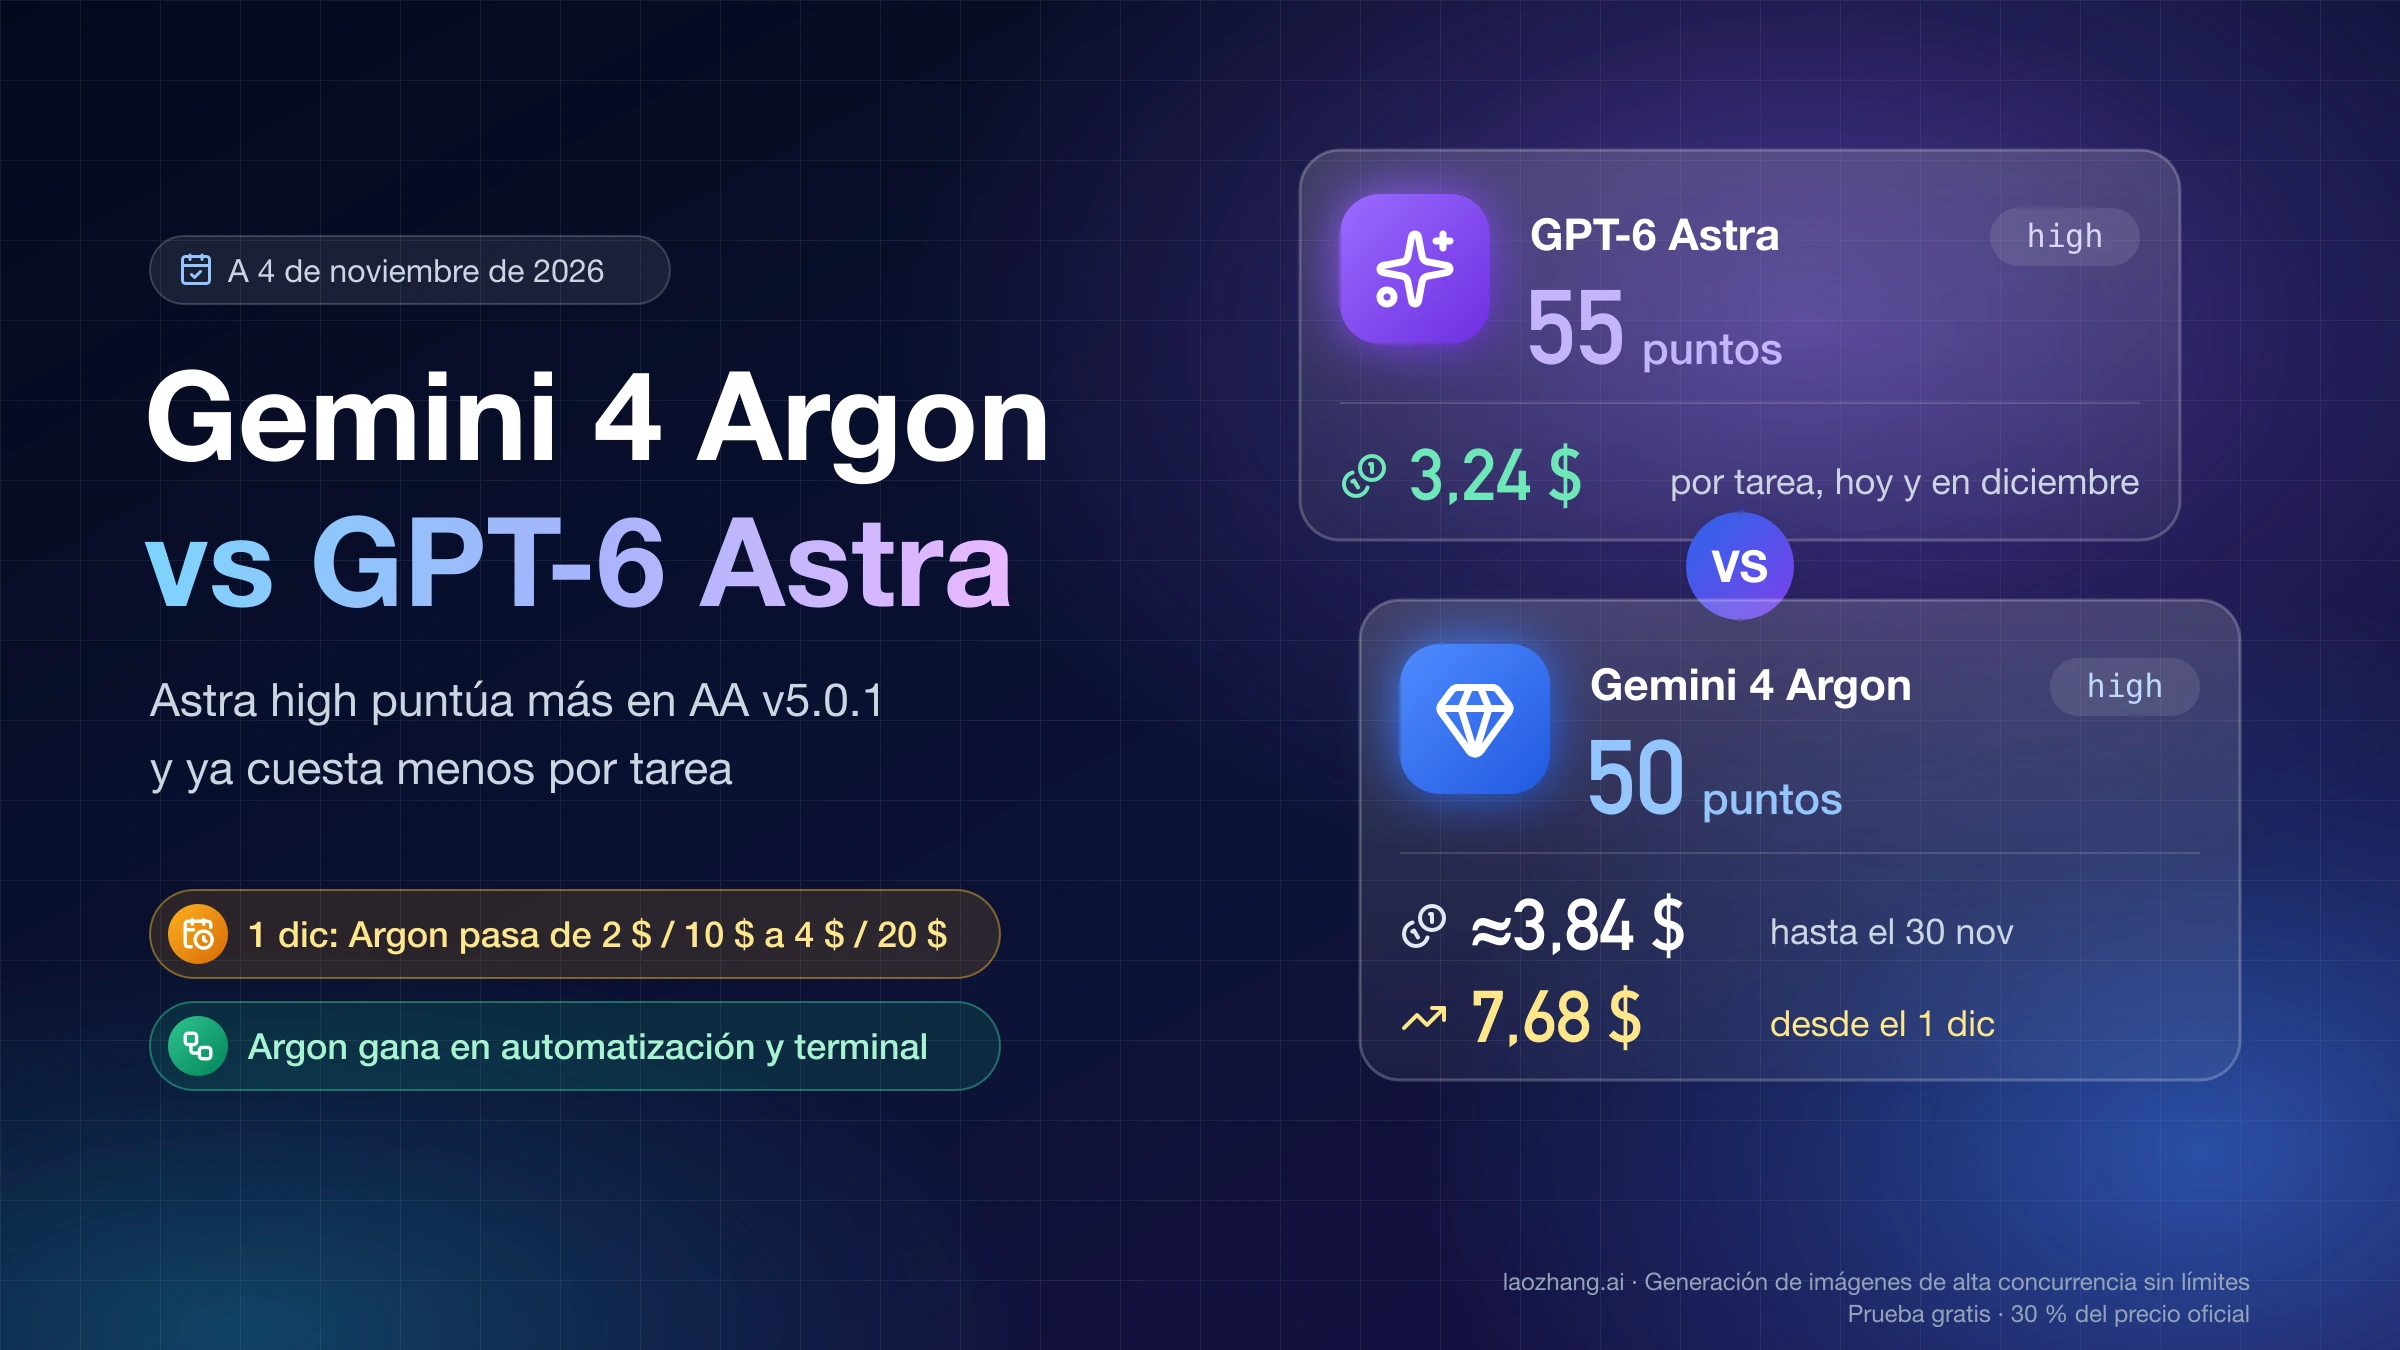
A 26 de octubre de 2026, GPT-6 Astra y Claude Fable 5.1 cobran la misma tarifa Standard en sus API, 10 $ por millón de tokens de entrada y 50 $ por millón de salida, pero ni rinden ni cuestan lo mismo. En el Intelligence Index v5.0 de Artificial Analysis, que el 27 y 28 de octubre sustituyó a la versión 4.3.2 con nueve evaluaciones, Astra saca 57 puntos frente a 49 con el razonamiento al máximo y supera a Fable por 5 a 8 puntos en cada nivel. En una prueba del 26 de octubre con ocho tareas de programación y texto que los dos resolvieron sin fallos, Fable costó entre 1,49 y 1,61 veces lo que Astra, porque contó más tokens para el mismo texto (1,88 veces en un párrafo en español y alrededor de 1,5 veces en inglés) y generó más salida.
Si tus tareas se resuelven en una o pocas llamadas, empieza por gpt-6-astra: con la misma tasa de acierto sale más barato. Claude Fable 5.1 solo recupera terreno en dos situaciones: un agente que relee muchas veces un prefijo grande en caché, porque la lectura cuesta 0,25 $ frente a 1 $, y una entrada única de más de 272.000 tokens, donde Astra cobra toda la petición con recargo: el doble por la entrada y 1,5 veces por la salida. Con textos en español, la diferencia de tokens anula la primera ventaja, porque el prefijo releído sale más caro en Fable (unos 0,78 $ por turno frente a 0,60 $), y deja la segunda en un empate práctico (6,58 $ frente a 6,75 $ por una entrada de 300.000 tokens), así que mide tus propios textos antes de cambiar de modelo.
Antes de pagar cualquiera de los dos, prueba también la alternativa más barata que cada proveedor propone para trabajo exigente. OpenAI presenta GPT-6.1 Sol (2 $ y 10 $) como un modelo cercano a Astra, y las mismas ocho tareas costaron allí alrededor de una quinta parte. Anthropic recomienda ahora empezar la mayoría de cargas con Claude Opus 5.5 y reservar Fable para el razonamiento exigente y las tareas autónomas largas. Si tu trabajo es de ese tipo, la prueba de aceptación descrita más abajo te dice cuál de los dos merece la diferencia.
El 9 de noviembre de 2026 Anthropic lanzó Claude Fable 5.2 a 8 $ por millón de tokens de entrada y 40 $ por millón de salida; Fable 5.1 sigue disponible. Esta página se mantiene sobre Fable 5.1; para el modelo nuevo, consulta Fable 5.2 vs GPT-6 Astra: niveles equivalentes y coste por tarea.
Primero comprueba qué puedes usar
Los dos modelos están disponibles desde principios de septiembre: OpenAI presentó GPT-6 Astra el 3 de septiembre y Anthropic lanzó claude-fable-5-1 el 1 de septiembre. A 26 de octubre de 2026, gpt-6-astra sigue siendo la única versión de Astra, OpenAI lo describe como su modelo más capaz y su registro de cambios no muestra una versión más nueva. La ficha técnica de Fable 5.1 lo marca como Active (latest), con retirada no antes del 1 de septiembre de 2027, y lo ofrece en Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud y Microsoft Foundry. Que un modelo figure en una plataforma no confirma la región, la cuota ni el permiso de tu cuenta.
En ChatGPT y Codex, la página de modelos de ChatGPT indica que Plus y Business estándar tienen entre 5 y 45 mensajes locales de Astra cada 5 horas en Work y Codex, que Pro no tiene límite de 5 horas y que algunos planes de pago no incluyen Astra Extra High; Free y Go reciben Luna. En Enterprise y Edu, Astra está desactivado hasta que el propietario del espacio de trabajo lo activa, y activarlo ahí no da acceso por API, que depende de la organización y el proyecto de la clave. Qué planes lo tienen en el chat solo aparece en informes de terceros, que lo sitúan en Pro, Business y Enterprise y dejan Plus en Work y Codex.
En Claude, según el artículo de ayuda sobre los modelos Fable en cada plan, Max y los planes Team y Enterprise premium incluyen Fable 5.1 hasta el 50 % del límite semanal; después pagas con créditos de uso o cambias de modelo. En Pro, Team estándar y Enterprise estándar, Fable no consume el límite del plan: se paga con créditos de uso desde el primer mensaje. Free no tiene acceso, y Claude Code necesita la versión 2.1.255 o posterior. Cómo se reparte ese límite semanal lo explica Límites de uso de Claude Pro y Max: Ultra sin límite de 5 horas.
Haz una llamada mínima en la misma superficie que usarías en producción. Guarda el modelo solicitado y el devuelto, el estado HTTP, el motivo de finalización, los campos de uso y cualquier error de organización o región. Un anuncio, un selector visible y una respuesta válida son hechos distintos; para Astra, los pasos están en Cómo acceder a GPT-6 Astra por API y comprobar la primera respuesta.
La letra pequeña separa dos precios aparentemente iguales
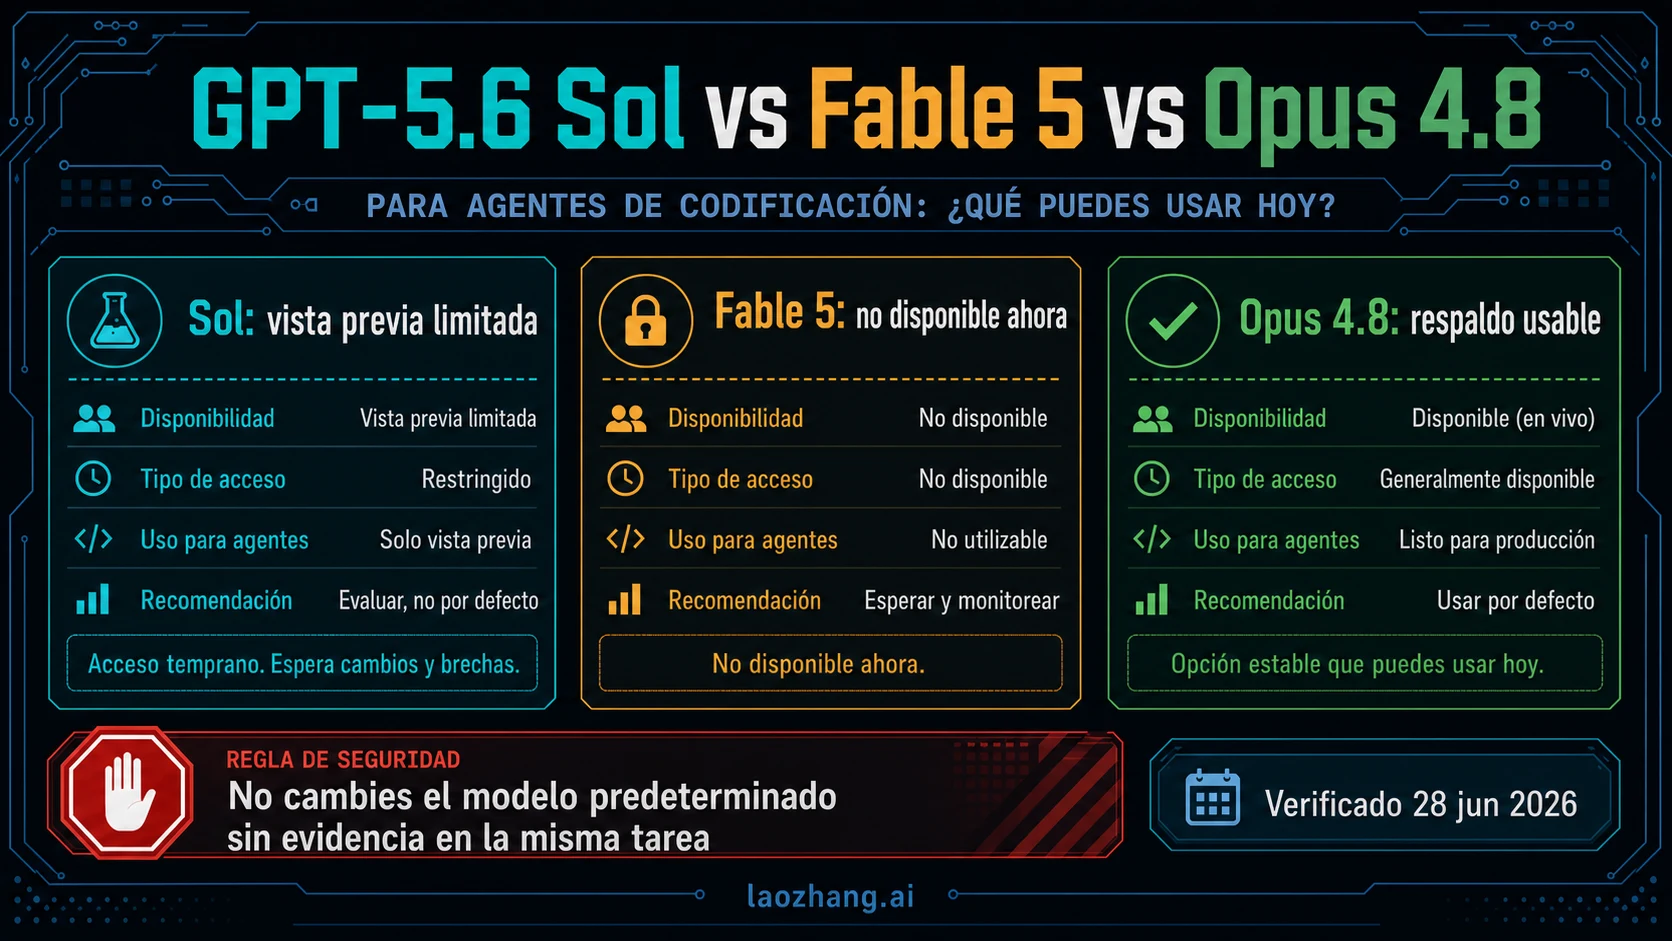
¿Cuánto cuesta GPT-6 Astra? En la API directa, 10 $ por millón de tokens de entrada y 50 $ por millón de salida, igual que Fable 5.1. Las diferencias están en la caché, en el recargo de Astra por encima de 272.000 tokens de entrada y en que Astra escribe la caché aunque no lo pidas. Esta es la tarifa Standard a 26 de octubre de 2026, según la página de precios de OpenAI y la tabla de precios de Claude:
| Por millón de tokens (Standard) | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Identificador | gpt-6-astra | claude-fable-5-1 |
| Ventana de contexto | 1.050.000 tokens (entrada máxima 922.000) | 1M tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Entrada | 10 $ | 10 $ |
| Salida | 50 $ | 50 $ |
| Lectura de caché | 1 $ | 0,25 $ |
| Escritura de caché | 12,50 $ a 30 min; 25 $ a 12 h (solo Responses API) | 12,50 $ a 5 min; 20 $ a 1 h |
| Más de 272K tokens de entrada | Toda la petición: 20 $ entrada, 2 $ lectura, 25 $ escritura a 30 min, 75 $ salida | Sin recargo: el millón completo a tarifa estándar |
| Si no configuras la caché | Escribe automáticamente los prefijos desde 1.024 tokens | No cachea nada sin cache_control |
| Batch | 50 % de descuento | 50 % de descuento |
La última fila de caché cambia facturas que parecen idénticas. La guía de caché de prompts de OpenAI dice que la caché está activada por defecto y que, desde GPT-5.6, escribir cuesta 1,25 veces la entrada normal con la duración predeterminada de 30 minutos; esa tarifa sustituye a la de entrada, no se suma. En la prueba del 26 de octubre, un prompt de 10.106 tokens enviado sin ninguna opción de caché devolvió 10.103 tokens escritos, cobrados a 12,50 $ en lugar de 10 $, unos 0,025 $ más. Si ese prefijo se relee antes de 30 minutos, la lectura a 1 $ lo compensa; si es una petición única, pagas un 25 % más por esa entrada, y lo evitas con prompt_cache_options.mode: "explicit" sin puntos de corte. Fable funciona al revés: según su documentación de caché de prompts, solo escribe cuando marcas cache_control, a partir de 512 tokens, y en esa misma prueba no escribió nada.
OpenAI también ofrece Flex al 50 %, Fast al doble y, desde el 29 de septiembre, Ultrafast a seis veces la tarifa (60 $ y 300 $ para Astra). Anthropic no ofrece modo rápido para Fable y cobra 1,1 veces si fijas la inferencia en Estados Unidos con inference_geo; los endpoints regionales de OpenAI suman un 10 % en los modelos elegibles. Las cifras de Fable proceden de la tabla de precios y de su documentación de contexto; un marketplace o un contrato empresarial puede aplicar otra cantidad. El desglose de cada modelo por separado está en Precio de la API de GPT-6 Astra: coste con caché y contexto largo y en Precio de la API de Claude Fable 5.1 y cuánto baja tu factura.
Mismas tareas y mismo acierto: Fable costó 1,5–1,6 veces más
El 26 de octubre de 2026 se enviaron las mismas ocho tareas a los dos modelos a través de la pasarela LaoZhang: Astra por Chat Completions y Fable 5.1 por Messages, con streaming, el nivel de razonamiento predeterminado de cada modelo (sin ningún campo de esfuerzo), un máximo de 32.000 tokens de salida y sin prompt de sistema, herramientas ni opciones de caché. Las tareas, corregidas con tests ocultos, fueron un problema de enunciado, merge_intervals, parse_duration, un recuento de palabras y un resumen en cinco puntos de un artículo de 6.723 palabras; en la segunda ronda, un evaluador de expresiones, un parser de líneas CSV y un recuento de sumas de dígitos, dos veces cada una. Los dos modelos aprobaron las 22 respuestas, así que la prueba mide coste, tokens y tiempo con la misma tasa de acierto, no inteligencia.
| Ronda | Modelo | Aprobadas | Tokens de entrada | Tokens de salida | Coste a precio de lista | Tiempo total |
|---|---|---|---|---|---|---|
| 1 (5 tareas) | GPT-6 Astra | 5/5 | 10.545 | 1.839 | 0,2227 $ | 50,3 s |
| 1 (5 tareas) | Claude Fable 5.1 | 5/5 | 15.948 | 3.431 | 0,3310 $ | 43,3 s |
| 2 (3 tareas × 2) | GPT-6 Astra | 6/6 | 862 | 3.656 | 0,1914 $ | 78,6 s |
| 2 (3 tareas × 2) | Claude Fable 5.1 | 6/6 | 1.254 | 5.896 | 0,3073 $ | 72,4 s |
En la primera ronda, Fable costó 1,49 veces lo que Astra y generó 1,87 veces más tokens de salida; en la segunda, 1,61 veces en ambos casos. Fable terminó cada ronda algo antes (un 14 % y un 8 %), y en la mayoría de las tareas cortas empezó a responder primero. Los costes se calcularon con el uso devuelto por cada API a precio de lista e incluyen la escritura automática de caché de Astra en el resumen largo; las 38 llamadas, contando las de recuento de tokens, sumaron 1,10 $.
Parte de la salida de Fable no se ve. En esta ruta, sus tokens de salida incluyen el pensamiento adaptativo, que no llegó en el stream: responder «ok» a una instrucción de una línea contó 132 tokens de salida y tardó 15,4 s, mientras que Astra usó 5 tokens y 2,8 s. Astra sí separa su razonamiento en reasoning_tokens (256 de 412 en la primera tarea). Si pruebas Fable por una ruta compatible, cuenta todos los tokens de salida como coste, porque no puedes separar el pensamiento.
Las mismas ocho tareas se pasaron el 25 de octubre a GPT-6.1 Sol, que también las aprobó todas por 0,0387 $ y 0,0368 $ por ronda: Astra costó 5,8 y 5,2 veces más. Si lo que comparas es el modelo alto de OpenAI con Claude, esa es la primera pregunta que conviene resolver, y GPT-6.1 Sol vs Astra vs GPT-6 Sol: cuál usar y si Astra compensa la desarrolla.
Los límites de estas cifras van con ellas: una sola pasarela, un día, una o dos muestras por tarea y tareas bien especificadas que ambos resuelven. Los tokens son los que cada API informó a través de la pasarela. No se probaron la Responses API, otros niveles de razonamiento, las lecturas de caché, entradas de más de 272.000 tokens ni los endpoints directos de OpenAI y Anthropic.
Fable cuenta más tokens por el mismo texto: 1,88 veces en español
Con la misma tarifa por token, lo que decide la factura es cuántos tokens cuenta cada modelo, y Fable 5.1 cuenta bastantes más. El 26 de octubre de 2026 se envió el mismo párrafo, con el mismo significado, en seis idiomas, y se restó a cada recuento el de la instrucción sola (23 tokens en Astra y 34 en Fable). En español, Astra contó 162 tokens y Fable 304, es decir, 1,88 veces; la misma entrada sin caché cuesta casi el doble en Fable.
| Texto | GPT-6 Astra | Claude Fable 5.1 | Fable / Astra |
|---|---|---|---|
| Párrafo en español | 162 | 304 | 1,88 |
| Párrafo en inglés | 137 | 199 | 1,45 |
| Párrafo en chino | 165 | 247 | 1,50 |
| Párrafo en japonés | 254 | 312 | 1,23 |
| Párrafo en coreano | 208 | 396 | 1,90 |
| Párrafo en ruso | 193 | 302 | 1,56 |
| Artículo largo en inglés (6.723 palabras) | 10.106 | 15.335 | 1,52 |
| Prompt de código (con instrucción) | 215 | 314 | 1,46 |
Cada idioma se midió con un solo párrafo de 120 a 150 palabras, así que la proporción de tu contenido puede variar; el código y el artículo largo en inglés quedaron en torno a 1,5. Anthropic no publica una comparación con OpenAI: su documentación de recuento de tokens solo dice que el tokenizador de Fable 5.1 cuenta alrededor de un 30 % más que los modelos Claude anteriores a Opus 4.7. Una prueba de Crazyrouter del 5 de septiembre llegó a una proporción parecida, 1,91, con texto de relleno en inglés.
La diferencia también reduce la ventana útil. Como estimación a partir de estos párrafos, el millón de tokens de Fable equivale a unos 670.000 tokens de Astra en inglés y a unos 532.000 en español, mientras que Astra admite hasta 922.000 tokens de entrada. Su umbral de 272.000 se cuenta en tokens de Astra.
Dos ejemplos convierten la tarifa en una decisión
Para comparar, llama r a la proporción entre los tokens de Fable y los de Astra para el mismo texto, expresa todas las cantidades en tokens de Astra y multiplica la cuenta de Fable por r. Los resultados son estimaciones a precio de lista, sin herramientas ni reintentos, y suponen que la salida también crece r veces; en la prueba, Fable generó además respuestas más largas, así que la cuenta real puede inclinarse todavía más hacia Astra.
Un agente que relee un prefijo grande es el caso que más favorece a Fable. Si un turno lee 250.000 tokens de caché, añade 10.000 nuevos y genera 5.000, Astra cuesta 0,25 × 1 + 0,01 × 10 + 0,005 × 50 = 0,60 $ y Fable r × (0,25 × 0,25 + 0,01 × 10 + 0,005 × 50) = r × 0,4125 $. Empatan cuando r vale 1,455: con texto en japonés (1,23), Fable sale a 0,51 $; en inglés (1,45), a 0,60 $, un empate; en español (1,88), a 0,78 $, más caro que Astra. La escritura inicial de ese prefijo cuesta 0,25 × 12,5 + 0,01 × 10 + 0,005 × 50 = 3,475 $ en Astra y r veces esa cifra en Fable (6,53 $ en español). Además, la caché de Fable dura 5 minutos con esa tarifa, frente a los 30 de Astra; si los turnos se espacian más, pagas la escritura de 1 hora a 20 $.
Una entrada larga puntual es el otro caso. Con 300.000 tokens sin caché y 10.000 de salida, Astra supera su umbral y cobra toda la petición con recargo: 0,30 × 20 + 0,01 × 75 = 6,75 $. Fable mantiene la tarifa estándar: r × (0,30 × 10 + 0,01 × 50) = r × 3,50 $, con el empate en r = 1,93. En inglés (1,5), Fable cuesta 5,25 $ y gana con claridad; en español (1,88), 6,58 $, prácticamente un empate. Los 6,75 $ de Astra suponen que desactivas la escritura implícita: si Astra escribe el prompt completo en caché, como hizo en la prueba con el de 10.106 tokens, esos 300.000 tokens se cobrarían a 25 $ y el total subiría a 0,30 × 25 + 0,01 × 75 = 8,25 $.
Las tareas cortas sin caché y por debajo de 272.000 tokens no tienen nada que compense la diferencia de tokens, y ahí está el resultado de la prueba: Fable a 1,49–1,61 veces el coste de Astra. Solo saldría más barato si necesitara menos intentos para llegar a un resultado aceptado. Por eso la unidad útil no es el precio por token, sino esta:
coste por tarea aceptada = coste de todos los intentos / resultados aceptados
Si no hay ningún resultado aceptado, no inventes una media: registra el lote como fallido y detén esa ruta.
La integración también cambia
GPT-6 Astra admite low, medium, high, xhigh y max como niveles de razonamiento y devuelve un error 400 con none. OpenAI no documenta cuál es su nivel predeterminado en la API, así que fíjalo siempre; en ChatGPT y Codex sugiere empezar Astra en Light (low). La guía de OpenAI para GPT-6 indica que Chat Completions no admite llamadas a funciones con Astra, de modo que las herramientas requieren la Responses API. Allí documenta llamadas a herramientas asíncronas, correcciones enviadas mientras el modelo trabaja y cambios del nivel de razonamiento a mitad de conversación sin perder la caché, algo útil para agentes con varias dependencias o con intervención humana. El uso del ordenador tiene su propia guía en GPT-6 Astra y el uso del ordenador: integración segura con Responses API.
Claude Fable 5.1 usa pensamiento adaptativo siempre activo y su nivel predeterminado de API es high. Las novedades de Fable 5.1 en la documentación de Claude enumeran varias peticiones que devuelven un error 400: tool_choice con any o tool, el prellenado de la respuesta del asistente, budget_tokens o desactivar el pensamiento, y temperature, top_p o top_k. auto y none siguen disponibles en tool_choice. Un cliente escrito para modelos Claude anteriores puede fallar con Fable sin cambiar una línea del prompt.
Por tanto, igualar la palabra «high» no iguala la prueba. Cada ruta conserva su protocolo nativo, pero debe recibir permisos equivalentes y la misma definición de resultado válido. Registra la configuración exacta para poder explicar una diferencia de coste, duración o fallo.
Los datos pueden vetar un modelo antes de medir su calidad
Con OpenAI, la retención cero de datos (Zero Data Retention) se configura por endpoint y requiere aprobación previa; según la página de controles de datos de OpenAI, /v1/responses y /v1/chat/completions son elegibles y no hay una exclusión específica para Astra. OpenAI se reserva el derecho de declarar modelos no elegibles para clientes concretos, avisando por escrito, así que confírmalo para tu organización y proyecto reales.
Fable 5.1 es un «modelo cubierto» que exige retención de 30 días: la documentación de retención de datos de la API de Claude dice que la retención cero no está disponible salvo autorización expresa de Anthropic y que las organizaciones que no cumplen el requisito reciben un error 400. Una organización con retención cero puede activar la de 30 días en un solo espacio de trabajo. Además, cuando las salvaguardas marcan una petición, las aplicaciones de Claude pueden pasar la respuesta a otro modelo y lo indican en pantalla, según el artículo de ayuda sobre el cambio de modelo en Fable; en la API, registra siempre el modelo devuelto y el resultado, no solo el código HTTP.
Si el código, los documentos de clientes o los datos regulados no pueden entrar en esa política, Fable queda descartado para esa tarea. Si sí pueden entrar, todavía falta demostrar que el resultado cumple los criterios de calidad y coste.
Por qué las tablas de lanzamiento no dictan la respuesta
¿Cuál es más inteligente? En el índice de Artificial Analysis, GPT-6 Astra, con cualquier nivel de razonamiento. En el Intelligence Index v5.0 de Artificial Analysis, a 28 de octubre de 2026, Astra saca 57 puntos frente a 49 en max, 55 a 50 en xhigh, 55 a 47 en high, 51 a 43 en medium y 43 a 38 en low, así que el mejor resultado de Fable (50, en xhigh) queda por debajo de Astra en medium. Fable también cuesta más por tarea del índice: 13,04 $ frente a 6,24 $ en max y 4,49 $ frente a 1,42 $ en low; según el nivel, entre 2,0 y 3,2 veces lo que paga Astra. Hasta el 27 de octubre, la versión 4.3.2 del índice los dejaba empatados a 53 puntos en max, pero las dos versiones no se comparan punto por punto; el «66 frente a 61» a favor de Fable que se citaba en la semana del lanzamiento pertenecía a la versión 4.1 y tampoco es válido.
Cada prueba tiene su líder, y el patrón ayuda a decidir qué tareas incluir en tu comparación:
| Prueba | Quién la publica | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | OpenAI, en el lanzamiento | 57,9 % | 55,8 % |
| Terminal-Bench 4.0 | Artificial Analysis | 59,1 % | 52,0 % |
| AutomationBench | OpenAI / Artificial Analysis | 41,4 % / 68,5 % | 31,4 % / 59,4 % |
| DeepSWE v1.1 | OpenAI | 74,1 % | 67,4 % |
| Humanity's Last Exam con herramientas | OpenAI | 57,2 % | 65,0 % |
| AA-Briefcase (trabajo profesional, Elo) | Artificial Analysis, v5.0 | 1.568 | 1.669 |
| AA-Omniscience (conocimiento factual) | Artificial Analysis, v5.0 | 42 | 46 |
| FrontierCode 2.0 | Artificial Analysis, v5.0 | 42,4 % | 31,6 % |
| CritPt | Artificial Analysis, v5.0 | 70,5 % | 51,0 % |
Las cifras de Artificial Analysis son las de max. De las nueve pruebas del índice v5.0, Astra gana siete: además de las de la tabla, Terminal-Bench-Science (63,3 % frente a 43,3 %), GDP.pdf (31,0 % frente a 26,2 %) y HLE-Diamond (63,8 % frente a 60,1 %). Fable solo va por delante en AA-Briefcase y AA-Omniscience. Las tres pruebas en que Fable ganaba con claridad en la versión 4.3.2, GDPval-AA v2.1 de trabajo profesional (1.754 frente a 1.573), SciCode (63,1 % frente a 56,5 %) y AA-LCR de contexto largo (85,3 % frente a 80,7 %), ya no forman parte del índice, así que su ventaja en código científico y contexto largo no tiene una medición actual de Artificial Analysis detrás; si esas tareas te importan, inclúyelas en tu propia prueba. Las filas de OpenAI proceden de su anuncio, que usa el nivel máximo de razonamiento y documenta diferencias de harness, fallback y salvaguardas; el anuncio de Fable 5.1 contiene otra evaluación del proveedor, también condicionada por su configuración. En velocidad, a 28 de octubre Artificial Analysis mide 71 tokens por segundo en Astra frente a 66 en Fable en max; el 26 de octubre la ventaja era de Fable (70 frente a 66,7). El primer token de Astra llega a los 268,7 s, y el de Fable se midió en 180,5 s el 26 de octubre; son datos en vivo que cambian.
Los informes de terceros apuntan en ambas direcciones y son muestras pequeñas. Crazyrouter publicó el 5 de septiembre una prueba de 29 preguntas construidas en la que Fable acertó 29 y Astra 16, porque Astra respondió de forma incompleta a los empates y aceptó una premisa falsa. Un creador en X comparó 15 casos de uso y prefirió los resultados de Fable, que tardó 37 min 12 s y costó 26,61 $ frente a 23 min 30 s y 12,14 $ de Astra; en Reddit, un usuario de Codex contó que Fable en max agotó una ventana de uso de 5 horas que Astra en max no agotó. Ninguna de estas cifras es un torneo independiente con tu repositorio, tus herramientas y tu regla de éxito.
Un benchmark sirve para decidir qué tarea incluir en la prueba. No sirve para omitirla ni para promediar dominios sin relación en una puntuación casera.
Diseña una comparación que pueda llevarte la contraria
Elige pocas tareas reales y caras: por ejemplo, una reparación en varios archivos con tests, una síntesis documental con citas verificables y un flujo de varias herramientas con un fallo recuperable. Repite lo suficiente para detectar una variación obvia, sin gastar hasta que gane tu favorito. Si puedes, añade como control la alternativa más barata que propone cada proveedor, GPT-6.1 Sol (la opción «cercana a Astra» de OpenAI) y Claude Opus 5.5 (el modelo con el que Anthropic recomienda empezar), porque es posible que ninguno de los dos modelos altos compense.
Fija antes de empezar:
- El commit, documentos o snapshot inicial y la misma petición.
- Herramientas y permisos equivalentes, presupuesto de tiempo y ayuda humana.
- El nivel de razonamiento de cada modelo de forma explícita, porque el predeterminado de Astra no está documentado, y el máximo de reintentos.
- La misma estrategia de caché en las dos rutas:
cache_controlen Fable y, en Astra, caché implícita oprompt_cache_options.mode: "explicit", anotando cuál usas. - Un criterio que pueda fallar: tests, conciliación numérica, fuentes correctas, alcance del cambio o resultado de negocio.
- Un entorno limpio por ejecución; el segundo modelo no debe recibir el parche ni las pistas del primero.
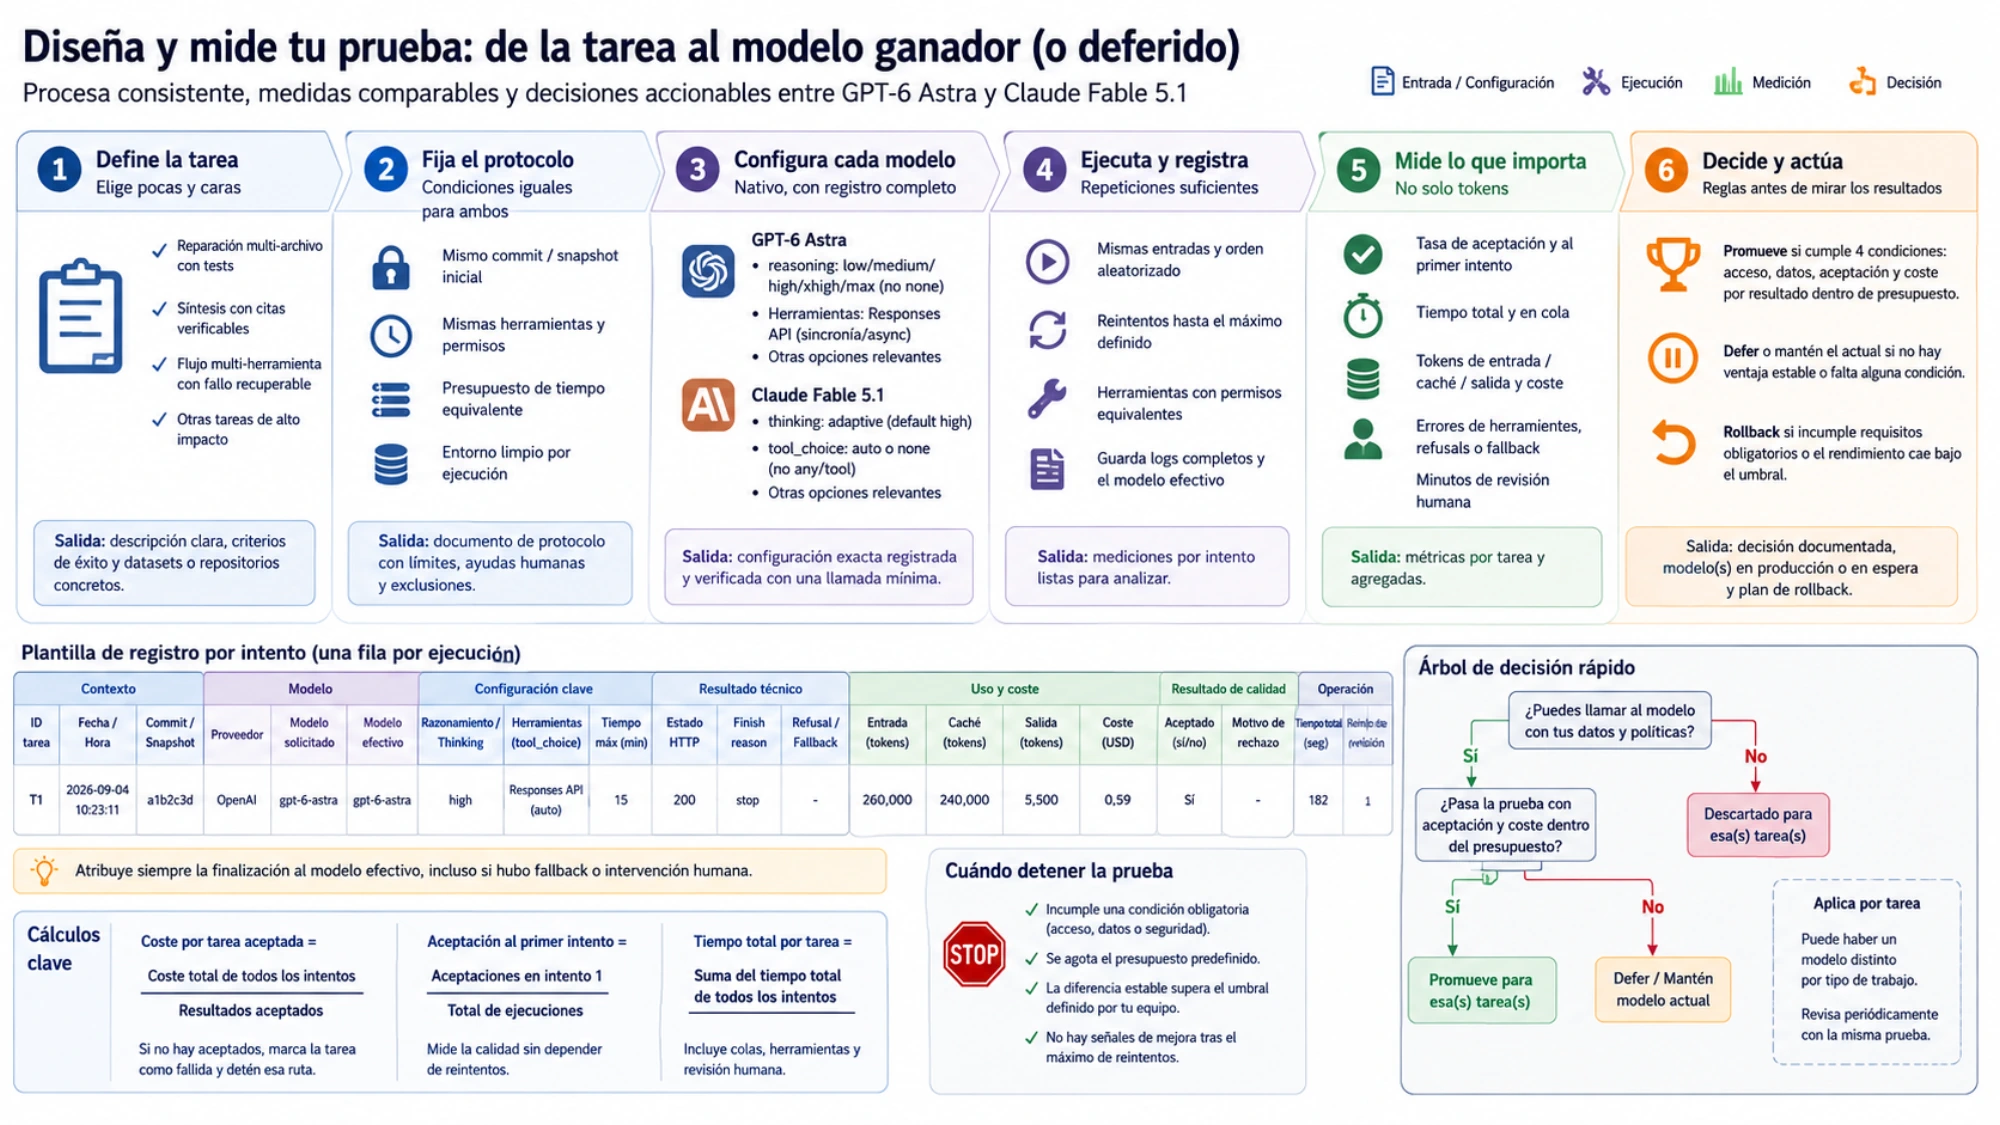
Mide tasa de aceptación, aceptación al primer intento, tiempo total y cola, tokens de entrada/caché/salida, errores de herramientas, refusals o fallback, minutos de revisión y gasto de todos los intentos. Envía antes a las dos API una muestra de tus propios textos y calcula tu r, porque esa proporción decide los ejemplos de coste más que la tarifa. Atribuye una finalización al modelo efectivo, aunque el fallback haya sido útil.
Termina cuando una opción incumpla una condición obligatoria, se agote el presupuesto predefinido o la diferencia estable sea suficiente para actuar. Si sigues ejecutando solo para rescatar al favorito, ya no estás evaluando.
Una selección por rutas suele ser más honesta
No siempre hace falta un único modelo. Astra puede quedarse con las tareas cortas o medianas, que en la prueba resolvió al mismo nivel por menos dinero, con el uso del ordenador y con una pila ya basada en Responses. Fable puede recibir las entradas únicas de más de 272.000 tokens en idiomas con una proporción baja, los prefijos muy releídos solo cuando tu texto da una proporción baja, como el japonés de la prueba (en inglés, a precio de lista, empata, y su salida más larga inclina la cuenta hacia Astra), y el razonamiento exigente donde gane en tu prueba. Mantener dos integraciones solo compensa cuando esa especialización supera el coste operativo añadido.
Promueve una opción cuando se cumplen cuatro condiciones: la cuenta puede llamarla, el tratamiento de datos permite la tarea, los resultados repetidos superan la aceptación y el coste por resultado cabe en el presupuesto. Conserva el modelo actual o un fallback probado hasta verificar el rollback. Si ninguna de las dos rutas supera a tu modelo actual con margen, no cambiar todavía también es una decisión válida.
Si dudas entre los dos modelos de Claude, Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más explica cuándo merece la pena pagar Fable; si buscas un Claude más barato frente a Astra, está Claude Sonnet 5.5 vs GPT-6 Astra: cuándo cambiar y qué pagas. Si ya usas Fable 5, la guía específica de migración y caché de Claude Fable 5.1 cubre sus cambios de API, y lo que se sabe de las próximas versiones está en Fable 5.5 vs Gemini 4 vs GPT-6.1: Fable 5.2 ya salió, 5.5 no. Para la elección entre proveedores, la regla duradera es otra: confirma el acceso, cuenta tus propios tokens, calcula el trabajo completo, ejecuta la misma prueba y deja que tu carga real, no el titular del día, decida.
Fuentes17
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
Fuentes17
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
- 1.presentó GPT-6 Astra el 3 de septiembreopenai.com/index/gpt-6-astra
- 2.ficha técnica de Fable 5.1platform.claude.com/docs/en/models/fable-5-1/overview
- 3.página de modelos de ChatGPTlearn.chatgpt.com/docs/models
- 4.artículo de ayuda sobre los modelos Fable en cada plansupport.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 5.página de precios de OpenAIdevelopers.openai.com/api/docs/pricing
- 6.tabla de precios de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 7.guía de caché de prompts de OpenAIdevelopers.openai.com/api/docs/guides/prompt-caching
- 8.documentación de caché de promptsplatform.claude.com/docs/en/build-with-claude/prompt-caching
- 9.documentación de contextoplatform.claude.com/docs/en/build-with-claude/context-windows
- 10.documentación de recuento de tokensplatform.claude.com/docs/en/build-with-claude/token-counting
- 11.guía de OpenAI para GPT-6developers.openai.com/api/docs/guides/latest-model
- 12.novedades de Fable 5.1 en la documentación de Claudeplatform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- 13.página de controles de datos de OpenAIdevelopers.openai.com/api/docs/guides/your-data
- 14.documentación de retención de datos de la API de Claudeplatform.claude.com/docs/en/manage-claude/api-and-data-retention
- 15.artículo de ayuda sobre el cambio de modelo en Fablesupport.claude.com/en/articles/15363606-why-claude-switched-models-in-your-conversation-with-fable-5-or-fable-5-1
- 16.Intelligence Index v5.0 de Artificial Analysisartificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-1
- 17.anuncio de Fable 5.1anthropic.com/claude-fable-and-mythos-5-1