Gemini 4 Argon vs GPT-6 Astra: precio de diciembre y cuál elegir
En el índice AA v5.0.1, GPT-6 Astra en high saca 55 puntos frente a 50 de Gemini 4 Argon y ya cuesta menos por tarea. El 1 de diciembre Argon duplica su tarifa.
En esta página
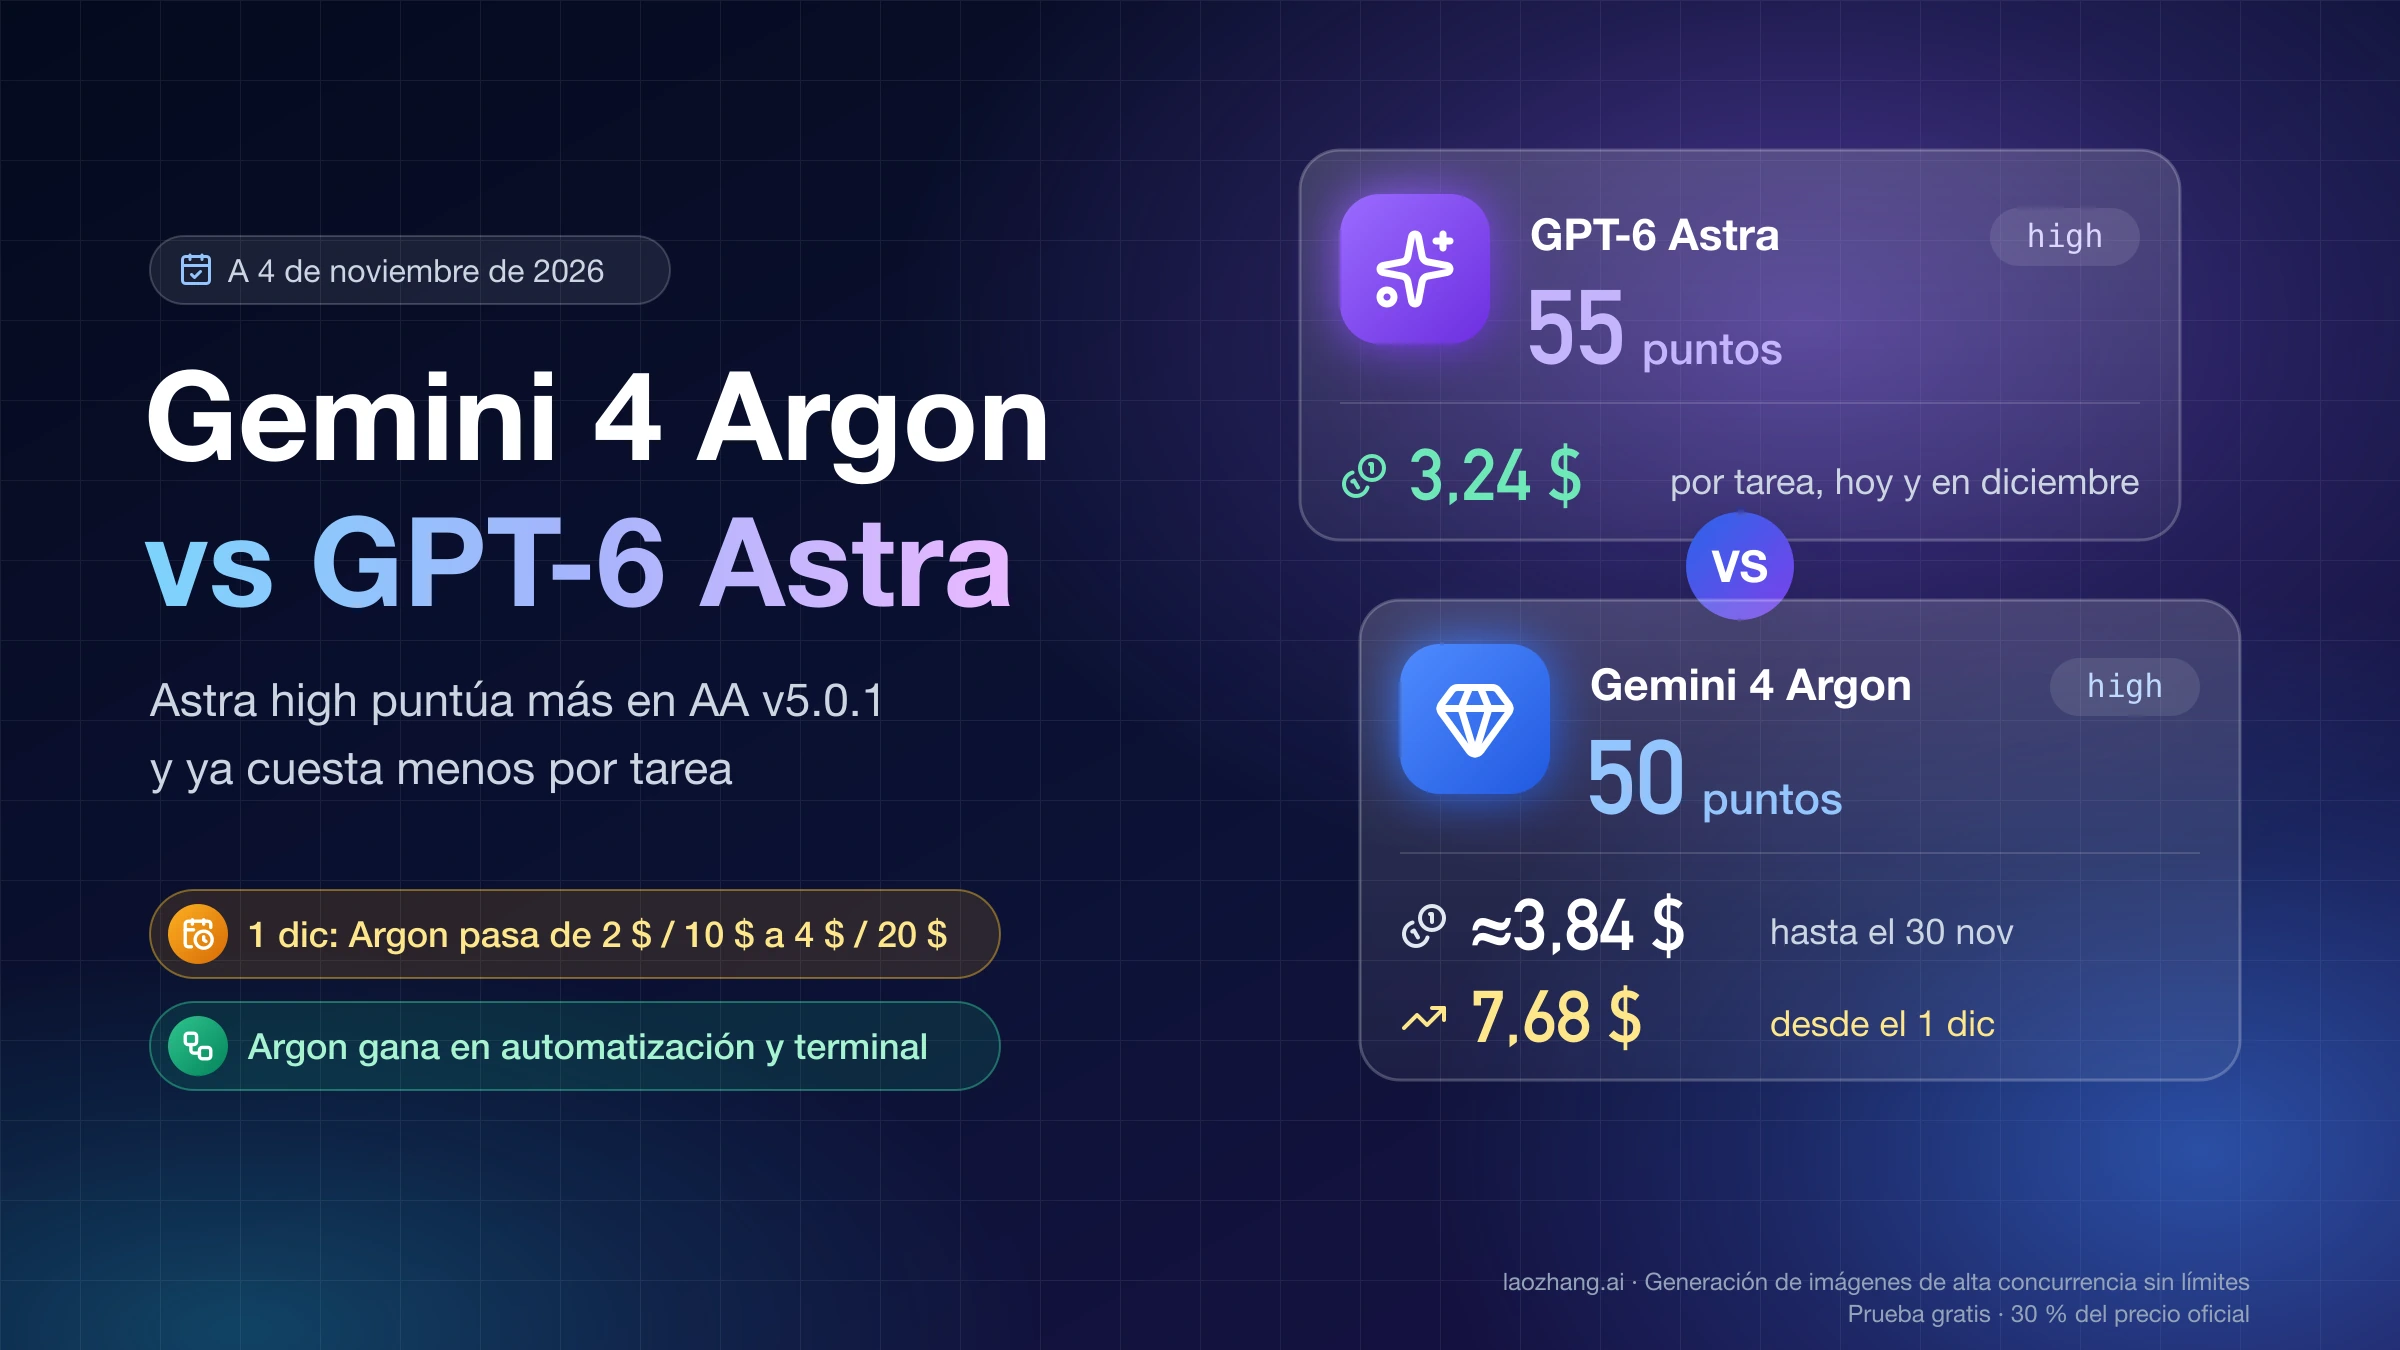
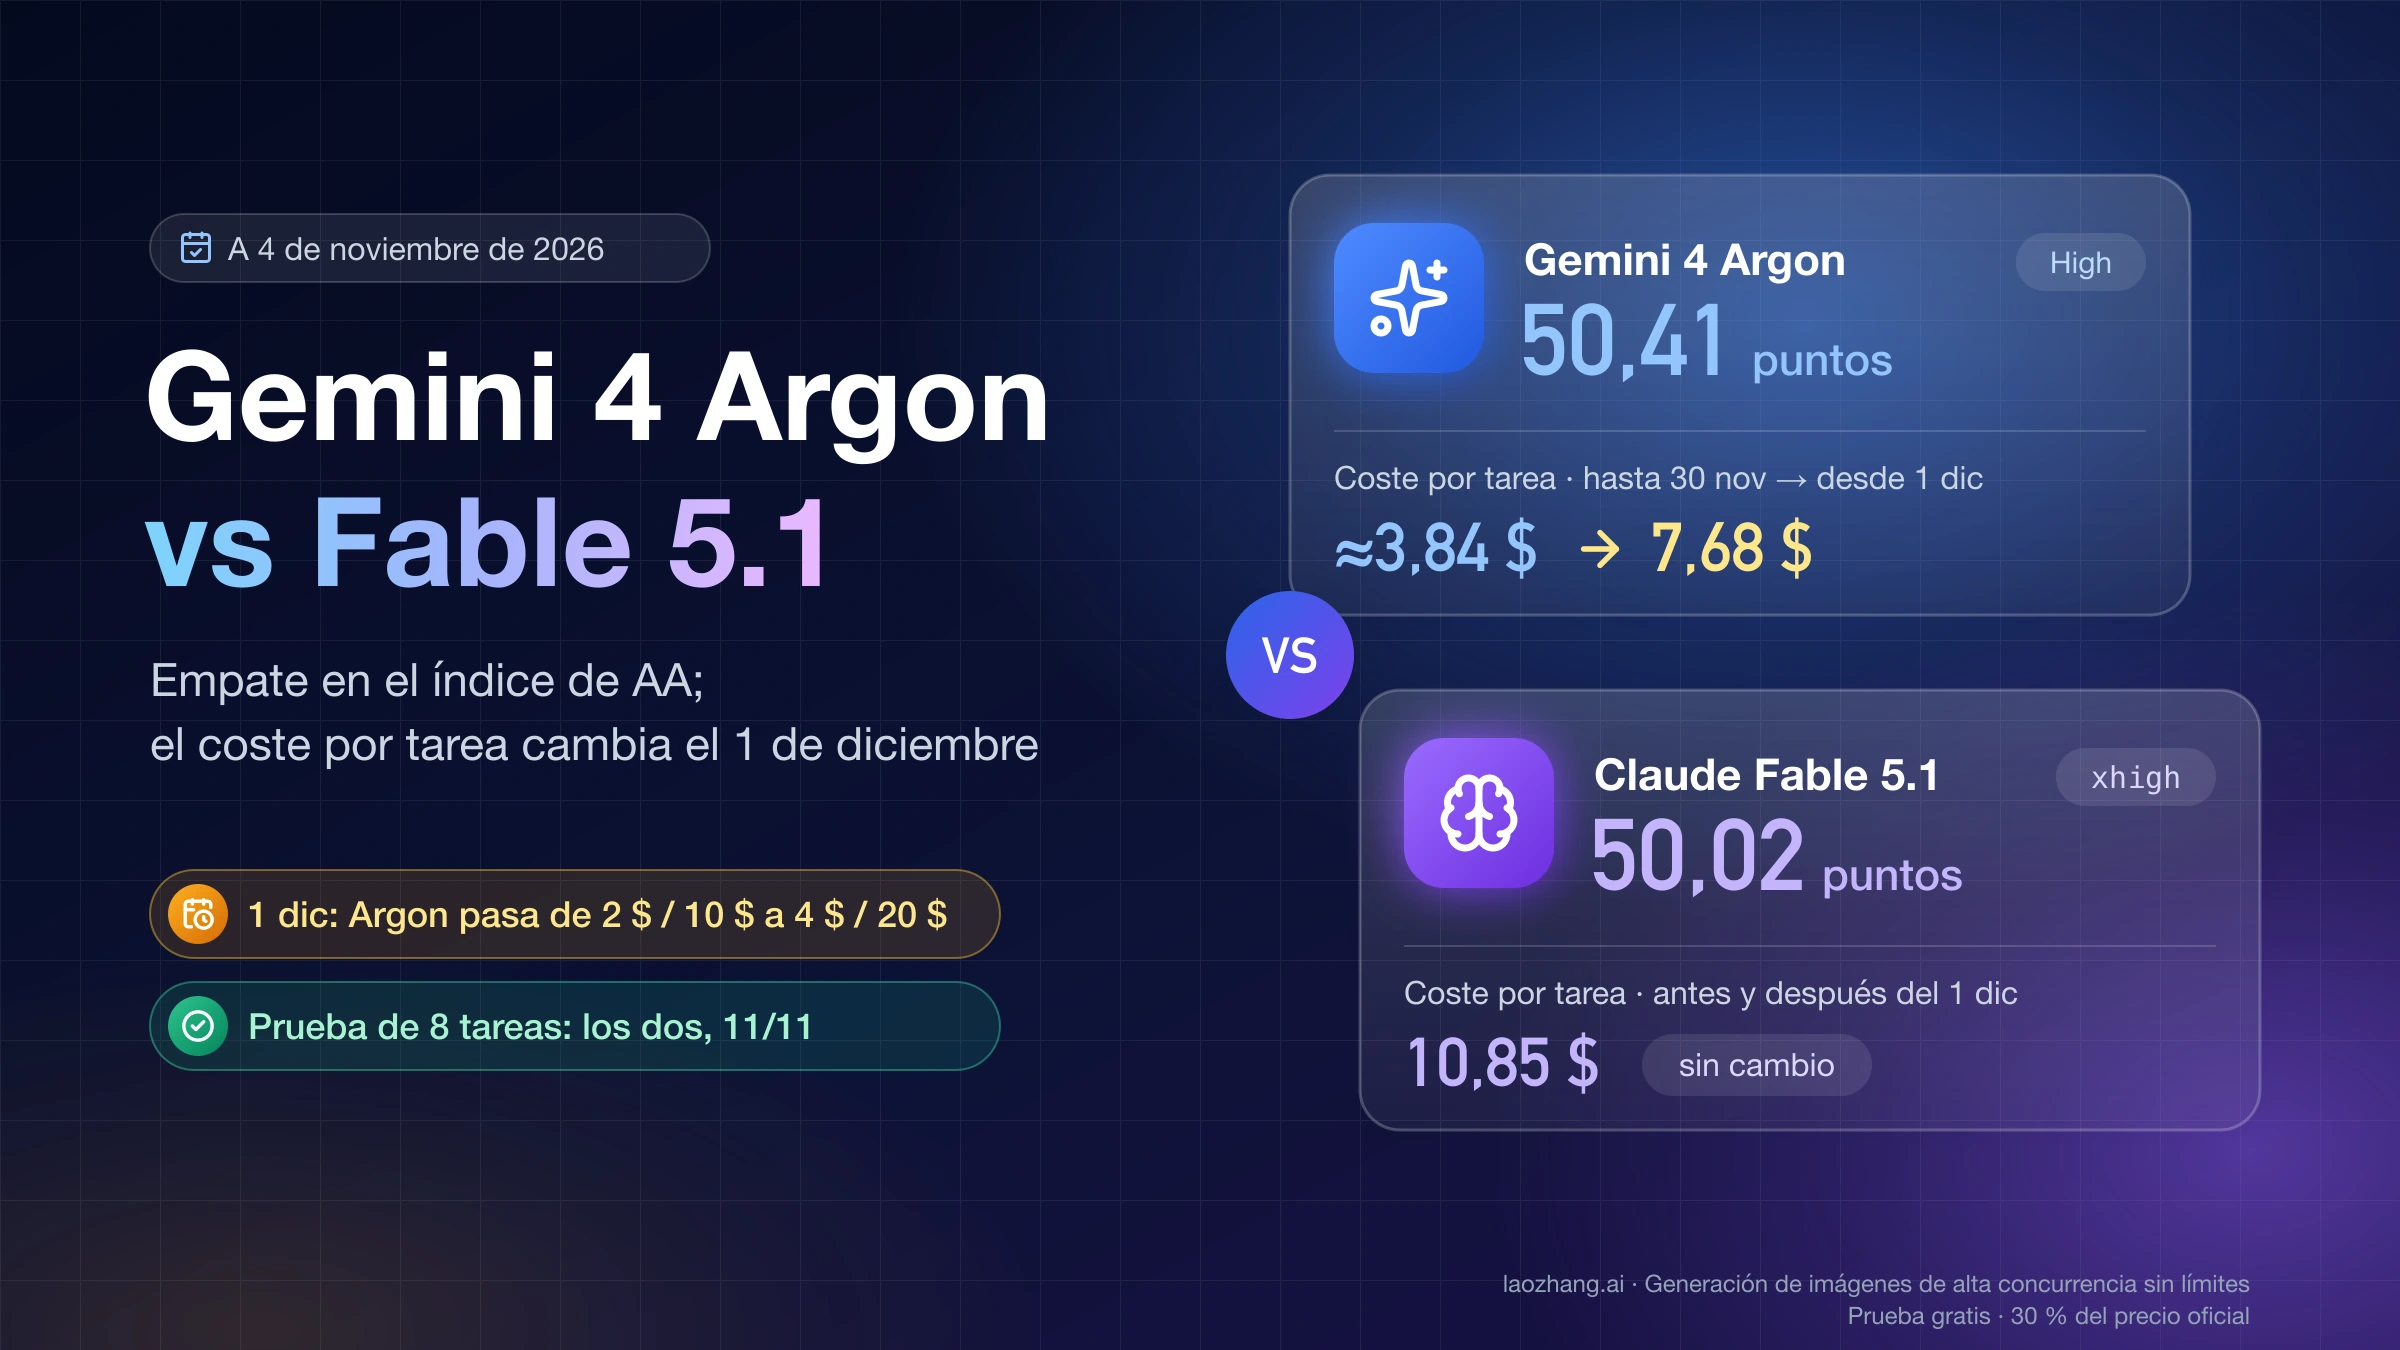
A 4 de noviembre de 2026, si tienes que pagar una sola API de modelo insignia para programar, montar agentes o trabajar con documentos y datos, empieza por GPT-6 Astra (gpt-6-astra) en medium o high. En la versión 5.0.1 del índice de Artificial Analysis (AA), Astra en high saca 55 puntos y Gemini 4 Argon, que AA solo publica en high, 50. Aun así, Astra cuesta 3,24 $ por tarea del índice frente a unos 3,84 $ de Argon con su tarifa actual y 7,68 $ desde el 1 de diciembre, cuando Argon pasa de 2 $ / 10 $ a 4 $ / 20 $ por millón de tokens de entrada y salida.
Gemini 4 Argon (gemini-4-argon) sigue siendo la mejor opción en tres casos: agentes de automatización y de terminal, donde lidera las dos evaluaciones de AA que miden ese trabajo; mucho volumen de peticiones cortas y comprobables con su razonamiento por defecto, donde sale entre 2 y 4 veces más barato que Astra; y entradas de más de 272.000 tokens, porque Astra cobra entonces toda la petición al doble en entrada y a 1,5 veces en salida. Lo que ya no conviene es elegirlo como «el equivalente barato»: eso era cierto en octubre, con el índice anterior y la tarifa de lanzamiento.
En una prueba del 4 de noviembre de 2026 hecha a través de la API de LaoZhang, con 8 tareas por modelo, los dos aprobaron casi todo, pero Argon en high escribió 4,2 veces más tokens que Astra en high, así que desde diciembre Astra high será el más barato de los dos en esas tareas. La única tarea que los separó fue contar errores exactos en un log largo: Astra acertó siempre en menos de 80 s y Argon solo acertó en high, con streaming y tras 4–7 minutos.
¿Es Gemini 4 Argon mejor que GPT-6 Astra? AA v5.0.1: 55 frente a 50
En el índice independiente más amplio, no: con la misma etiqueta high, GPT-6 Astra suma 55 puntos y Gemini 4 Argon 50 en la versión 5.0.1 del Artificial Analysis Intelligence Index, a 4 de noviembre de 2026. Astra además termina antes y, salvo en su nivel más bajo, cualquier ajuste de Astra puntúa por encima de Argon. Las cifras salen de la comparativa de Artificial Analysis entre Gemini 4 Argon y GPT-6 Astra y de la ficha de Gemini 4 Argon en Artificial Analysis.
| Modelo y nivel | Puntos AA v5.0.1 | Coste por tarea del índice | Tiempo por tarea |
|---|---|---|---|
Gemini 4 Argon high | 50 | 7,68 $ con la tarifa de diciembre (≈3,84 $ hasta el 30 de noviembre) | 1.363 s |
GPT-6 Astra low | 43 | 1,42 $ | 181 s |
GPT-6 Astra medium | 52 | 2,73 $ | 352 s |
GPT-6 Astra high | 55 | 3,24 $ | 404 s |
GPT-6 Astra xhigh | 55 | 3,66 $ | 450 s |
GPT-6 Astra max | 57 | 6,24 $ | 768 s |
AA ya calcula el coste de Argon con la tarifa de 4 $ / 20 $ que entra en vigor el 1 de diciembre, y su ficha lo indica. Como hasta el 30 de noviembre todos los precios de Argon son exactamente la mitad, los mismos tokens cuestan unos 3,84 $ por tarea; esa cifra es una división, no un dato publicado por AA. Con ella, Astra high cuesta 0,84 veces lo que Argon hoy (un 16 % menos) y 0,42 veces desde diciembre. Astra medium puntúa 2 puntos más que Argon por 0,71 veces su coste hoy y 0,36 veces en diciembre. Solo Astra low queda por debajo de Argon, y Argon cuesta 2,7 veces lo que ese nivel. Astra max, con 57 puntos, cuesta 1,63 veces lo que Argon hoy y 0,81 veces desde diciembre.
La diferencia de tiempo viene del volumen de razonamiento. Argon escribe unos 116.000 tokens de salida por tarea del índice, 68.000 de ellos de razonamiento, frente a 52.000 de Astra incluso en max, y tarda 3,4 veces más que Astra high. Argon empieza antes, eso sí: su primer token llega a los 41,5 s, mientras que Astra high tarda 101 s en emitir el primero. Ten en cuenta que una tarea del índice es un trabajo largo de agente con varios pasos, no una petición tuya.
«El mismo nivel» significa aquí la misma etiqueta, no el mismo esfuerzo. Argon se ajusta con thinkingLevel (low, medium o high; la API usa medium por defecto, según la documentación de razonamiento de la Gemini API) y Astra con reasoning_effort, de low a max, sin que OpenAI documente cuál aplica por defecto. Como AA solo publica Argon en high, tampoco existe en ese índice una comparación «por defecto contra por defecto».
Dónde gana cada uno: Argon en automatización, Astra en código y ciencia
Dentro del índice de AA, Argon gana en automatización de flujos de trabajo y en tareas de terminal, y Astra en código difícil, en la evaluación GDP.pdf y en ciencia. La tabla que publicó Google al lanzar Argon cuenta otra historia, con Argon por delante en 14 de 19 pruebas, y el Vals Index también lo coloca primero. Las tres fuentes miden cosas distintas, así que conviene leerlas por separado.
Evaluación de AA v5.0.1 (los dos en high) | Gemini 4 Argon | GPT-6 Astra |
|---|---|---|
| AutomationBench-AA | 77,5 % | 66,6 % |
| Terminal-Bench 4.0 | 57,1 % | 54,0 % |
| AA-Omniscience | 46 | 45 |
| AA-Briefcase (puntuación tipo Elo) | 1.484 | 1.505 |
| FrontierCode 2.0 | 25,7 % | 40,1 % |
| GDP.pdf | 21,8 % | 31,0 % |
| HLE-Diamond | 56,7 % | 59,3 % |
| CritPt v2 Hard | 52,5 % | 71,5 % |
| Terminal-Bench-Science | 52,9 % | 59,5 % |
Las ventajas grandes de Argon son AutomationBench-AA, casi 11 puntos, y Terminal-Bench 4.0, 3 puntos; en AA-Omniscience la diferencia es de un punto. Las de Astra son más numerosas y algunas mucho más amplias: 19 puntos en CritPt v2 Hard, 14 en FrontierCode 2.0 y 9 en GDP.pdf. Si tu trabajo se parece a encadenar herramientas y scripts, Argon merece una prueba; si se parece a resolver problemas técnicos o científicos difíciles, la ventaja es de Astra.
La presentación de Gemini 4 Argon en el blog de Google, del 30 de septiembre de 2026, incluye una tabla con 19 evaluaciones donde Argon supera a Astra en 14, Astra gana en 4 (FrontierSWE v2, Terminal-bench 4.0, Terminal-Bench Science y OSWorld-2.0 offline) y empatan en CWE-bench. Son resultados del fabricante, obtenidos según su metodología con el máximo nivel de razonamiento y un solo intento por prueba, y no todas las condiciones son iguales: en LVBench, Gemini veía el vídeo a 1 fotograma por segundo y Astra con 800 fotogramas. Las mismas cifras de Google atribuyen a Argon un 0,7 % de éxito en ataques de inyección indirecta de instrucciones de Gray Swan frente al 8,5 % de Astra, según la lectura de VentureBeat; si tu agente lee páginas o documentos que no controlas, es un dato a tener en cuenta, con la cautela de que lo publica el propio fabricante.
El Vals Index de Gemini 4 Argon es el índice independiente donde Argon va por delante: 68,90 % a 15,68 $ por prueba, con Argon en high y ya calculado a 4 $ / 20 $, frente al 63,13 % de Astra a 18,46 $ (la cifra de Astra procede de una recopilación de Kingy AI del 30 de septiembre de 2026). Vals y AA usan conjuntos de pruebas distintos, así que el desacuerdo no es un error de ninguno de los dos: indica que el ganador depende del tipo de tarea.
¿Cuál es mejor para programar?
Para programar, la evidencia está dividida y depende del tipo de código. En cambios difíciles sobre repositorios, Astra gana con claridad tanto en FrontierCode 2.0 de AA (40,1 % frente a 25,7 %) como en FrontierSWE v2 de la propia tabla de Google (65,5 % frente a 55,0 %). Argon gana en DeepSWE v1.1 (77,9 % frente a 74,1 %) y en Vibe Code Bench (91,9 % frente a 89,6 %) según Google. Terminal-Bench 4.0 cambia de ganador según quién lo mida: Argon le saca 3 puntos en AA y Astra menos de uno en la tabla de Google. En las funciones de Python con tests ocultos de la prueba del 4 de noviembre, los dos aprobaron todo salvo un fallo de Argon por defecto, de modo que en tareas pequeñas y bien especificadas la diferencia está en el coste, no en el acierto.
Por qué otras comparativas dicen que empatan y que Argon es más barato
Las comparativas que hablan de empate a 53 puntos, de un Argon un 40 % más barato por tarea que Astra en max o de un Astra 1,6 veces más caro citan la versión 4.3.2 del índice de AA y la tarifa de lanzamiento de Argon. Tenían razón en su fecha, pero los dos datos han cambiado.
AA pasó de la versión 4.3.2 a la 5.0 el 27 y 28 de octubre de 2026 y ahora la etiqueta como 5.0.1. En la 4.3.2, Argon en high sumaba 53 puntos y costaba 1,99 $ por tarea con la tarifa de 2 $ / 10 $. La 5.0 cambió las evaluaciones y todas las puntuaciones: Argon bajó a 50 y Astra high quedó en 55. Entre la lectura del 28 de octubre y la del 4 de noviembre, Astra medium pasó además de 51 a 52; el resto de valores de los dos modelos no se movió.
El segundo cambio es el precio. La página de precios de la Gemini API fija para Argon 2 $ / 10 $ hasta el 30 de noviembre de 2026 y 4 $ / 20 $ desde el 1 de diciembre, y AA ya aplica la segunda tarifa. Por eso una comparación escrita en octubre con el índice antiguo y el precio de lanzamiento no sirve hoy para presupuestar: las cifras de una versión del índice no se pueden mezclar con las de otra.
Prueba del 4 de noviembre de 2026: 8 tareas iguales y un log que los separa
El 4 de noviembre de 2026 se mandaron las mismas tareas a los dos modelos a través de la API de LaoZhang, con su configuración por defecto y con high. En las 8 tareas cortas los dos aprobaron casi todo, así que lo que se ve es coste, tokens y tiempo; solo el recuento exacto sobre un log largo marcó diferencias de acierto. Las llamadas pasaron por una misma pasarela, que lista gemini-4-argon a 2 $ / 10 $ y gpt-6-astra a 10 $ / 50 $ por millón, y que todavía no ha publicado su precio de Argon para diciembre; los costes de abajo se calculan con las tarifas oficiales de cada fabricante a partir del uso que devolvió cada API.
Las tareas fueron un problema de enunciado, tres funciones de Python comprobadas con tests ocultos, un resumen en 5 puntos de un artículo en inglés de 6.723 palabras, un analizador de expresiones (25 tests ocultos), un analizador de líneas CSV (16 tests) y un recuento de sumas de dígitos. Las tres últimas se repitieron dos veces, lo que da 11 respuestas evaluadas por configuración. Argon se llamó con generateContent sin streaming y Astra por Chat Completions con streaming, sin instrucciones de sistema ni herramientas. «Por defecto» significa no enviar ningún nivel: en Argon equivale a medium según Google, y en Astra no está documentado.
| Configuración | Aprobadas | Tokens de salida (de ellos, razonamiento) | Coste de las 11 hasta el 30 nov | Coste desde el 1 dic | Tiempo total |
|---|---|---|---|---|---|
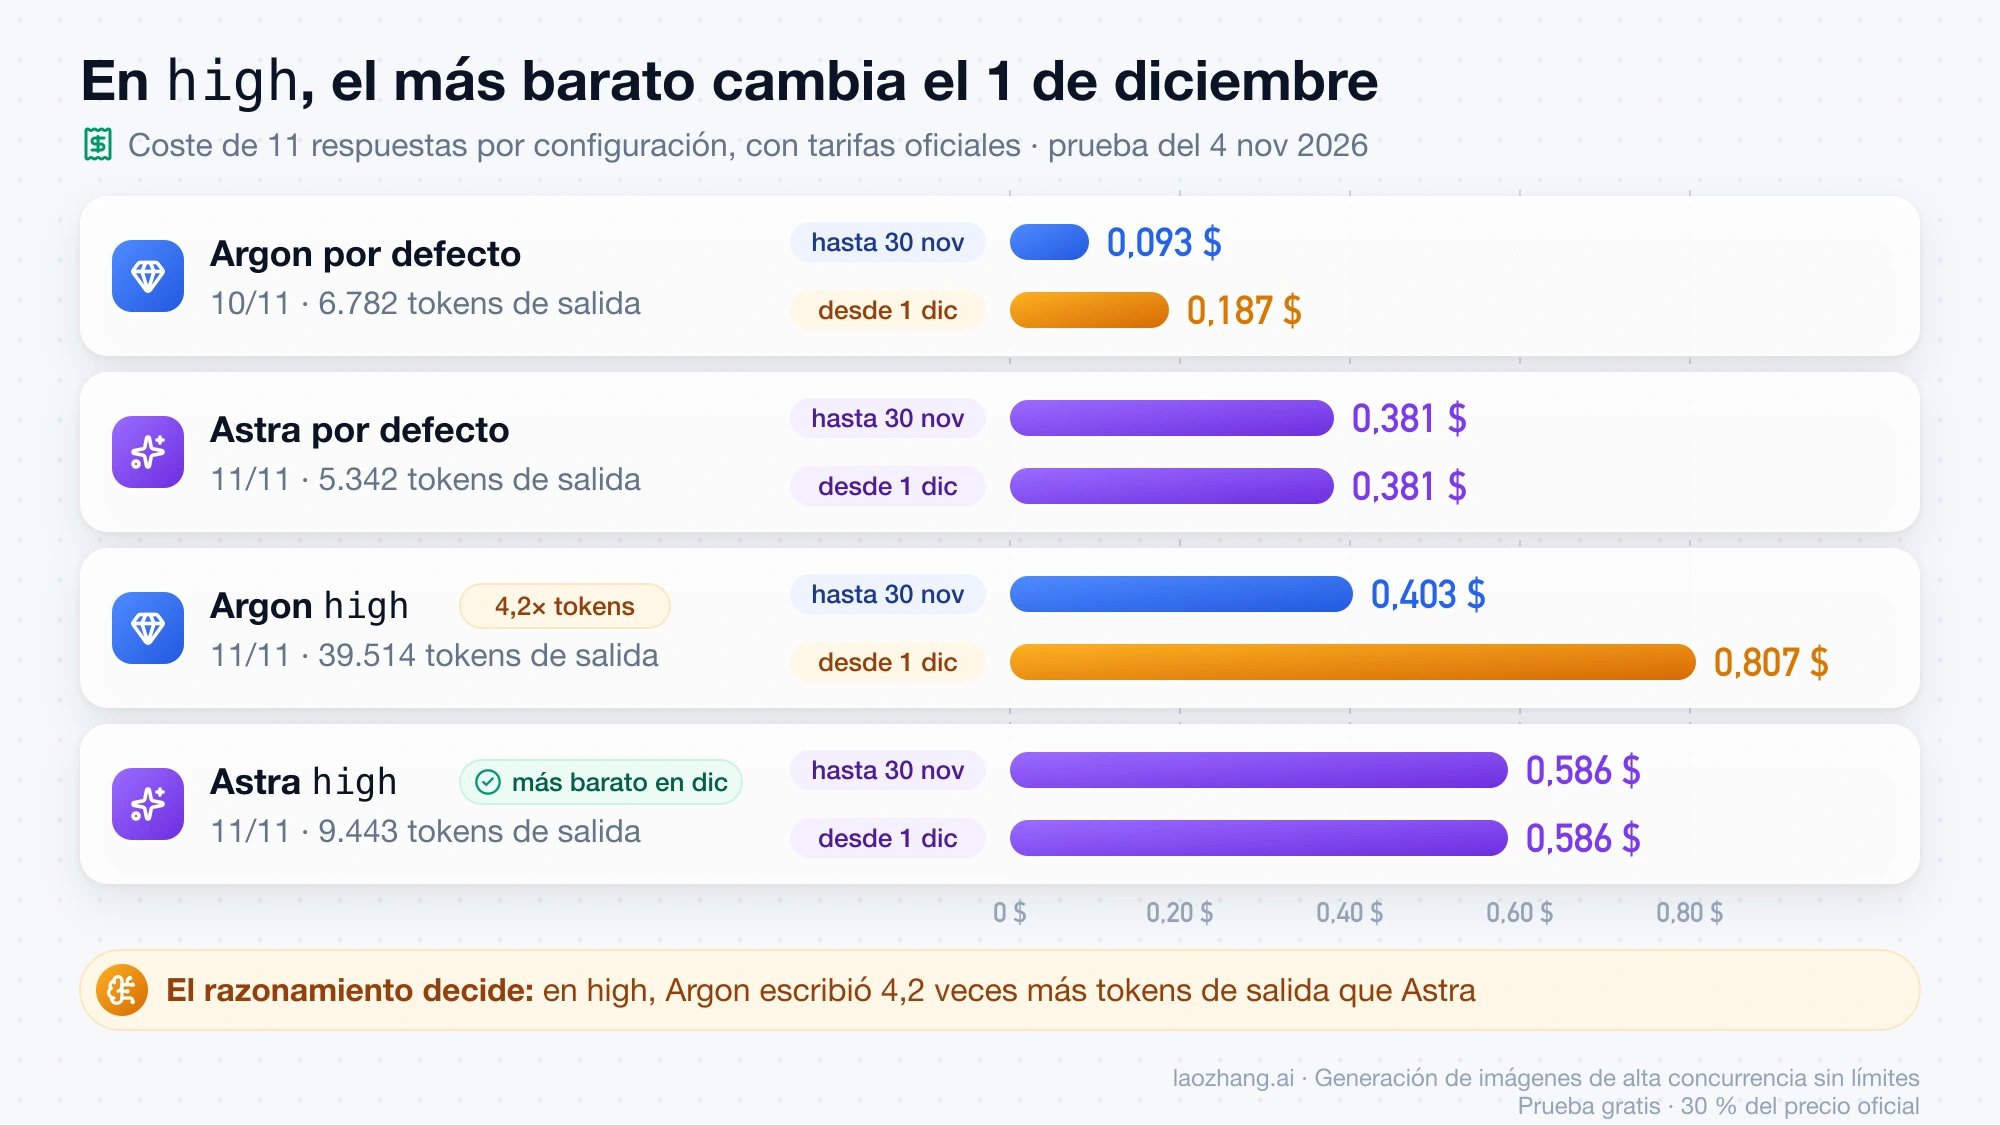
| Argon por defecto | 10/11 | 6.782 (1.727) | 0,093 $ | 0,187 $ | 163 s |
Argon high | 11/11 | 39.514 (33.105) | 0,403 $ | 0,807 $ | 463 s |
| Astra por defecto | 11/11 | 5.342 (1.885) | 0,381 $ | 0,381 $ | 117 s |
Astra high | 11/11 | 9.443 (5.982) | 0,586 $ | 0,586 $ | 215 s |
El único fallo fue de Argon por defecto en el analizador de expresiones: una de las dos veces, la entrada " 1 + 2 ", con espacios de más, lanzó un ValueError y suspendió 1 de los 25 tests. Por defecto, Argon cuesta una cuarta parte que Astra hoy y la mitad desde diciembre. En high la cuenta cambia, porque Argon escribió 4,2 veces más tokens que Astra: Astra cuesta 1,45 veces lo que Argon hasta el 30 de noviembre y 0,73 veces desde el 1 de diciembre.
El recuento exacto en un log de 146 KB
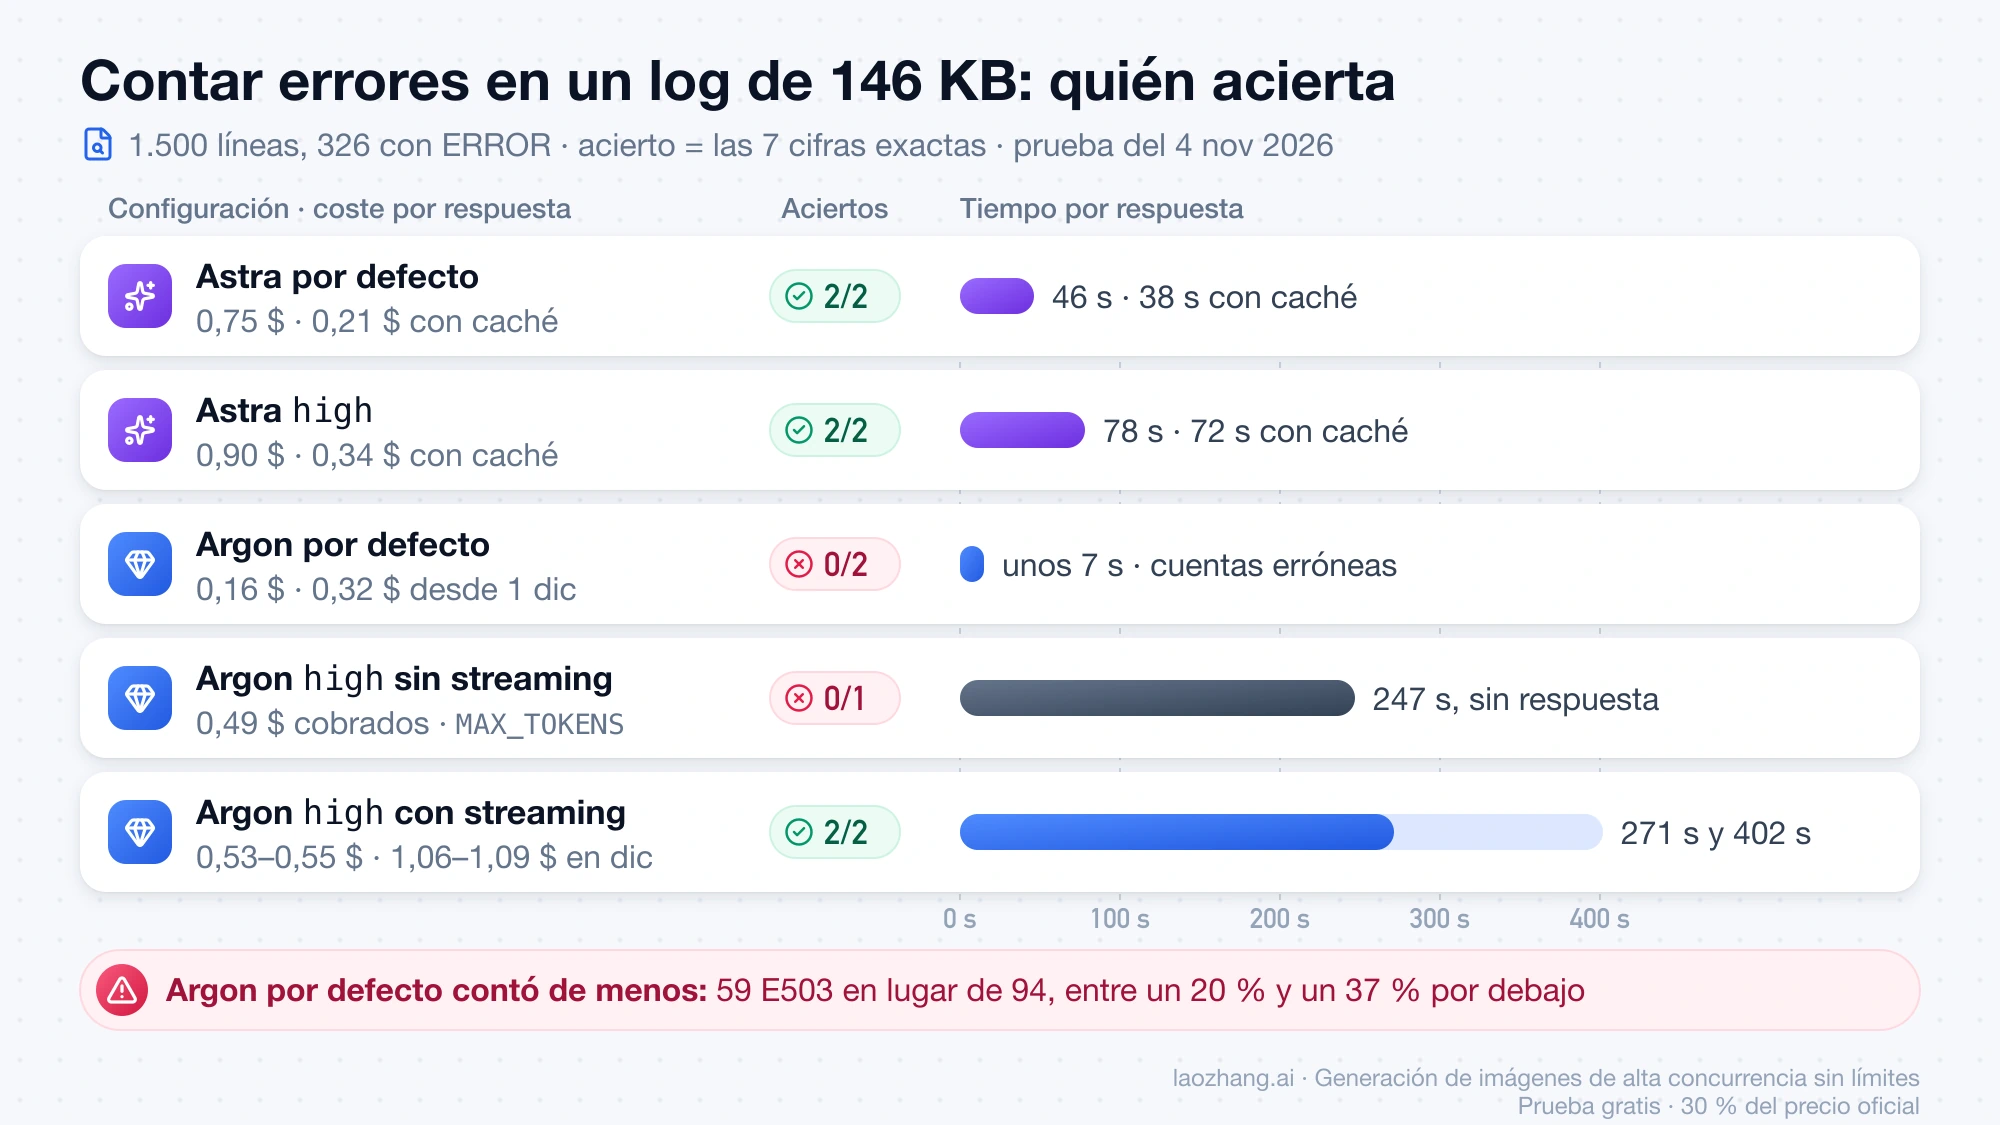
El log era sintético y reproducible: 1.500 líneas, 326 de ellas con ERROR, y líneas WARN que repetían los mismos códigos para despistar. Se pedía el número de ERROR de 5 códigos, cuántos usuarios distintos tuvieron E503 y qué petición tuvo más reintentos; la respuesta correcta se generó con el mismo script que creó el log y se comprobó con grep antes de llamar a ningún modelo. Una respuesta solo contaba como acierto si las 7 cifras eran exactas.
| Configuración | Aciertos | Tiempo por respuesta | Coste por respuesta hasta el 30 nov | Coste desde el 1 dic |
|---|---|---|---|---|
| Astra por defecto | 2/2 | 46 s; 38 s con el log en caché | 0,75 $; 0,21 $ con caché | igual |
Astra high | 2/2 | 78 s; 72 s con caché | 0,90 $; 0,34 $ con caché | igual |
| Argon por defecto | 0/2 | unos 7 s | 0,16 $ | 0,32 $ |
Argon high sin streaming | 0/1 | 247 s, sin respuesta | 0,49 $ | 0,97 $ |
Argon high con streaming | 2/2 | 271 s y 402 s | 0,53–0,55 $ | 1,06–1,09 $ |
Argon por defecto contestó rápido y barato, pero todas sus cuentas de errores salieron entre un 20 % y un 37 % por debajo (59 E503 en lugar de 94, 46 usuarios con E503 en lugar de 78), y la API no informó de ningún token de razonamiento en esas llamadas. En high sin streaming, Argon gastó los 32.768 tokens que admite una respuesta sin streaming solo en razonar, terminó con finishReason MAX_TOKENS, no devolvió nada y aun así se cobró. Con streaming y maxOutputTokens en 65.536 acertó las dos veces, pero tardó entre 6 y 10 veces más que Astra por defecto y, desde diciembre, costará más que Astra por defecto aunque Astra no aproveche la caché. Otras dos llamadas de Argon high se cortaron a los 300 s por un proxy local de la máquina de prueba, sin coste, y no se cuentan.
Esta prueba tiene límites claros: una sola pasarela, un solo día y 1–2 muestras por casilla. Las tareas cortas no distinguen la calidad de los modelos, y el log es un solo tipo de tarea, una agregación exacta sobre una entrada larga y ruidosa, no una clasificación general. El tiempo incluye la diferencia entre streaming y no streaming; los tokens y los aciertos, no.
También conviene leer juntas esta prueba y el índice de AA, porque en high apuntan en direcciones distintas hasta el 30 de noviembre. En las tareas largas de agente de AA, Astra high ya es más barato por tarea que Argon con la tarifa actual, mientras que en estas peticiones sueltas Argon high sale más barato este mes (0,403 $ frente a 0,586 $). Las dos fuentes coinciden en lo que importa para presupuestar: desde el 1 de diciembre, Astra high cuesta menos.
Cuánto cuesta una tarea y un mes de uso, antes y después del 1 de diciembre
Por token, Astra cuesta 5 veces lo que Argon hasta el 30 de noviembre y 2,5 veces desde el 1 de diciembre, tanto en entrada como en salida. La factura real depende además de cuántos tokens de razonamiento escribe cada modelo, del idioma de tu texto y de la caché, y en high el volumen de razonamiento de Argon puede borrar esa diferencia.
| Por millón de tokens (tarifa Standard) | Argon hasta el 30 nov | Argon desde el 1 dic | Astra hasta 272.000 tokens de entrada | Astra por encima de 272.000 |
|---|---|---|---|---|
| Entrada | 2,00 $ | 4,00 $ | 10,00 $ | 20,00 $ |
| Salida, razonamiento incluido | 10,00 $ | 20,00 $ | 50,00 $ | 75,00 $ |
| Entrada en caché | 0,10 $ | 0,20 $ | 1,00 $ | 2,00 $ |
| Escritura en caché | sin cargo | sin cargo | 12,50 $ (30 min) o 25,00 $ (12 h) | 25,00 $ o 50,00 $ |
Fuentes: la página de precios de la Gemini API y la página de precios de la API de OpenAI, a 4 de noviembre de 2026. En los dos casos, Batch y Flex cuestan la mitad. Argon no está en el nivel gratuito de la Gemini API y Google cobra cada token que procesa, incluidos los de razonamiento. En Astra, el modo Fast cuesta el doble y los endpoints regionales añaden un 10 %. El detalle de las escrituras en caché de Astra y del escalón de 272.000 tokens está en Precio de la API de GPT-6 Astra: coste con caché y contexto largo.
La fórmula para una petición es sencilla: tokens de entrada × precio de entrada + tokens de salida (razonamiento incluido) × precio de salida. Lo que cambia de un modelo a otro son los tokens. En la medición del 4 de noviembre de 2026, hecha a través de la API de LaoZhang con el mismo texto en español, Argon contó 154 tokens y Astra 162, es decir 0,95 veces; por eso la entrada de un texto en español sale unas 5,3 veces más cara en Astra hasta el 30 de noviembre (5 ÷ 0,95) y unas 2,6 veces desde diciembre. En inglés los dos contaron lo mismo (5 y 2,5 veces); en japonés Argon cuenta 0,67 veces, lo que sube la diferencia a 7,5 y 3,7 veces. Con logs llenos de marcas de tiempo, identificadores y pares clave=valor ocurre lo contrario: Argon contó 1,42 veces más tokens, y la diferencia de entrada baja a 3,5 veces hoy y 1,8 veces en diciembre. Cada idioma se midió con un solo pasaje, de unos 700–800 caracteres en español o inglés, así que toma estas proporciones como orden de magnitud.
En la salida manda el razonamiento. En la prueba de 8 tareas, Argon high escribió 4,2 veces los tokens de Astra high, lo que anula la diferencia de precio de 5 veces hoy y la invierte desde diciembre. Para estimar un mes, multiplica el coste de un lote representativo por las veces que lo repites. Si tu tráfico mensual equivaliese a repetir 1.000 veces esas 11 peticiones, pagarías 93 $ con Argon por defecto (187 $ desde diciembre), 403 $ con Argon high (807 $), 381 $ con Astra por defecto y 586 $ con Astra high.
La caché: Argon no cobra la escritura, Astra sí
La caché funciona distinto en cada API y puede pesar más que el precio por token si reenvías el mismo contexto. Argon solo tiene caché implícita: no hay que configurarla, no cobra la escritura y la lectura cuesta el 5 % de la entrada. OpenAI guarda en caché por defecto los prefijos de Astra de al menos 1.024 tokens, cobra la escritura a 1,25 veces la entrada en la caché de 30 minutos (2,5 veces en la de 12 horas, solo en la Responses API) y la lectura al 10 %. Si no quieres pagar escrituras en peticiones únicas, puedes desactivar el comportamiento automático con prompt_cache_options.mode: "explicit".
En la prueba del 4 de noviembre, Astra no informó de ningún cache_write_tokens en ninguna llamada, aunque el 26 de octubre el mismo prompt de 10.106 tokens por la misma pasarela registró 10.103 tokens escritos; aun así, al repetir el log de 55.843 tokens leyó 55.840 de la caché. Argon leyó de su caché implícita 9.056 de 11.110 tokens al repetir el artículo y 77.258 de 79.312 al repetir el log, sin ningún ajuste. Como no se sabe si la escritura de Astra no se hizo, no se informó o no se cobró ese día, revisa tus propios datos: en Astra, prompt_tokens_details.cache_write_tokens y prompt_tokens_details.cached_tokens; en Argon, cachedContentTokenCount.
Entradas de más de 272.000 tokens y respuestas largas
Con entradas de más de 272.000 tokens, Argon es más previsible en precio porque cobra la misma tarifa hasta su límite; con respuestas largas, en cambio, Argon necesita streaming o un límite de salida explícito para no quedarse a medias.
Argon tiene un presupuesto único de 1.048.576 tokens compartido entre entrada y salida y un solo precio en todo ese rango. Astra admite 1.050.000 tokens de contexto, hasta 922.000 de entrada y 128.000 de salida, pero en cuanto la entrada supera 272.000 tokens toda la petición paga el doble en entrada y 1,5 veces en salida (20 $ / 75 $ por millón). Una entrada de 300.000 tokens cuesta 6,00 $ en Astra, frente a 0,60 $ en Argon hasta el 30 de noviembre y 1,20 $ desde diciembre, antes de contar la salida.
La salida de Argon tiene sus propios topes: 65.536 tokens por defecto en una respuesta síncrona y 32.768 en una sola llamada sin streaming, aunque con generación larga puede llegar a 1 millón. Como el razonamiento cuenta dentro de esa salida, una tarea difícil sin streaming puede agotarlo antes de escribir la respuesta, que es lo que pasó con el log. Usa streamGenerateContent, fija maxOutputTokens y comprueba finishReason en cada respuesta; los casos de respuestas vacías o cortadas están en Gemini 4 Argon API: acceso, finish_reason y respuestas cortadas.
Argon o Astra según el trabajo: código, agentes, datos y textos largos
Elige por tipo de trabajo, no por el modelo: Astra para código difícil, datos exactos y ciencia; Argon para agentes de automatización, mucho volumen de peticiones cortas y entradas enormes, siempre con el precio de diciembre en la cuenta.
| Tu trabajo | Empieza con | Por qué |
|---|---|---|
| Cambios difíciles en repositorios grandes | Astra high | Gana FrontierCode 2.0 en AA (40,1 % frente a 25,7 %) y FrontierSWE v2 en la tabla de Google |
| Agentes que automatizan flujos o trabajan en terminal | Argon high, comparado con Astra en tus tareas | Lidera AutomationBench-AA y Terminal-Bench 4.0 en AA, y el Vals Index |
| Contar, sumar o cruzar cifras exactas en logs o tablas largas | Astra, ya por defecto | Acertó 4 de 4 en el log; Argon por defecto falló todas las cuentas y en high tardó 4–7 minutos |
| Ciencia y razonamiento técnico exigente | Astra high o max | CritPt v2 Hard 71,5 % frente a 52,5 %; también gana HLE-Diamond y Terminal-Bench-Science |
| Muchas peticiones cortas y comprobables (resúmenes, funciones pequeñas) | Argon por defecto | 10 de 11 aprobadas por una cuarta parte del coste de Astra hoy y la mitad en diciembre |
| Entradas de más de 272.000 tokens | Argon, con streaming | Una sola tarifa hasta 1.048.576 tokens; Astra cobra toda la petición al doble en entrada y a 1,5 veces en salida |
Si ya pagas Argon y te funciona, no hace falta cambiar este mes. Lo que sí conviene es rehacer el presupuesto con 4 $ / 20 $ antes del 1 de diciembre y mirar cuántos tokens de razonamiento genera tu tráfico, porque en high es lo que decide cuál de los dos sale más barato. Si dudas entre medium y high en Astra, empieza por medium, que en AA ya puntúa por encima de Argon high.
Cómo acceder a cada modelo: API, Gemini, ChatGPT, Codex y Antigravity
Por API, Argon solo funciona en el nivel de pago de la Gemini API, y Astra se cobra por token a cualquier organización o proyecto que tenga acceso a gpt-6-astra. En las apps, Argon pide una suscripción Google AI Pro o Ultra, y Astra no está en ChatGPT Free ni Go. Las cuotas de las suscripciones son independientes de la facturación de la API.
En la API de Google no hay nivel gratuito para Argon. En las apps de consumo, Argon aparece en la app de Gemini y en el Modo IA con Google AI Pro o Ultra; AI Studio lo ofrece con esos mismos planes, pero no en la cuenta gratuita, y para programar está en Antigravity con Google AI Pro de pago, Ultra o Enterprise. En la API de OpenAI, Astra solo admite llamadas a funciones por la Responses API, porque Chat Completions no las soporta con este modelo. En ChatGPT, los planes Free y Go usan GPT-6 Luna; en Codex y ChatGPT Work, Plus y Business estándar dan unos 5–45 mensajes locales de Astra cada 5 horas y Pro no tiene límite de 5 horas. Qué planes incluyen Astra en el chat normal no está confirmado por OpenAI; según terceros, Pro, Business y Enterprise.
Google no publica cuántas peticiones de Argon incluye cada plan. En OpenAI, activar Astra en un espacio de trabajo de ChatGPT no da acceso por API, y en Enterprise y Edu queda desactivado hasta que un administrador lo habilita. Para comprobar que tu proyecto ya ve el modelo y hacer la primera llamada, sigue Cómo acceder a GPT-6 Astra por API y comprobar la primera respuesta; si solo quieres saber qué te da el plan gratuito de ChatGPT, está en GPT-6 gratis en ChatGPT: el plan Free usa Luna, no Sol ni Astra.
Cómo comparar Argon y Astra con tus propias peticiones
Antes de comprometer un presupuesto, repite una prueba pequeña con peticiones tuyas cuya respuesta puedas comprobar sin opinar. Con 10–20 peticiones y dos ajustes por modelo basta para ver si tu caso se parece a las tareas cortas, donde manda el precio, o al log, donde manda el acierto.
- Reúne entre 10 y 20 peticiones reales con respuesta verificable: código con tests, cifras que puedas confirmar con
grepo una consulta, resúmenes con puntos que deben aparecer. - Prepara dos ajustes por modelo y anótalos: Argon sin
thinkingConfigy conthinkingLevel: "high"; Astra sinreasoning_efforty conhigh. Si la tarea usa herramientas, llama a Astra por la Responses API. - Llama a Argon con streaming y
maxOutputTokensfijado, y cuenta como fallo cualquier respuesta confinishReasonMAX_TOKENS. - Guarda el uso de cada respuesta. En Argon, la salida facturada es
candidatesTokenCountmásthoughtsTokenCount, y la caché aparece encachedContentTokenCount; en Astra,completion_tokensya incluyereasoning_tokens, y la caché está enprompt_tokens_details. - Calcula el coste con las dos tarifas de Argon (2 $ / 10 $ y 4 $ / 20 $) y la de Astra, y divídelo entre las respuestas aceptadas, no entre las llamadas.
- Repite al menos dos veces las peticiones que fallen o que tarden mucho, porque con una sola muestra un fallo puntual parece una tendencia.
Si llamas a los dos a través de una pasarela, comprueba también en cada respuesta que el modelo devuelto es el que pediste: modelVersion en la API de Gemini y model en la de OpenAI.
Preguntas frecuentes sobre Gemini 4 Argon y GPT-6 Astra
¿Cuándo salieron GPT-6 Astra y Gemini 4 Argon?
Los dos ya están disponibles. GPT-6 Astra está en la API de OpenAI desde el 3 de septiembre de 2026, y Gemini 4 Argon es un modelo estable de la Gemini API desde el 13 de octubre de 2026, después de su presentación del 30 de septiembre.
¿Hay una opción más barata de OpenAI o de Google?
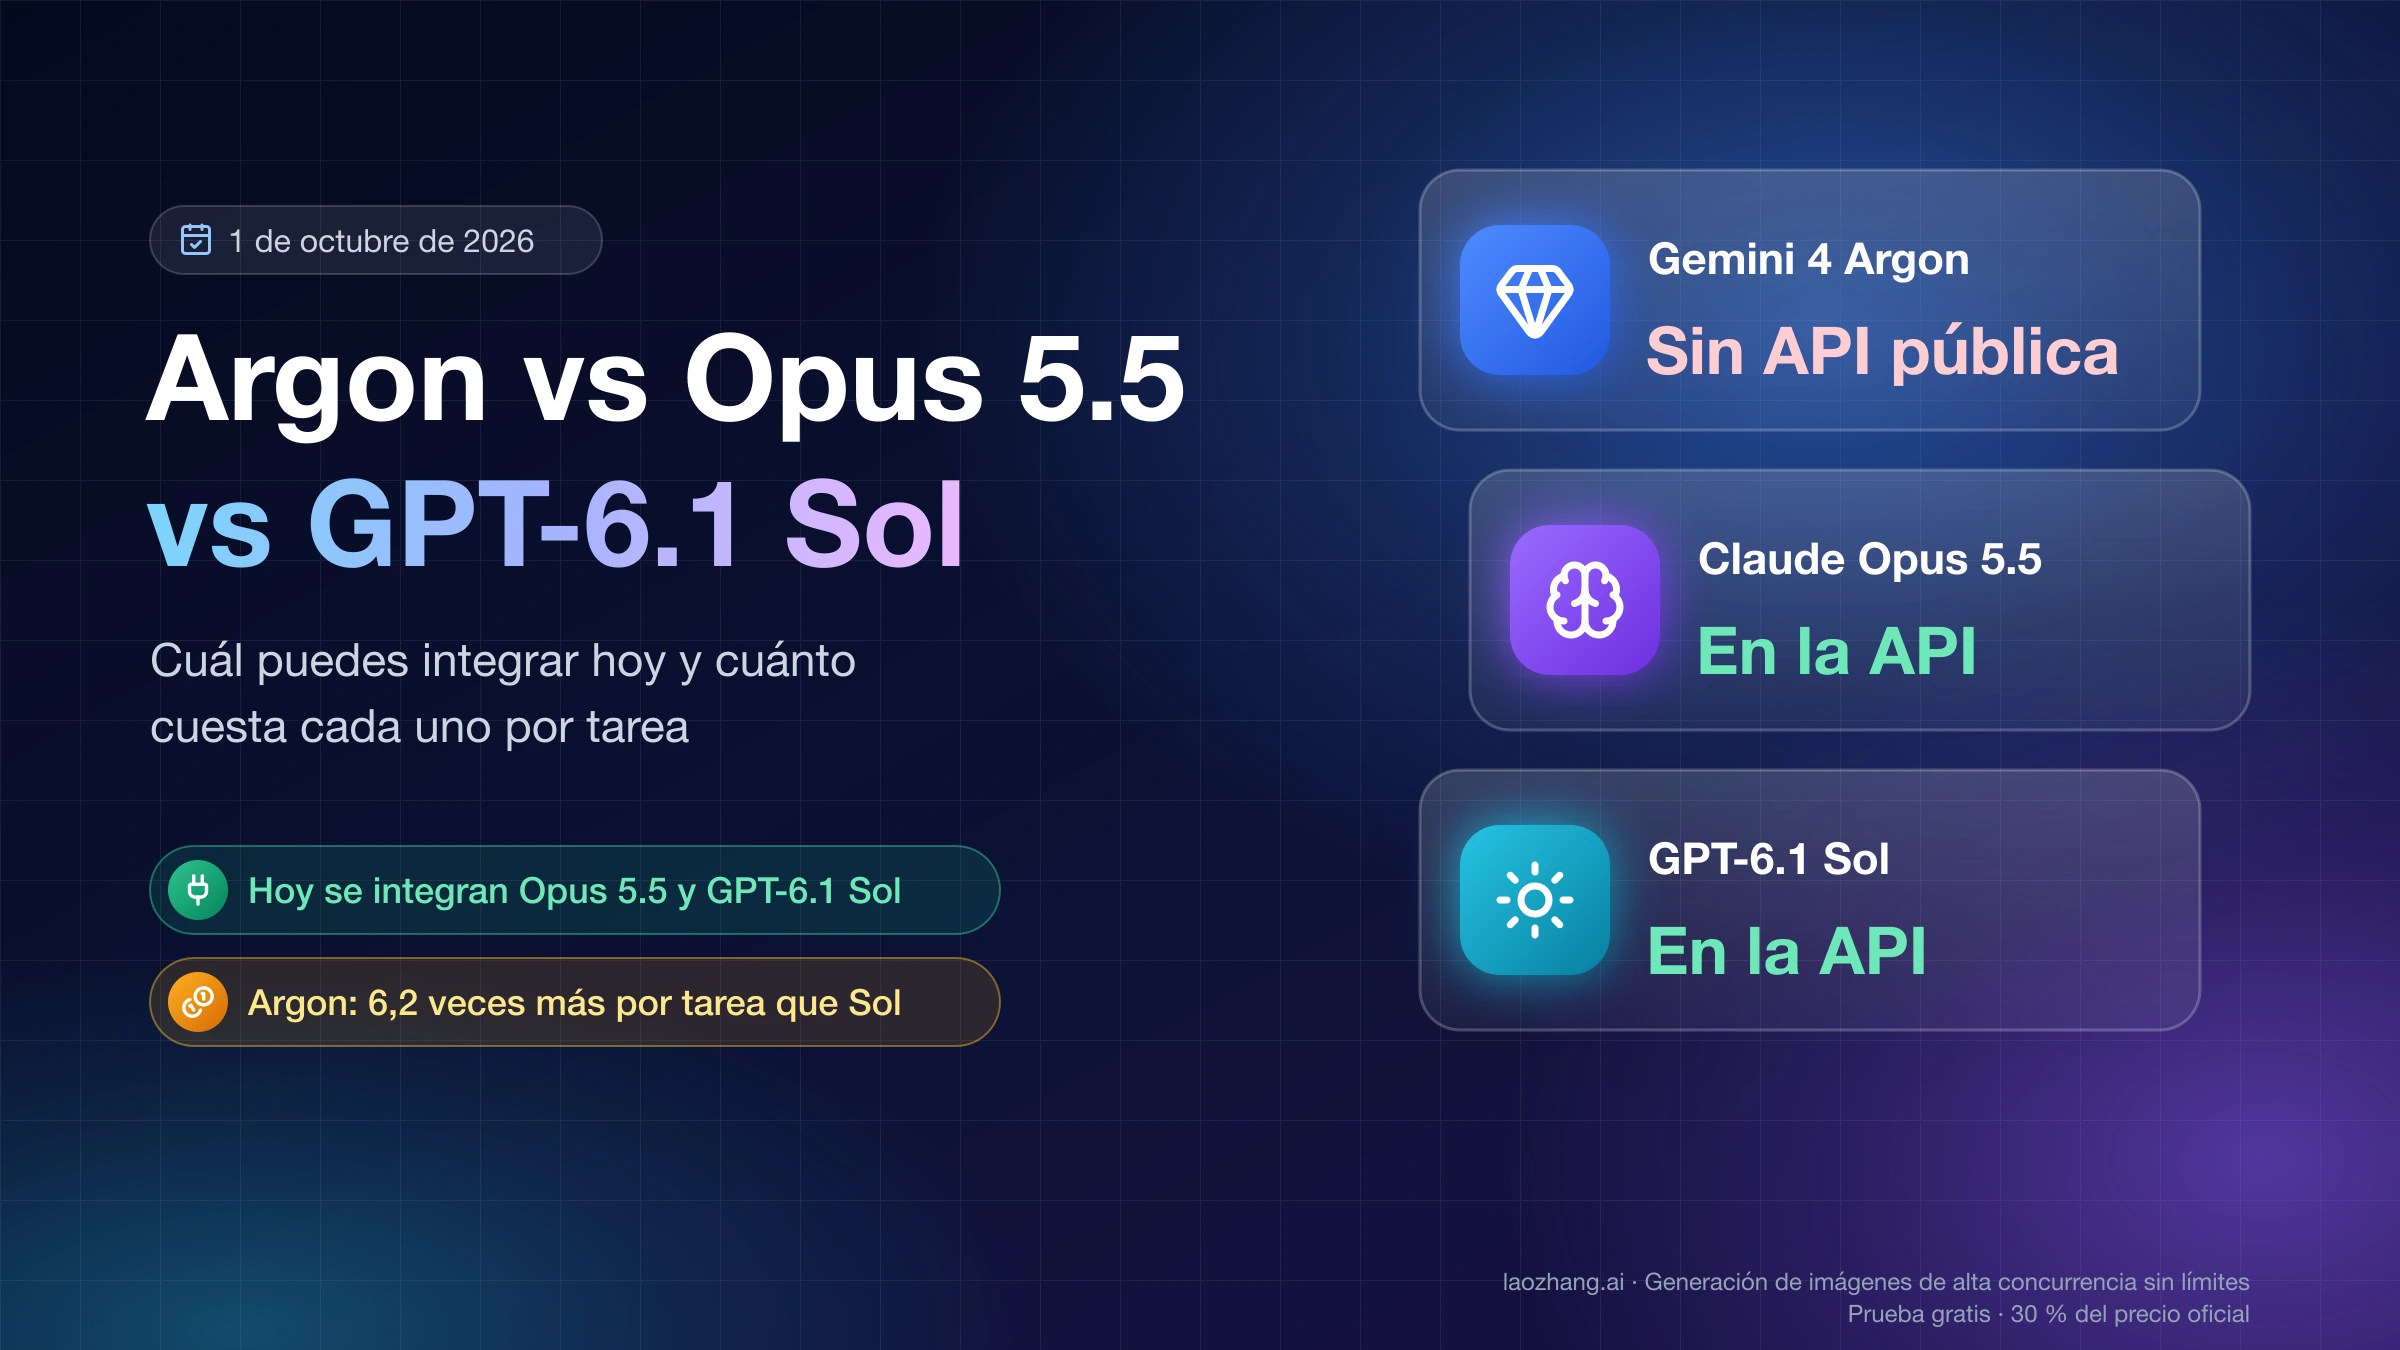
Sí, en los dos lados. OpenAI presenta GPT-6.1 Sol, a 2 $ / 10 $ por millón, como un rendimiento cercano al de Astra por menos dinero, y en AA v5.0.1 Sol max suma 55 puntos a 1,27 $ por tarea; la comparación completa está en GPT-6.1 Sol vs Astra vs GPT-6 Sol: cuál usar y si Astra compensa. El escalón más barato de Google es Gemini 3.8 Flash, comparado con una prueba de coste en Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar.
¿Y Gemini 4 Carbon?
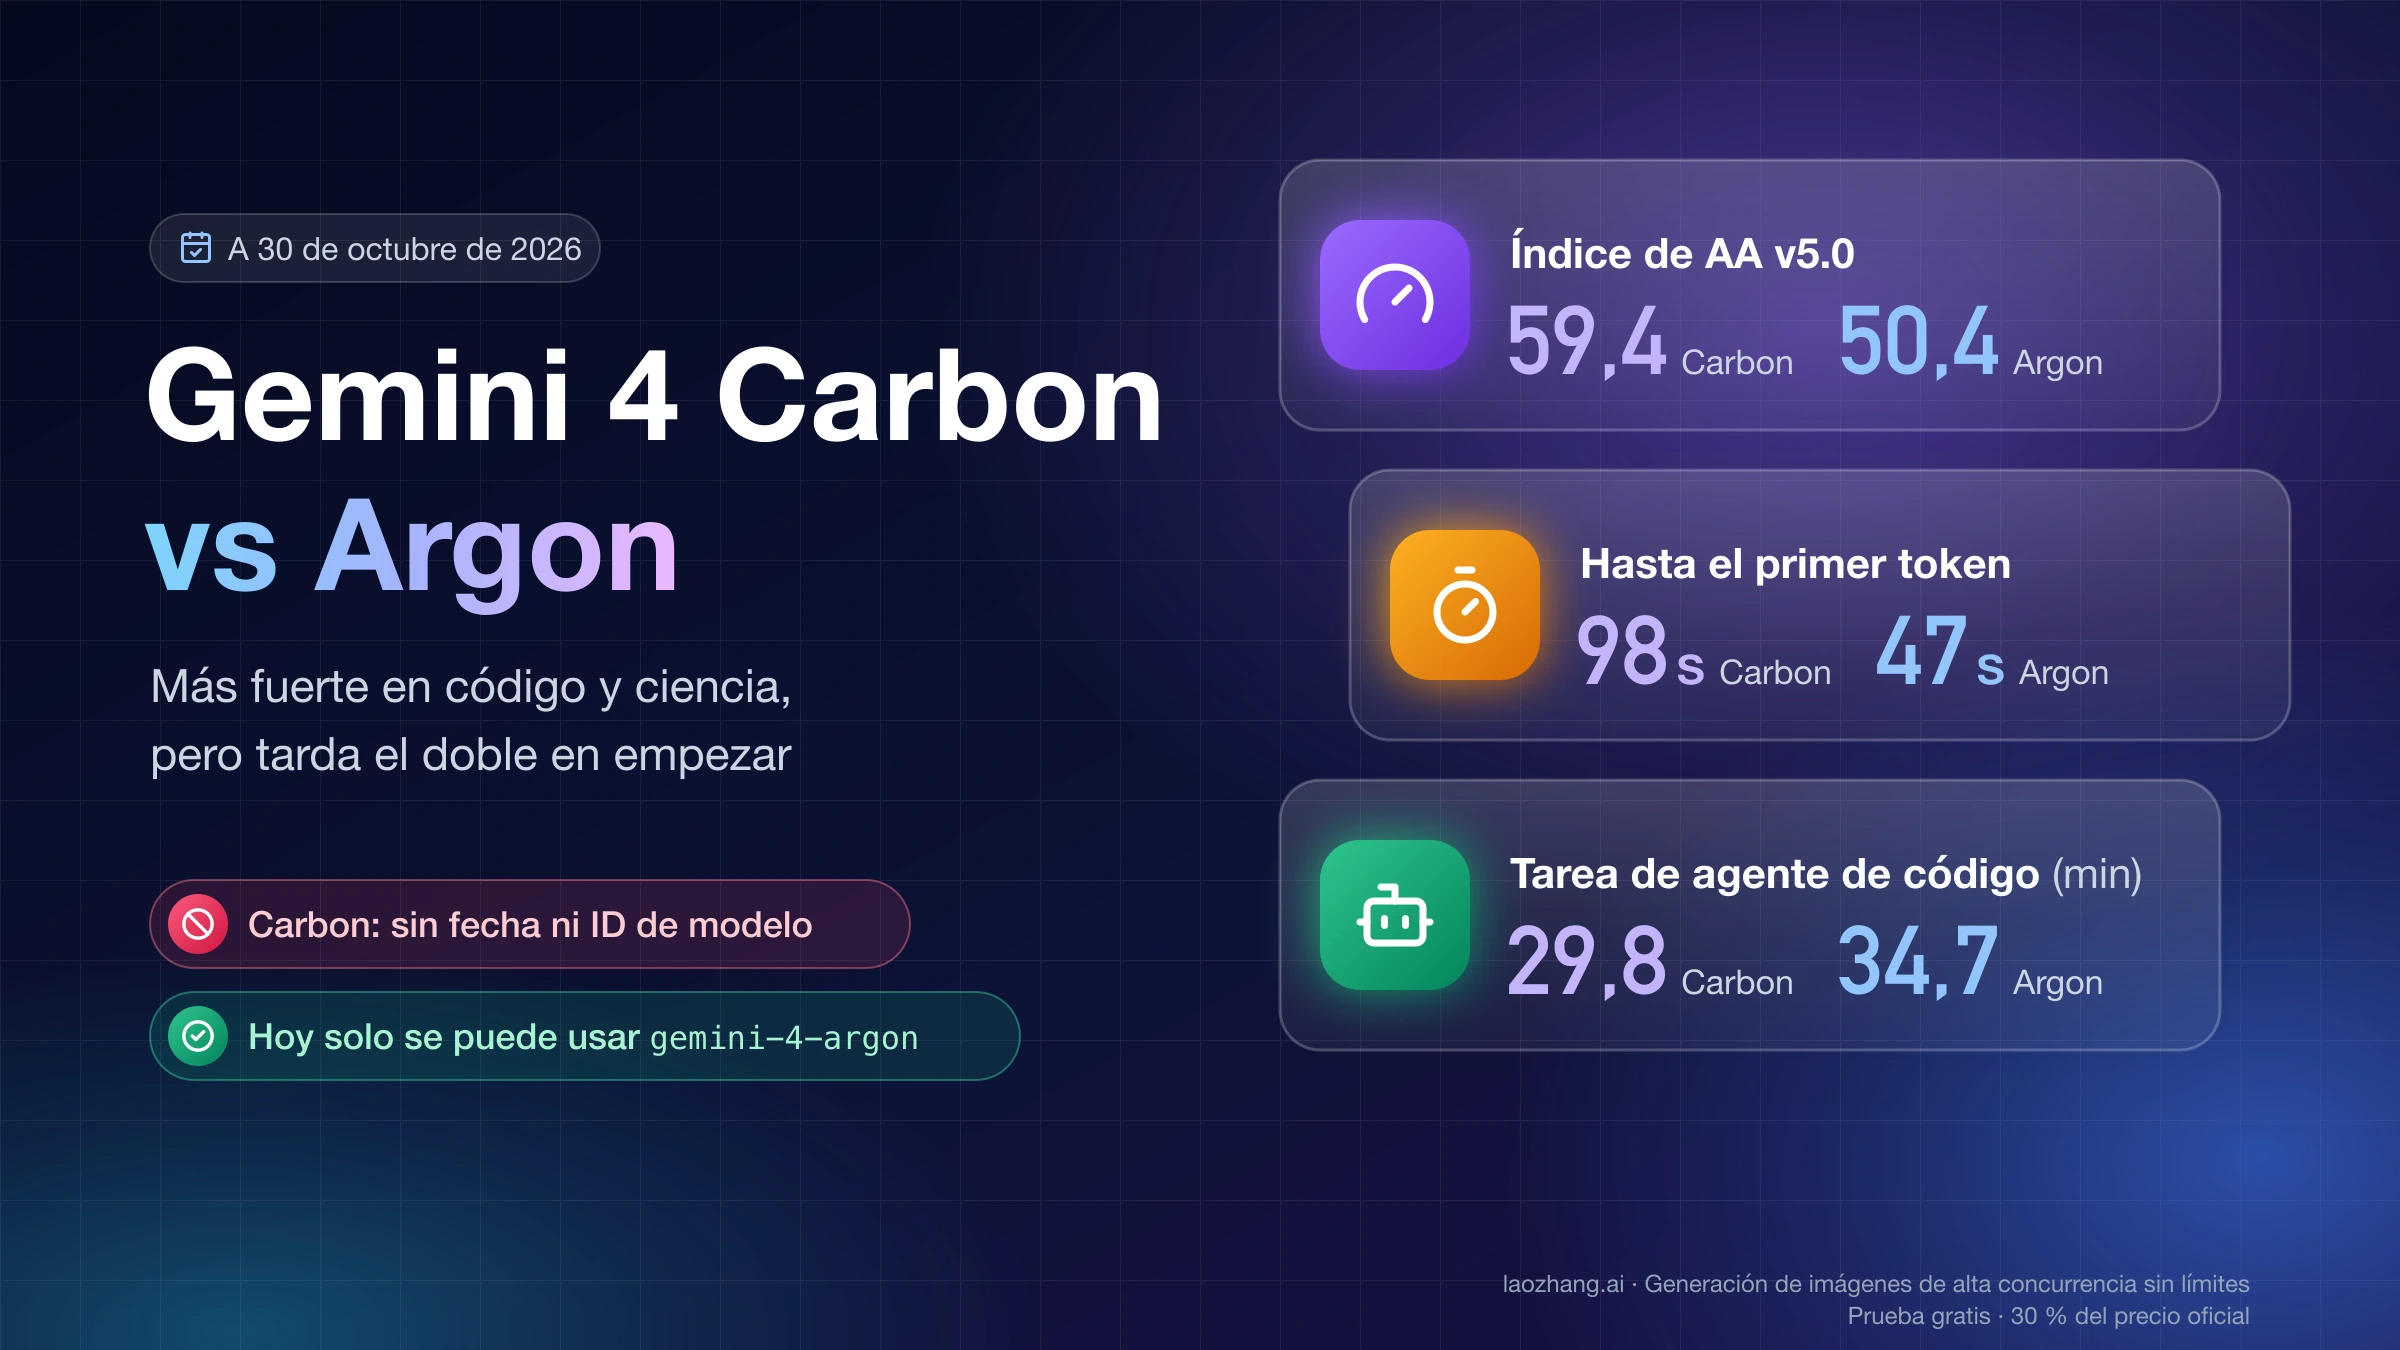
Gemini 4 Carbon se anunció el 28 de octubre de 2026 solo para los equipos de ciberseguridad del programa Fairwind y, a 4 de noviembre, no tiene identificador público en la API ni fecha de apertura, así que no se puede contratar como alternativa a Astra. Lo que se sabe de él está en Gemini 4 Carbon vs Argon: dónde gana, cuánto cuesta y si cambiar.
¿GPT-6 Astra es lo mismo que GPT-6?
No exactamente: Astra es el modelo más potente de la familia GPT-6, junto a Sol y Luna, y no existe un «GPT-6.1 Astra». Las diferencias de precio y uso entre ellos están en GPT-6 Sol, Luna y Astra frente a Terra 6.1: precios y cuál usar.
¿Y si también estoy valorando Claude Opus 5.5 o Sonnet 5.5?
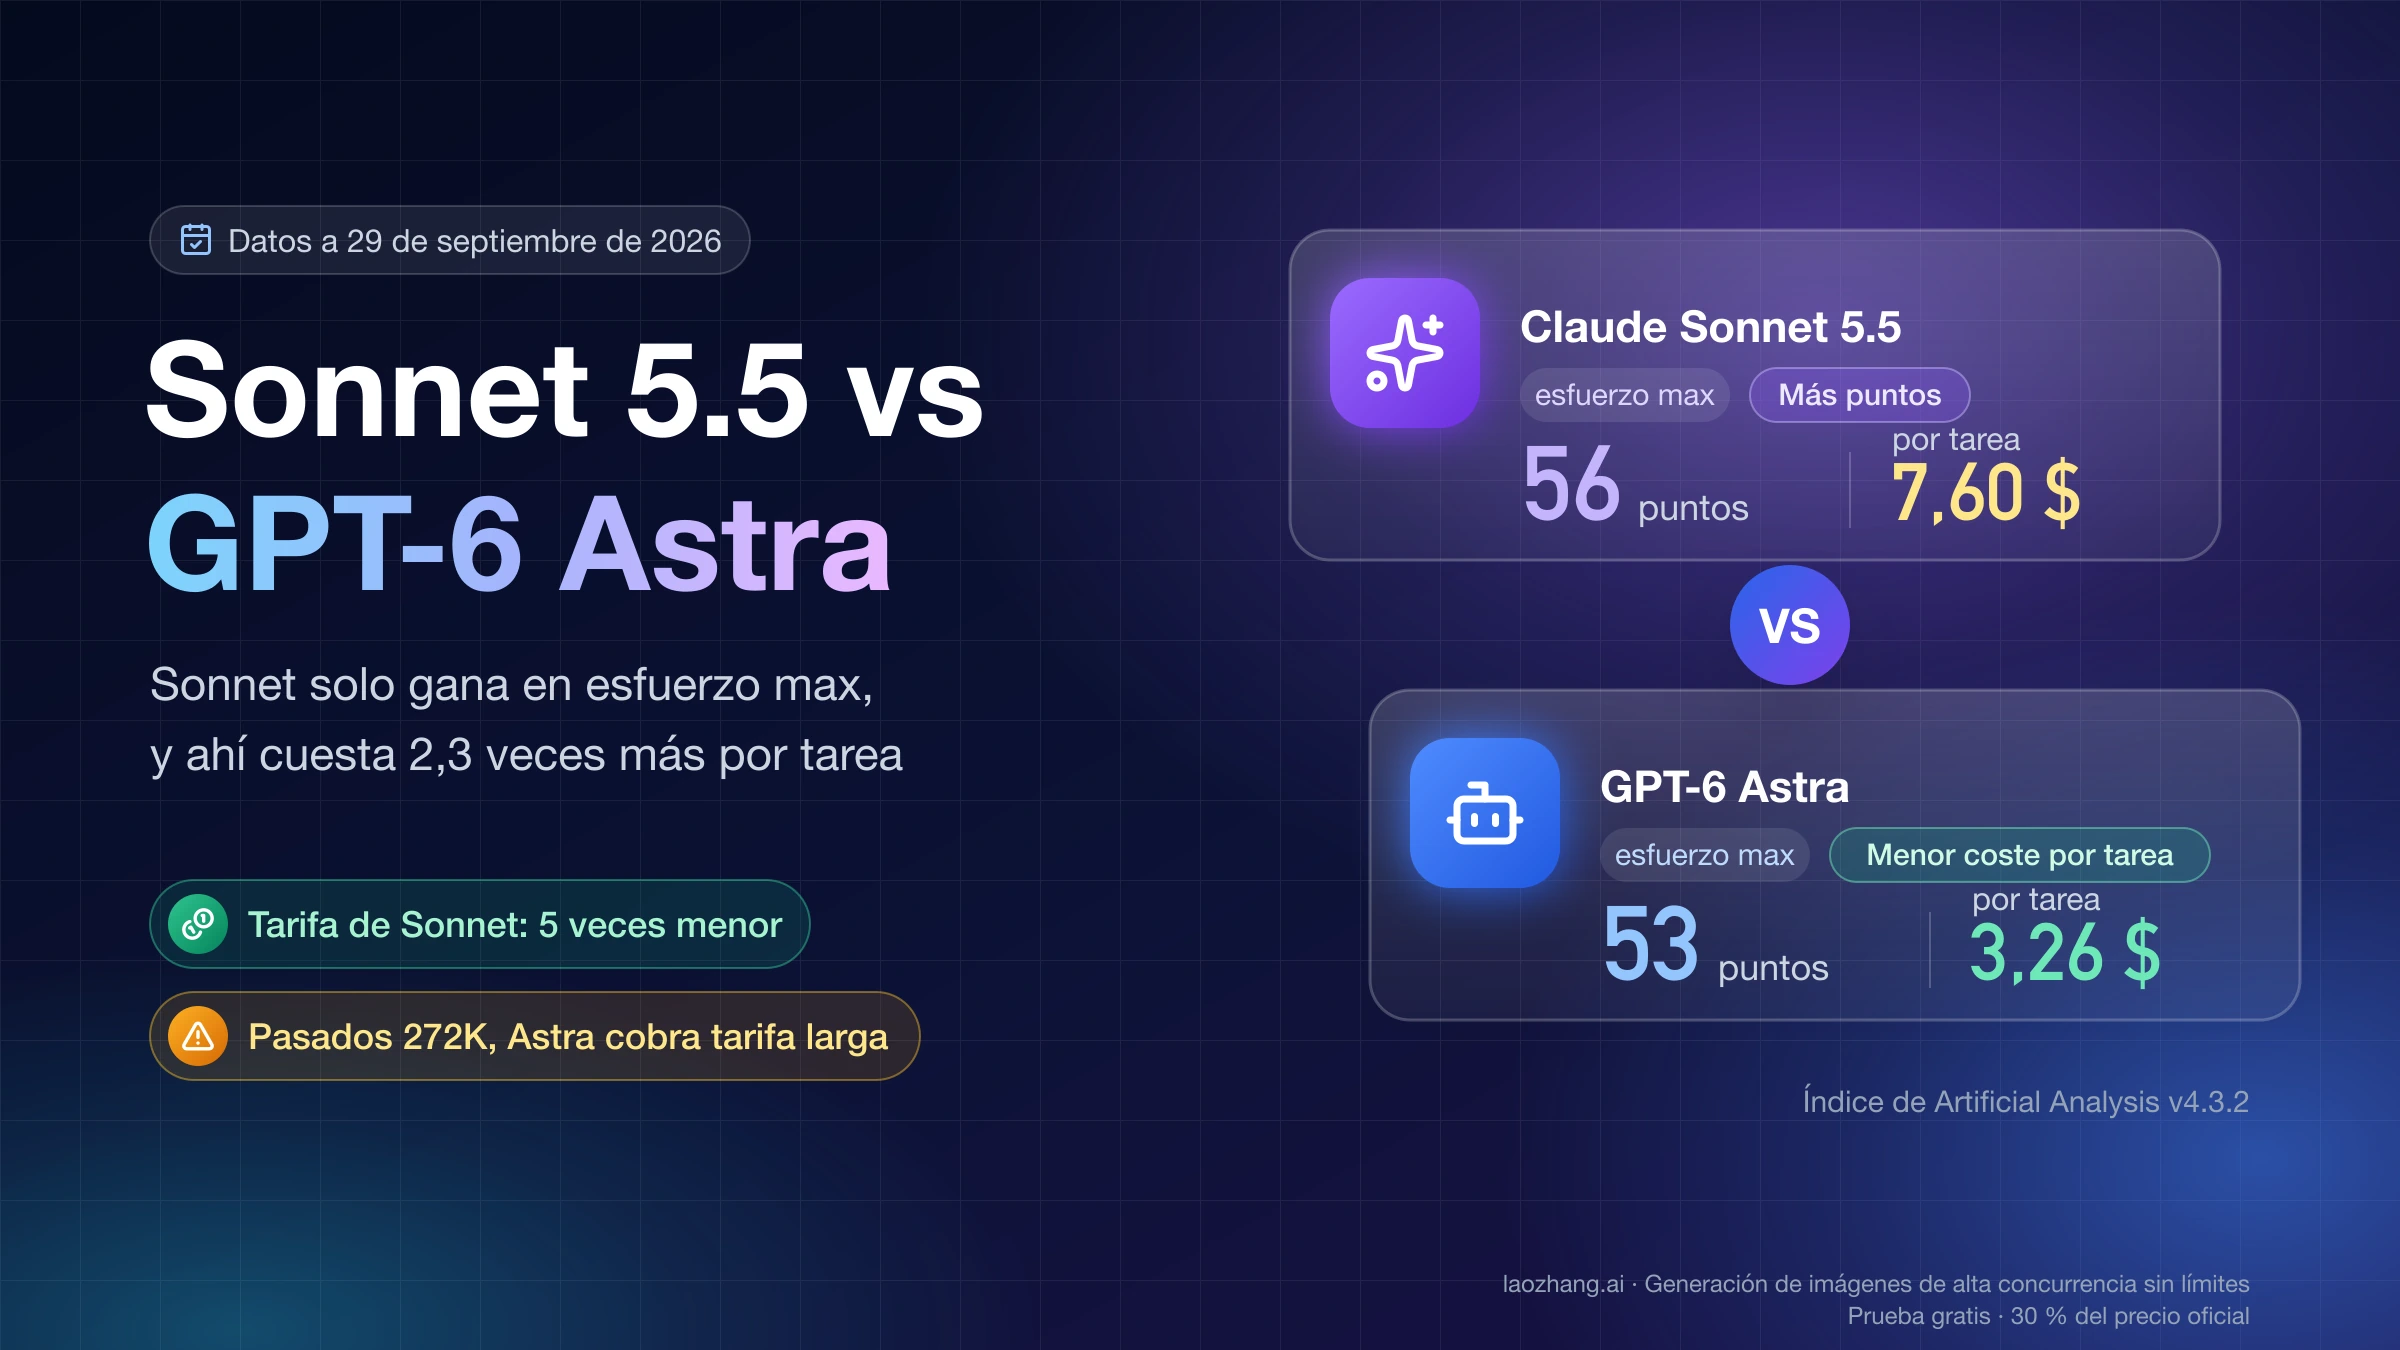
Argon frente a Opus 5.5 y GPT-6.1 Sol, con coste por tarea y el cambio de precio de diciembre, está en Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy. Si la duda es entre Astra y el modelo intermedio de Anthropic, sigue con Claude Sonnet 5.5 vs GPT-6 Astra: cuándo cambiar y qué pagas.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 4 nov 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 4 nov 2026.
- 1.comparativa de Artificial Analysis entre Gemini 4 Argon y GPT-6 Astraartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gpt-6-astra
- 2.ficha de Gemini 4 Argon en Artificial Analysisartificialanalysis.ai/models/gemini-4-argon
- 3.documentación de razonamiento de la Gemini APIai.google.dev/gemini-api/docs/thinking
- 4.presentación de Gemini 4 Argon en el blog de Googleblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 5.Vals Index de Gemini 4 Argonvals.ai/models/google_gemini-4-argon
- 6.página de precios de la Gemini APIai.google.dev/gemini-api/docs/pricing
- 7.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing