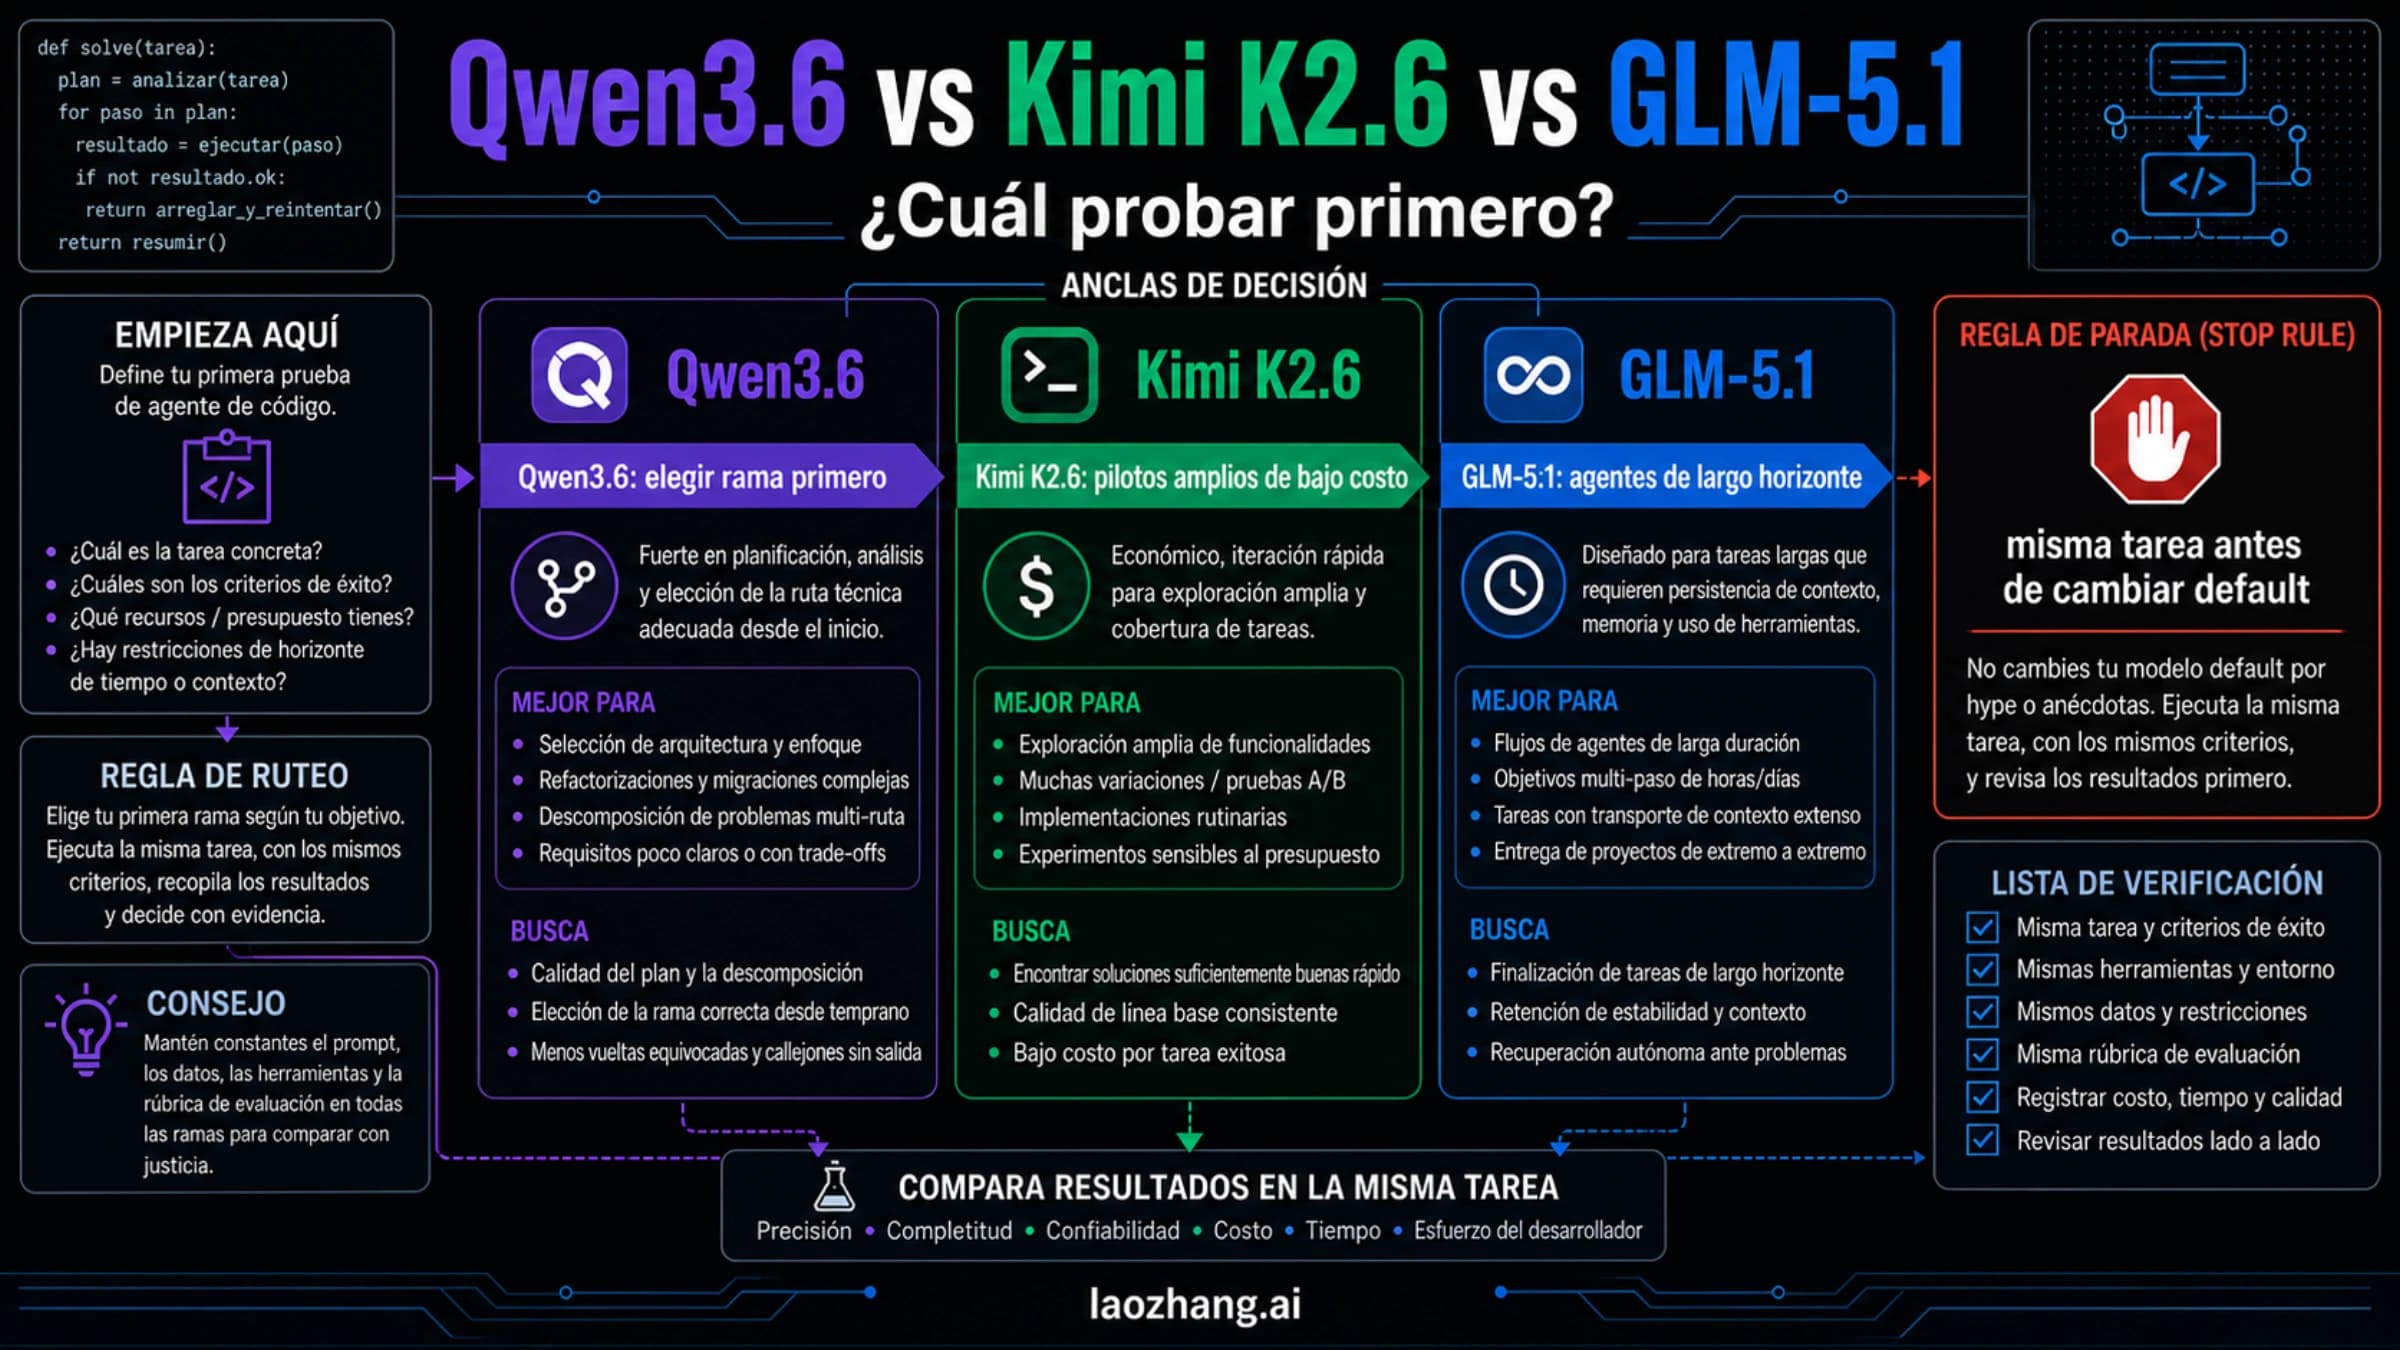
Qwen3.6 vs Kimi K2.6 vs GLM-5.1: cuál probar primero
Prueba primero GLM-5.1 para agentes de largo recorrido, Kimi K2.6 para pilotos baratos y Qwen3.6 solo después de elegir 35B-A3B u otra rama alojada.
10 min
Prueba primero GLM-5.1 para agentes de largo recorrido, Kimi K2.6 para pilotos baratos y Qwen3.6 solo después de elegir 35B-A3B u otra rama alojada.
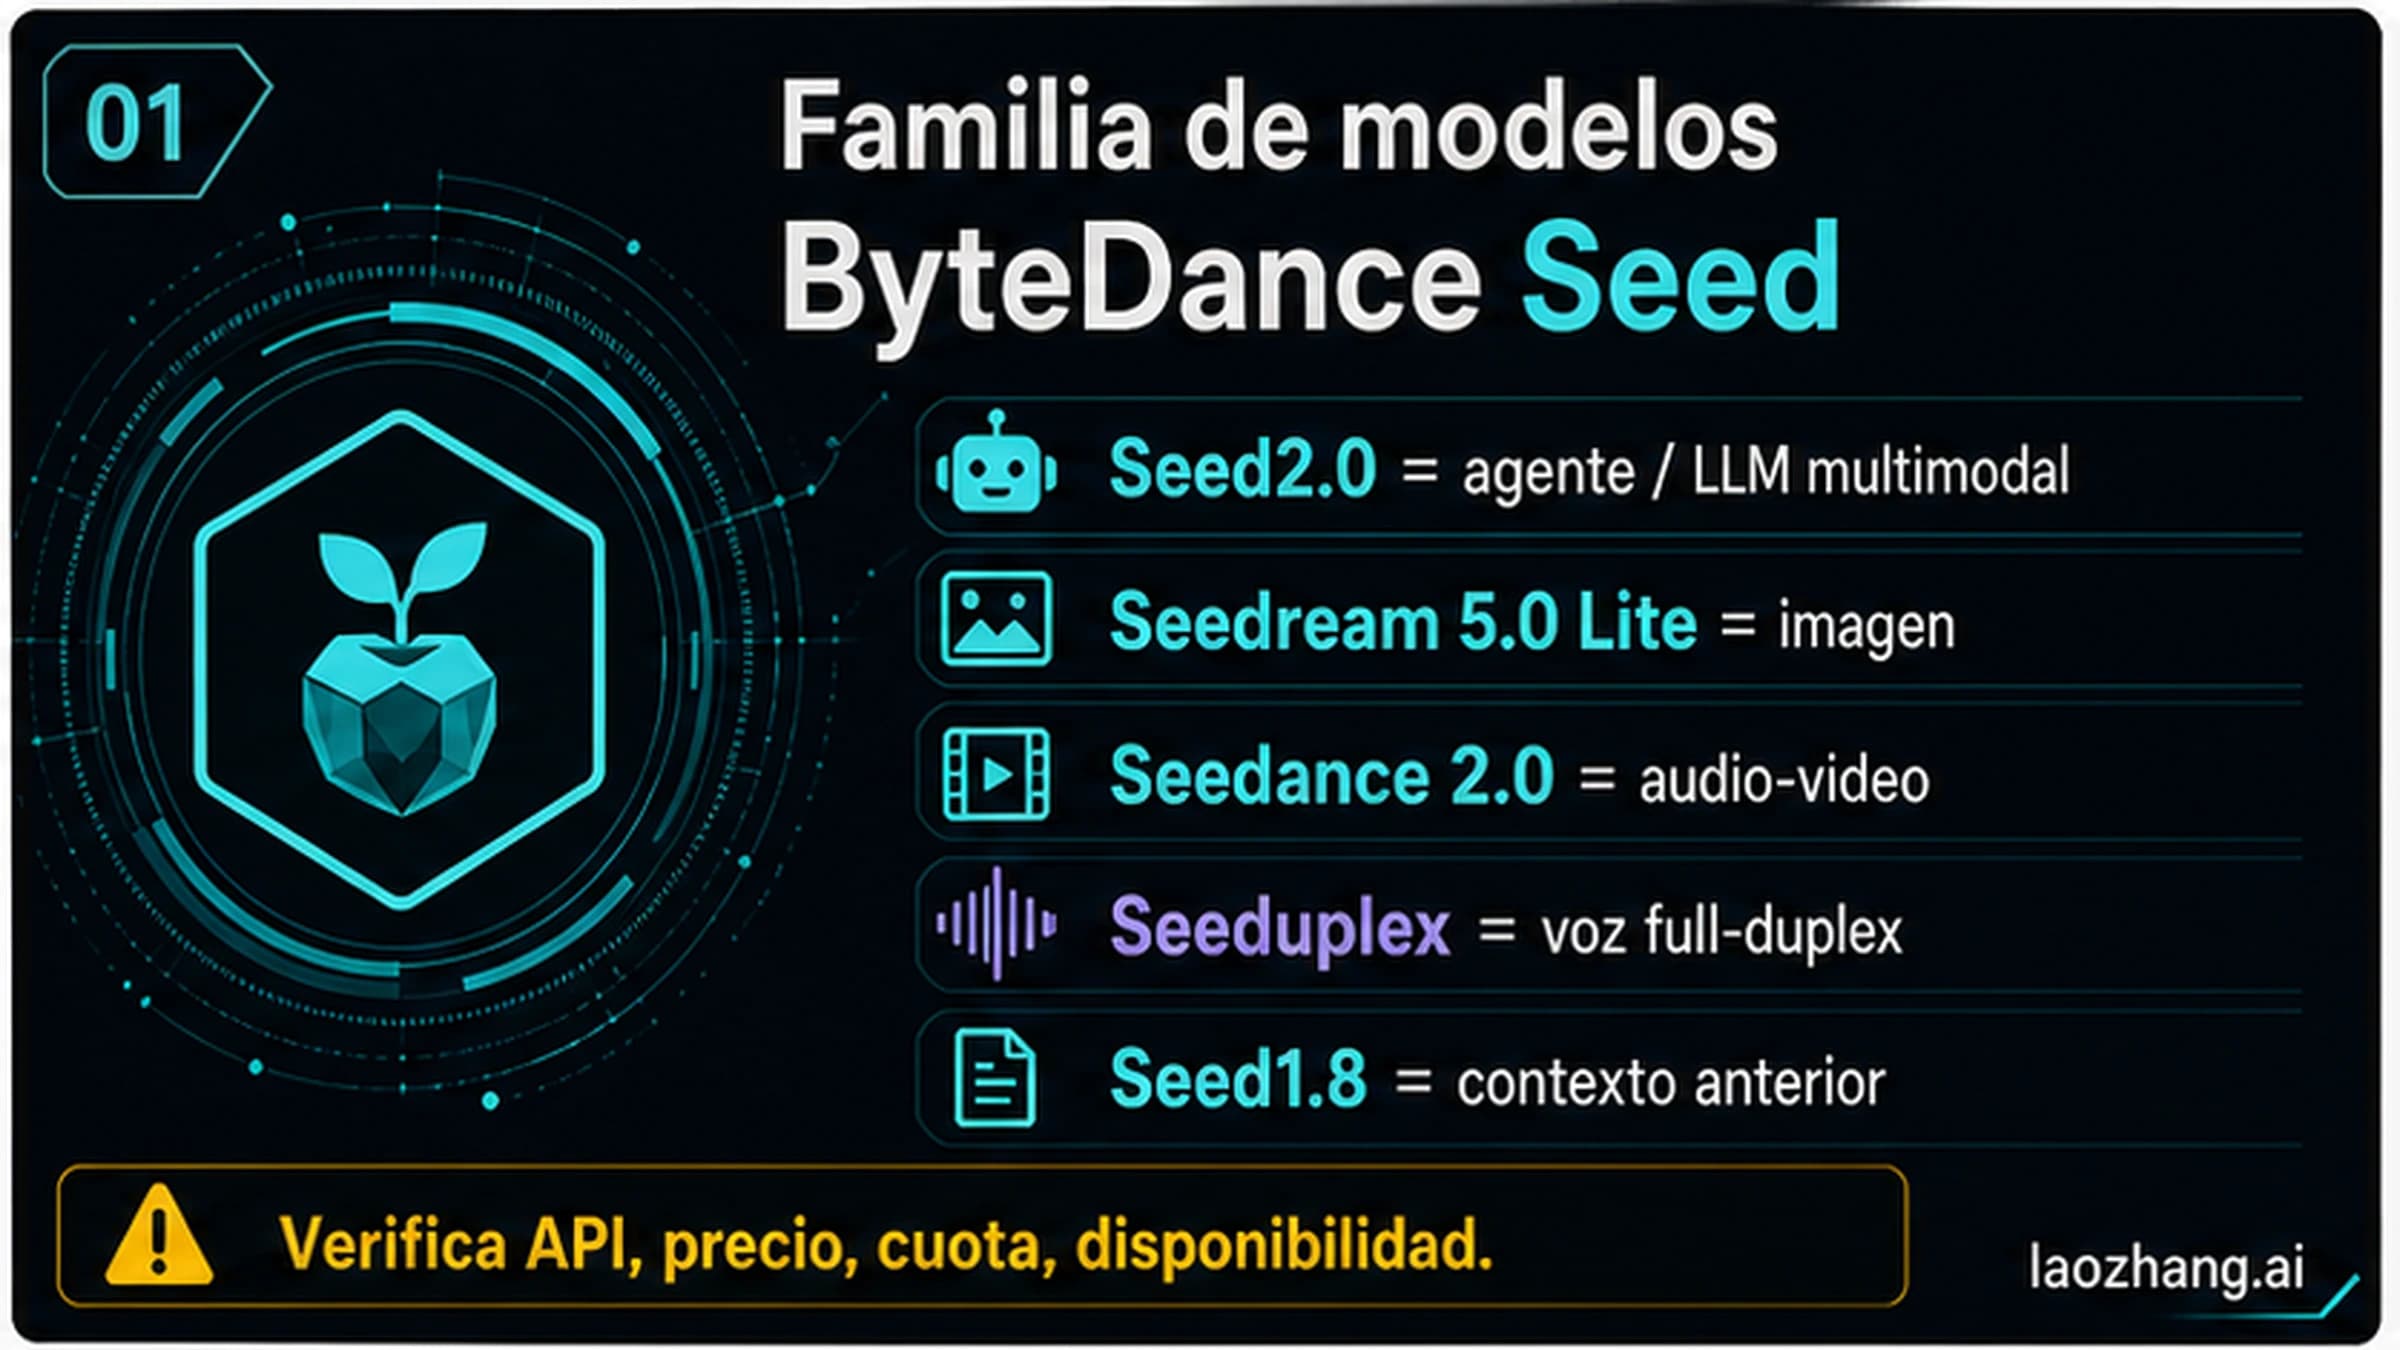
Usa Seed2.0 para trabajo agentic y multimodal, Seedream para imágenes, Seedance para audio-vídeo, Seeduplex para voz, y Seed1.8 solo como contexto previo.
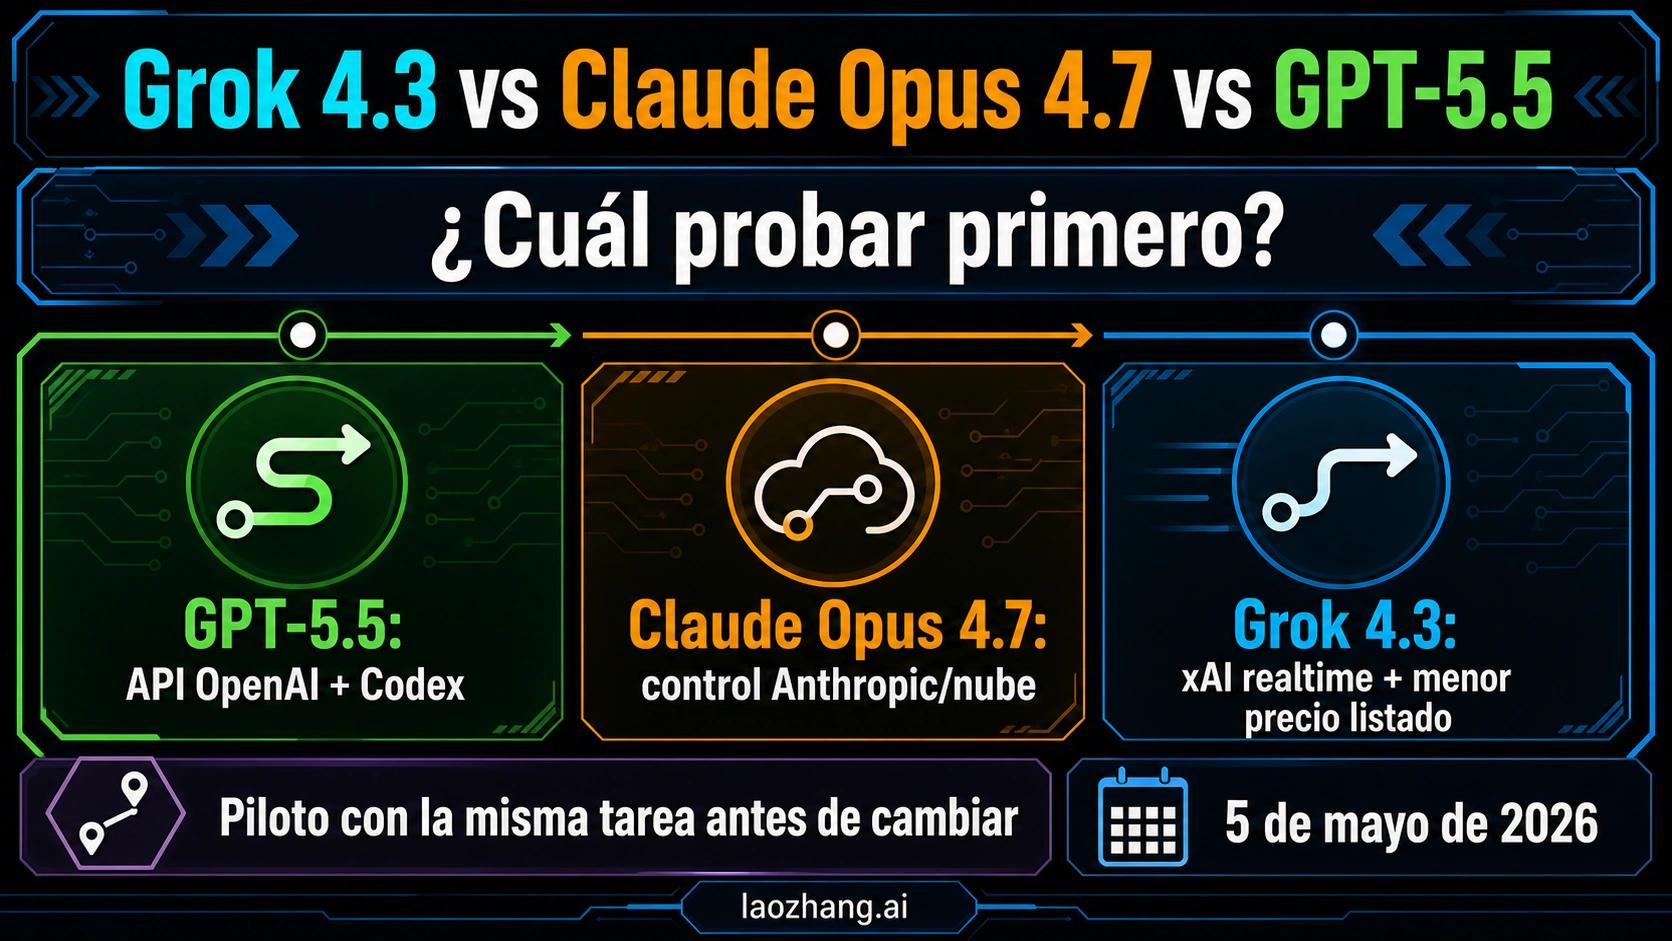
GPT-5.5 es la primera prueba para stacks OpenAI-native, Claude Opus 4.7 es el control premium y Grok 4.3 entra primero por xAI realtime, precio o long-context pilot.
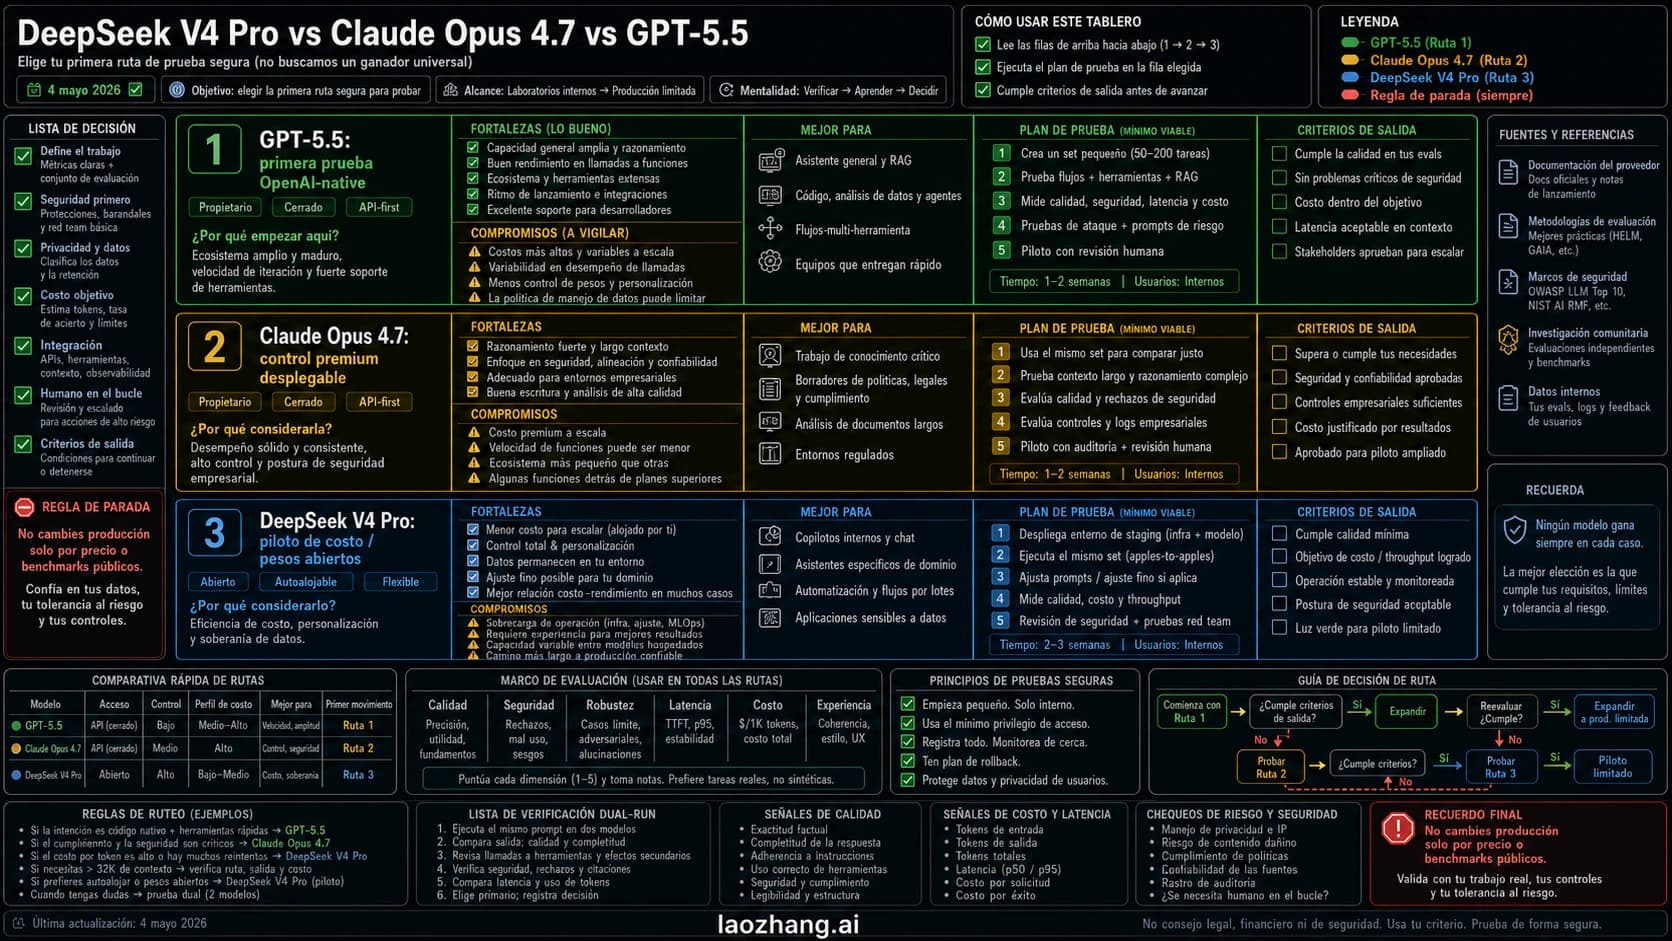
Prueba GPT-5.5 primero en flujos nativos de OpenAI, conserva Claude Opus 4.7 como control premium y usa DeepSeek V4 Pro como piloto de coste u open-weight con validación en la misma tarea.
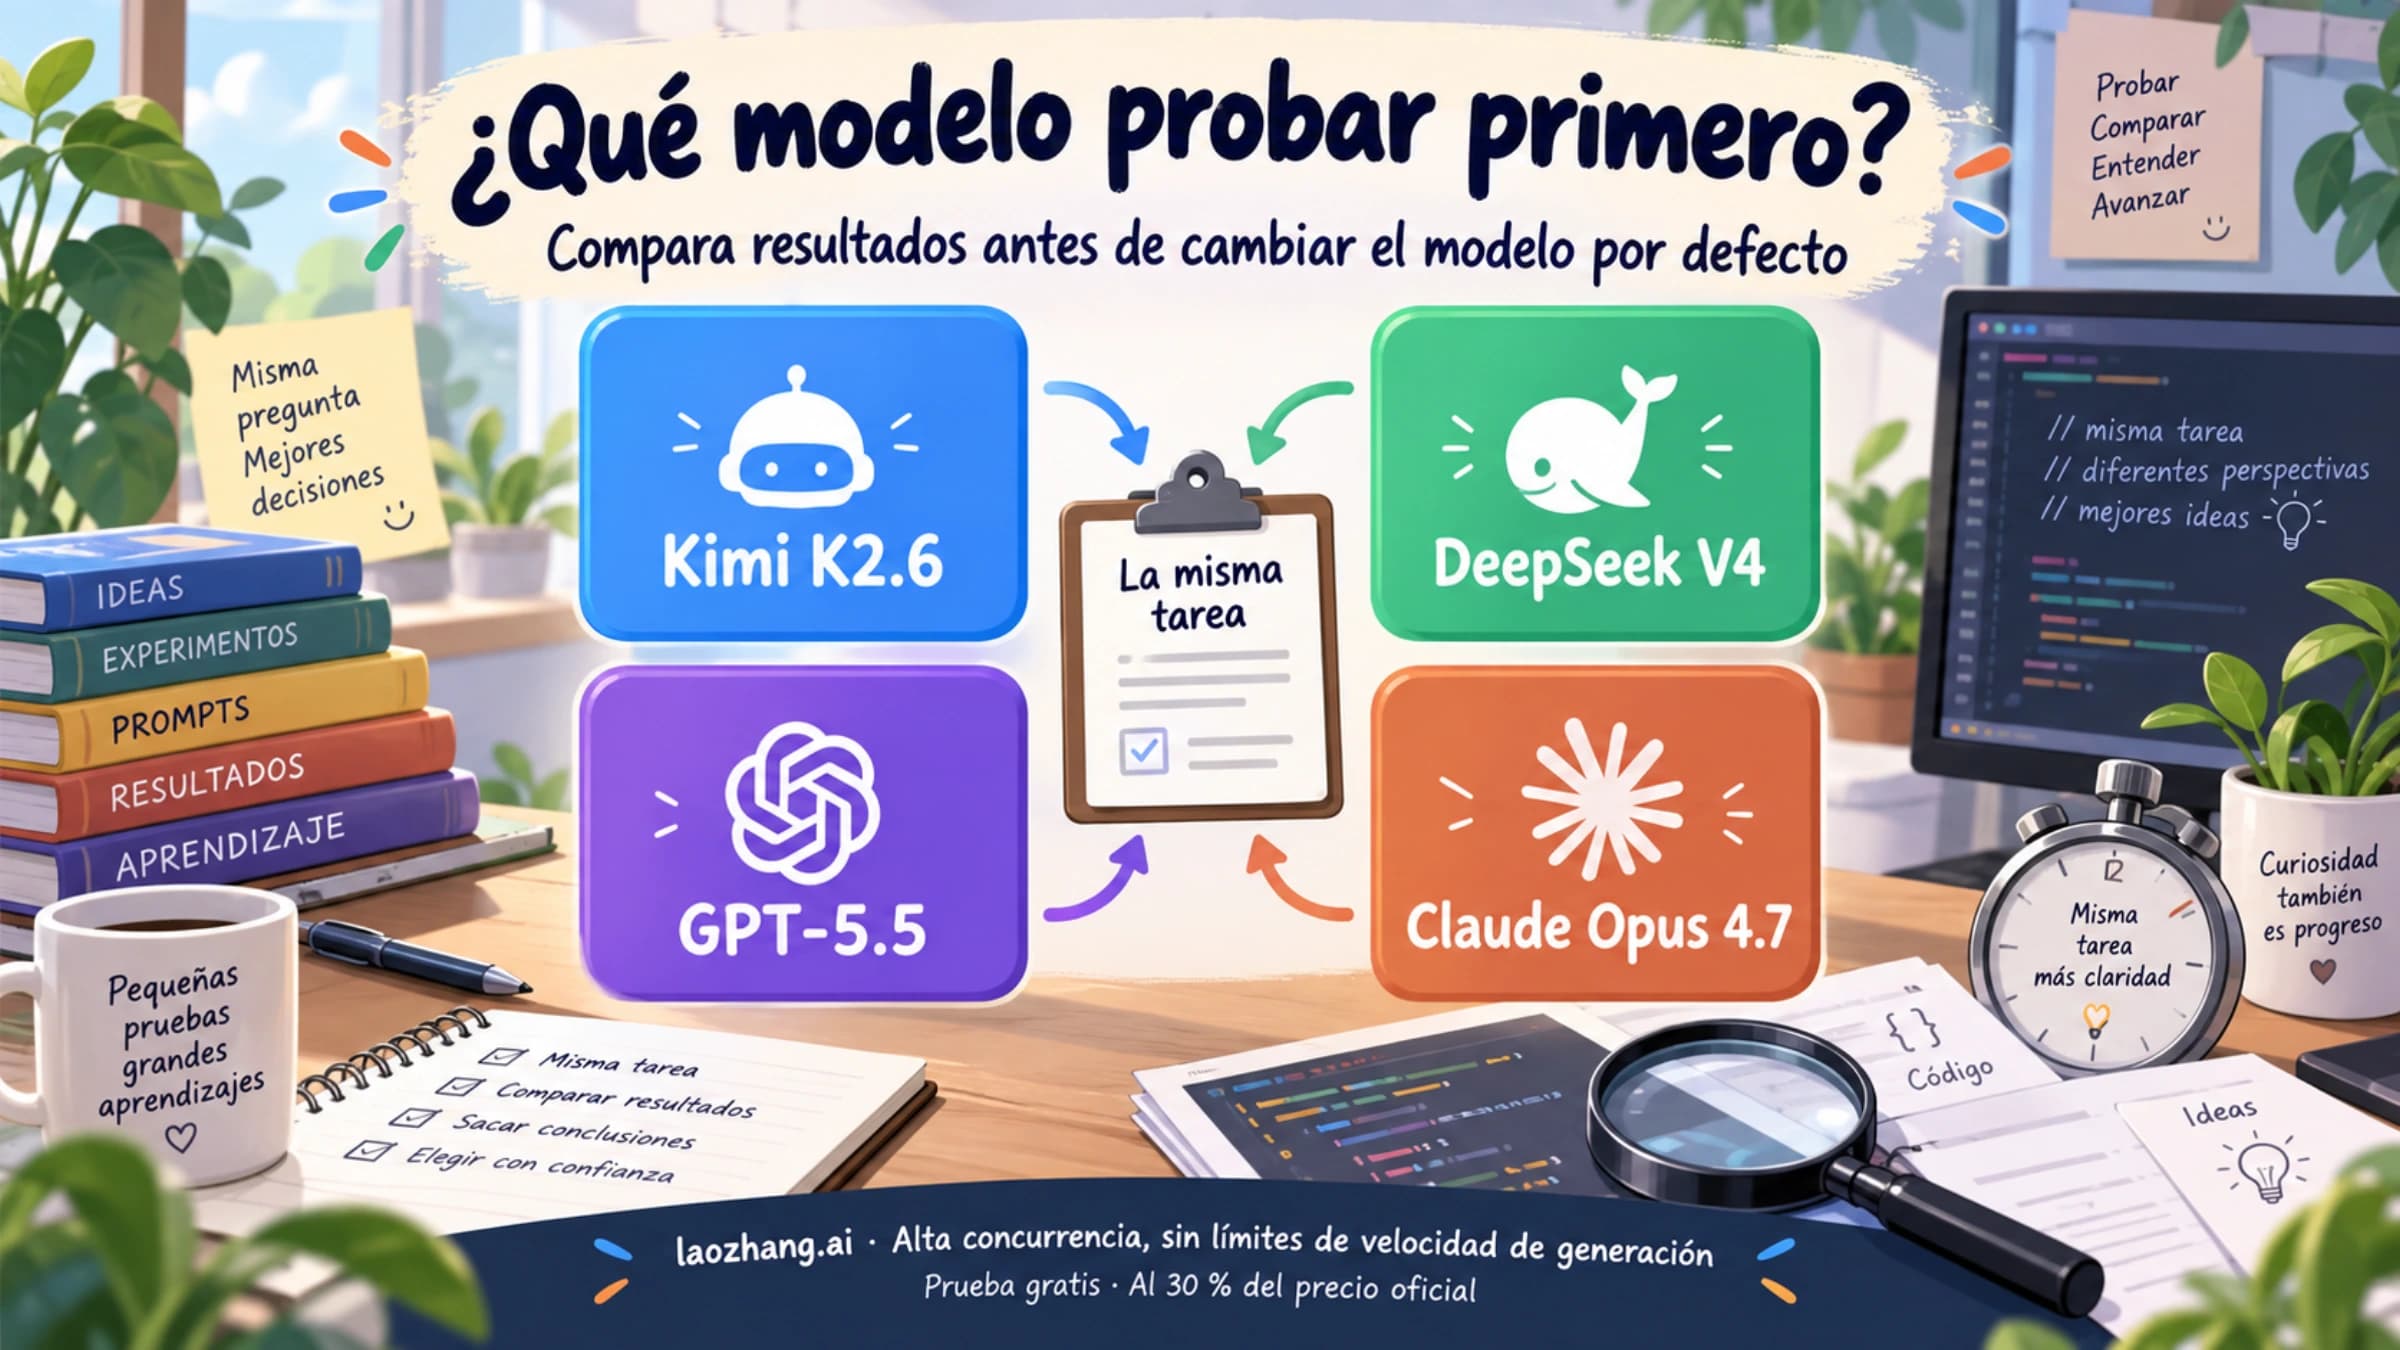
Kimi sirve para pilotos baratos, DeepSeek V4 para la API actual de bajo costo, GPT-5.5 para superficies OpenAI y Opus 4.7 para producción de alto riesgo.
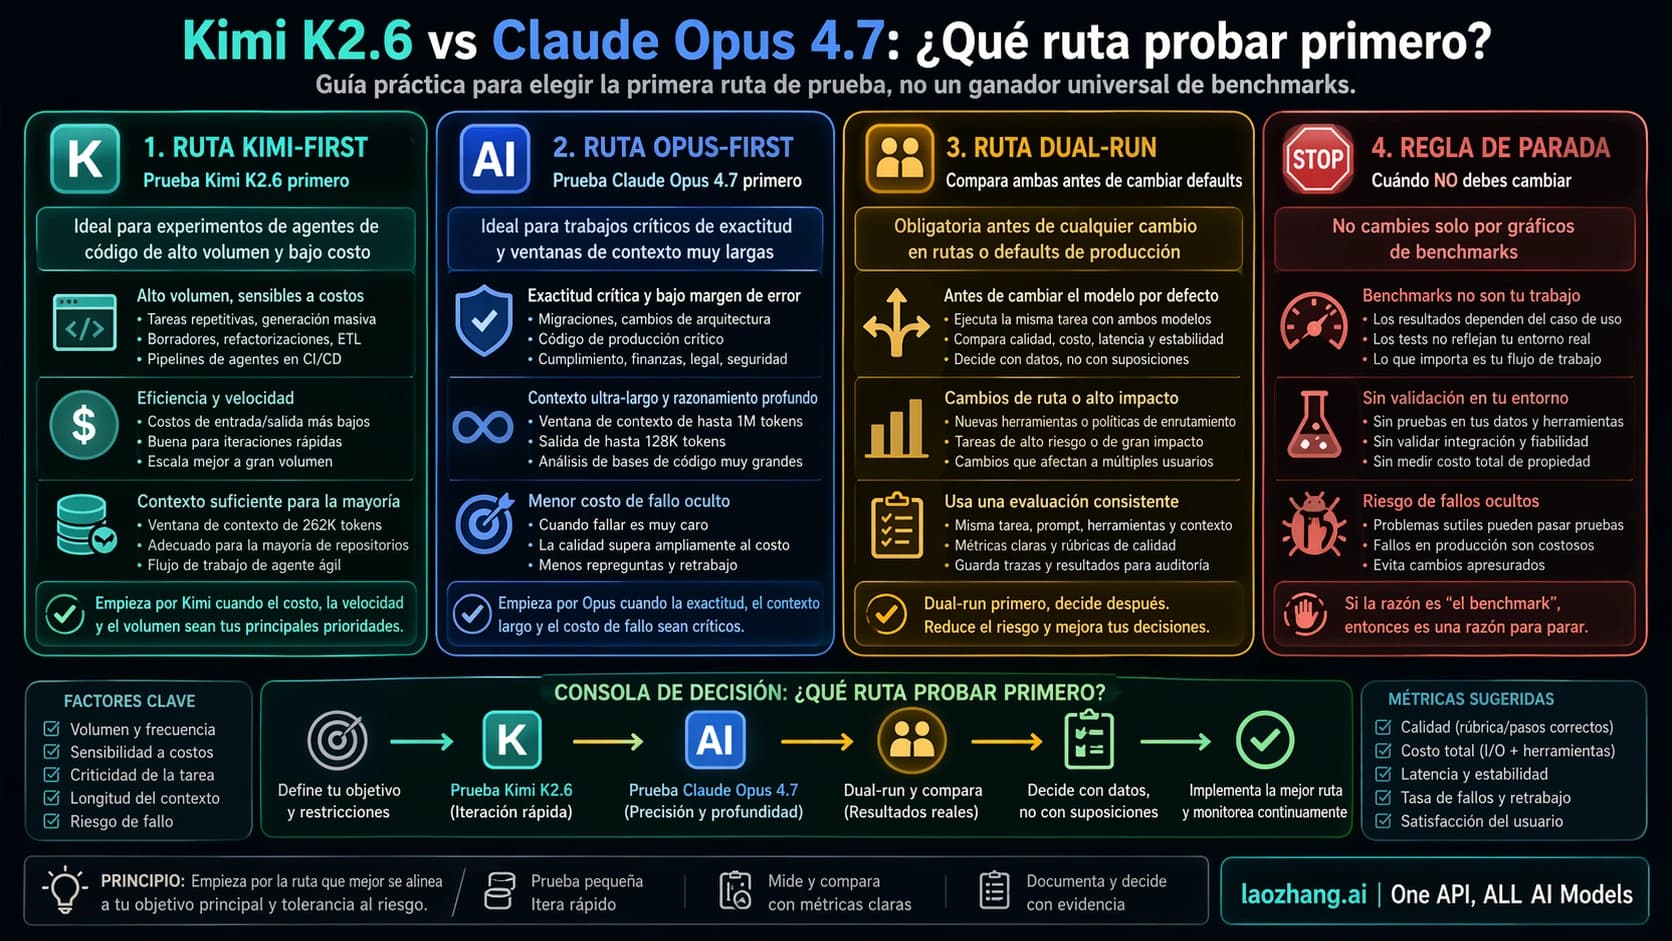
Empieza por Kimi cuando coste y volumen dominen, mantén Opus para producción de alto riesgo y corre dual-run antes de cambiar defaults.
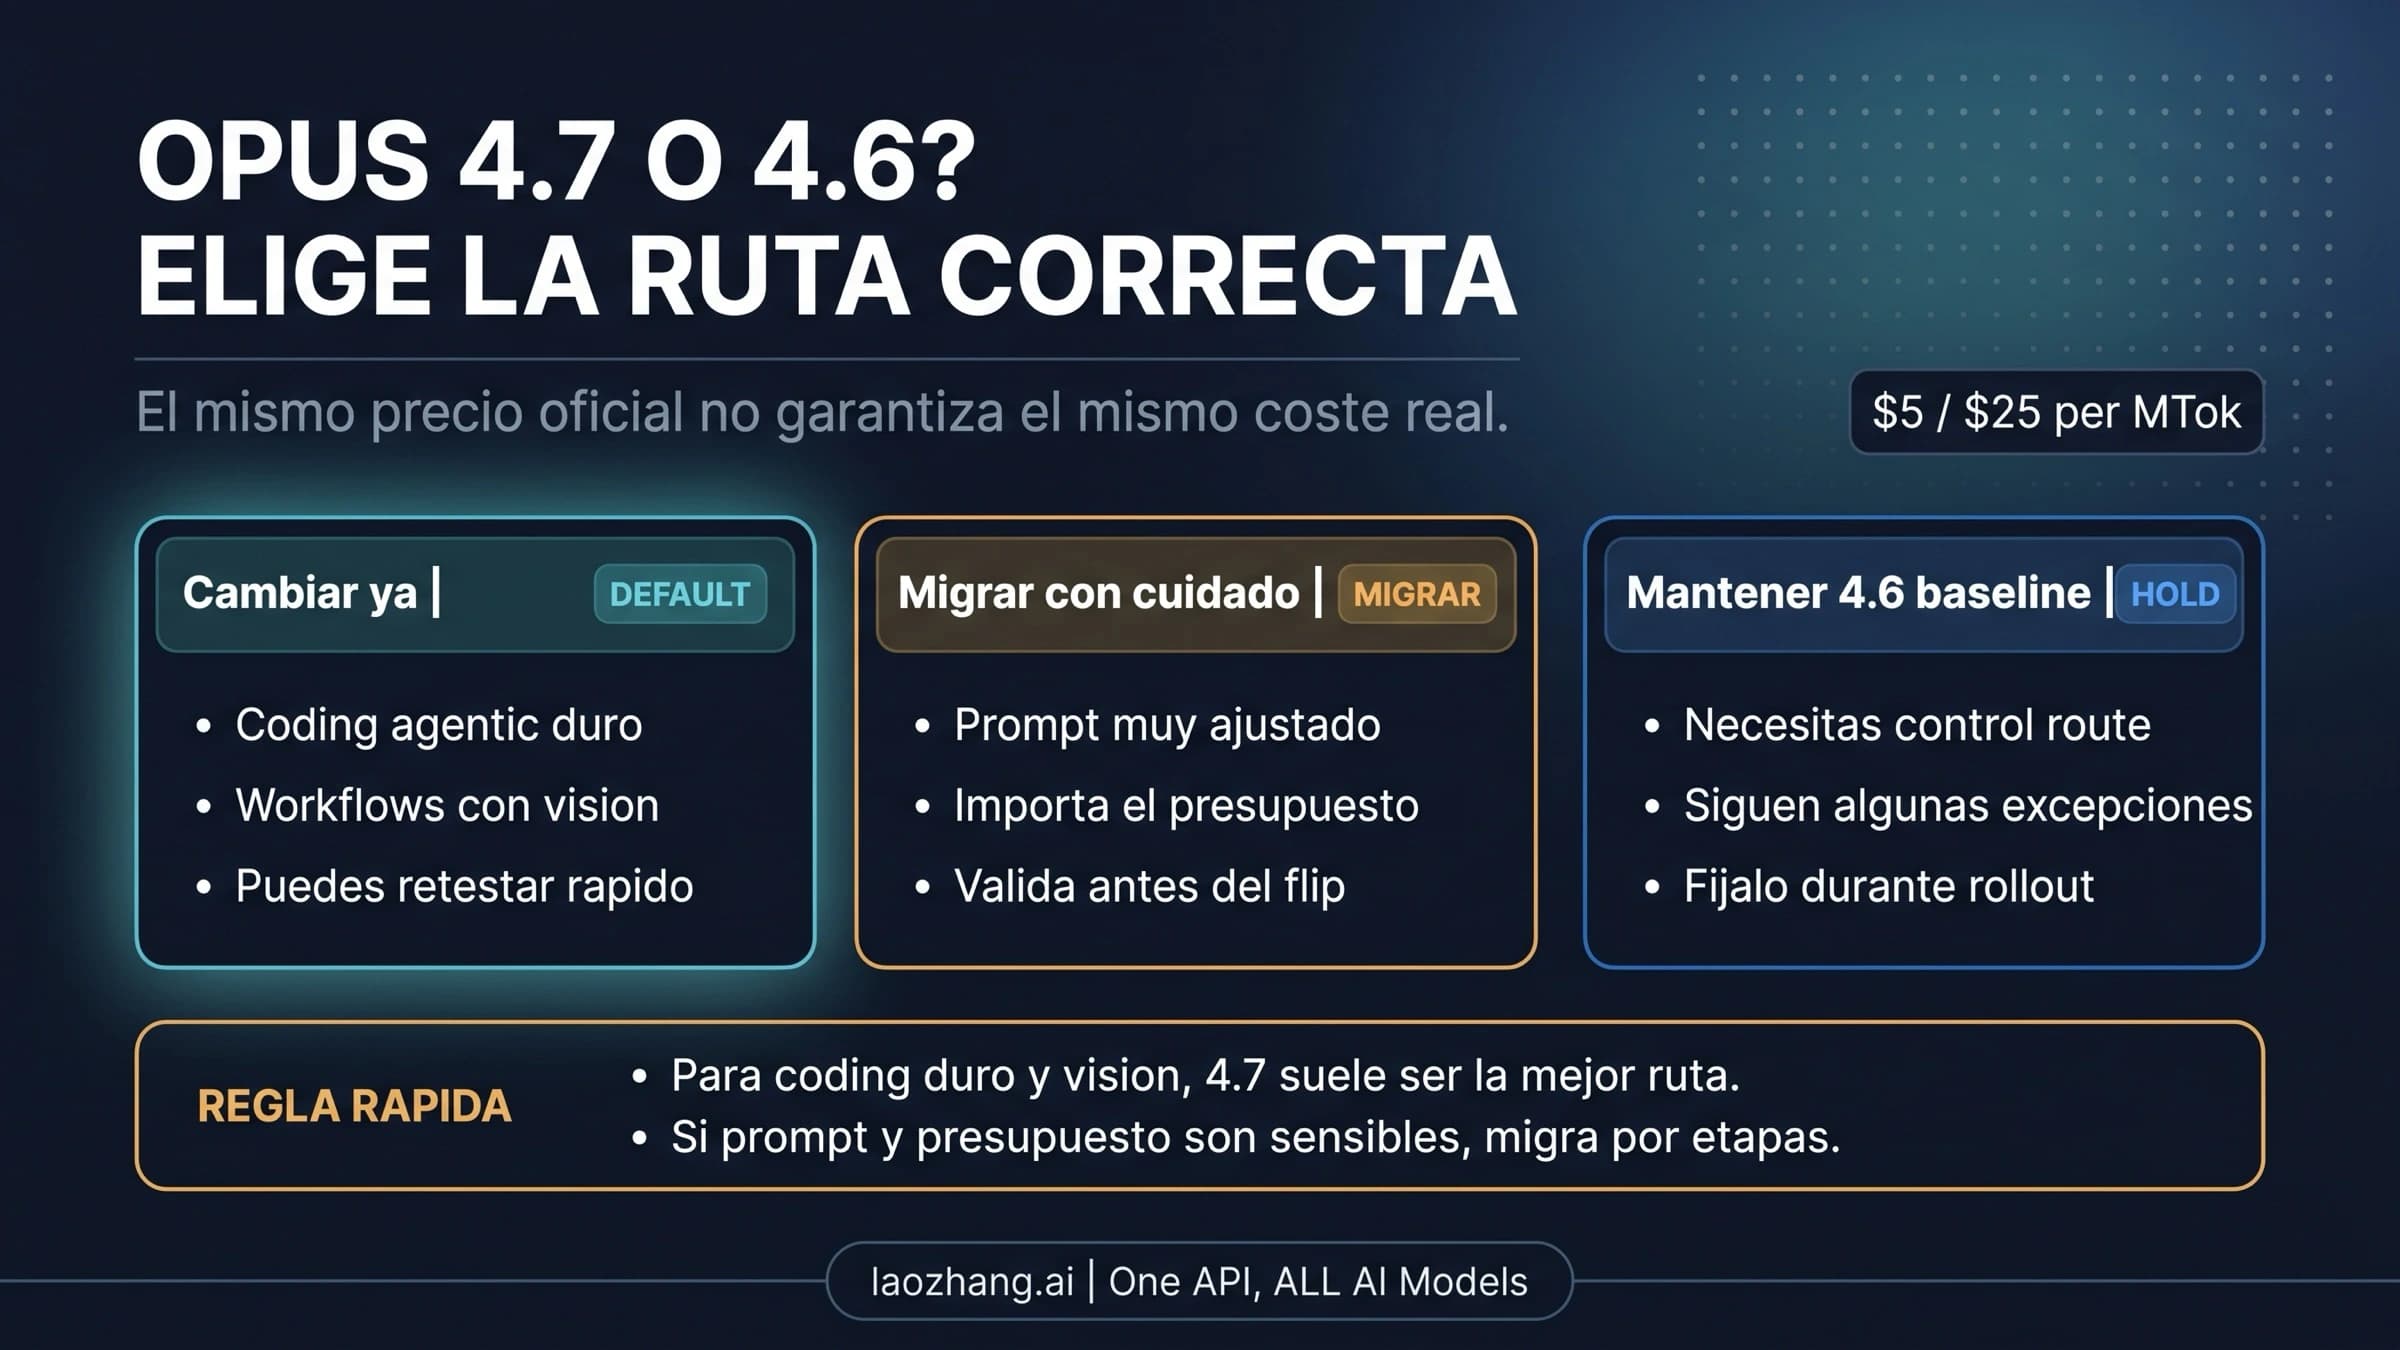
Guía de upgrade orientada a decisiones reales: cuándo pasar de Claude Opus 4.6 a Claude Opus 4.7, cuándo migrar por etapas y por qué el mismo precio oficial no significa el mismo coste operativo.
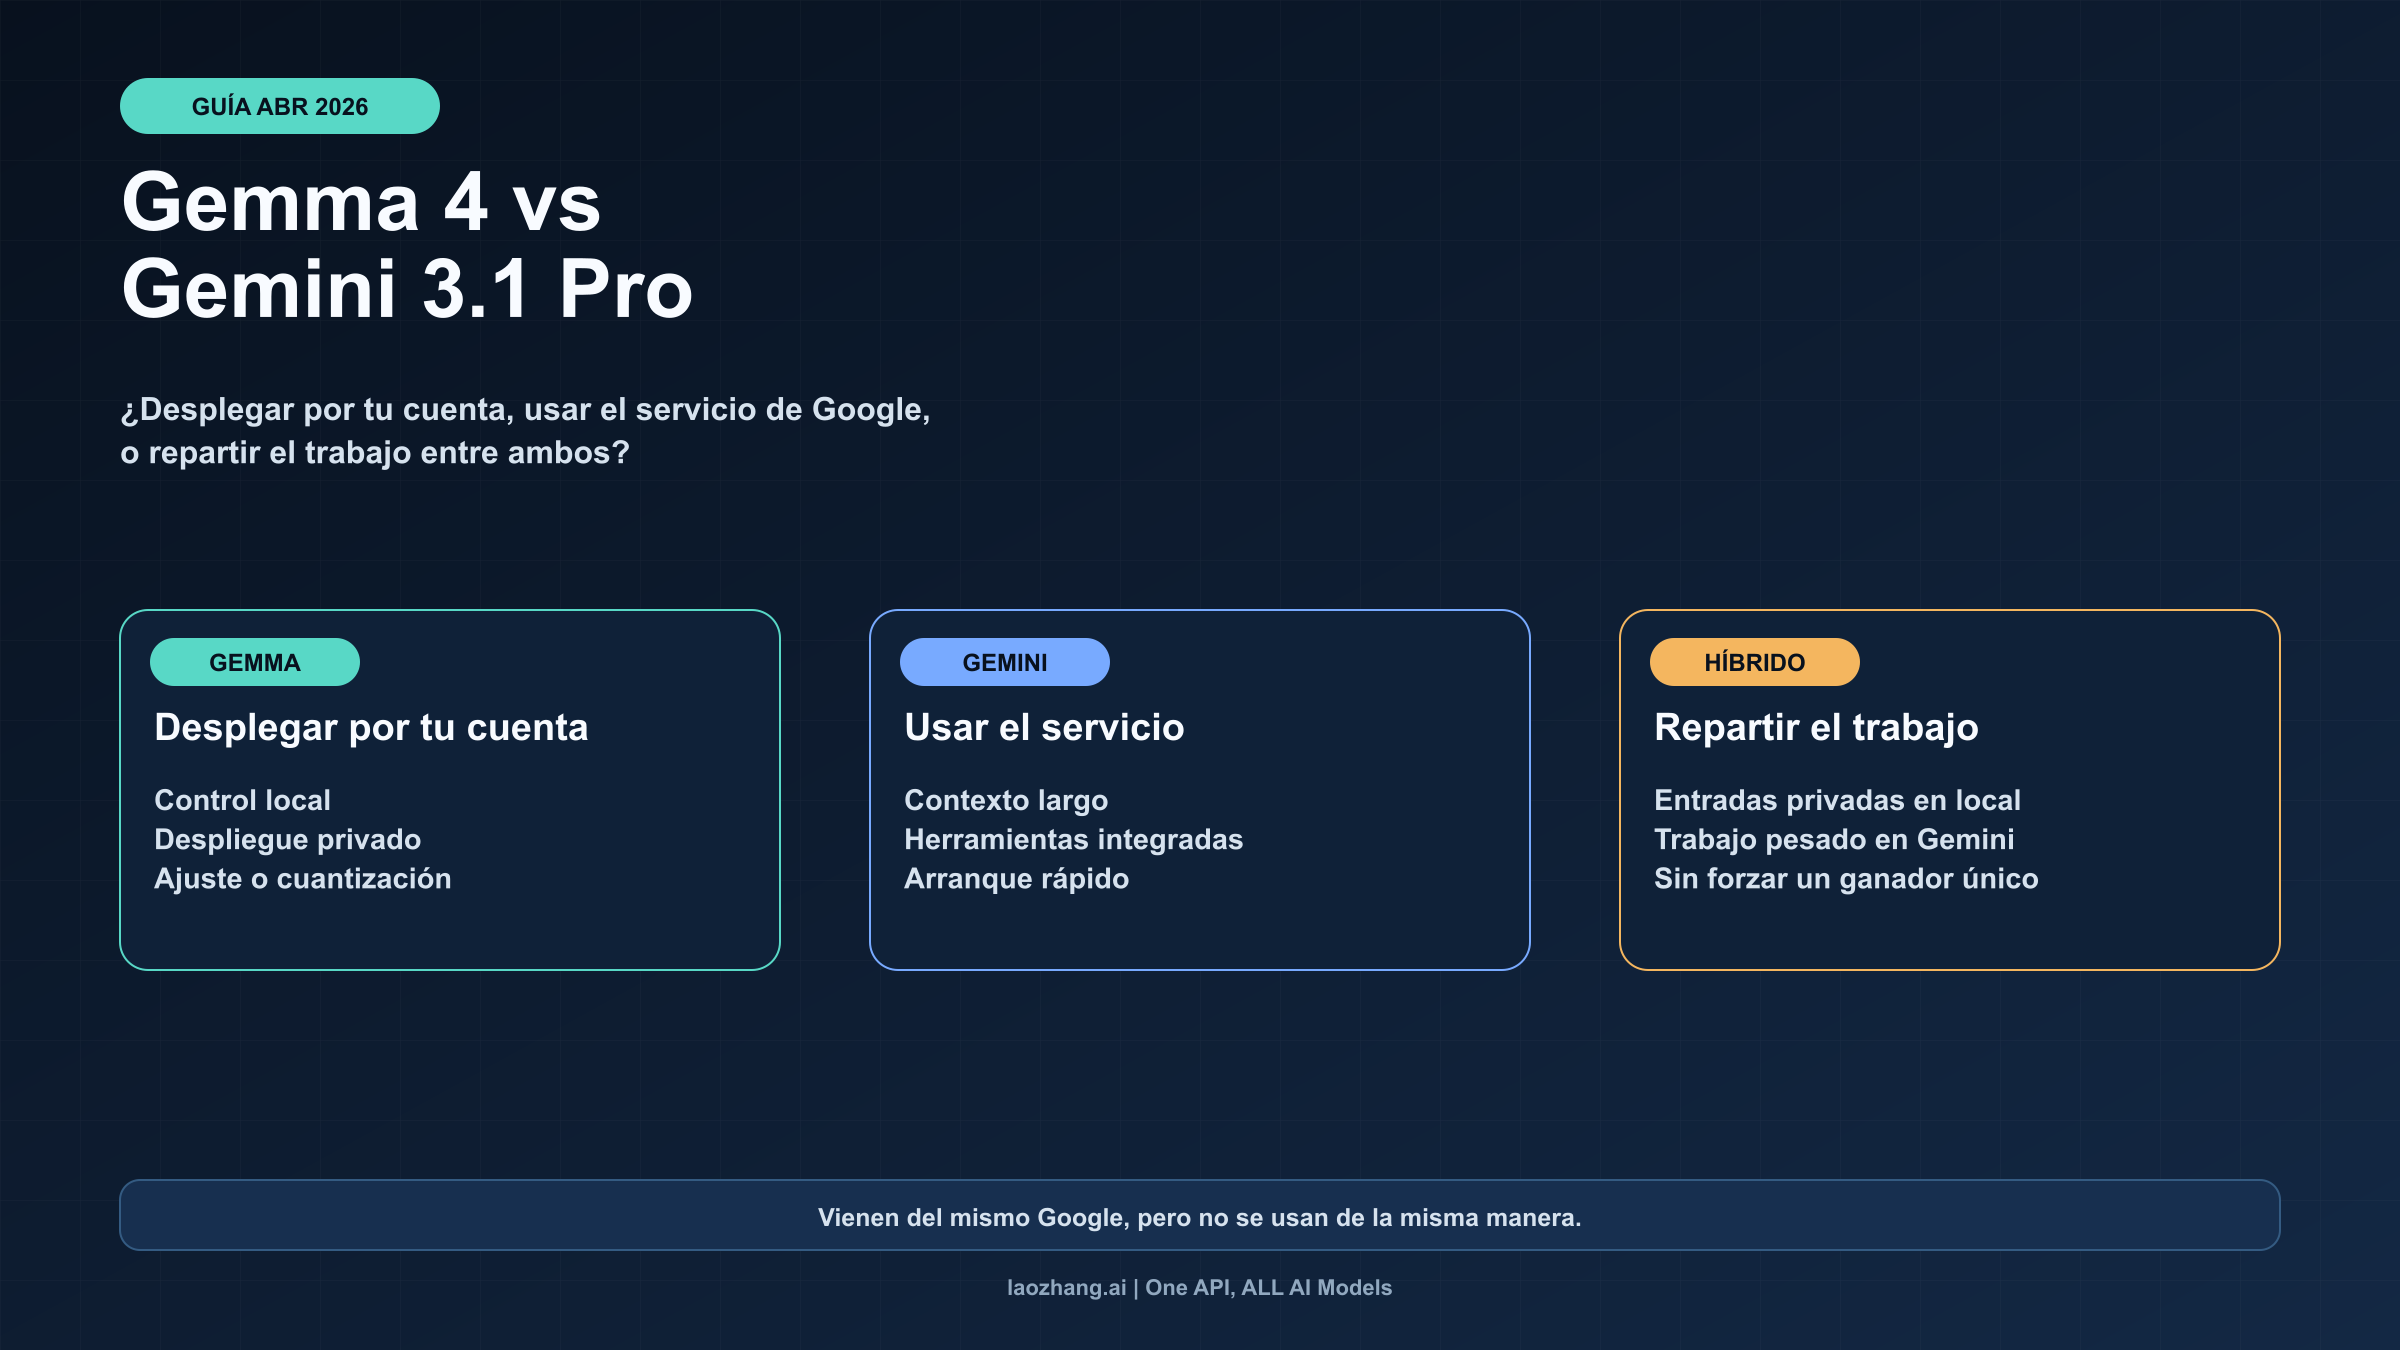
Si tu prioridad es controlar el despliegue, la privacidad o la personalización, empieza por Gemma 4. Si necesitas contexto largo, herramientas de Google y una puesta en marcha más rápida, empieza por Gemini 3.1 Pro. Si el trabajo realmente se divide en dos tipos de tareas, lo más honesto es combinarlos.
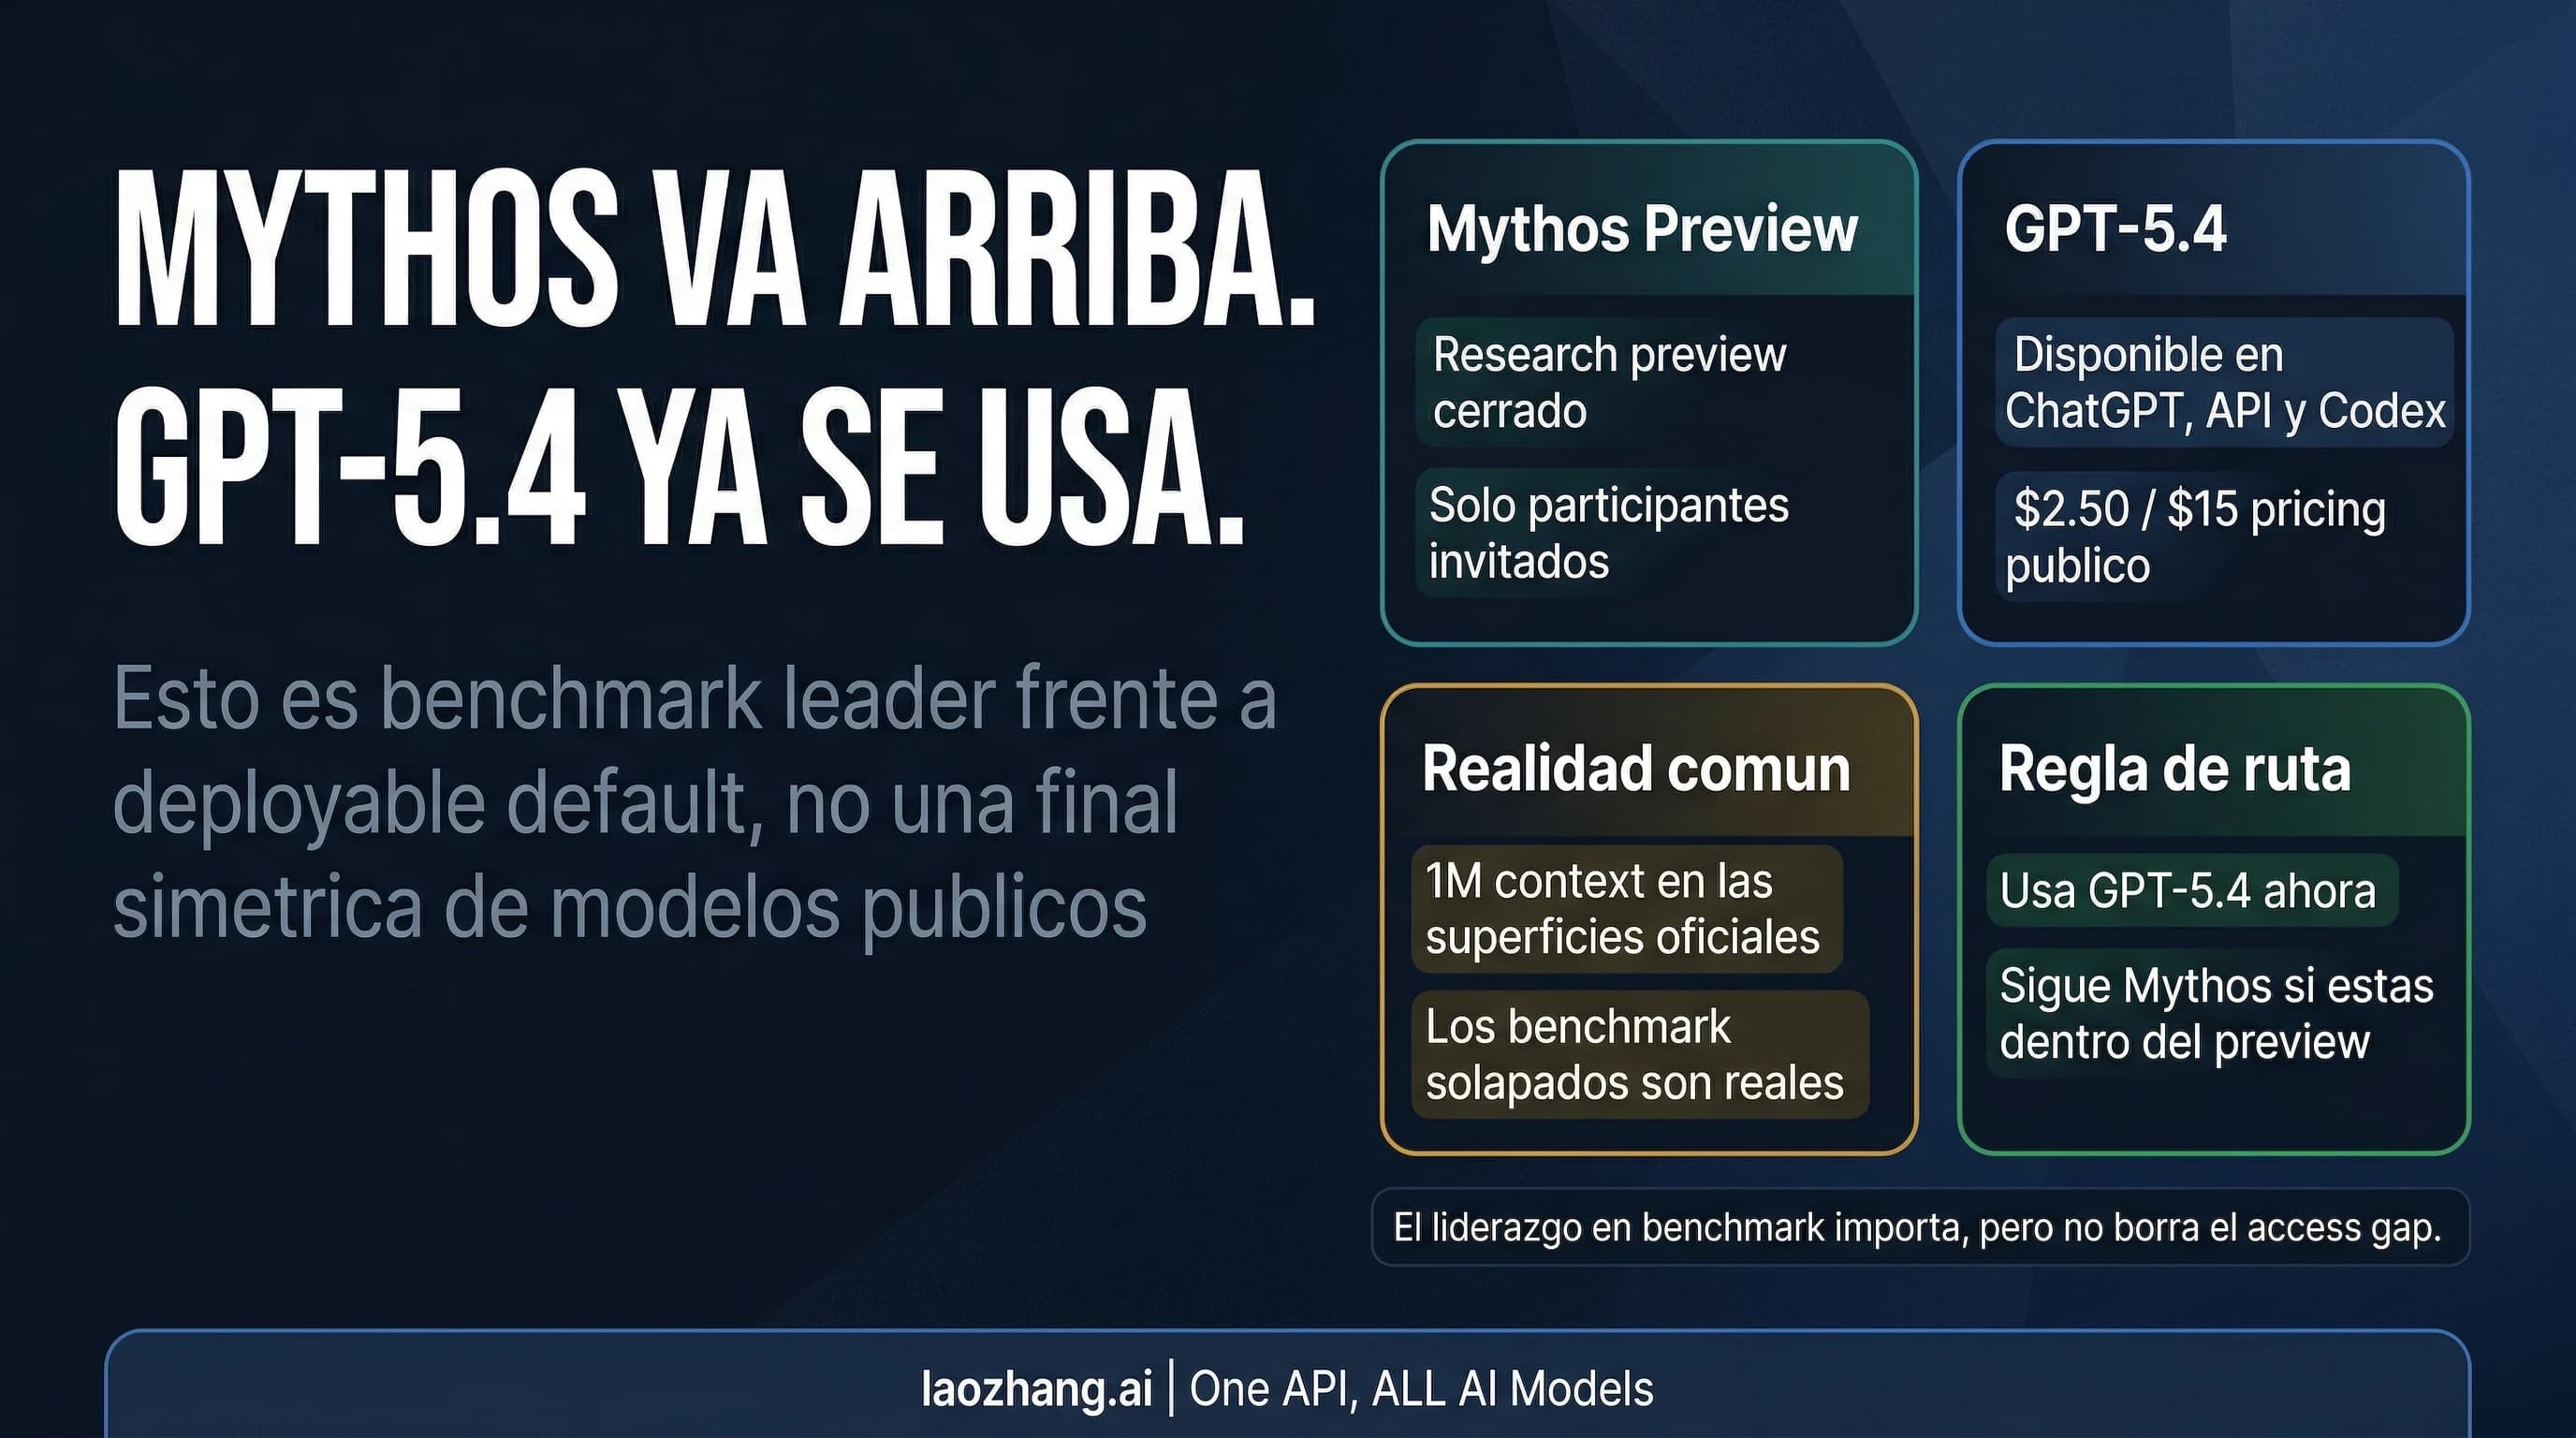
Si necesitas un modelo hoy, la respuesta práctica sigue siendo GPT-5.4. Claude Mythos Preview importa porque los benchmarks oficiales de Anthropic son fuertes, pero por ahora sigue siendo un research preview cerrado y no una ruta pública normal para la mayoría de usuarios.
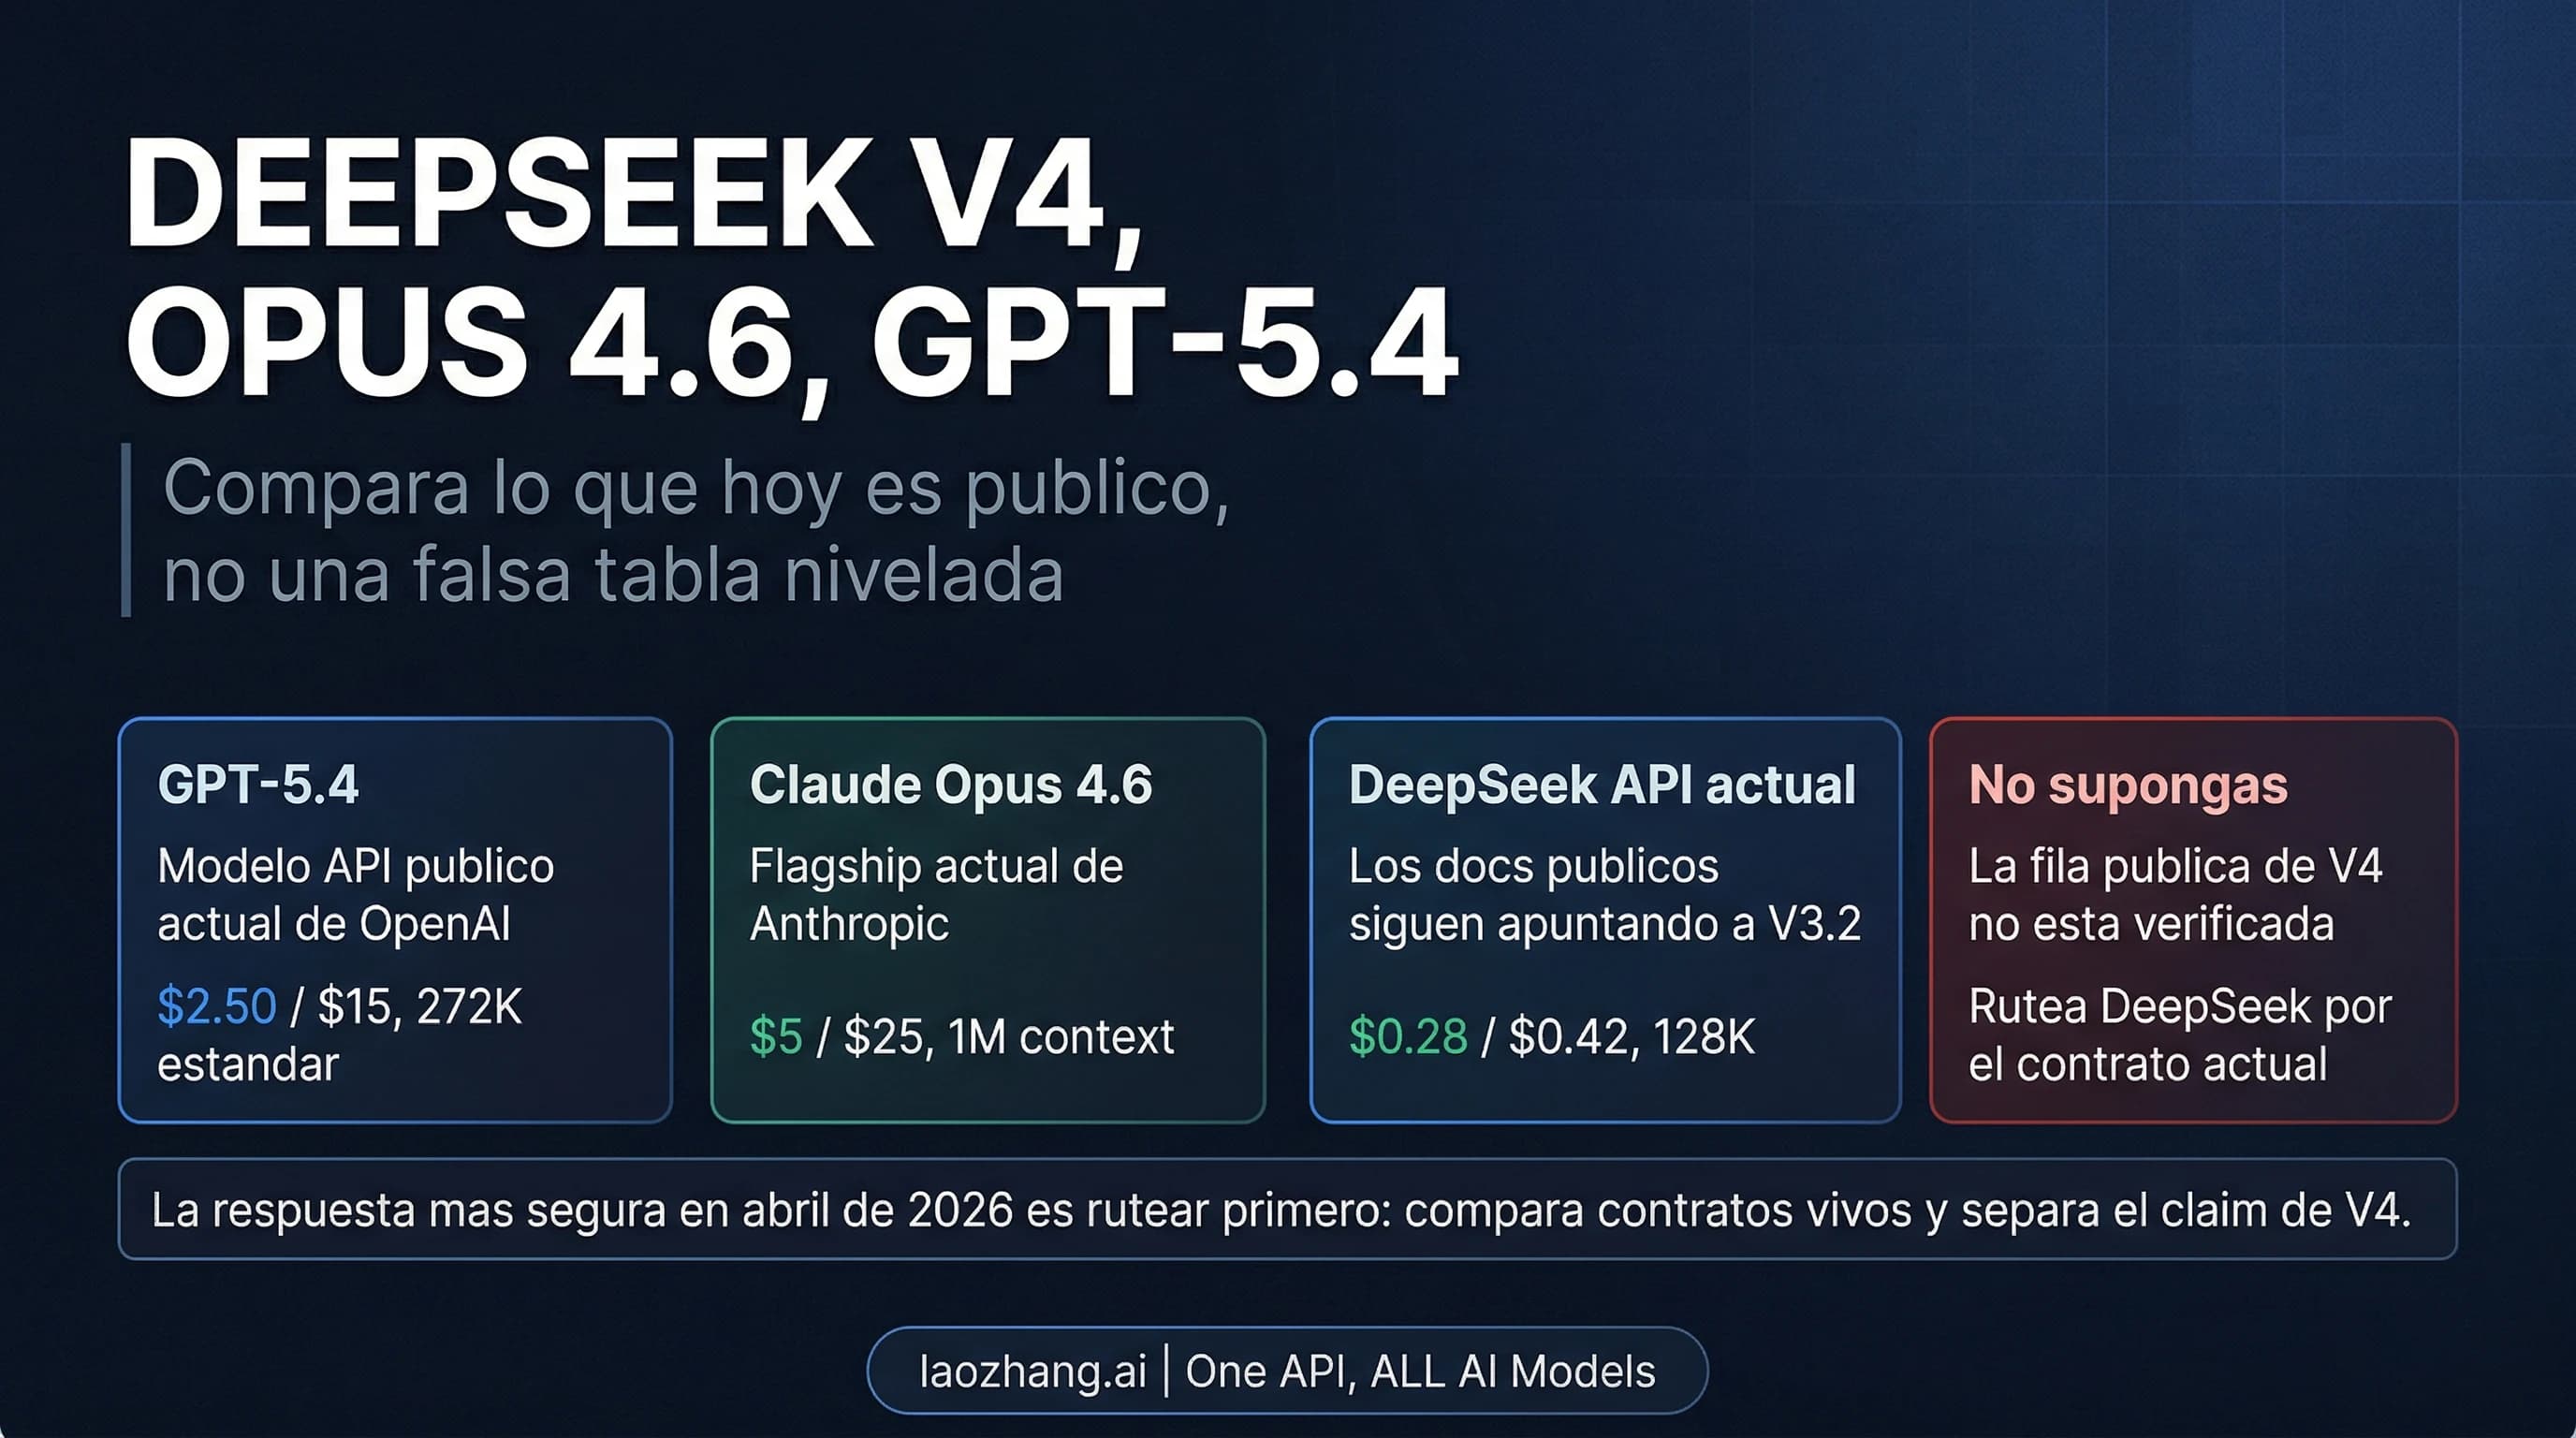
Si tienes que elegir hoy para produccion, no conviene empezar tratando a DeepSeek V4, Claude Opus 4.6 y GPT-5.4 como tres contratos publicos igual de claros. Lo mas util es comparar primero GPT-5.4 y Claude Opus 4.6 como los dos frontier contracts limpios y actuales, y despues ubicar a DeepSeek desde el API publico actual basado en V3.2.
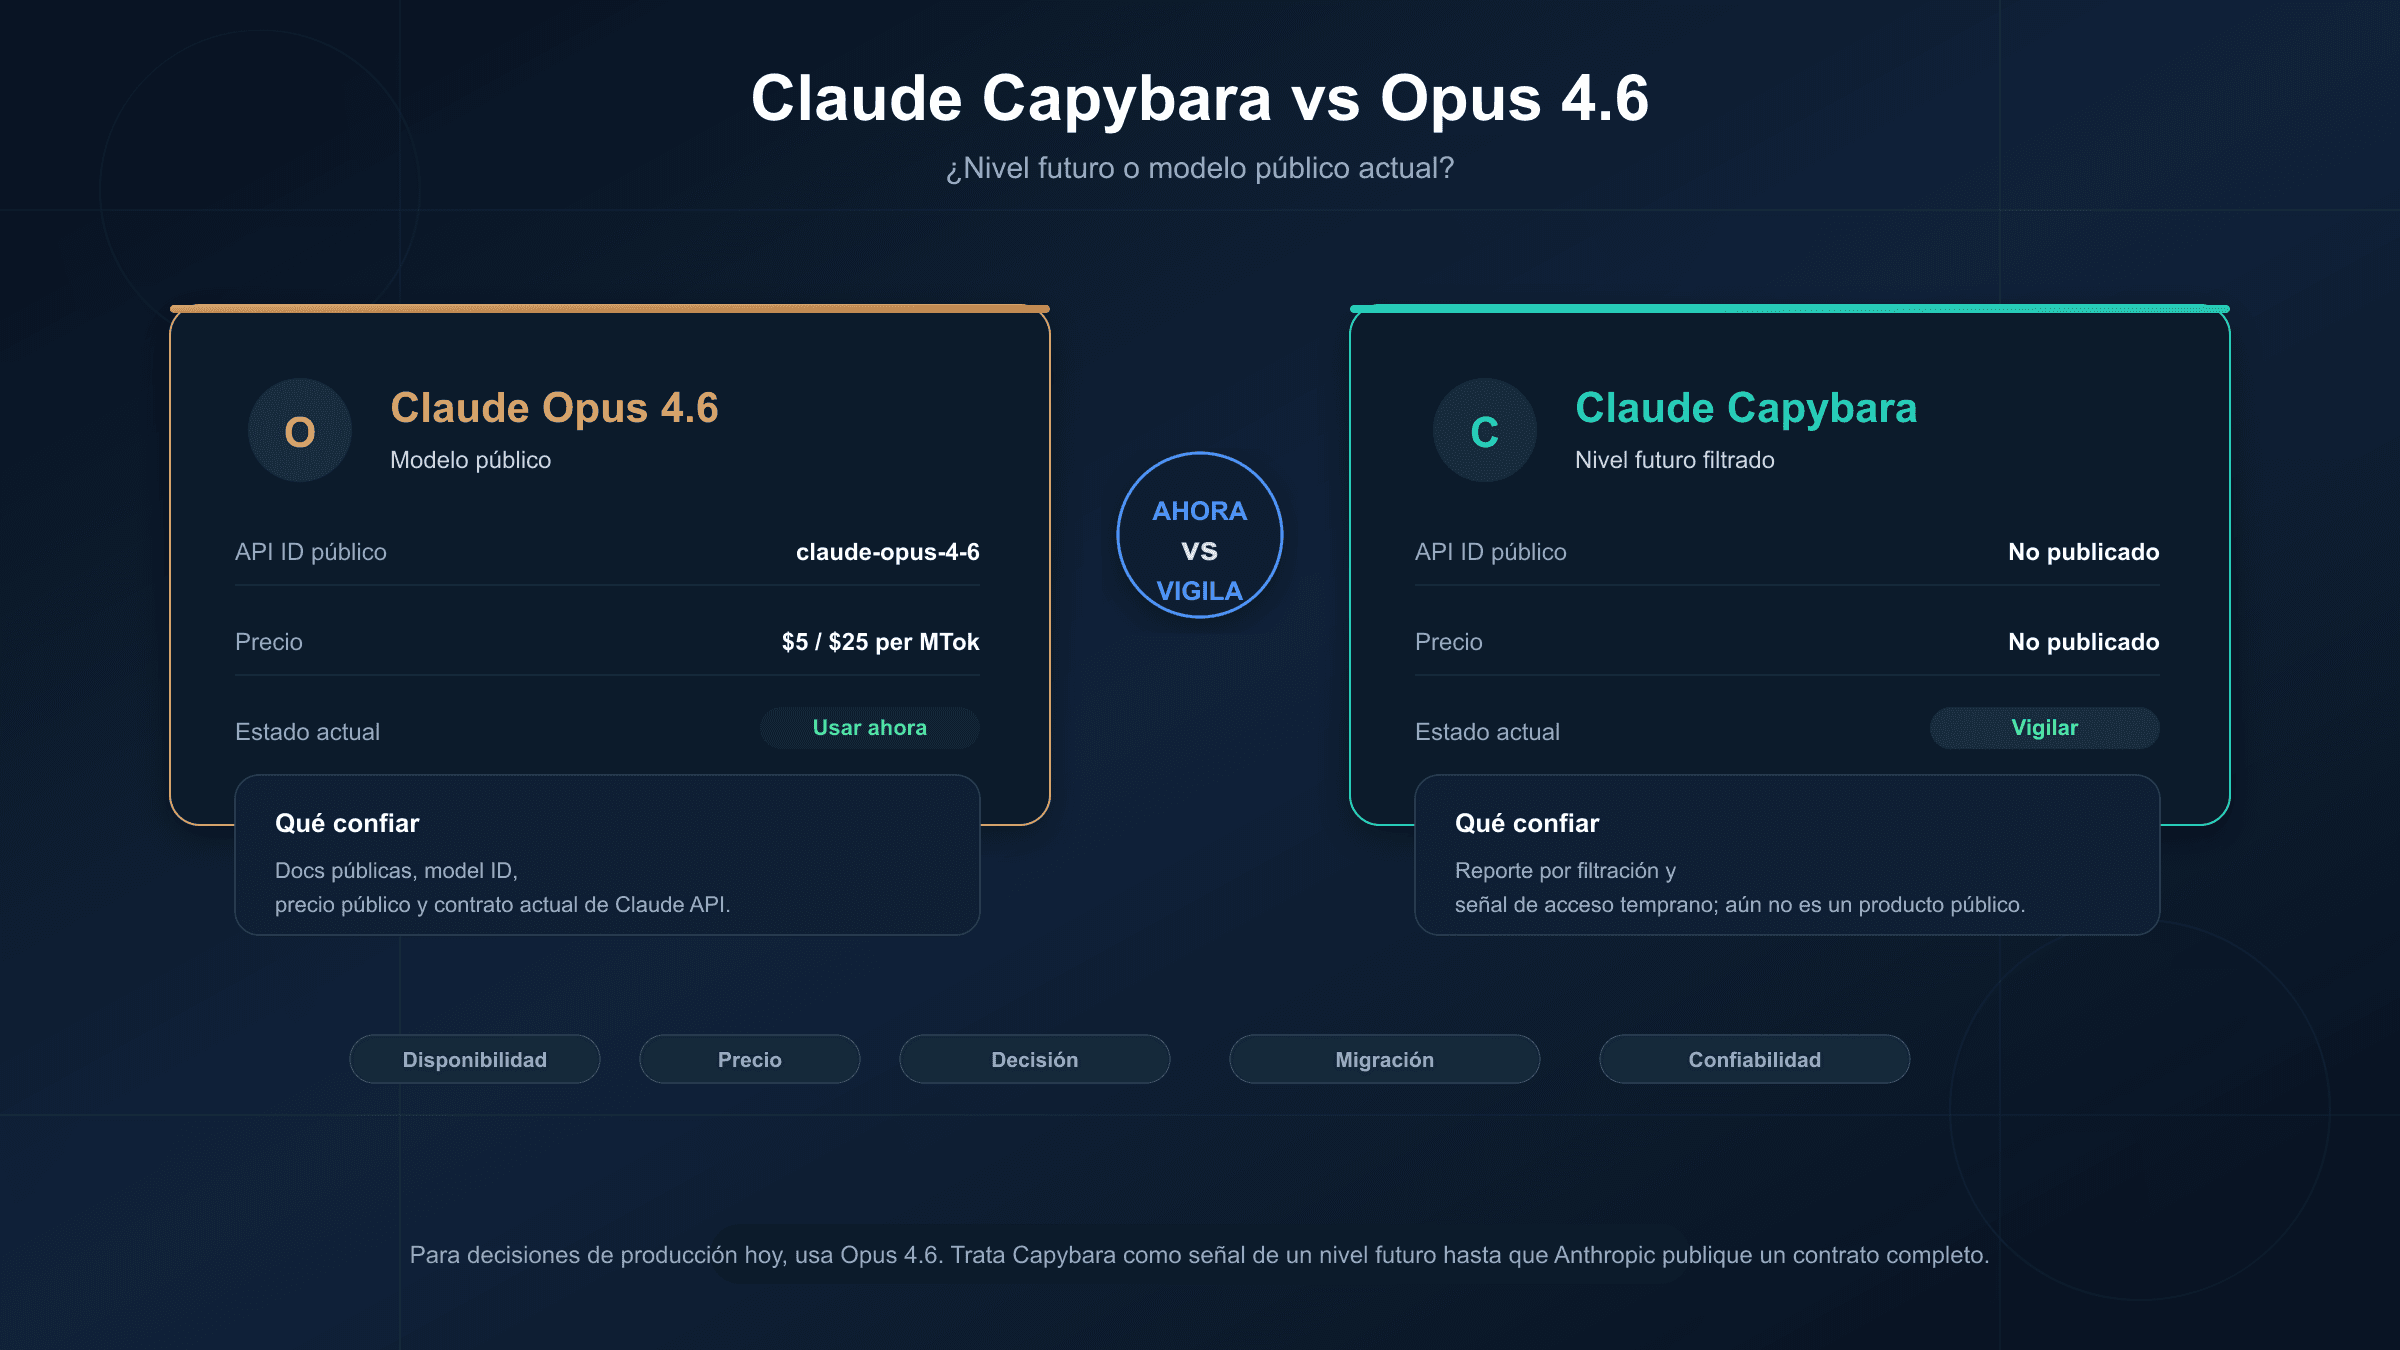
Claude Capybara todavía no es un contrato de modelo público de Anthropic que puedas seleccionar hoy. La documentación pública de Anthropic sigue señalando a Claude Opus 4.6 como su modelo público de nivel superior, mientras que Capybara funciona más como una señal de un nivel futuro que como una opción de despliegue inmediata.
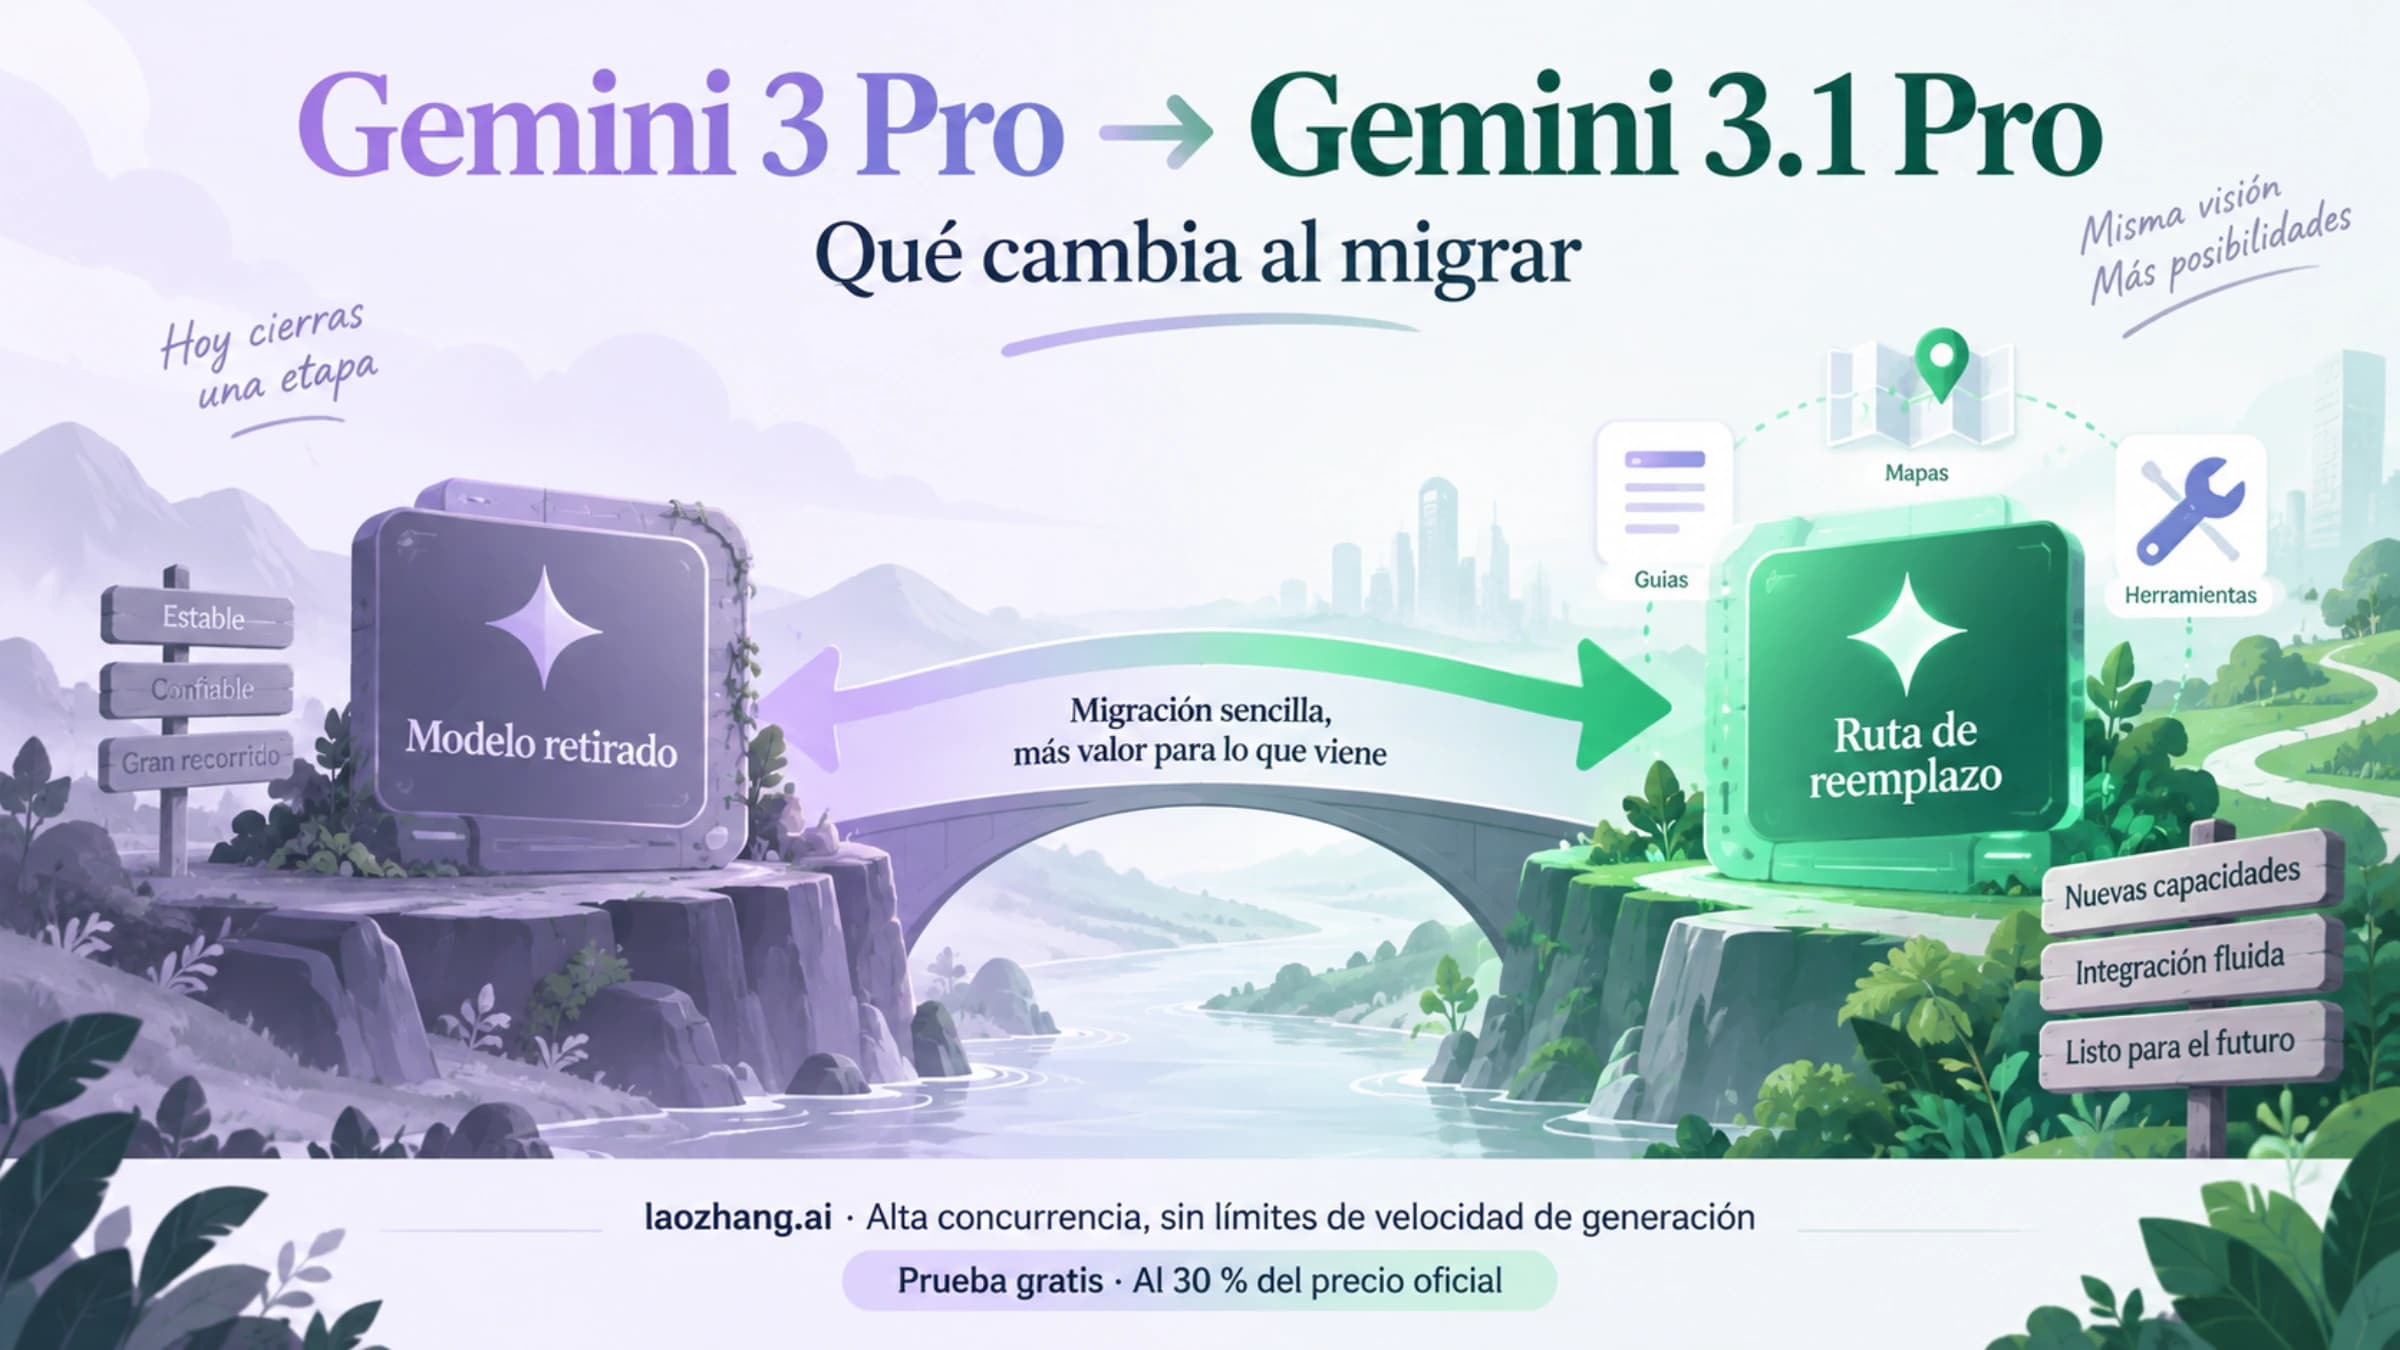
Gemini 3 Pro ya esta apagado, asi que esto ya no es una comparativa normal de nuevo contra viejo. Lo importante es que cambio en Gemini 3.1 Pro, que sigue igual y que hay que volver a validar al migrar.
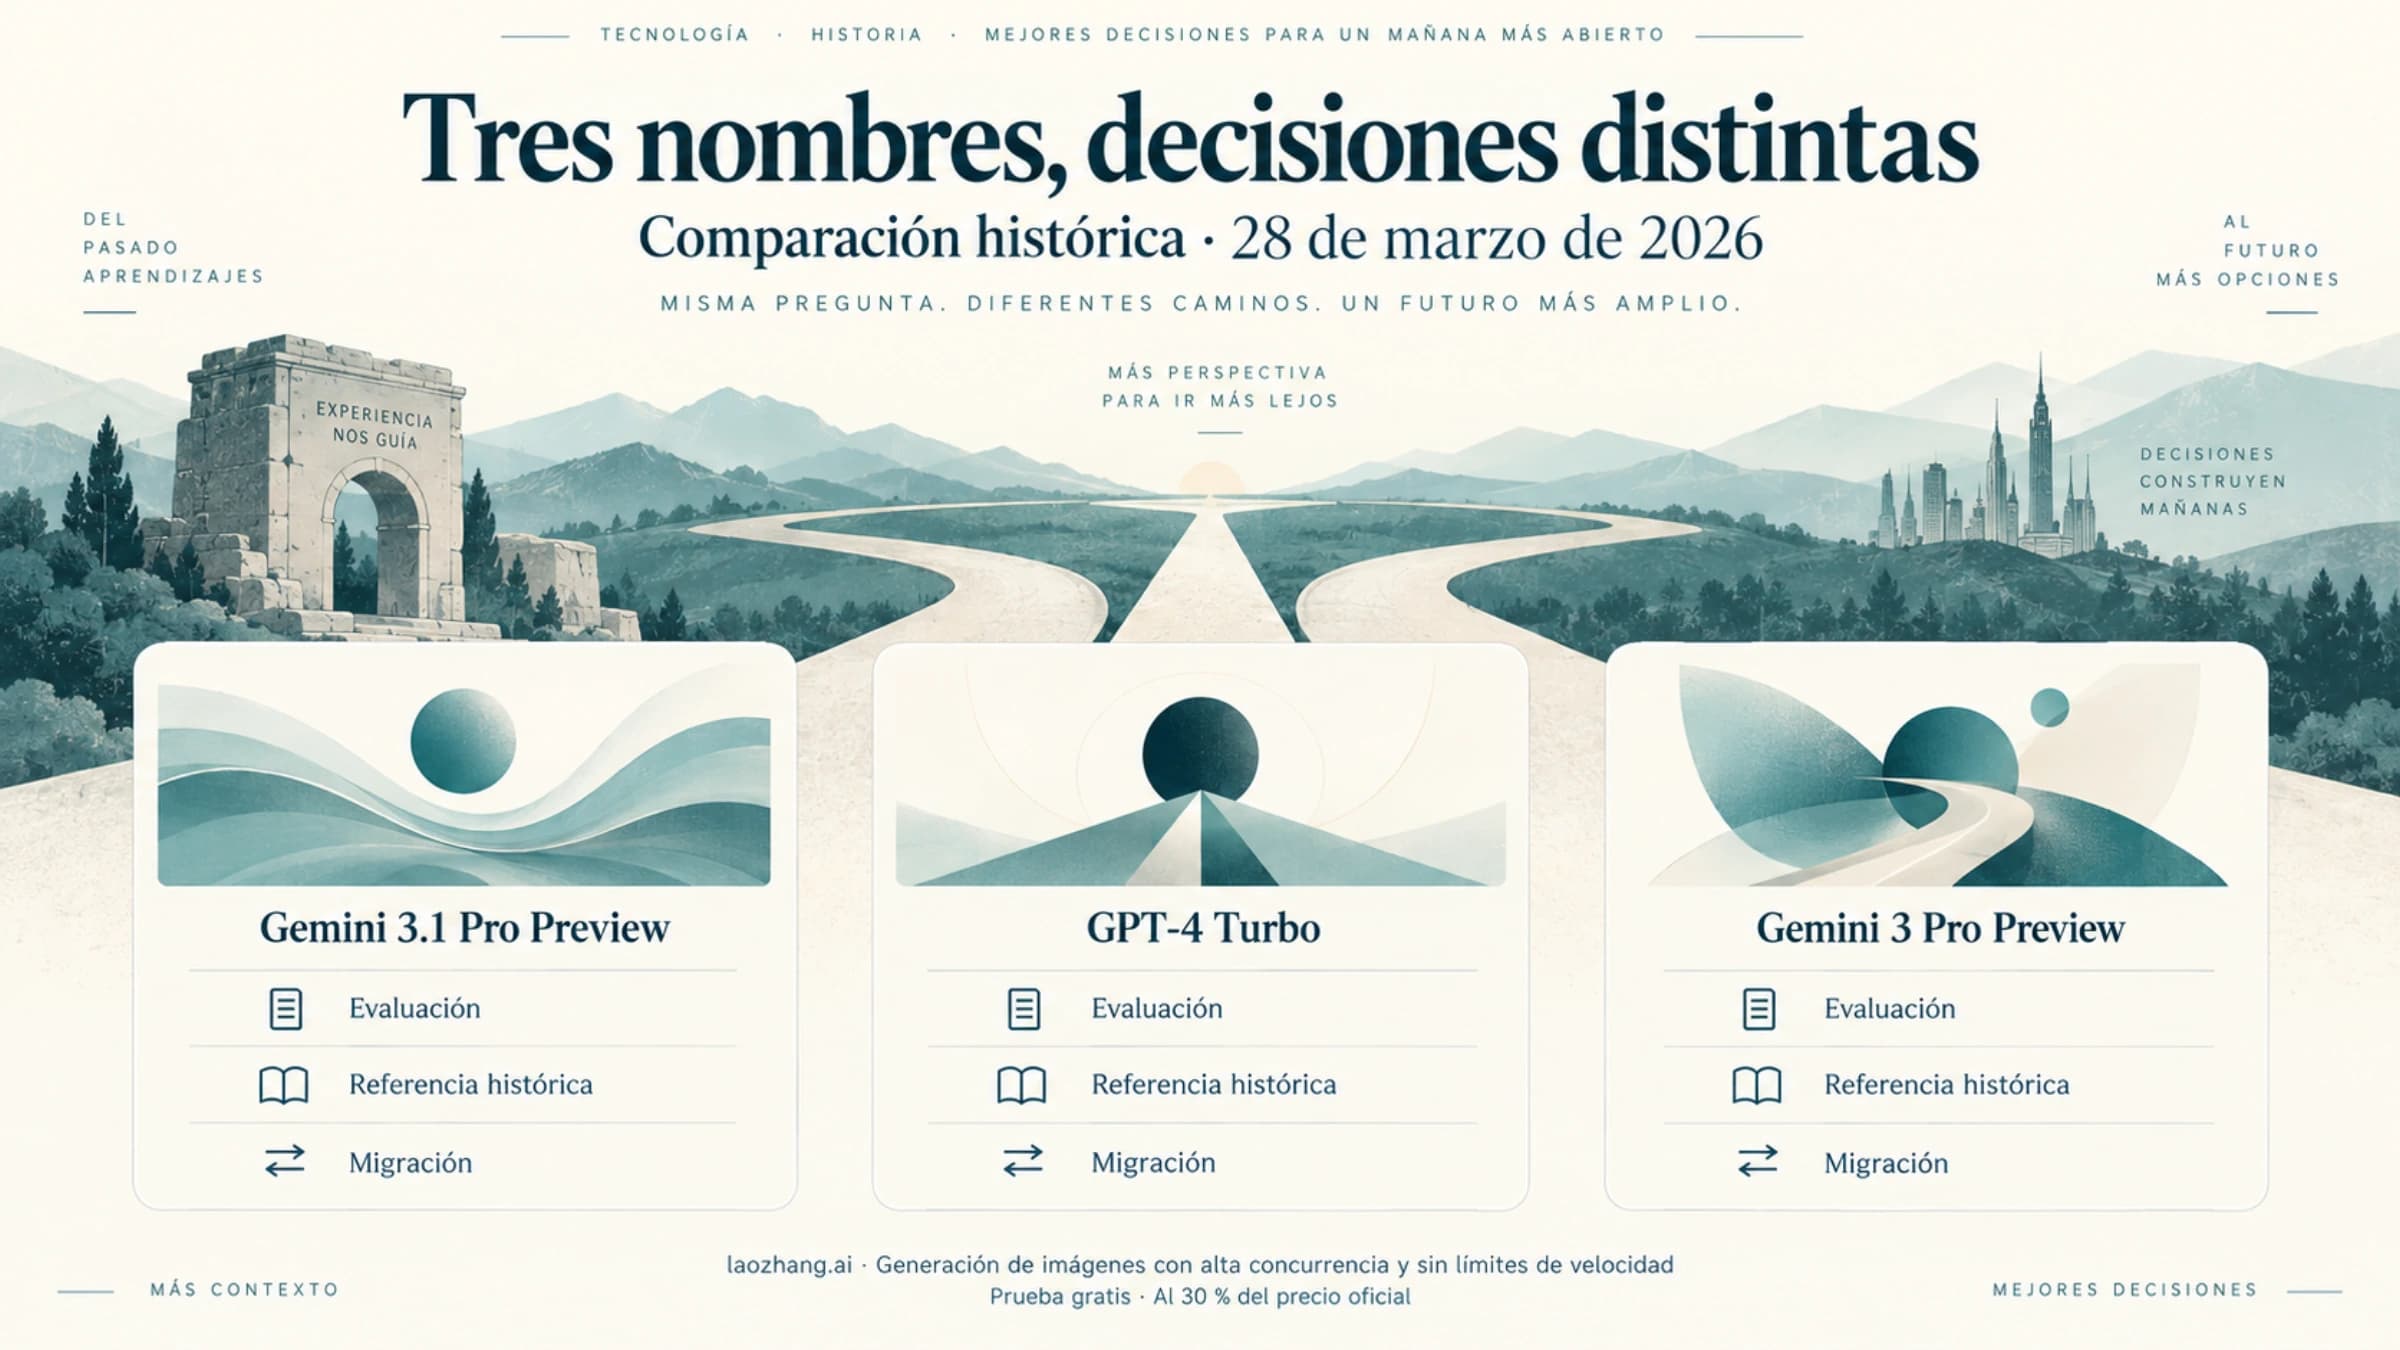
A 28 de marzo de 2026, Gemini 3.1 Pro Preview es la unica opcion realmente vigente entre estos tres nombres. Gemini 3 Pro Preview se apago el 9 de marzo de 2026, y OpenAI describe GPT-4 Turbo como una rama mas antigua mientras recomienda una ruta mas nueva como GPT-4o.
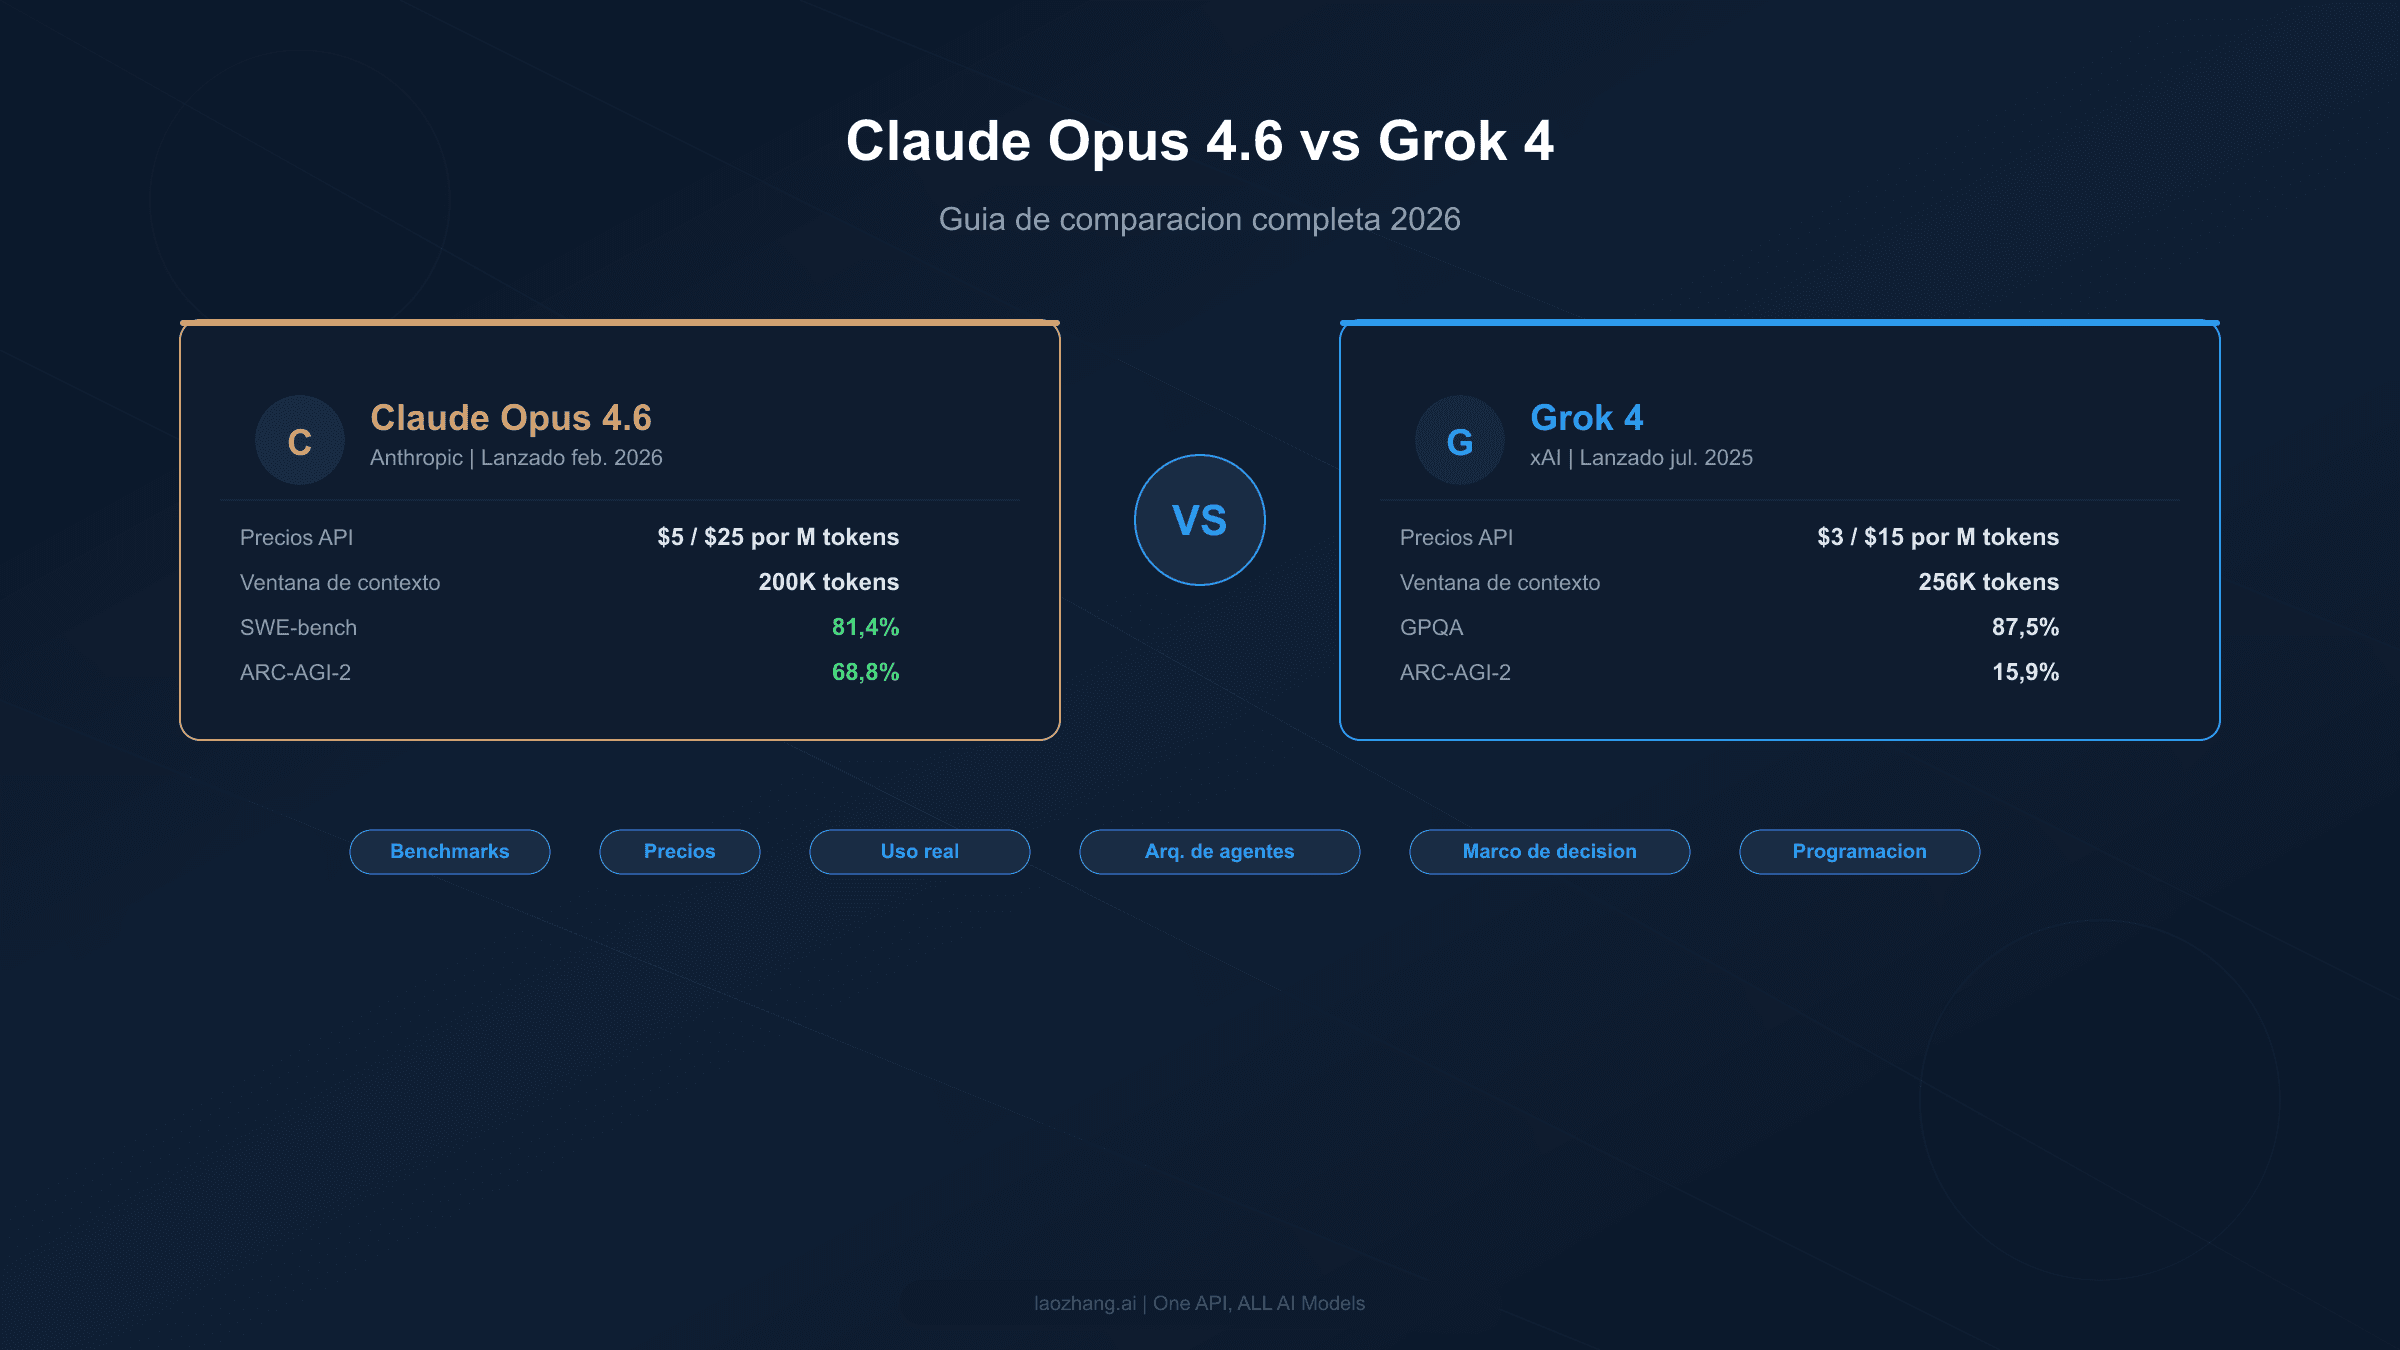
Claude Opus 4.6 supera a Grok 4 en benchmarks de programación (81,4% vs ~72% en SWE-bench) y tareas de razonamiento (68,8% vs 15,9% en ARC-AGI-2), mientras que Grok 4 cuesta un 40% menos a $3/$15 por millón de tokens. Esta comparación exhaustiva cubre benchmarks, precios, capacidades de programación, arquitectura de agentes y ofrece un marco de decisión basado en escenarios para ayudarte a elegir el modelo adecuado.