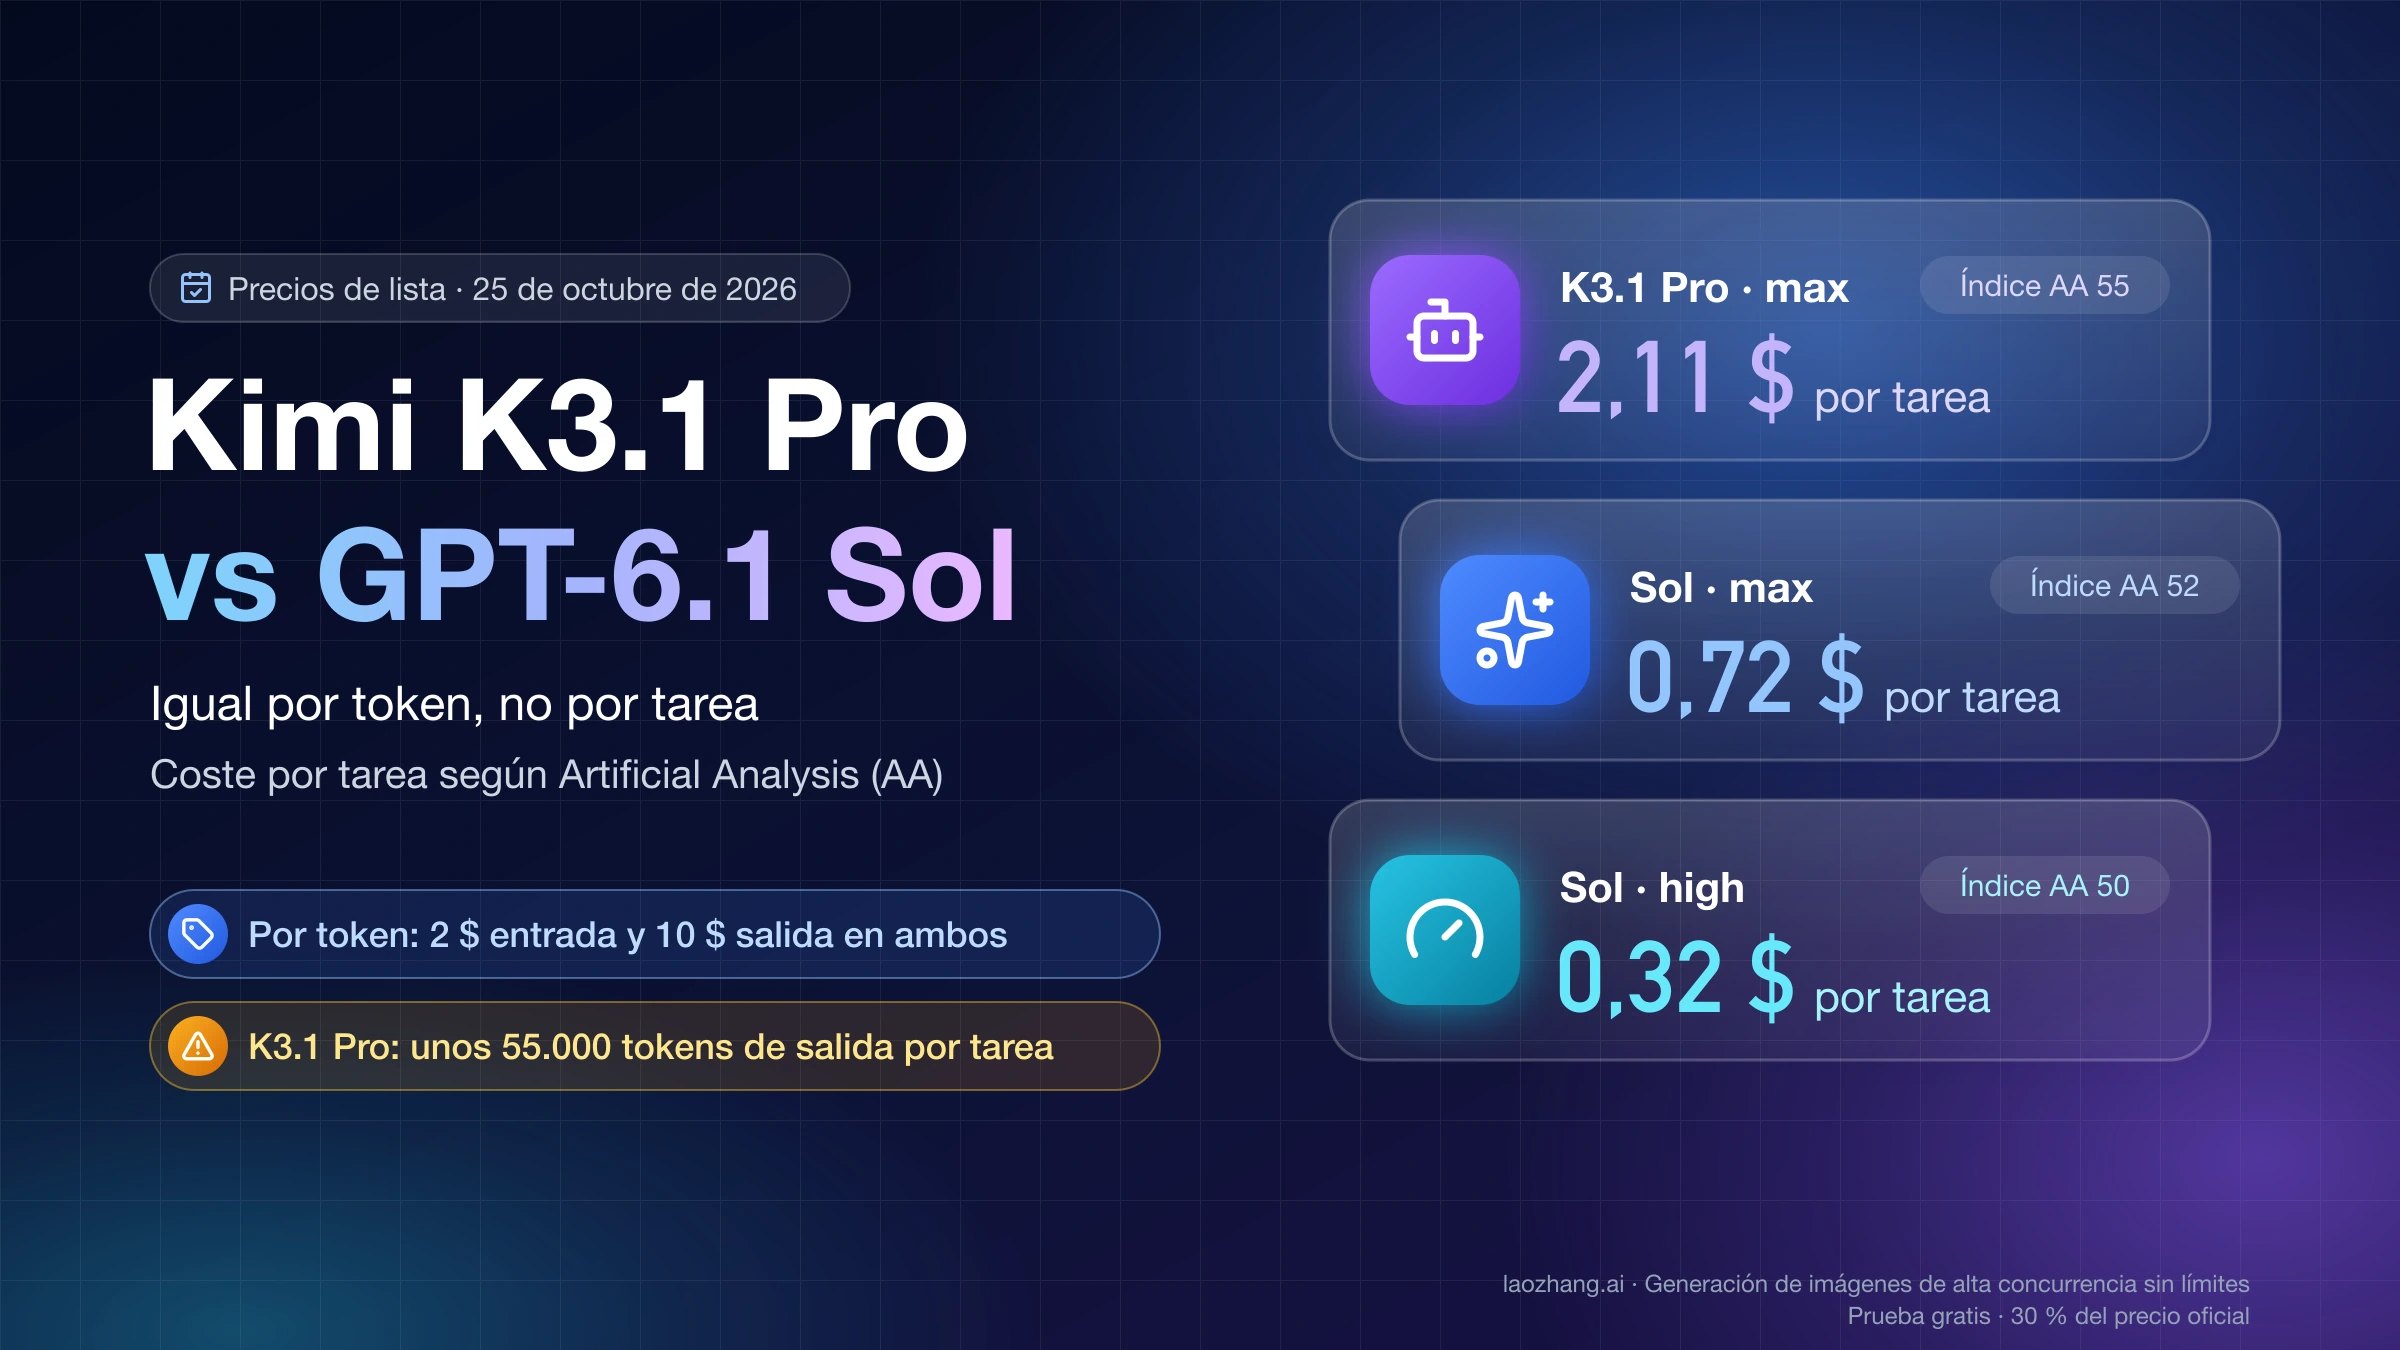
Claude Sonnet 5.5 vs GPT-6.1 Sol: mismo precio, distinta factura
Los dos cobran 2 $ y 10 $ por millón de tokens, pero Sonnet 5.5 cuesta de 2,2 a 7,9 veces más por tarea; por encima de 272.000 tokens, Sol sale más caro.
En esta página
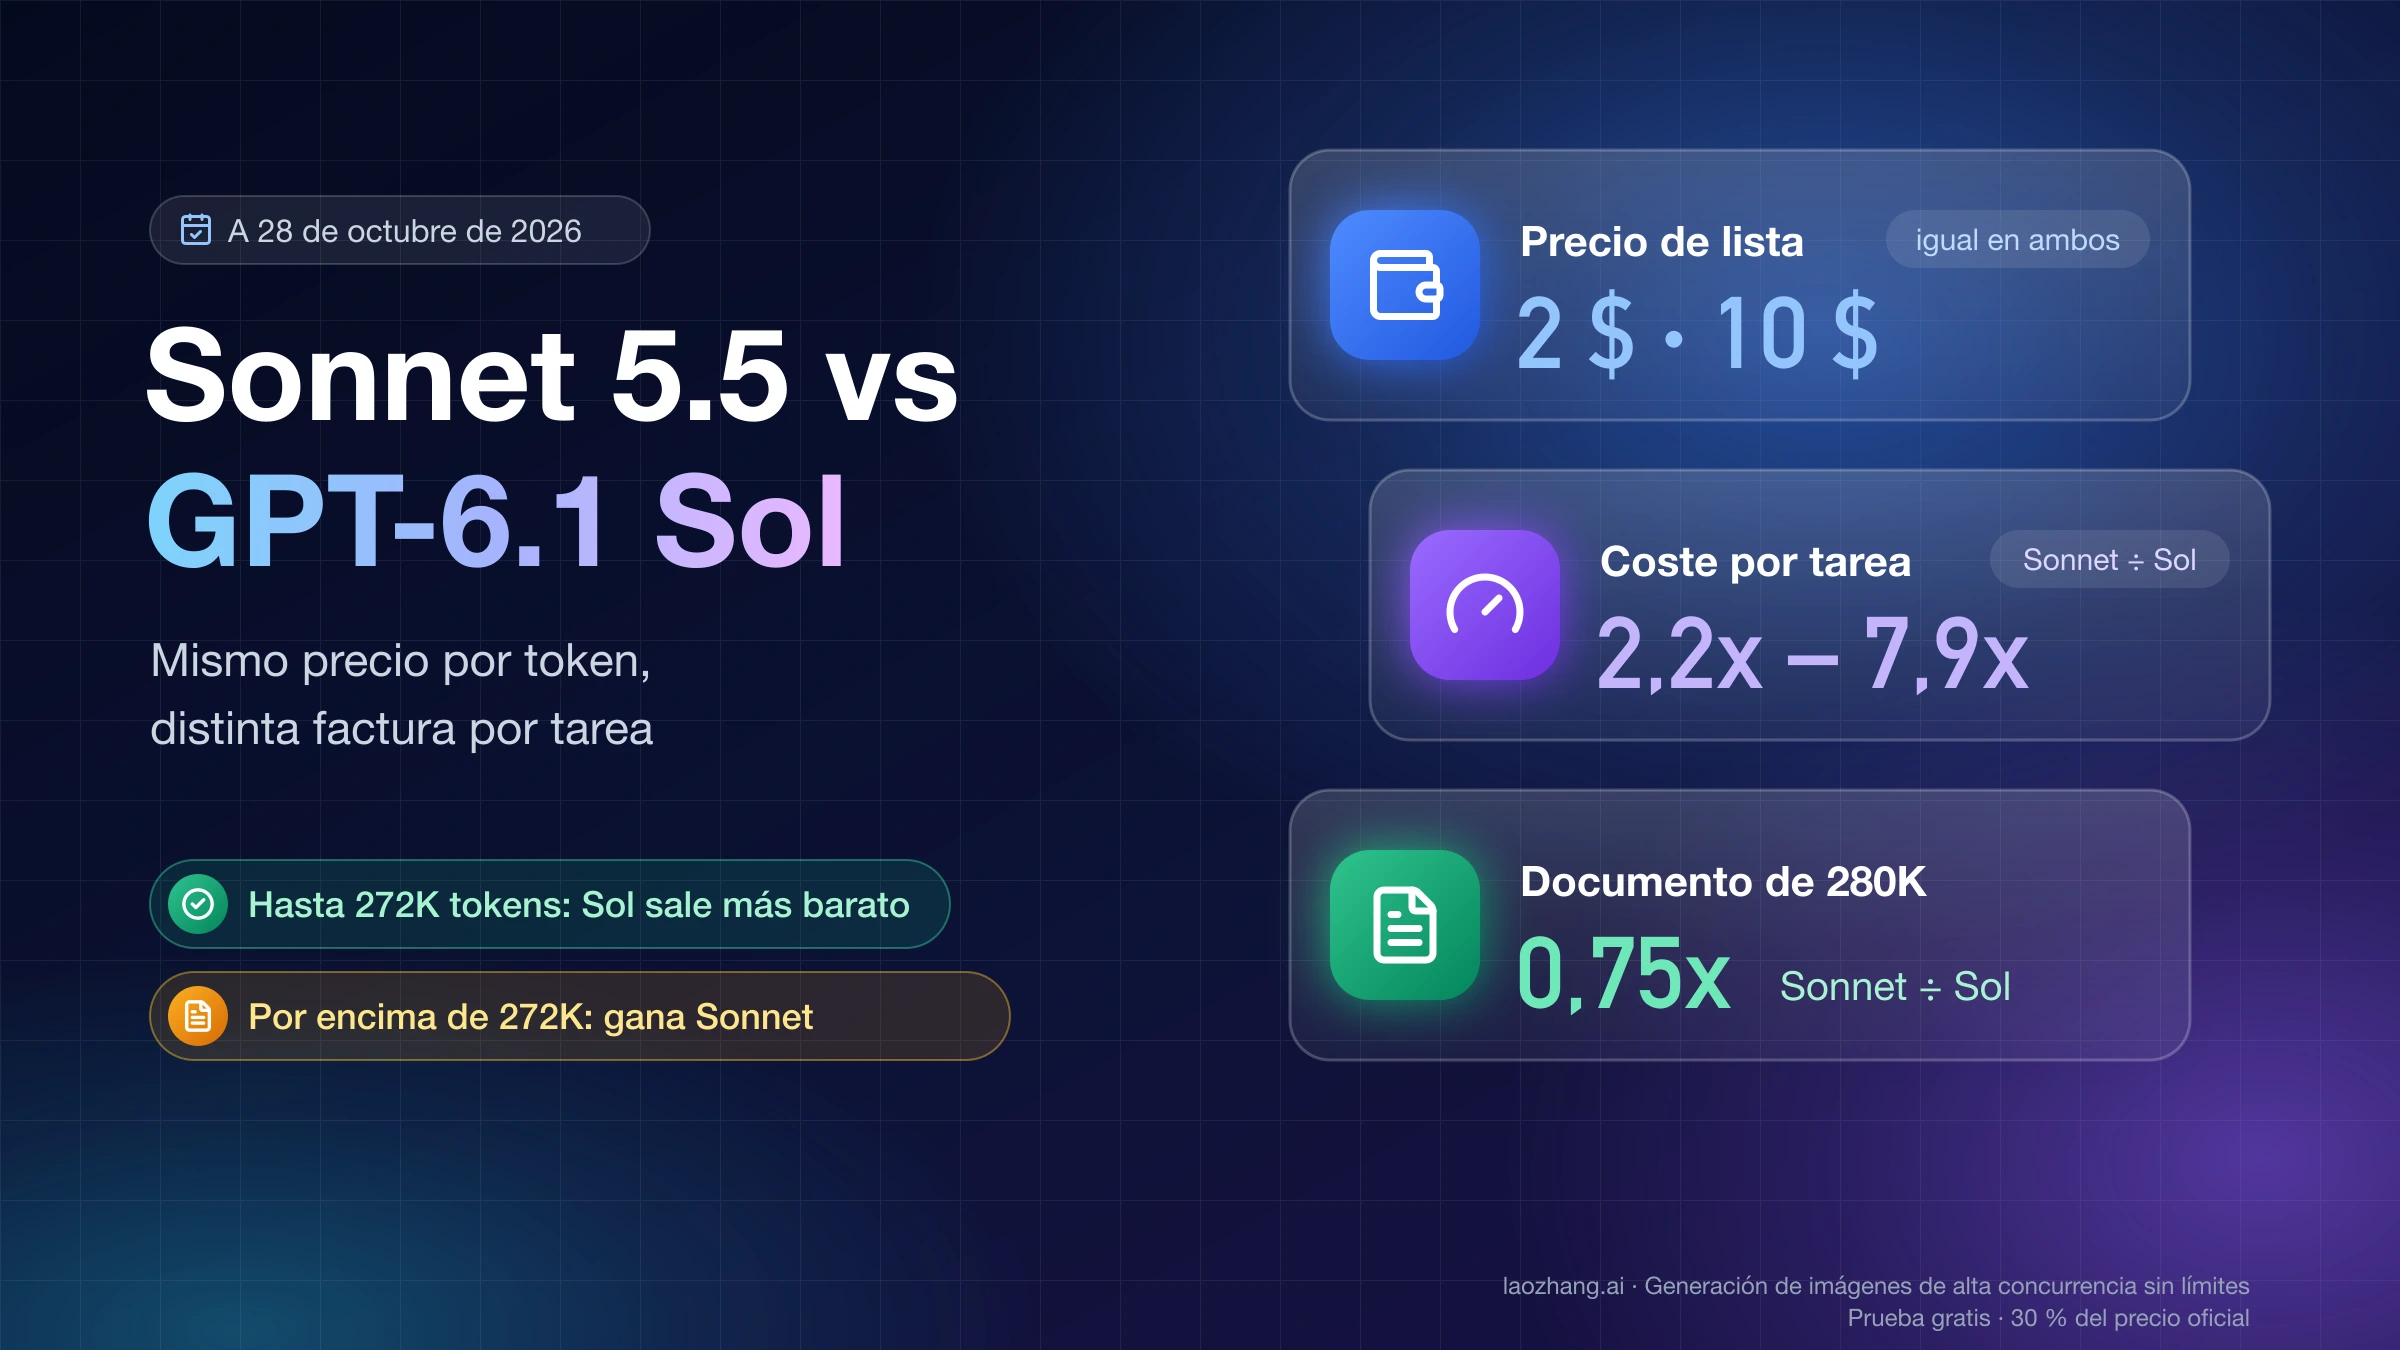
A 28 de octubre de 2026, si vas a llevar una carga de API a uno de los dos, empieza por GPT-6.1 Sol (gpt-6.1-sol) con su nivel de razonamiento (effort) por defecto, medium, y deja Claude Sonnet 5.5 (claude-sonnet-5-5) para los prompts de más de 272.000 tokens y para agentes de terminal que vayas a ejecutar en xhigh o max. Los dos cobran 2 $ por millón de tokens de entrada y 10 $ de salida, y desde el 7 de octubre también lo mismo por leer caché, 0,10 $. Aun así, en el Intelligence Index v5.0 de Artificial Analysis (AA), Sol en medium saca 46,1 puntos con un coste por tarea 4,6 veces menor que Sonnet en high, el valor por defecto de su API, que se queda en 41,1.
El mismo precio por token no da la misma factura por tres motivos. Según un recuento propio del 28 de octubre de 2026, el mismo texto en español ocupa un 52 % más de tokens en Sonnet que en Sol; con la misma etiqueta de effort, Sonnet escribe y relee mucho más por tarea, y en AA cuesta de 2,2 a 7,9 veces más; y Sol cobra toda la petición más cara cuando la entrada supera 272.000 tokens, hasta el punto de que, en un cálculo propio con precios de lista de esa misma fecha, un documento de 280.000 tokens en español sale un 25 % más barato en Sonnet. Si eliges Sonnet para un bucle de agente, marca el contexto con cache_control, porque sin él 50 turnos sobre 100.000 tokens cuestan unas 11 veces lo que en Sol, que cachea solo. Si eliges Sol y usas herramientas, tienes que pasar a la Responses API.
Las cifras de coste propias salen de una prueba del 28 de octubre de 2026: 12 tareas con comprobaciones escritas de antemano, enviadas a los dos modelos por una pasarela de API. Sonnet en high acertó 11 y costó 0,18 $; Sol en medium acertó 12 y costó 0,12 $. Con aciertos tan parejos, esa prueba mide coste, tokens y tiempo, no cuál es más listo, y para la calidad la referencia son las puntuaciones de AA. No se probaron las API directas de Anthropic y OpenAI, la Responses API, las llamadas a herramientas, los agentes de varios turnos, Sol en xhigh o max ni Sonnet fuera de high.
Qué elegir según tu carga: Sol para lo corto, Sonnet por encima de 272K
La elección cambia con el tamaño del prompt, con lo que hace el modelo dentro de la tarea y con el nivel de calidad que necesitas. Para casi todo lo que cabe por debajo de 272.000 tokens, Sol ofrece más puntuación por dólar en cada nivel de effort; Sonnet compensa cuando el escalón de precio de Sol entra en juego o cuando la tarea es de las pocas en las que Sonnet puntúa más alto en sus niveles superiores.
| Tu carga | Empieza por | Effort inicial | Por qué |
|---|---|---|---|
| Peticiones cortas, chat, extracción | GPT-6.1 Sol | medium | Mismo precio por token; el texto en español te sale 1,23x más caro en Sonnet y Sol puntúa más en cada nivel |
| Documentos de hasta 272.000 tokens | GPT-6.1 Sol | medium | Sonnet paga por el mismo documento en español casi 1,5 veces más |
| Documentos de más de 272.000 tokens | Claude Sonnet 5.5 | high | Sol cobra toda la petición a 4 $ y 15 $; con texto en español, Sonnet sale a 0,75x |
| Bucles de agentes con caché | GPT-6.1 Sol | medium o high | Misma lectura de caché; Sonnet sale 1,34x con cache_control y unas 11x sin él |
| Agentes de terminal y código difícil | Claude Sonnet 5.5 | xhigh o max | En Terminal-Bench 4.0, 57,1 % y 63,6 % frente a 54,0 % y 56,1 %, a un coste por tarea 5,4 y 7,9 veces mayor |
| Conocimiento, ciencia, lectura de PDF | GPT-6.1 Sol | high | Sol gana en AA-Omniscience, HLE-Diamond, CritPt y GDP.pdf en todos los niveles |
| Documentos y hojas de cálculo de oficina | Claude Sonnet 5.5 | high | Sonnet gana AA-Briefcase en todos los niveles |
| Interacción donde manda la latencia | Claude Sonnet 5.5 | low o medium | Primer token antes y unos 109 tokens por segundo frente a 59–61 de Sol, pero con menos puntuación |
| Batch de miles de peticiones | GPT-6.1 Sol | medium | Los dos descuentan el 50 %; Sol además tiene Flex |
Las cifras de puntuación y subpruebas son de AA v5.0; los cocientes de coste por carga son los casos calculados más abajo, con texto en español. Si lo que buscas es pagar menos sin salir de OpenAI, la comparativa GPT-6.1 Terra vs Sol: diferencias y cuándo Terra sale más barata cubre el modelo a mitad de precio. Si Sonnet en max no te basta, el escalón siguiente de Anthropic está en Claude Opus 5.5 vs GPT-6 Sol y 6.1 Sol: cuál probar y qué pagas, y para volumen masivo barato, en Claude Sonnet 5.5 vs GPT-6 Luna: cuándo compensa pagar 20x más.
Precios de lista: 2 $ y 10 $ en ambos, distintos por encima de 272K
Por debajo de 272.000 tokens de entrada, Claude Sonnet 5.5 y GPT-6.1 Sol tienen la misma tarifa en entrada, salida, lectura de caché y escritura de caché corta. Las diferencias están en la caché larga, en los modos rápidos y, sobre todo, en lo que pasa cuando la entrada de Sol supera 272.000 tokens. Son precios en dólares por millón de tokens, a 28 de octubre de 2026, según la tabla de precios de la API de Claude, la página de precios de la API de OpenAI y la ficha del modelo GPT-6.1 Sol:
| Por millón de tokens | Claude Sonnet 5.5 | GPT-6.1 Sol hasta 272K | GPT-6.1 Sol por encima de 272K |
|---|---|---|---|
| Entrada | 2 $ | 2 $ | 4 $ |
| Salida | 10 $ | 10 $ | 15 $ |
| Lectura de caché | 0,10 $ | 0,10 $ | 0,20 $ |
| Escritura de caché corta | 2,50 $ (5 minutos) | 2,50 $ (30 minutos) | 5 $ |
| Escritura de caché larga | 4 $ (1 hora) | 5 $ (12 horas, solo Responses API) | 10 $ |
| Batch, entrada y salida | 1 $ y 5 $ | 1 $ y 5 $ (Flex, igual) | 2 $ y 7,50 $ |
| Modo rápido | No existe | Fast 4 $ y 20 $; Ultrafast 12 $ y 60 $ | — |
OpenAI lo explica en la ficha del modelo: con más de 272.000 tokens de entrada, la entrada y la caché se cobran al doble y la salida a 1,5 veces en toda la petición, no solo en los tokens que pasan del límite. Sonnet 5.5 incluye el millón de tokens de contexto a precio estándar, sin recargo. En los dos hay suplementos regionales: la inferencia solo en Estados Unidos (inference_geo: "us") cuesta 1,1 veces en Claude, y el procesamiento con residencia de datos suma un 10 % en OpenAI.
Si has leído que la caché de Sol cuesta la mitad que la de Sonnet, es un dato anterior al 7 de octubre de 2026: hasta ese día Sonnet 5.5 cobraba 0,20 $ por leer caché y ahora cobra 0,10 $, igual que Sol. Los detalles de esa rebaja están en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras.
¿Es GPT-6.1 Sol más barato si el precio es el mismo? Depende de cómo cuentes
Sí, salvo con prompts de más de 272.000 tokens, pero la distancia cambia mucho según lo que midas: desde un empate por token hasta casi 8 veces por tarea, y al revés con documentos muy largos. Cada fila de la tabla es una forma legítima de contar; la que te importa es la que se parece a tu carga.
| Forma de contar | Sonnet 5.5 ÷ GPT-6.1 Sol | De dónde sale |
|---|---|---|
| Por token de lista, hasta 272K | 1x | Tarifas oficiales |
| Mismo texto en español, tokens de entrada | 1,52x | Recuento del 28 de octubre de 2026 |
12 tareas cortas, Sonnet high frente a Sol medium | 1,52x | Prueba del 28 de octubre de 2026 |
| Por tarea de AA, misma etiqueta de effort | De 2,2x (medium) a 7,9x (max) | AA Intelligence Index v5.0 |
| Por tarea de AA, valores por defecto de la API | 4,6x, y Sol puntúa 5 más | Sonnet high 41,1 frente a Sol medium 46,1 |
| Por tarea de AA, igual puntuación cerca de 50 | 6,9x | Sonnet xhigh 49,6 frente a Sol high 50,2 |
| Documento de 280.000 tokens en español | 0,75x | Cálculo con precios de lista |
La segunda fila es la menos conocida. El 28 de octubre de 2026 se envió el mismo texto a los dos modelos (los primeros 6.000 caracteres de un artículo escrito en español), pidiendo una salida mínima y restando los tokens de la instrucción: Sonnet 5.5 contó 2.937 tokens de entrada y GPT-6.1 Sol 1.926. En inglés la proporción fue 1,45x y en 6.000 caracteres de código Python, 1,46x, así que el efecto no es exclusivo del español, aunque aquí es algo mayor. GPT-6 Luna devolvió exactamente los mismos recuentos que Sol en todas las muestras. OpenAI no publica qué tokenizador usa GPT-6.x y la librería tiktoken no tiene un mapeo para gpt-6, de modo que para contar tus prompts con exactitud tienes que usar el endpoint de recuento de tokens de entrada de OpenAI y no encoding_for_model.
Un hilo de r/ClaudeAI titulado «Sonnet 5.5 30x more expensive than GPT 6.1 Sol» circula con esa cifra para tareas de 3D. Ninguna de las formas de contar de la tabla llega a 30 veces: el rango de AA por tarea, con la misma etiqueta de effort, va de 2,2 a 7,9 veces, y una sola tarea concreta puede salirse de cualquier media.
Sonnet 5.5 y GPT-6.1 Sol en cada nivel de effort: puntuación y coste por tarea
En el Intelligence Index v5.0 de AA, a 28 de octubre de 2026, GPT-6.1 Sol puntúa más que Claude Sonnet 5.5 con la misma etiqueta de effort en los cinco niveles y además cuesta menos por tarea en todos ellos. Solo en max se acercan las puntuaciones, 54,5 frente a 54,2, y es justo donde la diferencia de coste es mayor. Los datos son de la comparativa de Claude Sonnet 5.5 y GPT-6.1 Sol en Artificial Analysis, con los dos modelos llamados por sus API oficiales:
| Effort | Sol: puntuación | Sol: coste y tiempo por tarea | Sonnet: puntuación | Sonnet: coste y tiempo por tarea | Coste Sonnet ÷ Sol |
|---|---|---|---|---|---|
low | 34,5 | 0,16 $ · 104 s | 25,3 | 0,51 $ · 121 s | 3,2x |
medium | 46,1 | 0,36 $ · 231 s | 30,3 | 0,78 $ · 178 s | 2,2x |
high | 50,2 | 0,59 $ · 322 s | 41,1 | 1,64 $ · 332 s | 2,8x |
xhigh | 52,3 | 0,76 $ · 436 s | 49,6 | 4,09 $ · 691 s | 5,4x |
max | 54,5 | 1,27 $ · 858 s | 54,2 | 10,02 $ · 1.326 s | 7,9x |
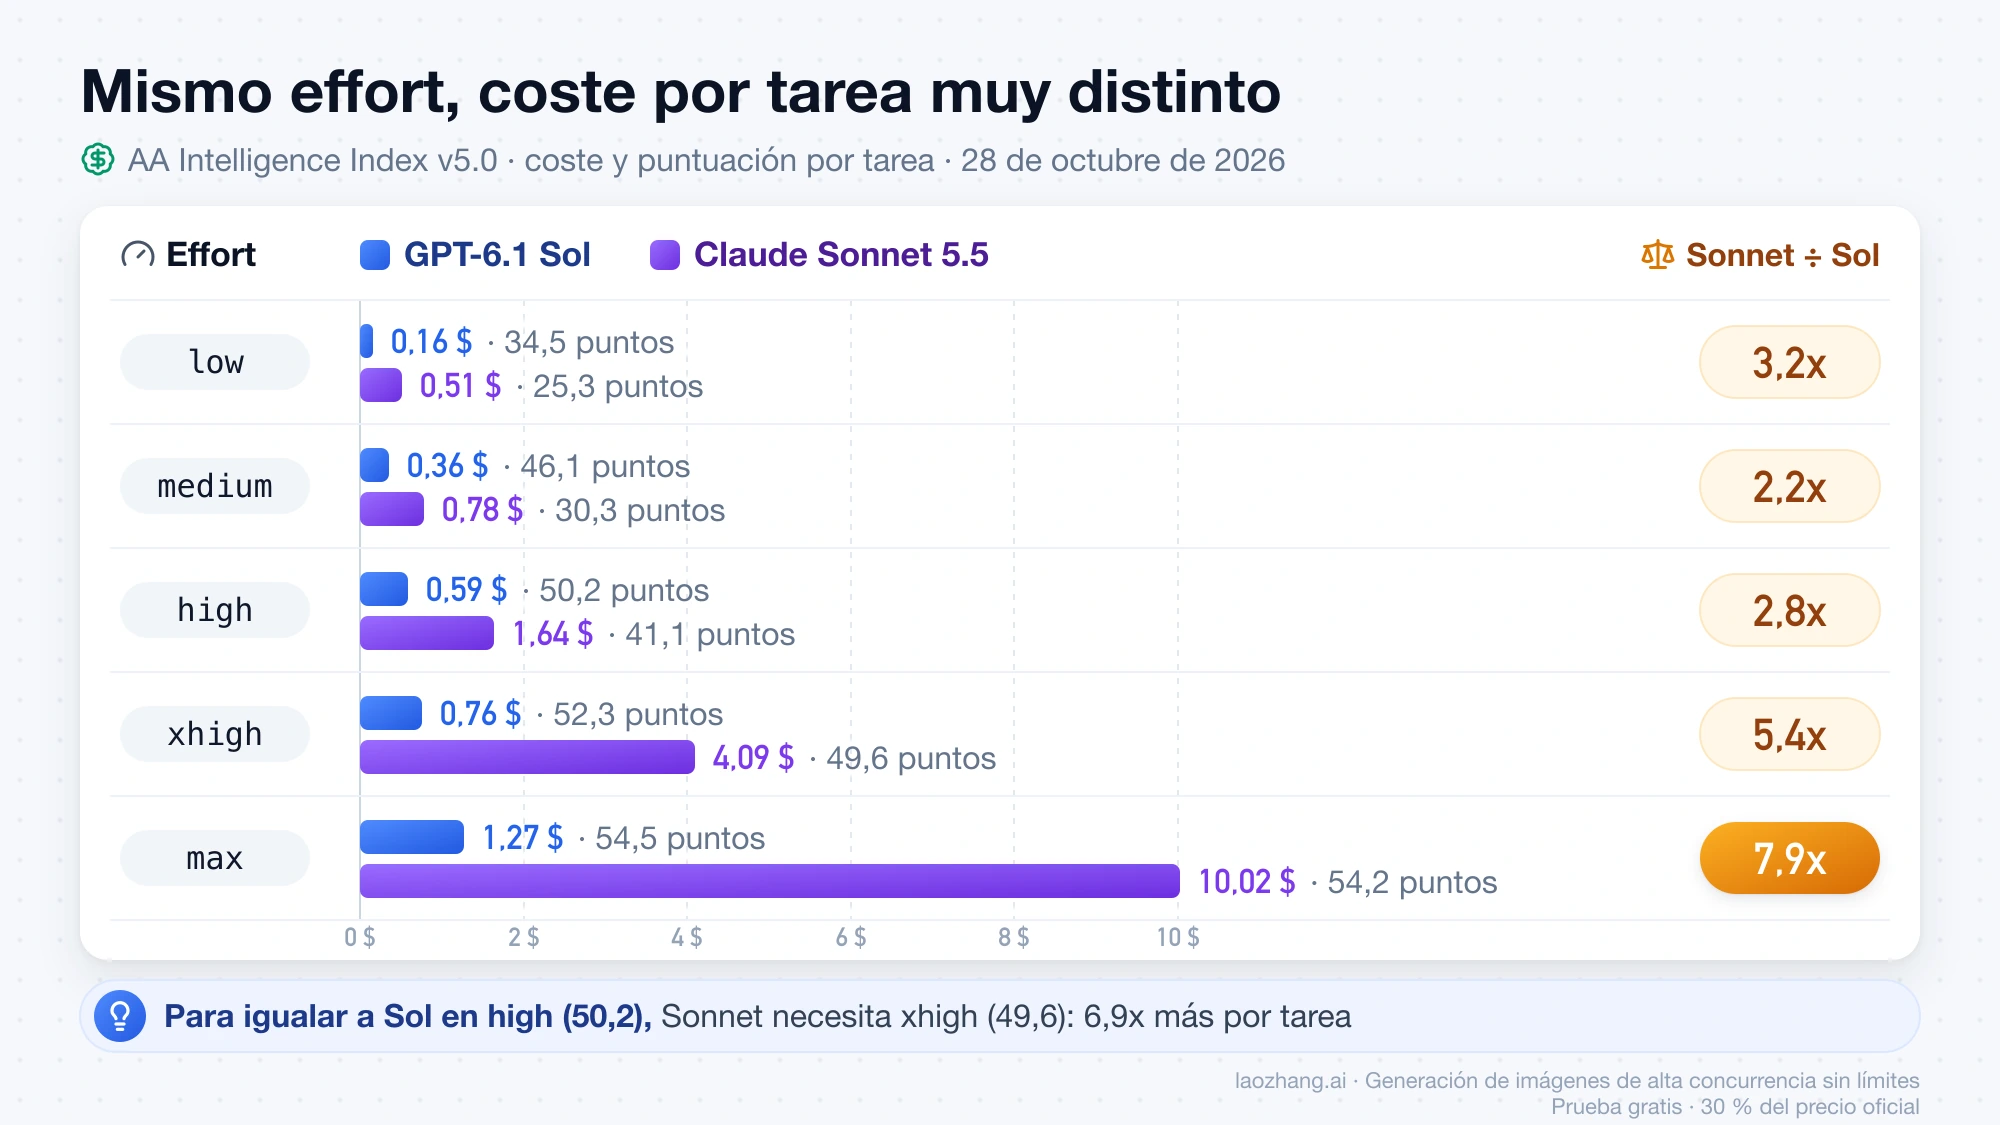
Comparar «por defecto contra por defecto» no es comparar el mismo nivel. En la API de Claude, Sonnet 5.5 usa high si no indicas nada, mientras que Claude Code y las apps de Claude usan medium; Sol usa medium en la API. Para llegar a la puntuación de Sol en high (50,2), Sonnet necesita xhigh (49,6), con un coste por tarea 6,9 veces mayor y más del doble de tiempo, 691 s frente a 322 s. Si quieres repasar qué hace cada nivel en Sonnet, está explicado en Claude Sonnet 5.5: precio, effort y qué cambia frente a Sonnet 5.
La mayor parte de la diferencia está en la entrada, no en la salida. En max, de los 10,02 $ por tarea de Sonnet, 7,17 $ son tokens de entrada (4,88 $ de lecturas de caché y 2,27 $ de escrituras), frente a 0,59 $ de entrada en Sol. Las tareas de AA son agénticas y de varios turnos, y Sonnet hace más turnos y relee más contexto en cada uno: para recorrer el índice completo en max consumió 30.600 millones de tokens de entrada, frente a 1.920 millones de Sol.
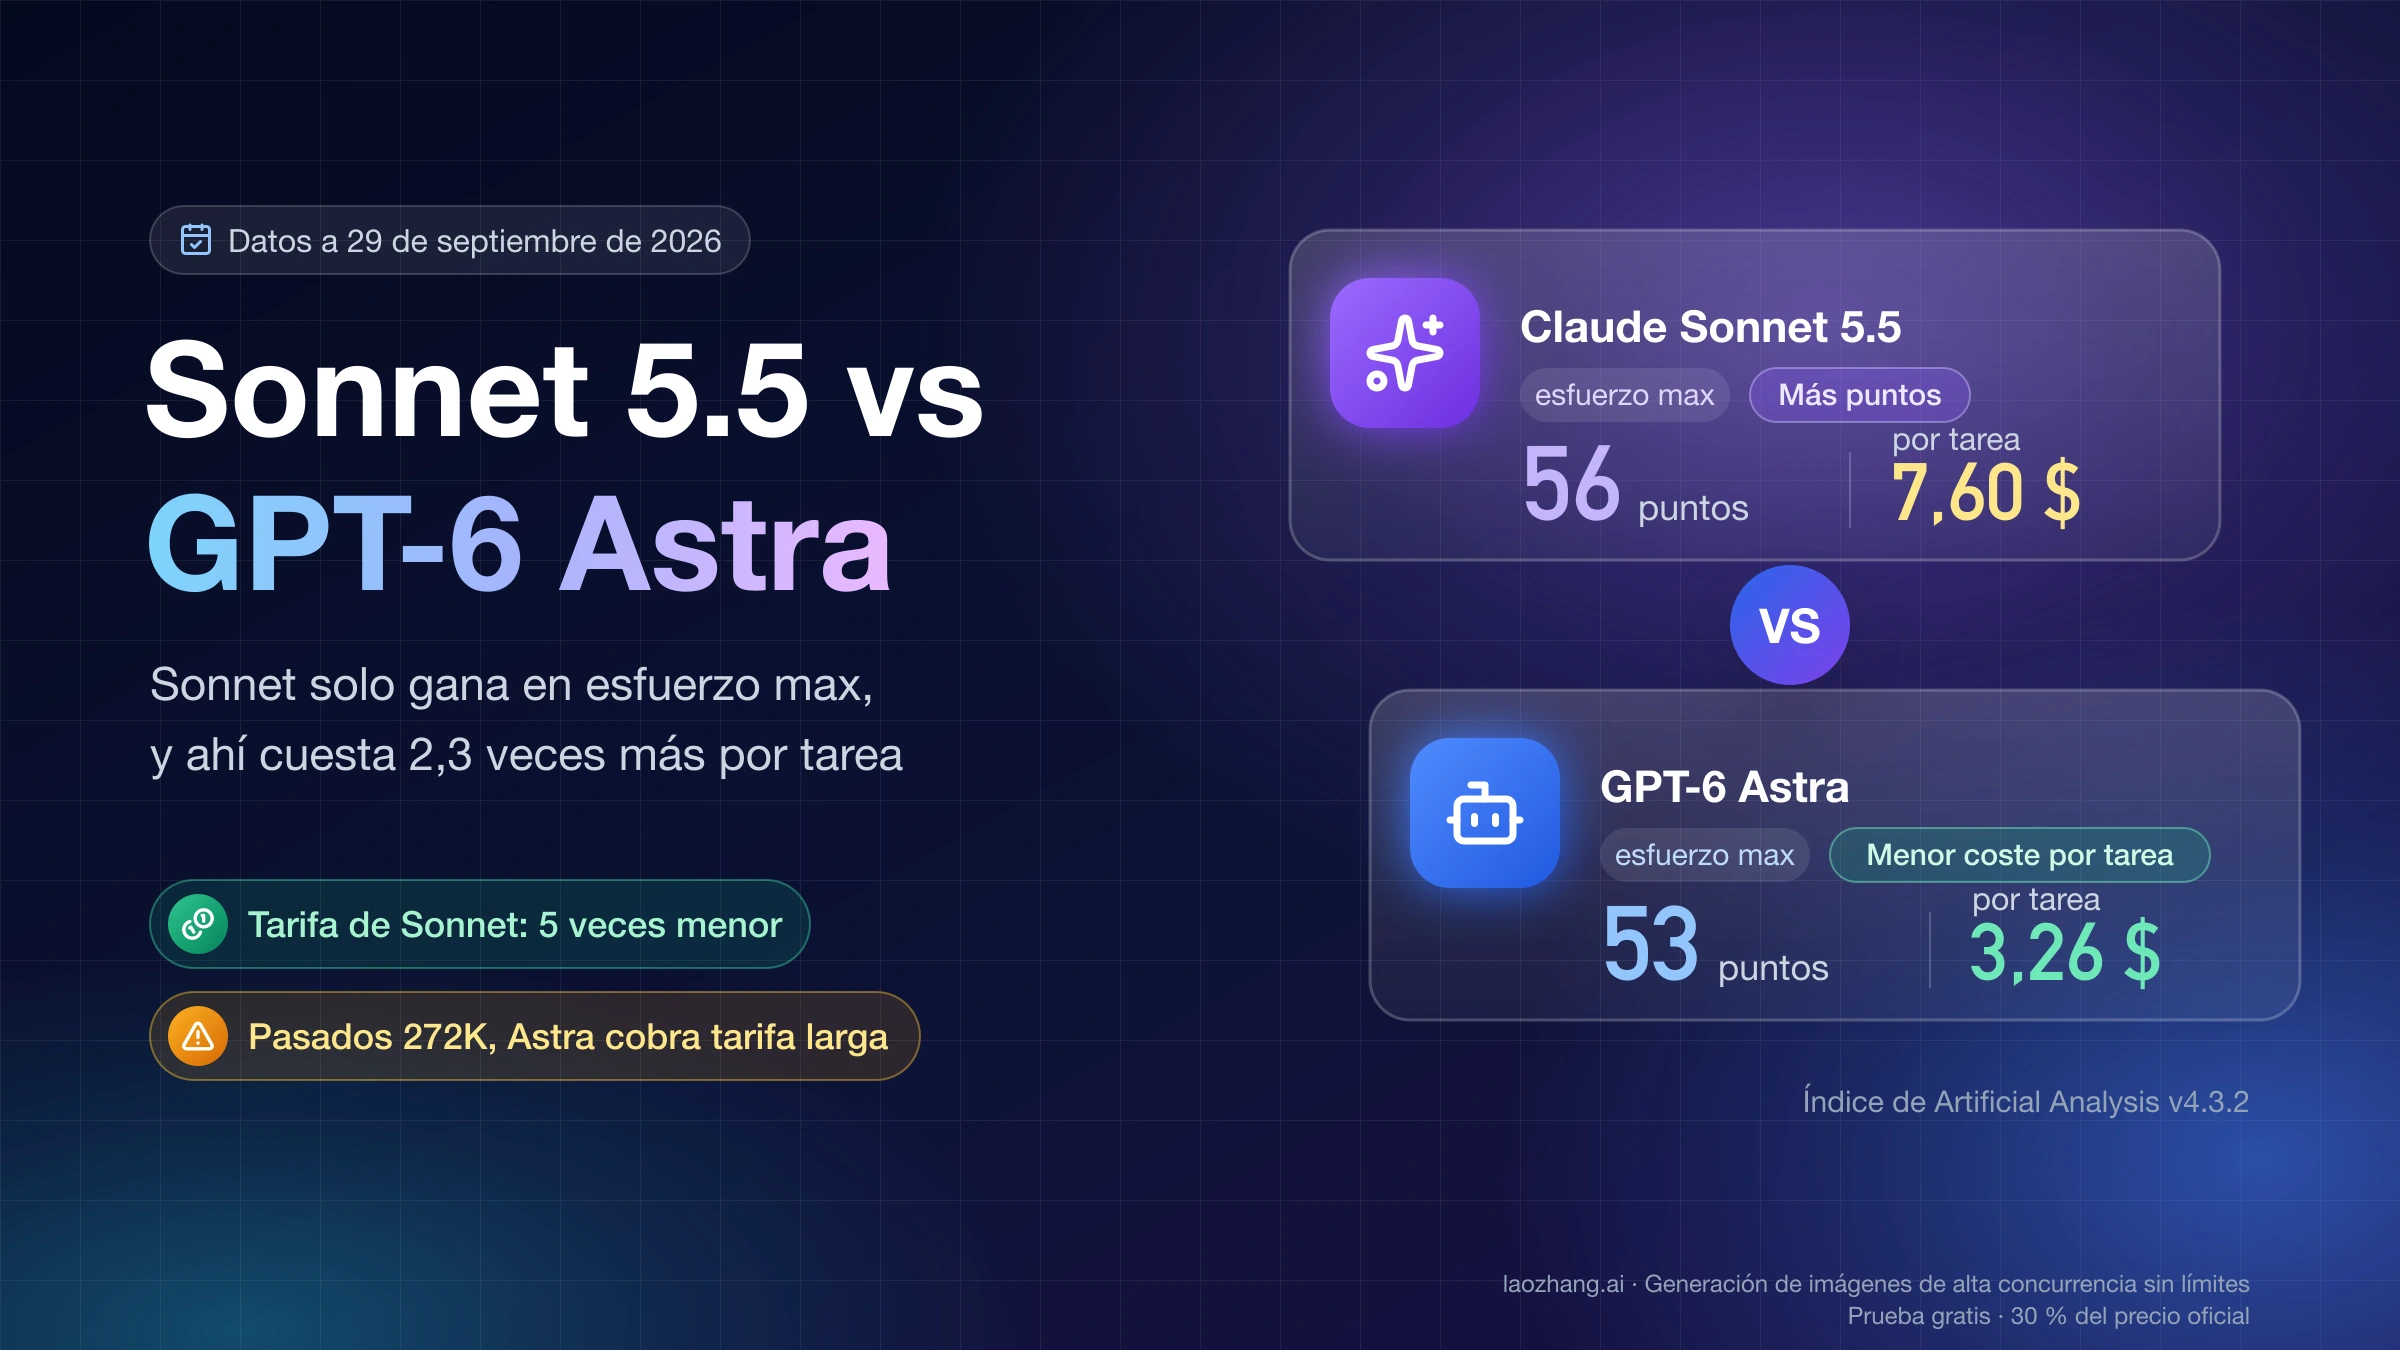
Si ves otras cifras de AA para estos modelos, como los 56 puntos de Sonnet en max, vienen del índice anterior, el v4.3.2. AA cambió en octubre de 2026 a la versión 5.0, que añade y retira pruebas, y con ese cambio el primer puesto entre los dos pasó de Sonnet a Sol, así que no mezcles números de las dos versiones.
Dónde gana cada uno: terminal y Briefcase para Sonnet, ciencia para Sol
Dentro del índice, Sonnet 5.5 solo se pone por delante en pocas pruebas y casi siempre en sus niveles altos: Terminal-Bench 4.0 en xhigh y max, Terminal-Bench-Science en xhigh, AutomationBench-AA y FrontierCode 2.0 en max, y AA-Briefcase, una prueba de trabajo con documentos de oficina, en todos los niveles. GPT-6.1 Sol gana todo lo demás, y en low y medium se impone en todas las pruebas salvo AA-Briefcase. Estas son seis subpruebas de AA v5.0 en high y max:
| Prueba de AA v5.0 | Sol high | Sonnet high | Sol max | Sonnet max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 51,5 % | 43,9 % | 56,1 % | 63,6 % |
| AutomationBench-AA | 64,5 % | 59,4 % | 64,9 % | 71,8 % |
| AA-Briefcase (Elo) | 1.466 | 1.634 | 1.555 | 1.812 |
| FrontierCode 2.0 | 36,7 % | 25,7 % | 40,6 % | 41,7 % |
| AA-Omniscience (puntos) | 41,0 | 18,7 | 42,0 | 30,5 |
| HLE-Diamond | 51,9 % | 33,8 % | 58,8 % | 53,3 % |
La lectura práctica es que la ventaja de Sonnet en agentes de terminal existe, pero se paga: en xhigh saca 57,1 % frente a 54,0 % de Sol con un coste por tarea 5,4 veces mayor. En conocimiento factual (AA-Omniscience) la distancia a favor de Sol es grande en todos los niveles, lo mismo ocurre en CritPt v2 Hard y GDP.pdf, y en Terminal-Bench-Science, que mide tareas científicas en terminal, Sol va por delante en todos los niveles salvo xhigh (50,5 % frente a 52,4 %).
Prueba del 28 de octubre: 12 tareas, mismo prompt, tres configuraciones
Con 12 tareas pequeñas y bien especificadas, los dos modelos acertaron casi todo y lo que separó a las configuraciones fue el coste, el volumen de salida y el tiempo. El 28 de octubre de 2026 se lanzaron las mismas tareas, con tests ocultos o respuestas exactas escritas antes, a través de la pasarela de LaoZhang: Sonnet 5.5 por /v1/messages con thinking: {"type": "adaptive"} y output_config: {"effort": "high"}, y Sol por /v1/chat/completions sin reasoning_effort (es decir, medium) y con reasoning_effort: "high". Cada tarea se ejecutó una vez por configuración, en un solo turno, sin instrucciones de sistema ni herramientas.
| Configuración | Aciertos | Coste a precio de lista | Tokens de salida | Suma de tiempos | Mediana por llamada |
|---|---|---|---|---|---|
Claude Sonnet 5.5, high | 11 de 12 | 0,1761 $ | 10.945 | 101 s | 7,6 s |
GPT-6.1 Sol, medium | 12 de 12 | 0,1157 $ | 6.162 (2.423 de razonamiento) | 187 s | 14,0 s |
GPT-6.1 Sol, high | 12 de 12 | 0,1581 $ | 10.398 (6.311 de razonamiento) | 442 s | 21,2 s |
Sobre las mismas 12 tareas, Sonnet costó 1,52 veces lo que Sol en medium y 1,11 veces lo que Sol en high; quitando las dos tareas con un documento largo, la proporción frente a Sol medium sube a 1,83. Sonnet escribió 1,78 veces más tokens de salida que Sol en medium y casi los mismos que Sol en high. Su único fallo fue de formato: un resumen en cinco viñetas cuya primera viñeta tenía 26 palabras con un límite de 25, en una llamada en la que el razonamiento adaptativo no se activó (devolvió bloques de razonamiento en 8 de las 12 tareas). Las tres configuraciones respondieron que no existen dos funciones inventadas de la biblioteca estándar de Python y las tres pasaron los 36 tests de una función de rangos de versiones al estilo de npm.
Sol escribió caché sin que nadie lo pidiera. En los dos prompts de unos 10.000 tokens, la respuesta de Sol incluyó cache_write_tokens (10.103 y 10.195) sin ningún ajuste de caché en la petición, y esa escritura se cobra a 2,50 $ por millón, 1,25 veces la entrada normal. El mismo prompt enviado de nuevo unos 5,5 minutos después, con reasoning_effort: "high", volvió a escribir caché y leyó 0 tokens cacheados; la causa no está clara y puede estar en el cambio de effort, en el enrutado de la pasarela o en OpenAI. Sonnet no cacheó nada, porque las peticiones no llevaban cache_control.
Cuánto costará tu carga: ocho casos con precios de lista
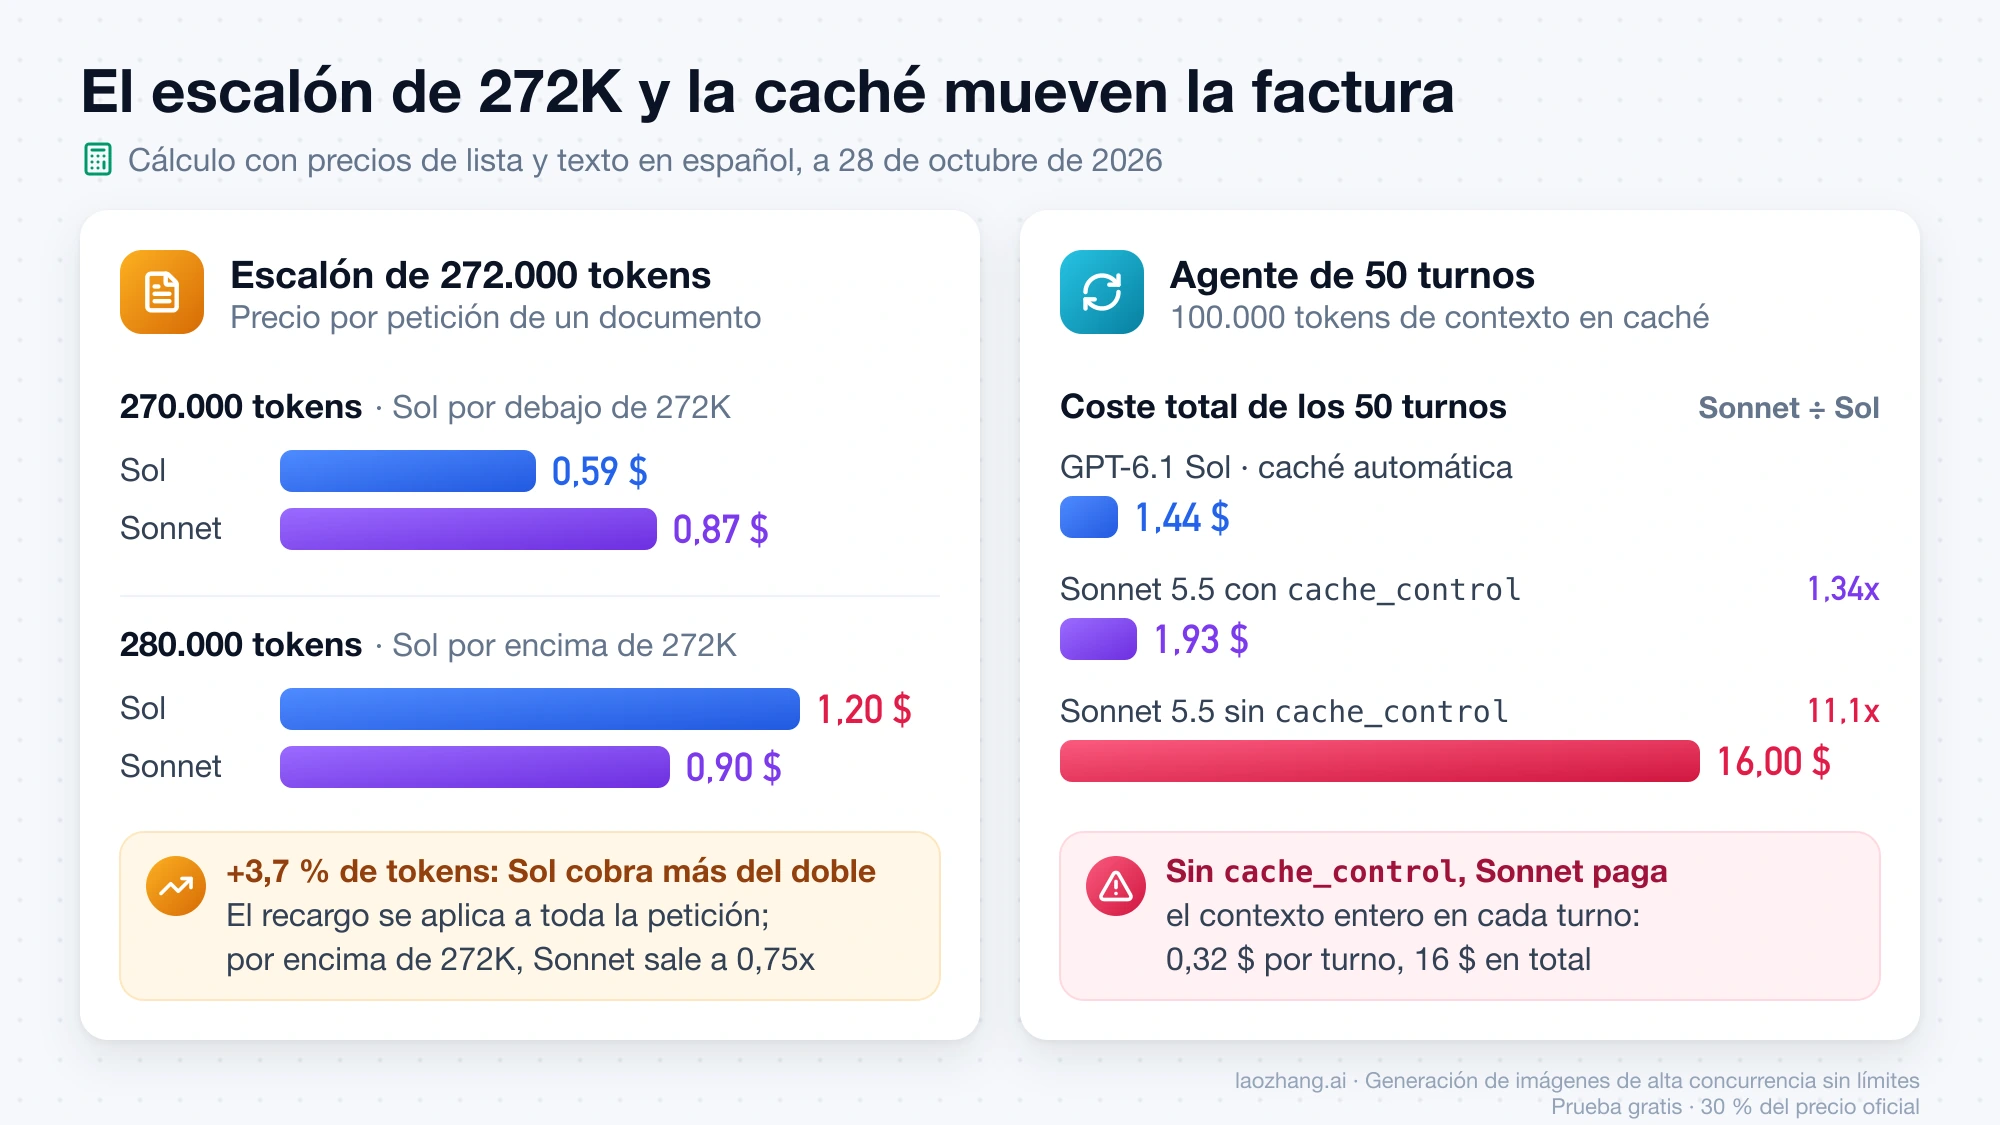
Por debajo de 272.000 tokens, Sonnet 5.5 sale entre 1,2 y 1,5 veces más caro que GPT-6.1 Sol con texto en español aunque ambos escriban la misma salida; por encima, Sonnet sale más barato; y en un bucle de agente sin cache_control, Sonnet puede costar 11 veces más. Los casos están calculados a 28 de octubre de 2026 con los precios de lista de la sección anterior:
| Caso | GPT-6.1 Sol | Claude Sonnet 5.5 | Sonnet ÷ Sol |
|---|---|---|---|
| Turno de chat: 2.000 de entrada y 500 de salida | 0,0090 $ | 0,0111 $ | 1,23x |
| Documento de 250.000 tokens y 5.000 de salida | 0,55 $ | 0,81 $ | 1,47x |
| Documento de 270.000 tokens (Sol justo por debajo de 272K) | 0,59 $ | 0,87 $ | 1,48x |
| Documento de 280.000 tokens (Sol por encima de 272K) | 1,20 $ | 0,90 $ | 0,75x |
| Documento de 600.000 tokens | 2,48 $ | 1,87 $ | 0,76x |
| Agente de 50 turnos, 100.000 tokens de contexto en caché | 1,44 $ | 1,93 $ | 1,34x |
El mismo agente, Sonnet sin cache_control | 1,44 $ | 16,00 $ | 11,1x |
| Batch de 10.000 peticiones (3.000 de entrada y 1.000 de salida) | 80 $ | 95,60 $ | 1,20x |
Supuestos: los tamaños están contados en tokens de Sol; la entrada de Sonnet es esa cifra multiplicada por 1,52, el cociente medido para texto en español; la salida es la misma en los dos, aunque en la práctica Sonnet suele escribir más. En el bucle de agente, cada turno añade 2.000 tokens nuevos y 1.000 de salida; el primero escribe los 100.000 tokens en caché (Sol en su caché automática de 30 minutos, Sonnet con cache_control de 5 minutos) y los 49 siguientes los leen, suponiendo que no pasa el tiempo de vida de la caché entre turnos. Sin cache_control, Sonnet paga cada turno 102.000 tokens de Sol × 1,52 × 2 $ por millón, más la salida: 0,32 $ por turno, 16 $ en total. El batch aplica el 50 % de descuento en los dos.
El escalón de 272.000 tokens es abrupto. En Sol, pasar de 270.000 a 280.000 tokens de entrada, un 3,7 % más, sube la petición de 0,59 $ a 1,20 $, más del doble. Por encima de ese límite, Sol cobra 4 $ por millón de entrada y Sonnet 2 $ por cada token suyo, así que la entrada de Sonnet sale más barata mientras el mismo texto ocupe menos del doble de tokens en Sonnet que en Sol, y 1,52 queda lejos de 2. Ten en cuenta también que la entrada máxima de Sol es de 922.000 tokens, aunque su contexto total sea de 1.050.000.
¿Cuál es más rápido, Sonnet 5.5 o GPT-6.1 Sol?
Sonnet 5.5 genera más tokens por segundo, pero eso no significa que termine antes en todas las tareas. En las mediciones de AA, Sonnet escribe entre 109 y 140 tokens por segundo según el nivel, frente a 59–81 de Sol, y devuelve antes el primer token de la respuesta en low, medium, high y xhigh (en high, 11,1 s frente a 40,8 s). Por tarea completa, en cambio, Sonnet solo termina antes en medium (178 s frente a 231 s): tarda algo más en low (121 s frente a 104 s) y en high (332 s frente a 322 s), y bastante más en xhigh y max (691 s y 1.326 s frente a 436 s y 858 s), porque escribe muchos más tokens; en max también tarda más en dar el primer token, 455 s frente a 278 s.
En la prueba del 28 de octubre de 2026 por la pasarela de LaoZhang, la mediana por llamada fue de 7,6 s en Sonnet high, 14,0 s en Sol medium y 21,2 s en Sol high, con una llamada de Sol high que tardó 150,6 s para 514 tokens de salida. OpenRouter publica sus propias medianas, con otro método y otros proveedores, así que no conviene ponerlas junto a las de AA. Si el tiempo de respuesta decide tu elección, mídelo en el endpoint que vas a usar; si es Sol lo que va lento, las causas y los ajustes están en GPT-6.1 Sol lento en Codex y API: qué lo frena y cómo acelerarlo.
Qué cambiar en el código al pasar de Sonnet 5.5 a Sol o al revés
Cambiar el nombre del modelo no basta en ninguna de las dos direcciones. Los parámetros de razonamiento, la caché y las llamadas a herramientas funcionan de forma distinta, y varios errores aparecen solo cuando la petición ya está en producción. Esta tabla recoge lo que documentan Anthropic en su resumen de modelos de Claude y OpenAI en la ficha de GPT-6.1 Sol y su guía de prompt caching, a 28 de octubre de 2026:
| Aspecto | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| Llamadas a herramientas | Messages API; el tool_choice forzado (any o tool) devuelve 400 | Solo en la Responses API; Chat Completions no admite llamadas a funciones con Sol |
| Niveles de effort | low, medium, high, xhigh, max en output_config.effort; por defecto high en la API | low, medium, high, xhigh, max en reasoning.effort; por defecto medium |
| Apagar el razonamiento | thinking: {"type": "disabled"} se rechaza; lo mínimo es between_tools | No admite none ni minimal; lo mínimo es low |
| Caché | Solo si la pides con cache_control; 5 minutos o 1 hora; desde 512 tokens | Automática desde 1.024 tokens, con escritura de 30 minutos cobrada por defecto; 12 horas solo en la Responses API |
| Contexto y salida | 1 millón de contexto; 128.000 de salida (300.000 en Batch con cabecera beta) | 1.050.000 de contexto, 922.000 de entrada máxima, 128.000 de salida |
| Modos rápidos y descuentos | Sin modo Fast; Batch al 50 % | Fast, Ultrafast, Batch y Flex |
| Razonamiento facturado | El texto del razonamiento se omite por defecto, pero se cobra | Los tokens de razonamiento van dentro de la salida y se cobran como tal |
Hay dos detalles más que conviene saber. En una prueba del 5 de octubre de 2026 por Chat Completions, a través de la pasarela de LaoZhang, Sol rechazó temperature: 0.2 con el mensaje «Only the default (1) value is supported», así que quita ese parámetro si venías de otro modelo. Y si llamas a Sonnet a través de cualquier proxy o pasarela, fija thinking y el effort de forma explícita: el 26 de octubre de 2026, por la pasarela de LaoZhang, las peticiones a Sonnet sin el campo thinking no devolvieron bloques de razonamiento en ninguna de 9 tareas, aunque Anthropic documenta que omitirlo equivale a razonamiento adaptativo en high. En laozhang.ai los dos modelos tienen precio de lista, pero Sol solo está disponible por Chat Completions, sin llamadas a herramientas, y la salida de Claude se limita a 32.768 tokens por llamada. Si vienes de GPT-6 Sol, la migración completa está en GPT-6.1 Sol: qué cambia, cuánto cuesta y qué revisar al migrar.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Cómo medir el coste por tarea aceptada antes de mover tráfico
La cifra que decide es el coste por tarea aceptada: lo que pagas en total dividido entre las tareas que pasan tus comprobaciones, contando reintentos. Con el mismo precio por token, los tokenizadores, el volumen de salida y la caché mueven la factura más que la tarifa, así que una prueba pequeña con tus propias tareas responde mejor que cualquier tabla general.
- Elige entre 20 y 50 tareas reales de tu carga y escribe la comprobación de cada una antes de ver ninguna respuesta: tests, respuesta exacta o una lista de requisitos.
- Fija la configuración de forma explícita: en Sonnet,
thinking: {"type": "adaptive"}y el effort enoutput_config; en Sol,reasoning.effort. Prueba dos niveles en cada uno, por ejemplo Sonnethighyxhighfrente a Solmediumyhigh. - Configura la caché como la usarás en producción:
cache_controlen el prefijo estable de Sonnet y, en Sol, la caché automática, contando suscache_write_tokens. - Guarda el uso de cada llamada: tokens de entrada, lecturas y escrituras de caché, salida con su parte de razonamiento, y tiempo total.
- Cuenta los tokens de tus prompts más largos con el endpoint de recuento de OpenAI y comprueba si alguno pasa de 272.000; si es así, separa esas peticiones y compáralas aparte.
- Calcula el coste por tarea aceptada en cada configuración y reparte el tráfico por tipo de tarea si el resultado no favorece a un solo modelo en todo.
Sonnet 5.5 y GPT-6.1 Sol: otras preguntas
¿Existe un modelo GPT-6.1 Sol Pro?
No. A 28 de octubre de 2026, la página de precios de la API de OpenAI solo lista gpt-6.1-sol en esta familia, sin ninguna variante Pro. Algunas webs de terceros usan ese nombre, pero no corresponde a un modelo que puedas llamar en la API de OpenAI.
¿Cuál gasta menos de tu plan, Sonnet 5.5 o GPT-6.1 Sol?
En las suscripciones no pagas por token, sino con los límites de uso de cada plan, así que las cifras de esta comparativa no se trasladan directamente. Cómo se consumen los planes de Claude y ChatGPT con sus agentes de código está en Claude Code vs Codex: coste de suscripción, límites y factura API.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
- 1.tabla de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 2.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 3.ficha del modelo GPT-6.1 Soldevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 4.comparativa de Claude Sonnet 5.5 y GPT-6.1 Sol en Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-sol
- 5.resumen de modelos de Claudeplatform.claude.com/docs/en/about-claude/models/overview
- 6.guía de prompt cachingdevelopers.openai.com/api/docs/guides/prompt-caching