Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy
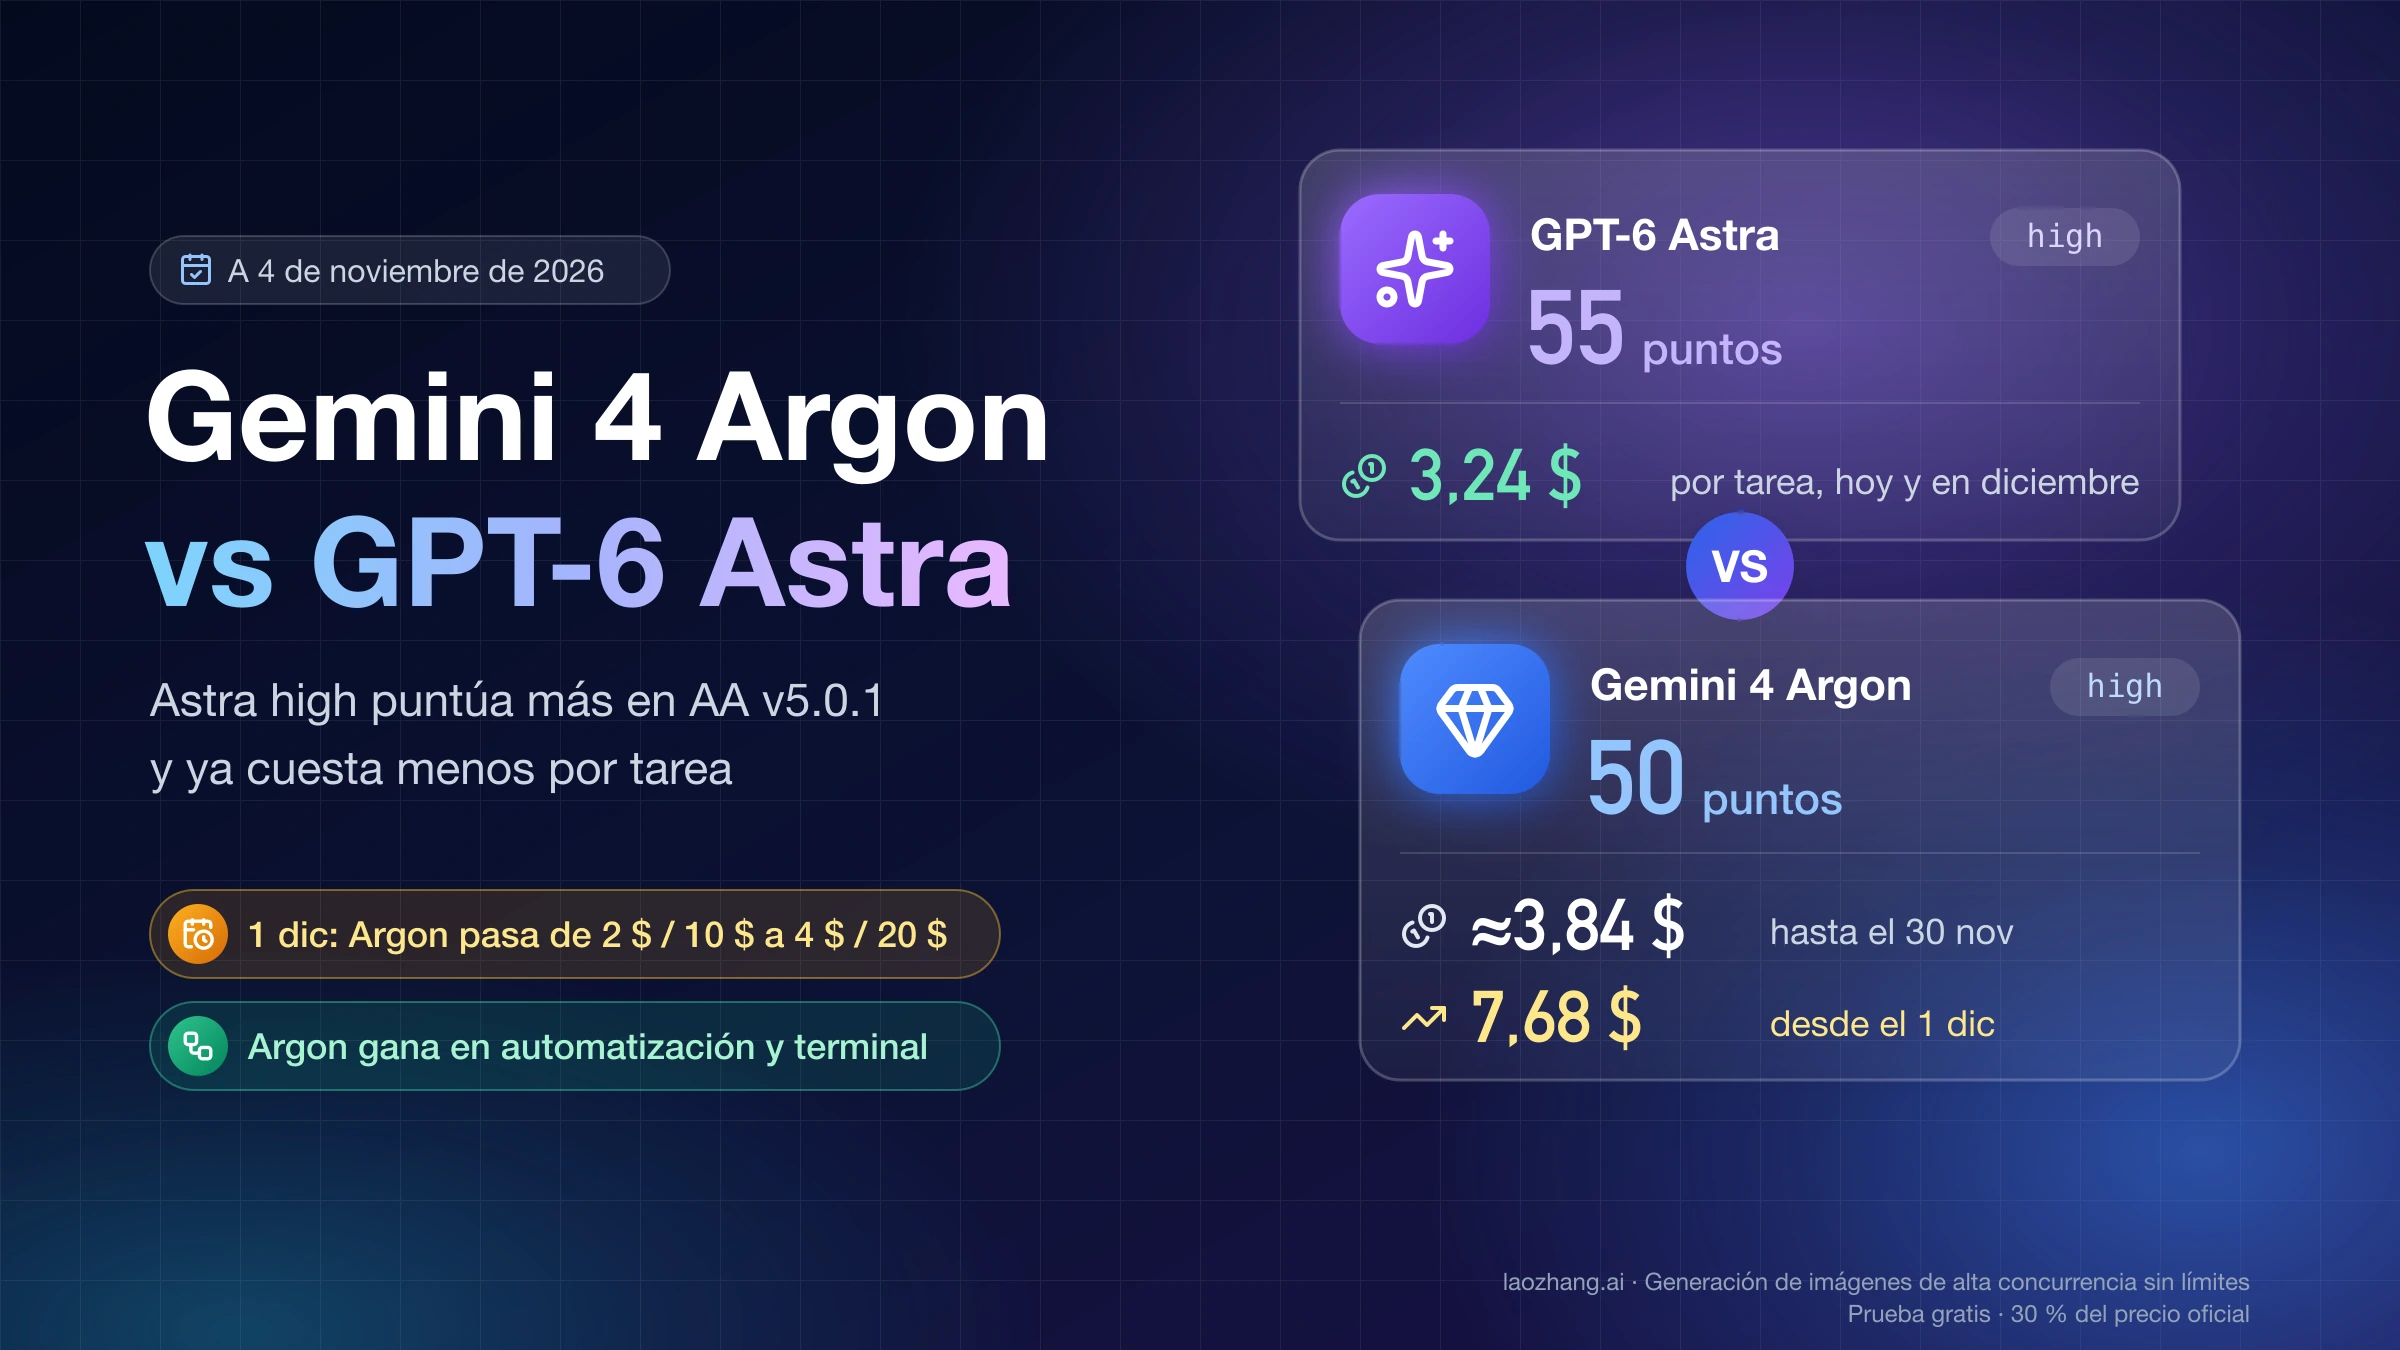
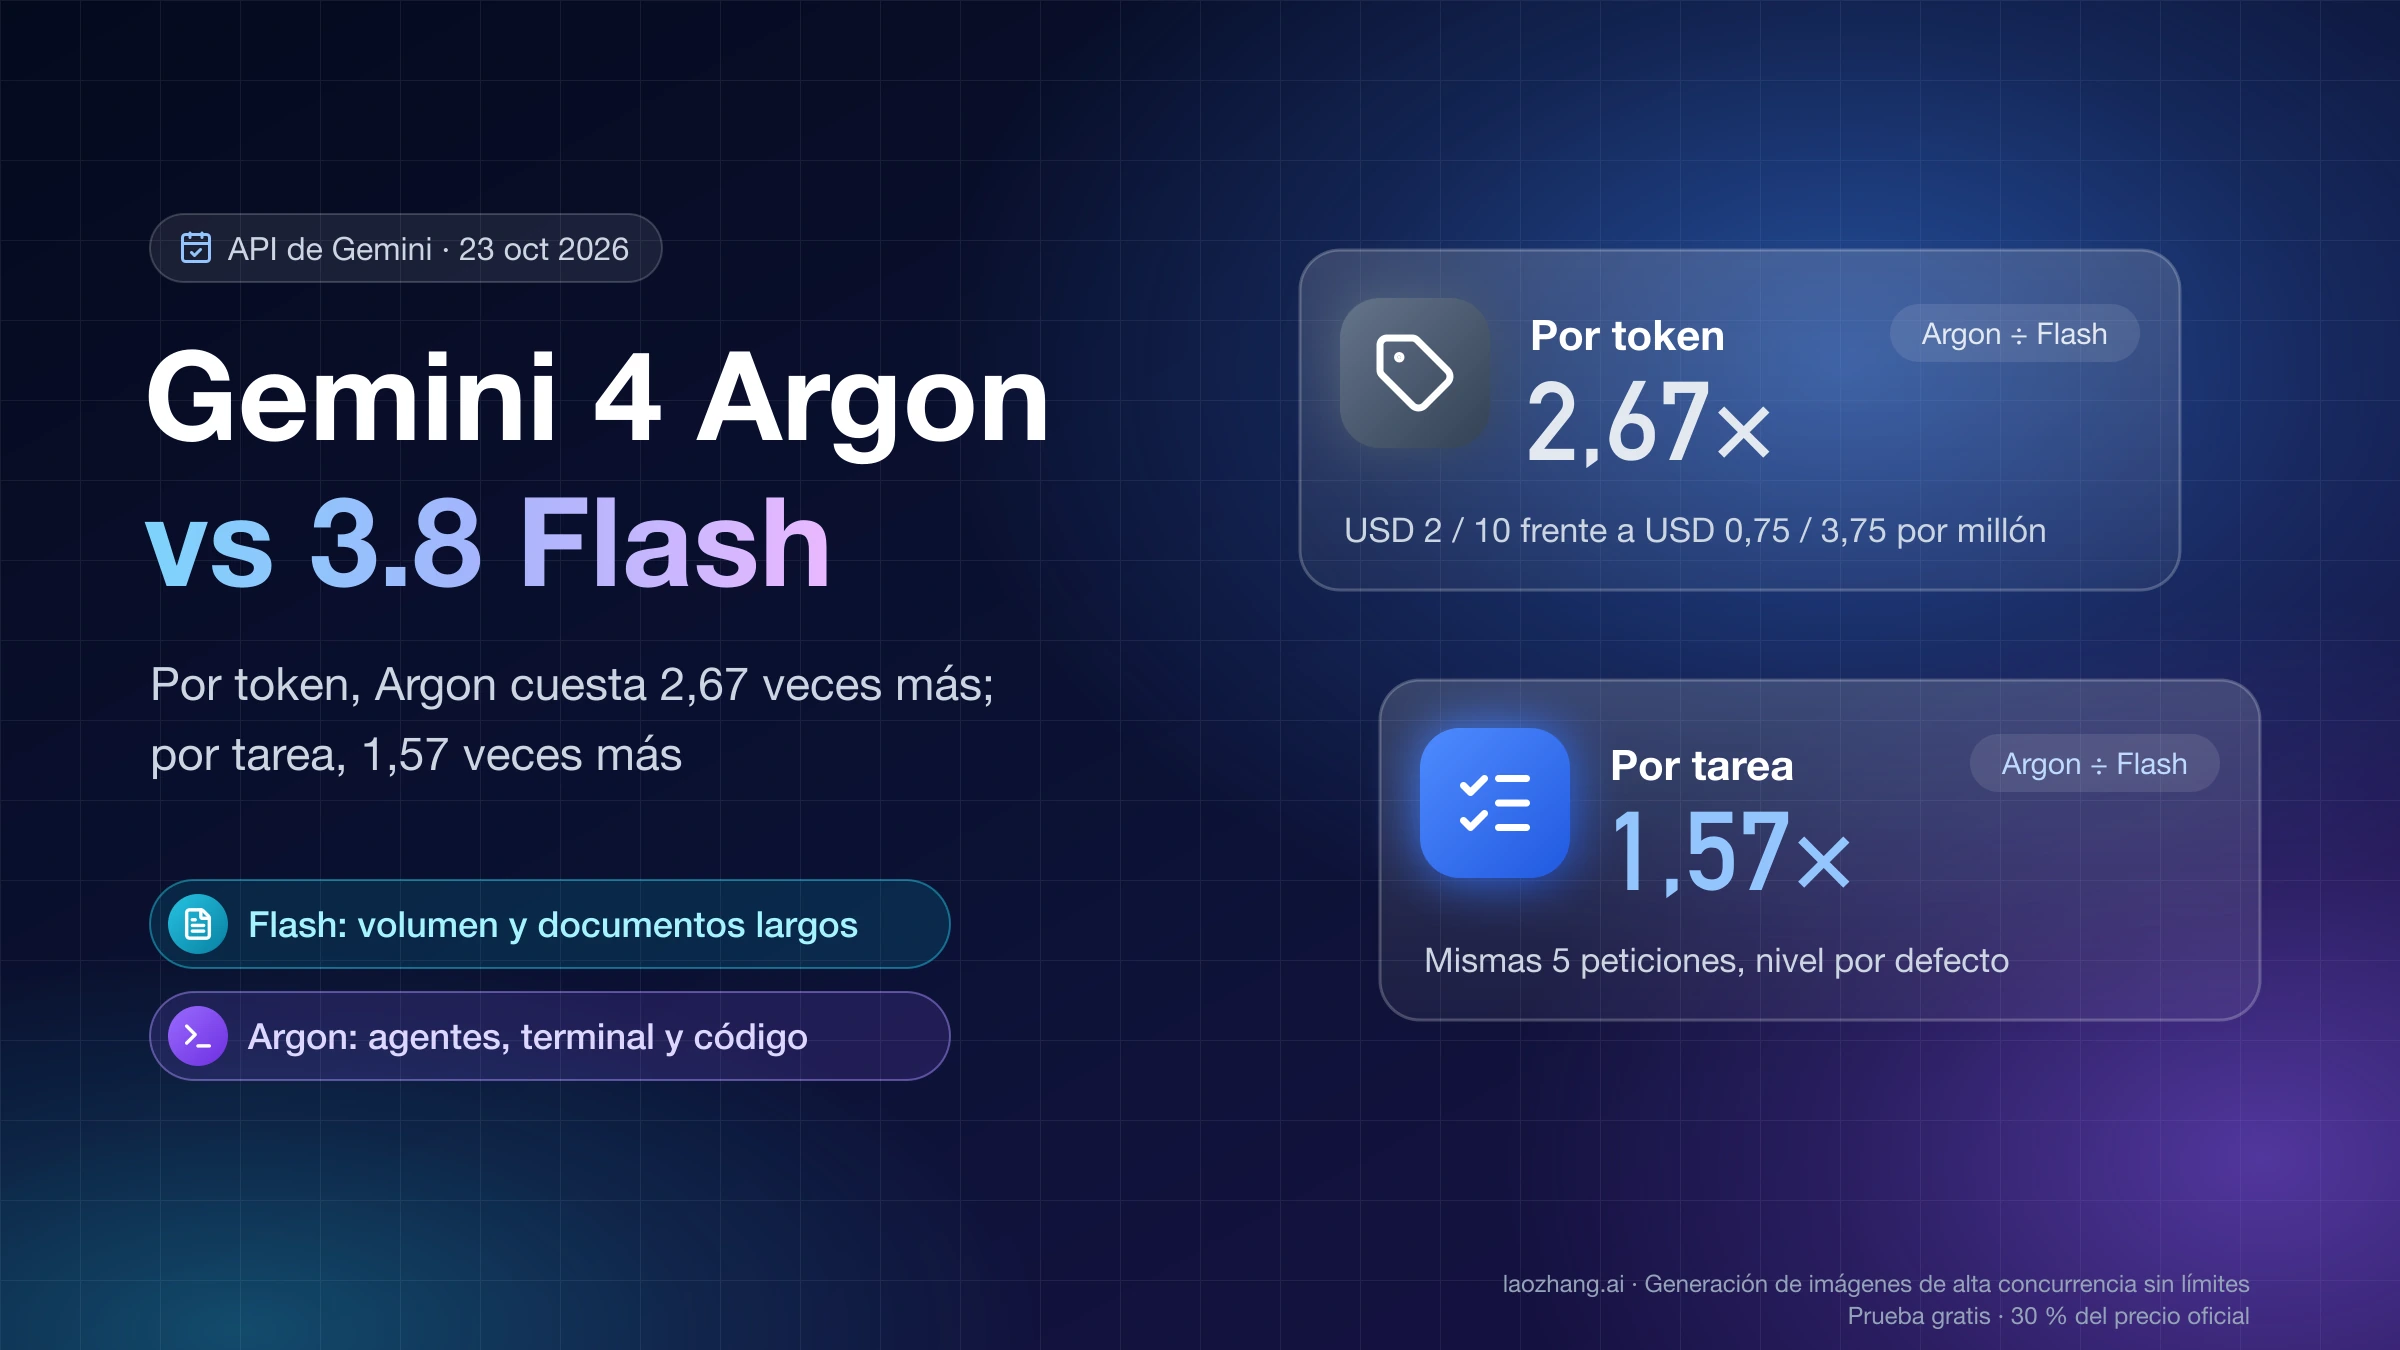
Argon cuesta por token la mitad que Opus 5.5 solo hasta el 30 de noviembre. Con las mismas tareas, Opus en alto salió más barato y acertó el recuento largo.
En esta página
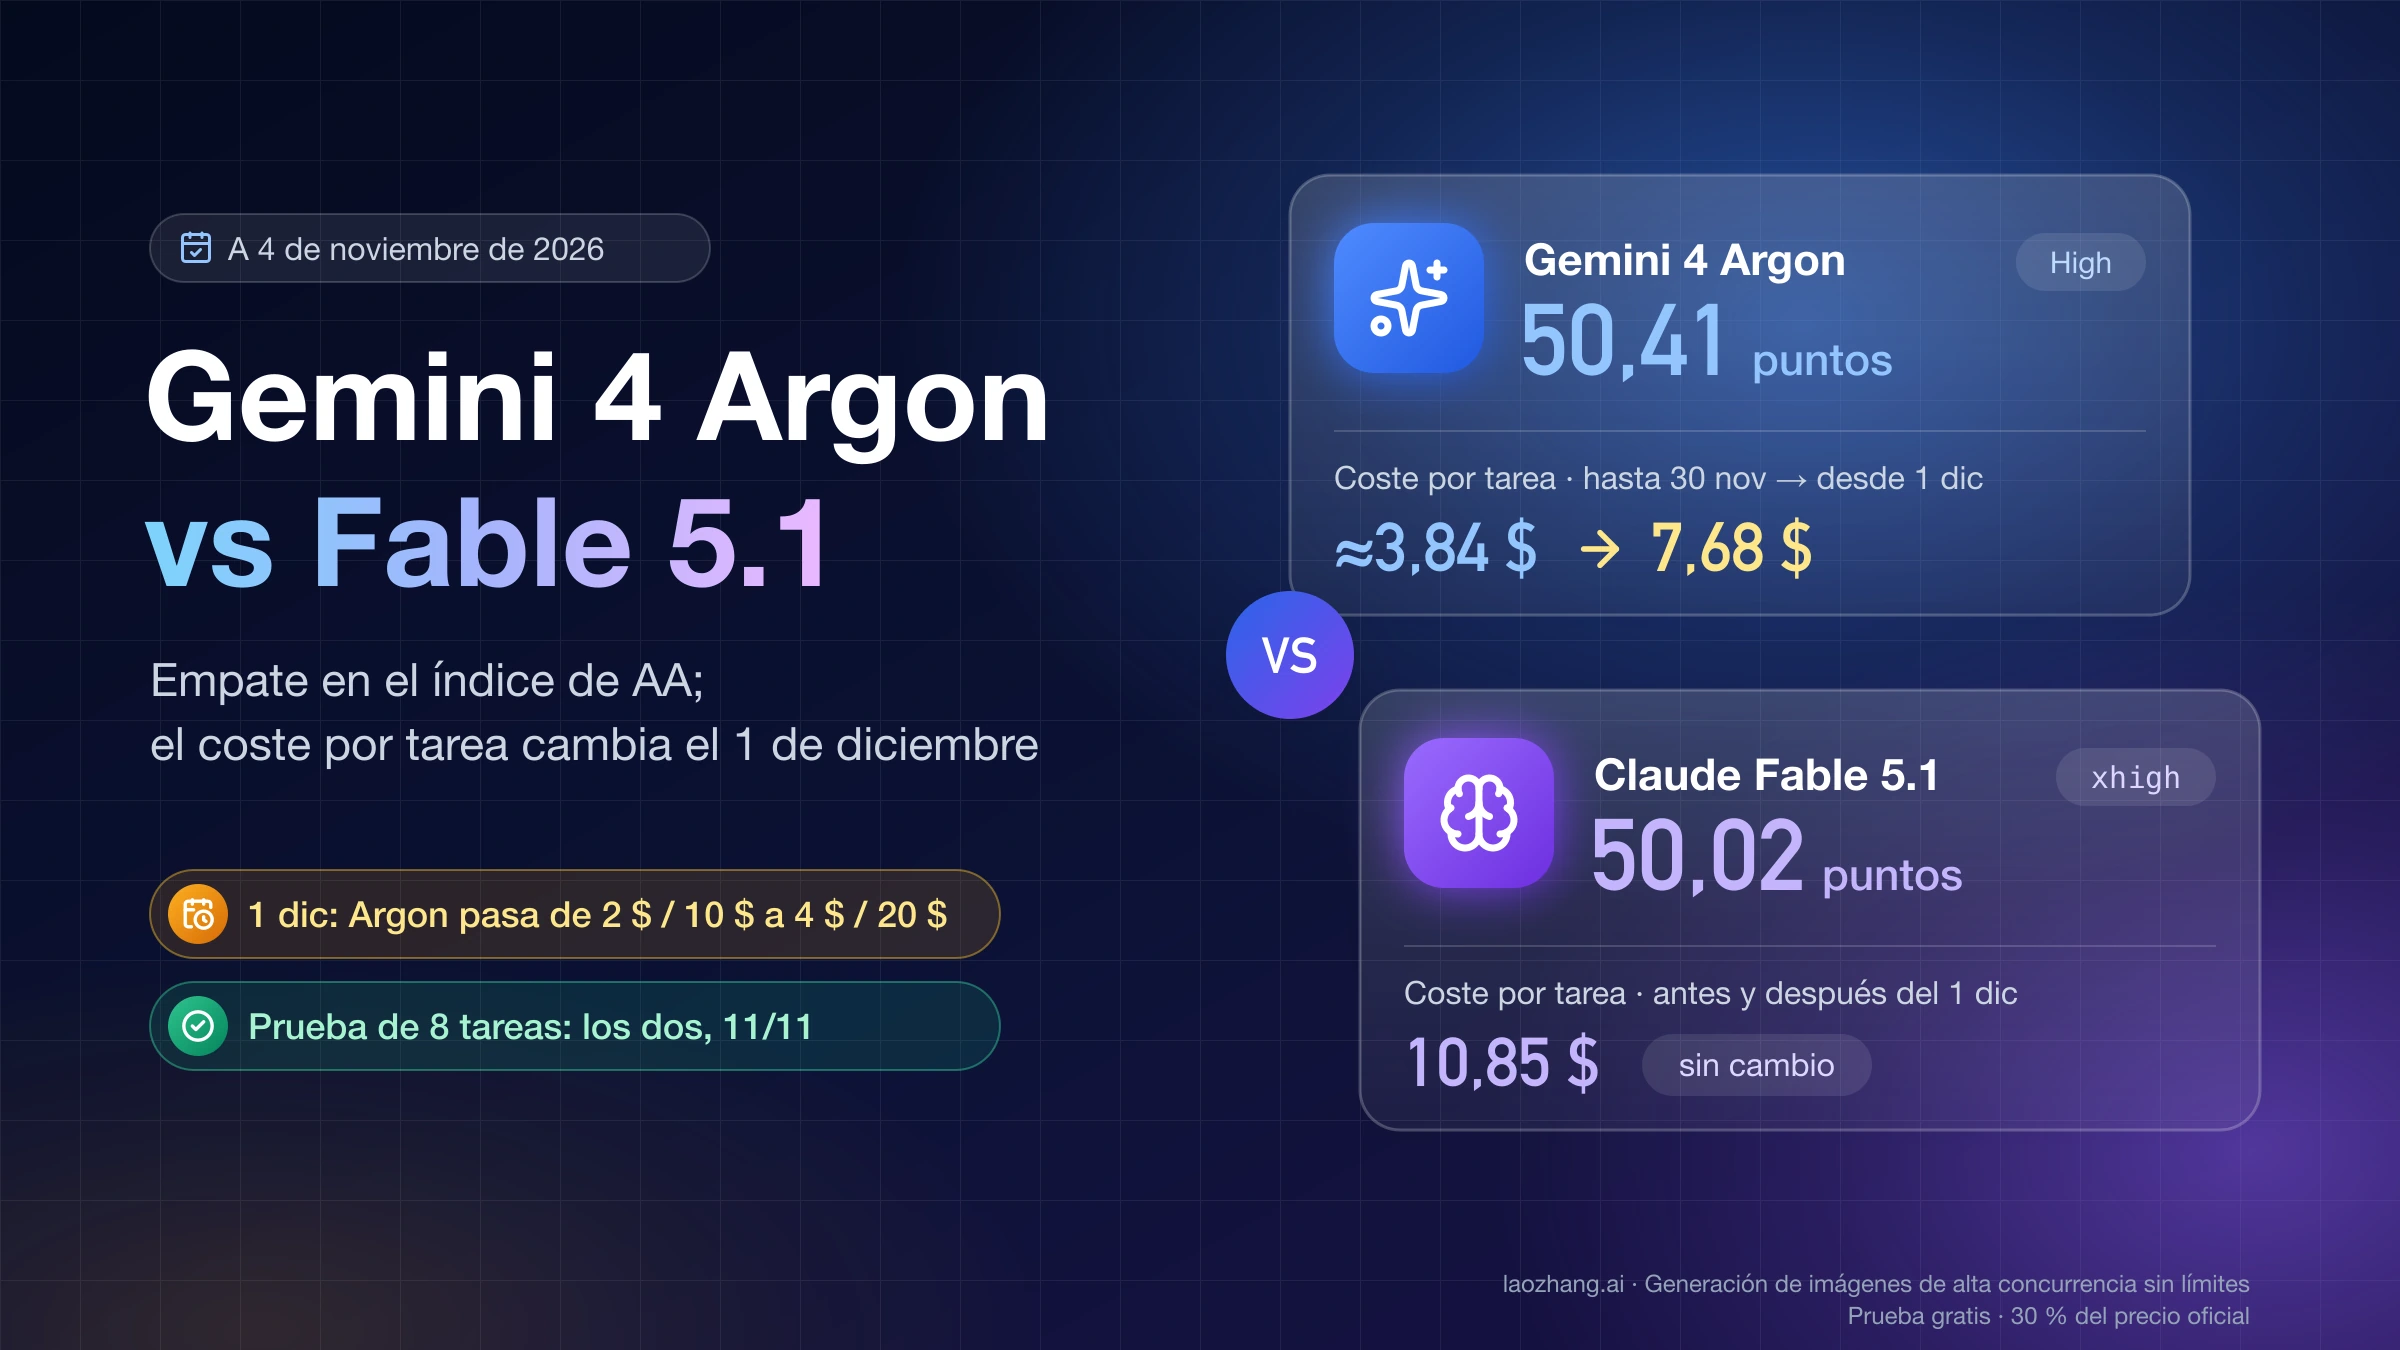
Si eliges entre Gemini 4 Argon y Claude Opus 5.5 para la API, «Argon cuesta la mitad» solo es verdad por token y hasta el 30 de noviembre de 2026. gemini-4-argon cobra 2 $ por millón de tokens de entrada y 10 $ por millón de salida hasta esa fecha, y 4 $ y 20 $ desde el 1 de diciembre, exactamente la tarifa de claude-opus-5-5. Por tarea, con el nivel alto de cada uno, Argon ya sale más caro: a 11 de noviembre de 2026, Artificial Analysis le asigna 9,95 $ por tarea de su índice con la tarifa de diciembre (unos 4,98 $ con la de lanzamiento) frente a 3,46 $ de Opus 5.5, con 50 y 52 puntos.
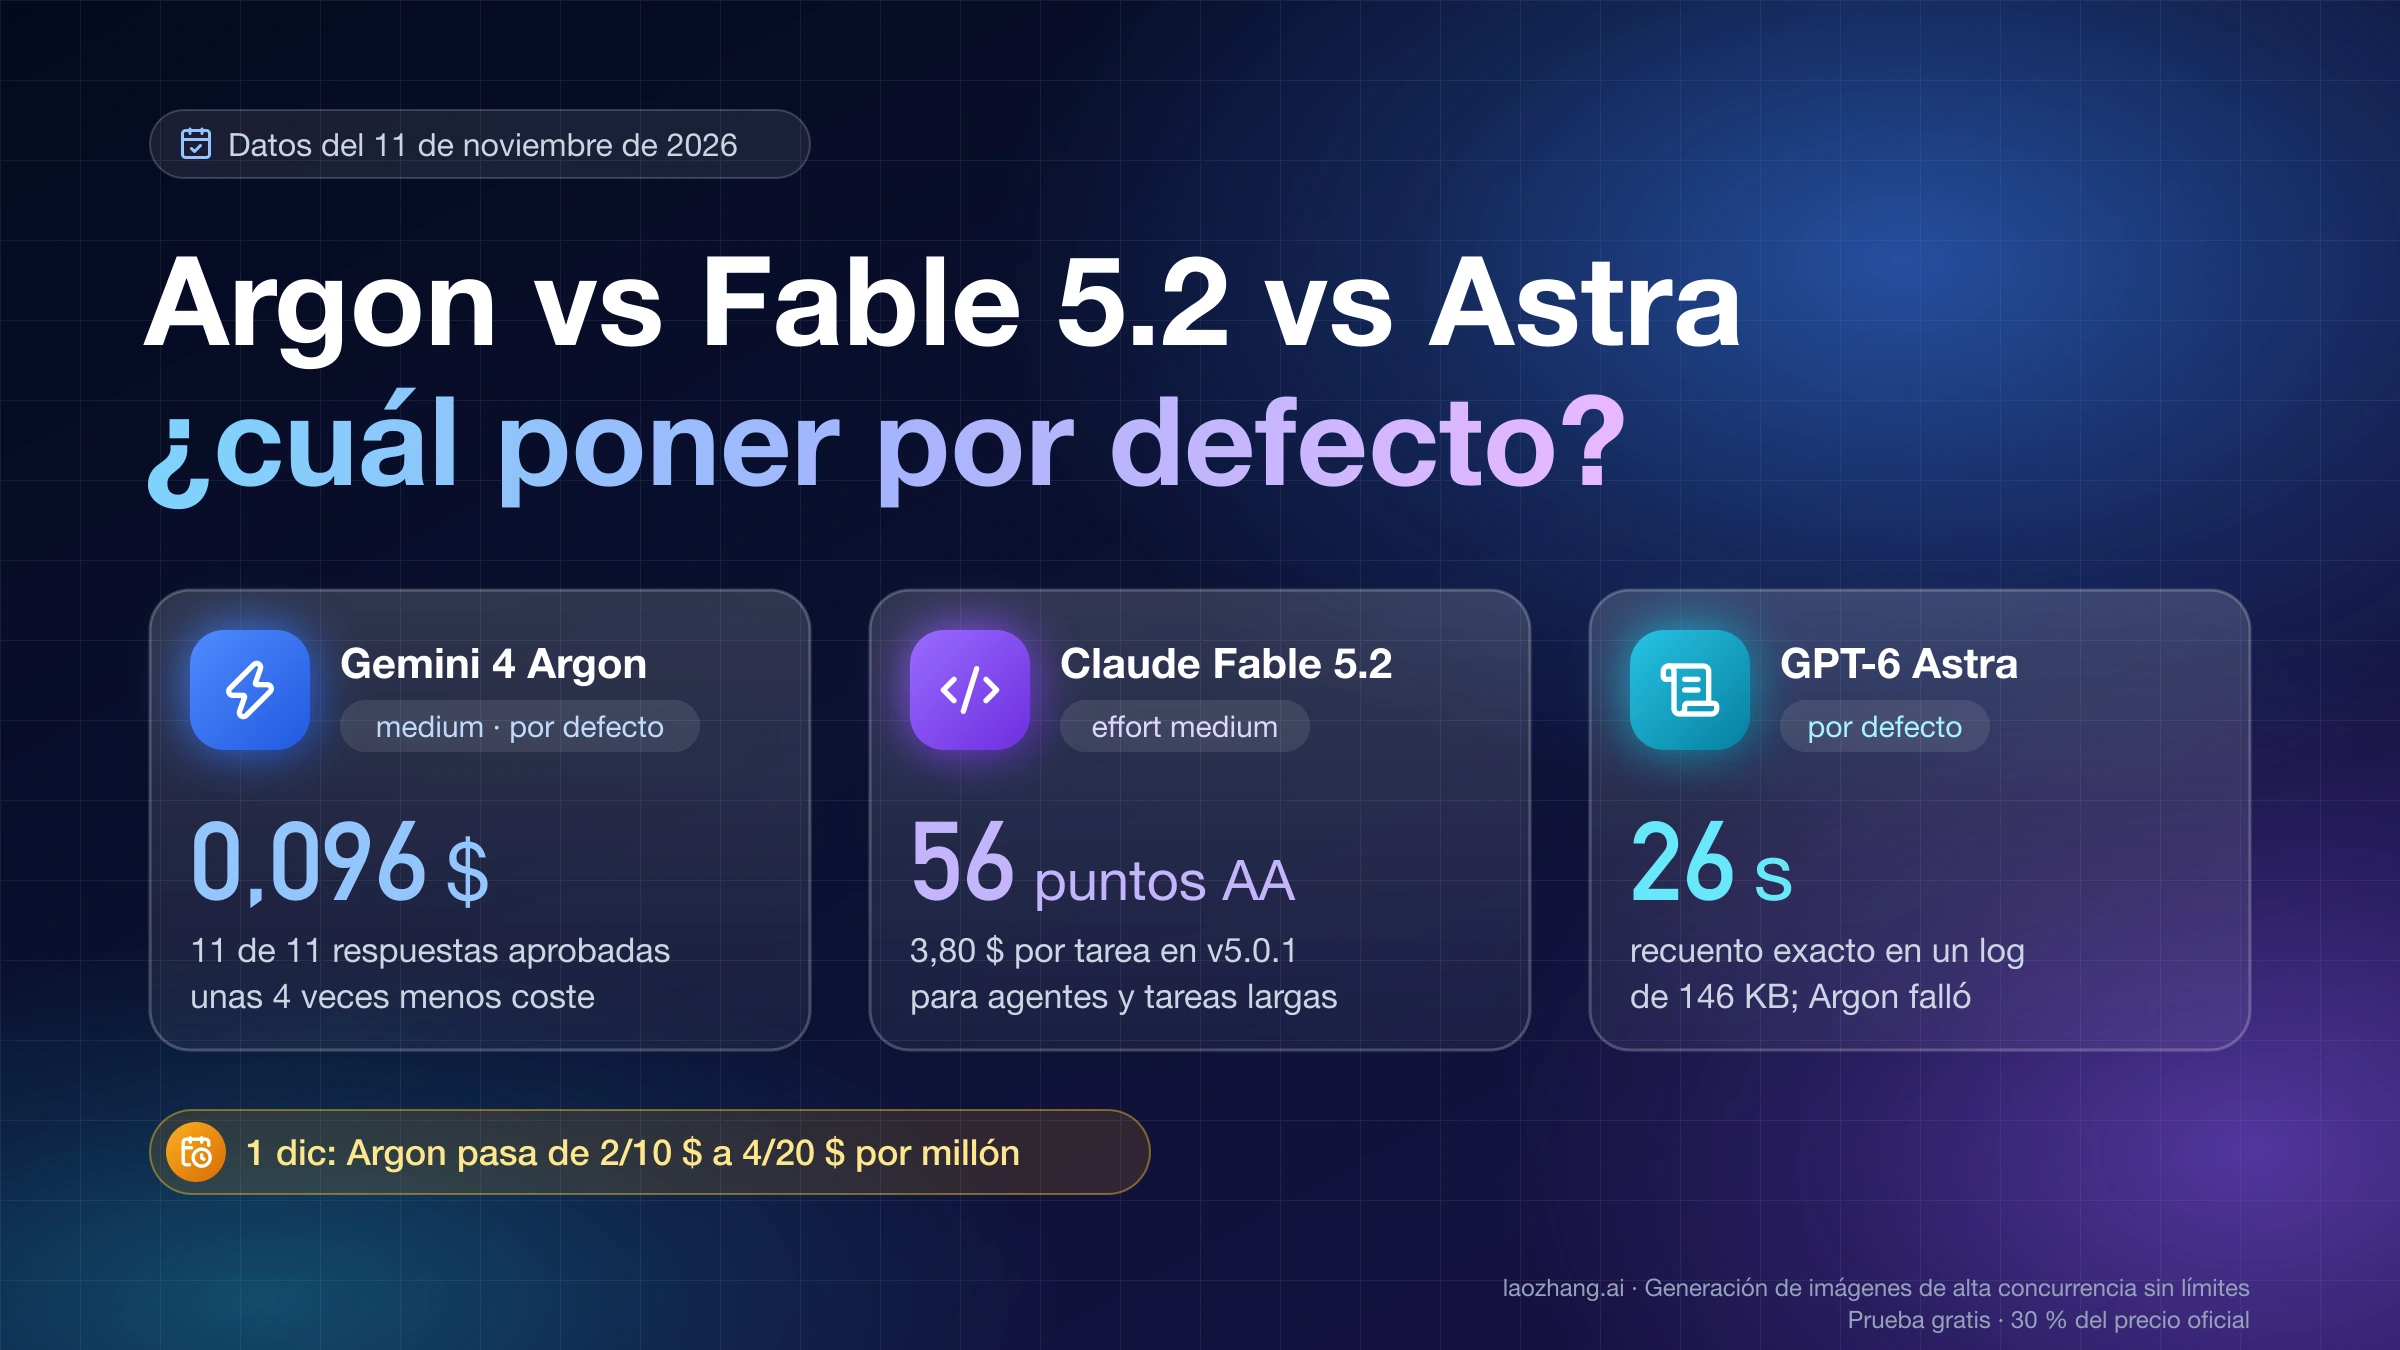
Una prueba con las mismas ocho tareas a través de la pasarela de LaoZhang, con Argon el 4 de noviembre y Opus el 11 de noviembre de 2026, apunta en la misma dirección. Con su ajuste por defecto, Argon fue el más barato en tareas cortas de código y razonamiento: 0,09 $ por 11 respuestas frente a 0,29 $ de Opus, con un fallo. Pero en un recuento exacto sobre un log de 146 KB falló las dos veces, y solo acertó en nivel alto y con streaming, tras 4,5–6,7 minutos y por 0,53–0,55 $ por intento (1,06–1,09 $ desde el 1 de diciembre); Opus acertó las cuatro veces en menos de un minuto por unos 0,47 $.
Para agentes de código y trabajo exacto sobre entradas largas, empieza por Opus 5.5 con su ajuste por defecto (effort en medium) y sube a high si fallan tus pruebas. Deja Argon en su ajuste por defecto para tareas cortas cuya respuesta puedas comprobar, y pásalo a alto, con streaming, solo en análisis de documentos, automatización o contexto muy largo, y con cuentas hechas a 4 $ y 20 $. GPT-6.1 Sol (gpt-6.1-sol), el modelo que OpenAI publicó el 29 de septiembre de 2026 y que no es el GPT-6 Astra de la tabla de Google, sigue siendo la referencia barata: la misma puntuación que Argon en Artificial Analysis por 0,59 $ por tarea.
Gemini 4 Argon vs Opus 5.5 con las mismas tareas: coste y aciertos
En tareas cortas y bien definidas, Argon y Opus 5.5 aprobaron prácticamente todo; lo que cambió fue el coste, y quién sale más barato depende del nivel. Con el ajuste por defecto de cada uno, Opus costó 3,11 veces lo de Argon hasta el 30 de noviembre y 1,55 veces desde el 1 de diciembre. En nivel alto se invierte: Opus costó un 24 % menos que Argon hasta el 30 de noviembre y un 62 % menos con la tarifa de diciembre, porque Argon en alto escribió 3,3 veces más tokens de salida.
La prueba usó una sola pasarela, LaoZhang (api.laozhang.ai), con una clave de pago por uso. Argon se llamó el 4 de noviembre de 2026 por el endpoint nativo de Gemini (generateContent, sin streaming), con su ajuste por defecto (sin thinkingConfig, que Google fija en medium) y con thinkingLevel en high. Opus 5.5 se llamó el 11 de noviembre por la API de Messages de Anthropic, con streaming, razonamiento adaptativo y effort en medium, el valor por defecto de la API de Claude, o en high. Las ocho tareas fueron idénticas: un problema de enunciado, tres funciones de Python con pruebas ocultas (fusionar intervalos, interpretar duraciones y contar palabras frecuentes), un resumen en exactamente cinco viñetas de un artículo de 6.723 palabras, un evaluador de expresiones sin eval, un lector de líneas CSV sin el módulo csv y un recuento de sumas de dígitos. Las tres últimas se ejecutaron dos veces, así que cada ajuste tiene 11 respuestas calificadas.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Ajuste (11 respuestas) | Aprobadas | Tokens de entrada | Tokens de salida | Tiempo total | Coste hasta el 30 de noviembre | Coste desde el 1 de diciembre |
|---|---|---|---|---|---|---|
Gemini 4 Argon, por defecto (medium) | 10 de 11 | 12.712 | 6.782 | 163 s | 0,093 $ | 0,187 $ |
Gemini 4 Argon, high | 11 de 11 | 12.712 | 39.514 | 463 s | 0,403 $ | 0,807 $ |
Claude Opus 5.5, por defecto (medium) | 11 de 11 | 17.202 | 11.056 | 126 s | 0,290 $ | 0,290 $ |
Claude Opus 5.5, high | 11 de 11 | 17.202 | 11.968 | 147 s | 0,308 $ | 0,308 $ |
Los costes salen del uso que devolvió cada API, a precio de tarifa; en Argon en alto, parte de la entrada del artículo largo se cobró como caché implícita, y por eso su coste queda algo por debajo de multiplicar los tokens por la tarifa. De los 39.514 tokens de salida de Argon en alto, 33.105 fueron de razonamiento, y de ahí que tardara 3,1 veces lo de Opus en alto. Con el ajuste por defecto, Opus escribió 1,63 veces más salida que Argon y terminó antes, 126 s frente a 163 s, aunque aquí los tiempos no son del todo comparables, porque Argon se llamó sin streaming y Opus con él.
El único fallo fue del ajuste por defecto de Argon: su evaluador de expresiones lanzó un ValueError con la entrada " 1 + 2 ", que lleva espacios de más, y no superó una de las 25 pruebas ocultas. En otra tanda del mismo día con las mismas tareas aprobó las 11, así que en total fueron 21 de 22. En Opus en alto, la respuesta de fusionar intervalos venía repartida en dos archivos, la función y sus pruebas; con los archivos separados, la función pasó las 8 pruebas ocultas y sus propias 6.
Recuento exacto en un log de 146 KB: Opus acierta con su ajuste por defecto
La segunda tarea separa más a los modelos. Es un log de aplicación sintético de 1.500 líneas, 326 de ellas de error, y hay que dar el número de errores de cinco códigos, cuántos usuarios distintos tuvieron un error E503 y qué petición tuvo el valor de reintentos más alto. Las respuestas exactas se generaron con un script y se comprobaron con grep antes de llamar a ningún modelo.
| Ajuste | Respuestas del todo correctas | Tiempo por intento | Coste por intento hasta el 30 de noviembre | Coste por intento desde el 1 de diciembre |
|---|---|---|---|---|
| Gemini 4 Argon, por defecto | 0 de 2 | 7–8 s | 0,16 $ | 0,32 $ |
Gemini 4 Argon, high sin streaming | Sin respuesta (1 intento) | 247 s | 0,49 $ | 0,97 $ |
Gemini 4 Argon, high con streaming | 2 de 2 | 271–402 s | 0,53–0,55 $ | 1,06–1,09 $ |
Claude Opus 5.5, por defecto (medium) | 2 de 2 | 58–59 s | 0,47–0,48 $ | 0,47–0,48 $ |
Claude Opus 5.5, high | 2 de 2 | 56–59 s | 0,47–0,48 $ | 0,47–0,48 $ |
Argon con su ajuste por defecto contestó en siete segundos, pero con recuentos entre un 20 y un 37 % por debajo de los reales: 59 errores E503 en vez de 94 y 46 usuarios en vez de 78. En alto y sin streaming, la llamada llegó al tope de 32.768 tokens de salida que Google fija para las respuestas sin streaming mientras aún razonaba, así que terminó sin respuesta y se cobró igualmente; dos llamadas más se cortaron hacia los 300 segundos por un proxy local, sin coste, y no cuentan. Solo con streaming, que admite hasta 65.536 tokens de salida, Argon acertó todo. El log ocupa casi lo mismo en los dos modelos, 78.537 tokens en Opus y 79.312 en Argon, así que la diferencia de coste aquí es de razonamiento.
Todo esto tiene límites claros: una sola pasarela, una o dos muestras por ajuste (cuatro en Opus en el log), Argon y Opus medidos con una semana de diferencia, y tareas pequeñas que casi no separan a los modelos, más un único tipo de tarea larga. No se probaron los endpoints de Google y Anthropic, la caché, el uso de herramientas, los bucles de agente ni los niveles xhigh y max de Opus. Sirve para ver cuánto cuesta cada ajuste y un tipo de fallo concreto, no como ranking de calidad; para eso están las tablas de Google y de Artificial Analysis de más abajo.
Mismo precio por token, coste por tarea muy distinto
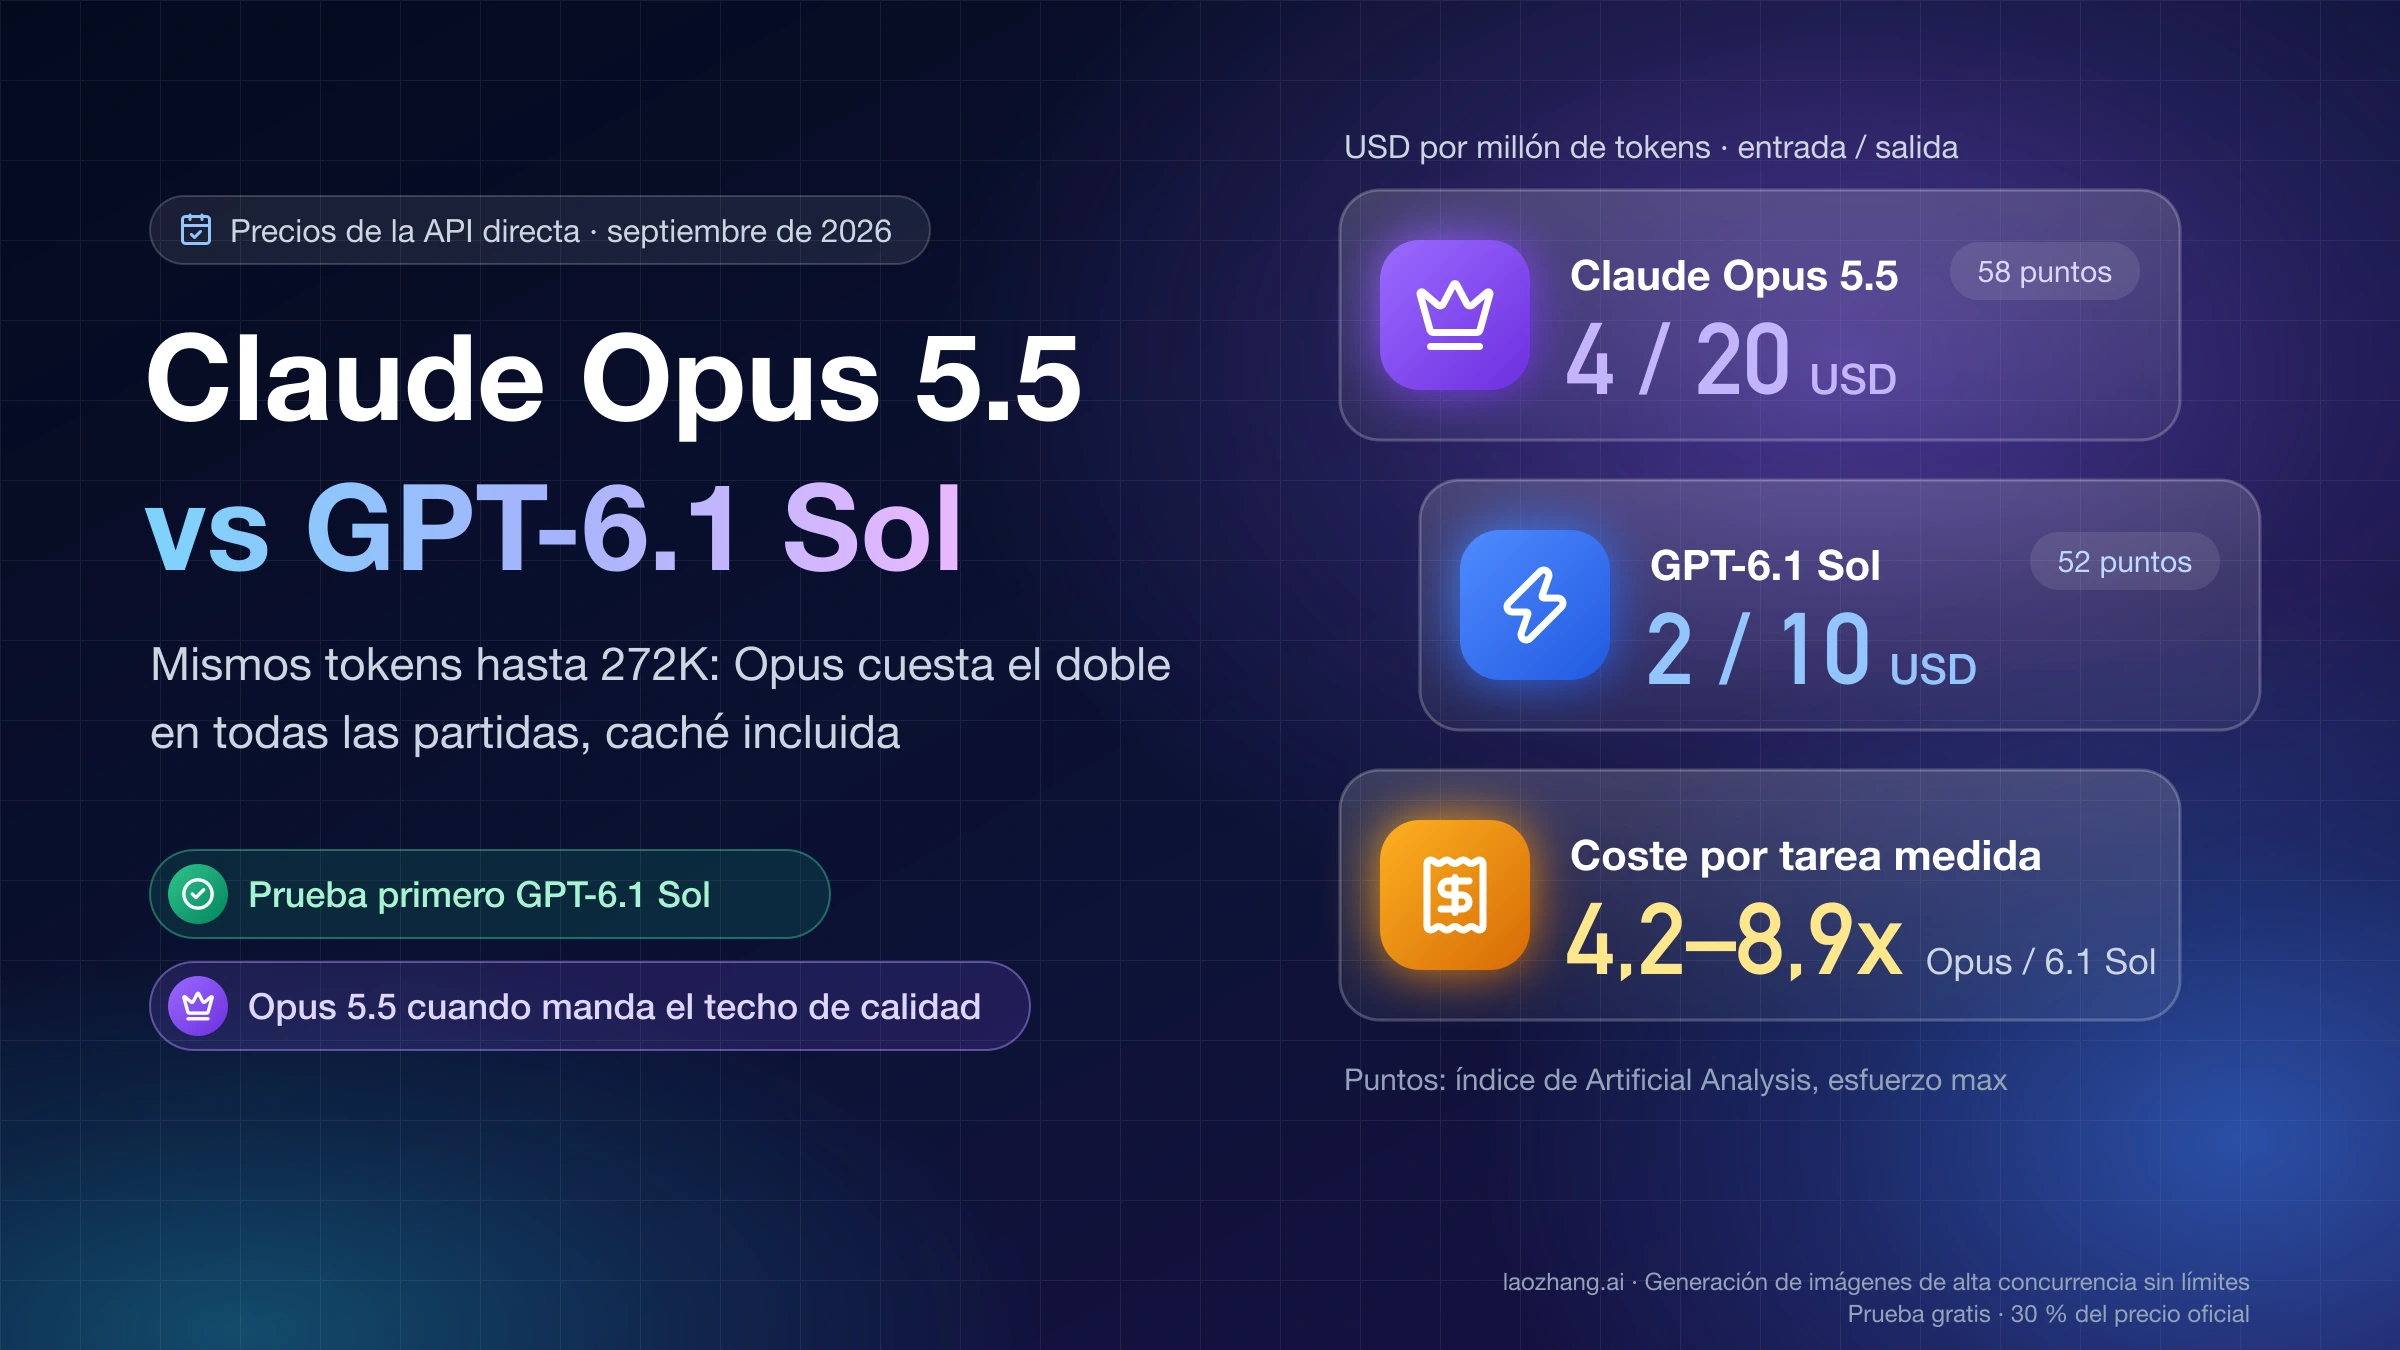
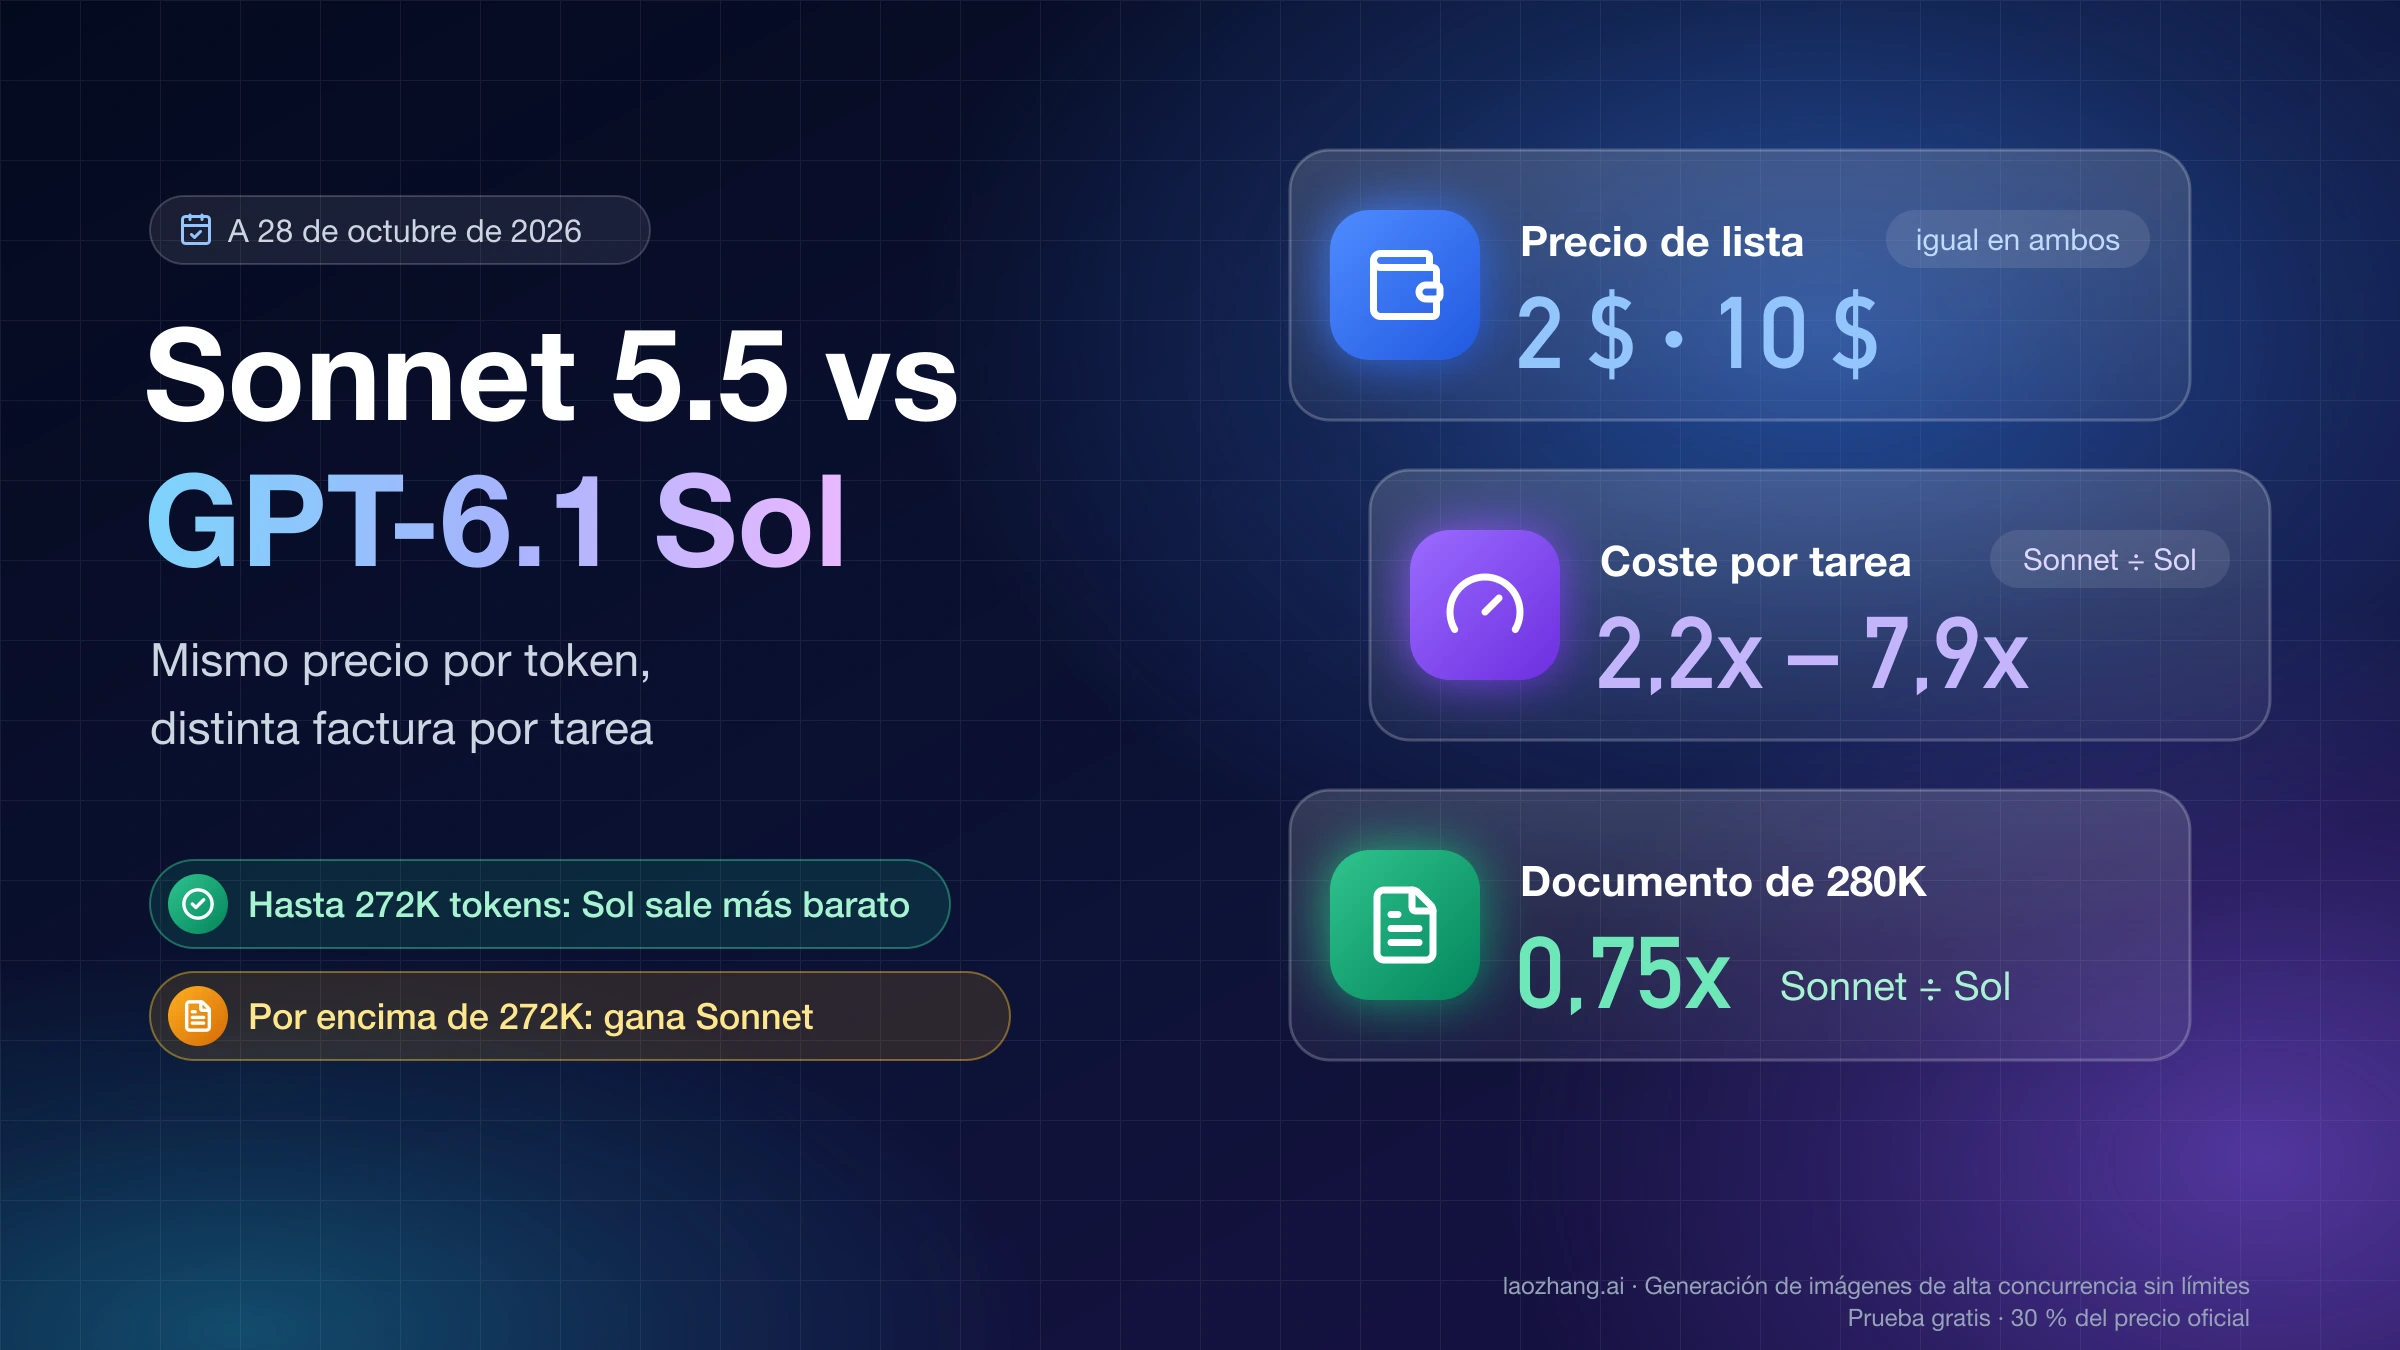
Desde el 1 de diciembre de 2026, Gemini 4 Argon y Claude Opus 5.5 cobran lo mismo por cada token, y hasta el 30 de noviembre Argon cobra la mitad que Opus, lo mismo que GPT-6.1 Sol. Lo que decide la factura es cuántos tokens gasta cada modelo para terminar una tarea, y en eso las diferencias son mucho mayores que en la tarifa.
La tarifa, con los mismos tokens
La factura de cada modelo se puede escribir con tres cantidades, todas en millones de tokens: U es la entrada nueva, R la entrada leída de caché y O la salida, que incluye los tokens de razonamiento.
| Modelo y tramo | Coste en dólares | Lo que no entra en la fórmula |
|---|---|---|
| Gemini 4 Argon, hasta el 30 de noviembre de 2026 | 2·U + 0,10·R + 10·O | Solo caché implícita, sin cargo por escritura; fundamentación con la Búsqueda de Google aparte: 5.000 solicitudes gratis al mes compartidas con Gemini 3 y posteriores, luego 14 $ por 1.000 |
| Gemini 4 Argon, desde el 1 de diciembre de 2026 | 4·U + 0,20·R + 20·O | Lo mismo que en la fila anterior; tampoco aquí hay tramo de contexto largo |
| GPT-6.1 Sol, hasta 272.000 tokens de entrada | 2·U + 0,10·R + 10·O | Escritura de caché a 2,50 $ por millón |
| GPT-6.1 Sol, por encima de 272.000 | 4·U + 0,20·R + 15·O | Escritura de caché a 5 $ por millón; el tramo se aplica a toda la solicitud |
| Claude Opus 5.5, en todo el contexto de 1M | 4·U + 0,20·R + 20·O | Escritura de caché a 5 $ por millón (5 minutos) o 8 $ (1 hora) |
Las tarifas de Argon proceden de la página de precios de la API de Gemini y las de Opus, de la página de precios de la API de Claude, vigentes a 11 de noviembre de 2026; las de GPT-6.1 Sol, de la página de precios de OpenAI, a 14 de octubre de 2026.
Un ejemplo para comprobarlo: una solicitud con 100.000 tokens de entrada nueva y 20.000 de salida, sin caché. Con Argon hasta el 30 de noviembre son 0,1 × 2 + 0,02 × 10 = 0,40 $. Con GPT-6.1 Sol, lo mismo, 0,40 $. Con Opus 5.5, 0,1 × 4 + 0,02 × 20 = 0,80 $, y con Argon desde el 1 de diciembre, también 0,80 $.
Así que, a igualdad de tokens, Argon cuesta hoy lo mismo que GPT-6.1 Sol y la mitad que Opus 5.5, y desde el 1 de diciembre costará exactamente lo mismo que Opus. El problema es que ninguna tarea real consume los mismos tokens en tres modelos distintos.
Ni siquiera la entrada. El mismo párrafo en español, con la misma instrucción, cuenta 304 tokens en Opus 5.5 y 154 en Argon, 1,97 veces más, según los contadores de tokens que devolvió cada API a través de la pasarela de LaoZhang (Opus el 11 y Argon el 4 de noviembre de 2026); en inglés la proporción es de 1,45, en un artículo largo en inglés de 1,38 y en un log con números e identificadores, de 0,99. Desde el 1 de diciembre, con la misma tarifa por token, un prompt largo en español te costará en Opus casi el doble de entrada que en Argon, aunque la salida, que es la partida más cara, depende de la tarea.
El coste por tarea que mide Artificial Analysis
Artificial Analysis ejecuta su Intelligence Index, un conjunto de nueve evaluaciones, ahora en la versión 5.0.1, y publica cuánto costó cada modelo por tarea del índice. Entre el 27 y el 28 de octubre de 2026 sustituyó la versión 4.3.2 por la 5.0, así que las cifras citadas antes de esa fecha son distintas. Los proveedores permiten elegir el nivel de razonamiento (effort), es decir, cuántos tokens dedica el modelo a pensar antes de responder. Argon tiene tres niveles, low, medium y high, y de él solo hay una configuración publicada, High, que es su nivel más alto. La comparación justa es, por tanto, la de los tres en ese mismo nivel:
| Nivel alto de razonamiento (high) | Puntuación en el índice | Coste por tarea del índice | Tarifa aplicada (entrada / salida) |
|---|---|---|---|
| Claude Opus 5.5 | 52 | 3,46 $ | 4 $ / 20 $ |
| Gemini 4 Argon | 50 | 9,95 $ (unos 4,98 $ con la tarifa de lanzamiento) | 4 $ / 20 $, la de diciembre |
| GPT-6.1 Sol | 50 | 0,59 $ | 2 $ / 10 $ |
Datos de Argon a 11 de noviembre de 2026, de Opus 5.5 a 10 de noviembre y de GPT-6.1 Sol a 4 de noviembre. Artificial Analysis ya calcula Argon con la tarifa de diciembre; los 4,98 $ son la mitad de su cifra, un cálculo y no una medición suya, que vale porque hasta el 30 de noviembre todas las tarifas de Argon son exactamente la mitad. Artificial Analysis subió entre el 4 y el 11 de noviembre la cifra publicada de Argon: el 4 de noviembre mostraba 7,68 $ por tarea y el 11 de noviembre, 9,95 $, con la misma puntuación y las mismas nueve subpuntuaciones, sin una nota que lo explique. Una diferencia de dos puntos en un solo índice compuesto es pequeña.
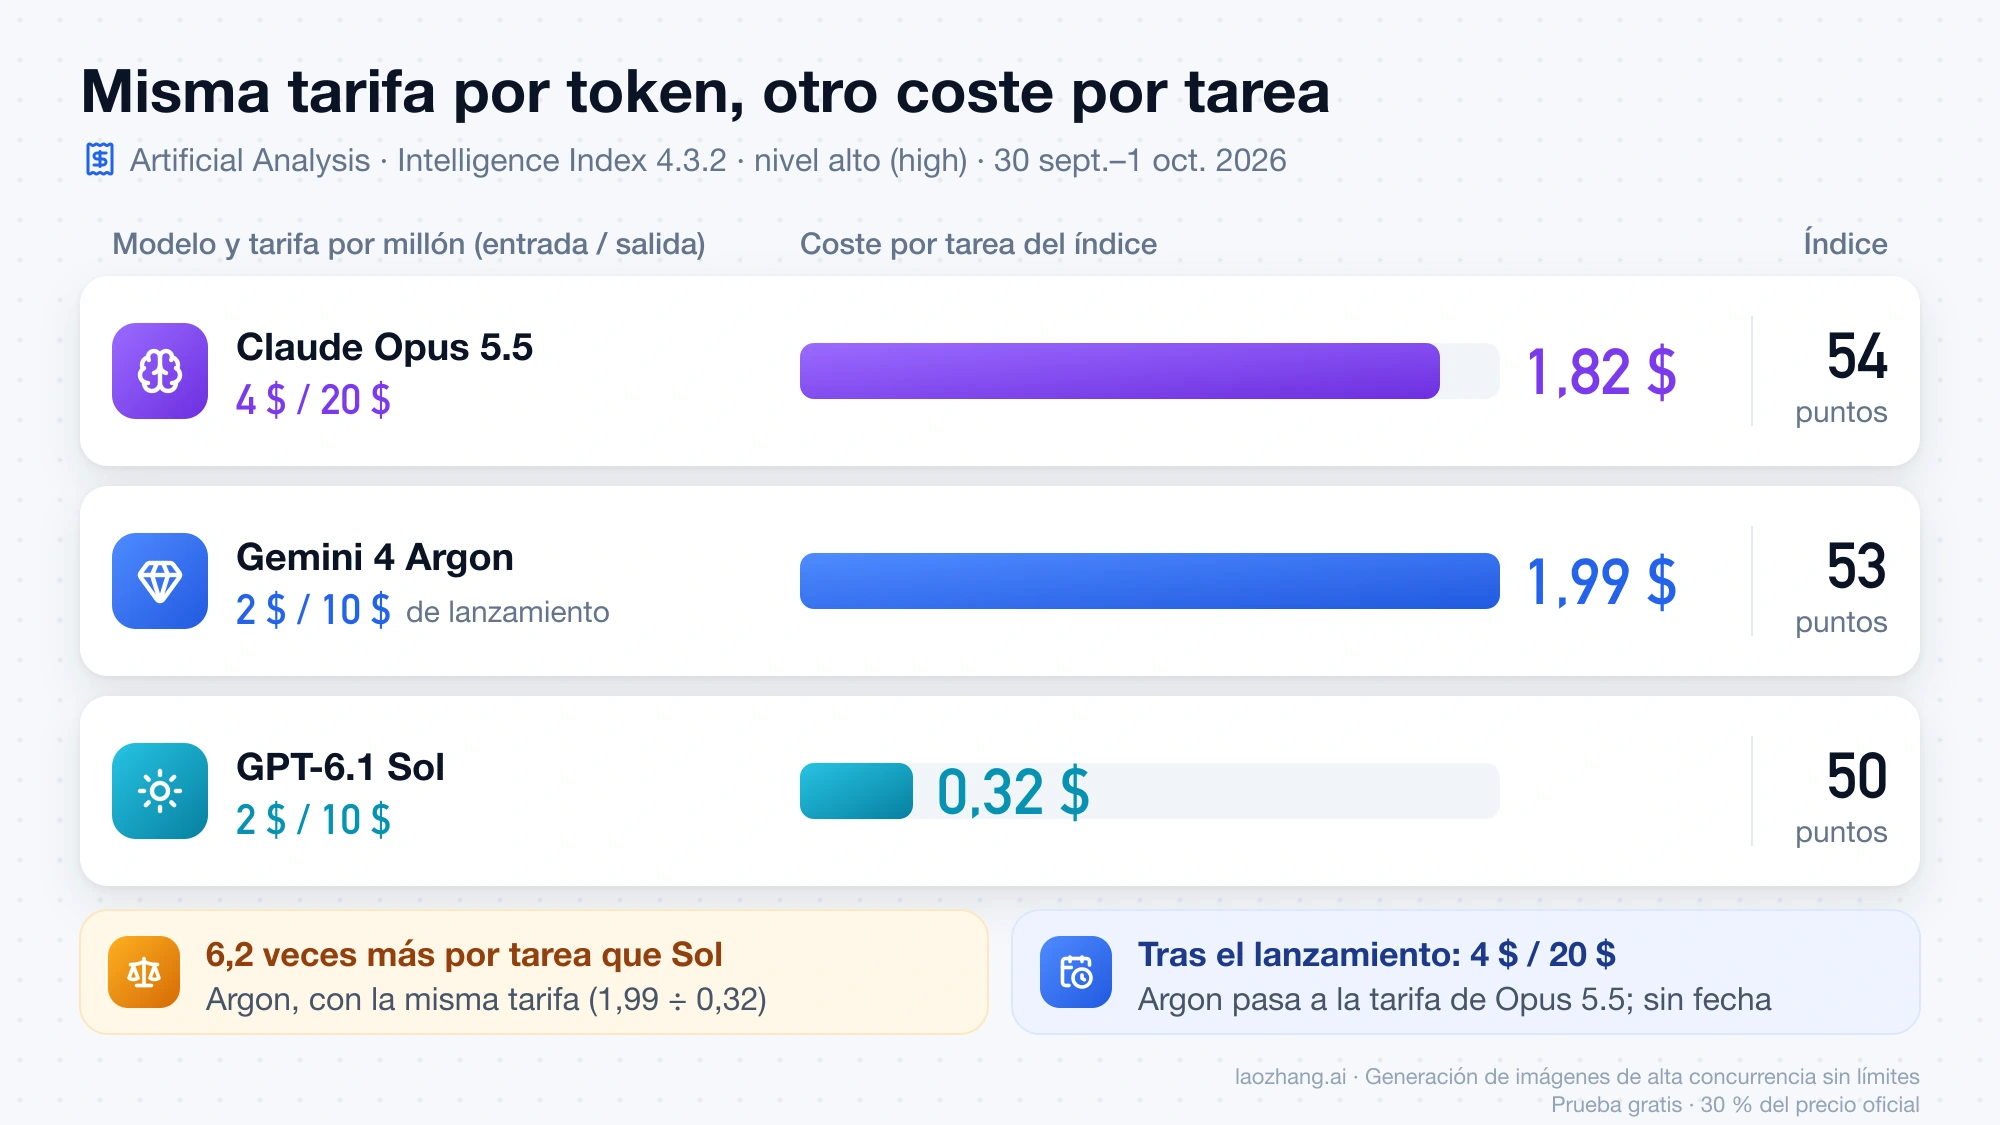
Gráfico con las cifras de coste por tarea de la versión 4.3.2 del índice de Artificial Analysis (1,82 $, 1,99 $ y 0,32 $); las vigentes, de la versión 5.0.1 a 11 de noviembre de 2026, están en la tabla de arriba.
Con el mismo nivel, Opus 5.5 saca dos puntos más que Argon y además cuesta menos por tarea: hasta el 30 de noviembre, Argon en high cuesta 1,44 veces lo de Opus en high (4,98 ÷ 3,46), aunque su token valga la mitad. La ventaja de tarifa se la comen los tokens, porque Argon escribe de media unos 116.000 tokens de salida por tarea del índice, 68.300 de ellos de razonamiento, y 113 millones en todo el índice. Frente a GPT-6.1 Sol, que empata con Argon a 50 puntos y tiene la misma tarifa hasta el 30 de noviembre, Argon cuesta 8,4 veces más por tarea (4,98 ÷ 0,59). También tarda más: 28,6 minutos de media por tarea, frente a 9,5 de Opus en high.
Subir el nivel de razonamiento inclina aún más el cuadro. En su nivel máximo, GPT-6.1 Sol obtiene 55 puntos a 1,27 $ por tarea: cinco puntos más que Argon en high por una cuarta parte de su coste con la tarifa de lanzamiento. Opus 5.5 en su nivel máximo llega a 59 puntos a 10,04 $ por tarea, prácticamente lo mismo que Argon en high con la tarifa de diciembre. La cifra «Opus 59 frente a Argon 50», que es la pareja que muestra la comparación de Gemini 4 Argon y Claude Opus 5.5 en Artificial Analysis (9,95 $ frente a 10,04 $ y 28,6 frente a 24,7 minutos por tarea), compara el nivel máximo de Opus con el nivel alto de Argon, que es también su tope: es el mejor resultado de cada uno, no el mismo nivel de razonamiento.
Qué pasa cuando termine el precio de lanzamiento el 30 de noviembre
Google ya ha puesto fecha: el precio de lanzamiento vale hasta el 30 de noviembre de 2026 y, desde el 1 de diciembre, todas las tarifas de Argon se duplican, también la de caché y las de las modalidades por lotes y de prioridad.
| Gemini 4 Argon, por millón de tokens | Hasta el 30 de noviembre de 2026 | Desde el 1 de diciembre de 2026 |
|---|---|---|
| Estándar: entrada / salida / entrada en caché | 2 $ / 10 $ / 0,10 $ | 4 $ / 20 $ / 0,20 $ |
| Lotes (Batch) y Flex | 1 $ / 5 $ / 0,05 $ | 2 $ / 10 $ / 0,10 $ |
| Prioridad (Priority) | 3,60 $ / 18 $ / 0,18 $ | 7,20 $ / 36 $ / 0,36 $ |
Es la tabla publicada el 14 de octubre de 2026, sin cambios a 11 de noviembre; Google podría cambiarla o prorrogar el periodo de lanzamiento.
Con la tarifa de diciembre, los 9,95 $ por tarea de Argon en high son 2,88 veces lo de Opus 5.5 en high (9,95 ÷ 3,46) y 16,9 veces lo de GPT-6.1 Sol en high (9,95 ÷ 0,59). Incluso Opus 5.5 en el nivel xhigh, con 57 puntos y 6,05 $ por tarea, cuesta un 39 % menos que Argon en high con siete puntos más. Son cifras con el consumo de tokens que mide un índice, no una factura de tus tareas, pero sirven para una cosa: un presupuesto calculado con el precio de lanzamiento no es el presupuesto de diciembre.
Vals AI también evalúa Argon con 4 $ y 20 $, la tarifa que regirá desde el 1 de diciembre, y con el nivel de razonamiento alto. En la versión 2.2 de su índice (clasificación del 30 de octubre, a 4 de noviembre de 2026), Argon cuesta 13,37 $ por prueba y Opus 5.5, 28,12 $. Según Kingy AI, la fila de Opus en Vals corresponde al nivel máximo con alternativas, no al alto, de modo que la mitad de coste de Argon frente a Opus en Vals no contradice el cálculo con Artificial Analysis: son niveles distintos. En la versión anterior de su índice, Vals ya advertía de que el coste de Argon se dispara en tareas largas de agente: 193,78 $ por prueba en CUA-bench y 57,82 $ en Code Migration.
Para el detalle de la factura entre Opus 5.5 y GPT-6.1 Sol, con el umbral de 272.000 tokens y la caché, está la comparativa Claude Opus 5.5 vs GPT-6 Sol y 6.1 Sol.
Lo que dice Google y lo que miden terceros
La tabla de Google pone a Argon por delante de Opus 5.5 en 14 de 18 pruebas, pero las mediciones independientes los dejan mucho más cerca: en los dos índices generales, Opus queda ligeramente por delante, por dos puntos en Artificial Analysis a 11 de noviembre de 2026 y por menos de uno en Vals a 4 de noviembre. Para elegir, importa más en qué tipo de trabajo gana cada uno que el recuento de filas.
La tabla de Google no incluye GPT-6.1 Sol
La tabla del anuncio de Google del 30 de septiembre compara Argon con GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.5. GPT-6.1 Sol no aparece en ninguna fila, así que de esa tabla no se puede extraer nada sobre él. Son resultados que publica el propio fabricante y que nadie ha reproducido de forma independiente; el anuncio de la apertura, el 13 de octubre, añade cifras propias, pero no las compara con ningún rival.
Frente a Opus 5.5, Argon queda por delante en 14 de las 18 filas en las que ambos tienen puntuación, y Opus en cuatro. Las cuatro son relevantes si lo tuyo es código y agentes en terminal:
| Prueba (tabla de Google, en %) | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Terminal-bench 4.0 | 57,4 | 66,4 |
| FrontierSWE v2 | 55,0 | 62,3 |
| Terminal-Bench Science 0.1 | 57,6 | 63,3 |
| PostTrainBench | 45,3 | 49,3 |
| DeepSWE v1.1 | 77,9 | 74,2 |
| Vibe Code Bench | 91,9 | 90,3 |
| AutomationBench | 51,3 | 42,5 |
| Vals Finance Agent v2 | 65,4 | 58,6 |
| Harvey Legal Agent | 19,6 | 3,8 |
| LABBench 2 | 88,8 | 73,1 |
| GraphWalks 256k–1M | 84,2 | 66,8 |
| LVBench | 91,7 | 83,7 |
Las ventajas más amplias de Argon están en trabajo de análisis (finanzas, legal, automatización), en ciencia y en contexto muy largo. En programación el reparto es mixto: gana en DeepSWE y Vibe Code Bench por poco y pierde con claridad en Terminal-bench 4.0 y FrontierSWE.
La metodología de Google está en un PDF aparte. Según la lectura que hace Kingy AI de ese documento, las pruebas usan el nivel de razonamiento más alto, DeepSWE se ejecutó con el arnés mini-swe, la prueba de ciencia en terminal tuvo seis veces más tiempo de verificación y LVBench dio a cada modelo un número distinto de fotogramas de vídeo. Es la interpretación de un tercero, pero basta para no tratar cada fila como una comparación en condiciones idénticas.
Sobre seguridad, Google afirma que Argon lidera en resistencia a la inyección indirecta de instrucciones: en el anuncio del 13 de octubre da una tasa de éxito de ataque del 0,7 % con 15 intentos adaptativos en la prueba de Gray Swan, y dice que el modelo está entrenado para pararse y pedir confirmación humana. VentureBeat recogió del gráfico de septiembre un 1,0 % para Opus 5.5; la cifra de Sol que figuraba allí, 27,0 %, es de GPT-6 Sol, el modelo anterior, y no hay dato de GPT-6.1 Sol.
Las mediciones independientes
Hay tres fuentes ajenas a Google, y miden cosas distintas. Artificial Analysis, con el mismo nivel de razonamiento y en la versión 5.0.1 de su índice, da 52 puntos a Opus 5.5 y 50 a Argon y GPT-6.1 Sol, así que Opus queda dos puntos por delante de Argon. Por pruebas, frente a Opus en high, Argon gana con claridad en AutomationBench-AA (77,5 % frente a 63,2 %) y pierde en CritPt v2 (52,5 % frente a 59,5 %).
Vals Index es un conjunto de tareas de finanzas, código, legal y fiscal. En su versión 2.2 (clasificación del 30 de octubre, a 4 de noviembre de 2026), Argon es cuarto de 32 modelos con un 69,24 %, por detrás de Claude Sonnet 5.5 (70,85 %), Gemini 4 Carbon (70,45 %) y Claude Opus 5.5 (70,18 %), y GPT-6.1 Sol queda en un 63,94 %. En la versión anterior, Argon era primero con un 68,90 %. Vals también señala un punto débil de Argon: un 4,83 % en CUA-bench.
Arena, en cambio, recoge votos de preferencia entre respuestas. Según Kingy AI, en la clasificación de texto del 30 de septiembre de 2026 Argon High es primero con 1.525 ±9 puntos y Opus 5.5 High tiene 1.504 ±10; GPT-6.1 Sol no estaba en esa tabla. Son preferencias de usuarios, no tareas resueltas.
¿Argon es realmente mejor que Opus 5.5, o solo en la tabla de Google? En automatización y trabajo de análisis, AutomationBench-AA apunta en la misma dirección que Google. En agentes de terminal, la propia tabla de Google pone a Opus por delante. Y en los dos índices generales Opus queda por delante por poco: dos puntos en Artificial Analysis con el mismo nivel de razonamiento y menos de un punto en Vals, donde la versión anterior ponía primero a Argon.
En Artificial Analysis, GPT-6.1 Sol empata con Argon y queda dos puntos por debajo de Opus, con 0,59 $ por tarea frente a 3,46 $ de Opus y 4,98–9,95 $ de Argon; en Vals queda por debajo de ambos, a unos cinco puntos de Argon. Si dudas entre los modelos de OpenAI, la comparativa GPT-6.1 Sol vs Astra vs GPT-6 Sol entra en cuándo compensa Astra.
¿Cuál es mejor para programar, Argon u Opus 5.5?
Para código, las tres fuentes inclinan la balanza hacia Opus 5.5, pero no por lo mismo ni con el mismo margen. En la tabla de Google, Opus gana las cuatro pruebas de agentes en terminal y de ingeniería (Terminal-bench 4.0, FrontierSWE v2, Terminal-Bench Science y PostTrainBench) y Argon gana por poco DeepSWE y Vibe Code Bench.
Las evaluaciones independientes de Artificial Analysis cuentan otra cosa en terminal: en Terminal-Bench 4.0, Argon en high saca un 57,1 % frente al 56,6 % de Opus en high y el 59,6 % de Opus en max, prácticamente un empate, lejos de los nueve puntos de la tabla de Google. Donde la distancia sí es grande es en FrontierCode 2.0: 25,7 % para Argon en high, 35,9 % para Opus en high y 46,4 % para Opus en max.
En la prueba con las mismas tareas de más arriba, las funciones cortas de Python las aprobaron los dos con su ajuste por defecto, y Argon solo falló una respuesta de 22 en dos tandas. La diferencia apareció en el trabajo exacto sobre una entrada larga: a Opus le bastó su ajuste por defecto, mientras que Argon necesitó nivel alto y streaming, con entre cuatro y siete veces más tiempo. Si tu agente de código lee mucho contexto y tiene que acertar a la primera, ese es el escenario que más se parece a tu trabajo.
Qué significa el límite de 1M de tokens: 65.536 de salida por defecto
El millón de tokens de Argon es un límite compartido entre entrada y salida, no un millón de salida. La ficha del modelo da 1.048.576 tokens como límite unificado de entrada y salida y fija la salida máxima en 65.536 tokens en una llamada síncrona normal; solo con la decodificación larga puede llegar a 1.048.576. Como el límite es común, cada token que envías como entrada reduce lo que queda para la respuesta.
En una llamada normal, por tanto, Argon devuelve como máximo más o menos la mitad de salida que Opus 5.5 o GPT-6.1 Sol, que llegan a 128.000 tokens. Y si llamas sin streaming, la documentación de la API de Gemini fija un tope aún menor, 32.768 tokens de salida, razonamiento incluido: en nivel alto se puede alcanzar, y la llamada se cobra aunque no llegue a dar respuesta, como pasó en el recuento del log. La decodificación larga es otro modo de petición y Google no ha aclarado cómo se relaciona con una única respuesta ininterrumpida, una duda que también plantea VentureBeat. La cifra de 262.000 tokens de salida que daba Vals correspondía al punto de acceso que evaluó antes de la apertura y no coincide con la ficha publicada. Hasta que pruebes ese modo en tu cuenta, no conviene diseñar un flujo que dependa de respuestas de cientos de miles de tokens.
Hay además una consecuencia de coste: la salida, que incluye el razonamiento, es la partida más cara, 10 $ por millón hasta el 30 de noviembre y 20 $ desde el 1 de diciembre. Una sola trayectoria de 300.000 tokens de salida cuesta 3 $ con el precio de lanzamiento y 6 $ después, solo en salida. Las cifras de CUA-bench y Code Migration que publicó Vals muestran hasta dónde sube la factura en trayectorias largas.
Cuál de los tres puedes integrar hoy
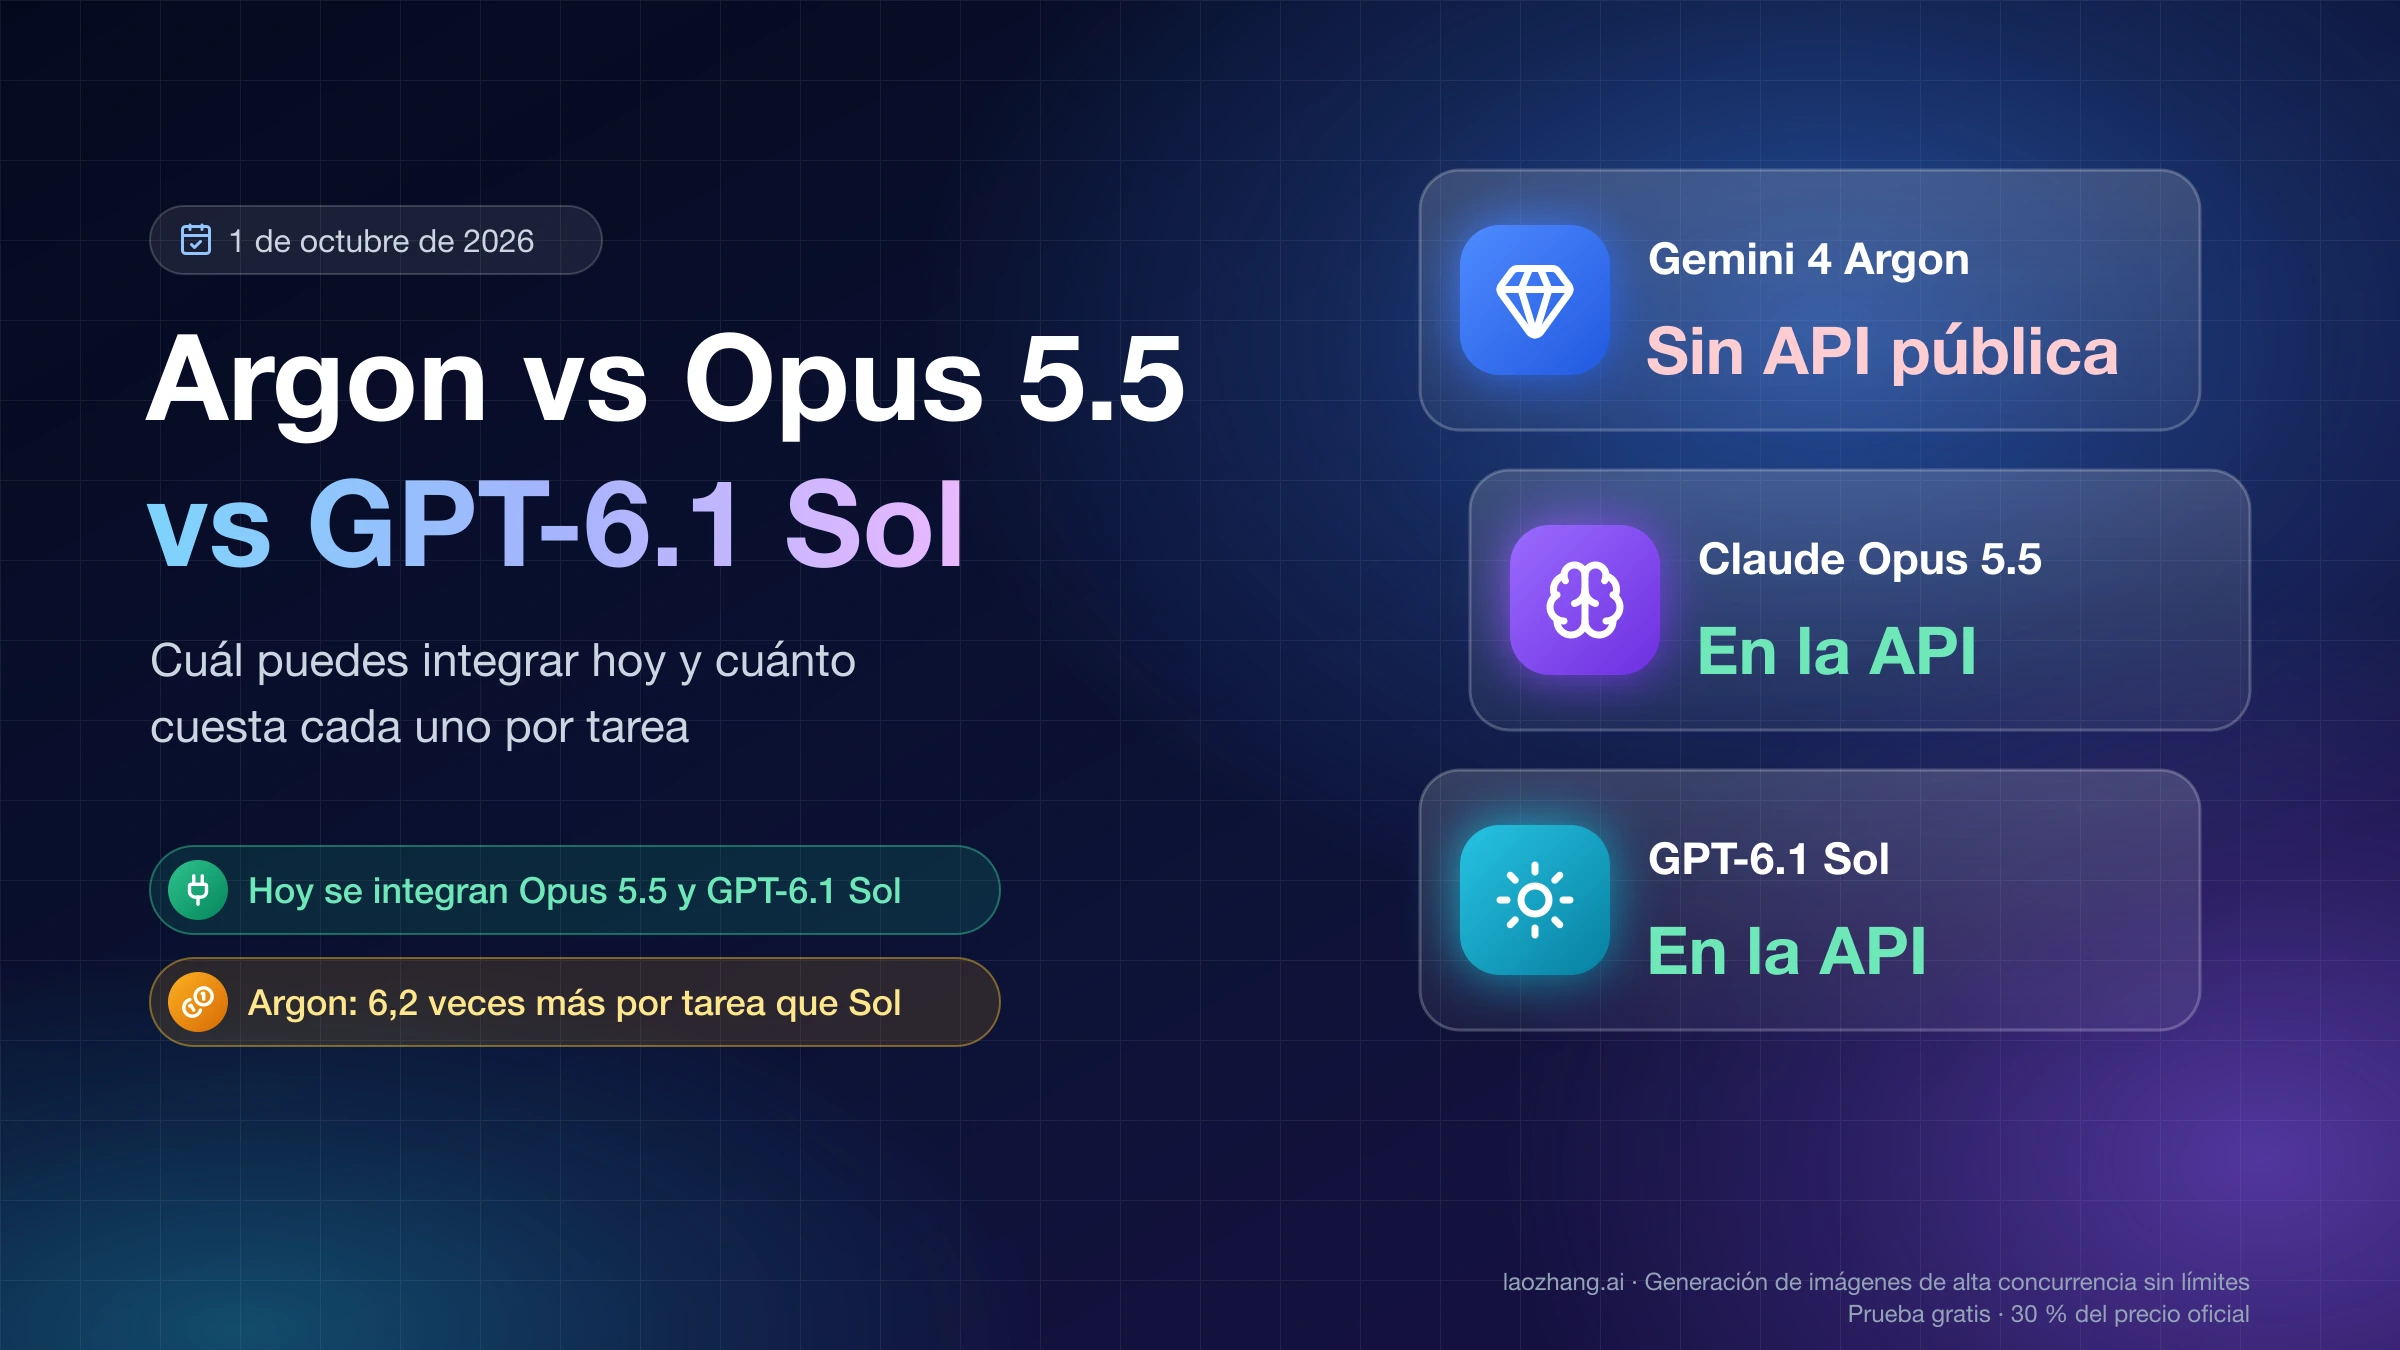
Los tres modelos están disponibles por API desde mediados de octubre de 2026: Gemini 4 Argon desde el 13 de octubre, después de dos semanas en las que solo llegó a equipos de ciberdefensa del programa Fairwind, y Claude Opus 5.5 y GPT-6.1 Sol desde finales de septiembre. Donde se diferencian es en los planes de las aplicaciones y en los límites de salida.
| Gemini 4 Argon | Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|---|
| Estado a 14 de octubre de 2026 | Disponible para todos desde el 13 de octubre de 2026 | Disponible desde el 22 de septiembre de 2026 | Disponible desde el 29 de septiembre de 2026 |
| API e identificador | Sí, gemini-4-argon, solo en el nivel de pago de la API de Gemini | Sí, claude-opus-5-5 | Sí, gpt-6.1-sol |
| Dónde se usa | API de Gemini, AI Studio, Google Cloud, Gemini for business, Google Antigravity, app de Gemini y Modo IA de la Búsqueda | Aplicaciones de Claude, Claude Code, API de Claude, AWS, Google Cloud y Azure | API de OpenAI; ChatGPT Work y Codex |
| Plan para usarlo en las aplicaciones | App de Gemini y Modo IA: Google AI Pro o Ultra. Antigravity, a 23 de octubre de 2026: Google AI Ultra, Google AI Pro de pago o la prueba de Pro que viene con un dispositivo premium elegible (app, CLI y extensiones para IDE; no en Antigravity IDE) | Pro, Max, Ultra, Team o Enterprise; en Free no hay Opus | Plus, Pro, Business, Enterprise o Edu |
| Contexto y salida máxima | 1.048.576 tokens compartidos entre entrada y salida; hasta 65.536 de salida por defecto y hasta 1.048.576 con decodificación larga (long decode) | 1M de contexto, 128.000 tokens de salida | 1.050.000 de contexto, 128.000 tokens de salida |
| Tarifa por millón de tokens (entrada / salida) | 2 $ / 10 $ hasta el 30 de noviembre de 2026; 4 $ / 20 $ desde el 1 de diciembre | 4 $ / 20 $ | 2 $ / 10 $ hasta 272.000 tokens de entrada; por encima, 4 $ / 15 $ |
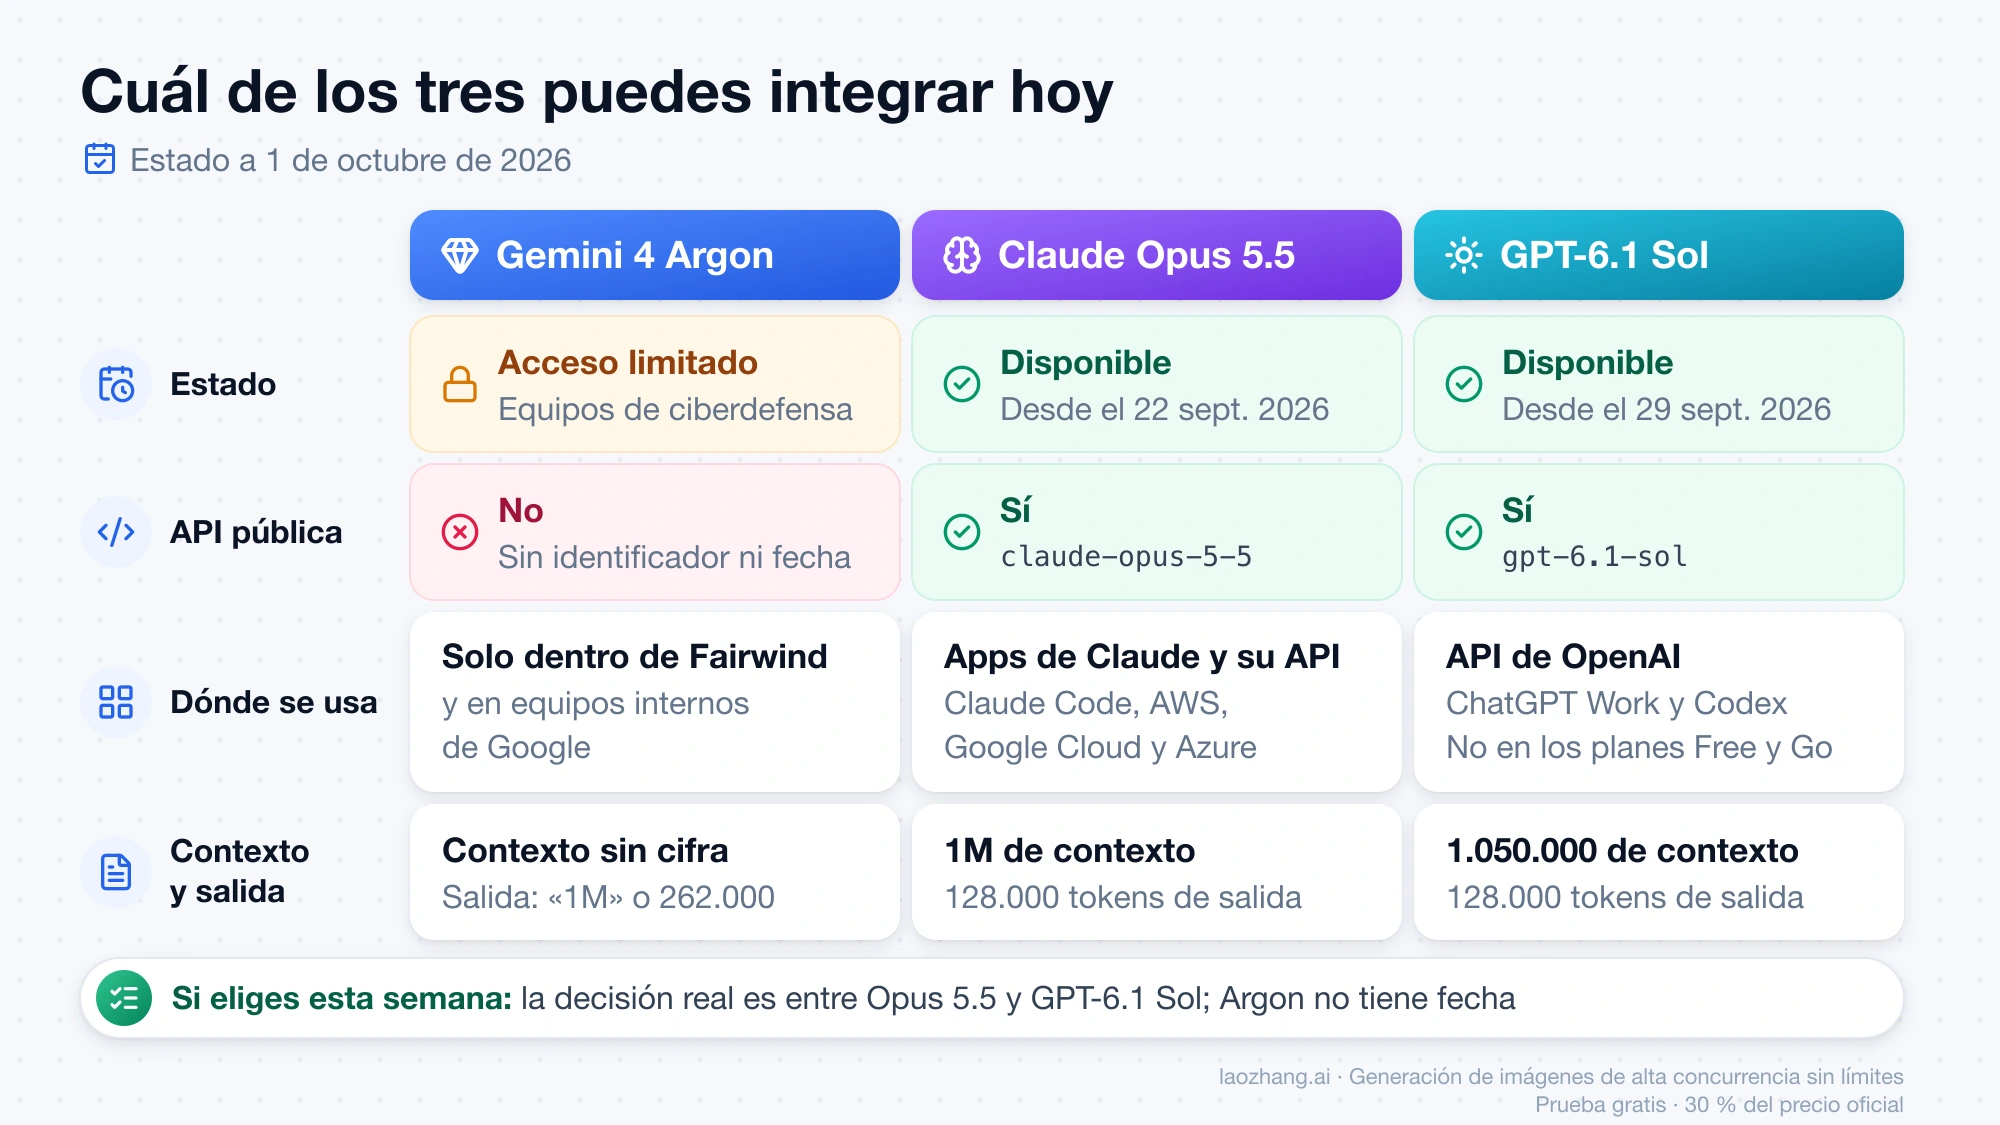
Gráfico con el estado a 1 de octubre de 2026, antes de que Gemini 4 Argon se abriera a todos el 13 de octubre; el estado vigente está en la tabla de arriba.
En Claude, el plan Max actual de 100 $ y Ultra, de 200 $, son los antiguos Max 5x y Max 20x, renombrados el 30 de octubre de 2026; qué plan pide cada uso de Opus y cómo probarlo está en Cómo usar Claude Opus 5.5: qué plan pide y cómo probarlo gratis. Ninguno de los dos modelos está disponible oficialmente para cuentas en Rusia, China continental o Hong Kong, según las listas de países de Anthropic y de Google.
En GPT-6.1 Sol hay dos detalles de acceso que conviene tener presentes: dentro de ChatGPT está en Work y en Codex, no en el chat normal ni en los planes Free y Go, y las llamadas a herramientas exigen la Responses API. El resto de cambios está en la guía de GPT-6.1 Sol.
Cómo usar Gemini 4 Argon en la API de Gemini y AI Studio
Necesitas un proyecto en el nivel de pago de la API de Gemini y el identificador gemini-4-argon. La página de precios de la API de Gemini lo dice sin rodeos: Argon no está disponible en el nivel gratuito. Con ese proyecto lo puedes probar en AI Studio o llamarlo desde tu código, y Google lo ofrece también en Android Studio y en Google Cloud, dentro de lo que su anuncio en el blog de Google Cloud llama Gemini platform. En la lista de modelos de la API de Gemini figura como modelo estable, no como versión preliminar.
La ficha de Gemini 4 Argon en la documentación de la API indica lo que admite: entrada de texto, imagen, vídeo, audio y PDF, salida de texto, niveles de razonamiento low, medium y high, llamadas a funciones, salidas estructuradas, ejecución de código, fundamentación con la Búsqueda de Google y con Maps, contexto de URL, búsqueda de archivos y uso del ordenador en versión preliminar. No genera imágenes ni audio y no funciona con la Live API. La caché es solo implícita: no puedes crear cachés explícitas, y el descuento se aplica a la entrada que el sistema reconoce como repetida. Dos datos no figuran ni en esa ficha ni en la de precios a 14 de octubre de 2026: los límites de peticiones y la fecha de corte de conocimiento.
Si tu código ya usa un endpoint compatible con OpenAI, laozhang.ai lista gemini-4-argon a 2 $ / 10 $ por millón y la lectura de caché a 0,10 $, a 11 de noviembre de 2026, con endpoint nativo de Gemini y compatible con OpenAI; no ha publicado qué tarifa aplicará desde el 1 de diciembre. Desde el 18 de octubre de 2026 vuelve a ofrecer modelos Claude, entre ellos claude-opus-5-5 a 4 $ / 20 $ y lectura de caché a 0,20 $, con un máximo de 32.768 tokens de salida por respuesta.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Fairwind sigue existiendo, pero ya solo para la versión de Argon sin restricciones de ciberseguridad, que Google está ampliando a cientos de socios más de forma escalonada. Si trabajas en un equipo de seguridad, la guía sobre Gemini 3.8 Flash Cyber y Fairwind explica qué es el programa y quién puede entrar; se escribió para aquel modelo y sus pasos no son un procedimiento específico para Argon.
Gemini 4 Argon en la app de Gemini: qué plan necesitas
Según el anuncio de Gemini 4 Argon del 13 de octubre, los suscriptores de Google AI Pro y Google AI Ultra lo tienen en la app de Gemini y en el Modo IA de la Búsqueda. Para Google Antigravity ese anuncio sigue hablando solo de Google AI Ultra, pero la página de modelos de Antigravity incluye ya, a 23 de octubre de 2026, también Google AI Pro de pago o la prueba de Pro que viene con un «dispositivo premium elegible» (expresión de Google, que no publica qué dispositivos son); la prueba gratuita normal de Pro no aparece. Argon está en la app de Antigravity, en la CLI y en las extensiones para IDE, no en Antigravity IDE. Google lo está desplegando poco a poco, así que puede que tu cuenta aún no lo muestre, y antes de ese cambio hubo usuarios que contaron que el Google AI Pro incluido con un móvil o en promociones tampoco lo recibía. Las cuentas de empresa lo usan en Gemini for business, en la web, el escritorio y el móvil. A 6 de noviembre de 2026, ni la versión gratuita de la app ni Google AI Plus incluyen Argon.
Una suscripción y la API son cosas distintas. A 11 de noviembre de 2026, la página de precios de la API solo dice que Argon no está disponible en el nivel gratuito, y la documentación de los planes de AI Studio da a Google AI Pro una cuota «más alta» con acceso a Argon y a Ultra la cuota «más alta posible»; con la cuenta gratuita no hay Argon. Ninguna suscripción cubre las llamadas a gemini-4-argon desde tu código: para eso hace falta una cuenta de facturación de la API de pago, que cobra por tokens.
Qué usar ahora y qué medir antes del 1 de diciembre
La elección depende de tu trabajo y del nivel de razonamiento, y tienes hasta el 30 de noviembre de 2026 para medir Argon con su tarifa de lanzamiento antes de que se iguale a la de Opus 5.5.
Esta semana: GPT-6.1 Sol, Opus 5.5 o Argon según tu trabajo
- Empieza por GPT-6.1 Sol si el volumen pesa en tu presupuesto o si puedes medir la calidad con tus propias pruebas. A 0,59 $ por tarea del índice en nivel alto, y 1,27 $ en el máximo, tienes margen para subir el nivel de razonamiento antes de acercarte al coste de los otros dos.
- Elige Claude Opus 5.5 si cada fallo te cuesta horas de revisión, si tu trabajo son agentes en terminal y cambios largos en repositorios, o si necesitas recuentos y extracciones exactas sobre entradas largas, donde en la prueba del log acertó con su ajuste por defecto. Con el nivel máximo alcanza 59 puntos, la cifra más alta de las tres familias, a 10,04 $ por tarea. Antes de fijarlo, mira si Sonnet 5.5 gasta menos por tarea en tu caso; el detalle de tarifas y límites está en Claude Opus 5.5: precio de la API y restablecimiento de límites. Anthropic lanzó el 9 de noviembre de 2026 Claude Fable 5.2, a 8 $ / 40 $, y aun así recomienda empezar la mayoría de los trabajos con Opus 5.5; cuándo compensa el salto lo explica Claude Fable 5.2 vs Opus 5.5: cuál es mejor y con qué effort.
- Prueba Gemini 4 Argon ahora si tu trabajo es análisis de documentos, finanzas, legal, automatización o contexto muy largo, donde la tabla de Google lo sitúa por delante. Su ajuste por defecto es barato en tareas cortas cuya respuesta puedas comprobar; si subes a high, llama con streaming para no chocar con el tope de 32.768 tokens. El precio de lanzamiento abarata la prueba, no la producción: ejecuta la comparación antes del 30 de noviembre, pero haz las cuentas de producción con 4 $ y 20 $.
- La regla para cambiar: compara el coste por tarea aceptada, es decir, el coste por intento dividido entre la proporción de tareas que dan por buenas tus pruebas. Con las cifras de Artificial Analysis, Argon en high solo sale más barato que Opus 5.5 en high si en tus tareas acepta más de 1,44 veces lo que acepta Opus hasta el 30 de noviembre, y más de 2,88 veces desde el 1 de diciembre. GPT-6.1 Sol en high sigue siendo más barato que Argon en high mientras acierte más del 11,9 % de lo que acierta Argon, y desde diciembre basta con el 5,9 %.
- Deja el modelo aislado en una capa de tu código, para que cambiar entre los tres sea una línea de configuración y no una migración.
Antes del 1 de diciembre: qué medir en tus propias tareas
- Coste por tarea aceptada en tus propias tareas, no por token. Ejecuta el mismo lote en Argon, Opus 5.5 y GPT-6.1 Sol y divide el gasto entre las tareas que dan por buenas tus pruebas. Después multiplica por dos la parte de Argon para ver cómo queda en diciembre.
- Tokens de salida por tarea. Es la variable que explica que Argon en high cueste 8,4 veces lo de Sol en high con la misma tarifa. Fija un máximo de salida y vigila cuánto razonamiento consume; recuerda que el tope síncrono es de 65.536 con streaming y de 32.768 sin él.
- Niveles de razonamiento por debajo de high. Opus baja de 3,46 $ a 2,45 $ por tarea en el nivel medio con 48 puntos. De Argon no hay mediciones publicadas de terceros por debajo de high; en la prueba con las mismas tareas, su ajuste por defecto (medium) aprobó 10 de 11 respuestas cortas, pero falló el recuento del log, así que comprueba en qué tipo de tarea te basta.
- Cuánta entrada te llega como caché. Argon solo tiene caché implícita, a 0,10 $ por millón hasta el 30 de noviembre y 0,20 $ después; si reutilizas prompts largos, mide la proporción real en tu facturación en lugar de suponerla.
- Tokens de entrada en tu idioma. Un mismo párrafo en español ocupa casi el doble de tokens en Opus 5.5 que en Argon; cuenta los tokens que devuelve cada API con tus prompts reales antes de comparar facturas de diciembre.
- Límites de peticiones de tu proyecto. No están publicados en la ficha del modelo ni en la página de precios a 14 de octubre de 2026; compruébalos en tu cuenta antes de mover una carga real.
- Tu tipo de tarea frente a los puntos débiles conocidos: agentes de terminal, FrontierSWE y uso del ordenador (CUA-bench).
Si lo que buscas es el precio más bajo y no el modelo más capaz, los tres quedan fuera de la respuesta; la comparativa de precios de API de IA explica cómo comparar ese caso.
Preguntas frecuentes sobre Gemini 4 Argon, Opus 5.5 y GPT-6.1 Sol
¿Ya se puede usar Gemini 4 Argon?
Sí, desde el 13 de octubre de 2026. Para desarrolladores, con el identificador gemini-4-argon en el nivel de pago de la API de Gemini, en AI Studio y en Google Cloud. Para suscriptores, en la app de Gemini y el Modo IA con Google AI Pro o Ultra, y en Google Antigravity con Ultra, con Google AI Pro de pago o con la prueba de Pro que viene con un dispositivo premium elegible (la prueba gratuita normal no aparece). Las empresas lo tienen en Gemini for business. Antes de esa fecha solo lo tenían equipos de ciberdefensa del programa Fairwind.
¿Se puede usar Gemini 4 Argon gratis?
No. En la API no está en el nivel gratuito, y en la app de Gemini y en AI Studio Google solo lo ofrece a suscriptores de Google AI Pro y Ultra, a 11 de noviembre de 2026. Esas suscripciones tampoco cubren las llamadas a gemini-4-argon desde tu código, que necesitan una cuenta de facturación de la API de pago. Las opciones para probarlo y el coste de cada consulta están en Cómo usar Gemini 4 Argon gratis y cuánto cuesta cada consulta.
¿Gemini 4 Argon cuesta lo mismo que GPT-6.1 Sol?
Por token, sí hasta el 30 de noviembre de 2026: 2 $ de entrada, 0,10 $ de entrada en caché y 10 $ de salida por millón. Por tarea, no: con el nivel alto, Artificial Analysis da a GPT-6.1 Sol 0,59 $ por tarea de su índice y a Argon 9,95 $ con la tarifa de diciembre, unos 4,98 $ con la actual. Desde el 1 de diciembre la tarifa de Argon sube a 4 $ y 20 $, la misma que Opus 5.5.
¿Gemini 4 Argon es mejor que Claude Opus 5.5?
Depende de la tarea. En la tabla de Google gana en 14 de 18 pruebas, sobre todo en análisis, ciencia y contexto largo, y pierde en Terminal-bench 4.0, FrontierSWE v2, PostTrainBench y Terminal-Bench Science. En los índices independientes Opus queda ligeramente por delante: 52 frente a 50 en Artificial Analysis con el mismo nivel de razonamiento (a 11 de noviembre de 2026) y 70,18 % frente a 69,24 % en Vals (a 4 de noviembre). En la prueba con las mismas tareas del 4 y el 11 de noviembre, los dos aprobaron el código corto, pero solo Opus acertó el recuento sobre un log largo con su ajuste por defecto.
¿Merece la pena cambiar de Opus 5.5 o GPT-6.1 Sol a Gemini 4 Argon?
Merece la pena probarlo ahora, mientras el precio de lanzamiento abarata las pruebas, pero no cambiar sin medir. Con el consumo que mide Artificial Analysis, Argon en high cuesta por tarea 1,44 veces lo de Opus 5.5 en high hasta el 30 de noviembre y 2,88 veces desde el 1 de diciembre, y frente a GPT-6.1 Sol en high, 8,4 y 16,9 veces. Cambia solo si en tus tareas resuelve claramente más que tu modelo actual a un coste por tarea aceptada que puedas pagar con la tarifa de diciembre.
Fuentes13
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 11 nov 2026.
Fuentes13
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 11 nov 2026.
- 1.página de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 2.página de precios de OpenAIdevelopers.openai.com/api/docs/pricing
- 3.Artificial Analysisartificialanalysis.ai/models/gemini-4-argon
- 4.comparación de Gemini 4 Argon y Claude Opus 5.5 en Artificial Analysisartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-opus-5-5
- 5.Vals AIvals.ai/models/google_gemini-4-argon
- 6.Kingy AIkingy.ai/blog/frontier-ai-models-gemini-4-argon-gpt-6-astra-sol-claude
- 7.anuncio de Google del 30 de septiembreblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 8.página de precios de la API de Geminiaistudio.google.com/docs/pricing
- 9.anuncio en el blog de Google Cloudcloud.google.com/blog/products/ai-machine-learning/gemini-4-argon-available-on-google-cloud
- 10.lista de modelos de la API de Geminiai.google.dev/gemini-api/docs/models
- 11.ficha de Gemini 4 Argon en la documentación de la APIai.google.dev/gemini-api/docs/models/gemini-4-argon
- 12.anuncio de Gemini 4 Argon del 13 de octubreblog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon
- 13.página de modelos de Antigravityantigravity.google/docs/models