Claude Haiku 5.5 vs Sonnet 5.5: cuál elegir y coste por tarea
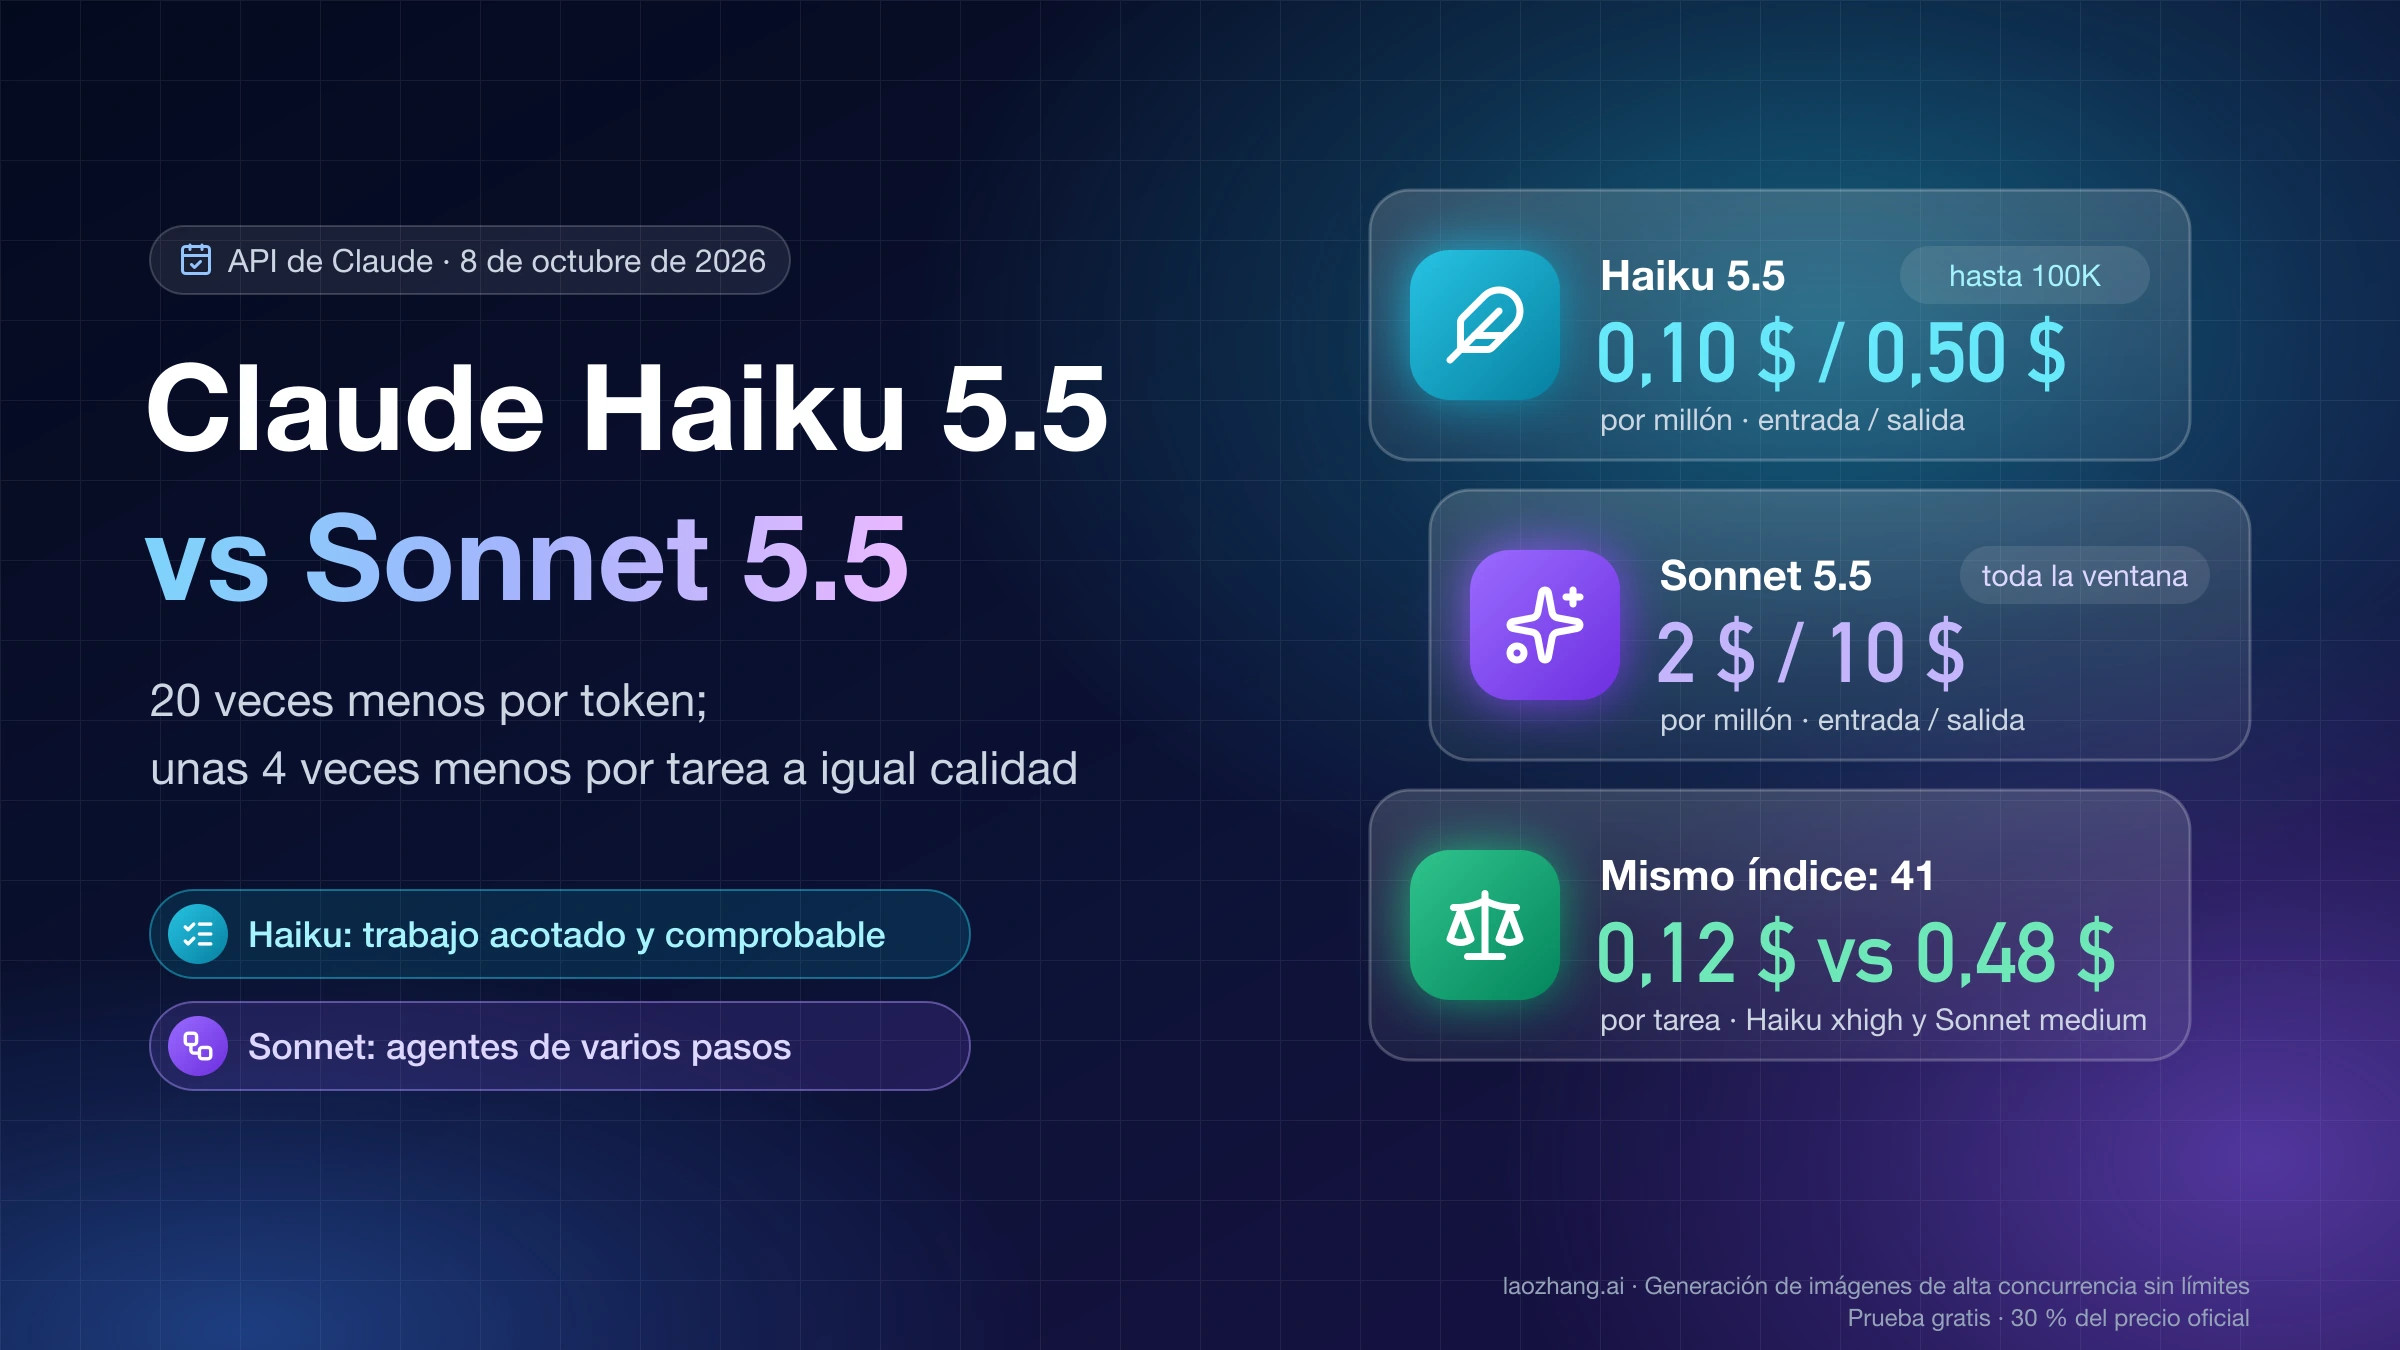
Claude Haiku 5.5 cuesta 20 veces menos por token que Sonnet 5.5; a igual calidad, unas 4 veces menos por tarea. Qué pasar a Haiku y cuándo subir a Sonnet.
En esta página
Usa Claude Haiku 5.5 para trabajo acotado, repetitivo y fácil de comprobar (clasificar, extraer datos, enrutar peticiones, resumir, compactar contexto o hacer de subagente) y deja Claude Sonnet 5.5 para la programación agéntica de varios pasos, la automatización de procesos con muchas herramientas y las respuestas en las que un dato inventado sale caro. En medio queda una tercera opción que suele ser la más barata: lanzar primero Haiku y mandar a Sonnet solo las tareas que no superan una comprobación automática.
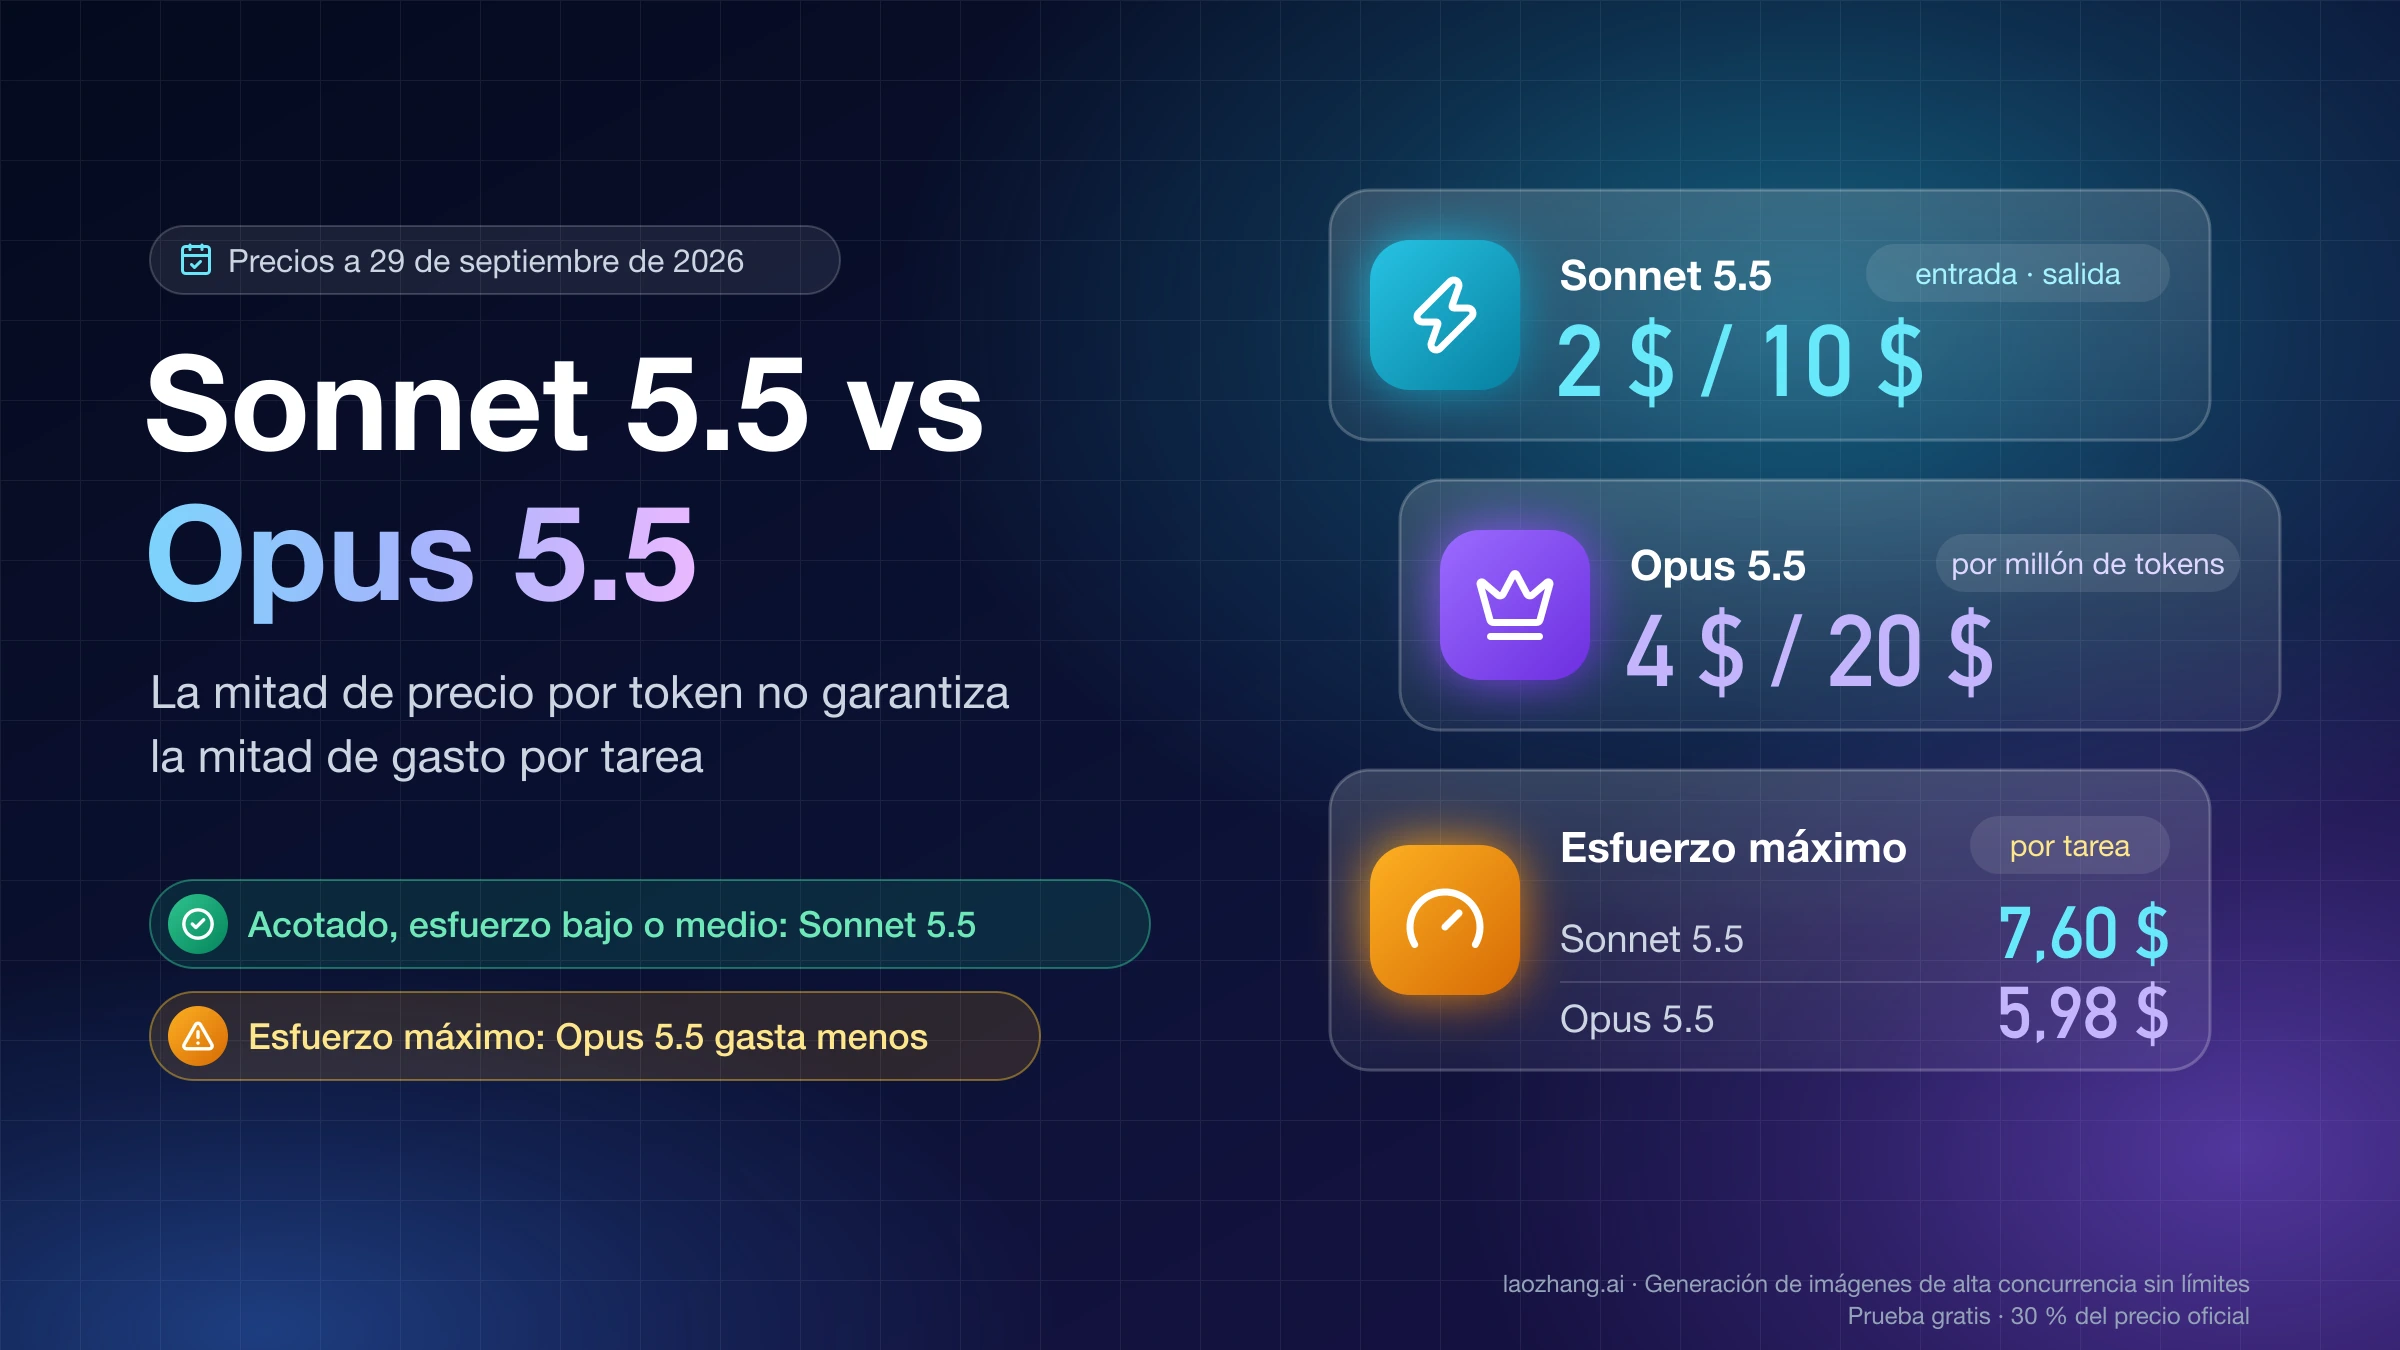
Según la tabla de precios de la API de Claude, a 8 de octubre de 2026 Haiku 5.5 cuesta 0,10 $ por millón de tokens de entrada y 0,50 $ por millón de salida mientras el prompt no pase de 100.000 tokens; Sonnet 5.5 cuesta 2 $ y 10 $. Son 20 veces menos por token. Por tarea la distancia es menor y depende del nivel de esfuerzo: en las mediciones de Artificial Analysis, cuando los dos modelos obtienen la misma puntuación en su índice, Haiku sale unas 4 veces más barato y tarda más del doble.
Haiku 5.5 y Sonnet 5.5: mismas especificaciones, precio y ajustes distintos
Los dos modelos comparten ventana de contexto, salida máxima, fecha de corte de conocimiento (junio de 2026) y tipo de entrada (texto e imágenes, salida en texto). Lo que cambia es el precio, el esfuerzo con el que arrancan y cómo se desactiva el razonamiento, según las fichas de Claude Haiku 5.5 y Claude Sonnet 5.5 en la documentación de Anthropic.
| Claude Haiku 5.5 | Claude Sonnet 5.5 | |
|---|---|---|
| Lanzamiento | 7 de octubre de 2026 | 28 de septiembre de 2026 |
| ID en la API | claude-haiku-5-5 | claude-sonnet-5-5 |
| Contexto / salida máxima | 1M / 128K tokens | 1M / 128K tokens |
| Entrada / salida, por millón de tokens | 0,10 $ / 0,50 $ hasta 100K tokens de prompt; 0,50 $ / 2,50 $ por encima | 2 $ / 10 $ en toda la ventana |
| Lectura de caché, por millón de tokens | 0,01 $ (0,05 $ por encima de 100K) | 0,10 $ (0,20 $ antes del 7 de octubre de 2026) |
| Esfuerzo por defecto en la API | medium | high |
| Esfuerzo por defecto en Claude Code | medium | medium |
| Razonamiento al mínimo | thinking: {"type": "disabled"}, hasta high | thinking: {"type": "between_tools"}, hasta high |
Forzar una herramienta con tool_choice | Funciona | Devuelve error |
| Latencia según Anthropic | «Fastest» | «Fast» |
Haiku 5.5 usa el tokenizador de Claude 4.7 y posteriores, la misma generación que Sonnet 5.5, así que un mismo prompt debería contar prácticamente los mismos tokens en los dos modelos. Por eso los precios por token se pueden comparar directamente. Si vienes de Haiku 4.5, ten en cuenta que el mismo texto ocupa alrededor de un 30 % más de tokens en Haiku 5.5 que en Haiku 4.5.
Las cifras de «un 90 % más barato» o «un 75 % menos» que circulan desde el lanzamiento comparan Haiku 5.5 con Haiku 4.5, no con Sonnet. Según el anuncio de Claude Haiku 5.5, el precio baja un 90 % en peticiones de hasta 100.000 tokens y un 50 % por encima, y el coste medio de ejecución baja en torno a un 75 %.
¿Qué es mejor, Claude Sonnet o Haiku? Sonnet 5.5 gana en cada prueba
Sonnet 5.5 gana en todas las pruebas que publica Anthropic. En la tabla del lanzamiento, Haiku 5.5 queda así frente a Sonnet 5.5:
| Prueba (según Anthropic) | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0 (programación agéntica en terminal) | 39,2 % | 70,6 % |
| FrontierCode 1.1, Main | 46,4 % | 52,1 % (Sonnet en xhigh) |
| OSWorld 2.1, subconjunto offline (uso de ordenador) | 72,4 % | 83,9 % |
| Humanity's Last Exam, sin herramientas / con herramientas | 45,9 % / 57,4 % | 56,9 % / 64,5 % |
| GDPval-AA v2.1 (trabajo de conocimiento) | 1620 | 1840 |
El propio anuncio lo resume: Sonnet 5.5 y Opus 5.5 siguen siendo mejores para tareas complejas de programación agéntica, y Haiku 5.5 encaja en tareas más acotadas, como compactar contexto, resumir o trabajar como subagente.
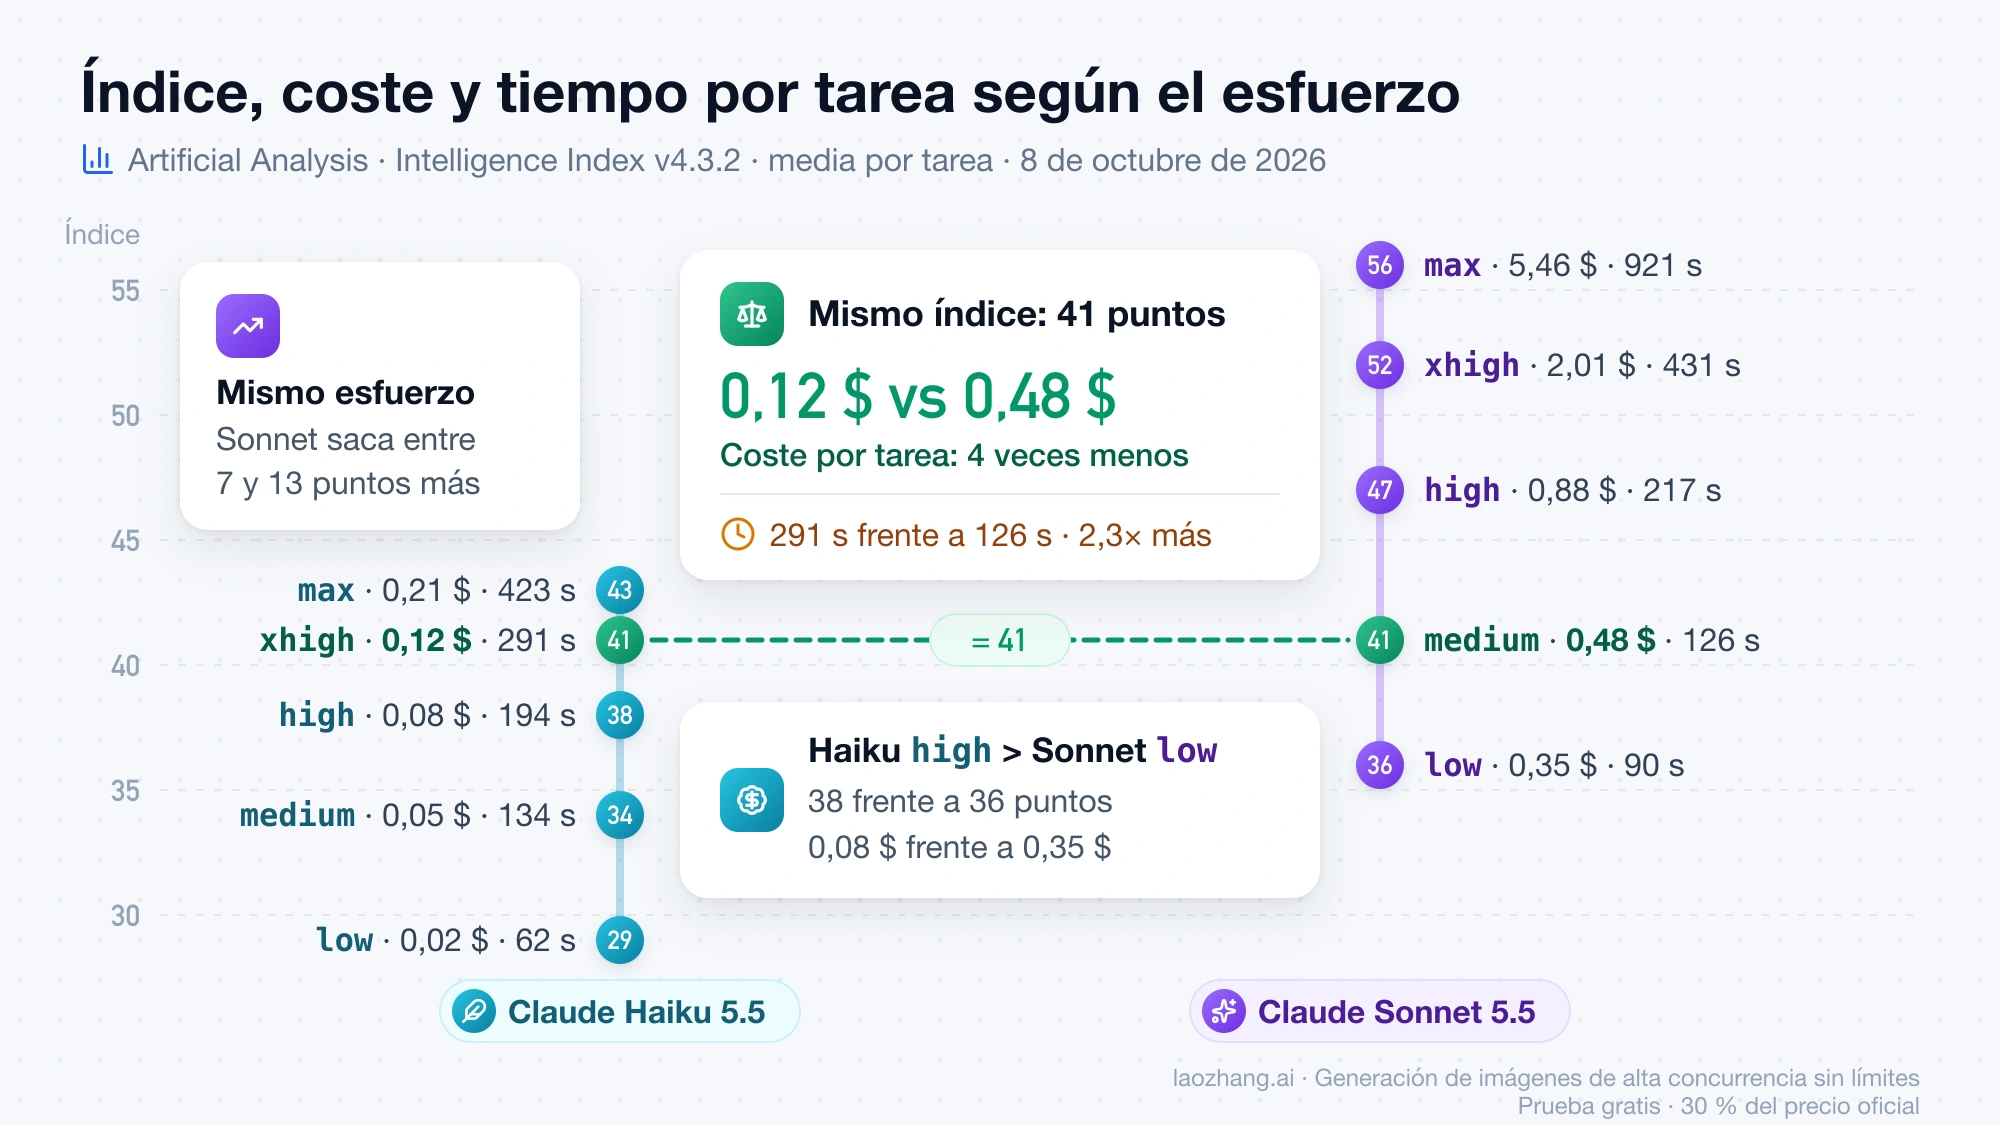
Lo que no dice esa tabla es cuánto cuesta cada punto. La comparativa de Artificial Analysis entre Haiku 5.5 y Sonnet 5.5 mide los dos modelos en sus cinco niveles de esfuerzo con el mismo banco de pruebas (Intelligence Index v4.3.2, coste medio y tiempo por tarea del índice, a 8 de octubre de 2026):
| Esfuerzo | Sonnet 5.5: índice · coste · tiempo | Haiku 5.5: índice · coste · tiempo |
|---|---|---|
max | 56 · 5,46 $ · 921 s | 43 · 0,21 $ · 423 s |
xhigh | 52 · 2,01 $ · 431 s | 41 · 0,12 $ · 291 s |
high | 47 · 0,88 $ · 217 s | 38 · 0,08 $ · 194 s |
medium | 41 · 0,48 $ · 126 s | 34 · 0,05 $ · 134 s |
low | 36 · 0,35 $ · 90 s | 29 · 0,02 $ · 62 s |
Con el mismo esfuerzo, Sonnet saca entre 7 y 13 puntos más. La comparación útil es otra: Haiku en xhigh empata con Sonnet en medium (41 puntos) por 0,12 $ frente a 0,48 $, es decir, 4 veces menos, pero tarda 291 s frente a 126 s, unas 2,3 veces más. Haiku en high (38 puntos, 0,08 $) supera a Sonnet en low (36 puntos, 0,35 $) por algo menos de una cuarta parte del coste. Y Haiku en max (43 puntos) supera a Sonnet en medium por menos de la mitad del precio, aunque con más del triple de tiempo.
Artificial Analysis etiqueta las ejecuciones de Sonnet como «with fallback» y calcula el coste de Haiku siempre con la tarifa de hasta 100K tokens. En tareas con prompts más largos, el coste real de Haiku sería mayor que el de la tabla.
Dónde se acerca Haiku 5.5 y dónde se queda atrás
El índice es una media de diez pruebas y esconde diferencias que cambian la decisión. Estas son las subpuntuaciones de Artificial Analysis que más separan o más igualan a los dos modelos:
| Prueba de Artificial Analysis | Haiku medium | Sonnet medium | Haiku max | Sonnet max |
|---|---|---|---|---|
| AA-LCR v1.1 (lectura de contexto largo) | 77,3 % | 76,3 % | 82,7 % | 82,7 % |
| SciCode (código científico) | 49,0 % | 52,9 % | 55,0 % | 61,0 % |
| Terminal-Bench 4.0 | 15,2 % | 29,8 % | 32,8 % | 63,6 % |
| AutomationBench-AA (automatización de procesos de negocio) | 28,6 % | 54,9 % | 35,4 % | 71,8 % |
| AA-Omniscience (fiabilidad del conocimiento; penaliza inventar) | 4 | 20 | 11 | 32 |
En leer documentos largos y extraer lo que dicen, Haiku 5.5 rinde casi como Sonnet 5.5. En automatizar procesos con varias herramientas, trabajar en una terminal o responder de memoria sin inventar, la diferencia es de otra magnitud: con el mismo esfuerzo, Sonnet saca entre 1,6 y 2,2 veces la nota de Haiku en Terminal-Bench y AutomationBench, y entre 3 y 6 veces más en AA-Omniscience. Traducido a decisiones: Haiku sirve para resumir y extraer de un texto que tú le das; no es buena idea dejar que responda datos de memoria ni que lleve solo un proceso de negocio de varios pasos.
Cuál sale más barato: 20 veces por token, unas 4 veces a igual calidad
Por petición, la cuenta es directa: tokens × precio por millón ÷ 1.000.000. Con las tarifas de lista y sin caché:
| Petición | Haiku 5.5 | Sonnet 5.5 | Sonnet / Haiku |
|---|---|---|---|
| 10K de entrada + 1K de salida | 0,0015 $ | 0,030 $ | 20× |
| 99K de entrada + 2K de salida | 0,0109 $ | 0,218 $ | 20× |
| 150K de entrada + 2K de salida | 0,080 $ (tarifa de más de 100K) | 0,32 $ | 4× |
| 1 millón de clasificaciones de 2K de entrada + 300 de salida | 350 $ | 7.000 $ | 20× |
La salida incluye los tokens de razonamiento, que se facturan aunque no los veas. Y el número de tokens depende del esfuerzo: Artificial Analysis contó 440 millones de tokens generados por Haiku 5.5 en max sobre su índice y 420 millones por Sonnet 5.5, así que en max ninguno de los dos es barato por tarea.
La caché de prompts y el umbral de 100.000 tokens
En un agente, la mayor parte de la entrada suele venir de la caché de prompts (prompt caching). Para un turno de ejemplo con 90K tokens leídos de caché, 5K de entrada nueva y 2K de salida:
- Haiku 5.5: 90.000 × 0,01 $ + 5.000 × 0,10 $ + 2.000 × 0,50 $, todo dividido entre un millón = 0,0024 $.
- Sonnet 5.5: 90.000 × 0,10 $ + 5.000 × 2 $ + 2.000 × 10 $, dividido entre un millón = 0,039 $. Con la lectura de caché anterior a 0,20 $ el mismo turno costaba 0,048 $, un 18,75 % más.
Aquí Sonnet cuesta 16,25 veces lo que Haiku. El umbral de 100K cambia mucho la cuenta. Si el mismo turno lleva 95K de caché y 10K nuevos (105K de entrada total), Haiku pasa a la tarifa alta: (95.000 × 0,05 $ + 10.000 × 0,50 $ + 2.000 × 2,50 $) ÷ 1.000.000 = 0,01475 $, unas seis veces lo que costaba el turno anterior. Sonnet cobra (95.000 × 0,10 $ + 10.000 × 2 $ + 2.000 × 10 $) ÷ 1.000.000 = 0,0495 $, y la diferencia baja a unas 3,4 veces.
La tabla de precios no aclara qué cuenta exactamente para el límite de 100.000 tokens de prompt, ni si los tokens leídos de caché entran. Para presupuestar sin sorpresas, suma toda la entrada (caché leída, caché escrita y entrada nueva) y aplica la tarifa alta a toda la petición, salida incluida, cuando esa suma pase de 100K. Sonnet 5.5 cobra lo mismo en toda la ventana de 1M.
Cómo calcular el coste por tarea terminada de tu carga
El precio por token no te dice cuánto pagas por trabajo hecho. Para tu caso:
- Ejecuta un lote de tareas reales en los dos modelos con el esfuerzo que usarías en producción, y fíjalo de forma explícita.
- Suma los tokens del campo
usagede cada respuesta:input_tokens,cache_read_input_tokens,cache_creation_input_tokensyoutput_tokens. - Aplica el precio que corresponda a cada petición; en Haiku, la tarifa alta cuando la entrada total supere 100K.
- Divide el coste medio por intento entre la proporción de tareas que pasan tu comprobación. Si reintentas con el mismo modelo, eso es el coste por tarea terminada.
Con los datos de Artificial Analysis en medium como ejemplo: si Haiku cuesta 0,05 $ por intento y acierta el 60 %, la tarea terminada sale a 0,083 $; si Sonnet cuesta 0,48 $ y acierta el 90 %, sale a 0,533 $. Las tasas de acierto de este ejemplo son supuestas; las tuyas salen del paso 4.
Cuándo usar Haiku 5.5 y cuándo Sonnet 5.5, por tipo de trabajo
La guía de Anthropic para elegir modelo en Claude recomienda empezar por Haiku 5.5 cuando importan el coste y la latencia, probar y subir solo donde falte capacidad, y recuerda que ajustar el esfuerzo suele ser mejor palanca que cambiar de modelo. Aplicado a los datos anteriores:
| Trabajo | Empieza con | Cambia cuando |
|---|---|---|
| Clasificar, extraer campos, enrutar peticiones | Haiku 5.5 en low o medium | Los errores en tu conjunto de prueba siguen altos en high |
| Resumir, compactar contexto, leer documentos largos | Haiku 5.5 | El prompt pasa de 100K con frecuencia y la ventaja por petición baja a unas 4 veces |
| Subagentes que buscan, leen código o hacen cambios pequeños | Haiku 5.5 como subagente, Sonnet 5.5 dirigiendo | El subagente da cambios por hechos sin comprobarlos o se detiene antes de tiempo |
| Chat y soporte en vivo | Haiku 5.5 en low o con razonamiento desactivado | Debe responder datos sin fuentes: Sonnet 5.5 |
| Programación agéntica de varios pasos, refactorizaciones, terminal | Sonnet 5.5 en medium | No basta ni en high: Opus 5.5 |
| Automatización de procesos con varias herramientas | Sonnet 5.5 | Haiku solo para pasos sueltos y verificables |
| Seguridad defensiva | Haiku 5.5, que admite más tareas defensivas que Sonnet 5.5 | Necesitas pruebas de penetración: Haiku las bloquea; el Cyber Verification Program de Anthropic amplía el acceso |
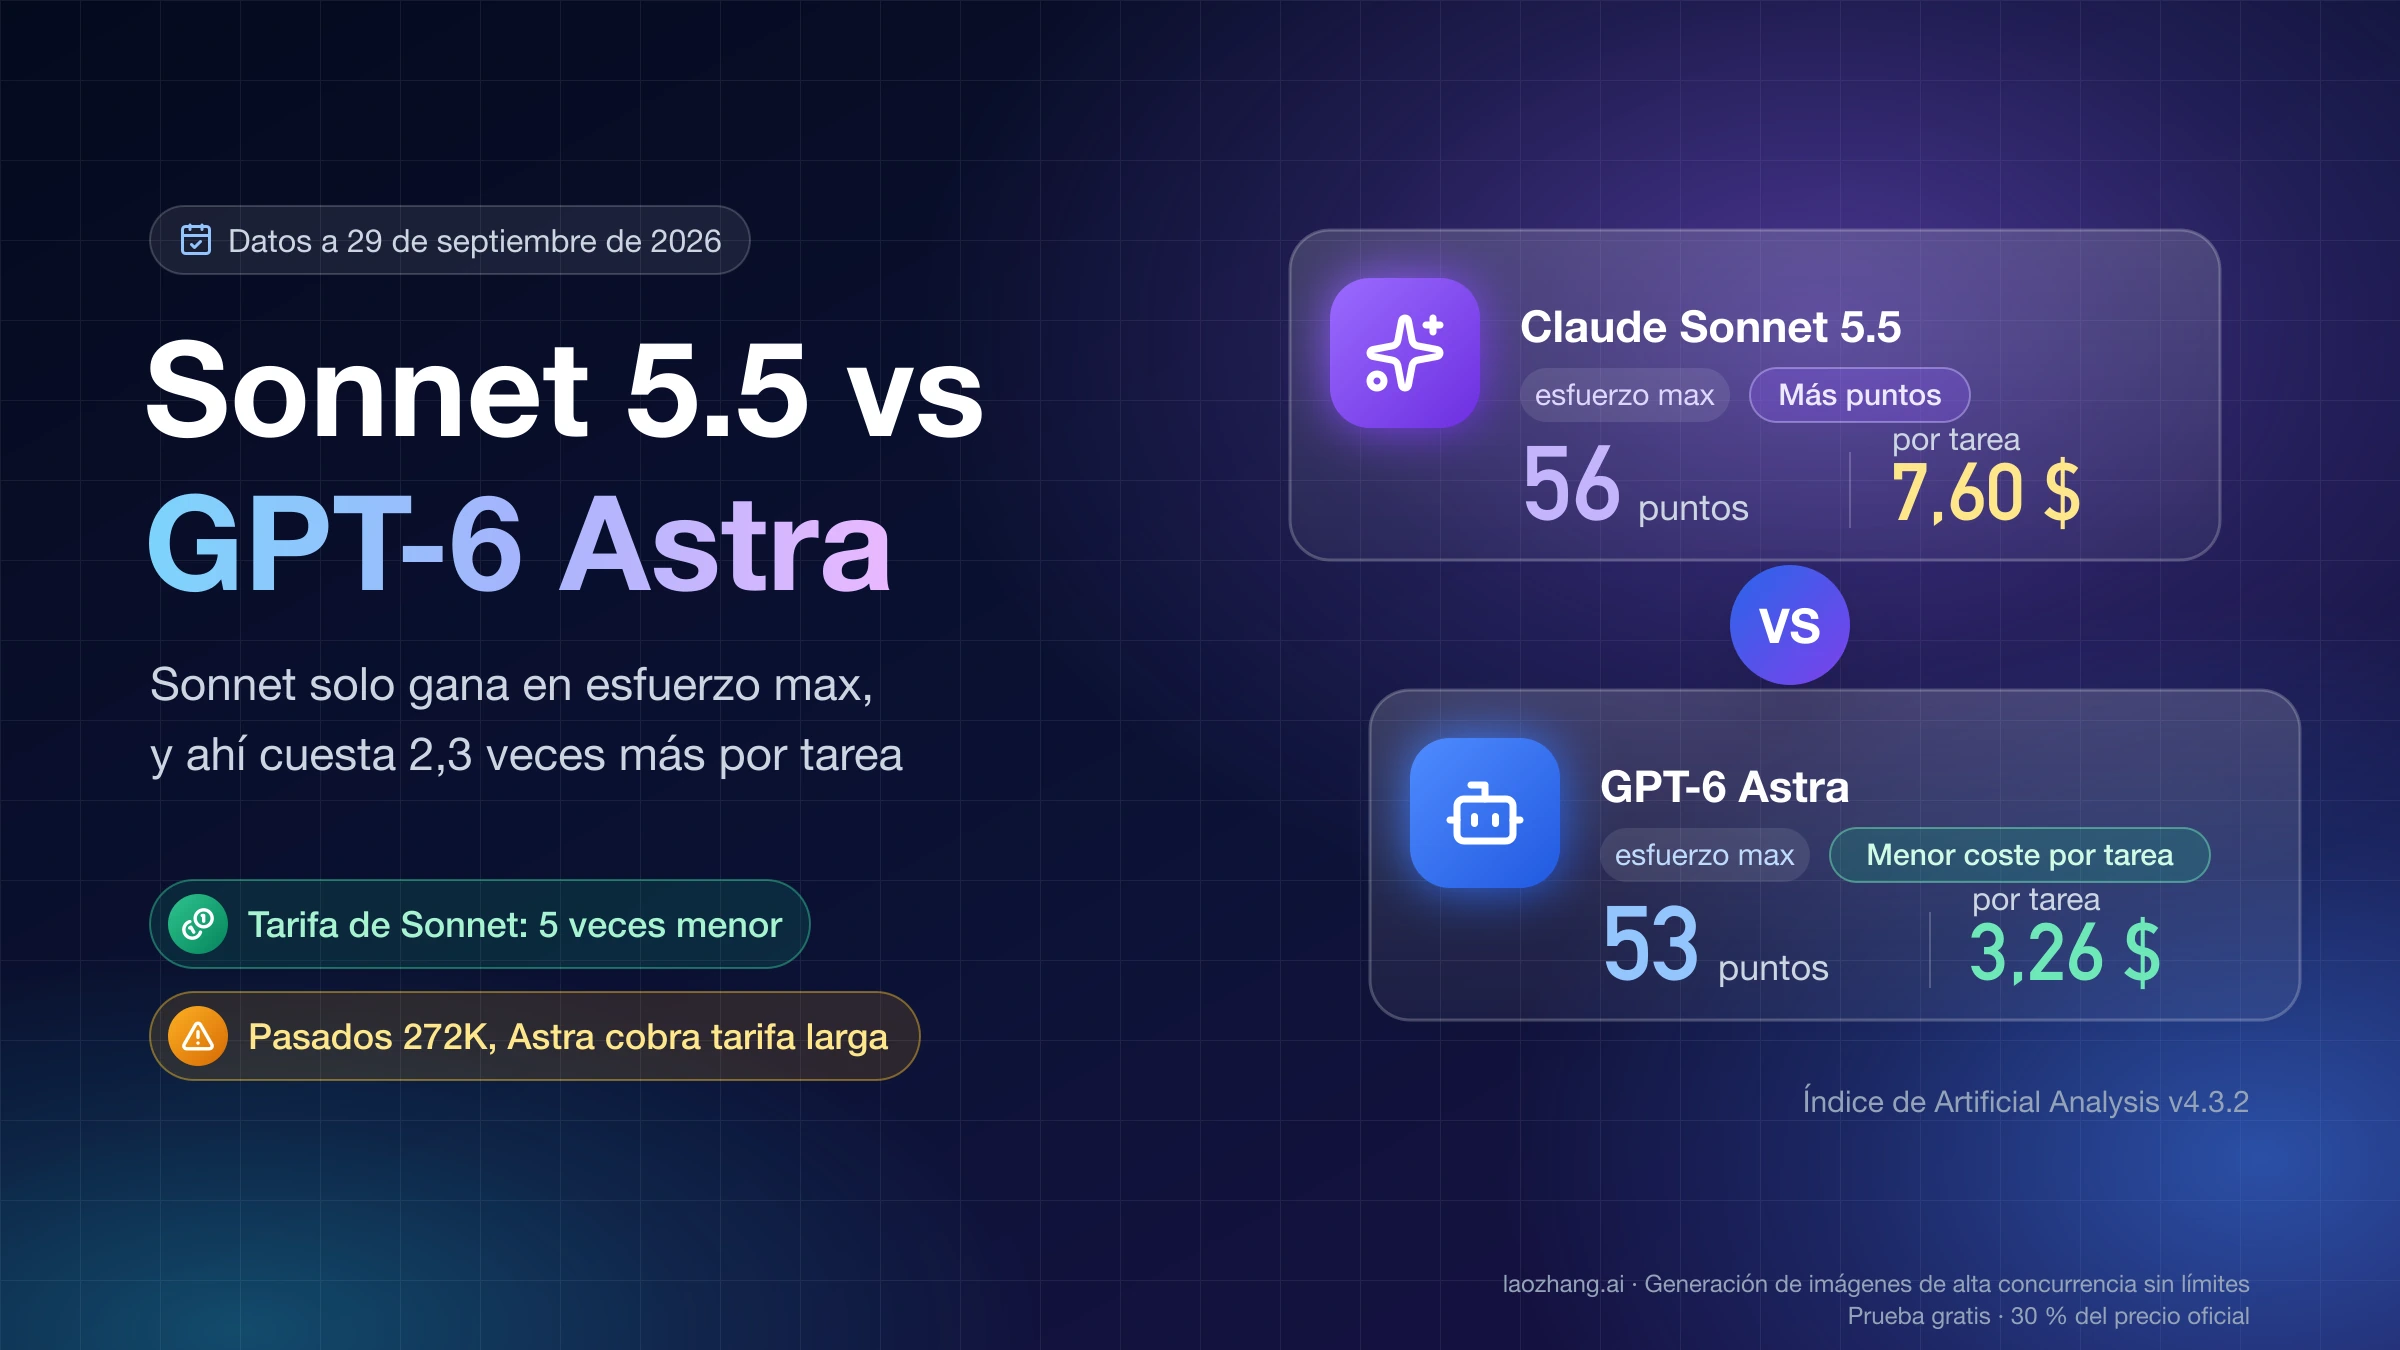
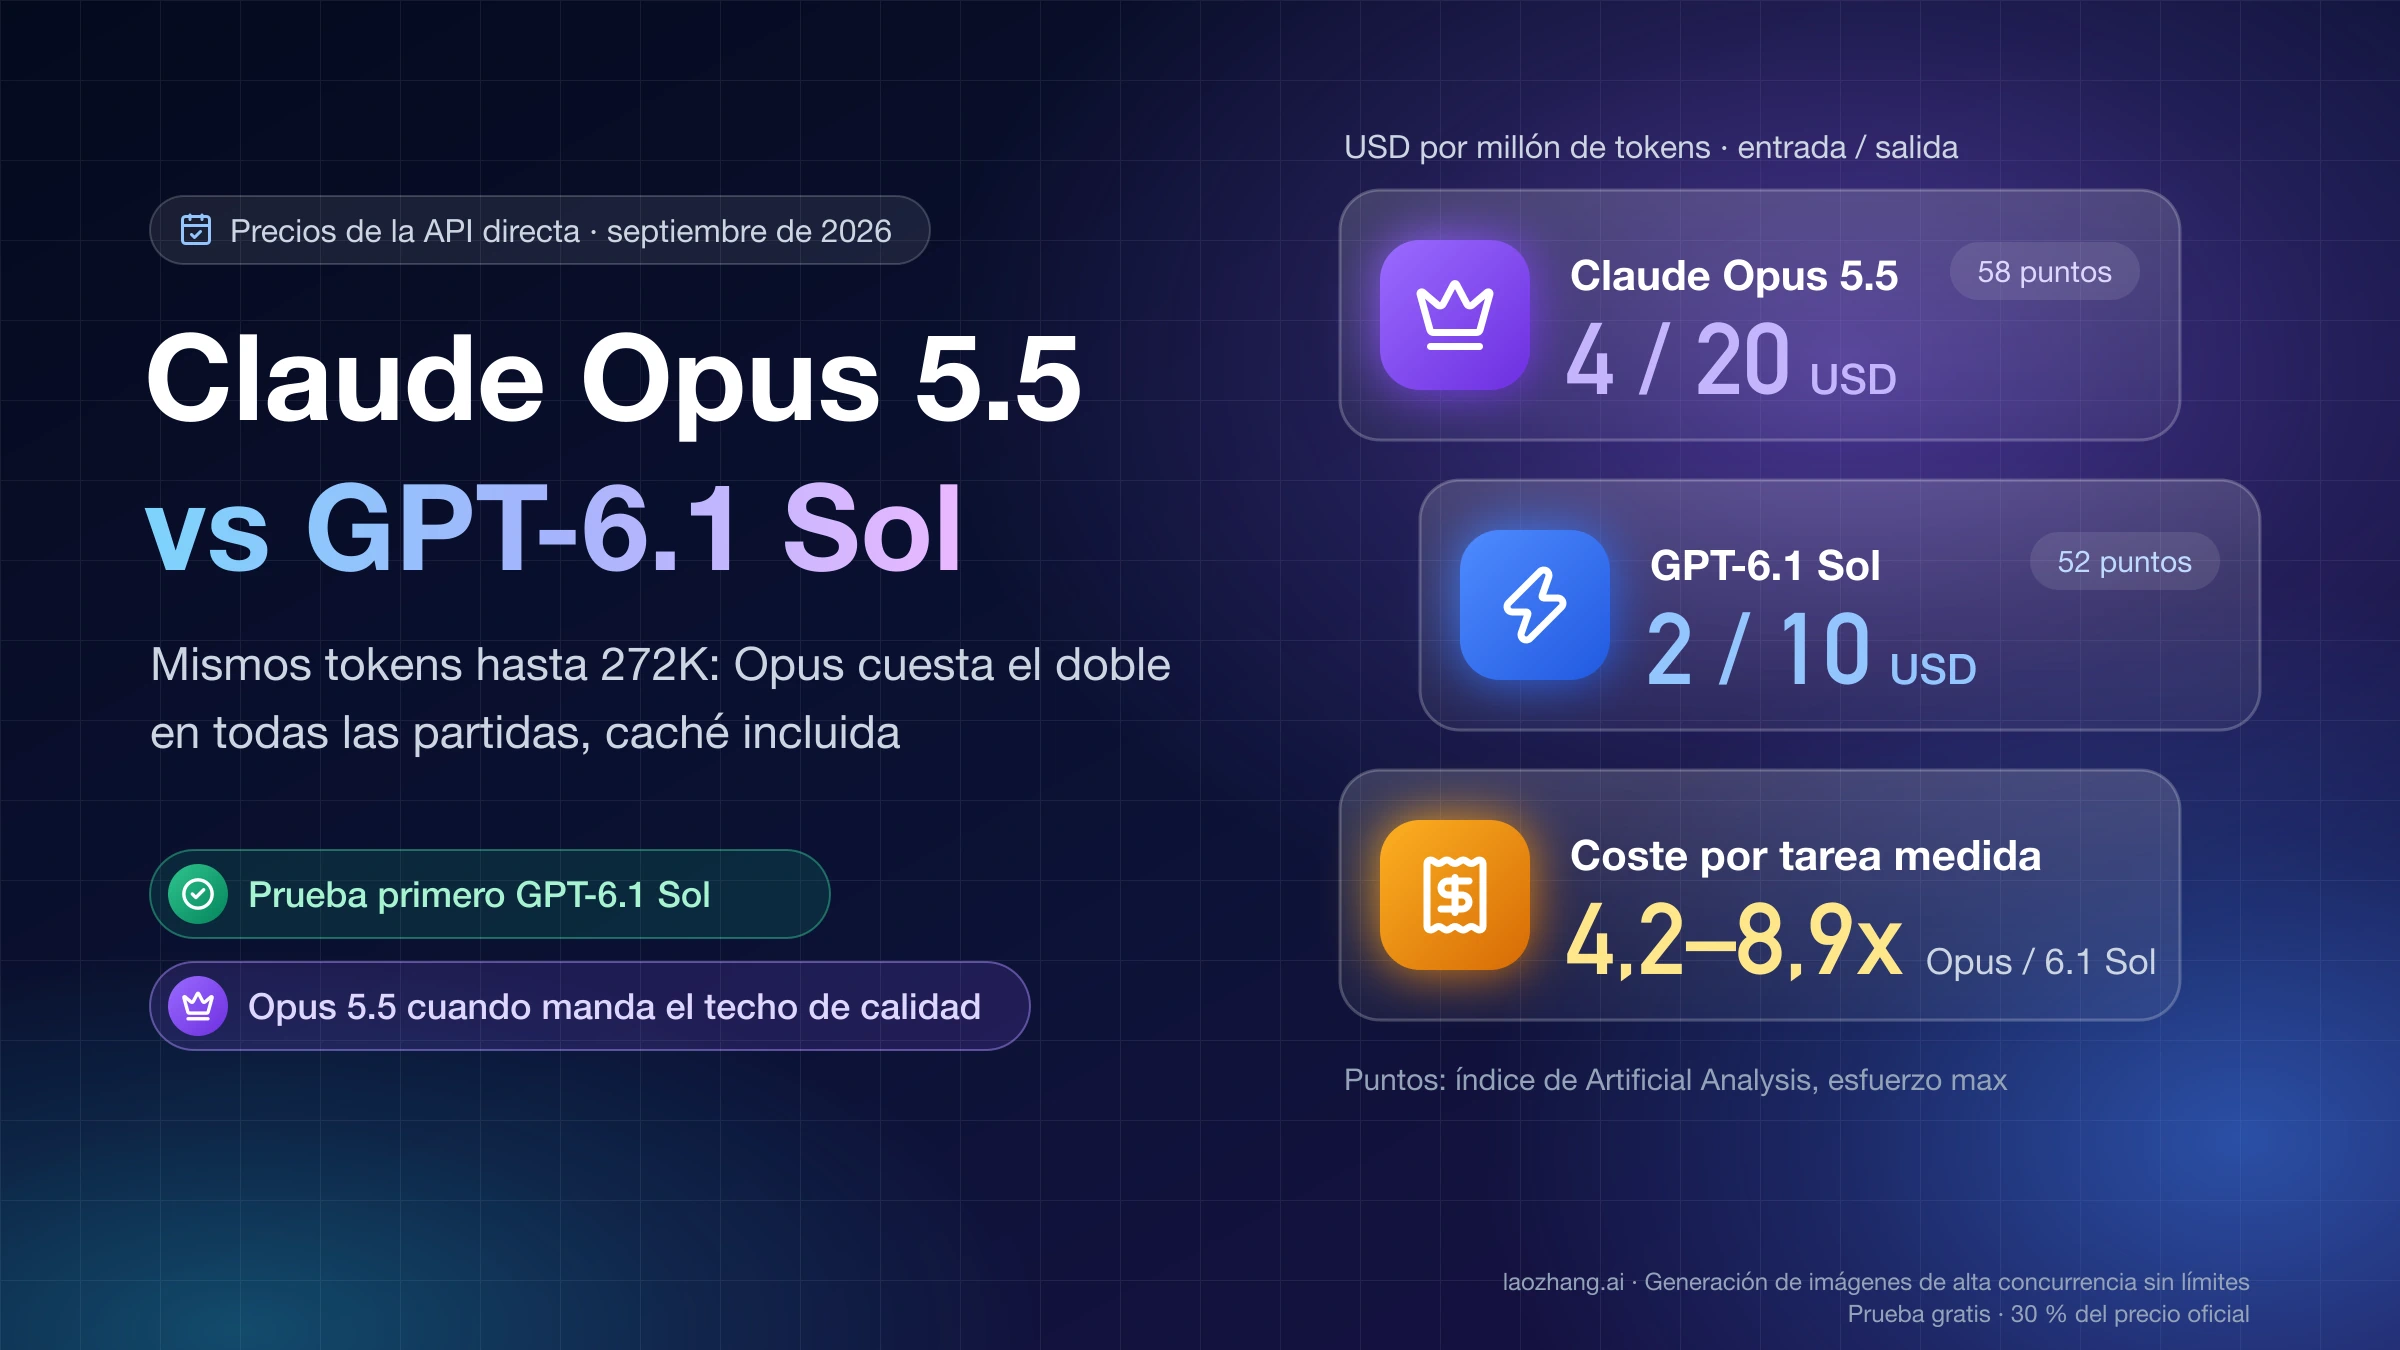
Dos matices. Subir Haiku a xhigh o max rara vez compensa sin medir: la documentación del nivel de esfuerzo en la API de Claude pide usar esos niveles solo si tus pruebas muestran mejora, y compararlos con Sonnet 5.5 en calidad, coste y velocidad. Y si Sonnet 5.5 tampoco basta, el siguiente paso es Opus 5.5 o Fable 5.1, que se comparan en Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más; el precio de Opus está en Claude Opus 5.5: precio de la API y restablecimiento de límites.
Primero Haiku y, si falla, Sonnet: compensa si Haiku acierta más del 10 %
Escalar significa mandar cada tarea a Haiku 5.5 y repetir en Sonnet 5.5 solo las que fallan una comprobación. El coste esperado por tarea es:
coste = coste_Haiku + (1 − p) × coste_Sonnet
donde p es la proporción de tareas que Haiku resuelve bien. Con los costes por tarea de Artificial Analysis en medium (0,05 $ Haiku, 0,48 $ Sonnet), el escalado sale más barato que usar solo Sonnet en cuanto p supera 0,05 ÷ 0,48, alrededor del 10 %. Por cada 1.000 tareas:
| Tasa de acierto de Haiku | Coste con escalado | Solo Sonnet |
|---|---|---|
| 50 % | 290 $ | 480 $ |
| 70 % | 194 $ | 480 $ |
| 90 % | 98 $ | 480 $ |
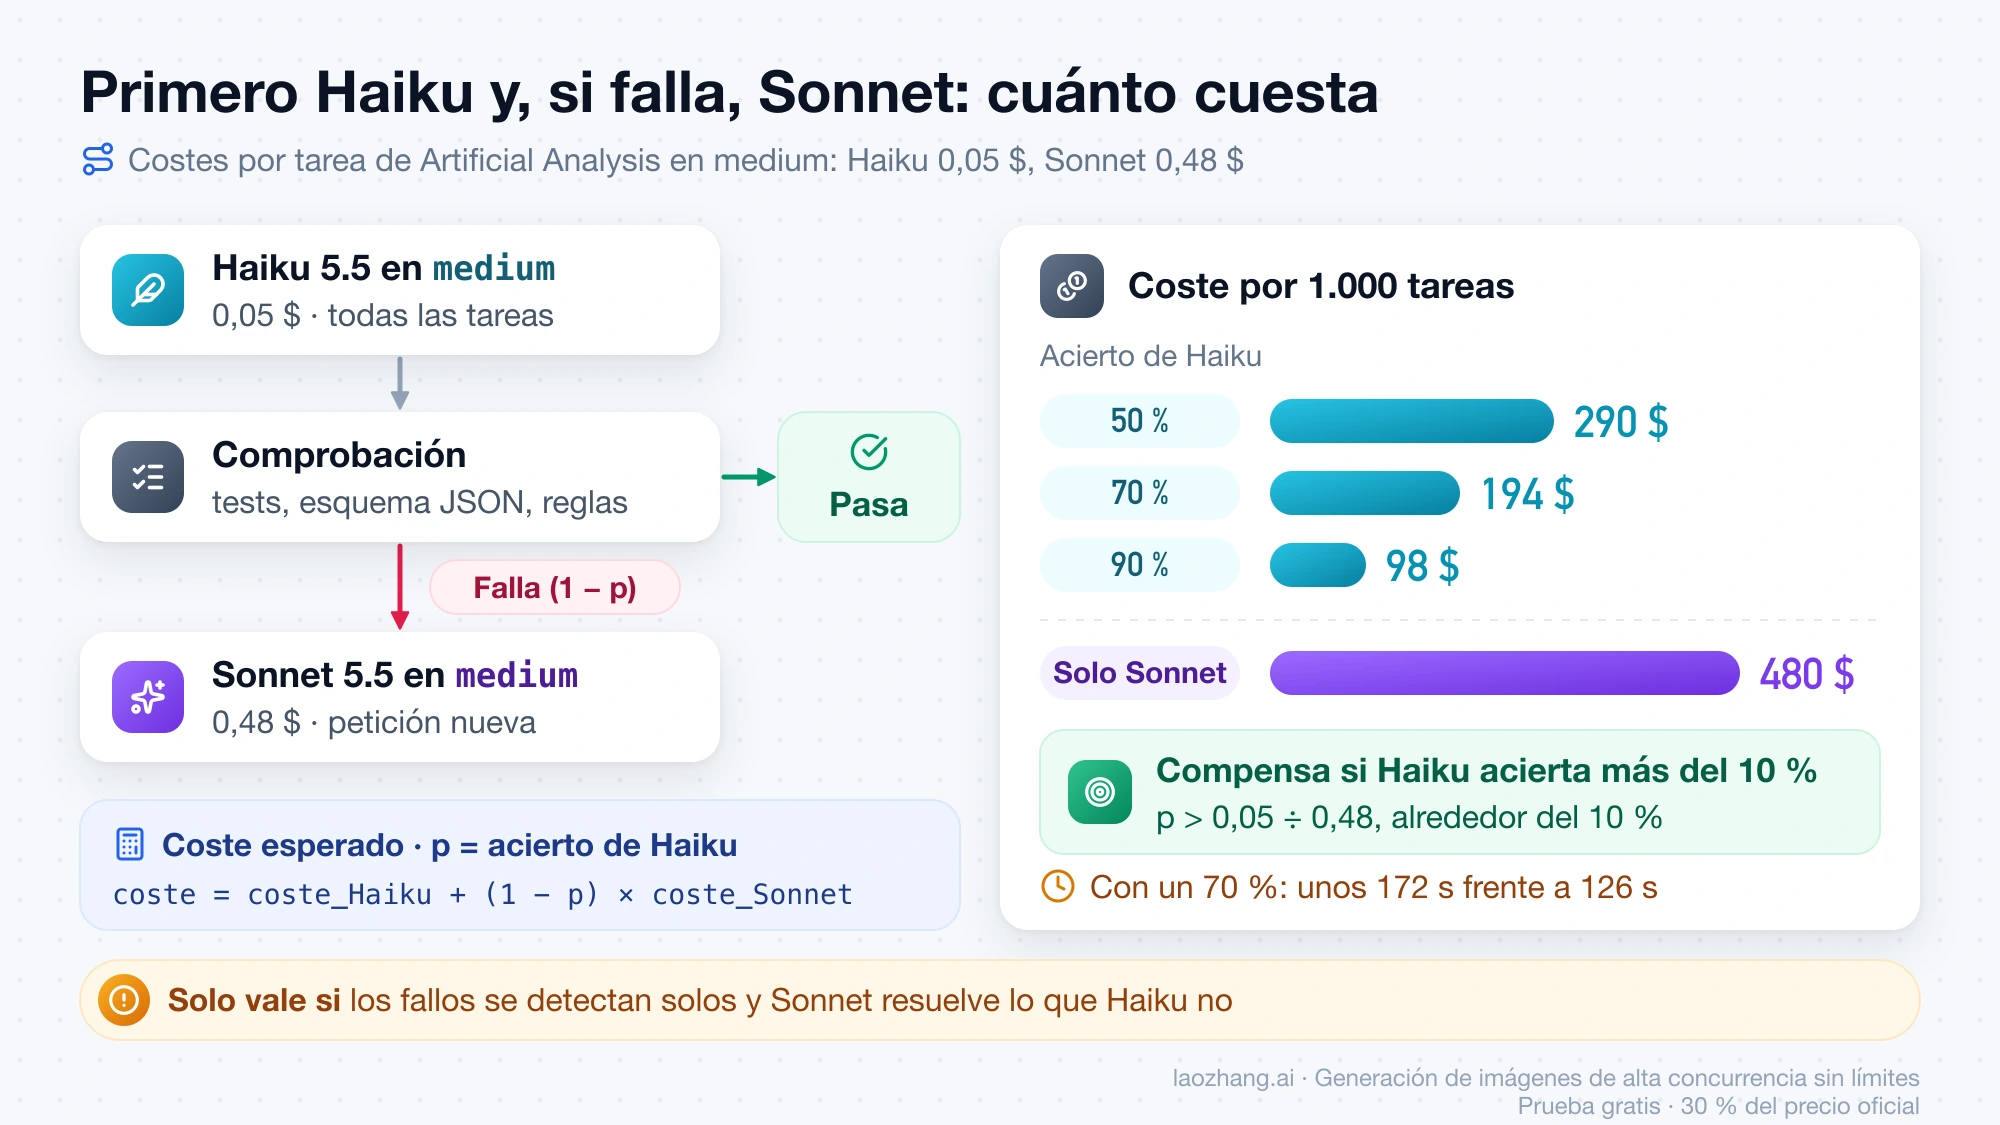
La cuenta solo vale si se cumplen tres condiciones:
- Los fallos se detectan solos y sin coste apreciable: tests, validación de un esquema JSON, un comprobador de reglas. Una respuesta incorrecta que nadie detecta no aparece en la tabla y es justo el riesgo de Haiku en preguntas de conocimiento.
- Sonnet resuelve lo que Haiku no. Si las tareas difíciles también fallan en Sonnet, pagas dos veces.
- Aceptas más latencia en las tareas que escalan. Con los tiempos de
medium(134 s Haiku, 126 s Sonnet), el tiempo medio es 134 + (1 − p) × 126 s: con un 70 % de acierto salen unos 172 s, frente a 126 s si vas directo a Sonnet.
Al reenviar a Sonnet, manda la tarea original en una petición nueva en lugar de reutilizar la conversación de Haiku: en Sonnet 5.5 los bloques de razonamiento quedan ligados al modelo y a la conversación que los produjeron. Y fija el esfuerzo de Sonnet. Si lo omites en la API, Sonnet 5.5 trabaja en high, que en Artificial Analysis cuesta 0,88 $ por tarea en lugar de 0,48 $.
¿Es Haiku 5.5 más rápido que Sonnet 5.5? Por token sí, por tarea no siempre
Haiku 5.5 genera más tokens por segundo: entre 137 y 243 según el esfuerzo, frente a 101–136 de Sonnet 5.5 en las mediciones de Artificial Analysis. Pero en esas mismas pruebas, con el razonamiento activado, Haiku tarda más en empezar a responder: 11,99 s hasta el primer token en low y 12,63 s en medium, frente a 1,05 s y 2,05 s de Sonnet. Haiku piensa antes de contestar.
En tiempo por tarea completa, Haiku termina antes en low (62 s frente a 90 s) y en high (194 s frente a 217 s), y casi empata en medium (134 s frente a 126 s). Si comparas a igual puntuación, Haiku en xhigh necesita 291 s donde Sonnet en medium necesita 126 s.
Para un chat o un servicio de soporte en el que cuenta el primer segundo, prueba Haiku en low o con thinking: {"type": "disabled"} y mide en tu entorno. Artificial Analysis no publica tiempos con el razonamiento desactivado, y la etiqueta «Fastest» de Anthropic es relativa: la propia documentación aclara que la latencia real depende del largo del prompt, de la salida y del esfuerzo.
Pasar de Sonnet 5.5 a Haiku 5.5 en la API: lo que cambia además del ID
Cambiar claude-sonnet-5-5 por claude-haiku-5-5 funciona en una petición sencilla, pero varias diferencias pueden romper código o cambiar el coste sin avisar. Revisa esto antes de mover tráfico, según la guía de novedades de Claude Haiku 5.5 y la de cómo escribir prompts para Claude Haiku 5.5:
- Fija el esfuerzo. Sin
output_config.effort, Sonnet 5.5 corre enhighy Haiku 5.5 enmedium. Para Haiku, Anthropic recomiendalowen chat, tareas cortas con herramientas y peticiones simples de gran volumen;mediumpara casi todo, incluida la programación agéntica; yhighpara trabajo de conocimiento, agentes largos y seguimiento estricto de instrucciones. - Cambia la forma de desactivar el razonamiento.
between_toolses el mínimo de Sonnet; en Haiku se usadisabled. Los dos funcionan solo hastahigh: enxhighomaxdevuelven un error 400. - Revisa
tool_choice. Haiku 5.5 acepta forzar una herramienta; Sonnet 5.5 devuelve error. Si el mismo código escala a Sonnet, no fuerces herramientas en esa rama. - JSON y herramientas con el razonamiento desactivado. En ese caso Haiku puede saltarse una llamada a herramienta necesaria cuando pides salida estructurada. Usa razonamiento adaptativo en esas peticiones, quita
output_config.formatdonde deba llamar a una herramienta o fuerza la llamada contool_choice. - Agentes largos. En
lowy con prompts de sistema largos, Haiku a veces se detiene antes de terminar; enlowymedium, a veces da por hecho un cambio de código sin ejecutar ninguna comprobación. La guía de prompts de Haiku incluye párrafos para el prompt de sistema que corrigen ambas cosas. Subir delowamediumredujo aproximadamente a la mitad las paradas prematuras en las pruebas de Anthropic, pero más que duplicó los tokens de salida. - Búsquedas. Si le das una herramienta de búsqueda, pon la fecha de hoy en el prompt de sistema o en la descripción de la herramienta.
- Rechazos. Haiku 5.5 lleva clasificadores de seguridad que devuelven
stop_reason: "refusal"y no tiene alternativa automática en el servidor (server-side fallback). Gestiona ese caso en tu cliente; reenviar la misma petición a Haiku suele dar otro rechazo. - Parámetros que fallan. En los dos modelos,
temperature,top_potop_kcon valores no predeterminados devuelven un 400. En Haiku 5.5 también fallan el relleno previo del mensaje del asistente (prefill) ybudget_tokens. - Forma de la respuesta. La respuesta puede empezar con bloques de razonamiento: selecciona los bloques por su
type, no por su posición, y deja margen enmax_tokens, porque el razonamiento cuenta dentro de ese límite. - Presupuesto. Recalcula con la tarifa de más de 100K si tus prompts, sumando la caché, superan ese tamaño.
Las dos peticiones equivalentes, con el esfuerzo fijado y el razonamiento al mínimo, quedan así:
{
  "model": "claude-haiku-5-5",
  "max_tokens": 8000,
  "output_config": {"effort": "low"},
  "thinking": {"type": "disabled"},
  "messages": [{"role": "user", "content": "Clasifica este ticket: ..."}]
}{
"model": "claude-sonnet-5-5",
"max_tokens": 8000,
"output_config": {"effort": "low"},
"thinking": {"type": "between_tools"},
"messages": [{"role": "user", "content": "Clasifica este ticket: ..."}]
}Elegir Haiku 5.5 en Claude Code y en la app de Claude
En Claude Code
Según la configuración de modelos de Claude Code, Haiku 5.5 necesita la versión 2.1.293 o posterior (Sonnet 5.5, la 2.1.284). Actualiza y elige el modelo para la sesión:
claude update
claude --model claude-haiku-5-5
Dentro de una sesión, /model claude-haiku-5-5 hace lo mismo. El alias haiku apunta a Haiku 5.5 solo con la API de Anthropic; en Claude Platform on AWS, Amazon Bedrock, Google Cloud y Microsoft Foundry, haiku sigue apuntando a Haiku 4.5 y sonnet a una versión anterior de Sonnet, así que allí conviene usar el nombre completo del modelo.
Para que Sonnet 5.5 dirija la sesión y los subagentes trabajen con Haiku 5.5, que es el reparto que Anthropic sugiere para programar, deja la sesión principal en sonnet y define el modelo de los subagentes:
export CLAUDE_CODE_SUBAGENT_MODEL=haikuEsa variable fija el modelo por defecto de los subagentes que no tienen otro asignado; el campo model en la definición de un subagente tiene prioridad. Otras diferencias respecto a la API: en Claude Code los dos modelos arrancan en esfuerzo medium, el razonamiento no se puede desactivar en ninguno y, en el modo plan, una sesión con Haiku normalmente pasa a Sonnet para planificar. Si usas Claude Code con facturación por API, el tramo de más de 100K tokens de prompt también se aplica a Haiku 5.5.
En la app de Claude
Anthropic indica que los planes Free, Pro, Max, Team y Enterprise pueden elegir Haiku 5.5 en Claude.ai, en web, iOS y Android; Sonnet 5.5 está disponible para cualquier usuario. Para preguntas rápidas, reescribir textos o resumir lo que pegas en el chat, Haiku 5.5 basta. Para analizar un problema con varias fuentes, programar o pedir datos que no le das tú, Sonnet 5.5 se equivoca menos, como muestran las pruebas de fiabilidad del conocimiento.
Preguntas frecuentes sobre Claude Haiku 5.5 y Sonnet 5.5
¿Gasta menos cuota de mi plan Claude usar Haiku 5.5 que Sonnet 5.5?
Probablemente sí, pero Anthropic no publica cuánto. El centro de ayuda de Claude sobre límites de uso dice que el consumo depende del largo de la conversación, las funciones que usas, el modelo y el nivel de esfuerzo, sin dar una proporción entre modelos. Bajar el esfuerzo en tareas rutinarias también reduce el consumo. Cómo funcionan los límites de cada plan está en Límites de uso de Claude Pro y Max: el 5x y 20x es por sesión.
¿Claude Haiku 5.5 sirve para programar?
Sirve para tareas acotadas y comprobables: buscar en el código, leer archivos, cambios pequeños con tests, trabajo de subagente. Para programación agéntica de varios pasos, Sonnet 5.5 está muy por delante: 70,6 % frente a 39,2 % en Terminal-Bench 4.0 según Anthropic. Si usas Haiku en un agente de código, pide en el prompt de sistema que ejecute los tests antes de dar un cambio por terminado.
¿Puedo usar el crédito mensual de API de Max o Team con Haiku 5.5?
Sí. Anthropic anunció el 7 de octubre un crédito mensual para la Claude Platform (100 $ en Max 5x, 200 $ en Max 20x y hasta 500 $ compartidos en Team) que se puede gastar en cualquier modelo. Como Haiku 5.5 cobra 20 veces menos por token de entrada y de salida (10 veces menos en lectura de caché), el mismo crédito da para bastante más trabajo mientras los prompts no pasen de 100K tokens. La diferencia entre pagar por API y por suscripción se explica en Claude API vs Claude Code: diferencias, cuál usar y cómo se paga.
¿Qué hago si Claude Sonnet 5.5 tampoco resuelve la tarea?
Antes de cambiar de modelo, sube el esfuerzo de Sonnet de medium a high. Si sigue sin bastar, Anthropic recomienda Opus 5.5 para la programación agéntica compleja y Fable 5.1 para las sesiones más largas y exigentes. Cuándo compensa cada uno está en Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
- 1.tabla de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 2.Claude Haiku 5.5platform.claude.com/docs/en/models/haiku-5-5/overview
- 3.Claude Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/overview
- 4.anuncio de Claude Haiku 5.5anthropic.com/claude-haiku-5-5
- 5.comparativa de Artificial Analysis entre Haiku 5.5 y Sonnet 5.5artificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-claude-sonnet-5-5
- 6.elegir modelo en Claudeplatform.claude.com/docs/en/about-claude/models/choosing-a-model
- 7.nivel de esfuerzo en la API de Claudeplatform.claude.com/docs/en/build-with-claude/effort
- 8.novedades de Claude Haiku 5.5platform.claude.com/docs/en/models/haiku-5-5/whats-new-haiku-5-5
- 9.cómo escribir prompts para Claude Haiku 5.5platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-haiku-5-5
- 10.configuración de modelos de Claude Codecode.claude.com/docs/en/model-config
- 11.centro de ayuda de Claude sobre límites de usosupport.claude.com/en/articles/11647753-understanding-usage-and-length-limits