Gemini 4 Carbon vs Argon: dónde gana, cuánto cuesta y si cambiar
Carbon saca 9 puntos a Argon en AA, sobre todo en código y ciencia, y tarda el doble en dar el primer token. A 30 de octubre de 2026 solo se puede usar Argon.
En esta página
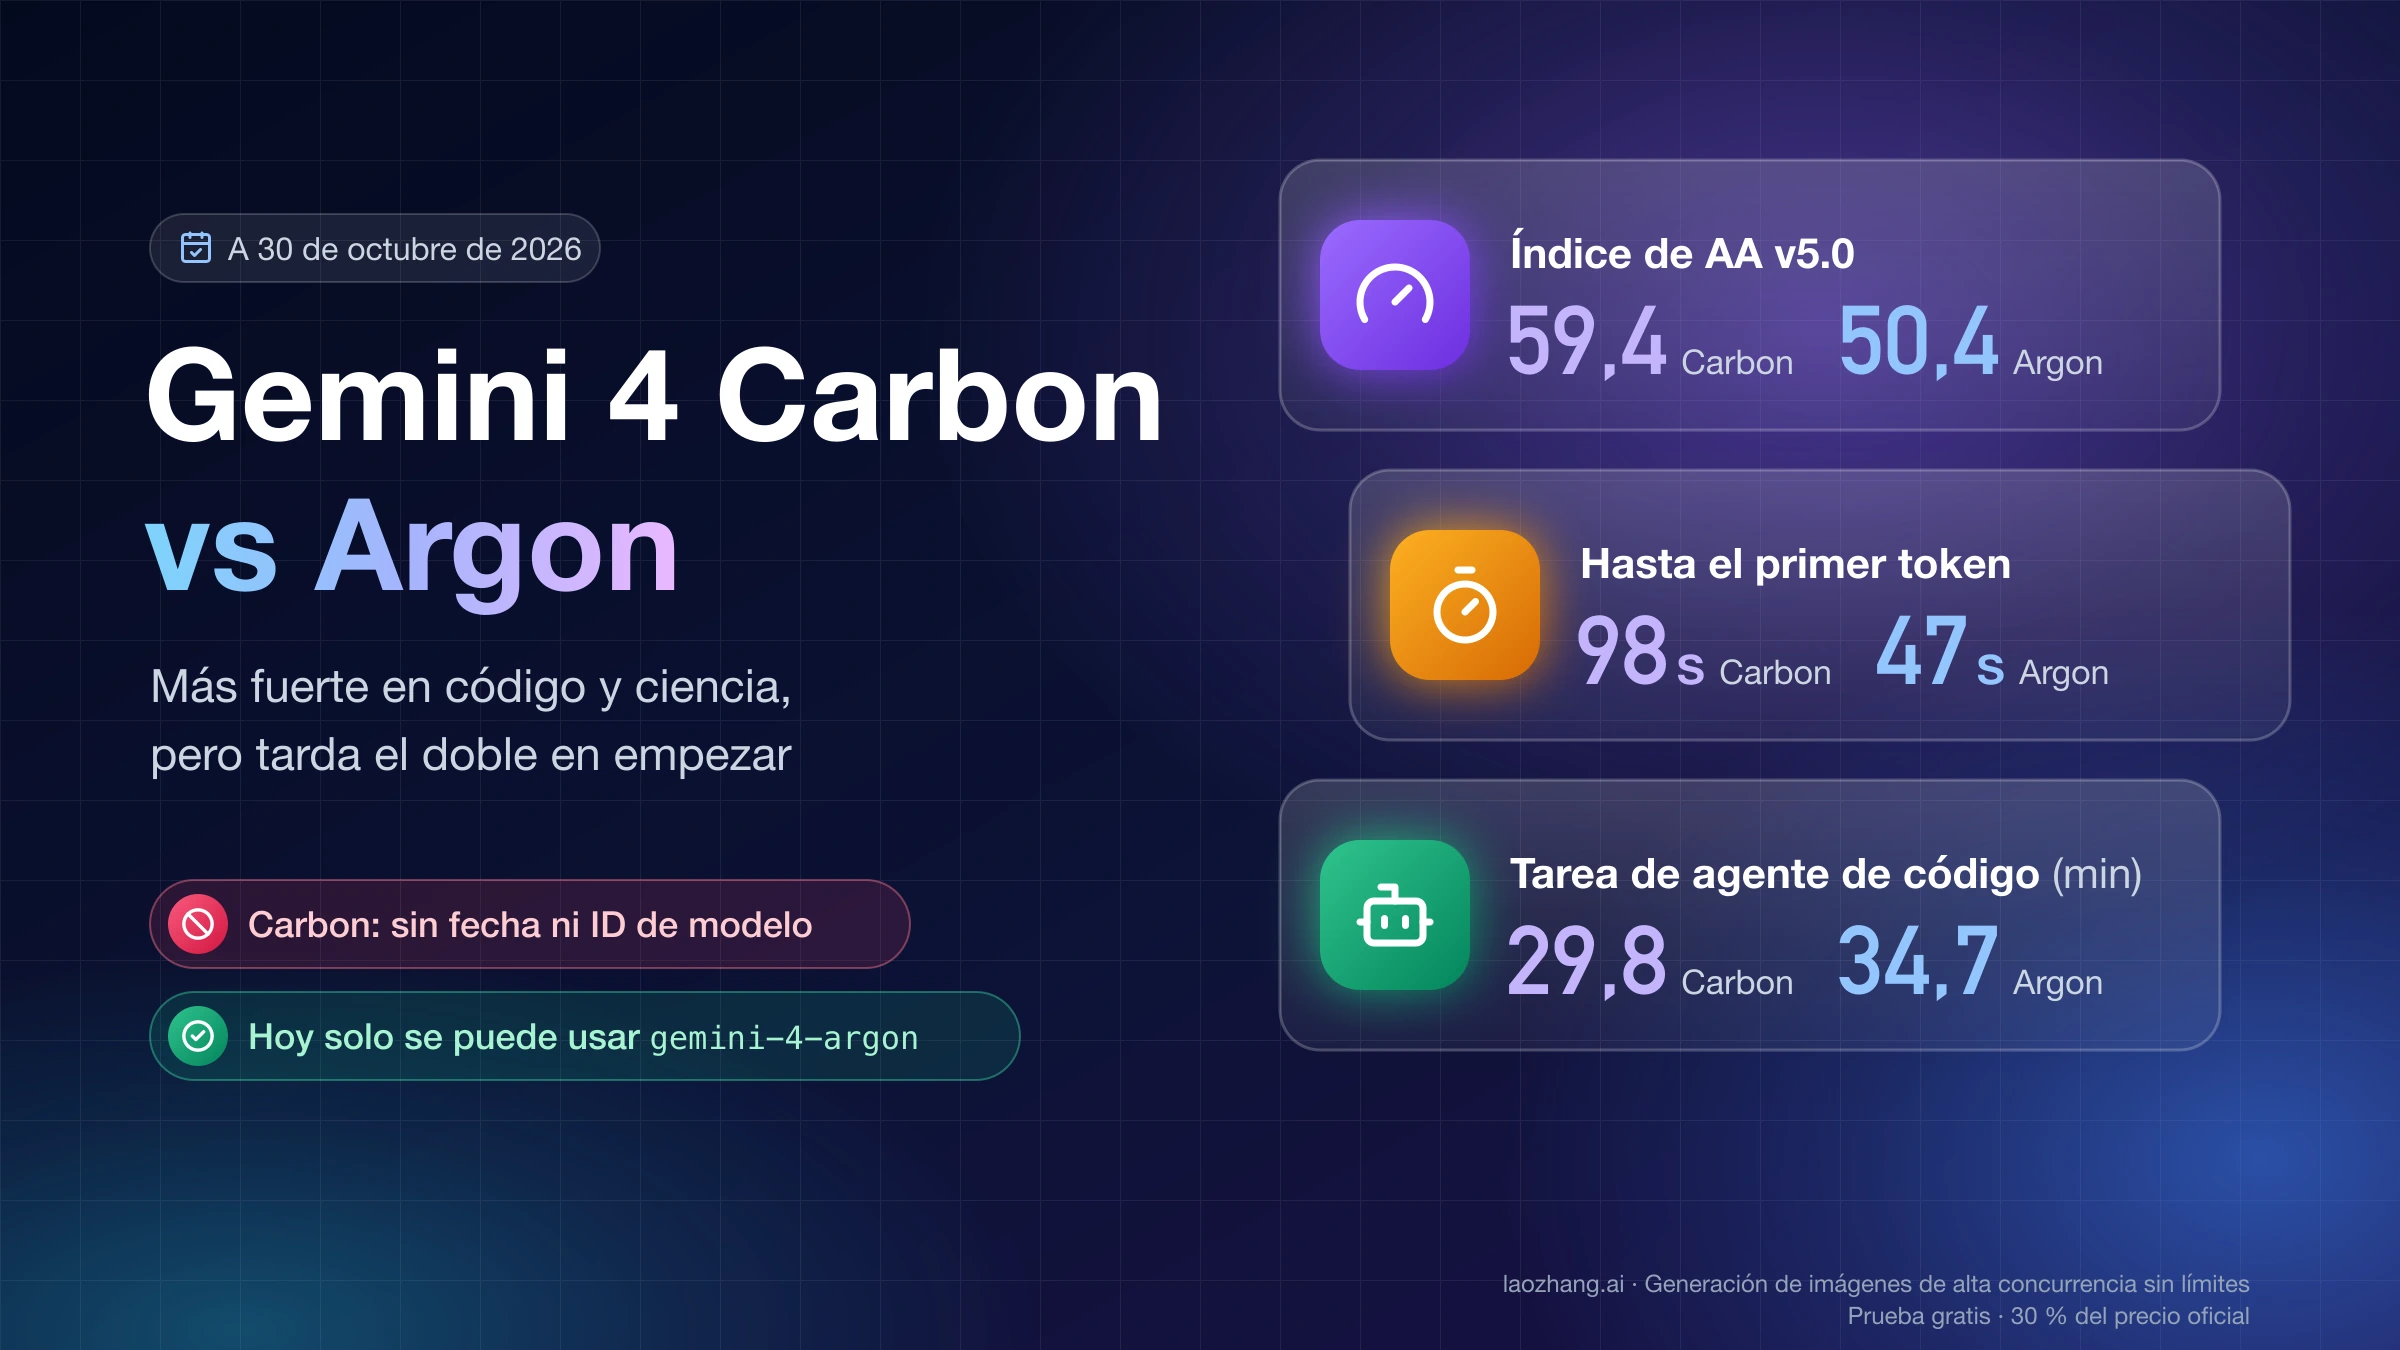
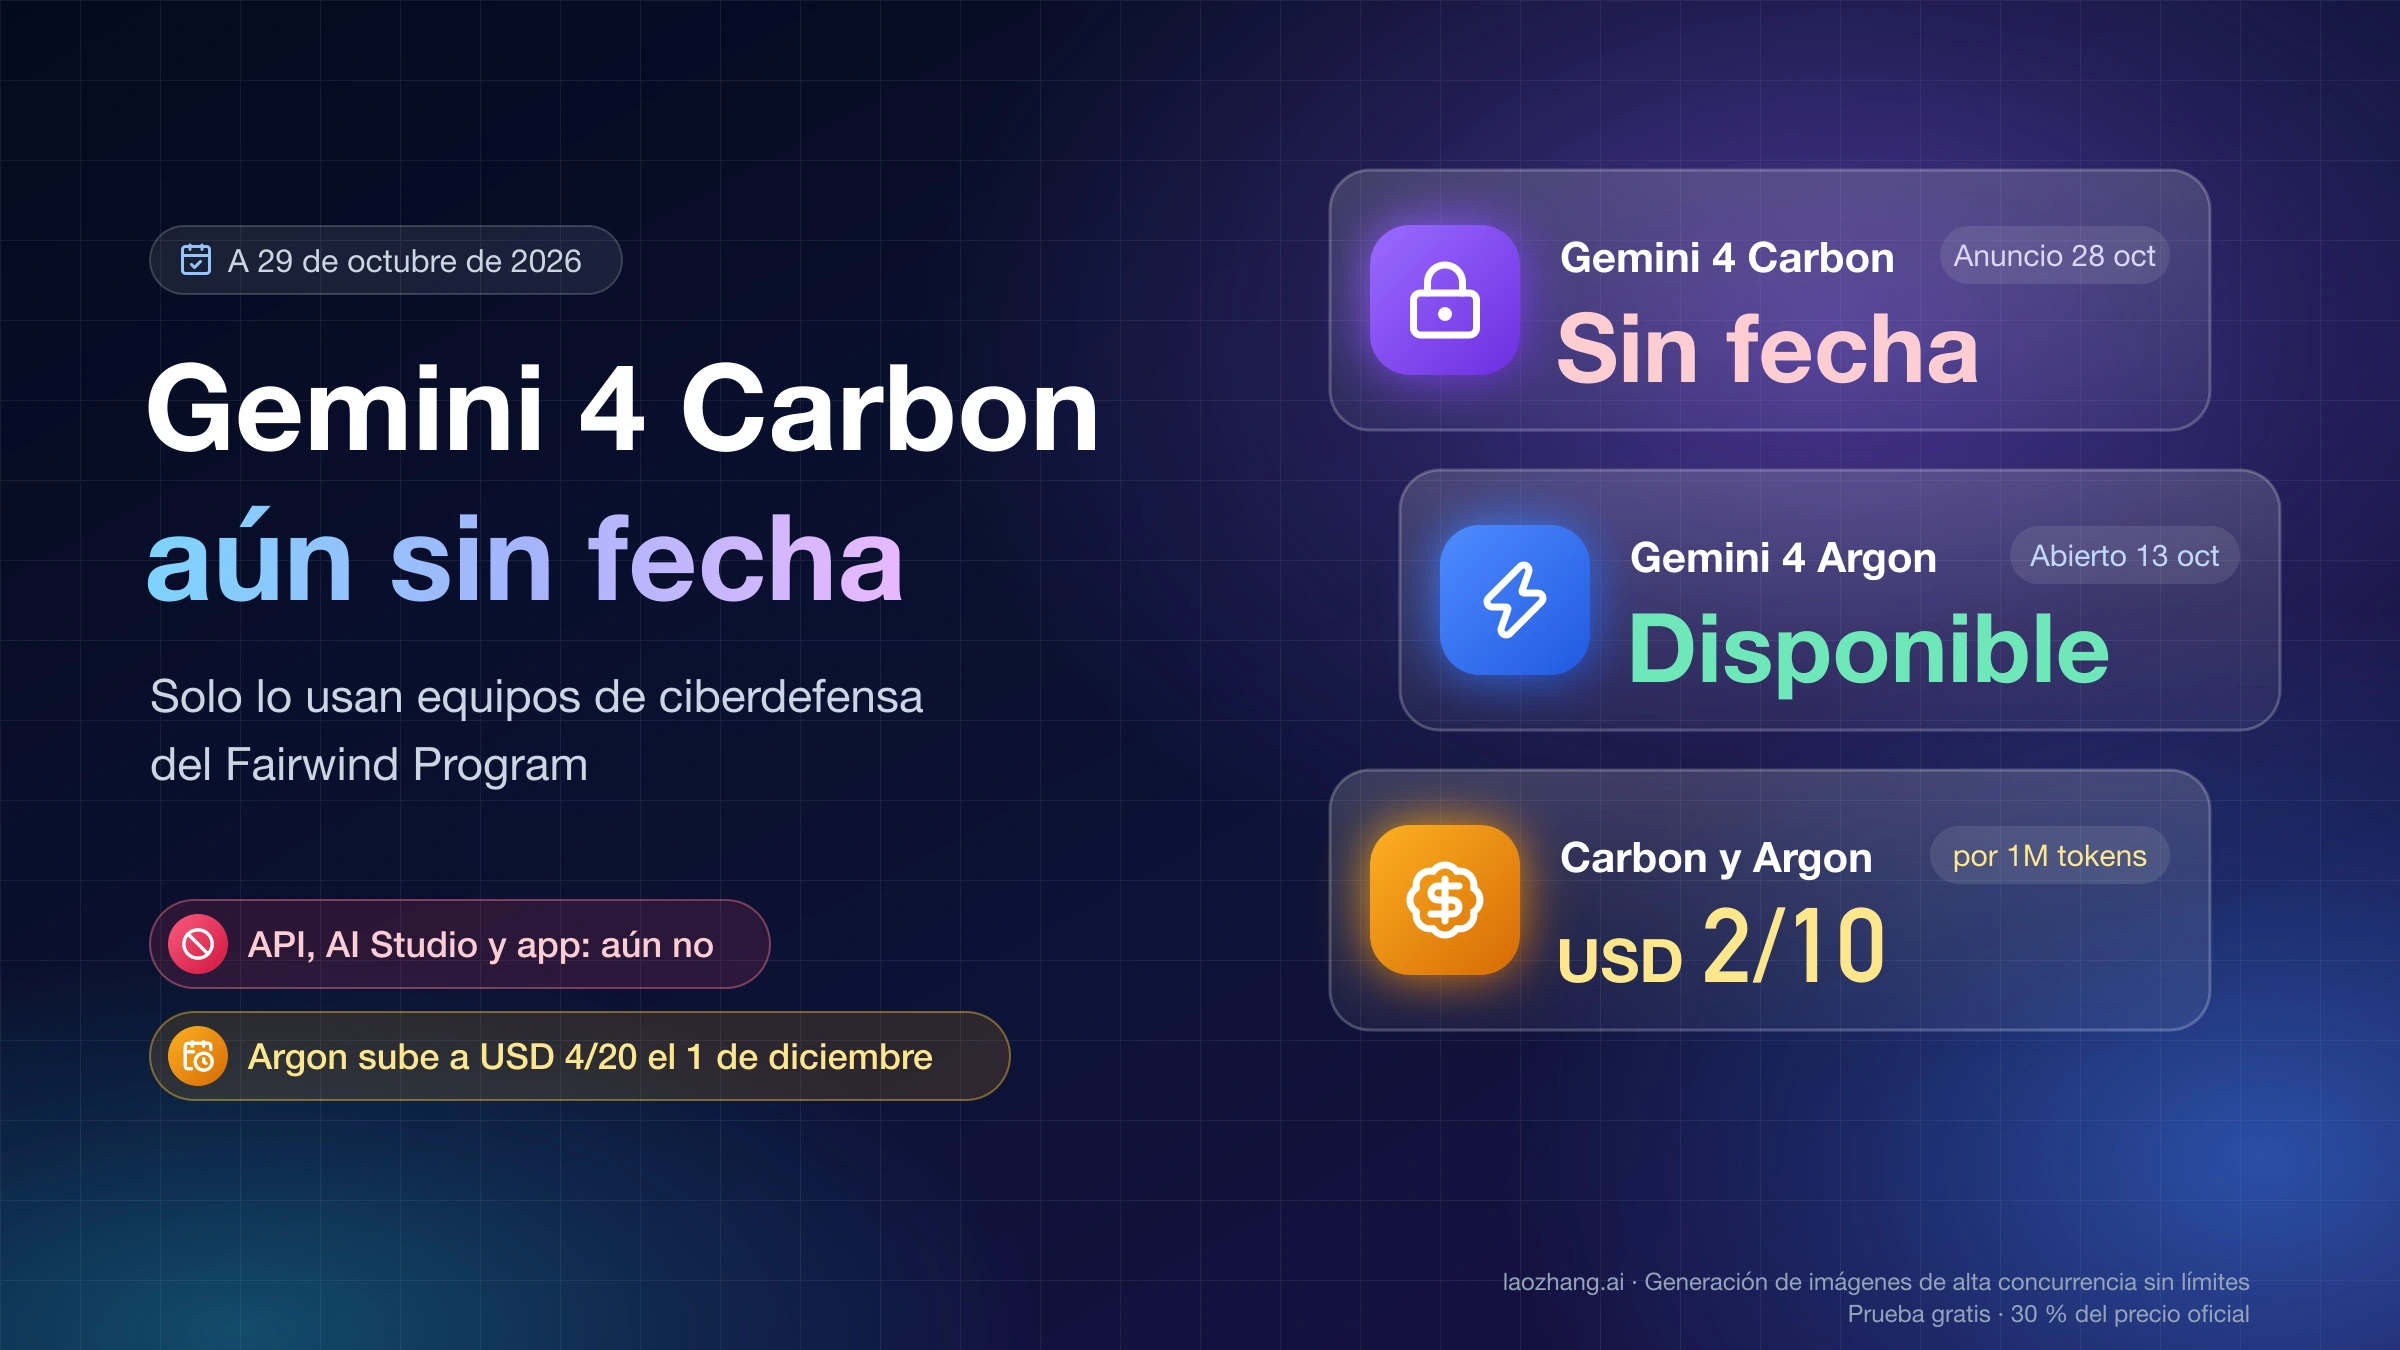
Gemini 4 Carbon es mejor que Gemini 4 Argon, pero no en todo ni por igual. En el Intelligence Index v5.0 de Artificial Analysis (AA) saca 59,4 puntos frente a 50,4, y la ventaja se concentra en agentes de código y en razonamiento científico; en automatización de flujos SaaS los dos empatan. Además, a 30 de octubre de 2026 solo Argon se puede llamar: Google ha dado Carbon primero a un grupo de defensores de ciberseguridad y no ha publicado ni fecha ni ID de modelo para el resto (quién puede usarlo y cuándo podría abrir está en Gemini 4 Carbon: sin fecha de acceso aún. ¿Esperar o usar Argon?).
Así que sigue publicando con gemini-4-argon, deja el nombre del modelo en un único valor de configuración y presupuesta ya el 1 de diciembre de 2026, cuando Argon pasa de 2 $ y 10 $ a 4 $ y 20 $ por millón de tokens de entrada y de salida. Por token, Carbon cuesta lo mismo que Argon dentro del mismo periodo de precios; la diferencia aparece si, cuando Carbon abra, Argon ya cobra el precio estándar y Carbon todavía el de lanzamiento. Y «Carbon es más lento» depende de lo que midas: en las mediciones de AA del 30 de octubre, Carbon tarda unos 98 s en dar el primer token frente a 47 s de Argon, pero en una tarea completa de agente de código termina antes.
La excepción son las preguntas factuales. En la prueba de conocimiento de AA, Carbon acierta más, pero también contesta mal más a menudo cuando no sabe la respuesta (11,4 % frente a 4,3 %), así que si tu producto responde datos a usuarios, mídelo con tus propias preguntas antes de cambiar.
¿Dónde gana Carbon a Argon? Las nueve pruebas de AA por tipo de trabajo
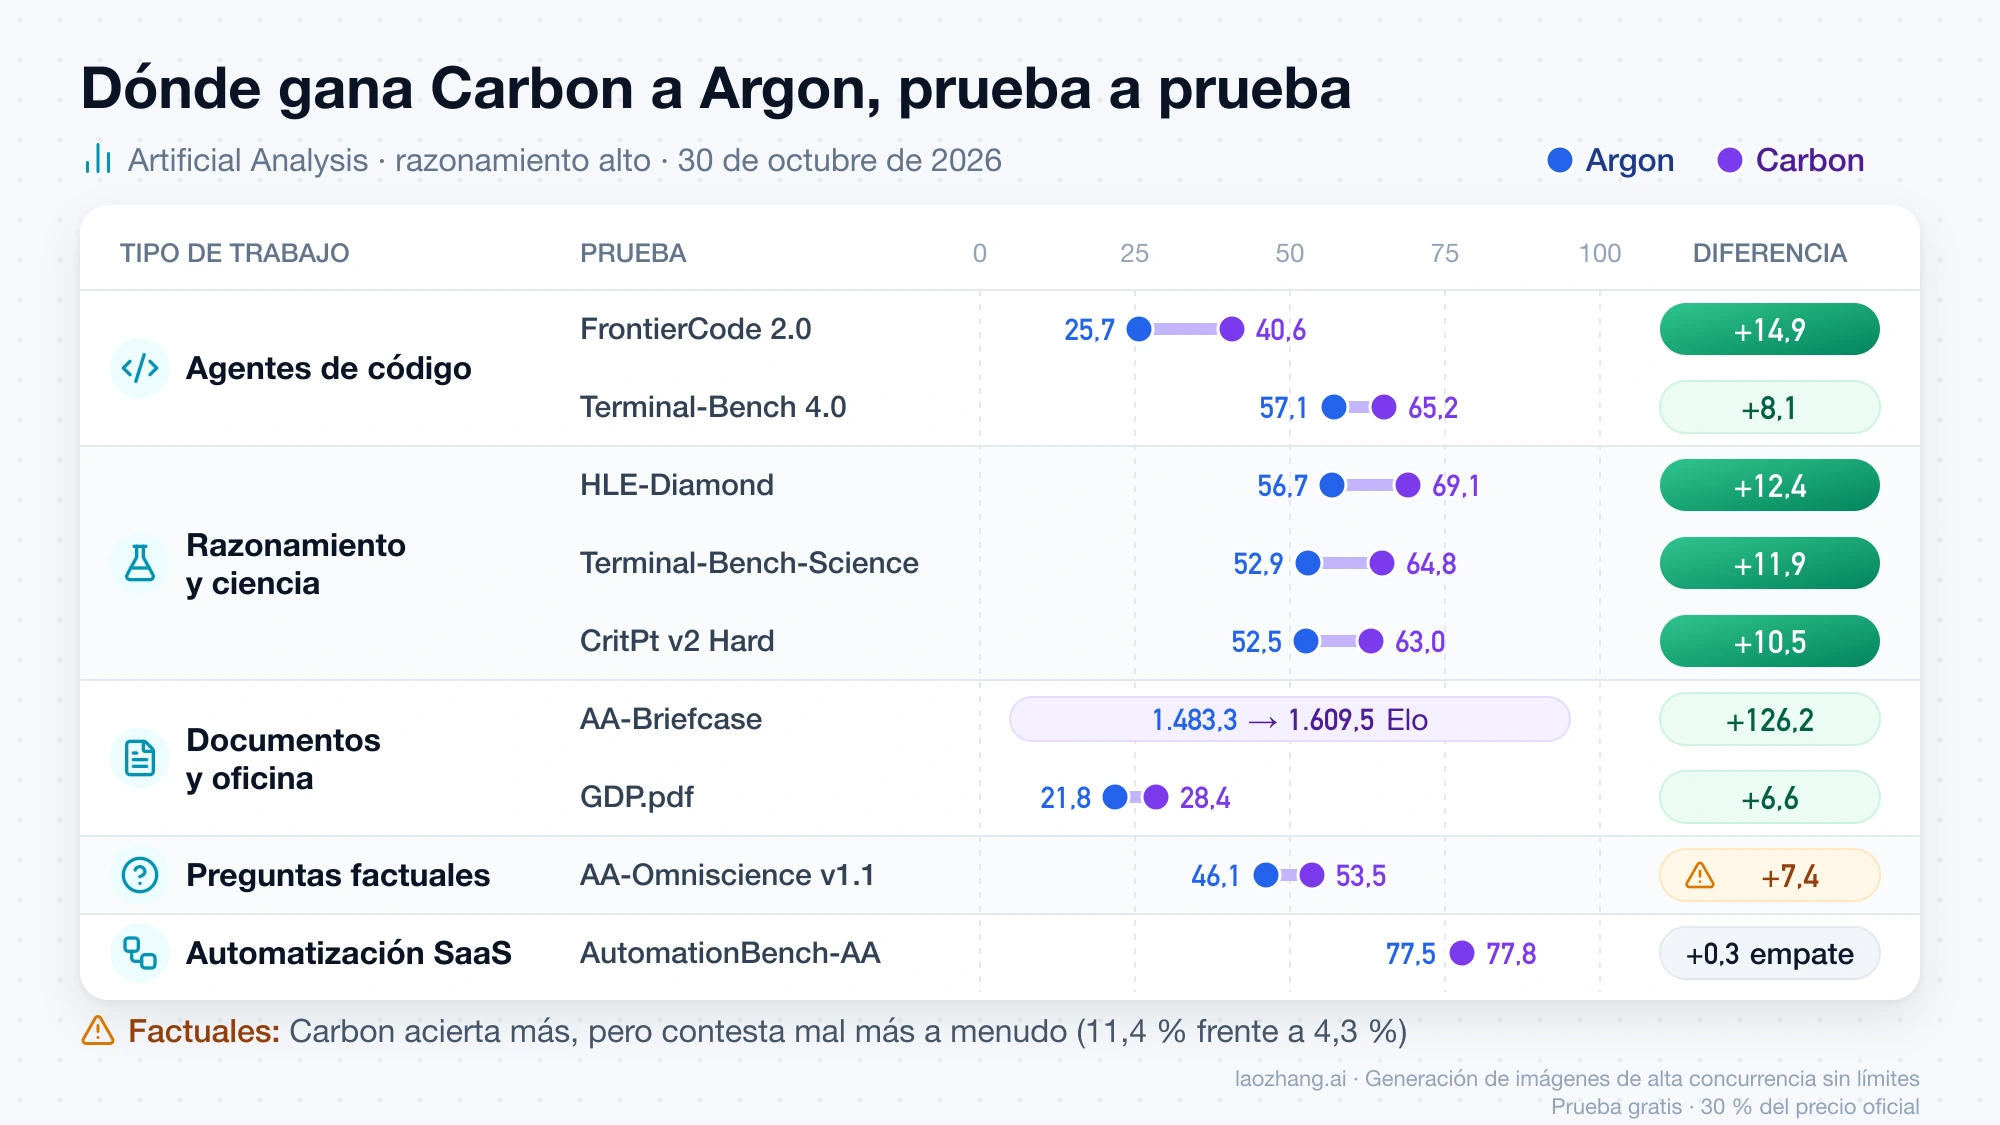
Carbon mejora en las nueve evaluaciones del índice de AA, pero la mejora va de casi 15 puntos en programación con agentes a 0,3 puntos en automatización SaaS, que en la práctica es un empate. Los datos son del comparador de Gemini 4 Argon y Gemini 4 Carbon de Artificial Analysis a 30 de octubre de 2026, con los dos modelos en razonamiento alto (High), el único nivel que AA ha medido; Carbon se midió con acceso previo al lanzamiento.
| Tipo de trabajo | Evaluación de AA y qué mide | Argon | Carbon | Diferencia |
|---|---|---|---|---|
| Agentes de código | FrontierCode 2.0: cambios hechos por un agente en repositorios reales de código abierto | 25,7 % | 40,6 % | +14,9 |
| Agentes de código | Terminal-Bench 4.0: tareas de programación y administración en una terminal | 57,1 % | 65,2 % | +8,1 |
| Razonamiento y ciencia | HLE-Diamond: preguntas de nivel experto de Humanity's Last Exam | 56,7 % | 69,1 % | +12,4 |
| Razonamiento y ciencia | Terminal-Bench-Science: tareas científicas resueltas en una terminal | 52,9 % | 64,8 % | +11,9 |
| Razonamiento y ciencia | CritPt v2 Hard: problemas de investigación en física | 52,5 % | 63,0 % | +10,5 |
| Documentos y trabajo de oficina | AA-Briefcase: trabajo de conocimiento con agente, en puntos Elo | 1.483,3 | 1.609,5 | +126,2 |
| Documentos y trabajo de oficina | GDP.pdf: documentos profesionales que tienen que pasar todas las comprobaciones | 21,8 % | 28,4 % | +6,6 |
| Preguntas factuales | AA-Omniscience v1.1: conocimiento; suma por acierto y resta por error | 46,1 | 53,5 | +7,4 |
| Automatización SaaS | AutomationBench-AA: flujos con agente entre aplicaciones SaaS | 77,5 % | 77,8 % | +0,3 |
Los índices por área profesional que AA calcula con estas pruebas cuentan lo mismo: finanzas pasa de 55,9 a 62,6, legal de 54,6 a 62,0, ingeniería de 57,3 a 64,7 y economía de 54,0 a 61,0, mientras que estrategia y operaciones solo sube de 57,2 a 60,9. En salud AA no publica dato de Carbon. Si tu trabajo es automatización SaaS o estrategia y operaciones, la etiqueta «supera a Argon en todo» es cierta, pero la diferencia no cambia ninguna decisión.
Lo que mide Google en su propia tabla: ciberseguridad y seguridad del modelo
La tabla del anuncio de Gemini 4 Carbon en el blog de Google, del 28 de octubre de 2026, la ha medido el propio fabricante, y las pruebas de ciberseguridad se ejecutaron con el máximo nivel de razonamiento y sin las salvaguardas del producto. Sirve sobre todo a equipos de seguridad, que son además los primeros en recibir Carbon. Terminal-Bench 4.0 aparece con el mismo 65,2 % frente a 57,1 % que en la prueba de modelo de AA; en la prueba de AA con agente (Antigravity CLI), Carbon saca 63,6 % frente a 56,1 %.
| Prueba en la tabla de Google | Qué mide | Argon | Carbon |
|---|---|---|---|
| SEC-bench Pro | encontrar vulnerabilidades reales en software | 83,4 % | 88,2 % |
| ExploitGym | comprobar si una vulnerabilidad se puede explotar | 42,0 % | 54,8 % |
| CWE-bench | corregir la causa de una vulnerabilidad con un parche | 68,0 % | 71,0 % |
| Gray Swan IPI | ataques con instrucciones inyectadas en contenido externo; menos es mejor | 0,7 % | 0,0 % |
| GraphWalks | seguir relaciones dentro de un contexto largo | 84,2 % | 96,2 % |
| OSWorld-2.1 (sin conexión) | manejar un ordenador con aplicaciones de escritorio | 74,7 % | 81,5 % |
| Vals Index v2.2 | índice de tareas profesionales de Vals AI | 69,2 % | 70,4 % |
Las subidas más pequeñas de la lista de Google son Vals Index (+1,2) y CWE-bench (+3,0). Google también afirma, con pruebas internas sin método publicado, que Carbon más que duplica la tasa de éxito de Argon al generar código seguro y que las alertas graves de desalineación en sus equipos bajaron casi un 80 %.
¿Cuál usar según tu trabajo? Dónde compensa preparar el cambio
Prepara el cambio a Carbon si tu carga principal son agentes de código o razonamiento científico, y quédate con Argon sin prisa si automatizas flujos SaaS o necesitas respuestas rápidas. Entre medias quedan los documentos, donde merece una prueba, y las preguntas factuales, donde la prueba es obligatoria.
Los agentes de código son el caso más claro. Además de los 14,9 puntos de FrontierCode, en el Coding Agent Index de AA con Antigravity CLI Carbon saca 59,4 frente a 53,2, y cada tarea le sale más barata y más corta que a Argon (los números están en las dos secciones siguientes). En razonamiento y ciencia la subida es de 10 a 12 puntos en las tres pruebas, así que si un análisis o un cálculo erróneo te cuesta más que esperar un minuto extra, Carbon es la opción cuando abra.
En documentos y trabajo de oficina la ganancia es real pero menor: 126 puntos Elo en AA-Briefcase y GDP.pdf de 21,8 % a 28,4 %, que sigue significando que más de siete de cada diez documentos profesionales no pasan todas las comprobaciones con ninguno de los dos. Compara con tus propios entregables antes de decidir. En automatización SaaS, el 77,8 % frente a 77,5 % de AutomationBench no justifica ni el trabajo de migrar ni la espera más larga.
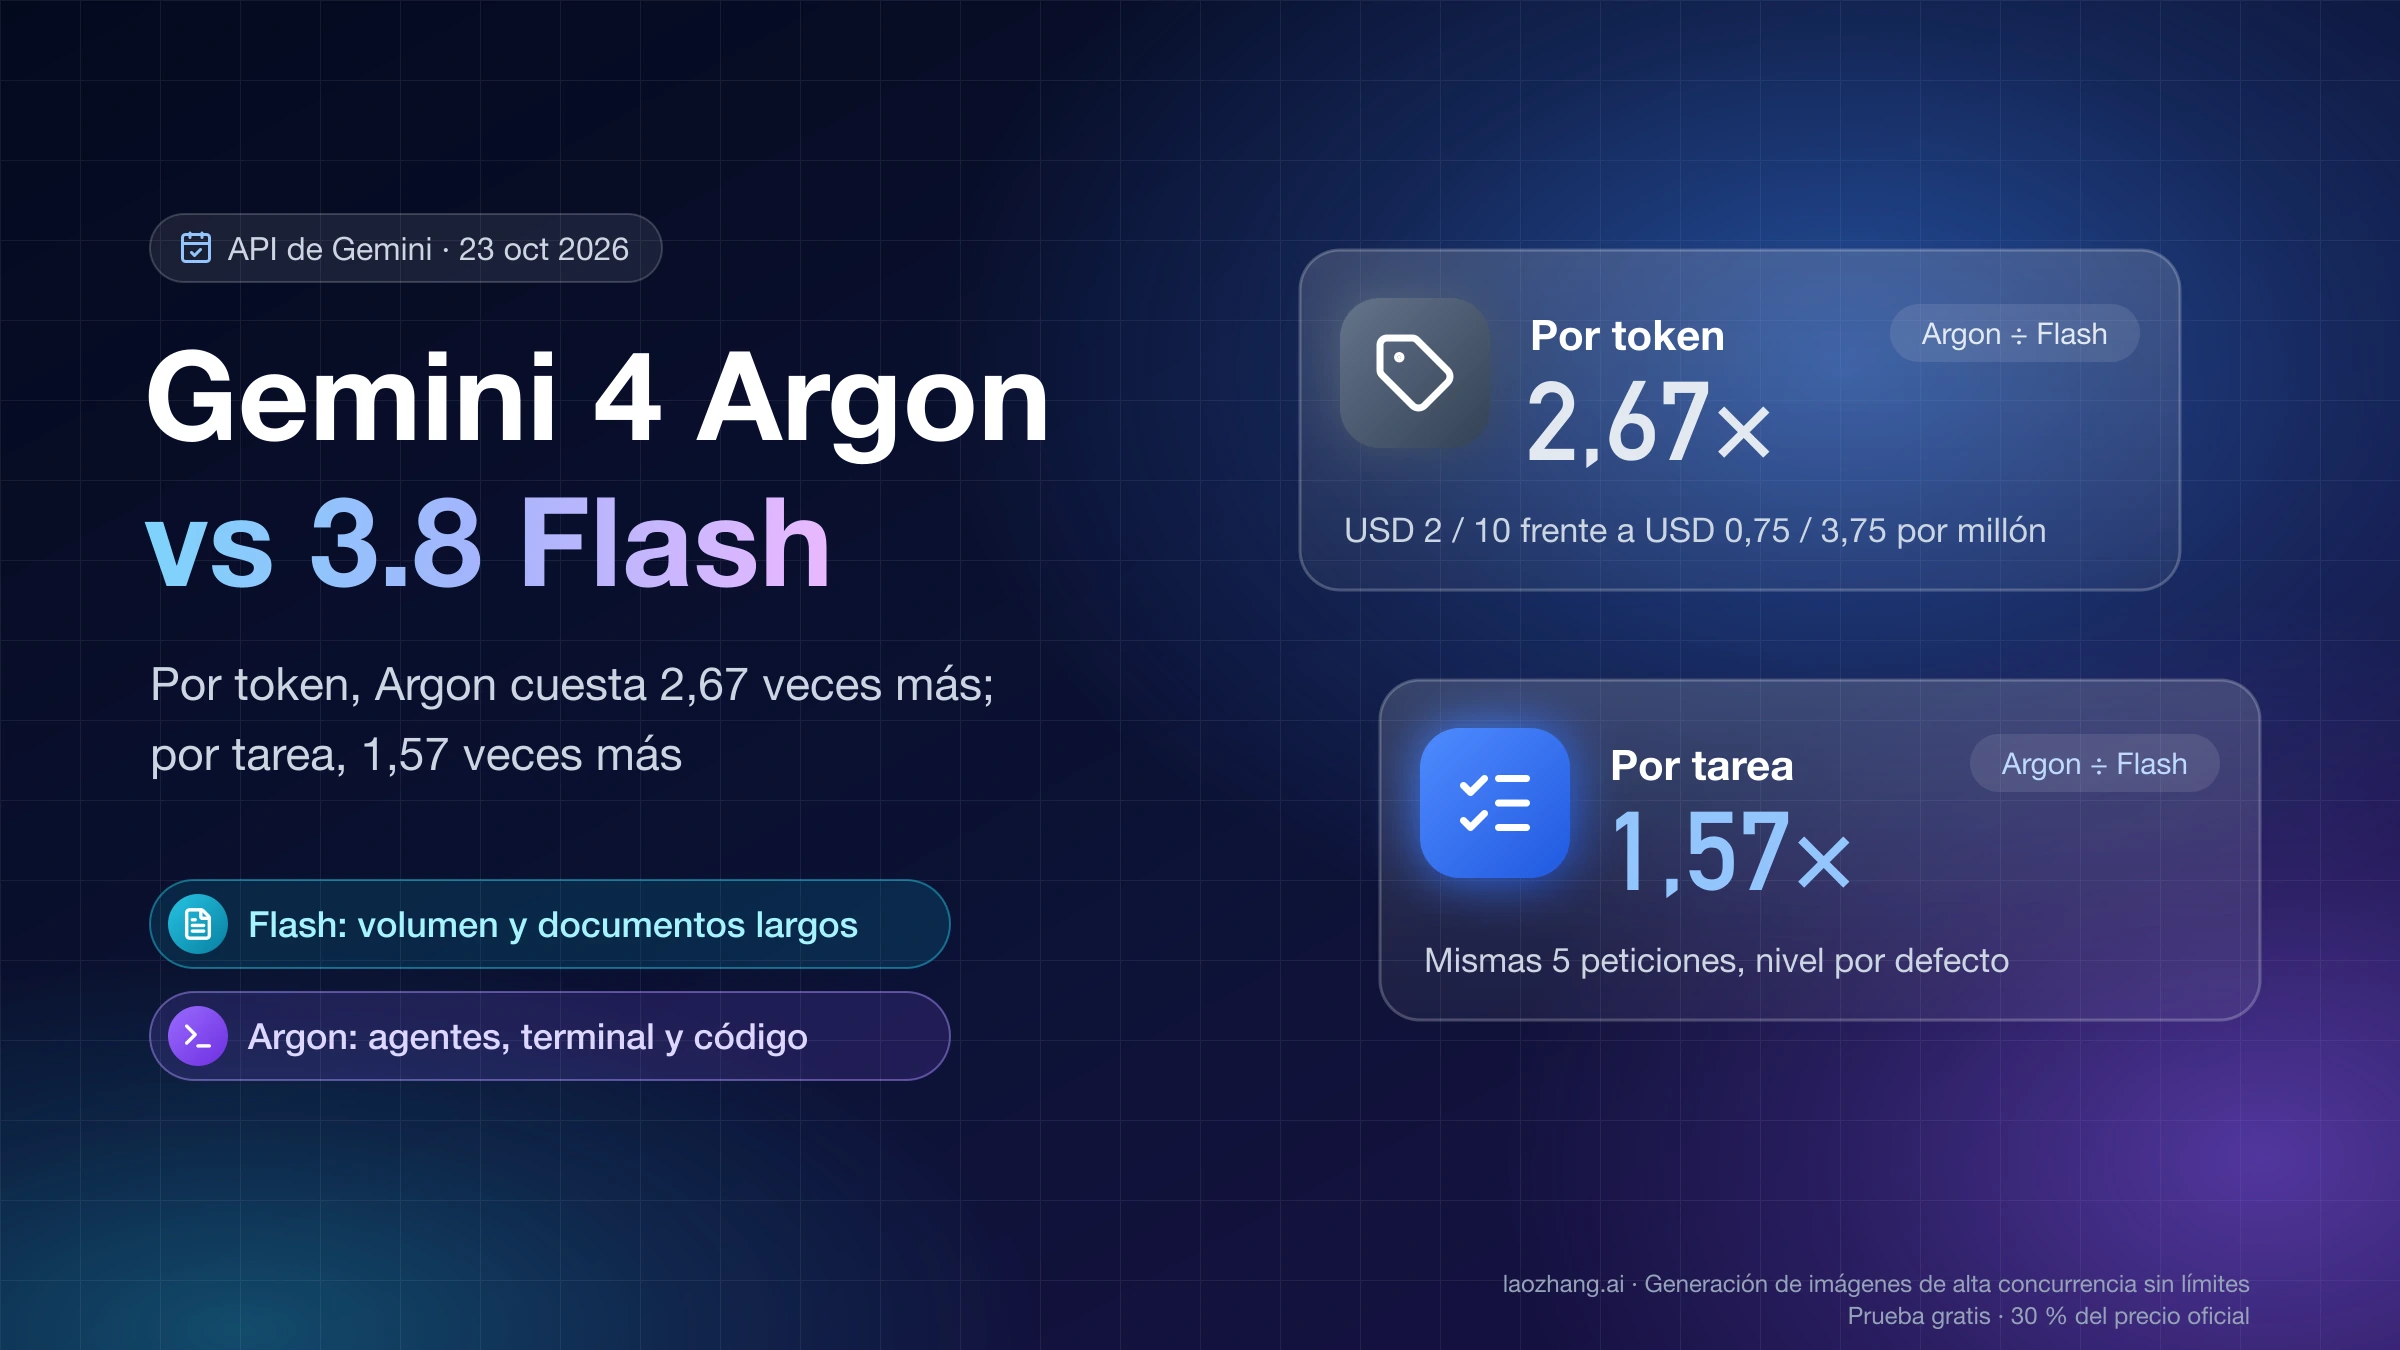
Para funciones interactivas, Argon sigue siendo la opción entre los dos, porque Carbon dobla el tiempo hasta el primer token. Si incluso los 47 s de Argon en razonamiento alto son demasiados para tu interfaz, el problema ya no es Carbon frente a Argon: Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar compara la alternativa más rápida.
¿Carbon es más caro? Coste por tarea antes y después del 1 de diciembre
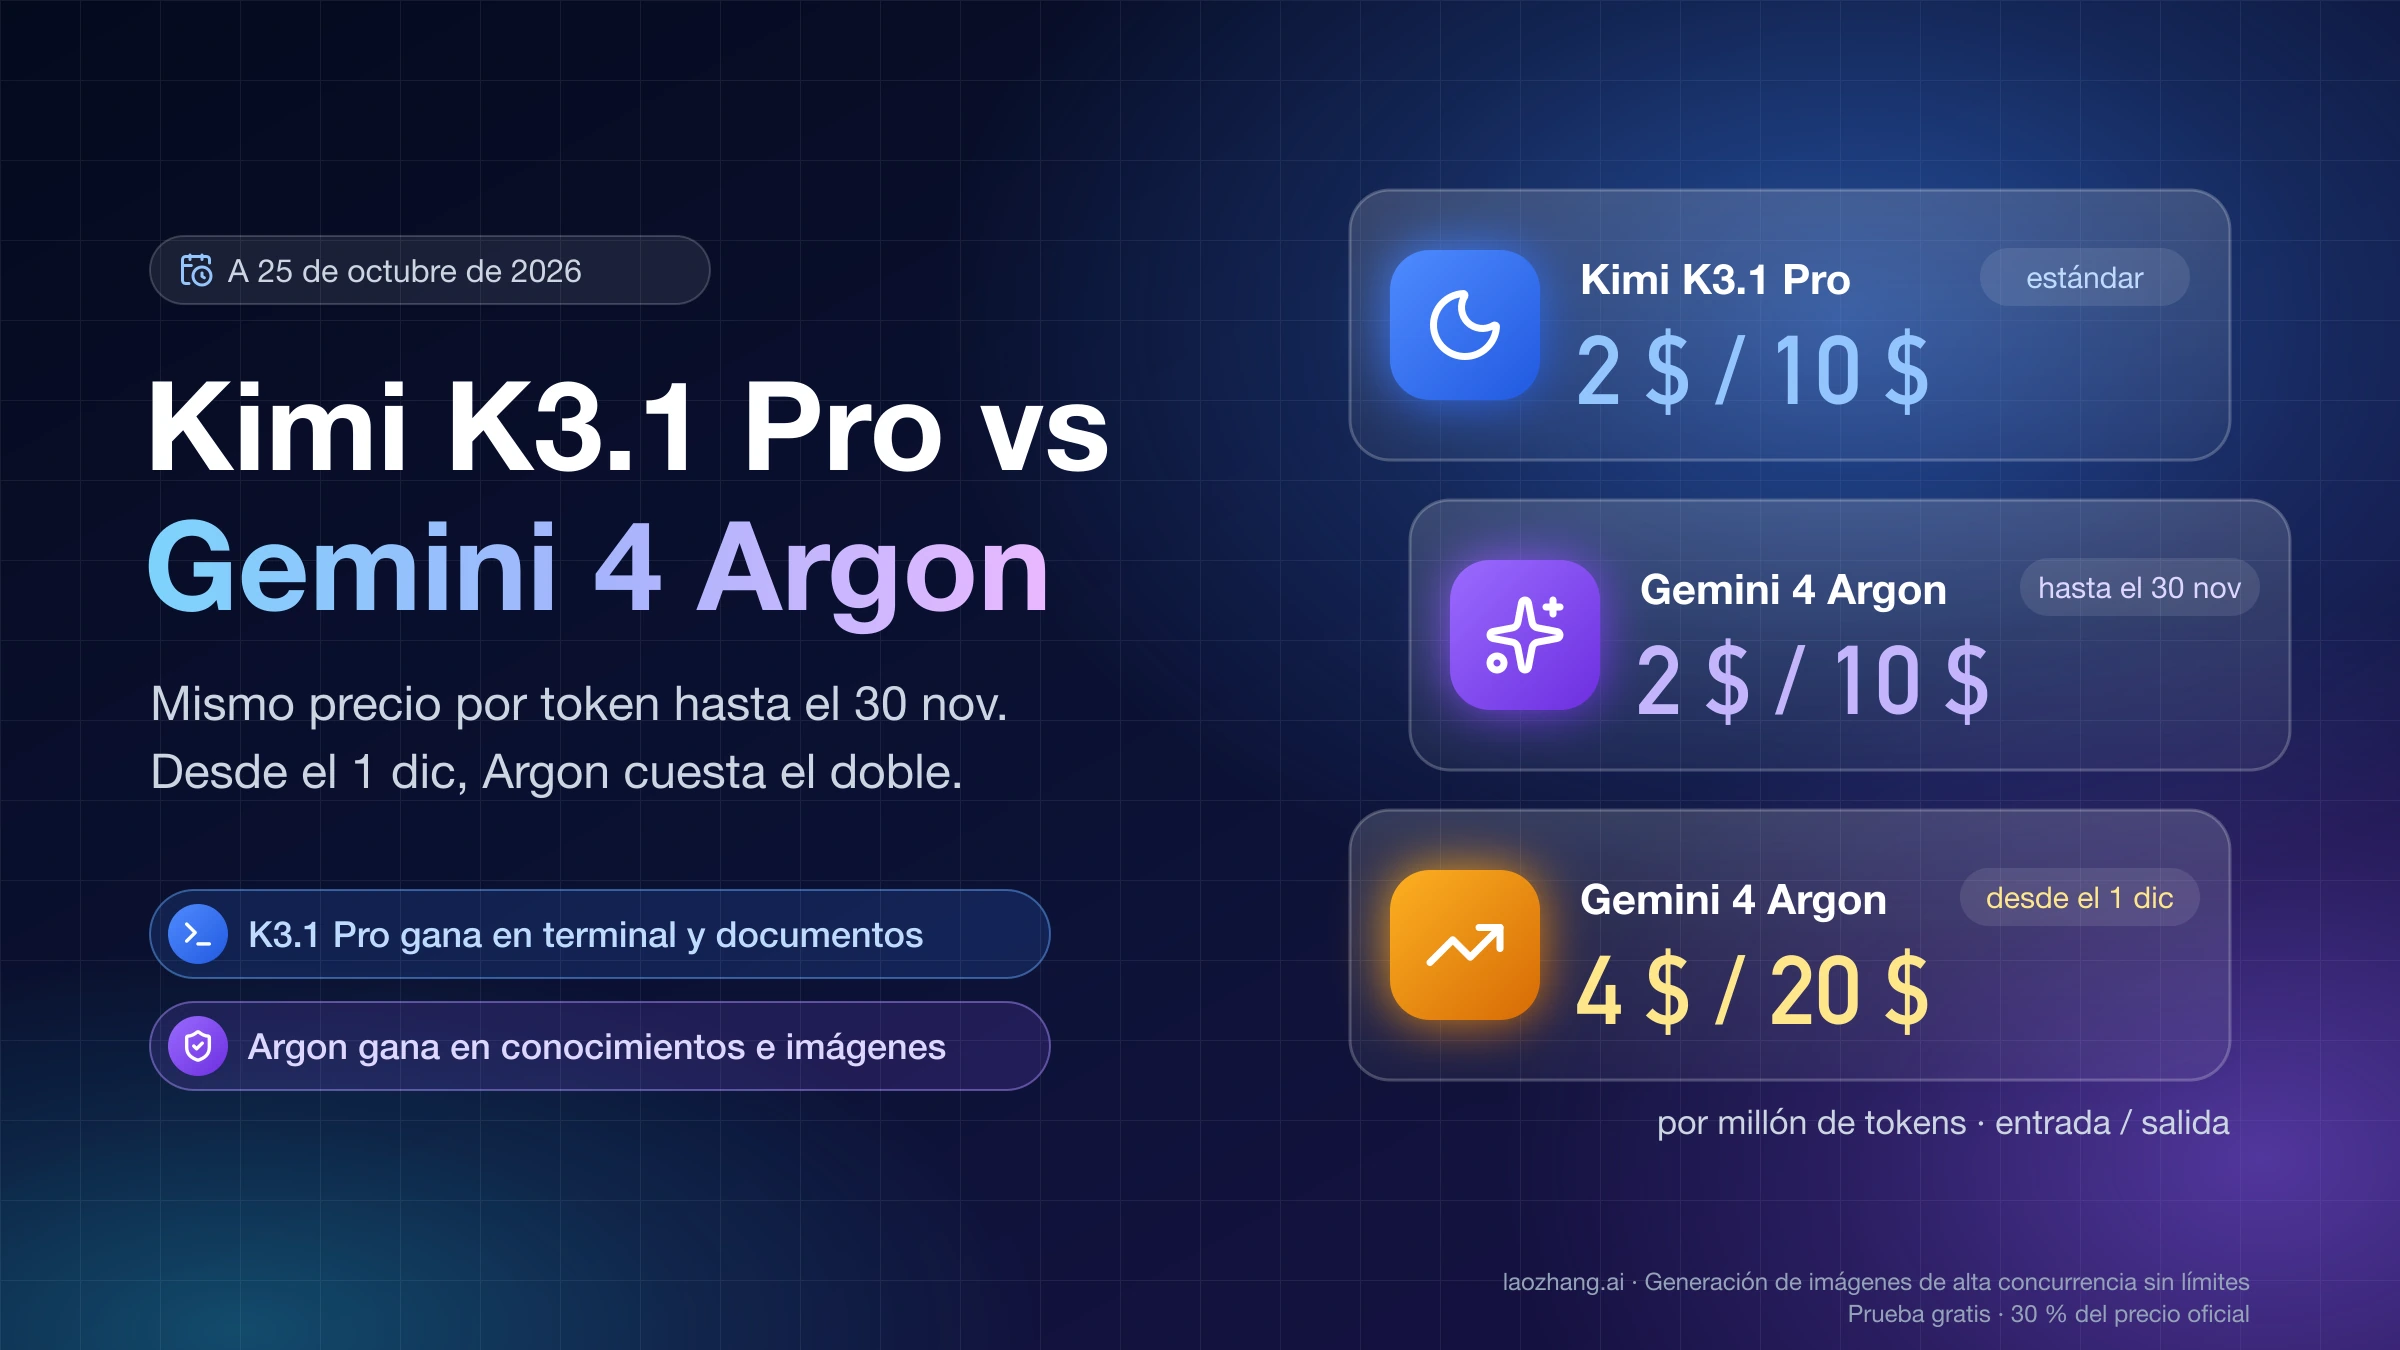
A precio estándar, Carbon y Argon cuestan casi lo mismo por tarea del índice de AA (7,76 $ frente a 7,68 $), y en tareas de agente de código Carbon sale más barato (7,74 $ frente a 11,73 $). La diferencia grande depende del calendario: Argon cobra su precio de lanzamiento de 2 $ y 10 $ por millón de tokens hasta el 30 de noviembre de 2026 y el precio estándar de 4 $ y 20 $ desde el 1 de diciembre, según la página de precios de la API de Gemini; Carbon saldrá con el mismo precio de lanzamiento, pero Google no ha publicado cuándo termina.
| Periodo de precios | Tarea del índice AA, Argon | Tarea del índice AA, Carbon | Tarea de agente de código, Argon | Tarea de agente de código, Carbon |
|---|---|---|---|---|
| Hoy, hasta el 30 de noviembre de 2026 | 3,84 $ | no se puede llamar | 5,87 $ | no se puede llamar |
| Los dos a precio de lanzamiento | 3,84 $ | 3,88 $ | 5,87 $ | 3,87 $ |
| Los dos a precio estándar | 7,68 $ | 7,76 $ | 11,73 $ | 7,74 $ |
| Desde el 1 de diciembre, si Carbon abre aún con precio de lanzamiento | 7,68 $ | 3,88 $ | 11,73 $ | 3,87 $ |
Las cifras de la tarea del índice se han recalculado a partir del desglose de costes que publica AA a precio estándar, que permite reconstruir los tokens de cada tarea. Argon usa de media 116.368 tokens de salida, lee unos 10,357 millones de tokens de la caché y paga unos 0,821 millones (820.963) de tokens de entrada a tarifa completa, así que a precio estándar sale (0,116 × 20) + (10,357 × 0,20) + (0,821 × 4), en millones de tokens por el precio por millón: 2,33 + 2,07 + 3,28 = 7,68 $, el mismo total que da AA. Carbon usa 122.768 de salida, unos 10,196 millones de caché y unos 0,815 millones (815.261) de entrada completa: 2,46 + 2,04 + 3,26 = 7,76 $. El precio de lanzamiento es exactamente la mitad en todos los conceptos, incluida la caché (0,10 $ frente a 0,20 $ por millón), y por eso cada cifra de esas filas es la mitad de la estándar. La parte que se escribe en la caché se cobra como entrada normal, porque Google no cobra aparte la caché implícita.
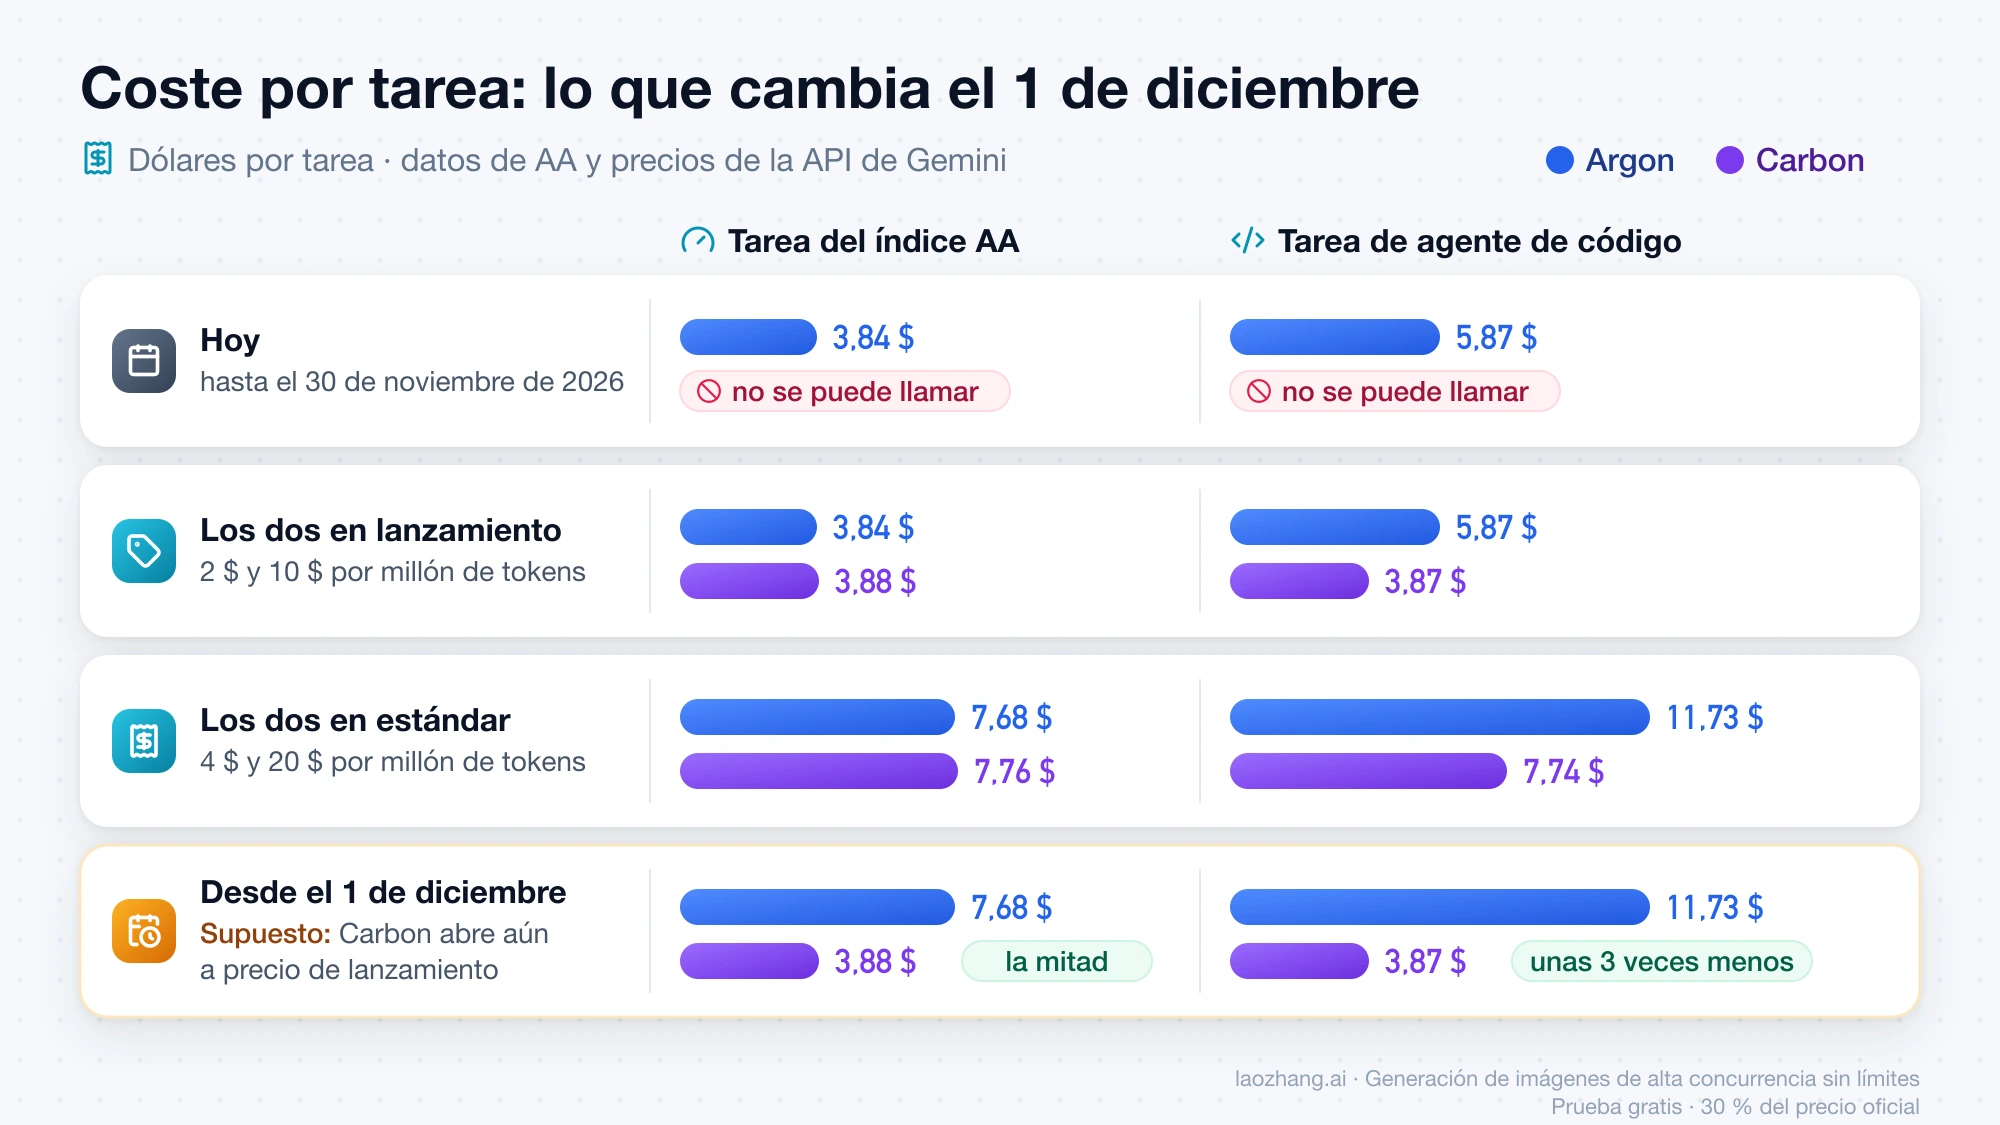
La última fila es un supuesto, no un precio anunciado: si Carbon abre al público antes de que termine su periodo de lanzamiento y ese periodo sigue vigente en diciembre, una tarea del índice costaría en Carbon la mitad que en Argon y una tarea de agente de código, unas tres veces menos. Las tareas de agente salen de la clasificación de agentes de programación de Artificial Analysis con Antigravity CLI, y ahí la ventaja de Carbon parece venir de la caché más que del precio: acierta en la caché el 95,2 % de las veces frente al 87,0 % y envía de media 12,44 millones de tokens de entrada frente a 13,76 millones. Es una inferencia a partir de esos datos, no algo que AA explique.
¿Carbon es más lento? Primer token, velocidad y tarea completa
Carbon tarda el doble en empezar a responder, genera tokens a la misma velocidad y, en la tarea completa de agente que mide AA, termina antes que Argon. Las tres respuestas son ciertas porque miden cosas distintas.
En el comparador de AA a 30 de octubre de 2026, el tiempo hasta el primer token es de 97,94 s en Carbon y 47,20 s en Argon, y una respuesta de 500 tokens con el razonamiento incluido tarda 103,82 s frente a 53,23 s. La velocidad de generación, en cambio, es casi igual: 85 tokens/s frente a 83. El 29 de octubre AA mostraba 99,8 tokens/s para Carbon, así que estas cifras se mueven de un día a otro y pueden cambiar cuando la API pública abra. El «tiempo por tarea» de AA (1.452,93 s frente a 1.364,94 s) solo cuenta el tiempo de generación y deja fuera el primer token, así que no es el tiempo que esperaría tu usuario.
En la tarea completa de agente de código, con Antigravity CLI, Carbon termina en 29,8 minutos frente a 34,7, aunque da más pasos (178 frente a 166), según los datos de AA del 29 de octubre. El «Carbon es entre 2 y 4 veces más lento» que circula viene de la comparativa de Gemini 4 Carbon y Argon de letslearngenai.com, del 28 de octubre, que recoge pruebas a ciegas en Arena con versiones previas al lanzamiento, y el propio texto aclara que no es un estudio de latencia estandarizado. Lo que mide AA respalda «el doble hasta el primer token», no «de 2 a 4 veces en todo».
¿Carbon alucina más? Qué mide el 11,4 % de AA y qué mide Google
Las dos afirmaciones que circulan son ciertas a la vez. En AA-Omniscience v1.1, Carbon pasa de un 48,3 % a un 58,3 % de aciertos, pero su tasa de alucinación sube del 4,3 % al 11,4 %; Google, por su parte, dice que Carbon reduce aproximadamente a la mitad las afirmaciones sin respaldo frente a Argon. No se contradicen porque no miden lo mismo.
AA plantea preguntas de conocimiento, suma por cada acierto, resta por cada error y no penaliza decir «no lo sé»; su tasa de alucinación refleja con qué frecuencia el modelo contesta mal en lugar de abstenerse cuando no sabe. Carbon se arriesga a contestar más a menudo, así que acierta más y también falla más. Aun así, según el análisis de Gemini 4 Carbon de Artificial Analysis, su 11,4 % es la segunda tasa más baja de todos los modelos medidos, solo por detrás de Argon, mientras que Claude Opus 5.5 y GPT-6 Astra en su nivel máximo rondan el 50 %. Google mide otra cosa en pruebas internas sin método publicado: si en un entregable (un informe, un parche) el modelo afirma algo sin pruebas o, en cambio, añade la advertencia o deja la acción pendiente con lo que falta.
Si tu producto responde preguntas de datos a usuarios finales, el cambio de comportamiento te afecta directamente. Antes de pasar a Carbon, prepara un conjunto de preguntas propias que incluya algunas sin respuesta conocida, deja que el modelo pueda decir que no lo sabe y cuenta por separado aciertos, errores y abstenciones con cada modelo. Si los errores suben más de lo que tu producto tolera, quédate con Argon para esa función aunque cambies el resto.
Prueba del 30 de octubre: gemini-4-carbon devuelve HTTP 503
El 30 de octubre de 2026 a las 00:12 UTC, con una clave de pago por uso de api.laozhang.ai, la lista de modelos (GET /v1/models) devolvió 192 modelos y el único Gemini 4 era gemini-4-argon. Las peticiones a gemini-4-carbon y gemini-4-carbon-preview por la ruta compatible con Chat Completions, y a gemini-4-carbon:generateContent por la ruta nativa de Gemini, devolvieron HTTP 503 con el mensaje «no available channels» en unos 1,1 s, sin cargo. El 29 de octubre a las 01:36 y a las 03:00 UTC el resultado fue el mismo.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Esto demuestra que hoy no se puede enrutar Carbon por esa pasarela con los ID probados. La prueba no incluye la API de Google con una clave propia de Google, pero a la misma fecha la página de modelos de la API de Gemini tampoco incluye ningún ID de Carbon. Mientras no aparezca ahí, un 503 o un error de modelo inexistente con gemini-4-carbon no significa que tu código falle.
Qué preparar hoy para pasar de Argon a Carbon sin reescribir nada
Lo que puedes hacer hoy no depende de cuándo abra Carbon, y el orden importa porque las primeras tareas te dan la referencia con la que medirás después.
- Saca
gemini-4-argondel código y déjalo en un único valor de configuración o variable de entorno, para que el cambio a Carbon, o la vuelta atrás, sea editar una línea. - Revisa los tiempos de espera del cliente, del proxy y de la interfaz con el razonamiento alto: Carbon necesita más de minuto y medio antes del primer token, así que un límite de 60 s sin recibir datos cortaría su respuesta antes de que empiece.
- Rehaz el presupuesto desde el 1 de diciembre de 2026 con el precio estándar de Argon y valora mover a Batch o Flex, que cuestan la mitad, los trabajos que no necesitan respuesta inmediata.
- Monta ahora con Argon un conjunto de pruebas por tipo de trabajo con criterios de aceptación claros, y guarda sus resultados, sus tiempos y su coste por tarea aceptada como referencia.
- El primer día de Carbon, confirma en las páginas de modelos y de precios de la API de Gemini el ID del modelo, el precio y la fecha de fin del precio de lanzamiento, y repite esas pruebas midiendo primer token, tiempo total, aciertos de caché y, en preguntas factuales, errores frente a abstenciones.
Si al pasar a respuestas largas te encuentras salidas cortadas, Gemini 4 Argon API: acceso, finish_reason y respuestas cortadas explica cómo leer el motivo de parada; conviene tenerlo resuelto en Argon antes de comparar.
Gemini 4 Carbon y Argon: otras preguntas
¿Gemini 4 Carbon sustituye a Argon?
A 30 de octubre de 2026, Google no ha dicho que vaya a retirar ni sustituir Gemini 4 Argon. Presenta Carbon como un modelo construido sobre Argon, lanzado dos semanas después, y Argon sigue en su página de precios con tarifa fijada hasta el 30 de noviembre y desde el 1 de diciembre.
¿Qué hace falta para entrar en el programa Fairwind?
Fairwind es el programa por el que Google irá dando acceso a Carbon a más socios de confianza después del primer grupo de defensores de ciberseguridad, antes de abrirlo a desarrolladores, empresas y consumidores. Los requisitos y cómo prepararse están en Gemini 3.8 Flash Cyber y Fairwind: requisitos de acceso y preparación.
¿Tiene Carbon más contexto o acepta audio y vídeo?
Google no ha publicado especificaciones de Carbon a 30 de octubre de 2026. Para Argon, la página de modelos de la API de Gemini indica una ventana de contexto unificada de 1 millón de tokens. AA muestra 1 millón para los dos en su ficha, pero eso no es una especificación de Google, y tampoco hay una lista oficial de modalidades de entrada de Carbon.
¿Carbon o Claude Opus 5.5?
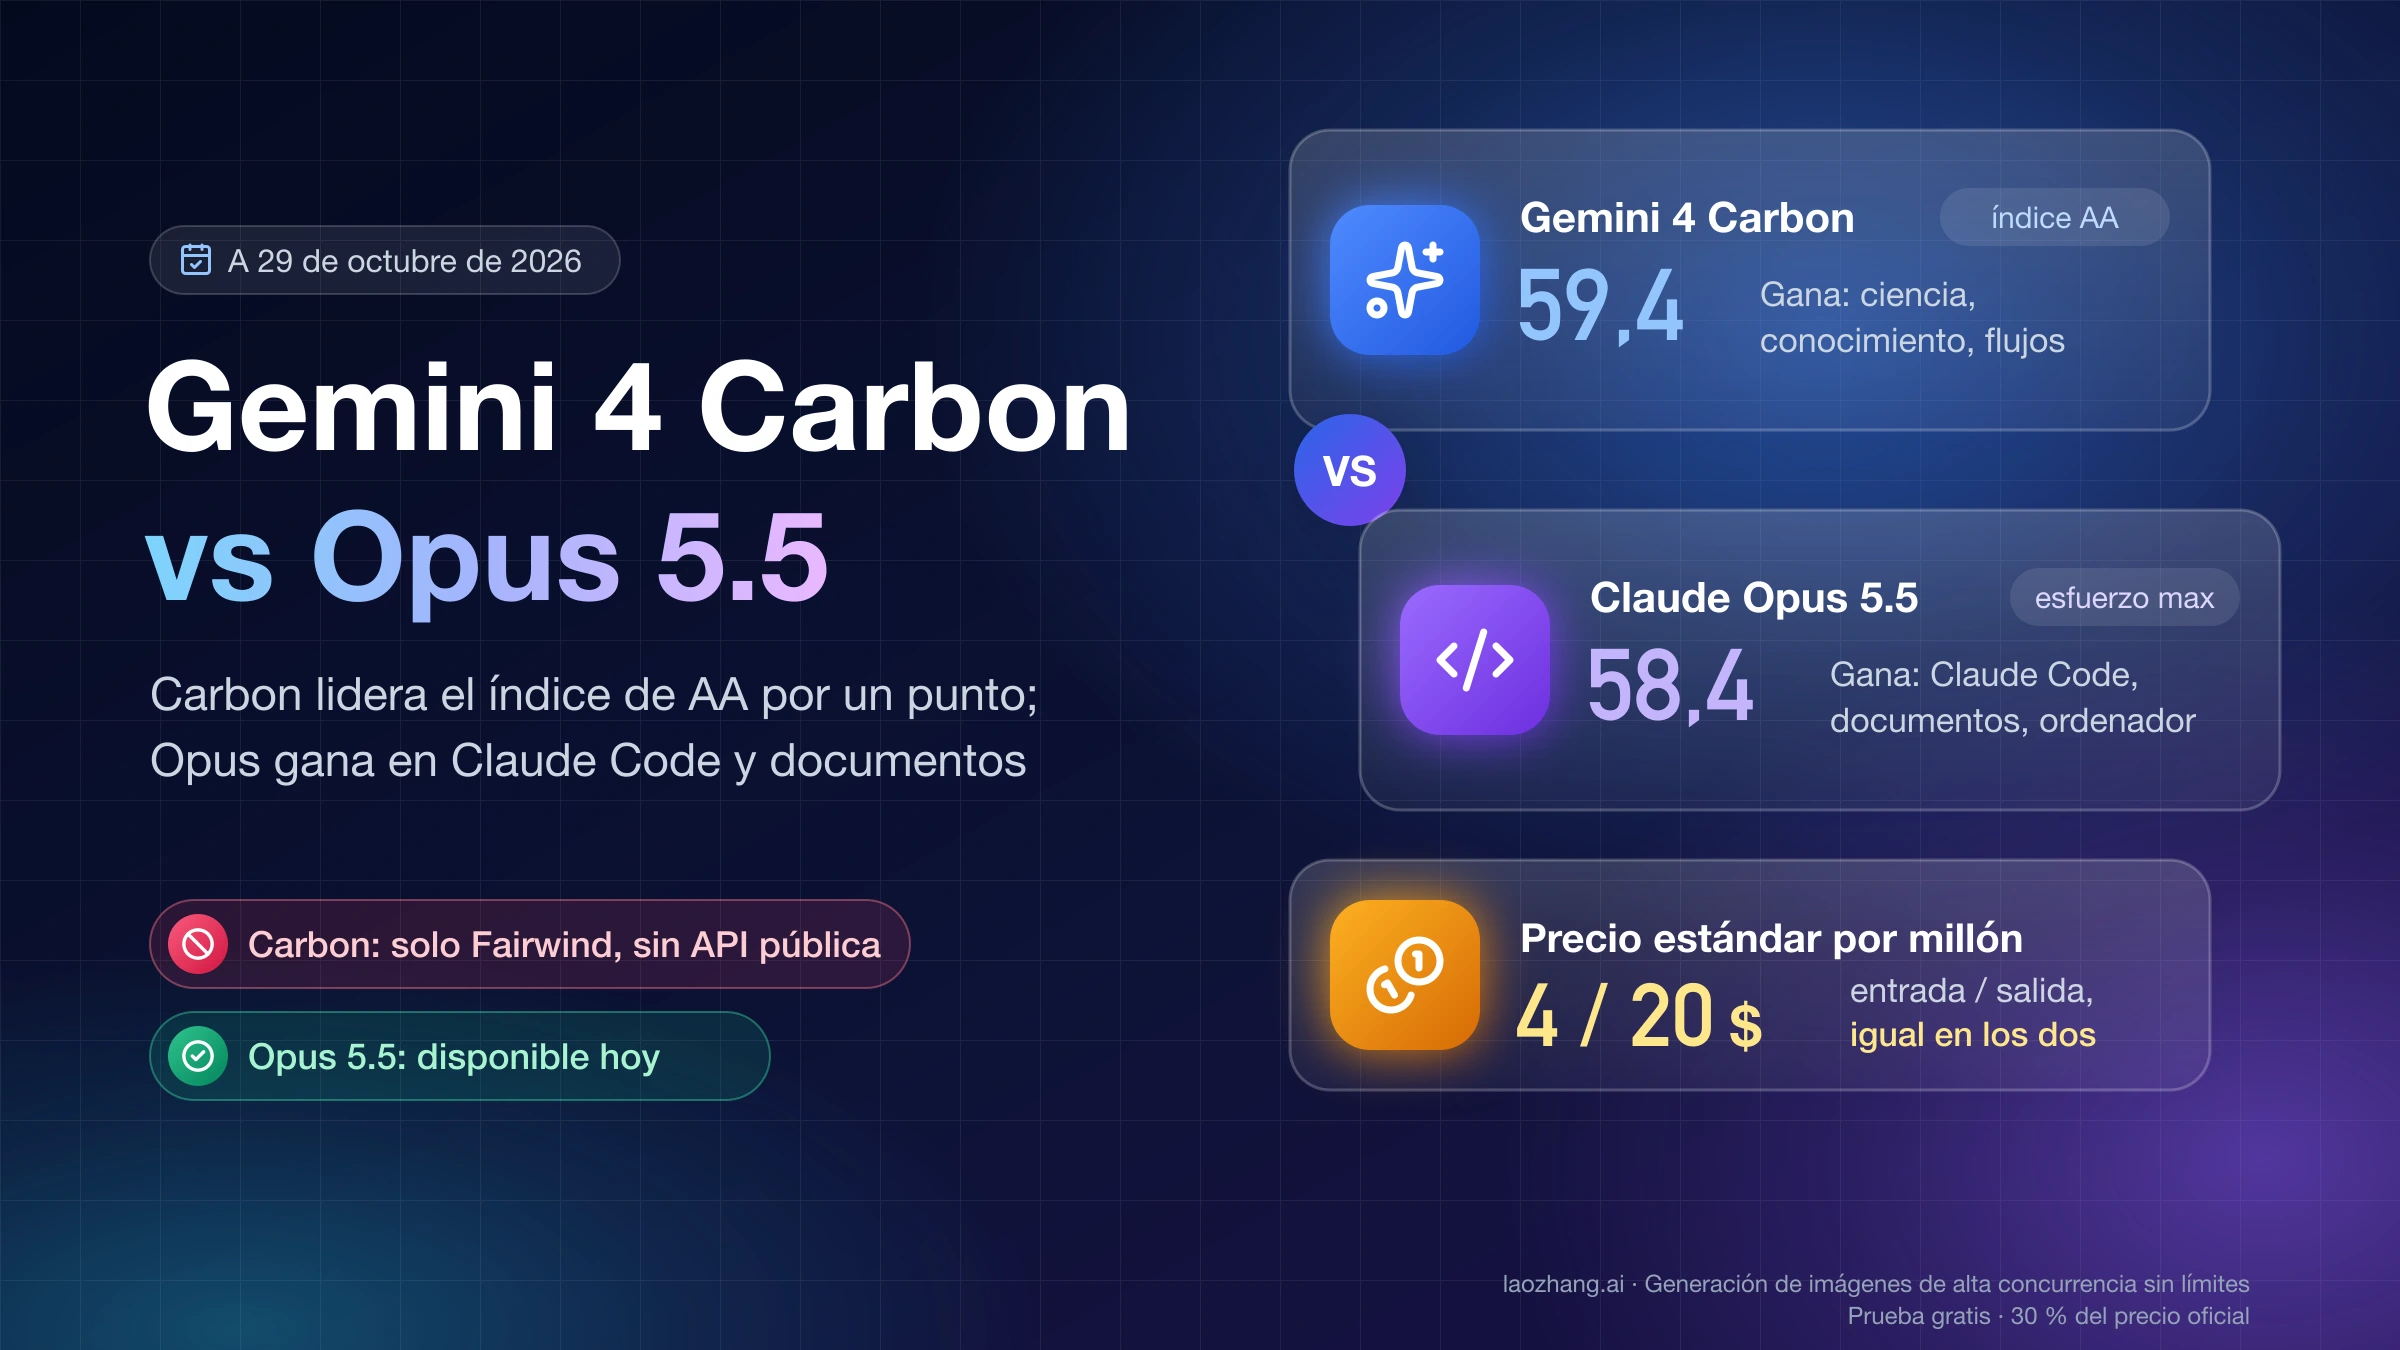
La comparación de Gemini 4 Carbon con Claude Opus 5.5, con precios y tareas de agente, está en Gemini 4 Carbon vs Opus 5.5: cuál usar para qué y cuánto cuesta. Si necesitas un modelo insignia que puedas usar hoy, Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy compara las tres opciones disponibles.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
- 1.comparador de Gemini 4 Argon y Gemini 4 Carbon de Artificial Analysisartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-4-carbon
- 2.anuncio de Gemini 4 Carbon en el blog de Googleblog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 3.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 4.clasificación de agentes de programación de Artificial Analysisartificialanalysis.ai/agents/coding-agents
- 5.comparativa de Gemini 4 Carbon y Argon de letslearngenai.comletslearngenai.com/articles/gemini-4-carbon-vs-gemini-4-argon-a-faster-flagship-becomes-a-harder-working-one-2026-10-28
- 6.análisis de Gemini 4 Carbon de Artificial Analysisartificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- 7.página de modelos de la API de Geminiai.google.dev/gemini-api/docs/models