Gemini 4 Carbon vs Opus 5.5: cuál usar para qué y cuánto cuesta
Gemini 4 Carbon lidera el índice de AA por un punto, pero Claude Opus 5.5 gana en Claude Code y documentos. A 29 de octubre de 2026 solo puedes usar Opus.
En esta página
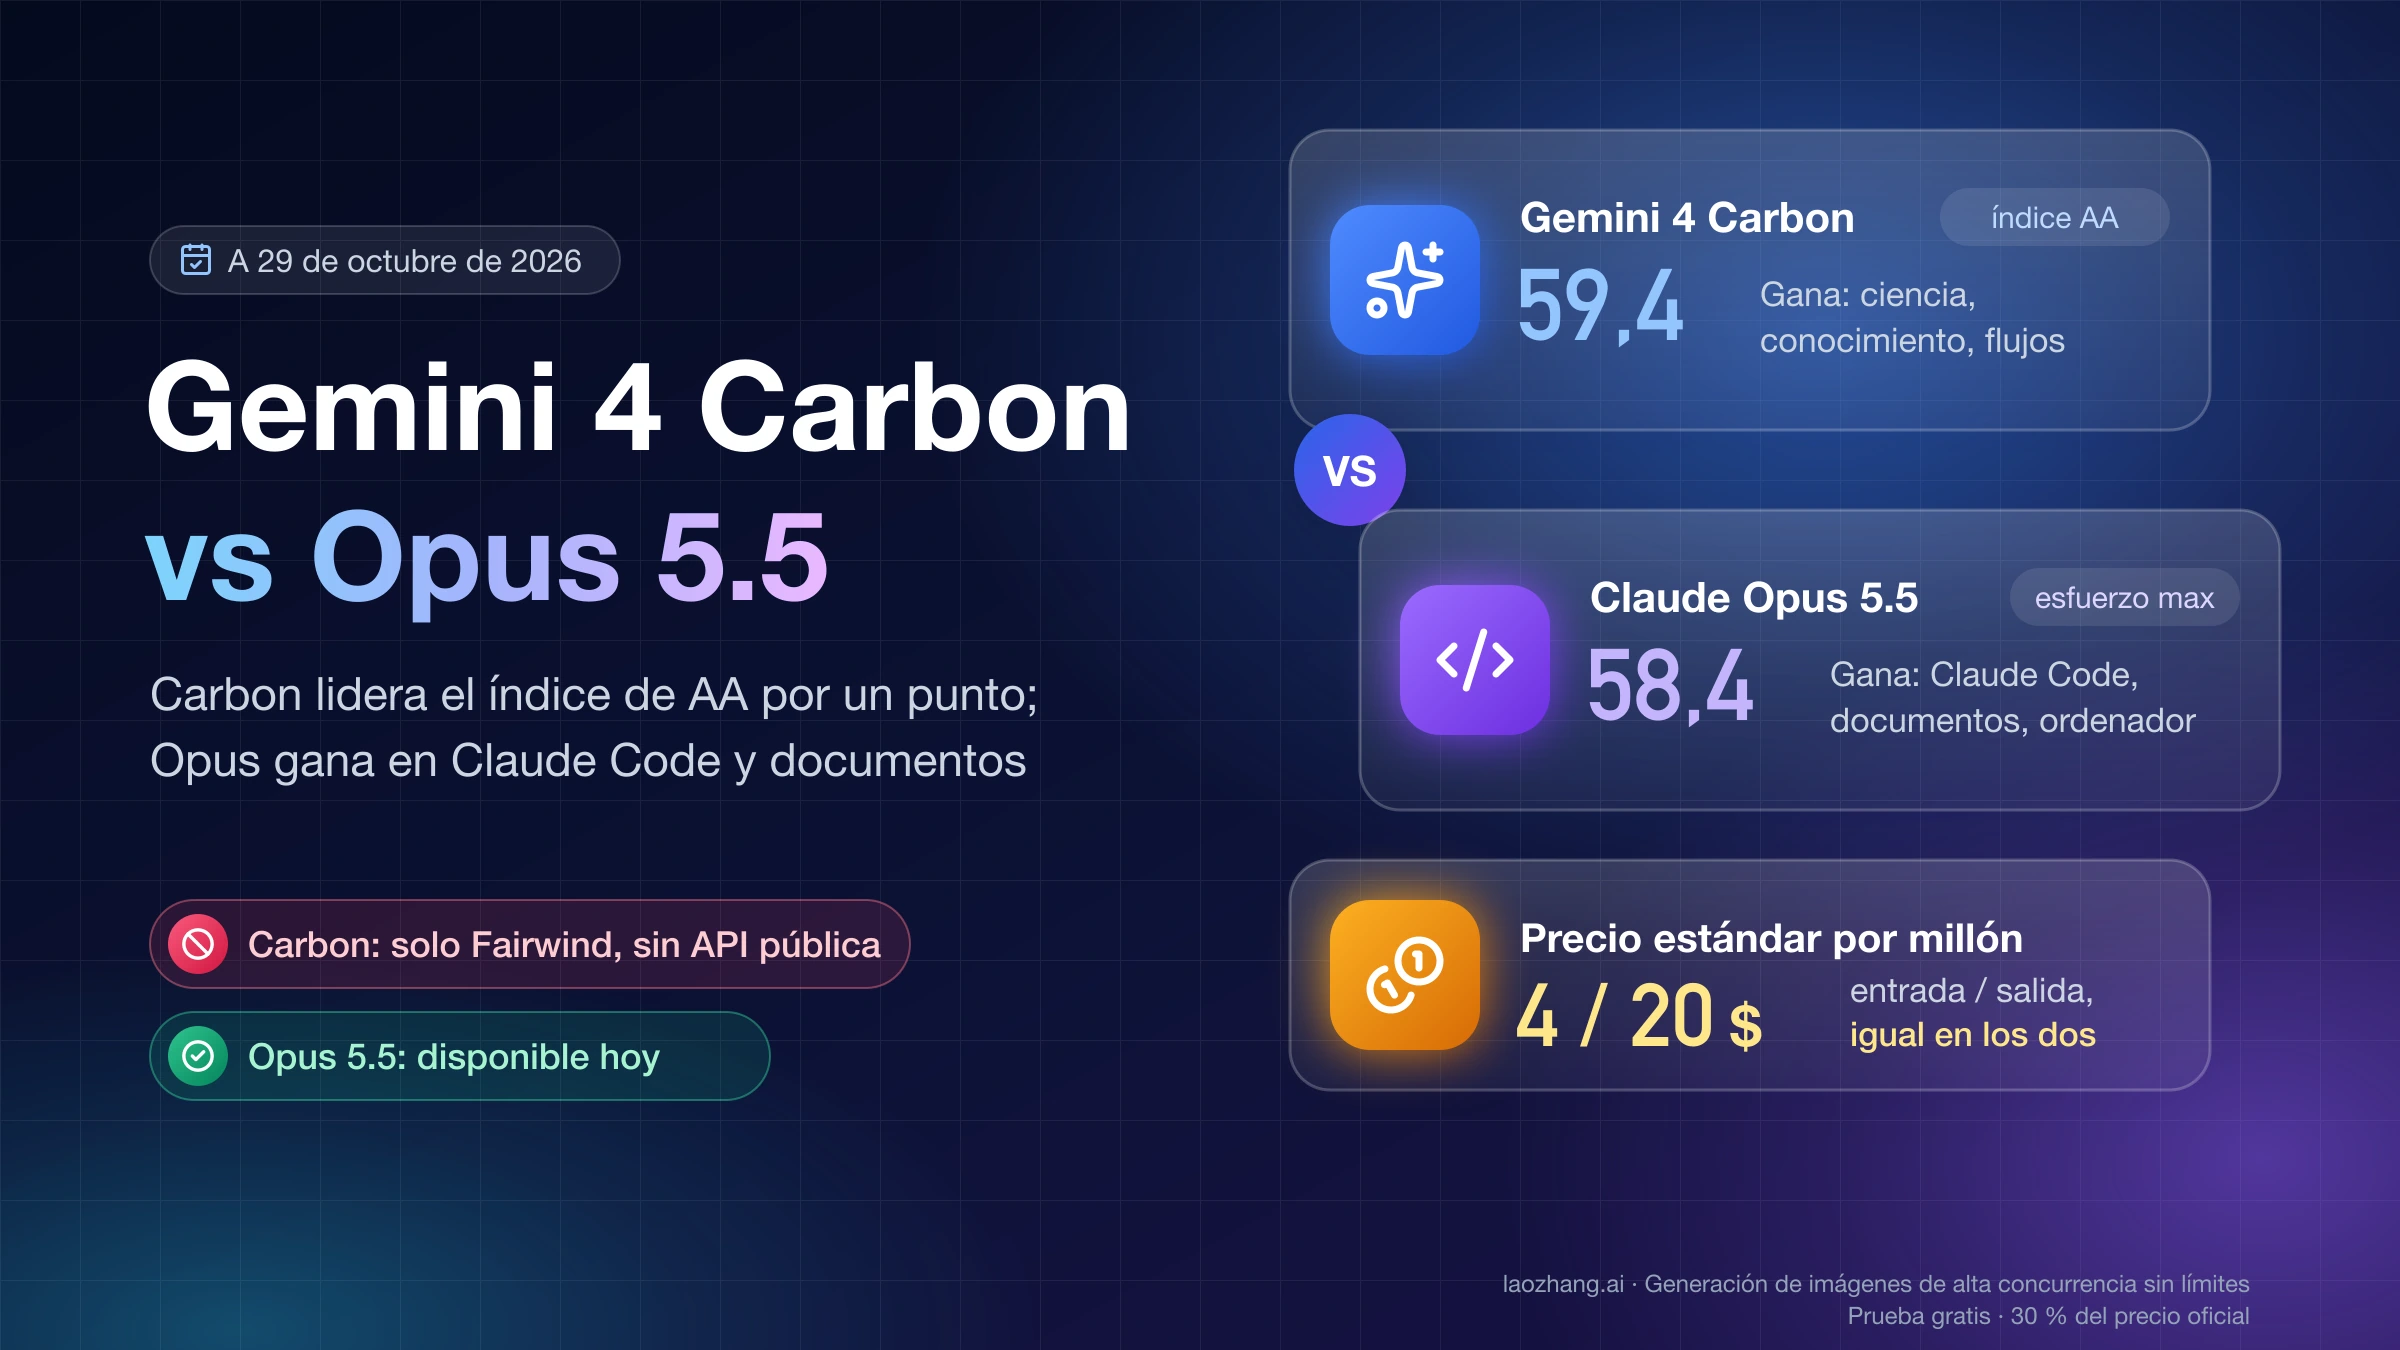
Gemini 4 Carbon es mejor que Claude Opus 5.5 en la media, pero por poco y no en todo. En la versión 5.0 del índice de inteligencia de Artificial Analysis (AA), Carbon saca 59,4 puntos y Opus 5.5 con su esfuerzo máximo, 58,4. Carbon va por delante en razonamiento científico, preguntas de conocimiento y automatización de flujos; Opus sigue ganando como agente de programación en Claude Code, en el trabajo con documentos y entregables que mide AA-Briefcase y, según la propia tabla de Google, en el uso del ordenador.
Lo que puedes hacer hoy es seguir con Opus 5.5, ya sea claude-opus-5-5 en la API o tu plan de Claude. A 29 de octubre de 2026, Carbon solo lo usa una parte de los equipos de ciberdefensa del programa Fairwind de Google, y ese día una llamada a gemini-4-carbon a través de una pasarela de API devolvió error. Cuando abra, compara los dos con tus propias tareas y mide dos cosas: el coste por tarea aceptada frente al nivel de esfuerzo de Opus que usas de verdad, y cuántos tokens cuenta cada API con tus textos en español.
Las dos cifras de precio que circulan son incompletas. Al precio estándar, Carbon y Opus cobran exactamente lo mismo por token, y Carbon cuesta la mitad solo durante un periodo de lanzamiento que no tiene fecha de fin. El «un 23 % más barato por tarea» de AA compara con Opus en max; Opus en xhigh saca 57,0 puntos y sale más barato por tarea que Carbon a precio estándar. Además, con el mismo texto en español, Opus contó 1,66 veces más tokens que Gemini 4 Argon en una prueba del 29 de octubre de 2026, así que a igual tarifa tu factura no es igual.
¿En qué trabajo gana Gemini 4 Carbon y en cuál Opus 5.5?
Carbon va por delante cuando el trabajo consiste en razonar, responder preguntas de conocimiento sin inventar o automatizar flujos de varias aplicaciones; Opus 5.5 sigue delante cuando el modelo tiene que actuar como agente sobre un repositorio, preparar documentos y presentaciones o manejar un ordenador. La tabla recoge las pruebas del índice 5.0 de AA, con Carbon en esfuerzo high, el único que AA ha medido y antes de su apertura al público, y con Opus en max y xhigh.
| Tipo de trabajo | Prueba de AA | Gemini 4 Carbon | Opus 5.5 max | Opus 5.5 xhigh | Va delante |
|---|---|---|---|---|---|
| Media general | Índice de inteligencia v5.0 | 59,4 | 58,4 | 57,0 | Carbon, por un punto |
| Agente de programación completo | Coding Agent Index, Antigravity CLI frente a Claude Code | 59,4 | 61,7 | sin medir | Opus |
| Programación difícil | FrontierCode 2.0 | 40,6 % | 46,4 % | 43,8 % | Opus |
| Tareas en terminal | Terminal-Bench 4.0, medición del modelo | 65,2 % | 59,6 % | 59,6 % | Carbon |
| Documentos y entregables con agentes | AA-Briefcase, Elo | 1.609 | 1.800 | 1.760 | Opus |
| Ciencia en terminal | Terminal-Bench-Science | 64,8 % | 59,0 % | 61,9 % | Carbon |
| Razonamiento de nivel experto | HLE-Diamond | 69,1 % | 67,9 % | 64,0 % | Carbon, por poco |
| Problemas de física de investigación | CritPt v2, difícil | 63 % | 61 % | 63 % | Empate con xhigh |
| Preguntas de conocimiento | AA-Omniscience | 53,5 | 48,1 | 43,1 | Carbon |
| Respuestas inventadas, menos es mejor | Tasa de alucinación en AA-Omniscience | 11,4 % | 50,3 % | 65,0 % | Carbon, con mucha diferencia |
| Automatizar flujos de trabajo | AutomationBench-AA | 77,8 % | 69,5 % | 65,0 % | Carbon |
Cifras de la ficha de Gemini 4 Carbon en Artificial Analysis a 29 de octubre de 2026. El propio análisis de AA lo resume así: Carbon tiene la mejor puntuación en 4 de las 9 pruebas del índice, pero «no lidera en programación ni en trabajo de conocimiento».
La fila que más pesa si trabajas con documentos es AA-Briefcase, donde Opus le saca casi 200 puntos Elo en max y 150 en xhigh. Eso no significa que Opus sepa más de cada materia: en los índices por área de AA, Carbon queda por delante en finanzas (62,6 frente a 59,4) y en derecho (62,0 frente a 58,0), empata en ingeniería y queda algo por detrás en estrategia y operaciones y en economía. Si tus documentos son contratos o informes financieros, la conclusión de Briefcase y la de esos índices tiran en direcciones distintas, y solo una prueba con tus archivos lo resuelve.
La tasa de alucinación también merece una lectura atenta. Mide cuántas veces el modelo responde mal en lugar de reconocer que no sabe, y Opus 5.5 lo hace en la mitad de los casos en max y en dos de cada tres en xhigh. Para un asistente que contesta preguntas factuales a clientes o a tu equipo, esa diferencia importa más que un punto de índice.
Las filas de la tabla de Google y la ciberseguridad
En la tabla que publicó Google con el anuncio, Carbon es el mejor en 15 de 17 filas. Las dos excepciones son OSWorld-2.1 en su versión offline, una prueba de uso del ordenador donde Opus 5.5 saca 87,2 % frente a 81,5 %, y FrontierSWE 2, que lidera GPT-6 Astra con 65,5 % por delante de Opus (62,3 %) y Carbon (61,2 %). En contexto largo, GraphWalks da 96,2 % a Carbon y 66,8 % a Opus; en el índice Vals v2.2 quedan prácticamente empatados, 70,4 % frente a 70,2 %. Son cifras del fabricante, transcritas por VentureBeat en su artículo sobre el lanzamiento de Carbon, y Google las obtuvo con su configuración de razonamiento más alta, en un solo intento y «sin salvaguardas».
Google presenta Carbon ante todo por su ciberseguridad defensiva. El anuncio de Gemini 4 Carbon en el blog de Google da 88,2 % en SEC-bench Pro para encontrar vulnerabilidades, 54,8 % en ExploitGym y 71,0 % en CWE-bench para corregirlas, pero el texto solo trae las cifras de Carbon, así que no hay una comparación directa con Opus que citar en esta área.
¿Son fiables los benchmarks de Carbon y Opus 5.5?
Sirven para orientarte, no para decidir por ti. AA midió Carbon en una sola configuración, con una ejecución por prueba y antes de que exista una API pública; la tabla de Google es del propio fabricante y se hizo sin las salvaguardas que tendrá el modelo cuando lo abra al público. Con una sola ejecución por configuración, un punto de diferencia en el índice general es poco para declarar un ganador, mientras que las brechas de Briefcase, alucinación o AutomationBench son lo bastante grandes como para tomarlas en serio.
Para programar con agentes, Opus 5.5 en Claude Code sigue primero
Si programas con un agente, el dato que te interesa es el Coding Agent Index de AA, y ahí Claude Code con Opus 5.5 en max saca 61,7 puntos frente a 59,4 de Antigravity CLI con Carbon. Por partes, Claude Code con Opus gana en FrontierCode v1.1 (56,0 % frente a 50,9 %) y en SWE-Atlas QnA (65,9 % frente a 63,7 %), y empatan en la ejecución de Terminal-Bench 4.0 como agente (63,1 % frente a 63,6 %). AA lo describe en su artículo sobre Carbon como nuevo número 1 como el mayor avance de Google en un terreno donde «históricamente ha rendido por debajo».
La pareja de Google gana en coste y en tiempo. En la clasificación de agentes de programación de AA, cada tarea cuesta de media 7,74 $ con Antigravity CLI y Carbon frente a 11,42 $ con Claude Code y Opus, tarda 30 minutos en lugar de 61 y genera 109.000 tokens de salida en lugar de 279.000. Si tu cuello de botella es esperar al agente y no la calidad del parche, ese es el argumento a favor de Carbon.
Este índice mide cada modelo dentro del agente de su propio fabricante, así que no aísla el modelo: parte de la diferencia puede venir de Claude Code o de Antigravity CLI. Tampoco confundas las tres cifras de Terminal-Bench 4.0 que verás citadas. Google da 65,2 % en su tabla, AA mide 65,2 % al probar el modelo y 63,6 % al probarlo como agente en Antigravity CLI; según cuál se cite, Carbon parece muy por delante de Opus o empatado con él.
Google añade afirmaciones propias que todavía no puedes comprobar: que sus equipos han visto a Carbon trabajar «durante días» en tareas de ingeniería de varios pasos, que sube 89 puntos Elo hasta el cuarto puesto de WebDev Arena (1.768) y que en Terminal-Bench 4.0 ninguno de sus intentos de hacer trampa tuvo éxito (0,0 %). Ninguna de ellas viene con una comparación con Opus. Si tu equipo trabaja en Claude Code, hoy no hay motivo para moverse.
¿Es Gemini 4 Carbon más barato? Igual por token, distinto por tarea
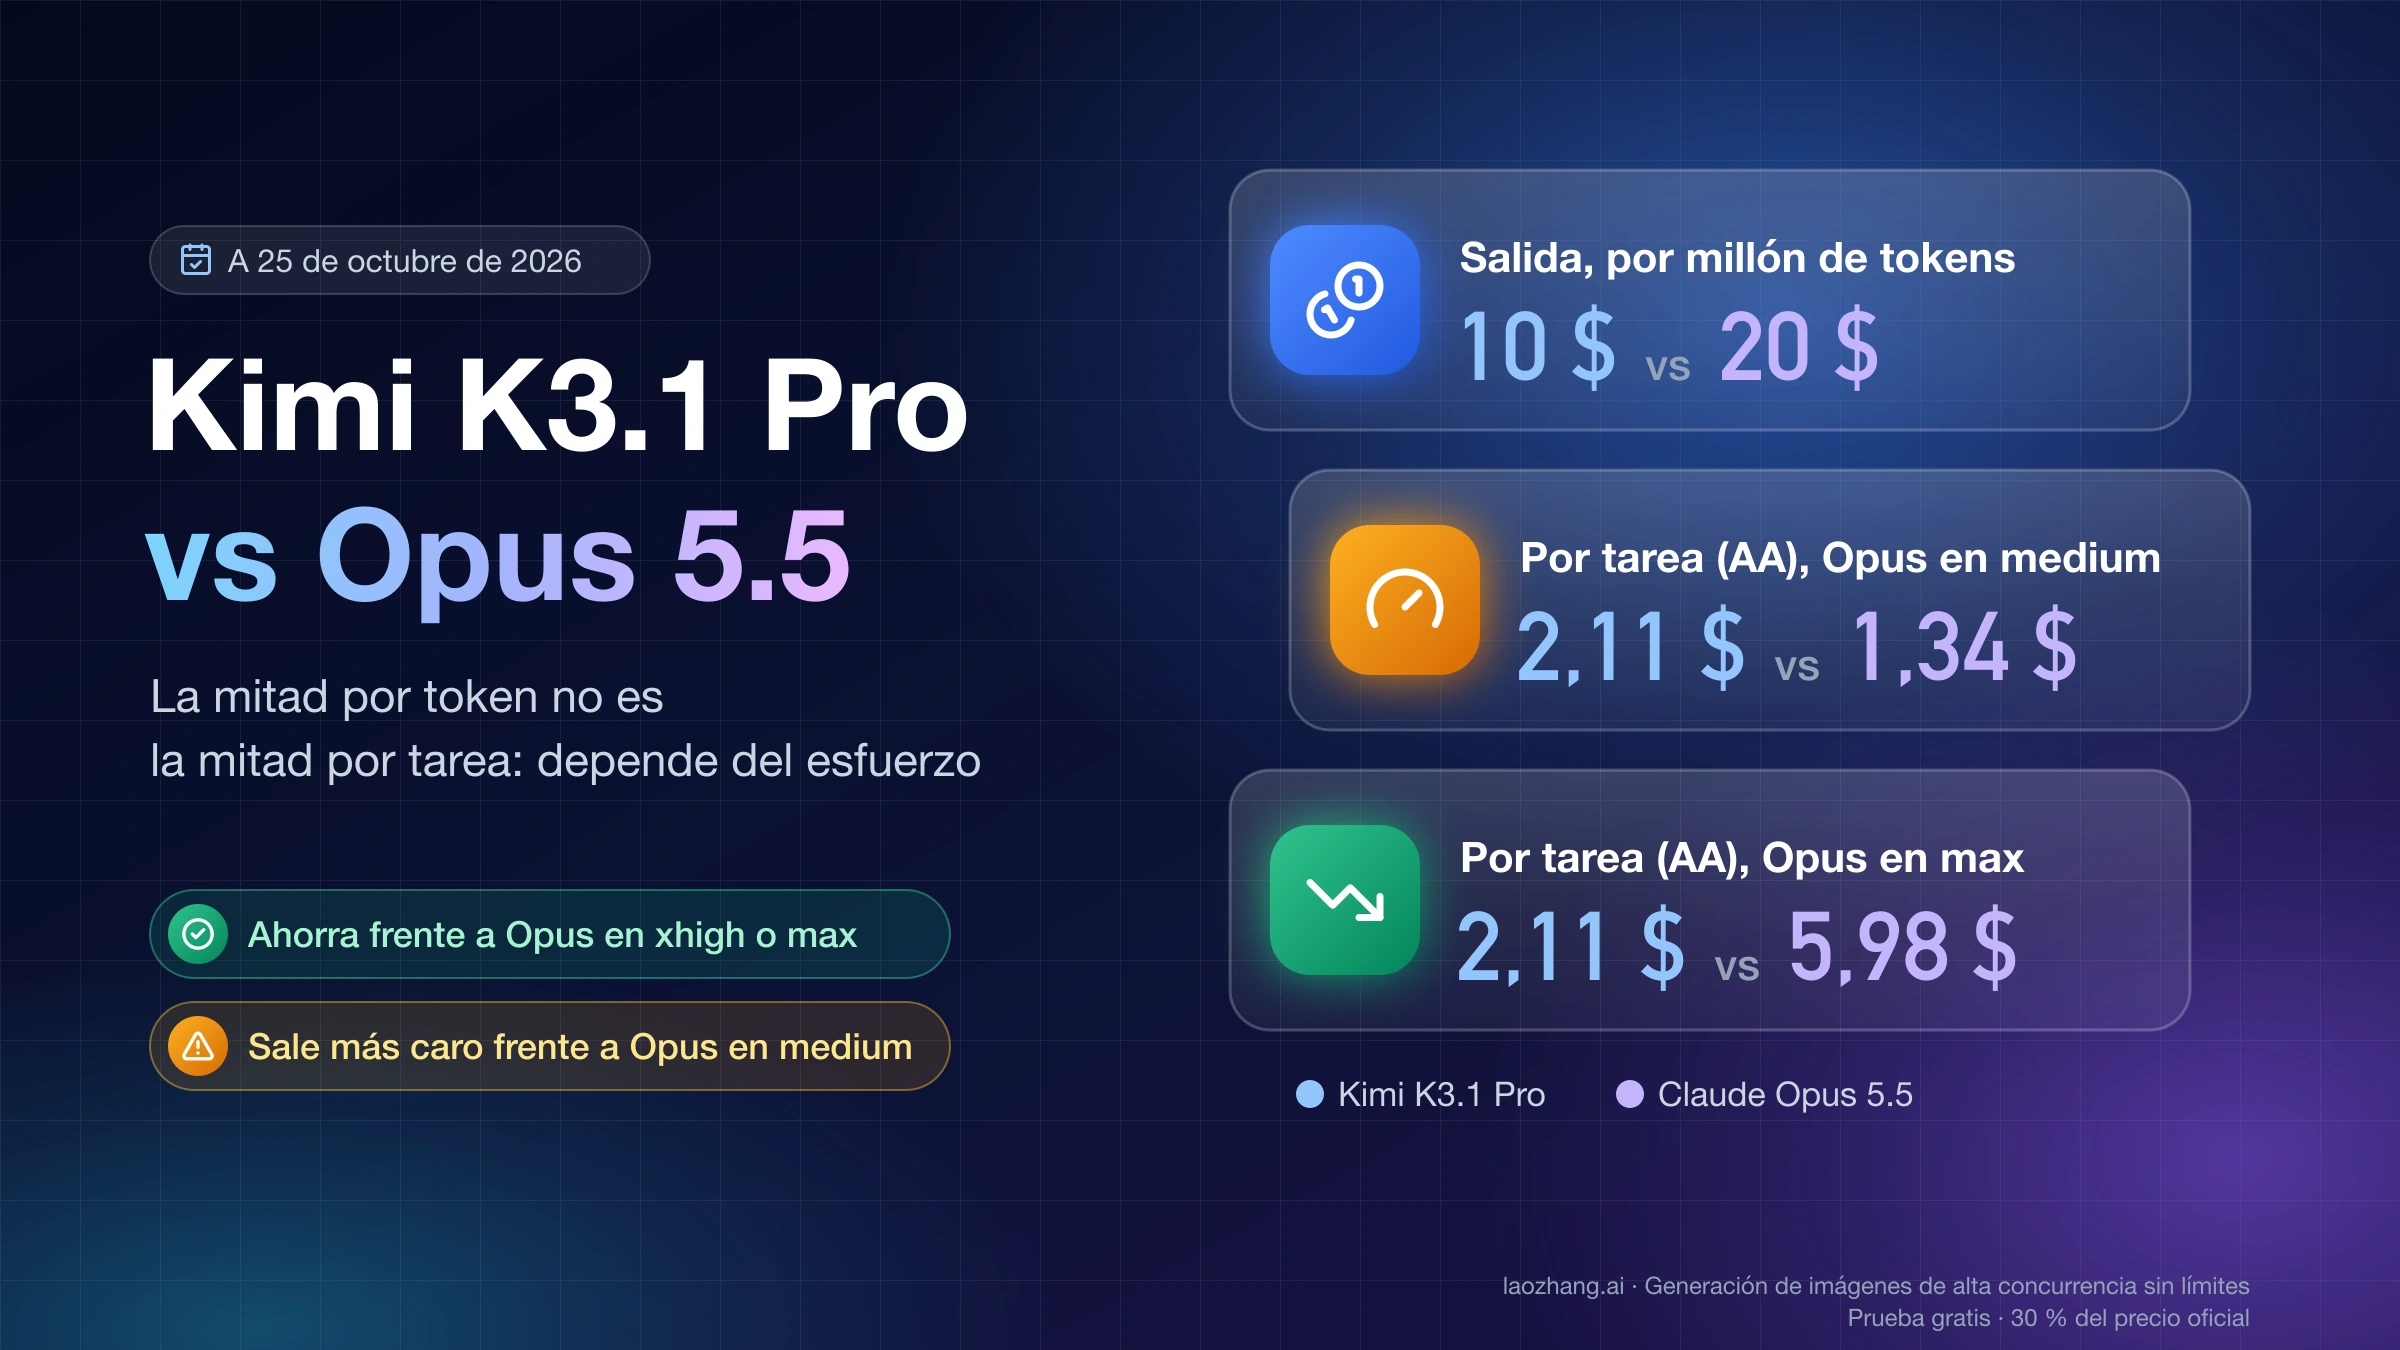
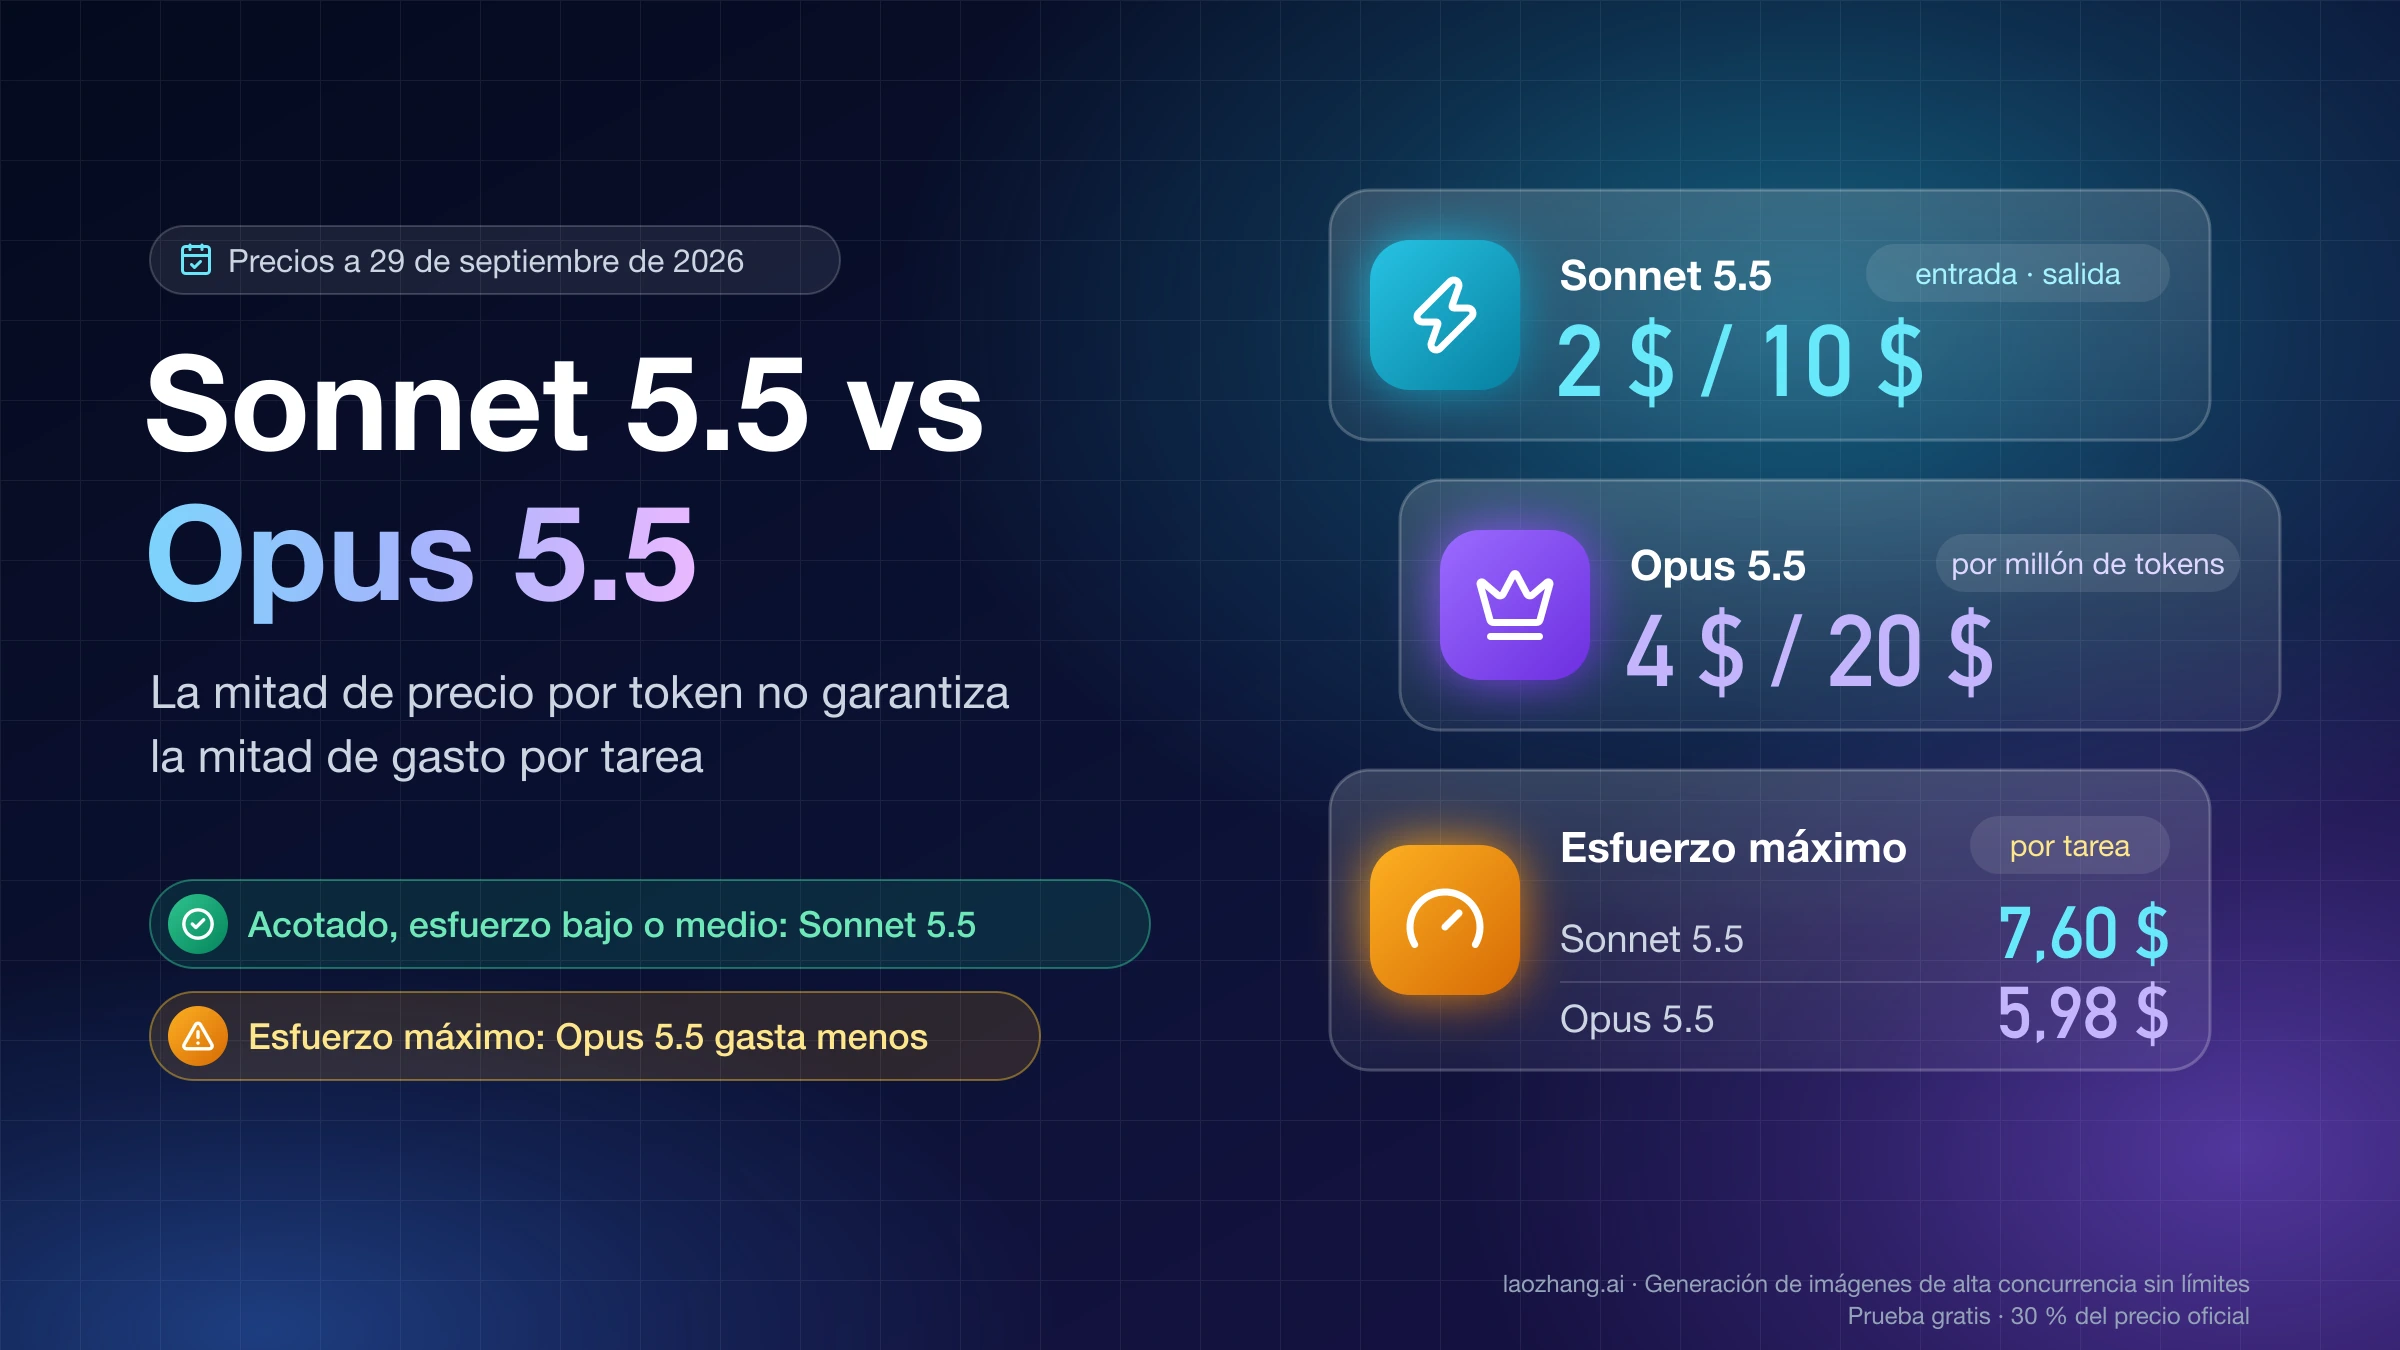
Por token, Carbon solo es más barato mientras dure su precio de lanzamiento; al precio estándar cuesta exactamente lo mismo que Opus 5.5. Por tarea, la respuesta cambia según el nivel de esfuerzo de Opus con el que compares: Carbon es más barato que Opus en max, pero más caro que Opus en xhigh salvo durante el periodo de lanzamiento.
| Por millón de tokens | Carbon, lanzamiento | Carbon, estándar | Opus 5.5 |
|---|---|---|---|
| Entrada | 2,00 $ | 4,00 $ | 4,00 $ |
| Salida | 10,00 $ | 20,00 $ | 20,00 $ |
| Lectura de caché | 0,10 $ | 0,20 $ | 0,20 $ |
| Escritura de caché | sin publicar | sin publicar | 5,00 $ a 5 minutos, 8,00 $ a 1 hora |
Precios de Carbon según el anuncio de Google del 28 de octubre de 2026, que fija el precio estándar en una nota al pie, y de Opus según la tabla de precios de la API de Claude. Opus cobra la misma tarifa en toda su ventana de un millón de tokens; para Carbon, Google no ha publicado recargo por contexto largo, Batch ni precio de escritura en caché. Gemini 4 Argon, que salió con los mismos precios, mantiene el de lanzamiento hasta el 30 de noviembre de 2026, pero Google no ha dicho que Carbon siga el mismo calendario.
Para el coste por tarea, AA mide lo que gasta cada configuración en su batería de pruebas al precio estándar, con los tokens que usa realmente cada modelo:
| Configuración | Índice AA v5.0 | Coste por tarea | Tokens de salida por tarea | Tiempo por tarea |
|---|---|---|---|---|
Gemini 4 Carbon high, precio estándar | 59,4 | 7,76 $ | 123.000 | 20,8 min |
Gemini 4 Carbon high, precio de lanzamiento | 59,4 | 3,88 $ estimado | 123.000 | 20,8 min |
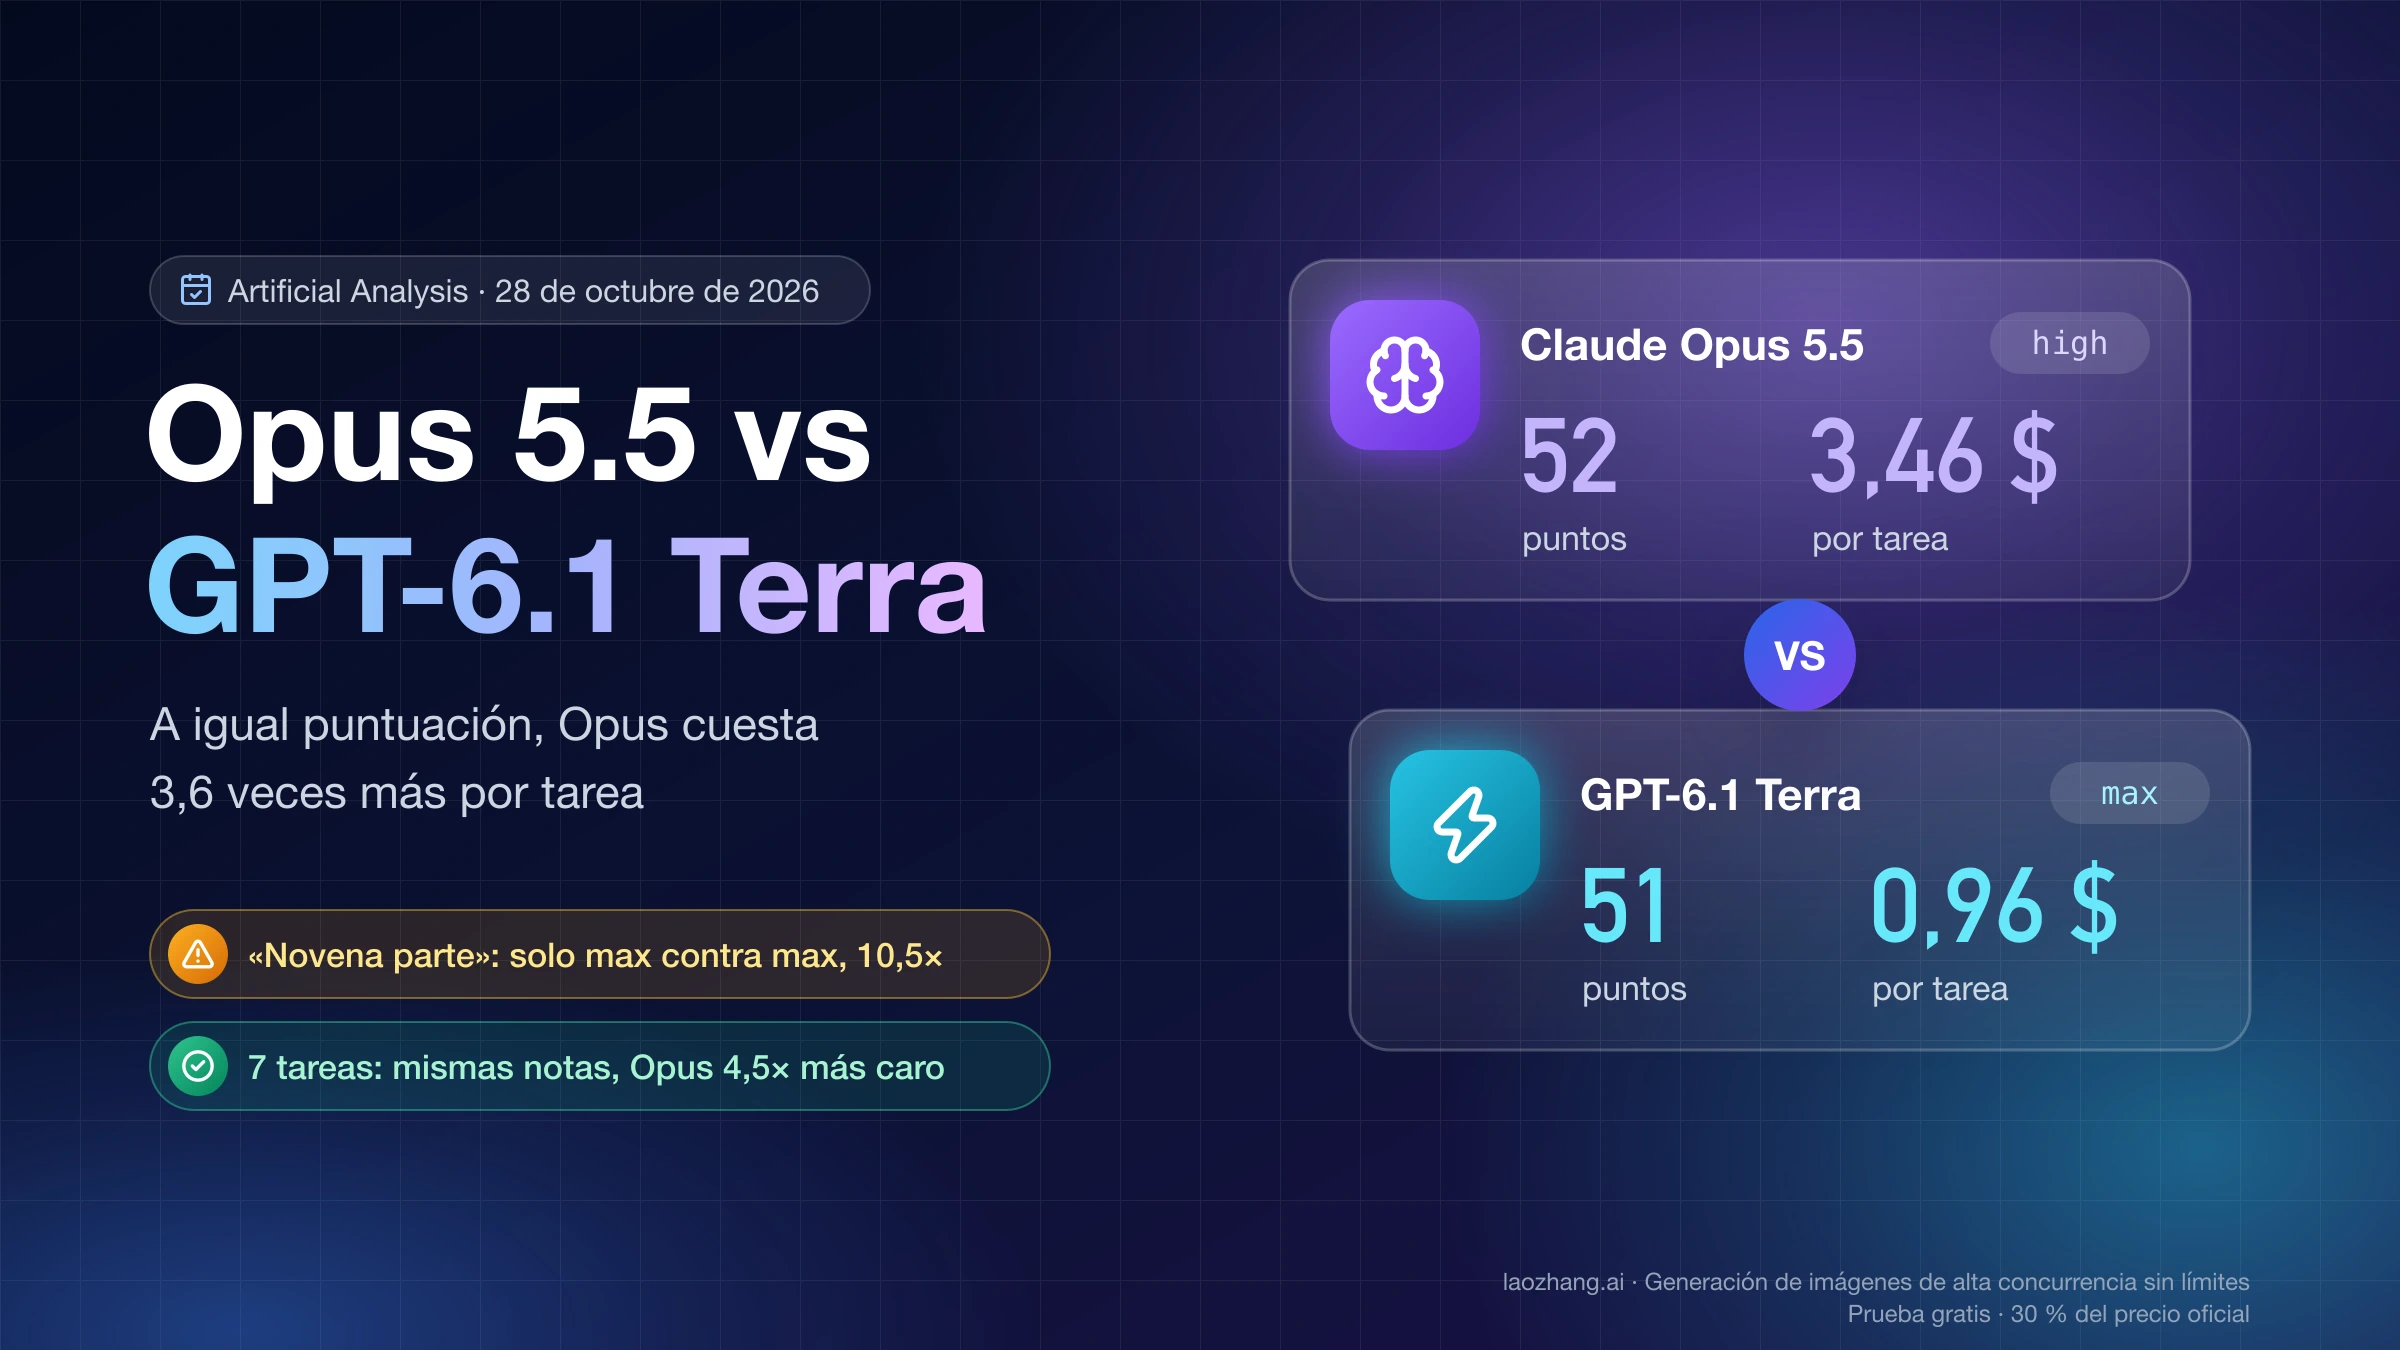
Opus 5.5 max | 58,4 | 10,04 $ | 173.000 | 19,1 min |
Opus 5.5 xhigh | 57,0 | 6,05 $ | 103.000 | 13,0 min |
Opus 5.5 high | 51,7 | 3,46 $ | 60.000 | 7,7 min |
Opus 5.5 medium | 48,1 | 2,45 $ | 44.000 | 5,5 min |
La fila del precio de lanzamiento es un cálculo: si Carbon gasta los mismos tokens, todos los componentes de su factura se dividen por dos, y 7,76 $ ÷ 2 = 3,88 $. Con esos datos, a precio estándar Carbon cuesta un 23 % menos que Opus en max (7,76 ÷ 10,04 = 0,77), pero 1,28 veces lo que cuesta Opus en xhigh (7,76 ÷ 6,05) a cambio de 2,4 puntos más. A precio de lanzamiento, Carbon queda un 61 % por debajo de Opus en max y un 36 % por debajo de Opus en xhigh, y solo Opus en high y en medium siguen siendo más baratos, con casi 8 y 11 puntos menos. En el índice de agentes de programación pasa algo parecido: Antigravity CLI con Carbon cuesta un 32 % menos por tarea que Claude Code con Opus a precio estándar, y en torno a un 66 % menos, unos 3,87 $, a precio de lanzamiento.
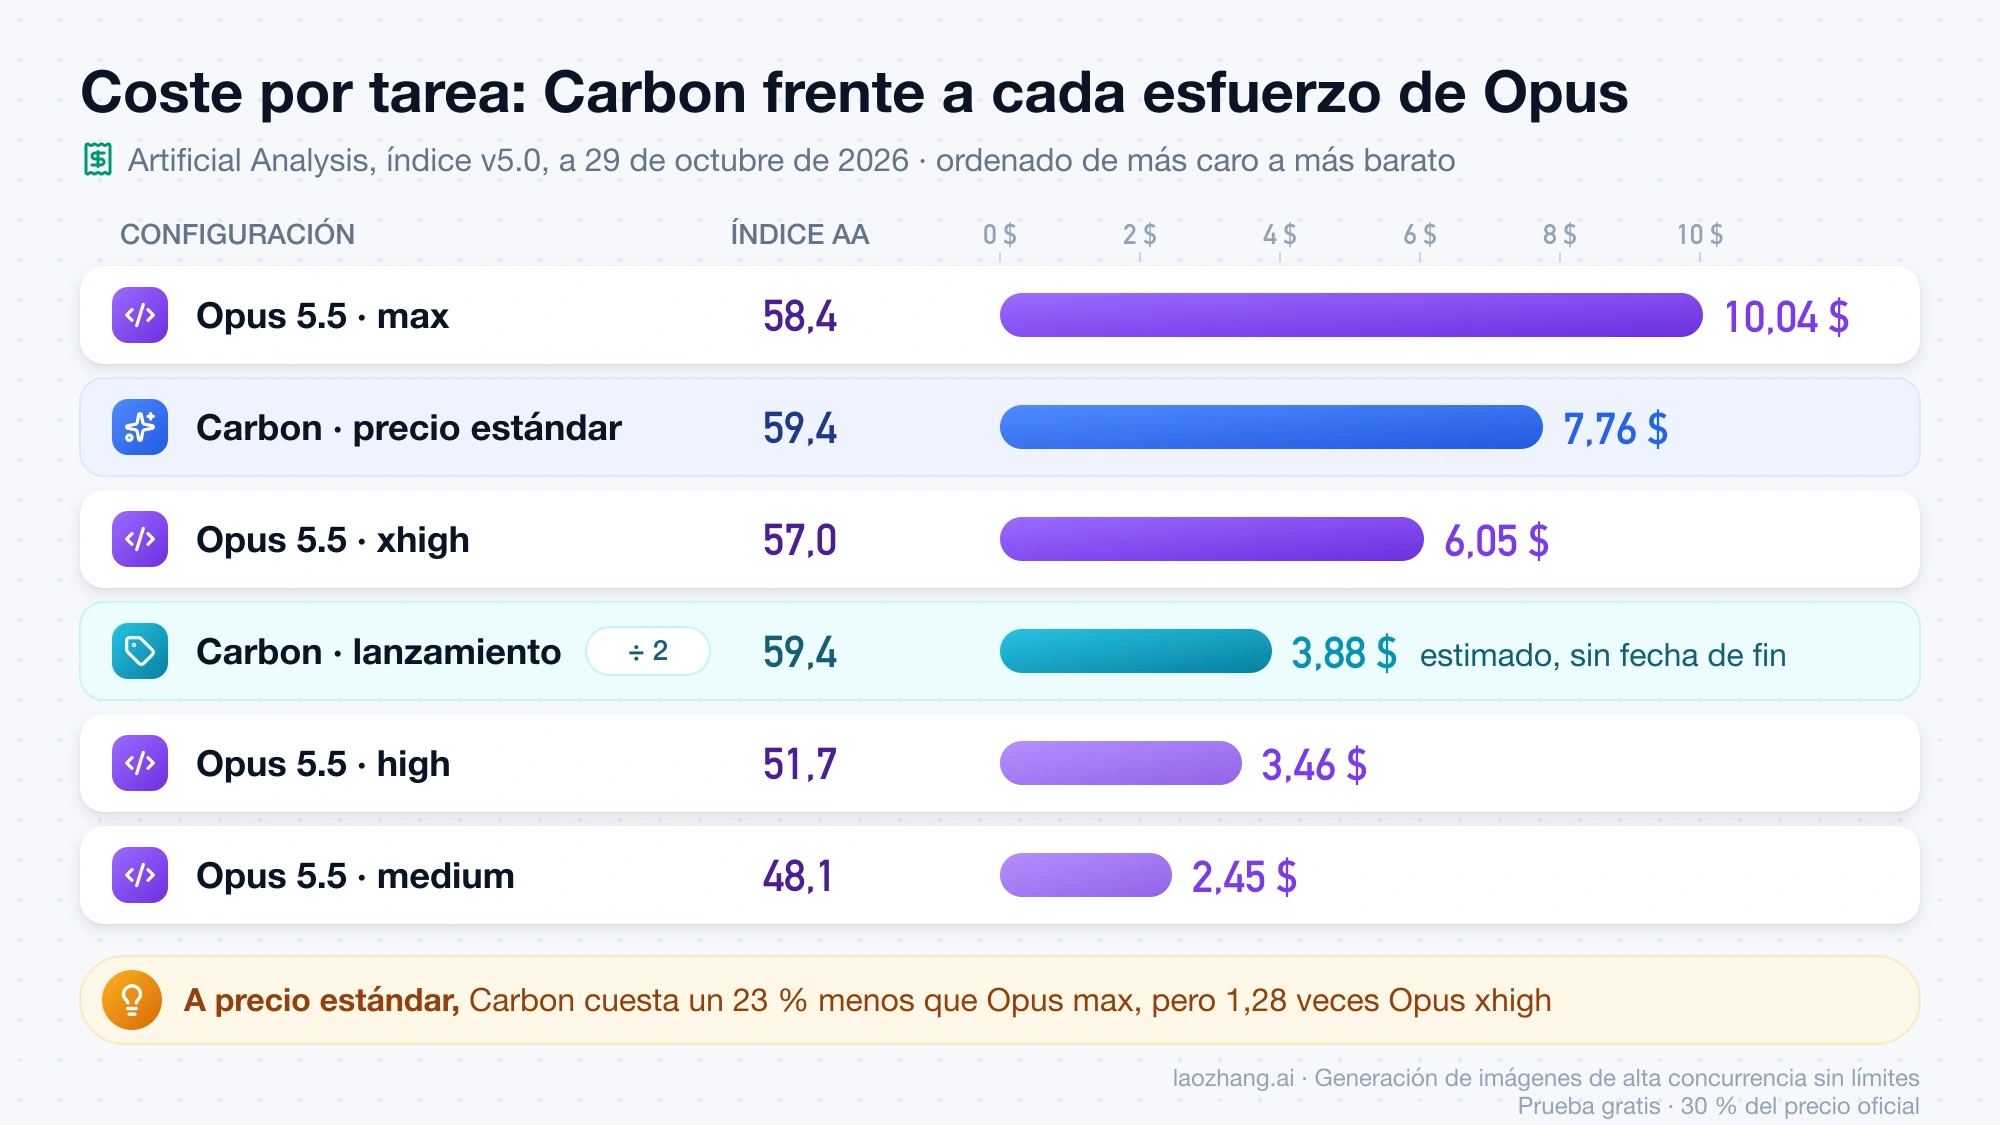
La regla práctica es esta: si ya usas Opus en xhigh o por debajo, Carbon a precio estándar no te ahorra dinero por tarea, y la ventaja del lanzamiento puede terminar en cualquier momento. Si usas Opus en max para todo, Carbon sale más barato incluso al precio estándar. El mismo método de coste por nivel de esfuerzo está aplicado a otro par en Claude Opus 5.5 vs GPT-6.1 Terra: coste real y cuándo cambiarse; si lo que buscas es gastar menos sin salir de Claude, mira Claude Sonnet 5.5 vs Opus 5.5: cuál gasta menos por tarea, y para los precios y límites de Opus, Claude Opus 5.5: precio de la API y restablecimiento de límites.
Mismo texto en español: Opus 5.5 cuenta 1,66 veces más tokens
A igual precio por token, el texto en español le sale más caro a Opus porque su contador de tokens lo trocea en más piezas. El 29 de octubre de 2026 a las 03:00 UTC se envió el mismo párrafo de 799 caracteres en español, con la misma instrucción de una línea, a claude-opus-5-5 por la API Messages de Anthropic y a gemini-4-argon por generateContent nativo, ambos a través de la pasarela api.laozhang.ai, y se anotaron los tokens de entrada que devolvió cada API: 322 en Opus y 194 en Argon. Carbon no se puede llamar todavía, así que Argon hace aquí de sustituto de Carbon; que los dos compartan el mismo contador es una suposición razonable por ser de la misma familia, pero Google no lo documenta.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Texto | Caracteres | Tokens en Opus 5.5 | Tokens en Gemini 4 Argon | Opus ÷ Gemini |
|---|---|---|---|---|
| Párrafo en español | 799 | 322 | 194 | 1,66 |
| Párrafo en inglés | 685 | 217 | 176 | 1,23 |
| Documento en inglés | 40.625 | 15.495 | 11.081 | 1,40 |
En los demás idiomas de la misma prueba, la proporción fue de 1,94 en coreano, 1,46 en chino, 1,45 en japonés y 1,43 en ruso; solo el coreano supera al español. El recuento de Opus coincidió con el de una medición idéntica del 28 de octubre, y el total de las llamadas costó 0,039 $ a precio de lista.
Traducido a factura, un millón de tokens de entrada en español según el recuento de Gemini cuesta 2 $ con Carbon a precio de lanzamiento, 4 $ a precio estándar y unos 6,64 $ con Opus, que son 4 $ × 1,66. Para un ejemplo completo, toma 1.000 llamadas con 20.000 tokens de entrada y 1.500 de salida cada una, contados por Gemini. Con Carbon a precio estándar cada llamada cuesta (20.000 × 4 $ + 1.500 × 20 $) ÷ 1.000.000 = 0,11 $, es decir, 110 $ en total, y 55 $ a precio de lanzamiento; con Opus, el mismo texto ocupa 1,66 veces más tokens y el total sube a 182,58 $.
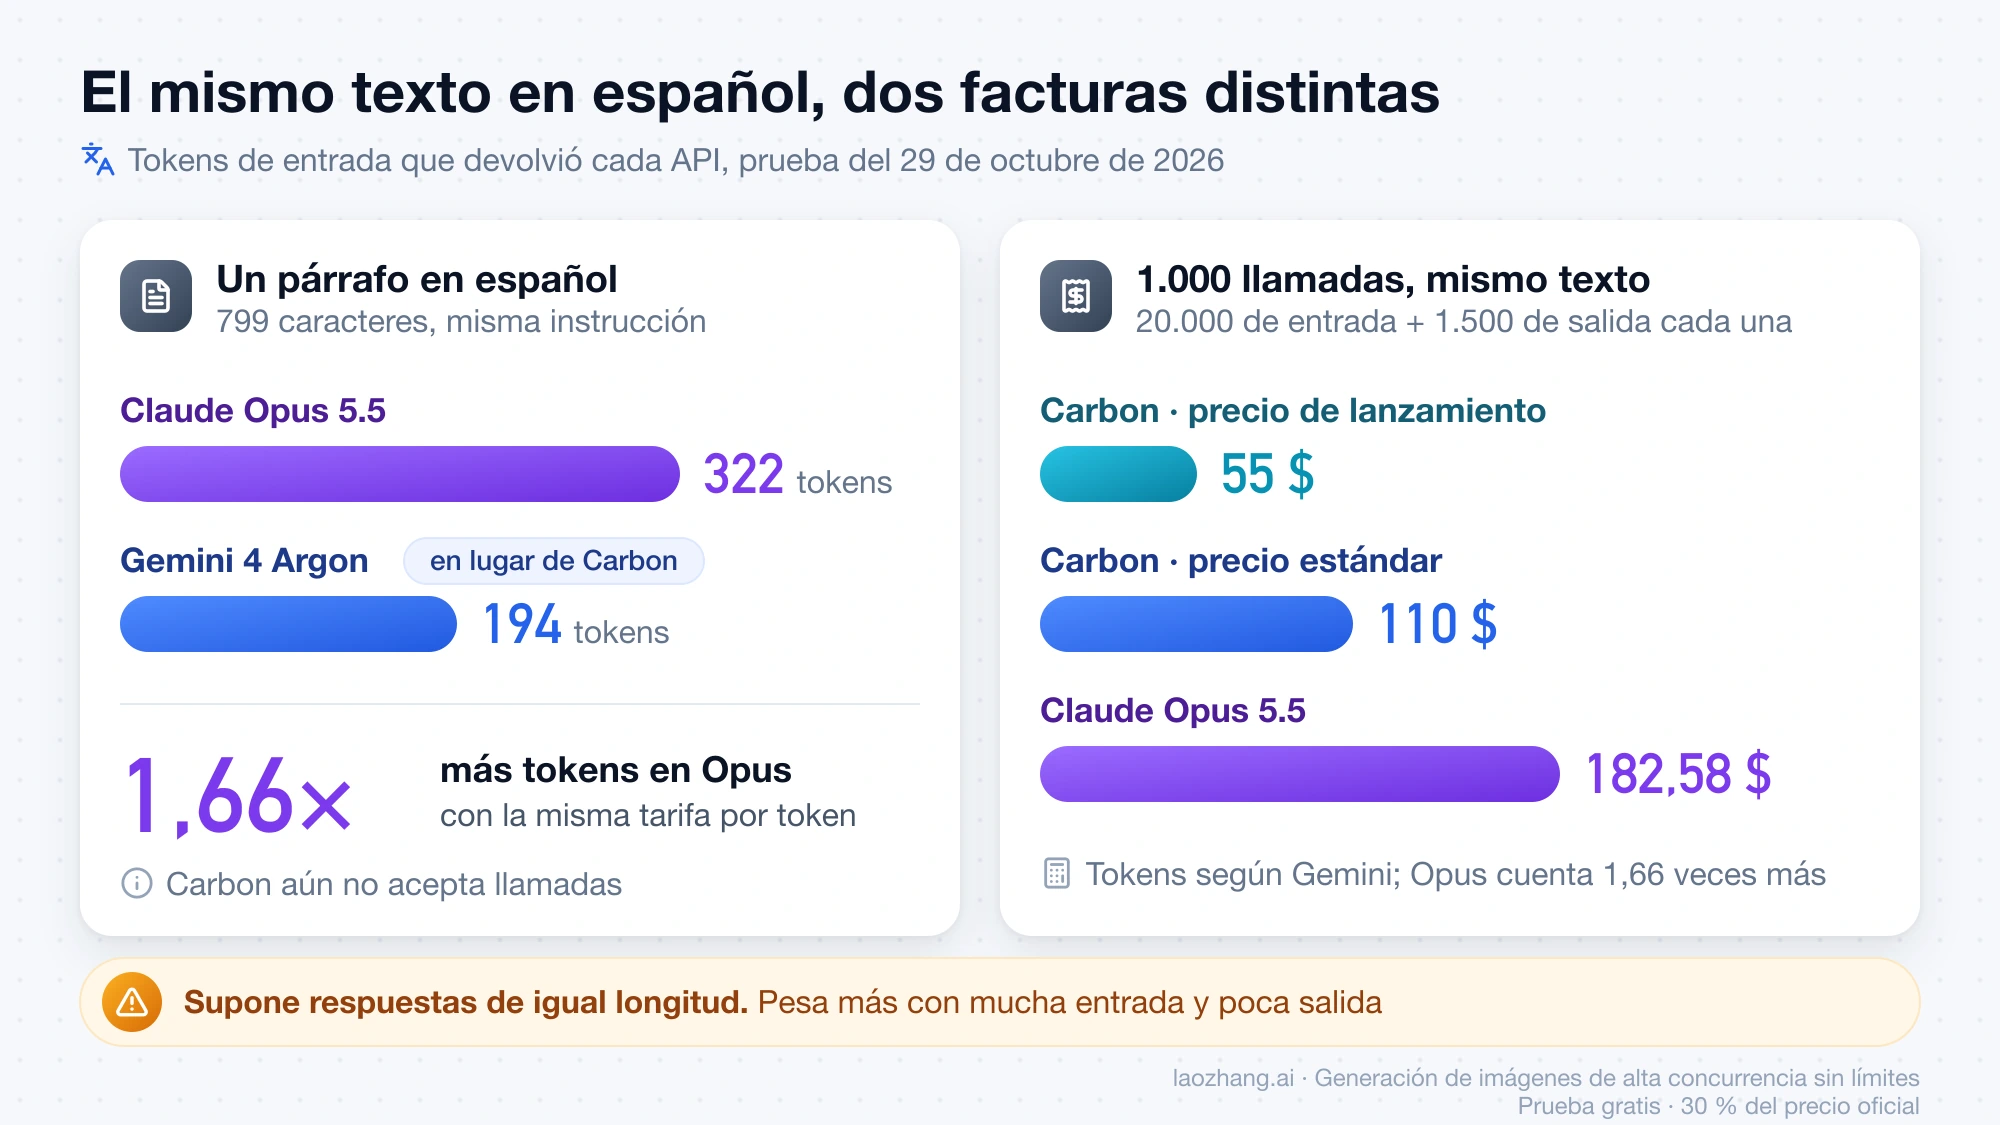
Este ejemplo supone que los dos modelos escriben respuestas de la misma longitud, cosa que no ocurre en la práctica: según AA, Carbon genera menos tokens de salida por tarea que Opus en max, pero más del doble que Opus en high. Tampoco multipliques los costes por tarea de AA de la sección anterior por 1,66, porque ya incluyen los tokens que cuenta cada modelo. Donde la diferencia pesa de verdad es en los trabajos con mucha entrada y poca salida, como resumir contratos, clasificar correos o leer documentación en español.
Qué puedes usar hoy: Opus 5.5 responde y Carbon devuelve un error 503
El 29 de octubre de 2026 a las 03:00 UTC, con una clave de pago por uso de api.laozhang.ai, la lista de modelos de GET /v1/models incluía claude-opus-5-5 y, de la familia Gemini 4, solo gemini-4-argon. Una petición a gemini-4-carbon por Chat Completions y otra por generateContent nativo devolvieron las dos HTTP 503 con un mensaje que dice has no available channels for model gemini-4-carbon, sin cobro, mientras que la misma clave obtuvo respuesta de claude-opus-5-5 en todas las llamadas de la prueba de tokens. El mismo 503 ya había aparecido a la 01:36 UTC de ese día.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Esto demuestra que Carbon no se puede enrutar por esa pasarela a esa fecha, no que Google lo tenga cerrado en todas partes: no se probó la API de Google directamente con una clave de Google. Lo que sí dice Google en su anuncio es que Carbon está disponible para «un subconjunto de defensores de ciberseguridad» y que llegará a desarrolladores, empresas y usuarios «lo antes posible», sin fecha; a 29 de octubre de 2026 no aparece en la app Gemini, AI Studio, la API de Gemini, Vertex AI ni Antigravity. Quién puede usarlo, cuándo abre y en qué se diferencia de Argon está en Gemini 4 Carbon: sin fecha de acceso aún. ¿Esperar o usar Argon?.
Si necesitas un modelo de Google ya, el más cercano es Gemini 4 Argon, con 50,4 puntos en el índice de AA; cómo queda frente a Opus 5.5 y GPT-6.1 Sol está en Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy, y cómo se factura la API de Gemini, en Clave de API de Gemini gratis y precio: qué sube en 2027. En api.laozhang.ai, a 28 de octubre de 2026, claude-opus-5-5 figura a 4 $ de entrada y 20 $ de salida por millón, como en Anthropic, con un tope de 32.768 tokens por respuesta frente a los 128.000 de la API de Anthropic.
¿Cambiar a Gemini 4 Carbon o esperar? Depende de tu tipo de trabajo
Hoy no hay nada a lo que cambiar, así que la decisión real es si preparas el cambio para cuando abra Carbon o sigues con Opus 5.5 sin más. Si tu trabajo es programar con agentes en Claude Code, preparar documentos y presentaciones o automatizar el uso del ordenador, sigue con Opus y prueba Carbon cuando esté disponible, sin plan de migración: en esas tres áreas Opus va por delante en las pruebas de AA o en la tabla de Google. Si lo que haces es investigación científica, preguntas de conocimiento donde una respuesta inventada te cuesta caro o automatización de flujos entre aplicaciones, prepara la prueba de Carbon para el primer día, porque ahí las brechas son grandes y, mientras dure el precio de lanzamiento, también cuesta menos por tarea.
Si mueves mucho texto en español con poca salida, la diferencia de tokens juega a favor de Gemini incluso cuando el precio por token es el mismo, y es la razón más fácil de comprobar con tus propios datos. Si usas Opus en xhigh, cuenta con que Carbon solo te ahorrará dinero mientras dure el descuento de lanzamiento. Y si trabajas en ciberdefensa para un gobierno, una infraestructura crítica o una gran plataforma, eres el único perfil que puede pedir acceso ahora mismo por Fairwind. Si tu equipo busca o corrige vulnerabilidades fuera de Fairwind, sigue hoy con Opus y, cuando Carbon abra, compara los dos con tus propias tareas de detección y parcheo: las cifras de Google en SEC-bench Pro, ExploitGym y CWE-bench no vienen con una comparación con Opus, así que no bastan para decidir.
El día que Carbon abra, compara con estas comprobaciones:
- Lanza las mismas 20 tareas reales, desde el mismo punto de partida, en Carbon y en Opus con el nivel de esfuerzo que usas hoy, y cuenta cuántos resultados aceptarías sin corregir.
- Calcula el coste por resultado aceptado con la factura real, separando entrada nueva, lectura de caché y salida.
- Compara
input_tokensde Anthropic conpromptTokenCountde Gemini para tus propios textos en español, en lugar de dar por bueno el 1,66 de un solo párrafo. - Repite la cuenta a 4 $ y 20 $ por millón, porque el precio de lanzamiento no tiene fecha de fin publicada.
- Revisa el ID del modelo, la ventana de contexto y los límites de uso que publique Google, ya que el anuncio no incluye ninguno de los tres.
A 29 de octubre de 2026, Anthropic no ha anunciado ningún sucesor de Opus 5.5, así que cualquier plan que cuente con un Opus nuevo antes de la apertura de Carbon se apoya en rumores. Todas las cifras de la comparación son a esa fecha y cambiarán cuando Carbon tenga una API pública y AA lo mida en más configuraciones.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 29 oct 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 29 oct 2026.
- 1.ficha de Gemini 4 Carbon en Artificial Analysisartificialanalysis.ai/models/gemini-4-carbon
- 2.VentureBeat en su artículo sobre el lanzamiento de Carbonventurebeat.com/technology/google-unveils-gemini-4-carbon-retaking-the-worlds-no-1-spot-on-updated-harder-benchmarks-but-access-is-limited
- 3.anuncio de Gemini 4 Carbon en el blog de Googleblog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 4.artículo sobre Carbon como nuevo número 1artificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- 5.clasificación de agentes de programación de AAartificialanalysis.ai/agents/coding
- 6.tabla de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing