DeepSeek V4.1 Flash vs Gemini 3.8 Flash: precio real por tarea
Con las mismas tareas y el mismo acierto, Gemini 3.8 Flash costó de 2,2 a 4,3 veces más que DeepSeek V4.1 Flash. Gemini compensa si envías audio, vídeo o PDF.
En esta página
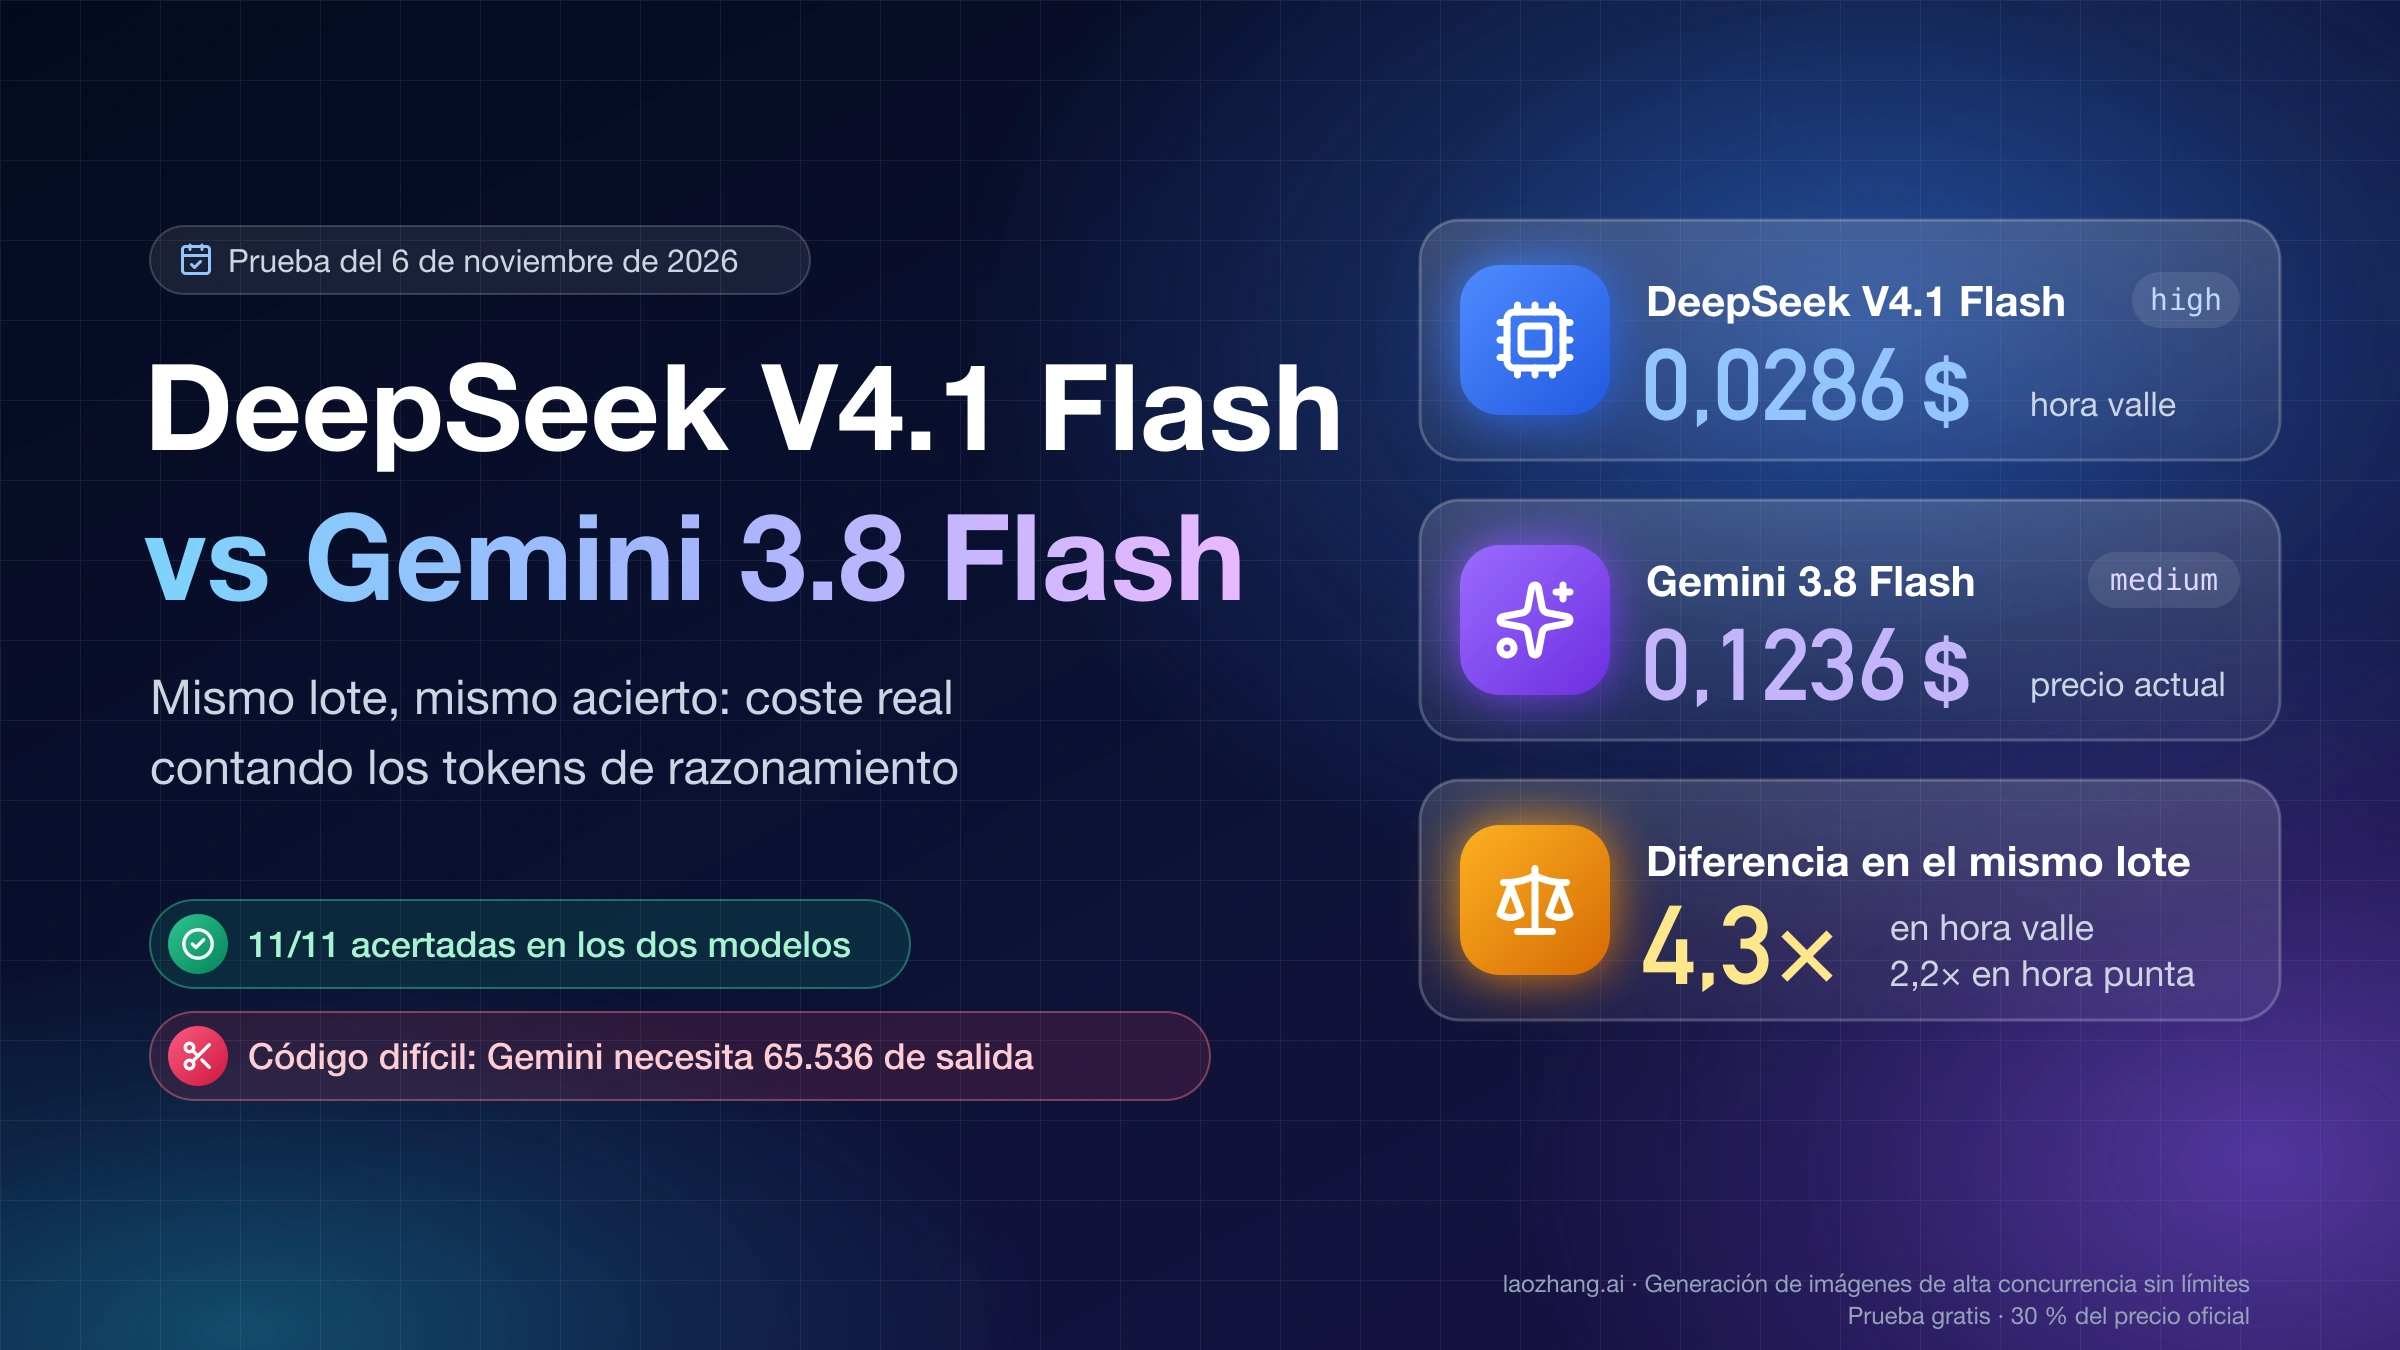
Para una carga solo de texto por API, como un backend de chat, un asistente de código o resúmenes por lotes, empieza por DeepSeek V4.1 Flash (deepseek-flash, que hoy sirve la instantánea 1017). El 6 de noviembre de 2026 se enviaron las mismas 8 tareas, 11 llamadas por modelo, a través de la pasarela LaoZhang con una sola clave: DeepSeek, con su razonamiento por defecto (high), acertó las 11 y costó 0,0286 $ a precio de lista en hora valle; Gemini 3.8 Flash (gemini-3.8-flash), con su nivel por defecto (medium), también las acertó todas y costó 4,3 veces más. Si llamas a DeepSeek en hora punta, la diferencia baja a 2,2 veces.
Elige Gemini 3.8 Flash si tienes que enviarle audio, vídeo o PDF, entradas que la documentación de la API de DeepSeek no incluye, o si tu aplicación responde preguntas de conocimiento general sin buscar en ninguna fuente. Y si lo usas para código difícil, sube maxOutputTokens a 65.536: en una tarea de rangos de versiones (semver), Gemini se quedó sin respuesta con un límite de 32.000 tokens porque seguía razonando, y con 65.536 la resolvió las cuatro veces, aunque cada llamada costó entre 8 y 15 veces lo que la de DeepSeek.
Cuánto cuesta el mismo trabajo contando el razonamiento
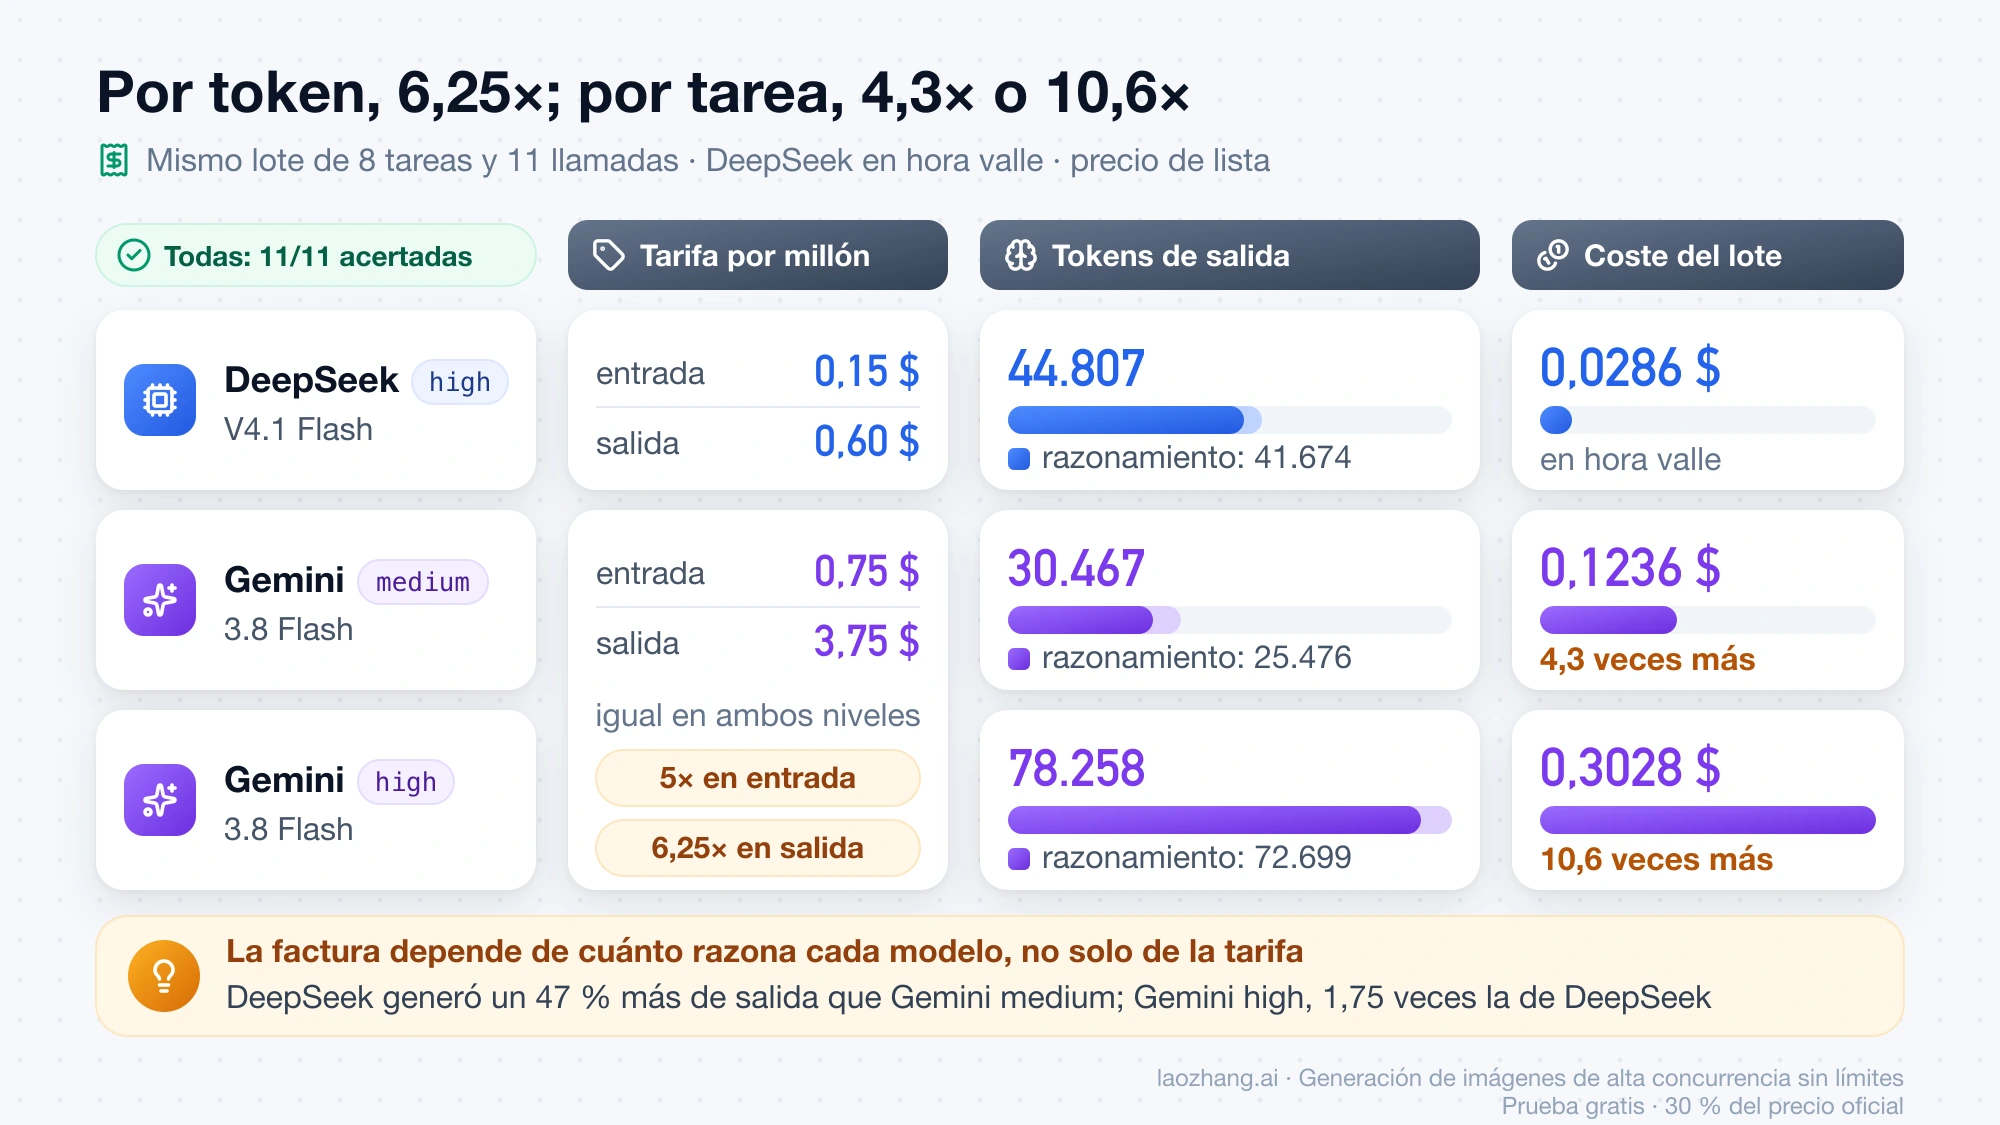
En la prueba del 6 de noviembre de 2026, el mismo lote de tareas costó más en Gemini 3.8 Flash que en DeepSeek V4.1 Flash con cualquiera de los dos niveles de razonamiento de Gemini, y cuánto más depende de ese nivel. El lote tenía un problema de aritmética con enunciado, cinco funciones de Python corregidas con tests ocultos, un recuento numérico con respuesta única y el resumen de un artículo de 6.723 palabras en cinco viñetas. Como las tres configuraciones acertaron las 11 llamadas, aquí no se compara calidad, solo coste y tiempo. El coste es el uso de tokens que devolvió cada API multiplicado por el precio de lista oficial, y en los dos modelos los tokens de razonamiento se cobran como salida.
| Configuración | Acertadas | Tokens de salida (de ellos, razonamiento) | Coste con el precio de hoy | Coste en el otro escenario |
|---|---|---|---|---|
DeepSeek V4.1 Flash, high (por defecto) | 11/11 | 44.807 (41.674) | 0,0286 $ en hora valle | 0,0572 $ en hora punta |
Gemini 3.8 Flash, medium (por defecto) | 11/11 | 30.467 (25.476) | 0,1236 $ | 0,2472 $ desde el 1 de enero de 2027 |
Gemini 3.8 Flash, high | 11/11 | 78.258 (72.699) | 0,3028 $ | 0,6057 $ desde el 1 de enero de 2027 |
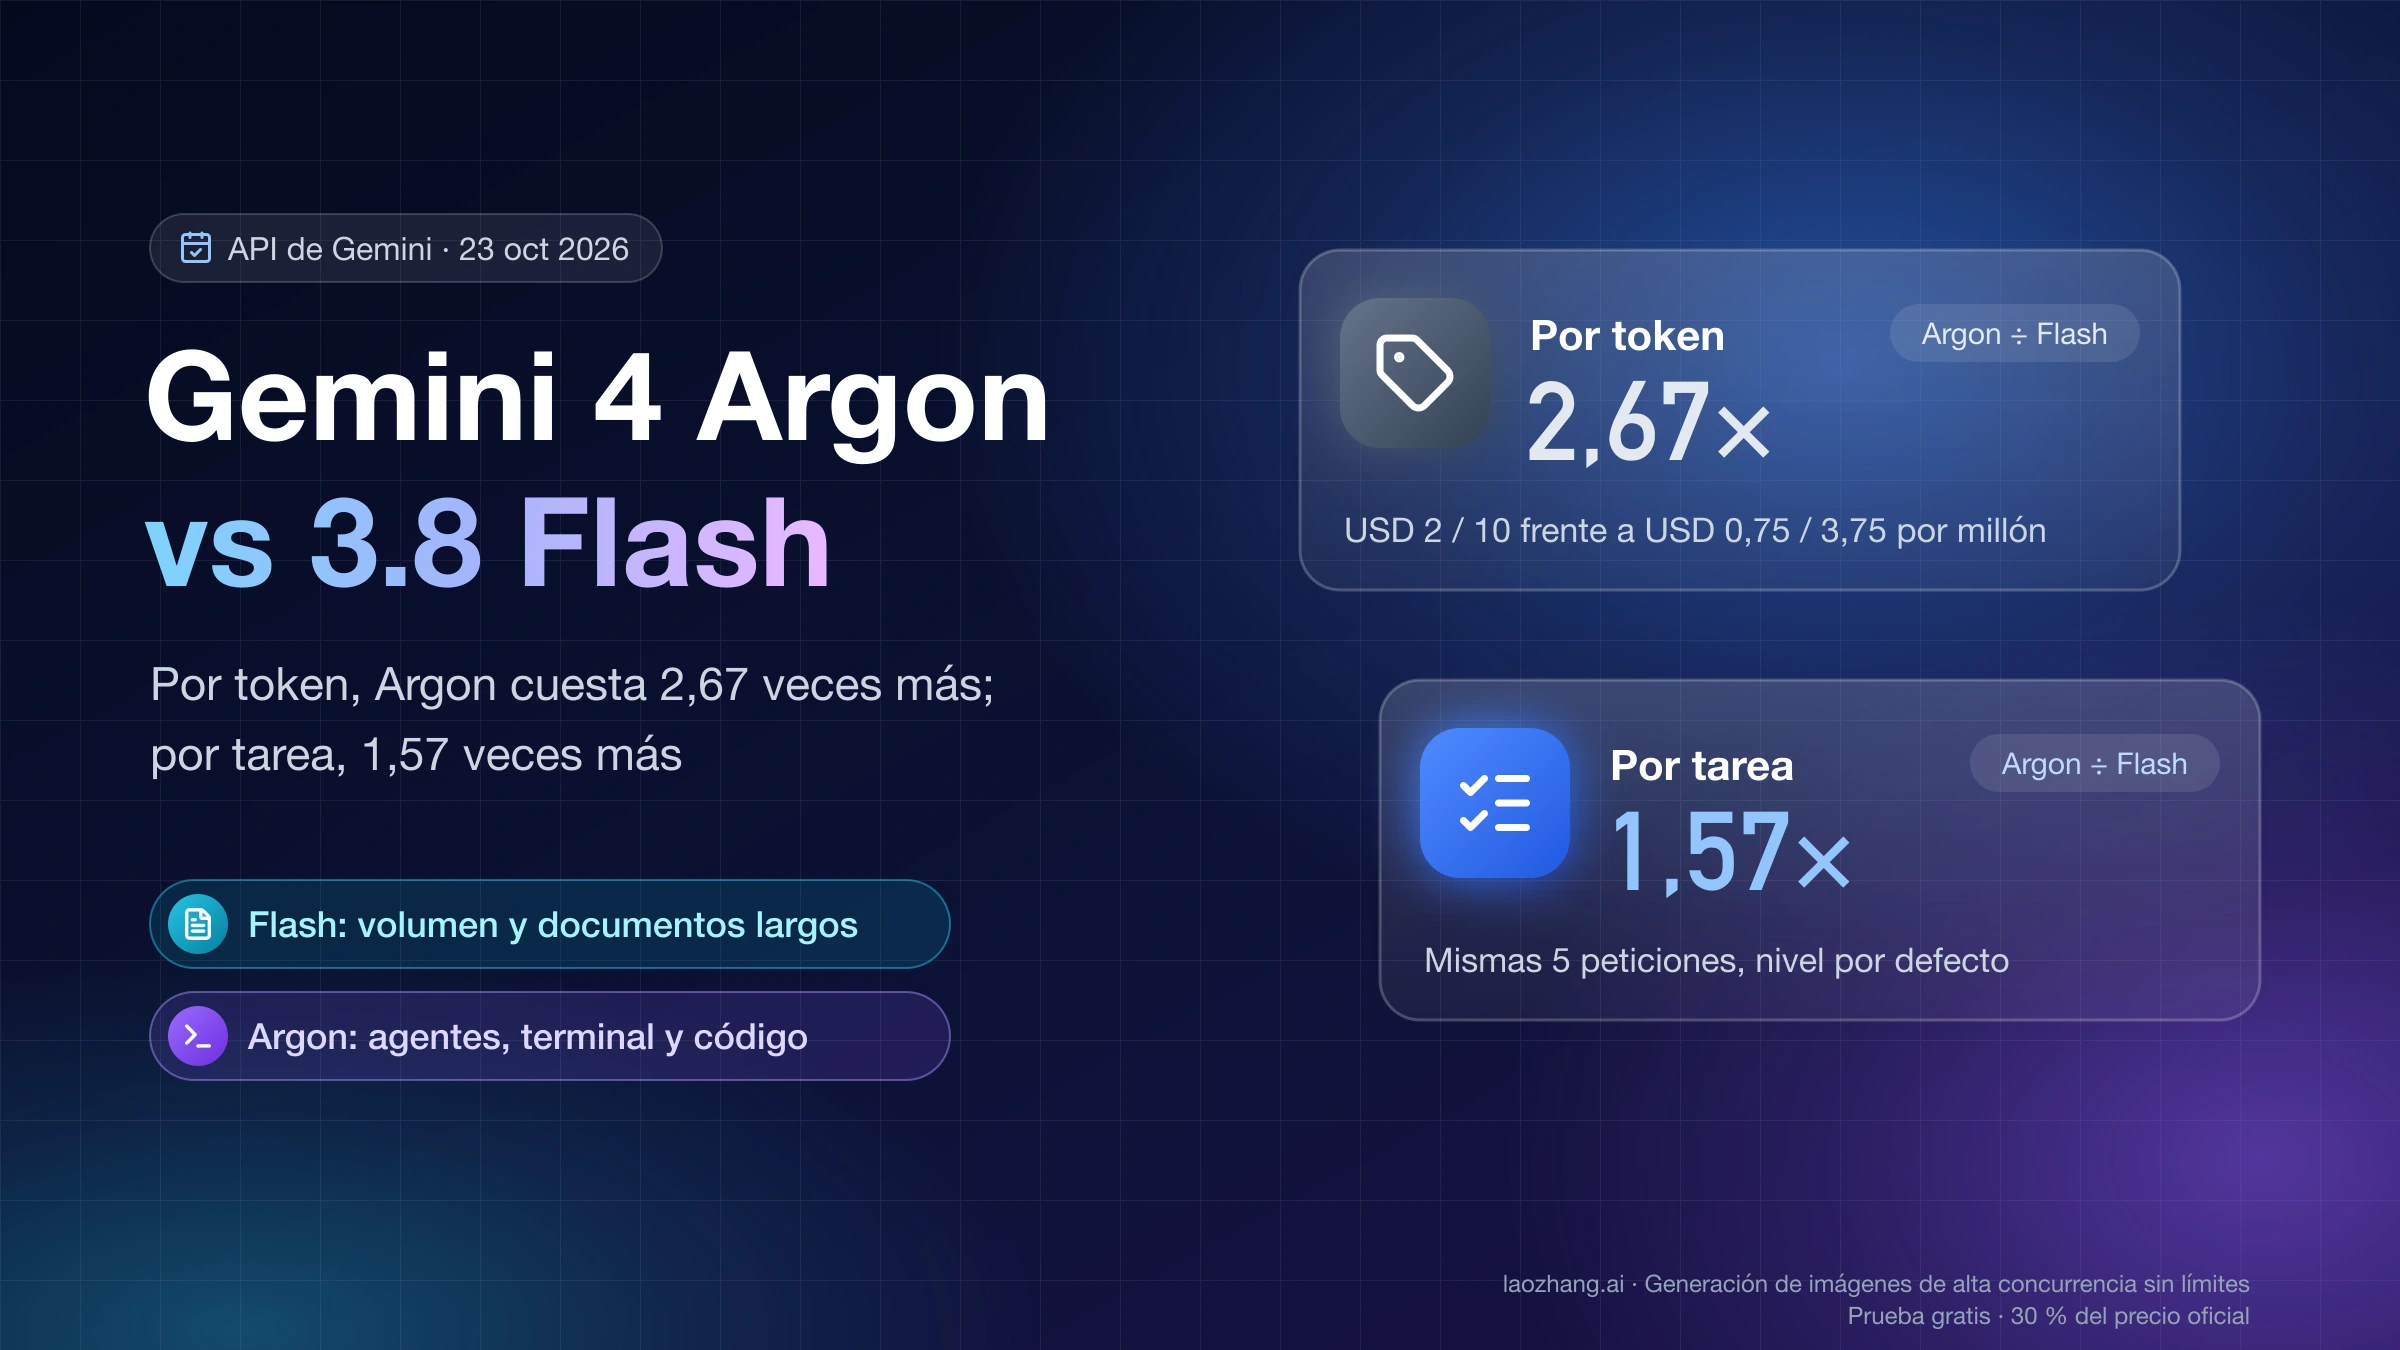
La diferencia de precio por token y la de coste por tarea no son el mismo múltiplo. Por millón de tokens, Gemini 3.8 Flash cobra 0,75 $ de entrada y 3,75 $ de salida, frente a 0,15 $ y 0,60 $ de DeepSeek en hora valle, según las páginas de precios de Gemini API y de DeepSeek API: 5 veces más en entrada y 6,25 veces más en salida. Pero DeepSeek generó un 47 % más de tokens de salida que Gemini en medium, casi todos de razonamiento, y eso deja la diferencia en 4,3 veces. Con Gemini en high pasa lo contrario: produjo 1,75 veces los tokens de DeepSeek y el múltiplo sube a 10,6. Lo que decide la factura es cuánto razona cada modelo con tu tarea, no la tarifa sola.
Puedes recalcular cualquier fila con la fórmula (entrada sin caché × precio de entrada + entrada en caché × precio de caché + salida × precio de salida) ÷ 1.000.000. Para DeepSeek en valle: 11.580 tokens × 0,15 + 256 tokens en caché × 0,003 + 44.807 × 0,60 da 0,0286 $. Para Gemini en medium: 12.486 × 0,75 + 30.467 × 3,75 da 0,1236 $. El razonamiento además varía de una llamada a otra: la misma tarea de evaluar expresiones sin eval consumió 8.708 tokens de salida en DeepSeek la primera vez y 19.986 la segunda, así que presupuesta con márgenes y no con una sola medición.
En trabajos de entrada larga la diferencia se acerca al múltiplo de la tarifa de entrada. Resumir el artículo de 6.723 palabras costó 0,0025 $ en DeepSeek y 0,0176 $ en Gemini medium, unas 7 veces más. El recuento de tokens apenas influye en español: 3.000 caracteres del mismo texto en español contaron 976 tokens en DeepSeek y 965 en Gemini, un 1,1 % menos; en inglés Gemini cuenta entre un 8,8 % y un 10,9 % más, que tampoco cambia la conclusión.
Las dos API aplican caché sin configurar nada. Al repetir una petición de 10.387 tokens, DeepSeek leyó 10.368 de caché y la llamada bajó de 0,0019 $ a 0,0004 $; Gemini reutilizó de forma implícita 8.168 de 11.300 tokens y pasó de 0,0107 $ a 0,0054 $. Si tu carga repite un contexto largo, como instrucciones de sistema o un documento base, DeepSeek abarata más esa parte.
Todas las llamadas de la prueba pasaron por la pasarela LaoZhang, que cobra deepseek-flash a 0,44 $ de entrada y 1,32 $ de salida por millón de tokens a cualquier hora, por encima del precio directo de DeepSeek incluso en hora punta, y gemini-3.8-flash al mismo precio que Google. Con esa tarifa, el lote costaría 0,0643 $ en DeepSeek y Gemini en medium saldría 1,9 veces más caro.
Código difícil: Gemini resolvió el semver solo con 65.536 tokens de salida
Las 8 tareas anteriores no separan a los dos modelos, así que el mismo día se repitieron dos veces otras tres más exigentes. La que marcó diferencias fue escribir un comprobador de rangos de versiones al estilo de npm (semver, con ^, ~, guiones, || y la regla de las versiones preliminares), corregido con 36 tests ocultos. DeepSeek V4.1 Flash lo resolvió las dos veces con un límite de salida de 32.000 tokens. Gemini 3.8 Flash, con el mismo límite, falló tres de sus cuatro intentos, y no porque escribiera mal el código: agotó el presupuesto mientras razonaba (finishReason: MAX_TOKENS) y no llegó a entregar código completo.
| Modelo y nivel | Límite de salida | Tests superados | Tokens de salida por llamada | Coste por llamada | Tiempo por llamada |
|---|---|---|---|---|---|
DeepSeek V4.1 Flash, high | 32.000 | 2 de 2 | 24.531 y 23.154 | 0,0148 $ y 0,0139 $ en valle | 150 s y 141 s |
Gemini 3.8 Flash, medium | 32.000 | 1 de 2 | 31.996 y 22.468 | 0,1203 $ y 0,0846 $ | 210 s y 193 s |
Gemini 3.8 Flash, high | 32.000 | 0 de 2 | 31.898 y 31.996 | 0,1199 $ y 0,1203 $ | 255 s y 237 s |
Gemini 3.8 Flash, medium | 65.536 | 2 de 2 | 30.421 y 30.794 | 0,1144 $ y 0,1158 $ | 199 s y 218 s |
Gemini 3.8 Flash, high | 65.536 | 2 de 2 | 55.224 y 38.875 | 0,2074 $ y 0,1461 $ | 308 s y 300 s |
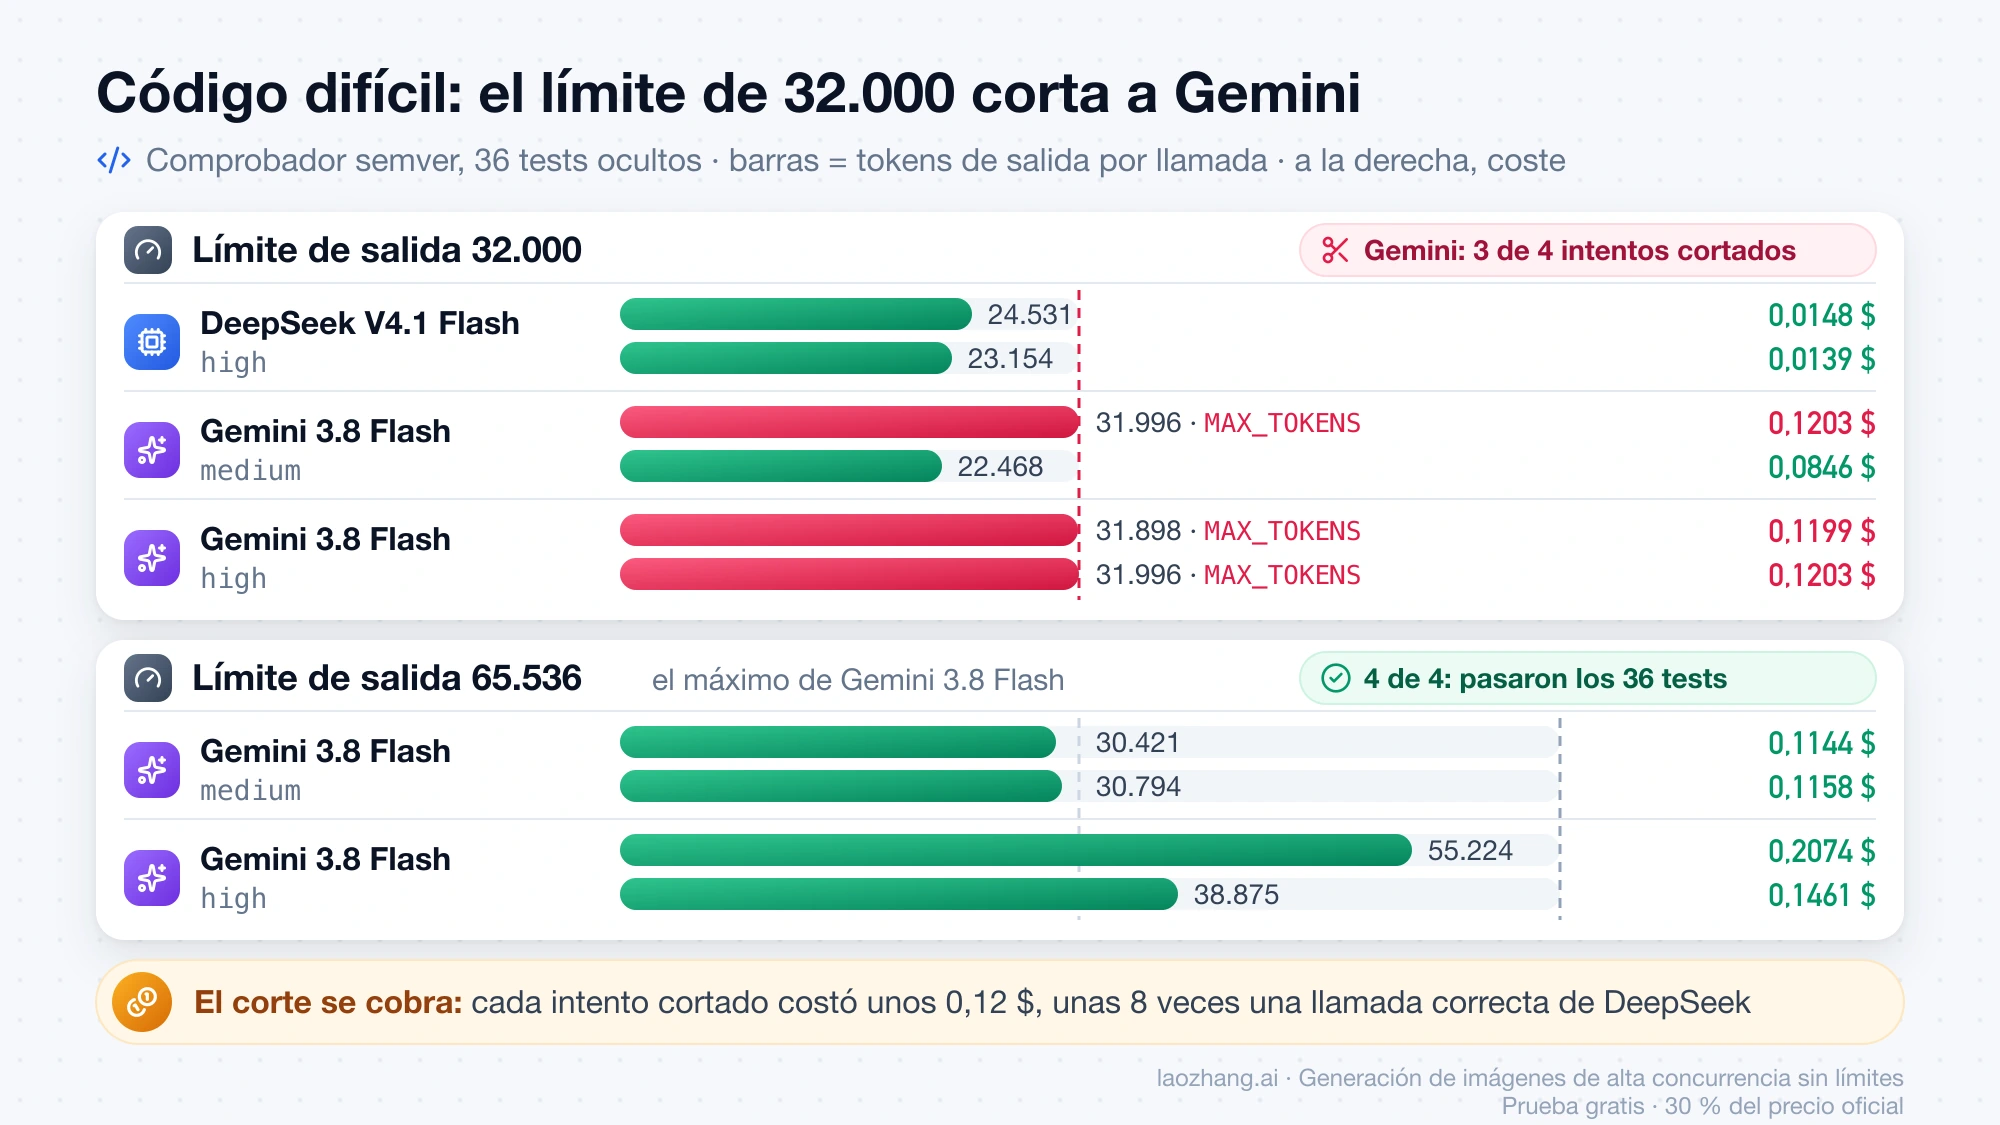
Al repetir el semver con 65.536 tokens, el máximo que admite Gemini 3.8 Flash, pasó los 36 tests en las cuatro llamadas. Gemini puede resolverlo; lo que necesita es más margen de salida, más tiempo y más dinero. La documentación de razonamiento de Gemini explica por qué el corte sale caro: el límite de salida incluye los tokens de razonamiento, y si el modelo lo alcanza mientras razona devuelve una respuesta vacía o cortada y cobra igualmente los tokens de razonamiento generados. Cada intento fallido costó unos 0,12 $, unas 8 veces una llamada correcta de DeepSeek. Google recomienda bajar thinking_level en lugar de poner un límite de salida pequeño cuando quieres ahorrar.
Las otras dos tareas no separaron a nadie. En la primera había que sacar una cifra de tres notas repartidas por el artículo largo, una de ellas con una corrección posterior del 25 %; los dos modelos dieron siempre 76,80 $. En la segunda se preguntaba por dos funciones de la biblioteca estándar de Python 3.13 que no existen, y todas las respuestas, 4 de DeepSeek y 8 de Gemini, dijeron que no existen en lugar de inventarlas. Son dos muestras por configuración y una sola tarea de código de este tipo, así que no es una clasificación de capacidad: indica que, en código con especificaciones largas, el presupuesto de salida de Gemini puede ser el límite antes que su capacidad.
Primera palabra de la respuesta: DeepSeek tardó la mitad en esta prueba
En la prueba del 6 de noviembre, en streaming y a través de la pasarela LaoZhang, la mediana hasta la primera palabra de la respuesta fue de 10,9 s en DeepSeek V4.1 Flash, 22,0 s en Gemini 3.8 Flash medium y 27,9 s en high; en las tareas difíciles, 9,4 s frente a 27,0 s y 42,1 s. La mediana del tiempo total por llamada siguió el mismo orden: 12,3 s, 24,1 s y 30,1 s. Artificial Analysis, en cambio, mide lo contrario con sus propias tareas y su propia infraestructura: 24,11 s hasta la primera palabra de la respuesta para DeepSeek en high y 10,01 s para Gemini en medium, según su comparativa de DeepSeek V4.1 Flash 1017 y Gemini 3.8 Flash. Esa misma página da a DeepSeek más velocidad de salida, 175 tokens por segundo frente a 116. Si la espera importa en tu producto, mídela con el proveedor y la región que vas a usar.
La forma de transmitir también cambia lo que ve tu usuario. DeepSeek envía su razonamiento en el campo reasoning_content desde el primer momento, con una mediana de 2,6 s hasta el primer fragmento, así que una interfaz de chat puede mostrar «pensando…» con texto real casi enseguida. Gemini no envía nada hasta la respuesta, salvo que pidas resúmenes del razonamiento con includeThoughts; con esa opción, en las tareas difíciles el primer fragmento llegó en unos 4–5 s. Las llamadas de DeepSeek también fueron menos regulares: una sola llamada de 153,5 s hizo que la suma de las 11 fuera de 363 s, frente a 301 s de Gemini medium. En un proceso por lotes nada de esto importa, y ahí cuenta más que Gemini ofrezca Batch y Flex a mitad de precio, como se explica más abajo.
¿Es Gemini 3.8 Flash más listo que DeepSeek V4.1 Flash 1017?
En el nivel por defecto de cada uno están empatados en la media, pero no en todo. En el índice de Artificial Analysis (versión 5.0.1, a 6 de noviembre de 2026), DeepSeek V4.1 Flash 1017 saca 29 puntos en high y 33 en max; Gemini 3.8 Flash, 30 en medium, 31 en high y 23 en low. DeepSeek gana en tareas de terminal (Terminal-Bench 4.0: 28,8 % en high y 33,8 % en max, frente a 19,7 % de Gemini en high), y Gemini gana con claridad en preguntas científicas (HLE-Diamond 33,1 % frente a 25,3 %; CritPt 46,5 % frente a 25,0 %) y, sobre todo, en conocimiento factual: en AA-Omniscience Gemini obtiene 23–24 y DeepSeek 1–2.
Traducido a cargas reales: si tu backend responde preguntas de conocimiento sin darle la información, Gemini 3.8 Flash es la opción más segura. Si el modelo escribe o corrige código, o procesa texto que tú le das (resumir, extraer, clasificar), las dos rondas del 6 de noviembre no muestran ventaja de calidad para Gemini y DeepSeek cuesta mucho menos. Artificial Analysis también calcula el coste de pasar su índice completo: 0,46 $ por tarea con DeepSeek en high y 6,26 $ con Gemini en medium. Ojo: Artificial Analysis aplica a DeepSeek el precio de hora punta, así que en hora valle esa cifra sería aproximadamente la mitad.
Por qué otras comparativas dan precios y ganadores distintos
Las cifras que circulan sobre este par no coinciden por tres motivos. El primero es la versión: DeepSeek publicó V4.1 Flash el 10 de septiembre de 2026 y la actualizó el 17 de octubre con la instantánea 1017, al mismo precio y, según su registro de cambios, con salidas más cortas y tareas más rápidas; las comparativas de septiembre, y pruebas como la que publicó aimlapi en X con seis escenas 3D (168.000 tokens de salida y hasta 3 minutos en DeepSeek frente a 21.000 tokens y menos de 25 s en Gemini), describen la versión anterior. El segundo es el precio: algunas tablas muestran tarifas de revendedores o precios con caché como si fueran el precio de DeepSeek. El tercero es el nivel de razonamiento: comparar DeepSeek en max con Gemini en medium, o DeepSeek en high con Gemini en high, puede invertir el ganador, como muestran las puntuaciones de Artificial Analysis de la sección anterior. Si ves un «DeepSeek V4.1 Pro», ese modelo no existe; el modelo Pro de DeepSeek es deepseek-v4-pro, que hoy sirve V4-Pro-0813.
Hora punta en España y precio de 2027: cuándo cambia la diferencia
La ventaja de DeepSeek se reduce a la mitad en su hora punta y se duplica cuando Gemini cambie de precio el 1 de enero de 2027. DeepSeek cobra en hora valle exactamente la mitad que en punta, y la punta en España peninsular es de lunes a viernes de 02:00 a 05:00 y de 07:00 a 11:00 (01:00–04:00 y 06:00–10:00 UTC, con el horario de invierno vigente desde el 25 de octubre); en Canarias, una hora menos. Los fines de semana y los festivos chinos son valle todo el día. Cuando vuelva el horario de verano, el 28 de marzo de 2027, las franjas pasarán a 03:00–06:00 y 08:00–12:00. Cómo mover trabajos fuera de esas franjas está en Precio de la API de DeepSeek en hora punta y valle desde España.
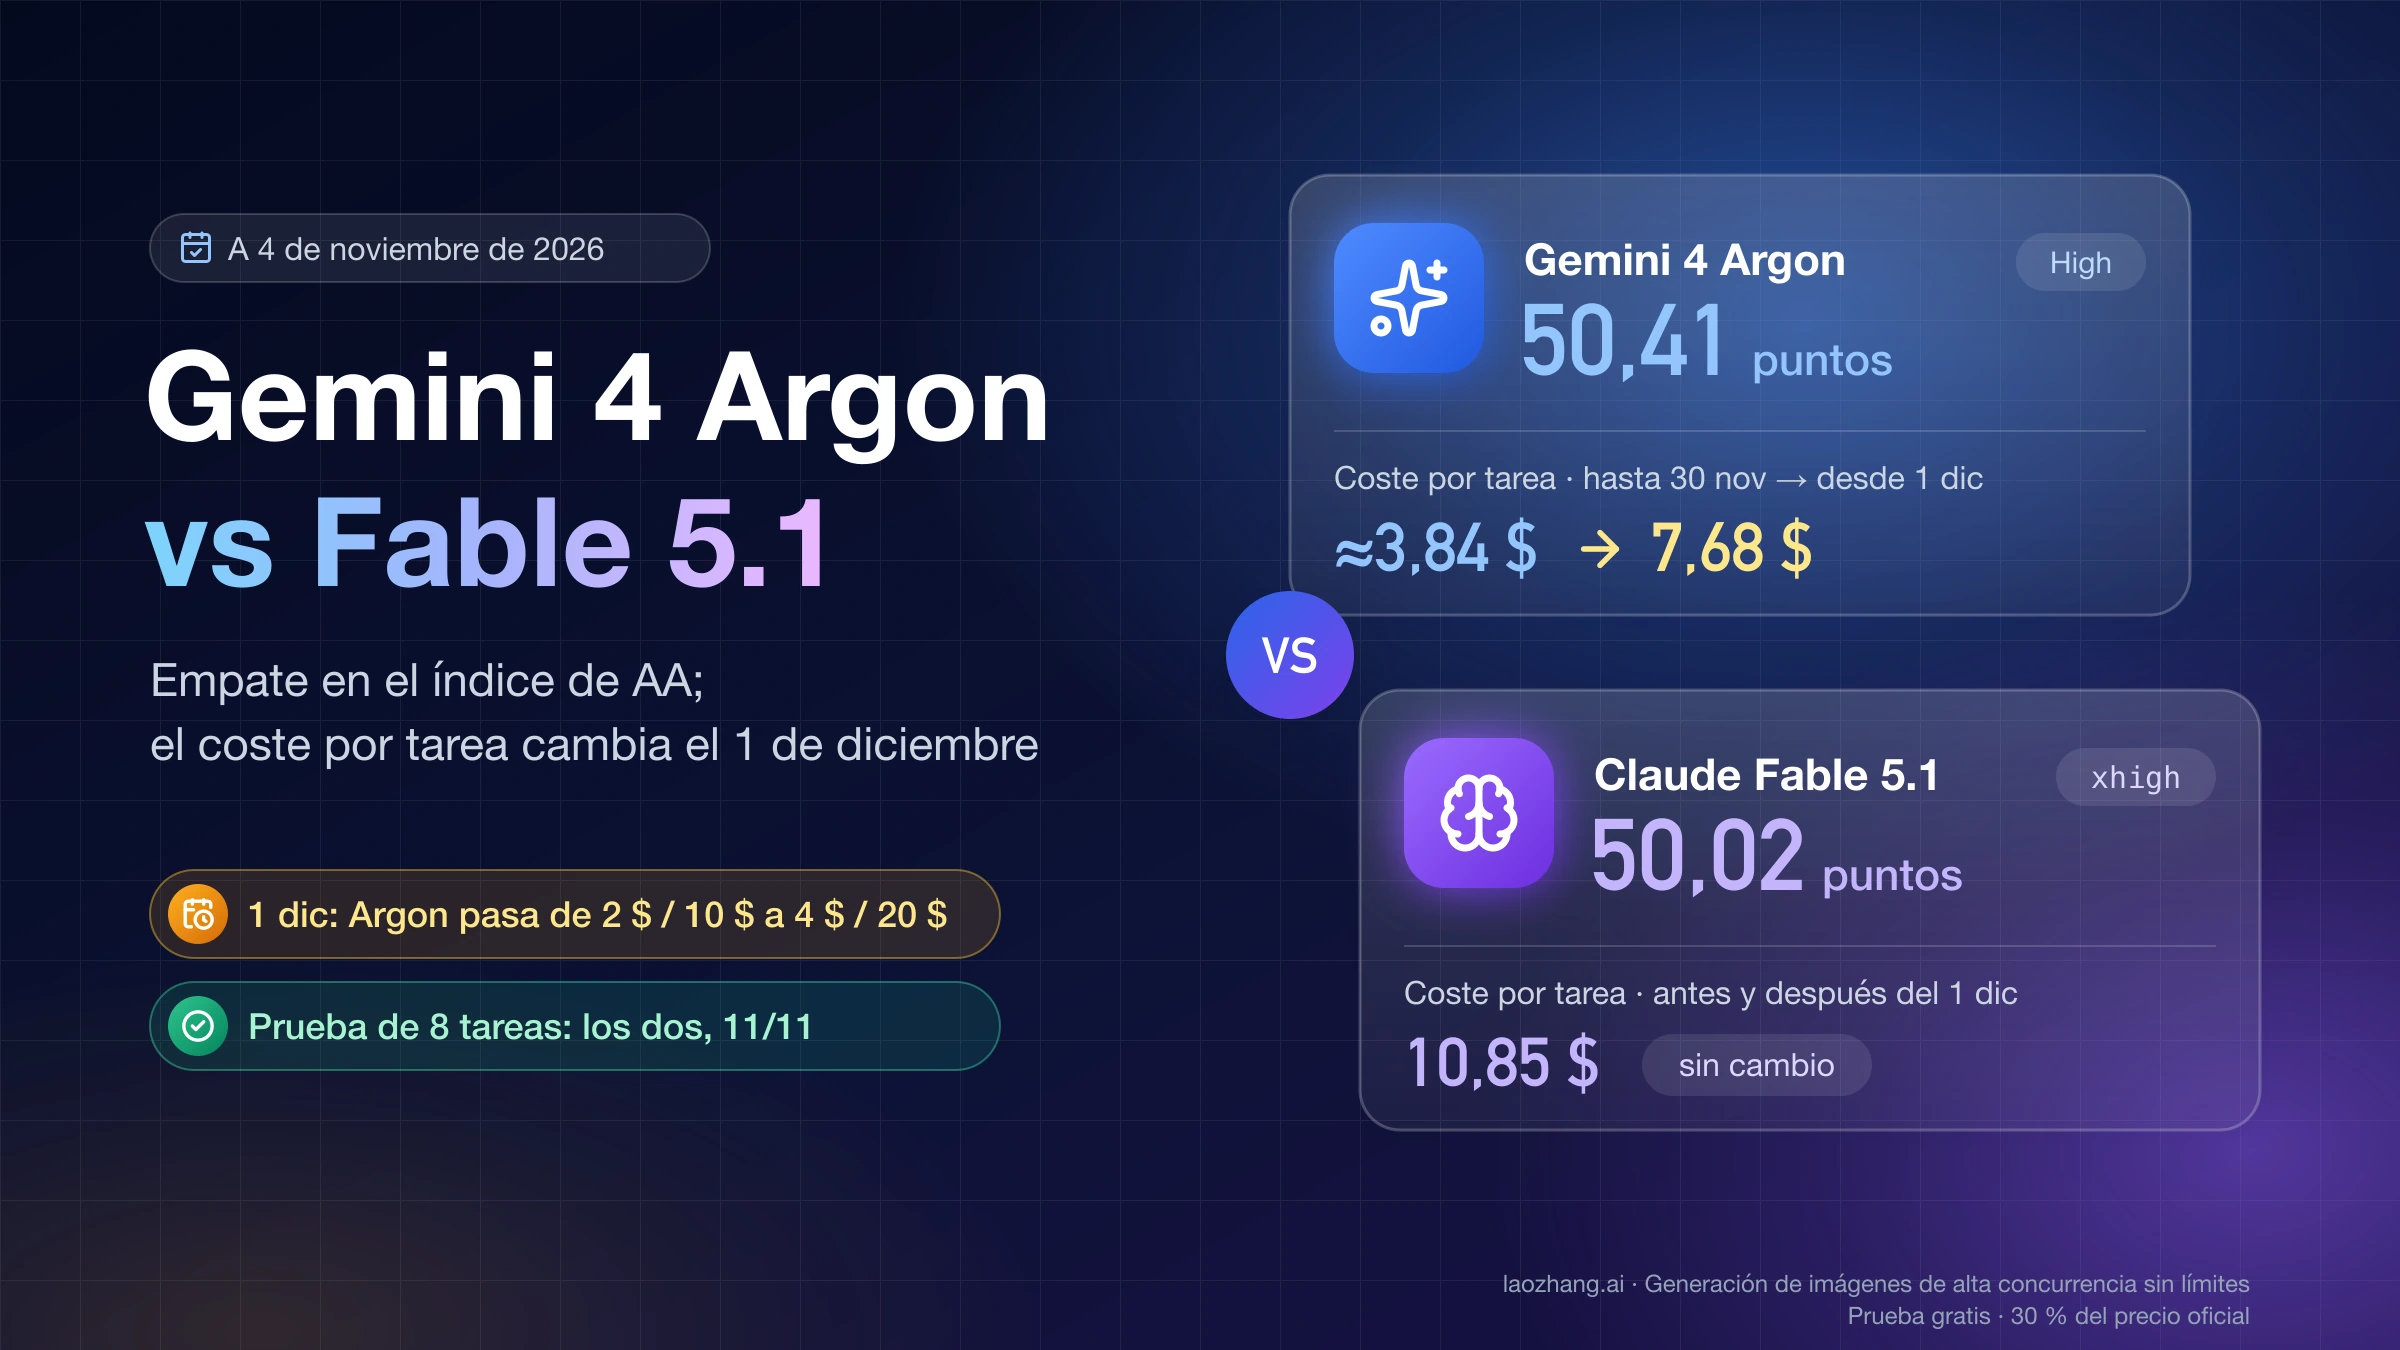
Gemini 3.8 Flash cobra 0,75 $ de entrada y 3,75 $ de salida por millón hasta el 31 de diciembre de 2026, y 1,50 $ y 7,50 $ desde el 1 de enero de 2027. Con la tarifa nueva, el mismo lote en medium costaría 8,6 veces DeepSeek en valle y 4,3 veces en punta. Si tu carga es por lotes y no necesitas respuesta inmediata, Gemini Batch y Flex cobran la mitad (0,375 $ y 1,875 $ en 2026): el lote en medium bajaría a 0,0618 $, 2,2 veces DeepSeek en valle. El detalle de tarifas y del cambio de 2027 está en Clave de API de Gemini gratis y precio: qué sube en 2027.
Audio, vídeo, PDF o salidas muy largas: qué acepta cada API
Si tu entrada incluye audio, vídeo o PDF, la elección es Gemini 3.8 Flash; si necesitas respuestas de más de 65.536 tokens, contando el razonamiento, es DeepSeek V4.1 Flash. Según la ficha de Gemini 3.8 Flash, el modelo acepta texto, imagen, vídeo, audio y PDF, con hasta 1.048.576 tokens de entrada y 65.536 de salida, y admite Batch, caché, ejecución de código, llamadas a funciones y búsqueda en archivos; no genera imágenes ni audio y no tiene Live API. DeepSeek V4.1 Flash tiene 1 millón de tokens de contexto y hasta 384.000 de salida, admite imagen, salida JSON, llamadas a herramientas, la Responses API y el formato de la API de Anthropic, pero su documentación no incluye audio, vídeo ni PDF, así que un PDF tendrías que convertirlo antes a texto.
Para búsquedas web, Gemini incluye 5.000 consultas al mes de fundamentación con la Búsqueda de Google, compartidas entre los modelos Gemini 3 y posteriores, y después cobra 14 $ por cada 1.000; DeepSeek cobra su búsqueda aparte, como se explica en DeepSeek Search API: precio, límites y cobro en Claude Code. La prueba del 6 de noviembre solo usó texto, sin herramientas ni contexto largo, así que no mide cómo se comporta cada modelo con imágenes o audio.
Razonamiento por defecto: high en DeepSeek, medium en Gemini
Si no tocas nada, DeepSeek V4.1 Flash razona en high y Gemini 3.8 Flash en medium, y esa es la pareja que compara la tabla de costes. En DeepSeek, según su guía del modo de pensamiento, reasoning_effort acepta low, high y max, y el razonamiento se desactiva con {"thinking": {"type": "disabled"}}. En Gemini, thinking_level acepta low, medium y high; no existe minimal para este modelo.
Subir el nivel de Gemini no compensó en estas tareas: en high costó 2,4 veces lo de medium, tardó más en responder y no acertó ninguna llamada más; en el semver incluso consumió más presupuesto antes de entregar código. Los niveles low y max no entraron en la prueba. Según Artificial Analysis, DeepSeek en max sube de 29 a 33 puntos y pasa de 0,46 $ a 0,60 $ por tarea de su índice, y Gemini en low baja de 30 a 23 puntos.
Estos son ejemplos de dónde va cada parámetro en la API oficial de cada empresa, con el nivel por defecto escrito de forma explícita. La prueba usó los mismos nombres de parámetro, pero envió todas las llamadas por la pasarela LaoZhang, no a estos endpoints, con 32.000 tokens de salida en las rondas 1 y 2; el valor de 65.536 y includeThoughts del ejemplo de Gemini corresponden a la repetición del semver (includeThoughts ya se activó en la ronda 2, no en la 1).
# DeepSeek V4.1 Flash, formato compatible con OpenAI
from openai import OpenAI

client = OpenAI(api_key="TU_CLAVE_DEEPSEEK", base_url="https://api.deepseek.com")
r = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "..."}],
    reasoning_effort="high",                        # low, high o max
    max_tokens=32000,
    extra_body={"thinking": {"type": "enabled"}},
)
print(r.choices[0].message.reasoning_content)       # razonamiento
print(r.choices[0].message.content) # respuesta{
"contents": [{ "role": "user", "parts": [{ "text": "..." }] }],
"generationConfig": {
"maxOutputTokens": 65536,
"thinkingConfig": { "thinkingLevel": "medium", "includeThoughts": true }
}
}En la API de Google, el segundo cuerpo va a POST https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:streamGenerateContent?alt=sse; en la Interactions API de Google el mismo ajuste se escribe generation_config.thinking_level. Al cambiar de un modelo a otro, revisa estos puntos:
- Si tu código envía
reasoning_effort: "medium"a DeepSeek, se ejecuta comohigh;minimalpasa alowyxhighahigh. - En modo de pensamiento, DeepSeek ignora
temperature,presence_penaltyyfrequency_penaltysin devolver error. maxOutputTokensde Gemini incluye el razonamiento y no pasa de 65.536; con 32.000 se cortaron tres de cuatro intentos de la tarea difícil.- Los nombres antiguos
deepseek-v4-flashydeepseek-v4-flash-vision-expsiguen funcionando y también los sirve 1017 al precio de Flash. - Para contar la salida facturable de Gemini, en la prueba se usó
totalTokenCount − promptTokenCount, porque en una llamada cortada el flujo repitió encandidatesTokenCountla cifra dethoughtsTokenCount.
Cómo se hizo la prueba del 6 de noviembre y qué no cubre
Las llamadas se hicieron el viernes 6 de noviembre de 2026 a partir de las 12:50 UTC, en hora valle de DeepSeek, todas en streaming y con una sola clave de la pasarela LaoZhang para los dos modelos. DeepSeek se llamó con deepseek-flash por el endpoint compatible con OpenAI, razonamiento activado en high y 32.000 tokens de límite, y devolvió deepseek-v4-1-flash-261017 como modelo en todas las llamadas. Gemini se llamó por su endpoint nativo en medium y en high con el mismo límite, y una llamada solo contaba si todos los fragmentos indicaban gemini-3.8-flash como versión del modelo. Sin mensaje de sistema, sin herramientas y sin ajustar la temperatura. Las tareas sencillas se enviaron una vez y las difíciles dos, y los tests ocultos se comprobaron antes contra implementaciones de referencia.
El resultado de Gemini se repite: el 26 de octubre de 2026, el mismo lote de 8 tareas en high por la misma pasarela, sin streaming, acertó 11 de 11 con 80.277 tokens de salida y 0,3104 $, a menos de un 3 % de lo medido el 6 de noviembre. Durante la prueba, la pasarela devolvió dos veces fragmentos de otro modelo de Google al pedir gemini-3.8-flash y cortó una vez una conexión silenciosa a los 300 s; esos intentos se descartaron y se repitieron, porque son fallos del intermediario y no del modelo.
Es una sola ruta, un solo día y una o dos muestras por tarea, no una evaluación formal. No se probaron la API directa de DeepSeek ni la de Google AI Studio, entradas de imagen, audio o vídeo, herramientas, contextos largos, DeepSeek en low o max ni Gemini en low, y los tiempos pueden reflejar la pasarela tanto como el modelo. Las puntuaciones de capacidad de este texto vienen de Artificial Analysis y del registro de cambios de DeepSeek, cada una con su enlace.
DeepSeek V4.1 Flash y Gemini 3.8 Flash: otras preguntas
¿Qué significa «1017» en DeepSeek V4.1 Flash?
Es la etiqueta de la instantánea del 17 de octubre de 2026, no un número de versión. A 6 de noviembre de 2026, el nombre de modelo deepseek-flash de la API de DeepSeek apunta a DeepSeek-V4.1-Flash-1017, con el mismo precio y la misma forma de llamada que la versión de septiembre, según la página de precios de DeepSeek API. Para comprobar qué instantánea te responde, mira el campo model de la respuesta.
¿Puedo usar la API de Gemini 3.8 Flash desde España?
Sí. España figura en la lista de regiones disponibles de Gemini API a 6 de noviembre de 2026. DeepSeek no publica una lista de regiones en su documentación de precios.
¿Gemini 3.8 Flash tiene nivel gratuito en la API?
Sí: en el nivel gratuito de Gemini API la entrada y la salida de gemini-3.8-flash no se cobran, pero Google no publica cuántas peticiones diarias permite. Qué modelos y límites entran está en Gemini API free tier 2026: modelos gratis, límites y API key.
¿Y frente a GLM-5.3-Flash, Claude Sonnet 5.5 o Gemini 4 Argon?
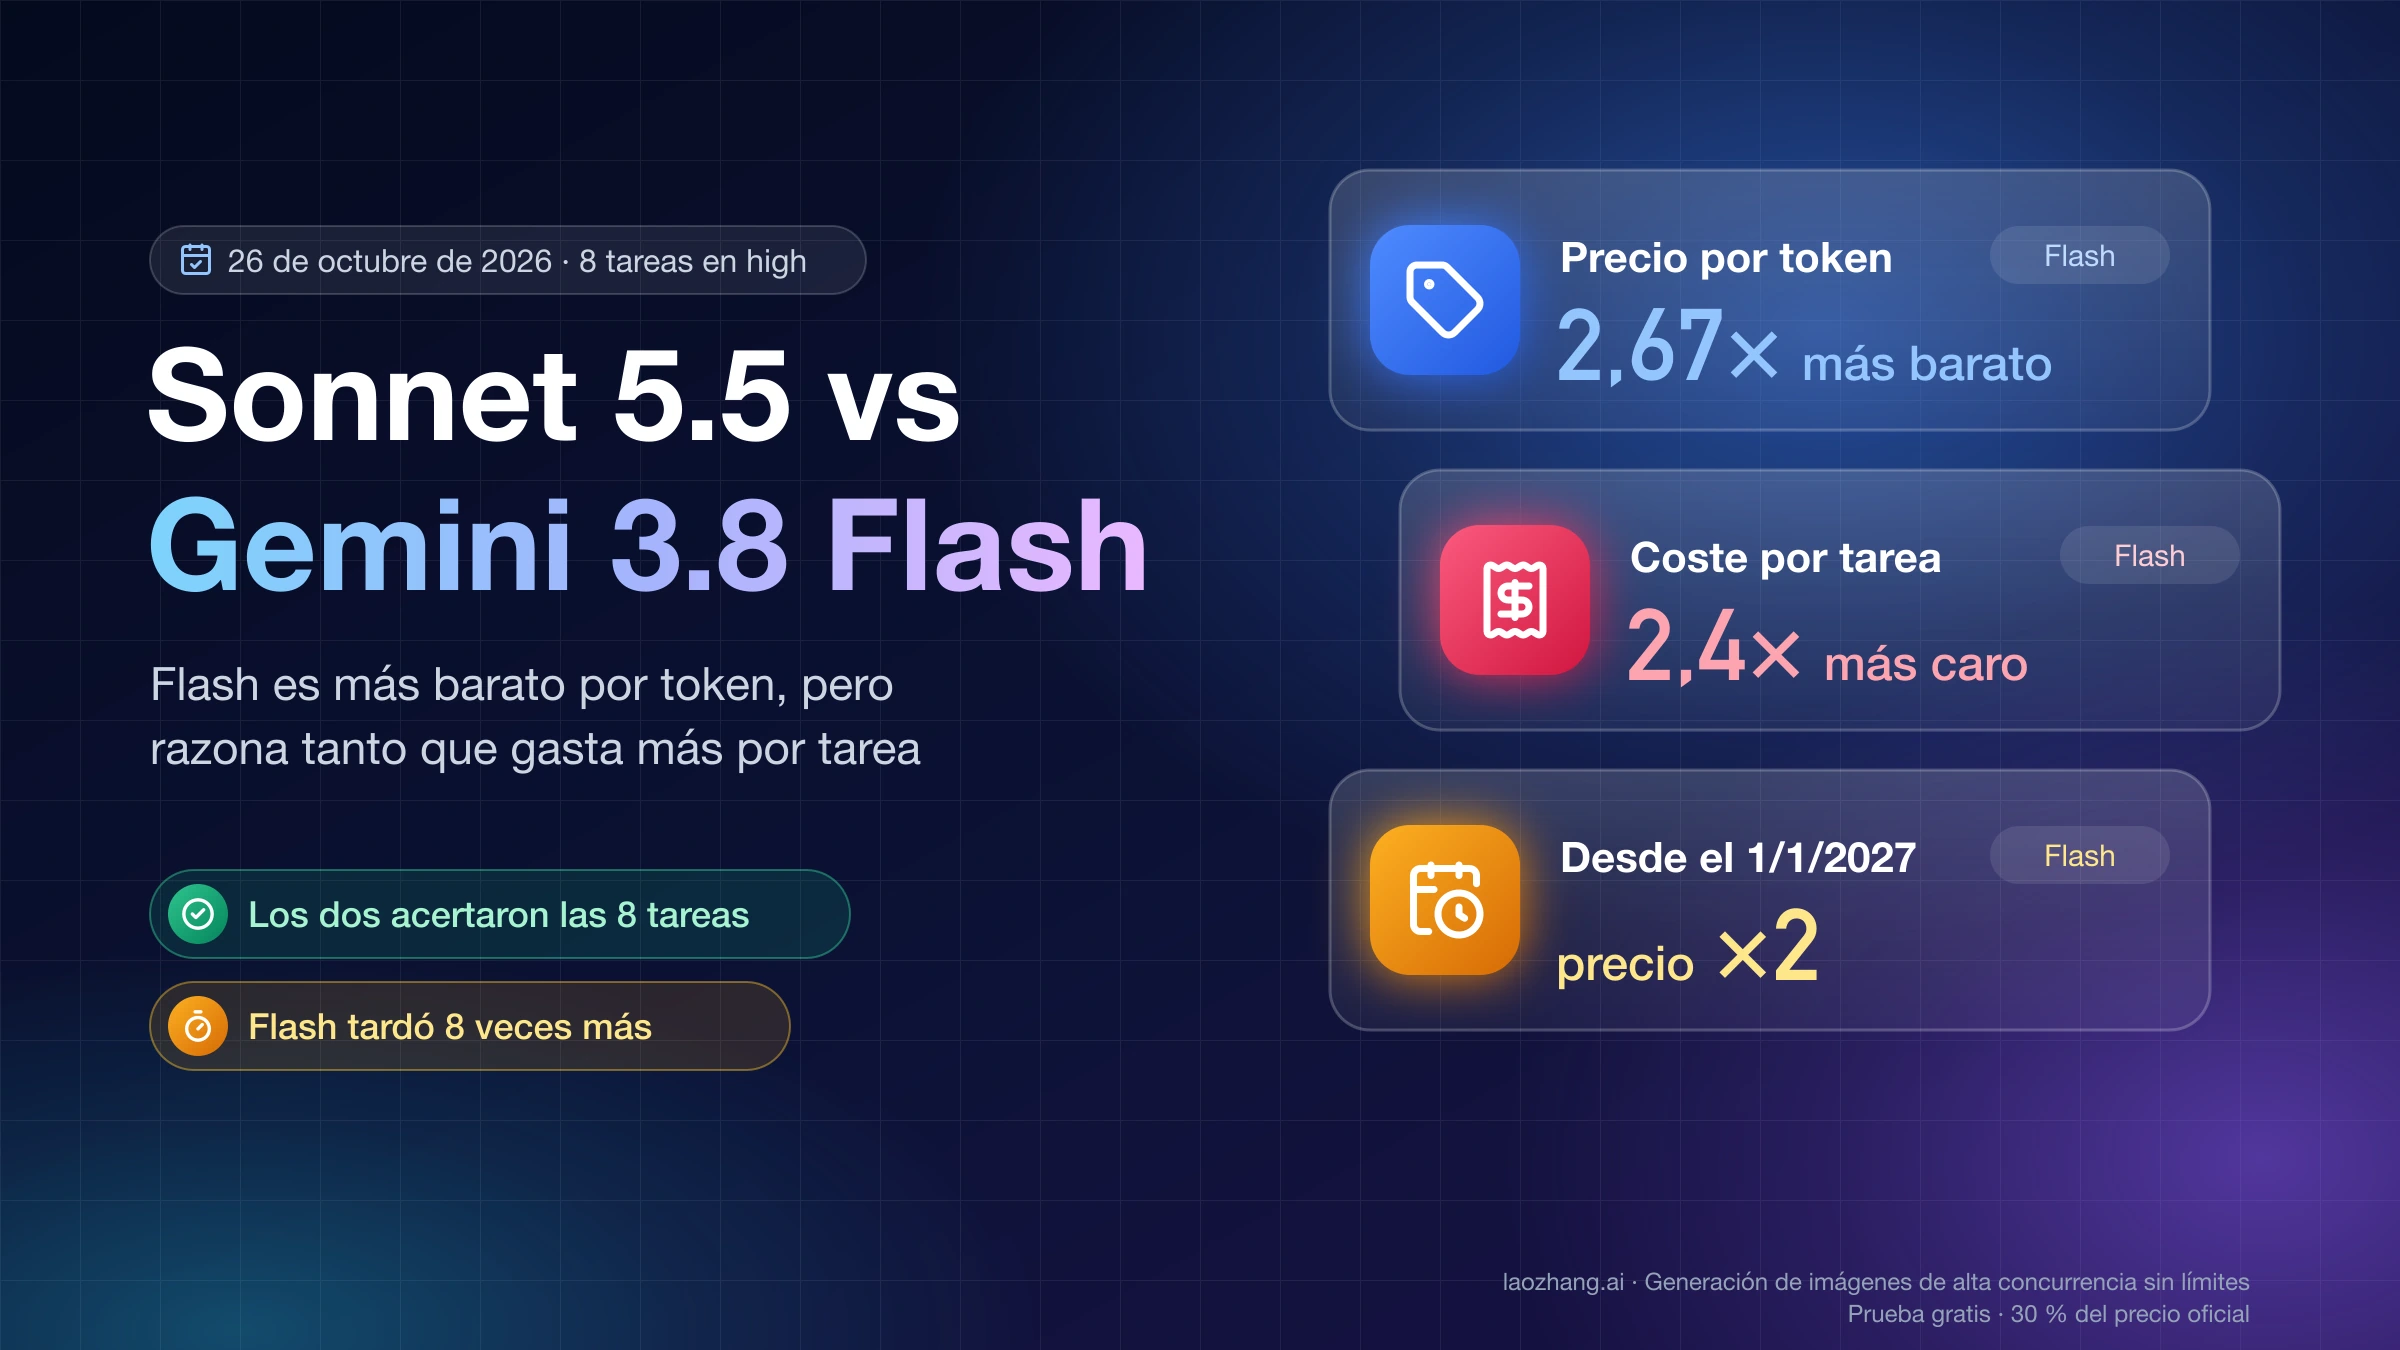
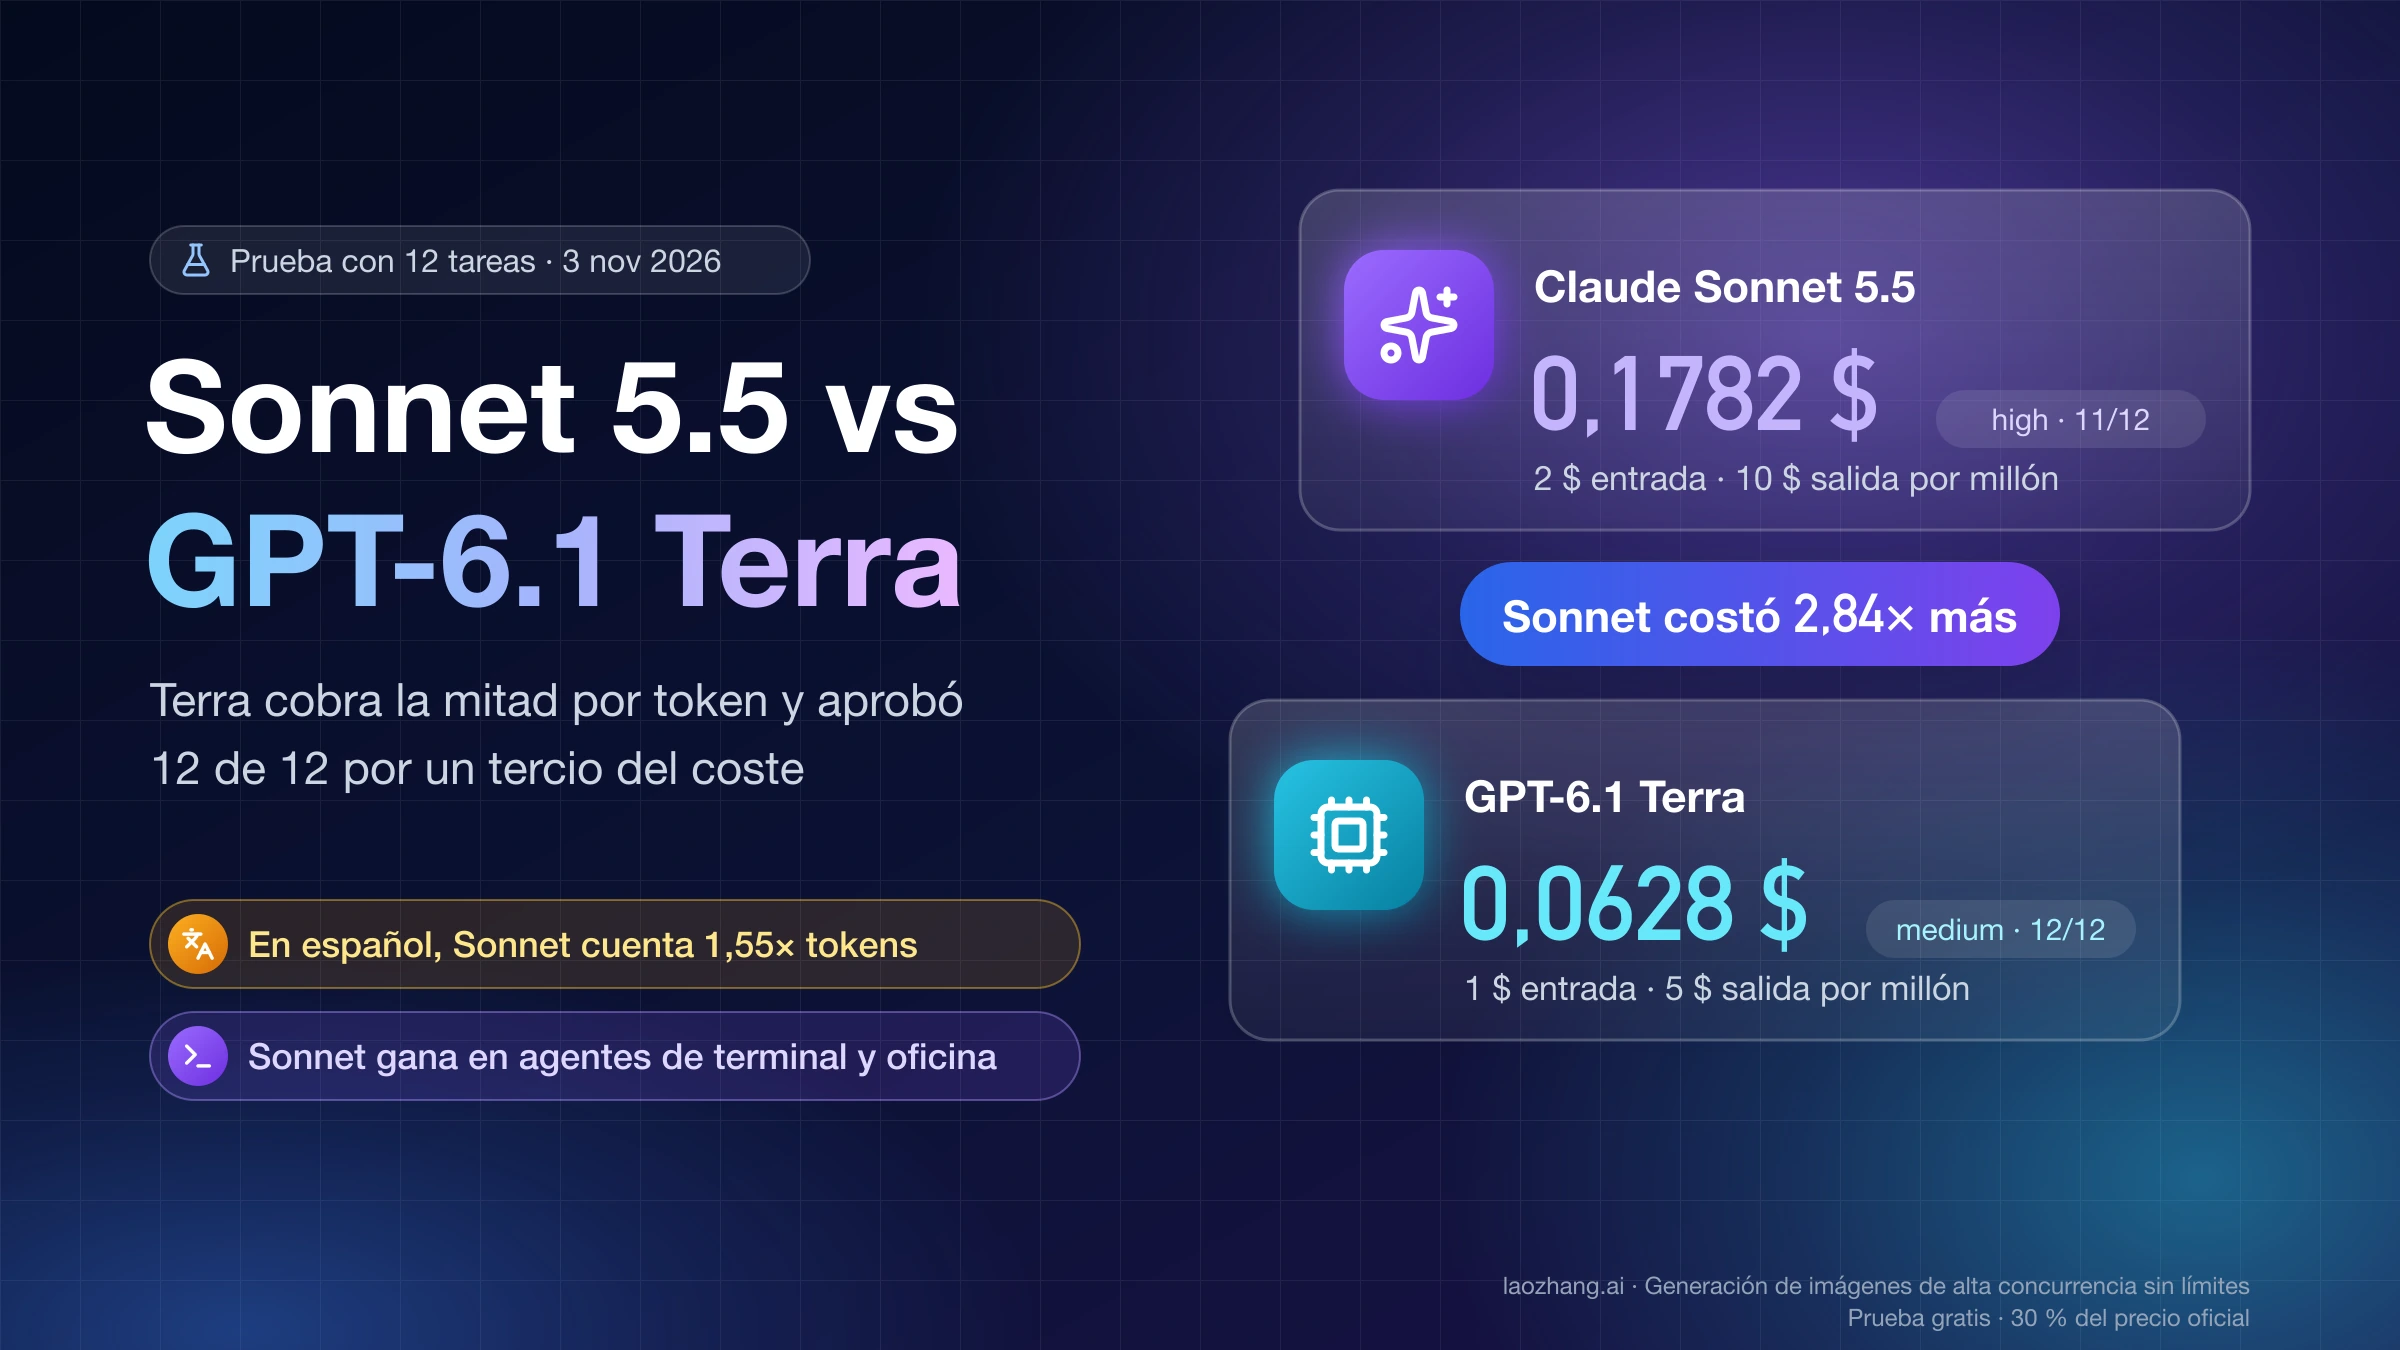
Si dudas entre los Flash baratos, la otra comparativa es DeepSeek V4.1 Flash vs GLM-5.3-Flash: precio en valle y punta. Para ver Gemini 3.8 Flash frente a un modelo más caro con las mismas tareas, lee Claude Sonnet 5.5 vs Gemini 3.8 Flash: coste real por tarea, y para saber cuándo subir dentro de Google, Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar. El ranking de precios más amplio está en Comparativa de precios de API de IA: qué modelo sale más barato.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 nov 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 nov 2026.
- 1.Gemini APIaistudio.google.com/docs/pricing
- 2.DeepSeek APIapi-docs.deepseek.com/quick_start/pricing
- 3.documentación de razonamiento de Geminiaistudio.google.com/docs/thinking
- 4.comparativa de DeepSeek V4.1 Flash 1017 y Gemini 3.8 Flashartificialanalysis.ai/models/releases/comparisons/deepseek-v4-1-flash-1017-vs-gemini-3-8-flash
- 5.registro de cambiosapi-docs.deepseek.com/updates
- 6.ficha de Gemini 3.8 Flashaistudio.google.com/docs/models/gemini-3.8-flash
- 7.guía del modo de pensamientoapi-docs.deepseek.com/guides/thinking_mode
- 8.lista de regiones disponibles de Gemini APIaistudio.google.com/docs/available-regions