Gemini 4 Argon vs Claude Fable 5.1: coste por tarea y cuál usar
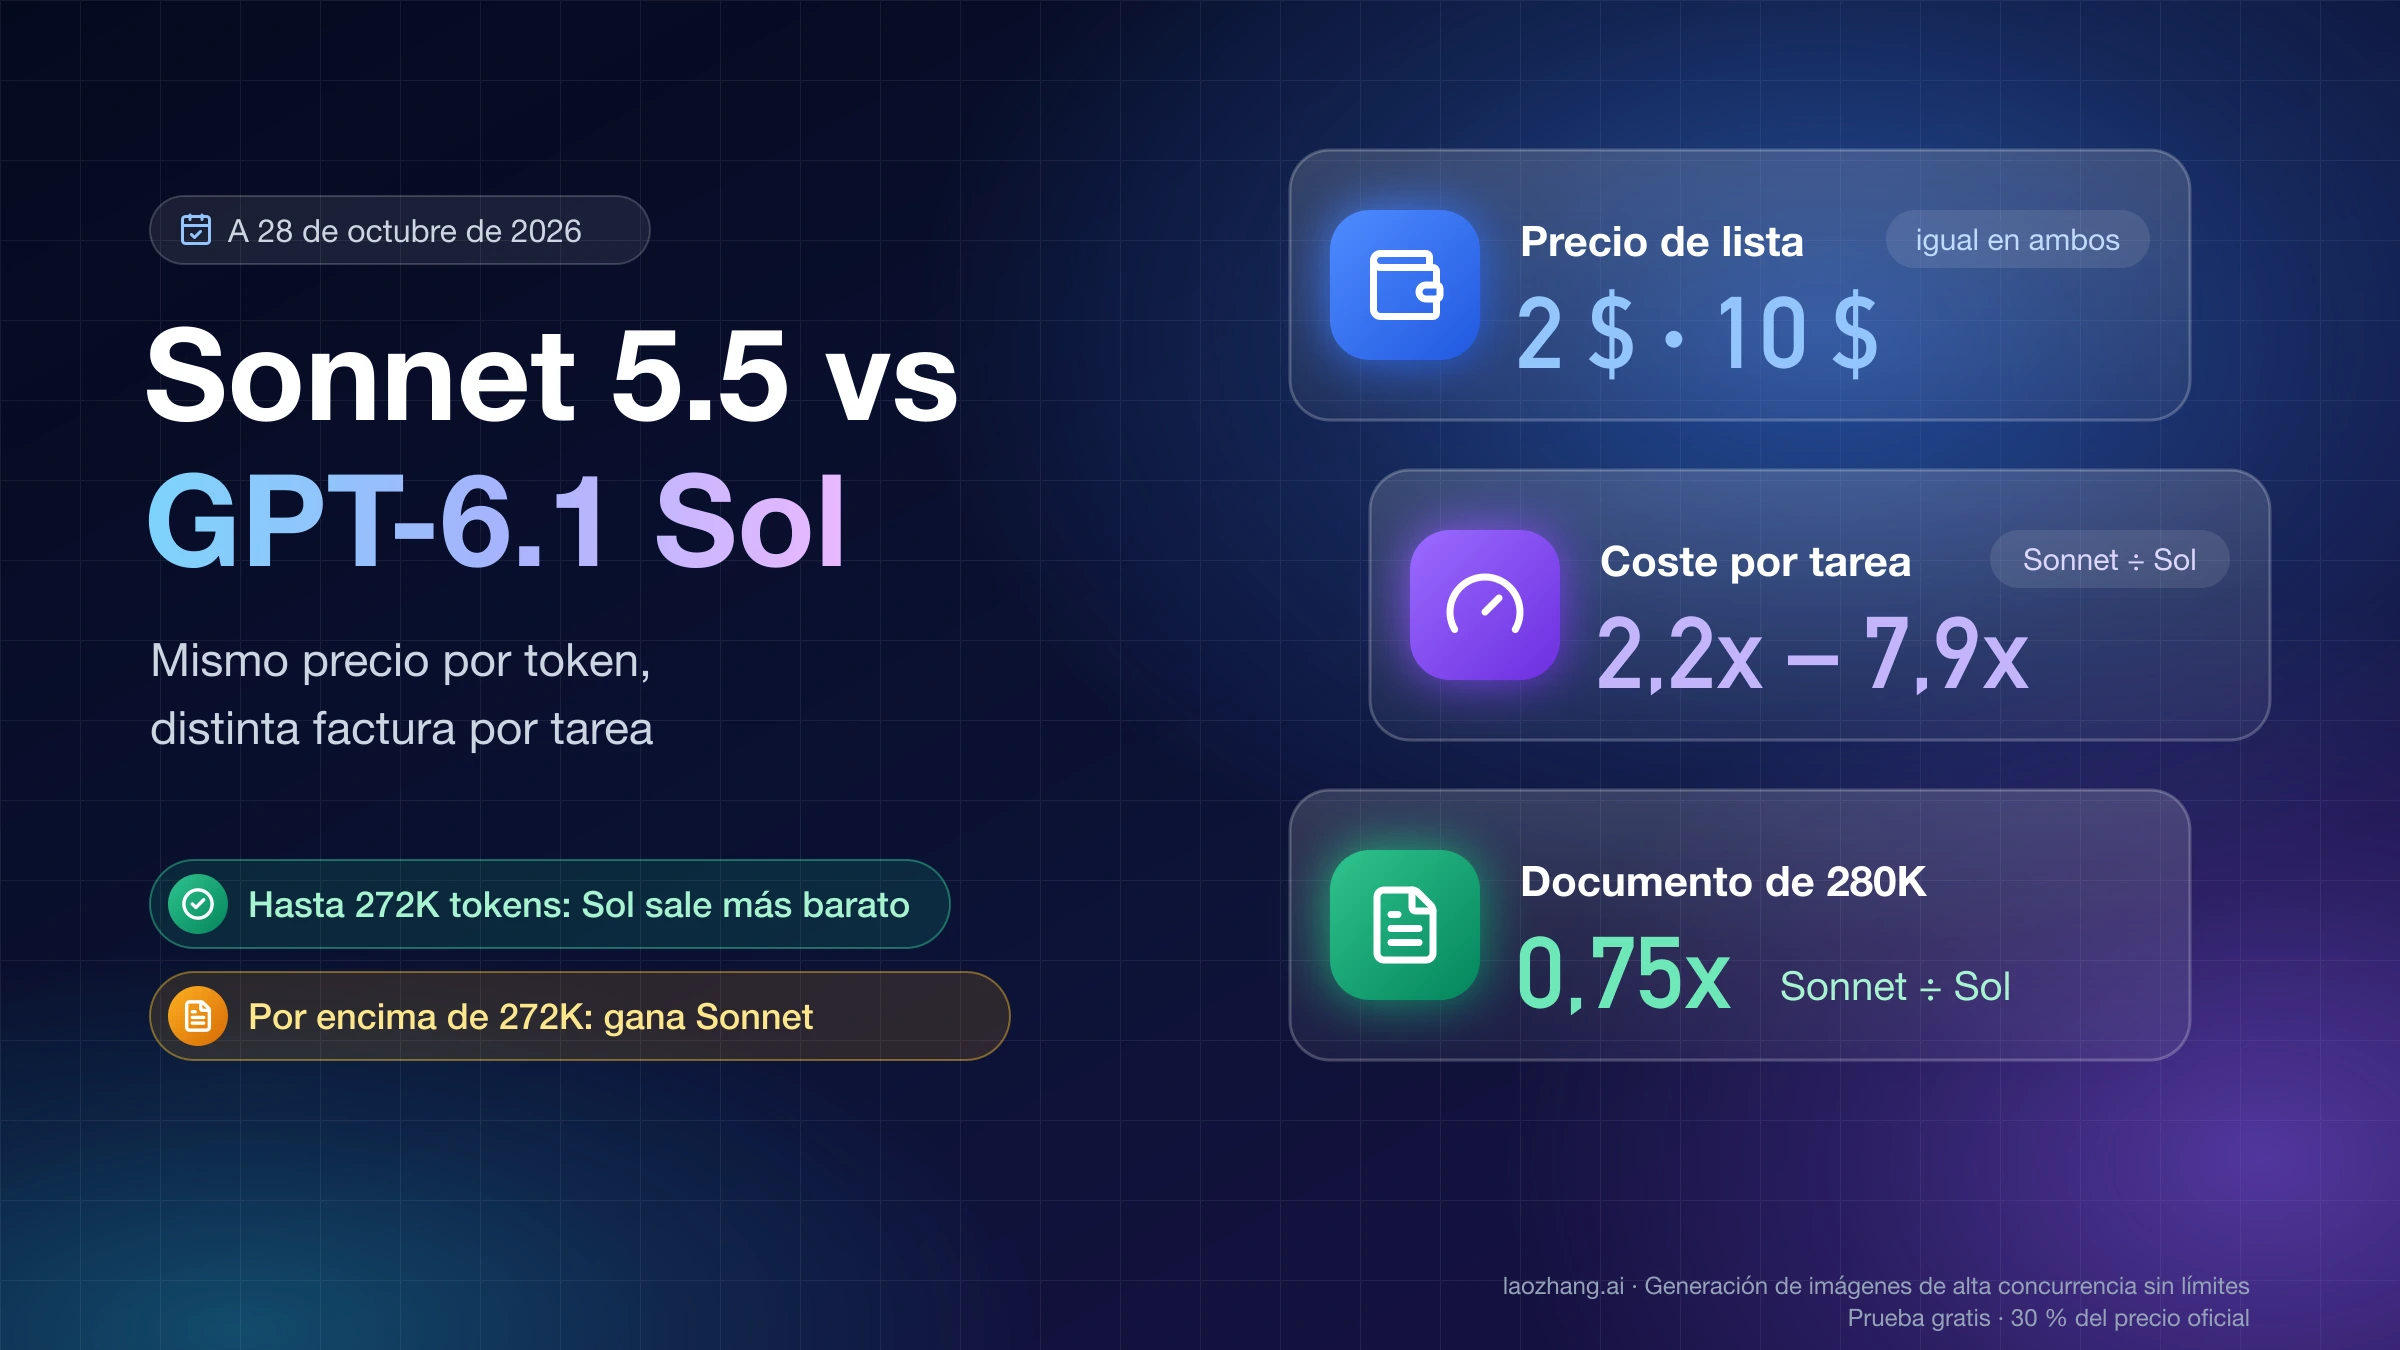
Gemini 4 Argon y Claude Fable 5.1 empatan en AA v5.0.1, pero en tareas cotidianas Fable costó 8,6 veces más; desde el 1 de diciembre, unas 4,3 veces.
En esta página
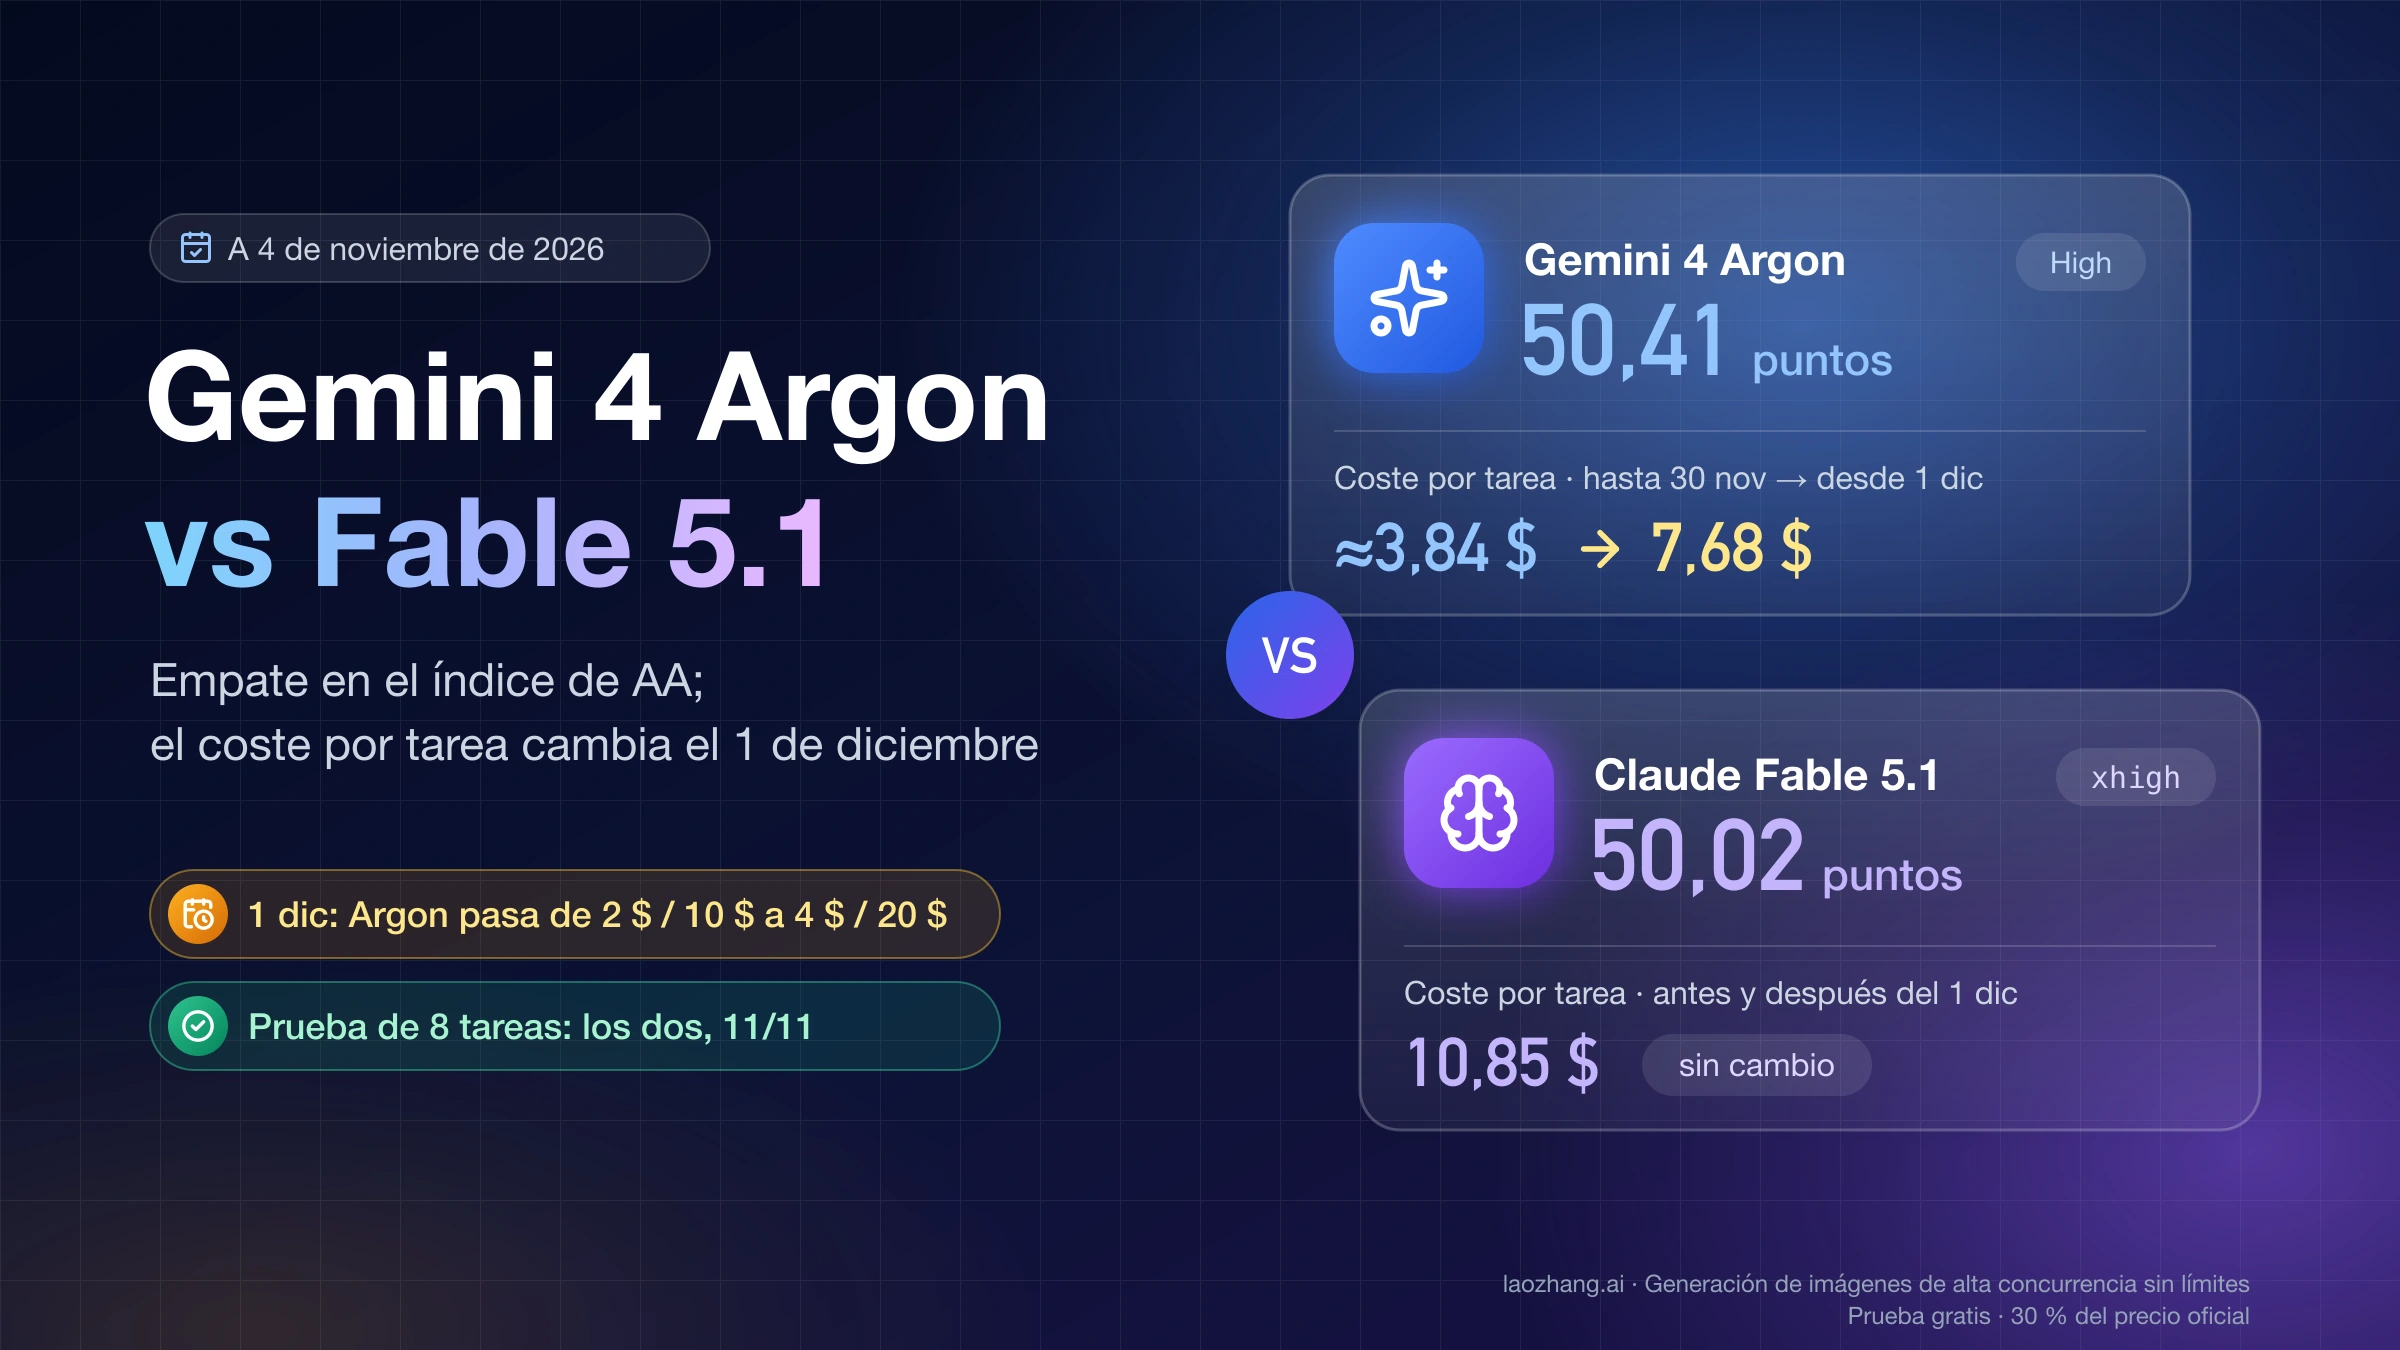
Si eliges entre Gemini 4 Argon y Claude Fable 5.1 para trabajar por API, empieza por Argon (gemini-4-argon) con su nivel de razonamiento por defecto y reserva Fable 5.1 (claude-fable-5-1) para documentos de oficina, código difícil que Argon no resuelve y equipos que ya lo tienen incluido en un plan de Claude. En capacidad están empatados: a 4 de noviembre de 2026, el índice de Artificial Analysis (AA) v5.0.1 da 50,41 puntos a Argon en High y 50,02 a Fable 5.1 en xhigh. Argon va por delante en agentes que encadenan herramientas y en tareas de terminal; Fable, en trabajo de oficina y en programación muy exigente.
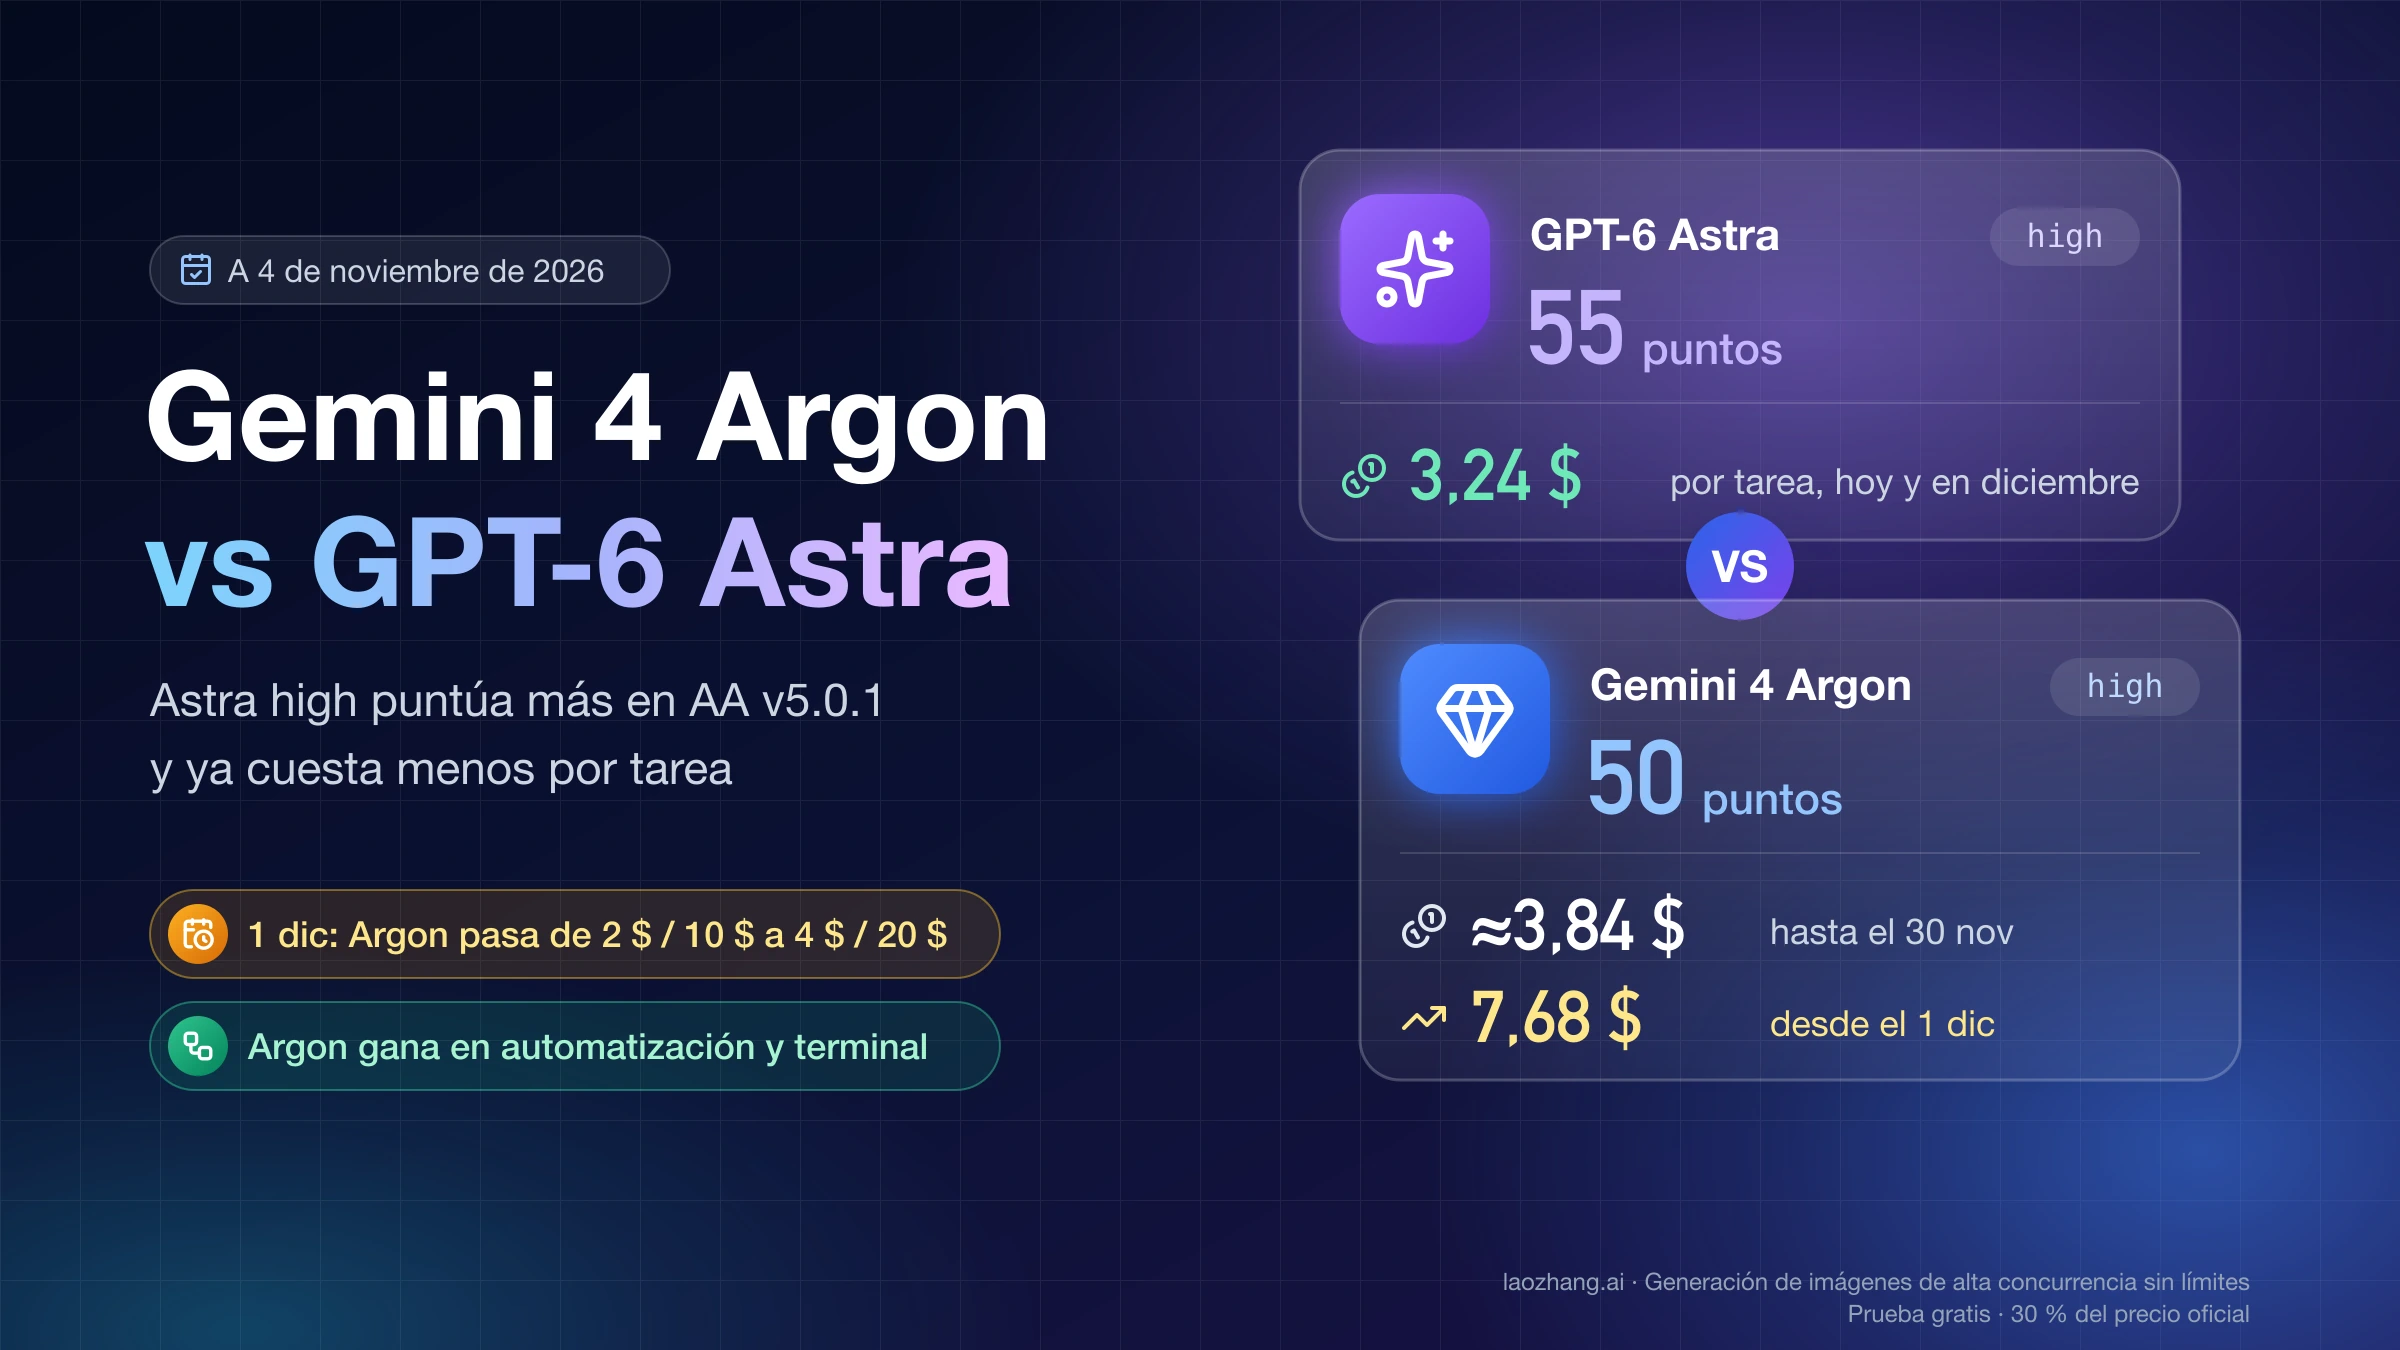
La diferencia de verdad está en la factura, y cambia el 1 de diciembre. Argon cuesta 2 $ por millón de tokens de entrada y 10 $ de salida hasta el 30 de noviembre, y 4 $ y 20 $ desde el 1 de diciembre; Fable 5.1 cuesta 10 $ y 50 $. En una prueba con las mismas 8 tareas y tests ocultos (Argon el 4 de noviembre de 2026, Fable el 26 de octubre), los dos aprobaron todo, pero en las tareas cotidianas Fable salió 8,6 veces más caro que Argon por defecto, y seguirá unas 4,3 veces por encima con el precio de diciembre. Con texto en español la distancia crece, porque Fable cuenta 1,97 veces más tokens para el mismo texto: esa entrada sin caché cuesta unas 9,9 veces más ahora y 4,9 veces desde el 1 de diciembre.
La excepción es el nivel de razonamiento. Si subes Argon a thinkingLevel: high, razona mucho más, tarda unas 4,6 veces más que Fable y, con el precio de diciembre, en las tareas difíciles de esa misma prueba costó más que Fable con su configuración por defecto. Así que prueba tus prompts con Argon en su valor por defecto (medium) antes del 1 de diciembre y sube de nivel solo donde falle. Y si la duda es dentro de la familia Claude, la propia Anthropic aconseja empezar por Opus 5.5 y pasar a Fable 5.1 cuando Opus no llegue.
Gemini 4 Argon o Claude Fable 5.1 según el trabajo que haces
Para automatizaciones, agentes con herramientas, terminal y cualquier trabajo de mucho volumen, Argon da la misma capacidad media por bastante menos dinero; Fable 5.1 compensa cuando el resultado es un documento de oficina, un problema de código que Argon no resuelve o cuando ya lo pagas dentro de Claude. Ten en cuenta que los niveles de razonamiento no se corresponden entre fabricantes: Argon usa el nivel de razonamiento (thinkingLevel) con low, medium y high, y por defecto medium; Fable usa el esfuerzo (effort) con low, medium, high, xhigh y max, y por defecto high. El high de uno no equivale al high del otro.
| Si tu trabajo es… | Empieza por | Por qué |
|---|---|---|
| Agentes que encadenan herramientas, automatizaciones, tareas de terminal | Argon, nivel por defecto | Gana en AutomationBench y Terminal-Bench-Science en AA y en la tabla de Google, y con su nivel por defecto cuesta bastante menos por tarea |
| Informes, hojas de cálculo y documentos de oficina | Fable 5.1 en xhigh | En xhigh y max va por delante en AA-Briefcase y GDP.pdf, las pruebas de trabajo de oficina del índice |
| Código difícil que Argon no termina de resolver | Fable 5.1 en xhigh | Es la configuración que más puntúa en FrontierCode 2.0 dentro de AA |
| Mucho volumen, sobre todo con entradas en español | Argon | Tarifa 5 veces menor hasta el 30 de noviembre (2,5 desde diciembre) y casi la mitad de tokens para el mismo texto |
| Respuestas de más de 65.536 tokens en una sola petición | Fable 5.1, o Argon con decodificación larga | Fable admite hasta 128K de salida; Argon necesita background=true o continuar desde el cliente |
| Ya trabajas en Claude Code o en la app con un plan Max o Ultra | Fable 5.1 | Viene incluido hasta la mitad de tu límite semanal, sin pagar por token |
| Datos que no pueden quedar retenidos 30 días | Argon | Fable 5.1 exige retención de datos de 30 días, según la página de Anthropic sobre retención de datos en la API |
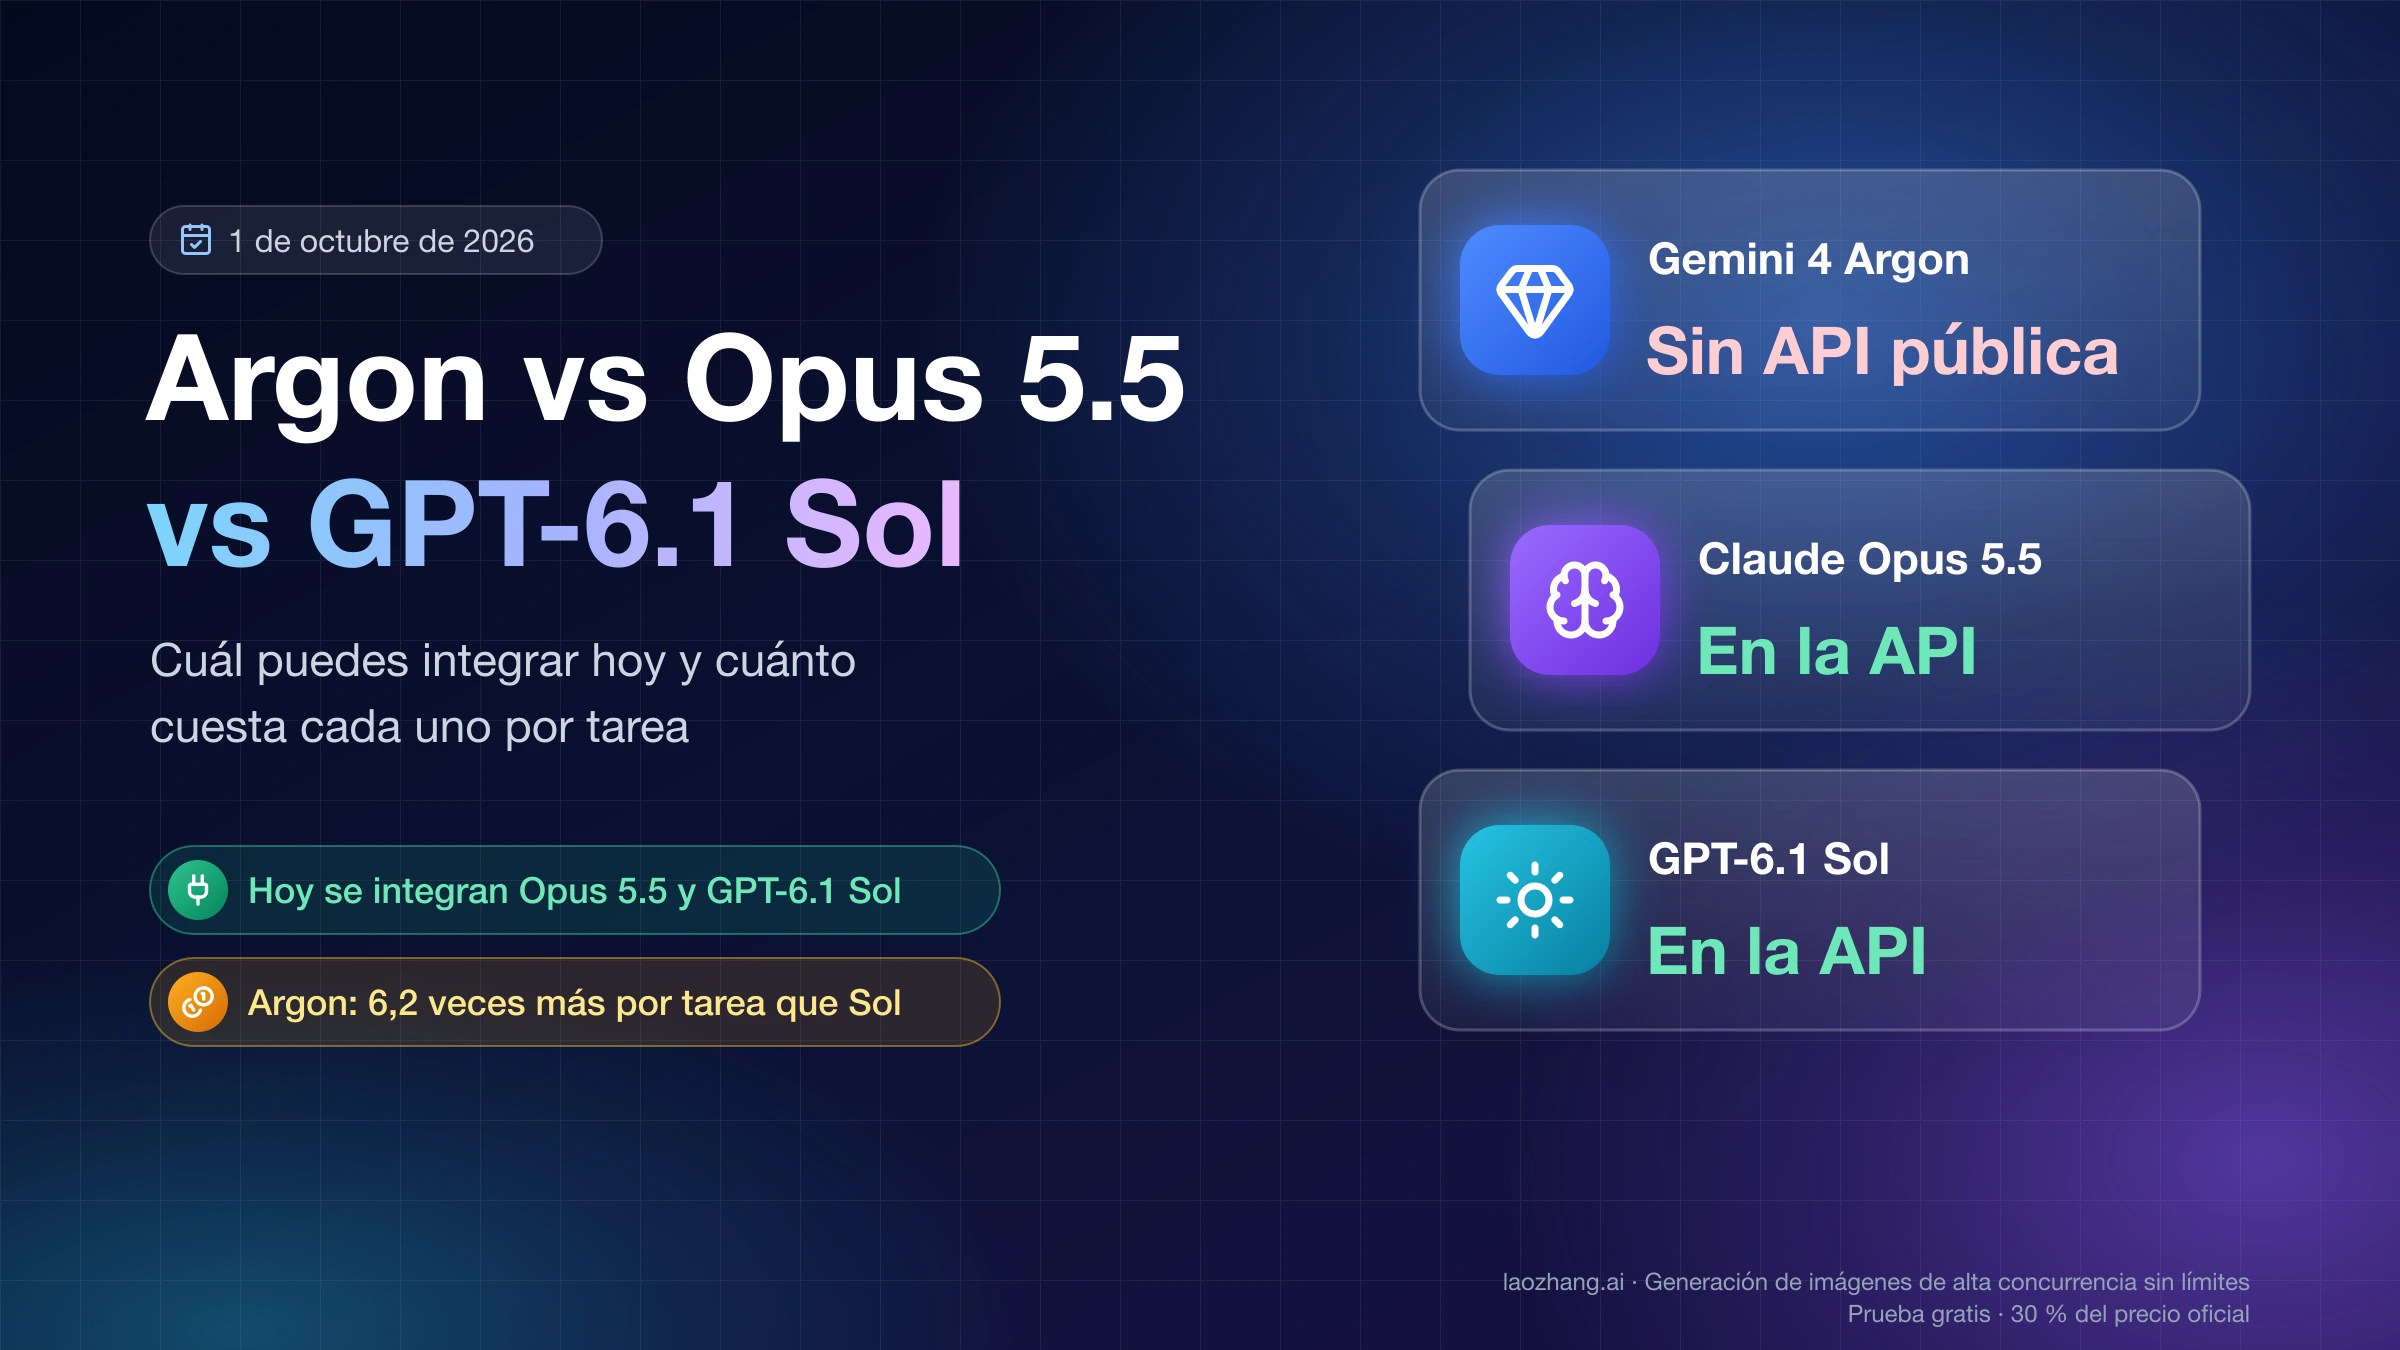
La tabla describe por dónde empezar, no un veredicto cerrado: si Argon falla en una tarea concreta, esa tarea es la candidata a Fable, y al revés. En la página de modelos de Anthropic, la recomendación es empezar por Claude Opus 5.5 para la mayoría de los trabajos y usar Fable 5.1 para razonamiento exigente y trabajo agéntico de largo recorrido, o cuando Opus 5.5 con más esfuerzo sigue sin llegar; si estás decidiendo dentro de Anthropic, la comparación está en Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más. Si la otra opción que barajas es el modelo grande de OpenAI, el cruce correspondiente es GPT-6 Astra o Claude Fable 5.1: cómo elegir por tarea y coste, y para Argon frente a Opus 5.5 y GPT-6.1 Sol, Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy.
Cuánto mejor es cada uno: empate a 50 puntos en AA v5.0.1
Ninguno es mejor en promedio. En el comparador de Artificial Analysis entre Gemini 4 Argon y Claude Fable 5.1, a 4 de noviembre de 2026, Argon en High suma 50,41 puntos y Fable 5.1 en xhigh 50,02, una diferencia que cae dentro del ruido del índice. AA solo mide Argon en High, un nivel por encima del valor por defecto de la API, así que la comparación justa es con Fable a igual puntuación (xhigh) y a igual coste (high, el valor por defecto de Fable).
| Configuración en AA v5.0.1 | Índice | Tiempo por tarea | Primer token | Tokens de salida por tarea |
|---|---|---|---|---|
| Gemini 4 Argon, High | 50,41 | 1.362,9 s | 41,5 s | 116.368 |
Claude Fable 5.1, max | 49,16 | 1.066,4 s | 252,5 s | 117.941 |
Claude Fable 5.1, xhigh | 50,02 | 965,7 s | 79,5 s | 97.059 |
Claude Fable 5.1, high (por defecto) | 47,17 | 719,8 s | 18,3 s | 66.031 |
Claude Fable 5.1, medium | 43,17 | 537,1 s | 14,7 s | 48.545 |
Claude Fable 5.1, low | 38,68 | 421,3 s | 2,6 s | 37.837 |
Dos detalles cambian la lectura. Primero, en esta versión Fable en max puntúa menos que en xhigh, así que pagar el nivel más alto no compra más índice. Segundo, Argon en High genera casi tantos tokens por tarea como Fable en max y tarda más, por lo que su ventaja de precio por token no se traslada entera al coste por tarea (se calcula en la sección de precios). Según la metodología de AA, la versión 5.0.1, de noviembre de 2026, mantiene las nueve evaluaciones y los pesos de la 5.0 y solo vuelve a corregir CritPt v2. Las cifras de la versión 4.3.2, de septiembre y octubre, no son comparables con estas: frases como «0,79 puntos de diferencia a cinco veces el precio» o «Argon en torno a 53, a la par de Fable» proceden de ese índice retirado.
Otros índices independientes apuntan al mismo empate. El Epoch Capabilities Index, actualizado el 3 de noviembre de 2026, da 166,36 a Fable 5.1 y 166,07 a Argon, con intervalos de confianza que se solapan casi por completo. El Vals Index v2.2, con datos a 30 de octubre, da a Argon un 69,24 %, cuarto de 32 modelos, pero Fable 5.1 no figura en esa clasificación; el 65,83 % que se le atribuía es de la versión 2.1 y no se puede poner al lado.
En qué pruebas gana cada uno: Argon en agentes, Fable en oficina
El empate en la media esconde direcciones claras: Argon gana en automatización y terminal, y Fable en trabajo de oficina, programación de frontera y razonamiento de nivel experto. Este es el desglose por evaluación de AA v5.0.1, a 4 de noviembre de 2026:
| Evaluación (AA v5.0.1) | Argon High | Fable 5.1 max | Fable 5.1 xhigh | Por delante |
|---|---|---|---|---|
| AutomationBench-AA | 77,5 % | 59,4 % | 57,8 % | Argon |
| Terminal-Bench 4.0 | 57,1 % | 52,0 % | 55,1 % | Argon |
| Terminal-Bench-Science | 52,9 % | 43,3 % | 40,5 % | Argon |
| AA-Briefcase (trabajo de oficina) | 1.484 | 1.669 | 1.649 | Fable |
| FrontierCode 2.0 | 25,7 % | 31,6 % | 35,7 % | Fable |
| GDP.pdf | 21,8 % | 26,2 % | 26,2 % | Fable |
| HLE-Diamond | 56,7 % | 60,1 % | 58,8 % | Fable |
| AA-Omniscience | 46,1 | 46,3 | 44,3 | Empate |
| CritPt v2 Hard | 52,5 % | 52,5 % | 60,0 % | Empate con max; Fable en xhigh |
La tabla que Google publicó con el anuncio de Gemini 4 Argon el 30 de septiembre es más favorable a Argon, pero la midió Google, con Argon en su nivel de razonamiento más alto y sin reproducción independiente. En ella Argon supera a Fable 5.1 en 15 de las 17 pruebas compartidas, con las mayores distancias en AutomationBench (51,3 frente a 31,4), Harvey Legal Agent (19,6 frente a 6,7) y GraphWalks con contexto de 256K a 1M (84,2 frente a 65,0); Fable solo queda por delante en FrontierSWE v2 (56,3 frente a 55,0) y en Terminal-bench 4.0 (57,9 frente a 57,4). Que Terminal-Bench 4.0 dé ventaja a Fable en la tabla de Google y a Argon en la de AA indica que, en esa prueba, la diferencia depende de quién la ejecute y con qué configuración.
Cuánto cuesta una tarea y qué cambia el 1 de diciembre
Por token, Fable 5.1 cuesta 5 veces lo que Argon hasta el 30 de noviembre y 2,5 veces desde el 1 de diciembre, cuando Google duplica todas las tarifas de Argon. Estas son las tarifas estándar, en dólares por millón de tokens, según la página de precios de la API de Gemini y los precios de la API de Claude, a 4 de noviembre de 2026:
| Por millón de tokens | Argon hasta el 30 de noviembre | Argon desde el 1 de diciembre | Fable 5.1 |
|---|---|---|---|
| Entrada | 2 $ | 4 $ | 10 $ |
| Salida (el razonamiento se cobra como salida) | 10 $ | 20 $ | 50 $ |
| Lectura de caché | 0,10 $ | 0,20 $ | 0,25 $ |
| Batch: entrada / salida | 1 $ / 5 $ | 2 $ / 10 $ | 5 $ / 25 $ |
La caché funciona distinto en cada uno. Argon solo tiene caché implícita, sin API para crearla, y se activa a partir de unos 4.000–6.000 tokens de prompt (la documentación de la API dice 4.096 y algunas páginas de Google Cloud, 6.144); Fable cobra 0,25 $ por lectura solo si marcas los bloques con cache_control, y la escritura cuesta 12,50 $ por millón con duración de 5 minutos o 20 $ con 1 hora. En lecturas de caché la distancia es de 2,5 veces hasta noviembre y de solo 1,25 desde diciembre. Si tu agente reenvía mucho contexto repetido, los detalles están en Claude prompt caching: cómo activarlo, precio y cuándo sale caro y en Gemini context caching en la API: caché de contexto y ahorro real. Google no ha dicho si prolongará el precio de lanzamiento de Argon.
El precio por token no dice cuánto cuesta terminar una tarea, porque cada modelo gasta un número distinto de tokens. AA publica el coste de cada tarea de su índice, y para Argon ya usa la tarifa de diciembre (4 $ y 20 $):
| Coste por tarea del índice de AA v5.0.1 | Hasta el 30 de noviembre | Desde el 1 de diciembre |
|---|---|---|
| Gemini 4 Argon, High | ≈3,84 $ | 7,68 $ |
Claude Fable 5.1, high | 7,54 $ | 7,54 $ |
Claude Fable 5.1, xhigh | 10,85 $ | 10,85 $ |
Claude Fable 5.1, max | 12,99 $ | 12,99 $ |
La cifra de Argon hasta el 30 de noviembre no es de AA: sale de dividir 7,68 $ entre dos, porque todas las tarifas de Argon valen la mitad hasta esa fecha. Con esas cifras, hasta finales de noviembre Fable en high cuesta unas 2,0 veces lo que Argon High, y Fable en xhigh, que es la configuración con su misma puntuación, unas 2,8 veces. Desde el 1 de diciembre el cuadro cambia: Argon High y Fable high cuestan casi lo mismo por tarea (7,68 $ frente a 7,54 $), con 3,2 puntos más para Argon, y para igualar la puntuación de Argon Fable necesita xhigh, 1,4 veces más caro. Si facturas Fable con frecuencia, en Precio de la API de Claude Fable 5.1 y cuánto baja tu factura se desglosan sus descuentos; para el resto de la facturación de Google, Clave de API de Gemini gratis y precio: qué sube en 2027.
La regla para estimar tu propia factura es multiplicar dos cocientes: la relación de precios (5 veces ahora, 2,5 desde diciembre) por la relación de tokens que cada modelo cuenta para el mismo trabajo, por separado en entrada y en salida. La de entrada depende del idioma; la de salida, sobre todo de cuánto razona cada modelo, y eso lo decide el nivel que elijas.
Prueba con las mismas 8 tareas: todas aprobadas, distinto coste
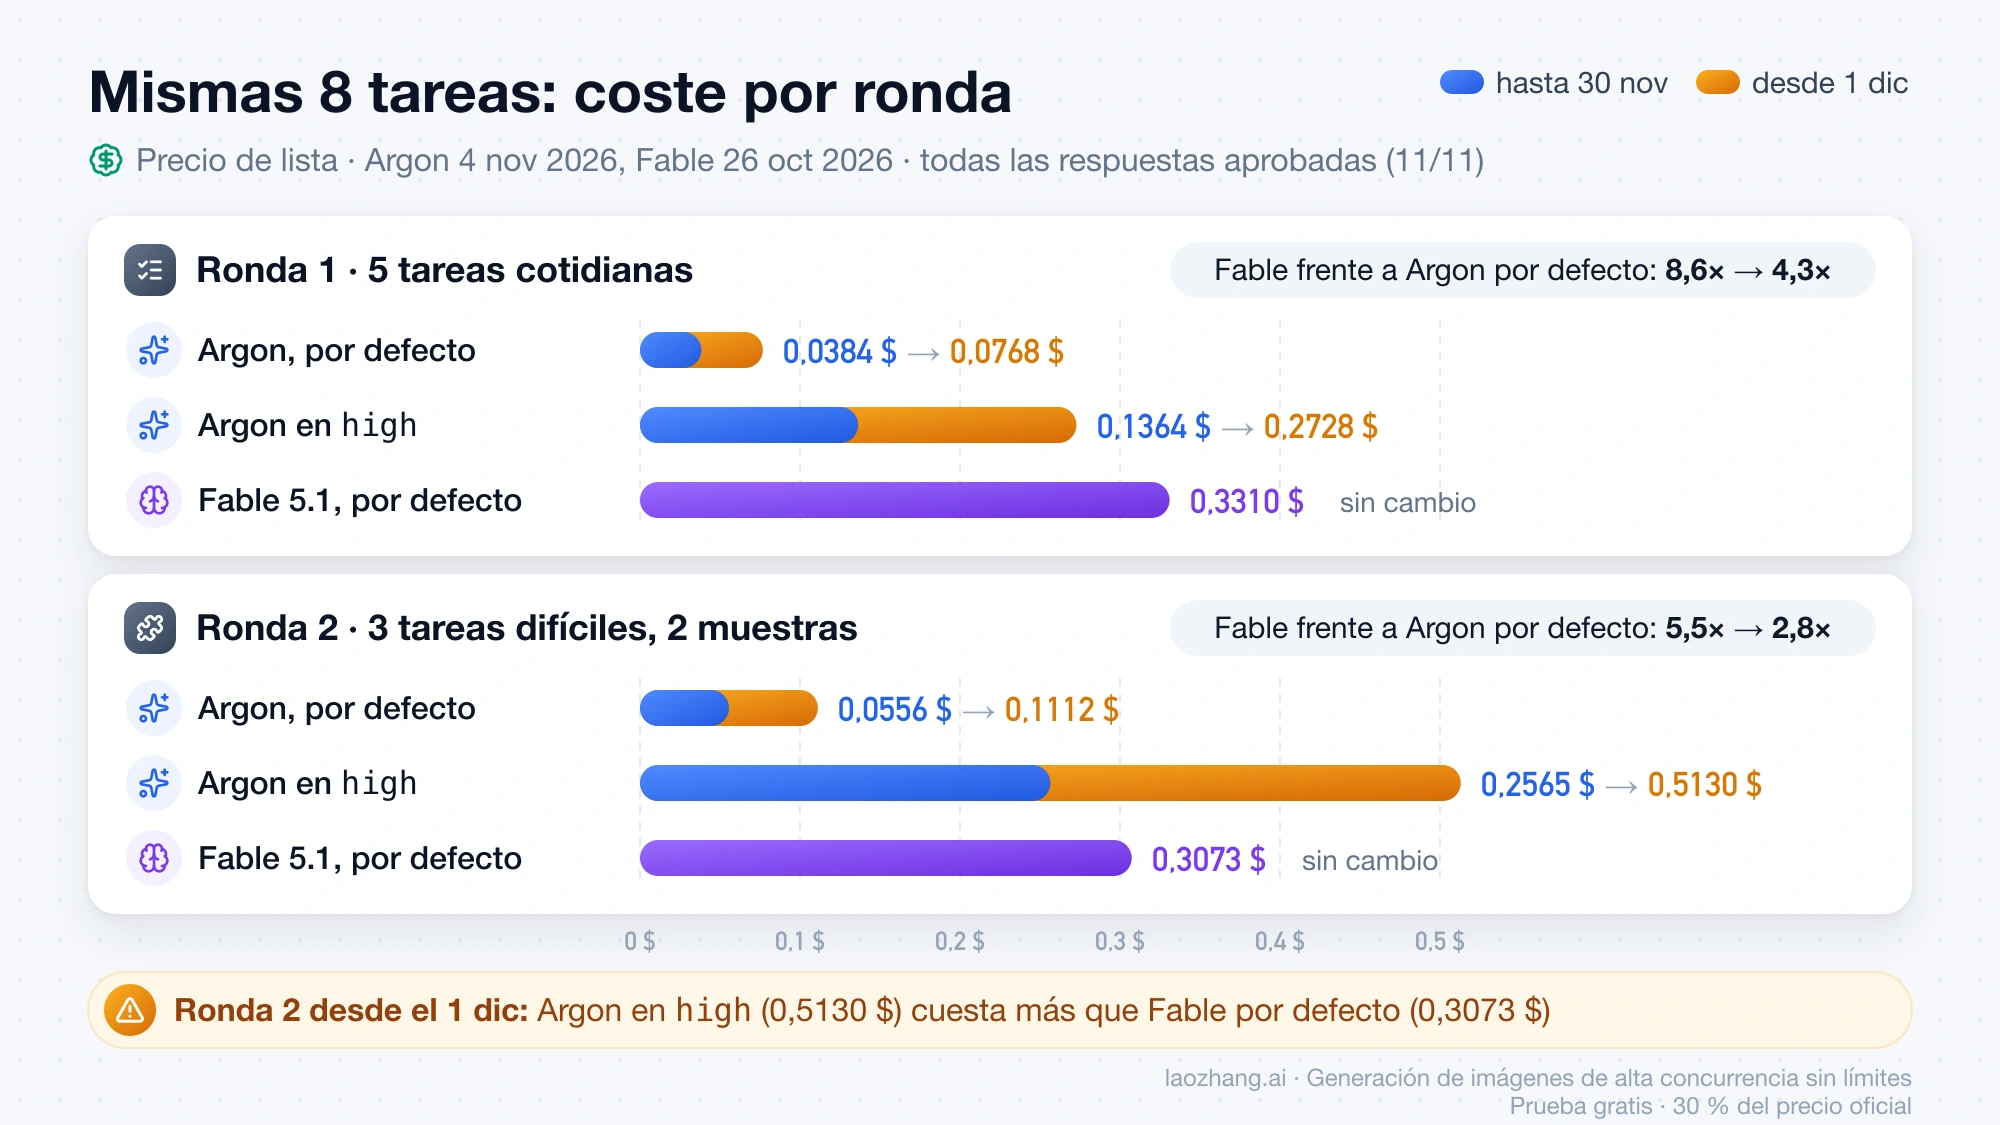
Con las mismas 8 tareas y tests ocultos, Argon y Fable 5.1 aprobaron todas sus respuestas, así que la prueba no los separa en calidad; lo que muestra es cuánto cuesta y cuánto tarda cada uno con la misma tarea. Argon se ejecutó el 4 de noviembre de 2026 con su configuración por defecto (sin thinkingConfig, es decir, medium) y con thinkingLevel: high; Fable 5.1, el 26 de octubre de 2026 con la suya (effort: high), y el 4 de noviembre una llamada de control confirmó el mismo modelo y el mismo recuento de tokens de entrada. Todo pasó por la misma pasarela, LaoZhang API, sin caché ni herramientas, y los costes se calcularon a precio de lista con el uso que devolvió cada respuesta.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
La primera ronda tenía 5 tareas cotidianas con una muestra cada una: un problema de aritmética, fusionar intervalos, interpretar duraciones de texto, contar las palabras más frecuentes y resumir un artículo en inglés de 6.723 palabras. La segunda, 3 tareas más difíciles con dos muestras cada una: un evaluador de expresiones, un analizador de líneas CSV y un acertijo de suma de dígitos.
| Configuración | Aprobadas | Ronda 1: hasta 30 nov → desde 1 dic | Ronda 2: hasta 30 nov → desde 1 dic | Salida facturada (de ella, razonamiento) | Tiempo de las 11 llamadas |
|---|---|---|---|---|---|
| Argon, por defecto | 11/11 | 0,0384 $ → 0,0768 $ | 0,0556 $ → 0,1112 $ | 6.859 (1.531) | 128 s |
Argon, thinkingLevel: high | 11/11 | 0,1364 $ → 0,2728 $ | 0,2565 $ → 0,5130 $ | 36.746 (31.016) | 532 s |
Fable 5.1, por defecto (effort: high) | 11/11 | 0,3310 $ | 0,3073 $ | 9.327 (incluido, sin desglose) | 116 s |
En la ronda cotidiana, Fable costó 8,6 veces lo que Argon por defecto con el precio actual y 4,3 veces con el de diciembre; en la difícil, 5,5 y 2,8 veces. El motivo es que Argon, en su nivel por defecto, apenas razonó: devolvió 0 tokens de razonamiento en 9 de las 11 llamadas y solo pensó en el acertijo de dígitos. Con high razonó en todas, generó más de cinco veces más salida y tardó 532 segundos frente a los 116 de Fable, unas 4,6 veces más. En la ronda difícil, con el precio de diciembre, eso lo vuelve más caro que Fable por defecto: 0,5130 $ frente a 0,3073 $, es decir, Fable cuesta 0,60 veces lo que Argon en high. En tiempo, Argon por defecto y Fable quedaron parejos (128 y 116 segundos).
Lo que la prueba no mide también importa. Son tareas pequeñas y bien especificadas, con una o dos muestras cada una, sin bucles de agente, sin herramientas, sin salidas largas y sin caché, así que no sirve como clasificación de calidad: para eso están AA y las tablas anteriores. Sí sirve para ver el orden de magnitud del coste con la configuración por defecto de cada modelo y el riesgo de subir Argon a high sin necesidad. El gasto total fue de 0,53 $.
Con texto en español, Fable cuenta 1,97 veces más tokens
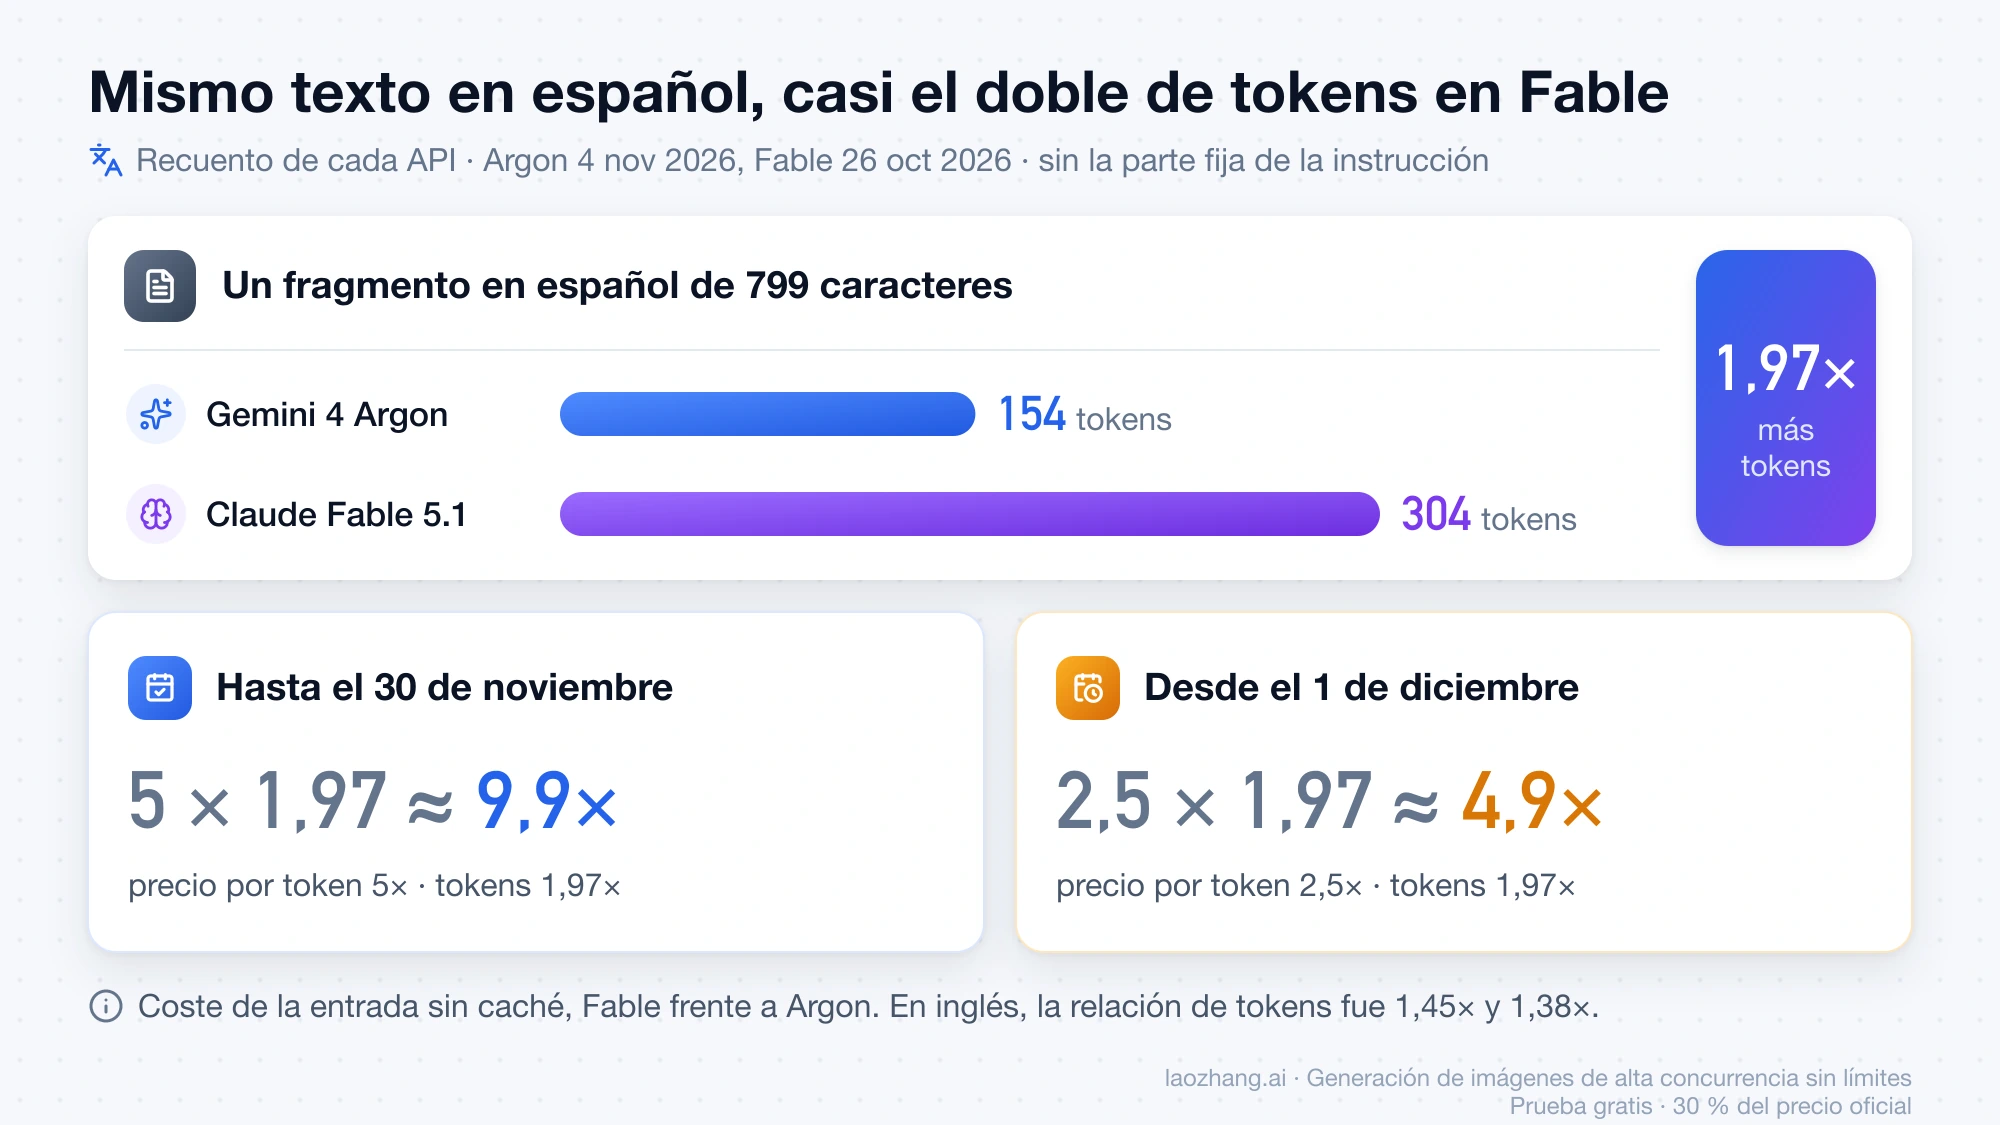
Sí, en español Fable sale proporcionalmente más caro que en inglés. Con el mismo fragmento de 799 caracteres en español, la API de Argon contó 154 tokens de texto y la de Fable 5.1, 304: 1,97 veces más. En inglés la relación fue de 1,45 veces con un fragmento corto y de 1,38 veces con el artículo de 6.723 palabras de la prueba anterior. Los recuentos de Argon son del 4 de noviembre de 2026 y los de Fable, del 26 de octubre, con los mismos textos y la misma instrucción, y se restó a cada total la parte fija de la instrucción. Anthropic explica en su documentación sobre el recuento de tokens que el tokenizador de Fable 5.1, el que estrenó Claude Opus 4.7, produce aproximadamente un 30 % más de tokens que el de los modelos Claude anteriores.
Aplicando la regla de los dos cocientes, la misma entrada en español sin caché cuesta en Fable 5 × 1,97 ≈ 9,9 veces lo que en Argon hasta el 30 de noviembre, y 2,5 × 1,97 ≈ 4,9 veces desde el 1 de diciembre. En la salida el efecto es otro, porque depende de cuánto razona cada modelo: en la prueba de las 8 tareas, Fable generó 1,4 veces la salida de Argon por defecto, pero solo 0,25 veces la de Argon en high. Si tus prompts, documentos o conversaciones son en español, cuenta con que la distancia de tu factura de entrada será mayor que la que sugiere la tarifa.
Dónde usar Argon y Fable: API, agentes de código y apps
Los dos están en sus API de pago, en agentes de código y en las apps de sus fabricantes, pero en las apps se pagan con planes y límites distintos. En la API, Argon (gemini-4-argon, en acceso general desde el 13 de octubre de 2026) no tiene nivel gratuito; Fable 5.1 está en la API de Claude, Amazon Bedrock, Google Cloud y Microsoft Foundry. Si vas a integrar Argon, en Gemini 4 Argon API: acceso, finish_reason y respuestas cortadas se cubren el acceso y los cortes de respuesta.
Tres límites de la API pueden decidir la elección. Argon devuelve hasta 65.536 tokens por petición síncrona, y un único salto sin streaming se corta en 32.768; para más, Google ofrece la decodificación larga con background=true. Fable 5.1 admite hasta 128K tokens de salida, aunque a través de LaoZhang API una respuesta de Claude se limita a 32.768 tokens. Y en las rutas compatibles con OpenAI, Argon ignora reasoning_effort: para cambiar su nivel hay que usar la ruta nativa de Gemini con thinkingConfig.thinkingLevel.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
En agentes de código, Fable 5.1 funciona en Claude Code desde la versión 2.1.255. Argon, a finales de octubre de 2026, estaba en Antigravity para suscriptores de pago de Google AI Pro y Ultra, con una cuota semanal propia, mientras que el README de Gemini CLI avisa de que Argon no está optimizado allí y remite a Antigravity.
En las apps, Argon llega a la app de Gemini con Google AI Pro (19,99 $ al mes en EE. UU.) y Ultra; el plan Google AI Plus solo da el modelo Flash, según la página de planes de Gemini. En Claude, el plan Free no incluye Fable 5.1, Pro lo cobra con créditos de uso desde el primer mensaje, y Max (100 $ al mes) y Ultra (200 $) lo incluyen hasta la mitad del límite semanal; Max y Ultra son los nombres que sustituyeron a Max 5x y Max 20x el 30 de octubre de 2026. Google no publica cuántos mensajes de Argon da cada plan: los límites de la app se calculan por cómputo y se renuevan cada 5 horas hasta un tope semanal, como explica la ayuda de la app de Gemini sobre límites; las reglas de Claude están en la ayuda de Claude sobre los modelos Fable en tu plan.
¿Esperar a Fable 5.5 o a Gemini 4 Carbon?
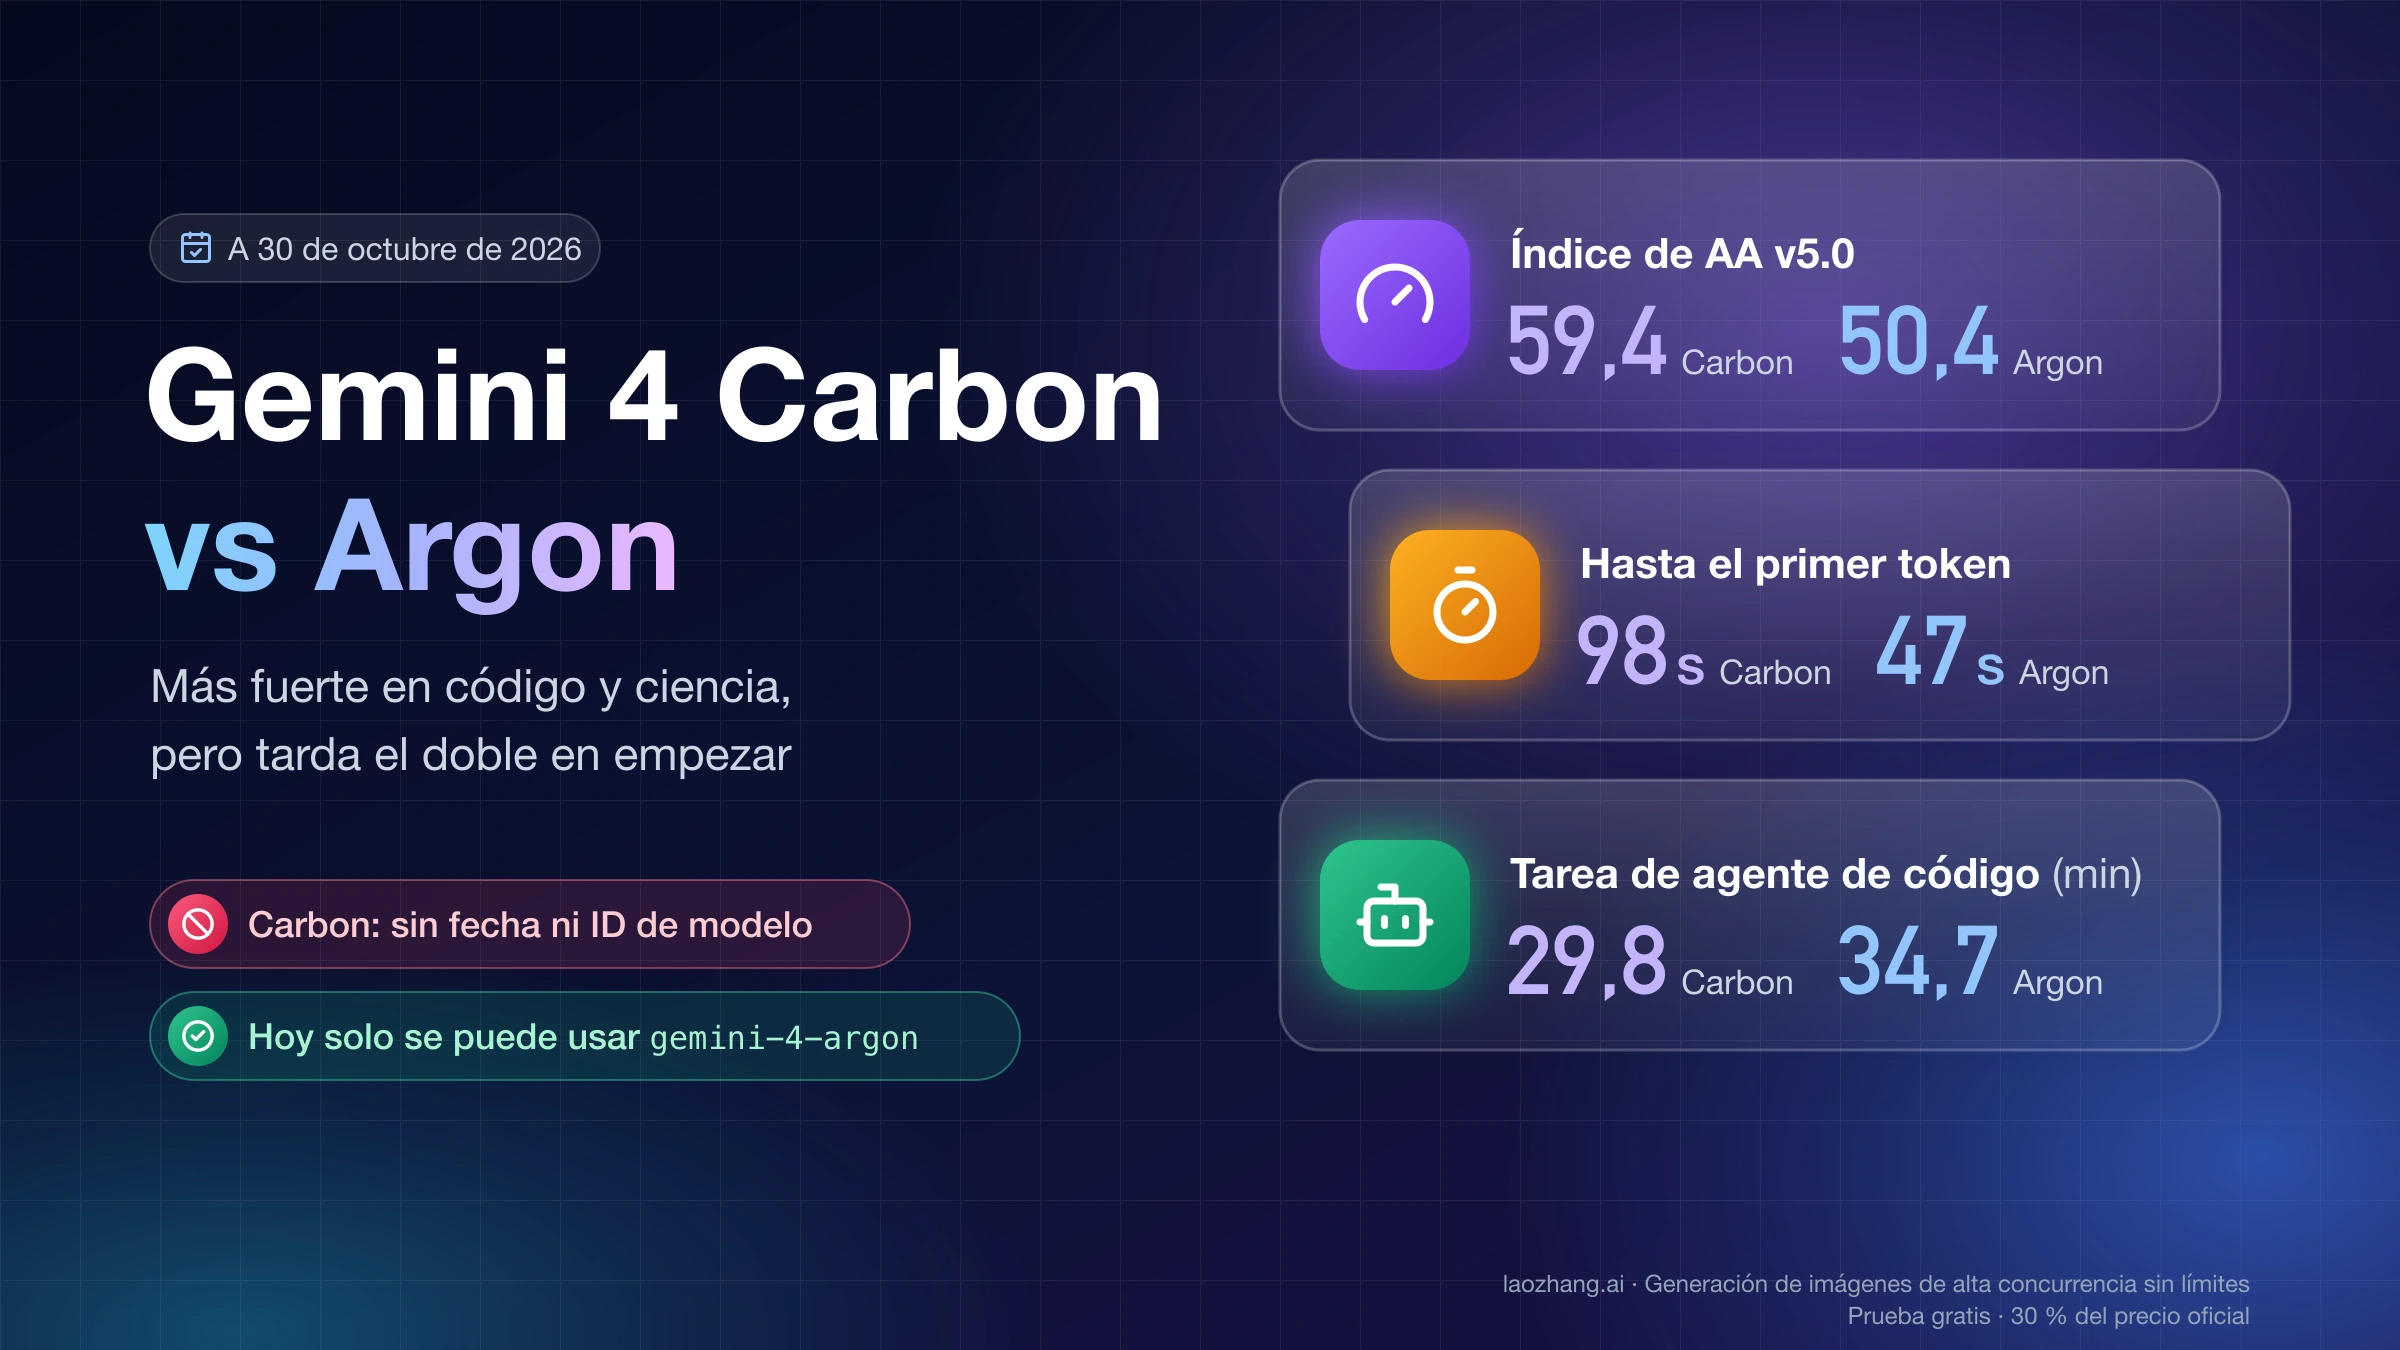
Esperar no tiene sentido hoy en ninguno de los dos casos. A 4 de noviembre de 2026, Anthropic no ha publicado ningún Fable 5.5 y Fable 5.1 sigue marcado como su modelo más reciente; lo que se sabe del rumor está en Fable 5.5 vs Gemini 4 vs GPT-6.1: Argon ya salió, Fable 5.5 no. Gemini 4 Carbon, anunciado el 28 de octubre, solo está abierto a un grupo de equipos de ciberdefensa, sin API ni fecha para el resto, y Google no ha dicho que vaya a retirar Argon; la comparación está en Gemini 4 Carbon vs Argon: dónde gana, cuánto cuesta y si cambiar y el estado del acceso en Gemini 4 Carbon: sin fecha de acceso aún. ¿Esperar o usar Argon?.
Cómo comparar Argon y Fable con tus prompts antes del 1 de diciembre
Hasta el 30 de noviembre, probar Argon cuesta la mitad, así que es el momento de medir con tus propias tareas y decidir con el precio de diciembre ya calculado. El orden que evita conclusiones falsas es este:
- Reúne entre 10 y 20 tareas reales de tu trabajo y define antes de empezar qué cuenta como aprobado: tests que pasan, un campo extraído correcto, un documento que no inventa cifras.
- Ejecuta cada tarea con Argon sin
thinkingConfig(su nivel por defecto) y con Fable 5.1 sin tocareffort(suhighpor defecto), con la misma entrada y sin caché en esta primera pasada. - Guarda de cada respuesta los tokens de entrada, los de salida (en los dos el razonamiento se factura como salida) y el tiempo, y calcula el coste dos veces para Argon: con 2 $ y 10 $ y con 4 $ y 20 $ por millón.
- Solo en las tareas que fallen, sube un nivel: Argon a
highy Fable axhigh. Divide el gasto de todos los intentos, incluidos los fallidos, entre las respuestas aprobadas. - Si tus prompts repiten un contexto largo, repite la medición con caché:
cache_controlen Fable y, en Argon, prompts de más de unos 4.000–6.000 tokens con el mismo inicio, comprobando en el uso devuelto cuántos tokens se leyeron de caché. - Elige por coste por respuesta aprobada con el precio de diciembre, tarea por tarea; el resultado puede ser un reparto, con Argon para el volumen y Fable para el grupo de tareas en que Argon falla.
Si llamas a Argon a través de una ruta compatible con OpenAI, el paso 4 no funciona con reasoning_effort: usa la ruta nativa de Gemini para cambiar thinkingLevel.
Preguntas frecuentes sobre Gemini 4 Argon y Claude Fable 5.1
¿Gemini 4 Argon es lo mismo que «Gemini 4 Pro»?
«Gemini 4 Pro» fue un nombre que circuló antes de que Google anunciara Gemini 4 Argon el 30 de septiembre de 2026, y las comparativas que lo usan describen un modelo sin precios ni pruebas publicadas. El modelo lanzado se llama Gemini 4 Argon (gemini-4-argon) y es distinto de Gemini 4 Carbon, que a 4 de noviembre de 2026 tiene acceso restringido.
¿Se puede usar Gemini 4 Argon gratis en la API?
No. La página de precios de la API de Gemini no ofrece nivel gratuito para Argon a 4 de noviembre de 2026, y las suscripciones Google AI Pro y Ultra dan cuota de Argon en la interfaz web de AI Studio y en la app, pero nunca cubren llamadas a la API.
¿Se puede desactivar el razonamiento de Argon para pagar menos?
No. Según la documentación de razonamiento de Gemini, en Argon el razonamiento no se puede apagar; el nivel más bajo es low, y Google recomienda el valor por defecto, medium, incluso para código complejo y agentes. El razonamiento se cobra como salida, así que si buscas reducir coste prueba low en tareas sencillas y comprueba que sigan aprobando.
Fuentes15
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 4 nov 2026.
Fuentes15
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 4 nov 2026.
- 1.página de Anthropic sobre retención de datos en la APIplatform.claude.com/docs/en/manage-claude/api-and-data-retention
- 2.página de modelos de Anthropicplatform.claude.com/docs/en/about-claude/models/overview
- 3.comparador de Artificial Analysis entre Gemini 4 Argon y Claude Fable 5.1artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-1
- 4.metodología de AAartificialanalysis.ai/methodology/intelligence-benchmarking
- 5.Epoch Capabilities Indexepoch.ai/benchmarks/eci
- 6.Vals Indexvals.ai/benchmarks/vals_index
- 7.anuncio de Gemini 4 Argonblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 8.página de precios de la API de Geminiaistudio.google.com/docs/pricing
- 9.precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 10.documentación sobre el recuento de tokensplatform.claude.com/docs/en/build-with-claude/token-counting
- 11.decodificación largaaistudio.google.com/docs/long-decode
- 12.página de planes de Geminigemini.google/us/subscriptions
- 13.ayuda de la app de Gemini sobre límitessupport.google.com/gemini/answer/17004136
- 14.ayuda de Claude sobre los modelos Fable en tu plansupport.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 15.documentación de razonamiento de Geminiaistudio.google.com/docs/thinking