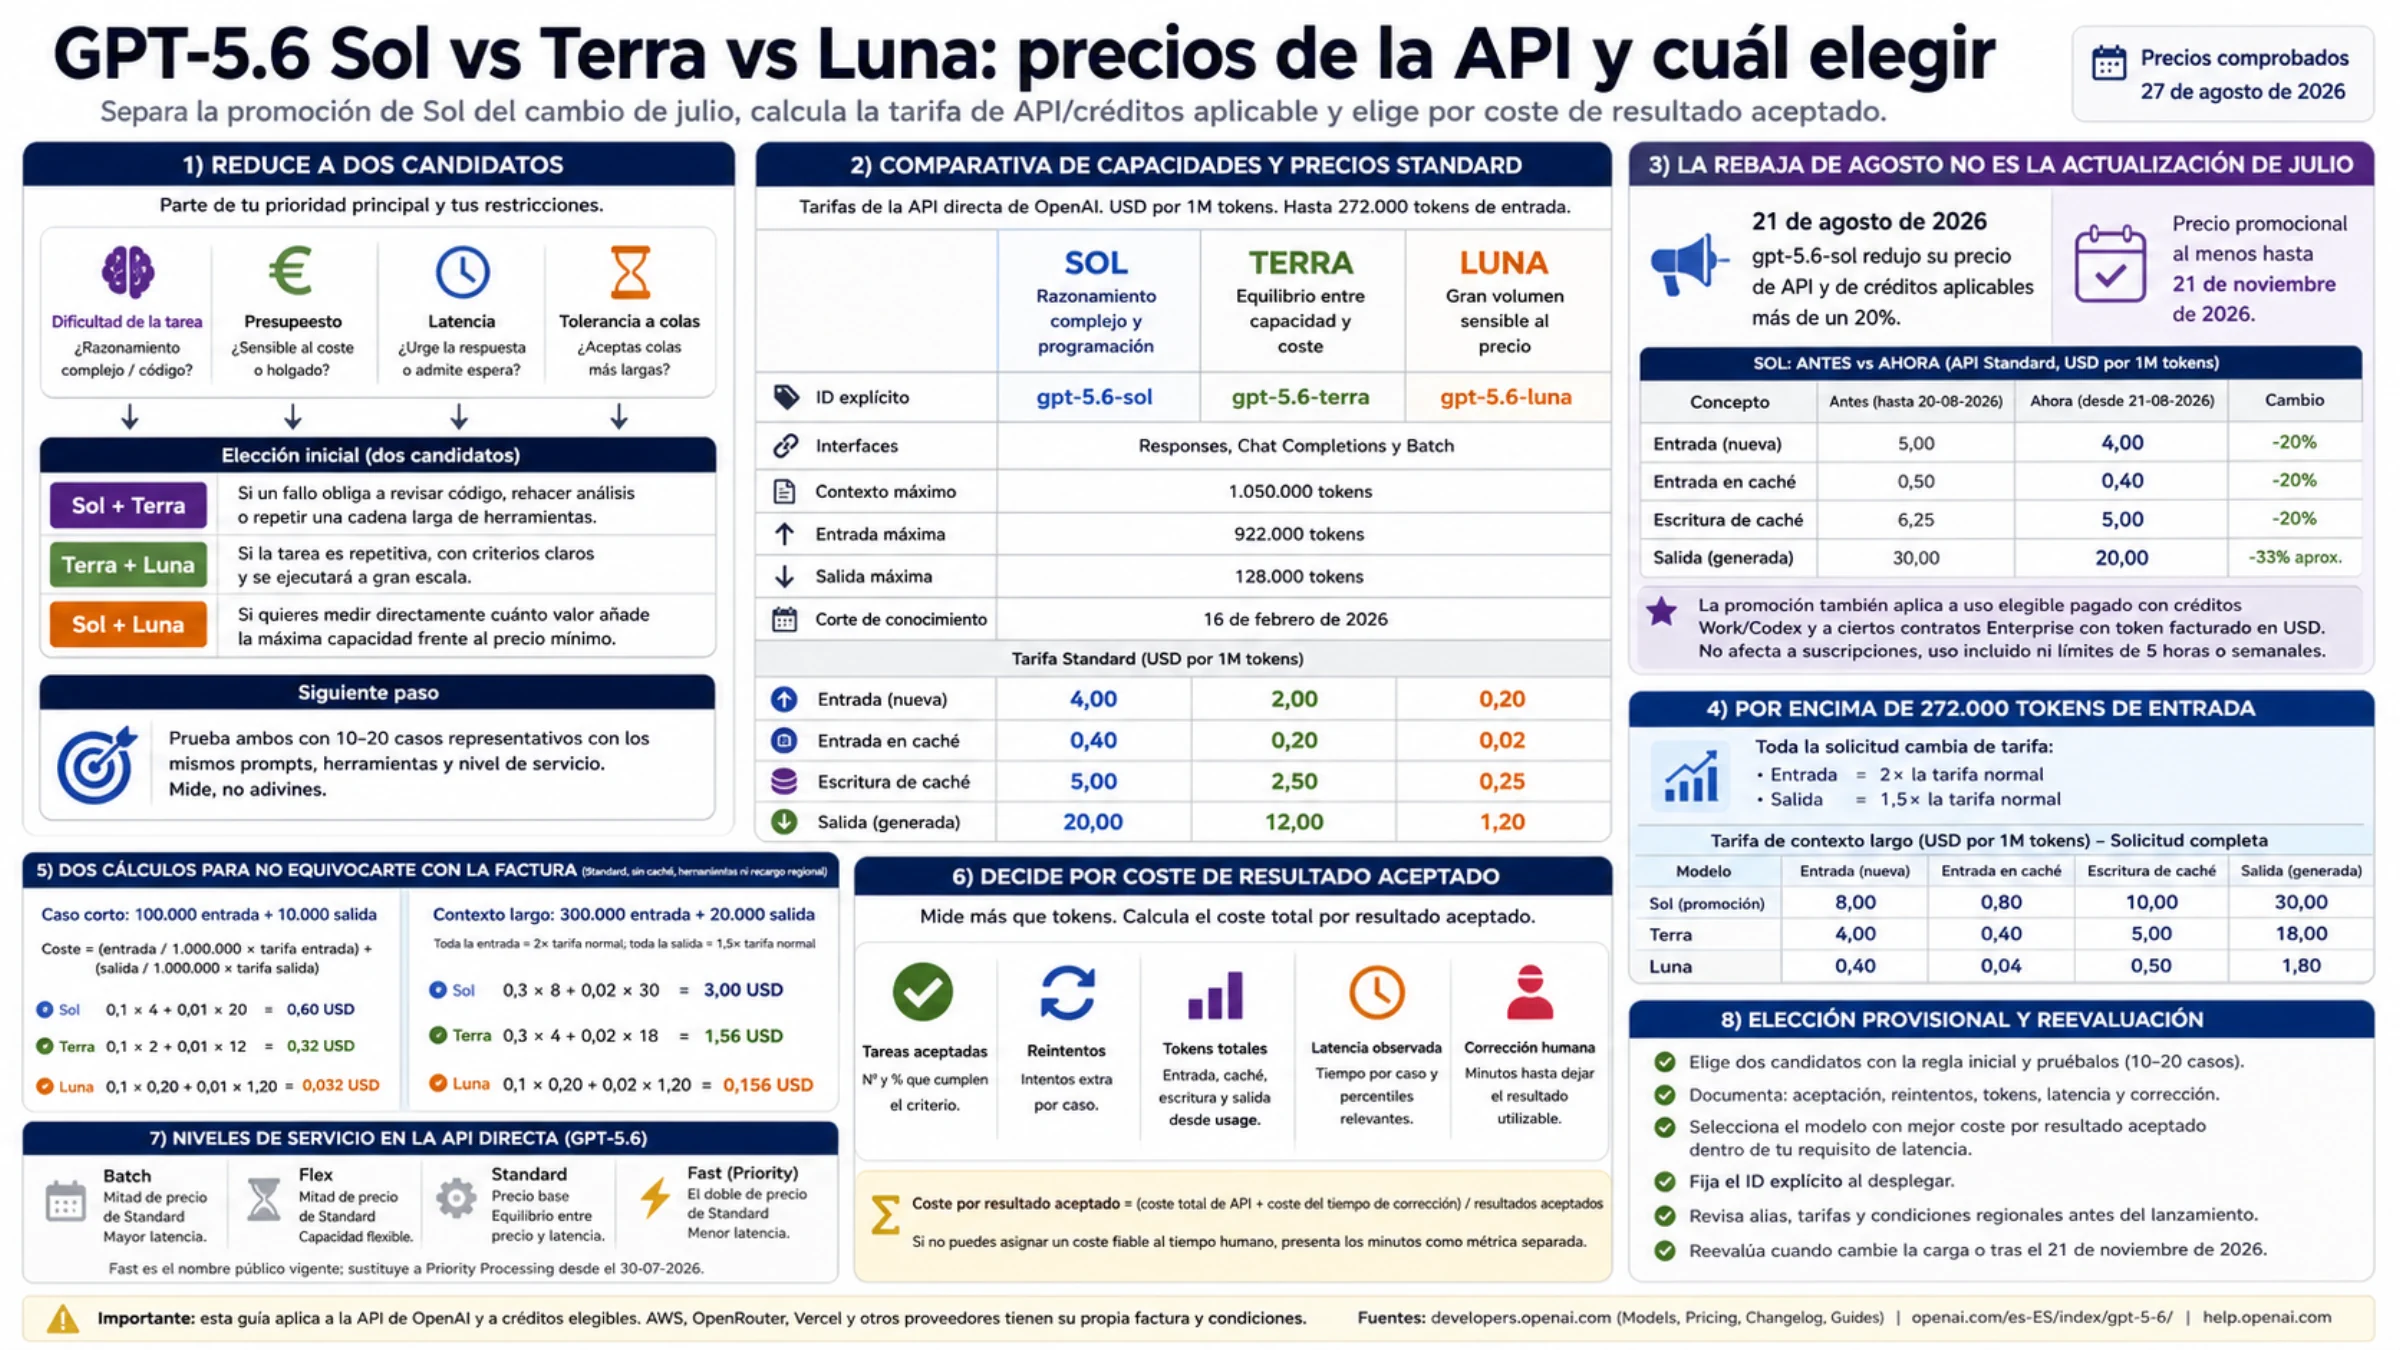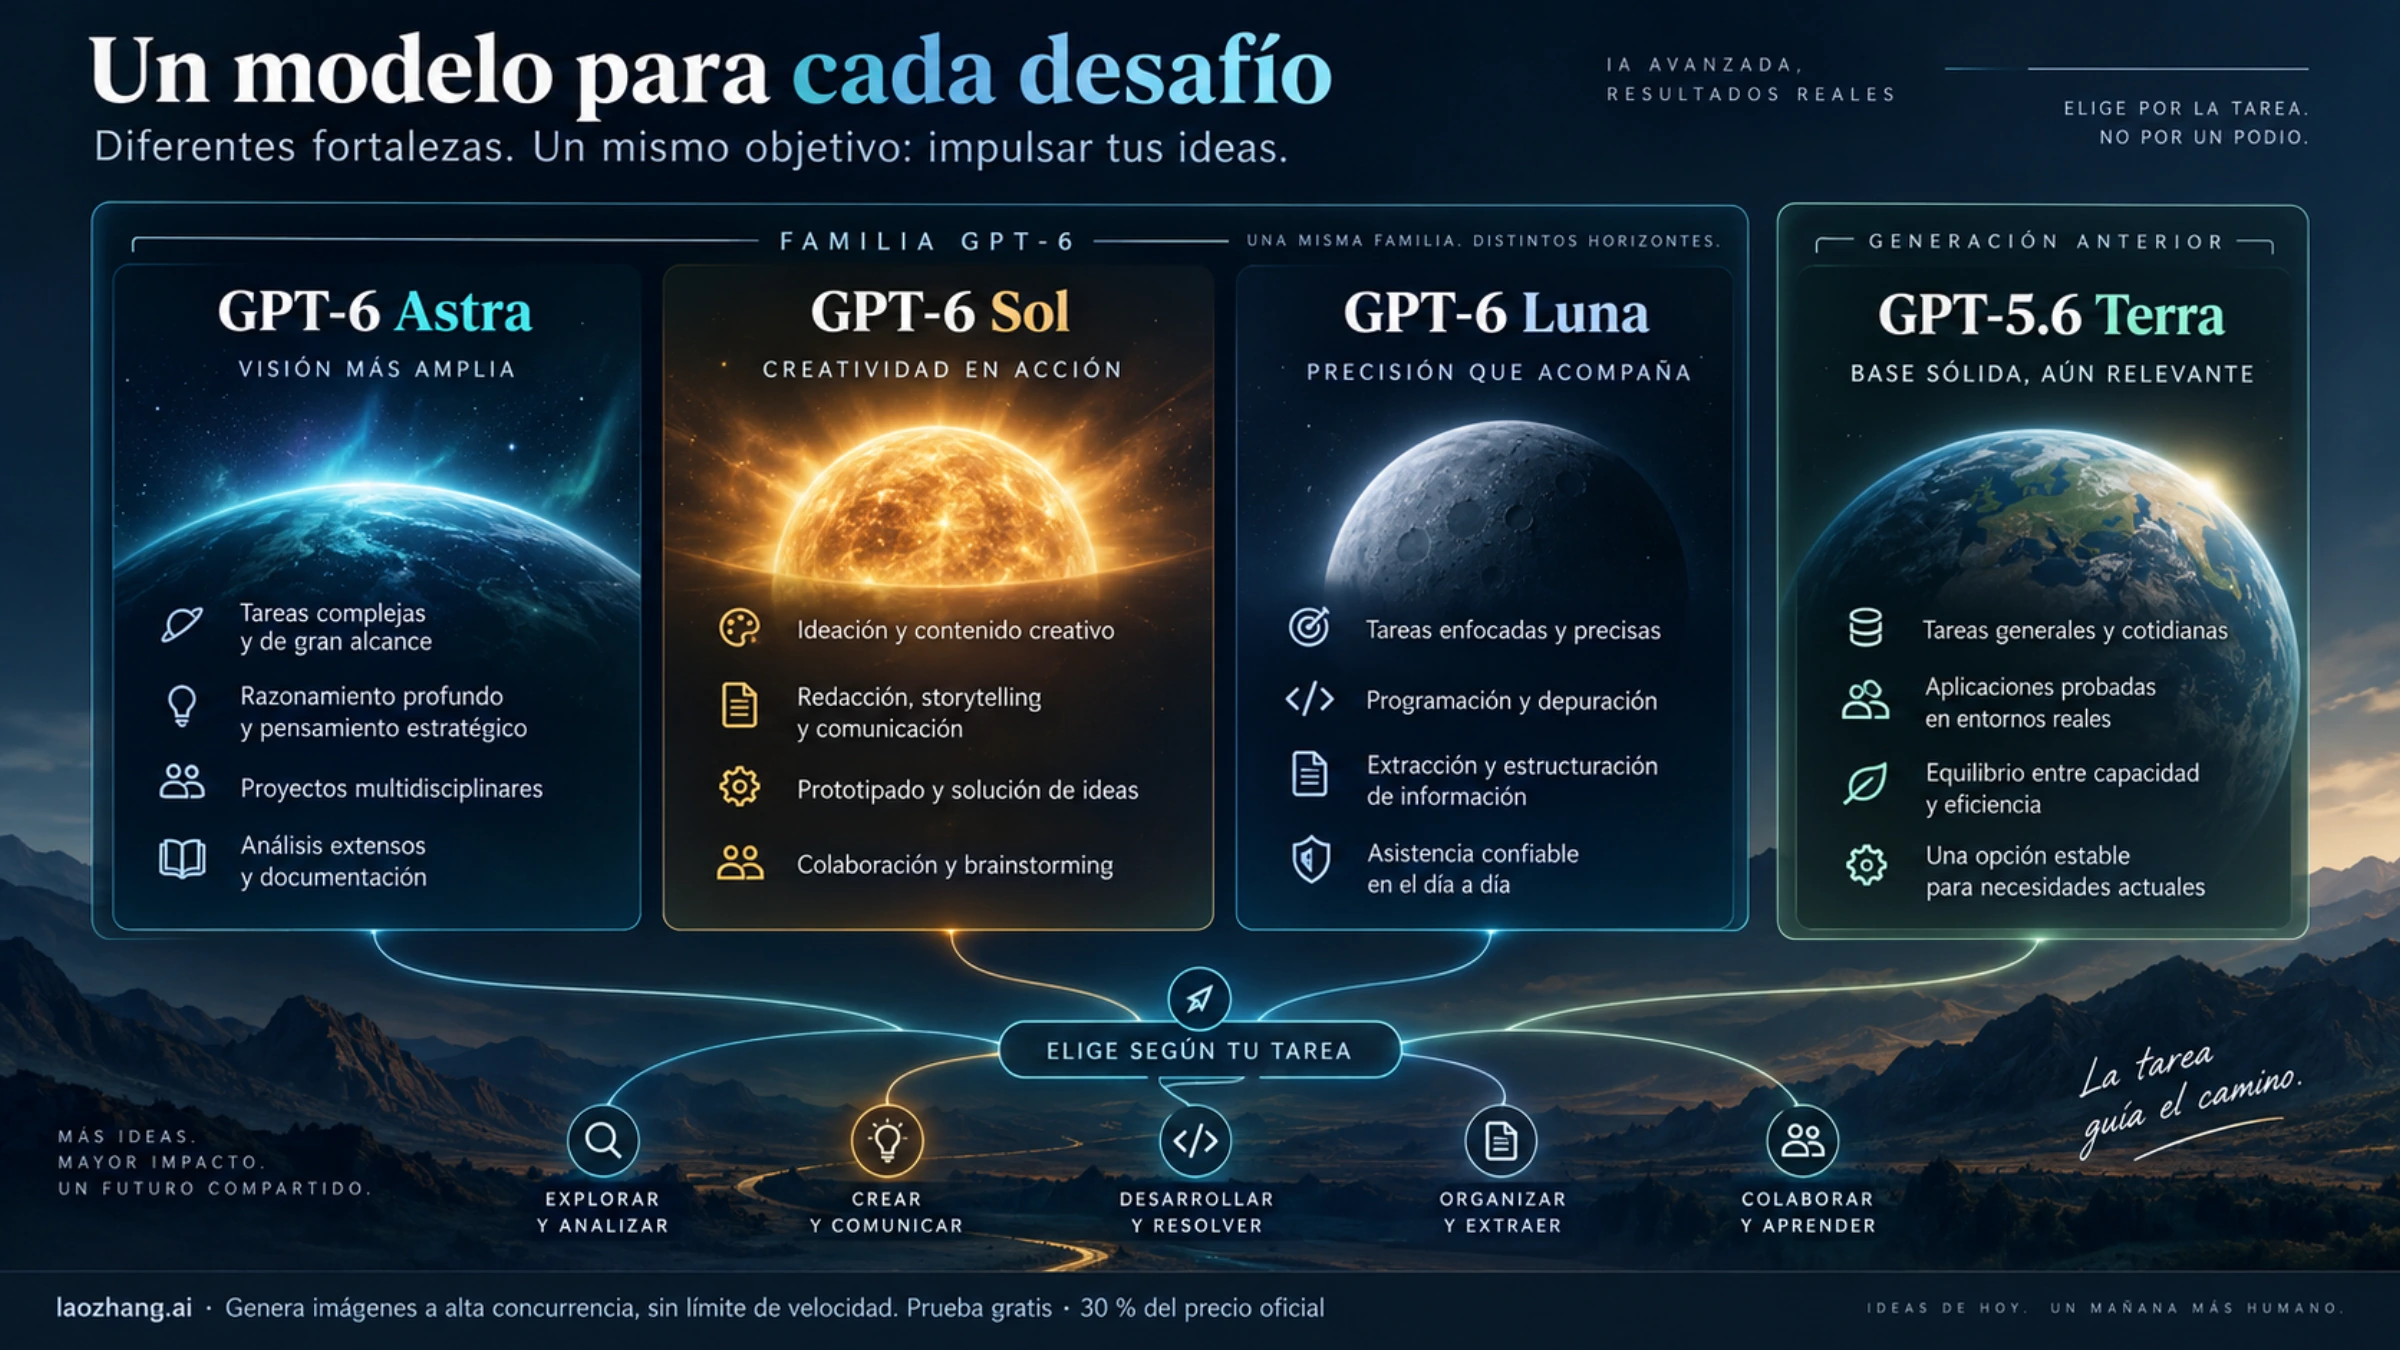
Terra no es un modelo GPT-6. La familia actual reúne gpt-6-astra, gpt-6-sol y gpt-6-luna; el cuarto nombre de esta comparación es gpt-5.6-terra. Para empezar, prueba Luna si la tarea es acotada y repetible, Sol si exige programar o resolver casos menos previsibles y Astra si una cadena larga de decisiones justifica evaluar el modelo de mayor capacidad. Si ya utilizas Terra, compáralo directamente con Sol antes de migrar. Son puntos de partida basados en el posicionamiento de OpenAI, no una clasificación de rendimiento obtenida con tus datos.
La distinción de generación importa porque una comparación publicada antes de la llegada de Sol y Luna puede llamar «Sol» y «Luna» a sus versiones GPT-5.6. Los IDs de modelo evitan esa ambigüedad. Esta guía usa precios de la API directa de OpenAI, comprobados el 23 de septiembre de 2026; la disponibilidad en Work o Codex es otra cuestión.
Qué modelo estás comparando realmente
| Nombre de esta guía | ID para la API | Punto de partida razonable |
|---|---|---|
| Astra | gpt-6-astra | Trabajo difícil de varios pasos, cuando merece la pena probar más capacidad. |
| Sol | gpt-6-sol | Programación compleja, agentes y tareas cotidianas que requieren criterio. |
| Luna | gpt-6-luna | Tareas concretas, repetibles y de mucho volumen. |
| Terra | gpt-5.6-terra | Referencia de la generación anterior si ya forma parte de tu flujo. |
Las tres primeras filas son la familia GPT-6. La ficha de Terra identifica expresamente su generación GPT-5.6: no existe un gpt-6-terra en esta comparación. Sol y Luna de GPT-6 aparecieron en el registro de cambios del 22 de septiembre de 2026. Si buscas exclusivamente la terna anterior, consulta nuestra comparativa de GPT-5.6 Sol, Terra y Luna, teniendo en cuenta la fecha de sus tarifas.
Las fichas de Astra, Sol y Luna indican una ventana de contexto de 1.050.000 tokens, hasta 922.000 de entrada y 128.000 de salida. Una ventana compartida no significa que los tres resuelvan igual una tarea ni que enviar el máximo contexto mejore la respuesta. Astra admite niveles de razonamiento de low a max; Sol y Luna también permiten none. Si comparas modelos, fija el nivel de razonamiento y el resto de la configuración que sea comparable, o registra esa diferencia como parte del experimento.
Cuánto cuesta la API con una petición de hasta 272.000 tokens de entrada
Estas son las tarifas oficiales de OpenAI para procesamiento Standard, en USD por cada millón de tokens, con 272.000 tokens de entrada o menos. «Caché» es lectura de entrada ya almacenada; «escritura» es guardar entrada para reutilizarla. No sumes las cuatro columnas a una misma cantidad de tokens: cada una corresponde a un uso distinto.
| Modelo | Entrada nueva | Entrada en caché | Escritura de caché | Salida |
|---|---|---|---|---|
gpt-6-astra | 10 | 1 | 12,50 | 50 |
gpt-6-sol | 2 | 0,20 | 2,50 | 10 |
gpt-6-luna | 0,10 | 0,01 | 0,125 | 0,50 |
gpt-5.6-terra | 2 | 0,20 | 2,50 | 12 |
Sol frente a Terra: con esos precios Standard y la misma cantidad de tokens de entrada nueva y salida, Sol cuesta lo mismo por entrada (2 USD/millón) y menos por salida (10 frente a 12 USD/millón). La entrada en caché y su escritura también tienen la misma tarifa en esta tabla. Esta es una comparación de precio unitario bajo las mismas condiciones, no una prueba de que Sol utilice los mismos tokens, produzca mejores respuestas o salga más barato por tarea terminada.
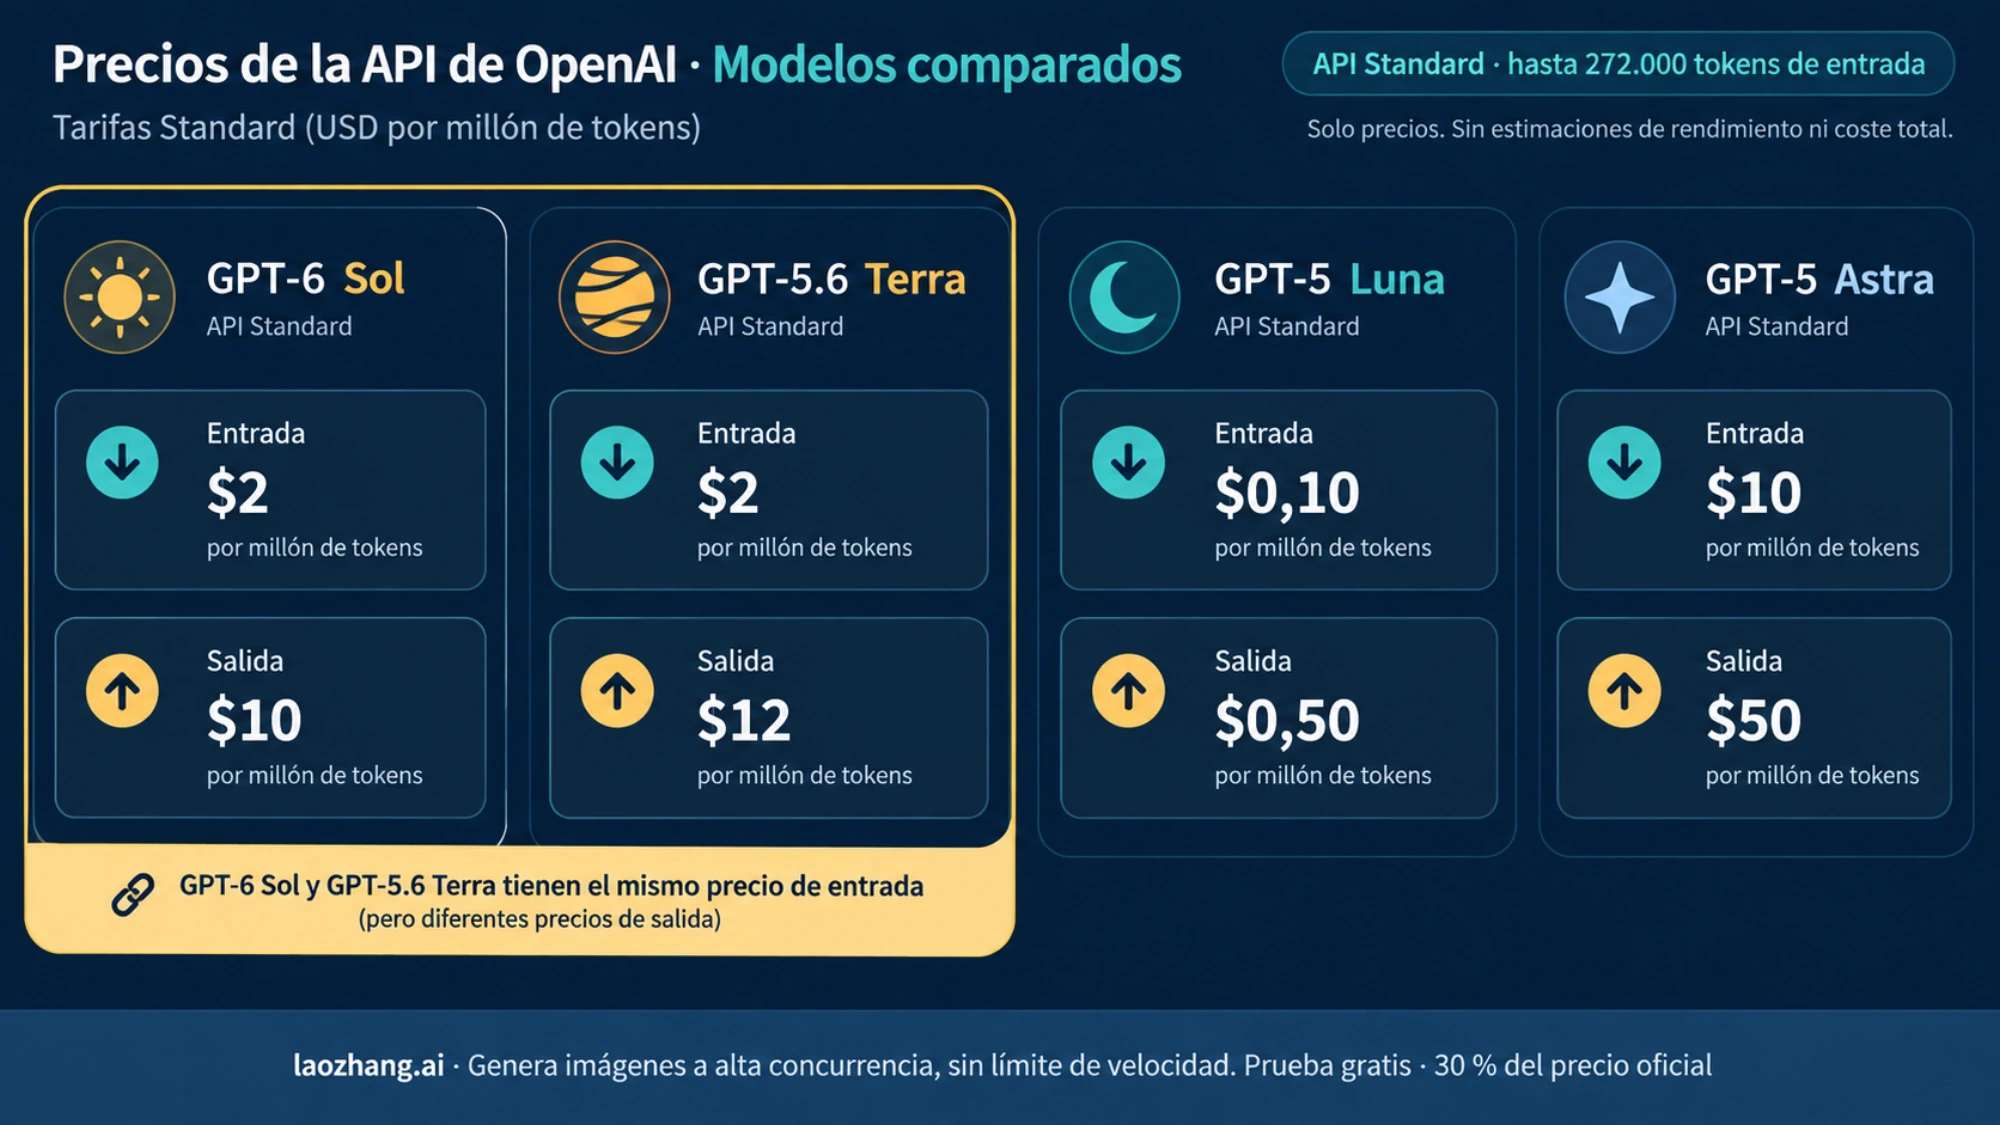
Por ejemplo, una petición hipotética con 100.000 tokens de entrada nueva y 10.000 de salida, sin caché, herramientas ni reintentos, costaría 0,30 USD con Sol (0,1 × 2 + 0,01 × 10) y 0,32 USD con Terra (0,1 × 2 + 0,01 × 12). Luna costaría 0,015 USD y Astra 1,50 USD con esa misma cantidad de tokens. No son facturas observadas: cada modelo puede generar una salida de distinta longitud, emplear tokens de razonamiento, necesitar reintentos o requerir corrección humana. Las herramientas pueden añadir cargos; consulta la tabla de precios para tu combinación concreta.
Si superas 272.000 tokens de entrada, cambia toda la petición
Según la tarifa oficial de contexto largo, al superar ese umbral se aplica el precio largo a toda la solicitud, no solo a los tokens que exceden 272.000. En Standard, los pares entrada nueva / salida pasan a 20 / 75 USD para Astra, 4 / 15 para Sol, 0,20 / 0,75 para Luna y 4 / 18 para Terra, siempre por millón de tokens. La caché, el modo de procesamiento y otros cargos tienen sus propias condiciones: vuelve a calcular antes de extrapolar la tabla de contexto corto.
Para una tarea con documentos extensos, prueba primero a enviar solo las partes pertinentes. Si realmente necesitas superar el umbral, compara la solicitud completa con alternativas que dividan el trabajo; el tamaño máximo de contexto es una capacidad de entrada, no una recomendación de gasto. Encontrarás el desglose específico del modelo más caro en nuestra guía de precio de GPT-6 Astra en la API.
Qué probar primero según el trabajo
Extracción, clasificación o transformación repetible: empieza por Luna. Define antes qué constituye una respuesta válida: campos obligatorios, errores tolerados y casos difíciles. Si incumple ese umbral, compara con Sol usando los mismos casos. El menor precio por token solo interesa si la tasa de resultados aceptados y el trabajo de reparación lo sostienen.
Programación, análisis con decisiones encadenadas o agentes: empieza por Sol. Compara Astra cuando los fallos del flujo completo sean costosos o Sol no alcance el criterio de aceptación. Las fichas de Sol y Astra explican su orientación; no demuestran que Astra gane en todos los repositorios ni que responda más rápido.
Un flujo que ya funciona con Terra: conserva Terra como referencia de calidad y mide Sol en paralelo. Su precio de salida Standard es menor a igualdad de tokens, pero una migración solo merece la pena si mantiene tus requisitos de calidad, tiempo y compatibilidad. La guía de selección de modelos recomienda evaluar con tareas reales; no basta con escoger la fila más barata.
Cómo calcular el coste de un resultado aceptado
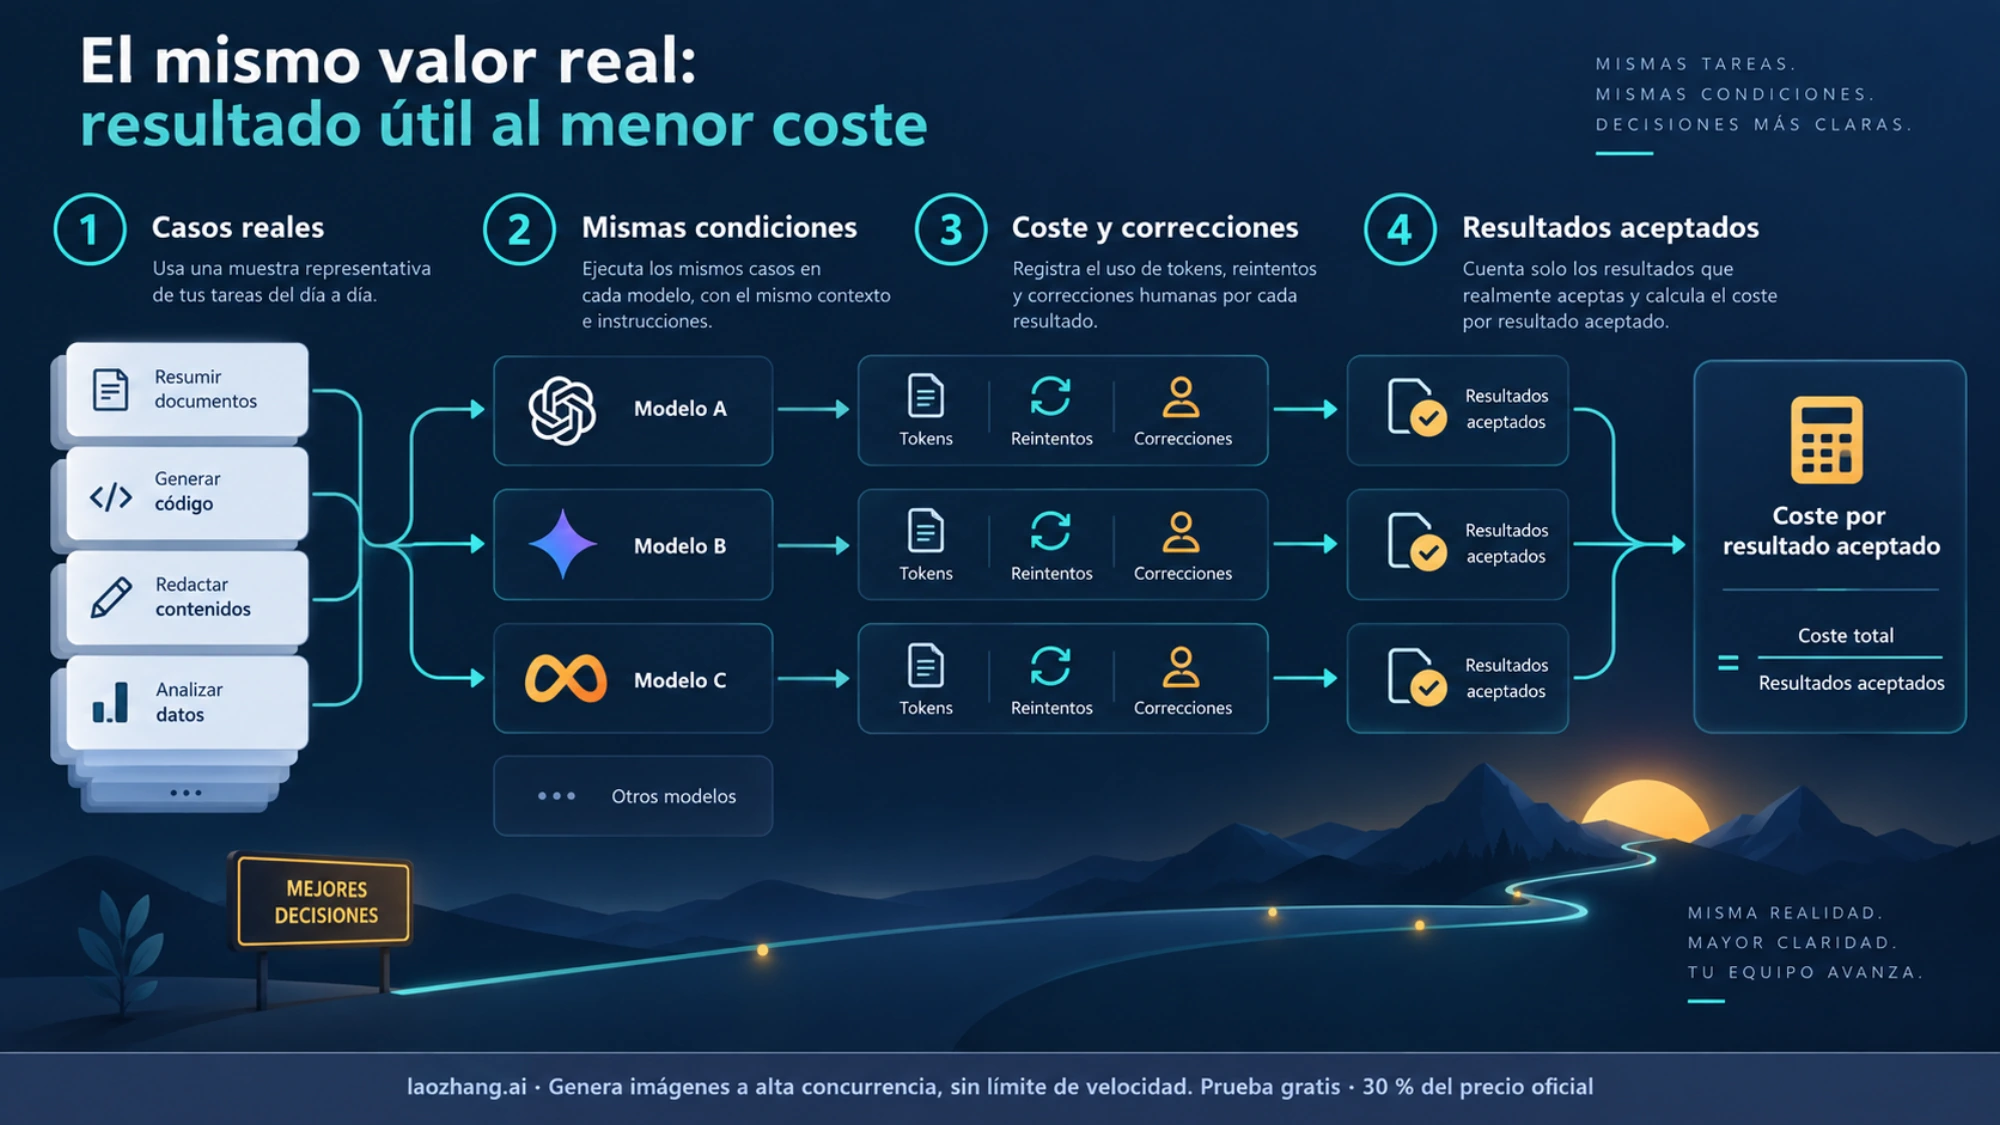
- Reúne una muestra de solicitudes reales, incluidos los casos difíciles, y define de antemano qué salida aceptarías. Incluye una revisión humana cuando tu proceso la necesite.
- Ejecuta cada candidato con la misma entrada, herramientas y límites de tiempo. Registra el nivel de razonamiento, el modo de procesamiento, el uso de caché y la versión o ID exacto. Si una función exige cambiar la configuración, deja esa diferencia visible.
- Anota tokens de entrada, caché y salida, cargos de herramientas, reintentos, tiempo y correcciones. Calcula el coste de cada ejecución con la tarifa aplicable; para el caso simple sin caché ni herramientas:
(tokens de entrada / 1.000.000 × tarifa de entrada) + (tokens de salida / 1.000.000 × tarifa de salida). - Divide el gasto total de todas las ejecuciones entre los resultados aceptados. Si un candidato no alcanza tu umbral de calidad o plazo, descártalo aunque su precio por token sea bajo.
Así obtienes una decisión para tu tarea. Aquí no se han ejecutado llamadas ni una prueba comparativa propia, por lo que no hay datos para afirmar una tasa de aciertos, velocidad o coste final por resultado de ninguno de los cuatro.
¿Lo verás en Work o Codex? No lo deduzcas de la tarifa API
La documentación de modelos de Work y Codex sitúa GPT-6 Sol y Luna en esas superficies cuando están habilitados, mientras que modelos GPT-5.6 pueden seguir disponibles durante el despliegue. Su presencia depende del cliente, plan, inicio de sesión y configuración del espacio de trabajo. Que un ID aparezca en la documentación de la API tampoco confirma el acceso de una cuenta concreta: comprueba el selector de modelos o el acceso efectivo en el proyecto donde lo usarás.
En Work/Codex intervienen las condiciones de su producto o plan; no conviertas una tarifa de USD por millón de tokens de la API en una cuota de mensajes o créditos. Del mismo modo, leer esta página en español no dice nada sobre la residencia de datos ni la elegibilidad de una cuenta. Si tu decisión exige una región o un modo de procesamiento específico, verifica sus condiciones actuales en la página oficial de precios y en la configuración de tu cuenta antes de estimar costes.