Claude Sonnet 5.5 vs Opus 5.5: cuál gasta menos por tarea
Sonnet 5.5 cobra la mitad por token que Opus 5.5, pero no siempre gasta menos por tarea: en AA ahorra hasta xhigh y en máximo cuesta igual con 4 puntos menos.
En esta página
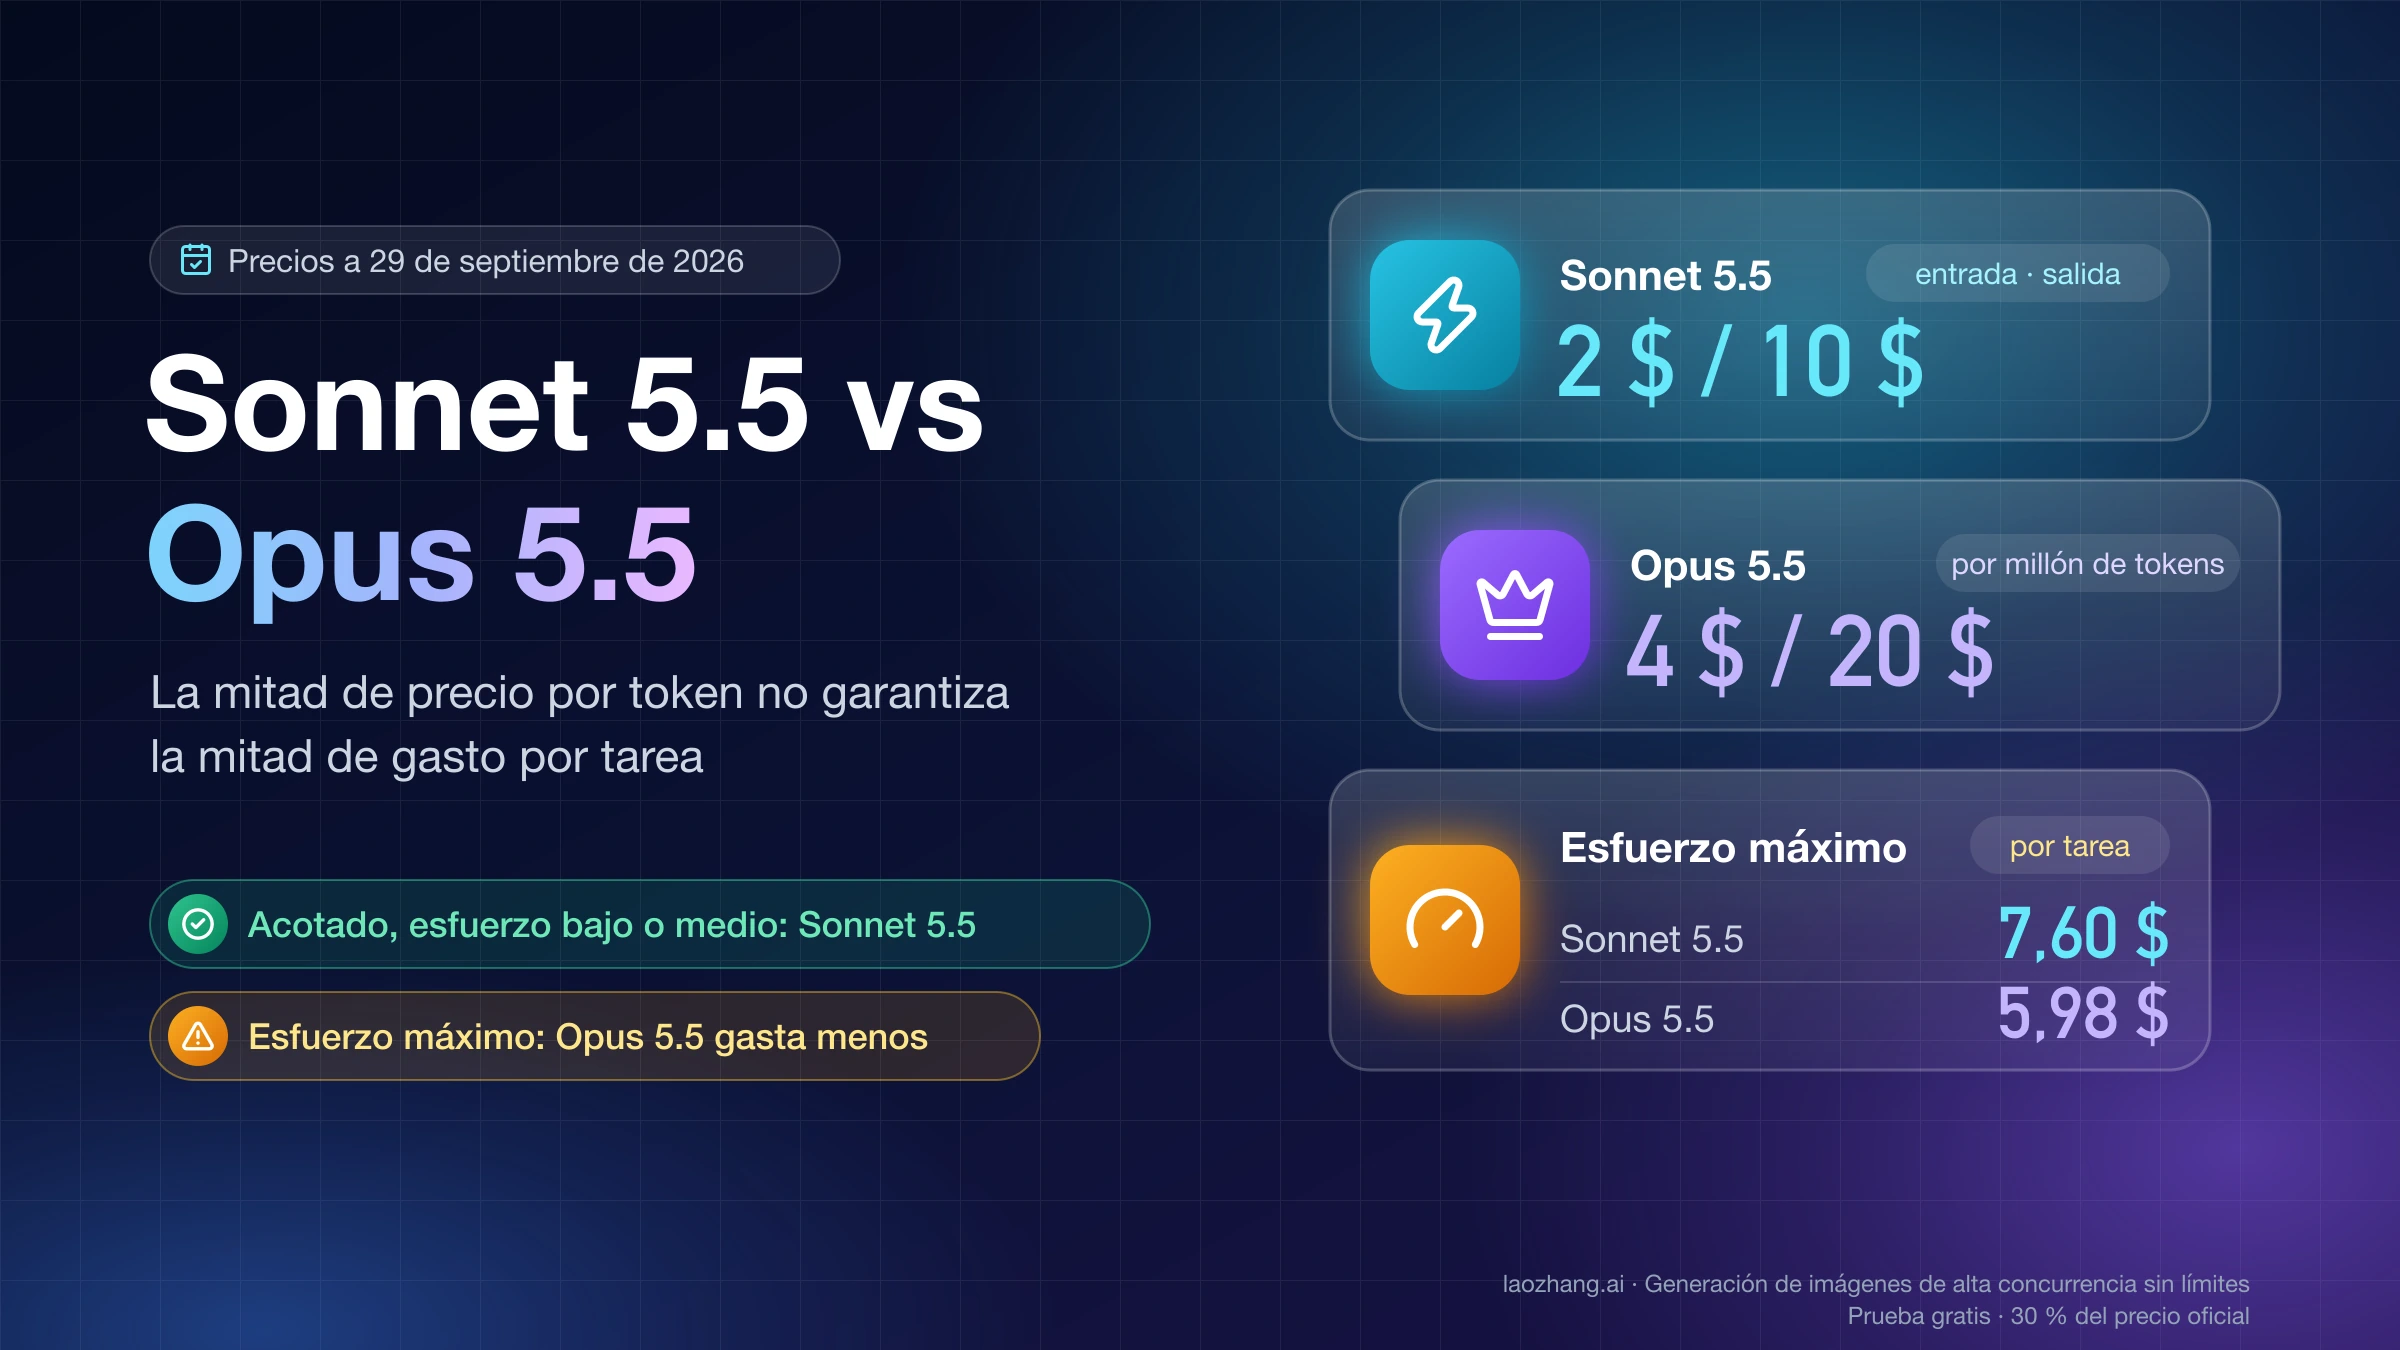
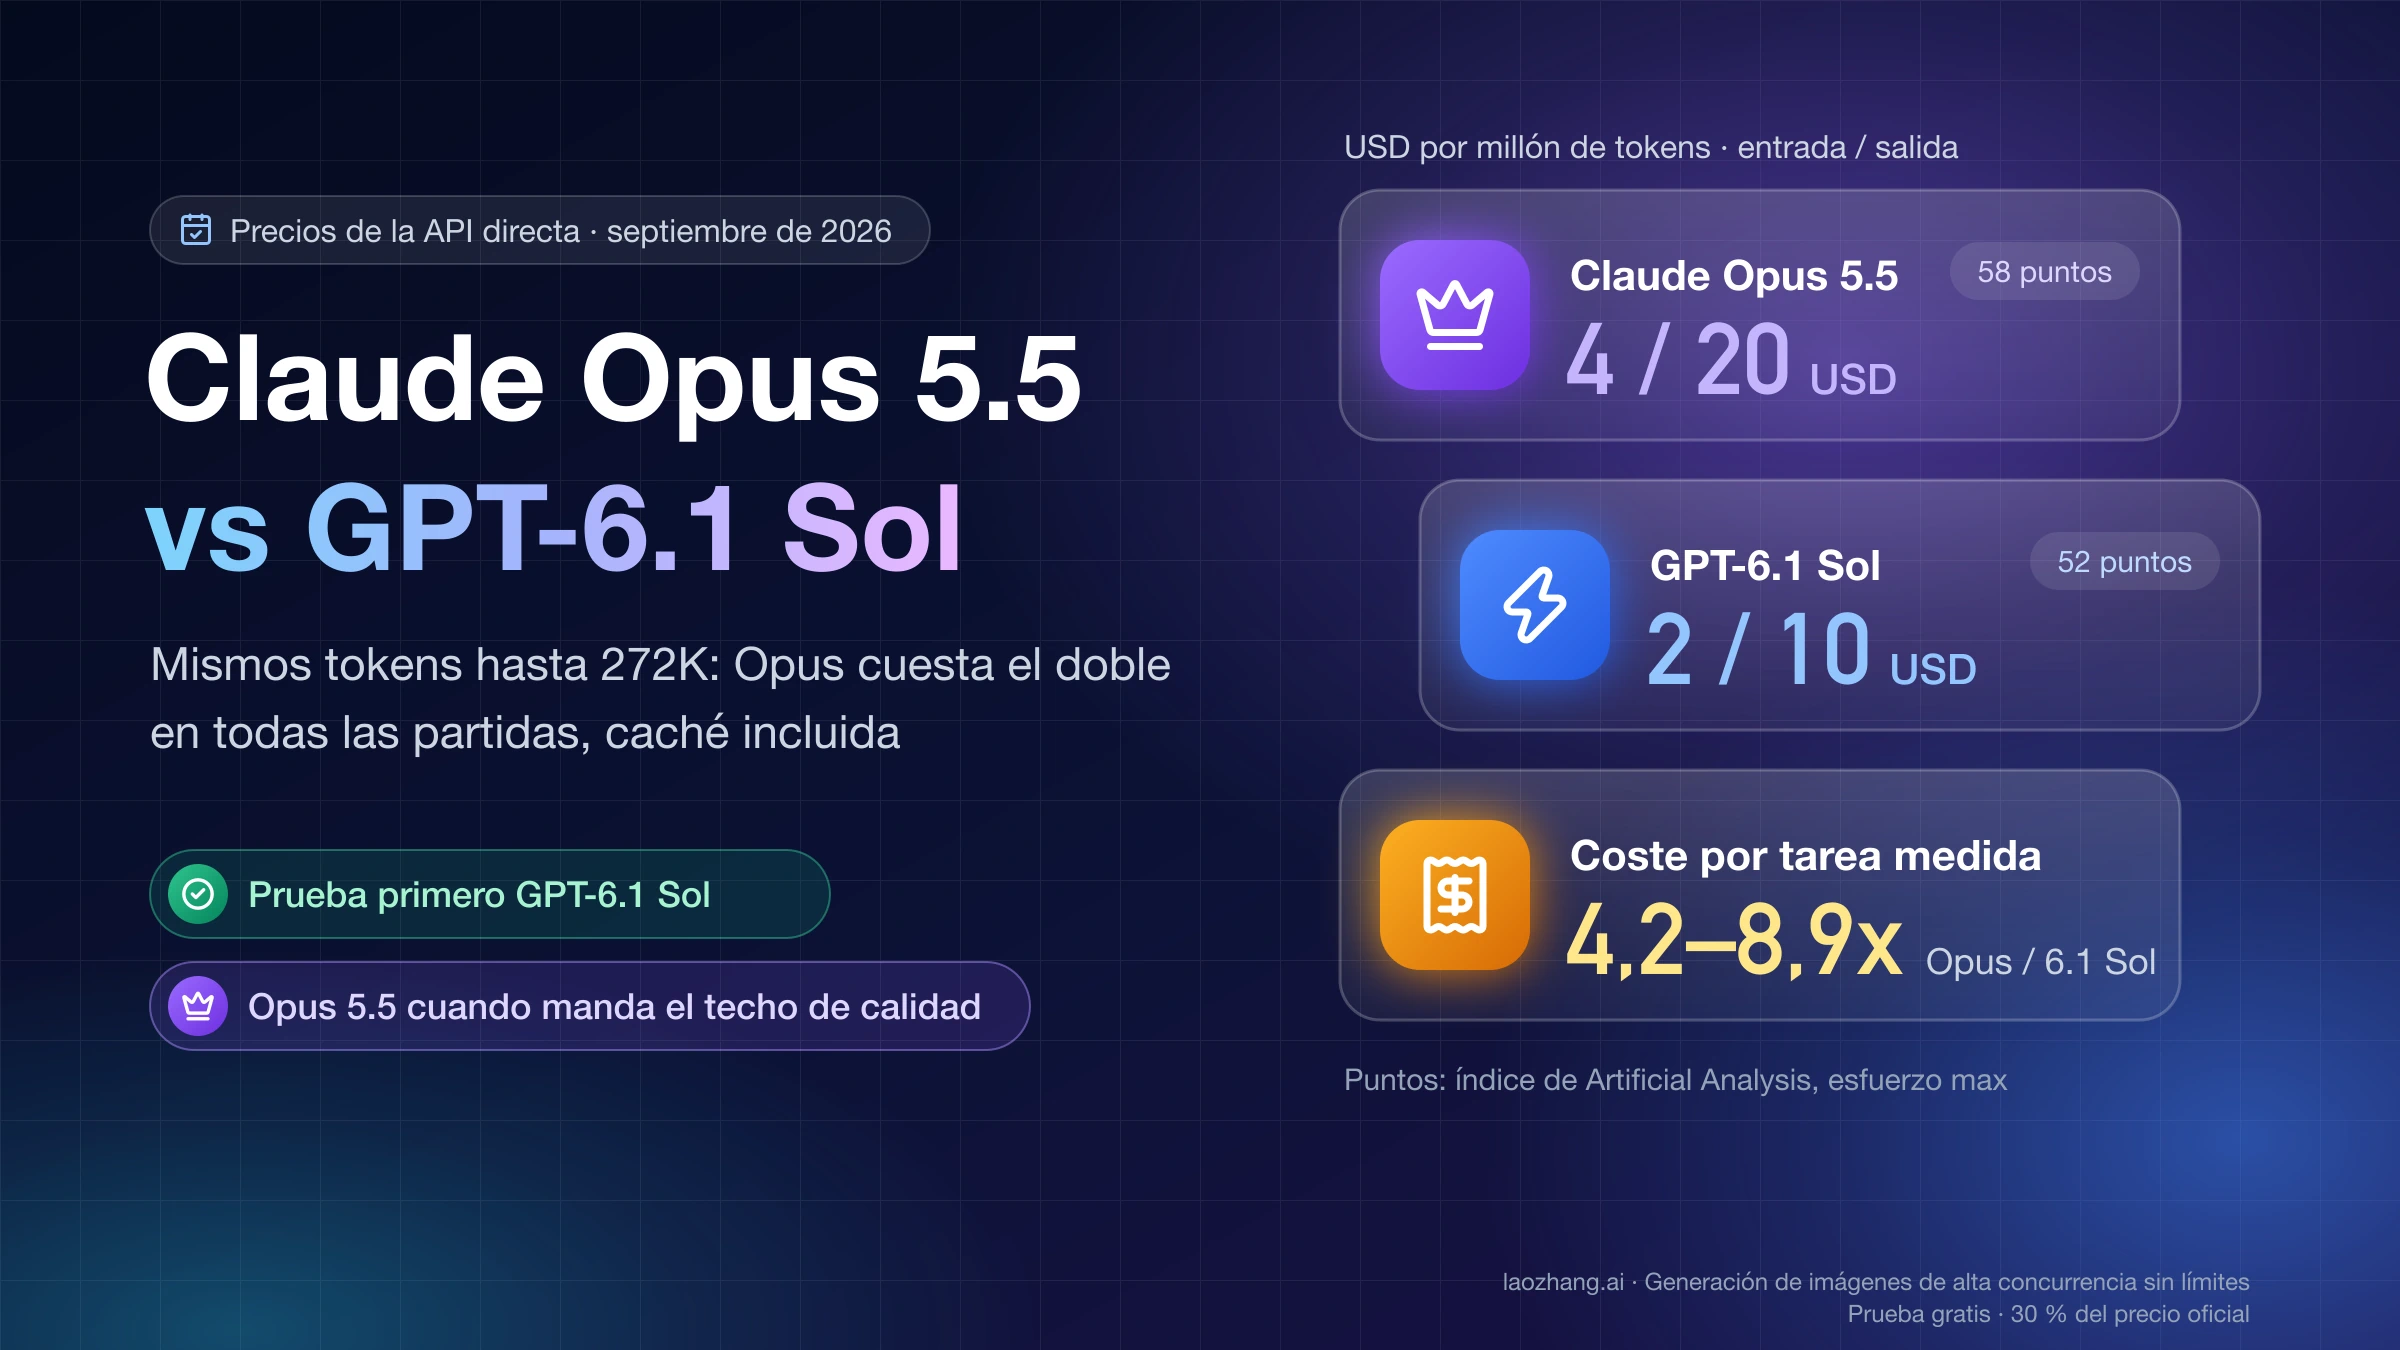
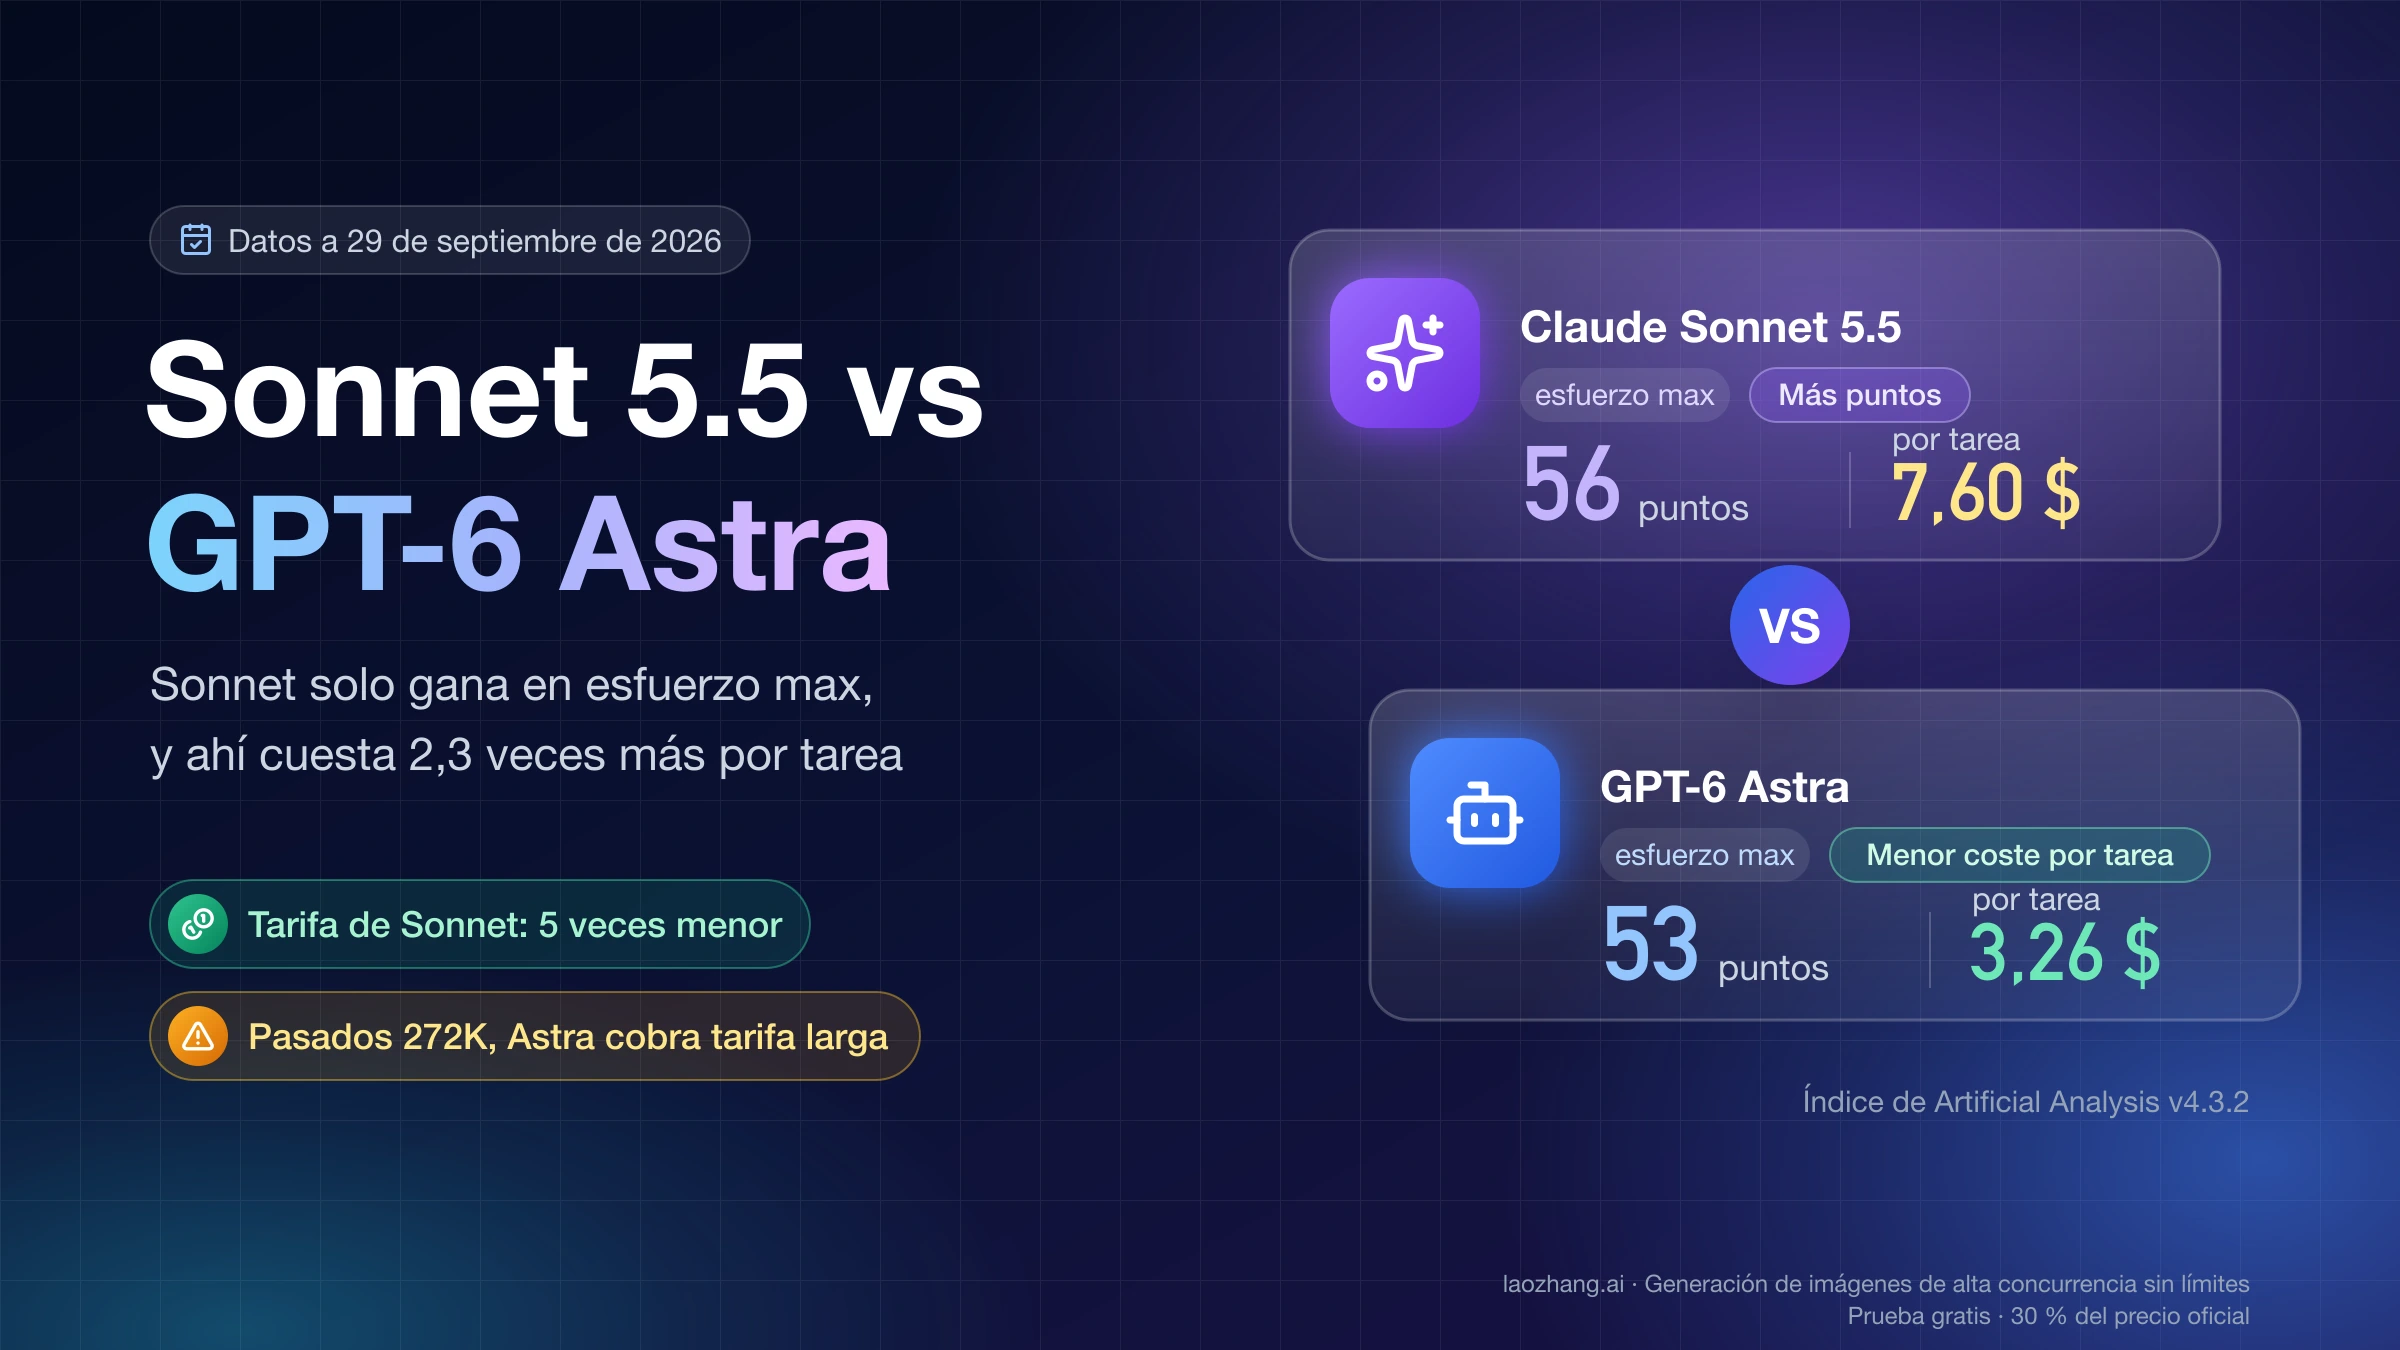
Por token, Claude Sonnet 5.5 cuesta exactamente la mitad que Opus 5.5: 2 $ frente a 4 $ por millón de tokens de entrada y 10 $ frente a 20 $ de salida. Por tarea, depende del esfuerzo y de cuánto trabajo necesite cada modelo para terminar. Sonnet 5.5 gasta menos en tareas acotadas y comprobables con esfuerzo low o medium, que es donde Anthropic dice que mejor complementa a Opus 5.5. Con esfuerzo máximo la ventaja desaparece: en el índice de Artificial Analysis, versión 5.0 (nueve evaluaciones, vigente desde el 27 y 28 de octubre de 2026), Sonnet 5.5 cuesta 10,02 $ por tarea y Opus 5.5, 10,04 $, con 54 puntos frente a 58. Y Opus 5.5 en xhigh ya supera a Sonnet 5.5 en max en puntuación por menos dinero. Para trabajo abierto, largo y lleno de decisiones de criterio, Opus 5.5 sigue siendo el punto de partida, y la propia Anthropic aconseja empezar por él si no tienes claro qué modelo usar.
Sonnet 5.5 salió el 28 de septiembre de 2026, seis días después de Opus 5.5. Los precios de este artículo son los de la tabla de precios de Anthropic a 28 de octubre de 2026, y las especificaciones, las de la comparativa de modelos a 29 de septiembre de 2026. Las cifras de rendimiento son de Anthropic, Artificial Analysis y CodeRabbit, y cada una va con el esfuerzo con que se midió.
Precios y especificaciones de Sonnet 5.5 y Opus 5.5
| Claude Sonnet 5.5 | Claude Opus 5.5 | |
|---|---|---|
| ID en la API | claude-sonnet-5-5 | claude-opus-5-5 |
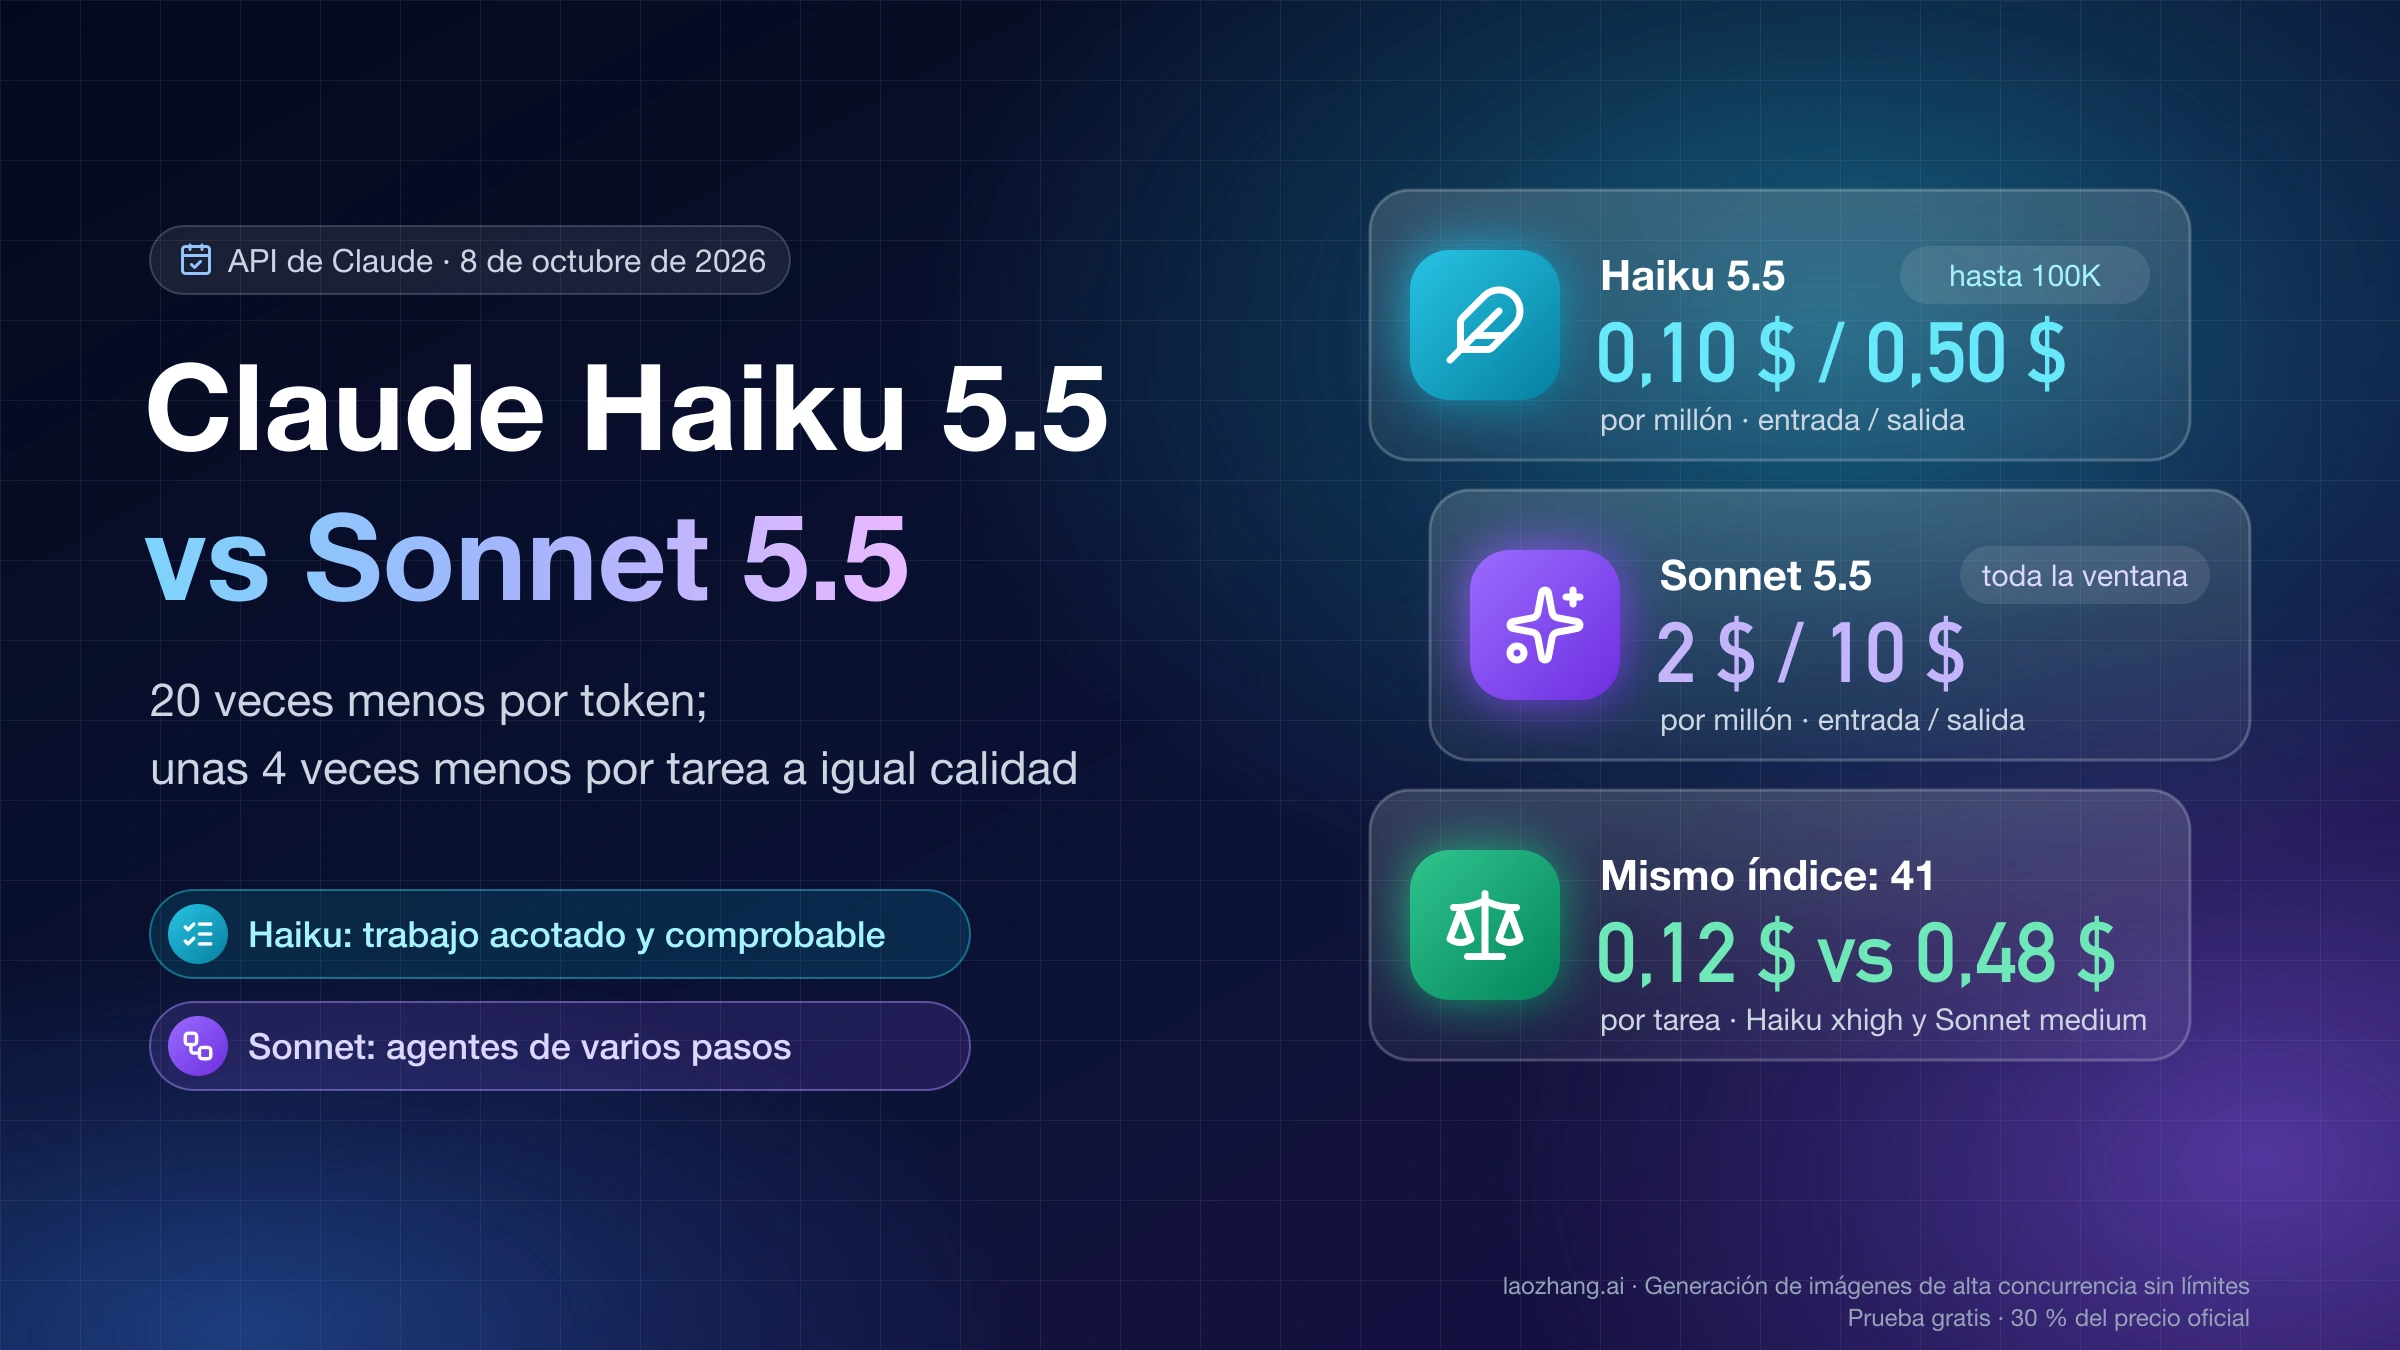
| Entrada, por millón de tokens | 2 $ | 4 $ |
| Salida, por millón de tokens | 10 $ | 20 $ |
| Escritura en caché, 5 min / 1 h | 2,50 $ / 4 $ | 5 $ / 8 $ |
| Lectura de caché | 0,10 $ | 0,20 $ |
| Batch, entrada / salida | 1 $ / 5 $ | 2 $ / 10 $ |
| Contexto / salida máxima | 1M / 128K tokens | 1M / 128K tokens |
| Esfuerzo por defecto en la API | high | medium |
| Razonamiento | Adaptativo; se puede quitar el razonamiento inicial con between_tools | Adaptativo y siempre activo |
| Latencia, según Anthropic | Rápida | Moderada |
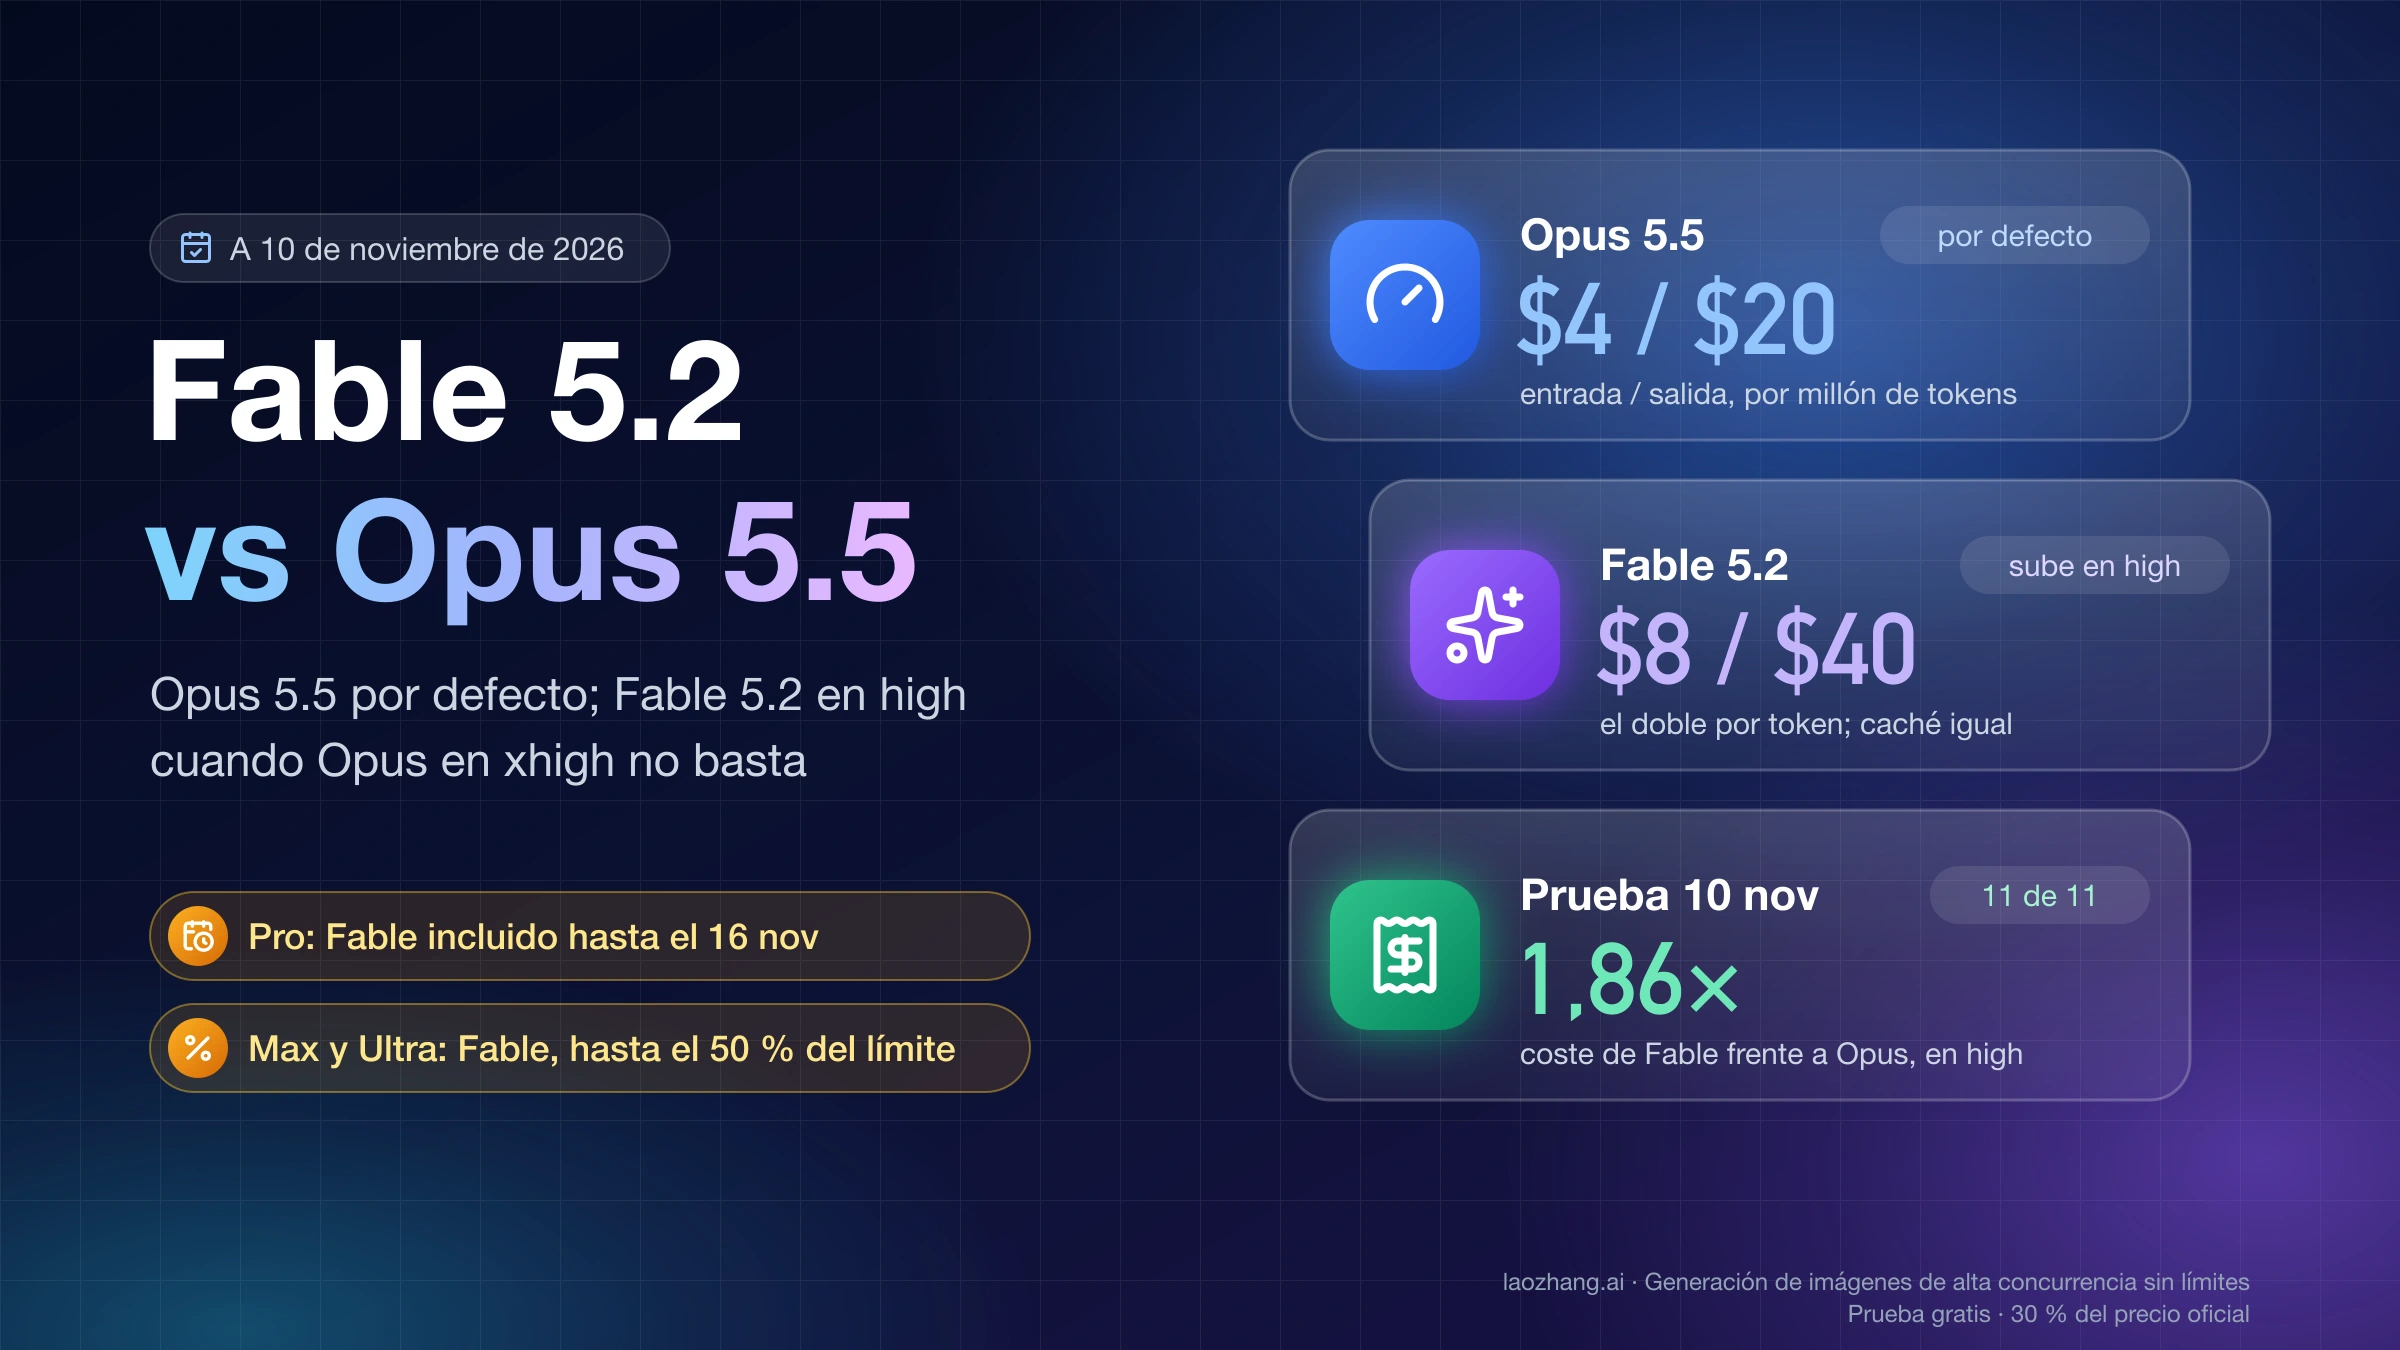
| Fast mode | No | Sí: 8 $ / 40 $ |
Tres filas de esta tabla deciden casi todo lo demás. La primera es la lectura de caché: los dos modelos tienen una tarifa especial de lectura del 5 % del precio de entrada, en lugar del 10 % habitual, así que desde el 7 de octubre de 2026 cuesta 0,10 $ en Sonnet 5.5 y 0,20 $ en Opus 5.5. Hasta esa fecha costaba 0,20 $ en los dos, y era la única línea en la que Sonnet no salía a mitad de precio; el cambio está explicado en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras. Ahora Sonnet cuesta exactamente la mitad en todas las líneas. La segunda es el esfuerzo por defecto: si no fijas effort en la API, estás comparando Sonnet en high con Opus en medium (en Claude Code, en cambio, los dos arrancan en medium). La tercera es el contexto: el millón de tokens se cobra a tarifa normal en los dos, así que no hay recargo por contexto largo que altere la cuenta.
Sonnet 5.5 mantiene las tarifas de entrada y salida de Sonnet 5 (la lectura de caché bajó a 0,10 $ el 7 de octubre), desglosadas en Anthropic cancela la subida de Sonnet 5: tarifas y cálculo del coste. La factura de Opus 5.5 y sus límites están en Claude Opus 5.5: precio de la API y restablecimiento de límites.
Por qué «la mitad de precio» y «gasta más» son ciertas a la vez
Lo que pagas por una tarea es la suma de todos los turnos que hacen falta para terminarla. En un turno de agente, con los tokens expresados en millones:
coste = lectura de caché × precio de lectura + entrada nueva × precio de entrada + salida × precio de salida
Si Sonnet 5.5 necesita más turnos, piensa más o relee más contexto, la mitad de precio se reparte entre más tokens. Estos tres perfiles de turno, con los mismos tokens en ambos modelos y a precio de lista (sin batch ni fast mode), muestran cuánto margen tiene con las tarifas actuales:
| Perfil del turno | Opus 5.5 | Sonnet 5.5 | Sonnet deja de ser más barato si necesita más de… |
|---|---|---|---|
| Sin caché: 5.000 de entrada y 6.000 de salida | 0,140 $ | 0,070 $ | 2 veces los tokens de Opus |
| Bucle con herramientas: 100.000 leídos de caché, 5.000 de entrada y 6.000 de salida | 0,160 $ | 0,080 $ | 2 veces |
| Mucho contexto en caché: 500.000 leídos, 2.000 de entrada y 3.000 de salida | 0,168 $ | 0,084 $ | 2 veces |
En el tercer perfil, los 500.000 tokens leídos cuestan 0,10 $ en Opus y 0,05 $ en Sonnet. El resto, 2.000 × 4 $ + 3.000 × 20 $ por millón, suma 0,068 $ en Opus y la mitad, 0,034 $, en Sonnet: 0,168 $ frente a 0,084 $. Con la lectura a 0,20 $ en los dos, ese mismo turno costaba 0,134 $ en Sonnet, y su margen se quedaba en 1,25 veces.
De ahí sale una regla que puedes aplicar a tu propia factura:
Sonnet 5.5 gasta menos mientras necesite menos del doble de tokens que Opus 5.5 para la misma tarea.
Da igual qué parte del gasto se vaya en lecturas de caché, porque todas las líneas, escrituras en caché incluidas, cuestan la mitad en Sonnet. Hasta el 7 de octubre de 2026 la regla era 2 / (1 + R), siendo R la parte del gasto de Opus 5.5 en lecturas de caché, y un agente con el 60 % del gasto en esa línea perdía la ventaja con solo un 25 % de trabajo extra; esa penalización por contexto en caché ya no existe. La cuenta supone que Sonnet gasta más en la misma proporción en todas las líneas; si solo alarga la salida, el margen es algo mayor.
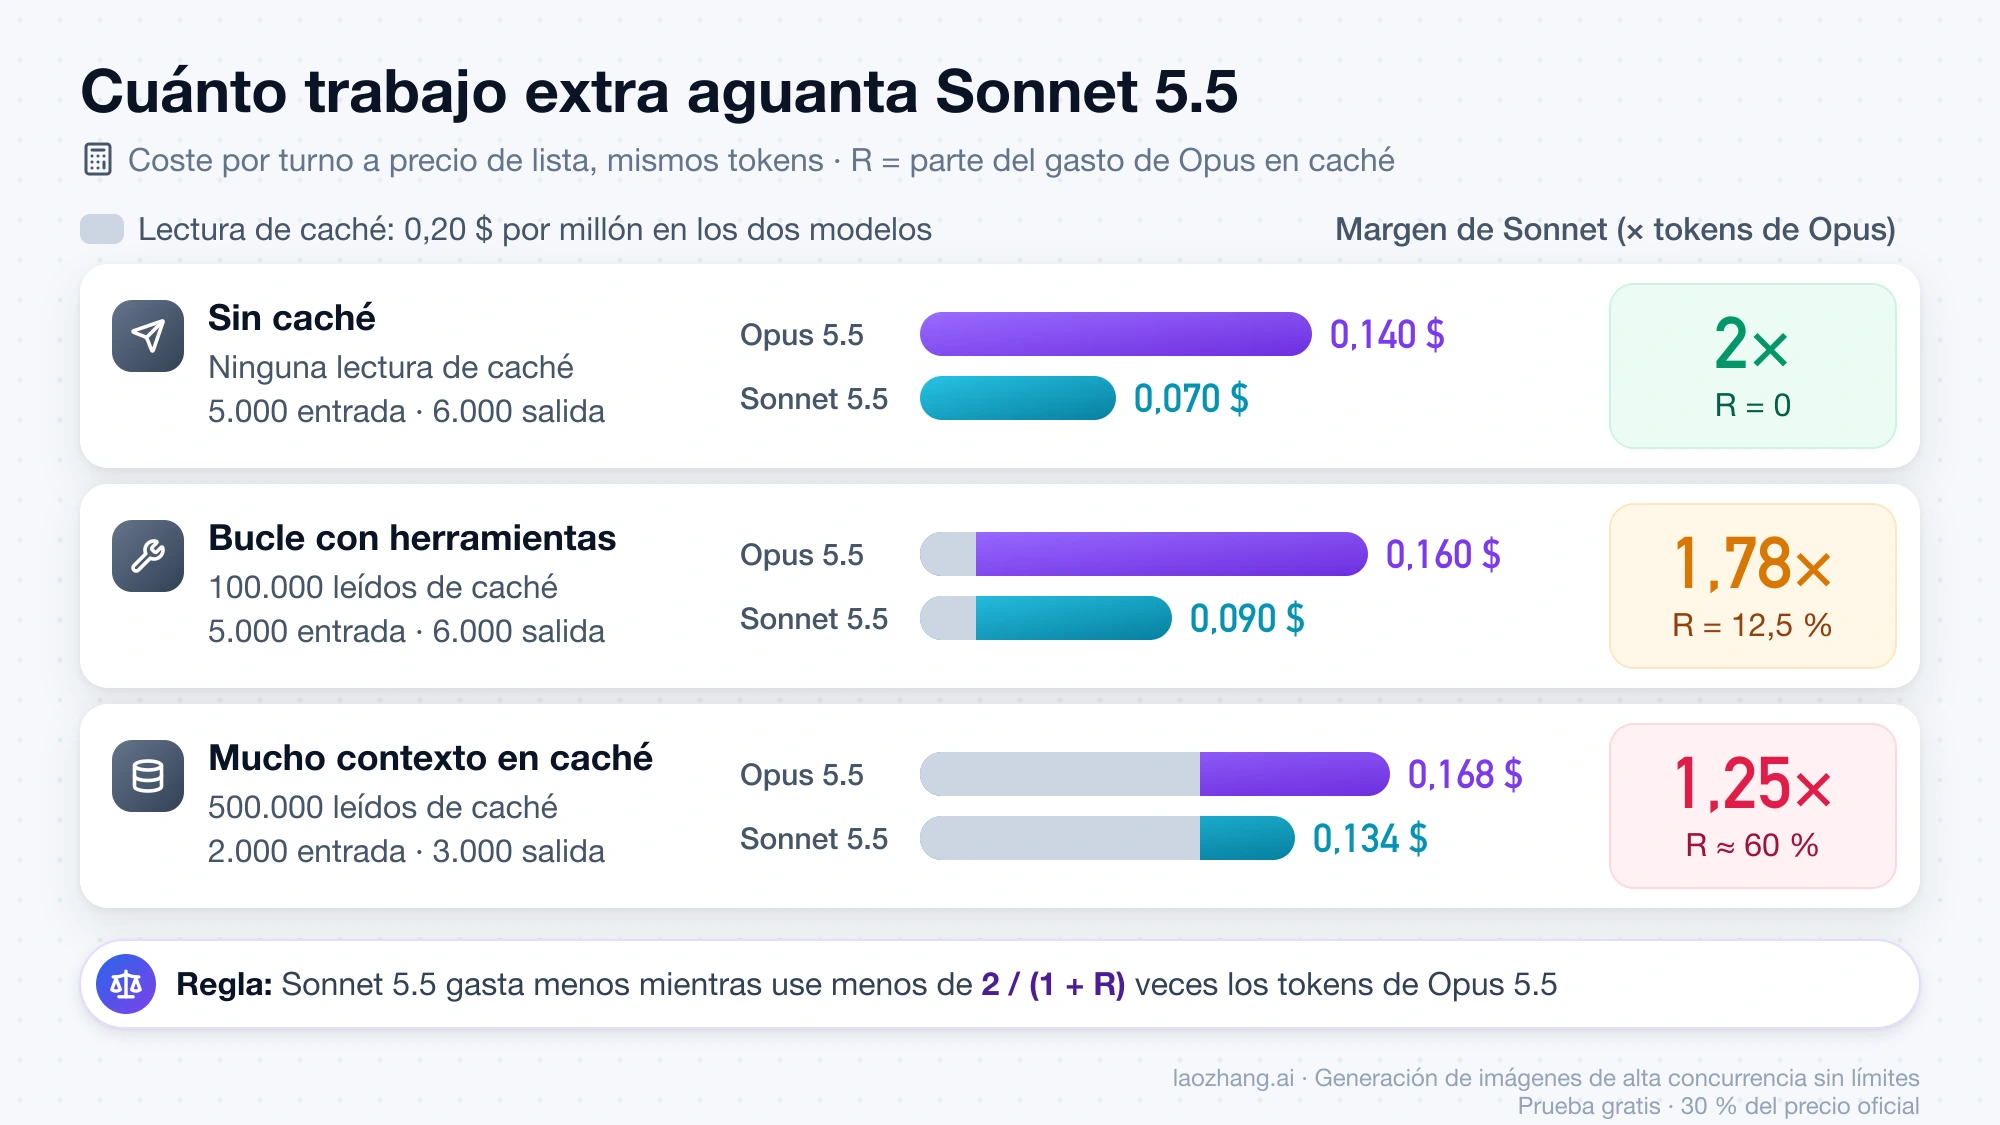
El gráfico usa la tarifa de lectura de caché anterior, 0,20 $ en los dos modelos; con la de Sonnet 5.5 a 0,10 $, a 28 de octubre de 2026, los tres perfiles quedan en 2 veces, como en la tabla.
Con esto se entiende el dato de Artificial Analysis, que en su índice 5.0 ya mide los dos modelos en los cinco niveles de esfuerzo:
| Esfuerzo | Sonnet 5.5 | Opus 5.5 | Coste de Sonnet frente a Opus |
|---|---|---|---|
low | 25 · 0,51 $ · 121 s | 35 · 0,98 $ · 147 s | 0,52 |
medium | 30 · 0,78 $ · 178 s | 48 · 2,45 $ · 337 s | 0,32 |
high | 41 · 1,64 $ · 332 s | 52 · 3,46 $ · 464 s | 0,47 |
xhigh | 50 · 4,09 $ · 691 s | 57 · 6,05 $ · 779 s | 0,68 |
max | 54 · 10,02 $ · 1.326 s | 58 · 10,04 $ · 1.133 s | 1,00 |
Puntuación · coste por tarea · segundos por tarea en el índice 5.0 de Artificial Analysis, a 28 de octubre de 2026.
A igual esfuerzo, Sonnet 5.5 cuesta menos por tarea en todos los niveles salvo en max, donde los dos cuestan prácticamente lo mismo y Sonnet saca 4 puntos menos y tarda más, aunque genere más rápido (140 tokens por segundo frente a 98). Ahí es donde Sonnet gasta más: produce unos 285.000 tokens de salida por tarea frente a 173.000 de Opus, 1,65 veces más. Si solo contara la salida, a mitad de precio seguiría costando alrededor de un 18 % menos; que cueste lo mismo significa que el resto del gasto (entrada, lecturas y escrituras en caché, que Artificial Analysis también incluye) creció algo más. Es el caso en que Opus resuelve casi a la primera (lo que se suele llamar «one-shot») lo que a Sonnet le cuesta varias vueltas.
Cruzar niveles aclara más que comparar el mismo nombre de esfuerzo. Opus 5.5 en high (52 puntos, 3,46 $, 464 s) supera a Sonnet 5.5 en xhigh (50 puntos, 4,09 $, 691 s) en puntuación, coste y tiempo, y Opus en xhigh (57 puntos, 6,05 $) supera a Sonnet en max (54 puntos, 10,02 $). Por debajo, la cuenta favorece a Sonnet o depende de cuánto valgan los puntos: Sonnet en high (41 puntos, 1,64 $) saca 6 puntos a Opus en low (35 puntos, 0,98 $) por 1,7 veces su coste, Opus en medium (48 puntos, 2,45 $) le saca 7 puntos a Sonnet en high por 1,5 veces el coste y en el mismo tiempo (337 s frente a 332 s), y Opus en low supera en 5 puntos a Sonnet en medium (30 puntos, 0,78 $) costando 1,26 veces más.
Encaja con lo que afirma Anthropic: Sonnet 5.5 complementa mejor a Opus 5.5 con esfuerzo bajo, donde cuesta menos por tarea, y en los ajustes altos puede rendir de forma comparable a un coste similar. La regla práctica es que, si tu tarea necesita Sonnet en xhigh o max, Opus un nivel por debajo da más puntuación por menos dinero; si te basta Sonnet en high o menos, Sonnet es la opción barata, y si la diferencia de puntos importa en tu trabajo lo dicen tus propias tareas.
Qué dicen las pruebas de rendimiento
Estas son cifras del fabricante, publicadas con Sonnet 5.5 y medidas en su mayoría con esfuerzo máximo:
| Prueba (datos de Anthropic) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % en xhigh |
| FrontierCode 1.1 (Main) | 52,1 % en xhigh; 46,2 % en max | 54,4 % |
| CursorBench 4.0 | 55,5 % | 57,8 % |
| OSWorld 2.1 (parcial) | 80,1 % | 81,8 % |
| Humanity's Last Exam, con herramientas | 64,5 % | 67,7 % |
| GDPval-AA v2.1 | 1.844 | 1.846 |
Sonnet 5.5 se queda a menos de tres puntos y medio en casi todo y supera a Opus en Terminal-Bench, pero la tabla enfrenta el mejor ajuste de cada modelo, no el uso diario. Hay dos lecturas que conviene evitar:
- Mezclar esfuerzos. Con su esfuerzo por defecto,
medium, Opus 5.5 marca 52,5 % en CursorBench y 54,6 % en FrontierCode. El 55,5 % de Sonnet 5.5 en CursorBench es su mejor resultado, no su valor enmedium; decir que Sonnet supera a Opus en CursorBench compara dos ajustes distintos. - Suponer que más esfuerzo siempre rinde más. En FrontierCode, Sonnet 5.5 puntúa menos en
maxque enxhigh. Según la nota de Anthropic, enmaxrecurría más a la habilidad de revisión de código de Claude Code, lo que acababa en tiempos agotados y en cambios fuera del alcance de la tarea.
Anthropic resume el reparto así: Sonnet 5.5 rinde mejor en tareas cotidianas bien delimitadas, corrección de errores y documentos, presentaciones y hojas de cálculo; Opus 5.5 está pensado para el trabajo complejo que exige criterio, y en sus pruebas internas y externas sigue siendo «claramente más fuerte» cuando ese criterio tiene que sostenerse durante mucho tiempo.
La prueba de revisión de código de CodeRabbit apunta en la misma dirección. Con 13 pull requests difíciles, Sonnet 5.5 con razonamiento detectó 6 de los 13 problemas conocidos, con una precisión útil del 41,2 %. Opus 5.5 en modo estándar detectó 8 (66,7 %) y en max, 10 (52 %). Las cifras de Opus proceden de una ejecución anterior de septiembre sobre los mismos casos, y 13 casos indican una tendencia, no una prueba concluyente. En la misma publicación, una construcción en paralelo con Claude Code terminó en 29 min 27 s con Sonnet 5.5 y en 44 min 50 s con Opus 5.5, con resultados casi idénticos y algo más de fidelidad en Opus; CodeRabbit aclara que fue una sola ejecución.
Qué modelo y qué esfuerzo usar según tu trabajo
La pregunta útil es qué tipo de tarea tienes y si puedes comprobar el resultado sin revisarlo a mano.
| Tu trabajo | Empieza con | Esfuerzo inicial | Cuándo cambiar |
|---|---|---|---|
| Tareas acotadas con prueba automática: corregir un error que reproduce un test, cambios en un módulo, scripts | Sonnet 5.5 | medium | Sube a high en las más largas; pasa a Opus 5.5 si falla una y otra vez en el mismo tipo de tarea |
| Documentos, presentaciones y hojas de cálculo | Sonnet 5.5 | medium | Opus 5.5 si el documento depende de juicio o de muchas fuentes contradictorias |
| Chat, soporte y trabajo sensible a la latencia | Sonnet 5.5 | low o medium | Opus 5.5 solo si la respuesta exige un análisis largo |
| Alto volumen con salida comprobable: clasificación, extracción, revisiones en lote | Sonnet 5.5, con Batch si puede esperar | low, repitiendo los fallos con más esfuerzo | Haiku 5.5, disponible desde el 7 de octubre de 2026, apunta a este uso |
| Revisión de código donde se te escapan fallos caros | Opus 5.5 | medium | high o max si lo que importa es no dejar pasar errores |
| Trabajo abierto: arquitectura, refactorizar varios módulos, depurar una causa desconocida, agentes que trabajan horas | Opus 5.5 | medium | high o xhigh si se queda corto; después, Claude Fable 5.2 vs Opus 5.5: cuál es mejor y con qué effort |
| Agentes con contexto enorme en caché | Opus 5.5 o Sonnet 5.5, midiendo | medium en ambos | Con la lectura de caché de Sonnet a 0,10 $, la caché ya no recorta su ventaja: la pierde si necesita más del doble de tokens que Opus |
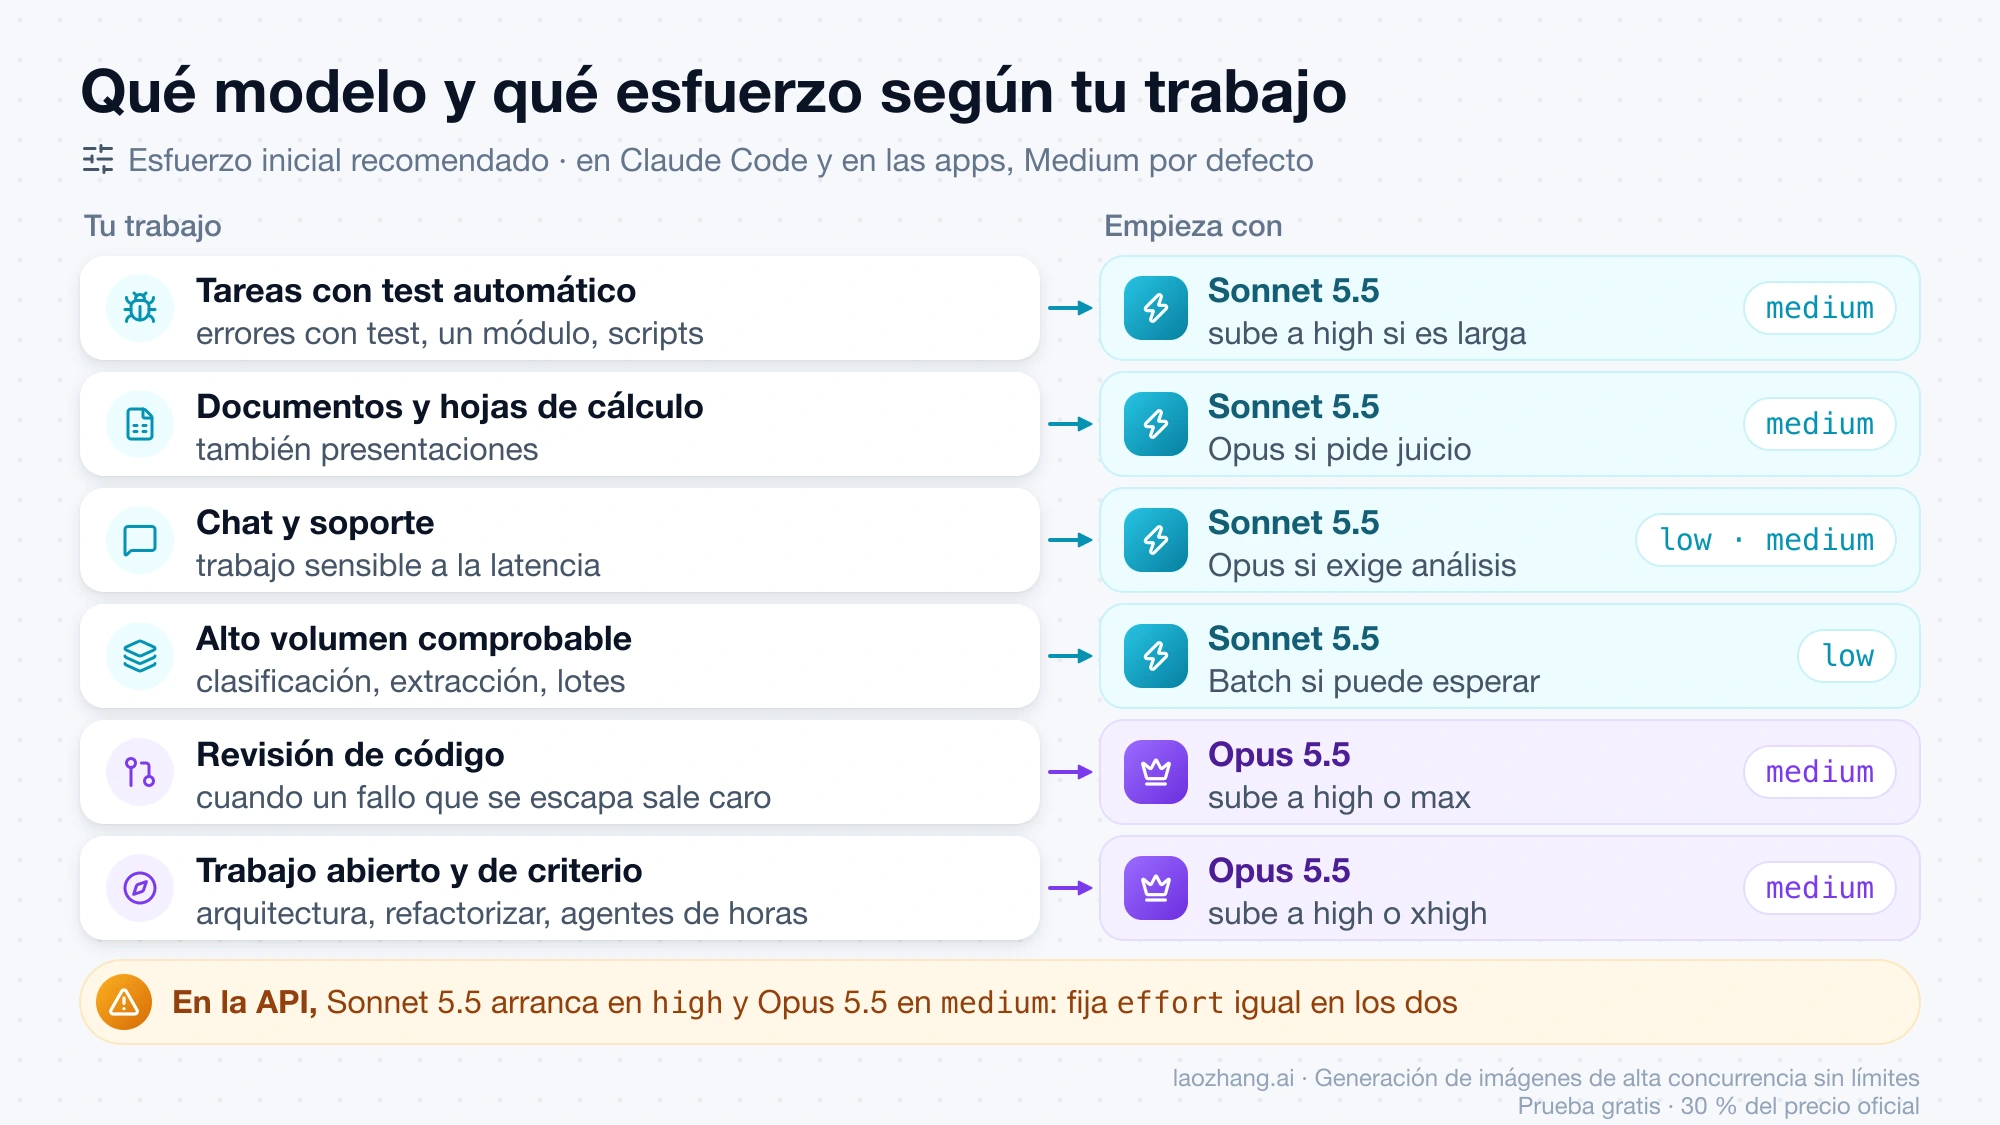
En la API: fija el esfuerzo siempre
El desajuste de valores por defecto es la primera fuente de comparaciones engañosas, y solo existe en la API. Allí Sonnet 5.5 arranca en high y Opus 5.5 en medium, así que un cambio de ID sin tocar nada más sube el esfuerzo del modelo barato y baja el del caro. Anthropic recomienda para Sonnet 5.5 empezar en high salvo en trabajo agéntico o sensible a la latencia; en programación agéntica con tareas bien especificadas, medium, y high para las difíciles o largas. Opus 5.5 piensa más por turno que Opus 5 con el mismo esfuerzo, sobre todo en xhigh y max, así que deja margen en max_tokens, que limita a la vez razonamiento y respuesta.
import anthropic

client = anthropic.Anthropic()

for model in ("claude-sonnet-5-5", "claude-opus-5-5"):
    response = client.messages.create(
        model=model,
        max_tokens=16000,
        output_config={"effort": "medium"},  # mismo esfuerzo en los dos
        messages=[{"role": "user", "content": "Revisa este diff y señala los fallos: ..."}],
    )
    print(model, response.usage)
En Claude Code y las apps: los dos arrancan en medium
En Claude Code, Opus 5.5 y Sonnet 5.5 empiezan en medium salvo que elijas otro nivel; el resto de modelos compatibles empiezan en high. En las apps de Claude, Anthropic indica también Medium por defecto. Así que, dentro de Claude Code, cambiar de modelo compara los dos con el mismo esfuerzo sin que tengas que hacer nada. Cómo subir o bajar ese nivel está en la sección siguiente. En suscripción no pagas por token, pero el mismo razonamiento de tokens y turnos decide cuánto trabajo te cabe en tus límites. Con el lanzamiento de Opus 5.5, Anthropic subió los límites de cinco horas de Pro, Max, Team y Enterprise por puesto.
En la tabla de modelos de claude.com, el plan gratuito incluye Sonnet pero no Opus; Pro (20 $ al mes, o 17 $ con pago anual) y Max (desde 100 $ al mes) incluyen los dos y Claude Code. La tabla no indica versiones, así que es de esperar que el Sonnet del plan gratuito sea el actual, Sonnet 5.5, aunque no lo diga expresamente. Para elegir entre esos dos planes está Claude Pro vs Max en 2026: precios, límites de Claude Code y cuándo compensa Max.
Repartir el trabajo entre los dos
La idea de que Opus planifique y Sonnet ejecute tiene dos formas concretas:
- En Claude Code, con
opusplano cambiando de modelo entre fases. El aliasopusplanya hace este reparto: usa Opus en el modo de planificación y Sonnet para ejecutar. Con la API de Anthropic o una suscripción, eso significa Opus 5.5 y Sonnet 5.5. En Amazon Bedrock y Google Cloud, en cambio, el aliassonnetapunta a Sonnet 4.5, y en Claude Platform on AWS a Sonnet 4.6, así que allíopusplanno ejecuta con Sonnet 5.5. Cada cambio de modelo tiene además un coste: la siguiente petición vuelve a leer toda la conversación sin aprovechar la caché, y enopusplancada entrada o salida del modo de planificación cuenta como cambio. El texto sobrevive al cambio, así que un plan guardado en un archivo llega entero a Sonnet. El razonamiento interno, probablemente no. En la API, Sonnet 5.5 no lee los bloques de razonamiento de Opus 5 ni de Opus 5.5, y ningún otro modelo lee los de Sonnet 5.5. La documentación de Claude Code no lo menciona, pero es razonable suponer que un/modela mitad de sesión deja atrás el razonamiento del modelo anterior. Por las dos razones, conviene cambiar de modelo entre tareas y, dentro de una tarea, ajustar el esfuerzo. - En la API, con la herramienta advisor (beta). Un ejecutor Sonnet 5.5 puede consultar a Opus 5.5 como asesor; la respuesta del asesor llega cifrada (
advisor_redacted_result). Anthropic no ha publicado mediciones de esta pareja concreta y su propia guía de costes marca la vara: calcula primero lo que cuesta Opus 5.5 solo con esfuerzolow, porque esa es la cifra que la combinación tiene que mejorar. En sus mediciones, cuando un solo modelo podía con el trabajo, ese mismo modelo con menos esfuerzo salió más barato que repartirlo.
Cómo cambiar de modelo y de esfuerzo en Claude Code
Dentro de Claude Code, /model abre un selector y el cambio se aplica al momento; /status muestra el modelo activo. En ese mismo selector, las flechas izquierda y derecha mueven el control de esfuerzo. Para el esfuerzo también tienes /effort: sin argumentos abre el control deslizante, /effort high fija el nivel directamente y /effort auto borra el nivel guardado para el modelo activo. El nivel se guarda por modelo, y la cabecera de la sesión lo muestra junto al nombre del modelo (por ejemplo, «with low effort»). max solo dura la sesión actual, salvo que lo fijes con la variable de entorno.
Desde la terminal:
# Solo para esta sesión
claude --model claude-sonnet-5-5 --effort medium
claude --model claude-opus-5-5 --effort high

# Por defecto en todas las sesiones (zsh; en bash, usa ~/.bashrc)
echo 'export ANTHROPIC_MODEL="claude-sonnet-5-5"' >> ~/.zshrc
echo 'export CLAUDE_CODE_EFFORT_LEVEL="medium"' >> ~/.zshrc
source ~/.zshrc
Después de cambiar ~/.zshrc, cierra la terminal y abre una nueva antes de lanzar claude. Si trabajas con Claude Code a través de Bedrock, Google Cloud o Claude Platform on AWS, usa el ID completo claude-sonnet-5-5 (o el del proveedor) en vez del alias sonnet, que allí no apunta a Sonnet 5.5. En Microsoft Foundry, incluso opus apunta a Opus 4.6.
Cambiar de esfuerzo y cambiar de modelo no cuestan lo mismo. Cada modelo tiene su propia caché, así que tras un /model la siguiente petición vuelve a leer toda la conversación sin ningún acierto de caché; mientras la caché sigue activa, Claude Code te pide confirmación. En cambio, en Opus 5.5 y Sonnet 5.5 con clave de API o suscripción, cambiar el esfuerzo conserva la caché y se aplica sin preguntar. Esto no se cumple en Amazon Bedrock, Google Cloud ni a través de un Claude apps gateway. En una sesión larga, bajar a low o subir a high sale mucho más barato que saltar de Sonnet a Opus.
En las apps de Claude hay un detalle que puede parecer un cambio de modelo por tu parte. Sonnet 5.5 es el primer Sonnet con salvaguardas de ciberseguridad: si una petición cae en seguridad ofensiva de alto riesgo (generar exploits, pruebas de penetración, análisis de vulnerabilidades sobre binarios) o en ciertos trabajos de desarrollo de modelos frontera, la conversación pasa a Sonnet 5. Opus 5.5 cae a Opus 4.8 por ciberseguridad y a Opus 5 por biología. En ambos casos el chat se queda en el modelo de respaldo hasta que vuelves a elegir el original en el selector. Revisar código fuente en busca de vulnerabilidades sigue en Sonnet 5.5, según la ayuda de Claude sobre el cambio de modelo con Sonnet 5.5.
Qué se rompe si solo cambias el ID en la API
Pasar de Sonnet 5 u Opus 5, o de uno de los 5.5 al otro, no es solo cambiar una cadena. Esta matriz recoge lo que devuelve error o cambia de forma silenciosa:
| Lo que usa tu código | Sonnet 5.5 | Opus 5.5 | Qué hacer |
|---|---|---|---|
thinking: {"type": "disabled"} | Error 400 | Error 400 | Sonnet: thinking: {"type": "between_tools"}, solo con esfuerzo low, medium o high. Opus: bajar effort |
budget_tokens manual | Error 400 | Error 400 | Controlar la profundidad con effort |
tool_choice de tipo any o tool | Error 400 | Error 400 | auto con strict: true o salidas estructuradas; indica en el prompt cuándo usar la herramienta |
temperature, top_p o top_k distintos del valor por defecto | Error 400 | Error 400 (igual desde Opus 4.7) | Quitarlos y dejar los valores por defecto |
Fast mode (speed: "fast") | No disponible | API de Claude, Google Cloud y Microsoft Foundry | Si dependes de él, Opus 5.5 es la única opción de las dos |
| Cambiar de modelo a mitad de conversación | No lee bloques de razonamiento de Opus 5 ni de Opus 5.5; nadie lee los suyos | No lee los de Sonnet 5.5 | La petición funciona, pero el razonamiento anterior se descarta sin aviso (y no se cobra) |
Editar mensajes, system o herramientas anteriores | Error 400 en cuentas creadas desde el 31 de agosto de 2026 | Igual | Conversaciones que solo crecen; o drop_block con la cabecera beta thinking-binding-controls-2026-08-01 |
| Texto entre llamadas a herramientas | Llega como bloques thinking vacíos con el display por defecto | Igual | Ajustar thinking.display; en Sonnet, between_tools devuelve el texto |
Herramienta computer_20251124 | Error 400 en la API de Claude y Google Cloud; Bedrock la acepta | Igual | Pasar a computer_toolset_20260801 |
| Advisor (beta) | Acepta Opus 5.5 como asesor; rechaza Opus 4.8, Opus 4.7 y Sonnet 5 | — | Elegir un asesor compatible |
| Rechazo por salvaguardas | HTTP 200 con stop_reason: "refusal"; fallbacks: "default" reintenta los casos de ciberseguridad y de modelos frontera en Sonnet 5 | HTTP 200 con stop_reason: "refusal" y reintento opcional en otro modelo | Tratar el rechazo en tu código |
La fila del texto entre herramientas es la más traicionera: una interfaz que mostraba al usuario las notas de progreso del agente se queda muda entre llamadas, sin ningún error. Y la del cambio de modelo afecta directamente a la idea de alternar Sonnet y Opus dentro de la misma conversación: cada salto empieza sin el razonamiento acumulado.
Los dos modelos están en la API de Claude, en AWS (Bedrock, como anthropic.claude-sonnet-5-5 y anthropic.claude-opus-5-5, y Claude Platform on AWS), en Google Cloud y en Microsoft Foundry. España figura en la lista de países admitidos de Anthropic.
Cómo comprobar cuál gasta menos con tus tareas
La guía de costes de Anthropic propone comparar el coste por tarea completada, no por token. Aplicado a esta decisión:
- Elige entre 10 y 20 tareas reales, en la proporción en que aparecen en tu trabajo, e incluye las más difíciles. En las tareas fáciles todos los modelos parecen iguales; la factura la deciden las que el modelo barato falla, porque un fallo cobra sus tokens, el reintento y lo que cueste arreglarlo.
- Define cuándo una tarea está aceptada: los tests pasan, la tabla tiene las filas correctas, el ticket queda cerrado. Sin esa señal no puedes contar fallos.
- Fija el mismo esfuerzo en los dos modelos y prueba cada nivel en una sesión distinta: cambiar el esfuerzo general a mitad de sesión invalida la caché y distorsiona la comparación.
- Suma el coste de cada petición, incluidas las que fallaron, con los cinco contadores de
usage. - Divide el gasto total entre las tareas aceptadas. Ese es el coste por resultado aceptado de cada modelo.
PRECIOS = {  # dólares por millón de tokens, precios de lista a 28/10/2026
    "claude-sonnet-5-5": {"entrada": 2.00, "salida": 10.00, "lectura": 0.10},
    "claude-opus-5-5":   {"entrada": 4.00, "salida": 20.00, "lectura": 0.20},
}

def coste_peticion(model, usage):
    p = PRECIOS[model]
    cw = usage.cache_creation
    escritura_5m = cw.ephemeral_5m_input_tokens if cw else 0
    escritura_1h = cw.ephemeral_1h_input_tokens if cw else 0
    return (
        usage.input_tokens * p["entrada"]
        + escritura_5m * p["entrada"] * 1.25
        + escritura_1h * p["entrada"] * 2.0
        + (usage.cache_read_input_tokens or 0) * p["lectura"]
        + usage.output_tokens * p["salida"]
    ) / 1_000_000

# coste por resultado aceptado = suma de coste_peticion de TODAS las peticiones / tareas aceptadas
Con los mismos datos puedes comprobar si Sonnet 5.5 se queda por debajo del doble de los tokens de Opus 5.5 en tus tareas, que es el punto en el que deja de ahorrar.
Si el resultado se puede comprobar automáticamente, prueba también a lanzar todo con poco esfuerzo y repetir solo los fallos con más. Anthropic lo midió con Opus 5.5 en un subconjunto de SWE-bench Pro: con low y los fallos repetidos en high resolvió cerca del 97 % a unos 0,17 $ por tarea, frente al 95,3 % a 0,29 $ haciendo todo en high. Con Sonnet 5.5 no hay medición equivalente, así que es algo que probar en tus tareas; el precio es más tiempo de espera en las que fallan a la primera.
Preguntas frecuentes
¿Qué modelo es mejor, Sonnet 5.5 u Opus 5.5?
Para trabajo abierto, largo y que exige criterio, Opus 5.5: en las pruebas de Anthropic queda unos pocos puntos por encima en casi todo, salvo en Terminal-Bench, y Anthropic lo considera claramente más fuerte en ese tipo de trabajo. Para tareas bien delimitadas y comprobables, Sonnet 5.5 da resultados parecidos más rápido y, con esfuerzo bajo o medio, más barato.
¿Qué consume menos, Opus 5.5 o Sonnet 5.5?
En tokens, Opus 5.5 con esfuerzo máximo: en el índice 5.0 de Artificial Analysis, a 28 de octubre de 2026, genera unos 173.000 tokens de salida por tarea frente a 285.000 de Sonnet 5.5, aunque por la diferencia de tarifa los dos acaban costando lo mismo (10,04 $ y 10,02 $). En dinero, Sonnet 5.5 consume menos en los niveles inferiores; en medium, 0,78 $ por tarea frente a 2,45 $, con 30 puntos frente a 48.
¿Qué es más caro, Sonnet 5.5 u Opus 5.5?
Por token, Opus 5.5 cuesta el doble en todas las tarifas, también en la lectura de caché desde que la de Sonnet 5.5 bajó a 0,10 $ por millón el 7 de octubre de 2026. Por tarea, Sonnet 5.5 sale más barato mientras necesite menos del doble de tokens que Opus; con esfuerzo máximo los dos cuestan prácticamente lo mismo en el índice de Artificial Analysis.
¿Se puede usar Opus 5.5 con el plan gratuito de Claude?
No. El plan gratuito incluye Sonnet, pero no Opus. Opus aparece a partir de Pro (20 $ al mes), que también incluye Claude Code.
¿Y si también dudo entre Claude y OpenAI?
La comparación con el modelo de OpenAI está en Claude Opus 5.5 vs GPT-6 Sol: cuál probar primero y qué pagas.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 nov 2026.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 nov 2026.
- 1.tabla de precios de Anthropicplatform.claude.com/docs/en/about-claude/pricing
- 2.comparativa de modelosplatform.claude.com/docs/en/about-claude/models/overview
- 3.ayuda de Claude sobre el cambio de modelo con Sonnet 5.5support.claude.com/en/articles/17161993-why-claude-switched-models-in-your-conversation-with-sonnet-5-5