Claude Sonnet 5.5 vs GPT-6 Astra: cuándo cambiar y qué pagas
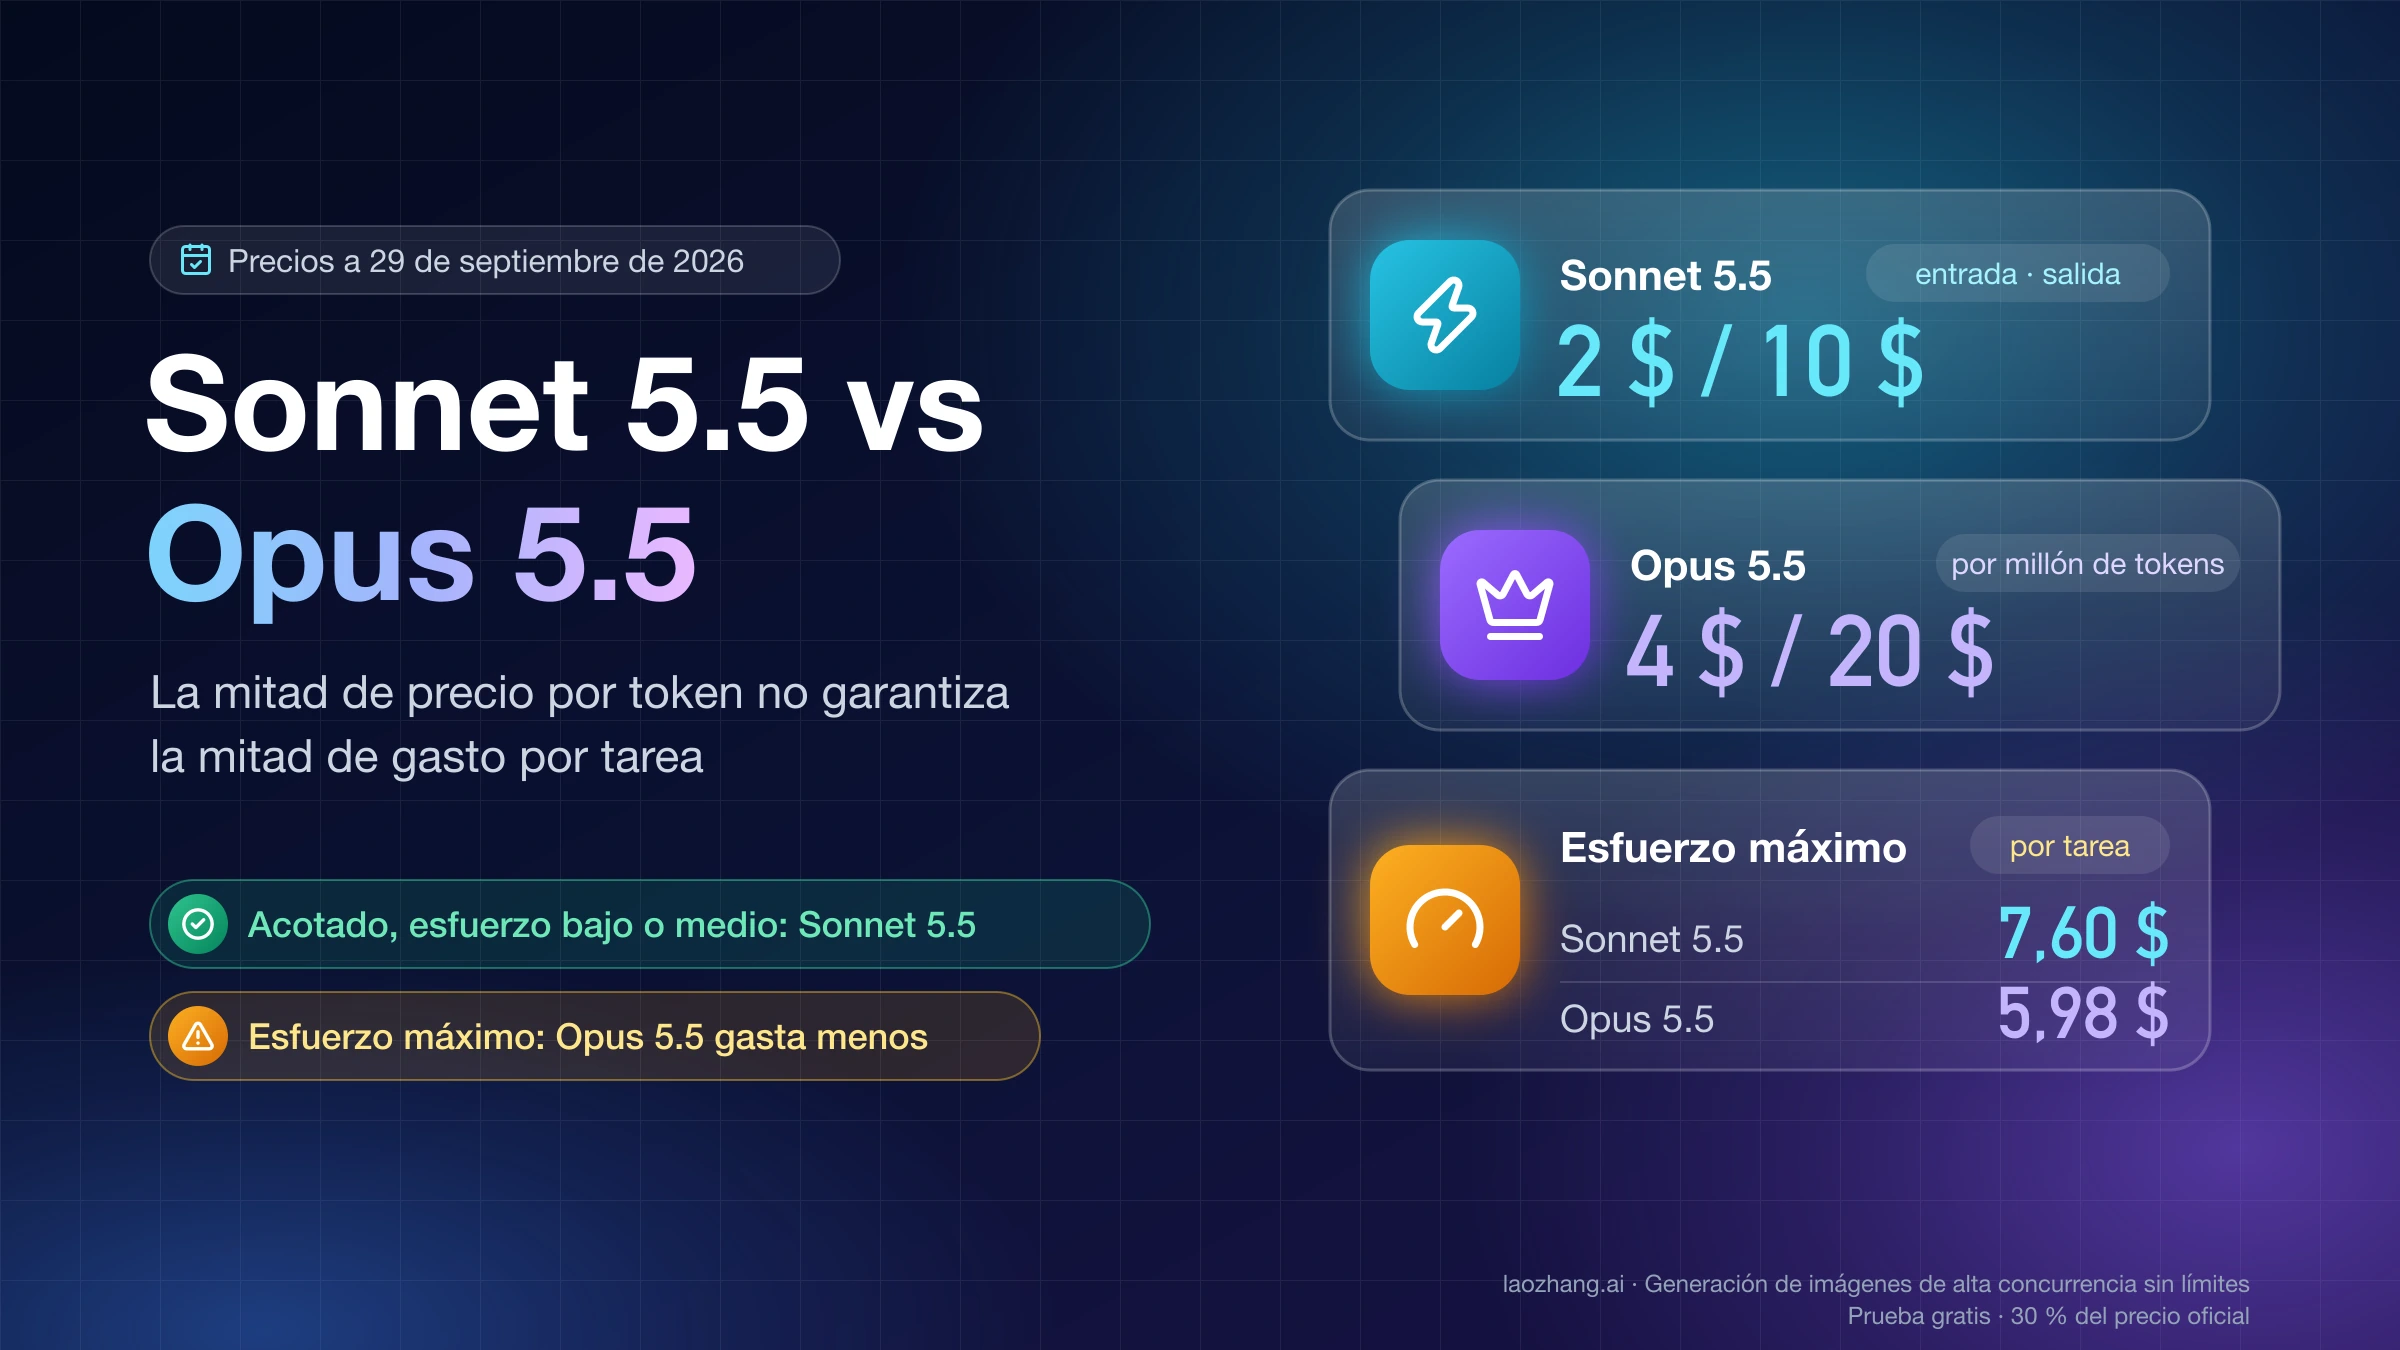
Sonnet 5.5 solo supera a GPT-6 Astra en esfuerzo max, donde cuesta unas 2,3 veces más por tarea. Su tarifa es 5 veces menor y la brecha crece pasados 272K.
En esta página
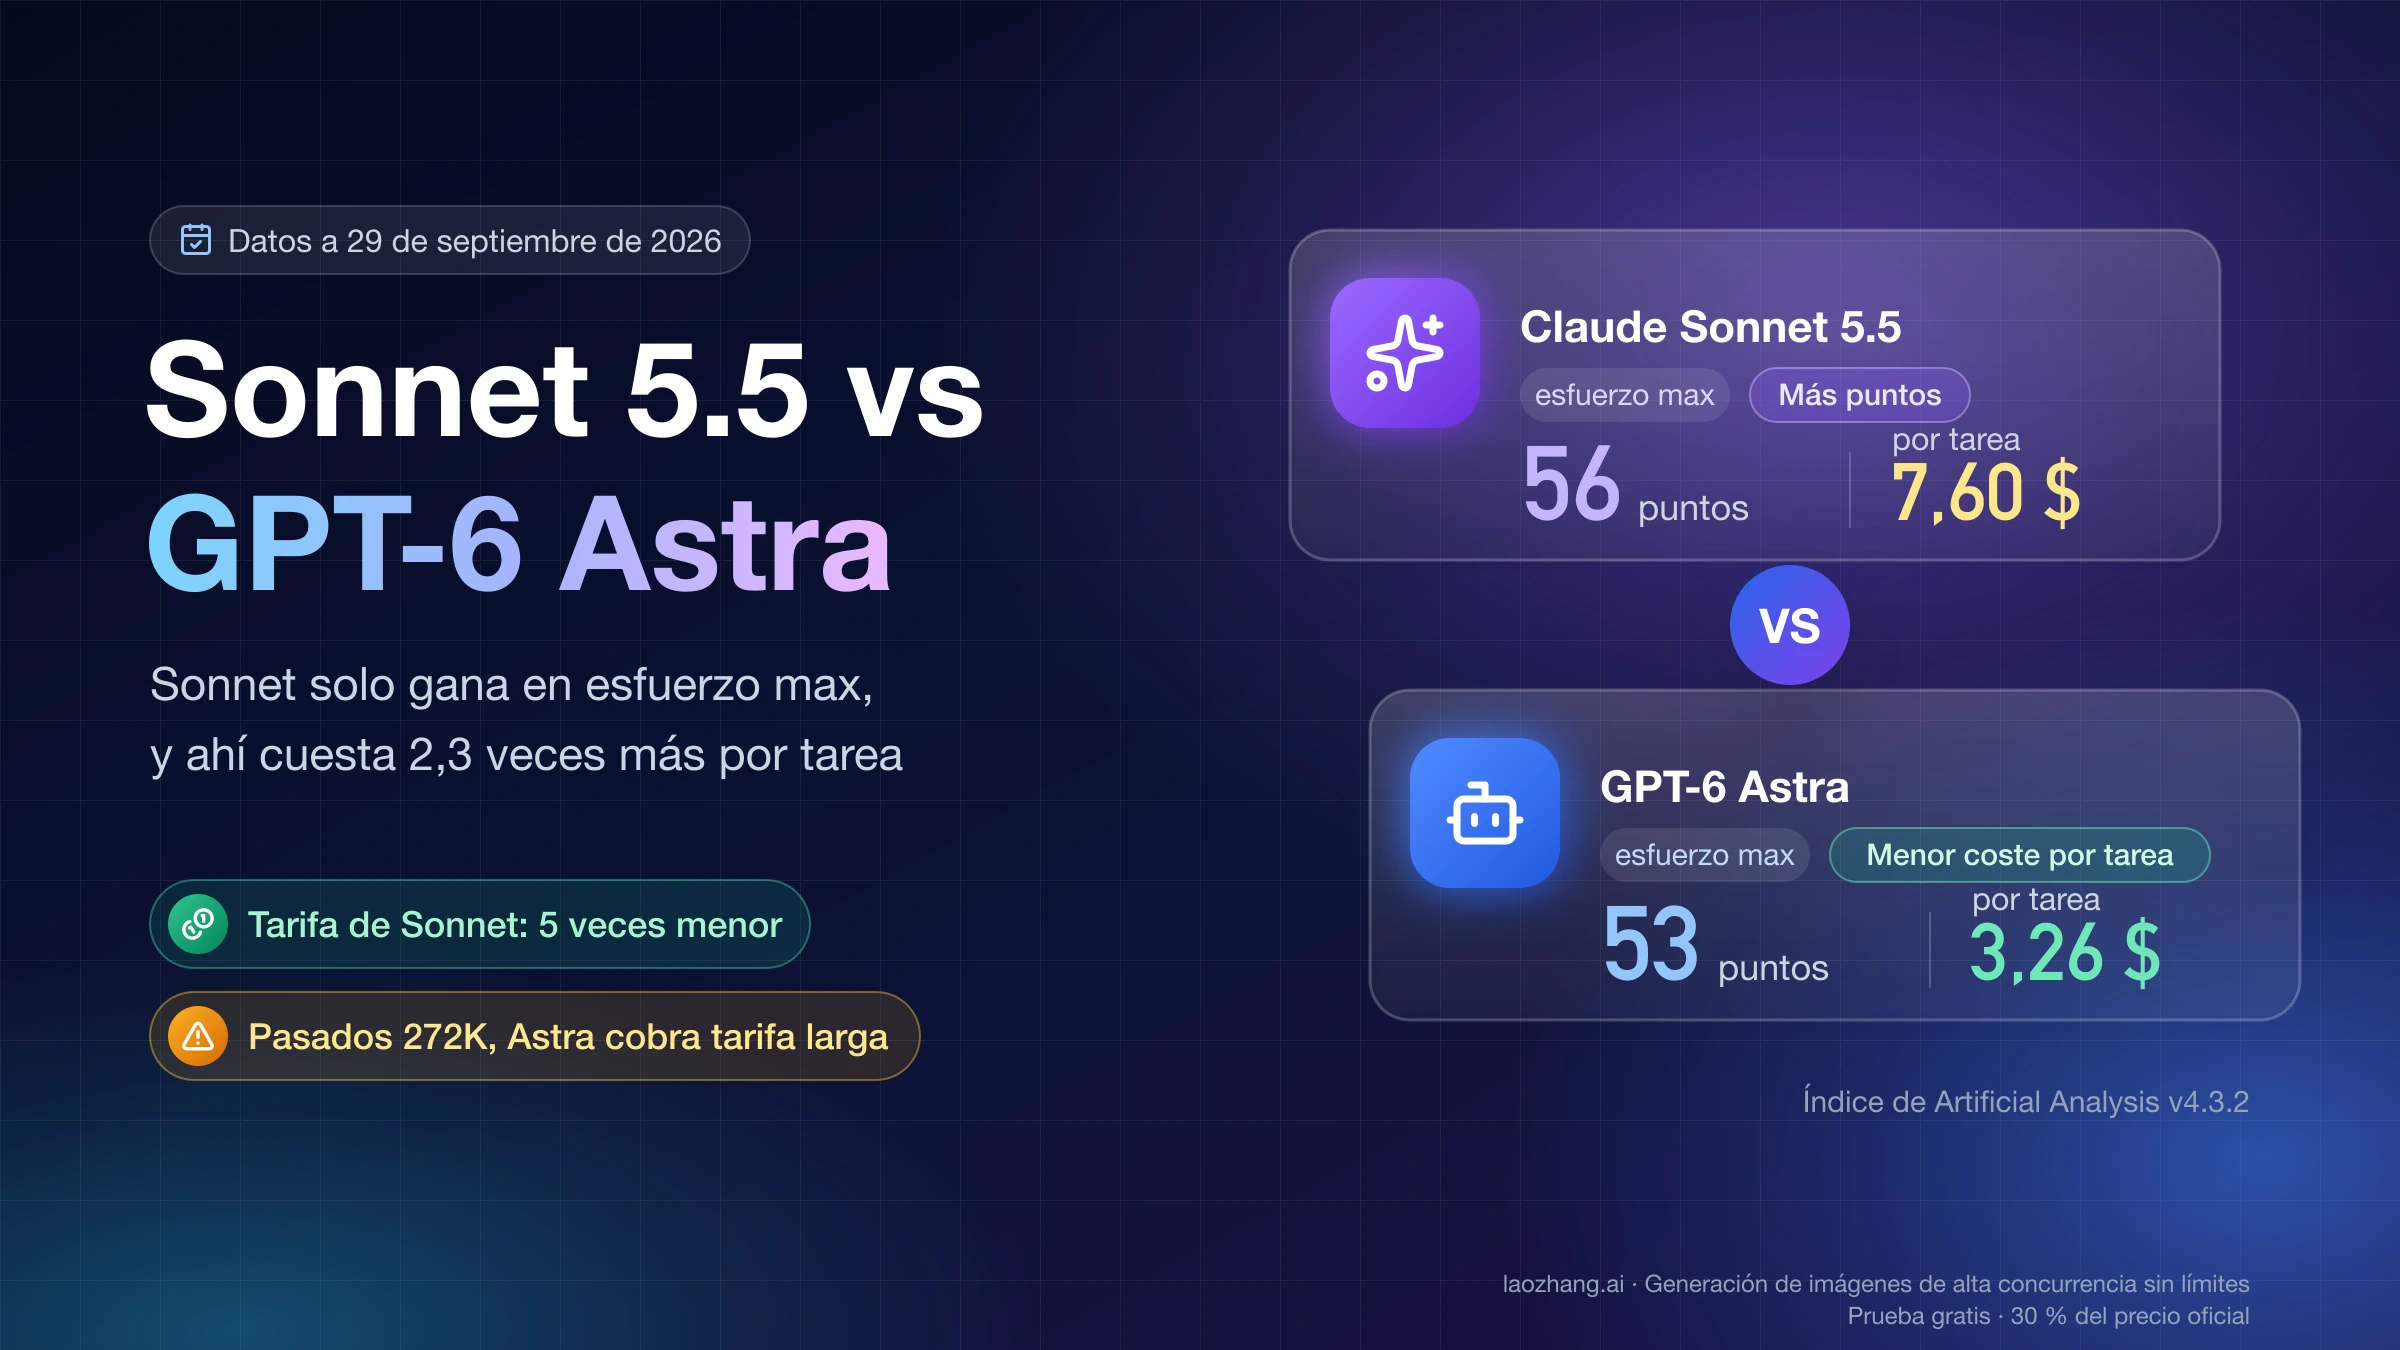
No cambies de GPT-6 Astra a Claude Sonnet 5.5 solo por el titular. El «Sonnet 5.5 supera a Astra» sale del índice de Artificial Analysis con los dos modelos en esfuerzo max (56 frente a 53 puntos), y en ese ajuste Sonnet gasta unas 2,3 veces más por tarea del índice (7,60 $ frente a 3,26 $) porque genera unas 7 veces más tokens de salida. Con la misma etiqueta de esfuerzo, Astra puntúa más de low a high y empata en xhigh.
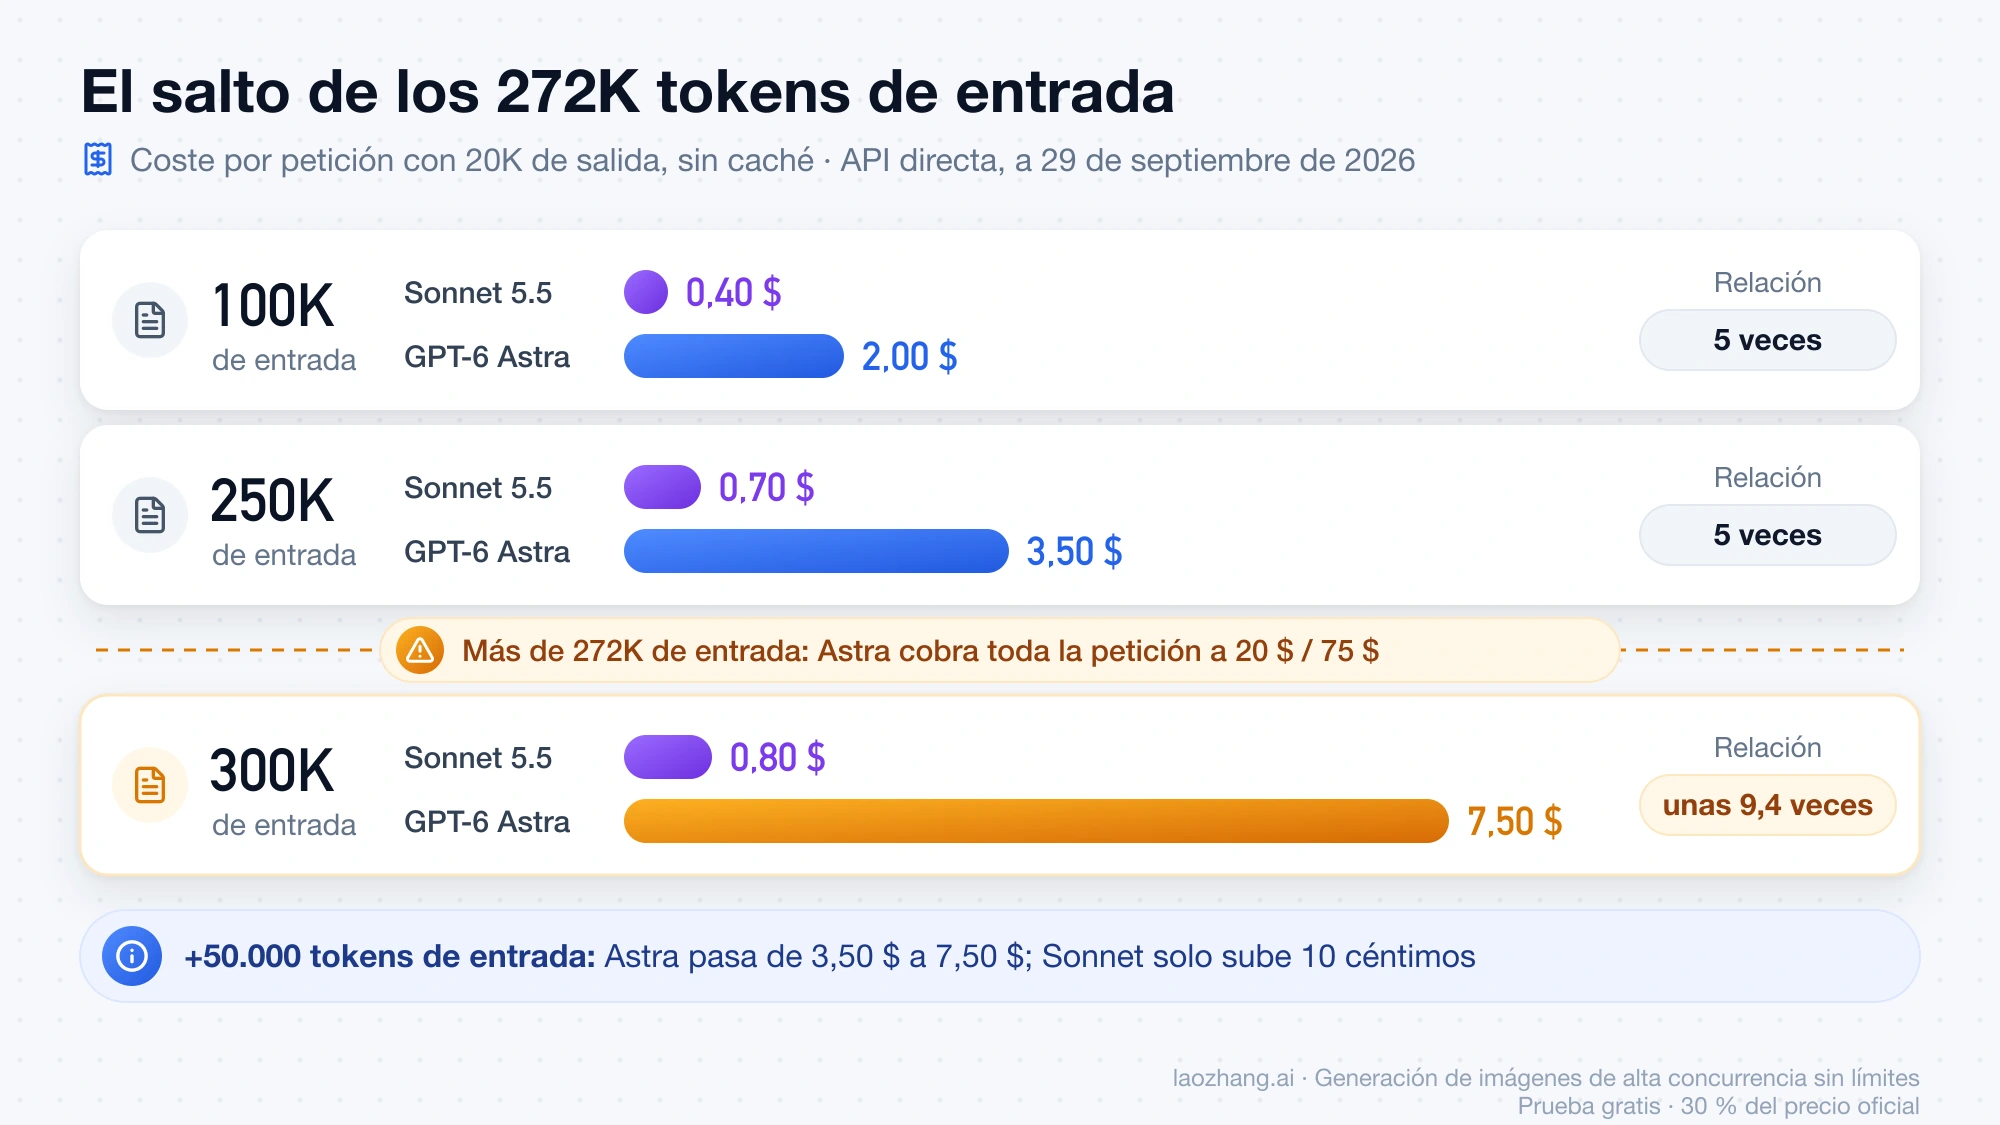
Sonnet 5.5 sí merece una prueba como sustituto cuando la tarifa pesa en tu factura: cobra la quinta parte por token (2 $ / 10 $ frente a 10 $ / 50 $ por millón de tokens de entrada y salida) y, cuando una petición supera los 272K tokens de entrada, Astra factura toda la petición a tarifa de contexto largo, así que en una petición de 300K tokens de entrada y 20K de salida la diferencia llega a unas 9,4 veces. Quédate con Astra para agentes de terminal, ciencia y operaciones, para tareas largas en las que el tiempo cuenta y para flujos que dependen de herramientas alojadas de OpenAI. Y si lo que buscas es un modelo potente al precio de Sonnet, el equivalente de OpenAI no es Astra sino GPT-6 Sol, que cobra exactamente lo mismo. Precios de la API directa en dólares, a 29 de septiembre de 2026.
Qué mide de verdad el «supera a Astra»
Los dos modelos aceptan cinco niveles de esfuerzo de razonamiento (effort): low, medium, high, xhigh y max. Cuanto más alto, más piensa el modelo, más tokens de salida genera y más tarda. Por eso una sola cifra no dice nada si no lleva al lado el esfuerzo con que se midió.
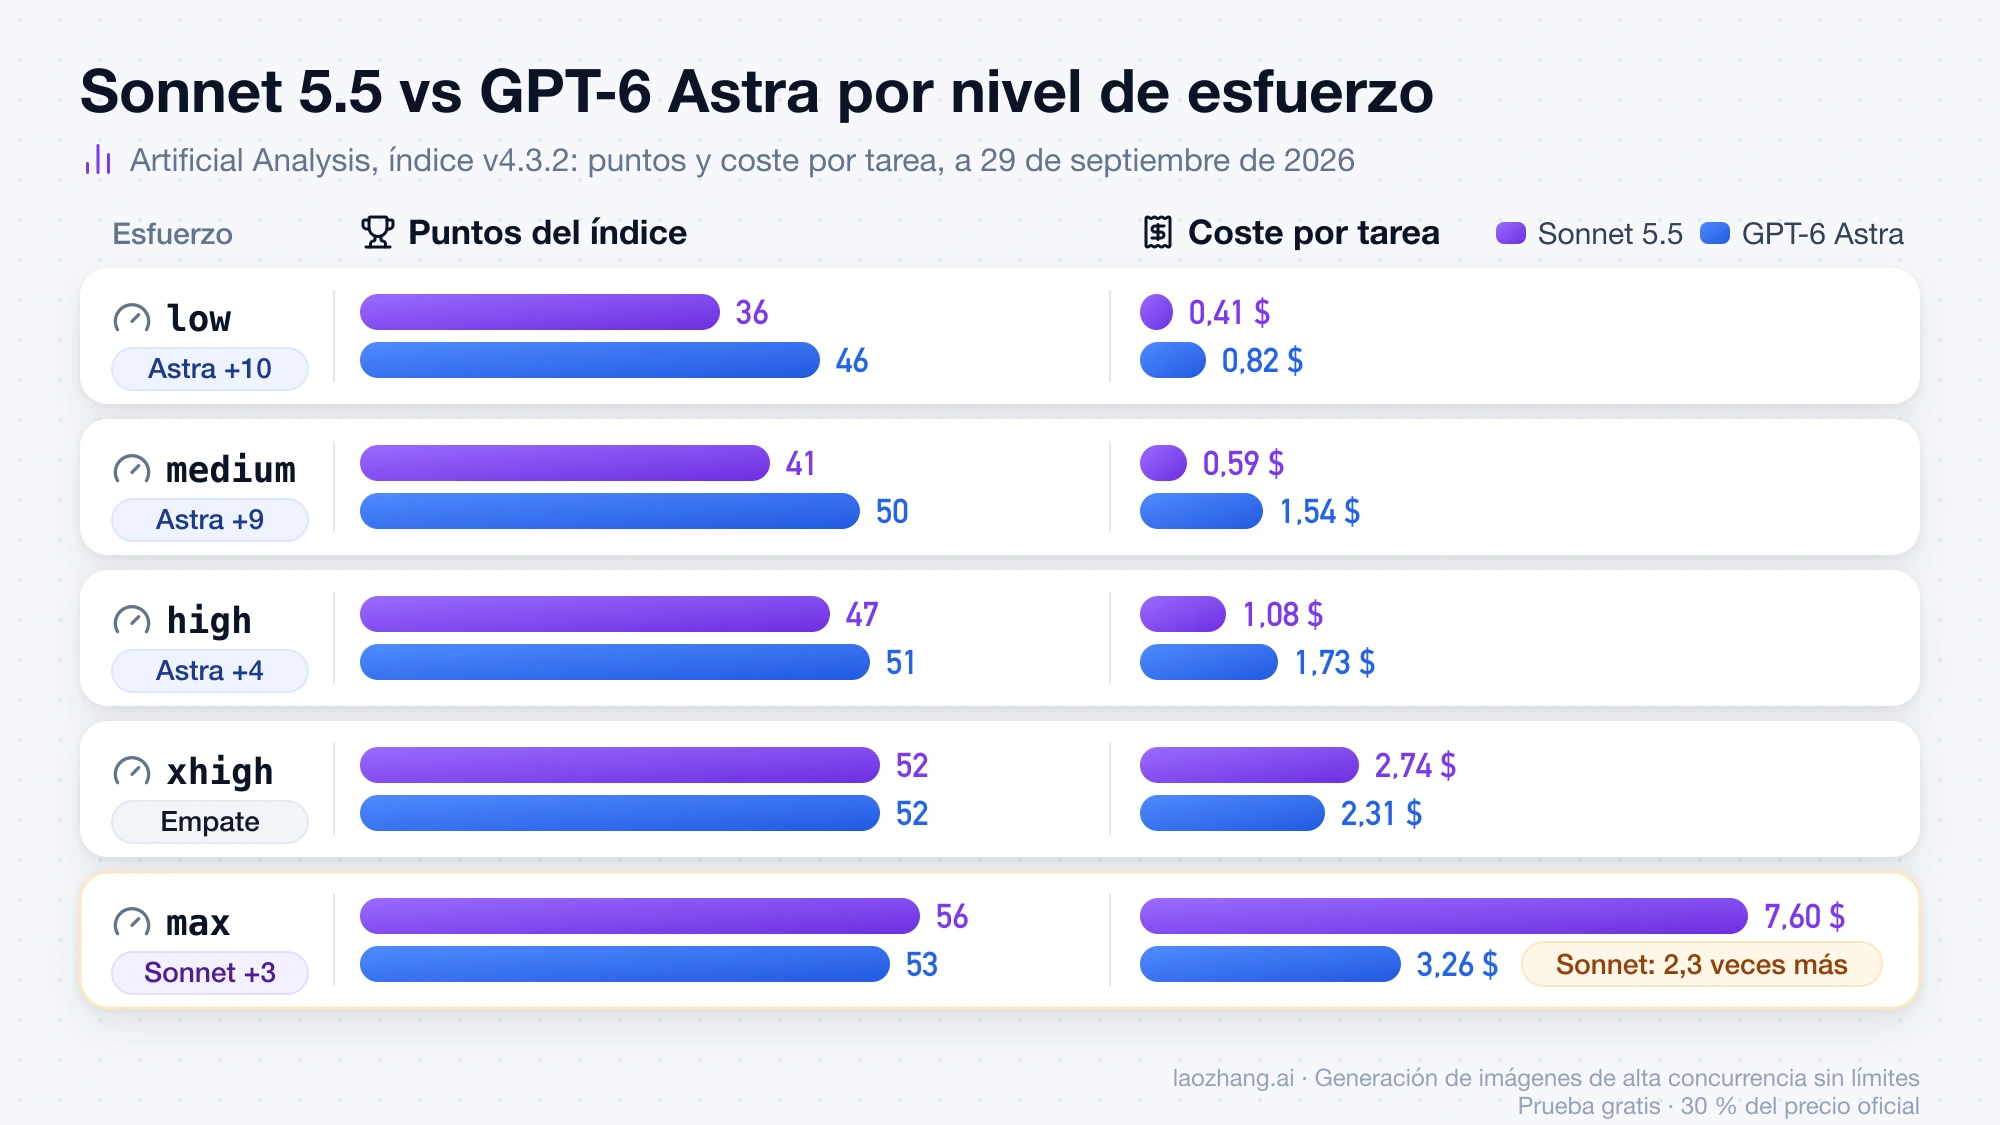
Artificial Analysis (AA) publica su índice de inteligencia para cada nivel. Estos son los datos de la versión 4.3.2 a 29 de septiembre de 2026; el coste por tarea es lo que le costó a AA, a precios de lista, resolver cada tarea de su batería de 10 evaluaciones:
| Esfuerzo | Sonnet 5.5: puntos | Sonnet 5.5: coste por tarea | GPT-6 Astra: puntos | GPT-6 Astra: coste por tarea |
|---|---|---|---|---|
low | 36 | 0,41 $ | 46 | 0,82 $ |
medium | 41 | 0,59 $ | 50 | 1,54 $ |
high | 47 | 1,08 $ | 51 | 1,73 $ |
xhigh | 52 | 2,74 $ | 52 | 2,31 $ |
max | 56 | 7,60 $ | 53 | 3,26 $ |
Fuente: Artificial Analysis, índice v4.3.2. AA evaluó una versión de Sonnet 5.5 anterior al lanzamiento que tenía un fallo con las salidas estructuradas; Anthropic lo corrigió en la versión pública y AA prevé repetir esas pruebas, así que las cifras de Sonnet pueden moverse.
De la tabla salen cuatro lecturas:
- El titular compara
maxconmax. Es el único nivel en el que Sonnet va por delante, y ahí cada tarea le cuesta 2,3 veces lo que a Astra. AA mide unos 193.000 tokens de salida por tarea para Sonnet 5.5 enmax, la cifra más alta que ha registrado y unas 7 veces la de Astra enmax. - A puntuación parecida, Astra sale más barato. Astra en
lowsaca 46 puntos por 0,82 $; Sonnet necesitahighpara llegar a 47, por 1,08 $. Enxhighempatan a 52, con 2,31 $ para Astra y 2,74 $ para Sonnet. - Sonnet solo es más barato por tarea en
lowymedium, donde saca 36 y 41 puntos, menos que cualquier ajuste de Astra. AA lo resume así: Sonnet 5.5 queda fuera de la frontera de mejor relación entre inteligencia y coste por tarea, y en esfuerzos bajos hay configuraciones de Astra o de GPT-6 Sol que rinden lo mismo por menos. - El ajuste por defecto no es el del titular. En la API, Sonnet 5.5 usa
highpor defecto (47 puntos en AA); en las apps de Claude y en Claude Code,medium(41). OpenAI no documenta cuál es el esfuerzo por defecto de Astra, y Astra no aceptanone.
Una advertencia sobre las etiquetas: high en Anthropic y high en OpenAI son nombres que cada proveedor calibra a su manera, no la misma cantidad de cálculo. Comparar por etiqueta sirve de referencia; lo que cuenta es la pareja de puntuación y coste.
Vals: 13 de 19 pruebas, con letra pequeña
Vals AI enfrentó a los dos modelos en max en 19 pruebas compartidas (datos a 29 de septiembre de 2026). Sonnet 5.5 queda por delante en 13 y Astra en 6, pero en 9 de las 19 los márgenes de error de ±1 desviación típica se solapan, y Vals avisa de que el recuento no es una prueba de significación estadística.
En el Vals Index, Sonnet saca 69,22 % frente al 66,61 % de Astra. En esa misma batería, a Sonnet le costó 20,80 $ frente a 19,09 $ y tardó 1 h 10 min frente a 25 min 11 s. Sonnet se evaluó con respaldo automático a Sonnet 5 en el servidor cuando rechazaba una tarea; si esas tareas se cuentan como fallos, su índice baja a 68,89 %.
Cifras de proveedores que no se pueden juntar
Si ves «70,6 % frente a 57,9 % en Terminal-Bench 4.0», no lo tomes como una comparación: el 70,6 % sale de la página de Anthropic y el 57,9 % de la de OpenAI, cada uno con su propio entorno de pruebas. La tabla de lanzamiento de Anthropic compara Sonnet 5.5 con GPT-6 Sol, no con Astra, y la de OpenAI no incluye a Sonnet. Las mediciones independientes ni siquiera coinciden en quién gana esa prueba: AA da 64 % a Sonnet en max frente a 60 % de Astra en xhigh, y Vals da 53,03 % a Sonnet frente a 57,07 % de Astra.
Lo mismo pasa con «más de un 30 % más rápido y hasta un 30 % más barato»: Anthropic lo dice respecto a Sonnet 5, no respecto a Astra. Y depende del esfuerzo: AA midió en max un coste por tarea de Sonnet 5.5 alrededor de un 50 % superior al de Sonnet 5 en max.
Cuánto pagas: 5 veces en la tarifa, otra cosa en la factura
Tarifas de la API directa por millón de tokens, a 29 de septiembre de 2026 (Anthropic, OpenAI):
| Concepto | Claude Sonnet 5.5 | GPT-6 Astra (hasta 272K de entrada) | GPT-6 Astra (más de 272K de entrada) |
|---|---|---|---|
| Entrada | 2 $ | 10 $ | 20 $ |
| Entrada leída de caché | 0,20 $ | 1 $ | 2 $ |
| Escritura en caché | 2,50 $ (5 min) / 4 $ (1 h) | 12,50 $ | 25 $ |
| Salida | 10 $ | 50 $ | 75 $ |
| Batch | 1 $ / 5 $ | 5 $ / 25 $ | 10 $ / 37,50 $ |
Sonnet 5.5 no tiene recargo por contexto largo en toda su ventana de un millón de tokens: una petición de 900.000 tokens paga por token lo mismo que una de 9.000. Astra, en cambio, pasa toda la petición a la tarifa larga en cuanto la entrada supera 272K: el doble en entrada y caché y 1,5 veces en salida. Otros ajustes: Astra ofrece modo Fast al doble de precio (sin garantía de latencia) y Flex a mitad de precio; Sonnet 5.5 no tiene modo rápido. La residencia de datos suma un 10 % en Astra y la inferencia solo en EE. UU. multiplica por 1,1 en Sonnet.
Con los mismos recuentos de tokens, sin caché ni herramientas, la cuenta queda así:
| Petición | Sonnet 5.5 | GPT-6 Astra | Relación |
|---|---|---|---|
| 100K entrada + 20K salida | 0,1 × 2 + 0,02 × 10 = 0,40 $ | 0,1 × 10 + 0,02 × 50 = 2,00 $ | 5 veces |
| 250K entrada + 20K salida | 0,25 × 2 + 0,02 × 10 = 0,70 $ | 0,25 × 10 + 0,02 × 50 = 3,50 $ | 5 veces |
| 300K entrada + 20K salida | 0,3 × 2 + 0,02 × 10 = 0,80 $ | 0,3 × 20 + 0,02 × 75 = 7,50 $ | unas 9,4 veces |
Fíjate en el salto entre la segunda y la tercera fila: 50.000 tokens más de entrada llevan a Astra de 3,50 $ a 7,50 $, mientras Sonnet solo sube 10 céntimos. Si tus peticiones rondan ese umbral (repositorios enteros, contratos largos, historiales de agente), la tarifa pesa mucho más que en peticiones cortas. El detalle de las tarifas largas de Astra está en Precio de la API de GPT-6 Astra: coste real, contexto largo y acceso.
Estas cuentas son aritmética con recuentos idénticos, no una factura. En la práctica los dos modelos no gastan los mismos tokens para la misma tarea: los tokenizadores son distintos, los tokens de razonamiento se cobran como salida y los reintentos se suman. El caso más claro es el de la tabla de AA: con una tarifa 5 veces menor, Sonnet en max acaba costando 2,3 veces más por tarea porque escribe unas 7 veces más. La relación de 5 a 1 solo se mantiene en tu factura si los dos modelos producen una cantidad de salida parecida, algo más probable en esfuerzos bajos y en respuestas cortas.
Cuál usar según el tipo de trabajo
Ninguno de los dos gana en todo. Este reparto sale de las mediciones de AA y Vals citadas arriba y de las tarifas; tómalo como punto de partida para tu propia prueba:
| Tipo de trabajo | Punto de partida | Por qué |
|---|---|---|
| Peticiones con más de 272K tokens de entrada | Prueba Sonnet 5.5 | Por token, Astra cobra 10 veces más en entrada y 7,5 veces más en salida en ese tramo |
| Chat y tareas cortas sensibles a la latencia | Prueba Sonnet 5.5 en low o medium | En low, AA mide 0,92 s hasta el primer token de respuesta frente a 2,42 s de Astra; comprueba que la calidad te basta, porque en low saca 36 puntos frente a 46 |
| Agentes de terminal, flujos científicos y operaciones (SRE) | Quédate con Astra | En Vals, Astra saca 65,71 % frente a 38,57 % en Terminal-Bench Science y 56,87 % frente a 30,15 % en SRE Bench |
| Programación competitiva y algoritmos | Quédate con Astra | En Vals, IOI: 100 % frente a 83,06 % |
| Agentes legales, fiscales y financieros | Prueba Sonnet 5.5 si buscas calidad | En Vals, Tax Agent Bench 73,39 % frente a 63,34 % y Legal Research Bench 48,08 % frente a 39,42 %; en max, a Sonnet le costó más por prueba que a Astra (9,25 $ frente a 5,80 $ en la fiscal) |
Tareas largas de agente en max | Quédate con Astra o baja el esfuerzo de Sonnet | En Vals, la migración de código tardó 3 h 20 min con Sonnet (75,83 $) frente a 58 min 30 s con Astra (44,36 $) |
Flujos con herramientas alojadas de OpenAI (hosted_shell, image_generation, code_interpreter) | Quédate con Astra | Esas herramientas son de la API Responses de OpenAI; con Claude tendrías que rehacerlas |
| Investigación en ciberseguridad | No cambies por esa prueba | La ventaja de Sonnet en CyberBench (59,58 % frente a 41,07 %) cae a 41,97 %, casi lo mismo que Astra, si las tareas resueltas por el respaldo a Sonnet 5 cuentan como fallos |
| Quieres calidad alta al precio de Sonnet | Compara también con GPT-6 Sol | GPT-6 Sol cobra 2 $ / 10 $, como Sonnet 5.5; AA sitúa a Sonnet en high muy cerca de GPT-6 Sol en inteligencia con prácticamente el mismo coste por tarea |
Repartir también es una opción razonable: los documentos largos van a Sonnet 5.5 y los agentes de terminal se quedan en Astra. Ambos están en Amazon Bedrock (Astra, en us-west-2), lo que ahorra gestionar otra cuenta de proveedor, aunque no evita las diferencias de API que verás más abajo.
Sobre ciberseguridad hay un detalle más: en las apps de Claude, cuando Sonnet 5.5 detecta contenido de ciberseguridad o de desarrollo de modelos de IA de frontera, puede pasar la conversación a Sonnet 5; las peticiones de biología peligrosa se bloquean.
Si la duda real es qué modelo de OpenAI elegir a igual precio, GPT-6 Sol, Luna y Astra frente a Terra: precios y cuál probar primero lo compara dentro de la misma API. Si lo que necesitas es la puntuación más alta, AA pone por delante a Claude Opus 5.5 en max con 58 puntos; la comparación con su rival de OpenAI está en Claude Opus 5.5 vs GPT-6 Sol: cuál probar primero y qué pagas.
Suscripción o API
Las tarifas de la API no dicen nada de lo que incluye una suscripción. En ChatGPT, GPT-6 Pro (que funciona con Astra) está en el chat de los planes Pro de 100 $ y 200 $, Business y Enterprise; Plus tiene Astra en ChatGPT Work y en Codex, pero no GPT-6 Pro en el chat; Free y Go no tienen Astra. Para Codex, OpenAI publica estimaciones de mensajes locales cada 5 horas (por ejemplo, de 5 a 45 en Plus), no límites fijos. En Claude, Sonnet 5.5 aparece en la web, las apps móvil y de escritorio, Cowork y Claude Code, con esfuerzo medium por defecto; Anthropic no publica qué planes lo incluyen.
Qué cambia en tu código antes de mover tráfico
Pasar de Astra a Sonnet 5.5 no es cambiar un nombre de modelo: cambias de proveedor y de API. Si ya usas Sonnet 5, el salto a 5.5 también trae cambios incompatibles.
Si vienes de GPT-6 Astra
- Otra API. Pasas de Responses o Chat Completions de OpenAI a la API Messages de Anthropic, con otro formato de herramientas y otro tokenizador. Las herramientas alojadas de OpenAI no tienen traslado directo.
- Parámetros de muestreo. Con Astra ya tienes que prescindir de
temperatureytop_p, porque siempre razona (no admitenone). En Sonnet 5.5, cualquier valor detemperature,top_potop_kdistinto del predeterminado devuelve un error 400. Si tus prompts ya funcionan sin ellos, se trasladan con menos trabajo. - Uso forzado de herramientas.
tool_choiceconanyo con una herramienta concreta devuelve 400 en Sonnet 5.5. Usaautoconstrict: trueo salidas estructuradas, y pide en el prompt que llame a la herramienta. - Prefill. Terminar la conversación con un turno del asistente prerrellenado devuelve 400; la conversación debe acabar con un mensaje del usuario.
- Caché. Anthropic cobra escrituras explícitas de 5 minutos o 1 hora y admite prompts de caché desde 512 tokens; en Astra la duración se fija con
prompt_cache_options.ttlen"30m". Recalcula tu tasa de aciertos de caché con el nuevo esquema antes de comparar precios. - Texto entre llamadas a herramientas. Sonnet 5.5 devuelve las notas de progreso entre herramientas como bloques
thinking, vacíos con el valor por defectodisplay: "omitted". Si tu interfaz muestra ese texto al usuario, se quedará en silencio sin dar error hasta que cambiesthinking.displayo usesbetween_tools. - Esfuerzo. Las escalas no equivalen entre proveedores. Anthropic recomienda empezar en
high, bajar amediumpara programación con agentes en tareas bien definidas y usarmediumolowpara chat.
Si necesitas poner Astra en marcha para la comparación, sigue Cómo acceder a GPT-6 Astra por API y comprobar la primera respuesta; para el lado de Claude, cómo elegir un acceso estable a Claude repasa la API directa, las nubes compatibles y la pasarela de laozhang.ai.
Si ya usas Sonnet 5
Anthropic lista cinco cambios incompatibles al pasar a Sonnet 5.5 (guía de migración):
thinking: {"type": "disabled"}y los presupuestos manuales conbudget_tokensdevuelven 400. Para quitar el razonamiento inicial se usathinking: {"type": "between_tools"}, que solo funciona enlow,mediumyhigh.- El uso forzado de herramientas devuelve 400 (ver arriba).
- Los bloques de razonamiento quedan ligados al modelo, a la conversación y a la cuenta. En cuentas creadas desde el 31 de agosto de 2026, reenviar un bloque después de editar el historial anterior (prompt de sistema, herramientas o mensajes previos) devuelve 400. Mantén las conversaciones en modo solo añadir.
- En la API de Claude y en Google Cloud se rechaza la herramienta
computer_20251124; hay que pasar acomputer_toolset_20260801. - La herramienta advisor no acepta Opus 4.8, Opus 4.7 ni Sonnet 5 como asesores.
Los precios y el tokenizador son los mismos que en Sonnet 5, así que tu conciliación de facturas sigue valiendo; el cálculo detallado está en Anthropic cancela la subida de Sonnet 5: tarifas y cálculo del coste. Lo que no debes arrastrar es el nivel de esfuerzo: Anthropic los ha recalibrado en 5.5 y recomienda repetir el barrido.
Cómo probarlo con tus propias tareas
La cifra que decide es el coste por tarea aceptada: todo lo que pagas en una prueba dividido entre las tareas que cumplen tu criterio de aceptación. Incluye los reintentos y el trabajo que una persona tiene que rehacer, que es donde un modelo barato puede salir caro.
- Elige entre 20 y 50 tareas reales con una regla de aceptación clara: pasa los tests, el revisor no cambia nada de fondo, el extracto coincide con el documento.
- Fija una pareja de esfuerzos y decláralo. Por ejemplo, Sonnet 5.5 en
highfrente a Astra enmediumy enhigh; después sube un nivel en ambos. Mismas entradas, mismas herramientas. - Guarda el uso facturado de cada llamada. En Anthropic:
input_tokens,cache_creation_input_tokens,cache_read_input_tokensyoutput_tokens. En OpenAI:input_tokens,input_tokens_details.cached_tokens,output_tokensyoutput_tokens_details.reasoning_tokens. Apunta también los reintentos, el tiempo total y los minutos de corrección humana. - Calcula el coste total de cada modelo y divídelo entre sus tareas aceptadas.
- Cambia solo si Sonnet 5.5 supera el mismo listón con menor coste por tarea aceptada. Si lo supera en unos tipos de tarea y no en otros, reparte.
Para una primera estimación antes de la prueba, este cálculo reproduce las tarifas de la tabla (sin caché, precios estándar):
# USD por millón de tokens, API directa, a 29 de septiembre de 2026
def coste_sonnet_55(entrada, salida):
    return (entrada * 2 + salida * 10) / 1_000_000

def coste_astra(entrada, salida):
    if entrada > 272_000:  # toda la petición pasa a la tarifa larga
        return (entrada * 20 + salida * 75) / 1_000_000
    return (entrada * 10 + salida * 50) / 1_000_000

print(coste_sonnet_55(300_000, 20_000))  # 0.8
print(coste_astra(300_000, 20_000))      # 7.5
La cuenta supone la misma salida para los dos. Si en tu prueba Sonnet necesita, por ejemplo, el triple de tokens de salida que Astra para la misma tarea, pasa el triple a coste_sonnet_55; en max, las mediciones de AA apuntan a unas 7 veces.
Preguntas frecuentes
¿Vale la pena pagar GPT-6 Astra si Sonnet 5.5 cuesta cinco veces menos?
Por token, Astra cuesta 5 veces más en peticiones de hasta 272K tokens de entrada y entre 7,5 y 10 veces más por encima, según el peso de la entrada y de la salida. Por tarea, la diferencia puede desaparecer o invertirse: en el índice de AA, Astra llega a la misma puntuación o más con menos coste por tarea, y Sonnet solo sale más barato por tarea en low y medium, con puntuaciones más bajas. Vale la pena en agentes de terminal, ciencia y operaciones, y cuando el tiempo de respuesta de tareas largas importa.
¿Qué es mejor para programar, Opus 5.5 o Sonnet 5.5?
En el índice de AA, Opus 5.5 en max saca 58 puntos frente a 56 de Sonnet 5.5 en max, y Sonnet usa en ese nivel alrededor de un 60 % más tokens de salida por tarea. En Terminal-Bench 4.0, AA da ventaja a Sonnet (64 % frente a 60 %). AA añade que, en los esfuerzos altos, Sonnet queda por detrás de Opus 5.5 en la relación entre inteligencia y coste por tarea. Para la programación diaria en esfuerzos más bajos, decide con la misma prueba de coste por tarea aceptada.
¿En qué planes de Claude está Sonnet 5.5?
Anthropic confirma que Sonnet 5.5 está en la web, las apps y Claude Code, con esfuerzo medium por defecto, pero no publica una lista de planes que lo incluyan. En la API está disponible para todos los clientes como claude-sonnet-5-5.
¿Por qué Claude cambió a Sonnet 5 en mitad de mi conversación?
Cuando Sonnet 5.5 marca una petición como de ciberseguridad o de desarrollo de modelos de IA de frontera, la app puede pasar la conversación a Sonnet 5. En la API, los rechazos llegan con stop_reason: "refusal" y un objeto stop_details que indica la categoría.