Claude Opus 5.5 vs GPT-6 Sol y 6.1 Sol: cuál probar y qué pagas
Con los mismos tokens, Opus 5.5 cuesta el doble que GPT-6.1 Sol hasta 272K, caché incluida, y nunca menos por encima. Por tarea medida, de 4 a 9 veces más.
En esta página
Si las dos API encajan en tu flujo, prueba primero GPT-6.1 Sol, el modelo que OpenAI publicó el 29 de septiembre de 2026 como actualización de GPT-6 Sol. Hasta 272.000 tokens de entrada cobra exactamente la mitad que Claude Opus 5.5 en todas las partidas, también en la lectura de caché, y por encima de ese umbral la única diferencia de tarifa es la salida. Pon Opus 5.5 primero cuando necesites el techo de calidad más alto y cada fallo te cueste horas de revisión: en las mediciones de Artificial Analysis, Opus llega a 58 puntos y GPT-6.1 Sol se queda en 52 con el esfuerzo máximo.
La comparación con GPT-6 Sol sigue siendo útil como referencia, porque el modelo continúa en la API sin fecha de retirada, pero ya no es el Sol que conviene enfrentar a Opus. Lo que decide el modelo por defecto no es la tarifa, sino el coste por tarea aceptada: con el mismo nivel de esfuerzo, Opus 5.5 gasta entre 4,2 y 8,9 veces más por tarea que GPT-6.1 Sol en el índice de Artificial Analysis. Precios de la API directa en USD: OpenAI a 30 de septiembre de 2026 y Anthropic a 25 de septiembre de 2026.
Dónde se aplica la diferencia de 2x
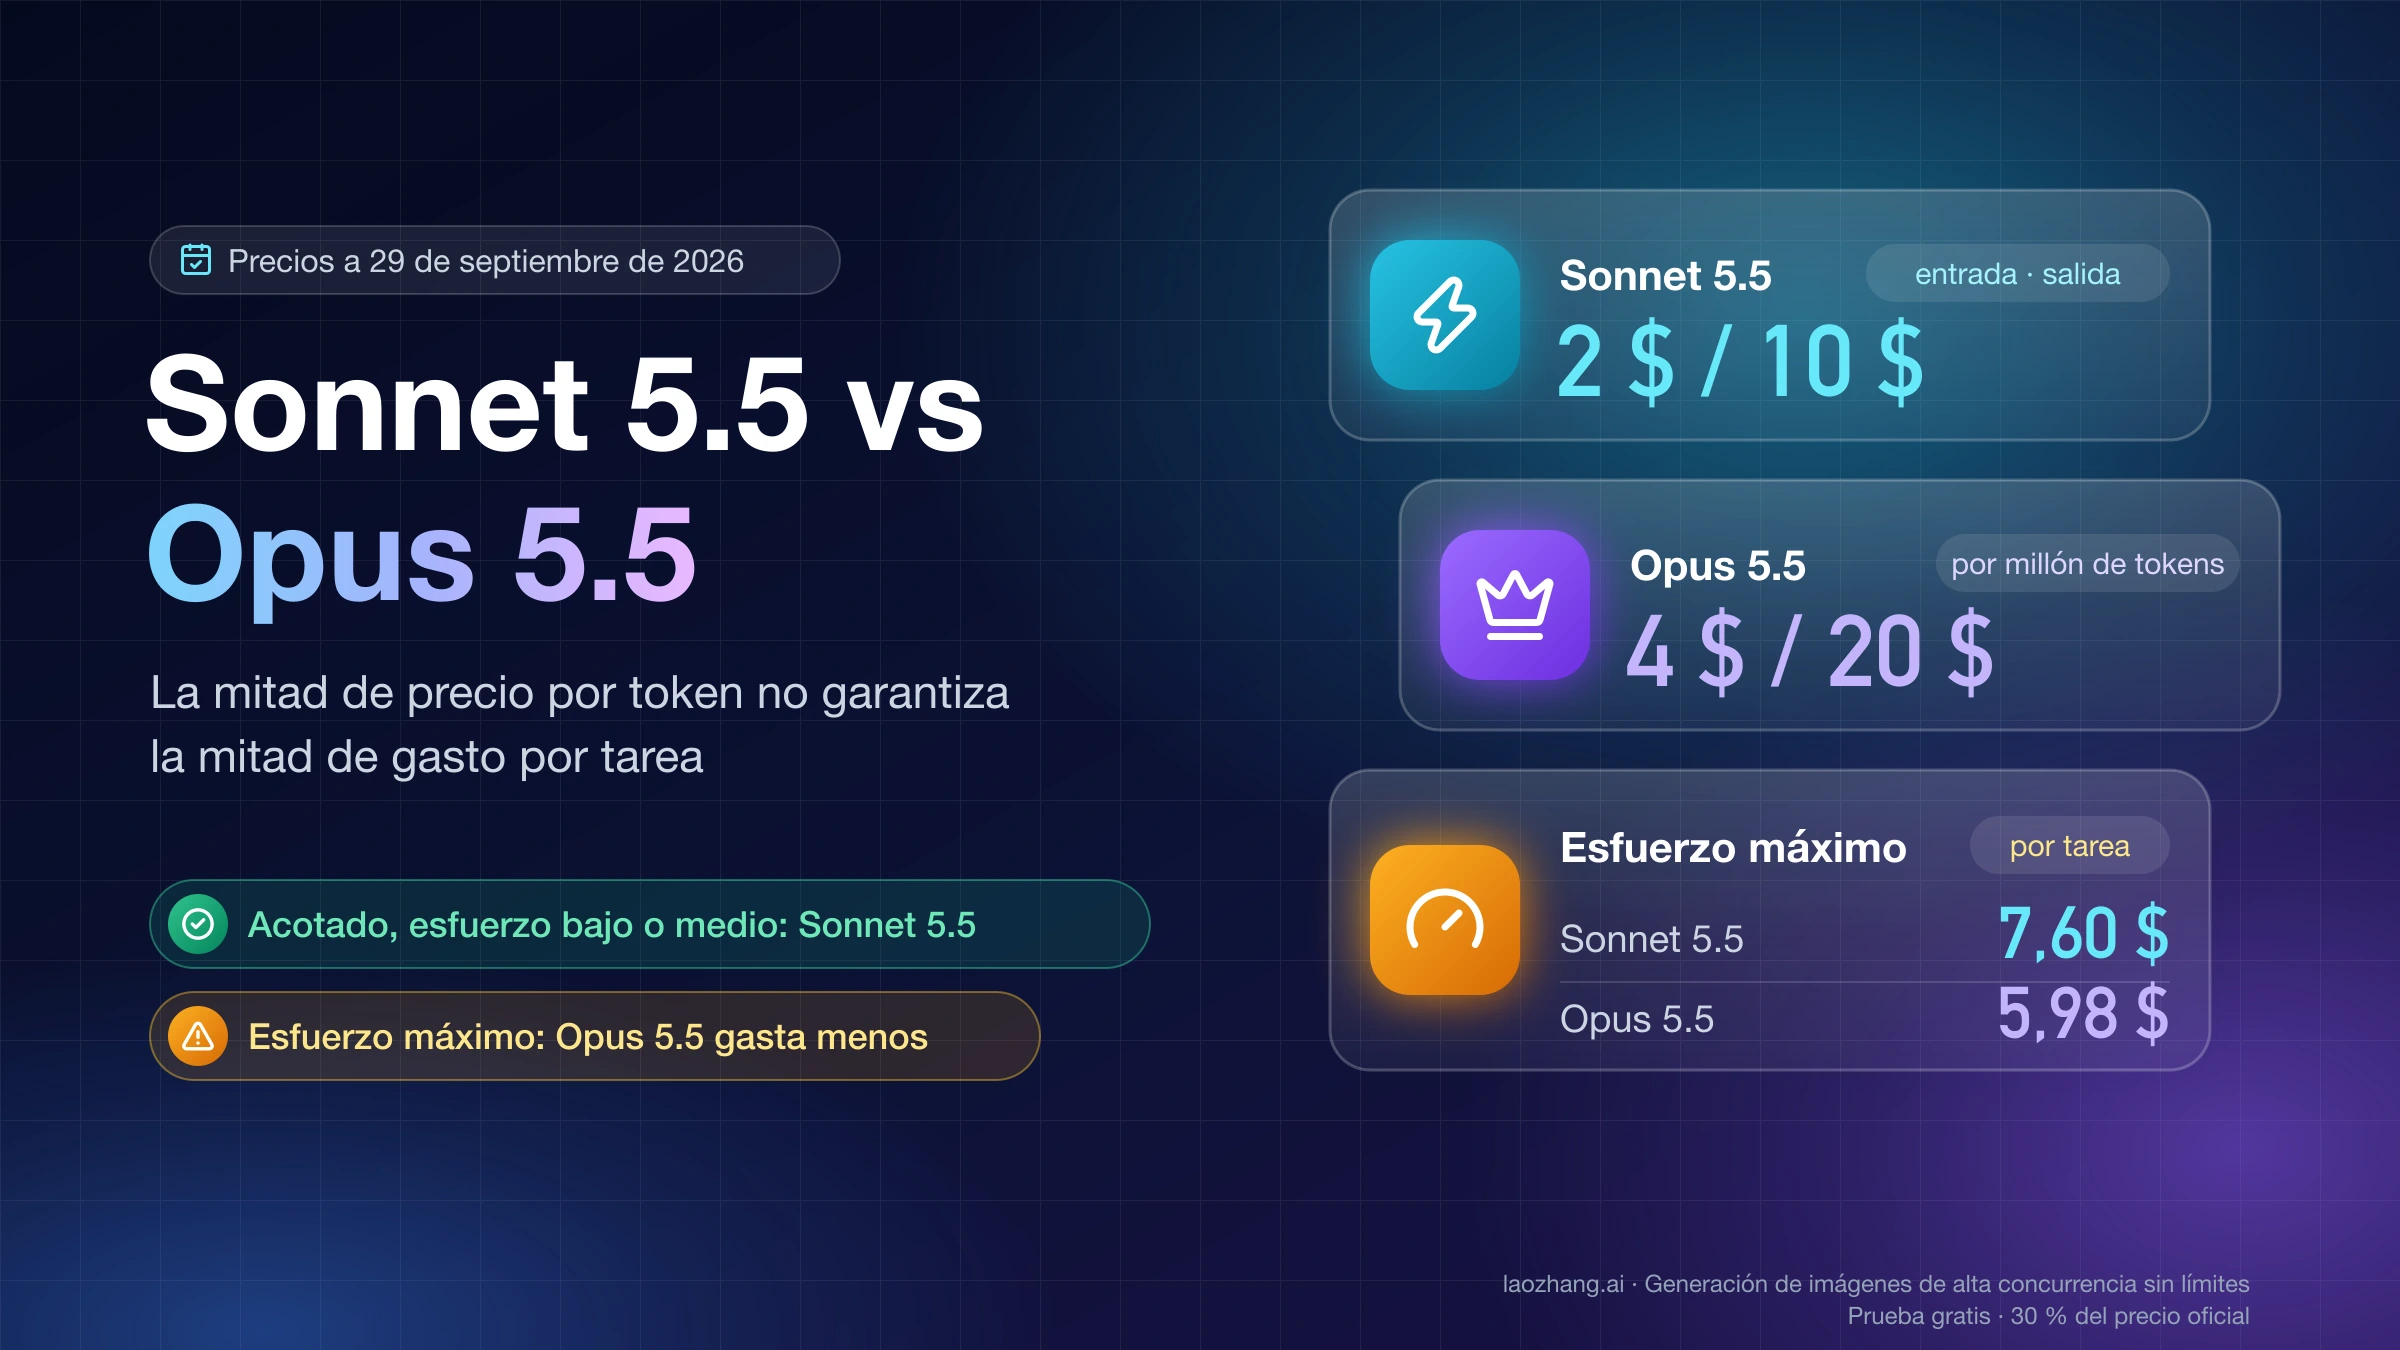
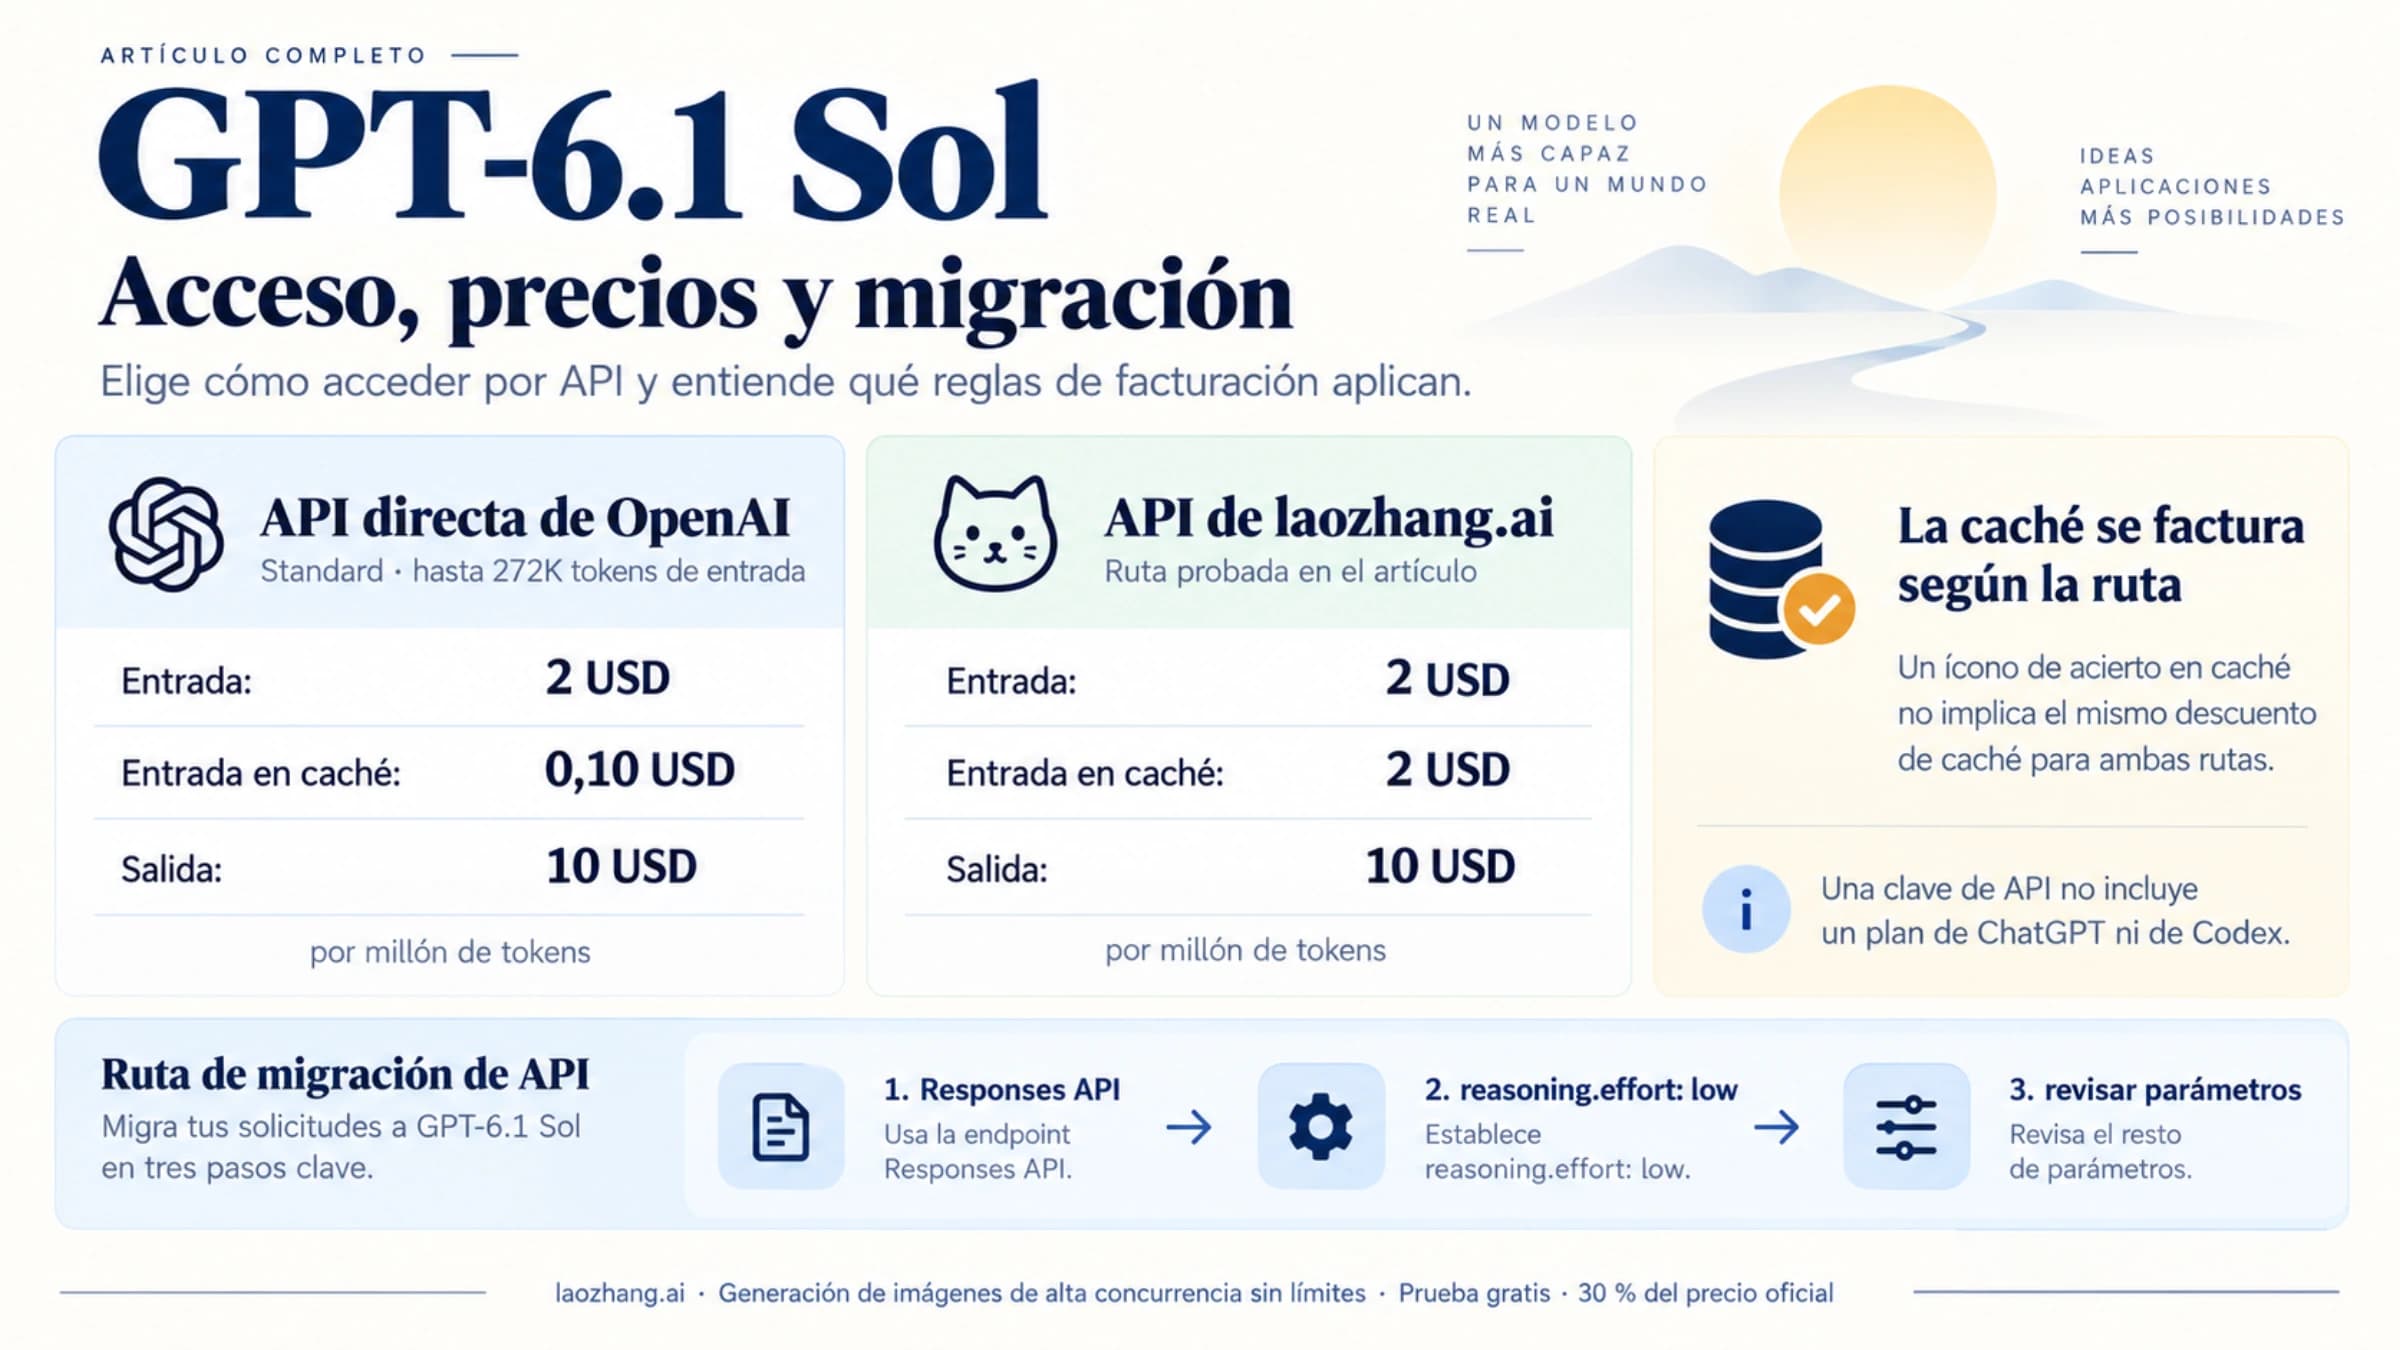
Opus 5.5 cuesta 4 USD por millón de tokens de entrada y 20 USD por millón de salida en la API de Claude. GPT-6.1 Sol cuesta 2 y 10 USD en la API de OpenAI. La factura se reparte en cuatro partidas, y con GPT-6.1 Sol el 2x se cumple en las cuatro mientras la solicitud no pase de 272K tokens de entrada:
| Partida (USD por millón de tokens) | GPT-6.1 Sol hasta 272K | GPT-6.1 Sol por encima de 272K | Claude Opus 5.5 (hasta 1M) | Opus frente a 6.1 Sol, corto | Opus frente a 6.1 Sol, largo |
|---|---|---|---|---|---|
| Entrada nueva (sin caché) | 2 | 4 | 4 | 2x | igual |
| Escritura en caché | 2,50 | 5 | 5 (caché de 5 min) | 2x | igual |
| Lectura de caché | 0,10 | 0,20 | 0,20 | 2x | igual |
| Salida (incluye razonamiento) | 10 | 15 | 20 | 2x | 1,33x |
GPT-6 Sol tiene las mismas tarifas salvo la lectura de caché, que cuesta el doble: 0,20 USD hasta 272K y 0,40 USD por encima. OpenAI ya no lo muestra en su tabla de precios, pero su página de modelo sigue activa y remite a GPT-6.1 Sol como «el modelo Sol más reciente».
Tres detalles cambian la lectura de esta tabla:
- La lectura de caché ya no iguala a los dos modelos. Con GPT-6 Sol costaba lo mismo que en Opus en contexto corto, así que un agente de programación que relee el mismo repositorio en cada turno apenas pagaba prima. GPT-6.1 Sol cobra la entrada en caché al 5 % de la entrada normal, 0,10 USD, y la prima vuelve a ser del 100 % también ahí. La propia Anthropic dice en el anuncio de Opus 5.5 que las lecturas de caché son la mayor parte del coste del trabajo de agentes y programación; es una afirmación del fabricante sobre su propio uso, pero indica por qué este cambio pesa en la factura.
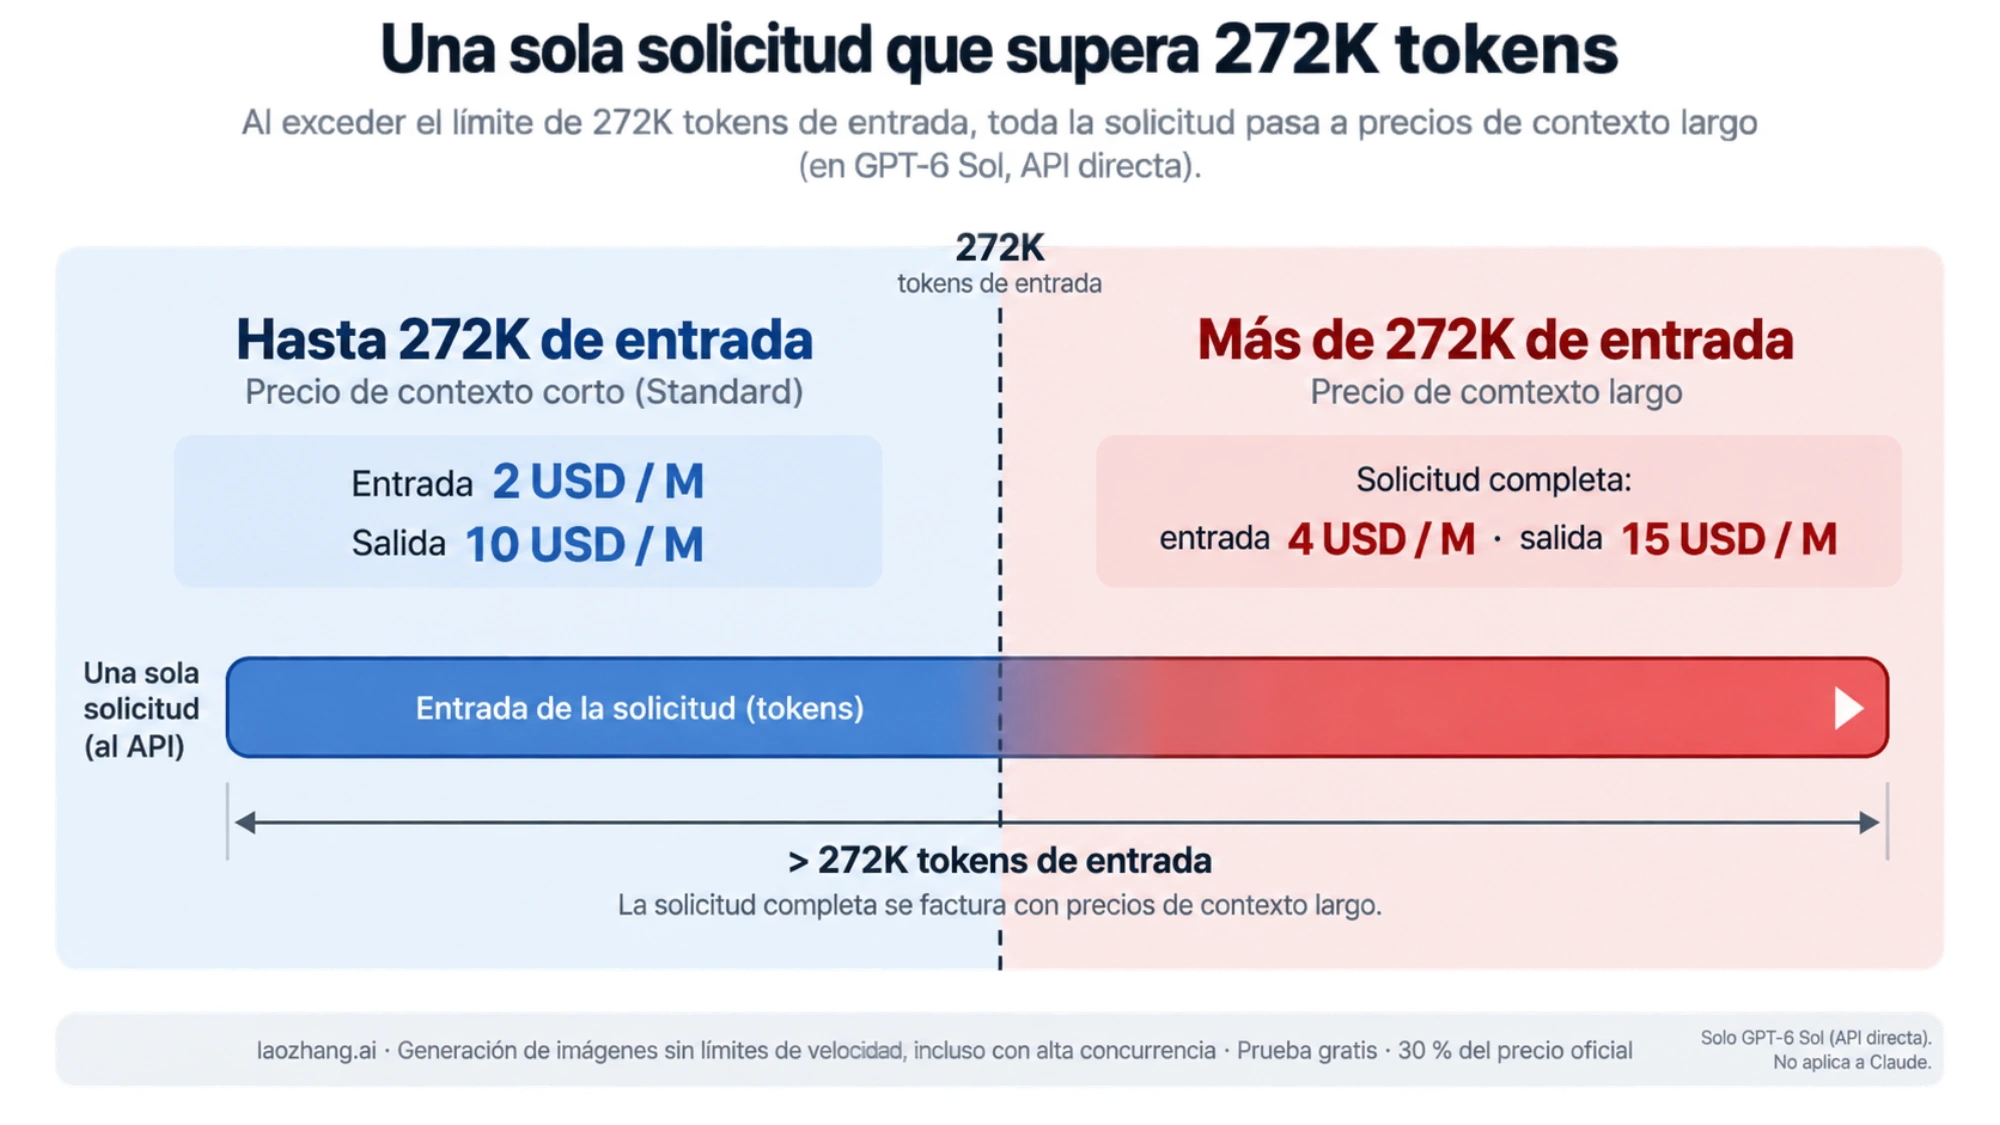
- El umbral de 272K es por solicitud y reprecia la solicitud entera. Si una sola llamada supera los 272K tokens de entrada, todas sus partidas pasan a la columna larga: el doble en entrada y caché, 1,5 veces en salida. No es un recargo solo sobre los tokens que sobran.
- Opus 5.5 no tiene recargo por contexto largo. Anthropic cobra la ventana completa de 1M al precio estándar: una solicitud de 900K tokens se factura al mismo precio por token que una de 9K.
La documentación de OpenAI no dice literalmente si los tokens en caché cuentan para llegar a los 272K. Habla de cobrar «el doble en entrada y en caché» a los prompts de más de 272K tokens de entrada, lo que da a entender que el umbral mide toda la entrada del prompt, en caché o no. Los cálculos de abajo parten de esa lectura; si tu factura muestra otra cosa, manda la factura.
La caché de 1 hora de Opus cuesta 8 USD por millón en escritura. Otros modificadores que alteran la comparación:
- Batch: la mitad en ambos. GPT-6.1 Sol ofrece además Flex, también a mitad de precio. Compara Batch con Batch: la proporción entre los dos se mantiene.
- Modo rápido: en GPT-6.1 Sol (antes llamado Priority) cuesta el doble de Standard. En Opus 5.5 es una vista previa de investigación, solo en la API directa de Claude, a 8 y 40 USD, y no se combina con Batch.
- Procesamiento regional: OpenAI añade un 10 % a los endpoints de residencia de datos, y con residencia de datos en la UE GPT-6.1 Sol no ofrece el modo rápido. En Anthropic,
inference_geo: "us"multiplica por 1,1 todas las partidas. - Herramientas: la búsqueda web cuesta 10 USD por cada 1.000 búsquedas en las dos API, además de los tokens que añade al contexto.
Cómo cambia la prima con tu mezcla de tokens
Con las tarifas de la tabla, el coste de cualquier carga se escribe así, con U = entrada nueva, W = escritura en caché, R = lectura de caché y O = salida, todo en millones de tokens facturados:
Opus 5.5                   = 4·U + 5·W + 0,2·R + 20·O
GPT-6.1 Sol, hasta 272K    = 2·U + 2,5·W + 0,1·R + 10·O
GPT-6.1 Sol, más de 272K   = 4·U + 5·W + 0,2·R + 15·O

GPT-6 Sol (referencia)     = 2·U + 2,5·W + 0,2·R + 10·O   hasta 272K
                             4·U + 5·W + 0,4·R + 15·O     más de 272K
Cinco mezclas hipotéticas, con el mismo número de tokens facturados en todos los modelos (sin escrituras en caché; D y E son solicitudes únicas por encima de 272K):
| Caso hipotético | U | R | O | Opus 5.5 | GPT-6.1 Sol | Opus / 6.1 Sol | GPT-6 Sol (referencia) |
|---|---|---|---|---|---|---|---|
| A. Llamadas cortas sin caché | 0,1 | 0 | 0,02 | 0,80 USD | 0,40 USD | 2,00 | 0,40 USD |
| B. Bucle de agente con llamadas cortas | 0,1 | 2,0 | 0,05 | 1,80 USD | 0,90 USD | 2,00 | 1,10 USD |
| C. Bucle dominado por la caché | 0,05 | 5,0 | 0,03 | 1,80 USD | 0,90 USD | 2,00 | 1,40 USD |
| D. Una solicitud de 800K, casi toda en caché | 0,05 | 0,75 | 0,02 | 0,75 USD | 0,65 USD | 1,15 | 0,80 USD |
| E. Una solicitud de 300K sin caché | 0,3 | 0 | 0,02 | 1,60 USD | 1,50 USD | 1,07 | 1,50 USD |
De las fórmulas salen dos reglas que puedes aplicar a tus propios datos:
- Por debajo de 272K, Opus cuesta exactamente el doble que GPT-6.1 Sol, sea cual sea la mezcla, porque todas las partidas guardan la proporción 2 a 1. Con GPT-6 Sol la prima bajaba de 2 hacia 1 a medida que la lectura de caché pesaba más (en el caso C era de un 29 %); con 6.1 Sol la caché ya no la reduce.
- Por encima de 272K, la diferencia por solicitud (Opus menos 6.1 Sol) es 5·O: entrada, escritura y lectura cuestan igual y solo la salida es más cara en Opus. Nunca sale negativa, así que con los mismos tokens Opus no cuesta menos en ningún caso. La regla de «Opus sale más barato cuando la lectura de caché supera 25 veces la salida» valía solo frente a GPT-6 Sol, cuya lectura larga costaba 0,40 USD: en el caso D Opus ganaba por 5 céntimos a GPT-6 Sol y ahora pierde por 10 frente a 6.1 Sol.
En solicitudes largas la prima relativa es pequeña cuando la entrada domina la factura (un 7 % en el caso E), pero no se invierte. Como el umbral se aplica solicitud a solicitud, una carga mixta hay que sumarla llamada por llamada: un agente que casi siempre trabaja con 150K de contexto y de vez en cuando carga 400K paga el doble en unas llamadas y solo la diferencia de salida en otras. Si la caché es la clave de tu factura, merece la pena entender por qué un fallo de caché dispara el coste; lo explica Claude Code cache miss y coste de tokens: por que un turn sale caro.
El supuesto de «mismos tokens» es el punto débil de estas tablas. Los dos modelos no generan la misma cantidad de razonamiento ni cuentan el texto igual, y eso es lo que miden los datos de la sección siguiente.
Por qué el coste medido por tarea supera con creces el 2x
Antes de leer puntuaciones hay que fijar el esfuerzo de razonamiento (effort), el parámetro que decide cuánto piensa el modelo antes de responder. GPT-6.1 Sol acepta low, medium (por defecto), high, xhigh y max; a diferencia de GPT-6 Sol, ya no admite none ni minimal, y OpenAI recomienda pasar a low las llamadas que usaban none. Opus 5.5 tiene el razonamiento adaptativo siempre activo, sin opción de apagarlo, y su esfuerzo por defecto también es medium. Ninguno de los dos puede, por tanto, responder sin razonar. Comparar un modelo en xhigh con el otro en medium mezcla dos cosas distintas.
La comparativa de Artificial Analysis (índice 4.3.2, diez evaluaciones, a 30 de septiembre de 2026) publica puntuación y coste por tarea para cada nivel de esfuerzo de los dos modelos:
| Esfuerzo | Opus 5.5: puntos | Opus 5.5: coste por tarea del índice | GPT-6.1 Sol: puntos | GPT-6.1 Sol: coste por tarea del índice | Coste Opus / 6.1 Sol |
|---|---|---|---|---|---|
| max | 58 | 5,98 USD | 52 | 0,72 USD | 8,3x |
| xhigh | 56 | 3,46 USD | 51 | 0,39 USD | 8,9x |
| high | 54 | 1,82 USD | 50 | 0,32 USD | 5,7x |
| medium | 51 | 1,34 USD | 48 | 0,21 USD | 6,4x |
| low | 42 | 0,55 USD | 42 | 0,13 USD | 4,2x |
Cómo leer esta tabla sin sacar conclusiones de más:
- Los puntos no son porcentaje de aciertos, y el coste por tarea del índice no es una factura de producción: es un promedio ponderado de lo que costaron entrada, lecturas y escrituras de caché, razonamiento y respuesta en las pruebas de ese evaluador.
- Si la tarifa difiere 2x y el coste medido es 6,4x en
medium, Opus consumió en esas pruebas unas 3,2 veces más tokens ponderados por precio que GPT-6.1 Sol. Encaja con la salida por tarea que publica el mismo evaluador: 26.000 tokens de Opus frente a 8.000 de 6.1 Sol enmedium, y 119.000 frente a 38.000 enmax. Por eso los casos A–E de arriba se quedan cortos. - Con un gasto similar, ahora gana GPT-6.1 Sol. En
max(52 puntos, 0,72 USD) supera a Opus enmedium(51 puntos, 1,34 USD) costando alrededor del 54 % por tarea, y enlowlos dos empatan a 42 puntos con Opus 4,2 veces más caro. La ventaja de Opus está arriba: 54, 56 y 58 puntos enhigh,xhighymax, cifras que 6.1 Sol no alcanza con ningún esfuerzo.
Como referencia, GPT-6 Sol marca 48 puntos y 1,05 USD por tarea en max en el mismo índice: con 6.1 Sol la distancia en coste frente a Opus crece y la de puntuación se estrecha.
En velocidad, el resultado depende de qué midas. Opus genera más rápido una vez empieza: 72 tokens por segundo en medium y 92 en max, frente a 59 y 66 de GPT-6.1 Sol. Pero GPT-6.1 Sol empieza a responder mucho antes (2,12 s en low y 5,72 s en medium, frente a 12,72 s y 22,95 s de Opus) y, como genera menos tokens, termina antes cada tarea del índice: unos 136 s en medium frente a 219 s. Artificial Analysis vuelve a medir con el tiempo, así que estas cifras valen a 30 de septiembre de 2026.
OpenAI publica sus propias comparaciones con Opus 5.5 en el anuncio de GPT-6.1 Sol, elegidas por el fabricante y con los datos de Opus tomados de informes públicos: en GDP.pdf, GPT-6.1 Sol puntúa por encima de Opus 5.5 en todos los niveles de razonamiento probados con menos de la mitad de coste por tarea; en AutomationBench 1.0.6 con esfuerzo medio, 2,2 puntos más con cerca de un tercio del coste; en Terminal-Bench Science 0.1 con esfuerzo máximo, un coste medio por tarea de 5,47 USD frente a 23,21 USD. El índice independiente, que agrega diez evaluaciones, sigue poniendo a Opus por delante en puntuación con el mismo esfuerzo desde medium hacia arriba. Las dos lecturas coinciden en el coste y discrepan en el techo.
Una prueba práctica de DataCamp, hecha todavía con GPT-6 Sol (un Tetris en un único archivo HTML, esfuerzo high, un intento por modelo), muestra el mismo efecto a pequeña escala: Opus 5.5 usó menos tokens en total (107.958 frente a 120.226) y aun así costó 0,87 USD frente a 0,26, porque generó 22.551 tokens de razonamiento frente a 8.123, y el razonamiento se cobra como salida. Es una sola tarea, pero muestra por qué contar turnos o tokens totales engaña.
Tampoco se pueden trasladar los recuentos de tokens de un proveedor a otro. Anthropic indica que sus modelos desde Claude 4.7 usan un tokenizador que produce aproximadamente un 30 % más de tokens para el mismo texto que Claude Sonnet 4.6 y anteriores, y ningún proveedor publica una equivalencia con los tokens de OpenAI. La única comparación fiable es la del consumo facturado de cada API en la misma tarea.
Tablas y cifras que comparan otra generación
Tres confusiones aparecen a menudo al contrastar estos modelos:
- La tabla de lanzamiento de Anthropic enfrenta Opus 5.5 con GPT-5.6 Sol, no con GPT-6 Sol ni con GPT-6.1 Sol. Por ejemplo, Terminal-Bench 4.0: 66,4 % para Opus en
xhighfrente a 37,3 % para GPT-5.6 Sol; GDPval-AA v2.1: 1846 frente a 1588 Elo. Opus usa esfuerzo máximo salvo indicación, y las cifras de GPT son las que publicó OpenAI. Útil para ver la mejora respecto a la generación anterior, no para decidir entre Opus 5.5 y el Sol actual. - El «40 % más barato» de Anthropic es frente a Opus 5, con la configuración por defecto y cargas típicas según sus pruebas. No es un ahorro frente a ningún Sol. Igual con cualquier cifra que compare un Sol con «Claude Opus 5»: es la versión anterior.
- Las cuentas hechas con GPT-6 Sol no valen tal cual para GPT-6.1 Sol. La comparativa de DataCamp, hecha con GPT-6 Sol, calcula que cuando cada solicitud supera el umbral la factura de Sol se queda a un 8 % de la de Opus. Con GPT-6.1 Sol la lectura de caché cuesta la mitad y esa distancia cambia; rehaz la cuenta con la fórmula de arriba.
La misma Anthropic reconoce en el anuncio que, a este nivel, las diferencias en benchmarks guían cada vez peor las diferencias en trabajo real. Es otro motivo para medir con tus tareas.
Suscripción: Claude Code y Codex no siguen el precio de la API
Si vas a usar los modelos desde Claude Code o Codex con tu plan, la tabla de precios de la API no te dice cuánto te dura el límite. OpenAI lo dice de forma explícita: los precios por token de la API van aparte del uso de la suscripción y no sirven para estimar cuántas tareas incluye el plan.
- GPT-6.1 Sol en ChatGPT está en Work y en Codex, no en el chat normal, en los planes Plus, Pro, Business, Enterprise y Edu; en Enterprise y Edu llega desactivado hasta que un administrador lo activa, y Free y Go no lo incluyen. En la terminal se elige con
codex --model gpt-6.1-sol. GPT-6 Sol sigue disponible en los mismos sitios, y elegir un modelo no garantiza el acceso en tu cuenta o espacio de trabajo. - OpenAI publica estimaciones, no límites fijos, de mensajes locales cada 5 horas en Plus y en Business estándar: 15–160 con GPT-6.1 Sol y 15–150 con GPT-6 Sol. El rango depende del contexto, el razonamiento, las herramientas y la caché, y puede haber límites semanales. Pro cuesta ahora 100, 200 o 500 USD al mes y, por ahora, no tiene límite de cinco horas. Detalles en la página de precios de ChatGPT Work y Codex.
- Opus 5.5 en Claude está en los planes Pro, Max, Team y Enterprise. En Claude Code necesitas la versión 2.1.280 o posterior, y es más seguro pedir el ID completo
claude-opus-5-5que el aliasopus, cuyo destino depende del proveedor. Anthropic subió los límites de 5 horas con este lanzamiento, pero no publica cuántos mensajes caben.
No existe, por tanto, una cifra pública que compare cuánto gasta el plan cada modelo, y la cuota de un plan no se deduce del precio por token. La comparación de planes está en Claude Code vs Codex: coste de suscripción, límites y factura API; qué hacer al agotar la cuota, en Límites de Codex en ChatGPT Plus: ventana de 5 horas y créditos, y el cambio de límites de Opus, en Claude Opus 5.5: precio de la API y restablecimiento de límites.
Prueba pequeña: coste por tarea aceptada
Una tarea aceptada es la que cumple unos criterios de aceptación escritos antes de lanzar la prueba: pasa los tests, el documento contiene lo que debe, no hay errores que obliguen a rehacerla. El coste por tarea aceptada suma todo lo que se gastó para llegar ahí:
coste por tarea aceptada =
  (cargos de API de todos los intentos, reintentos incluidos
   + tarifas de herramientas
   + horas de revisión × coste por hora)
  ÷ número de tareas que cumplen los criterios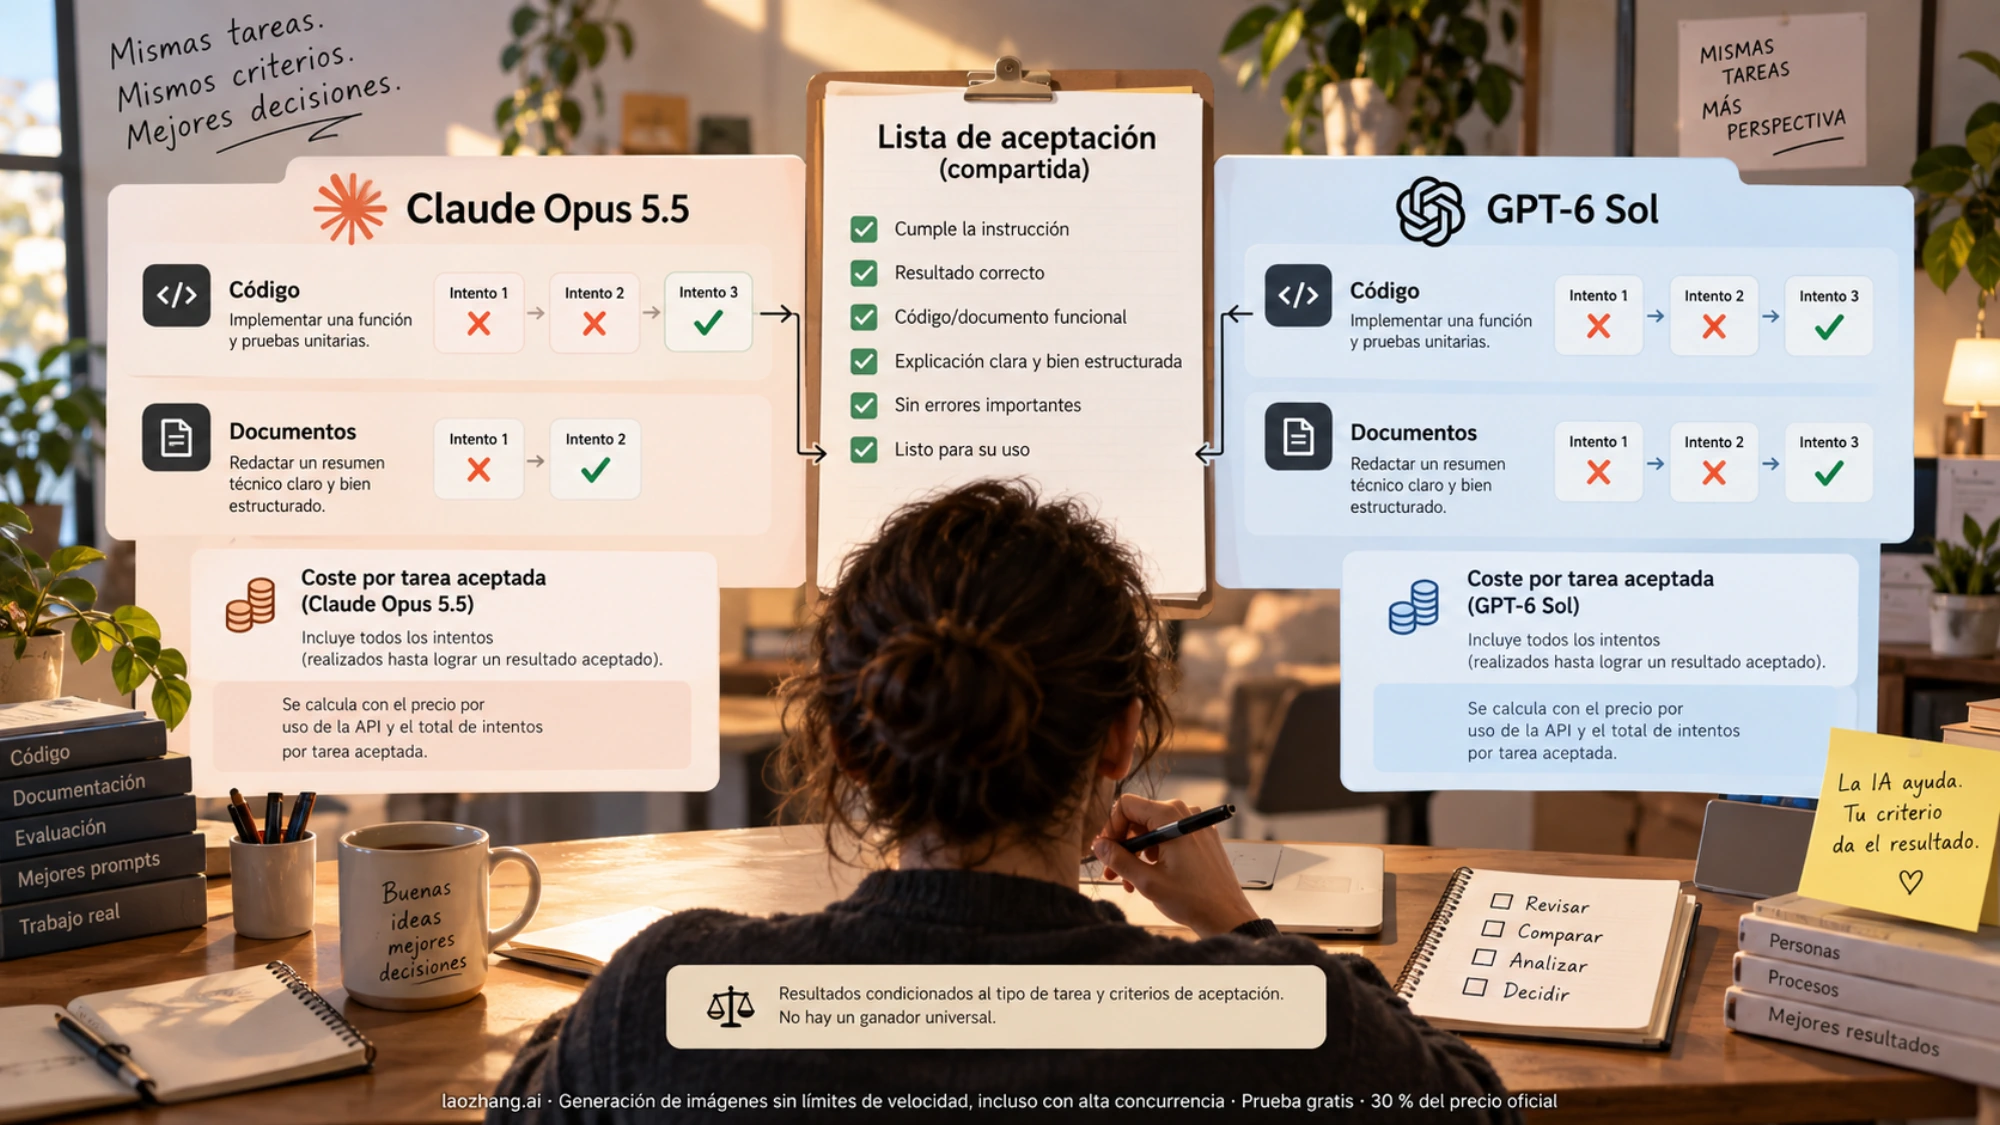
Pasos para montar la prueba:
- Elige tareas reales de tu trabajo, por ejemplo entre 10 y 20, repartidas entre los tipos que más pesan: corregir un fallo, añadir una función con tests, resumir un documento largo.
- Escribe los criterios de aceptación antes de ver ningún resultado y aplícalos igual a los dos modelos.
- Fija todo lo demás: mismo prompt, misma instantánea del repositorio, mismas herramientas, mismo nivel de esfuerzo y el mismo máximo de reintentos (por ejemplo, tres).
- Anota por cada llamada el ID del modelo, el esfuerzo, la política de caché, el nivel de servicio (Standard, Batch, Flex o rápido) y la fecha.
- Registra el consumo facturado de cada respuesta, no tokens estimados, y cuadra el total con el panel de facturación de cada proveedor al final.
- Mide el tiempo de revisión de cada salida, aceptada o no.
Para pasar el objeto usage de cada respuesta a dinero sirve un cálculo como este. Ojo con una diferencia: en la API de Anthropic, input_tokens ya excluye los tokens leídos o escritos en caché; en la Responses API de OpenAI, input_tokens los incluye, y cached_tokens y cache_write_tokens son partes de ellos.
# Tarifas Standard en USD por millón de tokens
# (OpenAI a 30 de septiembre de 2026; Anthropic a 25 de septiembre de 2026)
OPUS = {"U": 4.0, "W": 5.0, "R": 0.20, "O": 20.0}        # caché de 5 min; la de 1 h escribe a 8
SOL61_CORTO = {"U": 2.0, "W": 2.5, "R": 0.10, "O": 10.0}
SOL61_LARGO = {"U": 4.0, "W": 5.0, "R": 0.20, "O": 15.0}  # solicitud con más de 272K de entrada
# Con gpt-6-sol la lectura de caché cuesta 0.20 (corto) y 0.40 (largo)

def coste(t, p):
    return sum(t[k] * p[k] for k in "UWRO") / 1_000_000

def coste_opus(usage):
    # usage de la API de mensajes de Anthropic
    return coste({
        "U": usage["input_tokens"],
        "W": usage.get("cache_creation_input_tokens", 0),
        "R": usage.get("cache_read_input_tokens", 0),
        "O": usage["output_tokens"],  # incluye el razonamiento
    }, OPUS)

def coste_sol61(usage):
    # usage de la Responses API
    detalle = usage["input_tokens_details"]
    leidos = detalle.get("cached_tokens", 0)
    escritos = detalle.get("cache_write_tokens", 0)
    tarifa = SOL61_LARGO if usage["input_tokens"] > 272_000 else SOL61_CORTO
    return coste({
        "U": usage["input_tokens"] - leidos - escritos,
        "W": escritos,
        "R": leidos,
        "O": usage["output_tokens"],  # incluye el razonamiento
    }, tarifa)
La comprobación del umbral supone que la caché cuenta para los 272K, la misma lectura de antes. Suma los resultados de todas las llamadas de todos los intentos, añade las herramientas y la revisión, y divide entre las tareas aceptadas.
Qué resultado debería cambiar tu modelo por defecto:
- GPT-6.1 Sol acepta tantas tareas como Opus y su coste por tarea aceptada es menor: déjalo por defecto y reserva Opus para los tipos de tarea donde Sol falló.
- Opus acepta claramente más tareas y su coste por tarea aceptada, con revisión incluida, iguala o mejora al de Sol: pásalo a modelo por defecto para ese tipo de trabajo, aunque su factura de API sea mayor.
- Opus acepta más pero cuesta más incluso sumando la revisión: úsalo solo donde un fallo sea caro, y prueba subir el esfuerzo de GPT-6.1 Sol antes de cambiar de modelo.
- Tus solicitudes superan 272K con mucha caché: con GPT-6.1 Sol, las tarifas de lista ya no dan ventaja a Opus en ninguna mezcla, porque la diferencia es solo 5·O. Si elegiste Opus para ese tipo de llamada por la regla de los 25 veces la salida, repite la cuenta con 6.1 Sol.
Si vienes de GPT-6 Sol, antes de compararlo con Opus revisa qué cambia al migrar (el esfuerzo none desaparece, las herramientas exigen la Responses API) en GPT-6.1 Sol: qué cambia, cuánto cuesta y qué revisar al migrar. Si ninguno de los dos alcanza tu criterio en las tareas más difíciles, el siguiente escalón en Anthropic se analiza en Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más, y el de OpenAI, en GPT-6.1 Sol vs Astra vs GPT-6 Sol: cuál usar y si Astra compensa. Si Sol va sobrado y buscas algo más barato, compara la gama en GPT-6 Sol, Luna y Astra frente a Terra: precios y cuál probar primero.
Preguntas frecuentes
¿Claude Opus 5.5 cuesta el doble que GPT-6 Sol?
Frente a GPT-6.1 Sol, el Sol actual, sí en todas las partidas hasta 272K tokens de entrada, lectura de caché incluida (0,20 USD por millón frente a 0,10); por encima de 272K, Opus solo es más caro en la salida. Frente a GPT-6 Sol la prima era menor con mucha caché, porque la lectura costaba 0,20 USD en los dos. Por tarea medida, Opus cuesta entre 4,2 y 8,9 veces más que GPT-6.1 Sol en el índice de Artificial Analysis, según el esfuerzo.
¿GPT-6.1 Sol supera a Claude Opus 5.5?
Depende del nivel de calidad. En el índice de Artificial Analysis, a 30 de septiembre de 2026, Opus 5.5 tiene la puntuación más alta (58 en max frente a 52 de GPT-6.1 Sol), pero GPT-6.1 Sol en max puntúa por encima de Opus en medium por algo más de la mitad del coste por tarea. OpenAI publica evaluaciones propias en las que 6.1 Sol supera a Opus con menos coste; son pruebas elegidas por el fabricante.
¿Cuál es más rápido?
Según Artificial Analysis, a 30 de septiembre de 2026, Opus 5.5 genera más tokens por segundo (72 en medium frente a 59 de GPT-6.1 Sol), pero GPT-6.1 Sol empieza a responder antes (5,72 s frente a 22,95 s en medium) y termina antes cada tarea del índice porque produce menos tokens.
¿Tienen la misma ventana de contexto?
Casi: 1M de tokens en Opus 5.5 y 1.050.000 en GPT-6.1 Sol y GPT-6 Sol, con 128.000 tokens de salida máxima en todos. La diferencia práctica está en el precio por encima de 272K, no en el tamaño.
¿Puedo usar GPT-6.1 Sol en el chat de ChatGPT?
No en el chat normal: solo en ChatGPT Work y en Codex, en planes de pago. Opus 5.5 sí está en las apps de Claude, en Claude Code, en la API de Claude y en AWS, Google Cloud y Microsoft Azure (Foundry).
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 1 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 1 oct 2026.
- 1.API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 2.API de OpenAIdevelopers.openai.com/api/docs/pricing
- 3.anuncio de Opus 5.5anthropic.com/claude-opus-5-5
- 4.comparativa de Artificial Analysisartificialanalysis.ai/models/releases/comparisons/gpt-6-1-sol-vs-claude-opus-5-5
- 5.anuncio de GPT-6.1 Solopenai.com/index/introducing-gpt-6-1-sol
- 6.DataCampdatacamp.com/blog/gpt-6-sol-vs-claude-opus-5-5
- 7.página de precios de ChatGPT Work y Codexlearn.chatgpt.com/docs/pricing