Новое
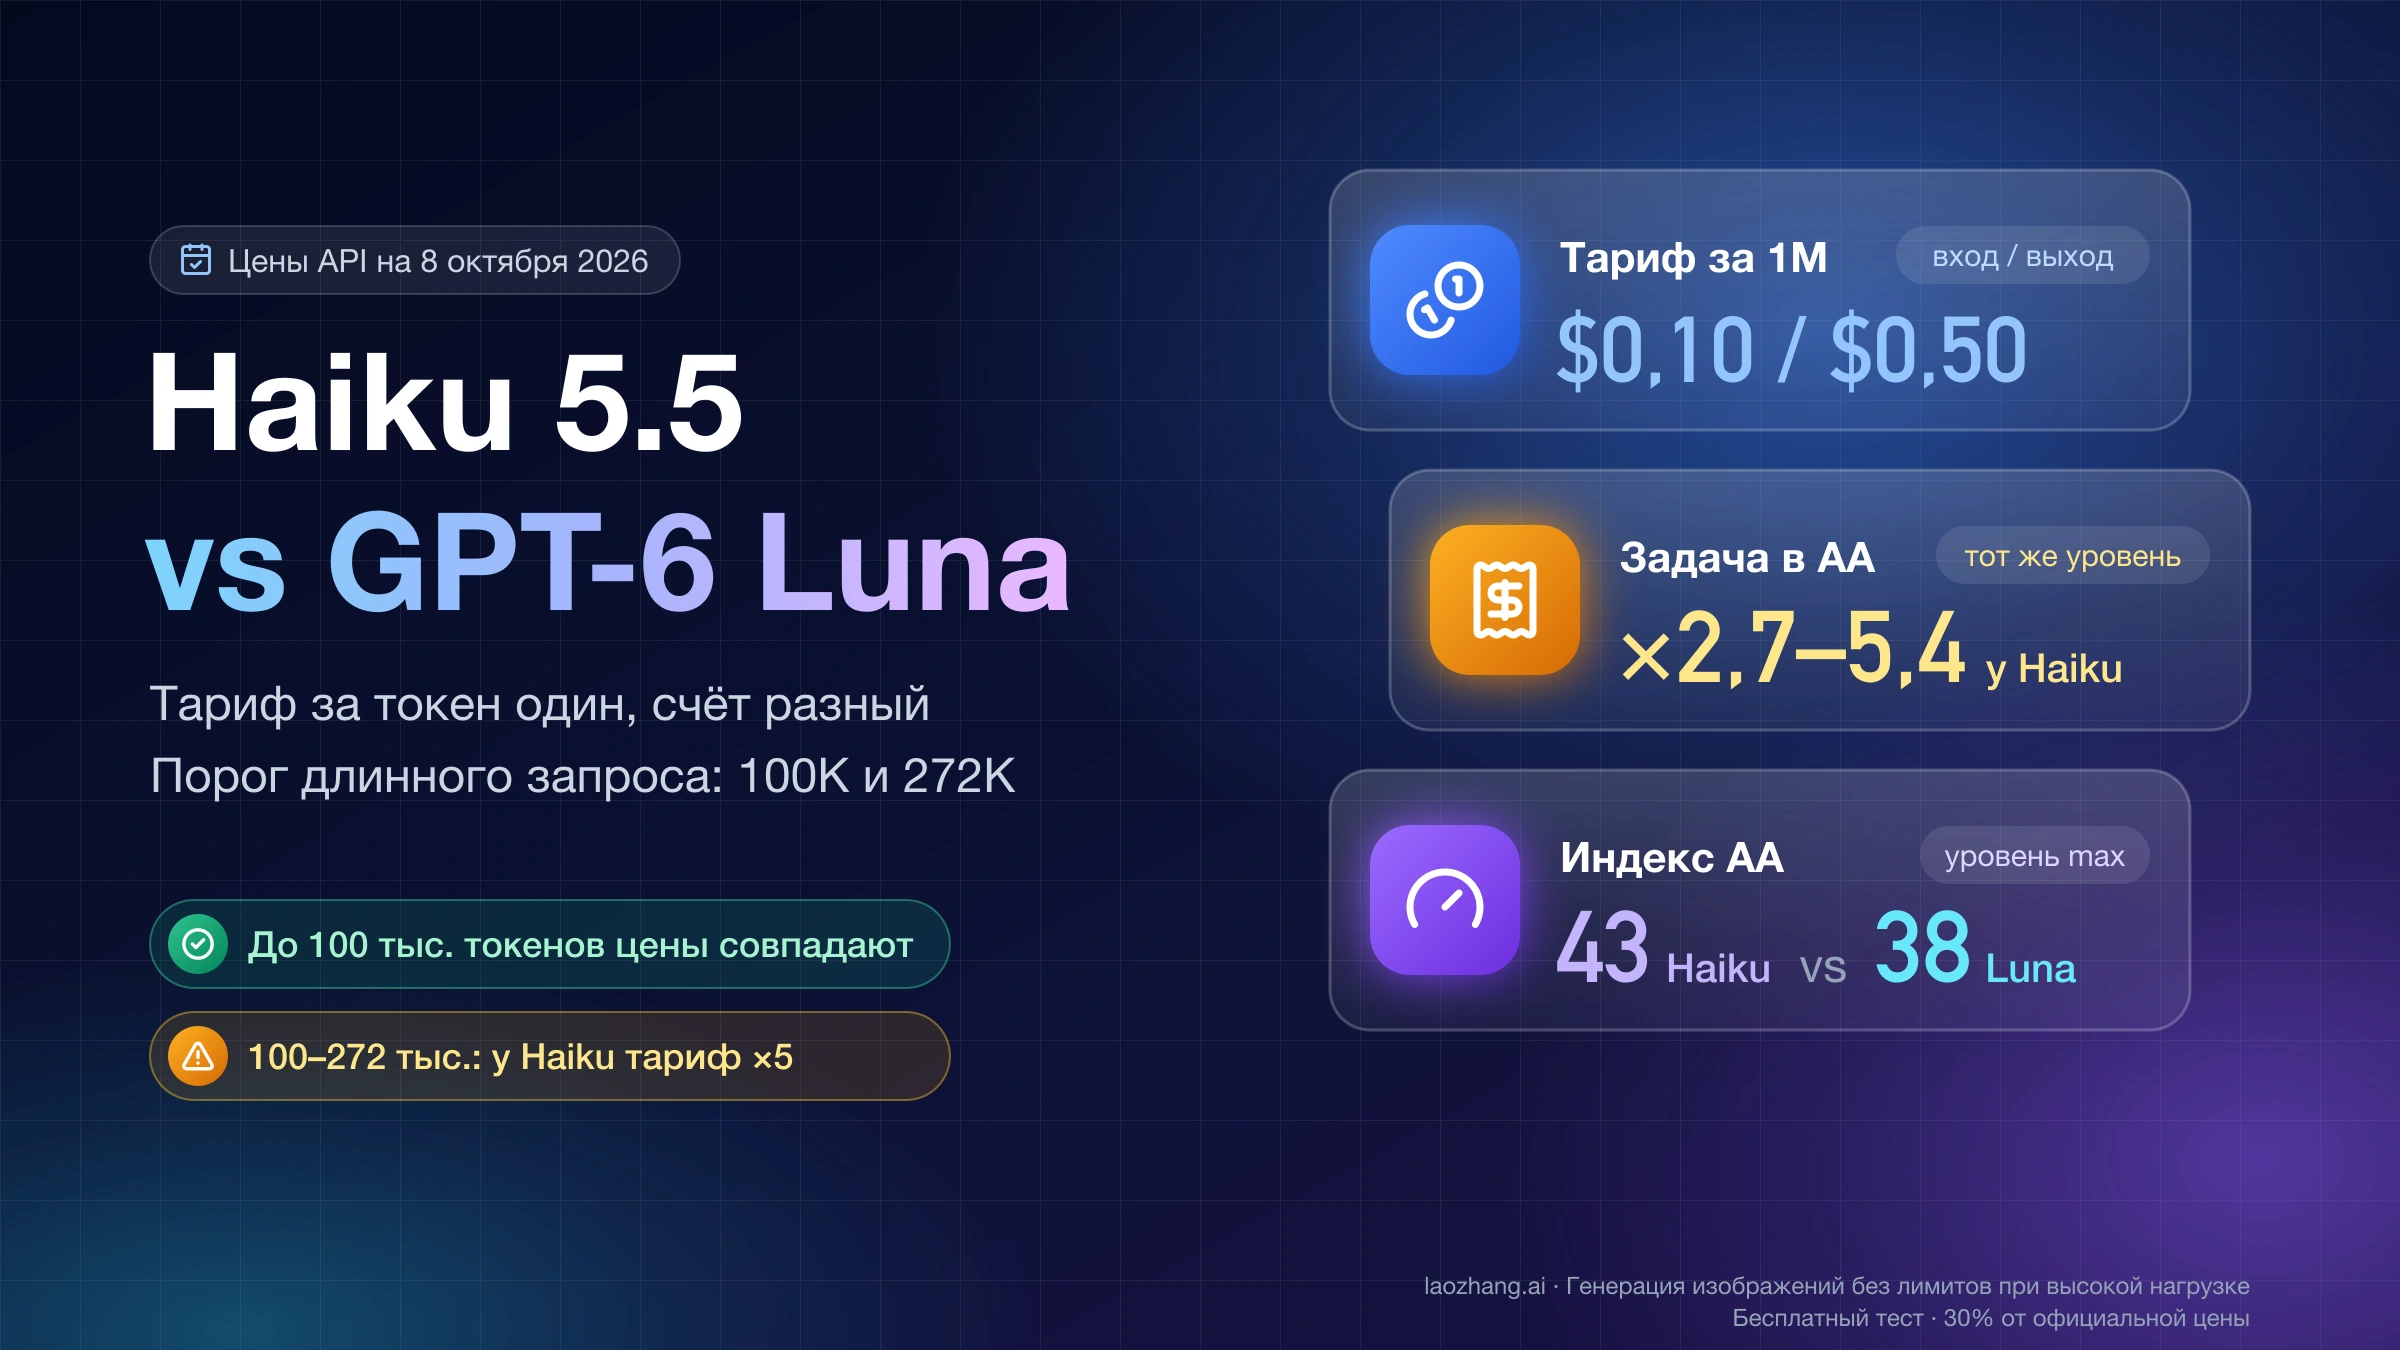
Haiku 5.5 vs GPT-6 Luna: сравнение — тариф один, счёт разный
Claude Haiku 5.5 и GPT-6 Luna стоят одинаково за токен до 100 тыс. в запросе, но Haiku тратит больше токенов на задачу и впятеро дорожает после 100 тыс.
16 мин
Claude Haiku 5.5 и GPT-6 Luna стоят одинаково за токен до 100 тыс. в запросе, но Haiku тратит больше токенов на задачу и впятеро дорожает после 100 тыс.
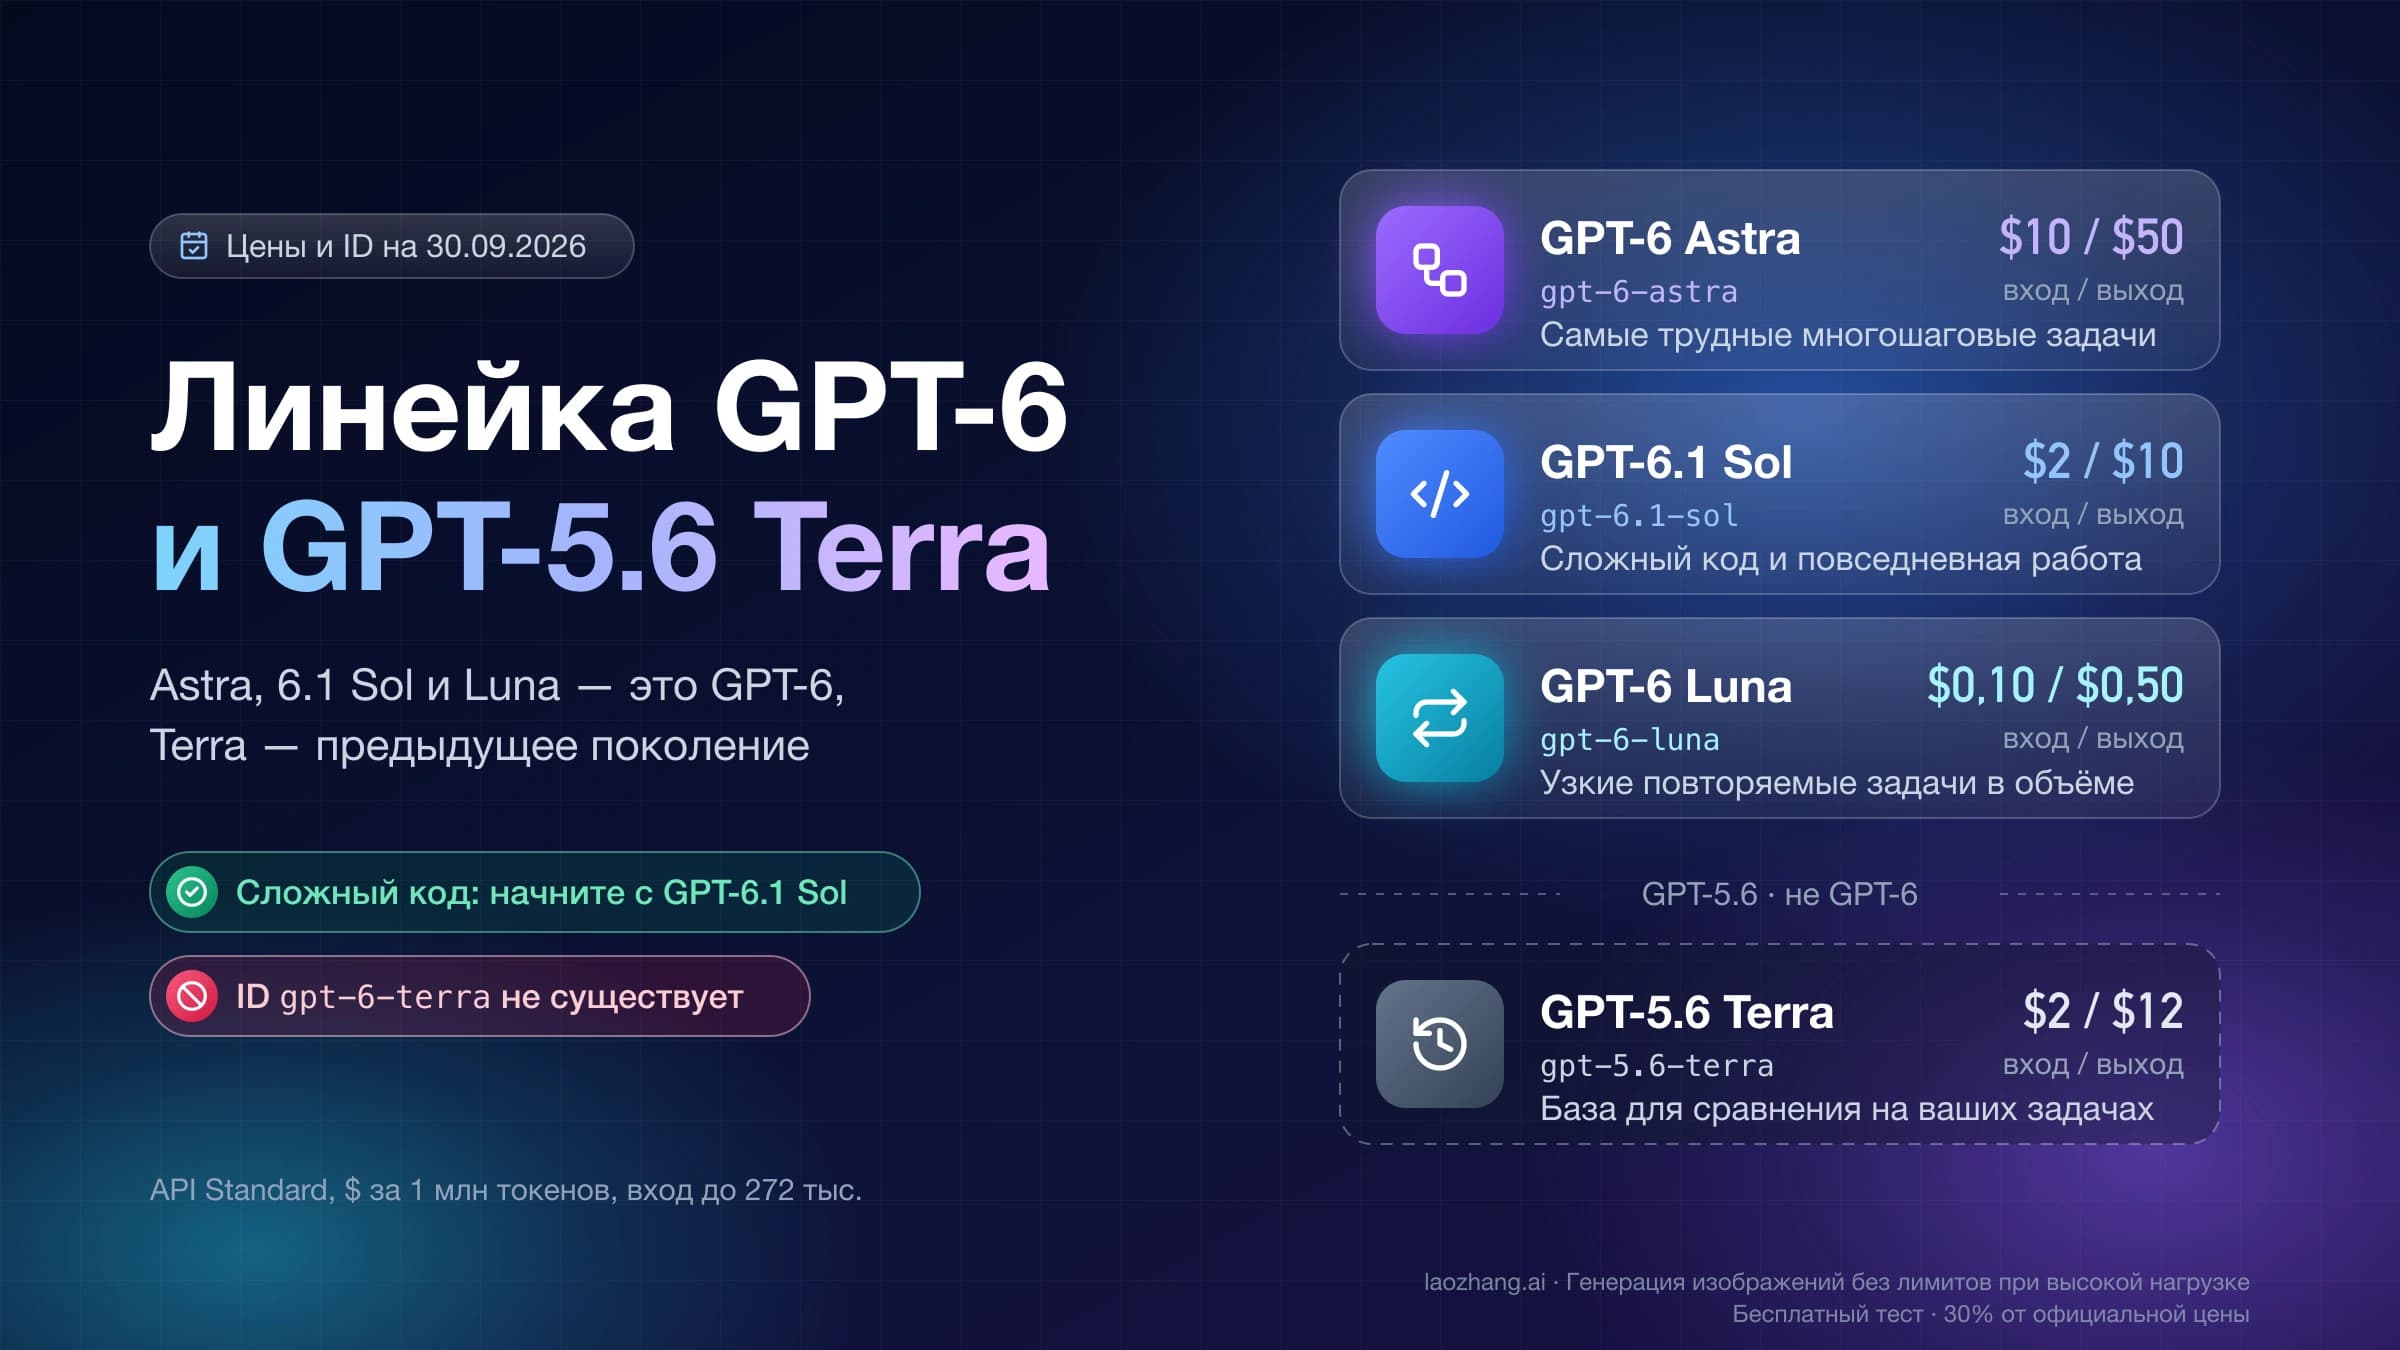
Для сложной разработки начните с GPT-6.1 Sol, для повторяемых коротких задач проверьте Luna, для самых трудных — Astra. Terra остаётся моделью GPT-5.6.
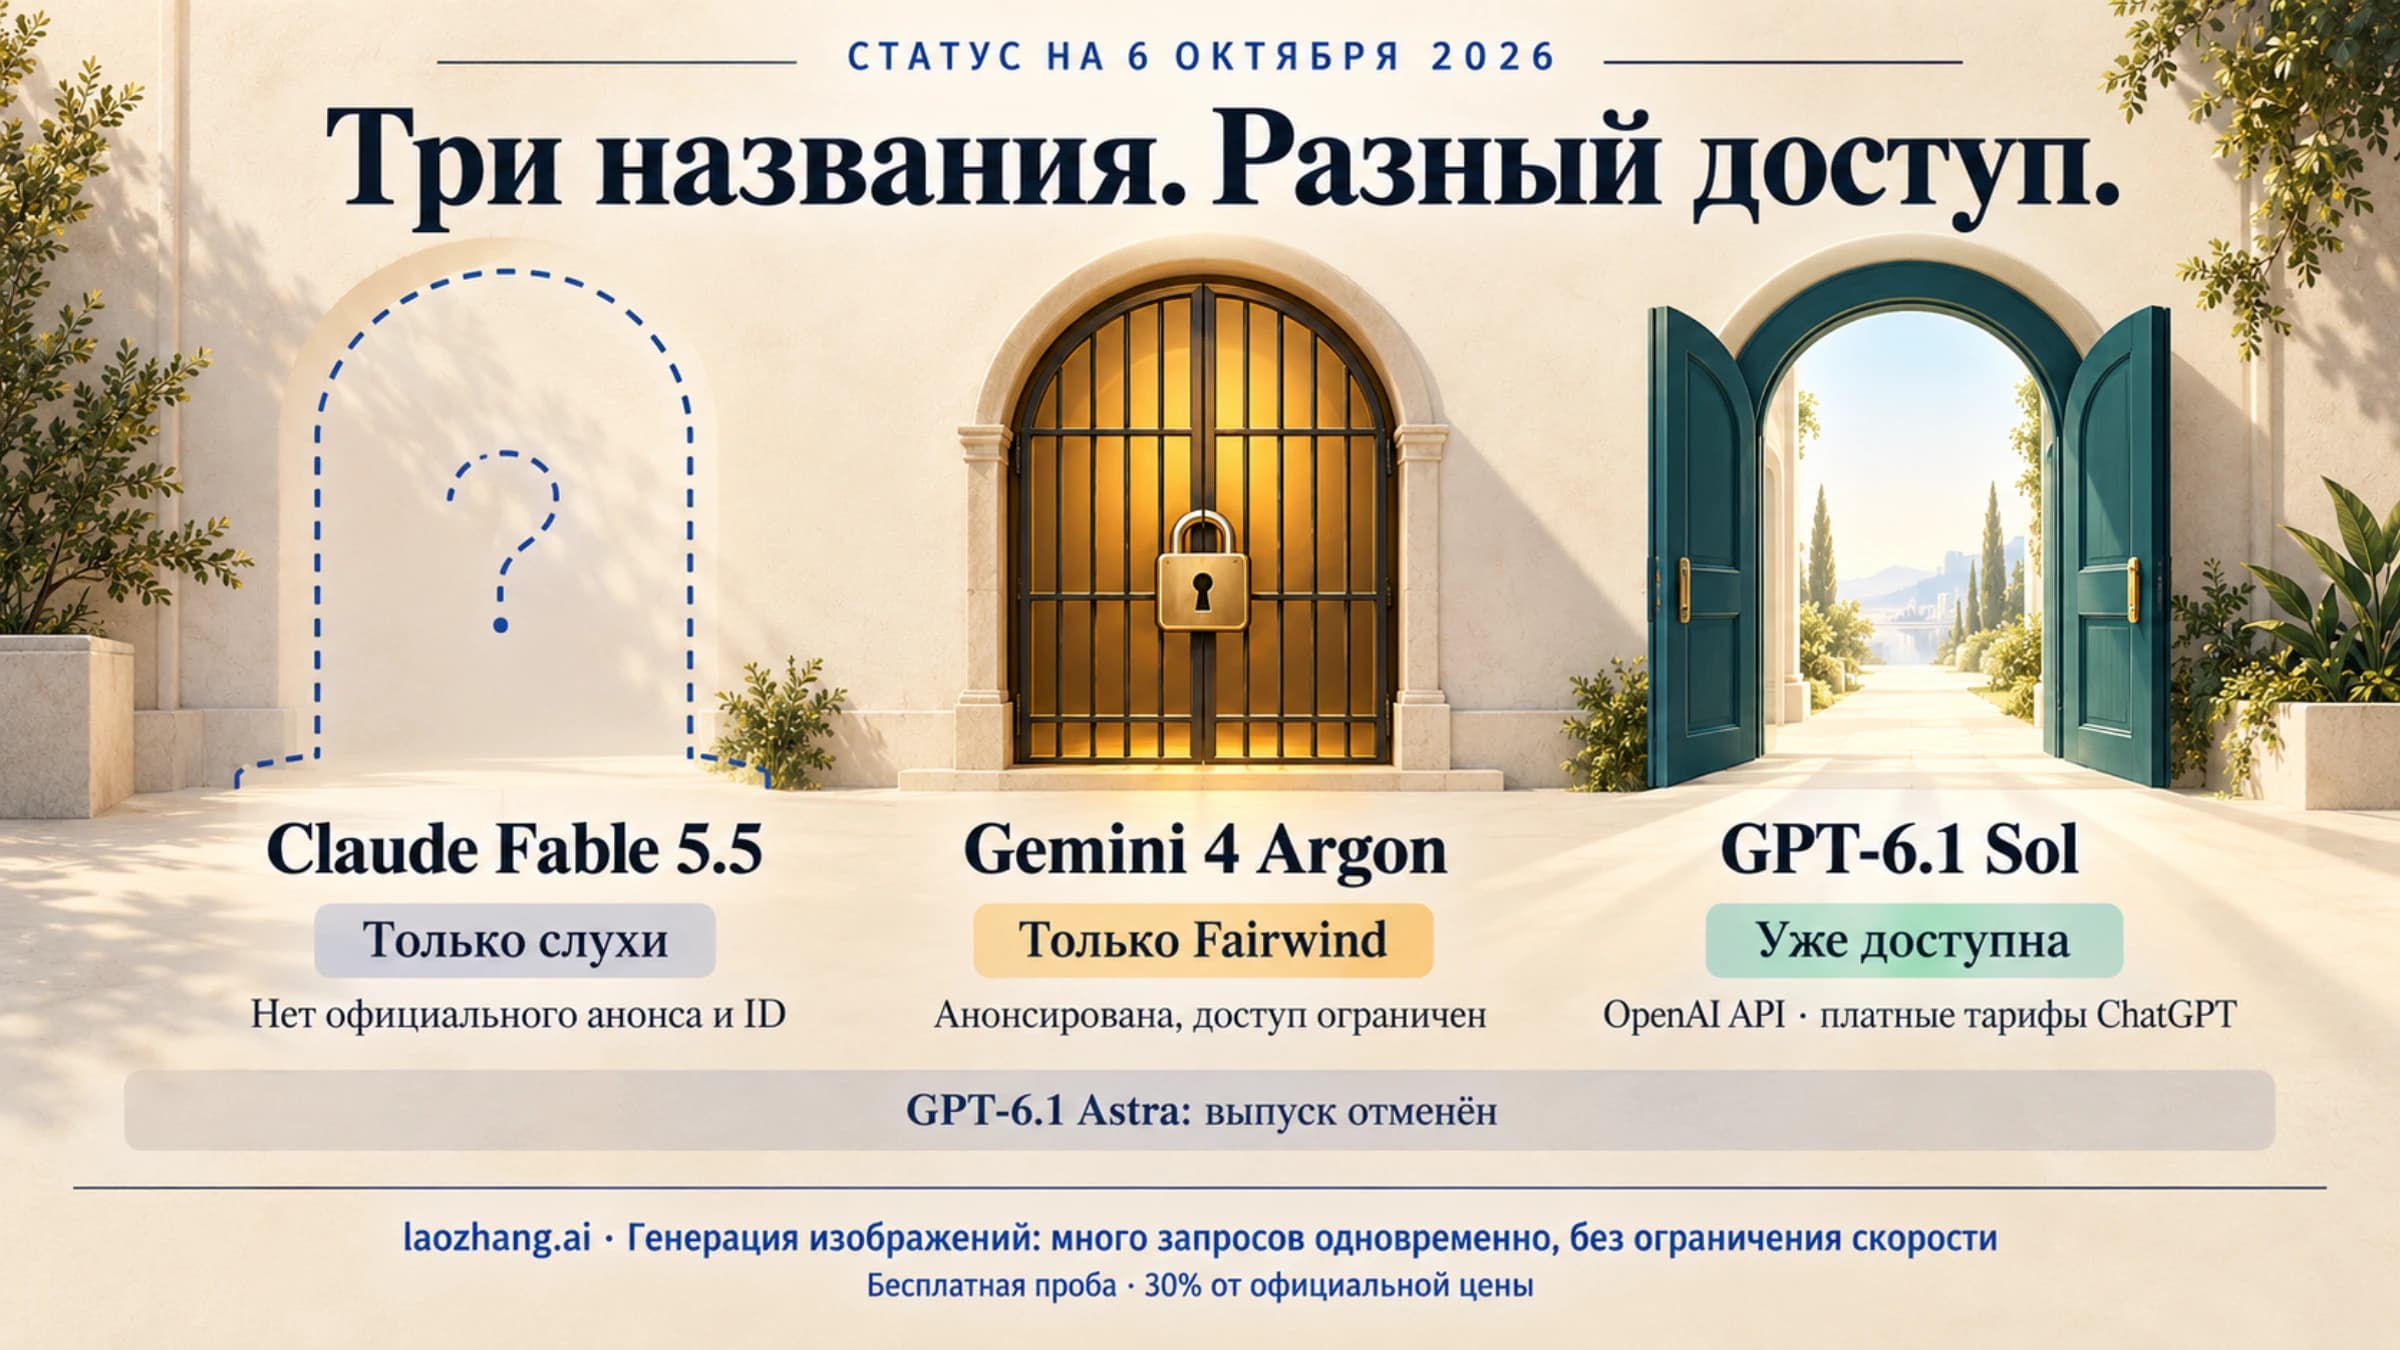
На 6 октября 2026 года работает только GPT-6.1 Sol: о Fable 5.5 известно лишь со слов пользователей, Gemini 4 Argon открыта только для Fairwind.
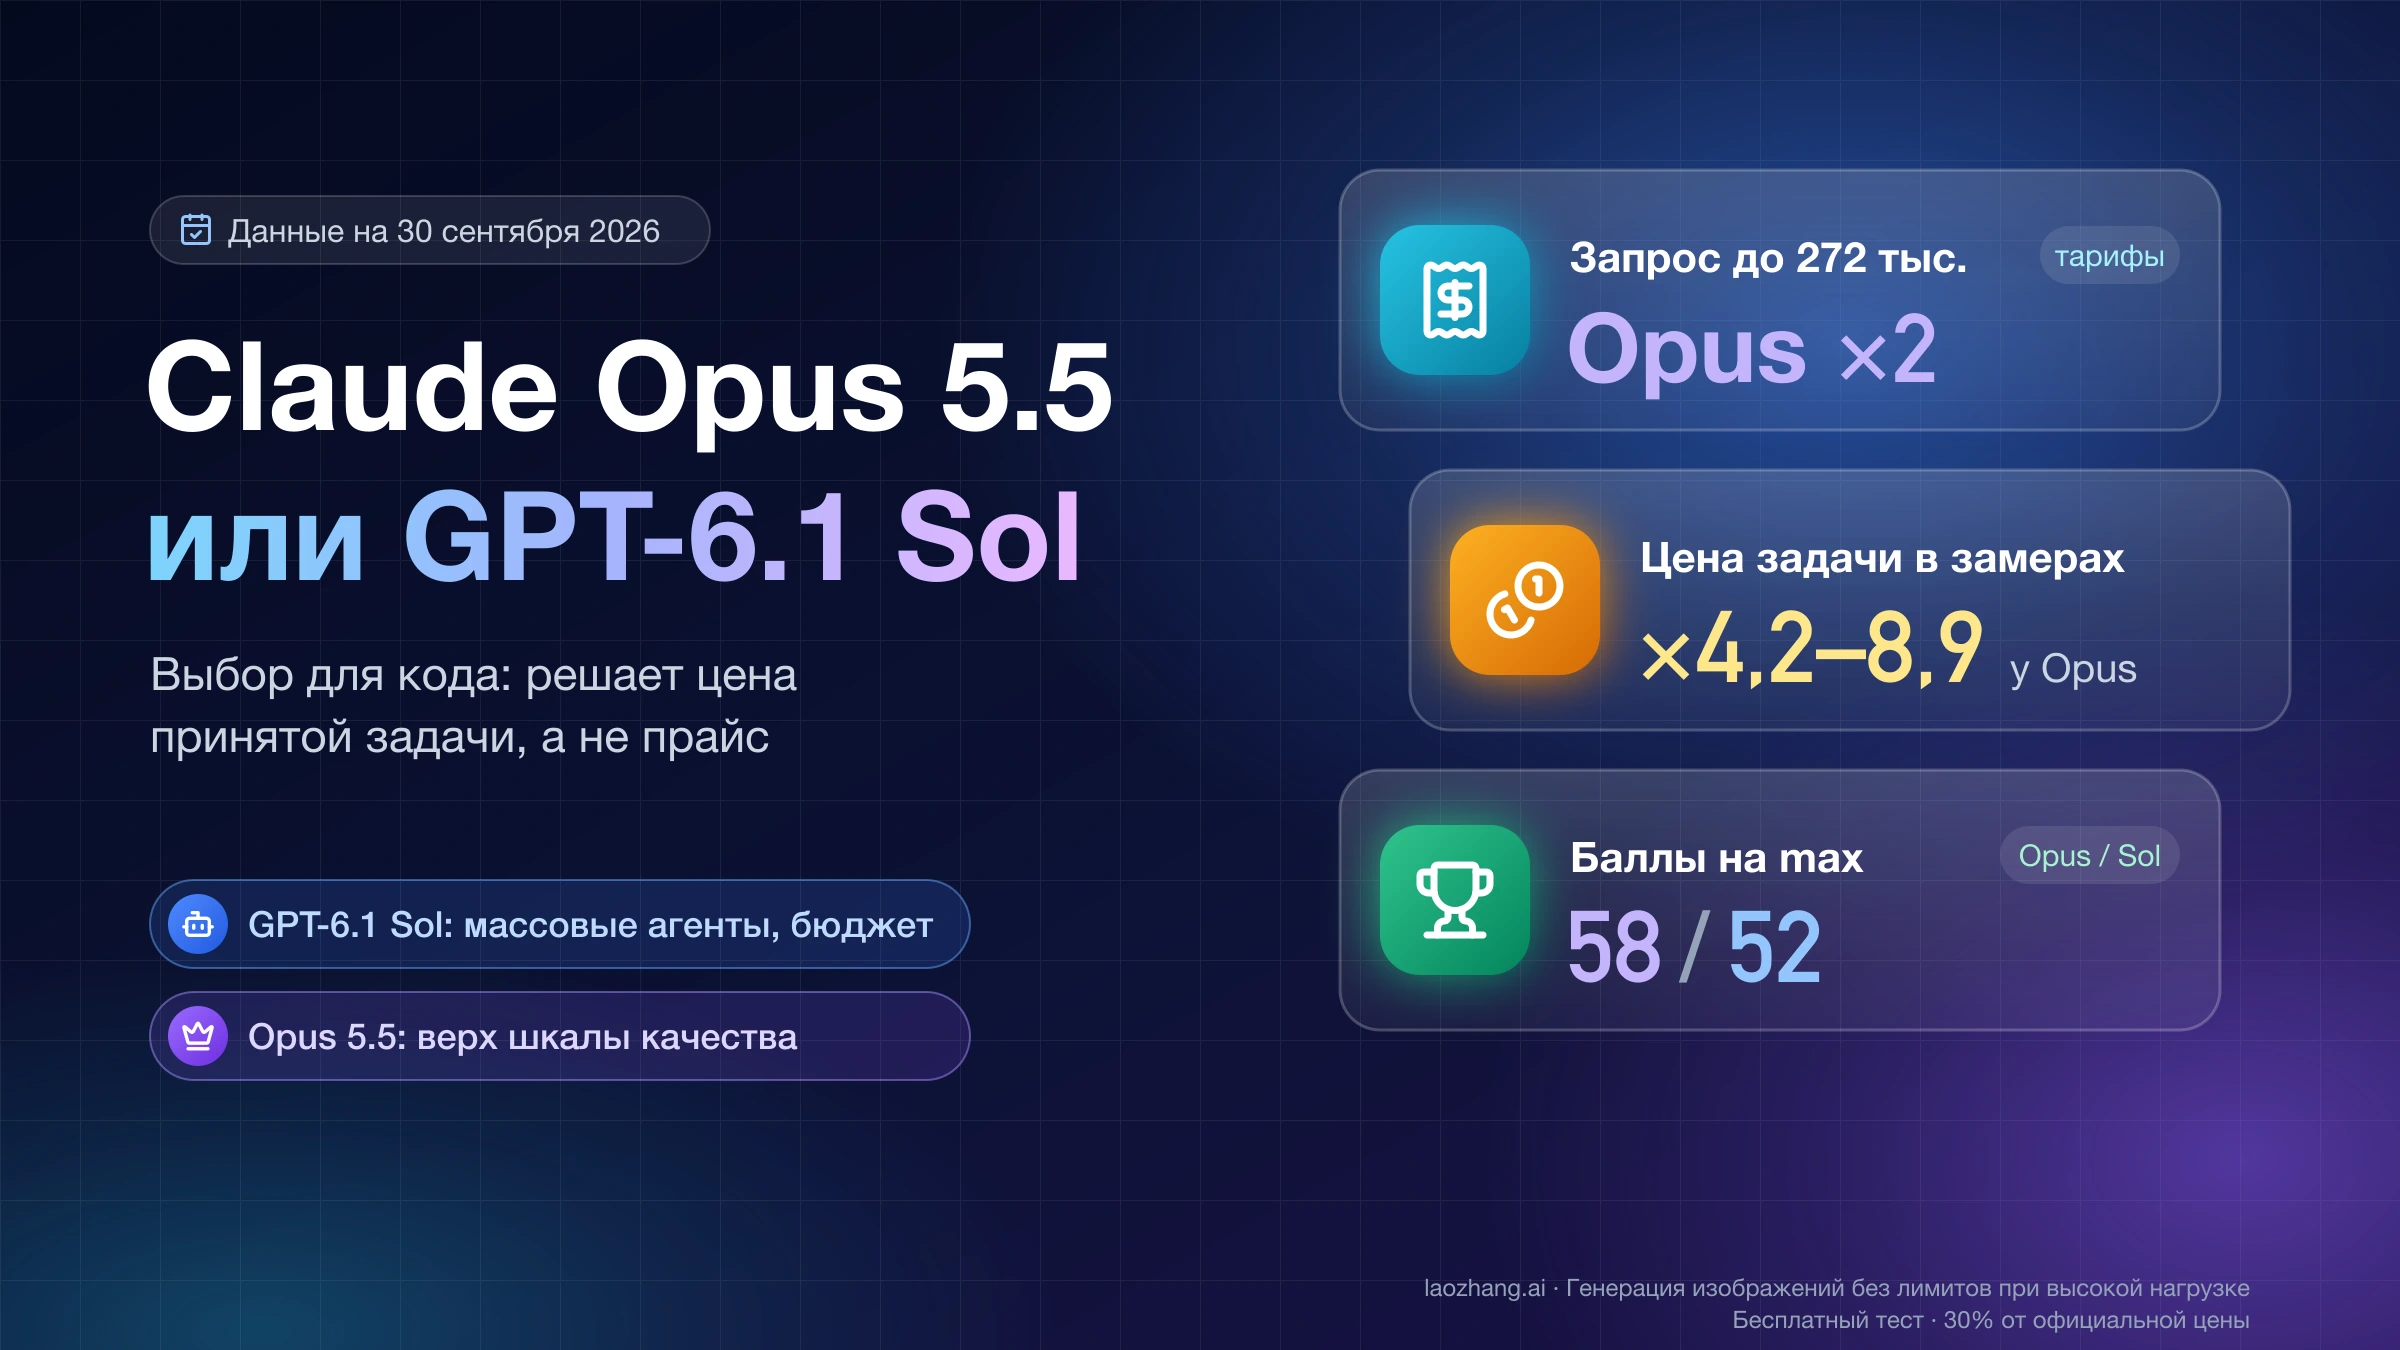
До 272 тыс. токенов GPT-6.1 Sol ровно вдвое дешевле Opus 5.5 по всем статьям, включая кэш. В замерах задача Opus дороже в 4–9 раз; решает цена принятой задачи.
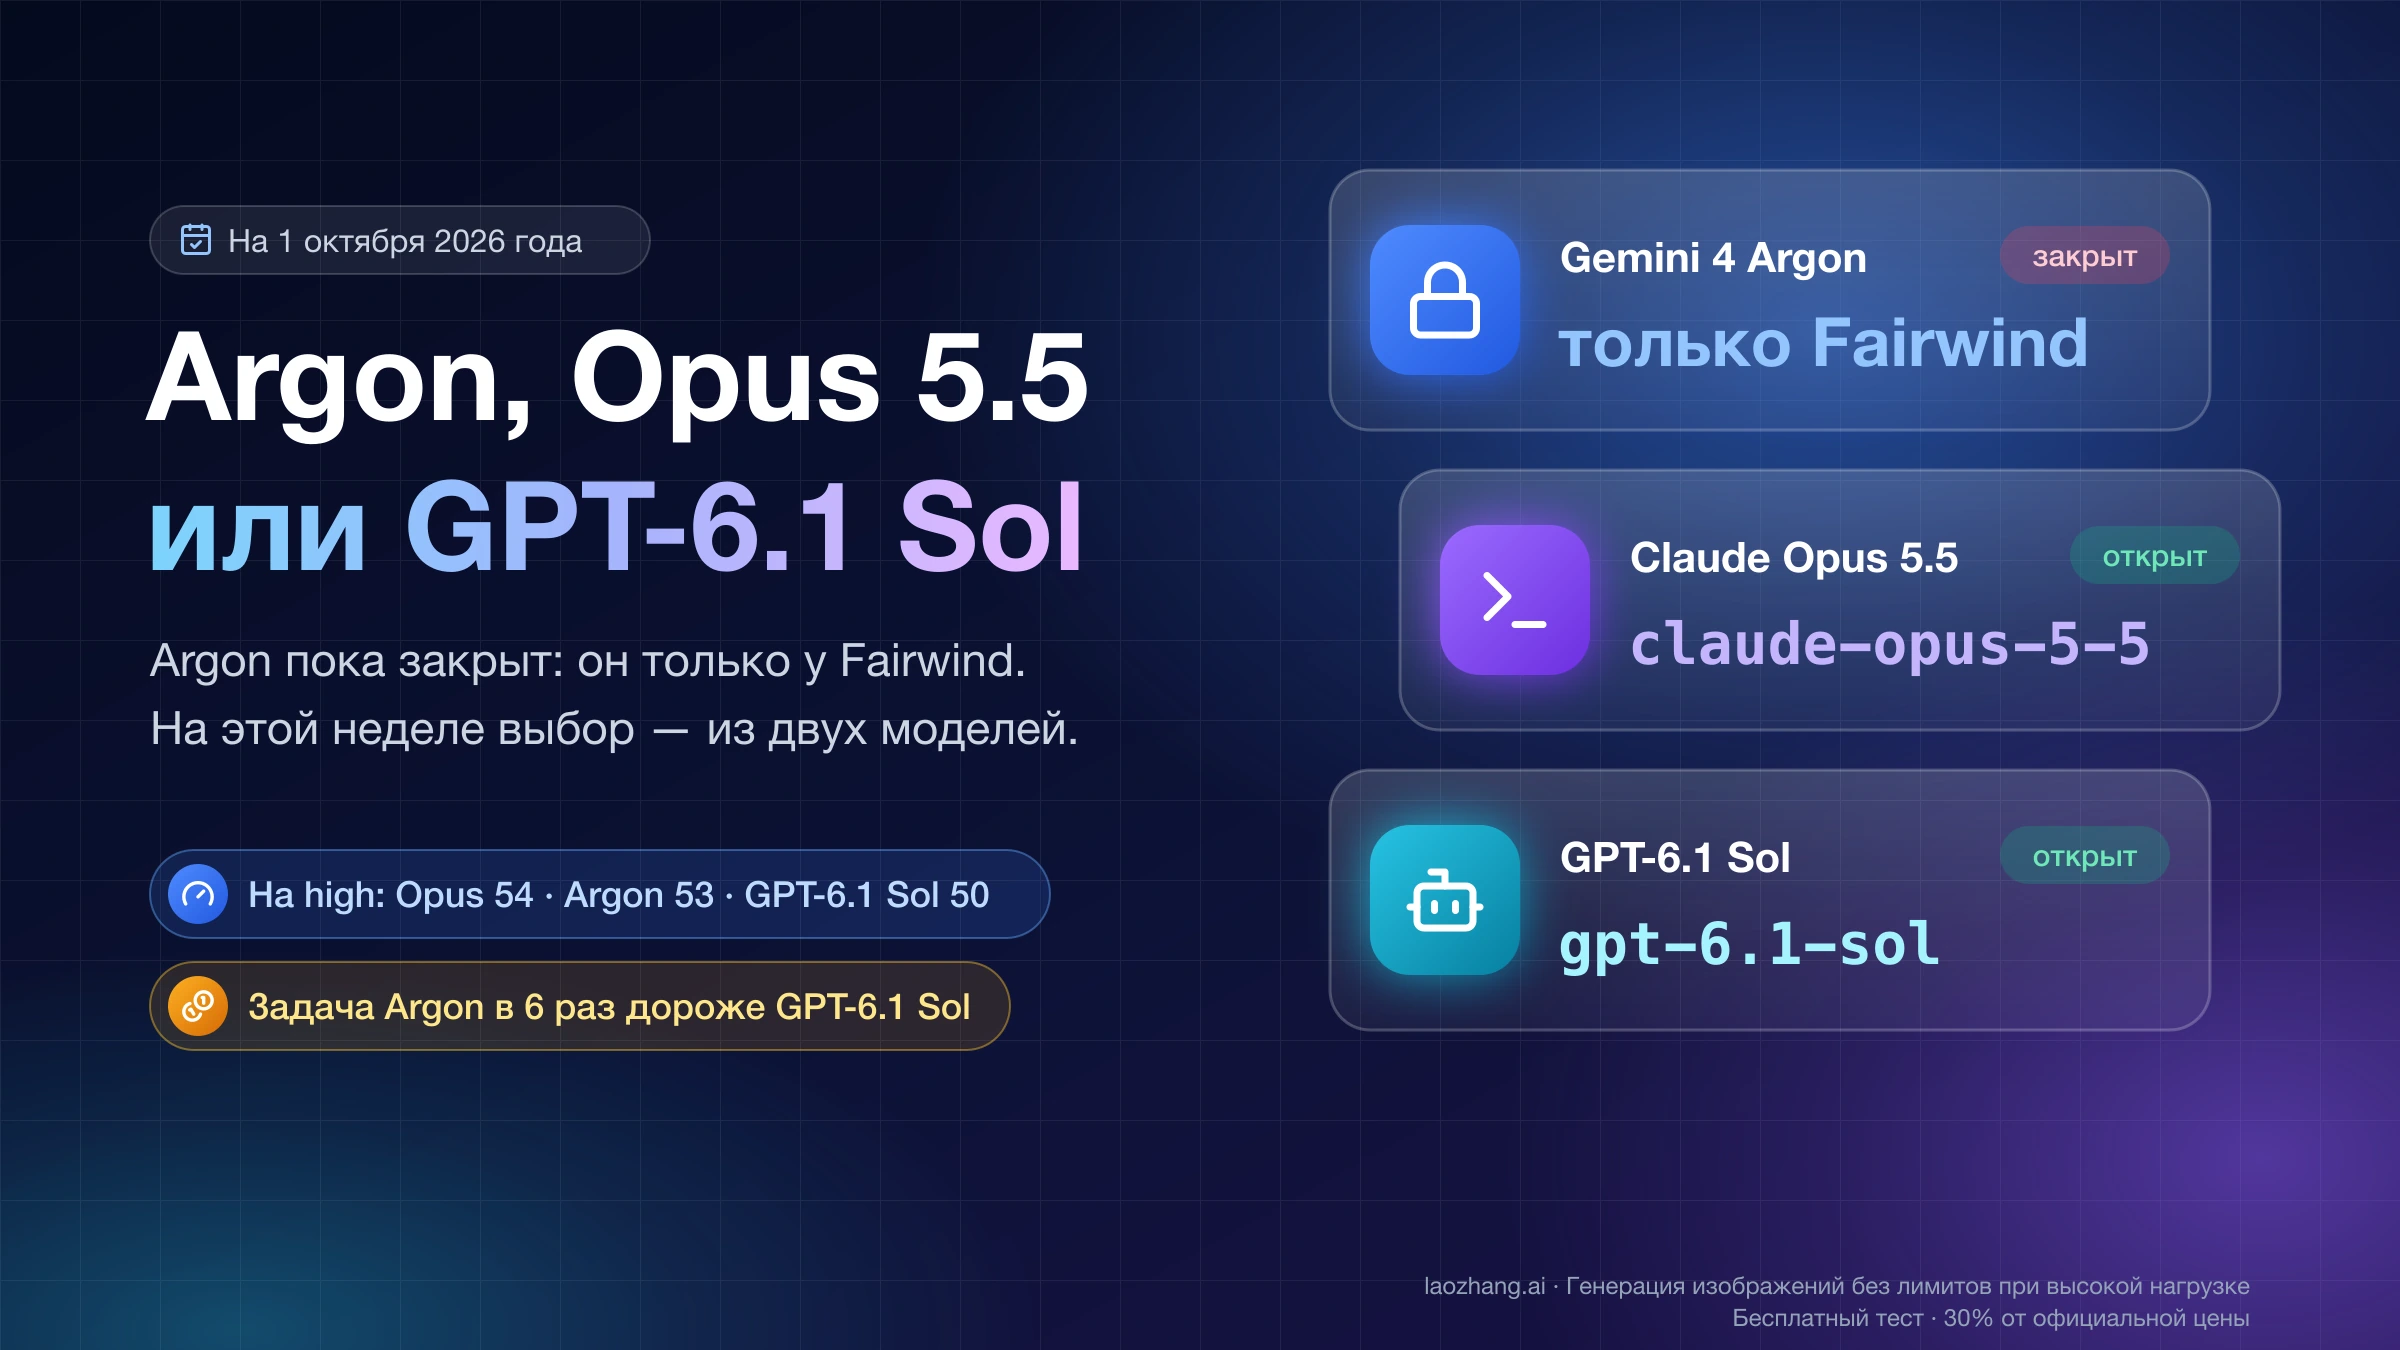
Argon пока открыт только участникам Fairwind. Сравнение на high: он равен Opus 5.5 по баллам, а его задача в 6 раз дороже, чем у GPT-6.1 Sol с тем же прайсом.
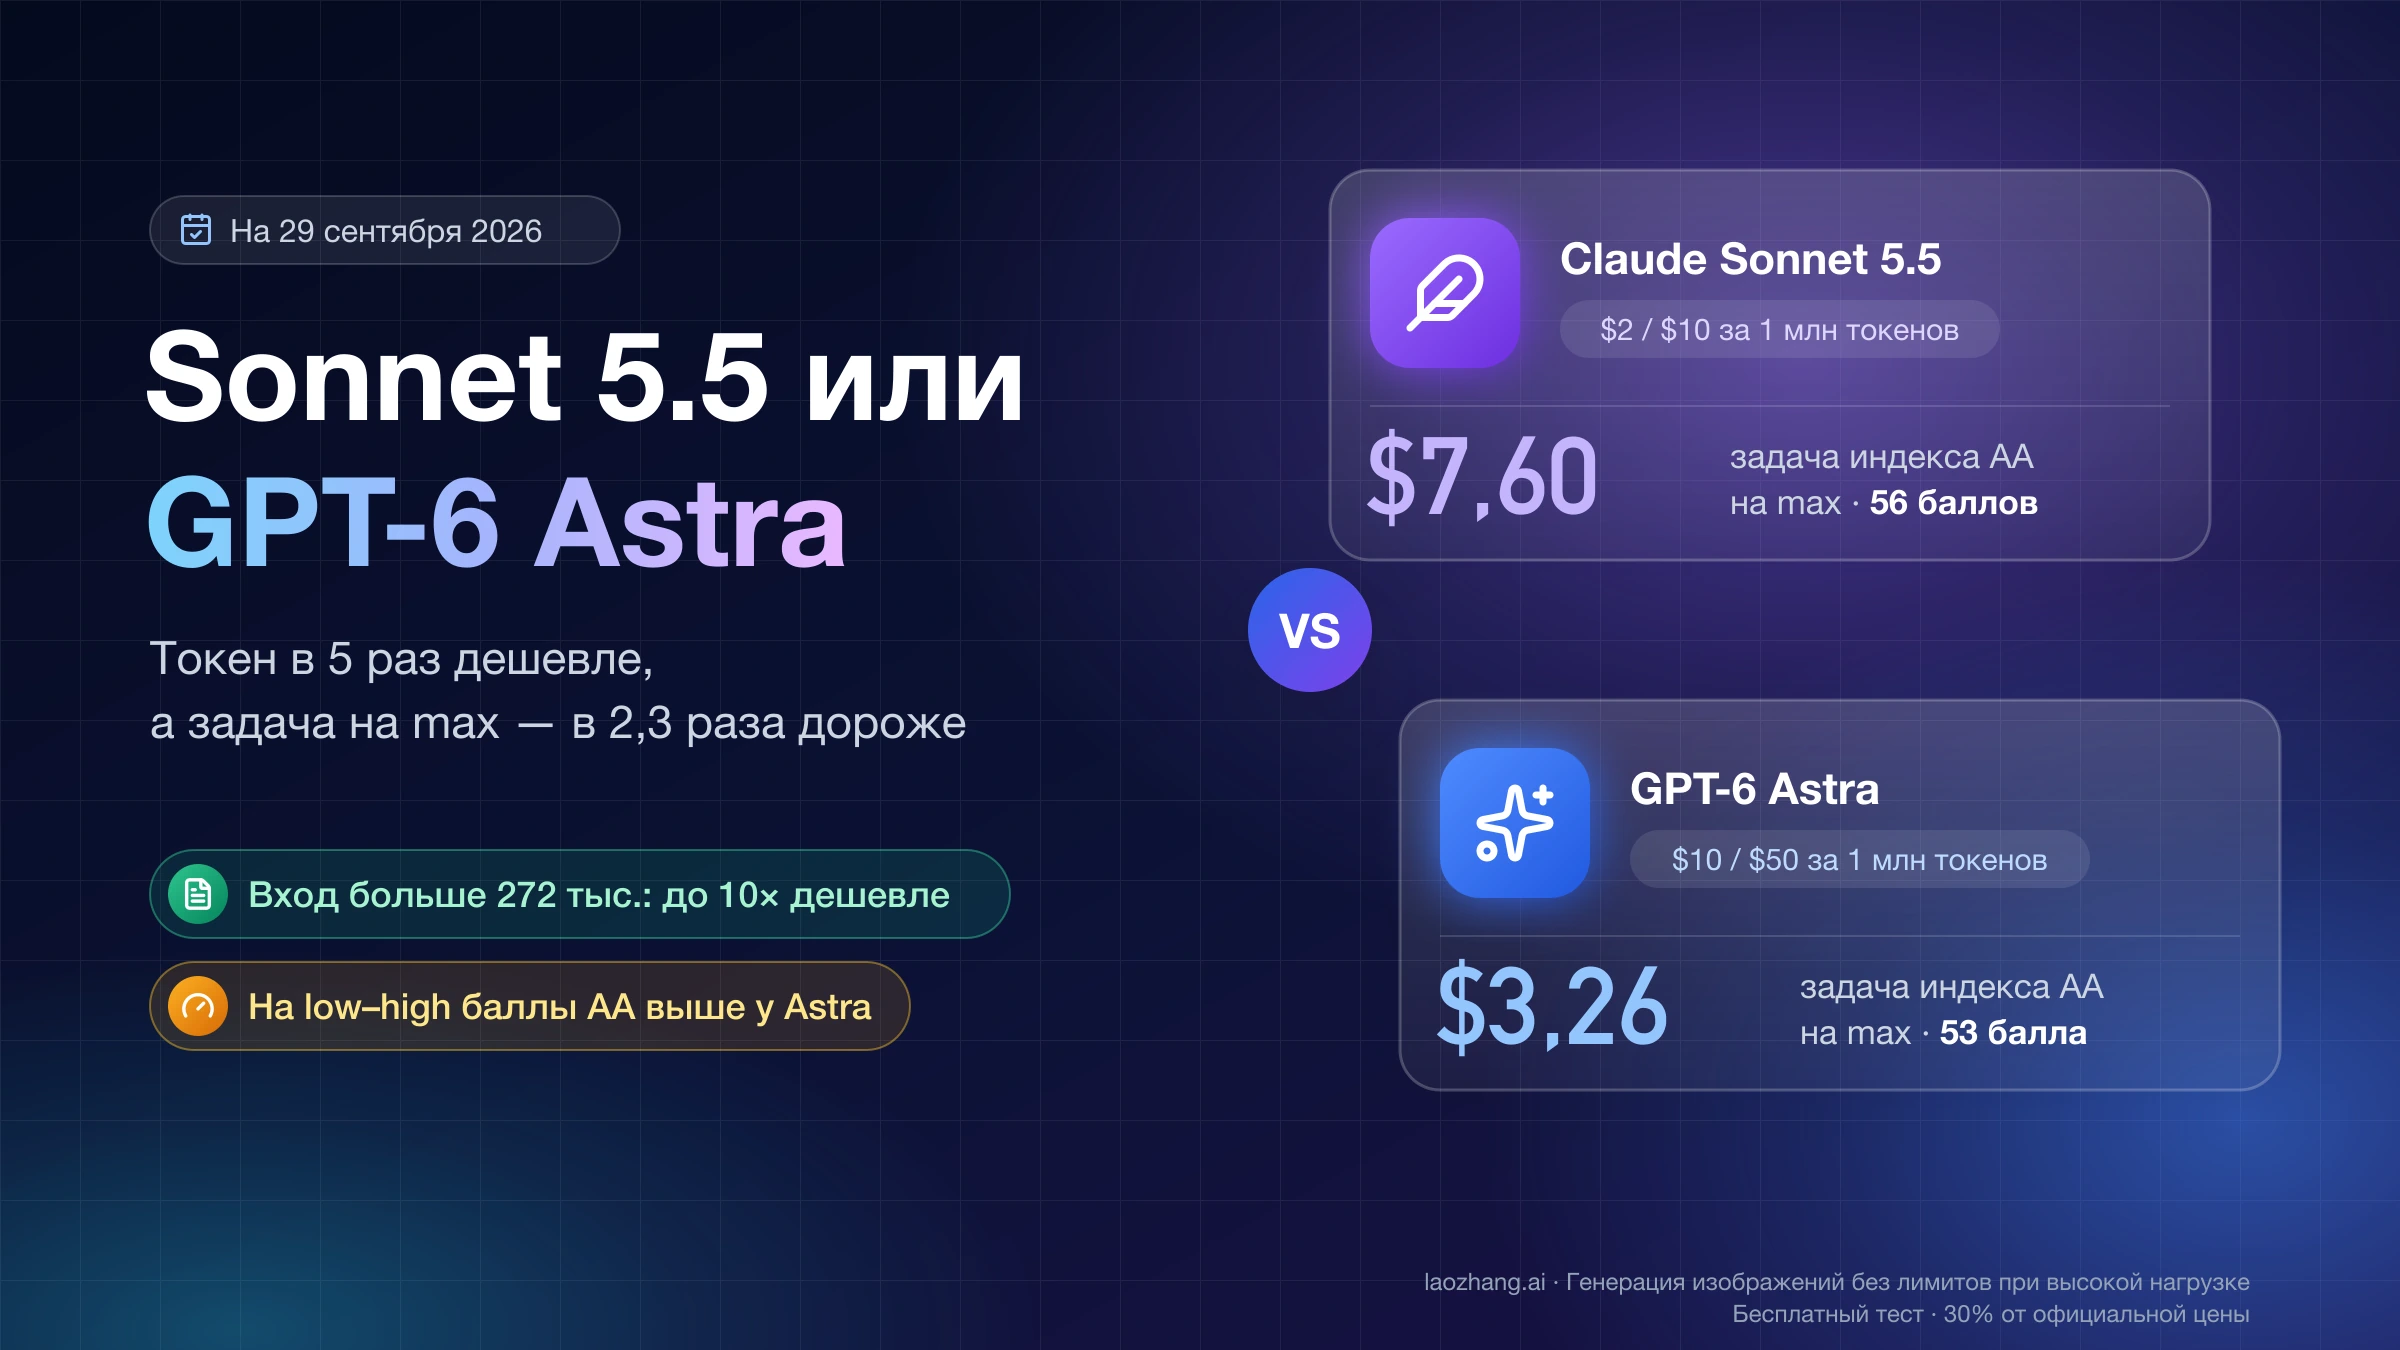
Sonnet 5.5 обходит GPT-6 Astra в индексе AA только на max, где задача у него в 2,3 раза дороже. На low–high сильнее Astra, хотя токен Sonnet дешевле в 5–10 раз.
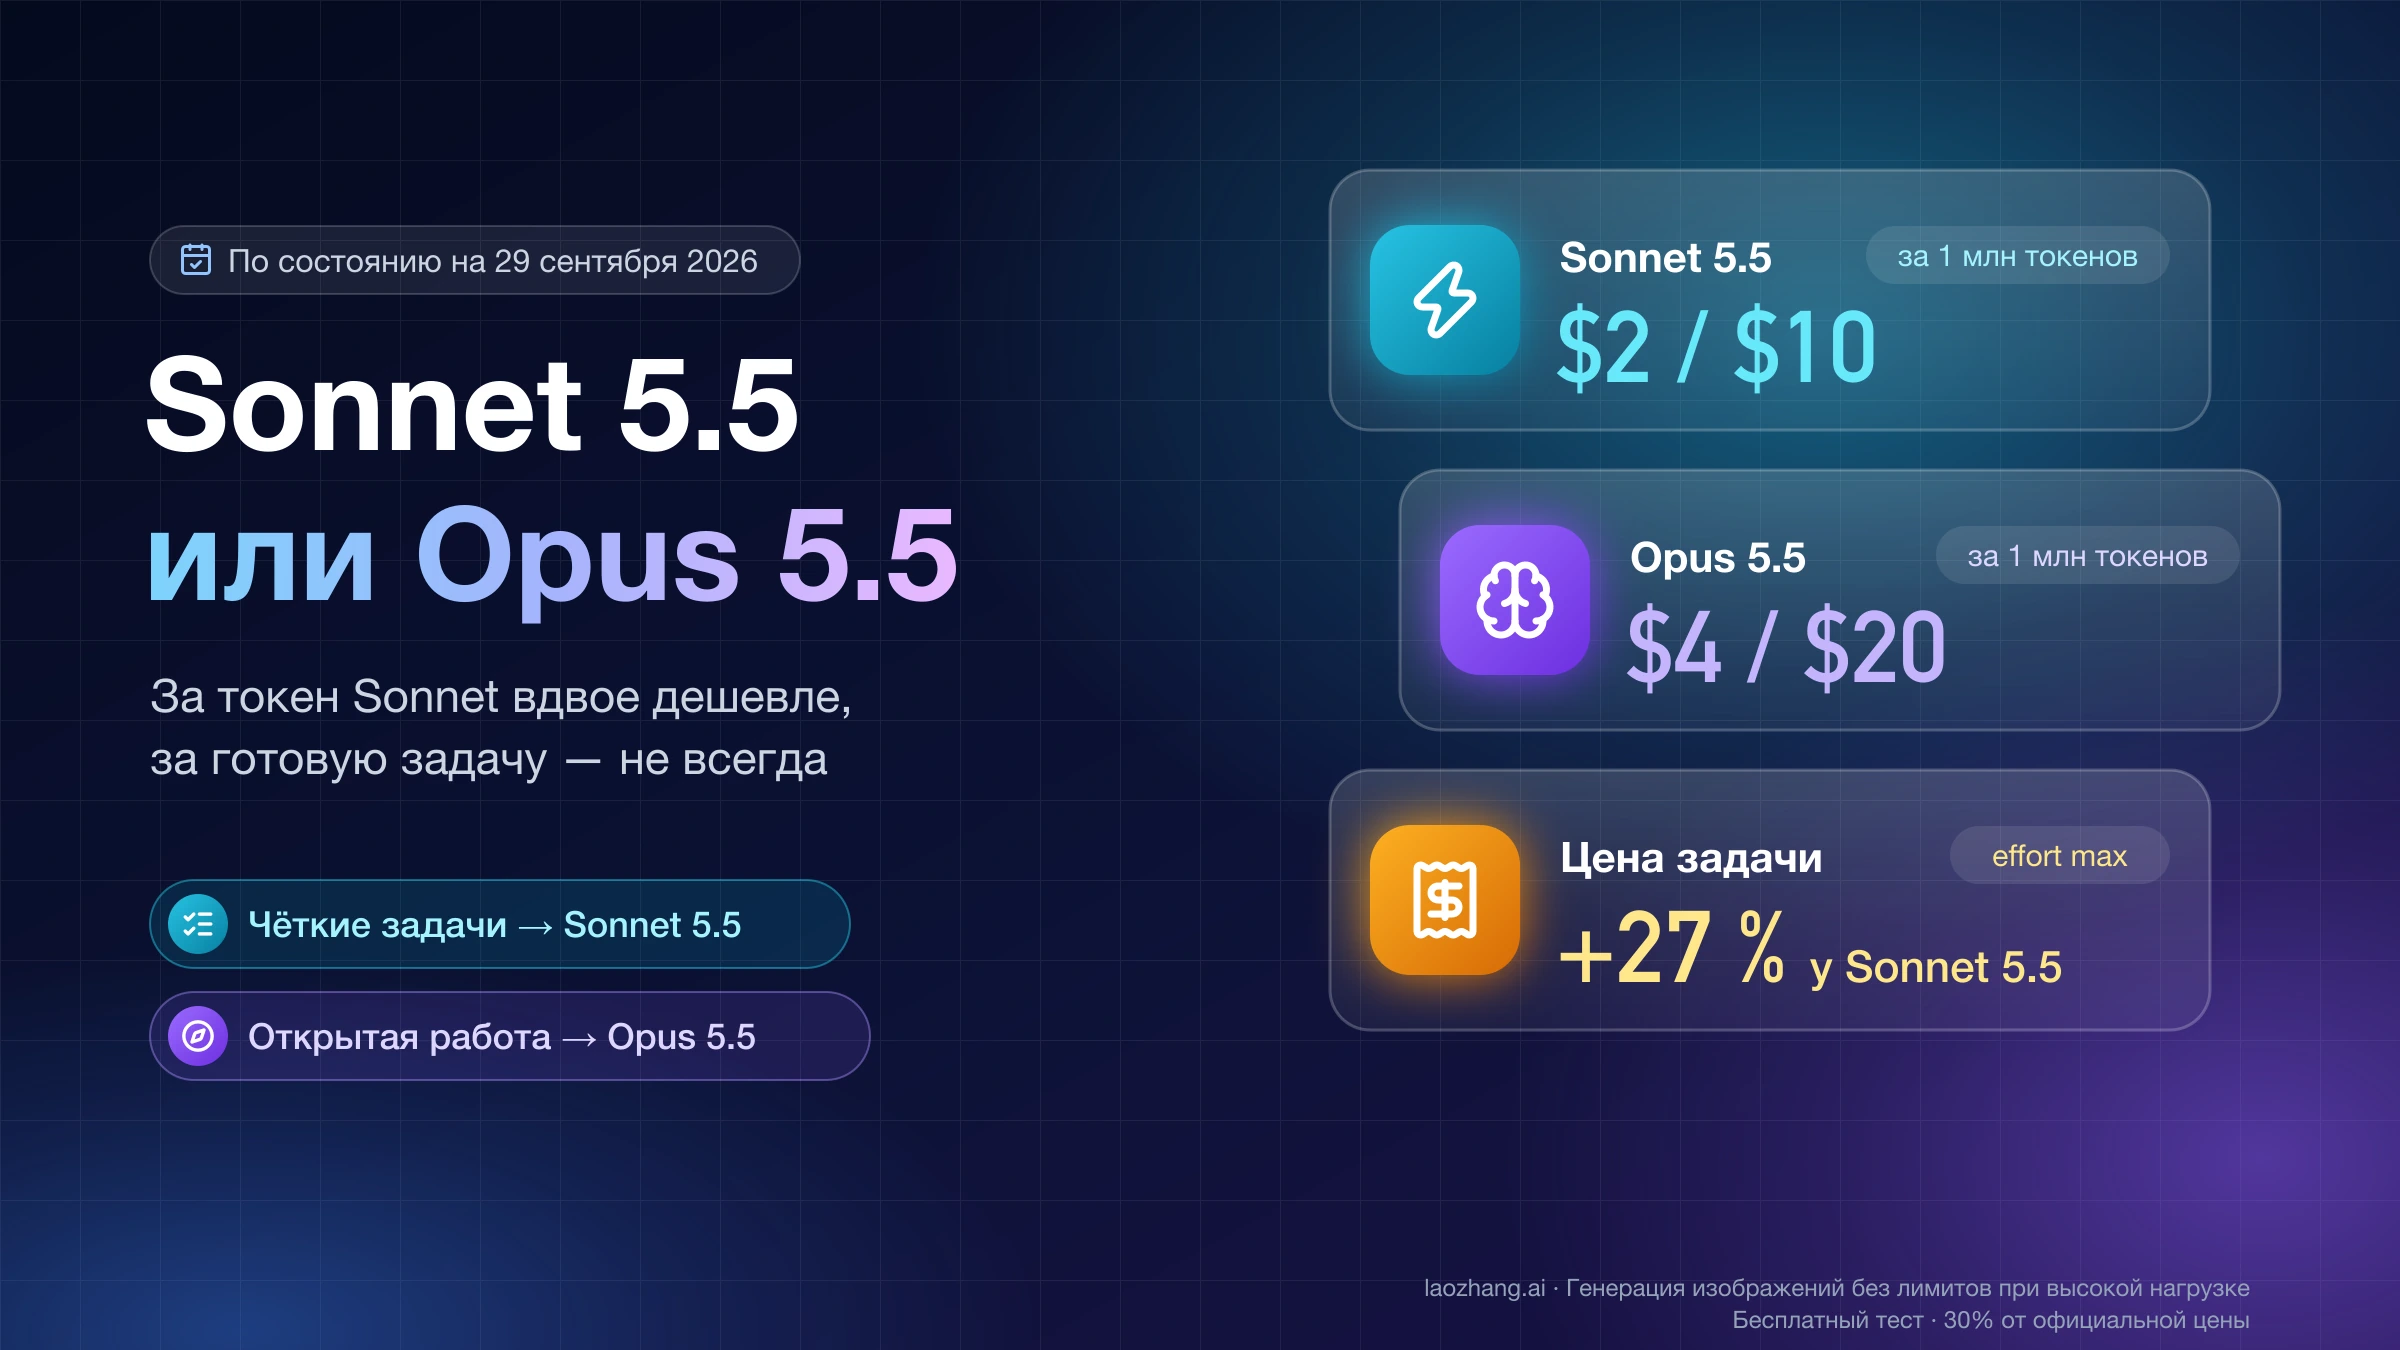
Sonnet 5.5 вдвое дешевле Opus 5.5 за токен, но не всегда за задачу. Чёткие задачи — Sonnet на low или medium, открытая работа с суждением — Opus 5.5.
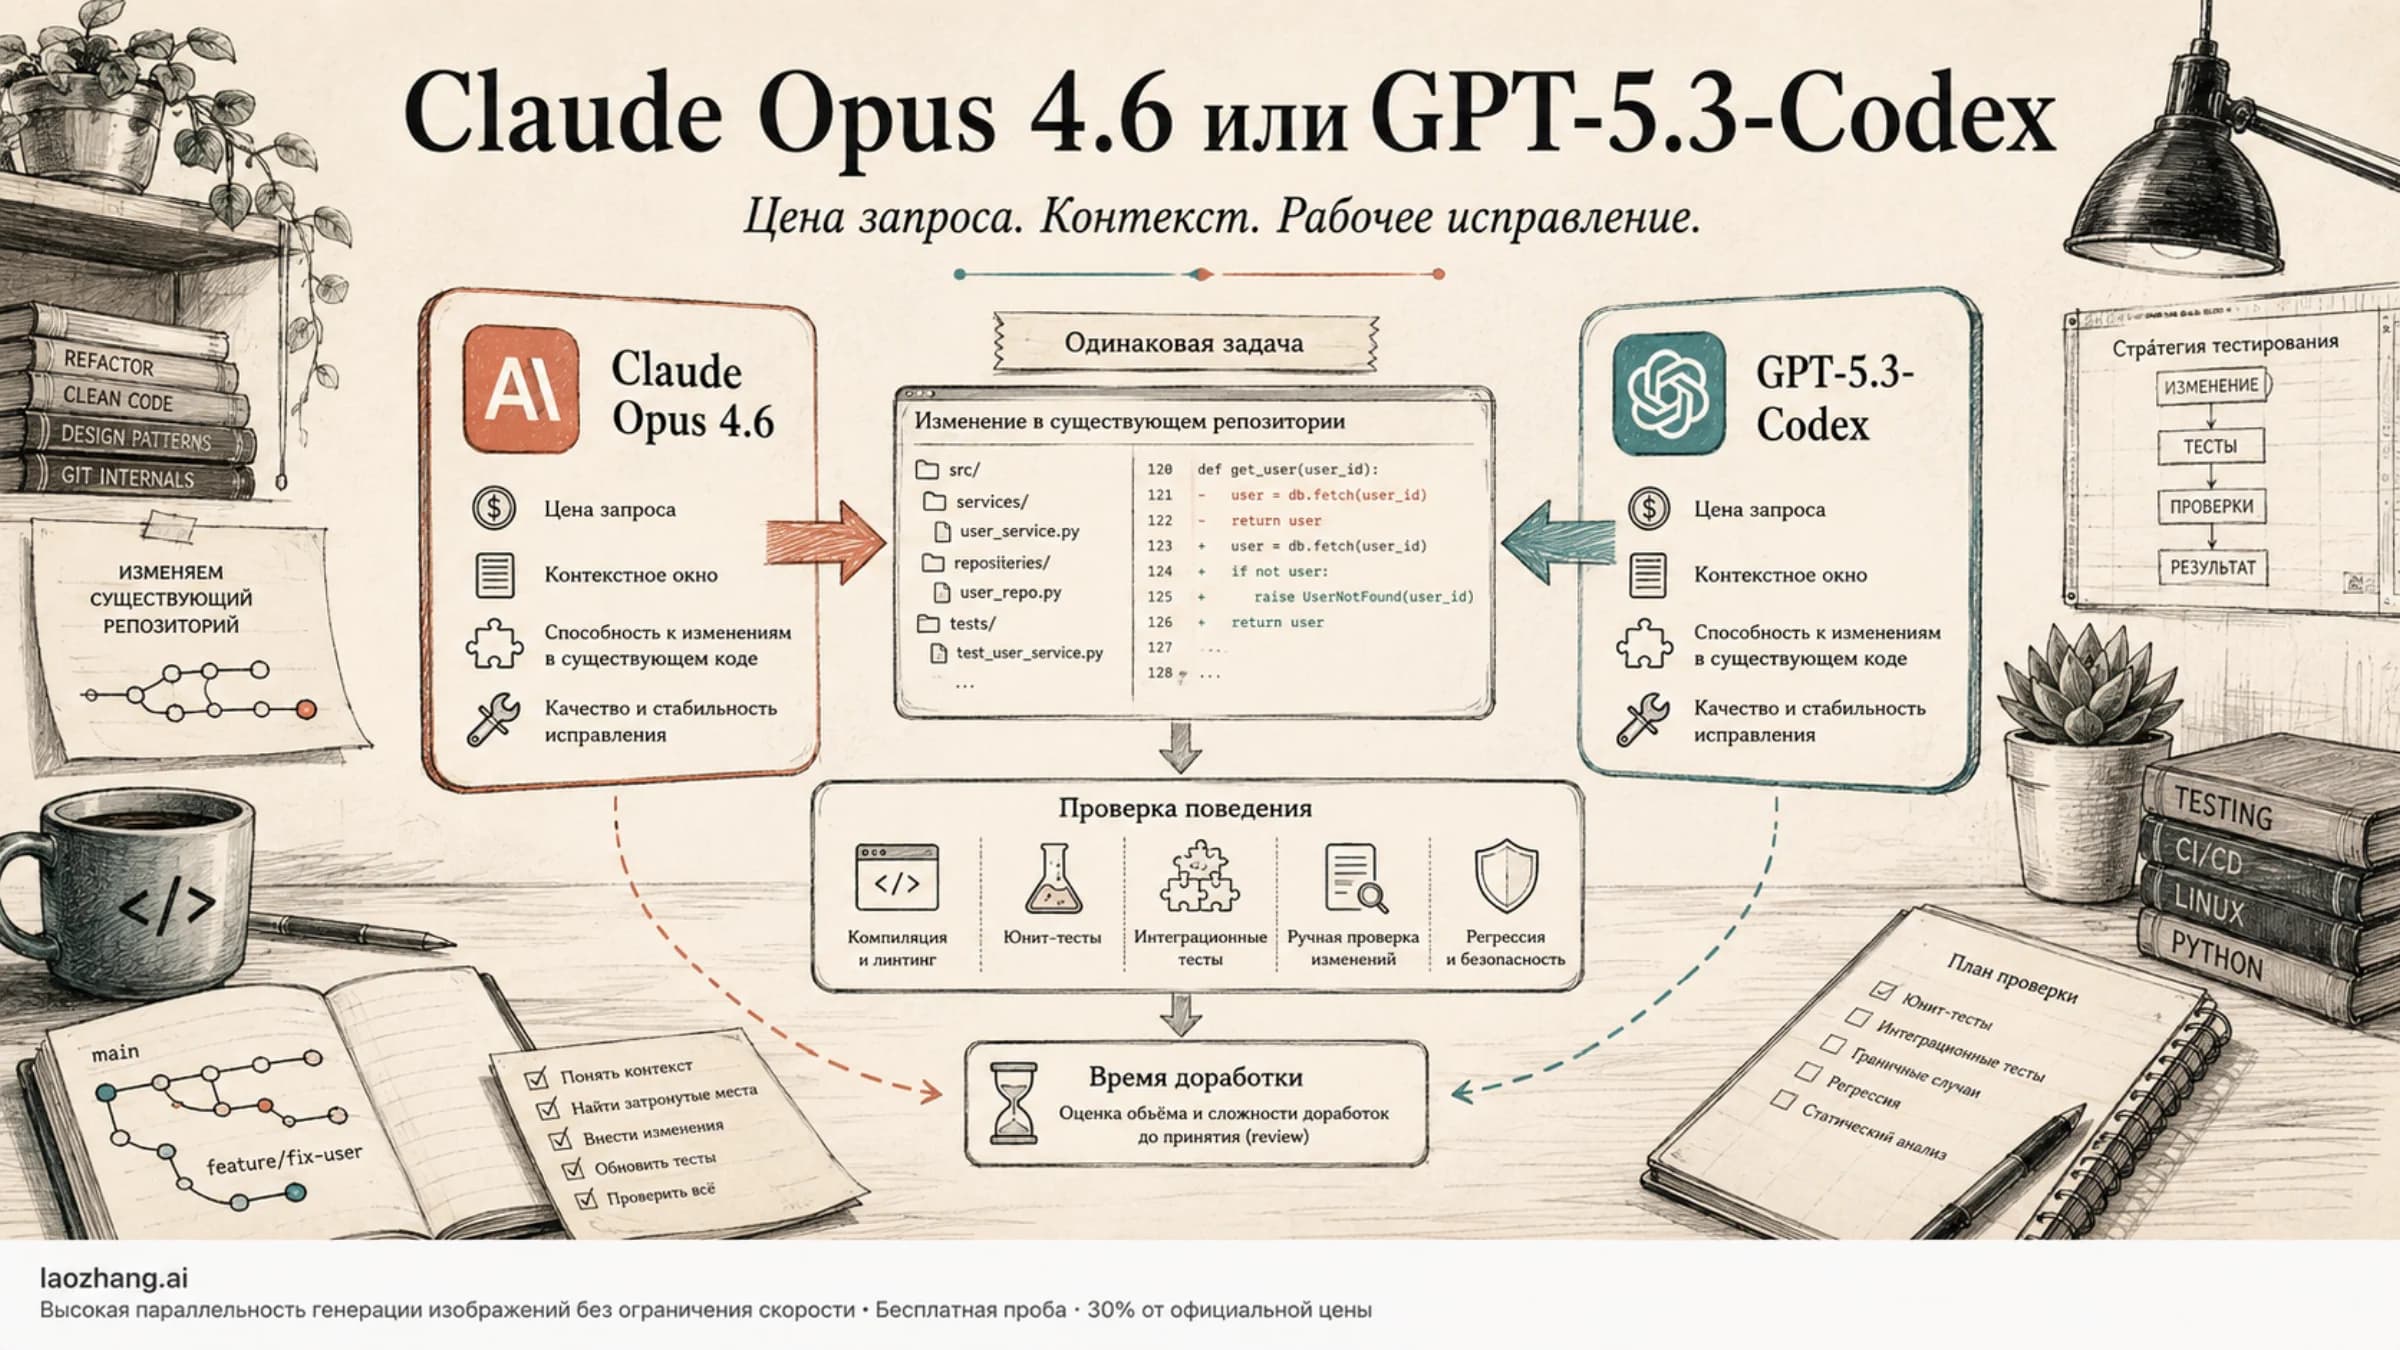
У GPT-5.3-Codex ниже тарифы API, у Claude Opus 4.6 больше окно контекста. Сравните стоимость одной задачи с кешированием и проверьте результат на своем репозитории: зеленые тесты еще не доказывают, что исправление работает.
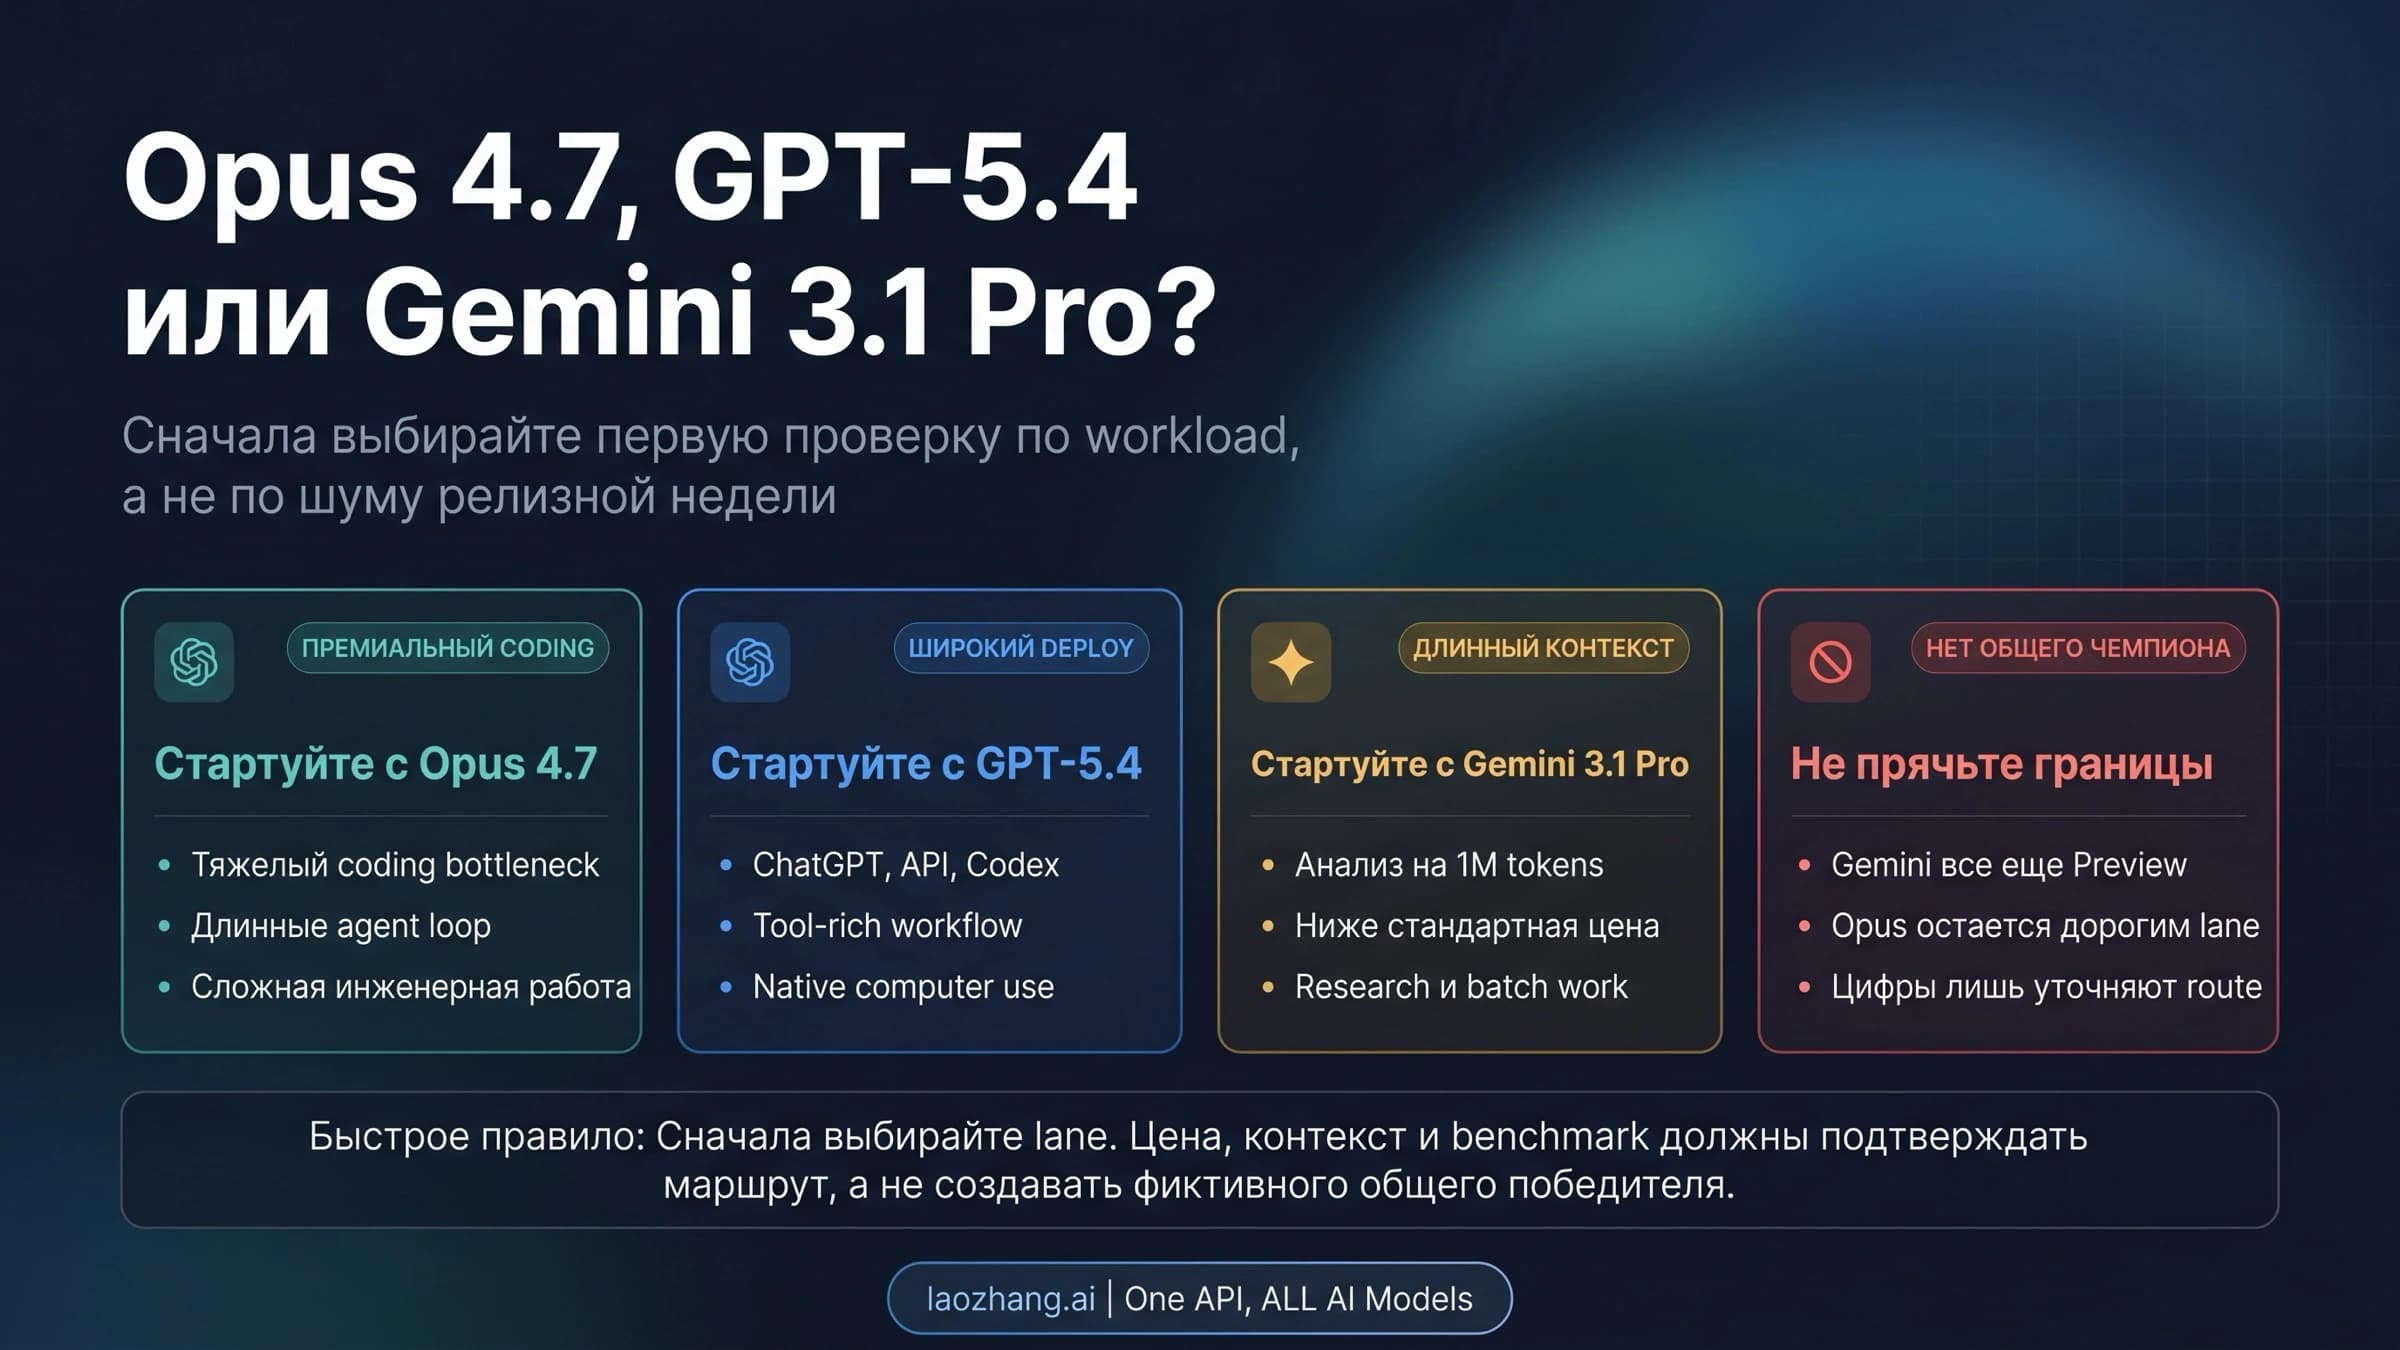
Сравниваем возможности API Claude Opus 4.7, GPT-5.4 и Gemini 3.1 Pro: форматы входных данных, контекст, инструменты, тарифы и стоимость успешно выполненной задачи.
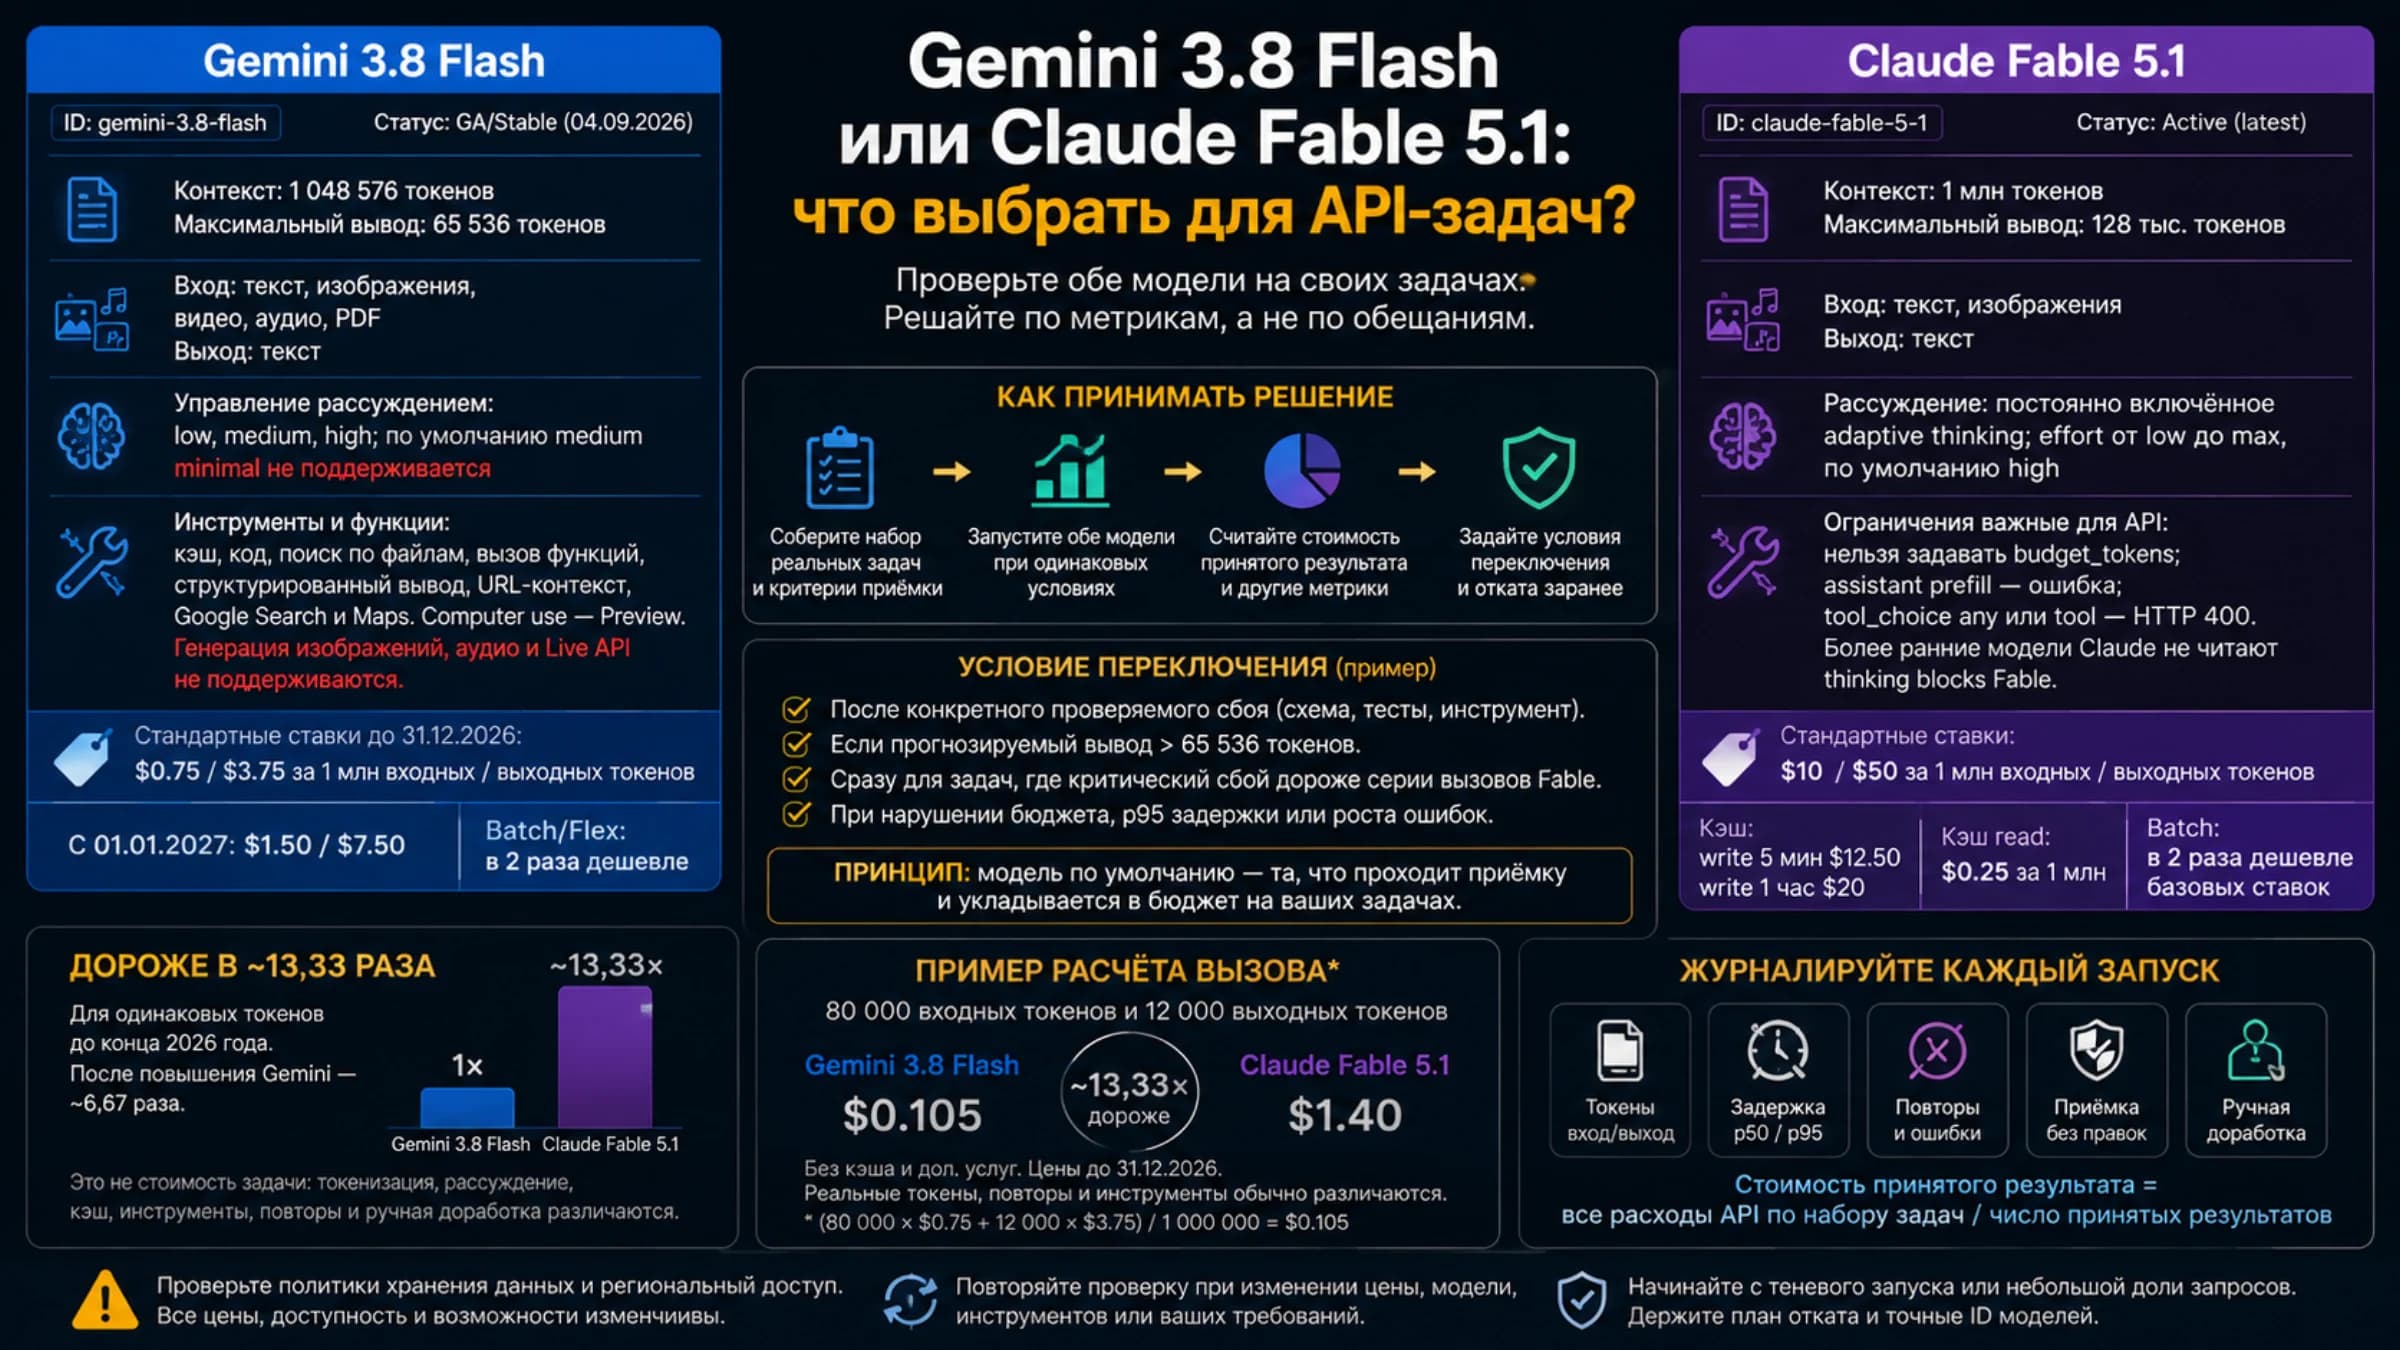
Gemini заметно дешевле по прейскуранту, но это ещё не доказывает меньшую стоимость готовой работы. Выберите первую модель, проверьте обе на одинаковых задачах и заранее задайте условия переключения и отката.
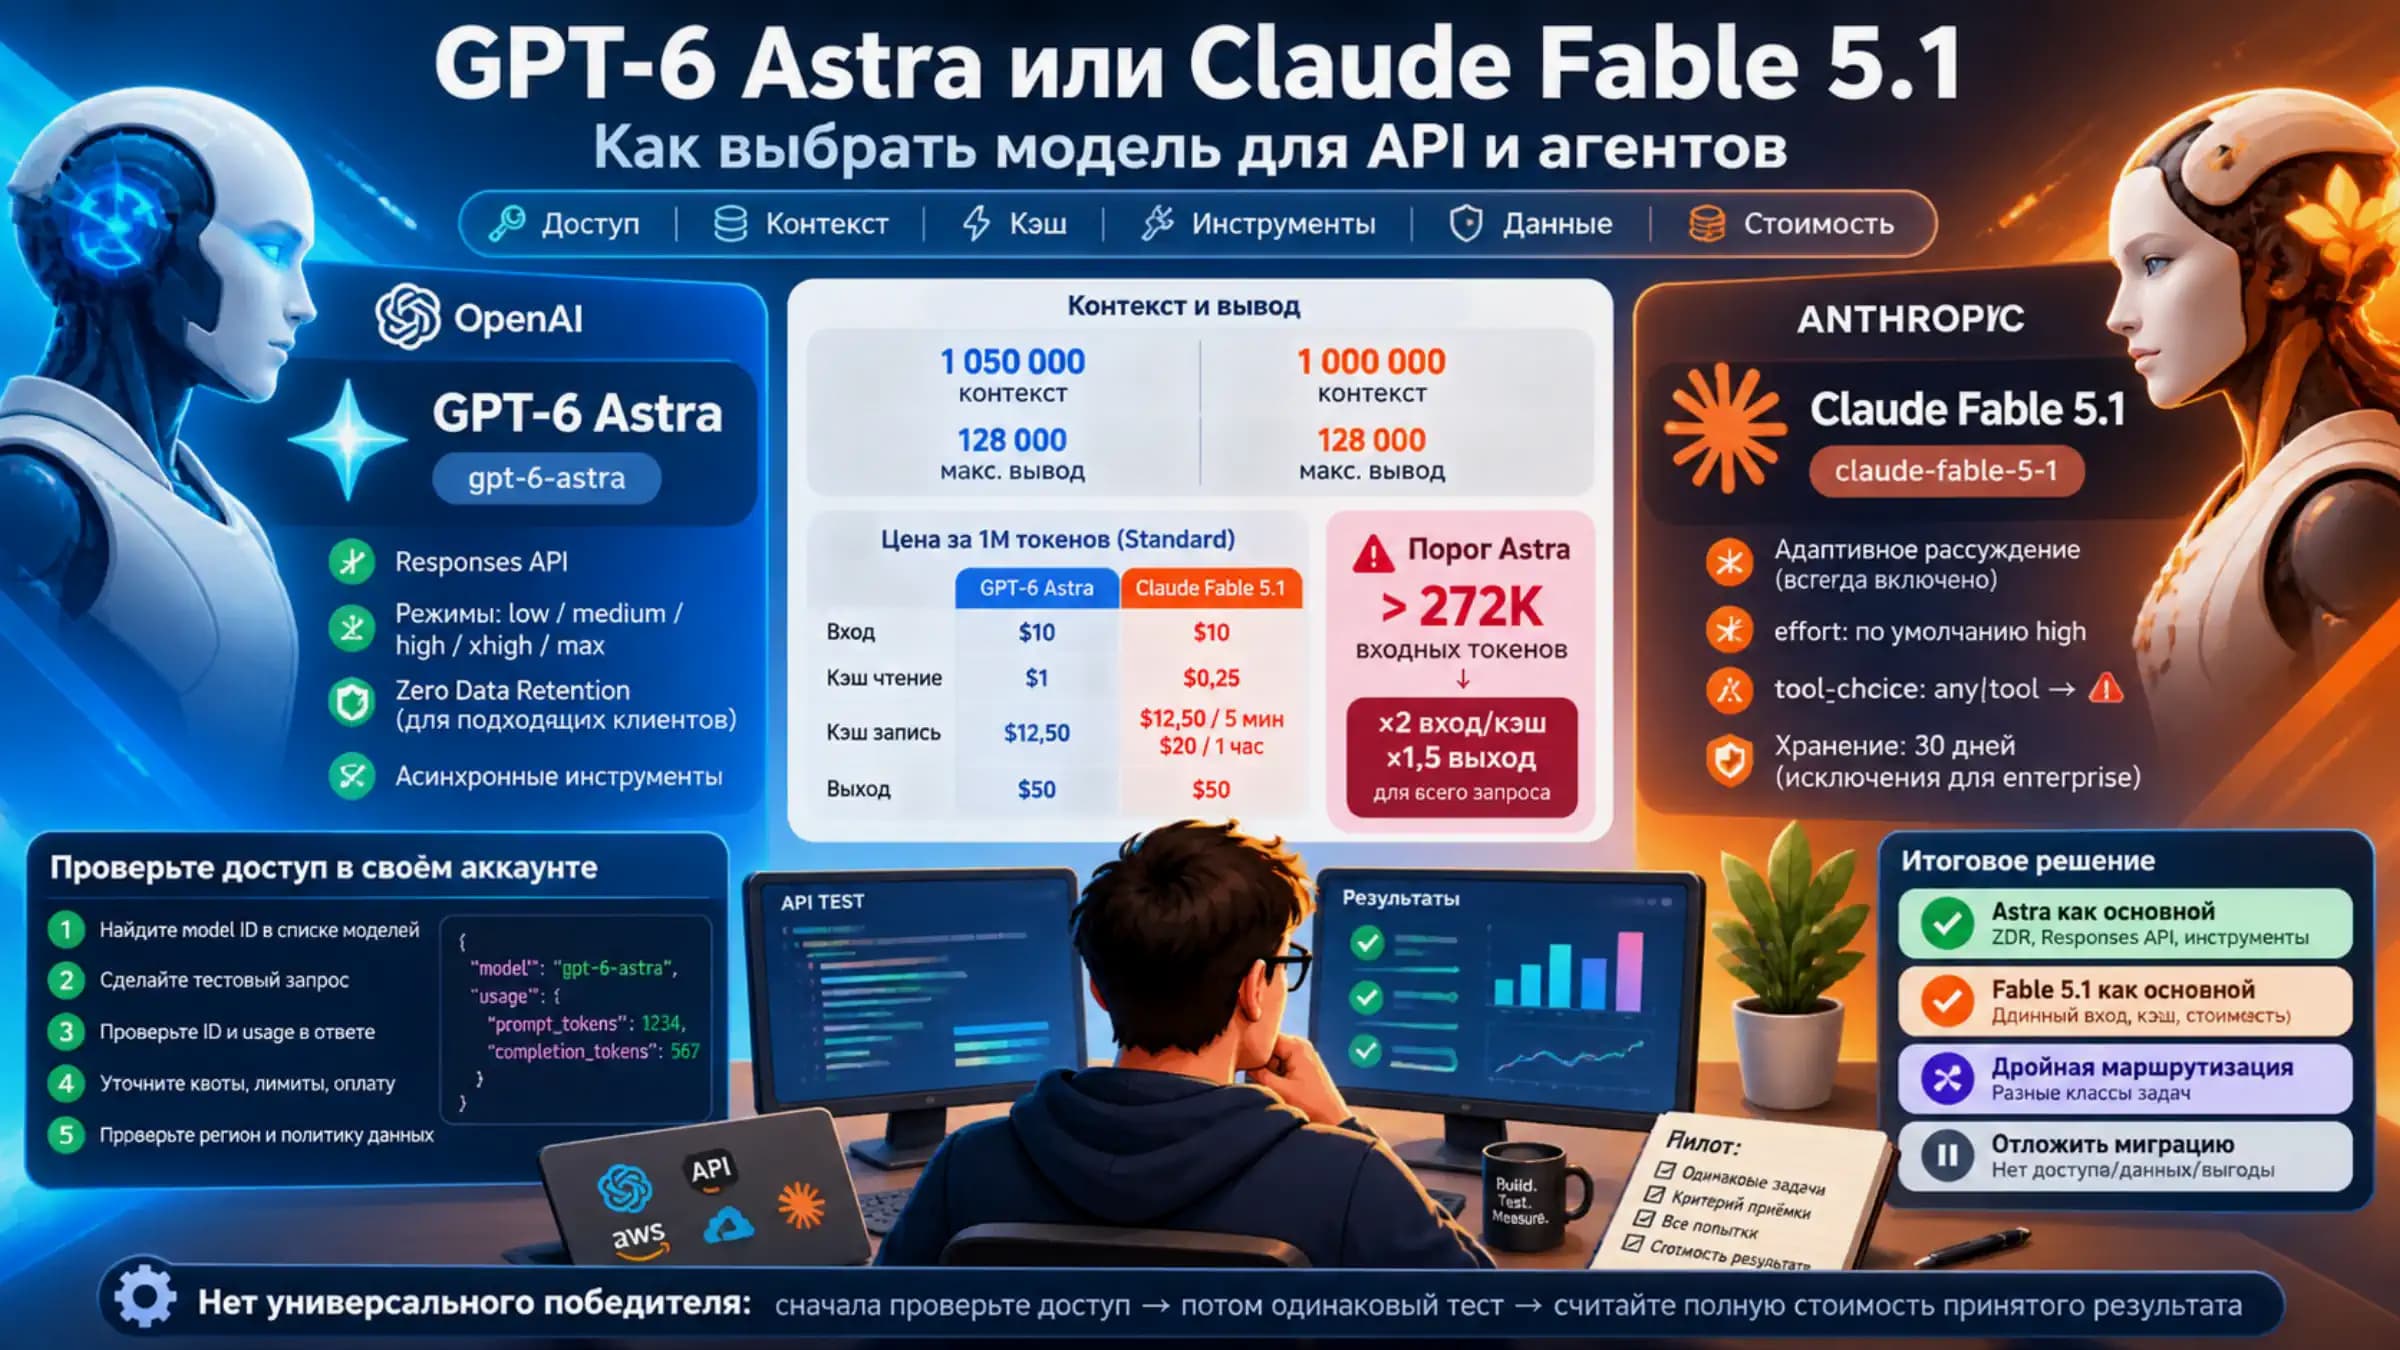
Универсального победителя нет: сначала проверьте доступ и ограничения, затем сравните обе модели на одинаковой задаче и посчитайте цену принятого результата.
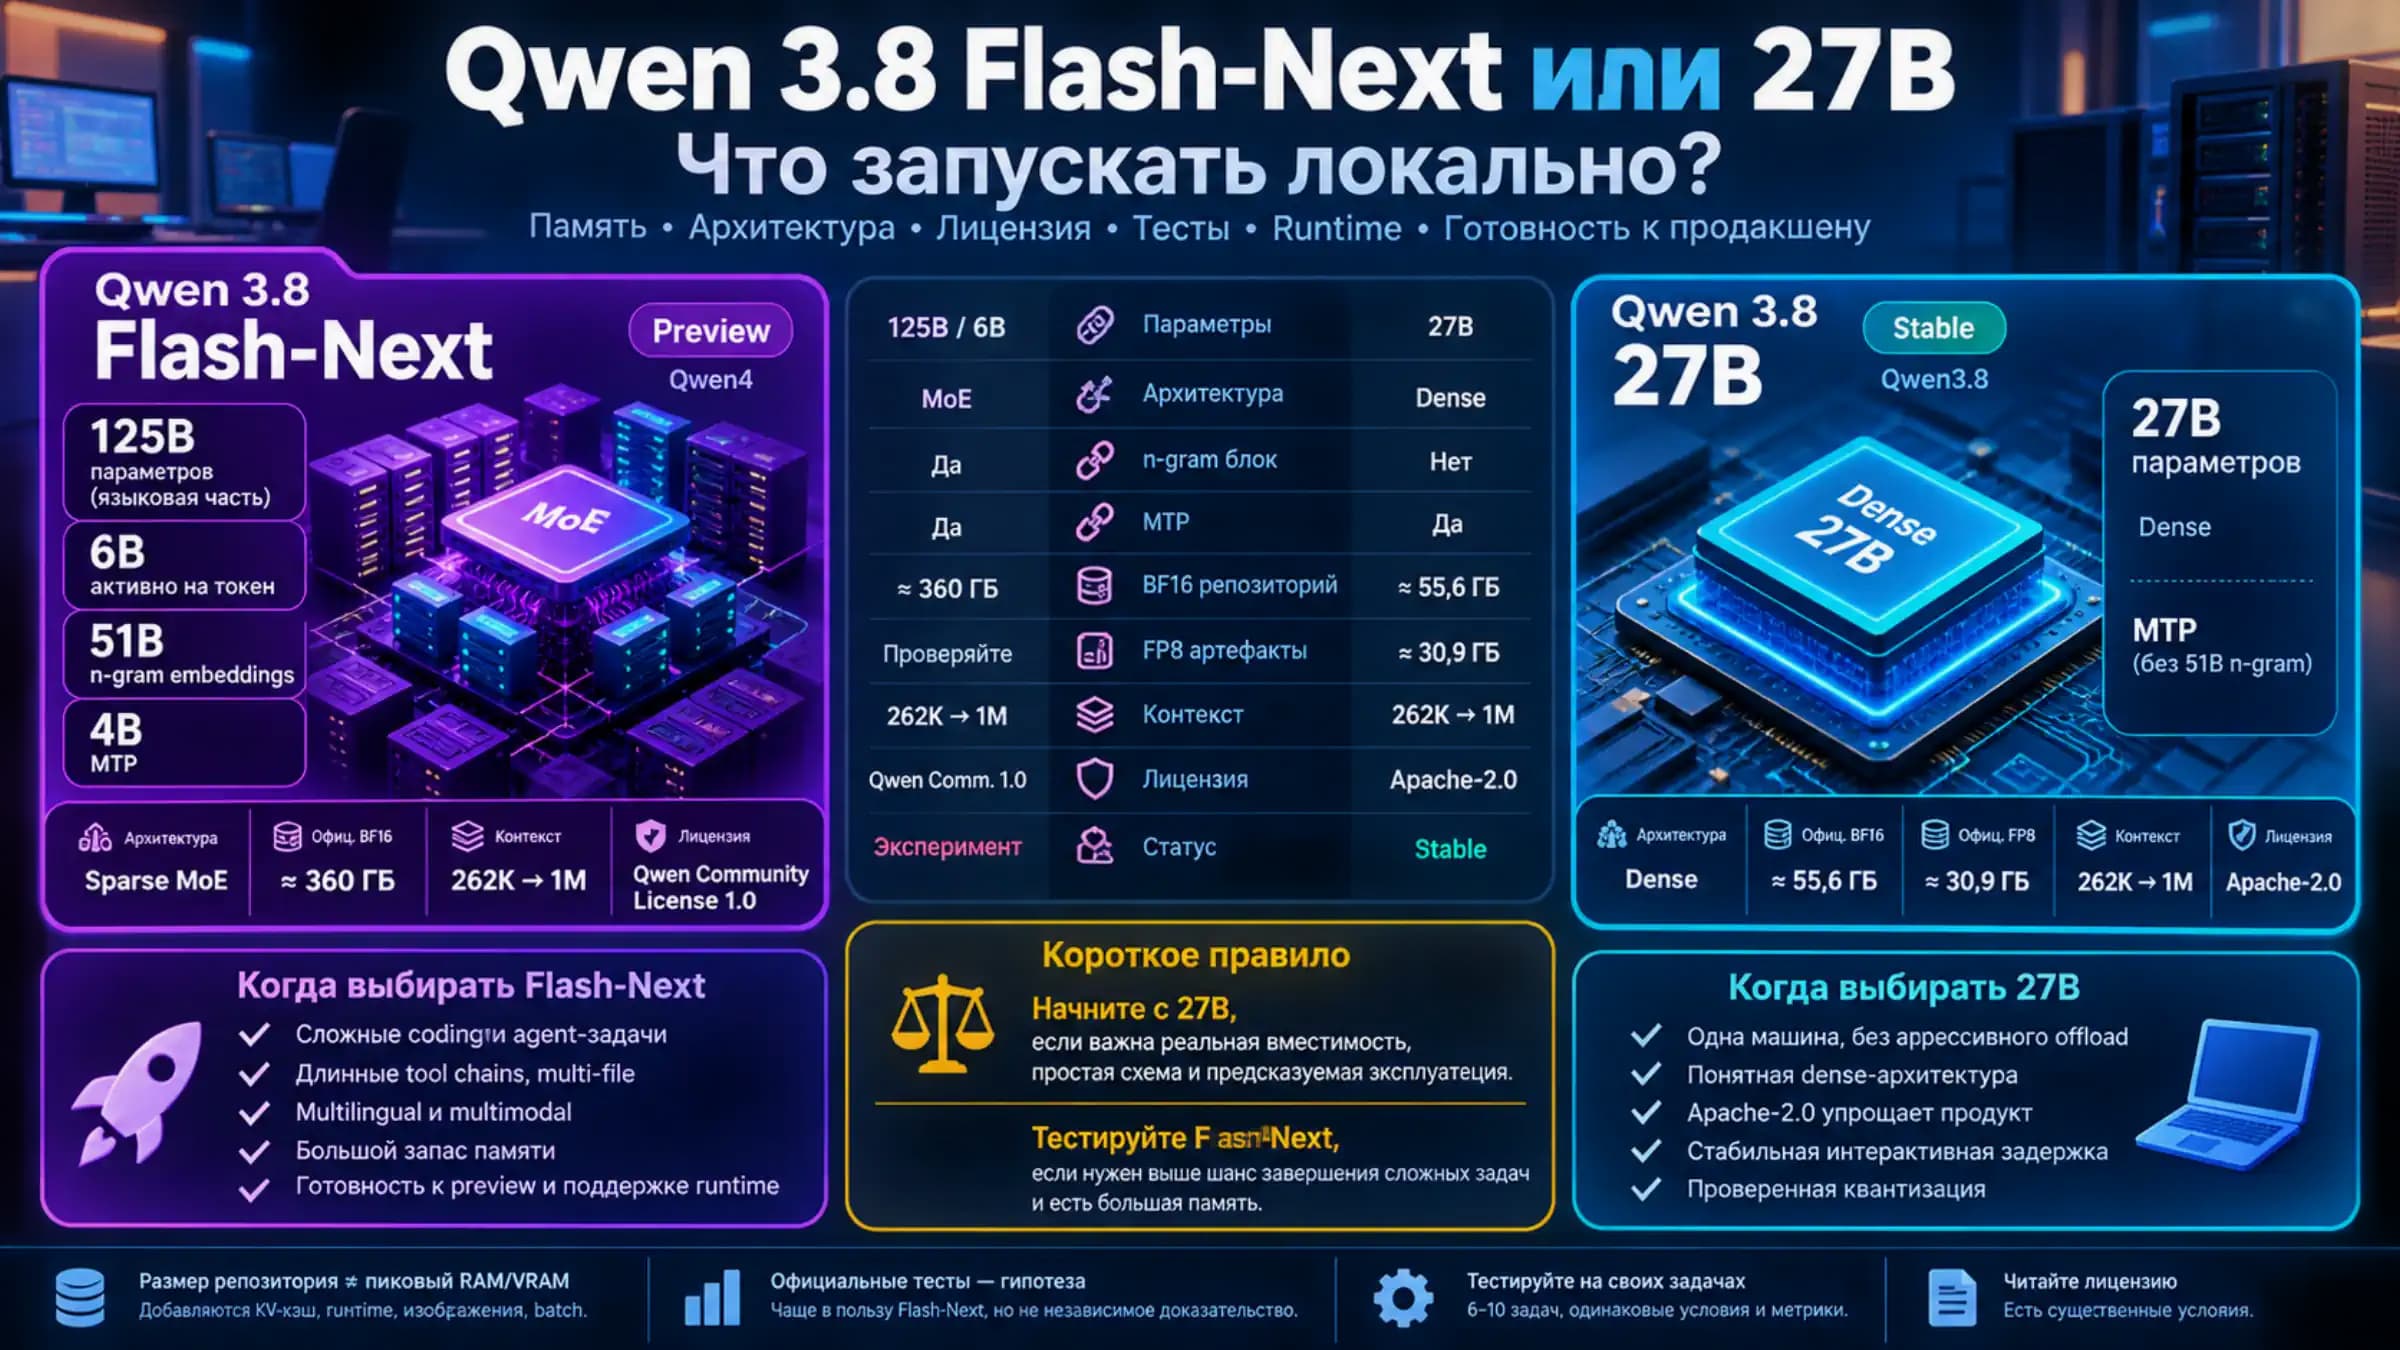
Qwen3.8-27B — практичный первый выбор для одной машины и понятного развёртывания плотной модели. Flash-Next стоит тестировать при большом запасе памяти и дорогих агентных задачах.
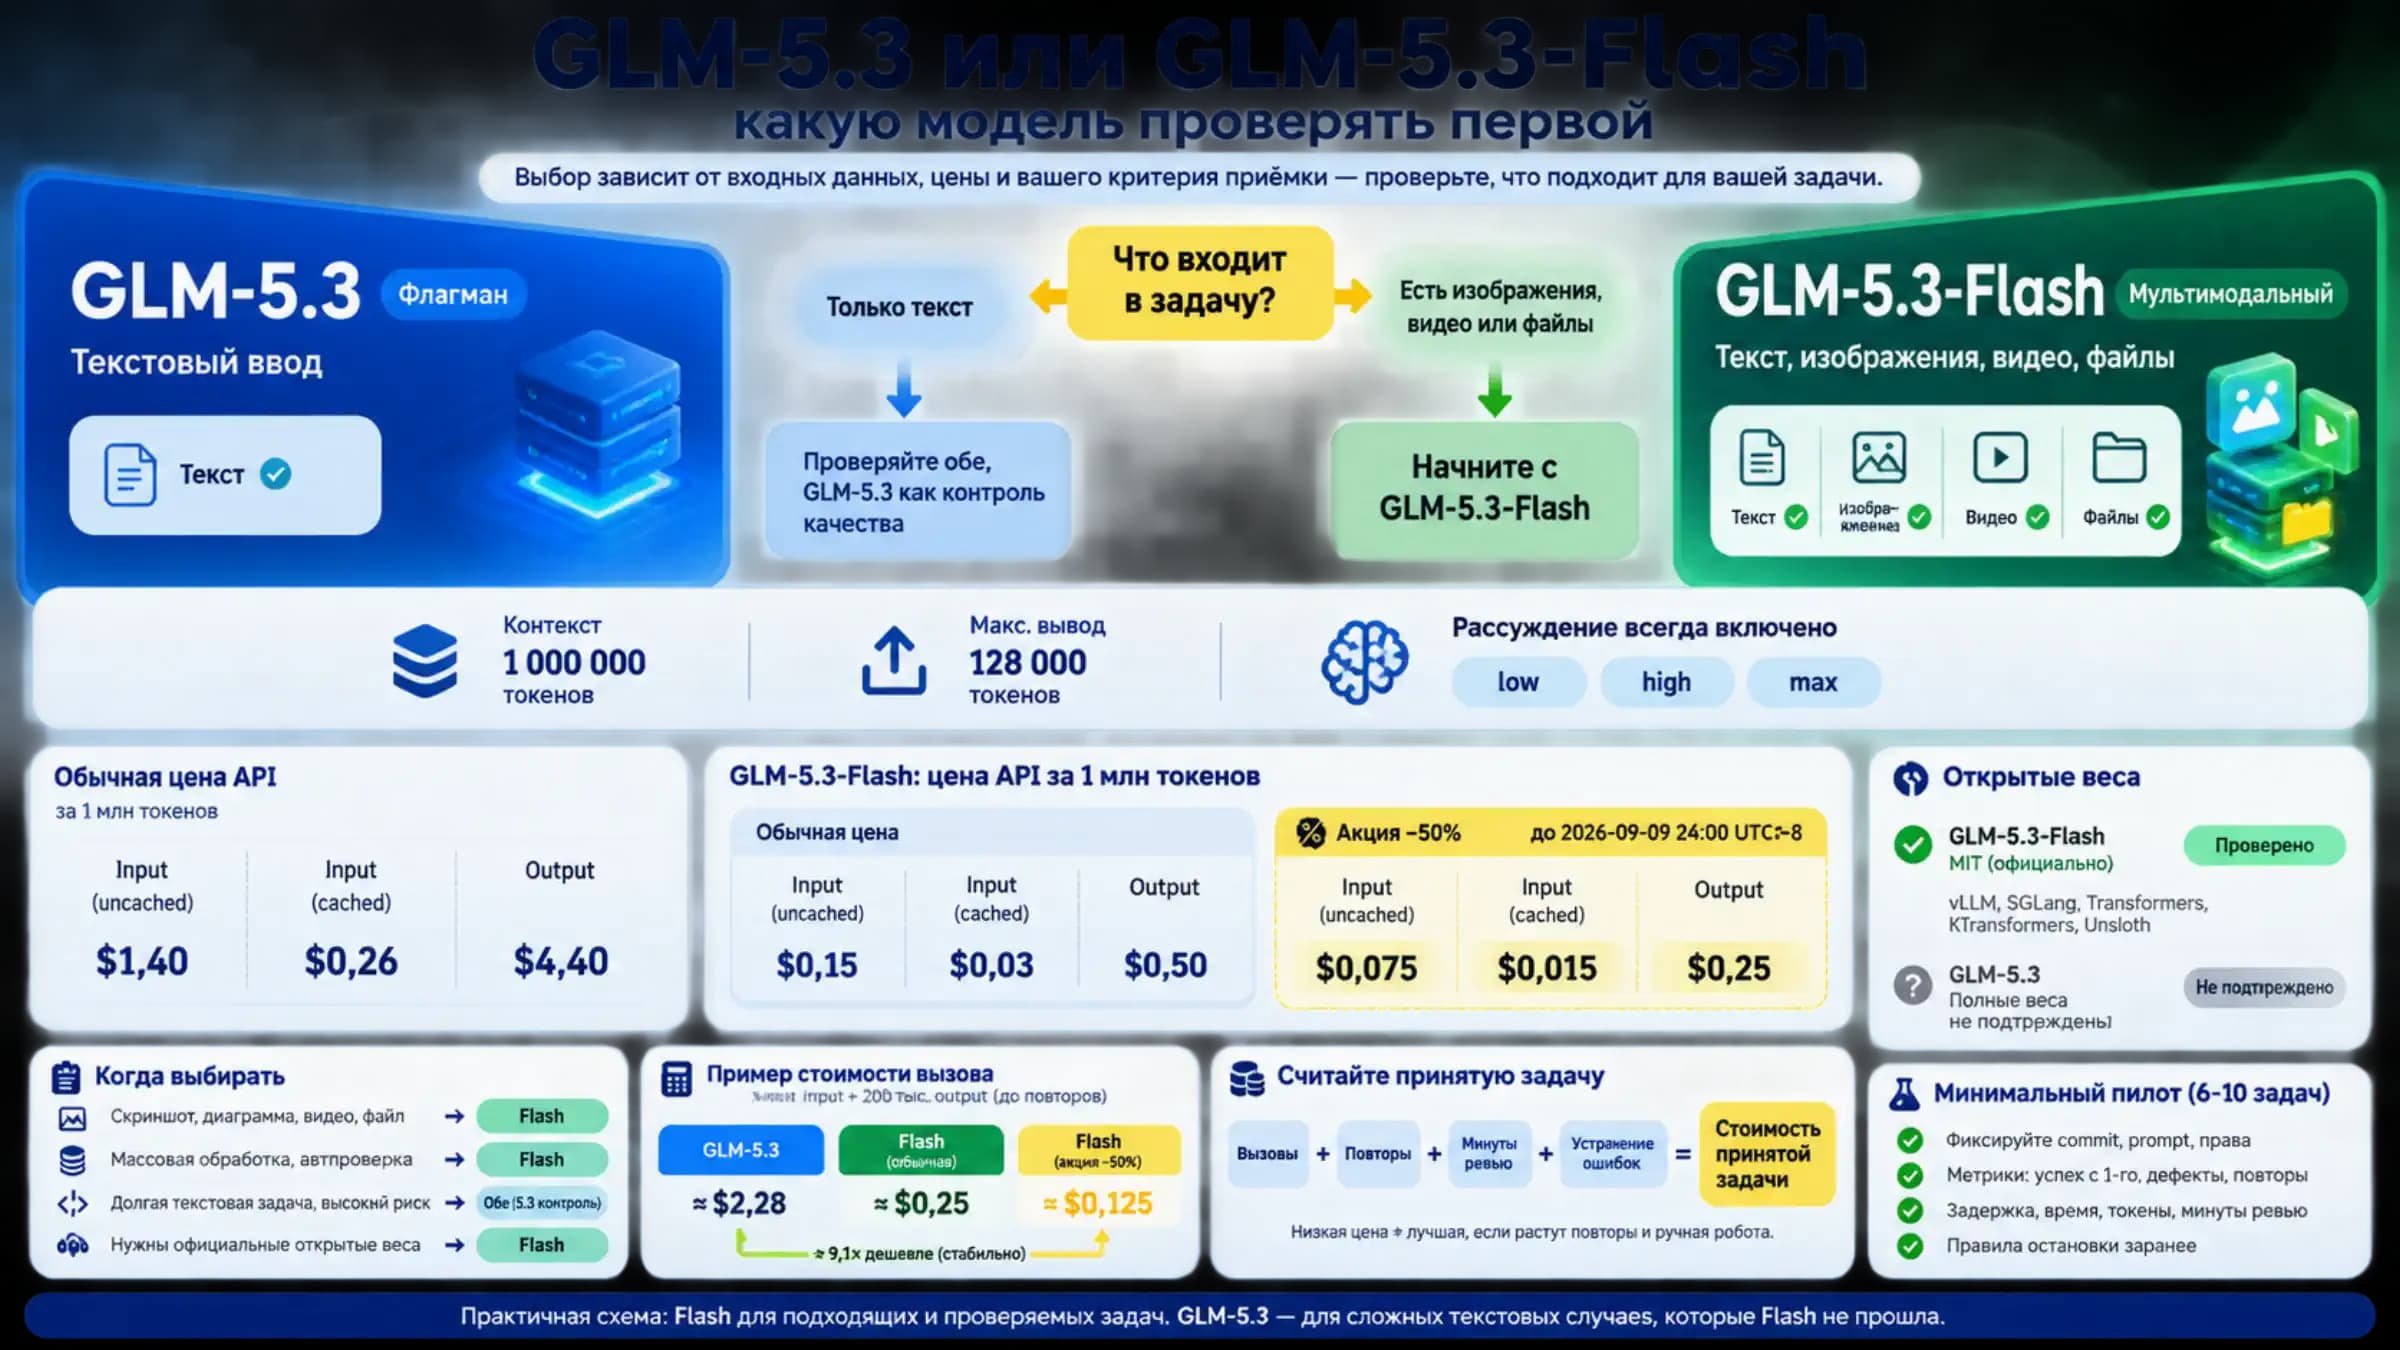
Для мультимодальных и массовых задач первой проверяйте GLM-5.3-Flash. В текстовых задачах с дорогой ошибкой оставьте GLM-5.3 как контроль качества.
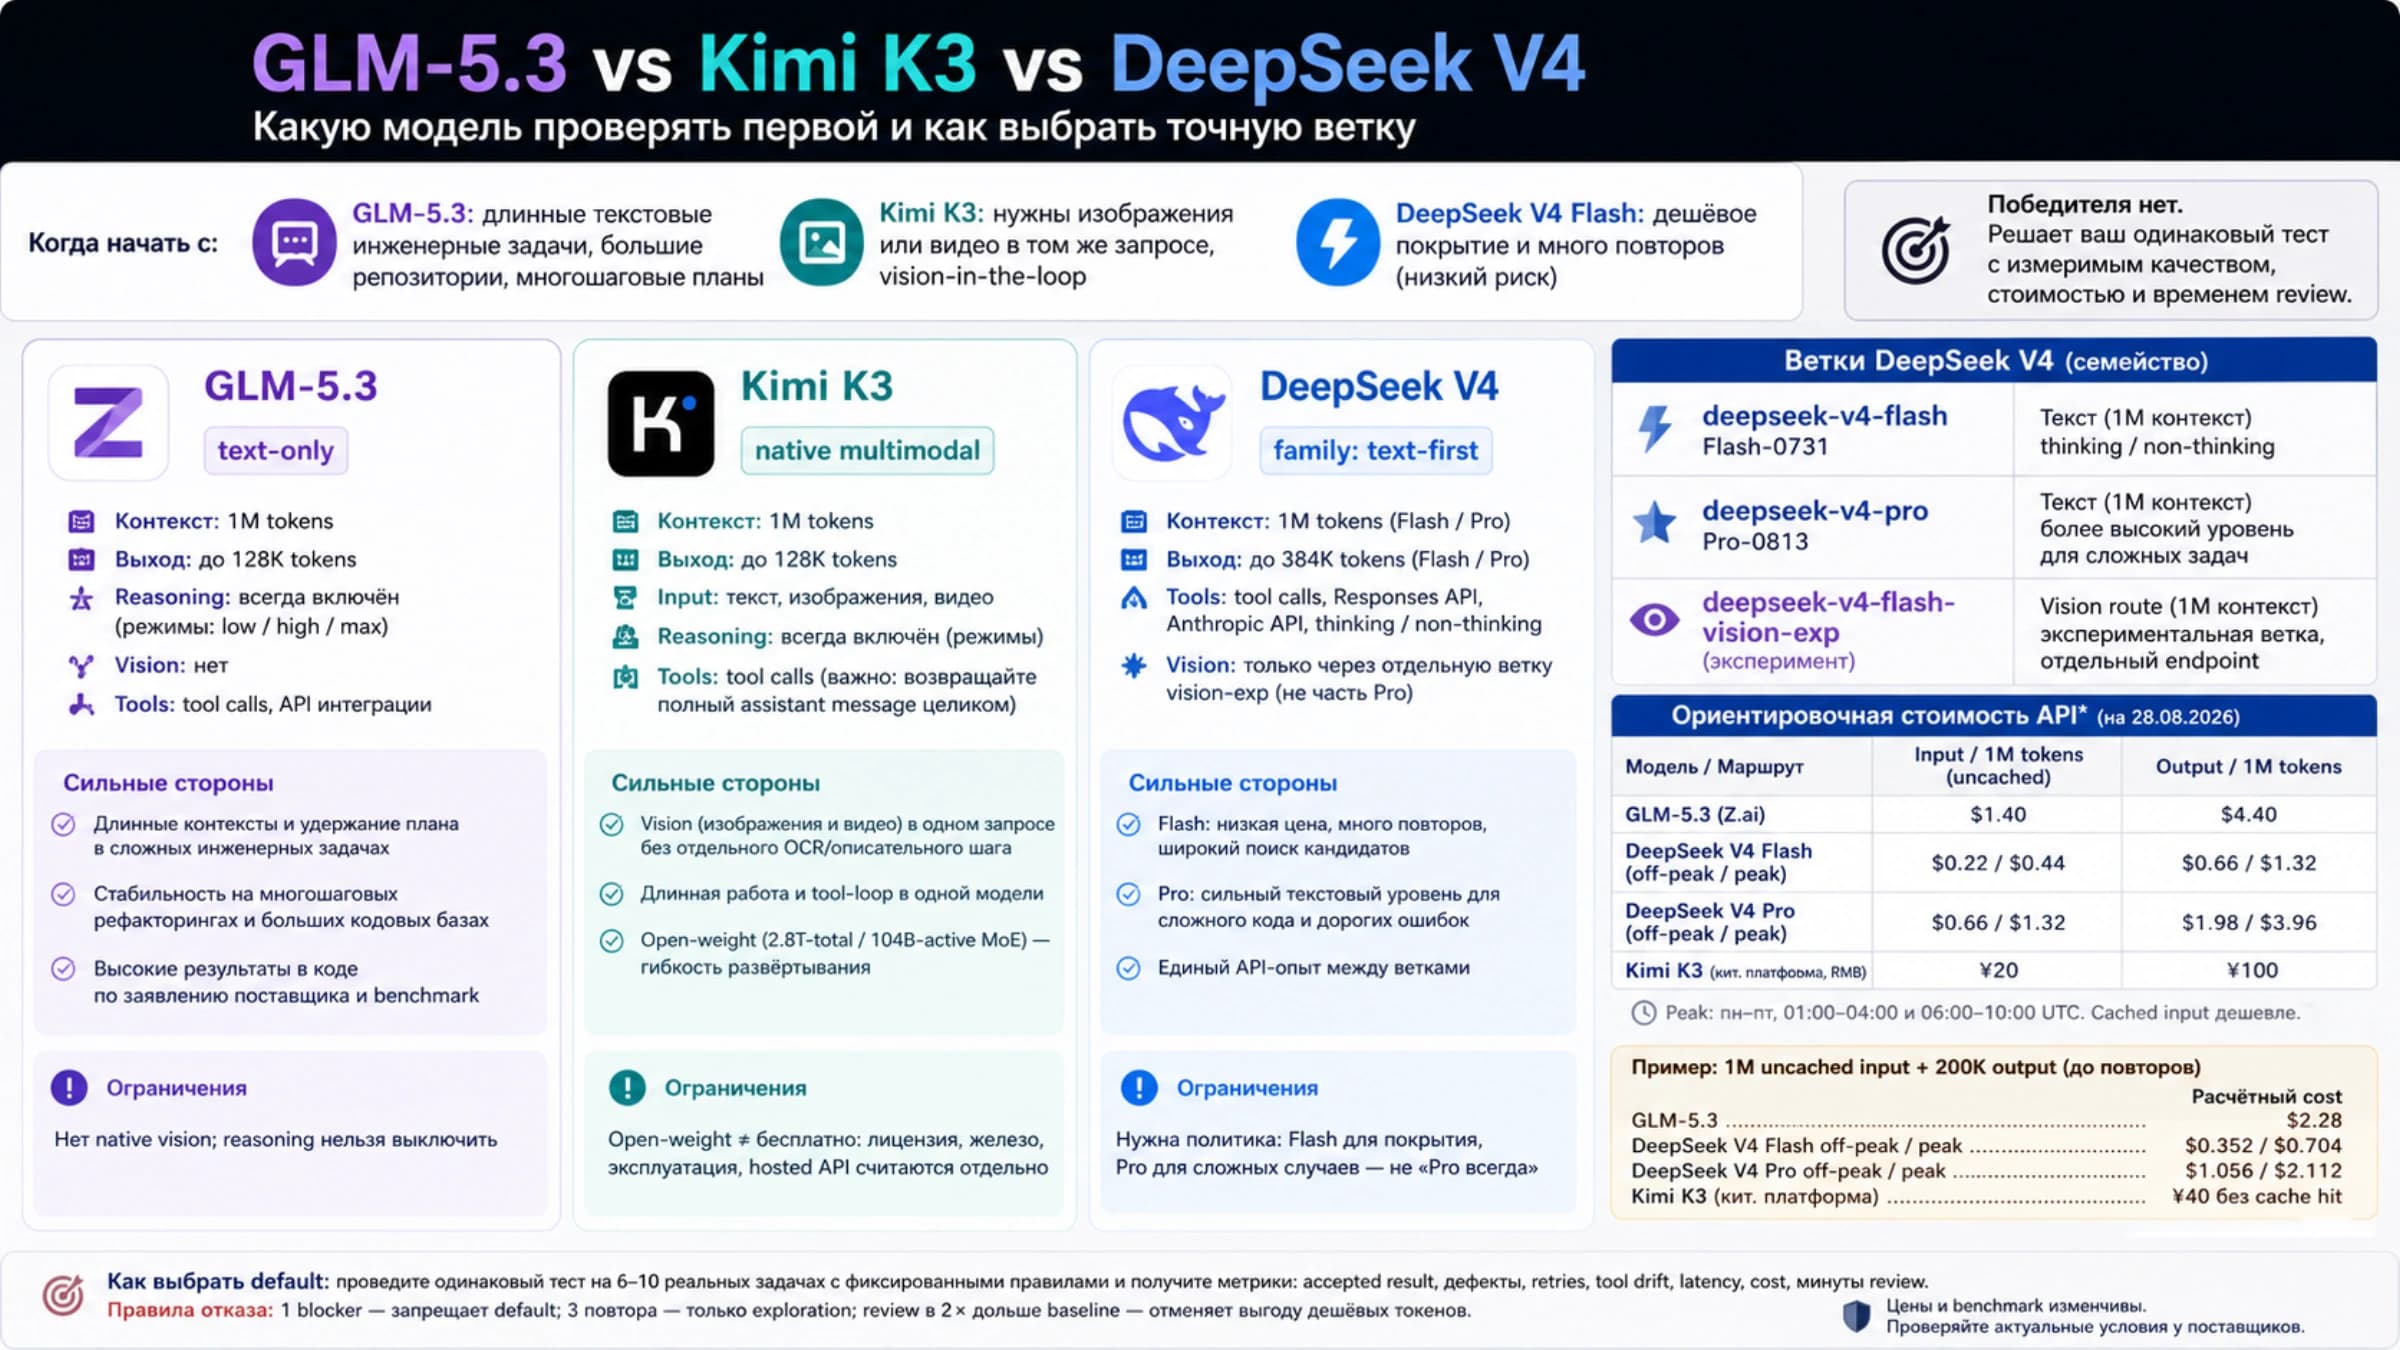
GLM-5.3 стоит первым проверить на долгих текстовых инженерных задачах, Kimi K3 — когда в цикле нужны изображения или видео, DeepSeek V4 Flash — для дешёвого покрытия, а Pro — для сложного контроля качества.
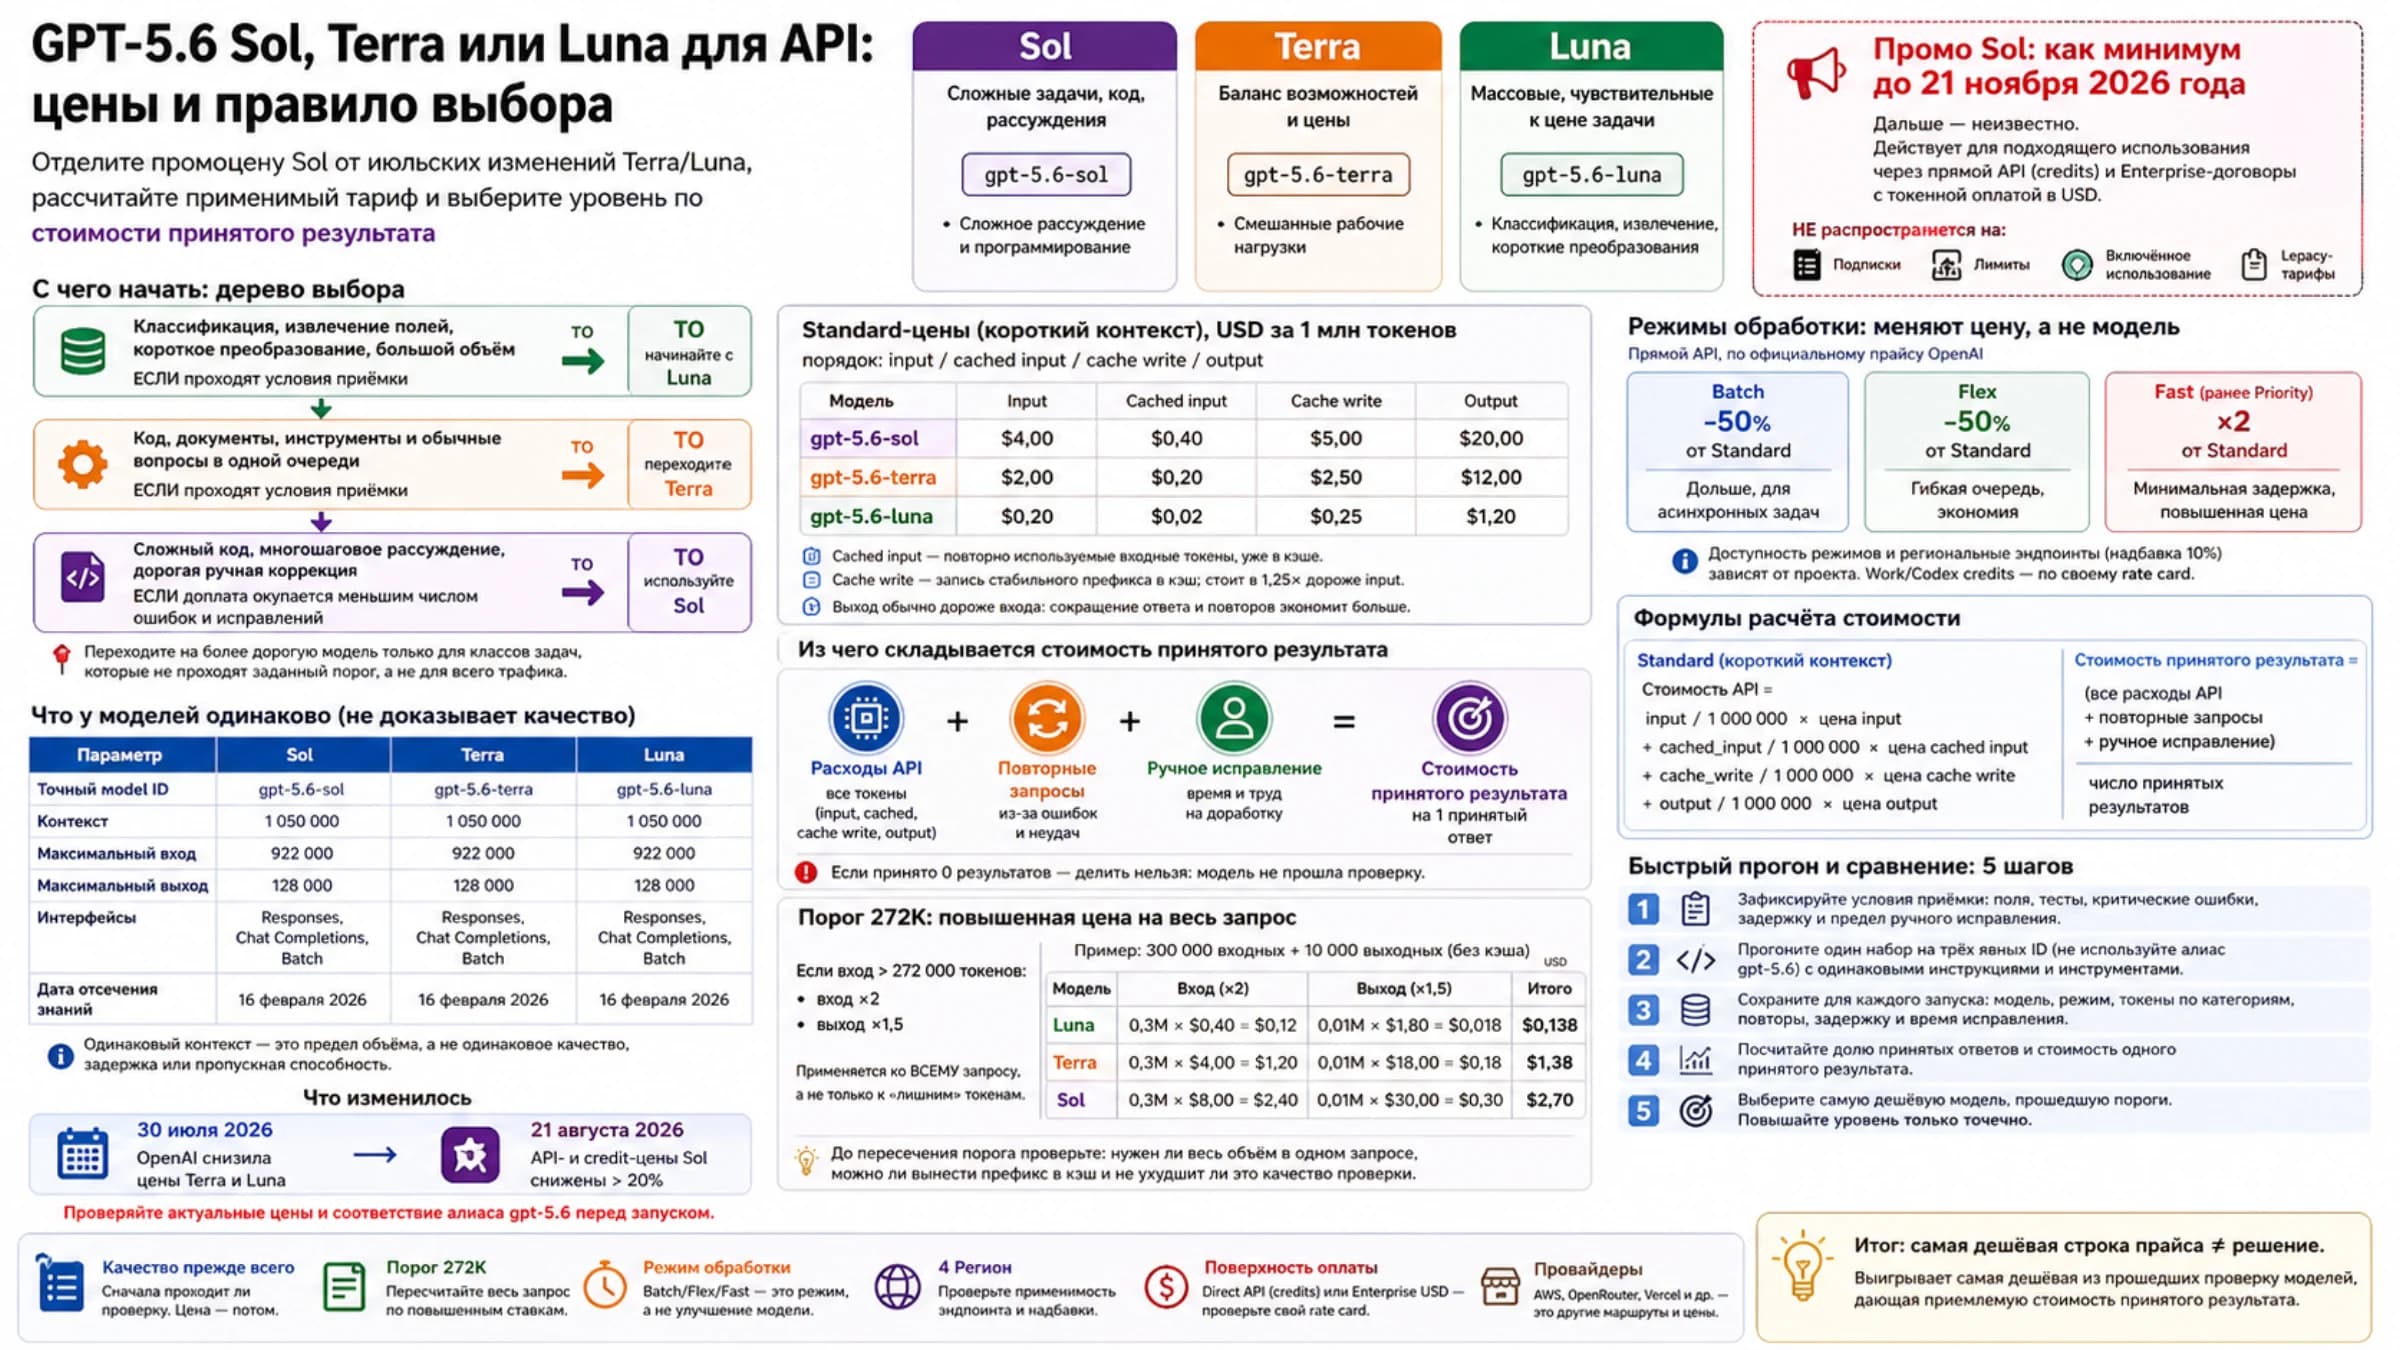
У Sol действует временная промоцена. Отделите API от лимитов и кредитов, пересчитайте запрос и сравните три модели по стоимости принятого результата.
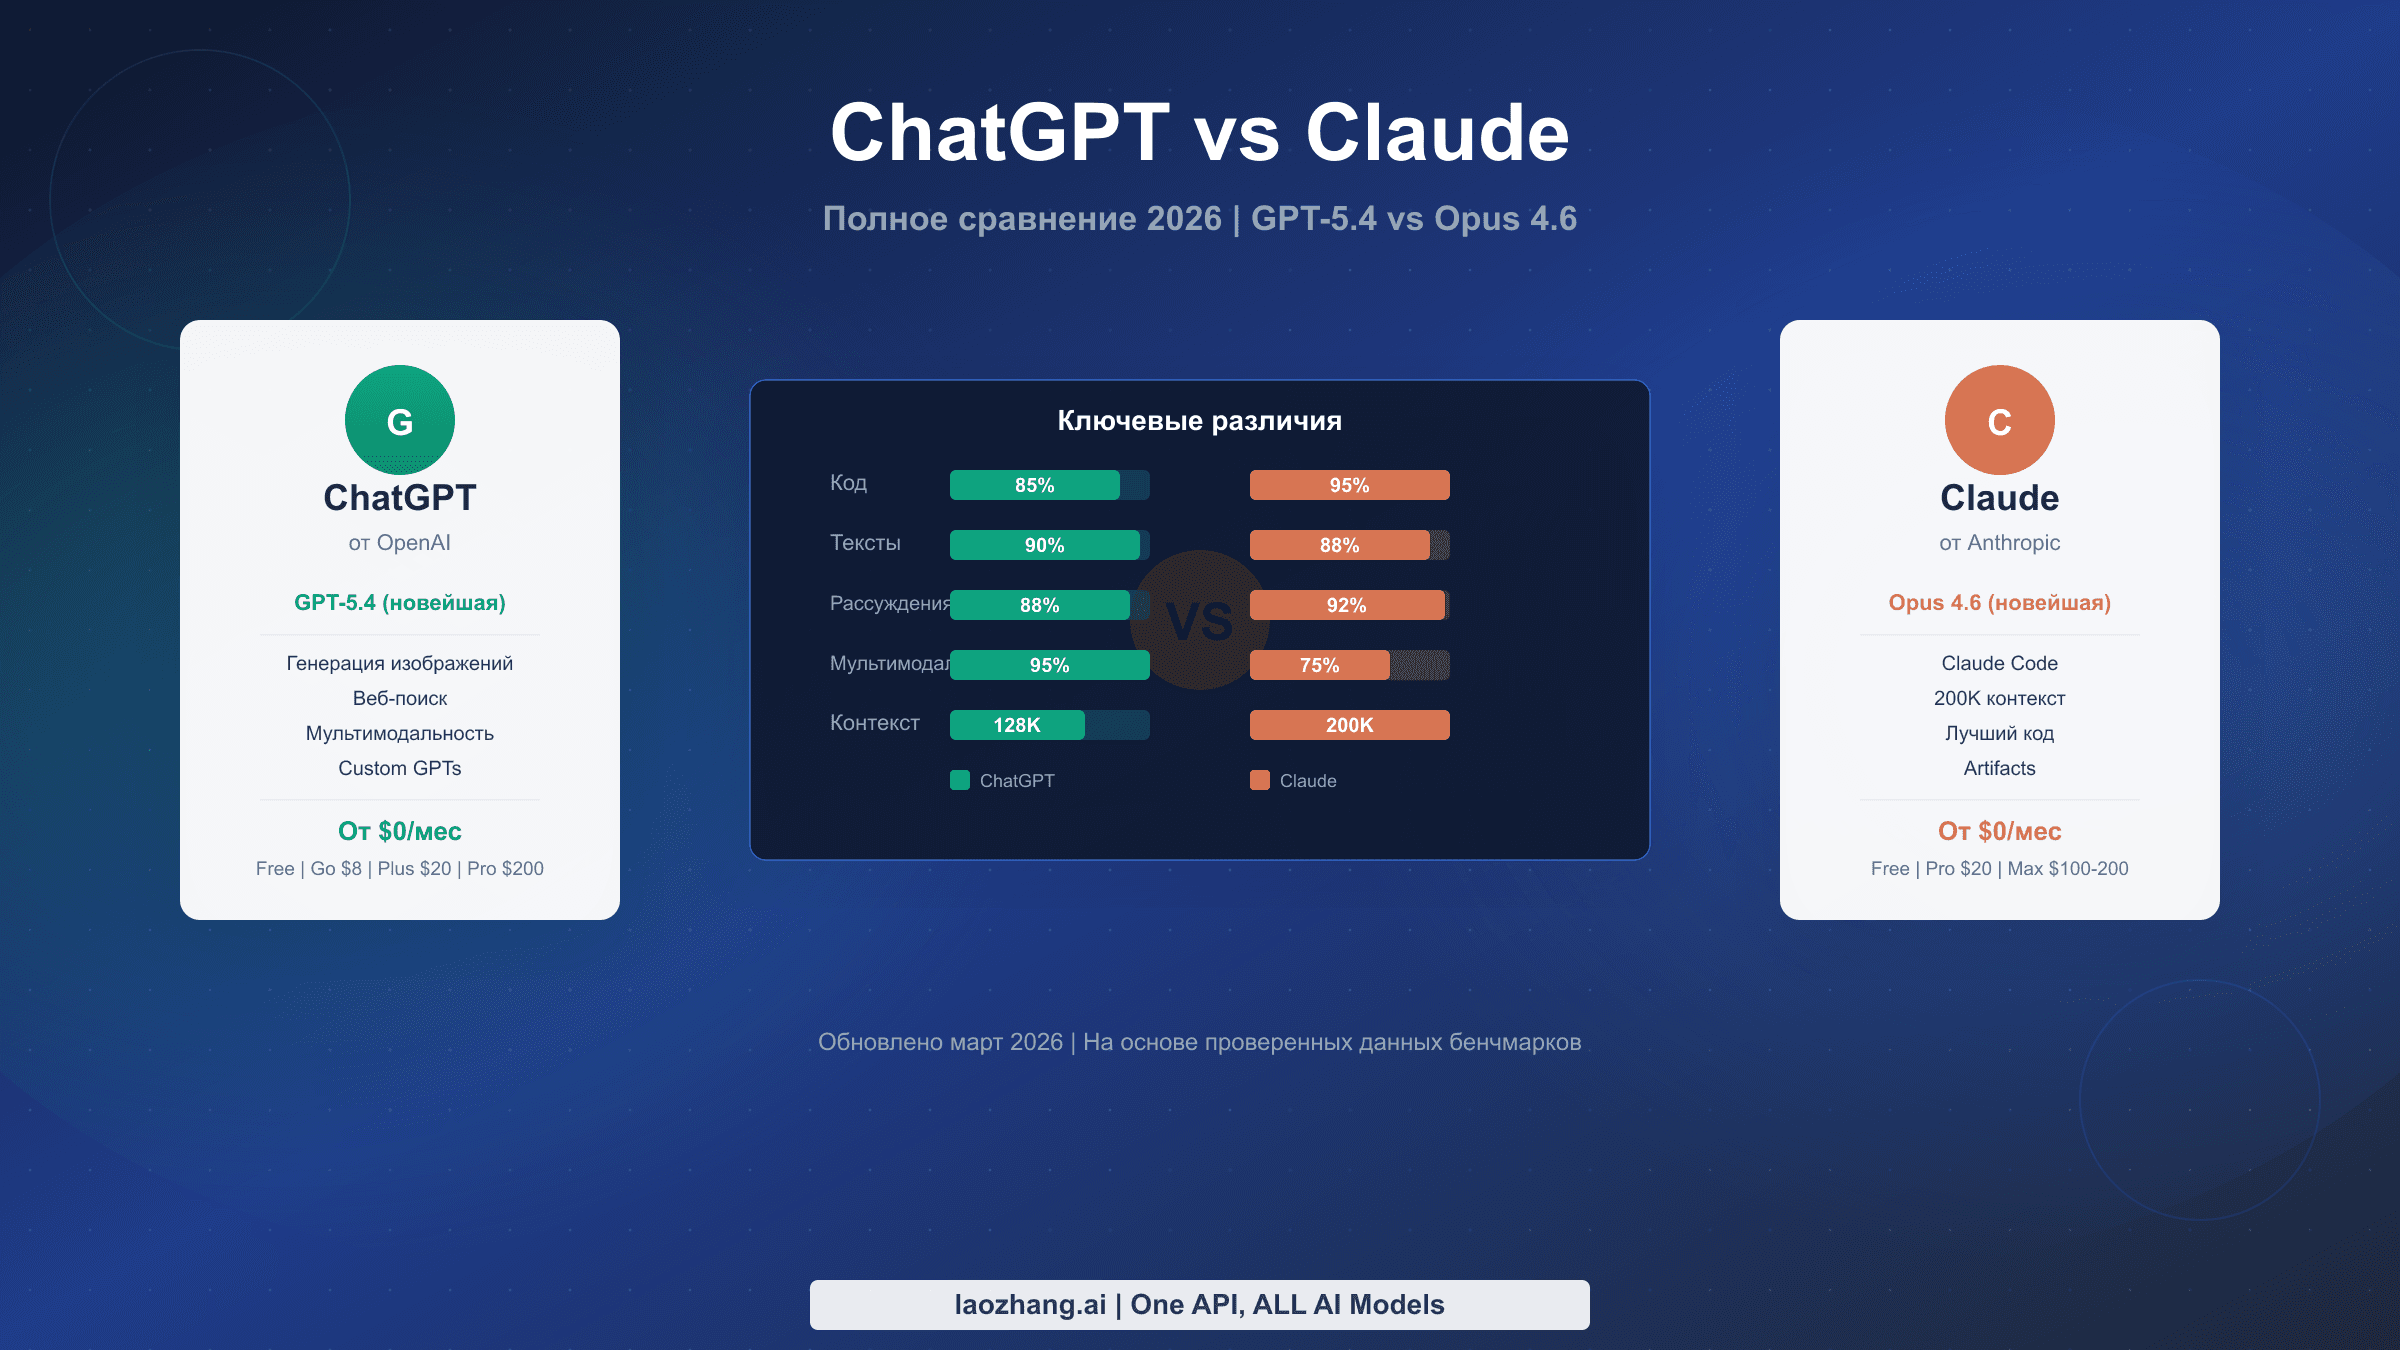
В марте 2026 года ChatGPT (GPT-5.4) и Claude (Opus 4.6) представляют двух ведущих ИИ-ассистентов с различными преимуществами. ChatGPT превосходит в мультимодальных задачах, генерации изображений и веб-поиске, тогда как Claude лидирует в точности кода, анализе длинных документов и инструментах для разработчиков. Оба предлагают бесплатные тарифы и платные планы за $20/месяц. Данное руководство сравнивает их по кодированию, написанию текстов, исследованиям, ценам и API на основе проверенных данных.
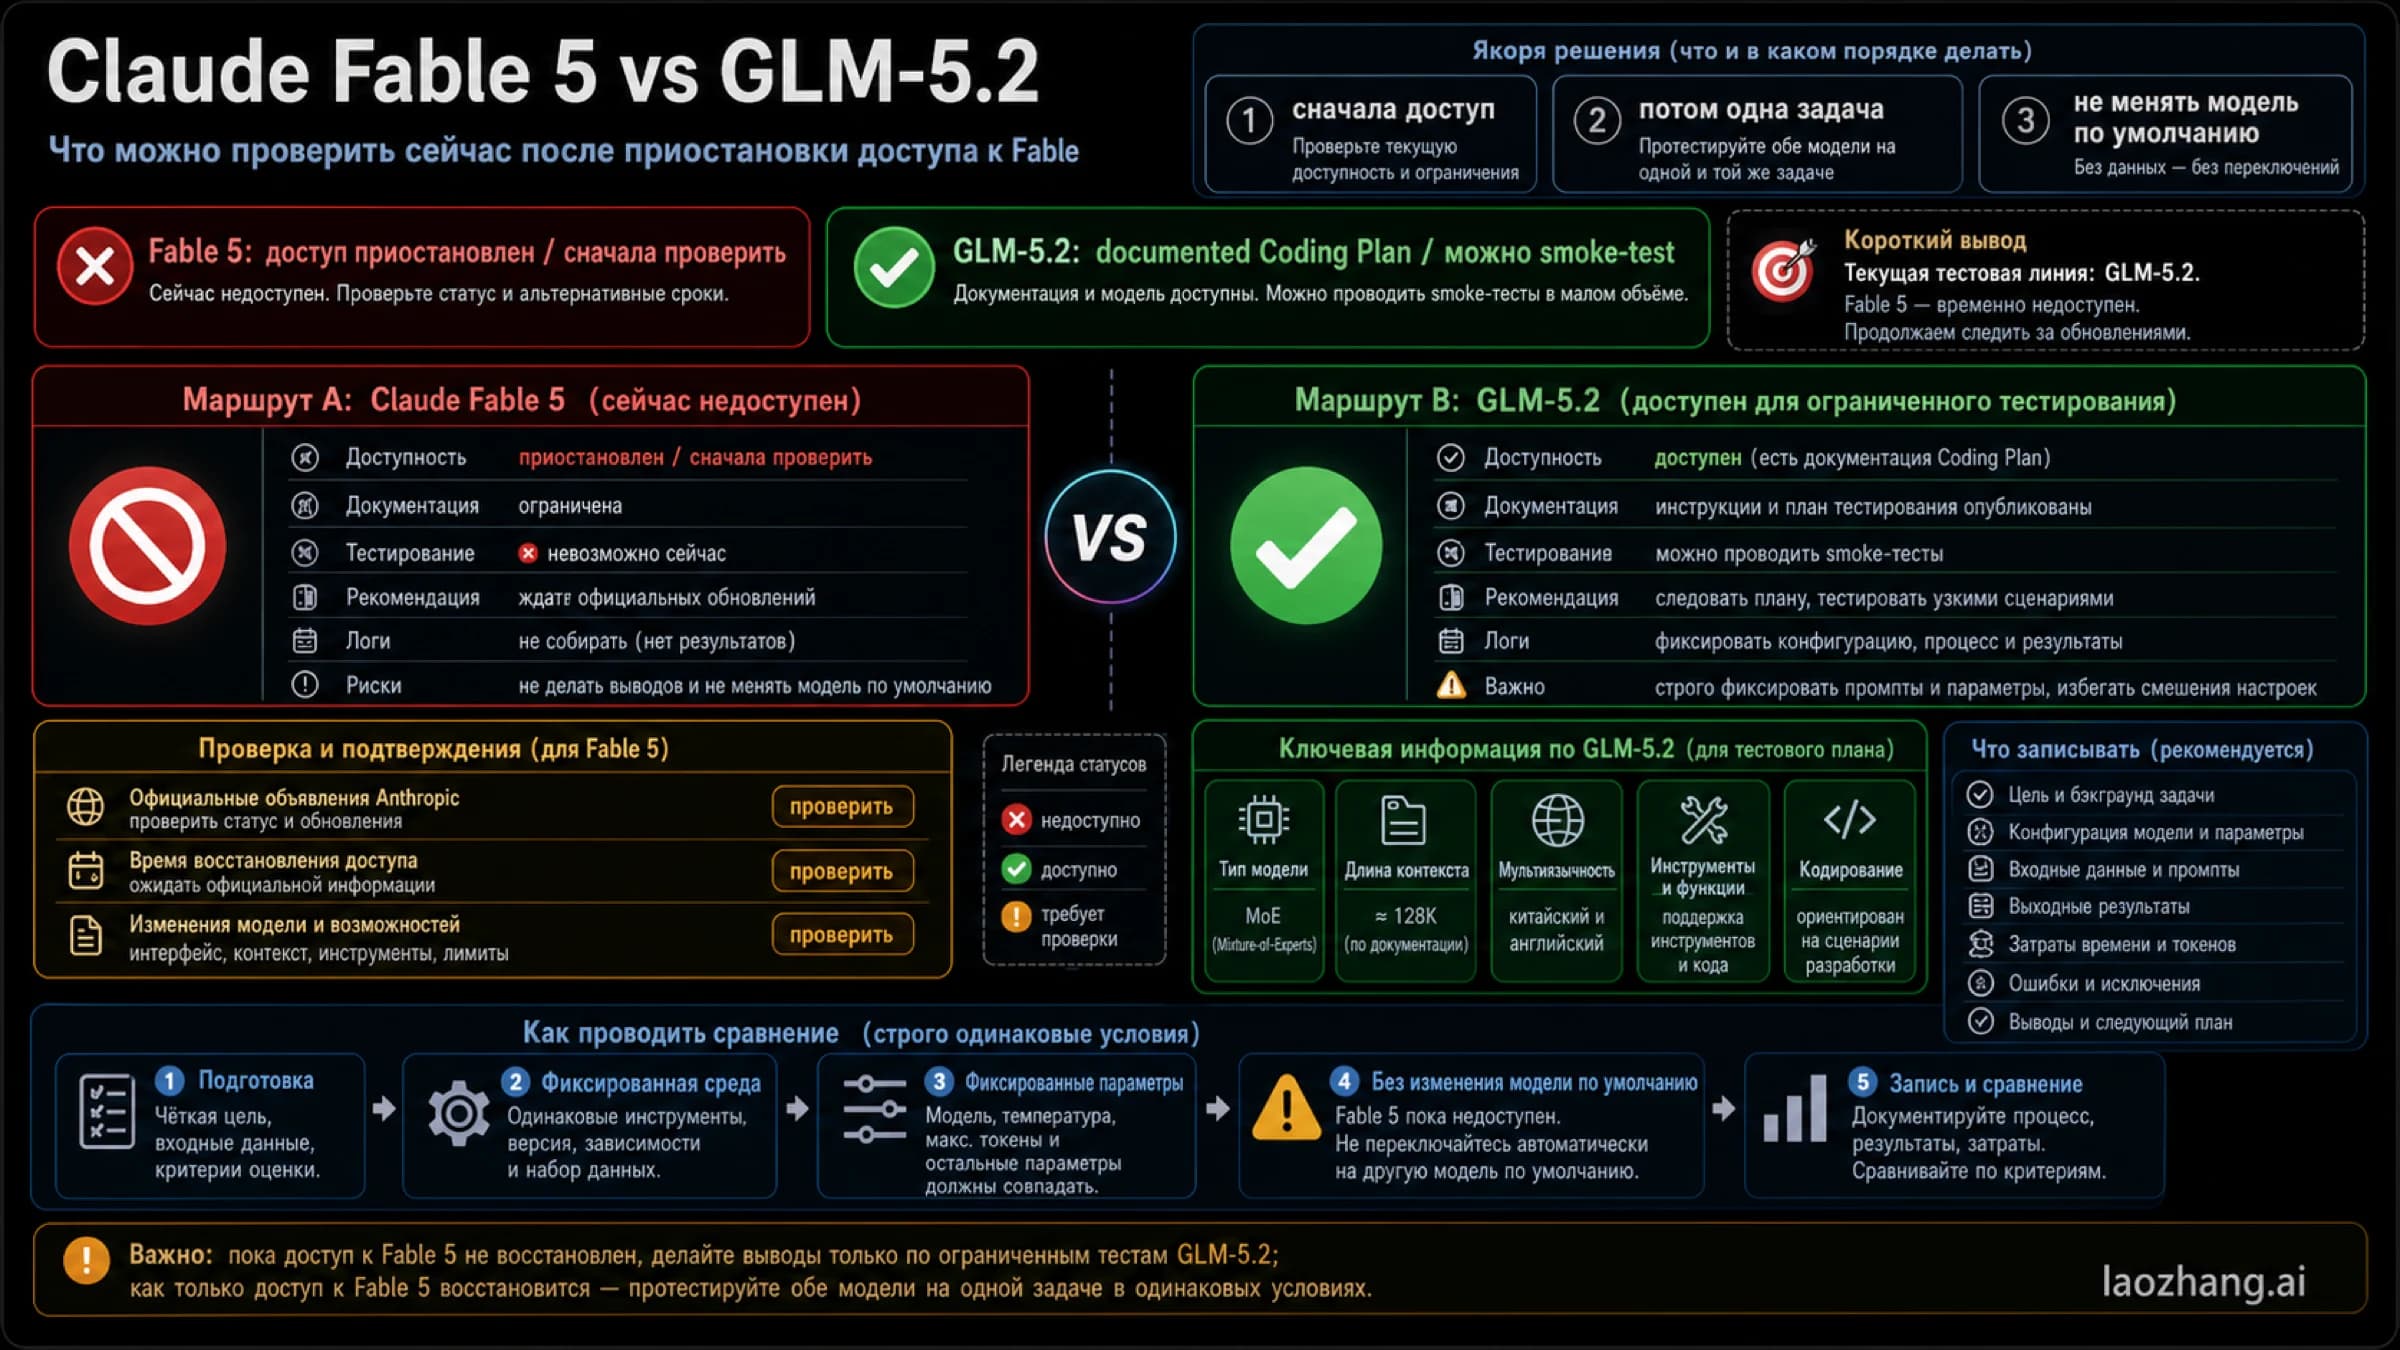
Fable 5 сейчас является веткой ожидания и повторной проверки, а GLM-5.2 — документированной веткой Z.AI Coding Plan для небольшого smoke test. Не меняйте default model без evidence from the same task.
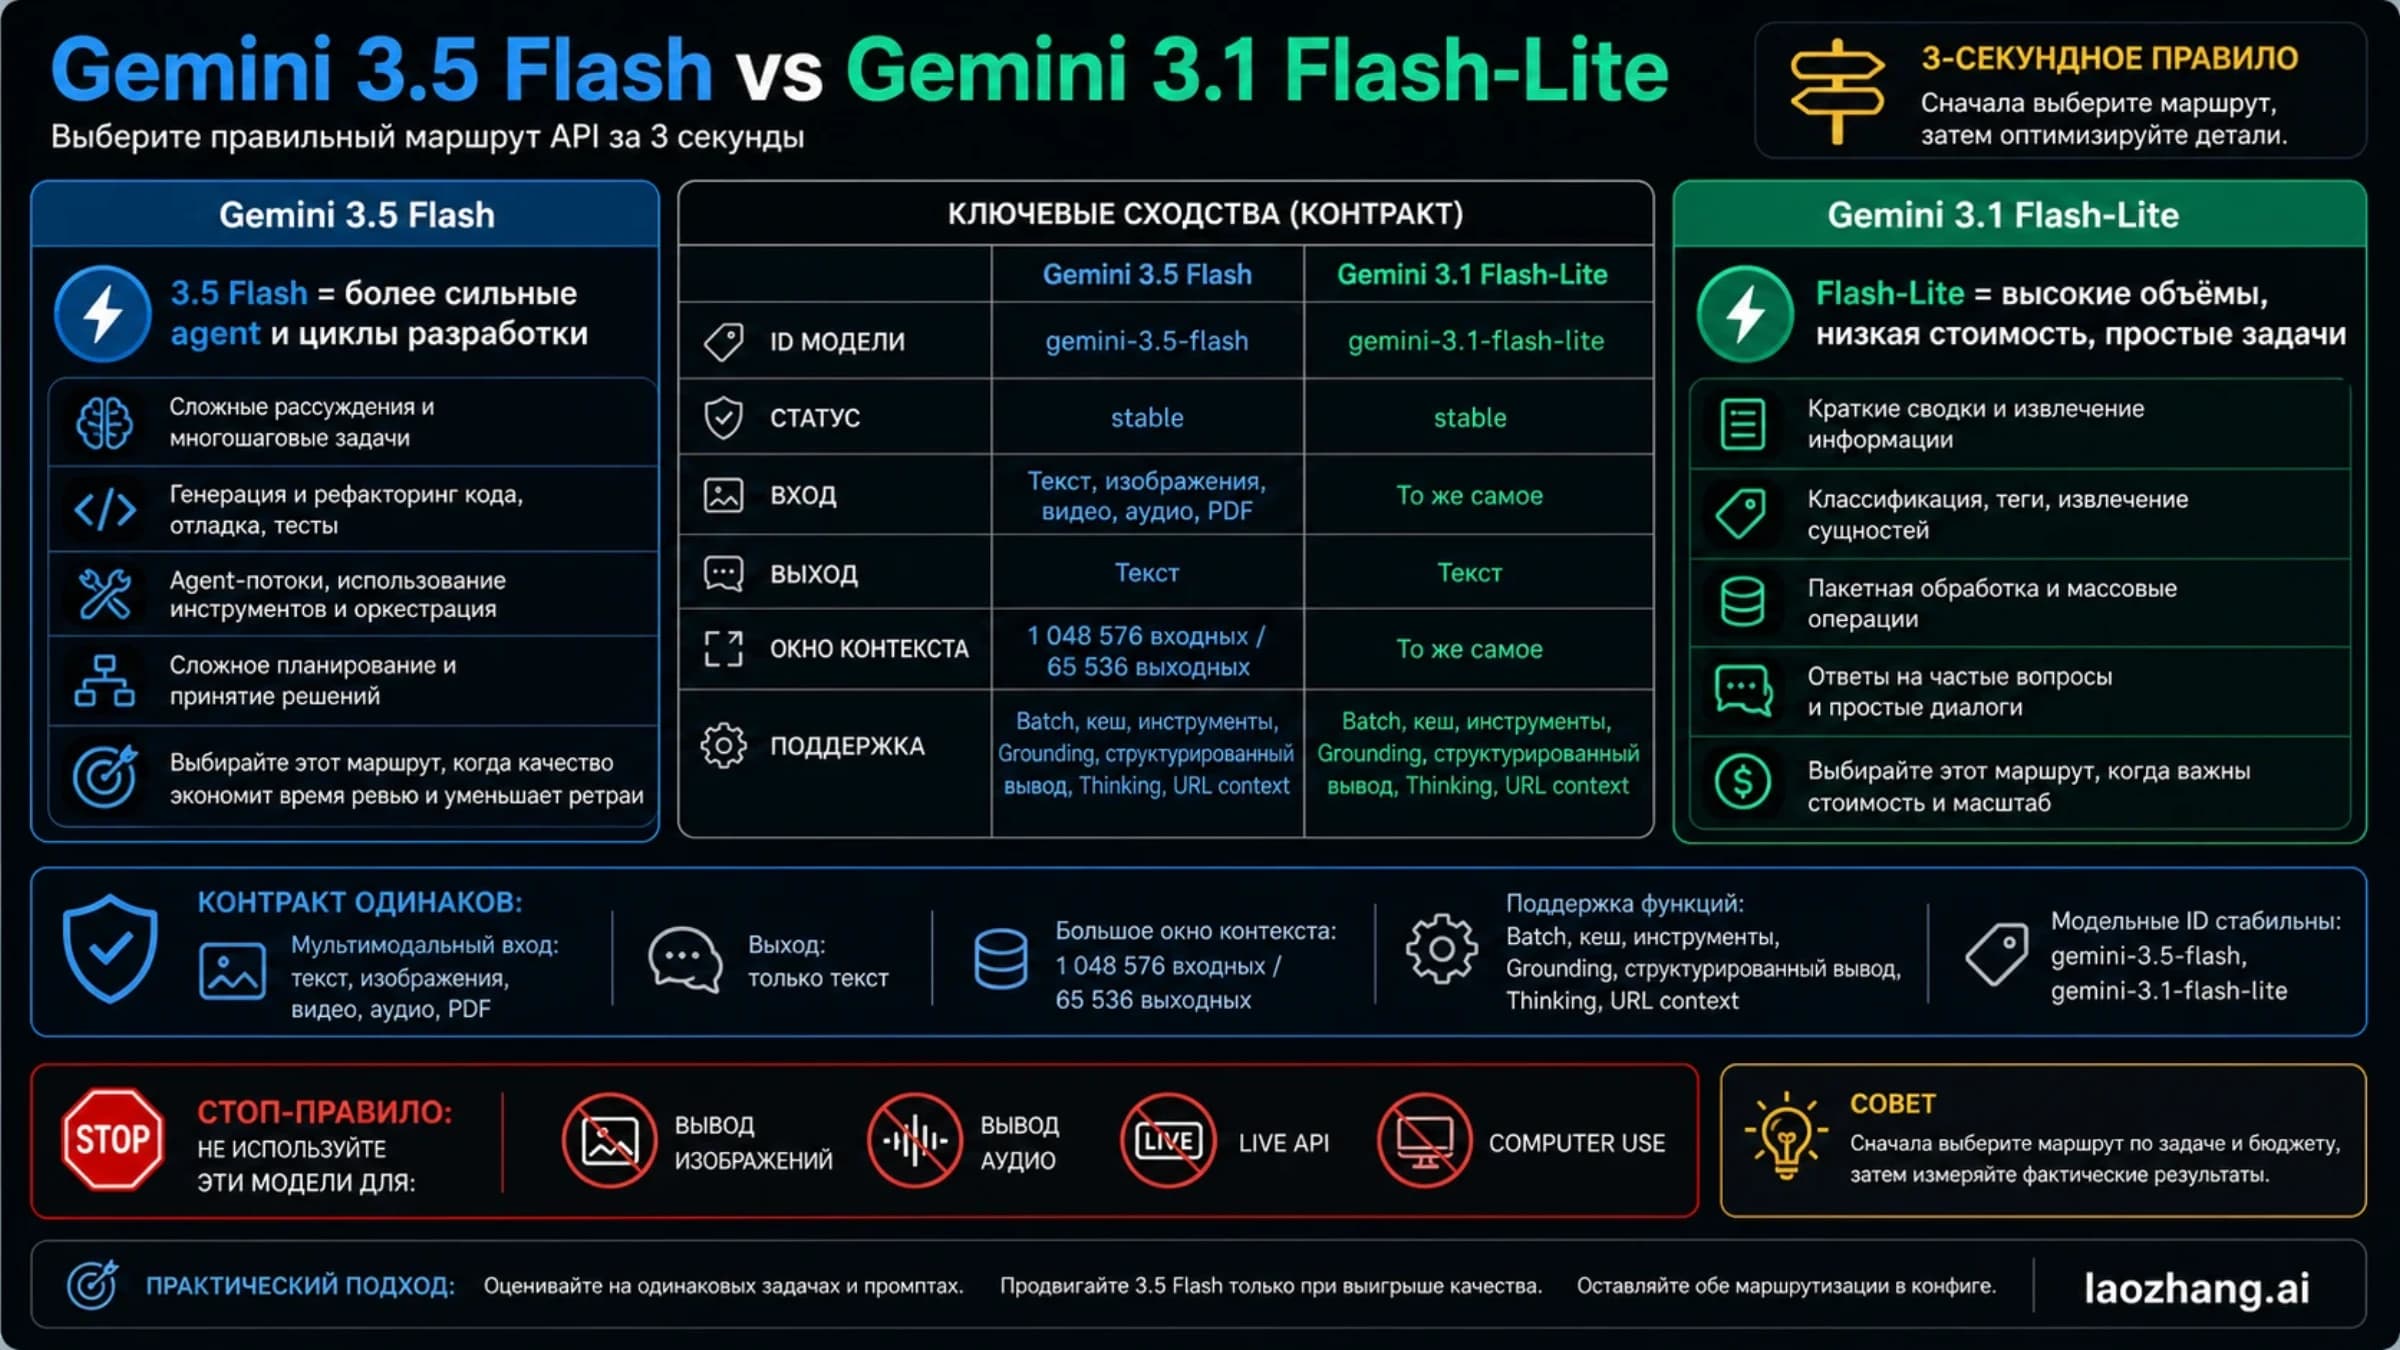
Gemini 3.5 Flash стоит тестировать для agent, coding и сложных tool loops. Gemini 3.1 Flash-Lite остается лучшим первым выбором для массовых простых задач с низкой стоимостью.
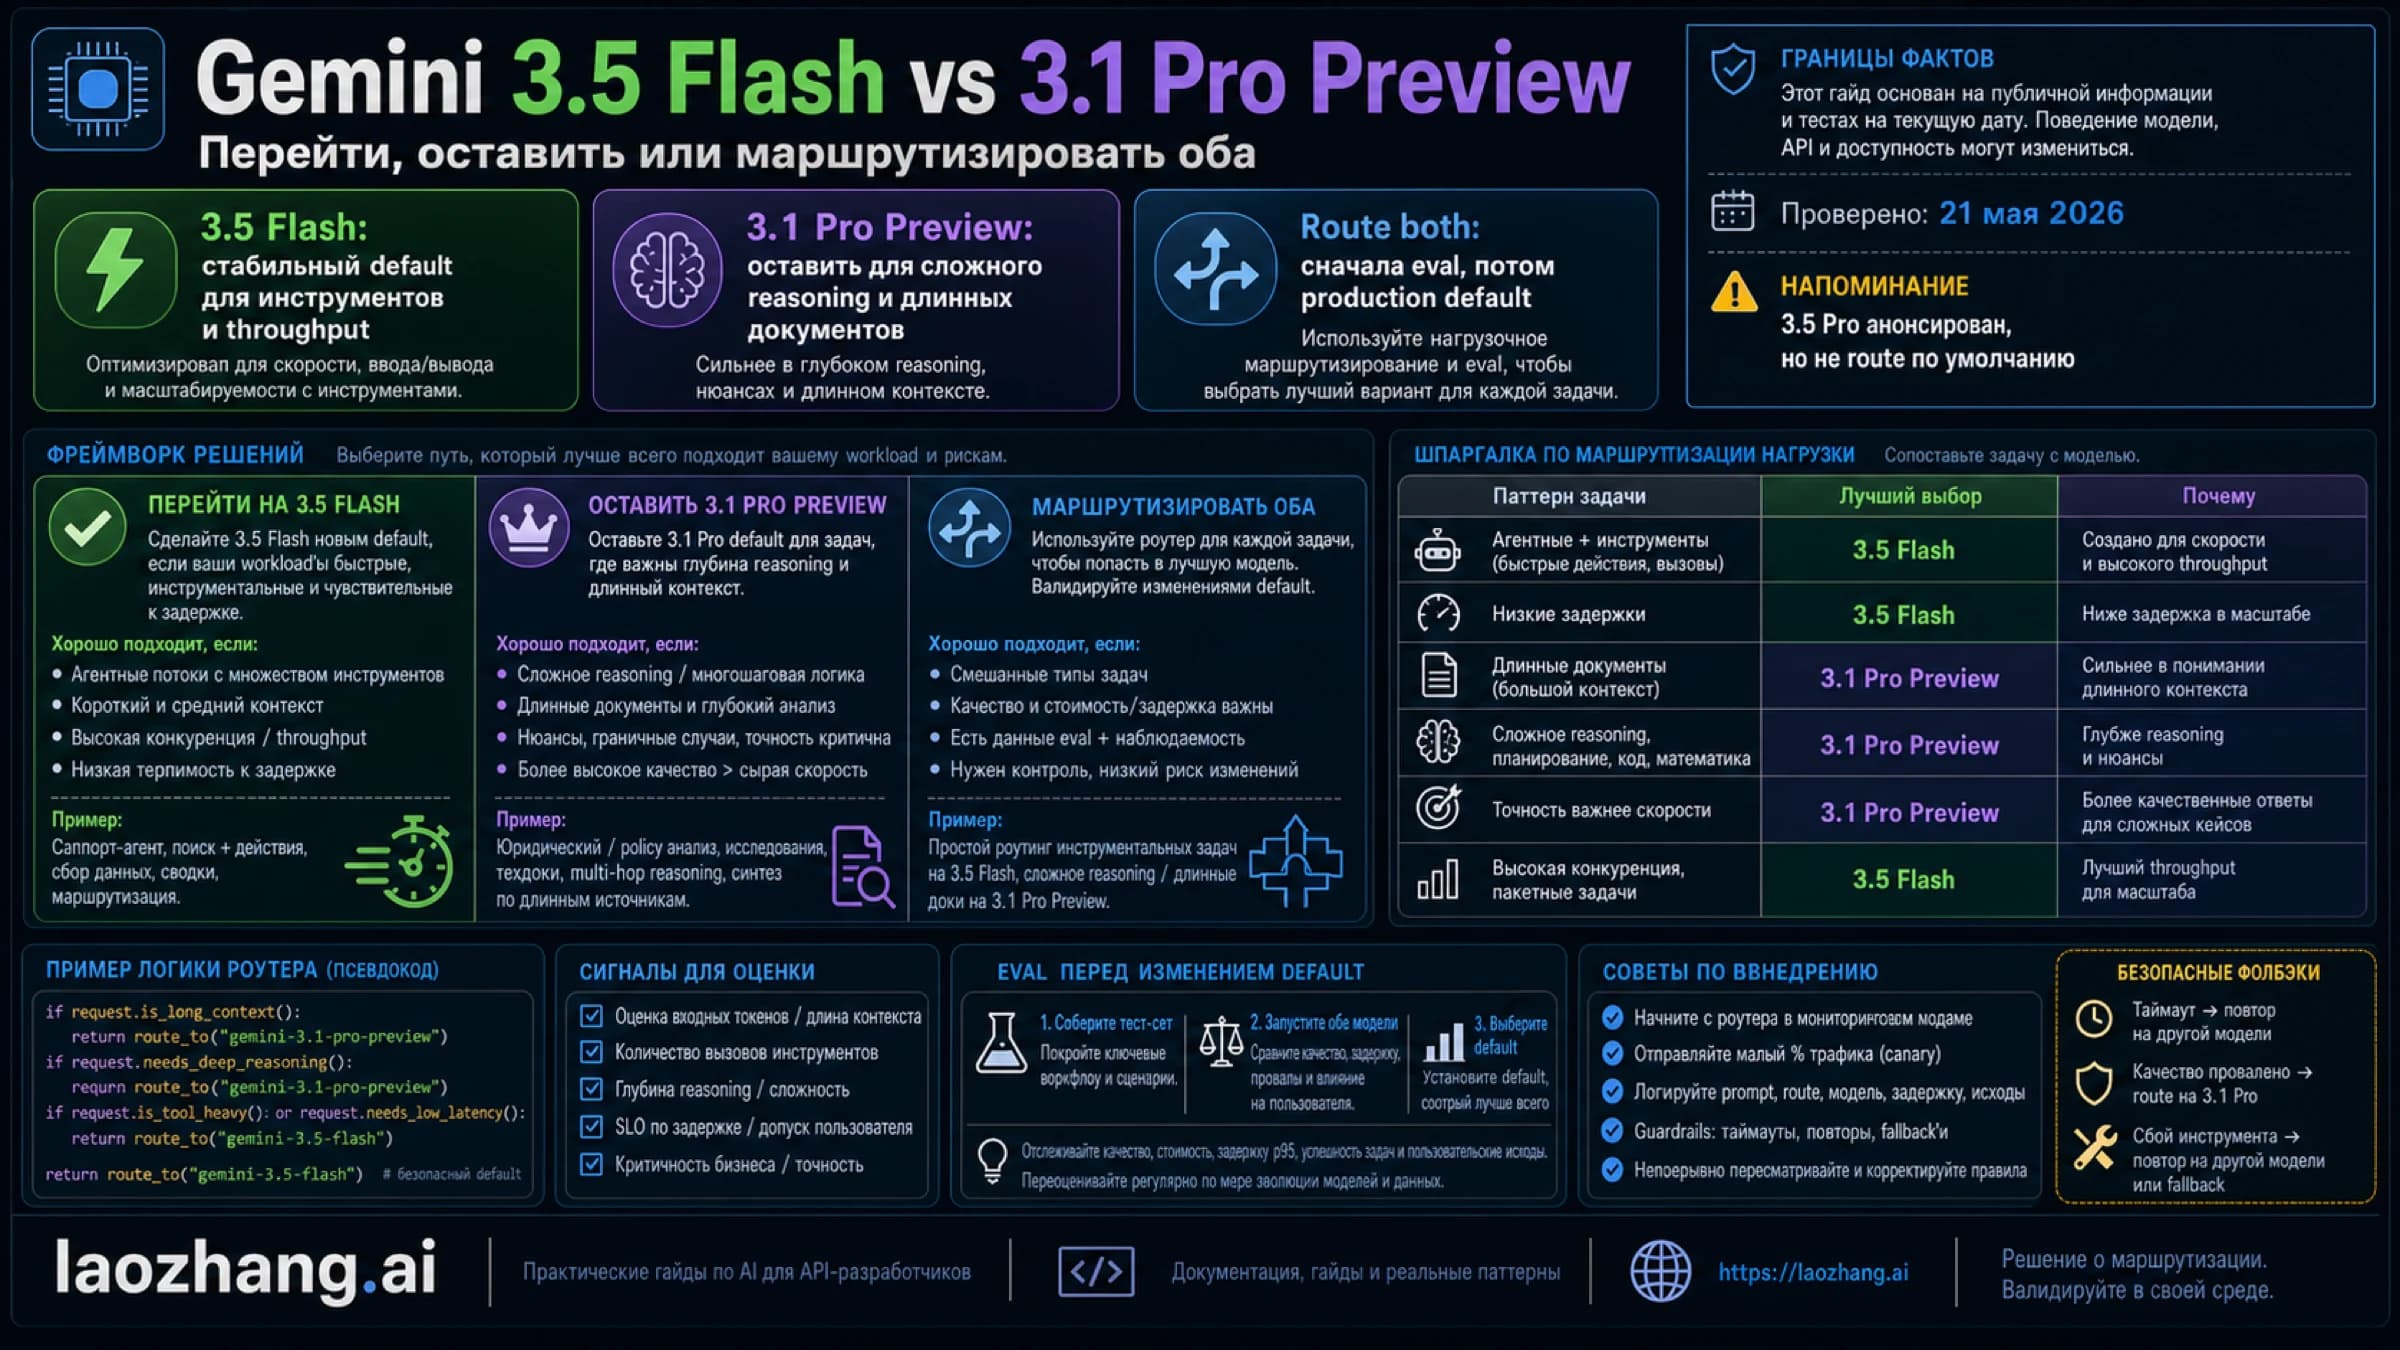
Gemini 3.5 Flash стоит первым тестом для быстрых агентных и кодовых задач, но Gemini 3.1 Pro Preview лучше оставить для глубокого анализа, длинных документов и customtools-маршрутов.
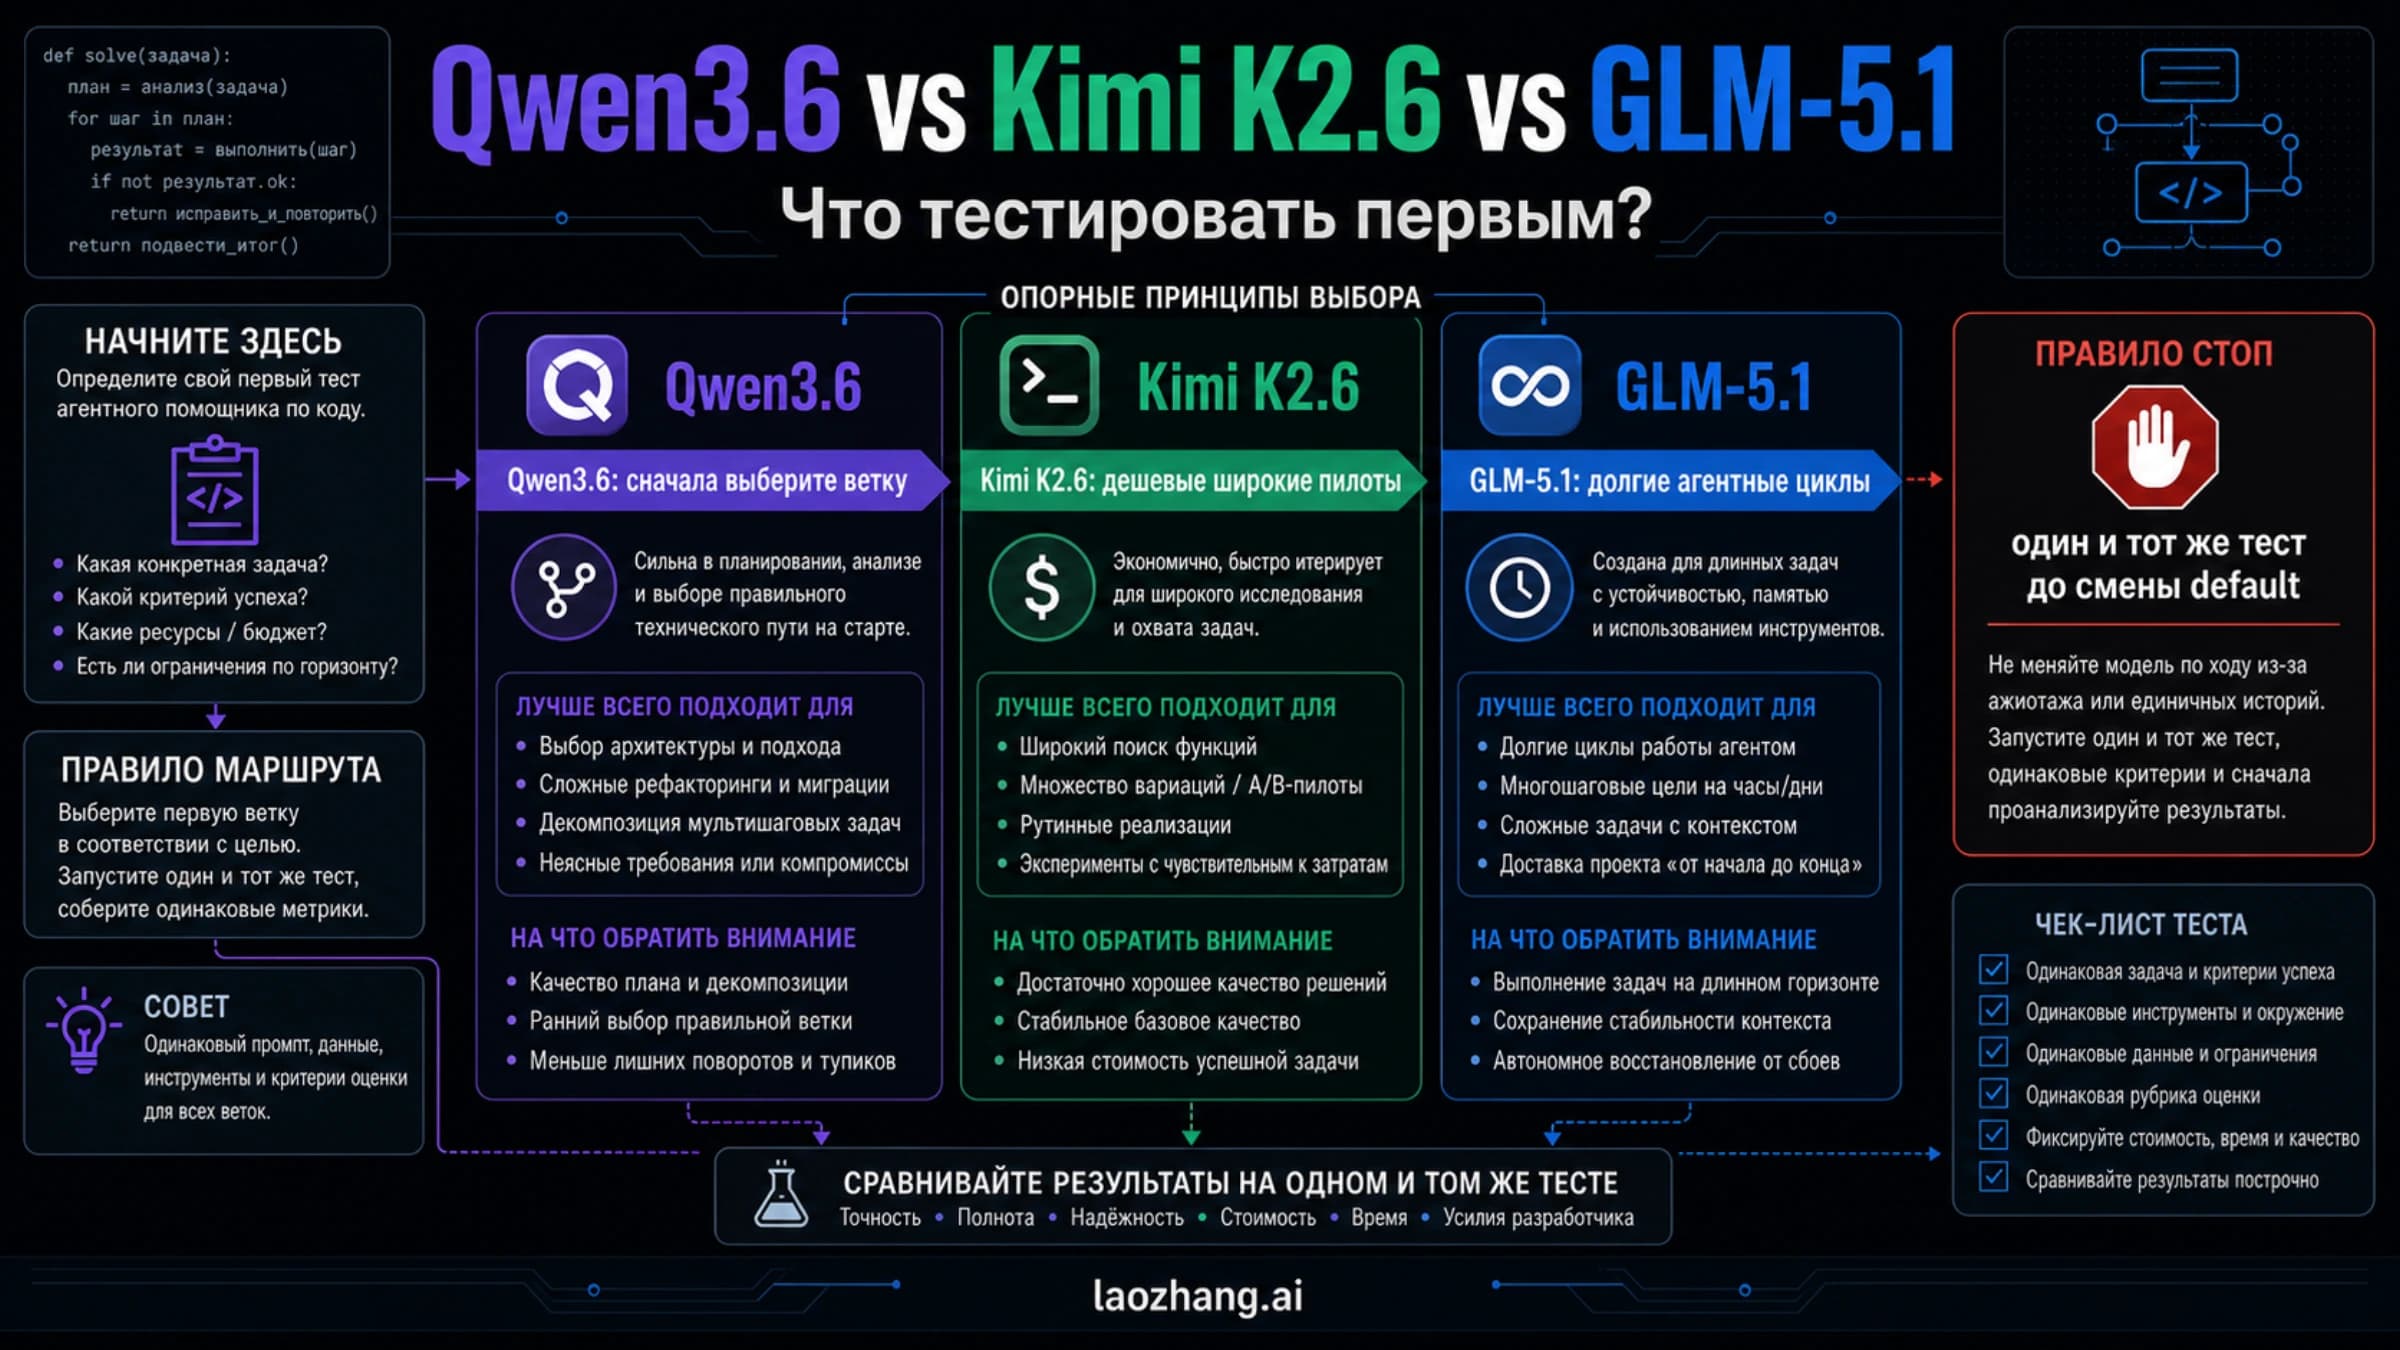
Для long-horizon agent work первым тестируйте GLM-5.1, для дешевых пилотов Kimi K2.6, а Qwen3.6 только после выбора 35B-A3B или hosted branch.
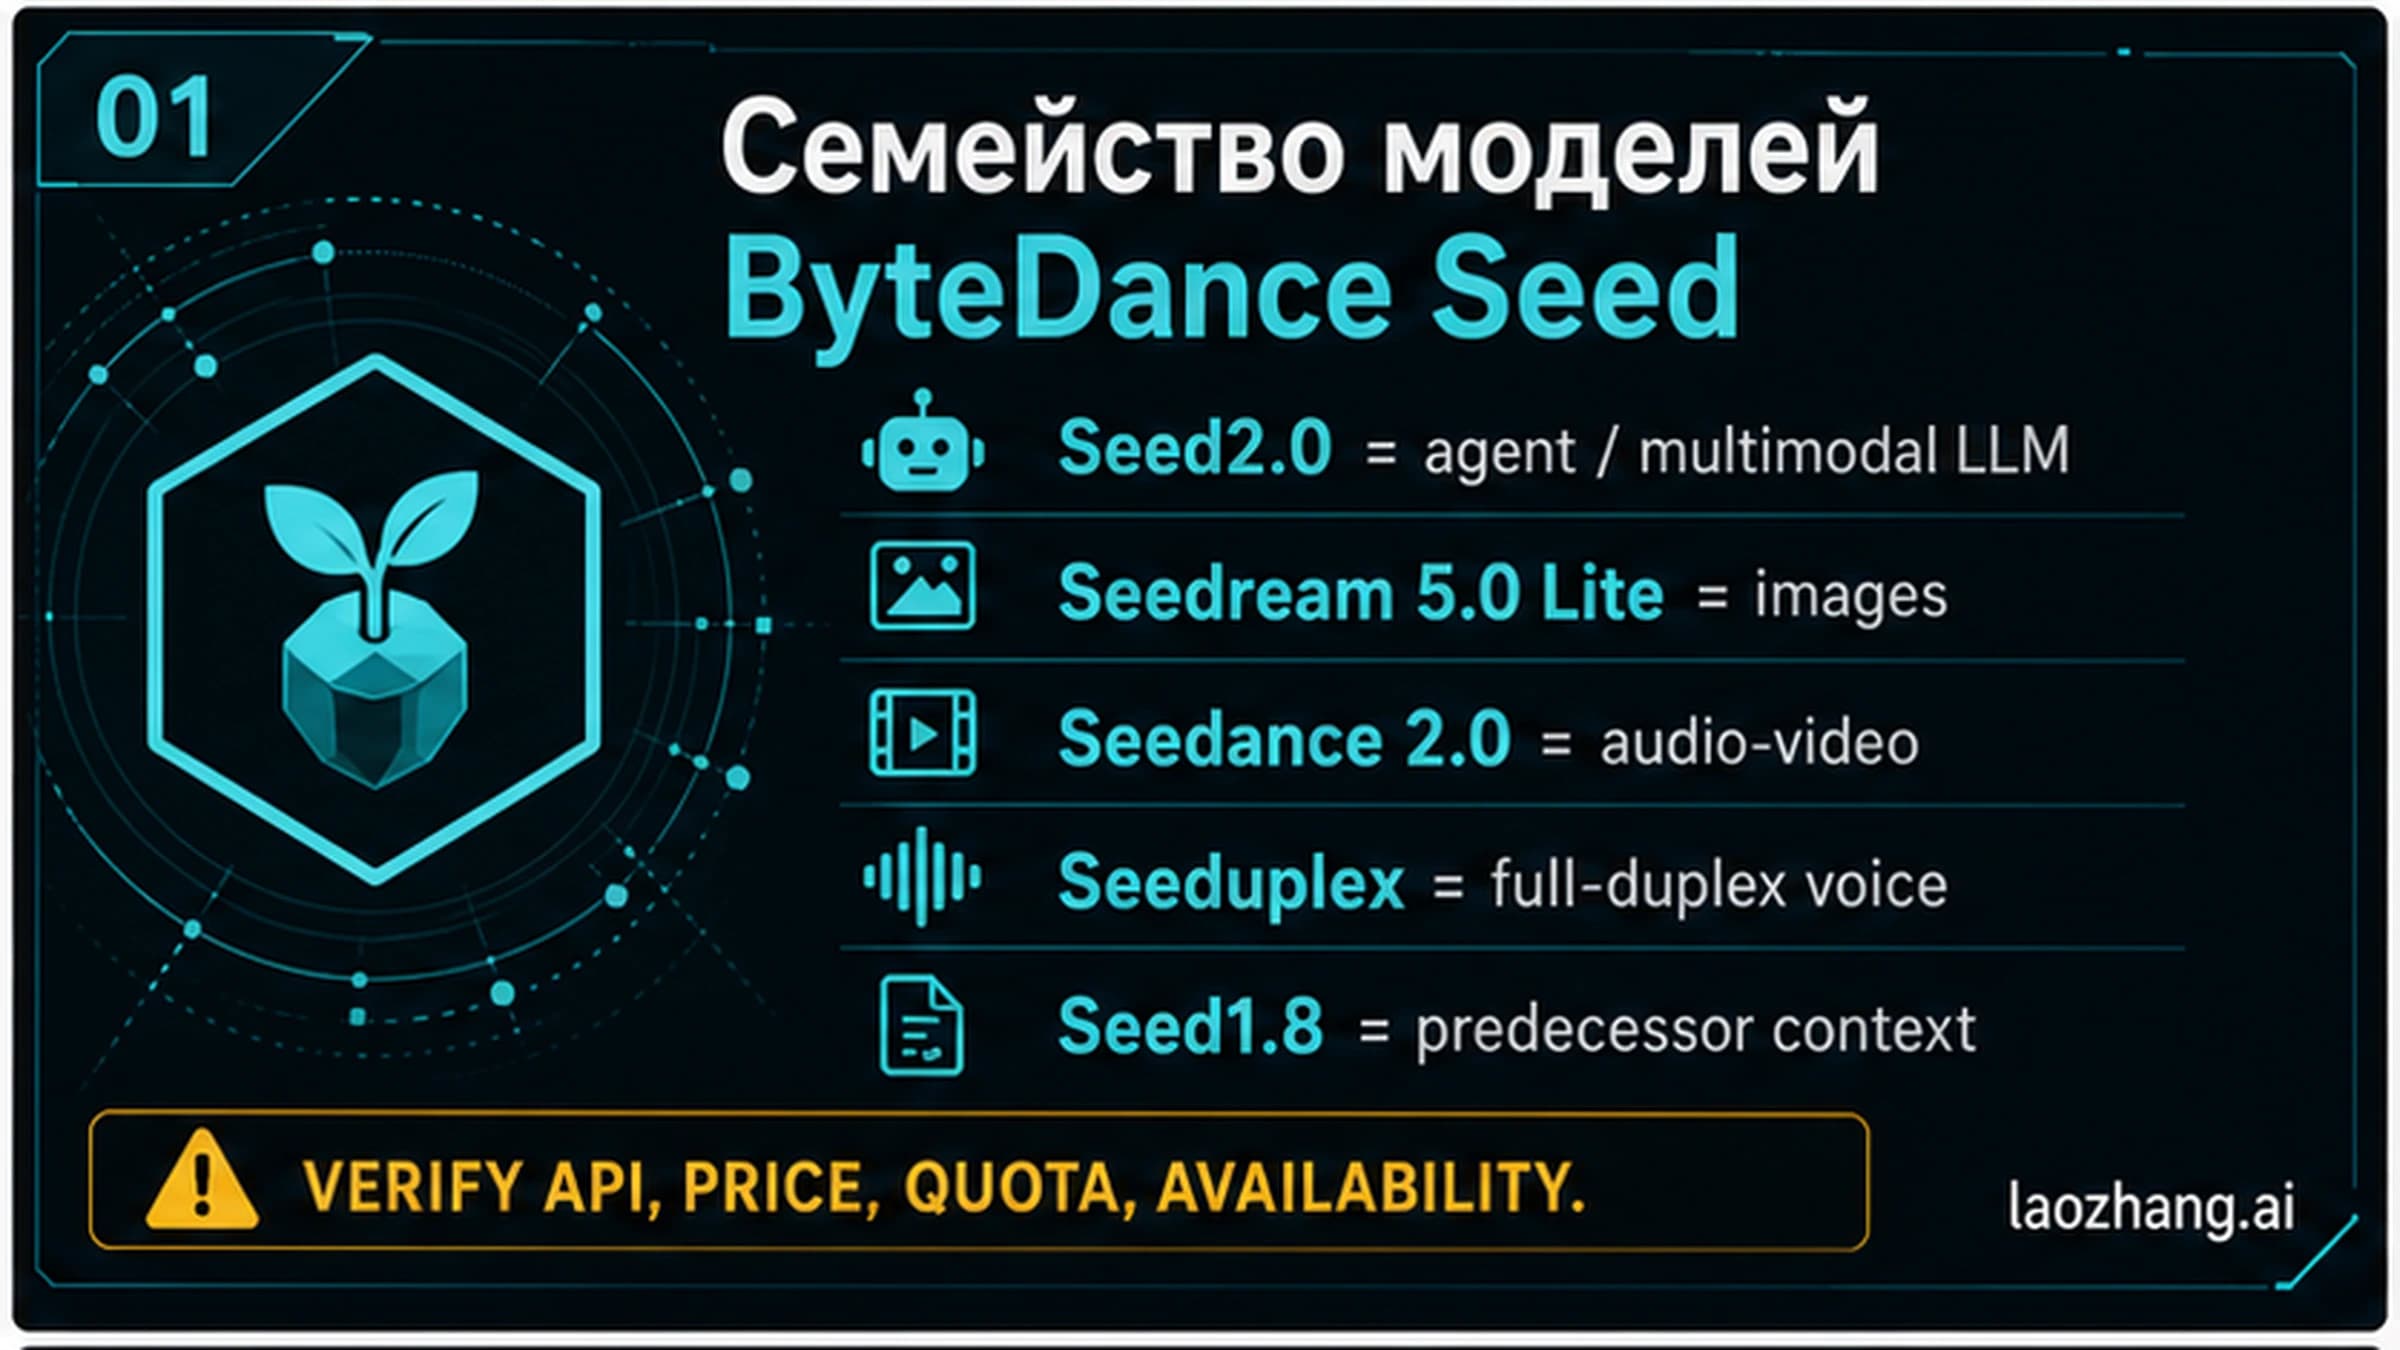
Для агентных LLM начните с Seed2.0, для изображений с Seedream, для аудио-видео с Seedance, для голоса с Seeduplex, а Seed1.8 оставьте как контекст прошлого поколения.
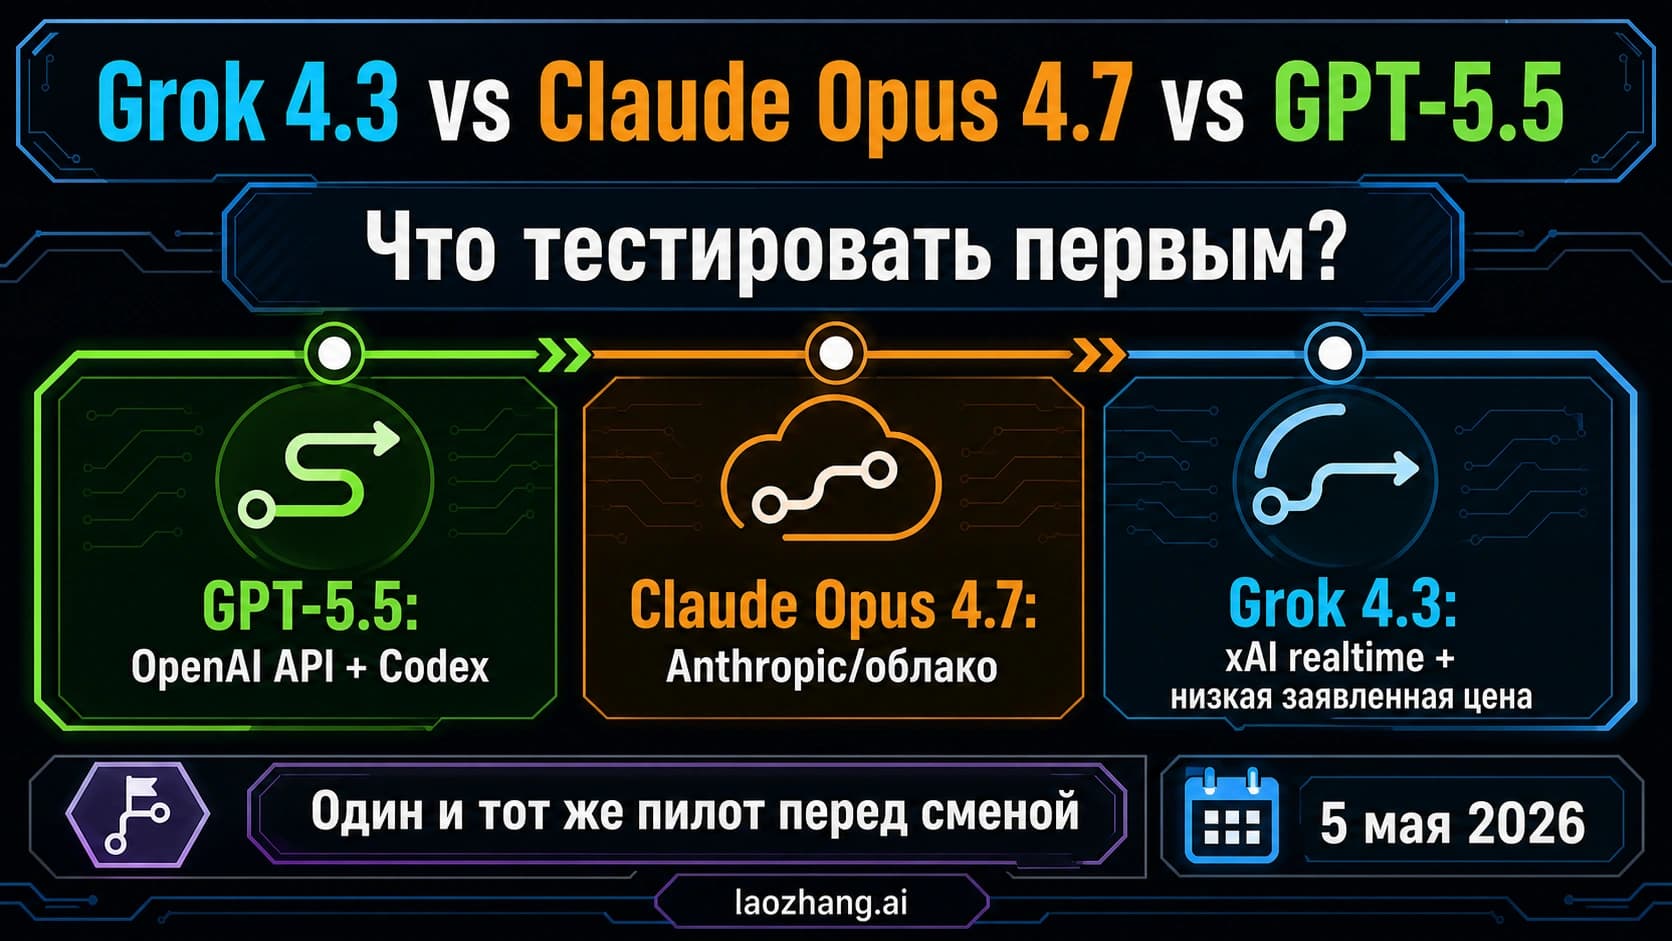
GPT-5.5 стоит тестировать первым в OpenAI-native стеке, Claude Opus 4.7 держать как premium control, а Grok 4.3 начинать при xAI realtime, цене или long-context пилоте.
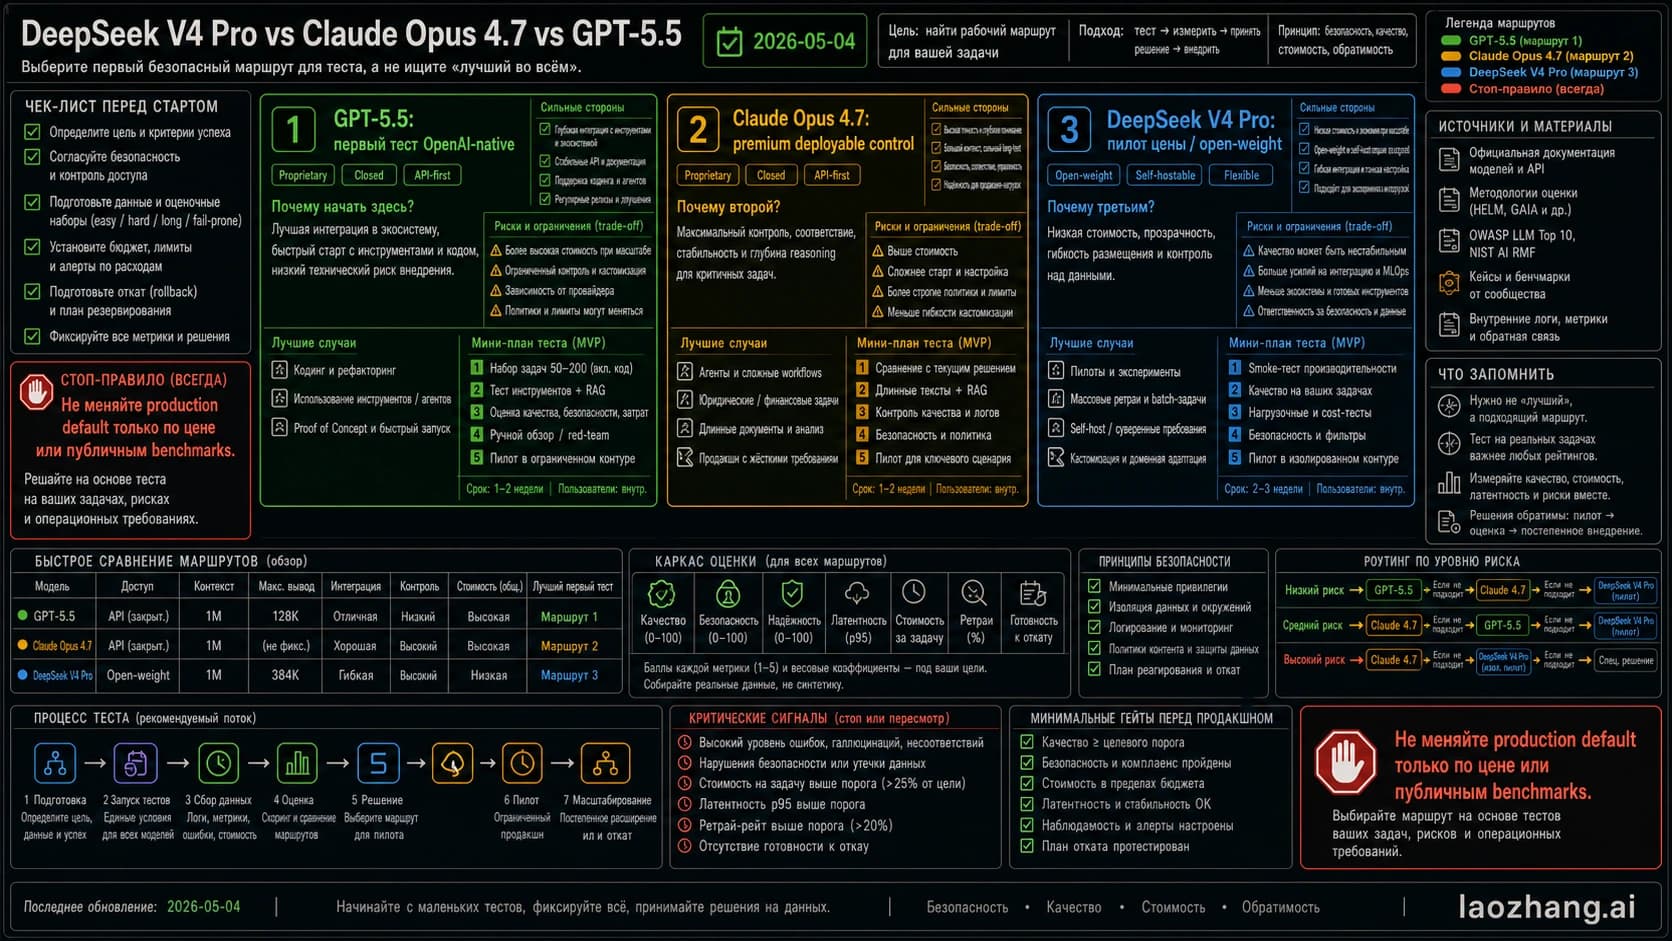
GPT-5.5 стоит тестировать первым в OpenAI-native задачах, Claude Opus 4.7 держать как premium control, а DeepSeek V4 Pro запускать как пилот для цены или open-weight сценариев.
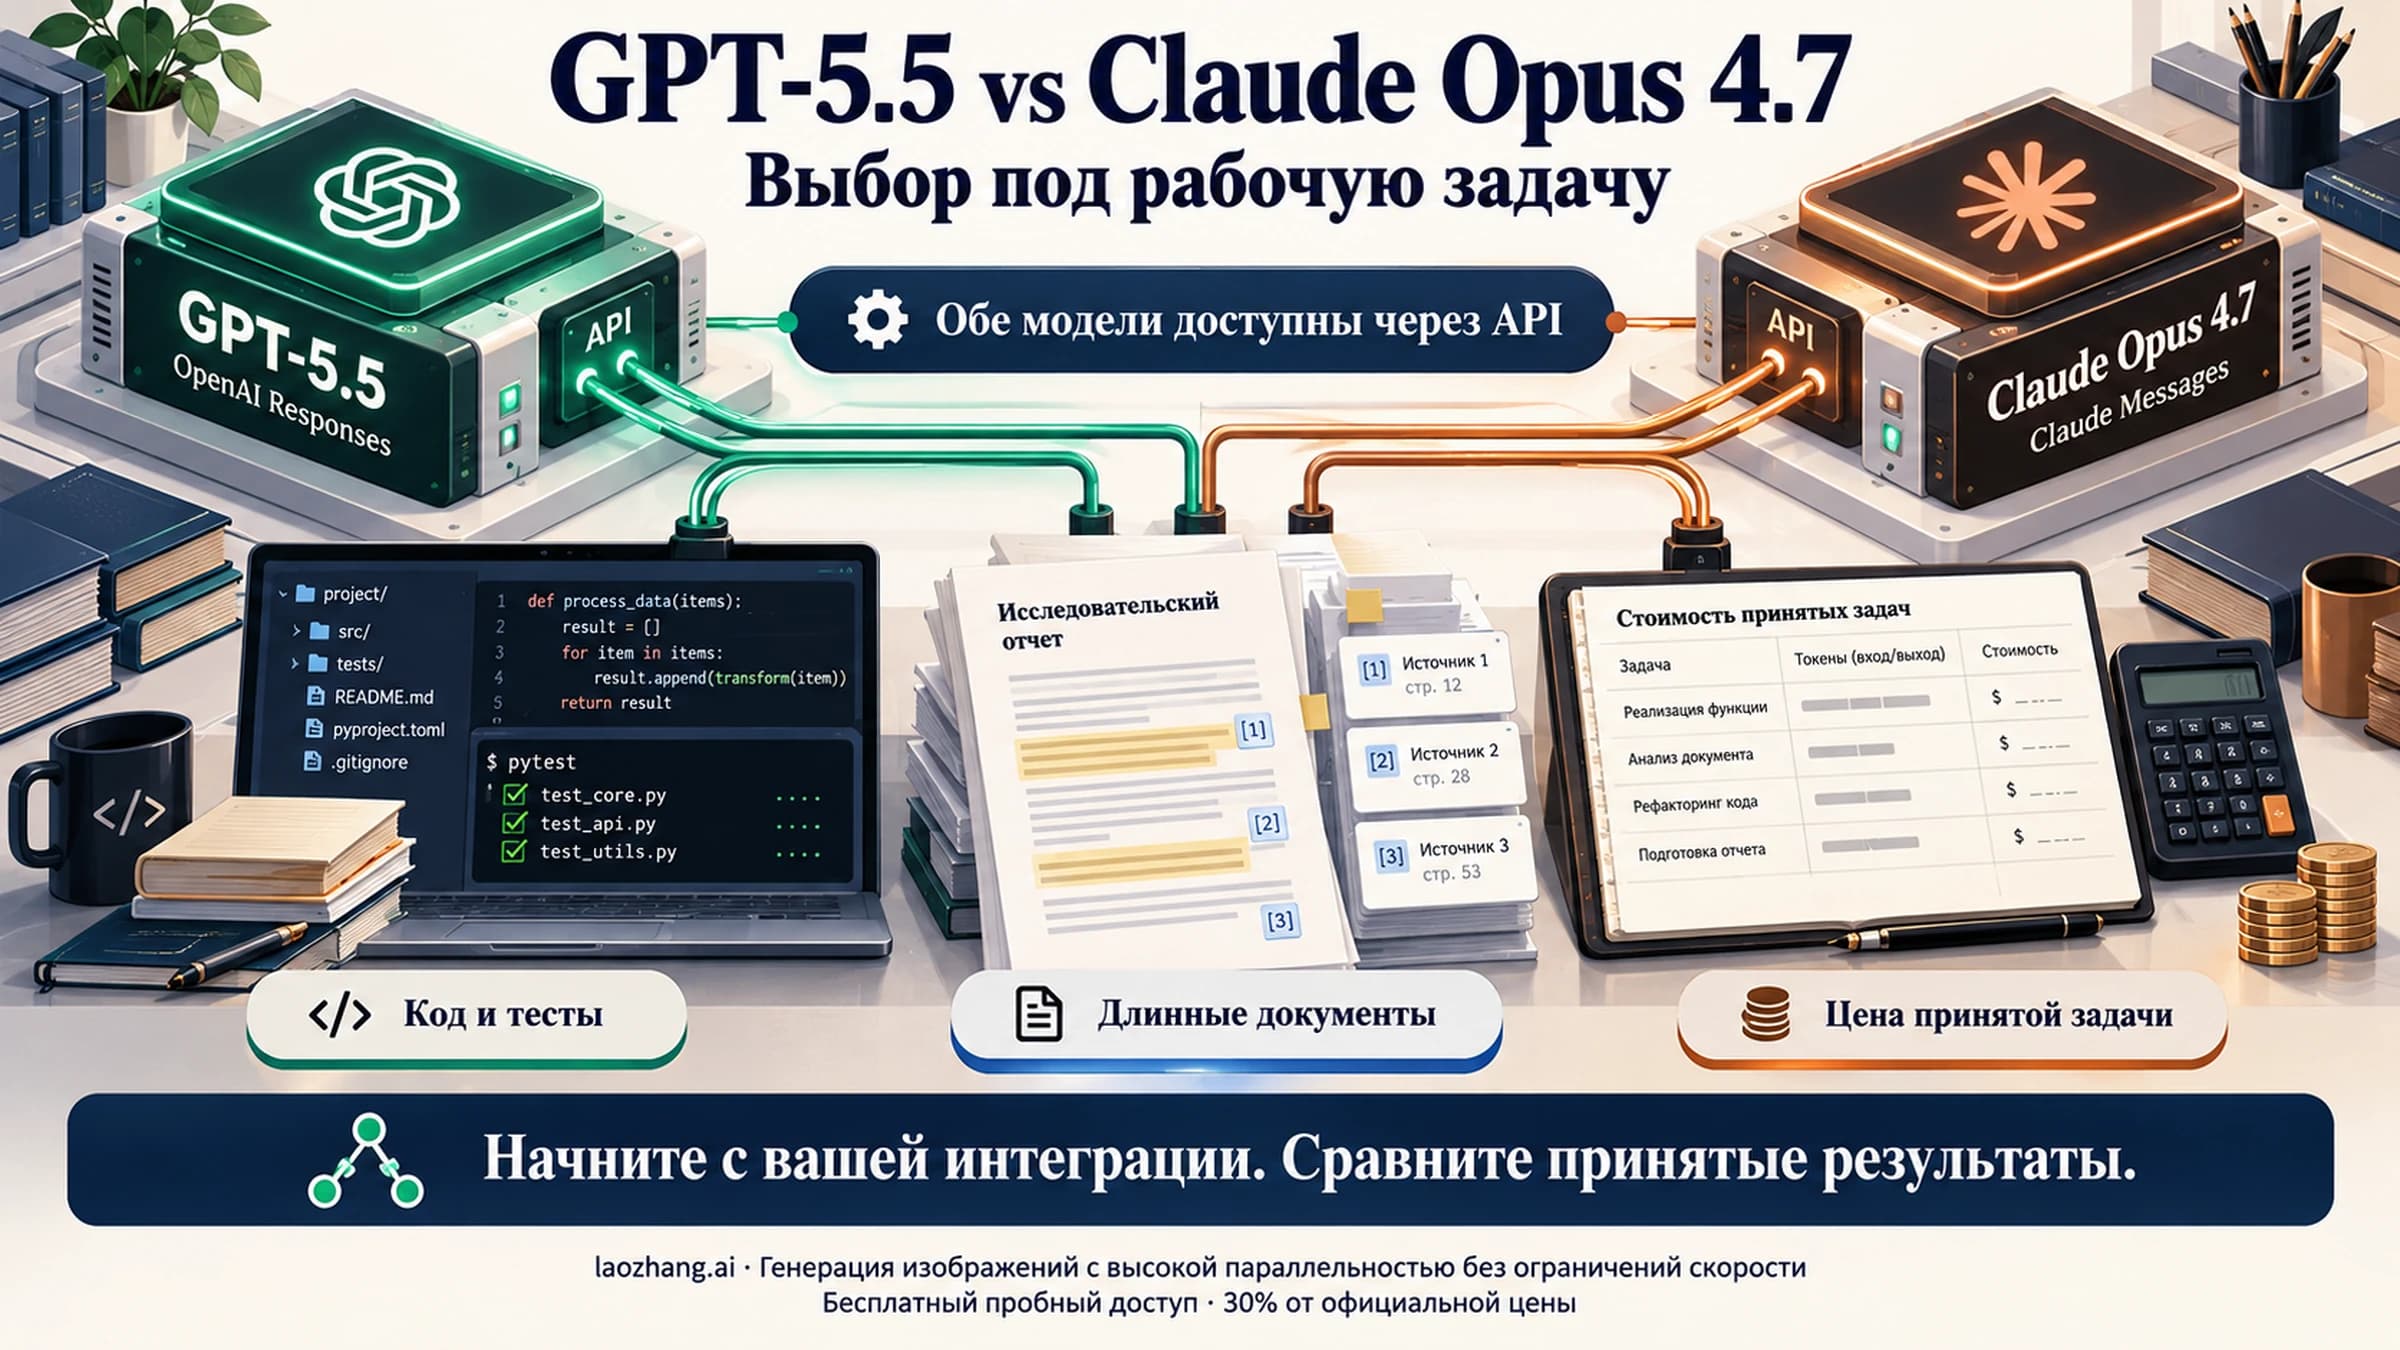
Пробуйте GPT-5.5 первой в ChatGPT, Codex и OpenAI-native потоках; выбирайте Claude Opus 4.7 первой для production API уже сегодня; перед заменой default запускайте обе модели на одних задачах.