Sonnet 5.5 vs GPT-6.1 Sol: сравнение — цена одна, счёт разный
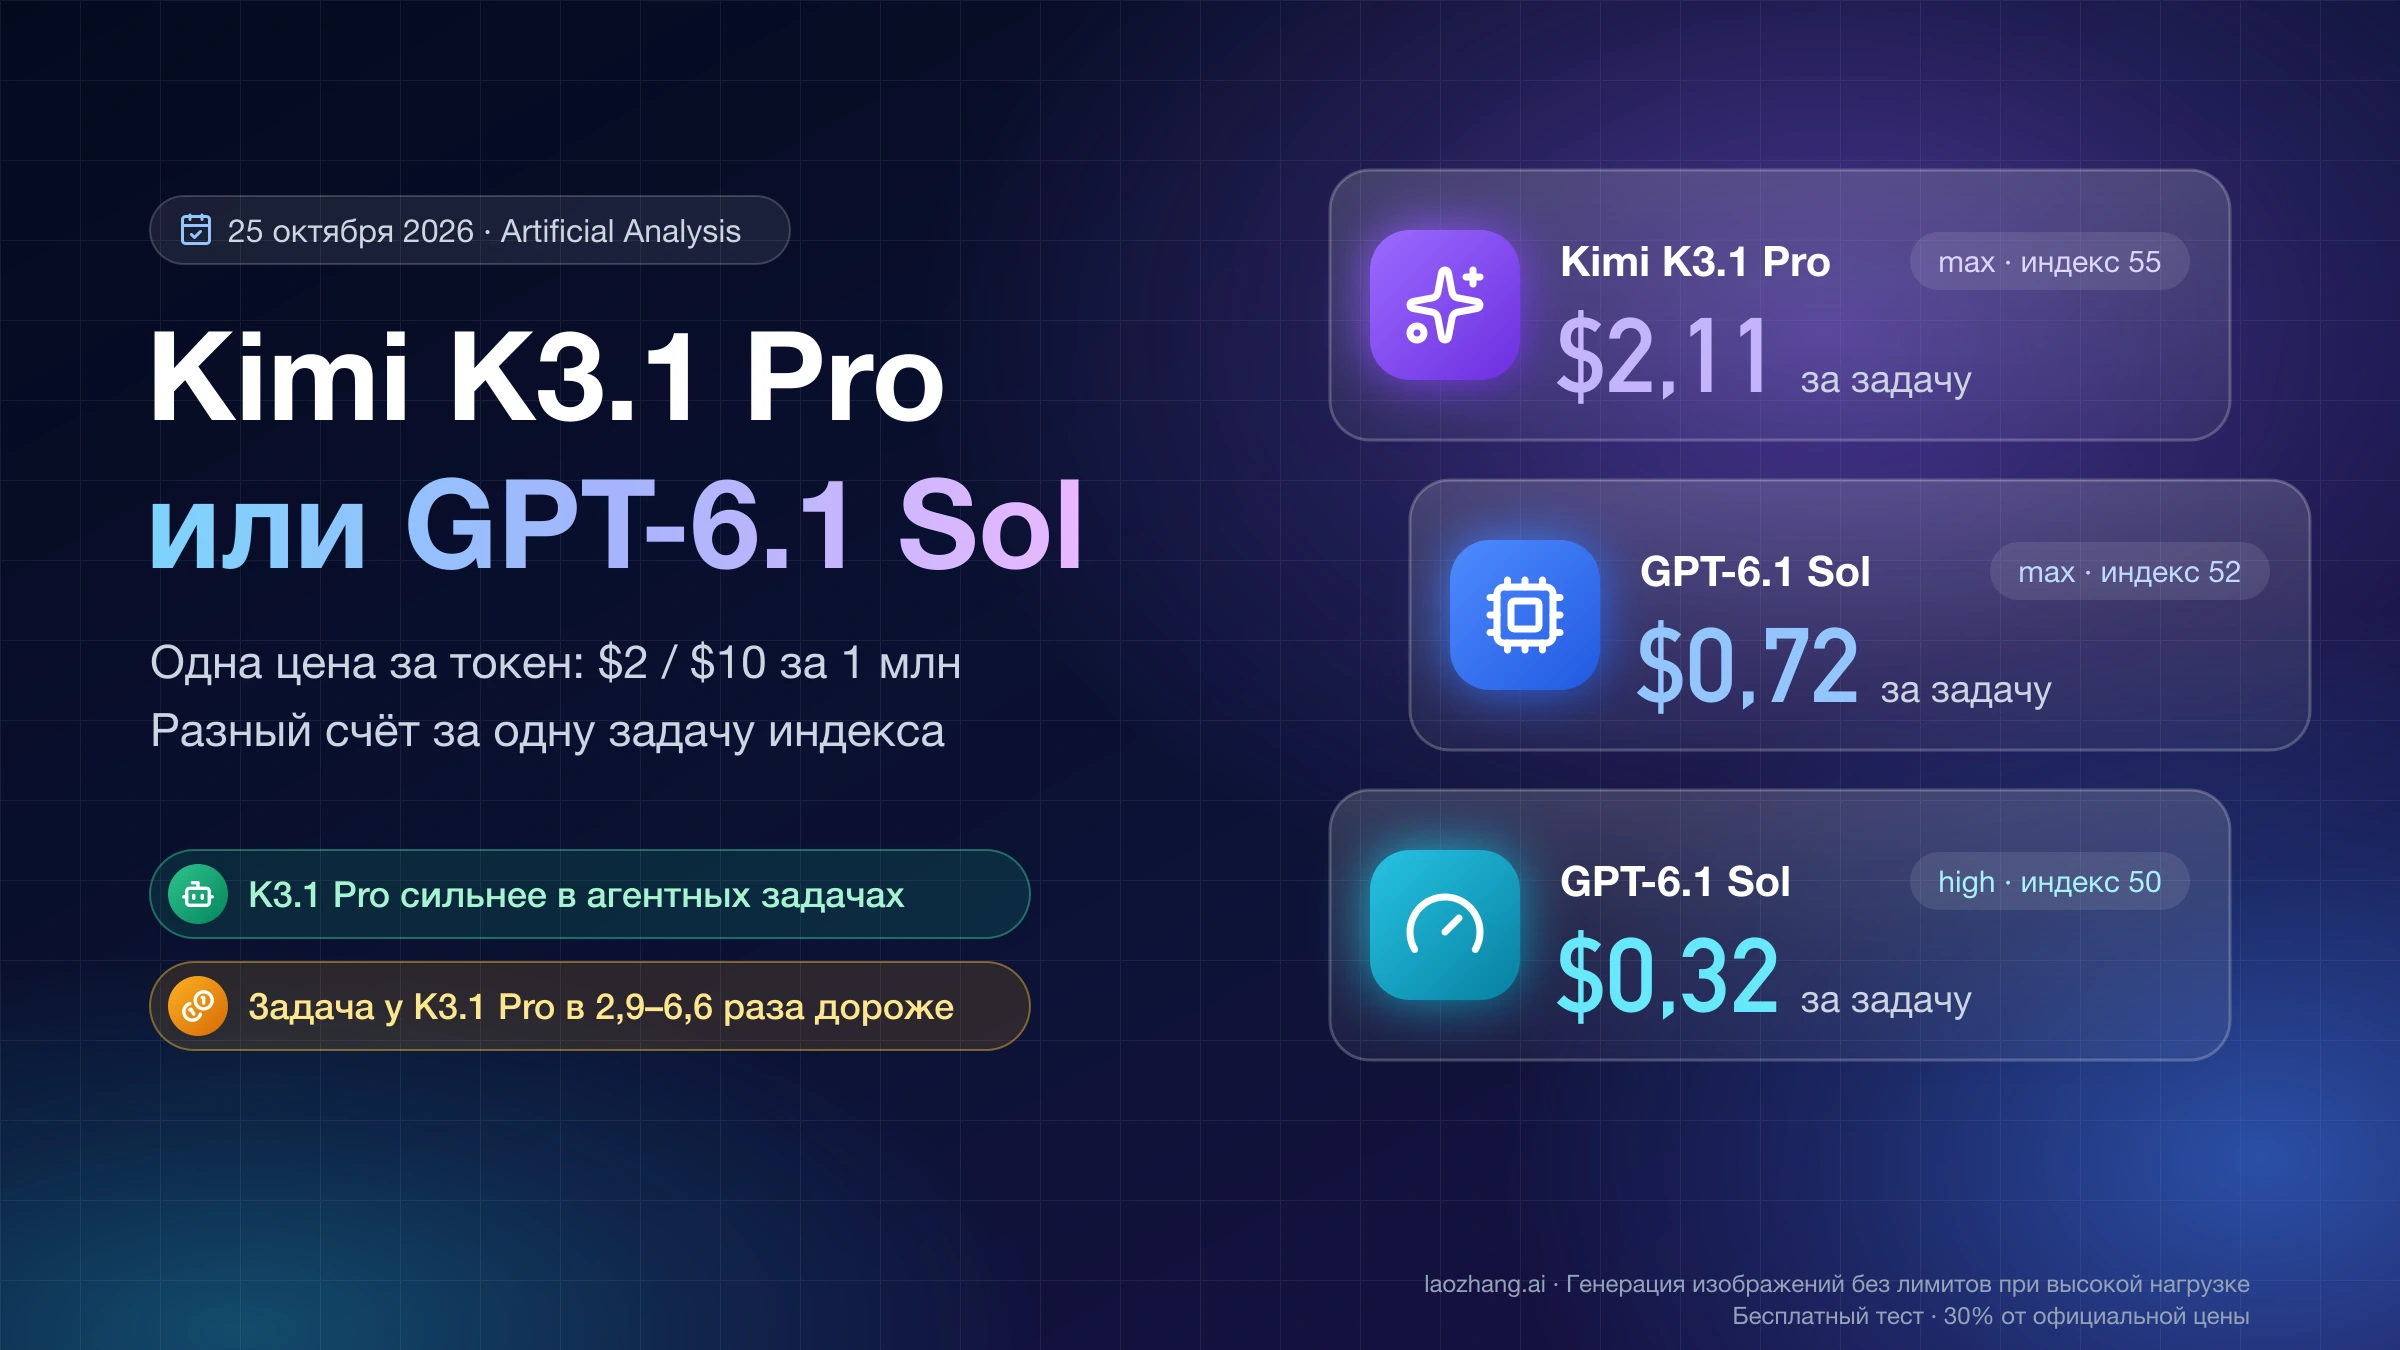
Claude Sonnet 5.5 и GPT-6.1 Sol стоят по $2 и $10 за 1 млн токенов, но задача AA у Sonnet в 2,2–7,9 раза дороже. За ступенью 272 тыс. дешевле уже Sonnet.
Содержание
Для большинства API-нагрузок первой пробуйте GPT-6.1 Sol (gpt-6.1-sol) на уровне medium или high, а Claude Sonnet 5.5 (claude-sonnet-5-5) подключайте там, где он выигрывает: запросы длиннее 272 тыс. входных токенов, агентная работа в терминале на уровнях xhigh и max и длинные ответы потоком, где важна скорость вывода. По прайсу на 28 октября 2026 года обе модели стоят одинаково — $2 за миллион входных и $10 за миллион выходных токенов, — но одна и та же задача у Sonnet обычно обходится дороже: в индексе Artificial Analysis Intelligence Index v5.0 в 2,2–7,9 раза в зависимости от уровня рассуждения, а при равном балле около 50 — в 6,9 раза.
Разница в счёте складывается из трёх причин. Русский текст у Sonnet превращается в 1,45 раза больше токенов, чем у Sol; на одном и том же уровне рассуждения (effort) Sonnet пишет больше и чаще перечитывает контекст; а по умолчанию у Sol стоит medium, у Sonnet в API — high. В обратную сторону работает ступень 272 тыс. токенов: если вход у Sol длиннее, весь запрос оплачивается по $4 за вход и $15 за выход, и длинный документ у Sonnet выходит примерно на 28 % дешевле. Перед переходом в любую сторону проверьте две вещи: инструменты у Sol вызываются только через Responses API, а Sonnet кэширует только с явным cache_control — без него агентный цикл с длинным общим контекстом стоит в 10 раз дороже, чем у Sol.
28 октября 2026 года обе модели получили 12 одинаковых задач со скрытыми тестами через шлюз LaoZhang: Sonnet на high решил 11 из 12 за $0,1761, Sol на medium — 12 из 12 за $0,1157, на high — 12 из 12 за $0,1581. Задачи одноходовые и без инструментов, поэтому тест показывает стоимость, токены и время при почти равном результате, а не то, какая модель умнее; качество ниже оценивается по замерам Artificial Analysis. Прямые API Anthropic и OpenAI, Responses API, вызов инструментов, многоходовые агенты, Sol на xhigh и max и Sonnet на уровнях, кроме high, в этом тесте не проверялись.
Sonnet 5.5 или GPT-6.1 Sol: какую модель брать под вашу нагрузку
Если запросы короткие или средние, а нужная планка качества — до 50 баллов AA, начинайте с Sol: на уровнях от low до high он набирает больше, чем Sonnet на тех же уровнях, а задача индекса обходится в 2,2–3,2 раза дешевле. Sonnet стоит ставить первым в трёх случаях: вход больше 272 тыс. токенов Sol, агенты в терминале и автоматизация, где вы готовы платить за xhigh или max, и чат с длинными ответами, которые пользователь читает по мере появления.
| Нагрузка | Первой брать | Уровень effort | Почему |
|---|---|---|---|
| Чат, короткие запросы, извлечение полей | Sol | medium | За тот же русский текст Sonnet дороже в 1,2 раза, а на low и medium Sol набирает 34,5 и 46,1 балла против 25,3 и 30,3 |
| Документы до 272 тыс. токенов Sol | Sol | medium или high | Sonnet дороже в 1,41 раза из-за токенизатора; в ответах по длинным PDF (GDP.pdf) Sol точнее на всех уровнях |
| Документы длиннее 272 тыс. токенов Sol | Sonnet | high | Sol переводит весь запрос на повышенную ставку, и Sonnet становится дешевле; точность по длинным PDF при этом остаётся за Sol |
| Агентные циклы с длинным общим контекстом | Sol или Sonnet строго с cache_control | high у обеих | Sol кэширует сам; Sonnet с кэшем дороже в 1,29 раза, без кэша — на порядок |
| Агенты в терминале, автоматизация SaaS через API | Sonnet, если бюджет позволяет | xhigh или max | Terminal-Bench 4.0: 57,1 и 63,6 % против 54,0 и 56,1 %, но задача дороже в 5,4–7,9 раза |
| Факты, наука, сложные вопросы | Sol | high и выше | Sol впереди в AA-Omniscience, HLE-Diamond и CritPt на всех уровнях |
| Чат с длинными ответами потоком | Sonnet | high | Вывод 115 токенов в секунду против 70 у Sol на high; короткие ответы быстрее даст Sol на medium |
| Пакетная обработка | Sol | Batch или Flex | Скидка 50 % у обеих, Sonnet дороже в 1,17 раза; у Sol есть ещё Flex |
Если нужна модель OpenAI ещё дешевле, посмотрите сравнение GPT-6.1 Terra vs Sol: в чем разница, цена задачи и тест в Codex: Terra стоит вдвое меньше Sol по каждой строке прайса. Для массовых простых запросов Sonnet разумнее сравнивать с GPT-6 Luna — это разобрано в материале Sonnet 5.5 vs GPT-6 Luna: сравнение — за что платить в 20 раз, — а если Sonnet не дотягивает по качеству, следующая ступень у Anthropic описана в статье Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода. Баллы AA на этих страницах приведены по прежней версии индекса и с цифрами ниже не сравниваются. Если вам нужен не API, а подписка для работы в агенте или приложении, это отдельная покупка со своими лимитами: Claude Code или Codex: стоимость подписки, лимиты и реальный счет API.
Цена одна — почему Sonnet 5.5 дороже и откуда «в 30 раз»
Цена за токен у двух моделей совпадает почти по всем строкам прайса: по странице цен Claude API и странице цен OpenAI API на 28 октября 2026 года вход стоит $2, выход $10, чтение из кэша $0,10, короткая запись в кэш $2,50 за миллион токенов (у Sonnet это запись на 5 минут, у Sol — на 30 минут). Отличаются только длинные запросы (у Sol выше 272 тыс. входных токенов), долгий кэш (у Sonnet 1 час за $4, у Sol 12 часов за $5) и режимы: у Sol есть Fast вдвое дороже, Ultrafast вшестеро дороже и Flex за полцены, у Sonnet 5.5 быстрого режима нет, а Batch за полцены есть у обеих. Поэтому разница в счёте возникает не в тарифе, а в количестве токенов, которое уходит на одну и ту же работу, и зависит от того, как считать.
| Как считать | Sonnet ÷ Sol | Откуда цифра |
|---|---|---|
| За токен по прайсу, вход до 272 тыс. | 1,00 | Прайсы Anthropic и OpenAI |
| За один и тот же русский текст на входе | 1,45 | Подсчёт токенов 28 октября 2026 года |
| Короткий запрос: 2 тыс. токенов на вход, 500 на выход | 1,20 | Расчёт по прайсу |
12 задач теста против Sol на medium и на high | 1,52 и 1,11 | Тест 28 октября 2026 года |
| Задача AA на одинаковом уровне effort | 2,2–7,9 | AA Intelligence Index v5.0 |
Задача AA на уровнях по умолчанию: Sonnet high, Sol medium | 4,6 | AA Intelligence Index v5.0 |
| Задача AA при равном балле около 50 и около 54 | 6,9 и 7,9 | AA Intelligence Index v5.0 |
| Документ на 280 тыс. токенов Sol | 0,72 | Расчёт по прайсу |
Агентный цикл, у Sonnet не включён cache_control | 10,6 | Расчёт по прайсу |
Самый большой разрыв дают агентные задачи, и дело в них не в цене вывода. В индексе AA задача Sonnet на max стоит $10,02, из них $7,17 приходится на входную сторону — $4,88 на чтение из кэша и $2,27 на запись, — и только $2,85 на вывод; у Sol на max из $1,27 на вход уходит $0,59, на вывод $0,68. За весь прогон индекса на max Sonnet прочитал 30,6 млрд входных токенов, Sol — 1,92 млрд, почти в 16 раз меньше. Sonnet делает больше шагов и на каждом заново читает накопленный контекст, поэтому даже дешёвое чтение из кэша складывается в большую сумму.
Цифру «в 30 раз дороже» из заголовка обсуждения на Reddit о 3D-задачах ни один из этих способов счёта не воспроизводит: максимальный разрыв за задачу в индексе AA — 7,9 раза. Ближе всего к ней подходит агентный цикл, в котором у Sonnet не включён кэш, а отдельная задача, на которой одна модель сделала много лишних шагов, может дать и больше. Единичный пример не заменяет подсчёта по вашим задачам.
Уровни effort: баллы AA v5.0, цена и время задачи
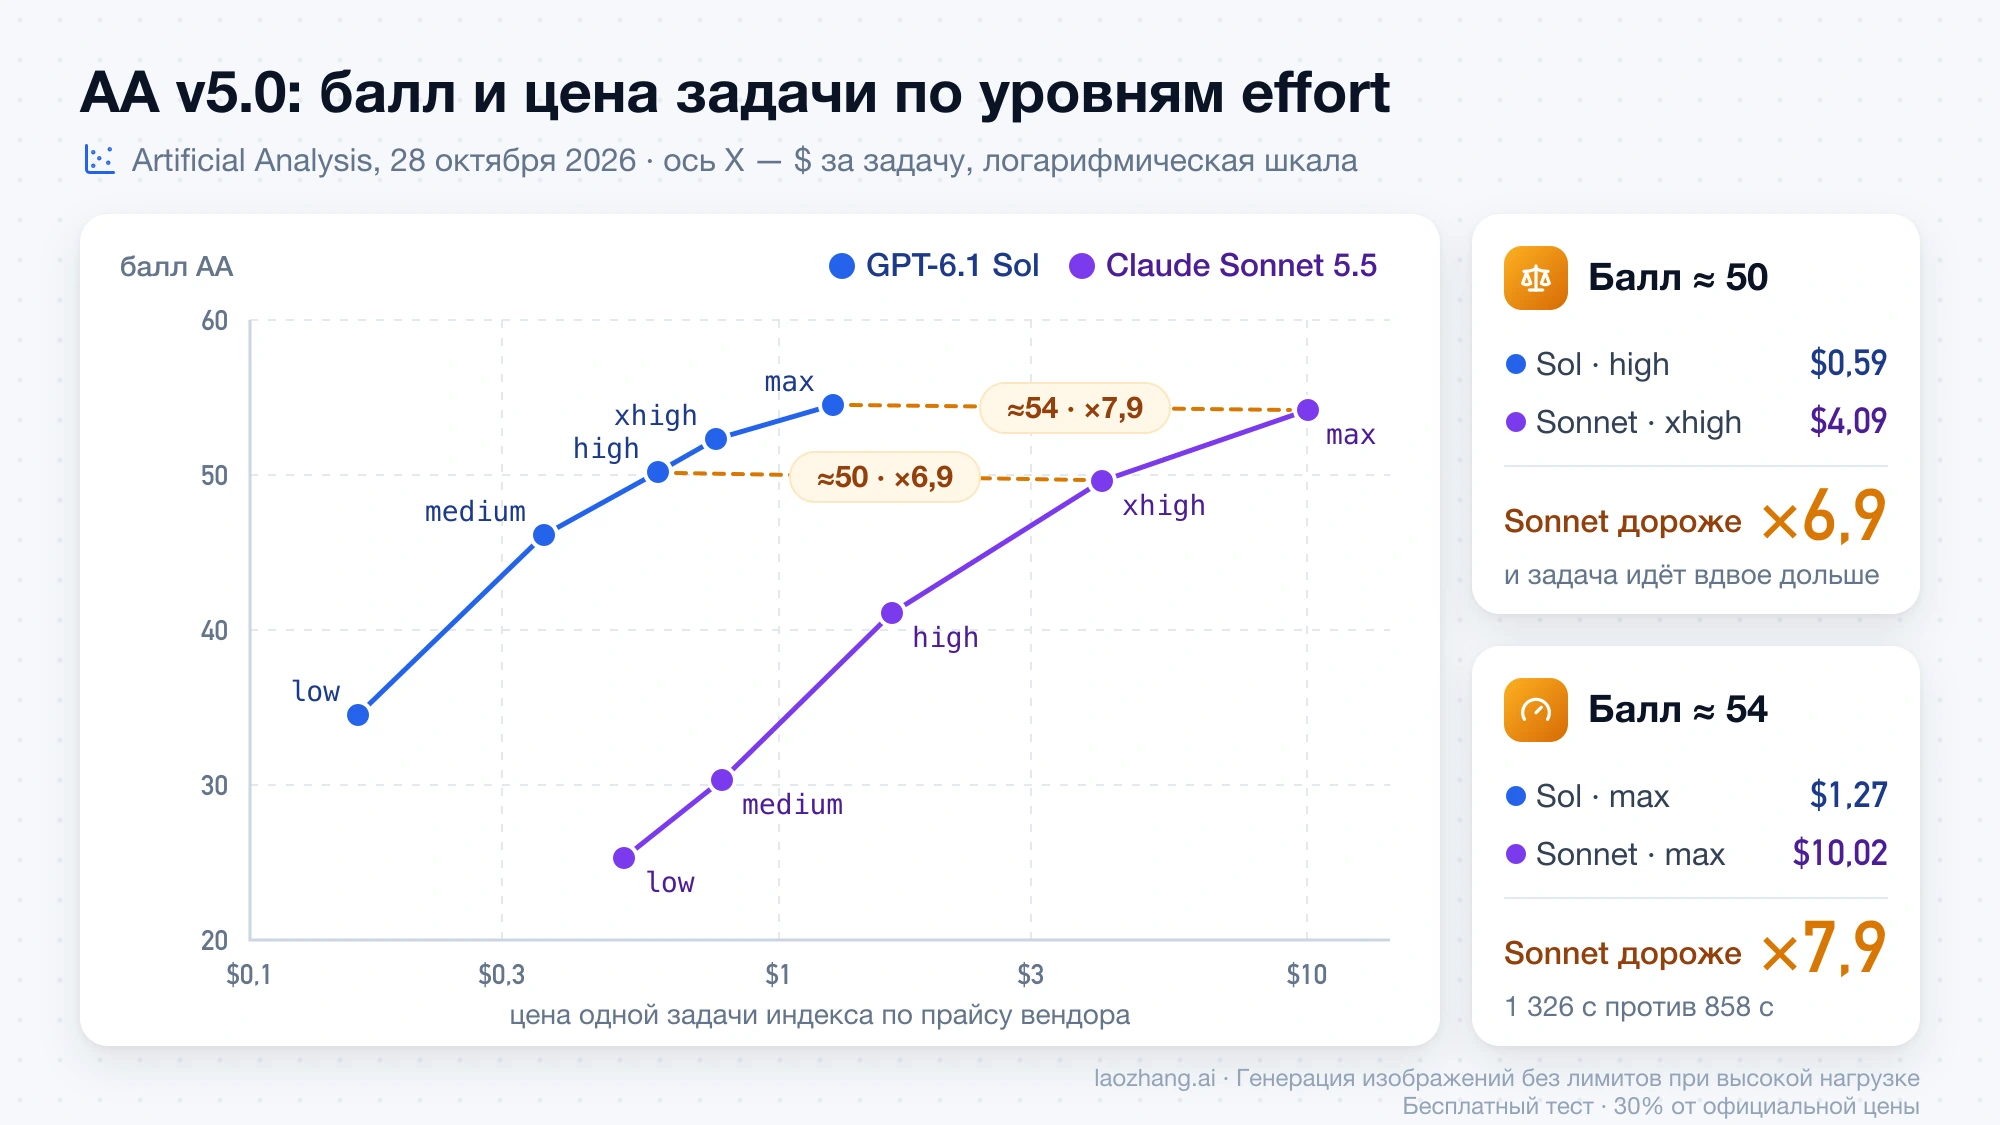
На каждом уровне рассуждения, от low до max, Sol набирает в индексе Artificial Analysis Intelligence Index v5.0 больше баллов, чем Sonnet, и тратит на задачу меньше денег — по данным страницы сравнения Claude Sonnet 5.5 и GPT-6.1 Sol на Artificial Analysis на 28 октября 2026 года. Догнать Sol на high (50,2) Sonnet может только на xhigh (49,6), и тогда задача у него стоит $4,09 против $0,59 и идёт вдвое дольше. На максимуме модели почти равны — 54,2 у Sonnet и 54,5 у Sol, — но и разрыв в цене задачи там самый большой.
| Уровень effort | Sol: балл | Sol: $ за задачу | Sol: время задачи | Sonnet: балл | Sonnet: $ за задачу | Sonnet: время задачи | Sonnet ÷ Sol по цене |
|---|---|---|---|---|---|---|---|
low | 34,5 | $0,16 | 104 с | 25,3 | $0,51 | 121 с | 3,2 |
medium | 46,1 | $0,36 | 231 с | 30,3 | $0,78 | 178 с | 2,2 |
high | 50,2 | $0,59 | 322 с | 41,1 | $1,64 | 332 с | 2,8 |
xhigh | 52,3 | $0,76 | 436 с | 49,6 | $4,09 | 691 с | 5,4 |
max | 54,5 | $1,27 | 858 с | 54,2 | $10,02 | 1 326 с | 7,9 |
AA Intelligence Index v5.0, баллы без округления до целых, стоимость и время одной задачи индекса по прайсу вендоров. Все уровни Sonnet AA помечает как «with fallback» (в сводке — «Default Fallback»); значение метки на странице сравнения не раскрыто.
Сравнивать «по умолчанию с по умолчанию» значит сравнивать разные уровни. В API Sonnet 5.5 по умолчанию работает на high (в Claude Code и приложениях Claude — на medium), Sol — на medium. В такой паре Sol набирает больше (46,1 против 41,1) и обходится в 4,6 раза дешевле. Что меняется на каждом уровне Sonnet и сколько он стоит относительно Sonnet 5, описано в материале Claude Sonnet 5.5: цены по уровням effort и переход с Sonnet 5.
Если на других страницах вы видели иные баллы — например, что Sonnet на max набирает 56 и обходит Sol с его 52, — это прежняя версия индекса, v4.3.2. В октябре 2026 года Artificial Analysis перешла на v5.0: добавила HLE-Diamond, FrontierCode 2.0 и Terminal-Bench-Science, убрала GDPval-AA, SciCode, AA-LCR и HLE, и лидер на максимальном уровне сменился. Баллы двух версий между собой не сравниваются.
Где сильнее каждая модель: подтесты AA от Terminal-Bench до CritPt
Sonnet 5.5 выигрывает у Sol в агентной работе на высоких уровнях и в многонедельных офисных проектах с файлами; Sol сильнее в знаниях и науке и на уровнях low и medium впереди во всех подтестах индекса, кроме AA-Briefcase. Ниже — оба верхних рабочих уровня из того же замера AA на 28 октября 2026 года.
| Подтест AA v5.0 | Что проверяет | Sol high | Sonnet high | Sol max | Sonnet max |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Задачи в терминале: разработка, администрирование, обработка данных | 51,5 % | 43,9 % | 56,1 % | 63,6 % |
| AutomationBench-AA | Автоматизация SaaS-процессов через REST API | 64,5 % | 59,4 % | 64,9 % | 71,8 % |
| AA-Briefcase, Elo | Многонедельные офисные проекты с тысячами исходных файлов | 1 466 | 1 634 | 1 555 | 1 812 |
| FrontierCode 2.0 | Изменения в реальных открытых репозиториях | 36,7 % | 25,7 % | 40,6 % | 41,7 % |
| AA-Omniscience, баллы | Точность фактов со штрафом за выдумки | 41,0 | 18,7 | 42,0 | 30,5 |
| HLE-Diamond | Вопросы Humanity's Last Exam | 51,9 % | 33,8 % | 58,8 % | 53,3 % |
| CritPt v2, трудная часть | Исследовательские задачи по физике | 67,5 % | 47,5 % | 68,5 % | 56,0 % |
Из таблицы следует правило выбора. Если ваша задача похожа на Terminal-Bench или AutomationBench и вы готовы включить xhigh или max, Sonnet даёт лучший результат: в Terminal-Bench 4.0 он обходит Sol уже на xhigh (57,1 % против 54,0 %), а в AutomationBench — только на max. В FrontierCode Sonnet впереди лишь на max, и то на 1,1 пункта, а на high отстаёт на 11, поэтому для правок кода в репозитории на рабочих уровнях выгоднее Sol. Там, где важны точные факты и научные рассуждения, Sol лучше на всех уровнях, и разница большая: в AA-Omniscience на high 41,0 против 18,7. Ответы по длинным документам (GDP.pdf) тоже за Sol — 32,0 % против 25,2 % на high; единственное исключение в научной части — Terminal-Bench-Science на xhigh, где Sonnet впереди на 1,9 пункта.
Тест 28 октября 2026 года: 12 задач, токены, кэш и время
В тесте 28 октября 2026 года обе модели решили почти всё, и Sonnet оказался дороже Sol на medium в 1,52 раза, а Sol на high — в 1,11 раза, зато отвечал быстрее. Задачи шли через шлюз LaoZhang: Sonnet — через Anthropic Messages с thinking: {type: "adaptive"} и output_config: {effort: "high"}, Sol — через Chat Completions без указания уровня (то есть на medium) и с reasoning_effort: "high". Набор — код со скрытыми тестами (разбор выражений и строк CSV, сравнение версий semver и диапазоны в стиле npm), текстовые задачи с точным ответом, сводка статьи на 6 723 слова и вопросы о двух несуществующих функциях стандартной библиотеки Python; по одной попытке на задачу, без системных инструкций и без инструментов.
| Конфигурация | Решено | Стоимость по прайсу | Выходные токены (из них рассуждение) | Сумма времени вызовов | Медиана вызова |
|---|---|---|---|---|---|
Sonnet 5.5, adaptive + high | 11 из 12 | $0,1761 | 10 945 (не выделяются) | 101 с | 7,6 с |
Sol, medium по умолчанию | 12 из 12 | $0,1157 | 6 162 (2 423) | 187 с | 14,0 с |
Sol, high | 12 из 12 | $0,1581 | 10 398 (6 311) | 442 с | 21,2 с |
Единственный промах Sonnet — формат: в сводке из пяти пунктов первый пункт занял 26 слов при лимите 25, и как раз в этом вызове модель не стала размышлять; блоки размышлений вернулись в 8 задачах из 12. Обе модели во всех трёх конфигурациях ответили, что придуманных функций в стандартной библиотеке нет, и прошли все 36 тестов на диапазоны версий. Без двух задач с длинным документом Sonnet дороже Sol на medium уже в 1,83 раза: на коротких задачах сильнее сказывается то, что он пишет больше — 10 945 выходных токенов против 6 162. Время зависит от шлюза и нагрузки: один вызов Sol на high занял 150,6 с при 514 выходных токенах.
Тот же прогон измерил разницу токенизаторов на одинаковом тексте. Первые 6 000 знаков русского текста (статьи блога о Claude Haiku 5.5 и GPT-6 Luna) Sonnet посчитал как 2 967 входных токенов, Sol — как 2 051, то есть в 1,45 раза меньше. На шести языках отношение составило от 1,29 для японского до 1,65 для корейского, для Python-кода — 1,46, а английская статья на 6 723 слова дала 15 335 токенов у Sonnet против 10 106 у Sol. GPT-6 Luna на каждом образце вернула ровно столько же токенов, сколько Sol. OpenAI не называет токенизатор GPT-6.x, а в библиотеке tiktoken сопоставления для gpt-6 нет, поэтому точное число для Sol даёт только эндпоинт /v1/responses/input_tokens из руководства OpenAI по подсчёту токенов.
Sol записывал кэш сам. В обоих запросах с документом примерно на 10 тыс. токенов ответ содержал cache_write_tokens — 10 103 и 10 195, — хотя никаких настроек кэша в запросе не было, а запись оплачивается по $2,50 за миллион, в 1,25 раза дороже обычного входа. Тот же документ, отправленный примерно через 5,5 минуты уже с reasoning_effort: "high", снова записал кэш и не прочитал из него ни одного токена; почему, по ответу не видно. Sonnet без cache_control не кэшировал ничего.
Ещё одно наблюдение касается размышлений Sonnet через шлюз. 26 октября 2026 года запросы к Sonnet 5.5 через тот же шлюз без параметров thinking и effort вернули ноль блоков размышлений в 9 задачах из 9, а с thinking: {type: "adaptive"} и high — в 7 из 9. По документации Anthropic отсутствие thinking у Sonnet 5.5 означает адаптивные размышления на high, но прямой API Anthropic в этих прогонах не проверялся. Практический вывод: при вызове через любой прокси или агрегатор задавайте thinking и effort явно.
Сколько будет стоить ваша нагрузка: 8 расчётов для русского текста
Для коротких запросов и документов до 272 тыс. токенов Sonnet дороже Sol в 1,2–1,4 раза, для документов длиннее — дешевле примерно на 28 %, в агентном цикле с кэшем дороже в 1,29 раза, а без cache_control — в 10,6 раза. Расчёт сделан 28 октября 2026 года по прайсу Anthropic и OpenAI. Объёмы указаны в токенах Sol; вход Sonnet получен умножением на 1,45 — отношение, измеренное для русского текста (2 967 ÷ 2 051). Выходных токенов у обеих моделей взято поровну, хотя на практике Sonnet пишет больше, как видно и в тесте выше, и в замерах AA, так что для него это оценка снизу. В агентном цикле общий префикс на 100 тыс. токенов записывается в кэш на первом шаге и читается на остальных 49; у Sol это автоматический кэш на 30 минут, у Sonnet — cache_control на 5 минут, и паузы между шагами короче этих сроков.
| Сценарий | GPT-6.1 Sol | Claude Sonnet 5.5 | Sonnet ÷ Sol |
|---|---|---|---|
| Вопрос в чате: 2 тыс. на вход, 500 на выход | $0,0090 | $0,0108 | 1,20 |
| Документ на 250 тыс. + 5 тыс. на выход | $0,550 | $0,774 | 1,41 |
| Документ на 270 тыс. + 5 тыс. на выход | $0,590 | $0,831 | 1,41 |
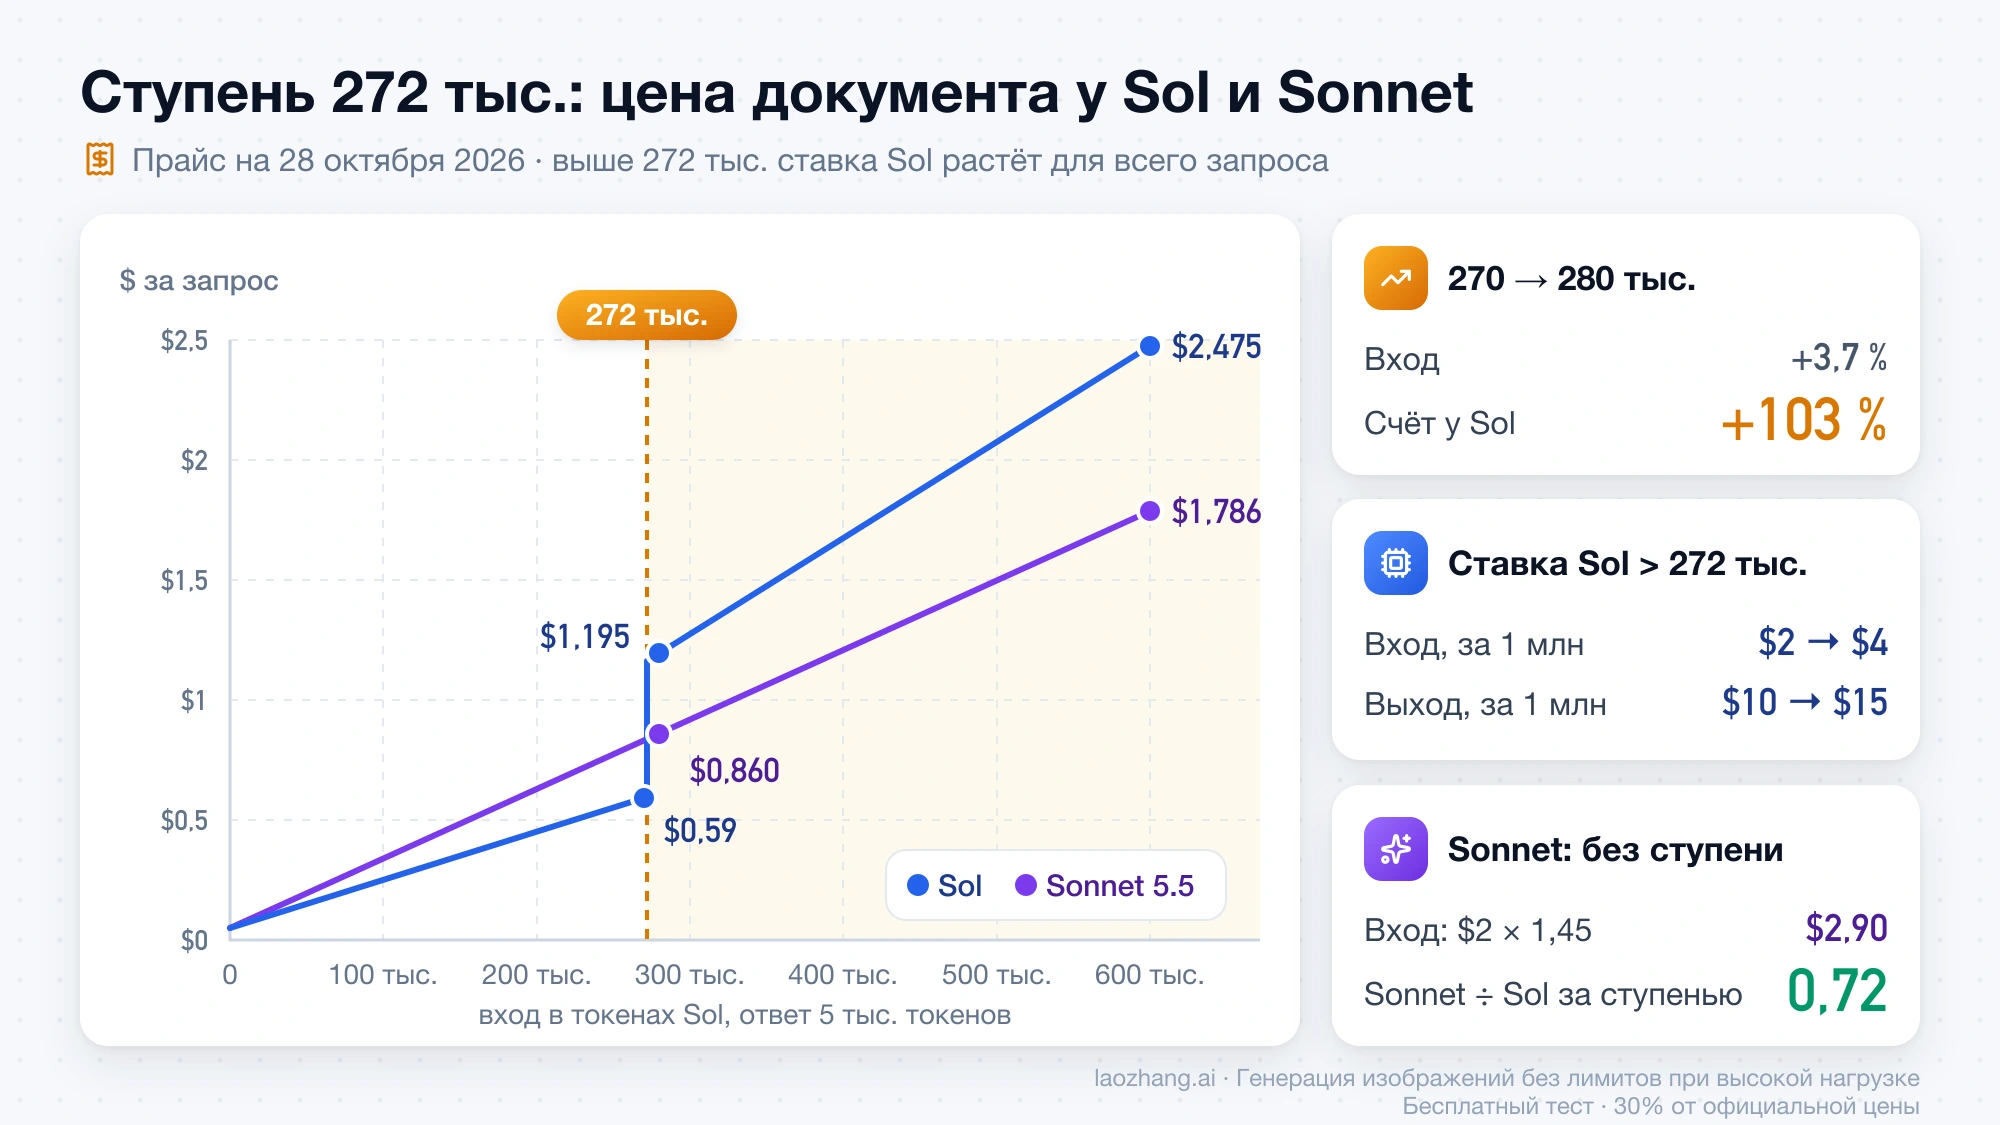
| Документ на 280 тыс. + 5 тыс. на выход | $1,195 | $0,860 | 0,72 |
| Документ на 600 тыс. + 5 тыс. на выход | $2,475 | $1,786 | 0,72 |
| Агентный цикл: 50 шагов, префикс 100 тыс. в кэше, за шаг 2 тыс. новых + 1 тыс. на выход | $1,44 | $1,86 | 1,29 |
Тот же цикл, у Sonnet не включён cache_control | $1,44 | $15,26 | 10,6 |
| Batch: 10 000 запросов по 3 тыс. + 1 тыс., скидка 50 % у обеих | $80,00 | $93,41 | 1,17 |
Ступень 272 тыс. — самое резкое место прайса. На странице модели GPT-6.1 Sol в документации OpenAI сказано, что при входе больше 272 тыс. токенов ставки входа и кэша удваиваются, а выхода растут в 1,5 раза для всего запроса, а не только для хвоста. Поэтому документ на 270 тыс. токенов с ответом на 5 тыс. стоит у Sol $0,59, а на 280 тыс. — $1,195: вход вырос на 3,7 %, счёт — на 103 %. За ступенью Sonnet дешевле по входу при любом отношении токенизаторов меньше 2 — для русского текста $2 × 1,45 = $2,90 против $4 за объём текста, равный миллиону токенов Sol, — а вывод у него стоит $10 против $15 у Sol. Если ваши документы колеблются около этой границы, держите вход у Sol ниже 272 тыс. или отправляйте длинные документы в Sonnet.
Окна тоже не так равны, как кажется по цифре «1 млн». У Sol контекст 1 050 000 токенов, но вход ограничен 922 000; у Sonnet окно 1 млн токенов без надбавки за длину. Поскольку русский текст у Sonnet занимает больше токенов, в его миллион помещается примерно столько текста, сколько в 690 тыс. токенов Sol; документ крупнее этого целиком примет только Sol, причём по повышенной ставке.
Чтение из кэша сейчас стоит одинаково. Утверждение, что у Sol оно вдвое дешевле, было верным до 7 октября 2026 года: в этот день Anthropic снизила цену чтения для Sonnet 5.5 с $0,20 до $0,10 — подробности в материале Claude Sonnet 5.5: цена чтения кэша $0,10 — расчёт экономии. Разница осталась в поведении. По руководству OpenAI по кэшированию промптов Sol кэширует префикс от 1 024 токенов автоматически и берёт за запись на 30 минут 1,25 цены входа; отключить это можно режимом explicit без точек кэширования, а 12-часовой кэш за 2,5 цены входа есть только в Responses API. Sonnet кэширует, только если вы поставили cache_control (от 512 токенов, на 5 минут или на 1 час), и забытый cache_control — самая дорогая ошибка в агентном цикле.
Какая быстрее: Sonnet выдаёт текст быстрее, на xhigh и max решает дольше
Текст Sonnet выдаёт быстрее: по замерам Artificial Analysis на 28 октября 2026 года — 109–140 токенов в секунду в зависимости от уровня против 59–81 у Sol. На уровнях от low до xhigh у Sonnet раньше появляются и первые слова ответа: на high через 11,1 с против 40,8 с у Sol на том же уровне. Но на xhigh и max задача у Sonnet занимает больше времени — 691 и 1 326 с против 436 и 858 с, — потому что он пишет примерно в 4 раза больше (122,2 тыс. и 285,4 тыс. выходных токенов на задачу против 30,2 тыс. и 67,8 тыс.), а на max и первый токен ответа приходит позже: через 455 с против 278 с.
Если сравнивать уровни по умолчанию, картина меняется: Sol на medium показывает первый токен ответа через 3,6 с и тратит на задачу 231 с, Sonnet на high — 11,1 с и 332 с. Для коротких ответов это аргумент за Sol на medium, а для длинных ответов, которые читают по мере появления, — за Sonnet, у которого текст идёт почти вдвое быстрее. В тесте 28 октября на коротких одноходовых задачах через шлюз медиана вызова у Sonnet на high была 7,6 с, у Sol на medium — 14,0 с, на high — 21,2 с. OpenRouter сообщает о 106 и 29 токенах в секунду, но это другая методика и другие провайдеры, и с цифрами AA её напрямую не сравнить. Если Sol кажется медленным, причины и настройки разобраны в материале GPT-6.1 Sol медленно работает: замеры по effort и как ускорить.
Что сломается при переходе: параметры Sonnet 5.5 и GPT-6.1 Sol
Самые частые поломки при переходе — вызов инструментов у Sol через Chat Completions, забытый cache_control у Sonnet и разные уровни effort по умолчанию. Агента, который вызывает инструменты через Chat Completions, при переходе на Sol придётся перевести на Responses API: в руководстве OpenAI по рассуждающим моделям сказано, что Chat Completions не поддерживает вызов функций у GPT-6.1 Sol, хотя обычную генерацию через этот эндпоинт модель выполняет. При переходе на Sonnet проверьте, не используете ли вы принудительный выбор инструмента и отключение размышлений: оба варианта Sonnet 5.5 отклоняет. Параметры ниже — по обзору моделей Claude и странице модели GPT-6.1 Sol на 28 октября 2026 года.
| Параметр | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| ID и дата выхода | claude-sonnet-5-5, 28 сентября 2026 года | gpt-6.1-sol, 29 сентября 2026 года |
| Уровни effort | low, medium, high, xhigh, max; в API по умолчанию high | low, medium, high, xhigh, max; по умолчанию medium |
| Отключить размышления | thinking: {type: "disabled"} отклоняется, минимум — between_tools | Нельзя: none и minimal не поддерживаются, минимум — low |
| Вызов инструментов | Messages API; принудительный tool_choice (any, tool) возвращает ошибку 400 | Только Responses API, в Chat Completions вызова функций нет |
| Кэш | Только с cache_control, от 512 токенов, на 5 минут или 1 час | Автоматически, от 1 024 токенов, на 30 минут; 12 часов только в Responses API |
| Контекст и вход | 1 млн токенов без надбавки за длину | 1 050 000, вход до 922 000; выше 272 тыс. повышенная ставка на весь запрос |
| Максимальный вывод | 128 тыс.; 300 тыс. в Batch с бета-заголовком output-300k-2026-03-24 | 128 тыс. |
| Режимы по цене и скорости | Batch за полцены, быстрого режима нет | Batch и Flex за полцены, Fast и Ultrafast дороже |
| Срез знаний | Июнь 2026 года | 30 апреля 2026 года |
Ещё одна мелочь, которая ломает перенос настроек: в тесте 5 октября 2026 года через тот же шлюз LaoZhang Sol в Chat Completions отклонил temperature: 0.2 с сообщением, что поддерживается только значение по умолчанию (1). Если обе модели нужны через один ключ, на laozhang.ai они доступны по прайсовым ставкам вендоров, включая ступень 272 тыс. у Sol, но Sol там подключён только через Chat Completions, поэтому вызывать инструменты у Sol через этот сервис нельзя. Что ещё меняется при переходе на GPT-6.1 Sol с GPT-6 Sol и как получить к ней доступ, описано в материале GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Как проверить перед переходом: тест «стоимость принятой задачи»
Решение о переходе стоит принимать по стоимости принятой задачи на ваших данных — сколько денег уходит на один ответ, прошедший вашу проверку, — а не по цене токена и не по чужому рейтингу. Небольшой прогон обходится дёшево: 12 задач на трёх конфигурациях в тесте 28 октября 2026 года стоили $0,45 по прайсу.
- Соберите 10–30 реальных задач, которые можно проверить автоматически: тесты, точный ответ, ограничения формата. Если у вас бывают длинные документы, добавьте одну-две такие задачи.
- Задайте уровень рассуждения явно с обеих сторон: у Sonnet
thinking: {type: "adaptive"}иoutput_config: {effort: "high"}, у Solreasoning.effortв Responses API илиreasoning_effortв Chat Completions. Начните с Sol наmediumиhighпротив Sonnet наhigh; Sonnet наxhighдобавьте, если Sol не проходит ваши задачи. - Включите кэш у Sonnet:
cache_controlна общем префиксе — системных инструкциях, документах, описании инструментов. У Sol проверьте вusageполеcache_write_tokens: эта запись оплачивается. - Для длинных запросов посчитайте вход Sol через
/v1/responses/input_tokensи проверьте, не переходите ли вы 272 тыс. токенов. - Посчитайте стоимость по полям
usage: обычный вход, чтение и запись кэша, выход вместе с токенами рассуждения — по прайсу на дату прогона. Разделите сумму на число задач, прошедших проверку. - Сравните стоимость принятой задачи и время ответа. Если разница небольшая, повторите прогон два-три раза: одна попытка на задачу даёт заметный разброс и по качеству, и по времени.
Можно ли пользоваться Sonnet 5.5 и GPT-6.1 Sol из России
Официально нет: OpenAI API и Claude не обслуживают Россию и Беларусь. По состоянию на 25 октября 2026 года обеих стран нет в списке поддерживаемых стран OpenAI API, а в списке регионов Anthropic они указаны среди тех, где Claude недоступен. Если на сторонних площадках вы видите название «GPT 6.1 Sol Pro», это не отдельная модель: в прайсе OpenAI есть только gpt-6.1-sol, поэтому сверяйте идентификатор модели и ставки, а не название на витрине.
Источники8
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
Источники8
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
- 1.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 2.странице цен OpenAI APIdevelopers.openai.com/api/docs/pricing
- 3.страницы сравнения Claude Sonnet 5.5 и GPT-6.1 Sol на Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-sol
- 4.руководства OpenAI по подсчёту токеновdevelopers.openai.com/api/docs/guides/token-counting
- 5.странице модели GPT-6.1 Sol в документации OpenAIdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 6.руководству OpenAI по кэшированию промптовdevelopers.openai.com/api/docs/guides/prompt-caching
- 7.руководстве OpenAI по рассуждающим моделямdevelopers.openai.com/api/docs/guides/reasoning
- 8.обзору моделей Claudeplatform.claude.com/docs/en/about-claude/models/overview