Сравнение Kimi K3.1 Pro и Opus 5.5: вдвое дешевле лишь за токен
Kimi K3.1 Pro вдвое дешевле Claude Opus 5.5 за токен, но не за задачу: по замерам Artificial Analysis Opus на high стоит дешевле, на max — в 2,8 раза дороже.
Содержание
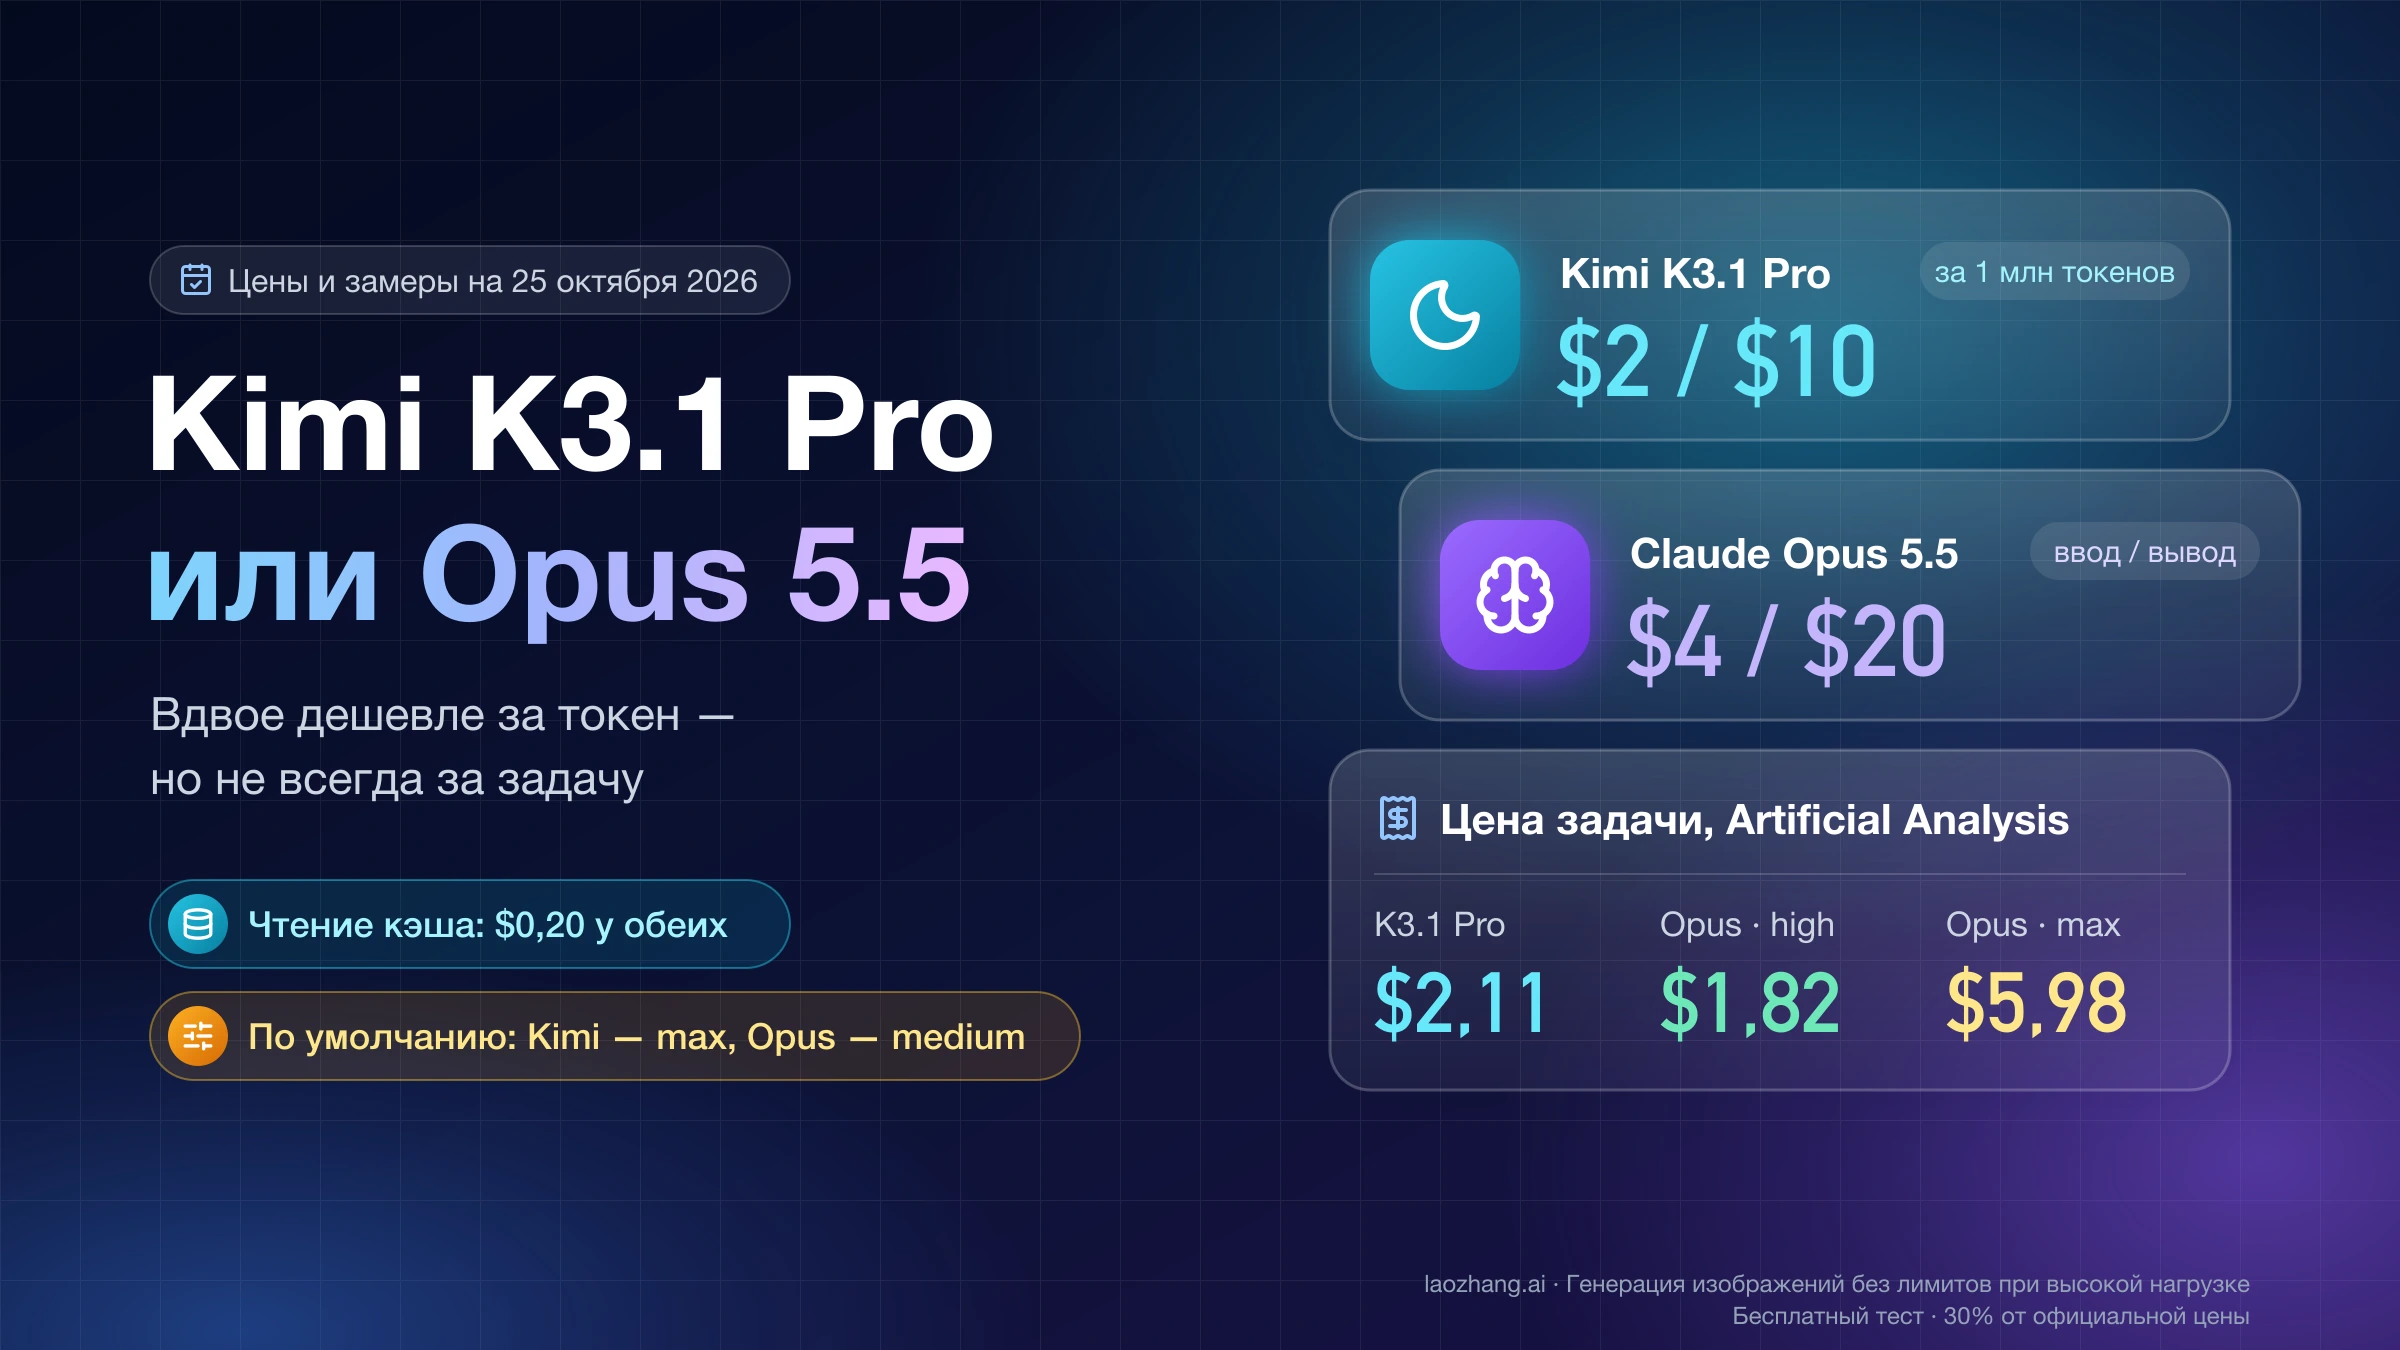
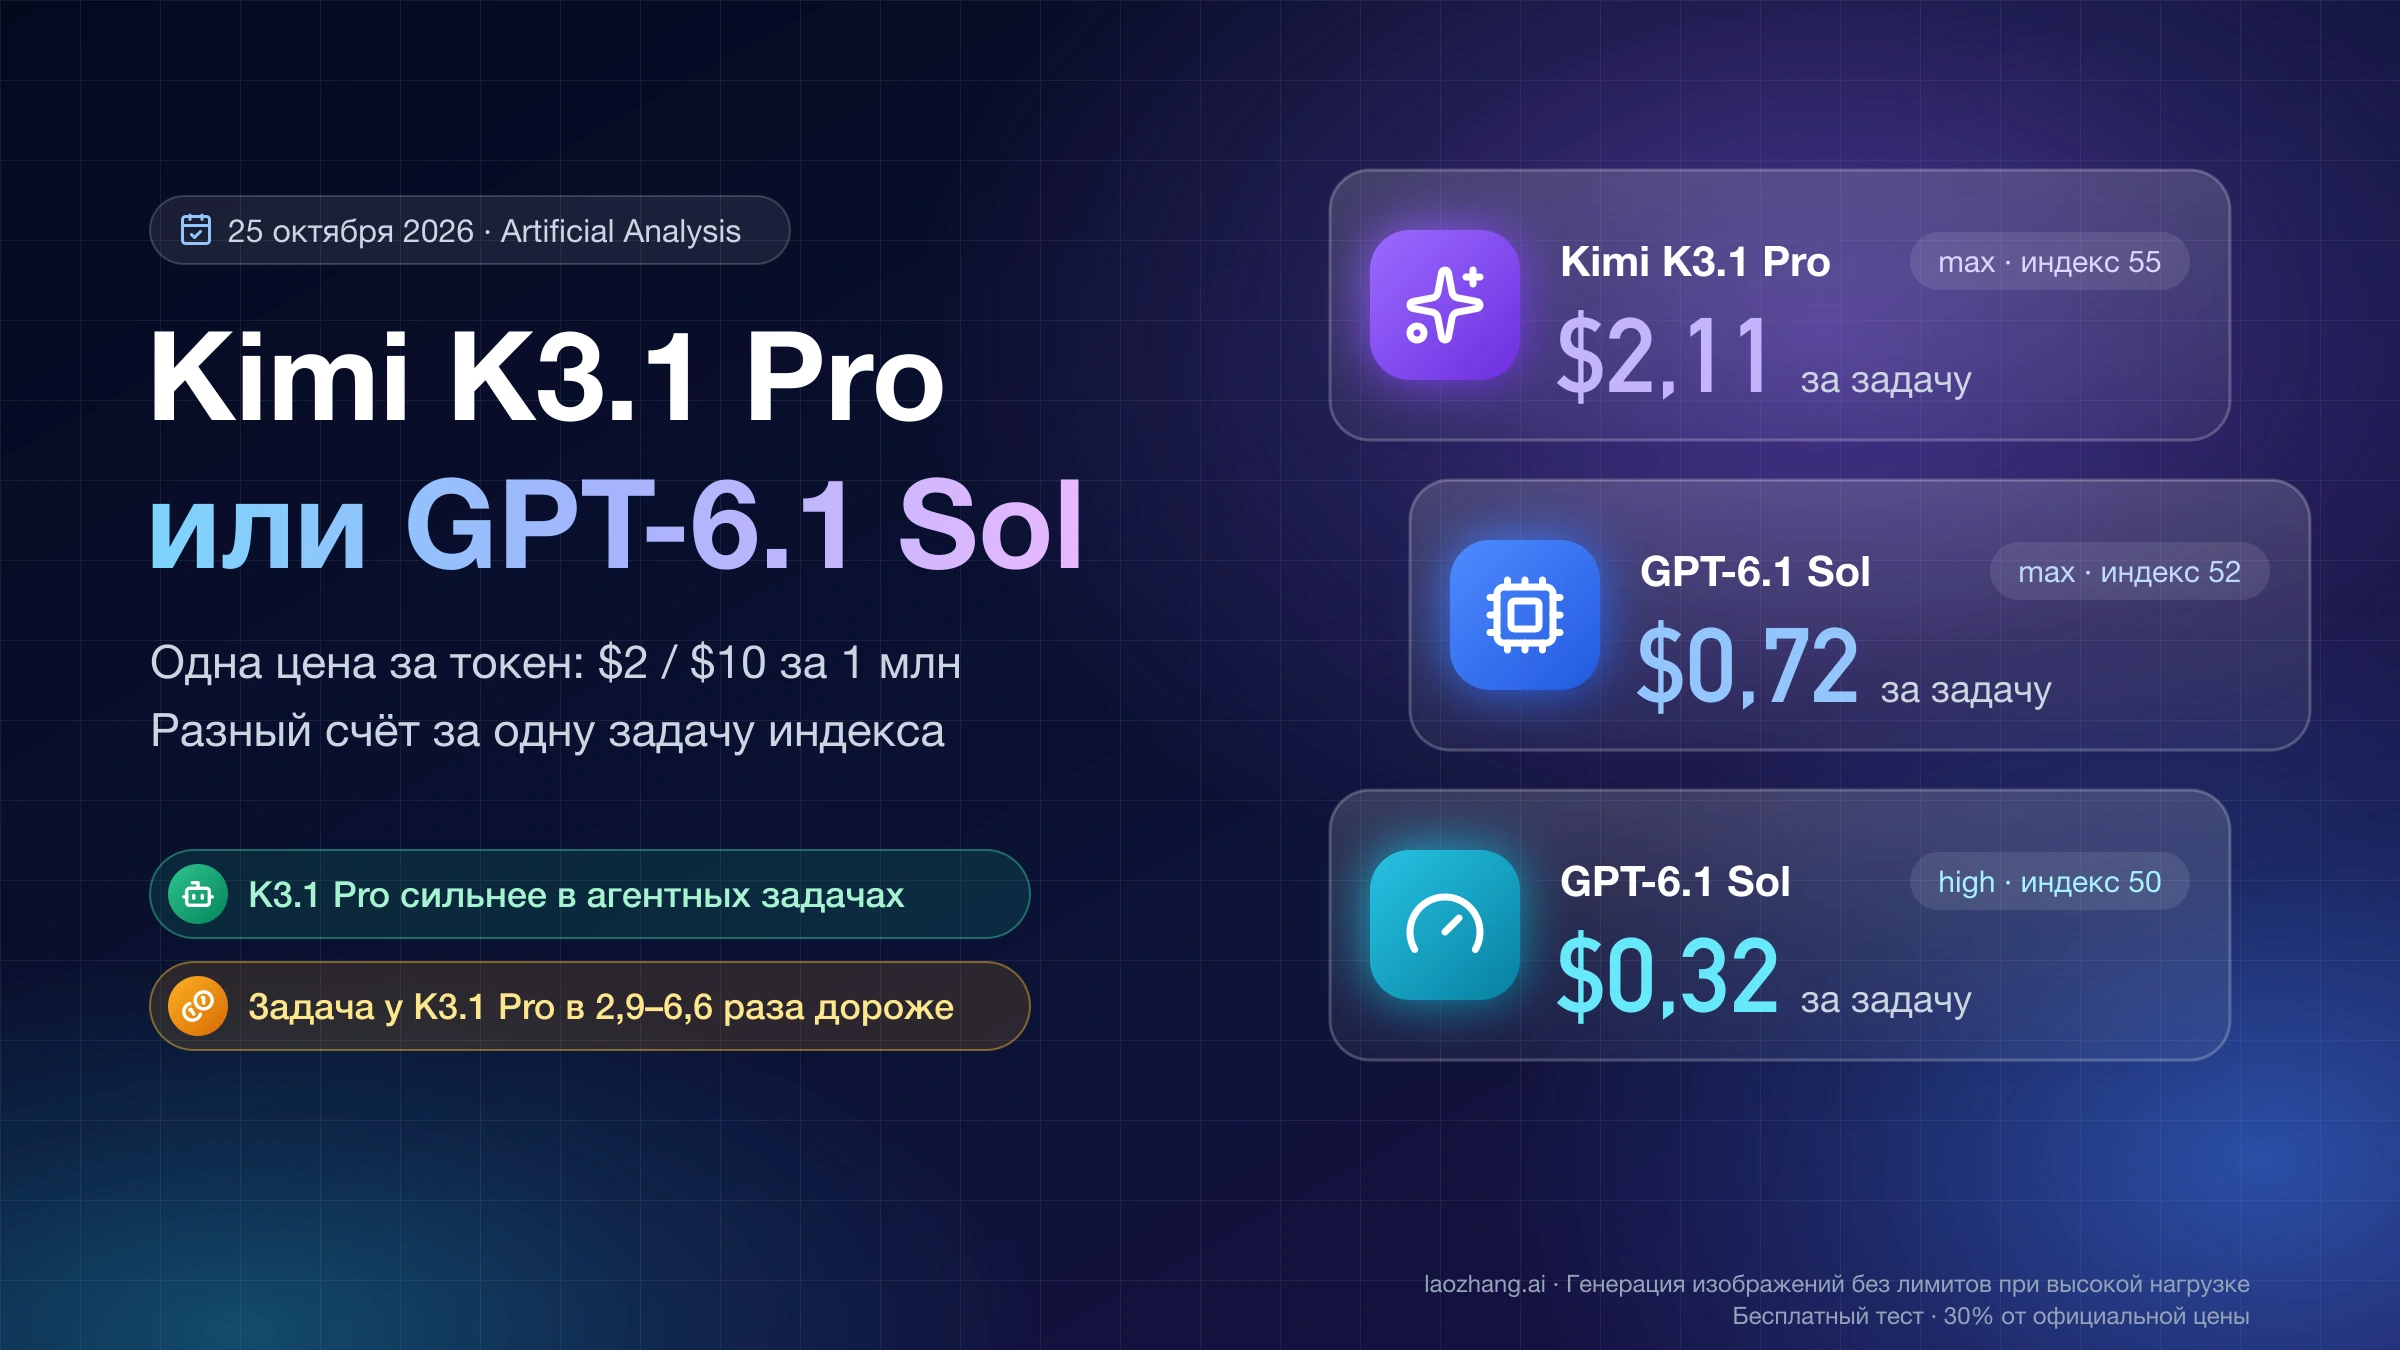
Kimi K3.1 Pro (kimi-k3.1-pro) стоит ровно вдвое меньше Claude Opus 5.5 за входной и выходной токен — $2 и $10 против $4 и $20 за 1 млн, — но чтение из кэша у обеих моделей стоит одинаково, $0,20, а сама K3.1 Pro по умолчанию думает на максимальном уровне и пишет много токенов. Поэтому за задачу вдвое дешевле она выходит не всегда. По замерам Artificial Analysis на 25 октября 2026 года задача из их индекса стоит у K3.1 Pro $2,11 при 55 баллах, у Opus 5.5 на уровне high — $1,82 при 54 баллах и более чем вдвое быстрее, а на max — $5,98 при 58 баллах.
Практический вывод: на K3.1 Pro стоит переносить задачи кода и агентов, которые сейчас идут на Opus с уровнем xhigh или max и где можно подождать дольше, — именно там разница в счёте настоящая. Начните с её уровня по умолчанию, reasoning_effort: "max", затем попробуйте high и low и сравнивайте стоимость и время задачи, а не цену токена. На Opus 5.5 оставьте работу, где важны скорость ответа, научные задачи и точность фактов, а также всё, что должно идти через Bedrock, Vertex или Azure: до выпуска весов, обещанного к 4 ноября, K3.1 Pro продаёт только Moonshot.
Две оговорки. Завершённого сравнения двух моделей на одном промпте здесь нет: 25 октября 2026 года одна и та же задача по коду была отправлена обеим через сторонний API-шлюз, но K3.1 Pro на max ни разу не ответила за пять минут (подробности — в разделе о замене модели). Поэтому цифры качества ниже — сторонние замеры с указанием условий, а стоимость пересчитана по прайс-листам. И для читателей из России: политика поддерживаемых регионов Anthropic в редакции, вступающей в силу 12 ноября 2026 года, не включает Россию и Беларусь. Ограничение распространяется на приложения, Claude Code, API, модели Claude на облачных платформах и у авторизованных реселлеров, а также на использование людьми, которые физически находятся в неподдерживаемом регионе. Доступ к платформе Kimi из России отдельно не проверялся.
Цены Kimi K3.1 Pro и Opus 5.5: вдвое дешевле на токенах, наравне на кэше
Двукратная разница верна ровно для двух статей расхода — обычного ввода и вывода. Чтение из кэша у обеих моделей стоит одинаково, а запись в кэш у Opus 5.5 дороже в 2–2,5 раза. Цены ниже — в долларах США за 1 млн токенов, без налогов, по прайс-листу Kimi (по состоянию на 24 октября 2026 года) и странице цен Claude API (по состоянию на 25 октября 2026 года).
| За 1 млн токенов | Kimi K3.1 Pro | Claude Opus 5.5 | Opus дороже в |
|---|---|---|---|
| Ввод | $2,00 | $4,00 | 2,0 раза |
| Вывод, включая рассуждения | $10,00 | $20,00 | 2,0 раза |
| Чтение из кэша | $0,20 | $0,20 | одинаково |
| Запись в кэш на 5 минут | $2,00 | $5,00 | 2,5 раза |
| Запись в кэш на 1 час | $4,00 | $8,00 | 2,0 раза |
Обе модели берут одну цену за токен во всём окне в 1 млн токенов, без надбавки за длинный контекст. У Kimi кэш включается автоматически, по умолчанию живёт 5 минут, а часовой срок задаётся через prompt_cache_options.ttl. Сама Kimi не пишет, тарифицируются ли токены рассуждения как вывод; OpenRouter и Artificial Analysis считают их выводом, и пересчёты ниже следуют этому. Чтобы K3.1 Pro вообще стала доступна в API, нужно пополнить баланс минимум на $1.
У обеих моделей есть варианты, которые сдвигают сравнение. K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed), по словам Moonshot, работает в 2–3 раза быстрее, но стоит $4 за ввод и $20 за вывод — столько же, сколько Opus 5.5. У Opus, наоборот, пакетный режим Batch стоит $2 и $10, то есть как обычная K3.1 Pro, если ответ не нужен сразу; быстрый режим (fast mode) — $8 и $40, а региональные эндпоинты Bedrock, Azure и Vertex в каталоге OpenRouter идут с надбавкой 10 %: $4,40 и $22. Подробнее о тарифах самой Opus — в материале «Claude Opus 5.5: цена API и как сбросить лимит подписки».
Сколько стоит задача на каждом уровне effort: пересчёт 25 октября 2026 года
Если обе модели тратят одинаковое число токенов, Opus 5.5 дороже в 1,05–2,00 раза в зависимости от доли кэша. Но одинаково они не тратят: K3.1 Pro пишет длинные рассуждения, а расход Opus сильно зависит от уровня effort. С учётом этого на medium Opus стоит почти столько же, сколько K3.1 Pro, а на max — в 2,8–4,2 раза дороже.
Пересчёт от 25 октября 2026 года выполнен по прайс-листам из таблицы выше и формуле: стоимость = (новый ввод × цена ввода + чтение из кэша × $0,20 + запись в кэш × цена записи + вывод × цена вывода) / 1 000 000. Объёмы токенов в первых трёх примерах условные, их можно заменить своими. Один холодный запрос на 8 тыс. токенов ввода и 2 тыс. вывода стоит $0,036 у Kimi и $0,072 у Opus — разница ровно 2,00 раза. Агентная сессия из 40 шагов с закэшированным префиксом на 60 тыс. токенов, где каждый шаг добавляет 4 тыс. нового ввода и 3 тыс. вывода, обходится в $2,108 против $3,808, то есть в 1,81 раза дороже у Opus: часть счёта приходится на чтение кэша, которое у обеих моделей стоит одинаково. Если же почти весь объём — чтение из кэша (1 млн закэшированных токенов и 1 тыс. вывода), разница сжимается до $0,210 против $0,220, в 1,05 раза.
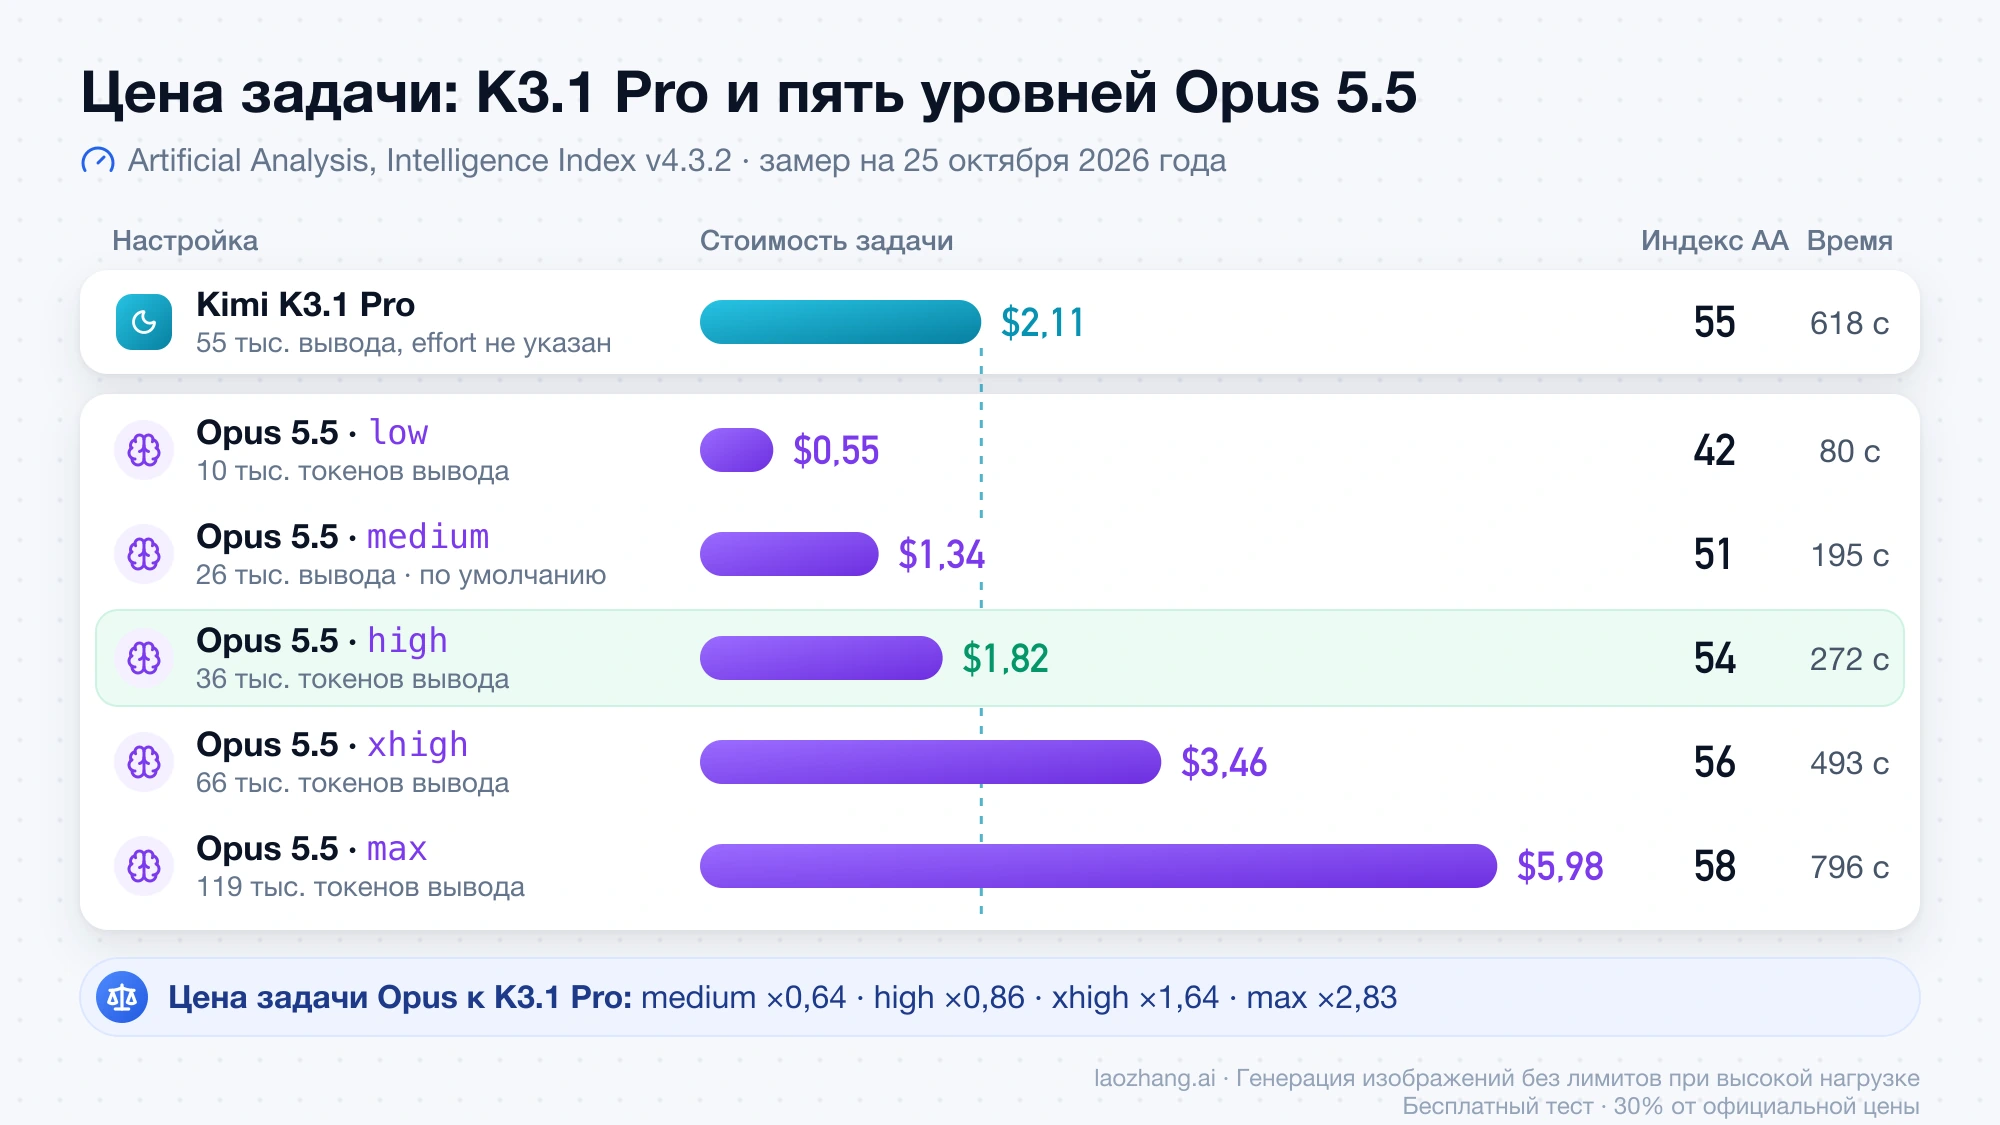
Дальше главное — длина вывода. Artificial Analysis (AA) измеряет, сколько выходных токенов каждая настройка тратит на задачу своего индекса Intelligence Index v4.3.2, и сколько эта задача стоит и длится. В последнем столбце — тот же пересчёт для запроса с 20 тыс. новых токенов ввода и выводом той длины, которую намерил AA: он показывает влияние одной только длины ответа. Для K3.1 Pro уровень effort в замерах AA не подписан; в API по умолчанию стоит max.
| Настройка | Индекс AA | Вывод на задачу | Стоимость задачи (AA) | Время задачи (AA) | Пересчёт: 20 тыс. ввода + вывод |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | 55 | 55 тыс. | $2,11 | 618 с | $0,59 |
Opus 5.5, low | 42 | 10 тыс. | $0,55 | 80 с | $0,28 |
Opus 5.5, medium (по умолчанию) | 51 | 26 тыс. | $1,34 | 195 с | $0,60 |
Opus 5.5, high | 54 | 36 тыс. | $1,82 | 272 с | $0,80 |
Opus 5.5, xhigh | 56 | 66 тыс. | $3,46 | 493 с | $1,40 |
Opus 5.5, max | 58 | 119 тыс. | $5,98 | 796 с | $2,46 |
По пересчёту Opus на medium стоит в 1,02 раза больше K3.1 Pro, на high — в 1,36 раза, на xhigh — в 2,37 раза, на max — в 4,17 раза, а на low вдвое дешевле её. По измеренной AA стоимости задач соотношения мягче: Opus на medium обходится в 0,64 от цены K3.1 Pro, на high — в 0,86 при индексе на 1 балл ниже и примерно 0,44 от времени, на xhigh — в 1,64 раза дороже, на max — в 2,83 раза. Расхождение объяснимо: в задачах AA кроме вывода есть многошаговый ввод и кэш, а пересчёт изолирует одну длину ответа. Прогон всего индекса AA обошёлся в $3 117 для K3.1 Pro и в $8 708 для Opus на max; сама AA называет K3.1 Pro «очень многословной»: на индекс ушло 150 млн токенов при медиане 87 млн. Это цены задач индекса, а не ваш счёт: на ваших задачах соотношение будет своим.
Похожую картину дал сторонний тест atomicagent.io, проведённый в день релиза, 23 октября 2026 года: небольшой Python-пакет с пятью внесёнными ошибками и двумя недостающими функциями, скрытые тесты, один и тот же агент, по три прогона на настройку. Все настройки прошли все скрытые тесты. K3.1 Pro на уровне по умолчанию max стоила $0,35–0,46 за задачу против $0,37 у Opus 5.5 и работала 4,9 минуты против 69 секунд; на low — $0,16–0,21, примерно половину цены Opus, но около 2,2 минуты. На max K3.1 Pro делала в среднем 28 вызовов модели против 7 у Opus и писала около 12 тыс. токенов рассуждений против 700, хотя примерно 96 % её ввода шло из кэша. Уровень effort для Opus авторы не указывают (запросы шли через OpenRouter с привязкой к Anthropic), а сами оговаривают, что это одна небольшая, хорошо описанная задача. Их вывод: дешёвый токен превращается в дешёвую задачу, только если убавить рассуждения.
Уровни effort: у Kimi по умолчанию max, у Opus 5.5 — medium
Если отправить оба запроса без параметров рассуждения, вы сравните K3.1 Pro на её максимуме с Opus 5.5 на втором уровне из пяти — и получите ответ про настройки, а не про модели. У K3.1 Pro три уровня в поле reasoning_effort: low, high и max, по умолчанию max. У Opus 5.5 пять уровней effort: low, medium, high, xhigh и max, по умолчанию medium — и, как подчёркивает документация Anthropic по effort, запрос без этого параметра теперь работает на уровень ниже, чем у Opus 5.
Одинаковые названия не означают одинаковый расход. По индексу AA K3.1 Pro с её 55 баллами ближе всего к Opus на high (54) и xhigh (56), поэтому именно эти два уровня Opus разумно ставить напротив неё; max у Opus тратит 119 тыс. выходных токенов на задачу против 55 тыс. у K3.1 Pro. Опускать K3.1 Pro ниже max стоит с проверкой качества: на собственном точечном графике Kimi «балл против стоимости задачи» в Terminal-Bench 4.0 её результат на high падает примерно с 65,7 до 53 %, а стоимость задачи — лишь примерно с $5,2 до $4,2 (значения сняты с графика на глаз).
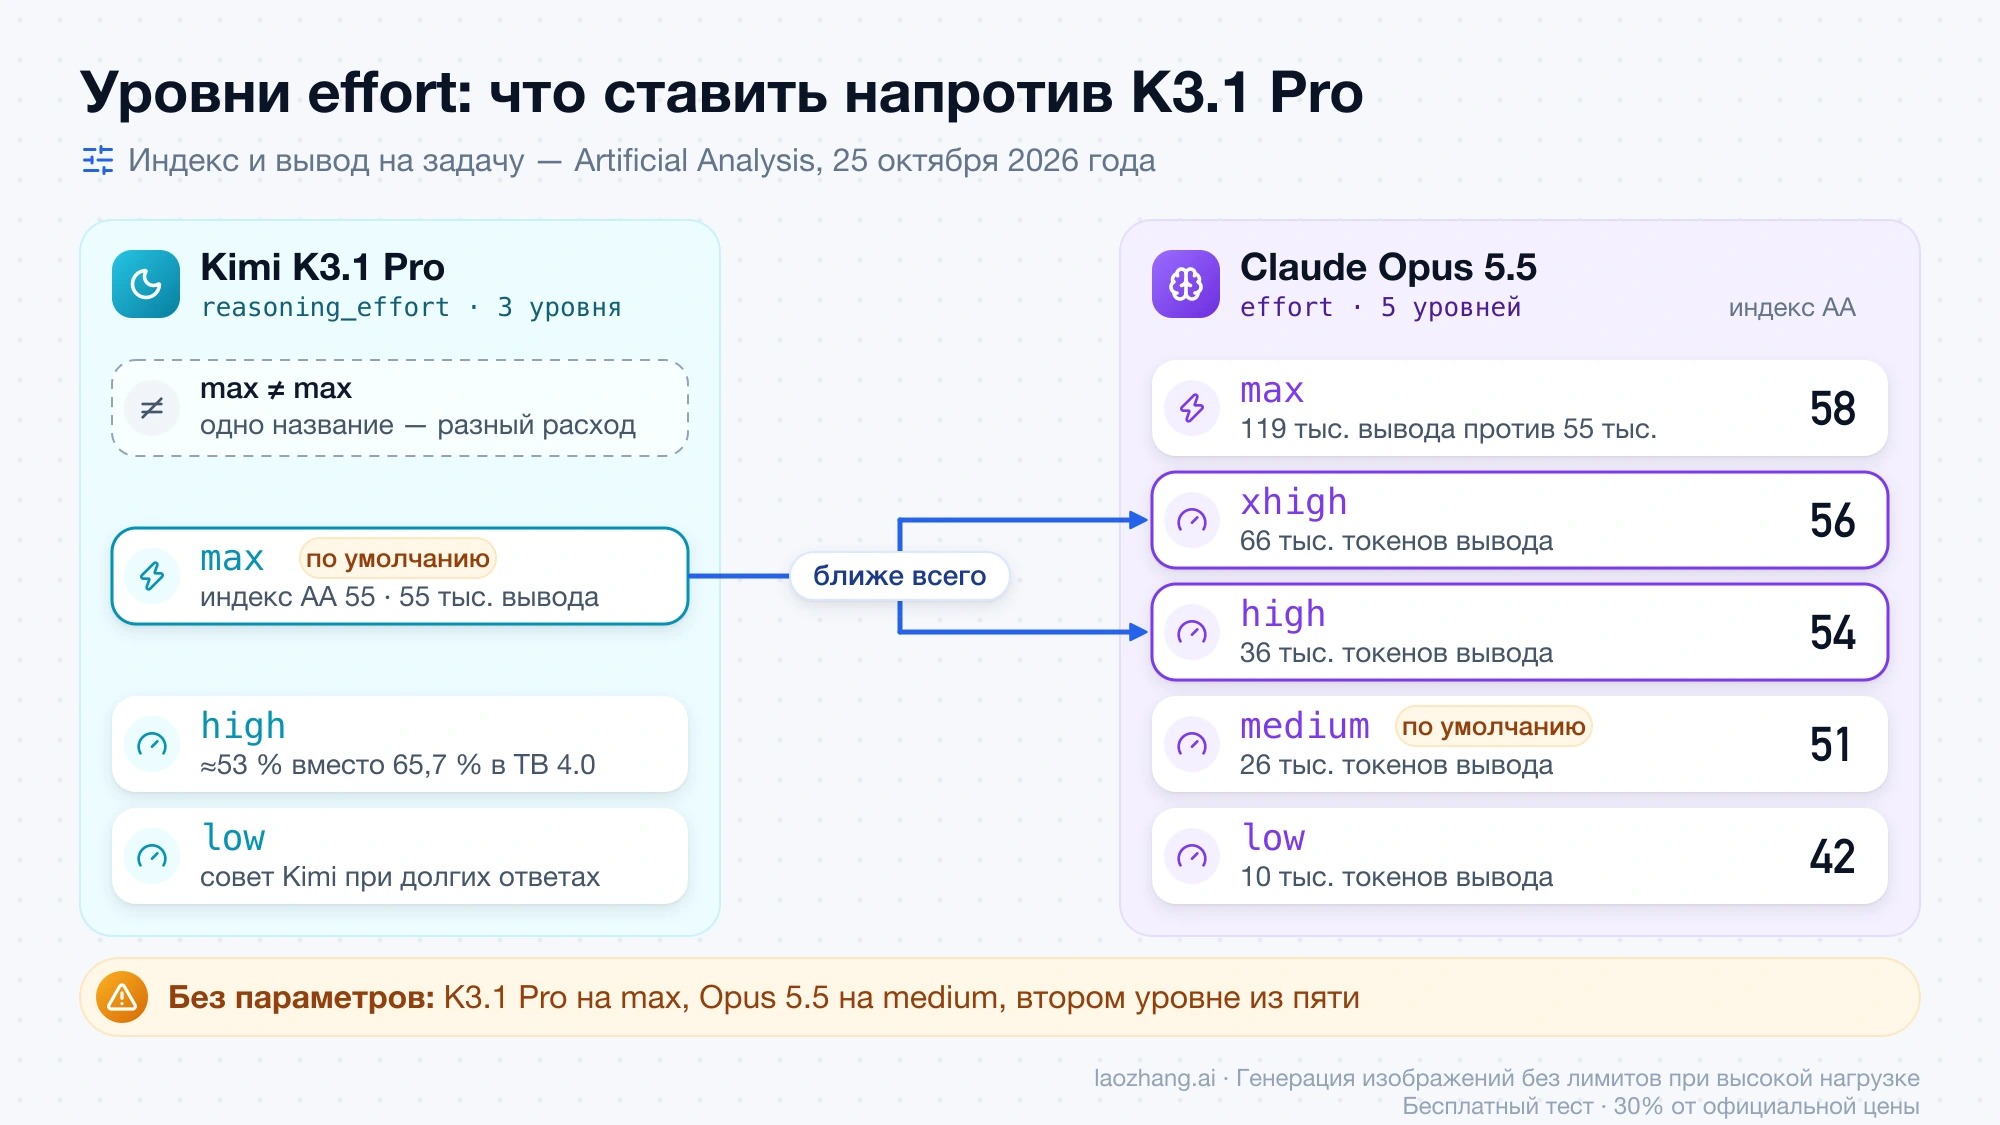
Отключить мышление нельзя ни у одной из моделей. У K3.1 Pro режим рассуждений включён всегда, и при слишком долгих ответах Kimi советует ставить low. У Opus 5.5 адаптивное мышление тоже включено всегда: thinking: {"type":"disabled"} возвращает ошибку 400 на любом уровне. Зато у Opus уровень можно менять посреди диалога через output_config в отдельном сообщении без потери кэша промпта — например, держать агента на high и поднимать до xhigh только на трудных шагах.
Каким бенчмаркам верить: 65,7 против 66,4, 67 против 60 и 64,8 %
Все три цифры по Terminal-Bench 4.0 верны в своих условиях — они получены разными людьми, в разных средах запуска (harness) и на разных уровнях effort. Поэтому по ним нельзя выбрать победителя, но можно понять, насколько модели близки.
| Источник | Условия | K3.1 Pro | Opus 5.5 |
|---|---|---|---|
| График Kimi при запуске | Сноска: «все модели на максимальном effort»; цифра Opus — собственный результат Anthropic на xhigh | 65,7 % | 66,4 % |
| Лидерборд tbench.ai, 25 октября 2026 года | Харнесс Claude Code, Opus на max | строки нет | 64,8 % ± 3,1 |
| Artificial Analysis | Собственный харнесс AA | 67 % | 60 % на max, 57 % на high |
Цифру 66,4 % Kimi взяла из таблицы Anthropic, где Terminal-Bench 4.0 единственный прогнан на xhigh, а не на max. На публичном лидерборде tbench.ai, на который ссылается график Kimi, на 25 октября 2026 года K3.1 Pro вообще нет; там первое место у Opus 5.5 на max с 64,8 %. По версии AA, наоборот, у K3.1 Pro лучший результат среди всех моделей в этом тесте. Тот же точечный график Kimi показывает Opus 5.5 примерно на 65 % при стоимости задачи около $14,3 против около $5,2 у K3.1 Pro на max — отсюда и формулировки «уровень Opus за треть цены».
В общей таблице Kimi из 14 тестов K3.1 Pro впереди в девяти, Opus 5.5 — в пяти: Terminal-Bench 4.0, Terminal-Bench Science (38,1 против 63,3), GDPval-AA (1846 против 1866), BenchCAD (92,7 против 96,2) и OSWorld (79,6 против 81,8). Колонка Opus там собрана из разных источников: GDPval 1866 совпадает с замером AA на max, а в таблице самой Anthropic стоит 1846. Независимые тесты AA рисуют ту же границу. K3.1 Pro впереди в Terminal-Bench 4.0, AutomationBench (73 против 70 %) и GDP.pdf (31 против 26 %). Opus на max заметно сильнее в задачах на знания и науку: HLE (61 против 52 %), SciCode (67 против 61 %), CritPt (32 против 25 %), AA-Omniscience (46 против 30) и AA-Briefcase (1801 против 1678). Итог по индексу — 55 у K3.1 Pro против 58 у Opus на max. Сама Anthropic в анонсе Opus 5.5 предупреждала, что отрыв в бенчмарках стал менее надёжным ориентиром для реальной разницы.
Что сломается при замене Opus 5.5 на K3.1 Pro в коде и агентах
Заменить имя модели недостаточно: у моделей разные API, названия уровней effort, лимиты вывода, время ответа и круг поставщиков. Основные различия — в таблице по руководству Kimi по K3.1 Pro и обзору моделей Claude.
| Что проверить | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Идентификатор модели | kimi-k3.1-pro, kimi-k3.1-pro-highspeed | claude-opus-5-5, на Bedrock anthropic.claude-opus-5-5 |
| Где работает | API Moonshot: https://api.moonshot.ai/v1, китайская площадка https://api.moonshot.cn/v1 | Claude API, Amazon Bedrock, Google Vertex AI, Microsoft Foundry, Claude Platform on AWS |
| Рассуждения | reasoning_effort: low / high / max, по умолчанию max, отключить нельзя | effort: low / medium / high / xhigh / max, по умолчанию medium, отключить нельзя |
| Контекст | 1 млн токенов | 1 млн токенов |
| Максимальный вывод | max_completion_tokens: по умолчанию 131 072, до 1 048 576 | 128 тыс.; 300 тыс. в Message Batches с бета-заголовком output-300k-2026-03-24 |
| Поставщики в каталоге OpenRouter, 25 октября 2026 года | 2 эндпоинта, оба Moonshot AI | 11 эндпоинтов: Anthropic, Amazon Bedrock, Google Vertex, Azure, Claude Platform on AWS |
Чаще всего ломаются параметры сэмплинга. У K3.1 Pro значения temperature=1.0, top_p=0.95, n=1, presence_penalty=0 и frequency_penalty=0 зафиксированы, и Kimi просит не передавать их в запросе; если ваш код по привычке шлёт temperature: 0.2, его придётся поправить. В многошаговых диалогах и вызовах инструментов Kimi требует возвращать сообщение ассистента целиком, без изменений. Картинки по публичной ссылке модель не принимает — только base64 или идентификатор файла ms://. Строгий json_schema поддерживается, а встроенный веб-поиск Kimi пока не рекомендует для рабочих сценариев, потому что он обновляется.
Вторая частая поломка — таймауты. 25 октября 2026 года одна и та же задача по коду (Python-модуль расчёта счетов с пятью внесёнными ошибками и двумя недостающими функциями, 36 скрытых тестов pytest) была отправлена обеим моделям через сторонний OpenAI-совместимый API-шлюз — без стриминга и без параметра effort, то есть на уровнях по умолчанию. Opus 5.5 на medium во всех трёх прогонах прошла все 36 тестов, отвечала за 21–23 секунды, а прогон стоил около $0,05 по прайсу. K3.1 Pro на max не ответила ни в одной из 18 попыток (три прогона по шесть попыток): шлюз каждый раз закрывал соединение примерно через 300 секунд — таков его лимит для запросов без стриминга. Оценки качества и стоимости K3.1 Pro по этой задаче поэтому нет, и победой Opus это считать нельзя: известно лишь, что ответ не уложился в пять минут. Это согласуется с 618 секундами на задачу у AA и 4,9 минуты на max у atomicagent.io, хотя задачи там другие. Практический вывод: если ваш клиент, прокси или шлюз обрывает запросы без стриминга через несколько минут, для K3.1 Pro включайте стриминг или снижайте reasoning_effort. Стриминг, пониженный effort, собственный эндпоинт Moonshot и Highspeed в этом прогоне не проверялись.
Данные о поставщиках взяты из публичного каталога OpenRouter: 25 октября 2026 года запросы GET /api/v1/models и /api/v1/models/{id}/endpoints без ключа вернули для moonshotai/kimi-k3.1-pro два эндпоинта, оба от Moonshot AI (обычный и highspeed, по тем же ценам, что у Moonshot), контекст 1 048 576 и максимум 943 718 токенов вывода. Температуры и top_p в списке поддерживаемых параметров нет, а reasoning_effort, инструменты и структурированный вывод есть. У anthropic/claude-opus-5.5 в том же каталоге 11 эндпоинтов у Anthropic и трёх облаков, пять из них региональные. Если вам нужен конкретный регион обработки данных или резервный поставщик на случай сбоя, у K3.1 Pro такого выбора пока нет.
Тем, кто хочет сохранить Claude Code и сменить только модель, Kimi описывает подключение через Anthropic-совместимый эндпоинт https://api.moonshot.ai/anthropic; для этого сравнения такой вариант не запускался.
Что лучше отдать K3.1 Pro, а что оставить на Opus 5.5
K3.1 Pro имеет смысл пробовать там, где Opus 5.5 сейчас работает на xhigh или max, задачи длинные и проверяются автоматически, а время ответа не критично. По замерам AA на этих уровнях задача у Opus стоит в 1,6–2,8 раза больше, а индекс у Opus выше лишь на 1–3 балла; в независимых тестах AA K3.1 Pro сильна в терминальных задачах и офисной автоматизации (Terminal-Bench 4.0, AutomationBench, GDP.pdf). Это же подходит для фоновой работы — ночных прогонов, разбора репозиториев, пакетной обработки документов, — где лишние минуты никому не мешают.
Opus 5.5 стоит оставить там, где важны скорость и знание фактов. В интерактивной работе разница во времени ощутима: у AA задача на high занимает 272 секунды против 618 у K3.1 Pro, в тесте atomicagent.io — 69 секунд против 2,2–4,9 минуты. Научные задачи и вопросы на эрудицию (HLE, SciCode, CritPt, AA-Omniscience) у AA уверенно за Opus. И если ваш Opus уже работает на medium или high и результат устраивает, переход на K3.1 Pro по данным AA денег не сэкономит. Остаются и требования к инфраструктуре: облака, регионы, второй поставщик.
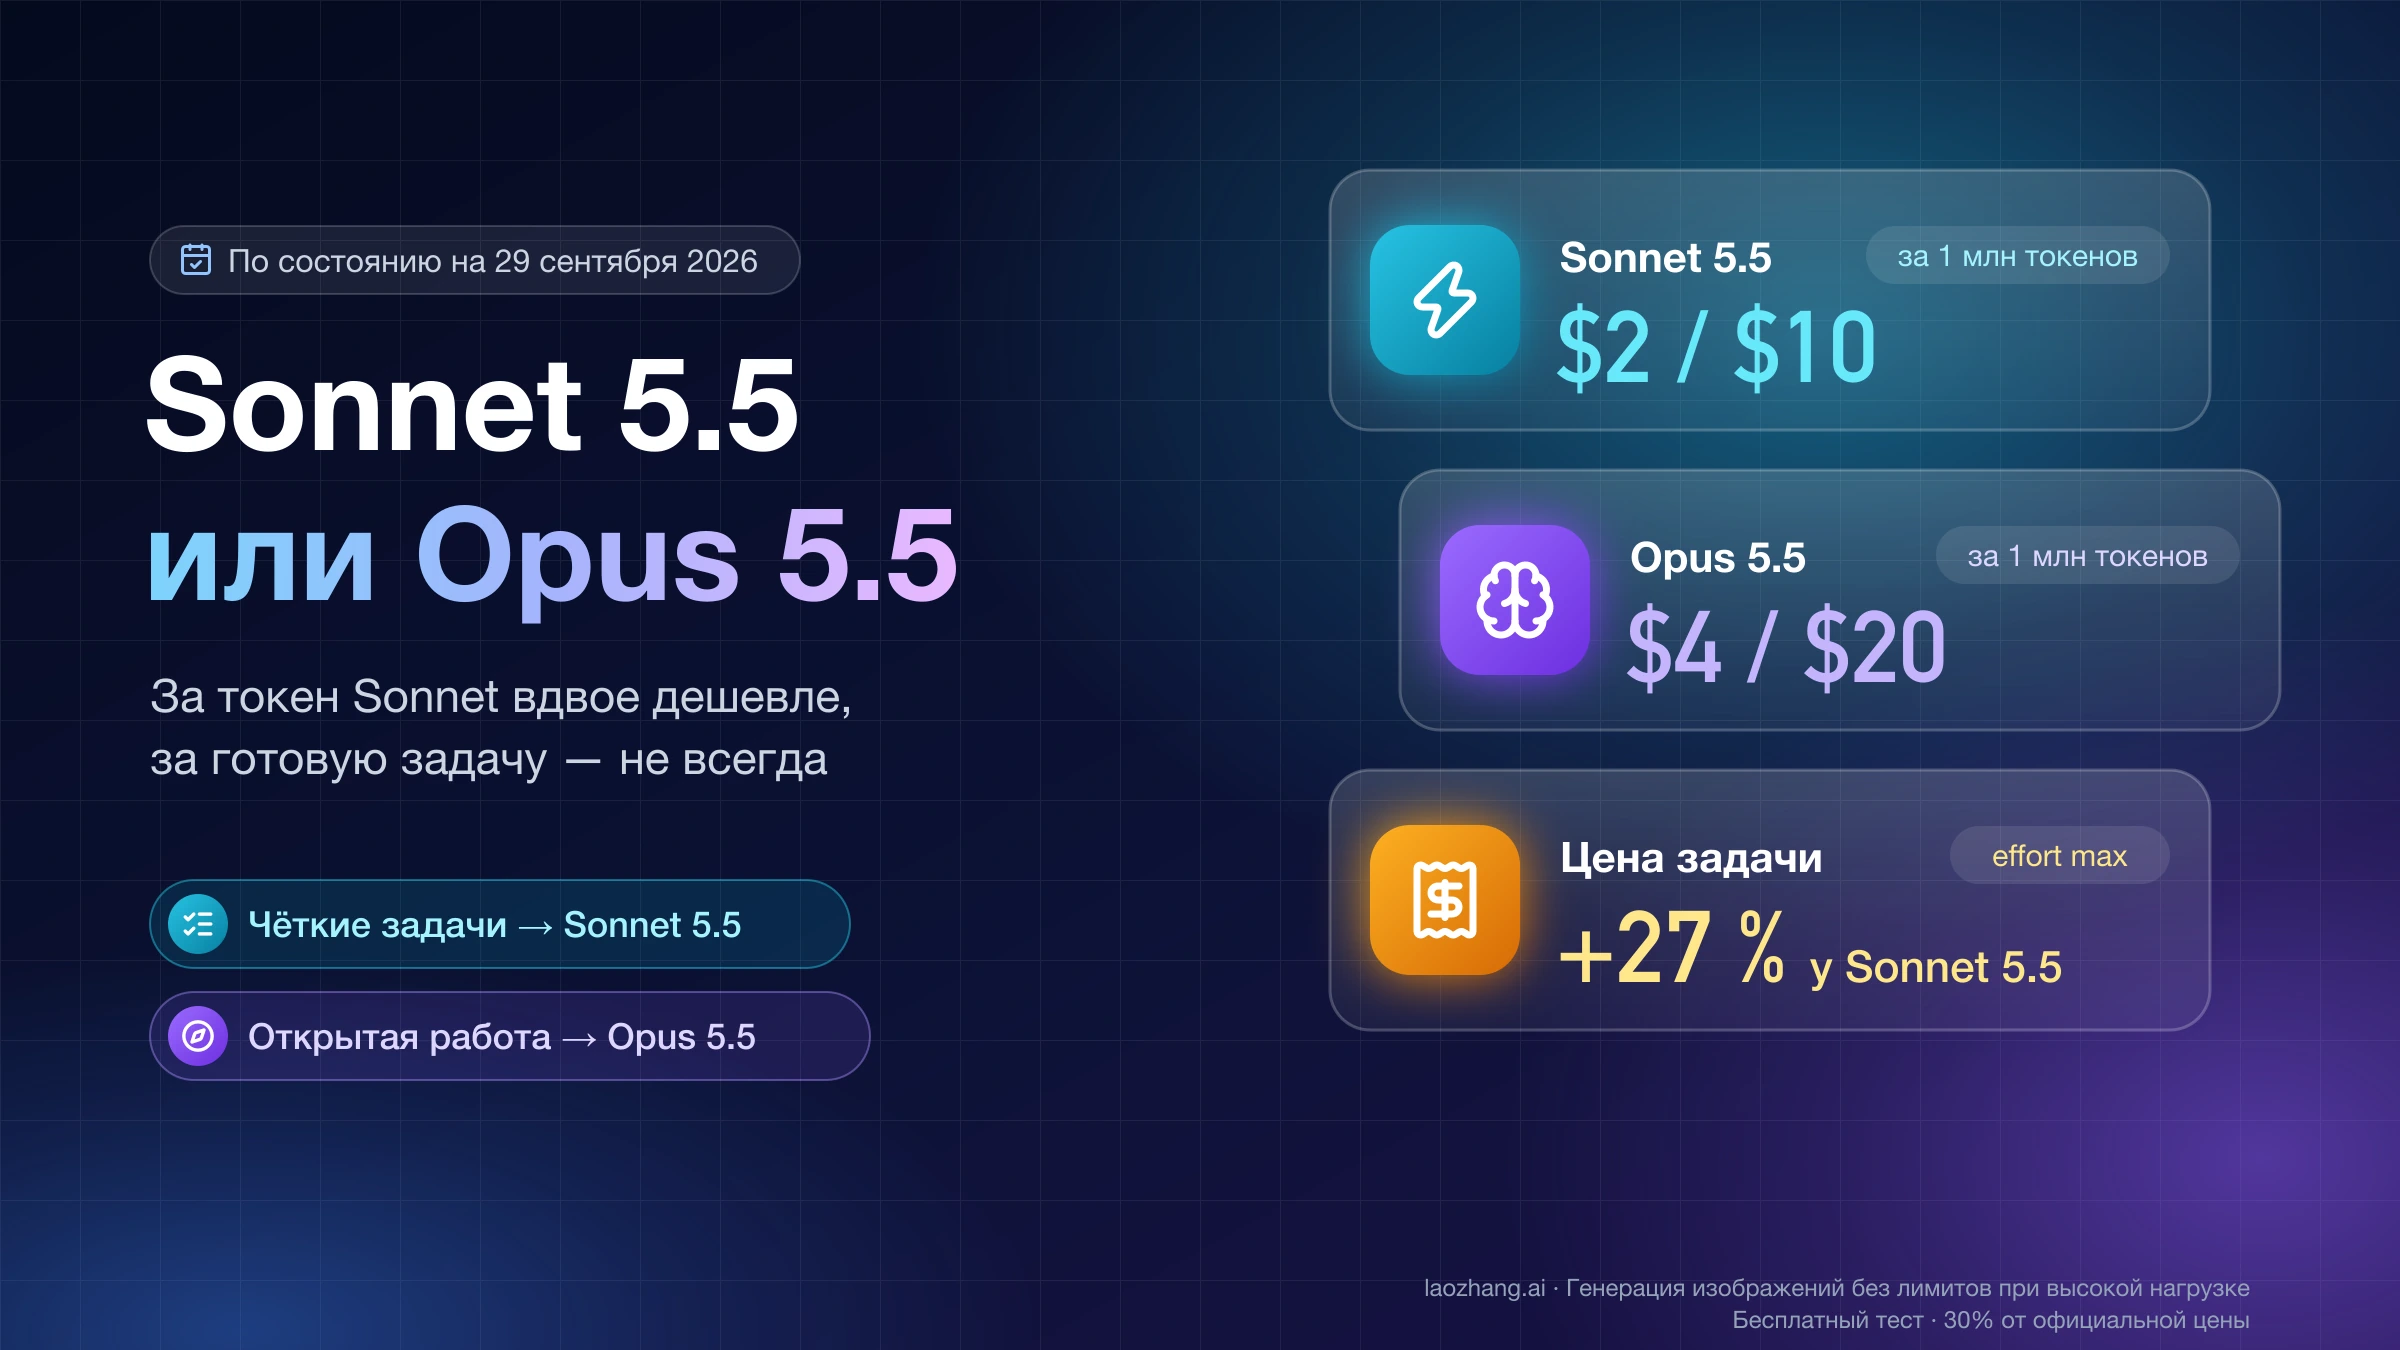
Если цель — именно цена K3.1 Pro, у Anthropic есть Claude Sonnet 5.5 с теми же ценами ввода и вывода, что у K3.1 Pro, и чтением из кэша за $0,10; разница между ним и Opus разобрана в материале «Claude Sonnet 5.5 или Opus 5.5: разница, цена задачи и выбор». Сравнение Opus с моделью OpenAI — в статье «Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода». Пара K3.1 Pro и GPT-6.1 Sol с одинаковой ценой $2/$10 за токен разобрана в статье «Kimi K3.1 Pro или GPT-6.1 Sol: сравнение цены задачи и качества». Подписки по API-ценам не сравнить: есть лишь единичный отчёт пользователя X, у которого одна и та же задача с 3D-сценой заняла 62 % пятичасовой сессии на плане Claude за $100 и 0,53 % сессии на плане Kimi Vivace. Это доли лимитов конкретных планов в одном примере, а не цены.
Как честно сравнить K3.1 Pro и Opus 5.5 на своих задачах
Решение о переводе нагрузки лучше принимать по цене решённой задачи на ваших данных, а не по бенчмаркам или прайсу. Порядок важен: сначала выравниваются условия, потом считаются деньги.
- Возьмите реальные задачи из своей работы, у которых есть автоматическая проверка: тесты, эталонный ответ, валидатор схемы. Без проверки сравнивать будет нечего, кроме ощущений.
- Запускайте обе модели в одном и том же агенте с одинаковыми инструментами и промптом. Для K3.1 Pro уберите из запросов
temperatureиtop_p, возвращайте сообщения ассистента без изменений и включите стриминг или поднимите таймаут клиента: наmaxответ может идти дольше пяти минут. - Задайте уровни рассуждения явно. Минимальный набор: K3.1 Pro на
maxиhigh, Opus 5.5 наhighиxhighплюс тот уровень, на котором Opus работает у вас сейчас. - Записывайте на каждую задачу результат проверки, фактическое списание с баланса, время от начала до конца и число вызовов модели. Подсчёт по токенам может расходиться со счётом: в тесте atomicagent.io баланс Kimi за шесть прогонов уменьшился на $2,02 при расчётных $1,52.
- Повторите каждую настройку хотя бы три раза. К прогонам первых дней после релиза относитесь осторожно: авторы atomicagent.io считают, что API тогда работал под высокой нагрузкой.
- Сравните стоимость одной успешно решённой задачи и время на неё, а затем распределите типы задач между моделями, а не переводите всё сразу.
Открытые веса K3.1 Pro к 4 ноября: что перепроверить после выхода
Пока K3.1 Pro — закрытая модель с одним поставщиком: Moonshot обещает выложить полные веса к 4 ноября 2026 года, а до этого AA помечает её как модель без открытых весов. Moonshot называет K3.1 Pro дообученной версией Kimi K3 и «моделью класса 3T»; AA и atomicagent.io указывают 2,8 трлн параметров, из них 104 млрд активных, — это масштаб K3. Для открытого выпуска, по словам Moonshot, из обучения убрали данные, связанные с кибербезопасностью.
После выхода весов стоит перепроверить три вещи. Во-первых, число поставщиков в каталоге OpenRouter: на 25 октября 2026 года это два эндпоинта одного Moonshot, и с открытыми весами картина может измениться. Во-вторых, появление K3.1 Pro на лидерборде tbench.ai — тогда цифры Terminal-Bench 4.0 впервые окажутся в одном харнессе с Opus 5.5. В-третьих, замеры Artificial Analysis: в первые дни после релиза их могут пересматривать, а от них зависит главный вывод о стоимости задачи по уровням effort.
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 окт. 2026 г..
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 окт. 2026 г..
- 1.Artificial Analysisartificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-claude-opus-5-5
- 2.политика поддерживаемых регионов Anthropicanthropic.com/legal/supported-regions
- 3.прайс-листу Kimiplatform.kimi.ai/docs/pricing/chat
- 4.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 5.atomicagent.ioatomicagent.io/blog/kimi-k3-1-pro
- 6.документация Anthropic по effortplatform.claude.com/docs/en/build-with-claude/effort
- 7.Лидерборд tbench.aitbench.ai/leaderboard/terminal-bench/4.0
- 8.руководству Kimi по K3.1 Proplatform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 9.обзору моделей Claudeplatform.claude.com/docs/en/models/overview