Claude Sonnet 5.5 или GPT-6 Astra: стоит ли переходить
В индексе AA v5.0 GPT-6 Astra выше Sonnet 5.5 на всех уровнях effort, а на xhigh и max ещё и дешевле за задачу, хотя токен Sonnet дешевле в 5–10 раз.
Содержание
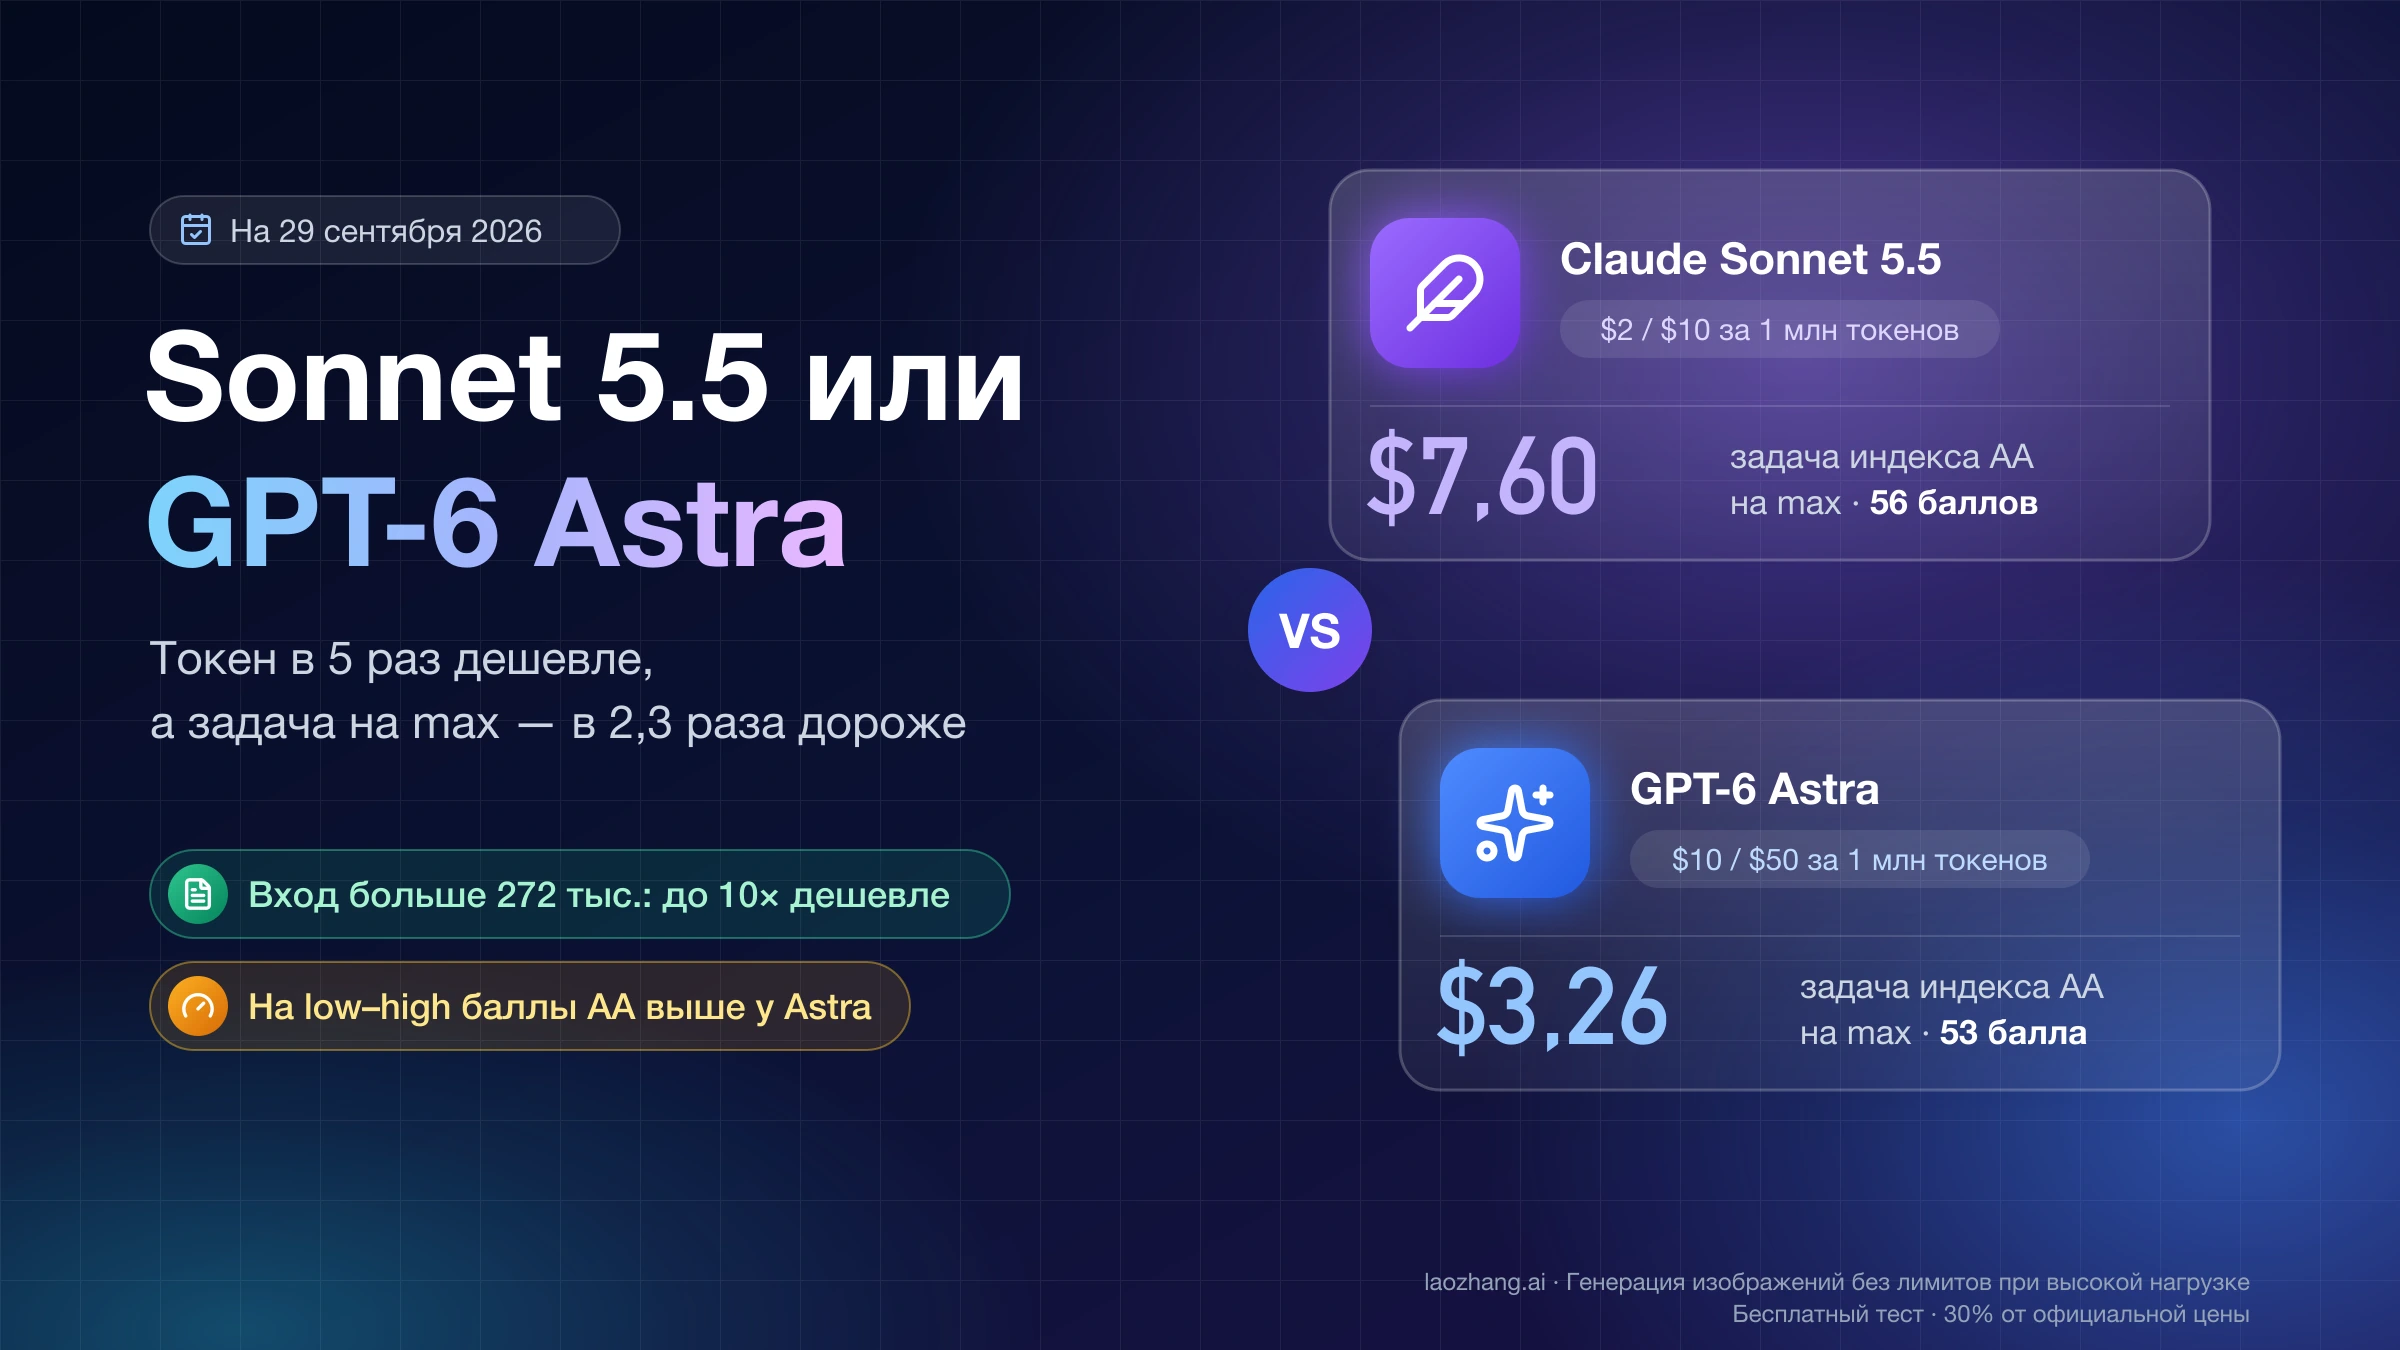
Новость «Claude Sonnet 5.5 обогнал GPT-6 Astra» держалась на одном сравнении: индексе Artificial Analysis (AA) версии v4.3.2 на 29 сентября 2026 года при максимальном уровне усилия рассуждений (effort). Там у Sonnet 5.5 было 56 баллов против 53 у Astra, но задача индекса стоила в 2,3 раза дороже. 27–28 октября 2026 года AA перешла на Intelligence Index v5.0 из 9 тестов, и перевеса Sonnet больше нет: Astra выше на всех пяти уровнях, от 43 баллов против 25 на low до 57 против 54 на max. На вопрос «Sonnet 5.5 лучше Astra?» сводный индекс AA теперь отвечает «нет». Sonnet 5.5 выигрывает в другом: на уровнях от low до high задача у него в 2–3,5 раза дешевле, и генерирует он быстрее — 109–140 токенов в секунду против 48–71. На xhigh и max Astra и выше, и дешевле: $3,66 против $4,09 и $6,24 против $10,02 за задачу.
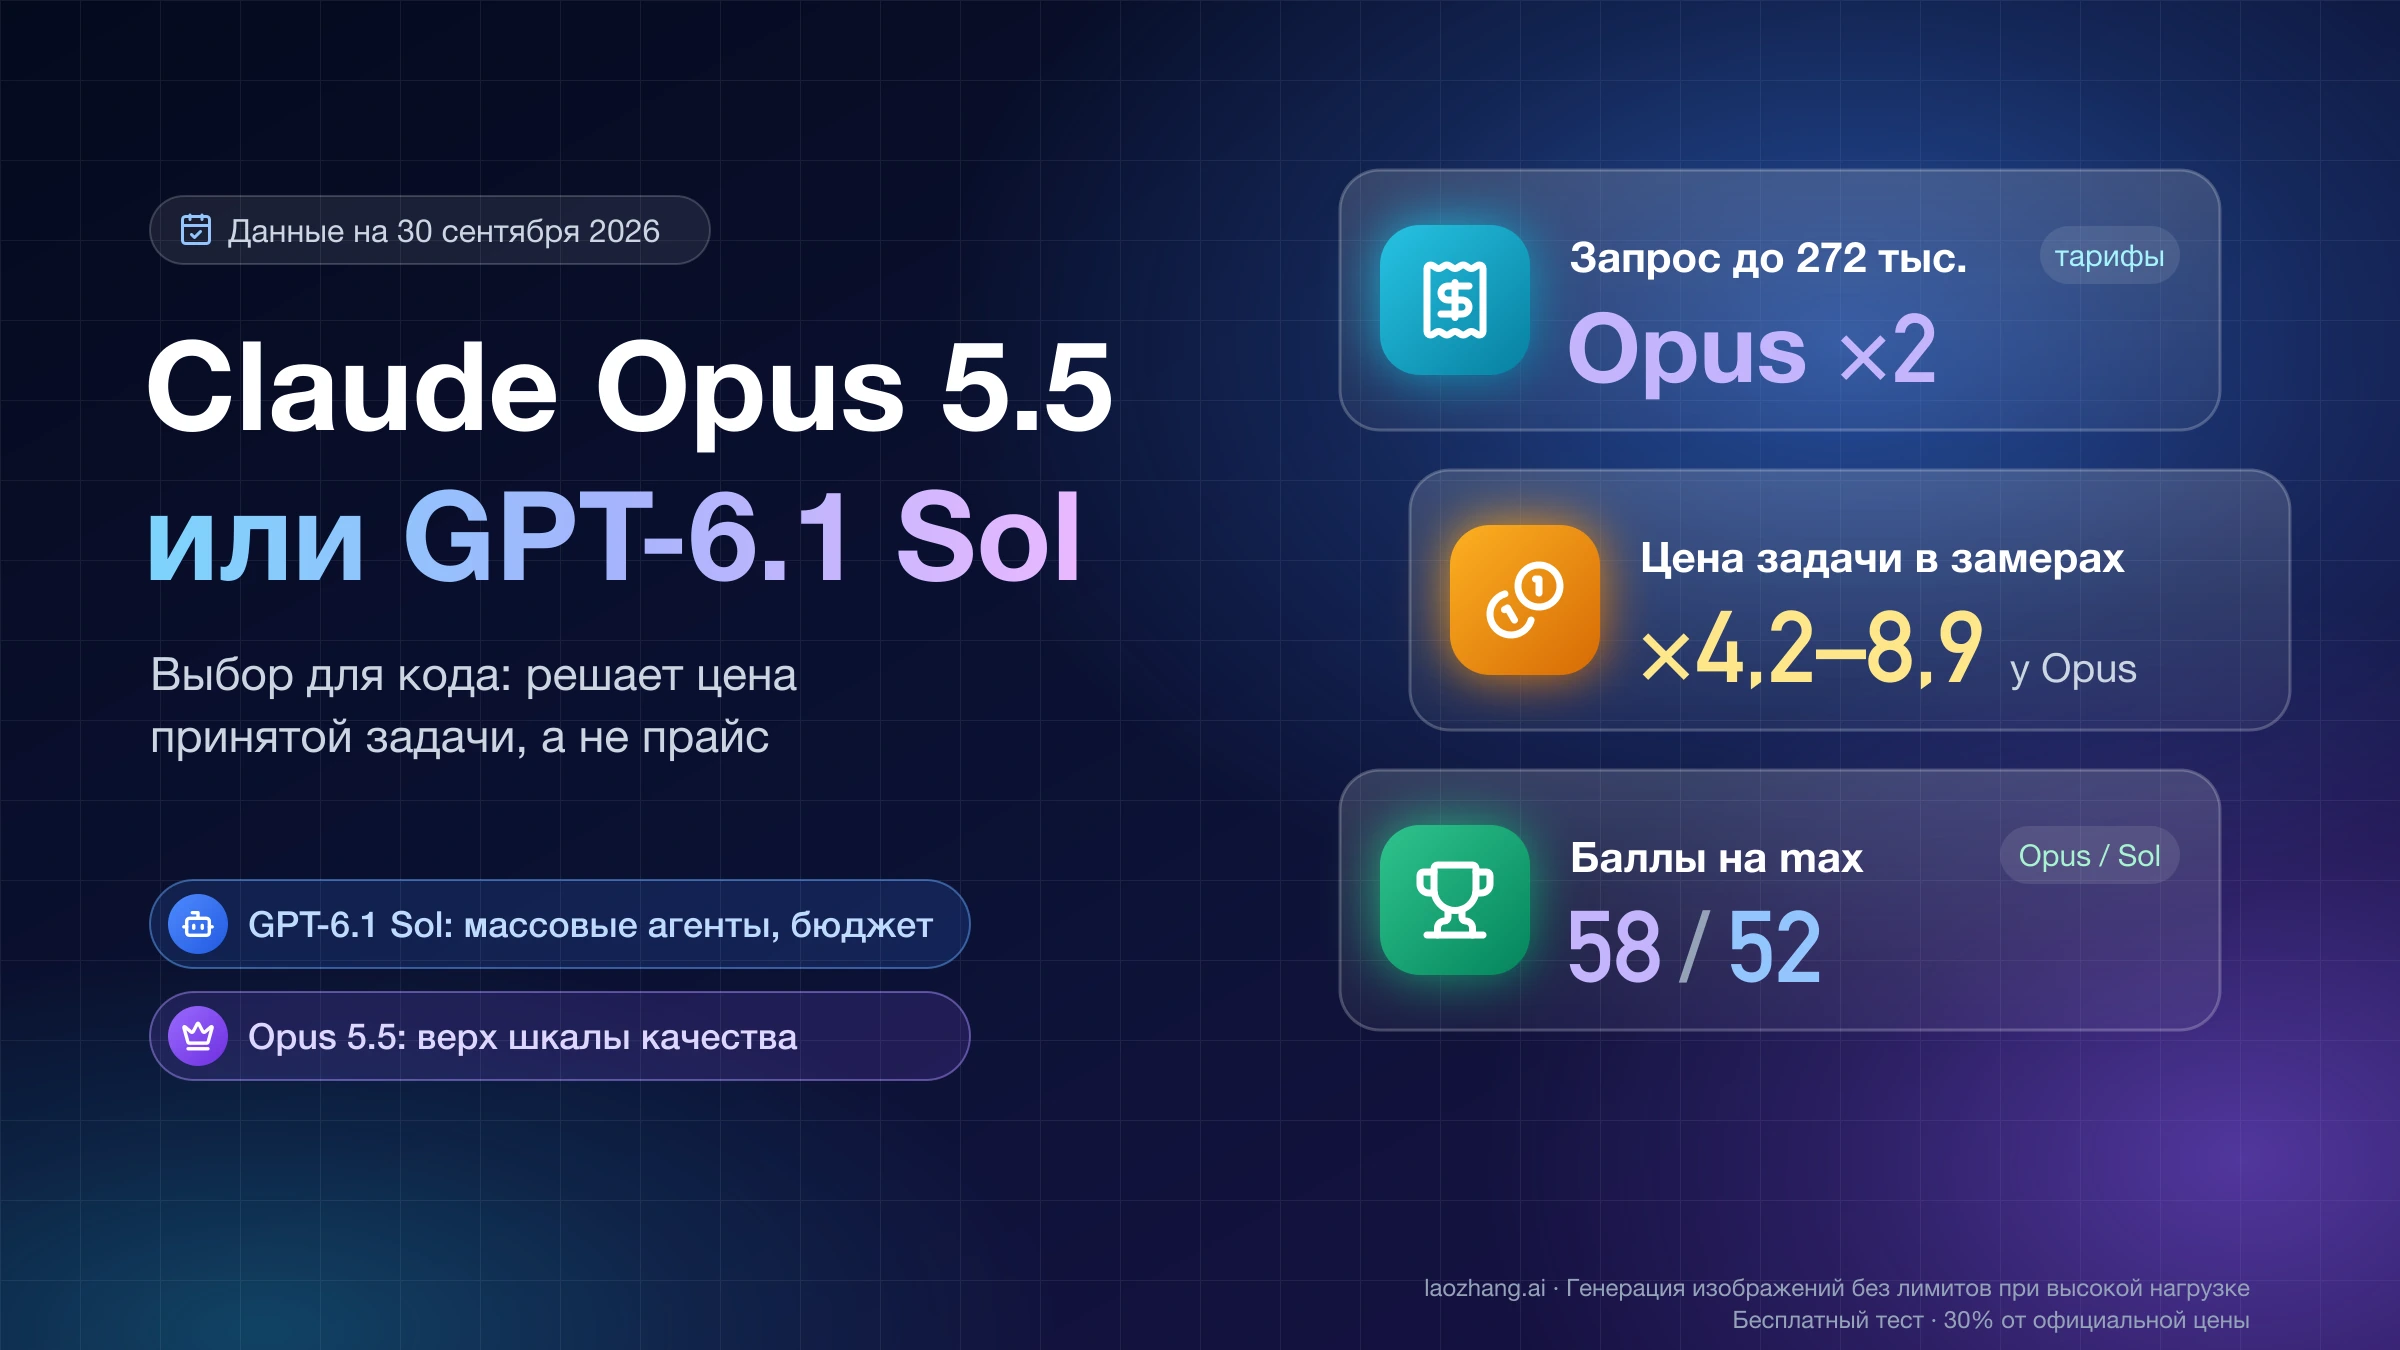
Тариф при этом действительно на стороне Sonnet 5.5: $2 за 1 млн входных и $10 за 1 млн выходных токенов против $10 и $50 у Astra. Если во входе больше 272 тыс. токенов, Astra считает весь запрос по повышенной ставке, и при одинаковом числе токенов разница вырастает до 7,5–20 раз: 7,5× на выходе, 10× на входе и 20× на чтении из кэша.
Рабочее правило из этого такое. Если Astra уже справляется с вашими задачами, более дешёвый токен ещё не означает более дешёвый результат: при близких баллах AA задача у Astra стоит меньше. Sonnet 5.5 стоит пробовать на запросах длиннее 272 тыс. токенов, на лёгких массовых вызовах, где хватает low или medium, в юридических, налоговых и финансовых агентах, где сторонние замеры показывают его перевес. Если Astra даже на max не проходит вашу проверку, следующий кандидат — Opus 5.5 на max (58 баллов в v5.0), а не Sonnet 5.5 на max (54). Научные расчёты в терминале, эксплуатационные задачи (SRE) и алгоритмическое программирование разумнее оставить на Astra. А если вопрос звучит как «что лучше за те же деньги», соперник Sonnet 5.5 — не Astra, а GPT-6 Sol с точно таким же тарифом.
Окончательно всё решает стоимость принятой задачи: сумма, заплаченная за все прогоны вместе с повторами, делённая на число результатов, которые прошли вашу проверку.
Что выбрать под свой тип задач
| Ваша ситуация | С чего начать | На чём основано |
|---|---|---|
| Astra уже проходит вашу проверку | Оставить Astra, Sonnet 5.5 проверять на части трафика | В индексе AA при близких баллах задача у Astra дешевле: у Astra на low — 43 балла за $1,42, у Sonnet на high — 41 за $1,64; на xhigh у Astra 55 баллов за $3,66, у Sonnet — 50 за $4,09 |
| Astra не справляется даже на max | Claude Opus 5.5 на max; Sonnet 5.5 — только после проверки на своих задачах | В индексе AA Sonnet max (54 балла, $10,02) ниже Astra max (57, $6,24); у Opus 5.5 на max — 58 баллов за $10,04 |
| Во входе больше 272 тыс. токенов | Сначала проверить Sonnet 5.5 | У Sonnet нет надбавки за длинный контекст; 300 тыс. входа + 20 тыс. выхода — $0,80 против $7,50 при тех же токенах |
| Лёгкие массовые запросы, чат, важен быстрый первый ответ | Sonnet 5.5 на low или medium, для сравнения — GPT-6 Sol | Задача AA у Sonnet low стоит $0,51, у medium — $0,78, у самой дешёвой настройки Astra — $1,42; первый токен ответа на low: 1,29 с против 2,71 с |
| Научные расчёты в терминале, SRE, олимпиадное программирование | Astra | Vals на max: Terminal-Bench Science 65,71 % против 38,57 %, SRE Bench 56,87 % против 30,15 %, IOI 100 % против 83,06 % |
| Юридические, налоговые и финансовые агенты | Проверить Sonnet 5.5 | Vals на max: Legal Research Bench 48,08 % против 39,42 %, Tax Agent Bench 73,39 % против 63,34 %, Finance Agent 58,10 % против 53,54 % |
| Работа идёт в подписке: Codex, ChatGPT, Claude Code | Выбирать по среде, а не по прайсу API | Лимиты подписок не выводятся из цен за токен |
| Нужна лучшая модель за $2 / $10 | Сравнить Sonnet 5.5 с GPT-6 Sol | У GPT-6 Sol тот же базовый тариф, и в собственной таблице Anthropic Sonnet 5.5 сравнивается именно с Sol |
Цифры AA — сторонние замеры по индексу v5.0 на 28 октября 2026 года, цифры Vals — на 29 сентября 2026 года; их условия разобраны в следующих двух разделах.
Последняя строка важнее, чем кажется. При запуске, по индексу v4.3.2 на 29 сентября 2026 года, Artificial Analysis отмечала, что самая сильная настройка Sonnet 5.5 по соотношению балла и цены — high, и там он лишь немного уступает GPT-6 Sol при практически той же стоимости задачи. В версии v5.0 GPT-6 Sol уже не оценивается, так что обновлённого сравнения этой пары у AA нет. Как Sol соотносится с Astra и другими моделями OpenAI, разобрано в материале GPT-6 Sol, Luna, Astra и GPT-6.1 Terra: что выбрать для работы.
С кибербезопасностью картина обманчива. В CyberBench у Vals Sonnet 5.5 набрал 59,58 % против 41,07 % у Astra, но в 54 задачах из 116 за него отвечал Sonnet 5 через серверный откат. Если считать такие задачи проваленными, результат падает до 41,97 %, то есть практически до уровня Astra. Тот же механизм работает и в продуктах: в приложениях Claude запрос, который классификаторы сочтут наступательным, может переключить разговор на Sonnet 5, а в API он вернётся как отказ с категорией cyber, если серверный откат (beta) не включён.
Откуда взялось «Sonnet 5.5 обогнал Astra»
Заголовок родился из индекса Artificial Analysis версии v4.3.2: 10 тестов, среди них Terminal-Bench 4.0, GDPval-AA, Humanity's Last Exam и SciCode. На 29 сентября 2026 года Sonnet 5.5 набирал там на max 56 баллов против 53 у Astra при задаче за $7,60 против $3,26; на low, medium и high впереди была Astra, на xhigh у обеих было по 52. В версии v5.0 GDPval-AA, Humanity's Last Exam, SciCode и тест длинного контекста AA-LCR из индекса убраны, добавлены FrontierCode 2.0, HLE-Diamond, CritPt и Terminal-Bench-Science, и перевес Sonnet на max исчез. Каждую модель AA по-прежнему прогоняет на всех пяти уровнях effort и публикует стоимость задачи индекса — цену одной задачи по тарифам вендора, с учётом входа, кэша, рассуждений и ответа.
| Effort | Sonnet 5.5: баллы / задача | GPT-6 Astra: баллы / задача | Итог |
|---|---|---|---|
| low | 25 / $0,51 | 43 / $1,42 | Astra +18, задача в 2,8 раза дороже |
| medium | 30 / $0,78 | 51 / $2,73 | Astra +21, задача в 3,5 раза дороже |
| high | 41 / $1,64 | 55 / $3,24 | Astra +14, задача в 2,0 раза дороже |
| xhigh | 50 / $4,09 | 55 / $3,66 | Astra +5 и дешевле |
| max | 54 / $10,02 | 57 / $6,24 | Astra +3 и в 1,6 раза дешевле |
Источник: Artificial Analysis, индекс v5.0, данные на 28 октября 2026 года.
Заголовки про победу Sonnet опирались на нижнюю строку прежней таблицы. В v5.0 у Sonnet 5.5 на max 54 балла, и выше него стоят Claude Opus 5.5 на max (58) и xhigh (57), Astra на max (57), на high и xhigh (55), а также GPT-6.1 Sol на max (55). Платит Sonnet за свой max прежде всего объёмом вывода: при запуске, по индексу v4.3.2, AA насчитала около 193 тыс. выходных токенов на задачу — самый большой расход из измеренных к тому моменту и примерно в 7 раз больше, чем у Astra на max. В v5.0 задача на max занимает у Sonnet 5.5 1 326 секунд против 711 у Astra.
При запуске AA писала, что Sonnet 5.5 не лежит на границе «баллы — стоимость задачи» (фронт Парето). В паре с Astra по данным v5.0 на этой границе остаются только Sonnet на low и medium — самые дешёвые настройки обеих моделей; Sonnet на high, xhigh и max каждый раз уступает настройке Astra, которая и выше, и дешевле. Поэтому корректнее сравнивать не одинаковые метки, а близкие баллы. Astra на low (43 балла, $1,42) выше Sonnet на high (41 балл, $1,64) и дешевле, а Astra на high (55 баллов, $3,24) выше Sonnet на max (54 балла, $10,02) при задаче втрое дешевле.
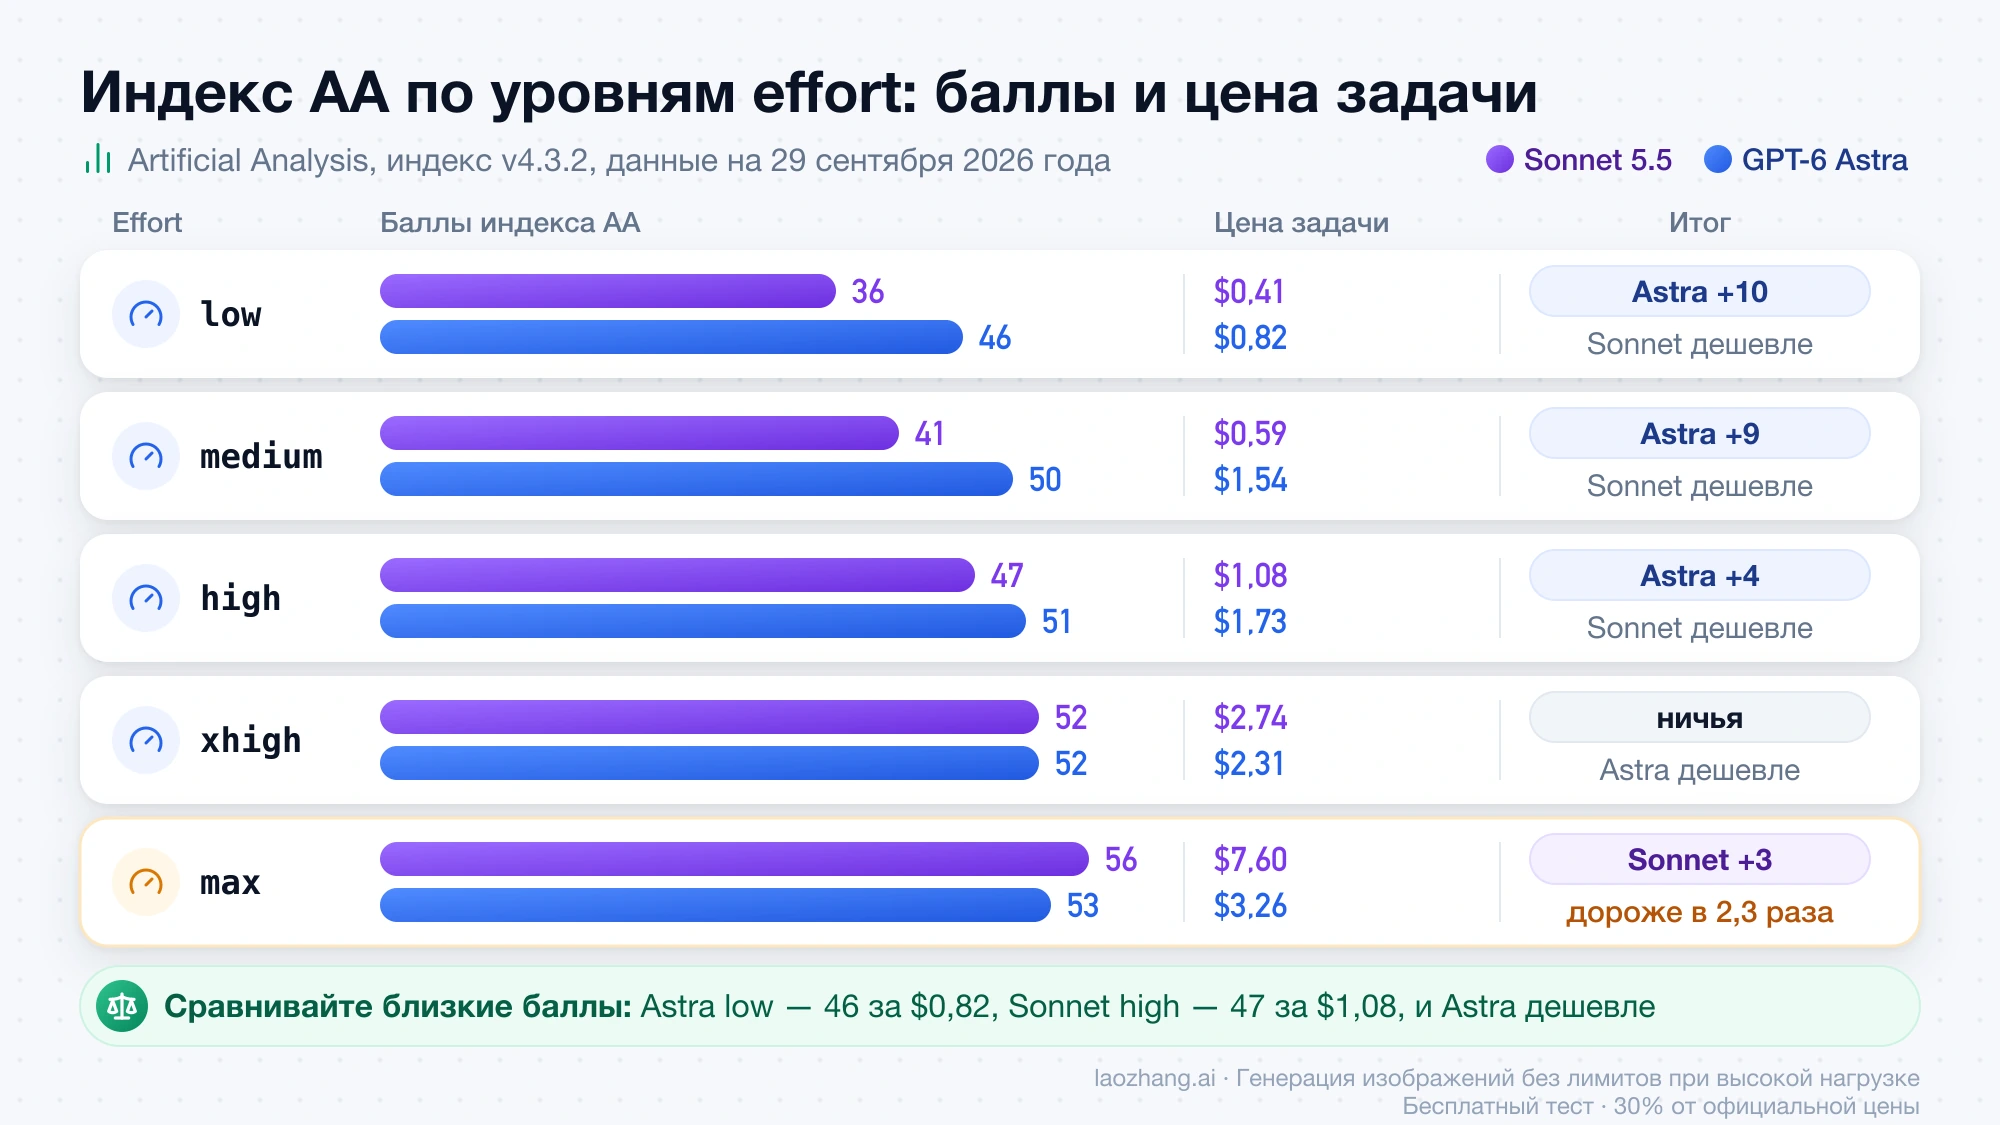
На графике — цифры Artificial Analysis v4.3.2; значения v5.0 по состоянию на 28 октября 2026 года приведены в таблице выше: Astra впереди на всех уровнях.
Сами метки effort у вендоров друг под друга не откалиброваны: high у Anthropic и high у OpenAI означают разный объём рассуждений. Сравнение «по одинаковому уровню» полезно как ориентир, но не как равенство затраченных вычислений.
Полезно знать, на каком уровне вы работаете сейчас. У Sonnet 5.5 по умолчанию high в API и medium в приложениях Claude и в Claude Code — в индексе AA v5.0 это 41 и 30 баллов. Astra принимает значения от low до max, а none вернёт ошибку 400. Значение по умолчанию для Astra в документации OpenAI не указано, поэтому effort в запросах к ней лучше задавать явно.
У первых замеров AA (индекс v4.3.2, 29 сентября 2026 года) было две оговорки. Sonnet 5.5 тестировали на предрелизной версии, в которой Anthropic нашла ошибку, ухудшавшую ответы со структурированным выводом; в публичной версии её исправили, и AA собиралась перепроверить результаты. Кроме того, около 0,1 % задач ушли на резервную модель Sonnet 5. С переходом на v5.0 цифры уже сдвинулись и могут сдвинуться снова, поэтому сверяйтесь со страницей AA на дату своего решения.
Другие замеры и почему нельзя склеивать таблицы вендоров
Vals AI сравнил обе модели на max в 19 общих тестах. Sonnet 5.5 набрал больше в 13 из них, Astra — в 6. При этом диапазоны ±1 стандартная ошибка пересекаются в 9 тестах из 19, и Vals отдельно предупреждает, что это не попарная проверка статистической значимости.
Итоговый Vals Index — 69,22 % у Sonnet 5.5 против 66,61 % у Astra, стоимость прогона — $20,80 против $19,09, время — 1 ч 10 мин против 25 мин 11 с.
Крупнейшие разрывы у Vals:
- в пользу Astra: Terminal-Bench Science (+27,14 п. п.), SRE Bench (+26,72 п. п.), IOI (+16,94 п. п.);
- в пользу Sonnet 5.5: Tax Agent Bench (+10,06 п. п.), Legal Research Bench (+8,65 п. п.) и формально CyberBench (+18,51 п. п.), где этот перевес почти целиком дают ответы Sonnet 5 через откат.
Sonnet 5.5 прогоняли с серверным откатом на Sonnet 5, и на отдельных тестах это заметно. Если засчитать задачи с откатом как проваленные, у Sonnet 5.5 остаётся 41,97 % в CyberBench вместо 59,58 %, 19,08 % в SRE Bench вместо 30,15 % (откат сработал в 126 задачах из 262) и 50,51 % в Terminal-Bench 4.0 вместо 53,03 %, а Vals Index снижается до 68,89 %.
На наборе Vals картина для Sonnet заметно благоприятнее, чем у AA: на max Sonnet дороже примерно на 9 %, а не в 1,6 раза, как в индексе AA v5.0. Это хорошая иллюстрация того, что цена задачи зависит от самих задач. Общее у обоих замеров одно: на max Sonnet тратит заметно больше времени — у AA 1 326 секунд на задачу против 711, у Vals почти втрое дольше.
С Terminal-Bench 4.0 легко ошибиться. Anthropic сообщает 70,6 % для Sonnet 5.5, OpenAI — 57,9 % для Astra на max, но это цифры из разных тестовых обвязок двух разных компаний, и ставить их рядом бессмысленно. В таблице Anthropic вообще нет Astra (там Sonnet 5, Opus 5.5 и GPT-6 Sol), а в таблице OpenAI нет Sonnet 5.5. Независимые замеры расходятся даже в направлении: у AA Sonnet на max набрал 63,6 %, а Astra на xhigh — 59,6 %, у Vals — 53,03 % против 57,07 % в пользу Astra. У OSWorld вендоры и вовсе указывают разные версии теста: 2.1 у Anthropic и 2.0 у OpenAI.
Цена за токен и цена задачи
Официальные тарифы в долларах США за 1 млн токенов, обычный режим (Standard), по состоянию на 29 сентября 2026 года:
| Статья счёта | Claude Sonnet 5.5 | GPT-6 Astra, вход до 272 тыс. | GPT-6 Astra, вход больше 272 тыс. |
|---|---|---|---|
| Вход | $2 | $10 | $20 |
| Чтение из кэша | $0,10 (с 7 октября 2026 года, до этого $0,20) | $1 | $2 |
| Запись в кэш | $2,50 (5 мин), $4 (1 час) | $12,50 (30 мин), $25 (12 ч) | $25 (30 мин), $50 (12 ч) |
| Выход, включая рассуждения | $10 | $50 | $75 |
| Пакетный режим (Batch), вход / выход | $1 / $5 | $5 / $25 | $10 / $37,50 |
У Sonnet 5.5 нет надбавки за длинный контекст во всём окне в 1 млн токенов: по формулировке Anthropic, запрос на 900 тыс. токенов тарифицируется по той же ставке, что и на 9 тыс. Цены такие же, как у Sonnet 5, быстрого режима у Sonnet 5.5 нет, а обработка только в США (inference_geo: "us") стоит в 1,1 раза дороже.
У Astra порог в 272 тыс. входных токенов переводит на повышенные ставки весь запрос целиком, а не только часть сверх порога. Batch и Flex стоят вдвое дешевле Standard, быстрый режим Fast mode (бывший Priority) — вдвое дороже и без гарантий по задержке, региональная обработка данных добавляет 10 %. Подробный разбор — в статье GPT-6 Astra API: тарифы, кэш и стоимость длинного контекста, а сверка счетов уровня Sonnet — в материале о том, как пересчитать расходы на API Claude Sonnet 5.
Стоимость одного запроса считается так: (вход × ставка входа + чтение кэша × ставка чтения + запись в кэш × ставка записи + выход × ставка выхода) ÷ 1 000 000. Та же формула в коде, чтобы подставить фактические токены из своих логов:
# Тарифы Standard, USD за 1 млн токенов, по состоянию на 29.09.2026;
# чтение кэша у Sonnet 5.5 — $0.10 с 07.10.2026.
# Порядок: вход, чтение кэша, запись в кэш (5 мин у Sonnet), выход.
SONNET_55 = (2.00, 0.10, 2.50, 10.00)
ASTRA_SHORT = (10.00, 1.00, 12.50, 50.00)
ASTRA_LONG = (20.00, 2.00, 25.00, 75.00)  # если во входе больше 272 тыс. токенов


def request_cost(model: str, fresh: int, cached: int = 0,
                 cache_write: int = 0, output: int = 0) -> float:
    """Стоимость запроса в USD; output включает токены рассуждений."""
    if model == "claude-sonnet-5-5":
        rates = SONNET_55
    elif model == "gpt-6-astra":
        total_input = fresh + cached + cache_write
        rates = ASTRA_LONG if total_input > 272_000 else ASTRA_SHORT
    else:
        raise ValueError(model)
    tokens = (fresh, cached, cache_write, output)
    return sum(t * r for t, r in zip(tokens, rates)) / 1_000_000


for fresh in (100_000, 300_000):
    s = request_cost("claude-sonnet-5-5", fresh, output=20_000)
    a = request_cost("gpt-6-astra", fresh, output=20_000)
    print(f"{fresh:>7} вход: Sonnet ${s:.2f}, Astra ${a:.2f}, разница {a / s:.1f}x")
Скрипт выводит два примера без кэша:
- 100 тыс. входа + 20 тыс. выхода: Sonnet 5.5 — 0,1 × $2 + 0,02 × $10 = $0,40; Astra — 0,1 × $10 + 0,02 × $50 = $2,00, ровно в 5 раз дороже;
- 300 тыс. входа + 20 тыс. выхода: Sonnet 5.5 — 0,3 × $2 + 0,02 × $10 = $0,80; Astra — 0,3 × $20 + 0,02 × $75 = $7,50, примерно в 9,4 раза дороже.
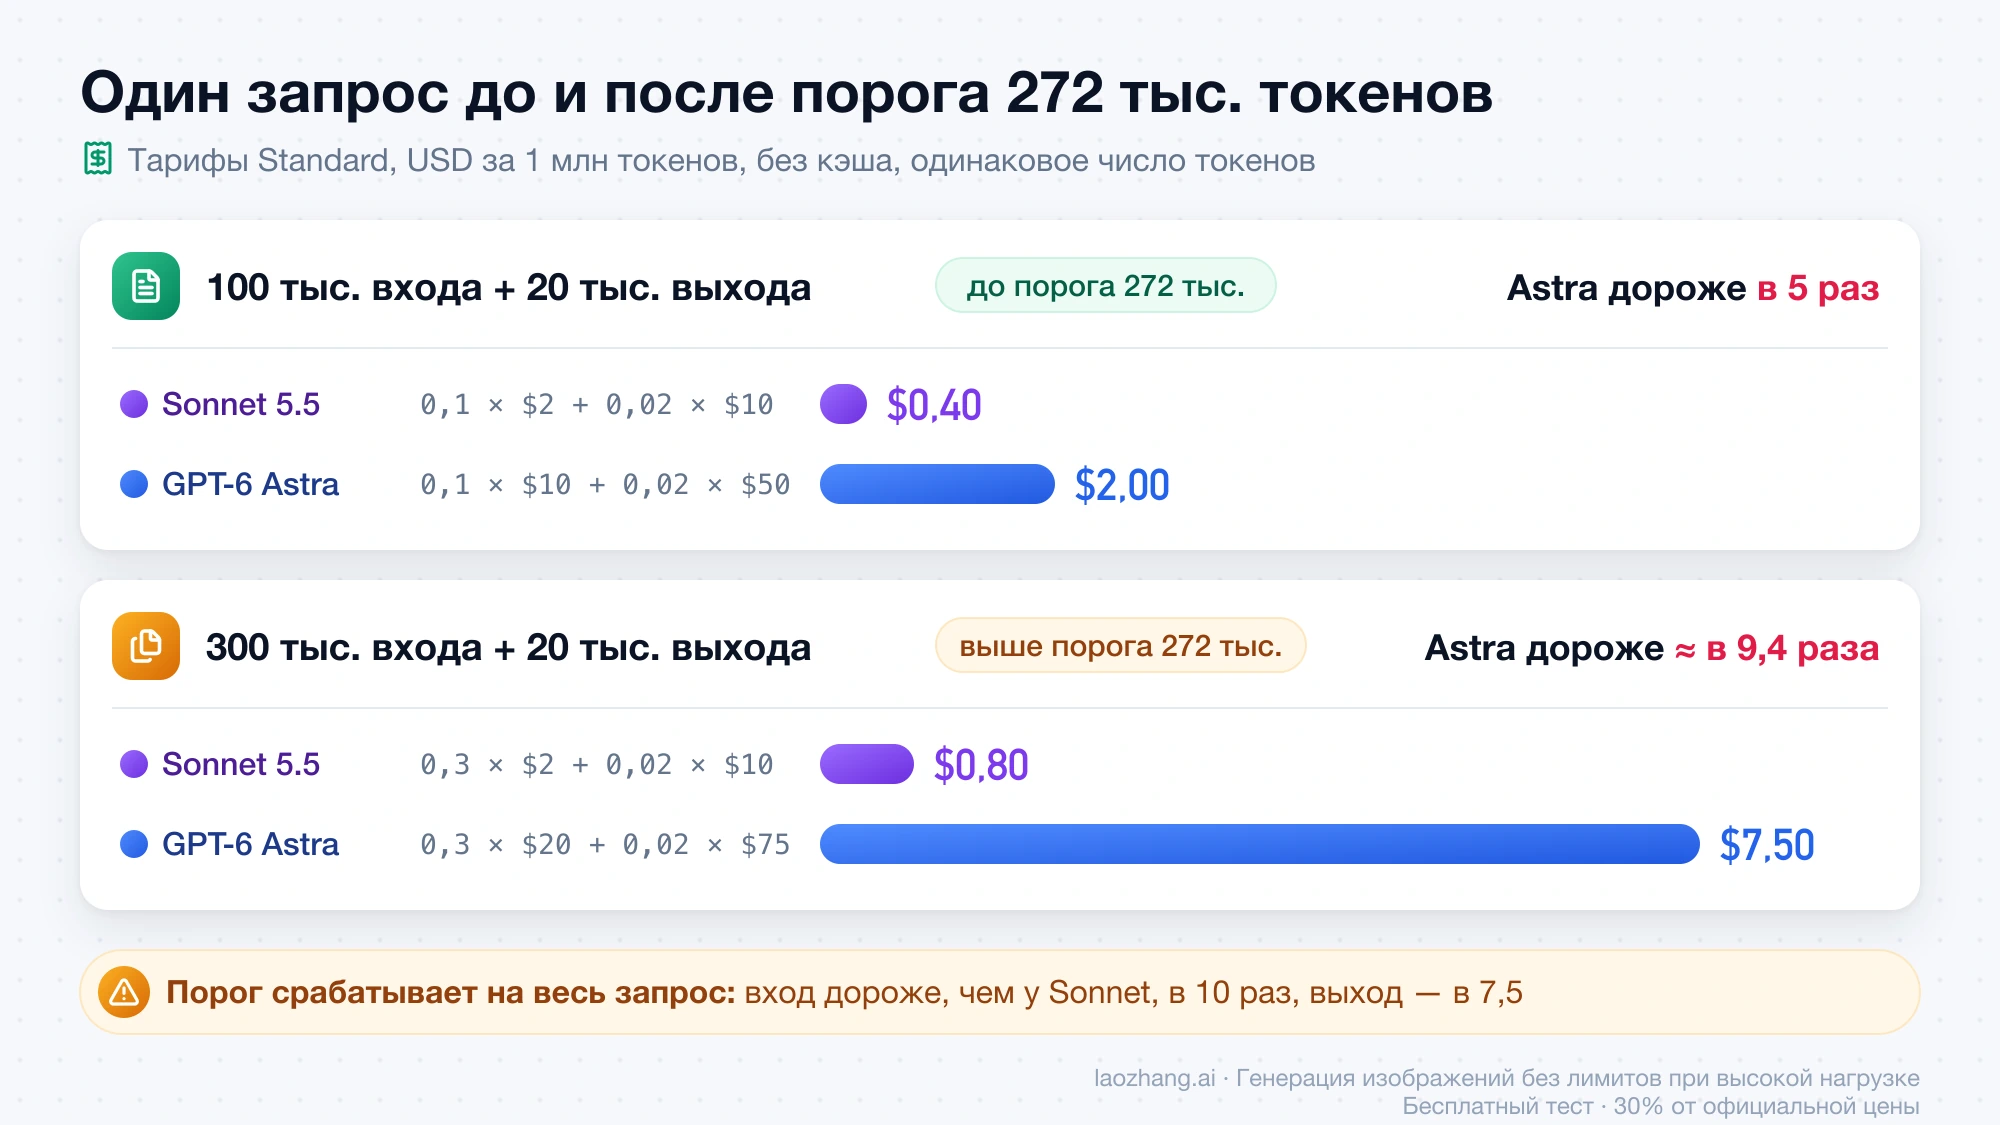
До порога вход, запись в кэш (если сравнивать с 5-минутной у Sonnet) и выход у Astra ровно в 5 раз дороже, а чтение кэша с 7 октября 2026 года — в 10 раз ($1 против $0,10), поэтому при одинаковых токенах соотношение — 5× без кэша и больше по мере роста доли чтения из кэша. Выше порога вход дорожает в 10 раз, выход — в 7,5, чтение кэша — в 20 ($2 против $0,10), и итог лежит между 7,5× и 20× в зависимости от того, что преобладает. Режим тоже меняет картину: если обе модели работают в Batch, остаются те же 5×; Astra в Flex против Sonnet в Standard — 2,5×; Astra в Fast mode — 10×.
Главное ограничение: всё это арифметика при одинаковом числе токенов, а не реальный счёт. Токенизаторы у моделей разные, рассуждения разной длины, повторы у каждой свои. До 272 тыс. токенов и при похожем составе запроса Sonnet 5.5 выигрывает по цене, пока его расход токенов не превышает расход Astra больше чем в 5 раз (при большой доле чтения из кэша запас больше, вплоть до 10×). По индексу v4.3.2 на max он тратил около 7× выходных токенов Astra, и в v5.0 задача на max у него тоже дороже: $10,02 против $6,24, на xhigh — $4,09 против $3,66. На low–high он обходится дешевле при той же метке, но у Astra выше балл на всех уровнях.
Обещание Anthropic «до 30 % дешевле для большинства задач» относится к сравнению с Sonnet 5, а не с Astra. И даже в этом сравнении оно зависит от уровня effort: по замерам AA при запуске (индекс v4.3.2, 29 сентября 2026 года) задача Sonnet 5.5 на max стоила примерно на 50 % дороже, чем у Sonnet 5 на max. В индексе v5.0 Sonnet 5 больше не оценивается, так что обновлённого сравнения нет.
Что изменится при переносе с Astra на Sonnet 5.5
Переход с Astra на Sonnet 5.5 — это смена вендора, а не замена идентификатора модели. Проверьте по списку:
- API и инструменты. Astra работает через Responses или Chat Completions, причём вызов инструментов требует Responses. Sonnet 5.5 — через Messages API Anthropic со своей схемой инструментов и ответом из блоков. Обе модели есть в Amazon Bedrock (Astra — в регионе us-west-2): это упрощает работу с аккаунтами, но формат запросов остаётся разным. Если выбираете, откуда брать сам Claude API, пригодится разбор как выбрать стабильный доступ к Claude.
- Effort подбирается заново. Для агентного кода и многошаговых вызовов инструментов Anthropic советует начинать с
mediumи переходить наhighдля сложных и длинных задач, для чата —mediumилиlow. Самый лёгкий режим у Sonnet 5.5 —thinking: {"type": "between_tools"}, и он работает только наlow,mediumиhigh. Запросы с{"type": "disabled"}или ручнымbudget_tokensвернут ошибку 400. - Параметры сэмплинга и prefill. У Astra нет уровня
none, а при любом другомtemperatureиtop_pприходится убирать, так что код под Astra обычно уже обходится без них — это облегчает перенос. На Sonnet 5.5 нестандартныеtemperature,top_pиtop_kдают ошибку 400, как и заранее заполненная реплика ассистента (prefill). - Принудительный вызов инструмента.
tool_choiceс типомanyилиtoolвозвращает 400. Остаютсяautoвместе со строгой проверкой схемыstrict: trueлибо структурированный вывод, а в промпте — прямо указывать, когда инструмент нужен. - Текст между вызовами инструментов. Пояснения длиннее одной-двух фраз приходят в блоках
thinking, которые при настройке по умолчанию (display: "omitted") пустые. Ошибки нет, но интерфейс, показывавший ход работы, замолкает. Помогаетdisplay: "summarized"(или"updates"в beta) при адаптивном мышлении либо режимbetween_tools. - История только дописывается. Блоки мышления привязаны к модели, разговору и аккаунту. Для аккаунтов, созданных 31 августа 2026 года и позже, повторная отправка блока после правки более ранней истории (system, tools, прошлых сообщений) даёт 400. Инструкции лучше менять системными сообщениями посреди диалога.
- Кэш. У Anthropic запись в кэш явная и платная (5 минут или 1 час), минимальный кэшируемый промпт — 512 токенов. У Astra срок хранения задаётся через
prompt_cache_options.ttl:"30m"(по умолчанию) или"12h"— только в Responses API, с 20 октября 2026 года, по 2,5 ставки входа. Экономику кэша придётся пересчитать. - Отказы. Отказ Sonnet 5.5 приходит с HTTP 200,
stop_reason: "refusal"и категорией вstop_details:cyber,bio,frontier_llm,reasoning_extractionилиgeneral_harms. Серверный откат (beta,fallbacks: "default") повторяет на Sonnet 5 толькоcyberиfrontier_llm, остальные нужно обрабатывать самим. - Чего нет у Sonnet. Sonnet 5.5 возвращает только текст. Если конвейер опирается на встроенные инструменты OpenAI вроде hosted shell или генерации изображений, их придётся заменить. Управление компьютером (computer use) на Claude API и Google Cloud работает только через
computer_toolset_20260801.
Если же вы переходите на Sonnet 5.5 с Sonnet 5, тарифы на вход и выход не меняются (чтение кэша с 7 октября подешевело до $0,10), но есть пять несовместимых изменений: отключение мышления через disabled и ручные бюджеты, принудительный вызов инструментов, привязка блоков мышления, старый инструмент computer_20251124 и советники Opus 4.8, Opus 4.7 и Sonnet 5 в инструменте advisor. Плюс текст между вызовами инструментов теперь приходит в блоках thinking — пункт 5 выше.
Подписки ChatGPT и Claude, доступ
В ChatGPT модель GPT-6 Pro на базе Astra доступна в чате на тарифах Pro $100, Pro $200, Business и Enterprise. На Plus Astra есть в ChatGPT Work и Codex, но не в чате, на Free и Go её нет. Для Codex OpenAI публикует ориентировочное число локальных сообщений с Astra за 5 часов — например, 5–45 на Plus — и подчёркивает, что это не фиксированный лимит.
В Claude модель Sonnet 5.5 есть в веб-, мобильном и десктопном приложениях, в Cowork и в Claude Code, с effort medium по умолчанию. На каких именно тарифах она доступна, официальные страницы Anthropic не перечисляют. В приложениях при срабатывании классификаторов кибербезопасности или разработки конкурирующих LLM разговор может переключиться на Sonnet 5, а запросы, связанные с биологическим вредом, блокируются без переключения.
Лимиты подписок не пересчитываются из цен API, так что сравнение тарифов выше относится только к работе через API. Если вы работаете в основном в Codex или в Claude Code, выбор модели фактически совпадает с выбором среды.
По состоянию на 29 сентября 2026 года Россия не входит в официальные списки поддерживаемых стран ни у Anthropic, ни у OpenAI; ограничения привязаны к стране, а не к языку. Рублёвые цены у посредников — их собственные тарифы, а не официальный прайс, поэтому сверяйте их с долларовыми ставками выше.
Пилот на своих задачах
Сторонние индексы показывают направление, но стоимость принятой задачи у каждого своя. Небольшой пилот устроен так:
- Возьмите 20–50 реальных задач и заранее запишите правило приёмки: тесты проходят, ревьюер принимает без правок, ответ совпадает с эталоном.
- Дайте обеим моделям одинаковые входные данные и инструменты и явно зафиксируйте пару уровней effort — например, Sonnet 5.5 на
highпротив Astra наmediumиhigh, затем каждую на шаг выше. - Записывайте из ответов API фактически оплаченные токены: вход, чтение и запись кэша, выход вместе с рассуждениями. Отдельно — повторы, время до результата и ручные доработки.
- Посчитайте стоимость принятой задачи: суммарная оплаченная стоимость ÷ число принятых задач. Формула и скрипт выше подходят для перевода токенов в доллары.
- Переводите трафик, только если Sonnet 5.5 проходит тот же порог приёмки дешевле или быстрее. В длинных агентных задачах следите за выходными токенами на
xhighиmax: именно там по данным AA Sonnet теряет ценовое преимущество.
Если часть задач приходит с входом больше 272 тыс. токенов, считайте их отдельной группой: для них соотношение цен другое, и смешивание с короткими запросами исказит средний результат.
Частые вопросы
Правда ли, что Sonnet 5.5 в пять раз дешевле Astra?
По тарифу — да: в запросах до 272 тыс. входных токенов вход, запись в кэш и выход у Astra в 5 раз дороже, чтение кэша — в 10 раз, а выше порога — в 10 раз по входу и в 7,5 раза по выходу. За задачу гарантии нет: в индексе AA v5.0 на 28 октября 2026 года задача Sonnet 5.5 на max стоит $10,02 против $6,24 у Astra, на xhigh — $4,09 против $3,66. Дешевле Sonnet выходит на low–high, но у Astra выше балл на всех уровнях.
Что лучше: Sonnet 5.5 или Opus 5.5?
В индексе AA v5.0 Opus 5.5 на max набирает 58 баллов, Sonnet 5.5 — 54, а задача у обоих стоит около $10. В агентных тестах AA-Briefcase и AutomationBench-AA Sonnet на max даже немного выше Opus (1812 против 1800 и 71,8 % против 69,5 %), но в индексе фактических знаний AA-Omniscience заметно уступает — 30 против 48, а в HLE-Diamond — 53,3 % против 67,9 %. GDPval-AA, Humanity's Last Exam и SciCode, по которым модели сравнивали при запуске, входили в индекс v4.3.2 и в v5.0 больше не входят. Anthropic позиционирует Sonnet 5.5 как дополнение к Opus на низких уровнях effort, где задача стоит меньше. Для выбора выше по линейке пригодятся материалы Claude Opus 5.5 или GPT-6 Sol: выбор для кода и сложных задач и Claude Fable 5.2 или Opus 5.5: что выбрать и на каком effort.
Почему у российских агрегаторов другие цены?
Посредники назначают собственные рублёвые тарифы, официальный прайс у Anthropic и OpenAI — в долларах. Если посредник сравнивает с Astra не Sonnet 5.5, а Sonnet 5, по цене это не ошибка: официально обе версии стоят одинаково. Но результаты тестов у них разные, так что о качестве такие сравнения ничего не говорят.
Можно ли верить обещанию «на 30 % быстрее и до 30 % дешевле»?
Это сравнение с Sonnet 5, а не с Astra, и слово «до» в нём важно. Anthropic пишет, что на нескольких тестах Sonnet 5.5 на low или medium превосходит лучший результат Sonnet 5 примерно за десятую часть стоимости задачи. Но на max, по данным AA при запуске (индекс v4.3.2), задача стоила примерно на 50 % дороже, чем у Sonnet 5. Скорость генерации у Sonnet 5.5 в замерах AA на 28 октября 2026 года выше, чем у Astra (109–140 токенов в секунду против 48–71), однако длинные прогоны Vals на max он заканчивал почти втрое дольше — из-за объёма токенов.