Claude Sonnet 5.5 или Opus 5.5: разница, цена задачи и выбор
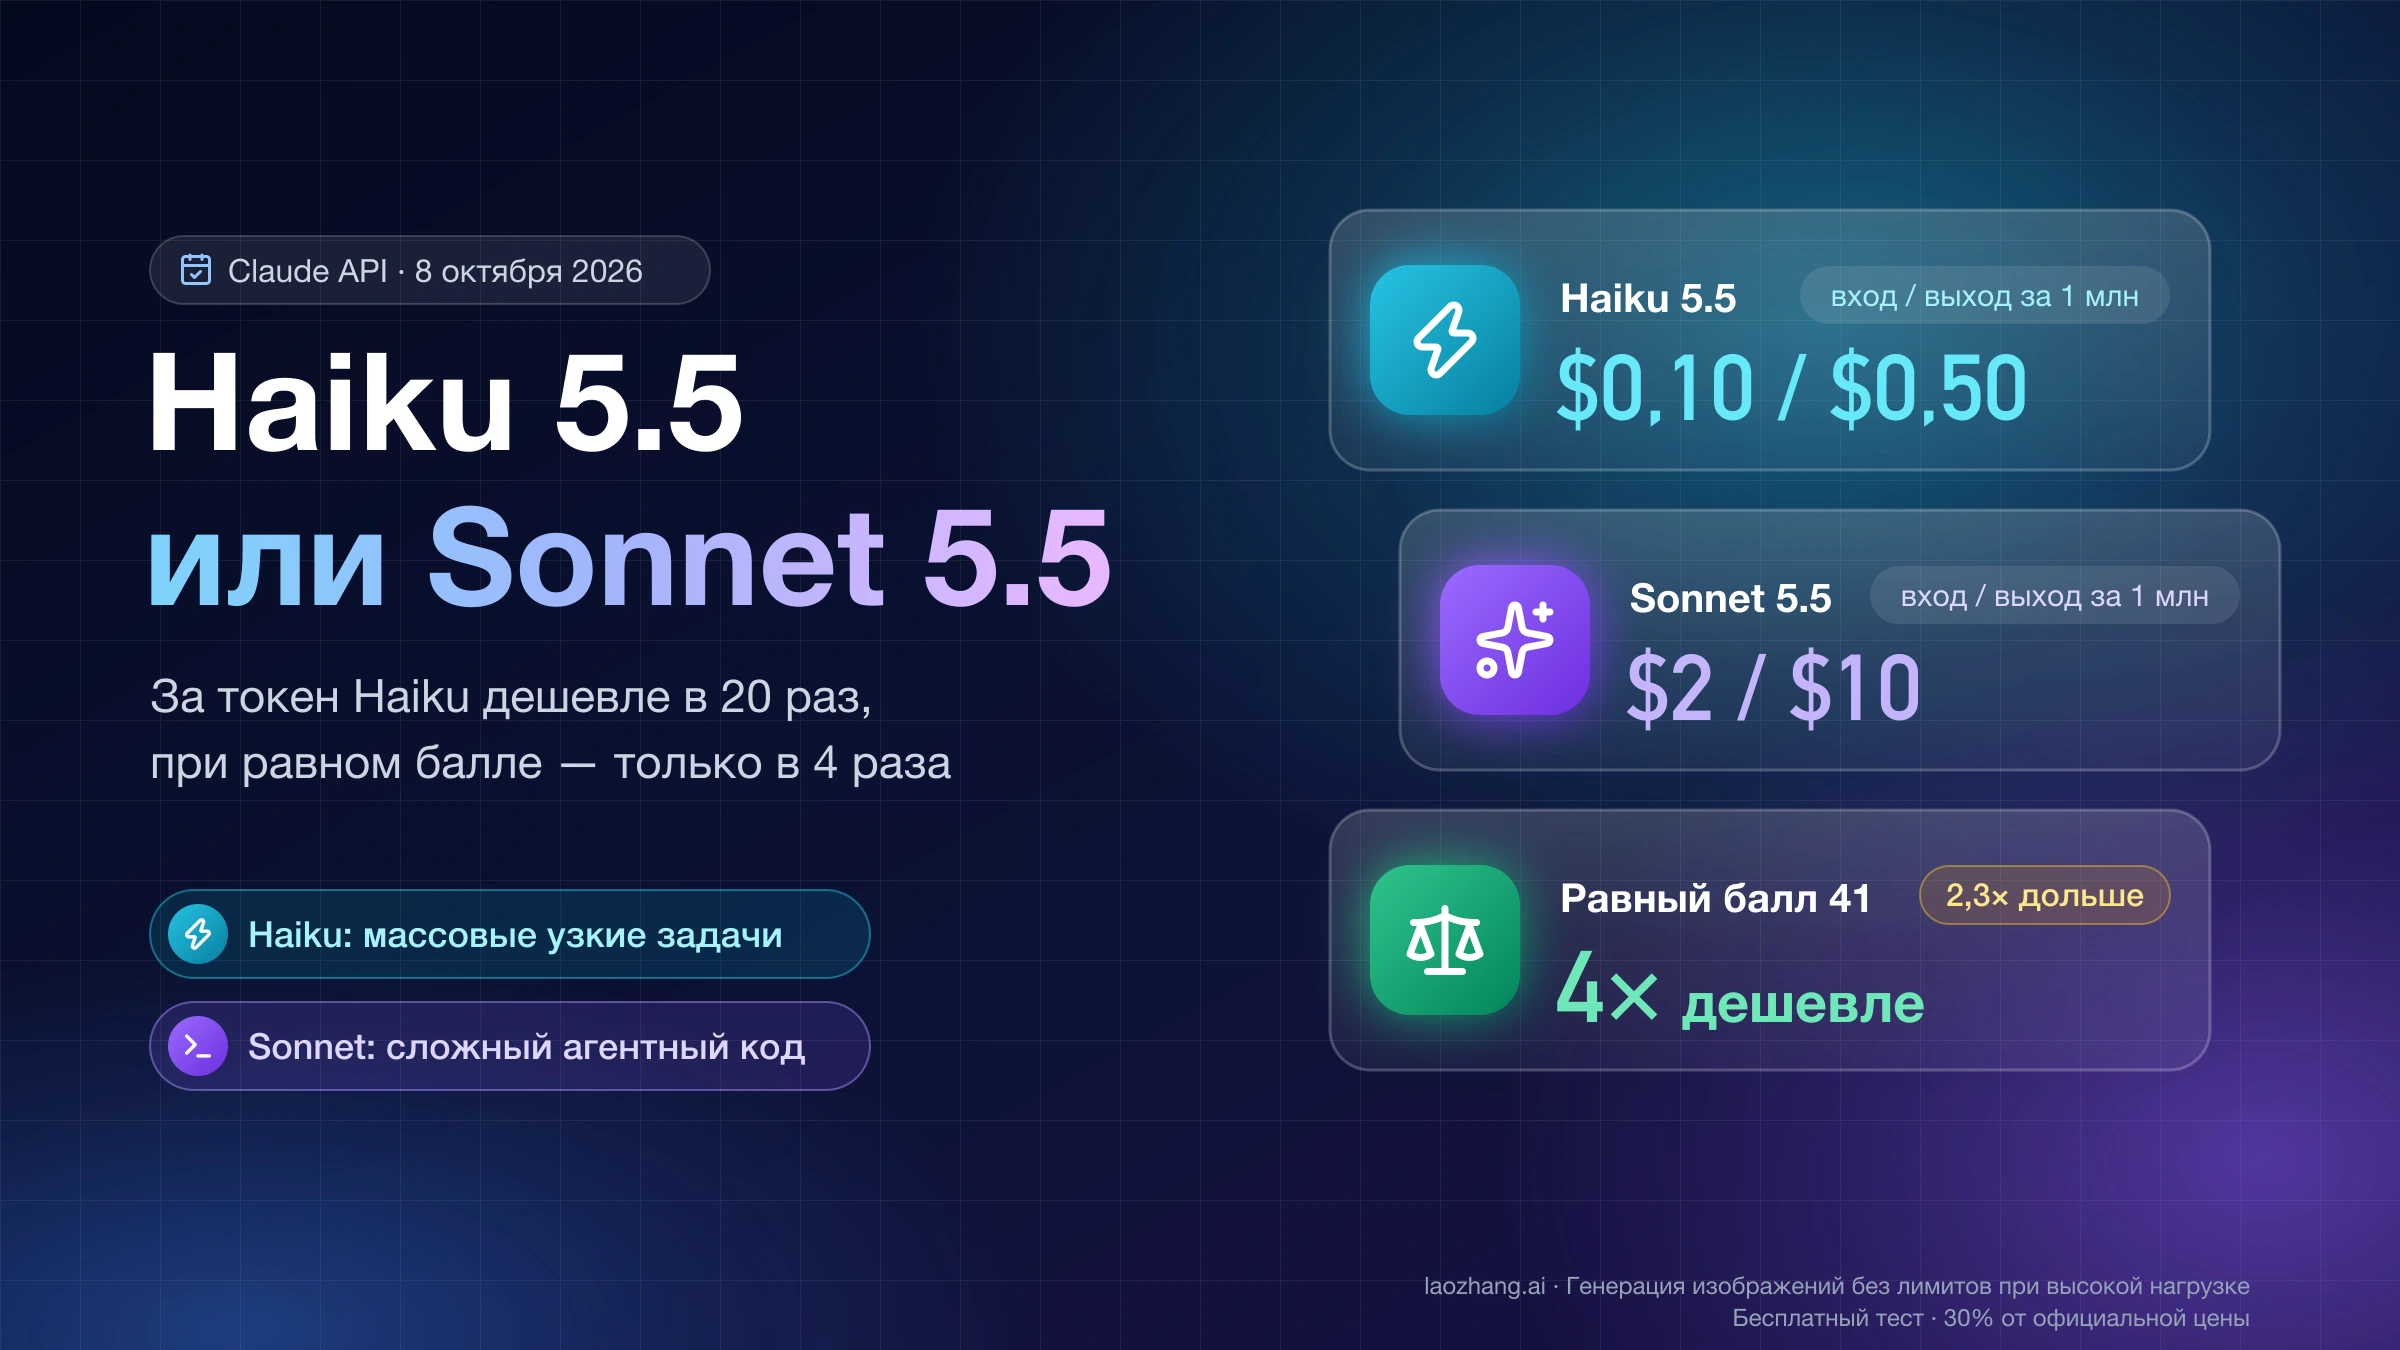
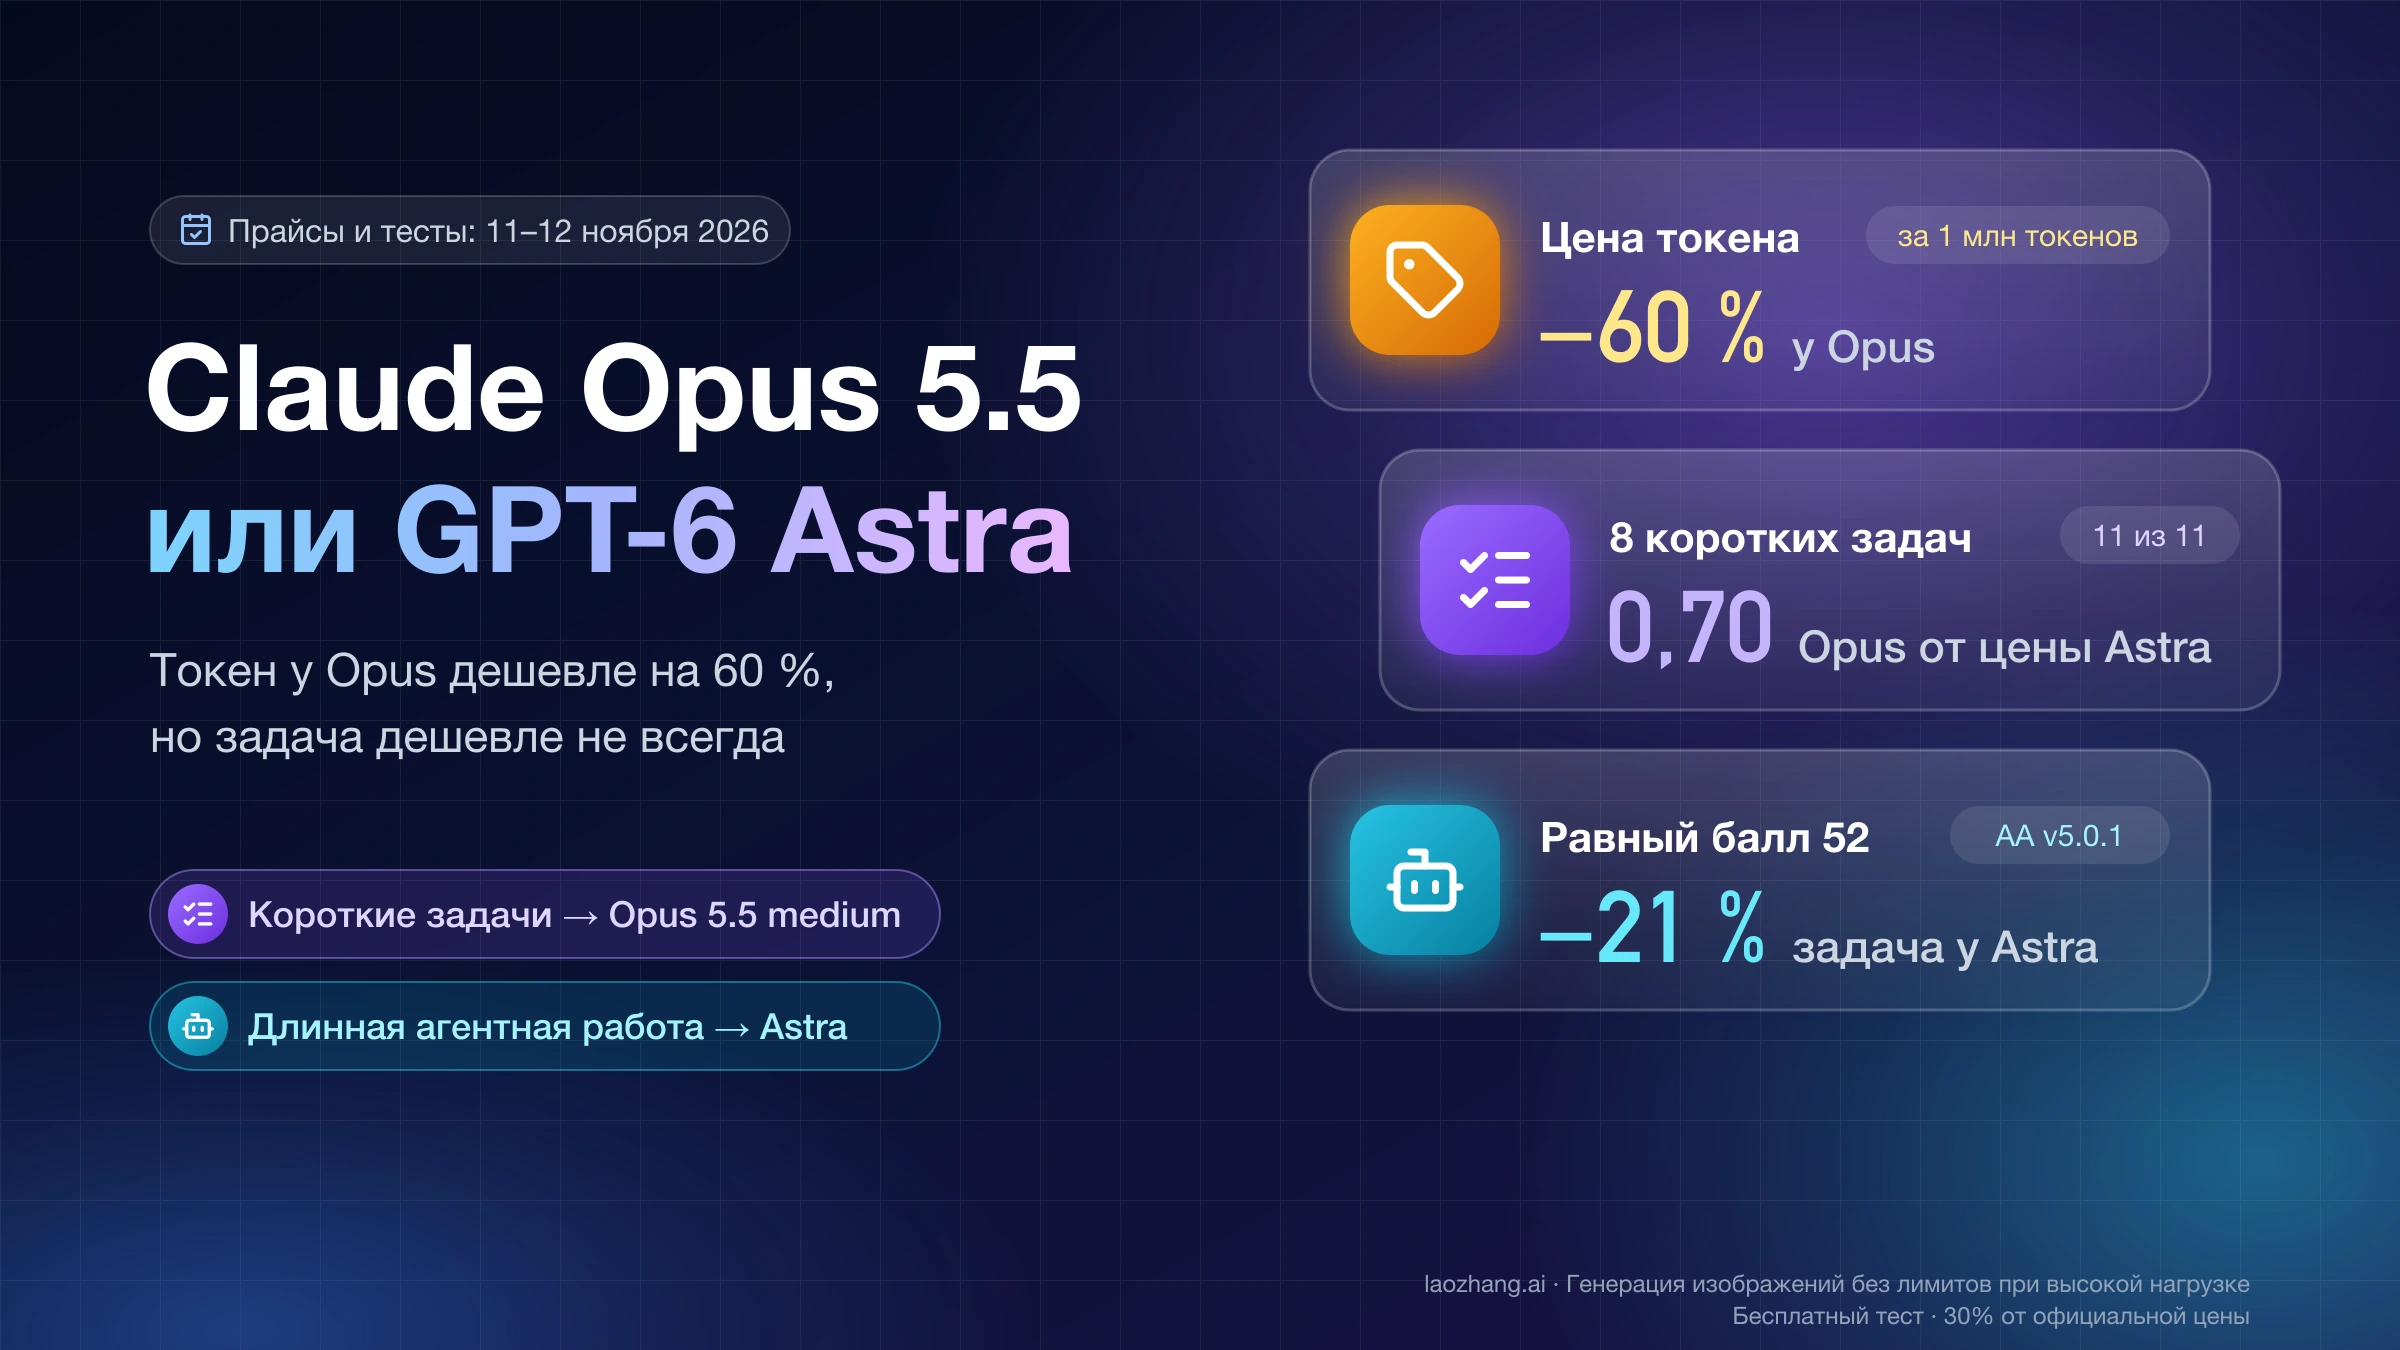
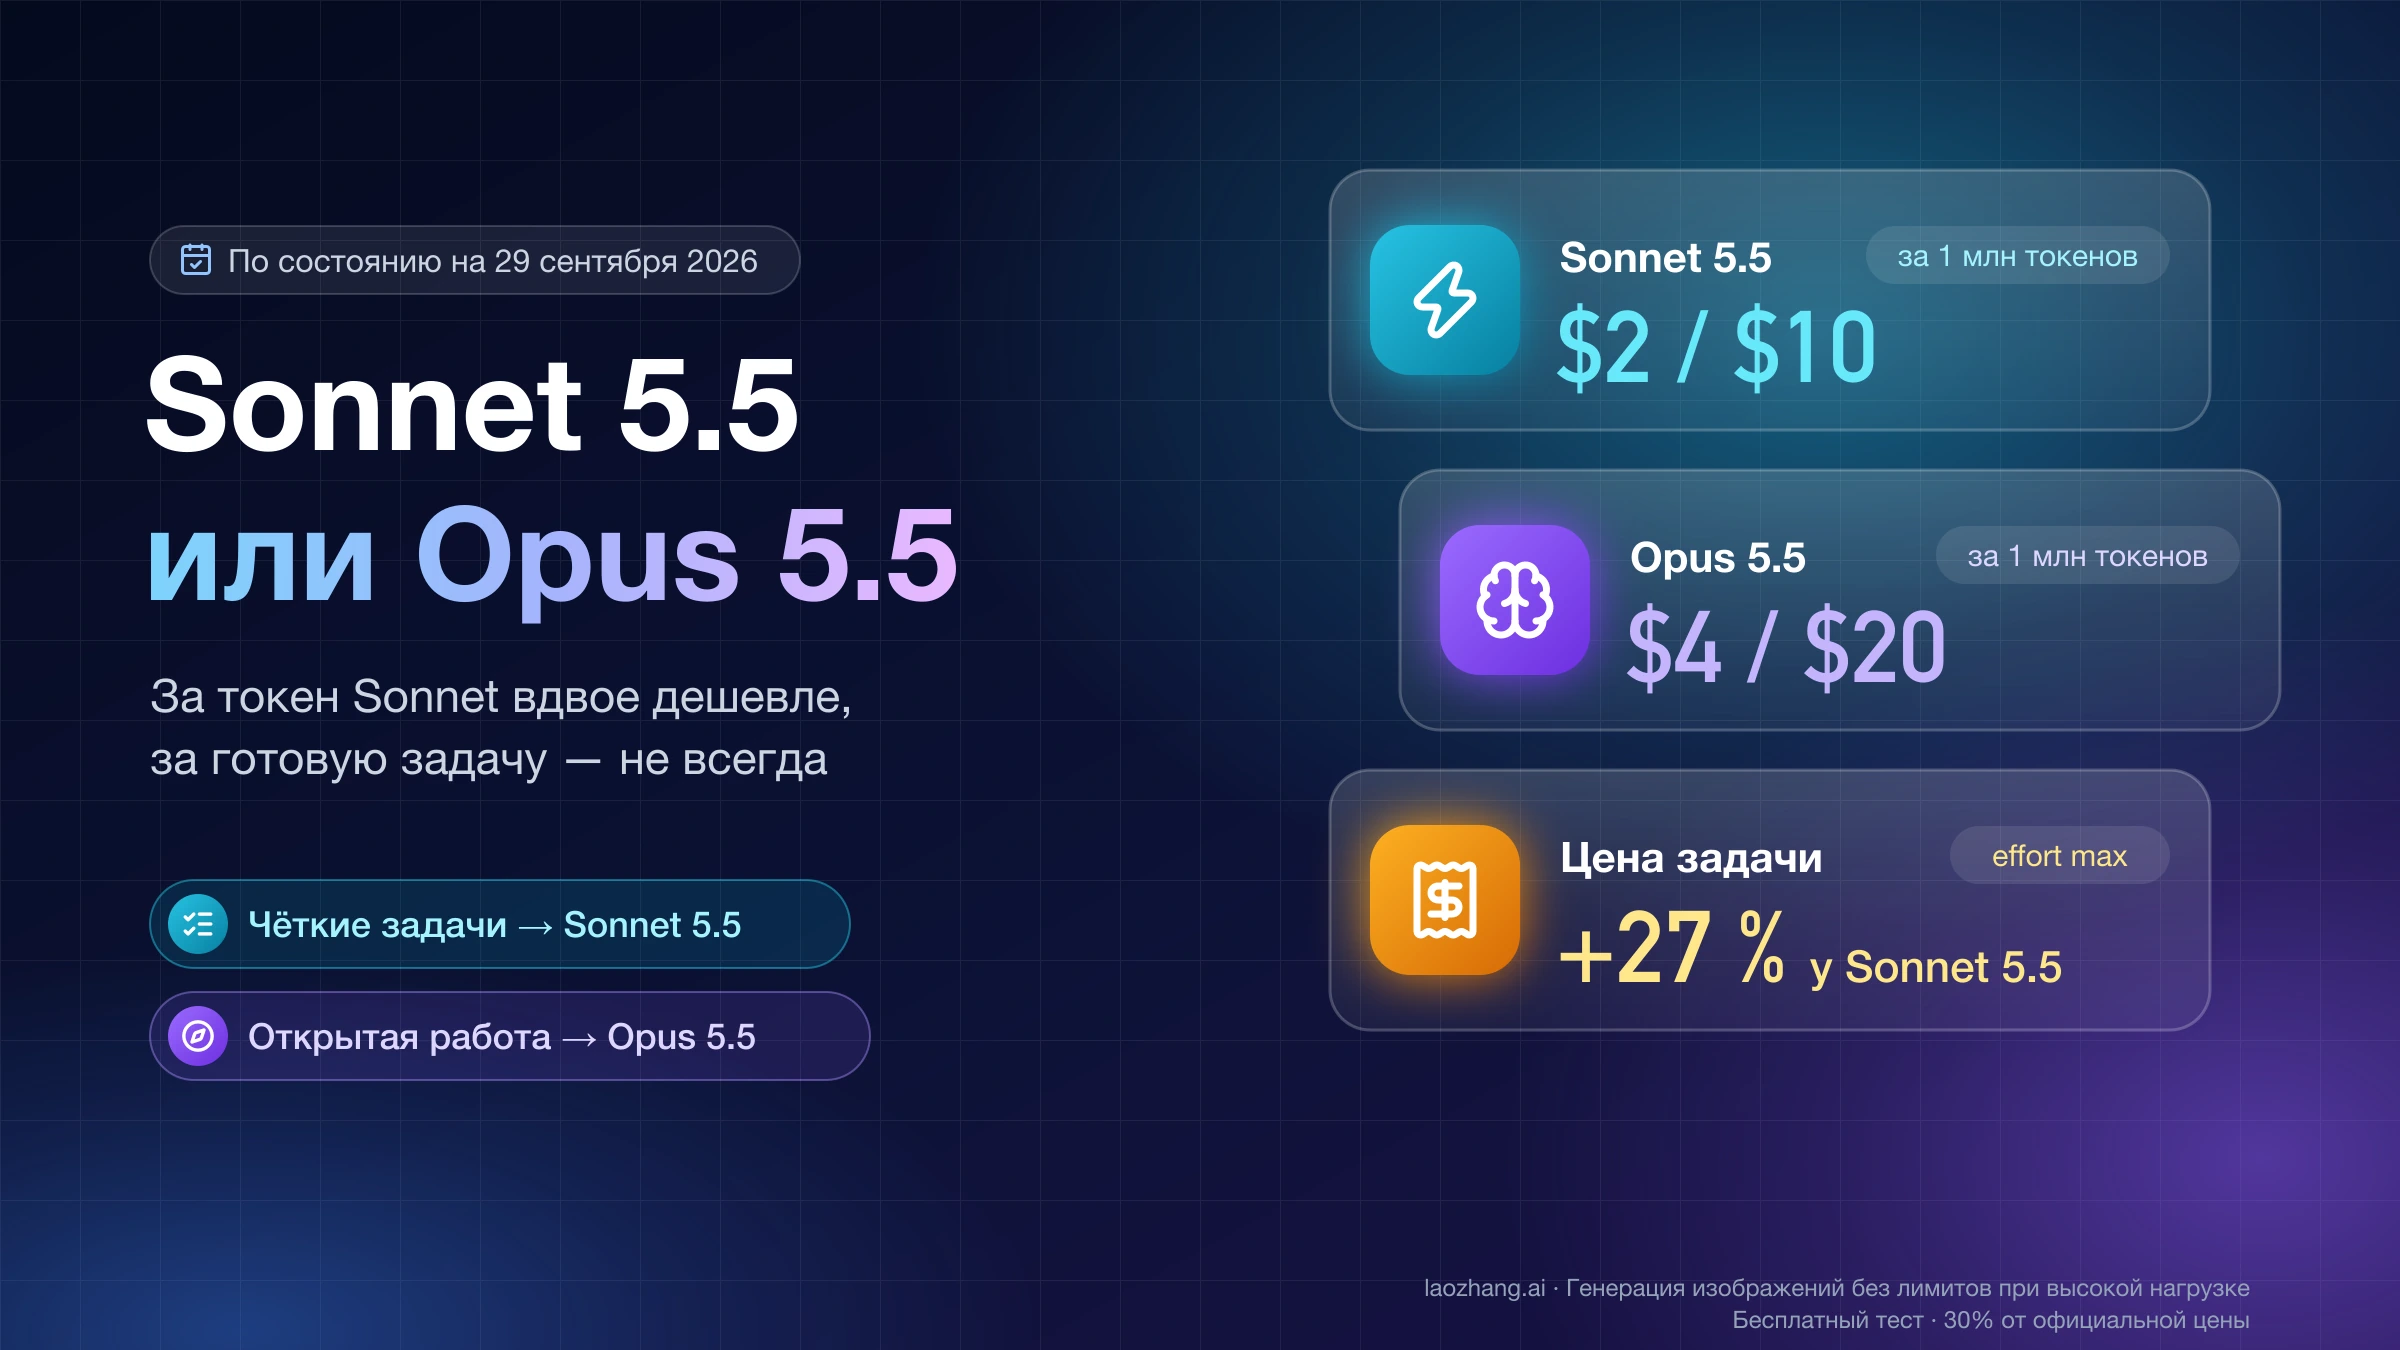
Sonnet 5.5 вдвое дешевле Opus 5.5 за токен, но не всегда за задачу. Чёткие задачи — Sonnet на low или medium, открытая работа с суждением — Opus 5.5.
Содержание
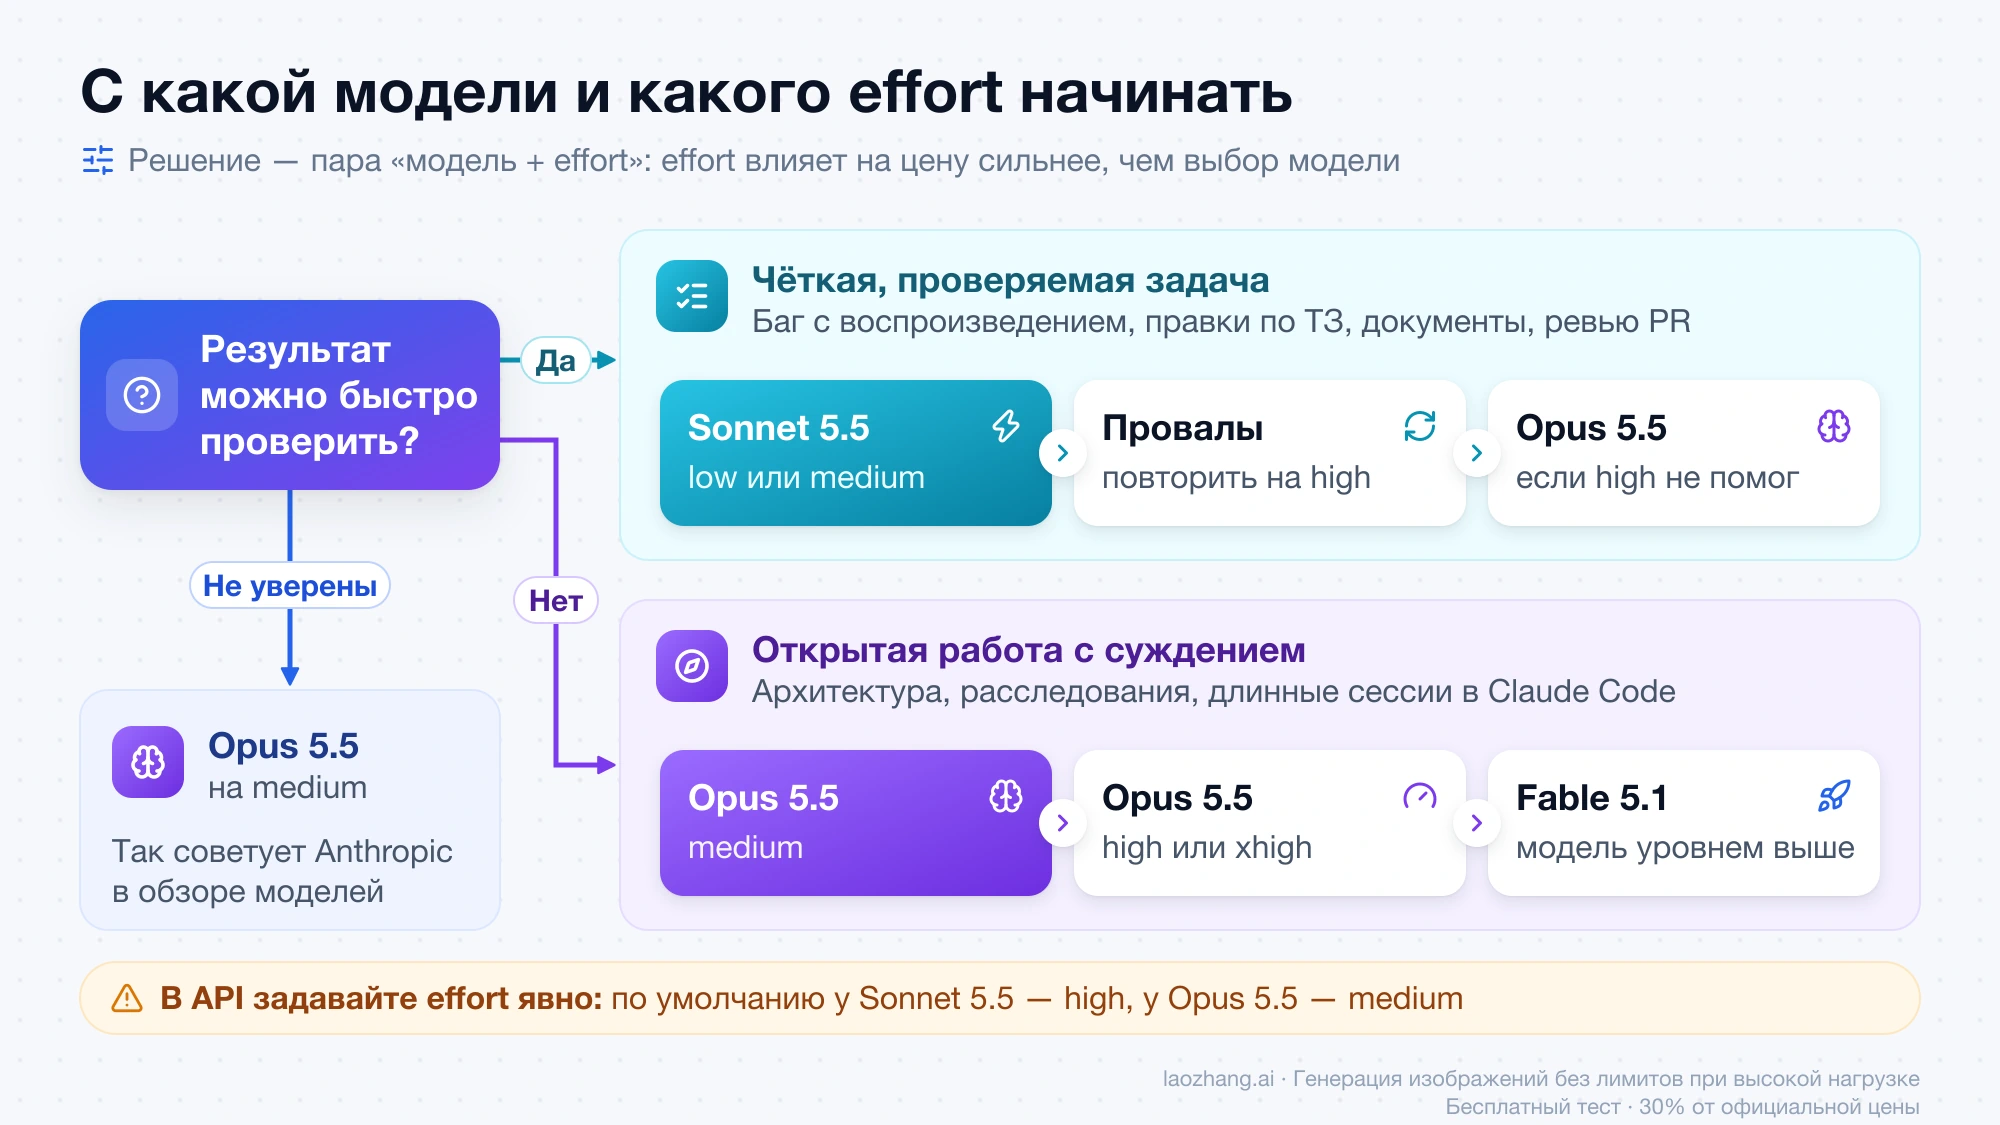
Для чётко поставленных задач начинайте с Claude Sonnet 5.5 на low или medium, для открытой и длинной работы, где нужно суждение, — с Claude Opus 5.5 на его стандартном medium. К первым относятся исправление бага с понятным воспроизведением, правки по готовой спецификации, документы, таблицы и слайды, ревью каждого пул-реквеста — всё, что быстро проверяется тестом или беглым взглядом. Ко вторым — проектирование, многочасовые агентные сессии, разбор инцидентов, ревью рискованных изменений, задачи без готового критерия «сделано». Если тип работы не ясен, сама Anthropic в обзоре моделей советует начинать с Opus 5.5.
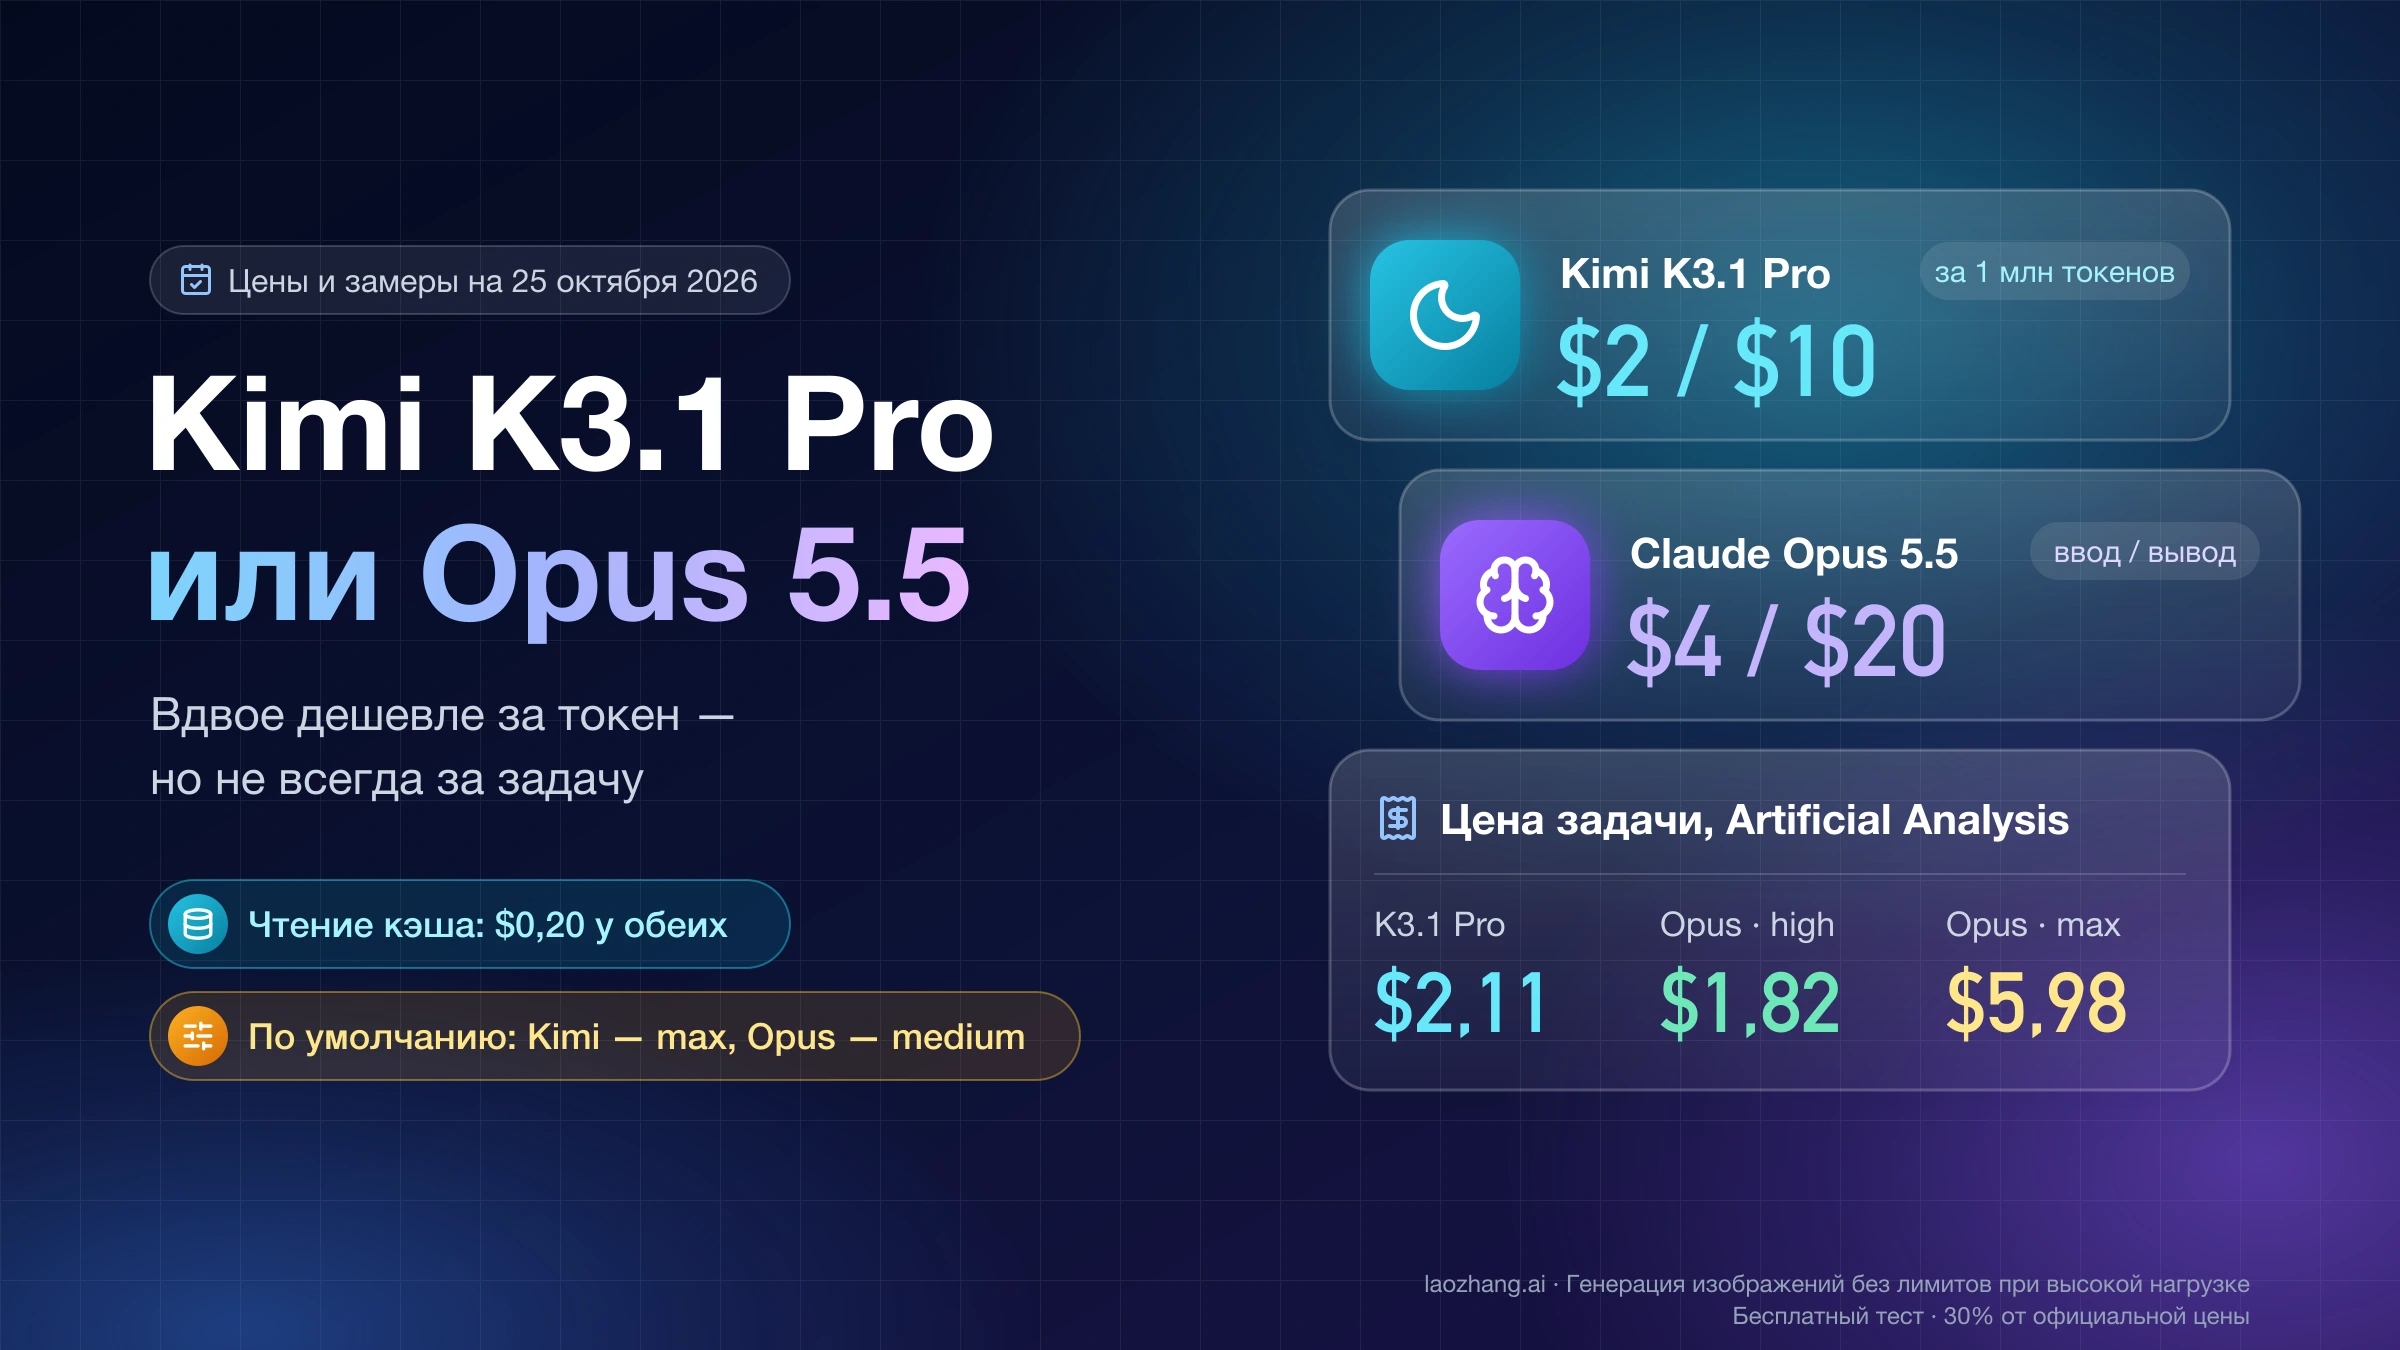
«Вдвое дешевле» верно только за токен: $2 и $10 против $4 и $20 за 1 млн входных и выходных токенов, а с 7 октября 2026 года и чтение кэша — $0,10 против $0,20. За готовую задачу разрыв зависит от effort. В Artificial Analysis Intelligence Index v5.0 (9 тестов; 27–28 октября 2026 года он заменил версию v4.3.2) задача у Sonnet 5.5 на уровнях от low до xhigh стоит в 1,5–3,1 раза меньше, чем у Opus 5.5 на том же уровне, а на max — столько же: $10,02 против $10,04 при 54 баллах против 58. Если же Sonnet 5.5 нужен xhigh, выгоднее Opus 5.5 на high: у него выше балл, ниже цена задачи и меньше время. Всё дело в том, сколько токенов и шагов модель тратит на задачу. Описание моделей приведено по состоянию на 29 сентября 2026 года, на следующий день после выхода Sonnet 5.5, цены кэша и замеры Artificial Analysis — на 28 октября 2026 года.
С какой модели и какого effort начинать
Effort — параметр, который задаёт, сколько модель думает, вызывает инструменты и перепроверяет себя. Уровней пять: low, medium, high, xhigh, max. От него стоимость задачи зависит сильнее, чем от выбора между двумя моделями, поэтому решение всегда состоит из пары «модель + effort».
| Тип работы | С чего начать | Куда двигаться, если не хватает |
|---|---|---|
| Баг с воспроизведением, правки по ТЗ, рефакторинг по образцу | Sonnet 5.5, medium | Провалившиеся задачи повторить на high; если и там не проходит — Opus 5.5 |
| Массовые проверяемые задачи: ревью каждого PR, разметка, генерация по шаблону | Sonnet 5.5, low или medium; то, что может подождать, — через Batch API со скидкой 50 % | Поднимать effort только для задач, не прошедших проверку |
| Чат и быстрые итерации, где важна задержка | Sonnet 5.5, low или medium | high для отдельных трудных вопросов |
| Документы, таблицы, слайды | Sonnet 5.5, high (стандарт в API) | Opus 5.5, если документ требует аналитических выводов, а не оформления |
| Открытые задачи: архитектура, исследование, расследование | Opus 5.5, medium | high или xhigh; дальше — Fable 5.1 |
| Длинные агентные сессии в Claude Code | Opus 5.5, medium | high для самых длинных и неоднозначных задач |
| Ревью изменений, где пропущенный баг стоит дорого | Opus 5.5 | max, если важнее полнота, чем число лишних замечаний |
Разделение повторяет позиционирование Anthropic из анонса Sonnet 5.5: Opus 5.5 рассчитан на «сложную работу, требующую взвешенного суждения», а Sonnet 5.5 сильнее всего в «чётко очерченных повседневных задачах», исправлении багов и подготовке документов, слайдов и таблиц. Там же сказано, что на ряде тестов Sonnet 5.5 на Max сопоставим с Opus 5.5, но в сложной открытой работе Opus 5.5 «остаётся заметно сильнее». Уровни effort для Sonnet 5.5 взяты из его документации: для агентной разработки начинать с medium на хорошо описанных задачах и переходить на high на трудных и длинных, для чата — medium или low, в остальных случаях — high.
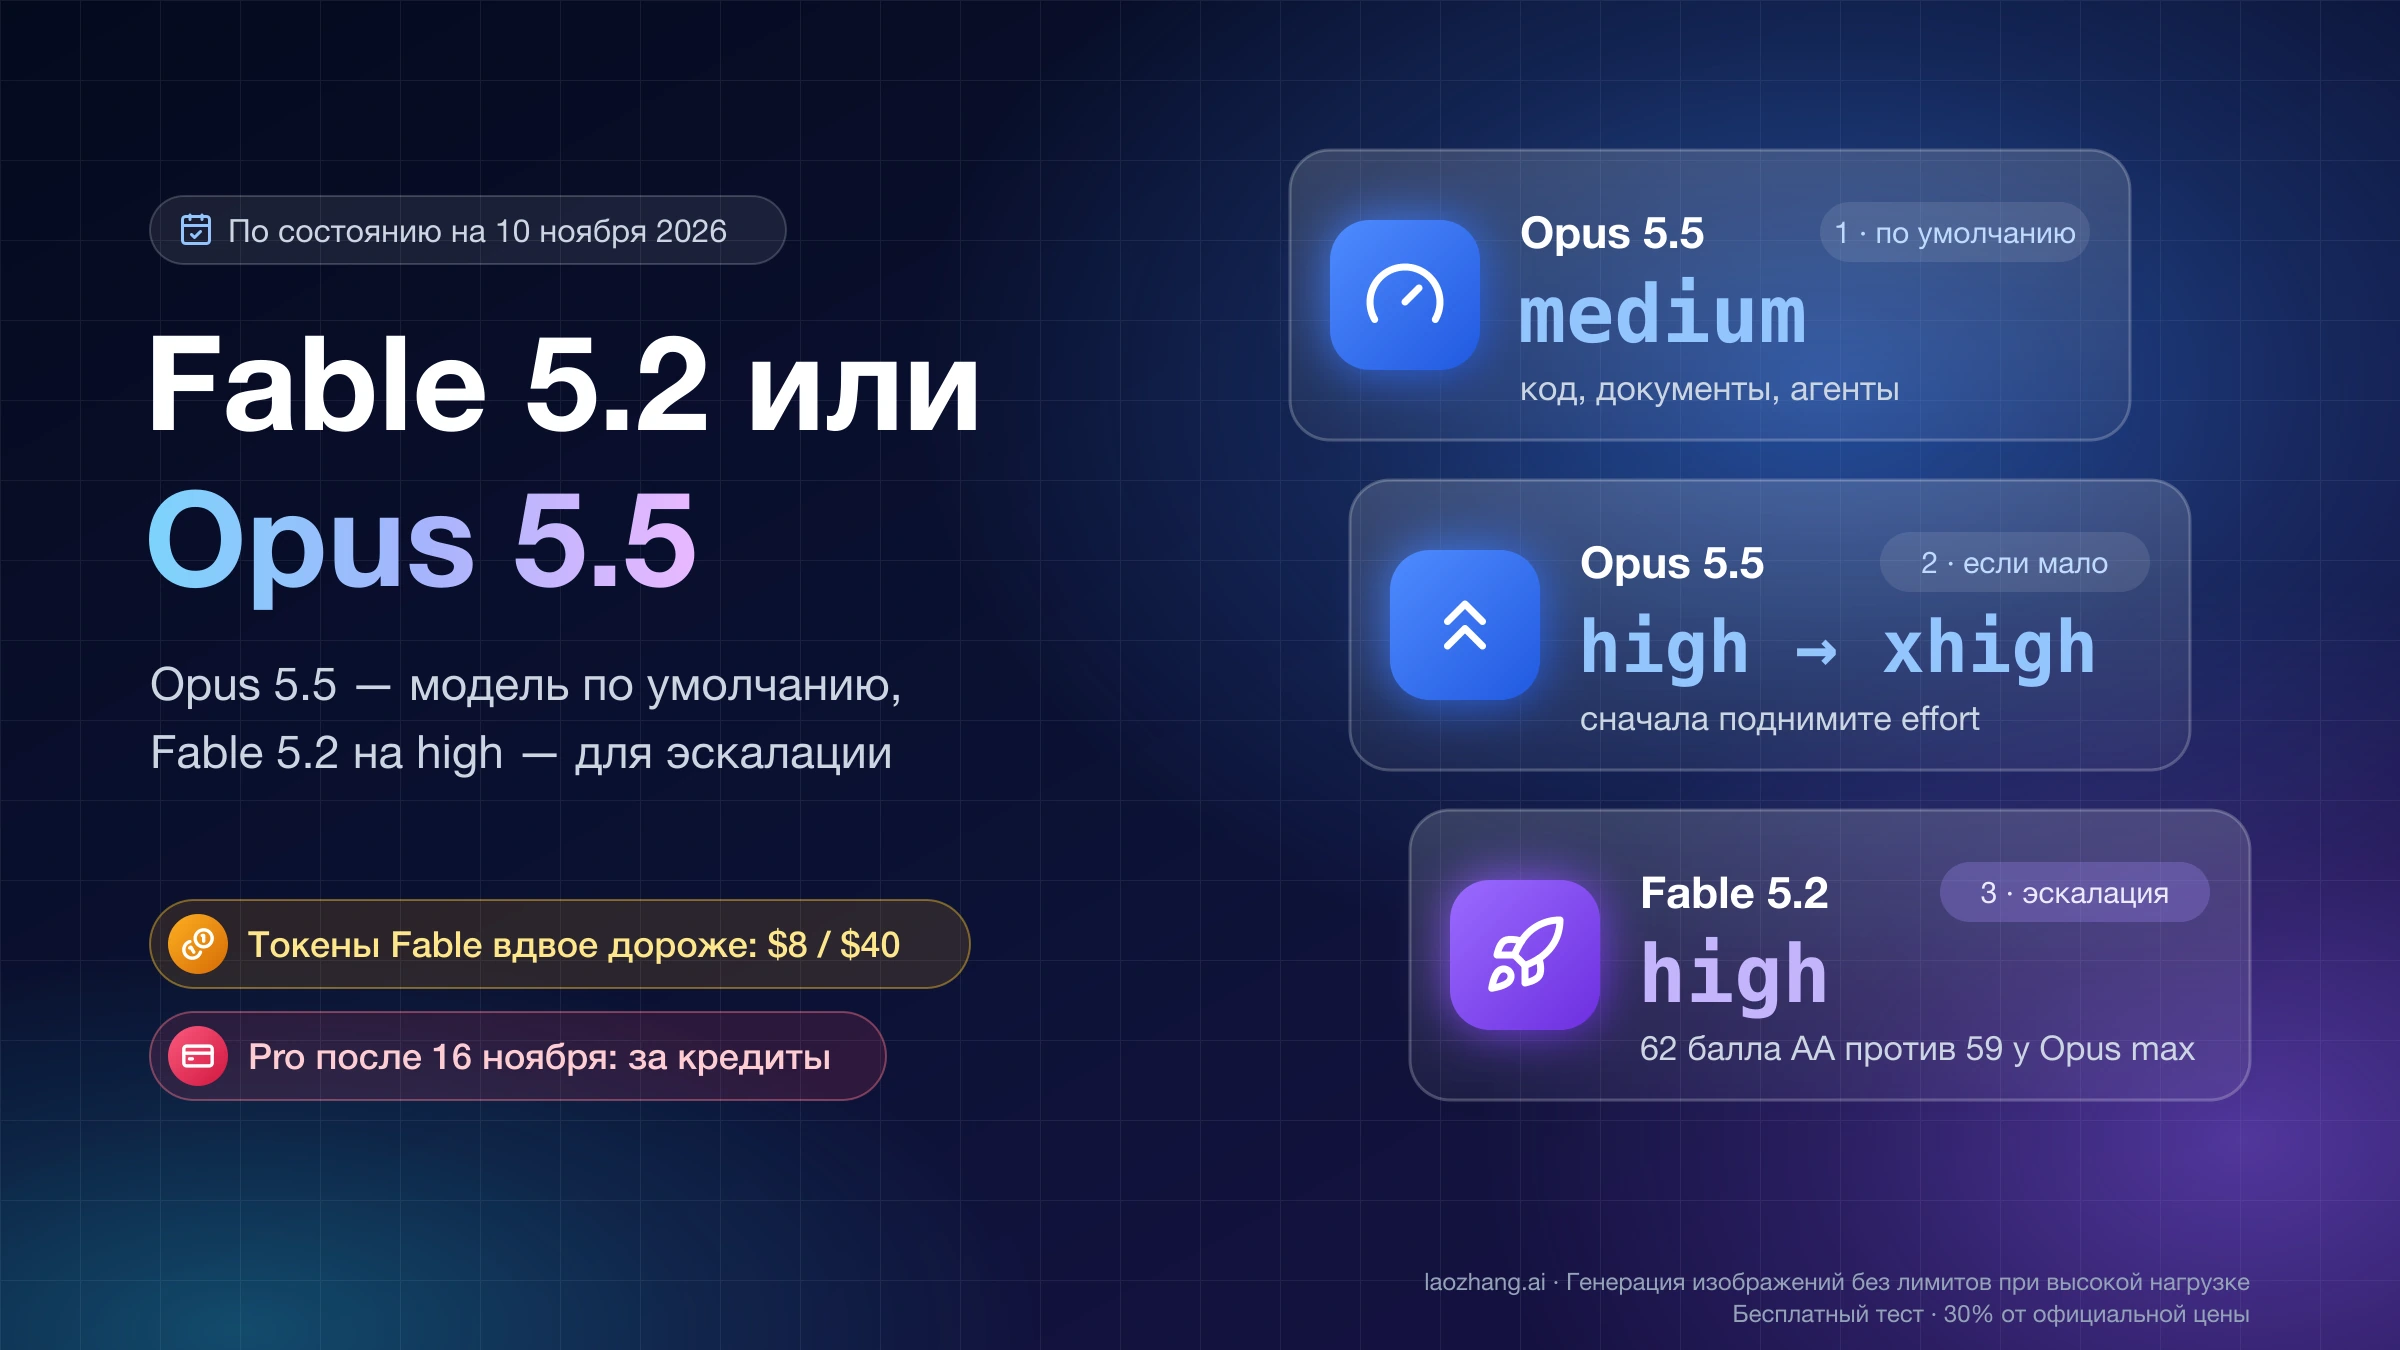
Когда и Opus 5.5 на высоком effort не справляется, следующий шаг — не Sonnet, а модель уровнем выше (9 ноября 2026 года текущей моделью Fable вместо Fable 5.1 стала Fable 5.2); об этом отдельно в материале Claude Fable 5.2 или Opus 5.5: что выбрать и на каком effort.
Effort по умолчанию зависит от канала
- Claude Code: обе модели по умолчанию работают на
medium(у большинства других моделей стандарт —high), так что сравнение «из коробки» здесь честное. В приложениях Claude, по данным анонса Sonnet 5.5, стандарт тоже Medium. - Claude API: Sonnet 5.5 по умолчанию работает на
high, Opus 5.5 — наmedium. Если сравнить их, не указав effort, дешёвая модель будет думать больше дорогой, и расхождение легко принять за разницу в качестве или цене.
Отсюда правило для API: всегда задавайте output_config.effort явно у обеих моделей и сравнивайте их на одинаковых уровнях.
Цены и характеристики рядом
| Claude Sonnet 5.5 | Claude Opus 5.5 | |
|---|---|---|
| ID в Claude API | claude-sonnet-5-5 | claude-opus-5-5 |
| Дата выхода | 28 сентября 2026 года | 22 сентября 2026 года |
| Описание Anthropic | «Лучшее сочетание скорости и интеллекта» | «Для долгой агентной разработки и интеллектуальной работы» |
| Задержка (относительная метка Anthropic) | Fast | Moderate |
| Вход / выход, за 1 млн токенов | $2 / $10 | $4 / $20 |
| Запись в кэш на 5 минут / на 1 час | $2,50 / $4 | $5 / $8 |
| Чтение из кэша | $0,10 (с 7 октября 2026 года, до этого $0,20) | $0,20 |
| Batch API, вход / выход | $1 / $5 | $2 / $10 |
| Fast mode | Нет | $8 / $40: Claude API, Google Cloud и Microsoft Foundry |
| Контекст / максимальный ответ | 1 млн / 128 тыс. токенов | 1 млн / 128 тыс. токенов |
| Рассуждение (thinking) | Adaptive, можно отключить предварительное рассуждение через between_tools | Adaptive, отключить нельзя |
| Effort по умолчанию в API | high | medium |
| Граница надёжных знаний | Июнь 2026 | Июнь 2026 |
Цены — прайс Claude API в долларах США. Весь контекст в 1 млн токенов тарифицируется по обычным ставкам, без надбавки за длину. На Amazon Bedrock модели называются anthropic.claude-sonnet-5-5 и anthropic.claude-opus-5-5; на Google Cloud, Microsoft Foundry и Claude Platform on AWS ID такие же, как в Claude API.
Вход, выход и запись в кэш у Sonnet 5.5 стоят как у Sonnet 5, а чтение кэша с 7 октября вдвое дешевле ($0,10 против $0,20), так что прежние расчёты по токенам переносятся с одной поправкой — см. как пересчитать расходы на API Claude Sonnet 5. Opus 5.5 подешевел по сравнению с Opus 5 ($5 / $25); подробности счёта и лимитов подписки — в статье Claude Opus 5.5: цена API и как сбросить лимит подписки.
Почему «вдвое дешевле за токен» не значит «вдвое дешевле задача»
Счёт за задачу зависит от цены токена, уровня effort и того, сколько токенов и шагов модель тратит. Ровно двукратная разница есть только в первом из трёх.
Effort. Anthropic в анонсе Sonnet 5.5 формулирует это прямо: модель лучше всего дополняет Opus 5.5 на низких уровнях effort, где стоит меньше за задачу, а на высоких «может работать сопоставимо при похожей стоимости». Графики стоимости задачи по уровням effort в анонсе даны картинками, точных значений для medium Anthropic не публикует.
Сколько токенов и шагов уходит на задачу. Artificial Analysis прогоняет обе модели на всех пяти уровнях effort по индексу v5.0. В таблице — балл индекса / стоимость одной задачи индекса / секунды на задачу по данным на 28 октября 2026 года:
| Effort | Sonnet 5.5 | Opus 5.5 | Цена задачи Sonnet / Opus |
|---|---|---|---|
low | 25 / $0,51 / 121 с | 35 / $0,98 / 147 с | 0,52 |
medium | 30 / $0,78 / 178 с | 48 / $2,45 / 337 с | 0,32 |
high | 41 / $1,64 / 332 с | 52 / $3,46 / 464 с | 0,47 |
xhigh | 50 / $4,09 / 691 с | 57 / $6,05 / 779 с | 0,68 |
max | 54 / $10,02 / 1 326 с | 58 / $10,04 / 1 133 с | 1,00 |
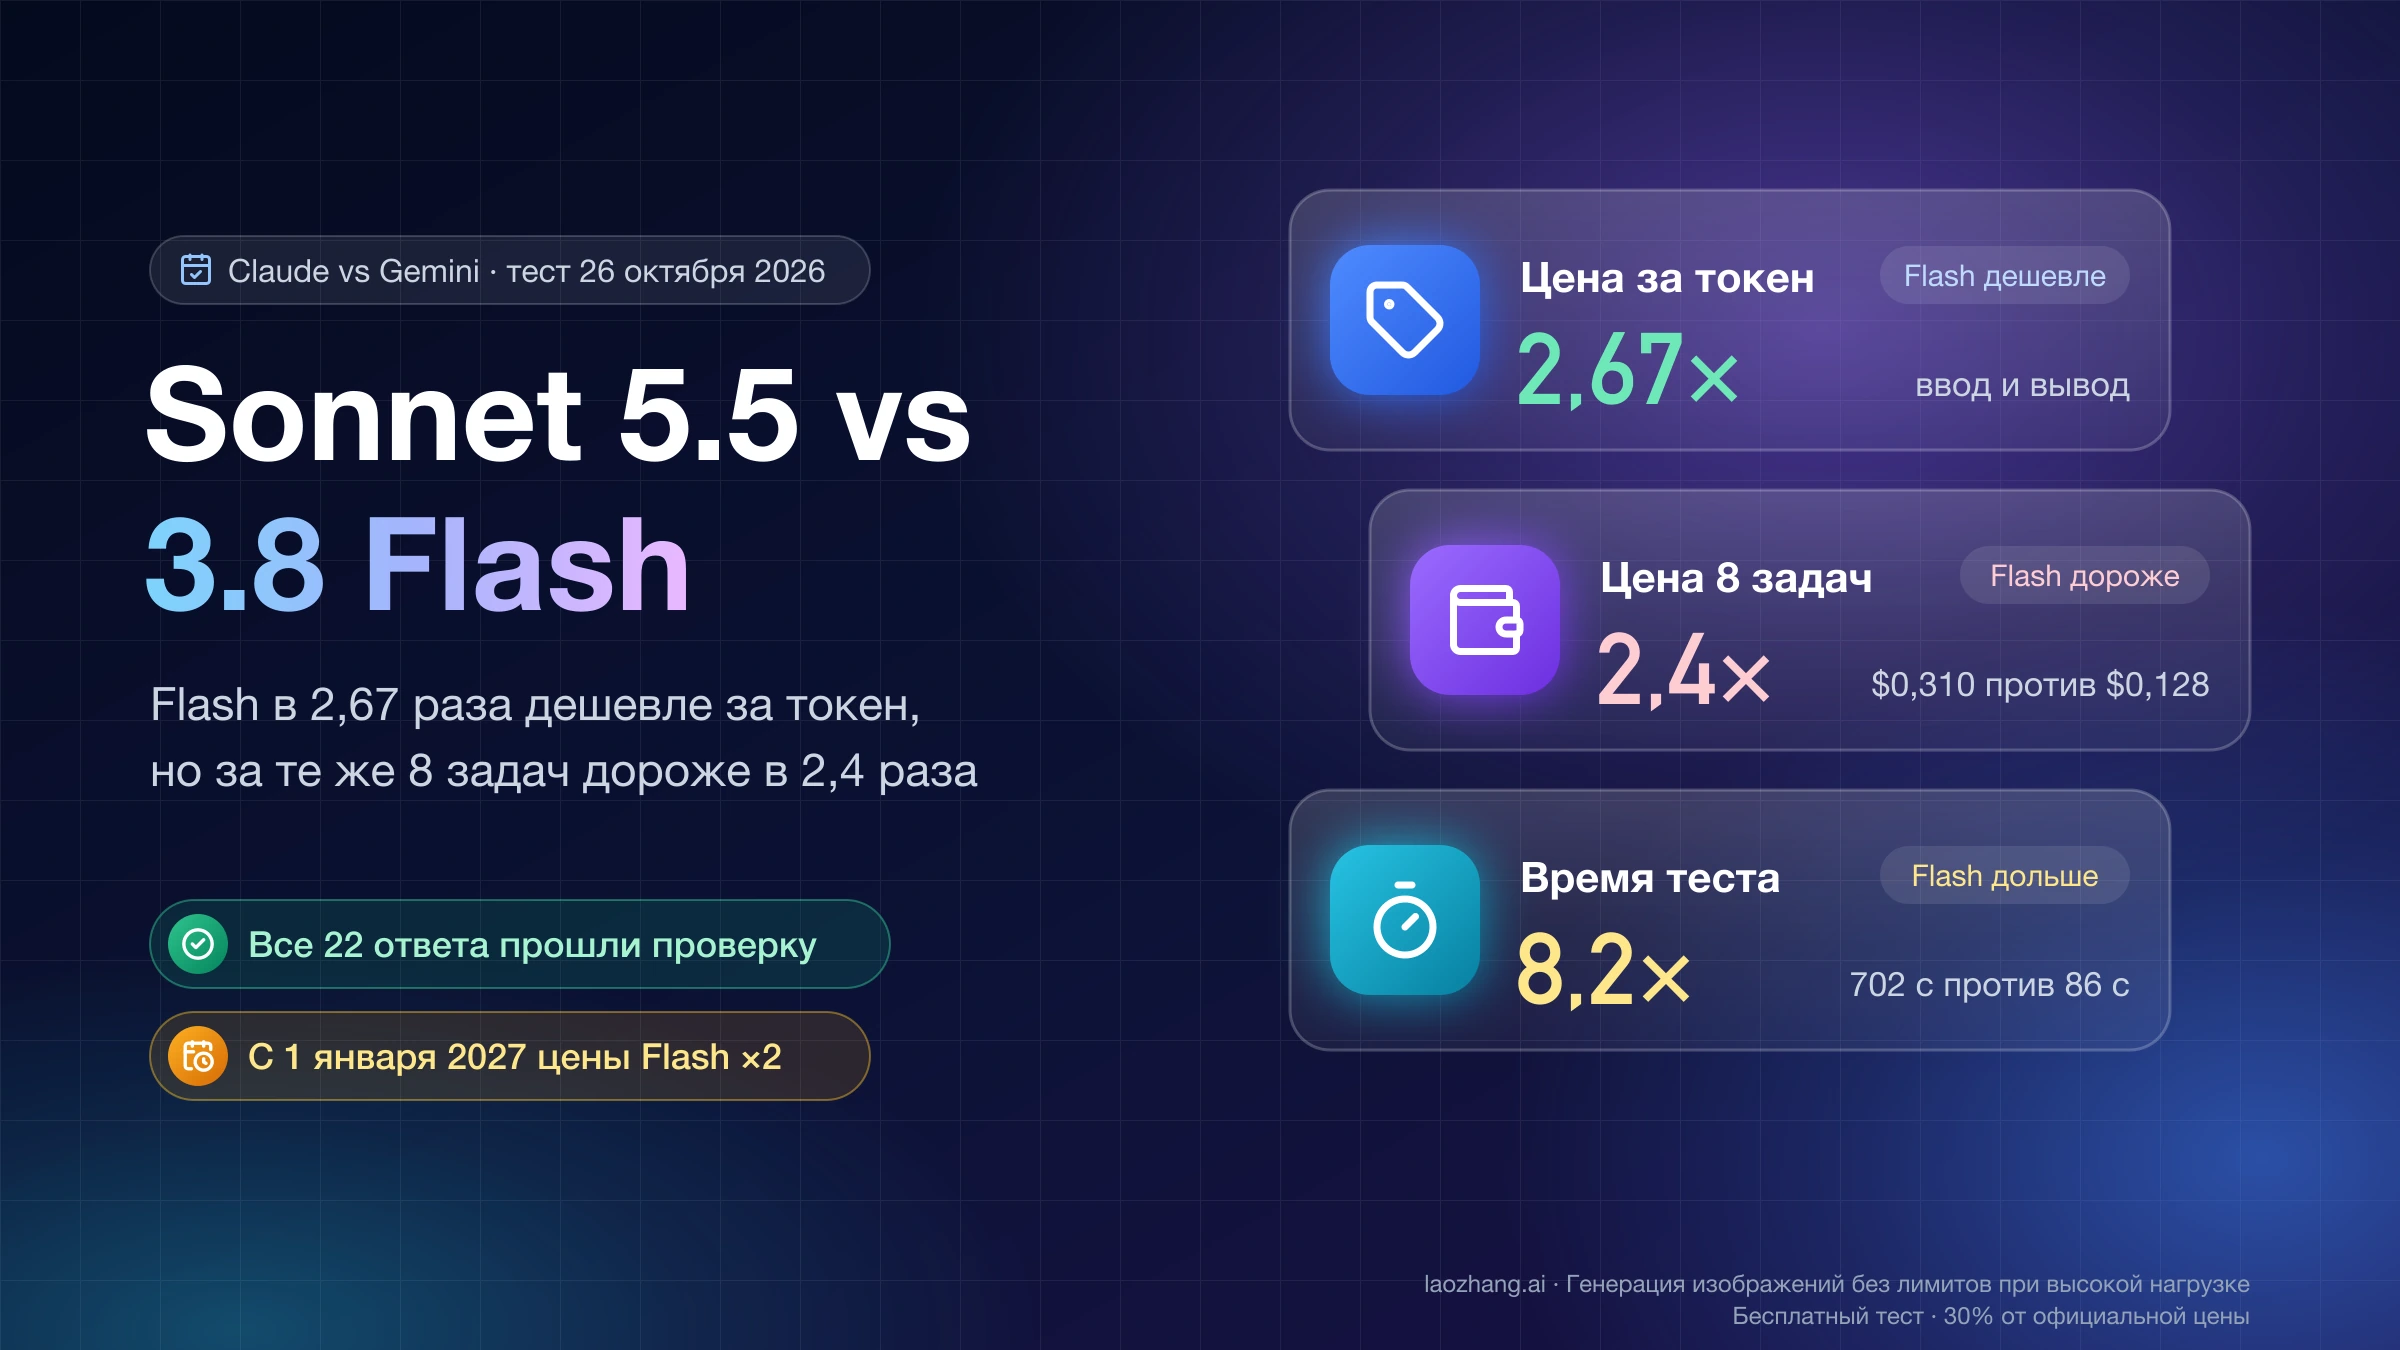
На одинаковом уровне Sonnet 5.5 дешевле на всех ступенях, кроме max, где задачи стоят одинаково, а Sonnet 5.5 набирает на 4 балла меньше и думает дольше. На max он выдаёт около 285 тыс. выходных токенов на задачу против 173 тыс. у Opus 5.5, то есть в 1,65 раза больше, хотя генерирует быстрее: 140 токенов в секунду против 98. На остальных уровнях скорость вывода у Sonnet 5.5 — 109–115 токенов в секунду, у Opus 5.5 — 81–84. В прежнем индексе v4.3.2 Artificial Analysis мерила обе модели только на max и насчитала Sonnet 5.5 задачу на 27 % дороже ($7,60 против $5,98), ещё по цене чтения кэша $0,20; в v5.0 этот разрыв исчез.
Таблица отвечает и на вопрос о смешанных парах. Opus 5.5 на high обходит Sonnet 5.5 на xhigh по всем трём параметрам: 52 балла против 50, $3,46 против $4,09 и 464 секунды против 691; так же Opus на xhigh (57 баллов, $6,05) обходит Sonnet на max (54 балла, $10,02). Ниже этой границы Sonnet дешевле, но за баллы приходится платить. Sonnet на high (41, $1,64) сильнее Opus на low (35, $0,98) на 6 баллов при цене в 1,7 раза выше, а Opus на medium (48, $2,45) обходит Sonnet на high на 7 баллов за 1,5 раза больше денег почти при том же времени. Sonnet на medium (30, $0,78) уступает Opus на low 5 баллов, а Opus на low дороже всего в 1,26 раза.
Чтение кэша теперь тоже вдвое дешевле. До 7 октября 2026 года чтение кэша стоило $0,20 за 1 млн токенов у обеих моделей, и в длинной агентной сессии, где модель на каждом ходу перечитывает весь накопленный контекст — репозиторий, историю, результаты инструментов, — двукратная разница в цене таяла. С 7 октября Anthropic снизила эту ставку у Sonnet 5.5 до $0,10; у обеих моделей она теперь равна 5 % от цены входа вместо обычных 10 %. Подробности — в статье Claude Sonnet 5.5: цена чтения кэша $0,10 — расчёт экономии. Теперь каждая ставка Sonnet 5.5 — вход, выход, обе записи в кэш и чтение — ровно вдвое ниже, чем у Opus 5.5, и доля кэша в счёте на это соотношение больше не влияет.
Расчёт точки безубыточности
Стоимость одного хода (цены за 1 млн токенов):
стоимость = чтение кэша × цена чтения кэша + свежий вход × цена входа + выход × цена выхода
Для Opus 5.5 эти цены — 0,20, 4 и 20, для Sonnet 5.5 — 0,10, 2 и 10, то есть ровно вдвое меньше по каждой строке. Если на ту же задачу Sonnet 5.5 тратит в k раз больше токенов и ходов, он остаётся дешевле, пока k меньше отношения «стоимость хода Opus / стоимость хода Sonnet» при одинаковом числе токенов. После снижения цены чтения кэша это отношение равно 2,0 при любой доле кэша:
| Профиль хода (одинаковые объёмы для обеих моделей) | Opus 5.5 | Sonnet 5.5 | Sonnet дешевле, пока тратит не больше | До 7 октября 2026 года (кэш Sonnet $0,20) |
|---|---|---|---|---|
| Цикл с инструментами: 100 тыс. чтения кэша, 5 тыс. свежего входа, 6 тыс. выхода | $0,160 | $0,080 | 2,0× токенов Opus | $0,090, ≈1,78× |
| Без кэша: 5 тыс. входа, 6 тыс. выхода | $0,140 | $0,070 | 2,0× | $0,070, 2,0× |
| Тяжёлый кэш: 500 тыс. чтения, 2 тыс. входа, 3 тыс. выхода | $0,168 | $0,084 | 2,0× | $0,134, ≈1,25× |
Первую строку можно пересчитать вручную, подставив объёмы в миллионах токенов. Opus 5.5: 0,1 × 0,20 + 0,005 × 4 + 0,006 × 20 = 0,02 + 0,02 + 0,12 = 0,160 доллара. Sonnet 5.5: 0,1 × 0,10 + 0,005 × 2 + 0,006 × 10 = 0,01 + 0,01 + 0,06 = 0,080 доллара. Отношение 0,160 / 0,080 = 2,0.
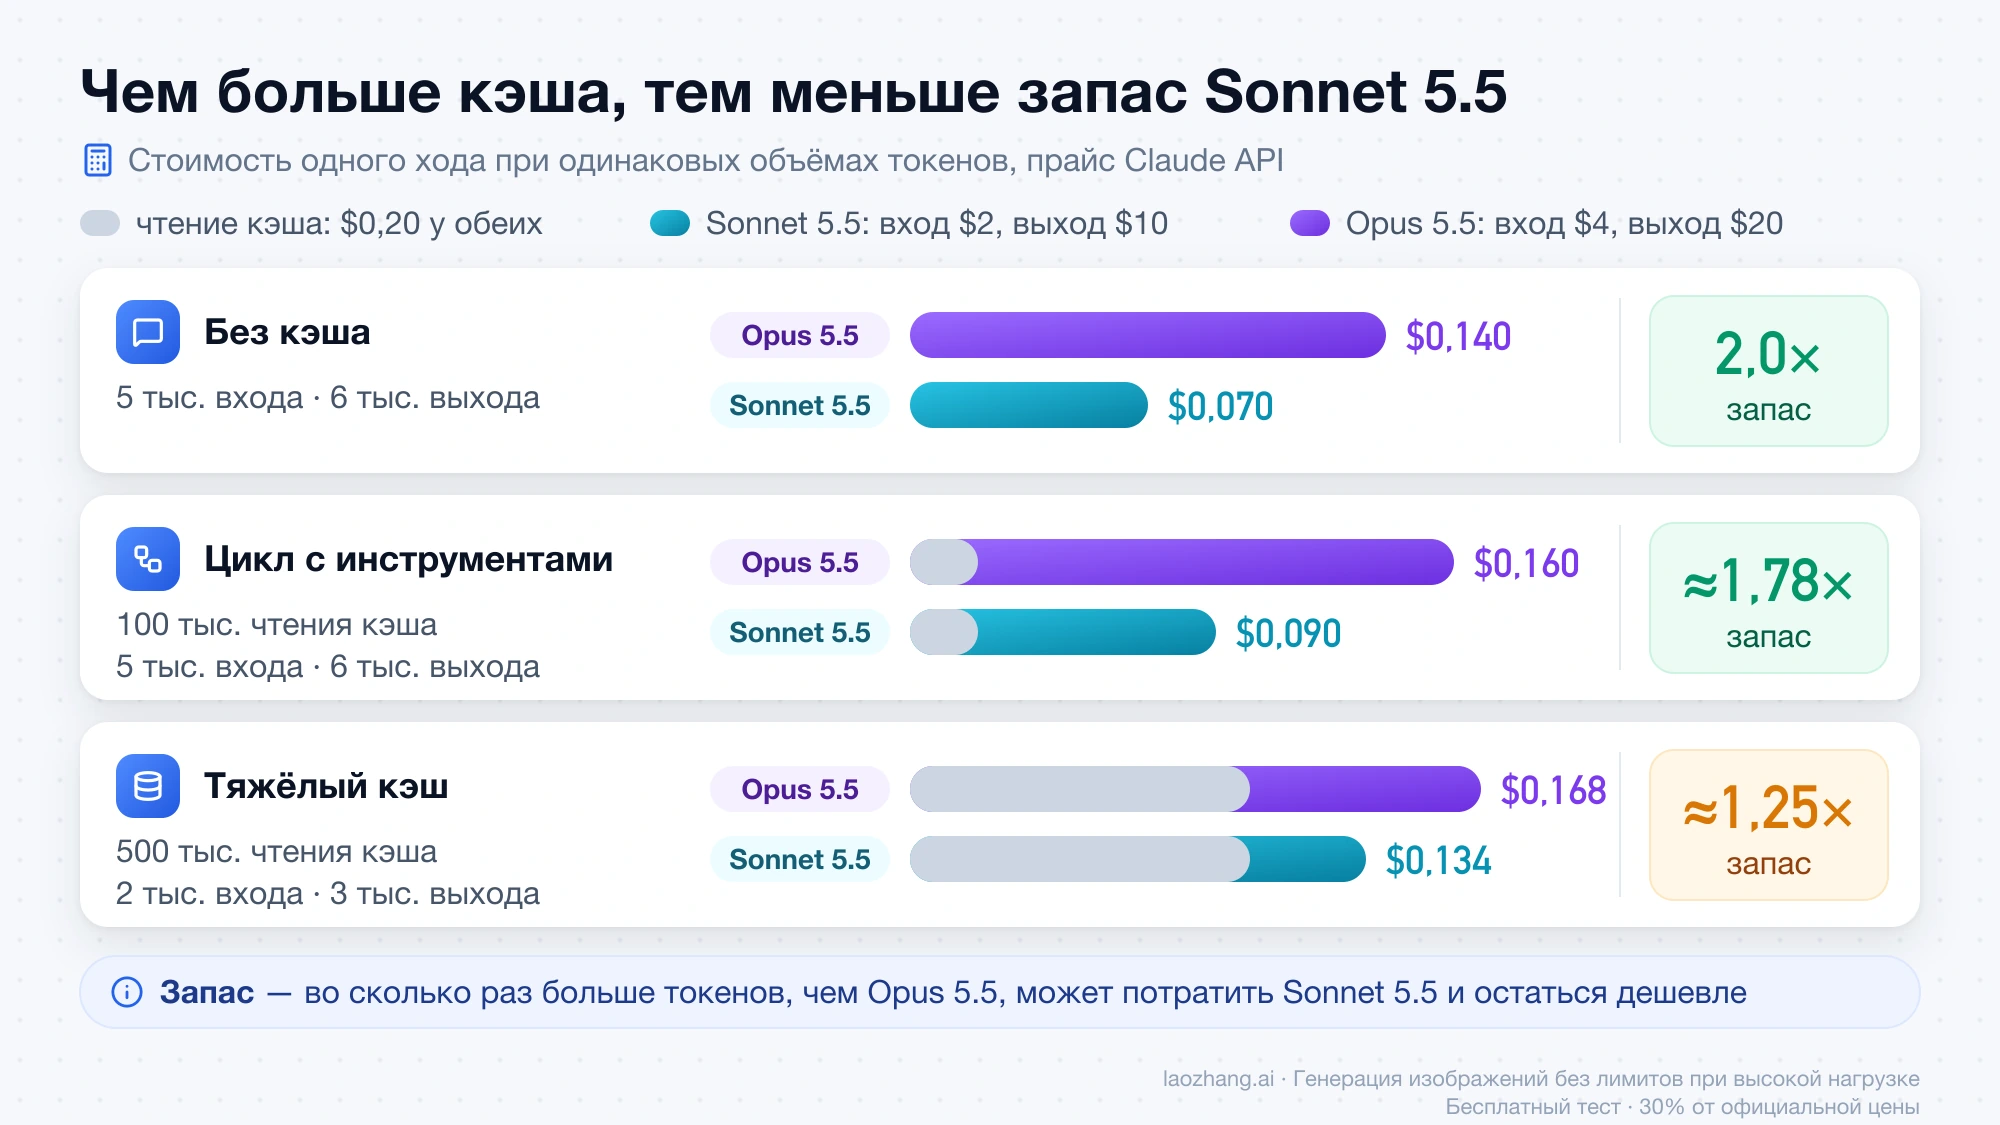
На графике — расчёт по прежней цене чтения кэша Sonnet 5.5 ($0,20); по ценам на 28 октября 2026 года запас Sonnet 5.5 во всех трёх профилях равен 2,0×, как в таблице выше.
Профили условные: это не замеренный трафик, а входные данные для арифметики по прайсу, без Batch API и fast mode. Раньше вывод зависел от доли кэша: в сессии, где основная часть счёта — перечитывание большого контекста, Sonnet 5.5 хватало сделать на четверть больше ходов, чтобы сравняться с Opus 5.5. Теперь граница одна — k = 2, и всё решает, во сколько раз больше токенов и ходов Sonnet 5.5 тратит на ваших задачах. По данным Artificial Analysis выше, на одинаковом effort он подходит к этой границе только на max, где задачи у обеих моделей стоят одинаково. Ваше собственное k видно из поля usage в ответах API; как его собрать, показано в разделе о проверке на своих задачах.
Что показывают бенчмарки и где сравнение некорректно
Таблица из анонса Sonnet 5.5 — результаты, которые публикует Anthropic; большинство получено на максимальном effort.
| Тест | Sonnet 5.5 | Opus 5.5 | Условия |
|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % | Opus 5.5 на xhigh, его лучший результат |
| FrontierCode 1.1 (Main) | 46,2 % на Max, 52,1 % на Xhigh | 54,4 % | На Max Sonnet чаще запускал навык код-ревью Claude Code и упирался в таймауты |
| CursorBench 4.0 | 55,5 % | 57,8 % | Лучший результат Sonnet в пределах примерно двух пунктов от Opus |
| GDPval-AA v2.1 | 1844 | 1846 | Прогон Artificial Analysis на предрелизной версии с уже исправленной ошибкой структурированного вывода; тест входил в индекс v4.3.2, в индекс v5.0 он больше не входит |
| Humanity's Last Exam (с инструментами) | 64,5 % | 67,7 % | — |
| OSWorld 2.1 | 80,1 % | 81,8 % | Частичный зачёт (partial) |
| Chartography (без инструментов) | 61,6 % | 64,4 % | — |
Главная ловушка — смешивать уровни effort. На стандартном medium Opus 5.5 набирает на CursorBench 52,5 %, и рядом с 55,5 % у Sonnet 5.5 это выглядит как победа Sonnet. Но 55,5 % — не результат на medium, так что это сравнение разных настроек. На FrontierCode Opus 5.5 на medium показывает 54,6 %, то есть на стандартном уровне он по-прежнему впереди.
Сторонний замер CodeRabbit на 13 трудных пул-реквестах из открытых проектов показывает ту же границу:
| Конфигурация | Найдено известных проблем | Точность замечаний |
|---|---|---|
| Sonnet 5.5, thinking включён | 6 из 13 (46,2 %) | 41,2 % |
| Sonnet 5.5, thinking выключен | 5 из 13 | 38,5 % |
| Sonnet 5 | 4 из 13 | 40,0 % |
| Opus 5.5 Standard | 8 из 13 (61,5 %) | 66,7 % |
| Opus 5.5 Max | 10 из 13 (76,9 %) | 52,0 % |
Цифры Opus 5.5 взяты из более раннего сентябрьского прогона CodeRabbit на тех же случаях. Вызовы Claude в одном ревью Sonnet 5.5 обходились в $0,46–0,47 против $1,16 у Sonnet 5; стоимость ревью Opus 5.5 в этой публикации не приводится. Вывод CodeRabbit: если пропуск бага в рискованном изменении обходится дорого, Opus 5.5 оправдывает лишние токены, а для ревью, которое запускается на каждом пул-реквесте, Sonnet 5.5 — первая модель линейки Sonnet, которую они готовы туда ставить. Сами авторы подчёркивают, что 13 случаев показывают направление, но не решают вопрос.
В том же материале есть параллельная сборка одного приложения в двух сессиях Claude Code: Sonnet 5.5 закончил за 29 минут 27 секунд, Opus 5.5 — за 44 минуты 50 секунд, результаты «почти идентичны», у Opus 5.5 чуть выше точность воспроизведения задания. CodeRabbit прямо называет это одним прогоном, а не бенчмарком.
Если вы выбираете между Opus 5.5 и моделью OpenAI, а не внутри линейки Claude, пригодится сравнение Claude Opus 5.5 и GPT-6 Sol для кода и сложных задач.
Как переключать модель и effort
В Claude Code
/model— интерактивный выбор модели, действует сразу, без перезапуска./status— показывает, какая модель сейчас активна.claude --model claude-sonnet-5-5илиclaude --model claude-opus-5-5— модель на одну сессию.- Постоянная модель по умолчанию — переменная окружения в конфиге оболочки:
# zsh (macOS); для bash замените ~/.zshrc на ~/.bashrc
echo 'export ANTHROPIC_MODEL="claude-sonnet-5-5"' >> ~/.zshrc
source ~/.zshrc
Если у вас Claude Code на Amazon Bedrock, Google Cloud или Claude Platform on AWS, указывайте полный ID claude-sonnet-5-5 (или ID провайдера), а не алиас sonnet. На Anthropic API sonnet означает Sonnet 5.5, но на Bedrock и Google Cloud он ведёт на Sonnet 4.5, а на Claude Platform on AWS — на Sonnet 4.6. Алиас opus у этих трёх провайдеров указывает на Opus 5.5.
Effort у обеих моделей в Claude Code по умолчанию medium. Менять его можно так:
/effortбез аргумента открывает ползунок,/effort highзадаёт уровень сразу,/effort autoсбрасывает сохранённое значение для текущей модели;- в
/modelуровень меняется стрелками влево и вправо на строке модели; claude --effort lowзадаёт уровень на одну сессию;- переменная окружения
CLAUDE_CODE_EFFORT_LEVELзадаёт уровень постоянно.
Текущий уровень виден в заголовке сессии рядом с названием модели, например «with low effort».
Менять effort внутри сессии дёшево, а менять модель — дорого. У каждой модели свой кэш промптов, поэтому после переключения через /model следующий запрос перечитывает всю историю диалога без попаданий в кэш; пока кэш ещё тёплый, Claude Code просит подтвердить переключение. Смена effort на Opus 5.5 и Sonnet 5.5 при работе через API-ключ или подписку Claude кэш сохраняет. На Bedrock, Google Cloud и через шлюз Claude apps это не действует. Кроме того, в API Sonnet 5.5 не читает thinking-блоки Opus 5.5, а блоки Sonnet 5.5 не читает ни одна другая модель. В документации Claude Code про это не сказано, но логично ожидать, что после смены модели накопленные рассуждения тоже теряются. Поэтому внутри одной задачи регулируйте effort, а модель меняйте на границе задач или в новой сессии, передавая краткий итог вместо всей истории.
Если вы выбираете подписку под Claude Code, сравнение лимитов есть в статье Claude Pro vs Max в 2026 году: цены, лимиты Claude Code и окупаемость Max.
В API
Модель и effort задаются в каждом запросе:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",          # или "claude-opus-5-5"
    max_tokens=16000,                   # на high и выше оставляйте запас под рассуждение
    output_config={"effort": "medium"}, # задавайте явно: стандарт у моделей разный
    messages=[{"role": "user", "content": "Исправь падающий тест в tests/test_parser.py"}],
)
Opus 5.5 на том же уровне effort думает за ход больше, чем Opus 5, особенно на xhigh и max, поэтому Anthropic советует оставлять место в max_tokens: это жёсткий предел для рассуждения и ответа вместе.
Что ломается при простой замене ID модели
Если интеграция написана под Sonnet 5 или Opus 5, замены строки model мало. Ниже — различия, из-за которых запросы начинают возвращать 400 или интерфейс ведёт себя иначе.
| Что есть в вашем коде | Sonnet 5.5 | Opus 5.5 | Что сделать |
|---|---|---|---|
thinking: {"type": "disabled"} | Ошибка 400 | Ошибка 400 | Sonnet 5.5: thinking: {"type": "between_tools"} (только на low, medium, high). Opus 5.5: снизить effort |
thinking: {"type": "enabled", "budget_tokens": N} | Ошибка 400 | Ошибка 400 | Убрать бюджет, управлять глубиной через effort |
tool_choice с типом any или tool | Ошибка 400 | Ошибка 400 | Оставить auto, включить strict: true или structured outputs; в промпте прямо сказать, когда вызывать инструмент |
Инструмент computer_20251124 | 400 в Claude API и Google Cloud, Bedrock принимает | То же | Перейти на computer_toolset_20260801 |
Нестандартные temperature, top_p, top_k | Ошибка 400 | Ошибка 400 (так на всех Opus начиная с 4.7) | Убрать параметры, оставить значения по умолчанию |
speed: "fast" (fast mode) | Нет | Claude API, Google Cloud и Microsoft Foundry | Не переносить на Sonnet 5.5 |
| Текст между вызовами инструментов | Приходит в thinking-блоках, при display: "omitted" они пустые | То же | Задать thinking.display; у Sonnet 5.5 с between_tools текст возвращается и так |
| Смена модели посреди диалога | Не читает блоки Opus 5 и Opus 5.5; его блоки не читает никто | Не читает блоки Sonnet 5.5 | Блоки молча отбрасываются, запрос проходит, рассуждение теряется |
| Правка истории перед thinking-блоком | 400 для аккаунтов, созданных с 31 августа 2026 года | То же | Вести историю только дописыванием или включить drop_block |
| Advisor tool (бета) | Советником может быть Opus 5.5, Opus 5, Fable, Mythos или сам Sonnet 5.5; Opus 4.8, Opus 4.7 и Sonnet 5 дают 400 | — | Сменить советника |
Отказ классификатора (stop_reason: "refusal") | Server-side fallback повторяет отказы категорий cyber и frontier_llm на Sonnet 5 | Fallback повторяет запрос на модели, которую Anthropic рекомендует для категории | Обрабатывать отказы и настроить fallback |
Ещё одна деталь Sonnet 5.5: его thinking-блоки работают только в аккаунте, который их создал, или в связанном с ним. Если одна и та же история диалога ходит между разными организациями, блоки будут отброшены.
Есть ли смысл делить работу между Sonnet и Opus
Самый дешёвый способ — маршрутизация по типу задачи: чёткие и проверяемые задачи идут в Sonnet 5.5, открытые — в Opus 5.5, каждая в своём запросе или своей сессии. Рассуждения при этом не теряются, потому что модели не передают друг другу thinking-блоки, и не приходится платить за перечитывание истории без кэша, как при переключении посреди диалога.
Более сложные схемы требуют расчёта:
- Советник (advisor tool, бета). Sonnet 5.5 ведёт цикл, а в трудных местах обращается к Opus 5.5 за советом; совет приходит зашифрованным. Измерений именно этой пары Anthropic не публиковала. По её руководству об оптимизации стоимости, советник окупается, когда он заметно дороже исполнителя и исполнитель действительно к нему обращается, а на низком effort исполнитель может перестать спрашивать. Здесь разница в цене всего двукратная по всем ставкам, включая чтение кэша, поэтому запас для экономии невелик. Базовая точка, которую схема должна обойти, — Opus 5.5 в одиночку на
low. - «Opus планирует, Sonnet исполняет». В Claude Code для этого есть готовый алиас
opusplan: в режиме планирования работаетopus, при исполнении —sonnet. Каждое переключение режима планирования — это смена модели, то есть новый кэш и перечитывание всей истории, так что на длинных сессиях с частыми переходами экономия тает. Данных о стоимостиopusplanс моделями 5.5 Anthropic не публиковала. На Bedrock, Google Cloud и Claude Platform on AWSsonnetв этой схеме означает не Sonnet 5.5, а более старую модель (см. выше). - Оркестратор в API (ведущая модель раздаёт подзадачи исполнителям). В замерах Anthropic такая схема экономила только в двух случаях: как страховка от редких очень дорогих прогонов на рутинных задачах и когда работа не помещается в одно контекстное окно. Если задача — одна цепочка зависимых шагов, одна модель на пониженном effort выходила дешевле.
Как проверить выбор на своих задачах
Решение «какая модель дешевле» принимается по стоимости принятого результата, а не по прайсу. Порядок, который описывает Anthropic в руководстве по стоимости, для этого сравнения выглядит так:
- Возьмите несколько десятков реальных задач в пропорциях вашего трафика и отдельно самую трудную десятую часть. Для каждой нужна автоматическая проверка: тесты прошли, тикет закрыт, число строк совпало.
- Прогоните Sonnet 5.5 и Opus 5.5 на двух-трёх уровнях effort, каждый уровень — в отдельной сессии: в API смена effort верхнего уровня посреди сессии сбрасывает кэш и искажает сравнение.
- Посчитайте стоимость всех запросов каждой задачи, включая неудачные попытки и повторы.
- Разделите общие расходы на число принятых результатов.
PRICES = {  # USD за 1 млн токенов
    "claude-sonnet-5-5": {"input": 2.00, "output": 10.00, "cache_read": 0.10},
    "claude-opus-5-5":   {"input": 4.00, "output": 20.00, "cache_read": 0.20},
}

def request_cost(model, usage):
    p = PRICES[model]
    writes = usage.cache_creation
    w1h = writes.ephemeral_1h_input_tokens if writes else 0
    w5m = writes.ephemeral_5m_input_tokens if writes else 0
    return (
        usage.input_tokens * p["input"]
        + w1h * p["input"] * 2.0      # запись в кэш на 1 час
        + w5m * p["input"] * 1.25     # запись в кэш на 5 минут
        + (usage.cache_read_input_tokens or 0) * p["cache_read"]
        + usage.output_tokens * p["output"]
    ) / 1_000_000

def cost_per_accepted(tasks):
    """tasks: список (model, [usage каждого запроса задачи], принят_ли_результат)"""
    total = sum(request_cost(m, u) for m, usages, _ in tasks for u in usages)
    accepted = sum(1 for _, _, ok in tasks if ok)
    return total / accepted if accepted else float("inf")
Отношение суммарных токенов Sonnet 5.5 и Opus 5.5 на одних и тех же задачах и есть ваше k из расчёта точки безубыточности.
Если результат проверяется автоматически, попробуйте ещё одну политику: всё запускать на низком effort, а на high повторять только провалы. Anthropic проверила её на Opus 5.5 на подмножестве SWE-bench Pro: старт на low с повтором провалов на high дал около 97 % решённых задач примерно за $0,17 на задачу, а всё на high — 95,3 % за $0,29. Условия две: нужен надёжный сигнал провала и готовность ждать двойное время на провалившихся задачах. На Sonnet 5.5 эту политику Anthropic не измеряла, но проверить её на своём наборе несложно. Перед окончательным переключением прогоните победителя в теневом режиме на части трафика.
Подписка, доступ и автоматическая смена модели
В тарифах Claude Opus доступен на Pro ($20 в месяц или $17 при оплате за год) и Max (от $100 в месяц); на бесплатном тарифе в таблице указан только Sonnet. Версии моделей в этой таблице не названы, так что доступ именно к Sonnet 5.5 на Free — вывод из того, что это текущая модель Sonnet. С выходом Opus 5.5 Anthropic подняла пятичасовые лимиты на Pro, Max, Team и Enterprise с оплатой за места.
В приложениях Claude обе модели иногда сами переключаются на предыдущие:
- Sonnet 5.5 при срабатывании классификаторов на рискованные запросы по наступательной безопасности (генерация эксплойтов, поиск уязвимостей в бинарных файлах, пентест) и на часть задач по разработке передовых LLM переходит на Sonnet 5. Запросы по биологии из запрещённого круга и попытки вытащить внутренние рассуждения модели блокируются без замены. Обычная безопасная разработка, включая поиск уязвимостей в исходном коде, остаётся на Sonnet 5.5.
- Opus 5.5 в киберкатегории переходит на Opus 4.8, по биологии — на Opus 5.
После автоматической смены чат остаётся на запасной модели, пока вы не вернёте нужную в меню выбора (справка Anthropic о смене модели у Sonnet 5.5). Классификаторы проверяют не только ваше сообщение, но и память, данные коннекторов, результаты поиска и файлы.
Россия не входит в список стран, где Anthropic официально предоставляет Claude и API, по состоянию на 29 сентября 2026 года. Модели также доступны через AWS, Google Cloud и Microsoft Foundry — на условиях этих провайдеров.
Частые вопросы
Какая модель лучше — Sonnet 5.5 или Opus 5.5?
Для открытой работы, где нужно долго держать контекст и принимать решения, сильнее Opus 5.5: так говорит сама Anthropic, и так же выходит в замере CodeRabbit на трудных ревью. Для чётких проверяемых задач Sonnet 5.5 на low или medium даёт близкий результат быстрее и дешевле. Если не уверены, начните с Opus 5.5 на medium.
Правда ли Sonnet 5.5 вдвое дешевле Opus 5.5?
За токен — да, по всем ставкам: $2 и $10 против $4 и $20, а чтение кэша с 7 октября 2026 года — $0,10 против $0,20. За задачу — не всегда. В индексе Artificial Analysis v5.0 на 28 октября 2026 года задача у Sonnet 5.5 на том же effort дешевле в 1,5–3,1 раза, а на max стоит столько же, сколько у Opus 5.5 ($10,02 против $10,04). Если Sonnet 5.5 приходится поднимать до xhigh, Opus 5.5 на high выходит дешевле и набирает больше баллов.
Можно ли пользоваться Opus 5.5 бесплатно?
Нет. На бесплатном тарифе Claude доступен Sonnet, а Opus — начиная с Pro. В API обе модели платные по прайсу.
Сколько стоил Opus 5 и что изменилось в Opus 5.5?
Opus 5 стоил $5 за 1 млн входных и $25 за 1 млн выходных токенов, Opus 5.5 — $4 и $20. Кроме того, у Opus 5.5 effort по умолчанию понижен с high до medium, а рассуждение нельзя отключить. Opus 5.5 — актуальная модель линейки Opus на конец сентября 2026 года.
Источники1
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 10 нояб. 2026 г..
Источники1
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 10 нояб. 2026 г..