Gemini 4 Argon vs Fable 5.1: что выбрать до и после 1 декабря
Claude Fable 5.1 и Gemini 4 Argon в индексе AA v5.0.1 идут вровень, но на повседневных задачах Fable дороже в 8,6 раза, с 1 декабря — в 4,3 раза.
Содержание
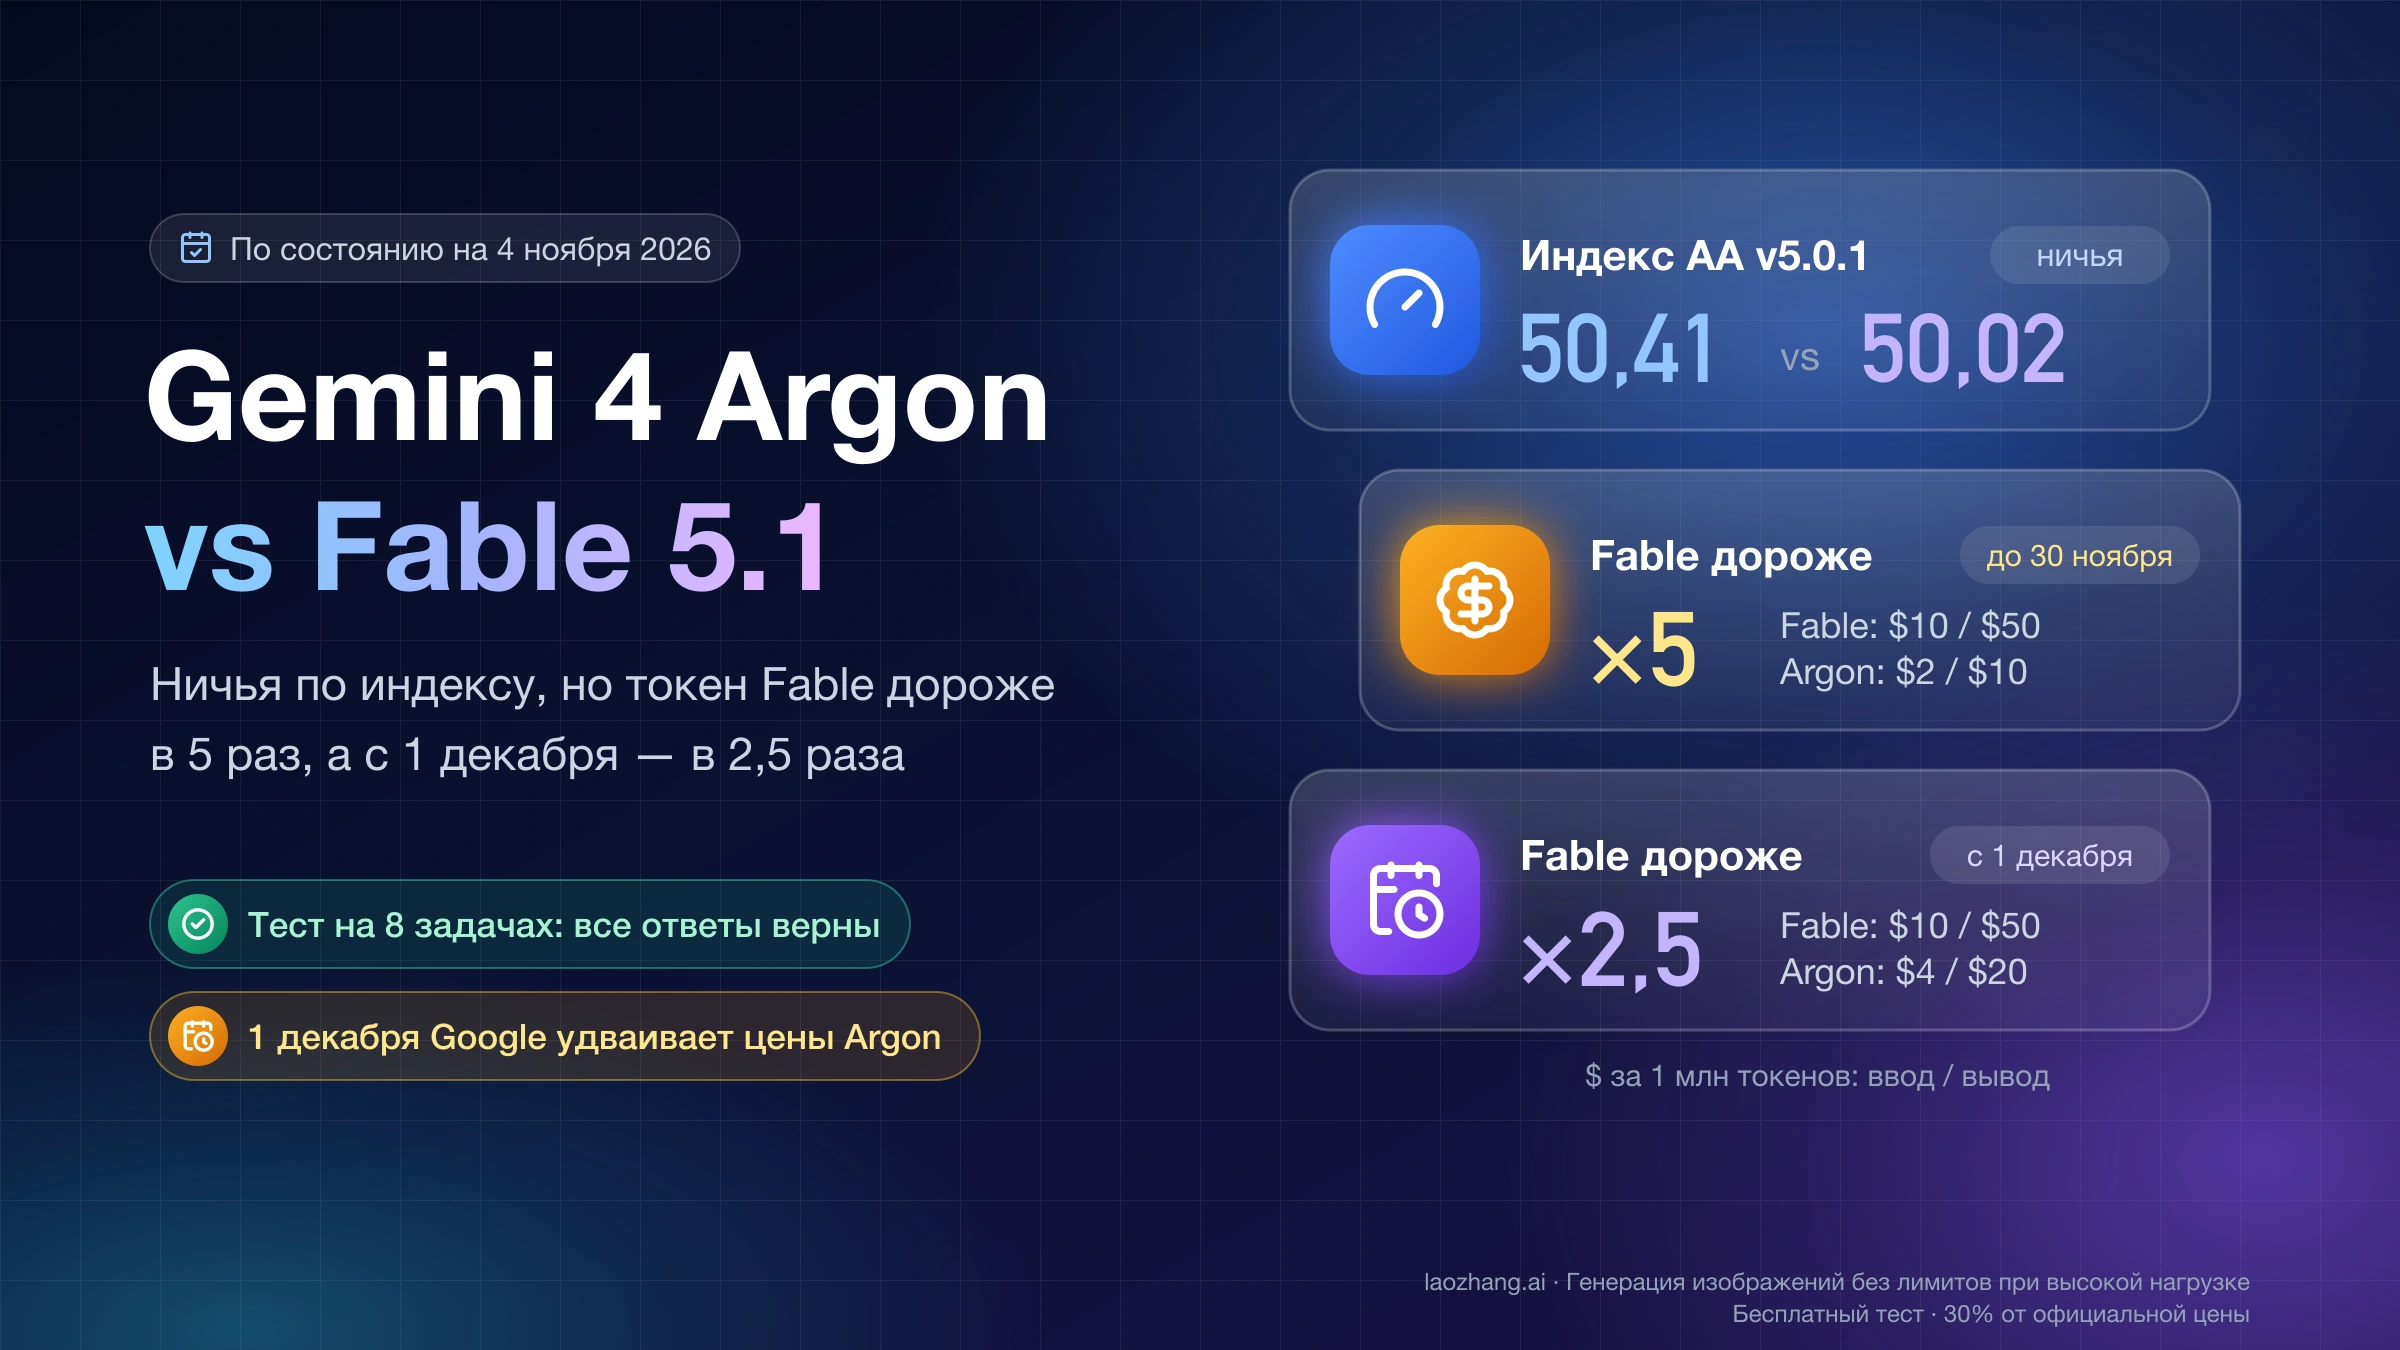
Если вы платите за Claude Fable 5.1 (claude-fable-5-1) по API и работа у вас — агенты, автоматизация, терминальные задачи или обработка длинных документов, начните с проверки Gemini 4 Argon (gemini-4-argon) на уровне размышления по умолчанию. По состоянию на 4 ноября 2026 года в индексе Artificial Analysis v5.0.1 Argon набирает 50,41 балла, Fable 5.1 на усилии xhigh — 50,02: это ничья. При этом токен Fable стоит в 5 раз дороже, чем у Argon до 30 ноября, и в 2,5 раза дороже с 1 декабря, когда Google удваивает цены Argon до $4 за ввод и $20 за вывод.
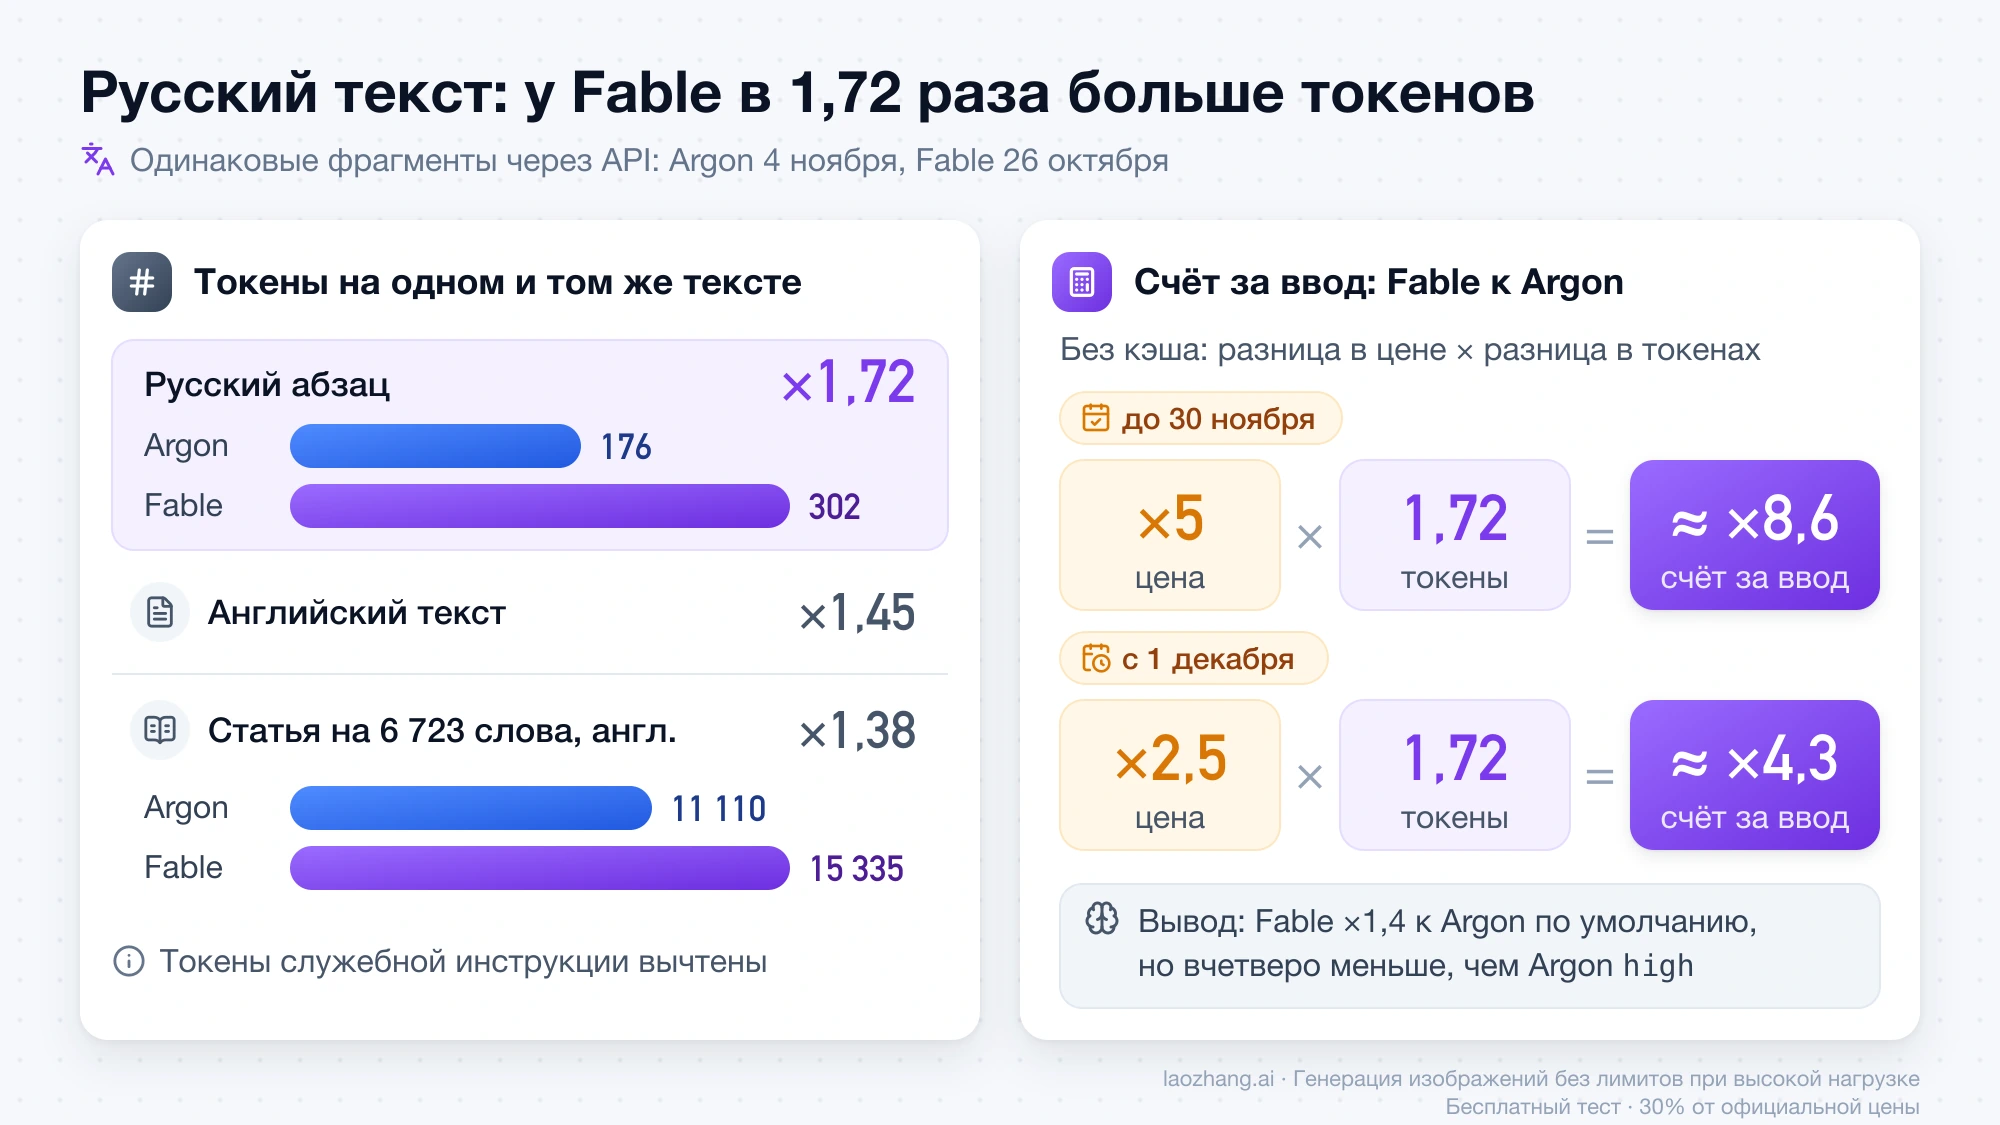
На восьми одинаковых задачах со скрытыми тестами (Argon прогнан 4 ноября, Fable — 26 октября, через один и тот же шлюз) обе модели прошли все проверки, а разница осталась только в счёте: на повседневных задачах Fable обошлась в 8,6 раза дороже Argon в режиме по умолчанию, с 1 декабря разрыв по той же арифметике — 4,3 раза. На русском тексте Fable насчитывает в 1,72 раза больше входных токенов, поэтому у русскоязычного проекта разрыв в счёте больше, чем разница в прайсе.
Fable 5.1 стоит оставить для офисной и аналитической работы с документами и для генерации сложного кода, где она впереди в независимых замерах, а также для ответов длиннее 65 536 токенов за один синхронный запрос. Если Argon переключить на high, он начинает много «думать», и в том же тесте на трудных задачах такой режим с 1 декабря обходится дороже Fable по умолчанию. Перед переходом прогоните на обеих моделях свои запросы и пересчитайте счёт по декабрьским ценам.
Gemini 4 Argon или Claude Fable 5.1: какую брать для какой работы
Выбор определяют три вещи: тип работы, объём счёта и дата. Там, где модели по качеству равны или Argon впереди, а платите вы за миллионы токенов, Argon выгоднее и после 1 декабря. Fable 5.1 оправдана там, где она стабильно выигрывает в сторонних замерах или где её технические возможности нужны напрямую. Ниже правило по ситуациям; цифры к каждой строке — в следующих разделах.
| Ваша работа | Что брать | Почему |
|---|---|---|
| Агенты, автоматизация процессов, терминальные задачи | Gemini 4 Argon, уровень medium (по умолчанию) | В AutomationBench и обоих Terminal-Bench у Artificial Analysis Argon впереди, а токен у него дешевле |
| Длинные документы, видео, аудио, PDF на входе | Gemini 4 Argon | Принимает видео и аудио, Fable 5.1 — только текст и изображения; в таблице Google заметный отрыв на контексте 256K–1M |
| Офисная и аналитическая работа: отчёты, таблицы, документы | Claude Fable 5.1, high или xhigh | Fable впереди в AA-Briefcase и GDP.pdf, начиная с усилия medium |
| Сложная генерация кода, где ошибка дороже токенов | Claude Fable 5.1, xhigh | FrontierCode 2.0: 35,7 % у Fable xhigh против 25,7 % у Argon |
| Очень длинный ответ одним синхронным запросом | Claude Fable 5.1 | До 128K токенов вывода, у Argon примерно вдвое меньше |
| Нужна быстрая первая реакция в чате или IDE | Claude Fable 5.1 на high или ниже | До первого токена 18,3 с против 41,5 с у Argon (замер AA) |
Если вы вообще не уверены, нужна ли вам Fable, сама Anthropic в обзоре моделей советует для большинства задач начинать с Claude Opus 5.5, а Fable 5.1 брать для требовательных рассуждений, долгих агентных задач или когда Opus 5.5 даже на высоком усилии не проходит ваши проверки; сравнение внутри линейки — в материале «Claude Fable 5.1 или Opus 5.5: что выбрать и когда стоит доплатить». Как Argon смотрится рядом с Opus 5.5 и GPT-6.1 Sol, разобрано в статье «Gemini 4 Argon, Claude Opus 5.5 или GPT-6.1 Sol: что выбрать».
Насколько Fable 5.1 лучше Argon: по индексу AA v5.0.1 — ничья
По состоянию на 4 ноября 2026 года Fable 5.1 не лучше Gemini 4 Argon по сводному индексу: в сравнении Gemini 4 Argon и Claude Fable 5.1 на Artificial Analysis (Intelligence Index v5.0.1) Argon на уровне High набирает 50,41, лучший результат Fable — 50,02 на xhigh. Разница меньше балла укладывается в разброс самого индекса, так что это ничья, а не победа Argon. Важная деталь: Argon у AA измерен только на High, на ступень выше настройки API по умолчанию, поэтому честно сравнивать его с Fable двумя способами — при той же цене задачи (Fable high) и при том же балле (Fable xhigh).
| Модель и уровень | Балл (AA v5.0.1) | Стоимость задачи индекса | Время на задачу | До первого токена | Выходных токенов на задачу |
|---|---|---|---|---|---|
| Gemini 4 Argon, High | 50,41 | $7,68 | 1 363 с | 41,5 с | 116 368 |
Claude Fable 5.1, low | 38,68 | $4,47 | 421 с | 2,6 с | 37 837 |
Claude Fable 5.1, medium | 43,17 | $5,56 | 537 с | 14,7 с | 48 545 |
Claude Fable 5.1, high (по умолчанию) | 47,17 | $7,54 | 720 с | 18,3 с | 66 031 |
Claude Fable 5.1, xhigh | 50,02 | $10,85 | 966 с | 79,5 с | 97 059 |
Claude Fable 5.1, max | 49,16 | $12,99 | 1 066 с | 252,5 с | 117 941 |
При почти равной стоимости задачи Argon на 3,2 балла выше Fable high. Чтобы догнать Argon по баллу, Fable нужен xhigh, и задача тогда стоит $10,85 — в 1,4 раза дороже. Уровень max в v5.0.1 даёт Fable меньше баллов, чем xhigh, при этом дороже и медленнее, так что выкручивать усилие до упора смысла нет. Обратная сторона Argon — время: на задачу индекса он тратит 1 363 секунды, дольше любого уровня Fable, и выдаёт столько же токенов, сколько Fable на max. Стоимость задачи Argon AA уже считает по декабрьским ценам; описание методики Artificial Analysis фиксирует, что v5.0.1 — те же девять тестов, что и v5.0, с перепроверкой CritPt v2.
Цифры вроде «0,79 балла разницы при цене в пять раз» или «Argon около 53, наравне с Fable» взяты из прежнего индекса v4.3.2, который AA сменил в октябре; его баллы с v5.0.1 не сравниваются. Другие независимые сводки говорят то же самое. В Epoch Capabilities Index на 3 ноября 2026 года у Fable 5.1 — 166,36, у Argon — 166,07, доверительные интервалы почти совпадают. В текущей версии Vals Index (v2.2, таблица на 30 октября) Argon набирает 69,24 % и стоит на 4-м месте из 32, а Fable 5.1 в этой таблице нет; причину Vals не указывает, а прежние 65,83 % Fable относятся к версии v2.1.
Где кто впереди: агентные тесты у Argon, документы и код у Fable
Сводный балл одинаковый, но внутри индекса модели сильны в разном. Argon впереди в автоматизации процессов и терминальных задачах, Fable — в офисной работе с документами (AA-Briefcase, GDP.pdf) и в генерации кода по FrontierCode, причём на всех трёх уровнях в таблице ниже. Остальные тесты зависят от того, с каким уровнем Fable сравнивать: против high Argon выигрывает HLE-Diamond и AA-Omniscience, против max уже нет.
| Тест AA v5.0.1 | Argon High | Fable high | Fable xhigh | Fable max |
|---|---|---|---|---|
| AutomationBench-AA | 77,5 % | 55,3 % | 57,8 % | 59,4 % |
| Terminal-Bench 4.0 | 57,1 % | 52,0 % | 55,1 % | 52,0 % |
| Terminal-Bench-Science | 52,9 % | 39,5 % | 40,5 % | 43,3 % |
| AA-Briefcase (рейтинг) | 1 484 | 1 576 | 1 649 | 1 669 |
| FrontierCode 2.0 | 25,7 % | 30,3 % | 35,7 % | 31,6 % |
| GDP.pdf | 21,8 % | 26,8 % | 26,2 % | 26,2 % |
| HLE-Diamond | 56,7 % | 50,4 % | 58,8 % | 60,1 % |
| AA-Omniscience | 46,1 | 39,9 | 44,3 | 46,3 |
| CritPt v2 (Hard) | 52,5 % | 62,0 % | 60,0 % | 52,5 % |
Самый большой отрыв у Argon — AutomationBench: 77,5 % против 55–59 % у Fable, то есть в этом тесте на автоматизацию рабочих процессов агент на Argon заметно чаще доводит дело до конца. Fable сильнее там, где нужно собрать отчёт, разобрать таблицу или написать нетривиальный код: в AA-Briefcase и FrontierCode её отрыв сохраняется даже на high, который по цене задачи равен Argon.
Таблица из анонса Gemini 4 Argon в блоге Google от 30 сентября 2026 года показывает больший отрыв: Argon впереди в 15 из 17 общих строк, например AutomationBench 51,3 против 31,4, Harvey Legal Agent 19,6 против 6,7, GraphWalks на контексте 256K–1M 84,2 против 65,0. Fable там выигрывает только FrontierSWE v2 (56,3 против 55,0) и Terminal-bench 4.0 (57,9 против 57,4). Это замеры самого Google: обе модели прогонял вендор, Argon — на максимальном уровне размышления, независимо таблицу никто не воспроизвёл. Поэтому направление она подтверждает, но для оценки разрыва надёжнее цифры AA.
Сколько стоит задача: Fable дороже в 5 раз сейчас и в 2,5 раза с 1 декабря
За токен Fable 5.1 дороже Gemini 4 Argon в 5 раз до 30 ноября 2026 года и в 2,5 раза с 1 декабря: по странице цен Gemini API вводная цена Argon действует до 30 ноября, а с 1 декабря все его ставки удваиваются; цены Claude API для Fable 5.1 не меняются. Продлит ли Google вводную цену, компания не сообщала. Токены размышлений у обеих моделей оплачиваются как вывод.
| Ставка за 1 млн токенов | Argon до 30 ноября | Argon с 1 декабря | Fable 5.1 |
|---|---|---|---|
| Ввод | $2 | $4 | $10 |
| Вывод, включая размышления | $10 | $20 | $50 |
| Чтение из кэша | $0,10 | $0,20 | $0,25 |
| Запись в кэш | нет, кэш только неявный | нет, кэш только неявный | $12,50 на 5 минут, $20 на час |
| Batch: ввод / вывод | $1 / $5 | $2 / $10 | $5 / $25 |
Бесплатного уровня для Argon в Gemini API нет, а весь контекст Fable в 1 млн токенов оплачивается по одной ставке. Подробности счёта за Fable разобраны в материале «Цена Claude Fable 5.1 API: тарифы, кэш и расчёт счёта».
Цена за токен — ещё не цена задачи, потому что модели тратят на одну и ту же работу разное число токенов. Если взять стоимость задачи индекса AA из предыдущего раздела, где Argon уже посчитан по декабрьским ставкам, то с 1 декабря Fable high стоит практически столько же (0,98 от Argon), а Fable xhigh с тем же баллом — в 1,4 раза дороже. До 30 ноября все ставки Argon вдвое ниже, и та же задача обходится примерно в $3,84 ($7,68 ÷ 2; это пересчёт, а не цифра AA): Fable high тогда дороже в 2,0 раза, xhigh — в 2,8 раза. На коротких задачах без долгих размышлений разрыв больше, это видно в тесте ниже.
Кэш меняет счёт у агентов с длинным повторяющимся контекстом. У Fable чтение из кэша стоит $0,25, но только если вы размечаете запрос через cache_control и платите за запись. У Argon явного кэша нет: Google кэширует повторы сам, начиная примерно с 4–6 тысяч токенов (в документации встречаются обе границы, 4 096 и 6 144), и попадание не гарантировано. С 1 декабря чтение из кэша у Argon ($0,20) всего в 1,25 раза дешевле, чем у Fable. Как устроены оба механизма, объяснено в статьях «Claude prompt caching: кэширование промптов, TTL, цены и тест» и «Gemini context caching: кэширование контекста, цены и тест».
Тест на 8 одинаковых задачах: все ответы верны, разница в счёте
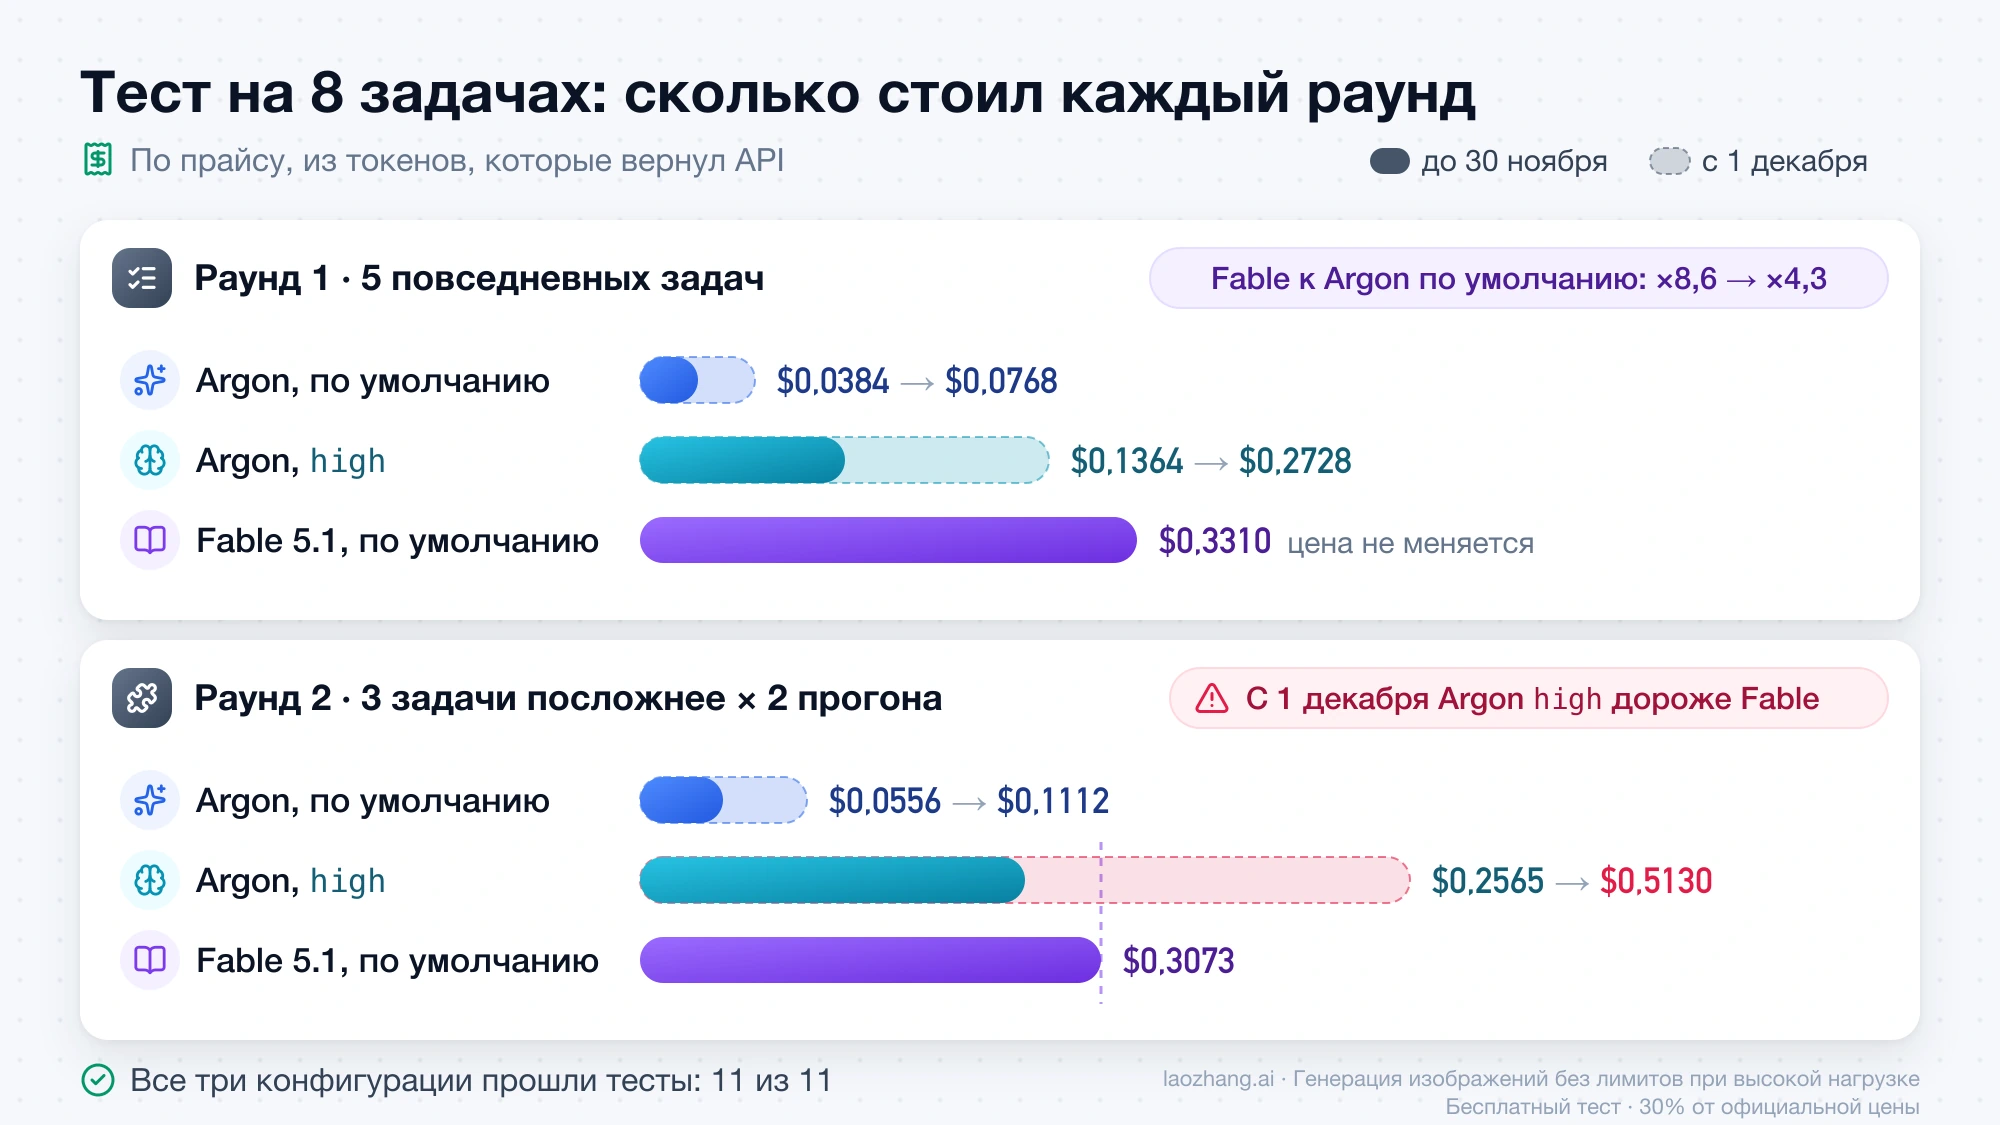
На одинаковых задачах со скрытыми тестами обе модели отвечают правильно, а стоят по-разному. Gemini 4 Argon прогнан 4 ноября 2026 года в двух режимах — по умолчанию (без thinkingConfig, то есть medium) и с thinkingLevel: high. Claude Fable 5.1 на настройке по умолчанию (усилие high) прогнана 26 октября 2026 года, а 4 ноября маршрут перепроверен одним вызовом: тот же идентификатор модели и то же число входных токенов. Все вызовы шли через шлюз LaoZhang API, без кэша и без инструментов. Первый раунд — пять повседневных задач по одному прогону, включая пересказ английской статьи на 6 723 слова; второй — три задачи посложнее (разбор выражения, разбор строки CSV, головоломка на сумму цифр) по два прогона.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Конфигурация | Прошли тесты | Раунд 1: до 30 ноября / с 1 декабря | Раунд 2: до 30 ноября / с 1 декабря | Выходные токены (из них размышления) | Время, все 11 вызовов |
|---|---|---|---|---|---|
| Argon, по умолчанию | 11 из 11 | $0,0384 / $0,0768 | $0,0556 / $0,1112 | 6 859 (1 531) | 128 с |
Argon, high | 11 из 11 | $0,1364 / $0,2728 | $0,2565 / $0,5130 | 36 746 (31 016) | 532 с |
| Fable 5.1, по умолчанию | 11 из 11 | $0,3310 | $0,3073 | 9 327 (размышления внутри, отдельно не выделяются) | 116 с |
Стоимость посчитана по прайсовым ставкам из токенов, которые вернул каждый API. На повседневных задачах Fable дороже Argon по умолчанию в 8,6 раза до 30 ноября и в 4,3 раза с 1 декабря, на задачах посложнее — в 5,5 и 2,8 раза. По умолчанию Argon почти не думает: токены размышлений появились только в 2 вызовах из 11, на головоломке с суммой цифр. На high он размышлял в каждом вызове, выдал в 4 раза больше токенов, чем Fable, и работал в 4,6 раза дольше. Поэтому на втором раунде с 1 декабря Argon high обходится в $0,5130 против $0,3073 у Fable: Fable стоит 0,60 от Argon, то есть дешевле. По времени Argon по умолчанию и Fable почти равны — 128 и 116 секунд на все вызовы.
Чего этот тест не показывает: качество. Задачи небольшие и чётко поставлены, все три конфигурации решили их без ошибок, поэтому ранжировать модели по ним нельзя, для этого есть замеры AA выше. В тесте не было агентных циклов, вызовов инструментов, длинного вывода и кэша, а на прогон приходилось по одному-два образца, так что разброс между запусками заметен: при перепроверке 4 ноября Fable на первой задаче выдала 674 токена вместо 773. Это ориентир по порядку затрат, а не прогноз вашего счёта.
Дороже ли Fable на русском: в 1,72 раза больше токенов
Да, для русскоязычного ввода разрыв в счёте больше, чем разница в прайсе. Один и тот же русский абзац Claude Fable 5.1 считает как 302 токена, Gemini 4 Argon — как 176, то есть в 1,72 раза больше; для английского текста соотношение 1,45, для длинной английской статьи на 6 723 слова — 1,38 (11 110 против 15 335 токенов). Замер сделан через те же API (Argon 4 ноября, Fable 26 октября, одинаковые фрагменты), из каждого числа вычтены токены служебной инструкции. В документации Anthropic по подсчёту токенов сказано, что токенизатор, который Fable 5.1 унаследовала от Claude Opus 4.7, даёт примерно на 30 % больше токенов, чем у прежних моделей Claude; сравнения с Gemini ни один из вендоров не публикует.
Счёт за одинаковую работу равен соотношению цен, умноженному на соотношение токенов. Для того же русского текста на входе без кэша это 5 × 1,72 ≈ 8,6 раза до 30 ноября и 2,5 × 1,72 ≈ 4,3 раза с 1 декабря. Совпадение с первым раундом теста случайное: там считались ввод, вывод и размышления вместе, здесь — только ввод. С выводом всё зависит от размышлений: в тесте Fable выдала в 1,4 раза больше токенов, чем Argon по умолчанию, но вчетверо меньше, чем Argon на high. Если ваши запросы — это длинные русские документы, переписка или база знаний, входная часть счёта у Fable вырастет сильнее всего.
Перед переходом: thinkingLevel не равен effort, разный предел вывода
Режимы рассуждения у двух моделей называются похоже, но работают по-разному, и одинаковые слова здесь ничего не значат. У Argon это уровень размышления (thinkingLevel) со значениями low, medium и high; по документации Gemini API о размышлениях по умолчанию стоит medium, и Google рекомендует его для большинства задач, включая сложный код и агентов, а выключить размышления нельзя. У Fable это усилие (effort) со значениями от low до max; документация Claude об усилии называет high значением по умолчанию и советует поднимать до xhigh или max для требовательного кода и агентов, задав большой max_tokens. Поэтому high у Argon — не то же самое, что high у Fable: в тесте выше Argon на high расходовал в разы больше токенов, чем Fable на своём high.
Пределы вывода тоже разные. Argon отдаёт до 65 536 токенов за один синхронный запрос, а без стриминга один шаг ограничен 32 768 токенами; дальше нужен длинный вывод в фоновом режиме (background=true) или продолжение на стороне клиента, тогда предел — 1 048 576 токенов вместе с вводом. Fable 5.1 отдаёт до 128K токенов за ответ при контексте 1 млн. Если ответы Argon у вас обрываются, разбор причин — в статье «Gemini 4 Argon API: доступ, finish_reason и обрыв ответа».
Ещё два различия, которые не видны в тестах. Для Fable 5.1 Anthropic требует 30-дневного хранения данных, и это стоит проверить, если у вас есть обязательства по их хранению. А через шлюзы есть свои ограничения: у Claude через LaoZhang API один ответ ограничен 32 768 токенами и нет Batch API, а в OpenAI-совместимом формате Argon игнорирует reasoning_effort, поэтому уровень размышления задаётся только в родном формате Gemini через thinkingConfig.thinkingLevel.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Где доступны Argon и Fable: API, агенты и приложения
Обе модели доступны по API и в агентах для кода, но у каждой свои каналы. Gemini 4 Argon вышел в общий доступ 13 октября 2026 года: он есть в Gemini API и Google AI Studio, в приложении Gemini — на тарифах Google AI Pro ($19,99 в месяц в США) и Ultra ($99,99 или $199,99), а Google AI Plus ($4,99) даёт только модель Flash. В агенте Antigravity, по состоянию на конец октября, Argon доступен с платными Pro и Ultra и отдельной недельной квотой; в Gemini CLI, по словам самого Google, модель не оптимизирована. Подписка не покрывает вызовы API.
Claude Fable 5.1 работает в Claude API, Amazon Bedrock, Google Cloud и Microsoft Foundry, а в Claude Code — начиная с версии 2.1.255. В приложении Claude на бесплатном тарифе Fable нет; на Pro ($20 в месяц) она оплачивается кредитами использования с первого сообщения, на Max ($100) и Ultra ($200) входит в подписку в пределах половины недельного лимита. С 30 октября 2026 года прежние тарифы Max 5x и Max 20x называются Max и Ultra. Числа запросов к Argon в приложении Google не публикует, а правила лимитов обеих компаний описаны в справке Gemini о лимитах приложения и в справке Claude о моделях Fable на тарифах.
Ни Google, ни Anthropic официально не обслуживают пользователей из России, поэтому разработчики здесь работают через зарубежные аккаунты или шлюзы. Как оплатить доступ к Gemini API, описано в материале «Как купить доступ к Gemini API в России: ключ $0, цены 2026–2027».
Как проверить Argon и Fable на своих задачах до перехода
Сводные индексы и чужой тест не скажут, во что обойдётся ваша нагрузка, поэтому перед переходом стоит прогнать обе модели на собственных запросах. Порядок такой:
- Соберите несколько десятков реальных запросов из своей работы, у каждого — способ проверки: тесты, эталонный ответ или критерий, по которому вы принимаете результат. Русскоязычные запросы берите в той доле, в какой они у вас есть, потому что они меняют счёт.
- Прогоните Argon дважды — без
thinkingConfig(этоmedium) и сthinkingLevel: high, а Fable 5.1 на усилии по умолчаниюhigh; если Fable не справляется, добавьте прогон наxhigh. Задайте достаточно большой предел вывода, чтобы ответы не обрывались. - Для каждого ответа сохраните входные и выходные токены из ответа API (размышления входят в вывод) и посчитайте стоимость: ввод в миллионах × ставка ввода + вывод в миллионах × ставка вывода. Argon считайте дважды — по ставкам до 30 ноября и с 1 декабря.
- Сравнивайте стоимость принятого ответа, а не запроса: разделите сумму на число ответов, прошедших проверку, а неудачные прогоните повторно, чтобы отличить случайный сбой от систематического.
- Если у вас длинный повторяющийся контекст, включите
cache_controlдля Fable и посмотрите, сколько токенов Argon прочитал из кэша сам: от этого зависит, сохранится ли разрыв в счёте. - Проверьте, укладываются ли самые длинные ответы в предел вывода Argon, и устраивает ли вас 30-дневное хранение данных у Fable, а потом решите, какие типы задач переводить, а какие оставить.
Gemini 4 Argon и Claude Fable 5.1: другие вопросы
Вышла ли Claude Fable 5.5?
Нет: по состоянию на 4 ноября 2026 года Fable 5.1 остаётся последней моделью Fable в документации и примечаниях к релизам Anthropic, а упоминание claude-fable-5-5 в октябре так и не подтвердилось. История этого слуха — в материале «Сравнение Fable 5.5, Gemini 4 и GPT-6.1: доступны две из трёх».
Стоит ли ждать Gemini 4 Carbon вместо Argon?
Для обычной работы — нет: Gemini 4 Carbon, анонсированная 28 октября 2026 года, доступна только части специалистов по киберзащите, у неё нет публичного идентификатора, API и даты открытия, а об отключении Argon Google не говорил. Что известно о сроках, собрано в статье «Gemini 4 Carbon когда выйдет: пока только для киберзащиты».
Gemini 4 Argon, GPT-6 Astra или Claude Fable 5.1?
Если в выбор входит и флагман OpenAI, сравнение Fable 5.1 с ним разобрано отдельно в материале «GPT-6 Astra или Claude Fable 5.1: как выбрать и что дешевле».
Источники12
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 4 нояб. 2026 г..
Источники12
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 4 нояб. 2026 г..
- 1.сравнении Gemini 4 Argon и Claude Fable 5.1 на Artificial Analysisartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-1
- 2.описание методики Artificial Analysisartificialanalysis.ai/methodology/intelligence-benchmarking
- 3.Epoch Capabilities Indexepoch.ai/benchmarks/eci
- 4.Vals Indexvals.ai/benchmarks/vals_index
- 5.анонса Gemini 4 Argon в блоге Googleblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 6.странице цен Gemini APIaistudio.google.com/docs/pricing
- 7.цены Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 8.документации Anthropic по подсчёту токеновplatform.claude.com/docs/en/build-with-claude/token-counting
- 9.документации Gemini API о размышленияхaistudio.google.com/docs/thinking
- 10.документация Claude об усилииplatform.claude.com/docs/en/build-with-claude/effort
- 11.справке Gemini о лимитах приложенияsupport.google.com/gemini/answer/17004136
- 12.справке Claude о моделях Fable на тарифахsupport.claude.com/en/articles/15424964-claude-fable-models-on-your-plan