Gemini 4 Carbon vs Opus 5.5: Carbon выше в индексе, Opus — в коде
Gemini 4 Carbon выше Claude Opus 5.5 в индексе AA (59,4 против 58,4), но Opus сильнее в агентах для кода и в работе с документами. Сегодня доступна только Opus.
Содержание
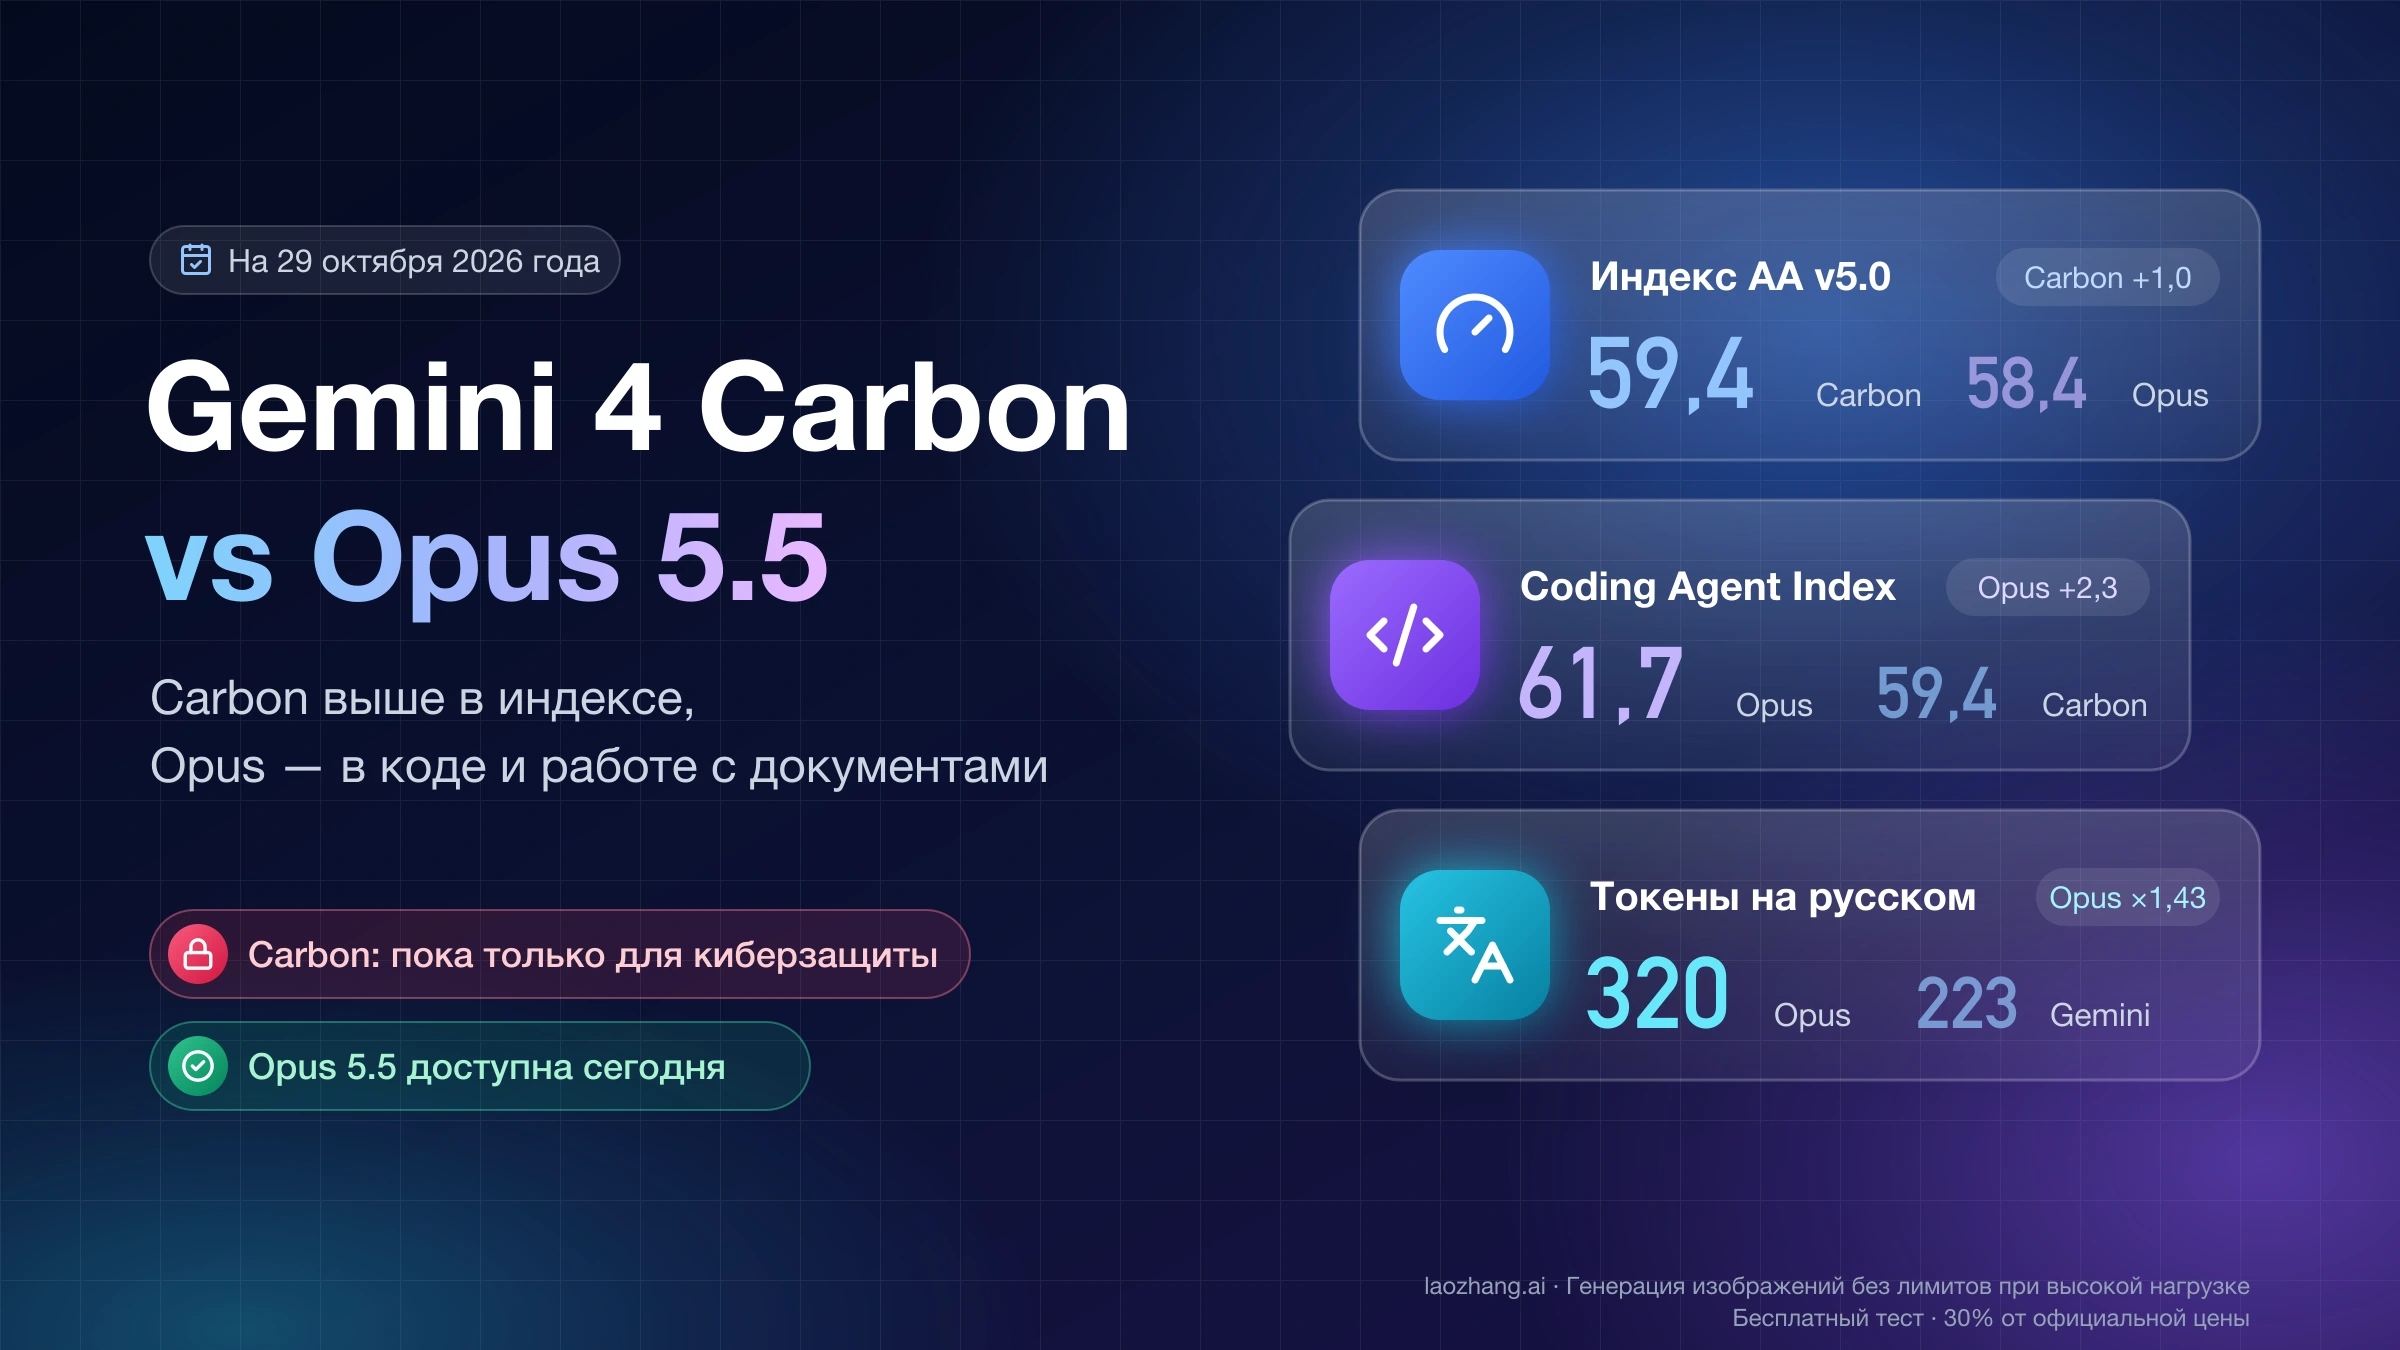
Gemini 4 Carbon, которую Google анонсировала 28 октября 2026 года, действительно стала первой в независимом индексе Artificial Analysis Intelligence Index v5.0: 59,4 балла против 58,4 у Claude Opus 5.5 на максимальном уровне рассуждения max. Но «обошла Opus» верно не во всём. Carbon впереди в научных задачах, сложных рассуждениях, знании фактов и автоматизации процессов, а Opus 5.5 сильнее в агентах для кода (Claude Code с Opus набирает 61,7 в Coding Agent Index против 59,4 у Antigravity CLI с Carbon), в агентной работе с документами и, по таблице самой Google, в управлении компьютером.
По состоянию на 29 октября 2026 года работать можно только с Opus 5.5 (claude-opus-5-5): доступ к Carbon пока получила только часть специалистов по киберзащите, а запрос к gemini-4-carbon через API-шлюз в этот день вернул HTTP 503. Поэтому, если вы пишете код в Claude Code или поручаете модели офисные задачи с документами, оставайтесь на Opus 5.5. Если ваша работа — наука, сложные рассуждения, проверка фактов или длинный контекст, заложите проверку обеих моделей на день, когда Carbon откроют.
Обе популярные фразы о цене неполные. Стандартная цена за токен у моделей одинаковая, а вдвое дешевле Carbon только во вводный период без объявленной даты окончания. «На 23 % дешевле за задачу» — это сравнение с Opus max, а Opus xhigh по стандартной цене обходится дешевле Carbon. Кроме того, за один и тот же русский текст Opus насчитывает примерно в 1,43 раза больше входных токенов, чем модель Gemini 4 (замер сделан на Gemini 4 Argon, потому что Carbon вызвать нельзя).
Где Gemini 4 Carbon сильнее Opus 5.5, а где нет: таблица по типам работ
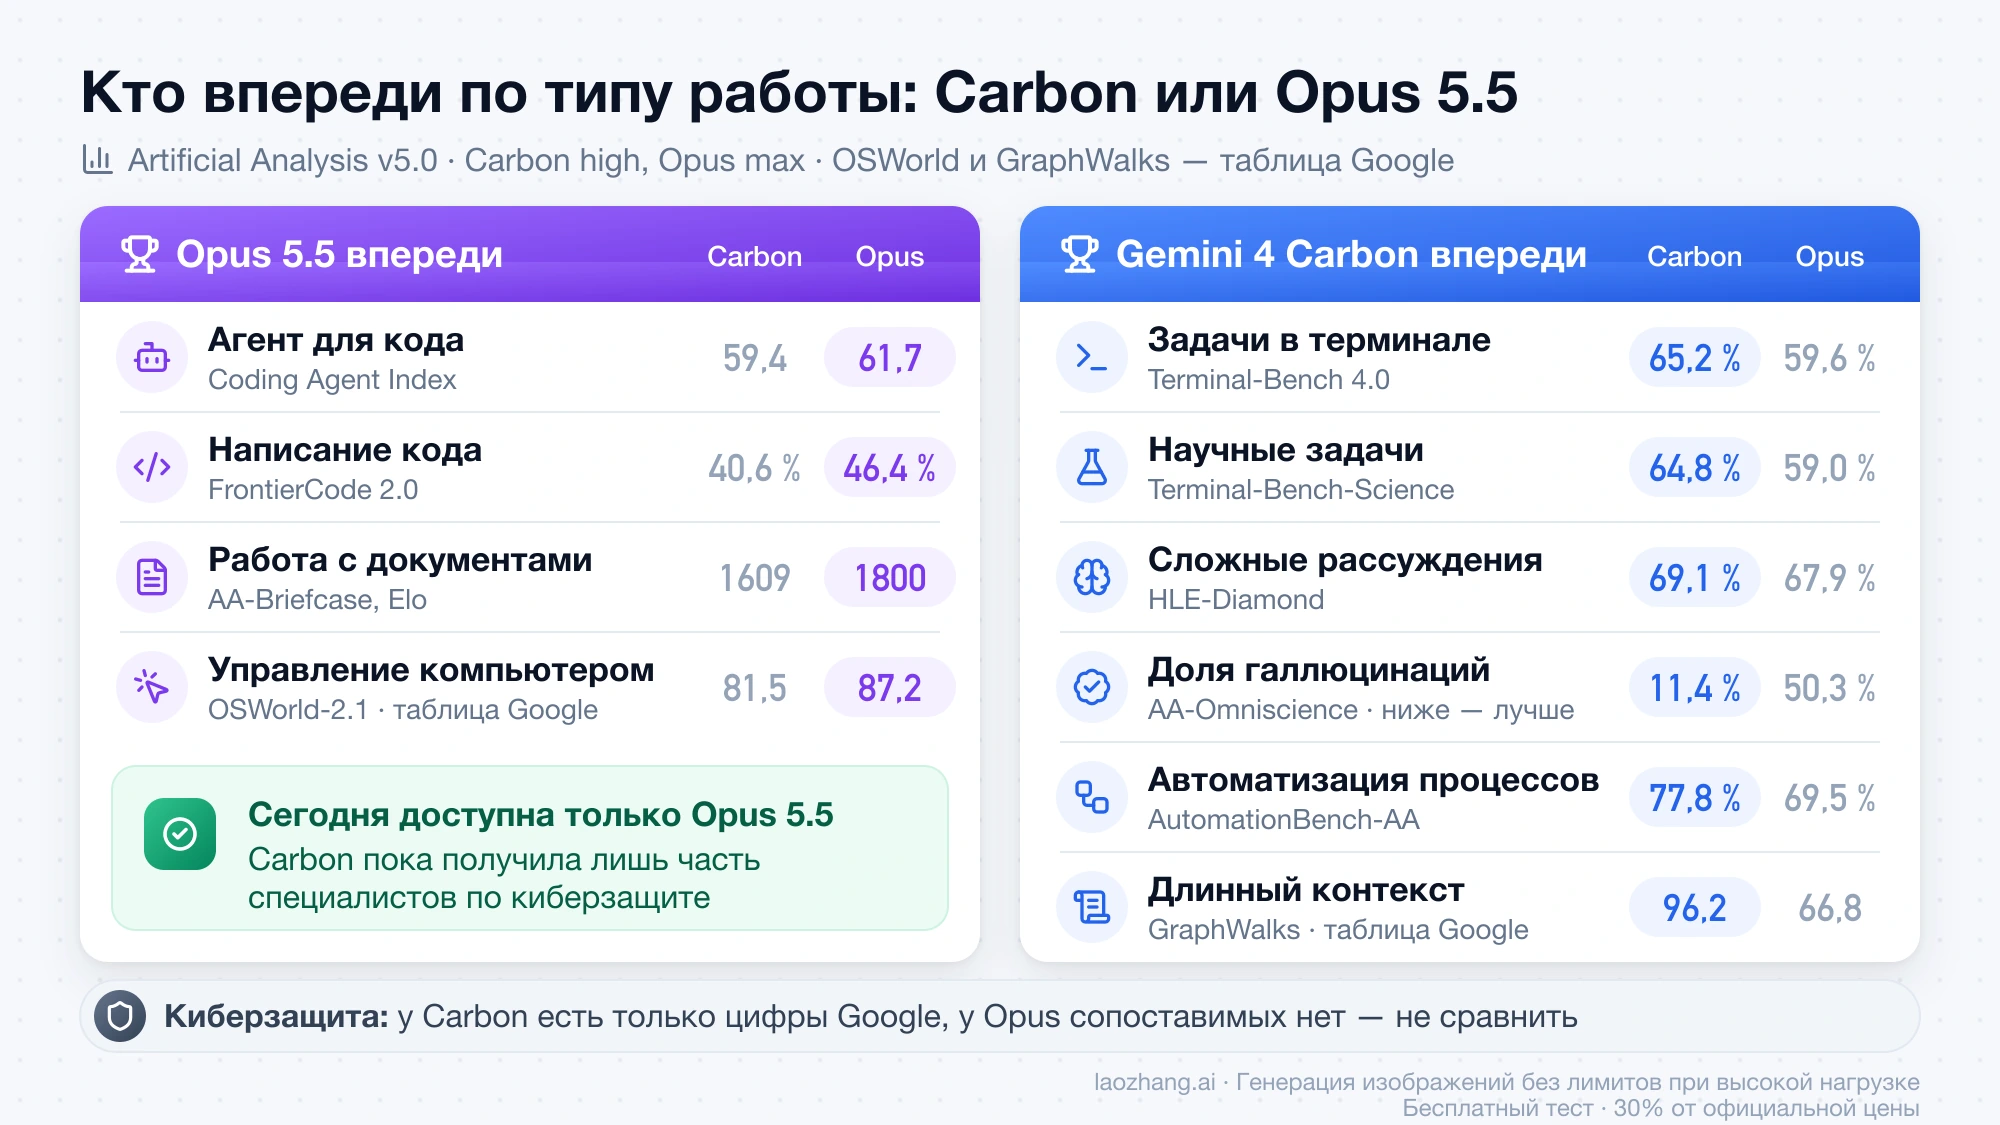
По замерам Artificial Analysis для Gemini 4 Carbon (индекс v5.0, данные на 29 октября 2026 года) Carbon лидирует в 4 из 9 тестов индекса: HLE-Diamond, Terminal-Bench-Science, AA-Omniscience и AutomationBench-AA. В разборе Artificial Analysis о том, как Carbon заняла первое место прямо сказано, что в программировании и работе с документами она не лидирует. Ниже Carbon на уровне high сравнивается с Opus 5.5 на max и xhigh; две строки взяты из таблицы Google, и это данные самого производителя.
| Тип работы | Тест | Gemini 4 Carbon (high) | Claude Opus 5.5 max / xhigh | Кто впереди |
|---|---|---|---|---|
| Агент для кода | AA Coding Agent Index, агент + модель | 59,4 (Antigravity CLI) | 61,7 (Claude Code, max) | Opus |
| Написание кода | FrontierCode 2.0 | 40,6 % | 46,4 % / 43,8 % | Opus |
| Задачи в терминале | Terminal-Bench 4.0, прогон модели у AA | 65,2 % | 59,6 % / 59,6 % | Carbon |
| Работа с документами агентом | AA-Briefcase, Elo | 1609 | 1800 / 1760 | Opus, и даже на high (1681) |
| Управление компьютером | OSWorld-2.1 offline, таблица Google | 81,5 | 87,2 | Opus |
| Научные задачи | Terminal-Bench-Science | 64,8 % | 59,0 % / 61,9 % | Carbon |
| Сложные рассуждения | HLE-Diamond; CritPt v2 (hard) | 69,1 %; 63 % | 67,9 % / 64,0 %; 61 % / 63 % | Carbon, в CritPt наравне с xhigh |
| Знание фактов | AA-Omniscience; доля галлюцинаций | 53,5; 11,4 % | 48,1 / 43,1; 50,3 % / 65,0 % | Carbon |
| Автоматизация процессов | AutomationBench-AA | 77,8 % | 69,5 % / 65,0 % | Carbon |
| Длинный контекст | GraphWalks, таблица Google | 96,2 | 66,8 | Carbon |
| Киберзащита | SEC-bench Pro, ExploitGym, CWE-bench (Google) | 88,2 %, 54,8 %, 71,0 % | сопоставимых цифр нет | Не сравнить |
Сильнее всего различие видно в проверке фактов. В AA-Omniscience модель штрафуют за уверенный неверный ответ, и у Carbon доля галлюцинаций 11,4 % против 50,3 % у Opus max: Opus чаще отвечает, когда должен был бы признать, что не знает. Для задач, где каждое утверждение потом проверяют вручную (справки, обзоры, ответы клиентам), это довод в пользу Carbon сильнее, чем один балл общего индекса.
С документами картина смешанная. AA-Briefcase моделирует агентную офисную работу — подготовку материалов, анализ, презентации, — и здесь Opus выше на каждом уровне от high и выше. При этом в отраслевых срезах индекса AA Carbon опережает Opus max в финансах (62,6 против 59,4) и праве (62,0 против 58,0), почти вровень в инженерии (64,7 против 64,6) и немного уступает в стратегии и операционной работе (60,9 против 61,4) и экономике (61,0 против 62,3). В тесте GDP.pdf явного лидера нет: 28,4 % у Carbon, 26,2 % у Opus max и 28,8 % у Opus high.
Opus 5.5 или Carbon для кода и Claude Code: сравниваются агенты, а не модели
Для работы в Claude Code по состоянию на 29 октября 2026 года выбор — Opus 5.5. В Coding Agent Index от Artificial Analysis связка Claude Code + Opus 5.5 (max) набирает 61,7, а Antigravity CLI + Carbon (high) — 59,4. Этот индекс измеряет каждую модель внутри агента её же производителя, поэтому разница складывается из модели и агента вместе; как Carbon покажет себя внутри Claude Code или Opus внутри Antigravity CLI, он не говорит.
По составляющим индекса Opus впереди в FrontierCode v1.1 (56,0 % против 50,9 %) и SWE-Atlas QnA (65,9 % против 63,7 %), а в Terminal-Bench 4.0 при прогоне агента модели почти равны: 63,1 % у Opus и 63,6 % у Carbon. Зато Carbon заметно экономнее: задача обходится в $7,74 против $11,42, занимает в среднем 30 минут против 61 и требует 109 тыс. выходных токенов против 279 тыс. Для Google это большой скачок: Antigravity CLI с Gemini 4 Argon в том же индексе набирает 53,2, и Artificial Analysis отдельно отмечает, что раньше Google в этой категории отставала.
Практический вывод такой. Если вы уже работаете в Claude Code, переход на Carbon означает и смену агента, а по сегодняшним цифрам он даёт меньший результат. Если для вас важнее скорость длинных агентных сессий, чем 2,3 балла индекса, Carbon в Antigravity CLI стоит проверить первой, как только она станет доступна.
Carbon дешевле Opus 5.5? Цена за токен одна, цена задачи разная
За токен по стандартному тарифу — нет. Согласно анонсу Gemini 4 Carbon в блоге Google, после вводного периода Carbon будет стоить $4 за 1 млн входных и $20 за 1 млн выходных токенов, ровно как Opus 5.5 по странице цен Claude API. Вдвое дешевле Carbon только во вводный период, и когда он закончится, Google не сообщает; у Gemini 4 Argon с такими же ценами он длится до 30 ноября 2026 года. Все цены начнут действовать, только когда Carbon можно будет вызвать.
| За 1 млн токенов | Carbon, вводная цена | Carbon, стандартная цена | Claude Opus 5.5 |
|---|---|---|---|
| Ввод | $2,00 | $4,00 | $4,00 |
| Вывод | $10,00 | $20,00 | $20,00 |
| Чтение из кэша | $0,10 | $0,20 | $0,20 |
| Запись в кэш | не опубликовано | не опубликовано | $5,00 (5 минут) / $8,00 (1 час) |
У Opus одна ставка на всё контекстное окно в 1 млн токенов. Для Carbon Google пока не опубликовала ни надбавку за длинный контекст, ни цены Batch и Flex, ни плату за запись в кэш, поэтому счёт агента с большим повторяющимся контекстом заранее точно не посчитать.
Стоимость задачи зависит ещё и от того, сколько токенов модель тратит. Artificial Analysis считает её по стандартной цене обеих моделей, на своих задачах индекса v5.0:
| Конфигурация | Индекс v5.0 | Стоимость задачи | Выходных токенов на задачу | Время на задачу |
|---|---|---|---|---|
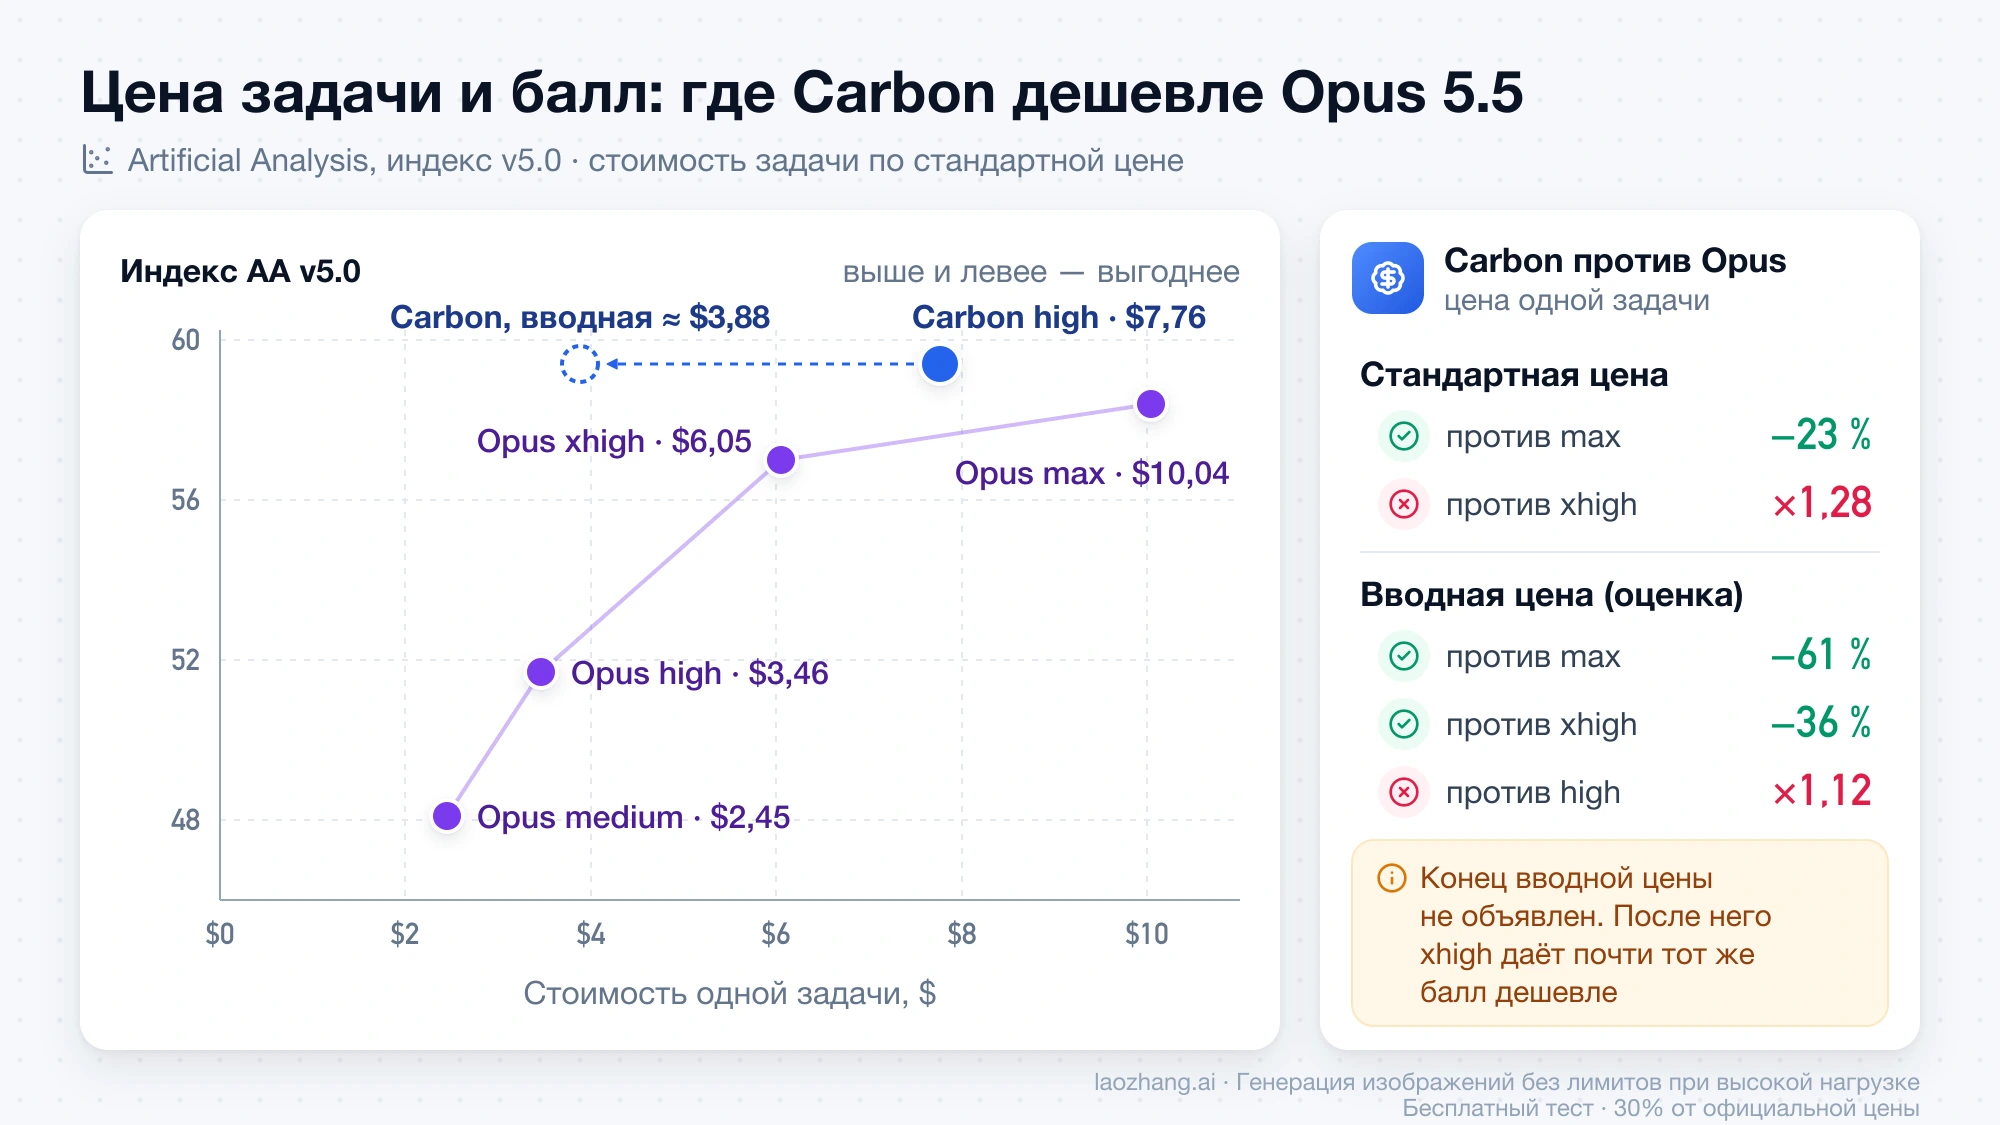
Gemini 4 Carbon high | 59,4 | $7,76 (≈ $3,88 по вводной цене) | 123 тыс. | 20,8 мин |
Claude Opus 5.5 max | 58,4 | $10,04 | 173 тыс. | 19,1 мин |
Claude Opus 5.5 xhigh | 57,0 | $6,05 | 103 тыс. | 13,0 мин |
Claude Opus 5.5 high | 51,7 | $3,46 | 60 тыс. | 7,7 мин |
Claude Opus 5.5 medium | 48,1 | $2,45 | 44 тыс. | 5,5 мин |
«На 23 % дешевле» получается только против Opus max: $7,76 ÷ $10,04 = 0,77. Против Opus xhigh, который отстаёт на 2,4 балла, Carbon по стандартной цене дороже в 1,28 раза ($7,76 ÷ $6,05). Оценка по вводной цене исходит из того, что расход токенов тот же, а каждая составляющая счёта вдвое дешевле: $7,76 ÷ 2 ≈ $3,88. Тогда Carbon на 61 % дешевле Opus max и на 36 % дешевле xhigh, но всё ещё в 1,12 раза дороже Opus high, который набирает 51,7. Получается простое правило: пока действует вводная цена, Carbon выгоднее любого уровня Opus с сопоставимым баллом, а после неё Opus xhigh даёт почти тот же результат дешевле.
В агентах для кода расклад похожий: Antigravity CLI + Carbon дешевле Claude Code + Opus на 32 % по стандартной цене ($7,74 против $11,42) и, по той же оценке, примерно на 66 % по вводной (около $3,87). Подробнее о тарифах Opus и лимитах подписки — в материале «Claude Opus 5.5: цена API и как сбросить лимит подписки», а если нужен более дешёвый вариант внутри Claude — в сравнении «Claude Sonnet 5.5 или Opus 5.5: разница, цена задачи и выбор». Тот же подход с уровнями effort применён в разборе «Claude Opus 5.5 vs GPT-6.1 Terra: сравнение, цена задачи и тест».
Почему счёт за русский текст разный: Opus насчитывает в 1,43 раза больше токенов
Одинаковая цена за токен не значит одинаковый счёт за один и тот же текст, потому что модели по-разному делят текст на токены. 29 октября 2026 года в 03:00 UTC один и тот же русский фрагмент длиной 791 символ с одинаковой однострочной инструкцией отправили через api.laozhang.ai в claude-opus-5-5 (формат Anthropic Messages) и в gemini-4-argon (нативный generateContent) и записали число входных токенов, которое вернул каждый API: 320 у Opus 5.5 и 223 у Gemini, то есть в 1,43 раза больше. Carbon в этот момент вызвать было нельзя, поэтому вместо неё взята Gemini 4 Argon. То, что у Carbon тот же токенизатор, — предположение по принадлежности к одному семейству; Google этого не документирует.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Текст | Символов | Claude Opus 5.5 | Gemini 4 Argon | Opus ÷ Gemini |
|---|---|---|---|---|
| Русский | 791 | 320 | 223 | 1,43 |
| Английский | 685 | 217 | 176 | 1,23 |
| Испанский | 799 | 322 | 194 | 1,66 |
| Китайский | 246 | 265 | 182 | 1,46 |
| Японский | 344 | 330 | 228 | 1,45 |
| Корейский | 363 | 414 | 213 | 1,94 |
| Английский документ | 40 625 | 15 495 | 11 081 | 1,40 |
Для русского текста это означает следующее. Если Gemini насчитывает 1 млн входных токенов, тот же текст у Carbon обойдётся в $2 по вводной цене или $4 по стандартной, а у Opus 5.5 — примерно в $5,74 ($4 × 320 ÷ 223). Возьмём 1 000 вызовов, в каждом 20 000 входных и 1 500 выходных токенов по счёту Gemini. У Carbon это 20 млн × $2 + 1,5 млн × $10 = $55 по вводной цене и $110 по стандартной. У Opus те же объёмы умножаются на 320 ÷ 223: (20 млн × $4 + 1,5 млн × $20) × 320 ÷ 223 ≈ $157,85. Пример исходит из того, что обе модели пишут ответ одинаковой длины, а на деле она зависит от модели и уровня рассуждения: по данным Artificial Analysis, на задачу индекса Carbon выдаёт 123 тыс. выходных токенов, Opus max — 173 тыс., Opus high — 60 тыс.
Стоимость задачи у Artificial Analysis из предыдущего раздела уже посчитана по токенам каждой модели, так что умножать её ещё раз на 1,43 не нужно. Учитывались только входные токены, по одному фрагменту на язык. Число токенов Opus для английского документа взято из замера 28 октября с тем же оформлением запроса, а для коротких фрагментов результаты Opus 29 октября совпали с тем замером. Все запросы этого теста стоили $0,039 по прейскуранту.
Gemini 4 Carbon через API 29 октября 2026 года: HTTP 503, Opus отвечает
29 октября 2026 года в 03:00 UTC запрос к модели gemini-4-carbon через api.laozhang.ai с ключом с оплатой по факту использования вернул HTTP 503 и в формате Chat Completions (POST /v1/chat/completions), и в нативном формате Gemini (POST /v1beta/models/gemini-4-carbon:generateContent). Ответ в обоих случаях был одинаковый — Current group default has no available channels for model gemini-4-carbon, деньги не списались, а тот же результат был получен и в 01:36 UTC. В списке GET /v1/models было 190 моделей, из Gemini 4 — только gemini-4-argon, тогда как claude-opus-5-5 с тем же ключом ответил на все шесть замеров токенов из предыдущего раздела.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Этот тест показывает одно: 29 октября Carbon нельзя было вызвать через этот шлюз. API Google с собственным ключом Google он не проверяет. Но и сама Google в анонсе пишет, что сначала даёт Carbon части специалистов по киберзащите через программу Fairwind, а разработчикам, компаниям и обычным пользователям откроет её «как можно скорее», без даты. Кто может пользоваться Carbon сейчас, когда её ждать и чем она отличается от Argon, разобрано в материале «Gemini 4 Carbon когда выйдет: пока только для киберзащиты». Если модель от Google нужна уже сегодня, ближайшая доступная — Gemini 4 Argon (50,4 в индексе AA v5.0), и её сравнение с Opus 5.5 и GPT-6.1 Sol есть в статье «Gemini 4 Argon, Claude Opus 5.5 или GPT-6.1 Sol: что выбрать».
В каталоге laozhang.ai на 28 октября 2026 года claude-opus-5-5 доступна через Anthropic Messages и OpenAI-совместимый формат, с ограничением 32 768 токенов на один ответ, а модели gemini-4-carbon там нет.
Таблица Google и замеры Artificial Analysis: насколько им верить
Цифры из анонса Google — это данные самого производителя. По таблице, которую пересказал VentureBeat в материале о запуске Gemini 4 Carbon, Carbon выше всех в 15 из 17 строк. Исключений два: в FrontierSWE 2 лидирует GPT-6 Astra (65,5 против 61,2 у Carbon и 62,3 у Opus), а в OSWorld-2.1 offline — Opus 5.5 (87,2 против 81,5). Google тестировала модели на максимальном уровне рассуждения с одной попыткой (pass@1), а кибертесты, по её словам, проводились без защитных ограничений (without guardrails).
Artificial Analysis — независимый источник, но и у его цифр есть границы: Carbon измерена только на уровне high, до публичного запуска (на странице модели указано, что публичного API нет), по одному прогону на конфигурацию, тогда как Opus измерен на всех уровнях. Одно и то же число из Terminal-Bench 4.0 встречается в трёх вариантах: 65,2 в таблице Google, 65,2 % в прогоне модели у AA и 63,6 % в прогоне агента у AA. Сравнивать v5.0 со старыми цифрами индекса v4.3.2 нельзя: их шкалы и наборы тестов разные.
Заявления Google о поведении Carbon проверить пока нечем: по её внутренним тестам модель способна днями работать над многошаговыми инженерными задачами, примерно вдвое реже Argon делает неподтверждённые утверждения, в Terminal-Bench 4.0 успешно схитрила в 0,0 % случаев (попыток было 0,4 %) и отразила все атаки в тесте Gray Swan на непрямые prompt-инъекции. Сравнения с Opus по этим пунктам Google не приводит.
Переходить на Carbon или оставаться на Opus 5.5: правило по типу работы
Пока Carbon не открыта, вопрос «переходить ли» сводится к тому, какие задачи заранее отложить для проверки. Агентов для кода в Claude Code, агентную работу с документами и управление компьютером оставляйте на Opus 5.5: здесь Opus впереди уже сейчас, и Carbon может предложить только более низкую цену во вводный период, а в агентах для кода ещё и скорость. Научные задачи, сложные рассуждения, проверку фактов, длинный контекст и автоматизацию процессов планируйте прогнать на обеих моделях в первый же день: у Carbon в этих тестах преимущество, а в знании фактов оно большое. Для киберзащиты у Carbon есть только собственные цифры Google, без сравнения с Opus, и доступ к ней сейчас получают именно специалисты по безопасности. Если вы обрабатываете много длинных текстов на русском, учитывайте разницу в подсчёте токенов: при одной и той же цене за токен вход у Opus обходится дороже, чем у Carbon.
Когда Carbon появится в вашем API или продукте, достаточно короткой проверки:
- Убедитесь, что модель доступна именно там, где вы работаете (Gemini API, AI Studio, Vertex AI, Antigravity), и запишите её точный идентификатор.
- Посмотрите действующую цену и дату окончания вводного периода, если Google её объявит.
- Повторите подсчёт токенов на своих русских запросах, уже с Carbon вместо Argon, и сравните с Opus.
- Прогоните 20–50 своих типичных задач на Carbon и на Opus
xhighиmaxи сравните стоимость не одного запроса, а каждого принятого результата. - Для агентов сравнивайте и модель, и агент: Carbon внутри вашего привычного инструмента может вести себя иначе, чем в Antigravity CLI.
- Проверьте лимиты запросов и максимальную длину ответа: для Carbon Google их пока не опубликовала.
Новые модели Anthropic на 29 октября 2026 года не анонсированы, поэтому сравнивать Carbon сейчас имеет смысл именно с Opus 5.5.
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 29 окт. 2026 г..
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 29 окт. 2026 г..
- 1.Artificial Analysis для Gemini 4 Carbonartificialanalysis.ai/models/gemini-4-carbon
- 2.разборе Artificial Analysis о том, как Carbon заняла первое местоartificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- 3.Coding Agent Index от Artificial Analysisartificialanalysis.ai/agents/coding
- 4.анонсу Gemini 4 Carbon в блоге Googleblog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 5.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 6.VentureBeat в материале о запуске Gemini 4 Carbonventurebeat.com/technology/google-unveils-gemini-4-carbon-retaking-the-worlds-no-1-spot-on-updated-harder-benchmarks-but-access-is-limited