Claude Opus 5.5 vs GPT-6.1 Terra: сравнение, цена задачи и тест
GPT-6.1 Terra дешевле Claude Opus 5.5 в девять раз только на уровне max. При равном балле AA разница 3,6 раза, а 57–58 баллов есть только у Opus.
Содержание
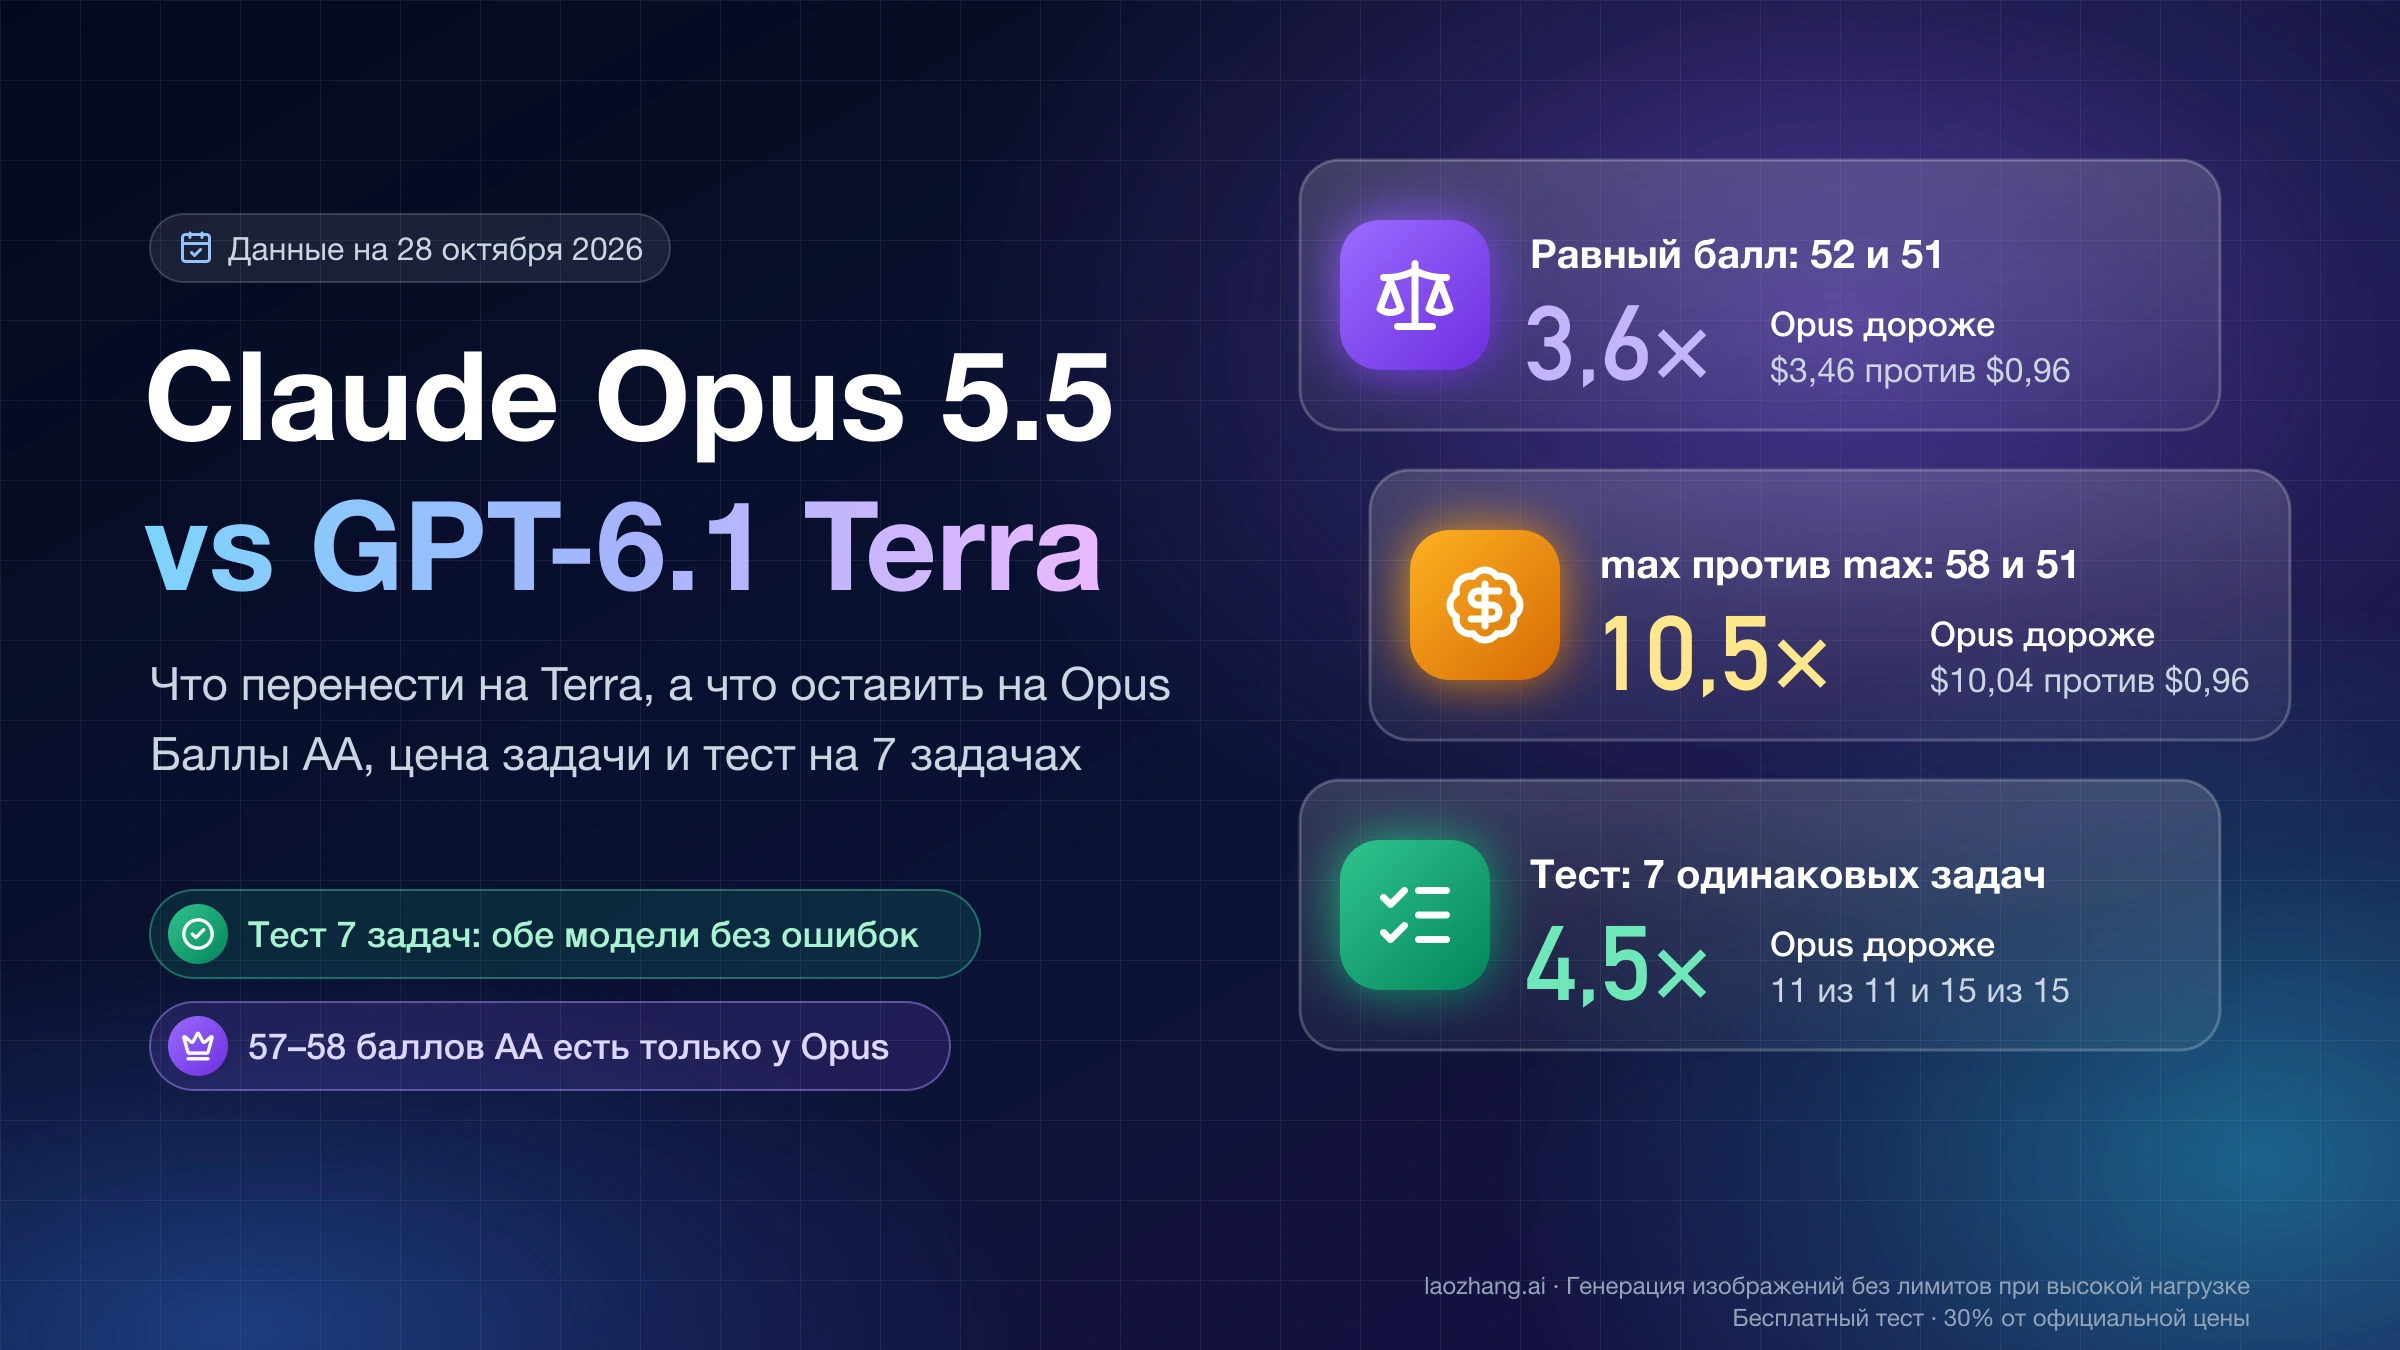
Переносить на GPT-6.1 Terra (gpt-6.1-terra) стоит задачи с чёткой постановкой: код по готовой спецификации, разбор и пересчёт текста, научные и вычислительные задачи, где Terra на уровне рассуждения max в тестах Artificial Analysis обходит Opus high. Claude Opus 5.5 (claude-opus-5-5) на уровне high и выше лучше оставить для работы с документами и знаниями (финансы, право, стратегия), для задач, где нужен балл выше 52 по Intelligence Index v5.0, и там, где важна скорость: при почти равном балле Opus high решает задачу индекса за 464 с, а Terra max — за 657 с. Так что Opus 5.5 не устарел: 57–58 баллов набирает только он.
Цифра из анонса OpenAI от 26 октября 2026 года — задача на Terra примерно в девять раз дешевле, чем на Opus 5.5, — верна только для сравнения уровня max с max, где Opus получает 58 баллов, а Terra 51. При равном балле (Opus high 52 против Terra max 51) задача на Opus дороже в 3,6 раза: $3,46 против $0,96 по данным Intelligence Index v5.0 на 28 октября 2026 года. В тесте 28 октября 2026 года на семи одинаковых задачах обе модели на уровне high прошли все проверки, а Opus обошёлся в 4,5 раза дороже.
Ваш собственный множитель складывается из цены за токен (у Opus она в 4 раза выше), разницы в числе токенов и выбранного уровня рассуждения. В одном и том же русском тексте Opus насчитывает в 1,55 раза больше токенов, чем Terra, поэтому русский ввод на Opus стоит примерно в 6,2 раза дороже, чем на Terra. Перед переходом прогоните пять–десять своих задач на Terra max и Opus high с заранее написанными проверками; порядок проверки — в последнем разделе.
Что перенести на GPT-6.1 Terra, а что оставить на Opus 5.5
Решение удобнее принимать по видам работы, а не по модели целиком: на одних задачах Terra max обходит Opus high при гораздо меньшей цене задачи, на других Opus впереди при любом уровне Terra. Таблица опирается на отдельные тесты Artificial Analysis (Intelligence Index v5.0, данные на 28 октября 2026 года) и на тест на одинаковых задачах от 28 октября; цифры разобраны в следующих разделах.
| Вид работы | Что брать | Почему |
|---|---|---|
| Код по чёткой спецификации: функции, парсеры, задачи с готовыми тестами | Terra, high | В тесте 28 октября обе модели прошли все проверки, Opus обошёлся в 4,5 раза дороже |
| Сложный код и научные расчёты | Terra max и Opus high, решает проверка на ваших задачах | Terra max выше Opus high в FrontierCode 2.0, CritPt и Terminal-Bench-Science; для самых сложных задач кода OpenAI сама советует GPT-6.1 Sol или GPT-6 Astra |
| Документы, финансы, право, стратегия, вопросы на знания | Opus, high | Opus high впереди в HLE-Diamond, AA-Briefcase и во всех отраслевых индексах AA |
| Агенты в терминале и автоматизация процессов | Обе подходят, решает проверка | Terminal-Bench 4.0: 56,6 % против 55,6 %, AutomationBench-AA: 63,2 % против 60,2 % |
| Нужен максимум качества, 57–58 баллов | Opus, xhigh или max | Terra выше 51 балла не поднимается ни на одном уровне |
| Важна скорость задачи при балле около 52 | Opus, high | При почти равном балле задачу индекса AA он решает примерно в 1,4 раза быстрее Terra max |
Если Terra max не хватает, а Opus xhigh слишком дорог, есть середина внутри OpenAI: GPT-6.1 Sol на уровне max набирает в том же индексе v5.0 55 баллов при $1,27 за задачу. Выбор между Terra и Sol, включая тест в Codex CLI, разобран в материале «GPT-6.1 Terra vs Sol: в чем разница, цена задачи и тест в Codex», сравнение Sol с Opus — в статье «Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода»; баллы AA в обеих статьях приведены по прежней версии индекса. Если вопрос в том, хватит ли более дешёвого Claude, ответ — в статье «Claude Sonnet 5.5 или Opus 5.5: разница, цена задачи и выбор».
«В девять раз дешевле»: верно только для max против max
Утверждение OpenAI сравнивает не одинаковые результаты, а одинаковые названия уровней рассуждения. В анонсе GPT-6.1 Terra от 26 октября 2026 года OpenAI пишет, что на максимальном уровне рассуждения Terra расходует токены более чем втрое экономнее Claude Opus 5.5, токен у неё стоит вчетверо дешевле, и в итоге задача обходится примерно в девять раз дешевле. Это заявление производителя по его собственным тестам, но независимые цифры с ним сходятся: в сравнении Artificial Analysis (Intelligence Index v5.0, данные на 28 октября 2026 года) задача индекса на Opus max стоит $10,04, на Terra max — $0,96, то есть в 10,5 раза больше.
Подвох в том, что за эти деньги Opus max даёт 58 баллов, а Terra max — 51. Opus на max пишет на задачу около 173 тыс. выходных токенов, из них 120 тыс. на рассуждение, а Terra — около 60 тыс., из них 39 тыс. на рассуждение. Почти втрое больше токенов при вчетверо более высокой цене и дают разницу больше чем в десять раз. Если вам достаточно 51 балла, сравнивать Terra max нужно с Opus high, а не с Opus max, и тогда разница в цене задачи сокращается почти втрое.
В том же анонсе OpenAI приводит Terminal-Bench-Science 0.1: на max Terra отстаёт от Opus 5.5 меньше чем на пять пунктов при оценочной стоимости меньше пятой части. В данных AA v5.0 разрыв ещё меньше: 57,6 % у Terra max против 59,0 % у Opus max. При этом OpenAI в том же тексте признаёт, что для самых сложных задач программирования лучше подходят GPT-6.1 Sol и GPT-6 Astra, а не Terra.
Цифры «58 против 48» и «54 против 48» (и выведенные из них «10 пунктов индекса»), которые встречаются в сторонних сравнениях, например у OrcaRouter, относятся к прежней версии индекса v4.3.2. Между 27 и 28 октября 2026 года Artificial Analysis перешла на v5.0 с другим набором из девяти тестов, и Terra max в ней поднялась с 48 до 51 балла, так что разрыв на max теперь 7 баллов.
Opus 5.5 и Terra по уровням рассуждения: при равном балле разница 3,6 раза
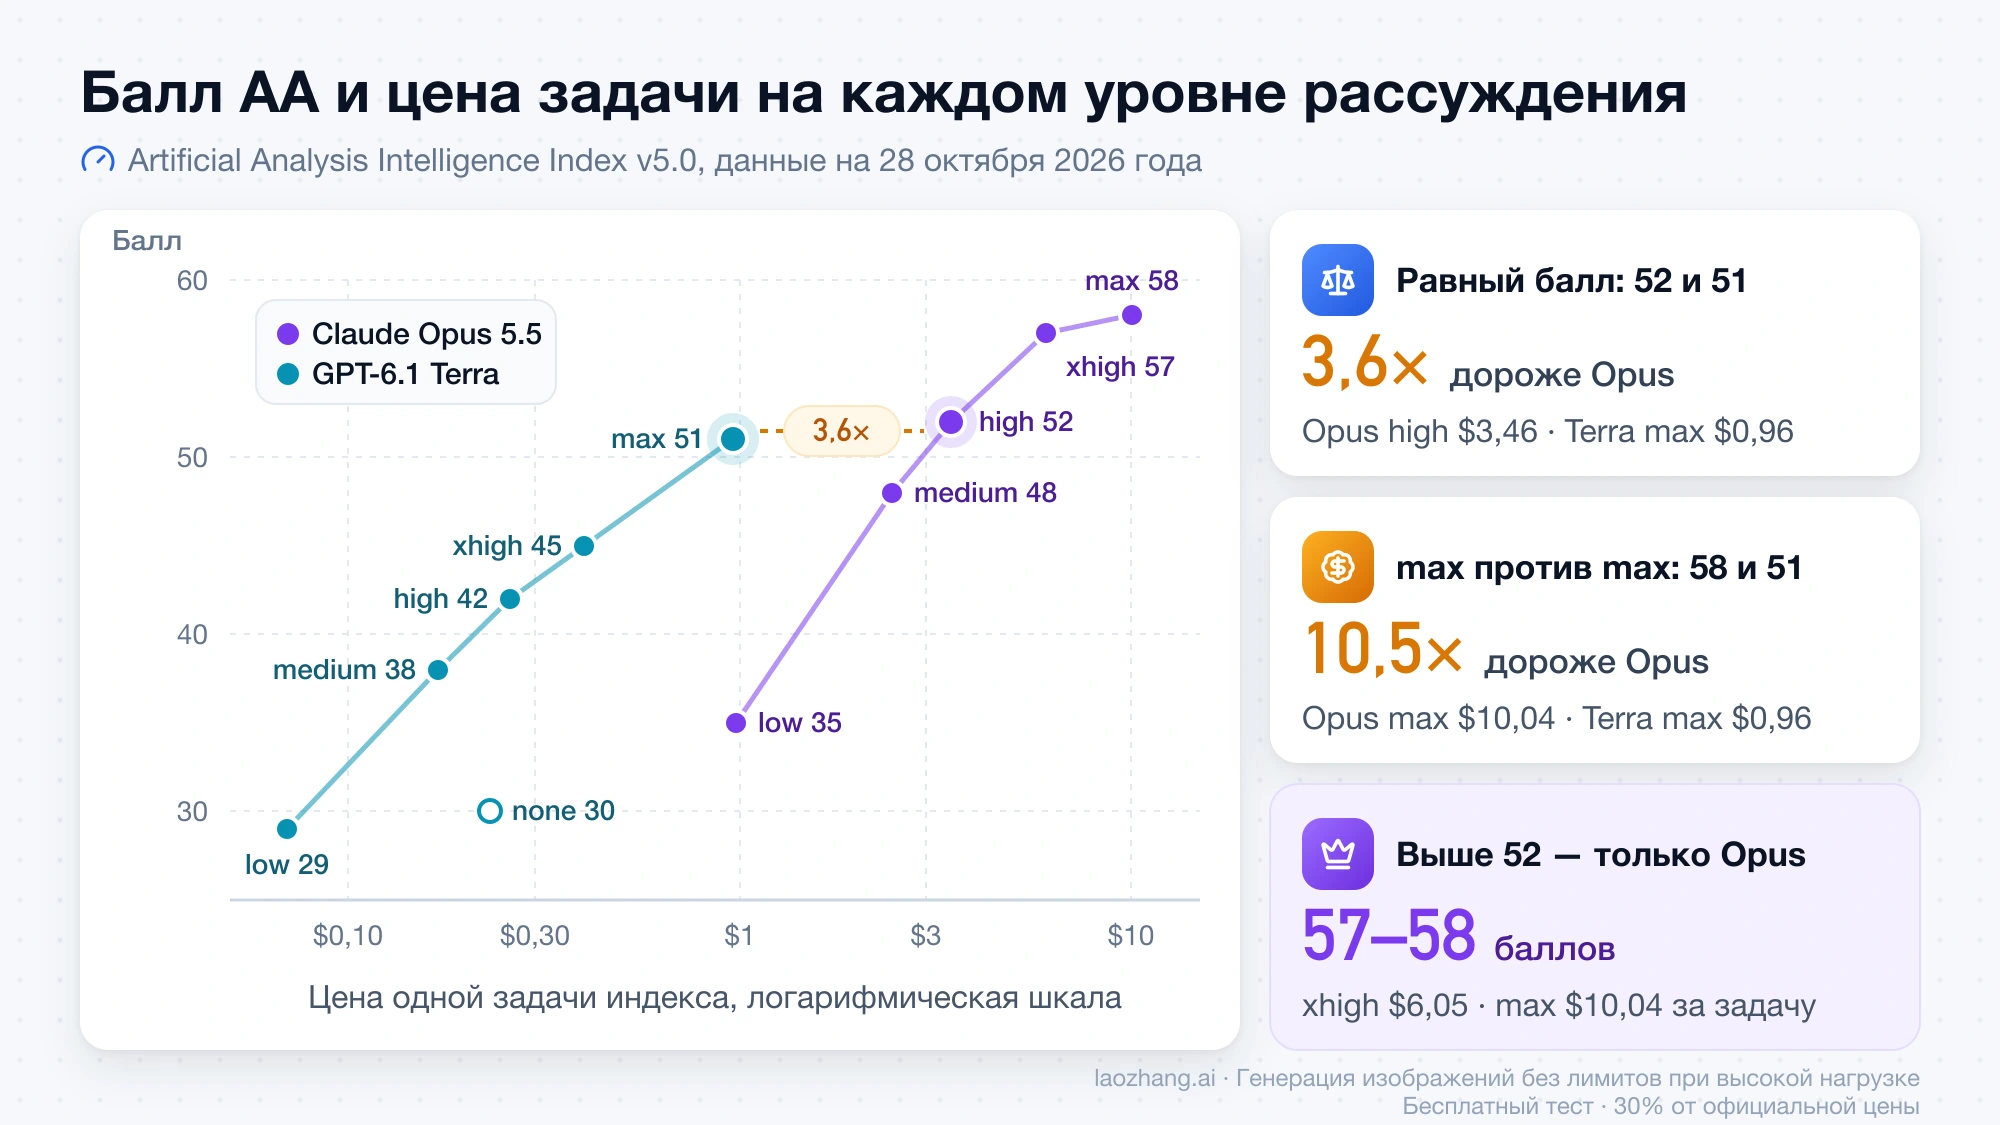
Честнее всего сравнивать модели при одинаковом балле: ближайшая пара — Opus high с 52 баллами и Terra max с 51, и здесь задача на Opus стоит в 3,6 раза дороже ($3,46 против $0,96), но решается быстрее (464 с против 657 с). Уровень рассуждения (reasoning effort) у обеих моделей называется одинаково, но значит разное: max у Terra по баллу соответствует high у Opus. Ниже все уровни обеих моделей по данным Artificial Analysis Intelligence Index v5.0 на 28 октября 2026 года, отсортированные по баллу.
| Модель и уровень рассуждения | Балл | Цена задачи индекса | Время на задачу |
|---|---|---|---|
Opus 5.5 max | 58 | $10,04 | 1 133 с |
Opus 5.5 xhigh | 57 | $6,05 | 779 с |
Opus 5.5 high | 52 | $3,46 | 464 с |
Terra max | 51 | $0,96 | 657 с |
Opus 5.5 medium | 48 | $2,45 | 337 с |
Terra xhigh | 45 | $0,40 | 287 с |
Terra high | 42 | $0,26 | 182 с |
Terra medium | 38 | $0,17 | 118 с |
Opus 5.5 low | 35 | $0,98 | 147 с |
| Terra без рассуждения | 30 | $0,23 | 104 с |
Terra low | 29 | $0,07 | 48 с |
Из таблицы следуют три вывода. Opus medium (48 баллов) уже ниже Terra max и при этом в 2,6 раза дороже ($2,45 против $0,96), поэтому держать Opus на medium ради экономии невыгодно. Opus low стоит почти столько же, сколько Terra max ($0,98 против $0,96), но отстаёт на 16 баллов. А всё, что выше 52 баллов, есть только у Opus: xhigh даёт 57 баллов за $6,05, max — 58 за $10,04. Цена задачи здесь — это набор токенов, который Artificial Analysis тратит на свои задачи, по прейскурантным ценам первичных API; на ваших задачах расход токенов будет другим, и цифры сменятся при следующем обновлении индекса.
Где Opus 5.5 впереди, а где Terra: отдельные тесты AA v5.0
Сводный балл скрывает направление: Terra max обходит Opus high в задачах на код и научные расчёты, а Opus high впереди в задачах на знания и офисную работу. Intelligence Index — это сводный индекс из девяти тестов, а не оценка одного программирования, поэтому смотреть стоит на тот тест, который ближе к вашей работе. Данные Artificial Analysis, Intelligence Index v5.0, на 28 октября 2026 года; для ориентира добавлен Opus max.
| Тест | Opus 5.5 high | Terra max | Opus 5.5 max |
|---|---|---|---|
| Terminal-Bench 4.0 (агент в терминале) | 56,6 % | 55,6 % | 59,6 % |
| FrontierCode 2.0 (сложный код) | 35,9 % | 42,3 % | 46,4 % |
| AutomationBench-AA (автоматизация процессов) | 63,2 % | 60,2 % | 69,5 % |
| AA-Briefcase v1.1 (офисные задачи, рейтинг) | 1 681 | 1 402 | 1 800 |
| HLE-Diamond (вопросы на знания) | 55,6 % | 47,3 % | 67,9 % |
| CritPt v2, сложная часть (физика) | 58,0 % | 64,5 % | 61,0 % |
| Terminal-Bench-Science 0.1 | 49,0 % | 57,6 % | 59,0 % |
| GDP.pdf (работа с документами) | 28,8 % | 28,6 % | нет данных |
В задачах на код и науку Terra max выигрывает у Opus high по 6–9 пунктов (FrontierCode, CritPt, Terminal-Bench-Science), а в CritPt даже у Opus max. В агентной работе в терминале и автоматизации разница в пределах 1–3 пунктов в пользу Opus. Зато в знаниях и офисной работе отрыв Opus заметный: 8 пунктов в HLE-Diamond, почти 280 очков рейтинга в AA-Briefcase, и во всех отраслевых индексах AA Opus high выше Terra max — финансы и учёт 53 против 49, стратегия и операции 58 против 50, право 52 против 46, инженерия 58 против 54, экономика 57 против 49. Управление компьютером, на котором OpenAI делает акцент в анонсе Terra, в индекс v5.0 не входит; OrcaRouter по своим данным пишет, что Terra отстаёт от Opus на 7,6 пункта в OSWorld.
Тест 28 октября 2026 года: 7 одинаковых задач, обе модели без ошибок
На семи одинаковых задачах с заранее написанными скрытыми проверками обе модели на уровне high прошли всё: Opus 5.5 — 11 вызовов из 11, Terra — 15 из 15. Ни одна задача модели не различила, а по прейскуранту Opus обошёлся в 4,5 раза дороже. Тест прогнан 28 октября 2026 года через один ключ шлюза LaoZhang API (laozhang.ai), где в тот день в списке /v1/models были обе модели. Opus вызывался через Anthropic Messages с thinking: {"type": "adaptive"} и output_config.effort: "high", Terra — через Chat Completions с reasoning_effort: "high"; каждый запрос шёл в потоковом режиме, одним сообщением пользователя, без системного промпта и без инструментов.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Задача и проверка | Opus 5.5 high | Terra high | Средний вызов: Opus / Terra | Во сколько раз дороже Opus |
|---|---|---|---|---|
Разбор арифметического выражения без eval, 25 тестов | 1 из 1 | 2 из 2 | $0,0389 / $0,0106 | 3,7 |
Разбор строки CSV без модуля csv, 16 тестов | 1 из 1 | 2 из 2 | $0,0184 / $0,0030 | 6,2 |
| Сколько чисел меньше 1 000 000 с суммой цифр 27 (ответ 55 252) | 1 из 1 | 2 из 2 | $0,0178 / $0,0021 | 8,4 |
| Проверка версий по диапазонам в стиле npm semver, 36 тестов | 2 из 2 | 2 из 2 | $0,0640 / $0,0169 | 3,8 |
| Документ на 6 723 слова с тремя спрятанными заметками, ответ $76,80 | 1 из 1 | 2 из 2 | $0,0667 / $0,0106 | 6,3 |
| Какие из четырёх функций есть в CPython 3.13 (две выдуманы) | 2 из 2 | 2 из 2 | $0,0056 / $0,0008 | 7,3 |
next_run для пятипольного выражения cron, 41 тест | 3 из 3 | 3 из 3 | $0,0698 / $0,0192 | 3,6 |
| Все 7 задач, по одному среднему вызову | 11 из 11 | 15 из 15 | $0,2812 / $0,0632 | 4,5 |
Стоимость посчитана как токены из ответа API, умноженные на прейскурантные цены производителей; это не то, что списал шлюз. Разница по задачам от 3,6 до 8,4 раза объясняется длиной ответа. На длинных ответах с кодом модели выдали почти одинаковое число токенов (semver: 3 066 у Opus и 3 294 у Terra, cron: 3 391 и 3 763), и разрыв близок к четырёхкратной разнице в цене токена. На коротких ответах Opus писал примерно вдвое больше токенов, и разрыв вырастал до 6–8 раз. По времени модели почти не различались: на задаче с cron 32,2 с у Opus и 27,5 с у Terra на вызов, на вопросе по длинному документу 5,1 с и 4,5 с.
Этот тест показывает одно: на однократных задачах с чёткой постановкой даже Terra high, у которой в индексе AA всего 42 балла, справляется так же, как Opus high, только в разы дешевле. Чего он не показывает: в нём не было вызова инструментов, многошаговой работы агента, изображений, контекста длиннее примерно 15 тыс. токенов и уровней max; по 1–3 прогона на задачу, один день и один шлюз. Где Opus сильнее, видно по тестам AA из предыдущего раздела, а не по этому набору.
Во сколько раз отличится ваш счёт: цена × токены × уровень
Реальный множитель вашего счёта — это четырёхкратная разница в цене токена, умноженная на разницу в числе токенов и на разницу в длине ответа, которую задаёт уровень рассуждения. На русском тексте с короткими ответами получается примерно 4,6–7,5 раза (расчёт ниже), а при сравнении max с max — больше 10.
По прейскуранту OpenAI API на 28 октября 2026 года (стандартный тариф, промпт до 272 000 токенов) GPT-6.1 Terra стоит $1,00 за 1 млн токенов ввода и $5,00 за 1 млн токенов вывода, причём рассуждение считается выводом; чтение из кэша стоит $0,05, запись в кэш — $1,25 на 30 минут или $2,50 на 12 часов. По странице цен Claude API у Claude Opus 5.5 те же статьи стоят $4,00, $20,00, $0,20 и $5,00 за запись на 5 минут ($8,00 на час). При одинаковом числе токенов Opus дороже ровно в 4 раза по каждой статье. Но число токенов одинаковым не бывает: модели по-разному режут текст на токены. 28 октября 2026 года один и тот же отрывок на каждом языке отправили обеим моделям и записали число входных токенов, которое вернул каждый API.
| Язык отрывка | Opus 5.5, токенов | Terra, токенов | Opus / Terra | С учётом 4-кратной цены |
|---|---|---|---|---|
| Русский | 320 | 206 | 1,55 | 6,2 |
| Английский | 217 | 150 | 1,45 | 5,8 |
| Китайский | 265 | 178 | 1,49 | 6,0 |
| Японский | 330 | 267 | 1,24 | 5,0 |
| Корейский | 414 | 221 | 1,87 | 7,5 |
| Испанский | 322 | 175 | 1,84 | 7,4 |
На длинном английском промпте из теста (6 723 слова) соотношение было 15 495 к 10 198 токенам, то есть 1,52, так что на коротких отрывках цифры не завышены. Почти такие же соотношения по языкам получились при замере пары Claude Fable 5.1 и GPT-6 Astra, он описан в материале «GPT-6 Astra или Claude Fable 5.1: как выбрать и что дешевле». Для выходных токенов отношение зависит не только от разбиения текста, но и от того, сколько модель рассуждает и пишет.
Пример для русскоязычного сервиса: 1 000 вызовов, в каждом 2 000 токенов ввода по счёту Terra и 1 000 токенов ответа. На Terra это 2 млн × $1 + 1 млн × $5 = $7,00. На Opus тот же ввод — это 2 млн × 1,55 = 3,1 млн токенов, то есть $12,40, плюс ответ 1 млн × $20 = $20,00, итого $32,40, в 4,6 раза дороже. Если Opus, как на коротких задачах теста, напишет вдвое больше токенов ответа, вывод обойдётся в $40,00, счёт вырастет до $52,40, и разница составит 7,5 раза. В агентном цикле с 50 000 свежих токенов ввода, 950 000 токенов чтения из кэша и 30 000 токенов ответа (по счёту Terra) Terra стоит $0,25, а Opus на русском тексте — $1,20 (0,0775 млн × $4 + 1,4725 млн × $0,20 + 0,03 млн × $20), то есть в 4,9 раза дороже.
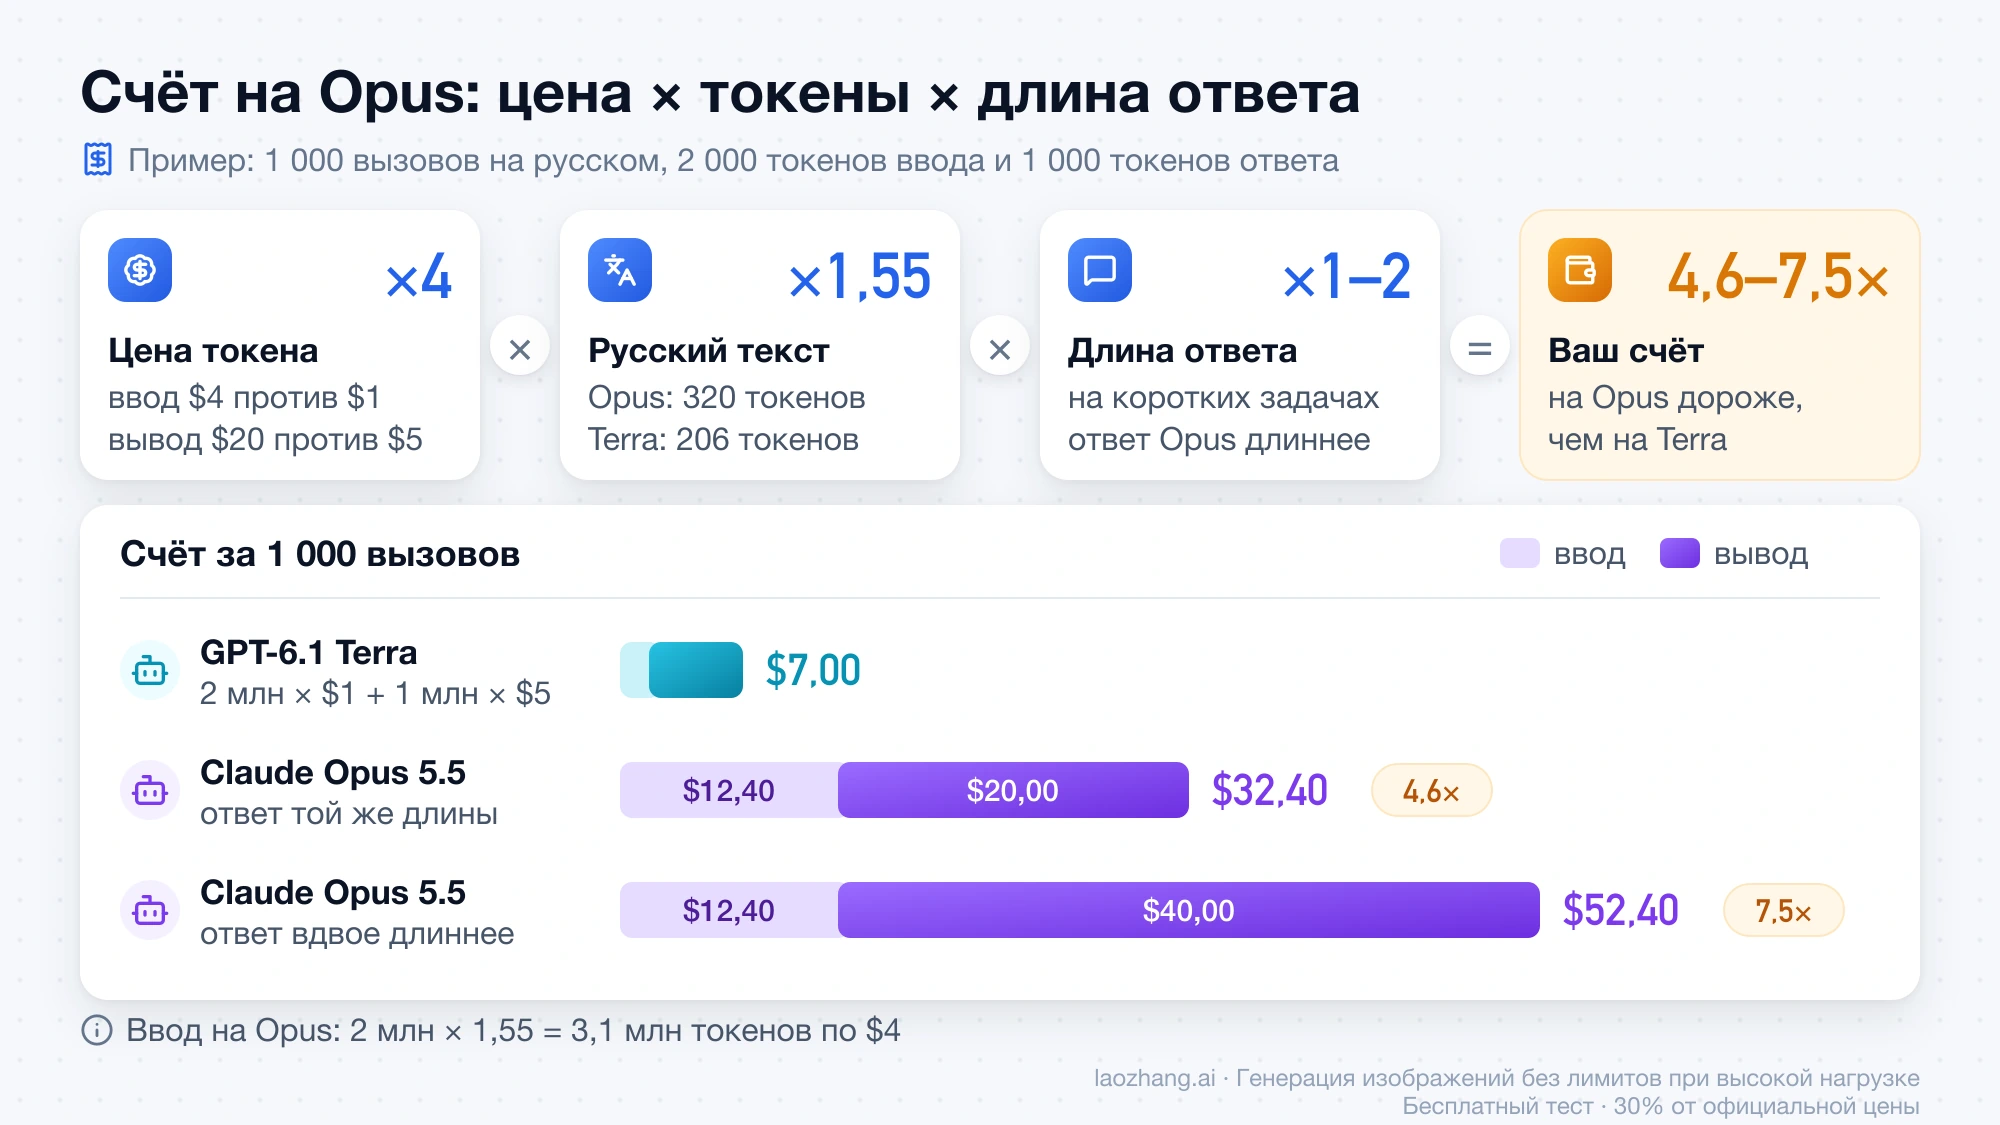
Уровень рассуждения может перекрыть всё остальное. На max Opus выдаёт на задачу индекса AA в 2,9 раза больше выходных токенов, чем Terra (173 тыс. против 60 тыс.), поэтому сравнение max с max и даёт десятикратную разницу. У Terra есть и обратный эффект: у OpenAI кэширование для GPT-5.6 и новее включено по умолчанию, и запись в кэш оплачивается, пока в запросе не задан prompt_cache_options.mode: "explicit", поэтому в счёте Terra стоит отдельно смотреть на строку записи в кэш.
Промпты длиннее 272 000 токенов: разница за токен падает до 2–2,7 раза
Если промпт длиннее 272 000 токенов, разрыв в цене за токен сокращается: у Terra для таких запросов действует тариф длинного контекста, а у Opus 5.5 ставка одинакова во всём окне в 1 млн токенов. На длинном тарифе весь запрос Terra стоит $2,00 за 1 млн токенов ввода, $0,10 за чтение из кэша, $2,50 за запись в кэш и $7,50 за 1 млн токенов вывода. Против ставок Opus это 2 раза по вводу и кэшу и 2,67 раза по выводу.
Для примера возьмём один запрос на 400 000 токенов ввода по счёту Terra с ответом в 20 000 токенов. На Terra это 0,4 млн × $2 + 0,02 млн × $7,50 = $0,95. Opus посчитает тот же русский текст как 620 000 токенов: 0,62 млн × $4 + 0,02 млн × $20 = $2,88, то есть разница около 3 раз вместо 4,6 на коротких запросах. Поэтому для анализа больших репозиториев или длинных документов решение сильнее зависит от качества ответа, чем от цены. Окно контекста у обеих моделей около 1 млн токенов (у Terra 1,05 млн), максимальный ответ — 128 тыс. токенов.
Где доступны: Terra в ChatGPT Work и Codex, Opus в Claude и Claude Code
В ChatGPT модель GPT-6.1 Terra доступна только в режиме Work и в Codex, а в обычном чате её нет. В анонсе OpenAI от 26 октября 2026 года названы тарифы Plus, Pro, Enterprise и Edu, а документация Codex дополнительно указывает Business. Claude Opus 5.5 доступен в приложениях Claude на тарифах Pro, Max, Team и Enterprise, в Claude Code, через Claude API и в облаках AWS, Google Cloud и Azure.
В API идентификаторы — gpt-6.1-terra и claude-opus-5-5. У Terra шесть уровней рассуждения (none, low, medium по умолчанию, high, xhigh, max), на вход она принимает текст и изображения, а вызов инструментов работает только через Responses API, так что агент на Chat Completions с инструментами придётся переводить. Сколько работы помещается в подписку, зависит от продукта, а не от цен API: OpenAI оценивает Terra в Codex на Plus в 35–285 локальных сообщений за пятичасовое окно и оговаривает, что это не фиксированный лимит, а Anthropic для Opus 5.5 чисел не публикует; лимиты подписок Claude разобраны в статье «Claude Opus 5.5: цена API и как сбросить лимит подписки».
Как проверить Opus 5.5 и Terra на своих промптах перед переходом
Небольшой тест на своих задачах займёт час и обойдётся в доллары, а покажет то, чего не покажет ни индекс, ни чужой тест: проходит ли Terra ваши проверки и сколько вы реально сэкономите. На тест из раздела выше, 26 вызовов, ушло $0,64 по прейскуранту.
- Возьмите 5–10 реальных задач из своей работы, по одной-две на каждый вид, который собираетесь переносить, и до запуска моделей напишите к ним проверки: тесты для кода, ожидаемые числа или факты для документов.
- Сопоставьте уровни по баллу, а не по названию: Terra
maxпротив Opushigh, а для простых задач добавьте Terrahighкак самый дешёвый вариант. - Задайте параметры явно. Terra
max, то есть уровень, который по баллу AA соответствует Opushigh, включается только через Responses API: 28 октября 2026 года через LaoZhang API запрос к/v1/responsesсreasoning: {"effort": "max"}прошёл, а Chat Completions сreasoning_effort: "max"вернул HTTP 400 со списком допустимых значений отnoneдоxhigh. Если остаётесь на Chat Completions, потолок —xhigh(45 баллов AA), и длину ответа там ограничивайте черезmax_completion_tokens: 28 октября 2026 года через LaoZhang API непотоковый запрос кgpt-6.1-terraсmax_tokensвернул HTTP 400 «Unsupported parameter: 'max_tokens' is not supported with this model. Use 'max_completion_tokens' instead.». Для Opus в Messages передавайтеthinking: {"type": "adaptive"}иoutput_config.effort, чтобы уровень не остался на значении по умолчанию. - Прогоните каждую задачу 2–3 раза на каждой модели и сохраните из ответа API поля usage: входные, выходные и кэшированные токены. Оценки по длине текста здесь не годятся, потому что модели считают токены по-разному.
- Посчитайте стоимость по ставкам из раздела о счёте и сравните по каждой задаче, прошла ли она проверку и во сколько раз отличается цена. У Terra отдельно проверьте строку записи в кэш.
- Переносите на Terra те виды задач, где она прошла все проверки; там, где ошибалась, оставьте Opus или попробуйте GPT-6.1 Sol.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Минимальные тела запросов для шага 3 выглядят так (первое — POST /v1/responses для Terra max, второе — POST /v1/messages для Opus high):
{
  "model": "gpt-6.1-terra",
  "reasoning": {"effort": "max"},
  "input": "..."
}{
"model": "claude-opus-5-5",
"max_tokens": 32000,
"thinking": {"type": "adaptive"},
"output_config": {"effort": "high"},
"messages": [{"role": "user", "content": "..."}]
}Если Opus вызывается через LaoZhang API, учтите ограничение шлюза: один ответ Claude там не длиннее 32 768 токенов, и больший max_tokens срезается до этого значения, тогда как у Anthropic напрямую потолок 128 тыс. Для длинной генерации, например большого файла кода за один ответ, это может изменить результат теста.
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
- 1.анонсе GPT-6.1 Terraopenai.com/index/introducing-gpt-6-1-terra
- 2.сравнении Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-1-terra
- 3.прейскуранту OpenAI APIdevelopers.openai.com/api/docs/pricing
- 4.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing