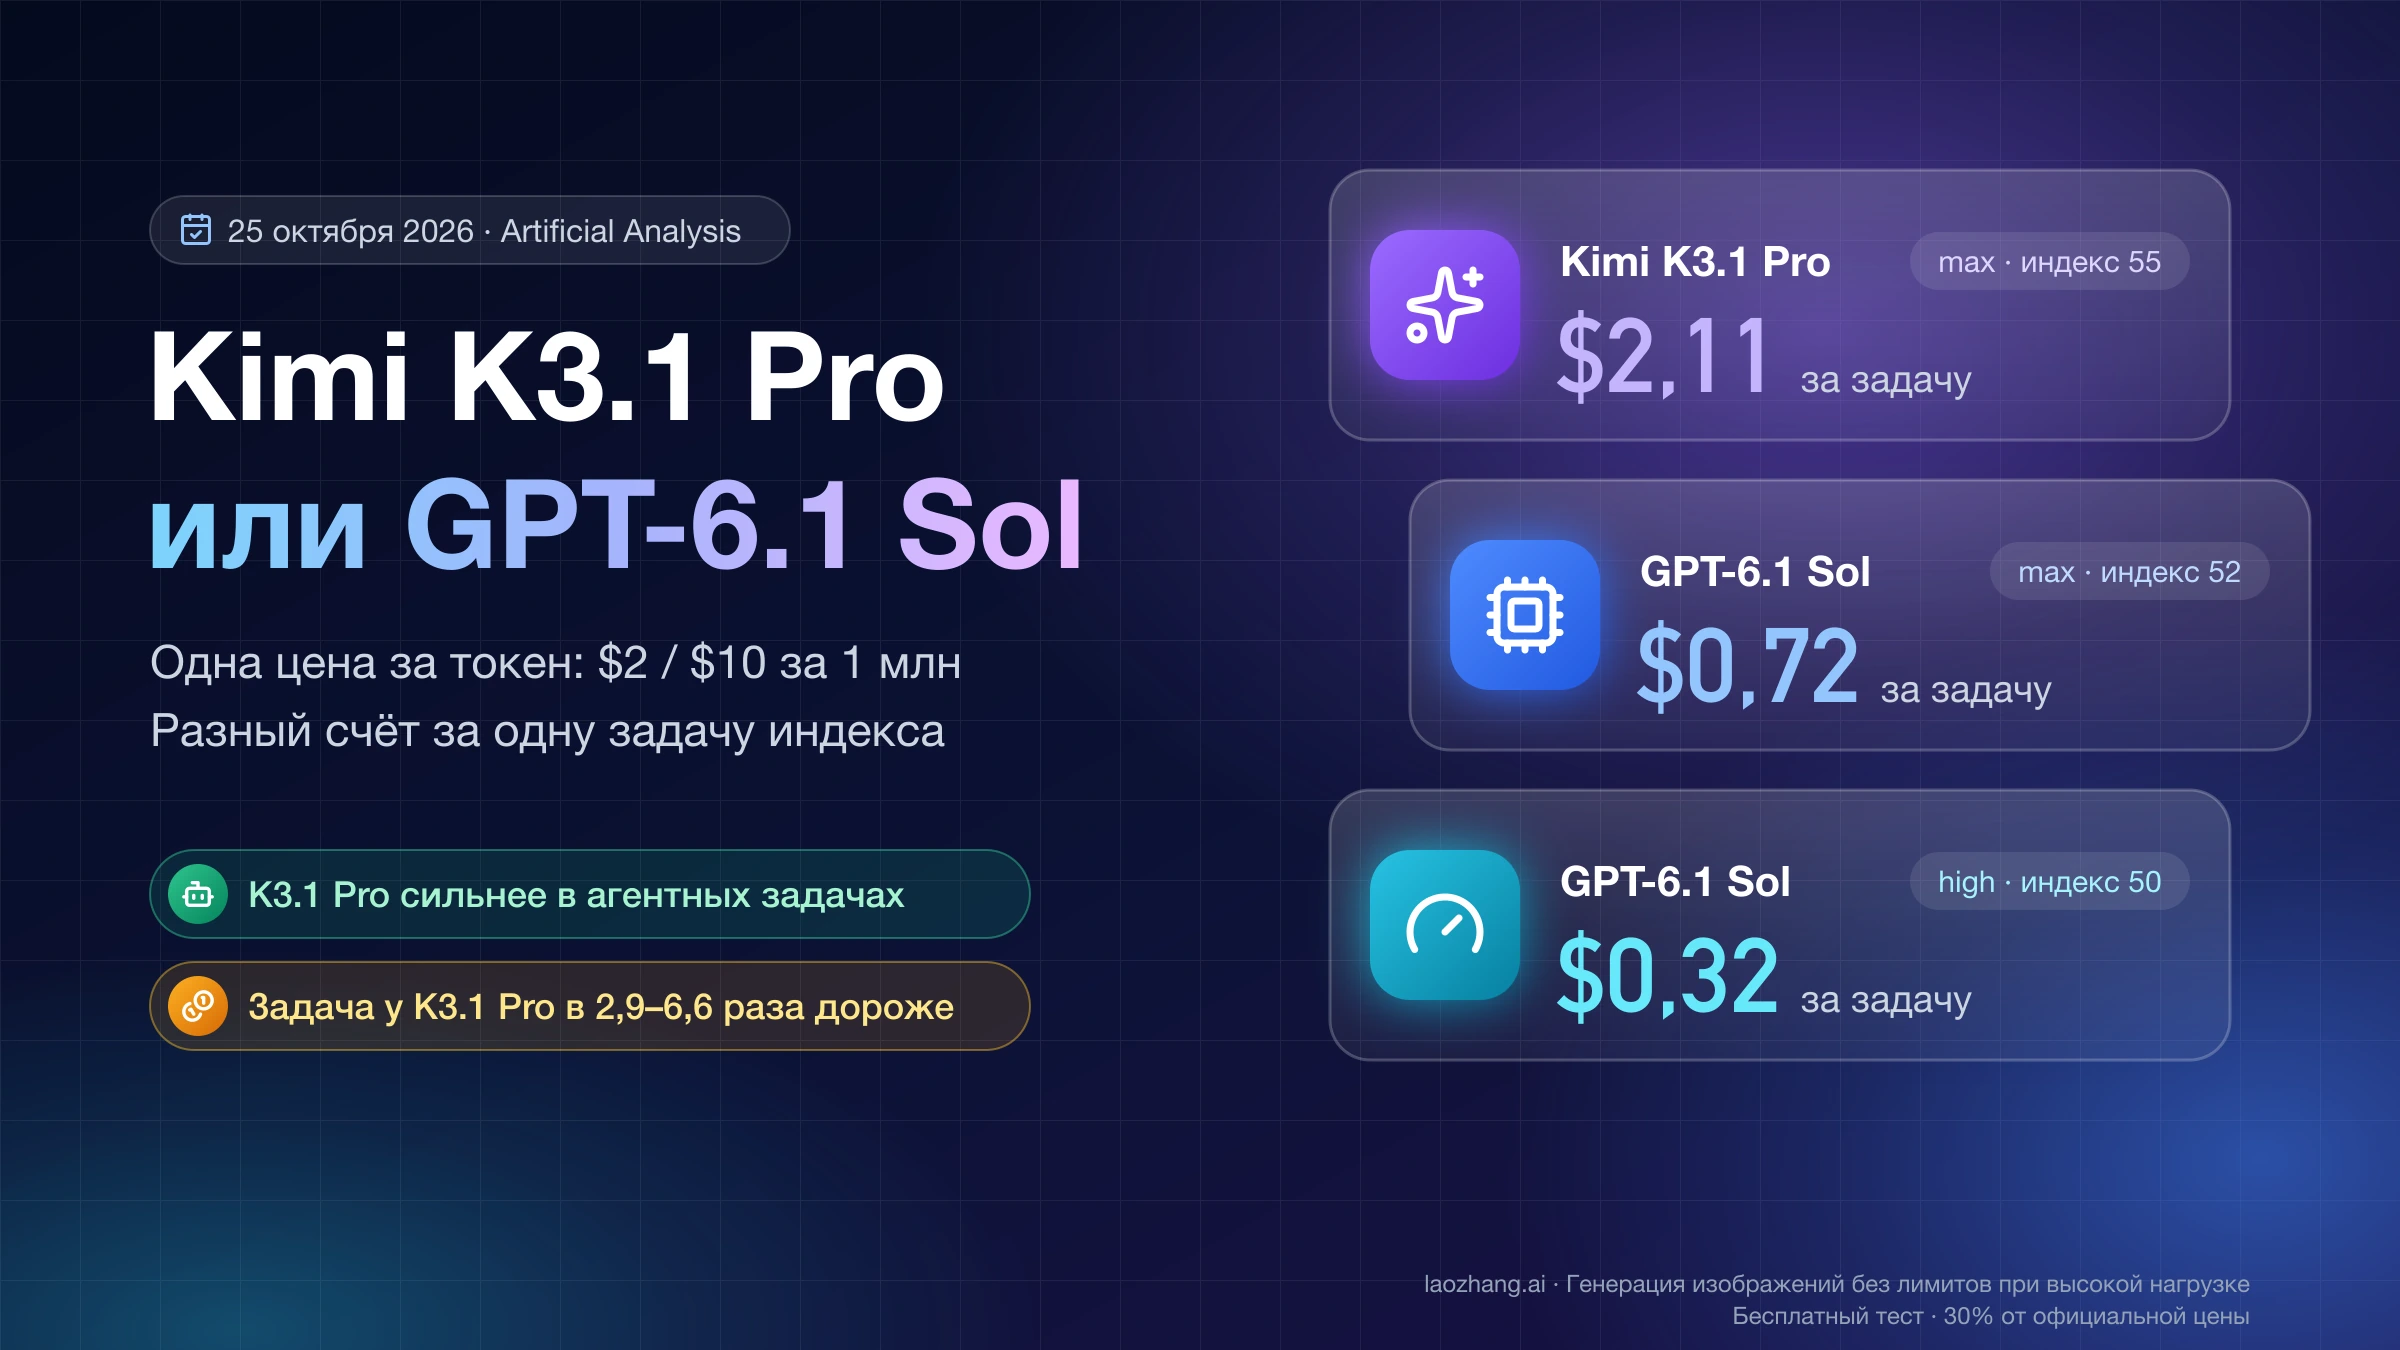
Kimi K3.1 Pro или GPT-6.1 Sol: сравнение цены задачи и качества
Обе модели стоят $2/$10 за 1 млн токенов, но задача индекса AA у Kimi K3.1 Pro стоит $3,68, у GPT-6.1 Sol — $1,27, и балл у Sol выше. Где доплата оправдана.
19 мин
Обе модели стоят $2/$10 за 1 млн токенов, но задача индекса AA у Kimi K3.1 Pro стоит $3,68, у GPT-6.1 Sol — $1,27, и балл у Sol выше. Где доплата оправдана.
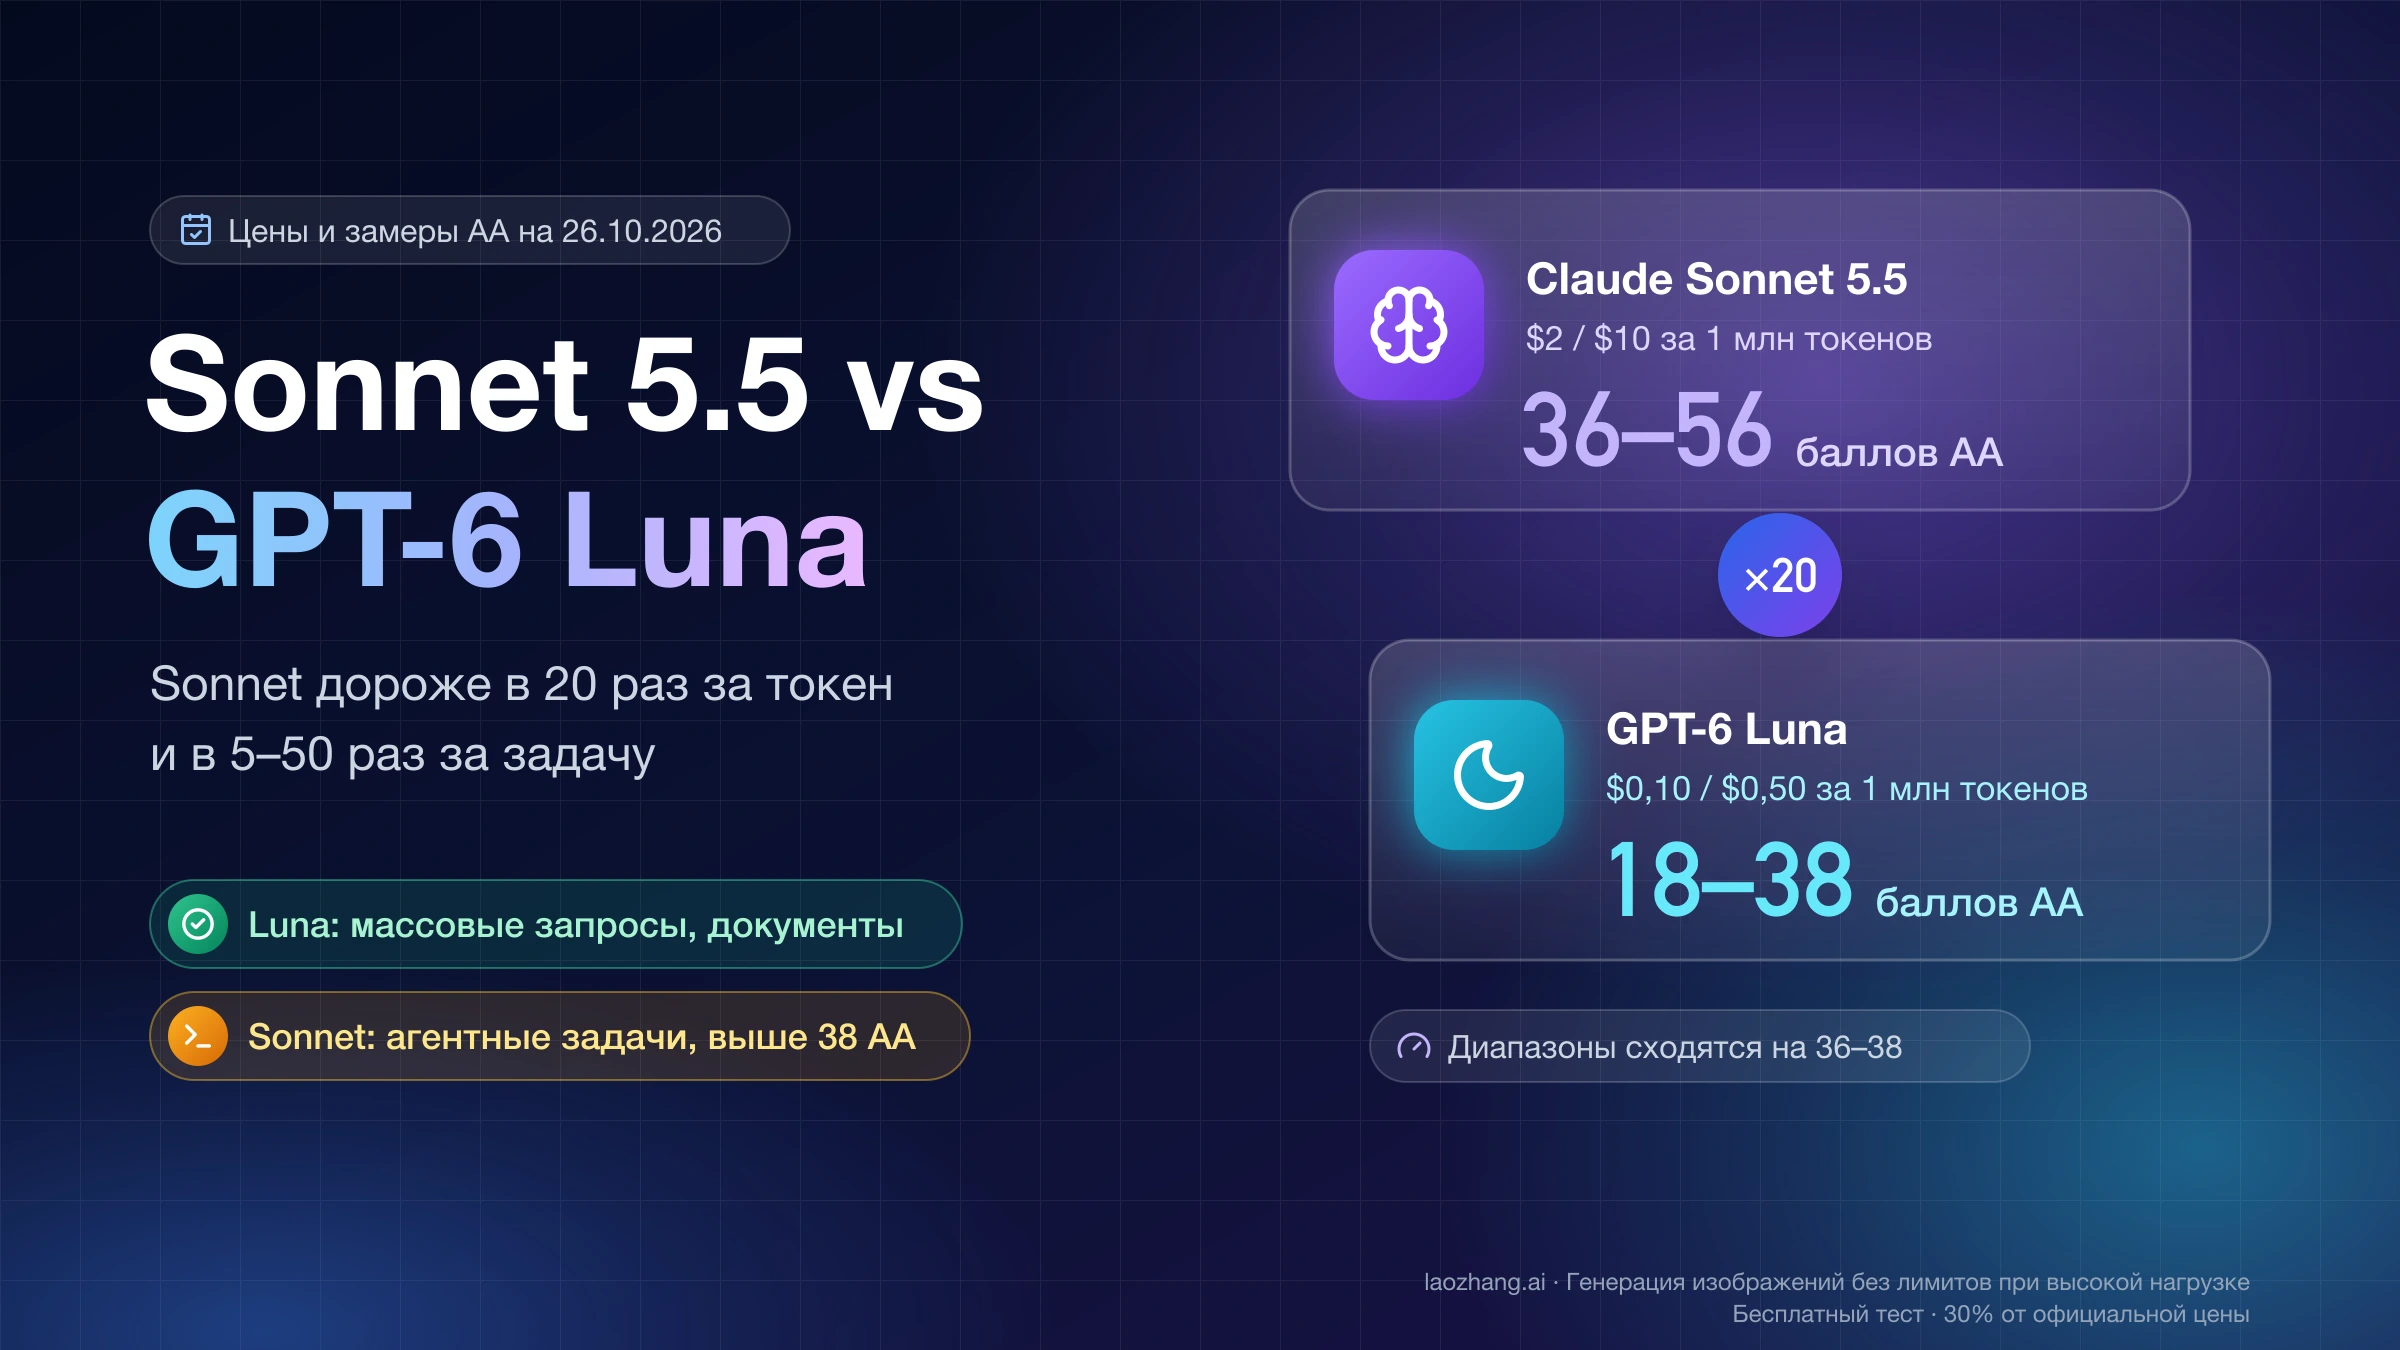
Claude Sonnet 5.5 в 20 раз дороже GPT-6 Luna за токен. Luna закрывает массовые запросы и документы, Sonnet нужен выше 38 баллов AA и в агентных задачах.
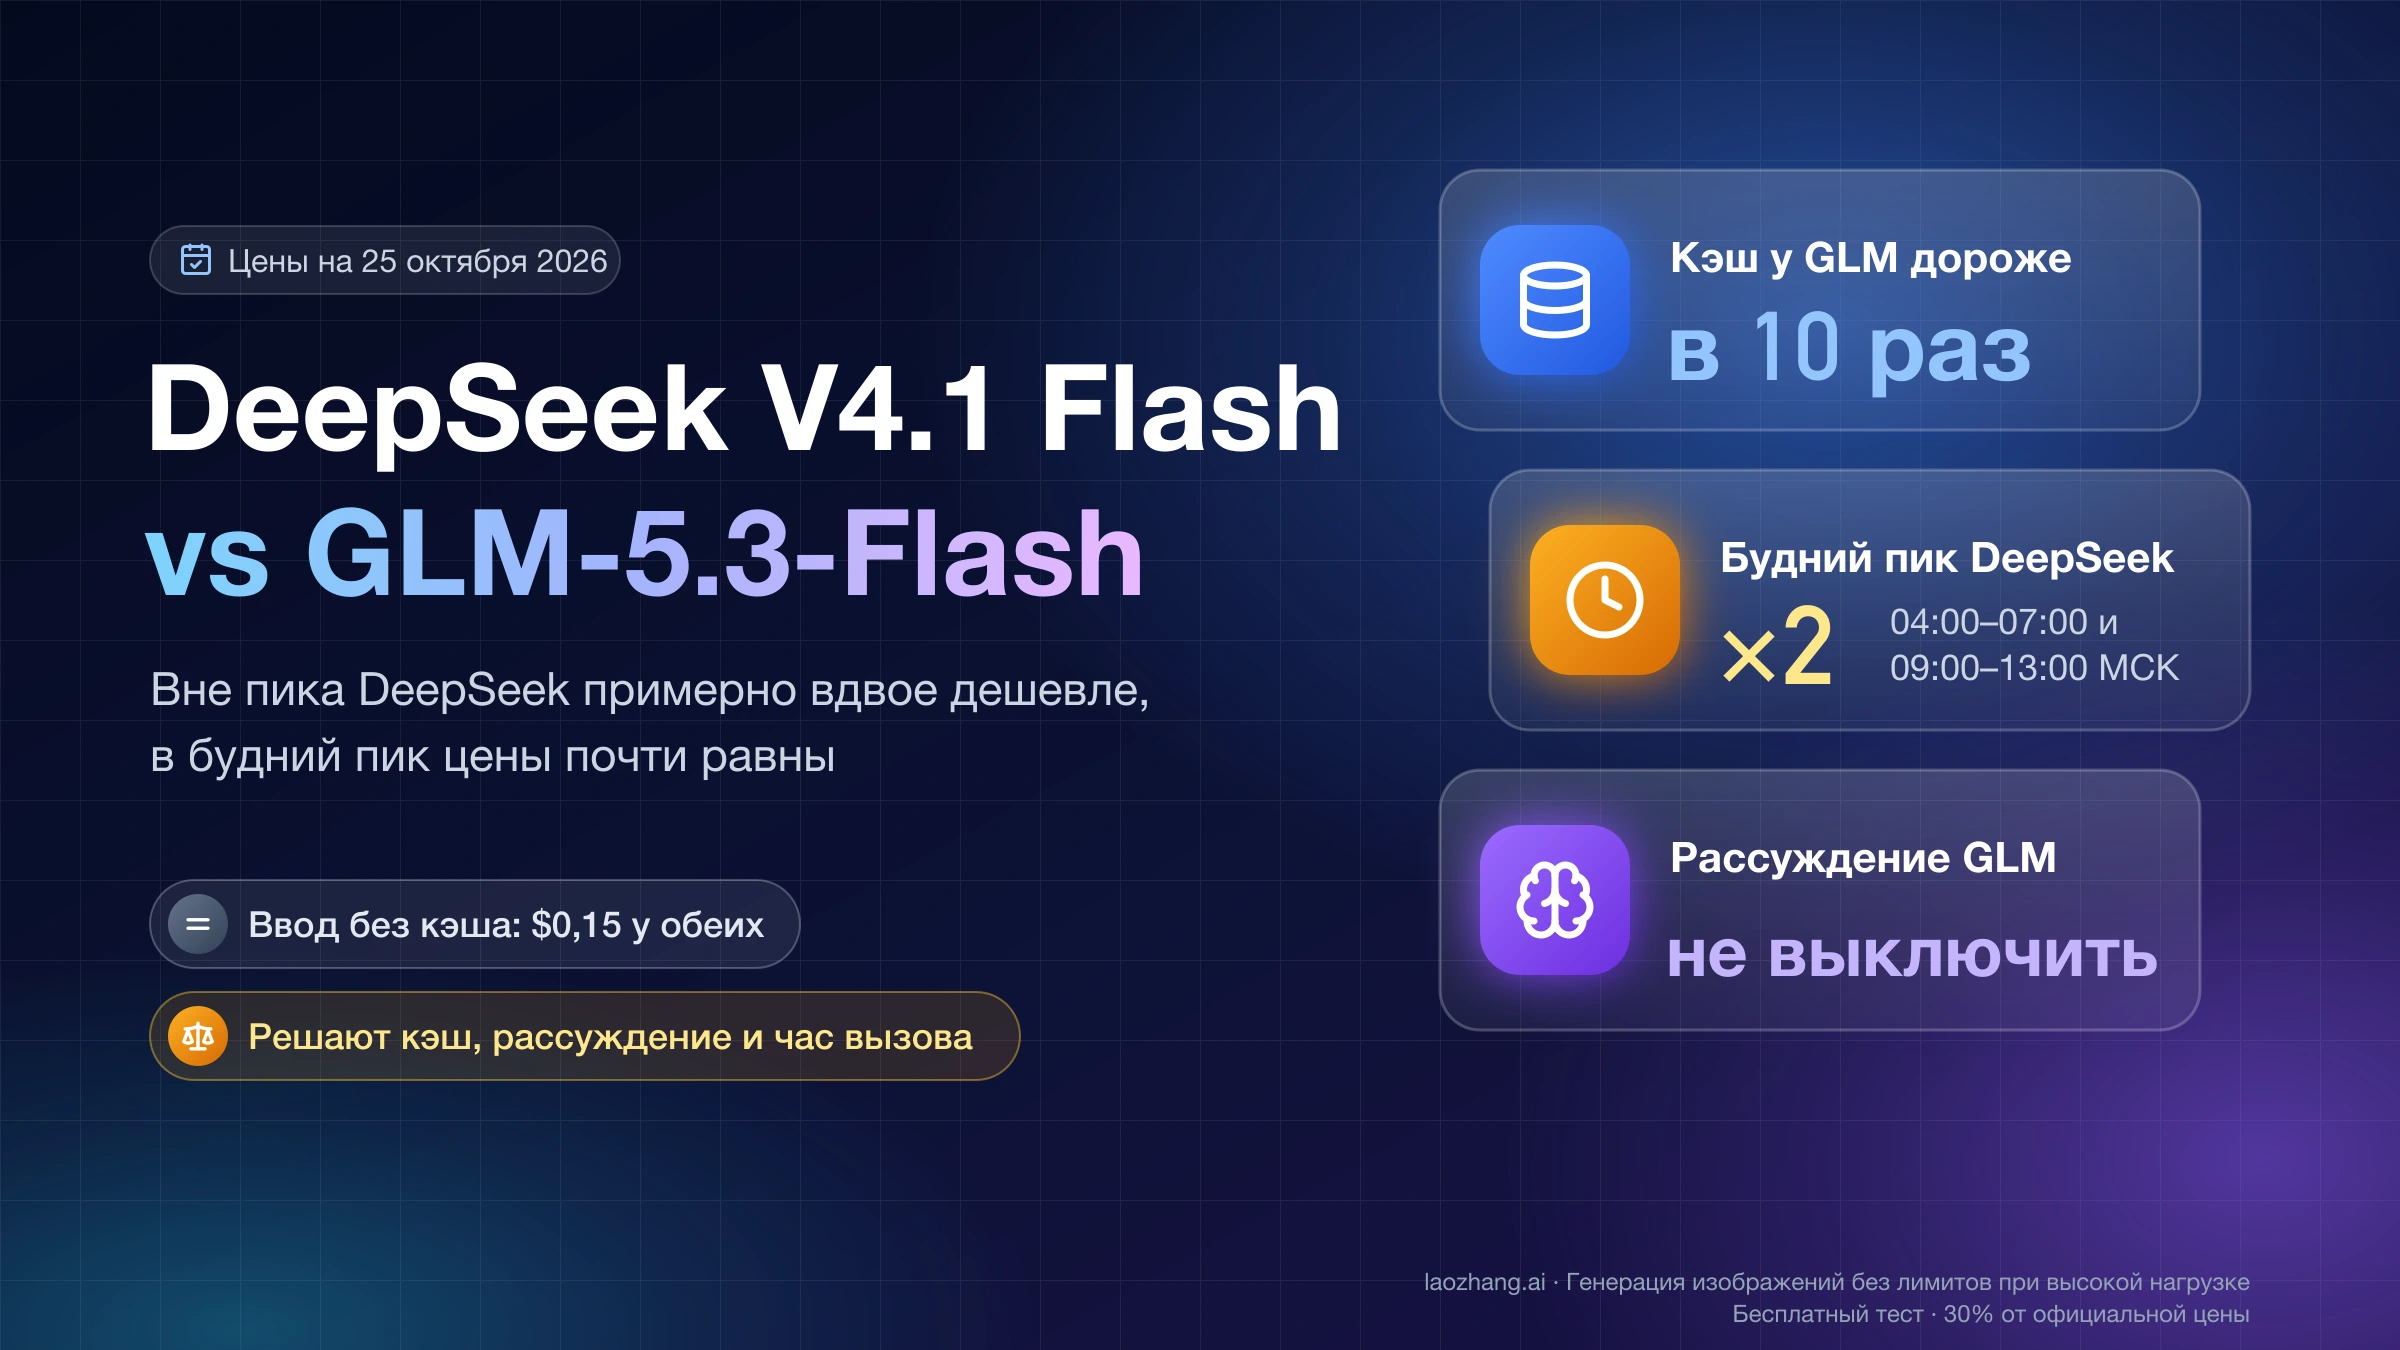
Вне будничного пика DeepSeek V4.1 Flash на той же задаче примерно вдвое дешевле GLM-5.3-Flash, в пик цены почти равны. Решают кэш, рассуждение и час вызова.
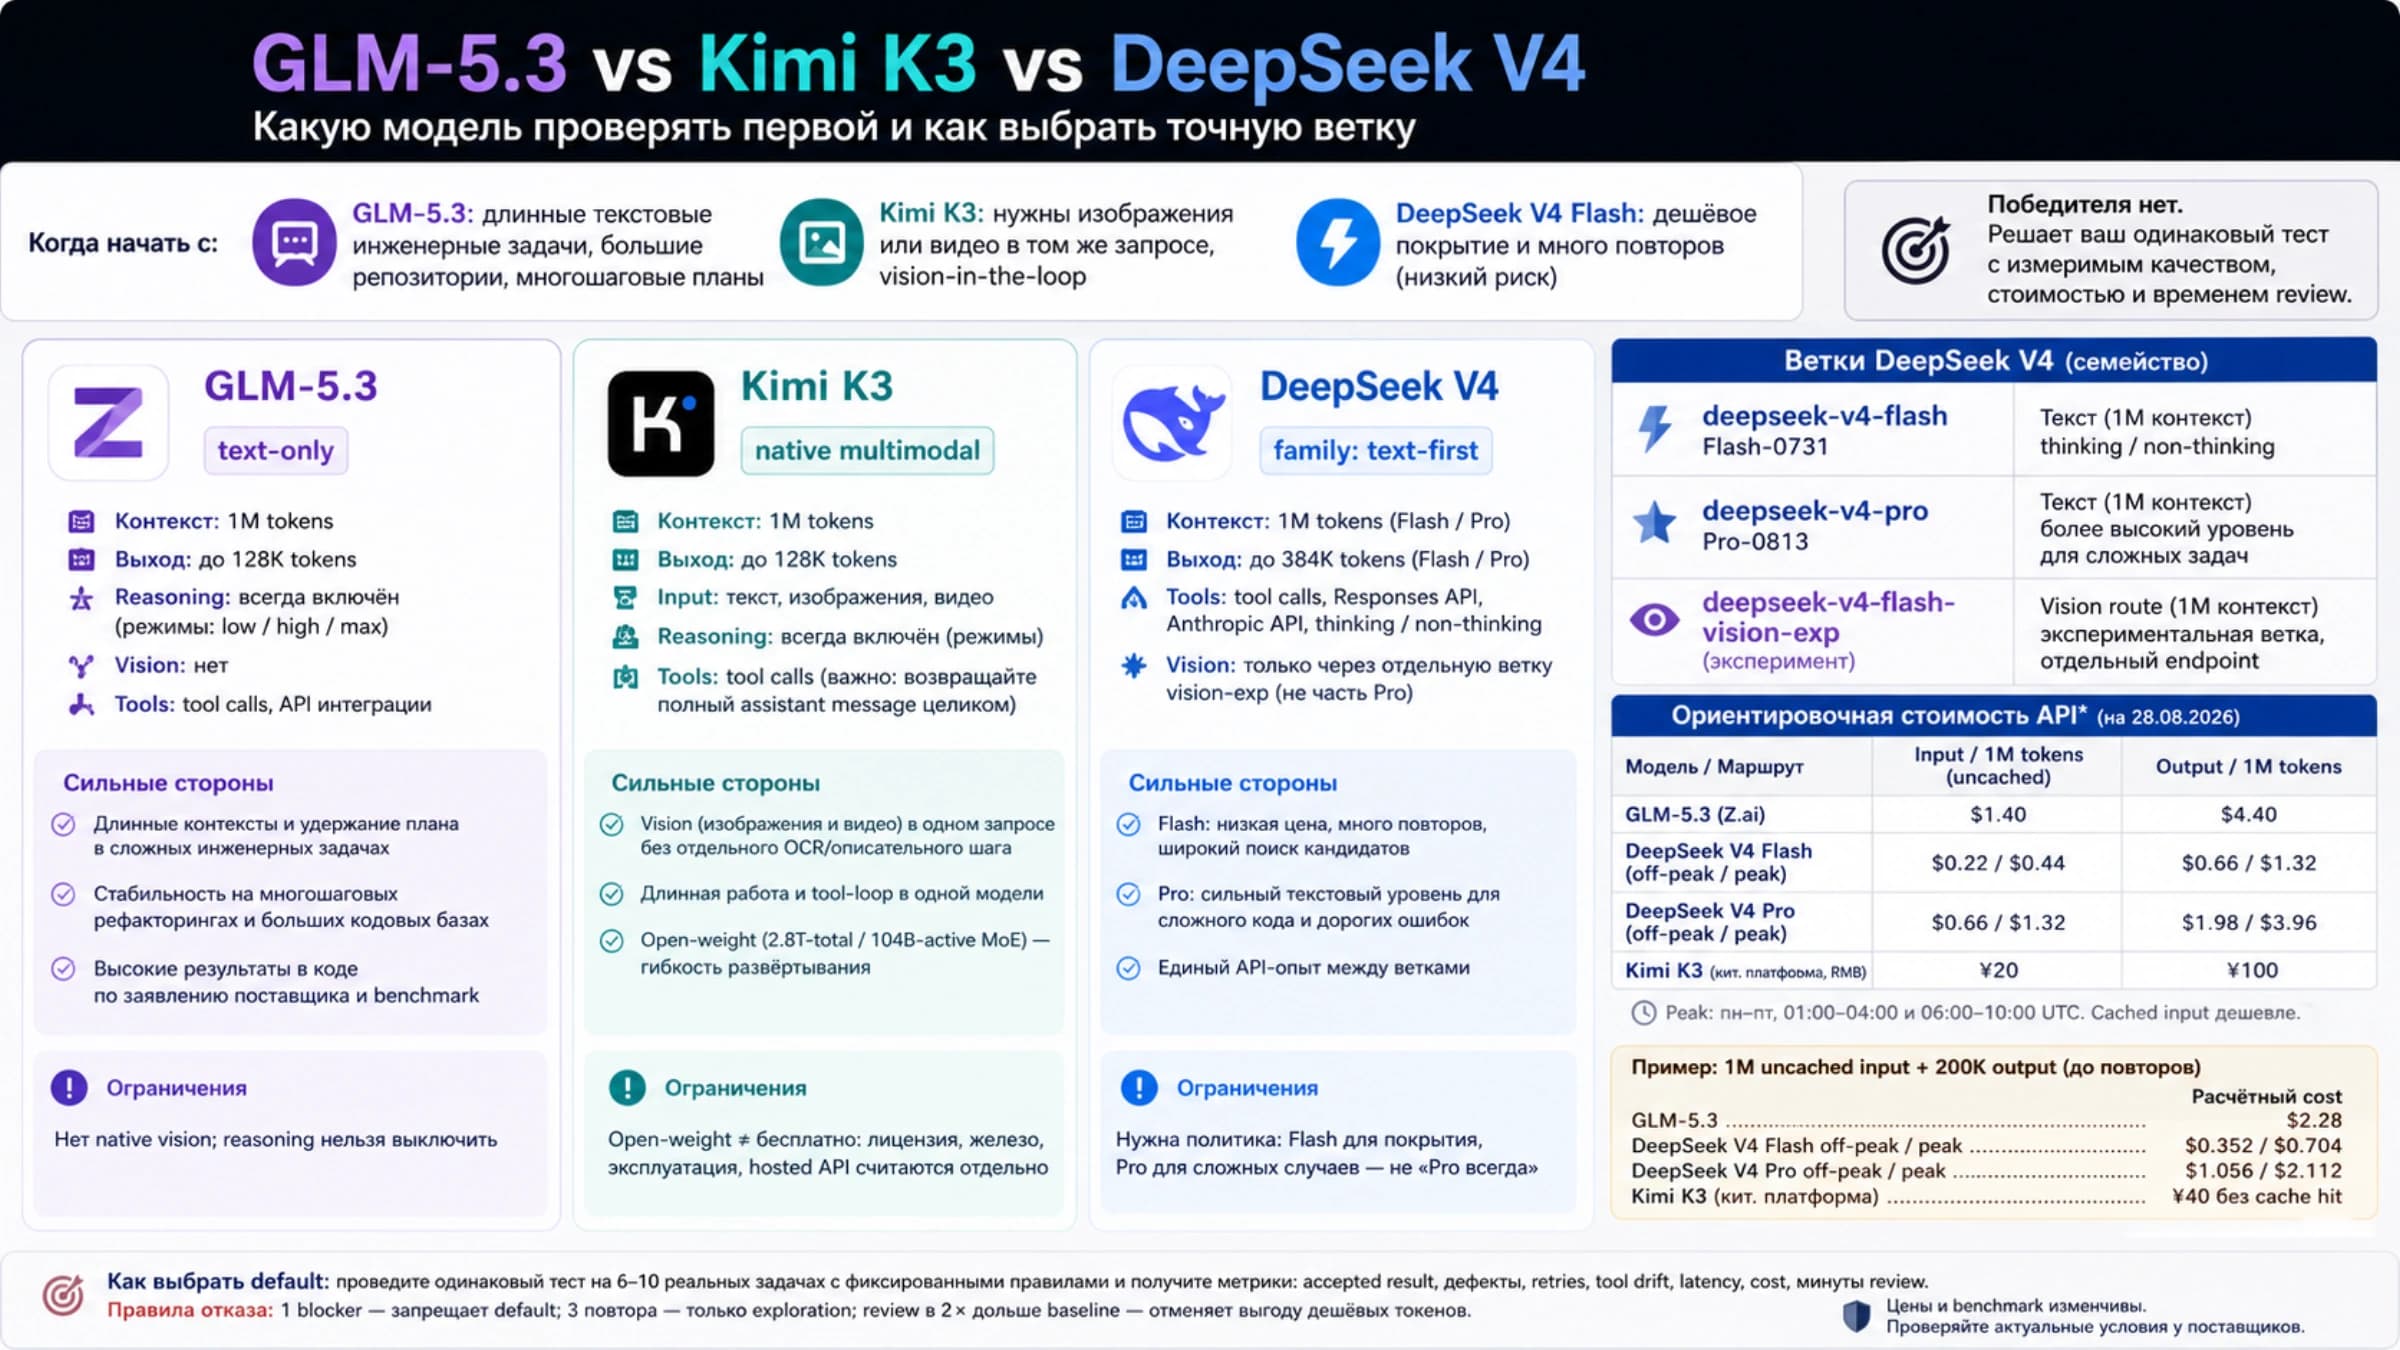
GLM-5.3 и DeepSeek V4 Pro проверяйте на долгих текстовых задачах, Kimi K3.1 Pro — на изображениях и видео, deepseek-flash — на дешёвых массовых прогонах.
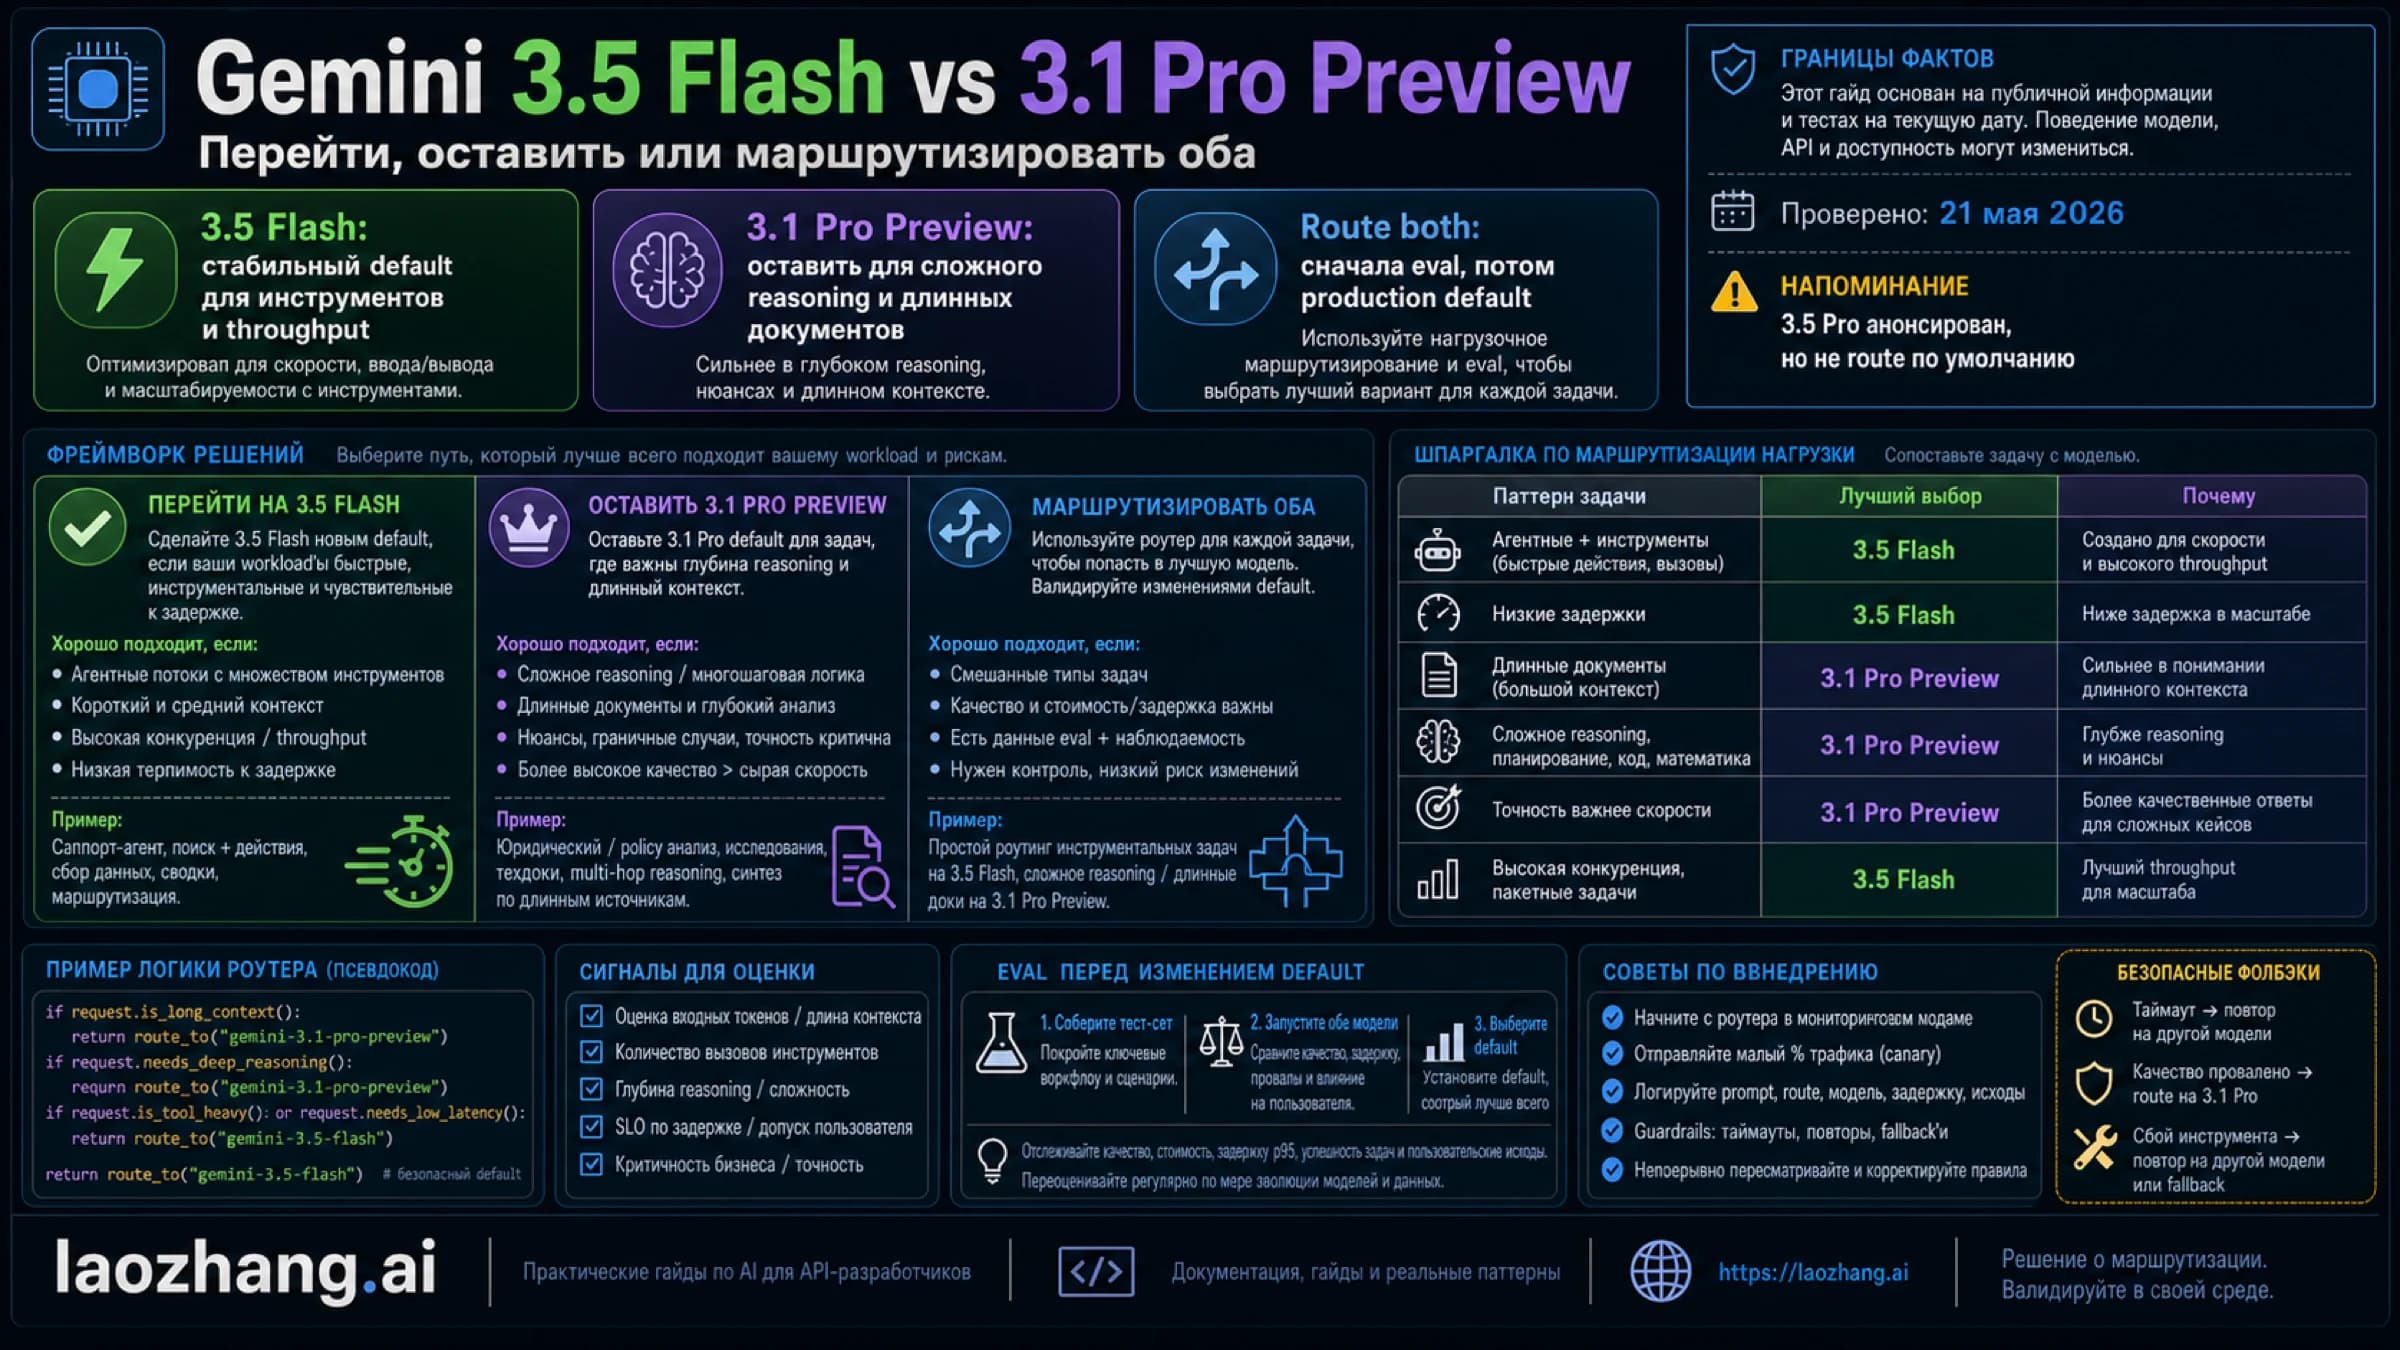
В мае 2026 года 3.5 Flash был первым тестом для быстрых агентных задач, 3.1 Pro Preview — для глубокого анализа. С 8 октября 3.5 Flash ведет на 3.6 Flash.
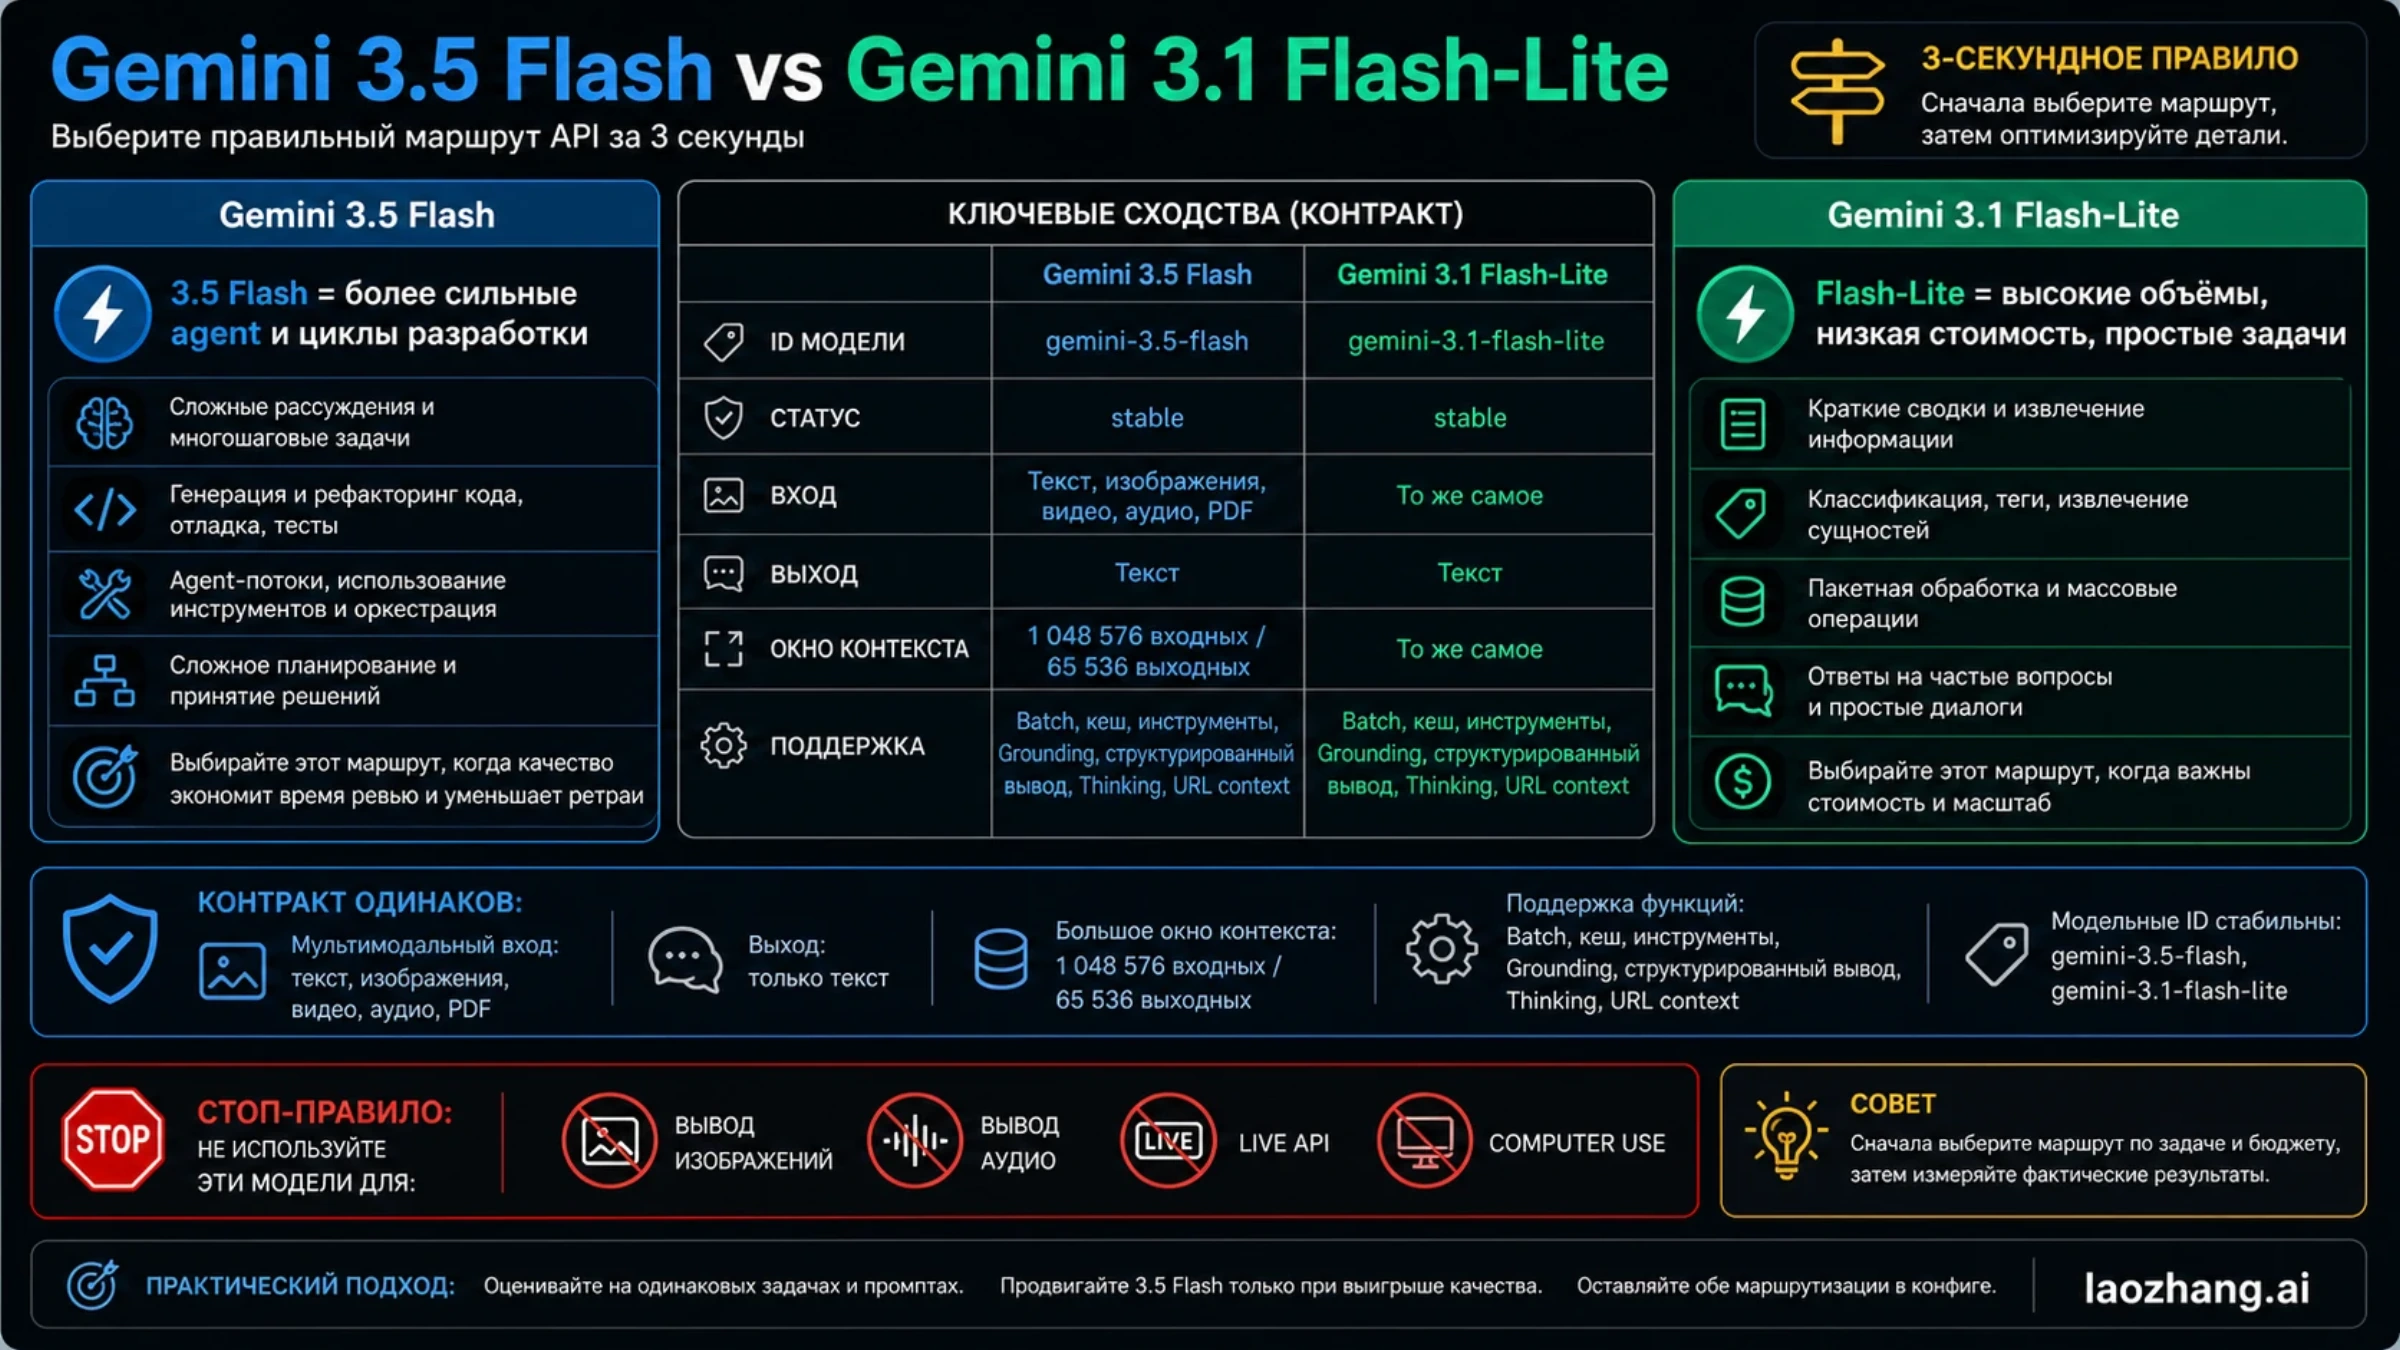
Для массовых простых задач начните с Gemini 3.1 Flash-Lite. Старый ID Gemini 3.5 Flash уже ведёт на 3.6: сравните текущие цены и стоимость принятого результата перед переходом.
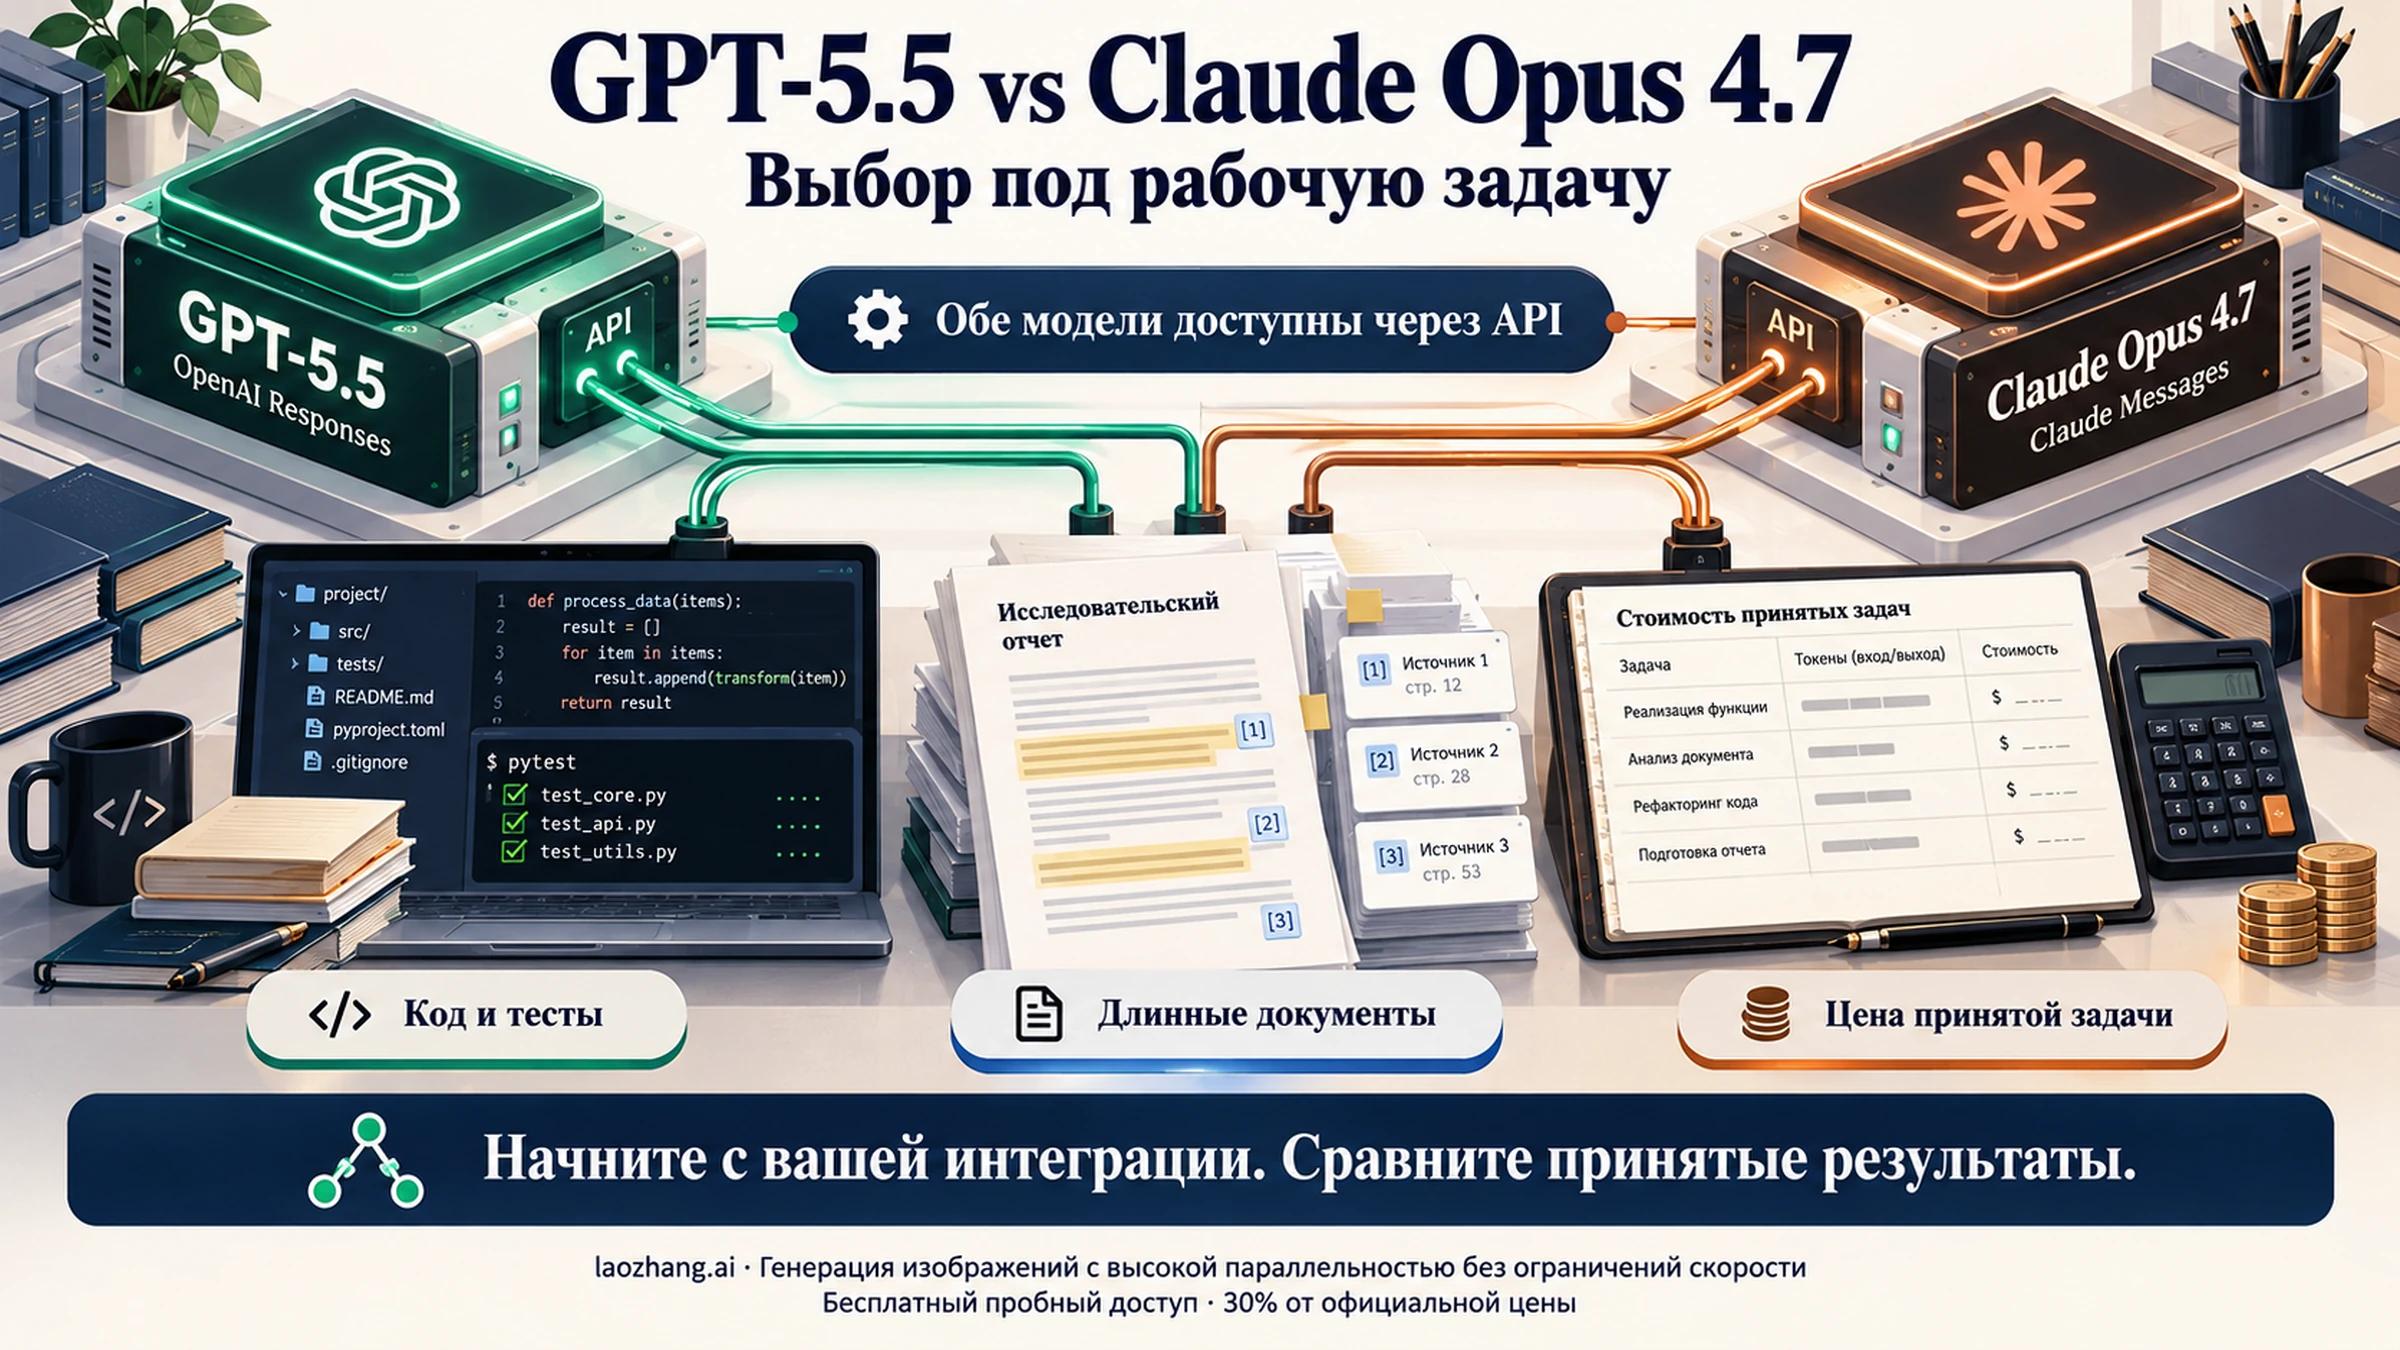
Обе модели доступны через API. Начните с существующей интеграции, сравните стоимость принятой задачи и учтите повышенный тариф GPT-5.5 после 272 000 входных токенов.
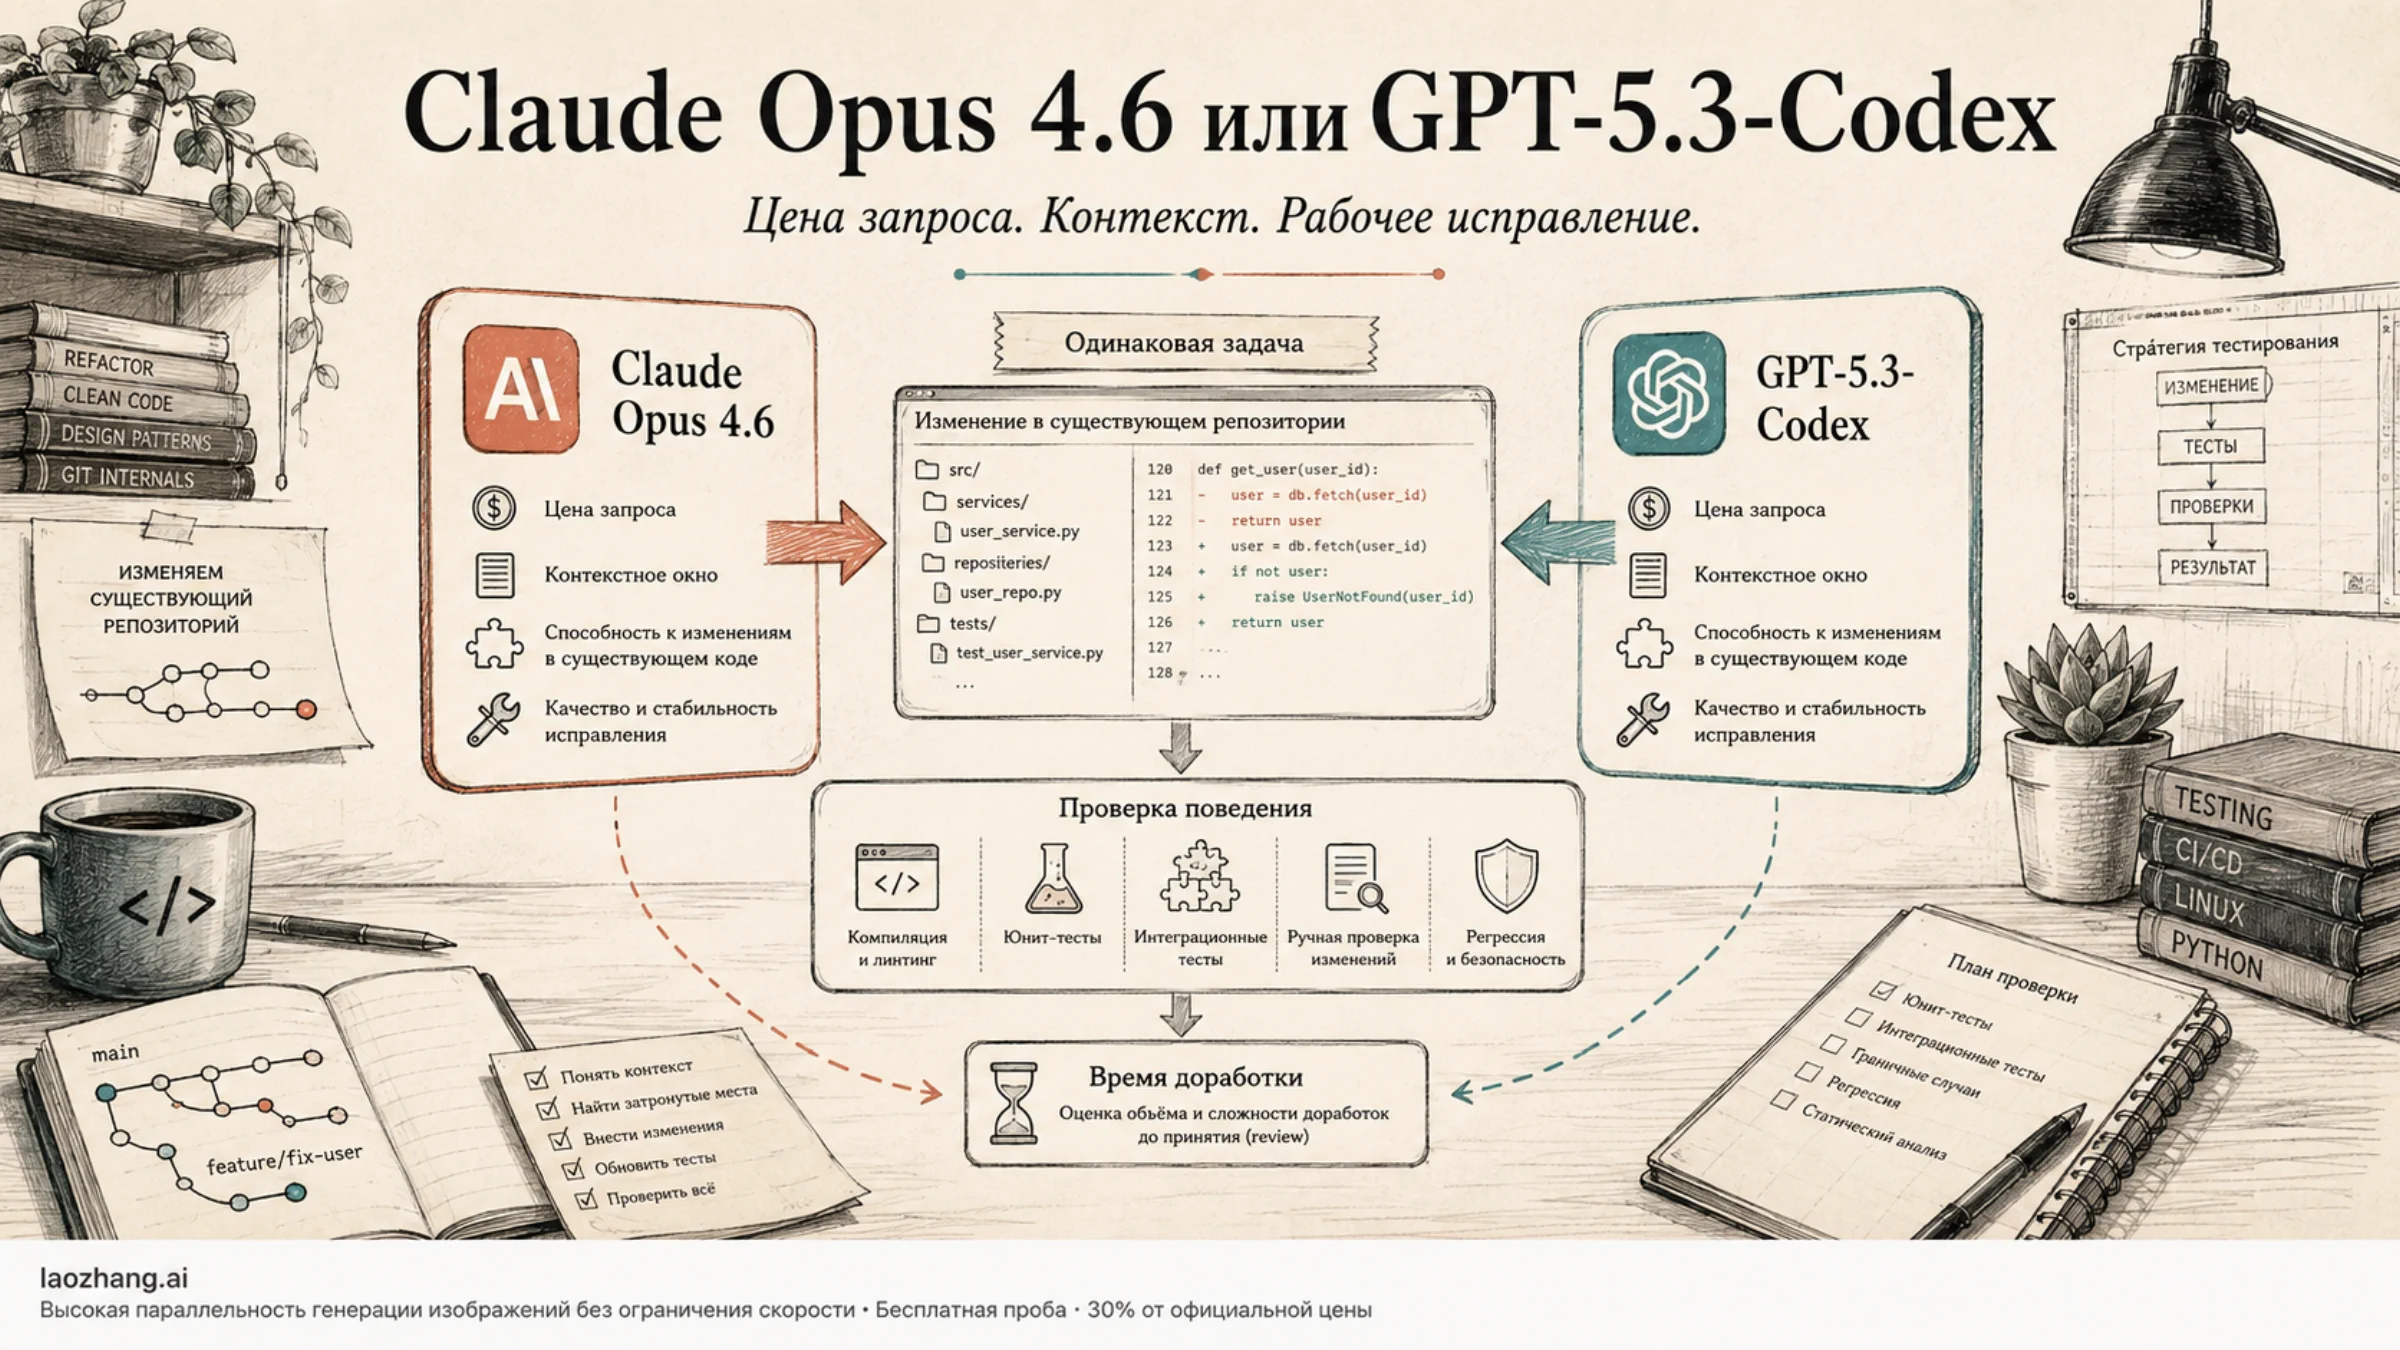
У GPT-5.3-Codex ниже тарифы API, у Claude Opus 4.6 больше окно контекста. Сравните стоимость одной задачи с кешированием и проверьте результат на своем репозитории: зеленые тесты еще не доказывают, что исправление работает.
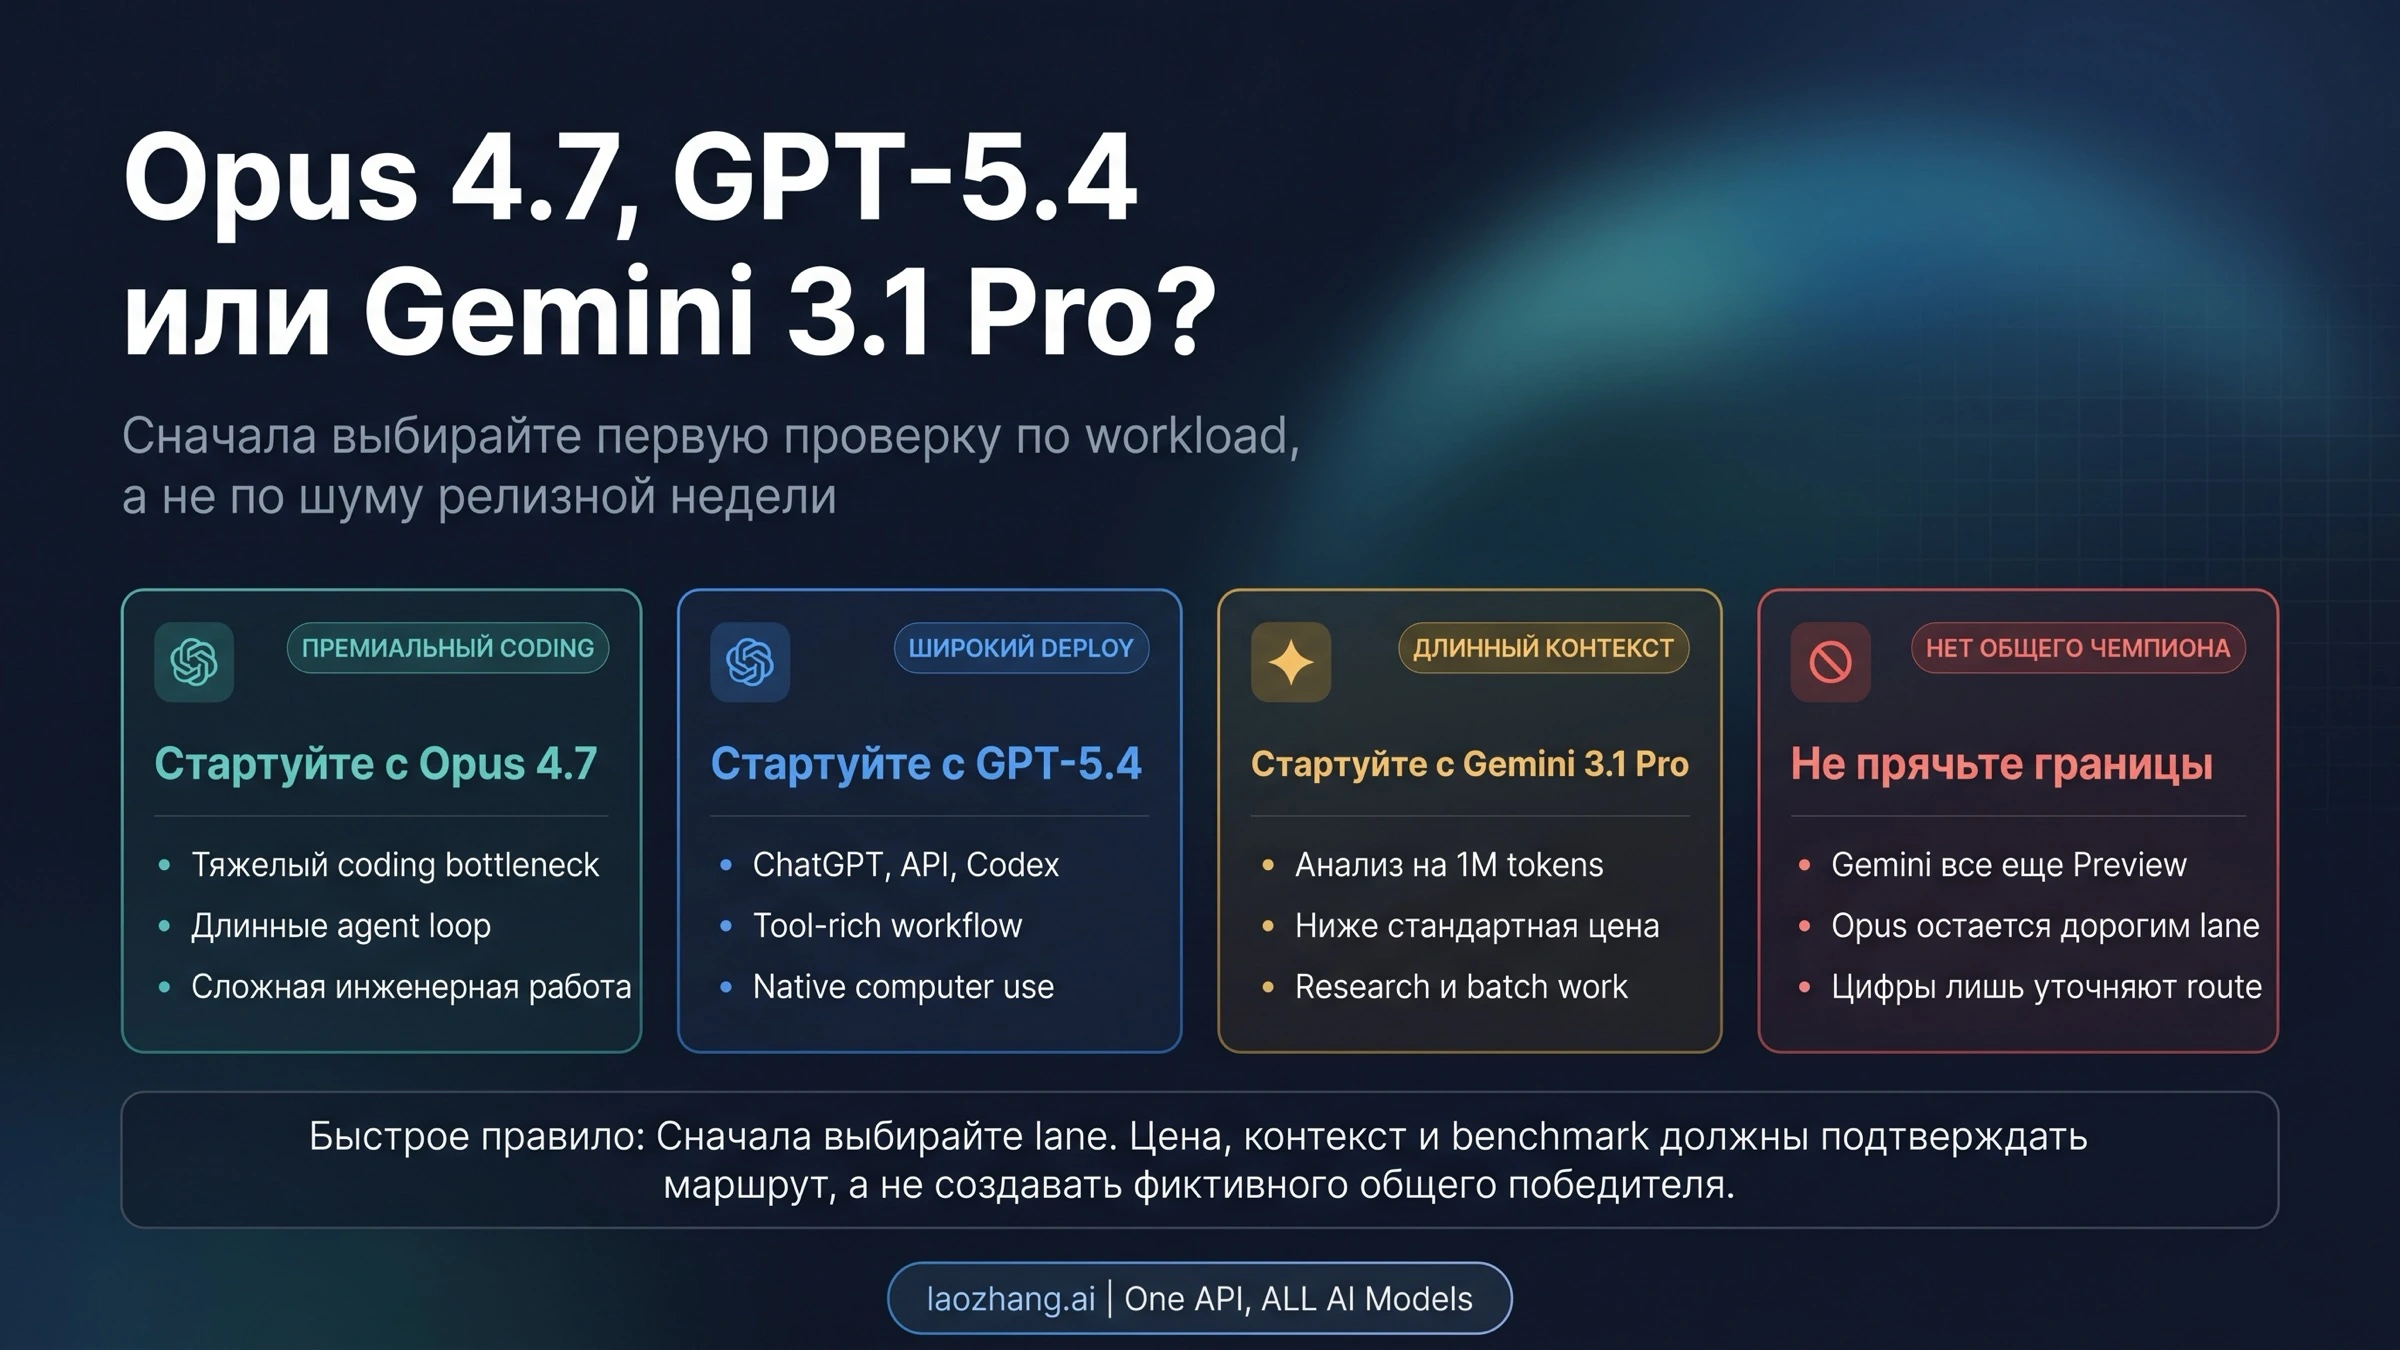
Сравниваем возможности API Claude Opus 4.7, GPT-5.4 и Gemini 3.1 Pro: форматы входных данных, контекст, инструменты, тарифы и стоимость успешно выполненной задачи.
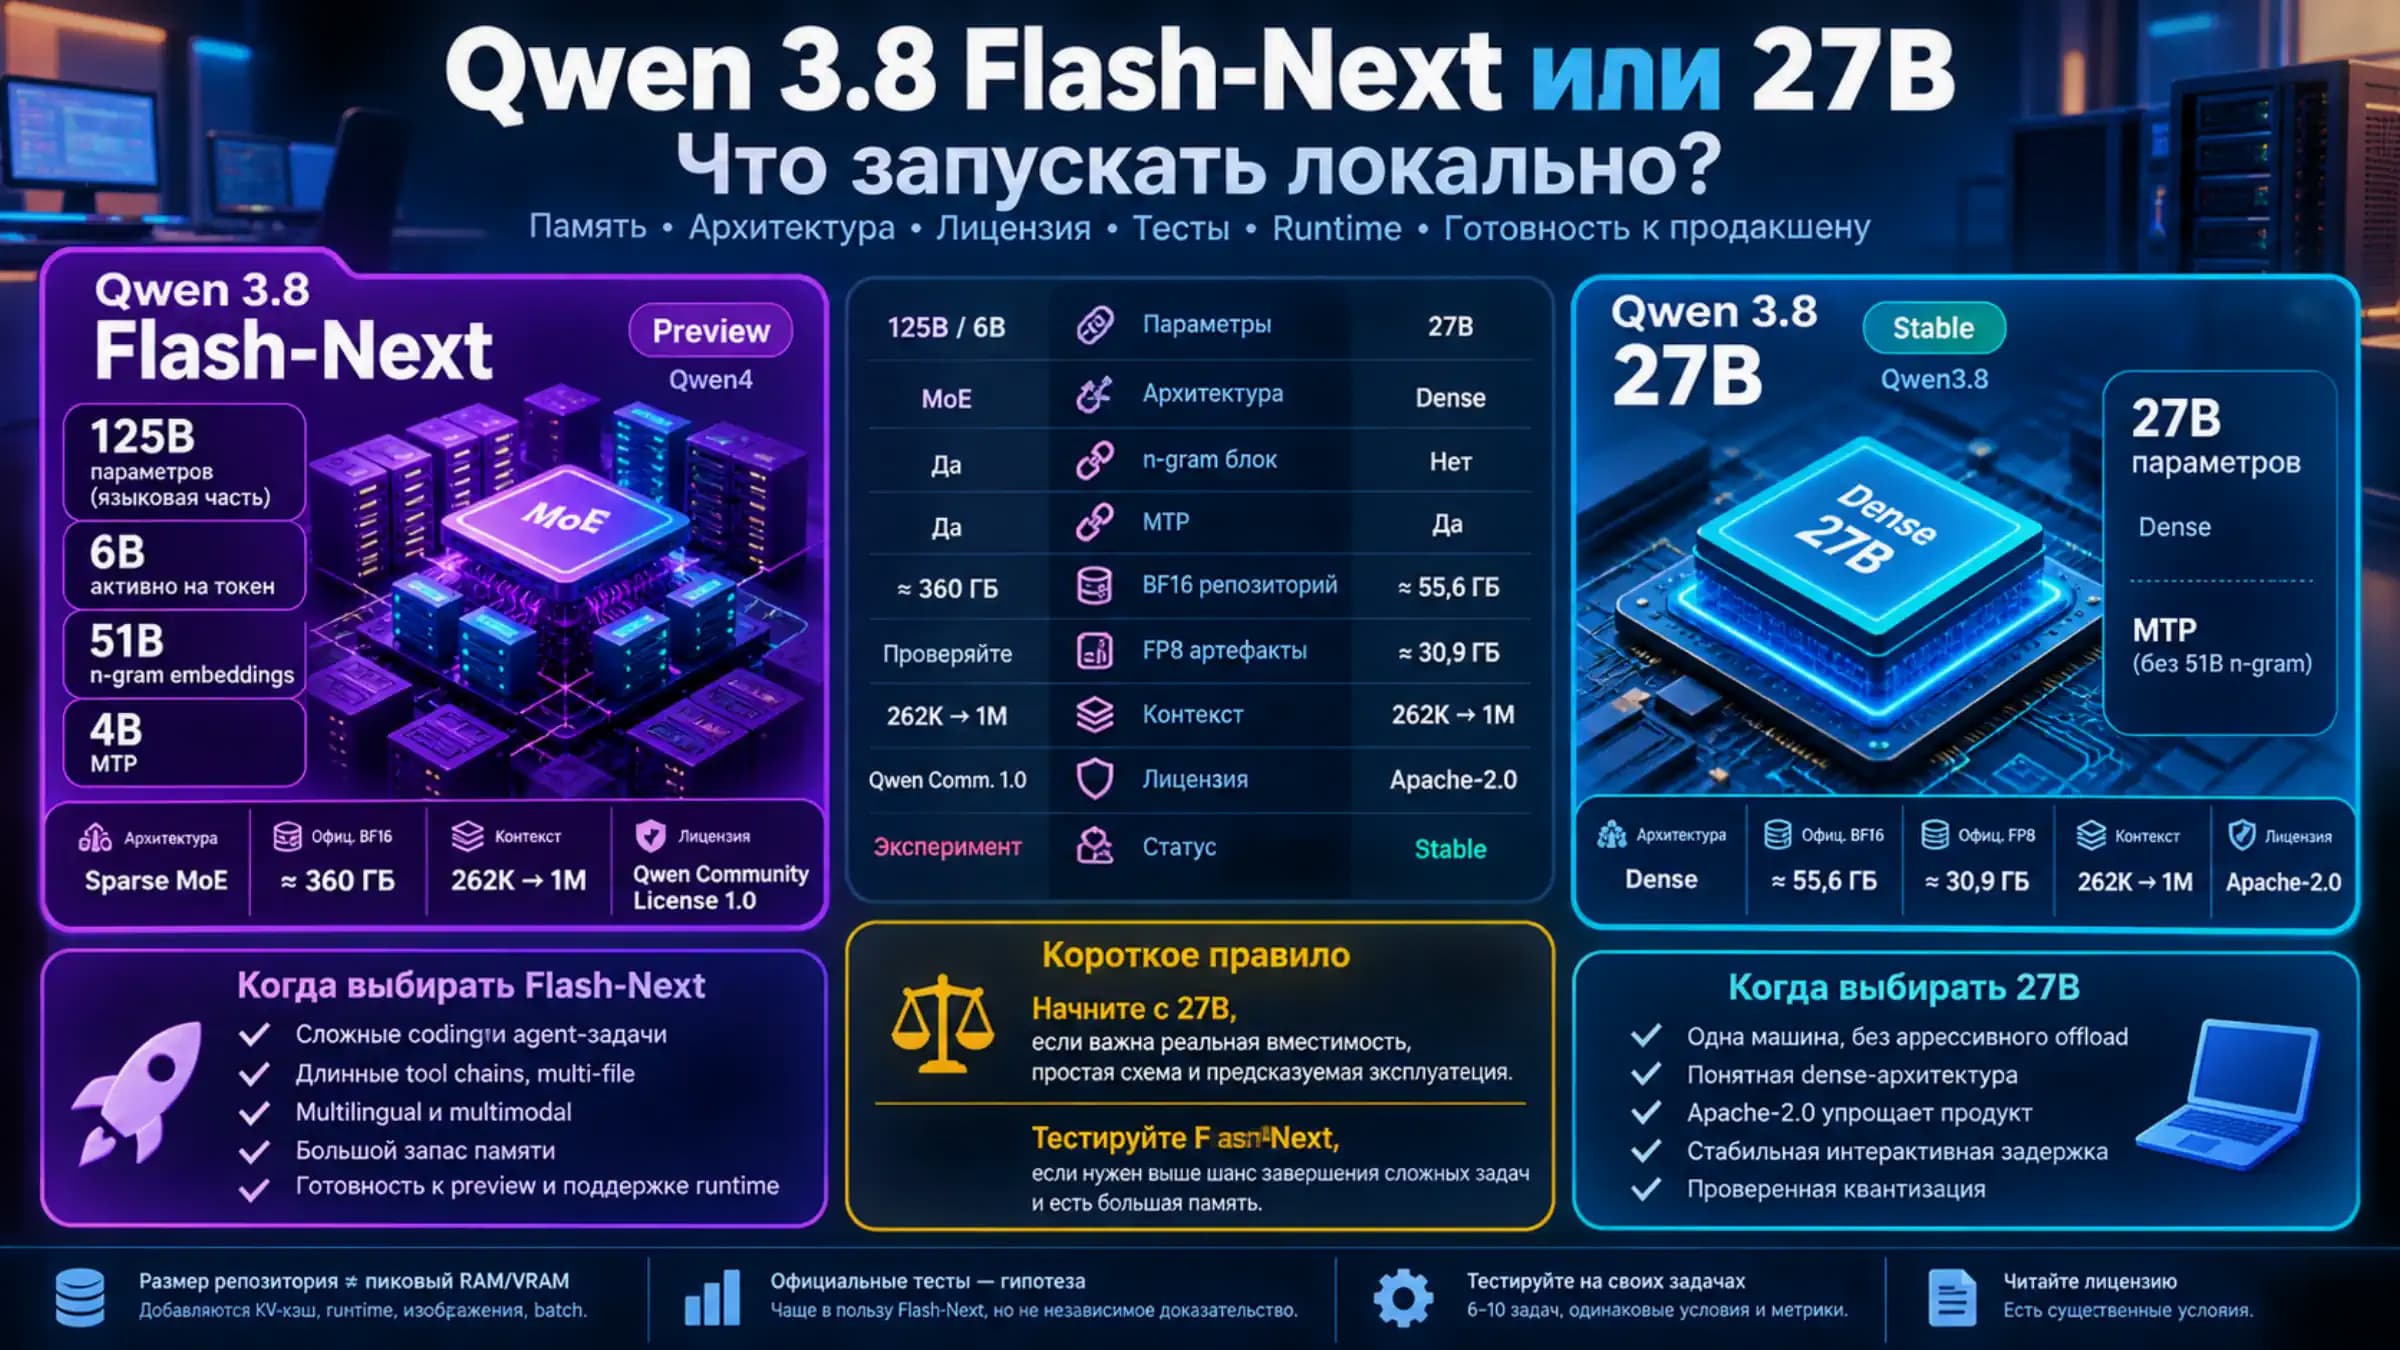
Qwen3.8-27B — практичный первый выбор для одной машины и понятного развёртывания плотной модели. Flash-Next стоит тестировать при большом запасе памяти и дорогих агентных задачах.
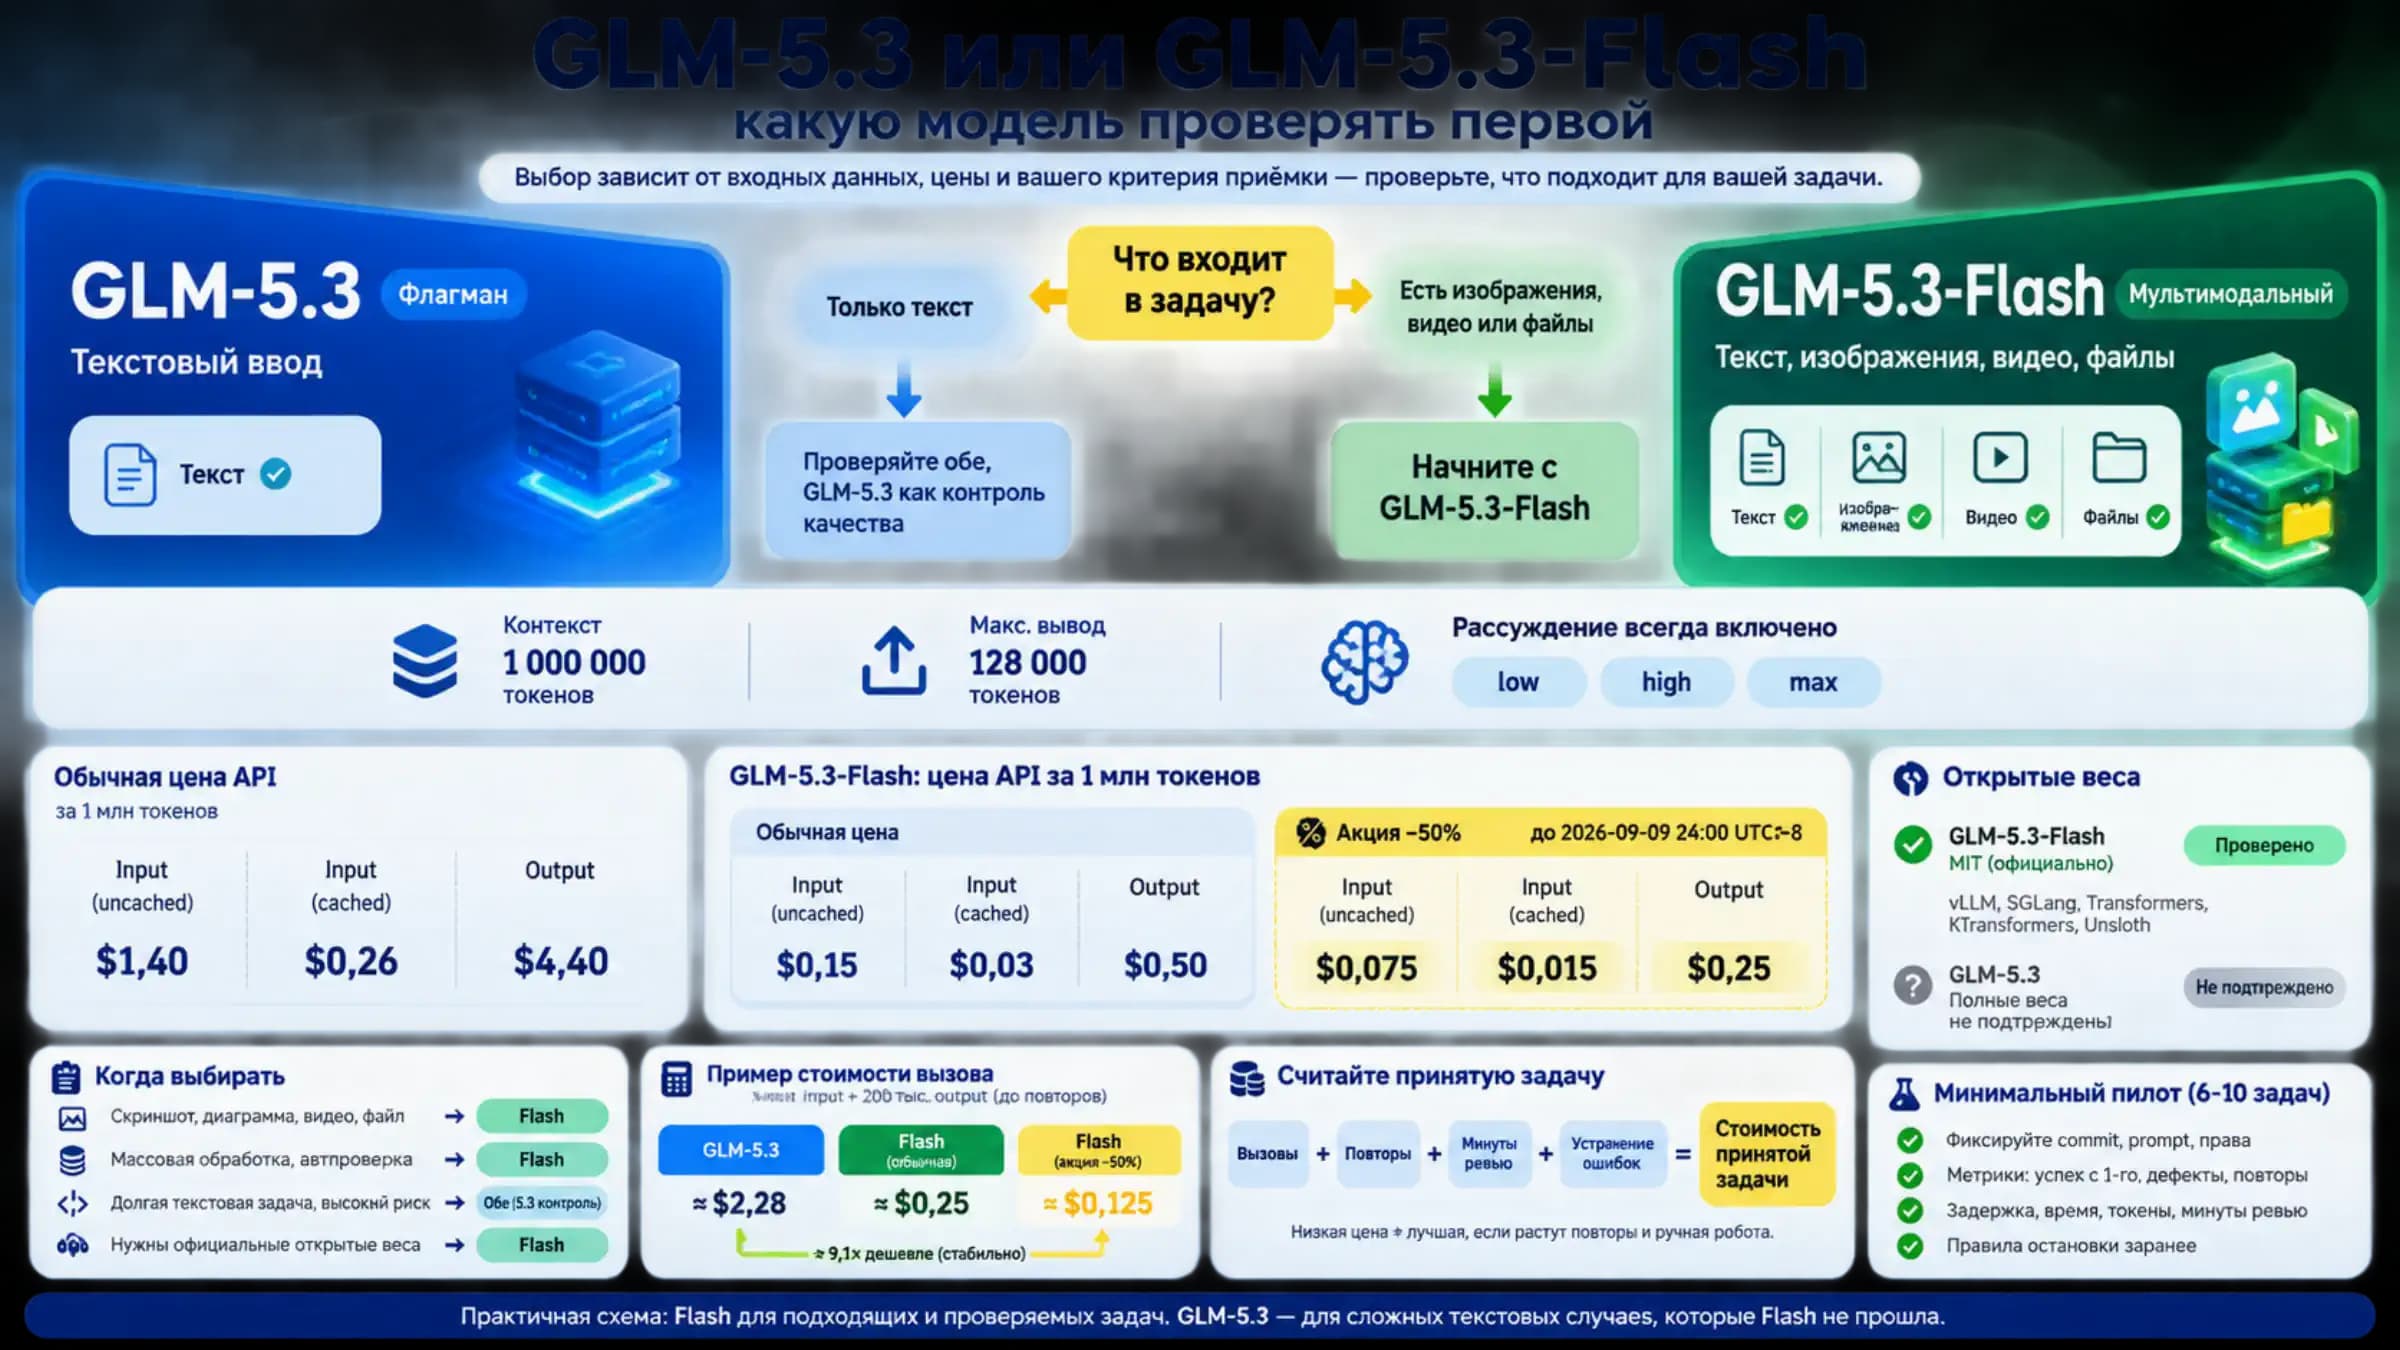
Для мультимодальных и массовых задач первой проверяйте GLM-5.3-Flash. В текстовых задачах с дорогой ошибкой оставьте GLM-5.3 как контроль качества.
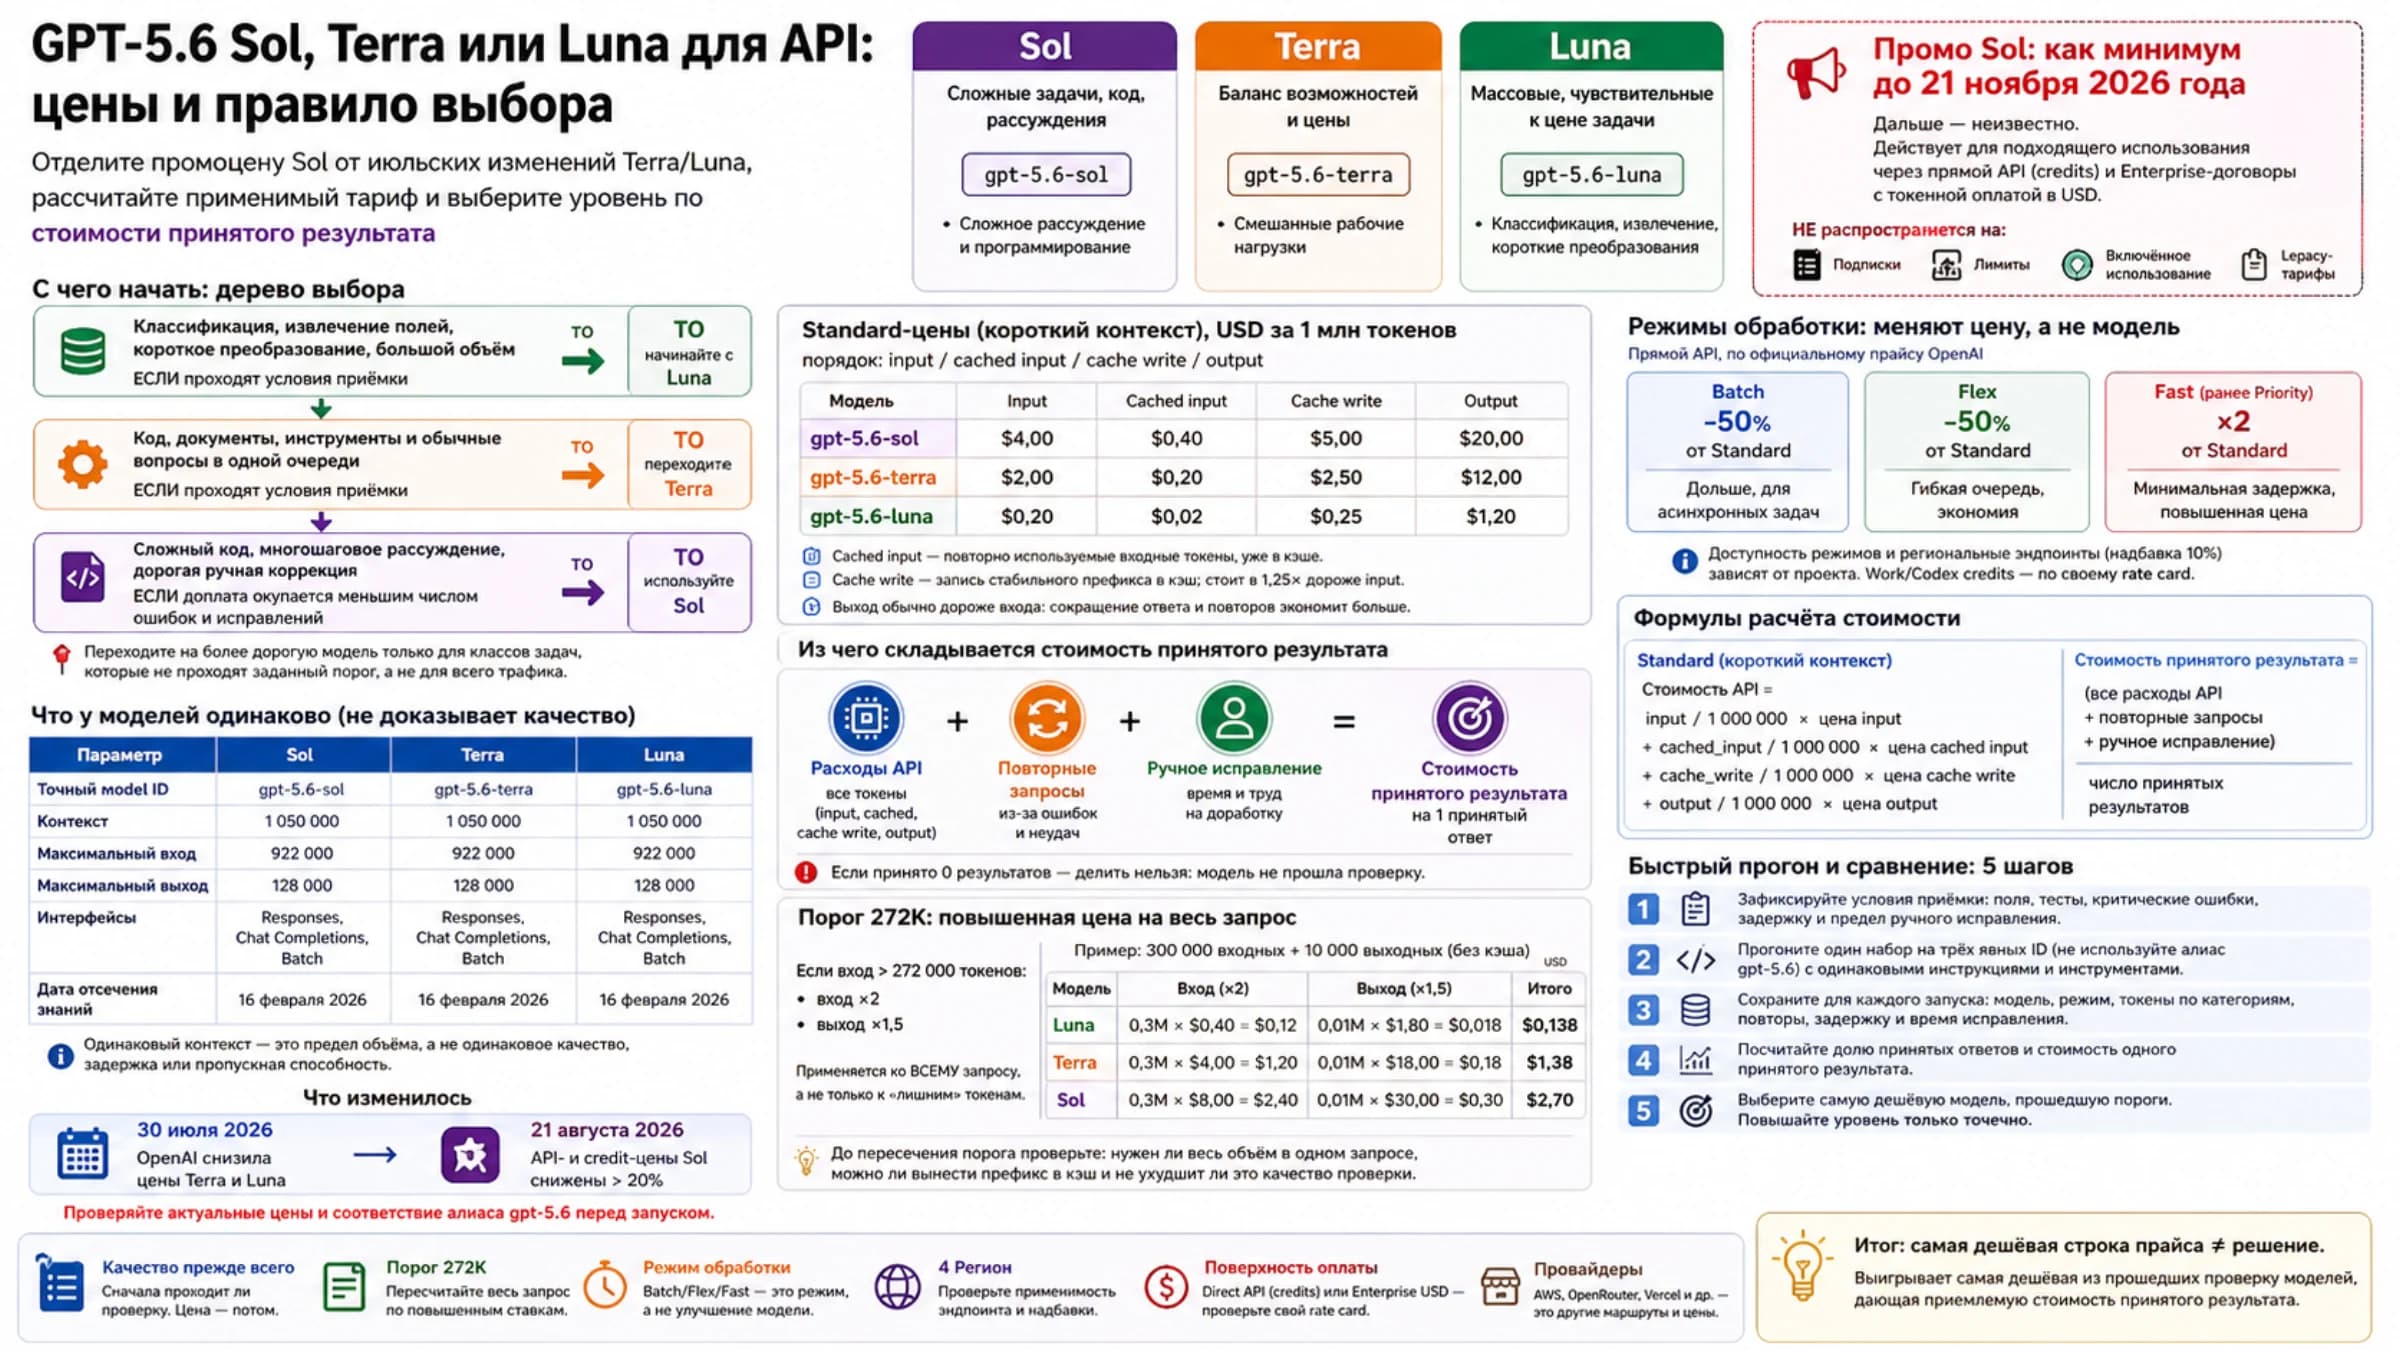
У Sol действует временная промоцена. Отделите API от лимитов и кредитов, пересчитайте запрос и сравните три модели по стоимости принятого результата.
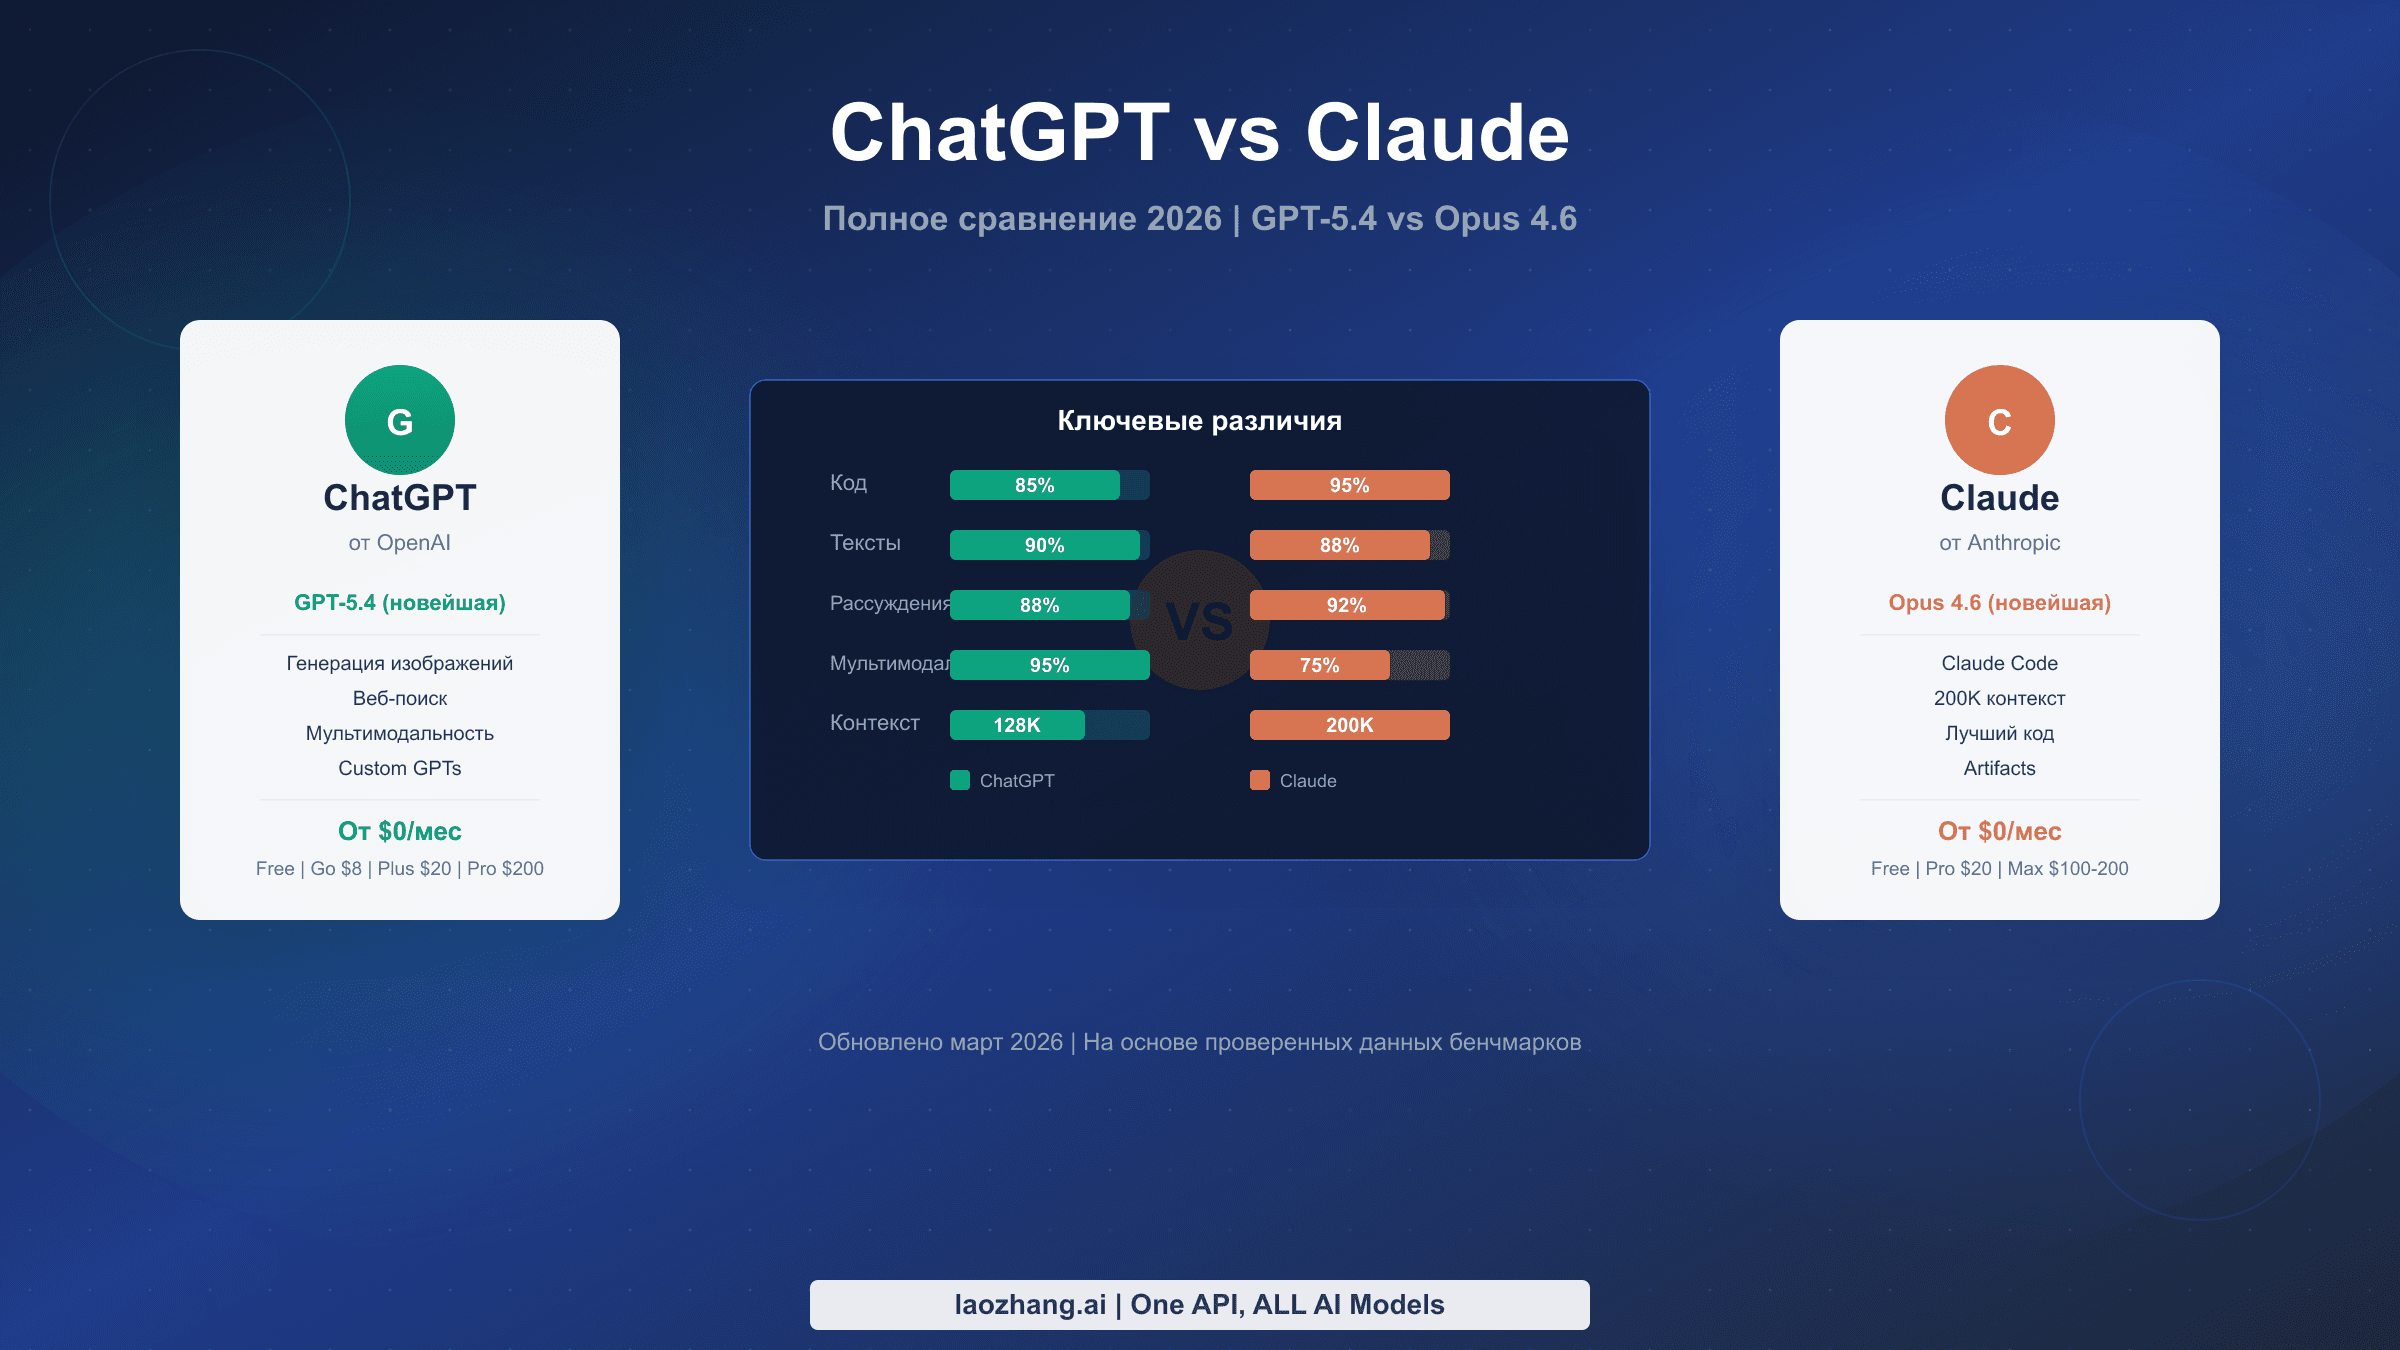
В марте 2026 года ChatGPT (GPT-5.4) и Claude (Opus 4.6) представляют двух ведущих ИИ-ассистентов с различными преимуществами. ChatGPT превосходит в мультимодальных задачах, генерации изображений и веб-поиске, тогда как Claude лидирует в точности кода, анализе длинных документов и инструментах для разработчиков. Оба предлагают бесплатные тарифы и платные планы за $20/месяц. Данное руководство сравнивает их по кодированию, написанию текстов, исследованиям, ценам и API на основе проверенных данных.
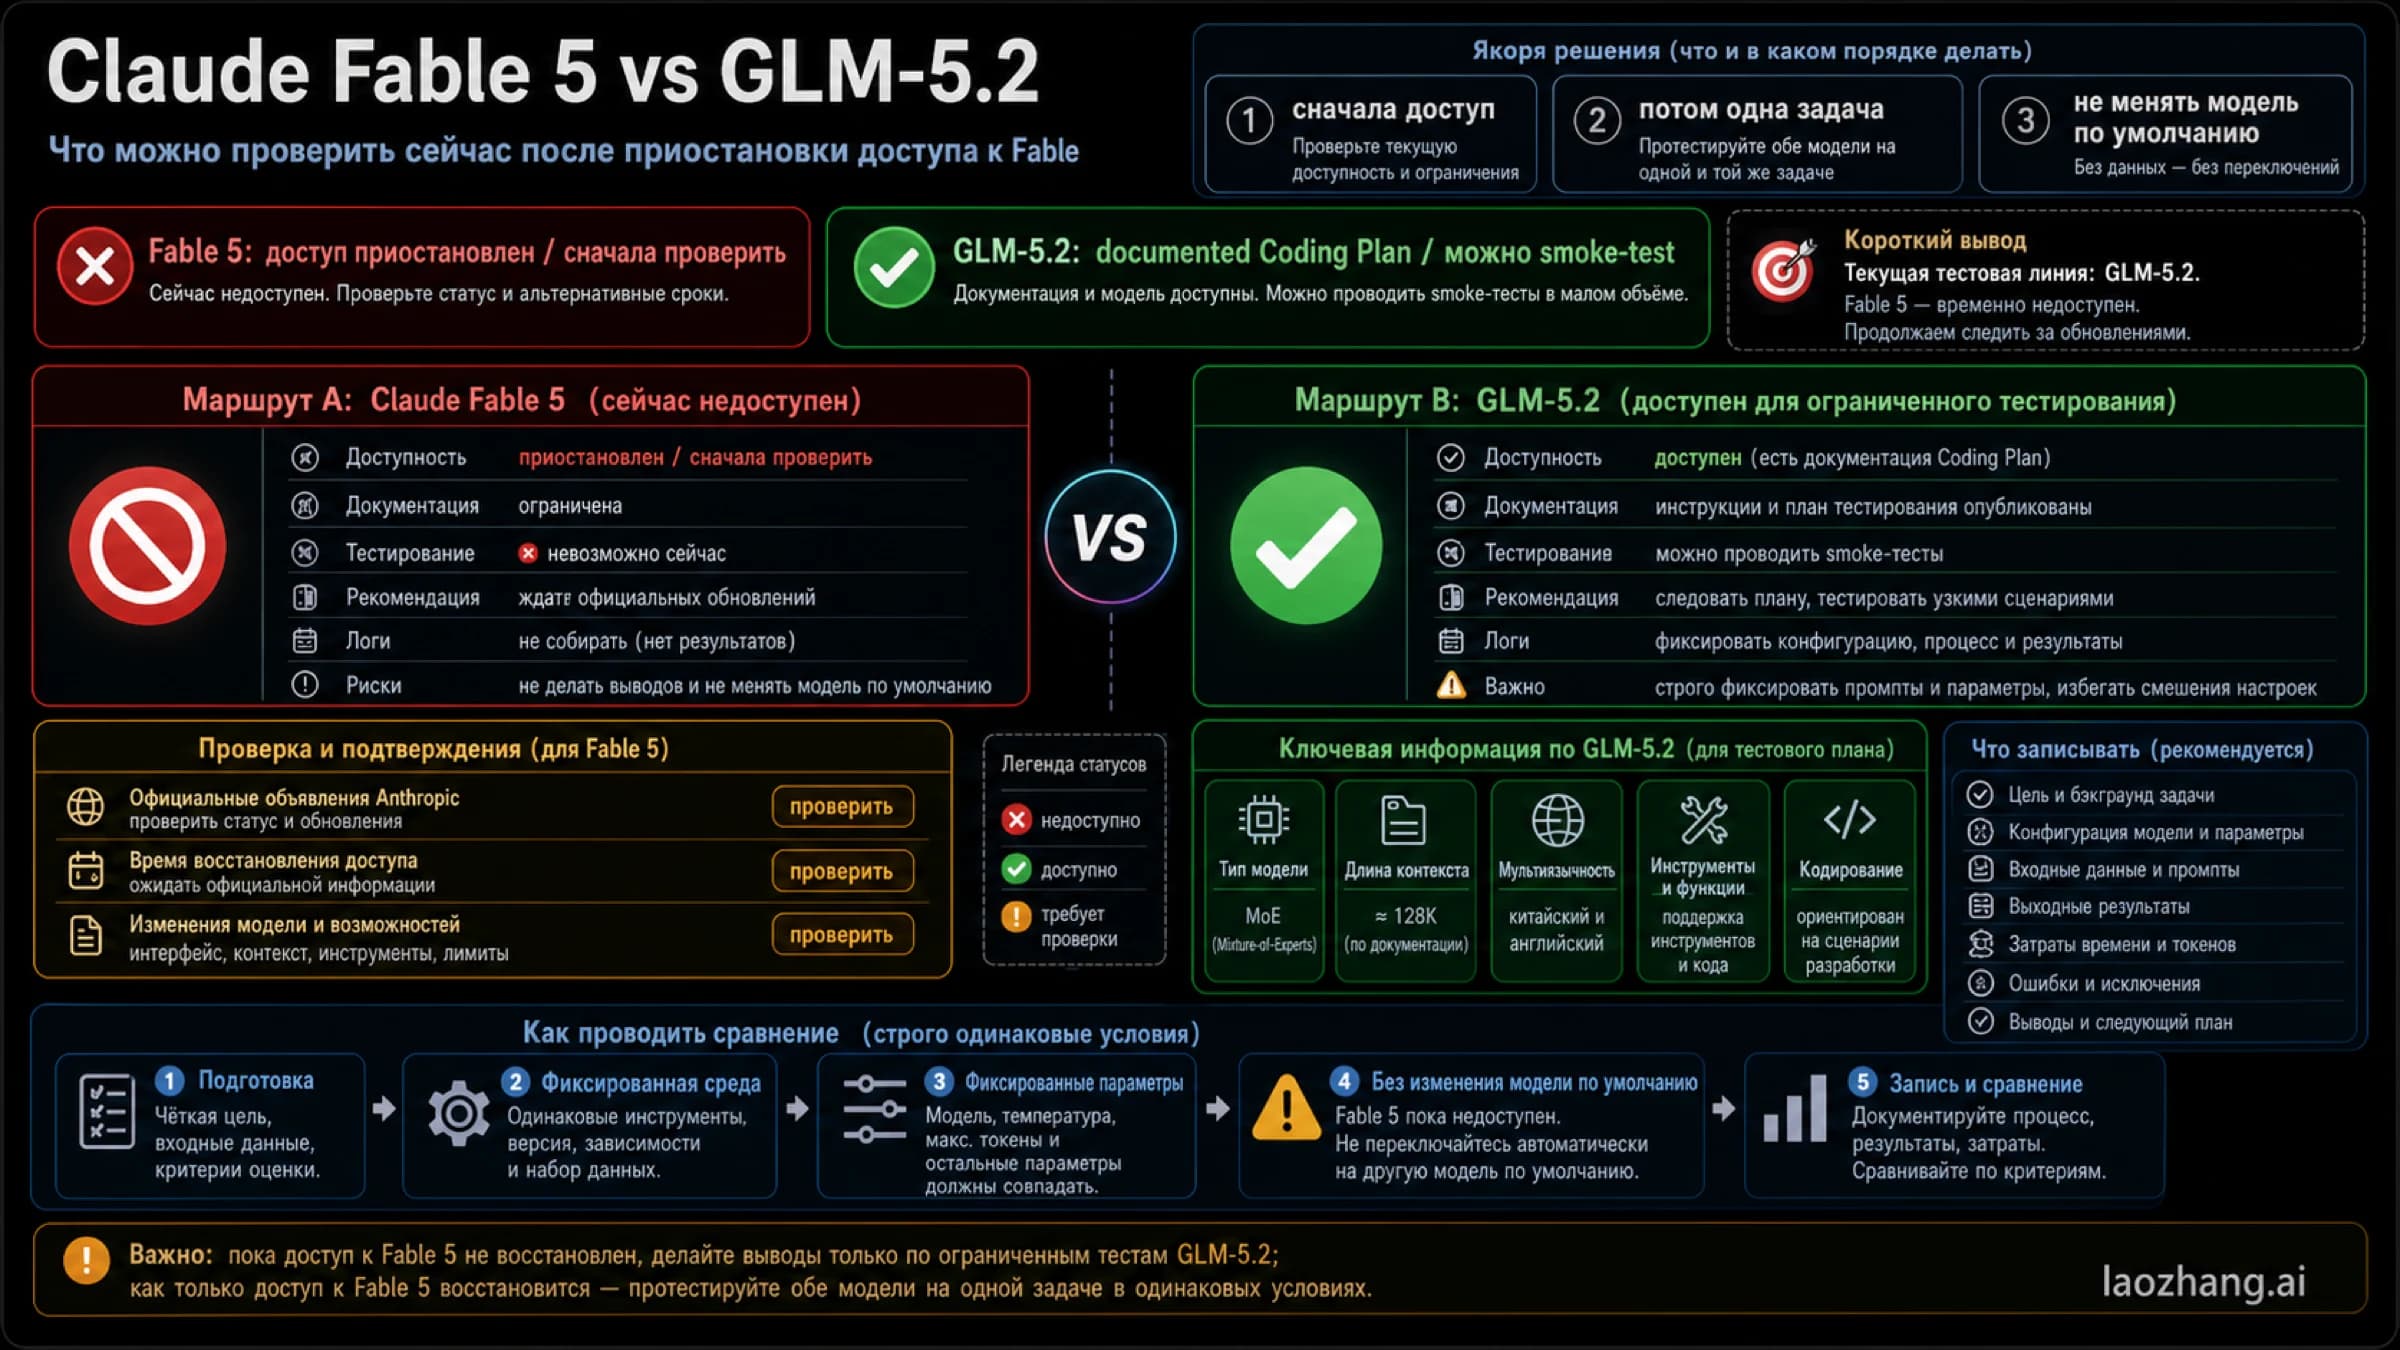
Fable 5 сейчас является веткой ожидания и повторной проверки, а GLM-5.2 — документированной веткой Z.AI Coding Plan для небольшого smoke test. Не меняйте default model без evidence from the same task.
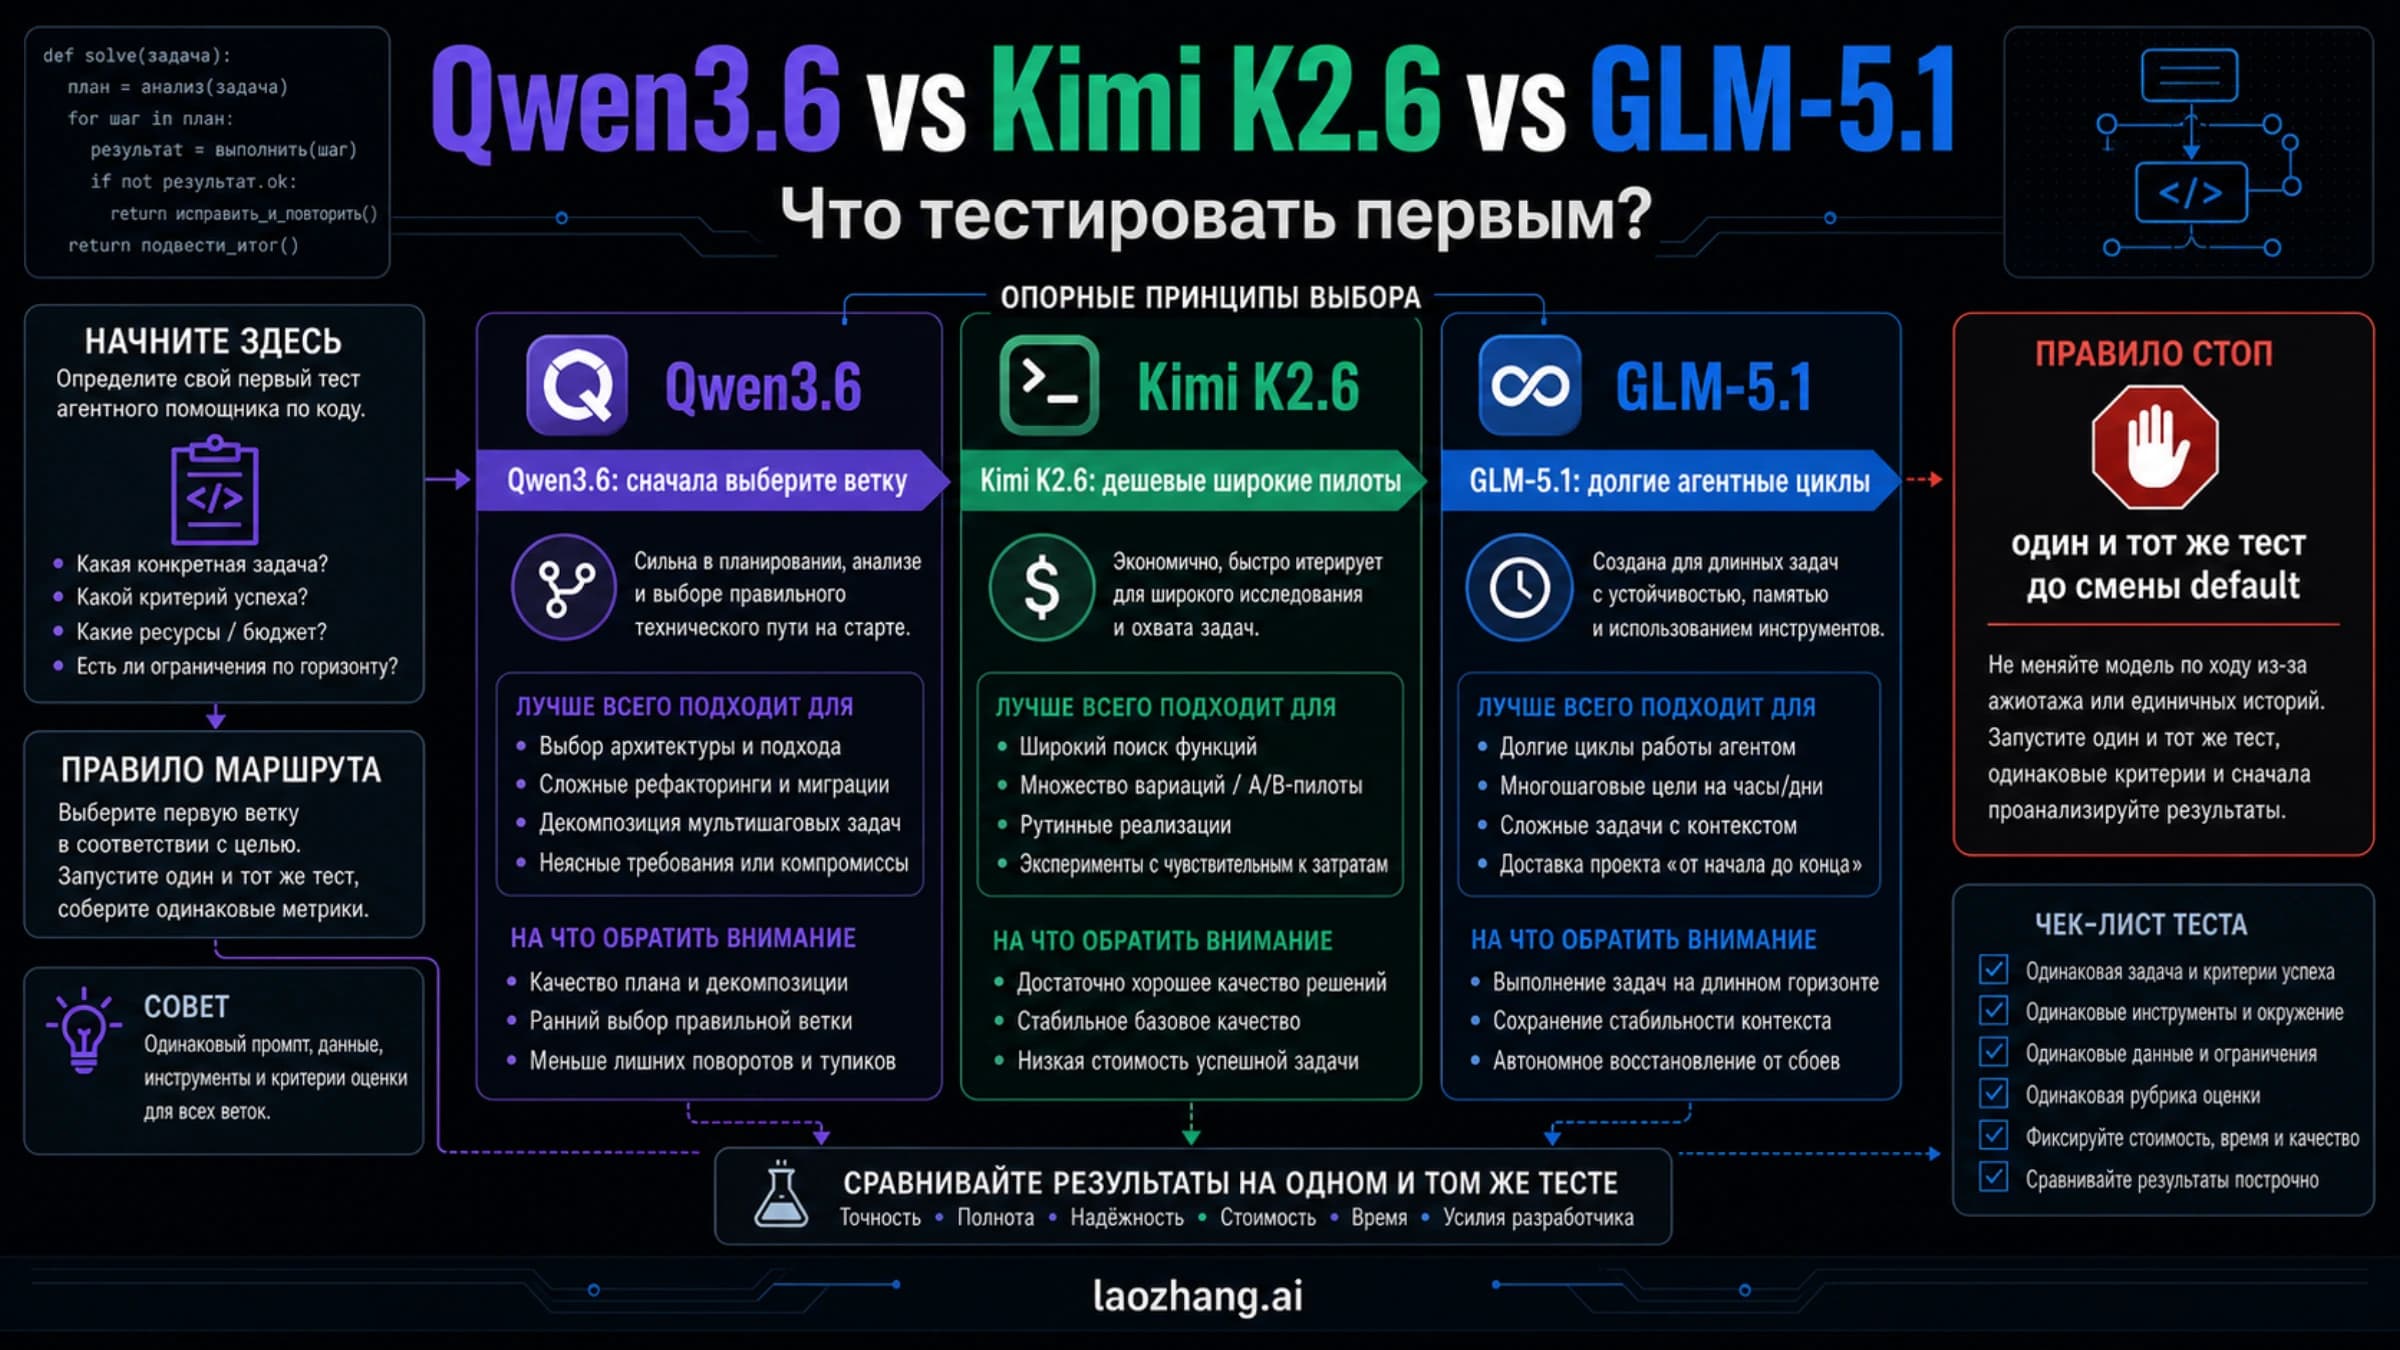
Для long-horizon agent work первым тестируйте GLM-5.1, для дешевых пилотов Kimi K2.6, а Qwen3.6 только после выбора 35B-A3B или hosted branch.
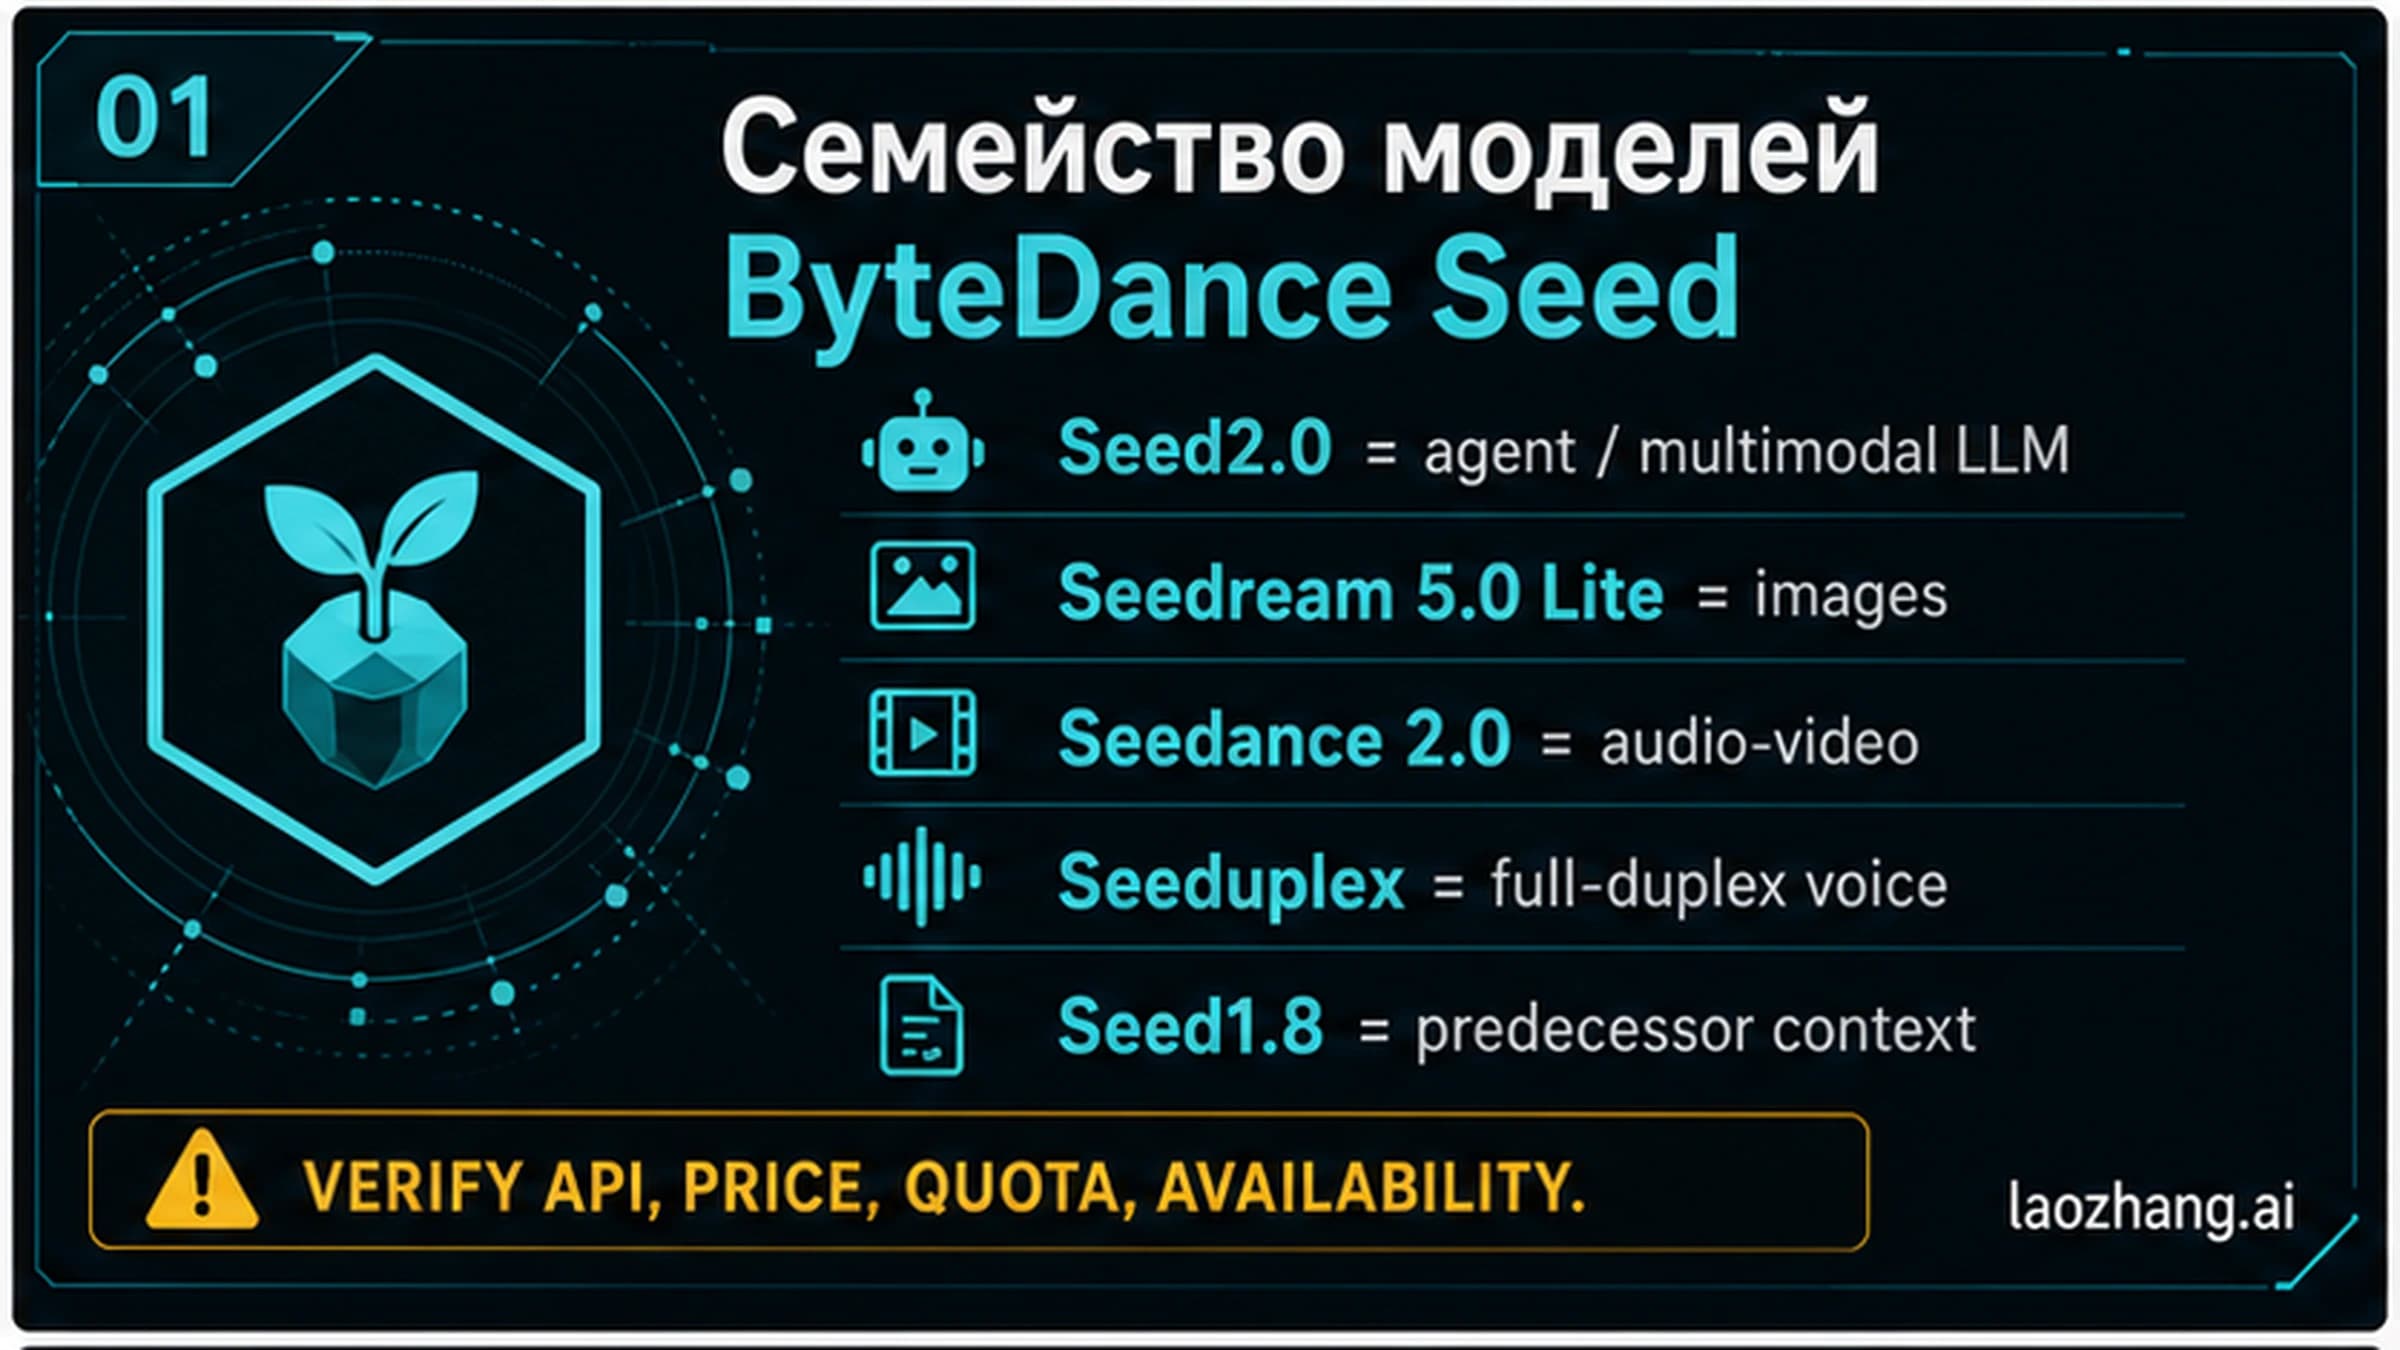
Для агентных LLM начните с Seed2.0, для изображений с Seedream, для аудио-видео с Seedance, для голоса с Seeduplex, а Seed1.8 оставьте как контекст прошлого поколения.
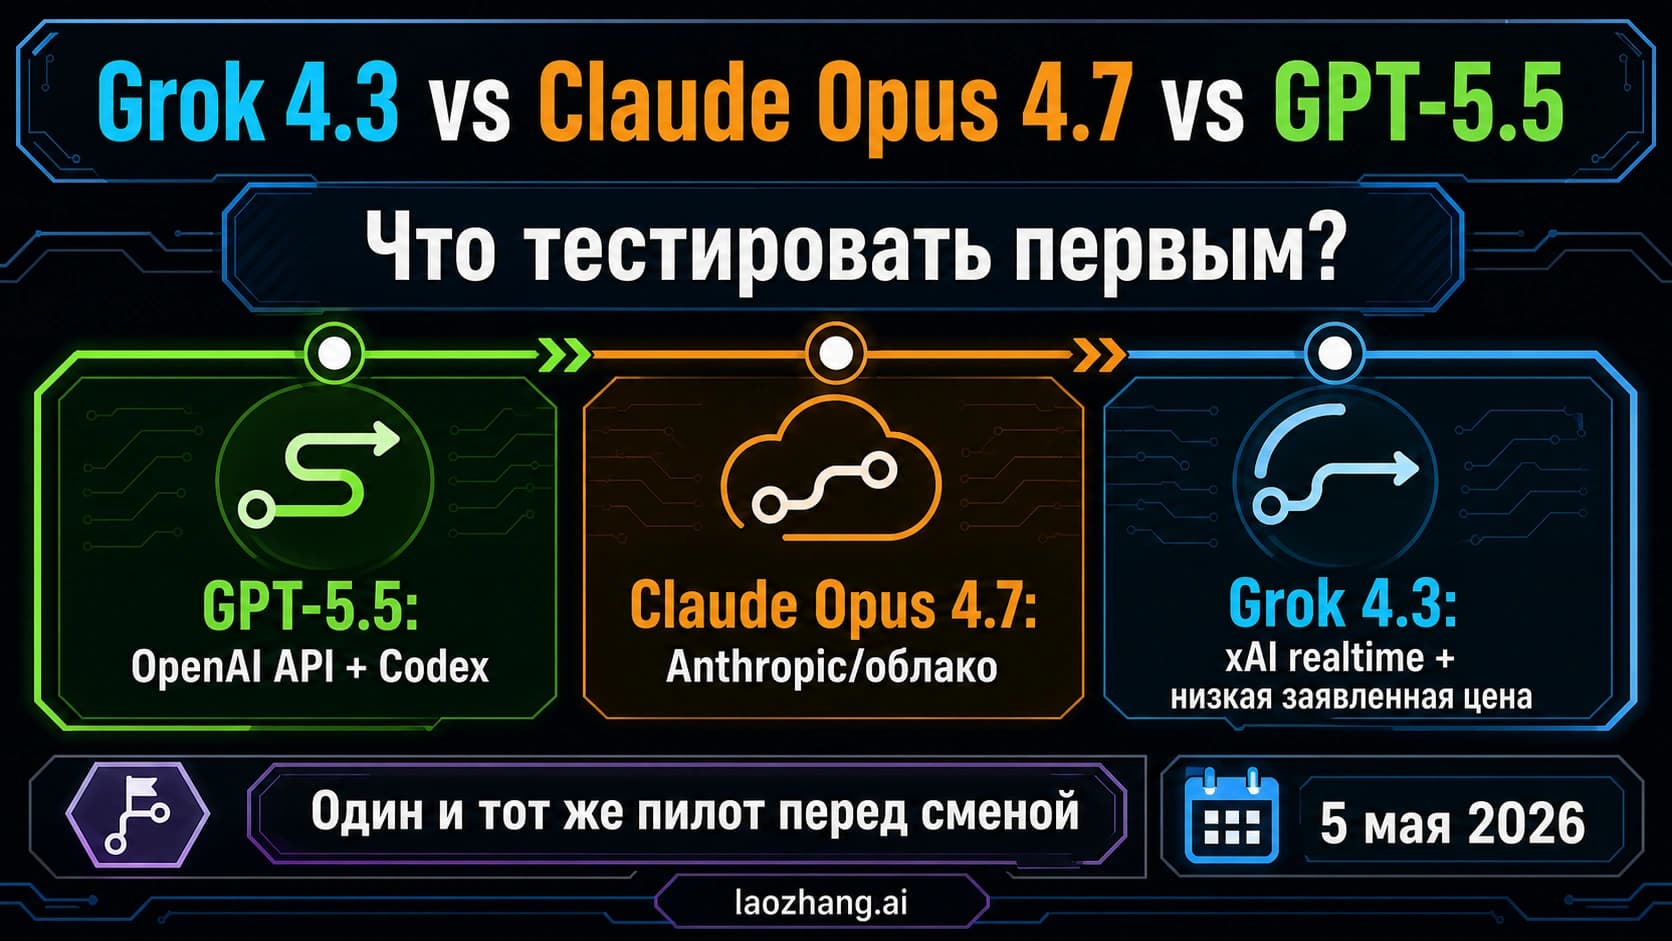
GPT-5.5 стоит тестировать первым в OpenAI-native стеке, Claude Opus 4.7 держать как premium control, а Grok 4.3 начинать при xAI realtime, цене или long-context пилоте.
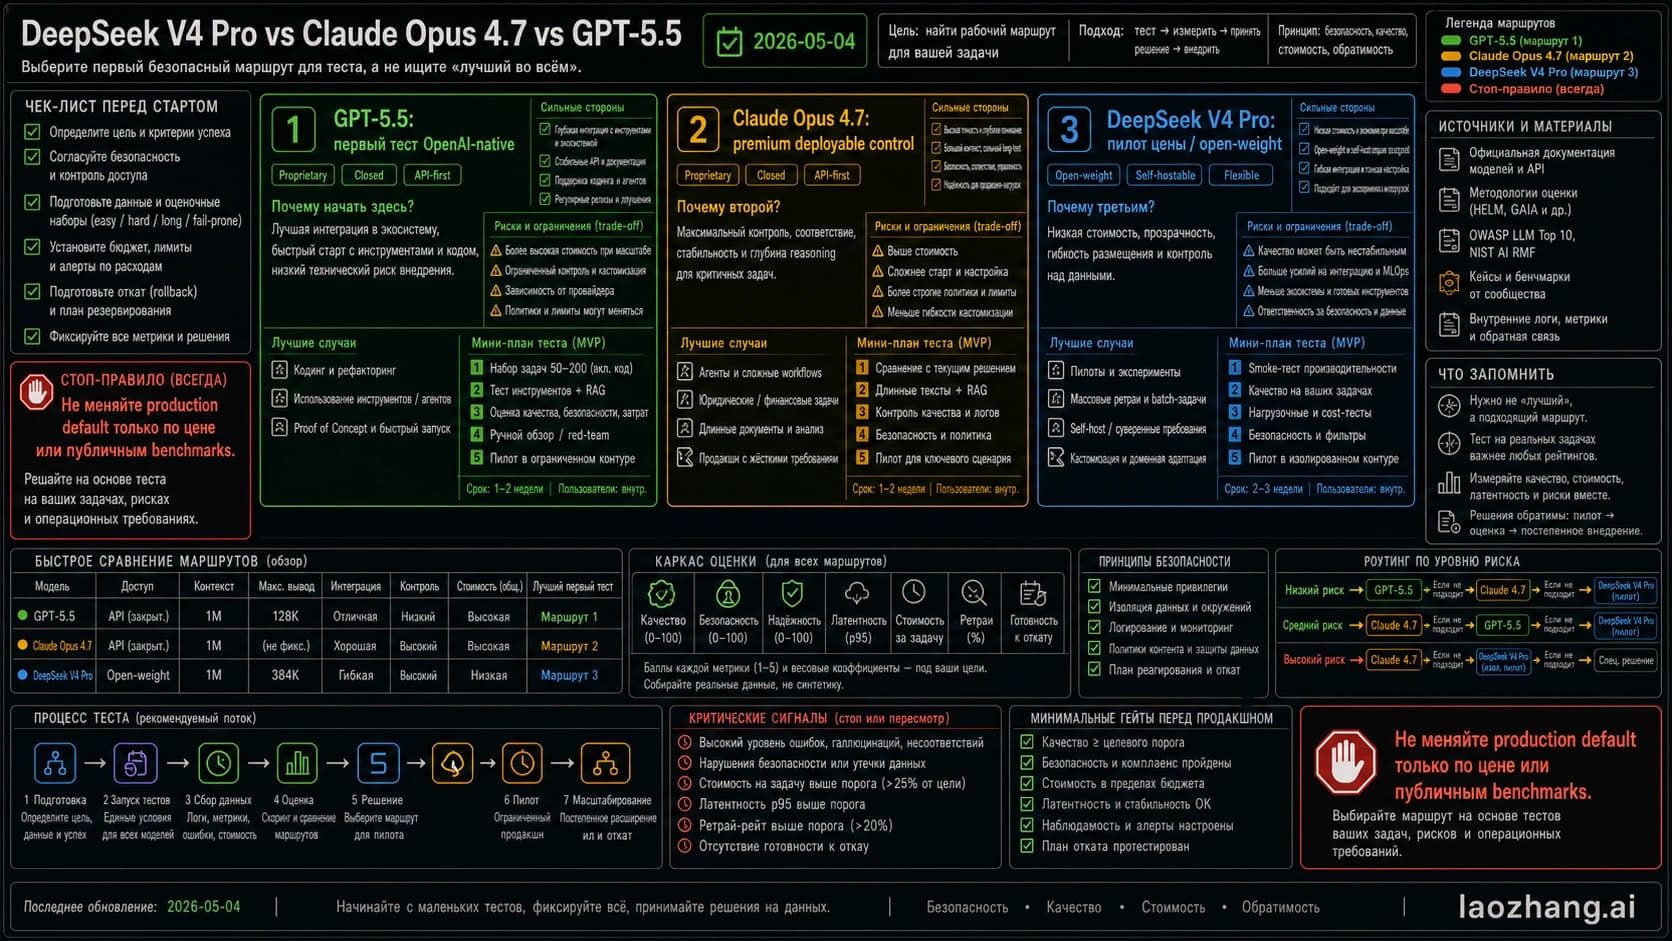
GPT-5.5 стоит тестировать первым в OpenAI-native задачах, Claude Opus 4.7 держать как premium control, а DeepSeek V4 Pro запускать как пилот для цены или open-weight сценариев.
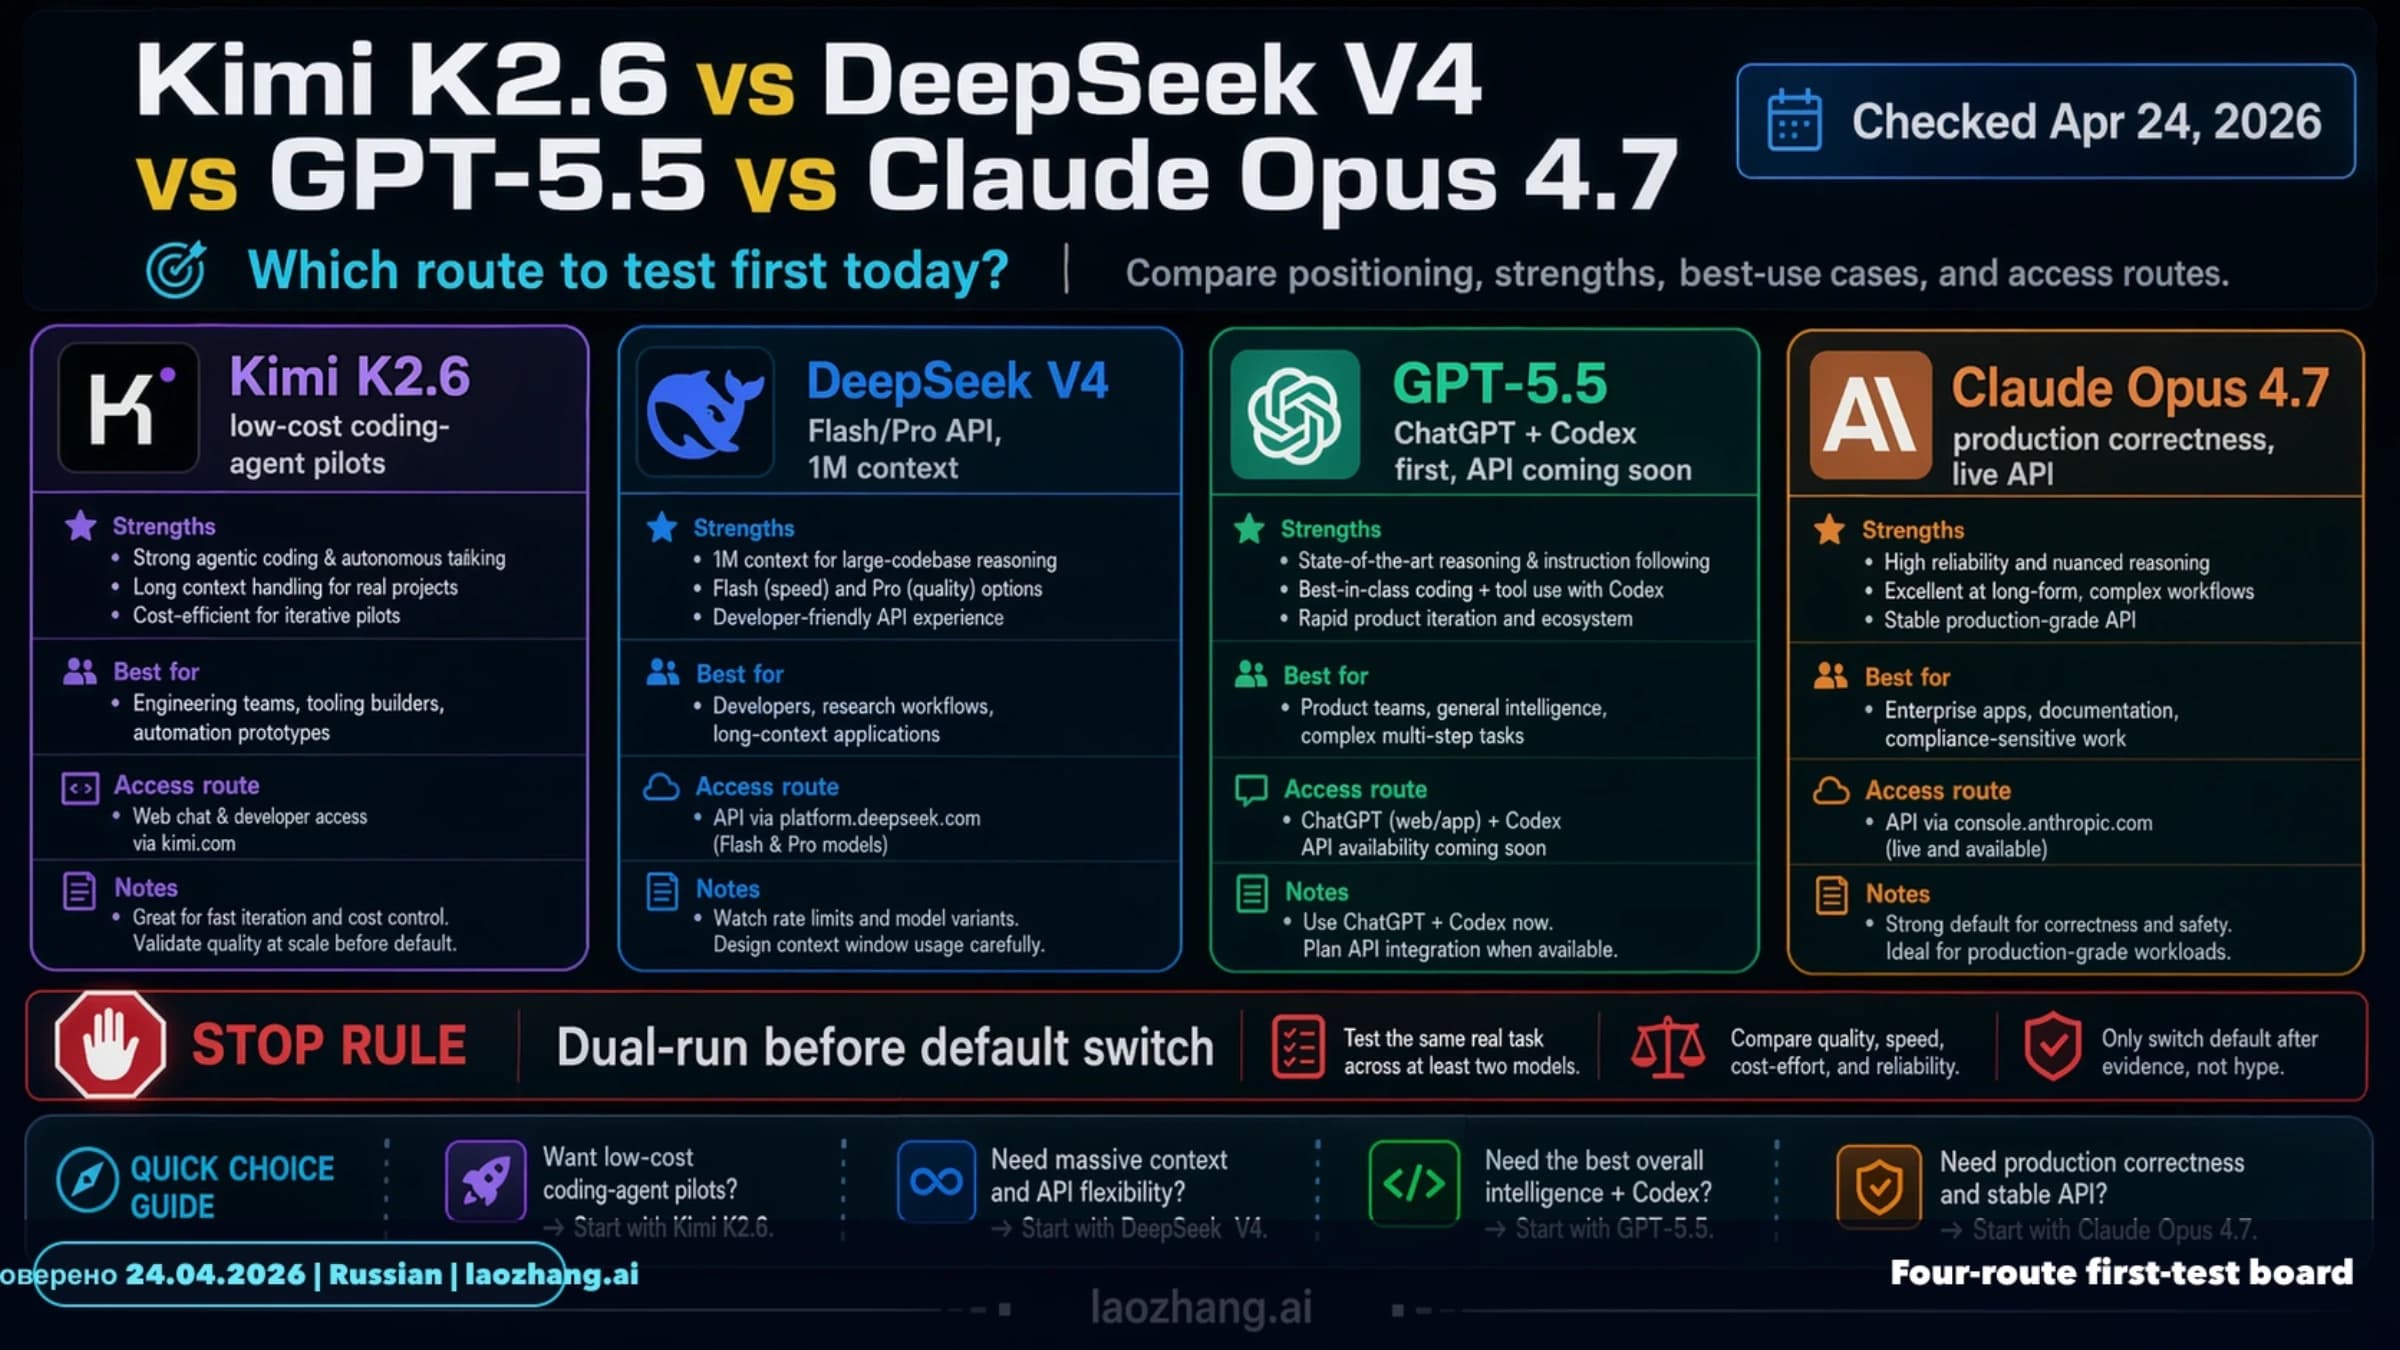
Kimi подходит для дешевых пилотов, DeepSeek V4 для текущих API-тестов, GPT-5.5 для OpenAI-поверхностей, Opus 4.7 для production correctness.
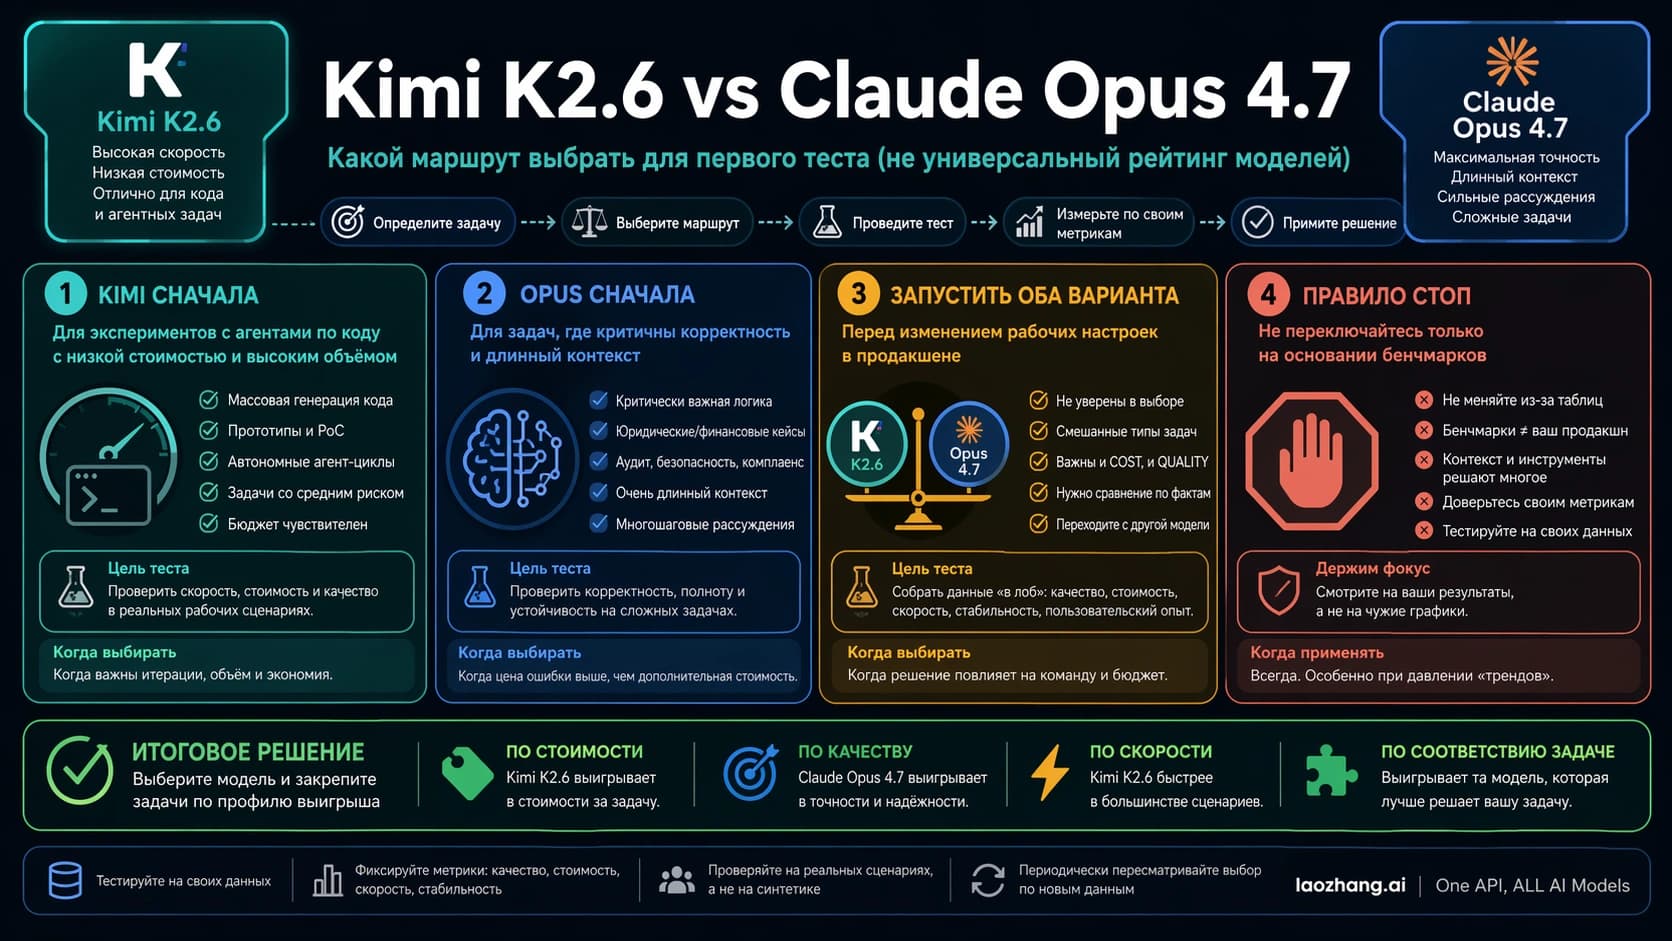
Начинайте с Kimi для дешевых массовых экспериментов, оставляйте Opus для рискованного production coding и запускайте dual-run перед сменой default.
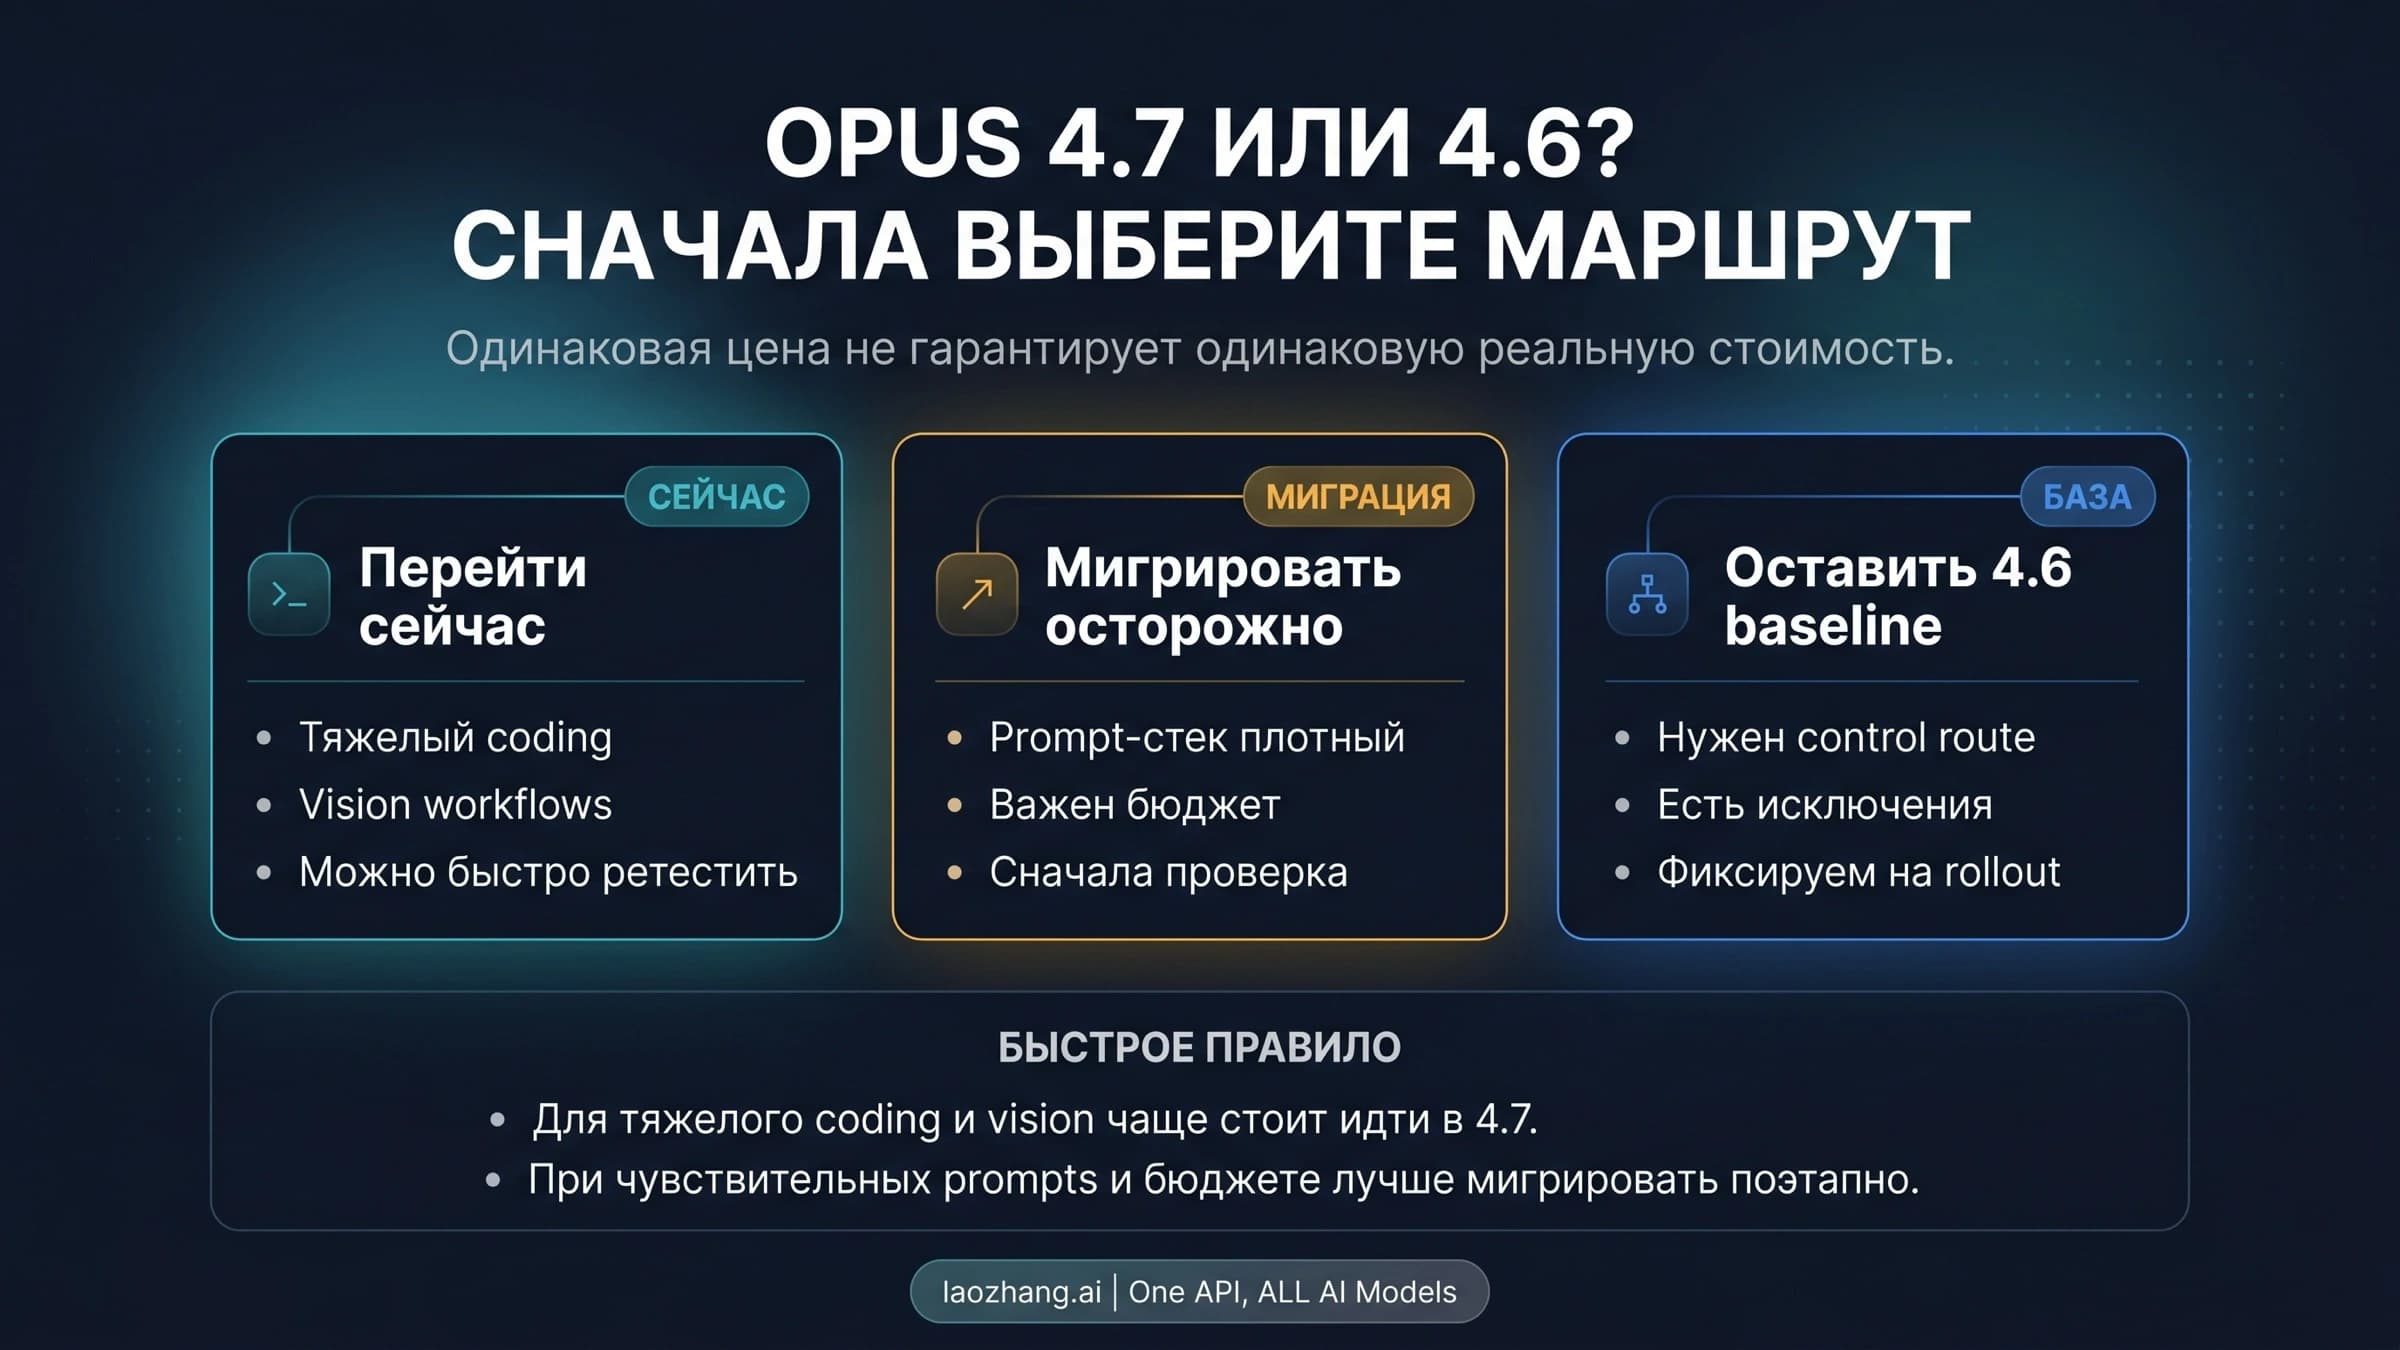
Это не пересказ релиза, а практическое руководство по upgrade: когда Claude Opus 4.7 уже стоит делать новым default, когда миграцию лучше растянуть по этапам и почему одинаковая цена в прайсе не означает одинаковую стоимость в реальной нагрузке.
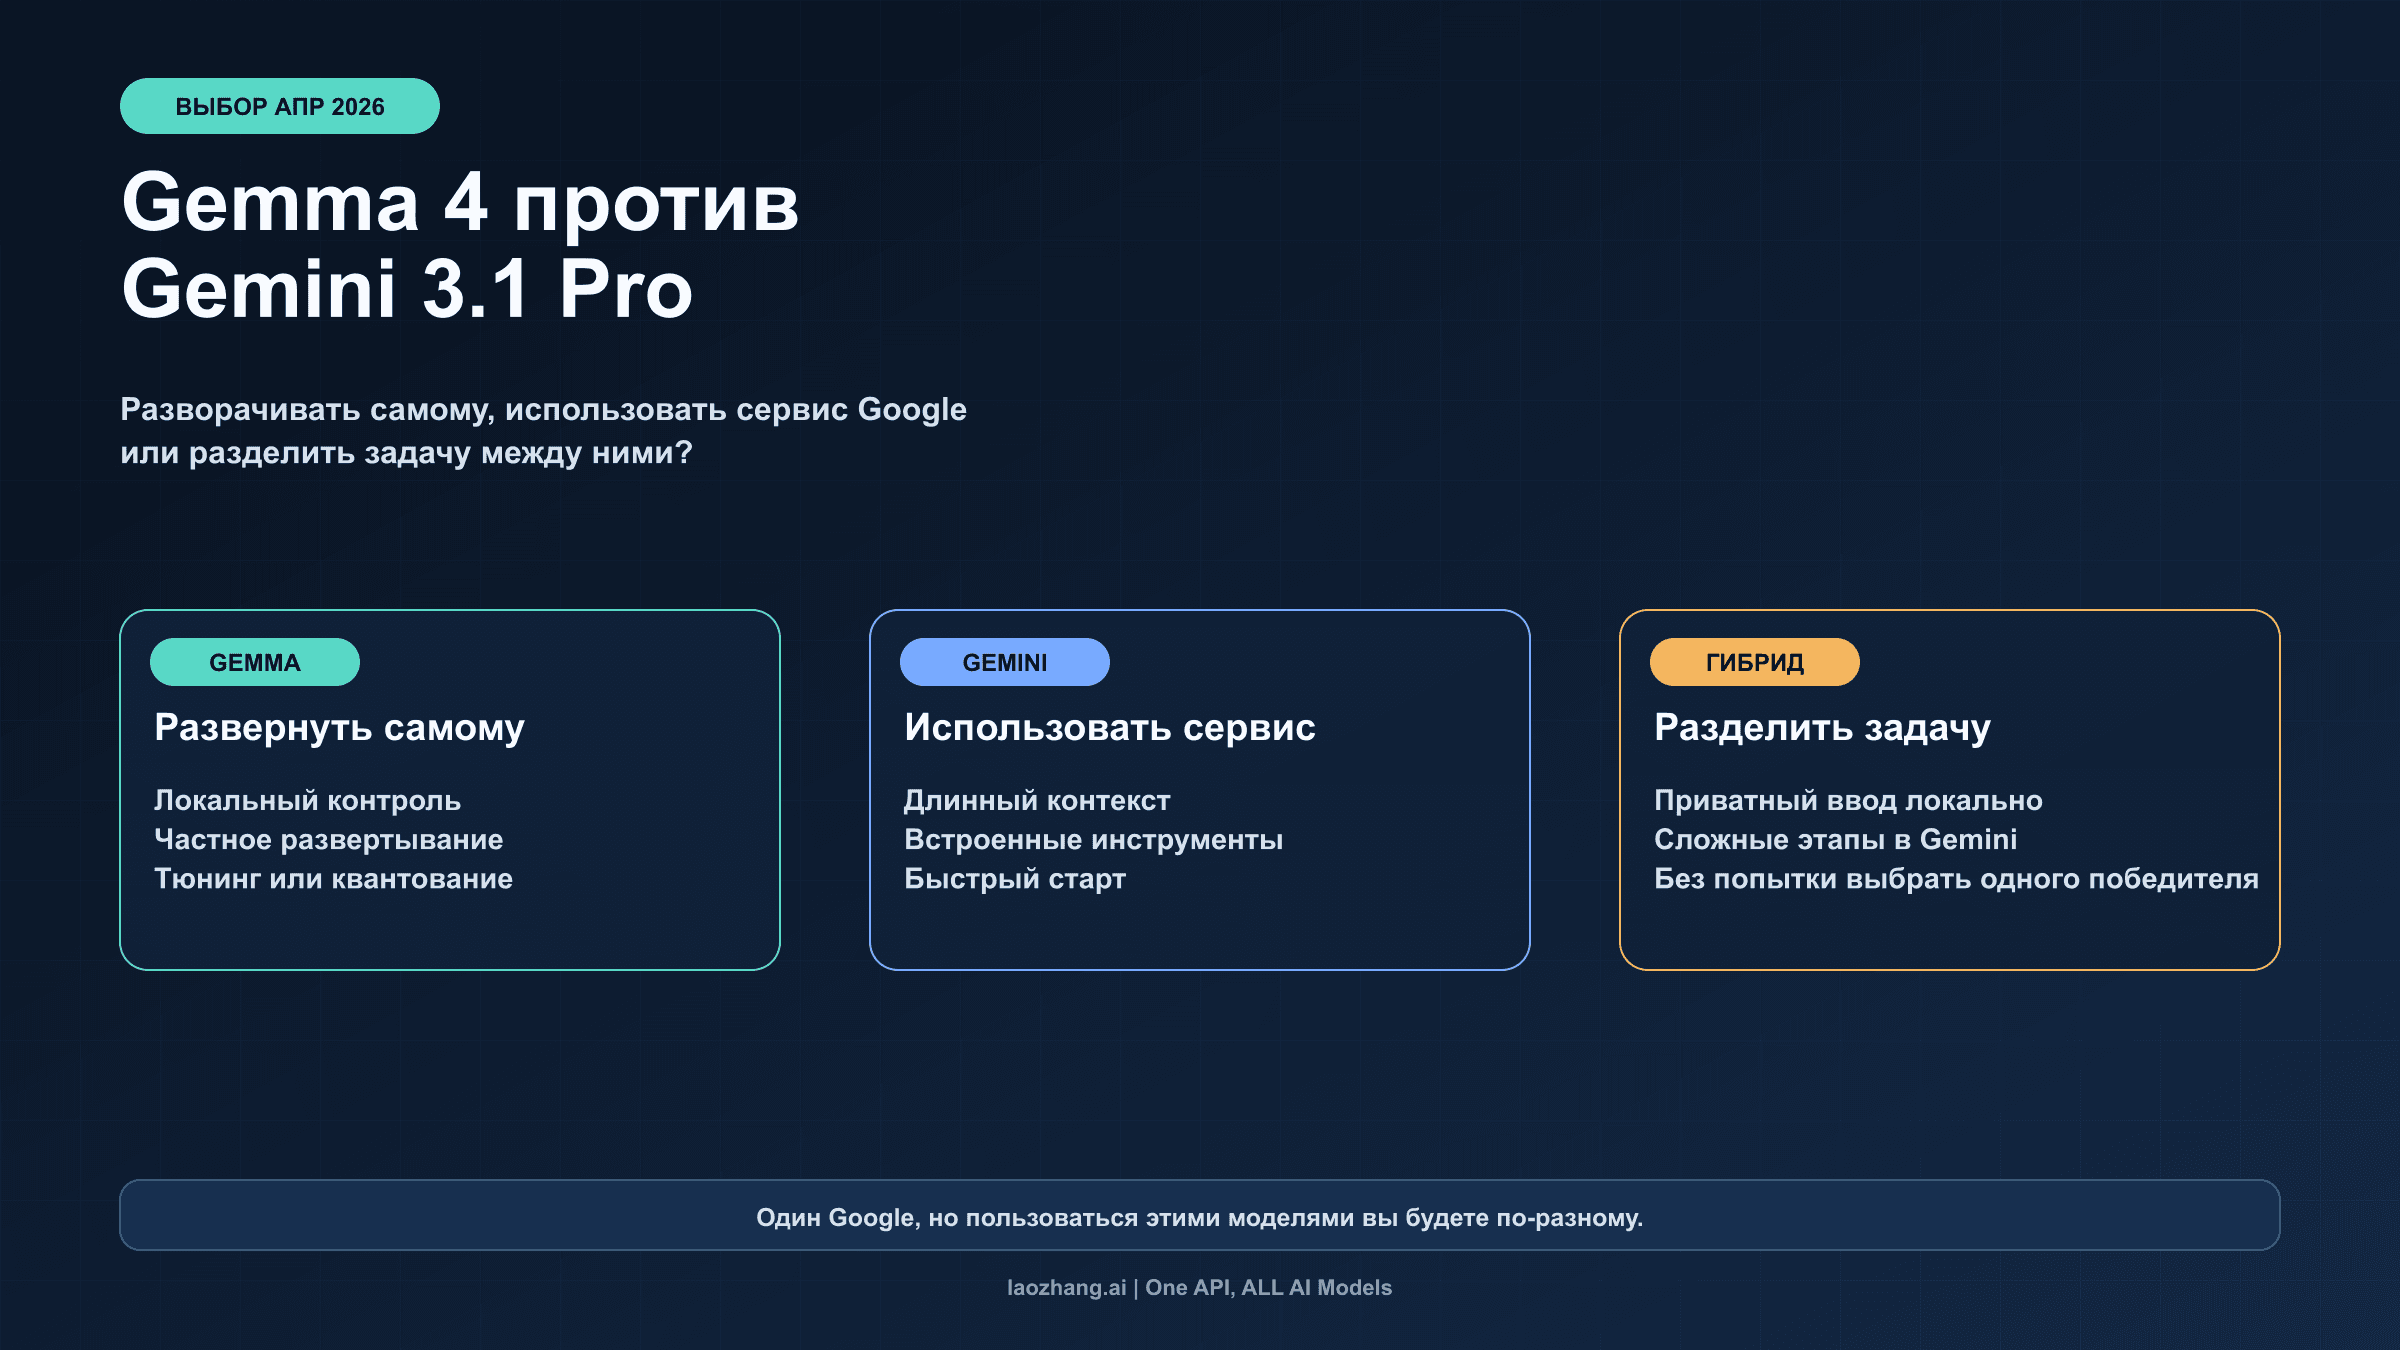
Если вам нужны открытые веса, собственный запуск, граница приватности и настройка, начните с Gemma 4. Если нужны длинный контекст, инструменты Google и более быстрый старт, начните с Gemini 3.1 Pro. Если процесс действительно делится на локальные и облачные этапы, выбирайте смешанную схему.
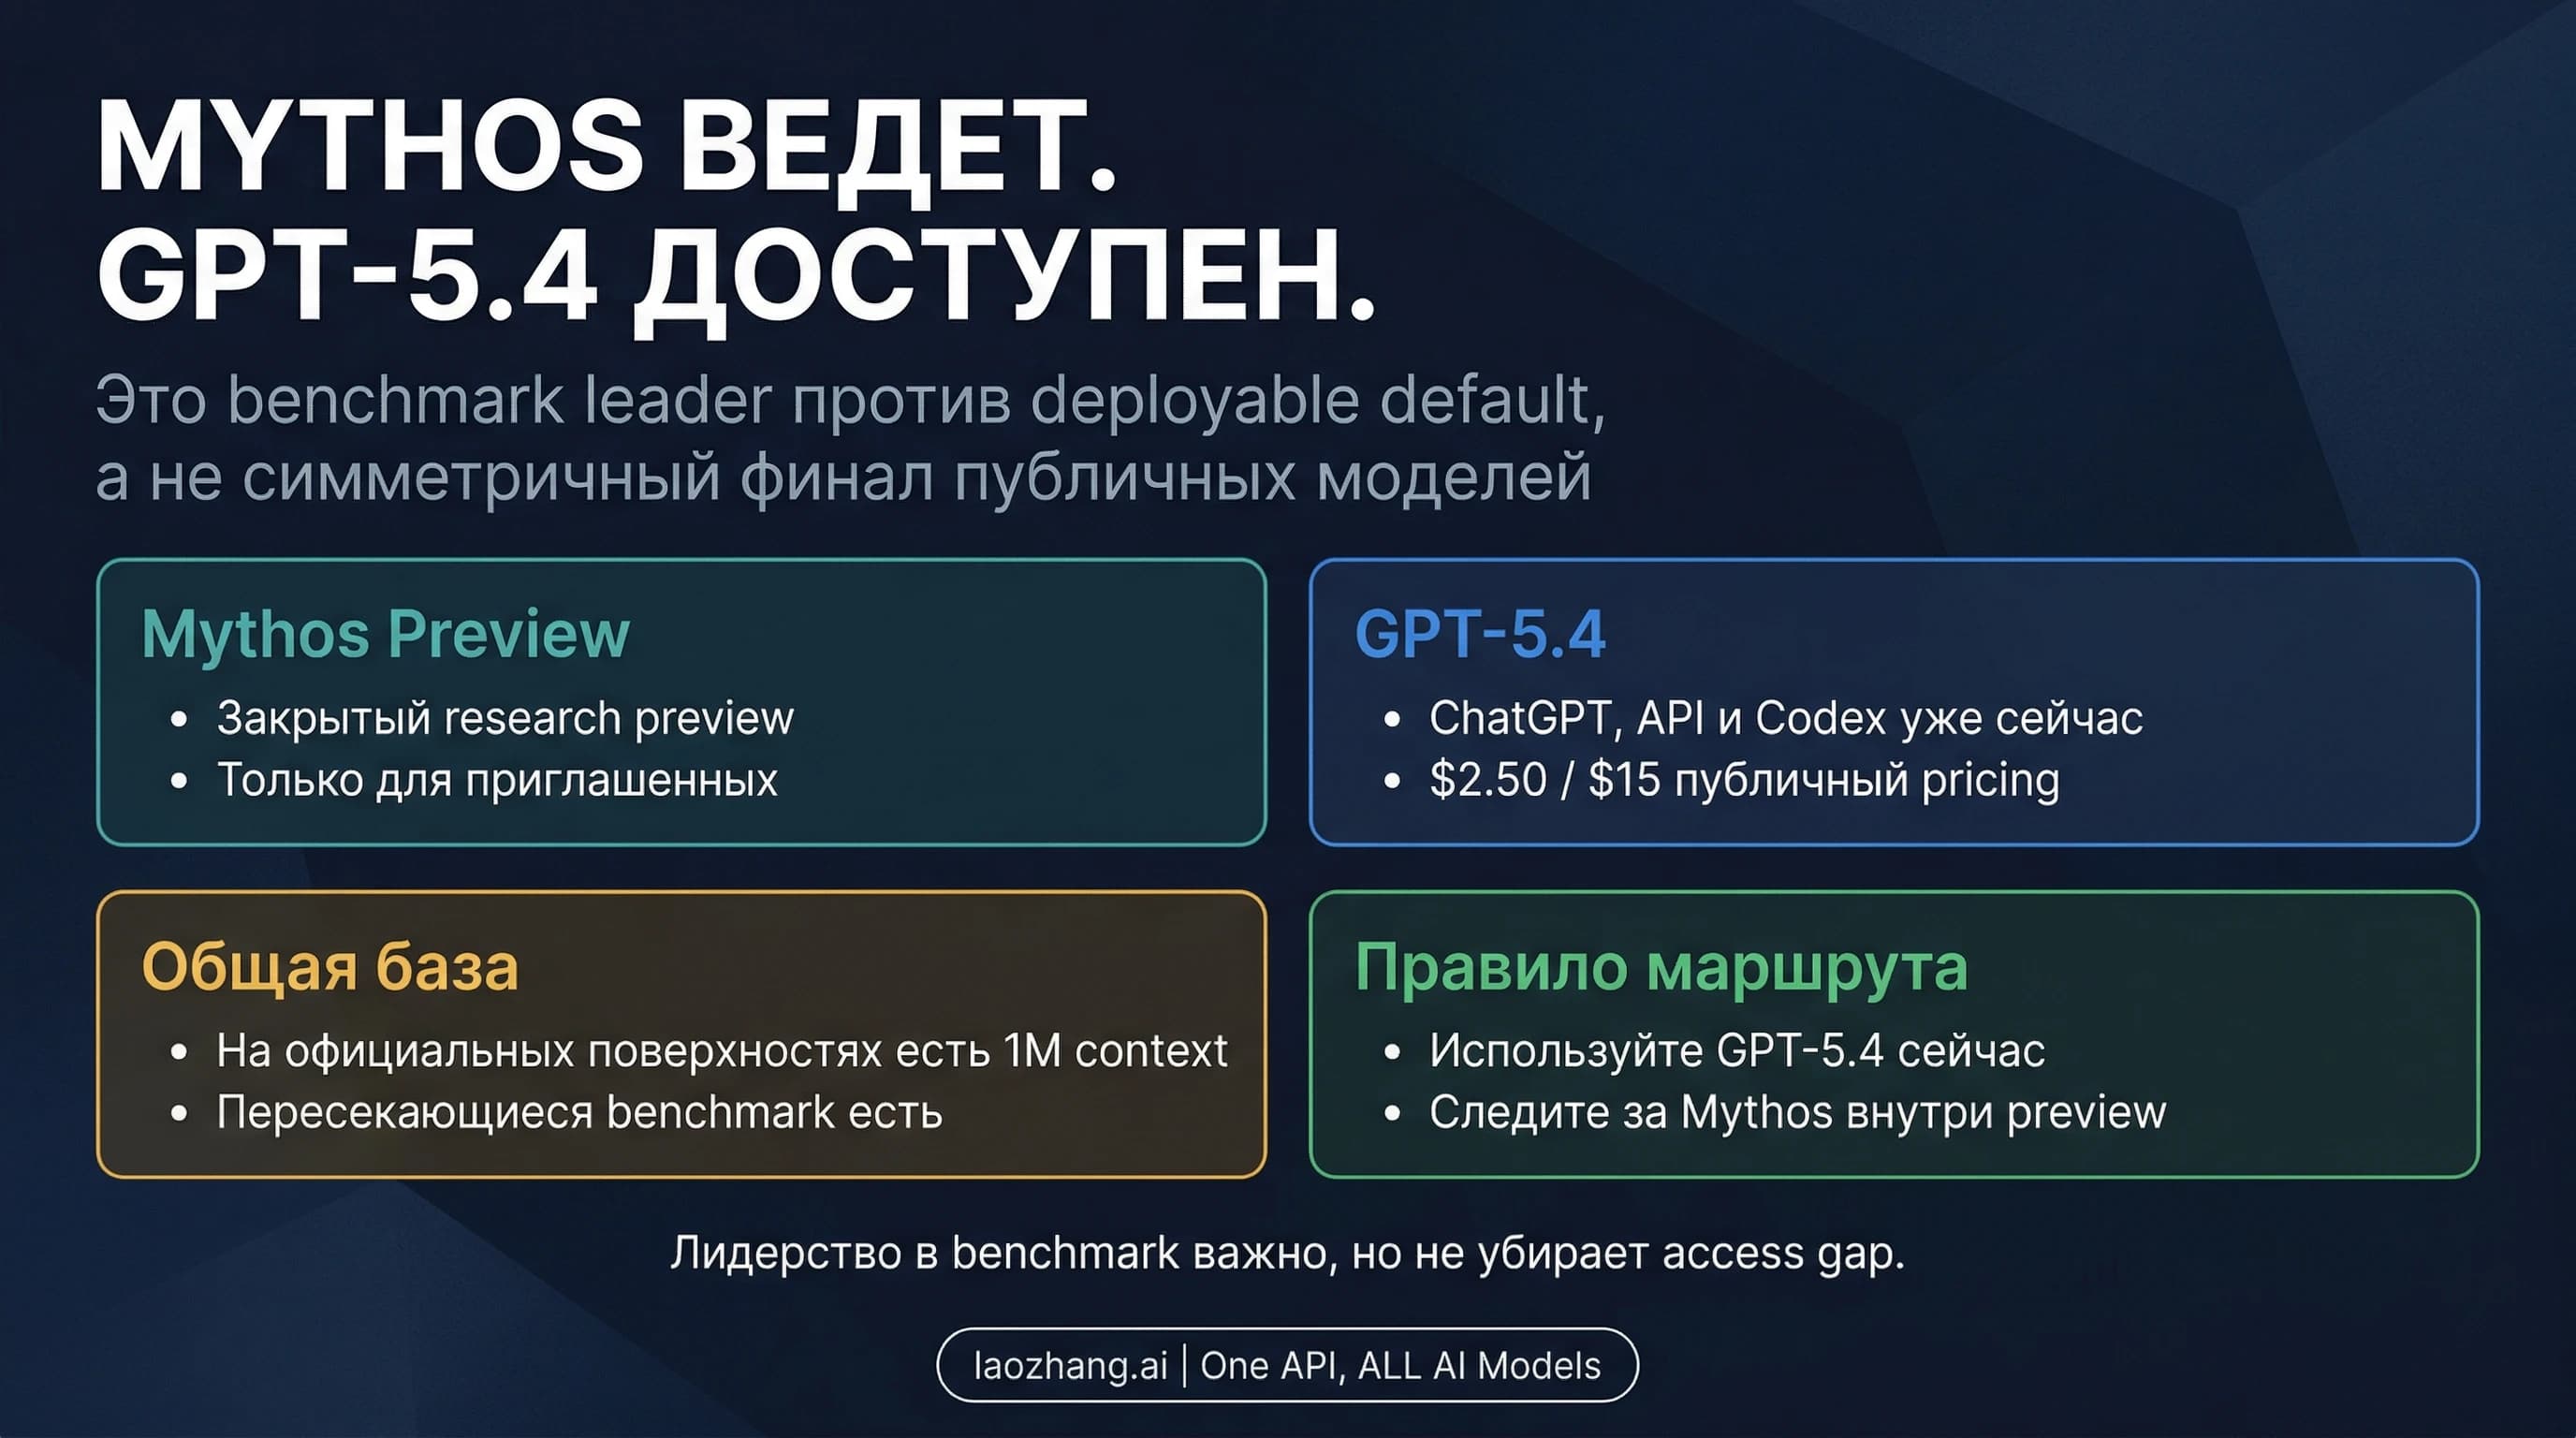
Если модель нужна вам сегодня, практический выбор по-прежнему GPT-5.4. Claude Mythos Preview важен из-за сильных официальных бенчмарков Anthropic, но это все еще закрытый research preview, а не обычный публичный маршрут для большинства пользователей.
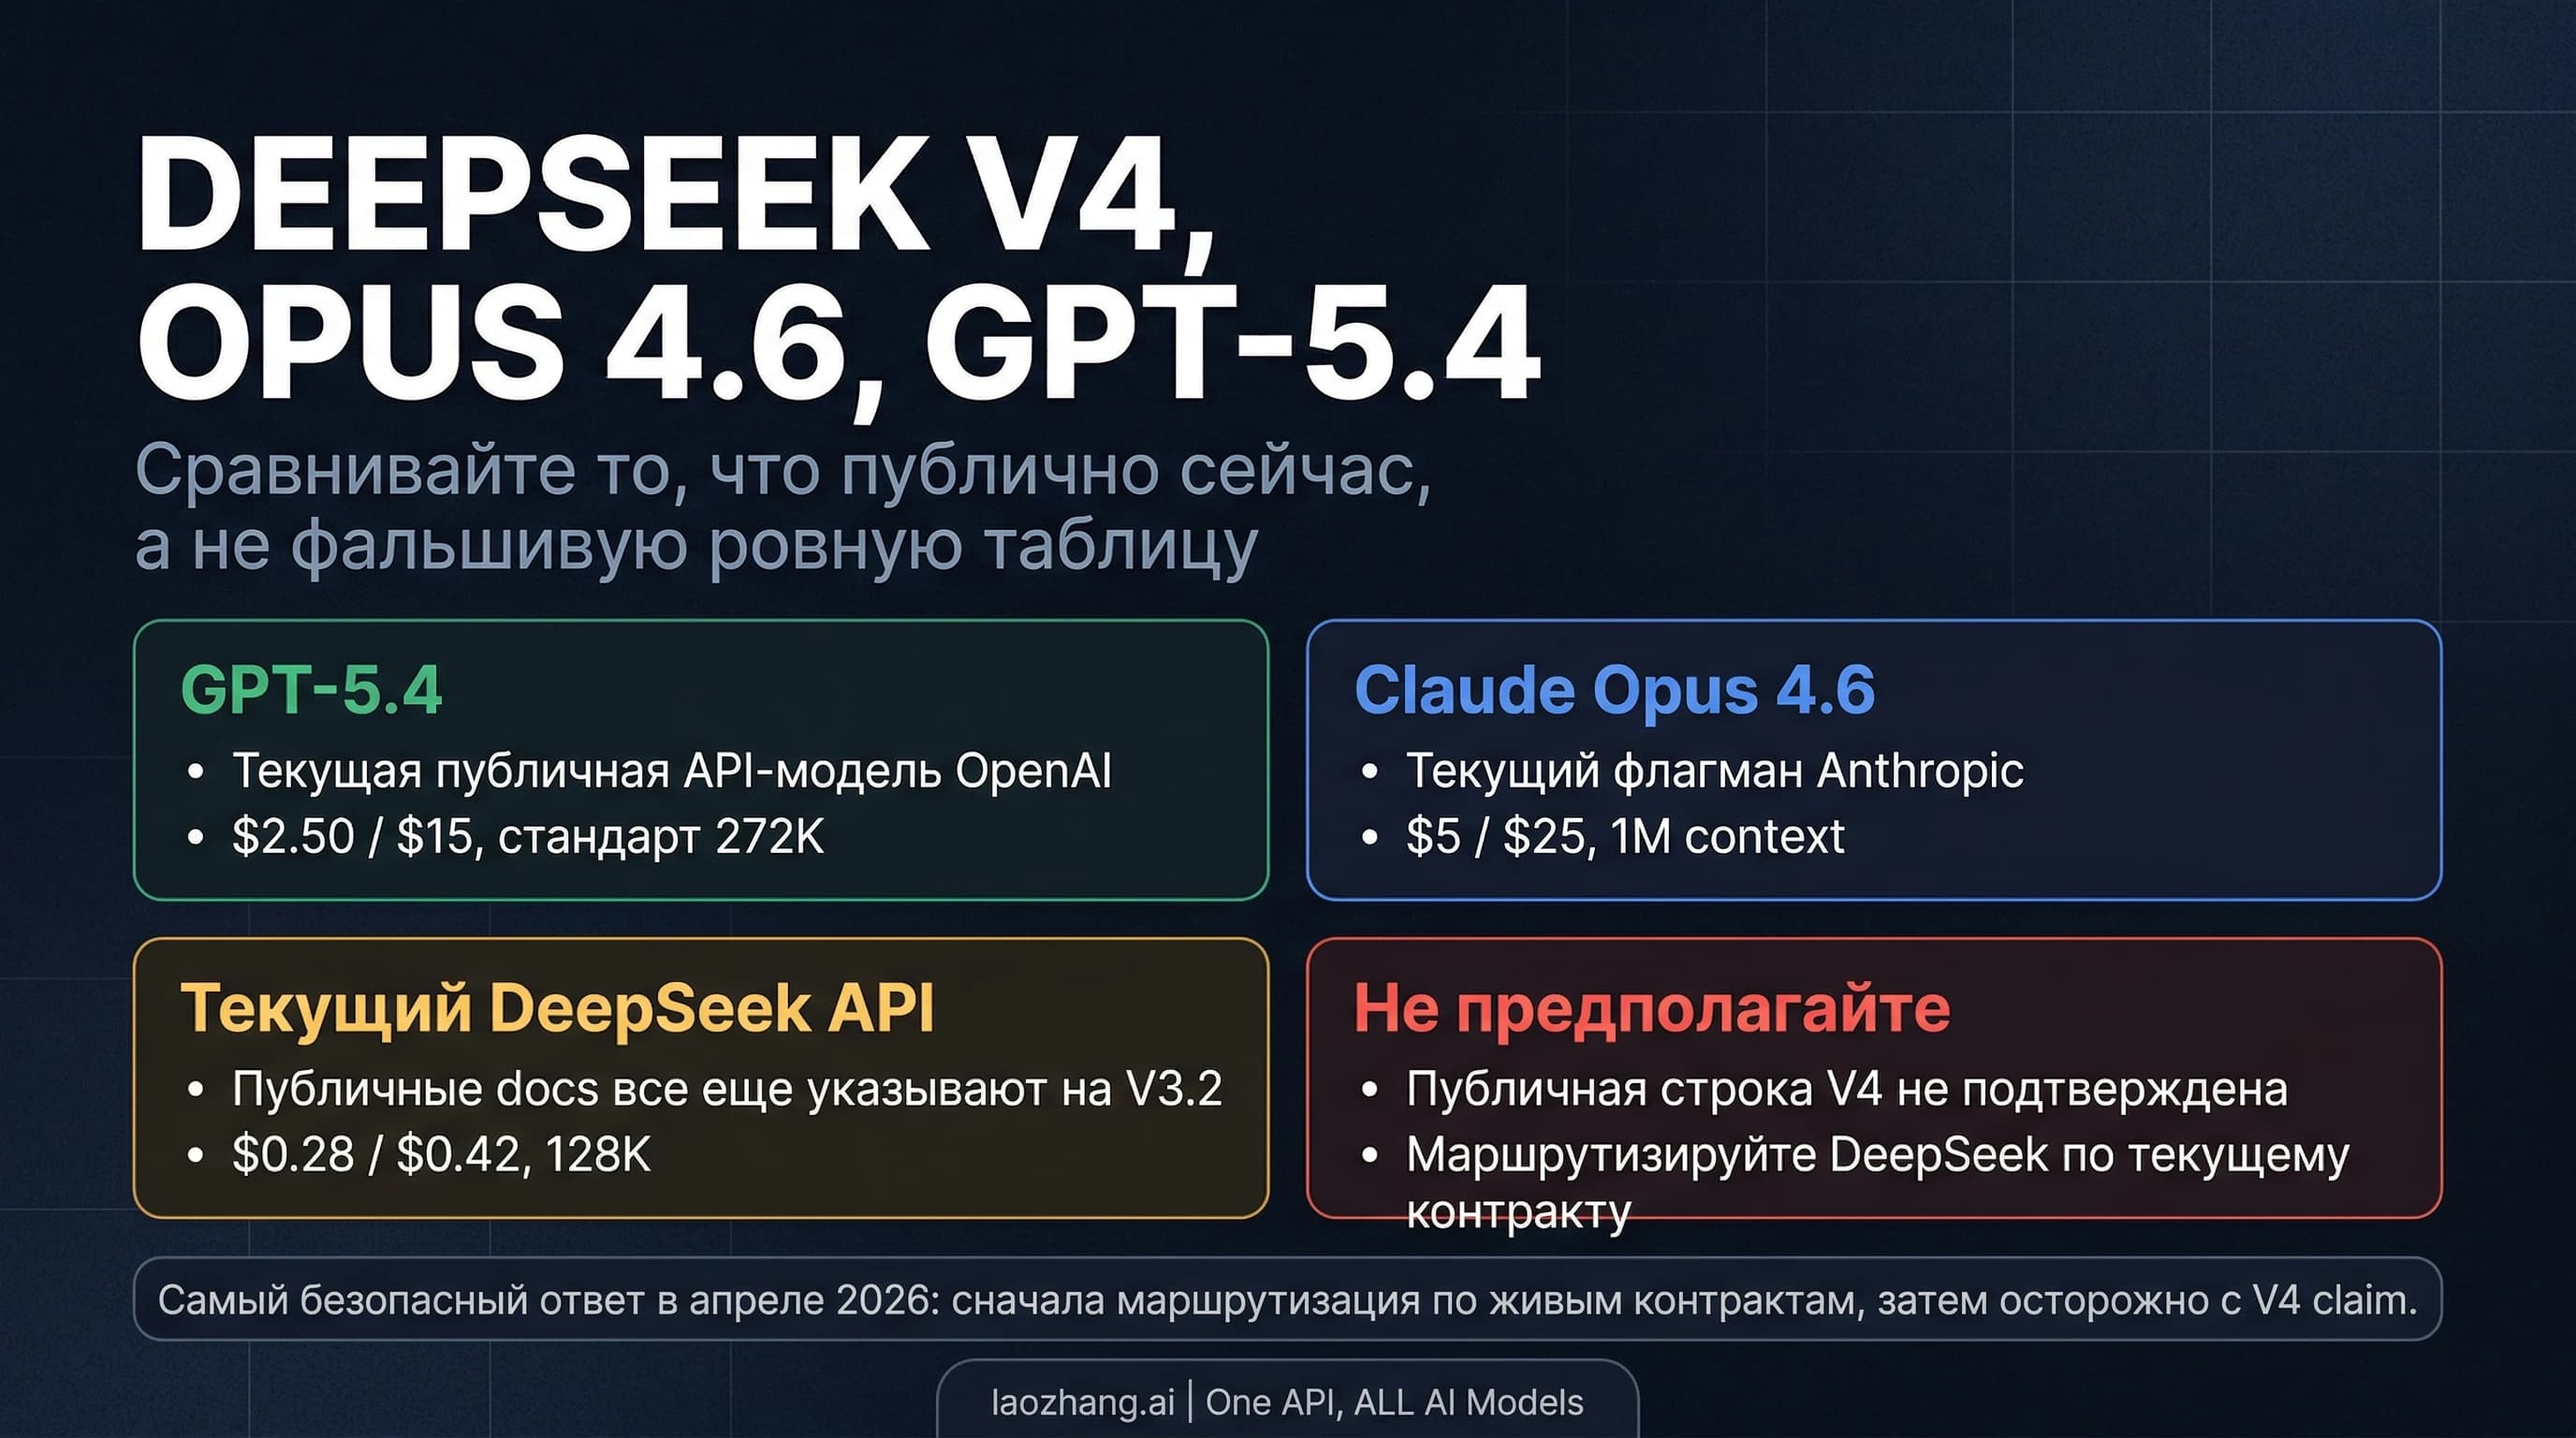
Если выбирать модель для продакшена сегодня, полезнее всего напрямую сравнить GPT-5.4 и Claude Opus 4.6 как два ясно опубликованных frontier-контракта, а DeepSeek ставить в решение через текущий публичный API на базе V3.2, а не через еще не подтвержденную строку V4.