Gemini 4 Argon, Claude Opus 5.5 или GPT-6.1 Sol: что выбрать
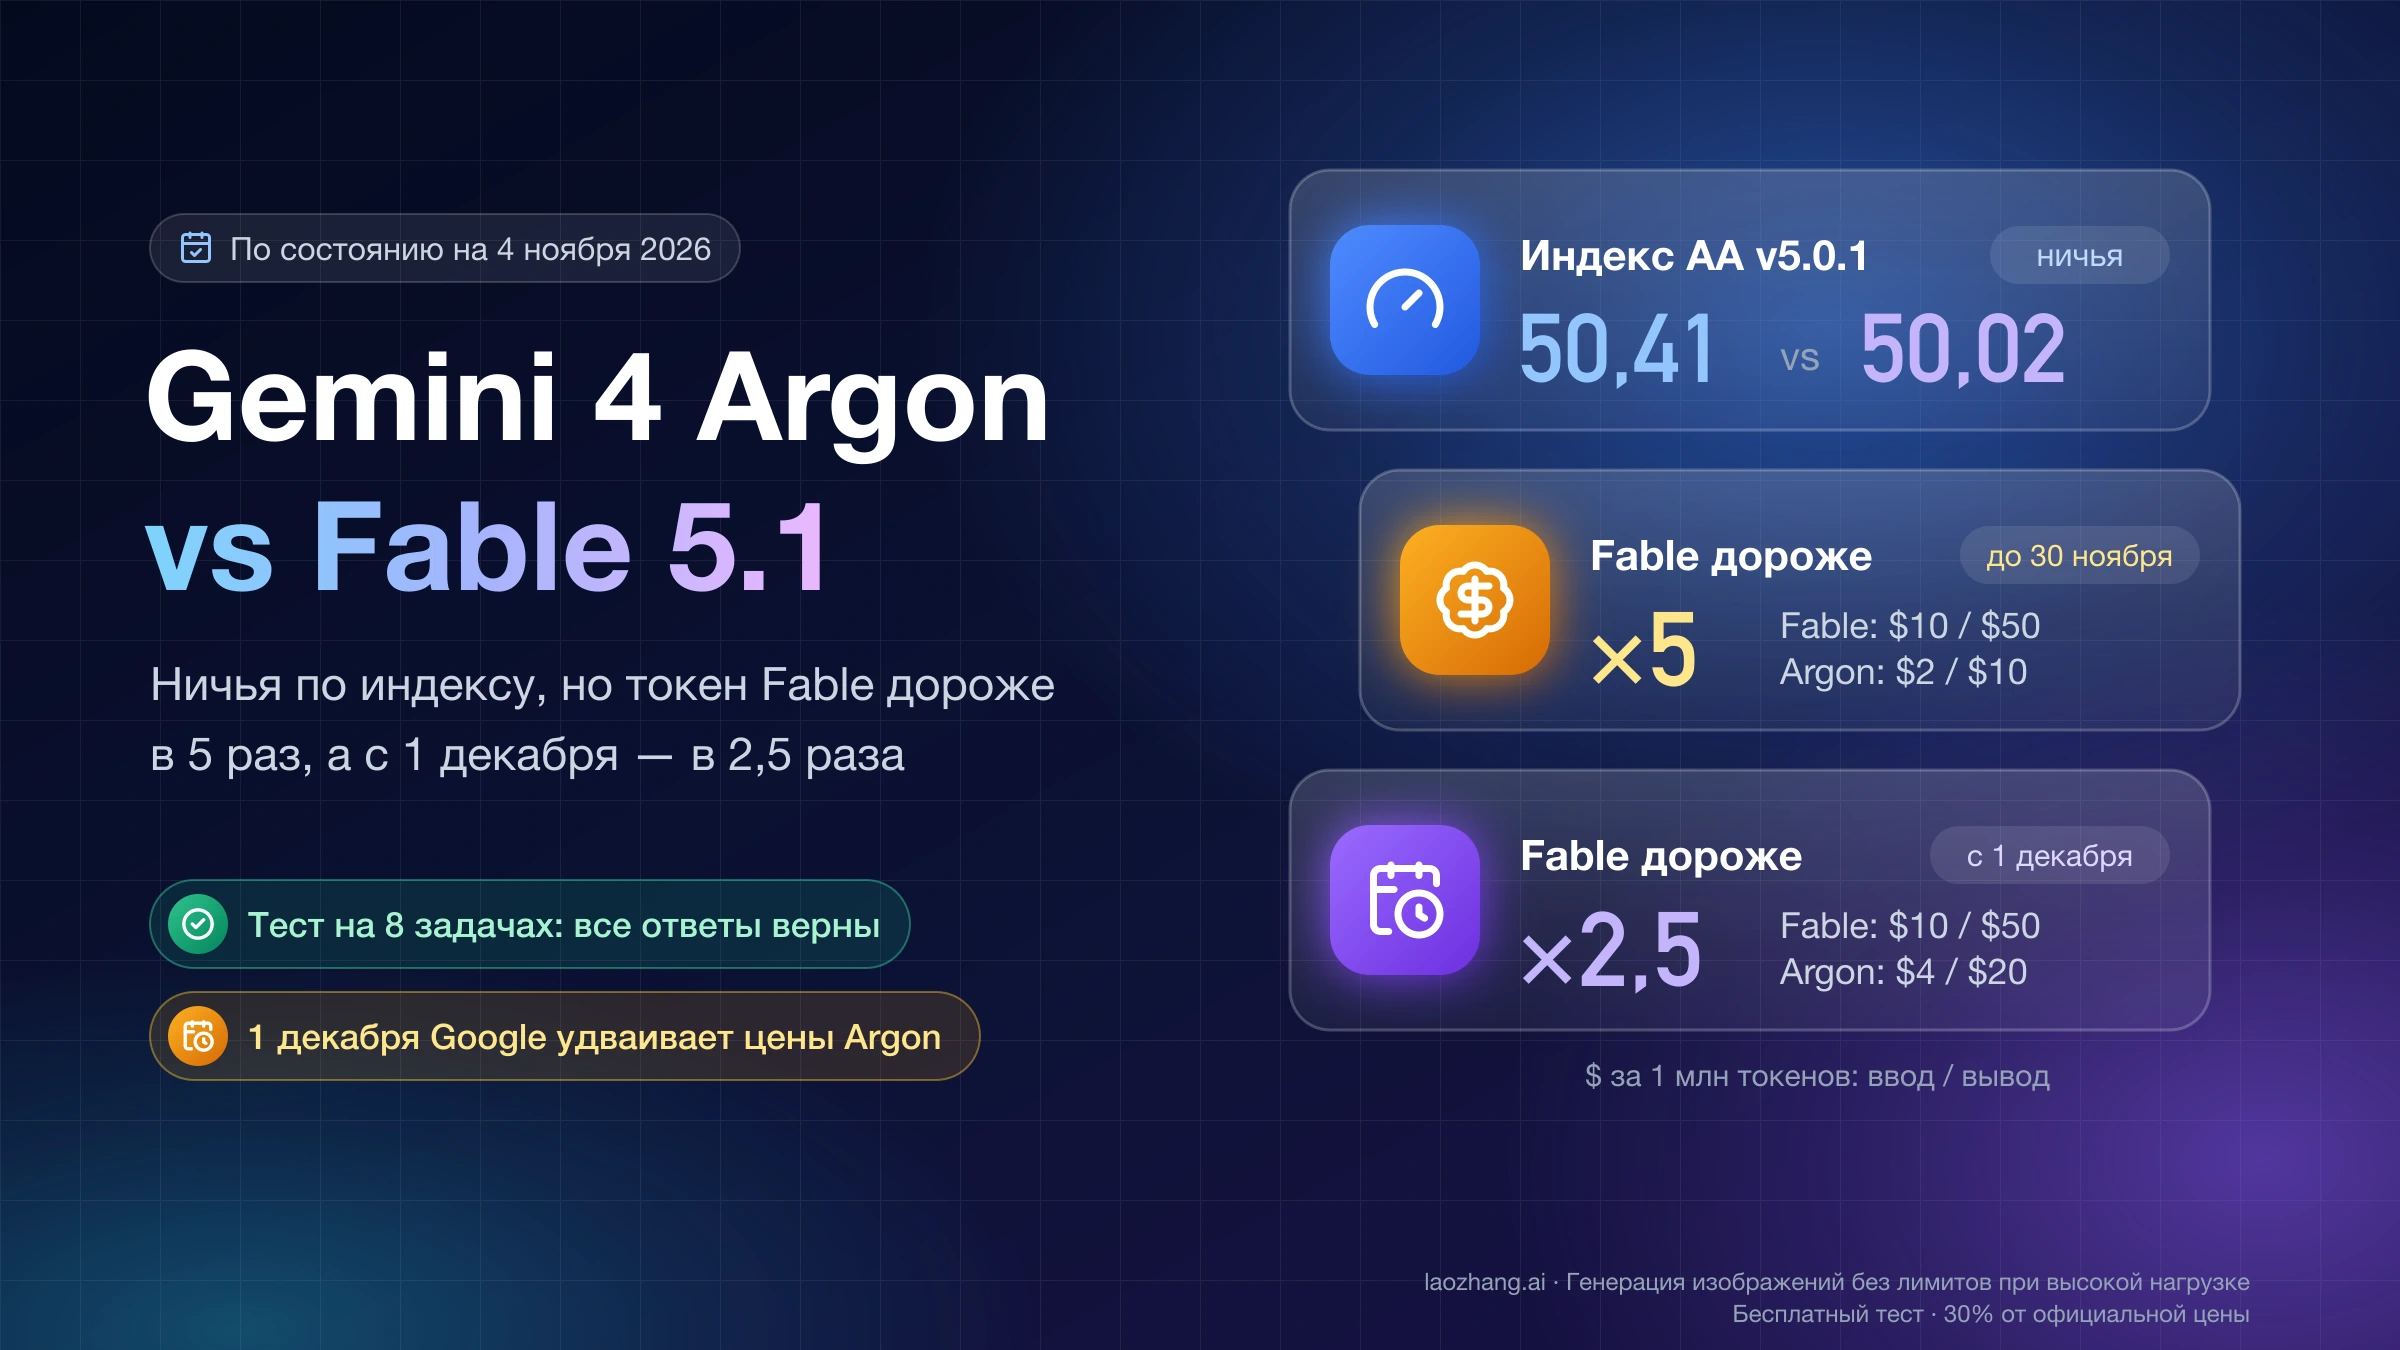
Argon вдвое дешевле Opus 5.5 лишь по цене токена и до 30 ноября. В тесте одних задач на high Opus уже дешевле и втрое быстрее, а с 1 декабря дешевле в 2,6 раза.
Содержание
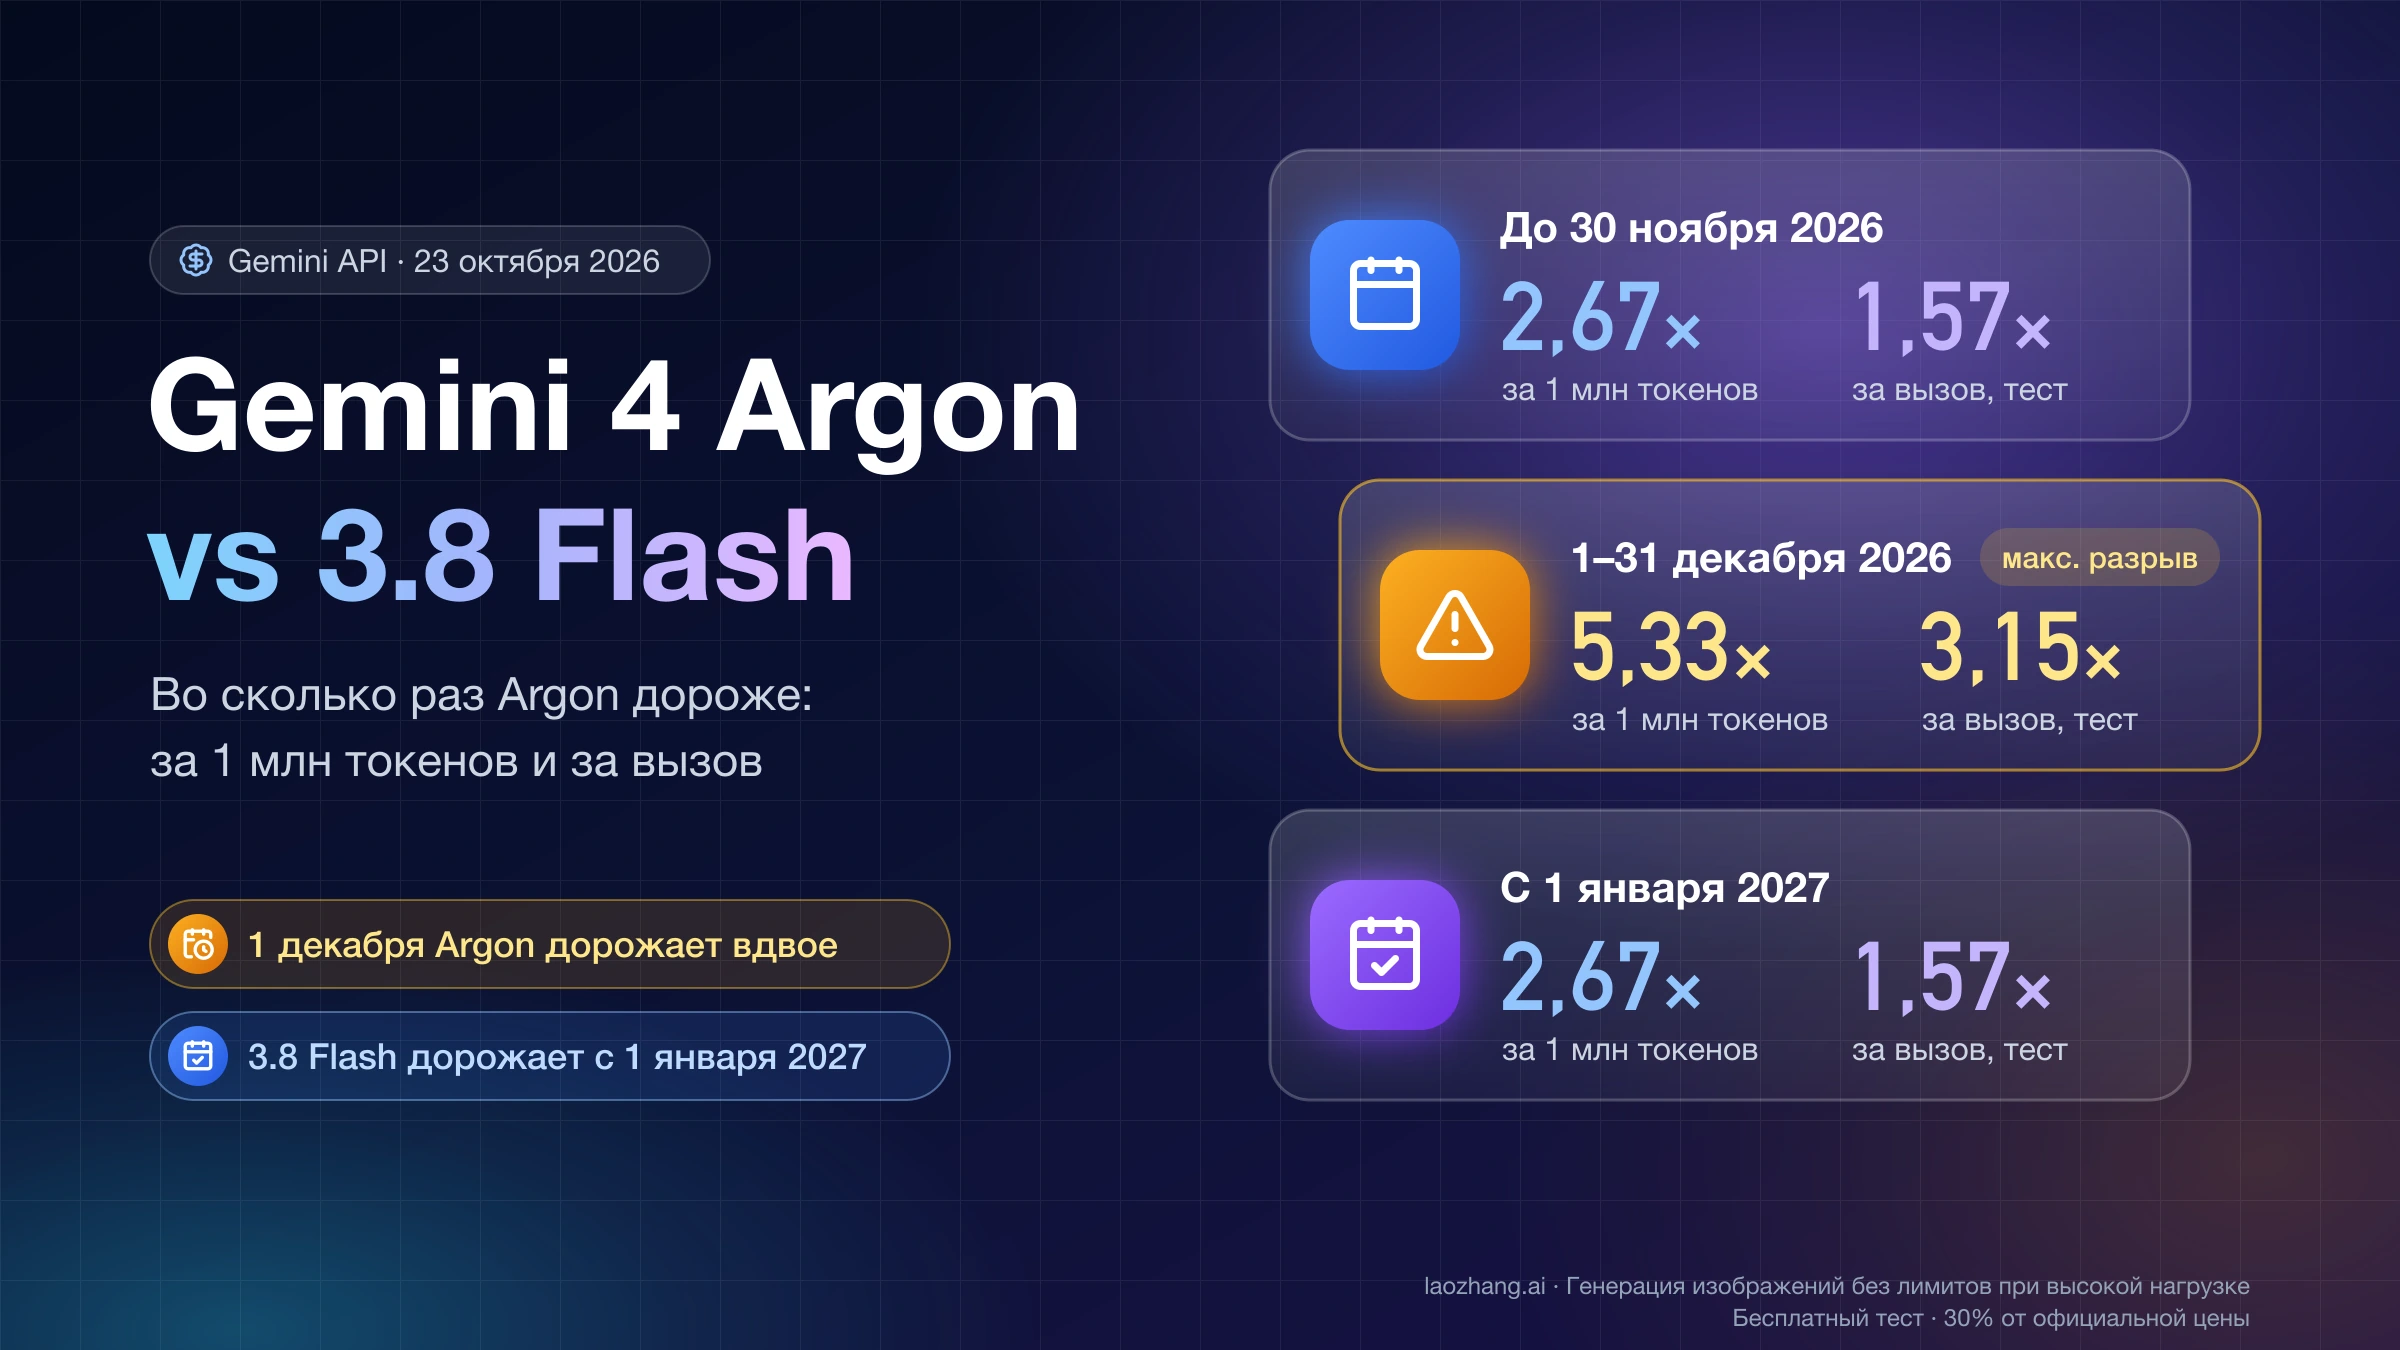
Gemini 4 Argon (gemini-4-argon) вдвое дешевле Claude Opus 5.5 (claude-opus-5-5) только по цене токена и только до 30 ноября 2026 года: $2 и $10 за миллион входных и выходных токенов против $4 и $20. С 1 декабря Google удваивает ставки Argon, и прайс двух моделей совпадает. По стоимости задачи на уровне high Argon дешевле не был никогда: в индексе Artificial Analysis (AA) по состоянию на 11 ноября его задача стоит $9,95 по декабрьской цене, около $4,98 по стартовой, а у Opus 5.5 — $3,46. Неделей раньше AA показывала для Argon $7,68 и с тех пор подняла оценку.
Прогон одинаковых задач через шлюз LaoZhang (Argon — 4 ноября, Opus — 11 ноября 2026 года) показывает, от чего это зависит. На настройке по умолчанию у каждой модели небольшие задачи на код и рассуждения проходят обе, и Argon дешевле: $0,093 за весь набор против $0,290 у Opus, с 1 декабря — $0,187. На high Argon пишет в 3,3 раза больше токенов и работает в 3,1 раза дольше, поэтому тот же набор стоит у него $0,403 против $0,308, а с 1 декабря — $0,807. На точном подсчёте по журналу в 146 КБ Opus 5.5 ответил верно все четыре раза уже на настройке по умолчанию, а Argon по умолчанию занизил счётчики на 20–37 % и справился только на high со стримингом, потратив 4,5–6,7 минуты.
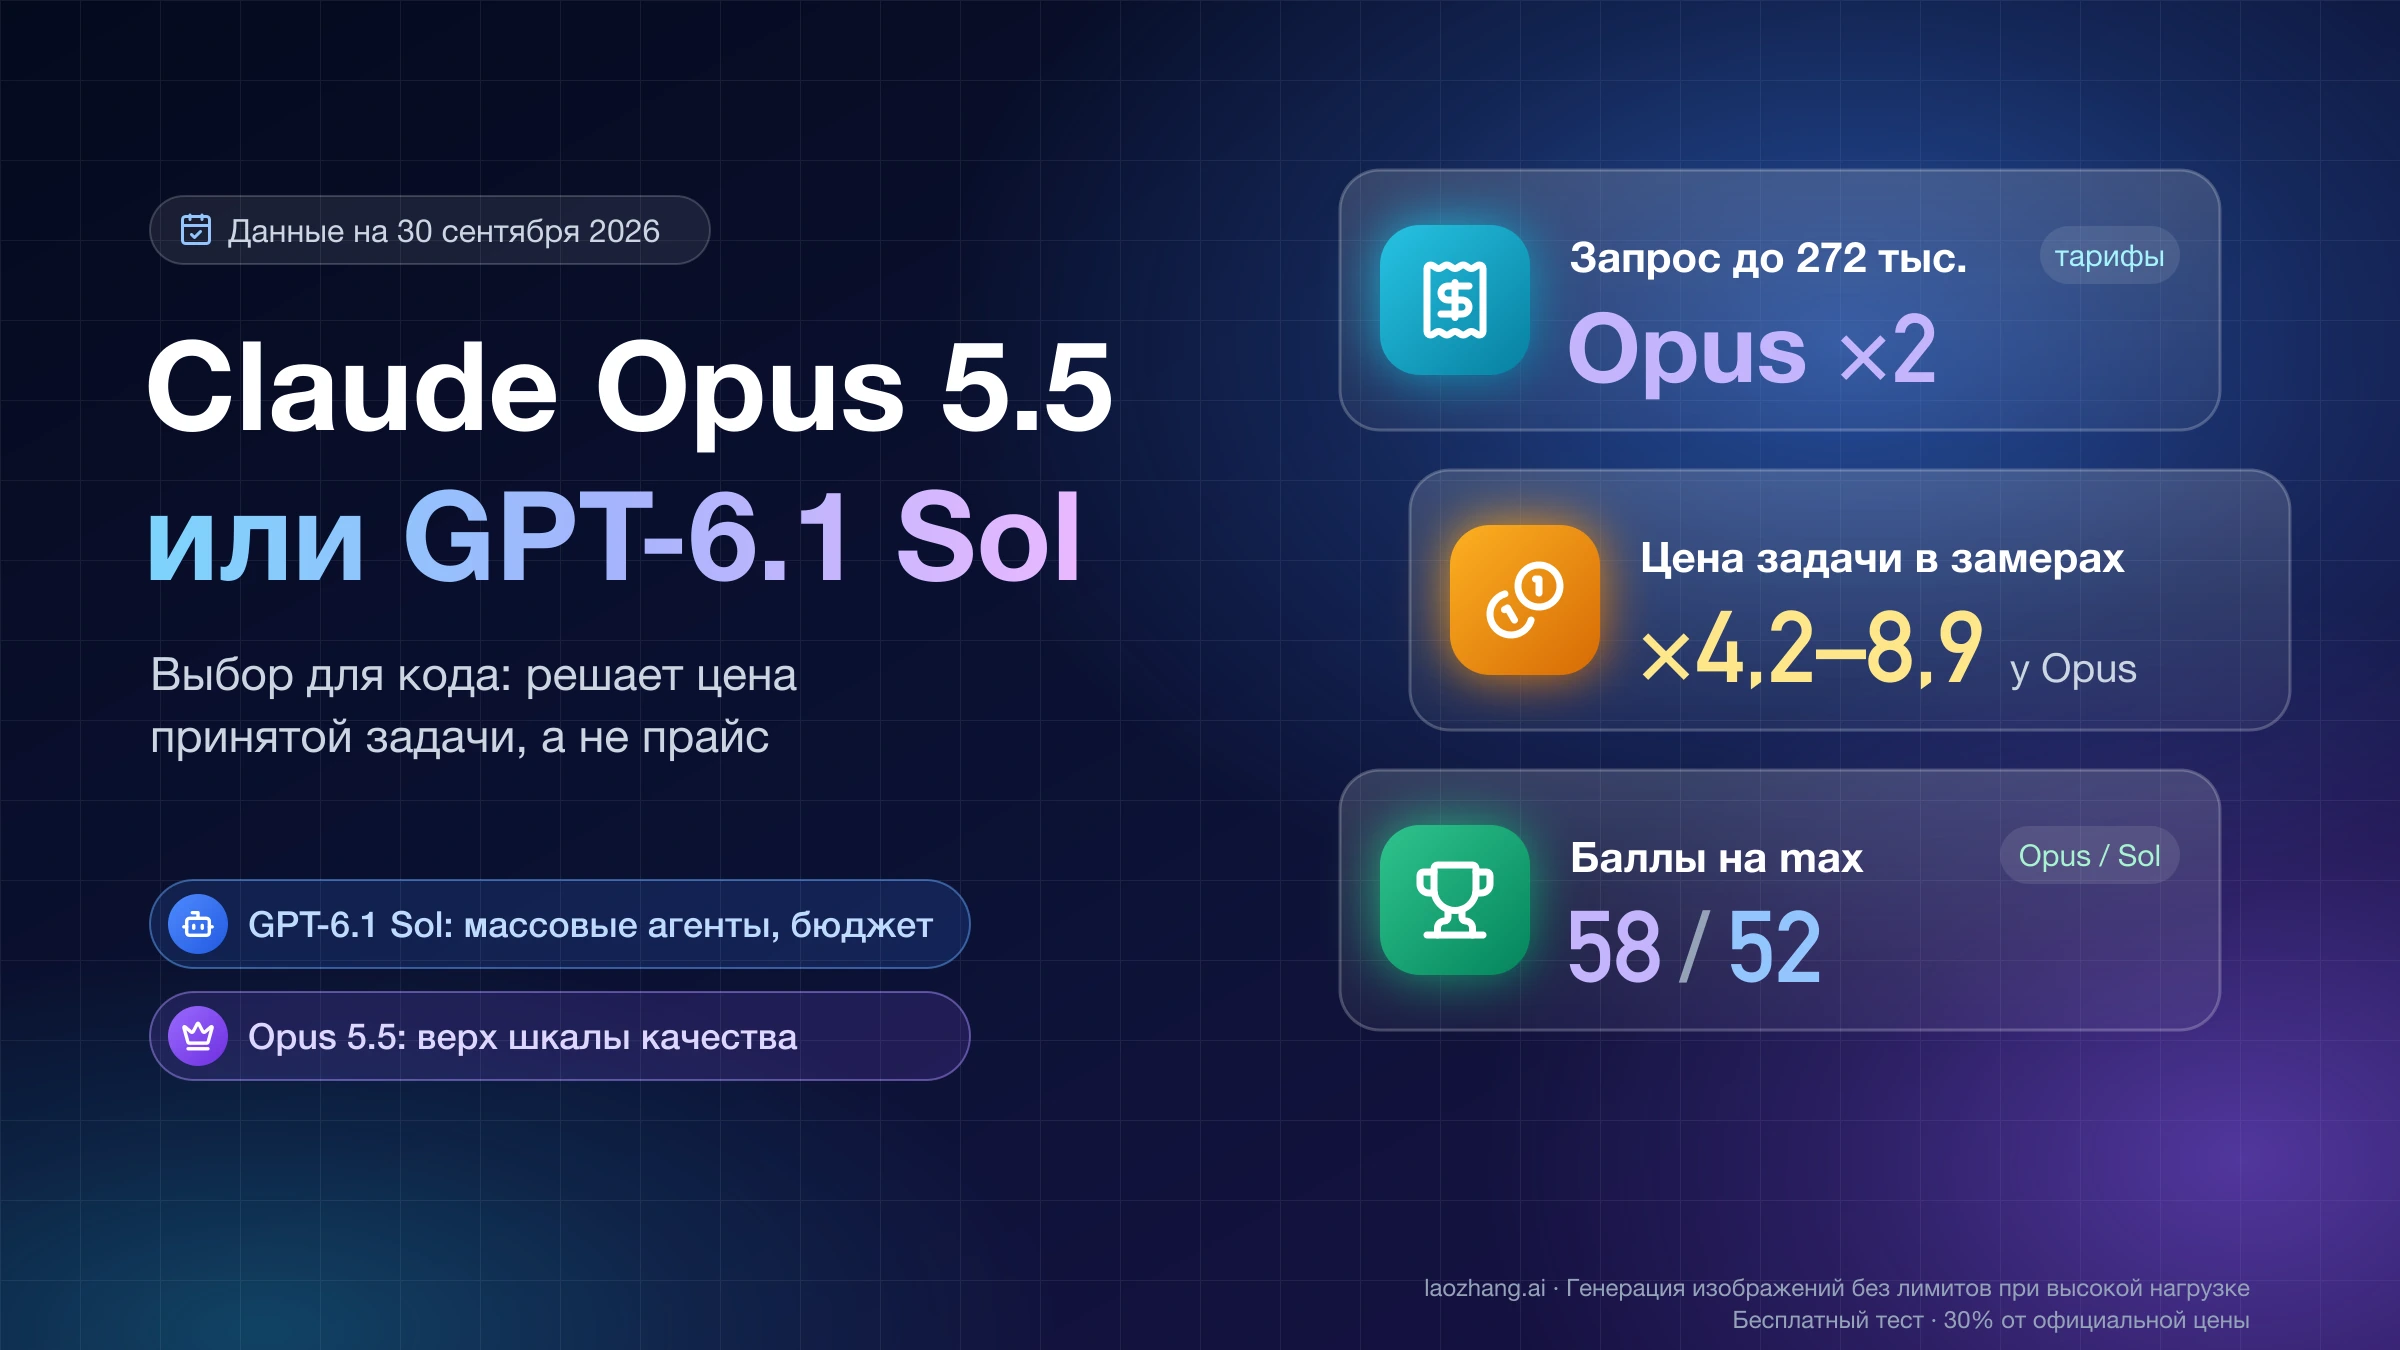
Поэтому для агентов, которые пишут код, и для точной работы с длинным вводом берите claude-opus-5-5 на настройке по умолчанию (effort medium) и поднимайте до high, только если её не хватает. gemini-4-argon на настройке по умолчанию стоит проверить на коротких, хорошо заданных задачах и в автоматизации процессов, где он впереди и в независимых замерах; гоняйте его по стартовой цене до 30 ноября, но решение о переводе нагрузки принимайте по ценам с 1 декабря. GPT-6.1 Sol (gpt-6.1-sol, её и имеют в виду, когда пишут «GPT 6.1») остаётся дешёвой точкой отсчёта: 50 баллов в индексе AA на high при $0,59 за задачу.
Что из трёх можно подключить сегодня: Argon открыт с 13 октября
По состоянию на 14 октября 2026 года открыты все три модели; подписки Claude указаны по состоянию на 6 ноября.
| Gemini 4 Argon | Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|---|
| Выпуск | анонс 30 сентября, общий доступ с 13 октября 2026 года | 22 сентября 2026 года | 29 сентября 2026 года |
| ID модели | gemini-4-argon | claude-opus-5-5 | gpt-6.1-sol |
| API | платный уровень Gemini API, AI Studio, Gemini platform; на бесплатном уровне недоступен | Claude API, AWS, Google Cloud, Azure | OpenAI API; вызовы инструментов через Responses API |
| Подписки и приложения | приложение Gemini и AI Mode — Google AI Pro и Ultra; Google Antigravity — Ultra и Google AI Pro (платная или пробная, полученная с подходящим премиальным устройством), кроме Antigravity IDE; Gemini for business | приложения Claude на тарифах Pro, Max, Ultra, Team и Enterprise, Claude Code; на Free Opus нет | ChatGPT Work и Codex на тарифах Plus, Pro, Business, Enterprise и Edu |
| Контекст | 1 048 576 токенов — общий лимит на вход и выход | 1 млн токенов | 1 050 000 токенов |
| Максимум вывода | 65 536 токенов в обычном ответе со стримингом (32 768 без него), до 1 048 576 в режиме long decode | 128 тыс. токенов | 128 тыс. токенов |
| Вход / выход за 1 млн токенов | $2 / $10 до 30 ноября, $4 / $20 с 1 декабря | $4 / $20 | $2 / $10 до 272 тыс. входных токенов, выше — $4 / $15 |
В посте Google о выходе Gemini 4 Argon от 13 октября модель названа доступной по всему миру для разработчиков и компаний через API в AI Studio и Gemini platform. На странице Gemini 4 Argon в документации Gemini API она отмечена как стабильная версия (Stable). В приложении Gemini и в AI Mode в Поиске Argon получили подписчики Google AI Pro и Ultra. В Google Antigravity анонс называет только подписчиков Ultra, но с тех пор доступ расширили: по состоянию на 23 октября 2026 года страница моделей Google Antigravity открывает Argon в платной подписке Google AI Pro, а также в пробном периоде Pro, полученном вместе с подходящим премиальным устройством (так это формулирует Google, список устройств не приводится), — в приложении Antigravity, Antigravity CLI и расширениях для IDE, но не в Antigravity IDE. Обычный бесплатный пробный период Pro там не назван, а включают доступ постепенно, поэтому у части платных аккаунтов модель может появиться не сразу. Для компаний модель включена в Gemini for business в браузере, на компьютере и в мобильных приложениях, сообщает блог Google Cloud о запуске Argon. Про тариф AI Plus и бесплатную версию приложения в анонсе ничего не сказано.
Подписка и API для Argon — разные вещи. На странице цен Gemini API по состоянию на 11 ноября 2026 года об Argon сказано только, что на бесплатном уровне его нет: вызовы через API оплачиваются по токенам с платного аккаунта, и ни одна подписка их не покрывает. В веб-интерфейсе AI Studio подписка работает иначе: по описанию тарифов Google AI в AI Studio на 6 ноября 2026 года на бесплатном плане Argon нет, Google AI Pro даёт повышенную квоту с доступом к нему, а Ultra — максимальную; в запросах эти квоты Google не выражает. В приложении Gemini и AI Mode Argon тоже открыт подписчикам Pro и Ultra. Поэтому ответ на вопрос «есть ли Argon в Pro» зависит от того, где именно вы собираетесь с ним работать. Лимиты запросов для Argon в API на страницах цен и модели не опубликованы.
Для читателей в России: по состоянию на 6 ноября 2026 года России нет ни в списке регионов, где работает Gemini API, ни в списке поддерживаемых стран Anthropic, так что официально ни Argon, ни Opus 5.5 аккаунтам в России не предоставляются. Какие пути доступа существуют и чем они ограничены, разобрано в материалах Gemini 4 Argon: как получить доступ бесплатно и сколько стоит и Claude Opus 5.5: как пользоваться, можно ли бесплатно и в России.
Fairwind теперь нужен только тем, кому требуется версия Argon без защитных ограничений в области кибербезопасности. По анонсу 13 октября Google расширяет программу на сотни новых партнёров и выдаёт им такую версию постепенно. Кому подходит Fairwind, разобрано в материале Gemini 3.8 Flash Cyber и Fairwind: кому дадут доступ и как подготовиться. Он написан для предыдущей модели, и порядок подачи заявки именно на Argon в нём не описан.
У двух других моделей с доступом ничего не изменилось. GPT-6.1 Sol в подписках есть только в ChatGPT Work и Codex; в обычном чате и на тарифах Free и Go её нет. Подробности по каждой — в разборах GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol и Claude Opus 5.5: цена API и как сбросить лимит подписки.
Цена токенов: на старте как у GPT-6.1 Sol, с 1 декабря как у Opus
Стартовая цена Argon действует по 30 ноября 2026 года, с 1 декабря Google удваивает все ставки: вход, выход и кэшированный вход. Так написано и на странице цен Gemini API, и в анонсе; по состоянию на 11 ноября 2026 года прайс не менялся. Цены за 1 млн токенов:
| Тариф Gemini API | Вход | Выход вместе с рассуждениями | Кэшированный вход |
|---|---|---|---|
| Standard, до 30 ноября | $2,00 | $10,00 | $0,10 |
| Standard, с 1 декабря | $4,00 | $20,00 | $0,20 |
| Batch и Flex, до 30 ноября | $1,00 | $5,00 | $0,05 |
| Batch и Flex, с 1 декабря | $2,00 | $10,00 | $0,10 |
| Priority, до 30 ноября | $3,60 | $18,00 | $0,18 |
| Priority, с 1 декабря | $7,20 | $36,00 | $0,36 |
Кэширование у Argon только неявное (implicit caching): явный кэш не поддерживается, поэтому строк за запись и хранение кэша в прайсе нет. Отдельного тарифа для длинных запросов тоже нет, ставка одна на всём окне. Привязка ответов к Google Поиску (grounding) даёт 5 000 бесплатных запросов в месяц на все модели Gemini 3 и новее, дальше — $14 за 1 000 запросов.
Если обозначить свежий вход как U, чтение кэша как R и выход вместе с токенами рассуждений как O (всё в миллионах токенов), счёт по прайсу выглядит так:
| Модель и тариф | Формула, $ |
|---|---|
| Gemini 4 Argon, до 30 ноября | 2·U + 0,10·R + 10·O |
| Gemini 4 Argon, с 1 декабря | 4·U + 0,20·R + 20·O |
| GPT-6.1 Sol, до 272 тыс. входных токенов | 2·U + 0,10·R + 10·O, запись в кэш $2,50 за миллион |
| GPT-6.1 Sol, более 272 тыс. входных токенов | 4·U + 0,20·R + 15·O |
| Claude Opus 5.5 | 4·U + 0,20·R + 20·O, запись в кэш на 5 минут $5 за миллион, на час — $8 |
Возьмём запрос со 100 тыс. свежих входных токенов и 20 тыс. выходных. Для Argon до 30 ноября это 2 × 0,1 + 10 × 0,02 = $0,40. У GPT-6.1 Sol те же $0,40. У Opus 5.5 получается 4 × 0,1 + 20 × 0,02 = $0,80, и ровно столько же будет стоить Argon с 1 декабря. При одинаковом числе токенов прайс Argon после стартового периода совпадает с Opus полностью, включая чтение кэша по $0,20; отличается только запись в кэш, за которую Opus берёт плату, а у неявного кэша Argon её нет.
Отсюда и расхожая формулировка «вдвое дешевле Opus». Она верна при двух условиях: запрос оплачен до 30 ноября и обе модели тратят одинаковое число токенов. Первое условие перестанет выполняться 1 декабря. Второе не выполняется ни на входе, ни на выходе, причём в разные стороны: на выходе больше пишет Argon, особенно на high (об этом два следующих раздела), а на входе меньше токенов насчитывает он же.
Разница на входе зависит от языка. Один и тот же русский абзац с одинаковой короткой инструкцией у Opus 5.5 занимает в 1,72 раза больше входных токенов, чем у Argon; для других языков отношение от 1,45 (английский) до 2,26 (корейский), для длинной английской статьи на 6 723 слова — 1,38. Журнал приложения из чисел и идентификаторов обе модели считают почти одинаково, отношение 0,99. Это замер через шлюз LaoZhang по счётчикам токенов, которые вернул API (Opus — 11 ноября, Argon — 4 ноября 2026 года), с вычетом токенов самой инструкции. Значит, с 1 декабря, когда ставки сравняются, тот же русский промпт у Opus будет стоить по входу примерно в 1,7 раза дороже.
Пакетная обработка у всех трёх вдвое дешевле стандартной: у Argon $1 / $5 до 30 ноября и $2 / $10 после, у Opus 5.5 $2 / $10, у GPT-6.1 Sol $1 / $5 в запросах до 272 тыс. входных токенов. Для пробных прогонов на десятках задач, где ответ не нужен сразу, это вдвое снижает счёт. Как сравнивать цены с учётом своего типа нагрузки, показано в материале Сравнение цен AI API: какая модель дешевле для вашей нагрузки; цены Argon в нём ещё не учтены.
Стоимость задачи: одинаковый прайс, восьмикратная разница
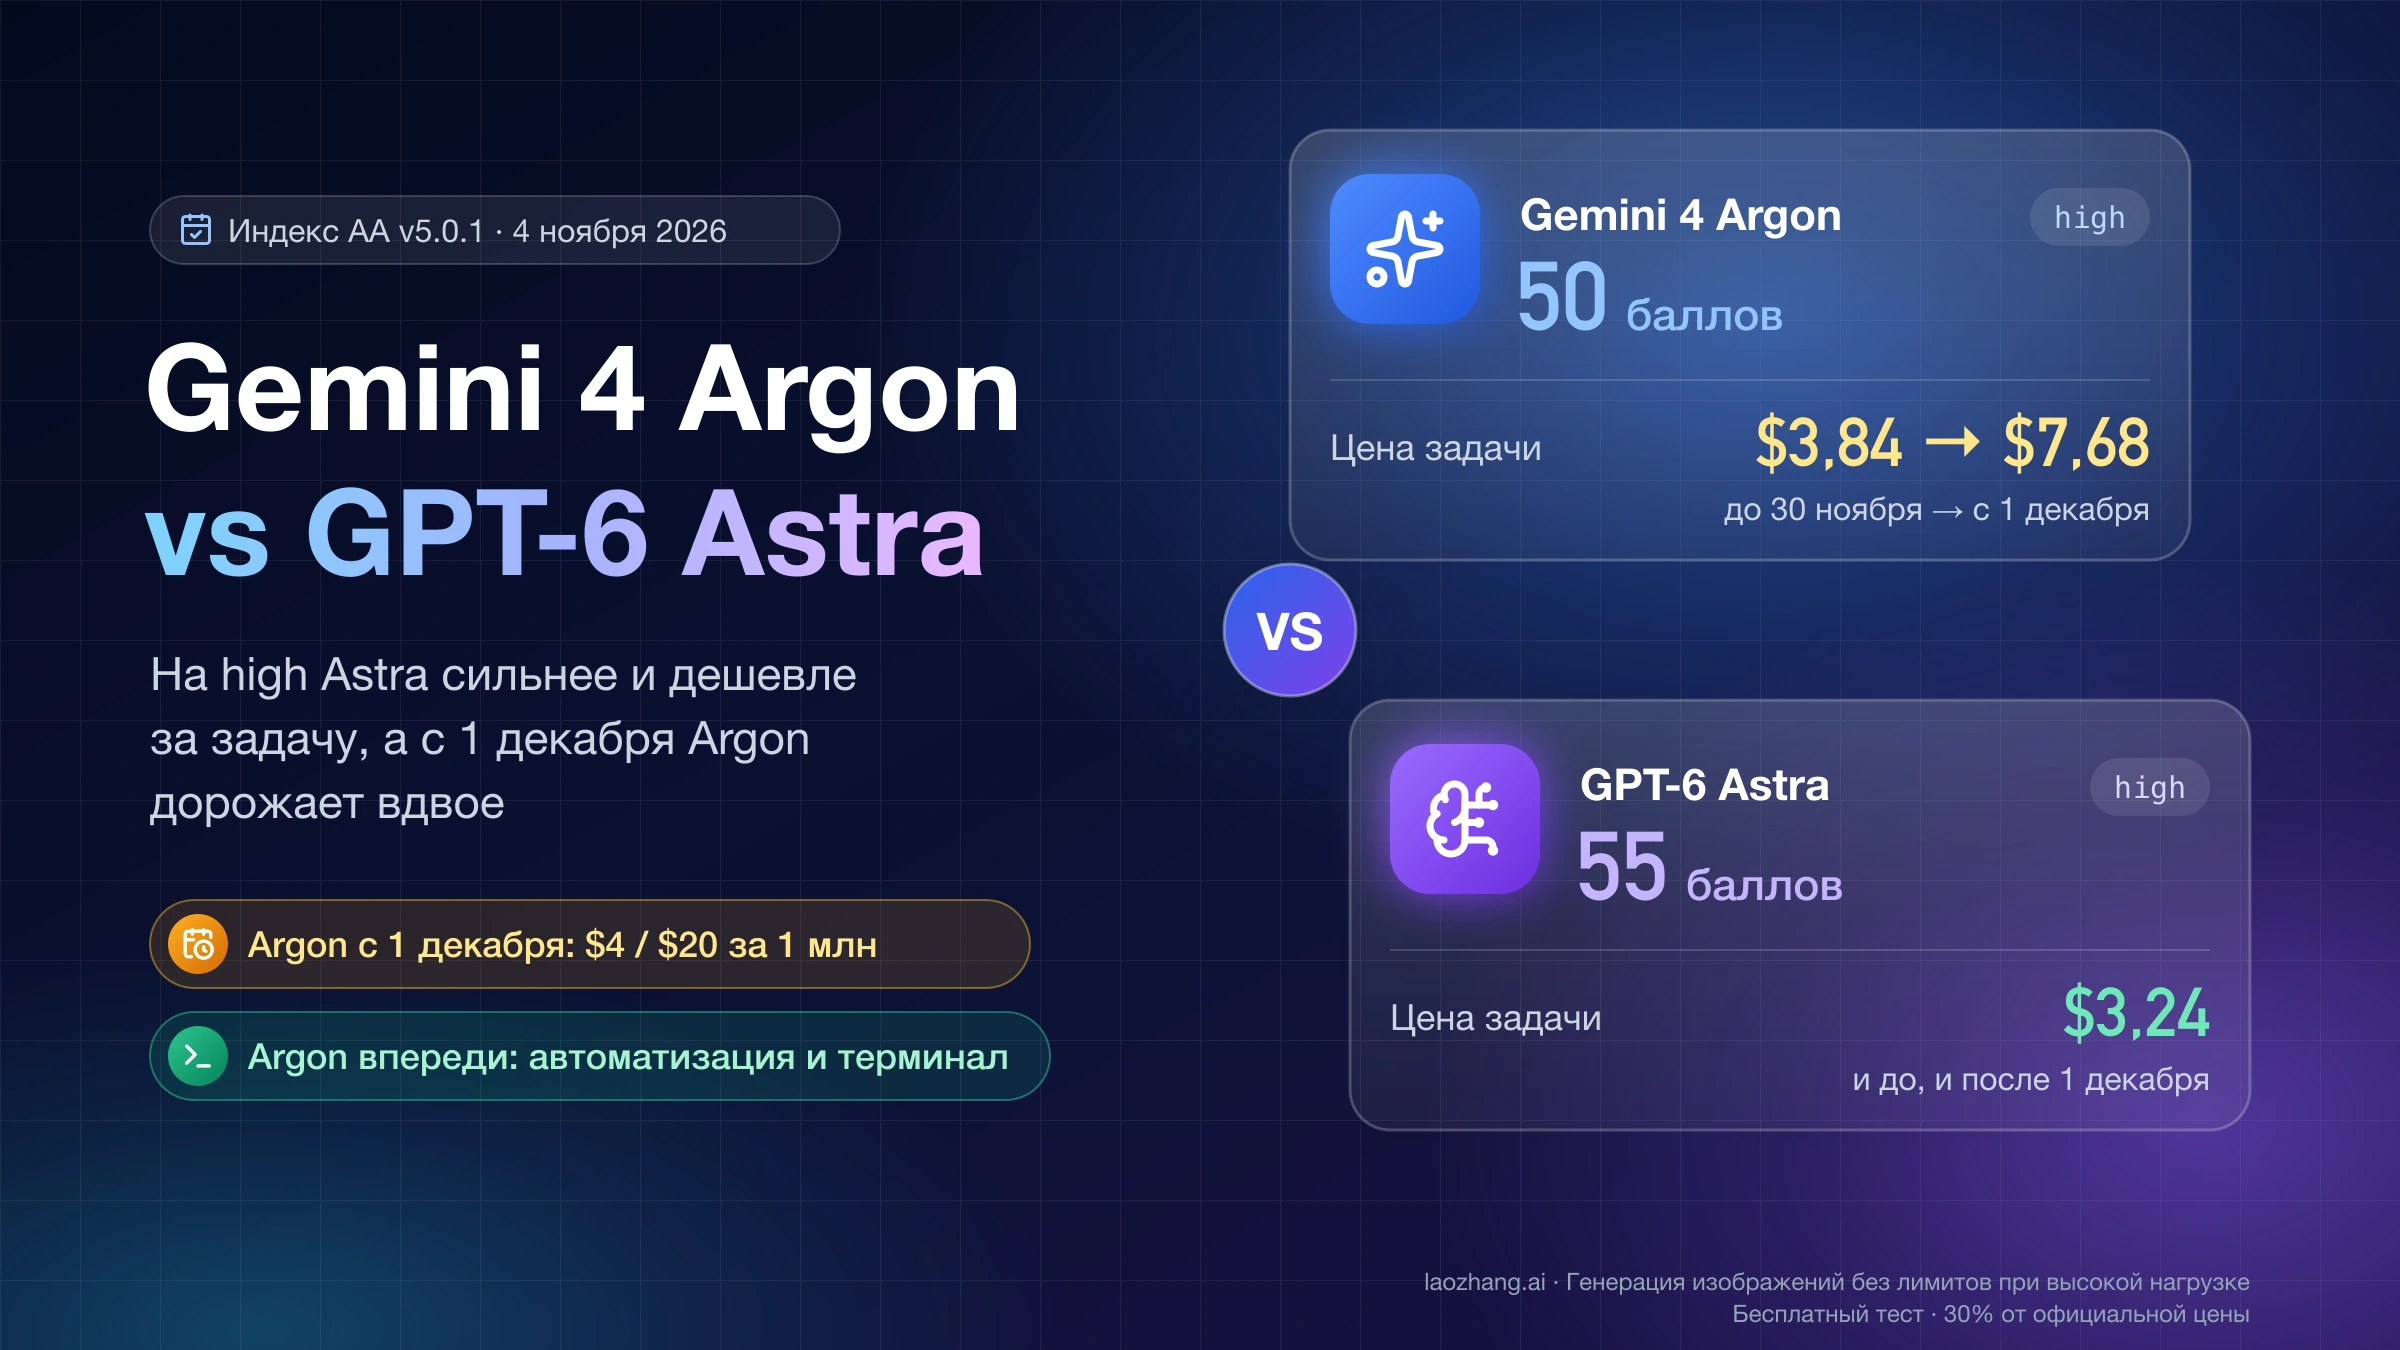
До 30 ноября у Gemini 4 Argon и GPT-6.1 Sol одинаковый прайс и одинаковый балл в индексе Artificial Analysis на уровне high — по 50, но задача Argon обходится примерно в 8,4 раза дороже, а с 1 декабря — в 16,9 раза. Вся разница в расходе: на одну задачу индекса Argon на high выдаёт в среднем 116 тыс. выходных токенов, из них 68,3 тыс. — рассуждения, и тратит 28,6 минуты. Прайс показывает цену токена, а счёт зависит ещё и от того, сколько токенов модель тратит, пока доведёт задачу до конца.
Индекс AA сейчас в версии 5.0.1 и состоит из девяти наборов тестов; между 27 и 28 октября 2026 года AA перешла с версии 4.3.2 на 5.0, поэтому прежние цифры с новыми не сравниваются. Уровни рассуждений у вендоров называются одинаково, но устроены по-разному: у Argon это параметр thinkingLevel, у Opus 5.5 — effort. Поэтому сравнение ниже идёт по одинаковым названиям уровней, а не по одинаковому бюджету на обдумывание.
| Уровень high | Балл индекса | Задача до 30 ноября | Задача с 1 декабря |
|---|---|---|---|
| Claude Opus 5.5 | 52 | $3,46 | $3,46 |
| Gemini 4 Argon | 50 | около $4,98, пересчёт | $9,95 |
| GPT-6.1 Sol | 50 | $0,59 | $0,59 |
Данные Artificial Analysis по состоянию на 11 ноября 2026 года, для Opus 5.5 и GPT-6.1 Sol на уровне high — на 10 и 4 ноября. AA считает Argon уже по декабрьской цене $4 / $20, поэтому $9,95 — её цифра, а $4,98 — половина от неё: стартовые ставки Argon ровно вдвое ниже декабрьских по всем видам токенов. Opus 5.5 в расчёте идёт по $4 / $20, GPT-6.1 Sol — по $2 / $10. Цифра Argon за последние две недели менялась дважды. 28 октября AA считала его по стартовой цене и показывала $3,84 за задачу; 4 ноября, уже по $4 / $20, — $7,68; к 11 ноября AA повысила опубликованную оценку до $9,95, а время на задачу — с 22,7 до 28,6 минуты, хотя балл и результаты всех девяти тестов остались прежними. Пояснений AA не дала.
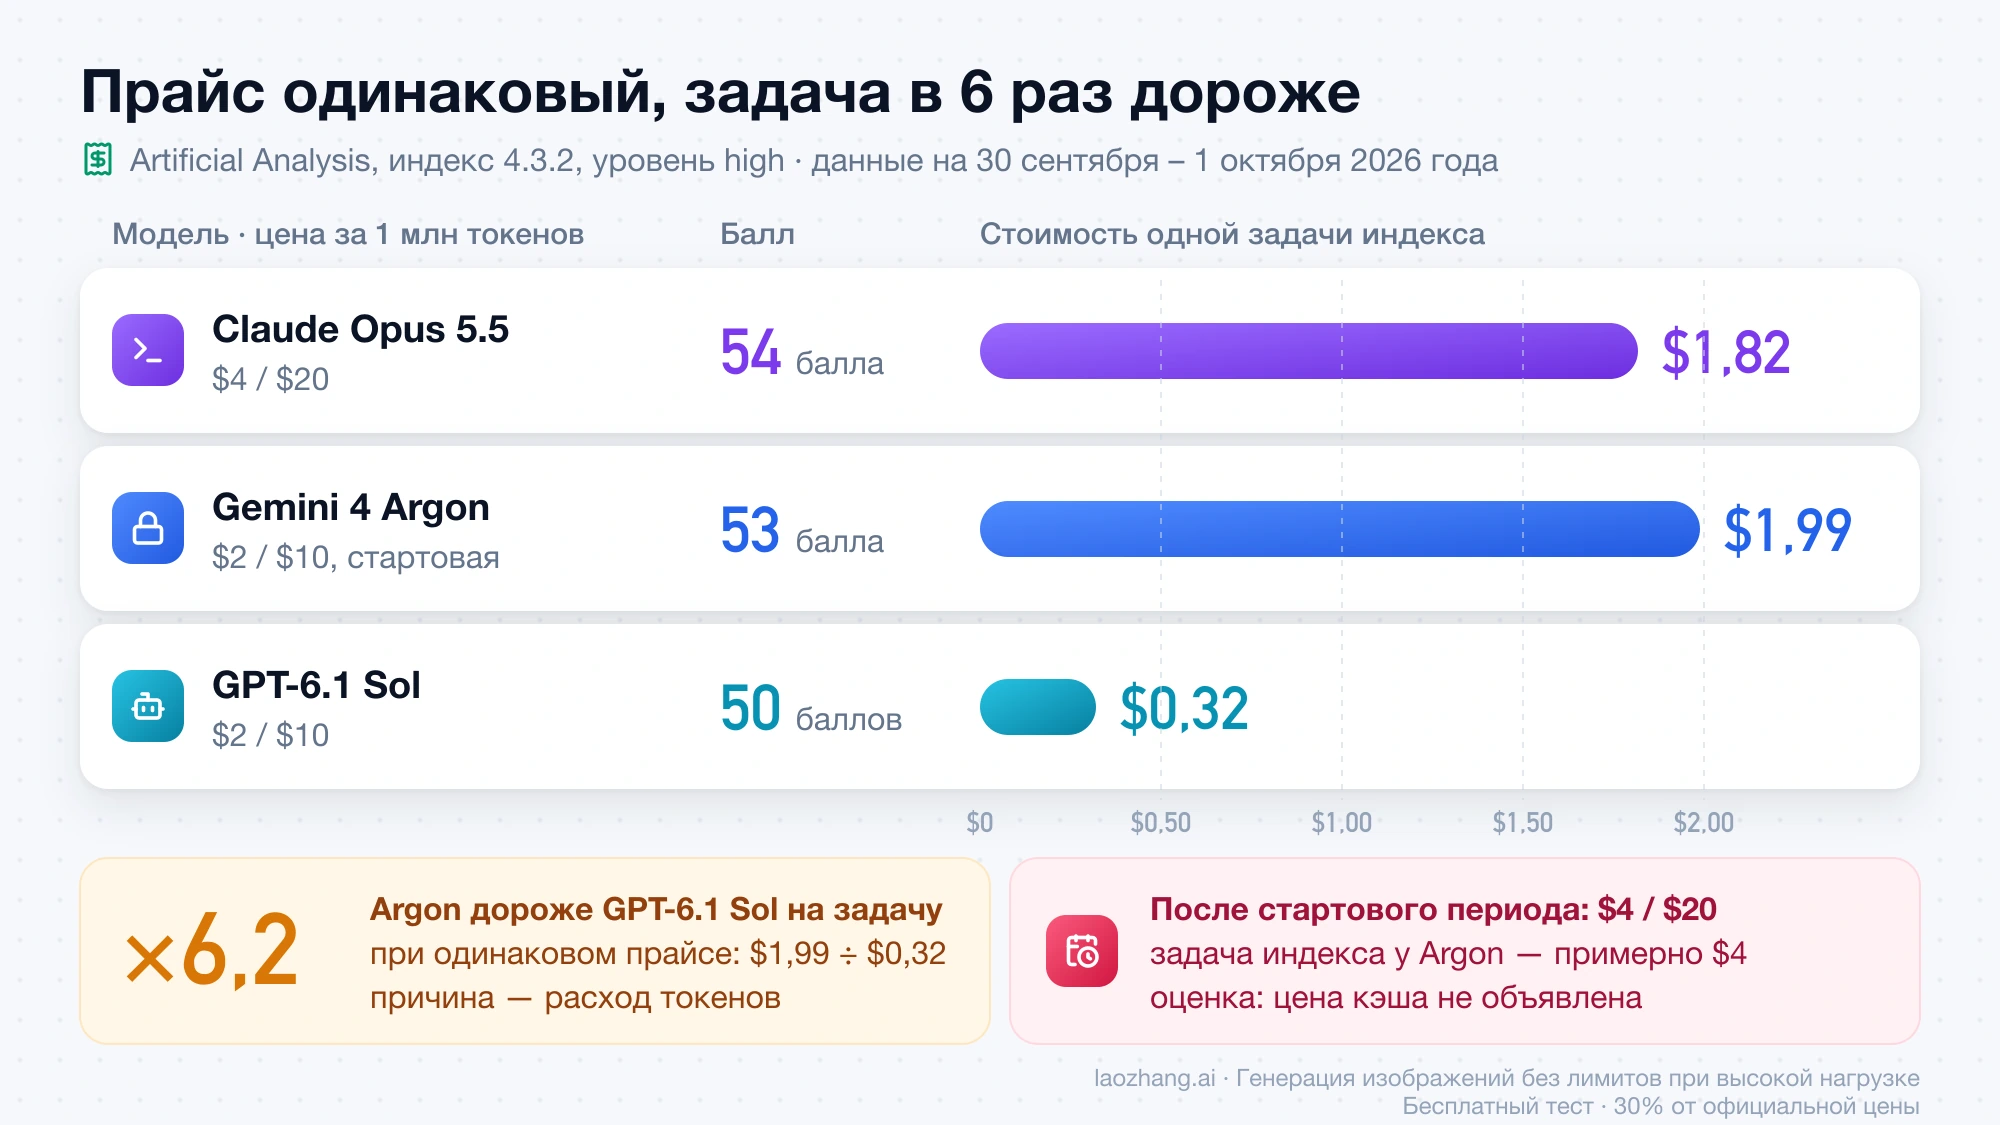
График по состоянию на октябрь 2026 года, до 28 октября (индекс Artificial Analysis версии 4.3.2); актуальные цифры — в таблице выше.
Из таблицы следуют четыре вывода.
- Argon в 8,4 раза дороже GPT-6.1 Sol на задачу до 30 ноября ($4,98 ÷ $0,59) и в 16,9 раза с 1 декабря ($9,95 ÷ $0,59), хотя прайс у них сейчас совпадает, а балл одинаковый. На прохождение всего индекса Argon выдал 113 млн выходных токенов.
- Argon на задачу дороже Opus 5.5 уже сейчас: $4,98 против $3,46, в 1,44 раза, при балле на два пункта ниже, хотя токены Opus до 30 ноября стоят вдвое больше. Преимущество «половины цены» расход токенов съедает целиком.
- С 1 декабря разрыв удвоится: $9,95 против $3,46, в 2,88 раза. Дешевле Argon окажется даже Opus 5.5 на xhigh: 57 баллов, на семь больше, за $6,05, то есть на 39 % меньше.
- GPT-6.1 Sol на уровне max набирает 55 баллов за $1,27. Это на пять пунктов больше, чем у Argon на high, около четверти его стоимости задачи по стартовой цене и около 13 % после 1 декабря.
Те же цифры можно перевести в стоимость принятой задачи: расход на одну попытку, делённый на долю результатов, которые прошли вашу проверку. Argon на high окупается против Opus на high, только если на ваших задачах он проходит в 1,44 раза чаще до 30 ноября и в 2,88 раза чаще с 1 декабря. GPT-6.1 Sol на high остаётся дешевле Argon на high, пока доля её принятых задач больше 11,9 % от доли Argon сейчас и 5,9 % с 1 декабря. Расчёт предполагает такой же расход токенов, как в индексе AA, и не учитывает время на проверку и повторы.
Для Argon AA публикует только уровень high, хотя в API у него есть и low, и medium. У двух других моделей шкала полная, и по ней видно, сколько стоит каждый следующий балл.
| Уровень | Opus 5.5: балл / задача | GPT-6.1 Sol: балл / задача |
|---|---|---|
| low | 35 / $0,98 | 35 / $0,16 |
| medium | 48 / $2,45 | 46 / $0,36 |
| high | 52 / $3,46 | 50 / $0,59 |
| xhigh | 57 / $6,05 | 52 / $0,76 |
| max | 59 / $10,04 | 55 / $1,27 |
Сравнения вида «Opus 59 против Argon 50» ставят рядом Opus на max и Argon на high; именно эту пару показывает и страница сравнения моделей у AA. Это разные точки шкалы: $10,04 и 24,7 минуты на задачу у Opus против $9,95 и 28,6 минуты у Argon. С 1 декабря по цене задачи они почти равны, а баллов у Opus на девять больше.
Vals считает иначе. В его индексе (финансы, код, право, налоги, с весами по вкладу в экономику) версии 2.2, по таблице лидеров на 30 октября 2026 года, Argon набирает 69,24 % и стоит на четвёртом месте из 32 при $13,37 за тест. Opus 5.5 там чуть выше, 70,18 %, и обходится в $28,12 за тест, но, по примечанию Kingy AI, запущен на уровне max. GPT-6.1 Sol — 63,94 %. Ещё 1 октября Vals предупреждал, что на длинных агентных задачах расход Argon резко растёт: $193,78 за тест в CUA-bench и $57,82 в Code Migration.
Всё это арифметика поверх сторонних замеров, а не счета за вашу нагрузку. Больше баллов на доллар в индексе не означает, что модель пройдёт именно ваши задачи. Как посчитать стоимость принятой задачи, подробно показано на паре Opus 5.5 и Sol в разборе Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода; тот же расчёт применим к Argon.
Сравнение на одних задачах: по умолчанию Argon дешевле, на high — Opus
На восьми небольших задачах с одинаковыми промптами Gemini 4 Argon и Opus 5.5 справляются почти без ошибок, а кто дешевле, решает настройка. По умолчанию у каждой модели Argon обходится в 3,1 раза дешевле Opus до 30 ноября и в 1,55 раза дешевле с 1 декабря. На high всё наоборот: Opus дешевле уже сейчас, в 1,3 раза, а с 1 декабря — в 2,6 раза, потому что Argon на high пишет в 3,3 раза больше выходных токенов.
Оба прогона шли через шлюз LaoZhang (api.laozhang.ai) с одним ключом. Argon вызывали 4 ноября 2026 года через родной метод Gemini API generateContent без стриминга: настройка по умолчанию — без thinkingConfig (по документации Google это medium), high — thinkingLevel: high. Opus 5.5 вызывали 11 ноября через Anthropic Messages API со стримингом, thinking: adaptive и effort medium (значение по умолчанию в API) или high. Задачи одни и те же: текстовая задача на рассуждение, три функции на Python со скрытыми тестами (слияние интервалов, разбор длительности, частые слова), пересказ английской статьи на 6 723 слова ровно пятью пунктами и три задачи потруднее — вычислитель выражений без eval (25 скрытых тестов), разбор строки CSV без модуля csv (16 тестов) и подсчёт по сумме цифр с точным ответом 55 252. Последние три прогнаны дважды, поэтому на каждую настройку приходится 11 оценённых ответов.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Настройка | Прошло | Вход / выход, токенов | Время | Набор до 30 ноября | Набор с 1 декабря |
|---|---|---|---|---|---|
| Argon, по умолчанию | 10 из 11 | 12 712 / 6 782 | 163 с | $0,093 | $0,187 |
| Argon, high | 11 из 11 | 12 712 / 39 514 | 463 с | $0,403 | $0,807 |
| Opus 5.5, по умолчанию | 11 из 11 | 17 202 / 11 056 | 126 с | $0,290 | $0,290 |
| Opus 5.5, high | 11 из 11 | 17 202 / 11 968 | 147 с | $0,308 | $0,308 |
Стоимость посчитана по прайсу из расхода токенов, который вернул API, с учётом чтения неявного кэша у Argon. Единственный промах Argon по умолчанию — вычислитель выражений, который в первом прогоне упал с ValueError на строке " 1 + 2 " с лишними пробелами; во втором прогоне в тот же день Argon по умолчанию прошёл все 11, так что из 22 ответов верными были 21. У Opus 5.5 на high одно замечание по форме: в задаче со слиянием интервалов он разнёс функцию и собственные тесты по двум файлам, и после разделения функция прошла все 8 скрытых тестов и его собственные 6. Входных токенов у Opus на 35 % больше при тех же промптах — это та самая разница в подсчёте токенов из раздела о цене.
Opus 5.5 в этом прогоне быстрее: по умолчанию весь набор занял 126 секунд против 163 у Argon, на high — 147 против 463. Индекс AA показывает то же на high: 9,5 минуты на задачу у Opus против 28,6 у Argon. Одна оговорка про время: Argon вызывали без стриминга, Opus — со стримингом, но на общее время ответа это почти не влияет.
Границы у этого замера узкие. Шлюз один, на каждую ячейку — один-два прогона, Argon и Opus замерены с разницей в неделю, а задачи небольшие и чётко поставленные, поэтому модели на них почти не различаются. Это проверка цены и поведения на типовых задачах, а не рейтинг качества: для качества ориентиром остаются индекс AA и таблица Google. Текст рассуждений Opus через API не возвращался, но его токены входят в выходные.
Подсчёт по журналу 146 КБ: Opus точен по умолчанию, Argon — на high
Там, где нужен точный ответ по длинному вводу, разница между моделями проявилась сильнее, чем на коротких задачах. Opus 5.5 верно посчитал всё уже на настройке по умолчанию, Argon по умолчанию ошибся оба раза, а правильный ответ дал только на high со стримингом — дороже и в несколько раз дольше.
Задача такая: синтетический журнал приложения на 1 500 строк (146 КБ), в нём 326 строк с уровнем ERROR. Нужно назвать число ошибок по пяти кодам, число разных пользователей с ошибкой E503 и запрос с наибольшим значением повторов. Точные ответы сгенерированы скриптом и сверены через grep до первого вызова; маршрут и даты те же, что в прогоне выше.
| Настройка | Верно | Время | Запуск до 30 ноября | Запуск с 1 декабря |
|---|---|---|---|---|
| Opus 5.5, по умолчанию и high | 4 из 4 | 56–59 с | $0,47–0,48 | $0,47–0,48 |
| Argon, по умолчанию | 0 из 2 | 7–8 с | $0,16 | $0,32 |
| Argon, high без стриминга | ответа нет | 247 с | $0,49 | около $0,97 |
| Argon, high со стримингом | 2 из 2 | 271 и 402 с | $0,53–0,55 | $1,06–1,09 |
Argon по умолчанию отвечал за семь секунд и почти без рассуждений, но занизил счётчики на 20–37 %: вместо 94 ошибок E503 назвал 59, вместо 78 пользователей с этой ошибкой — 46. На high без стриминга модель упёрлась в лимит 32 768 выходных токенов, ещё не закончив рассуждать: ответа нет, а $0,49 списано. Со стримингом тот же запрос дал верный ответ оба раза. Ещё два вызова Argon на high оборвал локальный прокси примерно на 300-й секунде; они не оплачены и в таблицу не вошли.
Итог для такой работы: верный ответ Argon сейчас стоит примерно столько же, сколько у Opus, с 1 декабря — в 2,2–2,3 раза дороже, и ждать его приходится в 4,6–7,2 раза дольше. Дешёвый ответ Argon по умолчанию здесь просто неверен. Это один тип задачи и два-четыре прогона на настройку, но если ваш агент считает что-то по логам, выгрузкам или длинным таблицам, проверьте именно это до переноса нагрузки.
Кто сильнее: таблица Google и сторонние замеры — Argon и Opus почти равны
В таблице из анонса Google от 30 сентября четыре столбца: Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 и Claude Opus 5.5. GPT-6.1 Sol в ней нет, поэтому из неё нельзя вывести, как Argon соотносится с этой моделью. С Opus 5.5 сравнение есть в 18 строках: в 14 выше Argon, в четырёх — Opus.
| Бенчмарк, данные Google | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Vals Index | 68,9 % | 67,0 % |
| AutomationBench | 51,3 % | 42,5 % |
| Vals Finance Agent v2 | 65,4 % | 58,6 % |
| DeepSWE v1.1 | 77,9 % | 74,2 % |
| GraphWalks, 256 тыс. – 1 млн токенов | 84,2 % | 66,8 % |
| LVBench | 91,7 % | 83,7 % |
| CWE-bench v1 | 68,0 % | 67,0 % |
| FrontierSWE v2 | 55,0 % | 62,3 % |
| Terminal-bench 4.0 | 57,4 % | 66,4 % |
| PostTrainBench | 45,3 % | 49,3 % |
| Terminal-Bench Science 0.1 | 57,6 % | 63,3 % |
Четыре строки, где впереди Opus, — это работа агента в терминале, набор FrontierSWE, дообучение моделей и научные задачи в терминале. Argon сильнее в аналитической и офисной работе, на длинном контексте и в понимании видео и графиков. В посте от 13 октября Google добавила собственные результаты Argon, например 87 % в ERQA, но цифр конкурентов там нет.
Эти цифры Google собрала и опубликовала сама, независимо их никто не воспроизводил. По прочтению Kingy AI, в методике указан максимальный уровень рассуждений, а условия прогонов местами разные: в DeepSWE Argon запускали через mini-swe, в Terminal-Bench Science тайм-аут проверки был в шесть раз больше, в LVBench Gemini получала кадр в секунду, а Opus — 600 кадров.
Сторонние замеры сужают разрыв, и в обоих независимых индексах впереди оказывается Opus. В Artificial Analysis (версия 5.0.1) на одинаковом уровне high он выше на два пункта, 52 против 50, а в Vals Index версии 2.2 по таблице на 30 октября — примерно на один, 70,18 % против 69,24 %. Vals же отмечает слабое место Argon: 4,83 % в CUA-bench. В слепом голосовании Arena, по снимку Kingy AI от 30 сентября, Argon High первый в текстовой категории с рейтингом 1 525 ±9 против 1 504 ±10 у Opus 5.5 High; GPT-6.1 Sol в этой таблице не было. Arena измеряет предпочтения людей, а не правильность решения.
Про GPT-6.1 Sol на том же поле известно меньше: 50 баллов в Artificial Analysis на high и 63,94 % в Vals Index версии 2.2. По качеству в AA она наравне с Argon и на два пункта ниже Opus, в Vals — ниже обеих, а по стоимости задачи на high намного дешевле: около 12 % от Argon по его стартовой цене, около 6 % после 1 декабря и 17 % от Opus. Подробно пара Opus 5.5 и Sol разобрана в материале Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода, а как Sol соотносится с другими моделями OpenAI — в материале GPT-6.1 Sol, GPT-6 Astra и GPT-6 Sol: какую модель выбрать.
Для агентов, читающих чужие страницы и документы, важна устойчивость к внедрению инструкций. Google пишет, что Argon здесь лидирует: в тесте Gray Swan атака удаётся в 0,7 % случаев при 15 адаптивных попытках. VentureBeat по графику из анонса 30 сентября приводит для Opus 5.5 значение 1,0 %. Для GPT-6.1 Sol на графике значения нет.
Что лучше для кода: Opus 5.5 впереди в терминале, Argon — в DeepSWE
Для агентов, которые пишут и запускают код, надёжнее выбрать Opus 5.5, но три вида данных сходятся в этом не полностью, и стоит видеть, где именно. В таблице самой Google Opus впереди во всех терминальных строках — Terminal-bench 4.0 (66,4 % против 57,4 %), FrontierSWE v2 (62,3 % против 55,0 %), Terminal-Bench Science и PostTrainBench, а Argon выигрывает DeepSWE v1.1 (77,9 % против 74,2 %) и Vibe Code Bench (91,9 против 90,3). Это замеры производителя на максимальном уровне рассуждений.
Независимые замеры Artificial Analysis на 11 ноября 2026 года меняют масштаб. В Terminal-Bench 4.0 разрыв почти исчезает: 57,1 % у Argon на high против 56,6 % у Opus на high и 59,6 % у Opus на max. А в FrontierCode 2.0, где модели решают большие задачи на код, разрыв, наоборот, широкий: 25,7 % у Argon на high против 35,9 % у Opus на high и 46,4 % на max. В AutomationBench, ближе к автоматизации рабочих процессов, впереди Argon: 77,5 % против 63,2 % у Opus на high.
Прогон одинаковых задач добавляет третью картину. Небольшие функции со скрытыми тестами обе модели пишут без проблем на любой настройке, а единственный промах Argon по умолчанию — лишние пробелы во вводе. Разница появляется там, где нужно точно обработать длинный ввод: Opus хватает настройки по умолчанию, Argon нужен high со стримингом и в несколько раз больше времени. Отсюда практическое правило: для агента в терминале или с длинными логами начинайте с Opus 5.5 на effort medium, а Argon проверяйте на своих задачах, если они похожи на DeepSWE или на автоматизацию процессов, и считайте его по ценам с 1 декабря.
Вывод до 1 млн токенов: общий лимит и 65 536 в обычном ответе
Миллион токенов у Argon — это общий бюджет на вход и выход, а не длина одного ответа. На странице модели в документации Gemini API записано: окно в 1 048 576 токенов — единый лимит для входных и выходных токенов. Обычный запрос возвращает не больше 65 536 выходных токенов, а без стриминга, по документации на 4 ноября 2026 года, — не больше 32 768. До 1 048 576 вывод доходит только в отдельном режиме длинной генерации (long decode).
Лимит 32 768 без стриминга важнее, чем кажется. Рассуждения входят в выходные токены, и на high длинная задача может исчерпать лимит, так и не дойдя до ответа; оплачены при этом будут все потраченные токены. Именно так закончился один из запусков подсчёта по журналу. Если вызываете Argon на high с длинным вводом, включайте потоковую выдачу.
Из общего бюджета следуют ещё два практических вывода. Если задача требует ответа длиннее 65 536 токенов, обычного вызова не хватит, нужен режим long decode; прежде чем закладывать его в проект, найдите в документации Gemini API, как он включается, и проверьте его на своём запросе. И в этом режиме вход и выход делят один бюджет: запрос на 900 тыс. входных токенов оставляет под вывод 148 576. VentureBeat отмечает, что Google не уточнила, как этот лимит соотносится с длиной одного непрерывного ответа.
В анонсе 30 сентября говорилось иначе — о лимите вывода, выросшем с 64 тыс. до 1 млн токенов. Vals тогда видел на своей точке доступа максимум вывода в 262 тыс. Обе цифры относятся ко времени до открытия общего доступа; для API сейчас действуют формулировки со страницы модели. У Opus 5.5 и GPT-6.1 Sol предел вывода один и тот же, 128 тыс. токенов, то есть в обычном вызове они отдают почти вдвое больше, чем Argon.
У длинного вывода есть и обратная сторона. Выходные токены — самая дорогая строка счёта, а с 1 декабря у Argon они стоят $20 за миллион. Именно длинные траектории дают те $193,78 за тест, которые Vals получил в CUA-bench.
На чём работать сейчас и что проверить в Argon до 1 декабря
Выбор до 1 декабря зависит от того, что в проекте дороже — токены или неудачная попытка, и от того, насколько точным должен быть ответ на длинном вводе.
- Массовые агенты, много вызовов, жёсткий бюджет. GPT-6.1 Sol: 50 баллов за $0,59 на high, а на max — 55 баллов за $1,27. Следите за порогом в 272 тыс. входных токенов: выше него весь запрос считается по $4 и $15.
- Агенты для кода, работа в терминале, точные ответы по длинному вводу. Opus 5.5 на effort medium: в прогоне одинаковых задач он прошёл всё и верно посчитал журнал с первой попытки, а в независимых Terminal-Bench 4.0 и FrontierCode он наравне с Argon или впереди. Переходите на high, когда medium не хватает: в индексе AA это плюс четыре балла за плюс $1,01 на задачу. Если полная цена Opus не оправдана, посмотрите на младшую модель: Claude Sonnet 5.5 или Opus 5.5: разница, цена задачи и выбор. С 9 ноября у Anthropic есть и более дорогой флагман Fable 5.2 ($8 / $40), но сама Anthropic советует начинать с Opus 5.5, а когда переходить выше, разобрано в материале Claude Fable 5.2 или Opus 5.5: что выбрать и на каком effort.
- Аналитика по большим документам, финансы и право, видео, автоматизация процессов. Здесь у Argon самые сильные заявленные результаты, а в автоматизации его перевес подтверждает и AA. Проверьте его на своих данных по стартовой цене, но держите слой вызова модели заменяемым: на high задача Argon в индексе AA уже сейчас дороже, чем у Opus на high, а с 1 декабря станет дороже в 2,88 раза.
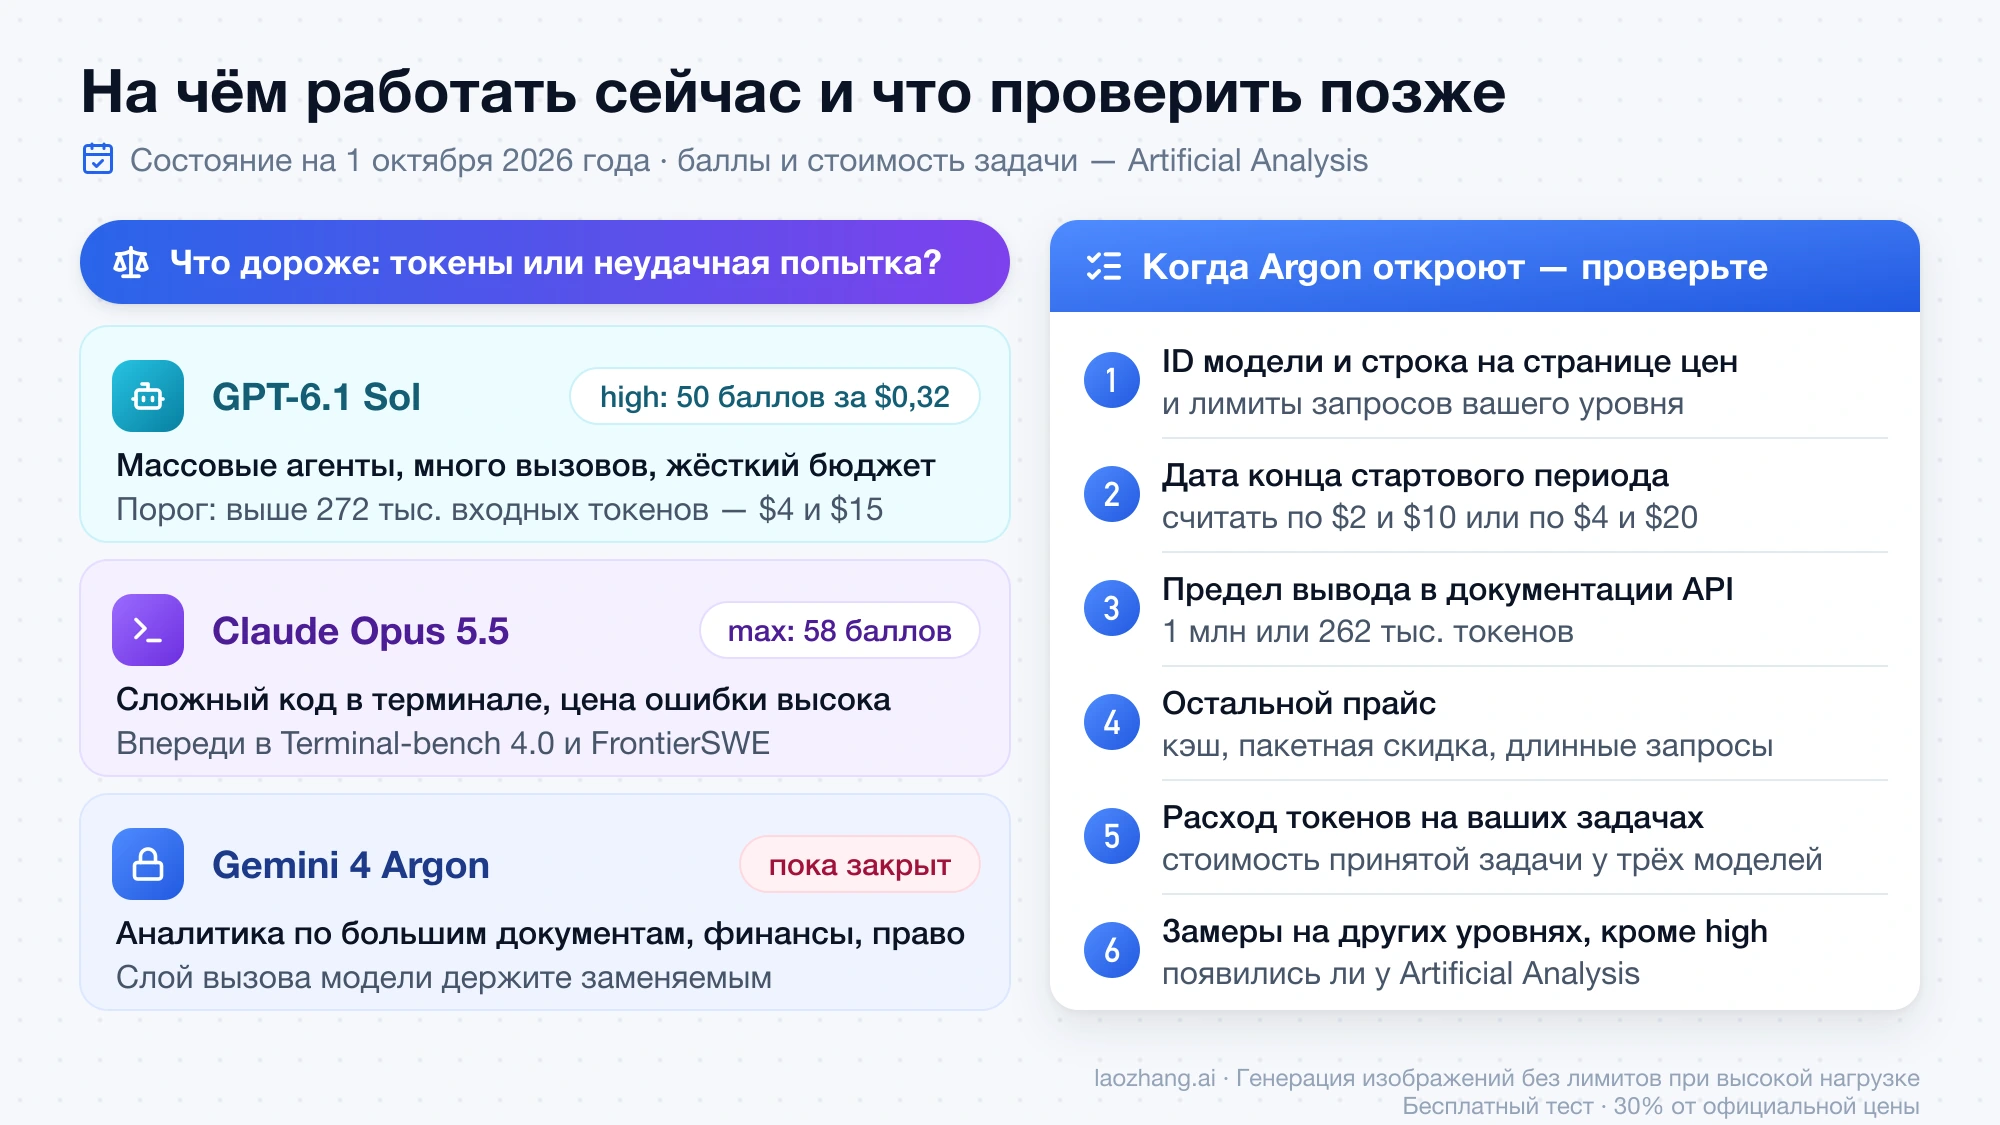
Схема по состоянию на 1 октября 2026 года, когда Argon ещё был закрыт; актуальный выбор — в списке выше, порядок проверки — в списке ниже.
Стартовая цена — удобное окно, чтобы дёшево замерить Argon, но не довод в пользу переезда: с 1 декабря его токены будут стоить как у Opus. Переводить нагрузку стоит только туда, где Argon выигрывает и по ценам с 1 декабря. Проверьте по порядку:
- Сколько токенов Argon тратит на ваших задачах и сколько результатов принимается. Прогоните несколько десятков собственных задач на всех трёх моделях и посчитайте стоимость принятой задачи: все расходы на попытки, делённые на число результатов, которые прошли вашу проверку. Пакетный режим (Batch) сделает такой прогон вдвое дешевле.
- Хватает ли Argon настройки по умолчанию. AA измерил только high; в прогоне одинаковых задач настройка по умолчанию справилась с короткими задачами, но ошиблась в подсчёте по длинному журналу. Если ваша работа требует точных ответов по длинному вводу, сравните medium и high на своих данных.
- Пересчитайте итог по ценам с 1 декабря: $4 за вход, $20 за выход, $0,20 за кэш. Учитывайте и разный счёт токенов: тот же русский текст у Opus занимает больше входных токенов, чем у Argon. Если при этих условиях Argon дороже Opus 5.5 за принятую задачу и не лучше по качеству, оставайтесь на Opus или Sol.
- Укладываются ли ваши ответы вместе с рассуждениями в 32 768 выходных токенов без стриминга и 65 536 со стримингом. Если нет, включите стриминг, а для ответов длиннее разберитесь с режимом long decode до переноса нагрузки.
- Какая доля входа реально попадает в кэш. Кэш у Argon только неявный, управлять им нельзя, а для длинных повторяющихся промптов от этого зависит заметная часть счёта.
- Какие лимиты запросов назначены вашему проекту. На страницах цен и модели их нет, а для массовых агентов это может решить вопрос раньше цены.
Частые вопросы о Gemini 4 Argon, Opus 5.5 и GPT-6.1 Sol
Можно ли уже пользоваться Gemini 4 Argon?
Да, с 13 октября 2026 года. Через API модель доступна на платном уровне Gemini API и в AI Studio под ID gemini-4-argon; на бесплатном уровне её нет. В приложении Gemini и AI Mode её получили подписчики Google AI Pro и Ultra, в Google Antigravity — подписчики Ultra, а по состоянию на 23 октября 2026 года и платной Google AI Pro или пробной Pro, полученной вместе с подходящим премиальным устройством; для компаний — Gemini for business. Россия в список регионов Gemini API не входит.
Когда Gemini 4 Argon станет доступен в API?
Уже стал. Дата выхода такая: анонс 30 сентября 2026 года, после которого 13 дней модель была только у участников Fairwind, и общий доступ с 13 октября 2026 года. На странице моделей Gemini API у gemini-4-argon стоит пометка Stable, на странице цен есть его строка. Лимиты запросов не опубликованы.
Входит ли Gemini 4 Argon в подписку Google AI Pro?
В приложении Gemini и в AI Mode — да, по анонсу Google модель доступна подписчикам AI Pro и Ultra. В веб-интерфейсе AI Studio — тоже да: по описанию тарифов Google AI на 6 ноября 2026 года AI Pro даёт повышенную квоту с доступом к Argon, Ultra — максимальную, а на бесплатном плане его нет. Вызовы через API подписка не покрывает ни на каком тарифе: для них нужен платный аккаунт Gemini API с оплатой токенов, на бесплатном уровне API Argon недоступен. В Google Antigravity — да, если подписка платная или это пробный период Pro, полученный вместе с подходящим премиальным устройством (обычный бесплатный пробный период Google не называет): Argon доступен в приложении Antigravity, CLI и расширениях для IDE, но не в Antigravity IDE.
Правда ли, что Argon стоит как GPT-6.1 Sol и вдвое дешевле Opus 5.5?
По прайсу за токены — только до 30 ноября 2026 года: $2 и $10 за миллион у Argon и у GPT-6.1 Sol в запросах до 272 тыс. входных токенов против $4 и $20 у Opus 5.5. С 1 декабря Argon стоит $4 и $20, как Opus. По стоимости задачи на уровне high — нет и сейчас: в индексе Artificial Analysis на 11 ноября задача Argon дороже, чем у Opus 5.5, в 1,44 раза до 30 ноября и в 2,88 раза с 1 декабря, а по сравнению с GPT-6.1 Sol — в 8,4 и 16,9 раза. Дешевле Opus Argon оказывается на настройке по умолчанию у каждой модели и на небольших задачах.
Argon действительно лучше Claude Opus 5.5?
Зависит от задачи и от того, кто измерял. В таблице Google Argon выше в 14 строках из 18, Opus — в четырёх, связанных с работой в терминале, FrontierSWE и дообучением моделей. В независимых индексах впереди Opus, но ненамного: на два пункта в Artificial Analysis (версия 5.0.1, уровень high) и примерно на один в Vals Index версии 2.2 (данные на 30 октября 2026 года). На небольших задачах через один шлюз обе модели почти не ошибаются, а точный подсчёт по длинному журналу Argon в ноябрьском прогоне решил только на high.
Где в сравнении Google модель GPT-6.1 Sol?
Её там нет: от OpenAI в таблице только GPT-6 Astra. Сопоставить три модели позволяют сторонние замеры: в Artificial Analysis на high GPT-6.1 Sol набирает 50 баллов — столько же, сколько Argon, — против 52 у Opus 5.5, а в Vals Index версии 2.2 на 30 октября 2026 года — 63,94 % против 69,24 % у Argon и 70,18 % у Opus.
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 11 нояб. 2026 г..
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 11 нояб. 2026 г..
- 1.посте Google о выходе Gemini 4 Argonblog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon
- 2.странице Gemini 4 Argon в документации Gemini APIai.google.dev/gemini-api/docs/models/gemini-4-argon
- 3.страница моделей Google Antigravityantigravity.google/docs/models
- 4.блог Google Cloud о запуске Argoncloud.google.com/blog/products/ai-machine-learning/gemini-4-argon-available-on-google-cloud
- 5.странице цен Gemini APIaistudio.google.com/docs/pricing
- 6.описанию тарифов Google AI в AI Studioaistudio.google.com/docs/google-ai-plans
- 7.списке регионов, где работает Gemini APIai.google.dev/gemini-api/docs/available-regions
- 8.Artificial Analysisartificialanalysis.ai/models/gemini-4-argon
- 9.Valsvals.ai/benchmarks/vals_index
- 10.анонса Google от 30 сентябряblog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 11.VentureBeatventurebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release