Gemini 4 Argon vs 3.8 Flash: сравнение, тест цены и что выбрать
Argon дороже 3.8 Flash в 2,67 раза за 1 млн токенов, но в тесте 23 октября 2026 года — в 1,57 раза за вызов. Он нужен для агентов и трудного кода.
Содержание
Если вы вызываете gemini-3.8-flash и думаете о переходе на gemini-4-argon, переводите не весь трафик, а те задачи, где модели действительно расходятся: многошаговые агентные цепочки, работу в терминале, код со скрытыми ошибками и трудную математику. Короткий чат, классификацию, извлечение данных и пересказ длинных документов разумно оставить на 3.8 Flash, пока она с ними справляется: на чтении длинного контекста и PDF-документов модели в бенчмарках почти равны, а за 1 млн токенов Argon дороже. Для смешанного трафика рабочий вариант — разделение: Flash по умолчанию, Argon для отобранных типов задач.
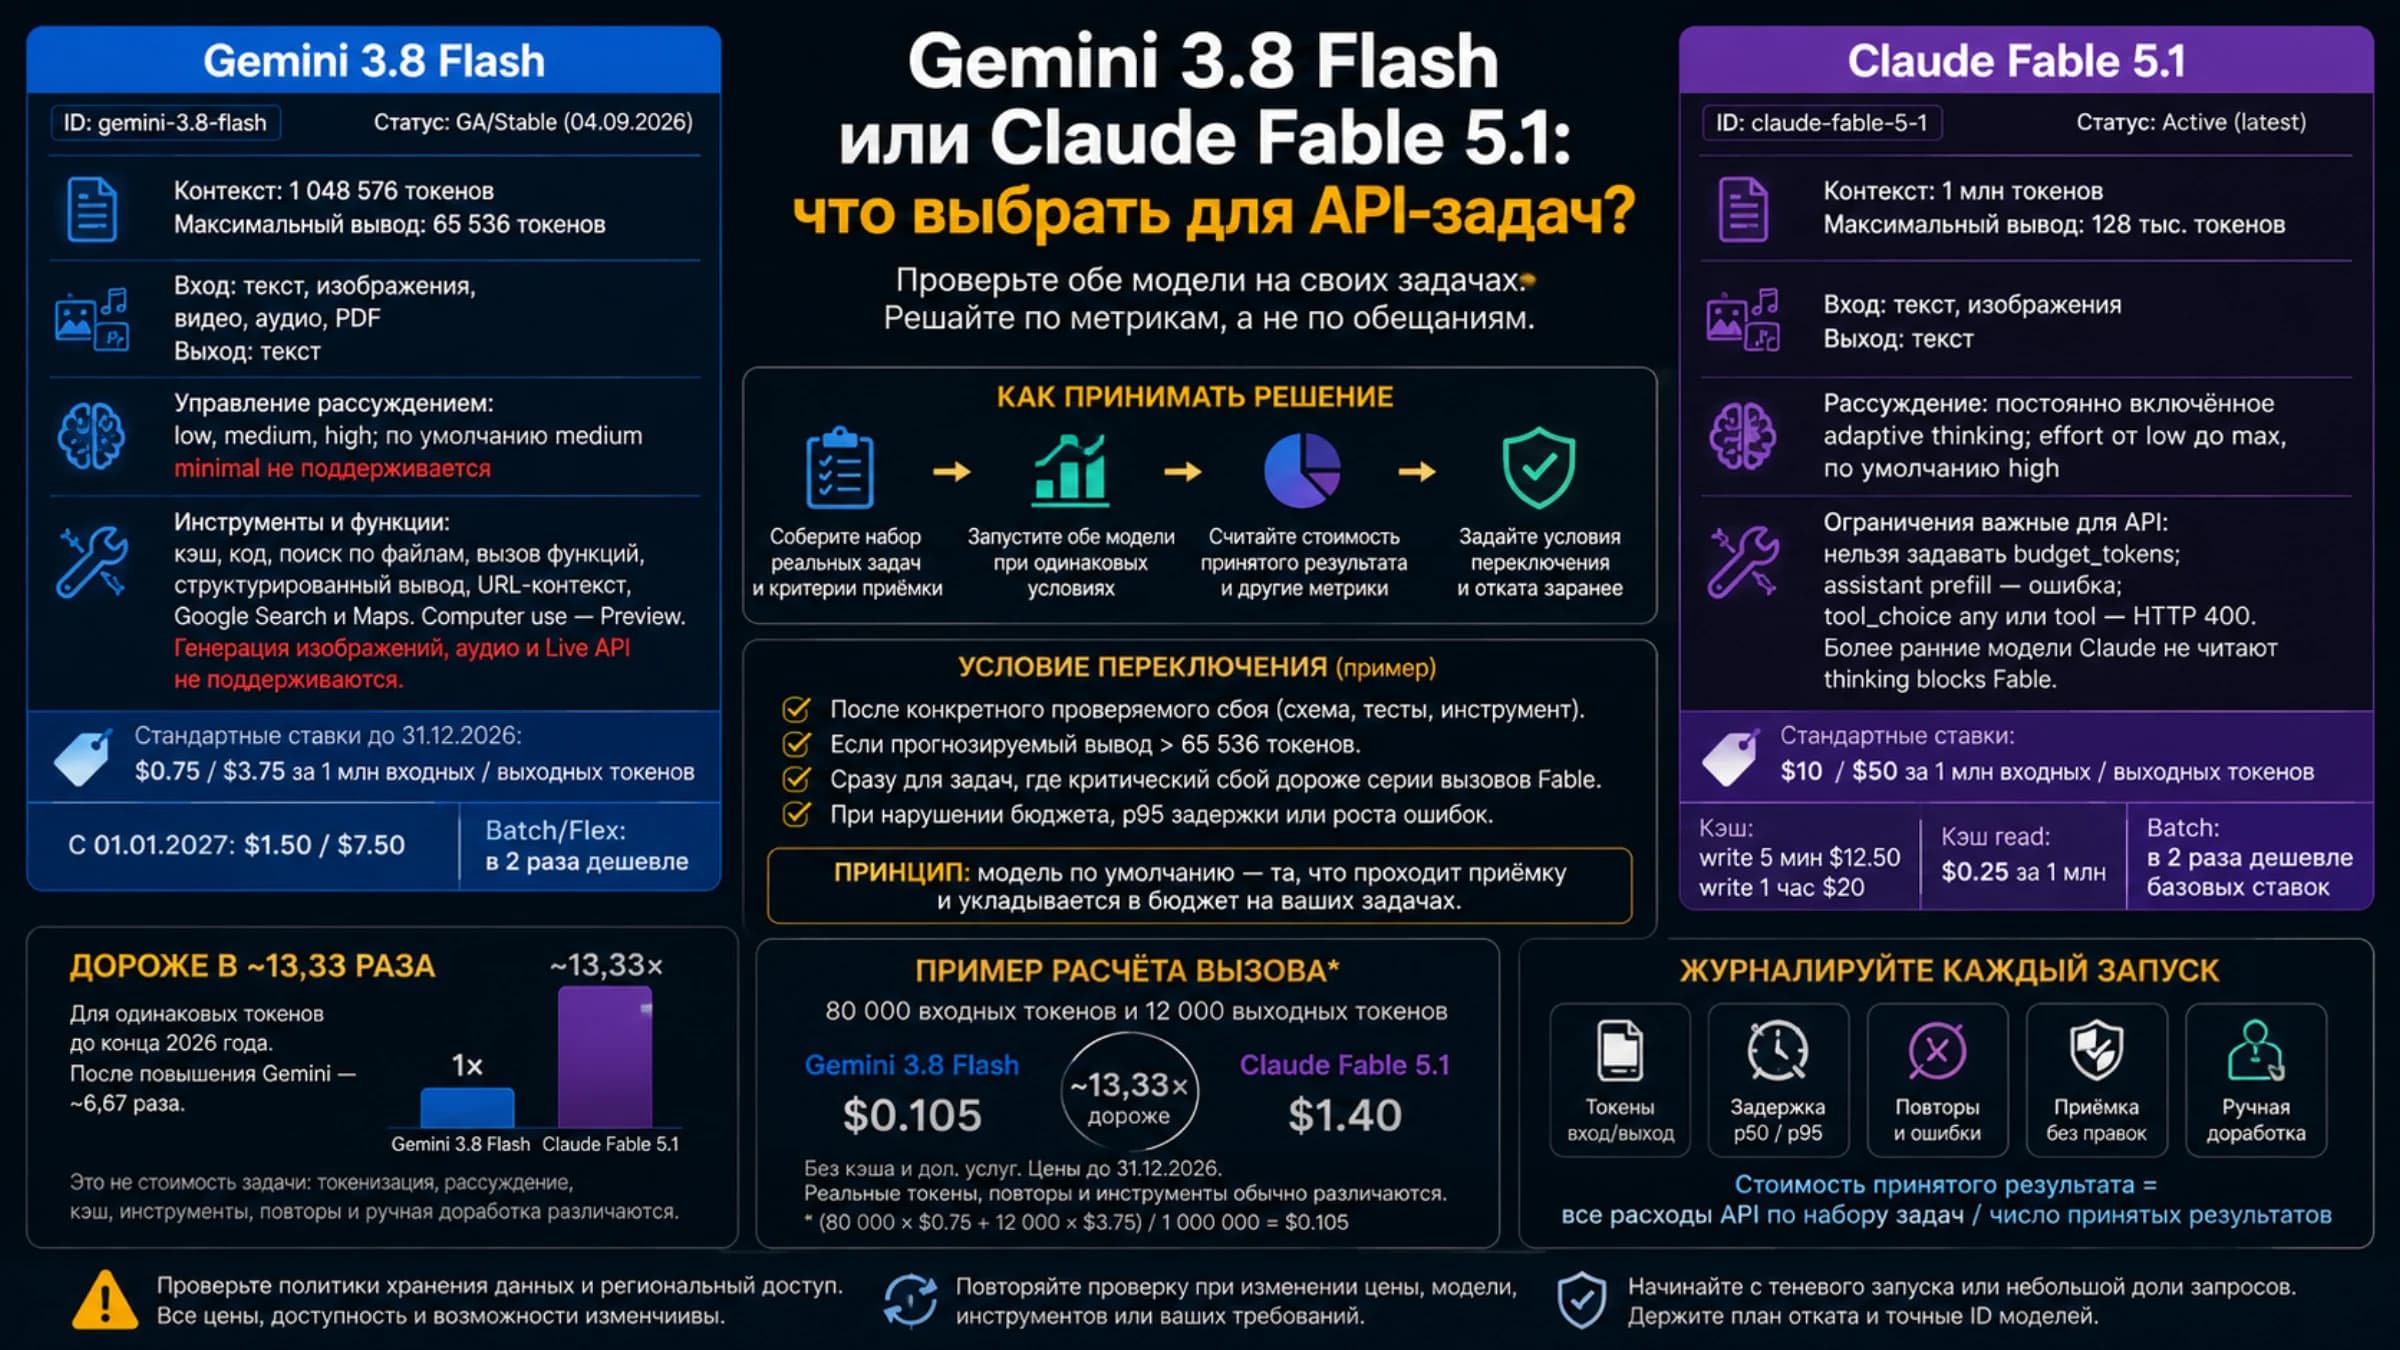
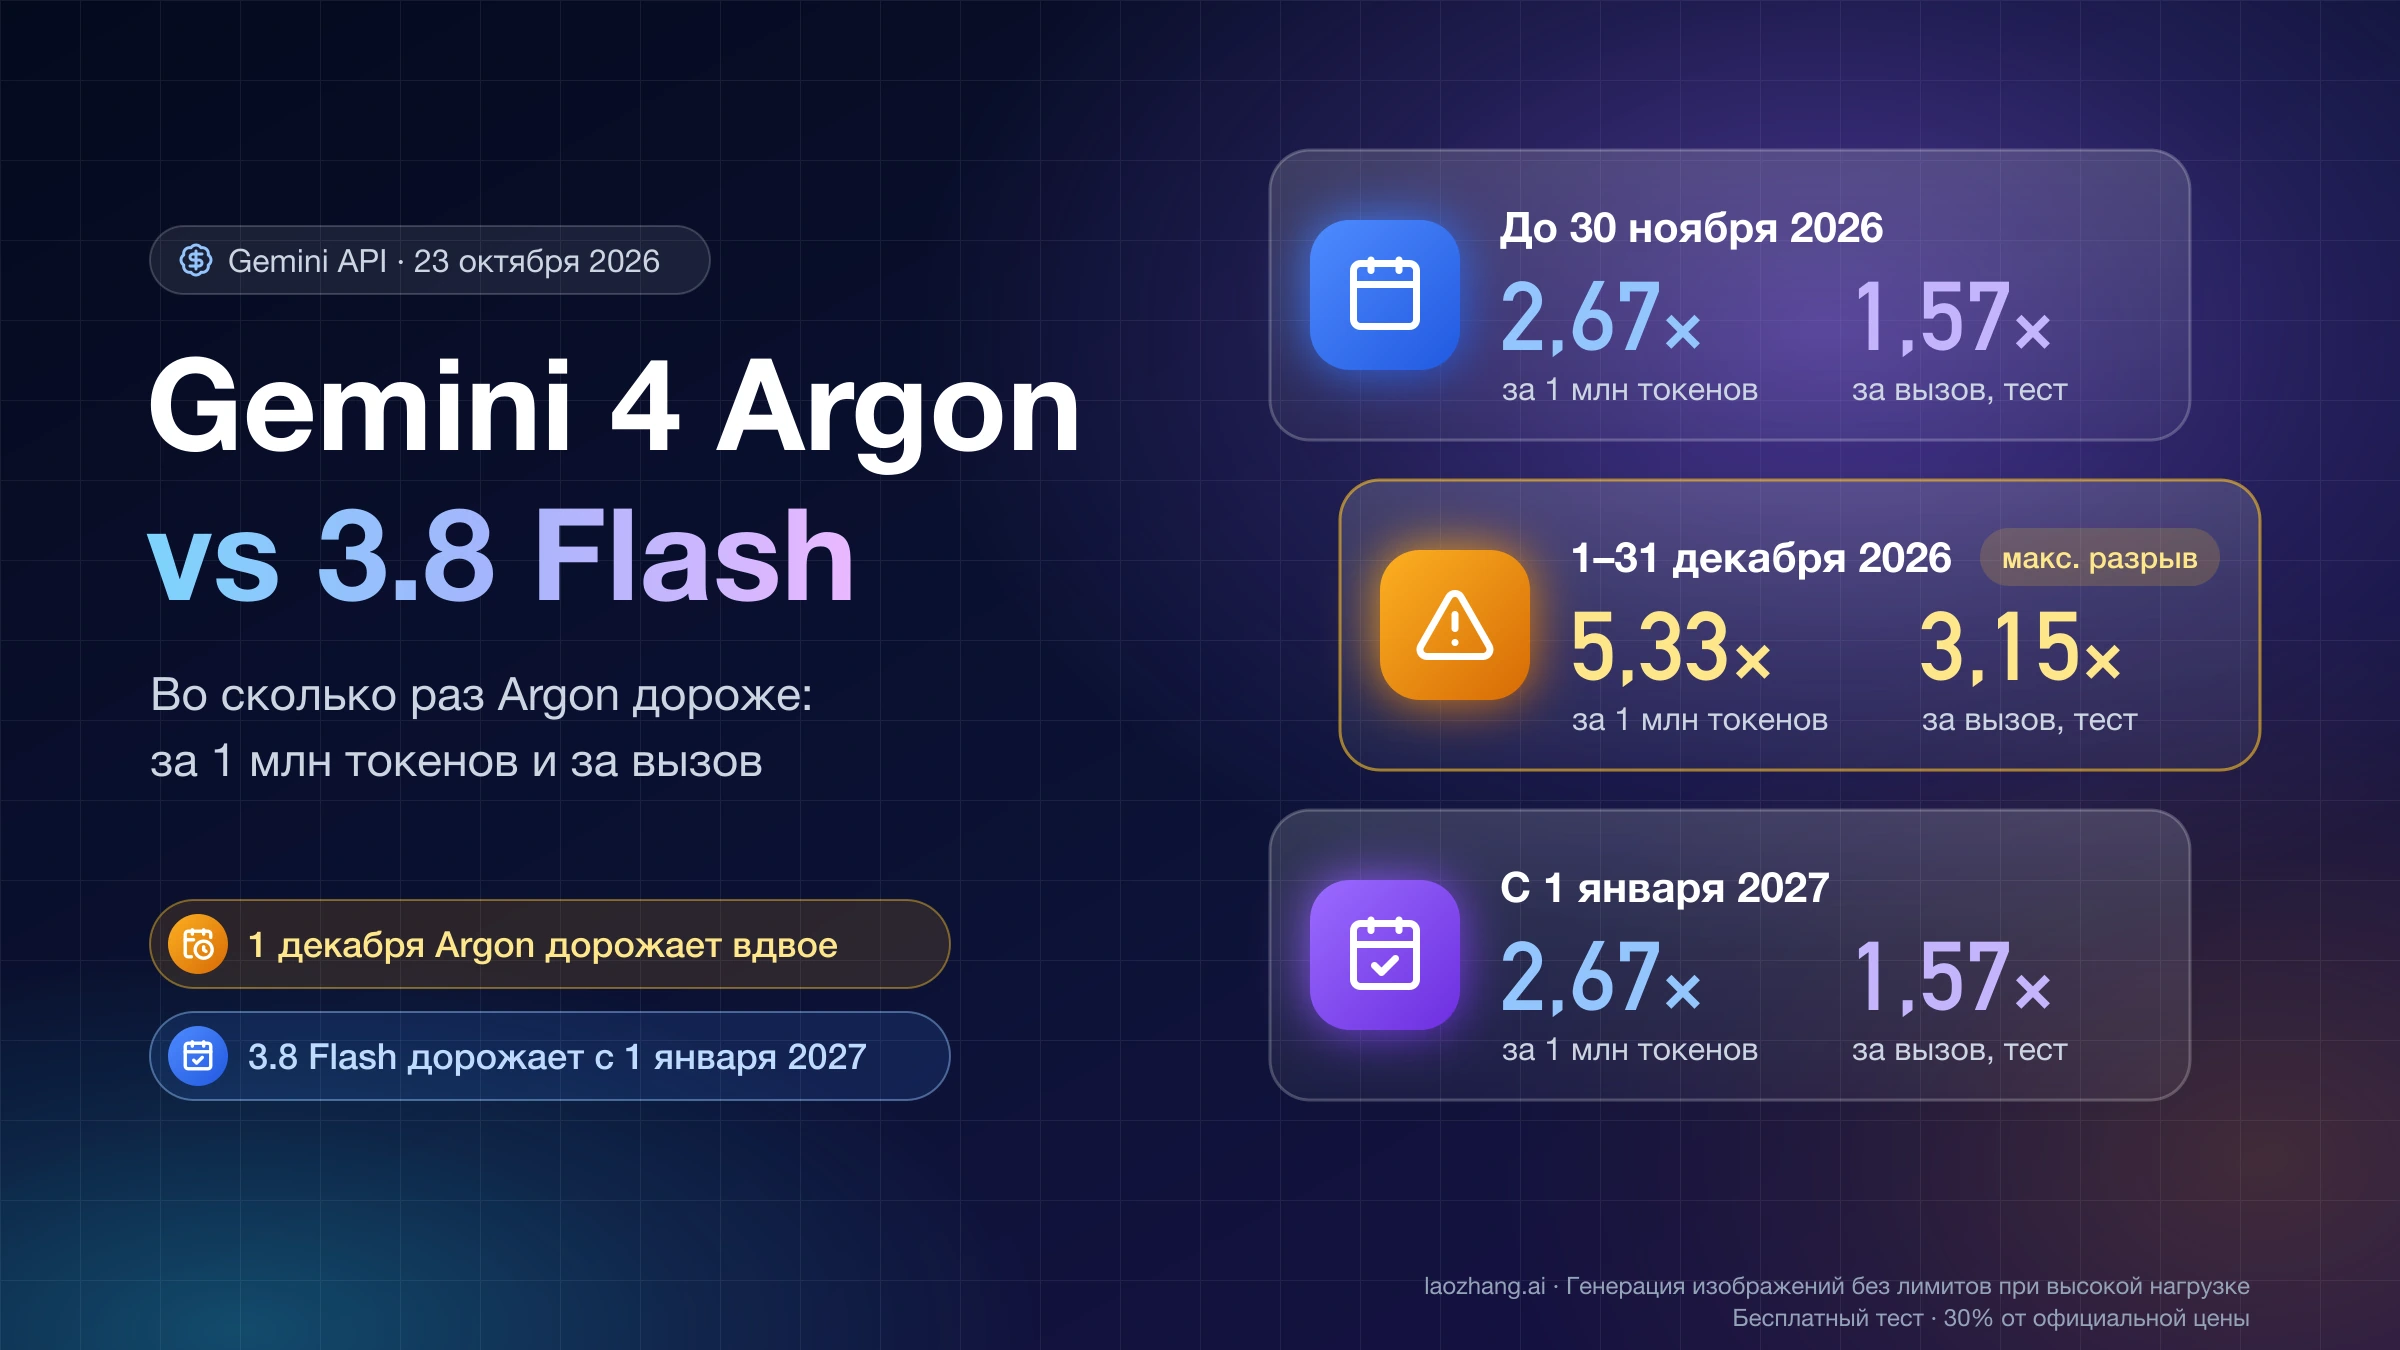
За 1 млн токенов Argon дороже в 2,67 раза, но за вызов разница меньше, потому что 3.8 Flash тратит больше токенов на размышления. В тесте на одинаковых запросах 23 октября 2026 года пять задач на уровне по умолчанию обошлись на Argon в 1,57 раза дороже, у Artificial Analysis на трудных задачах на уровне High — в 1,6 раза. Решающих дат две: с 1 декабря 2026 года Argon дорожает вдвое, а Flash — только с 1 января 2027 года, поэтому с 1 по 31 декабря разрыв временно вырастает примерно до 3,2 раза за задачу.
Замена ID — это не одна строка в коде. У Argon нет бесплатного уровня и явного кэширования, а Google советует поднять max_output_tokens минимум до 32 768 и тайм-аут клиента до 15 минут. Полный список изменений — в разделе о коде ниже.
Насколько Argon дороже 3.8 Flash: за 1 млн токенов, за вызов и за задачу
По странице цен Gemini API на 23 октября 2026 года Argon стоит $2,00 за 1 млн входных и $10,00 за 1 млн выходных токенов, 3.8 Flash — $0,75 и $3,75 (уровень Standard, платный тариф, без надбавки за длинные запросы у обеих моделей). И за ввод, и за вывод Argon дороже в 2,67 раза. Но цена каждой модели меняется в свою дату, а за вызов и за задачу кратность получается другой, поэтому в таблице все три мерки разведены по периодам.
| Период | Argon, ввод / вывод за 1 млн | 3.8 Flash, ввод / вывод за 1 млн | Кратность за 1 млн токенов | За задачу, Artificial Analysis (High, расчёт) | За вызов, тест 23 октября (по умолчанию, сумма 5 задач) |
|---|---|---|---|---|---|
| До 30 ноября 2026 года | $2,00 / $10,00 | $0,75 / $3,75 | 2,67 | 1,6 ($1,99 против $1,24) | 1,57 |
| 1–31 декабря 2026 года | $4,00 / $20,00 | $0,75 / $3,75 | 5,33 | ≈3,2 ($3,98 против $1,24) | 3,15 |
| С 1 января 2027 года | $4,00 / $20,00 | $1,50 / $7,50 | 2,67 | ≈1,6 ($3,98 против $2,48) | 1,57 |
Разница между кратностью за токен и за задачу возникает из-за размышлений: Google считает токены размышлений выходными и берёт за них цену вывода. В сравнении Artificial Analysis на уровне High 3.8 Flash выдаёт на задачу индекса около 71 тыс. выходных токенов (из них 43 тыс. — размышления), Argon — около 62 тыс. (36 тыс.), и задача стоит $1,24 против $1,99. Значения для декабря и 2027 года в таблице — расчёт: те же 62 и 71 тыс. токенов умножены на новые цены, а сама Artificial Analysis пересчитает свои цифры после повышения. Колонка теста — уровни по умолчанию (у обеих моделей это medium), а не High, поэтому смешивать её с колонкой Artificial Analysis в одну кратность нельзя: совпадение 1,57 и 1,6 говорит лишь о том, что оба метода показывают одно направление.
Стоимость вызова пересчитывается по формуле: входные токены × цена ввода + (размышления + ответ) × цена вывода. Например, пересказ длинной статьи в тесте: у Flash 11 191 входной токен × $0,75 / 1 млн + (1 456 + 741) × $3,75 / 1 млн ≈ $0,0166, у Argon 11 102 × $2,00 / 1 млн + 1 097 × $10,00 / 1 млн ≈ $0,0332. Для 100 000 таких вызовов это (расчёт, не измерение) около $1 663 на Flash и $3 317 на Argon до 30 ноября, $1 663 и $6 635 в декабре, $3 326 и $6 635 с 1 января 2027 года.
На счёт влияют и другие строки прайса. Batch и Flex у Argon вдвое дешевле Standard ($1/$5 до 30 ноября, $2/$10 после), Priority — $3,60/$18 и $7,20/$36. У Argon только неявное кэширование: попадание в кэш стоит $0,10 за 1 млн ($0,20 с 1 декабря), то есть скидка 95 %. У 3.8 Flash есть и явное кэширование: $0,075 за 1 млн кэшированных токенов плюс $0,50 за 1 млн токенов в час хранения (с 1 января 2027 года — $0,15 и $1,00). Поиск Google для обоснования ответов (grounding with Search) даёт 5 000 бесплатных запросов в месяц на все модели Gemini 3 и новее вместе, дальше — $14 за 1 000.
Тест 23 октября 2026 года: одинаковые запросы к Argon и 3.8 Flash
Вечером 23 октября 2026 года (по пекинскому времени) обе модели получили одни и те же 12 запросов через LaoZhang API. Задач пять: t1 — тема письма в одну строку, t2 — текстовая задача про упаковки ручек, t3 — функция merge_intervals на Python с шестью тестами pytest, t4 — пересказ статьи на 6 723 слова (около 11 100 входных токенов) с тремя утверждениями, которые стоит проверить, t5 — четырёхходовый диалог о поездке, итог которого — таблица с бюджетом в евро. Каждая задача шла на уровне по умолчанию, t3 — ещё на low и medium, t1–t5 — ещё на high. Каждый вызов выполнен один раз, без перезапусков ради лучшего ответа; во всех ответах вернулись ID gemini-3.8-flash и gemini-4-argon. Стоимость посчитана по возвращённым токенам и ценам Google до 30 ноября; весь тест стоил около $0,32.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Эндпоинты у моделей разные, и это ограничение теста. 3.8 Flash шла через OpenAI-совместимый /v1/chat/completions с параметром reasoning_effort, потому что нативный эндпоинт Gemini для gemini-3.8-flash в тот вечер четыре раза подряд не ответил до тайм-аута. Argon шёл через нативный generateContent с thinkingConfig.thinkingLevel, потому что в OpenAI-совместимом варианте reasoning_effort у Argon не давал видимого эффекта: high вёл себя как уровень по умолчанию и токенов размышлений в ответе не было. Оба варианта передают запрос в Google и оба возвращают счётчик токенов размышлений.
| Задача (уровень по умолчанию) | 3.8 Flash: ввод / размышления / ответ | Argon: ввод / размышления / ответ | 3.8 Flash | Argon | Argon ÷ Flash за вызов |
|---|---|---|---|---|---|
| t1, тема письма | 23 / 402 / 67 | 53 / 0 / 129 | $0,0018 | $0,0014 | 0,79 |
| t2, задача про ручки | 61 / 778 / 456 | 92 / 0 / 347 | $0,0047 | $0,0037 | 0,78 |
| t3, код с тестами | 61 / 522 / 503 | 91 / 0 / 577 | $0,0039 | $0,0060 | 1,53 |
| t4, пересказ длинной статьи | 11 191 / 1 456 / 741 | 11 102 / 0 / 1 097 | $0,0166 | $0,0332 | 1,99 |
| t5, диалог из четырёх ходов | 218 / 834 / 676 | 267 / 0 / 693 | $0,0058 | $0,0075 | 1,28 |
| Сумма t1–t5 | — | — | $0,0328 | $0,0516 | 1,57 |
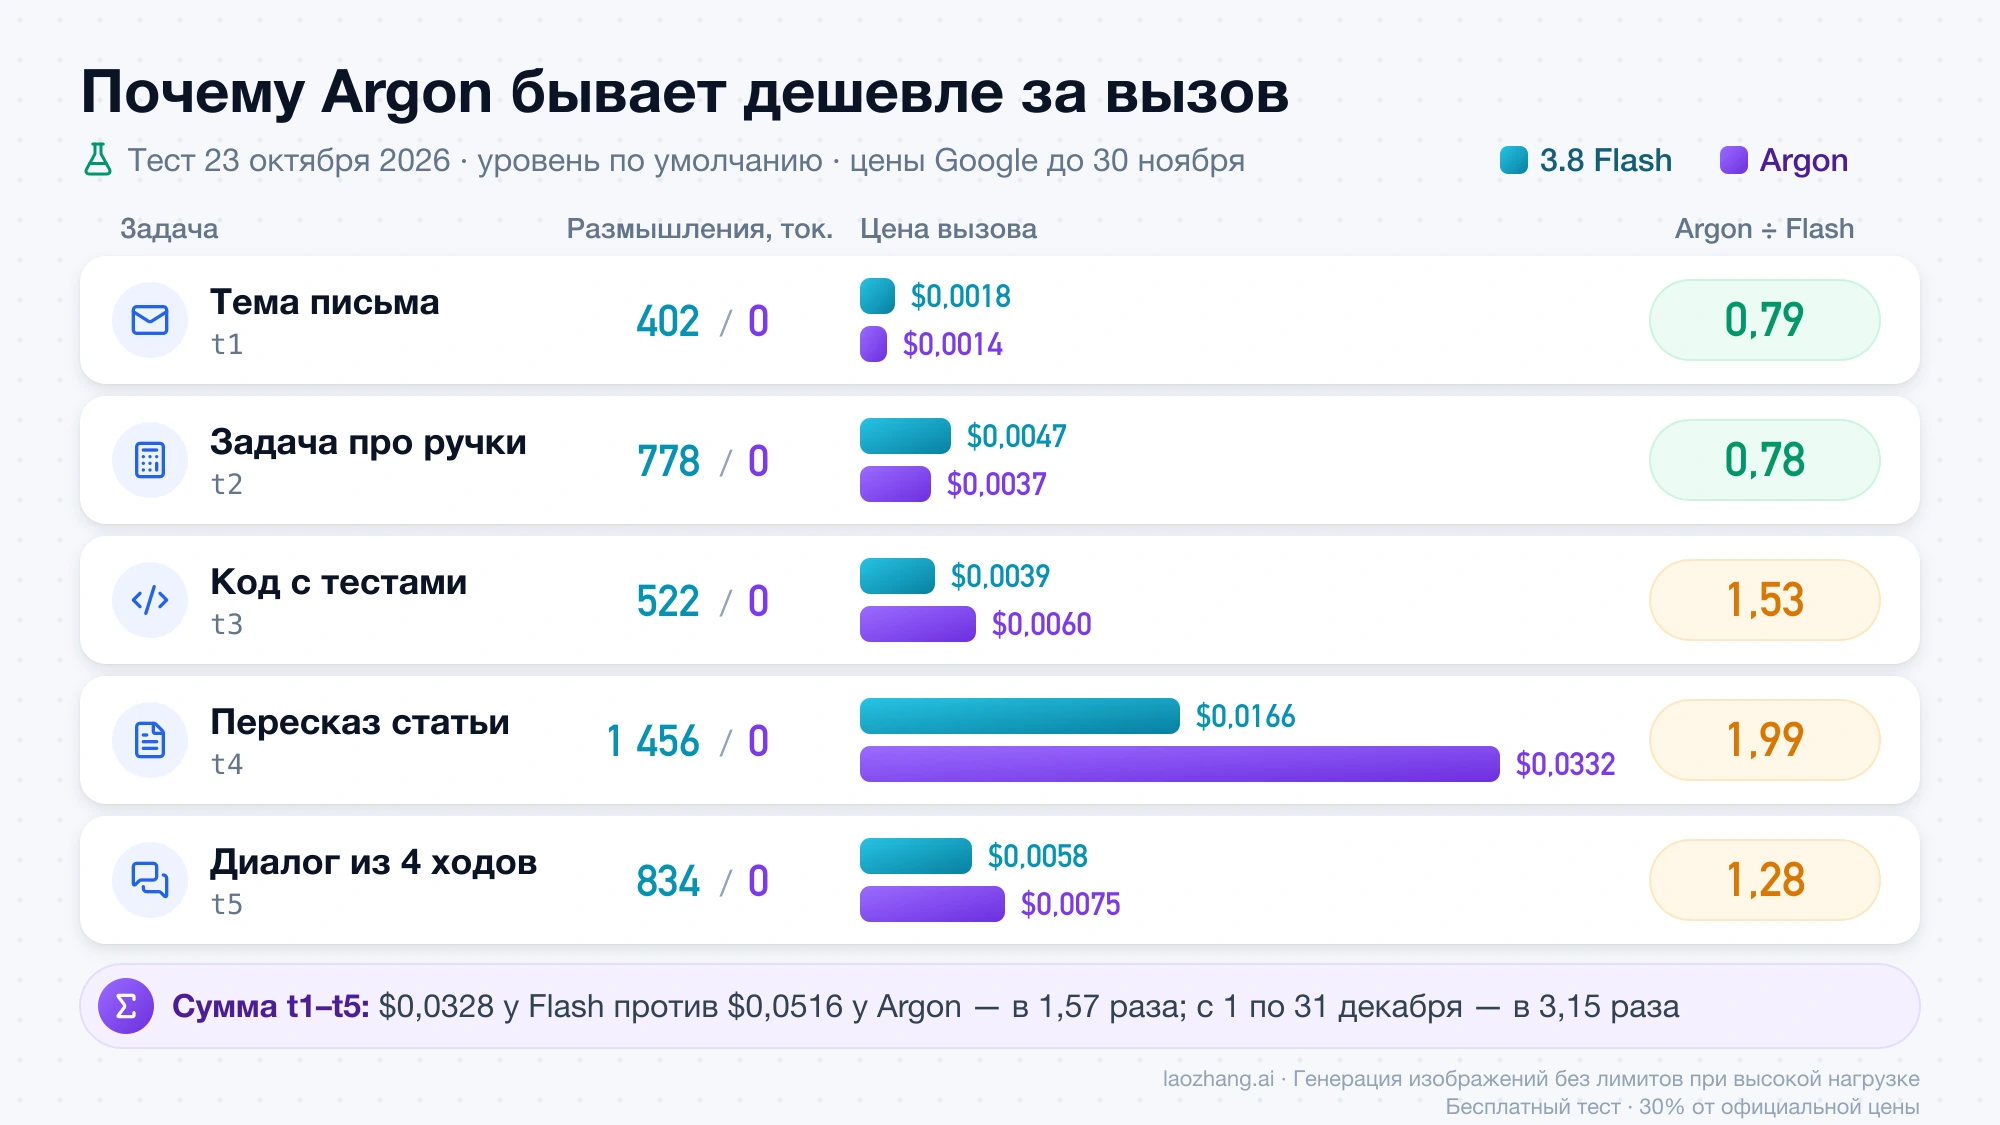
На коротких задачах t1 и t2 Argon за вызов вышел даже дешевле Flash, потому что 3.8 Flash потратила на размышления 402 и 778 токенов, а Argon не сообщил ни одного. Там, где ответ длинный или входной текст большой (код, пересказ, диалог), цена токена Argon перевешивает, и вызов дороже в 1,28–1,99 раза. На уровнях по умолчанию, low и medium Argon в этих задачах не возвращал токенов размышлений вовсе (так же было при прогоне тех же запросов на Argon 14 октября 2026 года); пропускает ли он размышления или они не попадают в счётчик, тест не показывает, но оплачиваются именно возвращённые токены. С 1 по 31 декабря 2026 года те же пять вызовов по новым ценам Argon стоили бы $0,1033 против $0,0328, то есть в 3,15 раза дороже, а с 1 января 2027 года кратность возвращается к 1,57.
На high Argon начал размышлять: от 445 токенов на теме письма до 2 439 на пересказе, и вызов стоил от $0,0055 до $0,0591. Сумма пяти задач — $0,1110 против $0,0322 у Flash, или 3,44 раза (6,89 в декабре). Но это не сравнение «High против High»: на OpenAI-совместимом эндпоинте уровень у Flash заметно не менялся (на t3 — 522 токена размышлений по умолчанию, 516 на low, 588 на medium и 512 на high), поэтому для сравнения на одинаковом высоком уровне годятся только цифры Artificial Analysis.
Качество проверялось на двух задачах. Код из всех восьми ответов на t3 (четыре уровня × две модели) запущен с pytest 9.1.1: во всех файлах прошли все шесть тестов. Все четыре ответа на t2 (Flash и Argon, по умолчанию и на high) верны: 4 упаковки по 10 и 3 упаковки по 6, 58 ручек за $41,50. Ответы на t1, t4 и t5 не оценивались. На таких задачах обе модели справились, поэтому тест показывает разницу в цене, а не в интеллекте.
Время ответа в этом тесте не годится как замер скорости. Около 20:17–20:21 по пекинскому времени (15:17–15:21 МСК) 3.8 Flash несколько минут отвечала ошибкой 429 о перегрузке и ошибкой 503 с текстом Google «This model is currently experiencing high demand», а позже несколько попыток оборвались по тайм-ауту чтения; поэтому t1 занял 98,6 с (с четвёртой попытки), t4 — 124,9 с, остальные задачи Flash — 8,8–15,5 с. Все вызовы Argon прошли с первого раза за 6,8–59,7 с. Это один вечер и один провайдер, и выводов о надёжности Flash из этого делать нельзя; по замерам Artificial Analysis Flash выдаёт 142 токена в секунду против 82 у Argon.
Не проверялись прямой эндпоинт Google, Vertex AI, Batch и Flex, длинные агентные сессии, приложение Gemini и Antigravity, а также качество ответов сверх задач t2 и t3.
Где Argon сильнее, а где 3.8 Flash не хуже: бенчмарки
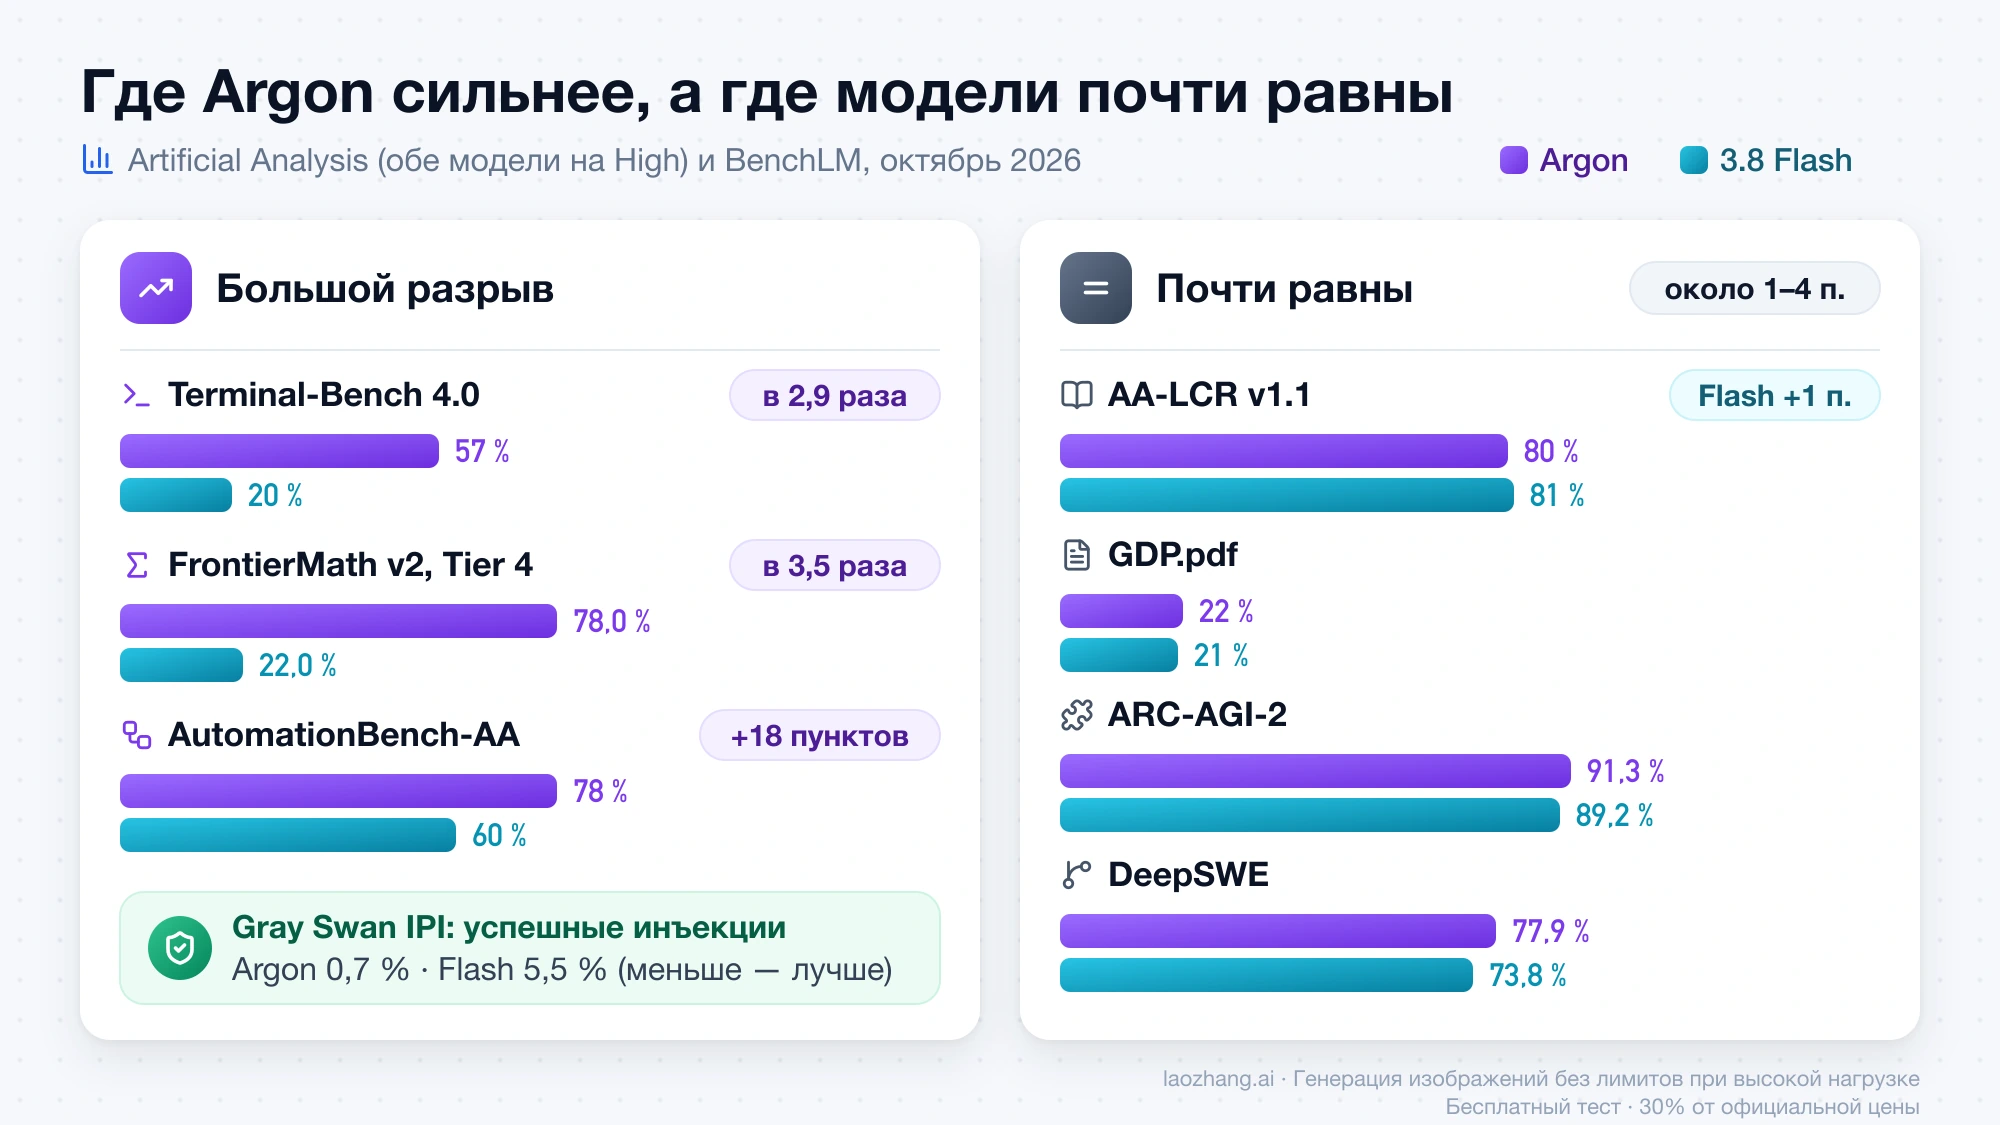
Argon заметно сильнее в терминале, в агентных сценариях и в трудной математике, а на чтении длинного контекста, разборе документов и части задач по коду модели почти равны. Ниже — выбранные строки из сравнения Artificial Analysis (обе модели на High, по состоянию на 23 октября 2026 года) и агрегатора BenchLM (обновлён 20 октября 2026 года, смесь результатов от разработчиков и сторонних замеров).
| Бенчмарк | Что проверяет | Gemini 4 Argon | Gemini 3.8 Flash | Источник |
|---|---|---|---|---|
| Intelligence Index v4.3.2 | сводный индекс | 53 | 41 | Artificial Analysis |
| Terminal-Bench 4.0 | работа в терминале | 57 % | 20 % | Artificial Analysis |
| AutomationBench-AA | автоматизация процессов | 78 % | 60 % | Artificial Analysis |
| HLE | трудные экспертные вопросы | 57 % | 48 % | Artificial Analysis |
| SciCode | научный код | 62 % | 57 % | Artificial Analysis |
| AA-LCR v1.1 | рассуждение по длинному контексту | 80 % | 81 % | Artificial Analysis |
| GDP.pdf | работа с PDF-документами | 22 % | 21 % | Artificial Analysis |
| FrontierMath v2, Tier 4 | самая трудная математика | 78,0 % | 22,0 % | BenchLM |
| ARC-AGI-3 | новые головоломки | 46,3 % | 10,4 % | BenchLM |
| OSWorld 2.0 | управление компьютером | 69,2 % | 59,0 % | BenchLM |
| DeepSWE | задачи из репозиториев | 77,9 % | 73,8 % | BenchLM |
| ARC-AGI-2 | абстрактные головоломки | 91,3 % | 89,2 % | BenchLM |
| Gray Swan IPI | успешные промпт-инъекции, меньше — лучше | 0,7 % | 5,5 % | BenchLM |
Разрыв распределён неравномерно. В Terminal-Bench Argon сильнее в 2,9 раза, в FrontierMath — в 3,5 раза, в AutomationBench — на 18 пунктов, а в AA-LCR, GDP.pdf, ARC-AGI-2 и DeepSWE разница около 1–4 пунктов, причём в AA-LCR Flash даже на пункт впереди. Сводный балл BenchLM от чтения к чтению меняется (около 69 у Flash против 81–83 у Argon), поэтому опираться лучше на отдельные строки. Для агентов с доступом к инструментам стоит отметить и устойчивость к промпт-инъекциям: в Gray Swan IPI атака удалась в 0,7 % случаев против Argon и в 5,5 % — против Flash.
Скорость — на стороне Flash. По замерам Artificial Analysis на High она выдаёт 142 токена в секунду против 82, первый токен появляется через 24,70 с против 48,05 с, а задача индекса занимает в среднем 489 с против 722 с. При этом, по отзывам пользователей (это не замеры), в длинных агентных сессиях Argon доходит до результата за меньшее число шагов: на r/singularity пишут, что Argon стал чемпионом в Pokémon, потратив меньше половины токенов, которые 3.8 Flash израсходовала на три значка, а разработчики в X жалуются, что Flash нужно «безумное количество шагов и вызовов инструментов». Если это верно для ваших агентов, разница в цене за задачу там может оказаться меньше, чем на коротких запросах.
Какие задачи оставить на 3.8 Flash, а какие перевести на Argon
На 3.8 Flash стоит оставить всё, что она уже делает правильно: короткий чат, классификацию, извлечение полей, пересказ длинных документов и простой код. На чтении длинного контекста и PDF-документов модели в бенчмарках почти равны (AA-LCR — 81 % у Flash против 80 % у Argon, GDP.pdf — 21 % против 22 %), в тесте 23 октября 2026 года арифметическую задачу и код с тестами обе модели решили верно, а Flash быстрее и дешевле за вызов, когда ответ длинный или входной текст большой (пересказ статьи — в 1,99 раза). Flash незаменима и там, где вы опираетесь на бесплатный уровень Gemini API или на явный кэш длинного общего контекста: у Argon нет ни того, ни другого. Сам Google называет 3.8 Flash «ежедневной рабочей лошадкой» (daily workhorse), а Argon — моделью для самых трудных задач.
Argon оправдан там, где Flash ошибается или делает лишнюю работу: агент выполняет команды в терминале, многошаговый процесс с инструментами разваливается на полпути, код содержит скрытые ошибки и узкие места (именно на это жалуются пользователи Flash 3.8 на Reddit в r/GoogleAntigravityIDE), нужна трудная математика или научные расчёты. В этих сценариях разрыв в Terminal-Bench, AutomationBench и FrontierMath измеряется десятками пунктов, и одна неудачная попытка Flash с повтором легко съедает разницу в цене.
Для смешанного трафика удобнее всего разделение по типу задачи: Flash остаётся моделью по умолчанию, а на Argon уходят заранее отобранные классы запросов или повторные попытки после явной неудачи Flash (не прошли тесты, агент упёрся в лимит шагов). Перед переводом прогоните несколько десятков своих типичных запросов через обе модели на уровне по умолчанию и сравните возвращённые токены: кратность за вызов зависит от того, сколько размышлений тратит Flash именно на ваши задачи, и в тесте она колебалась от 0,78 до 1,99. Google рекомендует проверять Argon на всех трёх уровнях размышлений и выбирать самый низкий, который даёт нужное качество.
Учитывайте календарь. Если вы переводите часть вызовов в ноябре, заложите в бюджет на декабрь двойную цену Argon при неизменной цене Flash; после 1 января 2027 года кратность вернётся к прежней, но обе модели будут стоить вдвое дороже, чем сейчас. Для фоновых задач без жёстких сроков Batch и Flex снижают цену Argon вдвое.
Ждать третьего варианта сейчас не из чего: по состоянию на 23 октября 2026 года модели с ID «Gemini 4 Flash» нет ни в списке моделей Gemini API, ни в журнале изменений, а Google в анонсе Argon лишь обещает остальные модели семейства Gemini 4 позже, без даты. Что из нового поколения моделей уже доступно, собрано в материале «Сравнение Fable 5.5, Gemini 4 и GPT-6.1: доступны две из трёх», а если вы выбираете между Argon и флагманами других компаний — в статье «Gemini 4 Argon, Claude Opus 5.5 или GPT-6.1 Sol: что выбрать».
Что поменять в коде при замене gemini-3.8-flash на gemini-4-argon
Минимальный перевод — новый ID модели, ключ с платным тарифом и более высокий лимит на вывод, но руководство Google по переходу на Gemini 4 Argon перечисляет ещё несколько изменений. Пройдите их до переключения трафика.
- Замените
gemini-3.8-flashнаgemini-4-argonи убедитесь, что ключ привязан к платному тарифу: на бесплатном уровне Argon недоступен. - Поднимите
max_output_tokensминимум до 32 768: лимит общий для размышлений и ответа, а Argon может потратить на размышления больше прежних моделей. В синхронном режиме потолок — 65 536, выше запрос вернёт ошибку 400; для более длинных ответов нуженbackground: true. - Задайте
thinking_levelявно и прогоните свои задачи наlow,mediumиhigh: по умолчанию стоитmedium, уровняminimalнет. - Уберите явное кэширование:
cachedContentsиcaches.createу Argon не поддерживаются. Неявное кэширование включено для запросов от 4 096 токенов и даёт скидку 95 % при попадании в кэш. - Удалите
temperature,top_pиtop_k: Argon их игнорирует. - Увеличьте тайм-аут HTTP-клиента минимум до 15 минут или используйте фоновое выполнение: трудные запросы занимают несколько минут.
- В многоходовых диалогах и при вызове функций храните состояние на сервере через
previous_interaction_id. - Пересчитайте бюджет на период с 1 декабря 2026 года, когда цена Argon удвоится.
Оставаться на 3.8 Flash ничто не мешает: она вышла в общий доступ 2 сентября 2026 года, Argon — 13 октября, обе помечены в списке моделей Gemini API как стабильные, и дата отключения Flash не объявлена. Вызовы gemini-3.7-flash с 8 октября 2026 года Google автоматически перенаправляет на gemini-3.8-flash, так что код на старом ID уже работает на 3.8 Flash.
Где доступны Argon и 3.8 Flash: API, приложение Gemini, Antigravity
В API разница одна: у 3.8 Flash есть бесплатный уровень, у Argon — нет, что входит в бесплатный уровень и какие там лимиты, разобрано в материале «Gemini API Free Tier 2026: ключ бесплатно, какие модели и лимиты». В приложении Gemini и в Antigravity доступ зависит от подписки Google, и для Argon он уже, чем для Flash. Ниже — состояние на 23 октября 2026 года по справке Gemini о моделях, таблице моделей Antigravity и README Gemini CLI на GitHub.
| Где | Gemini 4 Argon | Gemini 3.8 Flash |
|---|---|---|
| Gemini API, бесплатный уровень | нет | да |
| Gemini API, платный тариф | да | да |
| Приложение Gemini без подписки | нет, Argon виден в списке, но заблокирован | нет, доступны Gemini Auto или Flash-Lite |
| Приложение Gemini, Google AI Plus | нет | в списке есть Flash; что это именно 3.8, Google не уточняет |
| Приложение Gemini, Google AI Pro и Ultra | да | да |
| Antigravity, Free и Plus | нет | да |
| Antigravity, Google AI Pro, Ultra, Enterprise | да: в приложении, CLI и расширениях, но не в IDE Antigravity; на Pro — платная подписка или пробный период с подходящими устройствами | да |
| Gemini CLI | официально не оптимизирован, README отправляет в Antigravity | да |
Лимиты в приложении Gemini Google публикует не в сообщениях, а в виде общей нормы, которая обновляется каждые 5 часов до недельного предела, и прямо пишет, что более сильные модели и высокие уровни размышлений расходуют её быстрее. По отзывам пользователей (единичные случаи, не замеры), у одного подписчика норма Argon закончилась примерно через 10 сообщений, а у другого в Gemini CLI один ход Argon High съел в 27,8 раза больше квоты, чем ход Flash High; в Antigravity, по словам сотрудника Google, у Argon на Pro отдельная недельная квота, которая не трогает квоту Flash. Если 3.8 Flash в Antigravity отвечает медленно, причины и что с ними делать разобраны в статье «Gemini 3.8 Flash тормозит в Antigravity: что видно и что делать».
По спискам стран Google приложение Gemini и AI Studio в России не предлагаются, поэтому для части читателей реальный вариант — API через стороннего провайдера, где цены могут отличаться от прайса Google. Как оплатить Gemini API из России и сколько стоит 3.8 Flash до и после повышения 2027 года, описано в материале «Как купить доступ к Gemini API в России: ключ $0, цены 2026–2027».
Источники8
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 23 окт. 2026 г..
Источники8
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 23 окт. 2026 г..
- 1.странице цен Gemini APIai.google.dev/gemini-api/docs/pricing
- 2.сравнении Artificial Analysisartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash
- 3.BenchLMbenchlm.ai/compare/gemini-3-8-flash-vs-gemini-4-argon
- 4.руководство Google по переходу на Gemini 4 Argonai.google.dev/gemini-api/docs/latest-model
- 5.списке моделей Gemini APIai.google.dev/gemini-api/docs/models
- 6.справке Gemini о моделяхsupport.google.com/gemini/answer/18648722
- 7.таблице моделей Antigravityantigravity.google/docs/models
- 8.README Gemini CLI на GitHubgithub.com/google-gemini/gemini-cli